

Das richtige Tool zur Testdatenverwaltung zu finden, kann eine Herausforderung sein. Bei der großen Auswahl ist es schwierig festzustellen, welches Tool Ihre Anforderungen tatsächlich erfüllt, ohne wertvolle Zeit oder Ressourcen zu verschwenden. Wenn Sie bereits Probleme mit Tools hatten, die übermäßig komplex sind, nicht mit Ihren Projekten skalieren oder Datenschutzbestimmungen nicht einhalten, sind Sie nicht allein. Ein gutes Tool zur Testdatenverwaltung sollte die Erstellung, Verwaltung und Sicherheit Ihrer Datensätze vereinfachen und sich nahtlos in Ihre Testabläufe integrieren.
Als Fachkraft für Softwaretests mit praktischer Erfahrung mit Dutzenden von Tools bin ich auf dieselben Herausforderungen gestoßen, mit denen Sie konfrontiert sind, und habe sie bewältigt. Deshalb habe ich diesen Leitfaden erstellt: um Ihre Suche zu vereinfachen und eine sorgfältig zusammengestellte Liste der besten heute verfügbaren Tools zur Testdatenverwaltung bereitzustellen. Ganz gleich, ob für Sie Automatisierung, Compliance oder Skalierbarkeit im Vordergrund steht – dieser Beitrag hilft Ihnen, eine fundierte Entscheidung zu treffen.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle für Tools zur Testdatenverwaltung
Die folgende Tabelle vergleicht die Preisdetails meiner besten Tools zur Testdatenverwaltung.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für compliancegerechtes Maskieren mit automatischer Teilmengenerstellung | 14-tägige kostenlose Testversion | Preise auf Anfrage | Website | |
| 2 | Am besten geeignet für synthetische Testdaten mit nativer CI/CD-Unterstützung | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 3 | Am besten geeignet für die Verwaltung verschiedener Testdatenumgebungen von einem zentralen Ort aus | 14-tägige kostenlose Testversion | Ab 15.000 € pro Benutzer und Jahr (jährliche Abrechnung) | Website | |
| 4 | Am besten für TDM über den gesamten Lebenszyklus mit Datenbankklonen geeignet | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 5 | Am besten geeignet für Testdatenmaskierung einschließlich Mainframe-Umgebungen | Nicht verfügbar | Preis auf Anfrage | Website | |
| 6 | Am besten geeignet für Unternehmen mit komplexen Umgebungen | 30-tägige kostenlose Testversion verfügbar | Preis auf Anfrage | Website | |
| 7 | Beste datenbankübergreifende Teilmengenbildung in regulierten Branchen | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 8 | Am besten für die Maskierung in Pipelines mit mehreren Datenbanken geeignet | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 9 | Am besten für visuelles, abdeckungsorientiertes Datendesign | 14-tägige kostenlose Testversion | Preis auf Anfrage | Website | |
| 10 | Am besten geeignet für das Klonen von Datenbanken im Git-Stil über fünf Engines hinweg | Kostenlose Demo verfügbar | Preis auf Anfrage | Website |




Tests der besten Tools zur Testdatenverwaltung
Im Folgenden finden Sie meine ausführlichen Zusammenfassungen der besten Tools zur Testdatenverwaltung, die es in meine engere Auswahl geschafft haben. Meine Tests bieten einen detaillierten Überblick über die wichtigsten Funktionen, Vor- und Nachteile, Integrationen und idealen Anwendungsfälle jedes Tools, damit Sie das beste für sich finden.
 Am besten für compliancegerechtes Maskieren mit automatischer Teilmengenerstellung
- 14-tägige kostenlose Testversion
- Preise auf Anfrage
Visit WebsiteCustomer Rating:4.3/5
Tonic maskiert und de-identifiziert sensible Datenbankspalten für sichere Testdaten. Tonic Structural ist eine Plattform zur Verwaltung von Testdaten, die Produktionsdaten für Nicht-Produktionsumgebungen maskiert, Teilmengen erstellt und bereitstellt und relationale Datenbanken, NoSQL, Datenlager und Dateiquellen unterstützt.
Für wen ist Tonic am besten geeignet?
Tonic Structural eignet sich besonders für auf Compliance ausgerichtete Teams im Gesundheitswesen und im Finanzbereich, die Produktionsdaten maskieren und Teilmengen davon erstellen müssen und dabei prüfungsbereite Dokumentationen zum Datenschutz benötigen.
Warum ich Tonic ausgewählt habe
Tonic verdient einen Platz auf meiner Auswahlliste, weil seine Funktionen zum Maskieren und Erstellen von Teilmengen so eng miteinander verknüpft sind, wie ich es nur selten sehe. Ich finde besonders gut, wie der Datenschutz-Hub jede Spalte als Gefährdet, Geschützt oder Nicht sensibel kennzeichnet, anschließend die gleichzeitige Anwendung von Generatoren ermöglicht und einen vollständigen Datenschutzbericht für Prüfungszwecke exportiert. Der patentierte Teilmengenersteller verarbeitet virtuelle Fremdschlüssel und zirkuläre Abhängigkeiten automatisch, sodass Ihre maskierte Teilmenge auch bei komplexen Schemata mit mehreren Tabellen referenziell intakt bleibt.
Zentrale Funktionen von Tonic
- Structural-Agent: Ein in die Anwendung integrierter KI-Chatassistent, der die Ergebnisse von Sensibilitätsscans zusammenfasst, Generatoren empfiehlt und sie automatisch auf Ihre Spalten anwendet.
- Kontrollen für differentielle Privatsphäre: Kategorische und kontinuierliche Generatoren unterstützen differentielle Privatsphäre und verfügen über ein konfigurierbares Datenschutzbudget, um statistische Rückschlüsse aus transformierten Daten zu begrenzen.
- Ausgabe in Container-Repositorys: Structural schreibt maskierte Daten und erstellte Teilmengen direkt als Container-Volumes für PostgreSQL, MySQL und SQL Server und ermöglicht Ihnen dadurch, isolierte Datenbanken bei Bedarf zu starten.
- Versionsverlauf: Zeichnet jede Änderung an der Arbeitsbereich-Konfiguration auf – Generatoren, Regeln zur Erstellung von Teilmengen, Tabellenmodi und Skripte nach Auftragsausführung – einschließlich der Zuordnung zu einem Bearbeiter und der Möglichkeit, frühere Versionen wiederherzustellen.
Tonic-Integrationen
Tonic bietet native Integrationen mit PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, Snowflake, BigQuery, Redshift, Databricks und Amazon S3. Außerdem werden REST API, GitHub Actions, Kubernetes, Helm und Container-Repositorys wie Amazon ECR, Google Artifact Registry und Azure Container Registry unterstützt.
Pros and Cons
Pros:
- Bewahrt Verknüpfungen in komplexen Schemata
- Der Datenschutz-Hub ordnet sensible Spalten für Prüfungen zu
- Produktionsnahe Daten behalten statistische Zusammenhänge bei
Cons:
- Die Erstellung von Daten von Grund auf erfordert das separate Produkt Fabricate
- Containerisierte Datenbanken erfordern eine Kubernetes-Bereitstellung
Learn more about Tonic: Am besten geeignet für synthetische Testdaten mit nativer CI/CD-Unterstützung
- Kostenlose Demo verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.6/5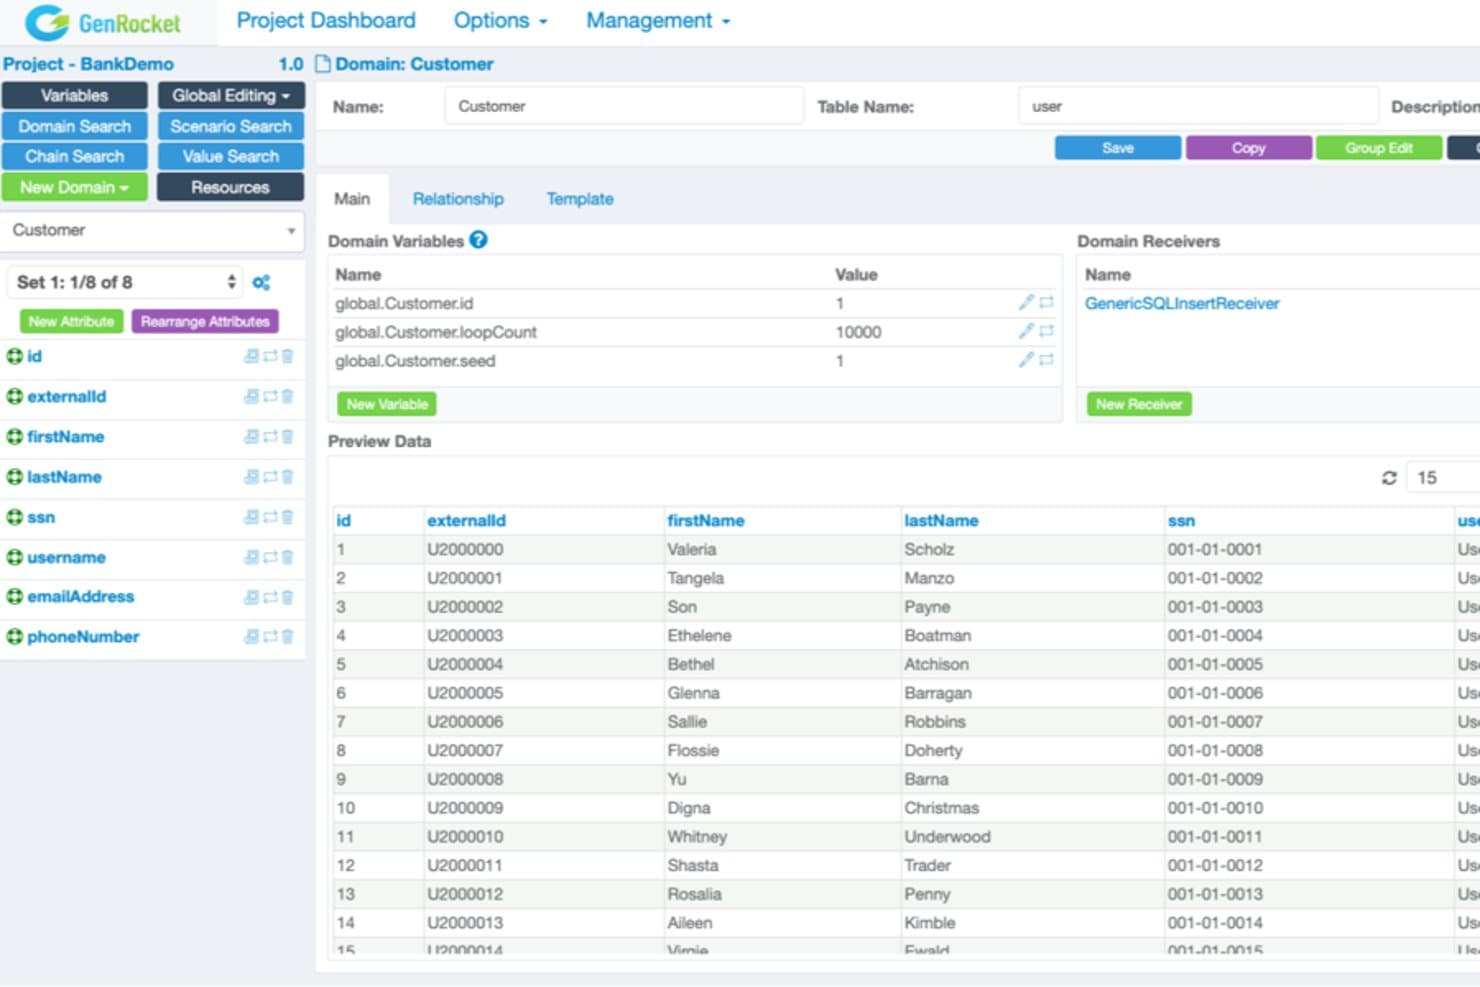
GenRocket ermöglicht es Benutzern, Testdatendomänen visuell in der Vorschau anzuzeigen und zu konfigurieren. GenRocket ist eine Plattform zur Verwaltung synthetischer Testdaten, die Daten in Echtzeit anhand von Metadaten und Schemata generiert und Datenmaskierung, intelligente Teilmengenbildung, Ausgabe in mehreren Formaten sowie die Selbstbedienungsbereitstellung über CI/CD-Pipelines hinweg abdeckt.
Für wen ist GenRocket am besten geeignet?
GenRocket eignet sich besonders für QA- und DevOps-Teams, die synthetische Testdaten bei Bedarf direkt innerhalb von CI/CD-Pipelines generieren müssen, ohne jemals Produktionsdaten zu verwenden.
Warum ich GenRocket ausgewählt habe
GenRocket steht auf meiner Auswahlliste, weil es die einzige mir bekannte Testdatenplattform ist, die speziell dafür entwickelt wurde, synthetische Daten in Echtzeit direkt innerhalb einer CI/CD-Pipeline zu generieren, ohne jemals Produktionsdaten zu verwenden. Die patentierte Engine zur Wahrung der referenziellen Integrität hält Daten gleichzeitig über mehrere Schemata und Datenbanken hinweg konsistent, was tatsächlich selten ist. Außerdem gefällt mir, dass jeder Testfalldatensatz in nur 100 Millisekunden generiert werden kann, sodass die Pipeline-Ausführung nicht auf die Bereitstellung von Daten warten muss.
Die wichtigsten Funktionen von GenRocket
- G-Delta-Erkennung von Schemaänderungen: Erkennt automatisch Änderungen an Datenbankschemata in MySQL, MS SQL, Oracle und PostgreSQL und löst anschließend G-Refactor aus, um alle betroffenen Testdatenfälle zu aktualisieren.
- Maskierung ohne Datenverschiebung: Ersetzt sensible Felder in Oracle-, MS-SQL-Server-, IBM-DB2-, PostgreSQL- und MySQL-Datenbanken durch synthetisch generierte Entsprechungen, ohne jemals echte Produktionswerte zu lesen.
- G-Portal-Selbstbedienungsportal: Bietet Entwicklern und Testern eine rollenbasierte Oberfläche zum Suchen, Anfordern, Verfolgen und Herunterladen von Testdatenfällen, ohne für jede Anfrage ein zentrales Datenteam einbeziehen zu müssen.
- Über 750 intelligente Datengeneratoren: Deckt praktisch jeden Datentyp, jede Domäne und jede Geschäftsregel ab, einschließlich bedingter Logik, Abhängigkeiten zwischen Feldern und regulärer Ausdrucksbedingungen.
GenRocket-Integrationen
GenRocket lässt sich in Jenkins, Azure DevOps, TeamCity, CircleCI, GitHub, Cucumber, Selenium, JUnit, JMeter und LoadRunner integrieren. Außerdem werden REST API, JDBC, SOAP, TCP/IP-Sockets und die Docker-Bereitstellung für benutzerdefinierte CI/CD-Workflows unterstützt.
Pros and Cons
Pros:
- Die Generierung synthetischer Daten bewahrt die referenzielle Integrität
- Echtzeit-Datenbereitstellung für CI/CD-Pipelines
- Unbegrenztes Datenvolumen ohne Aktualisierungszyklen
Cons:
- Keine formatbewahrende oder reversible Maskierung
- Die Erkennung personenbezogener Daten ist erst ab {{year}} vollständig verfügbar
Learn more about GenRocket: Am besten geeignet für die Verwaltung verschiedener Testdatenumgebungen von einem zentralen Ort aus
- 14-tägige kostenlose Testversion
- Ab 15.000 € pro Benutzer und Jahr (jährliche Abrechnung)
Visit WebsiteCustomer Rating:4.5/5
Datenmaskierung hilft Ihnen, vertrauliche Kundeninformationen zu schützen. DATPROF ist eine Plattform für Testdatenmanagement, die Datenmaskierung, Teilmengenbildung, synthetische Datengenerierung, die Erkennung personenbezogener Daten, Datenbankvirtualisierung und zentralisierte Bereitstellung für relationale, NoSQL- und Cloud-Datenquellen kombiniert.
Für wen eignet sich DATPROF am besten?
DATPROF eignet sich besonders für Dateningenieure und Datenbankadministratoren in mittelgroßen bis großen Unternehmen, die komplexe Umgebungen mit mehreren Datenbanken verwalten und bei denen referenzielle Integrität und Compliance unverzichtbar sind.
Warum ich DATPROF ausgewählt habe
Ich habe DATPROF als eine der besten Lösungen ausgewählt, weil sich das volumenunabhängige Lizenzmodell tatsächlich deutlich abhebt: Die Lizenzkosten bleiben gleich, unabhängig davon, ob Sie 500 GB oder 100 TB maskieren. Das ist besonders wichtig, wenn Sie eine Produktionsdatenbank wie die 23-TB-Datenbank von Heineken in eine 130-GB-Datenbank umwandeln. Die patentierte Erkennung von Fremdschlüsselzyklen in DATPROF Subset verarbeitet komplexe Schemata mit mehreren Tausend Tabellen und bewahrt dabei die referenzielle Integrität über verschiedene Systeme hinweg. In Kombination mit der zentralen Orchestrierung des Runtime-Portals kann jedes Teammitglied seine eigene aktualisierte Umgebung bereitstellen, ohne auf einen Datenbankadministrator warten zu müssen.
Die wichtigsten Funktionen von DATPROF
- Deterministische systemübergreifende Maskierung: Wendet für dieselben Eingabewerte gleichzeitig in mehreren Datenbanken konsistente maskierte Werte an und bewahrt so die referenzielle Integrität für eine durchgängige Rückverfolgbarkeit von Tests.
- Erkennung und Profilierung personenbezogener Daten: Durchsucht Datenbanken, um automatisch zu ermitteln, wo sich sensible Daten befinden, und unterstützt benutzerdefinierte Erkennungsregeln mithilfe regulärer Ausdrücke oder aus Listen bestehender Ausdrücke.
- Selbstbedienungsportal für die Bereitstellung: Ermöglicht Testern und Entwicklern, sich bei DATPROF Runtime anzumelden und ihre eigenen Testumgebungen unabhängig zu aktualisieren, ohne auf einen Datenbankadministrator warten zu müssen.
- Datenbankklonen mit Kopieren-beim-Schreiben: DATPROF Virtualize erstellt virtuelle Datenbankumgebungen in voller Größe, ohne zusätzlichen Speicherplatz zu verbrauchen. Das Zurücksetzen auf einen Snapshot ist in weniger als 20 Sekunden abgeschlossen.
Integrationen von DATPROF
DATPROF unterstützt CI/CD-Integrationen mit Jenkins, Azure DevOps, GitLab und Bamboo sowie Integrationen zur Testautomatisierung mit Parasoft und Tosca. Die REST-API unterstützt benutzerdefinierte Integrationen. Einträge im Azure Marketplace und AWS Marketplace sind ebenfalls verfügbar.
Pros and Cons
Pros:
- Maskierung bewahrt die referenzielle Integrität über mehrere Datenbanken hinweg
- Teilmengenbildung reduziert umfangreiche Produktionsdatensätze effizient
- Rollenbasiertes Webportal zur Selbstbedienungsaktualisierung
Cons:
- Begrenzte native Unterstützung für SaaS-Datenquellen
- Keine Unterstützung für Mainframe-Systeme oder eine größere Auswahl an NoSQL-Datenbanken
Learn more about DATPROF: Am besten für TDM über den gesamten Lebenszyklus mit Datenbankklonen geeignet
- Kostenlose Demo verfügbar
- Preis auf Anfrage

Enov8 bietet auf einen Blick einen Überblick über personenbezogene Daten aus verschiedenen Datenquellen für Führungskräfte. Enov8 ist eine Testdatenmanagement-Plattform, die den gesamten TDM-Lebenszyklus abdeckt, einschließlich KI-gestützter Datenprofilierung, Maskierung, Teilmengenbildung, Generierung synthetischer Daten und Datenbankvirtualisierung über ihre vME-Klon-Engine.
Für wen ist Enov8 am besten geeignet?
Enov8 eignet sich besonders für DevOps- und QA-Teams in regulierten Branchen, die eine einzige Plattform benötigen, um Maskierung, Teilmengenbildung, synthetische Daten und Datenbankvirtualisierung gemeinsam zu verwalten.
Warum ich Enov8 ausgewählt habe
Ich habe Enov8 als eines der besten Tools ausgewählt, weil es das einzige Tool auf meiner Liste ist, das TDM über den gesamten Lebenszyklus mit seiner vME-Datenbank-Klon-Engine kombiniert, die produktionsnahe Datenbankkopien mit einer Größe von ungefähr 40 MB pro Klon erstellt, unabhängig von der Größe der Quelle. Besonders gefällt mir, dass Maskierung, Teilmengenbildung und die Generierung synthetischer Daten direkt in die Virtualisierungsschicht einfließen, sodass Klone bereits datenschutzsicher sind, bevor sie eine Testumgebung erreichen.
Hauptfunktionen von Enov8
- KI-gestützte PII-Erkennung: Eine ML-basierte Profilierungs-Engine scannt verbundene Datenquellen automatisch, um sensible Felder zu klassifizieren und Spalten mit regulatorischem Risiko zu kennzeichnen, bevor die Maskierung beginnt.
- Reservierung von Testdaten: Ein integriertes Buchungssystem ermöglicht es Teams, Datensätze zentral zu reservieren und zu verwalten, wodurch Konflikte zwischen gleichzeitigen Benutzern und Umgebungen verhindert werden.
- Validierungsscan nach der Maskierung: Ein ML-gestützter Validierungslauf bestätigt die Wirksamkeit der Maskierung nach jedem Sicherungslauf und erstellt prüfungsbereite Nachweise für die Compliance.
- Integrationshub des DevOps Managers: Eine sprachunabhängige Orchestrierungsschicht, in der Automatisierungsskripte in Python, Bash, Ansible, Java und weiteren Sprachen verwaltet werden und die Enov8 mit CI/CD-Pipelines in Jenkins, GitLab CI/CD und Azure DevOps verbindet.
Enov8-Integrationen
Enov8 unterstützt mehr als 100 Integrationen, darunter Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy und Ansible. Die REST-API, Webhooks, der Scheduler und der DevOps Manager unterstützen benutzerdefinierte CI/CD-Workflows.
Pros and Cons
Pros:
- Datenbankvirtualisierung mit winzigen 40-MB-Klonen
- KI-gestützte PII-Erkennung und Validierung der Maskierung
- Zentrale Testdatenbuchung verhindert Konflikte bei der Zuweisung
Cons:
- Das Volumen öffentlicher Bewertungen ist relativ begrenzt
- Keine Bescheinigungen zur Compliance durch Dritte aufgeführt
Learn more about Enov8: Am besten geeignet für Testdatenmaskierung einschließlich Mainframe-Umgebungen
- Nicht verfügbar
- Preis auf Anfrage

Broadcom Test Data Manager verfolgt den Status von Importaufträgen in einer Ansicht. Broadcom Test Data Manager ist eine Testdatenmanagementplattform für Unternehmen, die Datenmaskierung, die Generierung synthetischer Daten, Teilmengenbildung, PII-Erkennung, Datenbankvirtualisierung und Self-Service-Bereitstellung kombiniert – mit dediziertem Support für Mainframe-Umgebungen neben modernen verteilten und Cloud-Datenbanken.
Für wen ist Broadcom Test Data Manager am besten geeignet?
Große Unternehmen, die Mainframe-Umgebungen neben modernen verteilten Systemen betreiben, profitieren am meisten von dieser Plattform.
Warum ich Broadcom Test Data Manager ausgewählt habe
Ich habe Broadcom Test Data Manager in meine Top-Auswahl aufgenommen, weil es die einzige Plattform ist, die ich kenne, die Mainframe-Umgebungen gleichberechtigt neben modernen verteilten Systemen unterstützt. Das dedizierte Modul CA TDM for Mainframe ermöglicht es Ihnen, Daten in z/OS, VSAM und IMS über dieselbe Benutzeroberfläche zu maskieren und Teilmengen zu bilden, die Sie auch für SQL Server oder Oracle verwenden. Die automatisierte PII-Heatmap durchsucht gesamte Mainframe-Schemata und markiert sensible Felder, bevor Sie eine einzige Maskierungsregel anwenden. Dadurch wird der manuelle Zuordnungsaufwand reduziert, der Compliance-Teams normalerweise ausbremst.
Wichtige Funktionen von Broadcom Test Data Manager
- Self-Service-Datenportal: Ein zentraler Katalog, in dem Tester Testdaten nach Bedarf über dynamische Formulare anfordern, reservieren und freigeben können, ohne auf Datenbankadministratoren warten zu müssen.
- DAVE-Datenbankvirtualisierung: Eine Klon-Engine nach dem Kopieren-beim-Schreiben-Prinzip, die innerhalb weniger Minuten unabhängige Datenbankklone aus einem gemeinsam genutzten Basis-Image erstellt und dabei nur minimalen Speicherplatz benötigt.
- Javelin-Workflow-Automatisierung: Eine integrierte visuelle Automatisierungsengine, die Maskierungs-, Teilmengenbildungs- und Bereitstellungsaufgaben orchestriert und über eine REST API oder CI/CD-Pipelines ausgelöst werden kann.
- Erhaltung der referenziellen Integrität: Maskierungs- und Teilmengenbildungsprozesse erhalten Beziehungen zwischen Tabellen, sodass Testdatensätze für End-to-End-Tests funktional konsistent bleiben.
Integrationen von Broadcom Test Data Manager
Zu den dokumentierten Integrationen gehören Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM und CA Agile Central. REST APIs unterstützen individuelle CI/CD-Workflows, während Docker und Kubernetes containerisierte Bereitstellungen ermöglichen.
Pros and Cons
Pros:
- Testdatenmaskierung einschließlich Mainframe-Umgebungen
- Automatisierte PII-Erkennung und Heatmaps
- Datenbankvirtualisierung nach dem Kopieren-beim-Schreiben-Prinzip (DAVE)
Cons:
- Keine SaaS-Bereitstellungsoption verfügbar
- Die Benutzeroberfläche wirkt veraltet und komplex
Learn more about Broadcom Test Data Manager: Am besten geeignet für Unternehmen mit komplexen Umgebungen
- 30-tägige kostenlose Testversion verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.5/5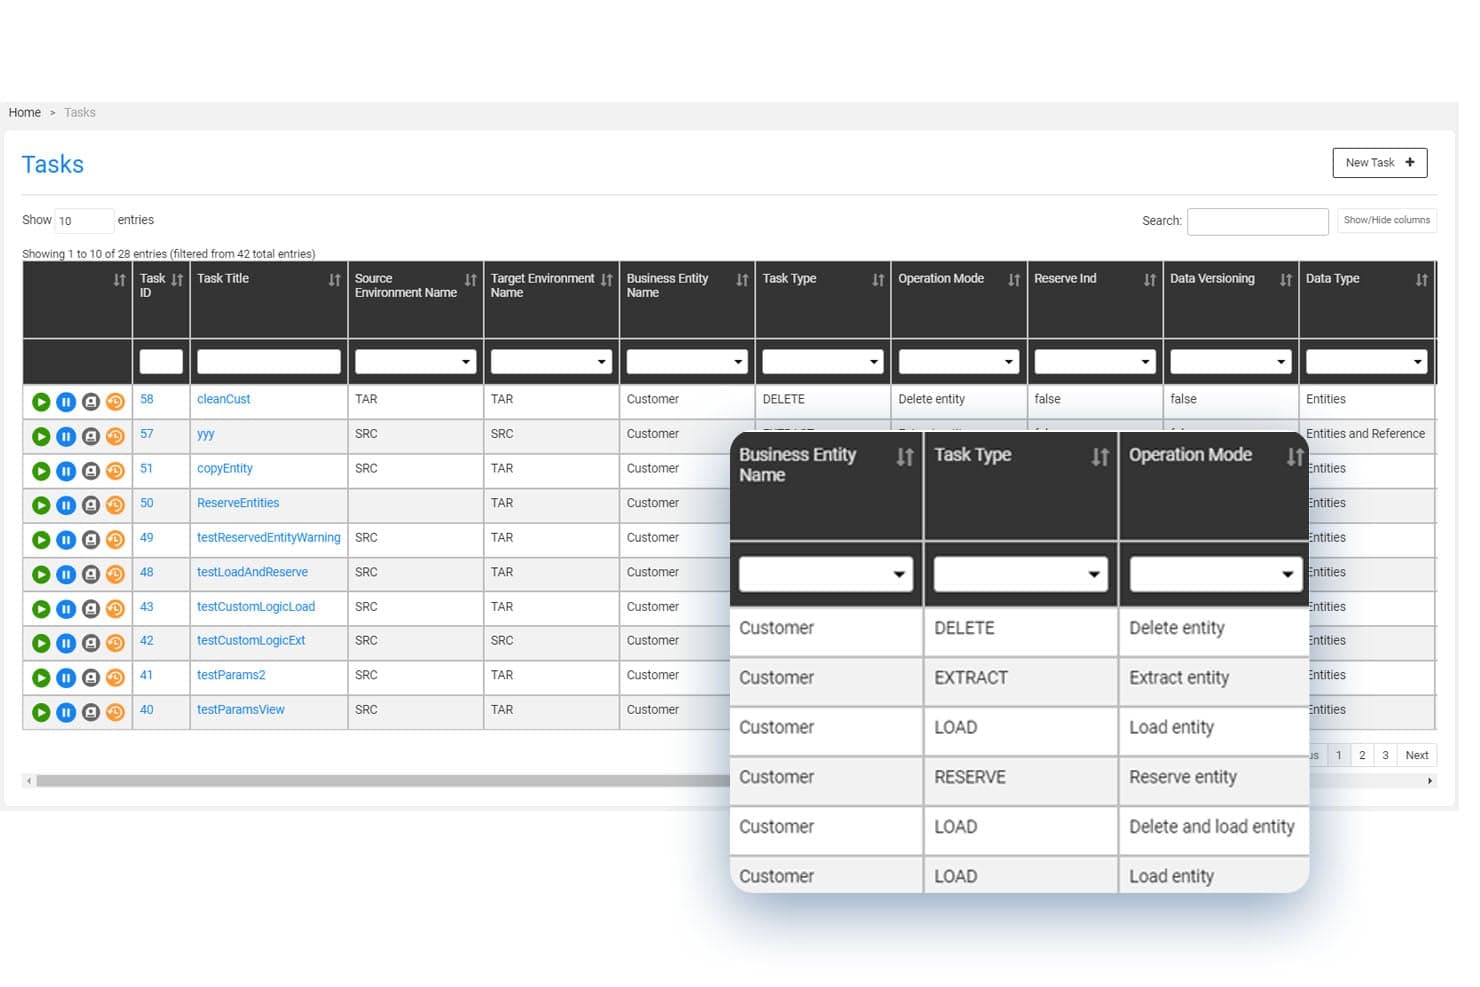
Mit K2View-Testdatenmanagement können Benutzer Datenaufgaben nach Typ und Betriebsmodus verwalten und filtern. K2View-Testdatenmanagement ist eine TDM-Plattform für Unternehmen, die Datenmaskierung, synthetische Datengenerierung, Teilmengenbildung und Selbstbedienungsbereitstellung für relationale, NoSQL-, Großrechner- und Cloud-Datenquellen über eine patentierte Mikrodatenbank™-Architektur vereint.
Für wen eignet sich K2View-Testdatenmanagement am besten?
K2View wurde für große Unternehmen entwickelt, die Testdaten über gemischte Umgebungen hinweg verwalten – Großrechner, Cloud, NoSQL und relationale Systeme gleichzeitig.
Warum ich mich für K2View-Testdatenmanagement entschieden habe
K2View hat sich seinen Platz auf meiner Auswahlliste verdient, weil die patentierte Mikrodatenbank™-Architektur ein Problem löst, das die meisten TDM-Tools umgehen: die Aufrechterhaltung der referenziellen Integrität über Großrechner-, NoSQL- und Cloud-Quellen hinweg. Besonders beeindruckt mich die Maskierung während der Verarbeitung, da personenbezogene Daten bereits am Ort der Extraktion maskiert werden und niemals unmaskiert in einer Testumgebung landen. Durch die entitätszentrierte Teilmengenbildung können Teams einen vollständigen Kundendatensatz, der sich über Oracle, Kafka und MongoDB erstreckt, in einem einzigen Vorgang abrufen, ohne manuelle Verknüpfungsregeln.
Wichtige Funktionen von K2View-Testdatenmanagement
- Selbstbedienungs-TDM-Portal: Eine webbasierte Oberfläche, über die Tester Testdaten anfordern, reservieren und zurücksetzen können, ohne Daten- oder Datenbankadministrationsteams einzubeziehen.
- Zeitmaschinen-Momentaufnahmen und Zurücksetzung: Speichert bestimmte Zustände von Testdaten zu jedem beliebigen Zeitpunkt, sodass Tester Umgebungen sofort auf eine bekannte Konfiguration zurücksetzen können.
- Automatisierte Erkennung personenbezogener Daten: Integrierte Klassifizierer durchsuchen alle verbundenen Quellen, kennzeichnen sensible Felder und empfehlen oder wenden Maskierungsrichtlinien automatisch an.
- Agentenbasiertes TDM: Eine KI-gestützte Funktion, die Testfälle liest und regelkonforme, für die Bereitstellung geeignete Datensätze ohne manuelle Konfiguration selbstständig zusammenstellt.
Integrationen von K2View-Testdatenmanagement
K2View bietet integrierte Konnektoren für Oracle, SQL Server, PostgreSQL, DB2, MongoDB, Snowflake, Salesforce, Amazon S3, Kafka und Großrechnersysteme. REST-, JDBC- und ODBC-Konnektivität unterstützt benutzerdefinierte Integrationen und CI/CD-Workflows mit Jenkins, GitHub Actions und Azure DevOps.
Pros and Cons
Pros:
- Maskierung während der Verarbeitung verhindert die Offenlegung unmaskierter personenbezogener Daten
- Entitätszentrierte Teilmengenbildung erstreckt sich über Großrechner und Cloud
- Automatisierte Erkennung personenbezogener Daten in die Plattform integriert
Cons:
- Nicht für kleine Teams entwickelt
- Die API-basierte CI/CD-Integration erfordert Konfiguration
Learn more about K2View Test Data Management: Beste datenbankübergreifende Teilmengenbildung in regulierten Branchen
- Kostenlose Demo verfügbar
- Preis auf Anfrage

IBM InfoSphere Optim hilft Ihnen, schnell Testdaten zu erstellen. IBM Test Data Management ist eine Unternehmenslösung für das Testdatenmanagement, die Datenmaskierung, datenbankübergreifende Teilmengenbildung und die bedarfsgesteuerte Datenbereitstellung über eine Vielzahl relationaler und Großrechner-Datenquellen hinweg abdeckt.
Für wen eignet sich IBM Test Data Management am besten?
IBM Test Data Management eignet sich besonders für große Unternehmen in regulierten Branchen – Finanzdienstleistungen, Gesundheitswesen und Versicherungen –, die komplexe Umgebungen mit mehreren Datenbanken oder Großrechnersystemen betreiben, in denen Datenmaskierung und datenbankübergreifende Teilmengenbildung Anforderungen an die Einhaltung von Vorschriften sind.
Warum ich IBM Test Data Management ausgewählt habe
IBM Test Data Management steht auf meiner engeren Auswahl, weil die Lösung die datenbankübergreifende Teilmengenbildung auf Ebene von Geschäftsobjekten beherrscht und gleichzeitig referenziell intakte Teilmengen aus mehreren verbundenen Datenbanken extrahiert. Besonders beeindruckt mich die föderierte Extraktionsfunktion, mit der Teams über heterogene Datenlandschaften hinweg arbeiten können, einschließlich Großrechner-Quellen wie VSAM und IMS, in denen praktisch kein Konkurrenzprodukt eingesetzt werden kann. Die mehr als 40 vordefinierten Maskierungsregeln mit formatbewahrender Ausgabe machen die Lösung in GDPR- und HIPAA-regulierten Umgebungen wirklich nützlich.
Wichtige Funktionen von IBM Test Data Management
- Integration in den Governance Catalog: Datenklassifizierungsregeln per Ziehen und Ablegen direkt auf Spaltenzuordnungen anwenden, um Maskierungsroutinen automatisch aus einem zentralen Richtlinienkatalog zuzuweisen.
- Apache-Spark-Laufzeitumgebung: Eine eingebettete Spark-Engine verarbeitet große Datenmengen innerhalb automatisierter Arbeitsabläufe zur Teilmengenbildung und Maskierung.
- Rollenbasierte Zugriffskontrolle: Das von Keycloak unterstützte RBAC mit Unterstützung für LDAP, SAML, OIDC und Kerberos steuert, wer auf Testdatensätze zugreifen, diese anfordern und aktualisieren darf.
- Berichte zur Einhaltung von Vorschriften: Integrierte Berichte überprüfen die Durchsetzung von Datenschutzrichtlinien in GDPR- und HIPAA-regulierten Umgebungen.
Integrationen von IBM Test Data Management
Zu den dokumentierten Integrationen gehören IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark sowie Datenbanken wie Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza und MongoDB mit eingeschränkter Unterstützung. Die REST-API nach OpenAPI 2.0 unterstützt eine benutzerdefinierte Orchestrierung und CI/CD-Arbeitsabläufe, während die z/OS-Edition eine Verbindung zu VSAM und IMS herstellt.
Pros and Cons
Pros:
- Bewahrt die referenzielle Integrität über Datenbanken hinweg
- Formatbewahrende Maskierung unterstützt regulierte Daten
- Verarbeitet VSAM- und IMS-Teilmengen
Cons:
- Keine native Generierung synthetischer Daten
- Physische Kopien ersetzen virtuelles Klonen
Learn more about IBM Test Data Management: Am besten für die Maskierung in Pipelines mit mehreren Datenbanken geeignet
- Kostenlose Demo verfügbar
- Preis auf Anfrage

Mit Tonic.ai können Benutzer Maskierungsregeln für Datenbanktabellen verwalten. Tonic.ai ist eine Plattform für das Management von Testdaten, die die Maskierung und Teilmengenerstellung strukturierter Daten, die Schwärzung unstrukturierter Daten sowie die vollständig synthetische Datengenerierung für relationale Datenbanken, NoSQL-Speicher und Cloud-Data-Warehouses abdeckt.
Für wen ist Tonic.ai am besten geeignet?
Tonic.ai eignet sich besonders für Dateningenieure und Datenbankadministratoren, die Testdaten in komplexen Umgebungen mit mehreren Datenbanken verwalten, darunter relationale Datenbanken, NoSQL-Speicher und Cloud-Data-Warehouses.
Warum ich Tonic.ai ausgewählt habe
Ich habe Tonic.ai als eine der besten Lösungen ausgewählt, weil die deterministische Maskierungs-Engine für dieselbe Eingabe gleichzeitig konsistente maskierte Werte in PostgreSQL, MongoDB, Snowflake und jeder anderen Quelle in Ihrer Pipeline anwendet. Das bedeutet, dass eine in Ihrer relationalen Datenbank maskierte Kunden-ID denselben maskierten Wert in Ihrem Data Warehouse und Dokumentenspeicher erhält, wodurch Verknüpfungen systemübergreifend intakt bleiben. Die patentierte Engine zur Teilmengenerstellung verstärkt dies, indem sie referenziell konsistente Ausschnitte extrahiert. So konnte eBay einen 8-PB-Datensatz auf eine saubere 1-GB-Testumgebung reduzieren, ohne Beziehungen zwischen Tabellen zu beschädigen.
Wichtige Funktionen von Tonic.ai
- Automatisierte Erkennung von PII/PHI: Durchsucht verbundene Datenquellen, erkennt sensible Felder und empfiehlt Maskierungstransformationen, ohne eine manuelle Zuordnung auf Spaltenebene zu erfordern.
- Tonic Ephemeral: Startet bedarfsgesteuerte, isolierte Datenbanken innerhalb von CI/CD-Pipelines über direkte DNS-Verbindungen und entfernt sie nach der Testausführung automatisch.
- Erkennung von Schemaänderungen: Erkennt neue oder geänderte Spalten und kann die Datengenerierung automatisch blockieren, um ein versehentliches Durchsickern von PII in Testumgebungen zu verhindern.
- Generatorvoreinstellungen: Ermöglicht das globale Speichern und Wiederverwenden benannter Maskierungs- und Transformationsregeln über Arbeitsbereiche hinweg, sodass Maskierungsrichtlinien in großem Maßstab konsistent bleiben.
Integrationen von Tonic.ai
Tonic.ai bietet eine native Integration für GitHub Actions sowie eine REST-API-Anbindung für Jenkins und GitLab CI. Die Plattform lässt sich mit PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, DynamoDB, Snowflake, BigQuery, Redshift und Databricks verbinden.
Pros and Cons
Pros:
- Patentierte Engine zur Teilmengenerstellung bewahrt die referenzielle Integrität
- Deterministische Maskierung über mehrere Datenbankplattformen hinweg
- Automatisierte PII-Erkennung mit KI-Empfehlungen
Cons:
- Keine native Unterstützung für Mainframe-Datenquellen
- Die Ersteinrichtung kann für Unternehmen komplex sein
Learn more about Tonic.ai: Am besten für visuelles, abdeckungsorientiertes Datendesign
- 14-tägige kostenlose Testversion
- Preis auf Anfrage

Curiosity Software visualisiert Datenbeziehungen mithilfe eines radialen Partitionsdiagramms. Curiosity Software ist eine Plattform zur Verwaltung von Testdaten, die Datenmaskierung, synthetische Datengenerierung, Teilmengenbildung, Virtualisierung und Self-Service-Bereitstellung über mehr als 250 Quellintegrationen hinweg kombiniert – einschließlich Mainframe-Systemen wie VSAM, IMS und CICS.
Für wen eignet sich Curiosity Software am besten?
Curiosity Software eignet sich für QA-Teams in Unternehmen und Dateningenieure, die in komplexen Umgebungen mit mehreren Datenquellen arbeiten – insbesondere für Teams, die Mainframe-Systeme unterstützen oder compliancegetriebene Testdaten in großem Umfang verwalten.
Warum ich Curiosity Software ausgewählt habe
Ich habe Curiosity Software als eine der besten Lösungen ausgewählt, weil sich der abdeckungsorientierte Ansatz für das Datendesign deutlich abhebt. Anstatt Regeln für Testdaten manuell zu skripten, erstellen Sie visuelle Datenflussmodelle, die Geschäftslogik und Einschränkungen abbilden. Die Plattform erkennt automatisch Lücken bei der Abdeckung und generiert synthetische Daten, um diese zu schließen. Besonders nützlich finde ich das Dienstprogramm „Suchen und Erstellen“: Es findet vorhandene Daten, die Ihre Tests benötigen, und generiert gezielte synthetische Datensätze nur dort, wo noch Lücken bestehen. So stellen Sie nie zu viele Daten bereit und arbeiten nicht im Blindflug.
Wichtige Funktionen von Curiosity Software
- Automatisierte Erkennung personenbezogener Daten: Durchsucht verbundene Datenquellen, um sensible Felder automatisch zu finden und zu kennzeichnen, bevor Daten in Nicht-Produktionsumgebungen bereitgestellt werden.
- Self-Service-Portal für die Bereitstellung: Über ein webbasiertes Portal können Teams Testdaten nach Bedarf anfordern und bereitstellen. Dafür werden parametrisierte, wiederverwendbare Aufträge genutzt, ohne das Testdatenteam einzubeziehen.
- Integration in CI/CD-Pipelines: Testdatenaufträge können dynamisch per API über Jenkins, GitLab, GitHub, Azure DevOps und Bitbucket ausgelöst werden, um Daten just in time bereitzustellen.
- Graphbasierte Datenherkunft: Speichert Rückverfolgbarkeit und Beziehungsdaten über mehrere Quellen hinweg mithilfe von Neo4j und erzeugt visuelle Darstellungen der Pipelines, die Fremdschlüssel, Verknüpfungen und verwaiste Referenzen sichtbar machen.
Integrationen von Curiosity Software
Curiosity Software bietet mehr als 250 Integrationen, darunter Oracle, SQL Server, Snowflake, Salesforce, VSAM, IMS, Jenkins, GitHub, GitLab und Azure DevOps. Die APIs unterstützen benutzerdefinierte Integrationen sowie die durch CI/CD ausgelöste Bereitstellung von Testdaten just in time über Cloud-, lokale und hybride Umgebungen hinweg.
Pros and Cons
Pros:
- Visuelles modellbasiertes Design von Testdaten
- Maskierung und Teilmengenbildung für Mainframe-Daten enthalten
- Automatisierte Erkennung personenbezogener Daten mit compliancegetriebenen Funktionen
Cons:
- Optionen zur Teilmengenbildung in der Dokumentation weniger detailliert
- Keine veröffentlichten SOC-2- oder ISO-27001-Zertifizierungen
Learn more about Curiosity Software: Am besten geeignet für das Klonen von Datenbanken im Git-Stil über fünf Engines hinweg
- Kostenlose Demo verfügbar
- Preis auf Anfrage

Redgate SQL Provision ermöglicht es Benutzern, Datenbankklone über mehrere SQL-Instanzen hinweg zu verwalten. Redgate SQL Provision ist ein Tool zur Verwaltung von Testdaten, das Datenmaskierung, Teilmengenbildung und das Klonen von Datenbanken im Git-Stil für SQL Server, PostgreSQL, MySQL, MariaDB und Oracle abdeckt.
Für wen ist Redgate SQL Provision am besten geeignet?
Redgate SQL Provision eignet sich besonders für Datenbankadministratoren und QA-Ingenieure, die schnelles, versionskontrolliertes Klonen und Maskieren von Datenbanken über mehrere relationale Datenbank-Engines hinweg benötigen.
Warum ich mich für Redgate SQL Provision entschieden habe
Ich habe Redgate SQL Provision als eines der besten Tools ausgewählt, weil sich das Klonen von Datenbanken im Git-Stil über fünf Engines hinweg tatsächlich von allem anderen unterscheidet, was ich bisher gesehen habe. Redgate Clone startet unabhängig von der Datenbankgröße in wenigen Sekunden einen Live-Datencontainer, sodass eine 5-TB-SQL-Server-Datenbank genauso schnell bereitgestellt wird wie eine 128-MB-Datenbank. Sie können Revisionen wie in einem Git-Workflow verzweigen, zurücksetzen und speichern. Dadurch lässt sich jedem Tester ganz einfach eine eigene isolierte Umgebung bereitstellen, ohne den Speicher zu duplizieren.
Die wichtigsten Funktionen von Redgate SQL Provision
- Anonymisierungs-CLI (
rganonymize): Ein dreistufiges Befehlszeilentool, das Spalten mit personenbezogenen Daten klassifiziert, Maskierungsregeln zuordnet und echte Werte in SQL Server, PostgreSQL, MySQL, MariaDB und Oracle ersetzt. - Deterministische Maskierung: Maskiert denselben Eingabewert jedes Mal mit einem festen Ausgangswert in denselben Ausgabewert und sorgt so dafür, dass maskierte Daten über zugehörige Tabellen hinweg konsistent bleiben.
- Daten-Teilmengenbildung: Die
rgsubset-CLI ruft einen konfigurierbaren Teil Ihrer Quelldatenbank ab – standardmäßig 10 % – und berücksichtigt dabei Fremdschlüssel, um die referenzielle Integrität zu wahren. - KI-benutzerdefinierte Datensätze: Ermöglicht es Ihnen, die benötigten Werte in natürlicher Sprache zu beschreiben, und generiert eine überprüfbare Liste mit bis zu 1.000 Werten zur Verwendung bei der Ersetzung durch Maskierungswerte.
Integrationen von Redgate SQL Provision
Redgate SQL Provision lässt sich in SQL Server, PostgreSQL, MySQL, MariaDB, Oracle, Docker, AWS CloudFormation, Azure Kubernetes Service, SQL Data Catalog, PowerShell und dbatools integrieren. Die CLIs unterstützen skriptbasierte CI/CD-Workflows, native Jenkins-, Azure-DevOps- und GitHub-Actions-Plugins sind jedoch nicht dokumentiert.
Pros and Cons
Pros:
- Verzweigungen im Git-Stil aktualisieren Testdatenbanken schnell
- Deterministische Maskierung bewahrt die Konsistenz über mehrere Tabellen hinweg
- Die Berücksichtigung von Fremdschlüsseln bei der Teilmengenbildung schützt die relationale Integrität
Cons:
- Die Generierung synthetischer Daten endet bei Wertelisten
- Die Produktpositionierung sorgt für Unsicherheit bei Käufern
Learn more about Redgate SQL Provision:
Weitere Tools zur Testdatenverwaltung
Hier finden Sie einige weitere Optionen für Tools zur Testdatenverwaltung, die es nicht in meine engere Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- 11Perforce DelphixAm besten geeignet für die Virtualisierung vollständiger Produktionsdatenbankklone
- 12SynthesizedAm besten für SAP-native Testdatenmaskierung geeignet
- 13Tricentis ToscaAm besten für KI-gestützte Tests
- 14InformaticaAm besten für Tests in Unternehmen geeignet
- 15BMC CompuwareAm besten für sofortige Tests geeignet
- 16Rocket Data ExpressAm besten zum Einsparen von Testressourcen geeignet
- 17Accelario Continuous DataOps PlatformAm besten für durch CI/CD ausgelöste Datenbankvirtualisierung geeignet
- 18Avo Test Data ManagementAm besten geeignet für schnelle und zuverlässige Testdatengenerierung
- 19SynthoAm besten für die datenschutzorientierte Generierung synthetischer Daten
- 20IRI VoracityAm besten für die gemeinsame Maskierung strukturierter und verborgener Daten geeignet
Wie ich Tools für das Testdatenmanagement bewerte
Ich teile meine Bewertung in drei Bereiche auf, wobei die Kernfunktionen am stärksten gewichtet werden: Ein Tool muss sensible Daten maskieren und realistische synthetische Datensätze erzeugen. Anschließend betrachte ich herausragende Funktionen wie die Erkennung sensibler Daten. Neben den Funktionen berücksichtige ich die Flexibilität bei der Bereitstellung, den Support des Anbieters und die Preistransparenz.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jedes Tool für jede unten aufgeführte Kernfunktion auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (zeichnet sich in diesem Bereich aus). Anschließend rechne ich die Gesamtpunktzahl in einen Prozentsatz um, um die allgemeine Eignung jedes Tools besser beurteilen zu können, wobei Funktionen, die ich als wesentlich eingestuft habe, zusätzlich gewichtet werden.
- Datenmaskierung (wesentlich): Ich prüfe, ob Maskierungstechniken über verschiedene Quellen hinweg konsistent bleiben – sodass eine maskierte Kunden-ID in einer Tabelle überall dort übereinstimmt, wo sie vorkommt.
- Generierung synthetischer Daten (wesentlich): Ich suche nach Tools, die statistisch realistische Datensätze erzeugen, nicht nur zufällige Zeichenfolgen, damit QA-Teams während des Testens auch Randfälle erkennen können.
- Daten-Teilmengenbildung: Ich bewerte, wie gut ein Tool kleinere Datensätze herauslösen kann, während Fremdschlüsselbeziehungen über komplexe Schemata mit mehreren Tabellen hinweg erhalten bleiben.
- Bereitstellung von Testumgebungen: Schnelle Klon- und Aktualisierungszyklen sind hier entscheidend. Ich prüfe, wie schnell Teams vor jedem Sprint eine frische Umgebung bereitstellen können.
- Verwaltung referenzieller Integrität: Beschädigte Beziehungen zwischen Tabellen machen Testergebnisse ungültig. Ich prüfe, ob Verknüpfungen und Einschränkungen nach Maskierungs- oder Teilmengenbildungsläufen erhalten bleiben.
- Integration in Pipelines: Ich suche nach nativen Anbindungen an CI/CD-Tools wie Jenkins oder GitLab, damit die Datenbereitstellung automatisch zusammen mit den Build- und Bereitstellungsschritten ausgeführt wird.
Sobald ich eine Liste von Tools zusammengestellt habe, die die Kriterien erfüllen, prüfe ich, wodurch sich die einzelnen Plattformen voneinander abheben.
Unterscheidungsmerkmale (wodurch sich Anbieter voneinander abheben)
So vergleiche ich verschiedene Anbieter miteinander:
Herausragende Funktionen
Ich suche nach einer KI-gestützten Datengenerierung, die Produktionsmuster erlernt und statistisch realitätsgetreue synthetische Datensätze erzeugt – ohne dass Regeln manuell erstellt werden müssen. Die Erkennung sensibler Daten ist ebenso wichtig, da die automatische Klassifizierung personenbezogener Daten über verschiedene Quellen hinweg Compliance-Risiken reduziert, bevor die Maskierung überhaupt beginnt. Außerdem bewerte ich versionskontrollierte Testdaten, mit denen Teams zwischen Sprint-Zyklen Datensätze abzweigen und zurücksetzen können.
Über die Funktionen hinaus
Ich prüfe, ob ein Anbieter On-Premises-, Cloud- und hybride Bereitstellungsmodelle anbietet, da Teams in regulierten Branchen Daten häufig hinter einer Firewall halten müssen. Preistransparenz ist ebenso wichtig – einige Anbieter berechnen Gebühren nach Datenvolumen, während andere pro Umgebung abrechnen, und dieser Unterschied beeinflusst, ob die Einführung über mehrere Produktteams hinweg skaliert werden kann. Außerdem prüfe ich die Unterstützung bei der Einführung und die Qualität der Dokumentation, insbesondere für Organisationen ohne umfangreiche Kapazitäten im Bereich Data Engineering.
So wählen Sie ein Tool zur Testdatenverwaltung aus
Bei langen Funktionslisten und komplexen Preisstrukturen verliert man leicht den Überblick. Damit Sie sich bei der individuellen Auswahl Ihrer Software auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was Sie berücksichtigen sollten |
|---|---|
| FaktorSkalierbarkeit | Was Sie berücksichtigen solltenWächst das Tool mit Ihrem Team? Berücksichtigen Sie das künftige Datenvolumen und das Wachstum der Benutzerzahl. Achten Sie auf flexible Tarife, die eine Skalierung ohne erhebliche Kostensteigerungen ermöglichen. |
| FaktorIntegrationen | Was Sie berücksichtigen solltenFunktioniert das Tool mit Ihren bestehenden Systemen? Prüfen Sie die Kompatibilität mit Ihren aktuellen Testtools, Datenbanken und Arbeitsabläufen, um Unterbrechungen zu vermeiden. |
| FaktorAnpassbarkeit | Was Sie berücksichtigen solltenKönnen Sie das Tool an Ihre Anforderungen anpassen? Prüfen Sie, ob das Tool benutzerdefinierte Datenvorlagen und Arbeitsabläufe ermöglicht, die zu Ihren Prozessen passen. |
| FaktorBenutzerfreundlichkeit | Was Sie berücksichtigen solltenIst das Tool für Ihr Team benutzerfreundlich? Berücksichtigen Sie die Lernkurve und prüfen Sie, ob auch nichttechnische Mitarbeiter das Tool ohne umfangreiche Schulungen problemlos bedienen können. |
| FaktorImplementierung und Einarbeitung | Was Sie berücksichtigen solltenWie schnell können Sie starten? Achten Sie auf Tools, die eine schnelle Einrichtung, Schulungsressourcen und Support bieten, um einen reibungslosen Übergang zu gewährleisten. |
| FaktorKosten | Was Sie berücksichtigen solltenPasst das Tool in Ihr Budget? Vergleichen Sie die Preismodelle und stellen Sie sicher, dass keine versteckten Gebühren anfallen. Prüfen Sie, ob es eine kostenlose Testversion oder Demo gibt, die Sie vor einer verbindlichen Entscheidung nutzen können. |
| FaktorSicherheitsvorkehrungen | Was Sie berücksichtigen solltenWie schützt das Tool Ihre Daten? Stellen Sie sicher, dass das Tool die Sicherheitsstandards für Daten erfüllt und Verschlüsselung sowie Zugriffskontrollen zum Schutz vertraulicher Informationen bietet. |
| FaktorCompliance-Anforderungen | Was Sie berücksichtigen solltenErfüllt das Tool die gesetzlichen Anforderungen? Prüfen Sie, ob das Tool die Einhaltung relevanter Datenschutzbestimmungen wie der DSGVO oder HIPAA unterstützt, abhängig von den Anforderungen Ihrer Branche. |
Was sind Tools zur Testdatenverwaltung?
Tools zur Testdatenverwaltung sind Softwarelösungen, die zum Erzeugen, Verwalten und Pflegen von Daten für Softwaretests verwendet werden. Sie übernehmen die Erstellung und Bearbeitung von Testdaten und stellen sicher, dass diese korrekt, sicher und für verschiedene Testszenarien geeignet sind.
Diese Tools spielen eine wichtige Rolle bei der Organisation und Bereitstellung von Daten für funktionale, Leistungs- und Regressionstests in der Softwareentwicklung und arbeiten häufig zusammen mit Datenbanktesttools, um eine umfassende Datenvalidierung sicherzustellen.
Funktionen
Bei der Auswahl von Testdatenverwaltungstools sollten Sie auf die folgenden wichtigen Funktionen achten:
- Datenmaskierung: Schützt vertrauliche Informationen, indem sie durch fiktive Daten ersetzt werden, und gewährleistet die Einhaltung von Datenschutzbestimmungen.
- Daten-Subset-Bildung: Extrahiert eine Teilmenge von Daten aus großen Datensätzen und macht Tests dadurch überschaubarer und effizienter.
- Integrationsmöglichkeiten: Verbindet sich mit vorhandenen Testtools und Datenbanken und ermöglicht reibungslose Arbeitsabläufe.
- Benutzerdefinierte Datenvorlagen: Ermöglicht es Benutzern, Vorlagen zu erstellen, die auf ihre spezifischen Testanforderungen zugeschnitten sind, und erhöht dadurch die Flexibilität.
- KI-gestützte Datengenerierung: Nutzt künstliche Intelligenz, um realistische Testdaten zu generieren und die Testgenauigkeit zu verbessern.
- Echtzeit-Datenbereitstellung: Ermöglicht sofortigen Zugriff auf benötigte Testdaten und reduziert Verzögerungen im Testprozess.
- Unterstützung mehrerer Cloud-Umgebungen: Ermöglicht den Einsatz des Tools in verschiedenen Cloud-Umgebungen und bietet Flexibilität bei der Bereitstellung.
- Verschlüsselung und Zugriffskontrollen: Gewährleistet die Datensicherheit durch Verschlüsselung der Daten und Festlegung von Benutzerzugriffsberechtigungen.
- Schulungsressourcen: Bietet Tutorials, Webinare und weitere Lernmaterialien zur Unterstützung der Einarbeitung und Einführung des Tools.
- Unterstützung der Compliance: Hilft sicherzustellen, dass der Umgang mit Daten Branchenstandards und Vorschriften wie der DSGVO oder HIPAA entspricht.
Vorteile
Die Implementierung von Testdatenverwaltungstools bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Verbesserter Datenschutz: Funktionen zur Datenmaskierung helfen beim Schutz vertraulicher Informationen und gewährleisten die Einhaltung von Datenschutzbestimmungen.
- Höhere Testeffizienz: Die Echtzeit-Datenbereitstellung reduziert Verzögerungen und ermöglicht schnellere Testzyklen.
- Höhere Datengenauigkeit: Die KI-gestützte Datengenerierung erstellt realistische Testdaten und erhöht die Zuverlässigkeit der Testergebnisse.
- Kosteneinsparungen: Die Bildung von Daten-Subsets extrahiert nur die erforderlichen Daten und reduziert dadurch Speicher- und Verarbeitungskosten.
- Flexibilität bei der Bereitstellung: Die Unterstützung mehrerer Cloud-Umgebungen ermöglicht den Einsatz des Tools in verschiedenen Umgebungen und passt es an Ihre Infrastrukturanforderungen an.
- Benutzerfreundliche Einarbeitung: Der Zugang zu Schulungsressourcen und Tutorials unterstützt eine schnelle Einführung und effiziente Nutzung des Tools.
- Einhaltung gesetzlicher Vorschriften: Funktionen zur Compliance-Unterstützung helfen bei der Erfüllung von Branchenstandards und reduzieren das Risiko rechtlicher Probleme.
Kosten & Preise
Bei der Auswahl von Testdatenverwaltungstools ist ein Verständnis der verschiedenen verfügbaren Preismodelle und Tarife erforderlich. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre Durchschnittspreise und typische enthaltene Funktionen von Lösungen für Testdatenverwaltungstools zusammen:
Vergleichstabelle der Tarife für Testdatenverwaltungstools
| Tarifart | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| TarifartKostenloser Tarif | Durchschnittlicher Preis$0 | Übliche FunktionenGrundlegende Datenmaskierung, eingeschränkte Daten-Subset-Bildung und eingeschränkte Integrationsmöglichkeiten. |
| TarifartPersönlicher Tarif | Durchschnittlicher Preis$5-$25/user/month | Übliche FunktionenVerbesserter Datenschutz, KI-gestützte Datengenerierung und grundlegender Support. |
| TarifartGeschäftstarif | Durchschnittlicher Preis$30-$75/user/month | Übliche FunktionenErweiterte Daten-Subset-Bildung, Unterstützung mehrerer Cloud-Umgebungen und Zugang zu Schulungsressourcen. |
| TarifartUnternehmenstarif | Durchschnittlicher Preis$100+/user/month | Übliche FunktionenBenutzerdefinierte Datenvorlagen, umfassende Compliance-Unterstützung, Premium-Kundenbetreuung und vollständige Integrationsmöglichkeiten. |
Häufig gestellte Fragen zu Testdatenmanagement-Tools
Hier finden Sie Antworten auf häufige Fragen zu Testdatenmanagement-Tools:
Sollten Sie Maskierungs- oder Funktionen für synthetische Daten wählen?
Maskierung schützt echte Daten, indem persönliche Details verborgen werden. Software zur Generierung synthetischer Daten erstellt gefälschte, aber realistische Datensätze. Wählen Sie Maskierung, wenn Sie Produktionsdaten verwenden, und synthetische Daten, wenn Sie sicherere, vollständig generierte Testsätze benötigen.
Wenn Sie sich noch in der Phase befinden, in der Sie “mehr Testdaten sammeln müssen”, probieren Sie Folgendes: Die 10 besten Tools für Usability-Tests mit echtem Nutzerfeedback.
Warum ist Datensicherheit bei TDM-Tools wichtig?
TDM-Software verarbeitet häufig sensible Produktionsdaten. Ohne ordnungsgemäße Maskierung oder Verschlüsselung riskieren Sie Datenlecks oder Compliance-Probleme. Wählen Sie immer ein Tool, das Verschlüsselung, Anonymisierung und Zugriffskontrollen unterstützt.
Welche Integrationen sollte ein TDM-Tool unterstützen?
Es sollte mit Ihren CI/CD-Tools wie Jenkins, GitLab oder Azure DevOps funktionieren. Die Integration in wichtige Datenbanken (Oracle, SQL Server, PostgreSQL) und Cloud-Plattformen ist ebenfalls entscheidend für eine reibungslose Automatisierung.
Wie testen Sie ein TDM-Tool vor dem Kauf?
Führen Sie einen kleinen Machbarkeitsnachweis durch. Probieren Sie das Klonen, Maskieren und Aktualisieren von Daten in Ihrer tatsächlichen Umgebung aus. Prüfen Sie, wie schnell es läuft und ob es sich in Ihren bestehenden Workflow integrieren lässt.
Wie können TDM-Tools bei der Compliance helfen?
Gute Tools protokollieren jede Datenänderung, führen Prüfprotokolle und stellen sicher, dass maskierte Daten konsistent bleiben. Dies hilft Ihrem Team, Vorschriften wie GDPR, HIPAA oder CCPA einzuhalten.