

Som erfaren professionel, der arbejder med API'er, mikrotjenester og en lang række fullstackteknologier, anerkender jeg den afgørende rolle, som effektiv ydeevneovervågning spiller. Gennem årene har jeg selv oplevet fordelene ved at bruge omfattende AIOps-platforme, såsom disse alternativer til Dynatrace, der tilbyder hurtig fejlfinding og funktioner til analyse af den grundlæggende årsag.
Disse Dynatrace-erstatninger er ikke kun brugervenlige, men imponerer også med deres robuste overvågningsfunktioner. Den problemfri integration med populære platforme som Slack bidrager til at forbedre kommunikationen i teamet under kritiske situationer. Med omfattende profilering og modulære løsninger til rådighed får du en effektiv overvågningsplatform, der kan løfte din teknologistak og din samlede produktivitet.
Hvad er Dynatrace?
Dynatrace er en platform til overvågning af applikationsydeevne (APM), som hjælper dig med at holde øje med, analysere og optimere, hvordan dine applikationer og din infrastruktur kører. Den bruges af DevOps-teams, SRE'er og it-ledere, der har brug for at opdage problemer tidligt og forbedre brugeroplevelsen. Overvågning i realtid, AI-drevne advarsler og sporing fra ende til anden hjælper med at finde forsinkelser, identificere de grundlæggende årsager og holde systemerne kørende uden problemer. Alt i alt hjælper Dynatrace dit team med at være på forkant med problemer med ydeevnen, før de påvirker brugerne.
Hvorfor du kan stole på vores softwareanbefalinger
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vores team har testet og anmeldt software siden 2012. Vi er selv teknologiledere, så vi ved, hvor svært og hvor vigtigt det er at vælge den rigtige software.
Til denne guide har vi vurderet værktøjerne gennem praktisk afprøvning og uafhængig research og givet dem point ud fra vores udvælgelseskriterier.
Vores anmeldelser bygger på vores egen redaktionelle vurdering. De er ikke et salgsargument.
Ekspertanmeldere:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel over alternativer til Dynatrace
Denne sammenligningstabel opsummerer prisoplysningerne for mine bedste alternativer til Dynatrace:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bedst til fejlløsning i realtid | 3.3 out of 5 | 4 | 4 | 1 | 3 | 4 | 4 | $26/måned Gratis abonnement tilgængeligt | Website |
Bedst til omfattende teknologisupport | 3.3 out of 5 | 3 | 3 | 4 | 3 | 3 | 4 | $32.92/måned Gratis abonnement tilgængeligt | Website |
Bedst til forskellige applikationsmiljøer | 3.2 out of 5 | 3 | 3 | 3 | 4 | 2 | 4 | $10/måned 30 dages gratis prøveperiode | Website |
Bedst til open source-overvågning på virksomhedsniveau | 3.3 out of 5 | 2 | 4 | 5 | 4 | 3 | 2 | Gratis Nej | Website |
Bedst til omfattende overvågning af IT-infrastruktur | Not rated | Not rated | 4 | 4 | 2 | 1 | 2 | $2,595 som engangsbetaling 30 dages gratis prøveperiode | Website |
Bedst til samlet sporing af cloudtjenester | 4.2 out of 5 | 5 | 4 | 3 | 4 | 4 | 5 | $15/måned Nej | Website |
Bedst til indsigt i forretningsydelse i realtid | 3.2 out of 5 | 2 | 3 | 4 | 4 | 2 | 4 | $6/vCPU/måned Nej | Website |
Bedst til forespørgsler på telemetri i et samlet datalager | 4.0 out of 5 | 4 | 4 | 4 | 3 | 4 | 5 | $12/bruger/måned Nej | Website |
Bedst til logstyring og sikkerhedsanalyse | 3.5 out of 5 | 3 | 4 | 4 | 3 | 4 | 3 | $108 pr. bruger pr. måned Nej | Website |
Bedst til dataanalyse og indsigt i stor skala | 3.7 out of 5 | 4 | 3 | 4 | 4 | 3 | 4 | $150/user/month Nej | Website |


Anmeldelser af de bedste alternativer til Dynatrace
Nedenfor finder du mine detaljerede opsummeringer af de bedste alternativer til Dynatrace, som kom med på min kortliste. Mine anmeldelser giver et detaljeret indblik i de vigtigste funktioner, fordele & ulemper, integrationer og ideelle anvendelsesområder for hvert værktøj, så du kan finde det bedste til dig.
 Bedst til fejlløsning i realtid
- Gratis abonnement tilgængeligt
- Fra $26/måned (faktureret årligt)
Visit WebsiteCustomer Rating:4.5/5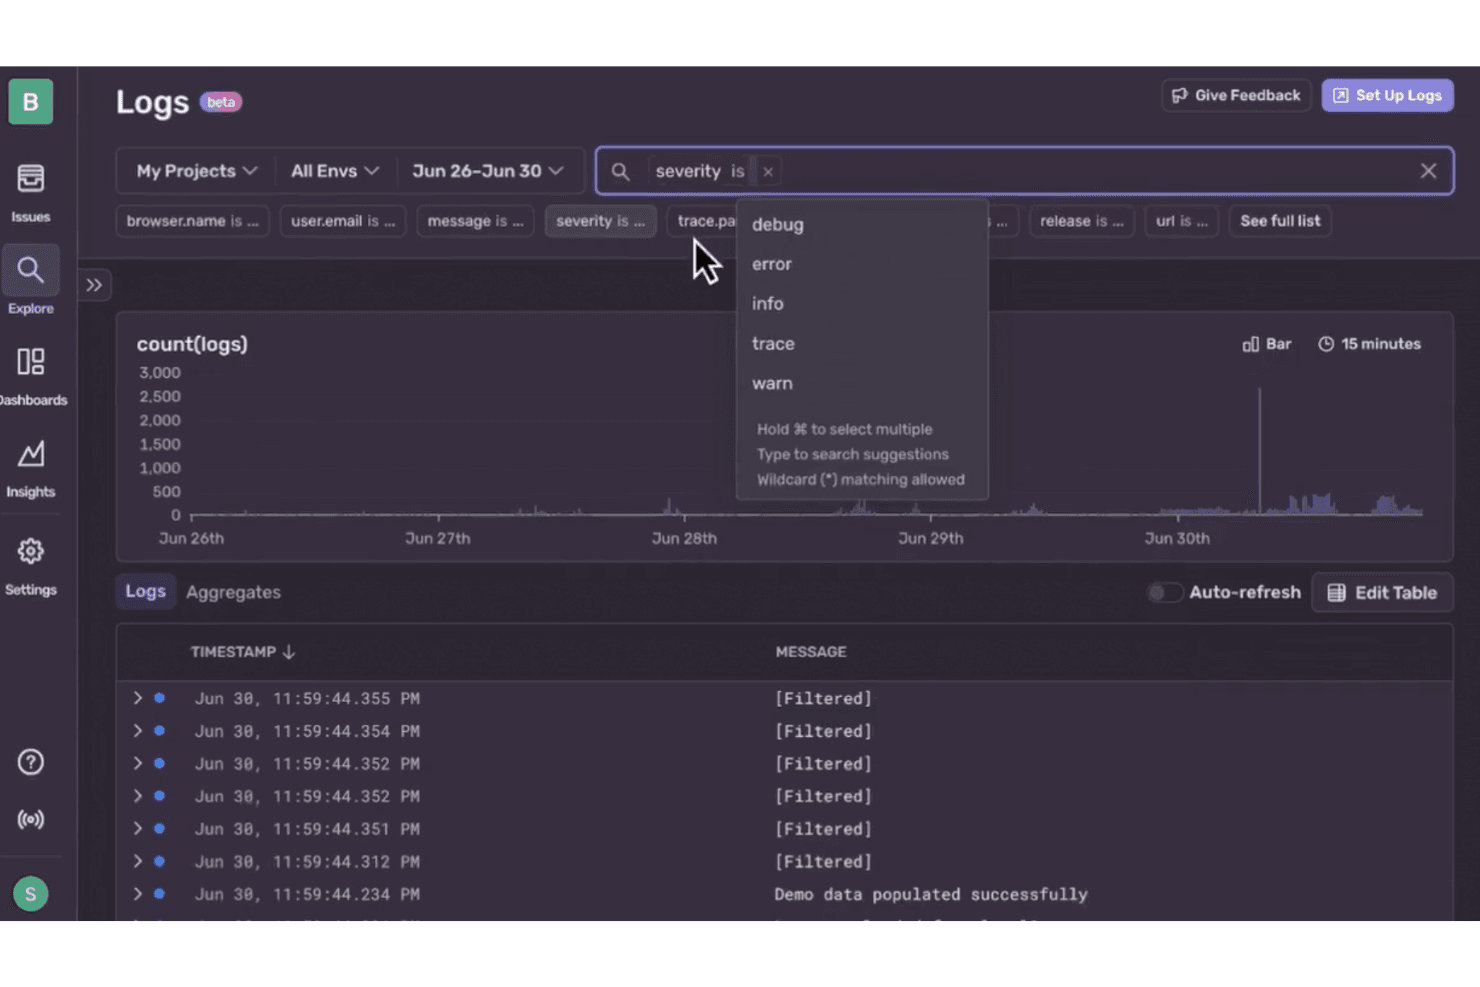
Sentry lader brugere filtrere logfiler efter alvorlighedsniveauer som fejlfinding, fejl eller advarsel. Sentry kombinerer overvågning af applikationsydelse med fejlsøgning og giver softwareteams et udviklerfokuseret alternativ til Dynatrace til diagnosticering af problemer på tværs af applikationer og tjenester.
Hvem er Sentry bedst egnet til?
Sentry er velegnet til softwareudviklings- og DevOps-teams, der har brug for at identificere og løse produktionsfejl i realtid.
Hvorfor valgte jeg Sentry?
Jeg valgte Sentry som mit valg til «Bedst til fejlløsning i realtid», fordi værktøjet forbinder produktionsfejl med stakspor og sporingsdata, så udviklere kan lokalisere fejlslagne kodestier. Udgivelsessundhed og regressionsovervågning kan også afsløre, når en udrulning introducerer nye problemer, så teams kan prioritere rettelser, mens de overvåger applikationsydelsen.
Sentrys vigtigste funktioner
- Kontinuerlig profilering: Se CPU-profiler på funktionsniveau for understøttede applikationer.
- Webmålinger: Spor browsermålinger som sideindlæsning og reaktionsevne ved interaktioner.
- Overvågning af databaseforespørgsler: Undersøg forespørgselsvarighed, og identificer langsomme databaseoperationer.
- Brugerdefineret instrumentering: Tilføj målinger for at overvåge applikationsspecifikke operationer.
Sentry-integrationer
Sentry tilbyder integrationer med GitHub, GitLab, Jira, Slack, Microsoft Teams, PagerDuty, Azure DevOps, Bitbucket, Vercel og Opsgenie. Integrationsplatformen og REST API'et understøtter brugerdefinerede integrationer.
Pros and Cons
Pros:
- Stakspor gør fejlfinding i produktion hurtigere
- Korrelerer fejl med spor og profiler
- Udgivelsessporing markerer regressioner i udrulninger
Cons:
- Ingen overvågning af værter eller infrastruktur
- Problemgruppering og advarsler kan skabe støj
Learn more about Sentry: Bedst til omfattende teknologisupport
- Gratis abonnement tilgængeligt
- Fra $32.92/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.3/5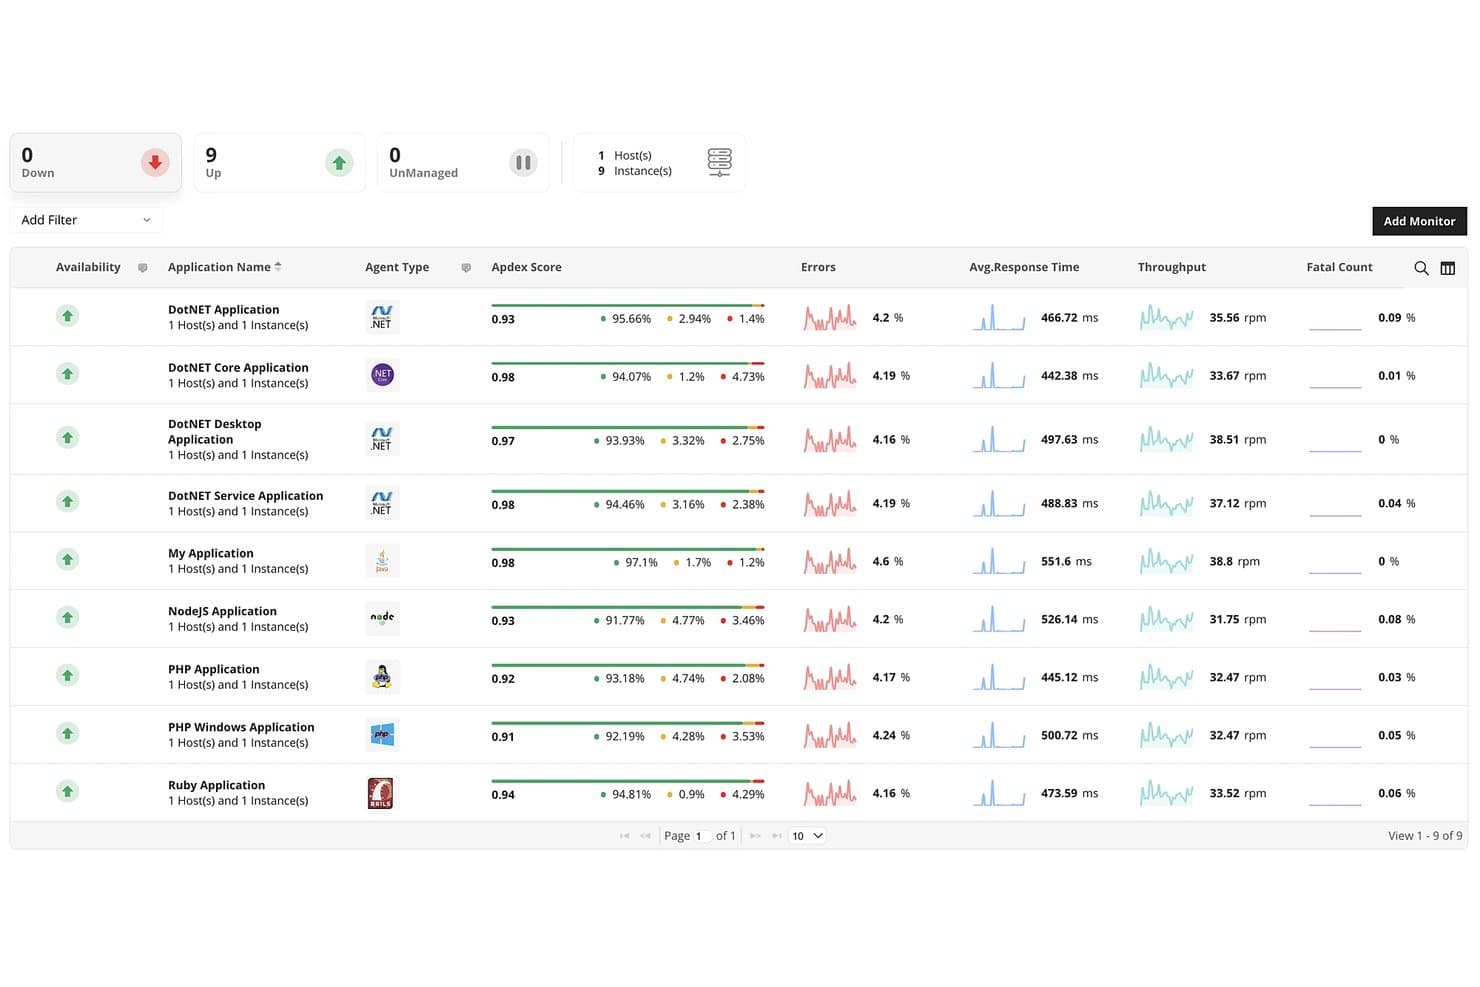
ManageEngine Applications Manager sporer målinger for applikationsydeevne på tværs af flere instanser. ManageEngine Applications Manager er en platform til overvågning af applikationsydelse for IT-teams, der har brug for at spore langsommelighed og driftsafbrydelser på tværs af applikationer, servere, databaser og cloudtjenester.
Hvem egner ManageEngine Applications Manager sig bedst til?
IT-driftsteams, der administrerer forskellige applikations- og infrastrukturmiljøer på tværs af lokale systemer og cloudsystemer.
Hvorfor valgte jeg ManageEngine Applications Manager?
Jeg valgte ManageEngine Applications Manager, 'Bedst til omfattende teknologisupport', fordi det overvåger applikationer sammen med servere, databaser og cloudtjenester. Jeg synes, at denne bredde er nyttig til at spore en langsom anmodning på tværs af applikations- og infrastrukturlag og derefter bruge transaktionsdiagnostik til at finde ud af, hvor latenstiden opbygges.
Vigtige funktioner i ManageEngine Applications Manager
- Afvigelsesregistrering: Sammenlign ydeevnemålinger med historiske basislinjer eller brugerdefinerede regler.
- Logstyring: Søg i, filtrer og fortolk applikations- og serverlogge i realtid.
- Overvågning af rigtige brugere: Spor sidevisninger, klik, sessionsvarighed og Apdex-scorer fra faktisk trafik.
- Kapacitetsprognoser: Gennemgå trendrapporter og maskinlæringsbaserede prognoser for at planlægge ressourcebehov.
Integrationer til ManageEngine Applications Manager
ManageEngine Applications Manager dokumenterer integrationer med ManageEngine ServiceDesk Plus, ManageEngine OpManager, Slack og ServiceNow samt Syslog-kompatible SIEM-platforme som Splunk, Microsoft Sentinel og ManageEngine Log360. Det tilbyder også REST API'er til at forbinde interne portaler og tredjepartssystemer.
Pros and Cons
Pros:
- Overvåger applikationer, databaser, servere og cloudmiljøer
- Advarsler i realtid understøtter proaktiv fejlfinding
- Bred dækning af ældre systemer og hybridmiljøer
Cons:
- Avanceret justering af tærskelværdier kræver opsætning
- Mindre dybde inden for sporing af cloudbaserede systemer
Learn more about ManageEngine Applications Manager: Bedst til forskellige applikationsmiljøer
- 30 dages gratis prøveperiode
- Fra $10/måned
Visit WebsiteCustomer Rating:4.7/5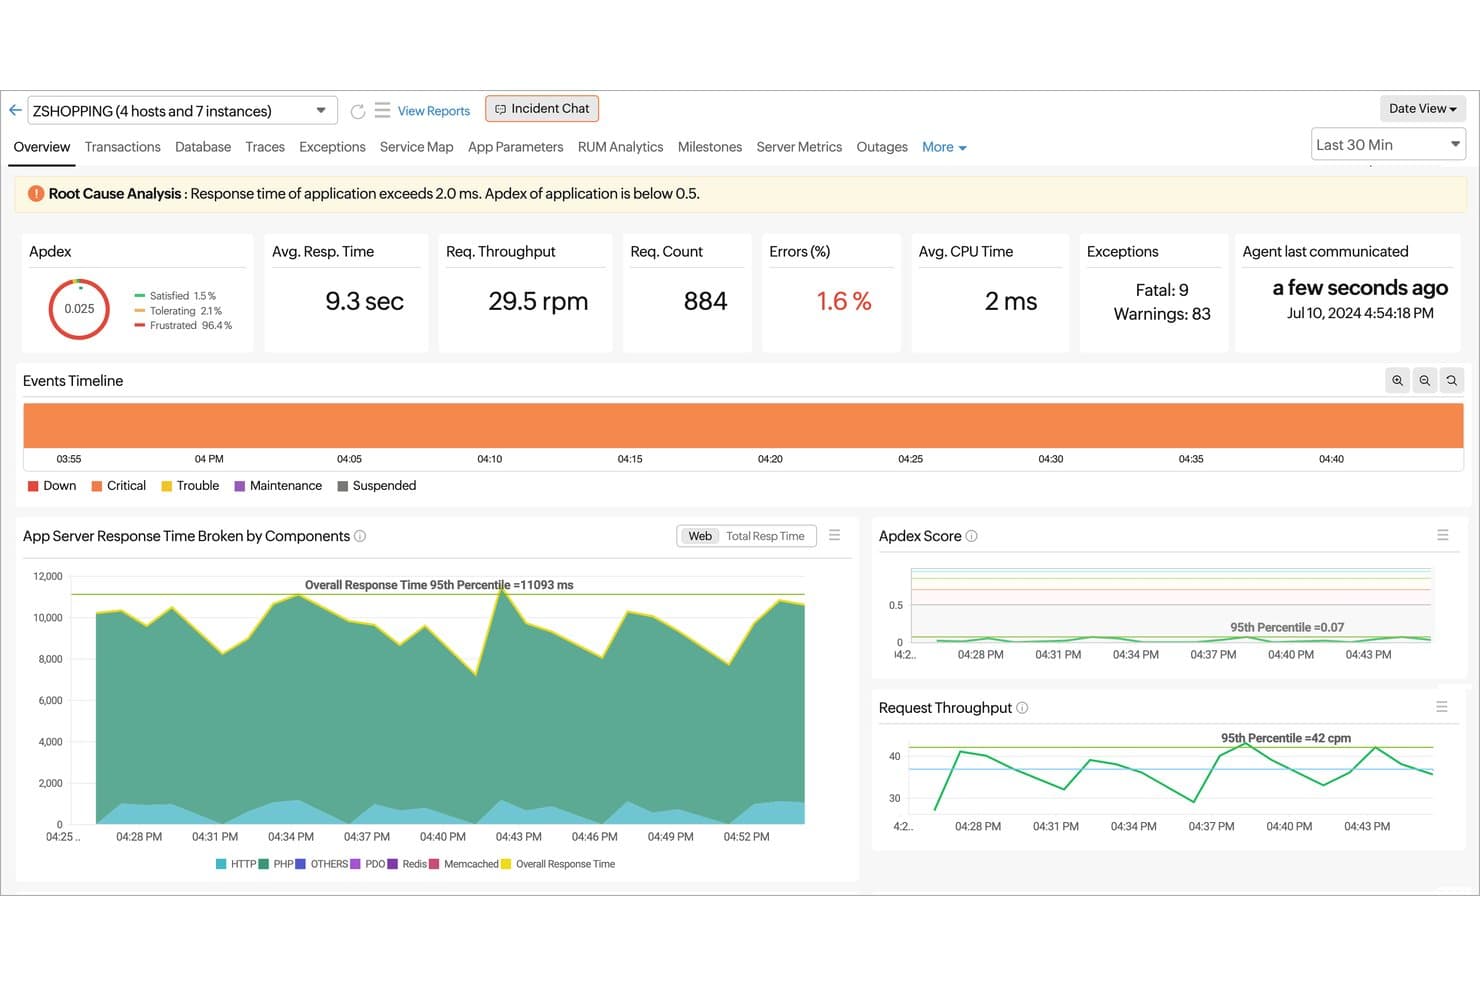
Site24x7 viser årsagsanalyse og APM-målinger i én visning. Site24x7 er en platform til IT-observabilitet og -overvågning for teams, der evaluerer alternativer til Dynatrace, og som hjælper IT-specialister med at spore applikations- og infrastrukturydelse, diagnosticere serviceproblemer og overvåge hybride miljøer.
Hvem er Site24x7 bedst egnet til?
Site24x7 er velegnet til IT-teams, der overvåger applikationer og infrastruktur på tværs af forskellige hybride miljøer.
Hvorfor jeg valgte Site24x7
Jeg valgte Site24x7 til anvendelsesområdet “Bedst til forskellige applikationsmiljøer”, fordi dets APM understøtter Java, .NET, PHP, Ruby, Node.js og Python. Jeg kan godt lide, hvordan distribueret sporing og diagnostik på kodeniveau hjælper mig med at følge langsomme transaktioner på tværs af tjenester, mens understøttelse af OpenTelemetry passer til instrumenterede miljøer.
Vigtige funktioner i Site24x7
- Serverovervågning: Sporer CPU-, hukommelses-, disk- og netværksmålinger på tværs af fysiske, virtuelle servere og cloudservere.
- Netværksovervågning: Måler enheders tilstand, båndbredde, latenstid og trafik på tværs af routere, switche og firewalls.
- Logadministration: Indsamler og søger i logfiler fra applikationer, systemer og cloudkilder.
- Webstedsovervågning: Kontrollerer websteders tilgængelighed fra mere end 130 globale placeringer.
Site24x7-integrationer
Site24x7 understøtter integrationer med ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, Opsgenie, Amazon EventBridge og Zapier. Den tilbyder også REST-API'er til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Overvåger applikationer på tværs af forskellige hybride miljøer
- Sporer transaktioner på tværs af understøttede applikationssprog
- Kontrollerer websteders tilgængelighed fra mere end 130 placeringer
Cons:
- Justering af alarmer kan generere falske positiver
- Dashboards føles rodede med begrænsede tilpasningsmuligheder
Learn more about Site24x7:
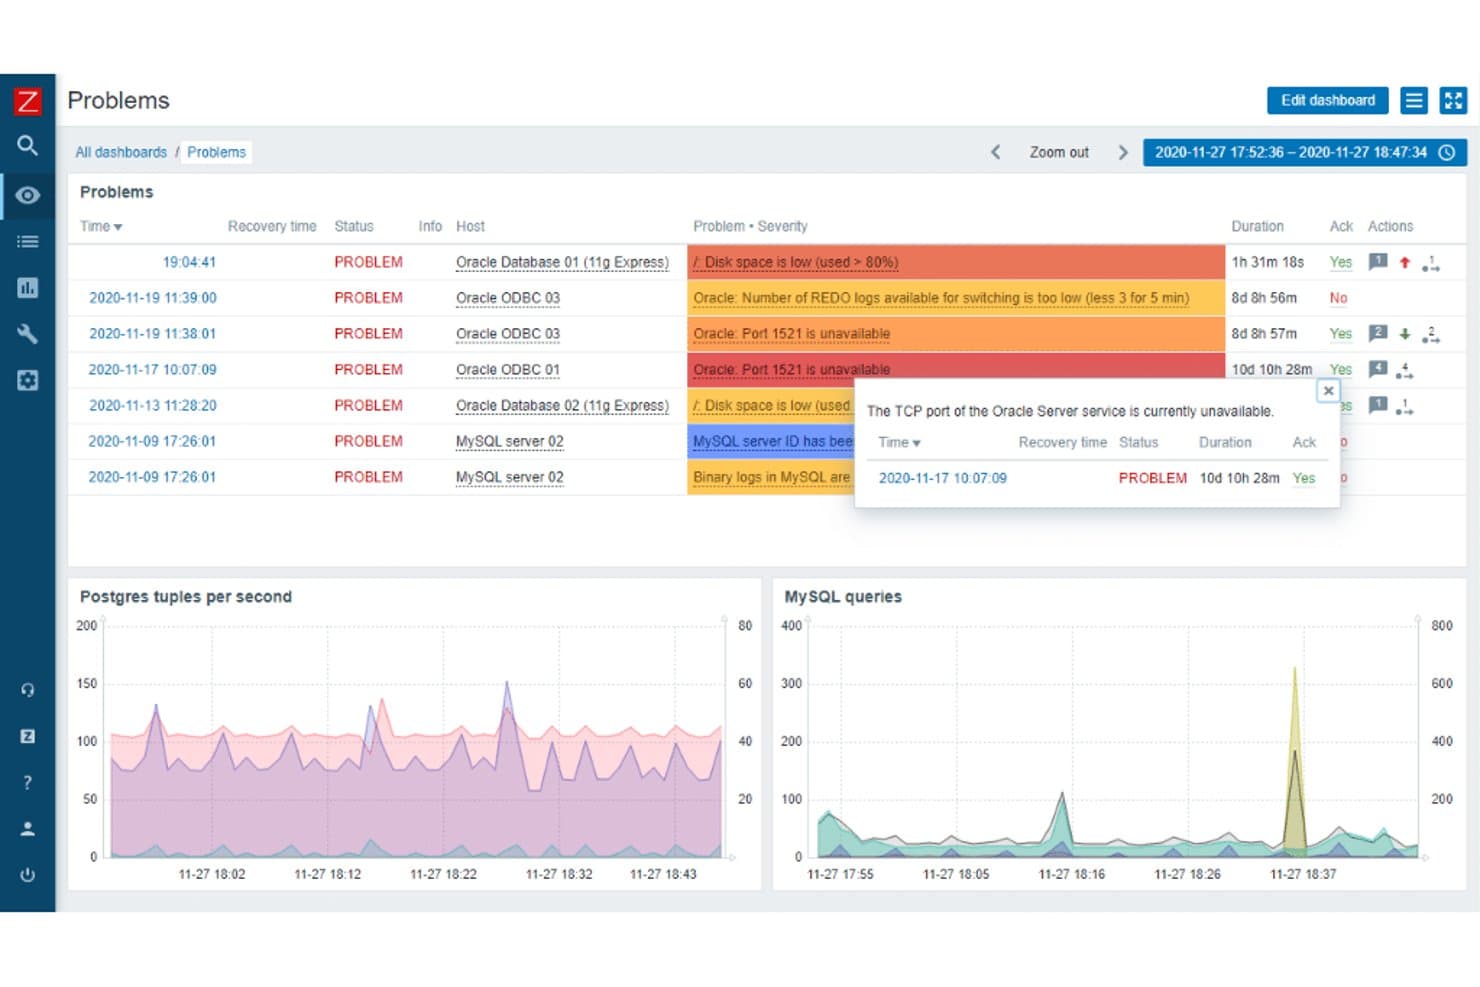
Zabbix viser aktive database- og serverproblemer med oplysninger om alvorlighedsgrad. Zabbix er en platform til infrastrukturovervågning for IT-teams, der har brug for at overvåge servere, netværk og applikationer, opdage tjenesteproblemer og skabe overblik på tværs af komplekse miljøer.
Hvem er Zabbix bedst egnet til?
Zabbix er velegnet til IT-driftsteams i større virksomheder, der har brug for tilpasningsdygtig open source-overvågning på tværs af store, distribuerede miljøer.
Hvorfor jeg valgte Zabbix
Jeg valgte Zabbix til denne guide til de bedste Dynatrace-alternativer, fordi det er bedst til open source-overvågning på virksomhedsniveau. Jeg kan godt lide, hvordan distribuerede proxyer indsamler data fra fjernlokationer, mens genanvendelige skabeloner anvender kontroller og udløsere på tværs af servere og netværksenheder. Det giver driftsteams mulighed for at overvåge et stort og blandet miljø uden at være afhængige af en proprietær platform.
Zabbix' vigtigste funktioner
- Hændelseskorrelation: Definer regler for at gruppere relaterede problemer og undertrykke symptom-hændelser.
- Webovervågning: Spor webscenarier i flere trin og svartider.
- Netværkskort: Opret kort, der viser overvågede værter, forbindelser og aktuelle problemer.
- Opgaveopdagelse på lavt niveau: Registrer automatisk enheder som netværksgrænseflader, og opret elementer til overvågning af dem.
Zabbix-integrationer
Zabbix' officielle katalog over integrationer viser 1,986 løsninger på tværs af 559 brands, herunder AWS, Azure, Kubernetes, ServiceNow, Slack, Jira og PagerDuty. Det tilbyder også en HTTP-baseret JSON-RPC API og tilpasningsdygtige JavaScript-webhooks til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Skalerer på tværs af distribuerede lokationer med proxyer
- Genanvendelige skabeloner standardiserer kontroller på tværs af serverparker
- Korrelerer relaterede alarmer for at reducere støj
Cons:
- Den indledende opsætning kræver omfattende manuel konfiguration
- Store installationer kræver justering af database og proxyer
 Bedst til omfattende overvågning af IT-infrastruktur
- 30 dages gratis prøveperiode
- Fra $2,595 som engangsbetaling
Visit WebsiteCustomer Rating:4.6/5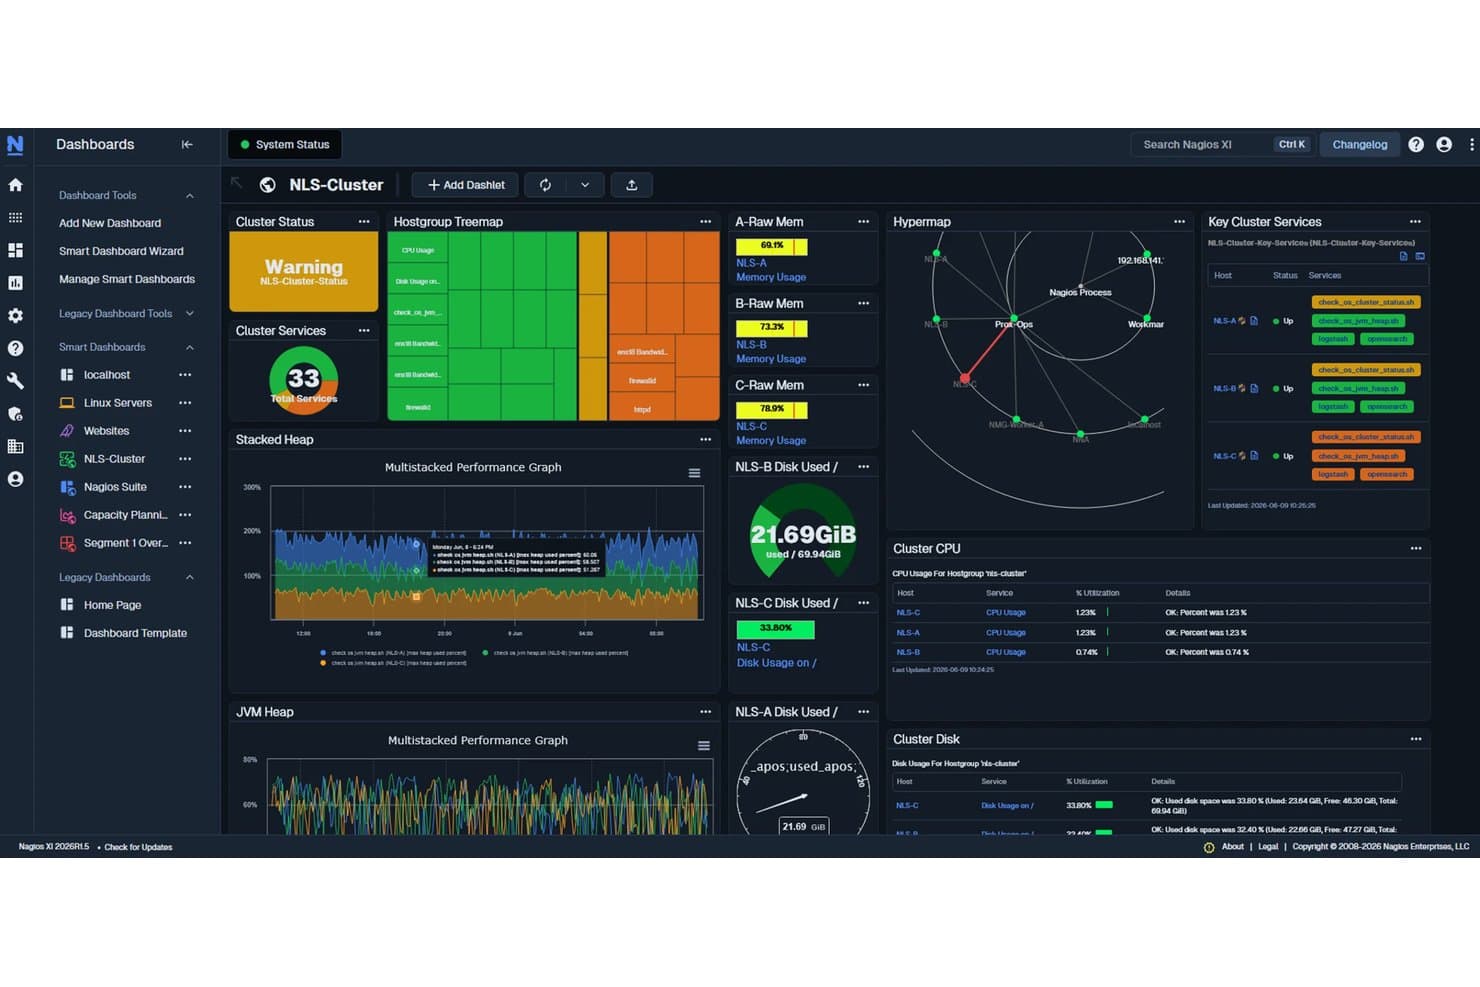
Nagios XI samler overvågning af klyngetilstand, CPU, diske og tjenester i ét dashboard. Nagios giver IT-teams konfigurerbar overvågning af værter og tjenester for at registrere driftsafbrydelser på tværs af servere, netværksenheder og applikationer i forskellige infrastrukturer.
Hvem er Nagios bedst egnet til?
Nagios er velegnet til infrastruktur- og driftsteams, der har brug for konfigurerbar overvågning på tværs af blandede miljøer, herunder etablerede systemer og netværksudstyr.
Hvorfor jeg valgte Nagios
Jeg valgte Nagios til en guide om alternativer til Dynatrace, fordi det passer til “Bedst til omfattende overvågning af IT-infrastruktur” med plugin-baserede kontroller af værter og tjenester. Jeg bruger SNMP-kontroller til at overvåge switche og routere sammen med servernes tilstand og konfigurerer derefter alarmer, når kontroller mislykkes. Det lader mig holde øje med blandet infrastruktur i ét overvågningssystem.
Nagios' vigtigste funktioner
- Automatisk registrering: Registrerer enheder og tjenester på dit netværk.
- Konfigurationsguider: Hjælper med opsætningen af almindelige enheder og applikationer.
- Dashboardoversigter: Viser statusoversigter, kort og grafer i tilpassede visninger.
- Ydelsesgrafer: Visualiserer overvågningsdata over tid.
Nagios-integrationer
Nagios XI har dokumenterede integrationer med Slack og PagerDuty til alarmnotifikationer og hændelseshåndtering, som konfigureres via scripts og notifikationsindstillinger. Dets REST API understøtter tilpassede forbindelser med værktøjer som CMDB- og ticketsystemer.
Pros and Cons
Pros:
- Overvåger blandede værter via tilpassede kontroller
- Pålidelige alarmer med konfigurerbare tærskelværdier
- Dashboardoversigter viser status og historiske tendenser
Cons:
- Den indledende opsætning kræver ekspertise i Linux-overvågning
- Eksterne plugins kan være forældede eller mangelfuldt dokumenterede
Learn more about Nagios: Bedst til samlet sporing af cloudtjenester
- Nej
- Fra $15/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.5/5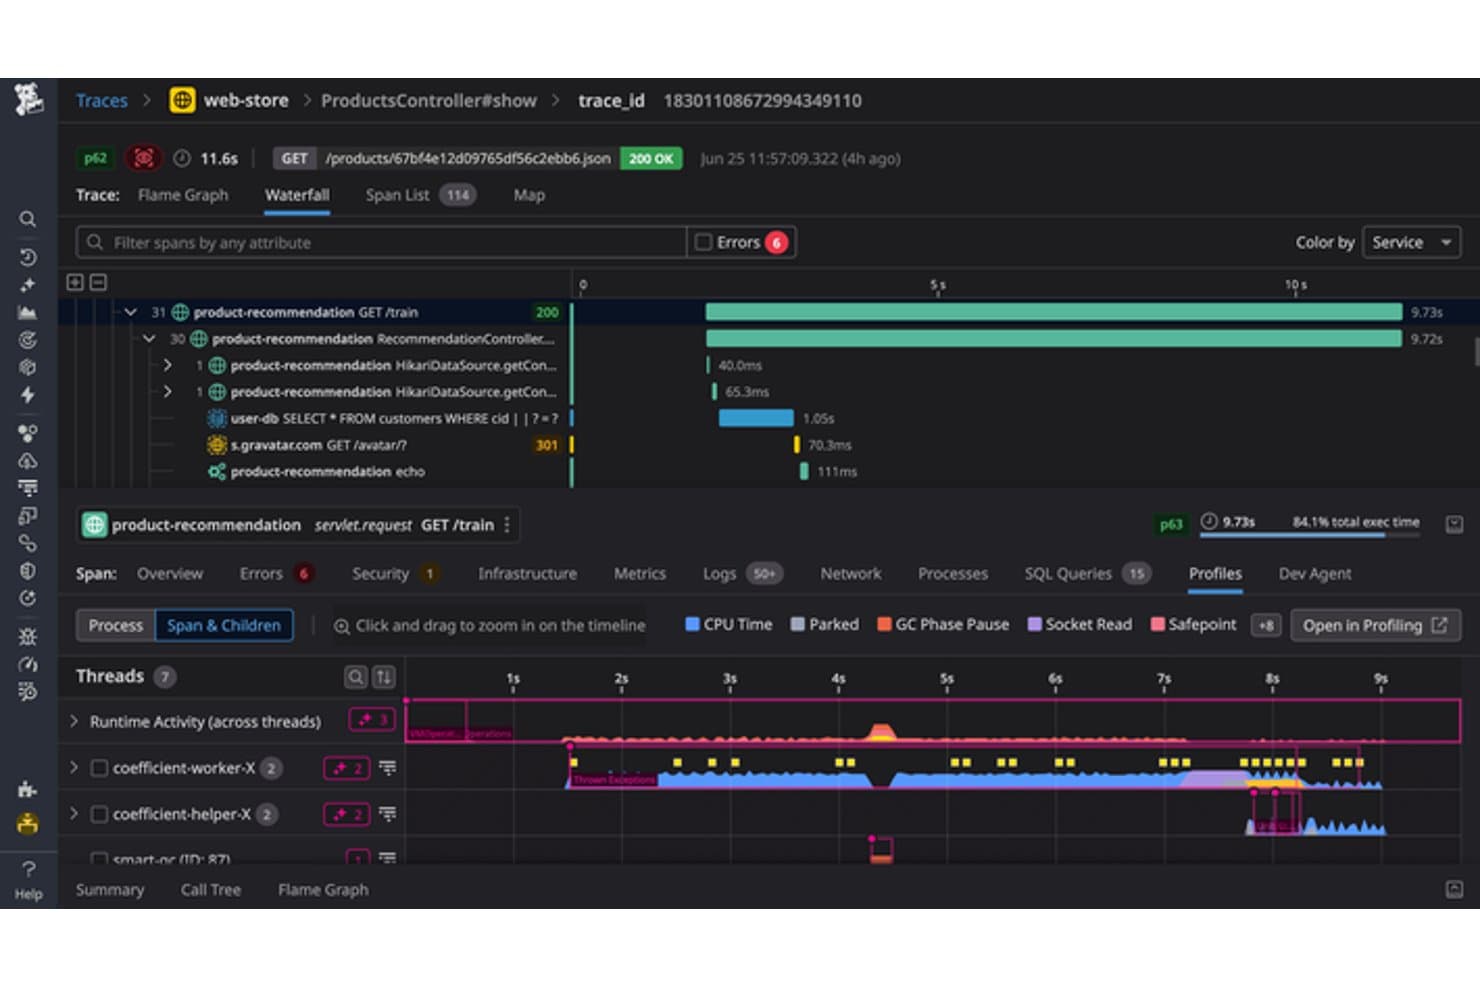
Datadogs APM viser CPU, tråde og tidslinjer for spor i detaljer. Datadog er en observabilitetsplatform til IT- og DevOps-teams, som samler data om applikationer, infrastruktur, logge og sikkerhed for at hjælpe med at diagnosticere problemer med ydeevnen på tværs af cloudbaserede miljøer.
Hvem er Datadog bedst til?
Clouddrifts- og SRE-teams kan bruge Datadog til at følge tjenesternes tilstand på tværs af distribueret infrastruktur og finde problemer, der påvirker produktionsarbejdsbelastninger.
Hvorfor jeg valgte Datadog
Jeg valgte Datadog til en guide til de bedste alternativer til Dynatrace, fordi den får titlen “Bedst til samlet sporing af cloudtjenester.” Jeg kan godt lide, hvordan dens infrastrukturmetrikker, distribuerede sporinger og logge lader mig følge en langsom forespørgsel fra en cloudvært gennem afhængige tjenester og undersøge relaterede fejl. Dens tjenestekort hjælper mig med at finde en forudgående afhængighed, der påvirker produktionens tilstand.
Datadogs vigtigste funktioner
- Overvågning af rigtige brugere: Registrerer browsersessioner, fejl i brugerfladen og sidens ydeevne.
- Syntetisk overvågning: Kører planlagte browser- og API-tests mod applikationer.
- Databaseovervågning: Viser metrikker på forespørgselsniveau og eksekveringsplaner for understøttede databaser.
- Overvågninger og alarmer: Evaluerer telemetri i forhold til tærskelværdier og sender meddelelser, når betingelser udløses.
Datadog-integrationer
Datadog tilbyder mere end 1.000 indbyggede integrationer, herunder AWS, Azure, Google Cloud, Kubernetes, Docker, PostgreSQL, GitHub, Jira, Slack og PagerDuty. Den understøtter også brugerdefinerede integrationer via sin API.
Pros and Cons
Pros:
- Sammenholder metrikker, logge og sporinger under hændelser
- Kortlægger afhængigheder for at finde fejl i forudgående tjenester
- Samler visninger af infrastrukturens og applikationernes tilstand
Cons:
- Vækst i telemetri gør regninger svære at forudsige
- Avancerede kontrolpaneler og forespørgsler kræver tid til konfiguration
 Bedst til indsigt i forretningsydelse i realtid
- Nej
- Fra $6/vCPU/måned (faktureret årligt)
Visit WebsiteCustomer Rating:4.3/5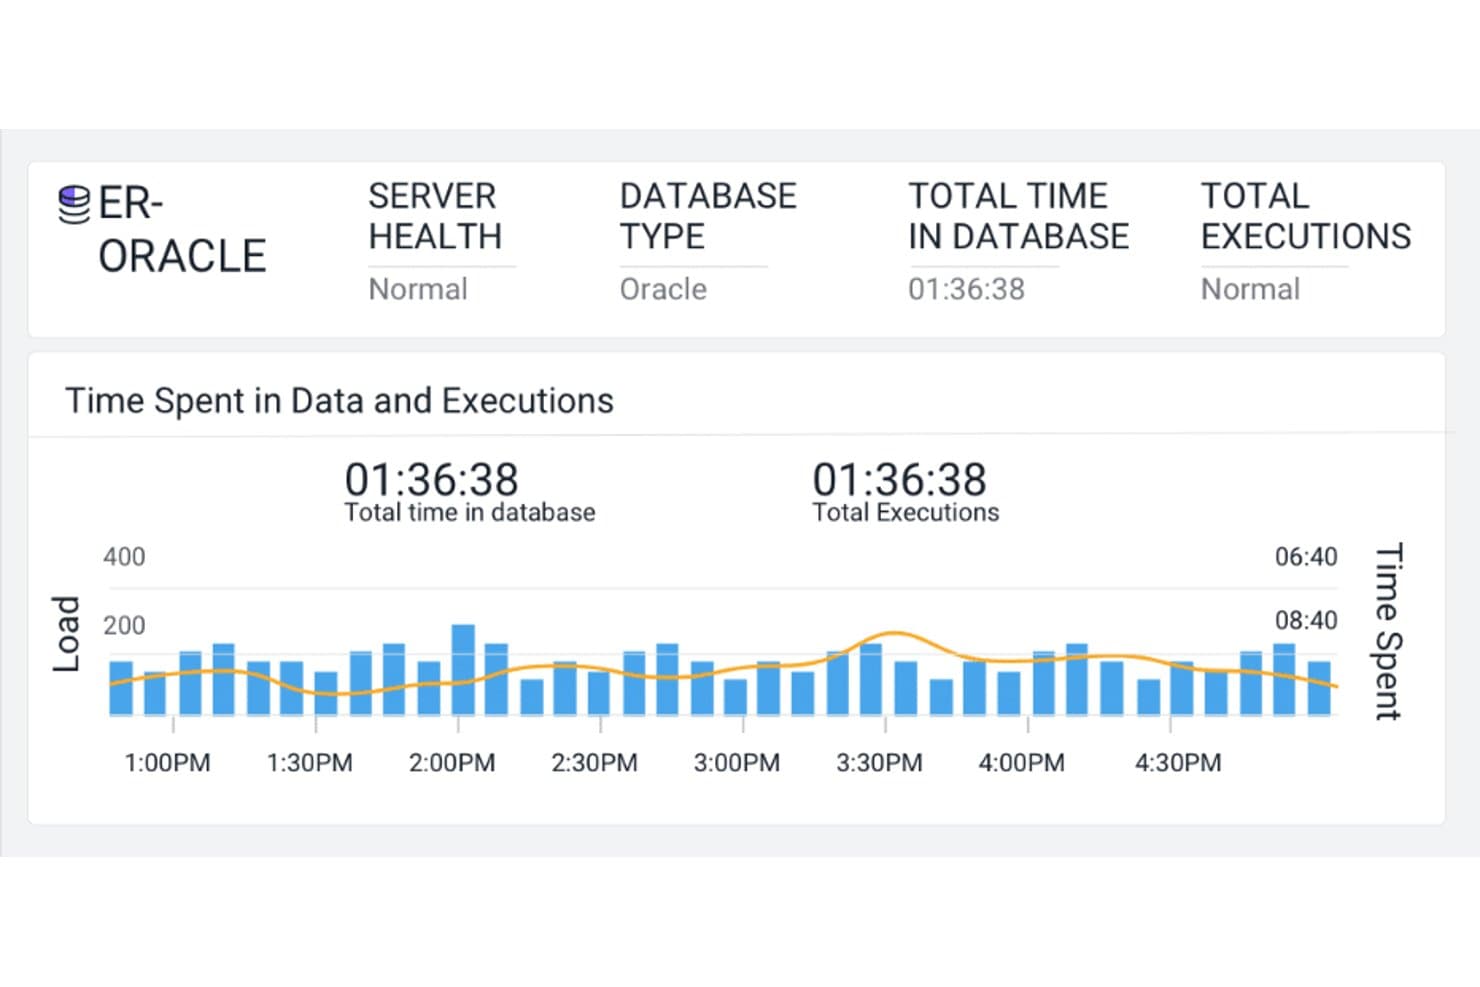
AppDynamics overvåger belastning og udførelsestider for Oracle-databaser visuelt. For IT- og ingeniørteams, der sammenligner alternativer til Dynatrace, kombinerer AppDynamics overvågning af applikationsydeevne med transaktionssporing for at hjælpe med at lokalisere langsomheder og fejl på tværs af komplekse, distribuerede tjenester.
Hvem egner AppDynamics sig bedst til?
AppDynamics egner sig til IT-drifts- og applikationsteams, der har brug for at forbinde den aktuelle applikationssundhed med de forretningstransaktioner, kunderne er afhængige af.
Hvorfor jeg valgte AppDynamics
Jeg valgte AppDynamics, fordi platformens fokus, “Bedst til indsigt i forretningsydelse i realtid”, forbinder den aktuelle applikationssundhed med de transaktioner, kunderne er afhængige af. Jeg kan godt lide, hvordan transaktionssporing hjælper med at lokalisere langsomheder på tværs af distribuerede tjenester, så jeg kan se, hvor en forespørgsel går i stå, og knytte problemet til forretningsaktivitet.
Vigtige funktioner i AppDynamics
- Applikationssikkerhed under kørsel: Registrer sårbarheder i applikationer, og bloker angreb.
- Overvågning af faktiske brugere: Registrer web- og mobilydelse på tværs af enheder og browsere.
- Syntetisk overvågning: Overvåg web-, mobil- og API-ydeevne med simuleret aktivitet.
- Registrering af afvigelser: Fastlæg baselines for ydeevne, og markér afvigelser med AI og maskinlæring.
AppDynamics-integrationer
AppDynamics har en indbygget tovejsintegration med Jira til oprettelse og opdatering af hændelsesbilletter samt en integration med Splunk Observability Cloud, der stadig er i tidlig forhåndsvisning. Den tilbyder også forudbyggede udvidelser og REST-API'er til integrationer og automatisering.
Pros and Cons
Pros:
- Kort over forretningstransaktioner forbinder telemetri med påvirkning
- Kaldgrafer understøtter analyse af den grundlæggende årsag på kodeniveau
- Referenceværdialarmer markerer afvigelser fra normalen
Cons:
- Instrumentering og opsætning af agenter kræver manuelt arbejde
- Grænsefladen virker forældet sammenlignet med nyere værktøjer til observerbarhed
Learn more about AppDynamics: Bedst til forespørgsler på telemetri i et samlet datalager
- Nej
- $12/bruger/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.3/5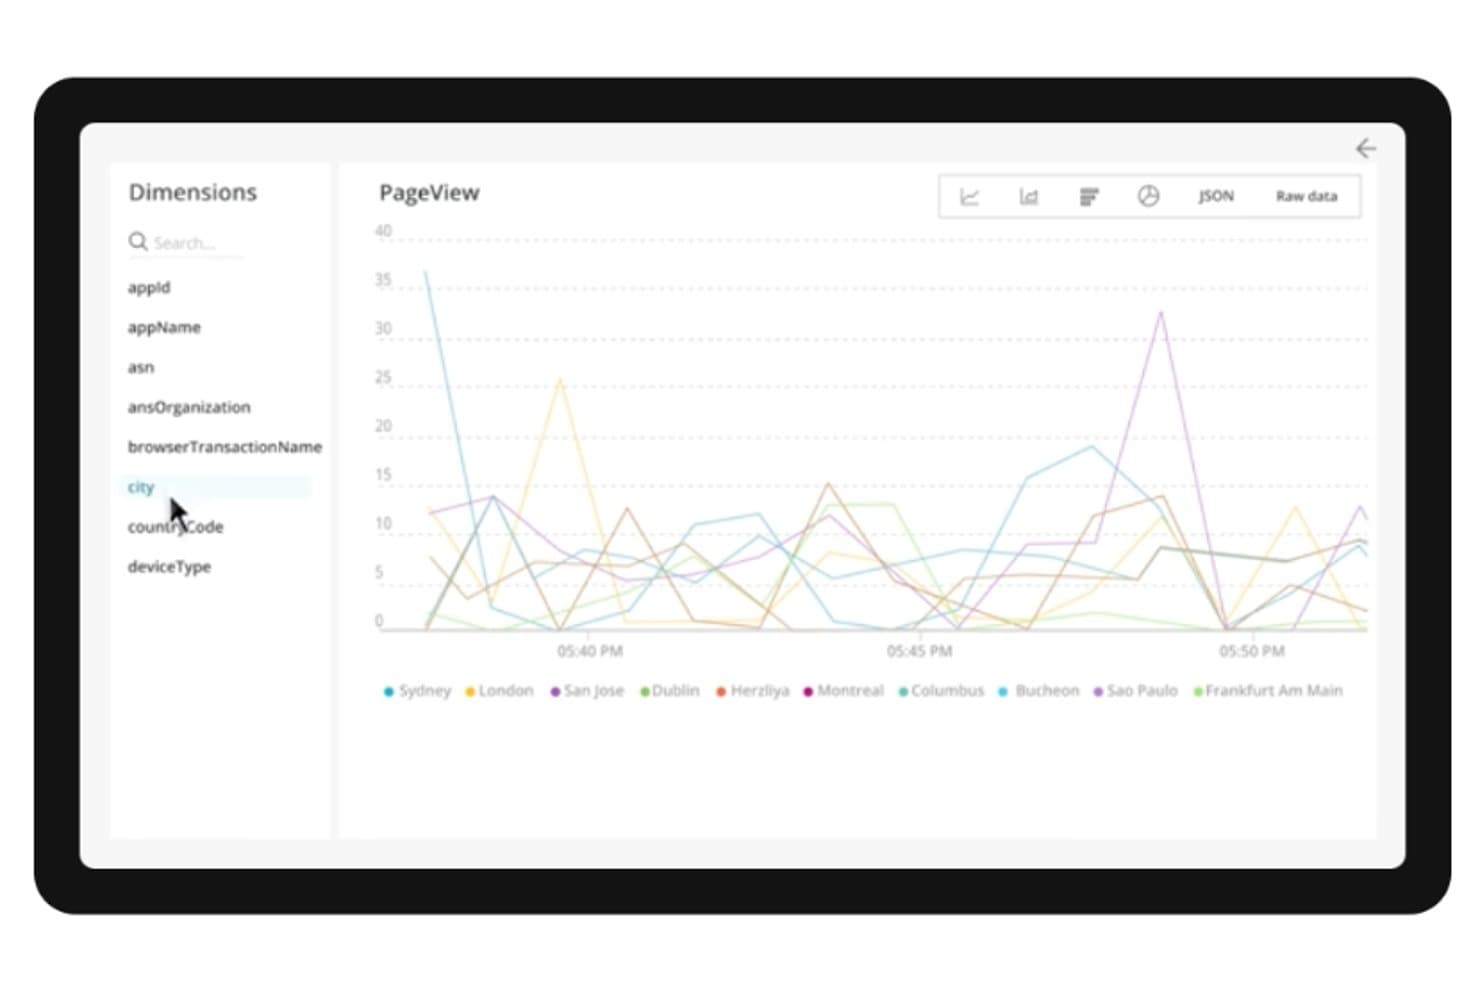
New Relic opdeler PageView-data efter by på tværs af en tidsserie. For IT- og ingeniørteams, der vurderer alternativer til Dynatrace, er New Relic en APM-platform, der hjælper med at spore applikationsproblemer, overvåge tjenesternes tilstand og undersøge forsinkelser på tværs af distribuerede systemer.
Hvem er New Relic bedst egnet til?
New Relic er velegnet til DevOps- og driftsteams med ansvar for websteders pålidelighed, som har brug for at forbinde applikationsspor, infrastrukturtal og logfiler, mens de diagnosticerer problemer i produktionen.
Hvorfor jeg valgte New Relic
Jeg valgte New Relic på grund af deres fokus på 'Bedst til omfattende overvågning af applikationsydelse': platformen forbinder distribuerede spor med tjenesternes tilstand og logfiler, så jeg kan følge forsinkelser på tværs af tjenester. Når en API bliver langsommere efter en udgivelse, kan jeg spore dens anmodningssti og kontrollere relaterede tjenestesignaler for at lokalisere den berørte afhængighed.
Vigtige funktioner i New Relic
- Databaseovervågning: Undersøg langsomme databaseforespørgsler og deres udførelsesdetaljer.
- Diagnostik på kodeniveau: Profilér applikationskode for at identificere metoder, der bruger CPU-tid.
- Udgivelsessporing: Markér udgivelser for at sammenligne applikationsydelsen før og efter ændringer.
- Alarmbetingelser: Indstil tærskler for applikationsmålinger, og modtag meddelelser, når de overskrides.
New Relic-integrationer
New Relic understøtter integrationer til alarmmeddelelser med Atlassian Jira, AWS EventBridge, Microsoft Teams, PagerDuty, ServiceNow og Slack samt mere end 400 værtsbaserede integrationer. Platformen tilbyder også API'er og Flex-integrationsværktøjet til at sende brugerdefinerede data til New Relic.
Pros and Cons
Pros:
- Sammenkæder spor, logfiler og infrastruktursignaler
- Sporer regressionsfejl efter udgivelser på tværs af distribuerede transaktioner
- Forbinder applikationsydelse med browseroplevelsen
Cons:
- Tæt navigation kan forsinke undersøgelsen af hændelser
- Vækst i datainput kan gøre omkostningerne uforudsigelige
Learn more about New Relic: Bedst til logstyring og sikkerhedsanalyse
- Nej
- $108 pr. bruger pr. måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.3/5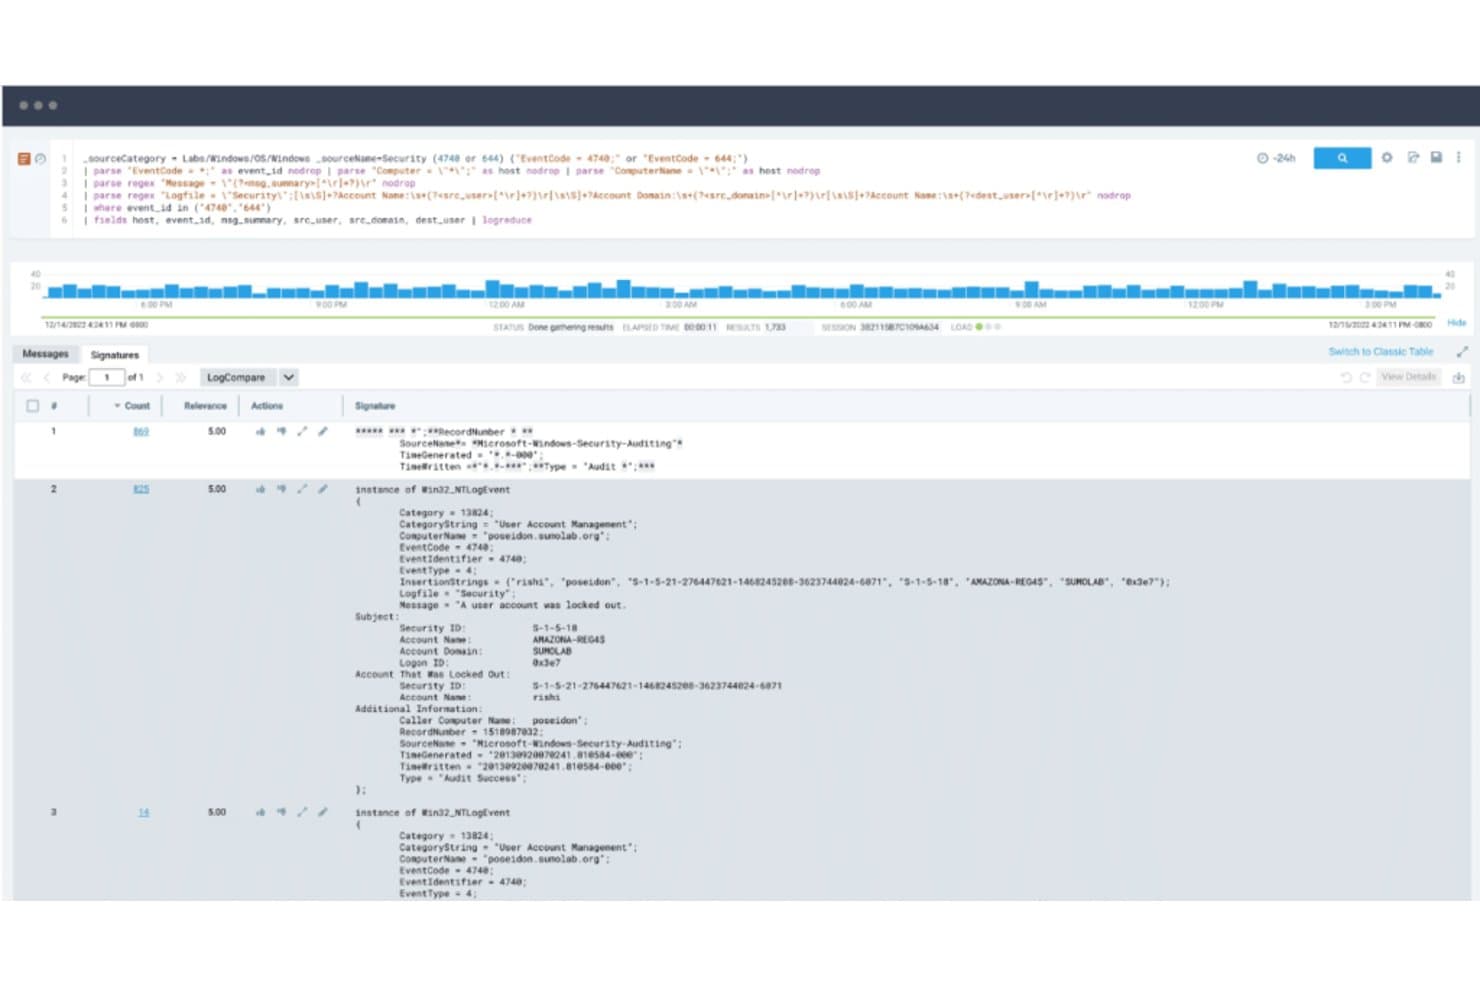
Sumo Logic registrerer hændelser med kontolåsning ved hjælp af sikkerhedsloganalyse. Sumo Logic er en cloudbaseret platform til observerbarhed, der hjælper infrastruktur- og sikkerhedsteams med at undersøge serviceforstyrrelser og forstå aktivitet på tværs af distribuerede applikationer, hvilket gør den til en mulighed for teams, der vurderer alternativer til Dynatrace.
Hvem er Sumo Logic bedst til?
Sikkerhedsanalytikere og IT-driftsteams, der har brug for centraliserede logdata til fejlfinding, trusselsdetektion og undersøgelser, passer godt til Sumo Logic.
Hvorfor jeg valgte Sumo Logic
Jeg valgte Sumo Logic til denne guide om alternativer til Dynatrace, fordi den matcher “Bedst til logstyring og sikkerhedsanalyse”. Logsøgefunktionen hjælper mig med at spore fejl på tværs af distribuerede tjenester, mens Cloud SIEM sammenkæder sikkerhedssignaler for at understøtte undersøgelsen af mistænkelig aktivitet.
Vigtigste funktioner i Sumo Logic
- Metrikanalyse: Forespørg på tidsseriemetrikker med Sumo Logics forespørgselssprog til metrikker.
- Distribueret sporing: Undersøg sporingsspænd for at følge anmodninger på tværs af instrumenterede tjenester.
- Kontrolpaneler: Opret visualiseringer ud fra telemetridata, og arranger dem i brugerdefinerede layout.
- Overvågninger og alarmer: Definer betingelser for metrikker eller forespørgsler, der udløser notifikationer.
Integrationer til Sumo Logic
Sumo Logics app-katalog omfatter hundredvis af leverandører og produkter, herunder AWS, Azure, Datadog, Dynatrace, GitHub og Jira, med tilbud såsom datakilder til dataindsamling, forudbyggede apps og automatiseringsintegrationer. Det indeholder indbyggede webhook-integrationer til ServiceNow og Slack samt REST-API'er til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Hurtige logsøgninger understøtter undersøgelse af hændelser
- Centraliserede logge understøtter alarmer i realtid
- Cloud SIEM sammenkæder trusler til undersøgelser
Cons:
- Det tager tid at lære forespørgselssproget
- Logindsamling og parsing har brug for forbedring
 10Bedst til dataanalyse og indsigt i stor skala
Splunk
- Nej
- $150/user/month
Visit WebsiteCustomer Rating:4.3/5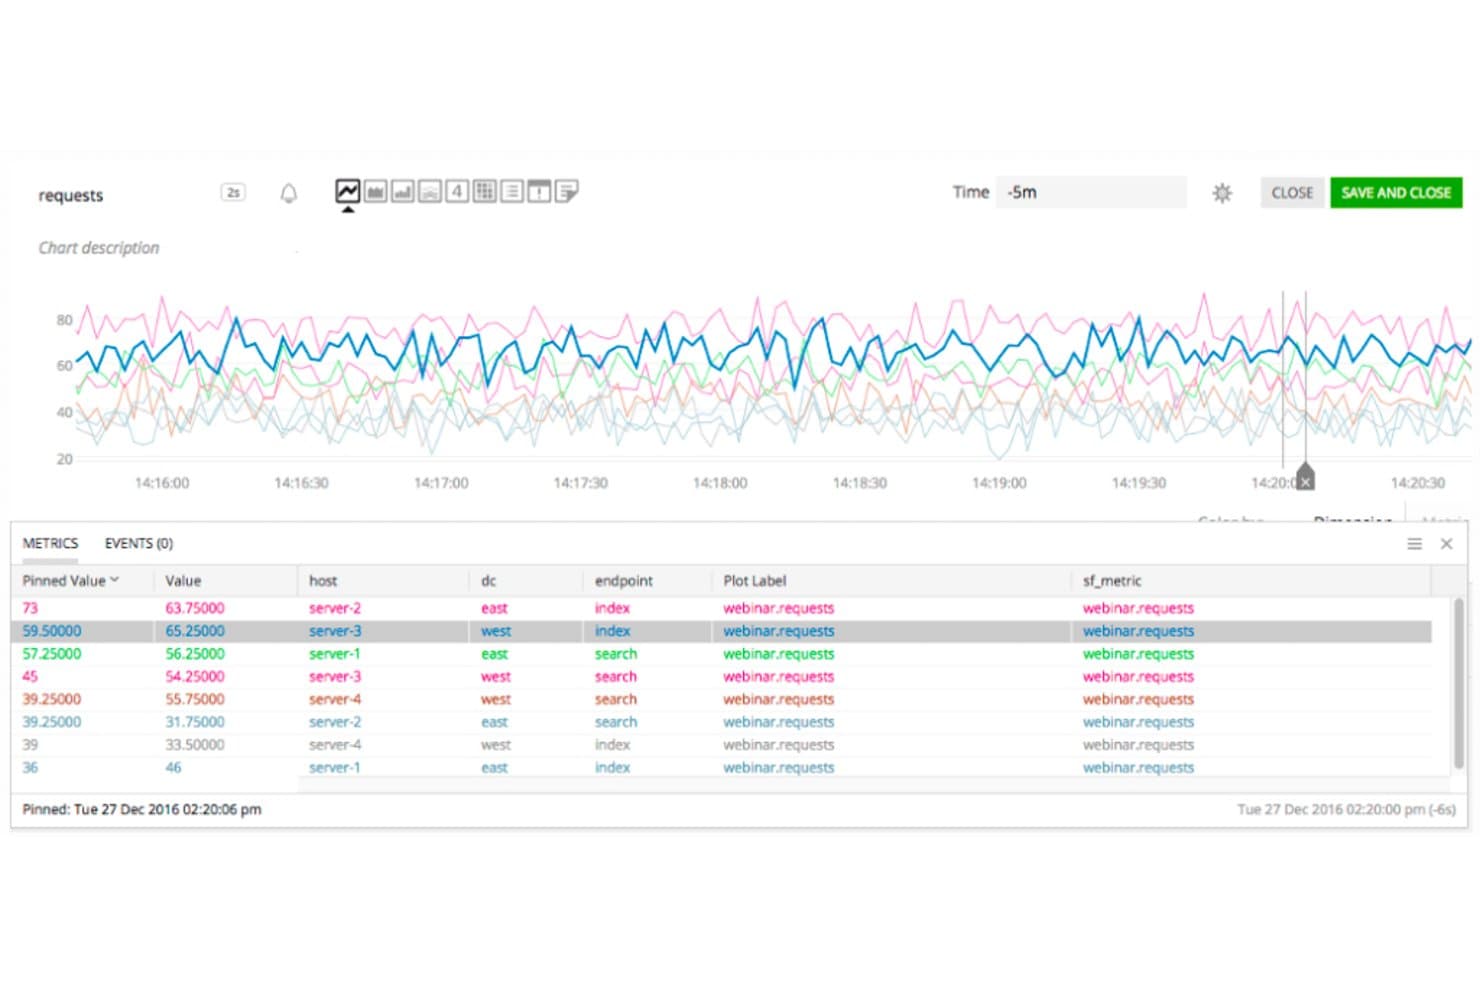
Splunk giver brugerne mulighed for at overvåge målinger af anmodninger i realtid på tværs af servere og slutpunkter. Splunk kombinerer infrastrukturovervågning med analyse af logfiler, målinger og spor, hvilket hjælper it- og driftsteams med at undersøge hændelser på tværs af komplekse, distribuerede miljøer.
Hvem egner Splunk sig bedst til?
Splunk egner sig til store it- og sikkerhedsteams, der har brug for at analysere store mængder maskindata og finde mønstre på tværs af komplekse miljøer.
Hvorfor jeg valgte Splunk
Jeg valgte Splunk som et alternativ til Dynatrace på grund af fokusset på “Bedst til dataanalyse og indsigt i stor skala”. Det kombinerer infrastrukturovervågning med analyse af logfiler, målinger og spor, så jeg kan undersøge en serviceforsinkelse på tværs af distribuerede systemer og forbinde signaler med relaterede hændelser. Det hjælper mig med at forespørge i store mængder maskindata under undersøgelse af hændelser.
Vigtige funktioner i Splunk
- Brugerdefinerede dashboards: Opret visuelle paneler med diagrammer, tabeller og servicedata.
- Alarmdetektorer: Angiv betingelser, der udløser alarmer, når overvågede signaler overskrider tærskler.
- Kubernetes-overvågning: Undersøg tilstanden for klynger, noder og arbejdsbelastninger i Kubernetes Navigator.
- Syntetisk overvågning: Kør scriptbaserede tests for at kontrollere applikationers tilgængelighed og svartider.
Splunk-integrationer
Splunk Observability Cloud understøtter integrationer med AWS CloudWatch, Google Cloud Platform, Microsoft Azure, Jira, Microsoft Teams, PagerDuty, ServiceNow og Slack. Dets integrations-API konfigurerer understøttede forbindelser, mens Splunkbase leverer apps, tilføjelser og forbindelser.
Pros and Cons
Pros:
- Søger i store mængder maskindata efter spor ved hændelser
- Korrelerer logfiler, målinger og spor til undersøgelser
- Brugerdefinerede dashboards og alarmer understøtter fokuseret fejlsøgning
Cons:
- Omkostningerne kan stige, når indtagelsen af telemetridata vokser
- Omfattende forespørgsler kan gøre dashboards langsommere i stor skala
Learn more about Splunk:
Andre alternativer til Dynatrace
Her er nogle yderligere alternativer til Dynatrace, som ikke kom med på min kortliste, men som stadig er værd at undersøge:
- 11PrometheusBedst til robust overvågning i Kubernetes-miljøer
- 12Grafana CloudBedst til open source-visualisering og -analyse
- 13ElasticBedst til søgning og dataanalyse i realtid
- 14SolarWinds Observability SaaSBedst til AI-drevet prioritering af alarmer
- 15SysdigBedst til containersikkerhed og Kubernetes-sikkerhed
- 16Dotcom MonitorBedst til simuleringer i ægte browsere
Andre softwareanmeldelser
- Kodegennemgangsværktøjer til udviklere
- Værktøjer til webudvikling
- Værktøjer til infrastrukturautomatisering
Sådan evaluerer jeg alternativer til Dynatrace
Jeg evaluerer hvert værktøj på to niveauer: de ufravigelige krav som APM i hele stakken og distribueret sporing samt de differentierende faktorer, der adskiller platforme for forskellige teams og teknologistakke.
Grundlæggende funktionalitet (minimumskrav for denne liste)
Når jeg udvælger værktøjer til min liste, vurderer jeg hvert enkelt på en skala fra 0 (tilbyder ikke funktionaliteten) til 5 (udmærker sig på dette område) for hver af de nedenstående grundlæggende funktioner. Derefter omregner jeg værktøjets samlede score til en procentdel. Hvert værktøj skal opnå en samlet score på mindst 75 % for at komme i betragtning til inkludering.
- APM i hele stakken: Jeg undersøger, om værktøjet tilbyder transaktionssporing på kodeniveau på tværs af større programmeringssprog og rammeværk, f.eks. ved at finde et langsomt databasekald, der ligger skjult i en Java-mikrotjeneste.
- Infrastrukturmonitorering: Hvert værktøj bør dække servere, containere, Kubernetes-klynger og cloudtjenester med automatisk registrering i stedet for at kræve manuel opsætning vært for vært.
- Distribueret sporing: Jeg evaluerer, hvordan spor bevæger sig på tværs af servicegrænser, og om platformen understøtter indlæsning via OpenTelemetry, hvilket er vigtigt, når teams anvender polyglotte teknologistakke.
- Loghåndtering & analyse: Logge skal korreleres med spor og metrikker i en samlet visning, så en SRE kan gå fra en stigning i fejlrater til de præcise loglinjer, der ligger bag.
- AI-drevet anomalidetektion: Jeg ser efter maskinlæring, der fastlægger normal adfærd og viser forslag til rodårsager, ikke blot statiske tærskelbaserede alarmer, der oversvømmer tilkaldevagtskanaler.
- Monitorering af rigtige brugere og syntetisk monitorering: Platformen bør tilbyde både RUM til analyse af trafik i realtid og syntetiske kontroller, der opdager ødelagte betalingsforløb eller API-fejl, før rigtige brugere gør det.
Når jeg har en liste over værktøjer, der opfylder dette kriterium, undersøger jeg, hvad der adskiller hver platform fra de andre.
Differentierende faktorer (det, der adskiller leverandørerne)
Sådan sammenligner jeg forskellige leverandører:
Fremtrædende funktioner
Gennemsigtighed i priserne er vigtig, når man skifter fra Dynatrace, så jeg vurderer, om en platform tilbyder forudsigelig, forbrugsbaseret prissætning med tydelig omkostningskontrol. Indbygget OpenTelemetry-understøttelse er en anden vigtig differentierende faktor — teams, der allerede er instrumenteret med OTel-indsamlere, bør ikke behøve at fjerne alt for at installere proprietære agenter. Jeg ser også efter automatiserede afhjælpningsworkflows, der udløser driftsvejledninger eller eskalerer via værktøjer som PagerDuty, når en anomali opstår, så alarmer omsættes til handling uden manuel indgriben.
Ud over funktionerne
Fleksibilitet ved implementering er en vigtig faktor — jeg undersøger, om en platform understøtter SaaS-, selvhostede og hybride modeller, eftersom teams i regulerede brancher ofte har brug for lokale installationer eller specifikke muligheder for datalokalitet. Integrationsøkosystemet har også betydning for, hvor godt et værktøj passer ind i din eksisterende teknologistak. Indbyggede forbindelser til CI/CD-forløb, ITSM-platforme som ServiceNow og hændelsesværktøjer som Opsgenie gør en reel forskel under implementeringen. Jeg evaluerer også certificeringer for regeloverholdelse som SOC 2 Type II og ISO 27001 samt SSO og rollebaserede adgangskontroller.
Hvorfor lede efter et alternativ til Dynatrace?
Selvom Dynatrace er et godt valg som platform til overvågning af applikationsydeevne (APM), er der flere grunde til, at nogle brugere søger efter alternative løsninger. Du leder måske efter et alternativ til Dynatrace, fordi…
- Prisen kan blive for høj for mindre teams
- Læringskurven føles for stejl for nye brugere
- Du ønsker enklere kontrolpaneler og rapportering
- Du har brug for mere fleksible muligheder for alarmer og meddelelser
- Du kører en hybridopsætning og har brug for bredere integrationer
- Du foretrækker værktøjer med mere gennemsigtig fakturering
Hvis noget af dette lyder bekendt, er du kommet til det rette sted. Min liste indeholder flere platformmuligheder til overvågning af applikationsydeevne (APM), der er bedre egnet til teams, som står over for disse udfordringer med Dynatrace og leder efter alternative løsninger.
Dynatraces vigtigste funktioner
Her er nogle af Dynatraces vigtigste funktioner, som kan hjælpe dig med at sammenligne, hvad alternative løsninger tilbyder:
- Overvågning af hele stakken: Giver dig mulighed for at følge applikationsydelse, infrastruktur og brugeroplevelse samlet ét sted.
- Davis AI-motor: Opdager automatisk problemer og forklarer den grundlæggende årsag, så dit team sparer tid.
- Overvågning af rigtige brugere: Viser, hvordan rigtige brugere interagerer med din app, så du kan løse de problemer, der betyder noget.
- Applikationssikkerhed: Markerer sårbarheder i realtid, mens din kode kører i produktion.
- Cloud-native-understøttelse: Fungerer godt med Kubernetes, AWS, Azure og andre cloudmiljøer.
- Smart alarmering: Sender kun alarmer, når det er nødvendigt, så dit team undgår alarmtræthed.
- Tilpassede dashboards: Giver dig mulighed for at opbygge visninger, der er skræddersyet til dit teams behov og målinger.
- Indsigt på kodeniveau: Hjælper dig med at undersøge ydeevnen helt ned på de enkelte kodelinjer.
- Logadministration: Giver dig mulighed for at søge i, filtrere og analysere logfiler, så du hurtigere kan fejlfinde.
- Syntetisk overvågning: Simulerer brugerhandlinger, så du kan teste applikationsydelsen fra forskellige placeringer.
Opsummering
I denne køberguide gik vi i dybden med alternativer til Dynatrace og undersøgte forskellige muligheder, der er skræddersyet til specifikke anvendelsesområder. Uanset om du søger et værktøj til overvågning af open source-miljøer på virksomhedsniveau, logadministration og sikkerhedsanalyse eller sikkerhed i containere og Kubernetes, har du mange robuste muligheder at overveje.
Her er tre vigtige pointer fra denne guide:
- Vurder dine behov: Forskellige værktøjer er udviklet med forskellige anvendelsesområder for øje. Nogle er gode til omfattende logadministration, andre til open source-miljøer, og andre igen til sikkerhed i containere og Kubernetes. Hvis du forstår din organisations unikke behov, kan det lede dig hen til det rigtige værktøj.
- Se på funktionerne: Værktøjer kan have lignende kernefunktioner, men det er detaljerne, der gør forskellen. De unikke funktioner i hvert værktøj, deres brugervenlighed og integrationer med andre værktøjer, du bruger, kan have stor betydning for din overvågningsoplevelse.
- Overvej prisen: Selvom omkostningerne ofte er en væsentlig faktor, er det vigtigt at overveje, hvad du får for pengene. Et dyrere værktøj kan tilbyde den robuste funktionalitet eller support, du har brug for, og i nogle tilfælde kan et billigere eller endda gratis værktøj opfylde dine behov.
Husk, at det 'bedste' værktøj helt afhænger af din organisations specifikke krav og omstændigheder. Med oplysningerne i denne guide er du godt på vej til at træffe en informeret beslutning.