

AI i toppklass: De 10 bästa programvarorna för djupinlärning 2026

Bästa programvaran för djupinlärning – kortlista


Genom att utnyttja kraften i artificiell intelligens är programvara för djupinlärning ditt verktyg för att lösa komplexa affärsproblem. Genom att använda ramverk och handledningar för högpresterande databehandling kan även ett nystartat företag bygga konvolutionella och rekurrenta neurala nätverk (RNN), vilket möjliggör omvälvande funktioner för bildigenkänning.
En sådan AI-plattform möjliggör modularitet med oberoende moduler och prediktiv analys, och blir en hörnsten i arbetet med datautvinning. Funktionerna för "utan kod" och hanteringen av stordata med Spark gör den lätt att använda samtidigt som CPU-användningen förblir effektiv. Att arbeta med noder eller inlärningsapplikationer som Javascript har aldrig varit enklare, vilket gör det möjligt för dig att smidigt navigera i världen av regression och prediktiv analys.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av den bästa programvaran för djupinlärning
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina bästa val av programvara för djupinlärning för att hjälpa dig hitta det bästa alternativet för din budget och dina affärsbehov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för lösningar för videoanalys i företagsmässig skala | Gratisabonnemang tillgängligt | Från $47.85/månad | Website | |
| 2 | Bäst för experimentdriven utveckling av maskininlärning | Nej | $39/användare/månad (debiteras årligen) | Website | |
| 3 | Bäst för automatiserad datamärkning och annotering inom AI | Not available | $49/user/month | Website | |
| 4 | Bäst för att hantera, automatisera och accelerera ML-arbetsflöden | Nej | På begäran | Website | |
| 5 | Bäst för att utnyttja kraftfulla GPU-accelererade verktyg för AI och djupinlärning | Not available | $0.09 per GPU-timme | Website | |
| 6 | Bäst för symbolisk och numerisk beräkning inom djupinlärning | Not available | $25/user/month (faktureras årsvis) | Website | |
| 7 | Bäst för snabb prototypframtagning och produktion av neurala nätverk | Not available | Gratis | Website | |
| 8 | Bäst för åtkomst till storskaliga, varierade och människomärkta datauppsättningar | Not available | På begäran | Website | |
| 9 | Bäst för avancerad algoritmutveckling med omfattande bibliotek | Nej | Gratis | Website | |
| 10 | Bäst för att förbättra inlärningsresultat med AI-driven adaptiv inlärning | Not available | På begäran | Website |
Recensioner av den bästa programvaran för djupinlärning
Nedan hittar du mina detaljerade sammanfattningar av den bästa programvaran för djupinlärning som hamnade på min kortlista. Mina recensioner ger en detaljerad överblick över de viktigaste funktionerna, fördelarna & nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
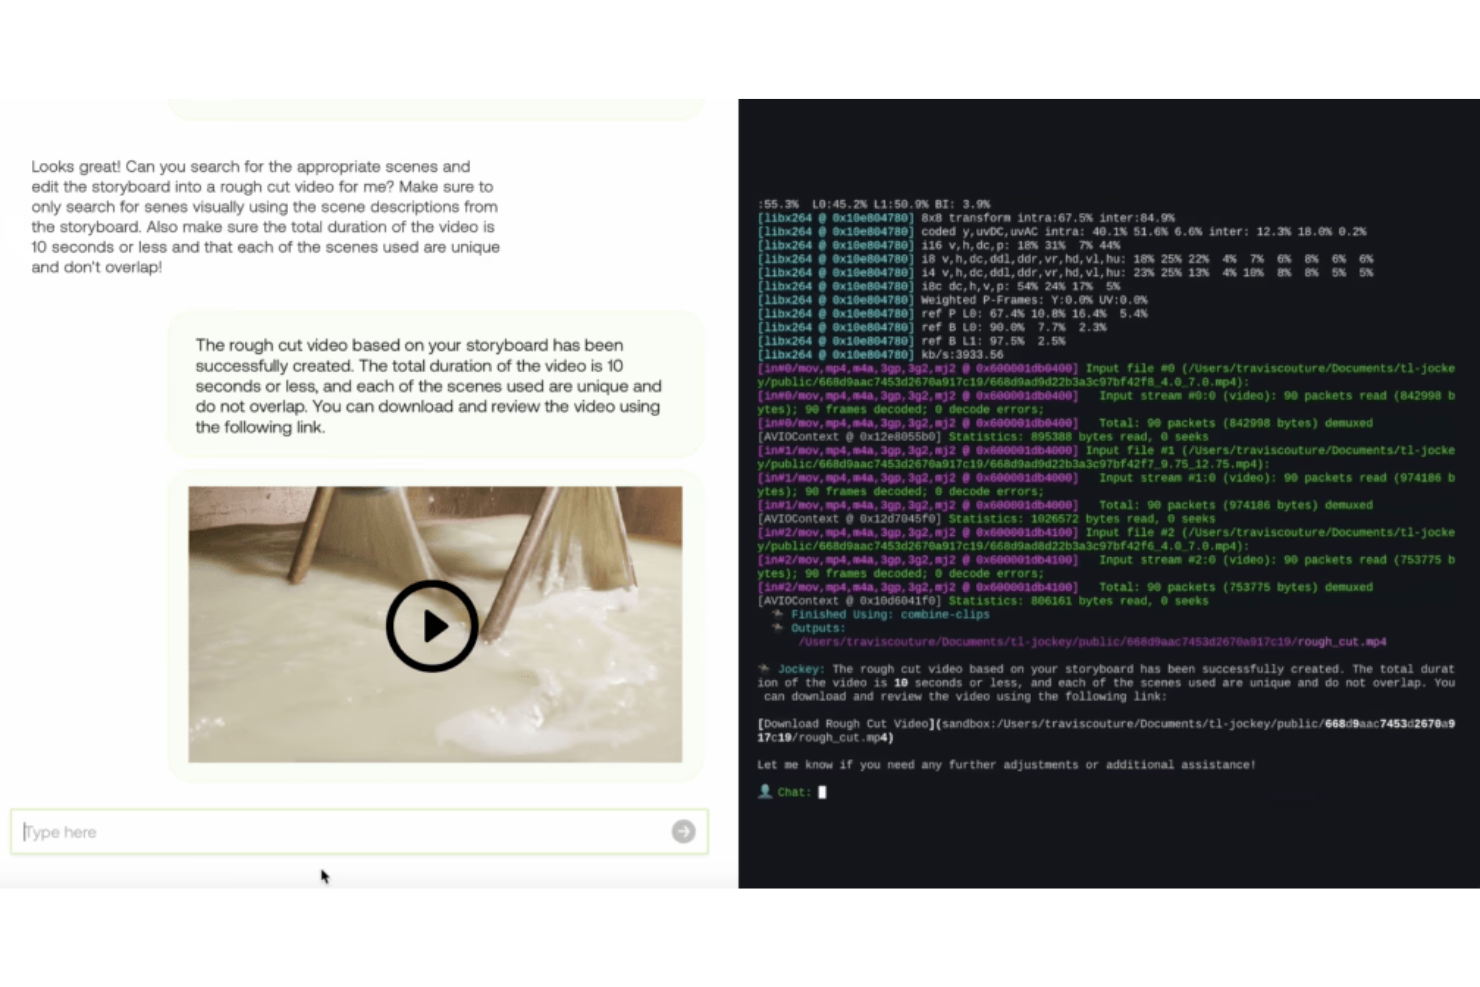
TwelveLabs är en video-AI-plattform byggd på multimodala djupinlärningsmodeller—Marengo och Pegasus—som ger utvecklare API-åtkomst till semantisk videosökning, generering av video till text, skapande av vektorinbäddningar och videoklassificering utan exempel.
Vem passar TwelveLabs bäst för?
TwelveLabs är idealiskt för utvecklare och ingenjörsteam som arbetar med storskaliga AI-applikationer där video står i centrum.
Varför jag valde TwelveLabs
TwelveLabs tar plats på min kortlista tack vare hur väl infrastrukturen klarar företagsmässig skala. Plattformen tar emot och indexerar video med ungefär 60 gånger realtidshastigheten och bearbetar över 10 000 timmar per dag genom en enda multimodal pipeline. Jag uppskattar också att den molnbaserade distribuerade infrastrukturen hanterar tusentals samtidiga förfrågningar, vilket är viktigt när teamet kör efterlevnadsskanningar eller innehållsanalyser över enorma arkiv. SOC 2 typ II-certifieringen och de flexibla distributionsalternativen gör den till ett realistiskt val för säkerhetsmedvetna företagsmiljöer.
Viktiga funktioner i TwelveLabs
- Pegasus för videogenerering från språk: En inbyggd grundmodell som genererar text från videoinnehåll, till exempel kapitelsammanfattningar, svar på öppna frågor och höjdpunktsklipp.
- Multimodala inbäddningar med Marengo: Skapar vektorrepresentationer för video, ljud, bilder och text från en enda modell, vilket stöder uppgifter som likhetssökning och klustring.
- Klassificering utan exempel: Klassificerar videoinnehåll med hjälp av taxonomier för etiketter på naturligt språk, utan märkta träningsdata eller anpassad modellträning.
- Finjustering av grundmodeller: Anpassar TwelveLabs basmodeller efter dina domänspecifika videodatamängder för att förbättra noggrannheten för specialiserade innehållstyper.
Integrationer med TwelveLabs
TwelveLabs erbjuder partnerintegrationer, bland annat med Adobe Premiere Pro, Pinecone, Weaviate, MongoDB, Milvus, Voxel51, MindsDB, Qdrant, Chroma och LanceDB. Databricks och Snowflake är också strategiska partner, där Databricks tillhandahåller en pipelineintegration för TwelveLabs inbäddningstjänst och Snowflake bygger anslutningar genom Cortex AI. Ett REST API stöder anpassade integrationer och fungerar med de flesta programmeringsspråk.
Pros and Cons
Pros:
- Flerspråkig sökning på över 100 språk
- Ger tidsstämplar, inte bara transkriptioner
- Kan distribueras i molnet, i ett privat moln eller lokalt
Cons:
- API-fokuserad design kräver utvecklarresurser
- Inga publicerade riktmärken för modellernas partiskhet

Comet
Bäst för experimentdriven utveckling av maskininlärning
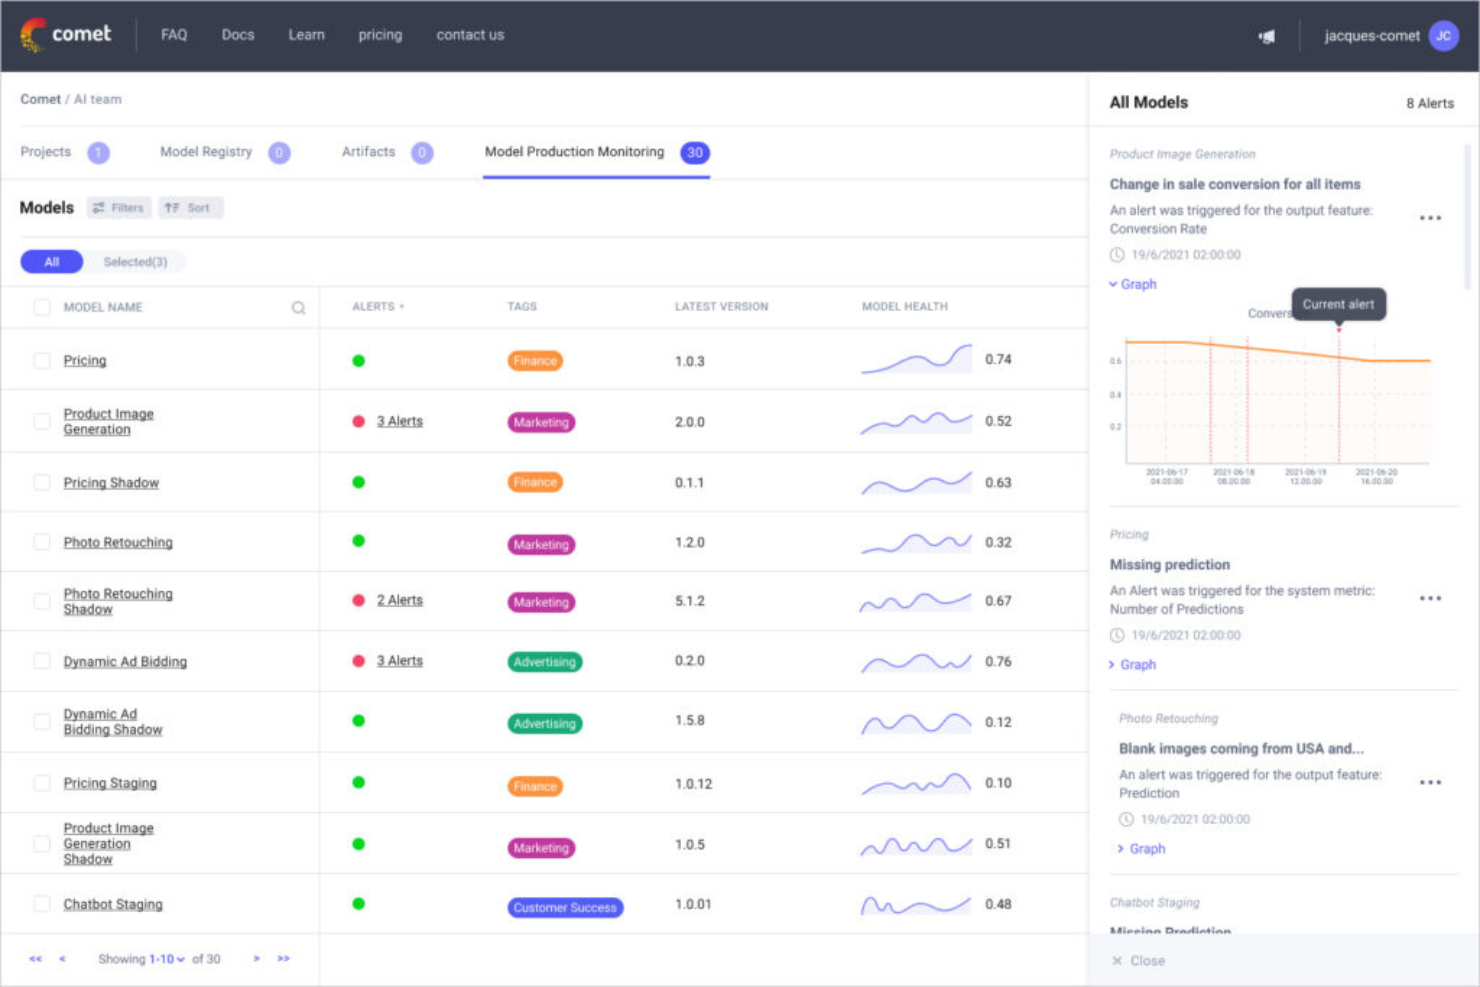
Comet finns på min lista eftersom det är en av de få AI-plattformarna som är byggda för djupgående, experimentdrivna arbetsflöden. När jag ser team skala upp djupinlärningsexperiment, spåra, jämföra och visualisera resultat i detalj är det här Comet passar in.
Det jag verkligen uppskattar är hur plattformen hanterar experimentmetadata, modellversioner och kodändringar på en och samma plats. Den är särskilt användbar när du behöver återskapa resultat i stora projekt som utvecklas snabbt.
Comets bästa användningsområden
- Datavetenskapliga team som hanterar spårning av stora mängder experiment
- Organisationer med fokus på reproducerbara, experimentdrivna arbetsflöden för maskininlärning
Comet passar mindre bra för
- Team som vill ha inbyggda funktioner för driftsättning och tillhandahållande av modeller
- Mindre projekt som inte kräver strikt experimenthantering
Vad skiljer Comet från mängden
Comet är byggt för experimentintensiva arbetsflöden, där det är minst lika viktigt att föra noggranna register som att bygga modellen. Till skillnad från verktyg som MLflow, som har stort fokus på driftsättning, förväntar sig Comet att du lägger mer tid på att utforma, spåra och jämföra experiment. Det känns naturligt när du granskar dussintals eller hundratals körningar, och versionshantering är helt enkelt en del av det dagliga arbetet.
Detta passar bra för forskningsdrivna team eller alla som har stora experimentpipelineer.
Kompromisser med Comet
Genom att prioritera experimentspårning lämnar Comet driftsättning och tillhandahållande av modeller utanför sitt användningsområde. Du behöver en separat plattform om du vill ha integrerad modellhantering.
Pros and Cons
Pros:
- Robust experimenthantering
- Effektiva prestandavisualiseringar
- Bred kompatibilitet med populära bibliotek
Cons:
- Priset kan vara högt för små team
- Användargränssnittet kan ha en brant inlärningskurva
- Begränsade funktioner för offlineanvändning

Bäst för automatiserad datamärkning och annotering inom AI
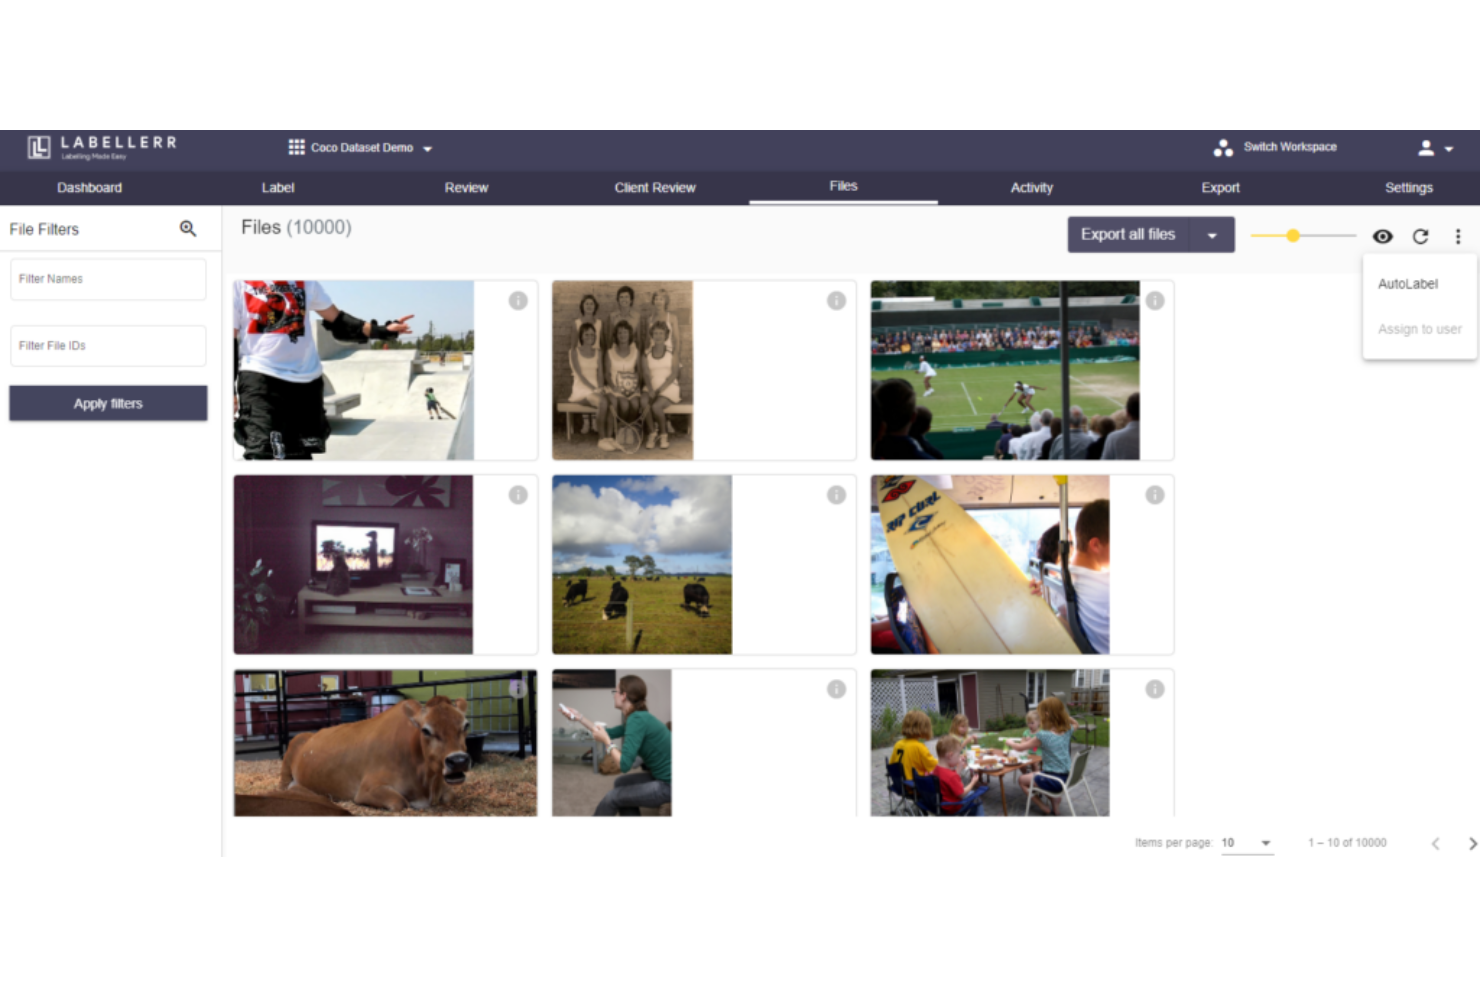
Labellerr sticker ut för mig eftersom det tillför automatisering till den mest krävande delen av djupinlärningsprojekt – att omvandla rådata till högkvalitativa etiketter. Jag har sett team som arbetar med datorseende eller NLP snabbt gå från manuella insatser till AI-assisterad annotering med hjälp av funktionerna för aktiv inlärning och kvalitetsarbetsflöden. Det jag uppskattar mest är hur Labellerr låter dig hantera stora mängder ostrukturerad data, med granskningsloggar och anpassningsbara granskningscykler som håller dina dataset produktionsklara.
Labellerrs bästa användningsområden
- AI- och datavetenskapsteam som hanterar stora ostrukturerade dataset
- Projekt som behöver automatiserad annotering av bilder, video eller text
Labellerrs mindre lämpliga användningsområden
- Enkla annoteringsuppgifter där automatisering inte behövs
- Team som behöver djupgående integration med äldre MLOps-plattformar
Vad som skiljer Labellerr från mängden
Labellerr är byggt kring automatisering och kvalitetskontroll för märkning av ostrukturerad data. Till skillnad från manuella annoteringssystem eller enklare verktyg som CVAT utgår Labellerr från att du vill automatisera huvuddelen av datamärkningen, samtidigt som kvalitetskontroller och teamgranskning införs där de gör störst skillnad. I praktiken ser jag team använda det när stora dataset eller frekventa modelluppdateringar gör manuella processer opraktiska.
Avvägningar med Labellerr
Labellerr är optimerat för automatiserad annotering i stora volymer, men detta fokus kan innebära mindre flexibilitet eller support om du främst arbetar med mindre engångsprojekt där manuell kontroll är viktigare.
Pros and Cons
Pros:
- Effektiv automatisering av datamärkning
- Stöder olika dataformat
- Robusta projekthanteringsverktyg
Cons:
- Kanske inte kostnadseffektivt för mindre projekt
- Kan vara komplicerat för nybörjare
- Begränsad flexibilitet i vissa arbetsflöden

cnvrg.io
Bäst för att hantera, automatisera och accelerera ML-arbetsflöden
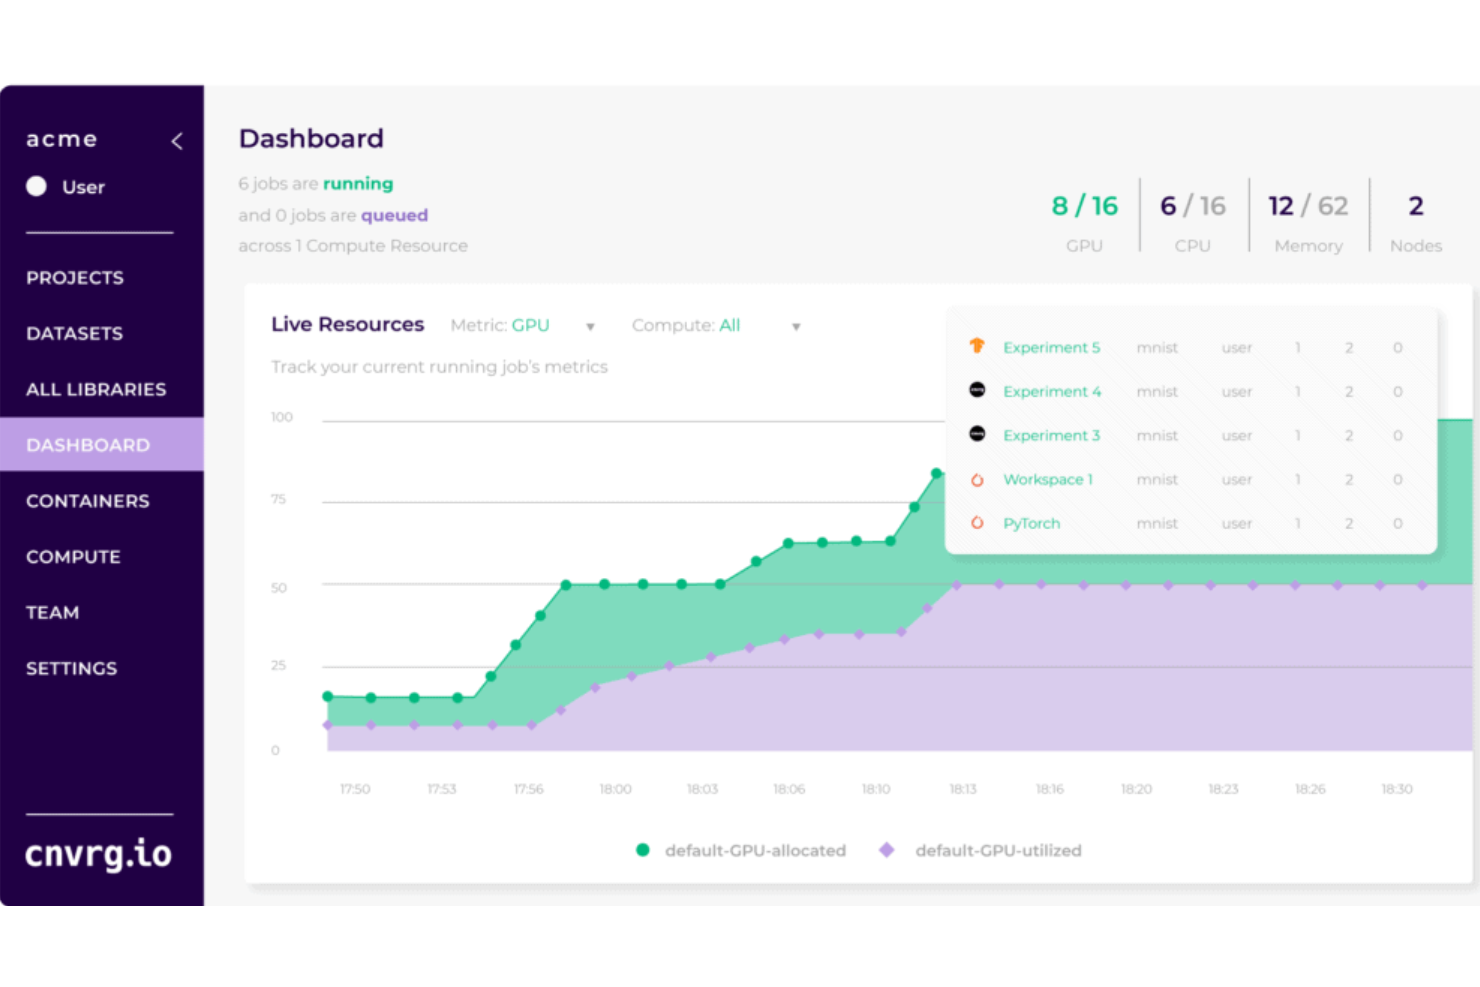
cnvrg.io tar plats eftersom det låter team köra, hantera och automatisera alla delar av maskininlärningens livscykel från en och samma plats. Jag valde det för organisationer som är redo att växa bort från utspridda Jupyter-anteckningsböcker och opålitliga pipelineskript, särskilt om ni behöver versionshantering och experimentuppföljning i verkliga samarbetsprojekt.
Det jag uppskattar mest är hur cnvrg.io stöder hybrid- och infrastruktur med flera moln, så att träning och driftsättning av djupinlärningsmodeller blir något ni kan skala och upprepa, inte bara köra tillfälligt.
cnvrg.io passar bäst för
- ML-ingenjörer som hanterar komplexa arbetsflöden för modeller i flera steg
- Organisationer som driftsätter modeller i hybridmiljöer eller miljöer med flera moln
cnvrg.io passar mindre bra för
- Små team som fokuserar på grundläggande ML-experiment med låg volym
- Alla som behöver en lättviktig eller kodfri plattform för djupinlärning
Vad som skiljer cnvrg.io från mängden
cnvrg.io är utformat för team som behöver heltäckande hantering av ML-arbetsflöden över varierande infrastruktur, inte bara enkel delning av anteckningsböcker eller experimenthantering som med Colab eller SageMaker Studio.
Det förväntar sig att ni strukturerar projekt kring versionshantering, samarbete och upprepningsbara pipelines som kan skalas, i stället för att bara köra fristående skript. I praktiken fungerar detta bäst när ni behöver konsekvens och spårbarhet över flera ML-projekt, inte bara när ni bygger enskilda modeller.
Avvägningar med cnvrg.io
Genom att fokusera på att orkestrera storskaliga och tillförlitliga arbetsflöden tillför cnvrg.io komplexitet, vilket innebär att små experiment eller snabb prototypframtagning kan kännas långsammare jämfört med mer lättviktiga verktyg för djupinlärning.
Pros and Cons
Pros:
- Omfattande hantering av ML-arbetsflöden
- Robusta integrationsmöjligheter
- Fokus på automatisering, vilket frigör dataforskare för mer komplexa uppgifter
Cons:
- Pristransparensen skulle kunna förbättras
- Kan innebära en inlärningskurva för nya användare
- Anpassningsmöjligheterna skulle kunna vara mer omfattande

Bäst för att utnyttja kraftfulla GPU-accelererade verktyg för AI och djupinlärning
NVIDIA GPU Cloud (NGC) finns med på min kortlista eftersom tjänsten gör enorma GPU-accelererade modellarbetsbelastningar praktiska, även för snabbfotade team. Jag har använt NGC för att distribuera containrar fyllda med optimerade ramverk, förtränade modeller och riktig forskningskod för datorseende och naturlig språkbehandling.
Det jag uppskattar är det kurerade och ständigt aktuella modellnavet – särskilt när team behöver resurser av företagsklass och support för djupinlärning i produktionsskala.
NGC passar bäst för
- Organisationer som kör AI- och djupinlärningsmodeller i produktionsskala
- Team som behöver tillgång till NVIDIA-optimerade ramverk och modellcontainrar
NGC passar mindre bra för
- Små team utan tillgång till GPU-infrastruktur
- Projekt med fokus på enkla, icke-accelererade maskininlärningsuppgifter
Vad som skiljer NGC från mängden
NGC är byggt för team som arbetar med djupinlärningsmodeller som kräver GPU-optimerade resurser och officiellt underhållna containrar. Till skillnad från Google Cloud Vertex AI, som försöker abstrahera bort infrastrukturen, förväntar sig NGC att du vet vilka ramverk och vilken maskinvara du behöver och låter dig köra allt med fullständig NVIDIA-optimering.
I praktiken passar detta när du vill ha detaljerad kontroll över acceleration och modelldistribution, snarare än färdigpaketerade arbetsflöden.
Avvägningar med NGC
NGC optimerar för hög kontroll och NVIDIA-specifik acceleration, men kräver särskild GPU-åtkomst. Därför slutar mindre projekt och CPU-baserade prototyper ofta med att betala för outnyttjade GPU-resurser eller extra konfiguration.
Pros and Cons
Pros:
- Kraftfull GPU-accelererad programvara
- Brett urval av förtränade modeller
- Integration med stora molnleverantörer
Cons:
- Kostnaden kan snabbt öka vid omfattande användning
- Kan vara överdimensionerat för mindre projekt eller företag
- Kräver kunskap om NVIDIAs ekosystem


Wolfram Mathematica förtjänar en plats här eftersom det är oöverträffat när det gäller både symbolisk och numerisk beräkning inom djupinlärning. Du får direkt tillgång till manipulation av matematiska uttryck och sömlösa numeriska beräkningar sida vid sida, vilket jag tycker är avgörande för team som forskar på anpassade neurala arkitekturer eller algoritmer.
Det jag uppskattar mest är hur enkelt du kan växla mellan analytisk utforskning och modellering av verkliga data, särskilt för experimentella eller hybrida AI-arbetsflöden.
Wolfram Mathematica passar bäst för
- Forskare som bygger anpassade neurala nätverksmodeller och experiment
- Arbetsflöden för djupinlärning som behöver hybrid symbolisk-numerisk kapacitet
Wolfram Mathematica passar inte bra för
- Team som vill ha färdiga arbetsflöden för djupinlärning
- Storskalig produktionsdistribution eller distribuerad modellservering
Vad skiljer Wolfram Mathematica från mängden
Mathematica utmärker sig genom att förena symbolisk beräkning och djupinlärning i en enda arbetsyta. Till skillnad från TensorFlow eller PyTorch, som förväntar sig att du bygger allt numeriskt, låter Mathematica dig manipulera formler och köra experiment sida vid sida. Jag tycker att detta fungerar bäst när du behöver snabb prototypframtagning av nya matematikdrivna modeller eller vill tolka resultat symboliskt.
Du ser vanligtvis att detta arbetssätt hjälper mer inom forskning och utveckling av anpassade AI-algoritmer än inom produktion.
Avvägningar med Wolfram Mathematica
Genom att optimera för flexibilitet och experimenterande saknar Mathematica till slut det fokus på distribution och skalning som dedikerade ramverk för djupinlärning har. I praktiken byter du produktionsberedskap mot kreativ frihet och avancerad analys.
Pros and Cons
Pros:
- Exceptionella möjligheter till symbolisk och numerisk beräkning
- Tillhandahåller ett brett utbud av beräkningsverktyg och funktioner
- Erbjuder integration med andra plattformar för dataanalys
Cons:
- Gränssnittet kan vara överväldigande för nya användare
- Högre kostnad jämfört med vissa andra beräkningsverktyg
- Kräver en brant inlärningskurva för optimal användning

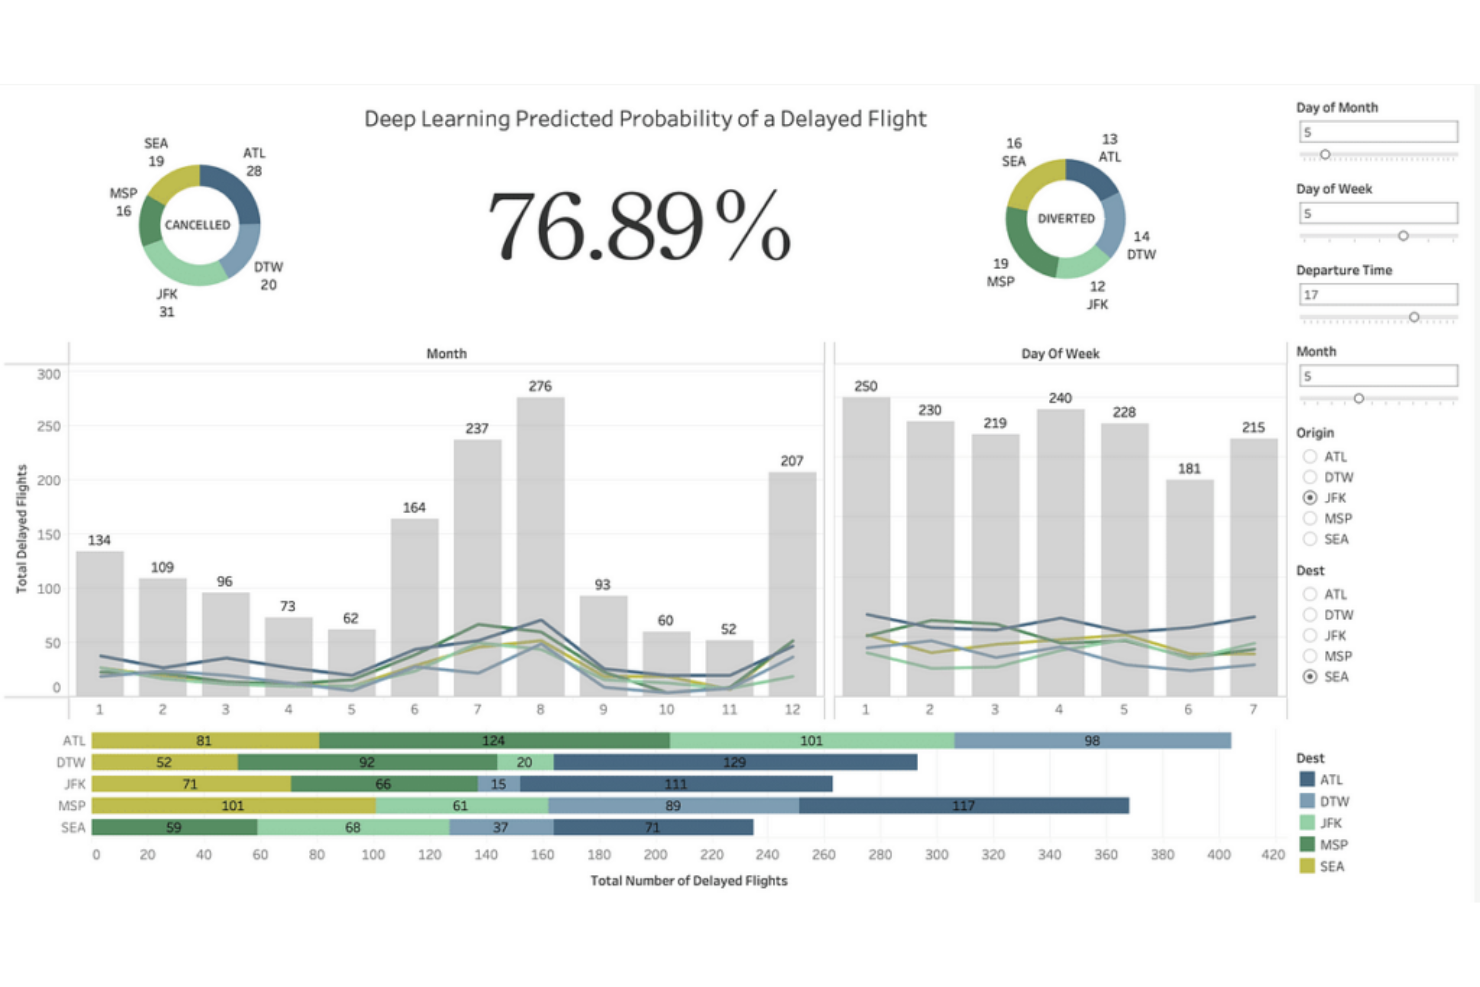
Keras förtjänar sin plats eftersom det är idealiskt för team som snabbt behöver gå från idé till fungerande neurala nätverksmodeller. Jag rekommenderar det när du prototypar eller itererar snabbt och vill ha så få hinder som möjligt mellan koncept och genomförande. Jag har upptäckt att dess API på hög nivå, täta integration med TensorFlow och modulära design gör det enkelt att testa idéer eller sätta arbetsflöden i produktion utan större friktion.
Det som utmärker Keras för mig är hur liten övergångskostnaden är när man går från en prototyp till något som kan distribueras – särskilt i verkliga projekt inom djupinlärning där tiden spelar roll.
Keras passar bäst för
- Snabb prototypframtagning av modeller och arbetsflöden för djupinlärning
- Forskare eller ingenjörer som snabbt sätter modeller i produktion
Keras passar mindre bra för
- Projekt som kräver mycket anpassad kontroll på låg nivå över neurala nätverk
- Team som arbetar utanför de etablerade ekosystemen kring Python och TensorFlow
Vad skiljer Keras från mängden
Keras är utformat för att snabbt gå från teori till körbar kod, så att du kan lägga mer tid på nätverkslogiken och mindre på konfiguration. Jämfört med PyTorch, som låter dig gå på djupet i detaljerna, vägleder Keras dig mot arbetsflöden på högre nivå med tydlig struktur. Jag tycker att det passar bäst när du vill testa och distribuera modeller snabbt utan att gå vilse i konfigurationen.
Avvägningar med Keras
Keras optimerar för snabbhet och enkelhet, men du förlorar en del kontroll över detaljer på lägre nivå i modellen, vilket begränsar anpassade arkitekturer och finjusterad felsökning.
Pros and Cons
Pros:
- Användarvänligt, vilket möjliggör snabb prototypframtagning
- Utbyggbart och mycket modulärt
- Omfattande uppsättning verktyg och funktioner
Cons:
- För mycket specifika uppgifter kan API:er på lägre nivå ge bättre kontroll
- Kan vara mindre effektivt för modeller med flera indata eller utdata
- Kräver förståelse för de underliggande plattformarna för optimering och felsökning

Appen
Bäst för åtkomst till storskaliga, varierade och människomärkta datauppsättningar

Appen finns med på min lista eftersom du får tillgång till ett av världens största bibliotek med människomärkta data, vilket är svårt att återskapa om du skalar upp projekt inom AI eller djupinlärning. Jag har sett team kämpa med att bygga varierade träningsdatauppsättningar, och det är här Appens kurerade uppsättningar (över olika språk, demografiska grupper och ämnesområden) gör skillnad.
Det jag uppskattar är möjligheten att få tillgång till domänspecifika text-, bild-, ljud- och videodatauppsättningar som andra plattformar inte erbjuder i den här omfattningen. Jag rekommenderar Appen när du bygger eller testar djupinlärningsmodeller som kräver omfattande och representativa indata, särskilt för flerspråkiga eller specialiserade tillämpningar.
Bäst lämpat för Appen
- AI- och datavetenskapsteam som behöver varierade, märkta träningsdata
- Djupinlärningsprojekt som kräver storskaliga, flerspråkiga datauppsättningar
Mindre lämpligt för Appen
- Team som behöver verktyg för att bygga anpassade modeller
- Mindre projekt med begränsade datakrav
Det som skiljer Appen från mängden
Appen är byggt för organisationer som behöver människomärkta datauppsättningar i stor skala utan att själva hantera logistiken kring datainsamling och märkning. Tjänsten förväntar sig att du utformar projekt kring verkliga data och inkluderar information från olika demografiska grupper och språk.
Till skillnad från plattformar som Hugging Face, som tillhandahåller förtränade modeller och värdtjänster, fokuserar Appen helt på att leverera anpassade och representativa data för träning och testning av djupinlärningsmodeller.
Avvägningar med Appen
Appen optimerar för djup och variation i märkta datauppsättningar, men du avstår från direkt kontroll över hur dessa datauppsättningar produceras eller vidareutvecklas. Det kan göra experimenterandet långsammare om du behöver omedelbara justeringar eller nischade datatyper.
Pros and Cons
Pros:
- Tillhandahåller stora, varierade och människomärkta datauppsättningar
- Höga krav på datakvalitet och säkerhet
- Integrationer med många maskininlärningsplattformar
Cons:
- Prissättningen är inte transparent
- Kan vara dyrt för mindre projekt eller företag
- Projektens komplexitet kan påverka leveranstiden


Torch finns på min kortlista tack vare det djup och den flexibilitet som verktyget ger vid utveckling av anpassade algoritmer. När jag har behövt implementera komplexa neurala arkitekturer eller testa banbrytande tekniker inom djupinlärning har jag upplevt att Torch omfattande biblioteksstöd gör det möjligt att faktiskt genomföra detta utan att behöva bygga ihop lösningar på konstgjord väg.
Jag tycker om att man kan använda både operationer på lägre nivå och färdiga moduler, så att team med avancerade behov inte begränsas av ramverkets begränsningar. Detta känns rätt för forskning, akademiska miljöer eller team som driver utvecklingen inom banbrytande AI.
Bäst för
- Forskarteam som bygger nya arkitekturer för neurala nätverk
- Projekt som behöver omfattande anpassning med bibliotek för djupinlärning
Mindre bra för
- Nybörjare som letar efter ett enkelt verktyg för djupinlärning
- Team som vill ha färdiga mallar för AI-modeller
Vad som skiljer Torch från mängden
Torch har ett mycket öppet förhållningssätt och ger dig direkt åtkomst till byggblock för modeller, samtidigt som du förväntas utforma arkitekturen själv. Detta liknar mer hur verktyg som TensorFlow fungerar, men Torch är mindre styrande när det gäller hur du definierar nätverk eller finjusterar algoritmer. Jag ser forskare och ingenjörer välja Torch när de behöver kontroll på detaljnivå, i stället för att förlita sig på konventionerna i ett ramverk som Keras.
Avvägningar med Torch
Torch prioriterar anpassning och flexibilitet, vilket gör konfiguration och experimentering långsammare för den som behöver enkla färdiga modeller. Om du föredrar att börja med färdiga mallar kommer du sannolikt att fastna i detaljerna.
Pros and Cons
Pros:
- Omfattande bibliotek för maskininlärning
- Hög beräkningseffektivitet
- Starkt stöd från communityn
Cons:
- Kan ha en brant inlärningskurva för nybörjare
- Främst Lua-baserat och mindre populärt än Python inom datavetenskapen
- Brist på stöd på företagsnivå

Amplifire
Bäst för att förbättra inlärningsresultat med AI-driven adaptiv inlärning
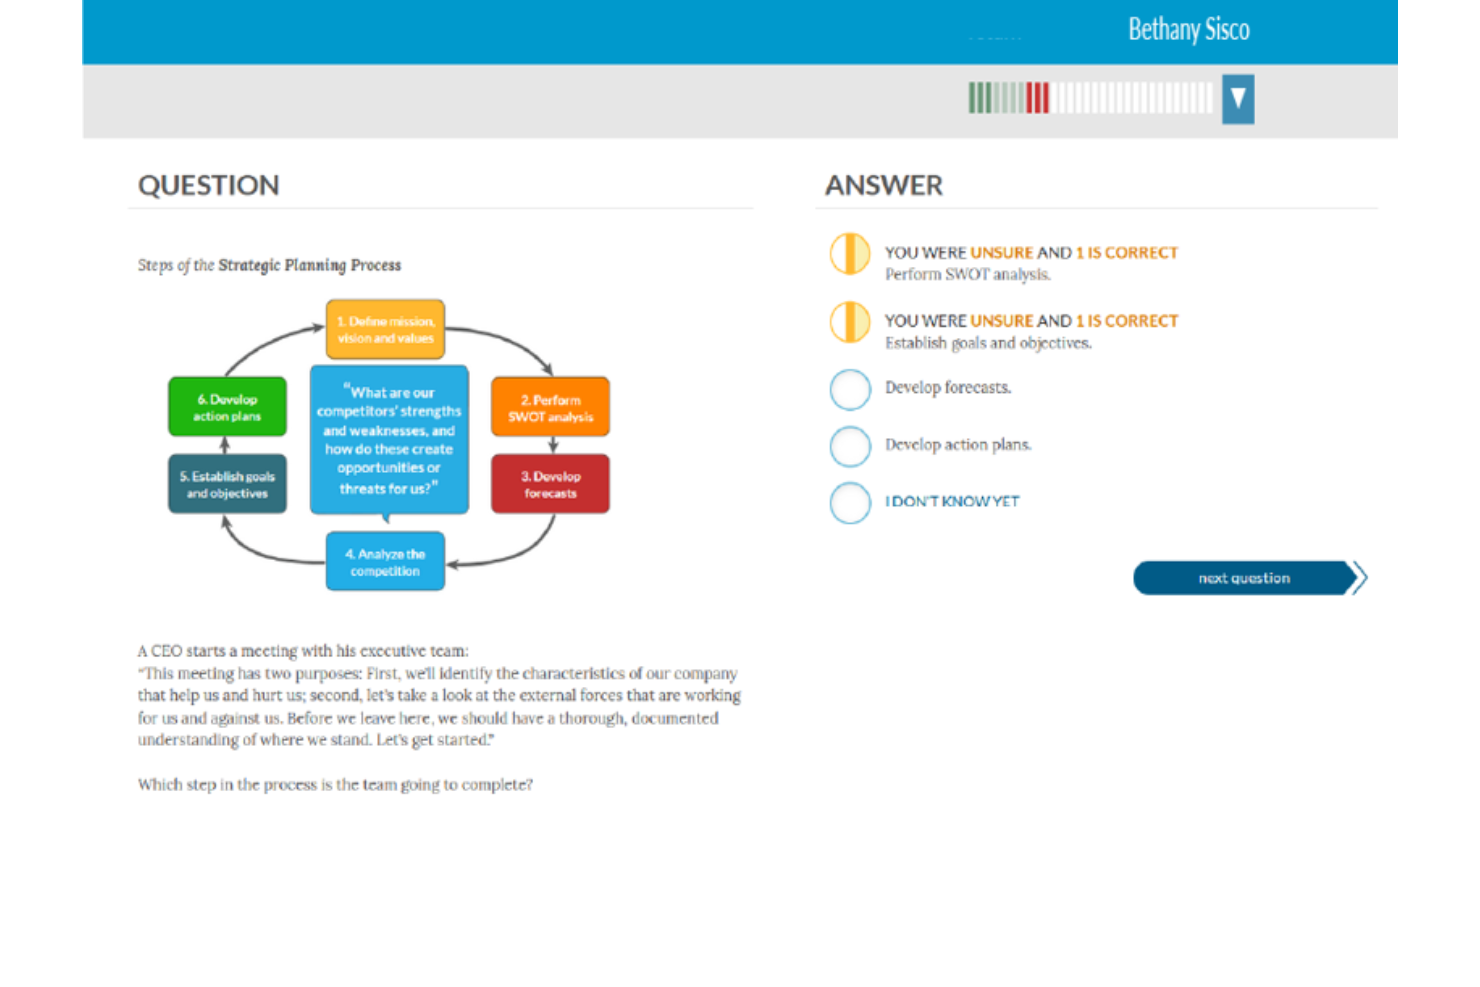
Amplifire sticker ut för mig eftersom det kombinerar AI-driven adaptiv inlärning med djupgående innehållsanalys för att identifiera kunskapsluckor hos varje elev. Jag rekommenderar det när organisationer vill förbättra inlärningsresultaten på systemövergripande nivå, särskilt inom starkt reglerade sektorer som hälso- och sjukvård eller finans.
Det som skiljer Amplifire från mängden är de diagnostiska bedömningarna och återkopplingen i realtid, som faktiskt anpassar inlärningsvägen utifrån påvisade styrkor och svagheter. Jag uppskattar att team snabbt kan identifiera riskområden och följa påvisade kunskaper över tid, i stället för att bara följa slutförandegrader.
Amplifire passar bäst för
- Stora organisationer som behöver adaptiv utbildning i stor skala
- Hälso- och sjukvård samt kunskapsdrivna sektorer som följer kunskapsrisker
Amplifire passar inte lika bra för
- Forskarteam som behöver bygga anpassade modeller för djupinlärning
- Små team som söker AI-verktyg med öppen källkod eller mycket stora anpassningsmöjligheter
Det som skiljer Amplifire från mängden
Amplifire betraktar utbildning som en datadriven process och anpassar innehållet automatiskt utifrån vad varje elev visar att hen kan eller inte kan. Till skillnad från plattformar som Coursera, som förlitar sig på breda, linjära inlärningsvägar, använder Amplifire diagnostiska verktyg från början och anpassar materialet i realtid när människor arbetar sig igenom det.
Detta fungerar väl för reglerade branscher som behöver belägg för att kunskaperna har behållits, snarare än att bara följa slutföranden.
Avvägningar med Amplifire
Amplifire optimerar för adaptiv innehållsleverans och bedömning, men du förlorar flexibilitet när det gäller att skapa eller finjustera underliggande modeller för djupinlärning. Om du behöver en plattform för anpassad AI-forskning eller -utveckling passar detta inte det arbetsflödet.
Pros and Cons
Pros:
- Använder AI-drivna metoder för att förbättra inlärningsresultaten
- Identifierar och åtgärdar kunskapsluckor
- Integreras med olika lärplattformar
Cons:
- Prisinformationen är inte transparent
- Kan kräva utbildning för att funktionerna ska kunna utnyttjas maximalt
- Skulle kunna erbjuda fler anpassningsalternativ för unika inlärningsmiljöer
Annan programvara för djupinlärning
Här är några ytterligare alternativ för programvara för djupinlärning som inte hamnade på min kortlista, men som ändå är värda att kolla in:
- Prime AI
Bäst för enkel integrering av maskininlärning i affärsverksamheten
- MIPAR
Bäst för bildanalys med djupinlärningsalgoritmer
- Cauliflower
Bäst för intuitivt skapande av AI-modeller med visuellt gränssnitt


Så utvärderar jag programvara för djupinlärning
Jag delar upp min utvärdering i grundläggande krav – som GPU-accelererad träning och stöd för driftsättning – samt särskiljande faktorer som skiljer verktyg byggda för MLOps i produktion från ramverk som enbart är avsedda för forskning.
Grundläggande funktionalitet (minimikrav för denna lista)
När jag väljer ut verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärkt inom området) för varje grundläggande funktionalitet som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- Stöd för neurala nätverksramverk: Jag kontrollerar om du kan bygga arkitekturer som CNN:er för bildklassificering, RNN:er för sekvensuppgifter och transformatorer för NLP inom plattformen.
- GPU/TPU-acceleration: Att träna en stor synmodell med enbart CPU kan ta veckor, så jag utvärderar varje verktygs stöd för konfigurationer med flera GPU:er och distribuerad träning.
- Bibliotek med förtränade modeller: Ett gediget bibliotek med förtränade modeller – som ResNet-, BERT- eller GPT-varianter – gör överföringsinlärning och finjustering betydligt mer tillgängliga för ditt team.
- Verktyg för modellträning: Jag letar efter inbyggd hyperparameterjustering, experimentspårning och visualisering av träning, så att du kan jämföra körningar utan att behöva kombinera separata verktyg.
- Möjligheter till modelldriftsättning: Övergången från en tränad modell till ett aktivt API eller en containeriserad tjänst är där många team får problem, så jag utvärderar exportformat, serveringsalternativ och stöd för edge-enheter.
- Stöd för datapipelines: Hantering av stora bilddataset, textkorpusar eller ljudfiler kräver förbehandlings- och augmenteringsverktyg som kan skalas – jag kontrollerar hur varje plattform hanterar dessa arbetsflöden.
När jag har en lista över verktyg som uppfyller dessa kriterier undersöker jag vad som särskiljer varje plattform.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Integrering med MLOps är mycket viktigt här. När ditt team tränar om modeller varje vecka kan inbyggda CI/CD-pipelines och detektering av drift spara er från att bygga den infrastrukturen själva. Jag utvärderar också verktyg för förklarbarhet – saliensdiagram och visualiseringar av uppmärksamhet hjälper team att felsöka modellbeteende och tillfredsställa intressenter som behöver förstå förutsägelserna. Optimering för edge-enheter och mobiler är en annan faktor jag tar hänsyn till, särskilt för team som distribuerar till IoT-enheter eller mobilappar, där kvantisering och beskärning direkt påverkar inferensfördröjningen.
Mer än funktioner
Kompatibilitet med ramverk är en av de första sakerna jag kontrollerar. Om en plattform låser dig till ett enda ramverk och ditt team arbetar med både PyTorch och TensorFlow är det en verklig begränsning. Flexibilitet vid driftsättning är nära relaterad till detta – jag utvärderar om ett verktyg stöder moln-, lokala och hybrida konfigurationer, eftersom många team tränar i molnet men kör modeller på intern infrastruktur. Den totala ägandekostnaden påverkar också mina rekommendationer. Kostnaderna för GPU-beräkningar stiger snabbt under stora träningskörningar, så jag undersöker hur transparent prissättningen är och om det finns kostnadsfria nivåer eller alternativ med öppen källkod.
Så väljer du programvara för djupinlärning
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan programvaran växa med dina behov? Kontrollera om den stöder ökande datamängder och fler användare utan att prestandan försämras. |
| Integrationer | Ansluter den till din befintliga AI-programvara? Leta efter kompatibilitet med dina datakällor och företagsapplikationer för att undvika isolerade system. |
| Anpassningsbarhet | Kan du anpassa programvaran efter dina arbetsflöden? Utvärdera om den erbjuder anpassningsalternativ för instrumentpaneler, rapporter och processer. |
| Användarvänlighet | Är den användarvänlig för ditt team? Tänk på inlärningskurvan och om det krävs omfattande utbildning för att komma igång. |
| Implementering och introduktion | Hur lång tid tar det att komma igång? Implementering inom programvara för virtuell verklighet kan till exempel ta längre tid än i traditionella kanaler. Bedöm konfigurationsprocessen, tillgången till introduktionsresurser och stödet under den inledande fasen. |
| Kostnad | Ryms den inom din budget? Jämför prisplaner, dolda avgifter och långsiktiga kostnader. Kontrollera om det finns testperioder för att utvärdera värdet innan du bestämmer dig. |
| Säkerhetsskydd | Hur skyddar den dina data? Säkerställ att den följer branschstandarder och erbjuder funktioner som kryptering och åtkomstkontroller. |
| Supporttillgänglighet | Får du hjälp när du behöver det? Leta efter supportalternativ dygnet runt och bedöm kvaliteten på resurser som dokumentation och communityforum. |
Vad är programvara för djupinlärning?
Programvara för djupinlärning är en uppsättning verktyg som är utformade för att skapa, träna och distribuera artificiella neurala nätverk för lösningar som bildigenkänning och programvara för konversationsintelligens. Dataforskare, maskininlärningsingenjörer och forskare använder vanligtvis dessa verktyg för att förbättra prediktiv modellering och automatisera komplex dataanalys. Funktioner för databearbetning, modellträning och integration underlättar hanteringen av datauppsättningar och förbättrar modellernas precision. Sammantaget erbjuder dessa verktyg betydande värde genom att förenkla komplexa datadrivna uppgifter och förbättra beslutsprocesser.
Funktioner
När du väljer programvara för djupinlärning bör du hålla utkik efter följande viktiga funktioner:
- Modellträning: Underlättar utvecklingen av neurala nätverk genom att tillhandahålla verktyg för att ställa in parametrar och optimera modeller.
- Integrationsmöjligheter: Möjliggör sömlös anslutning till befintliga datakällor och företagsapplikationer för ett effektivt dataflöde. Detta kan vara ännu viktigare för företag som använder programvara för bildigenkänning för att säkerställa precision i realtid.
- Anpassningsalternativ: Erbjuder flexibilitet att anpassa instrumentpaneler, rapporter och processer efter specifika arbetsflöden och behov.
- Användarvänligt gränssnitt: Säkerställer enkel användning, minskar inlärningskurvan och gör programvaran tillgänglig för olika teammedlemmar.
- Säkerhetsskydd: Tillhandahåller dataskydd genom kryptering och åtkomstkontroller och säkerställer efterlevnad av branschstandarder.
- Automatisk justering av hyperparametrar: Förbättrar modellens prestanda genom att automatiskt justera parametrar för optimala resultat.
- Databearbetning: Förenklar rensning och organisering av data och säkerställer kvalitativa indata för modellträning av verktyg som NLP-programvara.
- Realtidsanalys: Levererar omedelbara insikter från data och stöder snabba beslut och reaktionsförmåga.
- Mobil åtkomst: Gör det möjligt för användare att interagera med programvaran var de än befinner sig, vilket ökar flexibiliteten och tillgängligheten.
- Utbildningsresurser: Inkluderar handledningar, webbinarier och dokumentation som hjälper användare att lära sig och använda programvaran effektivt.
Fördelar
Att implementera programvara för djupinlärning ger flera fördelar för ditt team och ditt företag. Här är några av de fördelar du kan se fram emot:
- Förbättrad noggrannhet: Förbättrar prediktiv modellering med exakt dataanalys och funktioner för modellträning.
- Effektiv datahantering: Automatiserar uppgifter för förbehandling av data, vilket sparar tid och minskar manuella fel.
- Skalbara lösningar: Stödjer tillväxt med funktioner som hanterar ökande datamängder och fler användare.
- Välgrundat beslutsfattande: Erbjuder realtidsanalys för snabba insikter och lyhörda affärsstrategier.
- Anpassning efter specifika behov: Anpassar sig till era arbetsflöden med anpassningsbara instrumentpaneler och processer.
- Förbättrad datasäkerhet: Skyddar känslig information med säkerhetsåtgärder som kryptering och åtkomstkontroller.
- Tillgänglighet och flexibilitet: Ger mobil åtkomst, så att användare kan arbeta var som helst och hålla kontakten.
Kostnader och priser
För att välja programvara för djupinlärning krävs en förståelse för de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i programvarulösningar för djupinlärning:
Jämförelsetabell för programvara för djupinlärning
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisabonnemang | $0 | Grundläggande modellträning, begränsad datalagring och communitysupport. |
| Personligt abonnemang | $10-$30/user/ månad | Förbehandling av data, standardanalys och e-postsupport. |
| Företagsabonnemang | $50-$100/user/månad | Avancerad analys, integrationsfunktioner och prioriterad support. |
| Enterprise-abonnemang | $150-$300/user/månad | Anpassningsbara lösningar, dedikerad kundansvarig och förbättrad säkerhet. |
Vanliga frågor om programvara för djupinlärning
Här är några svar på vanliga frågor om programvara för djupinlärning:
Vilka maskinvarukrav finns för att köra programvara för djupinlärning?
Programvara för djupinlärning kräver ofta kraftfull maskinvara för att effektivt bearbeta stora datamängder. Högpresterande GPU:er, gott om RAM-minne och snabba lagringslösningar rekommenderas vanligtvis. Läs programvarans dokumentation för specifika maskinvarurekommendationer för att optimera prestandan och undvika flaskhalsar.
Är det möjligt att anpassa algoritmerna i programvara för djupinlärning?
Många programvarulösningar för djupinlärning låter dig anpassa algoritmer efter dina specifika behov. Leta efter verktyg som erbjuder flexibla arkitekturer för neurala nätverk och möjlighet att ändra parametrar. Denna anpassning kan förbättra modellens noggrannhet och relevans för just ditt användningsområde.
Kan programvara för djupinlärning integreras med befintlig IT-infrastruktur?
Ja, de flesta programvarulösningar för djupinlärning erbjuder integrationsfunktioner för befintlig IT-infrastruktur. Du bör kontrollera att verktyget stöder API:er eller har inbyggda anslutningar för dina nuvarande system, exempelvis databaser och molntjänster, för att säkerställa ett smidigt dataflöde och kompatibilitet.
Vad händer härnäst:
Om du håller på att undersöka programvara för djupinlärning kan du kontakta en SoftwareSelect-rådgivare för kostnadsfria rekommendationer.
Du fyller i ett formulär och har ett kort samtal där de går igenom detaljerna kring dina behov. Därefter får du en kortlista med programvara att granska. De hjälper dig även genom hela köpprocessen, inklusive prisförhandlingar.