

Att hitta rätt övervakningsverktyg kan vara en huvudvärk. Du vill ha något som passar teamets behov utan att vara onödigt komplicerat. Därför letar många organisationer efter LogicMonitor-alternativ.
Enligt min erfarenhet söker företag ofta andra lösningar som erbjuder bättre skalbarhet, specifika funktioner eller kostnadseffektivitet. De kan upptäcka att LogicMonitor inte passar deras nuvarande mål eller budget.
Jag har självständigt testat och granskat flera alternativ för att ge dig en opartisk bild av vad som finns tillgängligt. Jag guidar dig genom de bästa verktygen för att hantera dina specifika utmaningar.
Oavsett om du söker förbättrad molnintegration eller flexibiliteten hos öppen källkod hjälper den här listan dig att hitta rätt lösning. Låt oss utforska de bästa alternativen som kan göra dina övervakningsuppgifter mer lätthanterliga.
Vad är LogicMonitor?
LogicMonitor är en produktivitetsprogramvara utformad för IT-proffs och företag som behöver effektiva övervakningslösningar. Den används av IT-team för att övervaka infrastruktur, applikationer och nätverksprestanda samt ge värdefulla insikter i systemens drift.
Automatiserad övervakning, anpassningsbara instrumentpaneler och varningar i realtid hjälper till att identifiera problem och optimera prestandan. Sammantaget erbjuder LogicMonitor en centraliserad plattform som håller dina system igång utan problem.
Jämförelsetabell över LogicMonitor-alternativ
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta LogicMonitor-alternativ:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bäst för AI-driven observerbarhet | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $7/månad 15 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för kostnadseffektiv övervakning | 4.0 out of 5 | 4 | 3 | 4 | 4 | 4 | 5 | $325/månad Gratisplan + 5 dagars kostnadsfri provperiod + kostnadsfri demonstration tillgänglig | Website |
Bäst för molnövervakningstjänster | 4.3 out of 5 | 4 | 4 | 4 | 4 | 5 | 5 | $15/värd/månad Gratis abonnemang + 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för AI-driven dataanalys | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $15/värd/månad Gratisplan tillgänglig | Website |
Bäst för automatiserad dataåtkomst i realtid | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $0.04/månad 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för enhetlig och flexibel observerbarhet | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $19/månad Gratisplan tillgänglig | Website |
Bäst för integrerade IT-lösningar | 3.7 out of 5 | 3 | 3 | 4 | 3 | 5 | 4 | Prisuppgift på begäran 30 dagars kostnadsfri provperiod tillgänglig | Website |
Bäst för anpassningsbar instrumentpanel | 3.3 out of 5 | 4 | 2 | 4 | 3 | 4 | 3 | $200/månad Gratisplan + 30 dagars provperiod + demo tillgänglig | Website |
Bäst för observabilitet med öppen källkod | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $49/månad 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för AI-baserade insikter | 3.2 out of 5 | 3 | 4 | 3 | 2 | 3 | 4 | Pris på begäran Gratisplan + gratis demo tillgänglig | Website |


Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Recensioner av de bästa LogicMonitor-alternativen
Nedan finns mina detaljerade sammanfattningar av de bästa LogicMonitor-alternativen som kom med på min kortlista. Mina recensioner ger en detaljerad genomgång av varje verktygs viktigaste funktioner, för- och nackdelar, integrationer och ideala användningsområden för att hjälpa dig hitta det bästa alternativet för dig.
 Bäst för AI-driven observerbarhet
- 15 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $7/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.5/5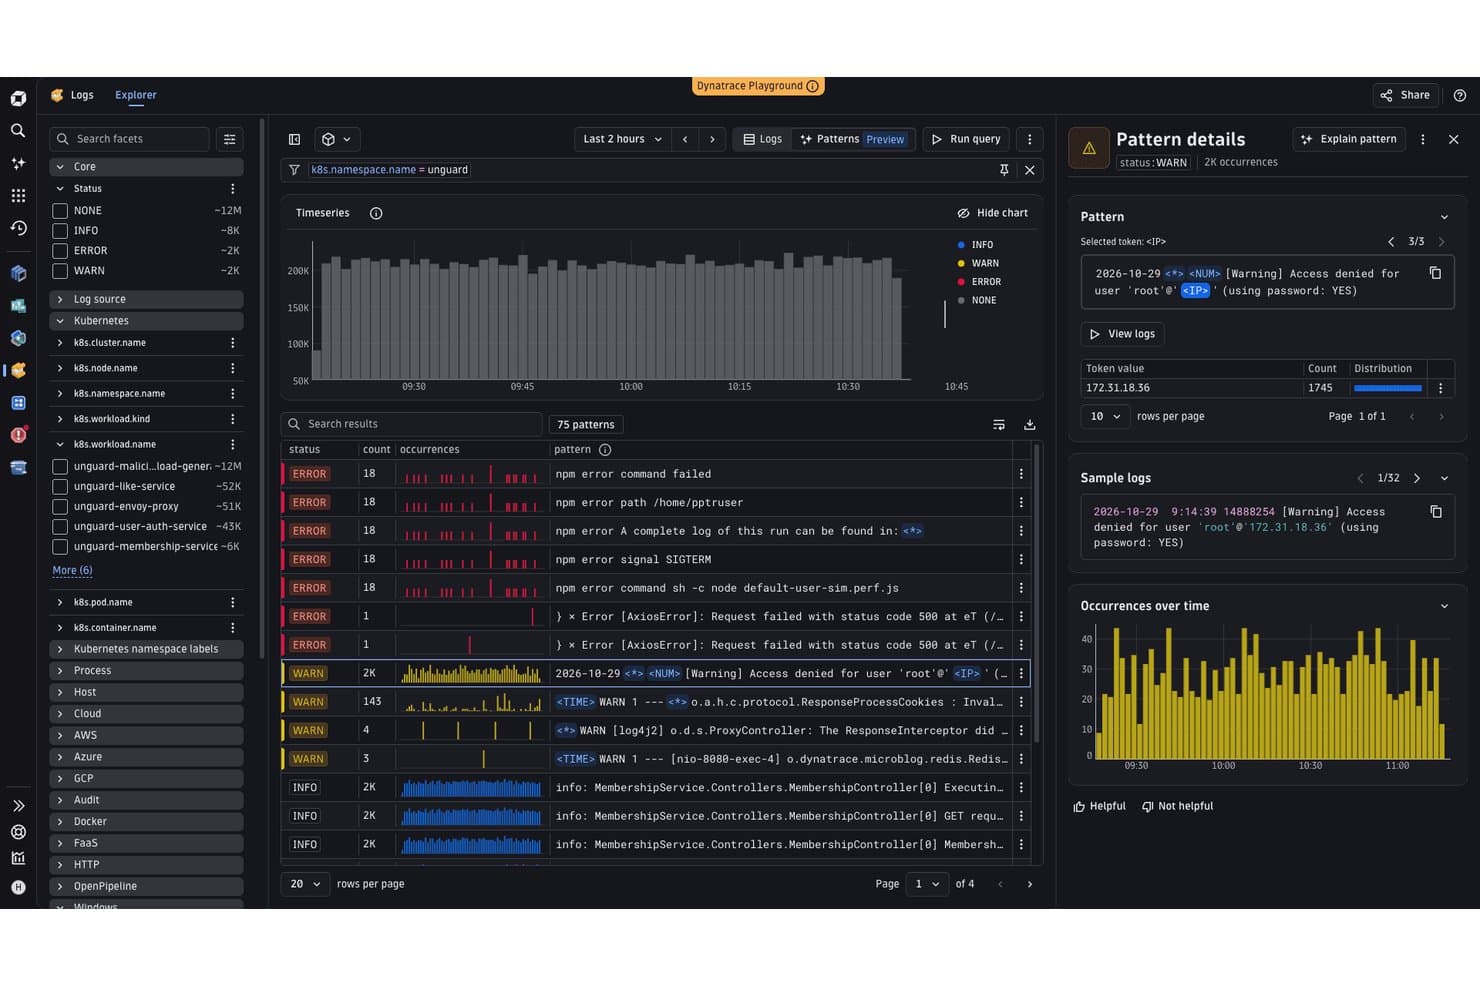
Dynatrace Logs-appen grupperar loggposter i mönster efter status, med diagram över förekomst och detaljer. Dynatrace är en fullstack-observabilitetsplattform som använder AI för att automatiskt upptäcka, kartlägga och övervaka dina applikationer, din infrastruktur och dina molnmiljöer – vilket gör den väl lämpad för IT-drift- och DevOps-team som hanterar komplexa, snabbt föränderliga system där manuell grundorsaksanalys inte är realistisk.
Vem passar Dynatrace bäst för?
Dynatrace passar bra för DevOps- och IT-driftteam som hanterar komplexa, distribuerade miljöer där fullstack-insyn och AI-driven grundorsaksanalys är viktigare än dedikerad nätverksövervakning.
Varför jag valde Dynatrace
Jag valde Dynatrace som ett av de bästa alternativen till LogicMonitor eftersom den AI-drivna observerbarheten sträcker sig långt bortom tröskelbaserad avisering. Davis AI använder Smartscape-topologi för att automatiskt korrelera händelser över värdar, containrar och tjänster, så i stället för att sortera bland dussintals aviseringar får jag en enda grundorsak. PurePath spårar varje transaktion från början till slut på kodnivå, vilket innebär att jag exakt kan fastställa var en fördröjning uppstår utan att manuellt behöva gå igenom loggar.
Viktiga funktioner i Dynatrace
- Automatisk identifiering med OneAgent: Installeras per värd och upptäcker automatiskt processer, tjänster och beroenden utan manuell konfiguration.
- Logganalys med DQL: Samlar in, berikar och söker i loggdata med Dynatrace Query Language, med konfigurerbar lagring från 10 dagar till 10 år.
- Syntetisk övervakning: Simulerar användarresor via Browser Monitor och kontrollerar API- och tjänstetillgänglighet via HTTP Monitor från offentliga och privata platser.
- Automatisering av arbetsflöden: Utlöser automatiserade arbetsflöden från händelser, scheman eller API-anrop, med stöd för villkor, loopar och nya försök.
Dynatrace-integrationer
Dynatrace har marknadsplatsintegrationer med Jira, Slack, Cursor, GitHub Copilot Coding Agent, JetBrains och Windsurf. Plattformen tillhandahåller även API:er för miljö-, konfigurations- och kontohantering för anpassade integrationer och anslutning till arbetsflöden.
Pros and Cons
Pros:
- Korrelerar aviseringar genom Smartscape-topologi
- OneAgent upptäcker beroenden mellan applikationer och infrastruktur
- PurePath spårar transaktioner till orsaker på kodnivå
Cons:
- Nätverksövervakningen ligger efter specialiserade plattformar
- Anpassade instrumentpaneler kräver arbete att konfigurera
 Bäst för kostnadseffektiv övervakning
- Gratisplan + 5 dagars kostnadsfri provperiod + kostnadsfri demonstration tillgänglig
- Från $325/månad (faktureras årligen)
Visit WebsiteCustomer Rating:4.5/5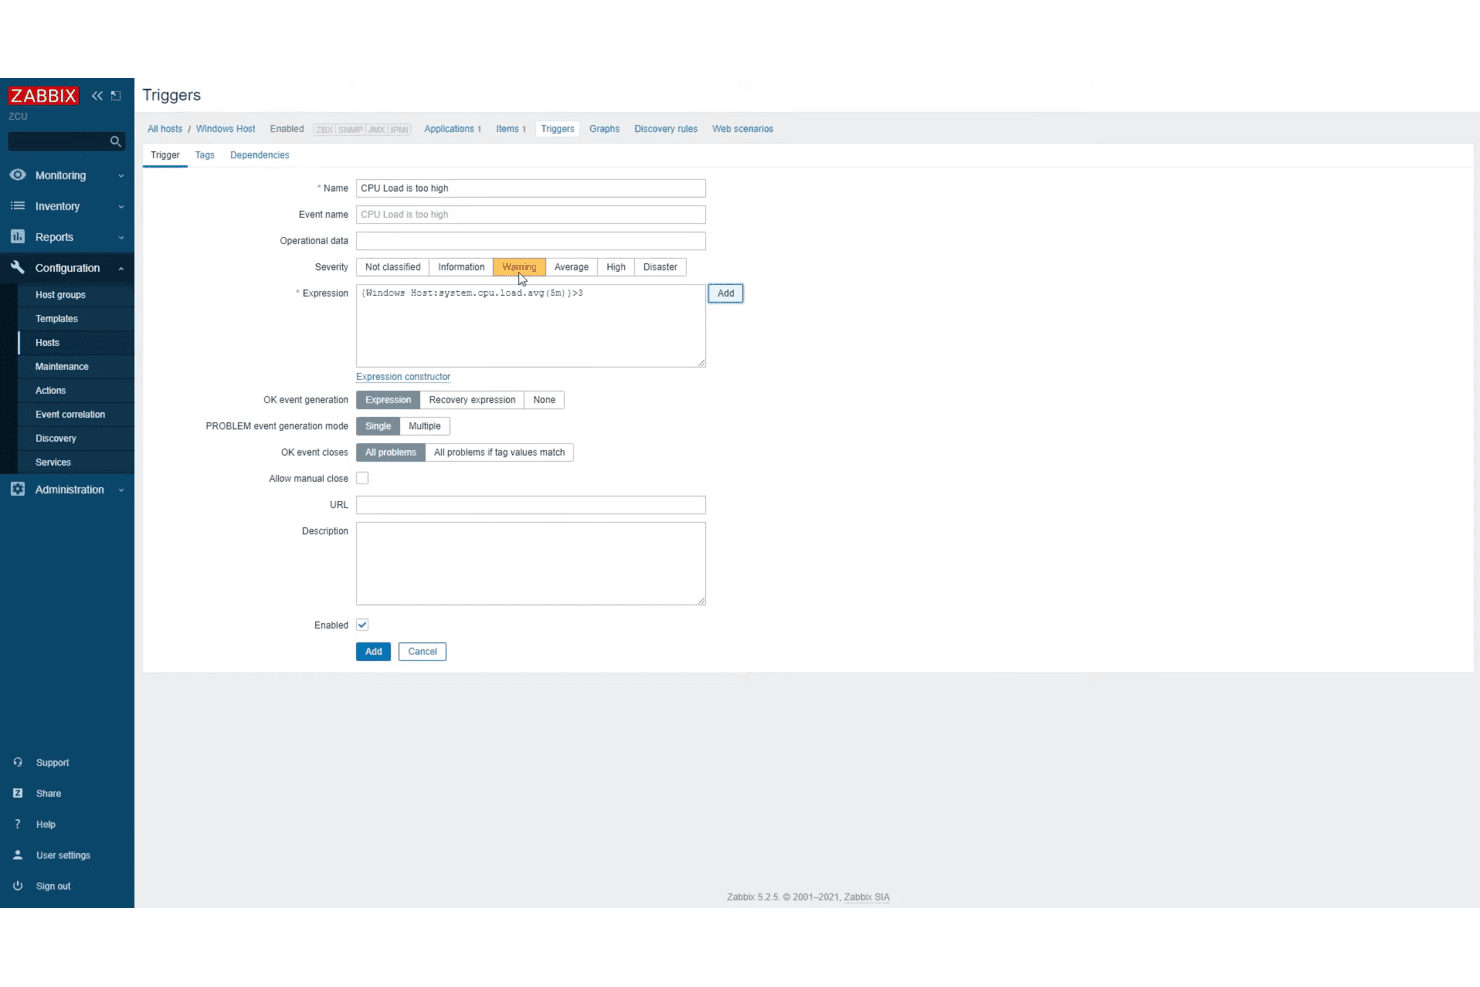
Konfigurering av en Zabbix-utlösare som varnar när CPU-belastningen på en Windows-värd överskrider ett tröskelvärde. Zabbix är en plattform med öppen källkod för övervakning som tilltalar IT-team som behöver bred insyn i infrastrukturen – över servrar, nätverk, moln, containrar och applikationer – utan att betala licensavgifter per enhet eller mätvärde.
Vem passar Zabbix bäst för?
Zabbix passar bra för IT-team som behöver övervakning av infrastruktur på företagsnivå men inte kan motivera licenskostnader per enhet.
Varför jag valde Zabbix
Jag valde Zabbix som ett av de bästa alternativen eftersom inget annat verktyg på den här listan låter dig ta bort licensiering per enhet helt och ändå få övervakning på företagsnivå av servrar, nätverk, moln och containrar. Kärnan med öppen källkod har inga begränsningar för antalet värdar, inga tak för antalet mätvärden och inga funktionsbegränsningar, så ett team som hanterar tusentals slutpunkter betalar lika mycket i licensavgifter som ett team som hanterar tio: noll. Jag uppskattar också de prediktiva utlösarfunktionerna, som använder historiska data för att uppskatta när ett tröskelvärde kommer att överskridas innan det faktiskt sker.
Zabbix viktigaste funktioner
- Regler för händelsekorrelation: Konfigurera regler för att gruppera relaterade händelser, ta bort dubbletter av fladdrande aviseringar och automatiskt stänga inaktuella problem över olika utlösare och avsökningsmetoder.
- Instrumentpaneler för kostnader i flera moln: Visa och jämför infrastrukturkostnader för AWS, Azure, Google Cloud och Oracle Cloud från en och samma instrumentpanel.
- Stöd för OpenTelemetry APM: Ta emot distribuerade spårningar, mätvärden och loggar från applikationer eller OpenTelemetry-insamlare via en Zabbix-proxy, med ClickHouse som källa för telemetridata.
- Automatiserade åtgärder för felavhjälpning: Kör konfigurerade skript eller kommandon som svar på upptäckta problem, inklusive omstart av tjänster eller omdimensionering av molnresurser.
Zabbix-integrationer
Zabbix listar 204 officiella mallar och 570 varumärken i 2 010 lösningar, inklusive AWS, Azure, Google Cloud Platform, ServiceNow, Slack, PagerDuty, Kafka och RabbitMQ. Dess JSON-RPC-API, strömmande REST-API, webhooks och Python-bibliotek stöder anpassade integrationer.
Pros and Cons
Pros:
- Bred insyn i servrar och nätverk
- Flexibla aviseringar och händelsekorrelation
- Prognoser flaggar mätvärden som närmar sig tröskelvärden
Cons:
- Aviseringströsklar kräver manuell finjustering
- Självhostade driftsättningar medför löpande databasunderhåll
 Bäst för molnövervakningstjänster
- Gratis abonnemang + 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $15/värd/månad (debiteras årsvis)
Visit WebsiteCustomer Rating:4.5/5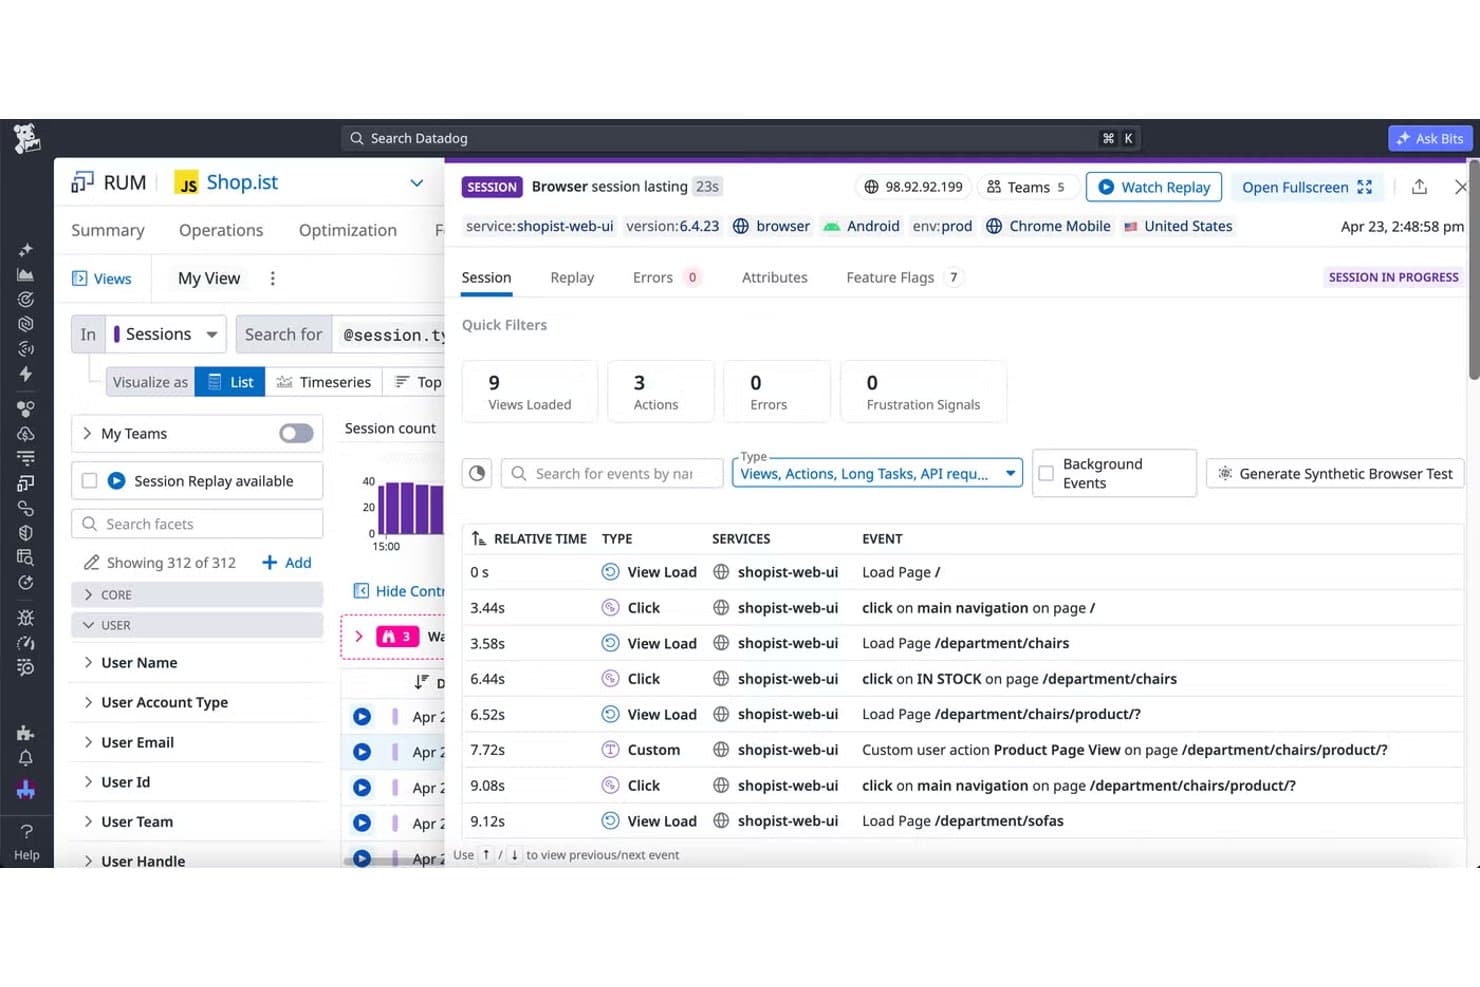
Datadogs RUM-sessionsvy visar en användares sidladdningar, klick och anpassade åtgärder i följd. Datadog är en SaaS-baserad plattform för observerbarhet som ger IT- och DevOps-team en enhetlig överblick över moln-, hybrid- och lokal infrastruktur—och kombinerar mätvärden, loggar, spårningar och säkerhetssignaler på en och samma plats för att minska behovet av att växla mellan olika kontexter under incidenthantering.
Vem passar Datadog bäst för?
Datadog passar bra för DevOps-ingenjörer och IT-driftteam som hanterar molnbaserade eller hybrida miljöer och behöver en enhetlig överblick över infrastruktur, loggar, spårningar och säkerhetssignaler på en och samma plattform.
Varför jag valde Datadog
Jag valde Datadog som ett av de bästa alternativen till LogicMonitor eftersom plattformen är särskilt utformad för molnövervakning och spårar tiotusentals mätvärden över AWS, Azure och GCP samtidigt som de korreleras med loggar, spårningar och säkerhetssignaler i en och samma vy. Jag uppskattar särskilt Watchdog, plattformens AI-motor som automatiskt upptäcker avvikelser, så att mitt team inte behöver sålla manuellt bland brus under en incident. Prognosbaserade övervakare är också genuint användbara: jag kan modellera CPU- eller minnestrender med hjälp av säsongsbaserade eller linjära algoritmer och ställa in varningströsklar upp till tre månader framåt.
Viktiga funktioner i Datadog
- Taggbaserad infrastruktursökning: Filtrera och analysera mätvärden över hela infrastrukturen med hjälp av anpassade taggar för att gruppera värdar, containrar och molnresurser efter valfri dimension.
- Korrelation mellan signaler: Koppla samman infrastruktursmätvärden med loggar, spårningar och säkerhetssignaler i en enda vy för att undersöka incidenter utan att växla mellan olika verktyg.
- Kartläggning av enhetstopologi: Visualisera nätverksenheter, gränssnitt och fysiska anslutningar, med möjlighet att granska trafik, SNMP-fällor, Syslog-meddelanden och närliggande enheter.
- Övervakning av aktiva processer: Visa aktivitet på processnivå i realtid över alla värdar och containrar, inklusive resursförbrukning och körda kommandon, från ett centraliserat gränssnitt.
Datadog-integrationer
Datadog erbjuder över 1 000 integrationer, bland annat Amazon Web Services, Microsoft Azure, Google Cloud Platform, Kubernetes, Docker, Jira, PagerDuty, OpenTelemetry, PostgreSQL och Redis. Plattformens REST API och klientbibliotek stöder anpassade integrationer.
Pros and Cons
Pros:
- Korrelerar infrastruktur, loggar och spårningar
- Anpassade instrumentpaneler tydliggör systemets aktuella hälsa
- Prognosbaserade övervakare hjälper till att förutse kapacitetstrender
Cons:
- Användningsbaserade fakturor kan vara svåra att förutse
- Finjustering av varningar kan leda till trötthet på aviseringar
 Bäst för AI-driven dataanalys
- Gratisplan tillgänglig
- Från $15/värd/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.3/5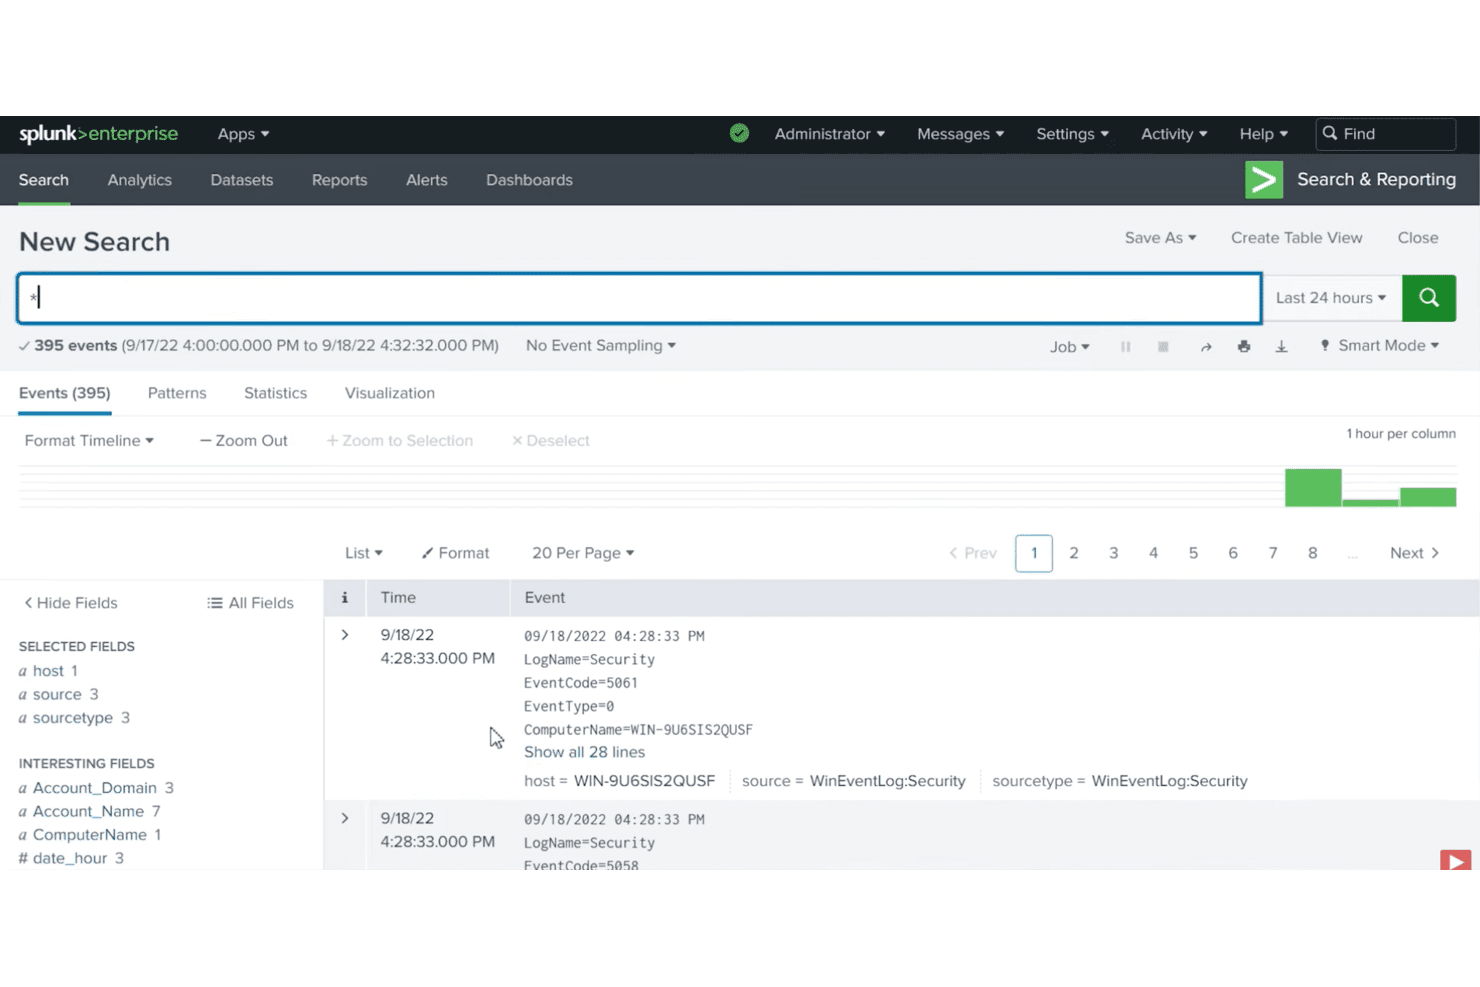
Splunk Enterprise-sökvyn visar Windows Security-händelser med valbara fält och en tidslinje. Splunk Observability Cloud är en SaaS-övervakningsplattform som förenar data om infrastruktur, applikationsprestanda och digitala upplevelser, vilket gör den väl lämpad för IT- och DevOps-team som behöver AI-assisterad grundorsaksanalys i hybrid- och molnmiljöer.
Vem passar Splunk bäst för?
Splunk Observability Cloud passar väl för DevOps- och IT-driftteam i medelstora och stora organisationer som behöver AI-assisterad grundorsaksanalys i hybrid- och molnmiljöer.
Varför jag valde Splunk
Jag valde Splunk som ett av de bästa alternativen till LogicMonitor eftersom dess AI SRE-lager hanterar utredningsarbetet som vanligtvis faller på ditt team så väl. AI-felsökningsagenten sammanför mätvärden, spårningar och loggar för att på ett tydligt språk visa sannolika grundorsaker, medan AI-assistenten låter dig söka i APM-, infrastruktur- och Kubernetes-data utan att skriva en enda fråga. Jag uppskattar särskilt att NoSample-spårning fångar 100 % av spårningsdata, så att inget försvinner före analysen.
Splunks viktigaste funktioner
- Infrastrukturinstrumentpaneler: Förbyggda instrumentpaneler och visualiseringar för molntjänster, system och Kubernetes-miljöer ger ditt team insyn i hybridinfrastrukturens hälsa i realtid.
- Dynamisk avisering med detektorer: Detektorer övervakar mätvärdessignaler och utlöser aviseringar baserat på regler med flera villkor, och skickar meddelanden till verktyg som PagerDuty, Slack, ServiceNow och Microsoft Teams.
- Insamling baserad på OpenTelemetry: Samlar in mätvärden, spårningar och loggar med hjälp av instrumentering baserad på öppna standarder, med stöd för Prometheus, Telegraf och collectd samt över 200 integrationer.
- Log Observer Connect: Länkar loggar som redan lagras i Splunk Cloud Platform eller Splunk Enterprise direkt till felsökningsarbetsflöden i Observability Cloud utan extra kostnad.
Splunk-integrationer
Splunk Observability Cloud dokumenterar över 200 integrationer baserade på öppna standarder, inklusive AWS, Microsoft Azure, Google Cloud Platform, Jira, Microsoft Teams, PagerDuty, ServiceNow, Slack och Amazon EventBridge. Plattformen stöder även OpenTelemetry, Prometheus, Telegraf, collectd och REST API-anslutningar.
Pros and Cons
Pros:
- Förenar telemetri för snabbare felsökning
- AI sammanfattar sannolika orsaker på ett tydligt språk
- Fångar varje spårning för utredningar
Cons:
- Kostnaderna ökar när antalet telemetrikällor blir fler
- SignalFlow kräver praktisk finjustering av detektorer
Learn more about Splunk: Bäst för automatiserad dataåtkomst i realtid
- 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $0.04/månad
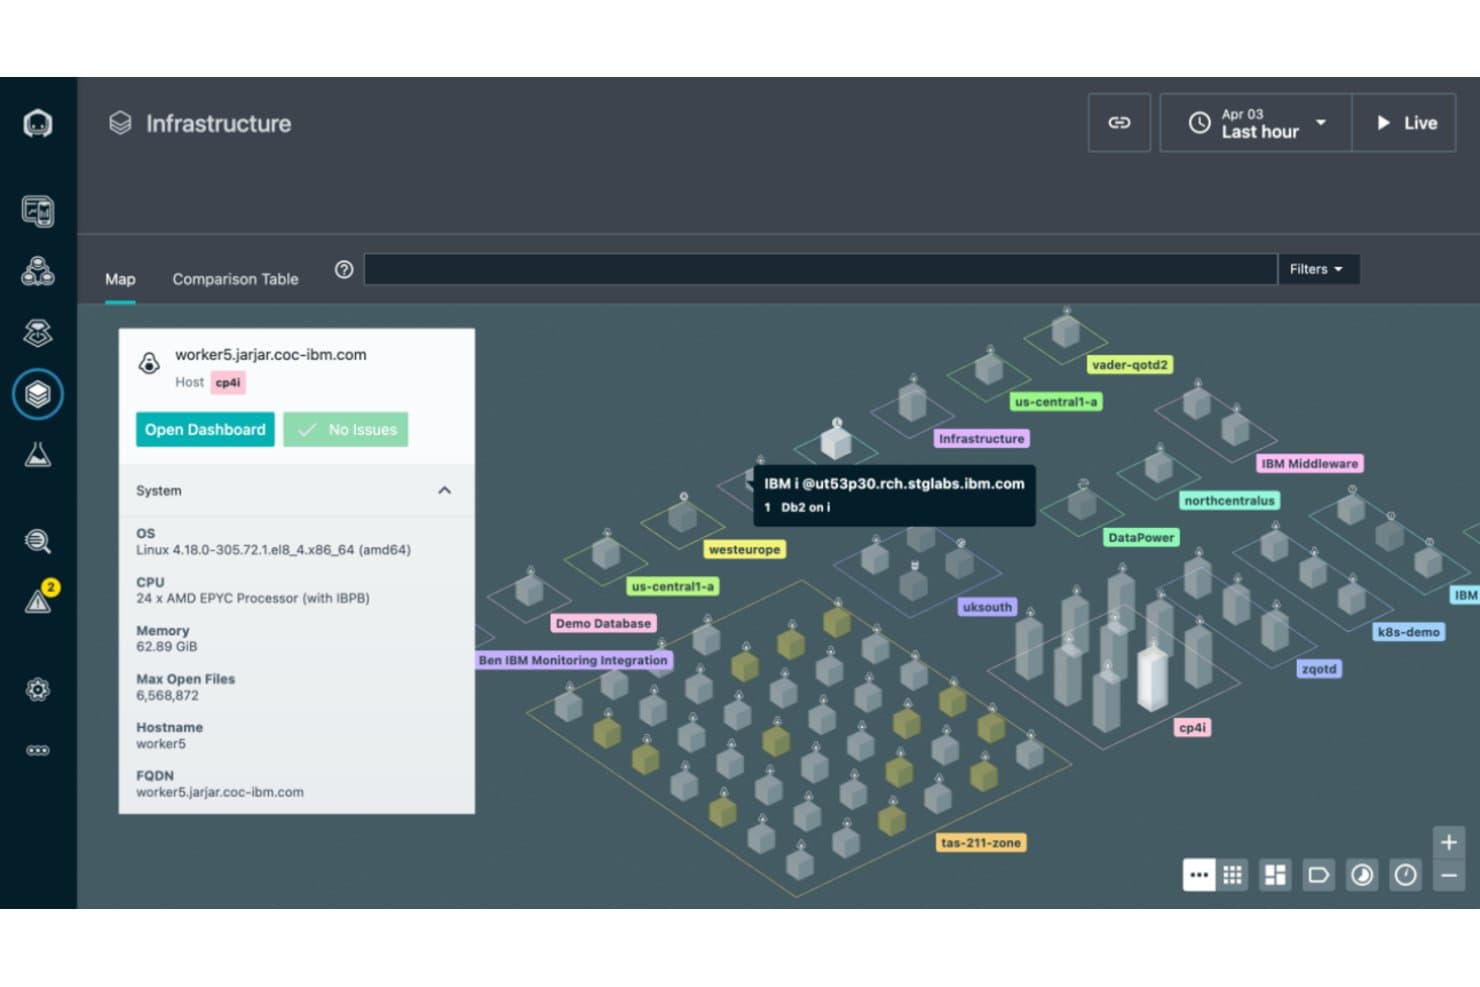
IBM Instanas infrastrukturkarta visar värdar grupperade efter zon, med värddetaljer och aktuell status. IBM Instana är en AI-driven plattform för observerbarhet, byggd för DevOps-team som behöver automatisk upptäckt, mappning av beroenden i realtid och djupgående insyn i applikationsprestanda i moln-, hybrid- och containeriserade miljöer.
Vem passar IBM Instana bäst för?
IBM Instana passar bra för DevOps-ingenjörer som hanterar komplexa molnbaserade miljöer och behöver automatisk upptäckt och mappning av beroenden i realtid utan manuellt instrumenteringsarbete.
Varför jag valde IBM Instana
Jag har tagit med IBM Instana bland mina främsta val eftersom den automatiserade dataåtkomsten i realtid verkligen skiljer ut plattformen: Dynamic Graph upptäcker och mappar kontinuerligt varje värd, tjänst och beroende och uppdateras varje sekund utan manuell instrumentering. Jag uppskattar hur detta kombineras med agentbaserad AI för grundorsaksanalys, som korrelerar spårningsstatistik, topologi och avvikelsesignaler för att snabbt identifiera sannolika orsaker. Under en pågående incident innebär det att mitt team inte behöver leta manuellt genom instrumentpaneler.
Viktiga funktioner i IBM Instana
- Smarta aviseringar med adaptiva tröskelvärden: Instanas aviseringsmotor använder statistiska baslinjer och förbyggda ritningar för att upptäcka incidenter, med grupperade aviseringar och vidarebefordran till Slack, PagerDuty, e-post och webhooks.
- Distribuerad transaktionsspårning: Instana spårar förfrågningar över applikationskomponenter utan sampling och fångar detaljer på kodnivå i databaser samt webbläsar- och mobillager.
- Integration med OpenTelemetry Collector: Instana hämtar telemetri från OpenTelemetry Collector för att övervaka mikrotjänster och molnbaserade applikationer tillsammans med komponenter som har instrumenterats inbyggt.
- Insikter om Kubernetes-kostnader: Instana tillhandahåller färdiga instrumentpaneler och historisk kostnadsanalys för övervakning av resurskostnader i Kubernetes-kluster.
Integrationer med IBM Instana
IBM Instana stöder över 300 tekniker, däribland Slack, PagerDuty, OpenTelemetry Collector, Splunk, Amazon EC2, AWS RDS, Google Cloud, Kubernetes och VMware Tanzu. REST- och GraphQL-API:er samt SDK:er stöder anpassade integrationer.
Pros and Cons
Pros:
- Beroendekartor i realtid underlättar incidenttriage
- Automatisk upptäckt minskar behovet av manuell instrumentering
- Snabb telemetri hjälper till att lokalisera tjänsteproblem
Cons:
- Luckor i nätverksenhetsövervakningen kan kräva separat övervakning
- Aviseringsvolymer behöver ofta filtreras manuellt
Learn more about IBM Instana: Bäst för enhetlig och flexibel observerbarhet
- Gratisplan tillgänglig
- Från $19/månad
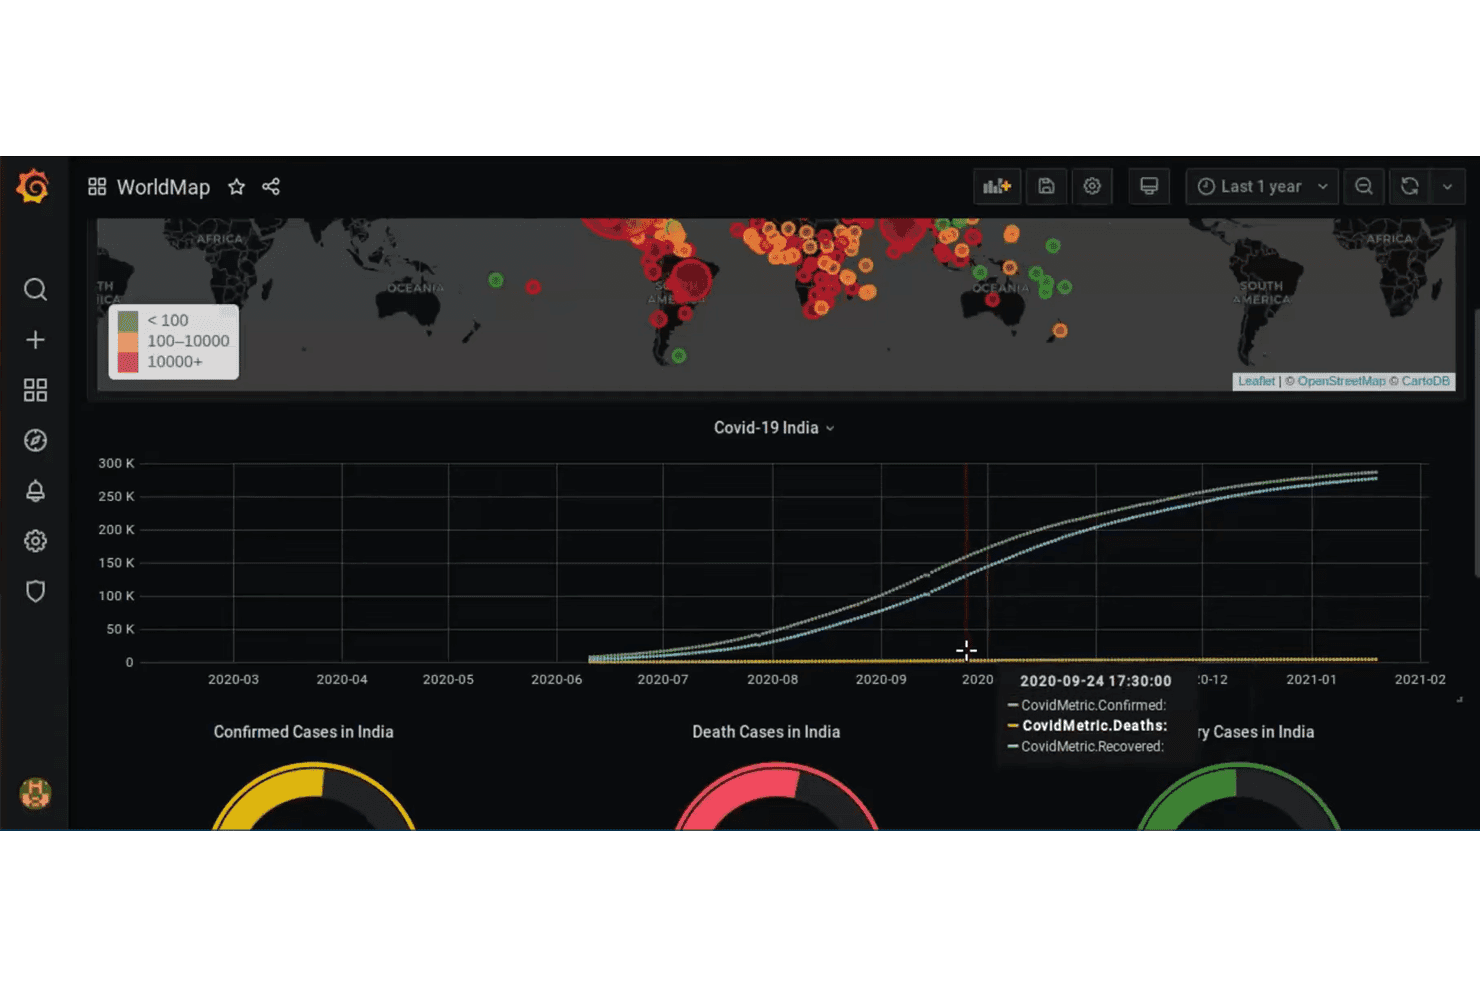
Grafana-instrumentpanel som visualiserar globala covid-19-fall och fall i Indien över tid som kartor och tidsseriediagram. Grafana Cloud är en hanterad observerbarhetsplattform som samlar mätvärden, loggar, spår och profiler på ett och samma ställe, vilket gör den väl lämpad för DevOps-ingenjörer och IT-driftteam som behöver flexibel övervakning baserad på öppna standarder i moln-, hybrid- och containeriserade miljöer.
Vem passar Grafana Cloud bäst för?
Grafana Cloud passar bra för DevOps-ingenjörer och IT-driftteam som vill samla mätvärden, loggar, spår och profiler i molnbaserade och hybrida miljöer med hjälp av öppna standarder som OpenTelemetry och Prometheus.
Varför jag valde Grafana Cloud
Jag har tagit med Grafana Cloud bland mina toppval eftersom plattformen samlar mätvärden, loggar, spår och profiler i en enda hanterad plattform, vilket är precis vad du behöver när LogicMonitors uppdelade arbetssätt börjar kännas begränsande. Jag uppskattar särskilt kunskapsgrafen, som kartlägger relationer mellan tjänster, Kubernetes-arbetsbelastningar, databaser och infrastruktur, så att du kan följa en latensökning genom distribuerade spår ända till en flaskhals i databasen utan att behöva växla mellan olika verktyg. Den AI-drivna funktionen Undersökningar kan automatiskt analysera dessa telemetridata, formulera hypoteser och returnera en strukturerad rapport när en avisering utlöses.
Viktiga funktioner i Grafana Cloud
- Adaptiv telemetri: Samlar automatiskt ihop, samplar eller tar bort telemetridata med lägre värde från mätvärden, loggar, spår och profiler för att kontrollera datamängder och kostnader.
- Syntetisk övervakning: Kontrollerar API-slutpunkter och webbapplikationer från sonder över hela världen och stöder HTTP/HTTPS-, DNS-, TCP- och ICMP Ping-kontroller för tillgänglighet och prestanda.
- Grafana Alloy-insamlare: En öppen källkodsbaserad OpenTelemetry-insamlare med stöd för Prometheus-pipelines som hanterar mätvärden, loggar, spår och profiler från din befintliga infrastruktur.
- RBAC med anpassade roller: Gör det möjligt att tilldela detaljerade behörigheter till användare, team och tjänstekonton, med anpassade roller som begränsas till specifika åtgärder i instrumentpaneler och datakällor.
Integrationer med Grafana Cloud
Grafana Cloud erbjuder över 150 integrationer med datakällor, bland annat AWS, Microsoft Azure, Google Cloud, SNMP, VMware vSphere och LogicMonitor-enheter. REST-, HTTP-, Grafana Cloud-, spårnings- och API:er för syntetisk övervakning samt webbkopplingar stöder anpassade integrationer.
Pros and Cons
Pros:
- Flexibla instrumentpaneler samlar telemetridata
- Vyer över flera signaler stöder incidentutredning
- Kunskapsgrafen kopplar avvikelser till orsaker
Cons:
- SNMP-konfiguration kräver manuell enhetskonfiguration
- Avancerade aviseringsregler kräver konfigurationsarbete
Learn more about Grafana Cloud: Bäst för integrerade IT-lösningar
- 30 dagars kostnadsfri provperiod tillgänglig
- Prisuppgift på begäran
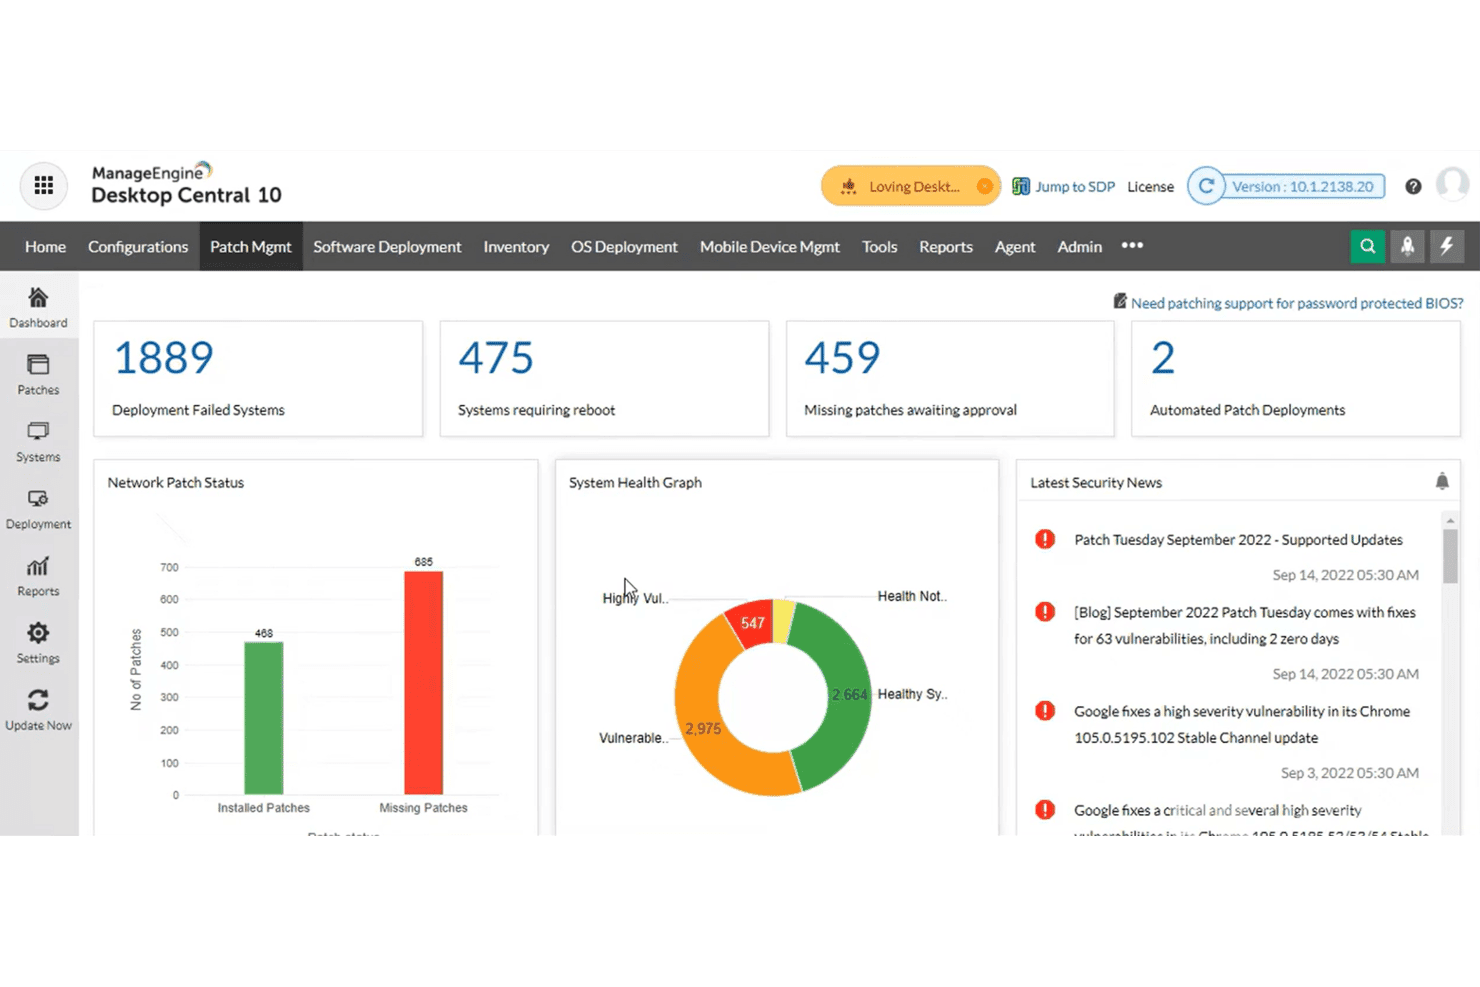
ManageEngine Desktop Central 10:s instrumentpanel för hantering av korrigeringar, som visar status för nätverkskorrigeringar och systemhälsa. ManageEngine OpManager är en plattform för nätverks- och infrastrukturoövervakning som tilltalar IT-driftteam som hanterar komplexa lokala miljöer och erbjuder djupgående insyn i enheter, servrar, lagring och virtuell infrastruktur med AI-driven prognostisering och arbetsflödesautomatisering utan kod.
Vem passar ManageEngine bäst för?
ManageEngine OpManager passar bra för IT-driftteam som hanterar stora lokala miljöer och behöver djupgående insyn i infrastrukturen utan att betala priser på SolarWinds-nivå.
Varför jag valde ManageEngine
Jag valde ManageEngine OpManager eftersom det täcker hela infrastrukturen på en och samma plats, vilket är precis vad du behöver när du ersätter LogicMonitor. Jag uppskattar särskilt dess topologikartläggning, som automatiskt bygger nätverkskartor för lager 2 så att du kan spåra ett fel från en avisering direkt till det berörda segmentet utan att behöva leta i separata verktyg. Dess AI-drivna kapacitetsplanering förutser när enheter kommer att nå minneströsklar, så att du kan agera innan ett avbrott inträffar.
Viktiga funktioner i ManageEngine OpManager
- Arbetsflödesautomatisering utan kod: Med en dra-och-släpp-byggare kan du skapa arbetsflöden som utlöses av nätverksfel eller enligt ett schema för att automatiskt hantera tjänster, processer, filer och mappar.
- 3D-vy av datacentergolvet: Renderar en 3D-replik i realtid av ditt datacenter och dess rack och visar enheternas aktuella status direkt i den fysiska layouten.
- Korrelation av problem och händelser: Grupperar relaterade aviseringar i en enda problemregistrering med allvarlighetsgrad, korrelationsmetod och en procentandel för brusreducering för att minska aviseringströtthet.
- MCP-serverintegrering: Gör det möjligt för AI-klienter som Claude Desktop eller Cursor att fråga OpManagers övervakningsdata, inklusive enhetshälsa, larm och prestandatrender, med hjälp av frågor på naturligt språk.
ManageEngine-integreringar
ManageEngine OpManager erbjuder inbyggda integreringar med ServiceNow, Jira Service Management, Microsoft Teams, Slack, Grafana, Microsoft Sentinel och ManageEngine ServiceDesk Plus. Dess REST API använder OpenAPI-dokumentation och webhooks stöder anpassade integreringar.
Pros and Cons
Pros:
- Samlad insyn i nätverk, servrar och lagring
- Topologikartor hjälper till att spåra fel till berörda segment
- Kapacitetsprognoser flaggar resursbrist i ett tidigt skede
Cons:
- Standardprofiler för aviseringar kan generera för många meddelanden
- Anpassade rapporter kan ta tid att konfigurera
Learn more about ManageEngine: Bäst för anpassningsbar instrumentpanel
- Gratisplan + 30 dagars provperiod + demo tillgänglig
- Från $200/månad (faktureras årligen)
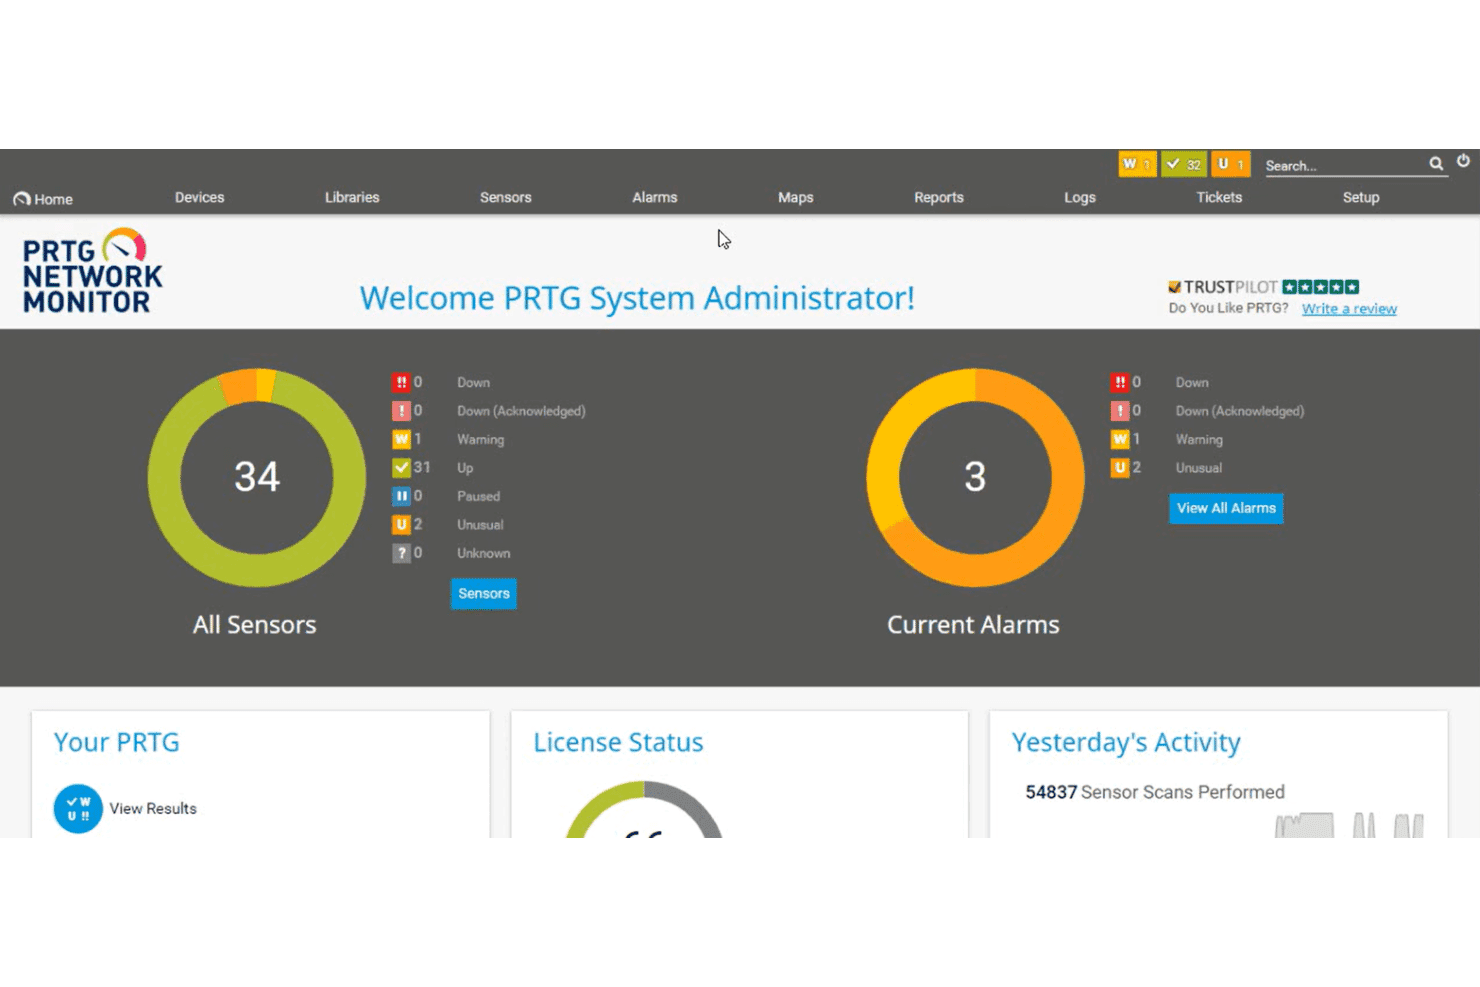
Instrumentpanelen i PRTG Network Monitor sammanfattar sensorstatus och aktuella larm med en blick. Paessler PRTG är ett lokalt installerat nätverksövervakningsverktyg som tilltalar nätverksadministratörer och IT-team som behöver bred insyn i IT-, OT- och IoT-infrastruktur – inklusive enheter, trafik, servrar och applikationer från en enda plattform.
Vem passar Paessler PRTG bäst för?
PRTG passar väl för nätverksadministratörer och IT-team som hanterar lokala eller hybrida miljöer och behöver en mycket visuell, sensorbaserad övervakningslösning som kan anpassas efter deras infrastruktur.
Varför jag valde Paessler PRTG
Jag valde Paessler PRTG som ett av de bästa alternativen till LogicMonitor eftersom dess möjligheter att anpassa instrumentpaneler och kartor går djupare än hos de flesta verktyg jag har testat. Jag kan bygga infrastrukturvyer med en dra-och-släpp-redigerare, lägga till ikoner för enhetsstatus, geografiska kartor och anpassade HTML-bakgrunder och sedan dela dem offentligt eller bädda in dem via iFrame. Med över 300 tillgängliga widgetar kan jag skapa NOC-liknande vyer som gör problem som påverkar hela platsen synliga med en blick, utan att behöva leta genom menyer.
Viktiga funktioner i Paessler PRTG
- Sensorbaserad automatisk upptäckt: Skannar nätverkssegment med hjälp av ping, SNMP och WMI och tillämpar sedan automatiskt enhets- och sensormallar för att påbörja övervakningen.
- Avisering via flera kanaler med eskalering: Skickar aviseringar via e-post, SMS, push, Teams eller Slack, med konfigurerbara eskaleringsnivåer och schemalagda aviseringsfönster.
- AI-baserad avvikelsedetektering: Analyserar historiska sensordata för att fastställa baslinjer och varnar när övervakade värden avviker från förväntade mönster.
- Schemalagd rapportering och rapportering på begäran: Genererar rapporter i HTML-, PDF-, CSV- eller XML-format för enskilda sensorer eller grupper, enligt ett fast schema eller manuellt utlöst.
Integrationer med Paessler PRTG
Paessler PRTG erbjuder inbyggda integrationer med Microsoft Teams, Slack och PagerDuty. Det tillhandahåller även REST API:er för anpassade integrationer samt övervakning av XML- eller JSON-data.
Pros and Cons
Pros:
- Anpassade kartor gör problem på platsen synliga
- Automatisk upptäckt omfattar sensorer för varierande infrastruktur
- Eskaleringar av aviseringar hjälper till att upptäcka serviceproblem tidigt
Cons:
- Topologi för grundorsaksanalys kräver ett separat betalt tillägg
- Djupet i molnövervakningen ligger efter plattformsleverantörsfokuserade lösningar
Learn more about Paessler PRTG: Bäst för observabilitet med öppen källkod
- 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $49/månad
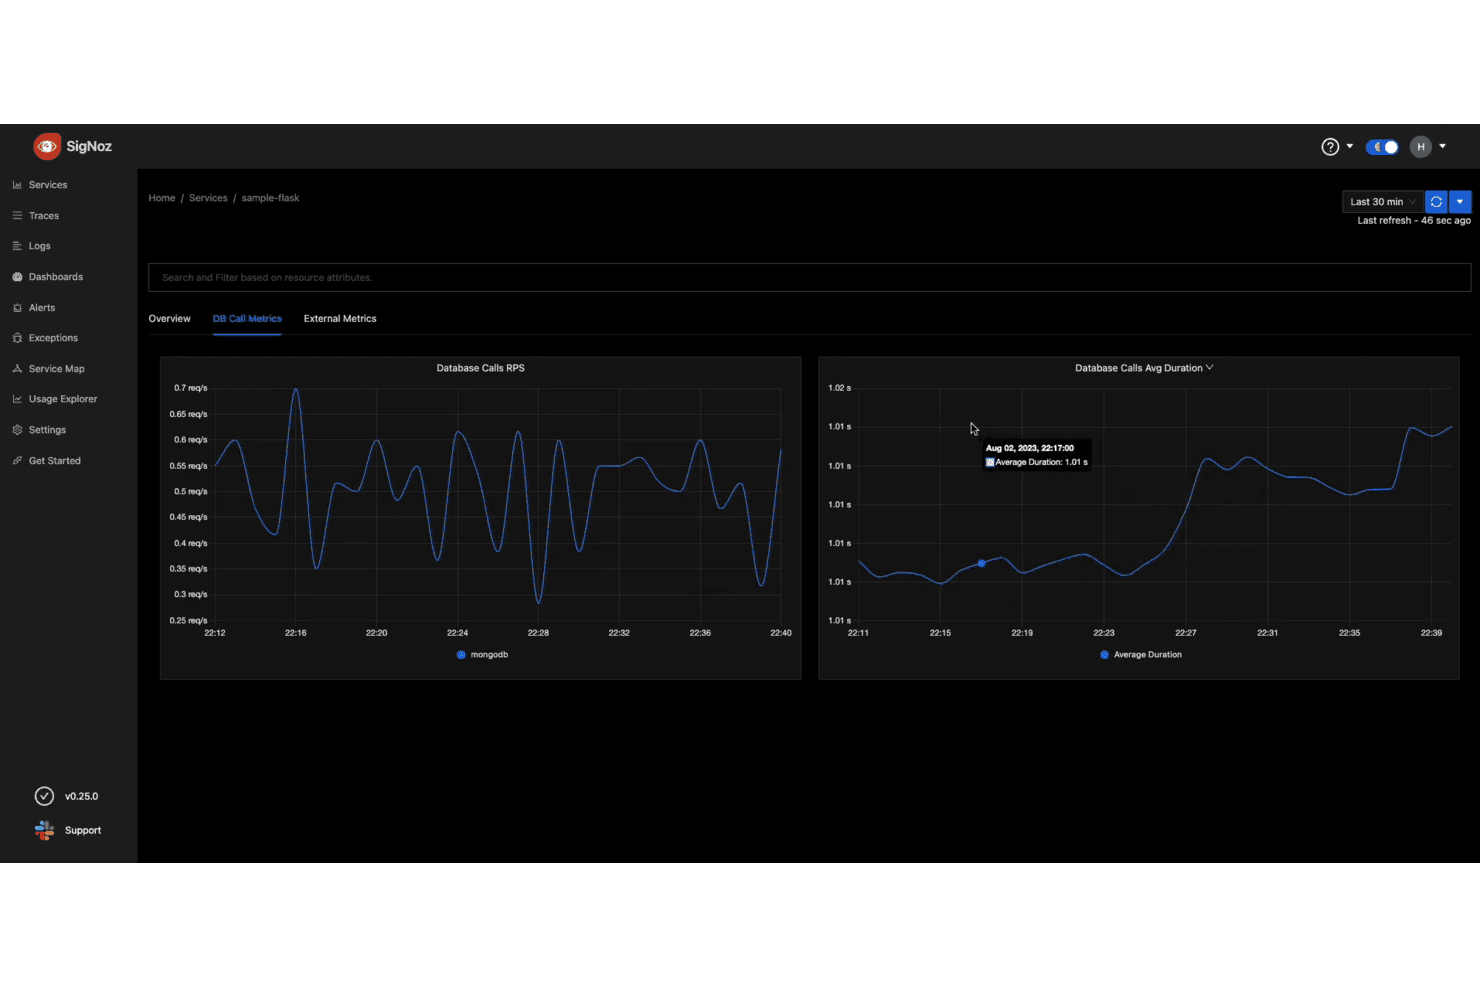
SigNoz-tjänstevy som visar anropsfrekvensen till MongoDB-databasen och genomsnittlig varaktighet över tid. SigNoz är en OpenTelemetry-infödd observabilitetsplattform som tilltalar DevOps-ingenjörer och infrastruktursteam som vill ha enhetliga loggar, mätvärden och spår utan de oförutsägbara avgifter per värd som följer med verktyg som Datadog eller New Relic.
Vem passar SigNoz bäst för?
SigNoz passar bra för DevOps-ingenjörer och plattformsteam som vill ha full kontroll över sin observabilitetsstack utan avgifter per värd.
Varför jag valde SigNoz
Jag valde SigNoz som ett av de bästa alternativen eftersom det är den enda OpenTelemetry-infödda plattformen på den här listan som låter dig självdrifta hela din observabilitetsstack utan avgifter per värd eller leverantörsinlåsning. Jag gillar att den förenar loggar, mätvärden och spår på ett ställe, så när en avisering utlöses kan jag gå direkt från en kant i tjänstekartan som visar förhöjd P99-latens till det korrelerade spåret och loggen utan att byta verktyg. Den AI-assisterade korrelationen av aviseringar via MCP-servern är ett genuint användbart lager ovanpå detta och låter mig kvantifiera vilken uppströmsliggande tjänst som orsakar en topp innan jag ens öppnar en terminal.
Viktiga funktioner i SigNoz
- Aviseringar för flera signaler: Skapa aviseringar för mätvärden, loggar, spår, undantag och avvikelser, med routningspolicyer som skickar aviseringar till Slack, PagerDuty, Opsgenie, Microsoft Teams, e-post eller webhooks.
- OpenTelemetry-infödd instrumentering: Samla in och vidarebefordra telemetri från applikationer, värdar, Kubernetes och molntjänster med OpenTelemetry Collector utan proprietära agenter.
- Frågebyggare: Filtrera, aggregera och tillämpa matematiska funktioner över loggar, mätvärden och spår från ett enda gränssnitt, med stöd även för PromQL och ClickHouse SQL.
- SOC 2 Type II- och HIPAA-efterlevnad: SigNoz Cloud uppfyller SOC 2 Type II- och HIPAA-standarderna, med datacenter tillgängliga i USA, EU och Indien.
SigNoz-integreringar
SigNoz dokumenterar 112 integreringar, inklusive AWS, Azure, Google Cloud Platform, PostgreSQL, MySQL, Redis, MongoDB, NGINX och RabbitMQ. Det tillhandahåller även ett API för anpassade integreringar och stöder anslutningar till OpenTelemetry Collector för SNMP-aktiverade brandväggar, routrar och switchar.
Pros and Cons
Pros:
- Självdrift håller telemetrin under din kontroll
- Loggar, mätvärden och spår delar undersökningar
- AI-assisterad korrelation av aviseringar påskyndar felsökningen
Cons:
- SNMP-avläsning kräver manuell OID-mappning
- Självdriven ClickHouse kräver löpande finjustering
Learn more about SigNoz:
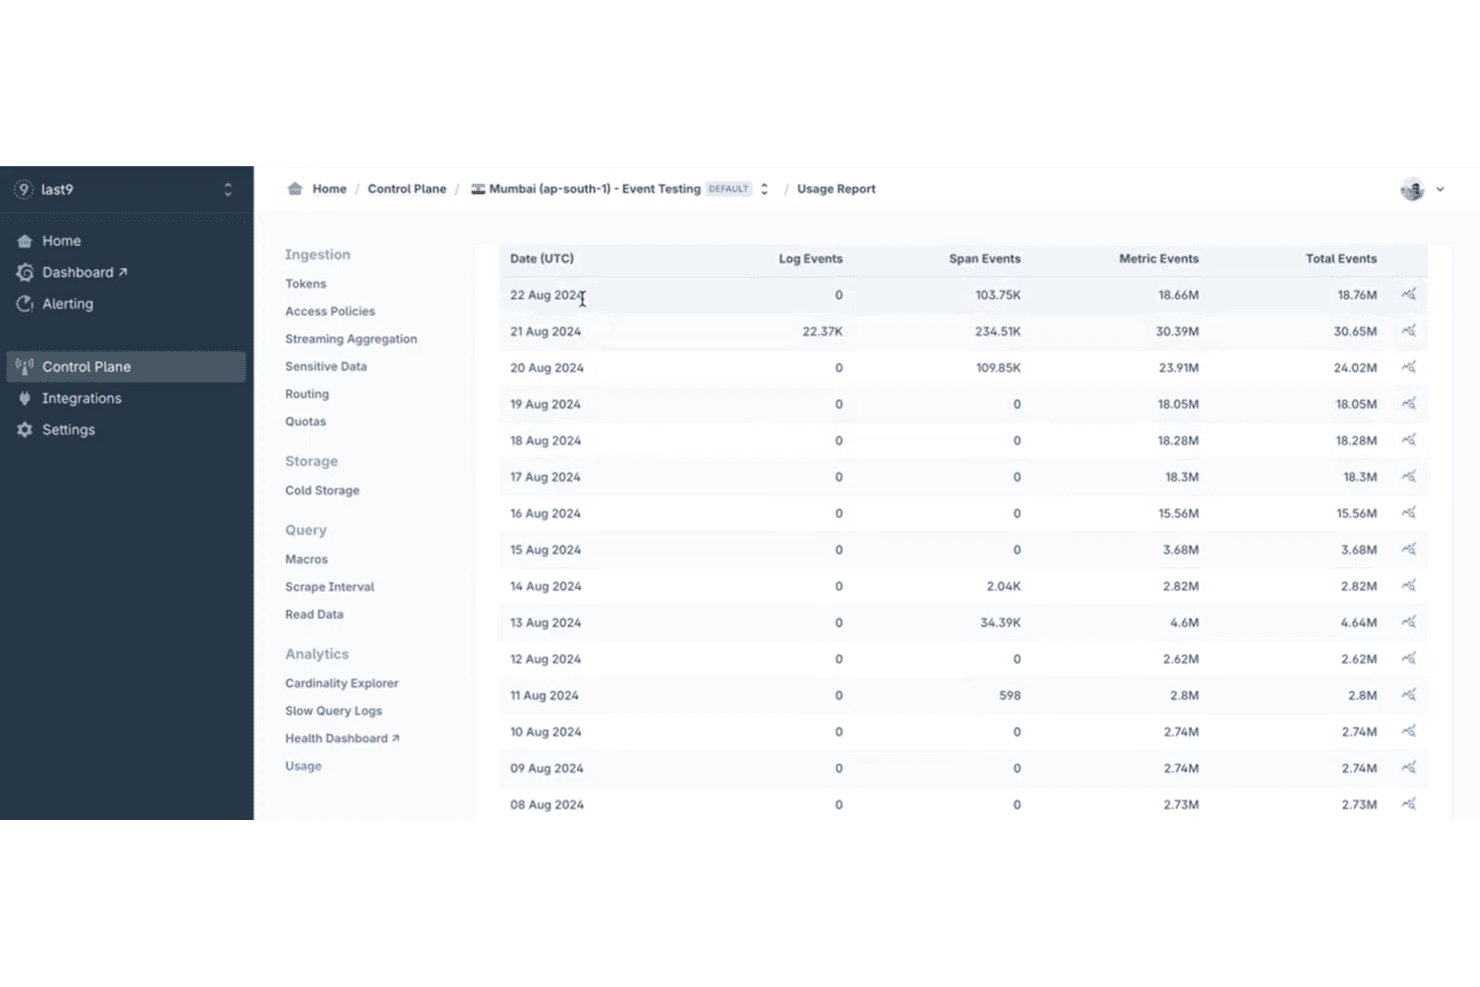
Last9 Control Plane-användningsrapport som visar dagliga volymer av logg-, spår- och mätvärdeshändelser efter datum. Last9 är en OpenTelemetry-baserad plattform för observerbarhet, byggd för DevOps- och ingenjörsteam som behöver förena mätvärden, loggar och spårdata – med AI-driven utredning och stöd för hög kardinalitet som gör den väl lämpad för team som växer ur kostnadskrävande övervakningsverktyg.
Vem passar Last9 bäst för?
Last9 passar bra för DevOps- och team för webbplatstillförlitlighet som behöver OpenTelemetry-baserad observerbarhet med inbyggd AI-driven utredning.
Varför jag valde Last9
Jag valde Last9 som en av de bästa eftersom dess AI-baserade utredning går djupare än en vanlig instrumentpanel för aviseringar. Last9 AI kan fråga dina aktiva mätvärden, loggar och spårdata tillsammans, sedan visa korrelerande bevis och föreslå aviseringsregler eller instrumentpaneler för ditt godkännande. Dess Discover Map visualiserar realtidsberoenden mellan tjänster med felfrekvenser och P95-latens, så när en incident utlöses kan jag spåra påverkansområdet över mikrotjänster utan att manuellt sammanfoga signaler.
Viktiga funktioner i Last9
- OpenTelemetry-baserad insamling: Last9 samlar in mätvärden, loggar och spårdata inbyggt via OpenTelemetry, utan behov av leverantörsspecifika agenter.
- Aviseringsregler med PromQL och LogQL: Aviseringsregler kan skrivas direkt i PromQL eller LogQL eller skapas med hjälp av en guidad regelbyggare i användargränssnittet.
- Trappad lagring av mätvärden: Data lagras i nivåerna Blaze, Hot och Cold och behålls som standard i upp till ett år utan nedsampling eller sammanläggningar.
- SNMP-baserad övervakning av nätverksenheter: Last9 samlar in telemetri från switchar, routrar, brandväggar och UPS-enheter med hjälp av OpenTelemetry Collectors SNMP-mottagare eller Prometheus SNMP Exporter.
Integreringar med Last9
Last9 listar över 100 integreringar, däribland AWS, Azure, Google Cloud, Kubernetes, Prometheus, Grafana, Slack, Datadog och New Relic. Plattformen erbjuder även ett REST API och en MCP-server för anpassade integreringar och arbetsflöden med AI-agenter.
Pros and Cons
Pros:
- Korrelerar loggar, mätvärden och spårdata med AI
- Recensenter rapporterar snabbare felsökning mellan tjänster
- Användare berömmer fokuserade och handlingsbara aviseringar
Cons:
- Lokal drift av plattformen är inte dokumenterad
- Vissa recensenter rapporterar fördröjningar vid uppdatering av instrumentpaneler
Learn more about Last9:
Andra LogicMonitor-alternativ
Här är några ytterligare LogicMonitor-alternativ som inte kom med på min kortlista men som ändå är värda att ta en titt på:
- 11NinjaOneBäst för hantering av slutpunkter
- 12ObkioBäst för optimering av nätverksprestanda
- 13Azure MonitorBäst för insikter om Azure-tjänster
Så utvärderar jag alternativ till LogicMonitor
Jag utvärderar varje alternativ i två lager: den grundnivå ett verktyg måste uppnå – hybridövervakning, flexibel datainsamling och intelligent avisering – samt det som särskiljer de bästa alternativen.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärkt inom området) för varje kärnfunktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå minst 75 % totalpoäng för att övervägas för inkludering.
- Övervakning av hybridinfrastruktur: Jag kontrollerar om varje verktyg kan hämta mätvärden från lokala servrar, arbetsbelastningar i molnet, containrar och nätverksutrustning i en och samma vy.
- Flexibla metoder för datainsamling: Varje verktyg bör stödja agentbaserad och agentlös insamling via protokoll som SNMP, WMI och REST API:er för att täcka olika miljöer.
- Intelligent avisering och AIOps: Jag letar efter dynamiska tröskelvärden och korrelation mellan aviseringar som minskar bruset, inte bara statiska regler som fyller inkorgen under en vanlig tillfällig ökning.
- Instrumentpaneler och rapportering: Med bra instrumentpaneler kan du skapa SLA-fokuserade vyer för ledningen och detaljerade paneler för tekniker utan att behöva ett separat BI-verktyg.
- Integrationsekosystem: Jag utvärderar hur väl varje verktyg ansluter till ITSM-plattformar, chattverktyg och automatiseringssystem som teamet redan använder dagligen.
- Skalbar arkitektur för flera klienter: För MSP:er och distribuerade team tittar jag på detaljnivån i RBAC, klientisolering och om du kan avgränsa vyer per kund eller affärsenhet.
När jag har en lista över verktyg som uppfyller dessa kriterier bedömer jag vad som särskiljer varje plattform.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Automatisk upptäckt med topologisk kartläggning är en viktig särskiljande faktor. När ett verktyg kartlägger tjänsteberoenden på egen hand lägger teamet mindre tid på att dokumentera infrastrukturen och mer tid på att hantera verkliga problem. Jag letar också efter inbyggd logganalys och APM vid sidan av infrastrukturmätvärden – verktyg som Datadog och Dynatrace samlar dessa funktioner i samma plattform, vilket innebär färre kontextbyten. Händelseutlöst automatisering är också viktig, särskilt när teamet behöver starta åtgärdsrutiner eller spåra konfigurationsavvikelser direkt från övervakningsplattformen.
Bortom funktionerna
Pristransparens är viktig när du lämnar LogicMonitor. Jag utvärderar om en leverantör tar betalt per enhet, per värd eller baserat på datainmatning – och hur förutsägbara kostnaderna förblir när miljön skalas upp. Flexibilitet vid driftsättning är en annan viktig faktor. Vissa team behöver SaaS, medan andra inom reglerade branscher kräver självhostade eller isolerade alternativ; verktyg som Zabbix och PRTG erbjuder lokala modeller, medan Datadog endast finns som SaaS. Jag tar också hänsyn till tiden till värde: hur snabbt kan du gå från den första installationen till meningsfulla instrumentpaneler och handlingsbara aviseringar?
Varför leta efter ett LogicMonitor-alternativ?
Även om LogicMonitor är ett bra val av produktivitetsprogramvara finns det flera anledningar till att vissa användare söker alternativa lösningar. Du kanske letar efter ett annat alternativ eftersom:
- Du behöver fler anpassningsalternativ
- Ditt team behöver bättre skalbarhet
- Du vill sänka kostnaderna
- Ditt företag behöver specifika integrationer
- Du letar efter enklare användargränssnitt
- Du behöver bättre regional support
Om något av detta känns relevant har du kommit rätt. Min lista innehåller flera alternativ inom produktivitetsprogramvara som passar bättre för team som står inför dessa utmaningar med LogicMonitor och letar efter alternativa lösningar.
Funktioner
Här är några av de viktigaste funktionerna i LogicMonitor som kan hjälpa dig att jämföra vad alternativa lösningar erbjuder:
- Enhetlig övervakning: Erbjuder omfattande övervakning av infrastruktur, molntjänster och loggar samt stöd för större molnleverantörer.
- AIOps-integration: Använder AI-drivna verktyg för händelseanalys och automatisering för att förbättra den operativa effektiviteten.
- Prediktiv analys: Erbjuder grundorsaksanalys och tjänsteinsikter för att förbättra lösningen av incidenter.
- Omfattande integrationer: Erbjuder över 3 000 teknikintegrationer för dynamisk skalning och motståndskraft.
- Anpassningsbara instrumentpaneler: Gör det möjligt att skapa och dela instrumentpaneler i realtid, anpassade efter dina specifika behov.
- Avvikelsedetektering: Identifierar proaktivt ovanligt beteende för att förhindra påverkan på användarna.
- Dynamiska tröskelvärden: Ställer automatiskt in intelligenta tröskelvärden baserat på historiska data.
- API:er och integrationer: Utökar funktionaliteten med API:er och integrationer för olika tekniker.
- Stöd för moln och flera moln: Övervakar containrar och större molnleverantörer som AWS, Google Cloud, Microsoft Azure och Oracle Cloud.
- Logghantering: Erbjuder funktioner för logghantering och analys.