

Oprogramowanie do zarządzania operacjami IT pomaga zarządzać całą infrastrukturą IT i lepiej ją rozumieć, obejmując monitorowanie, automatyzację, bezpieczeństwo oraz kondycję usług w środowiskach lokalnych i chmurowych.
Ta lista została przygotowana z myślą o dyrektorach technologicznych i liderach IT, którzy potrzebują ujednoliconych informacji, szybszej analizy przyczyn źródłowych oraz rozwiązań gotowych do obsługi środowisk hybrydowych i wielochmurowych. Znajdziesz tu opcje umożliwiające automatyzację opartą na sztucznej inteligencji, szczegółową obserwowalność, natywne integracje zabezpieczeń oraz możliwość dostosowania potrzebną do skalowania tego, co najważniejsze.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza programów do zarządzania operacjami IT
Porównaj ceny i najważniejsze specyfikacje wybranych przeze mnie programów do zarządzania operacjami IT w poniższej tabeli.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepszy do walidacji wydań całego stosu opartej na sztucznej inteligencji | 15-dniowy bezpłatny okres próbny | Od 7 USD/host/miesiąc | Website | |
| 2 | Najlepsze rozwiązanie do ujednoliconej telemetrii z wbudowanym FinOps | 14-dniowy bezpłatny okres próbny | Od $15/host/miesiąc (przy rozliczeniu rocznym) | Website | |
| 3 | Najlepsze rozwiązanie do połączonych operacji SecOps związanych z logami i metrykami | Dostępna bezpłatna wersja próbna | Od $0.15/credit | Website | |
| 4 | Najlepsze rozwiązanie do natywnego dla OTel wglądu w operacje w całym stosie | 14-dniowy bezpłatny okres próbny | Od $0.07/GB | Website | |
| 5 | Najlepszy dla wielodostępnych hybrydowych operacji IT klasy MSP | Dostępna bezpłatna wersja demonstracyjna | Ceny na żądanie | Website | |
| 6 | Najlepszy wybór do szczegółowego monitorowania operacji związanych z pamięcią masową i GPU | Dostępna bezpłatna wersja demonstracyjna | Ceny ustalane na życzenie | Website | |
| 7 | Najlepszy do automatyzacji przepływów pracy od awarii do rozwiązania bez użycia kodu | 30-dniowy bezpłatny okres próbny | Od 1 233 USD/rok (rozliczenie roczne) | Website | |
| 8 | Najlepsze do oceny ryzyka zmian opartej na AI | Dostępna bezpłatna prezentacja | Od $9/użytkownika/miesiąc (rozliczane rocznie) | Website | |
| 9 | Najlepsze do monitorowania operacji o otwartym kodzie źródłowym w dowolnej skali | Dostępne bezpłatne pobieranie | Od $325/miesiąc (rozliczane rocznie) | Website | |
| 10 | Najlepsze do redukcji szumu alertów opartej na ML | Dostępna bezpłatna wersja demonstracyjna | Wycena na życzenie | Website |


Recenzje najlepszych programów do zarządzania operacjami IT
Poniżej znajdują się moje szczegółowe podsumowania najlepszych programów do zarządzania operacjami IT, które trafiły na moją krótką listę. W recenzjach szczegółowo omawiam funkcje, najlepsze zastosowania i integracje każdej platformy, aby pomóc Ci znaleźć rozwiązanie najlepiej dopasowane do Twoich potrzeb.
 Najlepszy do walidacji wydań całego stosu opartej na sztucznej inteligencji
- 15-dniowy bezpłatny okres próbny
- Od 7 USD/host/miesiąc
Visit WebsiteCustomer Rating:4.5/5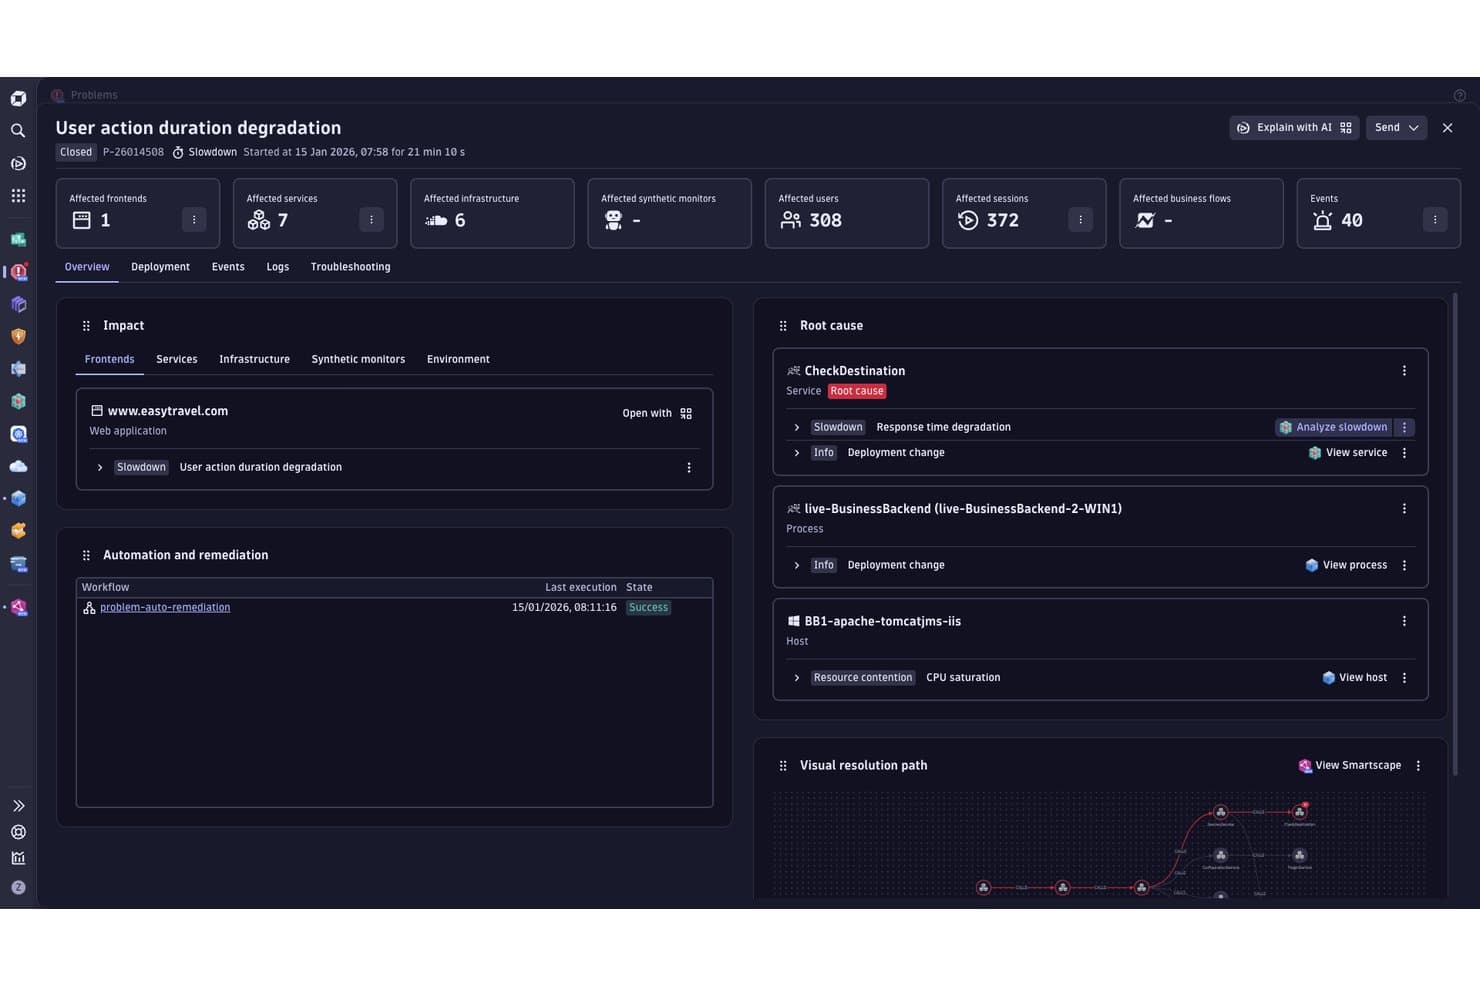
Dynatrace automatycznie wskazuje przyczyny źródłowe problemów z wydajnością. Dynatrace to platforma do zarządzania operacjami IT obejmująca cały stos technologiczny, która zapewnia monitorowanie infrastruktury, wykrywanie incydentów oparte na AIOps, analizę logów i automatyzację przepływów pracy w środowiskach hybrydowych i wielochmurowych.
Dla kogo Dynatrace jest najlepszym wyborem?
Dynatrace doskonale sprawdza się w przypadku zespołów korporacyjnych IT i SRE zarządzających złożonymi środowiskami hybrydowymi lub wielochmurowymi, które potrzebują obserwowalności opartej na sztucznej inteligencji, zautomatyzowanej reakcji na incydenty oraz walidacji wydań na dużą skalę.
Dlaczego wybrałem Dynatrace
Wybrałem Dynatrace jako jedno z najlepszych rozwiązań, ponieważ jego Site Reliability Guardian zapewnia najbardziej kompleksową konfigurację walidacji wydań, jaką widziałem w tej kategorii: automatycznie ocenia każde wdrożenie względem zdefiniowanych wcześniej SLO i KPI, zanim kod trafi na produkcję, blokując nieudane wydania bez konieczności ręcznej weryfikacji. Połącz to ze zdolnością Davis AI do prześledzenia anomalii produkcyjnej do pojedynczej przyczyny źródłowej wśród miliardów aktywnych zależności, a otrzymasz platformę, która wykrywa problemy przechodzące przez bramki jakości i dokładnie wyjaśnia, dlaczego wystąpiły.
Najważniejsze funkcje Dynatrace
- Mapowanie topologii Smartscape: Automatycznie wykrywa i wizualizuje zależności w czasie rzeczywistym między hostami, kontenerami, usługami i procesami w środowiskach hybrydowych i wielochmurowych.
- Jezioro danych Grail: Ujednolica metryki, logi, ślady, zdarzenia i sygnały bezpieczeństwa w jednym magazynie bez indeksu, który można przeszukiwać za pomocą DQL bez konfiguracji schematu.
- Kreator przepływów pracy AutomationEngine: Wizualny edytor niewymagający kodowania lub wymagający jego niewielkiej ilości, służący do tworzenia automatyzacji sterowanej zdarzeniami lub harmonogramem, opartej na aktualnych danych obserwowalności.
- Predykcyjne alerty: Prognozuje naruszenia limitów pojemności i wydajności, zanim do nich dojdzie, wykorzystując stale aktualizowane modele zachowania dla każdego monitorowanego komponentu.
Integracje Dynatrace
Dynatrace oferuje ponad 900 integracji za pośrednictwem Dynatrace Hub, w tym z ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud i OpenTelemetry. Jego interfejs REST API, webhooki i zestaw SDK AppEngine obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Pojedynczy agent automatycznie wykrywa zasoby całego stosu
- Davis AI wskazuje rzeczywistą przyczynę źródłową
- Zautomatyzowane działania naprawcze z mechanizmami kontroli człowieka w pętli
Cons:
- Ceny oparte na zużyciu utrudniają budżetowanie
- Wyłącznie model SaaS ogranicza możliwości w przypadku potrzeb dotyczących środowisk odizolowanych
 Najlepsze rozwiązanie do ujednoliconej telemetrii z wbudowanym FinOps
- 14-dniowy bezpłatny okres próbny
- Od $15/host/miesiąc (przy rozliczeniu rocznym)
Visit WebsiteCustomer Rating:4.5/5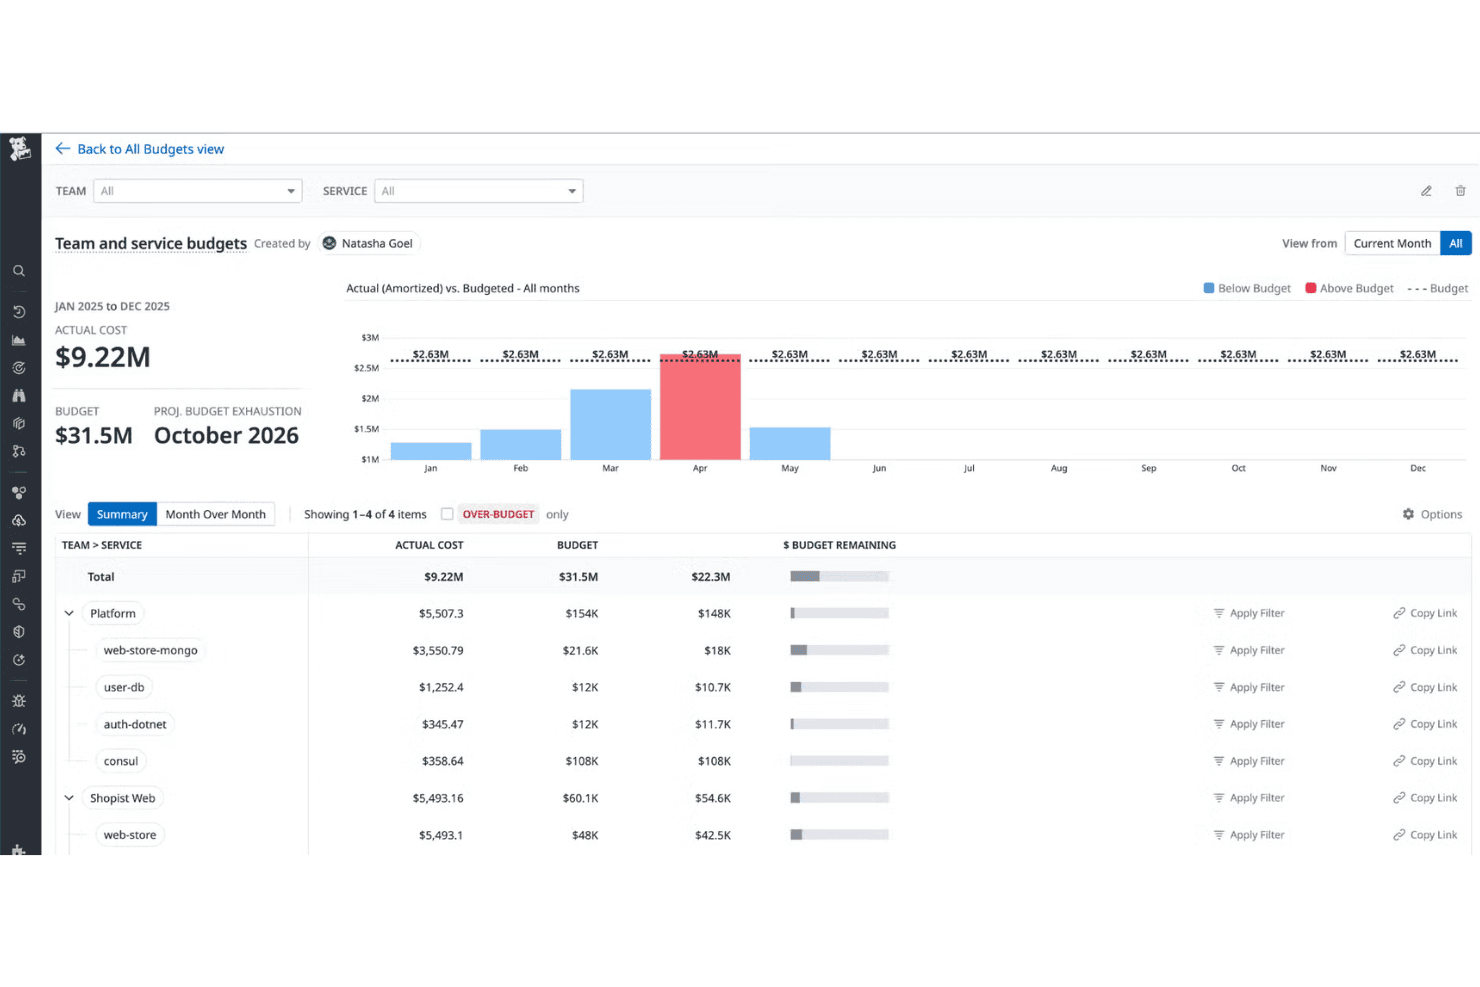
Datadog porównuje budżety zespołów i usług z rzeczywistymi wydatkami na chmurę. Datadog to oparta na chmurze platforma do zarządzania operacjami IT i obserwowalności, która ujednolica monitorowanie infrastruktury, APM, zarządzanie logami, monitorowanie sieci, zarządzanie incydentami, AIOps i automatyzację przepływów pracy w środowiskach hybrydowych i wielochmurowych.
Dla kogo Datadog jest najlepszym rozwiązaniem?
Datadog to dobre rozwiązanie dla zespołów inżynieryjnych i zespołów operacji IT zarządzających złożonymi środowiskami wielochmurowymi lub hybrydowymi, które potrzebują monitorowania infrastruktury, APM i widoczności kosztów chmury w jednym miejscu.
Dlaczego wybrałem Datadog
Datadog znalazł się na mojej krótkiej liście, ponieważ jest jedyną platformą, z której korzystałem, gdzie pełna telemetria stosu i widoczność kosztów chmury rzeczywiście znajdują się w jednym miejscu. Podoba mi się, że zarządzanie kosztami chmury łączy metryki infrastruktury bezpośrednio z wydatkami w AWS, Azure, GCP i OCI, więc gdy Watchdog wykryje anomalię procesora w klastrze Kubernetes, mogę zobaczyć jej wpływ na koszty bez przełączania narzędzi. Wbudowana warstwa FinOps w połączeniu z wykrywaniem anomalii opartym na sztucznej inteligencji dla metryk, logów i śladów sprawia, że platforma ta wyjątkowo dobrze odpowiada potrzebom zespołów, które wymagają odpowiedzialności operacyjnej i finansowej w jednym widoku.
Najważniejsze funkcje Datadog
- Wykrywanie anomalii Watchdog: Silnik sztucznej inteligencji, który automatycznie identyfikuje anomalie wydajności w metrykach infrastruktury, śladach APM i logach bez konieczności ręcznego konfigurowania progów.
- Planowanie dyżurów i zasady eskalacji: Konfigurowalne rotacje dyżurów z regułami routingu i wielokanałowymi powiadomieniami za pośrednictwem SMS-ów, połączeń głosowych, powiadomień push i poczty e-mail.
- Kreator automatyzacji przepływów pracy: Wizualny interfejs niskokodowy z ponad 1750 gotowymi akcjami i ponad 150 schematami do automatyzacji reagowania na incydenty, przepływów DevOps i przepływów bezpieczeństwa.
- Zarządzanie stanem bezpieczeństwa chmury (CSPM): Ciągłe sprawdzanie konfiguracji kont chmurowych i kontenerów pod kątem zgodności z ponad 15 ramami, w tym PCI DSS, HIPAA i SOC 2.
Integracje Datadog
Datadog oferuje ponad 1000 integracji wspieranych przez dostawców, w tym AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes i Prometheus. Jego interfejs REST API i zestawy SDK obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Ujednolicony widok infrastruktury, aplikacji i kosztów
- Wykrywanie anomalii przez sztuczną inteligencję pomaga ograniczyć liczbę zbędnych alertów
- Wbudowane kompleksowe zarządzanie incydentami
Cons:
- Modułowy cennik prowadzi do nieprzewidywalnych kosztów
- Brak wdrożenia lokalnego dla użytkowników spoza sektora rządowego
 Najlepsze rozwiązanie do połączonych operacji SecOps związanych z logami i metrykami
- Dostępna bezpłatna wersja próbna
- Od $0.15/credit
Visit WebsiteCustomer Rating:4.3/5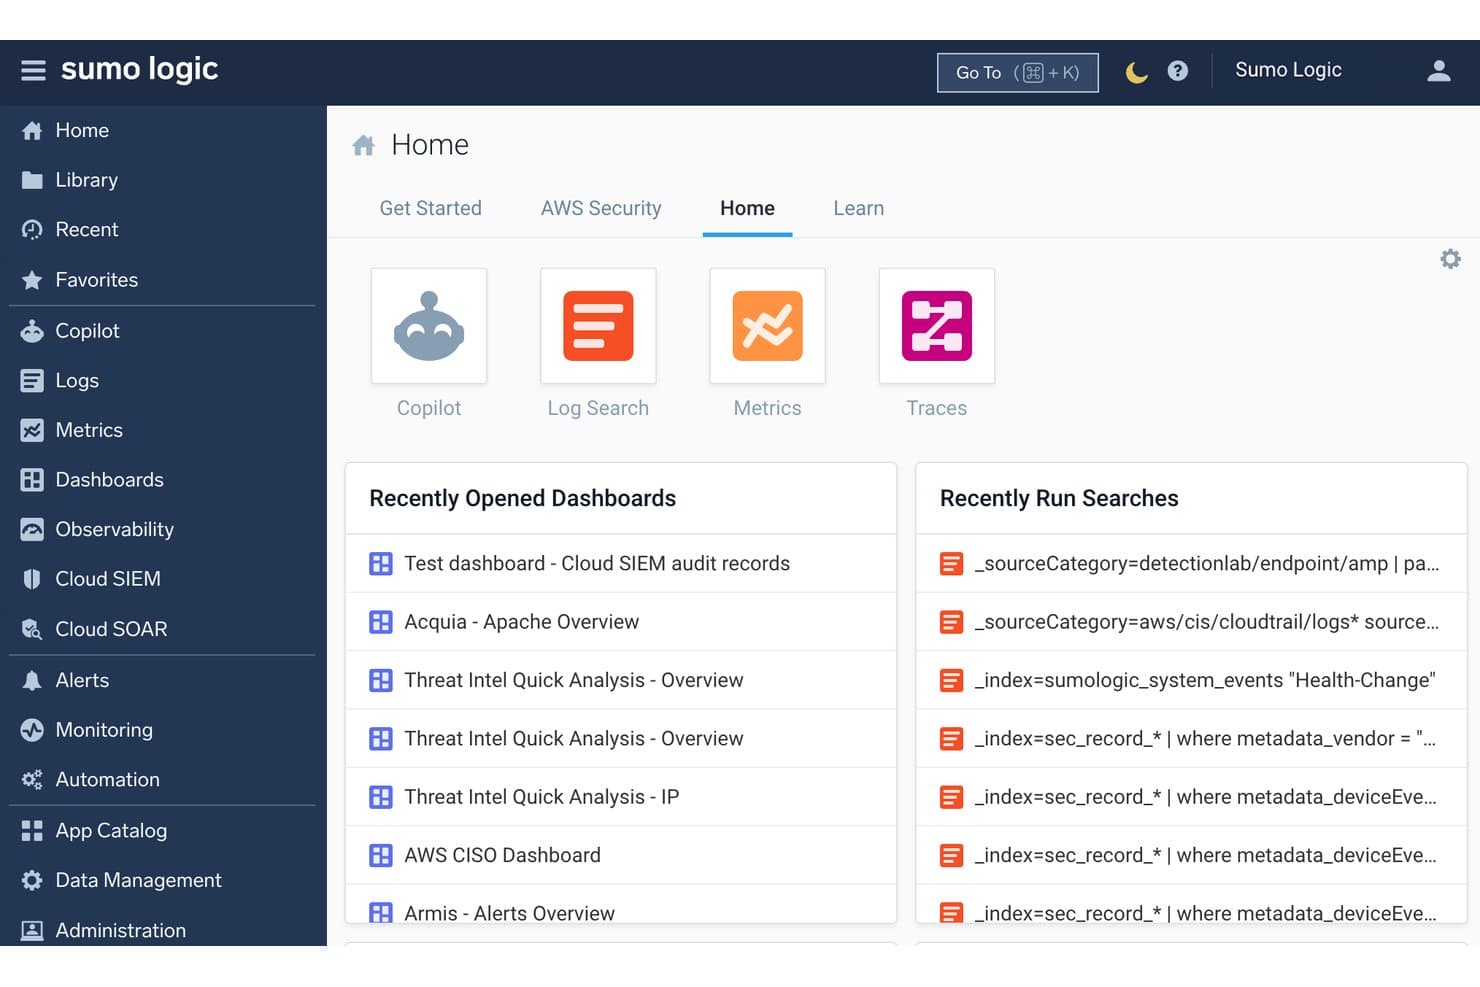
Sumo Logic zapewnia zespołom szybki dostęp do wyszukiwania logów, metryk i ostatniej aktywności. Sumo Logic to natywna dla chmury platforma do zarządzania operacjami IT, która łączy analizę logów, monitorowanie infrastruktury, metryki, rozproszone śledzenie i operacje bezpieczeństwa w jedno oparte na SaaS rozwiązanie do obserwowalności i SIEM.
Dla kogo Sumo Logic jest najlepszym wyborem?
Sumo Logic dobrze sprawdzi się w zespołach IT i operacyjnych, dla których bezpieczeństwo ma duże znaczenie i które potrzebują funkcji analizy logów, obsługi metryk oraz SIEM w ramach jednej platformy SaaS.
Dlaczego wybrałem Sumo Logic
Sumo Logic trafia na moją krótką listę, ponieważ jest jedną z niewielu platform, które łączą analizę logów i operacje bezpieczeństwa w jednym, rzeczywiście zintegrowanym narzędziu SaaS. Podoba mi się, że opatentowane operatory LogReduce i LogExplain wskazują przyczyny źródłowe bezpośrednio na podstawie surowych danych dzienników, ograniczając ręczne wyszukiwanie wzorców, które spowalnia rozwiązywanie incydentów. Wyróżnia się również wieloagentowa platforma Dojo AI: Agent Analityka SOC automatyzuje wstępną selekcję alertów poziomu 1 i dostarcza werdykty poparte dowodami, co mój zespół uważa za niezwykle cenne, gdy procesy SecOps i ITOps się nakładają.
Najważniejsze funkcje Sumo Logic
- Monitory metryk oparte na AI: Wykrywanie anomalii oparte na uczeniu maszynowym automatycznie dostosowuje sezonowe wartości bazowe w danych metryk, ograniczając liczbę fałszywie dodatnich alertów.
- Zarządzanie wieloma organizacjami: Organizacja nadrzędna kontroluje monitory, pulpity, role i dostęp w organizacjach podrzędnych z jednego scentralizowanego interfejsu.
- Pulpity raportowania zgodności: Gotowe pulpity porównują dane z wymaganiami PCI, HIPAA, GDPR, SOX i ISO, zapewniając ciągły wgląd w stan zgodności.
- Agent dystrybucji OpenTelemetry: Jeden ujednolicony agent zbiera logi, metryki i ślady w systemach Linux, Windows, macOS oraz z ponad 25 konfiguracji źródeł.
Integracje Sumo Logic
Sumo Logic oferuje ponad 450 integracji, w tym z ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes i Docker. Udostępnia również interfejsy API REST, webhooki, Terraform, SumoQL oraz otwarty system integracji do tworzenia niestandardowych połączeń.
Pros and Cons
Pros:
- Dojo AI automatyzuje selekcję alertów i rozwiązywanie incydentów
- Pulpity zgodności są bezpośrednio mapowane na najważniejsze standardy
- Centralizuje logi, metryki i ślady na jednej platformie
Cons:
- Zaawansowana automatyzacja jest ukierunkowana bardziej na bezpieczeństwo niż na operacje IT
- Wyszukiwanie w dużych historycznych zbiorach danych może działać wolno
 Najlepsze rozwiązanie do natywnego dla OTel wglądu w operacje w całym stosie
- 14-dniowy bezpłatny okres próbny
- Od $0.07/GB
Visit WebsiteCustomer Rating:4.3/5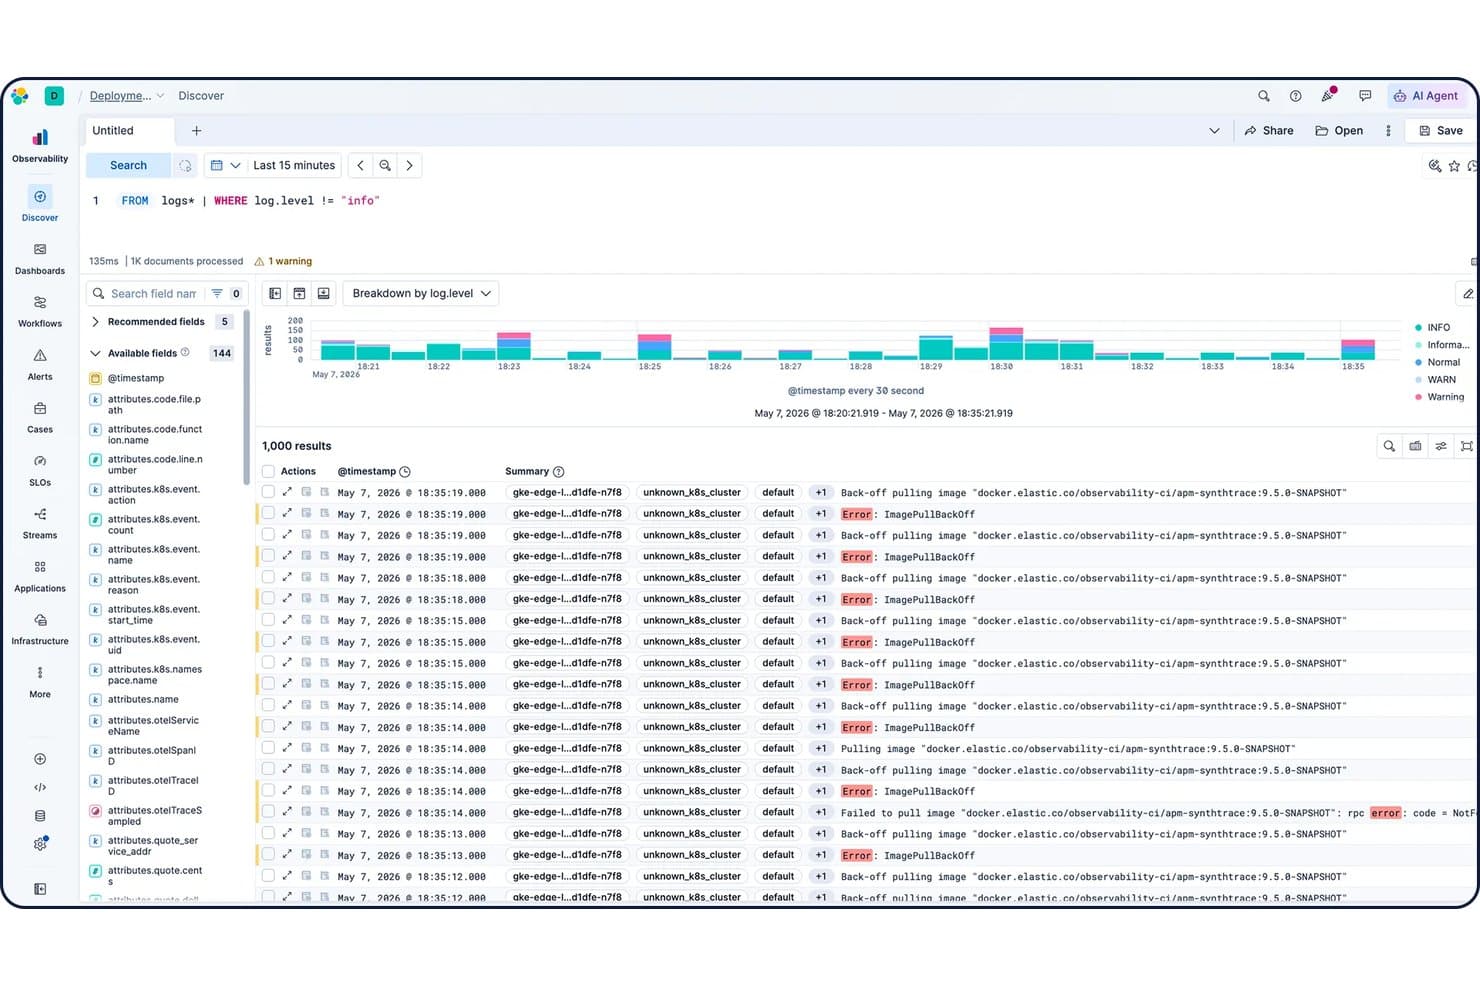
Elastic Observability filtruje logi według poziomu w widoku Discover. Elastic Observability to pełnostosowa platforma obserwowalności, która ujednolica monitorowanie logów, metryk infrastruktury, APM, śledzenie rozproszone, monitorowanie syntetyczne i AIOps w środowiskach lokalnych, chmurowych oraz hybrydowych.
Dla kogo Elastic Observability jest najlepszym wyborem?
Elastic Observability doskonale sprawdzi się w przypadku inżynierów SRE i inżynierów infrastruktury w średnich i dużych przedsiębiorstwach, którzy potrzebują ujednoliconego wglądu w logi, metryki, ślady i APM w środowiskach hybrydowych i wielochmurowych — szczególnie w zespołach, które już korzystają z OpenTelemetry.
Dlaczego wybrałem Elastic Observability
Elastic Observability znalazło się na mojej krótkiej liście, ponieważ jest jedną z niewielu platform zaprojektowanych z myślą o OpenTelemetry, co oznacza, że logi, metryki, ślady i dane APM trafiają do jednego schematu bez konieczności zmagania się z zastrzeżonymi agentami. Szczególnie podoba mi się warstwa ML bez konieczności konfiguracji: ponad 100 wstępnie skonfigurowanych zadań wykrywania anomalii działa automatycznie w każdym strumieniu danych, więc gdy pozyskiwanie danych odbywa się na skalę Comcastu, zespół nie musi ręcznie dostrajać modeli. Analizowanie logów oparte na strumieniach oraz silnik zapytań ES|QL sprawiają, że wskazywanie przyczyn źródłowych w środowiskach hybrydowych jest naprawdę szybkie.
Najważniejsze funkcje Elastic Observability
- Monitorowanie syntetyczne: Uruchamiaj lekkie i pełne testy przeglądarkowe dla ścieżek użytkowników, korzystając z globalnej zarządzanej infrastruktury testowej lub prywatnych lokalizacji lokalnych.
- Śledzenie celów poziomu usług (SLO): Definiuj, monitoruj i raportuj cele niezawodności bezpośrednio w Kibanie, obok istniejących pulpitów nawigacyjnych i alertów.
- Alerty Kibana: Konfiguruj alerty oparte na regułach dla danych APM, metryk, dostępności i bezpieczeństwa, korzystając z konfiguracji opartej na formularzach i obsługi powiadomień w wielu kanałach.
- Ponad 550 gotowych integracji: Łącz się z dostawcami chmury, narzędziami ITSM, platformami bezpieczeństwa i źródłami danych za pomocą gotowych agentów oraz kolektorów bez agentów.
Integracje Elastic Observability
Elastic Observability oferuje ponad 550 gotowych integracji, w tym AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes i OpenTelemetry. Obsługuje również interfejsy API REST, webhooki, Elastic Agent, Logstash, Beats oraz kolektory OpenTelemetry na potrzeby niestandardowej łączności.
Pros and Cons
Pros:
- Ujednolicony wgląd w środowiska hybrydowe i wielochmurowe
- ML bez konieczności konfiguracji automatycznie wykrywa anomalie
- Natywne dla OTel pozyskiwanie danych eliminuje uzależnienie od dostawcy
Cons:
- Natywne planowanie dyżurów nie jest uwzględnione
- Brak wystarczającej dokumentacji dotyczącej złożonych konfiguracji OTel
Learn more about Elastic Observability: Najlepszy dla wielodostępnych hybrydowych operacji IT klasy MSP
- Dostępna bezpłatna wersja demonstracyjna
- Ceny na żądanie
Visit WebsiteCustomer Rating:4.1/5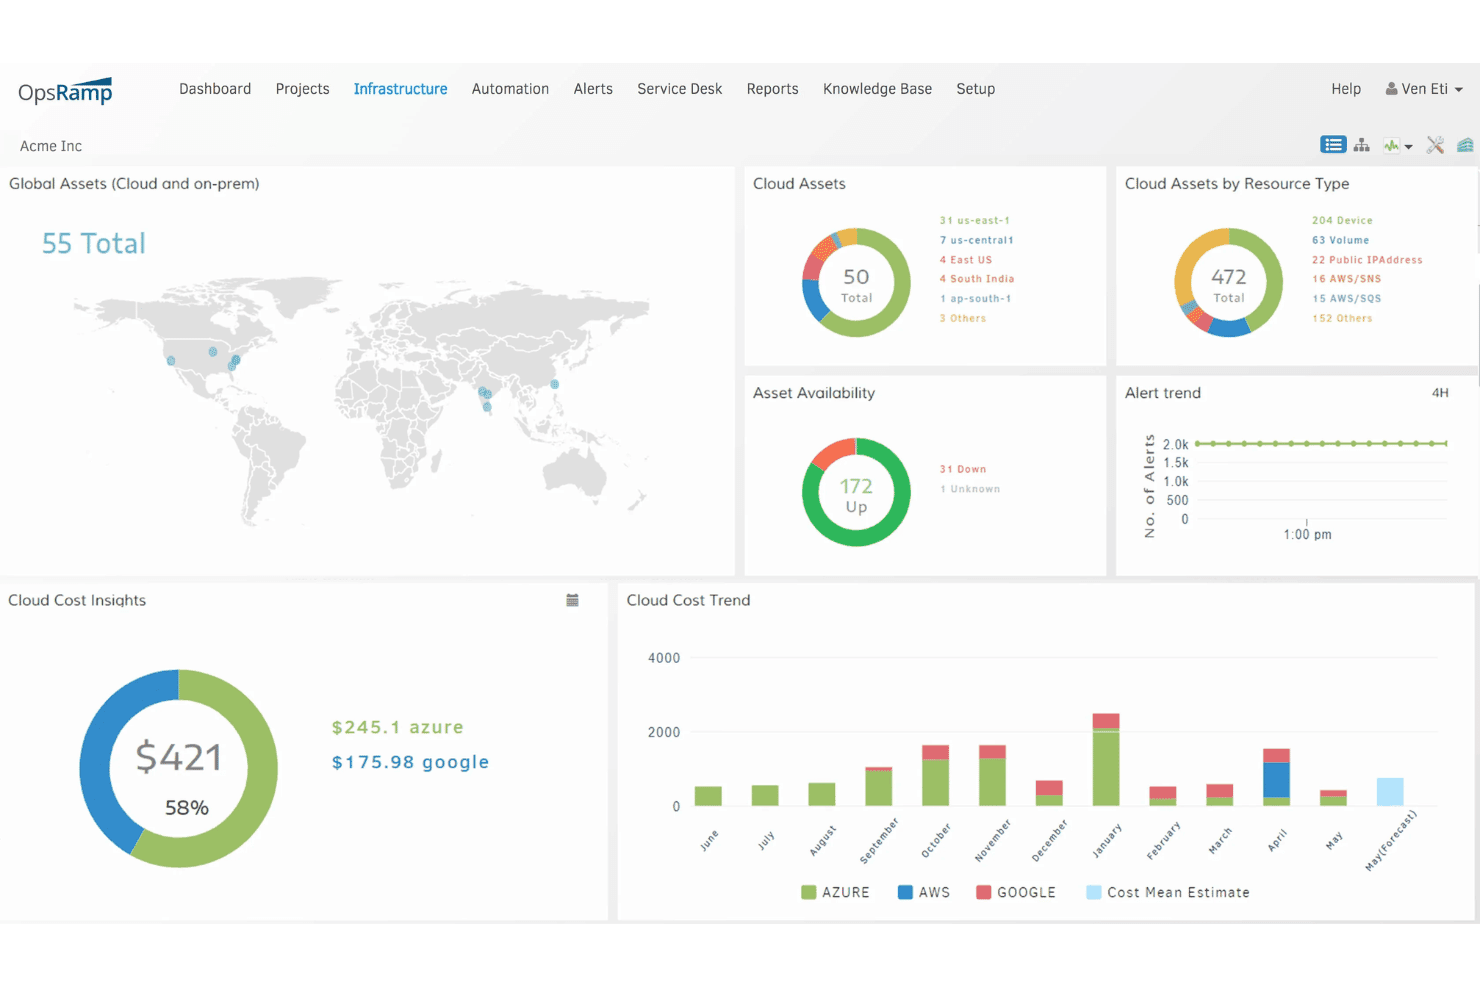
OpsRamp zapewnia użytkownikom ujednolicony widok kosztów chmury, zasobów i alertów. HPE OpsRamp to napędzana przez AIOps platforma do zarządzania operacjami IT, która ujednolica monitorowanie infrastruktury, korelację zdarzeń, zarządzanie incydentami, automatyzację procedur operacyjnych oraz widoczność środowisk hybrydowych i wielochmurowych w środowiskach lokalnych, chmurach prywatnych i chmurach publicznych.
Dla kogo OpsRamp jest najlepszym wyborem?
OpsRamp to doskonałe rozwiązanie dla dostawców usług zarządzanych oraz dużych przedsiębiorstw zarządzających złożonymi hybrydowymi środowiskami IT obejmującymi infrastrukturę lokalną i wiele chmur.
Dlaczego wybrałem OpsRamp
OpsRamp znalazł się na mojej krótkiej liście, ponieważ jego architektura wielodostępowa została zaprojektowana z myślą o dostawcach usług zarządzanych, którzy zarządzają dziesiątkami środowisk klientów z jednego, ujednoliconego widoku. Szczególnie podoba mi się silnik korelacji zdarzeń AIOps, który grupuje powiązane alerty między dzierżawcami i redukuje szum nawet o 90%, dzięki czemu zespół nie jest zalewany zgłoszeniami z kont klientów. Mapy topologii i usług zapewniają bieżący widok zależności w hybrydowych środowiskach obejmujących AWS, Azure, GCP i infrastrukturę lokalną, co przy takiej skali jest naprawdę trudne do odtworzenia.
Najważniejsze funkcje OpsRamp
- Silnik automatyzacji procedur operacyjnych: Automatycznie wykonuj wstępnie zdefiniowane skrypty naprawcze w odpowiedzi na wykryte problemy, korzystając z dostępu do zadań i przepływów procesów zarządzanego przez RBAC.
- Wielodostępne zarządzanie klientami: Zarządzaj wieloma środowiskami klientów z jednej instancji platformy, korzystając z konfiguracji integracji dla poszczególnych dzierżawców oraz odseparowanego przetwarzania danych.
- Raportowanie kosztów chmury: Rozbijaj wydatki na chmurę według konta, regionu, usługi i typu instancji w AWS, Azure i GCP, korzystając z konfigurowalnych zakresów dat.
- Pobieranie danych z OpenTelemetry: Pozyskuj metryki, logi i ślady z dowolnego źródła zgodnego z OpenTelemetry, a także korzystaj z automatycznej instrumentacji wspomaganej przez eBPF, aby uzyskać szczegółowy wgląd w obciążenia.
Integracje OpsRamp
OpsRamp oferuje ponad 3000 integracji, w tym ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry i Prometheus. Jego interfejs REST API OAuth 2.0, webhooki oraz obsługa importu i eksportu JSON umożliwiają tworzenie niestandardowych połączeń.
Pros and Cons
Pros:
- Wielodostępne zarządzanie środowiskami klientów MSP
- Redukcja szumu alertów nawet o 90 procent
- Wizualizacje topologii środowisk hybrydowych i wielochmurowych
Cons:
- Funkcje monitorowania aplikacji są nadal rozwijane
- Wydajność panelu może spadać przy dużej skali
Learn more about OpsRamp: Najlepszy wybór do szczegółowego monitorowania operacji związanych z pamięcią masową i GPU
- Dostępna bezpłatna wersja demonstracyjna
- Ceny ustalane na życzenie
Visit WebsiteCustomer Rating:4.3/5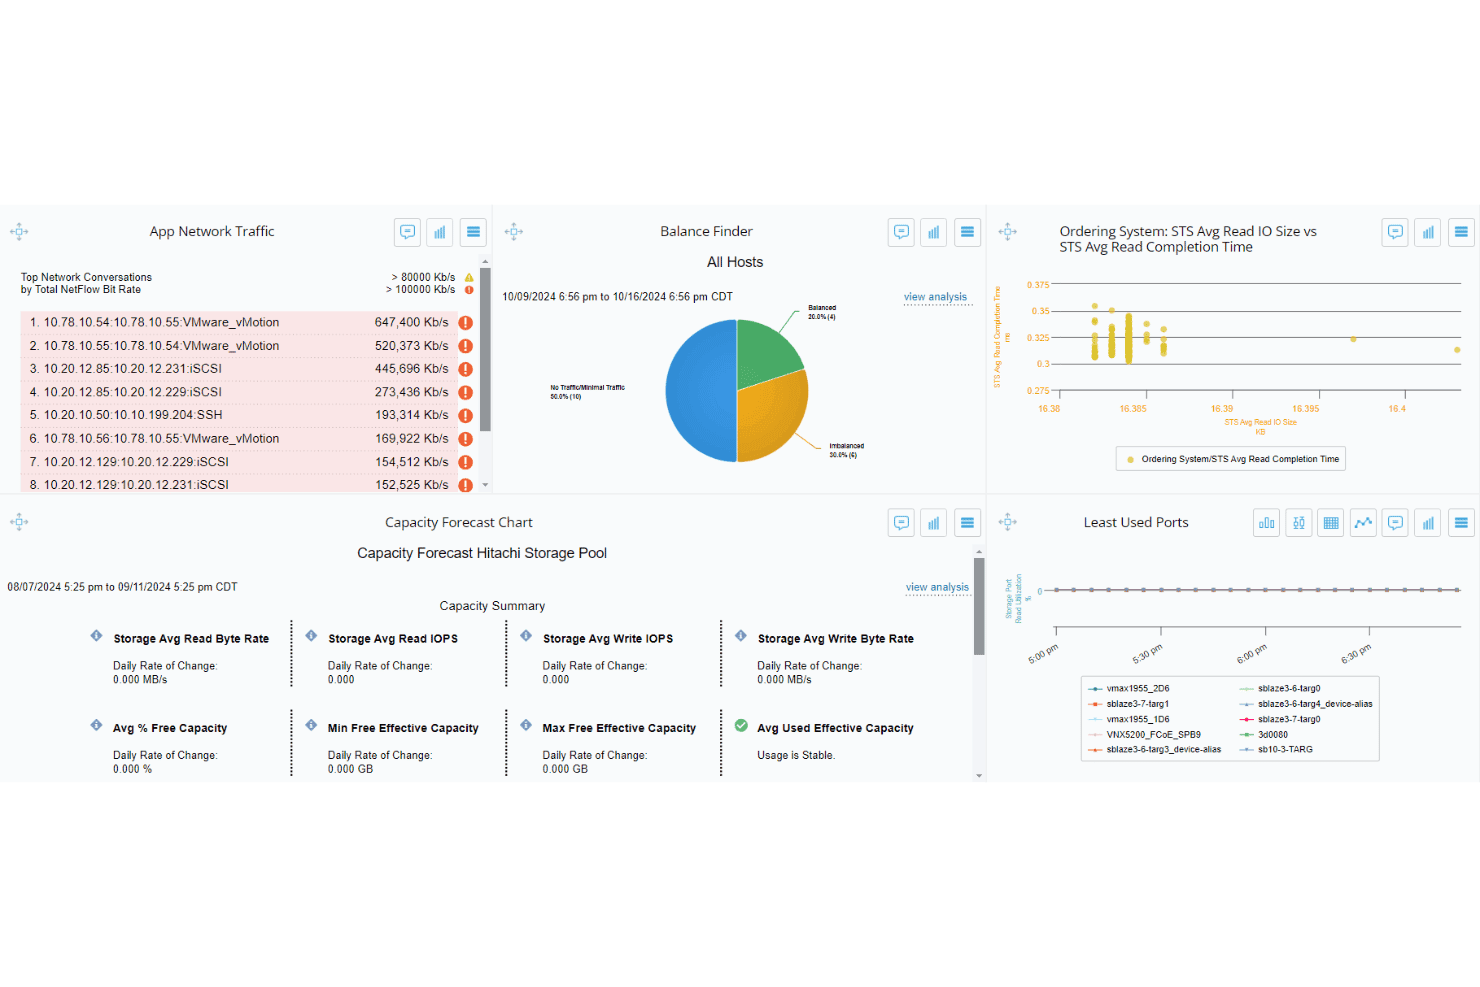
Virtana monitoruje ruch sieciowy, pojemność pamięci masowej i równowagę obciążenia hostów na jednym pulpicie nawigacyjnym. Virtana to platforma AIOps i obserwowalności infrastruktury, która monitoruje środowiska hybrydowe obejmujące moc obliczeniową, pamięć masową, sieć, Kubernetes i infrastrukturę GPU, a jej podstawowe funkcje obejmują korelację zdarzeń opartą na AI, wykrywanie anomalii oraz automatyczne zarządzanie incydentami.
Dla kogo Virtana jest najlepszym wyborem?
Virtana doskonale sprawdzi się w przypadku inżynierów infrastruktury i NetOps zarządzających złożonymi środowiskami hybrydowymi, w których szczegółowy wgląd w pamięć masową, widoczność obciążeń GPU oraz korelacja incydentów oparta na AI są niezbędne.
Dlaczego wybrałem Virtana
Wybrałem Virtana jako jedną z najlepszych platform, ponieważ żadna inna platforma z mojej krótkiej listy nie gromadzi metryk pamięci masowej na tak szczegółowym poziomie: ponad 16 000 metryk obejmujących środowiska blokowe, NAS, SAN, SDS i HCI, wszystkie korelowane w czasie rzeczywistym z kontekstem mocy obliczeniowej i sieci. Szczególnie imponuje mi dedykowany moduł obserwowalności fabryki AI, który śledzi wykorzystanie GPU, bezczynność zasobów, dławienie oraz przepustowość NVLink/PCIe dla zespołów uruchamiających na dużą skalę obciążenia związane ze szkoleniem lub wnioskowaniem modeli LLM. Wykrywanie anomalii oparte na ML osiąga dokładność do 95%, wskazując problemy, zanim dojdzie do przekroczenia progów, a nie dopiero po wystąpieniu szkód.
Najważniejsze funkcje Virtana
- Agentowe usuwanie problemów za pomocą AI: Agenci AI przemierzają graf zależności systemu, aby autonomicznie badać problemy i wykonywać nadzorowane procedury naprawcze bez ręcznego przekazywania zadań.
- Predykcyjne prognozowanie pojemności: Wykorzystuje dane historyczne z okresu do 12 miesięcy, aby prognozować zapotrzebowanie na moc obliczeniową, pamięć masową, sieć i GPU z wyprzedzeniem do jednego roku.
- Dwukierunkowa synchronizacja z ServiceNow: Automatycznie tworzy, aktualizuje i zamyka incydenty w ServiceNow na podstawie wykrytych zdarzeń, z mapowaniem krytyczności biznesowej i integracją z CMDB.
- Mapowanie topologii i zależności: Nieustannie automatycznie wykrywa i mapuje relacje między aplikacjami, usługami i infrastrukturą, aby utrzymywać aktualny, możliwy do przeszukiwania model systemu.
Integracje Virtana
Virtana oferuje natywną integrację z ServiceNow, a także integracje ze Slackiem, Microsoft Teams, PagerDuty, AWS, Azure, GCP, Kubernetes, VMware i OpenTelemetry. Interfejsy API REST oraz serwer MCP obsługują niestandardowe integracje i dostęp agentów AI.
Pros and Cons
Pros:
- Gromadzi ponad 16 000 metryk pamięci masowej w różnych środowiskach
- Natywnie śledzi wydajność GPU i obciążeń AI
- Wykrywanie anomalii oparte na AI osiąga wysoką dokładność
Cons:
- Wizualizacje w interfejsie użytkownika mogą wydawać się ograniczone
- Baza opinii jest mniejsza niż u głównych konkurentów
Learn more about Virtana: Najlepszy do automatyzacji przepływów pracy od awarii do rozwiązania bez użycia kodu
- 30-dniowy bezpłatny okres próbny
- Od 1 233 USD/rok (rozliczenie roczne)
Visit WebsiteCustomer Rating:4.3/5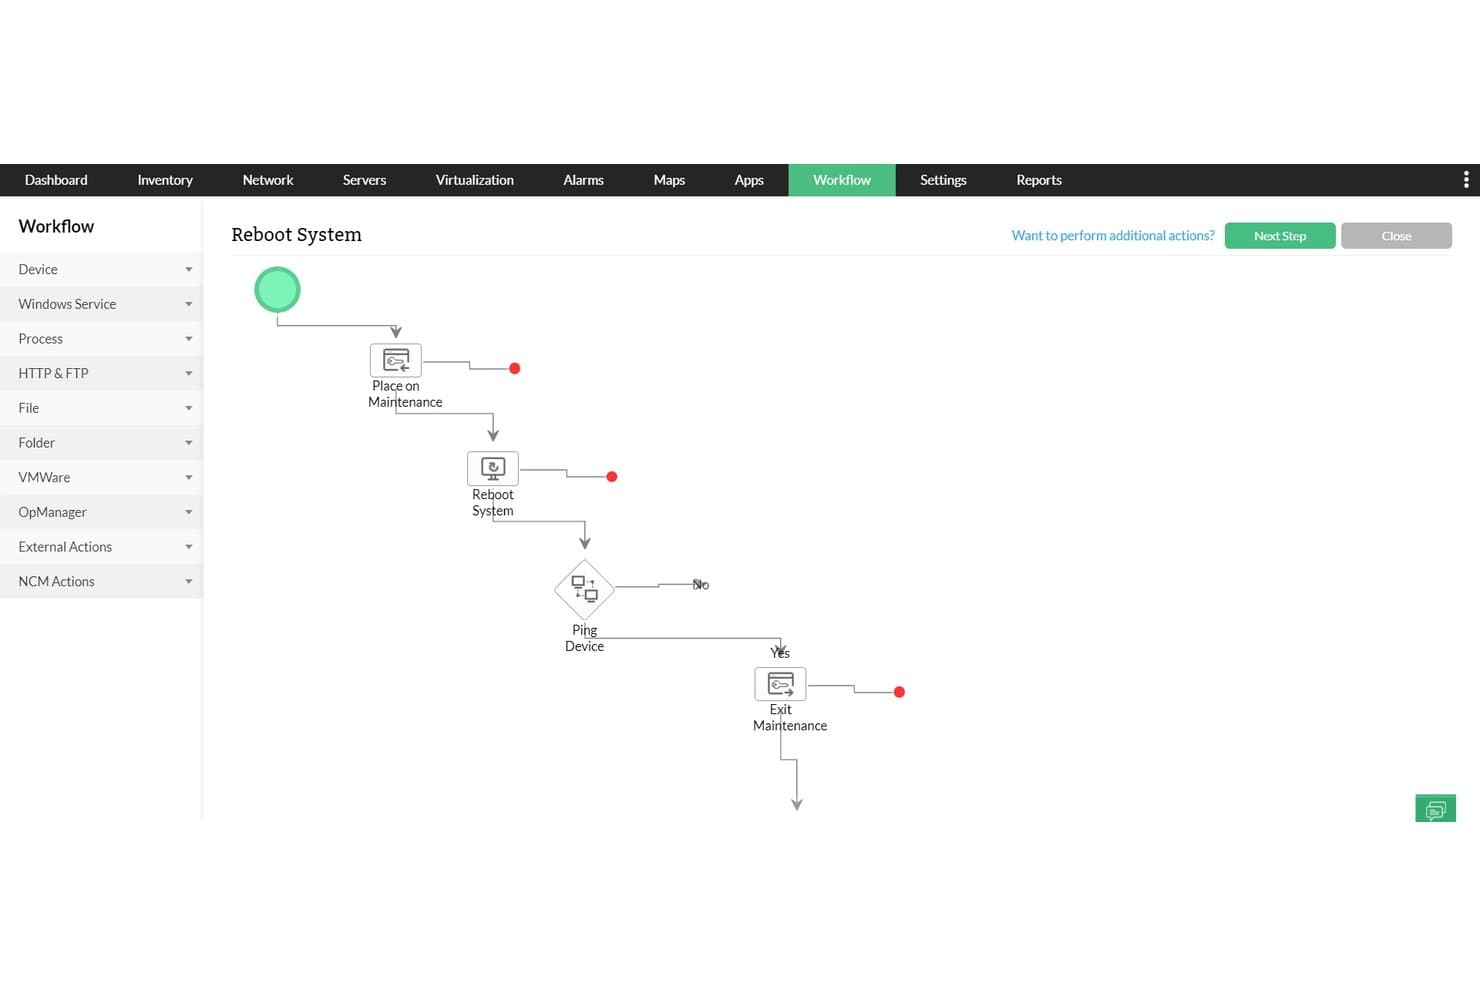
ManageEngine OpManager automatyzuje ponowne uruchamianie systemów za pomocą wizualnego konstruktora przepływów pracy. ManageEngine OpManager jest lokalnie wdrażaną platformą do zarządzania operacjami IT, która monitoruje urządzenia sieciowe, serwery fizyczne i wirtualne, pamięć masową oraz infrastrukturę chmurową, a także oferuje wbudowaną automatyzację przepływów pracy, alerty oparte na AIOps i integracje z systemami ITSM.
Dla kogo ManageEngine OpManager jest najlepszym wyborem?
OpManager doskonale sprawdzi się w zespołach odpowiedzialnych za infrastrukturę i NetOps, które zarządzają dużymi środowiskami lokalnymi lub hybrydowymi i potrzebują jednej konsoli obejmującej monitorowanie sieci, serwerów, pamięci masowej i wirtualizacji bez opłat za każdy interfejs.
Dlaczego wybrałem ManageEngine OpManager
Wybrałem ManageEngine OpManager jako jedno z najlepszych rozwiązań, ponieważ jego automatyzacja przepływów pracy bez użycia kodu jest naprawdę jedną z najbardziej zaawansowanych, jakie widziałem w tej kategorii. Konstruktor przepływów pracy typu przeciągnij i upuść oferuje ponad 70 gotowych działań w dziewięciu kategoriach, które można uruchamiać automatycznie po wykryciu awarii lub według harmonogramu. Szczególnie przydatna jest możliwość eksportowania przepływów pracy w formacie XML — po utworzeniu skutecznej sekwencji reagowania na awarie można wdrożyć ją w innych środowiskach bez budowania wszystkiego od podstaw.
Najważniejsze funkcje ManageEngine OpManager
- Adaptacyjne progi ML: Automatycznie uczy się na podstawie 14 dni danych historycznych i co godzinę aktualizuje wartości bazowe dla ponad 3000 wskaźników wydajności, ograniczając konieczność ręcznego dostrajania progów.
- Rozproszona architektura Probe-Central: Umożliwia wdrażanie zdalnych sond, które gromadzą i przechowują dane lokalnie, a następnie agregują je na centralnym serwerze — rozwiązanie skaluje się do ponad 50 000 urządzeń w rozproszonych lokalizacjach.
- Mapowanie topologii sieci warstwy 2: Automatycznie generuje wizualne mapy fizycznych połączeń sieciowych, w tym szczegółowe informacje na poziomie portów przełączników, trójwymiarowe widoki szaf rackowych i układy pomieszczeń centrów danych.
- Alarmy prognostyczne oparte na AIOps: Wykorzystuje wbudowany silnik ML Zia do przewidywania wyczerpania zasobów procesora, pamięci, dysku i przepustowości, zanim progi zostaną faktycznie przekroczone.
Integracje ManageEngine OpManager
ManageEngine OpManager oferuje natywne integracje z ServiceNow, Jira Service Management, ServiceDesk Plus, Freshdesk, Slack, Microsoft Teams, Grafana i ManageEngine Log360. Obsługuje również dostęp za pośrednictwem interfejsu REST API oraz webhooki na potrzeby niestandardowych integracji.
Pros and Cons
Pros:
- Konstruktor przepływów pracy bez użycia kodu do automatyzacji reagowania
- Adaptacyjne progi ML z cogodzinną aktualizacją wartości bazowych
- Widoczność w wielu chmurach dzięki aktualizacji platformy Nexus
Cons:
- Złożony proces konfiguracji w środowiskach mieszanych
- Inteligentna korelacja zdarzeń jest nadal w fazie beta
Learn more about ManageEngine OpManager: Najlepsze do oceny ryzyka zmian opartej na AI
- Dostępna bezpłatna prezentacja
- Od $9/użytkownika/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.4/5 Learn more about BigPanda:
 Najlepsze do monitorowania operacji o otwartym kodzie źródłowym w dowolnej skali
- Dostępne bezpłatne pobieranie
- Od $325/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.4/5 10Najlepsze do redukcji szumu alertów opartej na ML
Moogsoft
- Dostępna bezpłatna wersja demonstracyjna
- Wycena na życzenie
Visit WebsiteCustomer Rating:4.5/5Learn more about Moogsoft:
Inne programy do zarządzania operacjami IT
Oto dodatkowe opcje programów do zarządzania operacjami IT, które nie trafiły na moją krótką listę, ale nadal warto się z nimi zapoznać:
- 11CheckmkNajlepsze rozwiązanie do wyceny opartej na usługach w środowisku hybrydowym
- 12Grafana CloudNajlepsze rozwiązanie do obserwowalności operacji całego stosu wspomaganej uczeniem maszynowym
- 13SolarWinds Observability SaaSNajlepsze rozwiązanie do pełnej obserwowalności opartej na NetOps
How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
Jak wybrać oprogramowanie do zarządzania operacjami IT
Decydując, które oprogramowanie do zarządzania operacjami IT najlepiej pasuje do Twojego środowiska, zacznij od określenia najpilniejszych wyzwań operacyjnych:
| Jeśli Twoim priorytetem jest... | Szukaj... |
|---|---|
| Jeśli Twoim priorytetem jest...Szybka i dokładna analiza przyczyn źródłowych | Szukaj...Korelacja incydentów oparta na sztucznej inteligencji i zautomatyzowane procedury operacyjne |
| Jeśli Twoim priorytetem jest...Środowiska hybrydowe i wielochmurowe | Szukaj...Natywne konektory do środowisk lokalnych, AWS, Azure i GCP |
| Jeśli Twoim priorytetem jest...Ograniczenie liczby ręcznych zadań naprawczych | Szukaj...Wizualne kreatory przepływów pracy z gotową automatyzacją |
| Jeśli Twoim priorytetem jest...Kontrola wydatków związanych z monitorowaniem | Szukaj...Przejrzyste ceny zależne od użycia i pulpity kosztów |
| Jeśli Twoim priorytetem jest...Rozbudowane integracje z narzędziami ITSM | Szukaj...Gotowe konektory i otwarta dokumentacja API |
Jak ocenić rozwiązania z krótkiej listy
- Przetestuj przepływy pracy związane z obsługą incydentów: Przeprowadź 48-godzinny test i zasymuluj co najmniej trzy rodzaje awarii, aby zweryfikować grupowanie incydentów oraz automatyczne reakcje.
- Poproś o demonstrację mapy topologii: Poproś dostawcę o wygenerowanie kompleksowej mapy zależności — obejmującej klastry hybrydowe — na podstawie rzeczywistych lub zanonimizowanych przykładowych danych.
- Utwórz zgłoszenie obejmujące różne platformy: Otwórz zgłoszenie do pomocy technicznej dotyczące integracji wielochmurowej i przez 3 dni dokumentuj dokładność odpowiedzi oraz poziomy SLA.
- Oceń kompletność raportowania: Przejrzyj lub wyeksportuj przykładowy pulpit analityczny i potwierdź widoczność kosztów, SLA oraz niestandardowych metryk dla rzeczywistego stosu technologicznego.
- Elastyczność SaaS a kontrola rozwiązania hostowanego samodzielnie: Zdecyduj, czy szybkie dostarczanie funkcji w modelu SaaS przeważa nad potrzebami związanymi ze zgodnością i dostępem, które spełniają wdrożenia lokalne lub odizolowane.
Czym jest oprogramowanie do zarządzania operacjami IT?
Oprogramowanie do zarządzania operacjami IT to kategoria narzędzi zaprojektowanych do monitorowania, automatyzacji i zarządzania infrastrukturą IT, aplikacjami, sieciami oraz usługami w środowiskach lokalnych i chmurowych. Platformy te pomagają zespołowi centralizować alerty, utrzymywać sprawność systemów, zarządzać incydentami i optymalizować wykorzystanie zasobów. Dzięki konsolidacji danych operacyjnych i automatyzacji oprogramowanie do zarządzania operacjami IT przyspiesza rozwiązywanie problemów, zwiększa wydajność i umożliwia organizacji niezawodne skalowanie technologii.
Funkcje oprogramowania do zarządzania operacjami IT
Wybierając oprogramowanie do zarządzania operacjami IT, zwróć uwagę na następujące kluczowe funkcje:
- Monitorowanie infrastruktury i aplikacji: Śledzi serwery, sieci, kontenery i aplikacje w czasie rzeczywistym. Pomaga wykrywać nietypowe zachowanie systemu, pogorszenie wydajności lub awarie, zanim wpłyną one na użytkowników.
- Alerty i zarządzanie incydentami: Centralizuje alerty i usprawnia procedury eskalacji. Umożliwia zespołowi szybką reakcję, nadanie incydentom odpowiedniego kontekstu oraz śledzenie ich rozwiązania od początku do końca.
- Automatyzacja i orkiestracja: Zapewnia narzędzia do automatyzacji rutynowych zadań i koordynowania przepływów pracy w różnych środowiskach. Ogranicza nakład pracy ręcznej i zmniejsza ryzyko błędów ludzkich podczas wdrożeń lub konserwacji.
- Obsługa środowisk hybrydowych i wielu chmur: Oferuje ujednolicony wgląd w lokalną, prywatną i publiczną infrastrukturę chmurową. Pomaga zarządzać złożonymi środowiskami jako jednym podmiotem operacyjnym.
- Dostosowywane pulpity nawigacyjne i raportowanie: Umożliwia tworzenie pulpitów nawigacyjnych i raportów dopasowanych do potrzeb. Obsługuje analizę trendów, monitorowanie umów SLA oraz udostępnianie spostrzeżeń interesariuszom technicznym i biznesowym.
- Integracja i dostęp do interfejsu API: Łączy się z platformami do zarządzania usługami IT, DevOps i współpracy. Umożliwia zespołowi osadzanie danych dotyczących operacji IT bezpośrednio w systemach zgłoszeniowych, czatach i innych systemach.
- Mapowanie topologii i zależności: Wizualizuje relacje między systemami, usługami i komponentami infrastruktury. Ułatwia ustalenie głównej przyczyny incydentów i zrozumienie ryzyka operacyjnego.
- Kontrola dostępu użytkowników i oparta na rolach: Umożliwia określenie, kto może wyświetlać lub edytować poszczególne elementy środowiska. Chroni poufne dane i ogranicza dostęp na podstawie zakresu obowiązków użytkowników.
- Planowanie pojemności i prognozowanie: Analizuje trendy zużycia zasobów w celu przewidywania przyszłych potrzeb. Pomaga przewidywać modernizacje infrastruktury i planować budżet na rozwój.
- Śledzenie zmian i dzienniki audytowe: Rejestruje zmiany konfiguracji i działania użytkowników. Wspiera wymagania dotyczące zgodności i pomaga rozwiązywać wcześniejsze incydenty, zapewniając przejrzystą historię zmian.
Popularne funkcje AI w oprogramowaniu do zarządzania operacjami IT
Oprócz wymienionych powyżej standardowych funkcji oprogramowania do zarządzania operacjami IT wiele z tych rozwiązań wykorzystuje AI w funkcjach takich jak:
- Wykrywanie anomalii oparte na AI: Wykorzystuje uczenie maszynowe do automatycznego identyfikowania nietypowych wzorców lub zachowań w metrykach systemowych, dziennikach lub ruchu sieciowym. Pomaga to zespołowi wykrywać pojawiające się problemy, zanim się nasilą, nawet gdy progi nie zostały ustawione ręcznie.
- Automatyczna analiza głównej przyczyny: Stosuje algorytmy AI do korelowania zdarzeń, dzienników i danych dotyczących wydajności w całym stosie technologicznym. Funkcja ta wskazuje prawdopodobne źródło incydentów, skracając czas poświęcany przez zespół na analizę i przyspieszając przywracanie działania.
- Predykcyjne prognozowanie incydentów: Wykorzystuje dane historyczne i modele AI do przewidywania potencjalnych awarii lub spadków wydajności. Umożliwia to podejmowanie proaktywnych działań w celu zapobiegania incydentom i skuteczniejsze planowanie konserwacji.
- Inteligentne ograniczanie szumu alertów: Wykorzystuje AI do grupowania powiązanych alertów, wyciszania duplikatów i ustalania priorytetów powiadomień na podstawie wpływu i kontekstu. Ogranicza zmęczenie alertami i sprawia, że zespół koncentruje się na najważniejszych problemach.
- Sugestie działań naprawczych oparte na AI: Analizuje dane dotyczące incydentów i wcześniejsze rozwiązania, aby rekomendować kolejne kroki lub automatyczne poprawki. Pomaga to zespołowi szybciej reagować i ujednolica najlepsze praktyki w ramach operacji.
Korzyści z oprogramowania do zarządzania operacjami IT
Wdrożenie oprogramowania do zarządzania operacjami IT zapewnia zespołowi i firmie wiele korzyści. Oto kilka z nich:
- Scentralizowany wgląd: Ujednolic monitorowanie serwerów, sieci, aplikacji i zasobów chmurowych za pomocą jednego pulpitu, aby Twój zespół mógł wyprzedzać problemy w różnych środowiskach.
- Szybsze rozwiązywanie incydentów: Korzystaj z agregowania alertów, korelacji opartej na AI i funkcji automatycznej analizy przyczyn źródłowych, aby szybko identyfikować problemy operacyjne, ustalać ich priorytety i na nie reagować.
- Ograniczenie pracy ręcznej: Automatyzuj powtarzające się zadania związane z konserwacją, remediacją i przepływami pracy za pomocą gotowych narzędzi do automatyzacji i orkiestracji, zyskując czas na inicjatywy o większej wartości.
- Proaktywne zarządzanie ryzykiem: Przewiduj awarie i wąskie gardła zasobów dzięki opartym na AI narzędziom do wykrywania anomalii i prognozowania, które ujawniają potencjalne problemy, zanim się nasilą.
- Optymalizacja kosztów i zasobów: Śledź wykorzystanie infrastruktury, wydajność aplikacji i wydatki na zasoby za pomocą funkcji raportowania i analityki, co ułatwia zarządzanie budżetami i planowanie wydajności.
- Większe bezpieczeństwo i zgodność: Korzystaj z mechanizmów kontroli dostępu użytkowników, dzienników audytowych i funkcji śledzenia zmian, aby chronić wrażliwe dane i spełniać wymogi regulacyjne.
- Bezproblemowa integracja z ekosystemem: Łącz platformy ITSM, DevOps i czatowe za pomocą gotowych integracji oraz otwartych interfejsów API, ułatwiając osadzanie danych operacyjnych w sposobie pracy, który Twój zespół już wykorzystuje.
Koszty i ceny oprogramowania do zarządzania operacjami IT
Wybór oprogramowania do zarządzania operacjami IT wymaga zrozumienia różnych dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i innych czynników. Poniższa tabela podsumowuje typowe plany, ich średnie ceny oraz typowe funkcje uwzględniane w rozwiązaniach do zarządzania operacjami IT:
Tabela porównawcza planów oprogramowania do zarządzania operacjami IT
| Typ planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Typ planuPlan bezpłatny | Średnia cena$0 | Typowe funkcjePodstawowe monitorowanie infrastruktury, ograniczone alerty, dostęp dla małych zespołów i pomoc społeczności. |
| Typ planuPlan osobisty | Średnia cena$10–$30/użytkownika/miesiąc | Typowe funkcjeMonitorowanie w czasie rzeczywistym, automatyzacja na poziomie podstawowym, podstawowe pulpity, integracja z popularnymi narzędziami i pomoc przez e-mail. |
| Typ planuPlan biznesowy | Średnia cena$40–$80/użytkownika/miesiąc | Typowe funkcjeMonitorowanie całego stosu, alerty i zarządzanie incydentami, automatyzacja przepływów pracy, zaawansowane pulpity, dostęp do API i kontrola dostępu oparta na rolach. |
| Typ planuPlan dla przedsiębiorstw | Średnia cena$90–$200/użytkownika/miesiąc | Typowe funkcjeWgląd w środowiska hybrydowe i wielochmurowe, funkcje oparte na AI, niestandardowe umowy SLA, wsparcie zgodności, dedykowane integracje i pomoc premium. |
Najczęściej zadawane pytania dotyczące oprogramowania do zarządzania operacjami IT
Oto odpowiedzi na często zadawane pytania dotyczące oprogramowania do zarządzania operacjami IT:
Jak porównać różne platformy do zarządzania operacjami IT?
Zacznij od sporządzenia listy najważniejszych funkcji, takich jak obsługa wielu chmur, automatyzacja i zakres integracji. Następnie przetestuj platformy, korzystając z typowych scenariuszy obsługi incydentów, i porównaj sposób, w jaki każde narzędzie obsługuje alerty, analizę przyczyn źródłowych i raportowanie. Przed podjęciem ostatecznej decyzji warto również przeanalizować całkowity koszt posiadania, integracje z ekosystemem oraz elastyczność wdrażania.
Czy oprogramowanie do zarządzania operacjami IT może automatyzować reagowanie na incydenty?
Tak, większość nowoczesnych rozwiązań do zarządzania operacjami IT pozwala automatyzować reagowanie na incydenty za pomocą podręczników procedur, narzędzi do tworzenia przepływów pracy, a nawet automatycznego usuwania problemów sterowanego przez AI. Pomaga to ograniczyć liczbę czynności wykonywanych ręcznie i zapewnia spójne reagowanie na powtarzające się problemy.
Jakich integracji należy szukać w oprogramowaniu do zarządzania operacjami IT?
Szukaj dostępu do API, gotowych łączników do narzędzi ITSM (takich jak ServiceNow), platform komunikacyjnych (takich jak Slack lub Microsoft Teams) oraz potoków DevOps. Głębokie integracje pozwalają zespołowi przesyłać alerty, uruchamiać przepływy pracy i synchronizować zgłoszenia w istniejących systemach bez niestandardowego oprogramowania pośredniczącego.
Czy oprogramowanie do zarządzania operacjami IT pomaga w zapewnieniu zgodności i przeprowadzaniu audytów?
Tak, zaawansowane oprogramowanie do zarządzania operacjami IT śledzi zmiany w systemie i działania użytkowników oraz udostępnia dzienniki audytowe wymagane do zapewnienia zgodności. Jest to szczególnie przydatne w regulowanych sektorach, w których potrzebne są wyraźne dowody stosowania mechanizmów kontrolnych oraz pełna historia zmian do celów raportowania.
Jak zapobiec nieoczekiwanym kosztom związanym z oprogramowaniem do zarządzania operacjami IT?
Zawsze sprawdzaj, w jaki sposób platforma nalicza opłaty za pozyskiwanie danych, niestandardowe metryki i konta użytkowników. Wybieraj narzędzia z przejrzystym cennikiem opartym na wykorzystaniu oraz pulpitami kosztów w aplikacji, aby monitorować wydatki i unikać nieoczekiwanych przekroczeń limitów w miarę rozwoju środowiska.
Jak najlepiej uzyskać poparcie interesariuszy dla nowej platformy do zarządzania operacjami IT?
Pokaż, w jaki sposób platforma pomaga osiągać cele biznesowe: szybciej rozwiązywać incydenty, proaktywnie zarządzać ryzykiem i usprawniać raportowanie. Udostępnij prezentację lub wyniki pilotażu, podkreśl oczekiwane korzyści i powiąż funkcje z problemami, które interesariusze znają z własnego doświadczenia.