

Znalezienie odpowiedniego narzędzia do monitorowania może być uciążliwe. Potrzebujesz rozwiązania dopasowanego do potrzeb swojego zespołu, ale bez zbędnej złożoności. Dlatego wiele organizacji poszukuje alternatyw dla LogicMonitor.
Z mojego doświadczenia wynika, że firmy często szukają innych rozwiązań, które oferują lepszą skalowalność, konkretne funkcje lub większą opłacalność. Mogą uznać, że LogicMonitor nie odpowiada ich obecnym celom lub budżetowi.
Niezależnie przetestowałem i zrecenzowałem kilka opcji, aby przedstawić Ci bezstronną ocenę dostępnych rozwiązań. Przeprowadzę Cię przez najlepsze narzędzia do rozwiązywania konkretnych problemów.
Niezależnie od tego, czy szukasz lepszej integracji z chmurą, czy elastyczności oprogramowania open source, ten ranking pomoże Ci znaleźć odpowiednie rozwiązanie. Przyjrzyjmy się najlepszym propozycjom, które mogą ułatwić zarządzanie zadaniami związanymi z monitorowaniem.
Czym jest LogicMonitor?
LogicMonitor to oprogramowanie zwiększające produktywność, przeznaczone dla specjalistów IT i firm potrzebujących wydajnych rozwiązań do monitorowania. Jest używane przez zespoły IT do monitorowania infrastruktury, aplikacji i wydajności sieci, zapewniając cenne informacje na temat działania systemów.
Automatyczne monitorowanie, konfigurowalne pulpity nawigacyjne i alerty w czasie rzeczywistym pomagają identyfikować problemy i optymalizować wydajność. Ogólnie rzecz biorąc, LogicMonitor oferuje scentralizowaną platformę, która pomaga utrzymać płynne działanie systemów.
Tabela porównawcza alternatyw dla LogicMonitor
Ta tabela porównawcza zawiera podsumowanie informacji o cenach moich najlepszych alternatyw dla LogicMonitor:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Najlepszy wybór dla obserwowalności wspieranej przez sztuczną inteligencję | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | Od 7 USD miesięcznie 15-dniowy bezpłatny okres próbny + dostępne bezpłatne demo | Website |
Najlepszy do ekonomicznego monitorowania | 4.0 out of 5 | 4 | 3 | 4 | 4 | 4 | 5 | $325/month Bezpłatny plan + 5-dniowy bezpłatny okres próbny + dostępna bezpłatna wersja demonstracyjna | Website |
Najlepszy do usług monitorowania chmury | 4.3 out of 5 | 4 | 4 | 4 | 4 | 5 | 5 | $15/host/miesiąc Bezpłatny plan + 14-dniowy bezpłatny okres próbny + dostępne bezpłatne demo | Website |
Najlepszy do analizy danych wspomaganej przez AI | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $15/host/miesiąc Dostępny plan bezpłatny | Website |
Najlepsze rozwiązanie do automatycznego dostępu do danych w czasie rzeczywistym | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $0.04/miesiąc 14-dniowy bezpłatny okres próbny + dostępna bezpłatna demonstracja | Website |
Najlepszy wybór do ujednoliconej, elastycznej obserwowalności | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | Od 19 USD/miesiąc Dostępny bezpłatny plan | Website |
Najlepsze rozwiązanie dla zintegrowanej obsługi IT | 3.7 out of 5 | 3 | 3 | 4 | 3 | 5 | 4 | Ceny na żądanie Dostępna 30-dniowa bezpłatna wersja próbna | Website |
Najlepsze rozwiązanie do dostosowywalnych pulpitów nawigacyjnych | 3.3 out of 5 | 4 | 2 | 4 | 3 | 4 | 3 | $200/miesiąc Bezpłatny plan + 30-dniowy okres próbny + dostępne demo | Website |
Najlepszy do obserwowalności o otwartym kodzie źródłowym | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $49/miesiąc 30-dniowy bezpłatny okres próbny + dostępna bezpłatna demonstracja | Website |
Najlepszy wybór dla natywnych dla AI analiz | 3.2 out of 5 | 3 | 4 | 3 | 2 | 3 | 4 | Ceny dostępne na żądanie Dostępny bezpłatny plan i bezpłatne demo | Website |


Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Recenzje najlepszych alternatyw dla LogicMonitor
Poniżej znajdziesz moje szczegółowe podsumowania najlepszych alternatyw dla LogicMonitor, które trafiły na moją listę. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety i wady, integracje oraz idealne zastosowania każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Najlepszy wybór dla obserwowalności wspieranej przez sztuczną inteligencję
- 15-dniowy bezpłatny okres próbny + dostępne bezpłatne demo
- Od 7 USD miesięcznie (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5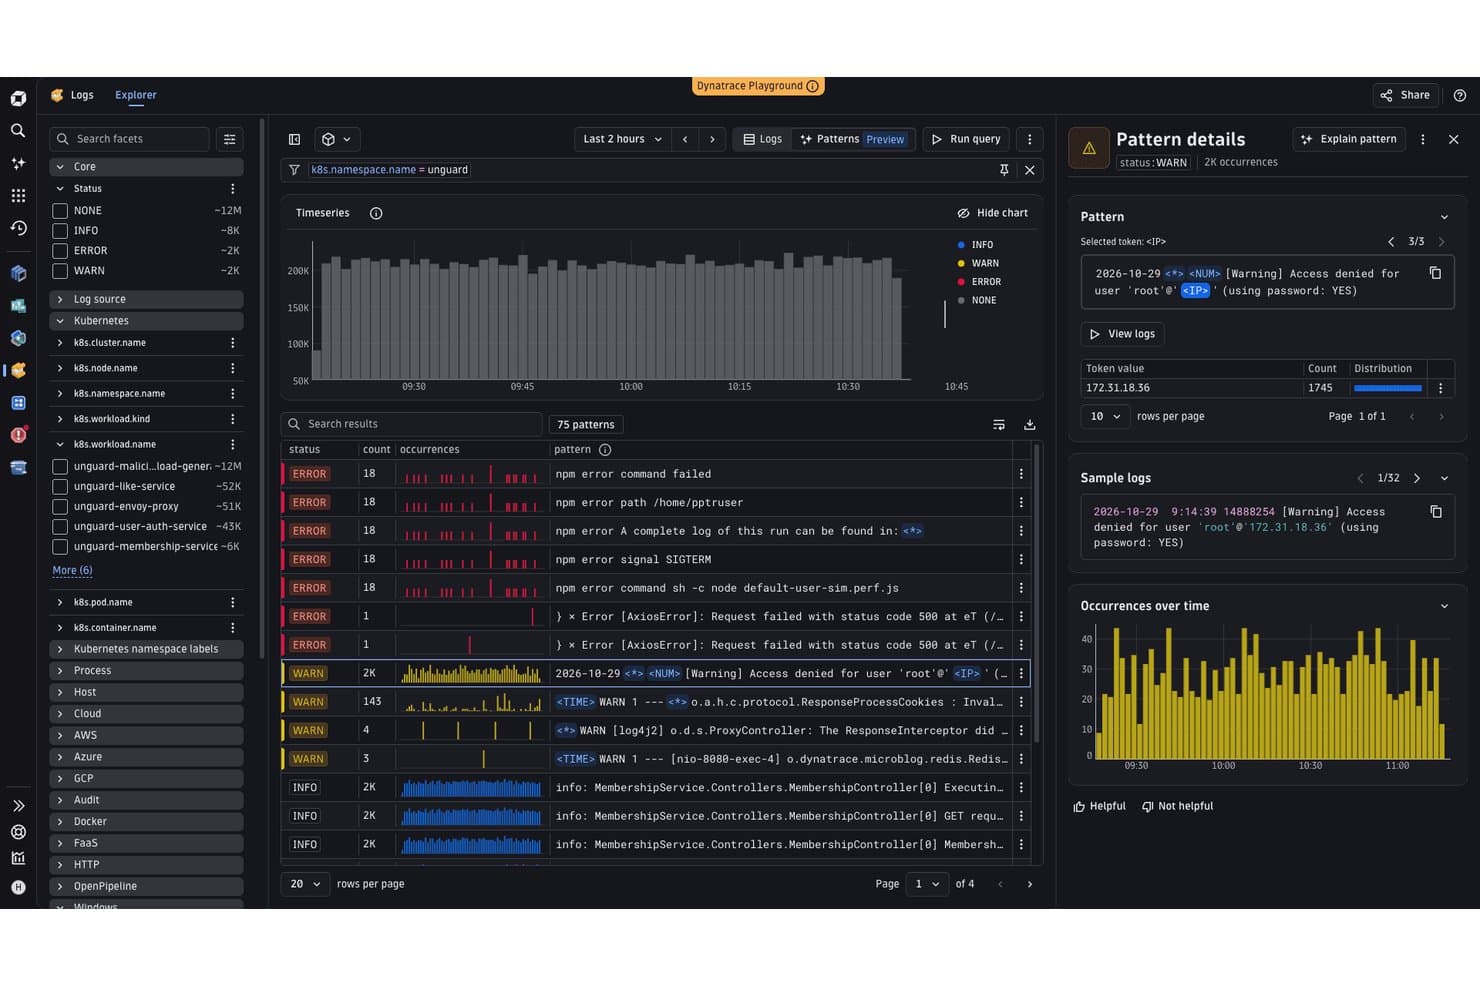
Aplikacja Dynatrace Logs grupująca wpisy dzienników we wzorce według statusu, wraz z wykresami wystąpień i szczegółami. Dynatrace to platforma obserwowalności całego stosu, która wykorzystuje sztuczną inteligencję do automatycznego wykrywania, mapowania i monitorowania aplikacji, infrastruktury oraz środowisk chmurowych — dzięki czemu doskonale sprawdza się w zespołach operacji IT i DevOps, które zarządzają złożonymi, dynamicznie zmieniającymi się systemami, gdzie ręczna analiza przyczyn źródłowych nie jest realistyczna.
Dla kogo Dynatrace jest najlepszym wyborem?
Dynatrace doskonale sprawdza się w zespołach DevOps i operacji IT zarządzających złożonymi, rozproszonymi środowiskami, w których pełna widoczność stosu i analiza przyczyn źródłowych oparta na sztucznej inteligencji są ważniejsze niż dedykowane monitorowanie sieci.
Dlaczego wybrałem Dynatrace
Wybrałem Dynatrace jako jedną z najlepszych alternatyw dla LogicMonitor, ponieważ jego obserwowalność oparta na sztucznej inteligencji znacznie wykracza poza alerty oparte na progach. Davis AI wykorzystuje topologię Smartscape do automatycznego korelowania zdarzeń między hostami, kontenerami i usługami, dzięki czemu zamiast analizować dziesiątki alertów, otrzymuję jedną przyczynę źródłową. PurePath śledzi każdą transakcję od początku do końca na poziomie kodu, co oznacza, że mogę dokładnie wskazać miejsce powstania spowolnienia bez ręcznego przeszukiwania dzienników.
Najważniejsze funkcje Dynatrace
- Automatyczne wykrywanie za pomocą OneAgent: Instaluje się na każdym hoście i automatycznie wykrywa procesy, usługi oraz zależności bez ręcznej konfiguracji.
- Analiza dzienników za pomocą DQL: Pozyskuje, wzbogaca i przeszukuje dane dzienników przy użyciu języka zapytań Dynatrace, z możliwością konfiguracji przechowywania danych od 10 dni do 10 lat.
- Monitorowanie syntetyczne: Symuluje ścieżki użytkowników za pomocą Browser Monitor oraz sprawdza dostępność interfejsów API i usług za pomocą HTTP Monitor z lokalizacji publicznych i prywatnych.
- Automatyzacja przepływów pracy: Uruchamia automatyczne przepływy pracy na podstawie zdarzeń, harmonogramów lub wywołań API, z obsługą warunków, pętli i ponowień.
Integracje Dynatrace
Dynatrace oferuje w serwisie Marketplace integracje z Jira, Slack, Cursor, GitHub Copilot Coding Agent, JetBrains i Windsurf. Udostępnia również interfejsy API do zarządzania środowiskiem, konfiguracją i kontem, które umożliwiają tworzenie niestandardowych integracji i łączenie przepływów pracy.
Pros and Cons
Pros:
- Koreluje alerty za pomocą topologii Smartscape
- OneAgent wykrywa zależności aplikacji i infrastruktury
- PurePath śledzi transakcje aż do przyczyn źródłowych na poziomie kodu
Cons:
- Monitorowanie sieci pozostaje w tyle za wyspecjalizowanymi platformami
- Konfiguracja niestandardowych pulpitów nawigacyjnych wymaga nakładu pracy
 Najlepszy do ekonomicznego monitorowania
- Bezpłatny plan + 5-dniowy bezpłatny okres próbny + dostępna bezpłatna wersja demonstracyjna
- Od $325/month (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5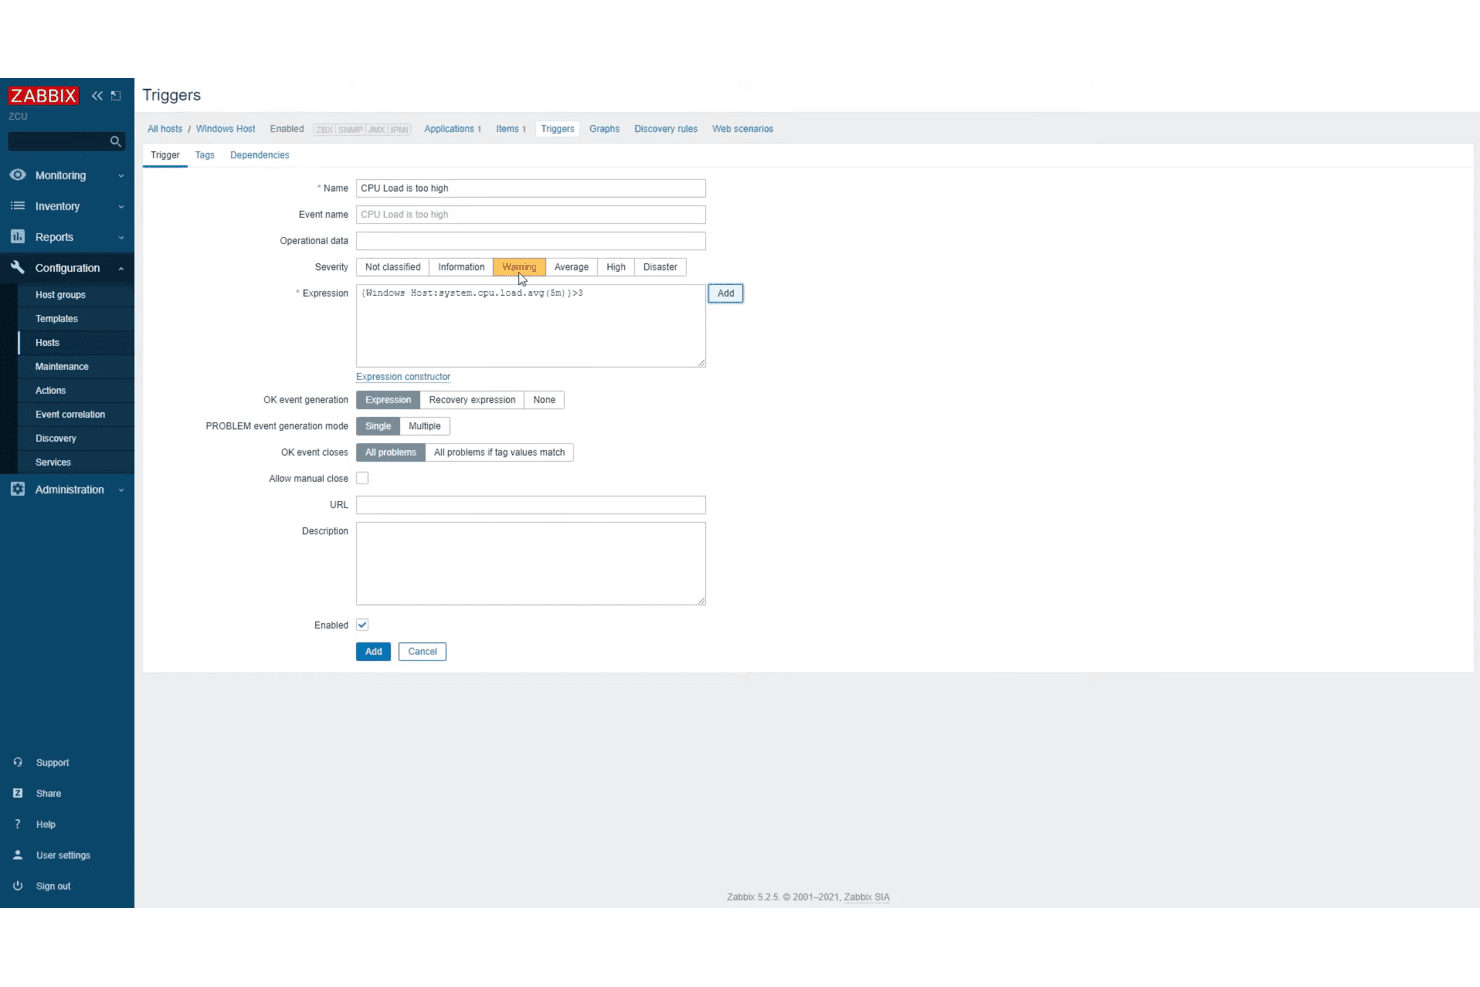
Konfigurowanie wyzwalacza Zabbix, który wysyła alert, gdy obciążenie procesora hosta Windows przekroczy próg. Zabbix to platforma monitoringu o otwartym kodzie źródłowym, która odpowiada zespołom IT potrzebującym szerokiego wglądu w infrastrukturę — obejmującego serwery, sieci, chmurę, kontenery i aplikacje — bez opłat licencyjnych naliczanych za urządzenie lub metrykę.
Dla kogo Zabbix jest najlepszym wyborem?
Zabbix dobrze sprawdza się w zespołach IT, które potrzebują monitoringu infrastruktury klasy korporacyjnej, ale nie mogą uzasadnić kosztów licencji naliczanych za urządzenie.
Dlaczego wybrałem Zabbix
Wybrałem Zabbix jako jedno z najlepszych rozwiązań, ponieważ żadne inne narzędzie z tej listy nie pozwala całkowicie zrezygnować z licencji naliczanych za urządzenie, a jednocześnie nadal zapewnia monitoring klasy korporacyjnej serwerów, sieci, chmury i kontenerów. Rdzeń o otwartym kodzie źródłowym nie ma limitów hostów, ograniczeń liczby metryk ani blokad funkcji, więc zespół zarządzający tysiącami punktów końcowych płaci tyle samo za licencje co zespół zarządzający dziesięcioma — zero. Doceniam również predykcyjne funkcje wyzwalaczy, które wykorzystują dane historyczne do oszacowania, kiedy próg zostanie przekroczony, zanim faktycznie do tego dojdzie.
Najważniejsze funkcje Zabbix
- Reguły korelacji zdarzeń: Konfiguruj reguły grupowania powiązanych zdarzeń, eliminowania zduplikowanych alertów wywoływanych przez niestabilne warunki oraz automatycznego zamykania nieaktualnych problemów pochodzących z różnych wyzwalaczy i metod odpytywania.
- Pulpity kosztów wielu chmur: Wyświetlaj i porównuj wydatki na infrastrukturę w AWS, Azure, Google Cloud i Oracle Cloud z poziomu jednego pulpitu.
- Obsługa OpenTelemetry APM: Odbieraj ślady rozproszone, metryki i logi z aplikacji lub kolektorów OpenTelemetry za pośrednictwem serwera proxy Zabbix, wykorzystując ClickHouse jako źródło danych telemetrycznych.
- Automatyczne działania naprawcze: Uruchamiaj skonfigurowane skrypty lub polecenia w odpowiedzi na wykryte problemy, w tym restartuj usługi lub zmieniaj skalę zasobów chmurowych.
Integracje Zabbix
Zabbix wymienia 204 oficjalne szablony i 570 marek w ramach 2 010 rozwiązań, w tym AWS, Azure, Google Cloud Platform, ServiceNow, Slack, PagerDuty, Kafka i RabbitMQ. Jego interfejs API JSON-RPC, interfejs API REST do strumieniowania, webhooki i biblioteka Python umożliwiają tworzenie niestandardowych integracji.
Pros and Cons
Pros:
- Szeroki wgląd w serwery i sieci
- Elastyczne alerty i korelacja zdarzeń
- Prognozowanie sygnalizujące zbliżanie się do progów metryk
Cons:
- Progi alertów wymagają ręcznego dostrajania
- Wdrożenia hostowane samodzielnie wymagają utrzymania bazy danych
 Najlepszy do usług monitorowania chmury
- Bezpłatny plan + 14-dniowy bezpłatny okres próbny + dostępne bezpłatne demo
- Od $15/host/miesiąc (przy rozliczeniu rocznym)
Visit WebsiteCustomer Rating:4.5/5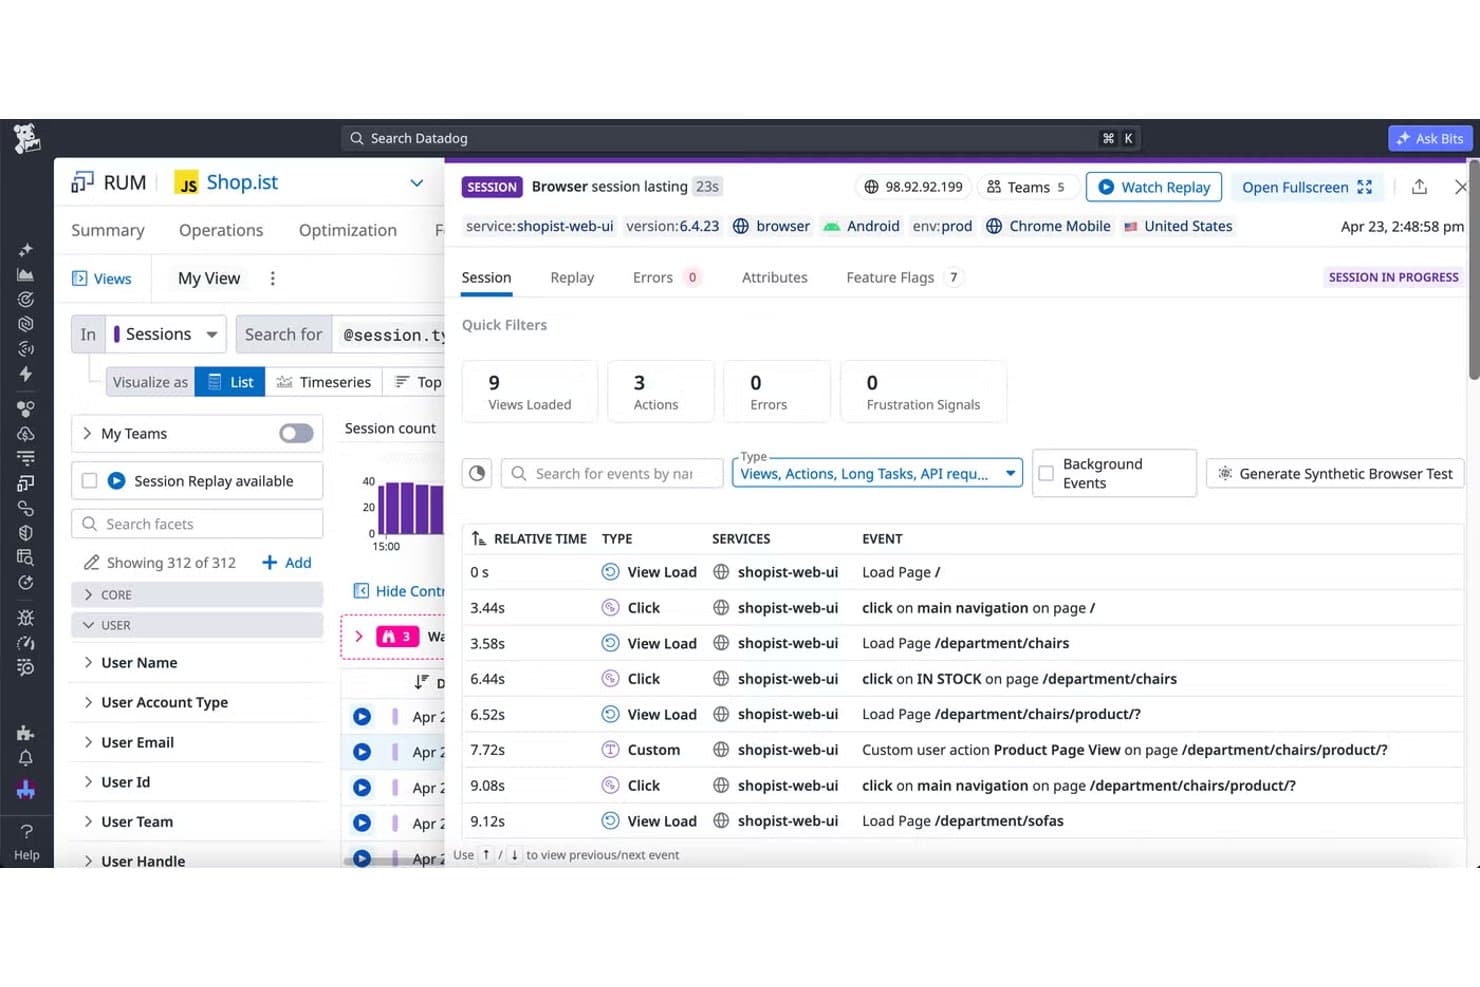
Widok sesji RUM w Datadog pokazujący kolejne ładowania stron, kliknięcia i niestandardowe działania użytkownika. Datadog to oparta na SaaS platforma obserwowalności, która zapewnia zespołom IT i DevOps ujednolicony wgląd w infrastrukturę chmurową, hybrydową i lokalną — łącząc metryki, logi, ślady i sygnały bezpieczeństwa w jednym miejscu, aby ograniczyć przełączanie kontekstu podczas reagowania na incydenty.
Dla kogo Datadog jest najlepszym wyborem?
Datadog to dobry wybór dla inżynierów DevOps i zespołów operacyjnych IT zarządzających środowiskami chmurowymi lub hybrydowymi, którzy potrzebują ujednoliconego wglądu w infrastrukturę, logi, ślady i sygnały bezpieczeństwa na jednej platformie.
Dlaczego wybrałem Datadog
Wybrałem Datadog jako jedną z najlepszych alternatyw dla LogicMonitor, ponieważ został stworzony z myślą o monitorowaniu chmury i śledzi dziesiątki tysięcy metryk w AWS, Azure i GCP, korelując je z logami, śladami i sygnałami bezpieczeństwa w jednym widoku. Szczególnie podoba mi się Watchdog, jego silnik AI, który automatycznie wykrywa anomalie, dzięki czemu mój zespół nie musi ręcznie przeszukiwać szumu podczas incydentu. Monitory prognozowania są również naprawdę przydatne: mogę modelować trendy użycia procesora lub pamięci za pomocą algorytmów sezonowych lub liniowych i ustawiać progi alertów z wyprzedzeniem do trzech miesięcy.
Najważniejsze funkcje Datadog
- Wyszukiwanie infrastruktury oparte na tagach: Filtruj i analizuj metryki w całej infrastrukturze za pomocą niestandardowych tagów, aby grupować hosty, kontenery i zasoby chmurowe według dowolnego wymiaru.
- Korelacja różnych sygnałów: Łącz metryki infrastruktury z logami, śladami i sygnałami bezpieczeństwa w jednym widoku, aby badać incydenty bez przełączania narzędzi.
- Mapowanie topologii urządzeń: Wizualizuj urządzenia sieciowe, interfejsy i połączenia fizyczne, z możliwością sprawdzania ruchu, pułapek SNMP, komunikatów Syslog i sąsiednich urządzeń.
- Monitorowanie procesów na żywo: Wyświetlaj aktywność na poziomie procesów w czasie rzeczywistym na hostach i w kontenerach, w tym zużycie zasobów i uruchomione polecenia, z poziomu scentralizowanego interfejsu.
Integracje Datadog
Datadog oferuje ponad 1000 integracji, w tym Amazon Web Services, Microsoft Azure, Google Cloud Platform, Kubernetes, Docker, Jira, PagerDuty, OpenTelemetry, PostgreSQL i Redis. Jego interfejs REST API oraz biblioteki klienckie obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Koreluje infrastrukturę, logi i ślady
- Niestandardowe pulpity ułatwiają ocenę bieżącego stanu systemu
- Monitory prognozowania pomagają przewidywać trendy wydajnościowe
Cons:
- Rachunki zależne od użycia mogą być trudne do przewidzenia
- Dostosowywanie alertów może powodować zmęczenie powiadomieniami
 Najlepszy do analizy danych wspomaganej przez AI
- Dostępny plan bezpłatny
- Od $15/host/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.3/5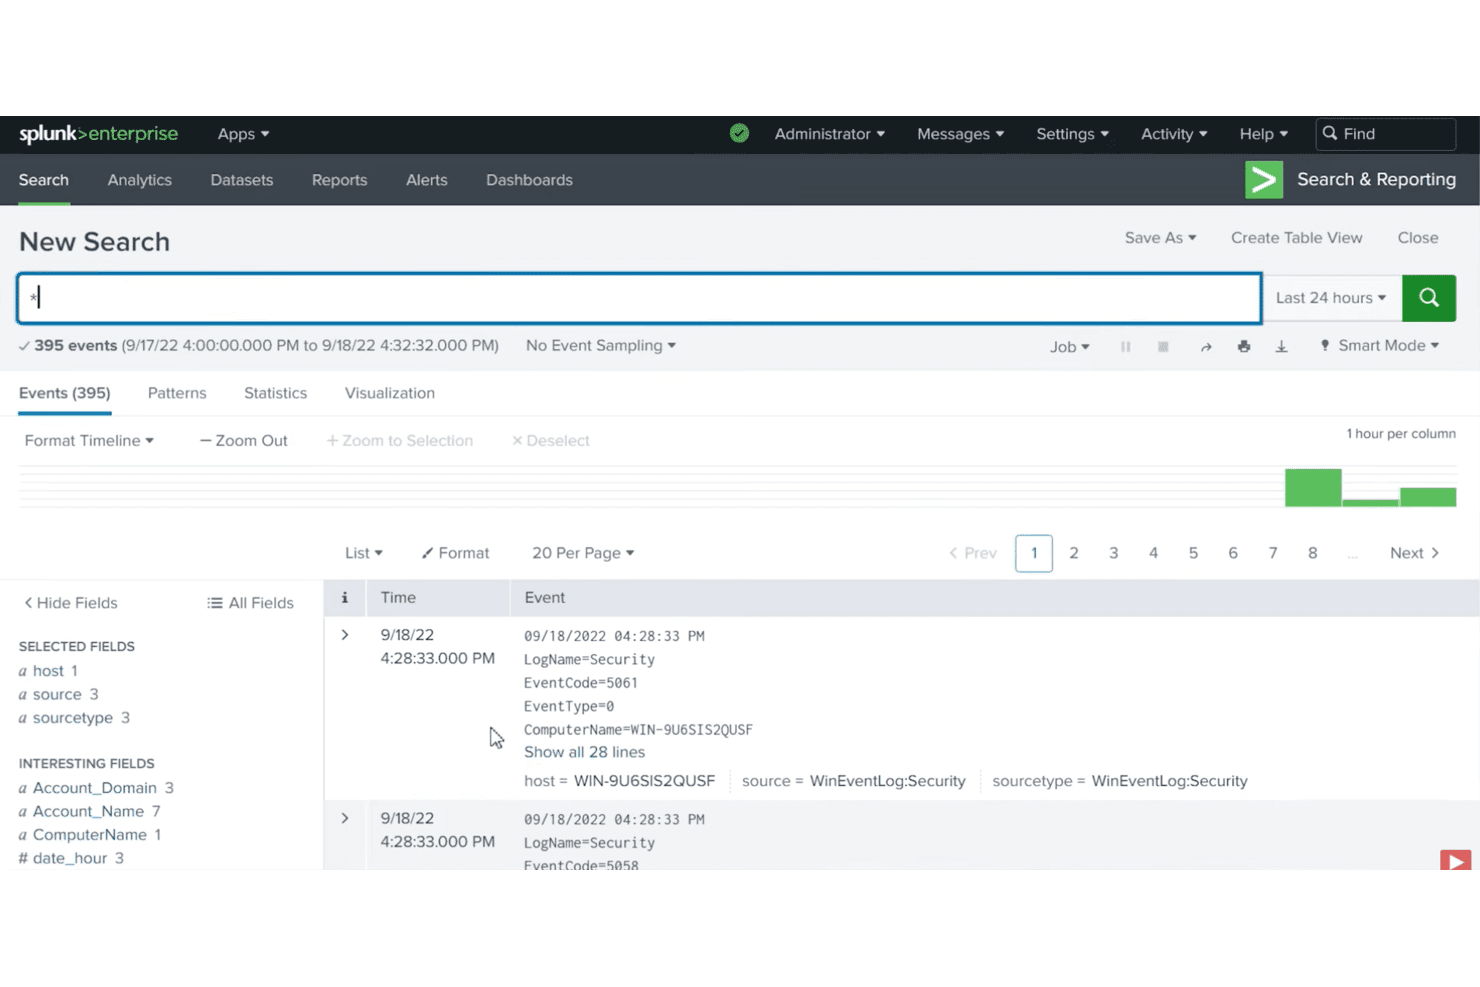
Widok wyszukiwania Splunk Enterprise przedstawiający zdarzenia Zabezpieczeń systemu Windows z wybieralnymi polami i osią czasu. Splunk Observability Cloud to platforma monitoringu SaaS, która ujednolica dane dotyczące infrastruktury, wydajności aplikacji i doświadczeń cyfrowych, dzięki czemu doskonale sprawdza się w zespołach IT i DevOps potrzebujących wspomaganej przez AI analizy przyczyn źródłowych w środowiskach hybrydowych i chmurowych.
Dla kogo Splunk sprawdzi się najlepiej?
Splunk Observability Cloud doskonale sprawdza się w zespołach DevOps i operacyjnych IT w średnich i dużych organizacjach, które potrzebują wspomaganej przez AI analizy przyczyn źródłowych w środowiskach hybrydowych i chmurowych.
Dlaczego wybrałem Splunk
Wybrałem Splunk jako jedną z najlepszych alternatyw dla LogicMonitor ze względu na to, jak dobrze jego warstwa AI SRE obsługuje prace dochodzeniowe, które zwykle spoczywają na Twoim zespole. Agent AI do rozwiązywania problemów łączy metryki, ślady i logi, aby przedstawiać prawdopodobne przyczyny źródłowe prostym językiem, natomiast Asystent AI umożliwia wyszukiwanie danych APM, infrastruktury i Kubernetes bez pisania choćby jednego zapytania. Szczególnie podoba mi się to, że śledzenie NoSample przechwytuje 100% danych śladów, dzięki czemu nic nie zostaje pominięte przed analizą.
Najważniejsze funkcje Splunk
- Pulpity infrastruktury: Gotowe pulpity i wizualizacje usług chmurowych, systemów i środowisk Kubernetes zapewniają zespołowi wgląd w stan infrastruktury hybrydowej w czasie rzeczywistym.
- Dynamiczne alerty z detektorami: Detektory monitorują sygnały metryk i uruchamiają alerty na podstawie reguł obejmujących wiele warunków, wysyłając powiadomienia do narzędzi takich jak PagerDuty, Slack, ServiceNow i Microsoft Teams.
- Pobieranie danych natywne dla OpenTelemetry: Gromadzi metryki, ślady i logi przy użyciu instrumentacji opartej na otwartych standardach, obsługując Prometheus, Telegraf i collectd, a także ponad 200 integracji.
- Log Observer Connect: Łączy logi przechowywane już w Splunk Cloud Platform lub Splunk Enterprise bezpośrednio z przepływami pracy związanymi z rozwiązywaniem problemów w Observability Cloud bez dodatkowych kosztów.
Integracje Splunk
Splunk Observability Cloud obejmuje ponad 200 obsługiwanych integracji opartych na otwartych standardach, w tym AWS, Microsoft Azure, Google Cloud Platform, Jira, Microsoft Teams, PagerDuty, ServiceNow, Slack i Amazon EventBridge. Obsługuje również OpenTelemetry, Prometheus, Telegraf, collectd oraz połączenia z REST API.
Pros and Cons
Pros:
- Ujednolica dane telemetryczne, przyspieszając rozwiązywanie problemów
- AI podsumowuje prawdopodobne przyczyny prostym językiem
- Przechwytuje każdy ślad na potrzeby analiz
Cons:
- Koszty rosną wraz ze zwiększaniem liczby źródeł danych telemetrycznych
- SignalFlow wymaga ręcznego dostrajania detektorów
Learn more about Splunk: Najlepsze rozwiązanie do automatycznego dostępu do danych w czasie rzeczywistym
- 14-dniowy bezpłatny okres próbny + dostępna bezpłatna demonstracja
- Od $0.04/miesiąc
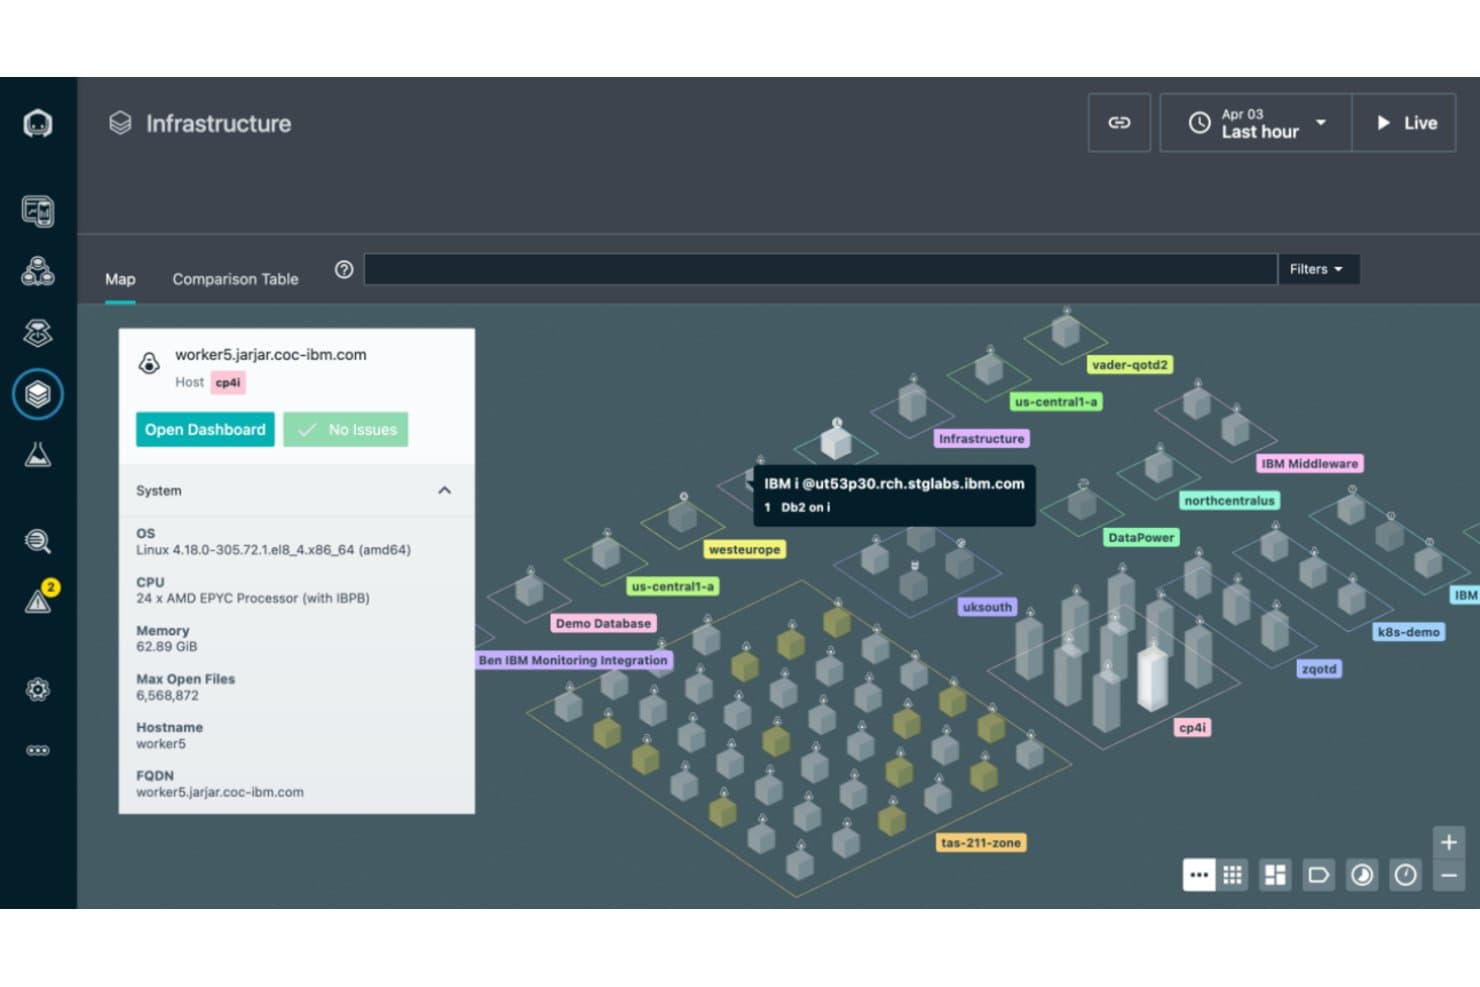
Mapa infrastruktury IBM Instana przedstawia hosty pogrupowane według stref, wraz ze szczegółami hostów i ich bieżącym stanem. IBM Instana to oparta na sztucznej inteligencji platforma obserwowalności stworzona dla zespołów DevOps, które potrzebują automatycznego wykrywania, mapowania zależności w czasie rzeczywistym oraz szczegółowego wglądu w wydajność aplikacji w środowiskach chmurowych, hybrydowych i kontenerowych.
Dla kogo IBM Instana jest najlepszym wyborem?
IBM Instana doskonale sprawdzi się w przypadku inżynierów DevOps zarządzających złożonymi środowiskami natywnymi dla chmury, którzy potrzebują automatycznego wykrywania i mapowania zależności w czasie rzeczywistym, bez konieczności ręcznej instrumentacji.
Dlaczego wybrałem IBM Instana
IBM Instana znalazła się wśród moich najlepszych propozycji, ponieważ jej zautomatyzowany dostęp do danych w czasie rzeczywistym naprawdę się wyróżnia: funkcja Dynamic Graph stale wykrywa i mapuje każdy host, usługę oraz zależność, aktualizując dane co sekundę bez ręcznej instrumentacji. Doceniam również połączenie tej funkcji z analizą przyczyn źródłowych opartą na sztucznej inteligencji, która koreluje statystyki śledzenia, topologię i sygnały anomalii, aby szybko wskazać prawdopodobne przyczyny. Podczas rzeczywistego incydentu oznacza to, że mój zespół nie musi ręcznie przeszukiwać pulpitów nawigacyjnych.
Najważniejsze funkcje IBM Instana
- Inteligentne alerty z adaptacyjnymi progami: Silnik alertów Instana wykorzystuje statystyczne wartości bazowe i gotowe schematy do wykrywania incydentów, a także grupuje alerty i kieruje je do Slack, PagerDuty, poczty elektronicznej oraz webhooków.
- Rozproszone śledzenie transakcji: Instana śledzi żądania w różnych komponentach aplikacji bez próbkowania, rejestrując szczegółowe dane na poziomie kodu w warstwach baz danych, przeglądarek i urządzeń mobilnych.
- Integracja z OpenTelemetry Collector: Instana pobiera dane telemetryczne z OpenTelemetry Collector, aby monitorować mikrousługi i aplikacje natywne dla chmury wraz z komponentami instrumentowanymi natywnie.
- Analiza kosztów Kubernetes: Instana udostępnia gotowe pulpity nawigacyjne i historyczną analizę wydatków do monitorowania kosztów zasobów w klastrach Kubernetes.
Integracje IBM Instana
IBM Instana obsługuje ponad 300 technologii, w tym Slack, PagerDuty, OpenTelemetry Collector, Splunk, Amazon EC2, AWS RDS, Google Cloud, Kubernetes i VMware Tanzu. Interfejsy API REST i GraphQL oraz zestawy SDK umożliwiają tworzenie niestandardowych integracji.
Pros and Cons
Pros:
- Szybka telemetria pomaga wskazać problemy z usługami
- Mapy zależności w czasie rzeczywistym ułatwiają analizę incydentów
- Automatyczne wykrywanie ogranicza potrzebę ręcznej instrumentacji
Cons:
- Luki w monitorowaniu urządzeń sieciowych mogą wymagać osobnego narzędzia monitorującego
- Duża liczba alertów często wymaga ręcznego filtrowania
Learn more about IBM Instana: Najlepszy wybór do ujednoliconej, elastycznej obserwowalności
- Dostępny bezpłatny plan
- Od 19 USD/miesiąc
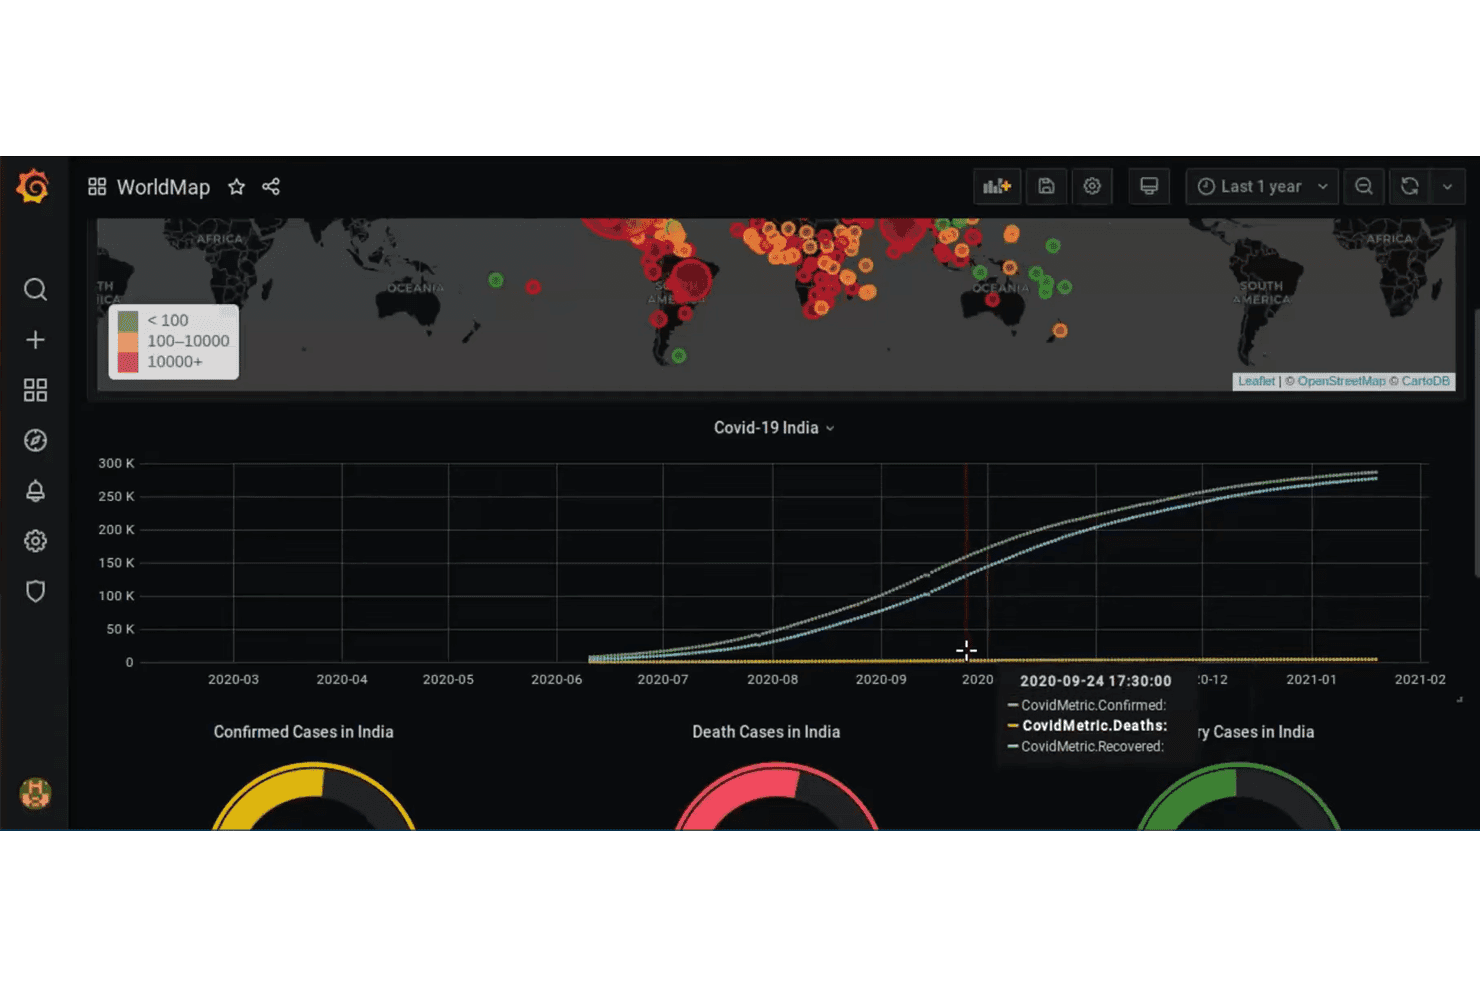
Pulpit Grafana wizualizujący dane dotyczące globalnych przypadków COVID-19 oraz przypadków w Indiach w czasie za pomocą map i wykresów szeregów czasowych. Grafana Cloud to zarządzana platforma obserwowalności, która unifikuje metryki, dzienniki, ślady i profile w jednym miejscu, dzięki czemu świetnie sprawdza się w przypadku inżynierów DevOps i zespołów operacji IT, którzy potrzebują elastycznego monitorowania opartego na otwartych standardach w środowiskach chmurowych, hybrydowych i kontenerowych.
Dla kogo Grafana Cloud jest najlepszym wyborem?
Grafana Cloud świetnie sprawdza się w przypadku inżynierów DevOps i zespołów operacji IT, którzy chcą ujednolicić metryki, dzienniki, ślady i profile w środowiskach natywnie chmurowych i hybrydowych, korzystając z otwartych standardów, takich jak OpenTelemetry i Prometheus.
Dlaczego wybrałem Grafana Cloud
Uwzględniłem Grafana Cloud wśród moich najlepszych propozycji, ponieważ łączy metryki, dzienniki, ślady i profile w jednej zarządzanej platformie, czyli dokładnie to, czego potrzebujesz, gdy odizolowane podejście LogicMonitor zaczyna być ograniczające. Szczególnie podoba mi się Graf wiedzy, który odwzorowuje zależności między usługami, obciążeniami Kubernetes, bazami danych i infrastrukturą, dzięki czemu można prześledzić skok opóźnienia od rozproszonych śladów aż do wąskiego gardła w bazie danych bez przełączania się między narzędziami. Funkcja Investigations oparta na AI może automatycznie analizować te dane telemetryczne, formułować hipotezy i zwracać uporządkowany raport po uruchomieniu alertu.
Najważniejsze funkcje Grafana Cloud
- Adaptacyjna telemetria: Automatycznie agreguje, próbuje lub odrzuca dane telemetryczne o niższej wartości w metrykach, dziennikach, śladach i profilach, aby kontrolować ilość danych i koszty.
- Monitorowanie syntetyczne: Sprawdza punkty końcowe API i aplikacje internetowe z wykorzystaniem sond rozmieszczonych na całym świecie, obsługując kontrole HTTP/HTTPS, DNS, TCP i ICMP Ping pod kątem dostępności i wydajności.
- Kolektor Grafana Alloy: Otwarty kolektor OpenTelemetry z obsługą potoków Prometheus, który obsługuje metryki, dzienniki, ślady i profile z istniejącej infrastruktury.
- RBAC z niestandardowymi rolami: Umożliwia przypisywanie szczegółowych uprawnień użytkownikom, zespołom i kontom usług, z niestandardowymi rolami ograniczonymi do określonych działań w różnych pulpitach nawigacyjnych i źródłach danych.
Integracje Grafana Cloud
Grafana Cloud oferuje ponad 150 integracji ze źródłami danych, w tym AWS, Microsoft Azure, Google Cloud, SNMP, VMware vSphere i urządzeniami LogicMonitor. Interfejsy API REST, HTTP, Grafana Cloud, śledzenia i monitorowania syntetycznego, a także webhooki, obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Elastyczne pulpity nawigacyjne łączą dane telemetryczne
- Widoki między sygnałami ułatwiają badanie incydentów
- Graf wiedzy łączy anomalie z ich przyczynami
Cons:
- Konfiguracja SNMP wymaga ręcznego skonfigurowania
- Zaawansowane reguły alertów wymagają skonfigurowania
Learn more about Grafana Cloud: Najlepsze rozwiązanie dla zintegrowanej obsługi IT
- Dostępna 30-dniowa bezpłatna wersja próbna
- Ceny na żądanie
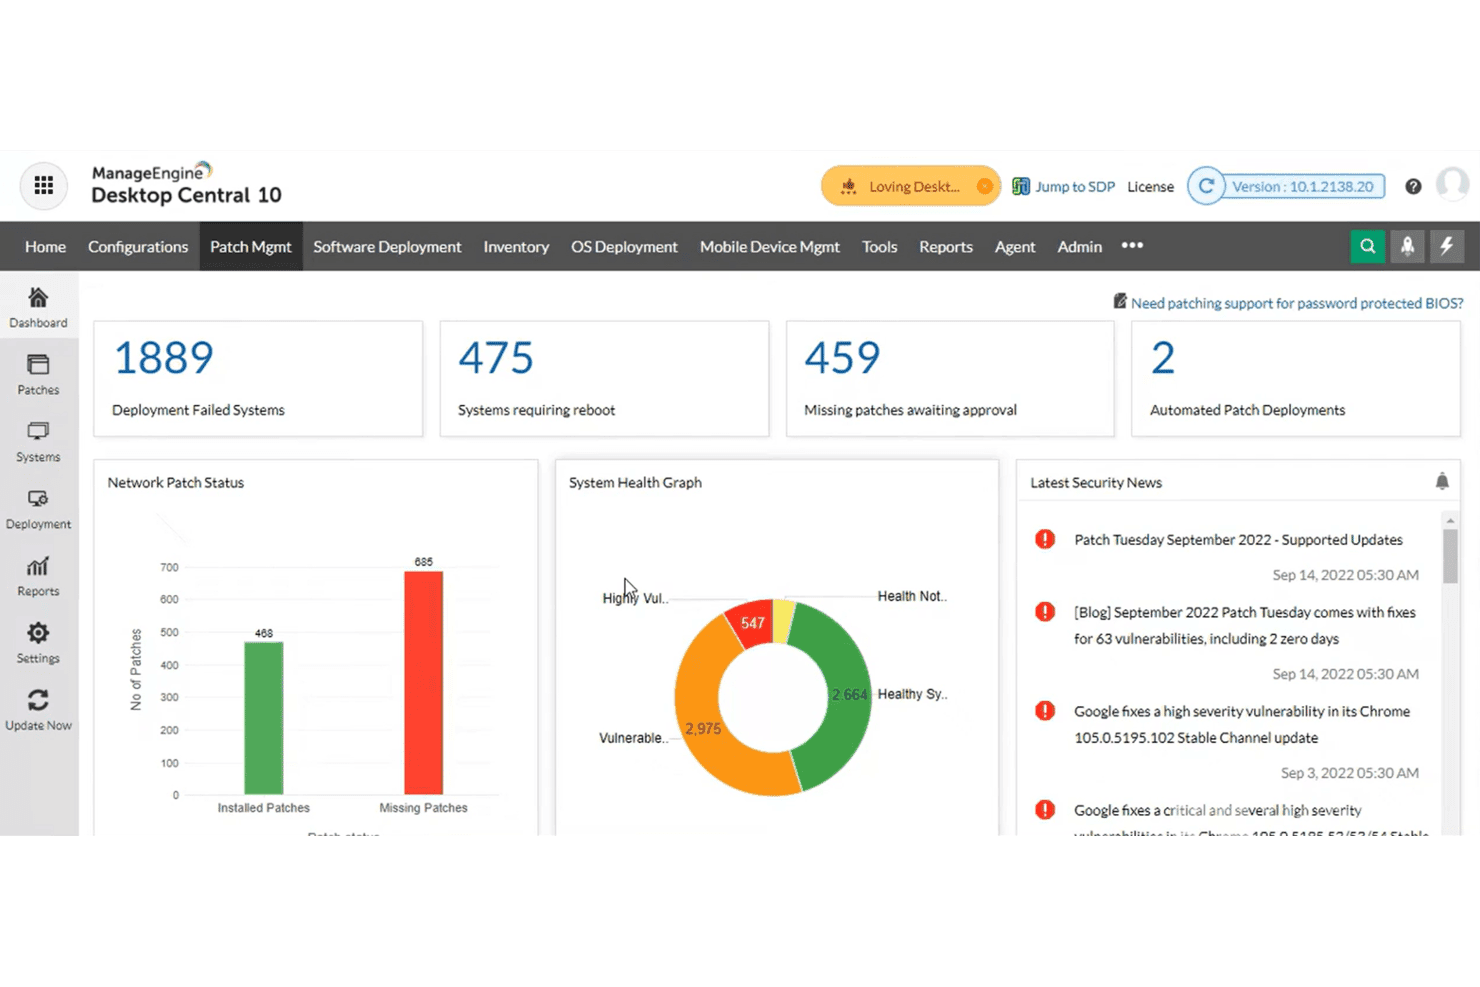
Panel zarządzania poprawkami ManageEngine Desktop Central 10 pokazujący stan poprawek sieciowych i kondycję systemu. ManageEngine OpManager to platforma do monitorowania sieci i infrastruktury, atrakcyjna dla zespołów operacyjnych IT zarządzających złożonymi środowiskami lokalnymi, oferująca szczegółowy wgląd w urządzenia, serwery, pamięć masową i infrastrukturę wirtualną, a także prognozowanie oparte na sztucznej inteligencji i automatyzację przepływów pracy bez użycia kodu.
Dla kogo najlepiej nadaje się ManageEngine?
ManageEngine OpManager doskonale sprawdza się w zespołach operacyjnych IT zarządzających dużymi środowiskami lokalnymi, które potrzebują szczegółowego wglądu w infrastrukturę bez ponoszenia kosztów na poziomie SolarWinds.
Dlaczego wybrałem ManageEngine
Wybrałem ManageEngine OpManager, ponieważ obejmuje cały stos infrastruktury w jednym miejscu, a tego właśnie potrzebujesz podczas zastępowania LogicMonitor. Szczególnie podoba mi się jego mapowanie topologii, które automatycznie tworzy mapy sieci warstwy 2, dzięki czemu można prześledzić usterkę od alertu bezpośrednio do dotkniętego segmentu, bez przeszukiwania oddzielnych narzędzi. Planowanie pojemności oparte na sztucznej inteligencji prognozuje, kiedy urządzenia osiągną progi wykorzystania pamięci, co pozwala zareagować, zanim dojdzie do awarii.
Najważniejsze funkcje ManageEngine OpManager
- Automatyzacja przepływów pracy bez użycia kodu: Konstruktor typu „przeciągnij i upuść” umożliwia tworzenie przepływów pracy uruchamianych w reakcji na usterki sieciowe lub zgodnie z harmonogramem w celu automatycznego zarządzania usługami, procesami, plikami i folderami.
- Widok 3D powierzchni centrum danych: Renderuje trójwymiarową replikę centrum danych i jego szaf w czasie rzeczywistym, wyświetlając bieżący stan urządzeń bezpośrednio w układzie fizycznym.
- Korelacja problemów i zdarzeń: Grupuje powiązane alerty w jeden rekord problemu wraz z poziomem ważności, metodą korelacji i wartością procentową redukcji szumu, aby ograniczyć zmęczenie alertami.
- Integracja z serwerem MCP: Umożliwia klientom AI, takim jak Claude Desktop lub Cursor, wysyłanie zapytań do danych monitorowania OpManager, w tym dotyczących stanu urządzeń, alarmów i trendów wydajności, za pomocą poleceń w języku naturalnym.
Integracje ManageEngine
ManageEngine OpManager oferuje natywne integracje z ServiceNow, Jira Service Management, Microsoft Teams, Slack, Grafana, Microsoft Sentinel i ManageEngine ServiceDesk Plus. Jego interfejs API REST korzysta z dokumentacji OpenAPI, a webhooki obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Ujednolicony wgląd w sieci, serwery i pamięć masową
- Mapy topologii pomagają prześledzić usterki do dotkniętych segmentów
- Prognozy pojemności wcześnie sygnalizują niedobory zasobów
Cons:
- Domyślne profile alertów mogą generować nadmierną liczbę powiadomień
- Konfiguracja niestandardowych raportów może zająć trochę czasu
Learn more about ManageEngine: Najlepsze rozwiązanie do dostosowywalnych pulpitów nawigacyjnych
- Bezpłatny plan + 30-dniowy okres próbny + dostępne demo
- Od $200/miesiąc (rozliczane rocznie)
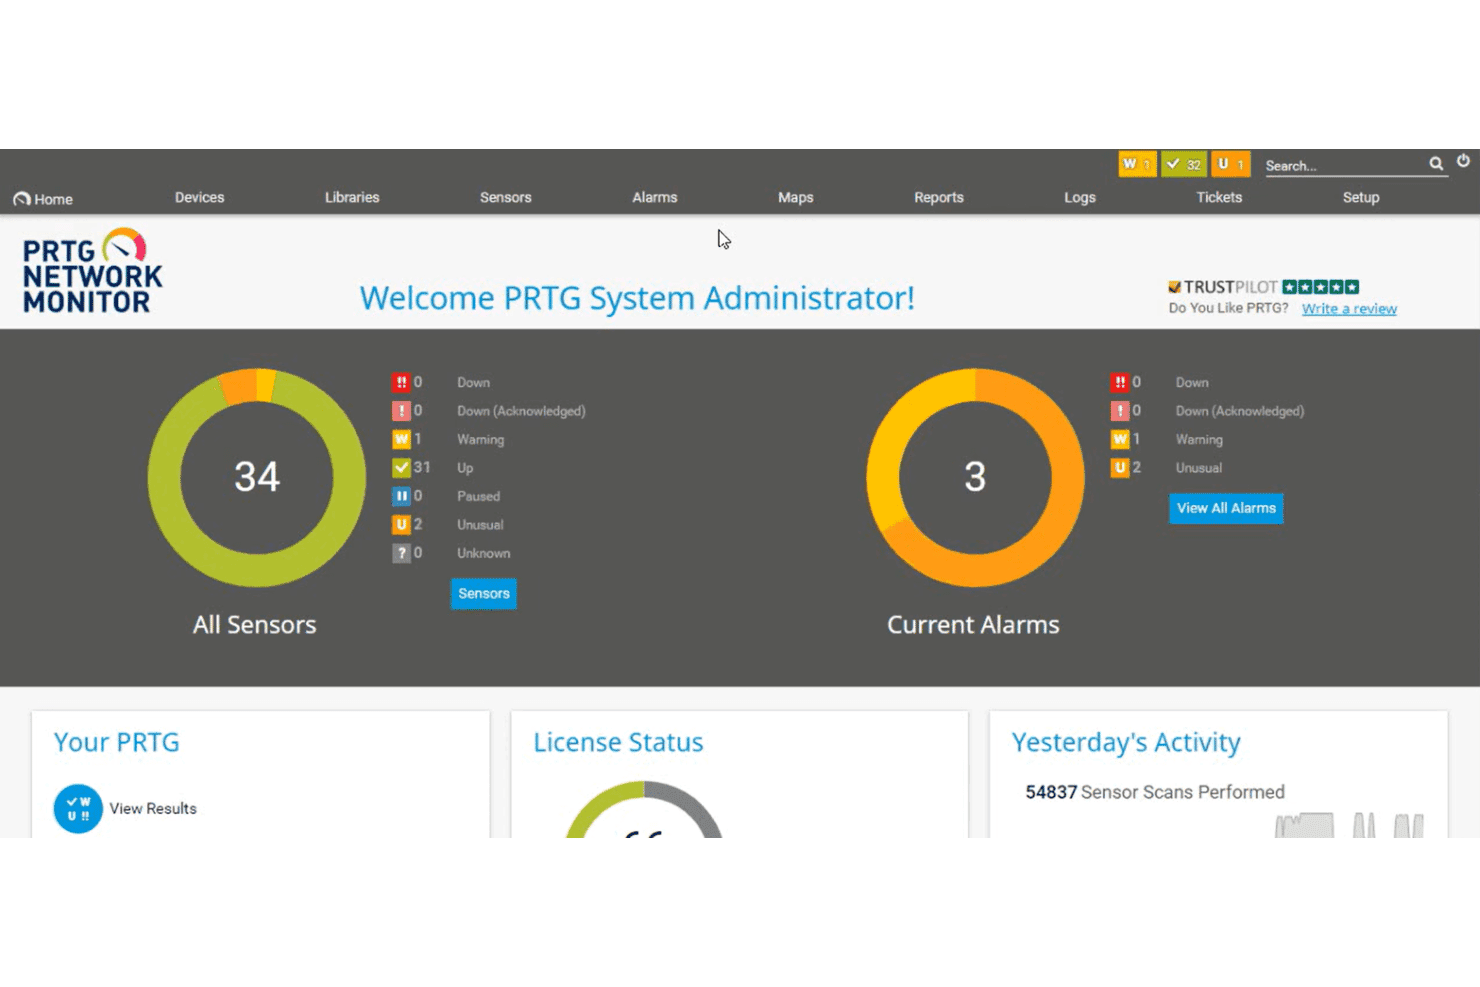
Pulpit nawigacyjny PRTG Network Monitor podsumowujący stan czujników i bieżące alarmy w jednym miejscu. Paessler PRTG to lokalne narzędzie do monitorowania sieci, które odpowiada administratorom sieci i zespołom IT potrzebującym szerokiego wglądu w infrastrukturę IT, OT i IoT — obejmującego urządzenia, ruch, serwery i aplikacje z poziomu jednej platformy.
Dla kogo Paessler PRTG jest najlepszym wyborem?
PRTG dobrze sprawdza się w przypadku administratorów sieci i zespołów IT zarządzających środowiskami lokalnymi lub hybrydowymi, którzy potrzebują wysoce wizualnego monitorowania opartego na czujnikach, dostosowanego do ich infrastruktury.
Dlaczego wybrałem Paessler PRTG
Wybrałem Paessler PRTG jako jedną z najlepszych alternatyw dla LogicMonitor, ponieważ możliwości dostosowywania pulpitów nawigacyjnych i map są bardziej zaawansowane niż w większości testowanych przeze mnie narzędzi. Mogę tworzyć widoki infrastruktury za pomocą edytora typu „przeciągnij i upuść”, dodawać ikony stanu urządzeń, mapy geograficzne i niestandardowe tła HTML, a następnie udostępniać je publicznie lub osadzać za pomocą iFrame. Dzięki ponad 300 dostępnym widżetom mogę tworzyć ekrany w stylu NOC, które pozwalają od razu dostrzec problemy dotyczące całej lokalizacji bez konieczności przeszukiwania menu.
Najważniejsze funkcje Paessler PRTG
- Automatyczne wykrywanie oparte na czujnikach: Skanuje segmenty sieci za pomocą ping, SNMP i WMI, a następnie automatycznie stosuje szablony urządzeń i czujników, aby rozpocząć monitorowanie.
- Wielokanałowe alerty z eskalacją: Wysyła powiadomienia za pośrednictwem poczty e-mail, SMS, powiadomień push, Teams lub Slack, z konfigurowalnymi poziomami eskalacji i zaplanowanymi przedziałami czasowymi alertów.
- Wykrywanie anomalii oparte na AI: Analizuje historyczne dane czujników w celu ustalenia wartości bazowych i wysyła alerty, gdy monitorowane wartości odbiegają od oczekiwanych wzorców.
- Raportowanie zaplanowane i na żądanie: Generuje raporty w formatach HTML, PDF, CSV lub XML dla pojedynczych czujników albo grup, zgodnie z ustalonym harmonogramem lub po ręcznym uruchomieniu.
Integracje Paessler PRTG
Paessler PRTG oferuje natywne integracje z Microsoft Teams, Slack i PagerDuty. Udostępnia także interfejsy API REST do tworzenia niestandardowych integracji oraz monitorowania danych XML lub JSON.
Pros and Cons
Pros:
- Niestandardowe mapy uwidaczniają problemy dotyczące lokalizacji
- Automatyczne wykrywanie obejmuje różnorodne czujniki infrastruktury
- Alerty eskalacyjne pomagają wcześnie wykrywać problemy z usługami
Cons:
- Topologia analizy przyczyn źródłowych wymaga osobnego płatnego rozszerzenia
- Zakres monitorowania chmury jest mniejszy niż w przypadku platform skoncentrowanych na dostawcach
Learn more about Paessler PRTG: Najlepszy do obserwowalności o otwartym kodzie źródłowym
- 30-dniowy bezpłatny okres próbny + dostępna bezpłatna demonstracja
- Od $49/miesiąc
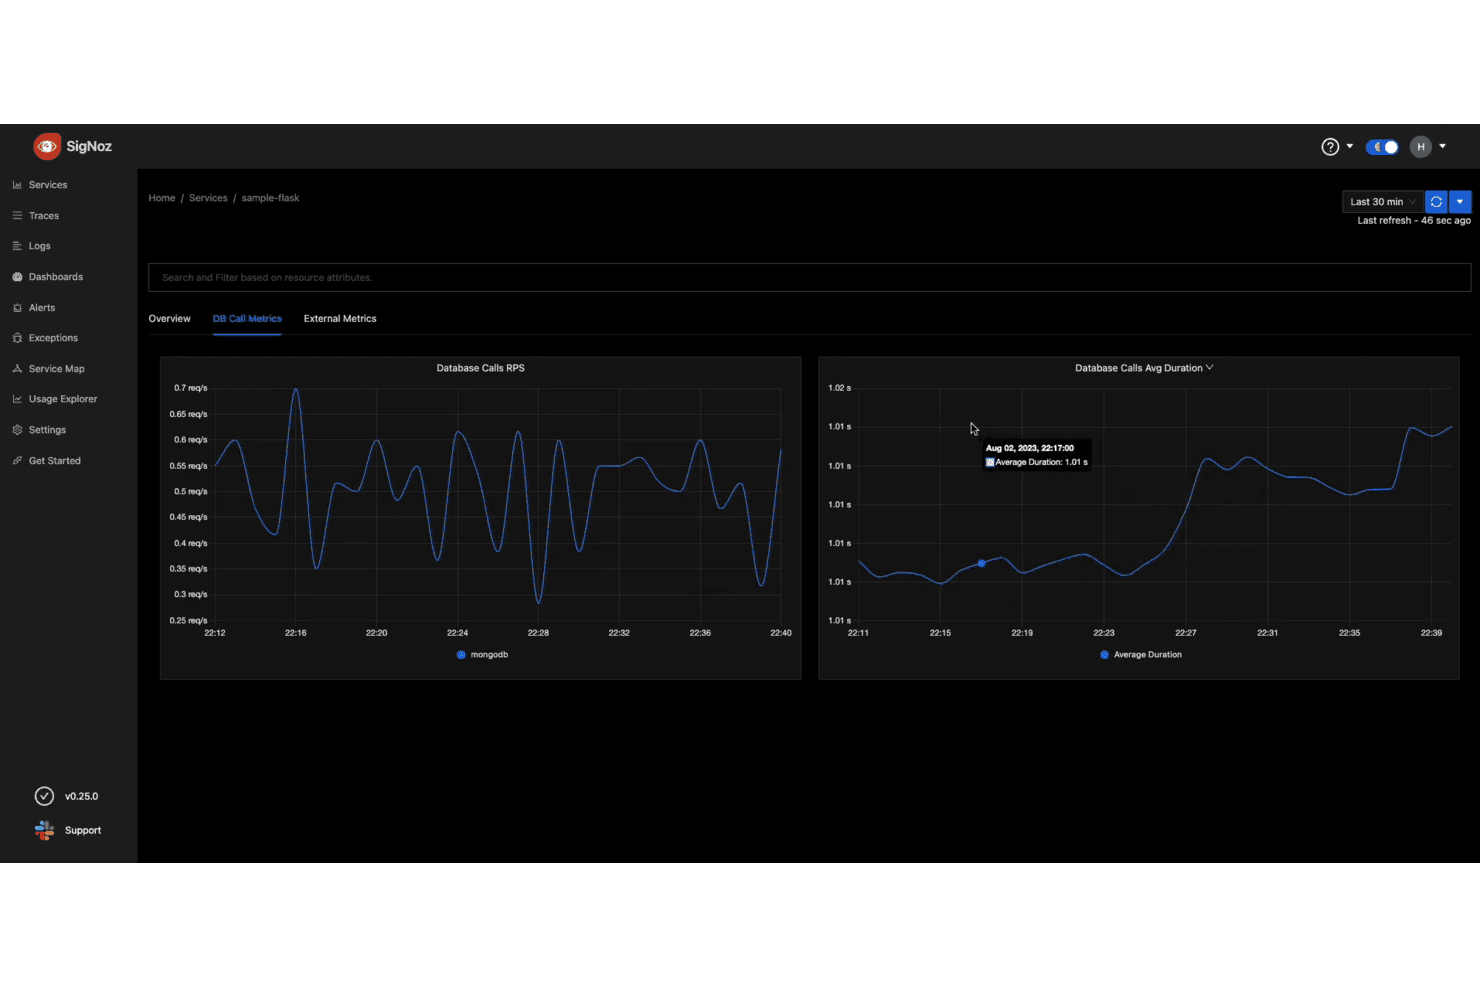
Widok usługi SigNoz pokazujący szybkość wywołań bazy danych MongoDB i średni czas trwania w czasie. SigNoz to natywna dla OpenTelemetry platforma do obserwowalności, która odpowiada inżynierom DevOps i zespołom infrastruktury potrzebującym ujednoliconych logów, metryk i śladów bez nieprzejrzystego rozliczania za hosta, charakterystycznego dla narzędzi takich jak Datadog czy New Relic.
Dla kogo SigNoz jest najlepszy?
SigNoz to dobry wybór dla inżynierów DevOps i zespołów platformowych, którzy chcą mieć pełną kontrolę nad swoim stosem obserwowalności bez opłat za hosta.
Dlaczego wybrałem SigNoz
Wybrałem SigNoz jako jedno z najlepszych rozwiązań, ponieważ jest to jedyna natywna dla OpenTelemetry platforma na tej liście, która pozwala samodzielnie hostować cały stos obserwowalności bez opłat za hosta i uzależnienia od dostawcy. Podoba mi się, że łączy logi, metryki i ślady w jednym miejscu, dzięki czemu po uruchomieniu alertu mogę przejść bezpośrednio z krawędzi mapy usług pokazującej podwyższone opóźnienie P99 do powiązanego śladu i logu bez przełączania narzędzi. Wspomagana przez sztuczną inteligencję korelacja alertów za pośrednictwem serwera MCP to naprawdę przydatna warstwa dodatkowa, która pozwala określić, która usługa nadrzędna odpowiada za skok, jeszcze zanim otworzę terminal.
Najważniejsze funkcje SigNoz
- Alertowanie na podstawie wielu sygnałów: Twórz alerty dotyczące metryk, logów, śladów, wyjątków i anomalii, korzystając z zasad routingu kierujących powiadomienia do Slacka, PagerDuty, Opsgenie, Microsoft Teams, poczty e-mail lub webhooków.
- Instrumentacja natywna dla OpenTelemetry: Zbieraj i przekazuj dane telemetryczne z aplikacji, hostów, Kubernetes i usług chmurowych za pomocą OpenTelemetry Collector, bez zastrzeżonych agentów.
- Kreator zapytań: Filtruj, agreguj i stosuj funkcje matematyczne do logów, metryk i śladów z jednego interfejsu; obsługiwane są również PromQL i SQL ClickHouse.
- Zgodność z SOC 2 Type II i HIPAA: SigNoz Cloud spełnia standardy SOC 2 Type II i HIPAA, a centra danych są dostępne w Stanach Zjednoczonych, Unii Europejskiej i Indiach.
Integracje SigNoz
SigNoz opisuje 112 integracji, w tym AWS, Azure, Google Cloud Platform, PostgreSQL, MySQL, Redis, MongoDB, NGINX i RabbitMQ. Udostępnia również interfejs API do tworzenia niestandardowych integracji oraz obsługuje połączenia OpenTelemetry Collector z zaporami sieciowymi, routerami i przełącznikami obsługującymi SNMP.
Pros and Cons
Pros:
- Samodzielny hosting pozwala zachować dane telemetryczne pod własną kontrolą
- Logi, metryki i ślady są wykorzystywane podczas wspólnych analiz
- Wspomagana przez sztuczną inteligencję korelacja alertów przyspiesza analizę awarii
Cons:
- Odpytywanie SNMP wymaga ręcznego mapowania identyfikatorów OID
- Samodzielnie hostowany ClickHouse wymaga ciągłego dostrajania
Learn more about SigNoz: 10Najlepszy wybór dla natywnych dla AI analiz
Last9
- Dostępny bezpłatny plan i bezpłatne demo
- Ceny dostępne na żądanie
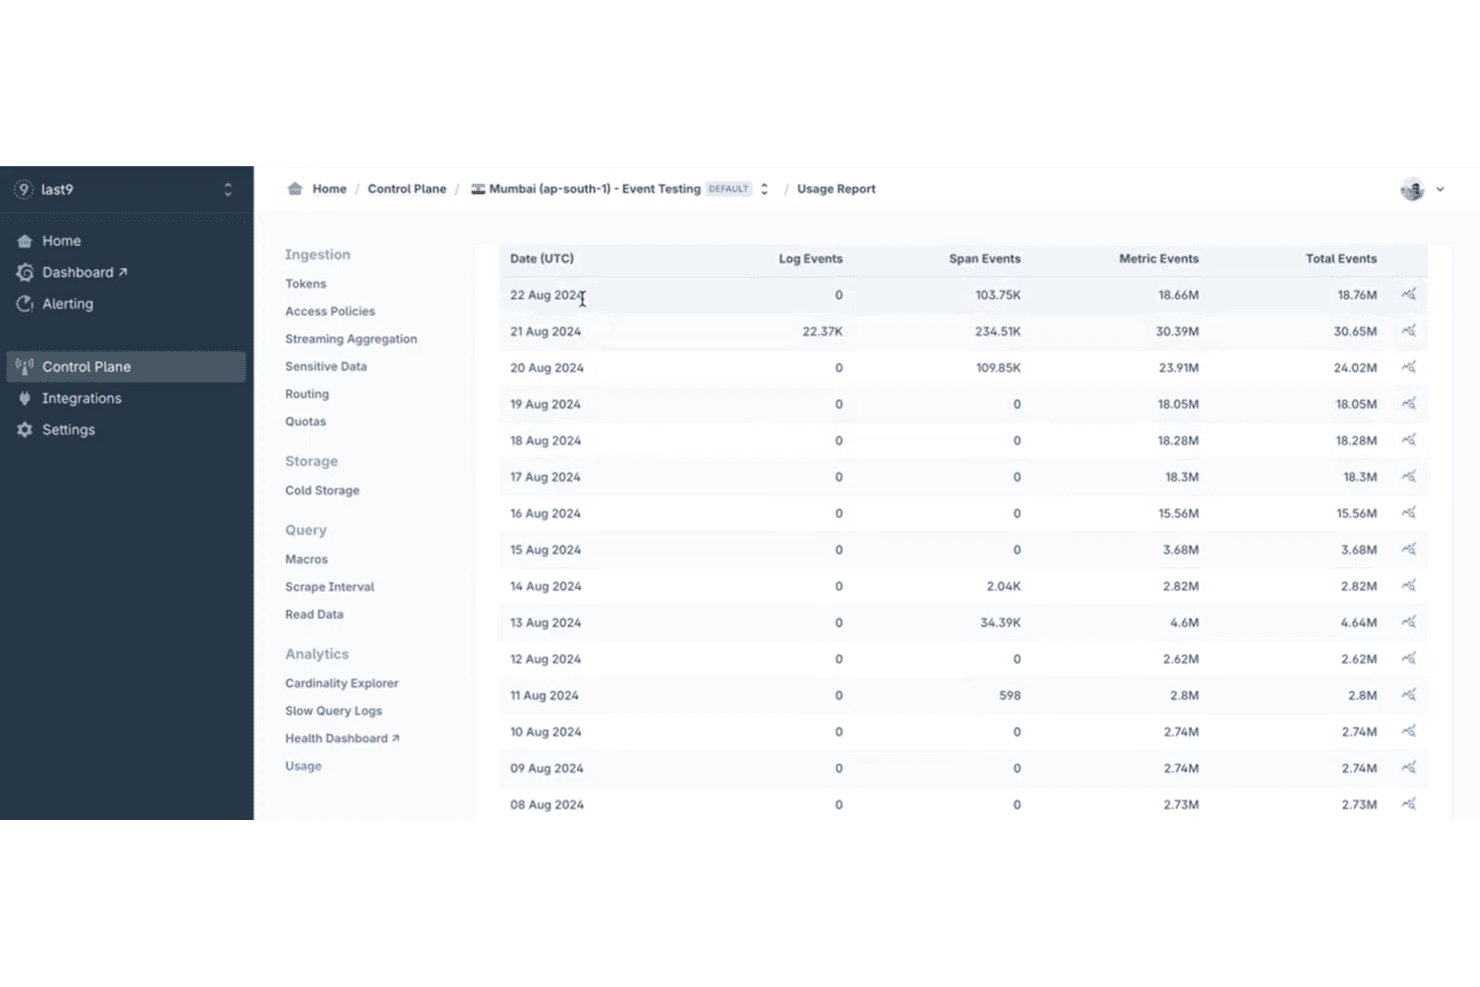
Raport wykorzystania płaszczyzny sterowania Last9 pokazujący dzienne wolumeny zdarzeń logów, spanów i metryk według daty. Last9 to natywna dla OpenTelemetry platforma obserwowalności stworzona dla zespołów DevOps i inżynierskich, które potrzebują ujednolicić metryki, logi i ślady — dzięki analizie opartej na AI oraz obsłudze dużej liczności kardynalnej jest to doskonały wybór dla zespołów wyrastających z kosztownych narzędzi monitorowania.
Dla kogo Last9 jest najlepszym wyborem?
Last9 doskonale sprawdza się w zespołach DevOps i inżynierii niezawodności witryn, które potrzebują natywnej dla OpenTelemetry obserwowalności z wbudowaną analizą opartą na AI.
Dlaczego wybrałem Last9
Wybrałem Last9 jako jedno z najlepszych rozwiązań, ponieważ jego natywna dla AI analiza sięga głębiej niż typowy pulpit alertów. Last9 AI może jednocześnie wyszukiwać dane w aktywnych metrykach, logach i śladach, a następnie przedstawiać skorelowane dowody oraz proponować reguły alertów lub pulpity do zatwierdzenia. Mapa Discover wizualizuje zależności między usługami w czasie rzeczywistym wraz ze wskaźnikami błędów i opóźnieniem P95, dzięki czemu po wystąpieniu incydentu mogę prześledzić zakres jego wpływu w mikrousługach bez ręcznego łączenia sygnałów.
Najważniejsze funkcje Last9
- Natywne pozyskiwanie danych przez OpenTelemetry: Last9 natywnie zbiera metryki, logi i ślady za pośrednictwem OpenTelemetry, bez konieczności korzystania z agentów zależnych od dostawcy.
- Reguły alertów PromQL i LogQL: Reguły alertów można pisać bezpośrednio w PromQL lub LogQL albo tworzyć za pomocą prowadzonego kreatora reguł w interfejsie użytkownika.
- Warstwowe przechowywanie metryk: Dane są przechowywane w warstwach Blaze, Hot i Cold, domyślnie nawet przez rok, bez zmniejszania rozdzielczości ani agregowania.
- Monitorowanie urządzeń sieciowych oparte na SNMP: Last9 zbiera dane telemetryczne z przełączników, routerów, zapór sieciowych i jednostek UPS za pomocą odbiornika SNMP w OpenTelemetry Collector lub eksportera SNMP Prometheus.
Integracje Last9
Last9 oferuje ponad 100 integracji, w tym AWS, Azure, Google Cloud, Kubernetes, Prometheus, Grafana, Slack, Datadog i New Relic. Udostępnia również interfejs REST API oraz serwer MCP do tworzenia niestandardowych integracji i obsługi przepływów pracy agentów AI.
Pros and Cons
Pros:
- Koreluje logi, metryki i ślady za pomocą AI
- Recenzenci informują o szybszym debugowaniu między usługami
- Użytkownicy chwalą skoncentrowane na działaniu alerty
Cons:
- Hosting platformy lokalnie nie jest udokumentowany
- Niektórzy recenzenci zgłaszają opóźnienia w odświeżaniu pulpitów
Learn more about Last9:
Inne alternatywy dla LogicMonitor
Oto kilka dodatkowych alternatyw dla LogicMonitor, które nie trafiły na moją listę, ale nadal warto je sprawdzić:
- 11NinjaOneNajlepsze rozwiązanie do zarządzania punktami końcowymi
- 12ObkioNajlepsze do optymalizacji wydajności sieci
- 13Azure MonitorNajlepsze rozwiązanie do uzyskiwania informacji o usługach Azure
Dlaczego szukać alternatywy dla LogicMonitor?
Chociaż LogicMonitor to dobry wybór wśród programów zwiększających produktywność, istnieje wiele powodów, dla których niektórzy użytkownicy szukają alternatywnych rozwiązań. Możesz szukać innej opcji, ponieważ:
- Potrzebujesz większych możliwości dostosowywania
- Twój zespół potrzebuje lepszej skalowalności
- Chcesz obniżyć koszty
- Twoja firma potrzebuje konkretnych integracji
- Szukasz prostszych interfejsów użytkownika
- Potrzebujesz lepszego wsparcia regionalnego
Jeśli któryś z tych powodów brzmi znajomo, jesteś we właściwym miejscu. Moja lista zawiera kilka opcji oprogramowania zwiększającego produktywność, które lepiej odpowiadają potrzebom zespołów mierzących się z tymi wyzwaniami związanymi z LogicMonitor i poszukujących alternatywnych rozwiązań.
Funkcje
Oto niektóre z kluczowych funkcji LogicMonitor, które pomogą Ci porównać i zestawić możliwości oferowane przez alternatywne rozwiązania:
- Ujednolicone monitorowanie: Zapewnia kompleksowe monitorowanie infrastruktury, chmury i zarządzania dziennikami, obsługując głównych dostawców usług w chmurze.
- Integracja z AIOps: Wykorzystuje narzędzia oparte na sztucznej inteligencji do analizy zdarzeń i automatyzacji w celu zwiększenia efektywności operacyjnej.
- Analityka predykcyjna: Zapewnia analizę przyczyn źródłowych i informacje o usługach, aby usprawnić rozwiązywanie incydentów.
- Rozbudowane integracje: Oferuje ponad 3000 integracji technologicznych umożliwiających dynamiczne skalowanie i odporność.
- Konfigurowalne pulpity nawigacyjne: Umożliwiają tworzenie i udostępnianie pulpitów nawigacyjnych w czasie rzeczywistym, dostosowanych do konkretnych potrzeb.
- Wykrywanie anomalii: Proaktywnie identyfikuje nietypowe zachowania, aby zapobiec ich wpływowi na użytkowników.
- Dynamiczne wartości progowe: Automatycznie ustawia inteligentne wartości progowe na podstawie danych historycznych.
- API i integracje: Rozszerza funkcjonalność za pomocą interfejsów API i integracji z różnymi technologiami.
- Obsługa chmury i wielu chmur: Monitoruje kontenery oraz głównych dostawców usług w chmurze, takich jak AWS, Google Cloud, Microsoft Azure i Oracle Cloud.
- Zarządzanie dziennikami: Zapewnia funkcje zarządzania dziennikami i analityki.