

ETL-werkstromen: ontwerpgids en beste praktijken

Gemiddeld hebben organisaties regelmatig te maken met 400 gegevensbronnen. Met letterlijk honderden gegevenssets om rekening mee te houden, kunnen gegevensintegratie en nauwkeurige gegevensanalyse onmogelijk zijn zonder de juiste werkstromen.
In deze handleiding laat ik je kennismaken met ETL-werkstromen en geef ik tips voor het bouwen van ETL-gegevenspijplijnen die verbeterde functionaliteit en gegevenskwaliteit ondersteunen.
Wat zijn ETL-werkstromen?
Onze uitgebreide handleiding voor ETL legt de details van het ETL-proces uit, waaronder de processen voor extraheren, transformeren en laden. Voor optimale functionaliteit moeten deze processen samenwerken, zodat informatie efficiënt van de gegevensbron naar de datawarehouseomgeving stroomt.

ETL-werkstromen zijn verantwoordelijk voor dit algehele proces. Ze omvatten doorgaans verschillende API-hulpprogramma's, connectoren en stappen voor gegevensverwerking om ervoor te zorgen dat het proces van extraheren, transformeren en laden goed werkt en organisatorische behoeften ondersteunt.
Voordelen van ETL-werkstromen
Enkele voordelen van sterke ETL-werkstromen zijn:
- Verbeterde toegang tot gegevens. Met de juiste ETL-processen kun je realtime toegang tot gegevens voor medewerkers ondersteunen. Het proces van extraheren, transformeren en laden zorgt ervoor dat gegevens klaar zijn voor gebruik zodra ze de gegevensopslag bereiken, waardoor het eenvoudiger wordt om SQL-rapporten, gegevensmodellen en andere query's uit te voeren.
- Mogelijkheid om grote hoeveelheden gegevens te verwerken. Geavanceerde ETL-processen kunnen grote gegevenssets verwerken en ongestructureerde gegevens integreren zonder tijdrovende handmatige processen. Hierdoor kunnen organisaties grote hoeveelheden gegevens eenvoudiger beheren en benutten.
- Betere processen voor gegevenstransformatie. De juiste ETL-werkstroom integreert elementen zoals het opschonen en transformeren van gegevens om de omzetting van onbewerkte gegevens naar gestructureerde gegevenssets die je kunt gebruiken te verbeteren.
- Ondersteuning van efficiëntie via automatisering. Het importeren van brongegevens, het uitvoeren van validatieprocessen en andere taken kunnen worden afgehandeld door ETL-hulpprogramma's die automatisering ondersteunen, waardoor minder tijd nodig is voor het beheren van gegevens.
- Mogelijkheid om bedrijfsregels toe te passen binnen gegevensbeheerprocessen. Je kunt ETL-oplossingen aanpassen aan verschillende organisatorische behoeften, waaronder het integreren van bedrijfs- en nalevingsregels in de werkstroom voor extraheren, transformeren en laden.
Overzicht van het ETL-proces
Voordat we de belangrijkste onderdelen van ETL-werkstromen en de manier waarop je deze modelleert bespreken, bekijken we eerst hoe deze processen werken, inclusief de doelen en uitdagingen van elke stap.
Extraheren
Tijdens het extractiegedeelte van ETL wordt informatie verzameld uit een of meer gegevensbronnen. Bij gegevensextractie kun je zowel onbewerkte als eerder verwerkte gegevens tegenkomen en heb je mogelijk te maken met verschillende bestandstypen, waaronder CSV en XML.
- Doel: De meest holistische en uitgebreide gegevens vastleggen die mogelijk zijn.
- Uitdagingen: Gegevensmeren en bronnen identificeren, passende toegang tot gegevens verkrijgen en het verzamelen van gegevens timen om actuele processen te garanderen.
Transformeren
Bij het gegevenstransformatieproces worden gegevens geconverteerd naar indelingen die werken met de relationele databases en andere methoden voor gegevensopslag en -analyse die je wilt gebruiken. Tijdens deze ETL-stap kun je hulpprogramma's voor gegevenskoppeling overwegen en het opschonen, ontdubbelen en formatteren van gegevens, het toevoegen van metagegevens en andere taken uitvoeren, zowel via automatisering als met handmatige werkstromen.
- Doel: Schone, bruikbare gegevens die zo zijn geformatteerd dat ze binnen je doelsysteem of gegevensopslag werken.
- Uitdagingen: Gegevenskwaliteit is een veelvoorkomende uitdaging waarmee organisaties te maken krijgen bij het transformeren van gegevens; hoe lager de kwaliteit, hoe meer werk nodig is voor gegevenstransformatie. Andere uitdagingen zijn mogelijk gegevensverlies, het integreren van meerdere gegevenstypen en het waarborgen van beveiliging gedurende het hele proces.
Laden
In de laatste stap van ETL-processen laad je gegevens in het uiteindelijke datawarehouse, zodat de organisatie deze naar behoefte kan gebruiken.
- Doel: Ervoor zorgen dat beveiligde, schone gegevens klaar zijn voor gebruik in analyses, door CRM-systemen of door andere bedrijfssoftware.
- Uitdagingen: Ook in deze stap vormen het waarborgen van gegevenskwaliteit en -beveiliging uitdagingen, en organisaties moeten processen voor gegevensbeheer opstellen om vast te leggen wie toegang heeft tot gegevens en hoe die toegang wordt verkregen. Het ondersteunen van realtime toegang tot gegevens — of toegang die daar zo dicht mogelijk bij in de buurt komt — kan ook belangrijk zijn, maar batchverwerking kan vertragingen in het proces veroorzaken.
Belangrijkste onderdelen van ETL-werkstromen
De eerste stap bij het opbouwen van ETL-werkstromen is bepalen welke belangrijkste onderdelen moeten worden opgenomen. De toepassingsmogelijkheden voor deze werkstromen variëren en mogelijk moet u rekening houden met unieke gegevens- en procesafhankelijkheden voor uw organisatie.
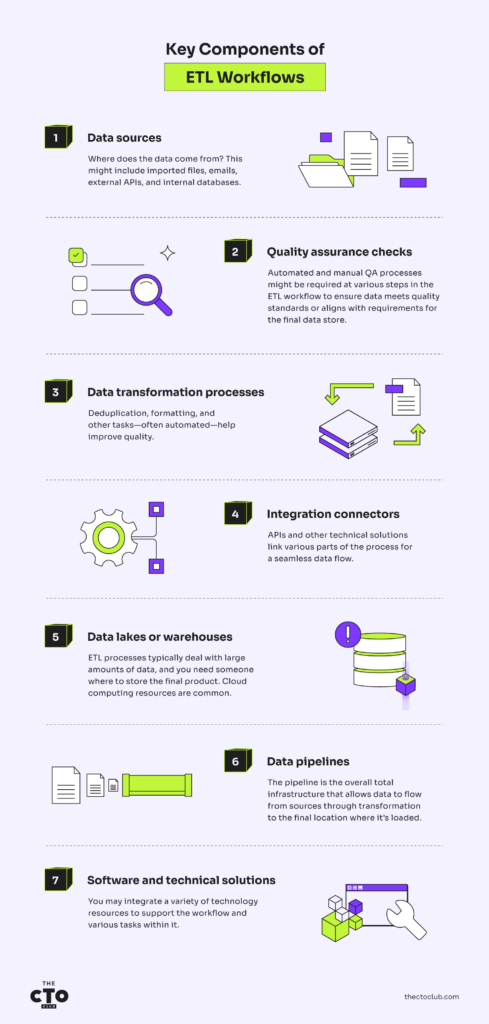
Veelvoorkomende onderdelen die gegevensengineers in ETL-werkstromen meenemen, zijn onder andere:
- Gegevensbronnen. Waar komen de gegevens vandaan? Dit kunnen geïmporteerde bestanden, e-mails, externe API's en interne databases zijn.
- Kwaliteitscontroles. Geautomatiseerde en handmatige kwaliteitscontroles kunnen op verschillende momenten in de ETL-werkstroom nodig zijn om ervoor te zorgen dat gegevens aan kwaliteitsnormen voldoen of aansluiten bij de vereisten voor de uiteindelijke gegevensopslag.
- Gegevenstransformatieprocessen. Deduplicatie, opmaak en andere taken—vaak geautomatiseerd—helpen de kwaliteit te verbeteren.
- Integratie-connectoren. API's en andere technische oplossingen verbinden verschillende onderdelen van het proces voor een naadloze gegevensstroom.
- Datalakes of datawarehouses. ETL-processen verwerken doorgaans grote hoeveelheden gegevens en er moet iemand zijn die weet waar het eindproduct moet worden opgeslagen. Cloudcomputingbronnen komen vaak voor.
- Datapijplijnen. De pijplijn is de volledige infrastructuur waarmee gegevens vanaf de bronnen via transformatie naar de uiteindelijke locatie kunnen stromen, waar ze worden geladen.
- Software en technische oplossingen. U kunt verschillende technologische hulpmiddelen integreren ter ondersteuning van de werkstroom en de verschillende taken daarin.
ETL-werkstromen modelleren
Bij het modelleren van uw ETL-pijplijnen moet u bepalen of u batchverwerking of streamverwerking wilt gebruiken.
Een ETL-pijplijn opbouwen met batchverwerking
Bij batchverwerking beheert de werkstroom gegevens in batches of gedeelten. Elke batch wordt doorgaans bepaald aan de hand van tijd: u kunt bijvoorbeeld dagelijks, periodiek gedurende de dag of aan het begin van elk uur batches verwerken.
Batchverwerking is een goede oplossing wanneer:
- U schaalvoordelen wilt benutten
- U automatisering hebt die grote gegevensbatches snel kan verwerken
- Toegang tot en verwerking van gegevens niet bijzonder tijdkritisch is
Een ETL-pijplijn opbouwen met streamverwerking
Met streamverwerking kunnen gegevens in realtime door ETL stromen zonder dat zich op enig moment in het proces gegevensbatches opbouwen. Dit is flexibeler dan batchverwerking, maar bij dit type pijplijn kan het moeilijker zijn om de gegevenskwaliteit en -consistentie te waarborgen.
Streamverwerking is een goede oplossing wanneer:
- Gegevens in kleine gedeelten en met onregelmatige tussenpozen uw proces binnenkomen
- Toegang tot gegevens tijdkritisch is, waardoor het van cruciaal belang is om gegevens onmiddellijk in het proces op te nemen
- U toegang wilt tot actuele inzichten zonder te wachten totdat gebatchte gegevens zijn verwerkt
Voorbeelden van ETL-werkstromen
Inzicht in de specifieke gegevensstroom en beheerbehoeften van uw sector is essentieel voor een succesvolle planning van ETL-werkstromen. Bekijk deze voorbeelden uit verschillende sectoren om te begrijpen hoe vereisten en afhankelijkheden kunnen variëren.
ETL voor gegevensstromen in de gezondheidszorg
Zorgorganisaties hebben nauwkeurige en tijdige toegang nodig tot patiënt- en behandelingsgegevens, waardoor ETL-processen essentieel zijn voor succes. Gegevens kunnen uit verschillende bronnen komen, waaronder patiëntenportalen, elektronische patiëntendossiers, beeldvormingsapparatuur en externe leveranciers zoals farmaceutische bedrijven.
Een van de grootste uitdagingen bij ETL in de gezondheidszorg is het creëren van veilige processen die voldoen aan regelgeving zoals HIPAA. Deze processen zijn ook afhankelijk van gegevensbronnen die door patiënten, zorgverleners en automatisering worden gevoed, wat extra uitdagingen in het gegevenstransformatieproces met zich meebrengt.
Bij het modelleren van datapijplijnen in de gezondheidszorg moet u mogelijk streamverwerking en batchverwerking gebruiken. Zorgverleners hebben bijvoorbeeld mogelijk realtime toegang tot diagnostische gegevens nodig, terwijl coderings- en factureringsgegevens aan het einde van de dag kunnen worden gebatcht voor declaraties.
ETL voor e-commercegegevensstromen
E-commercegegevens zijn afkomstig uit veel bronnen, waaronder e-mails, klantportalen, API's en apps, sociale media, websites, CRM-systemen en boekhoudkundige of betalingsprocessen. Dit maakt het transformeren van gegevens zonder kwaliteitsverlies tot een enorme uitdaging.
Batchverwerking werkt doorgaans goed voor veel e-commerceprocessen. U kunt bijvoorbeeld elk uur bestelgegevens ophalen en deze doorgeven aan ETL-processen die magazijn- en verzendtaken ondersteunen. U kunt ook dagelijks betalingsgegevens scrapen, zodat financiële gegevens worden bijgewerkt.
Als u echter 24/7 selfservice voor klanten wilt ondersteunen, zijn streamgebaseerde werkstromen mogelijk geschikter. Stel bijvoorbeeld dat u een chatbot hebt die klanten informatie geeft over bestellingen, betalingen, retouren en tegoeden. Als uw ETL-processen in dagelijkse batches worden uitgevoerd, is de informatie die uw chatbot verstrekt altijd minstens 24 uur verouderd.
ETL voor financiële gegevensstromen
Banken, creditcardmaatschappijen, apps voor geldbeheer en andere organisaties en diensten in de financiële sector zijn sterk afhankelijk van nauwkeurige gegevens. Deze organisaties moeten ook omgaan met strenge regelgeving en nalevingsnormen om gegevens veilig te houden.
Gegevensbronnen kunnen geïmporteerde gegevens van andere financiële organisaties, ACH- en clearinghousegegevens, informatie uit klantgerichte apps en minder gestructureerde indelingen zoals e-mails omvatten. Financiële organisaties willen mogelijk ook een combinatie van batch- en streampijplijnen gebruiken om aan de behoeften van klanten te voldoen.
Technologische vooruitgang in ETL-processen
Enkele decennia geleden zorgde cloudtechnologie voor een revolutie in gegevensverwerking, en deze technologie vormt nog steeds een belangrijk onderdeel van de vooruitgang in software en oplossingen voor datawarehouses. Momenteel richten trends in de technologische vooruitgang van ETL zich echter doorgaans op het integreren van AI, machinaal leren en automatisering in werkstromen. Enkele specifieke ontwikkelingen zijn:
- Het vermogen van AI om grote hoeveelheden gegevens te verwerken. Kunstmatige-intelligentietools kunnen enorme hoeveelheden gegevens in enkele seconden verwerken, waardoor ETL-processen schaalbaarder kunnen worden dan ooit tevoren.
- Natuurlijke taalverwerking. Machinaal leren en natuurlijke taalverwerking stellen geautomatiseerde oplossingen in staat om gegevens te transformeren met een uitgebreidere reeks vaardigheden op het gebied van "kritisch denken" dan voorheen mogelijk was. Dit creëert mogelijkheden voor het automatiseren van taken waarvoor historisch gezien menselijke tussenkomst nodig was.
- Ondersteuning voor gegevensbeheer. Bijna elke sector heeft tegenwoordig te maken met strengere wettelijke vereisten, en technologische oplossingen helpen steeds vaker bij de naleving en beveiliging van gegevens.
Beste werkwijzen voor het optimaliseren van ETL-werkstromen
Wat het beste werkt voor een andere organisatie, is mogelijk niet de beste werkwijze voor uw bedrijf als het om ETL gaat. Ik heb echter enkele algemene beste werkwijzen verzameld die u in vrijwel elke omgeving kunt toepassen om ETL-werkstromen te optimaliseren.
- Kies de juiste tools voor uw behoeften. Doe onderzoek naar hulpmiddelen voor ETL-werkstromen en -processen om partners en oplossingen te vinden die aan uw unieke gegevensbehoeften voldoen. Overweeg een team samen te stellen om de gewenste ETL-werkstromen in kaart te brengen, de uitdagingen waarmee u te maken hebt op te sommen en mogelijke oplossingen in het licht van die factoren te beoordelen.
- Zorg ervoor dat uw keuzes voor werkstromen correct zijn. Neem de tijd om het verschil tussen ETL en ELT te begrijpen en te bepalen of u batch- of streamwerkstromen nodig hebt.
- Houd uw processen regelmatig in de gaten. Gebruik hulpmiddelen zoals de prestatiemonitor van SQL Server — of andere relevante prestatiemonitors — om te begrijpen hoe uw ETL-werkstromen presteren. Houd efficiëntie- en kwaliteitsmetingen in de gaten en pas waar nodig verbeteringen toe voor voortdurende optimalisatie.
- Integreer technologie die kwaliteit en schaalbaarheid ondersteunt. Overweeg opties zoals parallelle verwerking en gegevenscompressie om uw werkstromen te optimaliseren.
Belangrijkste punten
Het ontwerp van uw ETL-werkstromen kan uw gegevensprocessen maken of breken. Neem de tijd om na te denken over de gevolgen van beslissingen met betrekking tot werkstromen, breng ideale werkstromen in kaart en kies de juiste hulpmiddelen ter ondersteuning van het extraheren, transformeren en laden van gegevens.
Blijf op de hoogte van technologie en beste werkwijzen voor gegevensbeheer door u te abonneren op de nieuwsbrief van CTO Club.


