

10 beste open-source-ETL-gereedschappen beoordeeld in 2026

Beste shortlist van open-source ETL-tools


De beste open-source ETL-tools helpen teams bij het automatiseren van gegevensextractie, transformatie en het laden van gegevens, zodat ze nauwkeurige en consistente datasets in verschillende systemen kunnen onderhouden. Ze maken het eenvoudiger om complexe gegevensbronnen te verwerken, transformaties op grote schaal toe te passen en handmatig werk bij het beheren van gegevenspijplijnen te verminderen.
Wanneer gegevenspijplijnen afhankelijk zijn van aangepaste scripts, schemawijzigingen tot stille fouten leiden of teams onvoldoende inzicht hebben in hoe gegevens tussen systemen worden verplaatst, kunnen de gegevenskwaliteit en betrouwbaarheid afnemen. Deze problemen vertragen analysetaken, verhogen de onderhoudstijd en veroorzaken wrijving tussen engineering- en datateams.
In mijn meer dan 20 jaar ervaring in de sector als Chief Technology Officer heb ik tientallen open-source ETL-tools getest en beoordeeld om prestaties, integratiekwaliteit en gebruiksgemak te beoordelen. In deze gids staan de beste opties die schaalbare workflows en beter voorspelbare gegevensbewerkingen ondersteunen. Elke beoordeling behandelt functies, voor- en nadelen en best passende gebruiksscenario's, zodat je de juiste tool kunt kiezen.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Samenvatting van de beste open-source ETL-tools
Deze vergelijkingsgrafiek vat de prijsgegevens van mijn selectie van de beste open-source ETL-tools samen, zodat je de beste optie voor je budget en zakelijke behoeften kunt vinden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Het beste voor complexe gegevenstaken | Gratis proefversie beschikbaar | Vanaf $5,500/eenheid/jaar | Website | |
| 2 | Het beste voor de verwerking van logboekgegevens | Een gratis proefversie van 7 dagen is beschikbaar | Prijzen op aanvraag | Website | |
| 3 | Ideaal voor Python-ETL-scripts | Not available | Gratis te gebruiken | Website | |
| 4 | Beste voor datatransformatie | 30 dagen gratis proefperiode | Vanaf $4/gebruiker/maand | Website | |
| 5 | Ideaal voor bigdata-integratie | Proefperiode van 14 dagen beschikbaar | Prijs op aanvraag | Website | |
| 6 | Beste voor geautomatiseerde data-integratie | 14 dagen gratis proefperiode + gratis abonnement + gratis demo beschikbaar | Vanaf $239/maand (jaarlijks gefactureerd) | Website | |
| 7 | Ideaal voor integratiepatronen | Not available | Gratis te gebruiken | Website | |
| 8 | Beste voor realtime gegevensstreaming | Gratis abonnement beschikbaar | Gratis | Website | |
| 9 | Beste voor automatisering van gegevensstromen | Not available | Gratis te gebruiken | Website | |
| 10 | Beste voor schaalbare ETL-oplossingen | Gratis abonnement beschikbaar | Gratis | Website |
Beoordelingen van de beste open-source ETL-tools
Hieronder vind je mijn uitgebreide samenvattingen van de beste open-source ETL-tools die op mijn shortlist staan. Mijn beoordelingen geven een gedetailleerd overzicht van de belangrijkste functies, voor- & nadelen, integraties en ideale gebruiksscenario’s van elke tool, zodat je de beste optie voor jou kunt vinden.
CloverDX
Het beste voor complexe gegevenstaken

CloverDX is een platform voor gegevensintegratie dat zakelijke gebruikers en IT-teams ondersteunt door gegevens te automatiseren, te orkestreren en te transformeren. Het ondersteunt verschillende implementatieopties, waardoor het veelzijdig is voor uiteenlopende bedrijfsbehoeften.
Waarom ik voor CloverDX heb gekozen: CloverDX is afgestemd op complexe gegevenstaken dankzij de intuïtieve interface en veelzijdige implementatieopties, waaronder lokale implementatie en clouddiensten zoals AWS, Azure en Google Cloud. Het biedt gegevensdiensten voor API-toegang en samenwerkingstools, zodat je team efficiënt kan werken in verschillende omgevingen. De opname van een gegevenscatalogus biedt betrouwbare toegang tot gegevens, wat cruciaal is voor het behoud van gegevensintegriteit. Deze functies maken CloverDX tot een uitstekende keuze voor teams die met ingewikkelde gegevensprocessen werken.
Opvallende functies & integraties:
Functies omvatten een intuïtieve interface voor zakelijke gebruikers, gegevensdiensten voor API-toegang en een gegevenscatalogus voor betrouwbare gegevenstoegang. Deze elementen zorgen ervoor dat je gegevens efficiënt kunt beheren en openen. Het platform biedt ook samenwerkingstools om de samenwerking binnen het team te verbeteren.
Integraties omvatten AWS, Azure, Google Cloud, Snowflake, Salesforce, Microsoft SQL Server, Oracle, PostgreSQL, MongoDB en Kafka.
Pros and Cons
Pros:
- Ondersteunt complexe gegevensprocessen
- Veelzijdige implementatieopties
- Sterke mogelijkheden voor API-toegang
Cons:
- Mogelijk steile leercurve
- Vereist technische expertise

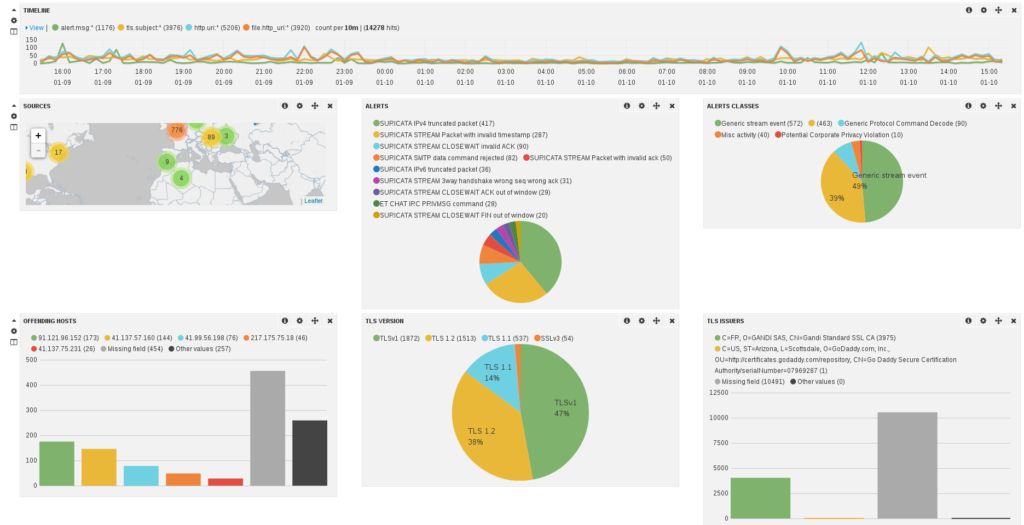
Logstash is een opensourcegegevensverwerkingspipeline waarmee ontwikkelaars en IT-teams logboeken uit verschillende bronnen kunnen verzamelen, transformeren en opslaan. Het systeem is ontworpen om grote hoeveelheden logboekgegevens te verwerken en is daardoor ideaal voor organisaties die hun logboekinformatie moeten centraliseren en analyseren.
Waarom ik voor Logstash heb gekozen: Logstash blinkt uit in de verwerking van logboekgegevens en biedt een flexibele pipelinearchitectuur waarmee je logboeken uit meerdere bronnen kunt samenvoegen. De tool biedt krachtige filter- en transformatiemogelijkheden, zodat je team gegevens kan aanpassen aan specifieke behoeften. Dankzij de realtimeverwerking van Logstash zijn je logboekgegevens actueel en direct bruikbaar. De compatibiliteit met Elasticsearch en Kibana maakt het een uitstekende keuze voor organisaties die de Elastic Stack al gebruiken.
Opvallende functies & integraties:
Functies omvatten een flexibele pipelinearchitectuur die complexe gegevenstransformaties ondersteunt, zodat je de verwerking van logboeken kunt aanpassen. De realtimeverwerkingsmogelijkheden van Logstash zorgen ervoor dat je logboekgegevens altijd actueel zijn. De tool biedt ook uitgebreide filteropties om gegevens af te stemmen op je specifieke vereisten.
Integraties omvatten Elasticsearch, Kibana, Beats, AWS, Azure, Google Cloud, Kafka, RabbitMQ, JDBC en Redis.
Pros and Cons
Pros:
- Verwerkt grote hoeveelheden logboeken
- Realtimegegevensverwerking
- Flexibele pipelinearchitectuur
Cons:
- Kan veel systeembronnen gebruiken
- Beperkte ingebouwde analysemogelijkheden

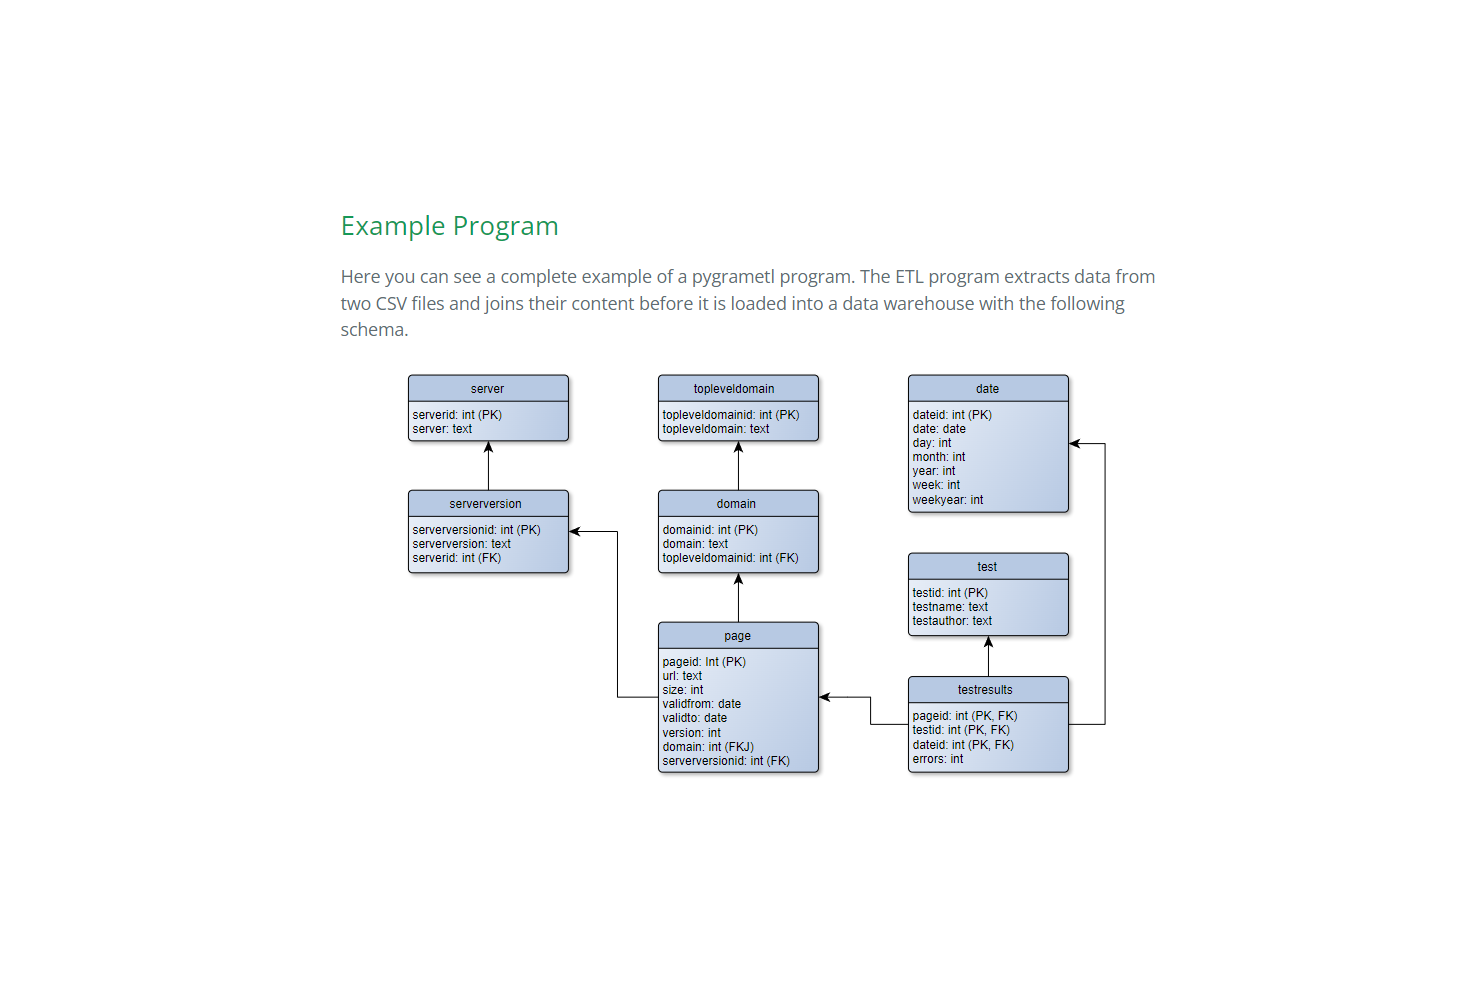
pygrametl is een open-source Python-framework voor het ontwikkelen van ETL-processen. Het is ontworpen als alternatief voor grafische BI-programma's, met hetzelfde gebruiksgemak. Het ondersteunt CPython en Jython, waardoor ETL-ontwikkelaars bestaande Java-code en JDBC-stuurprogramma's kunnen gebruiken.
Ontwikkelaars kunnen gegevens extraheren uit de vele bronnen die beschikbaar zijn in pygrametl, zoals SQL, CSV en Pandas. Gebruikers kunnen ook hun eigen gegevensbronnen definiëren. Het platform biedt filters en aggregatiefuncties voor het transformeren van gegevens. Standaardaggregatiefuncties zijn AVG, Count, CountDistinct, Max, Min en Sum.
pygrametl kan getransformeerde gegevens laden in elk datawarehouse dat dimensionele modellering ondersteunt. Het systeem biedt structuren voor het definiëren van feitentabellen en dimensies, waaronder langzaam veranderende dimensies en dimensies met een sneeuwvlokschema.
Ontwikkelaars kunnen pygrametl gratis downloaden.

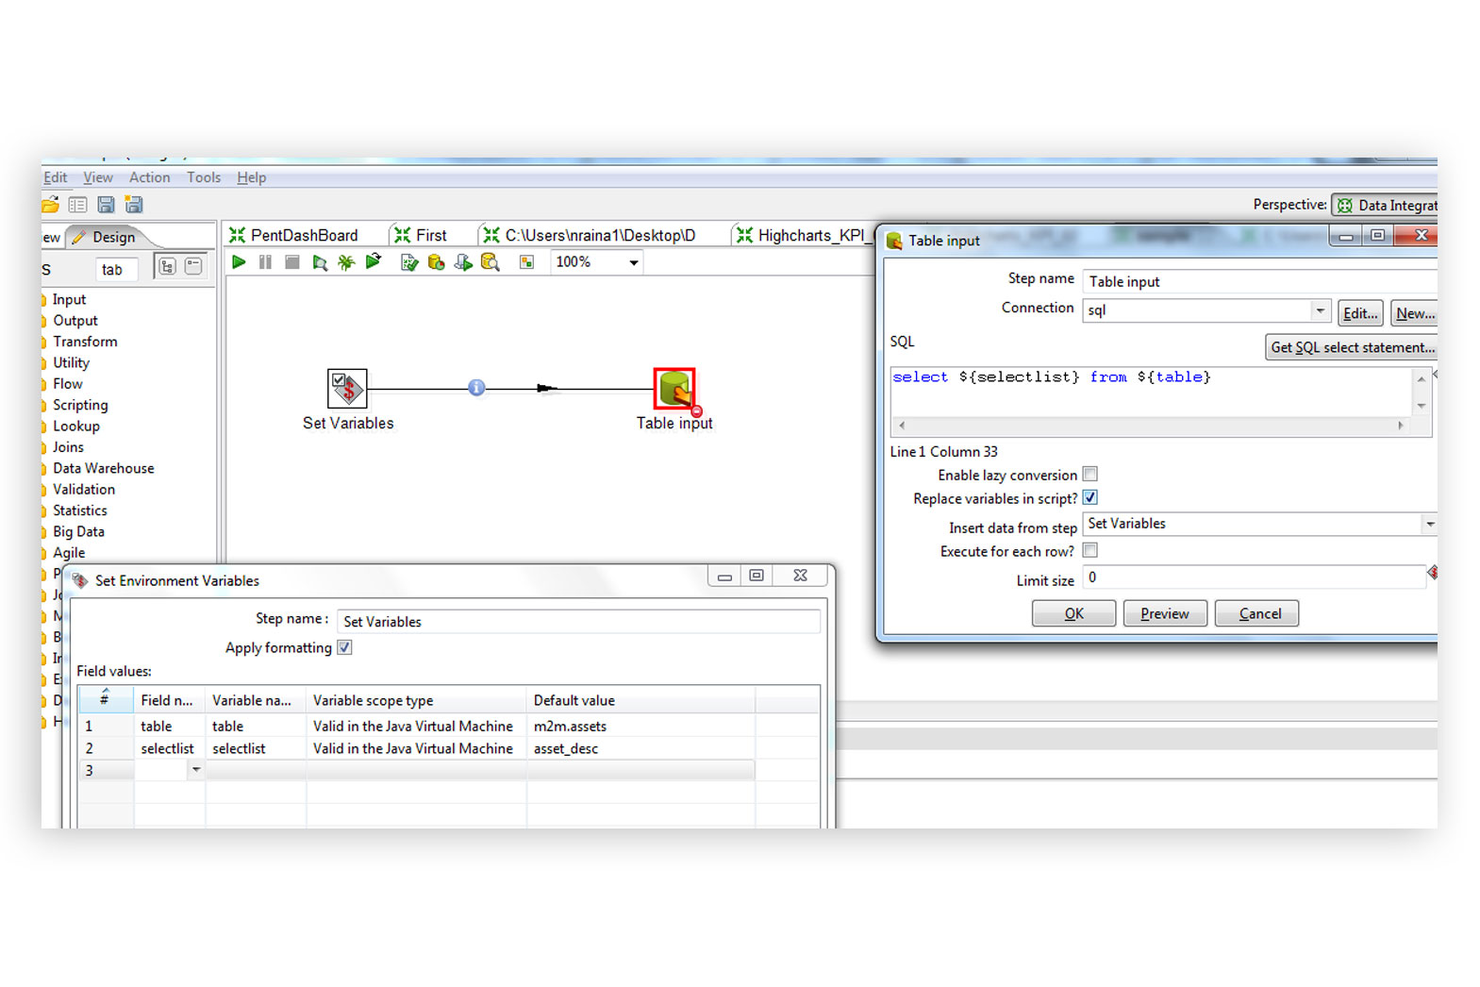
Pentaho Kettle is een open-source ETL-tool voor data-engineers en bedrijfsanalisten die complexe gegevenstransformaties moeten uitvoeren. Het biedt een visuele interface voor het ontwerpen van datapijplijnen, waardoor gegevensstromen eenvoudiger kunnen worden beheerd en transformaties efficiënt kunnen worden uitgevoerd.
Waarom ik Pentaho Kettle heb gekozen: Het staat bekend om zijn mogelijkheden voor datatransformatie en biedt een visuele interface met slepen-en-neerzetten die het opzetten van complexe workflows vereenvoudigt. Kettle biedt uitgebreide ondersteuning voor verschillende gegevensbronnen, zodat je team gegevens uit meerdere bronnen kan integreren. De grafische interface vermindert de behoefte aan uitgebreide programmeerkennis, wat voordelig is voor teams met beperkte programmeerervaring. Dankzij de flexibiliteit bij het verwerken van verschillende gegevenstypen en -indelingen is de tool een veelzijdige keuze voor uiteenlopende gegevensbehoeften.
Opvallende functies & integraties:
Functies omvatten een visuele interface met slepen-en-neerzetten die het ontwerpen van workflows vereenvoudigt, zodat je complexe gegevenstransformaties kunt opbouwen zonder code te schrijven. De tool ondersteunt een breed scala aan gegevensbronnen, waardoor integratie eenvoudig is. De flexibiliteit van Kettle bij het verwerken van meerdere gegevenstypen en -indelingen zorgt voor compatibiliteit met uiteenlopende gegevensomgevingen.
Integraties omvatten Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP en Hadoop.
Pros and Cons
Pros:
- Visuele interface voor transformaties
- Verwerkt uiteenlopende gegevenstypen
- Uitgebreide ondersteuning voor gegevensbronnen
Cons:
- Kan veel systeembronnen verbruiken
- Complexe eerste configuratie

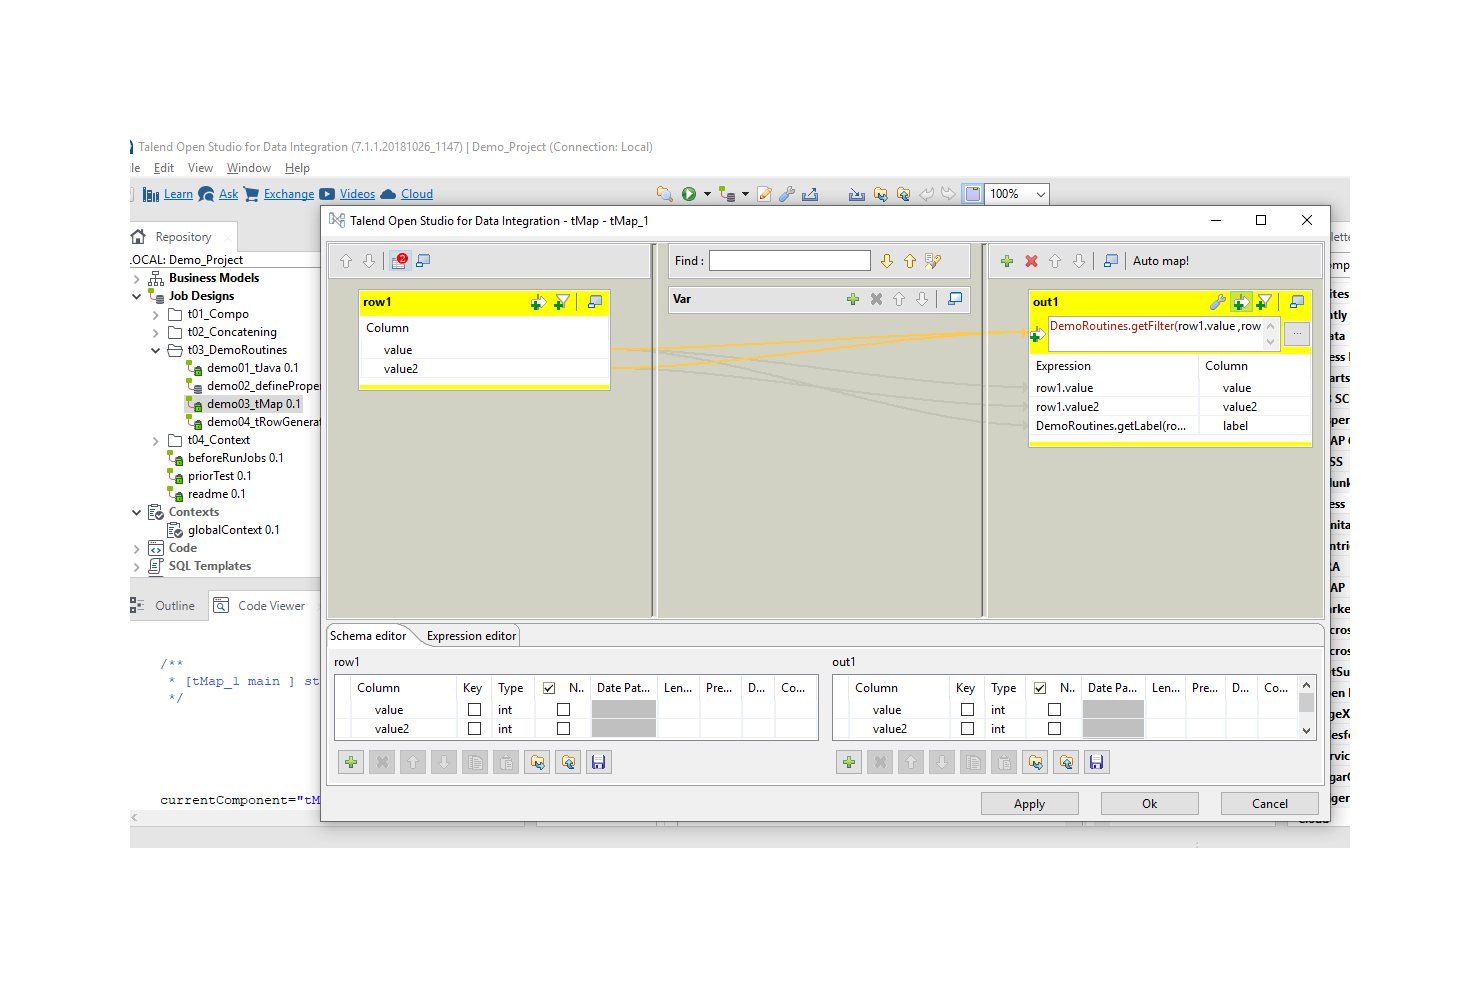
Talend Open Studio is een suite met opensourcehulpmiddelen waarmee ETL-ontwikkelaars in minder tijd eenvoudige datapijplijnen kunnen bouwen. De suite beschikt over een op Eclipse gebaseerde ontwikkelomgeving en meer dan 900 vooraf gebouwde connectoren, waaronder Oracle, Teradata, Marketo en Microsoft SQL Server. Het platform omvat vijf componenten: Talend Open Studio voor gegevensintegratie, big data, gegevenskwaliteit, Enterprise Service Bus (ESB) en Master Data Management (MDM).
Talend Open Studio is een uitstekende aanvulling op veel tools voor bedrijfsinformatie (BI). Het biedt verschillende methoden om meerdere gegevensverzamelingen om te zetten naar indelingen die compatibel zijn met populaire BI-platforms, waaronder Jasper, OLAP en SPSS. Gebruikers kunnen ook rechtstreeks inzichten verkrijgen uit Talend Open Studio, dat eenvoudige visualisaties kan genereren, waaronder staafdiagrammen.
Talend Open Studio ondersteunt integraties met verschillende databases, waaronder Microsoft SQL Server, Postgres, MySQL, Teradata en Greenplum.
Talend Open Studio is gratis te downloaden voor alle gebruikers.


Hevo Data is een ETL- en data-integratieplatform voor datateams die betrouwbare en geautomatiseerde datapijplijnen zoeken. Het maakt gegevensopname uit verschillende bronnen mogelijk met minimale configuratie en zonder programmeren, waardoor de gegevensnauwkeurigheid en besluitvorming worden verbeterd.
Waarom ik Hevo Data heb gekozen: Het blinkt uit in geautomatiseerde data-integratie, met functies zoals realtimebewaking van datapijplijnen en gegevensreplicatie op hoge snelheid, zodat je team met minimale inspanning up-to-date blijft. De nalevings- en beveiligingsfuncties van Hevo bieden gemoedsrust, vooral voor zakelijke gebruikers. Dankzij de transparante prijsstelling van het platform zijn er geen verborgen kosten, wat een groot pluspunt is voor budgettering. Dankzij de gebruiksvriendelijke interface kun je gegevens beheren zonder uitgebreide programmeerkennis.
Opvallende functies & integraties:
Functies omvatten realtimebewaking van datapijplijnen om je gegevens actueel te houden, geavanceerde beheermogelijkheden voor meer controle en nalevings- en beveiligingsfuncties om gevoelige informatie te beschermen. Deze functies helpen je team efficiënt en veilig te werken. Hevo biedt ook gegevensreplicatie op hoge snelheid om de gegevensconsistentie te waarborgen.
Integraties omvatten Salesforce, Google Analytics, Amazon Redshift, Snowflake, BigQuery, MySQL, PostgreSQL, Oracle, MS SQL Server en HubSpot.
Pros and Cons
Pros:
- Geautomatiseerde data-integratie
- Realtimebewaking
- Replicatie op hoge snelheid
Cons:
- Beperkte aanpassingsmogelijkheden
- Niet geschikt voor alle gegevenstypen


Apache Camel is een opensource-integratieframework dat is ontworpen voor ontwikkelaars en architecten die enterprise-integratiepatronen moeten implementeren. Het faciliteert de routering en bemiddeling van berichten tussen systemen, waardoor het ideaal is voor complexe integratiescenario's.
Waarom ik voor Apache Camel heb gekozen: Het blinkt uit in het gebruik van integratiepatronen om de connectiviteit tussen verschillende systemen te stroomlijnen. Camel ondersteunt een breed scala aan protocollen en gegevensindelingen, zodat je team eenvoudig uiteenlopende systemen kan verbinden. De domeinspecifieke taal (DSL) biedt een flexibele manier om routerings- en bemiddelingsregels te definiëren, wat cruciaal is voor het afhandelen van complexe integraties. Dankzij de mogelijkheid van de tool om met verschillende eindpunten te integreren, biedt deze ongeëvenaarde veelzijdigheid bij het ontwerpen van integratieoplossingen.
Belangrijkste functies & integraties:
Functies omvatten een uitgebreide verzameling enterprise-integratiepatronen die het integratieproces vereenvoudigen. Met de domeinspecifieke taal van de tool kun je eenvoudig complexe routeringsregels definiëren. Apache Camel ondersteunt ook een breed scala aan gegevensindelingen en protocollen, wat compatibiliteit met meerdere systemen garandeert.
Integraties omvatten AWS, Apache Kafka, ActiveMQ, RabbitMQ, Salesforce, Google Cloud, Azure, JMS, File en FTP.
Pros and Cons
Pros:
- Uitgebreide integratiepatronen
- Ondersteuning voor diverse gegevensindelingen
- Veelzijdige integratie van eindpunten
Cons:
- Documentatie kan beperkt zijn
- Resource-intensief voor grote implementaties


Apache Kafka is een gedistribueerd platform voor eventstreaming dat door ontwikkelaars en ondernemingen wordt gebruikt om realtime-datapijplijnen en streamingtoepassingen te bouwen. Het is ontworpen om grote hoeveelheden gegevens snel en efficiënt te verwerken, waardoor het ideaal is voor bedrijven die realtime gegevensverwerking nodig hebben.
Waarom ik Apache Kafka heb gekozen: Het is ontworpen voor realtime gegevensstreaming en ondersteunt verwerking met hoge doorvoer en lage latentie, wat essentieel is voor moderne datagestuurde toepassingen. De gedistribueerde architectuur van Kafka zorgt voor hoge beschikbaarheid en fouttolerantie, zodat je gegevens altijd toegankelijk zijn. Dankzij de schaalbaarheid van het platform kun je groeiende gegevensbehoeften aan zonder dat dit ten koste gaat van de prestaties. Kafka biedt ook sterke garanties voor gegevensduurzaamheid, waardoor de gegevensintegriteit na verloop van tijd behouden blijft.
Belangrijkste functies & integraties:
Functies omvatten een gedistribueerde architectuur die hoge beschikbaarheid garandeert, ingebouwde gegevensreplicatie voor fouttolerantie en een robuust berichtensysteem voor schaalbare gegevensverwerking. Deze functies maken het zeer geschikt voor het efficiënt verwerken van grote hoeveelheden gegevens. Kafka's loggebaseerde opslagsysteem garandeert de duurzaamheid en betrouwbaarheid van gegevens.
Integraties omvatten Confluent, AWS, Azure, Google Cloud, MongoDB, Cassandra, Elasticsearch, Splunk, Hadoop en MySQL.
Pros and Cons
Pros:
- Verwerkt gegevens met hoge doorvoer
- Verwerking met lage latentie
- Sterke gegevensduurzaamheid
Cons:
- Beperkte ingebouwde monitoring
- Configuratie kan uitdagend zijn

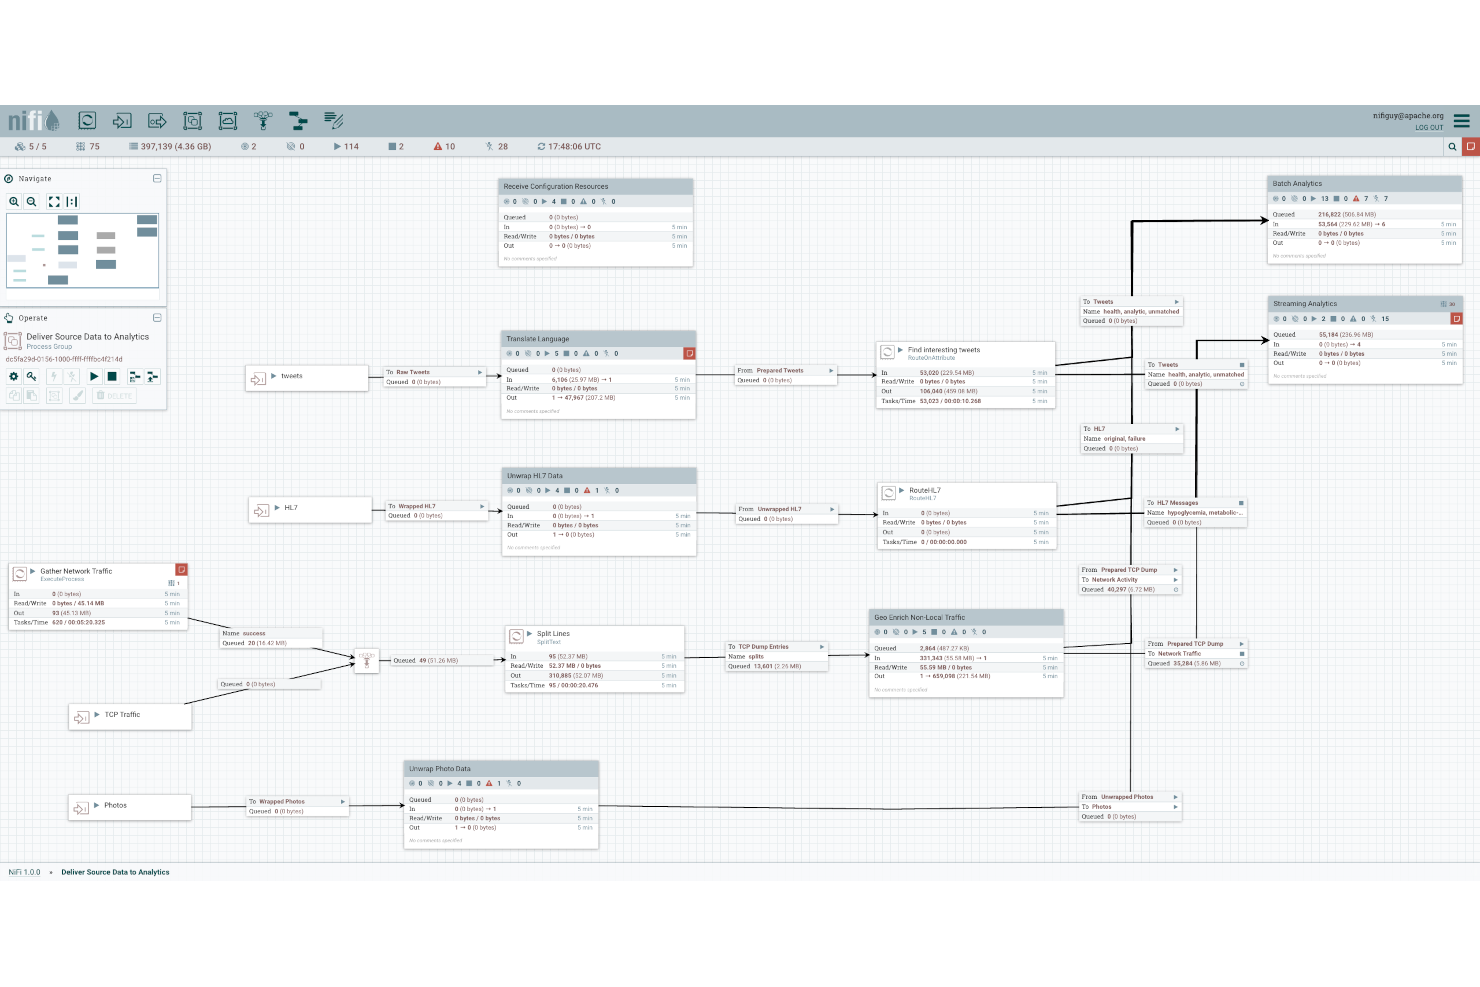
Apache NiFi is een opensourcetool voor gegevensintegratie, ontworpen voor ontwikkelaars en data-ingenieurs die gegevensstromen moeten automatiseren. Het maakt het verzamelen, verwerken en distribueren van gegevens tussen verschillende systemen mogelijk, waardoor het ideaal is voor realtime gegevensverwerking.
Waarom ik Apache NiFi heb gekozen: Het is afgestemd op de automatisering van gegevensstromen en biedt een gebruiksvriendelijke interface voor het ontwerpen van complexe werkstromen. De interface van NiFi met slepen-en-neerzetten vereenvoudigt het maken van gegevenspijplijnen, wat cruciaal is voor teams zonder uitgebreide programmeerervaring. De tool ondersteunt realtime beheer van gegevensstromen, zodat je gegevens actueel en relevant blijven. De ingebouwde beveiligingsfuncties voegen een extra beschermingslaag toe voor gevoelige gegevens.
Opvallende functies & integraties:
Functies omvatten een interface met slepen-en-neerzetten die het ontwerpen van werkstromen vereenvoudigt, zodat je eenvoudig gegevenspijplijnen kunt maken. Het realtime beheer van gegevensstromen van NiFi zorgt ervoor dat je gegevens altijd actueel zijn. De tool biedt ook ingebouwde beveiligingsfuncties om je gevoelige informatie te beschermen.
Integraties omvatten AWS, Azure, Google Cloud, Kafka, HDFS, MongoDB, Elasticsearch, MySQL, PostgreSQL en JMS.
Pros and Cons
Pros:
- Automatiseert gegevensstromen efficiënt
- Gebruiksvriendelijke interface met slepen-en-neerzetten
- Realtime gegevensbeheer
Cons:
- Kan veel systeembronnen vereisen
- Complexe eerste installatie

KETL is een open-source ETL-platform dat is ontworpen voor data-engineers en IT-professionals die schaalbare oplossingen voor gegevensintegratie en planning nodig hebben. Het biedt een multithreadarchitectuur op basis van XML die complexe gegevensmanipulaties ondersteunt, waardoor het geschikt is voor uitgebreide gegevensverwerkingstaken.
Waarom ik voor KETL heb gekozen: Het biedt schaalbare ETL-oplossingen dankzij de mogelijkheid om grote gegevensvolumes over meerdere servers en CPU's te verwerken. De taakuitvoerings- en planningsmanager van het platform zorgt voor efficiënt workflowbeheer, wat cruciaal is voor grootschalige activiteiten. De gecentraliseerde opslagplaats voor taakdefinities helpt bij het behouden van overzicht en controle over gegevensprocessen. Daarnaast stellen de mogelijkheden voor prestatiemonitoring van KETL uw team in staat om gegevensworkflows effectief te volgen en te optimaliseren.
Belangrijkste functies & integraties:
Functies omvatten een multithreadarchitectuur die de schaalbaarheid en prestaties verbetert. KETL ondersteunt een breed scala aan taaktypen, waaronder SQL, OS en XML, en biedt flexibiliteit bij het verwerken van verschillende gegevensindelingen. De gecentraliseerde opslagplaats voor taakdefinities van het platform helpt het workflowbeheer te stroomlijnen en consistentie te waarborgen.
Integraties omvatten Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP en Hadoop.
Pros and Cons
Pros:
- Schaalbaar over meerdere servers
- Ondersteunt complexe gegevensmanipulatie
- Gecentraliseerde taakopslagplaats
Cons:
- Beperkte ondersteuning vanuit de community
- Documentatie kan beperkt zijn
Andere open-source ETL-tools
Hier zijn enkele aanvullende opties voor open-source ETL-tools die mijn shortlist niet hebben gehaald, maar toch de moeite waard zijn om te bekijken:
- Singer
Het beste voor scripts voor gegevensextractie
- Scriptella
Het beste voor eenvoudige ETL-scripting
- Bubbles
Python ETL-framework voor het verwerken, controleren en inspecteren van gegevens


Hoe ik open-source-ETL-tools evalueer
Ik splits mijn evaluatie op in twee lagen—de basisfunctionaliteit voor ETL/ELT-pijplijnen om een tool te kwalificeren, en vervolgens onderscheidende factoren zoals CDC, Kubernetes-ondersteuning en het aantal connectors die op productieschaal van belang zijn.
Kernfunctionaliteit (minimale vereisten voor deze lijst)
Bij het selecteren van tools voor mijn lijst beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde kernfunctionaliteit. Vervolgens zet ik de totaalscore van de tool om in een percentage. Elke tool moet een minimale totaalscore van 65% behalen om voor opname in aanmerking te komen.
- Open-sourcelicentie: Ik controleer of het project een erkende, door de OSI goedgekeurde licentie gebruikt (Apache 2.0, MIT, GPL enzovoort) en of de broncode openbaar beschikbaar is voor zelfhosting, forking en bijdragen vanuit de community.
- Volledige ondersteuning voor ETL/ELT-pijplijnen: Elke tool moet extractie, transformatie en laden als een samenhangende workflow kunnen afhandelen—niet alleen gegevens van A naar B synchroniseren zonder enige logica ertussen.
- Bibliotheek met vooraf gebouwde connectors: Ik beoordeel de omvang van het aantal connectors voor databases, cloudwarehouses, SaaS-apps en bestandsindelingen, omdat je team met een tool die er maar een handvol heeft voor elke nieuwe bron aangepaste code moet schrijven.
- Engine voor gegevenstransformatie: Of het nu gaat om SQL-gebaseerde modellen zoals bij dbt, Python-scripts of visuele toewijzing, ik zoek naar een transformatielaag die praktische behoeften ondersteunt, zoals typeconversie, deduplicatie en joins.
- Pijplijnorkestratie & planning: Tools moeten geplande uitvoeringen, afhankelijkheidsbeheer, nieuwe pogingen en taakbewaking ondersteunen, zodat pijplijnen niet stilletjes om 2 uur 's nachts mislukken zonder dat iemand het weet.
- Uitbreidbaarheid & aangepaste connectors: Ik zoek naar een gedocumenteerde SDK of pluginframework waarmee je team connectors kan bouwen voor interne API's of gespecialiseerde systemen die niet in de standaardcatalogus staan.
Zodra ik een lijst met tools heb die aan deze criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (wat leveranciers van elkaar onderscheidt)
Zo vergelijk ik verschillende leveranciers:
Opvallende functies
Het vastleggen van gegevenswijzigingen is belangrijk wanneer je pijplijnen updates in de brondatabase bijna realtime moeten weerspiegelen—bijvoorbeeld wanneer wijzigingen in de bestelstatus naar een warehouse worden gesynchroniseerd zonder elk uur volledige tabellen opnieuw te laden. Ik beoordeel ook de gegevensherkomst en observeerbaarheid, omdat het bijhouden van afhankelijkheden op kolomniveau en het detecteren van schemaverschuivingen voordat een dashboard uitvalt uren aan foutopsporing kan besparen. Een visuele pijplijnbouwer is ook het vermelden waard, vooral voor teams waarin analisten of medewerkers die minder code schrijven naast engineers pijplijnen moeten kunnen bouwen of aanpassen.
Naast functies
De activiteit van de community is een sterke aanwijzing voor levensvatbaarheid op lange termijn—ik controleer de frequentie van commits, het releasetempo en hoe beheerders reageren op issues en PR's. Flexibiliteit bij implementatie is ook belangrijk: een tool die Docker, Kubernetes en Helm-charts ondersteunt, geeft je team opties, of je nu on-premises werkt of meerdere cloudproviders gebruikt. Ik let ook goed op de duidelijkheid van de licentie, omdat sommige open-coreprojecten belangrijke functies zoals RBAC of SSO achter betaalde abonnementen plaatsen, wat teams kan verrassen naarmate ze opschalen.
Open-source ETL-tools kiezen
Het is gemakkelijk om verstrikt te raken in lange functielijsten en complexe prijsstructuren. Om je te helpen gefocust te blijven terwijl je je unieke softwareselectieproces doorloopt, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waarop letten |
| Schaalbaarheid | Zorg ervoor dat de tool de groei van uw datavolume aankan. Houd rekening met toekomstige behoeften en ga na of de tool zowel batchverwerking als realtimeverwerking efficiënt ondersteunt. |
| Integraties | Controleer of de tool kan worden geïntegreerd met uw bestaande systemen en gegevensbronnen, zoals databases, cloudservices en toepassingen van derden, om workflows te stroomlijnen. |
| Aanpasbaarheid | Ga na of u dataworkflows kunt aanpassen aan uw specifieke processen. Hoe beter de aanpasbaarheid, hoe beter de tool zich kan aanpassen aan uw veranderende behoeften. |
| Gebruiksgemak | Beoordeel de gebruikersinterface. Een tool die eenvoudig te navigeren is, verkort de leercurve voor uw team en versnelt de implementatie. |
| Budget | Vergelijk de prijs met uw budget. Houd rekening met de totale eigendomskosten, inclusief verborgen kosten, om ervoor te zorgen dat de tool binnen uw financiële beperkingen past. |
| Beveiligingsmaatregelen | Zorg ervoor dat de tool robuuste beveiligingsfuncties biedt om uw gevoelige gegevens te beschermen. Let op versleuteling, toegangsbeheer voor gebruikers en naleving van regelgeving. |
| Ondersteuning | Controleer de beschikbaarheid van klantenondersteuning. Snelle ondersteuning kan cruciaal zijn tijdens de implementatie en het oplossen van problemen. |
| Prestaties | Beoordeel de verwerkingssnelheid en betrouwbaarheid van de tool. Deze moet consistent en zonder fouten gegevens op tijd leveren ter ondersteuning van uw bedrijfsactiviteiten. |
Trends in opensource-ETL-tools
Voor mijn onderzoek heb ik talloze productupdates, persberichten en releaselogboeken van verschillende leveranciers van opensource-ETL-tools geraadpleegd. Dit zijn enkele opkomende trends die ik in de gaten houd:
- Realtimeverwerking: Steeds meer tools richten zich op realtime gegevensverwerking, waardoor bedrijven snel kunnen reageren op veranderingen en goed geïnformeerde beslissingen kunnen nemen. Apache Kafka heeft bijvoorbeeld zijn streamingmogelijkheden uitgebreid om realtimeanalyses te ondersteunen.
- Gegevensobservatie: Leveranciers voegen functies toe om de zichtbaarheid en monitoring van gegevens te verbeteren, zodat teams problemen sneller kunnen identificeren en oplossen. Tools zoals Apache NiFi bieden nu verbeterde functies voor gegevenstracering en gegevensherkomst om de gegevensintegriteit te waarborgen.
- Architectuur die specifiek voor de cloud is ontwikkeld: Door de verschuiving naar cloudcomputing worden ETL-tools ontworpen om cloudresources efficiënt te benutten. Talend Open Studio biedt bijvoorbeeld mogelijkheden die specifiek voor de cloud zijn ontwikkeld om de prestaties en schaalbaarheid te optimaliseren.
- Interfaces met weinig code: Er is een groeiende vraag naar platforms waarvoor weinig of geen code nodig is en die ETL-tools toegankelijk maken voor niet-technische gebruikers. Tools zoals Pentaho Kettle maken steeds vaker gebruik van visuele interfaces om het creëren van datapijplijnen te vereenvoudigen.
- Gegevensbeheer: Naarmate de regelgeving inzake gegevensprivacy strenger wordt, integreren ETL-tools meer functies voor gegevensbeheer. Dit omvat opties voor gegevensmaskering en versleuteling, die standaard worden in oplossingen zoals Hevo Data om naleving en veilige gegevensverwerking te waarborgen.
Wat zijn opensource-ETL-tools?
Opensource-ETL-tools maken het mogelijk gegevens uit verschillende bronnen te extraheren, te transformeren en te laden naar een centrale locatie. Data-engineers, analisten en IT-professionals gebruiken deze tools doorgaans om grote hoeveelheden gegevens efficiënt te beheren en te verwerken.
Realtimeverwerking, gegevensobservatie en cloudmogelijkheden helpen bij snelle besluitvorming, het oplossen van problemen en efficiënt gebruik van middelen. Over het geheel genomen bieden deze tools de flexibiliteit en schaalbaarheid die nodig zijn om complexe dataworkflows te verwerken en datagedreven strategieën te ondersteunen. Om betrouwbaarheid op schaal te waarborgen, moeten teams hun ETL-tools aanvullen met robuuste tools voor geautomatiseerde ETL-tests.
Functies van opensource-ETL-tools
Let bij het selecteren van opensource-ETL-tools op de volgende belangrijke functies:
- Realtimeverwerking: Verwerkt gegevens zodra ze binnenkomen, zodat u tijdig beslissingen kunt nemen en snel op veranderingen kunt reageren.
- Observeerbaarheid van gegevens: Biedt inzicht in gegevensstromen, zodat u problemen snel kunt bewaken en oplossen.
- Cloudgebaseerde architectuur: Maakt efficiënt gebruik van cloudresources om schaalbaarheid en prestaties te verbeteren.
- Interfaces met weinig code: Vereenvoudigen het maken van datapijplijnen, waardoor de hulpmiddelen toegankelijk worden voor niet-technische gebruikers.
- Datagovernance: Waarborgt naleving en beveiliging met functies zoals gegevensmaskering en versleuteling.
- Integratie van meerdere bronnen: Maakt verbinding met verschillende gegevensbronnen om gegevensverwerking te centraliseren en te stroomlijnen.
- Schaalbaarheid: Verwerkt groeiende gegevensvolumes en ondersteunt zowel batchverwerking als realtimeverwerking.
- Aanpasbaarheid: Maakt het mogelijk gegevenswerkstromen af te stemmen op specifieke bedrijfsbehoeften en -processen.
- Prestatiebewaking: Volgt en optimaliseert gegevenswerkstromen om efficiëntie en nauwkeurigheid te behouden.
- Planningsbeheer: Automatiseert de uitvoering van taken en beheert werkstromen om de productiviteit te verbeteren.
Voordelen van ETL-hulpmiddelen met open broncode
Het implementeren van ETL-hulpmiddelen met open broncode biedt verschillende voordelen voor uw team en uw bedrijf. Hier zijn enkele voordelen waar u naar kunt uitkijken:
- Kostenefficiëntie: Omdat deze hulpmiddelen open broncode hebben, brengen ze vaak geen licentiekosten met zich mee, waardoor de totale kosten voor uw bedrijf dalen.
- Flexibiliteit: Aanpasbare werkstromen stellen u in staat gegevensprocessen af te stemmen op uw specifieke behoeften en ze aan te passen naarmate die behoeften veranderen.
- Schaalbaarheid: Ondersteunt zowel batchverwerking als realtimeverwerking, waardoor uw bedrijf groeiende gegevensvolumes kan verwerken zonder in te leveren op prestaties.
- Betere besluitvorming: Realtimegegevensverwerking zorgt ervoor dat uw team toegang heeft tot actuele informatie, zodat het tijdige en goed geïnformeerde beslissingen kan nemen.
- Verbeterde gegevenskwaliteit: Functies zoals observeerbaarheid van gegevens en datagovernance helpen de nauwkeurigheid en naleving van gegevens te behouden, waardoor het vertrouwen in uw gegevens toeneemt.
- Ondersteuning door de gemeenschap: Deze hulpmiddelen worden vaak ondersteund door een grote gemeenschap van ontwikkelaars, die hulpmiddelen en gedeelde kennis biedt voor probleemoplossing en verbeteringen.
- Integratiemogelijkheden: Maakt eenvoudig verbinding met verschillende gegevensbronnen en systemen en stroomlijnt zo het gegevensbeheer binnen uw organisatie.
Kosten en prijzen van ETL-hulpmiddelen met open broncode
Bij het selecteren van ETL-hulpmiddelen met open broncode is inzicht in de verschillende beschikbare prijsmodellen en abonnementen vereist. De kosten variëren op basis van functies, teamgrootte, uitbreidingen en meer. De onderstaande tabel vat veelvoorkomende abonnementen, hun gemiddelde prijzen en de typische functies van oplossingen met ETL-hulpmiddelen met open broncode samen:
Vergelijkingstabel van abonnementen voor ETL-hulpmiddelen met open broncode
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
| Gratis abonnement | $0 | Basis-gegevensextractie, beperkte integraties en ondersteuning door de gemeenschap. |
| Persoonlijk abonnement | $5-$25/gebruiker/maand | Verbeterde gegevenstransformaties, persoonlijke ondersteuning en beperkte aanpassingsmogelijkheden. |
| Zakelijk abonnement | $50-$100/gebruiker/maand | Geavanceerde gegevensverwerking, meerdere integraties en hulpmiddelen voor teamsamenwerking. |
| Bedrijfsabonnement | $100-$500/gebruiker/maand | Volledige aanpassing, ondersteuning op ondernemingsniveau en uitgebreide beveiligingsfuncties. |
Open-sourcetools voor ETL (veelgestelde vragen)
Hier zijn enkele antwoorden op veelgestelde vragen over open source ETL-tools:
Wat zijn de beperkingen van ETL-tools?
ETL-tools slaan gegevens vaak niet permanent op, waardoor je aanvullende opslagoplossingen nodig hebt. Ze kunnen ook gegevenslatentie veroorzaken, wat leidt tot vertragingen in de beschikbaarheid van gegevens. De leercurve kan steil zijn en voor het schalen van de tools om grote gegevensvolumes te verwerken zijn mogelijk extra resources nodig. Bovendien kunnen ze moeite hebben met ongestructureerde gegevens.
Welke open source ETL-tool is het beste?
De beste open source ETL-tool hangt af van je specifieke behoeften. Tools zoals Apache NiFi zijn uitstekend geschikt voor realtimegegevensstromen, terwijl Talend Open Studio uitermate geschikt is voor brede gegevensintegratietaken. Houd bij je keuze rekening met factoren zoals de expertise van je team, de complexiteit van de gegevens en je integratiebehoeften.
Waarin kunnen geavanceerde ETL-tools gestructureerde en ongestructureerde gegevens laden en converteren?
Geavanceerde ETL-tools kunnen zowel gestructureerde als ongestructureerde gegevens laden en converteren naar indelingen die compatibel zijn met systemen zoals Hadoop. Ze verwerken meerdere bestanden parallel, waardoor het proces van het samenvoegen van uiteenlopende gegevens tot één uniforme transformatieworkflow eenvoudiger wordt.
Wat is het verschil tussen API- en ETL-tools?
API’s zijn ideaal voor realtimegegevensuitwisseling en communicatie tussen applicaties. ETL-tools zijn daarentegen beter geschikt voor batchverwerkingstaken, waarbij gegevens uit meerdere bronnen moeten worden geconsolideerd, getransformeerd en in een doelsysteem geladen voor analyse.
Hoe gaan ETL-tools om met gegevensbeveiliging?
ETL-tools zorgen voor gegevensbeveiliging door versleuteling, toegangscontroles en nalevingsmaatregelen te implementeren. Ze zorgen ervoor dat gevoelige gegevens worden beschermd tijdens het extraheren, transformeren en laden. Sommige tools bieden ook ingebouwde auditfuncties om gegevenstoegang en wijzigingen bij te houden.
Kunnen ETL-tools integreren met clouddiensten?
Ja, veel ETL-tools integreren naadloos met clouddiensten. Ze ondersteunen het verplaatsen van gegevens van en naar cloudplatforms zoals AWS, Google Cloud en Azure, zodat je cloudopslag en verwerkingsmogelijkheden kunt benutten voor je gegevensworkflows.
Wat is de volgende stap?
Geef je SaaS-groei en leiderschapsvaardigheden een boost. Abonneer je op onze nieuwsbrief voor de nieuwste inzichten van CTO's en ambitieuze technologieleiders.
We helpen je slimmer te schalen en sterker leiding te geven met gidsen, hulpmiddelen en strategieën van toonaangevende experts!