

10 beste software voor IT-operationeel beheer in 2026

Beste software voor IT-operationeel beheer: shortlist


Software voor IT-operationeel beheer helpt je je volledige IT-infrastructuur te beheren en te begrijpen, met monitoring, automatisering, beveiliging en de servicestatus in zowel on-premise- als cloudomgevingen.
Deze lijst is samengesteld voor CTO's en IT-leiders die behoefte hebben aan uniform inzicht, een snellere analyse van de hoofdoorzaak en oplossingen die klaar zijn voor hybride en multicloudactiviteiten. Je vindt opties voor AI-gestuurde automatisering, diepgaande observeerbaarheid, native beveiligingsintegraties en de aanpasbaarheid die je nodig hebt om datgene wat belangrijk is op te schalen.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Vergelijk de beste software voor IT-operationeel beheer
Vergelijk de prijzen en specificaties naast elkaar van de software voor IT-operationeel beheer die op mijn shortlist staat.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Beste keuze voor SecOps-geïntegreerde log- en metriekactiviteiten | Gratis proefversie beschikbaar | Vanaf $0.15/credit | Website | |
| 2 | Het beste voor OTel-gebaseerde zichtbaarheid over de volledige stack | Gratis proefperiode van 14 dagen | Vanaf $99/maand | Website | |
| 3 | Het beste voor hybride ITOps met multi-tenantmogelijkheden op MSP-niveau | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 4 | Het beste voor diepgaand inzicht in opslag- en GPU-operaties | Gratis demo beschikbaar | Prijzen op aanvraag | Website | |
| 5 | Het beste voor AI-gestuurde releasevalidatie van de volledige stack | 15 dagen gratis proberen | Vanaf $7/host/maand | Website | |
| 6 | Het beste voor AI-gestuurde analyse van de hoofdoorzaak, van melding tot topologie | 14 dagen gratis proefperiode | Prijs op aanvraag | Website | |
| 7 | Het beste voor observatie over de volledige stack op transactieniveau | Gratis abonnement beschikbaar | Vanaf $99/gebruiker/maand | Website | |
| 8 | Het beste voor op CMDB gebaseerde hybride IT-activiteiten op grote schaal | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 9 | Beste voor Cisco-eigen beheer van servicegezondheid over meerdere domeinen | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 10 | Het beste voor agentische AI bij IT-operaties van mainframe tot cloud | Gratis demo beschikbaar | Prijs op aanvraag | Website |
Beoordelingen van de beste software voor IT-operationeel beheer
Hieronder vind je mijn gedetailleerde samenvattingen van de beste software voor IT-operationeel beheer die op mijn shortlist staat. Mijn beoordelingen bieden een gedetailleerd overzicht van de functies, beste gebruiksscenario’s en integraties van elk platform, zodat je de beste optie voor jou kunt vinden.

Beste keuze voor SecOps-geïntegreerde log- en metriekactiviteiten
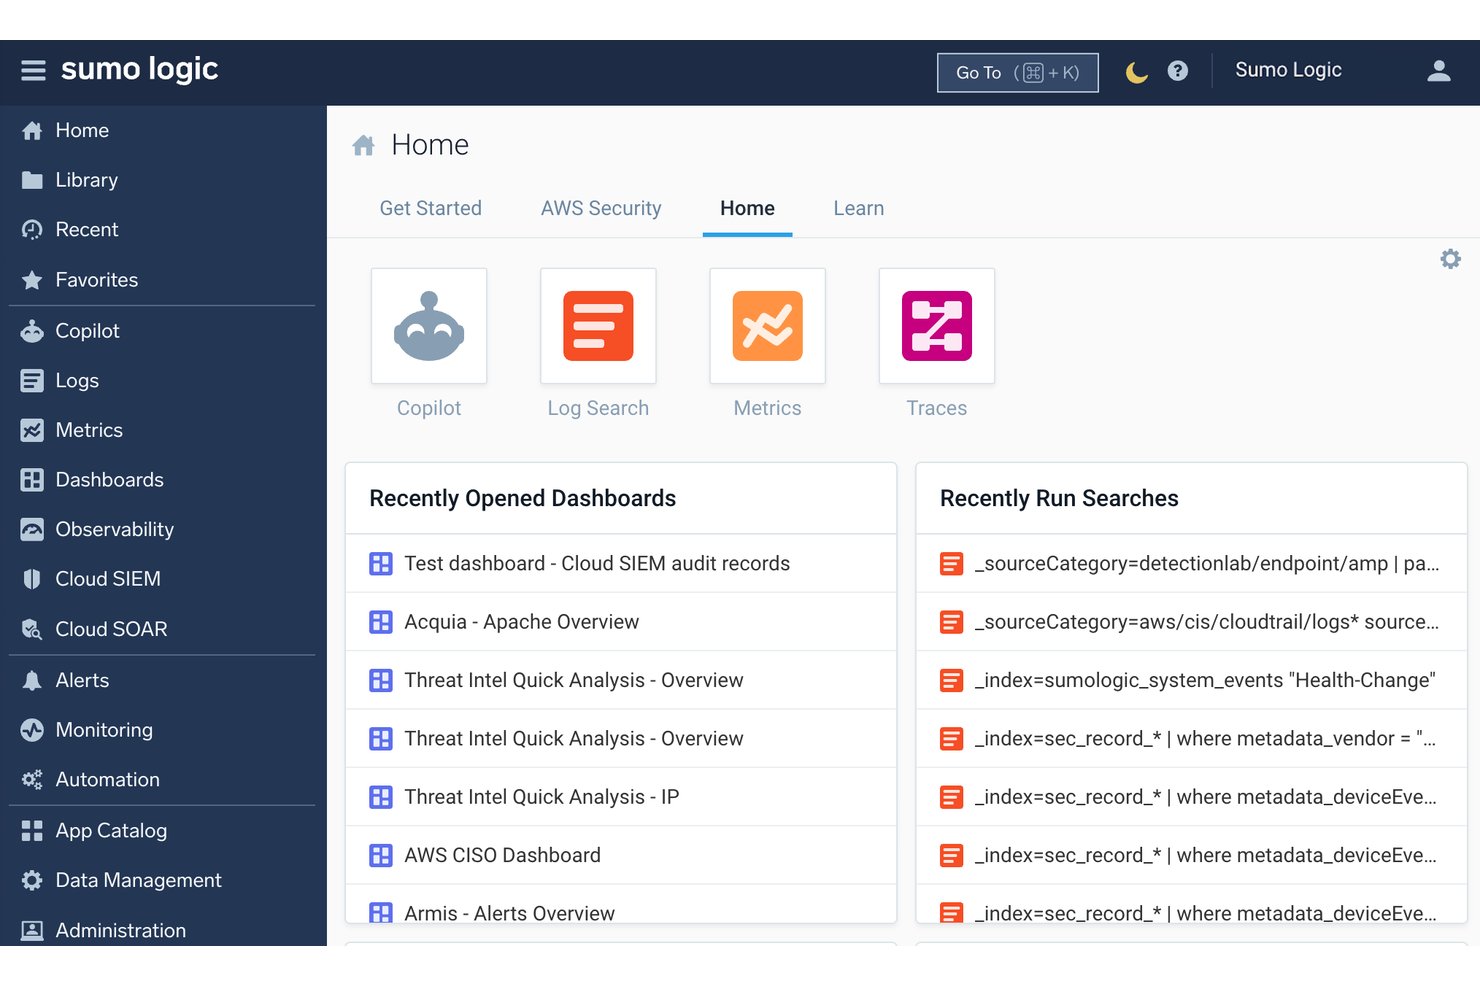
Sumo Logic is een cloud-native IT-operationeel beheerplatform dat loganalyse, infrastructuurbewaking, metriekgegevens, gedistribueerde tracering en beveiligingsactiviteiten verenigt in één SaaS-gebaseerde oplossing voor observability en SIEM.
Voor wie is Sumo Logic het meest geschikt?
Sumo Logic is zeer geschikt voor beveiligingsbewuste IT- en operationele teams die loganalyse, metriekgegevens en SIEM-mogelijkheden nodig hebben in één SaaS-platform.
Waarom ik voor Sumo Logic heb gekozen
Sumo Logic staat op mijn shortlist omdat het een van de weinige platforms is die loganalyse en beveiligingsactiviteiten samenbrengt in één echt geïntegreerde SaaS-tool. Ik vind het prettig dat de gepatenteerde LogReduce- en LogExplain-operators de hoofdoorzaken rechtstreeks uit onbewerkte loggegevens naar voren brengen, waardoor het handmatig zoeken naar patronen dat de oplossing van incidenten vertraagt, minder nodig is. Ook het platform met meerdere AI-agenten, Dojo AI, valt op: de SOC-analistenagent automatiseert de triage van waarschuwingen op niveau 1 en levert met bewijs onderbouwde beoordelingen, wat mijn team zeer waardevol vindt wanneer SecOps- en ITOps-werkstromen elkaar overlappen.
Belangrijkste functies van Sumo Logic
- AI-gestuurde metriekbewaking: Op machine learning gebaseerde anomaliedetectie stemt seizoensgebonden basislijnen voor je metriekgegevens automatisch af, waardoor het aantal fout-positieve waarschuwingen afneemt.
- Beheer van meerdere organisaties: Een bovenliggende organisatie beheert monitoren, dashboards, rollen en toegang voor onderliggende organisaties vanuit één centrale interface.
- Dashboards voor nalevingsrapportage: Vooraf gebouwde dashboards koppelen je gegevens aan PCI-, HIPAA-, GDPR-, SOX- en ISO-kaders voor voortdurend inzicht in de beveiligingsstatus.
- OpenTelemetry-distributieagent: Eén uniforme agent verzamelt logboeken, metriekgegevens en traceringen op Linux, Windows, macOS en via meer dan 25 bronconfiguraties.
Integraties van Sumo Logic
Sumo Logic biedt meer dan 450 integraties, waaronder ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes en Docker. Het biedt ook REST API's, webhooks, Terraform, SumoQL en een open integratieframework voor aangepaste connectiviteit.
Pros and Cons
Pros:
- Dojo AI automatiseert triage en oplossing van incidenten
- Dashboards voor naleving koppelen rechtstreeks aan belangrijke kaders
- Centraliseert logboeken, metriekgegevens en traceringen in één platform
Cons:
- Geavanceerde automatisering geeft de voorkeur aan beveiliging boven IT-activiteiten
- Het opvragen van grote historische gegevenssets kan traag zijn

Het beste voor OTel-gebaseerde zichtbaarheid over de volledige stack
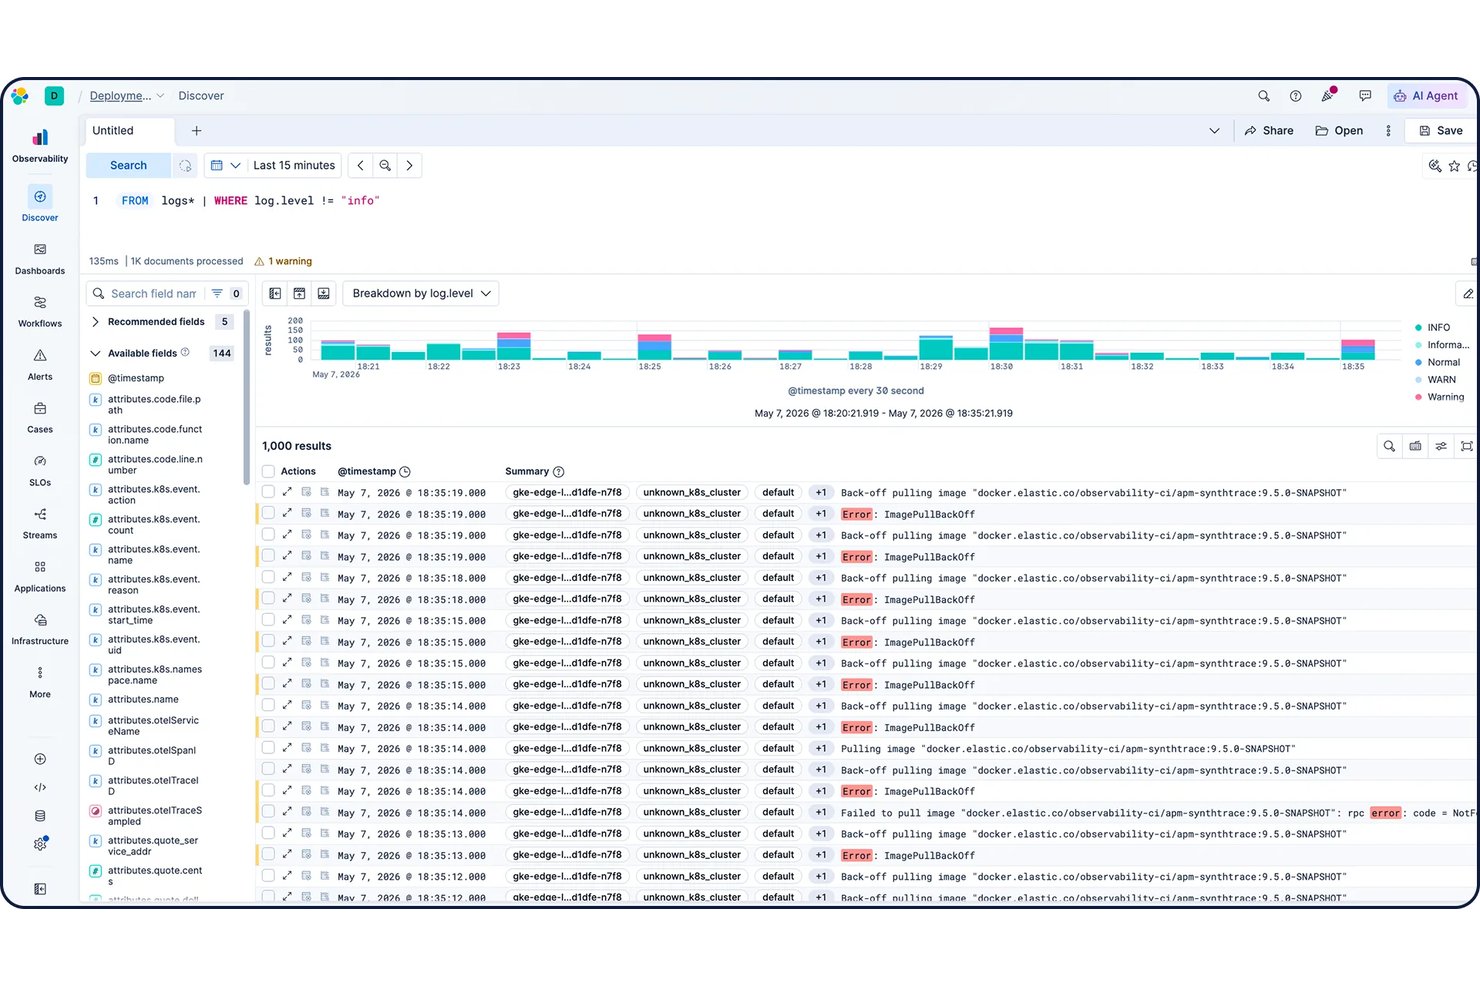
Elastic Observability is een platform voor observeerbaarheid over de volledige stack dat logmonitoring, infrastructuurmetrics, APM, gedistribueerde tracering, synthetische monitoring en AIOps verenigt voor on-premises-, cloud- en hybride omgevingen.
Voor wie is Elastic Observability het meest geschikt?
Elastic Observability is zeer geschikt voor SRE's en infrastructuuringenieurs bij middelgrote tot grote ondernemingen die behoefte hebben aan uniforme zichtbaarheid van logs, metrics, traces en APM in hybride en multicloudomgevingen—vooral teams die al in OpenTelemetry hebben geïnvesteerd.
Waarom ik voor Elastic Observability heb gekozen
Elastic Observability staat op mijn shortlist omdat het een van de weinige platforms is die vanaf het ontwerp op OpenTelemetry is gericht. Dat betekent dat je logs, metrics, traces en APM-gegevens allemaal in één schema terechtkomen, zonder dat je hoeft te worstelen met propriëtaire agents. Vooral de laag voor machinaal leren zonder configuratie spreekt me aan: meer dan 100 vooraf geconfigureerde anomaliedetectietaken worden automatisch uitgevoerd voor elke gegevensstroom, zodat je team bij gegevensverwerking op Comcast-schaal niet handmatig modellen hoeft af te stemmen. De op Streams gebaseerde logparsing en de ES|QL-query-engine maken het echt snel om hoofdoorzaken in hybride omgevingen te identificeren.
Belangrijkste functies van Elastic Observability
- Synthetische monitoring: Voer lichte en volledige browsertests uit voor gebruikersprocessen met behulp van een wereldwijd beheerde testinfrastructuur of private on-premiseslocaties.
- Tracking van serviceniveaudoelstellingen (SLO's): Definieer, monitor en rapporteer rechtstreeks in Kibana over betrouwbaarheidsdoelen, naast je bestaande dashboards en waarschuwingen.
- Kibana-waarschuwingen: Configureer regelgebaseerde waarschuwingen voor APM-, metrics-, uptime- en beveiligingsgegevens met behulp van formulieren, inclusief ondersteuning voor meldingen via meerdere kanalen.
- Meer dan 550 vooraf gebouwde integraties: Maak verbinding met cloudproviders, ITSM-tools, beveiligingsplatforms en gegevensbronnen via vooraf gebouwde agents en agentloze verzamelaars.
Integraties van Elastic Observability
Elastic Observability biedt meer dan 550 vooraf gebouwde integraties, waaronder AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes en OpenTelemetry. Het ondersteunt ook REST API's, webhooks, Elastic Agent, Logstash, Beats en OpenTelemetry-verzamelaars voor aangepaste connectiviteit.
Pros and Cons
Pros:
- Uniforme zichtbaarheid in hybride en multicloudomgevingen
- Machinaal leren zonder configuratie detecteert automatisch anomalieën
- OTel-gebaseerde gegevensopname voorkomt afhankelijkheid van één leverancier
Cons:
- Ingebouwde planning voor bereikbaarheidsdiensten is niet inbegrepen
- Documentatie schiet tekort voor complexe OTel-configuraties

OpsRamp
Het beste voor hybride ITOps met multi-tenantmogelijkheden op MSP-niveau
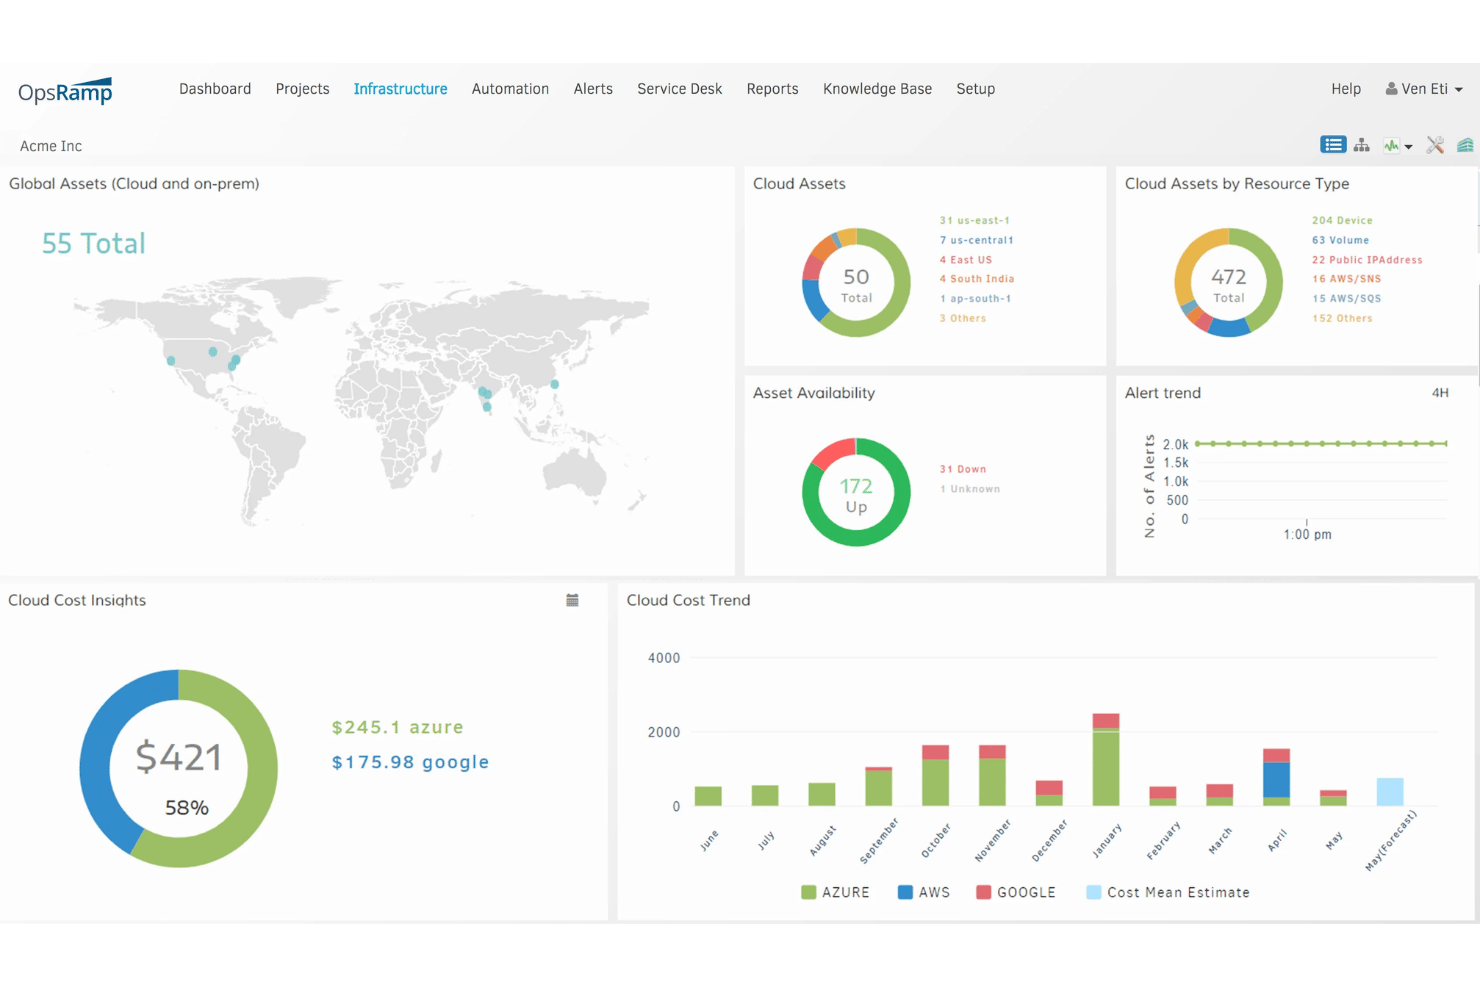
HPE OpsRamp is een door AIOps aangestuurd platform voor het beheer van IT-operaties dat infrastructuurmonitoring, gebeurteniscorrelatie, incidentbeheer, runbookautomatisering en inzicht in hybride en multi-cloudomgevingen verenigt voor on-premises-, privatecloud- en publiccloudomgevingen.
Voor wie is OpsRamp het meest geschikt?
OpsRamp is zeer geschikt voor managed serviceproviders en grote ondernemingen die complexe hybride IT-omgevingen beheren over on-premises- en multi-cloudomgevingen heen.
Waarom ik voor OpsRamp heb gekozen
OpsRamp staat op mijn shortlist omdat de multi-tenantarchitectuur speciaal is ontworpen voor MSP's die tientallen klantomgevingen vanuit één centraal overzicht beheren. Ik waardeer vooral de AIOps-engine voor gebeurteniscorrelatie, die gerelateerde waarschuwingen over tenants heen groepeert en ruis met maximaal 90% vermindert, zodat je team niet wordt overspoeld door tickets van verschillende klantaccounts. De topologie- en servicetoewijzingen bieden een live-overzicht van afhankelijkheden in hybride omgevingen over AWS, Azure, GCP en on-premises heen, iets wat op die schaal echt moeilijk te evenaren is.
Belangrijkste functies van OpsRamp
- Engine voor runbookautomatisering: Voer vooraf gedefinieerde herstelprocedures automatisch uit als reactie op gedetecteerde problemen, met door RBAC beheerde toegang tot taken en procesworkflows.
- Beheer van multi-tenantklanten: Beheer meerdere klantomgevingen vanuit één platforminstantie, met configuratie van integraties per tenant en geïsoleerde gegevensverwerking.
- Rapportage van cloudkosten: Splits clouduitgaven uit per account, regio, service en instantietype voor AWS, Azure en GCP, met aanpasbare datumbereiken.
- Opname via OpenTelemetry: Neem metingen, logboeken en traces op uit elke OpenTelemetry-compatibele bron, naast door eBPF ondersteunde automatische instrumentatie voor diepgaand inzicht in werkbelastingen.
Integraties van OpsRamp
OpsRamp biedt meer dan 3.000 integraties, waaronder ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry en Prometheus. De OAuth 2.0 REST API, webhooks en ondersteuning voor JSON-import en -export maken aangepaste verbindingen mogelijk.
Pros and Cons
Pros:
- Multi-tenantbeheer voor MSP-klantomgevingen
- Tot 90 procent minder ruis door waarschuwingen
- Visualisaties van hybride en multi-cloudtopologieën
Cons:
- Functies voor applicatiemonitoring zijn nog in ontwikkeling
- Dashboardprestaties kunnen op grote schaal vertragen
Virtana
Het beste voor diepgaand inzicht in opslag- en GPU-operaties
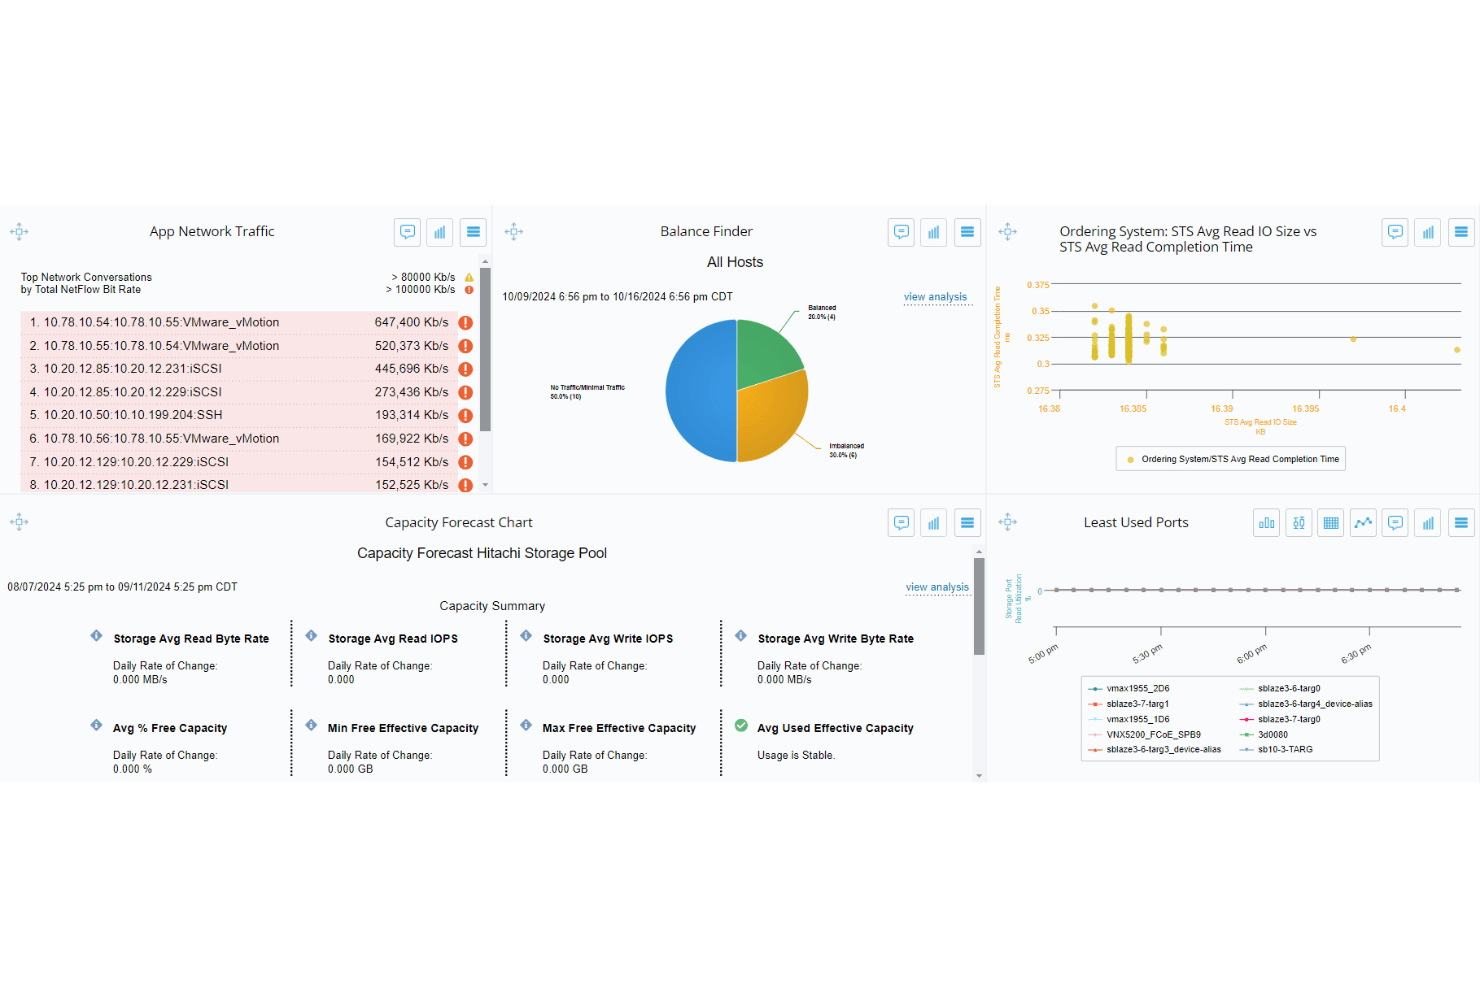
Virtana is een AIOps- en infrastructuurobservatieplatform dat hybride omgevingen bewaakt in reken-, opslag-, netwerk-, Kubernetes- en GPU-infrastructuren, met AI-gestuurde gebeurteniscorrelatie, anomaliedetectie en geautomatiseerd incidentbeheer als kernfunctionaliteit.
Voor wie is Virtana het meest geschikt?
Virtana is zeer geschikt voor infrastructuur- en NetOps-technici die complexe hybride omgevingen beheren waarin diepgaand inzicht in opslag, zichtbaarheid van GPU-workloads en AI-gestuurde incidentcorrelatie onmisbaar zijn.
Waarom ik voor Virtana koos
Ik koos Virtana als een van de beste oplossingen omdat geen enkel ander platform op mijn shortlist opslagstatistieken op dit detailniveau verzamelt: meer dan 16.000 statistieken voor blokopslag-, NAS-, SAN-, SDS- en HCI-omgevingen, allemaal in realtime gecorreleerd met reken- en netwerkcontext. Ik ben vooral onder de indruk van de speciale module voor observatie van AI-fabrieken, die GPU-gebruik, inactieve capaciteit, throttling en NVLink/PCIe-doorvoer bijhoudt voor teams die op grote schaal LLM-trainings- of inferentieworkloads uitvoeren. De op ML gebaseerde anomaliedetectie bereikt een nauwkeurigheid tot 95% en brengt problemen aan het licht voordat drempelwaarden worden overschreden, in plaats van nadat de schade is aangericht.
Belangrijkste functies van Virtana
- Herstel met autonome AI-agents: AI-agents doorlopen zelfstandig de afhankelijkheidsgrafiek van je systeem om problemen te onderzoeken en beheerde herstelwerkstromen uit te voeren, zonder handmatige overdrachten.
- Voorspellende capaciteitsprognoses: Gebruikt maximaal 12 maanden aan historische gegevens om de capaciteitsbehoeften voor rekenkracht, opslag, netwerk en GPU tot een jaar vooruit te voorspellen.
- Bidirectionele synchronisatie met ServiceNow: Maakt automatisch ServiceNow-incidenten aan, werkt deze bij en sluit ze op basis van gedetecteerde gebeurtenissen, met toewijzing van bedrijfscriticaliteit en CMDB-integratie.
- Topologie en afhankelijkheden in kaart brengen: Ontdekt en brengt relaties tussen applicaties, services en infrastructuur continu automatisch in kaart om een live, doorzoekbaar systeemmodel te onderhouden.
Virtana-integraties
Virtana heeft een ingebouwde ServiceNow-integratie en integraties met Slack, Microsoft Teams, PagerDuty, AWS, Azure, GCP, Kubernetes, VMware en OpenTelemetry. REST-API's en een MCP-server ondersteunen aangepaste integraties en toegang voor AI-agents.
Pros and Cons
Pros:
- Verzamelt meer dan 16.000 opslagstatistieken in verschillende omgevingen
- Bewaakt GPU- en AI-workloadprestaties native
- AI-gestuurde anomaliedetectie bereikt een hoge nauwkeurigheid
Cons:
- De visualisaties in de gebruikersinterface kunnen beperkt aanvoelen
- De beoordelingsbasis is kleiner dan die van grote concurrenten
Het beste voor AI-gestuurde releasevalidatie van de volledige stack
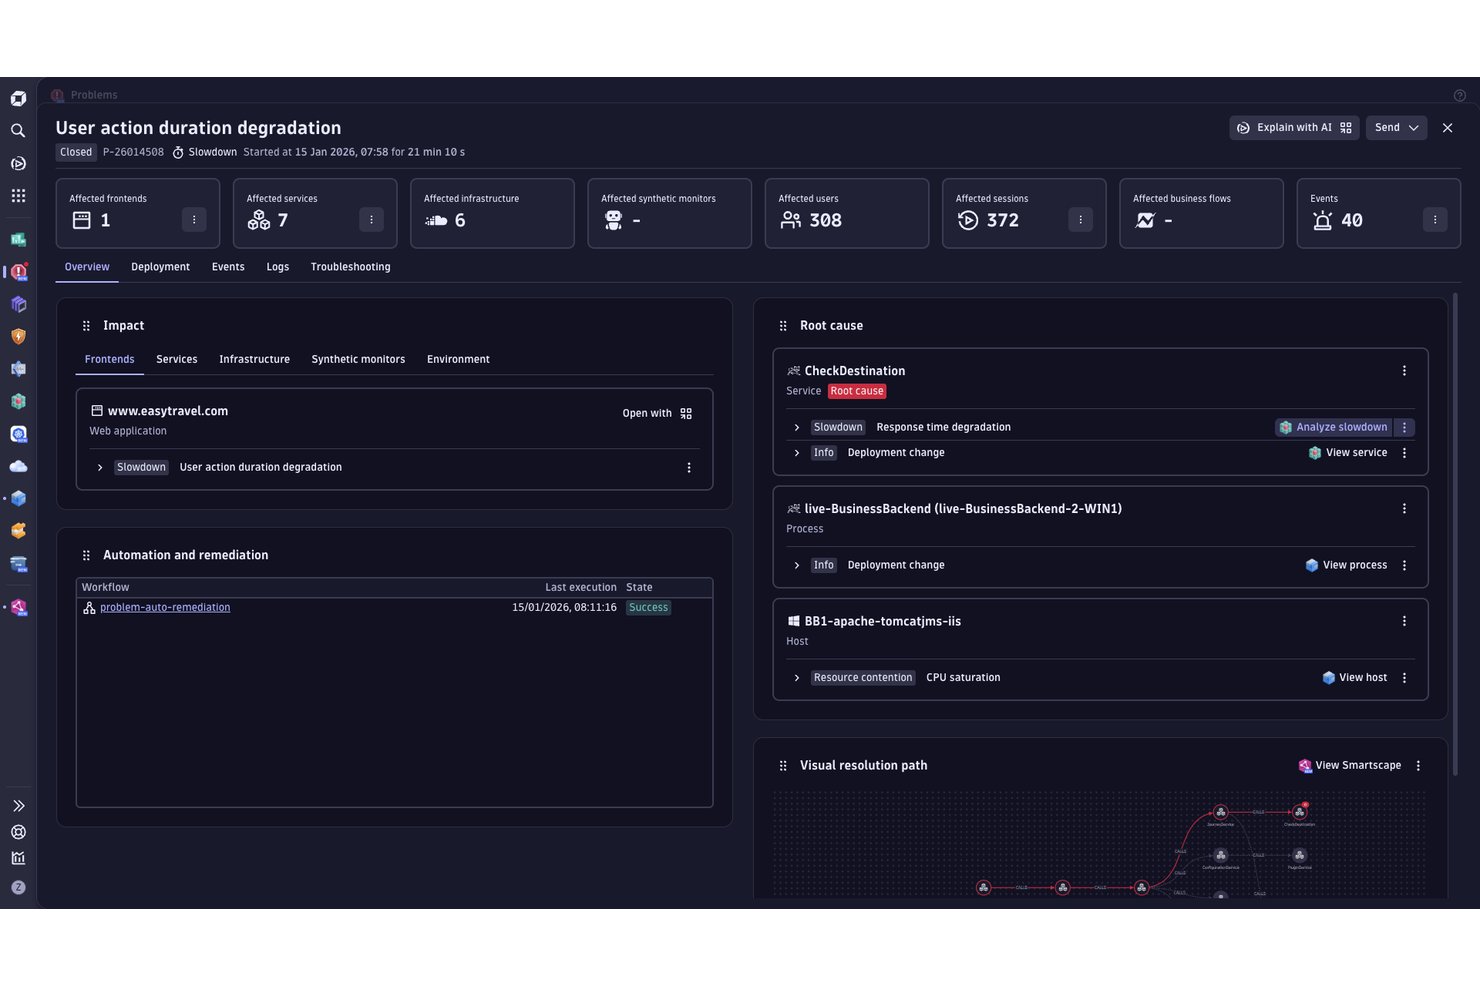
Dynatrace is een platform voor IT-operationsbeheer van de volledige stack, dat infrastructuurmonitoring, door AIOps aangestuurde incidentdetectie, loganalyse en workflowautomatisering omvat in hybride en multi-cloudomgevingen.
Voor wie is Dynatrace het meest geschikt?
Dynatrace is zeer geschikt voor IT- en SRE-teams van ondernemingen die complexe hybride of multi-cloudomgevingen beheren en behoefte hebben aan AI-gestuurde observeerbaarheid, geautomatiseerde incidentrespons en releasevalidatie op schaal.
Waarom ik voor Dynatrace heb gekozen
Ik heb Dynatrace gekozen als een van de beste oplossingen, omdat de Site Reliability Guardian de grondigste configuratie voor releasevalidatie is die ik in deze categorie heb gezien: elke implementatie wordt automatisch getoetst aan vooraf gedefinieerde SLO's en KPI's voordat de code productie bereikt, waarbij slechte releases zonder handmatige beoordeling worden geblokkeerd. Combineer dat met het vermogen van Davis AI om een afwijking in productie terug te voeren naar één hoofdoorzaak in miljarden actieve afhankelijkheden, en je krijgt een platform dat problemen opvangt die door kwaliteitscontroles glippen en precies uitlegt waarom dat gebeurt.
Belangrijkste functies van Dynatrace
- Smartscape-topologietoewijzing: Ontdekt automatisch afhankelijkheden in realtime en visualiseert deze voor hosts, containers, services en processen in hybride en multi-cloudomgevingen.
- Grail-datalakehouse: Brengt metrieken, logs, traces, gebeurtenissen en beveiligingssignalen samen in één opslag zonder index, die via DQL kan worden bevraagd zonder schemaconfiguratie.
- Workflowbouwer van AutomationEngine: Een visuele editor zonder code of met weinig code voor het bouwen van gebeurtenisgestuurde of geplande automatiseringsworkflows op basis van actuele observabilitygegevens.
- Voorspellende waarschuwingen: Voorspelt capaciteits- en prestatieovertredingen voordat deze zich voordoen, met behulp van continu aangeleerde gedragsbaselines voor elk bewaakt onderdeel.
Integraties van Dynatrace
Dynatrace biedt meer dan 900 integraties via Dynatrace Hub, waaronder ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud en OpenTelemetry. De REST API, webhooks en AppEngine SDK ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Eén agent ontdekt automatisch assets van de volledige stack
- Davis AI lokaliseert de werkelijke hoofdoorzaak
- Geautomatiseerde herstelacties met controles waarbij een medewerker betrokken blijft
Cons:
- Verbruiksgebaseerde prijzen zijn moeilijk te budgetteren
- Alleen SaaS beperkt de mogelijkheden voor omgevingen zonder netwerkverbinding
Het beste voor AI-gestuurde analyse van de hoofdoorzaak, van melding tot topologie
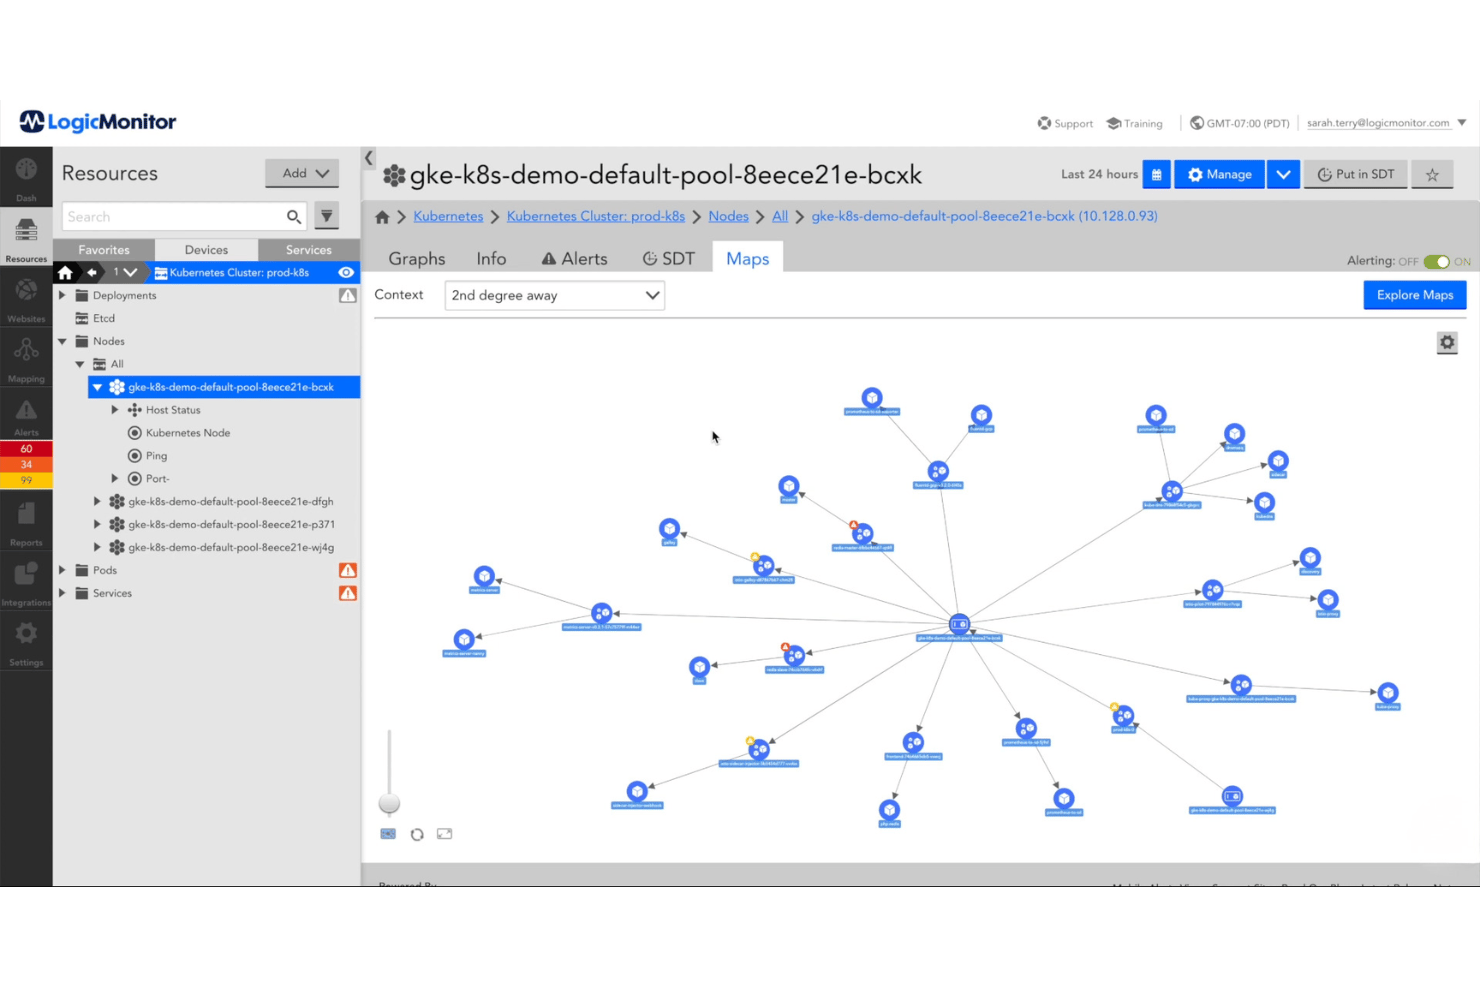
LogicMonitor is een platform voor IT-operatiebeheer van de volledige stack dat infrastructuur-, netwerk-, cloud-, container- en applicatiemonitoring omvat, naast door AIOps aangestuurde correlatie van meldingen, topologietoewijzing en loganalyse in één uniform platform.
Voor wie is LogicMonitor het meest geschikt?
LogicMonitor is zeer geschikt voor infrastructuur- en netwerkoperatieteams die grote, hybride omgevingen beheren in on-premises- en multicloudomgevingen.
Waarom ik voor LogicMonitor heb gekozen
LogicMonitor staat op mijn selectielijst omdat het de correlatie van meldingen zo nauw verbindt met topologiebewuste analyse van de hoofdoorzaak. Edwin AI brengt stortvloeden aan meldingen terug tot geprioriteerde, uitlegbare incidenten en de ITOps Context Graph combineert topologie-, telemetrie- en wijzigingsgegevens, zodat je binnen enkele minuten in plaats van uren een waarschijnlijke hoofdoorzaak kunt vaststellen. Ik heb gezien dat teams het aantal irrelevante meldingen na de implementatie van Edwin AI met 78% konden verminderen. Daardoor besteden technici van de bereikbaarheidsdienst minder tijd aan het sorteren van ruis en meer tijd aan het oplossen van het daadwerkelijke probleem.
Belangrijkste functies van LogicMonitor
- Infrastructuurmonitoring voor de volledige stack: Houdt servers, netwerkapparaten, VM's, databases, opslag en containers in hybride omgevingen bij vanuit één platform.
- LM Exchange: Geeft je toegang tot meer dan 2.000 vooraf gebouwde LogicModules voor cloudproviders, netwerkapparatuur, databases en applicaties.
- Loganalyse en -intelligentie: Correlereert loggegevens in realtime met metrische gegevens, zodat je incidenten kunt onderzoeken zonder van tool te wisselen.
- Bidirectionele ITSM-integraties: Synchroniseert de levenscycli van meldingen en tickets met ServiceNow, Jira Service Management, PagerDuty, ConnectWise en Autotask.
LogicMonitor-integraties
LogicMonitor biedt meer dan 2.000 integraties uit de marktplaats via LM Exchange, plus oorspronkelijke integraties met ServiceNow, Jira Service Management, PagerDuty, ConnectWise en Datto Autotask. Een gedocumenteerde REST API ondersteunt aangepaste integraties.
Pros and Cons
Pros:
- Vermindert het aantal irrelevante meldingen met Edwin AI
- Brengt de topologie in kaart voor een snelle analyse van de hoofdoorzaak
- Aanpasbare dashboards voor verschillende IT-rollen
Cons:
- De prijsstructuur is moeilijk te begrijpen
- Wijzigingen in de interface maken navigatie lastig
Het beste voor observatie over de volledige stack op transactieniveau
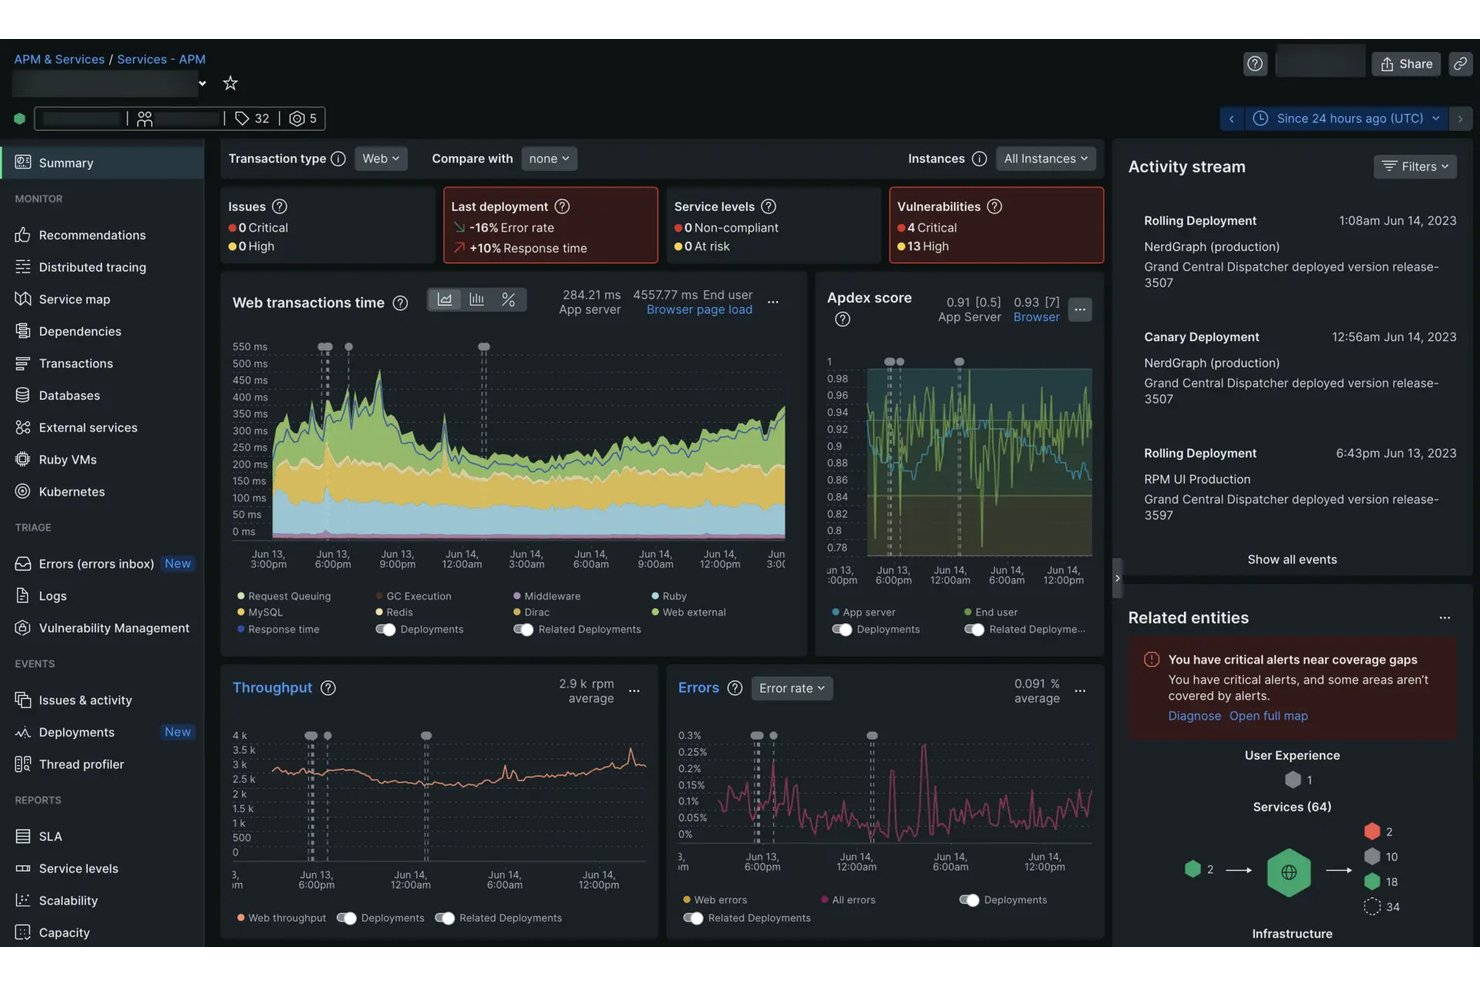
New Relic is een platform voor observatie over de volledige stack dat metrieken, logboeken, traces en gegevens over de digitale ervaring voor infrastructuur, applicaties, cloudomgevingen en netwerken samenvoegt in één interface.
Voor wie is New Relic het meest geschikt?
New Relic is zeer geschikt voor SRE's en infrastructuuringenieurs die complexe productieomgevingen met veel verkeer beheren, waar inzicht op transactieniveau in de volledige stack onmisbaar is.
Waarom ik voor New Relic heb gekozen
New Relic staat op mijn shortlist dankzij Transaction 360, dat telemetrie, waarschuwingen en implementatiewijzigingen op het niveau van individuele transacties correleert en de MTTR met maximaal 5 keer verkort. Ik vind het ook sterk dat Autopilot-agenten incidenten autonoom onderzoeken met behulp van live telemetrie en runbooks, en vervolgens transparante, controleerbare redeneringen tonen in plaats van alleen een herstelactie uit te voeren. Die combinatie van tracing op transactieniveau en agentgestuurde incidentoplossing maakt New Relic mijn eerste keuze voor observatie over de volledige stack.
Belangrijkste functies van New Relic
- Slimme waarschuwingen: Dynamische drempelafstelling gebruikt historische volatiliteit om fout-positieven te beperken en stuurt waarschuwingen automatisch naar het juiste team met behulp van entiteitstags.
- Inzicht in cloudkosten: Realtime kostenregistratie voor AWS, Azure, GCP en Kubernetes, met aanbevelingen voor de juiste schaal op basis van daadwerkelijke gebruikspatronen en waarschuwingen bij budgetdrempels.
- Workflowautomatisering: Met een canvas zonder code en met slepen en neerzetten kun je workflows voor herstel in meerdere stappen bouwen, met voorwaardelijke logica, lussen en live NRQL-query's.
- Gefedereerde logboeken: Query logboeken rechtstreeks vanuit S3-buckets zonder opnieuw inlezen of gegevensverplaatsing, ter ondersteuning van vereisten voor gegevensresidentie en naleving.
Integraties van New Relic
New Relic biedt meer dan 800 vooraf gebouwde integraties, waaronder ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud Platform, Kubernetes en VMware. NerdGraph, REST API, webhooks, OpenTelemetry en Prometheus ondersteunen aangepaste connectiviteit.
Pros and Cons
Pros:
- Correlatie van metrieken, logboeken en traces in realtime
- Automatiseert het routeren van waarschuwingen met behulp van entiteitstags
- Transparant AI-gestuurd incidentonderzoek
Cons:
- Op verbruik gebaseerde prijzen kunnen snel oplopen
- Voor langere gegevensbewaring is een betaald abonnement nodig

Het beste voor op CMDB gebaseerde hybride IT-activiteiten op grote schaal
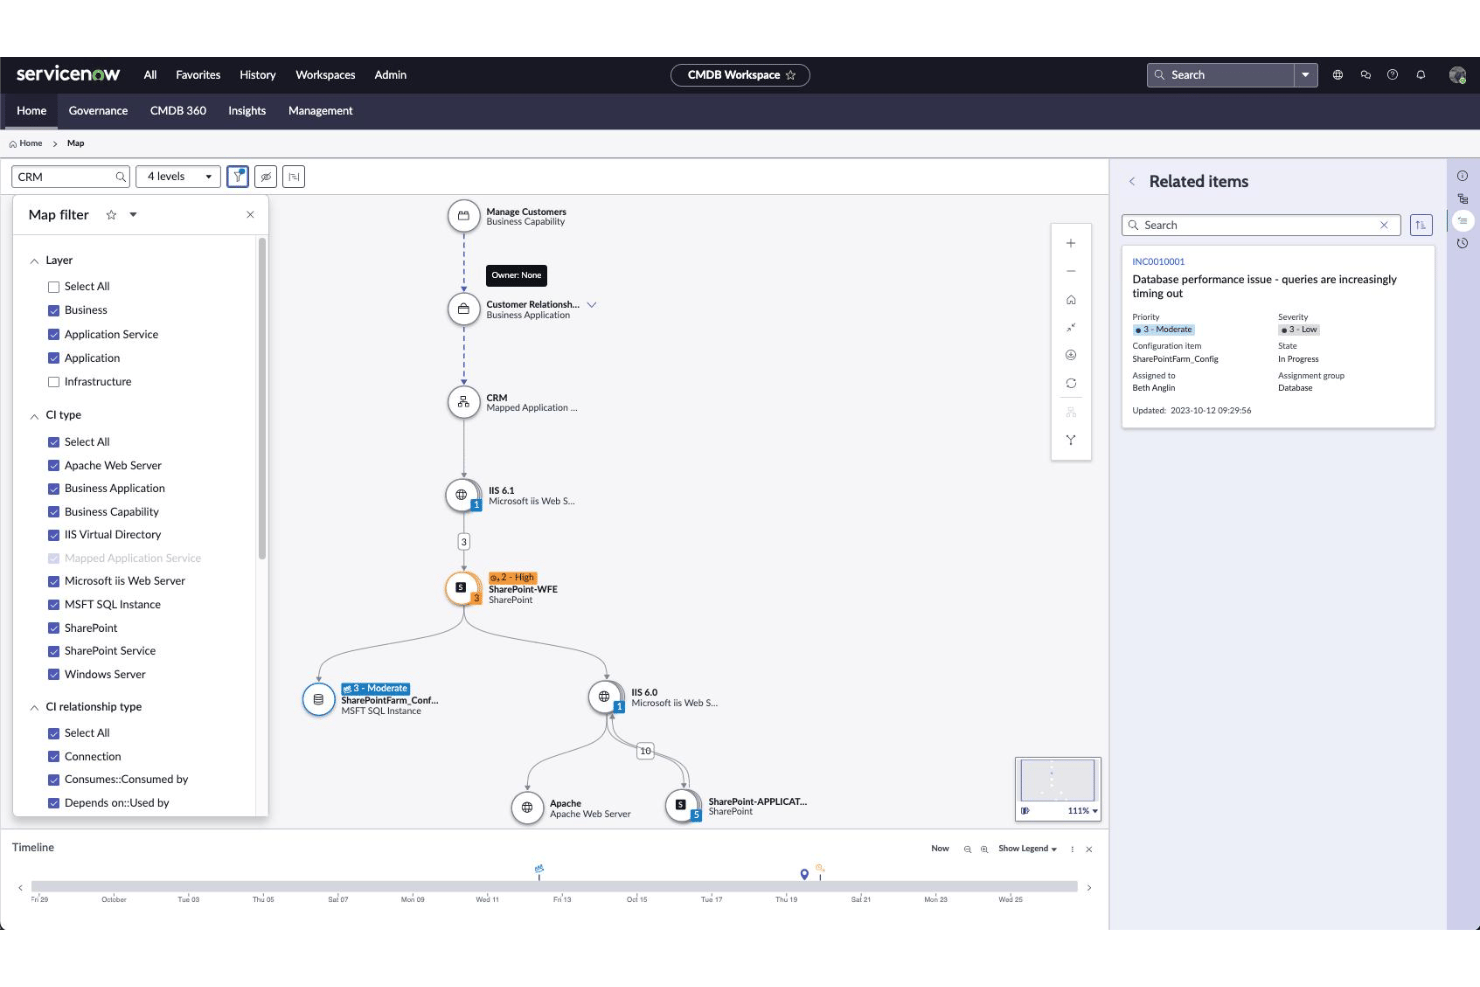
ServiceNow ITOM is een platform voor het beheer van IT-activiteiten voor ondernemingen, opgebouwd rond een continu bijgewerkte CMDB, met agentloze discovery, door AIOps aangedreven gebeurtenisbeheer, servicetoewijzing, cloudzichtbaarheid en geautomatiseerde orkestratie in hybride en multicloudomgevingen.
Voor wie is ServiceNow ITOM het meest geschikt?
ServiceNow ITOM is ontwikkeld voor grote ondernemingen met complexe hybride IT-omgevingen waarin een continu bijgewerkte CMDB de operationele ruggengraat vormt.
Waarom ik voor ServiceNow ITOM heb gekozen
ServiceNow ITOM staat op mijn shortlist omdat de CMDB hier niet alleen een database is, maar de live operationele ruggengraat die Discovery en Service Graph Connectors voortdurend voeden met echte gegevens uit je volledige hybride omgeving. Ik vind het vooral sterk hoe Service Mapping automatisch afhankelijkheidsvisualisaties tussen infrastructuur en bedrijfsservices opbouwt, zodat je precies kunt zien welke services worden beïnvloed voordat gebruikers iets merken wanneer een AWS-instantie minder goed presteert. AIOps LEAP gaat nog een stap verder door gesloten incidenten te analyseren om geautomatiseerde herstelplaybooks te genereren en uit te rollen, inclusief een ROI-dashboard dat bijhoudt wat er daadwerkelijk is bespaard.
Belangrijkste functies van ServiceNow ITOM
- Analyse van statuslogboeken: Gebruikt AI om loggegevens in realtime te analyseren, afwijkingen te signaleren en aanbevelingen voor herstel naar voren te brengen voordat problemen escaleren.
- Synthetische monitoring: Simuleert transacties van eindgebruikers om beschikbaarheids- en prestatieproblemen te detecteren voordat echte gebruikers worden getroffen.
- Cloudversnelling: Automatiseert het inrichten en buiten gebruik stellen van cloudresources en handhaaft tag-, kosten- en beveiligingsbeleid in AWS, Azure en GCP.
- Certificaatbeheer: Detecteert en volgt TLS/PKI-certificaten in je omgeving automatisch en activeert workflows voor verlenging voordat certificaten verlopen.
Integraties van ServiceNow ITOM
ServiceNow ITOM kan worden geïntegreerd met AWS, Microsoft Azure, Google Cloud Platform, Alibaba Cloud, Datadog, Dynatrace, Splunk, PagerDuty, Jenkins en GitHub. REST- en SOAP-API's, webhooks en ServiceNow Store-integraties ondersteunen aangepaste connectiviteit.
Pros and Cons
Pros:
- CMDB zorgt voor realtime inzicht in IT-activiteiten
- GenAI automatiseert incidenttriage en herstel
- Multicloud-discovery omvat AWS, Azure en GCP
Cons:
- Alleen SaaS, zonder optie voor zelfhosting
- Voor geavanceerde functies zijn afzonderlijke modulelicenties vereist

Beste voor Cisco-eigen beheer van servicegezondheid over meerdere domeinen
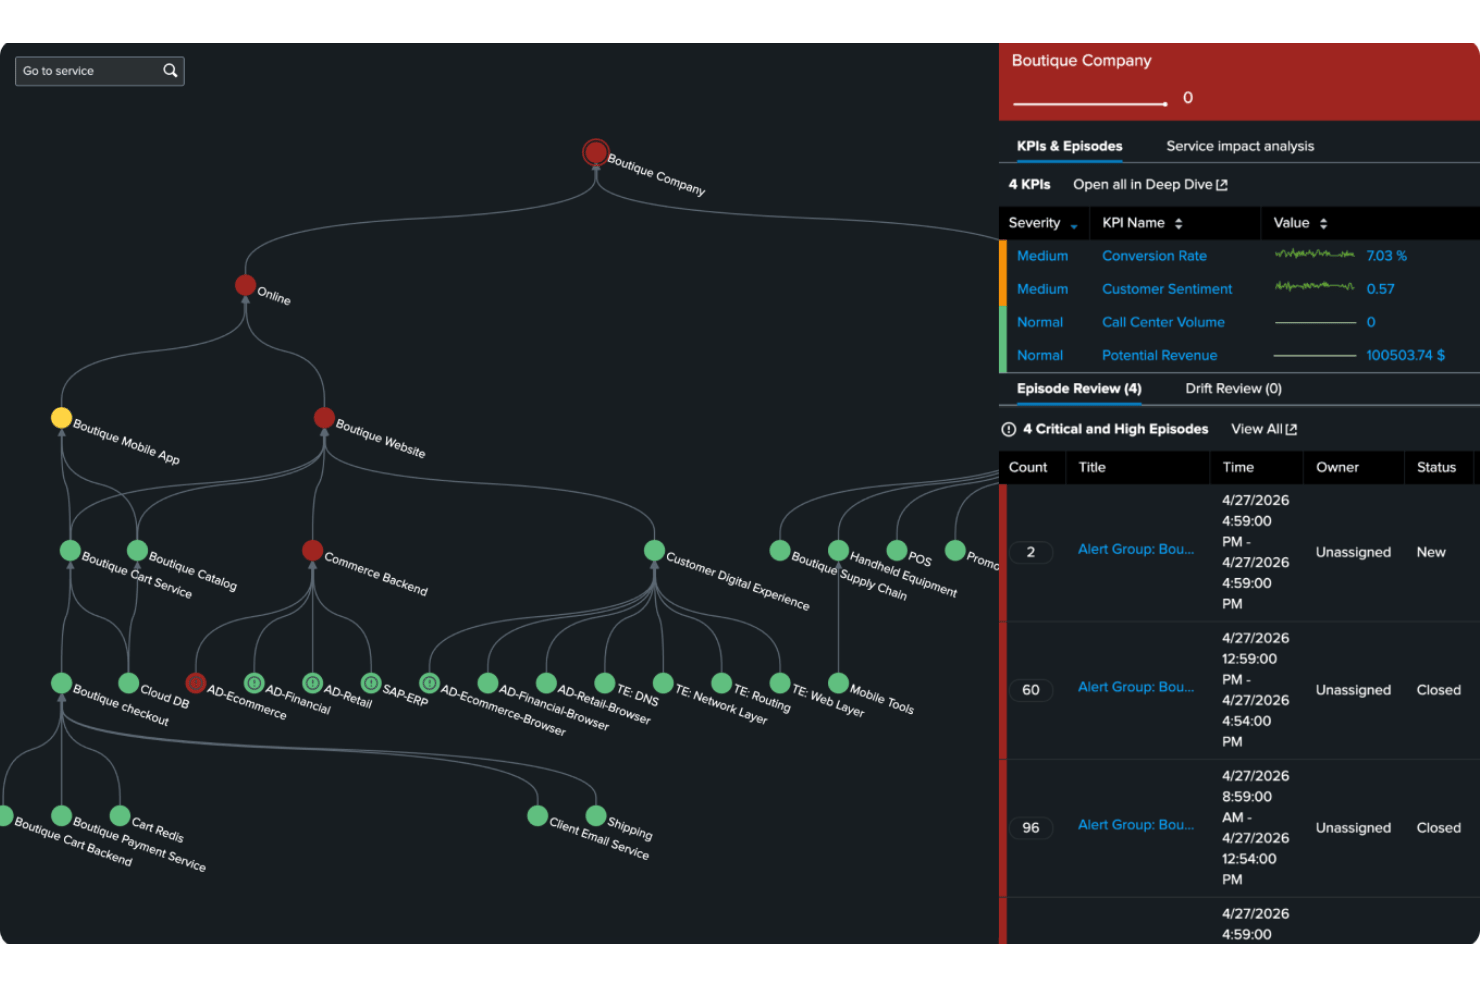
Splunk IT Service Intelligence (ITSI) is een door AIOps aangestuurd platform voor het beheer van IT-activiteiten dat KPI-gebaseerde scores voor servicegezondheid, door AI aangedreven alarmcorrelatie, topologietoewijzing en domeinoverstijgende zichtbaarheid over infrastructuur, applicaties en netwerken biedt.
Voor wie is Splunk IT Service Intelligence het meest geschikt?
Splunk ITSI is zeer geschikt voor IT-beheersteams van ondernemingen—met name teams die Splunk al gebruiken of binnen Cisco-omgevingen werken—die servicegezondheid op grote schaal over infrastructuur, applicaties en netwerken moeten correleren.
Waarom ik voor Splunk IT Service Intelligence heb gekozen
Splunk ITSI staat op mijn shortlist vanwege de manier waarop het domeinoverstijgende servicegezondheid in Cisco-eigen omgevingen afhandelt. Ik vind het geweldig dat het rechtstreeks signalen uit Cisco ThousandEyes, Meraki en Catalyst Center in zijn KPI-gebaseerde model voor gezondheidsscores verwerkt, zodat de zichtbaarheid van netwerk tot applicatie niet handmatig aan elkaar hoeft te worden gekoppeld. De Event iQ-engine correleert deze signalen vervolgens tot geconsolideerde episodes, waardoor alarmruis wordt verminderd voordat je team tijd verspilt aan duplicaten.
Belangrijkste functies van Splunk IT Service Intelligence
- Glasstafels: Bouw pixelperfecte dashboards met slepen en neerzetten die live scores voor servicegezondheid koppelen aan bedrijfs-KPI's zoals het behalen van SLA's of omzetimpact.
- Adaptieve drempelbepaling: ML-modellen brengen het normale gedrag van elke KPI in de loop van de tijd in kaart en activeren alarmen bij statistische afwijkingen in plaats van bij vaste drempelwaarden.
- Werkruimte voor episodebeoordeling: Een gecentraliseerde interface voor triage waarin door AI gecorreleerde alarmgroepen verschijnen met ernstscores, context over de getroffen service en aanbevolen vervolgstappen.
- Modellering van serviceafhankelijkheden: Definieer en visualiseer hiërarchische relaties tussen bedrijfsservices, subservices, hosts en netwerkapparaten om de hoofdoorzaken sneller te isoleren.
Integraties van Splunk IT Service Intelligence
Splunk IT Service Intelligence integreert met ServiceNow, PagerDuty, Jira Cloud, Cisco ThousandEyes, Cisco Catalyst Center, Cisco Meraki, Splunk Observability Cloud, AppDynamics en Red Hat Ansible Automation Platform. Het biedt ook integraties via de Splunkbase-marktplaats, toegang tot de REST API, Python-SDK's, webhooks en Kafka.
Pros and Cons
Pros:
- Geavanceerde, door AI aangedreven alarmcorrelatie en triage
- Uniforme domeinoverstijgende monitoring voor Cisco-omgevingen
- Zeer aanpasbare dashboards voor bedrijfsstatistieken
Cons:
- Hoge resourcevereisten voor grootschalige implementaties
- Complexe implementatie voor het modelleren van services en entiteiten
Het beste voor agentische AI bij IT-operaties van mainframe tot cloud
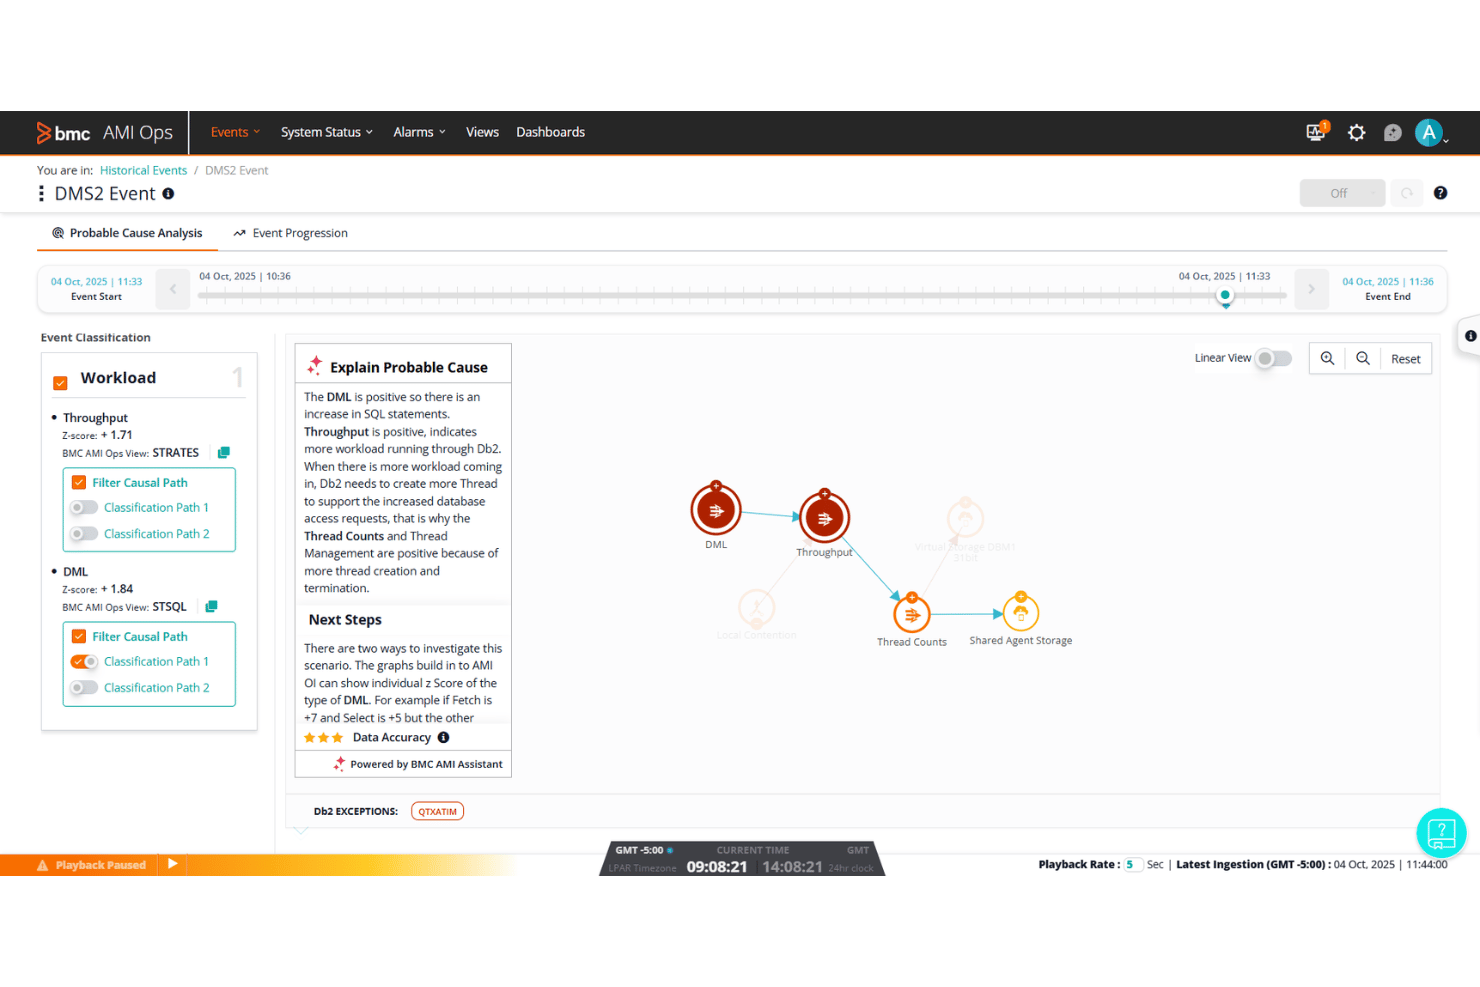
BMC Helix AIOps is een cloud-native platform voor IT-operatiebeheer dat gebeurtenismonitoring, door AI aangestuurde incidentcorrelatie, geautomatiseerde herstelacties en topologietoewijzing verenigt in on-premises-, cloud- en mainframeomgevingen.
Voor wie is BMC Helix AIOps het meest geschikt?
BMC Helix AIOps is ontwikkeld voor grote ondernemingen met complexe hybride omgevingen die mainframesystemen, on-premises infrastructuur en meerdere publieke clouds omvatten.
Waarom ik voor BMC Helix AIOps heb gekozen
BMC Helix AIOps staat op mijn shortlist omdat het een van de weinige platforms is die ik heb gezien dat zich daadwerkelijk uitstrekt van mainframe tot cloud, zonder een van beide uiteinden als bijzaak te behandelen. Ik vertrouw op de agentische AI-mogelijkheden van HelixGPT, met name Agent Builder en Ops Swarmer, om autonome incidenttriage uit te voeren in z/OS-omgevingen en Kubernetes-clusters binnen dezelfde werkstroom. De door AI aangestuurde situatiescorrelatie vermindert de hoeveelheid meldingen met maximaal 90%, wat er in de praktijk voor zorgt dat mijn team niet wordt overspoeld door dubbele meldingen in 600 dashboards.
Belangrijkste functies van BMC Helix AIOps
- Analyse van de waarschijnlijke oorzaak: AI correleert topologie- en gebeurtenisgegevens om de meest waarschijnlijke hoofdoorzaak van een situatie te identificeren voordat handmatig onderzoek begint.
- HelixGPT-analyse na incidenten: Genereert automatisch gedetailleerde samenvattingen van evaluaties na incidenten ter ondersteuning van SRE- en operationele teams na het oplossen van een incident.
- Dynamische blauwdrukken van services: Integreert met BMC Helix Discovery om automatisch servicemodellen te genereren en continu bij te werken, waarbij afhankelijkheden in uw hybride omgeving in kaart worden gebracht.
- Dashboardweergaven op basis van rollen: Segmenteert operationele gegevens en rapportages per rol, zodat elk teamlid een gefilterde weergave krijgt van de statistieken en gebeurtenissen die relevant zijn voor zijn of haar functie.
Integraties van BMC Helix AIOps
BMC Helix AIOps integreert met BMC Helix ITSM, ServiceNow, AWS, Azure, Google Cloud Platform, Microsoft Teams, Slack, BMC Helix Discovery en Jitterbit. Het ondersteunt ook REST API's, CMDB-connectiviteit, monitoringtools van derden en implementatie via AWS Marketplace.
Pros and Cons
Pros:
- Ingebouwde monitoring van mainframes en hybride clouds
- Door AI aangestuurde vermindering van meldingsruis tot 90%
- Geautomatiseerde topologie- en afhankelijkheidstoewijzing inbegrepen
Cons:
- Voor de configuratie is aanzienlijke technische expertise vereist
- Dashboardaanpassing minder intuïtief dan bij concurrenten
Andere software voor IT-operationeel beheer
Hier zijn enkele aanvullende opties voor software voor IT-operationeel beheer die mijn shortlist niet hebben gehaald, maar die toch de moeite waard zijn om te bekijken:
- Datadog
Het beste voor verenigde telemetrie met ingebouwde FinOps
- ManageEngine OpManager
Het beste voor no-code-workflowautomatisering van fout tot oplossing
- BigPanda
Ideaal voor AI-gestuurde risicoscores voor veranderingen
- PagerDuty
Het beste voor incidentrespons op schaal tijdens wachtdiensten
- Zabbix
E voor open-sourcemonitoring van operations op elke schaal
- Moogsoft
E voor door ML aangestuurde vermindering van waarschuwingsruis
- Checkmk
E voor servicegebaseerde prijsstelling voor hybride infrastructuur
- Ivanti Neurons
Het meest geschikt voor ITSM-verankerde IT- en SecOps-automatisering
- Grafana Cloud
Ideaal voor door ML aangestuurde observatie van full-stackactiviteiten
- SolarWinds Observability SaaS
Volledige-stack-observeerbaarheid, gebaseerd op NetOps


How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
Hoe kies je software voor IT-operationeel beheer?
Wanneer je bepaalt welke software voor IT-operationeel beheer het beste bij jouw omgeving past, begin je met de belangrijkste operationele uitdagingen:
| Als je prioriteit ligt bij... | Zoek dan naar... |
|---|---|
| Snelle, nauwkeurige analyse van de hoofdoorzaak | AI-gebaseerde correlatie van incidenten en geautomatiseerde draaiboeken |
| Hybride en multicloudomgevingen | Ingebouwde koppelingen voor on-premise, AWS, Azure en GCP |
| Het verminderen van handmatige herstelwerkzaamheden | Visuele bouwers van werkstromen met vooraf gebouwde automatisering |
| Het beheersen van monitoringgerelateerde uitgaven | Transparante, op gebruik gebaseerde prijzen en kostendashboards |
| Diepgaande integraties met ITSM-tools | Vooraf gebouwde koppelingen en open API-documentatie |
Hoe beoordeel je je shortlist?
- Test werkstromen voor incidenttriage: Voer een proefperiode van 48 uur uit en simuleer ten minste drie soorten storingen om de groepering van incidenten en geautomatiseerde reacties te verifiëren.
- Vraag om een demonstratie van een topologiekaart: Vraag de leverancier om een afhankelijkheidskaart van begin tot eind te genereren — inclusief hybride clusters — met behulp van live of geanonimiseerde voorbeeldgegevens.
- Dien een platformoverschrijdend ticket in: Open een supportticket met een verwijzing naar een multicloudintegratie en leg gedurende een periode van drie dagen de nauwkeurigheid van de antwoorden en de SLA's vast.
- Beoordeel de volledigheid van de rapportage: Bekijk of exporteer een voorbeeld van een analysedashboard en controleer of kosten, SLA's en aangepaste meetgegevens voor jouw daadwerkelijke technologiestack zichtbaar zijn.
- Flexibiliteit van SaaS versus controle bij zelfhosting: Bepaal of snelle functielevering in SaaS zwaarder weegt dan de compliance- en toegangsbehoeften die worden vervuld door on-premise- of volledig geïsoleerde implementaties.
Wat is software voor IT-operationeel beheer?
Software voor IT-operationsbeheer is een categorie tools die is ontworpen om IT-infrastructuur, applicaties, netwerken en services in on-premises- en cloudomgevingen te bewaken, automatiseren en beheren. Deze platforms helpen je team om waarschuwingen te centraliseren, de systeemstatus te bewaken, incidenten te beheren en het gebruik van resources te optimaliseren. Door operationele gegevens en automatisering te consolideren, ondersteunt software voor IT-operationsbeheer een snellere probleemoplossing, verhoogt het de efficiëntie en stelt het je organisatie in staat om technologie betrouwbaar op te schalen.
Functies van software voor IT-operationsbeheer
Let bij het selecteren van software voor IT-operationsbeheer op de volgende belangrijke functies:
- Bewaking van infrastructuur en applicaties: Volgt servers, netwerken, containers en applicaties in realtime. Helpt je abnormaal systeemgedrag, verminderde prestaties of storingen te signaleren voordat gebruikers er last van hebben.
- Waarschuwingen en incidentbeheer: Centraliseert waarschuwingen en stroomlijnt escalatieworkflows. Stelt je team in staat om snel te reageren, incidenten in de juiste context te plaatsen en de oplossing van begin tot eind te volgen.
- Automatisering en orkestratie: Biedt tools om routinetaken te automatiseren en workflows in verschillende omgevingen te coördineren. Vermindert handmatig werk en beperkt menselijke fouten tijdens implementaties of onderhoud.
- Ondersteuning voor hybride omgevingen en multicloud: Biedt uniform inzicht in on-premises-, privatecloud- en publiccloudinfrastructuur. Helpt je complexe omgevingen als één operationele entiteit te beheren.
- Aanpasbare dashboards en rapportages: Stelt je in staat dashboards en rapportages te maken die zijn afgestemd op je behoeften. Ondersteunt trendanalyse, SLA-monitoring en het delen van inzichten met technische en zakelijke belanghebbenden.
- Integratie en API-toegang: Maakt verbinding met ITSM-, DevOps- en samenwerkingsplatforms. Stelt je team in staat om gegevens over IT-operations rechtstreeks in ticketsystemen, chat en andere systemen te integreren.
- Topologie- en afhankelijkheidsmapping: Visualiseert de relaties tussen systemen, services en infrastructuurcomponenten. Maakt het eenvoudiger om de hoofdoorzaak van incidenten te traceren en operationele risico's te begrijpen.
- Toegangsbeheer op basis van gebruikers en rollen: Stelt je in staat te bepalen wie onderdelen van je omgeving mag bekijken of bewerken. Beschermt gevoelige gegevens en beperkt de blootstelling op basis van de verantwoordelijkheden van gebruikers.
- Capaciteitsplanning en prognoses: Analyseert trends in het gebruik van resources om toekomstige behoeften te voorspellen. Helpt je te anticiperen op infrastructuurupgrades en budget te reserveren voor groei.
- Wijzigingenregistratie en auditlogboeken: Registreert configuratiewijzigingen en gebruikersacties. Ondersteunt nalevingsvereisten en helpt bij het oplossen van eerdere incidenten door een duidelijke wijzigingsgeschiedenis te bieden.
Veelvoorkomende AI-functies van software voor IT-operationsbeheer
Naast de hierboven genoemde standaardfuncties van software voor IT-operationsbeheer integreren veel van deze oplossingen AI met functies zoals:
- Door AI aangestuurde anomaliedetectie: Gebruikt machinelearning om automatisch ongebruikelijke patronen of gedragingen in systeemstatistieken, logboeken of netwerkverkeer te identificeren. Hierdoor kan je team opkomende problemen signaleren voordat ze escaleren, zelfs wanneer drempelwaarden niet handmatig zijn ingesteld.
- Geautomatiseerde analyse van de hoofdoorzaak: Past AI-algoritmen toe om gebeurtenissen, logboeken en prestatiegegevens in je volledige stack met elkaar in verband te brengen. Deze functie lokaliseert de waarschijnlijke bron van incidenten, waardoor je team minder tijd kwijt is aan onderzoek en herstel sneller verloopt.
- Voorspellende incidentprognoses: Gebruikt historische gegevens en AI-modellen om mogelijke storingen of prestatieverminderingen te voorspellen. Hierdoor kun je proactieve stappen nemen om incidenten te voorkomen en onderhoud effectiever te plannen.
- Intelligente vermindering van waarschuwingsruis: Gebruikt AI om gerelateerde waarschuwingen te groeperen, duplicaten te onderdrukken en meldingen te prioriteren op basis van impact en context. Dit vermindert waarschuwingsmoeheid en zorgt ervoor dat je team zich op de belangrijkste problemen richt.
- Door AI aangestuurde suggesties voor herstel: Analyseert incidentgegevens en eerdere oplossingen om vervolgstappen of geautomatiseerde oplossingen aan te bevelen. Hierdoor kan je team sneller reageren en worden best practices binnen je operations gestandaardiseerd.
Voordelen van software voor IT-operationsbeheer
De implementatie van software voor IT-operationsbeheer biedt verschillende voordelen voor je team en je bedrijf. Hier zijn enkele voordelen waar je naar kunt uitkijken:
- Gecentraliseerd overzicht: Verenig de monitoring van servers, netwerken, applicaties en cloudresources via één dashboard, zodat je team problemen in verschillende omgevingen voor blijft.
- Snellere oplossing van incidenten: Gebruik functies voor het samenvoegen van meldingen, AI-gestuurde correlatie en geautomatiseerde analyse van de hoofdoorzaak om operationele problemen snel te identificeren, prioriteren en verhelpen.
- Minder handmatig werk: Automatiseer terugkerende onderhouds-, herstel- en workflowtaken met vooraf gebouwde automatiserings- en orkestratietools, zodat er tijd vrijkomt voor initiatieven met een hogere waarde.
- Proactief risicobeheer: Voorspel storingen en knelpunten in resources met AI-aangedreven tools voor anomaliedetectie en prognoses die mogelijke problemen aan het licht brengen voordat ze escaleren.
- Optimalisatie van kosten en resources: Volg infrastructuurgebruik, applicatieprestaties en resource-uitgaven via rapportage- en analysemogelijkheden, zodat je budgetten en capaciteitsplanning beter kunt beheren.
- Betere beveiliging en compliance: Maak gebruik van toegangsbeheer voor gebruikers, auditlogboeken en mogelijkheden voor het volgen van wijzigingen om gevoelige gegevens te beschermen en te voldoen aan wettelijke vereisten.
- Naadloze integratie met het ecosysteem: Verbind ITSM-, DevOps- en chatplatforms met vooraf gebouwde integraties en open API's, zodat operationele gegevens eenvoudiger kunnen worden geïntegreerd in de manier waarop je team al werkt.
Kosten en prijzen van software voor IT-operationeel beheer
Bij het selecteren van software voor IT-operationeel beheer is inzicht nodig in de verschillende beschikbare prijsmodellen en abonnementen. De kosten variëren op basis van functies, teamgrootte, uitbreidingen en meer. In de onderstaande tabel worden veelvoorkomende abonnementen, hun gemiddelde prijzen en de typische functies van oplossingen voor software voor IT-operationeel beheer samengevat:
Vergelijkingstabel van abonnementen voor software voor IT-operationeel beheer
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Gratis abonnement | $0 | Basismonitoring van de infrastructuur, beperkte meldingen, toegang voor kleine teams en ondersteuning door de community. |
| Persoonlijk abonnement | $10–$30/gebruiker/maand | Realtime monitoring, automatisering op instapniveau, basisdashboards, integratie met populaire tools en ondersteuning per e-mail. |
| Zakelijk abonnement | $40–$80/gebruiker/maand | Monitoring van de volledige stack, meldingen en incidentbeheer, workflowautomatisering, geavanceerde dashboards, API-toegang en op rollen gebaseerd toegangsbeheer. |
| Ondernemingsabonnement | $90–$200/gebruiker/maand | Overzicht van hybride en multicloudomgevingen, AI-aangedreven functies, aangepaste SLA's, compliance-ondersteuning, speciale integraties en premiumondersteuning. |
Veelgestelde vragen over software voor IT-operatiebeheer
Hier vind je antwoorden op veelgestelde vragen over software voor IT-operatiebeheer:
Hoe vergelijk je verschillende platforms voor software voor IT-operatiebeheer?
Begin met het opstellen van een lijst met essentiële functies, zoals ondersteuning voor meerdere clouds, automatisering en integratiediepte. Test de platforms vervolgens aan de hand van veelvoorkomende incidentscenario’s en vergelijk hoe elke tool omgaat met waarschuwingen, analyse van hoofdoorzaken en rapportage. De totale eigendomskosten, ecosysteemintegraties en flexibiliteit bij de implementatie zijn ook belangrijk om te onderzoeken voordat je een definitieve keuze maakt.
Kan software voor IT-operatiebeheer de incidentrespons automatiseren?
Ja, met de meeste moderne software voor IT-operatiebeheer kun je de incidentrespons automatiseren via draaiboeken, workflowbouwers en zelfs door AI aangestuurde automatische probleemoplossing. Zo verminder je het aantal handmatige stappen en zorg je voor een consistente reactie op terugkerende problemen.
Naar welke integraties moet ik zoeken in software voor IT-operatiebeheer?
Let op API-toegang, vooraf gebouwde connectoren voor ITSM-tools (zoals ServiceNow), chatplatforms (zoals Slack of Microsoft Teams) en DevOps-pijplijnen. Dankzij uitgebreide integraties kan je team waarschuwingen doorsturen, workflows activeren en tickets synchroniseren tussen je bestaande systemen, zonder aangepaste middleware.
Helpt software voor IT-operatiebeheer bij naleving en audits?
Ja, krachtige software voor IT-operatiebeheer houdt systeemwijzigingen en gebruikersacties bij en biedt auditlogs die nodig zijn voor naleving. Dit is vooral nuttig in gereguleerde sectoren waar je duidelijke bewijzen van controles en een volledige wijzigingsgeschiedenis nodig hebt voor rapportage.
Hoe kan ik onverwachte kosten met software voor IT-operatiebeheer voorkomen?
Controleer altijd hoe het platform kosten berekent voor gegevensinname, aangepaste meetwaarden en gebruikerslicenties. Kies tools met transparante prijzen op basis van gebruik en dashboards voor kosten in de app, zodat je de uitgaven kunt volgen en onverwachte meerkosten voorkomt naarmate je omgeving groeit.
Wat is de beste manier om draagvlak bij belanghebbenden te creëren voor een nieuw platform voor IT-operatiebeheer?
Laat zien hoe het platform helpt om bedrijfsdoelen te behalen: snellere incidentoplossing, proactief risicobeheer en verbeterde rapportage. Deel de resultaten van een demonstratie of pilot, benadruk de verwachte efficiëntiewinst en verbind functies aan pijnpunten die je belanghebbenden herkennen.