

Wie zich verdiept in de wereld van kunstmatige intelligentie, komt vaak een overvloed aan hulpmiddelen voor natuurlijke taalverwerking tegen, die elk unieke mogelijkheden bieden. Van bots die worden aangedreven door geavanceerde NLP-modellen tot apps voor automatische vertaling en samenvatting: deze tools vormen de ruggengraat van het huidige automatiseringslandschap.
Op basis van mijn ervaring met natuurlijketaalbegrip, vraagbeantwoording, entiteitsextractie en de finesses van programmeertalen heb ik gezien hoe virtuele assistenten en NLP-toepassingen interacties hebben gerevolutioneerd. Door deze opties te onderzoeken, kun je voorkomen dat je gegevens handmatig moet doorzoeken en de kloof overbruggen tussen enorme hoeveelheden informatie en bruikbare inzichten.
Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Samenvatting van de beste NLP-software
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Beste voor implementatie van conversationele NLP op locatie | Gratis abonnement + gratis demo beschikbaar | Prijzen op aanvraag | Website | |
| 2 | Het meest geschikt voor API-toegang tot de meest geavanceerde taalmodellen | Gratis abonnement beschikbaar | Vanaf $20 per gebruiker per maand | Website | |
| 3 | Het beste voor gecombineerde analyse van tekst en gestructureerde gegevens | 14 dagen gratis proefversie + gratis demonstratie beschikbaar | Prijs op aanvraag | Website | |
| 4 | Het meest geschikt voor documentverwerking met lange context via open LLM's | Niet beschikbaar | Prijs op aanvraag | Website | |
| 5 | Het beste voor volledige fijnafstemming van LLM's op schaal | Gratis abonnement beschikbaar | Vanaf $0.04/krediet | Website | |
| 6 | Het beste voor AWS-eigen tekstanalyse op schaal | Gratis abonnement beschikbaar | Vanaf $0.0001/eenheid | Website | |
| 7 | Het beste voor het implementeren van productieklaar gemaakte NLP-pijplijnen | Gratis abonnement beschikbaar | Gratis abonnement beschikbaar | Website | |
| 8 | Het beste voor beheerde NLP in hybride cloudimplementaties | Gratis abonnement + gratis proefperiode + gratis demo beschikbaar | Vanaf $1,110/maand | Website | |
| 9 | Beste voor GCP-eigen pijplijnen voor tekstanalyse | Gratis abonnement beschikbaar | Vanaf $0.90/1,000 tekens (jaarlijks gefactureerd) | Website | |
| 10 | Het beste voor het op schaal fijnafstemmen van opensourcemodellen | Gratis abonnement beschikbaar | Vanaf $9/maand | Website |




Beoordelingen van de beste NLP-software
 1Beste voor implementatie van conversationele NLP op locatie
Rasa
- Gratis abonnement + gratis demo beschikbaar
- Prijzen op aanvraag
Visit WebsiteCustomer Rating:4.2/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.
Met Rasa kunnen gebruikers conversationele flows configureren met een visuele flowbouwer. Rasa is een open-sourceframework voor conversationele NLP dat een modulaire NLU-pijplijn, aangepaste intentclassificatie, herkenning van benoemde entiteiten, LLM-integratie via de CALM-architectuur en implementatieopties voor productieomgevingen biedt, waaronder implementatie op locatie en in geïsoleerde omgevingen.
Voor wie is Rasa het meest geschikt?
Rasa is zeer geschikt voor ML/NLP-technici en DevOps-teams in gereguleerde sectoren die volledige controle nodig hebben over hun implementatieomgeving voor conversationele AI.
Waarom ik voor Rasa heb gekozen
Ik heb Rasa opgenomen in mijn topkeuzes omdat het de sterkste optie is die ik heb gevonden voor teams die conversationele NLP volledig op hun eigen infrastructuur moeten implementeren. De Kubernetes-native implementatie via Helm-grafieken, ondersteuning voor geïsoleerde omgevingen en het beheer van geheimen met HashiCorp Vault maken het een natuurlijke keuze voor gereguleerde sectoren zoals de gezondheidszorg en financiële dienstverlening, waar gegevens nooit buiten de eigen perimeter komen. Ik waardeer ook de CALM-architectuur, die door LLM's aangestuurd taalbegrip scheidt van deterministische bedrijfslogica, waardoor het gedrag van agents in productie voorspelbaar en controleerbaar blijft.
Belangrijkste functies van Rasa
- DIET-classificator: Een model op basis van transformers dat intentclassificatie en entiteitsextractie gelijktijdig uitvoert binnen één trainbare architectuur.
- Routering tussen meerdere LLM's: Hiermee kun je verschillende LLM's toewijzen aan verschillende taken binnen dezelfde agent, zodat je controle houdt over de afwegingen tussen kosten en latentie.
- RAG-module voor bedrijven: Maakt verbinding met aangepaste vectordatabases voor het in realtime ophalen van kennis en baseert antwoorden op je eigen gegevens zonder dat het model opnieuw moet worden getraind.
- Herbruikbaarheid van meertalige flows: Implementeert dezelfde conversatieflows in meerdere talen en ondersteunt het wisselen van taal tijdens een gesprek zonder contextverlies.
Rasa-integraties
Rasa documenteert integraties met Hugging Face Transformers, spaCy, scikit-learn, Duckling, GPT-4, Llama, Redis, Apache Kafka, HashiCorp Vault en OpenTelemetry. REST- en WebSocket-API's ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Implementatie op locatie en in geïsoleerde omgevingen ondersteund
- Volledig open source met aanpasbare pijplijnen
- Herbruikbaarheid van meertalige flows met behoud van context
Cons:
- Geen native sentimentanalyse of samenvatting
- De open-source-editie bevindt zich in onderhoudsmodus
Learn more about Rasa: Het meest geschikt voor API-toegang tot de meest geavanceerde taalmodellen
- Gratis abonnement beschikbaar
- Vanaf $20 per gebruiker per maand

De speelomgeving van OpenAI laat gebruikers query's voor code-interpreters uitvoeren via assistenten. OpenAI is een AI-platform dat ontwikkelaars API-toegang biedt tot een brede catalogus van grote taalmodellen, embeddingmodellen en spraakmodellen voor het bouwen van NLP-toepassingen voor taken zoals tekstclassificatie, entiteitsextractie, samenvatting, vertaling en semantisch zoeken.
Voor wie is OpenAI het meest geschikt?
OpenAI is zeer geschikt voor ML-ingenieurs en ontwikkelingsteams die betrouwbare, schaalbare API-toegang tot de meest geavanceerde taalmodellen nodig hebben zonder onderliggende infrastructuur te hoeven beheren.
Waarom ik OpenAI heb gekozen
OpenAI staat op mijn shortlist omdat geen enkel ander platform je directe API-toegang biedt tot een bredere catalogus van de meest geavanceerde modellen met dit kwaliteitsniveau. Ik vind vooral de manier waarop de Responses API, Batch API en embeddingmodellen samenwerken erg goed: je kunt grootschalige NER- of classificatietaken 50% goedkoper uitvoeren via de Batch API en de resultaten vervolgens invoeren in
text-embedding-3-largevoor semantische clustering, en dat allemaal zonder infrastructuur te hoeven beheren. Het programma voor aangepaste modellen is een ander sterk punt, met bewezen productieresultaten zoals de nauwkeurigheidswinst van 83% bij Harvey voor juridische NLP.Belangrijkste functies van OpenAI
- Tiktoken-tokeniser: Een opensource-BPE-tokeniser die de interne tokenisatie van OpenAI nabootst, zodat je tokens kunt tellen en limieten voor contextvensters kunt beheren voordat je API-aanroepen doet.
- Gestructureerde uitvoer via de JSON-modus: Dwingt modelreacties af in een gedefinieerd JSON-schema, waardoor het betrouwbaar wordt om entiteiten of classificatielabels op schaal te extraheren.
- API voor embeddings: Genereert dichte vectorrepresentaties van tekst met
text-embedding-3-smalloftext-embedding-3-largevoor semantisch zoeken, clustering en classificatietaken. - Batch-API: Verwerkt grote aantallen inferentieaanvragen asynchroon met 50% korting ten opzichte van synchrone API-aanroepen.
Integraties van OpenAI
OpenAI kan worden geïntegreerd met LangChain, LlamaIndex, Azure OpenAI Service, Pinecone, Weaviate, Qdrant, Chroma en Temporal. De API's en officiële SDK's ondersteunen aangepaste verbindingen met vectordatabases, bedrijfssystemen en CI/CD-werkstromen.
Pros and Cons
Pros:
- Geavanceerde taalmodellen die worden bijgewerkt met toonaangevende benchmarks
- Batch-API verlaagt de kosten voor grootschalige verwerking
- Fijnafstemming met bewezen casestudy's bij ondernemingen
Cons:
- Geen hosting op locatie of in een privécloud
- Geen blootgelegde klassieke NLP-voorverwerkingspipeline
Learn more about OpenAI: Het beste voor gecombineerde analyse van tekst en gestructureerde gegevens
- 14 dagen gratis proefversie + gratis demonstratie beschikbaar
- Prijs op aanvraag

Met SAS Model Studio kunnen gebruikers tekstanalyseprojecten op één plek organiseren. SAS Visual Analytics is een bedrijfsbreed analyse- en NLP-platform dat visuele gegevensverkenning, tekstanalyse, topicmodellering, sentimentanalyse en NER combineert met een pijplijnbouwer zonder code en een generatieve AI-assistent.
Voor wie is SAS Visual Analytics het meest geschikt?
SAS Visual Analytics is zeer geschikt voor bedrijfsteams voor datawetenschap die gestructureerde en ongestructureerde tekstgegevens binnen één beheerd platform moeten analyseren.
Waarom ik voor SAS Visual Analytics heb gekozen
Ik heb voor SAS Visual Analytics gekozen omdat het een van de weinige NLP-platforms is die analyse van gestructureerde gegevens en tekstanalyse daadwerkelijk verenigt, zonder dat je afzonderlijke tools aan elkaar hoeft te koppelen. SAS Visual Text Analytics, dat ernaast draait, verwerkt NER, op BERT gebaseerde sentimentanalyse en topicmodellering binnen dezelfde beheerde omgeving waarin je gestructureerde gegevens al staan. Ik waardeer vooral de functie voor LLM-kalibratie, waarmee je modelgedrag voor RAG-pijplijnen kunt afstemmen zonder het basismodel zelf aan te raken; dat is een groot voordeel bij het werken met gevoelige bedrijfsgegevens.
Belangrijkste functies van SAS Visual Analytics
- Tekstvoorverwerking in 33 talen: Tokenisatie, lemmatisering en woordsoorttagging zijn standaard beschikbaar in 33 talen, waaronder Arabisch, Hindi, Thai en Vietnamees.
- Hybride NLP-pijplijnbouwer: Met een visuele interface zonder code kun je op regels gebaseerde, ML- en knooppunten voor diep leren combineren in één pijplijn voor tekstanalyse.
- SAS Micro Analytic Score API: Een statusloze score-API die in het geheugen draait en is gebouwd voor hoogwaardige, realtime modelinferentie in productieomgevingen.
- Draagbare ASTORE-modelbestanden: Getrainde modellen worden geëxporteerd als binaire ASTORE-bestanden, zodat ze buiten de SAS-omgeving kunnen worden gescoord op cloud- en lokale doelomgevingen.
Integraties van SAS Visual Analytics
SAS Visual Analytics beschikt over ingebouwde integraties binnen het Microsoft-ecosysteem, waaronder Microsoft 365 en Azure, en biedt daarnaast ondersteuning voor implementatie op AWS, Google Cloud Platform en Red Hat OpenShift. De REST API's en SDK's van SAS Viya ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Ingebouwde meertalige ondersteuning voor 33 talen
- Geïntegreerd platform voor tekst en gestructureerde gegevens
- Generatieve AI met ingebouwde controles op vooringenomenheid
Cons:
- Voor geavanceerde NLP-functies is een afzonderlijke uitbreiding vereist
- Minder flexibel dan opensource-NLP-raamwerken
Learn more about SAS Visual Analytics: Het meest geschikt voor documentverwerking met lange context via open LLM's
- Niet beschikbaar
- Prijs op aanvraag

Met AI21 Studio kunnen gebruikers per API-uitvoering expliciete uitvoervereisten definiëren. AI21 Studio is een LLM-platform dat is gebouwd rond de Jamba-familie van hybride Mamba-Transformer-modellen en tekstgeneratie, samenvatting, vraagbeantwoording, classificatie, RAG-orkestratie en fijn afstemmen op meerdere niveaus biedt via een API, SDK en beheerde clouddiensten.
Voor wie is AI21 Studio het meest geschikt?
AI21 Studio is zeer geschikt voor ML-ingenieurs en bedrijfsteams die RAG-pijplijnen of kenniswerkstromen bouwen boven op grote, ongestructureerde documentverzamelingen.
Waarom ik voor AI21 Studio heb gekozen
AI21 Studio staat op mijn voorkeurslijst vanwege de manier waarop de Jamba-modelfamilie echt grote documentwerklasten verwerkt. Het contextvenster van 256K tokens is het grootste dat beschikbaar is onder modellen met open gewichten, waardoor ik volledige contracten, rapporten over klinische onderzoeken of M&A-dossiers in één inferentieaanroep kan invoeren zonder ze op te delen. Combineer dat met de Maestro RAG-orkestratielaag, die dynamisch wisselt tussen zoeken in bestanden, zoeken op het web en LLM's en daarbij een visuele uitvoeringsgrafiek biedt, en je hebt een krachtige pijplijn voor het extraheren van gestructureerde inzichten uit omvangrijke, ongestructureerde documentverzamelingen.
Belangrijkste functies van AI21 Studio
- Hybride Jamba-architectuur: Jamba-modellen combineren Mamba-SSM-lagen met Transformer-aandacht in een ontwerp met een mengsel van experts, waardoor ze tot 2,5× snellere inferentie leveren dan transformermodellen met vergelijkbare omvang.
- API voor fijn afstemmen op meerdere niveaus: Ondersteunt volledig fijn afstemmen, LoRA en QLoRA via standaard HuggingFace-bibliotheken, plus een beheerde service voor nabewerking voor bedrijfsteams die eigenaar willen blijven van het resulterende model.
- Intelligente toegangspoort: Een direct inzetbare routeringslaag die de kosten per agent in kaart brengt, overbodige context compacter maakt en per beurt adaptief modellen selecteert — momenteel gratis tijdens de bètafase.
- Open modelgewichten op Hugging Face: Jamba-modellen zijn openbaar beschikbaar onder de Jamba Open Model License, waardoor je team ze zelf kan hosten, inspecteren of verder kan aanpassen zonder afhankelijk te zijn van één leverancier.
Integraties van AI21 Studio
AI21 Studio integreert met AWS, Microsoft Azure, Google Cloud, NVIDIA NIM, Hugging Face, LangChain, LlamaIndex, Pinecone, Snowflake en Databricks. De REST API, Python SDK en TypeScript SDK ondersteunen aangepaste integraties en implementatiewerkstromen.
Pros and Cons
Pros:
- Verwerkt lange documentinvoer van 256K tokens
- Ondersteunt volledig fijn afstemmen, LoRA en QLoRA
- Open modelgewichten voor zelfhosting
Cons:
- Geen speciale NER- of sentiment-API
- Mist een visuele bouwer zonder code voor NLP-pijplijnen
Learn more about AI21 Studio: Het beste voor volledige fijnafstemming van LLM's op schaal
- Gratis abonnement beschikbaar
- Vanaf $0.04/krediet
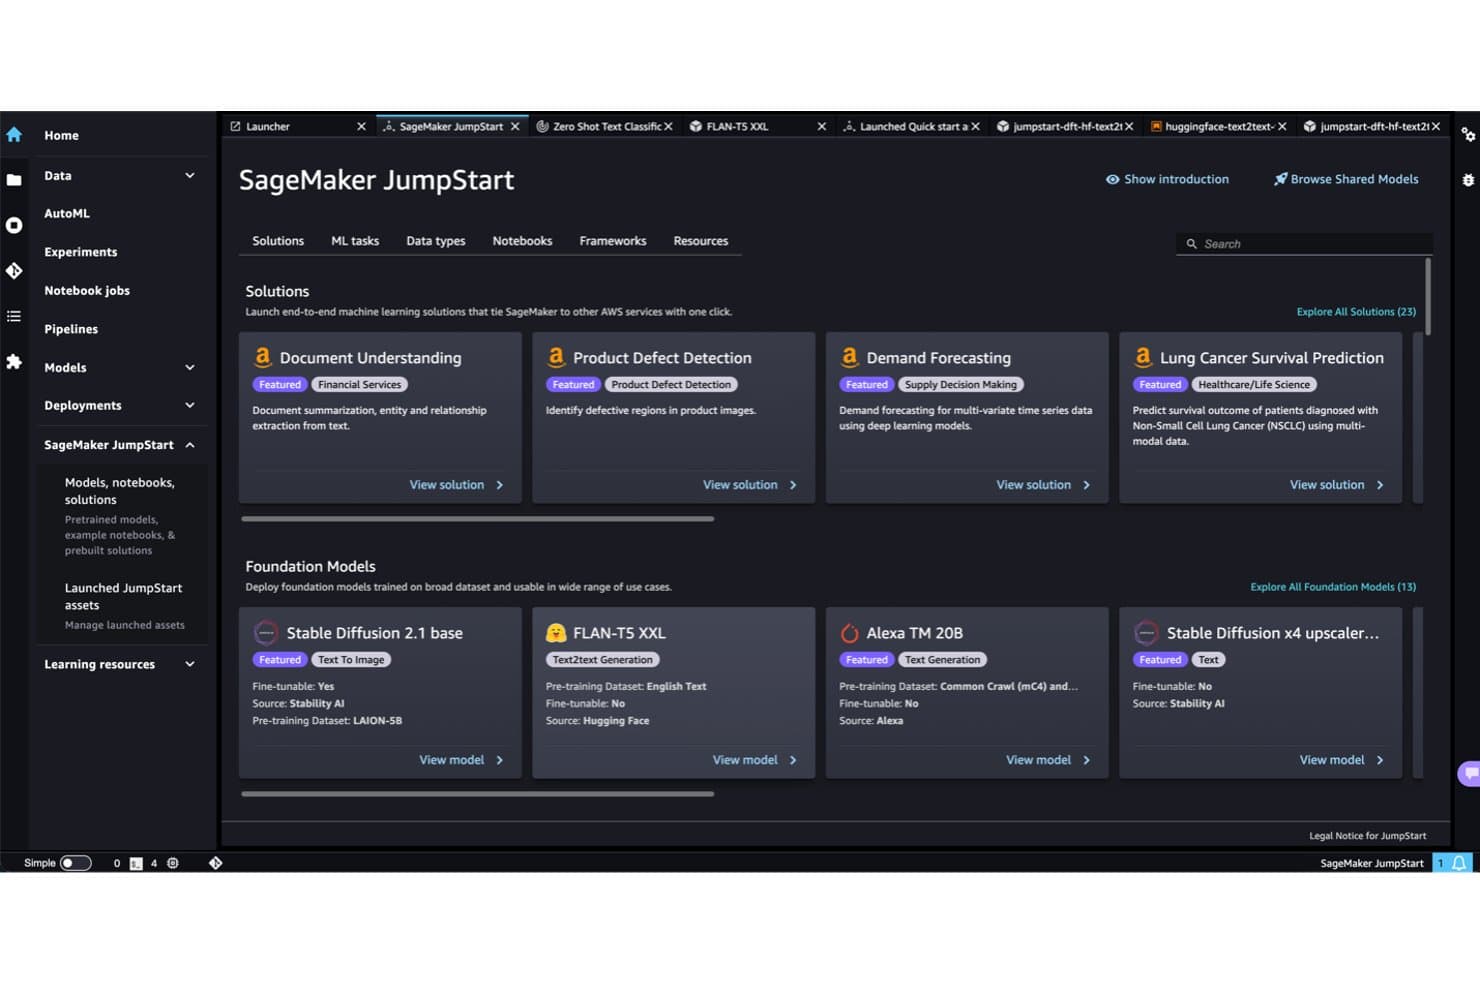
Amazon SageMaker JumpStart biedt vooraf gebouwde NLP-modellen die klaar zijn voor implementatie. Amazon SageMaker is het beheerde ML-platform van AWS dat de volledige levenscyclus van NLP-modellen omvat—van gegevensvoorbewerking en tokenisatie tot training, fijnafstemming en het op schaal implementeren van grote taalmodellen via tools zoals JumpStart, HyperPod en native integraties met Hugging Face.
Voor wie is Amazon SageMaker het meest geschikt?
Amazon SageMaker is de juiste keuze voor ML-engineers en MLOps-teams bij middelgrote tot grote ondernemingen die één platform nodig hebben om LLM's op schaal van onbewerkte gegevens naar productie te brengen.
Waarom ik voor Amazon SageMaker heb gekozen
Amazon SageMaker verdient een plek op mijn shortlist omdat geen ander beheerd ML-platform kan tippen aan de diepgang ervan voor volledige fijnafstemming van LLM's op schaal. Ik ben vooral onder de indruk van HyperPod, waarmee je gedistribueerde fijnafstemming kunt uitvoeren op honderden accelerators met elastische training zonder checkpoints, waardoor de trainingstijd met maximaal 40% wordt verkort. De catalogus van JumpStart met meer dan 1.000 modellen, waaronder Llama 4, DeepSeek R1 en medische LLM's van John Snow Labs, betekent dat ik van het selecteren van een domeinspecifiek basismodel naar het verfijnen ervan met aangepaste gegevens kan gaan zonder het platform te verlaten.
Belangrijkste functies van Amazon SageMaker
- SageMaker Clarify: Detecteert vooroordelen en genereert rapporten over uitlegbaarheid voor NLP-modellen tijdens training, evaluatie en monitoring na implementatie.
- SageMaker Data Wrangler: Biedt een interface waarvoor weinig code nodig is om tekstgegevens te importeren, transformeren en voorbereiden vóór modeltraining.
- Inferentie-eindpunten met meerdere modi: Ondersteunt realtime-, serverloze, asynchrone en batchinferentieopties op meer dan 70 instantietypen, waaronder Inferentia- en Trainium-chips.
- Beheerde MLflow-integratie: Houdt experimenten bij, vergelijkt modeluitvoeringen en beheert versiebeheer binnen NLP-workflows zonder dat afzonderlijke infrastructuur nodig is.
Integraties van Amazon SageMaker
Amazon SageMaker heeft native integraties met Amazon S3, Amazon Bedrock, Amazon OpenSearch Service, Amazon EKS, AWS Lambda, Amazon CloudWatch, AWS IAM, Hugging Face en MLflow. Het biedt ook REST API's, SDK's en toegang via de AWS CLI voor aangepaste integraties.
Pros and Cons
Pros:
- Grootste beschikbare catalogus met vooraf getrainde modellen
- HyperPod ondersteunt grootschalige gedistribueerde training van LLM's
- Volledige levenscyclus met tools voor uitlegbaarheid
Cons:
- Kosten bijhouden is voor de meeste teams moeilijk
- Risico op afhankelijkheid van één leverancier voor multicloudbedrijven
Learn more about Amazon SageMaker: Het beste voor AWS-eigen tekstanalyse op schaal
- Gratis abonnement beschikbaar
- Vanaf $0.0001/eenheid
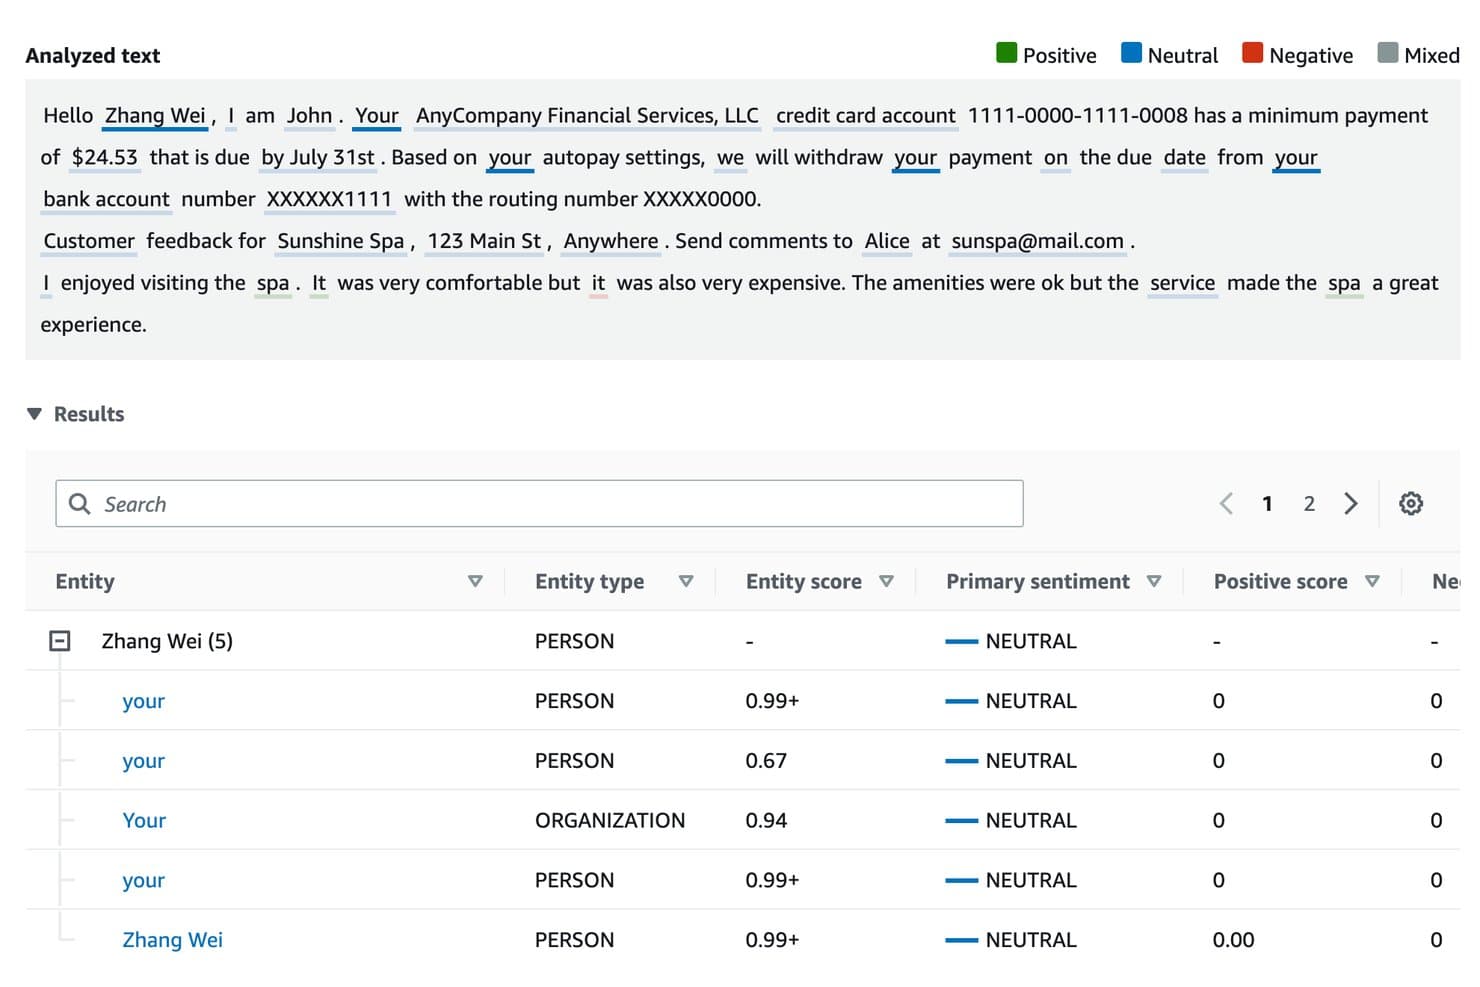
Amazon Comprehend identificeert entiteiten en sentimenten in geanalyseerde tekst. Amazon Comprehend is een volledig beheerde AWS NLP-service die vooraf gebouwde, API-gestuurde mogelijkheden voor tekstanalyse biedt, waaronder sentimentanalyse, herkenning van benoemde entiteiten, PII-detectie, extractie van kernzinnen en training van aangepaste modellen via AutoML, zonder dat u onderliggende infrastructuur hoeft te beheren.
Voor wie is Amazon Comprehend het meest geschikt?
Amazon Comprehend is zeer geschikt voor techniek- en DevOps-teams die al werklasten in AWS uitvoeren en productieklare NLP nodig hebben zonder ML-infrastructuur te beheren.
Waarom ik Amazon Comprehend heb gekozen
Amazon Comprehend staat op mijn shortlist omdat het de meest natuurlijke keuze is voor AWS-eigen tekstanalyse op schaal. Ik vind het prettig dat je sentimentanalyse, aspectgerichte entiteitsherkenning en PII-redactie rechtstreeks via beheerde API-eindpunten kunt uitvoeren, zonder ook maar één server te hoeven inrichten. In de praktijk betekent dit dat mijn team miljoenen klantgegevens asynchroon vanuit S3 kan verwerken, met volumegestuurde prijzen die daadwerkelijk lager worden naarmate je meer analyseert.
Belangrijkste functies van Amazon Comprehend
- Aangepaste entiteitsherkenning: Train een domeinspecifieke entiteitsherkenner met je eigen gelabelde voorbeelden om termen zoals polisnummers of interne codes te extraheren die vooraf gebouwde modellen niet herkennen.
- PII-detectie en -redactie: Identificeer en redigeer automatisch gevoelige persoonlijke gegevens—namen, SSN's, creditcardnummers—rechtstreeks binnen je documentverwerkingspijplijn.
- MLOps-automatisering met Flywheel: Beheer de volledige levenscyclus van aangepaste modellen, van gegevensopname tot en met hertraining en versiepromotie, zonder een afzonderlijke MLOps-laag te bouwen.
- Ontologiekoppeling van Comprehend Medical: Koppel geëxtraheerde klinische entiteiten aan gestandaardiseerde coderingssystemen zoals ICD-10-CM, RxNorm en SNOMED CT voor NLP-workflows in de gezondheidszorg.
Integraties van Amazon Comprehend
Amazon Comprehend heeft rechtstreekse integraties met Amazon S3, AWS Lambda, AWS KMS, AWS IAM, Amazon Kendra, Amazon Lex, Amazon Connect, AWS CloudTrail en Amazon CloudWatch. De REST-API, AWS SDK's, AWS CLI, Step Functions en EventBridge ondersteunen aangepaste pijplijnen en workflowautomatisering.
Pros and Cons
Pros:
- Rechtstreekse aansluiting op AWS-gerichte NLP-workflows
- NLP voor de gezondheidszorg met koppeling aan klinische ontologieën
- Ingebouwde PII-detectie en -redactie
Cons:
- Geen toegang tot interne modelgegevens
- Beperkte fijnafstemming naast eenvoudige AutoML
Learn more about Amazon Comprehend: Het beste voor het implementeren van productieklaar gemaakte NLP-pijplijnen
- Gratis abonnement beschikbaar
- Gratis abonnement beschikbaar
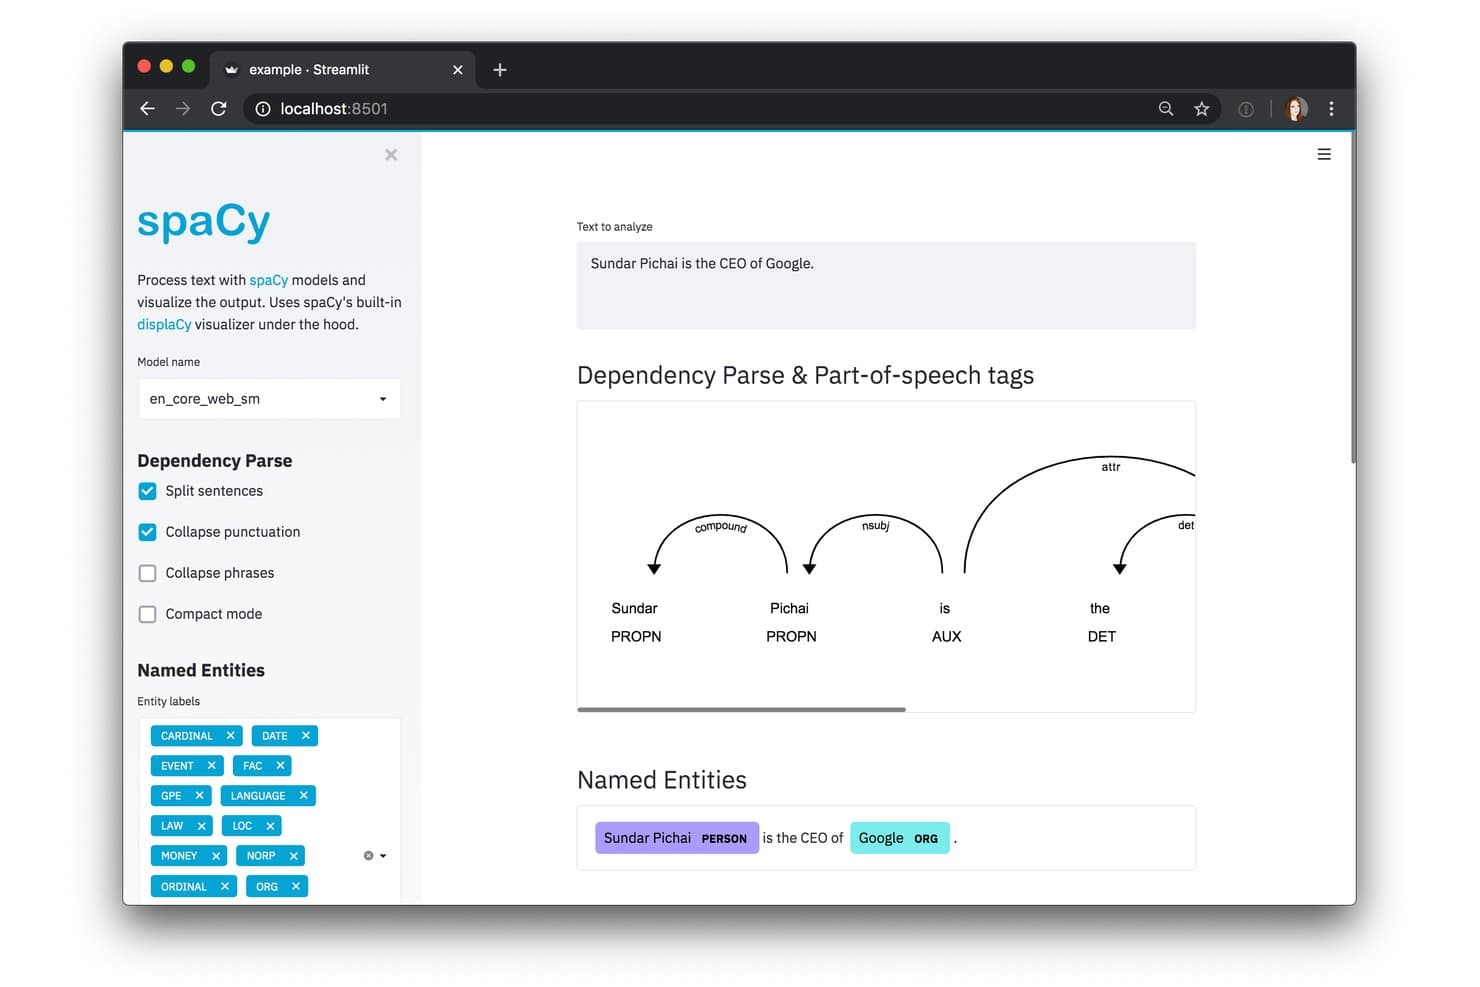
spaCy visualiseert afhankelijkheidsanalyses en benoemde entiteiten interactief. spaCy is een open-source-Pythonbibliotheek voor NLP die tokenisatie, herkenning van benoemde entiteiten, afhankelijkheidsanalyse, tekstclassificatie en het trainen van modellen op basis van transformers in meer dan 75 talen omvat.
Voor wie is spaCy het meest geschikt?
spaCy is zeer geschikt voor engineers voor machine learning en datawetenschappers die NLP-pijplijnen in Python moeten bouwen, trainen en implementeren zonder afhankelijk te zijn van een beheerd platform.
Waarom ik voor spaCy heb gekozen
spaCy staat op mijn shortlist omdat het vanaf de basis is gebouwd voor productiegebruik, niet alleen voor experimenten. Ik vind het geweldig dat getrainde pijplijnen als installeerbare Python-modules worden verpakt. Daardoor is het implementeren van een aangepast NER-model in een Docker-container of AWS Lambda-laag een herhaalbaar proces met versiebeheer, in plaats van een eenmalige haastklus. Het configuratiegestuurde systeem van
spaCy trainhoudt elke hyperparameter en architectuurkeuze in één bestand, zodat mijn pijplijnen in verschillende omgevingen reproduceerbaar zijn. Die combinatie van gedisciplineerde verpakking en door Cython aangedreven batchdoorvoer vianlp.pipe()maakt spaCy echt klaar voor productie.Belangrijkste functies van spaCy
- 84 vooraf getrainde pijplijnen: Download en gebruik vooraf getrainde pijplijnen in 25 talen, variërend van compacte, voor CPU geoptimaliseerde modellen tot volledige varianten op basis van transformers die zijn gebouwd met RoBERTa en BERT.
- Integratie met
spaCy-LLM: Koppel spaCy-pijplijnen rechtstreeks aan gehoste LLM-API's (OpenAI, Anthropic, Cohere) of open-sourcemodellen om NLP-taken uit te voeren zonder gelabelde trainingsgegevens. - displaCy-visualisatie: Geef annotaties van benoemde entiteiten en bomen voor afhankelijkheidsanalyses weer in de browser met behulp van de ingebouwde visualisatiecomponent van spaCy.
- Pijplijnecosysteem voor specifieke domeinen: Krijg toegang tot kant-en-klare communitypijplijnen voor de gezondheidszorg (medspaCy) en juridische teksten (Blackstone) via de spaCy Universe-bibliotheek.
Integraties van spaCy
spaCy integreert met Hugging Face Transformers, PyTorch, TensorFlow, OpenAI, Anthropic, Cohere, LangChain, Prodigy, DVC, Prefect en Ray. De Python-API ondersteunt aangepaste integraties, maar bevat geen native REST-API.
Pros and Cons
Pros:
- Draait volledig op je eigen infrastructuur
- Biedt domeinspecifieke pijplijnen voor de gezondheidszorg en juridische sector
- Verpakking maakt reproduceerbare modelimplementaties met versiebeheer mogelijk
Cons:
- Geen ingebouwde REST-API voor het aanbieden van modellen
- Geen interface voor werkwijzen zonder code of visuele werkstromen
Learn more about spaCy: Het beste voor beheerde NLP in hybride cloudimplementaties
- Gratis abonnement + gratis proefperiode + gratis demo beschikbaar
- Vanaf $1,110/maand

IBM watsonx.ai extraheert gestructureerde feiten uit SEC 10-K-rapporten met behulp van prompts met enkele voorbeelden. IBM watsonx.ai is een enterprise-AI-platform dat een catalogus met basismodellen van meerdere leveranciers, de Watson NLP-bibliotheek, LoRA/QLoRA-finetuning, AutoML en flexibele implementatieopties voor SaaS, on-premises en hybride cloud combineert voor het bouwen en opschalen van NLP-workloads.
Voor wie is IBM watsonx.ai het meest geschikt?
IBM watsonx.ai is zeer geschikt voor enterprise-IT- en datawetenschapsteams die NLP-workloads moeten bouwen, finetunen en implementeren in on-premises-, hybride en cloudomgevingen met strenge vereisten op het gebied van governance en compliance.
Waarom ik voor IBM watsonx.ai heb gekozen
IBM watsonx.ai staat op mijn shortlist vanwege de uitstekende manier waarop het beheerde NLP in hybride cloudomgevingen ondersteunt. Dat is een echte onderscheidende factor voor enterprise-teams met strenge compliancevereisten. Ik ben vooral onder de indruk van de Watson NLP-bibliotheek, die NER, sentimentanalyse, toonclassificatie en semantische rolannotatie in meer dan 20 talen binnen één controleerbare pijplijn ondersteunt. In combinatie met CP4D op Red Hat OpenShift voor on-premises- of hybride implementaties en AI Factsheets voor auditsporen van modellen, krijg je end-to-end governance in elke laag ingebouwd.
Belangrijkste functies van IBM watsonx.ai
- Catalogus met basismodellen van meerdere leveranciers: Krijg toegang tot vooraf getrainde modellen van IBM Granite, Meta Llama, Mistral, DeepSeek en NVIDIA vanuit één gehoste bibliotheek.
- LoRA/QLoRA-finetuning: Pas basismodellen aan voor domeinspecifieke NLP-taken met parameter-efficiënte finetuning in GPU-versnelde omgevingen.
- AutoAI-pijplijnbouwer: Verwerkt automatisch de gegevensvoorbereiding, feature-engineering, modelselectie en het afstemmen van hyperparameters voor voorspellende ML-workflows.
- OpenAI-compatibel API-eindpunt: Verbind bestaande applicaties met de inferentie van watsonx.ai via een OpenAI-compatibele REST API-indeling, naast SDK's voor Python, Node.js en Java.
Integraties van IBM watsonx.ai
IBM watsonx.ai integreert met Hugging Face, Red Hat OpenShift, watsonx.data, Watson Assistant, watsonx Orchestrate, Watson Discovery en IBM Cloud Object Storage. De REST API en de SDK's voor Python, Node.js en Java ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Brede dekking van NLP-taken in meer dan 20 talen
- IP-vrijwaring voor enterprise-modellen van IBM
- Native ondersteuning voor RAG en vectorzoekopdrachten
Cons:
- De propriëtaire modellen van IBM zijn niet beschikbaar voor AWS
- De interface kan verwarrend zijn voor nieuwe gebruikers
Learn more about IBM watsonx.ai: Beste voor GCP-eigen pijplijnen voor tekstanalyse
- Gratis abonnement beschikbaar
- Vanaf $0.90/1,000 tekens (jaarlijks gefactureerd)

Google Cloud Natural Language AI annoteert cv-entiteiten zoals vaardigheden en werkgevers. Google Cloud Natural Language AI is een beheerde NLP-API van Google die vooraf getrainde sentimentanalyse, entiteitsherkenning, syntaxisanalyse, inhoudclassificatie en tekstmoderatie levert via REST- en gRPC-interfaces, met clientbibliotheken voor acht programmeertalen.
Voor wie is Google Cloud Natural Language AI het meest geschikt?
Google Cloud Natural Language AI is zeer geschikt voor engineeringteams die al workloads op GCP uitvoeren en productieklare NLP nodig hebben zonder infrastructuur te hoeven beheren.
Waarom ik voor Google Cloud Natural Language AI heb gekozen
Google Cloud Natural Language AI staat op mijn shortlist vanwege de natuurlijke manier waarop het in GCP-eigen pijplijnen voor tekstanalyse past. Als je team al gegevens via BigQuery verwerkt, kun je
ML.UNDERSTAND_TEXTrechtstreeks in SQL aanroepen om sentiment- of entiteitsanalyse uit te voeren zonder het datawarehouse ooit te verlaten. Ik vind het ook prettig dat de v2-API een op PaLM gebaseerd model gebruikt voor entiteits- en sentimenttaken, en dat je met de methodeannotateTextmeerdere NLP-functies in één API-aanroep kunt ophalen, waardoor de overhead van heen-en-terugverzoeken aanzienlijk wordt beperkt.Belangrijkste functies van Google Cloud Natural Language AI
- Sentimentanalyse van entiteiten: Detecteert het sentiment dat bij elke benoemde entiteit in een tekst hoort en geeft scores per entiteit terug voor het Engels, Japans en Spaans.
- AutoML voor natuurlijke taal: Hiermee kun je via Vertex AI aangepaste modellen voor tekstclassificatie en entiteitsextractie trainen op je eigen gelabelde datasets, met behulp van een visuele interface waarvoor geen code nodig is.
- Eindpunten voor meerdere regio's: Stuurt API-aanvragen via eindpunten in de VS of de EU om gegevens binnen een specifieke regio te laten verwerken en opslaan voor naleving van voorschriften voor gegevensresidentie.
- HIPAA-conforme API: Valt onder de overeenkomst voor zakelijke partners van Google Cloud en kan daardoor worden gebruikt voor workflows waarin beschermde gezondheidsinformatie wordt verwerkt.
Integraties van Google Cloud Natural Language AI
Google Cloud Natural Language AI integreert met Vertex AI, BigQuery, Cloud Composer, Speech-to-Text, Translation API, Vision API, Dataflow, Cloud Run en Cloud Functions. REST, gRPC en acht clientbibliotheken ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Vooraf getrainde modellen vereisen geen trainingsgegevens
- Gegevens worden na API-verwerking nooit opgeslagen
- Meertalige ondersteuning voor belangrijke NLP-functies
Cons:
- Geen uitlegbaarheid van modellen of statistieken over vooringenomenheid
- Fijnafstemming is alleen beschikbaar via Vertex AI
Learn more about Google Cloud Natural Language AI: Het beste voor het op schaal fijnafstemmen van opensourcemodellen
- Gratis abonnement beschikbaar
- Vanaf $9/maand

Met HuggingChat kunnen gebruikers AI-modellen bevragen via een webchatinterface. Hugging Face is een opensource-NLP-platform dat je toegang geeft tot meer dan 2 miljoen vooraf getrainde modellen, naast een complete reeks tools voor tokenisatie, fijnafstemming en modelimplementatie in cloud- en on-premisesomgevingen.
Voor wie is Hugging Face het meest geschikt?
Hugging Face is het platform bij uitstek voor ML- en NLP-technici die directe toegang nodig hebben tot opensourcemodellen en de volledige toolchain om deze op schaal af te stemmen, te evalueren en te implementeren.
Waarom ik voor Hugging Face heb gekozen
Hugging Face staat op mijn selectie omdat geen enkel ander platform in de buurt komt voor het op schaal fijnafstemmen van opensourcemodellen. Ik vind het geweldig dat PEFT en QLoRA je in staat stellen om LLM's met miljarden parameters, zoals LLaMA of Mistral, op één GPU fijn af te stemmen. Dat verlaagt de rekenkosten aanzienlijk zonder aan kwaliteit in te boeten. De TRL-bibliotheek voegt daar volledige ondersteuning voor RLHF en DPO aan toe, zodat je domeinspecifieke modellen met minimale overhead kunt afstemmen.
Belangrijkste functies van Hugging Face
- Transformers Pipeline-API: Een interface met één regel voor het uitvoeren van NLP-taken — classificatie, NER, samenvatting, vertaling en QA — met elk model op de Hub.
- AutoTrain: Een trainingsinterface zonder code waarin je een gelabelde dataset uploadt, een taak selecteert en het platform automatisch het model selecteert en traint.
- Text Embeddings Inference (TEI): Een speciale inferentie-engine die is geoptimaliseerd voor het genereren van embeddings met hoge doorvoer en die semantisch zoeken en RAG-pijplijnen op schaal ondersteunt.
- Inference Providers-API: Een uniform eindpunt dat compatibel is met OpenAI en verzoeken via aanbieders zoals Groq, Together AI en Cerebras routeert met één Hugging Face-token.
Integraties van Hugging Face
Hugging Face integreert met PyTorch, TensorFlow, JAX, AWS SageMaker, Google Cloud, Azure, Weights & Biases, MLflow en Snowflake. De Python-, JavaScript-, REST- en CLI-API's ondersteunen aangepaste integraties en implementatieworkflows.
Pros and Cons
Pros:
- Ongeëvenaarde selectie van opensource-NLP-modellen
- Maakt het mogelijk om gigantische modellen op één GPU fijn af te stemmen
- Met AutoTrain kun je modellen trainen zonder code
Cons:
- Modellen van de gemeenschap verschillen in kwaliteit en beveiliging
- Implementatie op ondernemingsniveau vereist DevOps-expertise
Learn more about Hugging Face:
Andere NLP-software
Hieronder vind je een lijst met aanvullende NLP-software die ik op de shortlist heb gezet, maar die de top 10 niet heeft gehaald. Ze zijn zeker de moeite waard om te bekijken.
- 11NLP CloudBeste voor privacygerichte implementatie van NLP-API's
- 12SnorkelBeste voor programmatisch labelen op ondernemingsschaal
- 13ClaudeHet beste voor NLP waarbij veiligheid vooropstaat in alle grote cloudomgevingen
- 14Cohere NorthBeste voor de implementatie van NLP-modellen in een geïsoleerde omgeving
- 15Microsoft Azure AI LanguageHet meest geschikt voor geïsoleerde NLP in gereguleerde sectoren
- 16NLTKHet beste voor klassieke NLP zonder infrastructuurkosten
- 17Stanford NLPIdeaal voor taalkundige precisie in meer dan 80 talen
Hoe ik NLP-software evalueer
Van NER-pijplijnen tot transformerimplementaties in productie evalueer ik NLP-tools in twee lagen: de basis waaraan elk platform moet voldoen om op de lijst te komen en de onderscheidende factoren die de beste tools van de rest onderscheiden.
Basisfunctionaliteit (vereisten voor deze lijst)
Wanneer ik tools voor mijn lijst selecteer, beoordeel ik elk ervan op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde basisfunctionaliteit. Vervolgens bereken ik de totaalscore van de tool als percentage. Elke tool moet een minimale totaalscore van 75% behalen om in aanmerking te komen voor opname.
- Tekstvoorbewerking en tokenisatie: Ik controleer of een platform de volledige opschoningsketen ondersteunt—tokenisatie, stemming, lemmatisering en het verwijderen van stopwoorden—zodat onbewerkte tekst voor meerdere talen klaar is voor verwerking in een pijplijn.
- Voorgetrainde taalmodellen: Toegang tot actuele transformerarchitecturen is belangrijk. Ik zoek naar een brede, regelmatig bijgewerkte modelcatalogus in plaats van een handvol verouderde opties.
- Dekking van kerntaken binnen NLP: Elke tool moet fundamentele taken ondersteunen, zoals NER, sentimentanalyse, classificatie en samenvatting—de bouwstenen van de meeste NLP-werkstromen in productie.
- Modeltraining en afstemming: Ik evalueer of je je eigen dataset kunt gebruiken en modellen kunt afstemmen met echte controle over hyperparameters, in plaats van slechts enkele vooraf ingestelde opties achter een wizard in te schakelen.
- Toegang via API en SDK: Goede NLP-tools bieden REST-API's en SDK's in talen zoals Python en Java. Ik let op duidelijke documentatie, versiespecifieke eindpunten en compatibiliteit met raamwerken.
- Implementatie en schaalbaarheid: Ik kijk hoe elk platform omgaat met workloads in productie—of het automatisch schalen van inferentie, batchverwerking en flexibele rekenopties zoals GPU- of TPU-voorziening ondersteunt.
Zodra ik een lijst heb met tools die aan de criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (waarin leveranciers zich onderscheiden)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
RAG-raamwerken en ondersteuning voor vectorzoekopdrachten zijn momenteel belangrijke onderscheidende factoren. Teams die apps bouwen die door LLM's worden aangedreven, hebben behoefte aan ingebouwde generatie van vectorinbeddingen en ophaalpijplijnen, niet aan achteraf toegevoegde noodoplossingen. Ik zoek ook naar tools voor uitlegbaarheid en biasdetectie—wanneer je sentimentmodellen in productie implementeert, willen belanghebbenden begrijpen waarom een voorspelling is gedaan. Domeinspecifieke modelverzamelingen besparen ook echt tijd, vooral voor teams in de gezondheidszorg of juridische sector die anders weken zouden besteden aan het afstemmen van modellen voor algemene doeleinden.
Meer dan functies alleen
Flexibiliteit bij implementatie is belangrijk wanneer je beveiligingsteam hosting op locatie of geïsoleerde omgevingen zonder netwerkverbinding verplicht stelt. Ik evalueer of een platform cloud-, hybride en zelfgehoste opties ondersteunt naast Kubernetes-orkestratie. Controles voor gegevensprivacy zijn even belangrijk—ik controleer op SOC 2-naleving, opties voor gegevenslokalisatie en beleid voor het niet bewaren van gegevens, vooral wanneer pijplijnen gevoelige tekst verwerken, zoals medische dossiers. De aansluiting op het ecosysteem maakt het geheel compleet: een tool die aansluit op je MLOps-technologiestack en data-infrastructuur bespaart maanden aan maatwerk voor integratie.
Hoe kies je NLP-software?
Het is gemakkelijk om verstrikt te raken in lange lijsten met functies en complexe prijsstructuren. Om je te helpen gefocust te blijven tijdens je unieke selectieproces voor software, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waar je op moet letten |
|---|---|
| FactorSchaalbaarheid | Waar je op moet lettenKan de software meegroeien met je team? Zoek naar tools die grotere gegevensvolumes kunnen verwerken zonder extra kosten. Houd rekening met toekomstige behoeften en mogelijke uitbreidingen. |
| FactorIntegraties | Waar je op moet lettenWerkt de software met je bestaande systemen? Controleer de compatibiliteit met je huidige tools om verstoringen van je werkstromen te voorkomen. |
| FactorAanpasbaarheid | Waar je op moet lettenKun je de software aanpassen aan je behoeften? Zorg ervoor dat je instellingen of functies kunt wijzigen zodat ze aansluiten op je specifieke processen. |
| FactorGebruiksgemak | Waar je op moet lettenIs de interface gebruiksvriendelijk? Complexe tools kunnen de ingebruikname vertragen. Zoek naar intuïtieve ontwerpen waarvoor minimale training nodig is. |
| FactorImplementatie en ingebruikname | Waar je op moet lettenHoe lang duurt het voordat je aan de slag kunt? Beoordeel hoeveel tijd nodig is voor installatie en training. Een snelle ingebruikname kan tijd en middelen besparen. |
| FactorKosten | Waar je op moet lettenPast de software binnen je budget? Vergelijk prijsplannen en let op verborgen kosten. Houd rekening met de totale eigendomskosten, niet alleen met de aanvankelijke prijs. |
| FactorBeveiligingsmaatregelen | Waar je op moet lettenZijn je gegevens beschermd? Zorg voor naleving van normen voor gegevensprivacy en let op versleuteling en andere beveiligingsfuncties. |
| FactorBeschikbaarheid van ondersteuning | Waar je op moet lettenZijn ondersteuningsdiensten beschikbaar wanneer dat nodig is? Beoordeel de beschikbaarheid en kwaliteit van klantenservicekanalen zoals chat, e-mail of telefoon. |
Wat is NLP-software?
NLP-software is een hulpmiddel dat menselijke taalgegevens verwerkt en analyseert. Professionals zoals datawetenschappers, marketeers en klantenserviceteams gebruiken deze hulpmiddelen om inzichten te verkrijgen en de communicatie te verbeteren. Functies voor tekstanalyse, sentimentanalyse en taalvertaling helpen bij het begrijpen van en reageren op de behoeften van gebruikers.
Over het geheel genomen verbeteren deze hulpmiddelen, waaronder software voor gespreksintelligentie, de besluitvorming en efficiëntie bij taalgerelateerde taken.
Functies
Let bij het selecteren van NLP-software op de volgende belangrijke functies:
- Tekstanalyse: Verwerkt grote hoeveelheden tekstgegevens om betekenisvolle inzichten te verkrijgen, zodat teams trends en patronen kunnen begrijpen.
- Sentimentanalyse: Identificeert en categoriseert meningen die in tekst worden uitgedrukt om de houding van klanten te peilen en strategieën voor klantbetrokkenheid te verbeteren.
- Taalvertaling: Zet tekst om van de ene taal naar de andere, waardoor wereldwijde communicatie en toegankelijkheid worden bevorderd.
- Spraakherkenningssoftware: Zet gesproken taal om in tekst, waardoor spraakinvoer mogelijk wordt en de toegankelijkheid verbetert.
- Entiteitsherkenning: Identificeert en classificeert belangrijke elementen in tekst, zoals namen en datums, voor een betere gegevensorganisatie.
- Meertalige ondersteuning: Biedt mogelijkheden in meerdere talen, waardoor bredere toepassing in verschillende regio's mogelijk wordt.
- Aanpasbare modellen: Stelt gebruikers in staat algoritmen aan specifieke behoeften aan te passen, waardoor de relevantie en nauwkeurigheid van resultaten toenemen.
- Realtimeverwerking: Biedt directe analyse en feedback, wat cruciaal is voor tijdgevoelige toepassingen en besluitvorming.
- Instellingen voor gegevensprivacy: Zorgt voor naleving van regelgeving inzake gegevensbescherming en beschermt gevoelige informatie.
- Cloudintegratie: Maakt naadloze samenwerking en toegang tot gegevens op verschillende platforms en apparaten mogelijk.
Voordelen
De implementatie van NLP-software biedt verschillende voordelen voor je team en je bedrijf. Hier zijn enkele voordelen waar je naar kunt uitkijken:
- Verbeterde communicatie: Software voor het genereren van natuurlijke taal en spraakherkenning maken wereldwijde en toegankelijke communicatie eenvoudiger.
- Verbeterde besluitvorming: Tekstanalyse en sentimentanalyse bieden inzichten die strategieën en acties ondersteunen.
- Tijdsbesparing: Realtimeverwerking levert snel feedback, waardoor sneller kan worden gereageerd en gehandeld.
- Kostenefficiëntie: Het automatiseren van taken zoals entiteitsherkenning vermindert de behoefte aan handmatige gegevensverwerking en bespaart middelen.
- Verhoogde nauwkeurigheid: Aanpasbare modellen zorgen ervoor dat resultaten op specifieke behoeften zijn afgestemd, waardoor de precisie van uitvoer verbetert.
- Gegevensbeveiliging: Instellingen voor gegevensprivacy helpen gevoelige informatie veilig te houden en naleving van regelgeving te waarborgen.
- Schaalbaarheid: Meertalige ondersteuning en cloudintegratie maken groei en aanpasbaarheid in verschillende markten mogelijk.
Kosten & prijzen
Voor het selecteren van NLP-software is inzicht nodig in de verschillende beschikbare prijsmodellen en abonnementen. De kosten variëren op basis van functies, teamgrootte, uitbreidingen en meer. In de onderstaande tabel worden veelvoorkomende abonnementen, hun gemiddelde prijzen en de typische functies van NLP-softwareoplossingen samengevat:
Vergelijkingstabel voor NLP-software
| Abonnementstype | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| AbonnementstypeGratis abonnement | Gemiddelde prijs$0 | Veelvoorkomende functiesBasistekstanalyse, beperkte taalondersteuning en ondersteuning door de community. |
| AbonnementstypePersoonlijk abonnement | Gemiddelde prijs$10-$30/gebruiker/maand | Veelvoorkomende functiesSentimentanalyse, taalvertaling en ondersteuning via e-mail. |
| AbonnementstypeZakelijk abonnement | Gemiddelde prijs$40-$100/gebruiker/maand | Veelvoorkomende functiesSpraakherkenning, entiteitsherkenning en telefonische ondersteuning. |
| AbonnementstypeOndernemingsabonnement | Gemiddelde prijs$150+/gebruiker/maand | Veelvoorkomende functiesAanpasbare modellen, realtimeverwerking en toegewijd accountbeheer. |
Veelgestelde vragen over NLP-software
Hier vindt u antwoorden op veelgestelde vragen over NLP-software:
Kan NLP-software worden geïntegreerd met mijn bestaande tools?
De meeste NLP-software biedt integratiemogelijkheden met populaire platforms, zoals CRM-systemen en tools voor data-analyse. Controleer de compatibiliteit met uw huidige technologiestack om een soepele workflow en gegevensuitwisseling te garanderen. Voor sommige oplossingen is mogelijk aangepaste API-ontwikkeling nodig voor de integratie.
Hoe veilig is NLP-software?
Beveiligingsfuncties verschillen per aanbieder, maar let op gegevensversleuteling, naleving van regelgeving inzake gegevensbescherming en regelmatige beveiligingsupdates. Zorg ervoor dat de software voldoet aan de privacystandaarden en vereisten voor gegevensbescherming binnen uw sector, vooral wanneer u met gevoelige informatie werkt.
Is maatwerk mogelijk met NLP-software?
Veel NLP-tools bieden aanpassingsmogelijkheden om functies en modellen af te stemmen op uw behoeften. Dit kan bijvoorbeeld het aanpassen van algoritmen of het creëren van specifieke workflows voor gegevensverwerking omvatten. De mate van aanpassing kan echter verschillen, dus controleer de mogelijkheden voordat u een oplossing kiest.
Welke ondersteuning is beschikbaar voor gebruikers van NLP-software?
Ondersteuningsdiensten variëren van online bronnen, zoals veelgestelde vragen en handleidingen, tot live klantenondersteuning via chat, e-mail of telefoon. Beoordeel de beschikbaarheid en reactiesnelheid van deze diensten en overweeg hoe belangrijk toegewijde ondersteuning is, vooral tijdens de implementatie.
Is NLP hetzelfde als AI?
NLP is een deelgebied van kunstmatige intelligentie. Hoewel AI-software een breed scala aan mogelijkheden omvat, richt NLP zich specifiek op de verwerking van menselijke taal.
Kan NLP-software straattaal of informele taal begrijpen?
Sommige NLP-tools zijn getraind om informele taal, straattaal of regionale uitdrukkingen te herkennen, maar de nauwkeurigheid kan variëren afhankelijk van de gegevens die zijn gebruikt om het model te trainen.
Wat volgt:
Als u bezig bent met het onderzoeken van NLP-software, neem dan contact op met een SoftwareSelect-adviseur voor gratis aanbevelingen.
U vult een formulier in en heeft een kort gesprek waarin zij ingaan op de specifieke behoeften van u. Vervolgens ontvangt u een shortlist van software om te beoordelen. Zij ondersteunen u zelfs tijdens het volledige aankoopproces, inclusief prijsonderhandelingen.