

Å finne det riktige overvåkingsverktøyet kan være en hodepine. Du ønsker noe som dekker teamets behov uten unødvendig kompleksitet. Derfor er det mange organisasjoner som ser etter alternativer til LogicMonitor.
Etter min erfaring ser bedrifter ofte etter andre løsninger som tilbyr bedre skalerbarhet, spesifikke funksjoner eller mer kostnadseffektivitet. De kan oppleve at LogicMonitor ikke samsvarer med deres nåværende mål eller budsjett.
Jeg har testet og gjennomgått flere alternativer uavhengig for å gi deg en objektiv vurdering av hva som er tilgjengelig. Jeg skal veilede deg gjennom de beste verktøyene for å løse dine spesifikke utfordringer.
Enten du ser etter bedre skyintegrasjon eller fleksibiliteten ved åpen kildekode, vil denne artikkelen hjelpe deg med å finne det som passer best. La oss se nærmere på de beste alternativene som kan gjøre overvåkingsoppgavene dine mer håndterbare.
Hva er LogicMonitor?
LogicMonitor er produktivitetsprogramvare utviklet for IT-fagfolk og bedrifter som trenger effektive overvåkingsløsninger. Den brukes av IT-team til å overvåke infrastruktur, applikasjoner og nettverksytelse, og gir verdifull innsikt i systemdriften.
Automatisert overvåking, tilpassbare dashbord og varsler i sanntid hjelper med å finne problemer og optimalisere ytelsen. Alt i alt tilbyr LogicMonitor en sentralisert plattform som holder systemene dine i stabil drift.
Sammenligningstabell over alternativer til LogicMonitor
Denne sammenligningstabellen oppsummerer prisdetaljene for mine beste alternativer til LogicMonitor:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Best for AI-drevet observasjon | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $7/måned 15 dagers gratis prøveperiode + gratis demo tilgjengelig | Website |
Best for kostnadseffektiv overvåking | 4.0 out of 5 | 4 | 3 | 4 | 4 | 4 | 5 | $325/måned Gratisabonnement + 5 dagers gratis prøveperiode + gratis demo tilgjengelig | Website |
Best for skyovervåkingstjenester | 4.3 out of 5 | 4 | 4 | 4 | 4 | 5 | 5 | $15/vert/måned Gratisabonnement + 14 dagers gratis prøveperiode + gratis demo tilgjengelig | Website |
Best for AI-drevet dataanalyse | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $15/vert/måned Gratisabonnement tilgjengelig | Website |
Best for automatisert datatilgang i sanntid | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $0.04/måned 14 dagers gratis prøveperiode + gratis demonstrasjon tilgjengelig | Website |
Best for samlet, fleksibel observabilitet | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $19/måned Gratis abonnement tilgjengelig | Website |
Best for integrerte IT-løsninger | 3.7 out of 5 | 3 | 3 | 4 | 3 | 5 | 4 | Pris oppgis på forespørsel 30 dagers gratis prøveperiode tilgjengelig | Website |
Best for tilpassbart instrumentpanel | 3.3 out of 5 | 4 | 2 | 4 | 3 | 4 | 3 | $200/måned Gratisabonnement + 30 dagers prøveperiode + demo tilgjengelig | Website |
Best for observerbarhet basert på åpen kildekode | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $49/måned 30 dagers gratis prøveperiode + gratis demo tilgjengelig | Website |
Best for AI-baserte innsikter | 3.2 out of 5 | 3 | 4 | 3 | 2 | 3 | 4 | Pris oppgis på forespørsel Gratisabonnement + gratis demo tilgjengelig | Website |


Hvorfor du kan stole på våre programvareanbefalinger
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Teamet vårt har testet og anmeldt programvare siden 2012. Vi er selv teknologiledere, så vi vet hvor vanskelig og hvor viktig det er å velge riktig programvare.
I denne guiden har vi vurdert verktøyene gjennom praktisk testing og uavhengig research og gitt dem poeng ut fra våre utvelgelseskriterier.
Anmeldelsene våre bygger på vår egen redaksjonelle vurdering. De er ikke et salgsargument.
Ekspertanmeldere:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Anmeldelser av de beste alternativene til LogicMonitor
Nedenfor finner du mine detaljerte sammendrag av de beste alternativene til LogicMonitor som kom med på kortlisten. Anmeldelsene mine gir en grundig gjennomgang av de viktigste funksjonene, fordelene og ulempene, integrasjonene og de ideelle bruksområdene for hvert verktøy, slik at du kan finne det beste alternativet for deg.rn
 Best for AI-drevet observasjon
- 15 dagers gratis prøveperiode + gratis demo tilgjengelig
- Fra $7/måned (fakturert årlig)
Visit WebsiteCustomer Rating:4.5/5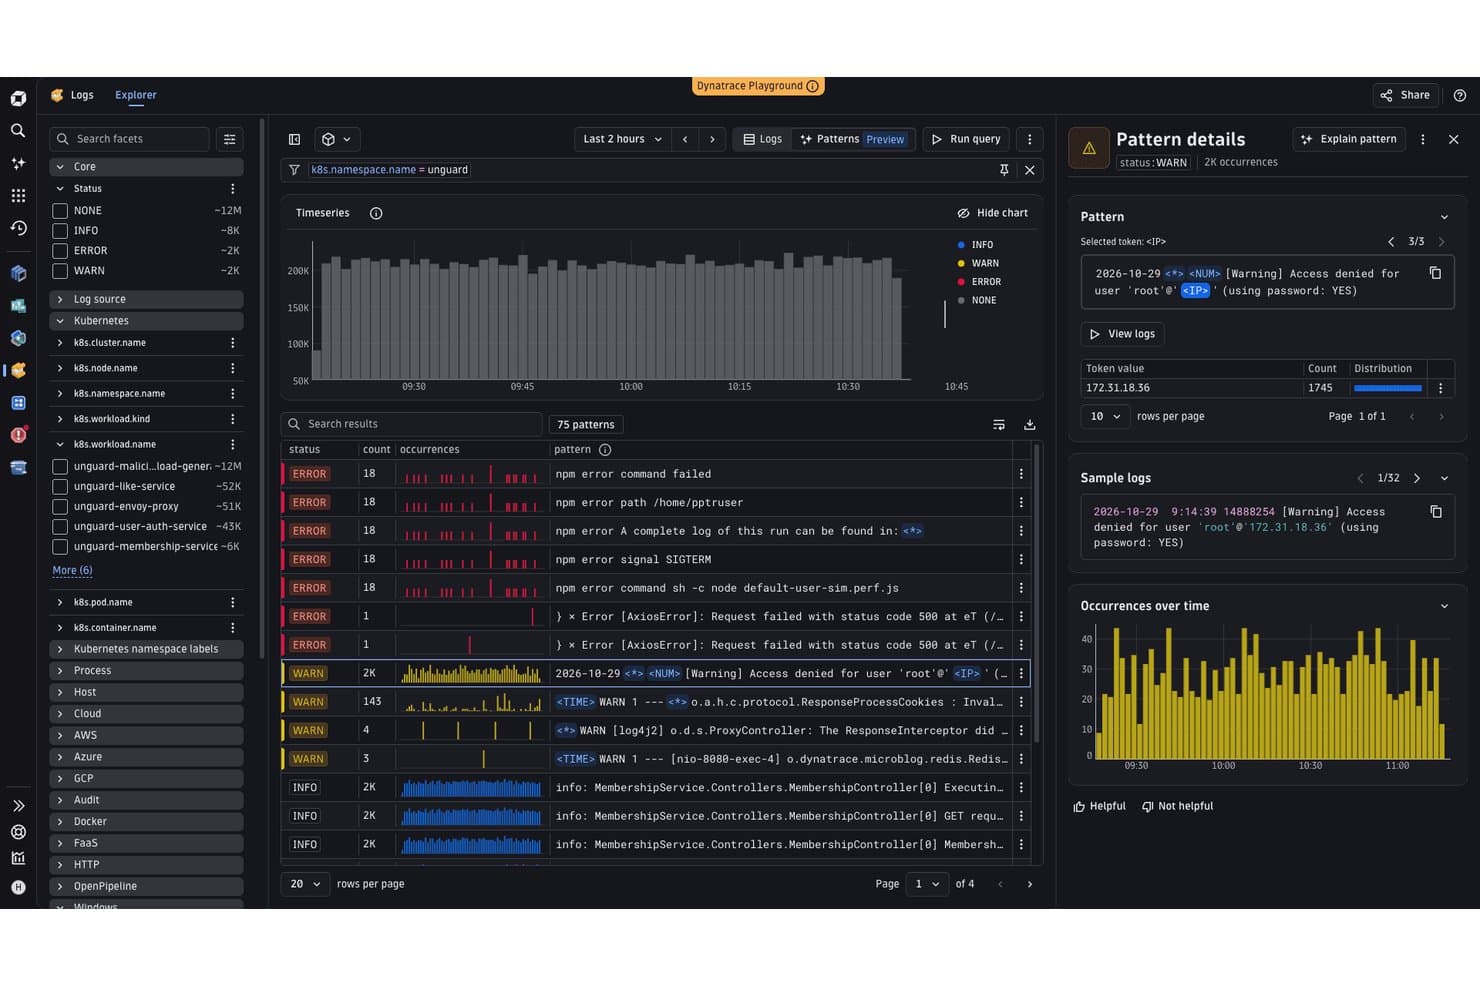
Dynatrace Logs-appen grupperer loggoppføringer i mønstre etter status, med forekomstdiagrammer og detaljer. Dynatrace er en plattform for fullstendig observasjon som bruker kunstig intelligens til automatisk å oppdage, kartlegge og overvåke applikasjonene, infrastrukturen og skymiljøene dine – noe som gjør den godt egnet for IT-drift og DevOps-team som håndterer komplekse, raskt skiftende systemer der manuell rotårsaksanalyse ikke er realistisk.
Hvem passer Dynatrace best for?
Dynatrace passer godt for DevOps- og IT-driftsteam som administrerer komplekse, distribuerte miljøer der fullstendig innsikt og AI-drevet rotårsaksanalyse er viktigere enn dedikert nettverksovervåking.
Hvorfor jeg valgte Dynatrace
Jeg valgte Dynatrace som et av de beste alternativene til LogicMonitor fordi den AI-drevne observasjonen går langt utover terskelbasert varsling. Davis AI bruker Smartscape-topologi til automatisk å korrelere hendelser på tvers av verter, containere og tjenester, slik at jeg i stedet for å sortere gjennom dusinvis av varsler får én enkelt rotårsak. PurePath sporer hver transaksjon fra ende til ende på kodenivå, noe som betyr at jeg kan finne nøyaktig hvor en forsinkelse oppstår uten å lete manuelt i logger.
Viktige funksjoner i Dynatrace
- Automatisk oppdagelse med OneAgent: Installeres per vert og oppdager automatisk prosesser, tjenester og avhengigheter uten manuell konfigurasjon.
- Logganalyse med DQL: Samler inn, beriker og søker i loggdata ved hjelp av Dynatrace Query Language, med konfigurerbar oppbevaring fra 10 dager til 10 år.
- Syntetisk overvåking: Simulerer brukerreiser via Browser Monitor og kontrollerer tilgjengeligheten til API-er og tjenester via HTTP Monitor fra offentlige og private lokasjoner.
- Automatisering av arbeidsflyter: Utløser automatiserte arbeidsflyter fra hendelser, tidsplaner eller API-kall, med støtte for betingelser, løkker og nye forsøk.
Integrasjoner med Dynatrace
Dynatrace har markedsplassintegrasjoner med Jira, Slack, Cursor, GitHub Copilot Coding Agent, JetBrains og Windsurf. Plattformen tilbyr også API-er for miljø-, konfigurasjons- og kontoadministrasjon for tilpassede integrasjoner og tilkobling til arbeidsflyter.
Pros and Cons
Pros:
- Korrelérer varsler gjennom Smartscape-topologi
- OneAgent oppdager avhengigheter mellom applikasjoner og infrastruktur
- PurePath sporer transaksjoner til årsaker på kodenivå
Cons:
- Nettverksovervåking ligger etter spesialiserte plattformer
- Tilpassede dashbord krever innsats å konfigurere
 Best for kostnadseffektiv overvåking
- Gratisabonnement + 5 dagers gratis prøveperiode + gratis demo tilgjengelig
- Fra $325/måned (fakturert årlig)
Visit WebsiteCustomer Rating:4.5/5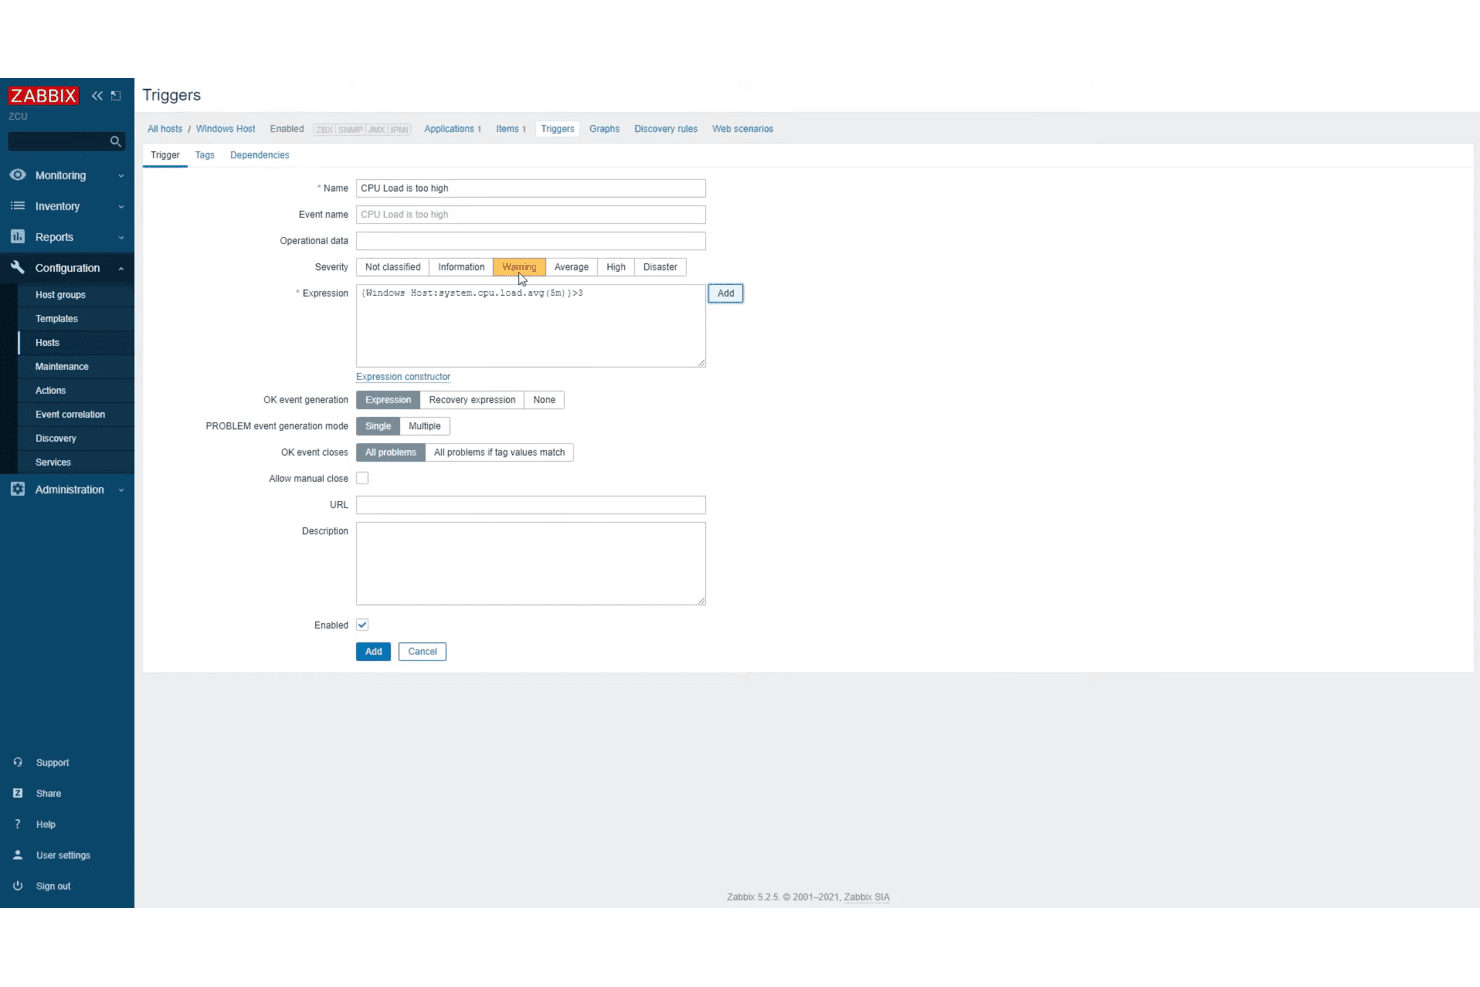
Konfigurerer en Zabbix-utløser som varsler når CPU-belastningen på en Windows-vert overskrider en terskel. Zabbix er en åpen kildekode-basert overvåkingsplattform som appellerer til IT-team som trenger bred infrastruktursynlighet—på tvers av servere, nettverk, sky, containere og applikasjoner—uten å betale lisensavgifter per enhet eller metrikk.
Hvem passer Zabbix best for?
Zabbix passer godt for IT-team som trenger overvåking av infrastruktur på bedriftsnivå, men som ikke kan forsvare lisenskostnader per enhet.
Hvorfor jeg valgte Zabbix
Jeg valgte Zabbix som et av de beste alternativene fordi ingen andre verktøy på denne listen lar deg fjerne lisensiering per enhet fullstendig og samtidig få overvåking på bedriftsnivå på tvers av servere, nettverk, sky og containere. Kjernen med åpen kildekode har ingen vertsbegrensninger, ingen begrensninger på antall metrikker og ingen funksjonsbegrensninger, så et team som administrerer tusenvis av endepunkter betaler det samme nullbeløpet i lisensiering som et team som administrerer ti. Jeg setter også pris på de prediktive utløserfunksjonene, som bruker historiske data til å anslå når en terskel vil bli overskredet før det faktisk skjer.
Viktige funksjoner i Zabbix
- Regler for hendelseskorrelasjon: Konfigurer regler for å gruppere relaterte hendelser, fjerne duplikater av ustabile varsler og automatisk lukke foreldede problemer på tvers av ulike utløsere og avspørringsmetoder.
- Instrumentpaneler for kostnader i flere skymiljøer: Vis og sammenlign infrastrukturutgifter på tvers av AWS, Azure, Google Cloud og Oracle Cloud fra ett enkelt instrumentpanel.
- Støtte for OpenTelemetry APM: Motta distribuerte spor, metrikker og logger fra applikasjoner eller OpenTelemetry Collectors via en Zabbix-proxy, med ClickHouse som datakilde for telemetri.
- Automatiserte utbedringstiltak: Kjør konfigurerte skript eller kommandoer som svar på oppdagede problemer, inkludert omstart av tjenester eller oppskalering av skyressurser.
Zabbix-integrasjoner
Zabbix oppgir 204 offisielle maler og 570 merkevarer på tvers av 2 010 løsninger, inkludert AWS, Azure, Google Cloud Platform, ServiceNow, Slack, PagerDuty, Kafka og RabbitMQ. JSON-RPC-API-et, REST-strømme-API-et, webhooks og Python-biblioteket støtter tilpassede integrasjoner.
Pros and Cons
Pros:
- Bred synlighet på tvers av servere og nettverk
- Fleksible varsler og hendelseskorrelasjon
- Varsler om at metrikkterskler nærmer seg
Cons:
- Varselterskler krever praktisk finjustering
- Selvhostede distribusjoner krever vedlikehold av databasen
 Best for skyovervåkingstjenester
- Gratisabonnement + 14 dagers gratis prøveperiode + gratis demo tilgjengelig
- Fra $15/vert/måned (fakturert årlig)
Visit WebsiteCustomer Rating:4.5/5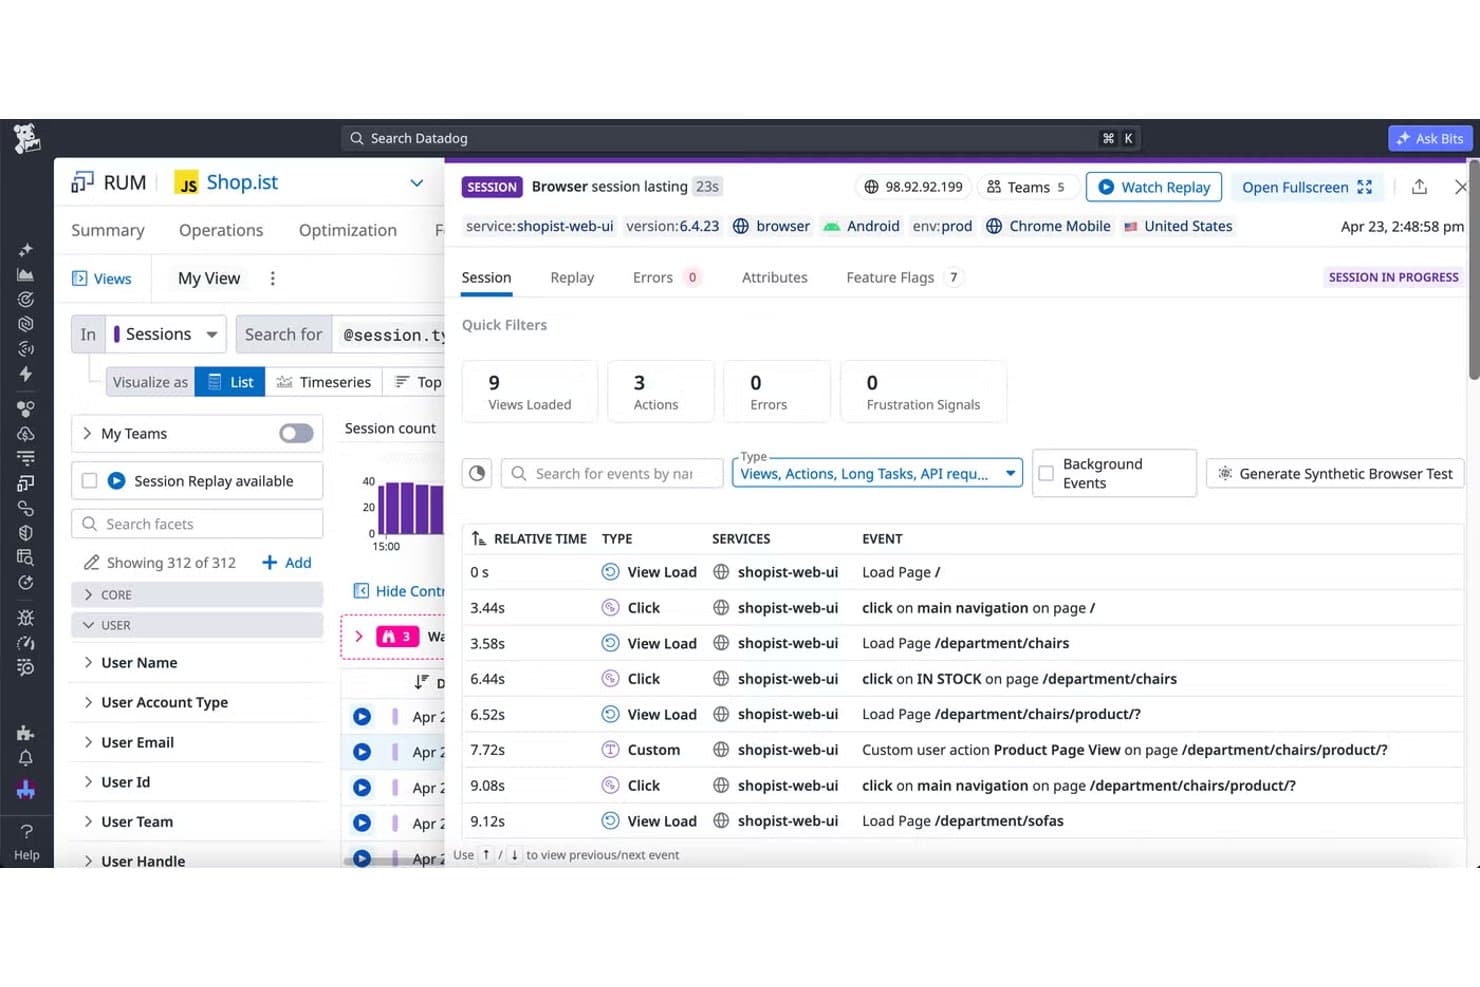
Datadog RUM-øktvisning som viser en brukers sidelastinger, klikk og egendefinerte handlinger i rekkefølge. Datadog er en SaaS-basert plattform for observerbarhet som gir IT- og DevOps-team samlet innsyn i sky-, hybrid- og lokal infrastruktur – og kombinerer måleverdier, logger, spor og sikkerhetssignaler på ett sted for å redusere kontekstbytte under hendelseshåndtering.
Hvem passer Datadog best for?
Datadog passer godt for DevOps-ingeniører og IT-driftsteam som administrerer skybaserte eller hybride miljøer, og som trenger samlet innsyn i infrastruktur, logger, spor og sikkerhetssignaler på én plattform.
Hvorfor jeg valgte Datadog
Jeg valgte Datadog som et av de beste alternativene til LogicMonitor fordi løsningen er utviklet spesielt for skyovervåking og sporer titusenvis av måleverdier på tvers av AWS, Azure og GCP, samtidig som de korreleres med logger, spor og sikkerhetssignaler i én visning. Jeg liker spesielt Watchdog, AI-motoren som automatisk avdekker avvik, slik at teamet mitt slipper å sile manuelt gjennom støy under en hendelse. Prognoseovervåkerne er også svært nyttige: Jeg kan modellere CPU- eller minnetrender ved hjelp av sesongbaserte eller lineære algoritmer og angi varselterskler opptil tre måneder frem i tid.
De viktigste funksjonene i Datadog
- Taggbasert infrastruktursøk: Filtrer og analyser måleverdier på tvers av hele infrastrukturen ved hjelp av egendefinerte tagger for å gruppere verter, containere og skyressurser etter hvilken som helst dimensjon.
- Korrelasjon på tvers av signaler: Koble infrastrukturmåleverdier med logger, spor og sikkerhetssignaler i én visning for å undersøke hendelser uten å bytte verktøy.
- Kartlegging av enhetstopologi: Visualiser nettverksenheter, grensesnitt og fysiske forbindelser, med mulighet til å inspisere trafikk, SNMP-feller, Syslog-meldinger og enheter i nærheten.
- Overvåking av aktive prosesser: Se aktivitet på prosessnivå i sanntid på tvers av verter og containere, inkludert ressursforbruk og kjørende kommandoer, fra et sentralisert grensesnitt.
Integrasjoner med Datadog
Datadog tilbyr over 1 000 integrasjoner, inkludert Amazon Web Services, Microsoft Azure, Google Cloud Platform, Kubernetes, Docker, Jira, PagerDuty, OpenTelemetry, PostgreSQL og Redis. REST-API-et og klientbibliotekene støtter egendefinerte integrasjoner.
Pros and Cons
Pros:
- Korrelerer infrastruktur, logger og spor
- Egendefinerte instrumentpaneler tydeliggjør systemets tilstand i sanntid
- Prognoseovervåkere bidrar til å forutse kapasitetsutvikling
Cons:
- Forbruksbaserte fakturaer kan være vanskelige å forutse
- Finjustering av varsler kan føre til varslingstretthet
 Best for AI-drevet dataanalyse
- Gratisabonnement tilgjengelig
- Fra $15/vert/måned (faktureres årlig)
Visit WebsiteCustomer Rating:4.3/5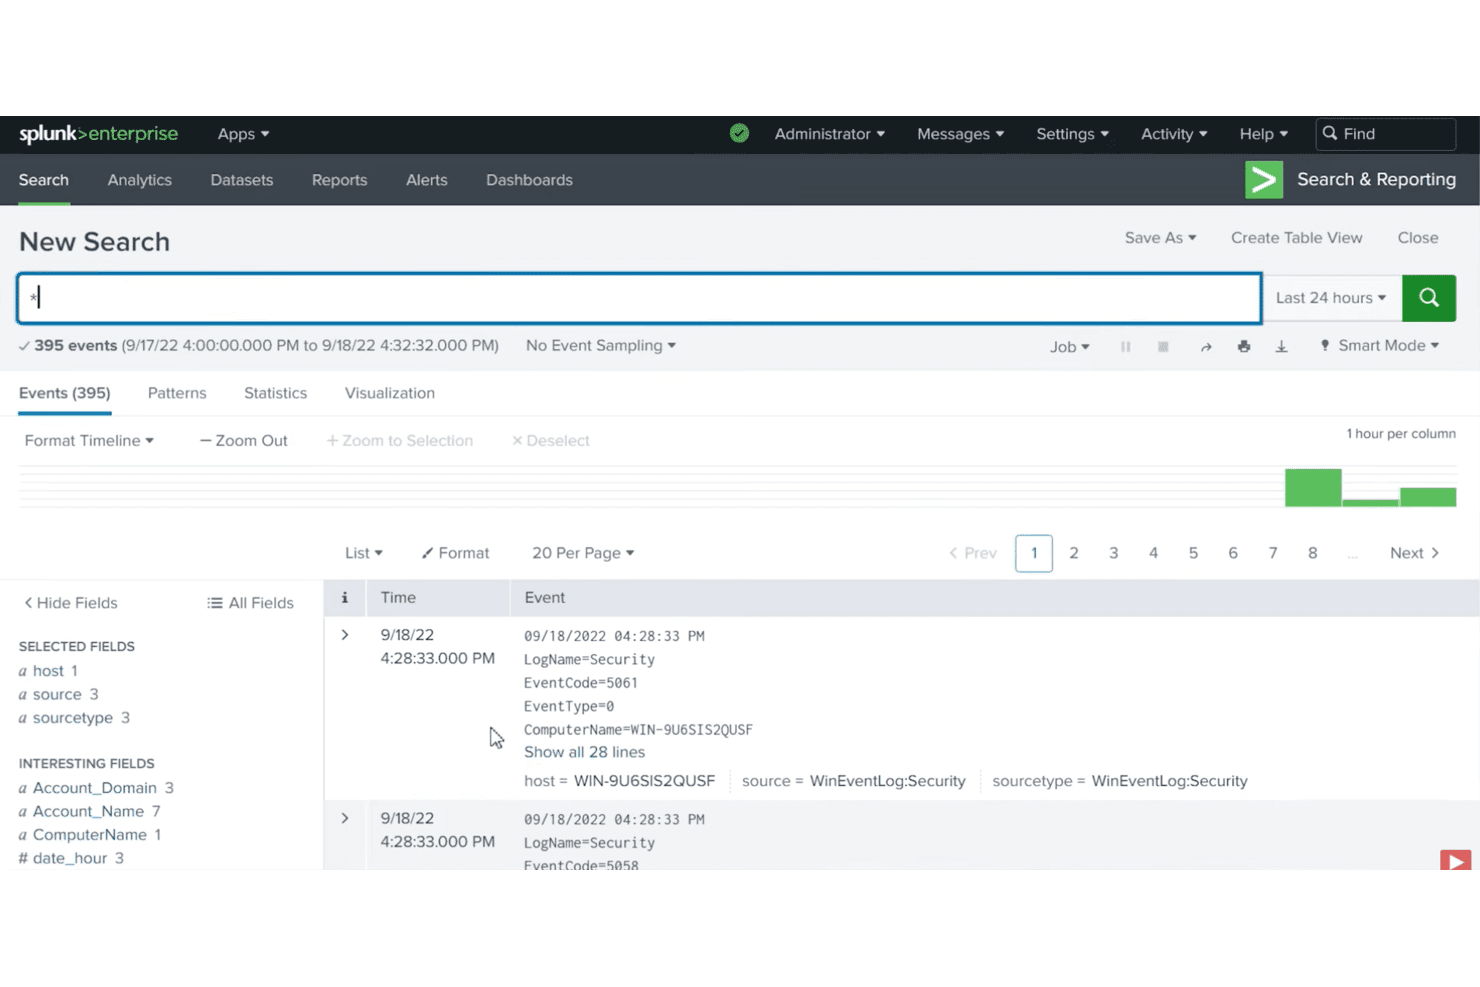
Splunk Enterprise-søk som viser Windows Security-hendelser med valgbare felt og en tidslinje. Splunk Observability Cloud er en SaaS-overvåkingsplattform som samler data om infrastruktur, applikasjonsytelse og digitale opplevelser, noe som gjør den godt egnet for IT- og DevOps-team som trenger AI-assistert analyse av rotårsaker på tvers av hybride miljøer og skymiljøer.
Hvem passer Splunk best for?
Splunk Observability Cloud passer godt for DevOps- og IT-driftsteam i mellomstore og store organisasjoner som trenger AI-assistert analyse av rotårsaker på tvers av hybride miljøer og skymiljøer.
Hvorfor jeg valgte Splunk
Jeg valgte Splunk som et av de beste alternativene til LogicMonitor på grunn av hvor godt AI SRE-laget håndterer undersøkelsesarbeidet som vanligvis faller på teamet ditt. AI-feilsøkingsagenten samler måledata, spor og logger for å avdekke sannsynlige rotårsaker i et lettfattelig språk, mens AI-assistenten lar deg søke på tvers av APM-, infrastruktur- og Kubernetes-data uten å skrive en eneste spørring. Jeg liker spesielt at NoSample-sporing fanger opp 100 % av sporingsdataene, slik at ingenting forkastes før analysen.
Viktige funksjoner i Splunk
- Infrastrukturdashbord: Ferdigbygde dashbord og visualiseringer for skytjenester, systemer og Kubernetes-miljøer gir teamet ditt sanntidsinnsikt i tilstanden til hybrid infrastruktur.
- Dynamisk varsling med detektorer: Detektorer overvåker målesignaler og utløser varsler basert på regler med flere betingelser, og sender varsler til verktøy som PagerDuty, Slack, ServiceNow og Microsoft Teams.
- OpenTelemetry-basert innsamling: Samler inn måledata, spor og logger ved hjelp av instrumentering basert på åpne standarder, med støtte for Prometheus, Telegraf og collectd samt over 200 integrasjoner.
- Log Observer Connect: Kobler logger som allerede er lagret i Splunk Cloud Platform eller Splunk Enterprise, direkte inn i arbeidsflyter for feilsøking i Observability Cloud uten ekstra kostnad.
Splunk-integrasjoner
Splunk Observability Cloud dokumenterer over 200 støttede integrasjoner basert på åpne standarder, inkludert AWS, Microsoft Azure, Google Cloud Platform, Jira, Microsoft Teams, PagerDuty, ServiceNow, Slack og Amazon EventBridge. Plattformen støtter også OpenTelemetry, Prometheus, Telegraf, collectd og REST API-tilkoblinger.
Pros and Cons
Pros:
- Samler telemetri for raskere feilsøking
- AI oppsummerer sannsynlige årsaker i et lettfattelig språk
- Fanger opp hvert eneste spor for undersøkelser
Cons:
- Kostnadene øker når antallet telemetrikilder øker
- SignalFlow krever praktisk justering av detektorer
Learn more about Splunk: Best for automatisert datatilgang i sanntid
- 14 dagers gratis prøveperiode + gratis demonstrasjon tilgjengelig
- Fra $0.04/måned
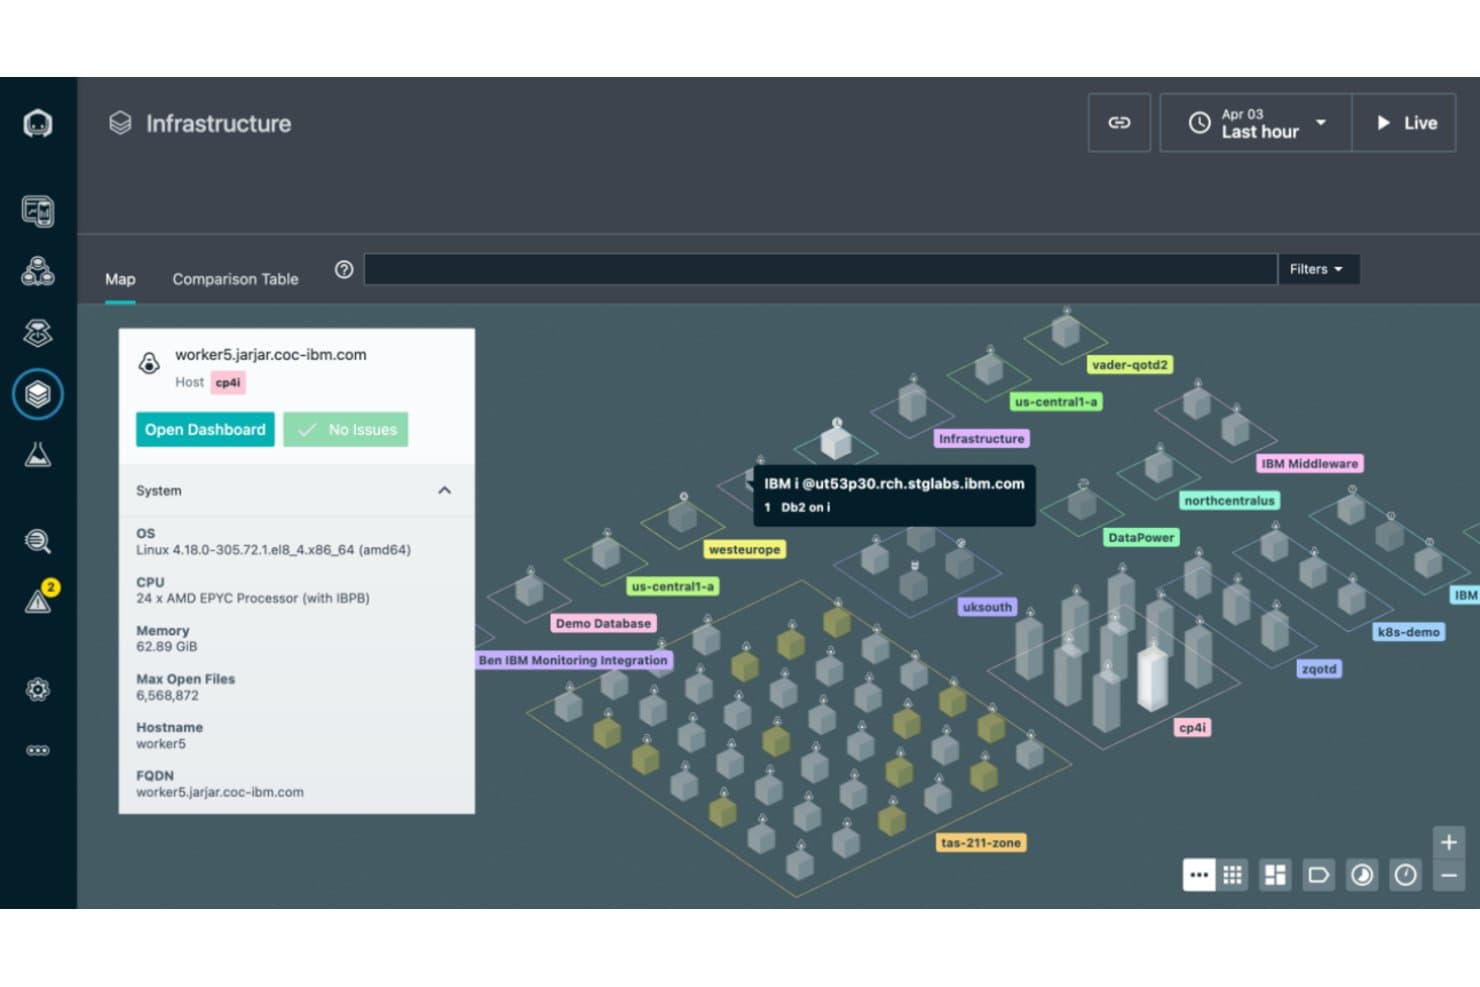
Infrastrukturoversikten i IBM Instana viser verter gruppert etter sone, med vertsinformasjon og sanntidsstatus. IBM Instana er en AI-drevet plattform for observasjon, utviklet for DevOps-team som trenger automatisk oppdagelse, sanntidskartlegging av avhengigheter og detaljert innsyn i applikasjonsytelse på tvers av sky-, hybride og containeriserte miljøer.
Hvem passer IBM Instana best for?
IBM Instana passer godt for DevOps-ingeniører som administrerer komplekse, skybaserte miljøer og trenger automatisk oppdagelse og kartlegging av avhengigheter i sanntid, uten manuelt instrumenteringsarbeid.
Hvorfor jeg valgte IBM Instana
Jeg har tatt med IBM Instana blant mine beste valg fordi den automatiserte datatilgangen i sanntid virkelig skiller seg ut: Den dynamiske grafen oppdager og kartlegger kontinuerlig alle verter, tjenester og avhengigheter, og oppdateres hvert sekund uten manuell instrumentering. Jeg setter pris på hvordan dette kombineres med agentisk AI for rotårsaksanalyse, som sammenstiller sporingsstatistikk, topologi og anomale signaler for raskt å finne sannsynlige årsaker. Under en pågående hendelse betyr det at teamet mitt ikke trenger å lete manuelt gjennom instrumentpaneler.
Viktige funksjoner i IBM Instana
- Smartere varsler med adaptive terskler: Varslingsmotoren i Instana bruker statistiske grunnlinjer og forhåndsbygde blåkopier for å oppdage hendelser, med grupperte varsler og ruting til Slack, PagerDuty, e-post og webhooks.
- Sporing av distribuerte transaksjoner: Instana sporer forespørsler på tvers av applikasjonskomponenter uten utvalgsbegrensning, og registrerer detaljert informasjon på kodenivå på tvers av databaser, nettlesere og mobilapper.
- Integrasjon med OpenTelemetry Collector: Instana tar inn telemetri fra OpenTelemetry Collector for å overvåke mikrotjenester og skybaserte applikasjoner sammen med komponenter som er instrumentert på opprinnelig vis.
- Kostnadsinnsikt for Kubernetes: Instana tilbyr ferdige instrumentpaneler og historisk kostnadsanalyse for overvåking av ressurskostnader på tvers av Kubernetes-klynger.
Integrasjoner med IBM Instana
IBM Instana støtter mer enn 300 teknologier, blant annet Slack, PagerDuty, OpenTelemetry Collector, Splunk, Amazon EC2, AWS RDS, Google Cloud, Kubernetes og VMware Tanzu. REST- og GraphQL-API-er samt SDK-er støtter tilpassede integrasjoner.
Pros and Cons
Pros:
- Kart over avhengigheter i sanntid gjør det enklere å håndtere hendelser
- Automatisk oppdagelse reduserer behovet for manuell instrumentering
- Rask telemetri gjør det enklere å finne tjenesteproblemer
Cons:
- Manglende dekning av nettverksenheter kan kreve separat overvåking
- Varslingsmengden krever ofte manuell filtrering
Learn more about IBM Instana: Best for samlet, fleksibel observabilitet
- Gratis abonnement tilgjengelig
- Fra $19/måned
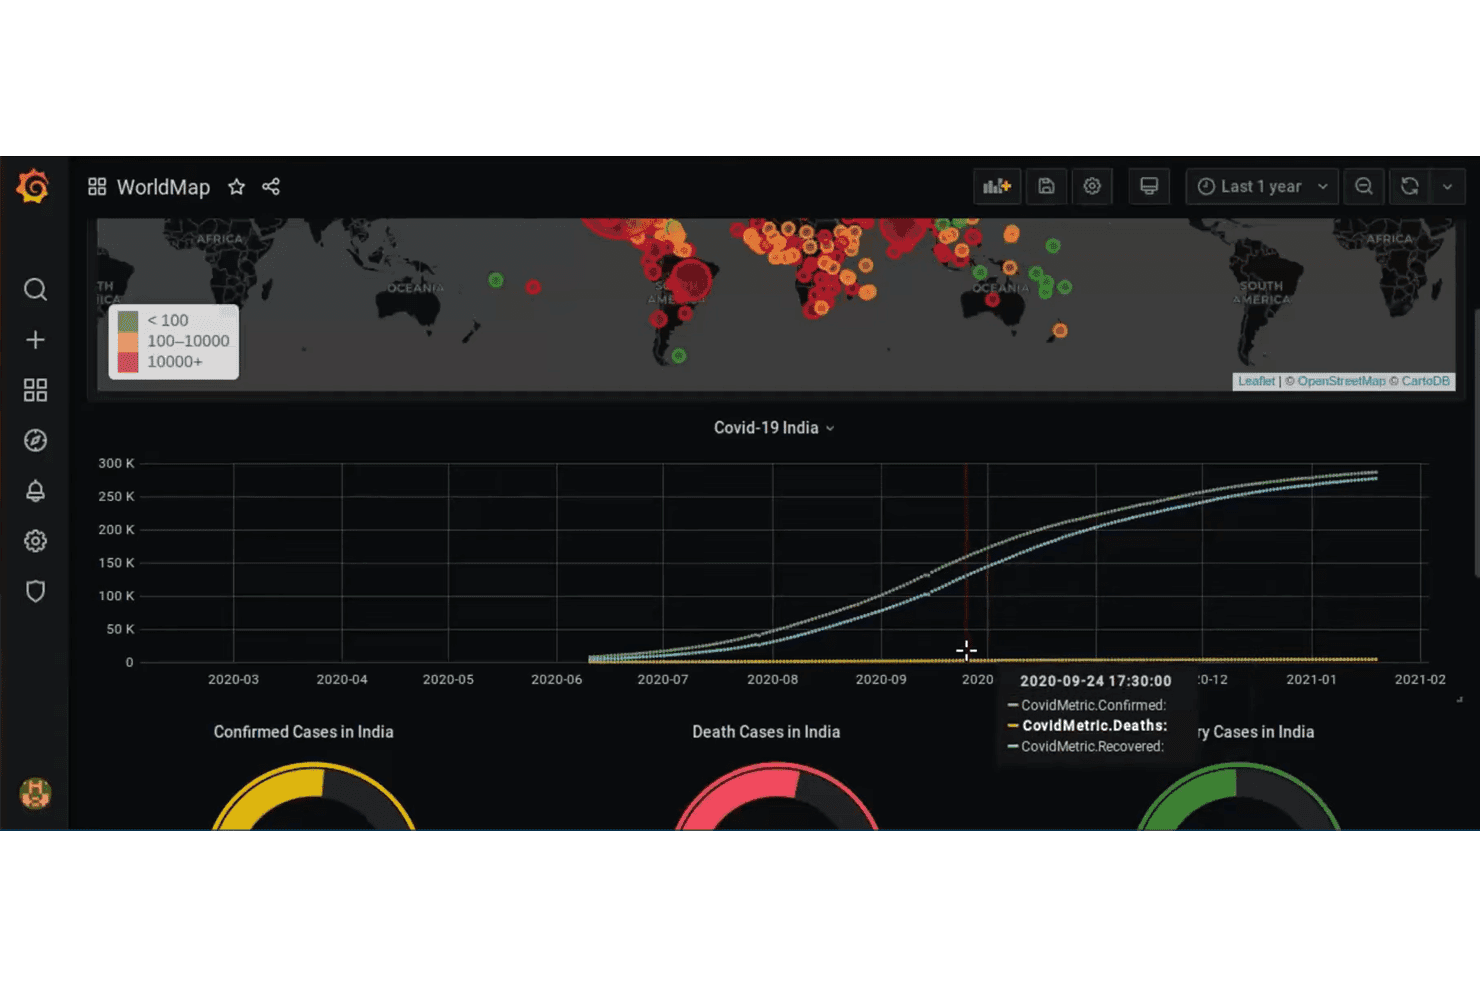
Grafana-kontrollpanel som visualiserer globale covid-19-data og data for India over tid som kart og tidsseriegrafer. Grafana Cloud er en administrert plattform for observabilitet som samler måledata, logger, spor og profiler på ett sted, noe som gjør den godt egnet for DevOps-ingeniører og IT-driftsteam som trenger fleksibel overvåking basert på åpne standarder på tvers av sky-, hybrid- og containerbaserte miljøer.
Hvem passer Grafana Cloud best for?
Grafana Cloud passer godt for DevOps-ingeniører og IT-driftsteam som ønsker å samle måledata, logger, spor og profiler på tvers av skybaserte og hybride miljøer ved hjelp av åpne standarder som OpenTelemetry og Prometheus.
Hvorfor jeg valgte Grafana Cloud
Jeg har tatt med Grafana Cloud blant toppvalgene mine fordi plattformen samler måledata, logger, spor og profiler i én administrert løsning, noe som er akkurat det du trenger når LogicMonitors siloerte tilnærming begynner å føles begrensende. Jeg liker spesielt kunnskapsgrafen, som kartlegger relasjoner på tvers av tjenester, Kubernetes-arbeidsbelastninger, databaser og infrastruktur, slik at du kan spore en økning i forsinkelse gjennom distribuerte spor helt ned til en flaskehals i databasen uten å måtte veksle mellom verktøy. Den KI-drevne funksjonen Undersøkelser kan automatisk analysere disse telemetridataene, utforme hypoteser og returnere en strukturert rapport når et varsel utløses.
Viktige funksjoner i Grafana Cloud
- Adaptiv telemetri: Samler, stikkprøvebaserer eller forkaster automatisk telemetridata med lavere verdi på tvers av måledata, logger, spor og profiler for å kontrollere datamengde og kostnader.
- Syntetisk overvåking: Kontrollerer API-endepunkter og nettapplikasjoner fra sonder over hele verden og støtter HTTP/HTTPS-, DNS-, TCP- og ICMP Ping-kontroller for tilgjengelighet og ytelse.
- Grafana Alloy-innsamler: En åpen kildekode-basert OpenTelemetry-innsamler med støtte for Prometheus-rørledninger som håndterer måledata, logger, spor og profiler fra den eksisterende infrastrukturen din.
- RBAC med egendefinerte roller: Lar deg tildele detaljerte tillatelser til brukere, team og tjenestekontoer, med egendefinerte roller begrenset til bestemte handlinger på tvers av kontrollpaneler og datakilder.
Integrasjoner med Grafana Cloud
Grafana Cloud tilbyr over 150 integrasjoner med datakilder, inkludert AWS, Microsoft Azure, Google Cloud, SNMP, VMware vSphere og LogicMonitor-enheter. REST-, HTTP-, Grafana Cloud-, sporings- og API-er for syntetisk overvåking, samt webhooks, støtter egendefinerte integrasjoner.
Pros and Cons
Pros:
- Fleksible kontrollpaneler samler telemetridata
- Visninger på tvers av signaler støtter hendelsesundersøkelser
- Kunnskapsgrafen kobler avvik til årsaker
Cons:
- SNMP-oppsett krever manuell enhetskonfigurasjon
- Avanserte varslingsregler krever konfigurasjonsarbeid
Learn more about Grafana Cloud: Best for integrerte IT-løsninger
- 30 dagers gratis prøveperiode tilgjengelig
- Pris oppgis på forespørsel
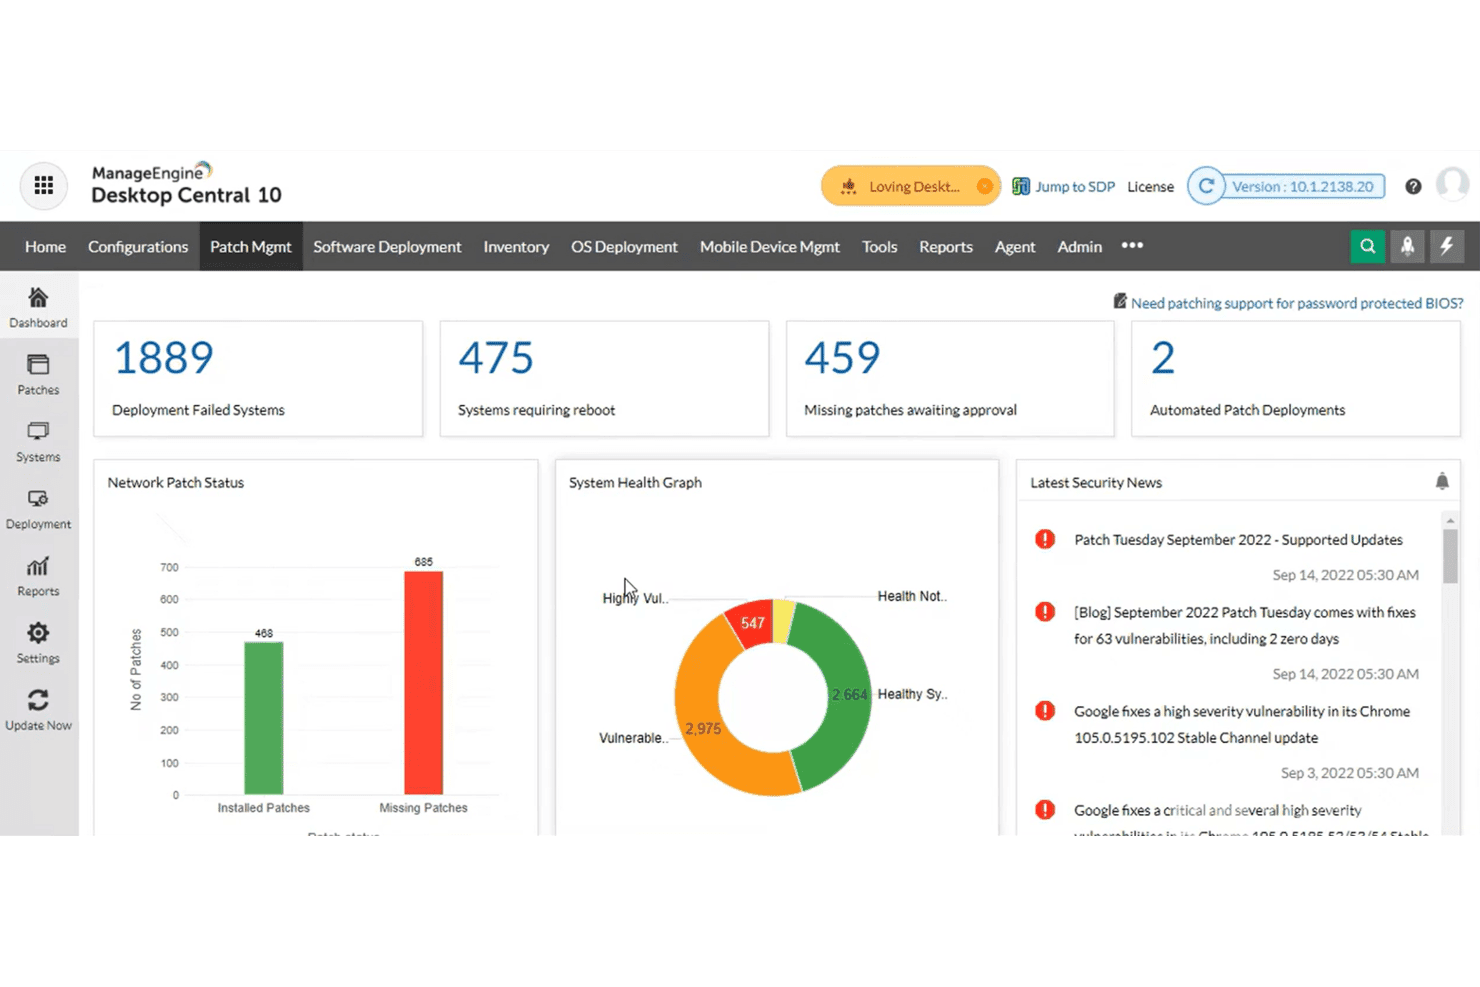
ManageEngine Desktop Central 10-oversikt for oppdateringsadministrasjon som viser status for nettverksoppdateringer og systemtilstand. ManageEngine OpManager er en plattform for overvåking av nettverk og infrastruktur som appellerer til IT-driftsteam som administrerer komplekse lokale miljøer, og tilbyr dyp innsikt på tvers av enheter, servere, lagring og virtuell infrastruktur med AI-drevet prognostisering og kodefri arbeidsflytautomatisering.
Hvem passer ManageEngine best for?
ManageEngine OpManager passer godt for IT-driftsteam som administrerer store lokale miljøer, og som trenger dyp innsikt i infrastrukturen uten å betale priser på SolarWinds-nivå.
Hvorfor jeg valgte ManageEngine
Jeg valgte ManageEngine OpManager fordi løsningen dekker hele infrastrukturen på ett sted, noe som er akkurat det du trenger når du erstatter LogicMonitor. Jeg liker spesielt topologikartleggingen, som automatisk bygger nettverkskart på lag 2 slik at du kan spore en feil fra et varsel direkte til det berørte segmentet uten å lete gjennom separate verktøy. Den AI-drevne kapasitetsplanleggingen varsler når enheter vil nå minnegrenser, slik at du kan handle før et driftsavbrudd oppstår.
Viktige funksjoner i ManageEngine OpManager
- Kodefri arbeidsflytautomatisering: En dra-og-slipp-bygger lar deg opprette arbeidsflyter som utløses av nettverksfeil eller etter en tidsplan, for automatisk å administrere tjenester, prosesser, filer og mapper.
- 3D-gulvvisning av datasenter: Gjengir en sanntids 3D-kopi av datasenteret og rackene, og viser enhetens aktive status direkte i den fysiske planløsningen.
- Problem- og hendelseskorrelasjon: Grupperer relaterte varsler i én enkelt problemoppføring med alvorlighetsgrad, korrelasjonsmetode og en prosentandel for støyreduksjon, slik at varseltretthet reduseres.
- MCP-serverintegrasjon: Lar AI-klienter som Claude Desktop eller Cursor spørre OpManager om overvåkingsdata, inkludert enhetstilstand, alarmer og ytelsestrender, gjennom instruksjoner i naturlig språk.
ManageEngine-integrasjoner
ManageEngine OpManager tilbyr innebygde integrasjoner med ServiceNow, Jira Service Management, Microsoft Teams, Slack, Grafana, Microsoft Sentinel og ManageEngine ServiceDesk Plus. REST API-et bruker OpenAPI-dokumentasjon, og webhooker støtter tilpassede integrasjoner.
Pros and Cons
Pros:
- Samlet innsikt på tvers av nettverk, servere og lagring
- Topologikart gjør det enklere å spore feil til berørte segmenter
- Kapasitetsprognoser varsler tidlig om ressursmangel
Cons:
- Standardprofiler for varsler kan generere svært mange varsler
- Tilpassede rapporter kan ta tid å konfigurere
Learn more about ManageEngine: Best for tilpassbart instrumentpanel
- Gratisabonnement + 30 dagers prøveperiode + demo tilgjengelig
- Fra $200/måned (fakturert årlig)
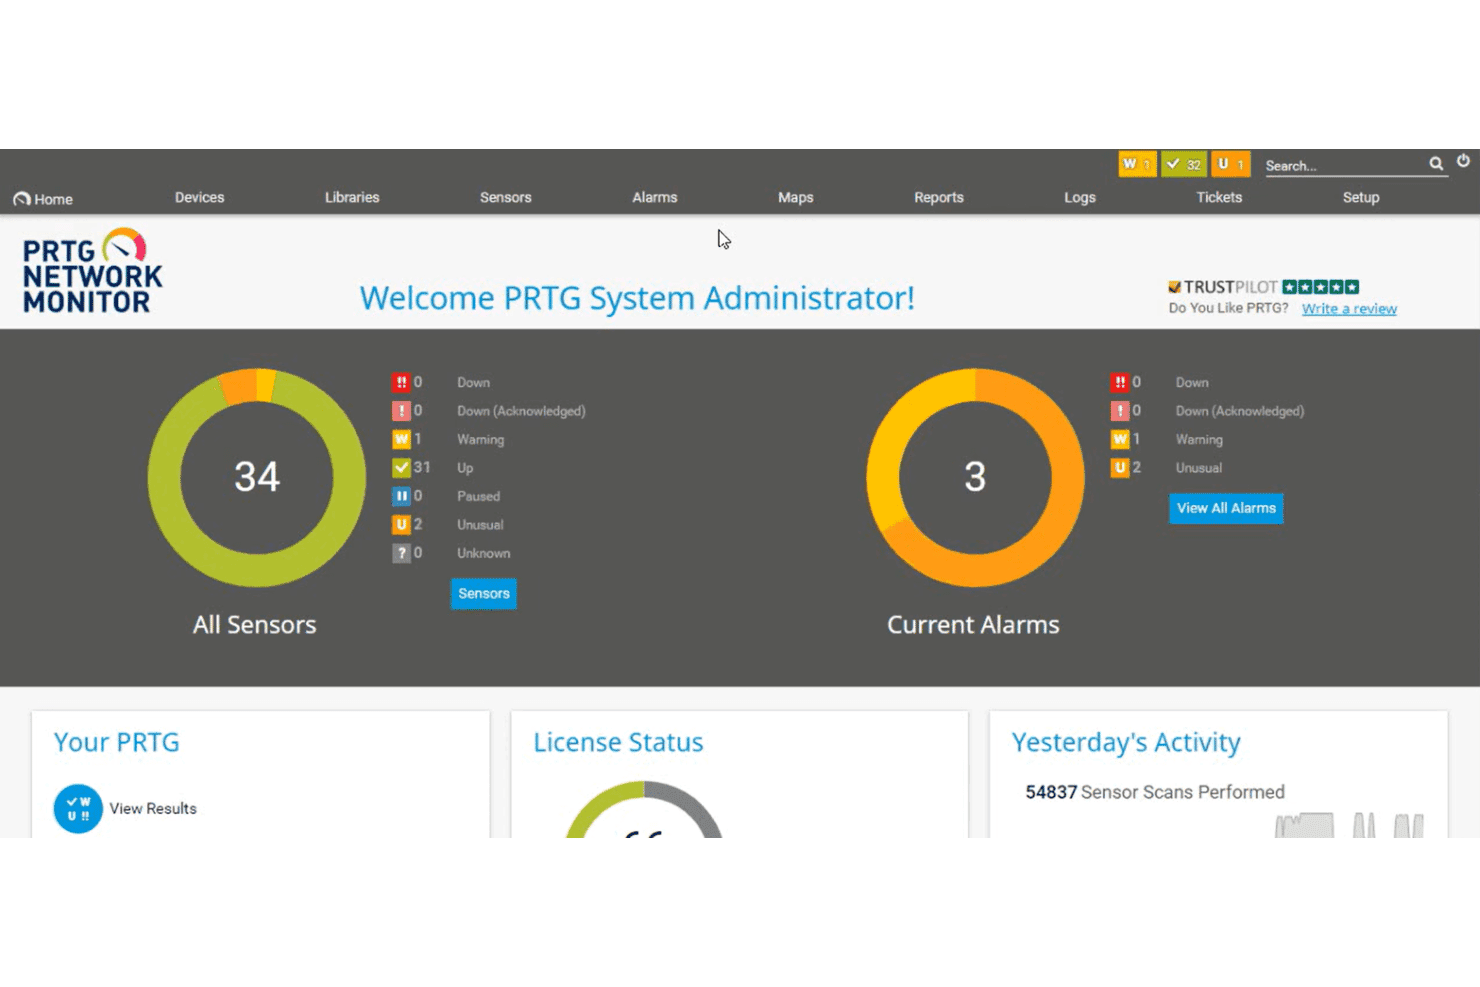
PRTG Network Monitor-instrumentpanelet oppsummerer sensorstatus og aktuelle alarmer på et øyeblikk. Paessler PRTG er et lokalt nettverksovervåkingsverktøy som appellerer til nettverksadministratorer og IT-team som trenger bred synlighet på tvers av IT-, OT- og IoT-infrastruktur – inkludert enheter, trafikk, servere og applikasjoner fra én enkelt plattform.
Hvem passer Paessler PRTG best for?
PRTG passer godt for nettverksadministratorer og IT-team som administrerer lokale eller hybride miljøer, og som trenger et svært visuelt, sensorbasert overvåkingsoppsett de kan tilpasse infrastrukturen sin.
Hvorfor jeg valgte Paessler PRTG
Jeg valgte Paessler PRTG som et av de beste alternativene til LogicMonitor fordi tilpasningen av instrumentpaneler og kart går dypere enn i de fleste verktøyene jeg har testet. Jeg kan bygge infrastrukturvisninger med en dra-og-slipp-redigering, legge inn ikoner for enhetsstatus, geografiske kart og egendefinerte HTML-bakgrunner, og deretter dele dem offentlig eller bygge dem inn via en iframe. Med over 300 tilgjengelige widgeter kan jeg opprette NOC-lignende visninger som gjør problemer på tvers av lokasjoner synlige på et øyeblikk, uten å måtte lete gjennom menyer.
Viktige funksjoner i Paessler PRTG
- Sensorbasert automatisk oppdagelse: Skanner nettverkssegmenter ved hjelp av ping, SNMP og WMI, og bruker deretter automatisk enhets- og sensormaler for å starte overvåkingen.
- Varsling i flere kanaler med eskalering: Sender varsler via e-post, SMS, push-varsler, Teams eller Slack, med konfigurerbare eskaleringsnivåer og planlagte tidsvinduer for varsler.
- AI-drevet avviksdeteksjon: Analyserer historiske sensordata for å etablere referanseverdier og varsler når overvåkede verdier avviker fra forventede mønstre.
- Planlagte rapporter og rapporter på forespørsel: Genererer rapporter i HTML-, PDF-, CSV- eller XML-format for individuelle sensorer eller grupper, etter en fast tidsplan eller manuelt utløst.
Integrasjoner med Paessler PRTG
Paessler PRTG tilbyr innebygde integrasjoner med Microsoft Teams, Slack og PagerDuty. Det tilbyr også REST API-er for egendefinerte integrasjoner og overvåking av XML- eller JSON-data.
Pros and Cons
Pros:
- Tilpassede kart gjør problemer på tvers av lokasjoner synlige
- Automatisk oppdagelse dekker sensorer i variert infrastruktur
- Eskaleringsvarsler bidrar til å oppdage tjenesteproblemer tidlig
Cons:
- Topologi for rotårsaksanalyse krever en separat betalt utvidelse
- Dybden i skyovervåkingen ligger etter leverandørfokuserte plattformer
Learn more about Paessler PRTG: Best for observerbarhet basert på åpen kildekode
- 30 dagers gratis prøveperiode + gratis demo tilgjengelig
- Fra $49/måned
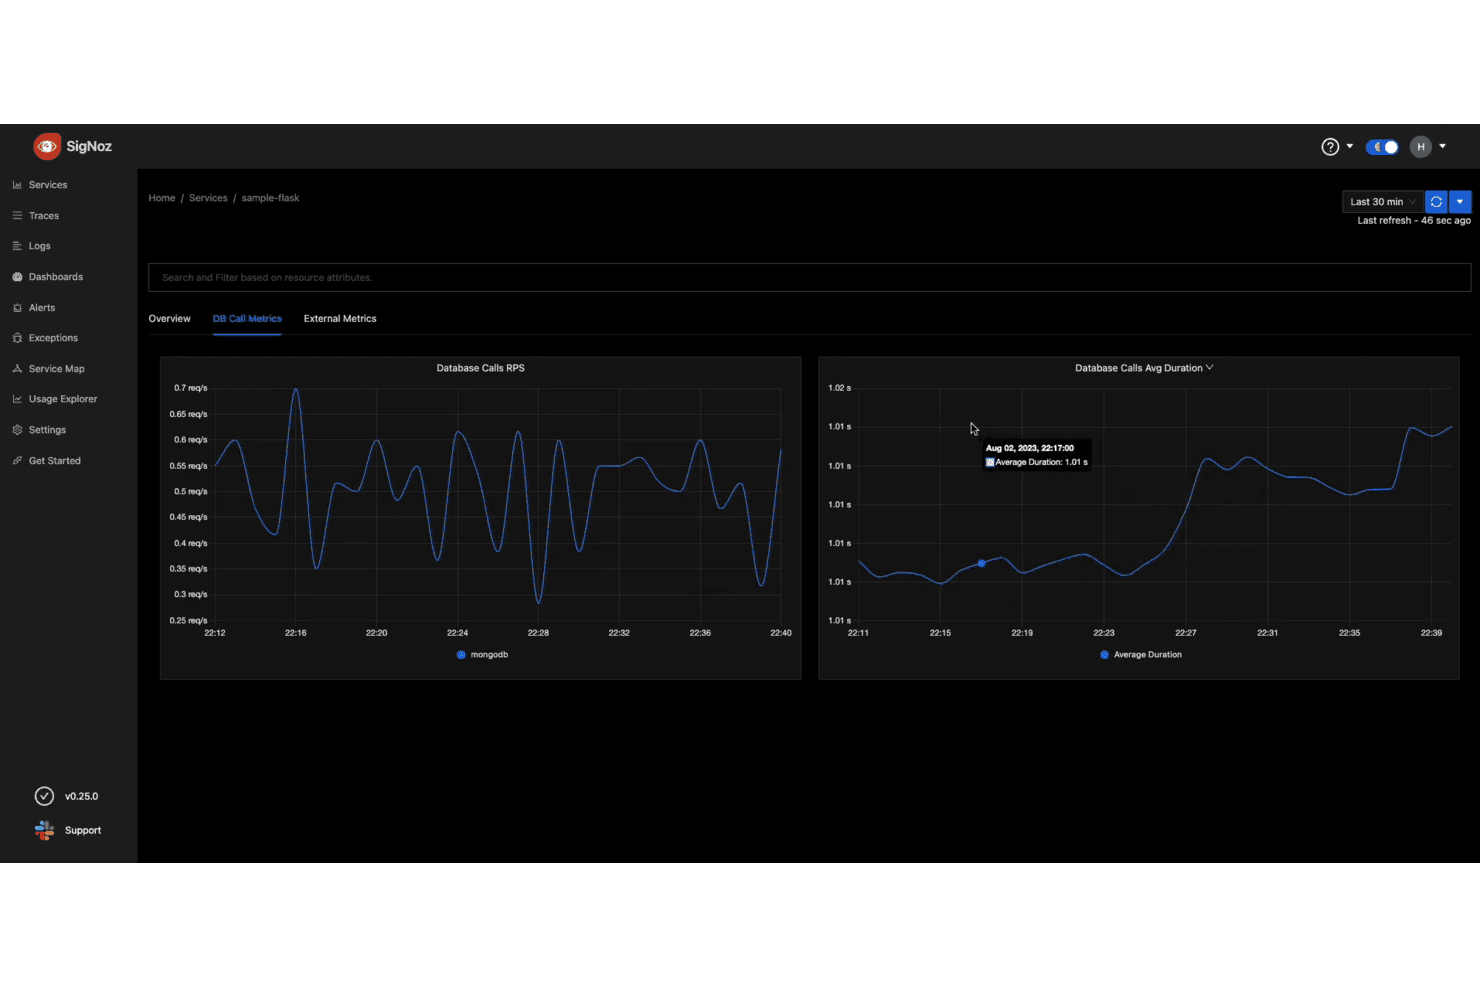
SigNoz-tjenestevisning som viser MongoDB-databasekallfrekvens og gjennomsnittlig varighet over tid. SigNoz er en OpenTelemetry-basert plattform for observerbarhet som henvender seg til DevOps-ingeniører og infrastrukturteam som ønsker samlede logger, metrikker og spor uten de uoversiktlige kostnadene per vert som følger med verktøy som Datadog eller New Relic.
Hvem passer SigNoz best for?
SigNoz passer godt for DevOps-ingeniører og plattformteam som ønsker full kontroll over observerbarhetsstakken sin uten å betale avgifter per vert.
Hvorfor jeg valgte SigNoz
Jeg valgte SigNoz som en av de beste fordi det er den eneste OpenTelemetry-baserte plattformen på denne listen som lar deg drifte hele observerbarhetsstakken selv uten avgifter per vert eller leverandørbinding. Jeg liker at den samler logger, metrikker og spor på ett sted, slik at jeg kan gå direkte fra en kant i tjenestekartet som viser forhøyet P99-forsinkelse til det korrelerte sporet og den korrelerte loggen når et varsel utløses, uten å bytte verktøy. Den AI-assisterte varselskorrelasjonen via MCP-serveren er et virkelig nyttig lag på toppen av dette, og lar meg kvantifisere hvilken oppstrøms tjeneste som er ansvarlig for en topp før jeg i det hele tatt åpner en terminal.
Viktige funksjoner i SigNoz
- Varsling på flere signaler: Opprett varsler basert på metrikker, logger, spor, unntak og avvik, med rutingspolicyer som sender varsler til Slack, PagerDuty, Opsgenie, Microsoft Teams, e-post eller webhooker.
- OpenTelemetry-basert instrumentering: Samle inn og videresend telemetri fra applikasjoner, verter, Kubernetes og skytjenester ved hjelp av OpenTelemetry Collector, uten proprietære agenter.
- Spørringsbygger: Filtrer, aggreger og bruk matematiske funksjoner på tvers av logger, metrikker og spor fra ett enkelt grensesnitt, med støtte også for PromQL og ClickHouse SQL.
- SOC 2 Type II- og HIPAA-samsvar: SigNoz Cloud oppfyller SOC 2 Type II- og HIPAA-standardene, med datasentre tilgjengelig i USA, EU og India.
SigNoz-integrasjoner
SigNoz dokumenterer 112 integrasjoner, inkludert AWS, Azure, Google Cloud Platform, PostgreSQL, MySQL, Redis, MongoDB, NGINX og RabbitMQ. Plattformen tilbyr også et API for egendefinerte integrasjoner og støtter OpenTelemetry Collector-tilkoblinger for SNMP-aktiverte brannmurer, rutere og svitsjer.
Pros and Cons
Pros:
- Egen drift holder telemetrien under din kontroll
- Logger, metrikker og spor brukes i samme undersøkelse
- AI-assistert varselskorrelasjon gjør feilsøking raskere
Cons:
- SNMP-avspørring krever manuell OID-tilordning
- Selvdriftet ClickHouse krever løpende finjustering
Learn more about SigNoz: 10Best for AI-baserte innsikter
Last9
- Gratisabonnement + gratis demo tilgjengelig
- Pris oppgis på forespørsel
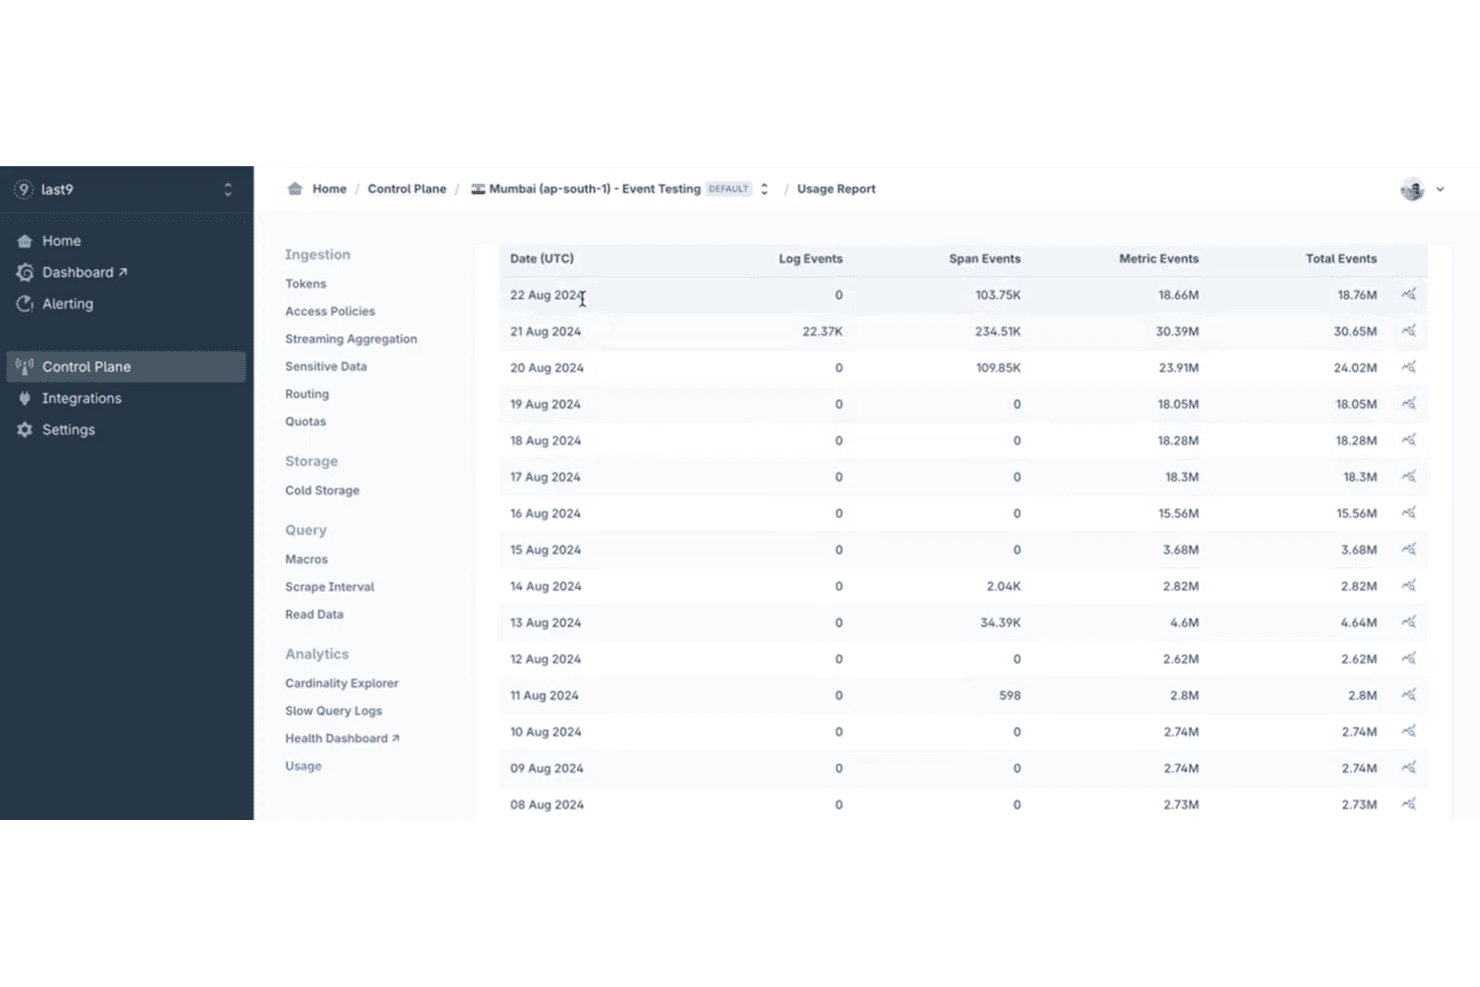
Bruksrapport fra Last9 Control Plane som viser daglige volumer av logg-, spor- og metrikkhendelser per dato. Last9 er en OpenTelemetry-basert plattform for observerbarhet utviklet for DevOps- og ingeniørteam som trenger å samle metrikk, logger og spor – med AI-drevet undersøkelse og støtte for høy kardinalitet som gjør den velegnet for team som vokser fra kostnadskrevende overvåkingsverktøy.
Hvem passer Last9 best for?
Last9 passer godt for DevOps- og team for driftssikkerhet som trenger OpenTelemetry-basert observerbarhet med innebygd AI-drevet undersøkelse.
Hvorfor jeg valgte Last9
Jeg valgte Last9 som en av de beste fordi den AI-baserte undersøkelsen går dypere enn et vanlig varslingsdashbord. Last9 AI kan spørre sanntidsmetrikk, logger og spor samlet, og deretter vise korrelert dokumentasjon og foreslå varslingsregler eller dashbord som du kan godkjenne. Oppdagelseskartet visualiserer avhengigheter mellom tjenester i sanntid, med feilrater og P95-latens, slik at jeg kan spore konsekvensomfanget på tvers av mikrotjenester når en hendelse utløses, uten å måtte sette sammen signalene manuelt.
Viktige funksjoner i Last9
- OpenTelemetry-basert innsamling: Last9 samler inn metrikk, logger og spor direkte via OpenTelemetry, uten behov for leverandørspesifikke agenter.
- Varslingsregler med PromQL og LogQL: Varslingsregler kan skrives direkte i PromQL eller LogQL, eller bygges med en veiledet regelbygger i brukergrensesnittet.
- Trinnvis oppbevaring av metrikk: Data lagres på tvers av nivåene Blaze, Hot og Cold, og oppbevares som standard i opptil ett år uten nedsampling eller sammenrullinger.
- SNMP-basert overvåking av nettverksenheter: Last9 samler inn telemetri fra svitsjer, rutere, brannmurer og UPS-enheter ved hjelp av OpenTelemetry Collector SNMP-mottakeren eller Prometheus SNMP Exporter.
Last9-integrasjoner
Last9 oppgir over 100 integrasjoner, blant annet AWS, Azure, Google Cloud, Kubernetes, Prometheus, Grafana, Slack, Datadog og New Relic. Plattformen tilbyr også et REST API og en MCP-server for tilpassede integrasjoner og arbeidsflyter med AI-agenter.
Pros and Cons
Pros:
- Korrelere logger, metrikk og spor med AI
- Anmeldere rapporterer raskere feilsøking på tvers av tjenester
- Brukere roser fokuserte og handlingsrettede varsler
Cons:
- Lokal drift av plattformen er ikke dokumentert
- Noen anmeldere rapporterer forsinkelser ved oppdatering av dashbord
Learn more about Last9:
Andre alternativer til LogicMonitor
Her er noen flere alternativer til LogicMonitor som ikke kom med på kortlisten min, men som likevel er verdt å se nærmere på:
- 11NinjaOneBest for endepunktadministrasjon
- 12ObkioBest for optimalisering av nettverksytelse
- 13Azure MonitorBest for innsikt i Azure-tjenester
Slik vurderer jeg alternativer til LogicMonitor
Jeg vurderer hvert alternativ gjennom to lag: grunnkravene et verktøy må oppfylle – hybrid overvåking, fleksibel datainnsamling og intelligent varsling – og det som skiller de beste fra resten.
Kjernefunksjonalitet (grunnkrav for denne listen)
Når jeg velger verktøy til listen min, rangerer jeg hvert av dem på en skala fra 0 (tilbyr ikke funksjonaliteten) til 5 (utmerker seg på dette området) for hver av kjernefunksjonene nedenfor. Deretter omregner jeg verktøyets totalscore til en prosentandel. Hvert verktøy må oppnå en samlet minimumsscore på 75 % for å bli vurdert for inkludering.
- Overvåking av hybrid infrastruktur: Jeg undersøker om hvert verktøy kan hente inn måledata fra lokale servere, arbeidsbelastninger i skyen, containere og nettverksutstyr i én samlet visning.
- Fleksible metoder for datainnsamling: Hvert verktøy bør støtte agentbasert og agentløs innsamling via protokoller som SNMP, WMI og REST API-er for å dekke ulike miljøer.
- Intelligent varsling og AIOps: Jeg ser etter dynamiske terskler og varselskorrelasjon som filtrerer bort støy, ikke bare statiske regler som fyller innboksen under en vanlig økning.
- Dashbord og rapportering: Gode dashbord lar deg bygge SLA-fokuserte visninger for ledelsen og detaljerte paneler for ingeniører uten behov for et separat BI-verktøy.
- Integrasjonsøkosystem: Jeg vurderer hvor godt hvert verktøy kobler seg til ITSM-plattformer, chatverktøy og automatiseringssystemer teamet allerede bruker i det daglige.
- Skalerbar arkitektur for flere leietakere: For MSP-er og distribuerte team ser jeg på hvor detaljert RBAC er, isolering av leietakere og om du kan avgrense visninger per kunde eller forretningsenhet.
Når jeg har en liste over verktøy som oppfyller disse kriteriene, vurderer jeg hva som skiller hver plattform fra de andre.
Ulike kjennetegn (det som skiller leverandørene)
Slik sammenligner jeg ulike leverandører:
Fremtredende funksjoner
Automatisk oppdagelse med topologikartlegging er en viktig forskjell. Når et verktøy kartlegger tjenesteavhengigheter på egen hånd, bruker teamet mindre tid på å dokumentere infrastrukturen og mer tid på å håndtere reelle problemer. Jeg ser også etter innebygd logganalyse og APM i tillegg til infrastrukturmåledata – verktøy som Datadog og Dynatrace samler dette i én løsning, noe som betyr færre kontekstbytter. Hendelsesutløst automatisering er også viktig, særlig når teamet trenger å starte utbedringskjørbøker eller spore konfigurasjonsavvik direkte fra overvåkingsplattformen.
Mer enn funksjoner
Pristransparens er viktig når du går bort fra LogicMonitor. Jeg vurderer om en leverandør tar betalt per enhet, per vert eller etter datainnhenting – og hvor forutsigbare kostnadene forblir når miljøet skaleres. Fleksibilitet ved distribusjon er en annen viktig faktor. Noen team trenger SaaS, mens andre i regulerte sektorer krever selvhostede eller fysisk isolerte alternativer; verktøy som Zabbix og PRTG tilbyr lokale modeller, mens Datadog kun tilbys som SaaS. Jeg vurderer også tiden til verdi: Hvor raskt kan du gå fra førstegangsoppsett til meningsfulle dashbord og handlingsrettede varsler?
Hvorfor se etter et alternativ til LogicMonitor?
Selv om LogicMonitor er et godt valg innen produktivitetsprogramvare, finnes det flere grunner til at enkelte brukere ser etter alternative løsninger. Det kan hende du ser etter et annet alternativ fordi:
- Du trenger flere tilpasningsmuligheter
- Teamet ditt trenger bedre skalerbarhet
- Du ønsker å redusere kostnadene
- Bedriften din trenger spesifikke integrasjoner
- Du ser etter enklere brukergrensesnitt
- Du trenger bedre regional støtte
Hvis noe av dette høres kjent ut, har du kommet til rett sted. Listen min inneholder flere alternativer innen produktivitetsprogramvare som passer bedre for team som møter disse utfordringene med LogicMonitor og ser etter alternative løsninger.
Funksjoner
Her er noen av de viktigste funksjonene i LogicMonitor som kan hjelpe deg med å sette opp mot hverandre og sammenligne hva alternative løsninger tilbyr:
- Samlet overvåking: Tilbyr omfattende overvåking av infrastruktur, sky og loggadministrasjon, med støtte for de største skyleverandørene.
- AIOps-integrasjon: Bruker AI-drevne verktøy for hendelsesintelligens og automatisering for å forbedre driftseffektiviteten.
- Prediktiv analyse: Tilbyr årsaksanalyse og tjenesteinnsikt for å forbedre hendelsesløsningen.
- Omfattende integrasjoner: Tilbyr over 3 000 teknologiintegrasjoner for dynamisk skalering og robusthet.
- Tilpassbare dashbord: Lar deg opprette og dele dashbord i sanntid, tilpasset dine spesifikke behov.
- Avviksdeteksjon: Identifiserer uvanlig atferd proaktivt for å forhindre påvirkning på brukerne.
- Dynamiske terskler: Angir automatisk intelligente terskler basert på historiske data.
- API-er og integrasjoner: Utvid funksjonaliteten med API-er og integrasjoner på tvers av ulike teknologier.
- Støtte for sky og flere skyer: Overvåker containere og store skyleverandører som AWS, Google Cloud, Microsoft Azure og Oracle Cloud.
- Loggadministrasjon: Tilbyr funksjoner for loggadministrasjon og analyse.