

I 10 migliori strumenti per la distribuzione dei modelli ML nel 2026
Elenco dei migliori strumenti per la distribuzione dei modelli ML


Gli strumenti per la distribuzione dei modelli ML consentono di prendere modelli di apprendimento automatico addestrati e trasformarli in servizi pronti per la produzione che puoi effettivamente utilizzare. Se stai cercando modi per lanciare, monitorare e gestire in modo affidabile le tue app basate sull’IA, è importante scegliere la piattaforma di distribuzione giusta. Sicurezza, scalabilità, automazione e trasparenza possono determinare il successo o il fallimento del tuo flusso di lavoro.
In questo elenco analizzerò gli strumenti per la distribuzione dei modelli ML di cui mi fido di più e ti mostrerò esattamente dove si inserisce ciascuno di essi nel tuo stack, così potrai scegliere la piattaforma che corrisponde alle esigenze del tuo progetto e alle aspettative del tuo team.
Perché Fidarti delle Nostre Recensioni Software
Testiamo e recensiamo software dal 2023. Come leader tecnologici, sappiamo quanto sia cruciale e difficile prendere la decisione giusta nella scelta di un software.
Investiamo in una ricerca approfondita per aiutare il nostro pubblico a effettuare scelte migliori di acquisto software. Abbiamo testato oltre 2.000 strumenti per diversi casi d’uso tecnologici e scritto più di 1.000 recensioni complete. Scopri come restiamo trasparenti e la nostra metodologia di recensione del software.
Riepilogo dei migliori strumenti per la distribuzione dei modelli ML
Questa tabella comparativa riassume i dettagli dei prezzi degli strumenti per la distribuzione dei modelli ML che ho selezionato, per aiutarti a trovare quello più adatto al tuo budget e alle esigenze della tua azienda.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideale per l'orchestrazione di modelli nativa di Kubernetes | Piano gratuito disponibile | Gratuito | Website | |
| 2 | Ideale per API di inferenza standardizzate su Kubernetes | Piano gratuito disponibile | Utilizzabile gratuitamente | Website | |
| 3 | Ideale per pacchettizzare modelli come API di produzione | Piano gratuito + demo gratuita disponibile | Prezzo su richiesta | Website | |
| 4 | Ideale per l'hosting di modelli transformer su larga scala | Piano gratuito + demo gratuita disponibile | A partire da $9/mese | Website | |
| 5 | Ideale per il deployment di funzioni Python serverless | Piano gratuito disponibile | Da $250 + calcolo/mese | Website | |
| 6 | Ideale per la gestione automatizzata end-to-end dei modelli | Piano gratuito disponibile | Prezzi su richiesta | Website | |
| 7 | Ideale per flussi di lavoro unificati di dati e IA | Piano gratuito disponibile | A partire da $0.085/ora | Website | |
| 8 | Ideale per creare interfacce web personalizzate per modelli | Piano gratuito disponibile | Prezzo su richiesta | Website | |
| 9 | Ideale per il serving distribuito con Python e Ray | Credito gratuito di $100 disponibile | Prezzi su richiesta | Website | |
| 10 | Ideale per la gestione dei modelli nei settori regolamentati | Not available | Prezzi su richiesta | Website |
Recensioni dei migliori strumenti per la distribuzione dei modelli ML
Di seguito trovi i miei riepiloghi dettagliati dei migliori strumenti per la distribuzione dei modelli ML inclusi nel mio elenco ristretto. Le mie recensioni offrono uno sguardo approfondito sulle funzionalità, sulle integrazioni e sui casi d’uso migliori di ciascuna piattaforma, per aiutarti a trovare quella più adatta a te.
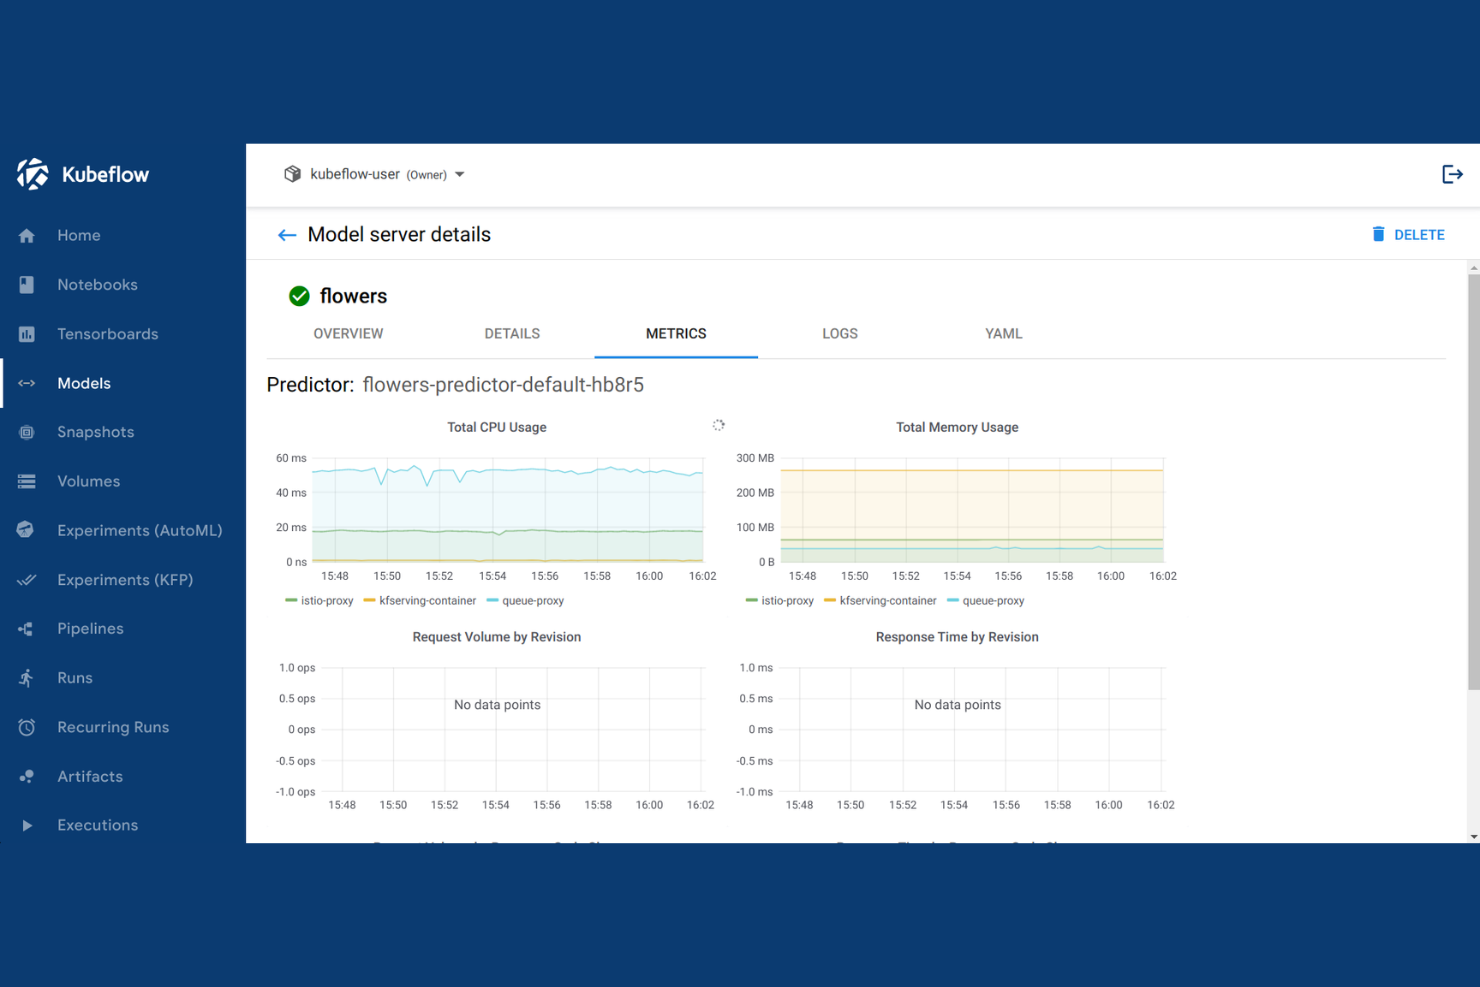
Kubeflow è una piattaforma ML open source basata su Kubernetes che copre l'orchestrazione delle pipeline, l'addestramento dei modelli, l'ottimizzazione degli iperparametri e la distribuzione di modelli con più framework su infrastrutture cloud e locali.
Per chi è più adatto Kubeflow?
Kubeflow è particolarmente adatto ai team di ingegneria ML che utilizzano già Kubernetes e hanno bisogno di gestire processi di addestramento su larga scala e la distribuzione di modelli in produzione sulla propria infrastruttura.
Perché ho scelto Kubeflow
Ho scelto Kubeflow come una delle soluzioni migliori perché è progettato appositamente per Kubernetes, il che significa che ogni componente viene eseguito come un carico di lavoro Kubernetes nativo. Mi piace il fatto che Kubeflow Pipelines permetta di definire flussi di lavoro ML end-to-end come grafi aciclici diretti containerizzati, in modo che ogni passaggio possa essere ridimensionato indipendentemente. Kubeflow Trainer gestisce l'addestramento distribuito con PyTorch, JAX e DeepSpeed senza richiedere una configurazione personalizzata del cluster. Posso anche utilizzare Katib per eseguire ricerche automatizzate degli iperparametri direttamente sui processi di addestramento in esecuzione nello stesso cluster.
Funzionalità principali di Kubeflow
- KServe: Distribuisci i modelli addestrati come servizi di inferenza scalabili su Kubernetes utilizzando ambienti di esecuzione predefiniti per TensorFlow, PyTorch e scikit-learn.
- Registro dei modelli: Archivia, assegna versioni e monitora i modelli registrati tra le diverse esecuzioni di addestramento prima di promuoverli agli ambienti di distribuzione.
- Server per notebook: Avvia istanze di notebook Jupyter direttamente sul cluster con allocazioni configurabili di CPU, GPU e memoria.
- Isolamento multiutente: Gestisci spazi dei nomi separati e controlli di accesso per team o progetti diversi all'interno di un cluster condiviso.
Integrazioni di Kubeflow
Kubeflow non offre integrazioni native tradizionali; funziona invece all'interno dell'ecosistema Kubernetes e supporta framework ML come TensorFlow, PyTorch, JAX, XGBoost, HuggingFace e Apache Spark tramite gli operatori dei relativi sottoprogetti. Puoi inoltre distribuirlo su servizi Kubernetes gestiti di AWS, Google Cloud, Microsoft Azure e Red Hat OpenShift.
Pros and Cons
Pros:
- Si distribuisce su tutti i principali provider cloud Kubernetes
- Ogni passaggio della pipeline viene eseguito in un container isolato
- Ottiene punteggi elevati nell'addestramento distribuito e nell'orchestrazione
Cons:
- La configurazione iniziale complessa richiede competenze in Kubernetes
- Richiede un team di piattaforma dedicato alla manutenzione

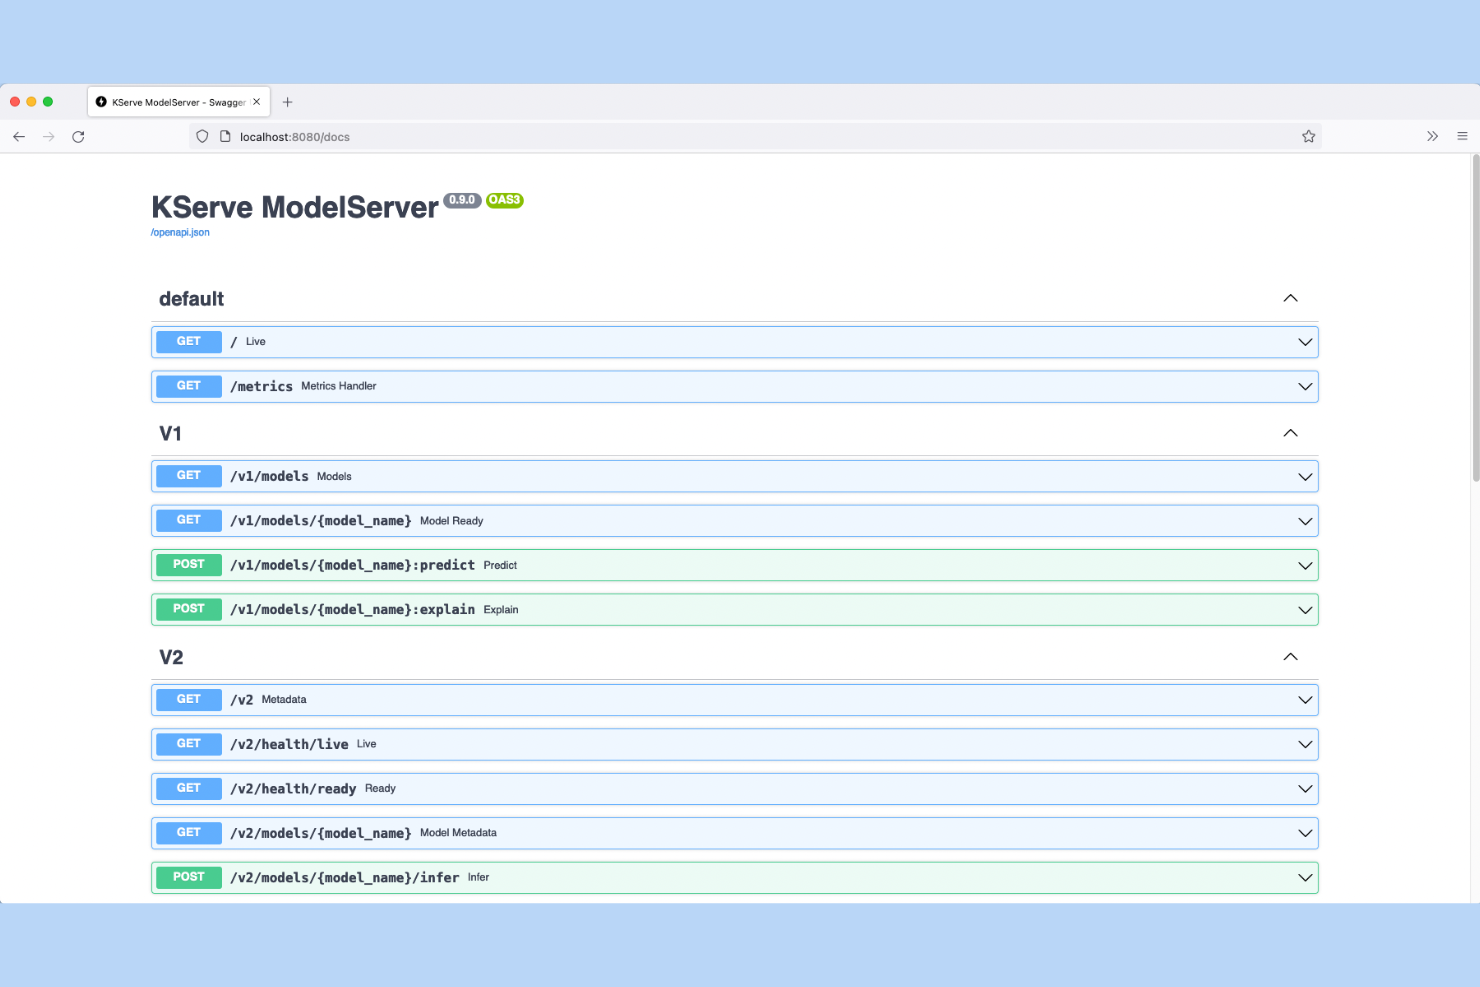
KServe è una piattaforma open source per l'inferenza dei modelli, nativa di Kubernetes, che gestisce la distribuzione di modelli basati su più framework, i rilasci canary, l'autoscaling e la spiegabilità dei modelli attraverso un livello API di inferenza standardizzato.
Per chi è più indicato KServe?
KServe è particolarmente adatto ai team di ingegneria ML di organizzazioni medio-grandi che eseguono la distribuzione di modelli su larga scala in Kubernetes e hanno bisogno di un livello di inferenza indipendente dal framework.
Perché ho scelto KServe
Ho scelto KServe come una delle soluzioni migliori perché è basato sull'Open Inference Protocol (V2), una specifica API standardizzata che consente al mio team di sostituire i sistemi di distribuzione, come Triton o vLLM, senza riscrivere il codice client. Mi affido inoltre alla CRD InferenceService per definire dichiarativamente i rilasci canary, instradando una percentuale del traffico attivo verso una nuova versione del modello prima della promozione completa. Sono supportati sia gli endpoint di inferenza REST sia quelli gRPC, quindi non sono vincolato a un unico livello di trasporto.
Funzionalità principali di KServe
- Autoscaling fino a zero: l'autoscaling basato su Knative riduce a zero i pod di inferenza quando sono inattivi e li riattiva su richiesta.
- Trasformatori di richieste/risposte: la logica di pre-elaborazione e post-elaborazione viene eseguita in un container trasformatore separato insieme al server del modello.
- Rilasci canary: spostano gradualmente il traffico verso una nuova versione del modello, consentendo di testare le modifiche in produzione senza esporle completamente.
- Registrazione dei payload: le richieste e le risposte di inferenza vengono registrate in destinazioni configurabili per creare tracce di audit e monitorare i modelli.
Integrazioni di KServe
KServe include integrazioni native con Knative, Istio e la Kubernetes Gateway API per il dimensionamento senza server e l'instradamento in ingresso. Viene fornito con runtime di distribuzione integrati per vLLM, llm-d, NVIDIA Triton Inference Server, Seldon MLServer, TorchServe e Hugging Face, e supporta l'archiviazione dei modelli in Amazon S3, Google Cloud Storage e Azure Blob Storage. Sono disponibili un SDK Python per la distribuzione e API di inferenza REST/gRPC per integrazioni personalizzate.
Pros and Cons
Pros:
- L'autoscaling fino a zero riduce i costi delle GPU inattive
- Distribuzione indipendente dal framework tramite un protocollo di inferenza standardizzato
- Rilasci canary integrati per aggiornamenti sicuri
Cons:
- Per la gestione è richiesta competenza sui cluster Kubernetes
- La modalità senza server limita la personalizzazione dei mount dei volumi

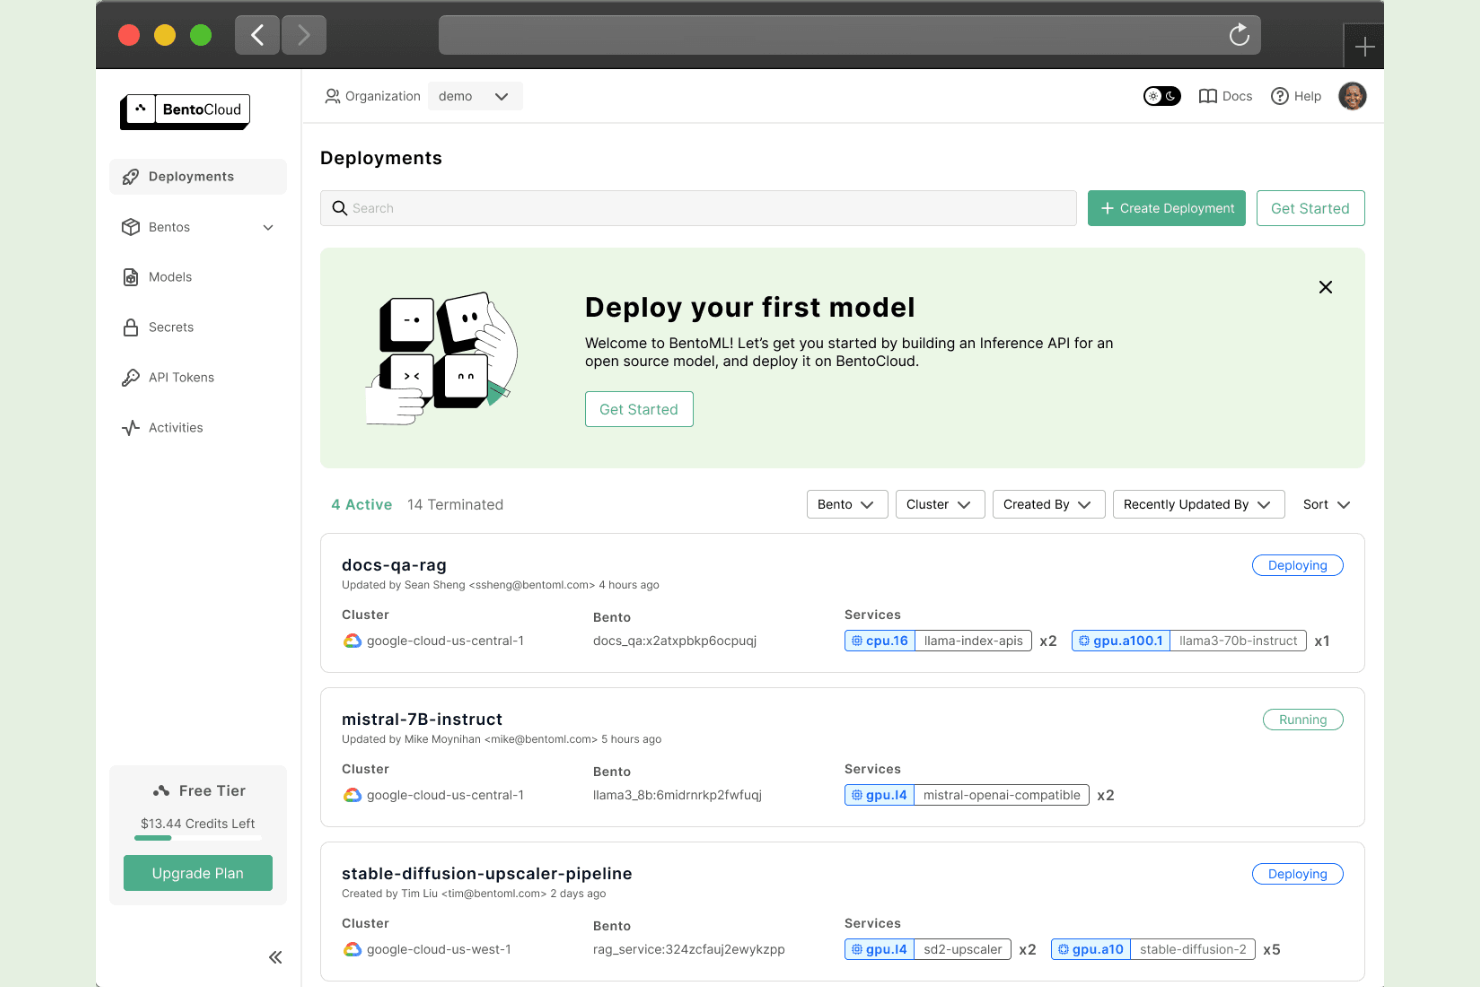
Basato sul concetto di artefatto 'Bento', BentoML è un framework per il serving di modelli nativo in Python che gestisce la definizione dei servizi, la containerizzazione e il packaging di modelli multi-framework per il deployment in produzione.
Per chi è ideale BentoML?
BentoML è particolarmente adatto a team ML in aziende in crescita che hanno bisogno di passare velocemente da un modello addestrato a una API pronta per la produzione senza una piattaforma MLOps dedicata.
Perché ho scelto BentoML
Ho incluso BentoML tra le mie migliori scelte perché è uno dei pochi framework che tratta l'artefatto modello e il livello di serving come un'unica unità versionata. Mi piace che BentoML generi automaticamente sia endpoint REST che gRPC dalla stessa definizione del servizio, così il mio team non deve mantenere specifiche API separate. L'astrazione dei runner mi consente di isolare ogni modello nel proprio processo, il che significa che un passaggio di pre-processing su CPU non compete per risorse con un runner di modello su GPU.
Funzionalità principali di BentoML
- Batching adattivo: Raggruppa automaticamente le richieste di inferenza concorrenti in un unico batch, riducendo l'overhead GPU per richiesta senza modifiche al codice.
- Metriche Prometheus integrate: Espone un endpoint /metrics pronto all'uso, così puoi monitorare latenza e throughput delle richieste senza strumentazione personalizzata.
- Gateway LLM: Fornisce un'interfaccia API unificata tra vari fornitori di LLM, offrendoti un controllo centralizzato su routing e costi.
- Build di immagini containerizzate: Genera un'immagine Docker pronta per la produzione direttamente da un artefatto Bento tramite un solo comando CLI.
Integrazioni BentoML
BentoML offre integrazioni documentate con strumenti dell'ecosistema MLOps, tra cui Airflow, MLflow, Ray, Spark, Arize AI, Flink e Triton Inference Server. Si integra anche con Datadog per la raccolta di metriche dei servizi BentoML. È disponibile una API per integrazioni personalizzate, e l'output containerizzato di BentoML funziona nativamente con Kubernetes e Docker per una maggiore flessibilità di deployment.
Pros and Cons
Pros:
- Versionamento e tracking rollback integrati per i modelli
- Genera contenitori Docker da config YAML
- Gestisce richieste concorrenti tramite scalabilità dei worker
Cons:
- I file di configurazione possono risultare inutilmente complessi
- I loader personalizzati dei modelli richiedono configurazione aggiuntiva

Ideale per l'hosting di modelli transformer su larga scala

Una piattaforma di inferenza gestita costruita sopra Hugging Face Hub, Hugging Face Inference Endpoints si occupa del deployment cloud dedicato, della configurazione degli endpoint e della selezione dell'hardware per i modelli di ML su AWS, Azure e Google Cloud.
Per chi è ideale Hugging Face Inference Endpoints?
È particolarmente adatto a startup focalizzate sull'IA e aziende tecnologiche di medie dimensioni che necessitano di un hosting dei modelli pronto per la produzione senza dover costruire e mantenere un'infrastruttura di serving propria.
Perché ho scelto Hugging Face Inference Endpoints
Hugging Face Inference Endpoints si guadagna un posto nella mia shortlist perché è progettato appositamente per l'ecosistema dei modelli transformer in un modo che nessun'altra piattaforma di deployment riesce a fare. Il mio team può prendere qualsiasi modello dall'Hub, compresi LLM di grandi dimensioni e transformer multimodali, e metterlo in servizio su scala di produzione con regole di autoscaling configurabili che rispondono al traffico reale. Apprezzo anche la rapidità zero-to-endpoint: un modello che normalmente richiederebbe giorni per essere containerizzato e distribuito manualmente, è attivo in pochi minuti.
Funzionalità chiave di Hugging Face Inference Endpoints
- Deployment multi-cloud: Scegli di distribuire il tuo endpoint su AWS, Azure o Google Cloud senza dover gestire separatamente gli account cloud.
- Rete privata: Isola gli endpoint all'interno di una VPC dedicata in modo che solo i tuoi sistemi interni possano accedere all'API del modello.
- Autenticazione tramite token: Proteggi ogni endpoint con un token API per controllare quali servizi o utenti possono inviare richieste di inferenza.
- Monitoraggio dell'utilizzo: Tieni traccia in tempo reale del volume delle richieste, della latenza e dei tassi di errore direttamente dalla dashboard degli endpoint.
Integrazioni di Hugging Face Inference Endpoints
Hugging Face Inference Providers funziona con un ecosistema in crescita di strumenti per sviluppatori, framework e piattaforme, e strumenti senza supporto esplicito risultano spesso comunque compatibili tramite la sua API compatibile con OpenAI. Le integrazioni documentate includono AWS Bedrock e SageMaker, Google Gemini Enterprise Agent Platform e Azure AI Foundry, oltre a framework LLM come LangChain, LlamaIndex, Haystack, CrewAI e PydanticAI. Gli Inference Endpoints possono essere completamente gestiti tramite API, con endpoint documentati tramite Swagger, così puoi costruire integrazioni personalizzate. Il supporto per Zapier non è chiaramente documentato.
Pros and Cons
Pros:
- Un solo clic per il deploy dall'Hugging Face Hub
- Supporta diversi motori di inferenza
- Autoscaling con fatturazione scale-to-zero
Cons:
- Avvii a freddo quando si scala da zero
- I costi del calcolo su GPU aumentano rapidamente su larga scala


Modal è una piattaforma cloud serverless per l'esecuzione di carichi di lavoro ML basati su Python, che copre inferenza accelerata da GPU, processi batch, sessioni di training e attività pianificate senza alcuna gestione di container o infrastruttura.
Per chi è ideale Modal?
È una soluzione naturale per startup e team in crescita che hanno bisogno di distribuire modelli ML rapidamente senza dover assumere ingegneri infrastrutturali dedicati.
Perché ho scelto Modal
Ho incluso Modal tra le mie scelte principali perché elimina il divario tra la scrittura in Python e la sua esecuzione su larga scala su GPU. Posso richiedere hardware specifico, come A100 o H100, direttamente nella definizione della funzione e Modal lo fornisce su richiesta. Non c'è alcun cluster da gestire né file YAML da scrivere. Apprezzo anche che la stessa funzione si comporti in modo identico sia in locale che in produzione, riducendo notevolmente il tempo di debug.
Funzionalità principali di Modal
- Immagini container personalizzate: Definisci dipendenze, variabili di ambiente e pacchetti di sistema direttamente nel codice, garantendo ambienti di runtime consistenti tra le diverse distribuzioni.
- Volumi persistenti: Monta volumi cloud per memorizzare nella cache i pesi dei modelli tra varie esecuzioni, riducendo i tempi di avvio a freddo nei deployment ripetuti.
- Gestione dei segreti: Conserva e inietta in modo sicuro chiavi API e credenziali durante l'esecuzione senza inserirle nel codice sorgente.
- Esecuzione batch parallela: Usa .map() per eseguire inferenze su grandi insiemi di dati in parallelo su più container simultaneamente.
Integrazioni Modal
Modal offre un piccolo insieme di integrazioni documentate focalizzate su osservabilità e notifiche, tra cui Datadog, qualsiasi provider compatibile con OpenTelemetry, Slack e Okta SSO. Supporta inoltre il montaggio di bucket cloud per AWS S3, Google Cloud Storage e Cloudflare R2, oltre a workflow CI/CD tramite GitHub Actions. Il supporto a Zapier non è documentato, ma Modal mette a disposizione un SDK Python e endpoint web che consentono integrazioni personalizzate.
Pros and Cons
Pros:
- Non servono Dockerfile né configurazioni Kubernetes
- Gestisce training, elaborazione batch e inferenza
- Distribuisce carichi di lavoro su più cloud e regioni
Cons:
- Il codice basato su decorator crea lock-in verso il fornitore
- Le funzionalità Enterprise richiedono un piano premium

Amazon SageMaker (noto anche come AWS SageMaker) è una piattaforma ML di AWS che copre l’intero ciclo di vita del modello—dall’addestramento e perfezionamento fino al deployment, al monitoraggio e alla governance—il tutto all’interno di un ambiente di sviluppo unificato basato su architettura lakehouse.
A Chi È Destinato Amazon SageMaker?
Amazon SageMaker è particolarmente adatto a team di data science e ingegneria ML che già lavorano all’interno dell’ecosistema AWS.
Perché Ho Scelto Amazon SageMaker
Amazon SageMaker si guadagna un posto tra i migliori nella mia lista perché gestisce in modo completamente automatizzato e integrato la gestione dei modelli, senza dover collegare strumenti separati. Apprezzo in particolare SageMaker MLOps, che si occupa di orchestrazione delle pipeline, registro dei modelli e tracciamento dei deployment in un’unica interfaccia. Mi affido anche alle capacità integrate di inferenza, AI ops e osservabilità di SageMaker AI per monitorare i modelli post-deployment e rilevare derive prima che diventino un problema in produzione.
Funzionalità Principali di Amazon SageMaker
- SageMaker JumpStart: Accedi a oltre 1.000 modelli AI predefiniti dai principali fornitori e distribuiscili o personalizzali direttamente all’interno di SageMaker.
- SageMaker HyperPod: Scala lavori di addestramento e ottimizzazione su cluster composti da centinaia o migliaia di acceleratori AI con gestione automatizzata del cluster.
- Inferenza multi-modale: Distribuisci modelli usando inferenza in tempo reale, serverless, asincrona o batch su oltre 70 tipi di istanze.
- MLflow gestito: Monitora, organizza e confronta esperimenti iterativi senza bisogno di provisioning di infrastruttura o gestione di server.
Integrazioni Amazon SageMaker
Amazon SageMaker si integra nativamente con l’ecosistema AWS, incluso Amazon S3, Amazon Redshift, Amazon Athena, Amazon EMR e AWS Glue, oltre ad Amazon Bedrock e Amazon Q Developer. Funziona anche con strumenti di terze parti come Datadog, Hugging Face, MLflow e Pinecone. È disponibile un’API per integrazioni personalizzate.
Pros and Cons
Pros:
- Modalità di inferenza multiple per diversi carichi di lavoro
- AutoML integrato e ottimizzazione degli iperparametri
- Shadow testing per rollout sicuri dei modelli
Cons:
- Strettamente legato all’ecosistema AWS
- Difficile il debug dei job di addestramento falliti


Gemini Enterprise Agent Platform (precedentemente Vertex AI) è la piattaforma ML end-to-end di Google Cloud che comprende addestramento, messa a punto, valutazione e distribuzione dei modelli, oltre allo sviluppo di agenti IA, all'interno di un unico ambiente gestito.
Per chi è più indicata Gemini Enterprise Agent Platform?
Gemini Enterprise Agent Platform è una scelta naturale per i team di ingegneria ML e di scienza dei dati che utilizzano già un'infrastruttura dati su Google Cloud Platform.
Perché ho scelto Gemini Enterprise Agent Platform
Ho incluso Gemini Enterprise Agent Platform tra le mie scelte principali perché riduce concretamente il divario tra gestione dei dati e gestione dei modelli. Apprezzo in particolare il modo in cui Gemini Enterprise Agent Platform Pipelines si collega direttamente a BigQuery, consentendo al mio team di creare pipeline di addestramento basate sui dati attivi del magazzino dati senza dover esportare nulla. Gemini Enterprise Agent Platform Feature Store ci consente inoltre di definire, distribuire e monitorare le funzionalità in modo coerente sia durante l'addestramento sia durante l'inferenza, eliminando così una delle principali cause delle discrepanze tra addestramento e distribuzione.
Funzionalità principali di Gemini Enterprise Agent Platform
- Gemini Enterprise Agent Platform Model Registry: un repository centralizzato per creare versioni, organizzare e gestire i modelli durante tutto il loro ciclo di vita, prima e dopo la distribuzione.
- Endpoint di previsione online: distribuisci i modelli su endpoint dedicati che forniscono previsioni in tempo reale, con risorse di calcolo configurabili e suddivisione del traffico tra diverse versioni del modello.
- Gemini Enterprise Agent Platform Model Monitoring: rileva le discrepanze nelle funzionalità e la deriva delle previsioni nei modelli distribuiti, confrontando il traffico attivo con una linea di base dei dati di addestramento.
- Gemini Enterprise Agent Platform Experiments: tiene traccia, confronta e visualizza le esecuzioni iterative dell'addestramento per aiutare i team a identificare le configurazioni dei modelli con le prestazioni migliori.
Integrazioni di Gemini Enterprise Agent Platform
Gemini Enterprise Agent Platform si integra nativamente nell'ecosistema Google Cloud, inclusi BigQuery, Cloud Storage, Dataflow e Pub/Sub, oltre a supportare Kubeflow Pipelines e container preconfigurati per TensorFlow, scikit-learn, XGBoost e PyTorch. I suoi archivi dati supportano inoltre connettori dati di terze parti per strumenti come Jira e Shopify. È disponibile su Zapier ed è disponibile un'API per le integrazioni personalizzate.
Pros and Cons
Pros:
- Model Garden offre oltre 200 modelli distribuibili
- La distribuzione basata su endpoint da Model Garden è semplice
- Integrazione nativa con BigQuery per i flussi di lavoro sui dati
Cons:
- Gli endpoint dedicati inattivi continuano a generare costi
- Le discrepanze nella regione configurata producono messaggi di errore poco chiari

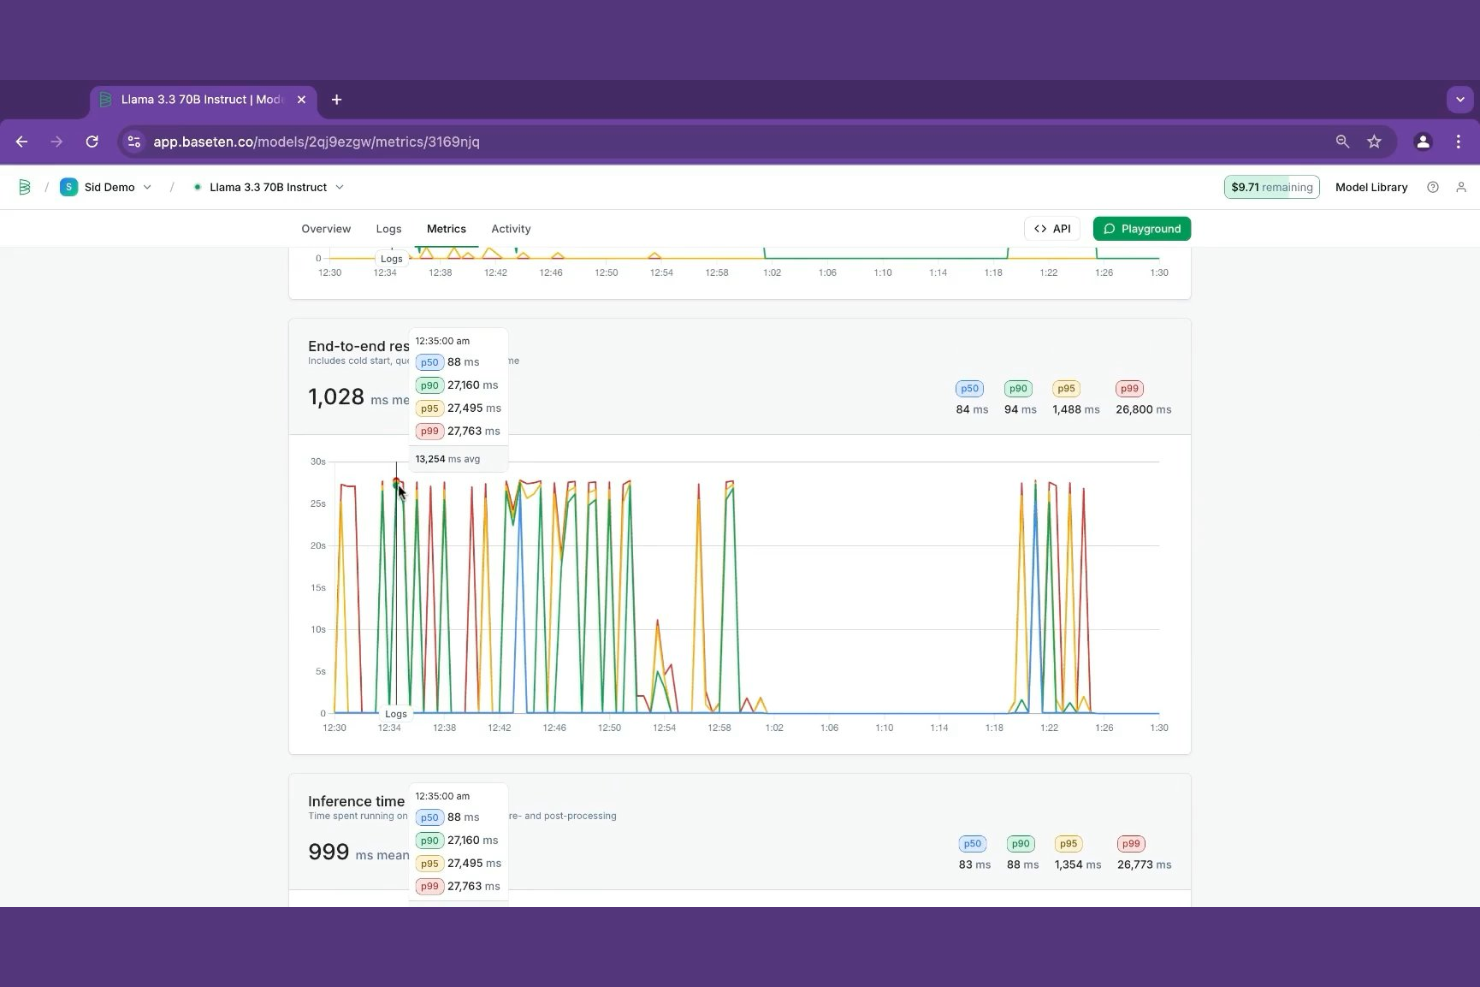
Baseten è una piattaforma di inferenza di modelli che consente ai team ML di distribuire modelli personalizzati, open-source e ottimizzati con servizio accelerato tramite GPU, autoscaling e strumenti di ottimizzazione delle prestazioni integrati direttamente nella piattaforma.
Per chi è Baseten?
Baseten è adatto ai team di prodotto AI nelle aziende in fase di crescita che necessitano di pieno controllo sulle prestazioni di inferenza per distribuzioni di modelli a bassa latenza o ad alto throughput.
Perché ho scelto Baseten
Baseten si è guadagnato un posto nella mia shortlist perché consente di costruire e distribuire interfacce web personalizzate sopra i modelli all'interno della stessa piattaforma, senza bisogno di uno stack frontend separato. Utilizzo il costruttore di applicazioni di Baseten per creare interfacce interattive che chiamano direttamente gli endpoint dei modelli, il che è utile per strumenti interni o demo per stakeholder. Il modello e la sua UI rimangono versionati e distribuiti insieme.
Funzionalità chiave di Baseten
- Packaging modelli Truss: Impacchetta qualsiasi modello personalizzato o ottimizzato come artefatto Python riproducibile con gestione delle dipendenze integrata e reload live per i test locali.
- Baseten Chains: Costruisci workflow AI composti multi-step dove ogni passaggio gira su hardware configurato in modo indipendente con la propria policy di autoscaling.
- Gestione segreti: Archivia e inserisci chiavi API e credenziali d'ambiente direttamente nelle distribuzioni dei modelli senza scriverle hardcoded nel codice di servizio.
- Suddivisione traffico A/B: Instrada traffico di inferenza live su più versioni di modelli contemporaneamente per confrontarne le prestazioni prima di promuovere completamente una nuova distribuzione.
Integrazioni Baseten
Baseten supporta l'esportazione di metriche verso Prometheus, Datadog, Grafana Cloud e New Relic tramite il suo endpoint metriche basato su OpenTelemetry. È pienamente compatibile con OpenAI, quindi puoi collegarlo a qualsiasi client o gateway che utilizzi l'SDK OpenAI, inclusi LiteLLM, LlamaIndex e Cloudflare AI Gateway. È disponibile un'API per integrazioni personalizzate.
Pros and Cons
Pros:
- Il packaging open-source Truss semplifica il deployment dei modelli
- Distribuzione one-click dai checkpoint di training
- Avvio a freddo inferiore al secondo su istanze GPU
Cons:
- La tariffazione basata sull'uso può variare in modo imprevedibile
- Richiede competenze di ingegneria ML per l'operatività


Basato sul framework open-source Ray, Anyscale è una piattaforma gestita per il serving di modelli ML che gestisce l'inferenza distribuita, l'autoscaling e il deployment di modelli multipli su cluster GPU e CPU.
A chi è rivolto Anyscale?
Anyscale è particolarmente adatto a ingegneri ML e team di data science di organizzazioni medie e grandi che eseguono carichi di lavoro basati su Python su larga scala e necessitano di gestione di cluster GPU senza complicazioni manuali dell'infrastruttura.
Perché ho scelto Anyscale
Ho scelto Anyscale tra i migliori perché è l'unica piattaforma gestita costruita direttamente su Ray; ciò significa che il mio team può scrivere Python standard per definire la logica di serving distribuito senza dover imparare un diverso DSL di orchestrazione. In particolare apprezzo l'API di graph di deploy di Ray Serve, che permette di comporre più modelli in una singola pipeline di inferenza con un routing esplicito delle richieste. L'allocazione frazionata delle GPU è un'altra funzione che uso spesso per raggruppare modelli leggeri su hardware condiviso senza dover avviare istanze dedicate.
Caratteristiche principali di Anyscale
- Autoscaling: Scala automaticamente il numero di repliche in base al throughput delle richieste in tempo reale e alla profondità della coda.
- Suddivisione del traffico: Instrada una percentuale configurabile di traffico live verso nuove versioni dei modelli per rollout graduali senza tempi di inattività.
- Batching delle richieste: Raggruppa le richieste di inferenza in arrivo in batch per massimizzare l'utilizzo della GPU tra chiamate concorrenti.
- Serving multi-nodo di modelli: Distribuisce un singolo modello di grandi dimensioni su più nodi quando supera i limiti di memoria di una singola GPU.
Integrazioni di Anyscale
Anyscale si integra con le principali librerie e framework AI/ML, con oltre 50 integrazioni che coprono piattaforme dati, orchestrazione, framework ML, osservabilità e framework per applicazioni LLM. Tra queste: MLflow, Weights & Biases, MongoDB, Snowflake, Databricks, Hugging Face, PyTorch e TensorFlow, oltre ad Airflow, Prefect, Dagster, Datadog, LangChain e LlamaIndex. È disponibile un'API per integrazioni personalizzate e la piattaforma può essere distribuita anche come servizio di prima parte su Amazon EKS, Google GKE, Azure AKS e OCI Kubernetes Engine.
Pros and Cons
Pros:
- Scala il codice Python su cluster GPU distribuiti
- Serving di modelli agnostico rispetto al framework tramite Ray Serve
- Supporto per spot instance con tolleranza ai guasti automatica
Cons:
- Fortemente integrato nell'ecosistema Ray
- Richiede una conoscenza approfondita dei sistemi distribuiti

Altri strumenti per la distribuzione dei modelli ML
Ecco alcuni strumenti aggiuntivi per la distribuzione dei modelli ML che non sono entrati nel mio elenco ristretto, ma che vale comunque la pena valutare:


Come valuto gli strumenti di Deployment dei Modelli ML
Divido la mia valutazione in due livelli: criteri di base che una piattaforma di serving in produzione deve soddisfare e fattori differenzianti che contano su larga scala tra cluster GPU e flussi di lavoro MLOps.
Funzionalità core (Requisiti minimi per questa lista)
Quando seleziono gli strumenti per la mia lista, valuto ciascuno su una scala da 0 (non offre la funzionalità) a 5 (eccelle in questo ambito) per ogni funzionalità core elencata di seguito. Poi, calcolo il punteggio totale dello strumento come percentuale. Ogni strumento deve raggiungere un punteggio minimo totale del 65% per essere considerato per l'inclusione.
- Model serving: Verifico se uno strumento supporta sia endpoint REST/gRPC in tempo reale sia inferenza batch, poiché la maggior parte dei carichi in produzione necessita di entrambi i pattern.
- Supporto multi-framework: I team spesso eseguono PyTorch per modelli di visione assieme a XGBoost per dati tabellari, quindi cerco il supporto nativo per i principali framework.
- Versioning del modello: Valuto come ogni strumento traccia artefatti e metadata dei modelli, soprattutto la possibilità di effettuare rollback di un deployment se una nuova versione performa peggio.
- Scalabilità e risorse: Il traffico in produzione è imprevedibile, quindi cerco autoscaling sia su GPU che CPU con bilanciamento del carico per gestire i picchi di inferenza.
- Monitoraggio: Intercettare una deriva dei dati prima che degradi le previsioni è importante, dunque valuto rilevamento integrato delle derive, monitoraggio della latenza e capacità di alerting.
- Automazione del deployment: Cerco supporto per pipeline CI/CD con opzioni di rollout canary o A/B, poiché aggiornare un modello in sicurezza richiede più di un deploy manuale.
Una volta che ho una lista di strumenti che soddisfano questi criteri, considero cosa distingue ogni piattaforma.
Fattori differenzianti (Cosa distingue i fornitori)
Ecco come confronto i diversi fornitori:
Funzionalità distinguibili
L'inferenza con scale-to-zero è un elemento fortemente distintivo. Alcune piattaforme mantengono gli endpoint sempre attivi, mentre altre scalano automaticamente a zero quando sono inattivi. Questa differenza impatta direttamente la spesa GPU per carichi con traffico imprevedibile. Il supporto a deployment canary e shadow differenzia anch'esso i fornitori. Instradare traffico reale verso una nuova versione del modello prima del passaggio definitivo è il modo più sicuro per intercettare regressioni di accuratezza. Ottimizzazioni a livello GPU come batching dinamico e quantizzazione sono importanti, soprattutto per casi d'uso sensibili alla latenza come la rilevazione frodi in tempo reale.
Oltre le funzionalità
L'integrazione con l'ecosistema MLOps è un elemento chiave che valuto. Uno strumento di deployment che si connette a tracker degli esperimenti come MLflow o Weights & Biases e ad orchestratori come Airflow evita al team di sviluppare codice custom per collegarli. Anche la flessibilità infrastrutturale è importante. Guardo se il fornitore offre opzioni cloud gestite, Kubernetes self-hosted o BYOC, poiché i team soggetti a regolamentazione spesso necessitano che i dati restino nel proprio VPC. Governance e compliance completano il quadro. La certificazione SOC 2 Type II, RBAC e audit logging sono prerequisiti per team che distribuiscono modelli in ambito sanitario o finanziario.
Come scegliere gli strumenti per la distribuzione dei modelli ML
È facile perdersi in lunghi elenchi di funzionalità e strutture tariffarie complesse. Per aiutarti a rimanere concentrato mentre affronti il tuo processo di selezione del software, ecco una lista di fattori da tenere presenti:
| Fattore | Cosa considerare |
|---|---|
| Scalabilità | Lo strumento riuscirà a gestire aumenti improvvisi del traffico di inferenza senza interventi manuali? Verifica il supporto sia per gli scenari di picco sia per quelli a basso volume. |
| Integrazioni | La piattaforma si collega nativamente ai tuoi strumenti di monitoraggio degli esperimenti, agli strumenti CI/CD o agli archivi di dati, oppure dovrai sviluppare e mantenere codice personalizzato? |
| Personalizzazione | Puoi adattare i flussi di lavoro di distribuzione, i controlli di accesso ai modelli e la gestione delle risorse per conformarli alle tue politiche specifiche e alla struttura del tuo team? |
| Facilità d’uso | Quanto è ripida la curva di apprendimento per il tuo team? Considera la complessità dell’interfaccia, la qualità della documentazione e se il processo di inserimento rallenterà altri progetti. |
| Implementazione e inserimento | Quanto tempo di progettazione servirà per passare dalla prova alla produzione? Fai attenzione ai passaggi di configurazione nascosti, ai prerequisiti di rete o alla formazione obbligatoria. |
| Costo | I modelli di prezzo sono trasparenti e prevedibili con l’aumento dell’utilizzo? Confronta i metodi di fatturazione — per inferenza, per ora di calcolo o per endpoint — in base ai tuoi carichi di lavoro. |
| Misure di sicurezza | Quali meccanismi di crittografia, controllo degli accessi e verifica sono disponibili? Valuta se l’offerta soddisfa i tuoi standard di sicurezza interni e le esigenze dei clienti. |
| Requisiti di conformità | Avrai bisogno di HIPAA, GDPR o SOC 2 di tipo II? Verifica che il fornitore offra le attestazioni richieste e supporti le necessarie tracce di verifica per il tuo settore. |
Cosa sono gli strumenti per la distribuzione dei modelli ML?
Gli strumenti per la distribuzione dei modelli ML sono piattaforme che aiutano a rendere operativi i modelli di machine learning addestrati, mettendoli a disposizione tramite API o endpoint per l'elaborazione in batch per l'utilizzo nel mondo reale. Questi strumenti gestiscono attività come la pubblicazione dei modelli, la scalabilità, il monitoraggio e il controllo delle versioni, consentendo di fornire previsioni accurate e mantenere l'affidabilità man mano che i carichi di lavoro evolvono.
Funzionalità
Quando scegli gli strumenti per la distribuzione dei modelli ML, presta attenzione alle seguenti funzionalità chiave:
- Supporto per più framework: distribuisci modelli creati con TensorFlow, PyTorch, scikit-learn, XGBoost e ONNX senza dover rielaborare il codice del modello o eseguire passaggi di conversione.
- Inferenza con scalabilità automatica: assegna automaticamente risorse di calcolo in base ai modelli di traffico, gestendo picchi improvvisi o periodi di bassa attività per mantenere sia le prestazioni sia l'efficienza dei costi.
- Controllo delle versioni dei modelli: tiene traccia delle diverse versioni dei modelli, facilitando il ripristino, il confronto o la promozione dei modelli nelle pipeline di produzione con interruzioni minime.
- Distribuzioni canary e shadow: consente implementazioni graduali o il mirroring del traffico in tempo reale, così puoi convalidare in sicurezza i nuovi modelli rispetto ai dati del mondo reale prima della distribuzione completa.
- Pubblicazione in batch e in tempo reale: supporta sia i casi d'uso delle API in tempo reale sia l'elaborazione asincrona in batch, offrendo flessibilità tra le applicazioni aziendali o i flussi di lavoro della data science.
- Gestione delle risorse: consente di allocare e monitorare l'utilizzo di CPU, GPU e memoria per ogni modello, aiutando a ottimizzare i costi e a mantenere l'integrità del servizio in produzione.
- Misure di sicurezza: include il controllo degli accessi, la crittografia e l'isolamento della rete per proteggere gli artefatti dei modelli e i dati sensibili di inferenza.
- Supporto all'integrazione: si connette in modo nativo o tramite API agli strumenti MLOps, alle pipeline CI/CD e all'infrastruttura dei dati per semplificare la distribuzione e il monitoraggio continui.
- Registrazione e monitoraggio: offre visibilità sui registri delle richieste, sulle metriche di latenza e sui tassi di errore per una risoluzione proattiva dei problemi e un'affidabilità operativa.
- Conformità e verificabilità: offre funzionalità come i registri di audit e il supporto alla conformità normativa, aiutandoti a soddisfare i requisiti di settore in ambito sanitario, finanziario o in altri settori regolamentati.
Funzionalità comuni dell'IA
Oltre alle funzionalità standard degli strumenti per la distribuzione dei modelli ML elencate sopra, molte di queste soluzioni stanno integrando l'IA con funzionalità come:
- Rilevamento automatizzato del drift: utilizza l'IA per monitorare i dati in ingresso e le previsioni alla ricerca di cambiamenti nella distribuzione, avvisando i team quando sono necessari un nuovo addestramento o un'indagine per mantenere la precisione del modello.
- Allocazione intelligente delle risorse: applica algoritmi di IA per prevedere i modelli di carico di lavoro e allocare dinamicamente le risorse di calcolo, riducendo i costi e minimizzando la latenza senza regolazioni manuali.
- Distribuzioni autoriparanti: sfrutta l'IA per rilevare endpoint dei modelli non riusciti o degradati e reindirizzare automaticamente il traffico o attivare una nuova distribuzione, riducendo al minimo i tempi di inattività e l'intervento manuale.
- Scalabilità predittiva: utilizza l'IA per prevedere picchi o cali di traffico sulla base dell'utilizzo storico, aumentando proattivamente la capacità dell'infrastruttura per garantire prestazioni costanti e il controllo dei costi.
- Rilevamento delle anomalie nell'inferenza: impiega l'IA per segnalare in tempo reale richieste di previsione insolite o sospette, aiutando i team a identificare potenziali problemi di qualità dei dati o minacce alla sicurezza.
- Analisi automatizzata delle cause principali: utilizza l'IA per analizzare registri e metriche, individuando la fonte dei cali di prestazioni o degli errori affinché i team possano risolvere i problemi più rapidamente e con meno tentativi.
Vantaggi
L'implementazione di strumenti per la distribuzione dei modelli ML offre diversi vantaggi al tuo team e alla tua azienda. Eccone alcuni che puoi aspettarti:
- Cicli di distribuzione accelerati: la creazione automatizzata dei pacchetti, il controllo delle versioni e l'integrazione con le pipeline CI/CD consentono ai team di trasferire rapidamente i modelli dallo sviluppo alla produzione.
- Scalabilità costante: la scalabilità automatica e la gestione dinamica delle risorse garantiscono che le distribuzioni rimangano stabili e reattive al variare della domanda.
- Postura di sicurezza più solida: i controlli di accesso integrati, la crittografia e la registrazione degli audit contribuiscono a proteggere modelli e dati sensibili in linea con i requisiti organizzativi e normativi.
- Riduzione del carico operativo: il monitoraggio, gli avvisi e la registrazione centralizzati riducono al minimo la risoluzione manuale dei problemi e liberano risorse ingegneristiche per attività di maggior valore.
- Governance affidabile dei modelli: la gestione delle versioni e la registrazione delle distribuzioni facilitano il monitoraggio dei modelli, il ripristino delle modifiche e la dimostrazione della conformità durante gli audit.
- Integrazione flessibile dei flussi di lavoro: il supporto per più framework, strategie di distribuzione e configurazioni degli ambienti consente ai team di adeguare le funzionalità degli strumenti alle proprie esigenze aziendali.
- Maggiore preparazione alla conformità: le tracce di audit complete e le funzionalità di conformità semplificano il rispetto dei requisiti HIPAA, GDPR o specifici del settore, riducendo i rischi per le aziende regolamentate.
Costi e prezzi
La scelta degli strumenti di distribuzione dei modelli ML richiede la comprensione dei vari modelli di prezzo e dei piani disponibili. I costi variano in base alle funzionalità, alle dimensioni del team, ai componenti aggiuntivi e ad altri fattori. La tabella seguente riassume i piani comuni, i relativi prezzi medi e le funzionalità generalmente incluse nelle soluzioni di strumenti di distribuzione dei modelli ML:
Tabella comparativa dei piani
| Tipo di piano | Prezzo medio | Funzionalità comuni |
|---|---|---|
| Piano gratuito | $0 | Distribuzioni limitate, monitoraggio di base, accesso per un singolo utente e supporto della community. |
| Piano personale | $10-$30/utente/mese | Utilizzo individuale, controllo standard delle versioni dei modelli, allocazione moderata delle risorse e supporto via e-mail. |
| Piano aziendale | $40-$100/utente/mese | Collaborazione tra team, scalabilità automatica, supporto all'integrazione, sicurezza avanzata e controlli degli accessi basati sui ruoli. |
| Piano aziendale | $150-$500+/utente/mese | Conformità avanzata, supporto premium, infrastruttura dedicata, SLA personalizzati e strumenti estesi per audit e sicurezza. |
Domande frequenti sugli strumenti di distribuzione dei modelli ML
Ecco alcune risposte alle domande comuni sugli strumenti di distribuzione dei modelli ML:
In che modo gli strumenti di distribuzione dei modelli ML differiscono dai tradizionali strumenti di distribuzione delle applicazioni?
Gli strumenti di distribuzione dei modelli ML sono progettati per gestire le sfide specifiche legate alla pubblicazione, al monitoraggio e all’aggiornamento dei modelli di apprendimento automatico, come la gestione delle versioni dei modelli, il monitoraggio dei registri delle inferenze, il supporto della scalabilità automatica per il traffico dei modelli e l’integrazione con le pipeline di dati. I tradizionali strumenti di distribuzione delle applicazioni generalmente non gestiscono questo tipo di requisiti.
È possibile distribuire modelli creati con framework diversi utilizzando lo stesso strumento di distribuzione?
Sì, la maggior parte degli strumenti di distribuzione dei modelli ML offre compatibilità con più framework, consentendo di distribuire modelli provenienti da TensorFlow, PyTorch, XGBoost e altri senza conversioni o riscritture manuali. Questo facilita il lavoro dei team con tecnologie diverse e la standardizzazione dei processi di produzione.
Quali funzionalità di sicurezza è opportuno cercare in questi strumenti?
È opportuno cercare funzionalità come controlli degli accessi, endpoint crittografati, tracce di audit e isolamento della rete. Queste funzionalità contribuiscono a garantire che solo gli utenti autorizzati possano distribuire o aggiornare i modelli e mantengono al sicuro le risorse dei modelli e i dati delle predizioni.
Questi strumenti supportano sia l'inferenza in tempo reale sia quella in batch?
Sì, i principali strumenti di distribuzione dei modelli ML supportano sia la pubblicazione di predizioni in tempo reale basata su API sia le modalità di elaborazione in batch. Questo offre al team la flessibilità necessaria per gestire diversi casi d’uso, dalle applicazioni rivolte agli utenti ai processi di valutazione offline su larga scala.
In che modo questi strumenti aiutano a monitorare e mantenere i modelli?
Forniscono pannelli di monitoraggio integrati, avvisi, registrazione e rilevamento automatizzato delle derive. Queste funzionalità consentono di individuare tempestivamente il peggioramento delle prestazioni, i problemi relativi ai dati o gli errori operativi, spesso prima che influiscano sugli utenti finali o sui risultati aziendali.