

Databricks e Cloudera: confronto e recensioni per il 2026
La scelta tra Databricks e Cloudera dipende da come il tuo team gestisce i dati tra ambienti cloud e ibridi. Confronto i loro punti di forza, i compromessi e i casi d'uso più adatti.

Recensiamo gli strumenti in modo indipendente e le commissioni ci aiutano a finanziare i nostri test. Consulta la nostra politica sulla trasparenza, la nostra metodologia, oppure suggerisci uno strumento.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
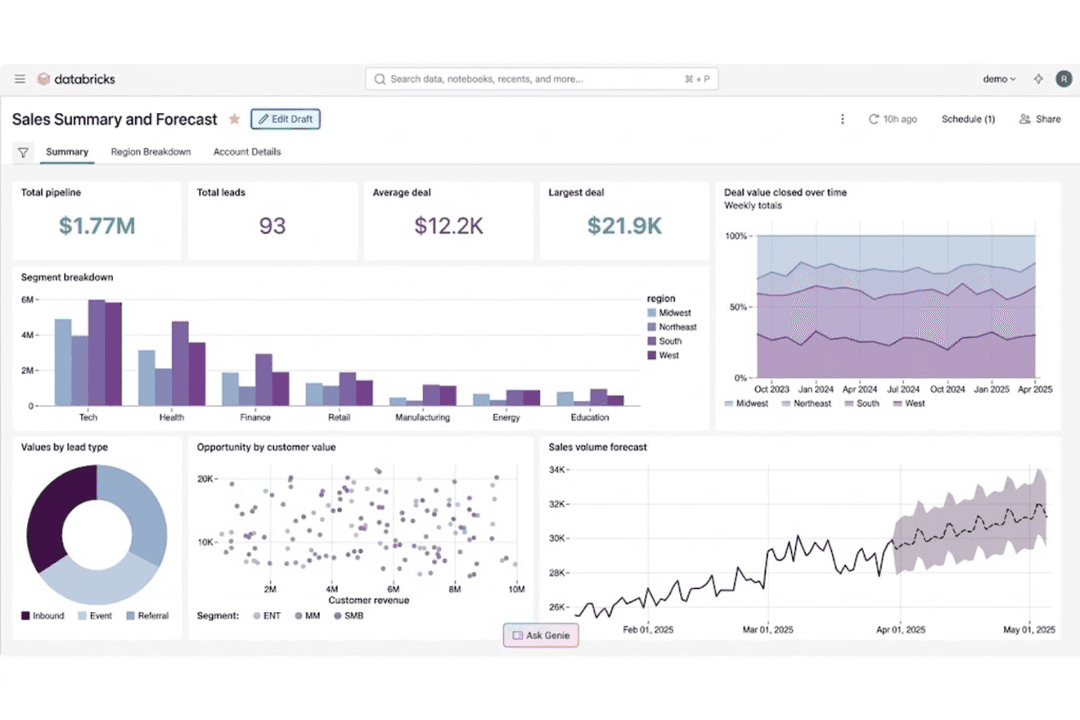
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Perché fidarsi dei nostri consigli sui software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Il nostro team testa e recensisce software dal 2012. In quanto leader tecnologici noi stessi, sappiamo quanto sia difficile — e importante — scegliere il software giusto.
Per questa guida, abbiamo valutato gli strumenti attraverso test praticie ricerche indipendenti, assegnando un punteggio agli strumenti in base ai nostri criteri di selezione.
Le nostre recensioni riflettono il nostro giudizio editoriale umano, non un discorso di vendita.
Revisori esperti:
- Paulo Gardini MiguelDirettore tecnico
 Tim FisherVP dell'IA
 Gabriel RosasTech Lead e architetto software
 Christhian GruhnTech Lead e architetto della piattaforma

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Prezzi e costi nascosti di Databricks e Cloudera
Databricks applica prezzi basati sul consumo per l'ingegneria dei dati, il data warehousing, l'intelligenza artificiale e altri carichi di lavoro, con costi determinati dall'utilizzo delle risorse di calcolo, oltre che dall'infrastruttura cloud, dall'archiviazione, dalla rete e dal supporto. Cloudera adotta un approccio ibrido: i suoi servizi cloud vengono fatturati in base al consumo tramite le Cloudera Compute Units (CCU), mentre le implementazioni on-premise utilizzano abbonamenti annuali. In entrambi i casi, l'infrastruttura e la rete possono aumentare il costo totale oltre alle tariffe della piattaforma principale.
Nel confrontare le due soluzioni, è utile andare oltre i prezzi pubblicizzati e stabilire dove verranno eseguiti i carichi di lavoro e con quale frequenza verranno eseguite pipeline, processi di streaming e trasformazioni. Con Databricks, un utilizzo inefficiente o prolungato delle risorse di calcolo e il trasferimento dei dati possono aumentare la spesa. Cloudera, invece, può aggiungere costi per infrastruttura, rete, Private Link, osservabilità e servizi come Data Flow o Lakehouse Optimizer. Considerare il modello di implementazione, il volume dei carichi di lavoro, il supporto e le esigenze di scalabilità offre una visione più realistica dei costi a lungo termine.
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Integrazione | Databricks | Cloudera |
|---|---|---|
| IntegrazioneMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntegrazioneAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntegrazioneGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntegrazioneTableau | Databricks✅ | Cloudera✅ |
| IntegrazioneInformatica | Databricks✅ | Cloudera✅ |
| IntegrazioneSalesforce | Databricks✅ | Cloudera✅ |
| IntegrazioneQlik | Databricks✅ | Cloudera✅ |
| IntegrazioneOracle Database | Databricks✅ | Cloudera✅ |
| IntegrazioneMongoDB | Databricks✅ | Cloudera✅ |
| IntegrazioneAPI | Databricks✅ | Cloudera✅ |
| IntegrazioneZapier | Databricks✅ | Cloudera❌ |
Sia Databricks sia Cloudera supportano ampi ecosistemi di piattaforme cloud, database, strumenti di business intelligence, API e servizi dati. Databricks integra queste connessioni in Lakeflow, Partner Connect e nei suoi flussi di lavoro gestiti per l'ingegneria dei dati, mentre Cloudera pone l'accento sulla connettività tra ambienti cloud, on-premise e ibridi.
| Fattore | Databricks | Cloudera |
|---|---|---|
| FattoreCrittografia | DatabricksCrittografa i dati inattivi e in transito, supportando chiavi gestite dal cliente, la gestione delle chiavi nativa del cloud e una protezione granulare per i dati e gli asset di IA sottoposti a governance. | ClouderaSupporta la crittografia dei dati inattivi e in transito, la gestione delle chiavi e i controlli di sicurezza negli ambienti cloud e in sede. |
| FattoreControlli degli accessi | DatabricksUnity Catalog centralizza le policy di accesso granulari per dati, modelli, applicazioni e asset di IA, con SSO, integrazioni con le identità, controlli a livello di riga e di colonna e associazioni agli spazi di lavoro. | ClouderaUtilizza Apache Ranger, Knox e integrazioni con le identità per gestire autenticazione, autorizzazione, SSO e accesso granulare negli ambienti ibridi. |
| FattoreConformità normativa | DatabricksDispone delle certificazioni SOC 1 Type II, SOC 2 Type II, ISO 27001, ISO 27017 e ISO 27018, con supporto alla conformità per HIPAA, PCI DSS, HITRUST e FedRAMP Moderate e High, a seconda del cloud, della regione e della configurazione. | ClouderaMantiene certificazioni e programmi tra cui SOC 2 Type II, ISO 27001, PCI DSS e FedRAMP Moderate per gli ambienti Cloudera idonei. |
| FattoreAffidabilità | DatabricksSupporta il ridimensionamento automatico, il calcolo serverless e gestito, l'isolamento dei carichi di lavoro e la disponibilità nativa del cloud su AWS, Azure e Google Cloud, con strategie di ripristino configurate in base ai requisiti dei carichi di lavoro. | ClouderaSupporta implementazioni multi-zona, infrastrutture ridondanti, commutazione automatica e ripristino di emergenza nelle implementazioni cloud e ibride. |
| FattoreGovernance dei dati | DatabricksUnity Catalog offre audit, individuazione, classificazione e tracciabilità automatizzati centralizzati, dai dati di origine fino a notebook, processi, modelli, servizi e pannelli di controllo. | ClouderaSDX combina Apache Ranger e Atlas per applicare policy, audit, gestione dei metadati, classificazione e tracciabilità ai dati cloud e in sede. |
Entrambe le piattaforme offrono sicurezza e governance di livello aziendale, ma l'enfasi è diversa. Databricks riunisce controllo degli accessi, audit, classificazione e tracciabilità tramite Unity Catalog per i carichi di lavoro di dati e IA, mentre Cloudera estende la governance centralizzata agli ambienti ibridi e in sede tramite SDX, Ranger e Atlas.
| Fattore | Databricks | Cloudera |
|---|---|---|
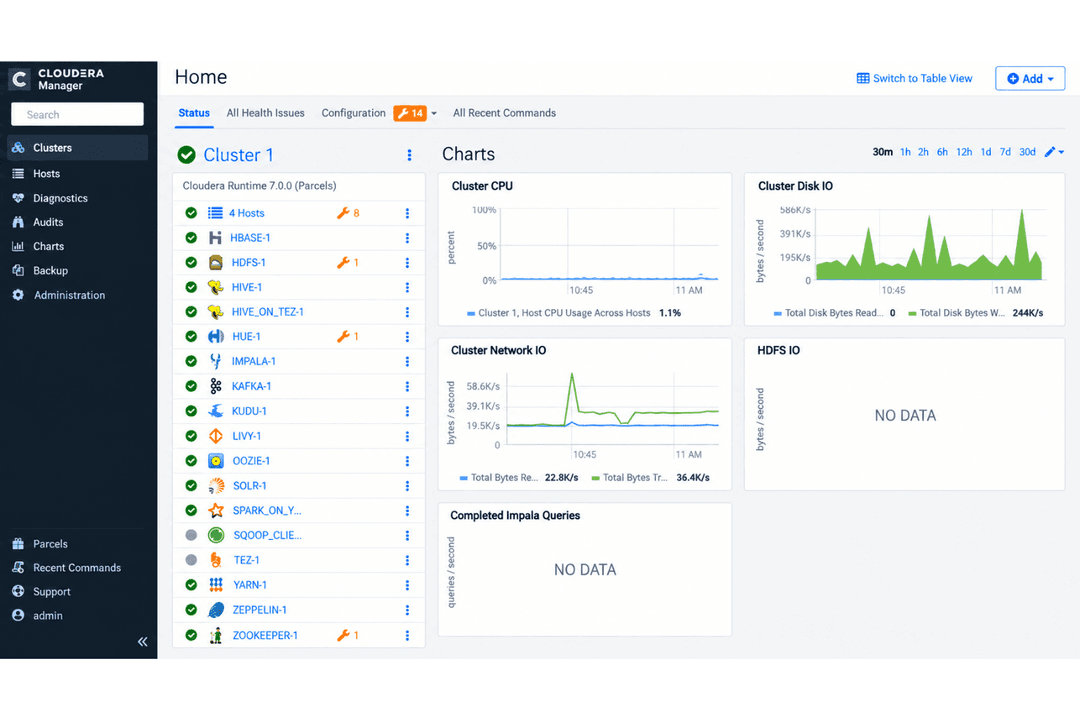
| FattoreInterfaccia utente | DatabricksCombina notebook collaborativi, strumenti SQL, pannelli di controllo e flussi di lavoro visivi in un unico spazio di lavoro per i team di ingegneria, analisi e IA. | ClouderaUtilizza console amministrative e interfacce specifiche per servizio per gestire dati e infrastrutture ibride. |
| FattoreProcesso di configurazione | DatabricksGli spazi di lavoro cloud possono essere predisposti rapidamente, mentre il calcolo serverless e gestito riduce la configurazione dell'infrastruttura per i carichi di lavoro comuni. | ClouderaLa configurazione dipende dal modello di implementazione, con ulteriori impostazioni per gli ambienti ibridi e in sede. |
| FattoreOnboarding | DatabricksOffre configurazione guidata, notebook di esempio, formazione e servizi gestiti che aiutano i team a passare dalla sperimentazione iniziale ai flussi di lavoro di produzione sottoposti a governance. | ClouderaRichiede familiarità con il suo ecosistema più ampio, soprattutto quando i team lavorano con tecnologie come NiFi, Spark, Ranger e infrastrutture ibride. |
| FattoreDocumentazione | DatabricksOffre un'ampia documentazione, tutorial, indicazioni per l'implementazione e formazione nell'ambito dell'ingegneria dei dati, della governance, dell'analisi e dell'IA. | ClouderaFornisce documentazione tecnica per cloud, ambienti in sede, sicurezza e amministrazione della piattaforma. |
| FattoreAccesso al supporto | DatabricksOffre risorse pubbliche e supporto a pagamento a livelli, con contatti tecnici, percorsi di escalation e copertura per gli incidenti critici nelle implementazioni aziendali. | ClouderaInclude supporto aziendale e risorse tecniche per le offerte cloud e in sede. |
Dal punto di vista della facilità d'uso, Databricks combina un ambiente di sviluppo tecnico con servizi gestiti che riducono il lavoro sull'infrastruttura per pipeline, analisi e IA. Cloudera supporta ambienti cloud, in sede e ibridi, comportando ulteriori considerazioni relative all'implementazione. Per i team di dati orientati al cloud, Databricks offre un flusso di lavoro coerente dallo sviluppo alla produzione, mentre Cloudera è adatto alle organizzazioni che devono operare su infrastrutture miste.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
Chi dovrebbe usare Databricks e chi dovrebbe usare Cloudera?
Se cerchi una piattaforma DataOps che riunisca ingegneria dei dati, analisi, governance e IA nello stesso ambiente orientato al cloud, Databricks è probabilmente la scelta più adatta. È particolarmente utile per i team che desiderano pipeline gestite, notebook collaborativi, supporto per lo streaming e governance centralizzata senza dover gestire manualmente una parte così ampia dell'infrastruttura.
Se, invece, hai bisogno di eseguire flussi di lavoro sui dati in ambienti cloud, locali e ibridi, Cloudera potrebbe adattarsi meglio alla tua infrastruttura. È una scelta solida per le aziende con rigorosi requisiti di conformità o di localizzazione dei dati, ecosistemi consolidati a codice aperto e team che gestiscono piattaforme di dati distribuite in più ambienti.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |