

10 meilleurs outils de déploiement de modèles d’apprentissage automatique en 2026
Sélection des meilleurs outils de déploiement de modèles de ML


Les outils de déploiement de modèles de ML vous permettent de prendre des modèles d’apprentissage automatique entraînés et de les transformer en services prêts pour la production que vous pouvez réellement utiliser. Si vous cherchez des moyens de lancer, surveiller et gérer de manière fiable vos applications basées sur l’IA, il est essentiel de choisir la bonne plateforme de déploiement. La sécurité, la mise à l’échelle, l’automatisation et la transparence peuvent faire ou défaire votre flux de travail.
Dans cette liste, je vais détailler les outils de déploiement de ML auxquels je fais le plus confiance et vous montrer exactement où chacun s’intègre dans votre pile technologique, afin que vous puissiez choisir la plateforme qui correspond aux besoins de votre projet et aux attentes de votre équipe.
Pourquoi faire confiance à nos avis logiciels
Nous testons et analysons des logiciels depuis 2023. En tant que dirigeants technologiques, nous savons à quel point il est crucial et difficile de faire le bon choix lors de la sélection d’un logiciel.
Nous investissons dans des recherches approfondies pour aider notre audience à prendre de meilleures décisions d’achat de logiciels. Nous avons testé plus de 2 000 outils pour différents usages technologiques et rédigé plus de 1 000 avis complets. Découvrez comment nous restons transparents & notre méthodologie d’évaluation des logiciels.
Résumé des meilleurs outils de déploiement de modèles de ML
Ce tableau comparatif récapitule les informations tarifaires de ma sélection des meilleurs outils de déploiement de modèles de ML afin de vous aider à trouver celui qui convient le mieux à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour l’orchestration de modèles native Kubernetes | Forfait gratuit disponible | Utilisation gratuite | Website | |
| 2 | Idéal pour les API d’inférence standardisées sur Kubernetes | Formule gratuite disponible | Utilisation gratuite | Website | |
| 3 | Idéal pour emballer des modèles en tant qu’APIs de production | Plan gratuit + démo gratuite disponible | Tarification sur demande | Website | |
| 4 | Idéal pour l'hébergement de modèles transformer à grande échelle | Plan gratuit + démo gratuite disponible | À partir de $9/mois | Website | |
| 5 | Idéal pour le déploiement de fonctions Python serverless | Plan gratuit disponible | À partir de $250 + calcul/mois | Website | |
| 6 | Idéal pour une gestion automatisée de bout en bout des modèles | Version gratuite disponible | À partir de $0.204/heure | Website | |
| 7 | Idéal pour les flux de travail unifiés liés aux données et à l’IA | Formule gratuite disponible | À partir de $0.085/heure | Website | |
| 8 | Idéal pour créer des interfaces web personnalisées pour les modèles | Offre gratuite disponible | Tarification sur demande | Website | |
| 9 | Idéal pour le service distribué avec Python et Ray | Crédit gratuit de 100 $ disponible | Tarification sur demande | Website | |
| 10 | Idéal pour la gestion des modèles dans les secteurs réglementés | Not available | Tarification sur demande | Website |
Avis sur les meilleurs outils de déploiement de modèles de ML
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils de déploiement de modèles de ML qui ont intégré ma sélection. Mes avis offrent un examen approfondi des fonctionnalités, des intégrations et des meilleurs cas d’utilisation de chaque plateforme afin de vous aider à trouver celle qui vous convient le mieux.
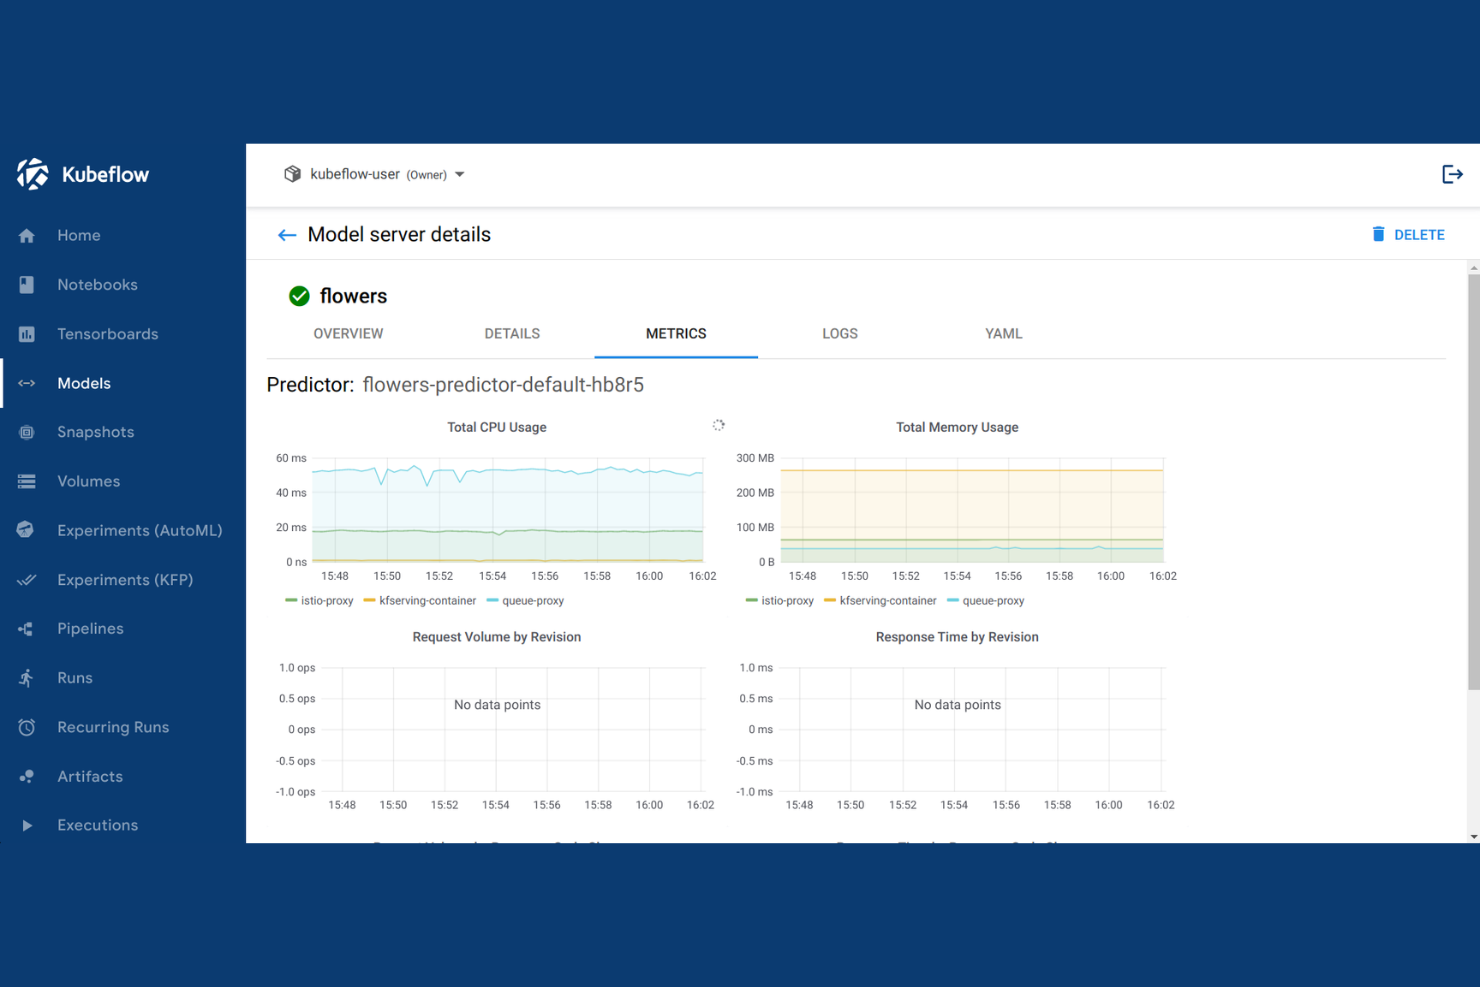
Kubeflow est une plateforme d’apprentissage automatique à code source ouvert conçue sur Kubernetes, qui couvre l’orchestration des pipelines, l’entraînement des modèles, l’optimisation des hyperparamètres et la mise à disposition de modèles prenant en charge plusieurs cadres sur des infrastructures infonuagiques et sur site.
À qui Kubeflow convient-il le mieux ?
Kubeflow convient particulièrement aux équipes d’ingénierie ML qui utilisent déjà Kubernetes et qui doivent gérer des tâches d’entraînement à grande échelle ainsi que la mise à disposition de modèles en production sur leur propre infrastructure.
Pourquoi j’ai choisi Kubeflow
J’ai choisi Kubeflow comme l’un des meilleurs outils parce qu’il est spécialement conçu autour de Kubernetes, ce qui signifie que chaque composant s’exécute comme une charge de travail Kubernetes native. J’apprécie le fait que Kubeflow Pipelines me permette de définir des workflows ML de bout en bout sous forme de graphes orientés acycliques conteneurisés, afin que chaque étape puisse évoluer indépendamment. Kubeflow Trainer gère l’entraînement distribué avec PyTorch, JAX et DeepSpeed sans nécessiter de configuration personnalisée du cluster. Je peux également utiliser Katib pour exécuter des explorations automatisées des hyperparamètres directement sur des tâches d’entraînement en cours d’exécution dans le même cluster.
Principales fonctionnalités de Kubeflow
- KServe : Déployez des modèles entraînés sous forme de services d’inférence évolutifs sur Kubernetes à l’aide d’environnements d’exécution de mise à disposition préconfigurés pour TensorFlow, PyTorch et scikit-learn.
- Registre de modèles : Stockez, versionnez et suivez les modèles enregistrés entre les différentes exécutions d’entraînement avant de les promouvoir vers des environnements de mise à disposition.
- Serveurs de carnets : Lancez des instances de carnets Jupyter directement sur le cluster avec des allocations configurables de processeur, de GPU et de mémoire.
- Isolation des utilisateurs : Gérez des espaces de noms et des contrôles d’accès distincts pour différentes équipes ou différents projets au sein d’un cluster partagé.
Intégrations de Kubeflow
Kubeflow ne propose pas d’intégrations natives traditionnelles ; il fonctionne plutôt au sein de l’écosystème Kubernetes et prend en charge des cadres ML tels que TensorFlow, PyTorch, JAX, XGBoost, HuggingFace et Apache Spark grâce aux opérateurs de ses sous-projets. Vous pouvez également le déployer sur des services Kubernetes gérés proposés par AWS, Google Cloud, Microsoft Azure et Red Hat OpenShift.
Pros and Cons
Pros:
- Déploiement possible chez tous les principaux fournisseurs cloud Kubernetes
- Chaque étape du pipeline s’exécute dans un conteneur isolé
- Excellents résultats en matière d’entraînement distribué et d’orchestration
Cons:
- La configuration initiale complexe requiert une expertise de Kubernetes
- Nécessite une équipe dédiée à la plateforme pour assurer la maintenance

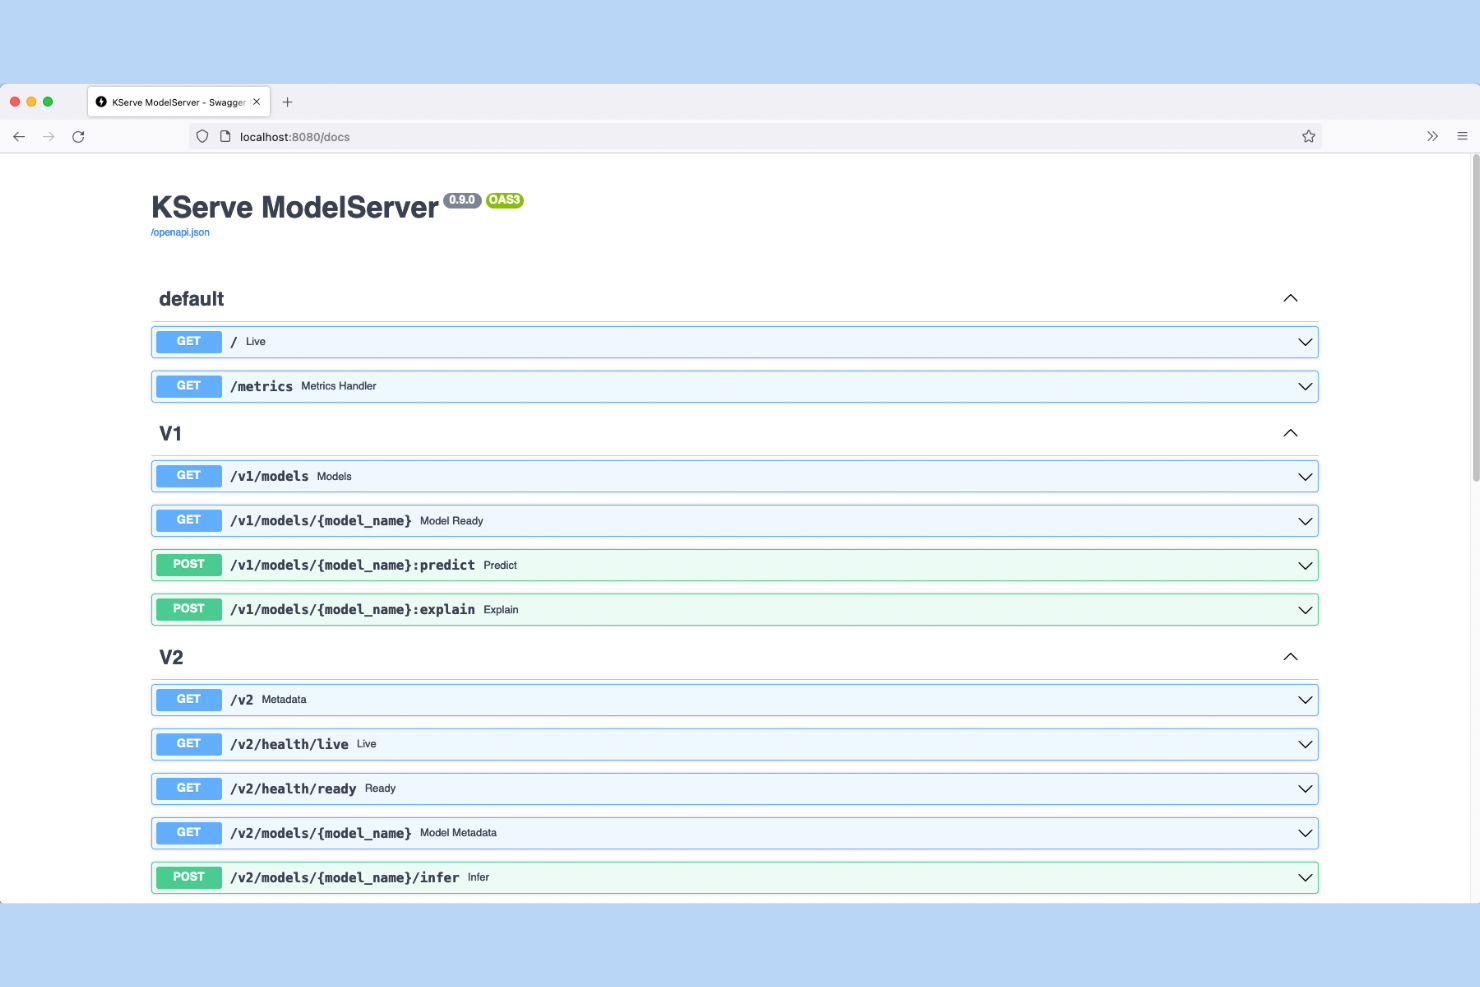
KServe est une plateforme open source d’inférence de modèles, native de Kubernetes, qui prend en charge le service de modèles multicadres, les déploiements en canari, la mise à l’échelle automatique et l’explicabilité des modèles grâce à une couche d’API d’inférence standardisée.
À qui KServe convient-il le mieux ?
KServe convient particulièrement aux équipes d’ingénierie ML des moyennes et grandes organisations qui exécutent le service de modèles à grande échelle sur Kubernetes et ont besoin d’une couche d’inférence indépendante des cadres logiciels.
Pourquoi j’ai choisi KServe
J’ai choisi KServe comme l’une des meilleures solutions, car elle repose sur le protocole d’inférence ouvert (V2), une spécification d’API standardisée qui permet à mon équipe de remplacer les moteurs de service, tels que Triton ou vLLM, sans réécrire le code client. Je m’appuie également sur sa CRD InferenceService pour définir déclarativement les déploiements en canari et acheminer un pourcentage du trafic réel vers une nouvelle version du modèle avant sa mise en production complète. Les points de terminaison d’inférence REST et gRPC sont tous deux pris en charge, je ne suis donc pas limité à une seule couche de transport.
Principales fonctionnalités de KServe
- Mise à l’échelle automatique jusqu’à zéro : la mise à l’échelle automatique optimisée par Knative arrête les pods d’inférence jusqu’à zéro lorsqu’ils sont inactifs, puis les redémarre à la demande.
- Transformateurs de requêtes/réponses : la logique de prétraitement et de post-traitement s’exécute dans un conteneur de transformation distinct aux côtés du serveur de modèles.
- Déploiements en canari : le trafic est progressivement redirigé vers une nouvelle version du modèle, ce qui permet de tester les changements en production sans exposition complète.
- Journalisation des charges utiles : les requêtes et réponses d’inférence sont enregistrées dans des destinations configurables afin d’assurer des pistes d’audit et la surveillance des modèles.
Intégrations de KServe
KServe intègre nativement Knative, Istio et l’API Kubernetes Gateway pour la mise à l’échelle sans serveur et le routage des entrées. Il est fourni avec des environnements d’exécution intégrés pour vLLM, llm-d, NVIDIA Triton Inference Server, Seldon MLServer, TorchServe et Hugging Face, et prend en charge le stockage des modèles sur Amazon S3, Google Cloud Storage et Azure Blob Storage. Un SDK Python de service ainsi que des API d’inférence REST/gRPC sont disponibles pour les intégrations personnalisées.
Pros and Cons
Pros:
- La mise à l’échelle automatique jusqu’à zéro réduit les coûts des GPU inactifs
- Service indépendant des cadres logiciels grâce à un protocole d’inférence standardisé
- Déploiements en canari intégrés pour des mises à jour sécurisées
Cons:
- Nécessite une expertise des clusters Kubernetes pour son exploitation
- Le mode sans serveur limite la personnalisation des montages de volumes


Construit autour du concept d'un artefact 'Bento', BentoML est un framework Python natif pour le déploiement de modèles qui gère la définition des services, la conteneurisation et l'emballage multi-framework des modèles pour le déploiement en production.
Pour qui BentoML est-il le plus adapté ?
BentoML convient particulièrement bien aux équipes ML de sociétés en croissance qui doivent passer rapidement d'un modèle entraîné à une API prête pour la production sans plateforme MLOps dédiée.
Pourquoi j'ai choisi BentoML
J'ai inclus BentoML parmi mes favoris car c'est l'un des rares frameworks à traiter l’artefact du modèle et la couche de service comme une seule unité versionnée. J'apprécie le fait que BentoML génère automatiquement des points de terminaison REST et gRPC à partir de la même définition de service, ce qui évite à mon équipe de maintenir des spécifications API séparées. L'abstraction des runners me permet aussi d'isoler chaque modèle dans son propre processus, ce qui signifie qu'une étape de prétraitement sur CPU n’entrera pas en concurrence pour les ressources avec un runner de modèle GPU.
Fonctionnalités clés de BentoML
- Traitement par lots adaptatif : Regroupe automatiquement les requêtes d'inférence simultanées dans un même lot, réduisant la surcharge GPU par requête sans modifications du code.
- Métriques Prometheus intégrées : Expose un point de terminaison /metrics prêt à l'emploi pour surveiller la latence et le débit des requêtes sans instrumentation personnalisée.
- Passerelle LLM : Fournit une interface API unifiée pour plusieurs fournisseurs de LLM, vous permettant de centraliser le routage et la gestion des coûts.
- Construction d’image conteneurisée : Génère une image Docker prête pour la production directement à partir d’un artefact Bento en une seule commande CLI.
Intégrations de BentoML
BentoML propose des intégrations documentées avec des outils de l’écosystème MLOps, dont Airflow, MLflow, Ray, Spark, Arize AI, Flink et Triton Inference Server. Il s’intègre également à Datadog pour la collecte des métriques des services BentoML. Une API est disponible pour des intégrations personnalisées, et la sortie conteneurisée de BentoML fonctionne nativement avec Kubernetes et Docker pour offrir une flexibilité de déploiement.
Pros and Cons
Pros:
- Versionnement et suivi des retours de modèles intégrés
- Génère des conteneurs Docker à partir d’une configuration YAML
- Gère les requêtes concurrentes par le scaling des workers
Cons:
- Les fichiers de configuration peuvent sembler inutilement complexes
- Les loaders personnalisés nécessitent une configuration supplémentaire

Idéal pour l'hébergement de modèles transformer à grande échelle
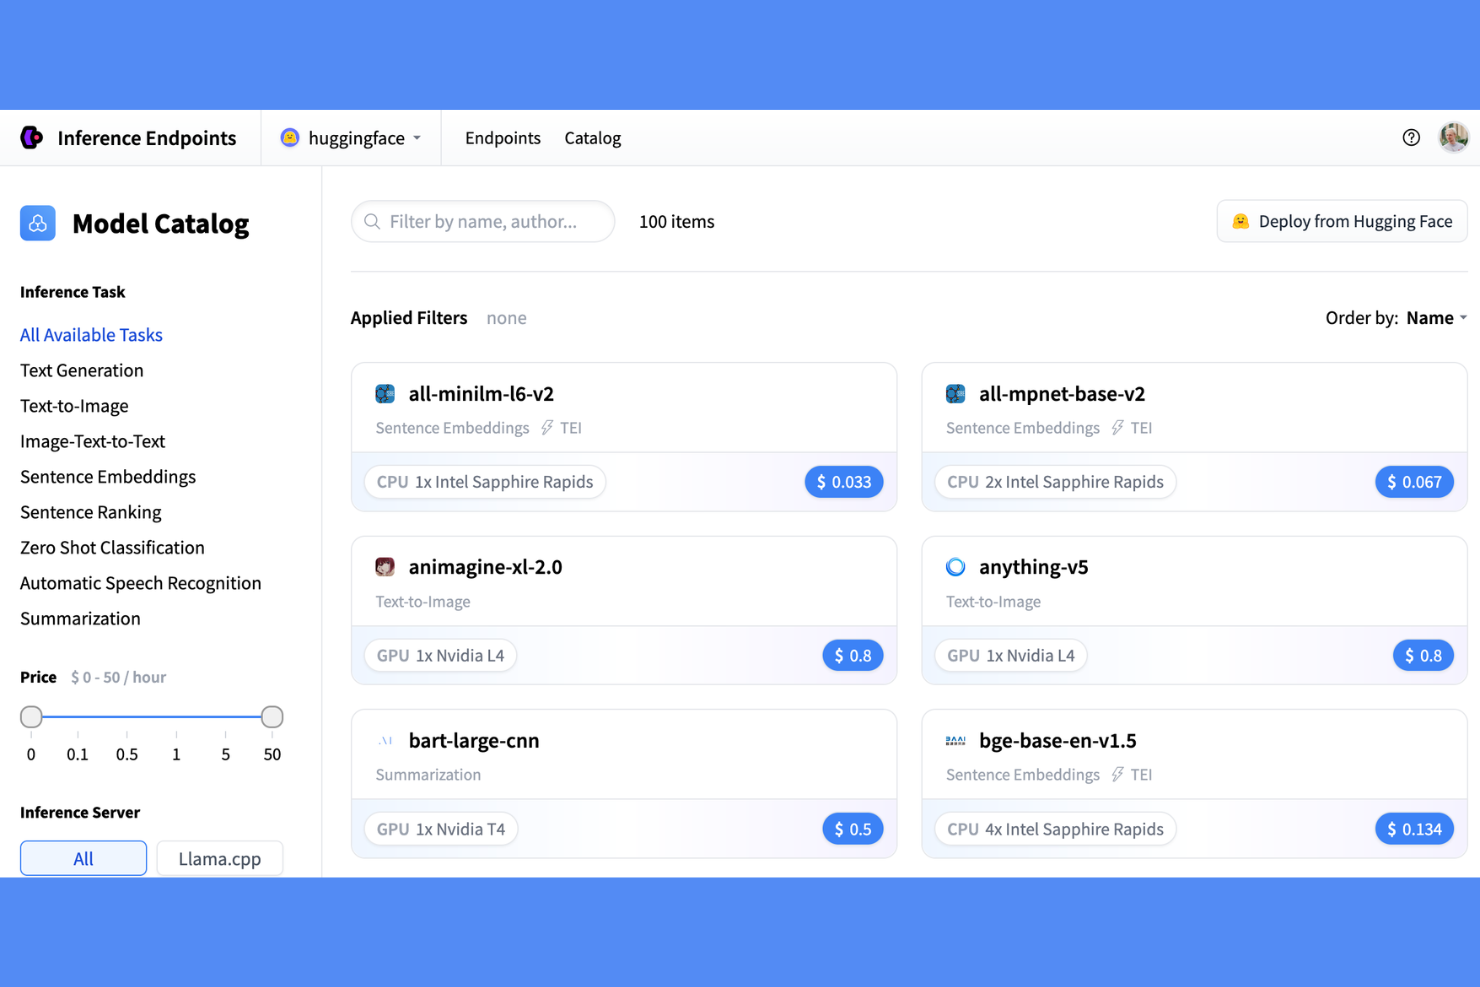
Une plateforme d'inférence gérée construite sur le Hugging Face Hub, Hugging Face Inference Endpoints prend en charge le déploiement cloud dédié, la configuration des points de terminaison et la sélection du matériel pour les modèles ML sur AWS, Azure et Google Cloud.
À qui s'adresse Hugging Face Inference Endpoints ?
Il convient particulièrement aux startups axées sur l'IA et aux entreprises technologiques de taille moyenne qui ont besoin d'une solution d'hébergement de modèles prête pour la production sans avoir à construire et maintenir leur propre infrastructure de service.
Pourquoi j'ai choisi Hugging Face Inference Endpoints
Hugging Face Inference Endpoints mérite sa place dans ma sélection car il est spécialement conçu pour l'écosystème des modèles de type transformer, d'une manière qu'aucune autre plateforme de déploiement ne propose. Mon équipe peut prendre n'importe quel modèle du Hub, y compris les grands LLM et les transformers multimodaux, et le mettre en service à l'échelle de la production avec des règles d'autoscaling configurables qui s'adaptent au trafic réel. J'apprécie également la rapidité de mise en service : un modèle qui nécessiterait des jours pour être conteneurisé et déployé manuellement passe en production en quelques minutes.
Fonctionnalités clés de Hugging Face Inference Endpoints
- Déploiement multi-cloud : Choisissez de déployer votre point de terminaison sur AWS, Azure ou Google Cloud sans gérer de comptes cloud séparés.
- Réseau privé : Isolez vos points de terminaison dans un VPC dédié afin que seuls vos systèmes internes puissent accéder à l'API du modèle.
- Authentification par jeton : Sécurisez chaque point de terminaison avec un jeton d'API afin de contrôler quels services ou utilisateurs peuvent envoyer des requêtes d'inférence.
- Suivi de l'utilisation : Suivez le volume des requêtes, la latence et le taux d'erreur directement depuis le tableau de bord du point de terminaison en temps réel.
Intégrations de Hugging Face Inference Endpoints
Hugging Face Inference Endpoints fonctionne avec un écosystème croissant d'outils de développement, de frameworks et de plateformes, et les outils non explicitement pris en charge sont souvent compatibles grâce à son API compatible OpenAI. Les intégrations documentées incluent AWS Bedrock et SageMaker, Google Gemini Enterprise Agent Platform, et Azure AI Foundry, ainsi que des frameworks LLM comme LangChain, LlamaIndex, Haystack, CrewAI et PydanticAI. Inference Endpoints peut être entièrement géré via API, avec des points de terminaison documentés via Swagger, ce qui permet de créer des intégrations personnalisées. La compatibilité avec Zapier n'est pas clairement documentée.
Pros and Cons
Pros:
- Déploiement en un clic depuis le Hugging Face Hub
- Prise en charge de plusieurs moteurs d'inférence
- Autoscaling avec facturation à l'arrêt complet
Cons:
- Temps de démarrage à froid lors de l'activation depuis zéro
- Les coûts de calcul GPU augmentent rapidement à grande échelle

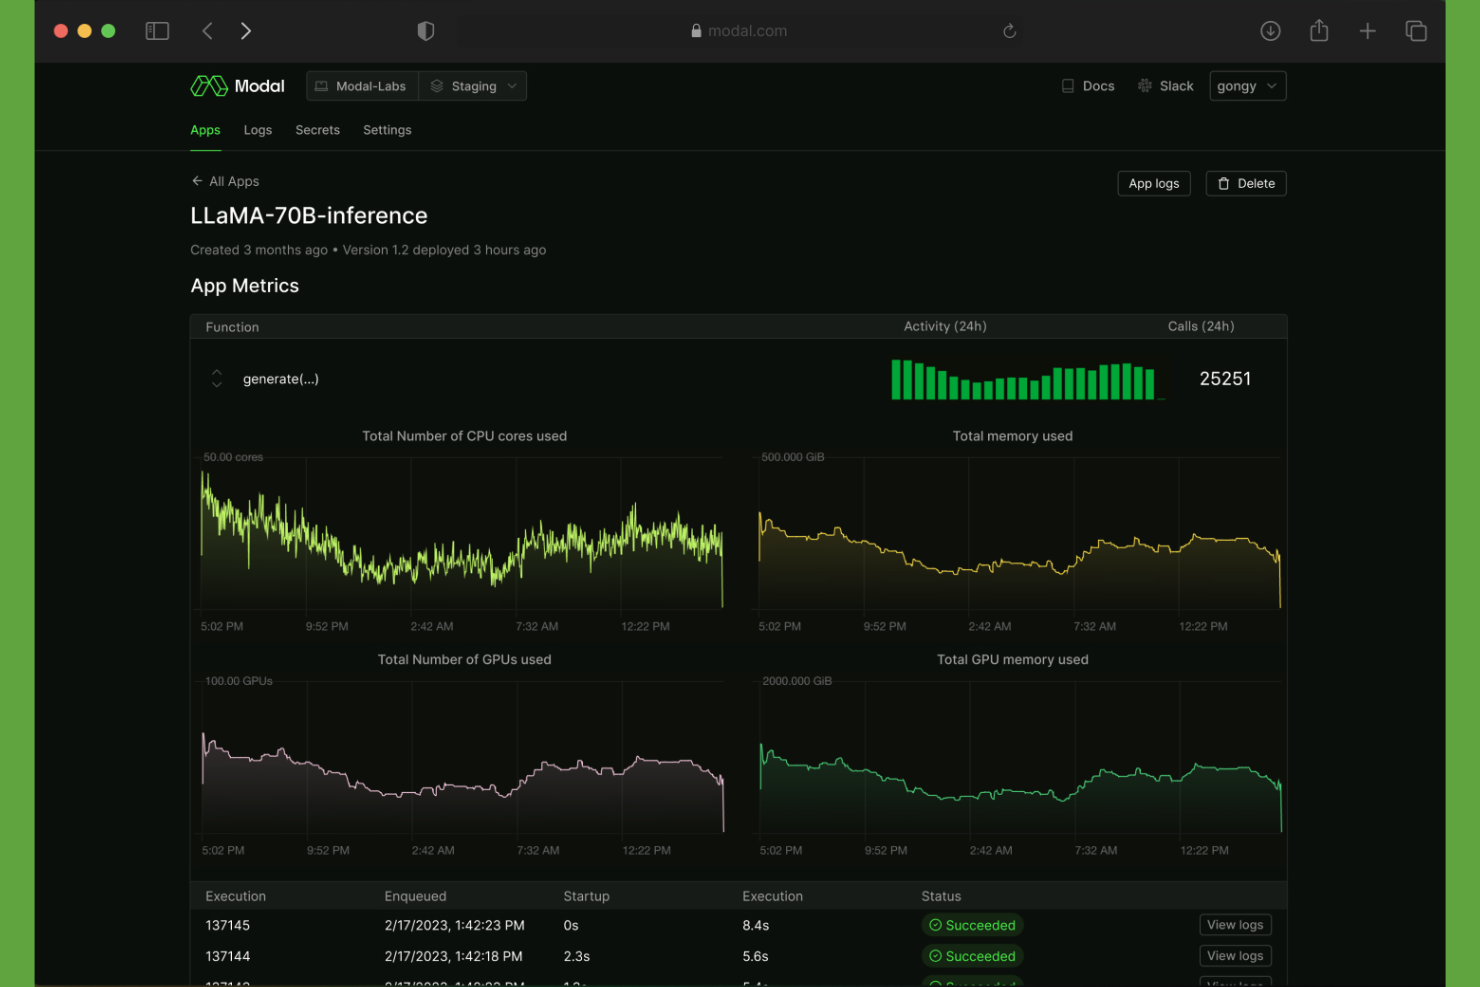
Modal est une plateforme cloud serverless pour exécuter des charges de travail ML basées sur Python, couvrant l'inférence accélérée par GPU, les tâches par lot, les sessions d'entraînement et les tâches planifiées, sans aucune gestion de conteneurs ou d'infrastructures.
À qui s'adresse Modal ?
C'est une solution idéale pour les startups et les équipes en croissance qui doivent déployer rapidement des modèles ML sans recruter d'ingénieurs d'infrastructure dédiés.
Pourquoi j'ai choisi Modal
J'ai inclus Modal dans mes meilleures sélections car il élimine l'écart entre l'écriture du code Python et son exécution à grande échelle sur des GPU. Je peux demander un matériel spécifique, comme un A100 ou un H100, directement dans la définition de ma fonction et Modal le provisionne à la demande. Il n'y a aucun cluster à gérer, ni YAML à rédiger. J'apprécie également que la même fonction s'exécute de façon identique localement et en production, ce qui réduit considérablement le temps de débogage.
Fonctionnalités clés de Modal
- Images de conteneur personnalisées : Définit les dépendances, les variables d'environnement et les paquets systèmes directement dans le code, garantissant des environnements d'exécution cohérents à travers les déploiements.
- Volumes persistants : Monter des volumes cloud pour mettre en cache les poids des modèles entre les exécutions, réduisant ainsi le temps de démarrage à froid lors de déploiements répétés.
- Gestion des secrets : Stocke et injecte de manière sécurisée les clés API et les identifiants d'accès à l'exécution, sans les coder en dur dans la base de code.
- Exécution par lot en parallèle : Utilise .map() pour lancer l'inférence sur de grands ensembles de données en parallèle à travers plusieurs conteneurs simultanément.
Intégrations Modal
Modal propose un petit ensemble d'intégrations documentées axées sur l'observabilité et les notifications, notamment Datadog, tout fournisseur compatible OpenTelemetry, Slack et Okta SSO. Il prend également en charge le montage de buckets cloud pour AWS S3, Google Cloud Storage et Cloudflare R2, ainsi que les flux CI/CD via GitHub Actions. Le support Zapier n'est pas documenté, mais Modal fournit un SDK Python et des endpoints web permettant des intégrations personnalisées.
Pros and Cons
Pros:
- Aucun Dockerfile ou configuration Kubernetes requis
- Gère l'apprentissage, le traitement par lots et l'inférence
- Orchestre les charges de travail entre clouds et régions
Cons:
- Le code basé sur des décorateurs crée une dépendance au fournisseur
- Les fonctionnalités pour entreprises nécessitent un abonnement premium

Amazon SageMaker (également connu sous le nom d’AWS SageMaker) est une plateforme de ML sur AWS qui couvre l’ensemble du cycle de vie des modèles — de l’entraînement et de l’ajustement à leur déploiement, leur surveillance et leur gouvernance — au sein d’un environnement de développement unifié, construit sur une architecture lakehouse.
Pour qui Amazon SageMaker est-il le mieux adapté ?
Amazon SageMaker convient parfaitement aux équipes de data science et d’ingénierie ML déjà intégrées à l’écosystème AWS.
Pourquoi j’ai choisi Amazon SageMaker
Amazon SageMaker mérite sa place parmi les meilleurs dans ma sélection car il gère la gestion automatisée de bout en bout des modèles sans avoir à assembler des outils distincts. J’apprécie particulièrement SageMaker MLOps, qui centralise l’orchestration des pipelines, le registre de modèles et le suivi des déploiements. Je compte aussi sur les capacités intégrées d’inférence, d’AI Ops et d’observabilité de SageMaker AI pour surveiller les modèles après leur mise en production et détecter la dérive avant qu’elle ne pose problème.
Fonctionnalités clés d’Amazon SageMaker
- SageMaker JumpStart : Accédez à plus de 1 000 modèles d’IA préconçus des principaux fournisseurs, déployez-les ou affinez-les directement dans SageMaker.
- SageMaker HyperPod : Échellez l’entraînement et l’ajustement des modèles sur des clusters réunissant des centaines ou milliers d’accélérateurs d’IA grâce à une gestion automatique des clusters.
- Inférence multi-mode : Déployez des modèles en temps réel, sans serveur, de façon asynchrone ou par lots sur plus de 70 types d’instances.
- MLflow managé : Suivez, organisez et comparez les expériences itératives sans provisionner d’infrastructure ni gérer de serveurs.
Intégrations d’Amazon SageMaker
Amazon SageMaker s’intègre nativement à tout l’écosystème AWS, notamment Amazon S3, Amazon Redshift, Amazon Athena, Amazon EMR et AWS Glue, ainsi qu’Amazon Bedrock et Amazon Q Developer. Il fonctionne aussi avec des outils tiers comme Datadog, Hugging Face, MLflow et Pinecone. Une API est disponible pour des intégrations personnalisées.
Pros and Cons
Pros:
- Multiples modes d’inférence pour différents types de charges de travail
- AutoML intégré et réglage automatique des hyperparamètres
- Test en miroir pour des déploiements de modèles en toute sécurité
Cons:
- Fortement lié à l’écosystème AWS
- Déboguer les échecs d’entraînement est difficile

Idéal pour les flux de travail unifiés liés aux données et à l’IA
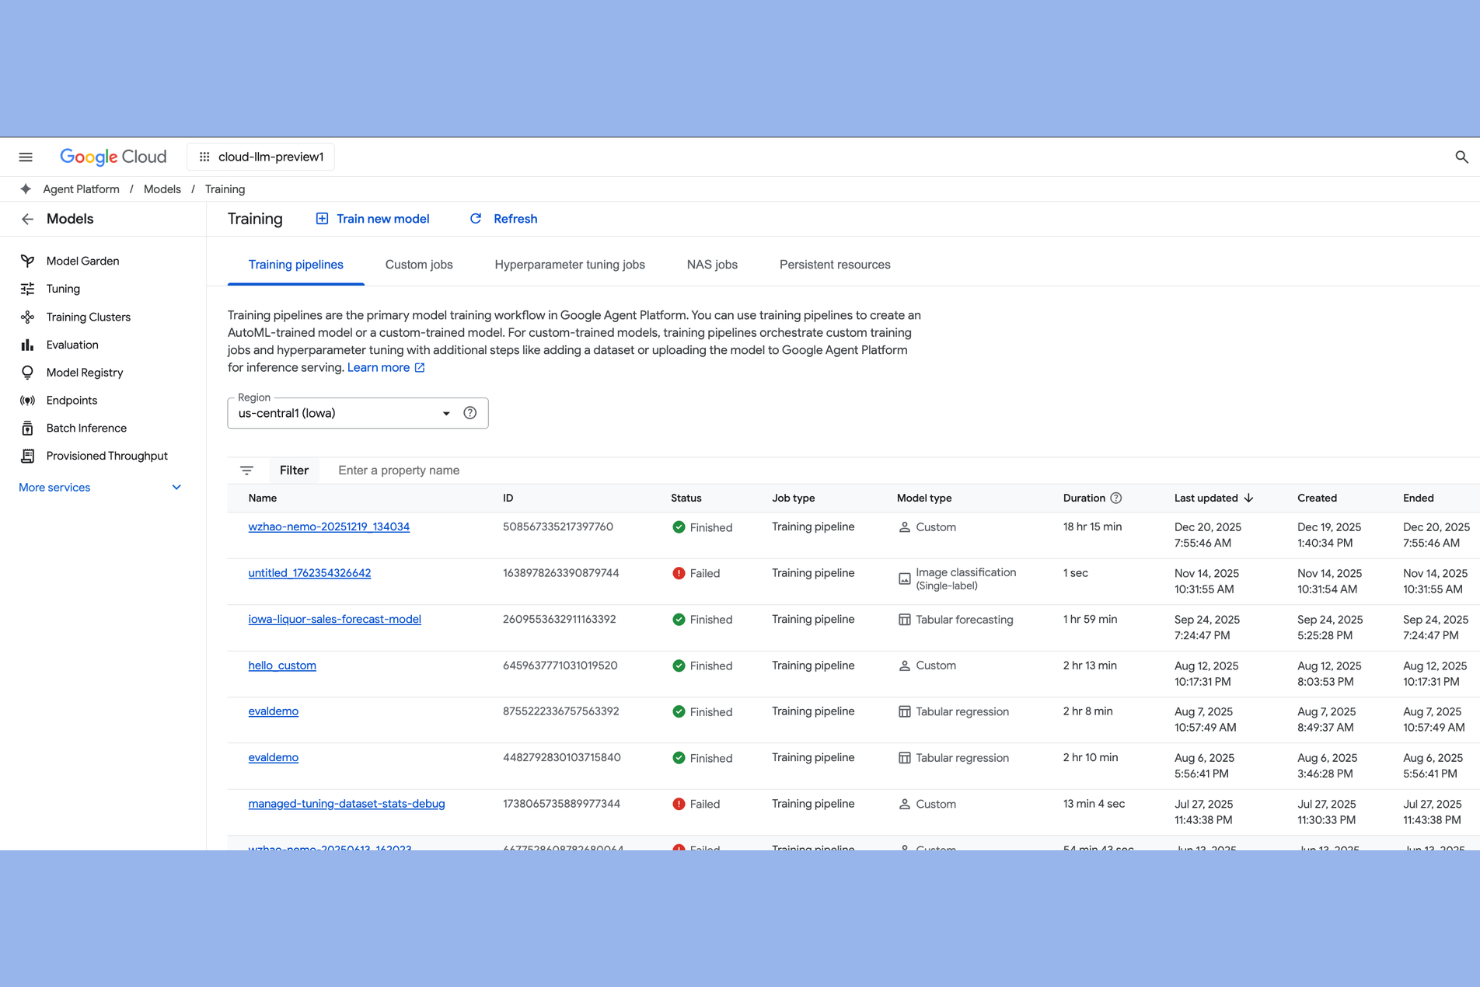
Gemini Enterprise Agent Platform (anciennement Vertex AI) est la plateforme d’apprentissage automatique de bout en bout de Google Cloud, qui couvre l’entraînement des modèles, leur ajustement fin, leur évaluation, leur déploiement et le développement d’agents d’IA au sein d’un environnement géré unique.
À qui Gemini Enterprise Agent Platform convient-elle le mieux ?
Gemini Enterprise Agent Platform convient naturellement aux équipes d’ingénierie ML et de science des données qui exécutent déjà leur infrastructure de données sur Google Cloud Platform.
Pourquoi j’ai choisi Gemini Enterprise Agent Platform
J’ai inclus Gemini Enterprise Agent Platform dans ma sélection principale, car cette plateforme réduit réellement l’écart entre la gestion des données et celle des modèles. J’apprécie particulièrement la manière dont Gemini Enterprise Agent Platform Pipelines se connecte directement à BigQuery, ce qui permet à mon équipe de créer des pipelines d’entraînement à partir de données d’entrepôt en temps réel sans rien exporter. Gemini Enterprise Agent Platform Feature Store nous permet également de définir, de fournir et de surveiller les caractéristiques de manière cohérente, aussi bien pendant l’entraînement que lors de l’inférence, ce qui élimine une source majeure de décalage entre l’entraînement et le service.
Principales fonctionnalités de Gemini Enterprise Agent Platform
- Registre des modèles Gemini Enterprise Agent Platform : Un référentiel centralisé permettant de gérer les versions, d’organiser et de gérer les modèles tout au long de leur cycle de vie, avant et après leur déploiement.
- Points de terminaison de prédiction en ligne : Déployez des modèles sur des points de terminaison dédiés qui fournissent des prédictions en temps réel, avec une capacité de calcul configurable et une répartition du trafic entre les versions des modèles.
- Surveillance des modèles Gemini Enterprise Agent Platform : Détecte le décalage des caractéristiques et la dérive des prédictions dans les modèles déployés en comparant le trafic en temps réel à une référence issue des données d’entraînement.
- Expériences Gemini Enterprise Agent Platform : Suit, compare et visualise les cycles d’entraînement successifs afin d’aider les équipes à identifier les configurations de modèles les plus performantes.
Intégrations de Gemini Enterprise Agent Platform
Gemini Enterprise Agent Platform s’intègre nativement à l’écosystème Google Cloud, notamment à BigQuery, Cloud Storage, Dataflow et Pub/Sub, tout en prenant en charge Kubeflow Pipelines et des conteneurs préconfigurés pour TensorFlow, scikit-learn, XGBoost et PyTorch. Ses magasins de données prennent également en charge des connecteurs de données tiers pour des outils tels que Jira et Shopify. La plateforme est disponible sur Zapier et une API est proposée pour les intégrations personnalisées.
Pros and Cons
Pros:
- Model Garden propose plus de 200 modèles déployables
- Le déploiement basé sur des points de terminaison depuis Model Garden est simple
- Intégration native à BigQuery pour les flux de travail liés aux données
Cons:
- Les points de terminaison dédiés inactifs restent facturés
- Les incohérences de région génèrent des messages d’erreur peu explicites

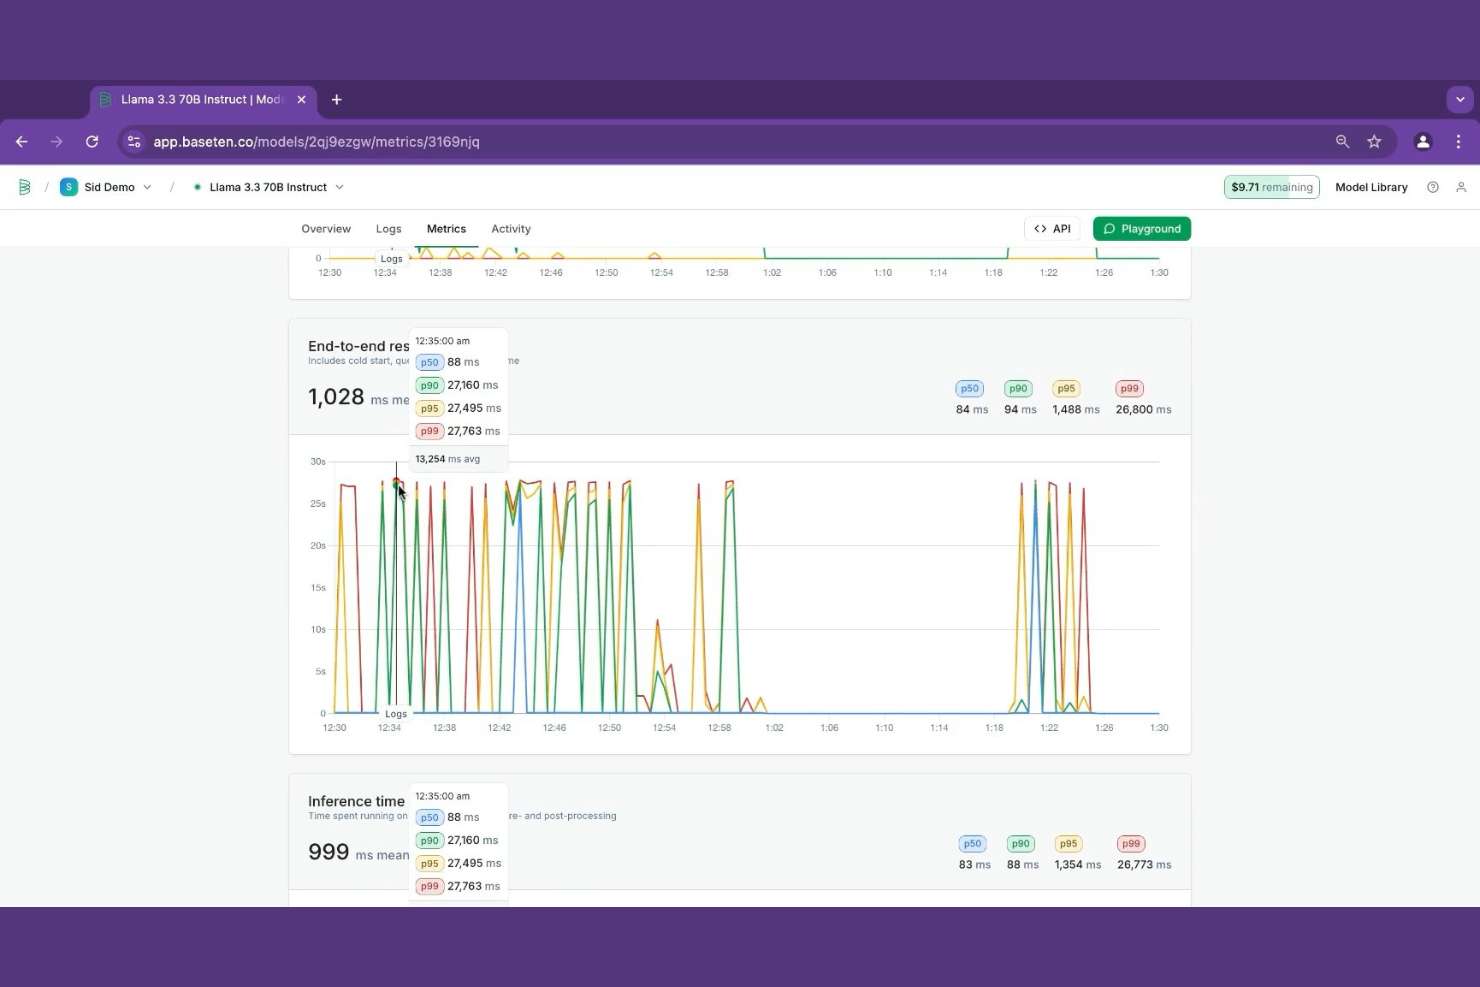
Baseten est une plateforme d'inférence de modèles qui permet aux équipes ML de déployer des modèles personnalisés, open source et ajustés, avec une distribution accélérée par GPU, une mise à l'échelle automatique et des outils d'optimisation des performances intégrés directement à la plateforme.
À qui s'adresse Baseten ?
Baseten convient aux équipes de produits IA dans les entreprises en croissance qui ont besoin d'un contrôle total sur les performances d'inférence pour des déploiements de modèles sensibles à la latence ou à haut volume.
Pourquoi j'ai choisi Baseten
Baseten trouve sa place sur ma liste restreinte car il vous permet de créer et de déployer des interfaces web personnalisées sur vos modèles au sein de la même plateforme, sans nécessiter une pile frontend distincte. J'utilise le concepteur d'applications de Baseten pour créer des interfaces interactives qui appellent directement les points de terminaison du modèle, ce qui est utile pour les outils internes ou les démonstrations aux parties prenantes. Le modèle et son interface restent versionnés et déployés ensemble.
Fonctionnalités clés de Baseten
- Emballage de modèles Truss : Emballez tout modèle personnalisé ou ajusté sous la forme d'un artefact Python reproductible avec gestion des dépendances intégrée et rechargement en direct pour les tests locaux.
- Baseten Chains : Construisez des workflows d'IA composés de plusieurs étapes où chacune s'exécute sur du matériel configuré indépendamment avec sa propre politique de mise à l'échelle automatique.
- Gestion des secrets : Stockez et injectez les clés d'API et les identifiants d'environnement directement dans les déploiements de modèles sans les coder en dur dans votre code de service.
- Répartition de trafic A/B : Dirigez le trafic d'inférence en direct entre plusieurs versions de modèles simultanément pour comparer les performances avant de passer entièrement à un nouveau déploiement.
Intégrations Baseten
Baseten prend en charge l'exportation des métriques vers Prometheus, Datadog, Grafana Cloud et New Relic via son point de terminaison de métriques basé sur OpenTelemetry. Il est entièrement compatible avec OpenAI, vous pouvez donc le connecter à tout client ou passerelle utilisant le SDK OpenAI, y compris LiteLLM, LlamaIndex et Cloudflare AI Gateway. Une API est disponible pour des intégrations personnalisées.
Pros and Cons
Pros:
- L'emballage open source Truss simplifie le déploiement des modèles
- Déploiement en un clic à partir des checkpoints d'entraînement
- Démarrages à froid sous la seconde sur les instances GPU
Cons:
- La tarification basée sur l'utilisation peut augmenter de façon imprévisible
- Nécessite une expertise en ingénierie ML pour fonctionner

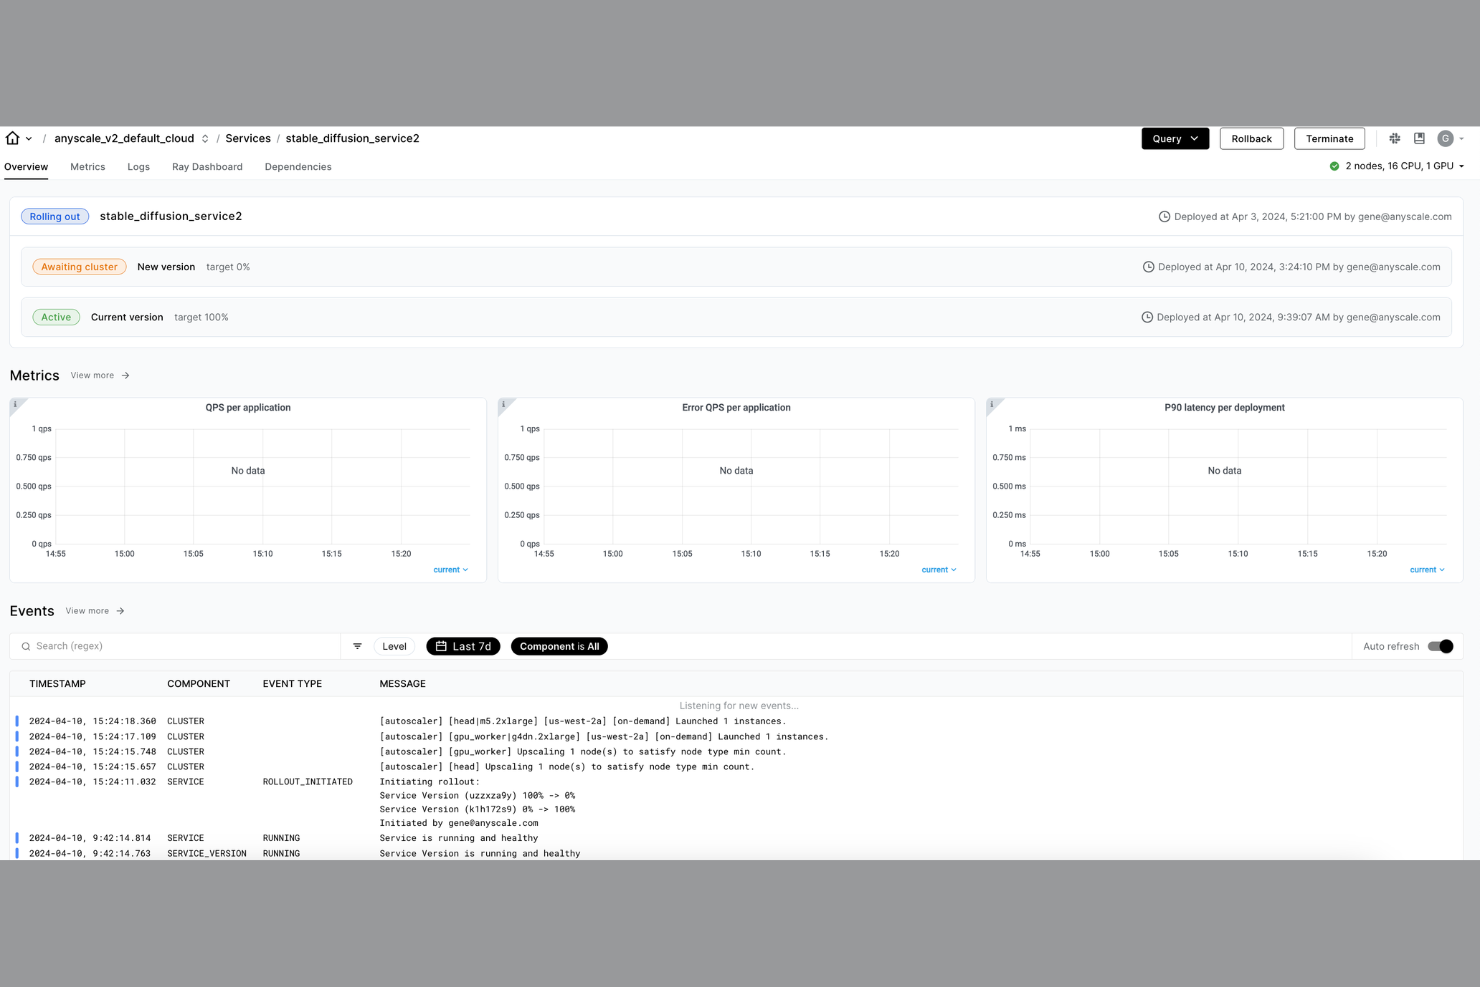
Construit sur le framework open source Ray, Anyscale est une plateforme de gestion et de déploiement de modèles ML qui gère l'inférence distribuée, l'autoscaling et le déploiement multi-modèles sur les clusters GPU et CPU.
À qui s'adresse Anyscale ?
Anyscale est idéal pour les ingénieurs en apprentissage automatique et les équipes data science travaillant dans des organisations de taille moyenne à grande qui exécutent des charges de travail Python à grande échelle et souhaitent gérer des clusters GPU sans la complexité de gestion manuelle de l'infrastructure.
Pourquoi j'ai choisi Anyscale
J'ai choisi Anyscale comme l'une des meilleures plateformes car c'est la seule plateforme managée conçue directement sur Ray, ce qui signifie que mon équipe peut écrire du code Python standard pour définir la logique de service distribué sans avoir à apprendre un langage d'orchestration séparé. J'apprécie particulièrement l'API de graphe de déploiement Ray Serve, qui me permet de composer plusieurs modèles dans un même pipeline d'inférence avec un routage explicite des requêtes. L'allocation fractionnaire de GPU est une autre fonctionnalité que j'utilise régulièrement pour regrouper des modèles légers sur la même machine sans avoir à lancer des instances dédiées.
Fonctionnalités clés d'Anyscale
- Autoscaling : Met automatiquement à l'échelle le nombre de réplicas en fonction du débit des requêtes en temps réel et de la profondeur de la file d’attente.
- Répartition du trafic : Permet de router un pourcentage configurable du trafic vers de nouvelles versions de modèles pour un déploiement progressif sans interruption.
- Regroupement des requêtes : Regroupe les requêtes d’inférence entrantes par lots pour maximiser l'utilisation du GPU lors des appels concurrents.
- Service de modèles multi-nœuds : Répartit un modèle volumineux sur plusieurs nœuds lorsqu’il dépasse la mémoire disponible sur un seul GPU.
Intégrations d'Anyscale
Anyscale s'intègre avec les principales bibliothèques et frameworks IA/ML, avec plus de 50 intégrations couvrant les plateformes de données, l'orchestration, les frameworks ML, l'observabilité et les frameworks applicatifs pour LLM. Cela inclut MLflow, Weights & Biases, MongoDB, Snowflake, Databricks, Hugging Face, PyTorch et TensorFlow, ainsi qu'Airflow, Prefect, Dagster, Datadog, LangChain et LlamaIndex. Une API est disponible pour les intégrations personnalisées, et la plateforme peut également être déployée en tant que service natif sur Amazon EKS, Google GKE, Azure AKS et OCI Kubernetes Engine.
Pros and Cons
Pros:
- Mise à l'échelle du code Python sur des clusters GPU distribués
- Service de modèles indépendant des frameworks via Ray Serve
- Prise en charge des instances spot avec tolérance aux pannes automatique
Cons:
- Étroitement lié à l'écosystème Ray
- Nécessite une solide expertise des systèmes distribués

Autres outils de déploiement de modèles de ML
Voici quelques outils supplémentaires de déploiement de modèles de ML qui n’ont pas intégré ma sélection, mais qui méritent tout de même d’être examinés :


Come Valuto gli Strumenti di Deploy dei Modelli ML
Valuto ogni strumento su due livelli: il livello di base per pubblicare un modello PyTorch su un endpoint REST con autoscaling e monitoraggio del drift, e i fattori differenzianti che contano per i team MLOps.
Funzionalità Principali (Requisiti Fondamentali per Questa Lista)
Quando seleziono gli strumenti per la mia lista, valuto ciascuno su una scala da 0 (non offre la funzionalità) a 5 (eccelle in quest'area) per ciascuna delle funzionalità principali elencate di seguito. Poi calcolo il punteggio totale dello strumento in percentuale. Ogni strumento deve raggiungere un punteggio totale minimo del 65% per essere considerato idoneo all'inclusione.
- Servizio del Modello & Inferenza: Valuto se uno strumento può ospitare modelli dietro endpoint REST o gRPC per predizioni in tempo reale, e se gestisce anche l'inferenza batch per lavori di scoring offline.
- Supporto Multi-Framework: Controllo quali framework ML sono supportati nativamente—come TensorFlow, PyTorch, XGBoost e ONNX—e se sono disponibili container personalizzati per runtime meno comuni.
- Versionamento del Modello & Registry: Un buon registro permette di tracciare gli artefatti dei modelli, i metadati e la loro provenienza, così da poter annullare un deploy problematico in pochi minuti invece di cercare disperatamente l'artefatto giusto.
- Scalabilità & Gestione delle Risorse: Valuto come funziona l'autoscaling sotto carico, se l'allocazione di GPU e CPU è configurabile e se lo strumento supporta il "scale-to-zero" per ridurre i costi nei periodi di inattività.
- Monitoraggio & Osservabilità: I modelli in produzione degradano silenziosamente, quindi cerco la rilevazione del drift dei dati, il monitoraggio della latenza delle predizioni e un sistema di allerta che segnali problemi di performance prima che impattino gli utenti finali.
- CI/CD & Automazione del Deploy: Considero se lo strumento supporta pipeline automatizzate con strategie di rollout progressive come canary o A/B test, oltre a trigger basati su Git per la ridistribuzione dei modelli.
Una volta che ho una lista di strumenti che soddisfano questi criteri, considero ciò che rende ogni piattaforma unica.
Fattori Differenzianti (Cosa Distingue i Vendor)
Ecco come confronto e metto a contrasto diversi vendor:
Funzionalità Distintive
I deploy canary e shadow rendono alcuni strumenti unici. Cerco la capacità di indirizzare una parte del traffico live verso una nuova versione del modello mentre quella attuale continua a servire—questo permette di individuare regressioni di accuratezza prima che raggiungano tutti gli utenti. L'ottimizzazione GPU è un altro elemento distintivo: il batching dinamico e il supporto alla quantizzazione tramite acceleratori come NVIDIA Triton o TensorRT possono ridurre drasticamente i costi per predizione ad alto volume. Lo scale-to-zero è altrettanto importante, poiché endpoint inattivi che consumano ore GPU fanno lievitare subito i costi in carichi di lavoro ad alta inferenza.
Oltre le Funzionalità
La capacità di integrarsi nell'ecosistema MLOps è fondamentale—controllo se uno strumento si collega a tracker di esperimenti come MLflow o Weights & Biases, orchestratori come Airflow e sistemi CI/CD come GitHub Actions. La flessibilità dell'infrastruttura è altrettanto importante: i team nei settori regolamentati spesso necessitano di soluzioni self-hosted Kubernetes o opzioni BYOC invece di SaaS puro. Valuto anche la governance e la conformità, in particolare RBAC, audit logging e certificazioni come SOC 2 o HIPAA, che i team di sicurezza aziendale richiederanno durante la fase di acquisto.
Comment choisir des outils de déploiement de modèles de ML
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré pendant votre processus particulier de sélection de logiciels, voici une liste de contrôle des facteurs à garder à l’esprit :
| Facteur | Éléments à prendre en compte |
|---|---|
| Évolutivité | L’outil gérera-t-il les augmentations soudaines du trafic d’inférence sans intervention manuelle ? Vérifiez la prise en charge des scénarios de pointe comme des scénarios à faible volume. |
| Intégrations | La plateforme se connecte-t-elle nativement à vos outils de suivi des expériences, à vos outils CI/CD ou à vos entrepôts de données, ou devrez-vous créer et maintenir du code personnalisé ? |
| Personnalisation | Pouvez-vous adapter les flux de travail de déploiement, les contrôles d’accès aux modèles et la gestion des ressources pour qu’ils correspondent à vos politiques et à la structure de votre équipe ? |
| Facilité d’utilisation | Quelle est la difficulté de la courbe d’apprentissage pour votre équipe ? Tenez compte de la complexité de l’interface utilisateur, de la qualité de la documentation et de la possibilité que l’intégration ralentisse d’autres projets. |
| Mise en œuvre et intégration | Combien de temps d’ingénierie faudra-t-il pour passer de l’essai à la production ? Soyez attentif aux étapes de configuration cachées, aux prérequis réseau ou aux formations obligatoires. |
| Coût | Les modèles tarifaires sont-ils transparents et prévisibles à mesure que l’utilisation augmente ? Comparez les méthodes de facturation — par prédiction, par heure de calcul ou par point de terminaison — en fonction de vos charges de travail. |
| Mesures de protection de la sécurité | Quels mécanismes de chiffrement, de contrôle des accès et d’audit sont en place ? Vérifiez si l’offre répond à vos normes de sécurité internes et aux besoins de vos clients. |
| Exigences de conformité | Aurez-vous besoin de la conformité HIPAA, GDPR ou SOC 2 Type II ? Confirmez que le fournisseur fournit les attestations requises et prend en charge les pistes d’audit nécessaires à votre secteur. |
Que sont les outils de déploiement de modèles de ML ?
Les outils de déploiement de modèles ML sont des plateformes qui vous aident à mettre en œuvre les modèles d'apprentissage automatique entraînés, en les rendant accessibles via des API ou des points de terminaison de traitement par lots pour une utilisation réelle. Ces outils gèrent des tâches telles que le service des modèles, la mise à l'échelle, la surveillance et la gestion des versions, afin que vous puissiez fournir des prédictions précises et maintenir la fiabilité à mesure que les charges de travail évoluent.
Fonctionnalités
Lors du choix d'outils de déploiement de modèles ML, prêtez attention aux fonctionnalités clés suivantes :
- Prise en charge de plusieurs frameworks : déployez des modèles conçus avec TensorFlow, PyTorch, scikit-learn, XGBoost et ONNX sans avoir à remanier le code du modèle ni à effectuer d'étapes de conversion.
- Inférence avec mise à l'échelle automatique : alloue automatiquement les ressources de calcul en fonction des schémas de trafic, en gérant les pics soudains ou les périodes creuses afin de maintenir à la fois les performances et la rentabilité.
- Gestion des versions des modèles : assure le suivi des différentes versions des modèles, ce qui facilite le retour à une version précédente, la comparaison ou la promotion des modèles dans les pipelines de production avec un minimum de perturbations.
- Déploiements canary et shadow : permet des déploiements progressifs ou la mise en miroir du trafic réel, afin que vous puissiez valider les nouveaux modèles en toute sécurité sur des données du monde réel avant leur déploiement complet.
- Service par lots et en temps réel : prend en charge les cas d'utilisation des API en temps réel et du traitement asynchrone par lots, offrant une grande flexibilité pour les applications métier ou les flux de travail de science des données.
- Gestion des ressources : vous permet d'allouer et de surveiller l'utilisation du CPU, du GPU et de la mémoire pour chaque modèle, contribuant ainsi à optimiser les coûts et à maintenir la fiabilité du service en production.
- Mesures de protection de la sécurité : comprend le contrôle des accès, le chiffrement et l'isolation réseau afin de protéger les artefacts des modèles et les données d'inférence sensibles.
- Prise en charge des intégrations : se connecte nativement ou via une API aux outils MLOps, aux pipelines CI/CD et à l'infrastructure de données afin de rationaliser la livraison et la surveillance continues.
- Journalisation et surveillance : offre une visibilité sur les journaux des requêtes, les indicateurs de latence et les taux d'erreur pour faciliter le dépannage proactif et la fiabilité opérationnelle.
- Conformité et auditabilité : fournit des fonctionnalités telles que les journaux d'audit et la prise en charge de la conformité réglementaire, vous aidant à respecter les exigences du secteur dans les domaines de la santé, de la finance ou d'autres secteurs réglementés.
Fonctionnalités courantes de l'IA
Au-delà des fonctionnalités standard des outils de déploiement de modèles ML énumérées ci-dessus, nombre de ces solutions intègrent l'IA avec des fonctionnalités telles que :
- Détection automatisée de la dérive : utilise l'IA pour surveiller les données entrantes et les prédictions afin de repérer les changements de distribution, en alertant les équipes lorsqu'un réentraînement ou une investigation est nécessaire pour maintenir la précision du modèle.
- Allocation intelligente des ressources : applique des algorithmes d'IA pour prédire les schémas de charge de travail et allouer dynamiquement les ressources de calcul, réduisant les coûts et minimisant la latence sans réglage manuel.
- Déploiements autoréparateurs : exploite l'IA pour détecter les points de terminaison de modèles défaillants ou dégradés et réacheminer automatiquement le trafic ou déclencher un redéploiement, réduisant ainsi les temps d'arrêt et les interventions manuelles.
- Mise à l'échelle prédictive : utilise l'IA pour prévoir les pics ou les baisses de trafic à partir de l'utilisation historique, en mettant proactivement l'infrastructure à l'échelle afin de garantir des performances constantes et de maîtriser les coûts.
- Détection des anomalies dans l'inférence : utilise l'IA pour signaler en temps réel les requêtes de prédiction inhabituelles ou suspectes, aidant les équipes à identifier les problèmes potentiels de qualité des données ou les menaces de sécurité.
- Analyse automatisée des causes profondes : utilise l'IA pour analyser les journaux et les indicateurs, en identifiant la source des baisses de performances ou des erreurs afin que les équipes puissent résoudre les problèmes plus rapidement et avec moins d'hypothèses.
Avantages
La mise en œuvre d'outils de déploiement de modèles ML offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques bénéfices dont vous pouvez profiter :
- Cycles de déploiement accélérés : L’empaquetage automatisé, la gestion des versions et l’intégration aux pipelines CI/CD permettent aux équipes de faire passer rapidement les modèles du développement à la production.
- Évolutivité constante : La mise à l’échelle automatique et la gestion dynamique des ressources garantissent la stabilité et la réactivité de vos déploiements lorsque la demande évolue.
- Posture de sécurité renforcée : Les contrôles d’accès intégrés, le chiffrement et la journalisation des audits contribuent à protéger les modèles et les données sensibles conformément aux exigences organisationnelles et réglementaires.
- Réduction de la charge opérationnelle : La supervision, les alertes et la journalisation centralisées réduisent au minimum le dépannage manuel et libèrent des ressources d’ingénierie pour des tâches à plus forte valeur ajoutée.
- Gouvernance fiable des modèles : La gestion des versions et la journalisation des déploiements facilitent le suivi des modèles, l’annulation des modifications et la démonstration de la conformité lors des audits.
- Intégration flexible aux flux de travail : La prise en charge de plusieurs cadriciels, stratégies de déploiement et configurations d’environnements permet aux équipes d’adapter les fonctionnalités des outils à leurs besoins métier.
- Meilleure préparation à la conformité : Les pistes d’audit complètes et les fonctionnalités de conformité simplifient le respect des exigences HIPAA, GDPR ou propres à un secteur, réduisant ainsi les risques pour les entreprises réglementées.
Coûts et tarification
La sélection d’outils de déploiement de modèles ML nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient selon les fonctionnalités, la taille de l’équipe, les modules complémentaires et d’autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leur prix moyen et les fonctionnalités généralement incluses dans les solutions d’outils de déploiement de modèles ML :
Tableau comparatif des forfaits
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Forfait gratuit | $0 | Déploiements limités, supervision de base, accès pour un seul utilisateur et assistance communautaire. |
| Forfait personnel | $10-$30/utilisateur/mois | Utilisation individuelle, gestion standard des versions des modèles, allocation modérée des ressources et assistance par e-mail. |
| Forfait professionnel | $40-$100/utilisateur/mois | Collaboration en équipe, mise à l’échelle automatique, assistance à l’intégration, sécurité renforcée et contrôles d’accès basés sur les rôles. |
| Forfait entreprise | $150-$500+/utilisateur/mois | Conformité avancée, assistance prioritaire, infrastructure dédiée, SLA personnalisés et outils étendus d’audit et de sécurité. |
FAQ sur les outils de déploiement de modèles ML
Voici quelques réponses aux questions courantes sur les outils de déploiement de modèles ML :
En quoi les outils de déploiement de modèles ML diffèrent-ils des outils traditionnels de déploiement d’applications ?
Les outils de déploiement de modèles ML sont conçus pour gérer les défis propres à la mise à disposition, à la supervision et à la mise à jour des modèles d’apprentissage automatique, notamment la gestion des versions des modèles, le suivi des journaux d’inférence, la prise en charge de la mise à l’échelle automatique du trafic des modèles et l’intégration aux pipelines de données. Les outils traditionnels de déploiement d’applications ne prennent généralement pas en charge ce type d’exigences.
Puis-je déployer des modèles créés avec différents cadriciels à l’aide du même outil de déploiement ?
Oui, la plupart des outils de déploiement de modèles ML sont compatibles avec plusieurs cadriciels, ce qui permet de déployer des modèles issus de TensorFlow, PyTorch, XGBoost et d’autres cadriciels sans conversions ni réécritures manuelles. Les équipes peuvent ainsi travailler plus facilement avec différentes technologies et standardiser les processus de production.
Quelles fonctionnalités de sécurité faut-il rechercher dans ces outils ?
Recherchez des fonctionnalités telles que les contrôles d’accès, les points de terminaison chiffrés, les pistes d’audit et l’isolation réseau. Elles contribuent à garantir que seuls les utilisateurs autorisés peuvent déployer ou mettre à jour les modèles, tout en protégeant vos ressources de modèles et les prédictions produites à partir des données.
Ces outils prennent-ils en charge l’inférence en temps réel et par lots ?
Oui, les principaux outils de déploiement de modèles ML prennent en charge à la fois la mise à disposition de prédictions en temps réel via API et les modes de traitement par lots. Votre équipe dispose ainsi de la flexibilité nécessaire pour gérer différents cas d’utilisation, des applications destinées aux utilisateurs aux tâches volumineuses de calcul de scores hors ligne.
Comment ces outils contribuent-ils à la supervision et à la maintenance des modèles ?
Ils fournissent des tableaux de bord de supervision intégrés, des alertes, la journalisation et la détection automatisée de la dérive. Ces fonctionnalités permettent de repérer rapidement la dégradation des performances, les problèmes de données ou les erreurs opérationnelles, souvent avant qu’ils n’affectent les utilisateurs finaux ou les résultats métier.