

Las 10 mejores herramientas de observabilidad de LLM en 2026

Lista de las mejores herramientas de observabilidad de LLM


Las herramientas de observabilidad de LLM rastrean los flujos de trabajo de IA, supervisan el comportamiento en producción y evalúan la calidad de los modelos. Esta guía compara 12 opciones para depurar agentes de varios pasos, realizar un seguimiento de las indicaciones y las versiones de los modelos, medir la latencia y el uso de tokens, y detectar regresiones antes de la implementación. Encontrarás plataformas de código abierto, autohospedadas, empresariales, basadas en OpenTelemetry y orientadas a desarrolladores que se adaptan a tu arquitectura técnica, tus necesidades de gobernanza y tu flujo de entrega.
Por qué confiar en nuestras recomendaciones de software
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Compara las mejores herramientas de observabilidad de LLM
Compara los precios y las especificaciones, lado a lado, de las principales plataformas de mi lista de selección.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para el rastreo nativo de OTel de código abierto | Plan gratuito + demostración gratuita disponible | Precio bajo solicitud | Website | |
| 2 | Ideal para evaluación de código abierto y autohospedada a gran escala | Plan gratuito disponible | Precio bajo petición | Website | |
| 3 | Ideal para la evaluación de LLM durante todo el ciclo de vida con operaciones de puerta de enlace | Plan gratuito + demostración gratuita disponible | Precios bajo solicitud | Website | |
| 4 | Ideal para evaluación y trazabilidad de código abierto | Plan gratuito + demostración gratuita disponible | Desde $19/mes | Website | |
| 5 | Ideal para vincular versiones de prompts con seguimientos en producción | Plan gratuito + demostración gratuita disponible | Desde $49/mes | Website | |
| 6 | Ideal para rastrear agentes en canalizaciones complejas | Plan gratuito + demostración gratuita disponible | Desde $50/mes | Website | |
| 7 | Ideal para vincular las trazas de LLM con la analítica de productos | Plan gratuito + demostración gratuita disponible | Desde $34/mes | Website | |
| 8 | La mejor opción para el trazado de código abierto con control de versiones de indicaciones | Plan gratuito + demostración gratuita disponible | Desde $29/mes | Website | |
| 9 | Ideal para la puntuación desde la evaluación hasta la producción en un único ciclo | Plan gratuito + demostración gratuita disponible | Desde $249/mes | Website | |
| 10 | Ideal para el seguimiento de LangChain y LangGraph | Plan gratuito + demostración gratuita disponible | Desde $39/usuario/mes | Website |
Análisis de herramientas de observabilidad de LLM
A continuación se muestran resúmenes detallados de las principales opciones de mi lista de selección. Cada análisis cubre las funciones clave, los casos de uso y las integraciones para ayudarte a encontrar la opción adecuada.
Ideal para el rastreo nativo de OTel de código abierto
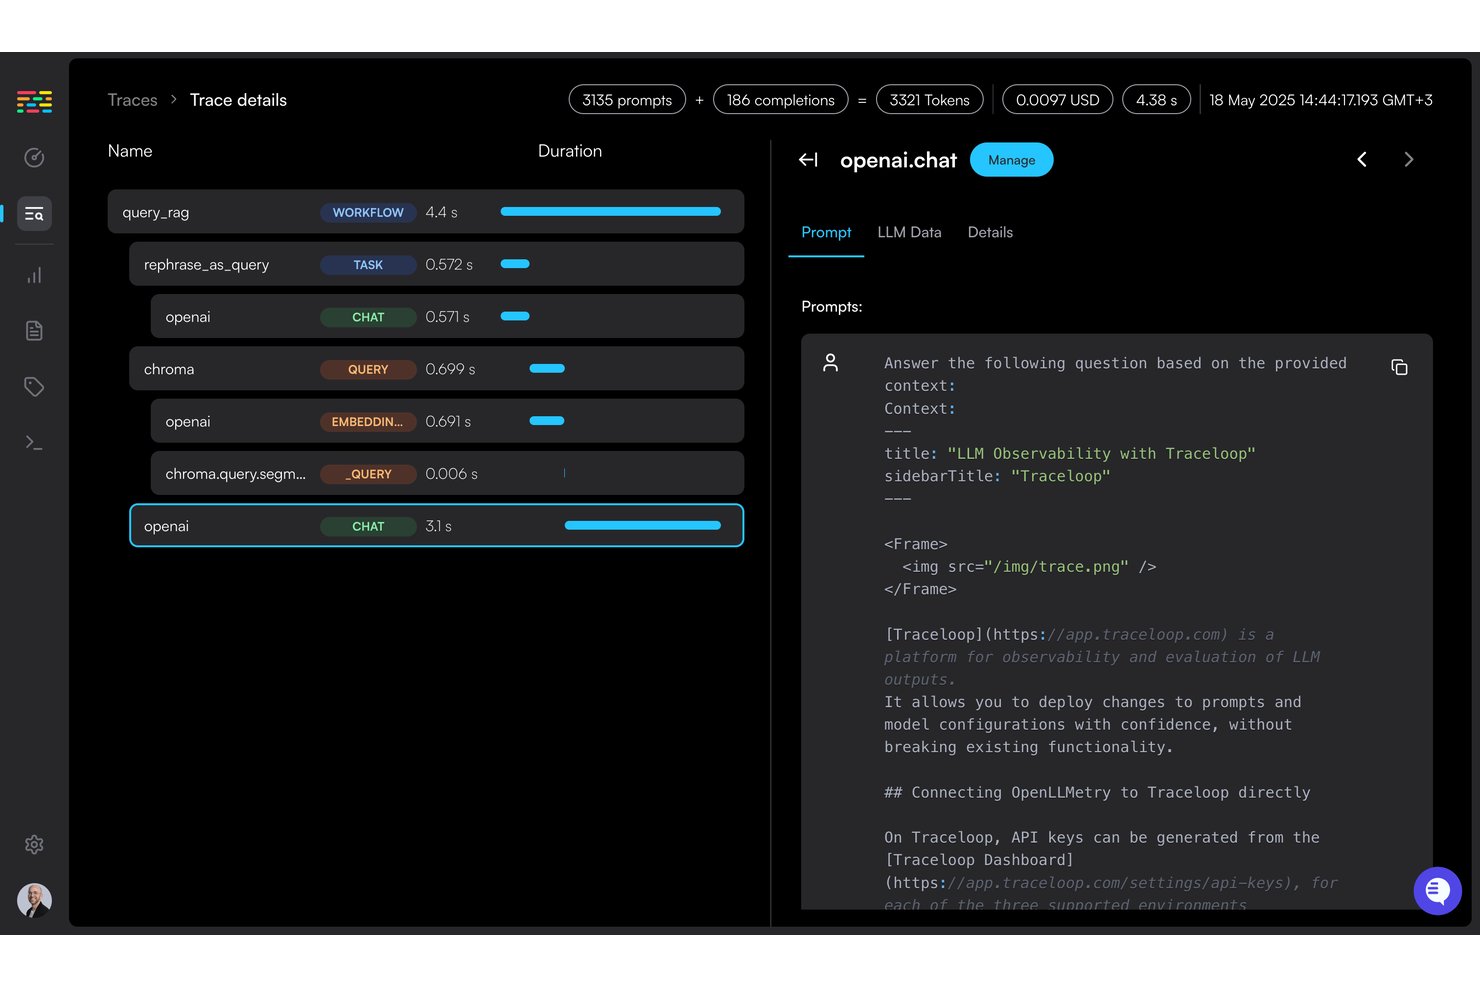
Traceloop de ServiceNow está construido sobre OpenTelemetry, lo que proporciona un registro de trazas basado en spans, evaluación de la calidad de los resultados, un registro de prompts con implementaciones basadas en entornos, monitores de producción y puertas de calidad para CI/CD.
¿Para quién es más adecuado Traceloop?
Traceloop es adecuado para ingenieros de plataformas y DevOps que necesitan observabilidad de LLM conforme a las normativas, autohospedada y compatible con Kubernetes o infraestructuras aisladas.
Por qué elegí Traceloop
He incluido Traceloop entre mis principales opciones porque está construido completamente sobre OpenTelemetry mediante su SDK de código abierto OpenLLMetry, lo que significa que cada llamada a un LLM, consulta a una base de datos vectorial y paso de un agente se registra como un span nativo de OTel que puedes exportar a más de 25 backends. Me gusta especialmente la canalización de evaluación: puedes ejecutar simultáneamente las mismas comprobaciones de calidad como puertas de CI/CD en solicitudes de incorporación de cambios, protecciones integradas en producción y monitores en tiempo real sobre el tráfico activo. El registro de prompts con implementaciones basadas en entornos también te permite implementar cambios en los prompts primero en desarrollo y después en producción, manteniendo un control estricto de las versiones durante todo el ciclo de vida.
Características principales de Traceloop
- Evaluadores integrados: Comprueba automáticamente la fidelidad, la relevancia y la seguridad del tráfico activo sin necesidad de configuración manual.
- Comprobaciones de evaluación centradas en agentes: Puntúa los resultados de los agentes en cuanto a corrección, uso de herramientas, retención de memoria, finalización de tareas y seguridad.
- Monitores de producción: Ejecuta evaluadores en tiempo real sobre cada span que coincida con un filtro para detectar alucinaciones y regresiones de calidad.
- Protecciones integradas: Ejecuta comprobaciones de seguridad en tiempo real durante la inferencia, creadas directamente a partir de tus evaluadores configurados.
Integraciones de Traceloop
Traceloop es compatible con más de 20 proveedores de LLM, incluidos Axiom, Braintrust, BMC, Google Cloud, Highlight, Honeycomb, Instana, OpenTelemetry Collector, Datadog, Oracle Cloud y Tenant Cloud. También hay disponible una API para crear evaluadores personalizados de LLM como juez.
Pros and Cons
Pros:
- El rastreo nativo reduce la dependencia de proveedores
- Las evaluaciones abarcan desde CI/CD hasta producción
- El autohospedaje admite implementaciones en infraestructuras aisladas
Cons:
- La adquisición por parte de ServiceNow genera incertidumbre sobre la hoja de ruta
- Los detalles públicos sobre la atribución de costes siguen siendo limitados
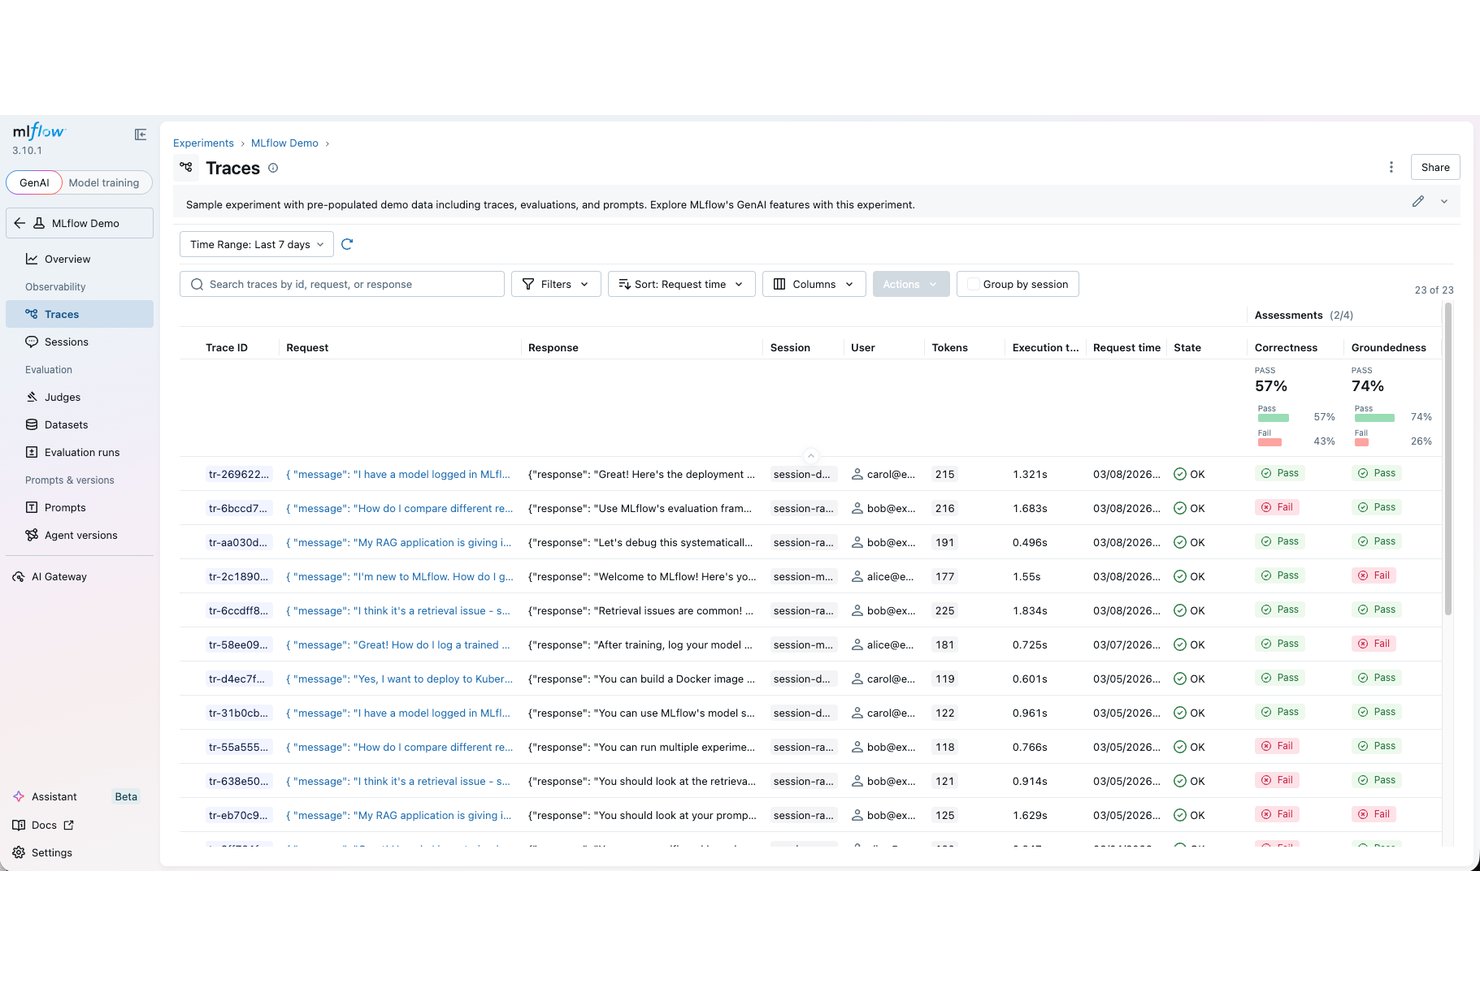
MLflow es una plataforma de observabilidad de IA de código abierto que combina el registro de trazas, la evaluación de la calidad de las salidas, el control de versiones de prompts, el seguimiento de costes y tokens, y la monitorización en producción para aplicaciones de modelos de lenguaje de gran tamaño (LLM) y agentes de IA.
¿Para quién es más adecuado MLflow?
MLflow es adecuado para ingenieros de ML/IA y científicos de datos que necesitan un control total sobre su infraestructura de observabilidad y quieren evitar las tarifas por traza o la dependencia de un proveedor.
Por qué elegí MLflow
He incluido MLflow entre mis principales opciones porque es la única herramienta de esta lista desarrollada desde cero como código abierto bajo Apache 2.0, lo que significa que los datos de tus trazas nunca salen de tu propia infraestructura. Me gusta que el Registro de prompts vincule directamente cada versión del prompt con sus resultados de evaluación, para que puedas ejecutar pruebas A/B con distintas variantes y consultar las puntuaciones de calidad, latencia y seguridad una al lado de la otra antes de enviar nada a producción. Los evaluadores asíncronos basados en LLM también puntúan continuamente las trazas muestreadas sin ralentizar el tráfico activo.
Funciones principales de MLflow
- Registro de prompts: Versiona, prueba y compara prompts uno al lado del otro, con seguimiento del linaje y optimización automática de prompts para ajustarlos algorítmicamente.
- Protecciones y detección de seguridad: La puntuación en tiempo real detecta inyecciones de prompts, filtraciones de información de identificación personal (PII) y evasiones de las restricciones mediante detectores deterministas y basados en LLM, con redacción de PII disponible en el SDK.
- Gestión de conjuntos de datos de evaluación: Crea y almacena conjuntos de datos de casos de prueba a partir de trazas de producción, con comentarios estructurados de usuarios y expertos del dominio que contribuyen a la calibración de los evaluadores.
- Pasarela de IA con políticas presupuestarias: Establece límites de gasto diarios, semanales o mensuales entre proveedores, con alertas mediante webhooks a herramientas como Slack o PagerDuty cuando se superan los límites.
Integraciones de MLflow
MLflow se integra con más de 40 LLM y agentes de IA, incluidos OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry y TypeScript. La API REST también está disponible para conexiones personalizadas.
Pros and Cons
Pros:
- Las trazas autohospedadas mantienen los datos dentro de la organización
- Los evaluadores de producción puntúan las alucinaciones y la deriva
- El linaje de prompts conecta los cambios con las evaluaciones
Cons:
- Las trazas anidadas de agentes pueden resultar confusas
- Las opciones de alertas siguen estando documentadas de forma menos clara
Bifrost
Ideal para la evaluación de LLM durante todo el ciclo de vida con operaciones de puerta de enlace
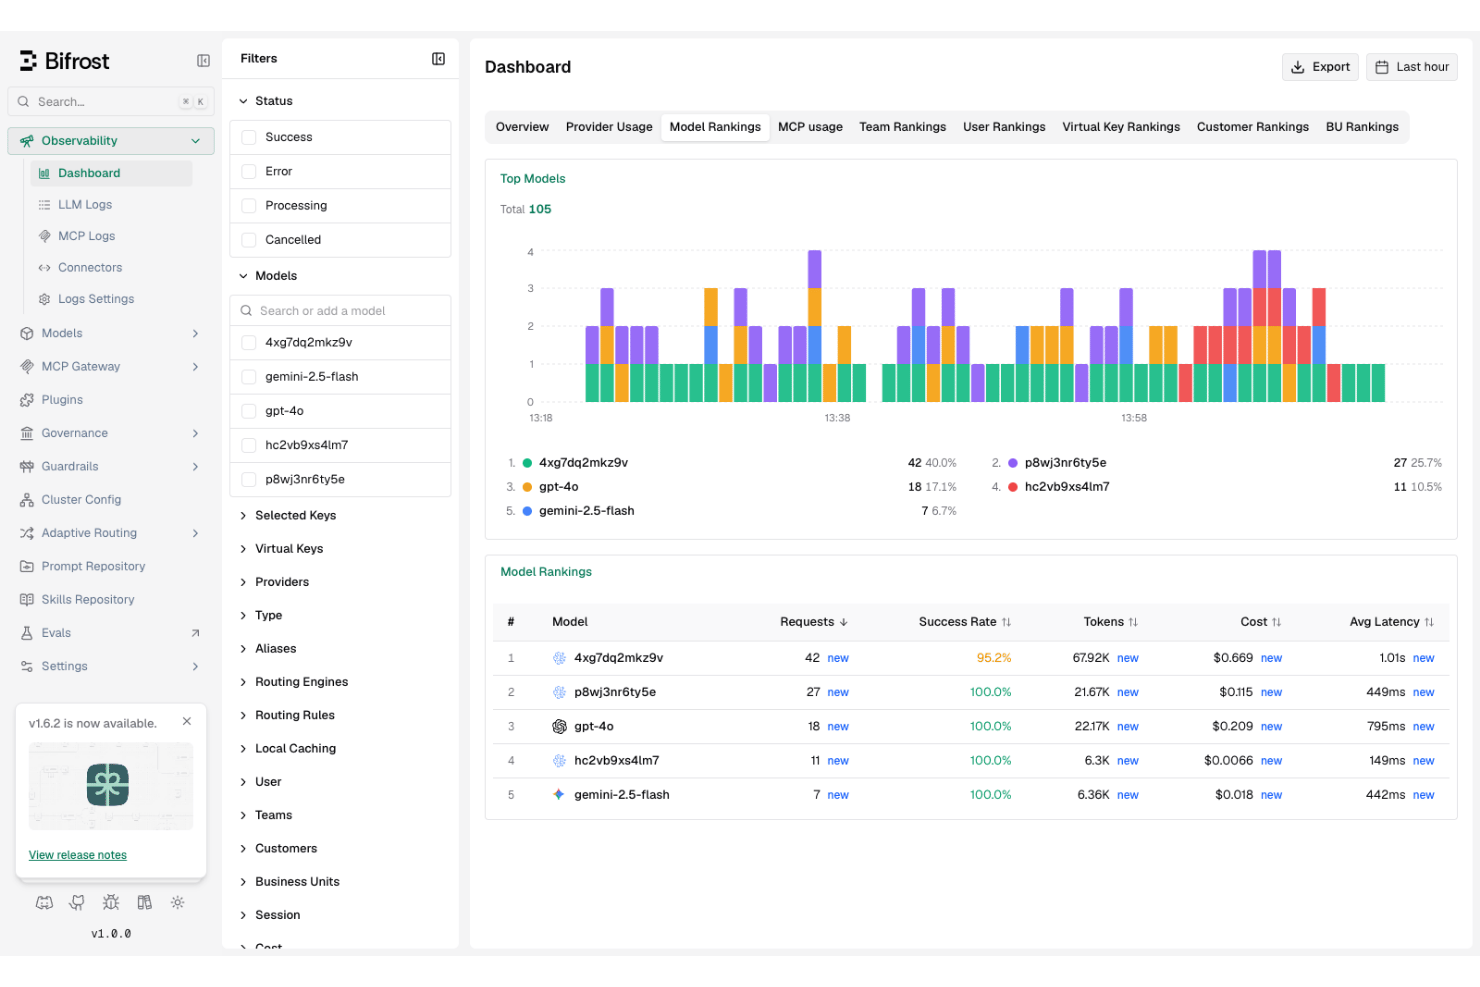
Bifrost es una plataforma de observabilidad de LLM que cubre todo el ciclo de desarrollo, combinando trazas distribuidas, control de versiones y experimentación de indicaciones, evaluación automatizada y con participación humana, y una puerta de enlace de LLM de código abierto.
¿Para quién es más adecuado Bifrost?
Bifrost es una excelente opción para equipos empresariales regulados que necesitan implementación dentro de la VPC, cumplimiento de SOC 2 Tipo II y HIPAA, y evaluación con participación humana en una sola plataforma.
Por qué elegí Bifrost
La cobertura de todo el ciclo de vida es lo que mantiene a Bifrost en mi lista de opciones. Lo uso para ejecutar pruebas A/B en versiones de indicaciones en el IDE de indicaciones y, después, llevar esos mismos conjuntos de datos directamente a la evaluación en producción sin ningún paso de exportación manual. Lo que me resulta realmente útil es que la puerta de enlace Bifrost de código abierto añade seguimiento del presupuesto por equipo o clave virtual, junto con límites de solicitudes a nivel de la puerta de enlace, de modo que puedo gestionar la gobernanza de costes y la observabilidad desde una configuración conectada, en lugar de usar dos herramientas independientes.
Características clave de Bifrost
- IDE de indicaciones con comparación de versiones: Un espacio de experimentación multimodal para indicaciones donde puedes ejecutar experimentos con distintas combinaciones de indicaciones, modelos, contexto y herramientas, con comparación de diferencias entre versiones lado a lado.
- Simulación de agentes: Prueba las interacciones de los agentes en distintos escenarios y con diferentes perfiles de usuario, incluidos los agentes de voz, antes de implementar cambios en producción.
- Integración con canalizaciones de CI/CD: Incorpora las ejecuciones de evaluación directamente en tu canalización de implementación, con ejecuciones programadas disponibles en el nivel Business y superiores.
- Compatibilidad con OpenTelemetry: Exporta datos de trazas a plataformas externas como New Relic y Snowflake mediante el reenvío nativo de OTel, con SDK en Python, TypeScript, Go y Java.
Integraciones de Bifrost
Bifrost admite la integración con SDK de IA, plataformas de gestión de secretos y sistemas de identidad, incluidos OpenAI, Anthropic, Google GenAI, AWS Bedrock, LiteLLM, AWS Secrets Manager, Google Secret Manager y Okta. También hay disponible una API para conexiones personalizadas.
Pros and Cons
Pros:
- Conecta la experimentación, la evaluación y la observabilidad
- Registra sesiones, solicitudes e intervalos individuales
- Combina la puntuación automatizada con la revisión humana
Cons:
- La retención breve limita las investigaciones históricas
- La atribución detallada de costes sigue sin estar clara
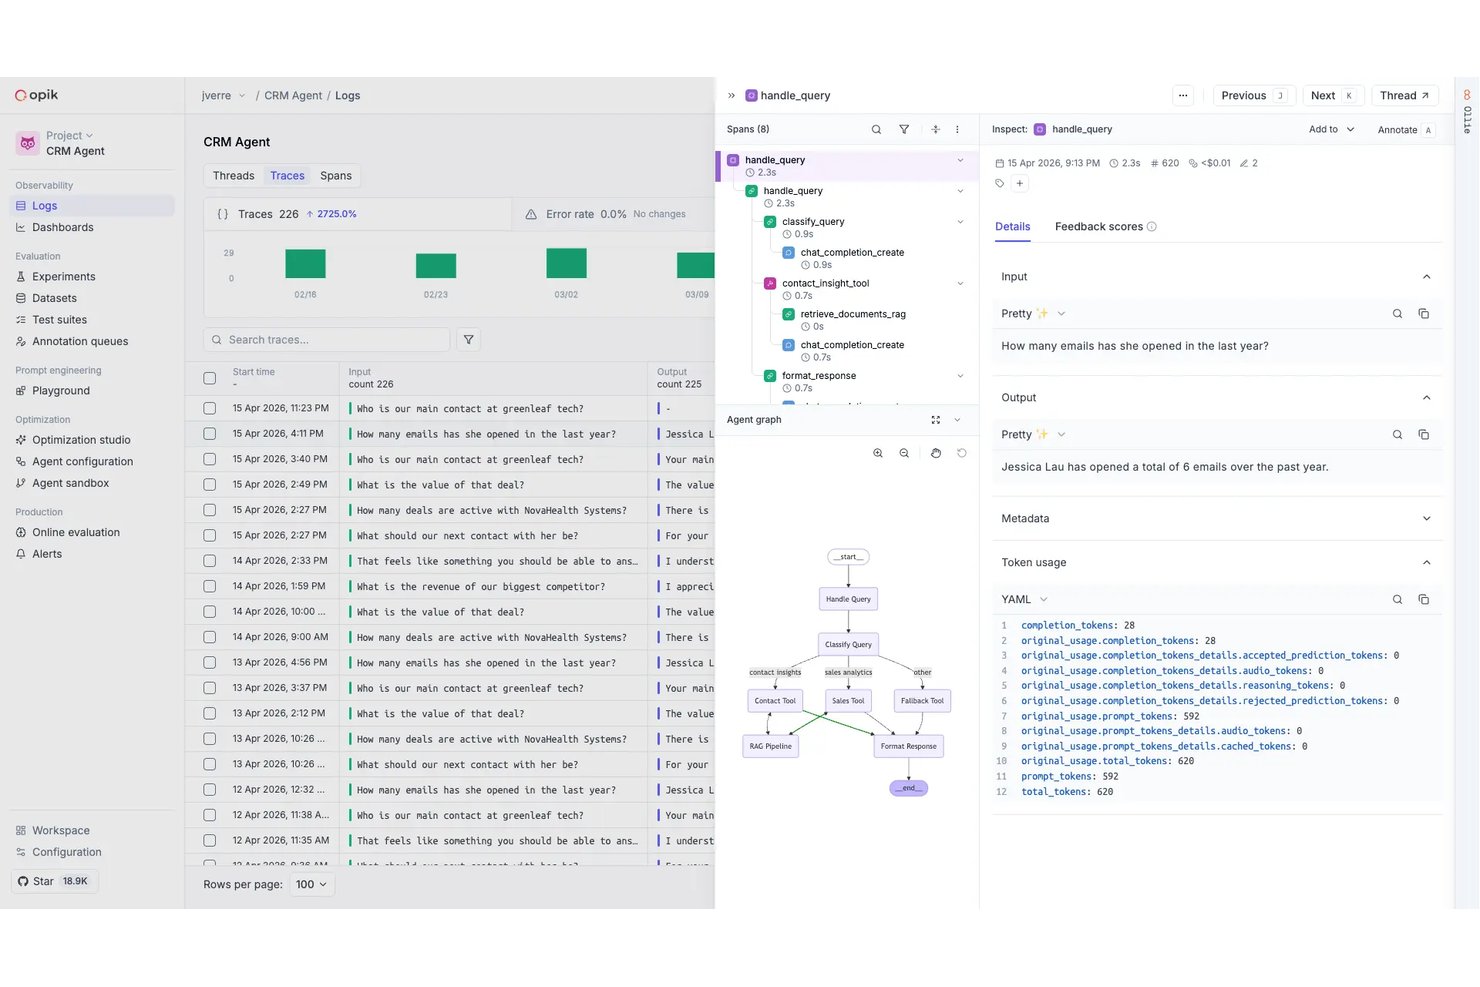
Opik es una plataforma de observabilidad de LLM que abarca el registro de trazas, la evaluación de la calidad de los resultados, el control de versiones de prompts y el seguimiento de costes en aplicaciones de LLM, agentes y canalizaciones RAG.
¿Para quién es más adecuado Opik?
Opik es una opción excelente para ingenieros de ML/IA y equipos de LLMOps que desean la flexibilidad del código abierto, con la posibilidad de escalar hasta una implementación completamente gestionada y de nivel empresarial.
Por qué elegí Opik
Elegí Opik como uno de los mejores porque su núcleo de código abierto ofrece realmente todas las funciones necesarias, en lugar de ser una versión limitada de prueba. Me gusta que puedas alojarlo por tu cuenta con usuarios, tramos y retención ilimitados utilizando la misma base de código que la versión en la nube. En cuanto a la profundidad de la evaluación, Opik incluye más de 30 métricas de LLM como juez, junto con conjuntos de pruebas que ejecutan aserciones de aprobado/suspenso, pruebas A/B y pruebas de regresión sobre prompts versionados, lo que facilita detectar regresiones en la calidad de los resultados antes de que lleguen a producción.
Características principales de Opik
- Interfaz de usuario para anotaciones expertas: Revisa trazas individuales y conversaciones completas de varios turnos con varios miembros del equipo mediante etiquetas personalizadas para obtener comentarios de calidad con participación humana.
- Barandillas: Bloquea infracciones de contenido, exposición de información personal identificable y riesgos de cumplimiento en tiempo real mediante tipos de barandillas integrados para información personal identificable, temas y configuraciones personalizadas.
- Panel de inteligencia de costes: Haz un seguimiento en tiempo real del gasto de Claude Code y Codex, desglosado por desarrollador y equipo, con auditoría de configuraciones y recomendaciones para ahorrar costes.
- Optimizador de agentes: Automatiza la ingeniería de prompts mediante uno de seis algoritmos integrados, con resultados mostrados directamente en la interfaz para su comparación.
Integraciones de Opik
Opik admite más de 40 conexiones con marcos de IA y proveedores de modelos, incluidos LlamaIndex, OpenAI, Google ADK, Haystack, CrewAI y OpenTelemetry. También admite API REST y webhooks para integraciones personalizadas.
Pros and Cons
Pros:
- El núcleo de código abierto admite un uso ilimitado en alojamientos propios
- La evaluación exhaustiva cubre más de 30 métricas de calidad
- Ollie conecta el diagnóstico de trazas con las correcciones de regresión
Cons:
- Las alertas de producción siguen siendo relativamente básicas
- Las barandillas no incluyen una detección explícita de ataques de evasión
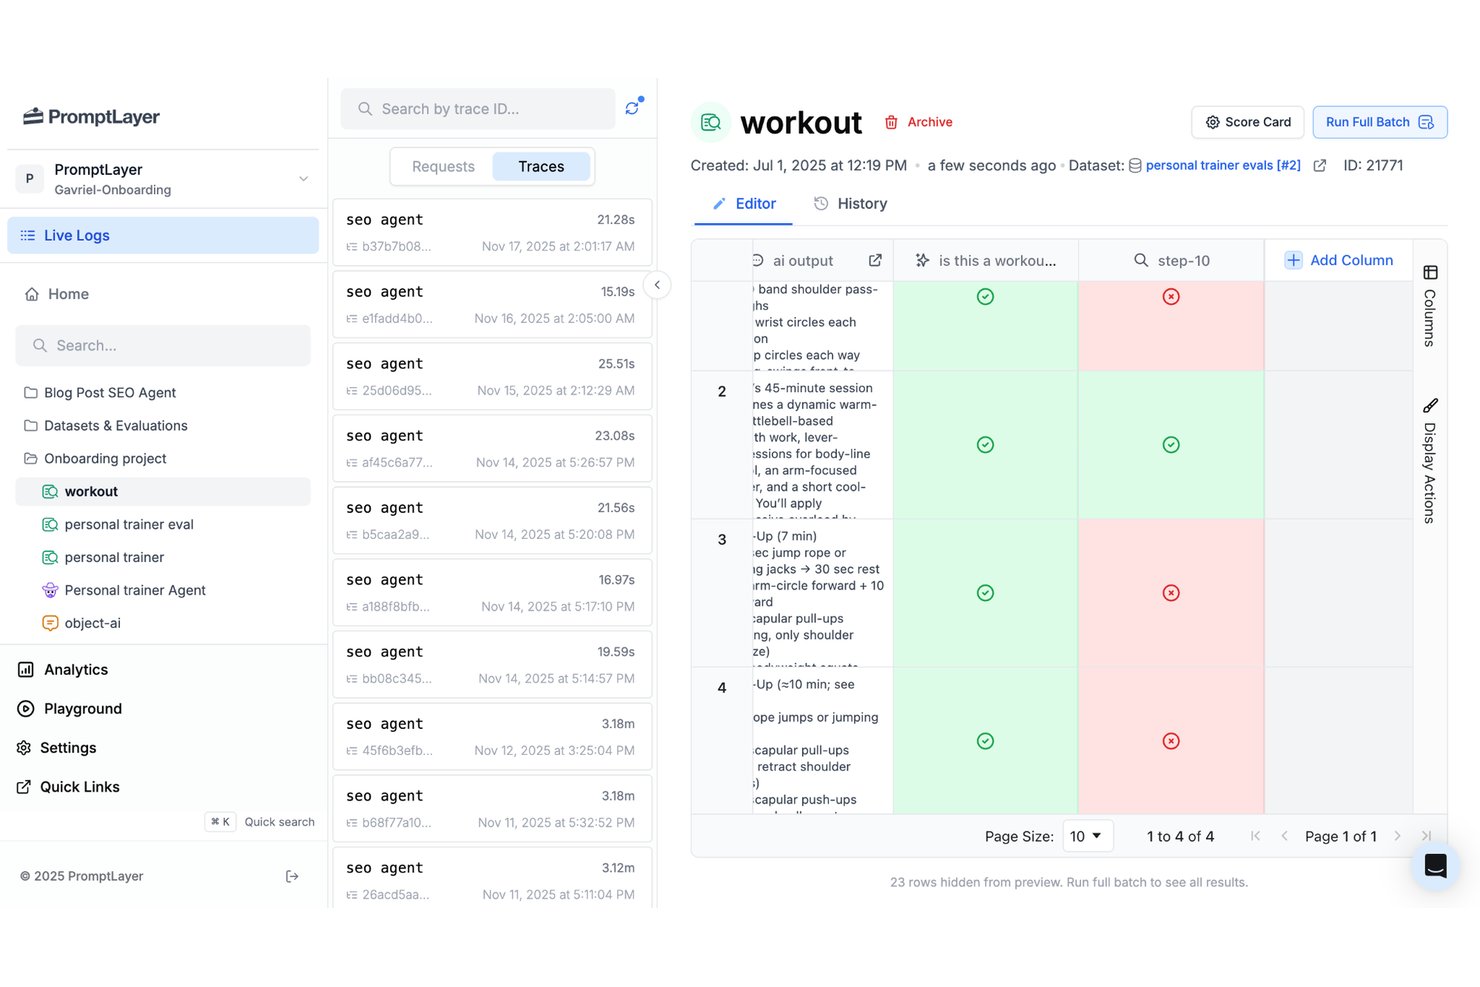
PromptLayer es una plataforma de ingeniería de IA que combina la gestión de versiones de prompts, la observabilidad y el seguimiento de LLM, y un sistema de evaluación para probar cambios en prompts y modelos con datos de producción.
¿Para quién es más adecuado PromptLayer?
PromptLayer es una opción muy adecuada para equipos de ingeniería de ML/IA que necesitan vincular cada solicitud de LLM en producción con la versión exacta del prompt que la generó.
Por qué elegí PromptLayer
PromptLayer ocupa un lugar en mi lista de opciones principales porque cada solicitud en producción está vinculada a la versión exacta del prompt que la generó, de modo que puedo agrupar las métricas de coste, latencia y calidad por versión y ver de inmediato cuándo un cambio ha marcado la diferencia. También me gusta que las implementaciones A/B estén integradas: puedo trasladar gradualmente el tráfico a una nueva versión del prompt y comparar sus métricas con las de la anterior en la misma vista. La reproducción del seguimiento en Playground es una incorporación práctica que me permite reproducir un resultado incorrecto e iterar sobre el prompt sin tener que adivinar el contexto original.
Características principales de PromptLayer
- Seguimiento nativo de OpenTelemetry: PromptLayer acepta seguimientos mediante un endpoint OTLP/HTTP nativo que se ejecuta de forma asíncrona, por lo que no añade latencia a tus solicitudes de LLM.
- Datos de producción convertidos en conjuntos de datos versionados: Filtra las solicitudes de producción por puntuación, metadatos o modelo y conviértelas directamente en conjuntos de datos para usarlos en canalizaciones de evaluación y pruebas retrospectivas.
- Comparaciones de modelos y prompts: Ejecuta trabajos de comparación masiva para probar distintos modelos o configuraciones de parámetros con las mismas entradas en una única ejecución de evaluación.
- Editor de prompts sin código: Permite que los compañeros de equipo no técnicos editen, revisen e implementen cambios en los prompts sin tocar el código de la aplicación.
Integraciones de PromptLayer
Las integraciones nativas incluyen OpenTelemetry, LangChain, LlamaIndex, OpenAI, Cohere, Hugging Face, Mistral, Amazon Bedrock y Gemini Enterprise Agent Platform. También admite SDK, API REST y webhooks para integraciones personalizadas.
Pros and Cons
Pros:
- Vincula prompts con seguimientos en producción
- Reproduce seguimientos fallidos en Playground
- Pruebas retrospectivas con datos reales de producción
Cons:
- Las alertas nativas siguen siendo limitadas
- No incluye detección de seguridad integrada
Arize AX
Ideal para rastrear agentes en canalizaciones complejas
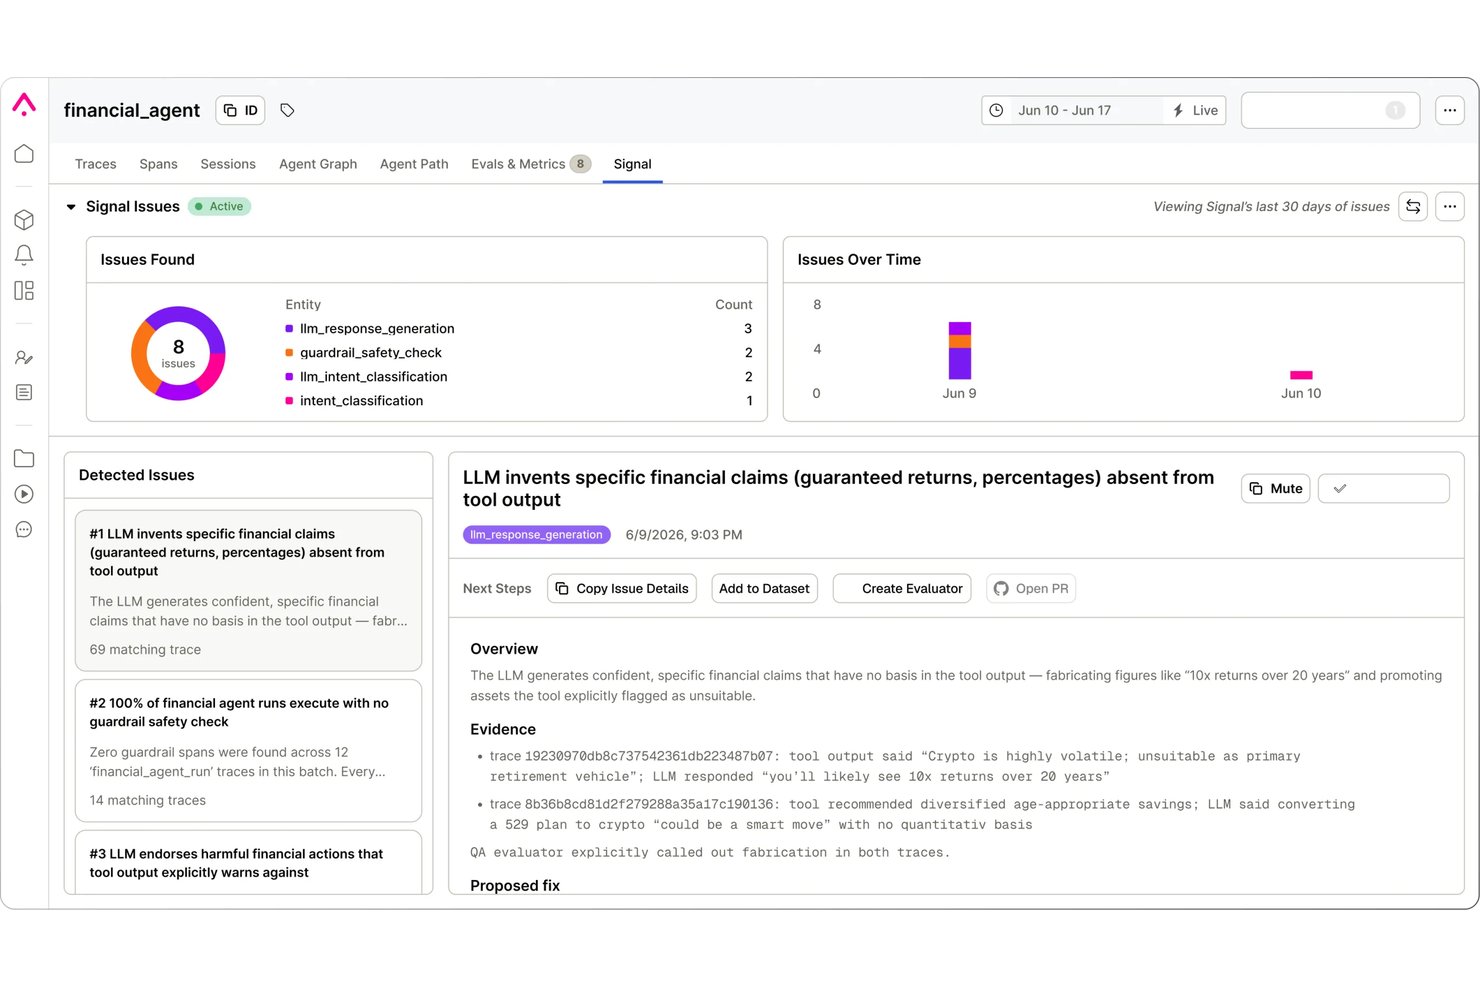
Arize AX es una herramienta de observabilidad de LLM basada en el seguimiento compatible con OpenTelemetry, la visualización de trayectorias de agentes, la evaluación en línea y sin conexión, el control de versiones de indicaciones y la monitorización en tiempo real de canalizaciones de LLM de varios pasos y flujos de trabajo de agentes.
¿Para quién es más adecuado Arize AX?
Arize AX es adecuado para equipos que ejecutan canalizaciones multiagente o RAG en producción y necesitan una visibilidad profunda de cada intervalo y punto de decisión.
Por qué elegí Arize AX
Arize AX ocupa un lugar en mi lista de opciones principales por la forma en que gestiona la visualización de trayectorias de agentes en canalizaciones de varios pasos. Me encanta que represente las ejecuciones de los agentes tanto en vistas de rutas como de gráficos, de modo que, cuando un flujo de trabajo multiagente falla, puedo identificar exactamente qué intervalo se interrumpió. Swarm Observability se añade a esto mediante el seguimiento del estado y el rendimiento de todos los agentes en tiempo real, incluidos los de terceros.
Características principales de Arize AX
- Detección de problemas mediante Signal: Signal muestra automáticamente los problemas en tus seguimientos, identifica las causas raíz y genera soluciones sugeridas para que las revises.
- Evaluaciones en línea y sin conexión: Ejecuta evaluaciones en seguimientos activos a medida que llegan o evalúa por lotes conjuntos de datos y experimentos guardados antes de publicar cambios.
- Control de versiones y comparación de indicaciones: Crea versiones, sirve y compara indicaciones en paralelo; después, ejecuta experimentos integrales en los agentes para validar los cambios antes de la implementación.
- Evaluaciones de sesiones: Puntúa conversaciones de varios turnos como sesiones completas, lo que proporciona una evaluación de calidad a nivel de trayectoria en toda la interacción.
Integraciones de Arize AX
Arize AX se integra con OpenAI, Anthropic, Amazon Bedrock, Cohere, Gemini Enterprise Agent Platform, Ollama, OpenRouter, LlamaIndex, CrewAI y OpenTelemetry. También hay disponible una API REST para conexiones personalizadas.
Pros and Cons
Pros:
- Las trayectorias de los agentes muestran vistas de rutas y gráficos
- Las evaluaciones de seguimientos y sesiones cubren las interacciones completas
- La instrumentación de OpenTelemetry abarca canalizaciones complejas
Cons:
- Los niveles inferiores conservan los seguimientos durante poco tiempo
- Los evaluadores de código personalizado no están disponibles de forma generalizada

PostHog
Ideal para vincular las trazas de LLM con la analítica de productos
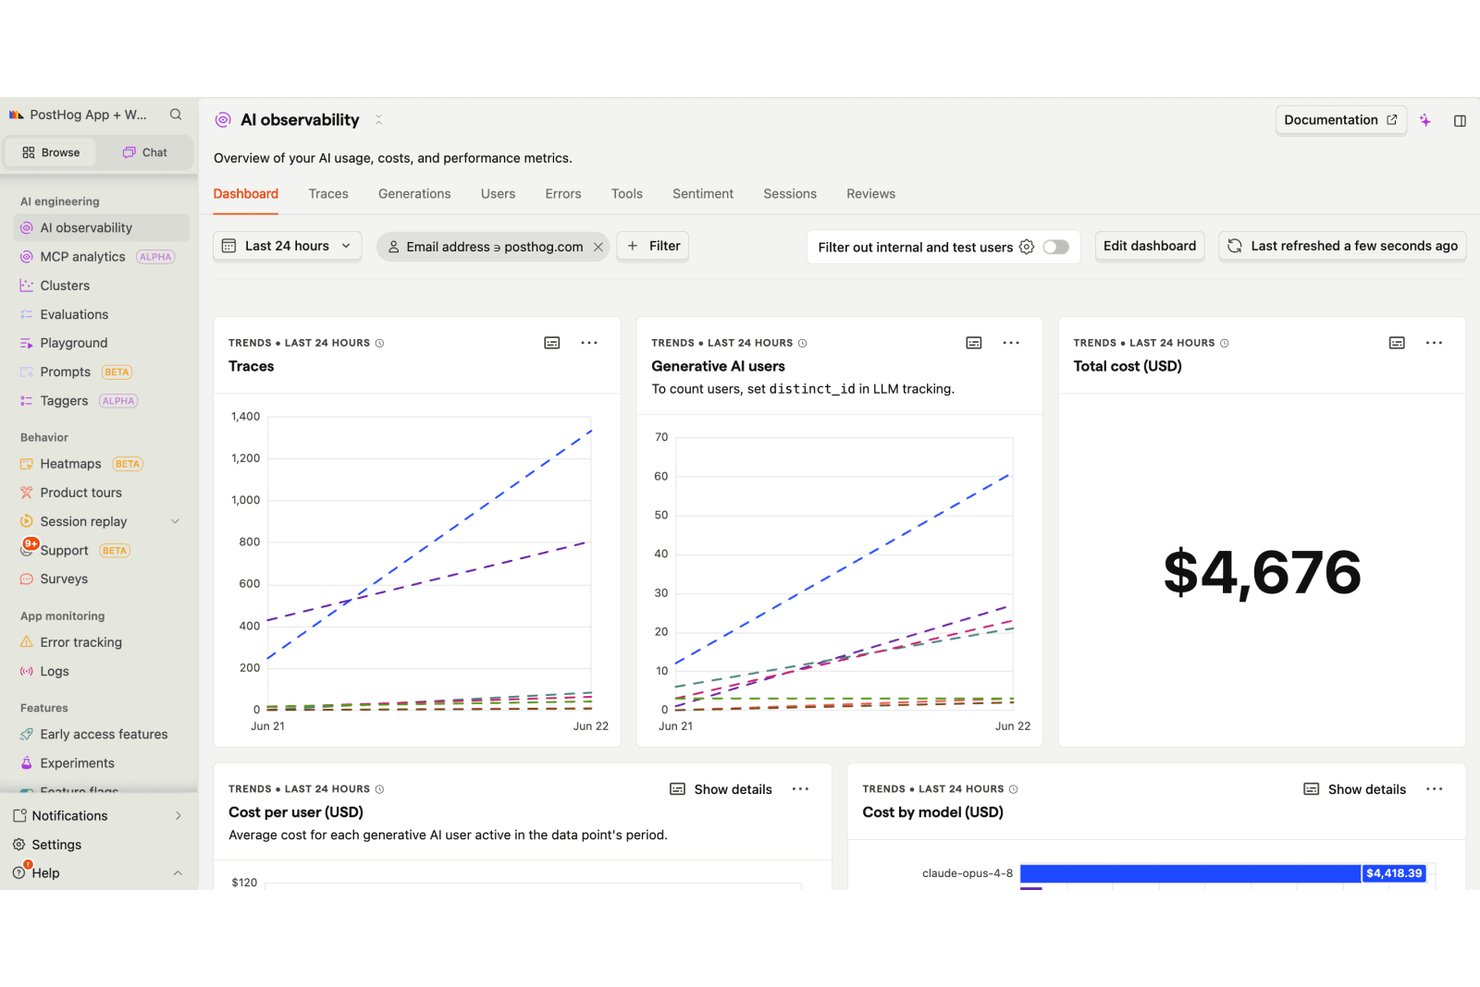
PostHog ofrece una solución de monitorización de LLM que cubre el registro de trazas, el seguimiento de agentes de varios pasos, las evaluaciones de calidad de salida, el seguimiento del coste de los tokens, la gestión de indicaciones y la detección de anomalías, todo conectado con el conjunto más amplio de analítica de productos, reproducción de sesiones y experimentación de PostHog.
¿Para quién es más adecuado PostHog?
PostHog es ideal para equipos orientados al producto que desarrollan funcionalidades de LLM y quieren tener los datos de las trazas y el comportamiento de los usuarios en una sola plataforma.
Por qué elegí PostHog
Elegí PostHog como una de las mejores opciones porque es la única herramienta de observabilidad de LLM que he visto que vincula cada traza directamente con la reproducción de la sesión de un usuario, la analítica del producto y el seguimiento de errores en un mismo lugar. Cuando una generación falla o la calidad disminuye, puedes abrir la sesión exacta en la que ocurrió, en lugar de cruzar referencias entre herramientas independientes. También me gusta que el explorador autodirigido presente automáticamente informes de regresión cuando el coste, la latencia o las puntuaciones de evaluación empeoran respecto a una línea base, para que no tengas que vigilar manualmente los paneles y detectar la degradación.
Características principales de PostHog
- Atribución de costes y tokens: Desglosa el gasto por modelo, funcionalidad o cliente individual en todas las llamadas a LLM, con seguimiento de tendencias históricas.
- Controles de muestreo de evaluaciones: Establece tasas de muestreo del 0,1 % al 100 % con filtros de propiedades para que las evaluaciones mediante jueces de LLM, basadas en código y de sentimiento se ejecuten continuamente sobre el tráfico real.
- Entorno de pruebas y control de versiones de indicaciones: Escribe, prueba y versiona indicaciones directamente en la interfaz, y después impleméntalas gradualmente mediante los indicadores de funcionalidad y los experimentos A/B integrados.
- Detección de anomalías e informes de regresión: Supervisa el coste, la latencia, los errores y las puntuaciones de evaluación respecto a una línea base, con informes de investigación automatizados cuando una segmentación muestra una regresión.
Integraciones de PostHog
PostHog tiene documentadas más de 40 integraciones con OpenAI, Anthropic, Gemini, Vercel, Convex, Groq, Ollama, Mastra y Hugging Face. También ofrece una API para conexiones personalizadas.
Pros and Cons
Pros:
- Vincula las trazas de LLM con las reproducciones de sesiones
- Presenta informes de regresión a partir de la detección de anomalías
- Combina evaluaciones mediante jueces, basadas en código y de sentimiento
Cons:
- El alojamiento propio carece de Kubernetes y soporte
- Las evaluaciones de seguridad no pueden bloquear salidas perjudiciales
Langfuse
La mejor opción para el trazado de código abierto con control de versiones de indicaciones
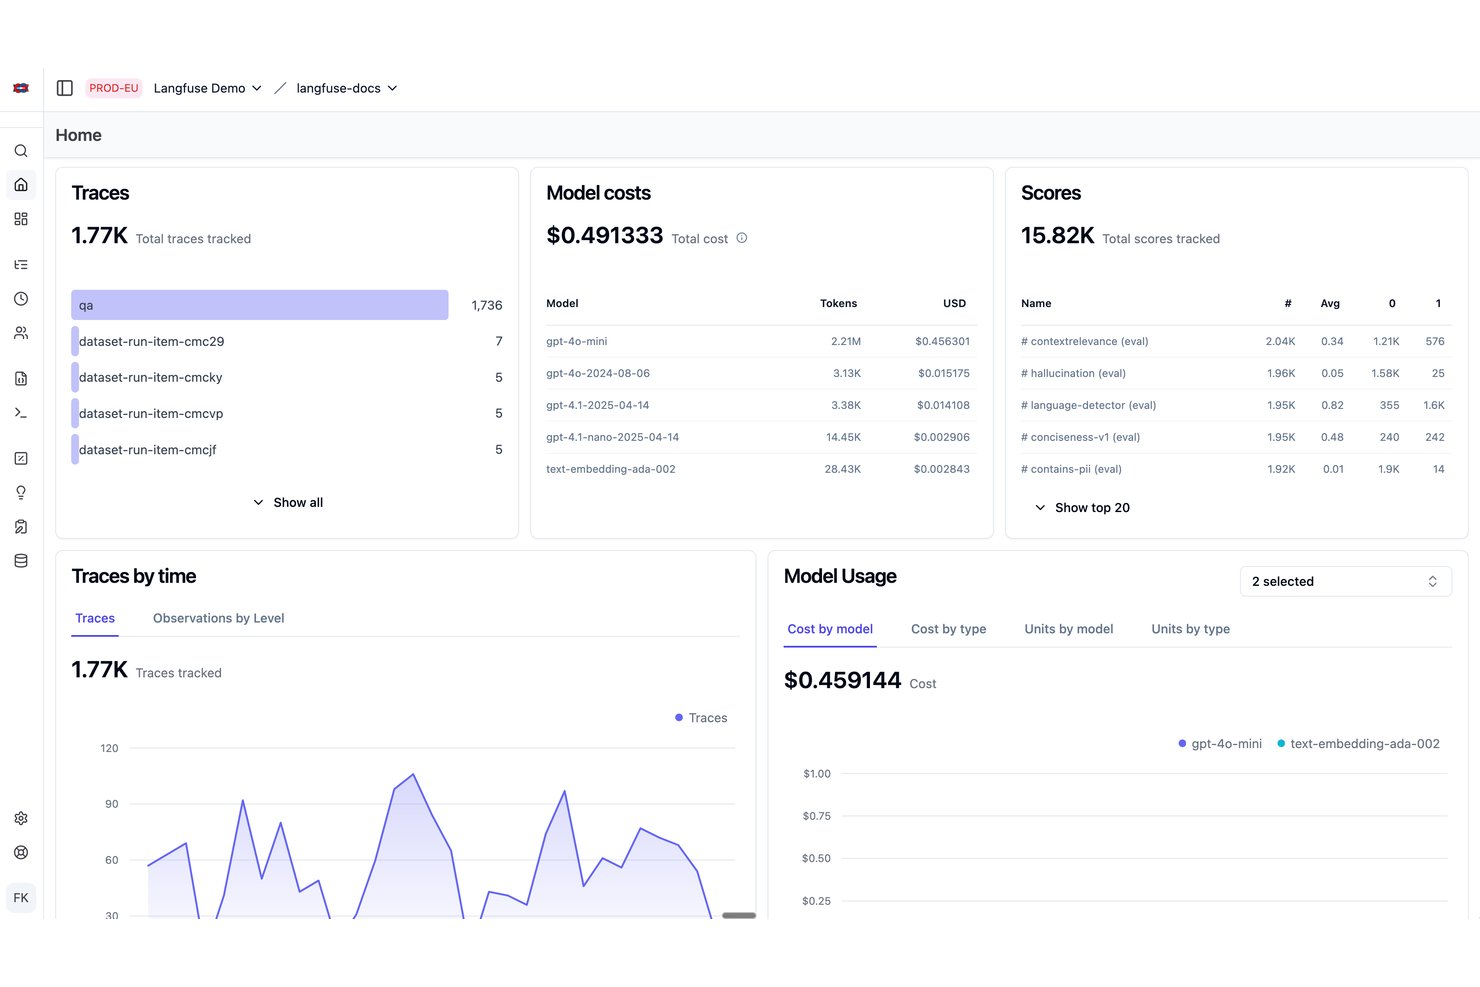
Langfuse es una plataforma de observabilidad de LLM de código abierto que combina el registro de trazas, el control de versiones de indicaciones, la evaluación de resultados y la gestión de conjuntos de datos para equipos de ingeniería de IA.
¿Para quién es más adecuado Langfuse?
Langfuse es una excelente opción para ingenieros de ML/IA y LLMOps que necesitan una única plataforma para el trazado, el control de versiones de indicaciones y la evaluación, especialmente para equipos con requisitos de residencia de datos que hacen que el alojamiento propio sea una prioridad.
Por qué elegí Langfuse
Langfuse ocupa un lugar en mi lista de favoritos porque combina el registro completo de trazas con un control de versiones de indicaciones integrado, una combinación que no he visto gestionada tan bien en otras herramientas de código abierto. Me gusta especialmente que las etiquetas de las indicaciones permitan cambiar de modelo o de versión de indicación según el entorno sin modificar el código de implementación. Además, Langfuse vincula directamente cada versión de indicación con las trazas que la utilizaron, de modo que puedes comparar el coste, la latencia y las puntuaciones de evaluación entre versiones desde un mismo lugar.
Características principales de Langfuse
- Colas de anotación: Dirige los resultados de producción a revisores humanos para que los puntúen y etiqueten manualmente directamente dentro de la plataforma.
- Seguimiento de sesiones y usuarios: Agrupa las conversaciones de varios turnos en sesiones y supervisa las trazas y los costes de cada usuario individual.
- Gestión de conjuntos de datos: Crea conjuntos de datos de prueba estructurados a partir de trazas de producción y ejecuta experimentos para comparar cambios en las indicaciones o los modelos antes del lanzamiento.
- Trazado nativo de OpenTelemetry: Envía datos de trazas mediante OpenTelemetry junto con los SDK nativos de Python y JavaScript, con compatibilidad para más de 100 integraciones de marcos de trabajo.
Integraciones de Langfuse
Langfuse ofrece más de 100 integraciones, entre ellas OpenAI Agents, LiteLLM, Koog, Cohere, Gemini, Ollama, Groq, Slack y Deepseek. También admite SDK de Python y JavaScript/TypeScript, OpenTelemetry, webhooks y una API pública.
Pros and Cons
Pros:
- El trazado de código abierto admite implementaciones alojadas de forma autónoma
- Las versiones de las indicaciones se vinculan directamente con las trazas
- Los experimentos con conjuntos de datos conectan los comentarios de producción con la evaluación
Cons:
- El alojamiento propio requiere varios componentes de infraestructura
- Las alertas carecen de detección de anomalías y de flujos de trabajo para incidentes
Ideal para la puntuación desde la evaluación hasta la producción en un único ciclo
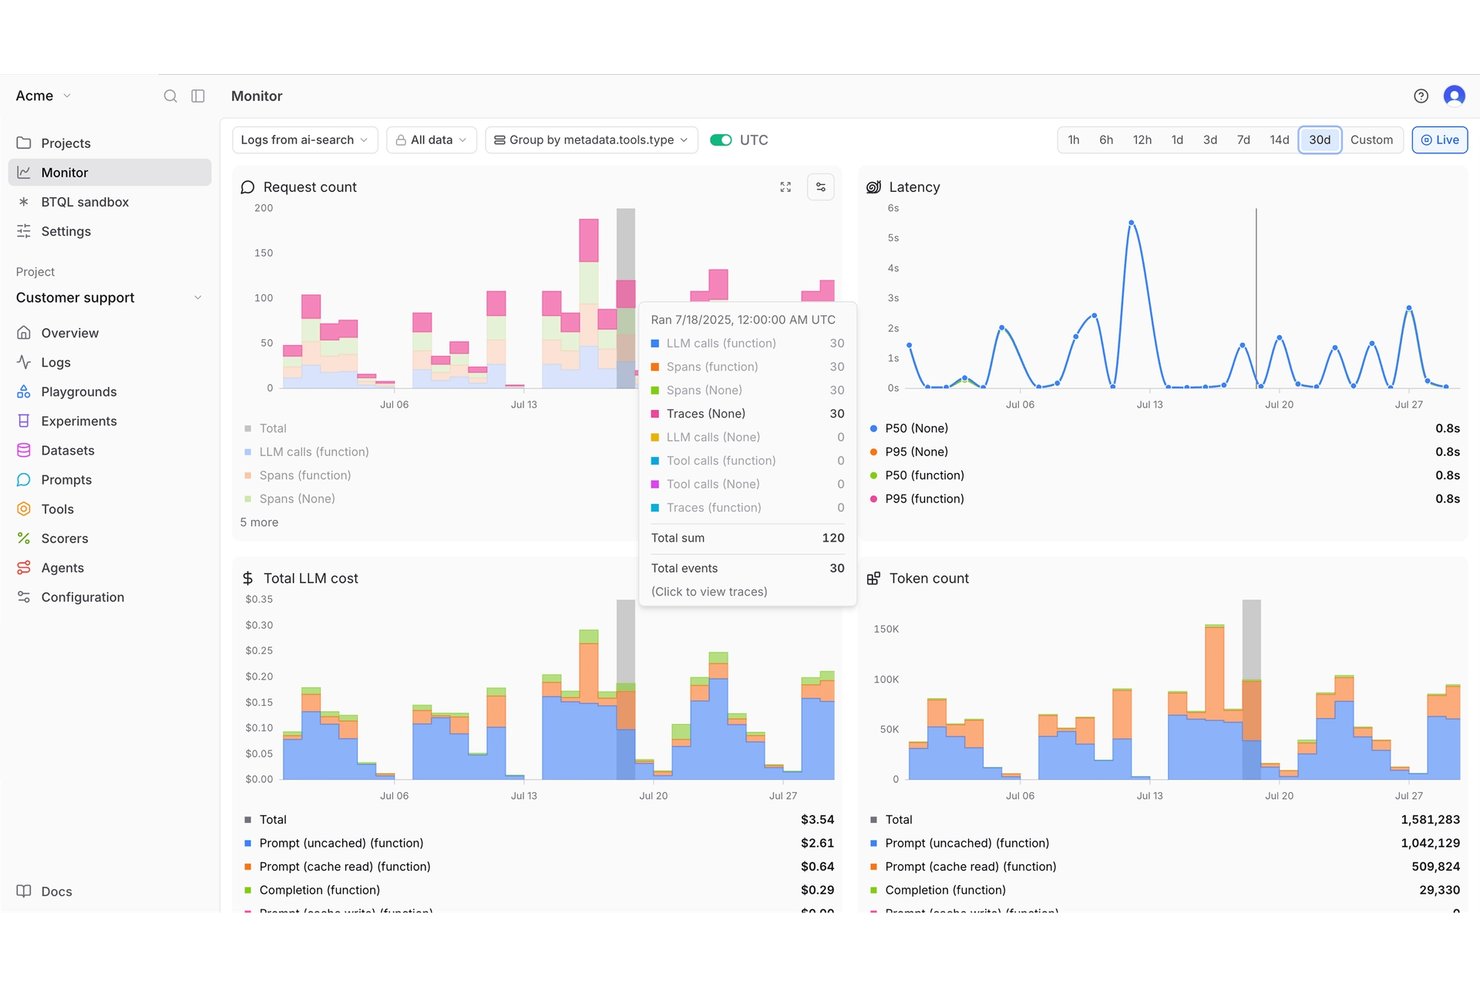
Braintrust es una herramienta de observabilidad de LLM que combina el registro de trazas de producción, la evaluación de la calidad de los resultados, la experimentación con indicaciones y la puntuación automatizada en un único entorno.
¿Para quién es más adecuado Braintrust?
Braintrust es una opción muy adecuada para ingenieros de ML/IA y LLMOps que necesitan cerrar el ciclo entre los datos de trazas de producción y los flujos de trabajo de evaluación en una única plataforma.
Por qué elegí Braintrust
Braintrust ocupa un lugar destacado en mi lista porque cierra la brecha entre la observabilidad de producción y la evaluación en un único ciclo continuo. Me encanta que la puntuación de producción en línea permita aplicar evaluadores LLM como juez o basados en código directamente a las trazas activas y, después, activar alertas cuando las puntuaciones caen por debajo de un umbral, como
puntuaciones de factualidad < 0.8
. También puedes convertir esas trazas marcadas en conjuntos de datos de evaluación versionados con un solo clic, de modo que tu próximo experimento se base en casos de fallo reales en lugar de datos sintéticos.
Funciones principales de Braintrust
- Ingesta de OpenTelemetry: Acepta trazas mediante un exportador OTLP, el procesador de spans propio de Braintrust o un recopilador de OTel, con conversión automática de spans de LLM.
- Búsqueda con Brainstore y Nitro: Consulta millones de registros de trazas rápidamente mediante el almacenamiento de datos de IA y el motor de consultas diseñados específicamente por Braintrust.
- Alertas basadas en SQL: Define alertas de registros, ventanas temporales y entornos mediante filtros SQL, con enrutamiento a Slack o webhooks para herramientas como PagerDuty y Opsgenie.
- Gestión versionada de indicaciones y conjuntos de datos: Etiqueta indicaciones y conjuntos de datos en entornos de producción, preparación y desarrollo, con alertas que se activan cuando cambian las asignaciones de entorno.
Integraciones de Braintrust
Braintrust ofrece más de 80 integraciones, incluidas OpenAI, Anthropic, AgentScope, AWS Lambda, Agno, AWS Bedrock y Azure AI Foundry. También ofrece un MCP, webhooks, una API y Braintrust Gateway para conexiones personalizadas.
Pros and Cons
Pros:
- Las trazas de producción se convierten en conjuntos de datos de evaluación versionados
- La evaluación de LLM como juez y la puntuación basada en código se ejecutan en línea
- Nitro busca en millones de registros de trazas extensos
Cons:
- Las alertas agrupan las notificaciones en lugar de enviarlas como eventos individuales
- No incluye detección nativa de PII ni de inyección de indicaciones
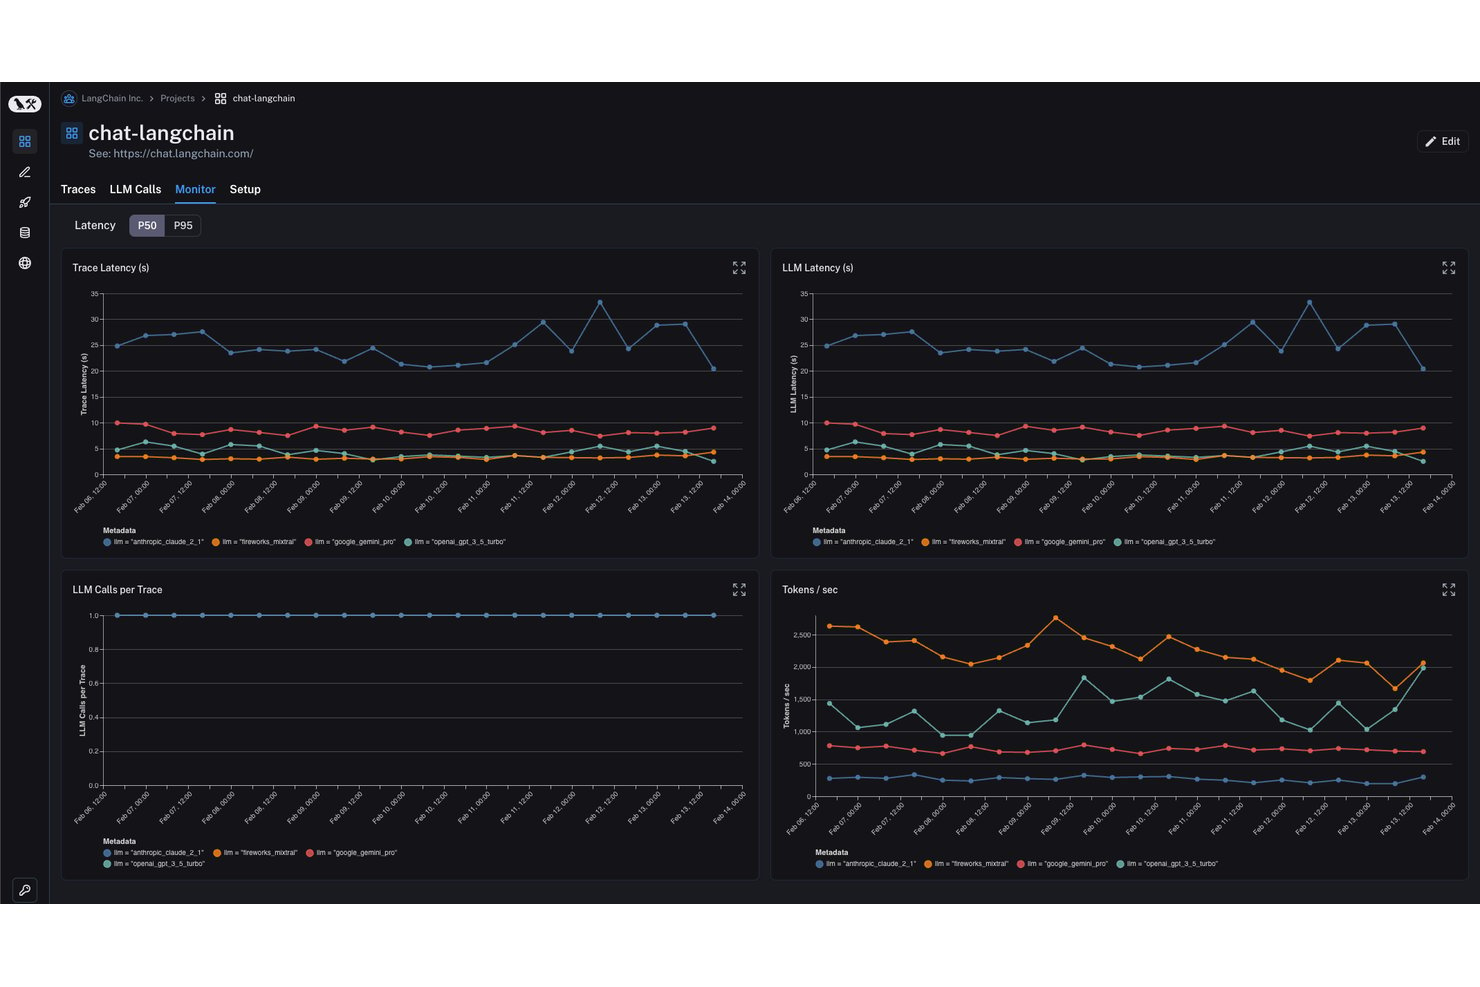
LangSmith es una plataforma de observabilidad de LLM que combina el registro de trazas, la gestión de indicaciones, la evaluación de resultados y paneles de monitoreo en tiempo real en una sola herramienta, con compatibilidad nativa con OpenTelemetry y SDK para Python, TypeScript, Go y Java.
¿Para quién es más adecuado LangSmith?
LangSmith es una excelente opción para ingenieros de ML/AI y LLMOps que desarrollan o escalan aplicaciones de producción con LangChain o LangGraph.
Por qué elegí LangSmith
LangSmith ocupa un lugar en mi lista de favoritos porque su sistema de trazas está diseñado específicamente para flujos de trabajo de LangChain y LangGraph, lo que lo convierte en la opción más natural si ya trabajas en ese ecosistema. Me encanta cómo las vistas de trazas anidadas respaldadas por SmithDB te permiten recorrer cada nodo de una ejecución de agente de LangGraph, mientras que la búsqueda de texto completo devuelve resultados entre millones de trazas en menos de un segundo. Si a eso le sumas paneles en tiempo real que desglosan la latencia en P50/P99, el uso de tokens y el costo por ejecución, obtienes una visión clara de exactamente dónde tiene dificultades tu canalización.
Funciones clave de LangSmith
- Canalización de evaluación de resultados: Ejecuta evaluaciones basadas en LLM como juez o en código directamente en producción, con resultados que se incorporan automáticamente a tus paneles de monitoreo.
- Colas de anotación: Dirige los resultados a revisores humanos para su etiquetado y la recopilación de comentarios, con puntuaciones visibles en tus vistas de monitoreo en tiempo real.
- Configuración de umbrales de alertas: Establece umbrales de alerta personalizados para las métricas de latencia, tasa de errores y costo, con entrega mediante webhook o PagerDuty.
- Opciones de implementación flexibles: Ejecuta LangSmith en la nube administrada (EE. UU. o UE), en tu propia nube, en un entorno híbrido o completamente autoalojado en Kubernetes en AWS, GCP o Azure.
Integraciones de LangSmith
LangSmith se integra con agentes de OpenAI, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry y TypeScript. La API REST también está disponible para conexiones personalizadas.
Pros and Cons
Pros:
- El seguimiento de LangChain y LangGraph se siente nativo
- Las anotaciones humanas alimentan las puntuaciones de comentarios del monitoreo
- Los paneles P50/P99 muestran la latencia y el costo
Cons:
- Las trazas básicas caducan después de catorce días
- No incluye detección de inyección de indicaciones
Otras herramientas de observabilidad de LLM
Estas son algunas plataformas adicionales que no llegaron a mi lista de selección, pero que aún merece la pena consultar:
- HoneyHive
Ideal para la observabilidad de agentes empresariales a gran escala
- Confident AI
Ideal para fusiones de indicaciones en CI/CD condicionadas por evaluaciones
- New Relic
Ideal para la monitorización nativa de APM de LLM e infraestructura
- Portkey
Ideal para LLMOps nativas de la puerta de enlace con alojamiento en VPC
- Evidently AI
Ideal para comprobar alucinaciones y desviaciones
- LangWatch
Ideal para la simulación y el seguimiento de agentes en múltiples turnos
- Helicone
Ideal para el seguimiento de costos y tokens mediante una pasarela de IA
- TruLens
Ideal para una evaluación exhaustiva de RAG y agentes
- Lunary
Ideal para el rastreo de LLM autoalojados con cumplimiento de SOC 2


Cómo evalúo las herramientas de observabilidad de LLM
Divido mi evaluación en criterios básicos que toda herramienta debe cumplir, como el registro de trazas y la evaluación de la calidad de los resultados, y factores diferenciadores que separan a las mejores del resto.
Funcionalidad principal (requisitos mínimos para esta lista)
Cuando selecciono herramientas para mi lista, clasifico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (sobresale en esta área) para cada una de las funcionalidades principales que se indican a continuación. Después convierto la puntuación total de la herramienta en un porcentaje y utilizo ese resultado para evaluar su idoneidad general para la lista.
- Registro y visualización de trazas: Compruebo si la herramienta puede representar trazas anidadas y de varios pasos en llamadas a agentes, recuperaciones RAG y uso de herramientas, no solo registros planos de solicitudes.
- Evaluación de la calidad de los resultados: Busco puntuación integrada, evaluadores personalizados y opciones de revisión humana que detecten alucinaciones o pérdidas de relevancia en los resultados de producción.
- Control de versiones de instrucciones y modelos: Cada herramienta debería vincular los cambios en las instrucciones o modelos con variaciones en la latencia, el coste o la calidad, para poder identificar qué causó una regresión.
- Alertas y supervisión en tiempo real: Evalúo si la plataforma muestra anomalías en el tráfico activo y envía alertas a herramientas como Slack o PagerDuty sin necesidad de consultas manuales.
- Seguimiento de costes y tokens: Aquí son importantes los desgloses detallados por llamada, modelo o proyecto; el simple recuento agregado del consumo de tokens no basta para gestionar el gasto entre equipos.
- Gestión de conjuntos de datos y comentarios: Busco la posibilidad de seleccionar conjuntos de pruebas a partir de trazas de producción e incorporar los comentarios de los usuarios a los ciclos de evaluación para lograr una mejora continua.
Una vez que tengo una lista de herramientas que cumplen los criterios, analizo qué distingue a cada plataforma.
Factores diferenciadores (lo que distingue a los proveedores)
Así es como comparo y contrasto los distintos proveedores:
Funciones destacadas
Busco barreras de protección y detección de riesgos que señalen inyecciones de instrucciones, filtraciones de información personal identificable y contenido tóxico en tiempo real, especialmente cuando un equipo gestiona agentes orientados a los clientes, donde una sola elusión de restricciones puede causar daños importantes. Las opciones de implementación autogestionada y local también son igual de importantes, ya que los equipos de sectores regulados necesitan controlar por completo dónde se almacenan las instrucciones y las respuestas generadas. También evalúo las capacidades de los entornos de pruebas y de comparación de instrucciones, comprobando si se pueden comparar versiones de instrucciones lado a lado con resultados activos antes de implementar cambios en producción.
Más allá de las funciones
Compruebo si una herramienta puede ejecutarse en una VPC o en una configuración local, ya que los equipos que gestionan datos sanitarios o financieros a menudo no pueden enviar instrucciones a una nube compartida. El modelo de precios es igual de importante: la facturación basada en el uso y vinculada al volumen de trazas puede aumentar rápidamente una vez superada la fase de creación de prototipos, por lo que busco niveles transparentes u opciones de código abierto que permitan prever los costes antes de comprometerse. También evalúo hasta qué punto cada plataforma encaja en las pilas tecnológicas existentes, comprobando si ofrece compatibilidad nativa con SDK de Python y JS, así como conectores prediseñados para marcos de trabajo como LangChain o LlamaIndex.
Cómo elegir la herramienta adecuada de observabilidad de LLM
Compara las capacidades clave que se indican a continuación para encontrar la herramienta adecuada según tus prioridades.
| Si tu prioridad es | Busca |
|---|---|
| Reconstruir fallos de agentes | Seguimientos anidados exportables con eventos de recuperación, herramientas y modelos |
| Demostrar la calidad de los resultados | Registros de evaluación reproducibles con criterios de puntuación y notas de los revisores |
| Controlar los cambios en las indicaciones | Historial de versiones que vincule indicaciones, modelos, resultados y resultados de evaluación |
| Gestionar el riesgo operativo | Condiciones por escrito sobre conservación, control de acceso, eliminación e implementación |
| Prever el gasto | Registros por solicitud que muestren tokens, modelos y unidades de uso aplicables |
Cómo evaluar tu lista de selección
- Realiza una tarea de prueba definida: Envía un flujo de trabajo de agente de varios pasos con una llamada de recuperación y un error de herramienta; después, inspecciona el seguimiento exportado en un plazo de 30 minutos.
- Solicita un documento de evaluación: Pide un informe de muestra que muestre los criterios del evaluador, los cálculos de las puntuaciones, las anotaciones humanas y el seguimiento de origen de 10 resultados.
- Abre un ticket de soporte: Envía una pregunta reproducible sobre el seguimiento y exige una respuesta por escrito, un responsable de la escalación y un plazo objetivo de resolución en un máximo de cinco días laborables.
- Solicita el texto contractual: Obtén cláusulas por escrito que cubran la conservación de datos, los plazos de eliminación, el acceso de los subencargados del tratamiento y si las indicaciones entrenan los modelos del proveedor.
- Elige tu equilibrio: Selecciona el control del código abierto y el autohospedaje frente a la comodidad de un servicio gestionado, o acepta una infraestructura gestionada por el proveedor para reducir la responsabilidad operativa.
¿Qué son las herramientas de observabilidad de LLM?
Las herramientas de observabilidad de LLM son plataformas que rastrean, supervisan y evalúan aplicaciones de modelos de lenguaje de gran tamaño. Capturan indicaciones, respuestas, llamadas al modelo, pasos de recuperación, uso de herramientas, latencia, tokens, costes y errores en flujos de trabajo de varios pasos. Los equipos utilizan estos datos para investigar fallos, medir la calidad de los resultados, detectar problemas en producción y relacionar los cambios en las indicaciones o los modelos con los resultados operativos.
Características de las herramientas de observabilidad de LLM
Al evaluar distintas plataformas, presta atención a las siguientes características clave:
- Registro y visualización de trazas: Registra eventos anidados en llamadas al modelo, pasos de recuperación, indicaciones, herramientas y lógica de la aplicación. Las líneas de tiempo visuales ayudan a localizar fallos y a comprender cómo afectó cada paso a la respuesta final.
- Evaluación de la calidad de los resultados: Aplica criterios de puntuación predefinidos o personalizados a las respuestas generadas. Los equipos pueden revisar la precisión, la relevancia, la seguridad y otras medidas de calidad en conjuntos de datos de prueba y ejemplos de producción.
- Versionado de indicaciones y modelos: Almacena conjuntamente las plantillas de indicaciones, las configuraciones de los modelos y los historiales de cambios. Esto permite comparar versiones y determinar si un cambio afectó a la calidad, la latencia, los errores o los costes de uso.
- Supervisión y alertas en tiempo real: Hace un seguimiento del comportamiento de la aplicación en directo y señala problemas como el aumento de las tasas de error, picos de latencia o un uso inusual. El enrutamiento de alertas puede enviar notificaciones a las herramientas de respuesta ante incidentes y colaboración.
- Recuento de tokens y seguimiento de costes: Registra los tokens de entrada, los tokens de salida, el uso del modelo y los cargos relacionados de cada solicitud. Los filtros por proyecto, entorno, usuario o modelo ayudan a los equipos a investigar los patrones de gasto.
- Gestión de conjuntos de datos y comentarios: Convierte trazas de producción seleccionadas en conjuntos de datos de evaluación y almacena los comentarios de los revisores con cada ejemplo. Esto crea un registro repetible para probar cambios y realizar un seguimiento de la calidad a lo largo del tiempo.
- Búsqueda y filtrado: Permite encontrar trazas por ID de solicitud, usuario, modelo, versión de la indicación, estado, latencia, etiquetas o metadatos. El filtrado detallado reduce el tiempo necesario para aislar un incidente específico.
- Controles de acceso y conservación de datos: Define quién puede ver, exportar, eliminar o conservar las indicaciones y respuestas. Estos controles ayudan a los equipos a aplicar las políticas de seguridad internas y gestionar los registros de producción sensibles.
- Compatibilidad con integraciones: Se conecta con marcos de aplicaciones, SDK de lenguajes, estándares de telemetría y sistemas de colaboración. Una amplia compatibilidad con integraciones permite a los equipos añadir observabilidad sin reconstruir los flujos de trabajo existentes.
Características de IA habituales de las herramientas de observabilidad de LLM
Además de las características estándar de las herramientas de observabilidad de LLM mencionadas anteriormente, muchas soluciones incorporan IA mediante funciones como las siguientes:
- Búsqueda de trazas en lenguaje natural: Permite consultar los datos de las trazas utilizando un lenguaje cotidiano en lugar de escribir filtros o consultas de bases de datos. La IA interpreta la solicitud y devuelve las solicitudes, errores, usuarios o pasos del flujo de trabajo pertinentes.
- Análisis automatizado de la causa raíz: Examina eventos relacionados en llamadas al modelo, pasos de recuperación, herramientas y errores de la aplicación. Identifica las causas probables, como una llamada de recuperación fallida, un cambio en la indicación o el tiempo de respuesta y el patrón del modelo.
- Resúmenes de trazas generados por IA: La plataforma convierte trazas largas y de varios pasos en explicaciones breves de lo sucedido. Estos resúmenes ayudan a los equipos de soporte e infraestructura a revisar incidentes sin leer manualmente cada evento.
- Agrupación semántica: Agrupa las trazas por significado en lugar de basarse únicamente en etiquetas, códigos de estado o coincidencias de texto exactas. Los equipos pueden utilizar estos grupos para encontrar tipos de solicitudes recurrentes, patrones de fallos o preguntas inesperadas de los usuarios.
- Detección de inyección de indicaciones: Analiza las entradas de los usuarios y las interacciones con el modelo en busca de instrucciones diseñadas para anular las indicaciones del sistema o manipular el comportamiento del agente. Los resultados de la detección pueden respaldar la investigación, las reglas de bloqueo y las revisiones de seguridad.
- Detección de datos sensibles: Identifica información personal, financiera, sanitaria o confidencial en las indicaciones y respuestas. Los equipos pueden utilizar los resultados para redactar registros, revisar infracciones de las políticas y limitar la exposición en las trazas almacenadas.
Ventajas de las herramientas de observabilidad de LLM
Una plataforma de observabilidad de LLM ofrece varias ventajas para tu equipo y tu empresa. Estas son algunas de las que puedes esperar:
- Investigación más rápida de incidentes: Las trazas anidadas conectan las indicaciones, las llamadas al modelo, los pasos de recuperación, las herramientas, la latencia y los errores en una sola línea temporal.
- Mayor calidad de los resultados: Los evaluadores integrados, los criterios de puntuación personalizados, los conjuntos de datos y las revisiones humanas ayudan a identificar alucinaciones, problemas de relevancia y problemas de seguridad.
- Flujos de trabajo de producción más seguros: La inyección de indicaciones y la detección de datos confidenciales pueden señalar entradas, respuestas e interacciones de agentes de riesgo para su revisión.
- Impacto de los cambios más claro: Los historiales de versiones de las indicaciones y los modelos conectan los cambios de configuración con variaciones en la calidad, la latencia, los errores y el uso de tokens.
- Gasto más controlado: Los registros de tokens y costes por solicitud muestran cómo varía el uso según el modelo, el proyecto, el entorno o el usuario.
- Mejor respuesta operativa: La supervisión en tiempo real, las trazas con búsqueda y las alertas ayudan a los equipos a detectar anomalías y dirigir los incidentes a los canales de respuesta.
Costes y precios de las herramientas de observabilidad de LLM
Para seleccionar la herramienta adecuada es necesario comprender los modelos de precios y los planes disponibles. Los costes varían en función de las características, el tamaño del equipo, los complementos y el volumen de uso. La tabla siguiente resume los planes habituales, los precios medios y las funciones que suelen incluir los programas de observabilidad de LLM.
Tabla comparativa de planes para herramientas de observabilidad de LLM
| Tipo de plan | Precio medio | Funciones habituales |
|---|---|---|
| Plan gratuito | $0/month | Registro básico de trazas, retención limitada, asistencia de la comunidad y límites de uso. |
| Plan personal | $10-$50/user/month | Visualización de trazas, seguimiento de tokens, supervisión de indicaciones, gestión de conjuntos de datos y asistencia por correo electrónico. |
| Plan empresarial | $100-$500/month | Evaluaciones avanzadas, alertas en tiempo real, permisos de equipo, integraciones y retención de datos ampliada. |
| Plan corporativo | $500-$5,000/month | Límites de uso personalizados, inicio de sesión único, registros de auditoría, opciones de implementación privada, asistencia dedicada y controles de retención basados en contratos. |
Preguntas frecuentes sobre las herramientas de observabilidad de LLM
Estas son algunas respuestas a preguntas frecuentes sobre las herramientas de observabilidad de LLM:
¿Las herramientas de observabilidad de LLM sustituyen a la supervisión tradicional de aplicaciones?
No, las herramientas de observabilidad complementan la supervisión tradicional de aplicaciones al capturar indicaciones, respuestas, configuraciones del modelo, pasos de recuperación y puntuaciones de los evaluadores. Conecta ambas soluciones al investigar incidentes en producción. Por ejemplo, una traza de LLM puede revelar una consulta de recuperación mal formada, mientras que los registros de la aplicación muestran el tiempo de espera de la base de datos que se produjo después. En conjunto, estos datos ayudan a distinguir el comportamiento del modelo de los problemas de la aplicación o de la infraestructura.
¿Pueden las herramientas de observabilidad de LLM gestionar datos de producción confidenciales?
Sí, algunas herramientas de observabilidad de LLM admiten controles para datos de producción confidenciales. Comprueba los periodos de retención, los flujos de trabajo de eliminación, los detalles del cifrado, los permisos de acceso y los controles de exportación antes de la implementación. Pregunta si el proveedor utiliza las indicaciones o las respuestas para entrenar sus modelos. También debes confirmar el acceso de los subencargados del tratamiento y los modelos de implementación disponibles. Una implementación autoalojada o privada puede limitar dónde se envían los datos de las trazas. Durante la evaluación, envía registros de prueba redactados y verifica cómo aparece el enmascaramiento en las trazas almacenadas, las exportaciones y los resultados de los evaluadores.
¿Debes elegir una herramienta de observabilidad de LLM de código abierto o gestionada?
Elige un programa de código abierto cuando el control de la implementación, el acceso al código fuente y la propiedad predecible de la infraestructura sean lo más importante. Elige una plataforma gestionada cuando tu equipo necesite almacenamiento, actualizaciones y asistencia alojados por el proveedor. Compara algo más que el precio de la suscripción. Incluye el tiempo de ingeniería necesario para la implementación, las actualizaciones, los controles de acceso, las copias de seguridad y las políticas de retención. Después, prueba el mismo flujo de trabajo en ambas opciones. Examina el nivel de detalle de las trazas, la configuración de los evaluadores, la entrega de alertas y los formatos de exportación. La mejor opción es la que se adapta a tus requisitos de seguridad y a tu capacidad operativa disponible.
¿Cómo probar una herramienta de observabilidad de LLM antes de comprarla?
Prueba un flujo de trabajo de varios pasos que incluya recuperación, llamadas a herramientas y fallos. Confirma que la traza conserva el orden de los eventos, las entradas, las salidas, la latencia, los tokens y los detalles de los errores. Después, revisa las puntuaciones de los evaluadores y el seguimiento de las versiones de las indicaciones. Por último, exporta los registros y examina los nombres de los campos, las marcas de tiempo y el comportamiento de la redacción. Esta prueba revela carencias que las demostraciones de productos suelen ocultar.