

Las herramientas de extracción de datos web son aplicaciones que automatizan la extracción de datos de sitios web, lo que facilita la recopilación de información sin tener que copiar y pegar manualmente. Si buscas las mejores herramientas de extracción de datos web, probablemente necesites recopilar grandes volúmenes de datos web de forma fiable, sin encontrarte con obstáculos como las defensas contra bots o los cambios en las estructuras de los sitios.
Con tantas opciones disponibles en el mercado, es difícil saber qué herramienta se adaptará realmente a tu conjunto tecnológico, gestionará tus sitios objetivo y escalará según tus necesidades. Esta guía analiza las mejores herramientas para que puedas comparar funciones y enfoques, y encontrar exactamente lo que funciona para tus proyectos de TI.
Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

Resumen de las mejores herramientas de extracción de datos web
Esta tabla comparativa resume los detalles de precios de mi selección de las mejores herramientas de extracción de datos web para ayudarte a encontrar la más adecuada para tu presupuesto y las necesidades de tu empresa.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Lo mejor para control de navegador sin cabeza integrado | Plan gratuito disponible | Desde $30/mes | Website | |
| 2 | Ideal para scraping sigiloso y evasión de detección | Prueba gratuita de 14 días | Desde $69/mes | Website | |
| 3 | Mejor para manejar sitios web dinámicos con JavaScript | Plan gratuito disponible | Desde $189/mes | Website | |
| 4 | Mejor para integración directa en pipelines | Prueba gratuita de 30 días | Desde $199/mes (facturación anual) | Website | |
| 5 | Mejor para plantillas de automatización con robots preconstruidos | Plan gratuito disponible | Desde $19/mes (facturado anualmente) | Website | |
| 6 | Ideal para usuarios de interfaces de apuntar y hacer clic | Plan gratuito disponible | Desde $69/mes (facturado anualmente) | Website | |
| 7 | Ideal para la recopilación de datos gestionada contra bots | Prueba gratuita disponible | Desde $0.5/1,000 registros | Website | |
| 8 | Mejor para infraestructura de proxy a escala empresarial | Plan gratuito disponible | Desde $1.5/1.000 registros/mes | Website | |
| 9 | La mejor para la detección automática de esquemas de datos | Prueba gratuita de 30 días | Desde $0.13/1,000 solicitudes | Website | |
| 10 | La mejor para flujos de scraping simples impulsados por API | Plan gratuito disponible | Desde $49/mes | Website |


Análisis de las mejores herramientas de extracción de datos web
A continuación encontrarás mis resúmenes detallados de las mejores herramientas de extracción de datos web que llegaron a mi lista de selección. Mis análisis ofrecen una visión detallada de las funciones, integraciones y mejores casos de uso de cada herramienta para ayudarte a encontrar la más adecuada para ti.
 Lo mejor para control de navegador sin cabeza integrado
- Plan gratuito disponible
- Desde $30/mes
Visit WebsiteCustomer Rating:4.9/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.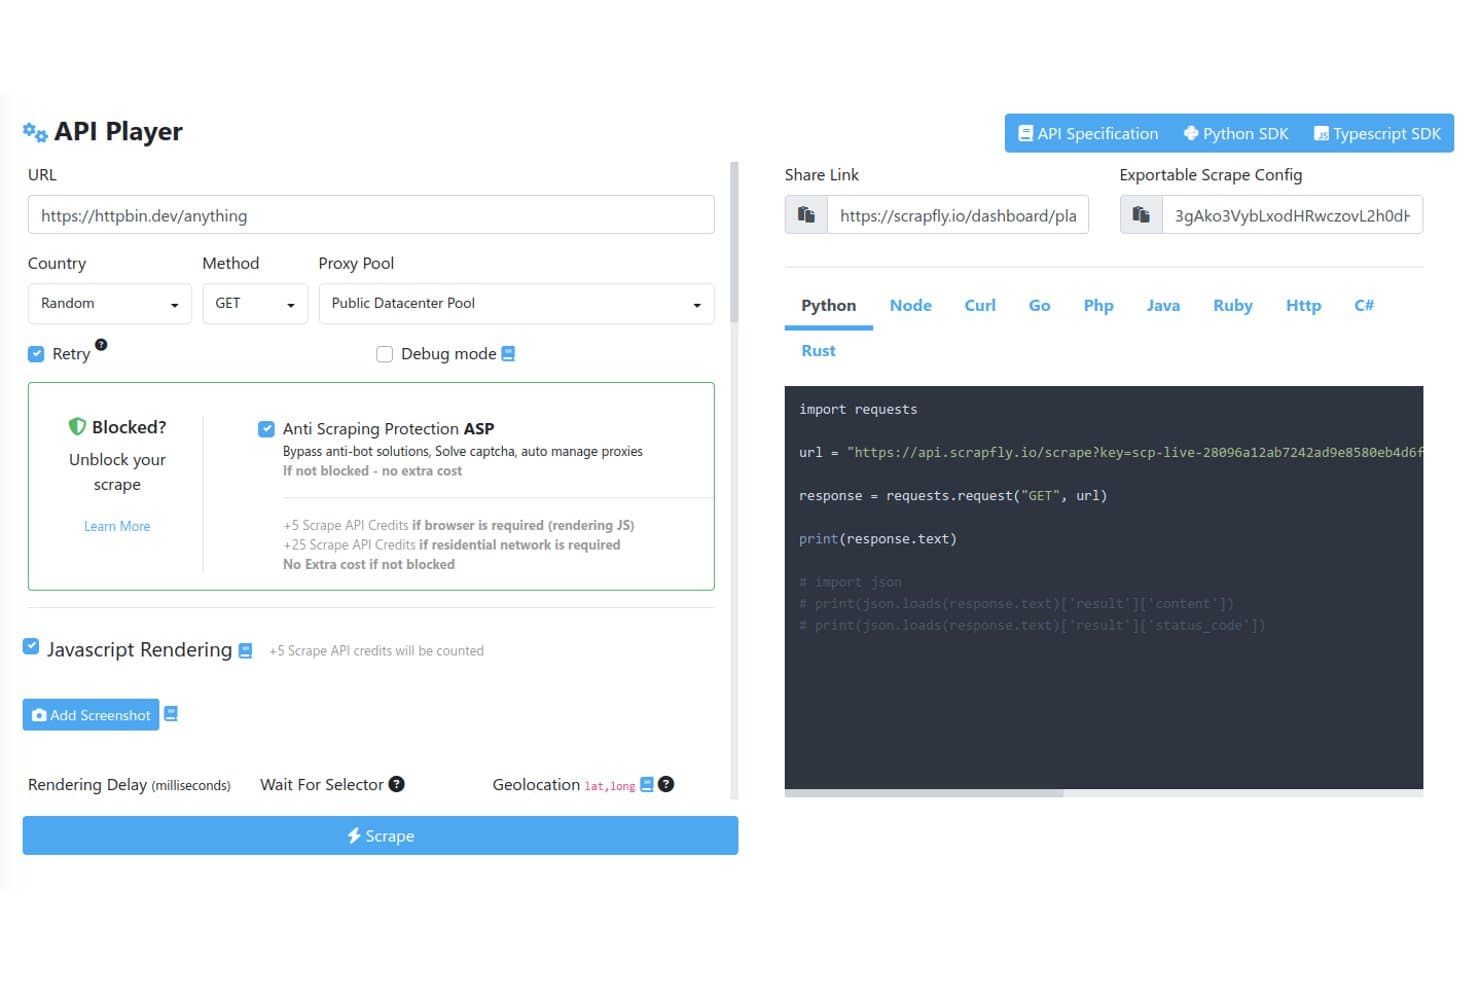
Scrapfly ofrece un API Player interactivo con opciones de scraping configurables, que incluyen pools de proxies, evasión de protecciones anti-scraping, renderizado de JavaScript y fragmentos de código autogenerados en varios lenguajes. Scrapfly es una API de web scraping que combina rotación de proxies, elusión de sistemas anti-bot, renderizado de navegador sin cabeza, rastreo de sitios, captura de pantallas y extracción de datos impulsada por LLM bajo una sola clave API.
¿Para quién es mejor Scrapfly?
Scrapfly es una excelente opción para desarrolladores e ingenieros de datos que buscan una API de scraping orientada al código con SDKs en Python, TypeScript, Go y Rust.
Por qué elegí Scrapfly
Elegí Scrapfly porque su arquitectura de navegador de doble motor es única en comparación con todo lo que he probado. Curlium maneja una suplantación de huellas digitales JA4 de Chrome perfecta a nivel de bytes para mayor velocidad, mientras que Scrapium ejecuta Chromium en modo sigiloso sobre CDP con huellas coincidentes, lo que permite que las sesiones cambien a mitad del rastreo sin activar la detección. También me gusta que Scrapium sea totalmente compatible con Playwright y Puppeteer, lo que significa que puedo escribir escenarios JS personalizados y reglas de espera sin modificar mi código de automatización de navegador existente.
Características clave de Scrapfly
- API de extracción multimétodo: Extrae datos estructurados usando CSS, XPath, regex, esquemas JSON y plantillas con tecnología LLM.
- Pools de proxies integrados: Proporciona proxies gestionados de centro de datos y residenciales con geolocalización y soporte para llevar tu propio proxy.
- API de rastreador: Recorre sitios completos con control sobre la profundidad de rastreo, límites de velocidad y partición de proyectos.
- Integraciones nativas de programación: Compatible con Zapier, Make y n8n para flujos de trabajo automatizados, tareas recurrentes y activadores de webhooks.
Integraciones de Scrapfly
Scrapfly ofrece integraciones nativas con Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI y OpenClaw. También proporciona SDKs para Python, TypeScript, Go y Rust. Hay una API disponible para integraciones personalizadas.
Pros and Cons
Pros:
- Motores de navegador sigilosos duales
- Elude Cloudflare, DataDome e Imperva
- Plantillas de extracción para tipos de sitios comunes
Cons:
- Sin programador de tareas nativo en el producto
- No apto para usuarios no técnicos
Learn more about Scrapfly: Ideal para scraping sigiloso y evasión de detección
- Prueba gratuita de 14 días
- Desde $69/mes
Visit WebsiteCustomer Rating:4.7/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.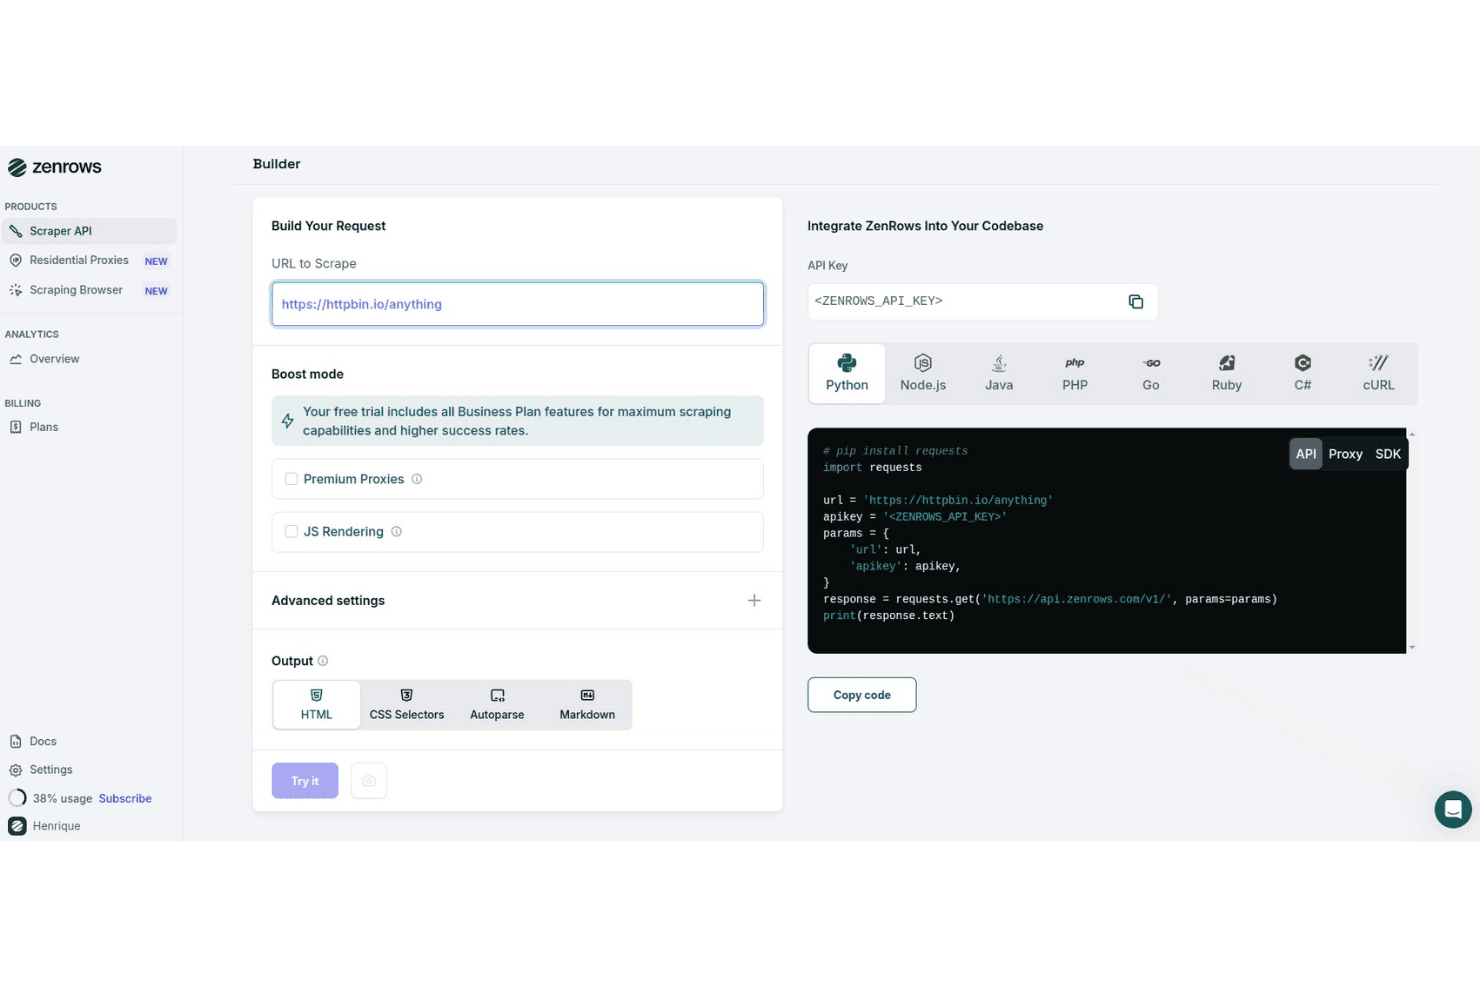
ZenRows ofrece un generador visual de solicitudes con generación de código en varios lenguajes, opciones de modo boost y selección de formato de salida para scraping web. ZenRows es una API de scraping web y una plataforma de navegador en la nube que combina eludir sistemas anti-bot, rotación de proxies residenciales, renderizado de JavaScript y extracción de datos estructurados en un único conjunto de herramientas para desarrolladores.
¿Para Quién Es Ideal ZenRows?
ZenRows es muy adecuado para desarrolladores e ingenieros de datos que necesitan extraer datos de sitios con protección anti-bot agresiva a gran escala.
Por Qué Elegí ZenRows
ZenRows se gana su lugar en mi lista corta por la forma en que maneja la protección anti-bot. He extraído datos de sitios protegidos por Cloudflare donde las herramientas estándar fallan sistemáticamente, y ZenRows lo logra utilizando técnicas de elusión de huellas digitales y resolución automática de CAPTCHAs sin necesidad de configuración manual. El Navegador de Scraping va aún más lejos, ejecutando sesiones completas de Chromium con cabeceras de sigilo que imitan de cerca el comportamiento real de los usuarios para evitar la detección en sitios que usan DataDome o PerimeterX.
Características Clave de ZenRows
- API de Scraper Universal: Realiza solicitudes usando un único endpoint que se adapta a diferentes estructuras de sitio y requisitos de scraping.
- Infraestructura de proxy residencial: Elige entre un grupo de más de 55 millones de IPs residenciales en más de 185 países para rastreo geo-dirigido.
- Auto-análisis para salida estructurada: Extrae y recibe datos automáticamente en JSON, HTML o Markdown con análisis integrado para sitios populares.
- SDKs multilenguaje: Accede a SDKs oficiales para Python, Node.js, Go, PHP, Ruby, Java y C# para integrar con los flujos de trabajo de desarrollo.
Integraciones de ZenRows
ZenRows ofrece integraciones nativas con Playwright, Puppeteer, n8n, Make, Clay y Zapier. Hay una API disponible para integraciones personalizadas.
Pros and Cons
Pros:
- Logra evadir Cloudflare y DataDome de forma confiable
- Alta tasa de éxito en páginas protegidas
- Sesiones completas de navegador headless con modo sigiloso
Cons:
- Sin programación nativa ni orquestación de trabajos
- El coste aumenta rápidamente con volúmenes altos de solicitudes
Learn more about ZenRows: Mejor para manejar sitios web dinámicos con JavaScript
- Plan gratuito disponible
- Desde $189/mes
Visit WebsiteCustomer Rating:4.4/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.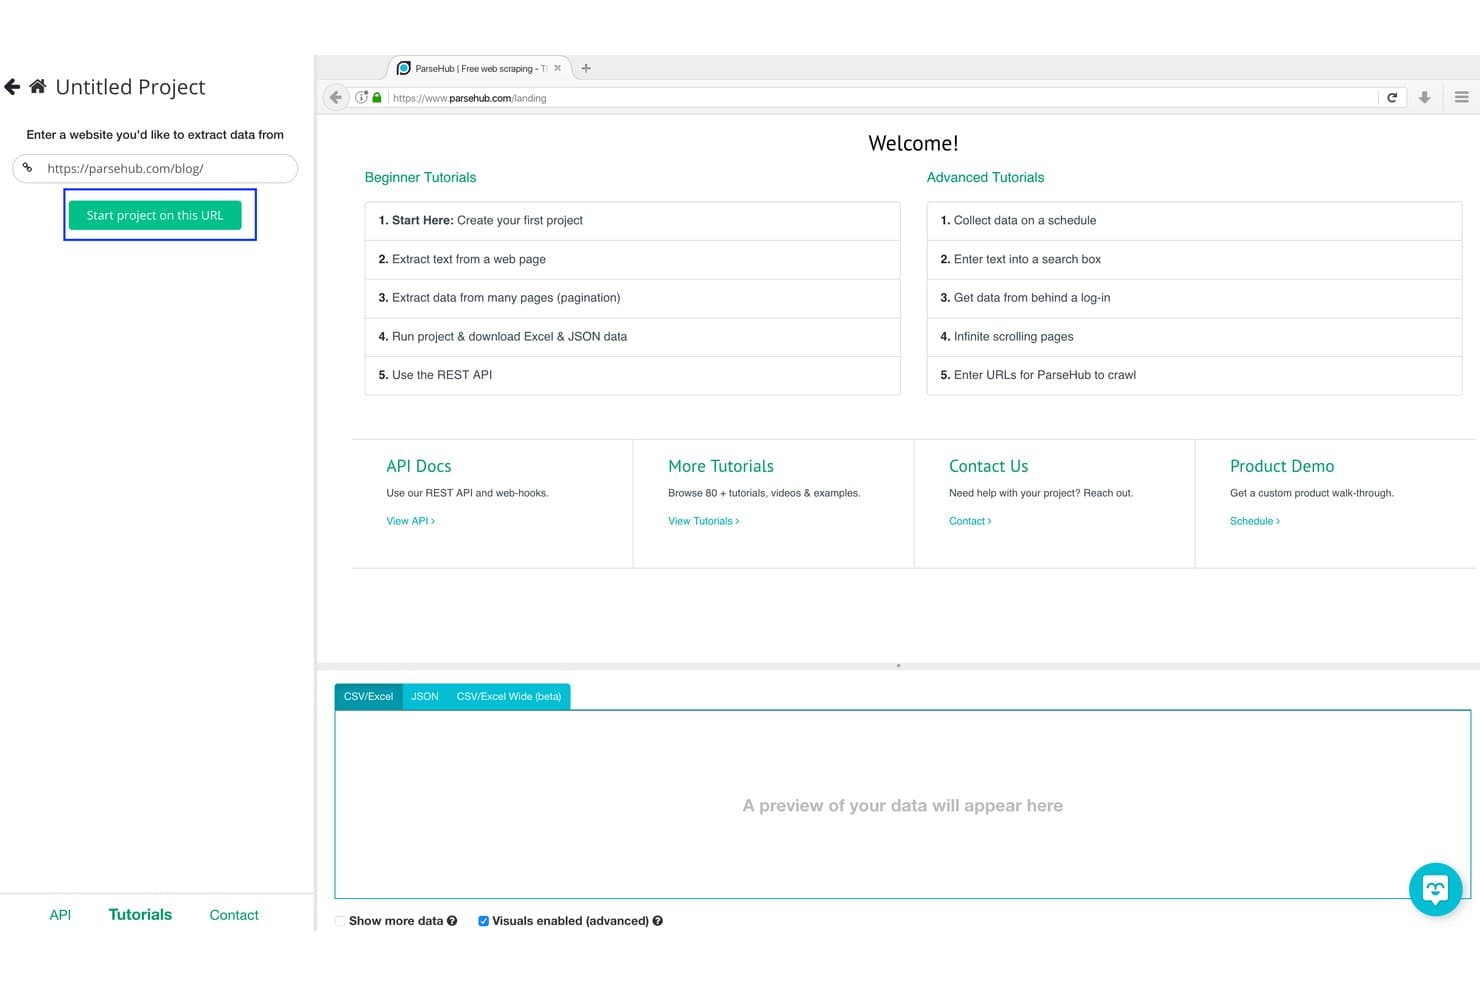
ParseHub ofrece una interfaz visual para configurar proyectos en la que los usuarios introducen una URL y hacen clic en 'Iniciar proyecto en esta URL' para comenzar a extraer datos de sitios web. ParseHub es una herramienta visual de extracción de datos web que obtiene información de sitios web dinámicos mediante una interfaz basada en clics, con soporte para JavaScript, AJAX, scroll infinito, entradas de formularios y ejecuciones programadas en la nube.
¿Para quién es mejor ParseHub?
ParseHub es adecuado para analistas de inteligencia competitiva e investigadores no técnicos que necesitan recopilar datos de sitios con mucho JavaScript sin escribir código.
Por qué elegí ParseHub
ParseHub se gana su lugar como uno de los mejores en mi lista porque resuelve los problemas de renderizado de JavaScript que rompen a la mayoría de los scrapers sin código. Lo he utilizado para extraer datos de páginas con scroll infinito y contenido que se muestra mediante menús desplegables, donde los scrapers de HTML estático devuelven resultados vacíos. Su motor de aprendizaje automático detecta automáticamente la estructura de la página, lo que significa que puedo crear un scraper funcional para un catálogo de productos con mucho AJAX sin escribir una sola línea de XPath.
Características clave de ParseHub
- Constructor visual de apuntar y clicar: Selecciona y extrae elementos de la página sin la codificación manual de selectores.
- Programación en la nube: Programa tareas recurrentes de extracción de datos en la infraestructura en la nube de ParseHub.
- Acceso API REST: Gestiona, activa y descarga resultados de extracciones de forma programática utilizando la API.
- Rotación automática de IPs: Reduce los bloqueos rotando IPs salientes en las ejecuciones en la nube.
Integraciones de ParseHub
ParseHub ofrece integraciones nativas con Google Sheets, Tableau, Dropbox y AWS S3. Hay una API disponible para integraciones personalizadas y automatización de flujos de trabajo.
Pros and Cons
Pros:
- Maneja JavaScript, AJAX y scroll infinito de forma nativa
- El constructor visual no requiere codificación de selectores
- Las extracciones se ejecutan automáticamente en la infraestructura en la nube
Cons:
- Tiene límite en grandes trabajos concurrentes de extracción de datos
- No cuenta con resolución de CAPTCHA incorporada
Learn more about ParseHub: Mejor para integración directa en pipelines
- Prueba gratuita de 30 días
- Desde $199/mes (facturación anual)
Visit WebsiteCustomer Rating:4.2/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.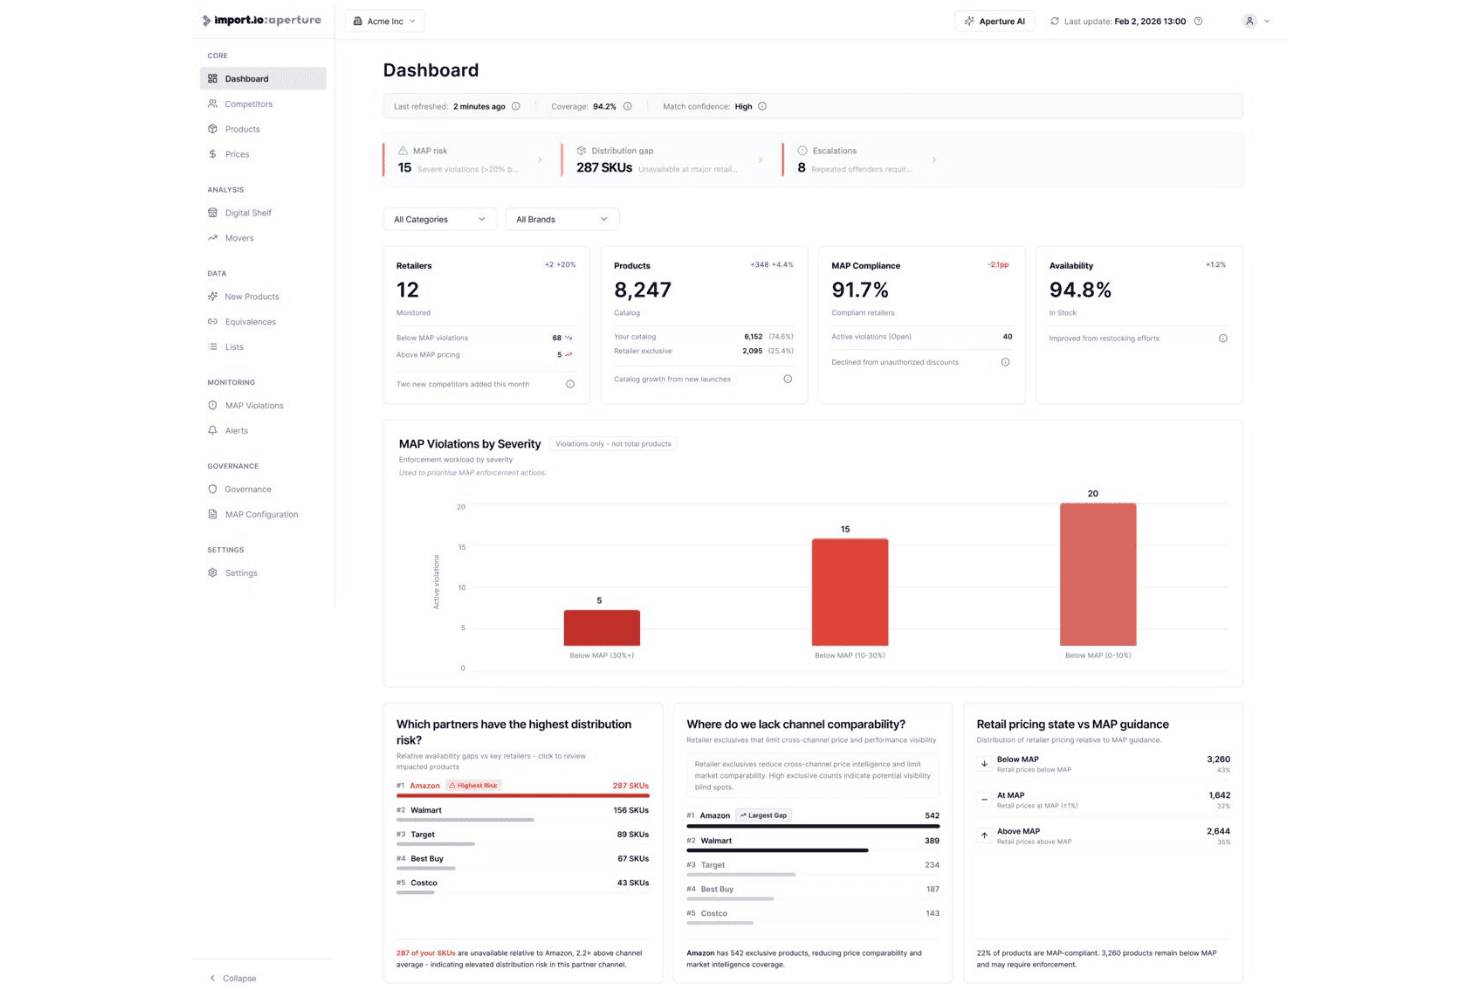
La plataforma Aperture de Import.io ofrece un panel que muestra el cumplimiento de MAP, la disponibilidad de productos, brechas de distribución en minoristas y violaciones de precios. Import.io es una plataforma de extracción web gestionada y nativa de IA que extrae datos estructurados de sitios web a escala empresarial, manejando páginas renderizadas por JavaScript, fuentes protegidas y entrega directa en flujos de datos y sistemas de análisis.
¿Para quién es mejor Import.io?
Import.io es ideal para equipos de ingeniería de datos e inteligencia competitiva en empresas medianas y grandes que necesitan flujos de datos gestionados sin tener que crear o administrar scrapers internamente.
Por qué elegí Import.io
Import.io merece su lugar en mi lista porque los datos estructurados pasan directamente de la web a tu almacén, panel o endpoint API sin que sea necesaria una exportación manual intermedia. Me gusta que los webhooks y la entrega por API sean funciones nativas de la plataforma y no añadidos secundarios. Lo que considero más valioso son los flujos de datos autorreparables: se adaptan automáticamente cuando los sitios objetivo se reestructuran, así que no tengo que rehacer extractores cada vez que un minorista cambia el diseño de su página.
Funciones clave de Import.io
- Modelos de extracción asistidos por IA: Detectan automáticamente las estructuras de las páginas y adaptan el esquema según cambian los sitios web.
- Gestión de proxies empresariales: Admite proxies premium y residenciales para extraer datos de sitios protegidos o con restricción geográfica.
- Constructor visual de apuntar y hacer clic: Permite seleccionar y extraer datos de páginas web complejas sin escribir código.
- Enmascaramiento automático de PII: Identifica y elimina información personal identificable dentro de los conjuntos de datos extraídos para el cumplimiento normativo.
Integraciones de Import.io
Import.io ofrece integraciones nativas con Google Sheets, Power BI, Tableau y Excel, y proporciona una API para integraciones personalizadas y webhooks hacia otros sistemas.
Pros and Cons
Pros:
- Los flujos de datos autorreparables se adaptan automáticamente a los cambios en los sitios
- Maneja sitios altamente protegidos y con acceso restringido por login
- La extracción gestionada reduce la carga de trabajo de ingeniería interna
Cons:
- Transparencia limitada sobre la infraestructura subyacente de scraping
- Idoneidad limitada para tareas de scraping a pequeña escala
Learn more about Import.io: Mejor para plantillas de automatización con robots preconstruidos
- Plan gratuito disponible
- Desde $19/mes (facturado anualmente)
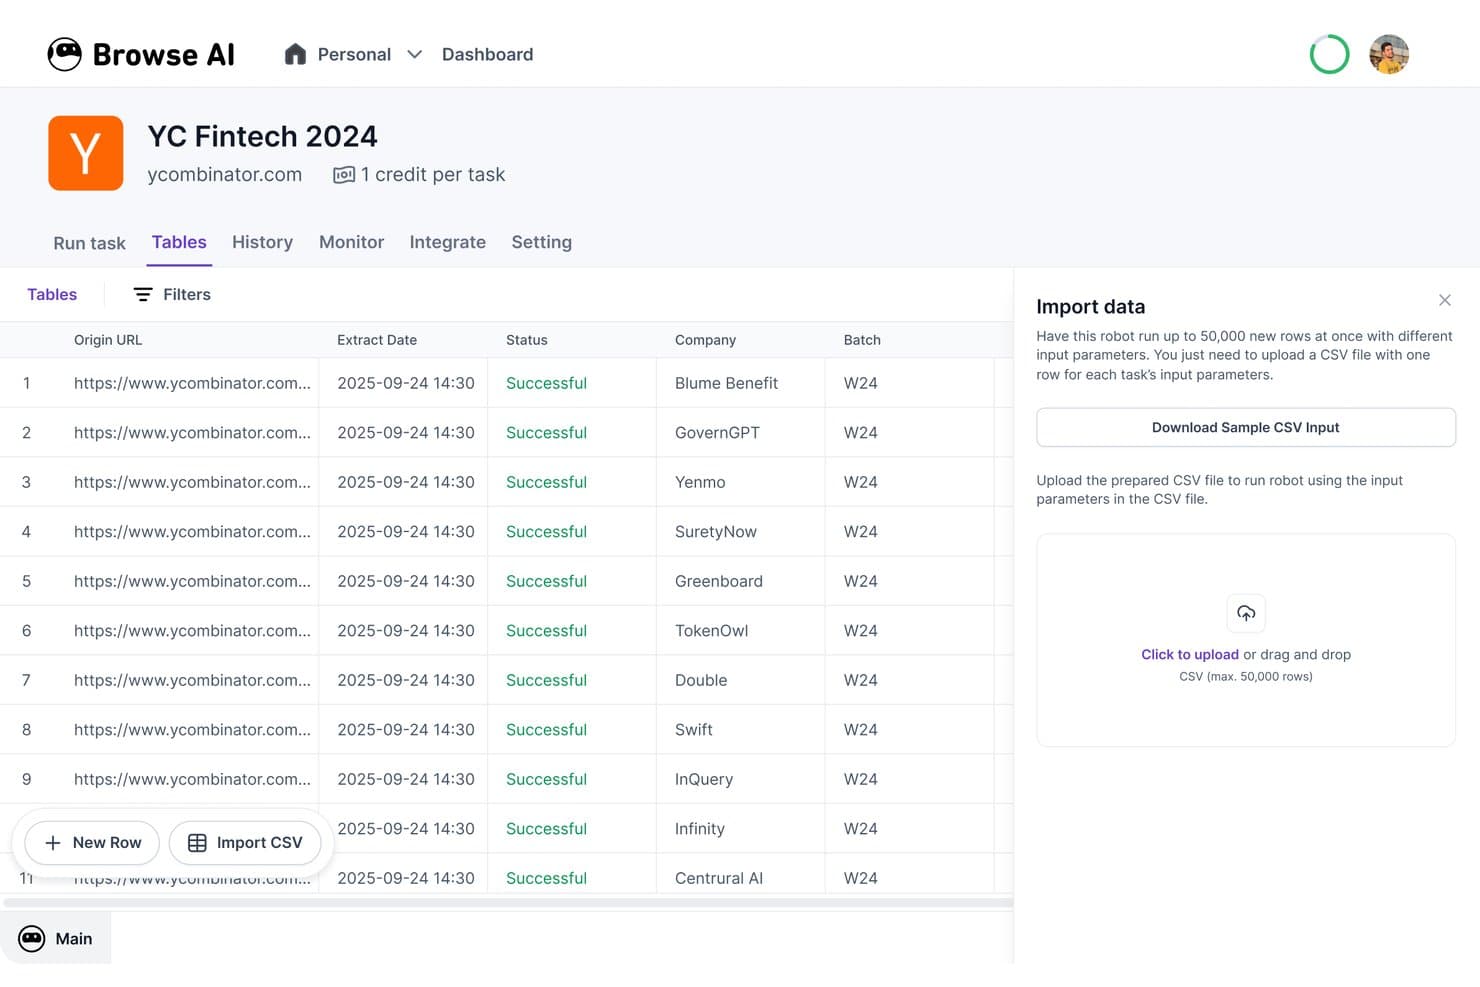
Browse AI ofrece un panel de extracción de datos web sin código donde los usuarios pueden extraer datos estructurados de sitios como Y Combinator y exportar los resultados como archivos CSV. Browse AI es una plataforma de extracción de datos web y monitoreo de sitios web sin código que combina un extractor visual de datos punto y clic con más de 250 plantillas de robots preconstruidos para la recolección automática y programada de datos de sitios web.
¿Para quién es mejor Browse AI?
Browse AI es ideal para analistas de inteligencia competitiva y equipos no técnicos que necesitan recopilar datos web estructurados sin escribir código.
Por qué elegí Browse AI
Browse AI se gana su lugar en mi lista corta por lo avanzada que es su biblioteca de robots preconstruidos. Puedo extraer listados estructurados de Amazon, Google Maps o Indeed sin crear un extractor desde cero, y cada robot ya gestiona la paginación y el contenido dinámico para ese sitio específico. También valoro la adaptación de diseño impulsada por inteligencia artificial, que actualiza automáticamente un robot cuando el sitio objetivo cambia su estructura de página, así las extracciones no se rompen silenciosamente en mitad del proceso.
Funciones clave de Browse AI
- Renderizado de JavaScript: Automatiza la extracción en sitios modernos con mucho JavaScript y aplicaciones de una sola página.
- Soporte de proxy residencial: Rota IPs residenciales automáticamente para evadir sistemas anti-bots sin configuración manual de proxies.
- Webhooks y acceso API: Permite el envío programático de tareas de extracción y la recuperación de datos para integración con sistemas internos.
- Detección automática de cambios: Monitorea sitios web para detectar cambios visuales o de contenido y envía alertas cuando se identifican actualizaciones.
Integraciones de Browse AI
Browse AI ofrece integraciones nativas con Google Sheets, Airtable, AWS S3, Zapier y Make.com. El acceso API y webhooks está disponible para integraciones personalizadas.
Pros and Cons
Pros:
- Más de 250 robots preconstruidos listos para usar
- Se adapta automáticamente cuando cambian los diseños de los sitios objetivo
- Gestiona CAPTCHAs y páginas dinámicas de forma nativa
Cons:
- Control limitado a nivel de selectores para desarrolladores
- El coste por créditos aumenta rápidamente con grandes volúmenes
Learn more about Browse AI: Ideal para usuarios de interfaces de apuntar y hacer clic
- Plan gratuito disponible
- Desde $69/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.7/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.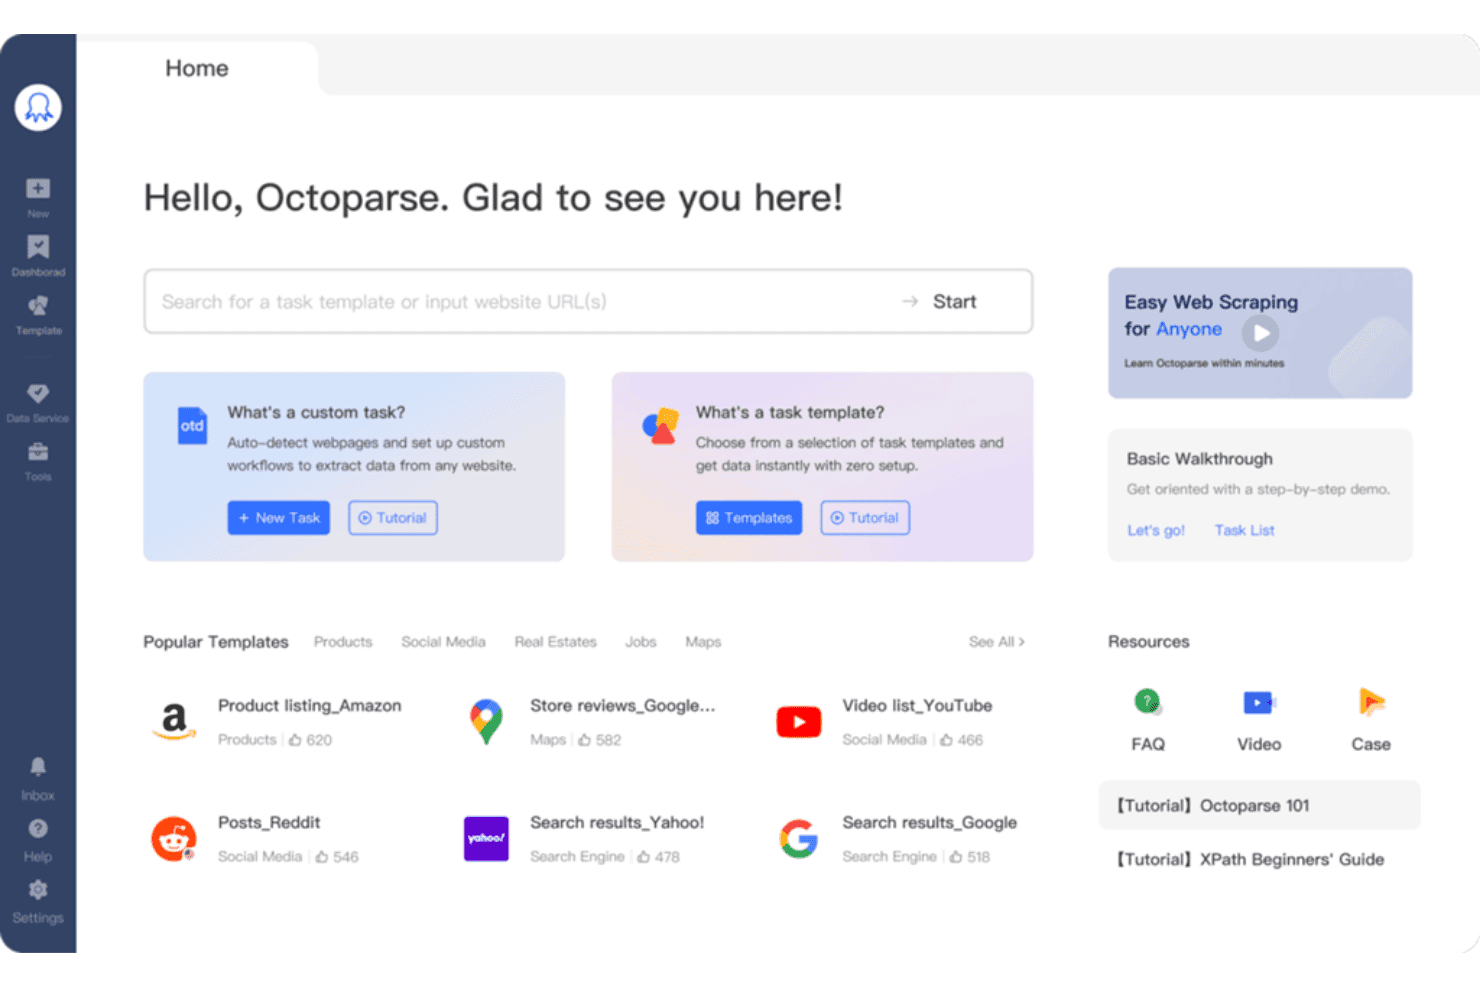
Octoparse ofrece un panel de inicio con plantillas populares de extracción, creación de tareas personalizadas y recursos de inicio rápido para extraer datos web. Octoparse es una herramienta de extracción web sin código que combina un constructor de flujos de trabajo visual, detección automática potenciada por IA, extracción basada en la nube y soporte para páginas renderizadas por JavaScript para recopilar datos estructurados de sitios web.
¿Para quién es mejor Octoparse?
Octoparse es ideal para analistas de inteligencia competitiva y usuarios de negocio que necesitan recopilar datos web regularmente y no tienen experiencia en programación.
Por qué elegí Octoparse
Octoparse se gana su lugar en mi lista porque el constructor de flujos de trabajo de apuntar y hacer clic realmente elimina la barrera técnica para la extracción web. Me gusta que la función de Detección automática por IA crea todo el flujo de extracción al analizar automáticamente la página objetivo, así no tengo que mapear selectores manualmente desde cero. Las más de 500 plantillas prediseñadas para sitios como Amazon o Google Maps me permiten poner en funcionamiento un extractor en minutos para los objetivos más comunes.
Características clave de Octoparse
- Ejecuciones concurrentes basadas en la nube: Ejecuta hasta 20 tareas de extracción en paralelo utilizando el motor en la nube de Octoparse para una recopilación de datos más rápida.
- Rotación de IP y proxies residenciales: Rota direcciones IP automáticamente y accede a proxies residenciales para reducir bloqueos y evitar medidas anti-bot.
- Exportaciones a bases de datos y a la nube: Exporta los datos extraídos directamente a MySQL, SQL Server, PostgreSQL, Oracle, Google Sheets, Dropbox, Amazon S3 o vía API.
- Resolución automática de CAPTCHA: Resuelve CAPTCHAs comunes durante las tareas de extracción para mantener la continuidad y reducir la intervención manual.
Integraciones de Octoparse
Octoparse ofrece integraciones nativas con Google Sheets, Google Drive, Dropbox, Amazon S3, MySQL, SQL Server, PostgreSQL y Oracle. También se conecta con Zapier y proporciona una API para integraciones personalizadas.
Pros and Cons
Pros:
- Más de 500 plantillas predefinidas para sitios web comunes
- La IA detecta y extrae automáticamente borradores
- Gestiona scroll infinito, Ajax y páginas dinámicas
Cons:
- El cliente de escritorio sólo funciona en Windows
- Limitado a 20 procesos concurrentes en la nube
Learn more about Octoparse: Ideal para la recopilación de datos gestionada contra bots
- Prueba gratuita disponible
- Desde $0.5/1,000 registros
Visit WebsiteCustomer Rating:4.5/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.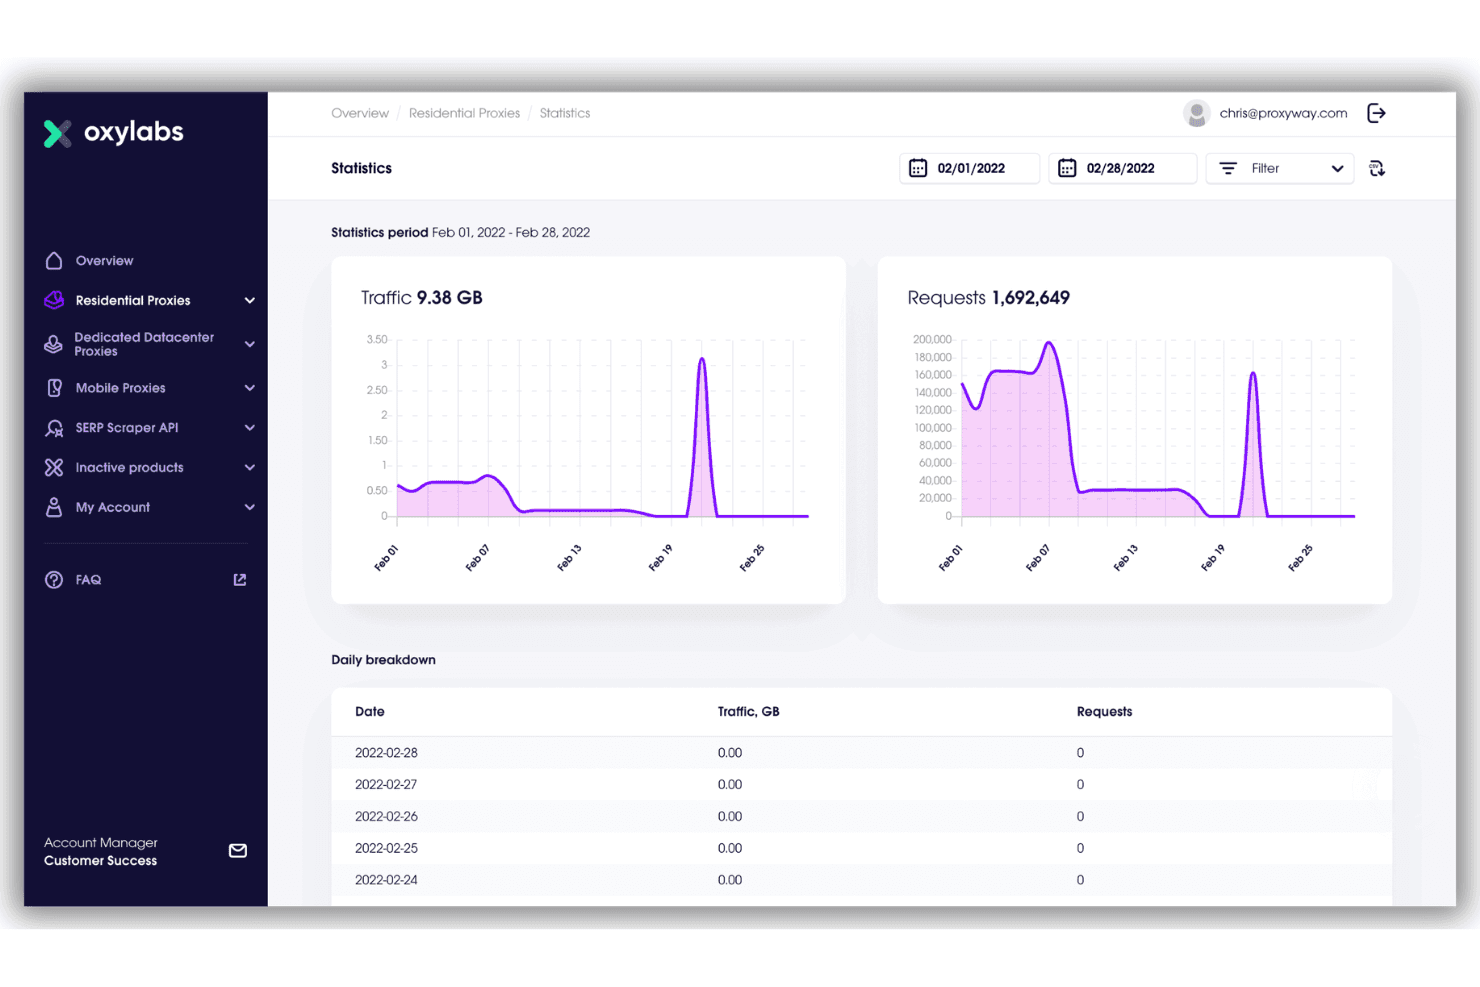
Oxylabs ofrece un panel de estadísticas detallado para proxies residenciales, que muestra el tráfico y las métricas de solicitudes durante un intervalo de fechas seleccionado en febrero de 2022. Oxylabs es una API de extracción web que gestiona la administración de proxies, la resolución de CAPTCHA, la renderización de JavaScript y la extracción de datos estructurados en más de 50 objetivos de sitios web preconfigurados.
¿Para quién es más adecuado Oxylabs?
Ingenieros de datos y desarrolladores backend que ejecutan procesos de extracción a gran escala y de misión crítica, y necesitan una infraestructura de nivel empresarial y fiabilidad contra bots.
Por qué elegí Oxylabs
Oxylabs ocupa un lugar en mi lista de opciones principales por la forma en que gestiona la parte más difícil de la extracción web: superar la detección de bots sin tener que administrarla personalmente. La API gestiona la resolución de CAPTCHA, la rotación de proxies entre más de 177 millones de IP residenciales y los reintentos automáticos sin que yo tenga que implementar ninguna lógica personalizada de gestión de errores. También me gusta el modelo de precios basado en el éxito, en el que solo las respuestas 2xx y 4xx cuentan para tu cuota, por lo que los fallos del lado del sistema no consumen tus resultados.
Características principales de Oxylabs
- Analizador personalizado: Define selectores CSS o XPath para extraer datos estructurados con precisión del contenido de las páginas.
- Asistente de IA OxyCopilot: Genera instrucciones de extracción y lógica de análisis mediante indicaciones en lenguaje natural.
- Conectores de objetivos prediseñados: Utiliza endpoints específicos para Amazon, Google, eBay, Walmart, Zillow y otros sitios importantes.
- Integraciones de almacenamiento en la nube: Exporta los resultados directamente a AWS S3 y Google Cloud Storage para utilizarlos en procesos de datos.
Integraciones de Oxylabs
Oxylabs ofrece integraciones nativas con AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com y Zapier. También hay una API y SDK para Python y Go disponibles para integraciones personalizadas.
Pros and Cons
Pros:
- Más de 177 millones de IP residenciales en 195 países
- Los precios basados en el éxito evitan desperdiciar la cuota de solicitudes
- Endpoints prediseñados para más de 50 sitios importantes
Cons:
- Coste más elevado que las herramientas de extracción autogestionadas
- No hay disponible una interfaz visual de extracción sin código
Learn more about Oxylabs: Mejor para infraestructura de proxy a escala empresarial
- Plan gratuito disponible
- Desde $1.5/1.000 registros/mes
Visit WebsiteCustomer Rating:4.7/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.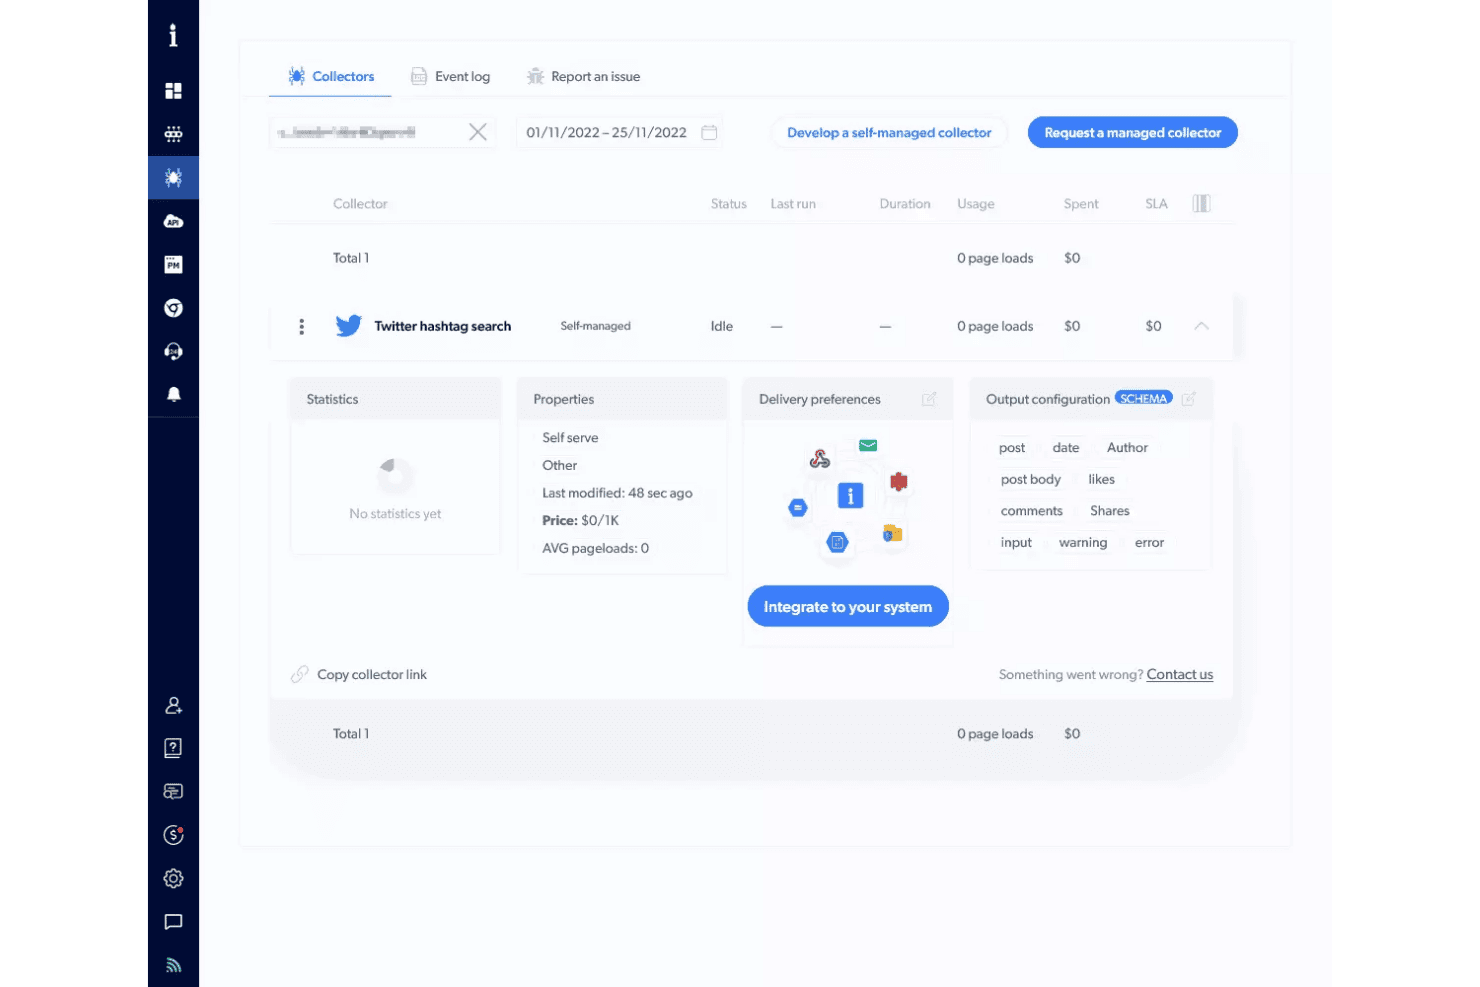
El panel de Coleccionistas de Bright Data ofrece un colector de búsqueda de hashtags de Twitter con opciones de autogestión de estado, configuración de salida e integración con sistemas. Bright Data es una API de extracción de datos web y una plataforma de scraping sin código que combina gestión de proxies, renderizado de JavaScript, resolución de CAPTCHA y entrega de datos estructurados a través de más de 1.278 extractores preconstruidos para sitios web populares.
¿Para quién es mejor Bright Data?
Ingenieros de datos y desarrolladores backend en organizaciones medianas a grandes que necesitan recopilar datos web estructurados a gran escala sin gestionar por sí mismos la infraestructura de proxy.
Por qué elegí Bright Data
Bright Data se gana su puesto en mi lista por la magnitud de su red de proxies: más de 400M de IPs residenciales en 195 países, con rotación automática, resolución de CAPTCHA y Web Unlocker diseñado para vencer a Cloudflare, Akamai y DataDome sin ninguna configuración. He extraído datos de LinkedIn Sales Navigator y Amazon a gran volumen usando Bright Data y no tuve ningún bloqueo en miles de solicitudes. AI Scraper Studio también me permite generar una API de scraping funcional para cualquier nuevo dominio en minutos.
Funciones clave de Bright Data
- Plantillas de extractores preconfigurados: Más de 1.200 extractores listos para desplegar rápidamente en plataformas principales como LinkedIn, Amazon y YouTube.
- Detección de esquemas impulsada por IA: AI Scraper Studio genera esquemas de salida personalizados y automatiza el mapeo de datos de nuevos dominios.
- APIs de gestión de tareas: Proporciona programación por lotes, ejecuciones recurrentes y disparadores webhook para integraciones con herramientas de automatización de flujos de trabajo.
- Entrega directa de datos: Permite exportar datos a JSON, NDJSON, CSV, XLSX, o enviar directamente a S3, Snowflake, GCS, PubSub o SFTP.
Integraciones de Bright Data
Bright Data ofrece integraciones nativas con Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake y Pub/Sub, y proporciona una API para integraciones personalizadas.
Pros and Cons
Pros:
- Más de 400M de IPs residenciales en 195 países
- Extractores preconstruidos para más de 1.200 sitios web populares
- Web Unlocker evita Cloudflare y DataDome
Cons:
- Usuarios reportan disputas de facturación en extracciones fallidas
- Demasiado complejo para compradores sin experiencia en desarrollo
Learn more about Bright Data: La mejor para la detección automática de esquemas de datos
- Prueba gratuita de 30 días
- Desde $0.13/1,000 solicitudes
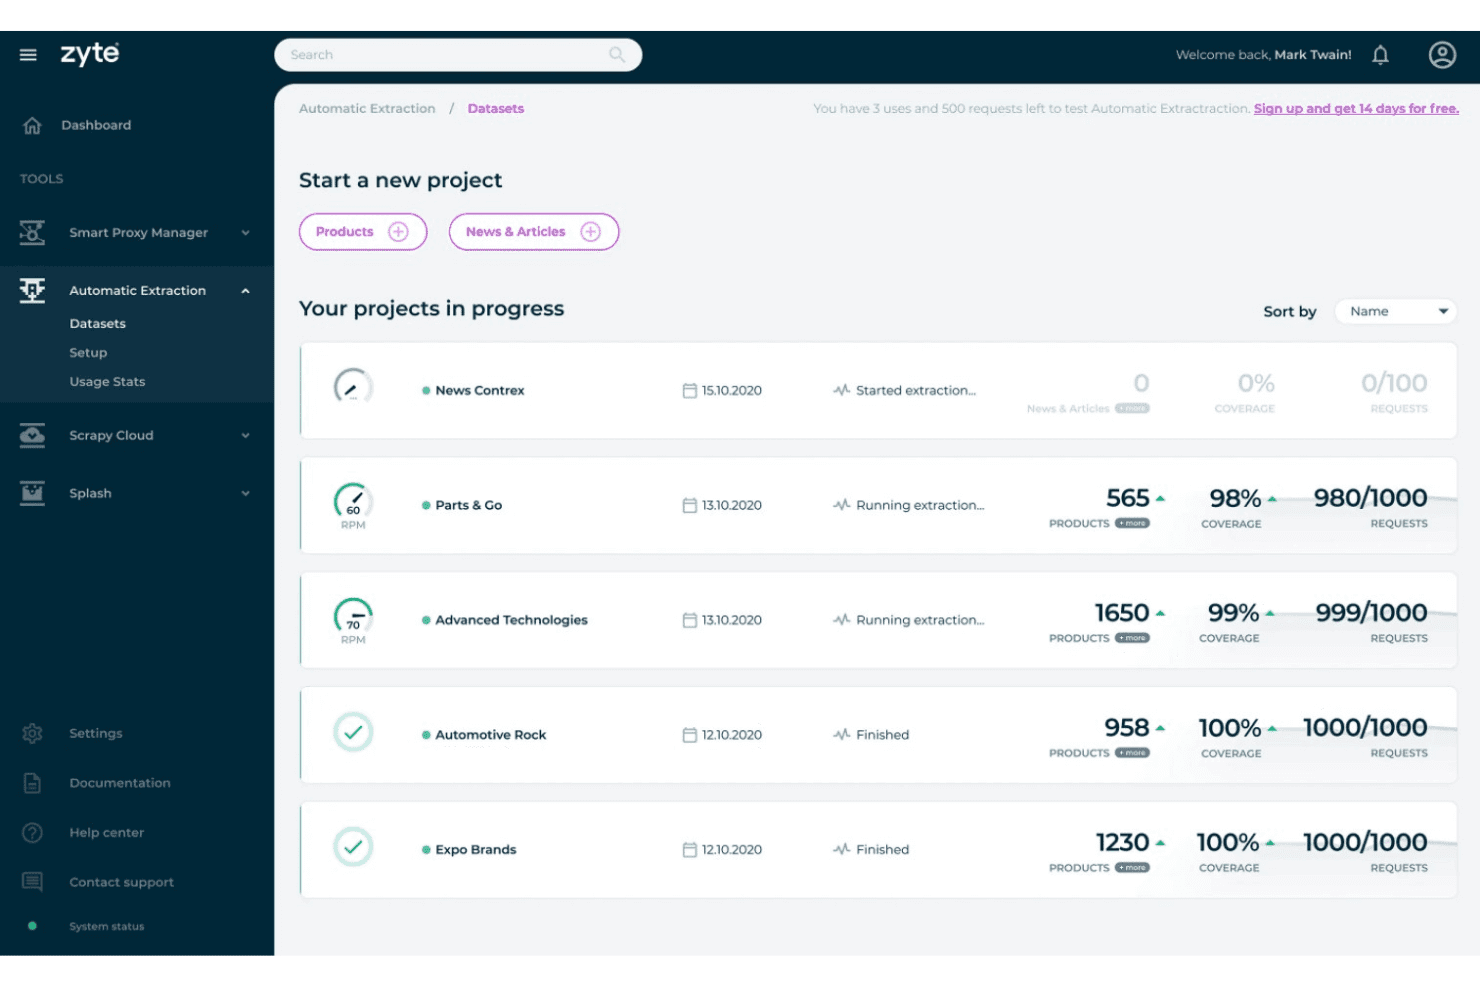
La función de extracción automática de Zyte ofrece proyectos de extracción de datos en curso y completados con métricas de cobertura, conteo de productos y uso de solicitudes. Zyte API es una API de extracción web que combina renderizado de navegador sin interfaz, rotación automática de proxies, resolución de CAPTCHAs y extracción de datos impulsada por IA en un único punto de acceso.
¿Para Quién es Mejor Zyte API?
Zyte API es especialmente adecuada para ingenieros de datos y desarrolladores de Python que construyen canalizaciones de scraping a escala de producción que alimentan modelos de ML o sistemas de analítica.
Por Qué Elegí Zyte API
Zyte API se ganó su lugar en mi lista corta por la forma en que maneja la detección automática de esquemas. Señálala hacia una página de producto o artículo y su capa de extracción potenciada por LLM devuelve un JSON tipado y estructurado sin que yo tenga que usar ni un solo selector CSS o expresión XPath. Cuando un sitio actualiza su diseño, la IA se adapta, lo que significa que no tengo que estar parcheando los parsers cada vez que un competidor rediseña su página de catálogo.
Características Clave de Zyte API
- Renderizado instantáneo de navegador: Zyte API inicia navegadores sin interfaz precalentados para cargar sitios dinámicos bajo demanda.
- Infraestructura de proxies completa: Rota direcciones IP residenciales, de centros de datos y móviles automáticamente con cada solicitud.
- Gestión de sesiones: Mantiene cookies persistentes y sesiones de usuario para flujos de trabajo que requieren autenticación o acciones en múltiples pasos.
- Integraciones de entrega en la nube: Envía los datos extraídos directamente a destinos como AWS S3, Google Cloud o Azure para su procesamiento posterior.
Integraciones de Zyte API
Zyte API ofrece integraciones nativas con Scrapy, Scrapy Cloud y SDKs de Python, y proporciona una API para integraciones personalizadas. También soporta entrega en la nube a AWS S3, Google Cloud y Azure.
Pros and Cons
Pros:
- La IA detecta esquemas automáticamente sin selectores manuales
- Evita protecciones anti-bot sin configuración adicional
- Los navegadores precalentados eliminan los retrasos por arranque en frío
Cons:
- La programación recurrente de tareas requiere herramientas externas
- Requiere conocimientos de programación para implementarse
Learn more about Zyte API: La mejor para flujos de scraping simples impulsados por API
- Plan gratuito disponible
- Desde $49/mes
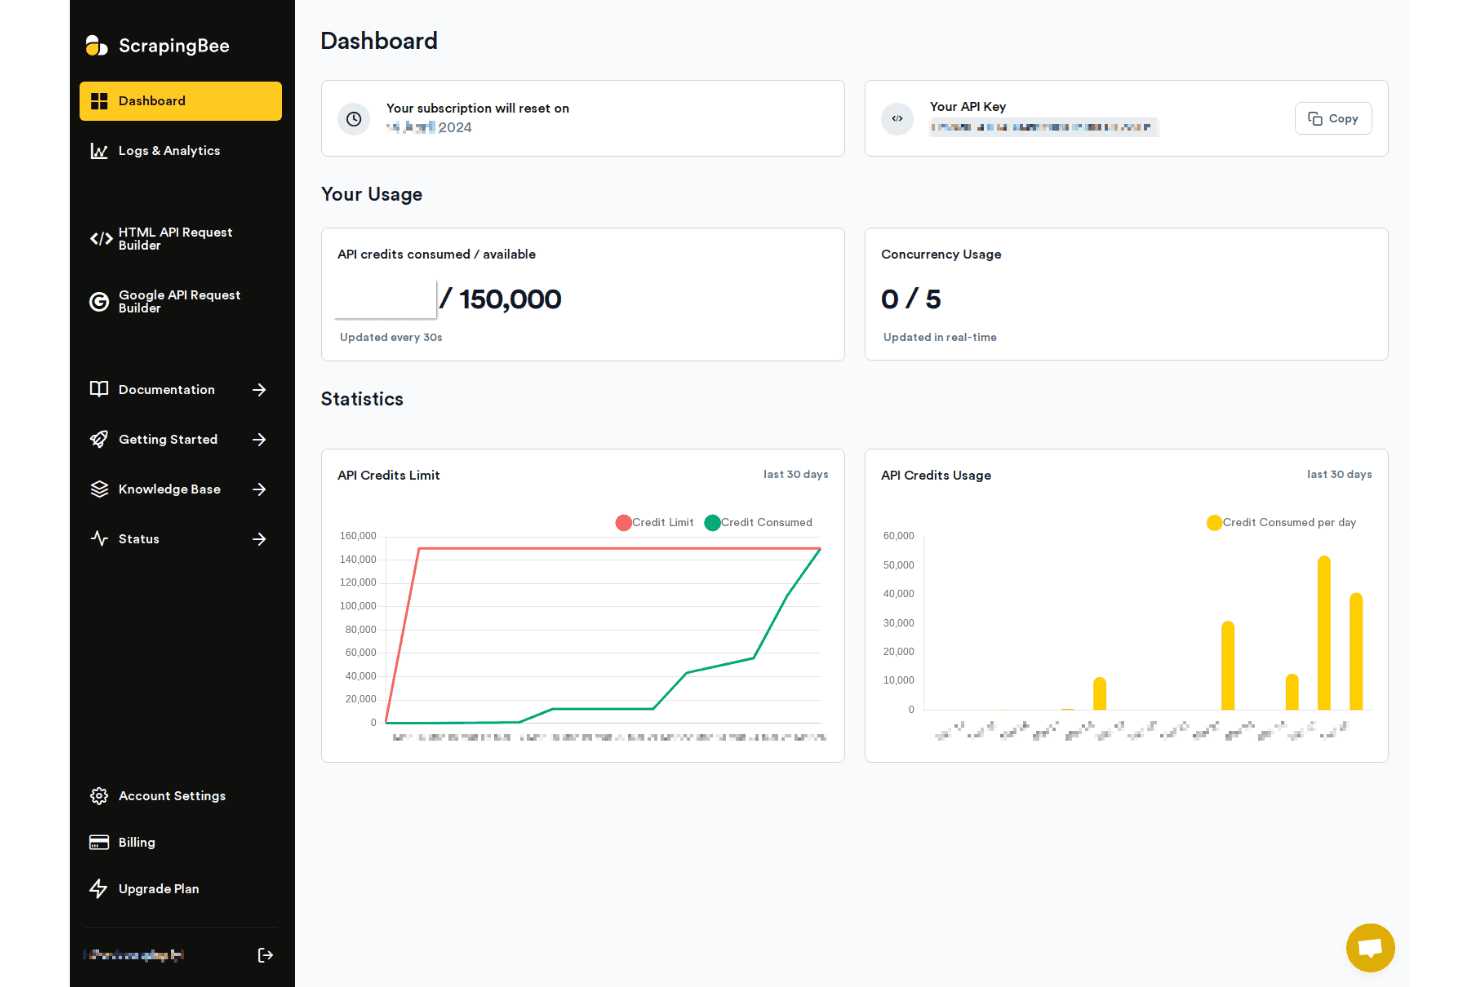
ScrapingBee ofrece un panel de control con uso de créditos API, estadísticas de concurrencia y gráficos de uso de 30 días para monitorear la actividad de scraping. ScrapingBee es una API de scraping web que gestiona el renderizado de Chrome sin interfaz, la rotación de proxies y la evasión de sistemas anti-bot, con APIs de extracción dedicadas para plataformas como Google, Amazon y Walmart.
¿Para quién es mejor ScrapingBee?
ScrapingBee es una excelente opción para desarrolladores e ingenieros de datos que necesitan una API confiable y orientada al código para extraer datos web sin tener que construir infraestructura de proxies o navegadores desde cero.
Por qué elegí ScrapingBee
ScrapingBee se gana su lugar en mi lista porque su API abstrae eficazmente la complejidad del scraping web moderno. Una sola solicitud maneja el renderizado sin interfaz de Chrome, la rotación sigilosa de proxies y la ejecución de JavaScript, por lo que no tengo que escribir código de gestión de navegadores ni configurar pools de proxies por separado. También me gusta la función de Consulta con IA, que me permite describir qué extraer en lenguaje natural en lugar de escribir selectores CSS o XPath para cada nuevo sitio al que apunto.
Características clave de ScrapingBee
- APIs de scraping dedicadas: Elija endpoints preconstruidos para plataformas como Amazon, Walmart y Google Search para simplificar tareas comunes de recopilación de datos.
- Extracción por Consulta con IA: Describa qué datos extraer en lenguaje natural y genere resultados estructurados automáticamente.
- De scraper a Markdown: Convierta cualquier página web en Markdown o texto plano para una ingestión rápida por modelos de IA o bases de datos.
- Integraciones sin código: Conéctese con Make, n8n y Zapier para automatizar flujos de trabajo sin escribir scripts de programación personalizados.
Integraciones de ScrapingBee
ScrapingBee ofrece integraciones nativas con Make, n8n y Zapier, y proporciona una API para integraciones personalizadas.
Pros and Cons
Pros:
- Solo cobra por solicitudes exitosas
- Gestiona Chrome sin interfaz sin configuración extra
- APIs dedicadas para Amazon y Google
Cons:
- No tiene programador de tareas integrado nativo
- El coste por créditos aumenta rápido a gran escala
Learn more about ScrapingBee:
Otras herramientas de extracción de datos web
Estas son algunas opciones adicionales de herramientas de extracción de datos web que no llegaron a mi lista de selección, pero que todavía merece la pena conocer:
- 11ScraperAPIIdeal para rotación de IPs sin complicaciones a escala
- 12CrawlbaseIdeal para el acceso API a fuentes de datos globales
- 13ScrapyLo mejor para frameworks de scraping en Python personalizables
- 14ScrapingdogIdeal para una implementación rápida con una configuración mínima
Wie ich Web-Scraping-Tools bewerte
Ich unterteile meine Bewertung in zwei Ebenen: Den Grundstandard, den ein Tool erfüllen muss, um echtes Webscraping zu ermöglichen – JS-Rendering, Proxy-Rotation, geplante Aufgaben – und die Unterscheidungsmerkmale, die die besten Optionen hervorheben.
Kernfunktionen (Mindestanforderungen für diese Liste)
Wenn ich Tools für meine Liste auswähle, bewerte ich jedes auf einer Skala von 0 (Funktionalität wird nicht geboten) bis 5 (in diesem Bereich herausragend) für jede der unten aufgeführten Kernfunktionen. Anschließend berechne ich die Gesamtpunktzahl des Tools als Prozentsatz. Jedes Tool muss eine Mindestpunktzahl von 65 % erreichen, um in die engere Auswahl zu kommen.
- Datenextraktions-Engine: Ich bewerte, ob ein Tool mehrere Selektormethoden wie CSS, XPath und Regex unterstützt oder über einen visuellen Builder für Teams verfügt, die eine Point-and-Click-Konfiguration bevorzugen.
- JavaScript-Rendering: Seiten, die auf React, Vue oder Angular basieren, benötigen Headless-Browser-Unterstützung. Ich prüfe, ob zuverlässiges Rendering mit konfigurierbaren Wartebedingungen geboten wird.
- Proxy- & Anti-Bot-Handling: Ich achte auf integrierte Proxyrotation, CAPTCHA-Lösungen und Umgehungsmechanismen, die Schutzmaßnahmen wie Cloudflare oder DataDome ohne zusätzlichen Konfigurationsaufwand bewältigen.
- Planung & Automatisierung: Wiederkehrende Scrapes sollten unbeaufsichtigt ablaufen. Ich bewerte, ob das Tool Cron-ähnliche Zeitpläne, Webhook-Trigger und Logik für Wiederholungsversuche bei Fehlern unterstützt.
- Export strukturierter Daten: Ich prüfe, welche Ausgabeformate verfügbar sind und ob das Tool Daten direkt an Ziele wie S3, Google Sheets, Datenbanken oder APIs senden kann.
- Skalierbarkeit & Parallelität: Große Aufträge mit Tausenden von Seiten erfordern parallele Anfragen. Ich schaue auf Parallelitätsgrenzen und darauf, ob das Tool verteiltes Crawling unterstützt.
Sobald ich eine Liste von Tools habe, die die Kriterien erfüllen, schaue ich mir an, wodurch sich jede Plattform abhebt.
Unterscheidungsmerkmale (Was Anbieter auszeichnet)
So vergleiche und kontrastiere ich verschiedene Anbieter:
Besondere Funktionen
Anti-Bot-Umgehung ist der Bereich, in dem ich die größten Unterschiede zwischen Tools sehe. Ich achte auf eingebaute CAPTCHA-Lösung und Browser-Fingerprinting, die Schutzmechanismen wie Cloudflare oder DataDome abfangen, ohne dass Drittanbieter-Proxy-Services benötigt werden. Auto-Erkennungs-Vorlagen sind ebenfalls sehr wichtig – Tools wie Bright Data und Zyte bieten vorgefertigte Scraper für gängige Ziele wie Amazon oder Google-Suchergebnisse, was stundenlange manuelle Selektorkonfiguration erspart. Ebenfalls bewerte ich Planungs- und Überwachungsfunktionen, insbesondere Fehlerbenachrichtigungen und automatische Wiederholungen, die Datenpipelines am Laufen halten, wenn sich die Layouts der Zielseiten über Nacht ändern.
Über die Funktionen hinaus
Preismodelle variieren in diesem Bereich stark – einige Anbieter rechnen pro API-Anfrage ab, andere nach Bandbreite oder erfolgreich zurückgegebenen Seiten. Ich bewerte, ob die Kosten auch bei Skalierung auf Millionen von Seiten pro Monat kalkulierbar bleiben. Proxy-Infrastruktur ist ein weiteres wichtiges Unterscheidungsmerkmal. Ich prüfe, ob ein Tool Residenz- und Rechenzentrums-Proxypools mit eingebaurem Geo-Targeting bis auf Stadtebene anbietet, da separate Proxy-Verträge zusätzliche Kosten und Komplexität verursachen. Auch die Compliance ist wichtig, besonders für Teams, die in regulierten Branchen scrapen, in denen GDPR-Konformität und robots.txt-Berücksichtigung klar dokumentiert sein müssen.
Cómo elegir herramientas de extracción de datos web
Es fácil perderse entre largas listas de funciones y complejas estructuras de precios. Para ayudarte a mantener la atención mientras llevas a cabo tu proceso específico de selección de software, aquí tienes una lista de factores que debes tener en cuenta:
| Factor | Qué debes tener en cuenta |
|---|---|
| FactorEscalabilidad | Qué debes tener en cuenta¿Puede la herramienta gestionar los aumentos de volumen previstos y los rastreos en paralelo sin grandes incrementos de costes ni límites de velocidad? |
| FactorIntegraciones | Qué debes tener en cuenta¿La herramienta enviará los datos directamente a tus sistemas objetivo (almacenamiento en la nube, bases de datos y flujos de trabajo) o requerirá pasos manuales? |
| FactorPersonalización | Qué debes tener en cuenta¿Puedes adaptar la lógica de extracción a estructuras de sitios únicas o estás limitado a plantillas y reglas predefinidas? |
| FactorFacilidad de uso | Qué debes tener en cuenta¿Pueden los usuarios técnicos y no técnicos gestionar las extracciones o necesitarás la participación continua de desarrolladores para realizar cambios? |
| FactorImplementación e incorporación | Qué debes tener en cuenta¿Con qué rapidez puede tu equipo configurar una primera canalización de datos y qué asistencia o documentación hay disponible si surgen problemas? |
| FactorCoste | Qué debes tener en cuenta¿Es predecible el precio a medida que aumenta el uso? Sé realista con respecto a los picos, la lógica de reintento y los falsos positivos de tu carga de trabajo. |
| FactorMedidas de seguridad | Qué debes tener en cuenta¿Expone la herramienta a tu empresa o flujo de trabajo a riesgos de cumplimiento, filtraciones de datos o puntos de acceso no autorizados? |
| FactorRequisitos de cumplimiento | Qué debes tener en cuenta¿El enfoque del proveedor se ajusta a tus normas internas y regionales (por ejemplo, el RGPD, el cumplimiento de robots.txt y el tratamiento de PII)? |
¿Qué son las herramientas de extracción de datos web?
Las herramientas de extracción de datos web son plataformas de software que automatizan la recuperación y extracción de datos estructurados de sitios web. Estas herramientas permiten capturar información de las páginas, incluido el contenido dinámico y generado mediante JavaScript, para utilizarla en análisis, informes o integraciones con bases de datos internas. La mayoría ofrece opciones para configurar reglas de extracción y exportar datos en formatos adecuados para desarrolladores.
Características de las herramientas de extracción de datos web
Al seleccionar herramientas de extracción de datos web, presta atención a las siguientes características clave:
- Motor de extracción de datos: Permite definir cómo se recopila el contenido de los sitios web mediante selectores CSS, XPath o interfaces de selección visual para obtener resultados estructurados.
- Renderizado de JavaScript: Carga aplicaciones dinámicas o de página única mediante la ejecución de JavaScript, lo que garantiza que se capture la información que no aparece en el HTML estático.
- Gestión de proxies: Rota las direcciones IP, a menudo mediante servicios de proxy residenciales, para eludir bloqueos geográficos, límites de solicitudes o sistemas de protección contra bots, de modo que puedas extraer datos de sitios de forma fiable y a gran escala.
- Gestión de CAPTCHA: Detecta y resuelve o elude automáticamente los desafíos CAPTCHA para mantener en funcionamiento las canalizaciones de datos cuando se activan medidas contra bots.
- Programación y automatización: Configura extracciones recurrentes o activa tareas en intervalos específicos, lo que permite el funcionamiento desatendido y la integración en canalizaciones de datos.
- Exportación de datos estructurados: Admite la salida en JSON, CSV y XML, o el envío directo a almacenamiento en la nube, API o bases de datos, eliminando los pasos manuales de conversión y carga.
- Detección de cambios y alertas: Supervisa los sitios objetivo en busca de actualizaciones de contenido, cambios de precios o nuevos anuncios, y te notifica si los resultados difieren de las ejecuciones anteriores.
- Controles de concurrencia: Gestiona varias solicitudes en paralelo para acelerar las sesiones de extracción y admite tareas de rastreo a gran escala en miles de páginas.
- Gestión de errores y registros: Registra extracciones fallidas, interrupciones de conexión o cambios en los sitios, y proporciona registros detallados de errores para diagnosticar y solucionar rápidamente los problemas de extracción.
- Controles de acceso de usuarios: Restringe quién puede editar proyectos, gestionar tareas o ver exportaciones para mantener la seguridad y evitar cambios accidentales o no autorizados.
Características habituales de inteligencia artificial de las herramientas de extracción de datos web
Además de las características estándar de las herramientas de extracción de datos web mencionadas anteriormente, muchas de estas soluciones están incorporando inteligencia artificial con funciones como:
- Detección automática de campos de datos: Utiliza inteligencia artificial para identificar y asignar automáticamente los campos de datos relevantes en páginas web complejas o desconocidas, reduciendo la configuración manual de selectores.
- Reconocimiento adaptable de la estructura de los sitios: Aprende y se adapta a los cambios en los diseños de los sitios web, minimizando el tiempo de inactividad y el mantenimiento cuando los sitios objetivo actualizan su diseño.
- Elusión inteligente de sistemas contra bots: Aplica inteligencia artificial para imitar patrones de navegación humanos y adaptar las estrategias de extracción en tiempo real, ayudando a eludir sistemas avanzados de detección de bots.
- Análisis de contenido en lenguaje natural: Utiliza inteligencia artificial para extraer, resumir o categorizar texto no estructurado, lo que facilita el análisis de reseñas, artículos o publicaciones de foros.
- Generación automatizada de plantillas: Crea plantillas de extracción reutilizables para sitios similares mediante el análisis de la estructura de las páginas y los patrones de contenido con aprendizaje automático.
- Corrección inteligente de errores: Detecta y resuelve errores o anomalías habituales de extracción mediante diagnósticos basados en inteligencia artificial, reduciendo la necesidad de solucionar problemas manualmente.
Beneficios de las herramientas de extracción de datos web
La implementación de herramientas de extracción de datos web proporciona varios beneficios para tu equipo y tu empresa. Estos son algunos de los que puedes esperar:
- Recopilación de datos a gran escala: Automatiza la extracción de información de muchos sitios y páginas, poniendo a disposición grandes conjuntos de datos para el análisis o el aprendizaje automático.
- Información del mercado en tiempo real: Supervisa al instante los precios de la competencia, los catálogos de productos y los cambios en los sitios web mediante funciones de programación, detección de cambios y alertas.
- Eficiencia de los recursos: Programa y automatiza tareas, reduciendo el esfuerzo manual y permitiendo que los desarrolladores se centren en proyectos de mayor valor.
- Calidad de datos uniforme: Exporta datos estructurados en formatos fiables como JSON o CSV, minimizando el tedioso trabajo de limpieza e integración de datos.
- Elusión de obstáculos contra bots: Utiliza la rotación de proxies integrada, la gestión de CAPTCHA y la elusión de sistemas contra bots para acceder a contenido que otras soluciones no pueden alcanzar.
- Adaptabilidad a los cambios de los sitios: Aprovecha la gestión inteligente de errores y, en el caso de las herramientas con inteligencia artificial, la extracción auto adaptable cuando cambian los diseños o las estructuras de los sitios web.
- Acceso seguro y cumplimiento normativo: Protege las canalizaciones de datos mediante permisos de usuario, registros de auditoría y alineación con marcos de cumplimiento normativo o reglamentos de privacidad.
Costes y precios de las herramientas de extracción de datos web
Seleccionar herramientas de extracción web requiere comprender los diversos modelos de precios y planes disponibles. Los costes varían en función de las características, el tamaño del equipo, los complementos y otros factores. La tabla siguiente resume los planes habituales, sus precios medios y las funciones que suelen incluir las soluciones de herramientas de extracción web:
Tabla comparativa de planes para herramientas de extracción web
| Tipo de plan | Precio medio | Funciones habituales |
|---|---|---|
| Tipo de planPlan gratuito | Precio medio$0-$10/mes | Funciones habitualesEjecuciones de extracción limitadas, programación básica, asistencia de la comunidad y formatos iniciales de exportación de datos. |
| Tipo de planPlan personal | Precio medio$15-$40/mes | Funciones habitualesMás créditos de extracción, renderizado de JavaScript, acceso a la API y gestión básica de errores. |
| Tipo de planPlan empresarial | Precio medio$55-$150/mes | Funciones habitualesMayor concurrencia, rotación de proxies, programación avanzada, herramientas de colaboración en equipo y asistencia prioritaria. |
| Tipo de planPlan corporativo | Precio medio$250+/mes | Funciones habitualesIntegraciones personalizadas, garantías de SLA, proxies orientados geográficamente, incorporación gestionada y gestión de cuentas dedicada. |
Preguntas frecuentes sobre las herramientas de extracción web
Estas son algunas respuestas a preguntas habituales sobre las herramientas de extracción web:
¿Necesito conocimientos de programación para utilizar herramientas de extracción web?
No, no es necesario tener conocimientos de programación. Muchas herramientas visuales ofrecen una solución sin código, como una extensión de Chrome de tipo apuntar y hacer clic, que permite a los usuarios sin conocimientos técnicos crear rutinas de extracción visualmente y recorrer el mapa del sitio de una página para recopilar registros destinados a tareas como la generación de clientes potenciales.
Sin embargo, la lógica personalizada, las canalizaciones de datos complejas o la extracción a gran escala suelen depender de herramientas de programación:
\u003cul\u003e
\t\u003cli\u003ePython: Una biblioteca tradicional de Python como BeautifulSoup es ideal para analizar documentos HTML estáticos de forma limpia.\u003c/li\u003e
\t\u003cli\u003eJavaScript: Una biblioteca especializada de Node.js, como Puppeteer o Playwright, permite a los desarrolladores interactuar mediante programación con elementos web dinámicos.\u003c/li\u003e
\u003c/ul\u003e
¿Pueden las herramientas de extracción web gestionar sitios web dinámicos y con mucho JavaScript?
Sí, la mayoría de las herramientas modernas ofrecen motores de renderizado de JavaScript para extraer contenido dinámico de aplicaciones de una sola página (SPAs) y sitios interactivos.
¿Cómo abordan las herramientas de extracción web las medidas contra bots de los sitios web?
Para superar las protecciones contra bots, las herramientas avanzadas emplean varias estrategias de evasión:
\u003cul\u003e
\t\u003cli\u003eProxies rotatorios: Distribuyen las solicitudes entre grandes grupos de direcciones IP, tanto de centros de datos como residenciales, para evitar los límites de frecuencia o los bloqueos de IP.\u003c/li\u003e
\t\u003cli\u003eSolucionadores automatizados de CAPTCHA: Resuelven o eluden los desafíos visuales y de comportamiento.\u003c/li\u003e
\t\u003cli\u003eEnmascaramiento de la huella digital del navegador: Modifican las cabeceras del navegador, las huellas del lienzo y los agentes de usuario en motores como WebKit o Chromium para imitar las interacciones humanas en los principales navegadores, como Firefox o Chrome.\u003c/li\u003e
\u003c/ul\u003e
¿Es legal la extracción web?
La legalidad de la extracción web depende de los datos que recopiles, del uso que hagas de ellos y de las condiciones de servicio del sitio web. Revisa siempre las directrices legales y los requisitos de cumplimiento antes de proceder.
¿Cómo recibo y almaceno los datos extraídos?
Normalmente puedes exportar los datos a formatos como CSV, JSON o Excel, o enviarlos directamente a un almacenamiento en la nube, webhooks o bases de datos, según las opciones de integración de la herramienta.