

Encontrar la herramienta de monitorización adecuada puede ser un quebradero de cabeza. Quieres algo que se adapte a las necesidades de tu equipo sin añadir complejidad. Por eso muchas organizaciones buscan alternativas a LogicMonitor.
Según mi experiencia, las empresas suelen buscar otras soluciones que ofrezcan una mejor escalabilidad, funciones específicas o una mayor rentabilidad. Puede que descubran que LogicMonitor no se ajusta a sus objetivos actuales o a su presupuesto.
He probado y analizado varias opciones de forma independiente para ofrecerte una visión imparcial de lo que hay disponible. Te guiaré por las mejores herramientas para abordar tus desafíos específicos.
Tanto si buscas una integración mejorada con la nube como la flexibilidad del código abierto, esta lista te ayudará a encontrar la opción adecuada. Exploremos las mejores alternativas que pueden hacer que tus tareas de monitorización sean más manejables.
¿Qué es LogicMonitor?
LogicMonitor es un software de productividad diseñado para profesionales y empresas de TI que necesitan soluciones de monitorización eficientes. Los equipos de TI lo utilizan para monitorizar infraestructuras, aplicaciones y el rendimiento de las redes, proporcionando información valiosa sobre el funcionamiento de los sistemas.
La monitorización automatizada, los paneles personalizables y las alertas en tiempo real ayudan a identificar problemas y optimizar el rendimiento. En general, LogicMonitor ofrece una plataforma centralizada para que tus sistemas funcionen sin problemas.
Tabla comparativa de alternativas a LogicMonitor
Esta tabla comparativa resume los detalles de precios de mis principales alternativas seleccionadas a LogicMonitor:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Ideal para la observabilidad basada en IA | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $7/mes Prueba gratuita de 15 días + demostración gratuita disponible | Website |
Ideal para un monitoreo rentable | 4.0 out of 5 | 4 | 3 | 4 | 4 | 4 | 5 | $325/mes Plan gratuito + prueba gratuita de 5 días + demostración gratuita disponible | Website |
Ideal para servicios de monitorización de la nube | 4.3 out of 5 | 4 | 4 | 4 | 4 | 5 | 5 | $15/host/mes Plan gratuito + prueba gratuita de 14 días + demostración gratuita disponible | Website |
Ideal para análisis de datos impulsado por IA | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $15/servidor/mes Plan gratuito disponible | Website |
Ideal para el acceso automatizado a datos en tiempo real | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $0.04/mes Prueba gratuita de 14 días + demostración gratuita disponible | Website |
La mejor opción para una observabilidad unificada y flexible | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $19/mes Plan gratuito disponible | Website |
Ideal para soluciones de TI integradas | 3.7 out of 5 | 3 | 3 | 4 | 3 | 5 | 4 | Precios bajo solicitud Prueba gratuita de 30 días disponible | Website |
La mejor opción para paneles personalizables | 3.3 out of 5 | 4 | 2 | 4 | 3 | 4 | 3 | $200/mes Plan gratuito + prueba de 30 días + demostración disponible | Website |
Ideal para la observabilidad de código abierto | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $49/mes Prueba gratuita de 30 días + demostración gratuita disponible | Website |
La mejor opción para obtener información basada en IA | 3.2 out of 5 | 3 | 4 | 3 | 2 | 3 | 4 | Precios disponibles previa solicitud Plan gratuito + demostración gratuita disponible | Website |


Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

Análisis de las mejores alternativas a LogicMonitor
A continuación encontrarás mis resúmenes detallados de las mejores alternativas a LogicMonitor que han entrado en mi selección. Mis análisis ofrecen una visión detallada de las funciones principales, las ventajas y desventajas, las integraciones y los casos de uso ideales de cada herramienta para ayudarte a encontrar la mejor opción para ti.
 Ideal para la observabilidad basada en IA
- Prueba gratuita de 15 días + demostración gratuita disponible
- Desde $7/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5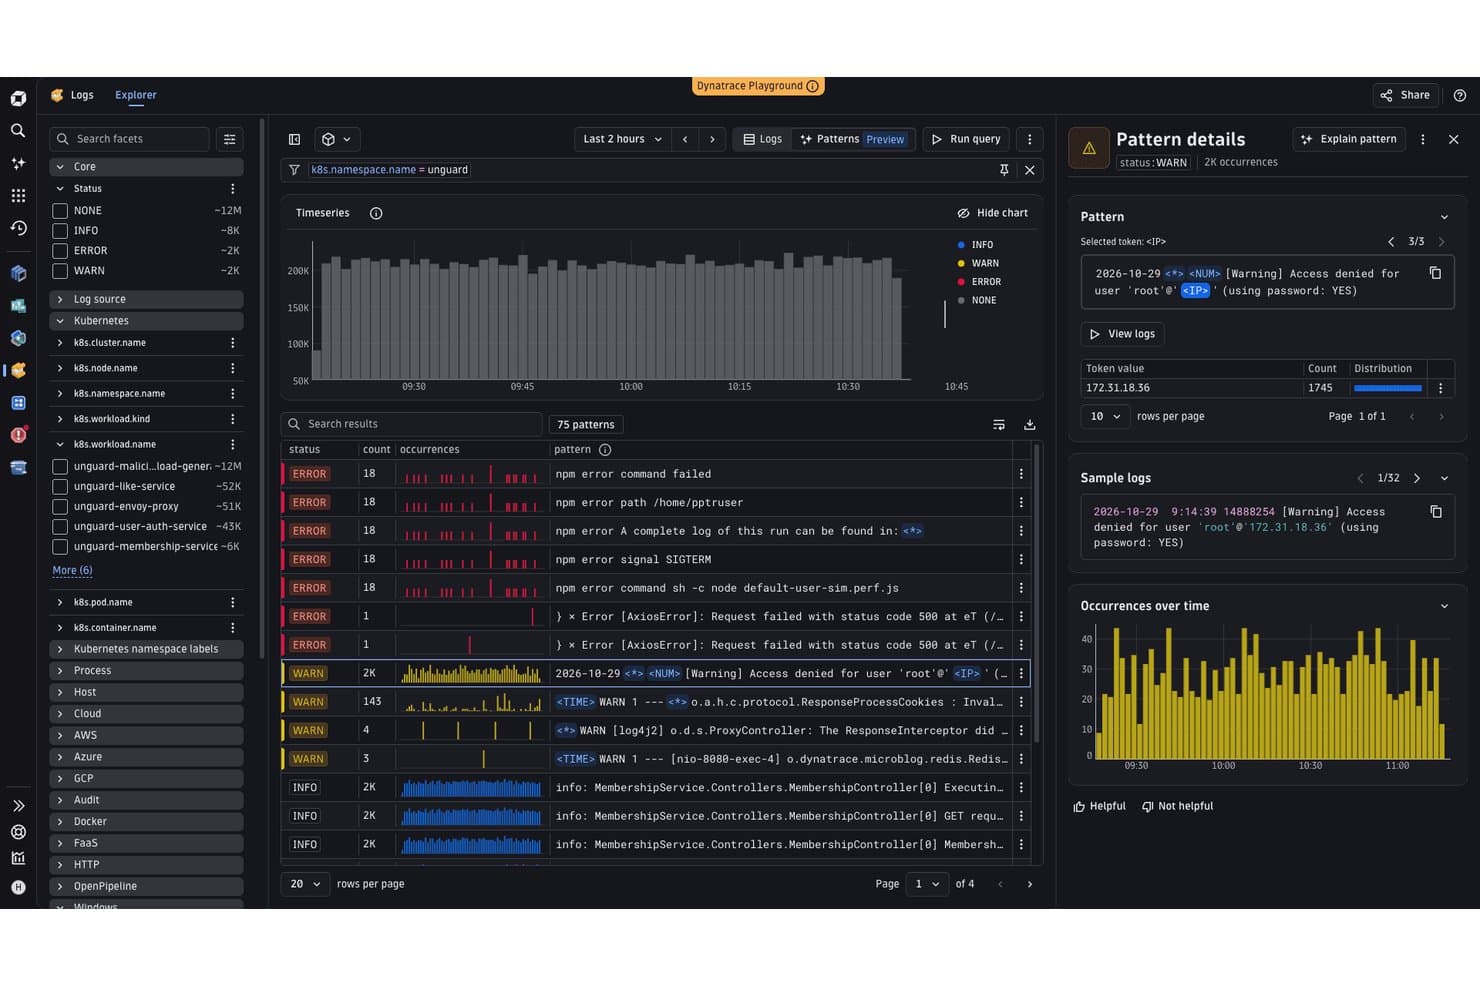
Aplicación Logs de Dynatrace que agrupa las entradas de registro en patrones por estado, con gráficos de ocurrencias y detalles. Dynatrace es una plataforma de observabilidad de pila completa que utiliza IA para descubrir, mapear y supervisar automáticamente tus aplicaciones, infraestructura y entornos en la nube, lo que la convierte en una opción sólida para los equipos de operaciones de TI y DevOps que trabajan con sistemas complejos y dinámicos en los que el análisis manual de la causa raíz no es realista.
¿Para quién es más adecuado Dynatrace?
Dynatrace es una opción sólida para los equipos de DevOps y operaciones de TI que gestionan entornos complejos y distribuidos en los que la visibilidad de pila completa y el análisis de la causa raíz basado en IA son más importantes que la supervisión de red especializada.
Por qué elegí Dynatrace
Elegí Dynatrace como una de las mejores alternativas a LogicMonitor porque su observabilidad basada en IA va mucho más allá de las alertas basadas en umbrales. Davis AI utiliza la topología Smartscape para correlacionar automáticamente los eventos entre hosts, contenedores y servicios, de modo que, en lugar de clasificar docenas de alertas, obtengo una única causa raíz. PurePath rastrea cada transacción de extremo a extremo a nivel de código, lo que significa que puedo identificar exactamente dónde se origina una ralentización sin tener que revisar manualmente los registros.
Funciones principales de Dynatrace
- Descubrimiento automático con OneAgent: Se instala por host y descubre automáticamente procesos, servicios y dependencias sin configuración manual.
- Análisis de registros con DQL: Ingiere, enriquece y consulta datos de registros mediante Dynatrace Query Language, con una retención configurable de 10 días a 10 años.
- Supervisión sintética: Simula recorridos de usuario mediante Browser Monitor y comprueba la disponibilidad de API y servicios mediante HTTP Monitor desde ubicaciones públicas y privadas.
- Automatización de flujos de trabajo: Activa flujos de trabajo automatizados a partir de eventos, programaciones o llamadas a la API, con compatibilidad para condiciones, bucles y reintentos.
Integraciones de Dynatrace
Dynatrace cuenta con integraciones del mercado para Jira, Slack, Cursor, GitHub Copilot Coding Agent, JetBrains y Windsurf. También proporciona API de gestión de entornos, configuración y cuentas para integraciones personalizadas y conectividad con flujos de trabajo.
Pros and Cons
Pros:
- Correlaciona las alertas mediante la topología Smartscape
- OneAgent descubre las dependencias de las aplicaciones y la infraestructura
- PurePath rastrea las transacciones hasta las causas a nivel de código
Cons:
- La supervisión de red está por detrás de las plataformas especializadas
- Los paneles personalizados requieren esfuerzo para configurarse
 Ideal para un monitoreo rentable
- Plan gratuito + prueba gratuita de 5 días + demostración gratuita disponible
- Desde $325/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5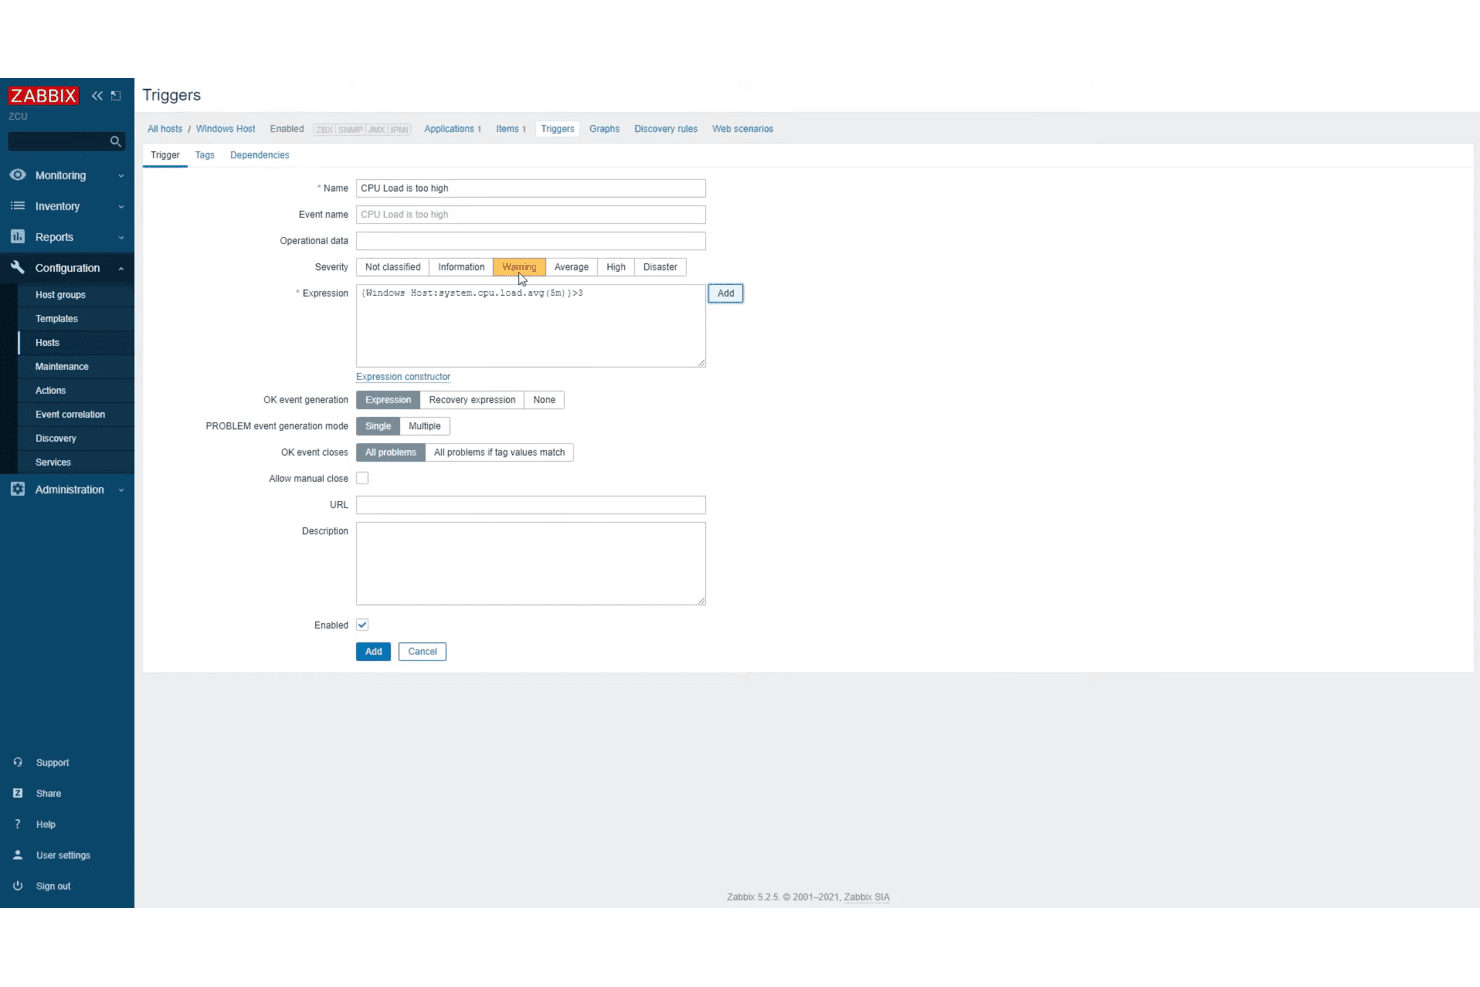
Configuración de un activador de Zabbix que alerta cuando la carga de CPU del host de Windows supera un umbral. Zabbix es una plataforma de monitoreo de código abierto que atrae a los equipos de TI que necesitan una amplia visibilidad de la infraestructura —en servidores, redes, nubes, contenedores y aplicaciones— sin pagar tarifas de licencia por dispositivo o por métrica.
¿Para quién es más adecuado Zabbix?
Zabbix es una opción sólida para los equipos de TI que necesitan monitoreo de infraestructura de nivel empresarial, pero no pueden justificar los costos de licencia por dispositivo.
Por qué elegí Zabbix
Elegí Zabbix como una de las mejores opciones porque ninguna otra herramienta de esta lista permite eliminar por completo las licencias por dispositivo y, aun así, obtener monitoreo de nivel empresarial en servidores, redes, nubes y contenedores. El núcleo de código abierto no tiene límites de hosts, límites de métricas ni funciones restringidas, por lo que un equipo que administra miles de endpoints paga cero en licencias, al igual que uno que administra diez. También valoro las funciones de activadores predictivos, que utilizan datos históricos para estimar cuándo se superará un umbral antes de que realmente ocurra.
Características principales de Zabbix
- Reglas de correlación de eventos: Configure reglas para agrupar eventos relacionados, eliminar alertas duplicadas e inestables y cerrar automáticamente problemas obsoletos en diferentes activadores y métodos de sondeo.
- Paneles de costos multicloud: Consulte y compare el gasto en infraestructura de AWS, Azure, Google Cloud y Oracle Cloud desde un único panel.
- Compatibilidad con APM de OpenTelemetry: Reciba trazas distribuidas, métricas y registros de aplicaciones o recopiladores de OpenTelemetry mediante un proxy de Zabbix, con ClickHouse como fuente de datos de telemetría.
- Acciones de corrección automatizadas: Ejecute scripts o comandos configurados en respuesta a problemas detectados, incluido el reinicio de servicios o el ajuste de escala de recursos en la nube.
Integraciones de Zabbix
Zabbix incluye 204 plantillas oficiales y 570 marcas en 2.010 soluciones, entre ellas AWS, Azure, Google Cloud Platform, ServiceNow, Slack, PagerDuty, Kafka y RabbitMQ. Su API JSON-RPC, API de streaming REST, webhooks y biblioteca de Python permiten crear integraciones personalizadas.
Pros and Cons
Pros:
- Amplia visibilidad en servidores y redes
- Alertas flexibles y correlación de eventos
- Las previsiones señalan que se aproximan los umbrales de las métricas
Cons:
- Los umbrales de alerta necesitan ajustes manuales
- Las implementaciones autohospedadas requieren mantenimiento de la base de datos
 Ideal para servicios de monitorización de la nube
- Plan gratuito + prueba gratuita de 14 días + demostración gratuita disponible
- Desde $15/host/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5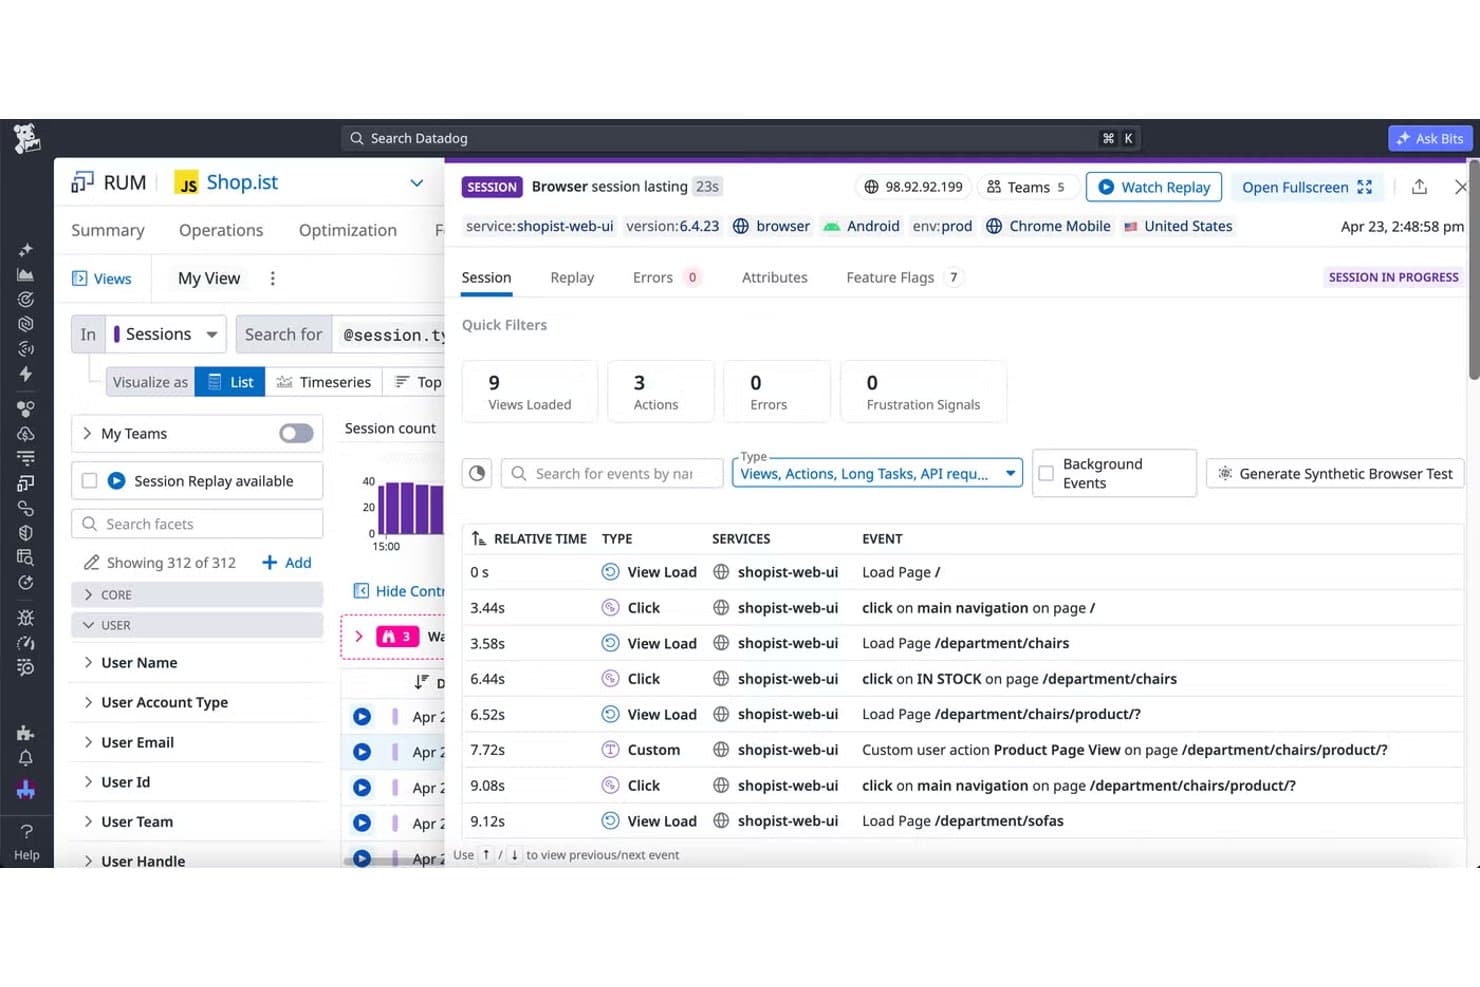
Vista de sesión de RUM de Datadog que muestra las cargas de página, los clics y las acciones personalizadas de un usuario en secuencia. Datadog es una plataforma de observabilidad basada en SaaS que proporciona a los equipos de TI y DevOps una visibilidad unificada de la infraestructura en la nube, híbrida y local, al combinar métricas, registros, trazas y señales de seguridad en un solo lugar para reducir los cambios de contexto durante la respuesta a incidentes.
¿Para quién es más adecuado Datadog?
Datadog es una opción muy adecuada para ingenieros de DevOps y equipos de operaciones de TI que gestionan entornos nativos de la nube o híbridos y necesitan visibilidad unificada de la infraestructura, los registros, las trazas y las señales de seguridad en una sola plataforma.
Por qué elegí Datadog
Elegí Datadog como una de las mejores alternativas a LogicMonitor porque está diseñado específicamente para la monitorización de la nube y realiza un seguimiento de decenas de miles de métricas en AWS, Azure y GCP, al tiempo que las correlaciona con registros, trazas y señales de seguridad en una sola vista. Me gusta especialmente Watchdog, su motor de IA que detecta anomalías automáticamente, de modo que mi equipo no tiene que revisar manualmente el ruido durante un incidente. Los monitores de pronóstico también son realmente útiles: puedo modelar las tendencias de la CPU o la memoria mediante algoritmos estacionales o lineales y establecer umbrales de alerta con hasta tres meses de antelación.
Características principales de Datadog
- Búsqueda de infraestructura basada en etiquetas: Filtra y analiza métricas en toda tu infraestructura utilizando etiquetas personalizadas para agrupar hosts, contenedores y recursos de la nube por cualquier dimensión.
- Correlación entre señales: Vincula las métricas de infraestructura con registros, trazas y señales de seguridad en una sola vista para investigar incidentes sin cambiar de herramienta.
- Mapeo de topología de dispositivos: Visualiza dispositivos de red, interfaces y conexiones físicas, con la posibilidad de inspeccionar el tráfico, las trampas SNMP, los mensajes Syslog y los dispositivos vecinos.
- Monitorización de procesos en vivo: Consulta la actividad en tiempo real a nivel de proceso en tus hosts y contenedores, incluido el consumo de recursos y los comandos en ejecución, desde una interfaz centralizada.
Integraciones de Datadog
Datadog ofrece más de 1.000 integraciones, incluidas Amazon Web Services, Microsoft Azure, Google Cloud Platform, Kubernetes, Docker, Jira, PagerDuty, OpenTelemetry, PostgreSQL y Redis. Su API REST y sus bibliotecas cliente permiten crear integraciones personalizadas.
Pros and Cons
Pros:
- Correlaciona la infraestructura, los registros y las trazas
- Los paneles personalizados aclaran el estado del sistema en tiempo real
- Los monitores de pronóstico ayudan a anticipar las tendencias de capacidad
Cons:
- Las facturas basadas en el uso pueden ser difíciles de prever
- El ajuste de las alertas puede generar fatiga por notificaciones
 Ideal para análisis de datos impulsado por IA
- Plan gratuito disponible
- Desde $15/servidor/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5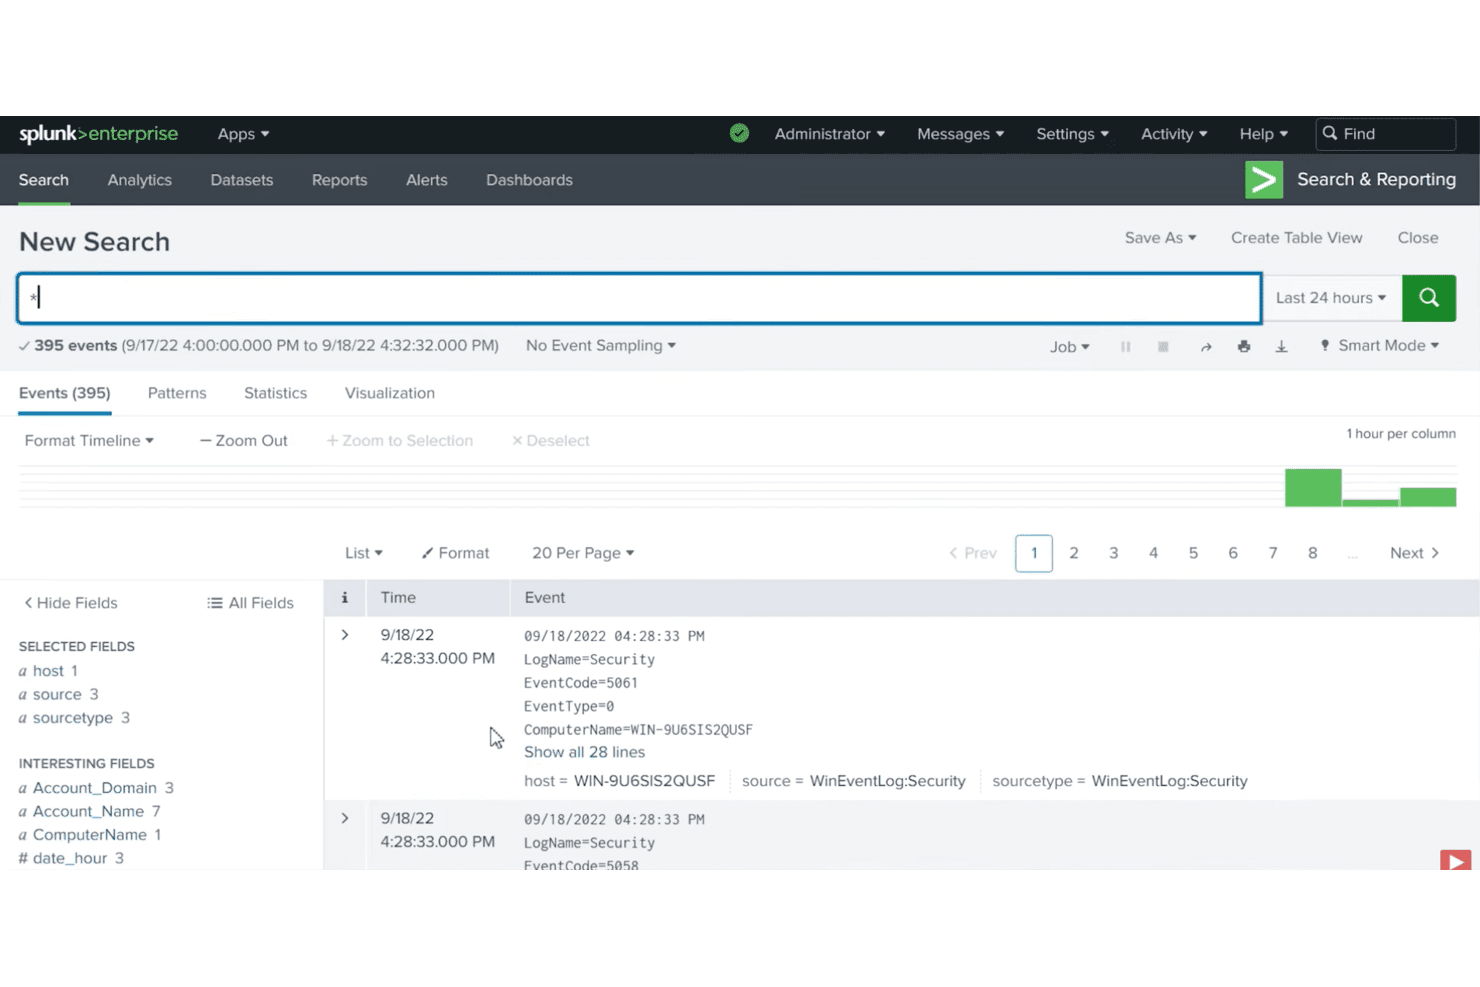
Vista de búsqueda de Splunk Enterprise que muestra eventos de seguridad de Windows con campos seleccionables y una línea de tiempo. Splunk Observability Cloud es una plataforma de monitoreo SaaS que unifica los datos de infraestructura, rendimiento de aplicaciones y experiencia digital, lo que la convierte en una opción sólida para los equipos de TI y DevOps que necesitan análisis de causa raíz asistido por IA en entornos híbridos y de nube.
¿Para quién es más adecuado Splunk?
Splunk Observability Cloud es una opción sólida para los equipos de DevOps y operaciones de TI de organizaciones medianas y grandes que necesitan análisis de causa raíz asistido por IA en entornos híbridos y de nube.
Por qué elegí Splunk
Elegí Splunk como una de las mejores alternativas a LogicMonitor por lo bien que su capa AI SRE gestiona el trabajo de investigación que normalmente recae en tu equipo. El agente de resolución de problemas con IA reúne métricas, trazas y registros para mostrar las causas raíz probables en un lenguaje sencillo, mientras que AI Assistant te permite consultar datos de APM, infraestructura y Kubernetes sin escribir una sola consulta. Me gusta especialmente que el rastreo NoSample capture el 100 % de los datos de trazas, para que no se descarte nada antes del análisis.
Características principales de Splunk
- Paneles de infraestructura: Los paneles y las visualizaciones prediseñados para servicios en la nube, sistemas y entornos de Kubernetes proporcionan a tu equipo visibilidad en tiempo real del estado de la infraestructura híbrida.
- Alertas dinámicas con detectores: Los detectores supervisan las señales de las métricas y activan alertas según reglas con varias condiciones, enviando notificaciones a herramientas como PagerDuty, Slack, ServiceNow y Microsoft Teams.
- Ingesta nativa de OpenTelemetry: Recopila métricas, trazas y registros mediante instrumentación basada en estándares abiertos, con compatibilidad con Prometheus, Telegraf y collectd, además de más de 200 integraciones.
- Log Observer Connect: Vincula los registros que ya están almacenados en Splunk Cloud Platform o Splunk Enterprise directamente con los flujos de trabajo de resolución de problemas de Observability Cloud sin costo adicional.
Integraciones de Splunk
Splunk Observability Cloud documenta más de 200 integraciones compatibles basadas en estándares abiertos, incluidas AWS, Microsoft Azure, Google Cloud Platform, Jira, Microsoft Teams, PagerDuty, ServiceNow, Slack y Amazon EventBridge. También admite conexiones con OpenTelemetry, Prometheus, Telegraf, collectd y REST API.
Pros and Cons
Pros:
- Unifica la telemetría para agilizar la resolución de problemas
- La IA resume las causas probables en un lenguaje sencillo
- Captura cada traza para las investigaciones
Cons:
- Los costos aumentan a medida que se multiplican las fuentes de telemetría
- SignalFlow requiere ajustes manuales de los detectores
Learn more about Splunk: Ideal para el acceso automatizado a datos en tiempo real
- Prueba gratuita de 14 días + demostración gratuita disponible
- Desde $0.04/mes
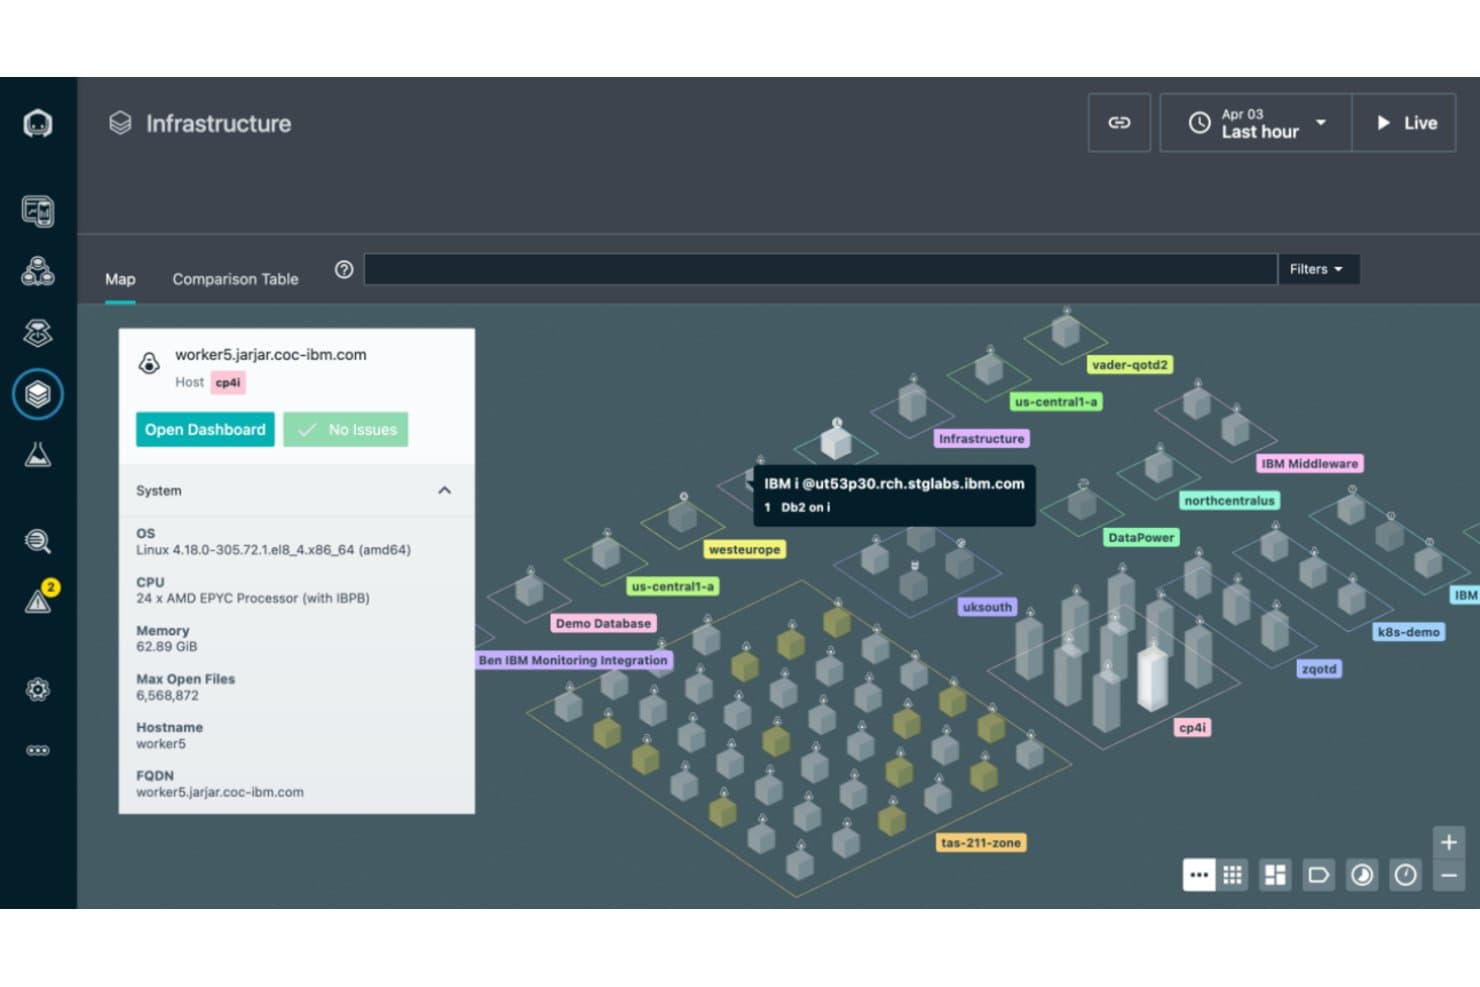
El mapa de infraestructura de IBM Instana muestra los hosts agrupados por zona, con detalles de los hosts y estado en tiempo real. IBM Instana es una plataforma de observabilidad impulsada por IA, creada para equipos de DevOps que necesitan descubrimiento automático, mapeo de dependencias en tiempo real y visibilidad profunda del rendimiento de las aplicaciones en entornos de nube, híbridos y contenedorizados.
¿Para quién es más adecuado IBM Instana?
IBM Instana es una opción ideal para ingenieros de DevOps que gestionan entornos complejos nativos de la nube y necesitan descubrimiento y mapeo de dependencias automáticos y en tiempo real, sin trabajo manual de instrumentación.
Por qué elegí IBM Instana
He incluido IBM Instana entre mis principales opciones porque su acceso automatizado a los datos en tiempo real realmente lo diferencia: el Grafo dinámico descubre y mapea continuamente cada host, servicio y dependencia, y se actualiza cada segundo sin instrumentación manual. Me gusta cómo esto se combina con el análisis de causa raíz mediante IA agéntica, que correlaciona estadísticas de trazas, topología y señales de anomalías para revelar rápidamente las causas probables. Durante un incidente activo, esto significa que mi equipo no tiene que buscar manualmente en los paneles.
Características principales de IBM Instana
- Alertas inteligentes con umbrales adaptativos: el motor de alertas de Instana utiliza líneas base estadísticas y planos predefinidos para detectar incidentes, con alertas agrupadas y enrutamiento a Slack, PagerDuty, correo electrónico y webhooks.
- Seguimiento de transacciones distribuidas: Instana rastrea las solicitudes en los componentes de las aplicaciones sin muestreo, capturando detalles a nivel de código en las capas de bases de datos, navegadores y dispositivos móviles.
- Integración con OpenTelemetry Collector: Instana incorpora telemetría de OpenTelemetry Collector para supervisar microservicios y aplicaciones nativas de la nube junto con componentes instrumentados de forma nativa.
- Información sobre costos de Kubernetes: Instana proporciona paneles listos para usar y análisis históricos del gasto para supervisar los costos de recursos en los clústeres de Kubernetes.
Integraciones de IBM Instana
IBM Instana admite más de 300 tecnologías, incluidas Slack, PagerDuty, OpenTelemetry Collector, Splunk, Amazon EC2, AWS RDS, Google Cloud, Kubernetes y VMware Tanzu. Las API REST y GraphQL, además de los SDK, permiten realizar integraciones personalizadas.
Pros and Cons
Pros:
- Los mapas de dependencias en tiempo real facilitan la clasificación de incidentes
- El descubrimiento automático reduce la instrumentación manual
- La telemetría rápida ayuda a localizar problemas de los servicios
Cons:
- Las deficiencias en dispositivos de red pueden requerir una supervisión independiente
- Los volúmenes de alertas suelen requerir filtrado manual
Learn more about IBM Instana: La mejor opción para una observabilidad unificada y flexible
- Plan gratuito disponible
- Desde $19/mes
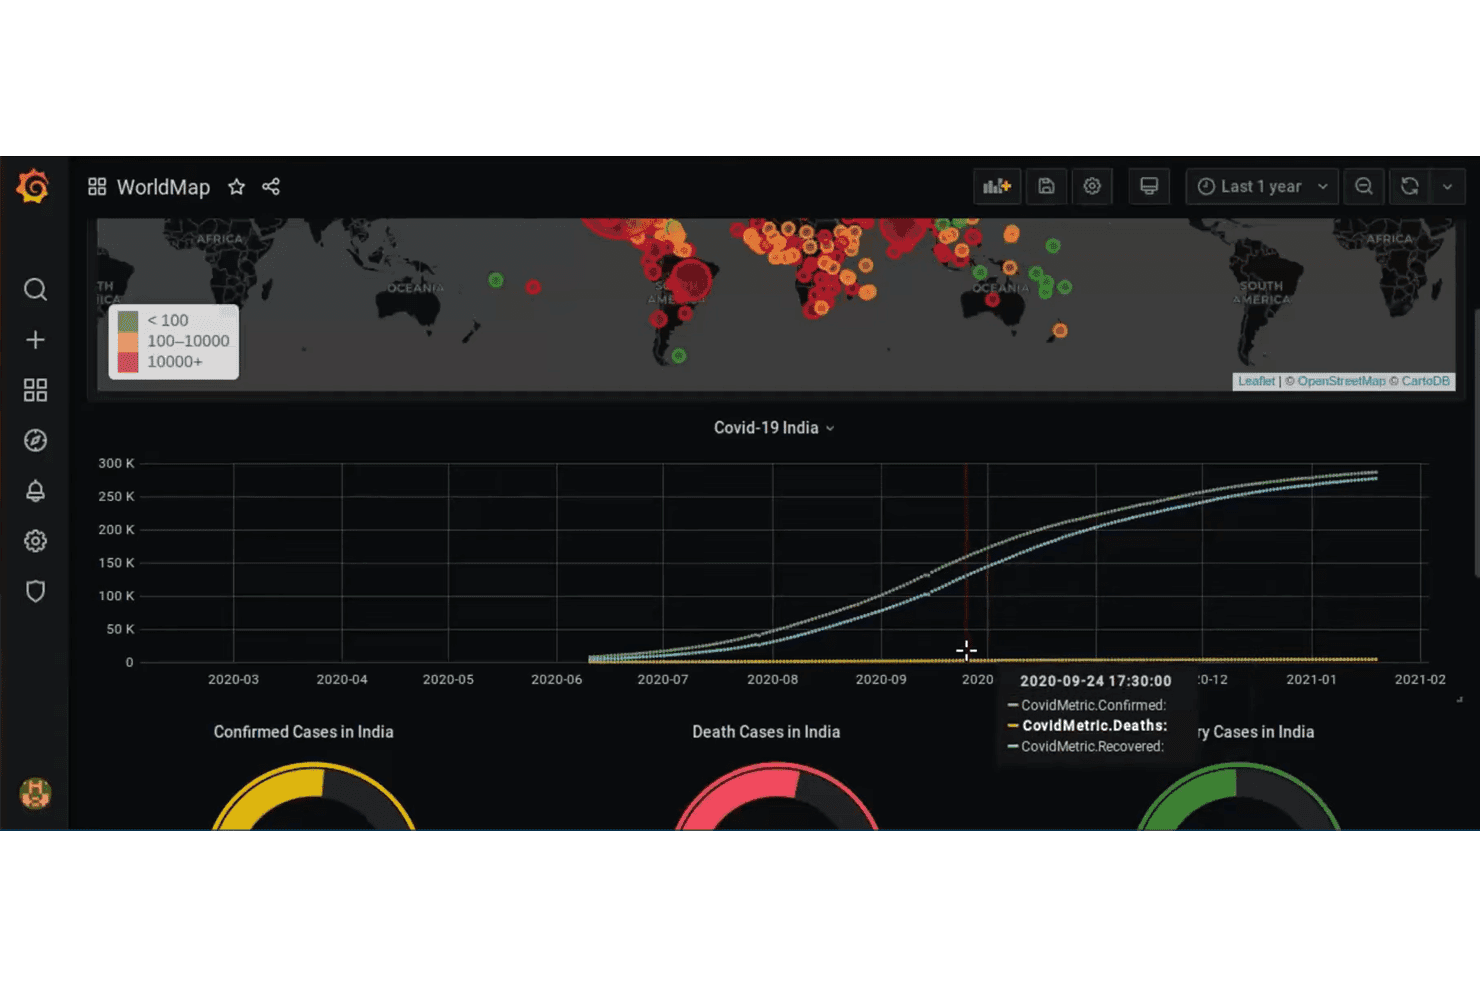
Panel de Grafana que visualiza datos de casos de COVID-19 a nivel mundial y en India a lo largo del tiempo mediante mapas y gráficos de series temporales. Grafana Cloud es una plataforma de observabilidad gestionada que unifica métricas, registros, trazas y perfiles en un solo lugar, lo que la convierte en una opción adecuada para ingenieros de DevOps y equipos de operaciones de TI que necesitan una supervisión flexible basada en estándares abiertos en entornos de nube, híbridos y contenerizados.
¿Para quién es más adecuada Grafana Cloud?
Grafana Cloud es una opción adecuada para ingenieros de DevOps y equipos de operaciones de TI que quieren unificar métricas, registros, trazas y perfiles en entornos nativos de la nube e híbridos mediante estándares abiertos como OpenTelemetry y Prometheus.
Por qué elegí Grafana Cloud
He incluido Grafana Cloud entre mis principales opciones porque reúne métricas, registros, trazas y perfiles en una sola plataforma gestionada, exactamente lo que necesitas cuando el enfoque aislado de LogicMonitor empieza a resultar limitante. Me gusta especialmente el Grafo de conocimiento, que establece relaciones entre servicios, cargas de trabajo de Kubernetes, bases de datos e infraestructura, para que puedas rastrear un aumento de latencia a través de trazas distribuidas hasta llegar a un cuello de botella en una base de datos sin tener que cambiar de herramienta. La función Investigaciones basada en IA puede analizar automáticamente esos datos de telemetría, formular hipótesis y devolver un informe estructurado cuando se activa una alerta.
Características principales de Grafana Cloud
- Telemetría adaptativa: Agrega, muestrea o descarta automáticamente los datos de telemetría de menor valor en métricas, registros, trazas y perfiles para controlar el volumen de datos y los costes.
- Supervisión sintética: Comprueba los puntos de conexión de API y las aplicaciones web desde sondas de todo el mundo, con compatibilidad para comprobaciones HTTP/HTTPS, DNS, TCP y ping ICMP de disponibilidad y rendimiento.
- Recopilador Grafana Alloy: Recopilador de OpenTelemetry de código abierto con compatibilidad con canalizaciones de Prometheus que gestiona métricas, registros, trazas y perfiles de tu infraestructura existente.
- RBAC con roles personalizados: Permite asignar permisos detallados a usuarios, equipos y cuentas de servicio, con roles personalizados delimitados a acciones específicas en paneles y fuentes de datos.
Integraciones de Grafana Cloud
Grafana Cloud ofrece más de 150 integraciones de fuentes de datos, incluidas AWS, Microsoft Azure, Google Cloud, SNMP, VMware vSphere y dispositivos de LogicMonitor. Las API de REST, HTTP, Grafana Cloud, trazas y supervisión sintética, además de los webhooks, permiten crear integraciones personalizadas.
Pros and Cons
Pros:
- Los paneles flexibles reúnen los datos de telemetría
- Las vistas de señales cruzadas facilitan la investigación de incidentes
- El Grafo de conocimiento vincula las anomalías con sus causas
Cons:
- La configuración de SNMP requiere configurar manualmente los dispositivos
- Las reglas de alerta avanzadas requieren esfuerzo de configuración
Learn more about Grafana Cloud: Ideal para soluciones de TI integradas
- Prueba gratuita de 30 días disponible
- Precios bajo solicitud
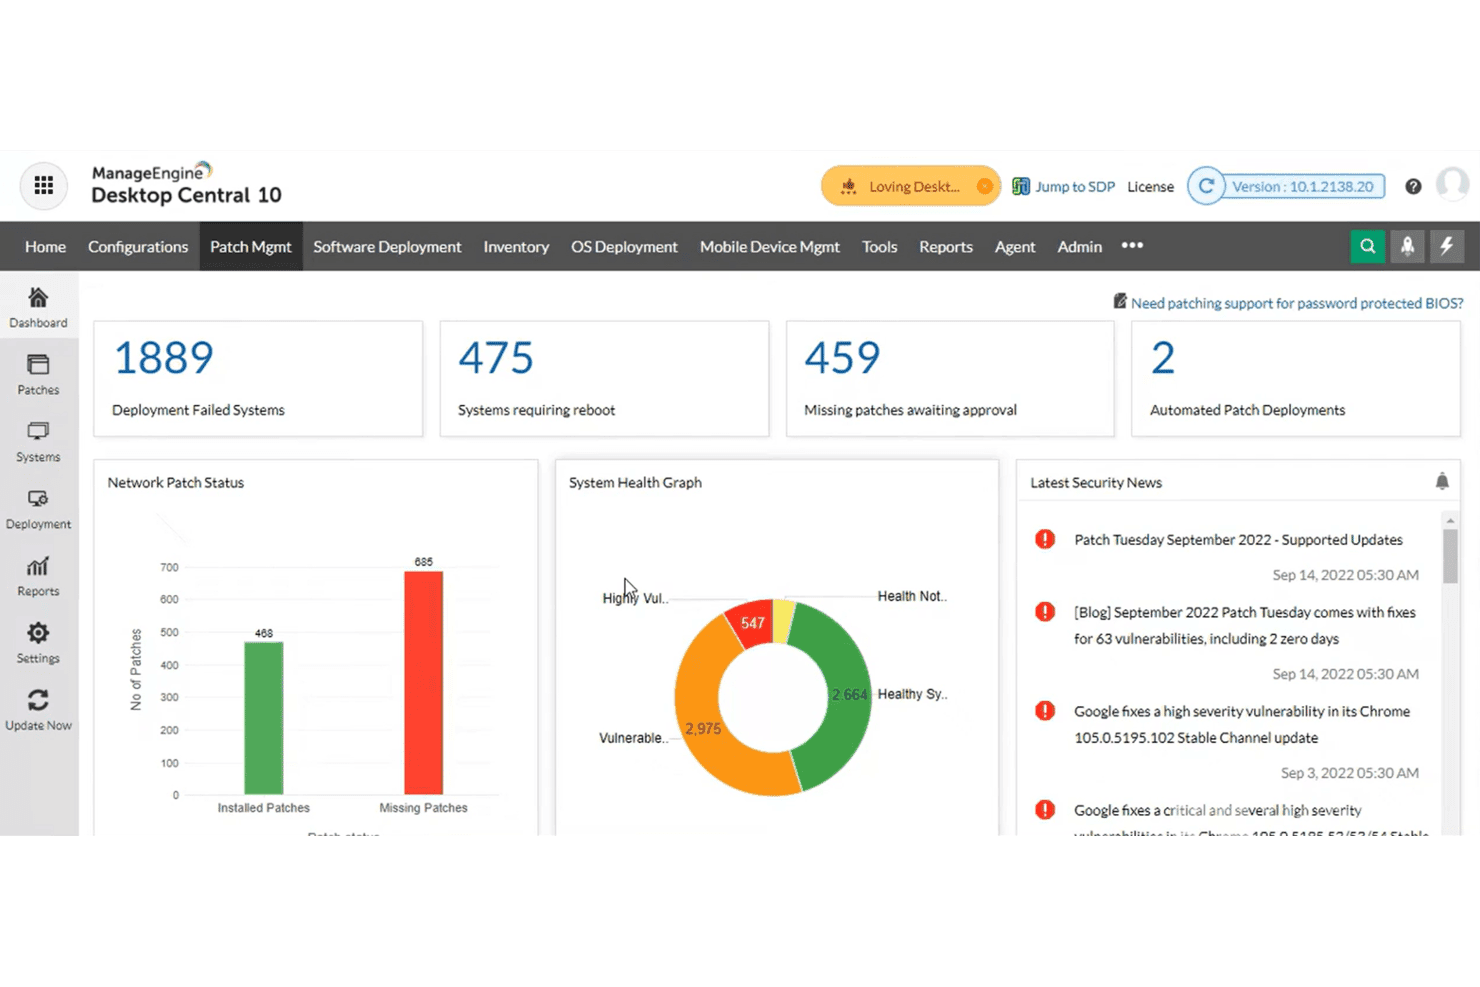
Panel de gestión de parches de ManageEngine Desktop Central 10 que muestra el estado de los parches de red y el estado del sistema. ManageEngine OpManager es una plataforma de monitorización de redes e infraestructuras dirigida a equipos de operaciones de TI que gestionan entornos locales complejos, ya que ofrece una visibilidad detallada de dispositivos, servidores, almacenamiento e infraestructura virtual, junto con previsiones basadas en IA y automatización de flujos de trabajo sin código.
¿Para quién es más adecuado ManageEngine?
ManageEngine OpManager es una opción especialmente adecuada para equipos de operaciones de TI que gestionan grandes entornos locales y necesitan una visibilidad profunda de la infraestructura sin pagar precios del nivel de SolarWinds.
Por qué elegí ManageEngine
Elegí ManageEngine OpManager porque cubre toda la pila de infraestructura en un solo lugar, que es exactamente lo que necesitas al sustituir LogicMonitor. Me gusta especialmente su mapeo de topología, que crea automáticamente mapas de red de capa 2 para que puedas rastrear un fallo desde una alerta directamente hasta el segmento afectado sin tener que revisar herramientas independientes. Su planificación de capacidad basada en IA pronostica cuándo los dispositivos alcanzarán los umbrales de memoria, lo que te permite actuar antes de que se produzca una interrupción.
Funciones principales de ManageEngine OpManager
- Automatización de flujos de trabajo sin código: Un creador de tipo arrastrar y soltar permite crear flujos de trabajo que se activan ante fallos de red o según una programación para gestionar automáticamente servicios, procesos, archivos y carpetas.
- Vista 3D de la planta del centro de datos: Representa una réplica 3D en tiempo real de tu centro de datos y sus bastidores, mostrando el estado activo de los dispositivos directamente dentro de la distribución física.
- Correlación de problemas y eventos: Agrupa las alertas relacionadas en un único registro de problema con su gravedad, método de correlación y porcentaje de reducción del ruido para disminuir la fatiga por alertas.
- Integración con el servidor MCP: Permite que clientes de IA como Claude Desktop o Cursor consulten datos de monitorización de OpManager, incluido el estado de los dispositivos, las alarmas y las tendencias de rendimiento, mediante indicaciones en lenguaje natural.
Integraciones de ManageEngine
ManageEngine OpManager ofrece integraciones nativas con ServiceNow, Jira Service Management, Microsoft Teams, Slack, Grafana, Microsoft Sentinel y ManageEngine ServiceDesk Plus. Su API REST utiliza documentación de OpenAPI, y los webhooks permiten realizar integraciones personalizadas.
Pros and Cons
Pros:
- Visibilidad unificada de redes, servidores y almacenamiento
- Los mapas de topología ayudan a rastrear los fallos hasta los segmentos afectados
- Las previsiones de capacidad detectan con antelación la escasez de recursos
Cons:
- Los perfiles de alertas predeterminados pueden generar demasiadas notificaciones
- Los informes personalizados pueden tardar en configurarse
Learn more about ManageEngine: La mejor opción para paneles personalizables
- Plan gratuito + prueba de 30 días + demostración disponible
- Desde $200/mes (facturado anualmente)
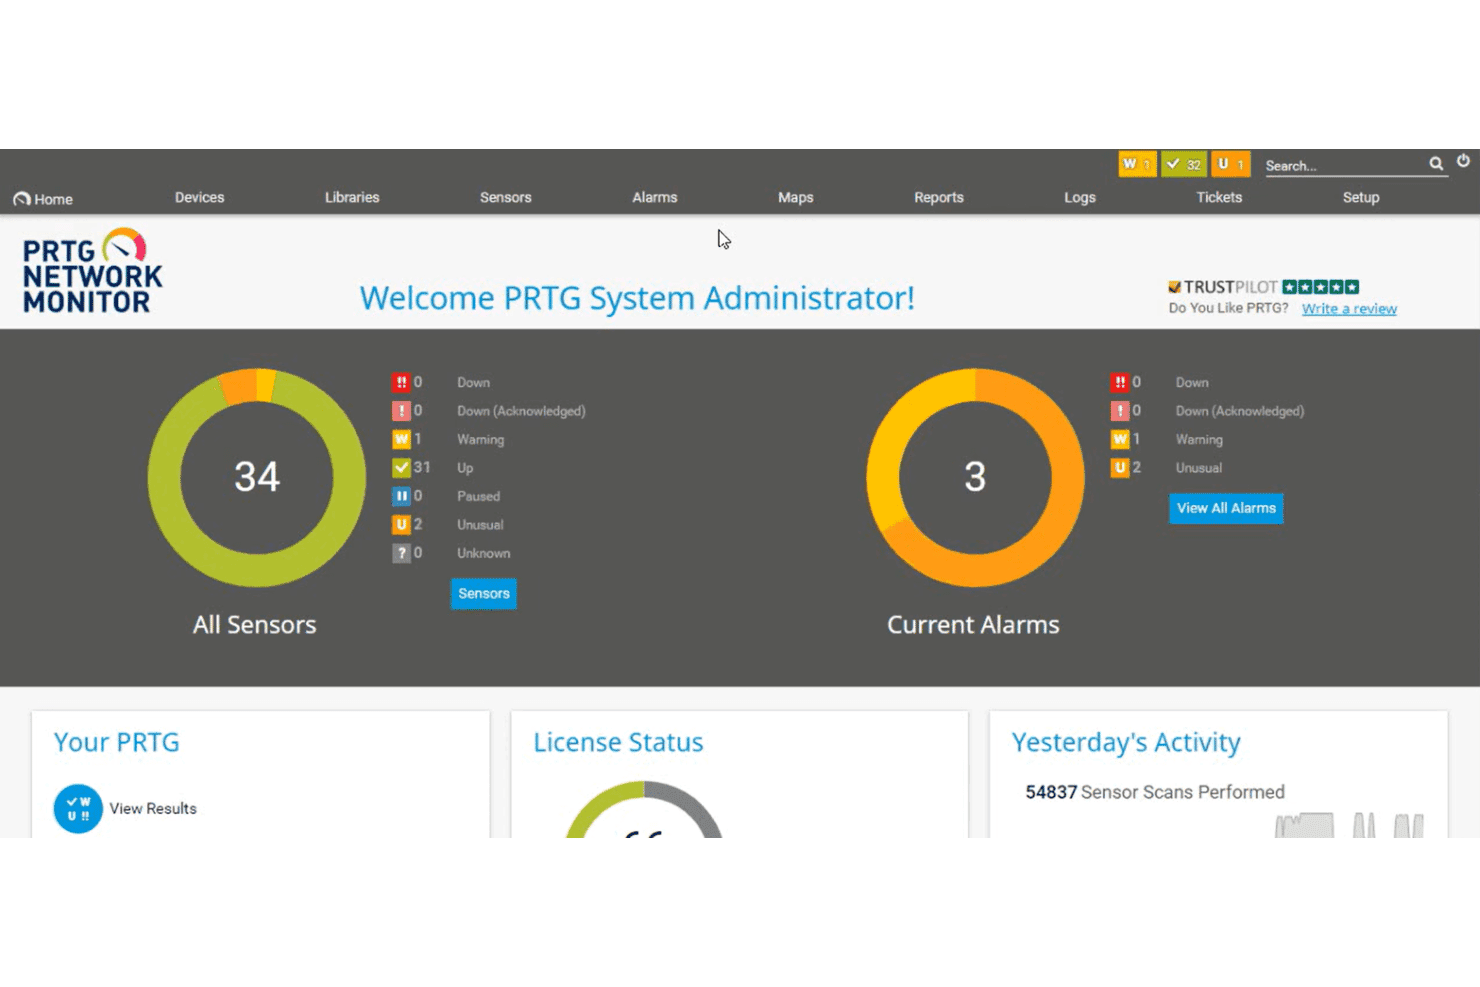
El panel de PRTG Network Monitor resume de un vistazo el estado de los sensores y las alarmas actuales. Paessler PRTG es una herramienta de monitorización de redes local que resulta atractiva para administradores de redes y equipos de TI que necesitan una amplia visibilidad de la infraestructura de TI, OT e IoT, incluidos dispositivos, tráfico, servidores y aplicaciones desde una única plataforma.
¿Para quién es más adecuado Paessler PRTG?
PRTG es una excelente opción para administradores de redes y equipos de TI que gestionan entornos locales o híbridos y necesitan una configuración de monitorización altamente visual basada en sensores que puedan adaptar a su infraestructura.
Por qué elegí Paessler PRTG
Elegí Paessler PRTG como una de las mejores alternativas a LogicMonitor porque la personalización de sus paneles y mapas es más profunda que la de la mayoría de las herramientas que he probado. Puedo crear vistas de infraestructura con un editor de arrastrar y soltar, incorporar iconos de estado de los dispositivos, mapas geográficos y fondos HTML personalizados, y después compartirlas públicamente o insertarlas mediante un iFrame. Con más de 300 widgets disponibles, puedo crear pantallas al estilo de un NOC que hacen visibles de un vistazo los problemas de todo el sitio sin tener que explorar los menús.
Características principales de Paessler PRTG
- Detección automática basada en sensores: Explora segmentos de red mediante ping, SNMP y WMI, y después aplica automáticamente plantillas de dispositivos y sensores para comenzar la monitorización.
- Alertas multicanal con escalado: Envía notificaciones por correo electrónico, SMS, push, Teams o Slack, con niveles de escalado configurables y ventanas de alerta programadas.
- Detección de anomalías basada en IA: Analiza los datos históricos de los sensores para establecer líneas base y envía alertas cuando los valores monitorizados se desvían de los patrones esperados.
- Informes programados y bajo demanda: Genera informes en HTML, PDF, CSV o XML para sensores individuales o grupos, según un horario establecido o activados manualmente.
Integraciones de Paessler PRTG
Paessler PRTG ofrece integraciones nativas con Microsoft Teams, Slack y PagerDuty. También proporciona API REST para integraciones personalizadas y para monitorizar datos XML o JSON.
Pros and Cons
Pros:
- Los mapas personalizados hacen visibles los problemas del sitio
- La detección automática abarca sensores de infraestructuras variadas
- Las alertas de escalado ayudan a detectar pronto los problemas de servicio
Cons:
- La topología para el análisis de la causa raíz requiere una extensión de pago independiente
- La profundidad de la monitorización en la nube queda por detrás de las plataformas centradas en proveedores
Learn more about Paessler PRTG: Ideal para la observabilidad de código abierto
- Prueba gratuita de 30 días + demostración gratuita disponible
- Desde $49/mes
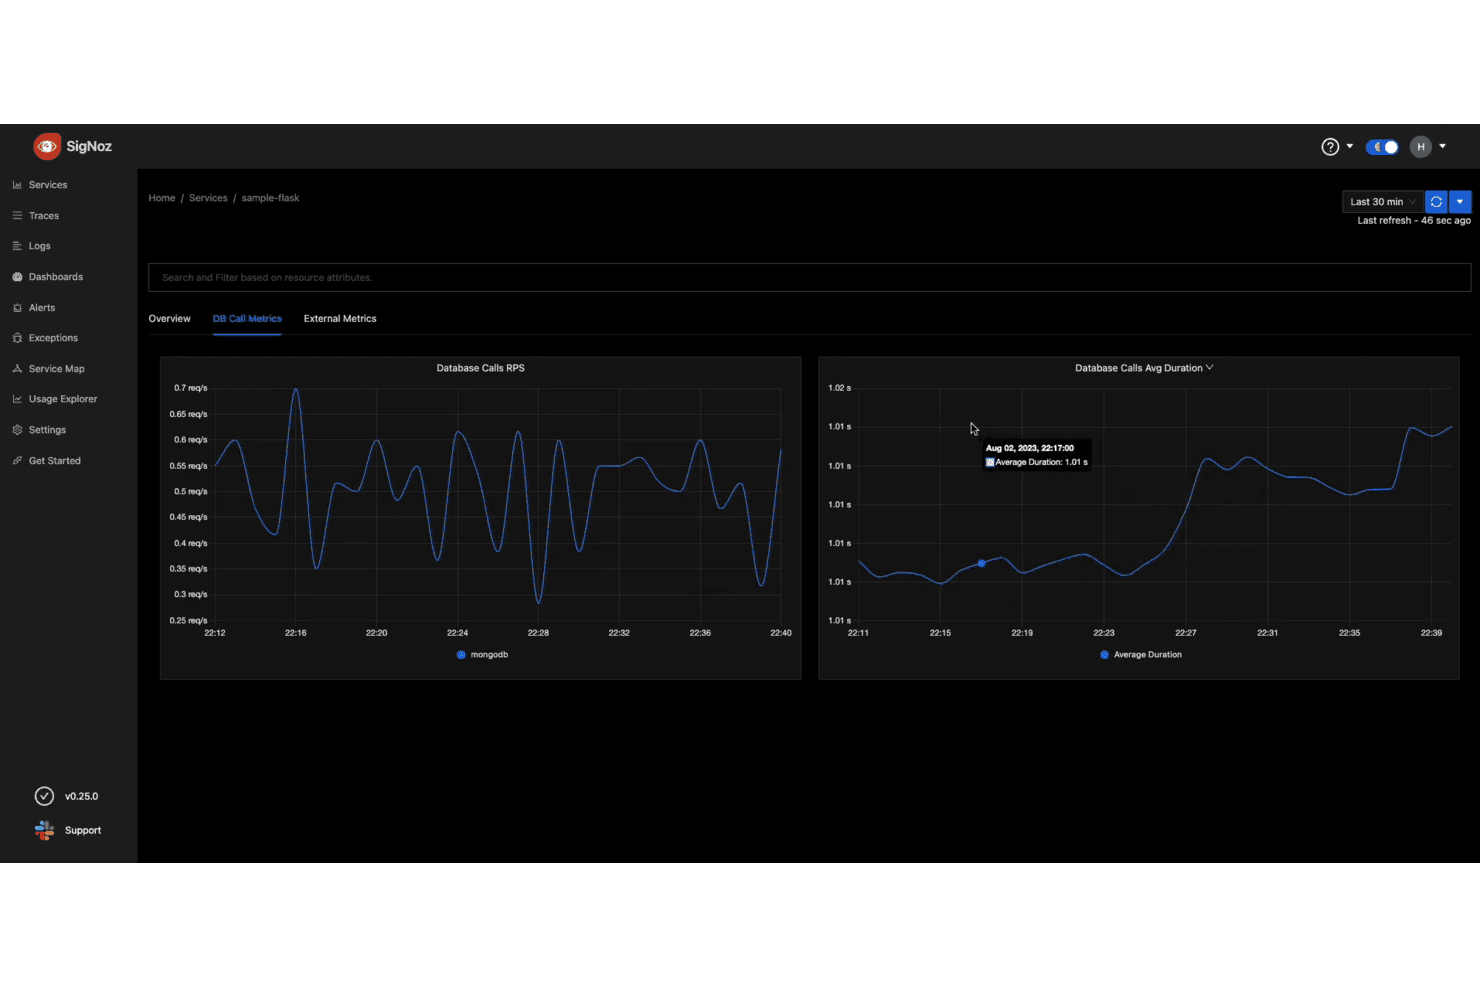
Vista de servicio de SigNoz que muestra la tasa de llamadas a la base de datos MongoDB y la duración media a lo largo del tiempo. SigNoz es una plataforma de observabilidad nativa de OpenTelemetry que atrae a ingenieros de DevOps y equipos de infraestructura que buscan registros, métricas y trazas unificados sin la facturación opaca por host que ofrecen herramientas como Datadog o New Relic.
¿Para quién es mejor SigNoz?
SigNoz es una excelente opción para ingenieros de DevOps y equipos de plataformas que quieren tener un control total sobre su pila de observabilidad sin pagar tarifas por host.
Por qué elegí SigNoz
Elegí SigNoz como una de las mejores opciones porque es la única plataforma nativa de OpenTelemetry de esta lista que permite autoalojar toda la pila de observabilidad sin tarifas por host ni dependencia del proveedor. Me encanta que unifique registros, métricas y trazas en un solo lugar, de modo que, cuando se activa una alerta, puedo pasar directamente desde un enlace del mapa de servicios que muestra una latencia P99 elevada a la traza y el registro correlacionados sin cambiar de herramienta. La correlación de alertas asistida por IA mediante el servidor MCP es una capa realmente útil, ya que me permite cuantificar qué servicio ascendente es responsable de un pico incluso antes de abrir un terminal.
Funciones clave de SigNoz
- Alertas multiseñal: Crea alertas sobre métricas, registros, trazas, excepciones y anomalías, con políticas de enrutamiento que dirigen las notificaciones a Slack, PagerDuty, Opsgenie, Microsoft Teams, correo electrónico o webhooks.
- Instrumentación nativa de OpenTelemetry: Recopila y reenvía telemetría de aplicaciones, hosts, Kubernetes y servicios en la nube mediante OpenTelemetry Collector, sin agentes propietarios.
- Generador de consultas: Filtra, agrega y aplica funciones matemáticas a registros, métricas y trazas desde una única interfaz; también admite PromQL y SQL de ClickHouse.
- Conformidad con SOC 2 Tipo II y HIPAA: SigNoz Cloud cumple las normas SOC 2 Tipo II y HIPAA, con centros de datos disponibles en EE. UU., la UE y la India.
Integraciones de SigNoz
SigNoz documenta 112 integraciones, incluidas AWS, Azure, Google Cloud Platform, PostgreSQL, MySQL, Redis, MongoDB, NGINX y RabbitMQ. También ofrece una API para integraciones personalizadas y admite conexiones de OpenTelemetry Collector para firewalls, enrutadores y conmutadores compatibles con SNMP.
Pros and Cons
Pros:
- El autoalojamiento mantiene la telemetría bajo tu control
- Los registros, las métricas y las trazas comparten las investigaciones
- La correlación de alertas asistida por IA acelera el diagnóstico de fallos
Cons:
- El sondeo SNMP requiere asignar manualmente los OID
- ClickHouse autoalojado requiere ajustes continuos
Learn more about SigNoz: 10La mejor opción para obtener información basada en IA
Last9
- Plan gratuito + demostración gratuita disponible
- Precios disponibles previa solicitud
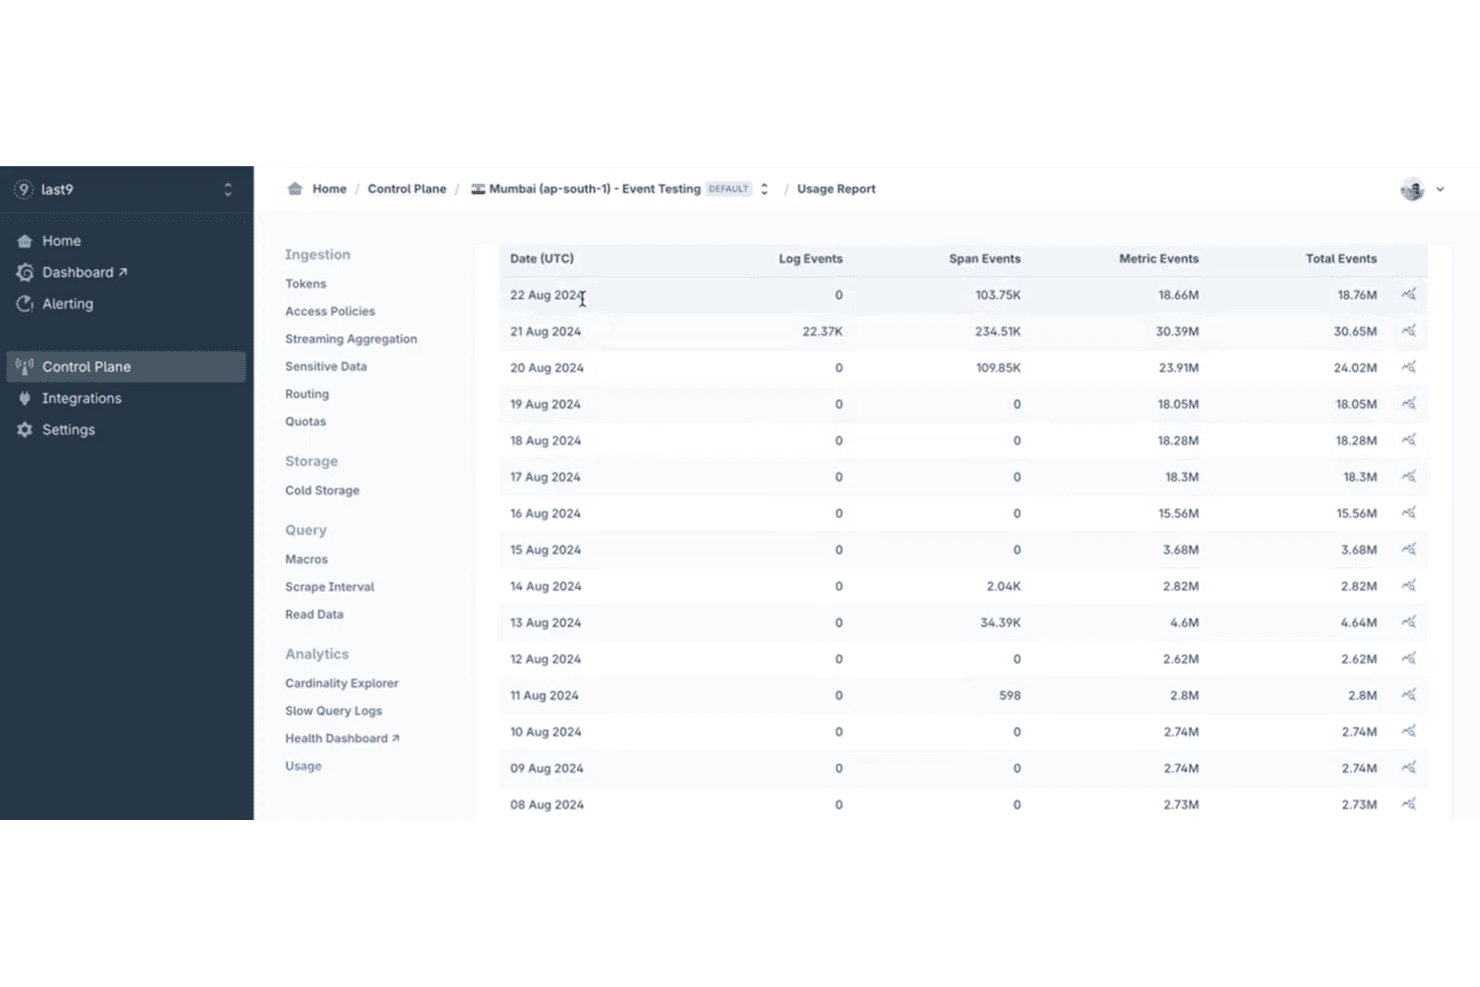
Informe de uso del plano de control de Last9 que muestra los volúmenes diarios de eventos de registros, spans y métricas por fecha. Last9 es una plataforma de observabilidad nativa de OpenTelemetry diseñada para equipos de DevOps e ingeniería que necesitan unificar métricas, registros y trazas, con investigación basada en IA y compatibilidad con alta cardinalidad, lo que la convierte en una opción sólida para equipos que están superando las herramientas de monitorización costosas.
¿Para quién es más adecuada Last9?
Last9 es una opción sólida para equipos de DevOps e ingeniería de confiabilidad del sitio que necesitan observabilidad nativa de OpenTelemetry con investigación basada en IA integrada.
Por qué elegí Last9
Elegí Last9 como una de las mejores opciones porque su investigación nativa de IA profundiza más que un panel de alertas típico. Last9 AI puede consultar conjuntamente tus métricas, registros y trazas en tiempo real, y después mostrar evidencias correlacionadas y proponer reglas de alerta o paneles para que los apruebes. Su mapa Discover visualiza las dependencias entre servicios en tiempo real junto con las tasas de error y la latencia P95, de modo que, cuando se activa un incidente, puedo rastrear el alcance del impacto en los microservicios sin tener que unir manualmente las señales.
Funciones principales de Last9
- Ingesta nativa de OpenTelemetry: Last9 recopila métricas, registros y trazas de forma nativa mediante OpenTelemetry, sin necesidad de agentes específicos del proveedor.
- Reglas de alerta de PromQL y LogQL: Las reglas de alerta se pueden escribir directamente en PromQL o LogQL, o crear mediante un generador de reglas guiado en la interfaz.
- Retención de métricas por niveles: Los datos se almacenan en los niveles Blaze, Hot y Cold, con una retención predeterminada de hasta un año sin reducción de resolución ni agregaciones.
- Monitorización de dispositivos de red basada en SNMP: Last9 recopila telemetría de conmutadores, enrutadores, firewalls y unidades UPS mediante el receptor SNMP de OpenTelemetry Collector o Prometheus SNMP Exporter.
Integraciones de Last9
Last9 incluye más de 100 integraciones, entre ellas AWS, Azure, Google Cloud, Kubernetes, Prometheus, Grafana, Slack, Datadog y New Relic. También ofrece una API REST y un servidor MCP para integraciones personalizadas y flujos de trabajo con agentes de IA.
Pros and Cons
Pros:
- Correlaciona registros, métricas y trazas mediante IA
- Los evaluadores informan de una depuración más rápida entre servicios
- Los usuarios elogian las alertas enfocadas y prácticas
Cons:
- La documentación no indica el alojamiento de la plataforma en las instalaciones
- Algunos evaluadores informan de retrasos en la actualización de los paneles
Learn more about Last9:
Otras alternativas a LogicMonitor
Estas son algunas alternativas adicionales a LogicMonitor que no han entrado en mi selección, pero que merece la pena conocer:
- 11NinjaOneIdeal para la gestión de dispositivos terminales
- 12ObkioMejor para la optimización del rendimiento de la red
- 13Azure MonitorIdeal para obtener información sobre los servicios de Azure
Cómo evalúo las alternativas a LogicMonitor
Evalúo cada opción en dos niveles: el estándar mínimo que debe cumplir una herramienta—monitoreo híbrido, recopilación flexible, alertas inteligentes—y lo que diferencia a las mejores.
Funcionalidades básicas (requisitos fundamentales para esta lista)
Cuando selecciono las herramientas para mi lista, califico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (sobresale en esta área) para cada funcionalidad básica que se enumera a continuación. Luego, calculo la puntuación total de la herramienta como un porcentaje. Cada herramienta debe lograr una puntuación total mínima del 75% para ser considerada para su inclusión.
- Monitoreo híbrido de infraestructura: Verifico si cada herramienta puede recopilar métricas de servidores locales, cargas de trabajo en la nube, contenedores y equipos de red en una sola vista.
- Métodos flexibles de recopilación de datos: Cada herramienta debe soportar recopilación con y sin agente a través de protocolos como SNMP, WMI y REST APIs, para cubrir entornos diversos.
- Alertas inteligentes & AIOps: Busco umbrales dinámicos y correlación de alertas que eliminen el ruido, no sólo reglas estáticas que saturan tu bandeja de entrada durante un pico rutinario.
- Paneles y reportes: Buenos paneles permiten crear vistas centradas en los SLA para la dirección y tableros detallados para ingenieros sin necesitar una herramienta de BI aparte.
- Ecosistema de integraciones: Evalúo qué tan bien se conecta cada herramienta con plataformas ITSM, herramientas de chat y sistemas de automatización en los que tu equipo ya confía diariamente.
- Arquitectura multiusuario escalable: Para MSPs y equipos distribuidos, reviso la granularidad de los RBAC, el aislamiento de inquilinos y si puedes segmentar vistas por cliente o unidad de negocio.
Una vez que tengo una lista de herramientas que cumplen con estos criterios, considero qué distingue a cada plataforma.
Factores diferenciales (qué distingue a los proveedores)
Así es como comparo y distingo a los diferentes proveedores:
Funciones destacadas
El auto-descubrimiento con mapeo de topología es un diferenciador importante. Cuando una herramienta mapea dependencias de servicios automáticamente, tu equipo dedica menos tiempo a documentar la infraestructura y más a atender problemas reales. También busco análisis de logs y APM integrados junto a las métricas de infraestructura—herramientas como Datadog y Dynatrace incluyen esto, lo que significa menos cambios de contexto. La automatización disparada por eventos también es relevante, especialmente cuando tu equipo necesita ejecutar manuales de remediación o rastrear desviaciones de configuración directamente desde la plataforma de monitoreo.
Más allá de las funcionalidades
La transparencia en los precios es importante al dejar LogicMonitor. Evalúo si el proveedor cobra por dispositivo, por host o por ingreso de datos, y cuán predecible se mantienen los costos a medida que tu entorno escala. La flexibilidad de despliegue es otro factor clave. Algunos equipos necesitan SaaS, mientras que otros en sectores regulados requieren opciones autogestionadas o aisladas; herramientas como Zabbix y PRTG ofrecen modelos locales, mientras que Datadog es sólo SaaS. También considero el tiempo hasta el valor: ¿qué tan rápido puedes pasar del despliegue inicial a paneles significativos y alertas accionables?
¿Por qué buscar una alternativa a LogicMonitor?
Aunque LogicMonitor es una buena opción de software de productividad, hay varios motivos por los que algunos usuarios buscan soluciones alternativas. Puede que estés buscando otra opción porque:
- Necesitas más opciones de personalización
- Tu equipo necesita una mejor escalabilidad
- Quieres ahorrar costes
- Tu empresa necesita integraciones específicas
- Buscas interfaces de usuario más sencillas
- Necesitas un mejor soporte regional
Si alguna de estas situaciones te resulta familiar, has llegado al lugar adecuado. Mi lista incluye varias opciones de software de productividad más adecuadas para equipos que se enfrentan a estos desafíos con LogicMonitor y buscan soluciones alternativas.
Funciones
Estas son algunas de las características clave de LogicMonitor que le ayudarán a contrastar y comparar lo que ofrecen las soluciones alternativas:
- Supervisión unificada: Proporciona una supervisión amplia de la infraestructura, la nube y la gestión de registros, con compatibilidad con los principales proveedores de servicios en la nube.
- Integración de AIOps: Utiliza herramientas basadas en IA para la inteligencia de eventos y la automatización, con el fin de mejorar la eficiencia operativa.
- Análisis predictivo: Proporciona análisis de la causa raíz e información sobre los servicios para mejorar la resolución de incidentes.
- Amplias integraciones: Ofrece más de 3.000 integraciones tecnológicas para permitir un escalado dinámico y una mayor resiliencia.
- Paneles personalizables: Permiten crear y compartir paneles en tiempo real adaptados a sus necesidades específicas.
- Detección de anomalías: Identifica de forma proactiva los comportamientos inusuales para evitar que afecten a los usuarios.
- Umbrales dinámicos: Establece automáticamente umbrales inteligentes basados en datos históricos.
- API e integraciones: Amplía la funcionalidad mediante API e integraciones con diversas tecnologías.
- Compatibilidad con la nube y múltiples nubes: Supervisa contenedores y los principales proveedores de servicios en la nube, como AWS, Google Cloud, Microsoft Azure y Oracle Cloud.
- Gestión de registros: Proporciona capacidades de gestión y análisis de registros.