

Databricks ist leistungsstark, aber nicht immer die passende Lösung. Vielleicht ist Ihr Team bei den Preisen an seine Grenzen gestoßen, hatte Schwierigkeiten mit der Lernkurve der Plattform oder benötigt mehr Flexibilität für Multi-Cloud- oder On-Premises-Umgebungen. Was auch immer der Grund ist: Wenn Sie hier sind, suchen Sie wahrscheinlich nach einer Alternative, die ähnliche Data-Lakehouse-Funktionen bietet – ohne die damit verbundenen Nachteile.
Ich habe mit Datenteams in Start-ups und Unternehmen zusammengearbeitet, um Plattformen wie Databricks, Snowflake und andere zu bewerten und zu implementieren. Ich habe aus erster Hand erlebt, was erforderlich ist, um Analysen in großem Maßstab zu unterstützen, unübersichtliche Datenquellen zu vereinheitlichen und zuverlässige Datenpipelines zu entwickeln, die tatsächlich genutzt werden.
In diesem Leitfaden stelle ich Ihnen die Databricks-Alternativen vor, die eine Überlegung wert sind – Tools, mit denen Sie Daten intuitiver speichern, transformieren und untersuchen können und die Ihnen gleichzeitig den nötigen Spielraum geben, um zu skalieren und sich an das Wachstum Ihres Teams anzupassen.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle: Databricks-Alternativen
Diese Vergleichstabelle fasst die Preisinformationen für meine wichtigsten Databricks-Alternativen zusammen.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für Cloud-Datenlagerung | Nein | Preis auf Anfrage | Website | |
| 2 | Die beste Lösung für die Bereitstellung von Daten in mehreren Clouds | Kostenloser Tarif verfügbar | Preis auf Anfrage | Website | |
| 3 | Am besten für Datenintegrationsaufgaben geeignet | Kostenlose Testversion verfügbar | $1,170/user/year (jährlich abgerechnet) | Website | |
| 4 | Am besten für die Verarbeitung im Arbeitsspeicher | Kostenloser Tarif verfügbar | Preise auf Anfrage | Website | |
| 5 | Am besten für schnelle SQL-Abfragen | Ja | Ab $6.25/TiB verarbeitet | Website | |
| 6 | Best for dataintegrasjon i sanntid og kvalitetskontroll | Nei | $1,170/user/month (fakturert årlig) | Website | |
| 7 | Am besten für SQL-Analysen | 30-tägige kostenlose Testversion | $30/user/month (jährlich abgerechnet) | Website | |
| 8 | Am besten für Hadoop-Verarbeitung | Nicht verfügbar | Ab $0.007084/vCPU-Stunde | Website | |
| 9 | Am besten für verwaltetes Spark und Hadoop | Nicht verfügbar | Ab $0.06/DCU-hour | Website | |
| 10 | Am besten für AI- und ML-Lösungen geeignet | Kostenlose Demo verfügbar | Preise auf Anfrage | Website |


Testberichte zu den besten Databricks-Alternativen
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Databricks-Alternativen, die es in meine Auswahl geschafft haben. Meine Testberichte bieten einen detaillierten Überblick über die wichtigsten Funktionen, Vor- & Nachteile, Integrationen und idealen Anwendungsfälle jedes Tools, damit Sie die beste Lösung für sich finden.

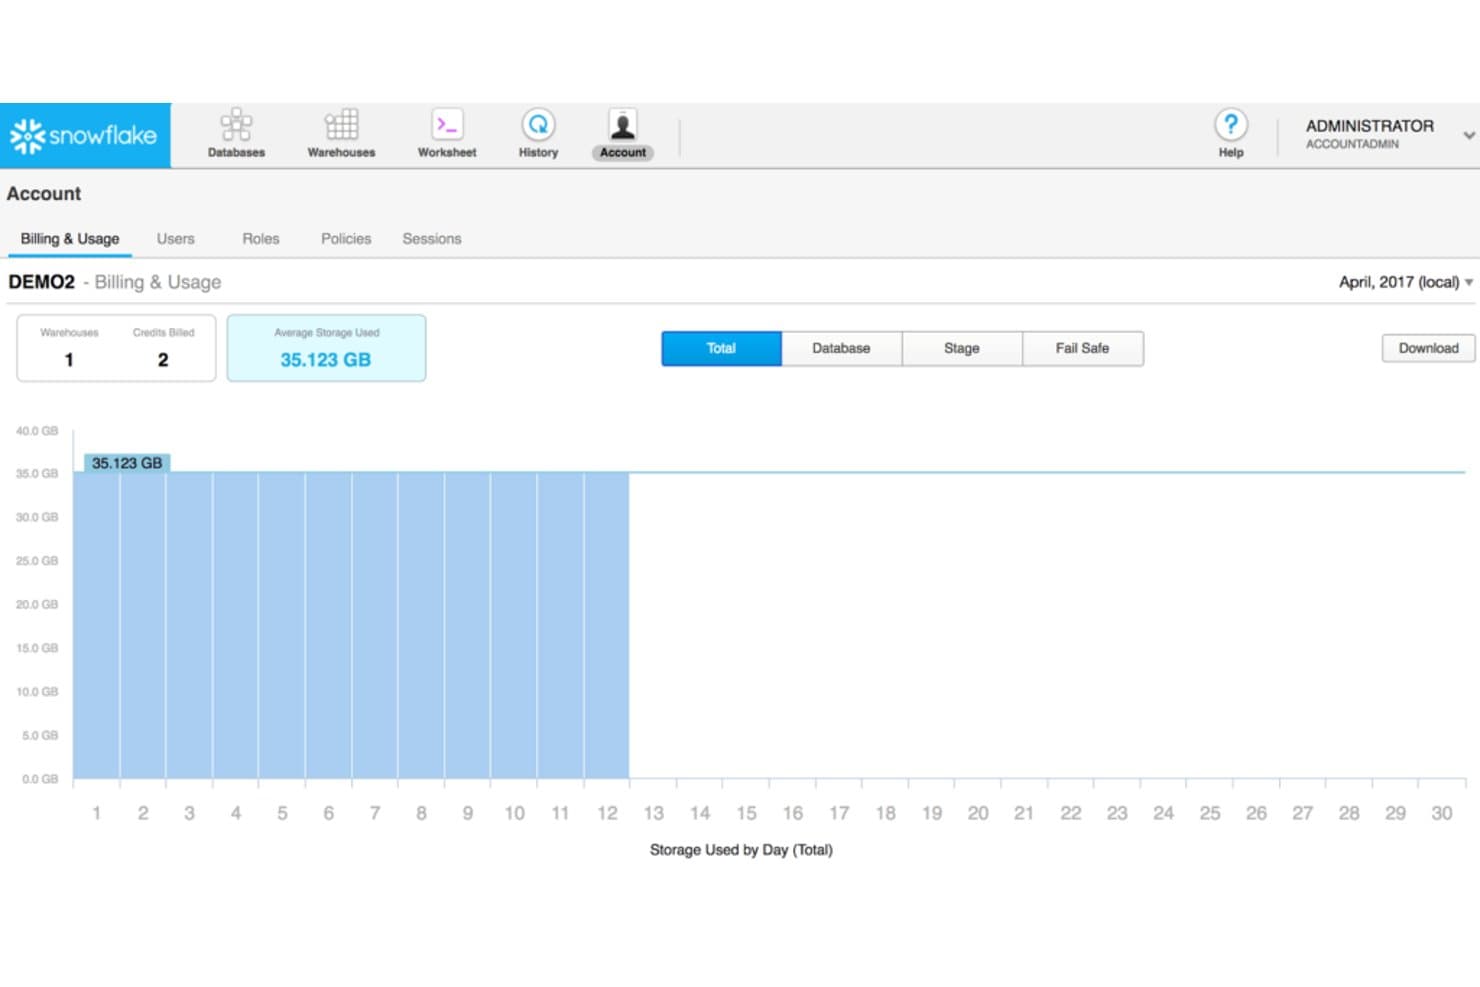
Snowflake erfasst die Speicher- und Guthabennutzung pro Tag in einem Dashboard. Snowflake bietet IT- und Analyseteams eine Cloud-Datenplattform, um unterschiedliche Datensätze zusammenzuführen, SQL-Abfragen in großem Umfang auszuführen und kontrollierten Zugriff bereitzustellen, ohne die Infrastruktur des Datenlagers verwalten zu müssen.
Für wen ist Snowflake am besten geeignet?
Datenengineering- und Analyseteams, die ein Cloud-Datenlager benötigen, um Daten aus verschiedenen Geschäftssystemen abzufragen und gemeinsam zu nutzen.
Warum ich Snowflake ausgewählt habe
Ich habe Snowflake als „Am besten für Cloud-Datenlagerung“ ausgewählt, weil ich dank der getrennten Speicherung und Rechenleistung SQL-Analysen skalieren kann, ohne die Datenebene neu dimensionieren zu müssen. Außerdem schätze ich die kontrollierte Datenfreigabe, wenn Teams Datensätze aus verschiedenen Geschäftssystemen abfragen müssen, ohne sie in separate Datenlager zu kopieren.
Die wichtigsten Funktionen von Snowflake
- Dynamische Tabellen: Datenpipelines mit SQL definieren und die gewünschte Aktualisierungsverzögerung festlegen.
- Snowpipe: Daten aus bereitgestellten Dateien laden, sobald sie eintreffen.
- Zeitreise: Historische Daten innerhalb des Aufbewahrungszeitraums abfragen, klonen oder wiederherstellen.
- Snowflake-Marktplatz: Datensätze und Anwendungen von Drittanbietern entdecken und darauf zugreifen.
Snowflake-Integrationen
Snowflake bietet Openflow-Konnektoren für Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL und Microsoft SQL Server. Außerdem stehen native Konnektoren für ServiceNow, MySQL und Kafka sowie REST-APIs für benutzerdefinierte Integrationen zur Verfügung.
Pros and Cons
Pros:
- Unabhängige Skalierung der Rechenleistung bewältigt schwankende Arbeitslasten
- Verwaltete SQL-Datenlager reduzieren den Infrastrukturaufwand
- Sichere Freigabe vermeidet das Kopieren von Datensätzen zwischen Teams
Cons:
- Nutzungsspitzen können die Ausgaben unvorhersehbar machen
- Proprietäre Funktionen können die Migration zu einer anderen Plattform erschweren
Learn more about Snowflake: Die beste Lösung für die Bereitstellung von Daten in mehreren Clouds
- Kostenloser Tarif verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.5/5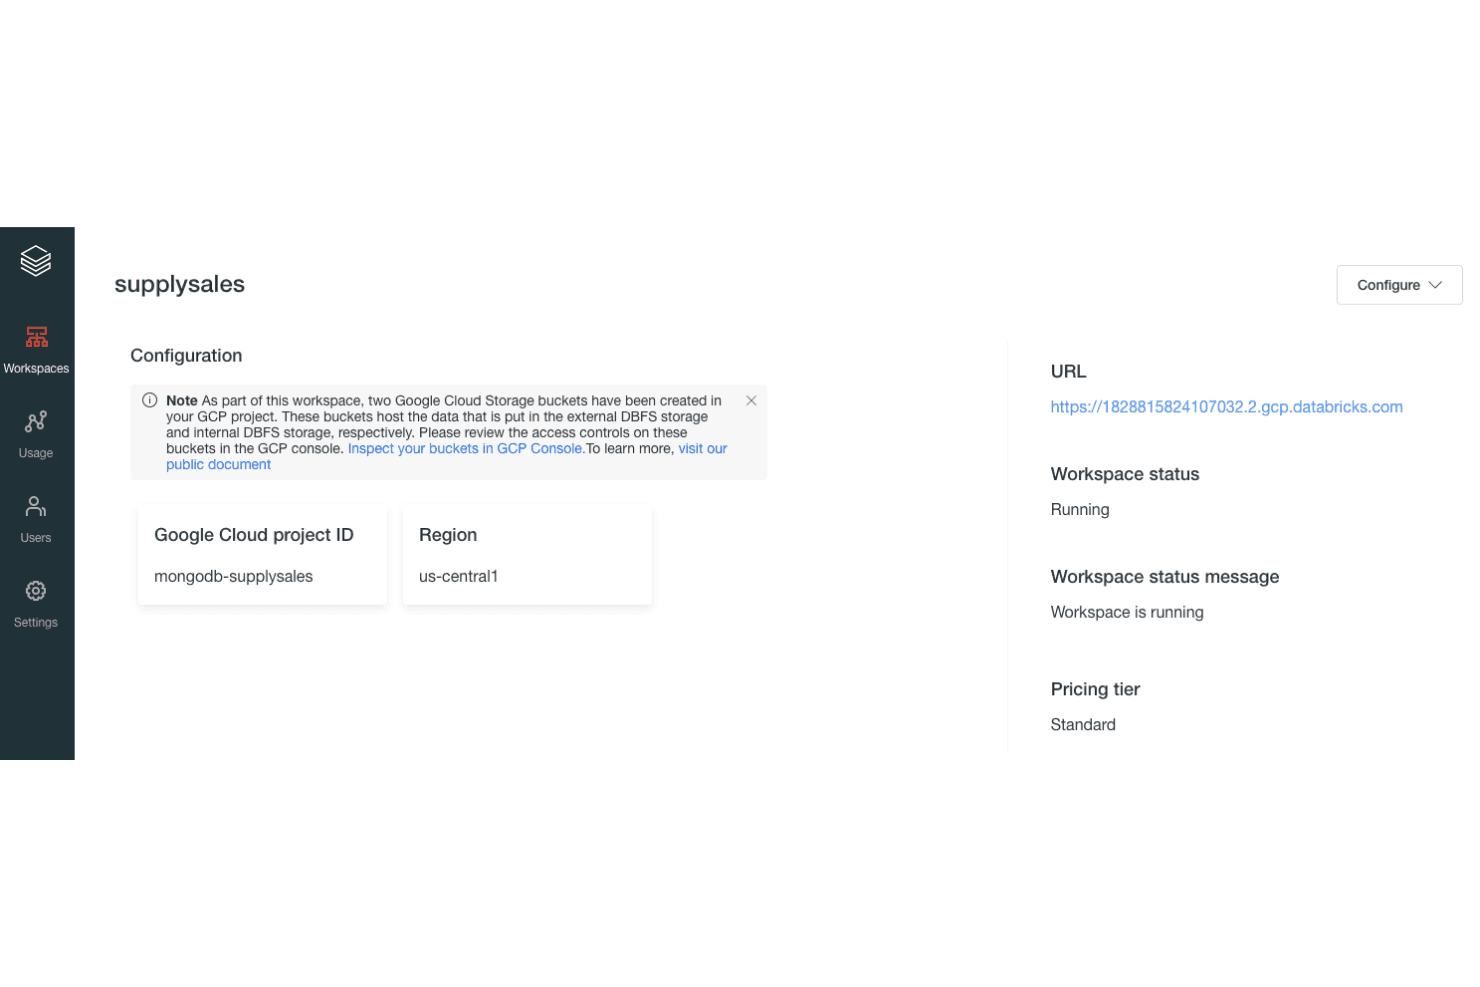
MongoDB Atlas lässt sich für die Datenverarbeitung auf GCP in Databricks-Arbeitsbereiche integrieren. MongoDB Atlas bietet IT- und Datenteams eine verwaltete Dokumentdatenbank für Anwendungen, die flexible Datenmodelle, zuverlässige Abfragen und weniger Datenbankwartung benötigen.
Für wen ist MongoDB Atlas am besten geeignet?
IT- und Plattformteams, die Anwendungen über mehrere Cloud-Anbieter hinweg bereitstellen, werden die verwaltete Datenbank und die Multi-Cloud-Flexibilität von MongoDB Atlas zu schätzen wissen.
Warum ich MongoDB Atlas ausgewählt habe
Ich habe MongoDB Atlas als Databricks-Alternative für die beste Lösung für die Bereitstellung von Daten in mehreren Clouds ausgewählt. Atlas unterstützt Multi-Cloud-Cluster in AWS, Azure und Google Cloud, während die Aggregationspipeline die Analyse von in MongoDB gespeicherten Anwendungsdaten ermöglicht. Ich würde es verwenden, um operative Daten in der Nähe von Diensten abzufragen, die über verschiedene Cloud-Anbieter hinweg ausgeführt werden.
Wichtige Funktionen von MongoDB Atlas
- Atlas Search: Erstellen Sie Volltextindizes und führen Sie nach Relevanz sortierte Suchen durch.
- Atlas Charts: Erstellen Sie Dashboards und Visualisierungen aus MongoDB-Daten.
- Datenföderation: Fragen Sie Daten aus Atlas-Datenbanken und Cloud-Objektspeichern ab.
- Automatisierte Backups: Planen Sie Datenbank-Snapshots und stellen Sie Daten aus gespeicherten Wiederherstellungspunkten wieder her.
Integrationen von MongoDB Atlas
MongoDB Atlas dokumentiert Integrationen mit Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta und Microsoft Entra ID. Außerdem bietet es eine Administrations-API für benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Multi-Cloud-Cluster über AWS, Azure und Google Cloud hinweg
- Flexible Dokumente passen sich an veränderliche Anwendungsdatenmodelle an
- Aggregationspipelines analysieren operative Daten direkt am Speicherort
Cons:
- Weniger geeignet für umfassende Lakehouse-Analyseworkloads
- Die Aggregationsleistung kann eine sorgfältige Optimierung der Abfragen erfordern
Learn more about MongoDB Atlas: Am besten für Datenintegrationsaufgaben geeignet
- Kostenlose Testversion verfügbar
- $1,170/user/year (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.2/5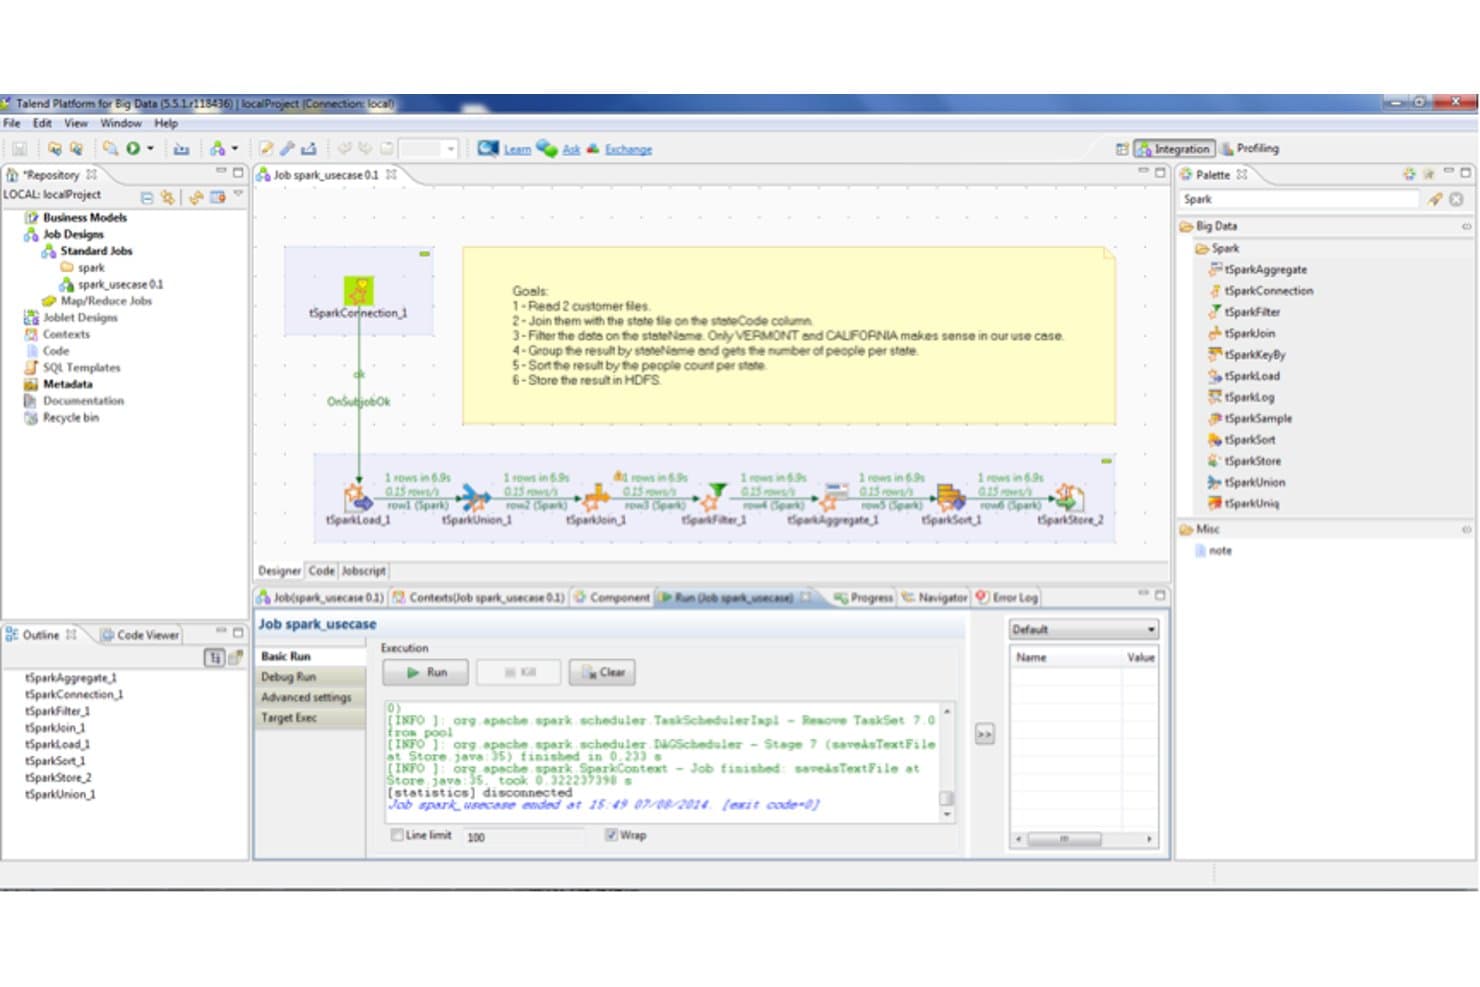
Mit Talend können Benutzer Spark-Datenpipelines visuell erstellen und ausführen. Talend ist eine Datenintegrationsplattform für IT- und Datenteams, die Informationen systemübergreifend verbindet und dabei hilft, Datensilos zu reduzieren und Datenpipelines auch bei wachsender Umgebung überschaubar zu halten.
Für wen eignet sich Talend am besten?
Talend eignet sich für IT- und Datenengineering-Teams, die Cloud-, lokale und Altsysteme miteinander verbinden müssen.
Warum ich Talend ausgewählt habe
Ich habe Talend als Databricks-Konkurrenten ausgewählt, weil „Am besten für Datenintegrationsaufgaben geeignet“ genau dem Einsatzbereich entspricht. Mit dem visuellen Auftragsdesigner und den tMap-Transformationen kann ich Datensätze zwischen einer Altdatenbank und einem Datenlager in der Cloud zusammenführen und neu strukturieren. Außerdem schätze ich Talends Komponenten zur Datenqualität, mit denen fehlerhafte Datensätze erkannt werden können, bevor sie nachgelagerte Systeme erreichen.
Wichtige Funktionen von Talend
- Konnektoren: Datenbanken, Cloud-Anwendungen, Dateien und andere Systeme über vorgefertigte Konnektoren verbinden.
- Erfassung von Datenänderungen: Datenbankeinfügungen, -aktualisierungen und -löschungen erfassen, sobald sie auftreten.
- Datenherkunft: Datenflüsse von Quellsystemen über Aufträge bis zu ihren Zielsystemen nachverfolgen.
- Metadatenermittlung: Datenquellen durchsuchen, um Datensätze, Formate und Muster zu identifizieren.
Talend-Integrationen
Talend umfasst Konnektoren oder Komponenten für Systeme wie Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle und MongoDB. Außerdem werden REST- und SOAP-Dienste unterstützt, und Qlik Talend Data Integration stellt APIs zur Verwaltung von Datenverbindungen bereit.
Pros and Cons
Pros:
- Visuelle Aufträge verarbeiten Verknüpfungen und Neustrukturierungen
- Batch- und Echtzeitpipelines unterstützen unterschiedliche Arbeitslasten
- Tools zur Datenqualität kennzeichnen fehlerhafte Datensätze
Cons:
- Große Aufträge können eine Optimierung der JVM erfordern
- Generierter Java-Code erschwert die Fehlersuche und Prüfung
Learn more about Talend: Am besten für die Verarbeitung im Arbeitsspeicher
- Kostenloser Tarif verfügbar
- Preise auf Anfrage
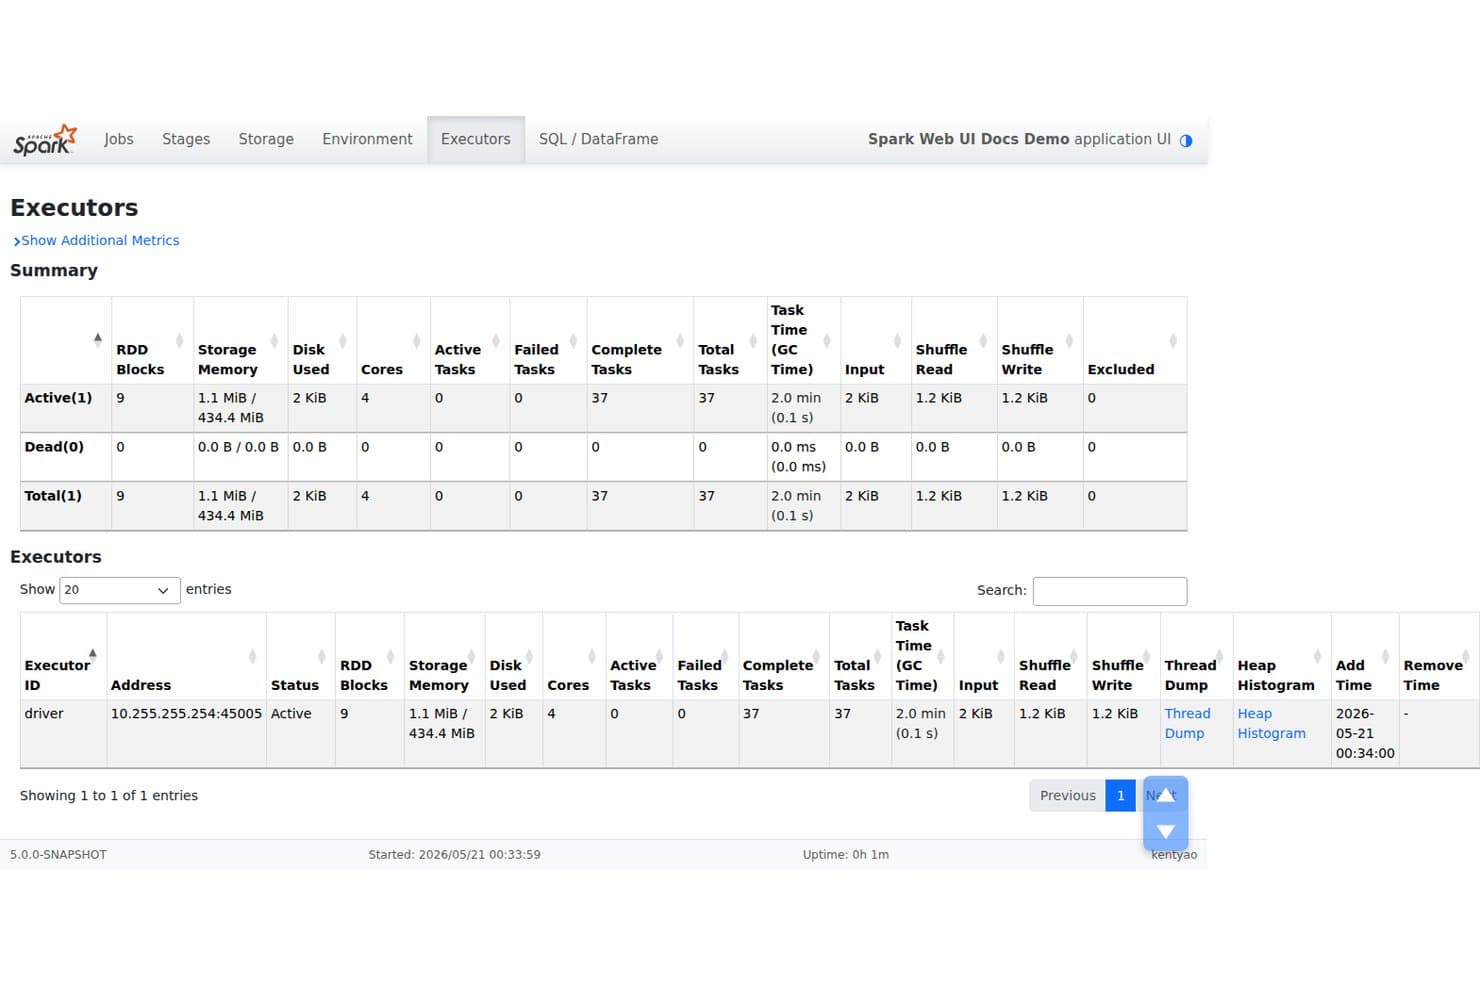
Apache Spark verfolgt Executor-Ressourcen, Aufgaben und Arbeitsspeicher in Echtzeit. Apache Spark ist eine quelloffene Analyse-Engine für Daten- und Infrastrukturteams, die große Datensätze verarbeiten, verteilte Workloads ausführen und Datenpipelines in unterschiedlichen Umgebungen erstellen müssen.
Für wen ist Apache Spark am besten geeignet?
Datenengineering- und Analyseteams, die eine schnelle, iterative Verarbeitung großer Datensätze über Cluster hinweg benötigen, sind für Apache Spark gut geeignet.
Warum ich Apache Spark ausgewählt habe
Ich habe Apache Spark als Databricks-Alternative ausgewählt, weil es am besten für die Verarbeitung im Arbeitsspeicher geeignet ist. Spark kann RDDs und DataFrames im Arbeitsspeicher zwischenspeichern oder persistent speichern, sodass wiederholte Abfragen und iterative Berechnungen das Quelldatenmaterial nicht erneut einlesen müssen. Das ist hilfreich, wenn große Ereignisdaten-Aggregationen über mehrere Analysedurchläufe hinweg verfeinert werden.
Wichtige Funktionen von Apache Spark
- Spark SQL: Strukturierte Daten mit SQL- und DataFrame-APIs abfragen.
- Strukturiertes Streaming: Livedaten mit den Streaming-APIs von Spark verarbeiten.
- MLlib: Workflows für maschinelles Lernen mit skalierbaren Algorithmen und Pipelines erstellen.
- Cluster-Manager: Anwendungen auf eigenständigen Clustern, YARN oder Kubernetes bereitstellen.
Integrationen von Apache Spark
Apache Spark unterstützt Konnektoren für Apache Kafka und Apache Hive sowie JDBC-Verbindungen zu Datenbanken wie PostgreSQL, MySQL, Oracle und Microsoft SQL Server. Seine Data Source API unterstützt benutzerdefinierte Konnektoren; Abhängigkeiten für den Kafka-Konnektor und datenbankspezifische JDBC-Treiber müssen möglicherweise separat hinzugefügt werden.
Pros and Cons
Pros:
- Zwischengespeicherte Datensätze beschleunigen iterative Workloads
- Batchverarbeitung, Streaming, SQL und ML nutzen eine gemeinsame Engine
- Lokal oder über Kubernetes- und YARN-Cluster ausführen
Cons:
- Speicherdruck kann Fehler durch unzureichenden Arbeitsspeicher auslösen
- Die Abstimmung und Fehlersuche bei verteilten Aufträgen erfordern Fachkenntnisse
Learn more about Apache Spark:
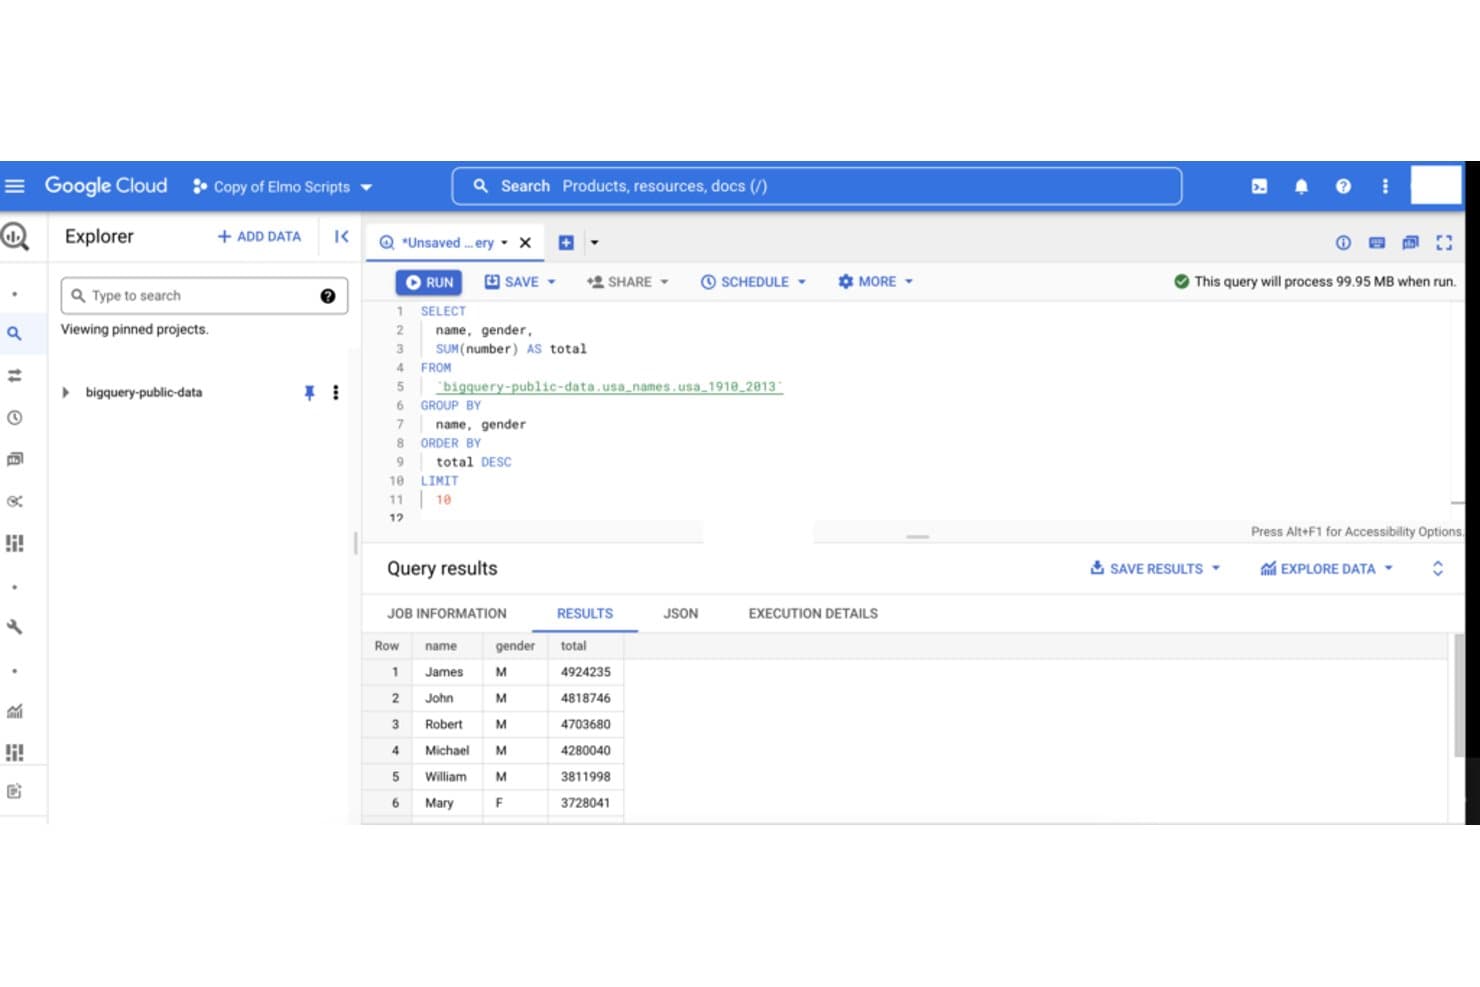
Mit Google BigQuery können Nutzer SQL-Abfragen über große öffentliche Datensätze ausführen. Für IT- und Datenteams, die skalierbare Analysen benötigen, ohne die Infrastruktur eines Cloud-Datenlagers verwalten zu müssen, ist Google BigQuery ein Cloud-Datenlager zum Abfragen und Analysieren großer Datensätze mit SQL.
Für wen ist Google BigQuery am besten geeignet?
Datenanalysten und Dateningenieure, die schnelle SQL-Abfragen über große Cloud-Datensätze ausführen müssen, finden in Google BigQuery eine praktische Lösung.
Warum ich Google BigQuery ausgewählt habe
Ich habe Google BigQuery als meine Alternative zu Databricks ausgewählt, die am besten für schnelle SQL-Abfragen geeignet ist. Die serverlose Abfrage-Engine führt GoogleSQL über große Datensätze aus, während die Partitionierung und Clusterbildung von Tabellen die Menge der für wiederkehrende Berichte gescannten Daten reduzieren kann. Ich schätze es für die Abfrage von Anwendungsprotokollen oder Ereignisdaten, ohne Datenlager-Cluster verwalten zu müssen.
Wichtige Funktionen von Google BigQuery
- BigQuery ML: Erstellen und Ausführen von Modellen für maschinelles Lernen mit SQL.
- Geplante Abfragen: SQL-Aufträge so einrichten, dass sie in ausgewählten Intervallen ausgeführt werden.
- BigQuery-Datenübertragungsdienst: Datenimporte aus unterstützten Quellen planen.
- Autorisierte Ansichten: Abfrageergebnisse freigeben, ohne Zugriff auf die zugrunde liegenden Tabellen zu gewähren.
Integrationen von Google BigQuery
Google dokumentiert direkte BigQuery-Integrationen mit Looker, Looker Studio, Vertex AI Workbench, dem verwalteten Dienst für Apache Spark und Tableau. Datenverbindungen und Workflows zum Laden von Daten unterstützen außerdem Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 und Azure Blob Storage; die REST- und Storage-APIs von BigQuery unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Schnelle SQL-Scans über große Datensätze
- Der serverlose Betrieb macht die Clusterverwaltung überflüssig
- Partitionierung und Clusterbildung können die Menge der gescannten Daten reduzieren
Cons:
- Abfragekosten können ohne Schutzmechanismen stark ansteigen
- Die Untersuchung durch Geschäftsanwender erfordert häufig SQL-Kenntnisse
Learn more about Google BigQuery: Best for dataintegrasjon i sanntid og kvalitetskontroll
- Nei
- $1,170/user/month (fakturert årlig)
Her ser du funksjonen for datapreparering i Talend, som viser datamønstrene samt prosentandelen gyldige og ugyldige poster. Talend, et omfattende verktøy med åpen kildekode for dataintegrasjon og datahåndtering, utmerker seg ved å kombinere, rense og flytte data i sanntid. Verktøyets ekspertise innen dataintegrasjon i sanntid og sterke fokus på kvalitetskontroll gjør det til det ideelle valget for organisasjoner som krever øyeblikkelig datainnsikt samtidig som dataintegriteten opprettholdes.
Hvorfor jeg valgte Talend: Jeg valgte Talend på grunn av verktøyets evne til å håndtere dataintegrasjon i sanntid effektivt og opprettholde et sterkt fokus på kvalitetskontroll. Det som skiller verktøyet fra konkurrentene, er en robust samling funksjoner som legger til rette for sanntidshåndtering av data. Denne kombinasjonen gjør det til en ideell kandidat for virksomheter som trenger å behandle data raskt og opprettholde høye datastandarder.
Fremtredende funksjoner og integrasjoner:
Talends fremtredende funksjoner omfatter dataintegrasjon i sanntid, profilering og kvalitet, katalogisering og et brukervennlig grensesnitt. Med Talend kan brukere bygge, distribuere og administrere datapipelines for ulike bruksområder, som ETL, ELT og automatisering av datavarehus. I tillegg tilbyr verktøyet omfattende integrasjoner med databaser, skyplattformer og CRM-verktøy, inkludert AWS, Azure, Google Cloud, Salesforce og SAP, for å nevne noen.
Pros and Cons
Pros:
- Sterke funksjoner for dataintegrasjon i sanntid
- Omfattende funksjoner for datakvalitetskontroll
- Omfattende integrasjoner med databaser og skyplattformer
Cons:
- Prisen kan være høy for mindre organisasjoner
- Det store antallet funksjoner kan virke overveldende for nybegynnere
- Tilpassede integrasjoner kan kreve teknisk ekspertise
Learn more about IBM Db2: Am besten für SQL-Analysen
- 30-tägige kostenlose Testversion
- $30/user/month (jährlich abgerechnet)
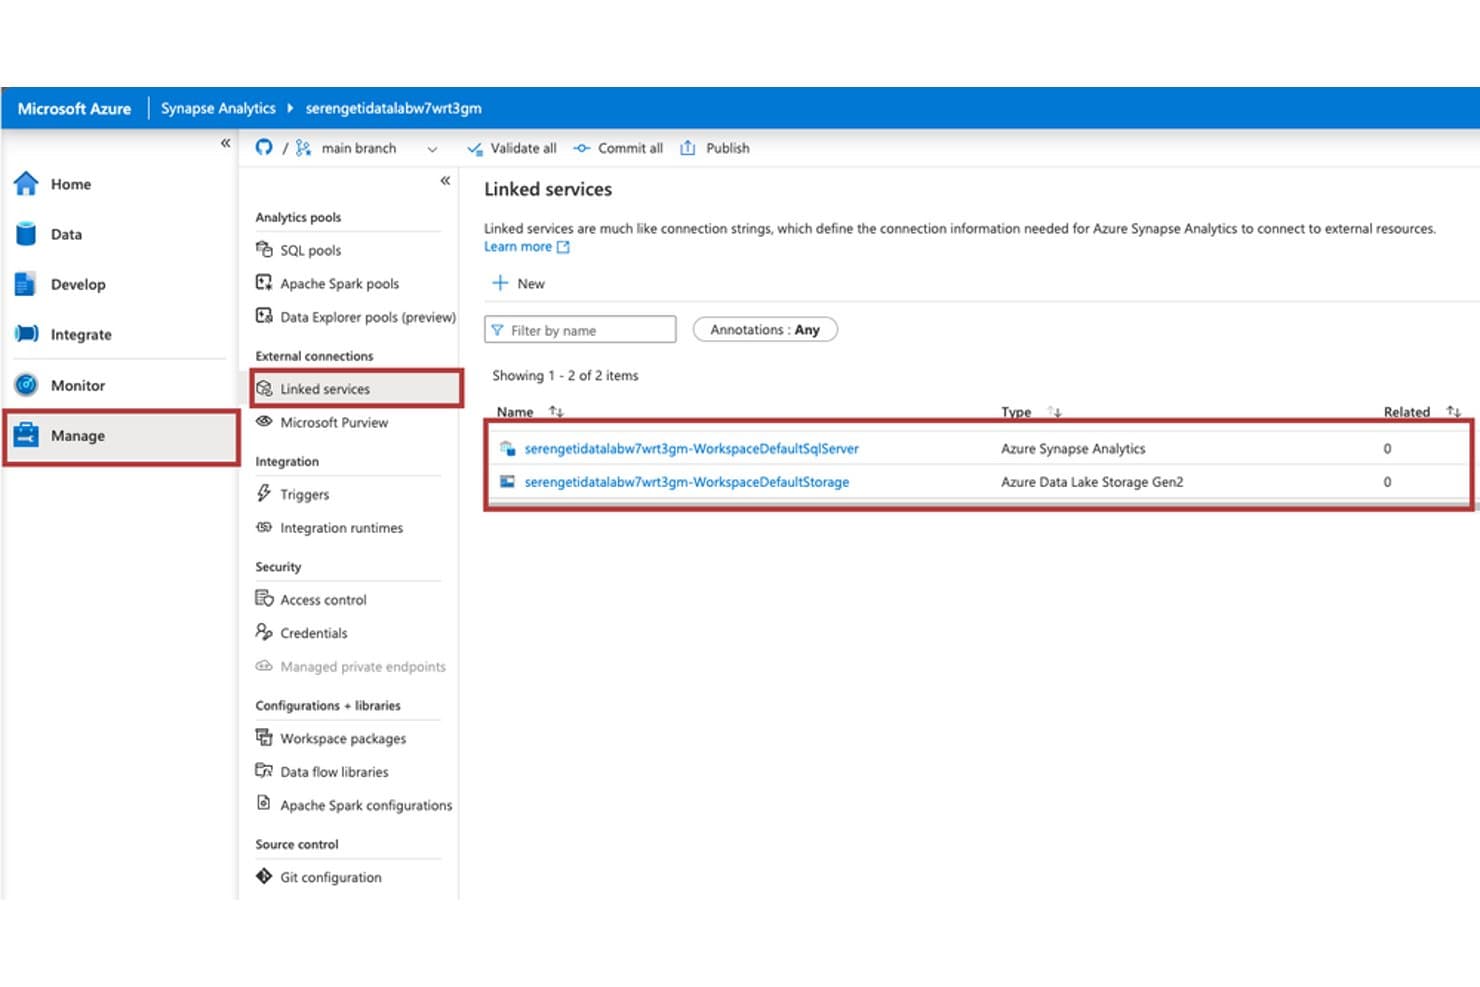
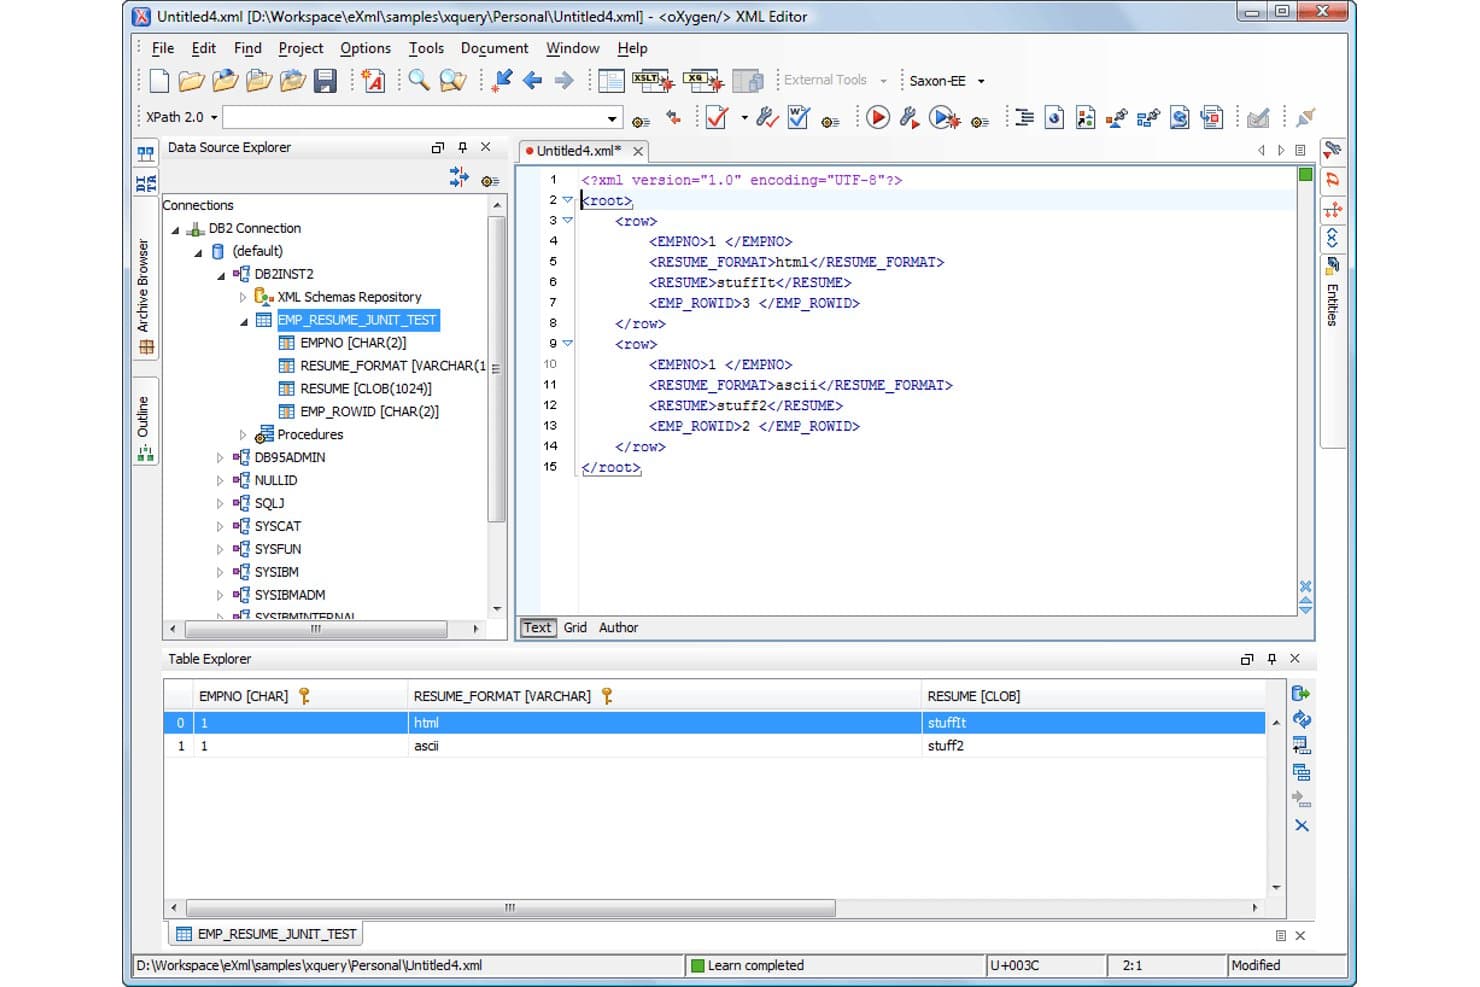
Azure Synapse Analytics verwaltet externe Verbindungen über verknüpfte Dienste. Azure Synapse Analytics ist eine Cloud-Analyseplattform für Daten- und IT-Teams, die Unternehmensdaten verbinden, Abfragen ausführen und Berichte für Data-Warehouse- und Big-Data-Arbeitslasten unterstützen müssen.
Für wen eignet sich Azure Synapse Analytics am besten?
Es eignet sich für Dateningenieure und Analysten, die SQL-Zugriff auf integrierte Datensätze für Unternehmensberichte und Analysen benötigen.
Warum ich Azure Synapse Analytics ausgewählt habe
Ich habe Azure Synapse Analytics für den Anwendungsfall „am besten für SQL-Analysen“ ausgewählt: Der serverlose SQL-Pool fragt Dateien im Datenlake mit T-SQL ab, während dedizierte SQL-Pools bereitgestellte Data-Warehouse-Arbeitslasten unterstützen. Diese Aufteilung gefällt mir, wenn ich Rohdatensätze untersuchen und wiederkehrende BI-Berichte über SQL bereitstellen muss.
Die wichtigsten Funktionen von Azure Synapse Analytics
- Apache-Spark-Pools: Führen Sie Spark-Aufträge und Notebooks für die verteilte Datenverarbeitung aus.
- Datenpipelines: Orchestrieren Sie die Datenverschiebung und -transformation über verbundene Quellen hinweg.
- Synapse Studio: Verwalten Sie Daten, Code und Analyse-Ressourcen in einem gemeinsam genutzten Arbeitsbereich.
- Power-BI-Integration: Verbinden Sie Synapse-Daten mit Power BI zur Erstellung von Berichten.
Integrationen von Azure Synapse Analytics
Azure Synapse Analytics verfügt über integrierte Pipeline-Konnektoren für Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 und SAP HANA sowie über eine direkte Power-BI-Verbindung über Synapse Studio. Außerdem werden REST-APIs für benutzerdefinierte Integrationen bereitgestellt.
Pros and Cons
Pros:
- Serverlose T-SQL-Abfragen lesen Dateien aus dem Datenlake
- Dedizierte MPP-Pools verarbeiten Data-Warehouse-Arbeitslasten
- Kombiniert SQL-Abfragen mit Spark-Verarbeitung
Cons:
- Die Optimierung von SQL-Pools erfordert praktische Fachkenntnisse
- Das Debugging und die Überwachung von Pipelines können eingeschränkt sein
Learn more about Azure Synapse Analytics:
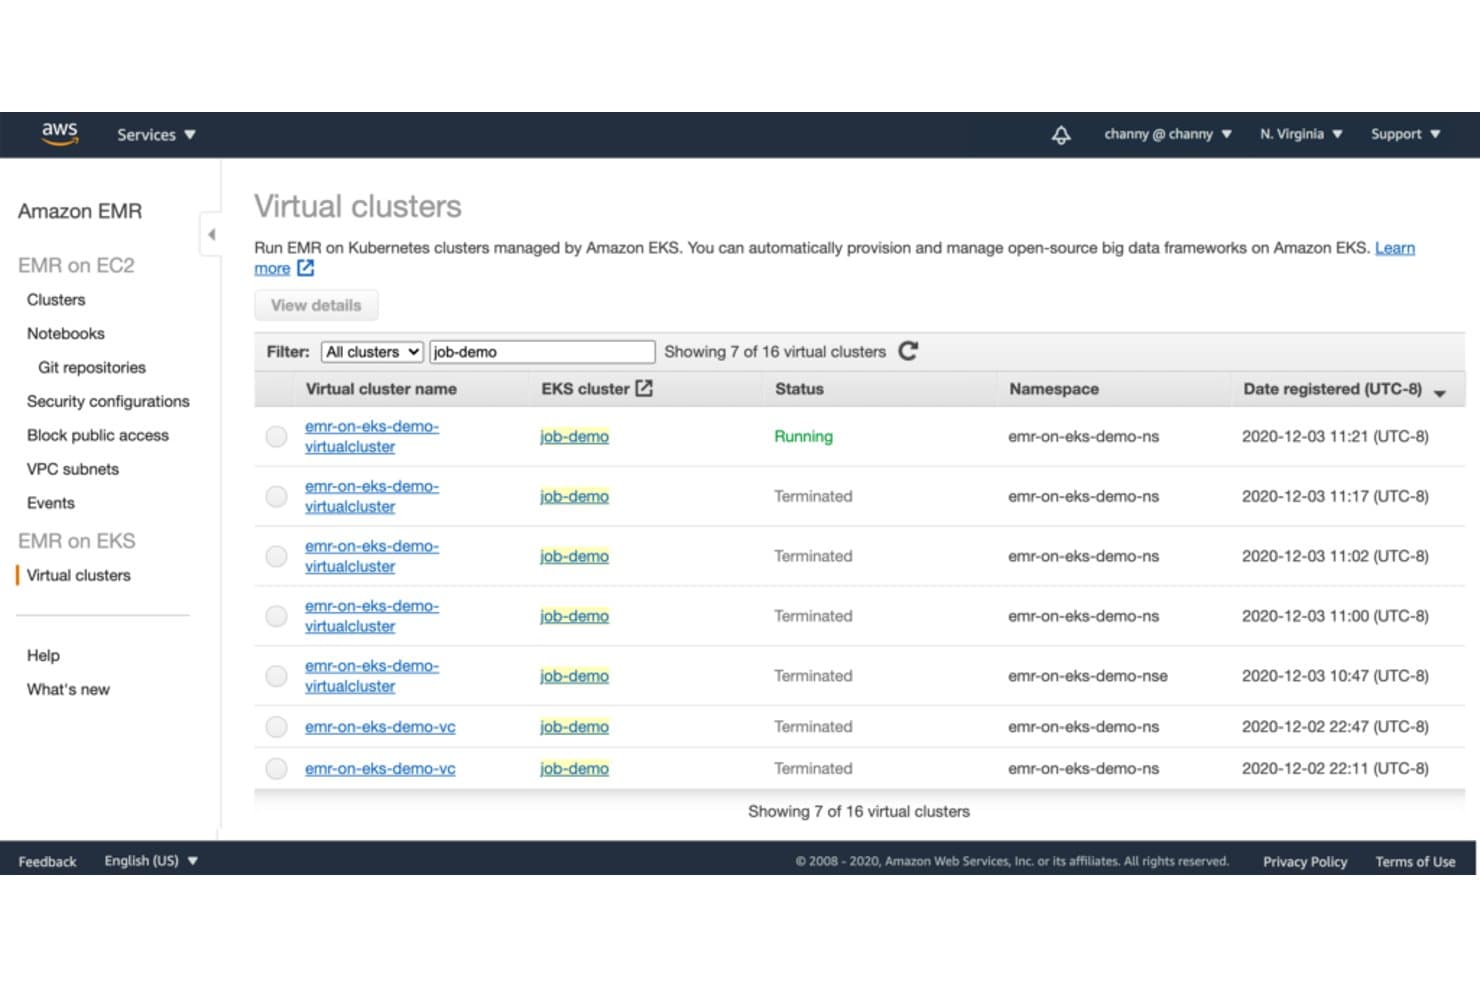
Amazon EMR ermöglicht es Benutzern, virtuelle Cluster zu verwalten, die auf Amazon EKS ausgeführt werden. Amazon EMR ist die verwaltete Big-Data-Plattform von AWS für Datenengineering- und Analyseteams, die große Datensätze verarbeiten, verteilte Arbeitslasten skalieren und den Betriebsaufwand für Rechencluster reduzieren müssen.
Für wen ist Amazon EMR am besten geeignet?
Amazon EMR eignet sich für Datenengineering-Teams, die Hadoop- oder Spark-Aufträge ausführen, um große Datensätze über verteilte Cluster hinweg zu verarbeiten.
Warum ich Amazon EMR ausgewählt habe
Ich habe Amazon EMR aus einem Grund als Databricks-Alternative ausgewählt: Am besten für Hadoop-Verarbeitung. Die verwalteten Cluster führen Apache Hadoop und Spark aus, sodass ich MapReduce zur Verarbeitung archivierter Anwendungsprotokolle und Spark zur Analyse der Ergebnisse verwenden kann.
Wichtige Funktionen von Amazon EMR
- EMR Serverless: Führen Sie Datenanwendungen aus, ohne Cluster bereitzustellen oder zu verwalten.
- Automatische Skalierung: Passen Sie die Clusterkapazität an den Bedarf der Arbeitslast an.
- EMR auf EKS: Führen Sie EMR-Arbeitslasten auf Amazon-EKS-Clustern aus.
- AWS Glue Data Catalog: Verwenden Sie einen gemeinsamen Katalog für Tabellenmetadaten.
Integrationen von Amazon EMR
Amazon EMR verfügt über dokumentierte Integrationen mit AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 und Amazon CloudWatch. Außerdem bietet es eine API für den programmgesteuerten Zugriff und benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Führt etablierte Hadoop- und Spark-Arbeitslasten aus
- Unterstützt Cluster-, serverlose und EKS-Bereitstellungen
- Verarbeitet große Datensätze über unterschiedliche Arbeitslasten hinweg
Cons:
- Eine langsame automatische Skalierung kann dazu führen, dass Aufträge unzureichend mit Ressourcen versorgt werden
- Die Cluster-Skalierung erfordert manchmal eine manuelle Feinabstimmung
Learn more about Amazon EMR: Am besten für verwaltetes Spark und Hadoop
- Nicht verfügbar
- Ab $0.06/DCU-hour
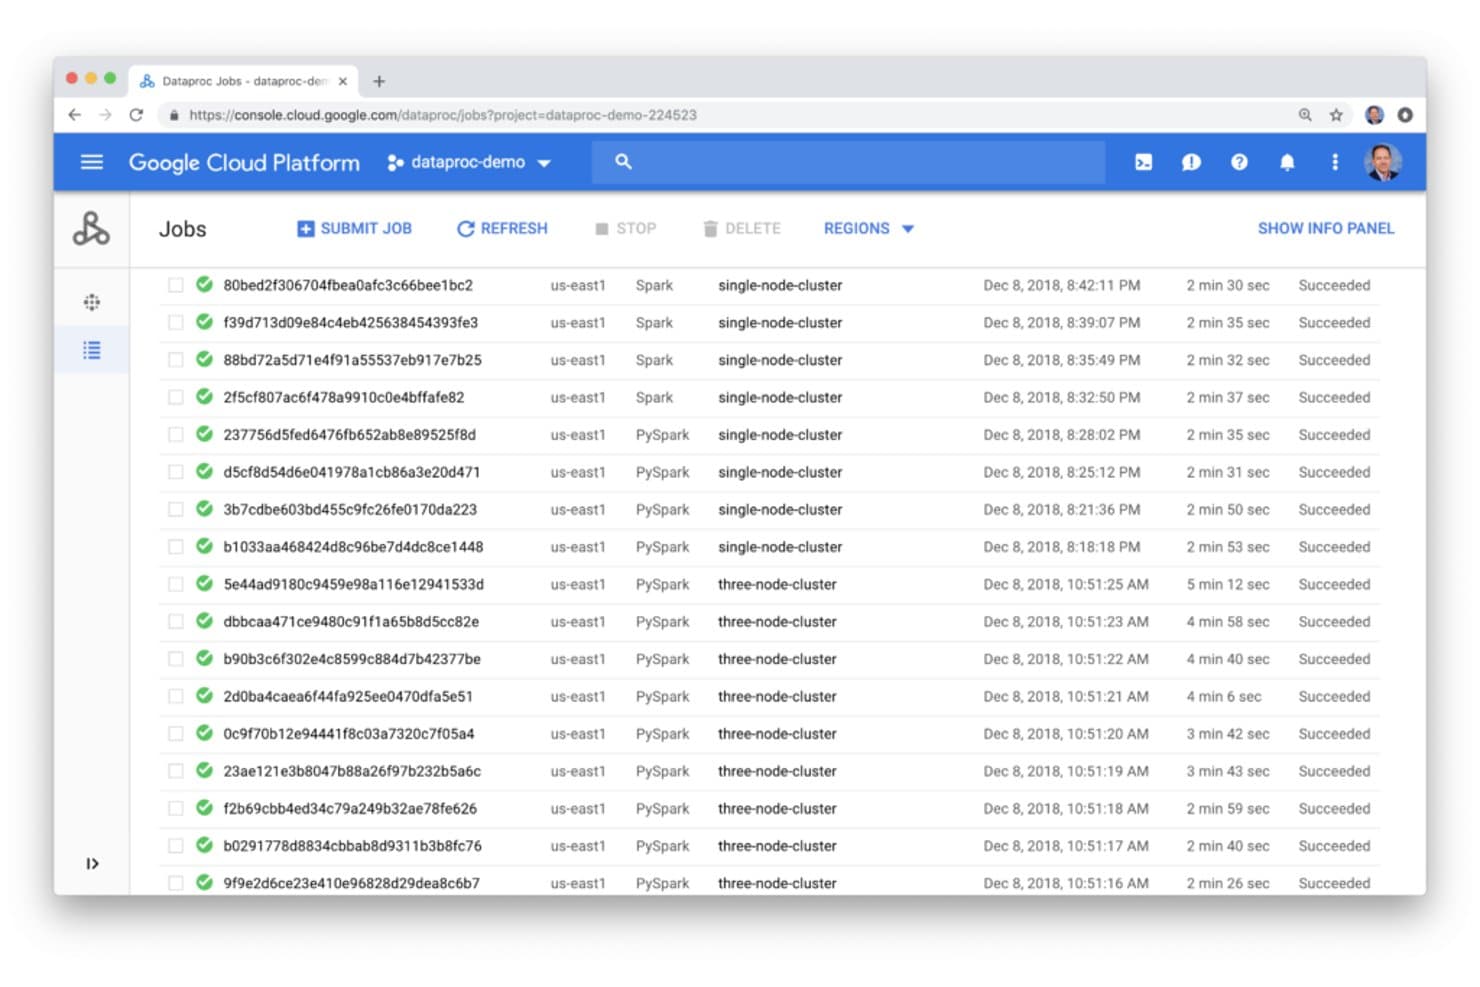
Mit Google Cloud Dataproc können Nutzer Spark-Aufträge auf einen Blick überwachen und verwalten. Google Cloud Dataproc bietet Datenengineering- und IT-Teams eine verwaltete Cloud-Plattform für Analyse-Workloads im großen Maßstab, trägt zur Reduzierung der Clusterverwaltung bei und unterstützt Datenpipelines in Google Cloud.
Für wen ist Google Cloud Dataproc am besten geeignet?
Datenengineering-Teams, die Spark- oder Hadoop-Aufträge in Google Cloud ausführen, können Dataproc zur Verwaltung des Clusterbetriebs einsetzen.
Warum ich mich für Google Cloud Dataproc entschieden habe
Ich habe mich für Google Cloud Dataproc bei Workloads entschieden, bei denen „Am besten für verwaltetes Spark und Hadoop“ Priorität hat. Verwaltete Cluster und Richtlinien für die automatische Skalierung helfen bei der Verarbeitung von Batch-Aufträgen mit wechselndem Ressourcenbedarf, während Dataproc serverlose Spark-Batch-Verarbeitungen ohne Clusterbereitstellung ausführt. Beispielsweise können Sie nächtliche Ereignisprotokolle mit Spark verarbeiten und vermeiden, dass ein Cluster zwischen den Ausführungen ungenutzt bleibt.
Wichtige Funktionen von Google Cloud Dataproc
- Beschleunigungs-Engine: Beschleunigt die Spark-Ausführung durch vektorisierte Verarbeitung, Caching und optimiertes Mischen.
- Unterstützung für Apache Iceberg: Funktioniert mit offenen Tabellenformaten in Google Cloud Storage.
- GPU-Beschleunigung: Unterstützt NVIDIA RAPIDS für GPU-gestützte Datenverarbeitung.
- Sicherheitskontrollen: Integriert sich in IAM, VPC Service Controls und Kerberos.
Integrationen von Google Cloud Dataproc
Google Cloud Dataproc verfügt über integrierte Integrationen mit BigQuery, Cloud Storage, Bigtable, Cloud Logging und Cloud Monitoring. Außerdem bietet es eine REST-API und das Cloud SDK zur Verwaltung von Clustern und Aufträgen.
Pros and Cons
Pros:
- Führt vorhandene Spark-Aufträge mit minimalen Anpassungen aus
- Schnelle Erstellung und Auflösung von Clustern
- Serverlose Batch-Verarbeitung vermeidet die Clusterverwaltung
Cons:
- Die Clusteroptimierung erfordert weiterhin Infrastrukturkenntnisse
- Die Kosten können bei dauerhaften Workloads hoch erscheinen
Learn more about Google Cloud Dataproc:
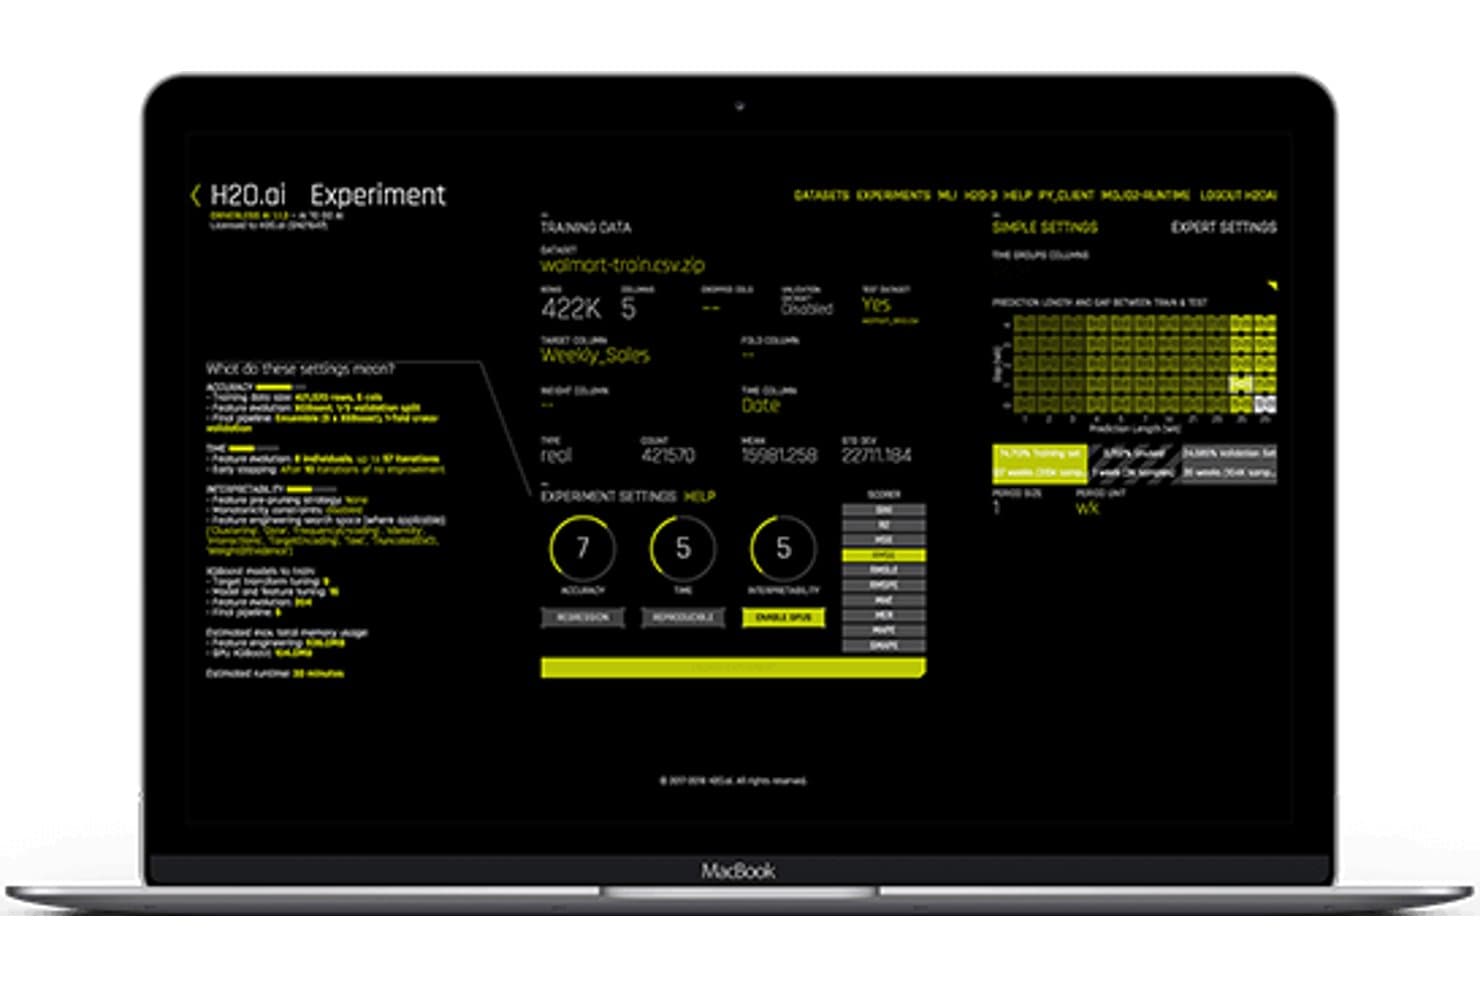
Mit H2O.ai können Benutzer AutoML-Experimente visuell konfigurieren und ausführen. Für Teams, die Alternativen zu Databricks prüfen, bietet H2O.ai eine Plattform für AI und maschinelles Lernen, die Daten- und IT-Teams dabei unterstützt, aus großen Datensätzen prädiktive Modelle zu erstellen und Analysen in die Praxis umzusetzen.
Für wen ist H2O.ai am besten geeignet?
H2O.ai eignet sich für Datenwissenschaftler und Ingenieure für maschinelles Lernen, die für die Entwicklung von AI-Modellen und deren Überführung in die Produktion verantwortlich sind.
Warum ich mich für H2O.ai entschieden habe
Ich habe H2O.ai als meine Alternative zu Databricks „am besten für AI- und ML-Lösungen“ ausgewählt, weil die Plattform sich auf die Erstellung prädiktiver Modelle aus großen Datensätzen konzentriert. H2O-3 verteilt In-Memory-Maschinenlernen über Cluster, während AutoML Algorithmen testet und Modelle in einer Rangliste anordnet. Diese Kombination gefällt mir, wenn ich Modelle vergleichen muss, bevor ich eines davon in die Produktion überführe.
Wichtige Funktionen von H2O.ai
- Flexible Bereitstellung: Führen Sie die Plattform lokal, in einer privaten Cloud, in der Cloud oder in Air-Gap-Umgebungen aus.
- Modellunabhängige Unterstützung: Wählen, wechseln oder optimieren Sie Modelle und große Sprachmodelle.
- Erklärbarkeit: Prüfen Sie Erklärungen für AI-gesteuerte Entscheidungen.
- Prüfpfade: Verfolgen Sie Plattformaktivitäten mithilfe prüfbereiter Protokolle.
Integrationen von H2O.ai
H2O Driverless AI stellt Datenkonnektoren für Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, JDBC-Quellen und Delta Tables bereit. Mit diesen Konnektoren können Teams Daten aus bestehenden Plattformen für Arbeitsabläufe des maschinellen Lernens abfragen oder importieren.
Pros and Cons
Pros:
- AutoML beschleunigt den Modellvergleich und die Prototypenerstellung
- Verteiltes In-Memory-Training lässt sich über Cluster skalieren
- Air-Gap-Bereitstellung unterstützt kontrollierte Umgebungen
Cons:
- Die Möglichkeiten zur Datenbearbeitung sind begrenzt
- Die umständliche Benutzeroberfläche kann Arbeitsabläufe verlangsamen
Learn more about H2O.ai:
Weitere Databricks-Alternativen
Hier sind einige weitere Alternativen zu Databricks, die es nicht in meine Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- 11DremioAm besten für Self-Service-Analysen geeignet
- 12QuboleAm besten geeignet für Big Data-Workloads
- 13Azure DatabricksAm besten für kollaborative Analysen
- 14TigerGraphAm besten für Graphenanalyse
Come valuto i concorrenti di Databricks
Che il vostro team esegua pipeline Spark su larga scala o gestisca un ciclo di vita ML, valuto ciascuna alternativa su due livelli: prima le esigenze fondamentali di lakehouse e calcolo, poi i fattori differenzianti.
Funzionalità di base (requisiti minimi per questa lista)
Quando seleziono gli strumenti per la mia lista, valuto ciascuno su una scala da 0 (non offre la funzionalità) a 5 (eccelle in questo ambito) per ogni funzionalità fondamentale elencata di seguito. Poi calcolo il punteggio totale dello strumento in percentuale. Ogni strumento deve raggiungere un punteggio totale minimo del 65% per essere considerato per l'inclusione.
- Architettura lakehouse unificata: Verifico che una piattaforma gestisca sia query su dati strutturati tipo data warehouse sia l'archiviazione di dati non strutturati, con supporto per formati tabellari aperti come Delta, Iceberg o Hudi.
- Elaborazione dati distribuita: I carichi batch e streaming su larga scala richiedono un motore distribuito che possa effettuare autoscaling, così valuto le opzioni di calcolo e come la piattaforma gestisce attività come ETL multi-terabyte.
- Workflow ML/AI integrati: Cerco il supporto completo al ciclo di vita ML, dal tracciamento degli esperimenti e la registry dei modelli fino al deployment e al serving, non solo un notebook in grado di eseguire script di training.
- Ambiente notebook collaborativo: Team di data engineer, analisti e ML engineer hanno bisogno di notebook multiutente e multilinguaggio, quindi valuto la collaborazione in tempo reale, il controllo versione e il supporto di linguaggi come SQL, Python, Scala ed R.
- Data governance e sicurezza: Conta qui un catalogo dati unificato, controlli di accesso granulari e tracciabilità delle origini. Valuto come ciascuna piattaforma gestisce permessi su tabelle, colonne e asset AI in un punto centralizzato.
- Multi-cloud e integrazione aperta: Il rischio di lock-in è reale, quindi verifico se lo strumento funziona su AWS, Azure e GCP e quanto bene si integra con orchestratori come Airflow, strumenti BI come Tableau e layer di ingestione come dbt.
Dopo aver definito una lista di strumenti che soddisfano questi criteri, considero cosa distingue ogni piattaforma.
Fattori di differenziazione (cosa distingue i fornitori)
Ecco come metto a confronto i diversi fornitori:
Funzionalità distintive
Il calcolo serverless è un grande elemento differenziante. Valuto se una piattaforma permette ai team di eseguire query e job senza gestire i cluster, il che riduce i costi per chi ha workload imprevedibili. Gli strumenti GenAI nativi sono sempre più importanti, specialmente per chi costruisce pipeline RAG o fa il fine-tuning di LLM direttamente nella piattaforma dati. Valuto anche i controlli di ottimizzazione dei costi come il monitoraggio della spesa per workload e le policy automatiche sui cluster, poiché i costi cloud possono crescere rapidamente nei team di ingegneria di grandi dimensioni.
Oltre le funzionalità
Il costo totale di proprietà è una delle prime cose che valuto. Il pricing a consumo può sembrare vantaggioso finché tariffe di uscita dati e supporto premium non fanno lievitare la fattura. Anche la profondità dell'ecosistema conta: verifico quanto ogni piattaforma si integri con strumenti come Airflow, dbt e Tableau, dato che pochi team sostituiscono il proprio stack completo. La fase di implementazione e la rapidità di messa in produzione completano la mia valutazione. Strumenti di migrazione da sistemi legacy come Hadoop o Redshift possono ridurre le tempistiche di settimane, e una buona documentazione rende l'onboarding di nuovi ingegneri molto meno complicato.
So wählen Sie eine Databricks-Alternative aus
Bei langen Funktionslisten und komplexen Preisstrukturen verliert man leicht den Überblick. Damit Sie sich bei der individuellen Auswahl Ihrer Software auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was zu beachten ist |
| Skalierbarkeit | Stellen Sie sicher, dass die Lösung Ihr Datenwachstum ohne Leistungseinbußen bewältigen kann. Prüfen Sie, ob sie sowohl horizontale als auch vertikale Skalierung für mehr Flexibilität unterstützt. |
| Integrationen | Achten Sie auf die Kompatibilität mit Ihren bestehenden Tools, etwa Data Lakes oder BI-Tools, um einen reibungslosen Datenfluss zu gewährleisten und isolierte Prozesse zu vermeiden. |
| Anpassbarkeit | Bewerten Sie, wie gut sich die Plattform an die spezifischen Arbeitsabläufe und Prozesse Ihres Teams anpassen lässt. Anpassbare Dashboards können den unterschiedlichen Anforderungen verschiedener Teams gerecht werden. |
| Benutzerfreundlichkeit | Berücksichtigen Sie die Lernkurve und wie intuitiv die Benutzeroberfläche für Ihr Team ist. Eine benutzerfreundliche Plattform kann den Schulungsaufwand reduzieren und die Akzeptanz erhöhen. |
| Budget | Vergleichen Sie die Preismodelle und stellen Sie sicher, dass sie in Ihr Budget passen. Berücksichtigen Sie versteckte Kosten wie Speicherplatz oder zusätzliche Gebühren für Nutzer, die Ihre Entscheidung beeinflussen könnten. |
| Sicherheitsvorkehrungen | Bewerten Sie die Sicherheitsfunktionen der Plattform, etwa Datenverschlüsselung und die Einhaltung von Branchenstandards, um sensible Daten zu schützen. |
| Unterstützung | Prüfen Sie die Verfügbarkeit von Kundensupport-Optionen, einschließlich Live-Chat und Community-Foren, damit Ihr Team bei Bedarf Hilfe erhalten kann. |
| Leistung | Untersuchen Sie, wie die Plattform große Datensätze und die Verarbeitung in Echtzeit bewältigt, um sicherzustellen, dass sie die Leistungserwartungen Ihres Teams erfüllt. |
Trends bei Databricks-Konkurrenten
Im Rahmen meiner Recherche habe ich unzählige Produktaktualisierungen, Pressemitteilungen und Versionsprotokolle verschiedener Anbieter von Databricks-Konkurrenten ausgewertet. Hier sind einige der aufkommenden Trends, die ich im Auge behalte:
- Echtzeitanalysen: Unternehmen verlangen zunehmend nach Dateneinblicken in Echtzeit. Anbieter verbessern ihre Plattformen, um Daten in Echtzeit zu verarbeiten und zu analysieren, sodass Nutzer sofortige Entscheidungen treffen können. Lösungen wie Google BigQuery integrieren Funktionen, die das Streaming von Daten in Echtzeit unterstützen.
- Erweiterte Analysen: Bei diesem Trend werden AI und maschinelles Lernen eingesetzt, um Datenanalyseprozesse zu verbessern. Er wird immer beliebter, da er Nutzern hilft, ohne manuellen Aufwand Erkenntnisse zu gewinnen. IBM Watson Studio ist ein Beispiel dafür und bietet Funktionen für erweiterte Analysen zur Automatisierung der Datenanalyse.
- Demokratisierung von Daten: Immer mehr Plattformen konzentrieren sich darauf, Daten für technisch nicht versierte Nutzer zugänglich zu machen. Dieser Trend ist entscheidend für die Förderung einer datengestützten Kultur innerhalb von Unternehmen. Tools werden mit intuitiven Benutzeroberflächen und Self-Service-Funktionen entwickelt, wie sie beispielsweise in Alteryx zu finden sind.
- Daten-Governance: Da die Datenschutzbestimmungen strenger werden, gewinnen Funktionen für die Daten-Governance zunehmend an Bedeutung. Anbieter integrieren Governance-Tools, um Nutzern dabei zu helfen, Vorschriften einzuhalten und Daten verantwortungsvoll zu verwalten. Azure Synapse Analytics bietet beispielsweise integrierte Governance-Funktionen.
- Unterstützung hybrider Clouds: Viele Unternehmen wünschen sich Flexibilität bei ihren Cloud-Strategien. Die Unterstützung hybrider Clouds nimmt zu und ermöglicht es Nutzern, Daten sowohl in lokalen als auch in Cloud-Umgebungen zu verwalten. Cloudera führt diesen Trend an und bietet Lösungen zur Unterstützung hybrider Cloud-Bereitstellungen.
Was ist ein Databricks-Konkurrent?
Databricks-Konkurrenten sind Softwarelösungen, die Funktionen für Datenverarbeitung, Datenanalyse und maschinelles Lernen bereitstellen. Diese Tools werden in der Regel von Datenwissenschaftlern, Ingenieuren und Analysten eingesetzt, um Erkenntnisse zu gewinnen und Geschäftsentscheidungen voranzutreiben.
Funktionen für Echtzeitanalysen, erweiterte Analysen und Daten-Governance helfen dabei, Daten effizient zu verarbeiten, Erkenntnisse zu gewinnen und Daten verantwortungsvoll zu verwalten. Insgesamt ermöglichen diese Tools Unternehmen, ihre Daten für bessere Entscheidungen und eine strategische Planung zu nutzen.
Funktionen eines Databricks-Konkurrenten
Achten Sie bei der Auswahl eines Databricks-Konkurrenten auf die folgenden wichtigen Funktionen:
- Echtzeitanalysen: Ermöglichen die sofortige Datenverarbeitung und Erkenntnisgewinnung, sodass Sie schnelle Geschäftsentscheidungen treffen können.
- Erweiterte Analysen: Nutzen KI zur Automatisierung der Datenanalyse und helfen dabei, Erkenntnisse ohne manuellen Aufwand aufzudecken.
- Datenverwaltung: Stellt die Einhaltung von Datenschutzbestimmungen und eine verantwortungsvolle Datenverwaltung sicher.
- Unterstützung hybrider Clouds: Ermöglicht die Verwaltung von Daten sowohl in lokalen als auch in Cloud-Umgebungen und sorgt so für Flexibilität.
- Interaktive Zusammenarbeit: Erleichtert die Teamarbeit durch gemeinsam genutzte Arbeitsbereiche und Werkzeuge für die gemeinsame Datenanalyse.
- Automatische Skalierung: Passt Ressourcen auf Grundlage der Arbeitslast an und optimiert die Leistung ohne manuelle Eingriffe.
- Integration maschinellen Lernens: Bietet integrierte Funktionen für maschinelles Lernen zur Erstellung fortschrittlicher Datenprognosen und Erkenntnisse.
- Anpassbarkeit: Ermöglicht personalisierte Arbeitsabläufe und Dashboards, die an die spezifischen Anforderungen und Prozesse des Teams angepasst werden können.
- Sicherheitsvorkehrungen: Bietet Verschlüsselungs- und Compliance-Funktionen zum Schutz vertraulicher Daten.
- Benutzerfreundliche Oberfläche: Gewährleistet eine einfache Bedienung, verkürzt die Einarbeitungszeit und steigert die Akzeptanz in Ihrem Team.
Vorteile eines Konkurrenten von Databricks
Die Implementierung eines Konkurrenten von Databricks bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Verbesserte Entscheidungsfindung: Echtzeitanalysen und erweiterte Analysen liefern sofortige Erkenntnisse und verbessern die Entscheidungsfähigkeit Ihres Teams.
- Verbesserte Zusammenarbeit: Funktionen für die interaktive Zusammenarbeit ermöglichen Ihrem Team eine effektive Zusammenarbeit und führen zu besser abgestimmten Datenprojekten.
- Skalierbarkeit: Durch die automatische Skalierung kann Ihr System wachsende Datenmengen effizient verarbeiten, ohne dass manuelle Anpassungen erforderlich sind.
- Kosteneffizienz: Nutzungsabhängige Preismodelle stellen sicher, dass Sie nur für die Ressourcen zahlen, die Sie verwenden, und optimieren so die Budgetverwaltung.
- Verbesserte Sicherheit: Integrierte Sicherheitsvorkehrungen schützen Ihre Daten und stellen die Einhaltung von Branchenstandards sicher.
- Flexibilität: Die Unterstützung hybrider Clouds bietet die Flexibilität, Daten in verschiedenen Umgebungen zu verwalten und sich an Ihre geschäftlichen Anforderungen anzupassen.
- Anpassung: Mit anpassbaren Funktionen können Sie Arbeitsabläufe und Dashboards auf Ihre spezifischen Anforderungen zuschneiden und so die Produktivität steigern.
Kosten und Preise eines Konkurrenten von Databricks
Bei der Auswahl eines Konkurrenten von Databricks ist ein Verständnis der verschiedenen verfügbaren Preismodelle und Tarife erforderlich. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre Durchschnittspreise und die typischerweise in Lösungen von Konkurrenten von Databricks enthaltenen Funktionen zusammen:
Tarifvergleichstabelle für einen Konkurrenten von Databricks
| Tarifart | Durchschnittspreis | Übliche Funktionen |
| Kostenloser Tarif | $0 | Grundlegende Datenverarbeitung, begrenzter Speicherplatz und Community-Support. |
| Persönlicher Tarif | $10-$30 /Benutzer /Monat | Erweiterte Datenanalysen, persönliche Dashboards und E-Mail-Support. |
| Geschäftstarif | $50-$100 /Benutzer /Monat | Fortschrittliche Analysewerkzeuge, Funktionen für die Teamzusammenarbeit und bevorzugter Support. |
| Unternehmenstarif | $150-$300/Benutzer /Monat | Individuelle Integrationen, dedizierte Kontoverwaltung und Sicherheit auf Unternehmensniveau. |
Häufig gestellte Fragen zu Databricks-Konkurrenten
Hier finden Sie Antworten auf häufig gestellte Fragen zu Databricks-Konkurrenten:
Wer ist der größte Konkurrent von Databricks?
Snowflake gilt aufgrund seiner ähnlichen cloudbasierten Datenplattformfunktionen häufig als größter Konkurrent von Databricks. Beide bieten umfangreiche Funktionen zur Datenverarbeitung und -analyse, aber Snowflake ist für seine Stärken im Bereich der Datenlagerung bekannt. Abhängig von Ihren spezifischen Anforderungen kann jede der beiden Plattformen eine gute Wahl sein.
Was wird Databricks ersetzen?
Obwohl kein einzelnes Tool Databricks ersetzen soll, bieten Alternativen wie SQL Server überzeugende Funktionen. SQL Server lässt sich gut in Datenanalysetools wie Power BI integrieren und bietet ein leistungsfähiges relationales Datenbankmanagementsystem. Ihre Wahl hängt von Ihren spezifischen Anforderungen an die Datenverarbeitung ab.
Welche Einschränkungen hat Databricks?
Databricks weist einige Einschränkungen auf, beispielsweise Beschränkungen hinsichtlich der Anzahl von Widgets in einem Notebook sowie Zeichenbegrenzungen für Widget-Namen und -Eingaben. Diese Einschränkungen können sich darauf auswirken, wie Sie Daten in Notebooks entwerfen und bearbeiten. Planen Sie daher entsprechend, wenn diese Begrenzungen Ihre Arbeitsabläufe beeinflussen.
Wer sind die Konkurrenten von Amazon Databricks?
Amazon Databricks steht im Wettbewerb mit Plattformen wie Snowflake, die ähnliche Funktionen zur Datenverarbeitung bieten. Snowflake stellt eine cloudbasierte Datenlagerlösung bereit, die weithin für ihre Skalierbarkeit und Benutzerfreundlichkeit anerkannt ist, wodurch sie zu einem starken Wettbewerber auf dem Markt wird.
Wie vergleichen sich die Preise von Databricks mit denen der Wettbewerber?
Die Preise von Databricks können je nach Nutzung und Funktionen erheblich variieren. Es ist wichtig, Databricks mit Wettbewerbern wie Snowflake und Google BigQuery zu vergleichen und dabei Faktoren wie Datenspeicherung, Verarbeitungskosten und zusätzliche Funktionen zu berücksichtigen. Bewerten Sie die Preisstruktur jeder Plattform, um die beste Lösung für Ihr Budget zu finden.
Auf welche Funktionen sollte ich bei einem Konkurrenten von Databricks achten?
Bei der Bewertung von Databricks-Konkurrenten sollten Sie auf Funktionen wie Echtzeitanalysen, die Integration von maschinellem Lernen und Daten-Governance achten. Diese Funktionen verbessern Ihre Datenverarbeitung und -analyse und schaffen einen Mehrwert für Ihr Team. Berücksichtigen Sie Ihre spezifischen Geschäftsanforderungen, um zu bestimmen, welche Funktionen am wichtigsten sind.