

Die Überwachung Ihres Netzwerks mit einer umfassenden Überwachungsplattform kann eine Herausforderung sein, insbesondere wenn Ihre derzeitigen Tools Ihre Anforderungen nicht vollständig erfüllen. Vielleicht verwenden Sie PRTG und stellen fest, dass es nicht zu den spezifischen Anforderungen Ihres Teams passt oder bestimmte Funktionen fehlen.
Meiner Erfahrung nach kann die Suche nach der richtigen Netzwerküberwachungslösung Ihre Arbeitsbelastung deutlich verringern, Ausfallzeiten reduzieren und die Gesamtleistung verbessern. Deshalb habe ich verschiedene PRTG-Alternativen recherchiert und getestet, damit Sie die beste Lösung für Ihr Unternehmen finden.
In diesem Artikel finden Sie unvoreingenommene Bewertungen führender Alternativen, wobei der Schwerpunkt auf ihren einzigartigen Funktionen und Vorteilen liegt. Ganz gleich, ob Sie eine bessere Skalierbarkeit, die Einhaltung bestimmter Branchenvorschriften oder eine verbesserte Benutzererfahrung suchen – ich führe Sie durch die verfügbaren Optionen. Finden wir die Netzwerküberwachungssoftware, die Ihr Team am besten unterstützt.
Was ist PRTG?
Paessler Router Traffic Grapher (PRTG), häufig als PRTG Network Monitor bezeichnet, ist ein Überwachungstool, mit dem Sie den Zustand und die Leistung Ihres Netzwerks verfolgen können. Fachleute für IT-Überwachung und Netzwerkadministratoren verwenden PRTG im Allgemeinen, weil es detaillierte Einblicke in den Netzwerkverkehr und die Systemverfügbarkeit bietet. Funktionen wie Echtzeitüberwachung, anpassbare Benachrichtigungen und detaillierte Berichte unterstützen Ihren Bedarf an einer effizienten Netzwerkverwaltung. PRTG kann wertvolle Einblicke liefern, die zum reibungslosen Betrieb Ihrer Systeme beitragen, aber es gibt auch Alternativen.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle der PRTG-Alternativen
Diese Vergleichstabelle fasst die Preisdetails meiner wichtigsten PRTG-Alternativen zusammen:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Am besten für detaillierte SLA-Berichte geeignet | 4.0 out of 5 | 4 | 4 | 4 | 4 | 4 | 4 | $1,400/Jahr Kostenloser Tarif + 60-tägige kostenlose Testversion verfügbar | Website |
Am besten für die Fernverwaltung von IT-Systemen geeignet | 2.7 out of 5 | 3 | 4 | 2 | 2 | 2 | 3 | Preis auf Anfrage Kostenlose Demo verfügbar | Website |
Am besten für Open-Source-Skalierbarkeit geeignet | 4.2 out of 5 | 4 | 5 | 4 | 4 | 4 | 4 | $325/Monat Kostenloser Tarif + 5-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für cloudbasierte Beobachtbarkeit geeignet | 3.5 out of 5 | 4 | 4 | 3 | 3 | 3 | 4 | $0.60/Monat Kostenloser Tarif + 14-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für anpassbare Übersichtsseiten geeignet | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $2,595 einmalig Kostenloser Tarif + 30-tägige Testversion + Demo verfügbar | Website |
Am besten für die Sichtbarkeit von Internetpfaden | 3.2 out of 5 | 4 | 3 | 2 | 3 | 3 | 4 | Preis auf Anfrage 15-tägige kostenlose Testversion + Demo verfügbar | Website |
Am besten für einheitliches Endpunktmanagement geeignet | 3.3 out of 5 | 4 | 4 | 4 | 3 | 2 | 3 | $3.75/Monat 14-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für die automatische Netzwerkerkennung geeignet | 3.3 out of 5 | 4 | 4 | 4 | 3 | 3 | 2 | Preise auf Anfrage Kostenloser Tarif + kostenlose Demo verfügbar | Website |
Am besten für die synthetische Netzwerküberwachung geeignet | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $249/Monat Kostenloser Tarif + 14-tägige Testversion + kostenlose Demo verfügbar | Website |
Am besten für die automatisierte Netzwerkzuordnung geeignet | 3.8 out of 5 | 4 | 4 | 5 | 4 | 4 | 2 | Preise auf Anfrage 14-tägige kostenlose Testversion + Demo verfügbar | Website |


Bewertungen der besten PRTG-Alternativen
Im Folgenden finden Sie meine ausführlichen Zusammenfassungen der besten PRTG-Alternativen, die es auf meine Auswahlliste geschafft haben. Meine Bewertungen bieten einen detaillierten Überblick über die wichtigsten Funktionen, Vor- und Nachteile, Integrationen und idealen Einsatzmöglichkeiten jedes Tools, damit Sie die beste Lösung für sich finden.
 Am besten für detaillierte SLA-Berichte geeignet
- Kostenloser Tarif + 60-tägige kostenlose Testversion verfügbar
- Ab $1,400/Jahr (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.7/5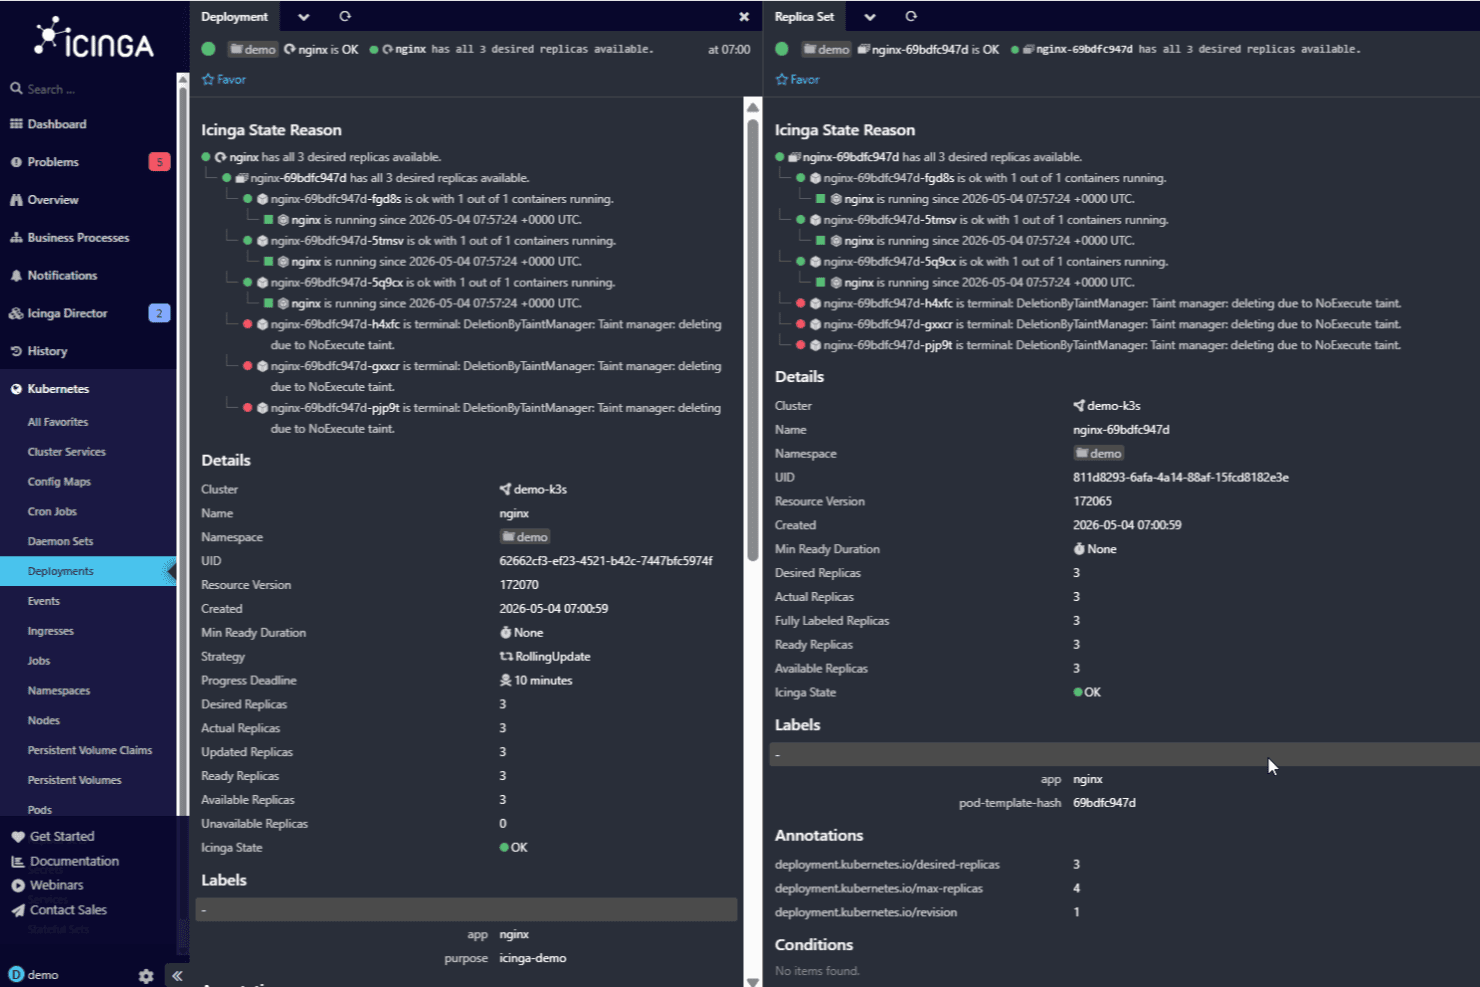
Icinga verfolgt alle Bereitstellungen auf einem Dashboard mit Beschriftungen, Details und Anmerkungen. Icinga ist eine Open-Source-Plattform zur Infrastrukturüberwachung, die sich an Systemingenieure, Netzwerkadministratoren und MSPs richtet, die eine unbegrenzte Überwachung von Hosts, flexible Prüfmethoden und detaillierte SLA-Berichte ohne Einschränkungen durch eine Lizenzierung pro Sensor benötigen.
Für wen ist Icinga am besten geeignet?
Icinga eignet sich besonders für Systemingenieure und MSP-Techniker, die eine große, verteilte Infrastruktur überwachen müssen, ohne durch Lizenzkosten pro Host eingeschränkt zu werden.
Warum ich Icinga ausgewählt habe
Ich habe Icinga als eines der besten Tools ausgewählt, weil die SLA-Berichte detaillierter sind als bei den meisten Überwachungstools, mit denen ich gearbeitet habe. Icinga DB verwaltet separate SLA-Verlaufstabellen, in denen genau die für Verfügbarkeitsberechnungen erforderlichen Daten gespeichert werden, und der Verlauf wird standardmäßig nicht gelöscht. Sie können Verfügbarkeitsberichte für Hosts und Dienste erstellen, sie in Icinga Web in der Vorschau anzeigen, als PDFs exportieren und so planen, dass sie automatisch in regelmäßigen Abständen versendet werden.
Wichtige Funktionen von Icinga
- Verteilte Master-/Satelliten-/Agentenarchitektur: Verteilt die Überwachung auf mehrere Standorte mithilfe von übergeordneten und untergeordneten Knoten, die auch bei Netzwerkausfällen weiterhin Prüfungen durchführen und Daten sammeln.
- Kostenlose Edition mit unbegrenzter Host-Anzahl: Überwacht unbegrenzt viele Hosts und Dienste kostenlos, ohne Lizenzbeschränkungen pro Sensor oder Gerät.
- API-gesteuerte Konfigurationsverwaltung: Verwendet eine REST API, um Hosts, Dienste und Konfigurationsobjekte dynamisch zu erstellen, zu ändern und zu löschen, mit Unterstützung für versionierte Konfigurationen und Rollbacks.
- Unterstützung mehrerer Prüfprotokolle: Überwacht Geräte und Dienste über SNMP, SSH, ICMP, agentenbasierte Prüfungen, NSClient++ und passive Ergebnisse, die über die REST API übermittelt werden.
Icinga-Integrationen
Icinga verfügt über dokumentierte Integrationen mit Grafana, Elasticsearch, NetBox, Graphite, InfluxDB, Prometheus, Ansible, Puppet und Terraform. Die REST API unterstützt benutzerdefinierte Integrationen, Konfigurationsautomatisierung, Ereignisströme und Verbindungen zu Ticketing-Workflows.
Pros and Cons
Pros:
- Detaillierte SLA-Verfügbarkeitsberichte
- Verteilte Prüfungen werden bei Ausfällen fortgesetzt
- Benutzerdefinierte Prüfungen decken gemischte Infrastrukturen ab
Cons:
- Die Einrichtung erfordert eine umfangreiche manuelle Konfiguration
- Für langfristige Trendanalysen werden separate Tools benötigt
Learn more about Icinga: Am besten für die Fernverwaltung von IT-Systemen geeignet
- Kostenlose Demo verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.7/5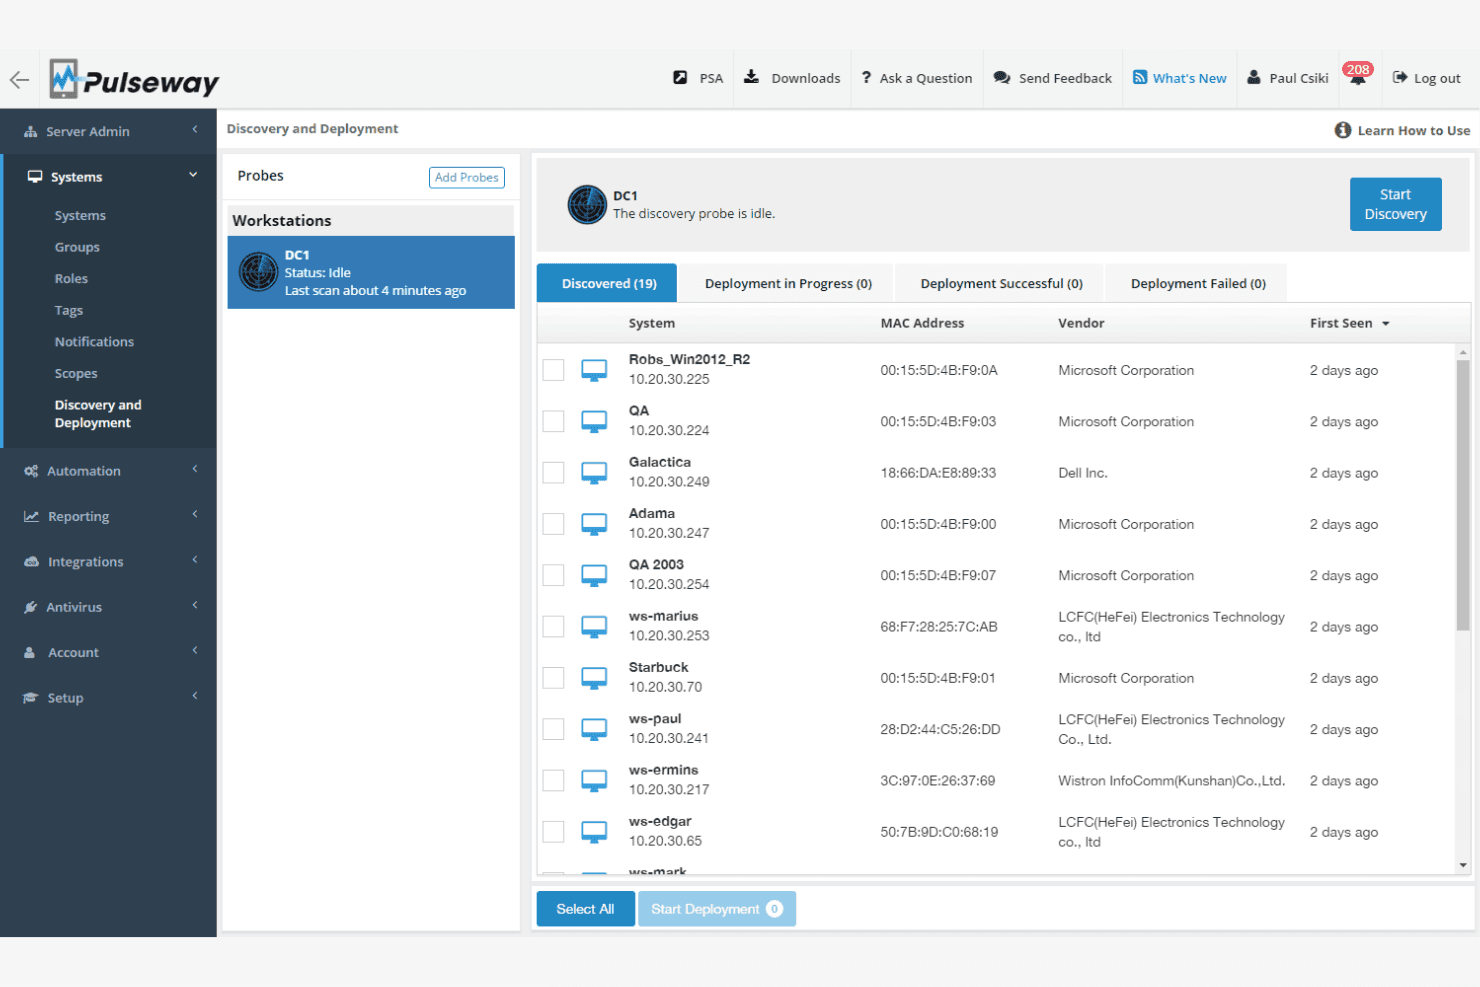
Der Bildschirm „Erkennung und Bereitstellung“ von Pulseway findet Geräte im Netzwerk und verfolgt deren Bereitstellungsstatus. Pulseway ist eine RMM-Plattform für MSPs und IT-Teams, die Endgeräte, Server und Netzwerkgeräte überwachen, verwalten und Fehler beheben müssen – mit einem starken Fokus auf mobilen Fernzugriff und die Reaktion auf Warnmeldungen.
Für wen ist Pulseway am besten geeignet?
Pulseway eignet sich besonders für MSP-Techniker, die Kundenendgeräte aus der Ferne überwachen und verwalten müssen, insbesondere über ein mobiles Gerät.
Warum ich Pulseway ausgewählt habe
Ich habe Pulseway als eine der besten Lösungen ausgewählt, weil sich die mobilgeräteorientierte Fernverwaltung von Tools wie PRTG abhebt, bei denen man an eine Desktop-Konsole gebunden ist. Ich kann direkt von meinem Smartphone aus auf eine kritische Serverwarnung reagieren, ein Behebungsskript ausführen und einen Dienst neu starten, bevor jemand einen Ausfall bemerkt. Die SNMP-basierten bedingten Warnmeldungen lassen sich in Automatisierungsabläufe integrieren, sodass die Reaktion nicht nur aus einer Benachrichtigung besteht, sondern eine Behebung bereits eingeleitet wird.
Wichtige Funktionen von Pulseway
- Netzwerktopologiekarten: Erstellt automatisch anpassbare Topologiekarten mit bearbeitbaren Gerätetypen, logischen Gruppierungen und Netzwerkbeziehungen.
- Patchverwaltung: Automatisiert die Installation von Betriebssystem- und Drittanbieteranwendungs-Patches unter Windows, Mac und Linux mit konfigurierbaren Richtlinien und Zeitplänen.
- Aufzeichnung von Fernsteuerungssitzungen: Zeichnet Fernsteuerungssitzungen für Windows-Agenten manuell oder automatisch auf und unterstützt dabei sowohl gemeinsam genutzte als auch private Sitzungen.
- Durch Warnmeldungen ausgelöste Automatisierungsabläufe: Führt als Reaktion auf Warnmeldungen Skripte und Abläufe aus, um IT-Probleme ohne manuelles Eingreifen automatisch zu beheben.
Pulseway-Integrationen
Pulseway bietet native Integrationen mit PagerDuty, Slack, ConnectWise Manage, Autotask, Zendesk und IT Glue. Außerdem stehen REST-, Client- und Cloud-APIs sowie Plug-ins für benutzerdefinierte Verbindungen zur Verfügung.
Pros and Cons
Pros:
- Mobile Warnmeldungen ermöglichen eine schnelle Reaktion aus der Ferne
- Durch Warnmeldungen ausgelöste Skripte reduzieren wiederkehrende Fehlerbehebungsaufgaben
- Topologiekarten verdeutlichen die Beziehungen zwischen gefundenen Geräten
Cons:
- Die Einrichtung von SNMP kann schwierig sein
- Die Berichterstellung bietet nur begrenzte Anpassungsmöglichkeiten und Detailtiefe
Learn more about Pulseway: Am besten für Open-Source-Skalierbarkeit geeignet
- Kostenloser Tarif + 5-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $325/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5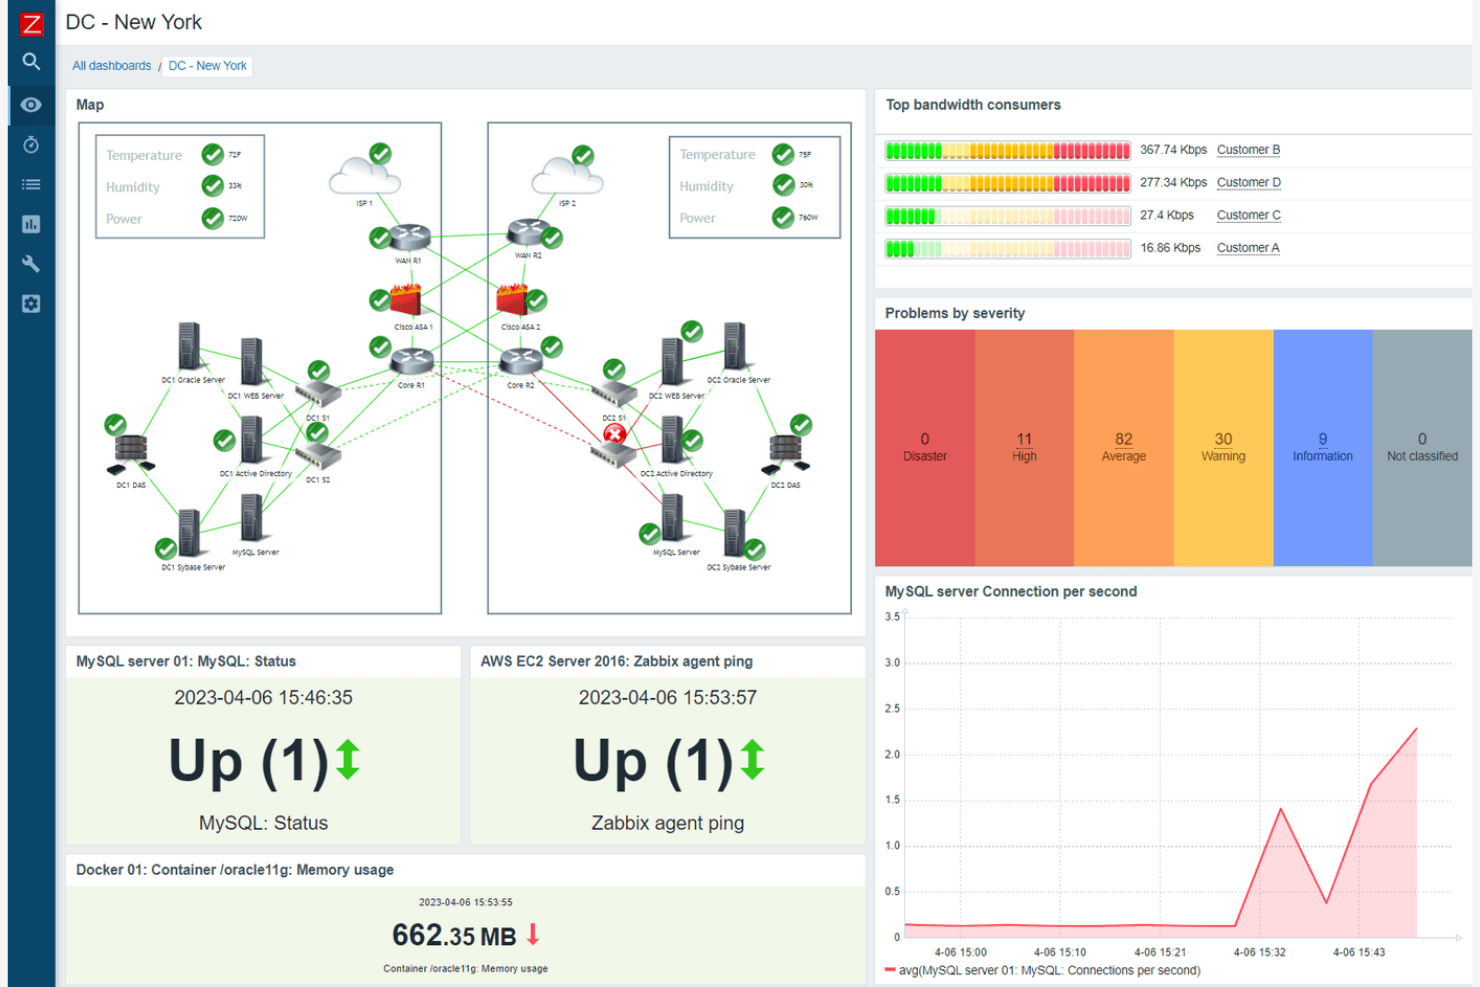
Zabbix-Dashboard mit einer Netzwerkübersicht eines Rechenzentrums, Bandbreitennutzung und Problemen nach Schweregrad. Zabbix ist eine Open-Source-Überwachungsplattform, mit der Infrastruktur- und Betriebsteams Server, Netzwerkgeräte, Cloud-Ressourcen und Anwendungen überwachen können, ohne pro Sensor oder Gerät zu bezahlen.
Für wen ist Zabbix am besten geeignet?
Zabbix eignet sich hervorragend für Infrastruktur- und Betriebsteams, die große, komplexe Umgebungen überwachen müssen, ohne die Kosten einer Lizenzierung pro Gerät oder Sensor tragen zu müssen.
Warum ich Zabbix ausgewählt habe
Zabbix hat sich seinen Platz auf meiner Auswahlliste verdient, weil es eine der wenigen Überwachungsplattformen ist, die tatsächlich auf Millionen von Messwerten skaliert, ohne pro Gerät oder Sensor Gebühren zu erheben. Ich schätze, dass die auf Proxys basierende Architektur es mir ermöglicht, die Datensammlung auf entfernte Standorte, DMZs und Firewalls zu verteilen, sodass ein einzelner Zabbix-Server realistisch eine weitläufige Infrastruktur mit mehreren Standorten abdecken kann. Die Open-Source-Lizenz bedeutet, dass keine Sensorbegrenzung wie bei PRTG im Hintergrund darauf wartet, Sie bei wachsender Umgebung einzuschränken.
Wichtige Funktionen von Zabbix
- Agentenlose Überwachung mit mehreren Protokollen: Überwachen Sie Netzwerkgeräte, Server und Dienste mithilfe von SNMP, IPMI, SSH/Telnet, ICMP/TCP, Prometheus, Modbus und MQTT, ohne einen Agenten bereitzustellen.
- Eskalationsworkflows: Konfigurieren Sie mehrstufige Alarmeskalationen mit Verzögerungen, wiederholten Benachrichtigungen, Weiterleitung an Benutzergruppen und der automatisierten Ausführung entfernter Befehle.
- Geschäftsservice-Strukturen: Definieren Sie Servicehierarchien, berechnen Sie den Servicestatus mithilfe konfigurierbarer Algorithmen und messen Sie die Verfügbarkeit anhand von SLA-Zielen.
- JSON-RPC-API: Greifen Sie auf mehr als 200 API-Methoden zu, um die Konfiguration zu automatisieren, historische Daten abzurufen und Drittanbieter-Tools in Zabbix zu integrieren.
Zabbix-Integrationen
Zabbix bietet native Integrationen mit ServiceNow, Jira ServiceDesk, Slack, Microsoft Teams, PagerDuty, AWS, Microsoft Azure, Google Cloud, Kubernetes und VMware. Seine JSON-RPC-API stellt mehr als 200 Methoden für benutzerdefinierte Integrationen bereit, mit Streaming zu Kafka, RabbitMQ, Amazon SQS und Amazon Kinesis.
Pros and Cons
Pros:
- Das Proxy-basierte Abrufen puffert Daten von entfernten Standorten
- Agentenlose und agentenbasierte Überwachung deckt unterschiedliche Systeme ab
- Keine lizenzbedingte Obergrenze für Sensoren
Cons:
- Die anfängliche Einrichtung von Hosts und Auslösern erfordert Aufwand
- Alarmschwellen müssen angepasst werden, um das Benachrichtigungsrauschen zu reduzieren
 Am besten für cloudbasierte Beobachtbarkeit geeignet
- Kostenloser Tarif + 14-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $0.60/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5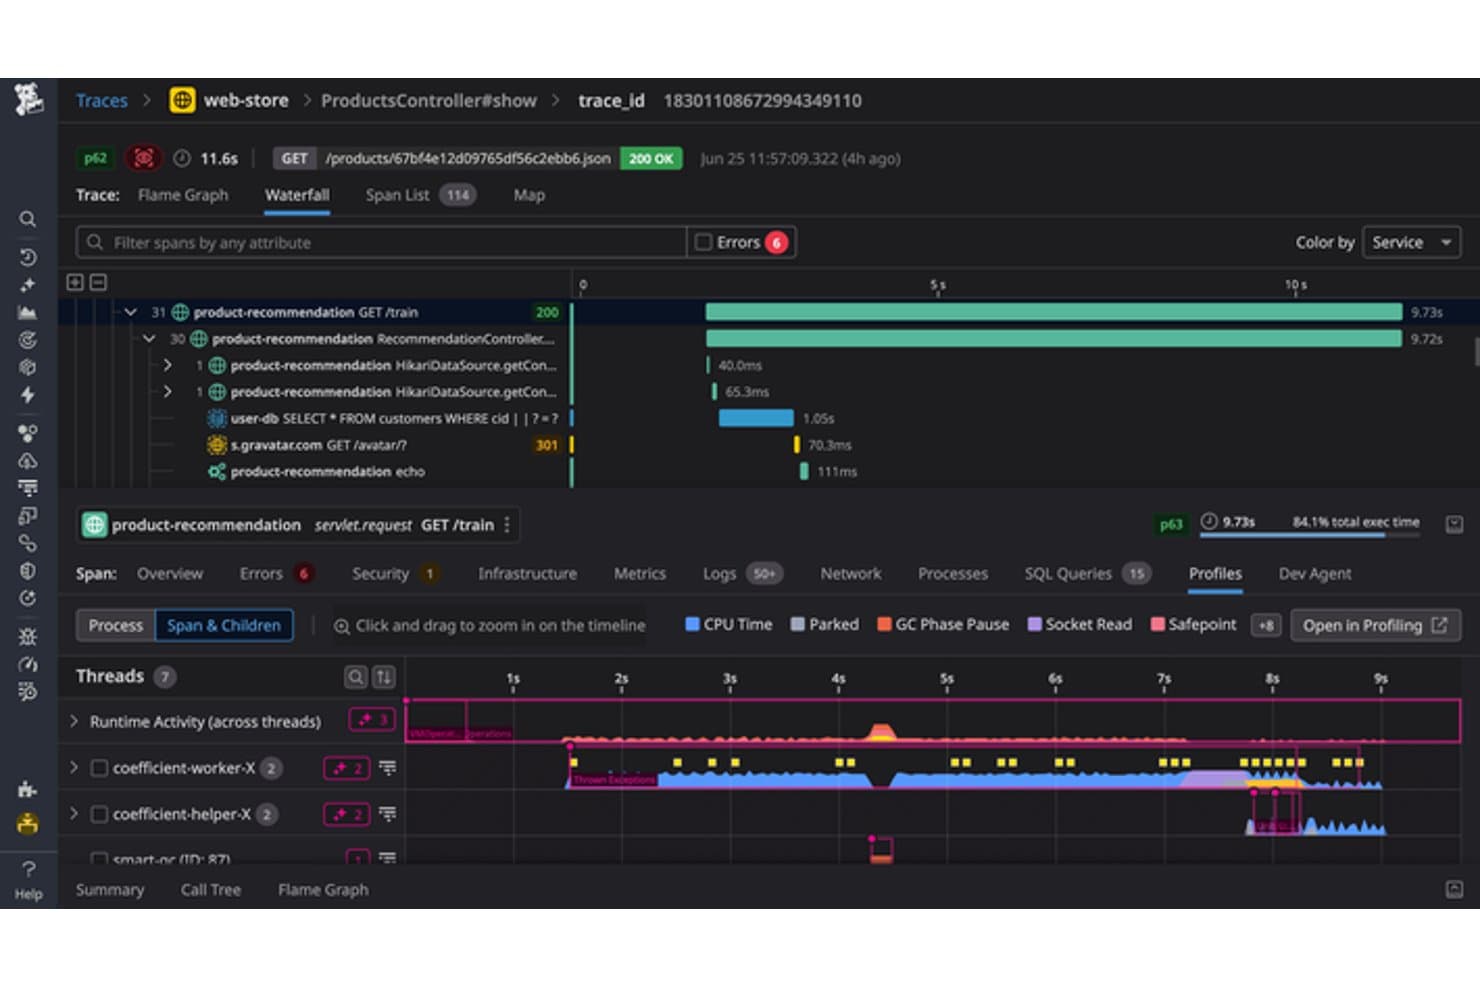
Datadog-APM-Ablaufverfolgungs-Wasserfalldiagramm mit Profilerstellungsansicht für eine Anfrage an einen Produktempfehlungsdienst. Datadog ist eine cloudnative Überwachungsplattform, die Netzwerk-, Infrastruktur- und Anwendungsvisibilität in Multi-Cloud- und Hybridumgebungen vereinheitlicht – eine leistungsstarke Lösung für IT-Betriebsteams, die korrelierte, über mehrere Ebenen hinweg gewonnene Einblicke benötigen, ohne mehrere Tools verwalten zu müssen.
Für wen eignet sich Datadog am besten?
Datadog eignet sich für IT-Betriebsteams, die Multi-Cloud- und Hybridumgebungen verwalten und Netzwerk-, Infrastruktur- und Anwendungsdaten an einem Ort benötigen.
Warum ich Datadog ausgewählt habe
Ich habe Datadog als eine der besten PRTG-Alternativen ausgewählt, weil die Plattform cloudnative Beobachtbarkeit auf eine Weise in die Netzwerküberwachung integriert, wie es herkömmliche NMS-Tools einfach nicht können. Besonders gut gefällt mir, wie die Cloud-Netzwerküberwachung den Datenverkehr zwischen Microservices, Cloud-Endpunkten und lokalen Infrastrukturen in einer einzigen Ansicht korreliert. Dadurch kann mein Team von einer Netzwerkanomalie zur dahinterliegenden Anwendung oder zum dahinterliegenden Host wechseln, ohne zwischen Tools wechseln zu müssen. Die Netzwerkpfadanalyse bietet eine Hop-für-Hop-Ansicht von Latenz und Paketverlust über VPCs, WANs und SaaS-Anbieter hinweg. Dadurch lassen sich beeinträchtigte Pfade in hybriden Umgebungen wirklich praxisnah nachverfolgen.
Wichtige Funktionen von Datadog
- Überwachung von Netzwerkgeräten: Erkennt physische und virtuelle Geräte über SNMP (v1–v3), Traps, NetFlow und Syslog und erstellt automatisch Geräte- und Schnittstellen-Dashboards.
- Topologiekarte der Geräte: Visualisiert automatisch physische Netzwerkverbindungen sowie Abhängigkeiten von vorgelagerten und nachgelagerten Komponenten im gesamten Gerätebestand.
- NetFlow-Überwachung: Erfasst NetFlow-v5/v9-, IPFIX-, sFlow- und jFlow-Daten, um die aktivsten Kommunikationspartner, Protokolle und Bandbreitennutzungstrends zu identifizieren.
- Kontoverwaltung für mehrere Organisationen: Trennt Kundendaten in isolierte untergeordnete Organisationen und bietet Einblick in die Nutzung auf übergeordneter Ebene sowie eine programmatische Einrichtung über API oder Terraform.
Datadog-Integrationen
Datadog listet plattformweit mehr als 1.000 integrierte Integrationen auf, darunter Arista, Aruba, Cisco, Cisco Meraki, F5 und Juniper. Darüber hinaus bietet die Plattform eine PRTG-Marktplatzintegration, eine Anreicherung der ServiceNow-CMDB sowie eine HTTP-REST-API für benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Korreliert Probleme in Netzwerk, Infrastruktur und Anwendungen
- Bildet Latenz und Paketverlust Hop für Hop ab
- Dashboards helfen Teams, Probleme mit dem Systemzustand zu erkennen
Cons:
- Die SNMP-Einrichtung kann arbeitsintensiv sein
- Die Aufbewahrung von Netzwerkdaten bleibt hinter dedizierten NMS-Tools zurück
 Am besten für anpassbare Übersichtsseiten geeignet
- Kostenloser Tarif + 30-tägige Testversion + Demo verfügbar
- Ab $2,595 einmalig
Visit WebsiteCustomer Rating:4.6/5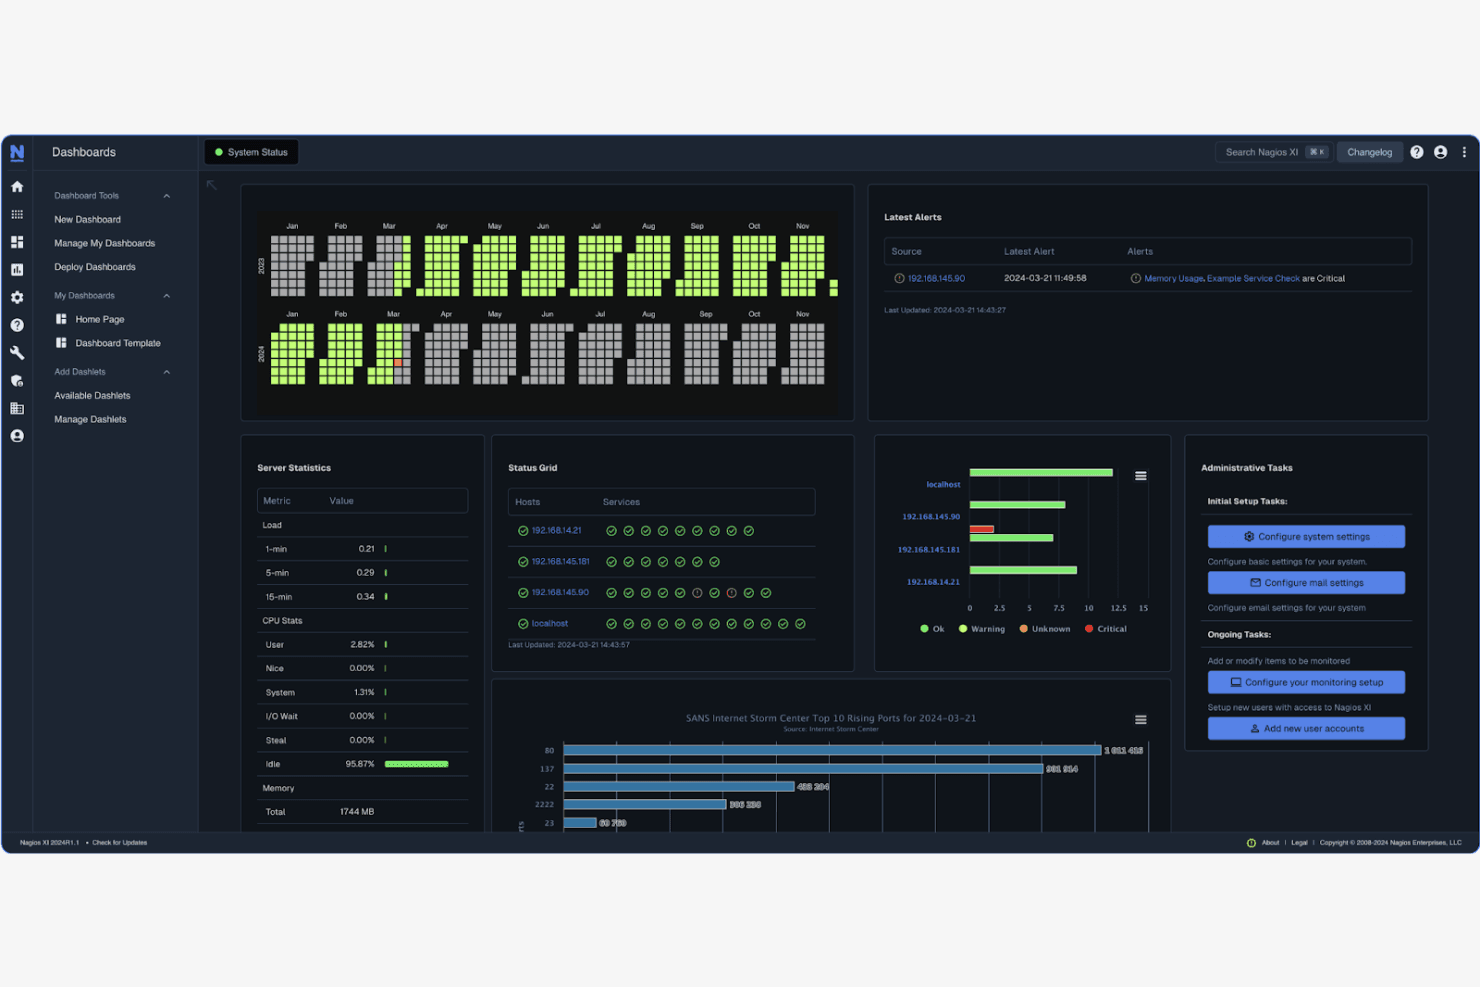
Die Nagios-XI-Übersichtsseite mit einer Zusammenfassung von Warnmeldungen, Host- und Servicestatus, Serverstatistiken und Verwaltungsaufgaben. Nagios XI ist eine selbst gehostete Plattform zur Infrastrukturüberwachung für Netzwerkadministratoren und IT-Betriebsteams, die eine detaillierte Kontrolle darüber benötigen, wie sie Server, Netzwerkgeräte und Anwendungen überwachen – ohne die Einschränkungen der Preisgestaltung pro Sensor, die bei PRTG gelten.
Für wen eignet sich Nagios XI am besten?
Nagios XI eignet sich besonders für Netzwerkadministratoren und Systemingenieure, die eine umfassende Kontrolle über eine selbst gehostete Überwachungsumgebung ohne sensorbezogene Lizenzbeschränkungen benötigen.
Warum ich Nagios XI ausgewählt habe
Ich habe Nagios XI als eines der besten Produkte ausgewählt, weil die Anpassungsmöglichkeiten für Übersichtsseiten weiter gehen als bei den meisten selbst gehosteten Alternativen. Jeder Benutzer erstellt seine eigene taktische Ansicht aus Elementen mit Diagrammen, Statusübersichten, Netzwerkkarten und Messanzeigen, und die Unternehmensedition ermöglicht es Administratoren, diese Übersichtsseiten an andere Benutzer zu verteilen oder mit einer zentralen Administratoransicht zu synchronisieren. Außerdem schätze ich, dass sich Übersichtsseiten regelmäßig als PDF-Anhänge per E-Mail versenden lassen. So können Beteiligte ohne manuellen Berichtsaufwand problemlos auf dem Laufenden gehalten werden.
Wichtige Funktionen von Nagios XI
- Lizenzierung pro Knoten: XI lizenziert nach überwachten Knoten statt nach Sensor oder Prüfung, ohne eine festgelegte Begrenzung der Anzahl von Prüfungen, die Sie pro Gerät ausführen können.
- Richtlinien zur Benachrichtigungseskalation: Sie können Eskalationen konfigurieren, sodass Warnmeldungen nach einer festgelegten Anzahl von Benachrichtigungen automatisch an eine andere Kontaktgruppe weitergeleitet werden.
- Zurücksetzen der Konfiguration: Administratoren können Konfigurationsfehler auf eine bekannte funktionierende Momentaufnahme zurücksetzen und so das Risiko verringern, dass eine Fehlkonfiguration die Überwachung außer Betrieb setzt.
- Kapazitätsplanung: Die Unternehmensedition visualisiert die voraussichtliche zukünftige Leistung und kann Sie benachrichtigen, wenn absehbar ist, dass Schwellenwerte überschritten werden.
Integrationen von Nagios XI
Nagios XI bietet dokumentierte Integrationen mit Microsoft Azure AD für SSO und Slack für Benachrichtigungen. Außerdem stellt es eine REST-API für benutzerdefinierte Integrationen bereit und unterstützt die Verbindung über SNMP-Traps.
Pros and Cons
Pros:
- Die Lizenzierung pro Gerät vermeidet Obergrenzen bei der Sensoranzahl
- Elemente der Übersichtsseite ermöglichen auf den jeweiligen Bediener zugeschnittene Infrastrukturansichten
- Verteilte Arbeitsknoten erweitern die Abdeckung für Prüfungen an entfernten Standorten
Cons:
- Die anfängliche Geräteintegration kann erheblichen Aufwand erfordern
- Berichtsvorlagen bieten nur begrenzte Flexibilität
Learn more about Nagios XI: Am besten für die Sichtbarkeit von Internetpfaden
- 15-tägige kostenlose Testversion + Demo verfügbar
- Preis auf Anfrage
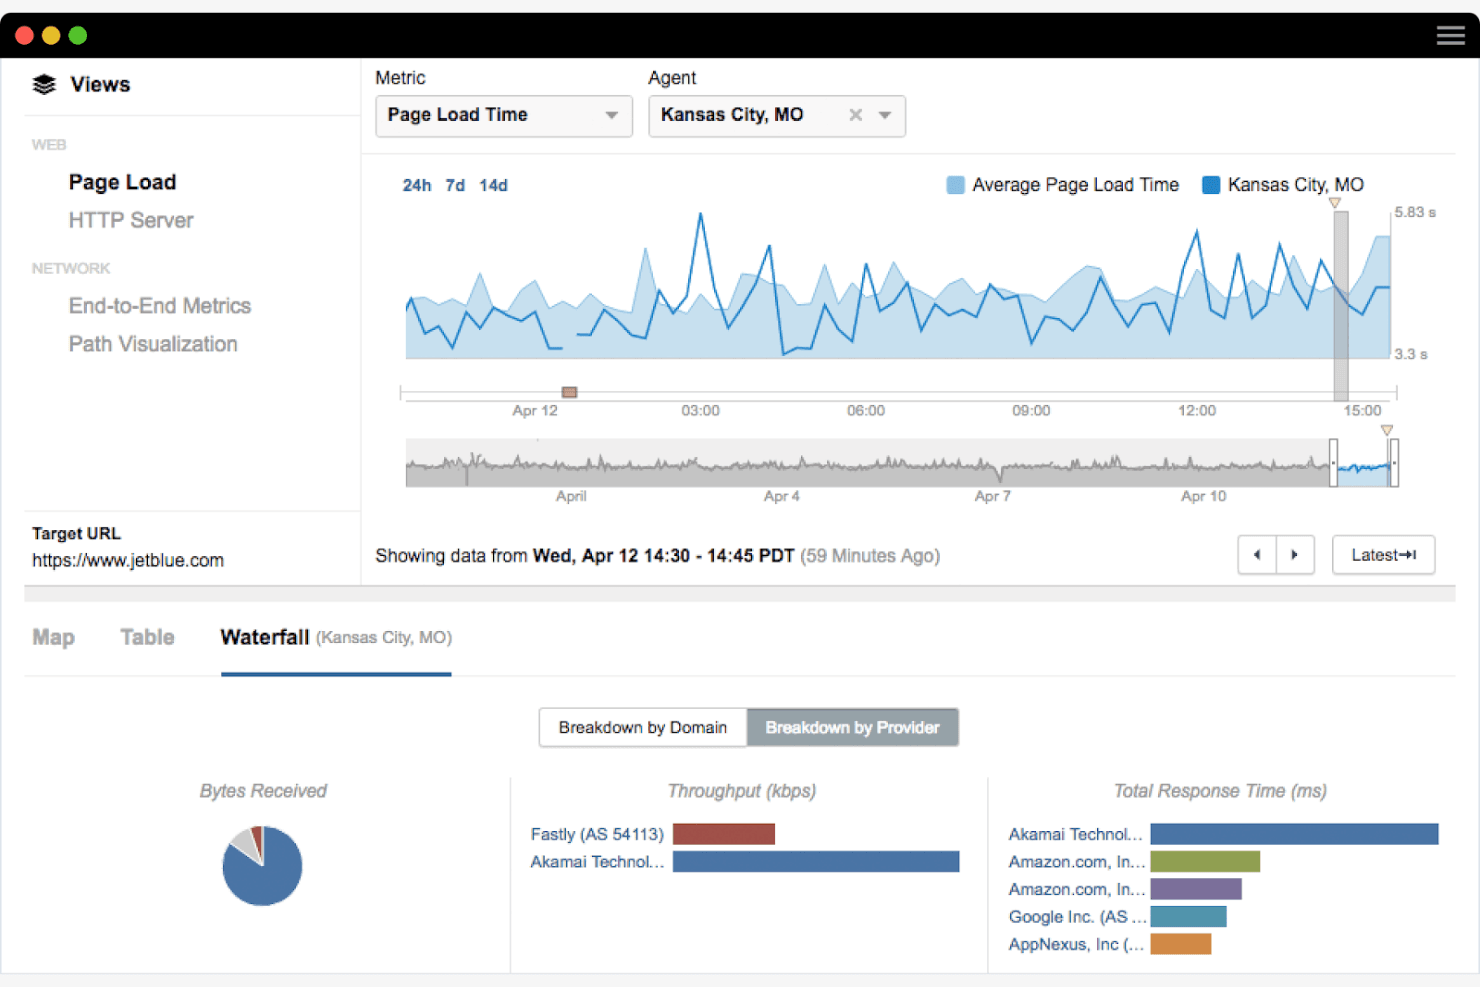
ThousandEyes-Ansicht zur Seitenladezeit, die Ladezeiten von einem Agenten in Kansas City mit Aufschlüsselungen auf Anbieterebene verfolgt. ThousandEyes ist eine von Cisco unterstützte Plattform zur Netzwerküberwachung, die IT-Teams eine durchgängige Transparenz darüber bietet, wie sich Datenverkehr durch das Internet, Cloud-Dienste und SaaS-Anwendungen bewegt – besonders nützlich, wenn Sie genau feststellen müssen, ob ein Leistungsproblem innerhalb Ihres Netzwerks oder irgendwo außerhalb liegt.
Für wen ist ThousandEyes am besten geeignet?
ThousandEyes eignet sich besonders für IT- und Netzwerkbetriebsteams in mittelständischen bis großen Unternehmen, die stark auf Cloud-Dienste, SaaS-Anwendungen oder verteilte Niederlassungsumgebungen angewiesen sind und bei denen die Transparenz über Internetpfade Priorität hat.
Warum ich ThousandEyes ausgewählt habe
Ich habe ThousandEyes als eine der besten Lösungen ausgewählt, weil es etwas leistet, was herkömmliche PRTG-Konfigurationen einfach nicht können: Es zeigt Ihnen genau, an welcher Stelle im Internetpfad ein Problem liegt. Wenn eine SaaS-Anwendung wie Salesforce Probleme macht, verfolgt die Visualisierung des Netzwerkpfads von ThousandEyes jeden Hop zwischen Ihren Benutzern und diesem Dienst, sodass ich sofort erkennen kann, ob die Ursache in meinem Netzwerk, bei einem Internetdienstanbieter oder in der Infrastruktur des Cloud-Anbieters liegt. Die Cloud-Agenten sind in 276 Städten in 71 Ländern verteilt und bieten mir eine Außenperspektive, die kein lokaler Sensor nachbilden kann.
Wichtige Funktionen von ThousandEyes
- Arten synthetischer Tests: Führt HTTP-, FTP-, Browser-, DNS-, BGP-Routen-, VoIP- und UCaaS-Überwachungstests über Cloud- und Unternehmensagenten aus.
- Überwachung auf SNMP-Geräteebene: Fragt Netzwerkgeräte mithilfe von SNMPv2c oder SNMPv3 über bereitgestellte Unternehmensagenten ab, mit manuellen oder geplanten Erkennungsscans.
- Mehrstufige API-Tests: Simuliert Backend-Interaktionen mit API-Endpunkten, validiert Antwortinhalte und unterstützt Zusicherungen zur Datenintegrität sowie Tests von Sonderfällen.
- Konfiguration von Alarmregeln: Unterstützt sowohl manuelle als auch adaptive Alarmregeln mit Benachrichtigungsweiterleitung an PagerDuty, Slack, ServiceNow oder benutzerdefinierte Webhooks.
Integrationen von ThousandEyes
ThousandEyes bietet dokumentierte Integrationen mit PagerDuty, Slack, ServiceNow, Splunk Observability Cloud, AppDynamics, OpenTelemetry und CyberArk Secrets Manager. Außerdem stehen eine REST-API und benutzerdefinierte Webhooks für zusätzliche Integrationen zur Verfügung.
Pros and Cons
Pros:
- Grenzt Fehler über externe Netzwerkpfade hinweg ein
- Macht Latenz, Paketverlust und Probleme bei der SaaS-Konnektivität sichtbar
- Vergleicht die Leistung von globalen Netzwerkstandorten aus
Cons:
- Begrenzte lokale Telemetrie für Switches und Server
- Die Geräteabfrage unterstützt weniger Protokolle als PRTG
Learn more about ThousandEyes: Am besten für einheitliches Endpunktmanagement geeignet
- 14-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $3.75/Monat
Visit WebsiteCustomer Rating:5/5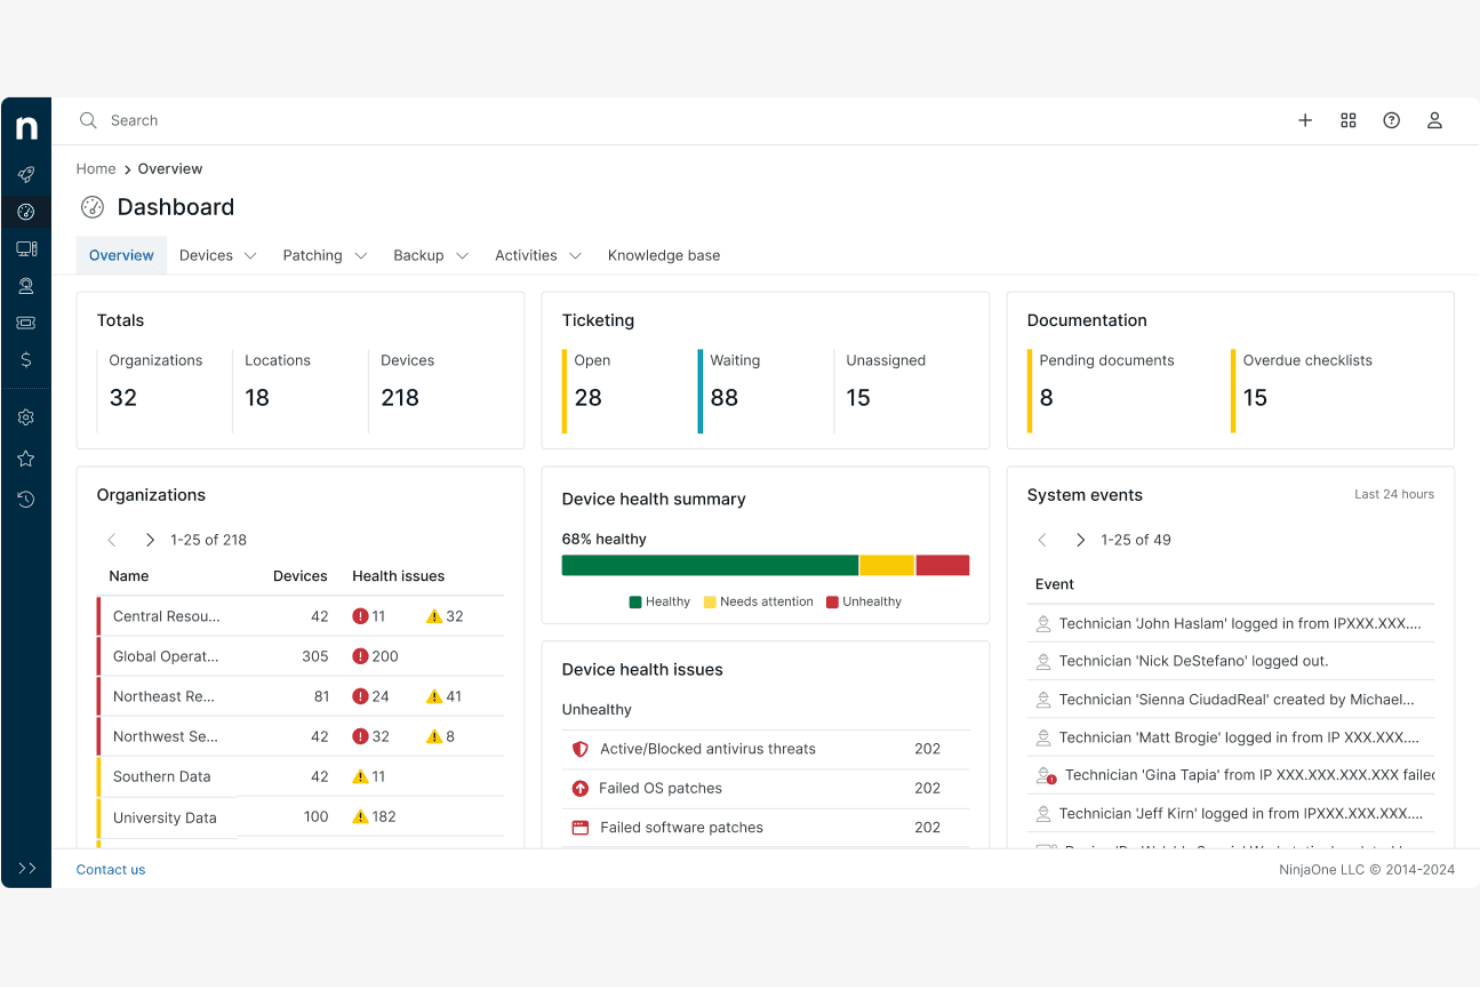
NinjaOnes Dashboard-Übersicht mit einer Zusammenfassung von Geräten, Organisationen, Tickets, Gerätezustand und Systemereignissen in einer Ansicht. NinjaOne RMM ist eine Plattform zur Überwachung von Endpunkten und Netzwerken, die für MSPs und IT-Teams entwickelt wurde, die eine zentrale Übersicht über Endpunkte, Netzwerkgeräte und Cloud-Infrastruktur benötigen – mit integrierten Funktionen für Patch-Management, Alarmierung und Fernverwaltung zur Reduzierung manueller Arbeit.
Für wen eignet sich NinjaOne am besten?
NinjaOne eignet sich besonders für MSP-Techniker und IT-Betriebsteams, die Endpunkte in mehreren Kundenumgebungen über eine zentrale Konsole verwalten.
Warum ich mich für NinjaOne entschieden habe
Ich habe NinjaOne als eine der besten Alternativen zu PRTG ausgewählt, weil es Endpunktüberwachung, die Sichtbarkeit von Netzwerkgeräten und automatisierte Behebung in einer einzigen Konsole vereint – genau das, was MSP-Techniker bei der Verwaltung mehrerer Kundenumgebungen benötigen. Mir gefällt, dass NMS direkt in das RMM integriert ist, sodass mein Team Router, Switches und Firewalls neben Windows-, macOS- und Linux-Endpunkten überwachen kann, ohne zwischen verschiedenen Tools wechseln zu müssen. Richtlinienbasierte Bedingungen ermöglichen es mir, Schwellenwerte für CPU, Arbeitsspeicher, Adapterverkehr und Ping-Latenz festzulegen und anschließend automatische Behebungsmaßnahmen auszulösen, wenn diese Schwellenwerte überschritten werden.
Wichtige Funktionen von NinjaOne
- Alarmierung über mehrere Kanäle: Konfigurieren Sie Benachrichtigungskanäle wie E-Mail, SMS, Slack, PagerDuty, Microsoft Teams und Webhooks, um Ihrem Team schwellenwertbasierte Warnmeldungen zuzustellen.
- Bedingungsbasierte automatische Behebung: Definieren Sie Skriptabläufe, die Endpunktprobleme wie beendete Dienste, offene Ports oder ausstehende Neustarts automatisch erkennen und beheben, ohne dass ein Techniker eingreifen muss.
- Unterstützung der Flow-Überwachung: Erfassen und analysieren Sie NetFlow-, JFlow-, sFlow- und IPFIX-Daten von unterstützten Netzwerkgeräten, um Einblick in Verkehrsmuster zu erhalten.
- Öffentliche API und Webhooks: Greifen Sie auf NinjaOne-Daten zu und lösen Sie mithilfe einer OAuth-2.0-API mit vollständiger Unterstützung der Methoden POST, GET, PATCH, DELETE und PUT programmgesteuert Aktionen aus.
NinjaOne-Integrationen
NinjaOne führt Integrationen mit ServiceNow, Autotask, ConnectWise Manage, HaloPSA, Slack, PagerDuty, Microsoft Azure und AWS auf. Die öffentliche OAuth-2.0-API und Webhooks unterstützen benutzerdefinierte Integrationen und Überwachungsabläufe.
Pros and Cons
Pros:
- Zentralisiert die Übersicht über Endpunkte und Netzwerke bei mehreren Kunden
- Richtlinienautomatisierung trägt dazu bei, den manuellen Aufwand für routinemäßige Reaktionen zu reduzieren
- Überwacht Flow-Daten zusammen mit Messwerten zum Gerätezustand
Cons:
- Die Netzwerküberwachung kann eine manuelle OID-Zuordnung erfordern
- Begrenzte dokumentierte Aufbewahrung von Leistungsdaten
Learn more about NinjaOne: Am besten für die automatische Netzwerkerkennung geeignet
- Kostenloser Tarif + kostenlose Demo verfügbar
- Preise auf Anfrage
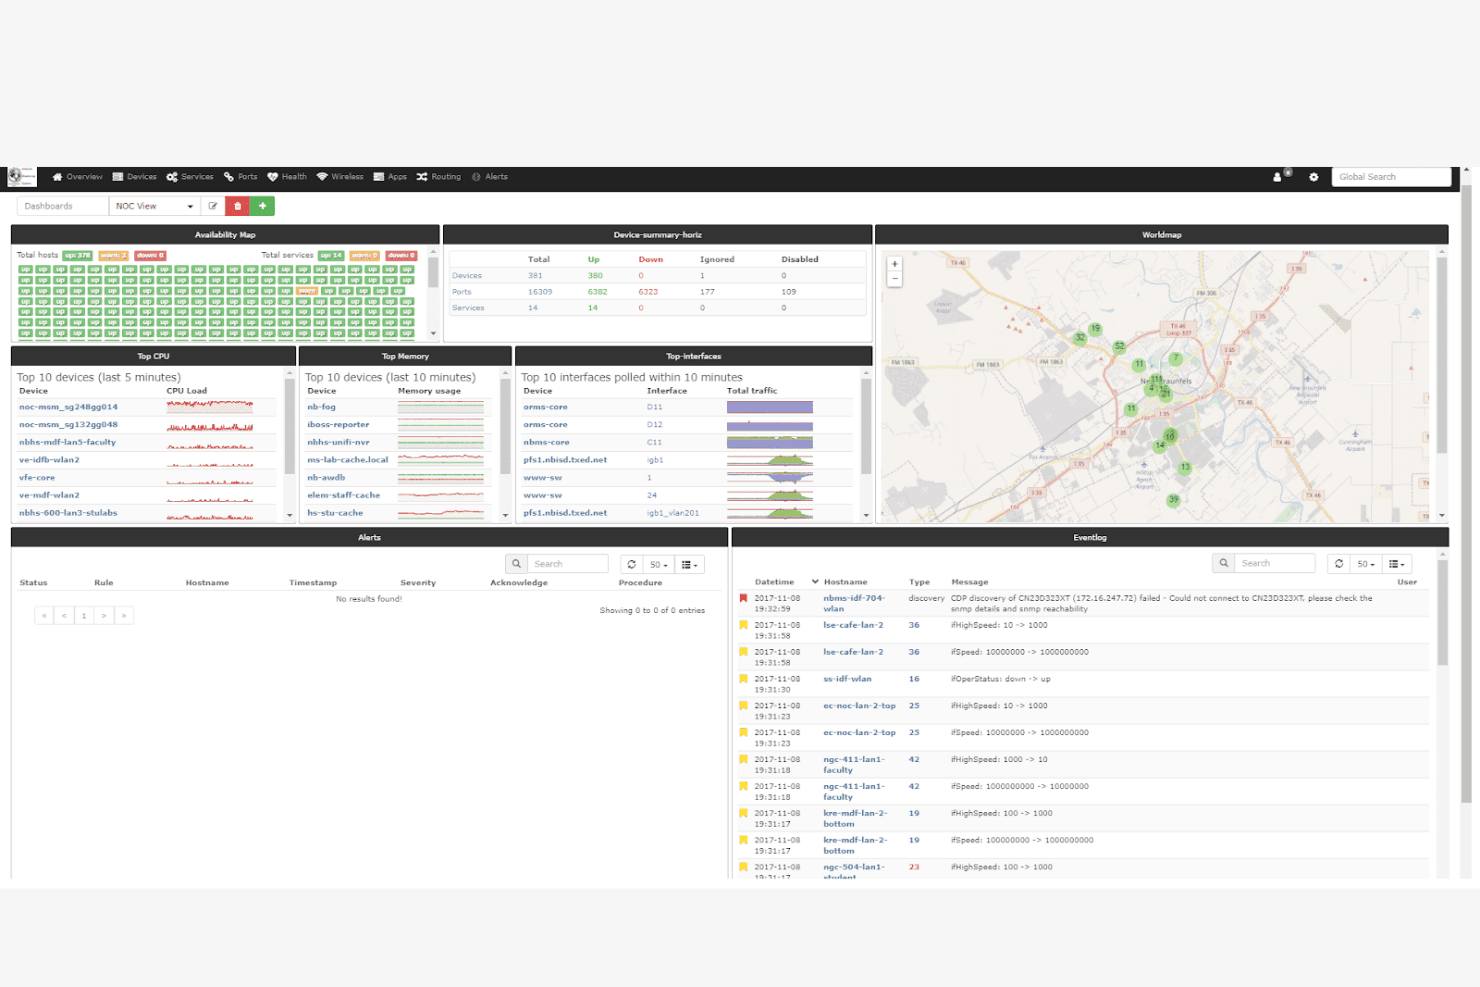
LibreNMS-NOC-Dashboard mit Geräteverfügbarkeit, der höchsten CPU- und Speicherauslastung, Schnittstellenverkehr und einem Live-Ereignisprotokoll. LibreNMS ist ein kostenloses, quelloffenes Netzwerküberwachungssystem, das sich an Systemingenieure und Netzwerkadministratoren richtet, die eine umfassende Geräteerkennung und Transparenz über ihre Infrastruktur benötigen, ohne die Kosten oder Lizenzbeschränkungen kommerzieller Tools in Kauf nehmen zu müssen.
Für wen eignet sich LibreNMS am besten?
LibreNMS eignet sich besonders für Systemingenieure und Netzwerkadministratoren, die eine umfassende Geräteerkennung und Transparenz über ihre Infrastruktur wünschen, ohne sensorbasierte Lizenzkosten tragen zu müssen.
Warum ich LibreNMS ausgewählt habe
Ich habe LibreNMS als eine der besten Lösungen ausgewählt, weil die automatische Netzwerkerkennung wirklich beeindruckend ist: Sie verwendet CDP, LLDP, OSPF, BGP, SNMP und ARP, um Geräte in Ihrem Netzwerk ohne manuelle Eingaben zu finden. Ich habe erlebt, wie Router, Switches und Zugriffspunkte kurz nach der Einrichtung schnell erkannt wurden – genau das benötigen Sie, wenn Sie ein durch Sensoren begrenztes Tool wie PRTG ersetzen. Die integrierten ICMP-Verfügbarkeitsprüfungen und die Anwendungsüberwachung für Dienste wie NGINX, MySQL und Docker runden die Transparenz ab, die Sie bereits ab dem ersten Tag erhalten.
Wichtige Funktionen von LibreNMS
- Anpassbare Alarmabläufe: Konfigurieren Sie mehrstufige Benachrichtigungsabläufe mit zeitgesteuerten Segmenten, die über Kanäle wie Slack, E-Mail und Telegram eskalieren, bis ein Alarm behoben oder bestätigt wurde.
- System zur Bandbreitenabrechnung: Erstellen Sie innerhalb der Plattform Abrechnungen für Netzwerkports auf Grundlage der tatsächlichen Nutzung oder des übertragenen Datenvolumens.
- Verteiltes Polling: Verteilen Sie Polling- und Erkennungsaufgaben auf mehrere Server, indem Sie Geräten mit zunehmender Netzwerkgröße Pollergruppen zuweisen.
- Anwendungsüberwachung über mehrere Protokolle: Erfassen Sie Anwendungsstatistiken von Diensten wie MySQL, NGINX, Docker und PostgreSQL über eine direkte Verbindung, SNMP extend oder den Check_MK-Agenten.
Integrationen von LibreNMS
Zu den dokumentierten Integrationen gehören NfSen, collectd, SmokePing, RANCID und Oxidized. LibreNMS stellt außerdem eine HTTP-API mit JSON- und PNG-Antworten für benutzerdefinierte Integrationen, die Geräteverwaltung, die Diagrammerstellung und den Datenabruf bereit.
Pros and Cons
Pros:
- Umfassende automatische Geräteerkennung
- Eskaliert Alarme über mehrere Benachrichtigungskanäle
- Überwacht Betriebszeit und Netzwerkleistung
Cons:
- Begrenzte native Berichtsfunktionen
- Verteiltes Polling ist nicht für entfernte Standorte ausgelegt
Learn more about LibreNMS: Am besten für die synthetische Netzwerküberwachung geeignet
- Kostenloser Tarif + 14-tägige Testversion + kostenlose Demo verfügbar
- Ab $249/Monat
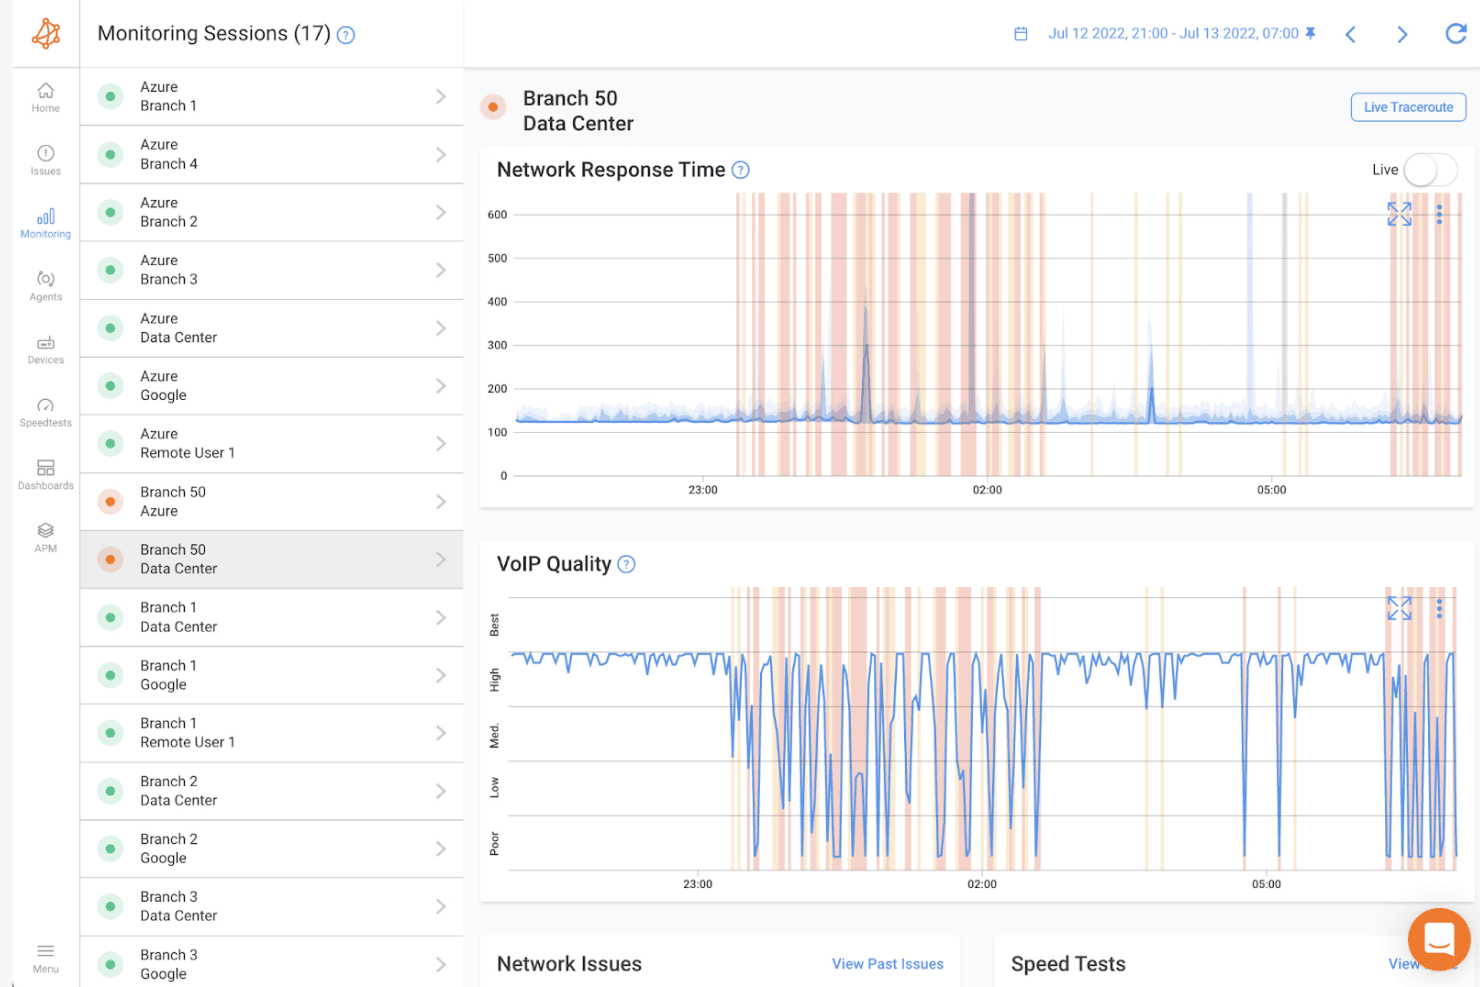
Das Überwachungsdashboard von Obkio verfolgt die Netzwerkantwortzeit und VoIP-Qualität über Sitzungen zwischen Zweigstellen und Rechenzentren. Obkio ist ein cloudbasiertes Tool zur Überwachung der Netzwerkleistung, das synthetischen Datenverkehr zwischen verteilten Agenten nutzt, um Netzwerkadministratoren und MSPs dabei zu unterstützen, Latenz, Paketverluste und Verbindungsprobleme in Umgebungen mit mehreren Standorten zu erkennen, zu diagnostizieren und zu beheben.
Für wen ist Obkio am besten geeignet?
Obkio eignet sich besonders für Netzwerkadministratoren und MSP-Techniker, die die Leistung in verteilten Umgebungen mit mehreren Standorten mithilfe synthetischen Datenverkehrs überwachen müssen.
Warum ich Obkio ausgewählt habe
Obkio hat sich seinen Platz auf meiner Auswahlliste verdient, weil es die Netzwerküberwachung anders angeht als PRTG: Statt Geräte von einem einzigen Punkt aus abzufragen, setzt es an jedem Standort Agenten ein und tauscht kontinuierlich alle 500 Millisekunden synthetischen UDP-Datenverkehr zwischen ihnen aus. Besonders gut gefällt mir das Akkorddiagramm, das eine Live-Ansicht der bidirektionalen Verbindungsqualität an allen Standorten bietet. Die Funktion Obkio Insights korreliert außerdem automatisch Leistungsdaten, SNMP-Metriken und Traceroute-Ergebnisse, um eine wahrscheinliche Grundursache aufzuzeigen, ohne dass eine manuelle Analyse erforderlich ist.
Wichtige Funktionen von Obkio
- Überwachung von SNMP-Geräten: Überwacht Router, Switches, Firewalls und WLAN-Zugriffspunkte und erfasst automatisch CPU-Auslastung, Bandbreitennutzung, Schnittstellenfehler und Verfügbarkeit über SNMP v1, v2c oder v3.
- Visuelle Traceroutes: Führt neben Überwachungssitzungen kontinuierliche, automatische Traceroutes aus und zeigt Latenz, Paketverluste und Jitter pro Hop in interaktiven, farbcodierten Pfadkarten an.
- Benachrichtigungen über mehrere Kanäle: Sendet schwellenwertbasierte Benachrichtigungen per E-Mail, Slack, Microsoft Teams, PagerDuty, ServiceNow oder HTTP-Webhooks mit konfigurierbaren Schweregraden und intelligenter Ereignisgruppierung.
- Geplante Berichte: Erstellt automatisch Excel-, PDF- oder JSON-Berichte nach einem täglichen, wöchentlichen oder monatlichen Zeitplan und sendet sie per E-Mail an Empfänger, die kein Obkio-Konto benötigen.
Obkio-Integrationen
Obkio bietet vier dokumentierte native Integrationen: Microsoft Teams, PagerDuty, ServiceNow und Slack. Außerdem werden HTTP-Webhooks für Benachrichtigungen und fertige Berichte unterstützt, eine allgemeine öffentliche API war jedoch nicht dokumentiert.
Pros and Cons
Pros:
- Bidirektionale Transparenz über verteilte Standorte hinweg
- Synthetische Sonden erkennen kurzzeitige WAN-Leistungseinbußen
- Rezensenten loben die übersichtlichen Visualisierungen des Netzwerkzustands
Cons:
- Die Geräteabfrage hängt von lokalen Collector-Agenten ab
- Rezensenten wünschen sich bessere Exporte historischer Berichte
Learn more about Obkio: 10Am besten für die automatisierte Netzwerkzuordnung geeignet
Auvik
- 14-tägige kostenlose Testversion + Demo verfügbar
- Preise auf Anfrage
Visit WebsiteCustomer Rating:4.7/5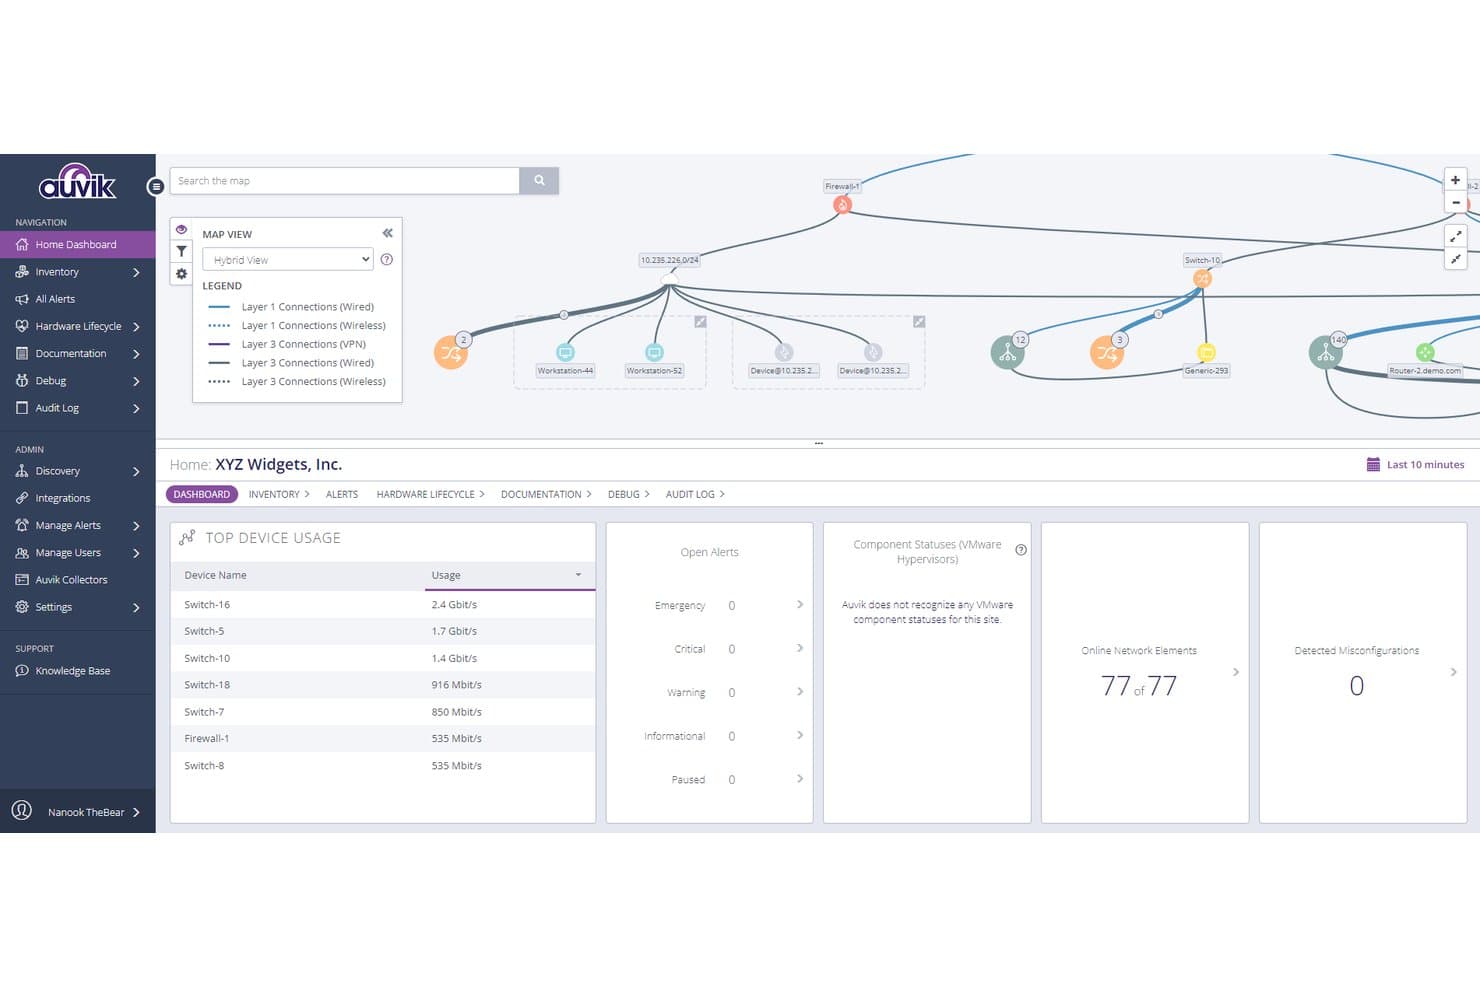
Die Startübersicht von Auvik kombiniert eine Echtzeit-Netzwerkkarte mit Übersichten zur Gerätenutzung und zu Warnmeldungen. Auvik ist eine cloudbasierte Netzwerkmanagement-Plattform für IT-Teams und MSPs, die eine automatisierte Geräteerkennung, Echtzeit-Topologiekarten und standortübergreifende Transparenz benötigen, ohne den manuellen Aufwand für die Dokumentation und Pflege von Netzwerkaufzeichnungen.
Für wen ist Auvik am besten geeignet?
Auvik eignet sich besonders für MSP-Techniker und Netzwerkadministratoren, die Umgebungen von Kunden an mehreren Standorten überwachen und dokumentieren müssen, ohne dafür stundenlang manuelle Erkennungs- und Kartierungsaufgaben durchzuführen.
Warum ich Auvik ausgewählt habe
Ich habe Auvik als eine der besten Lösungen ausgewählt, weil die automatisierte Netzwerkzuordnung zu den Bereichen gehört, in denen die Lösung die Funktionen von PRTG im Auslieferungszustand deutlich übertrifft. Sobald ein Datensammler bereitgestellt wird, erkennt Auvik jedes IP-verbundene Gerät und erstellt eine Echtzeit-Topologiekarte über die Ebenen 1, 2 und 3, die kontinuierlich aktualisiert wird, wenn sich Ihr Netzwerk verändert. Besonders gut gefällt mir, dass historische Topologie-Snapshots gespeichert werden, sodass ich genau sehen kann, wie das Netzwerk vor einem Vorfall ausgesehen hat.
Die wichtigsten Funktionen von Auvik
- Mehrschichtige Datenverkehrsanalyse: Auvik verarbeitet NetFlow v5/v9-, J-Flow-, IPFIX- und sFlow-Daten, um die meistkommunizierenden Geräte, bandbreitenintensive Anwendungen und Aufschlüsselungen des Datenverkehrs auf Protokollebene in Ihrem Netzwerk anzuzeigen.
- Automatisierte Konfigurationssicherungen: Auvik sichert Gerätekonfigurationen kontinuierlich, verfolgt den Versionsverlauf und ermöglicht den direkten Vergleich von Änderungen für Prüfungs- und Fehlerbehebungszwecke.
- Vorkonfigurierte Warnmeldungsbibliothek: Auvik wird mit über 50 sofort einsatzbereiten Warnmeldungen geliefert, die Gerätestatus, Schnittstellenauslastung, Paketfehler, Latenz, Jitter und Syslog-Ereignisse abdecken und anpassbare Schwellenwerte bieten.
- Integrationen mit MSP-Werkzeugen: Auvik lässt sich nativ mit ConnectWise Manage, Datto Autotask und IT Glue verbinden, um den Gerätebestand zu synchronisieren und Tickets in Kundenumgebungen bidirektional zu verwalten.
Auvik-Integrationen
Auvik bietet native Integrationen mit ConnectWise Manage, Datto Autotask, ServiceNow, PagerDuty, Slack, Microsoft Teams und Opsgenie. Außerdem stellt die Plattform APIs und Webhooks für benutzerdefinierte Integrationen bereit, einschließlich eines generischen eingehenden Webhooks.
Pros and Cons
Pros:
- Automatisierte Topologiekarten beschleunigen die Fehlerbehebung
- Zentralisierte Ansichten decken mehrere Kundenstandorte ab
- Der Konfigurationsverlauf hilft dabei, Netzwerkänderungen nachzuverfolgen
Cons:
- Einige Karten müssen manuell bereinigt werden
- Standardwarnmeldungen können zahlreiche Fehlalarme erzeugen
Learn more about Auvik:
Weitere PRTG-Alternativen
Hier sind einige weitere PRTG-Alternativen, die es nicht auf meine Auswahlliste geschafft haben, aber dennoch einen Blick wert sind:
Related Reviews
Wie ich PRTG-Alternativen bewerte
Ich teile meine Bewertung in zwei Ebenen auf: die grundlegenden Funktionen – wie die Überwachung von SNMP-Geräten und die Benachrichtigung bei Schwellenwertüberschreitungen –, die ein Tool als Ersatz für PRTG bieten muss, sowie die Unterscheidungsmerkmale, durch die sich die verschiedenen Optionen voneinander abheben.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jedes einzelne auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (ist in diesem Bereich hervorragend) für jede der unten aufgeführten Kernfunktionen. Anschließend rechne ich die Gesamtpunktzahl des Tools in einen Prozentsatz um. Jedes Tool muss eine Mindestgesamtpunktzahl von 65 % erreichen, um für die Aufnahme berücksichtigt zu werden.
- Überwachung von Netzwerkgeräten: Ich prüfe die Unterstützung mehrerer Protokolle (SNMP, ICMP, NetFlow) sowie vorgefertigte Vorlagen für Router, Switches, Firewalls und drahtlose Zugangspunkte großer Hersteller.
- Server- und Infrastrukturüberwachung: Jedes Tool sollte Betriebssystemmetriken unter Windows und Linux erfassen und außerdem VMware, Hyper-V, Container sowie Cloud-Anbieter wie AWS und Azure unterstützen.
- Warn- und Benachrichtigungssystem: Ich achte auf die Detailtiefe bei der Konfiguration von Schwellenwerten und auf die verfügbaren Optionen für die Zustellung über mehrere Kanäle, einschließlich der Frage, ob Warnmeldungen in Tools wie PagerDuty, Slack oder Teams integriert werden können.
- Dashboards und Visualisierung: Echtzeit-Dashboards mit Topologiekarten und Ansichten zum schrittweisen Drill-down sind hier wichtig, insbesondere für NOC-Teams, die den Status Hunderter Geräte auf einen Blick erfassen müssen.
- Historische Berichte und Analysen: Ich bewerte die Flexibilität bei der Datenaufbewahrung, die Erstellung von SLA- und Verfügbarkeitsberichten sowie die Frage, ob Trends für die Kapazitätsplanung problemlos für Präsentationen vor Stakeholdern abgerufen werden können.
- Automatische Erkennung und Skalierbarkeit: Das Tool sollte Assets automatisch scannen und zuordnen. Außerdem achte ich genau darauf, wie Lizenzierung und Architektur das Wachstum über verteilte Standorte hinweg bewältigen.
Sobald ich eine Liste von Tools zusammengestellt habe, die diese Kriterien erfüllen, prüfe ich, wodurch sich die einzelnen Plattformen voneinander abheben.
Unterscheidungsmerkmale (Was Anbieter voneinander abhebt)
So vergleiche ich die verschiedenen Anbieter:
Herausragende Funktionen
Die KI-gestützte Erkennung von Anomalien ist ein wichtiges Unterscheidungsmerkmal. Tools, die normale Datenverkehrsmuster als Basis erfassen und Abweichungen kennzeichnen, erkennen Probleme, die statische Schwellenwerte vollständig übersehen – etwa ein langsames Speicherleck auf einem Produktionsserver. Ich achte außerdem auf eine integrierte Protokollverwaltung, da die Korrelation von Syslog-Daten mit Leistungsmetriken während eines Ausfalls im Vergleich zum Wechsel zwischen separaten Tools viel Zeit spart. Für MSP-Teams entscheidet die Unterstützung mehrerer Mandanten mit Kundentrennung und Dashboards im eigenen Branding darüber, ob eine Plattform über Kundenumgebungen hinweg skalieren kann.
Mehr als nur Funktionen
Die Lizenzierungsstruktur ist besonders wichtig, wenn man von PRTG wechselt. Ich bewerte, ob sich die Preise beim Hinzufügen von Geräten vorhersehbar entwickeln – Modelle auf Sensorbasis können in einer Umgebung mit 1.000 Knoten schnell teuer werden. Die Flexibilität bei der Bereitstellung ist ein weiterer Faktor, den ich prüfe, da einige Teams lokale Installationen für vom Internet getrennte Netzwerke benötigen, während andere SaaS bevorzugen. Außerdem berücksichtige ich das Integrationsökosystem, insbesondere native Verbindungen mit ITSM-Tools wie ServiceNow oder Jira, da Überwachungsdaten besonders nützlich sind, wenn sie direkt in die Workflows für die Bearbeitung von Vorfällen einfließen.
Warum nach einer PRTG-Alternative suchen?
Obwohl PRTG eine gute Wahl für Überwachungstools ist, gibt es mehrere Gründe, warum manche Nutzer nach alternativen Lösungen suchen. Vielleicht suchen Sie nach einer PRTG-Alternative, weil …
- Sie eine bessere Skalierbarkeit für wachsende Netzwerke benötigen
- Sie nach mehr Anpassungsmöglichkeiten suchen
- Ihr Team eine einfachere Integration mit Cloud-Diensten benötigt
- Sie fortschrittlichere Analysefunktionen benötigen
- Sie sich eine intuitivere Benutzeroberfläche wünschen
Wenn Sie sich in einem dieser Punkte wiedererkennen, sind Sie hier richtig. Meine Liste enthält mehrere Optionen für Überwachungstools, die besser für Teams geeignet sind, die mit diesen Herausforderungen bei PRTG konfrontiert sind und nach alternativen, kostengünstigen Lösungen suchen.
Die wichtigsten Funktionen von PRTG
Hier sind einige der wichtigsten Funktionen von PRTG, damit Sie die Angebote alternativer Lösungen gegenüberstellen und vergleichen können:
- Netzwerk- und Serverüberwachung: Bietet eine Echtzeitüberwachung für Router, Switches, Firewalls und mehr und stellt sicher, dass Ihr Netzwerk reibungslos funktioniert.
- Bandbreitenüberwachung: Verfolgt die Bandbreitennutzung, damit Sie Netzwerkverkehrsmuster verstehen und Engpässe verhindern können.
- Anpassbare Dashboards: Bietet Echtzeitkarten und Dashboards, die Sie so anpassen können, dass sie die wichtigsten Kennzahlen für Ihr Team anzeigen.
- Warnungen und Benachrichtigungen: Sendet anpassbare Warnungen per E-Mail, SMS oder Push-Benachrichtigung, damit Sie über alle Probleme informiert bleiben.
- Verteilte Überwachung: Ermöglicht die zentrale Überwachung mehrerer entfernter Standorte und Rechenzentren und bietet einen vollständigen Überblick über Ihr gesamtes Netzwerk.
- Individuelle Berichte: Ermöglicht es Ihnen, maßgeschneiderte Berichte zu erstellen, um den Status Ihrer IT-Infrastruktur effektiv zu kommunizieren.
- SNMP-Überwachung: Unterstützt SNMP zur Überwachung verschiedener Netzwerkgeräte und gewährleistet die Kompatibilität mit einer Vielzahl von Hardware.
- WLAN-Überwachung: Überwacht WLAN-Netzwerke, um eine zuverlässige Verbindung und Leistung in Ihrer gesamten drahtlosen Infrastruktur sicherzustellen.