

Tools zur Überwachung von ML-Modellen erfassen, analysieren und melden Ihnen die Leistung und den Zustand von Machine-Learning-Modellen in der Produktion. Wenn Sie dafür verantwortlich sind, Modelle zuverlässig und präzise zu halten, wissen Sie, wie schnell Datenverschiebungen oder Vorhersagefehler Ihre Ergebnisse – oder Ihr Unternehmen – gefährden können. Diese Tools helfen Ihnen, Probleme schnell zu erkennen, die Ursachen zu verstehen und das Vertrauen in Ihre Lösungen aufrechtzuerhalten.
In diesem Leitfaden erhalten Sie einen klaren Vergleich der führenden Plattformen zur Überwachung von ML-Modellen, damit Sie die passende Lösung für die Arbeitsabläufe Ihres Teams, Ihre Compliance-Anforderungen und die Herausforderungen der Praxis finden.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle der Tools zur Überwachung von ML-Modellen
Diese Vergleichstabelle fasst die Preisinformationen für meine Auswahl der besten Tools zur Überwachung von ML-Modellen zusammen:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für integrierte, einheitliche Observability | 14-tägige kostenlose Testversion | Ab $15/Host/Monat (jährliche Abrechnung) | Website | |
| 2 | Am besten geeignet für agentenbasierte Evaluierung mittels Rückverfolgung | Kostenloser Plan verfügbar | Ab $39/Nutzer/Monat | Website | |
| 3 | Am besten für Automatisierung von Produktions-Workflows | 14-tägige kostenlose Testphase verfügbar | Preise auf Anfrage | Website | |
| 4 | Am besten für automatisierte Gesundheitsberichte | Kostenloser Tarif verfügbar | Ab $19/Monat | Website | |
| 5 | Am besten geeignet für sichere Unternehmensbereitstellung | Kostenloser Tarif verfügbar | Ab $0.204/Stunde | Website | |
| 6 | Am besten geeignet für skalierbare Log-Analysen | 14-tägige kostenlose Testversion verfügbar | Ab $0,42/GB | Website | |
| 7 | Am besten für Echtzeit-Leistungsüberwachung | Kostenloser Plan verfügbar | Ab $50/Monat | Website | |
| 8 | Am besten geeignet für erklärbare Überwachung | Kostenlose Demo verfügbar | Preise auf Anfrage | Website | |
| 9 | Am besten geeignet für End-to-End-Experiment-Tracking | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 10 | Am besten für Open-Source-Flexibilität | Kostenlos nutzbar | Kostenlos nutzbar | Website |


Tests der besten Tools zur Überwachung von ML-Modellen
\u003cspan data-slate-fragment=\u0022JTVCJTdCJTIyY2hpbGRyZW4lMjIlM0ElNUIlN0IlMjJ0ZXh0JTIyJTNBJTIyQmVsb3clMjBhcmUlMjBteSUyMGRldGFpbGVkJTIwc3VtbWFyaWVzJTIwb2YlMjB0aGUlMjBiZXN0JTIwTUwlMjBtb2RlbCUyMG1vbml0b3JpbmclMjB0b29scyUyMHRoYXQlMjBtYWRlJTIwaXQlMjBvbnRvJTIwbXklMjBzaG9ydGxpc3QuJTIwTXklMjByZXZpZXdzJTIwb2ZmZXIlMjBhJTIwZGV0YWlsZWQlMjBsb29rJTIwYXQlMjB0aGUlMjBmZWF0dXJlcyUyQyUyMGludGVncmF0aW9ucyUyQyUyMGFuZCUyMGJlc3QlMjB1c2UlMjBjYXNlcyUyMG9mJTIwZWFjaCUyMHBsYXRmb3JtJTIwdG8lMjBoZWxwJTIweW91JTIwZmluZCUyMHRoZSUyMGJlc3QlMjBvbmUlMjBmb3IlMjB5b3UuJTIyJTdEJTVEJTJDJTIydHlwZSUyMiUzQSUyMnAlMjIlMkMlMjJpZCUyMiUzQSUyMlJJTm1LR0JHVnUlMjIlN0QlNUQ=\u0022\u003eIm Folgenden finden Sie meine ausführlichen Zusammenfassungen der besten Tools zur Überwachung von ML-Modellen, die es in meine Auswahl geschafft haben. Meine Tests bieten einen detaillierten Einblick in die Funktionen, Integrationen und besten Anwendungsfälle jeder Plattform, damit Sie die beste Lösung für sich finden.\u003c/span\u003e
 Am besten für integrierte, einheitliche Observability
- 14-tägige kostenlose Testversion
- Ab $15/Host/Monat (jährliche Abrechnung)
Visit WebsiteCustomer Rating:4.5/5
Der Service-Katalog von Datadog bietet eine zentrale Ansicht für Service-Besitz, Metadaten, On-Call-Routing und Einrichtungsanleitungen für Engineering-Teams. Datadog ist eine Full-Stack-Observability-Plattform, die Infrastrukturüberwachung, APM und Log-Management auf ML-Workflows erweitert. Sie deckt LLM-Tracing, Anomalieerkennung und Observability von ML-Pipelines über Cloud-Umgebungen hinweg ab.
Für wen ist Datadog am besten geeignet?
Die Plattform eignet sich besonders für ML-Plattformarchitekten und Engineering-Teams in mittelgroßen bis großen Unternehmen, die Datadog bereits für Infrastruktur- und Anwendungsüberwachung nutzen.
Warum ich Datadog ausgewählt habe
Datadog verdient seinen Platz auf meiner Shortlist, weil kein anderes Tool die Gesundheit von ML-Pipelines so mit dem Rest des Stacks verbindet. Ich finde besonders gut, wie Watchdog RCA Anomalien automatisch über Services hinweg nachverfolgt – wenn ein Modell-Endpunkt abfällt, kann ich ihn in einer Ansicht mit Infrastrukturmetriken, Logs und Traces korrelieren. Agent Observability ermöglicht meinem Team Span-Level-Tracing durch jeden LLM-Aufruf, Tool-Aufruf und Retrieval-Schritt, ganz ohne manuelle Instrumentierung.
Wichtige Funktionen von Datadog
- Log-Management und Analyse: Sammeln und analysieren Sie umfangreiche Modell-Logs mit benutzerdefiniertem Parsing, Tagging und flexiblen Aufbewahrungsrichtlinien.
- Integration mit PyTorch und TorchServe: Überwachung von Deep-Learning-Inferenzpipelines direkt durch Plug-and-Play-Metrikerfassung.
- Benutzerdefinierte Metrikaufnahme: Prognosequalität und ML-Metriken in Datadog einspeisen zur Echtzeitüberwachung und historischen Analyse.
- Dynamisches Dashboarding: Erstellen Sie einheitliche Dashboards, um die ML-Modellleistung gemeinsam mit Infrastruktur- und Anwendungsdaten zu visualisieren.
Datadog-Integrationen
Datadog bietet über 1.000 native Integrationen, darunter Amazon SageMaker, Azure Machine Learning, Google Vertex AI, Databricks, PyTorch/TorchServe, OpenAI, Anthropic, Gemini, LangChain, CrewAI und LiteLLM. Für benutzerdefinierte Integrationen steht eine API zur Verfügung.
Pros and Cons
Pros:
- Verbindet ML-Metriken mit Full-Stack-Observability
- Unterstützt LLM- und Agent-Tracing nativ
- Integrierte Anomalieerkennung für Modellendpunkte
Cons:
- Keine integrierte Erkennung von Feature- oder Konzeptdrift
- Fehlende Tools für Fairness- und Bias-Überwachung
 Am besten geeignet für agentenbasierte Evaluierung mittels Rückverfolgung
- Kostenloser Plan verfügbar
- Ab $39/Nutzer/Monat
Visit WebsiteCustomer Rating:4.4/5
LangSmith bietet eine Monitor-Ansicht, mit der Nutzer LLM-Call-Traces nach Metadaten wie Modelltyp, Langserve-Version oder User Agent über individuell anpassbare Zeiträume gruppieren können. LangSmith ist eine Agenten-Engineering-Plattform, die auf LLM-Überwachbarkeit, evaluationsbasierte Rückverfolgung und Agentenbereitstellung ausgerichtet ist, mit Tools zur Überwachung von Kosten, Latenz und Ausgabequalität in produktiven KI-Systemen.
Für wen ist LangSmith am besten geeignet?
LangSmith eignet sich besonders für KI-Engineering-Teams, die LLM-basierte Anwendungen und Agenten in der Produktion entwickeln und weiterentwickeln.
Warum habe ich LangSmith ausgewählt?
Ich habe LangSmith als eines der besten Systeme ausgewählt, weil der evaluationsbasierte Workflow mit Rückverfolgung wirklich einzigartig in diesem Bereich ist. Jeder Schritt, den ein Agent ausführt, von Tool-Aufrufen bis zur Delegation an Unteragenten, wird vollständig erfasst und ist vollständig überprüfbar. Ich verwende die LLM-as-judge-Evaluatoren, um strukturierte Qualitätsprüfungen direkt anhand realer Produktions-Traces durchzuführen, und der Insights Agent clustert fehlgeschlagene Durchläufe automatisch, sodass wiederkehrende Muster schnell erkannt werden können.
Wichtige Funktionen von LangSmith
- Überwachungs-Dashboards: Überwachen Sie das Verhalten von Agenten, Kosten, Latenz und Fehlermetriken in Echtzeit über ein zentrales Dashboard.
- Agent Studio Debugging: Analysieren und modifizieren Sie die Ausführungsabläufe von Agenten mit Breakpoints und Visualisierungstools während der Fehlersuche.
- Bereitstellungs-Registry: Verwalten Sie Agentenversionen mit Rollbacks, zentraler Registrierung und Unterstützung für Bereitstellungen in verschiedenen Umgebungen.
- Unternehmensweite Steuerung: Nutzen Sie SSO, RBAC, Audit-Logs und Multi-Regionen-Bereitstellungsoptionen, um die Sicherheitsanforderungen von Organisationen zu erfüllen.
LangSmith-Integrationen
LangSmith bietet native Integrationen mit den Frameworks LangChain und LangGraph und unterstützt Protokolle wie A2A, MCP und Agent Protocol. Eine API steht für benutzerdefinierte Integrationen zur Verfügung.
Pros and Cons
Pros:
- Spezialisiert auf LLM- und Agenten-Workflows
- Erfasst und visualisiert detaillierte Ausführungsspuren
- Ermöglicht LLM-as-judge-Bewertung auf realen Daten
Cons:
- Keine Erkennung von Daten- oder Konzeptdrift
- Fehlende Metriken für traditionelle ML-Modelle
Learn more about LangChain LangSmith: Am besten für Automatisierung von Produktions-Workflows
- 14-tägige kostenlose Testphase verfügbar
- Preise auf Anfrage

DataRobot zeigt ein Service-Health-Dashboard, das Bereitstellungslatenz, Durchsatz, Fehlerraten und die Gesamtzahl der Prognoseanfragen im Zeitverlauf verfolgt. DataRobot ist eine Plattform zur KI-Überwachung, die prädiktive, generative und agentenbasierte KI-Modelle in der Produktion überwacht. Sie umfasst Drift-Erkennung, Leistungsüberwachung, Prognoseprotokollierung, Ursachenanalyse und automatisiertes Retraining in Cloud-, On-Premises- und hybriden Umgebungen.
Für wen ist DataRobot am besten geeignet?
DataRobot eignet sich besonders für Enterprise-MLOps- und Plattform-Engineering-Teams, die groß angelegte KI-Einsätze in regulierten Branchen wie Banken, Gesundheitswesen und Versicherungen verwalten.
Warum habe ich mich für DataRobot entschieden?
Ich habe DataRobot als eines der besten Tools gewählt, weil die automatisierten Trainings- und Challenger-Politiken die manuellen Schritte eliminieren, die die Reaktion auf Produktionsvorfälle verlangsamen. Wenn ein Drift erkannt wird, vergleicht DataRobot ein Challenger-Modell mit dem aktuellen Produktionsmodell und kann es ohne einen manuellen Bereitstellungszyklus austauschen. Außerdem gefällt mir, dass man einen bestimmten Agenten pausieren, umleiten oder zurücksetzen kann, ohne den Rest des eingesetzten Systems zu stören.
Wichtige Funktionen von DataRobot
- Vereinheitlichte Agentenbeobachtbarkeit: Überwachen Sie prädiktive, generative und agentenbasierte KI-Modelle in unterschiedlichen Umgebungen von einem einzigen Dashboard aus.
- LLM- und Vektor-Datenbankmetriken: Verfolgen Sie LLM-spezifische Signale wie Kosten, Toxizität und Verzerrung sowie die Leistung von Vektor-Datenbanken.
- End-to-End-KI-Herkunftsverfolgung: Erfassen und organisieren Sie den gesamten Lebenszyklus von Modellen, Prompts und Vektor-DB-Assets für Transparenz und Prüfpfade.
- Integrierte Schutzmechanismen und Moderation: Nutzen Sie Prompt-Moderation, Verhinderung von PII-Lecks und NVIDIA NeMo Guardrails für KI-Sicherheit und Compliance.
DataRobot Integrationen
DataRobot bietet native Integrationen mit Snowflake, BigQuery, Databricks, AzureML, SAP, AWS und Salesforce und unterstützt OpenTelemetry zum Einlesen externer Agenten-Telemetrie. Für individuelle Integrationen steht eine API zur Verfügung.
Pros and Cons
Pros:
- Automatisches Retraining und Austausch von Challenger-Modellen
- Überwacht prädiktive, generative und agentenbasierte KI-Assets
- Integrierte Schutzmechanismen für Bias- und PII-Erkennung
Cons:
- Preisgestaltung ist nicht transparent
- Für einige erweiterte Einstellungen ist Unterstützung durch den Anbieter erforderlich
Learn more about DataRobot: Am besten für automatisierte Gesundheitsberichte
- Kostenloser Tarif verfügbar
- Ab $19/Monat
Visit WebsiteCustomer Rating:4.7/5
SuperWise bietet ein Modal zur Applikationserstellung, in dem Nutzer zwischen den Anwendungstypen 'AI-Assistant Retrieval' und 'Advanced Agent' wählen können. SuperWise ist eine Plattform für ML-Überwachung und Governance, die die Leistung von Produktionsmodellen überwacht, Daten- und Konzeptdrift erkennt, Vorhersagen im großen Maßstab protokolliert und automatisierte Anomalieerkennung mit Echtzeit-Dashboards für traditionelle ML-Modelle, LLMs und KI-Agenten bietet.
Für wen ist SuperWise am besten geeignet?
SuperWise ist besonders geeignet für MLOps- und KI-Engineering-Teams in Unternehmen aus regulierten Branchen, die eine prüfungsfähige, governance-konforme Modellüberwachung im großen Maßstab benötigen.
Warum habe ich SuperWise ausgewählt
SuperWise verdient seinen Platz als einer der Besten auf meiner Liste wegen seiner automatisierten Gesundheitsberichte für Produktionsmodelle. Besonders gut gefällt mir die adaptive Anomalieerkennung, die sowohl Saisonalität als auch statistisches Rauschen berücksichtigt, statt bei jeder kleinen Metrikschwankung einen Alarm auszulösen. In Kombination mit der AI Consensus-Bewertung verknüpft das Tool automatisch Input-Drift mit Leistungseinbußen, sodass mein Team für jeden Alarm direkt eine Ursachenanalyse erhält.
SuperWise Schlüsselfunktionen
- Echtzeit-Betriebstelemetrie: Überwachen Sie Latenz, Durchsatz und Fehlerraten mehrerer Modelle mit Dashboard-Aktualisierungen in unter einer Sekunde.
- Individuelle Governance-Dashboards: Erstellen Sie visuelle Berichte mit Diagrammen, Tabellen und Verteilungen für alle überwachten Kennzahlen.
- Flexible Integrationsunterstützung: Verbinden Sie Datenquellen und Benachrichtigungskanäle wie Slack, Datadog, PagerDuty, REST API und mehr.
- Audit-Trail-Protokollierung: Zeichnen Sie jede Modellentscheidung und Interaktion mit vollständigem Kontext für Compliance- und Vorfallbewertungen auf.
SuperWise Integrationen
SuperWise bietet native Integrationen mit Slack, PagerDuty, OpsGenie, Datadog, New Relic, Grafana, AWS S3, BigQuery und Snowflake. Eine API und ein Python SDK stehen für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Echtzeit-Dashboards aktualisieren Latenz und Durchsatz sofort
- Automatisierte Anomalieerkennung passt sich der Saisonalität an
- KI-gestützte Ursachenanalyse für Alarme
Cons:
- Eingeschränkte Tools zur Analyse von Fairness und Verzerrungen
- Vollständige Datenaufbewahrung erfordert einen Enterprise-Plan
Learn more about SuperWise: Am besten geeignet für sichere Unternehmensbereitstellung
- Kostenloser Tarif verfügbar
- Ab $0.204/Stunde

Amazon SageMaker Studio bietet ein Home-Dashboard mit Schnellaktionen, vorgefertigten Lösungen und einem linken Navigationsbereich zur Verwaltung von ML-Workflows. Amazon SageMaker ist eine End-to-End-ML-Plattform von AWS, die das Modelltraining, die Bereitstellung und die Überwachung im Produktivbetrieb abdeckt – einschließlich Erkennung von Datenabweichungen, Verfolgung von Verzerrungen, Merkmalsattribution und Protokollierung von Leistungskennzahlen mithilfe von SageMaker Model Monitor.
Für wen ist Amazon SageMaker am besten geeignet?
Es eignet sich besonders für ML-Plattformteams in Unternehmen, die große Workloads in regulierten Branchen betreiben, in denen AWS-native Sicherheitskontrollen zwingend erforderlich sind.
Warum ich Amazon SageMaker gewählt habe
Ich habe Amazon SageMaker ausgewählt, weil es Überwachungsdaten in regulierten Umgebungen besonders absichert. Die Data Capture-Funktion verschlüsselt Vorhersageeingaben und -ausgaben im Ruhezustand mithilfe von KMS, leitet den Datenverkehr über VPC-Endpunkte und speichert alles in einem von Ihnen definierten S3-Bucket mit fein abgestuften Zugriffskontrollen. Die Überwachung mit CloudTrail erfasst die gesamte Model Monitor-Pipeline und protokolliert jeden API-Aufruf im Zusammenhang mit Ihrer Überwachungskonfiguration – genau das, was InfoSec-Teams verlangen, bevor sie eine ML-Produktionseinführung genehmigen.
Schlüssel-Funktionen von Amazon SageMaker
- Modelldashboard: Bietet zentralisierte Sicht auf bereitgestellte Modelle, Endpunkte und Überwachungsstatus in einer Oberfläche.
- Überwachung von Drift und Verzerrung: Nutzt integrierte Regeln, um auf Datenabweichungen, Qualitätsprobleme, Verzerrungen und Änderungen der Merkmalsattribution zu prüfen.
- CloudWatch-Integration: Streamt detaillierte Überwachungsmetriken und Protokolle zu Amazon CloudWatch für individuelle Dashboards und Alarmierung.
- Flexible Konfiguration der Datenerfassung: Ermöglicht die Auswahl von Stichprobenraten, Nutzlasttypen und Speicheroptionen für erfasste Eingaben und Vorhersagen.
Amazon SageMaker Integrationen
Amazon SageMaker bietet native Integrationen mit Amazon S3, Amazon Redshift, Amazon CloudWatch, AWS CloudTrail, Amazon EventBridge und unterstützt eine tiefe Anbindung im gesamten AWS-Ökosystem. Eine API steht für benutzerdefinierte Integrationen zur Verfügung. KI-Apps aus dem Marketplace umfassen Lakera Guard, Comet, DeepChecks und Fiddler.
Pros and Cons
Pros:
- Datenerfassung unterstützt verschlüsselte Nutzlasten in S3
- Zentralisierte Ansicht für Modellüberwachungsstatus
- Überwacht Verzerrung und Merkmalsattributions-Drift
Cons:
- Ursachenanalyse erfordert manuelle Notebook-Arbeit
- Drift-Benachrichtigungen sind nicht ML-basiert oder automatisiert
Learn more about Amazon SageMaker: Am besten geeignet für skalierbare Log-Analysen
- 14-tägige kostenlose Testversion verfügbar
- Ab $0,42/GB
Visit WebsiteCustomer Rating:4.8/5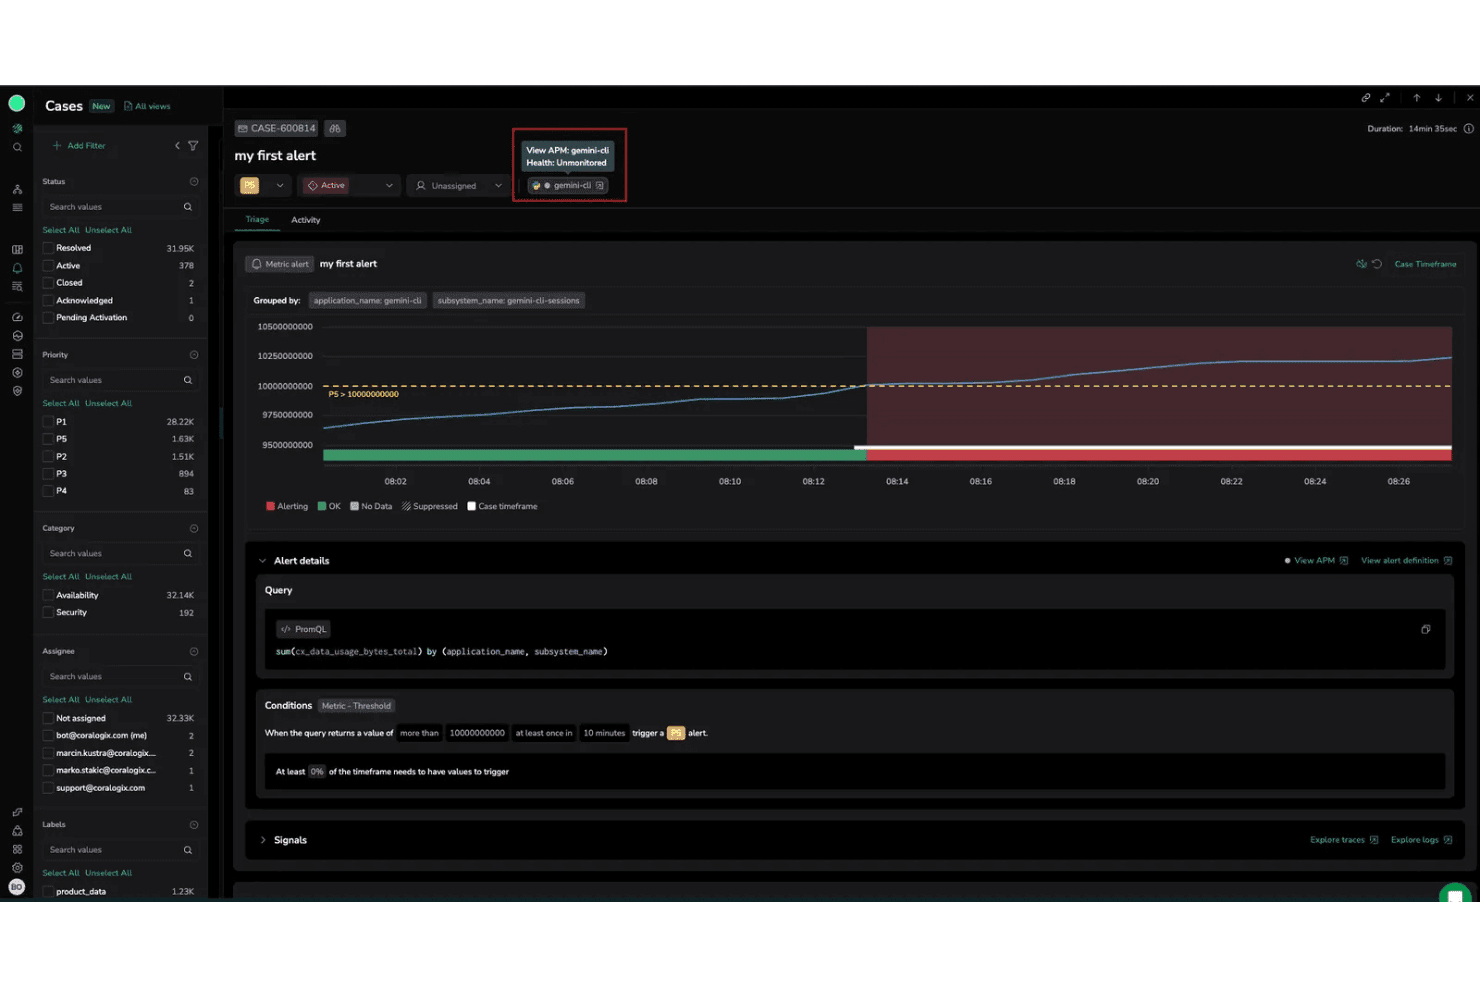
Coralogix bietet ein Case-Management-Dashboard mit Überwachung von Metrik-Alarmerkennungen, Unterstützung für PromQL-Abfragen und Visualisierung des APM-Gesundheitsstatus. Coralogix ist eine Full-Stack-Observability-Plattform, die Echtzeit-Log-Analysen, verteiltes Tracing, Metriküberwachung und KI/LLM-Observability durch eine In-Stream-Verarbeitungsarchitektur kombiniert, welche Daten vor der Speicherung analysiert.
Für wen ist Coralogix am besten geeignet?
Coralogix eignet sich besonders für DevOps- und SRE-Teams in mittelständischen bis großen Unternehmen, die Cloud-native- oder Kubernetes-basierte Infrastrukturen im großen Maßstab betreiben.
Warum ich Coralogix ausgewählt habe
Coralogix hat es auf meine Auswahlliste geschafft, weil seine In-Stream-Log-Verarbeitungspipeline Vorhersage-Logs in einem Umfang bewältigt, den die meisten Tools nicht erreichen. Statt alles im Voraus zu indexieren, werden Daten analysiert, sobald sie einlaufen. So kann ich Anomalieerkennung auf Modell-Inferenz-Logs in weniger als fünf Sekunden durchführen. Die Loggregation-Funktion gruppiert Log-Muster automatisch, so dass ungewöhnliche Vorhersageausgaben erscheinen, ohne dass für jede Alarm-Schwelle manuell Konfigurationen erforderlich sind.
Coralogix Hauptfunktionen
- AI Center Dashboards: Ansicht von LLM-Evaluator-Ergebnissen, Token-Nutzung, Latenzen und Nutzerfeedback in zentralisierten Dashboards.
- Sitzungs-Explorer: Vollständige Nutzer- und Vorhersageabläufe vom Eingabe- bis zum Ausgabeprozess zurückverfolgen, um Modelle besser analysieren zu können.
- Kostenüberwachung für KI-Workloads: Token-Verbrauch überwachen und unerwartete Nutzungsmuster in Echtzeit aufzeigen.
- Guardrails für KI-Antworten: Durchsetzung von Sicherheits- und Qualitätsrichtlinien für Prompts und LLM-Antworten, um Prompt-Injections und Lecks sensibler Daten zu verhindern.
Coralogix-Integrationen
Coralogix bietet native Integrationen mit AWS CloudWatch, AWS S3, Amazon Bedrock, Azure Cognitive Services, Kubernetes, Jenkins, GitHub, GitLab, PagerDuty und Slack, sowie eine API für kundenspezifische Integrationen.
Pros and Cons
Pros:
- Skalierbare Log-Analysen für hochvolumige Modelldaten
- Echtzeit-Anomalieerkennung bei Vorhersage-Logs
- LLM-Observability mit Unterstützung für benutzerdefinierte Evaluatoren
Cons:
- Keine klassische ML-Modelldrift-Erkennung
- Fehlendes integriertes Monitoring für ML-Metriken
Learn more about Coralogix: Am besten für Echtzeit-Leistungsüberwachung
- Kostenloser Plan verfügbar
- Ab $50/Monat
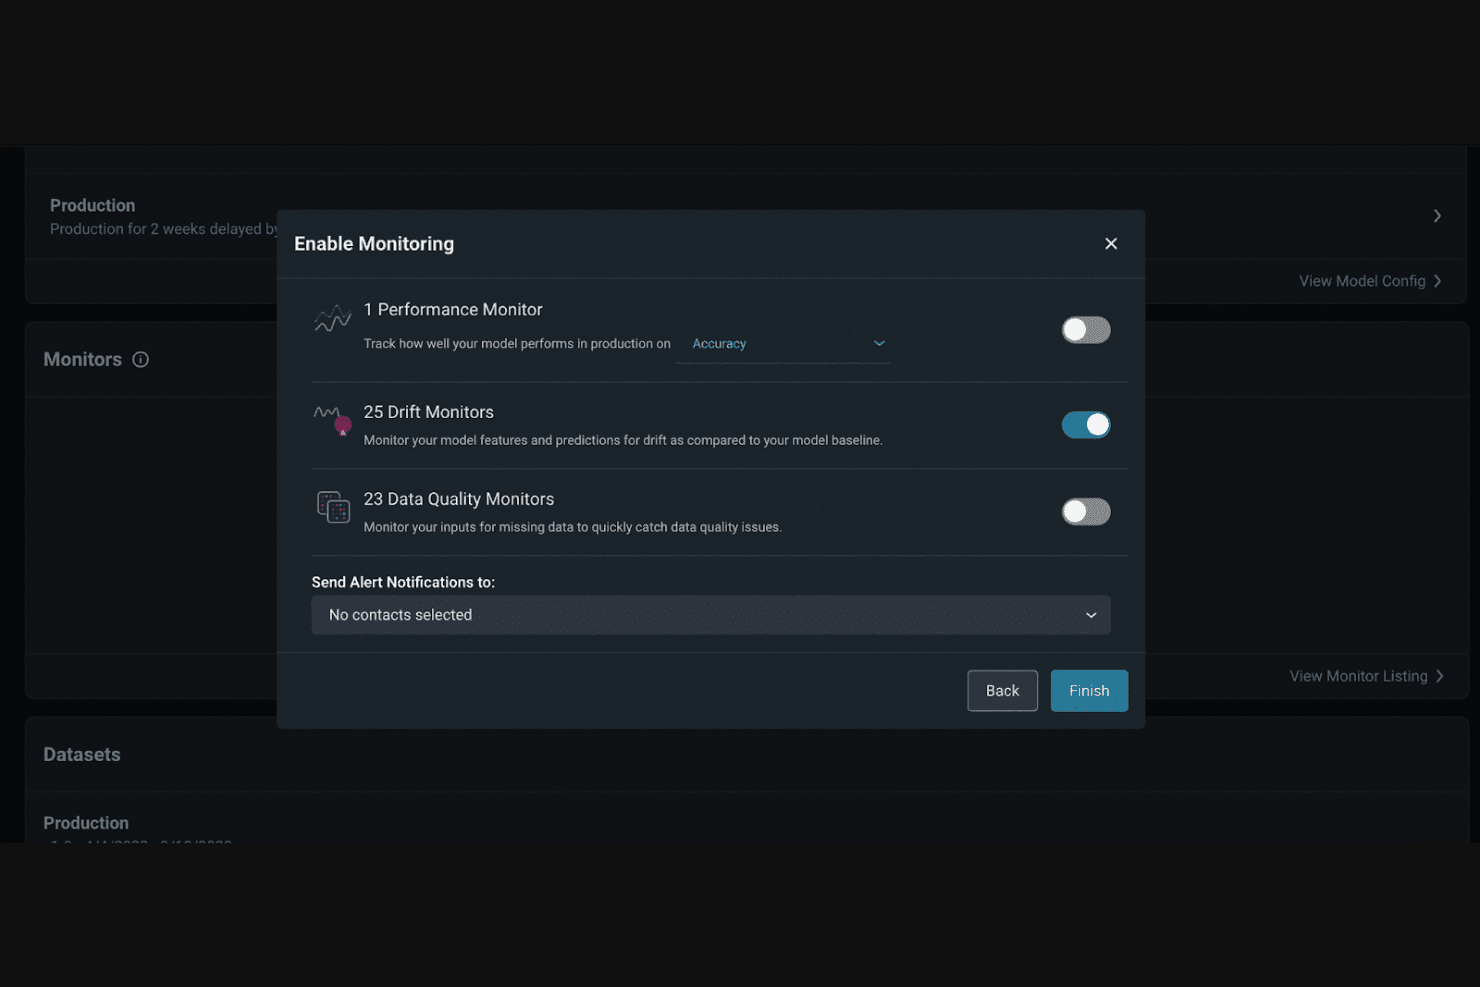
Arize AI bietet einen Dialog "Überwachung aktivieren", in dem Nutzer Kontrollen für Performance-, Drift- und Datenqualitätsüberwachung durch Umschaltoptionen konfigurieren können. Arize AI ist eine ML-Überwachungsplattform, die Echtzeit-Überwachung von Modellen, Drift-Erkennung, Prognose-Protokollierung und Ursachenanalyse sowohl für klassische ML-Modelle als auch für LLM-basierte Anwendungen kombiniert.
Für wen ist Arize AI am besten geeignet?
Arize AI eignet sich für MLOps-Engineers und ML-Plattform-Teams in mittelgroßen bis großen Unternehmen, die produktive ML-Modelle gemeinsam mit LLM-basierten Anwendungen betreiben.
Warum ich Arize AI gewählt habe
Arize AI verdient seinen Platz auf meiner Auswahlliste, weil es das Modellverhalten auf Span-Ebene in Echtzeit so tief nachverfolgt. Mir gefällt, wie die Plattform jeden Input, Output und jeden Zwischenschritt im Ausführungspfad eines Modells erfasst, sodass ich bei Leistungsabfällen genau nachvollziehen kann, welcher Span das Problem verursacht hat, statt zu raten. Signal identifiziert automatisch Fehlermodi und generiert Pull Requests zu deren Behebung – ein Automatisierungsgrad, den ich sonst nirgendwo in diesem Bereich gesehen habe.
Arize AI Hauptfunktionen
- Drift-Erkennung und Analyse: Erkennt Daten-, Feature- und Embedding-Drift über Produktions- und Trainingsverteilungen hinweg.
- Alyx AI Engineering-Agent: Bietet einen KI-gestützten Assistenten zur Fehlerbehebung bei Modellproblemen.
- Workflows für ML und LLM-Evaluation: Unterstützt sowohl klassische ML-Modelle als auch LLM-basierte Anwendungen für Tracing und Überwachung.
- OpenTelemetry-native Integration: Ermöglicht standardisierte Datenerfassung und nahtlose Interoperabilität mit bestehenden MLOps-Stacks.
Arize AI Integrationen
Arize AI bietet native Integrationen mit Pandas, Apache Spark, AWS SageMaker, MLflow, Flask, Ray, Apache Kafka, OpenAI, Anthropic, Google und Amazon Bedrock. Für individuelle Integrationen steht eine API zur Verfügung.
Pros and Cons
Pros:
- Echtzeit-Zeitraumüberwachung der Modell-Performance auf Span-Ebene
- Automatisierte Identifikation von Fehlerursachen
- Native Unterstützung sowohl für ML- als auch LLM-Workloads
Cons:
- Standard-Alerts können zu übermäßiger Benachrichtigung führen
- Komplexer Einrichtungsprozess bei Unternehmenseinführungen
Learn more about Arize AI: Am besten geeignet für erklärbare Überwachung
- Kostenlose Demo verfügbar
- Preise auf Anfrage
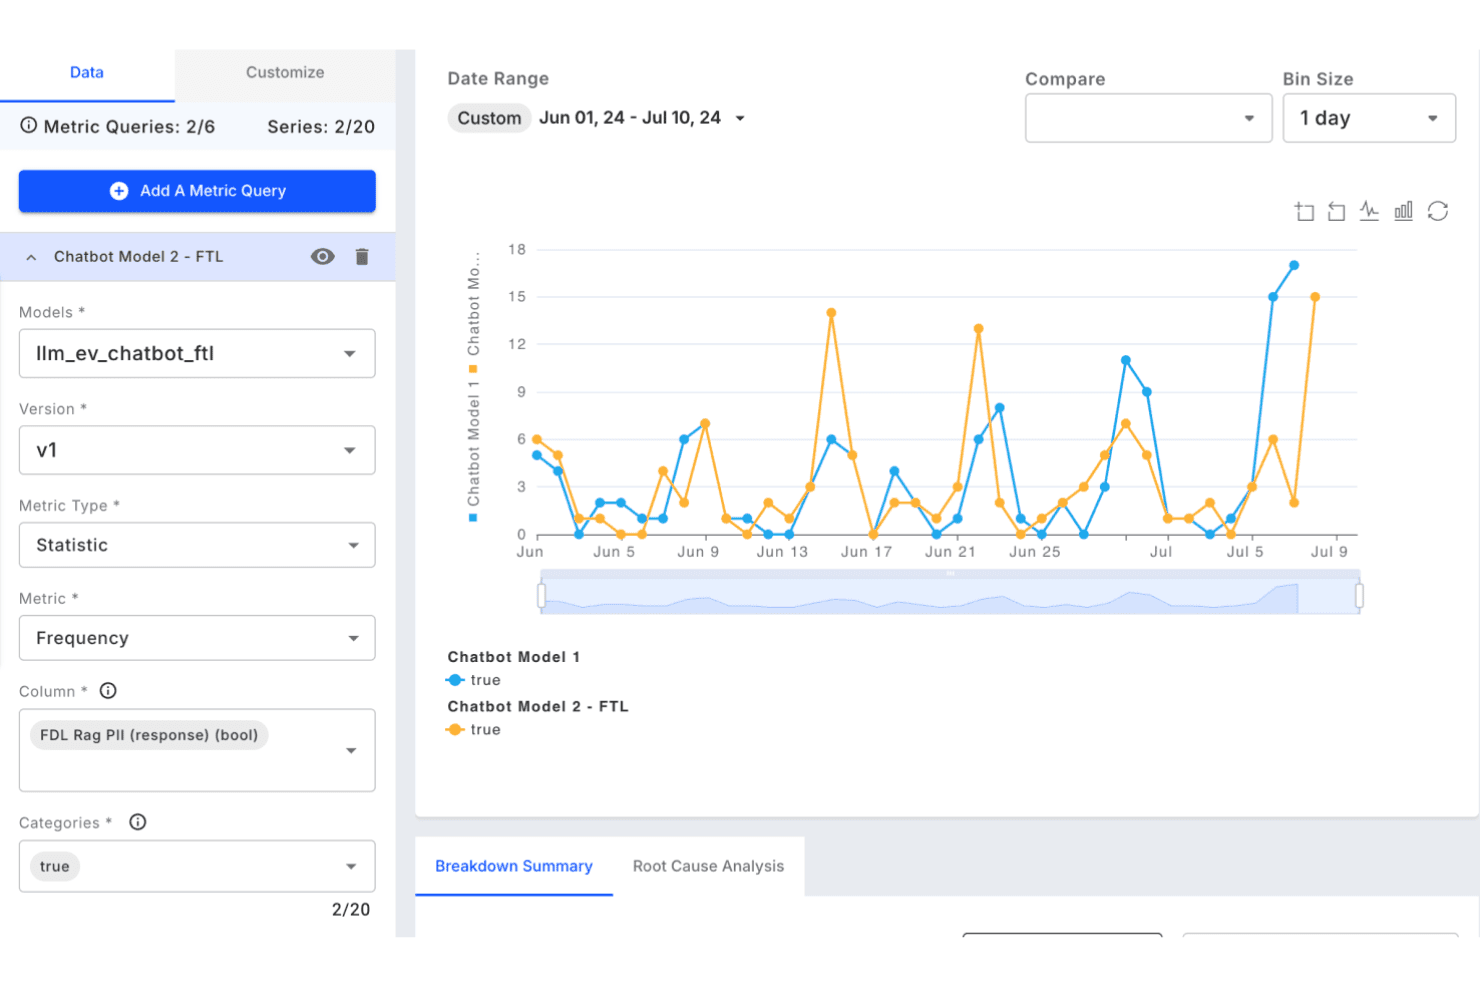
Fiddler AI bietet ein Dashboard zur Metriküberwachung, das die Häufigkeit der PII-Erkennung über zwei Chatbot-Modelle hinweg in einem benutzerdefinierten Datumsbereich mit Tabs für Aufschlüsselung und Ursachenanalyse verfolgt. Fiddler AI ist eine KI-Beobachtungsplattform, die ML-Modellüberwachung, Erkennung von Abweichungen, Erklärbarkeit (XAI), Fairness-Tracking und Ursachenanalyse für Produktionsmodelle kombiniert.
Für wen ist Fiddler AI am besten geeignet?
Fiddler AI eignet sich für ML-Teams in Unternehmen regulierter Branchen – wie Finanzdienstleistungen, Gesundheitswesen und Behörden –, in denen Modelltransparenz und Compliance unverzichtbar sind.
Warum ich Fiddler AI gewählt habe
Ich habe Fiddler AI als eines der besten ausgewählt, weil seine Erklärbarkeitsfunktionen tiefer gehen als bei jedem anderen Überwachungstool, das ich verwendet habe. Anstatt nur eine generische Warnung anzuzeigen, ermöglicht Fiddler es mir, mithilfe von SHAP-Werten die Merkmalsattribution zu analysieren, nach Kohorten zu segmentieren und Leistungsabfälle auf bestimmte Eingabeverteilungen zurückzuführen. Dieses Diagnoseniveau unterscheidet es von Tools, die nur melden, wenn etwas nicht stimmt – nicht aber, warum.
Fiddler AI Hauptfunktionen
- Echtzeit-Benachrichtigungen: Konfigurierbare Alarme einrichten, die bei Leistungs-, Drift- oder Datenqualitätsmetriken in Echtzeit ausgelöst werden.
- Artefaktüberwachung: Überwachen Sie nicht nur Modelle, sondern auch Modell-Artefakte, um Konsistenz und Reproduzierbarkeit über verschiedene Umgebungen hinweg zu gewährleisten.
- Verzögerte Ground-Truth-Verarbeitung: Unterstützt asynchrone Aktualisierungen der Ground-Truth-Labels, sodass Sie Live-Prognosen überwachen und bewerten können.
- Rollenbasierte Zugriffskontrolle (RBAC): Legen Sie Benutzerrechte und Zugriffsebenen fest, um die Datenintegrität und -sicherheit zu erhalten.
Fiddler AI Integrationen
Fiddler AI bietet native Integrationen mit Amazon SageMaker, Google Cloud Vertex AI, Databricks, Datadog, PagerDuty, Slack, OpenAI, Anthropic, NVIDIA NIM und Okta. Eine API steht für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Tiefe Erklärbarkeit mit SHAP-basierten Einblicken
- Echtzeit-Erkennung von Anomalien und Drift
- Ursachenanalyse für Vorfälle in der Produktion
Cons:
- Begrenzte öffentliche Nutzercommunity
- Komplexe Einrichtung bei Vor-Ort-Bereitstellungen
Learn more about Fiddler AI: Am besten geeignet für End-to-End-Experiment-Tracking
- Kostenlose Demo verfügbar
- Preis auf Anfrage
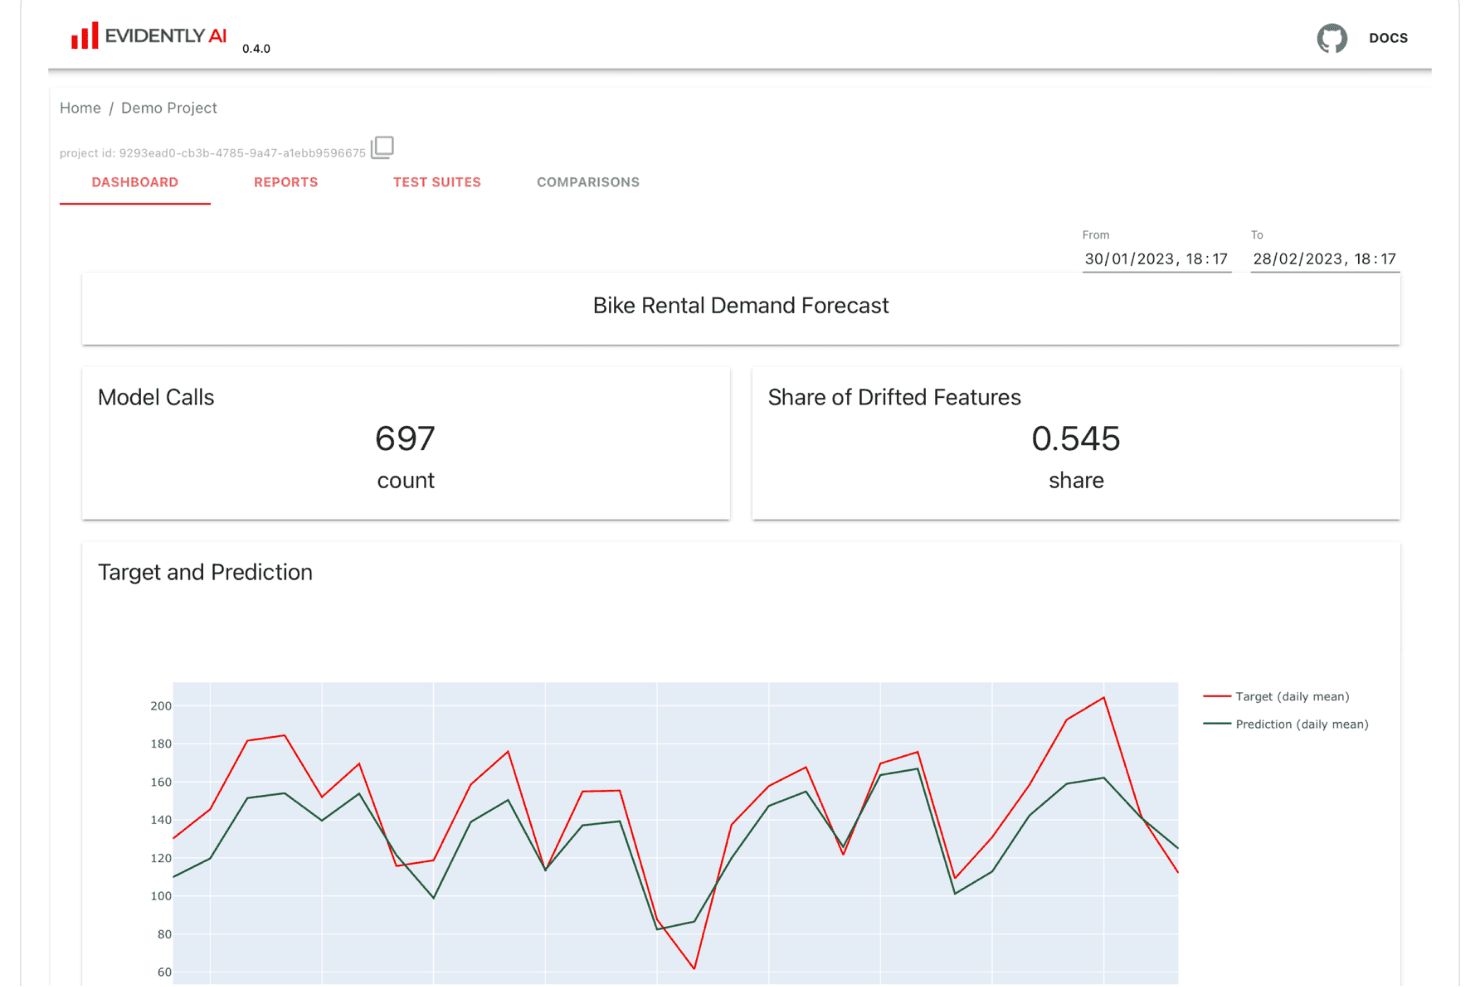
Evidently AI bietet ein Modellüberwachungs-Dashboard für die Vorhersage der Nachfrage nach Fahrradvermietungen, das Modellaufrufe, abgewichene Merkmale und Ziel-vs.-Vorhersage-Trends anzeigt — im Gegensatz zum Experiment-Tracking-Fokus von MLflow. MLflow ist eine Open-Source-MLOps-Plattform, die Experiment-Tracking, Modellregister, LLM-Tracing, KI-Monitoring in der Produktion und Evaluierung über den gesamten Lebenszyklus von ML- und generativen KI-Anwendungen abdeckt.
Für wen ist MLflow am besten geeignet?
MLflow eignet sich hervorragend für MLOps-Engineers und ML-Plattform-Teams, die eine framework-unabhängige, selbst gehostete Grundlage zur Verwaltung des gesamten Modell-Lebenszyklus benötigen.
Warum habe ich MLflow ausgewählt?
MLflow bekommt einen Platz auf meiner Auswahlliste, weil kein anderes Open-Source-Tool das Experiment-Tracking so eng mit dem Produktionsmonitoring verknüpft. Ich finde es großartig, dass jeder Modelllauf, der während der Experimentierphase protokolliert wird, in das Modellregister und direkt in den KI-Monitoring-Stack übergeht. In der Praxis bedeutet das, dass ich eine Qualitätsverschlechterung in der Produktion auf ein bestimmtes Training zurückverfolgen, die protokollierten Evaluierungsmetriken vergleichen und genau herausfinden kann, wo die Abweichung begonnen hat.
MLflow Hauptfunktionen
- KI-Monitoring-Stack: Erfassen Sie Traces, Nutzerkontext und menschliches Feedback für LLM- und Agentenmodelle.
- Vereinheitlichtes API-Gateway: Leiten und verwalten Sie LLM-Anfragen mit Kostenüberwachung, Ratenbegrenzung und Fallback-Unterstützung.
- Integrierte Qualitätsdrift-Erkennung: Produktions-Traces werden kontinuierlich von LLM-Judges bewertet und die Stichprobenziehung der Traces wird automatisiert.
- Sicherheitschecks für die Produktion: Überwachen Sie Prompt Injection, PII-Leckagen und Jailbreak-Angriffe mit integrierten Scorern.
MLflow-Integrationen
MLflow bietet native Integrationen mit OpenTelemetry, LangChain, OpenAI, PyTorch, TensorFlow, scikit-learn, AWS SageMaker, Azure ML und Databricks und stellt eine API für eigene Integrationen zur Verfügung.
Pros and Cons
Pros:
- Starkes Experiment-Tracking mit Modellherkunft
- LLM-Anwendungstrace-Erfassung und -Bewertung
- Framework-unabhängig für ML- und LLM-Stacks
Cons:
- Keine integrierte statistische tabellarische Drift-Erkennung
- Benachrichtigungen erfordern externes Setup oder gemanagten Service
Learn more about MLflow:

Evidently AI zeigt ein Dashboard zur Nachfrageprognose für Fahrradverleih mit Modellaufrufzahlen, Anteilen driftender Merkmale und Trendlinien für Zielwert vs. Vorhersage. Evidently AI ist ein Open-Source-Beobachtungsframework für maschinelles Lernen, das Drift-Erkennung, Leistungsüberwachung, LLM-Evaluierung und automatisierte Testsuiten für Produktionsmodelle abdeckt.
Für wen ist Evidently AI am besten geeignet?
MLOps-Ingenieure und Teams für ML-Plattformen, die eine code-basierte, selbstgehostete Monitoring-Lösung mit voller Kontrolle über ihren Observability-Stack benötigen.
Warum ich Evidently AI ausgewählt habe
Evidently AI hat seinen Platz auf meiner Auswahlliste verdient, da die Apache 2.0-Lizenz bedeutet, dass ich die gesamte Monitoring-Infrastruktur besitze, ohne an einen Anbieter gebunden zu sein. Besonders gefällt mir die modulare Architektur: Ich kann eigenständige Drift-Berichte mit statistischen Tests wie Kolmogorov-Smirnov und PSI ausführen oder komplette Testsuiten bauen, die direkt in CI/CD-Pipelines eingebunden werden, ohne dass ich eine kostenpflichtige SaaS-Stufe benötige. Die selbstgehostete Enterprise-Option bietet dieselbe Flexibilität für Teams mit strengen Anforderungen an die Datenresidenz.
Wichtige Funktionen von Evidently AI
- Interaktives Monitoring-Dashboard: Visualisiert Produktionsdaten, Modellmetriken und Performance-Trends mit anpassbaren Diagrammen.
- LLM- und RAG-Evaluierung: Unterstützt integrierte Bewertung und Überwachung von großen Sprachmodellen und Retrieval-Augmented Generation Systemen.
- Automatisierte Testsuiten: Ermöglicht die Erstellung von Bestehen-/Nichtbestehen-Qualitätsprüfungen für Modelle in CI/CD- und Produktionsabläufen.
- Trace Viewer: Ermöglicht die detaillierte Untersuchung einzelner Prognoseverläufe zur Fehleranalyse und Verhaltensanalyse von Modellen.
Evidently AI Integrationen
Evidently AI bietet native Integrationen mit MLflow, Apache Airflow, Grafana und Prometheus. Eine API steht für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Open-Source und vollständig selbst-hostbar
- Tiefgehende statistische Driftüberwachungsoptionen
- Modulare Testsuiten für automatisierte Modellprüfungen
Cons:
- Native Alarmierungsfunktionen erfordern kostenpflichtige Stufe
- Keine eingebauten Visualisierungen zur Modelleinsicht
Learn more about Evidently AI:
Weitere Tools zur Überwachung von ML-Modellen
\u003cspan data-slate-fragment=\u0022JTVCJTdCJTIyY2hpbGRyZW4lMjIlM0ElNUIlN0IlMjJ0ZXh0JTIyJTNBJTIySGVyZSUyMGFyZSUyMHNvbWUlMjBhZGRpdGlvbmFsJTIwTUwlMjBtb2RlbCUyMG1vbml0b3JpbmclMjB0b29scyUyMG9wdGlvbnMlMjB0aGF0JTIwZGlkbiVFMiU4MCU5OXQlMjBtYWtlJTIwaXQlMjBvbnRvJTIwbXklMjBzaG9ydGxpc3QlMkMlMjBidXQlMjBhcmUlMjBzdGlsbCUyMHdvcnRoJTIwY2hlY2tpbmclMjBvdXQlM0ElMjIlN0QlNUQlMkMlMjJ0eXBlJTIyJTNBJTIycCUyMiUyQyUyMmlkJTIyJTNBJTIyUzc1bk1FVVhtZSUyMiU3RCU1RA==\u0022\u003eHier finden Sie einige weitere Optionen für Tools zur Überwachung von ML-Modellen, die es nicht in meine Auswahl geschafft haben, aber dennoch einen Blick wert sind:\u003c/span\u003e
- 11DeepchecksAm besten geeignet für individuell anpassbare Validierungssuiten
- 12ArthurAm besten geeignet für die Bewertung von Verzerrungen und Fairness
- 13GrafanaAm besten für individuelle Visualisierungs-Dashboards
- 14QualdoAm besten für die Korrelation von Unternehmenskennzahlen
- 15TrueFoundryAm besten für die schnelle Integration in Deployment-Pipelines
- 16JFrog MLAm besten geeignet für das Lebenszyklusmanagement von Artefakten
- 17BraintrustAm besten geeignet für die Zusammenarbeit im Data-Science-Workflow
Wie ich ML-Modellüberwachungs-Tools bewerte
Ich unterteile meine Bewertung in grundlegende Kriterien – wie Drifterkennung und Prognoseprotokollierung – sowie differenzierende Faktoren, die zeigen, welche Tools sich im Produktionsumfeld besonders auszeichnen.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Wenn ich Tools für meine Liste auswähle, bewerte ich jedes auf einer Skala von 0 (Funktion nicht vorhanden) bis 5 (überzeugend in diesem Bereich) hinsichtlich jeder unten aufgeführten Kernfunktionalität. Danach rechne ich die Gesamtpunktzahl in einen Prozentsatz um. Jedes Tool muss mindestens eine Gesamtnote von 65% erreichen, um berücksichtigt zu werden.
- Drifterkennung: Ich prüfe, ob das Tool Daten-, Feature- und Konzeptdrift erkennt – mittels statistischer Verfahren wie PSI oder KS-Tests – insbesondere, wenn Produktionseingaben sich über Monate hinweg schleichend verändern.
- Leistungsüberwachung: Die Verfolgung von Genauigkeit, Präzision, Recall oder RMSE im Zeitverlauf ist ausschlaggebend. Ich achte darauf, dass das Tool auch verzögert eintreffende Ground-Truth-Labels unterstützt, wie sie häufig bei Betrugs- oder Abwanderungsmodellen vorkommen.
- Prognoseprotokollierung: Ich bewerte, wie gut das Tool Modell-Eingaben und -Ausgaben im großen Maßstab erfassen und speichern kann, da in Hochdurchsatzumgebungen täglich Millionen von Vorhersagen entstehen.
- Alarmierung & Anomalieerkennung: Gute Alarmfunktionen gehen über statische Schwellenwerte hinaus. Ich suche nach konfigurierbaren Benachrichtigungen, die bei ungewöhnlichen Ausgabemustern beispielweise an Slack, PagerDuty oder per E-Mail weitergeleitet werden.
- Ursachenanalyse: Wenn die Kennzahlen eines Modells abfallen, sind Analysen auf Segment-Ebene gefragt. Ich prüfe, ob das Tool Kohorten-Slicing und Erklärbarkeitsfunktionen wie SHAP- oder LIME-Attributionsmethoden bietet.
- ML-Framework-Integrationen: Ich kontrolliere die SDK-Unterstützung für Frameworks wie TensorFlow, PyTorch und scikit-learn sowie Konnektoren zu Deployment-Umgebungen wie Kubernetes oder Databricks.
Habe ich eine Liste von Tools, die diese Anforderungen erfüllen, betrachte ich die besonderen Merkmale der einzelnen Plattformen.
Differenzierende Faktoren (Was Anbieter unterscheidet)
So vergleiche und unterscheide ich verschiedene Anbieter:
Hervorstechende Funktionen
Observability für LLMs und generative KI ist ein Schlüsselfaktor. Teams, die generative Modelle zusammen mit klassischer ML einsetzen, benötigen Einblick in Prompt-Qualität, Halluzinationen und Token-Kosten. Ebenso sind Erklärbarkeit und Bias-Überwachung wichtig – ich achte auf SHAP-basierte Attributionen und Fairness-Metriken aufgeschlüsselt nach demografischen Teilgruppen, um regulatorische Prüfungen zu unterstützen. Individuell konfigurierbare Alertings sind ebenfalls entscheidend, da anpassbare Service-Level-Ziele (SLOs) und weitergeleitete Anomaliealarme (z. B. an Slack oder PagerDuty) Regressionen häufig erkennen, bevor Kunden sie bemerken.
Mehr als reine Features
Flexibilität beim Deployment ist besonders wichtig. Ich prüfe, ob eine Plattform SaaS-, VPC- oder On-Premises-Optionen anbietet, da Teams in regulierten Branchen wie Gesundheitswesen oder Finanzwesen oft keine Inferenz-Protokolle außerhalb ihrer Umgebung lagern dürfen. Auch Skalierbarkeit ist entscheidend – ich überprüfe, ob das Tool umfangreiches Prognoseprotokollieren ohne Sampling bewältigen kann und ob die Preisgestaltung bei wachsender Modellanzahl nachvollziehbar bleibt. Compliance-Zertifizierungen wie SOC 2 Type II und HIPAA sind für Unternehmenskunden relevant, die Audit-Trails und rollenbasierte Zugriffskontrollen erfordern.
So wählen Sie Tools zur Überwachung von ML-Modellen aus
Bei langen Funktionslisten und komplexen Preisstrukturen verliert man leicht den Überblick. Damit Sie sich bei der Auswahl der für Sie passenden Software auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was ist zu beachten? |
|---|---|
| FaktorSkalierbarkeit | Was ist zu beachten?Kann das Tool Ihr maximales Aufkommen an Vorhersagen und Ihren Speicherbedarf bewältigen, wenn Modelle und Datenmengen wachsen? Prüfen Sie Aufbewahrungsgrenzen und den Dateneingabedurchsatz. |
| FaktorIntegrationen | Was ist zu beachten?Verbindet es sich mit den ML-Frameworks, Bereitstellungsplattformen und Data Warehouses, auf die Sie angewiesen sind? Lücken können manuellen Aufwand verursachen und die Geschwindigkeit von Arbeitsabläufen beeinträchtigen. |
| FaktorAnpassbarkeit | Was ist zu beachten?Können Sie benutzerdefinierte Metriken, Warnungen oder Dashboards definieren, die zu Ihren Anwendungsfällen passen? Stellen Sie sicher, dass Sie nicht ausschließlich an voreingestellte Optionen des Anbieters gebunden sind. |
| FaktorBenutzerfreundlichkeit | Was ist zu beachten?Ist die Benutzeroberfläche übersichtlich und lassen sich Dashboards und Warnungen intuitiv konfigurieren? Komplexe Tools können die Fehlerbehebung und die Einarbeitung neuer Benutzer verlangsamen. |
| FaktorImplementierung und Einarbeitung | Was ist zu beachten?Wie schnell kann Ihr Team von der Installation des SDK bis zur aktiven Überwachung gelangen? Achten Sie auf Beispiel-Notebooks, sofort einsatzbereite Vorlagen und Unterstützung bei der Einarbeitung. |
| FaktorKosten | Was ist zu beachten?Wie entwickeln sich die Preise, wenn Sie Modelle, Benutzer oder Vorhersagen hinzufügen? Klären Sie die Preise pro Einheit, um unangenehme Kostenüberraschungen bei einer Erweiterung Ihres Umfangs zu vermeiden. |
| FaktorSicherheitsvorkehrungen | Was ist zu beachten?Welche Datenzugriffskontrollen, Authentifizierungsmethoden und Prüfprotokolle sind verfügbar? Berücksichtigen Sie SSO, RBAC und die Verschlüsselung von Daten sowohl im Ruhezustand als auch während der Übertragung. |
| FaktorCompliance-Anforderungen | Was ist zu beachten?Benötigen Sie Zertifizierungen wie SOC 2, HIPAA oder einen Datenstandort in der EU? Stellen Sie sicher, dass der Compliance-Status des Tools tatsächlich die Verpflichtungen Ihrer Organisation erfüllt. |
Was sind Tools zur Überwachung von ML-Modellen?
Tools zur Überwachung von ML-Modellen sind Plattformen, die die Leistung, Datenqualität und den Zustand von Machine-Learning-Modellen in der Produktion verfolgen. Diese Tools helfen Ihrem Team, Datenverschiebungen, Leistungseinbußen und Anomalien zu erkennen, sodass Sie Probleme schnell beheben können. Durch die kontinuierliche Überwachung von Vorhersageausgaben und zugehörigen Metriken stellen Sie sicher, dass Ihre bereitgestellten Modelle für den realen geschäftlichen Einsatz präzise, fair und zuverlässig bleiben.
Funktionen
Achten Sie bei der Auswahl von Tools zur Überwachung von ML-Modellen auf die folgenden wichtigen Funktionen:
- Erkennung von Datenverschiebungen: Erkennt Veränderungen in Daten oder im Modellverhalten zwischen Trainings- und Produktionsumgebungen und weist auf potenzielle Probleme hin, bevor diese die Modellgenauigkeit beeinträchtigen.
- Leistungsüberwachung: Misst kontinuierlich Modellmetriken wie Genauigkeit, Präzision, Trefferquote und Fehlerraten, um zu verfolgen, wie gut Ihre bereitgestellten Modelle im Laufe der Zeit funktionieren.
- Protokollierung von Vorhersagen: Zeichnet alle Modelleingaben, -ausgaben und Vorhersagen auf und ermöglicht es Ihnen, das Modellverhalten jederzeit in Ihrem Arbeitsablauf zu prüfen, zu analysieren und Fehler zu beheben.
- Warnungen und Benachrichtigungen: Sendet Echtzeitwarnungen, wenn bestimmte Schwellenwerte überschritten werden oder anomales Modellverhalten erkannt wird, und hilft Teams dabei, schnell auf Probleme zu reagieren.
- Ursachenanalyse: Ermöglicht die Untersuchung von Leistungseinbußen oder Anomalien bei Vorhersagen mithilfe von Segmentierungs-, Aufschlüsselungs- und Zuordnungstools, um die Ursache von Problemen zu bestimmen.
- Integration in ML-Frameworks: Verbindet sich mit beliebten Machine-Learning-Bibliotheken, Bereitstellungsplattformen und Bereitstellungstools und optimiert so die Überwachung innerhalb bestehender Arbeitsabläufe.
- Rollenbasierte Zugriffskontrolle: Beschränkt den Systemzugriff und Aktionen auf Grundlage von Benutzerrollen, unterstützt Anforderungen an die Datenverwaltung und erhöht die Systemsicherheit.
- Optionen zur Datenaufbewahrung: Ermöglicht die Konfiguration, wie lange protokollierte Daten und Vorhersagen gespeichert werden, und schafft einen Ausgleich zwischen Compliance-Anforderungen und Speicherkosten.
- Verfolgung benutzerdefinierter Metriken: Ermöglicht es Ihnen, geschäfts- oder modellspezifische Metriken zu definieren und zu überwachen, die für Ihre Anwendung oder Ziele besonders wichtig sind.
Gängige KI-Funktionen von Tools zur Überwachung von ML-Modellen
Über die oben aufgeführten Standardfunktionen von Tools zur Überwachung von ML-Modellen hinaus integrieren viele dieser Lösungen KI mit Funktionen wie:
- Automatisierte Anomalieerkennung: Verwendet KI-Algorithmen, um ungewöhnliche Muster oder Ausreißer in Vorhersagedaten zu erkennen, reduziert den manuellen Überwachungsaufwand und macht Probleme sichtbar, die herkömmliche Regeln möglicherweise übersehen.
- Ursachenanalyse mit erklärbarer KI: Wendet KI-gestützte Verfahren zur Erklärbarkeit an, um automatisch hervorzuheben, welche Merkmale oder Datensegmente am stärksten zu Leistungseinbußen oder Anomalien beigetragen haben.
- Adaptive Erkennung von Datenverschiebungen: Nutzt KI, um Schwellenwerte und Methoden zur Erkennung von Datenverschiebungen dynamisch an sich verändernde Datenmuster anzupassen, wodurch die Empfindlichkeit verbessert und die Zahl der Fehlalarme reduziert wird.
- Prädiktive Warnungen: Verwendet KI-Modelle, um potenzielle Modellfehler oder Leistungseinbußen vorherzusagen, bevor sie auftreten, sodass Teams proaktive Maßnahmen ergreifen können.
- Analyse von Verzerrungen und Fairness: Setzt KI ein, um kontinuierlich aufkommende Verzerrungen in Modellvorhersagen über demografische Gruppen hinweg zu erkennen und so verantwortungsvolle KI-Praktiken sowie Compliance-Anforderungen zu unterstützen.
Vorteile
Die Implementierung von Tools zur Überwachung von ML-Modellen bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Schnellere Erkennung von Problemen: Automatisierte Warnungen zu Drift und Anomalien ermöglichen es Ihrem Team, Probleme sofort nach ihrem Auftreten zu erkennen und zu beheben.
- Verbesserte Modellzuverlässigkeit: Die kontinuierliche Leistungsverfolgung und Protokollierung von Vorhersagen tragen dazu bei, sicherzustellen, dass Ihre Modelle in Produktivumgebungen weiterhin wie erwartet funktionieren.
- Stärkere Compliance und Sicherheit: Funktionen wie Prüfpfade, RBAC und Kontrollen zur Datenaufbewahrung erleichtern die Erfüllung regulatorischer Anforderungen und den Schutz sensibler Daten.
- Vereinfachte Fehlerbehebung: Tools zur Ursachenanalyse, Erklärbarkeit und Kohortenaufteilung helfen Ihrem Team, schnell zu ermitteln, was Leistungsänderungen oder Anomalien bei den Ausgaben verursacht.
- Bessere Ausrichtung auf das Geschäft: Die Nachverfolgung benutzerdefinierter Metriken und Warnungen ermöglicht es Ihnen, die für Ihre Organisation wichtigsten KPIs und Ergebnisse zu überwachen.
- Geringeres Betriebsrisiko: Echtzeitüberwachung und proaktive Warnungen begrenzen die Auswirkungen fehlerhafter Vorhersagen auf Geschäftsergebnisse und Entscheidungsfindung.
- Unterstützung für verantwortungsvolle KI: Die Überwachung von Verzerrungen und Fairnessmetriken helfen Ihnen, Modelle zu entwickeln und zu pflegen, die über Nutzergruppen hinweg genau und gerecht sind.
Kosten & Preise
Für die Auswahl von Tools zur Überwachung von ML-Modellen ist ein Verständnis der verschiedenen verfügbaren Preismodelle und Tarife erforderlich. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre Durchschnittspreise und typische Funktionen zusammen, die in Lösungen für Tools zur Überwachung von ML-Modellen enthalten sind:
Vergleichstabelle der Tarife für Tools zur Überwachung von ML-Modellen
| Tarifart | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| TarifartKostenloser Tarif | Durchschnittlicher Preis$0 | Übliche FunktionenGrundlegende Überwachung, eingeschränkte Drift-Erkennung, Community-Support, begrenzte Datenaufbewahrung und Nutzungsbeschränkungen. |
| TarifartPersönlicher Tarif | Durchschnittlicher Preis$10-$50/Benutzer/Monat | Übliche FunktionenZugriff für einzelne Benutzer, erweiterte Datenprotokollierung, grundlegende Leistungsmetriken, einige Integrationen und E-Mail-Support. |
| TarifartGeschäftstarif | Durchschnittlicher Preis$50-$200/Benutzer/Monat | Übliche FunktionenTeamzusammenarbeit, erweiterte Drift- und Anomalieerkennung, anpassbare Warnungen, API-Zugriff und bevorzugter Support. |
| TarifartUnternehmenstarif | Durchschnittlicher Preis$200+/Benutzer/Monat | Übliche FunktionenUnbegrenzte Benutzer, umfassende Compliance-Optionen, lokale Bereitstellung, dediziertes Onboarding, Prüfpfade, SLA-Garantien und SSO. |