

10 bästa verktygen för SRE-övervakning 2026

Kortlista över de bästa SRE-övervakningsverktygen


SRE-övervakningsverktyg är plattformar som hjälper driftsäkerhetsingenjörer att följa systemens hälsa, upptäcka incidenter och analysera prestanda i komplexa infrastrukturer. Dessa verktyg är nära kopplade till verktyg för incidenthantering och är utformade för att övervaka produktionssystem samtidigt som de stöder moderna arbetsflöden för programvaruutveckling. De samlar in och analyserar mätvärden, loggar och spår för att ge insyn i realtid, så att team snabbt kan identifiera problem och minska driftstopp. Den här guiden hjälper dig att sålla bland alternativen, jämföra de främsta verktygen, förstå vad som skiljer dem åt och välja det som bäst passar teamets behov under 2026.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av de bästa SRE-övervakningsverktygen
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av SRE-övervakningsverktyg för att hjälpa dig hitta det bästa alternativet för din budget och verksamhetens behov
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för övervakning av hela teknikmiljön | Gratis plan tillgänglig | Från $49/användare/månad | Website | |
| 2 | Bäst för molnbaserad logganalys | 30 dagars kostnadsfri provperiod + kostnadsfritt abonnemang + kostnadsfri demo tillgänglig | Från $79/månad (faktureras årsvis) | Website | |
| 3 | Bäst för mätvärden och aviseringar med öppen källkod | Gratis att använda | Ingen licenskostnad | Website | |
| 4 | Bäst för observerbarhet i Google Cloud | Gratisabonnemang tillgängligt | Från $0.1510/MiB för inmatade mätvärden | Website | |
| 5 | Bäst för AWS-inbyggd övervakning | Kostnadsfri plan tillgänglig | Pris på begäran | Website | |
| 6 | Bäst för visualisering av övervakningsdata | Gratisabonnemang tillgängligt | Från $19/månad + användning | Website | |
| 7 | Bäst för pipelines för loggbearbetning | 7 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 8 | Bäst för övervakning av tidsseriedata | 30 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 9 | Bäst för flexibel infrastrukturövervakning | 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Från $3/nod/månad (faktureras årsvis) | Website | |
| 10 | Bäst för realtidsbaserad felspårning | Gratisabonnemang + kostnadsfri provperiod + kostnadsfri demo tillgänglig | Från $26/månad (faktureras årsvis) | Website |
Recensioner av de bästa SRE-övervakningsverktygen
Nedan hittar du mina detaljerade sammanfattningar av de SRE-övervakningsverktyg som kom med på min kortlista. Mina recensioner ger en detaljerad genomgång av funktionerna, integrationerna och de bästa användningsområdena för varje plattform, så att du kan hitta det bästa alternativet för dig.
Bäst för övervakning av hela teknikmiljön
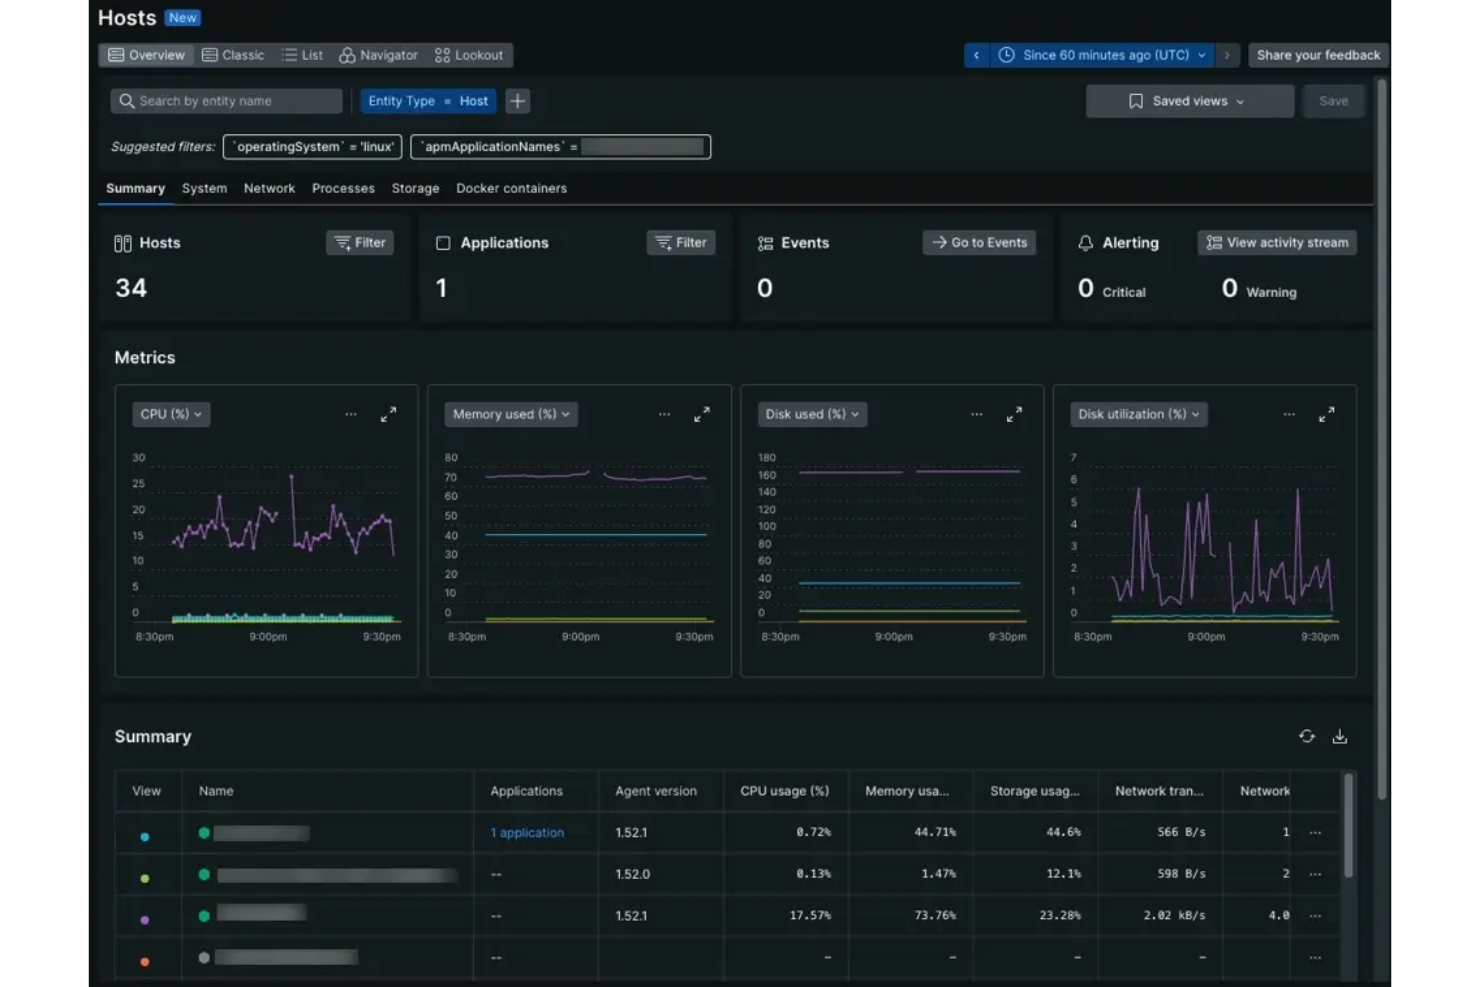
New Relic är en plattform för observabilitet i hela teknikstacken för SRE-övervakning som samlar övervakning av applikationsprestanda, infrastrukturövervakning, distribuerad spårning och logghantering i ett och samma system.
Vem passar New Relic bäst för?
New Relic passar bra för SRE-team och DevOps-ingenjörer på medelstora till stora organisationer som hanterar komplexa molnbaserade applikationer.
Varför jag valde New Relic
Jag valde New Relic som ett av de bästa alternativen eftersom jag förlitar mig på dess enhetliga telemetripattform för att samla mätvärden, spårningar och loggar på ett ställe. Jag uppskattar hur dess AI-drivna insikter hjälper mitt team att snabbt identifiera och lösa incidenter i hela vår teknikmiljö. Mitt team använder New Relics observabilitet i hela teknikstacken för att övervaka allt från molninfrastruktur till applikationsprestanda i realtid.
Viktiga funktioner i New Relic
- Syntetisk övervakning: Simulerar användarinteraktioner för att testa applikationens drifttid och prestanda.
- Distribuerad spårning: Följer förfrågningar när de passerar genom mikrotjänster och infrastruktur.
- Anpassningsbara instrumentpaneler: Låter dig skapa visualiseringar anpassade efter dina övervakningsbehov.
- Aviseringsprinciper: Gör det möjligt att ange tröskelvärden och automatisera incidentaviseringar.
New Relic-integreringar
New Relic erbjuder över 800 inbyggda integreringar, inklusive AWS, Azure, Google Cloud Platform, Kubernetes, Docker, Slack, PagerDuty, Jira, GitHub, ServiceNow och Salesforce, samt ett API för anpassade integreringar.
Pros and Cons
Pros:
- Dataströmning i realtid för snabb incidenthantering
- Anpassningsbara instrumentpaneler för SRE-arbetsflöden
- Erbjuder djupgående observabilitet över molnbaserade teknikmiljöer
Cons:
- Höga kostnader för datainmatning i stora miljöer
- Begränsade alternativ för lokal distribution

Loggly
Bäst för molnbaserad logganalys
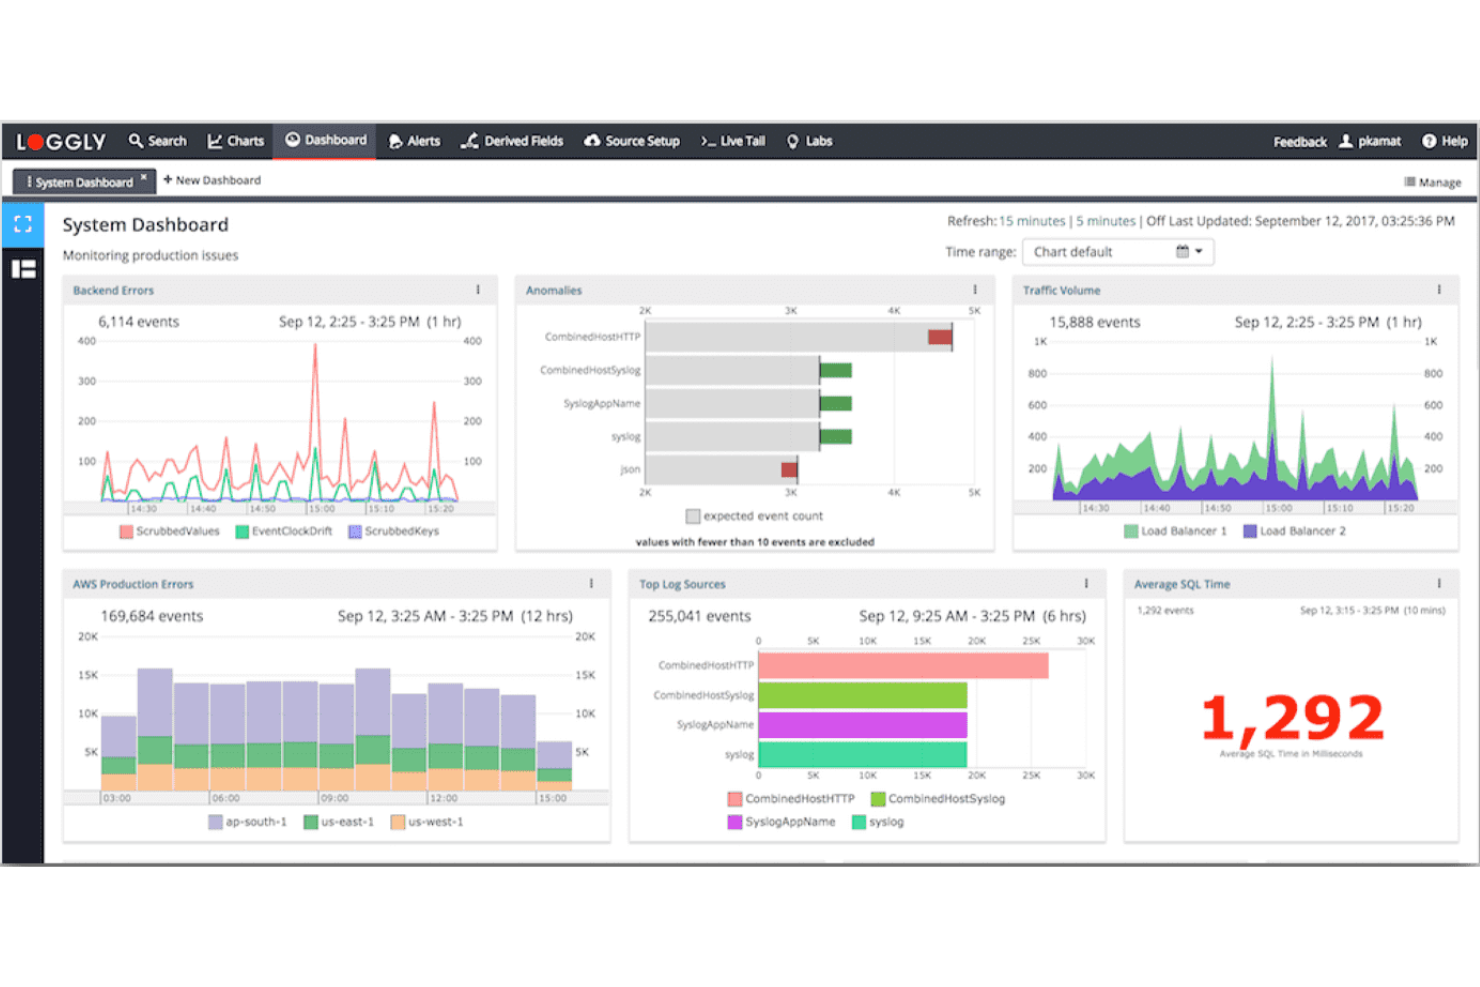
Loggly är en molnbaserad plattform för logghantering och SRE-övervakning som samlar in, indexerar och analyserar loggdata från servrar, applikationer och molntjänster i realtid.
Vem passar Loggly bäst för?
Loggly passar bra för SRE:er och IT-team i medelstora till stora organisationer som hanterar distribuerad molninfrastruktur.
Varför jag valde Loggly
Jag valde Loggly som ett av de bästa alternativen eftersom jag förlitar mig på dess molnbaserade logghantering för att snabbt söka i och visualisera stora mängder loggar. Jag gillar hur den dynamiska fältutforskaren och de interaktiva instrumentpanelerna låter mig gå på djupet i loggdata utan att behöva skapa anpassade frågor. Mitt team använder dess realtidssökning och automatiserade tolkning för att övervaka distribuerade system och snabbt upptäcka problem.
Viktiga funktioner i Loggly
- Automatiserade aviseringar: Skapa anpassade aviseringar baserade på logghändelser och tröskelvärden.
- Loggarkivering: Lagra och hämta historiska loggdata för efterlevnad och revisioner.
- Åtkomst till RESTful API: Integrera loggdata med externa verktyg och arbetsflöden.
- Stöd för flera loggkällor: Samla in loggar från servrar, molnplattformar och nätverksenheter.
Loggly-integreringar
Loggly erbjuder inbyggda integreringar med AWS CloudWatch, GitHub, Jira, Slack, Microsoft Teams och PagerDuty samt ett API för anpassade integreringar.
Pros and Cons
Pros:
- Hanterar olika loggformat och loggkällor
- Visualiserar loggdata med interaktiva instrumentpaneler
- Stöder strukturerade och ostrukturerade loggformat
Cons:
- Inget inbyggt stöd för lokal driftsättning
- Aviseringar saknar avancerad korrelationslogik

Bäst för mätvärden och aviseringar med öppen källkod
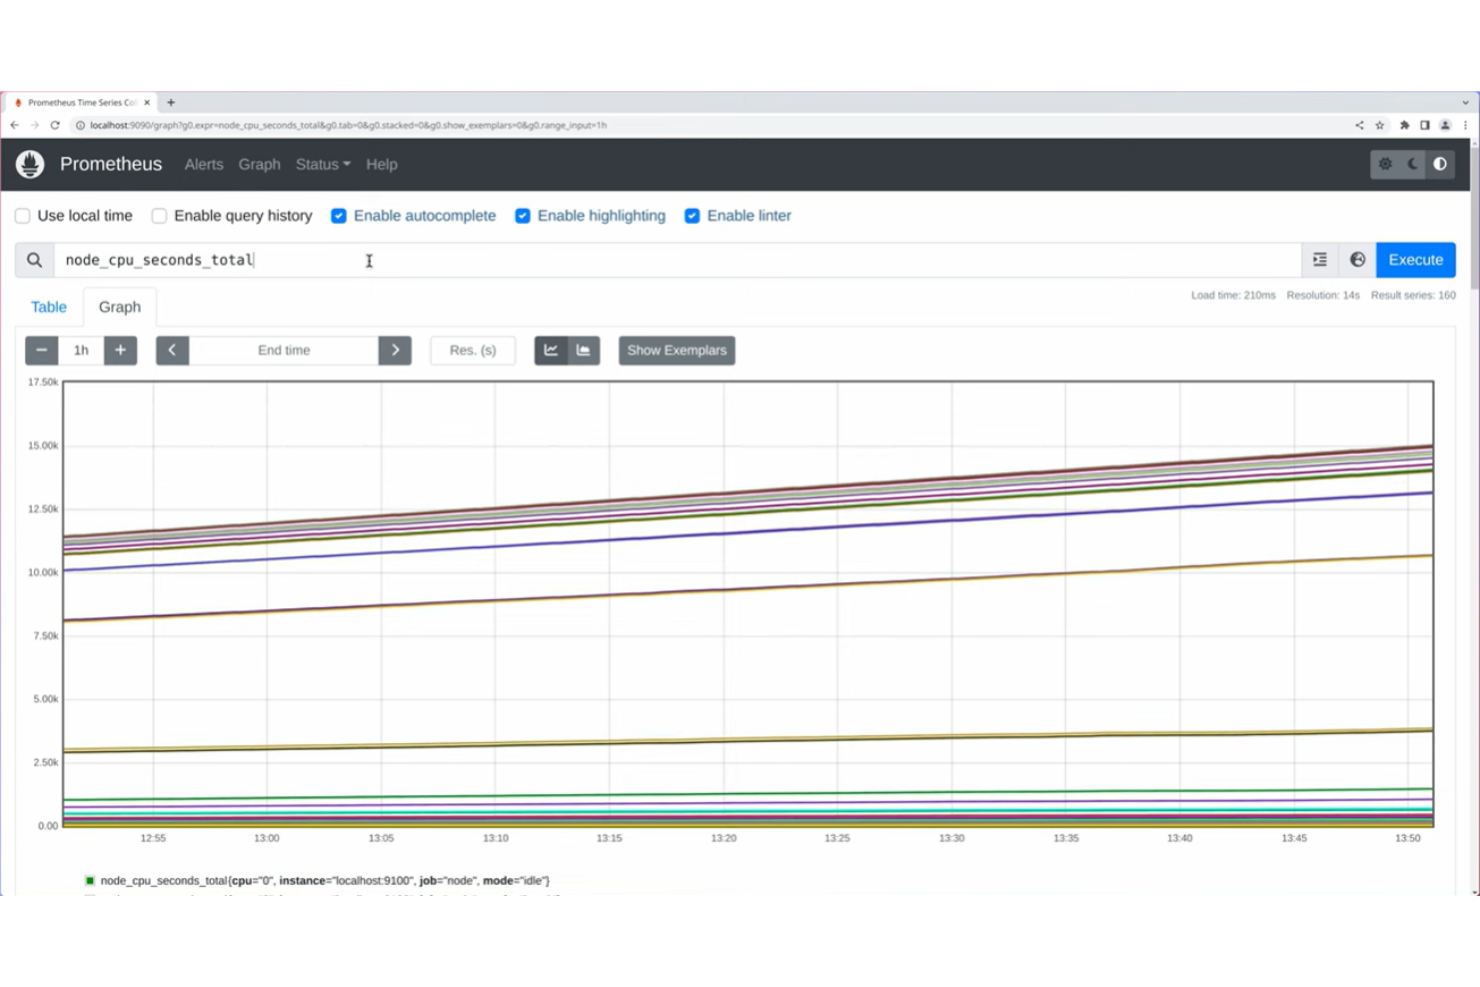
Prometheus är ett system med öppen källkod för övervakning och aviseringar, utformat för driftsäkerhetsingenjörer som behöver samla in, lagra och fråga efter tidsseriemått från infrastruktur och applikationer.
Vem passar Prometheus bäst för?
Prometheus passar bra för driftsäkerhetsingenjörer och DevOps-team i teknikdrivna organisationer som hanterar storskalig, containerbaserad infrastruktur.
Varför jag valde Prometheus
Jag valde Prometheus som ett av de bästa alternativen eftersom jag förlitar mig på dess verktygslåda med öppen källkod för att samla in och lagra tidsseriedata från dynamisk infrastruktur. Jag uppskattar hur det flexibla frågespråket låter mig skapa anpassade instrumentpaneler och aviseringar för alla mätvärden som är viktiga för mitt team. Mitt team använder Prometheus för att övervaka Kubernetes-kluster och containerbaserade arbetsbelastningar och drar nytta av dess pull-baserade datainsamling och tjänsteidentifiering.
Viktiga funktioner i Prometheus
- Integration med Alertmanager: Dirigera aviseringar till e-post, PagerDuty eller Slack baserat på anpassade regler.
- Flerdimensionell datamodell: Lagra mätvärden med etiketter för flexibel sökning och filtrering.
- Tjänsteidentifiering: Identifiera automatiskt mål i moln- och containerbaserade miljöer.
- Konfiguration av datalagringstid: Ange anpassade lagringsperioder för tidsseriedata.
Integrationer med Prometheus
Prometheus erbjuder inbyggda integrationer med Alertmanager, Grafana, Kubernetes, Consul och Docker samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Pull-baserad mätvärdesinsamling stöder dynamiska miljöer
- Flexibelt PromQL-frågespråk för anpassade mätvärden
- Aktiv gemenskap och dokumentation med öppen källkod
Cons:
- Ingen inbyggd långtidslagring för mätvärden
- Saknar inbyggt stöd för distribuerad spårning

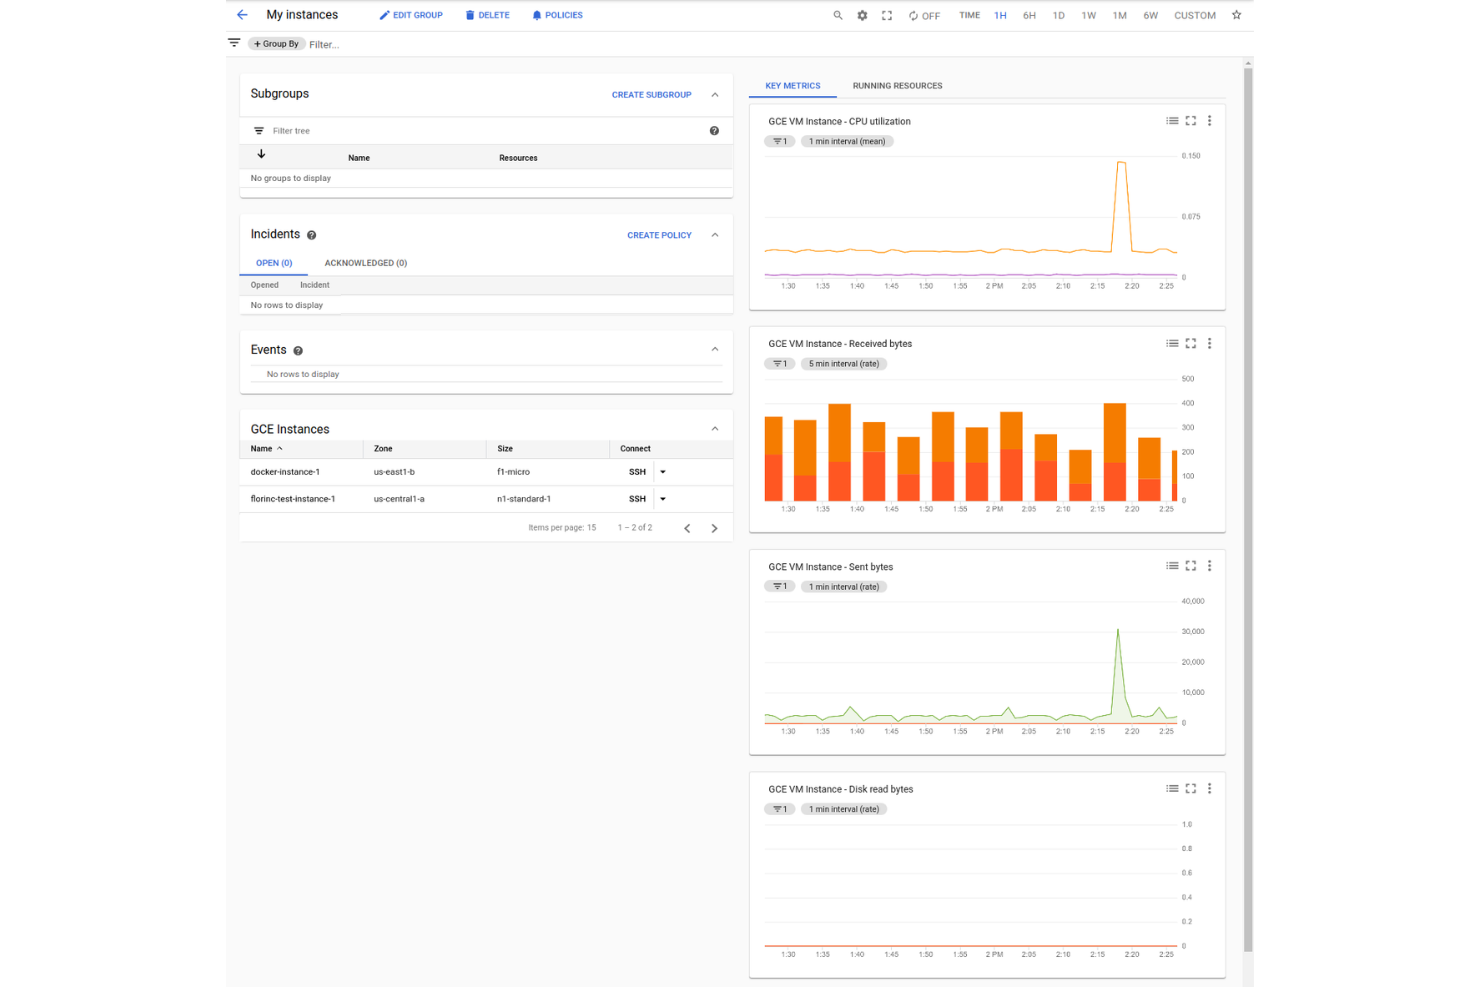
Google Cloud Monitoring är en molnbaserad övervakningsplattform för teknik för webbplatstillförlitlighet som samlar in, visualiserar och analyserar mätvärden, händelser och loggar från Google Cloud och hybrida miljöer.
Vem passar Google Cloud Monitoring bäst för?
Google Cloud Monitoring passar bra för SRE-team som hanterar arbetsbelastningar i Google Cloud eller hybrida molnmiljöer.
Varför jag valde Google Cloud Monitoring
Jag valde Google Cloud Monitoring som ett av de bästa alternativen eftersom det ger mig inbyggd övervakning och observerbarhet för Google Cloud-resurser utan extra konfiguration. Jag uppskattar att jag kan visualisera mätvärden, loggar och drifttidskontroller för mina moln- och hybrida arbetsbelastningar på ett och samma ställe. Mitt team använder dess aviseringspolicyer och anpassade instrumentpaneler för att följa tjänsternas hälsa och snabbt reagera på incidenter.
Viktiga funktioner i Google Cloud Monitoring
- Övervakning i flera moln: Samlar in och visar mätvärden från AWS och lokala system tillsammans med Google Cloud.
- SLO-spårning: Låter dig definiera och övervaka tjänstenivåmål för tillförlitlighet.
- Drifttidsövervakning: Kontrollerar kontinuerligt tjänsternas tillgänglighet från flera platser världen över.
- Incidenttidslinjer: Visualiserar incidenter och relaterade händelser i kronologisk ordning för snabbare felsökning.
Integrationer med Google Cloud Monitoring
Google Cloud Monitoring erbjuder inbyggda integrationer i hela Google Cloud-ekosystemet, inklusive Google Compute Engine, Google Kubernetes Engine, Google App Engine, Google Cloud Functions och Google Cloud Storage. Ett API är tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Stöder övervakning i flera moln och hybrida miljöer
- Anpassade funktioner för SLO- och SLA-spårning
- Skalbart för stora, distribuerade miljöer
Cons:
- Navigeringen i användargränssnittet kan vara otydlig för nya användare
- Priset kan öka snabbt vid stora datamängder

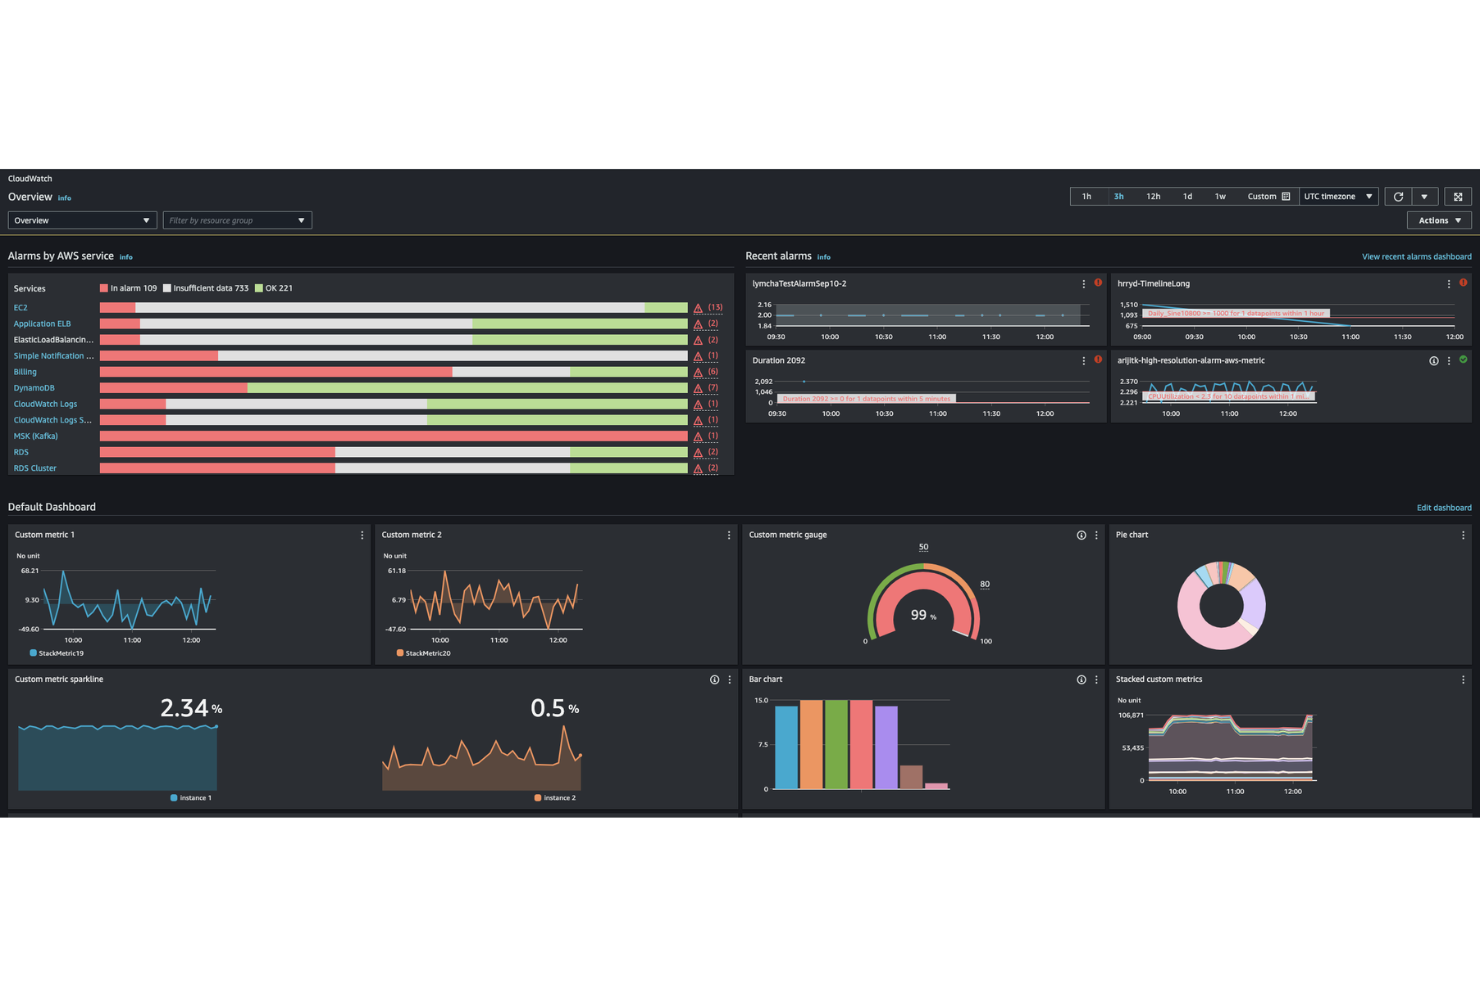
Amazon CloudWatch är en molnbaserad plattform för övervakning och observerbarhet från AWS som erbjuder insamling av mätvärden, logghantering, händelseövervakning och automatiserade aviseringar för infrastruktur och applikationer som körs på AWS.
Vem passar Amazon CloudWatch bäst för?
Amazon CloudWatch passar bra för SRE-team som fokuserar på AWS och ingenjörer inom molninfrastruktur i medelstora till stora företag.
Varför jag valde Amazon CloudWatch
Jag valde Amazon CloudWatch som en av de bästa lösningarna eftersom den ger mig inbyggd AWS-övervakning och observerbarhet utan extra konfiguration. Jag uppskattar att jag kan samla in och visualisera mätvärden, loggar och händelser från alla mina AWS-resurser på ett och samma ställe. Mitt team använder de automatiserade larmen och instrumentpanelerna för att följa molninfrastrukturens hälsa och applikationernas prestanda i realtid.
Viktiga funktioner i Amazon CloudWatch
- Anpassade mätvärden: Skicka och övervaka applikationsspecifika mätvärden tillsammans med data om AWS-resurser.
- Logginsikter: Kör frågor och analysera loggdata interaktivt vid felsökning.
- Avvikelsedetektering: Upptäck automatiskt ovanliga mönster i mätvärden med hjälp av maskininlärning.
- Syntetisk övervakning: Simulera användarinteraktioner för att övervaka slutpunktstillgänglighet och svarstid.
Integrationer med Amazon CloudWatch
Amazon CloudWatch erbjuder inbyggda integrationer med över 70 AWS-tjänster, inklusive Amazon EC2, Amazon S3, Amazon API Gateway och Amazon RDS. Tjänsten har även stöd för integration med Amazon OpenSearch Service och tillhandahåller ett API för anpassade integrationer.
Pros and Cons
Pros:
- Djupgående integration med AWS-tjänster och resurser
- Stöd för anpassade mätvärden och instrumentpaneler
- Detaljerade behörigheter med AWS IAM-integration
Cons:
- Begränsad insyn i miljöer som inte använder AWS
- Inga inbyggda arbetsflöden för incidenthantering

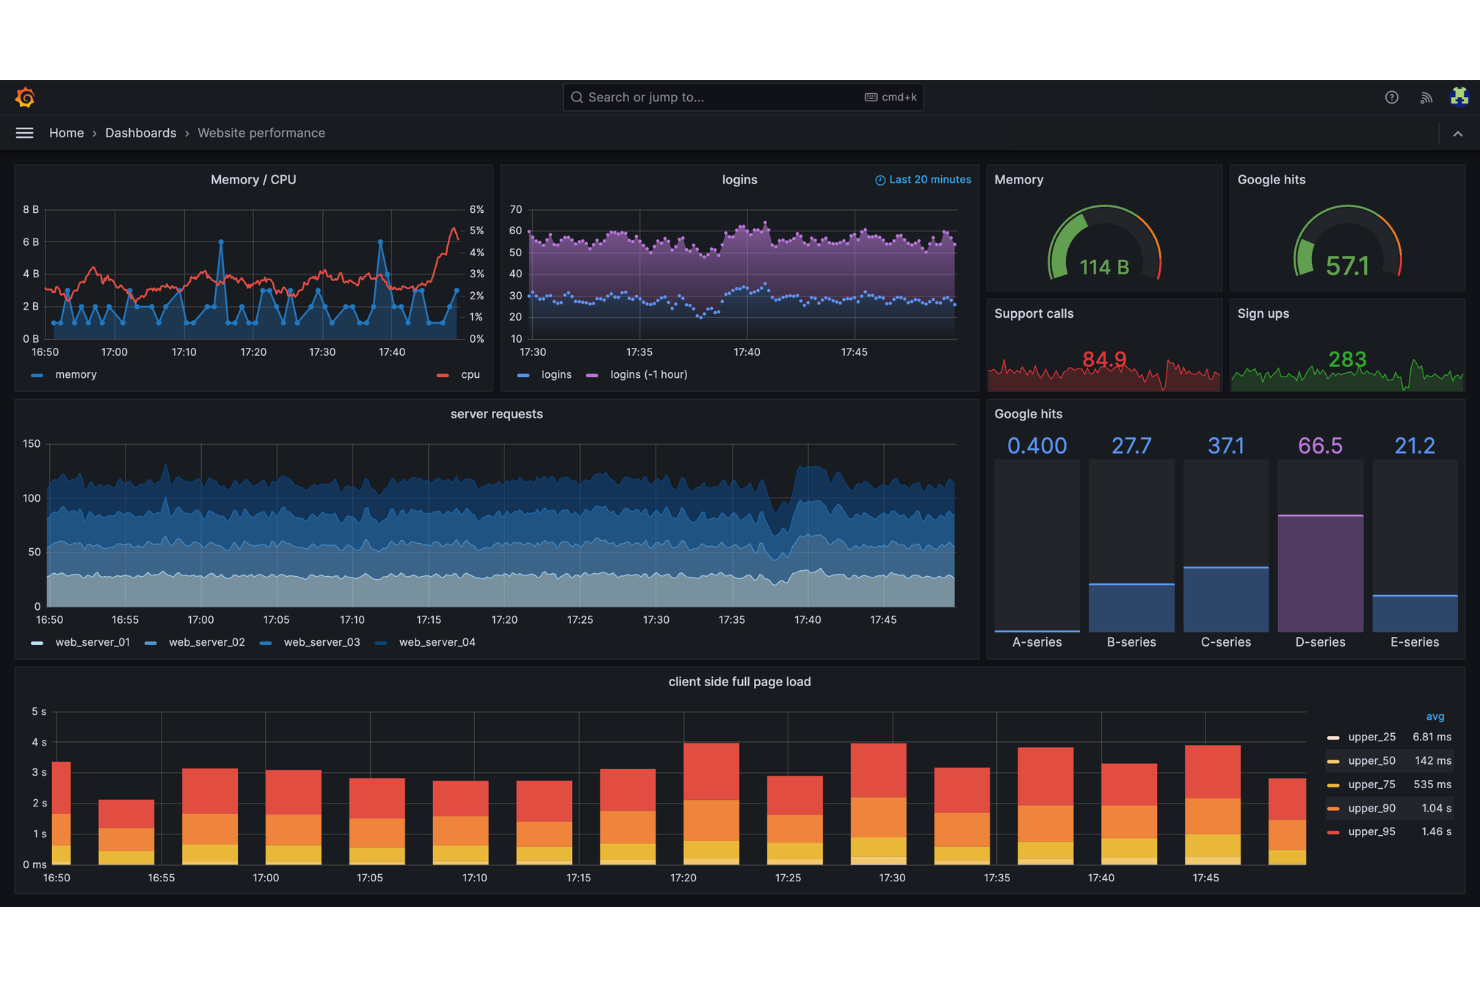
Grafana Labs är en plattform med öppen källkod för övervakning och analys för ingenjörer inom webbplatsers driftsäkerhet, som låter dig visualisera, fråga efter och korrelera tidsseriedata från flera källor i anpassningsbara instrumentpaneler.
Vem passar Grafana Labs bäst för?
Grafana Labs passar bra för ingenjörer inom webbplatsers driftsäkerhet och DevOps-team på organisationer som behöver visualisera och analysera mätvärden från olika datakällor.
Varför jag valde Grafana Labs
Jag valde Grafana Labs som en av de bästa eftersom jag förlitar mig på deras instrumentpaneler med öppen källkod för att visualisera tidsseriedata från Prometheus, Loki och andra källor på samma plats. Jag uppskattar att jag kan skapa anpassade paneler och aviseringar för SRE-mätvärden och sedan dela dessa instrumentpaneler med mitt team. Mitt team använder Grafana Labs för att korrelera loggar, mätvärden och spårningar för snabbare incidenthantering.
Viktiga funktioner i Grafana Labs
- Rollbaserad åtkomstkontroll: Hantera användarbehörigheter och begränsa åtkomsten till känsliga instrumentpaneler.
- Pluginer för datakällor: Anslut till databaser som MySQL, PostgreSQL, InfluxDB och Elasticsearch.
- Stöd för annoteringar: Markera händelser direkt på instrumentpaneler för att ge sammanhang vid incidentgenomgångar.
- Mallbaserade instrumentpaneler: Använd variabler för att skapa återanvändbara, dynamiska instrumentpaneler för olika miljöer eller team.
Integrationer med Grafana Labs
Grafana Labs erbjuder inbyggda integrationer med MongoDB, AppDynamics, Jira, Oracle, GitLab, Salesforce och Splunk samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Stöder aggregering av data från flera källor i instrumentpaneler
- PromQL möjliggör avancerade mätvärdesförfrågningar
- Starkt ekosystem av pluginer med öppen källkod
Cons:
- Data med hög kardinalitet kan påverka prestandan
- Stödet för distribuerad spårning är begränsat

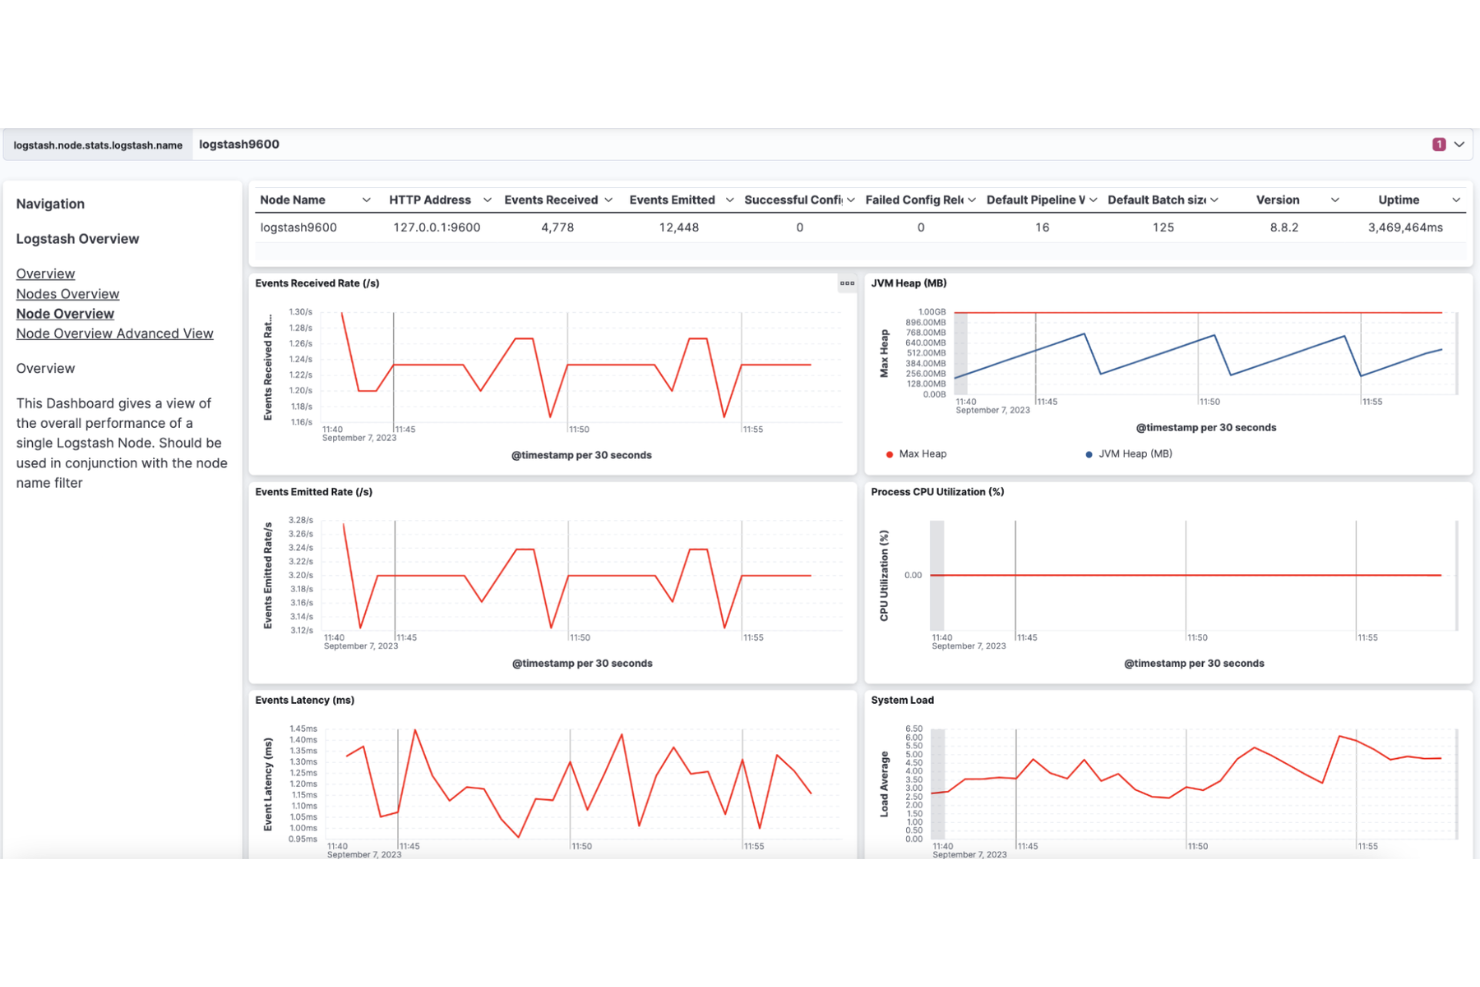
Logstash är ett verktyg för datapipelines i realtid för SRE-övervakning som samlar in, omvandlar och vidarebefordrar loggar och händelsedata från olika källor till olika utdata.
Vilka passar Logstash bäst för?
Logstash passar bra för SRE:er och IT-team på stora företag som behöver centralisera och bearbeta stora mängder logg- och händelsedata.
Därför valde jag Logstash
Jag valde Logstash som ett av de bästa alternativen eftersom jag förlitar mig på dess datapipeline i realtid för att samla in, omvandla och vidarebefordra loggar från dussintals källor. Mitt team använder dess omfattande ekosystem av plugin-program för att tolka, berika och dirigera data till Elasticsearch och andra utdata. Jag uppskattar att vi kan bygga komplexa pipelines för SRE-övervakning utan att skriva anpassad kod för varje datakälla.
Viktiga funktioner i Logstash
- Centraliserad pipelinehantering: Konfigurera och övervaka flera pipelines från ett enda gränssnitt.
- Omfattande stöd för kodare: Hantera olika dataformat som JSON, CSV och syslog.
- Beständiga köer: Buffra händelser på disk för att förhindra dataförlust vid driftstörningar.
- Kö för obearbetade händelser: Fånga upp och isolera misslyckade händelser för senare granskning och felsökning.
Logstash-integrationer
Logstash erbjuder över 200+ inbyggda plugin-program för indata, filter och utdata, inklusive inbyggda integrationer med Elasticsearch, Amazon S3, Kafka, JDBC och AWS CloudWatch, samt tillhandahåller ett API för utveckling av anpassade plugin-program.
Pros and Cons
Pros:
- Hanterar komplex loggtolkning och berikning
- Erbjuder beständiga köer för datatålighet
- Flexibel pipelinekonfiguration för anpassade arbetsflöden
Cons:
- Det kan vara svårt att felsöka pipelinefel
- Kompatibilitetsproblem med plugin-program efter större uppdateringar

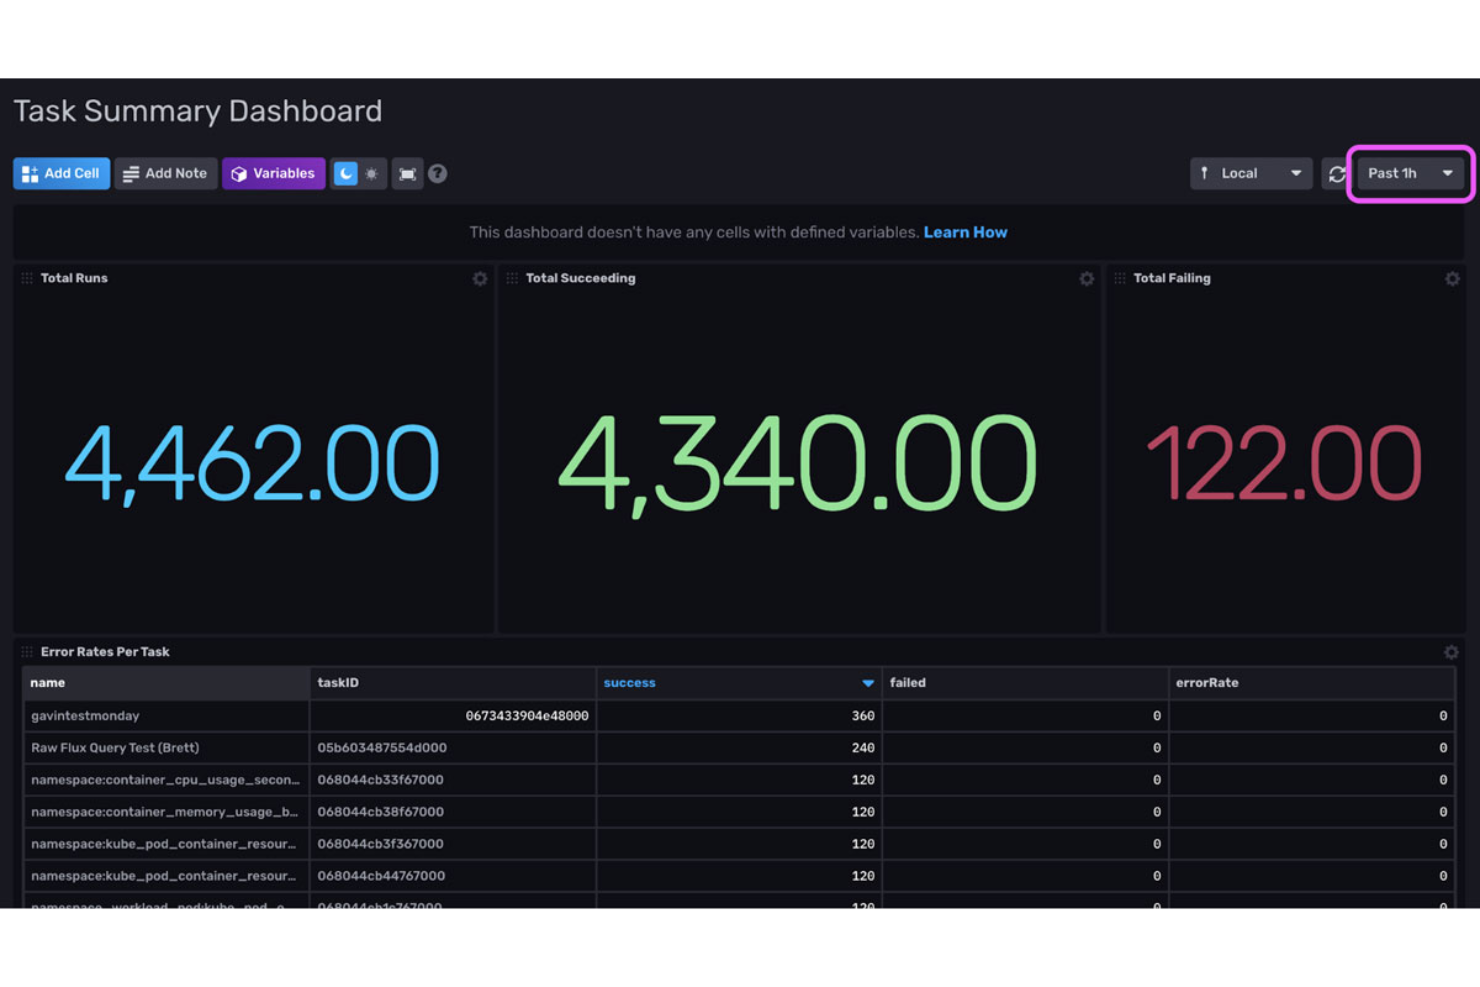
InfluxDB är en tidsseriedatabas och övervakningsplattform utformad för SRE-team som behöver samla in, lagra och analysera nätverks- och infrastrukturmått i stora volymer.
Vem passar InfluxDB bäst för?
InfluxDB passar bra för SRE- och DevOps-team på organisationer som hanterar nätverks- och infrastrukturövervakning med hög genomströmning.
Varför jag valde InfluxDB
Jag valde InfluxDB som ett av de bästa alternativen eftersom det är särskilt utvecklat för högpresterande tidsseriedata, vilket är avgörande för nätverksövervakning i stor skala. Jag uppskattar att jag kan ta emot, lagra och fråga miljontals mått per sekund utan fördröjning. Mitt team använder frågespråket Flux för att analysera mönster i nätverkstrafiken och upptäcka avvikelser i realtid. InfluxDB:s flexibla scheman gör att vi snabbt kan anpassa oss när våra övervakningsbehov förändras.
Viktiga funktioner i InfluxDB
- Inbyggt stöd för Telegraf-agenten: Samlar in mått från hundratals källor med hjälp av lättviktiga insticksprogram.
- Nedskalning och policyer för datalagring: Hanterar automatiskt lagringen genom att aggregera och ta bort gamla data när de löper ut.
- Anpassade instrumentpaneler: Låter dig skapa visualiseringar för nätverksdata i realtid och historiska nätverksdata.
- Aviseringsmotor: Utlöser aviseringar baserat på användardefinierade tröskelvärden och villkor.
InfluxDB-integrationer
InfluxDB erbjuder inbyggda integrationer med Telegraf, Grafana, Kapacitor, Chronograf och MQTT samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Hanterar stora datavolymer av tidsseriedata med hög inmatningshastighet
- Flexibla policyer för lagring och nedskalning
- Frågespråket Flux möjliggör avancerad analys
Cons:
- Saknar inbyggda funktioner för maskininlärning
- Ingen inbyggd avisering i versionen med öppen källkod

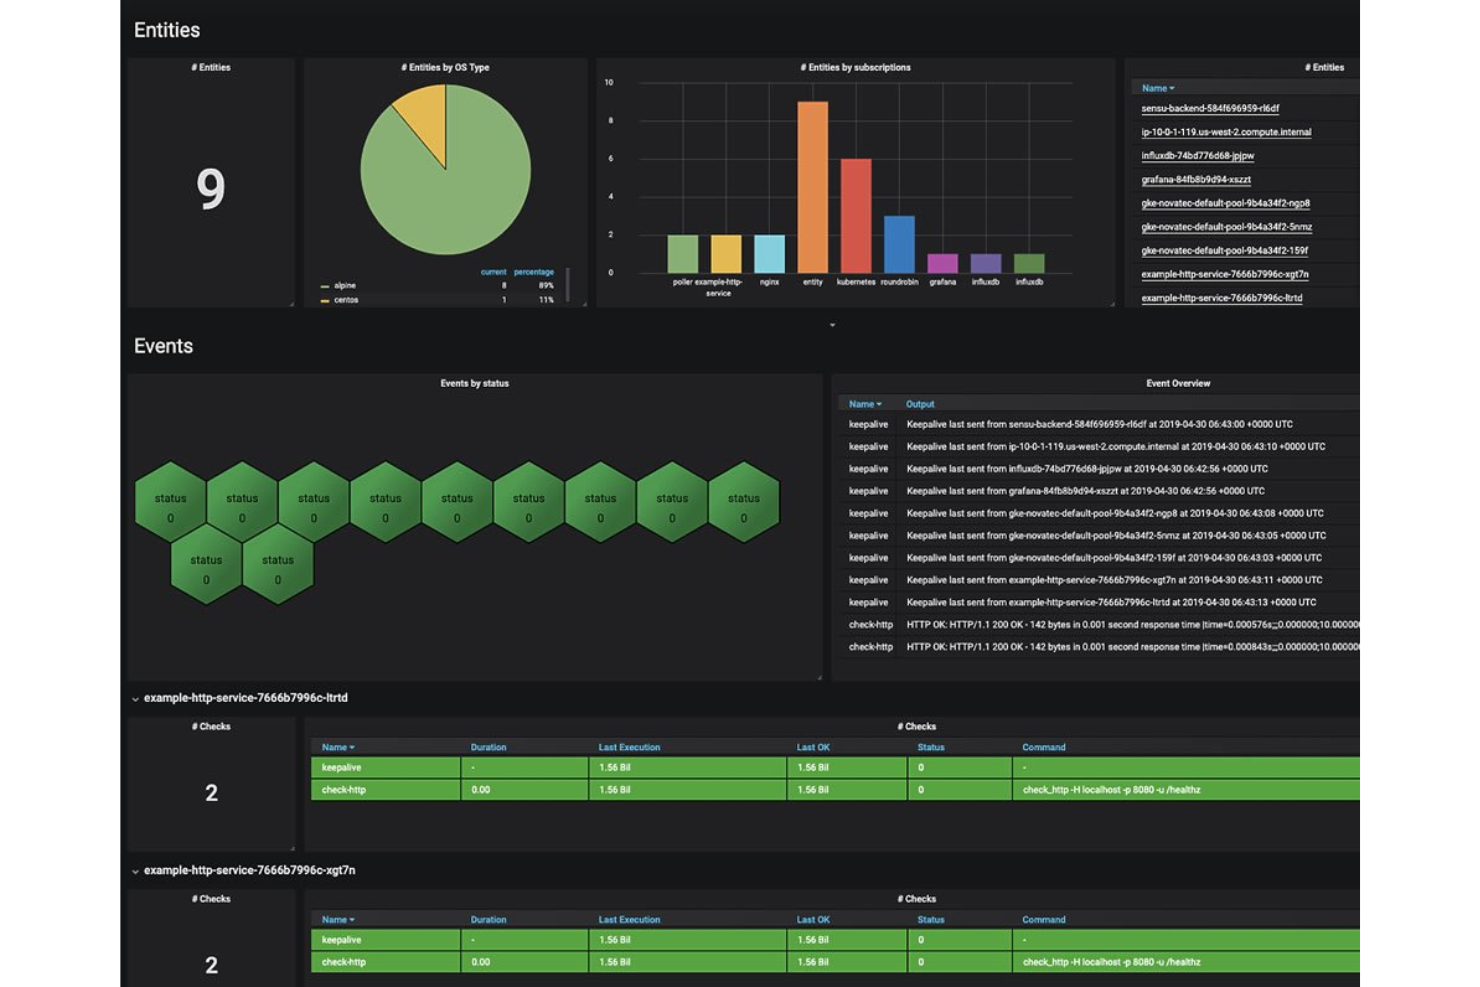
Sensu är en övervakningsplattform med öppen källkod för SRE:er som tillhandahåller händelsebearbetning, hälsokontroller, telemetriinsamling och automatiserad åtgärdshantering för dynamisk infrastruktur och molnbaserade miljöer.
Vem passar Sensu bäst för?
Sensu passar mycket bra för SRE- och DevOps-team som hanterar komplex, dynamisk infrastruktur i molnbaserade eller hybrida miljöer.
Varför jag valde Sensu
Jag valde Sensu som ett av de bästa alternativen eftersom jag uppskattar hur det ger mig flexibel övervakning av dynamisk infrastruktur—särskilt i molnbaserade och hybrida miljöer. Mitt team använder dess händelsepipeline för att automatisera hälsokontroller, telemetriinsamling och arbetsflöden för åtgärdshantering. Jag förlitar mig på stödet för anpassade kontroller och insticksprogram för att skräddarsy övervakningen efter våra unika miljöer.
Sensus viktigaste funktioner
- Rollbaserad åtkomstkontroll: Hantera användarbehörigheter och åtkomst till övervakningsresurser.
- Tystning och underhållsläge: Undertryck tillfälligt aviseringar under planerat underhåll eller vid kända problem.
- Inbyggd hantering av hemligheter: Lagra och hantera känsliga autentiseringsuppgifter för kontroller och hanterare på ett säkert sätt.
- Dynamisk entitetsidentifiering: Registrera och avregistrera automatiskt infrastrukturkomponenter när de skalas.
Integrationer för Sensu
Sensu har inbyggda integrationer med PagerDuty, Slack, InfluxDB, Nagios, Prometheus och ServiceNow, samt tillhandahåller ett API för anpassade integrationer.
Pros and Cons
Pros:
- Stöder anpassade insticksprogram för unika övervakningsbehov
- Hanterar storskaliga miljöer med dynamisk infrastruktur
- Händelsepipeline möjliggör automatiserade arbetsflöden för åtgärdshantering
Cons:
- Konfigurationssyntaxen kan vara komplex för nybörjare
- Begränsad inbyggd visualisering och instrumentpanelshantering

Sentry
Bäst för realtidsbaserad felspårning
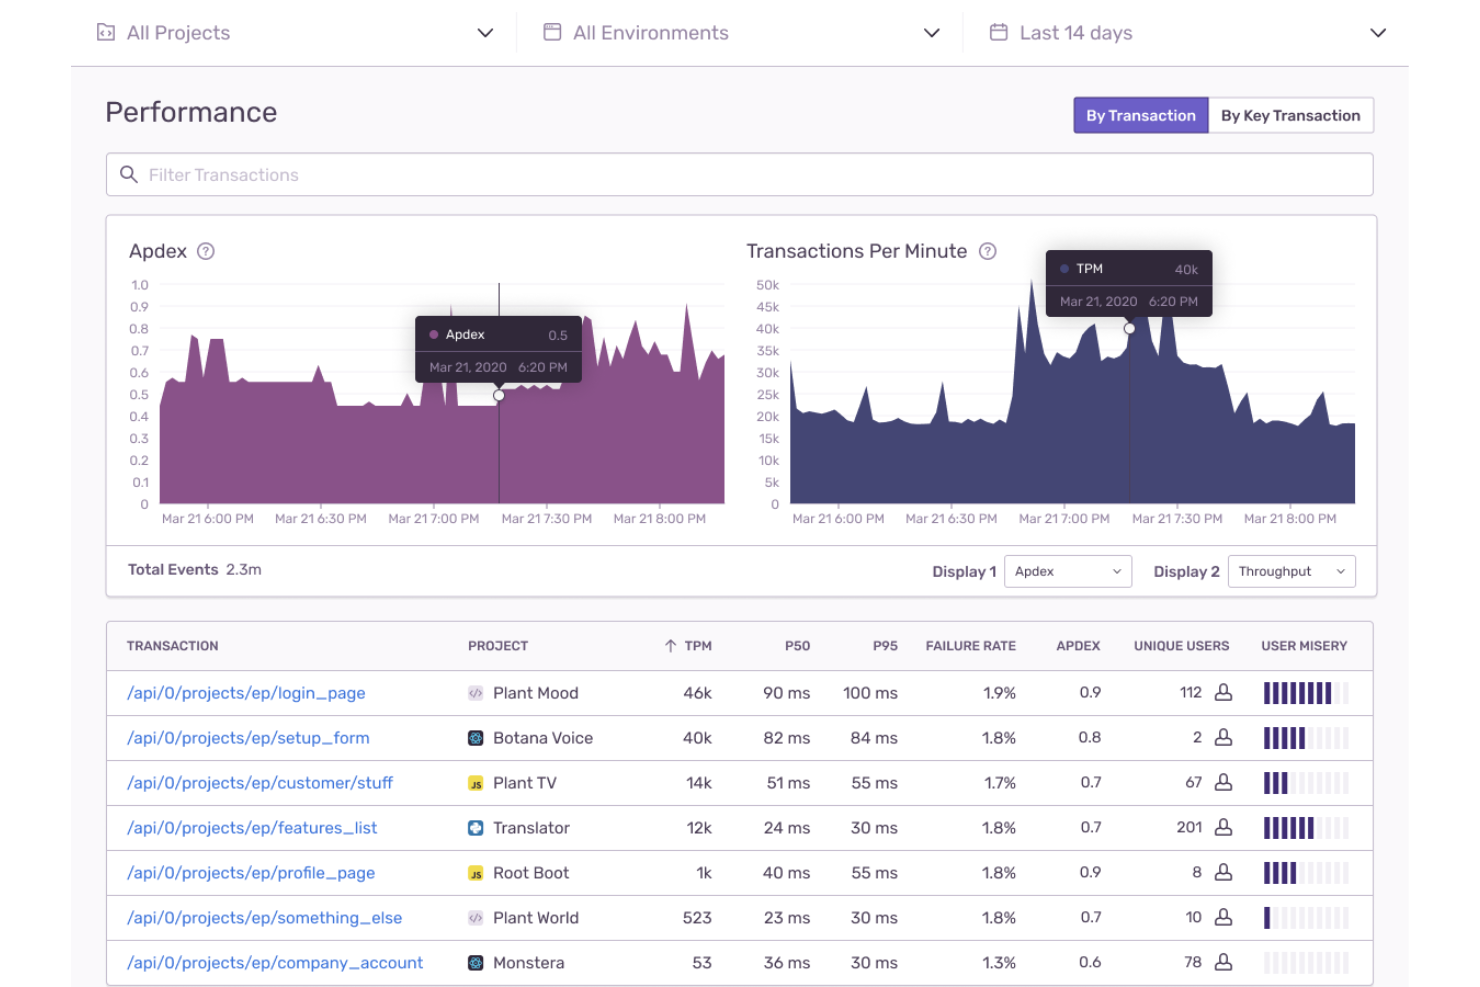
Sentry är en plattform för applikationsövervakning för ingenjörer inom webbplatsers driftsäkerhet, med fokus på realtidsbaserad felspårning, prestandaövervakning och versionshälsa för flera programmeringsspråk och ramverk.
Vem passar Sentry bäst för?
Sentry passar bra för utvecklingsteam på teknikföretag som behöver insyn i applikationsfel och prestanda i realtid.
Varför jag valde Sentry
Jag valde Sentry som ett av de bästa alternativen eftersom jag förlitar mig på dess realtidsbaserade felspårning för att upptäcka problem så snart de uppstår. Jag gillar hur verktyget grupperar fel efter grundorsak och tillhandahåller detaljerade stackspår, vilket hjälper mitt team att snabbt lokalisera och lösa problem. Funktionen för versionshälsa gör att vi kan övervaka stabiliteten i nya driftsättningar utan extra konfiguration.
Sentrys viktigaste funktioner
- Prestandaövervakning: Följ applikationers fördröjning, genomströmning och transaktionsspår över olika tjänster.
- Miljömärkning: Filtrera och analysera fel efter miljö, till exempel produktion, testmiljö eller utveckling.
- Spårning av användarpåverkan: Se vilka användare som påverkas av specifika fel eller krascher.
- Tredjepartsintegrationer: Anslut till verktyg som Slack, Jira och GitHub för aviseringar och automatisering av arbetsflöden.
Sentrys integrationer
Sentry erbjuder inbyggda integrationer med Slack, Jira, GitHub, GitLab, Trello, PagerDuty, Datadog, Microsoft Teams, Bitbucket och Azure DevOps. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Realtidsbaserad felspårning med detaljerad kontext
- Övervakning av versionshälsa för nya driftsättningar
- Stöd för flera programmeringsspråk och ramverk
Cons:
- Begränsade funktioner för övervakning av infrastruktur och servrar
- Ingen inbyggd loggsamling eller logganalys
New Product Updates from Sentry

Sentry Lets Seer Iterate on Pull Requests
Sentry lets Seer continue working on the pull requests it opens by responding to review feedback, fixing certain CI failures, and pushing follow-up commits. This keeps updates, discussion, and revision history in the same pull request. For more information, visit Sentry’s official site.
 .
Andra SRE-övervakningsverktyg
Här är några ytterligare alternativ bland SRE-övervakningsverktyg som inte kom med på min kortlista, men som ändå är värda att titta närmare på:


Hur jag utvärderar verktyg för SRE-övervakning
Jag utvärderar varje verktyg i två lager: grundläggande krav – spårning av SLO:er, aviseringar och telemetri för hela teknikstacken – samt särskiljande faktorer som spelar roll när felbudgetar förbrukas.
Grundläggande funktioner (minimikrav för denna lista)
När jag väljer ut verktyg till min lista bedömer jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje grundläggande funktion som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att kunna tas med.
- Fullstack-observabilitet: Jag letar efter enhetlig insamling av mätvärden, loggar och spårningar, så att en SRE kan gå från en latensökning i en utcheckningstjänst till de underliggande containerloggarna utan att byta verktyg.
- Spårning av SLO:er och felbudgetar: Varje verktyg bör låta dig definiera anpassade SLI:er, ange SLO-mål och visualisera hur snabbt felbudgeten förbrukas – sättet som Datadog och Nobl9 hanterar detta på säger mycket om anpassningen till SRE-principer.
- Aviseringar i realtid och incidentdetektering: Jag utvärderar hur omfattande konfigurationen av aviseringar är, inklusive dynamiska tröskelvärden och anomalibaserade utlösare, samt dirigering till jourverktyg som PagerDuty eller Opsgenie.
- Distribuerad spårning och analys av grundorsaker: En bra spårningsvy visar hur förfrågningar går genom mikrotjänster och markerar det felande spannet, så jag kontrollerar om verktyget tydligt synliggör flaskhalsar i beroenden.
- Stöd för Kubernetes och molnbaserade miljöer: Jag kontrollerar om verktyget har inbyggd automatisk identifiering av poddar, noder och kluster i AWS, GCP och Azure, i stället för att kräva manuell agentkonfiguration för varje arbetsbelastning.
- Instrumentpaneler och tillförlitlighetsrapportering: Team behöver anpassningsbara instrumentpaneler som följer MTTR, drifttidstrender och data från efterincidentanalyser över tid – jag utvärderar hur flexibelt rapporteringslagret är utöver de fördefinierade vyerna.
När jag har en lista över verktyg som uppfyller kriterierna undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Inbyggt stöd för OpenTelemetry är en viktig faktor – team som standardiserar på OTel kan byta backend utan att instrumentera varje tjänst på nytt. Jag utvärderar också AI-baserad anomalidetektering, vilket är särskilt viktigt under händelser med hög trafik när statiska tröskelvärden missar långsamt ökande försämringar. Automatiserad incidenthantering kompletterar helheten. Verktyg som utlöser körböcker eller automatisk åtgärd när ett SLO överträds minskar MTTR dramatiskt jämfört med helt manuella eskaleringsvägar.
Utöver funktionerna
Prissättningsmodellen spelar stor roll här – telemetrivolymerna ökar oförutsägbart, så jag kontrollerar om leverantören tar betalt per värd, datainhämtning eller händelse och hur transparent kostnadsökningen är. Hur väl verktyget passar in i ekosystemet är lika avslöjande. Ett verktyg som ansluter till din befintliga CI/CD-pipeline, Terraform-konfigurationer och Slack-kanaler sparar veckor av arbete med integrationskod. Jag tittar också på efterlevnadscertifieringar som SOC 2 Type II och stöd för RBAC, särskilt för team som hanterar känsliga arbetsbelastningar där granskningsloggning och SSO är grundläggande förväntningar.
Så väljer du SRE-övervakningsverktyg
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du går igenom din unika process för val av programvara kommer här en checklista över faktorer att tänka på:
| Faktor | Att tänka på |
| Skalbarhet | Kan verktyget hantera din nuvarande och beräknade infrastrukturstorlek? Leta efter beprövat stöd för stora, dynamiska miljöer. |
| Integrationer | Ansluter det direkt till dina verktyg för aviseringar, ärendehantering och meddelanden? Kontrollera kompatibiliteten med din befintliga teknikstack. |
| Anpassningsmöjligheter | Kan du anpassa kontroller, aviseringar och arbetsflöden efter teamets behov? Bedöm stödet för anpassade insticksprogram eller skript. |
| Användarvänlighet | Kommer teamet att kunna börja använda och hantera verktyget snabbt? Ta hänsyn till inlärningskurvan och gränssnittets tydlighet. |
| Implementering och introduktion | Hur lång tid tar det att distribuera och konfigurera verktyget? Fråga om stöd vid migrering, dokumentation och tillgängliga resurser för introduktion. |
| Kostnad | Är prisnivåerna transparenta och förutsägbara? Räkna med både initiala och löpande kostnader, inklusive tillägg eller användningsbaserade avgifter. |
| Säkerhetsåtgärder | Erbjuder verktyget kryptering, åtkomstkontroller och granskningsloggar? Säkerställ att det uppfyller organisationens säkerhetsstandarder. |
| Supporttillgänglighet | Finns det snabb support när du behöver den? Kontrollera om support dygnet runt, servicenivåavtal och tillgång till teknisk expertis ingår. |
Vad är SRE-övervakningsverktyg?
SRE-övervakningsverktyg är programvaruplattformar som hjälper SRE-ingenjörer att spåra, analysera och reagera på systemprestanda och tillförlitlighet. Dessa verktyg tillhandahåller instrumentering för att samla in mätvärden, loggar och spårningar, vilket ger insyn från början till slut i applikationer och infrastruktur. De integreras med plattformar för incidenthantering och arbetsflöden som jour schemaläggning för att varna jouringenjörer och hantera hela incidentlivscykeln. Funktioner som körböcker och orkestrering bidrar till att automatisera åtgärder och lösningar. SRE-verktyg ansluter även till APM, konfigurationshantering och infrastruktur som kod (IaC), vilket stödjer processer för provisionering och felsökning.
Funktioner i SRE-övervakningsverktyg
Var uppmärksam på följande viktiga funktioner när du väljer SRE-övervakningsverktyg:
- Insamling av mätvärden i realtid: Samlar kontinuerligt in data om systemets och applikationernas prestanda, vilket ger aktuella insikter för proaktiv övervakning och felsökning.
- Anpassningsbara aviseringar: Gör det möjligt att definiera specifika tröskelvärden och villkor som utlöser aviseringar, så att teamet snabbt kan reagera på incidenter och avvikelser.
- Automatiserad incidenthantering: Stödjer arbetsflöden som automatiskt utför åtgärder eller eskalerar problem baserat på fördefinierade regler, vilket minskar behovet av manuella insatser.
- Rollbaserad åtkomstkontroll: Gör det möjligt att hantera användarbehörigheter och begränsa åtkomsten till känsliga övervakningsdata och konfigurationsinställningar.
- Stöd för integrationer: Ansluter inbyggt till populära verktyg för aviseringar, ärendehantering, meddelanden och infrastrukturhantering, vilket effektiviserar arbetsflödena.
- Bevarande av historiska data: Lagrar övervakningsdata över tid, vilket möjliggör trendanalys, kapacitetsplanering och granskningar efter incidenter.
- Dynamisk upptäckt av entiteter: Identifierar och registrerar automatiskt nya infrastrukturkomponenter när miljön skalas upp eller förändras.
- Hantering av hemligheter: Lagrar och hanterar på ett säkert sätt autentiseringsuppgifter eller känslig information som behövs för kontroller, integrationer eller automatiseringsuppgifter.
- Underhållsläge: Gör det möjligt att tillfälligt undertrycka aviseringar under planerat underhåll eller kända avbrott, vilket förhindrar onödigt brus.
- Stöd för anpassade insticksprogram: Gör det möjligt att utöka övervakningsfunktionerna med skript eller insticksprogram som är anpassade efter unika system och krav.
Vanliga AI-funktioner i SRE-övervakningsverktyg
Utöver standardfunktionerna i SRE-övervakningsverktyg som anges ovan inför många av dessa lösningar AI-funktioner som:
- Avvikelsedetektering: Använder AI-algoritmer för att automatiskt identifiera ovanliga mönster eller avvikelser i systemets mätvärden, vilket hjälper team att upptäcka incidenter innan de eskalerar.
- Prediktiva aviseringar: Använder maskininlärning för att förutsäga potentiella avbrott eller prestandaproblem baserat på historiska data och trender, vilket möjliggör proaktiva åtgärder.
- Automatiserad orsaksanalys: Använder AI för att korrelera händelser och loggar, identifiera den sannolika källan till incidenter och minska tiden som läggs på manuell undersökning.
- Intelligent brusreducering: Filtrerar och grupperar relaterade aviseringar med hjälp av AI, vilket minskar aviseringströtthet genom att endast lyfta fram de mest relevanta och handlingsbara aviseringarna.
- Prioritering av incidenter: Använder AI för att bedöma incidenternas potentiella påverkan och rangordna dem automatiskt, vilket hjälper team att först fokusera på de mest kritiska problemen.
Fördelar med SRE-övervakningsverktyg
Implementering av SRE-övervakningsverktyg ger flera fördelar för teamet och verksamheten. Här är några av de fördelar du kan se fram emot:
- Snabbare incidenthantering: Automatiserade aviseringar och incidentarbetsflöden hjälper teamet att snabbt upptäcka och lösa problem, vilket minimerar driftstopp.
- Förbättrad systemtillförlitlighet: Kontinuerlig övervakning och proaktiva åtgärdsfunktioner bidrar till högre drifttid och stabilare tjänster.
- Bättre resursplanering: Bevarande av historiska data och trendanalys möjliggör smartare kapacitetsplanering och optimering av infrastrukturen.
- Minskad aviseringströtthet: Intelligenta aviserings- och brusreduceringsfunktioner säkerställer att teamet endast får handlingsbara aviseringar.
- Förbättrad säkerhet och efterlevnad: Rollbaserad åtkomstkontroll och hantering av hemligheter skyddar känsliga data och stödjer regulatoriska krav.
- Förenklat samarbete: Integration med meddelande- och ärendehanteringsverktyg håller alla samordnade under incidenter och efteranalyser.
- Skalbarhet för dynamiska miljöer: Dynamisk upptäckt av entiteter och flexibla integrationer gör det enklare att övervaka växande eller förändrad infrastruktur.
Kostnader och prissättning för SRE-övervakningsverktyg
Att välja övervakningsverktyg för SRE kräver en förståelse av de olika prismodellerna och planerna som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga planer, deras genomsnittliga priser och typiska funktioner som ingår i lösningar med övervakningsverktyg för SRE:
Jämförelsetabell för planer för övervakningsverktyg för SRE
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
| Gratisplan | $0 | Grundläggande övervakning, begränsad avisering, communitysupport och åtkomst för ett litet team. |
| Personlig plan | $5-$25/användare/månad | Utökade mätvärden, anpassade aviseringar, integrationer med meddelandeverktyg och grundläggande rapportering. |
| Företagsplan | $25-$75/användare/månad | Avancerad incidenthantering, rollbaserad åtkomstkontroll, lagring av historiska data och förbättrad support. |
| Plan för stora företag | $75-$150/användare/månad | Stöd för anpassade insticksprogram, dynamisk upptäckt av entiteter, avancerade säkerhetsfunktioner, dedikerad introduktion och SLA:er. |
Vanliga frågor om övervakningsverktyg för SRE
Här är några svar på vanliga frågor om övervakningsverktyg för SRE:
Hur skiljer sig övervakningsverktyg för SRE från traditionella övervakningslösningar?
Övervakningsverktyg för SRE fokuserar på metoder inom tillförlitlighetsteknik och erbjuder funktioner som automatiserad incidenthantering, felbudgetering och dynamisk upptäckt av infrastruktur. Traditionella övervakningsverktyg kanske endast spårar mätvärden och skickar aviseringar, medan SRE-verktyg hjälper team att hantera mål för tillförlitlighet och förenkla incidentarbetsflöden.
Kan övervakningsverktyg för SRE integreras med befintliga DevOps-verktygskedjor?
Ja, de flesta övervakningsverktyg för SRE erbjuder integrationer med populära DevOps-plattformar, ärendehanteringssystem, meddelandeappar och CI/CD-pipelines. Det gör att teamet kan koppla övervakningsdata till de verktyg för incidenthantering, samarbete och automatisering som ni redan använder.
Vad bör jag tänka på när jag skalar övervakningsverktyg för SRE i en växande miljö?
Leta efter lösningar som stöder dynamisk upptäckt av entiteter, flexibla integrationer och skalbar datalagring. Se till att verktyget kan hantera större datamängder, fler användare och komplex infrastruktur utan prestandaproblem eller alltför stora kostnadsökningar.
Finns det säkerhetsrisker med att implementera övervakningsverktyg för SRE?
Ja, precis som med alla övervakningslösningar finns det säkerhetsaspekter att ta hänsyn till. Välj verktyg med starka åtkomstkontroller, krypterad datalagring och granskningsloggning. Granska hur verktyget hanterar känsliga autentiseringsuppgifter och säkerställ att det följer organisationens säkerhetspolicyer.
Hur lång tid tar det att implementera ett övervakningsverktyg för SRE?
Implementeringstiden varierar beroende på verktyget och miljöns komplexitet. Många lösningar erbjuder snabbstartsguider, mallar och stöd vid introduktionen, så att små team kan komma igång på några timmar eller dagar. Större eller mer komplexa miljöer kan kräva mer planering och en stegvis utrullning.