

När man utforskar området artificiell intelligens stöter man ofta på en mängd verktyg för naturlig språkbehandling, där vart och ett erbjuder unika funktioner. Från botar som drivs av avancerade NLP-modeller till appar för maskinöversättning och sammanfattning – dessa verktyg utgör ryggraden i dagens automationslandskap.
Med utgångspunkt i min erfarenhet av naturlig språkförståelse, frågebesvarande, entitetsutvinning och programmeringsspråkens särdrag har jag sett hur virtuella assistenter och NLP-applikationer har revolutionerat interaktioner. Genom att fördjupa dig i dessa alternativ kan du slippa utmaningen med att sålla igenom data manuellt och överbrygga avståndet mellan stora informationsmängder och användbara insikter.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Sammanfattning av de bästa NLP-programmen
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för lokal distribution av konversationsbaserad NLP | Gratisplan + gratisdemo tillgänglig | Pris på begäran | Website | |
| 2 | Bäst för åtkomst till ledande LLM:er via API | Gratis plan tillgänglig | Från $20/användare/månad | Website | |
| 3 | Bäst för enhetlig analys av textdata och strukturerade data | 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Pris på begäran | Website | |
| 4 | Bäst för dokumentbearbetning med lång kontext via öppna LLM:er | Inte tillgängligt | Pris på begäran | Website | |
| 5 | Bäst för heltäckande finjustering av LLM:er i stor skala | Gratisabonnemang tillgängligt | Från $0.04/credit | Website | |
| 6 | Bäst för AWS-inbyggda textinsikter i stor skala | Gratisabonnemang tillgängligt | Från $0.0001/enhet | Website | |
| 7 | Bäst för driftsättning av produktionsklara NLP-bearbetningsflöden | Gratisplan tillgänglig | Gratisplan tillgänglig | Website | |
| 8 | Bäst för styrd NLP i hybridmolndistributioner | Gratisplan + kostnadsfri provperiod + kostnadsfri demo tillgängliga | Från $1,110/månad | Website | |
| 9 | Bäst för GCP-interna pipelines för textanalys | Gratisabonnemang tillgängligt | Från $0.90/1,000 tecken (faktureras årsvis) | Website | |
| 10 | Bäst för finjustering av modeller med öppen källkod i stor skala | Gratisabonnemang finns tillgängligt | Från $9/månad | Website |




Recensioner av de bästa NLP-programmen
 1Bäst för lokal distribution av konversationsbaserad NLP
Rasa
- Gratisplan + gratisdemo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.2/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.
Rasa låter användare konfigurera konversationsflöden med en visuell flödesbyggare. Rasa är ett NLP-ramverk med öppen källkod för konversationsbaserade system som erbjuder en modulär NLU-pipeline, anpassad avsiktsklassificering, namngiven entitetsigenkänning, LLM-integration via sin CALM-arkitektur samt produktionsklara distributionsalternativ, inklusive lokala och isolerade miljöer.
Vem passar Rasa bäst för?
Rasa passar bra för ML/NLP-ingenjörer och DevOps-team i reglerade branscher som behöver full kontroll över sin distributionsmiljö för konversationsbaserad AI.
Varför jag valde Rasa
Jag har tagit med Rasa bland mina främsta val eftersom det är det starkaste alternativet jag har hittat för team som behöver distribuera konversationsbaserad NLP helt på sin egen infrastruktur. Den Kubernetes-nativa distributionen via Helm-diagram, stödet för isolerade miljöer och hanteringen av hemligheter med HashiCorp Vault gör Rasa till ett naturligt val för reglerade branscher som sjukvård och finans, där data aldrig lämnar den egna säkerhetsperimetern. Jag uppskattar också CALM-arkitekturen, som separerar språkförståelse driven av LLM från deterministisk affärslogik och därmed håller agentens beteende förutsägbart och granskningsbart i produktion.
Rasas viktigaste funktioner
- DIET-klassificerare: En transformerbaserad modell som hanterar avsiktsklassificering och entitetsidentifiering samtidigt inom en enda träningsbar arkitektur.
- Routning mellan flera LLM: Gör det möjligt att tilldela olika LLM till olika uppgifter inom samma agent, vilket ger dig kontroll över avvägningen mellan kostnad och svarstid.
- Enterprise-RAG-modul: Ansluter till anpassade vektordatabaser för kunskapsinhämtning i realtid och förankrar svaren i dina egna data utan att modellen behöver tränas om.
- Återanvändning av flöden på flera språk: Distribuerar samma konversationsflöden på flera språk och stöder språkbyte mitt i en konversation utan att kontexten går förlorad.
Rasa-integrationer
Rasa dokumenterar integrationer med Hugging Face Transformers, spaCy, scikit-learn, Duckling, GPT-4, Llama, Redis, Apache Kafka, HashiCorp Vault och OpenTelemetry. REST- och WebSocket-API:er stöder anpassade integrationer.
Pros and Cons
Pros:
- Lokal distribution och distribution i isolerade miljöer stöds
- Helt öppen källkod med anpassningsbara pipelines
- Återanvändning av flöden på flera språk med bibehållen kontext
Cons:
- Ingen inbyggd sentimentanalys eller textsammanfattning
- Utgåvan med öppen källkod är i underhållsläge
Learn more about Rasa: Bäst för åtkomst till ledande LLM:er via API
- Gratis plan tillgänglig
- Från $20/användare/månad

OpenAI Playground låter användare köra frågor med kodtolken via assistenter. OpenAI är en AI-plattform som ger utvecklare API-åtkomst till en omfattande katalog av stora språkmodeller, inbäddningsmodeller och talmodeller för att bygga NLP-applikationer för uppgifter som textklassificering, entitetsutvinning, textsammanfattning, översättning och semantisk sökning.
Vem passar OpenAI bäst för?
OpenAI passar bra för ML-ingenjörer och utvecklingsteam som behöver tillförlitlig, skalbar API-åtkomst till ledande språkmodeller utan att hantera någon underliggande infrastruktur.
Varför jag valde OpenAI
OpenAI finns med på min kortlista eftersom ingen annan plattform ger dig direkt API-åtkomst till en bredare katalog av ledande modeller på den här kvalitetsnivån. Jag uppskattar särskilt hur Responses API, Batch API och inbäddningsmodellerna samverkar: du kan köra NER- eller klassificeringsjobb i stor skala till 50 % lägre kostnad via Batch API och sedan mata utdata till
text-embedding-3-largeför semantisk klustring, allt utan att hantera någon infrastruktur. Programmet för anpassade modeller är ytterligare en höjdpunkt, med bevisade produktionsresultat som Harveys 83-procentiga ökning av träffsäkerheten inom juridisk NLP.Viktiga funktioner i OpenAI
- Tiktoken-tokeniserare: En tokeniserare med öppen källkod baserad på BPE som speglar OpenAI:s interna tokenisering och låter dig räkna token och hantera gränserna för kontextfönstret innan du gör API-anrop.
- Strukturerade utdata via JSON-läge: Tvingar modellsvar att följa ett definierat JSON-schema, vilket gör det tillförlitligt för att extrahera entiteter eller klassificeringsetiketter i stor skala.
- API för inbäddningar: Genererar täta vektorrepräsentationer av text med hjälp av
text-embedding-3-smallellertext-embedding-3-largeför semantisk sökning, klustring och klassificeringsuppgifter. - Batch API: Bearbetar stora volymer inferensförfrågningar asynkront till 50 % lägre kostnad jämfört med synkrona API-anrop.
OpenAI-integrationer
OpenAI integreras med LangChain, LlamaIndex, Azure OpenAI Service, Pinecone, Weaviate, Qdrant, Chroma och Temporal. Dess API:er och officiella SDK:er stöder anpassade anslutningar till vektordatabaser, företagssystem och CI/CD-arbetsflöden.
Pros and Cons
Pros:
- Ledande LLM:er uppdateras med branschens bästa riktmärken
- Batch API minskar kostnaderna för bearbetning i stor skala
- Finjustering med bevisade fallstudier från företag
Cons:
- Ingen lokal installation eller värdtjänst i privat moln
- Ingen klassisk NLP-förbearbetningspipeline exponeras
Learn more about OpenAI: Bäst för enhetlig analys av textdata och strukturerade data
- 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Pris på begäran

SAS Model Studio låter användare organisera textanalysprojekt på en och samma plats. SAS Visual Analytics är en plattform för företagsanalys och NLP som kombinerar visuell datautforskning, textanalys, ämnesmodellering, sentimentanalys och NER med en pipelinebyggare utan kod samt en generativ AI-assistent.
Vem passar SAS Visual Analytics bäst för?
SAS Visual Analytics passar bra för datavetenskapsteam inom företag som behöver analysera strukturerade och ostrukturerade textdata inom en enda styrd plattform.
Varför jag valde SAS Visual Analytics
Jag valde SAS Visual Analytics eftersom det är en av få NLP-plattformar som verkligen förenar analys av strukturerade data med textanalys utan att tvinga dig att koppla samman separata verktyg. SAS Visual Text Analytics, som körs parallellt med plattformen, hanterar NER, BERT-baserad sentimentanalys och ämnesmodellering i samma styrda miljö där dina strukturerade data redan finns. Jag uppskattar särskilt LLM-kalibreringsfunktionen, som låter dig justera modellens beteende för RAG-pipelines utan att ändra själva basmodellen, vilket är en stor fördel när du arbetar med känsliga företagsdata.
Viktiga funktioner i SAS Visual Analytics
- Textförbehandling på 33 språk: Tokenisering, lemmatisering och POS-taggning finns inbyggt för 33 språk, däribland arabiska, hindi, thailändska och vietnamesiska.
- Hybrid NLP-pipelinebyggare: Ett visuellt gränssnitt utan kod låter dig kombinera regelbaserade noder, maskininlärningsnoder och djupinlärningsnoder i en enda textanalys-pipeline.
- SAS Micro Analytic Score API: Ett tillståndslöst, minnesbaserat API för poängsättning som är byggt för högpresterande modellinferens i realtid i produktionsmiljöer.
- Portabla ASTORE-modellfiler: Tränade modeller exporteras som binära ASTORE-filer, vilket möjliggör modellkörning utanför SAS-miljön i molnbaserade och lokala målmiljöer.
Integrationer med SAS Visual Analytics
SAS Visual Analytics har inbyggda integrationer i Microsoft-ekosystemet, inklusive Microsoft 365 och Azure, samt stöd för distribution på AWS, Google Cloud Platform och Red Hat OpenShift. SAS Viya REST API:er och SDK:er stöder anpassade integrationer.
Pros and Cons
Pros:
- Inbyggt stöd för 33 språk
- Enhetlig plattform för textdata och strukturerade data
- Generativ AI med inbyggda kontroller av snedvridning
Cons:
- Avancerade NLP-funktioner kräver ett separat tillägg
- Mindre flexibel än NLP-ramverk med öppen källkod
Learn more about SAS Visual Analytics: Bäst för dokumentbearbetning med lång kontext via öppna LLM:er
- Inte tillgängligt
- Pris på begäran

AI21 Studio låter användare definiera uttryckliga utdatakrav för varje API-körning. AI21 Studio är en LLM-plattform byggd kring Jamba-familjen av hybrida Mamba-Transformer-modeller, som erbjuder textgenerering, sammanfattning, frågebesvarande, klassificering, RAG-orkestrering och finjustering i flera nivåer via API, SDK och hanterade molntjänster.
Vem passar AI21 Studio bäst för?
AI21 Studio passar bra för ML-ingenjörer och företagsteam som bygger RAG-datapipelines eller kunskapsarbetsflöden ovanpå stora, ostrukturerade dokumentsamlingar.
Varför jag valde AI21 Studio
AI21 Studio tar plats på min kortlista tack vare hur väl Jamba-modellfamiljen hanterar verkligt stora dokumentarbetsbelastningar. Kontextfönstret på 256K token är det största som finns bland modeller med öppna vikter, vilket innebär att jag kan mata in hela avtal, kliniska prövningsrapporter eller M&A-dokument i ett enda inferensanrop utan att dela upp dem i segment. Kombinera detta med orkestreringslagret Maestro RAG, som dynamiskt dirigerar mellan filsökning, webbsökning och LLM:er samtidigt som det tillhandahåller en visuell körningsgraf, så får du en kraftfull pipeline för att extrahera strukturerade insikter från täta, ostrukturerade dokumentsamlingar.
Viktiga funktioner i AI21 Studio
- Jambas hybrida arkitektur: Jamba-modeller kombinerar Mamba-SSM-lager med Transformer-uppmärksamhet i en blandning av experter, vilket ger upp till 2,5× snabbare inferens än transformerbaserade modeller av jämförbar storlek.
- API för finjustering i flera nivåer: Stöder fullständig finjustering, LoRA och QLoRA via standardbibliotek från HuggingFace, samt en hanterad efterträningstjänst för företagsteam som vill äga den resulterande modellen.
- Intelligent routningslager: Ett routningslager som kan läggas till direkt och som analyserar kostnaden per agent, komprimerar överflödig kontext och adaptivt väljer modeller för varje tur – för närvarande kostnadsfritt under betaperioden.
- Öppna modellvikter på Hugging Face: Jamba-modellerna är offentligt tillgängliga under Jamba Open Model License, vilket gör att ditt team kan drifta dem själva, inspektera eller vidareanpassa dem utan leverantörsinlåsning.
AI21 Studio-integrationer
AI21 Studio integreras med AWS, Microsoft Azure, Google Cloud, NVIDIA NIM, Hugging Face, LangChain, LlamaIndex, Pinecone, Snowflake och Databricks. Dess REST-API, Python-SDK och TypeScript-SDK stöder anpassade integrationer och distributionsarbetsflöden.
Pros and Cons
Pros:
- Hanterar långa dokumentindata på 256K token
- Stöder fullständig finjustering samt LoRA och QLoRA
- Öppna modellvikter för självhosting
Cons:
- Inget dedikerat API för NER eller sentimentanalys
- Saknar en visuell NLP-pipelinebyggare utan kod
Learn more about AI21 Studio: Bäst för heltäckande finjustering av LLM:er i stor skala
- Gratisabonnemang tillgängligt
- Från $0.04/credit
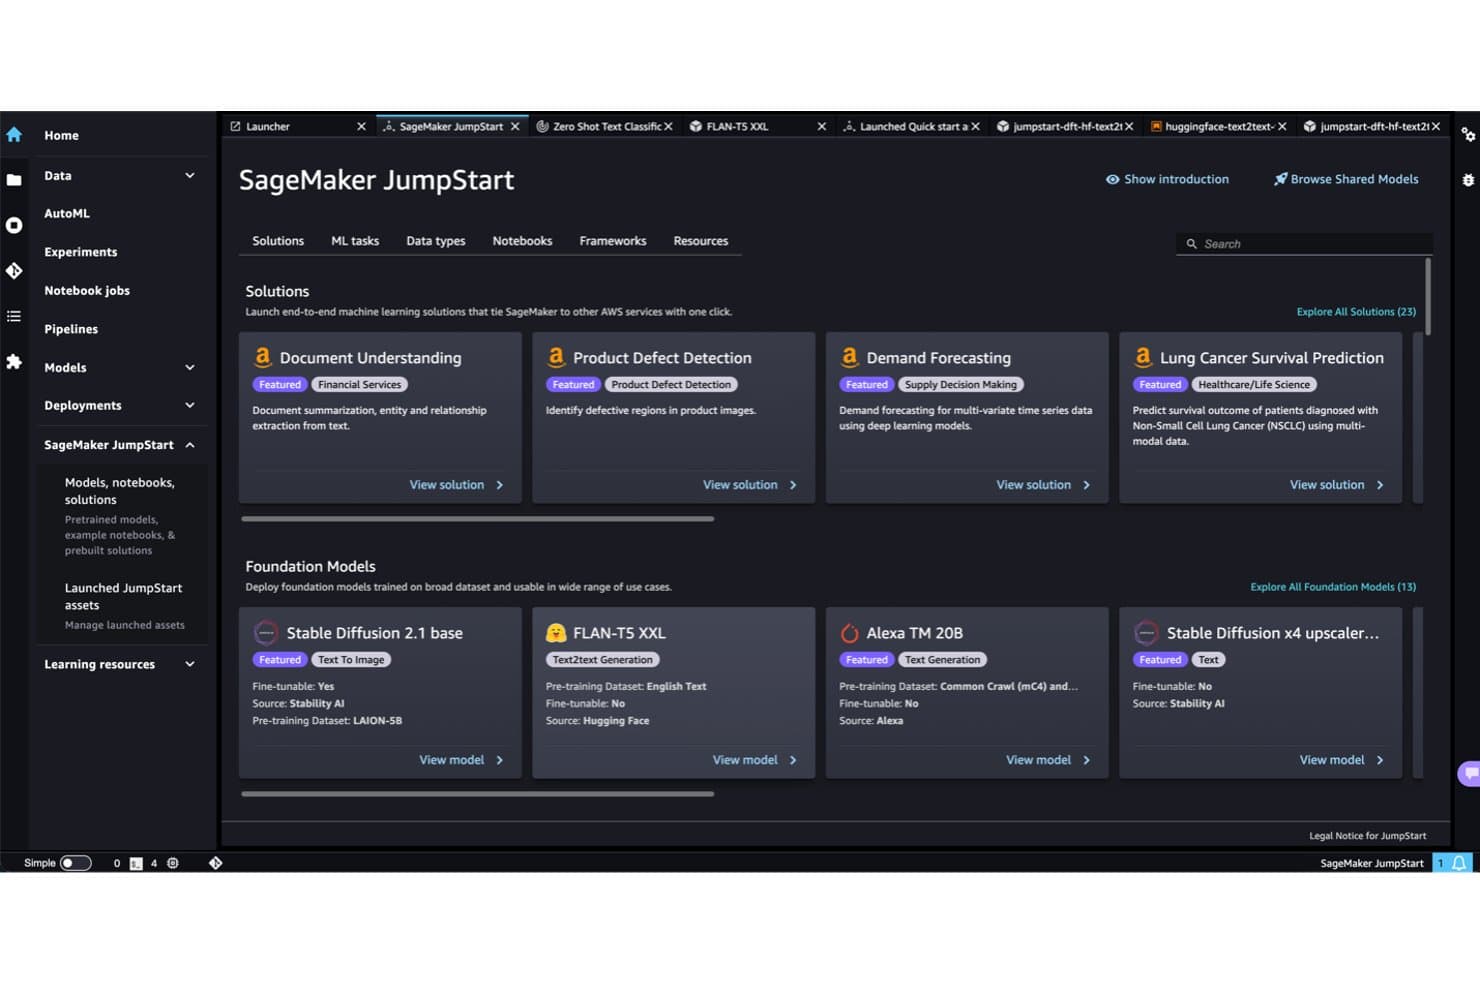
Amazon SageMaker JumpStart erbjuder förbyggda NLP-modeller som är redo att driftsättas. Amazon SageMaker är AWS:s hanterade ML-plattform som täcker hela livscykeln för NLP-modeller – från databearbetning och tokenisering till träning, finjustering och driftsättning av stora språkmodeller i stor skala via verktyg som JumpStart, HyperPod och inbyggda integrationer med Hugging Face.
Vem passar Amazon SageMaker bäst för?
Amazon SageMaker passar ML-ingenjörer och MLOps-team på medelstora till stora företag som behöver en enda plattform för att ta LLM:er från rådata till produktion i stor skala.
Varför jag valde Amazon SageMaker
Amazon SageMaker tar plats på min kortlista eftersom ingen annan hanterad ML-plattform kan mäta sig med dess djupgående stöd för heltäckande finjustering av LLM:er i stor skala. Jag är särskilt imponerad av HyperPod, som låter dig köra distribuerad finjustering över hundratals acceleratorer med elastisk träning utan kontrollpunkter, vilket minskar träningstiden med upp till 40 %. JumpStarts katalog med över 1 000 modeller, inklusive Llama 4, DeepSeek R1 och medicinska LLM:er från John Snow Labs, innebär att jag kan gå från att välja en domänspecifik basmodell till att finjustera den med anpassade data utan att lämna plattformen.
Viktiga funktioner i Amazon SageMaker
- SageMaker Clarify: Identifierar bias och genererar rapporter om förklarbarhet för NLP-modeller under träning, utvärdering och övervakning efter driftsättning.
- SageMaker Data Wrangler: Tillhandahåller ett gränssnitt med lite kod för att importera, transformera och förbereda textdata före modellträning.
- Inferenspunkter med flera lägen: Stöder realtidsinferens, serverlös, asynkron och batchbaserad inferens på över 70 instanstyper, inklusive Inferentia- och Trainium-chip.
- Hanterad MLflow-integration: Spårar experiment, jämför modellkörningar och hanterar versionshantering i NLP-arbetsflöden utan krav på separat infrastruktur.
Integrationer med Amazon SageMaker
Amazon SageMaker har inbyggda integrationer med Amazon S3, Amazon Bedrock, Amazon OpenSearch Service, Amazon EKS, AWS Lambda, Amazon CloudWatch, AWS IAM, Hugging Face och MLflow. Plattformen erbjuder även REST-API:er, SDK:er och åtkomst via AWS CLI för anpassade integrationer.
Pros and Cons
Pros:
- Största tillgängliga katalogen med förtränade modeller
- HyperPod stöder omfattande distribuerad LLM-träning
- Heltäckande livscykel med verktyg för förklarbarhet
Cons:
- Kostnadsuppföljning är svår för de flesta team
- Risk för leverantörsinlåsning för verksamheter med flera moln
Learn more about Amazon SageMaker: Bäst för AWS-inbyggda textinsikter i stor skala
- Gratisabonnemang tillgängligt
- Från $0.0001/enhet
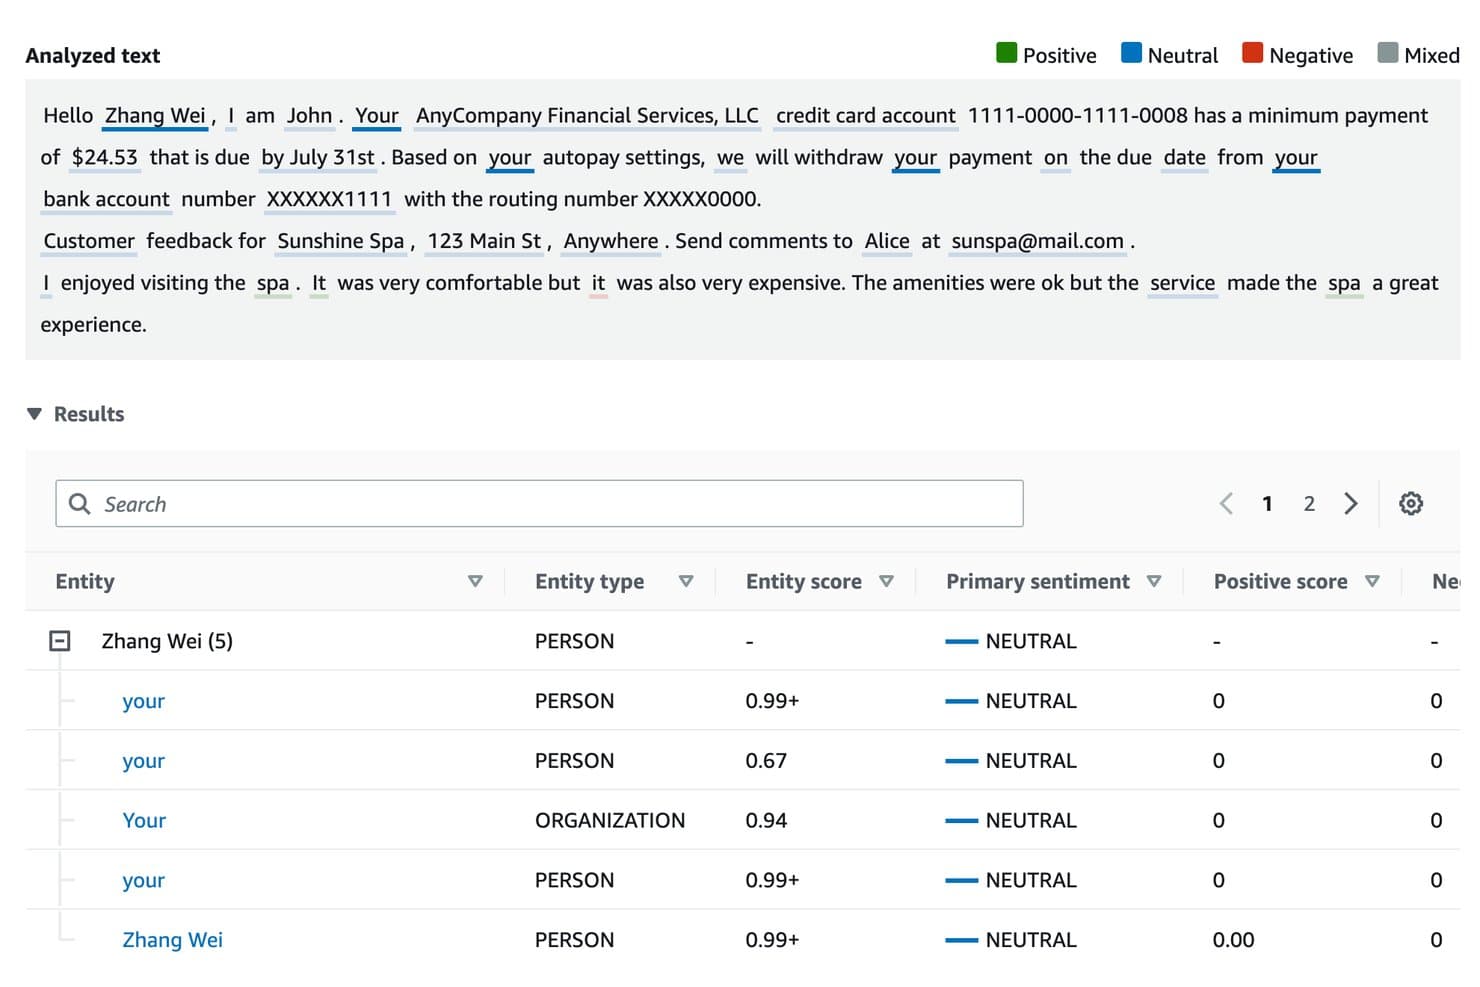
Amazon Comprehend identifierar entiteter och känslolägen i analyserad text. Amazon Comprehend är en helt hanterad AWS NLP-tjänst som levererar förbyggda, API-drivna funktioner för textanalys – inklusive sentimentanalys, identifiering av namngivna entiteter, upptäckt av personligt identifierbar information, extrahering av nyckelfraser och träning av anpassade modeller via AutoML – utan att du behöver hantera någon underliggande infrastruktur.
Vem passar Amazon Comprehend bäst för?
Amazon Comprehend passar bra för teknik- och DevOps-team som redan kör arbetsbelastningar i AWS och behöver produktionsklar NLP utan att hantera någon ML-infrastruktur.
Varför jag valde Amazon Comprehend
Amazon Comprehend finns med på min kortlista eftersom tjänsten är det mest naturliga valet för AWS-inbyggd textanalys i stor skala. Jag gillar att du kan köra sentimentanalys, riktad identifiering av entiteter och maskering av personligt identifierbar information direkt via hanterade API-slutpunkter utan att tillhandahålla en enda server. I praktiken innebär det att mitt team kan bearbeta miljontals kundposter från S3 asynkront, med volymbaserad prissättning som faktiskt blir billigare ju mer du analyserar.
Viktiga funktioner i Amazon Comprehend
- Anpassad identifiering av entiteter: Träna en domänspecifik entitetsidentifierare på dina egna märkta exempel för att extrahera termer som försäkringsnummer eller interna koder som de förbyggda modellerna inte upptäcker.
- Upptäckt och maskering av personligt identifierbar information: Identifiera och maskera automatiskt känsliga personuppgifter – namn, SSNs, kreditkortsnummer – direkt i din dokumentbearbetningspipeline.
- Automatisering av MLOps med Flywheel: Hantera hela livscykeln för anpassade modeller, från dataimport till omskolning och versionsbefordran, utan att bygga ett separat MLOps-lager.
- Ontologikoppling i Comprehend Medical: Mappa extraherade kliniska entiteter till standardiserade kodsystem som ICD-10-CM, RxNorm och SNOMED CT för NLP-arbetsflöden inom vården.
Integrationer med Amazon Comprehend
Amazon Comprehend har inbyggda integrationer med Amazon S3, AWS Lambda, AWS KMS, AWS IAM, Amazon Kendra, Amazon Lex, Amazon Connect, AWS CloudTrail och Amazon CloudWatch. Dess REST API, AWS SDK:er, AWS CLI, Step Functions och EventBridge stöder anpassade pipelines och automatisering av arbetsflöden.
Pros and Cons
Pros:
- Naturlig passform för AWS-centrerade NLP-arbetsflöden
- NLP för vården med mappning till kliniska ontologier
- Inbyggd upptäckt och maskering av personligt identifierbar information
Cons:
- Ingen åtkomst till modellernas interna funktioner
- Begränsad finjustering utöver grundläggande AutoML
Learn more about Amazon Comprehend: Bäst för driftsättning av produktionsklara NLP-bearbetningsflöden
- Gratisplan tillgänglig
- Gratisplan tillgänglig
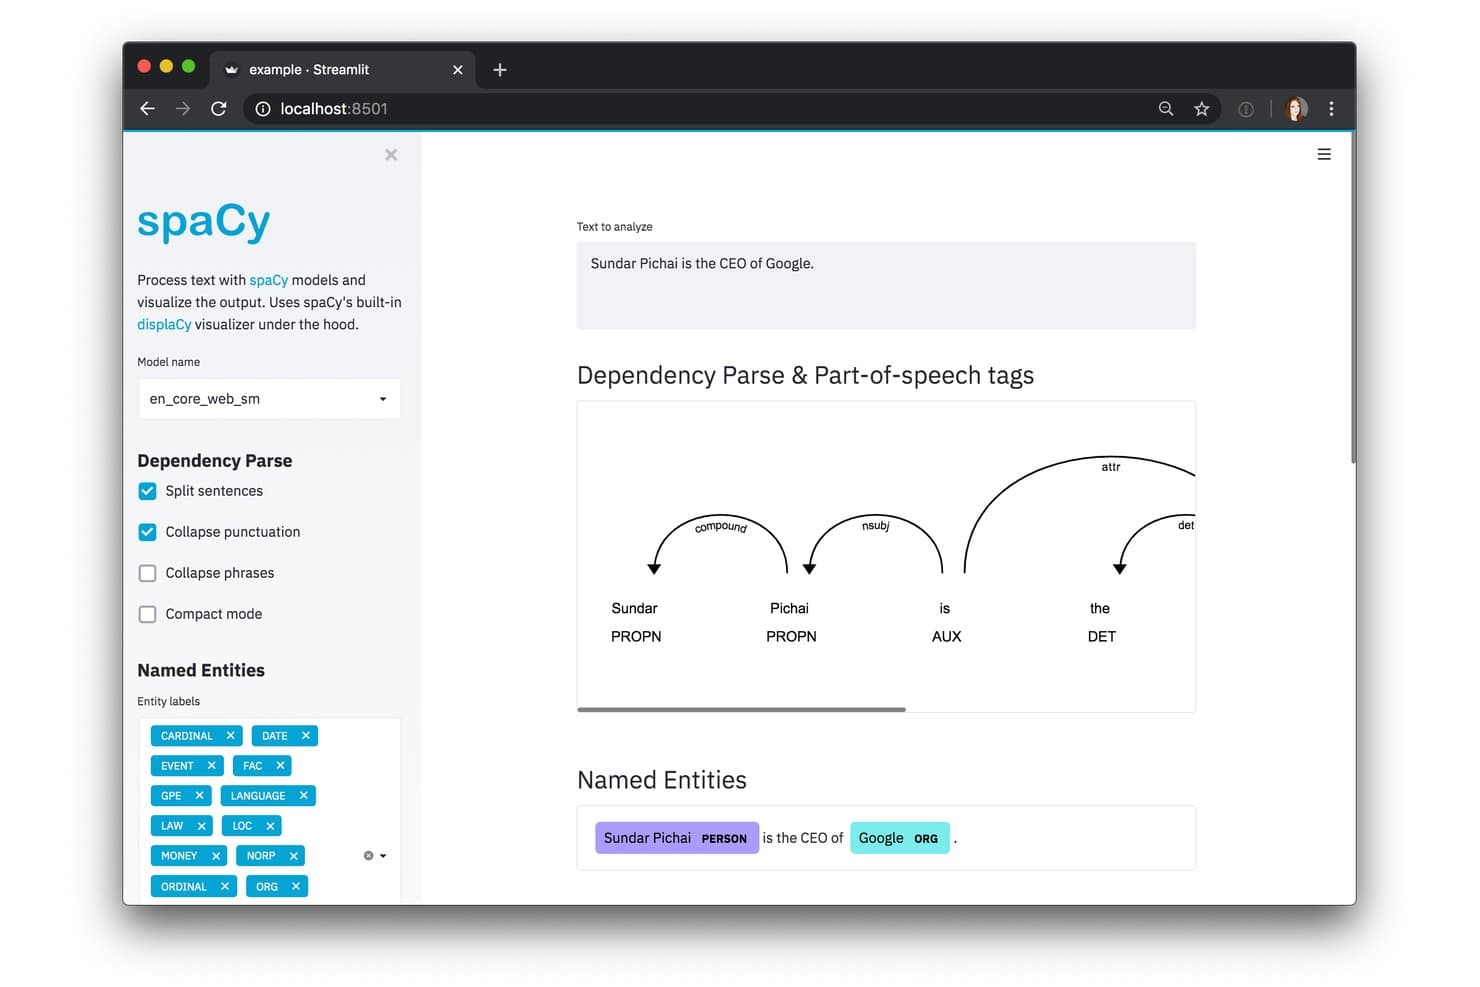
spaCy visualiserar beroendeparsning och namngivna entiteter interaktivt. spaCy är ett Python-bibliotek med öppen källkod för NLP som omfattar tokenisering, igenkänning av namngivna entiteter, beroendeparsning, textklassificering och modellträning baserad på transformatorer på över 75 språk.
Vem passar spaCy bäst för?
spaCy passar bra för ML-ingenjörer och datavetare som behöver bygga, träna och driftsätta NLP-bearbetningsflöden i Python utan att förlita sig på en hanterad plattform.
Varför jag valde spaCy
spaCy finns med på min kortlista eftersom det är byggt från grunden för produktion, inte bara experiment. Jag uppskattar att tränade bearbetningsflöden paketeras som installerbara Python-moduler, vilket innebär att driftsättning av en anpassad NER-modell i en Docker-container eller ett AWS Lambda-lager blir en repeterbar, versionshanterad process i stället för ett improviserat engångsarbete. Det konfigurationsstyrda systemet
spaCy trainsamlar varje hyperparameter och arkitekturval i en enda fil, så att mina bearbetningsflöden kan återskapas i olika miljöer. Den kombinationen av disciplinerad paketering och Cython-baserad batchgenomströmning vianlp.pipe()är det som gör spaCy verkligt produktionsklart.Viktiga funktioner i spaCy
- 84 förtränade bearbetningsflöden: Ladda ned och kör förtränade bearbetningsflöden på 25 språk, från kompakta CPU-optimerade modeller till fullständiga transformatorbaserade varianter byggda på RoBERTa och BERT.
spaCy-LLM-integrering: Anslut spaCy-bearbetningsflöden direkt till värdbaserade LLM-API:er (OpenAI, Anthropic, Cohere) eller modeller med öppen källkod för att köra NLP-uppgifter utan att behöva märkta träningsdata.- displaCy-visualiserare: Återge annoteringar av namngivna entiteter och träd för beroendeparsning i webbläsaren med hjälp av spaCys inbyggda visualiseringskomponent.
- Ekosystem för domänspecifika bearbetningsflöden: Få tillgång till färdiga bearbetningsflöden från communityn för hälso- och sjukvård (medspaCy) och juridiska texter (Blackstone) via biblioteket spaCy Universe.
Integrationer med spaCy
spaCy integreras med Hugging Face Transformers, PyTorch, TensorFlow, OpenAI, Anthropic, Cohere, LangChain, Prodigy, DVC, Prefect och Ray. Dess Python-API stöder anpassade integreringar, men det innehåller inget inbyggt REST-API.
Pros and Cons
Pros:
- Körs helt på din egen infrastruktur
- Erbjuder domänspecifika bearbetningsflöden för hälso- och sjukvård samt juridik
- Paketering möjliggör reproducerbara, versionshanterade modelldriftsättningar
Cons:
- Inget inbyggt REST-API för tillhandahållande
- Inget gränssnitt för kodfria eller visuella arbetsflöden
Learn more about spaCy: Bäst för styrd NLP i hybridmolndistributioner
- Gratisplan + kostnadsfri provperiod + kostnadsfri demo tillgängliga
- Från $1,110/månad

IBM watsonx.ai extraherar strukturerade fakta från SEC:s 10-K-rapporter med hjälp av few-shot-promptar. IBM watsonx.ai är en företagsplattform för AI som kombinerar en katalog med grundmodeller från flera leverantörer, Watson NLP-biblioteket, LoRA/QLoRA-finjustering, AutoML samt flexibla distributionsalternativ för SaaS, lokala miljöer och hybridmoln för att bygga och skala NLP-arbetsbelastningar.
Vem passar IBM watsonx.ai bäst för?
IBM watsonx.ai passar väl för företags-IT- och datavetenskapsteam som behöver bygga, finjustera och distribuera NLP-arbetsbelastningar i lokala miljöer samt hybrid- och molnmiljöer, med strikta krav på styrning och efterlevnad.
Varför jag valde IBM watsonx.ai
IBM watsonx.ai tar plats på min kortlista tack vare hur väl plattformen hanterar styrd NLP i hybridmolnmiljöer, vilket är en verklig särskiljande faktor för företagsteam med strikta krav på efterlevnad. Jag är särskilt imponerad av Watson NLP-biblioteket, som omfattar entitetsigenkänning, sentimentanalys, tonklassificering och semantisk rollmärkning på över 20 språk i en enda granskningsbar pipeline. Kombinera detta med CP4D på Red Hat OpenShift för lokala distributioner eller hybriddistributioner och AI Factsheets för granskningsspår för modeller, så får du heltäckande styrning inbyggd i varje lager.
Viktiga funktioner i IBM watsonx.ai
- Katalog med grundmodeller från flera leverantörer: Få tillgång till förtränade modeller från IBM Granite, Meta Llama, Mistral, DeepSeek och NVIDIA i ett enda värdbaserat bibliotek.
- LoRA/QLoRA-finjustering: Anpassa grundmodeller för domänspecifika NLP-uppgifter med parametereffektiv finjustering i GPU-accelererade miljöer.
- AutoAI-pipelinebyggare: Hanterar automatiskt dataförberedelse, funktionskonstruktion, modellval och hyperparameterjustering för prediktiva ML-arbetsflöden.
- OpenAI-kompatibel API-slutpunkt: Anslut befintliga applikationer till inferens i watsonx.ai med ett OpenAI-kompatibelt REST API-format tillsammans med SDK:er för Python, Node.js och Java.
IBM watsonx.ai-integrationer
IBM watsonx.ai integreras med Hugging Face, Red Hat OpenShift, watsonx.data, Watson Assistant, watsonx Orchestrate, Watson Discovery och IBM Cloud Object Storage. Dess REST API samt SDK:er för Python, Node.js och Java stöder anpassade integrationer.
Pros and Cons
Pros:
- Brett stöd för NLP-uppgifter på över 20 språk
- Skadeersättning för immateriella rättigheter för IBMs företagsmodeller
- Inbyggt stöd för RAG och vektorsökning
Cons:
- IBMs proprietära modeller är inte tillgängliga för AWS
- Gränssnittet kan vara förvirrande för nya användare
Learn more about IBM watsonx.ai: Bäst för GCP-interna pipelines för textanalys
- Gratisabonnemang tillgängligt
- Från $0.90/1,000 tecken (faktureras årsvis)

Google Cloud Natural Language AI annoterar entiteter i CV:n, som kompetenser och arbetsgivare. Google Cloud Natural Language AI är ett hanterat NLP-API från Google som tillhandahåller förtränad sentimentanalys, entitetsigenkänning, syntaxanalys, innehållsklassificering och textmoderering via REST- och gRPC-gränssnitt med klientbibliotek för åtta programmeringsspråk.
Vem passar Google Cloud Natural Language AI bäst för?
Google Cloud Natural Language AI passar bra för utvecklingsteam som redan kör arbetsbelastningar på GCP och behöver produktionsklar NLP utan att hantera infrastrukturen själva.
Varför jag valde Google Cloud Natural Language AI
Google Cloud Natural Language AI tar plats på min kortlista eftersom det passar så naturligt in i GCP-interna pipelines för textanalys. Om ditt team redan kör data genom BigQuery kan du anropa
ML.UNDERSTAND_TEXTdirekt i SQL för att köra sentiment- eller entitetsanalys utan att någonsin lämna datalagret. Jag uppskattar också att v2-API:et använder en PaLM-baserad modell för entitets- och sentimentuppgifter, och att metodenannotateTextlåter dig hämta flera NLP-funktioner i ett enda API-anrop, vilket minskar omkostnaderna för rundresor avsevärt.Viktiga funktioner i Google Cloud Natural Language AI
- Entitetsbaserad sentimentanalys: Identifierar sentimentet som hör samman med varje namngiven entitet i en text och returnerar poäng per entitet för engelska, japanska och spanska.
- AutoML Natural Language: Låter dig träna anpassade modeller för textklassificering och entitetsutvinning på dina egna märkta dataset via ett visuellt gränssnitt utan kod i Vertex AI.
- Slutpunkter i flera regioner: Dirigerar API-förfrågningar via slutpunkter i USA eller EU för att hålla data bearbetad och lagrad inom en specifik region i enlighet med krav på dataresidens.
- HIPAA-berättigat API: Omfattas av Google Clouds avtal om affärspartner, vilket gör det användbart för arbetsflöden som hanterar skyddad hälsoinformation.
Integrationer med Google Cloud Natural Language AI
Google Cloud Natural Language AI integreras med Vertex AI, BigQuery, Cloud Composer, Speech-to-Text, Translation API, Vision API, Dataflow, Cloud Run och Cloud Functions. REST, gRPC och åtta klientbibliotek stöder anpassade integrationer.
Pros and Cons
Pros:
- Förtränade modeller kräver inga träningsdata
- Data lagras aldrig efter API-bearbetning
- Flerspråksstöd för viktiga NLP-funktioner
Cons:
- Ingen modellförklarbarhet eller några mått på snedvridning
- Finjustering är endast tillgänglig via Vertex AI
Learn more about Google Cloud Natural Language AI: Bäst för finjustering av modeller med öppen källkod i stor skala
- Gratisabonnemang finns tillgängligt
- Från $9/månad

HuggingChat låter användare ställa frågor till AI-modeller via ett webbchattgränssnitt. Hugging Face är en NLP-plattform med öppen källkod som ger dig tillgång till över 2 miljoner förtränade modeller samt en komplett uppsättning verktyg för tokenisering, finjustering och modelldistribution i moln- och lokala miljöer.
Vem passar Hugging Face bäst för?
Hugging Face är förstahandsplattformen för ML- och NLP-ingenjörer som behöver direkt tillgång till modeller med öppen källkod och hela verktygskedjan för att finjustera, utvärdera och distribuera dem i stor skala.
Varför jag valde Hugging Face
Hugging Face finns med på min kortlista eftersom ingen annan plattform kommer i närheten när det gäller finjustering av modeller med öppen källkod i stor skala. Jag uppskattar att PEFT och QLoRA låter dig finjustera LLM-modeller med miljarder parametrar, som LLaMA eller Mistral, på en enda GPU, vilket minskar beräkningskostnaderna avsevärt utan att kvaliteten försämras. TRL-biblioteket lägger dessutom till fullt stöd för RLHF och DPO, så att du kan anpassa domänspecifika modeller med minimala omkostnader.
Viktiga funktioner i Hugging Face
- Transformers API för pipelines: Ett gränssnitt på en enda rad för att köra NLP-uppgifter—klassificering, NER, textsammanfattning, översättning och frågor och svar—mot valfri modell på Hubben.
- AutoTrain: Ett gränssnitt för träning utan kod där du laddar upp ett märkt dataset, väljer en uppgift och låter plattformen automatiskt hantera modellval och träning.
- Inferens för textinbäddningar (TEI): En särskild inferensmotor optimerad för generering av inbäddningar med hög genomströmning, med stöd för semantisk sökning och RAG-pipelines i stor skala.
- API för inferensleverantörer: En enhetlig OpenAI-kompatibel slutpunkt som dirigerar förfrågningar mellan leverantörer som Groq, Together AI och Cerebras med hjälp av en enda Hugging Face-token.
Hugging Face-integreringar
Hugging Face integreras med PyTorch, TensorFlow, JAX, AWS SageMaker, Google Cloud, Azure, Weights & Biases, MLflow och Snowflake. Plattformens API:er för Python, JavaScript, REST och CLI stöder anpassade integreringar och distributionsarbetsflöden.
Pros and Cons
Pros:
- Oöverträffat urval av NLP-modeller med öppen källkod
- Möjliggör finjustering av enorma modeller på en enda GPU
- AutoTrain möjliggör modellträning utan kod
Cons:
- Modeller från communityn varierar i kvalitet och säkerhet
- Företagsklar distribution kräver DevOps-kompetens
Learn more about Hugging Face:
Andra NLP-program
Nedan finns en lista över ytterligare NLP-program som jag valde ut men som inte kom med bland de 10 bästa. De är definitivt värda att ta en titt på.
- 11NLP CloudBäst för integritetsfokuserad NLP API-distribution
- 12SnorkelBäst för programmatisk märkning i företagsskala
- 13ClaudeBäst för säkerhetsfokuserad NLP i alla större moln
- 14Cohere NorthBäst för distribution av NLP-modeller i isolerade nätverk
- 15Microsoft Azure AI LanguageBäst för NLP i isolerade nätverk inom reglerade branscher
- 16NLTKBäst för klassisk NLP utan infrastrukturkostnad
- 17Stanford NLPBäst för språklig precision på över 80 språk
Så utvärderar jag NLP-programvara
Från NER-bearbetningskedjor till produktionsdistributioner av transformatorer utvärderar jag NLP-verktyg i två lager: den grundnivå som varje plattform måste klara för att komma med på listan och de särskiljande egenskaper som skiljer de bästa från resten.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer verktyg till min lista rangordnar jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärkt inom området) för varje kärnfunktion nedan. Därefter räknar jag om verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en minsta totalpoäng på 75 % för att komma i fråga.
- Textförbehandling och tokenisering: Jag kontrollerar om en plattform hanterar hela rensningskedjan—tokenisering, stemming, lemmatisering och borttagning av stoppord—så att råtext blir klar för bearbetningskedjan på flera språk.
- Förtränade språkmodeller: Tillgång till aktuella transformatorarkitekturer är viktig. Jag letar efter en bred och regelbundet uppdaterad modellkatalog snarare än en handfull föråldrade alternativ.
- Täckning av centrala NLP-uppgifter: Varje verktyg bör stödja grundläggande uppgifter som NER, sentimentanalys, klassificering och sammanfattning—byggstenarna i de flesta produktionsarbetsflöden för NLP.
- Modellträning och finjustering: Jag utvärderar om du kan använda din egen datamängd och finjustera modeller med verklig kontroll över hyperparametrar, inte bara växla mellan några förinställningar bakom en guide.
- API- och SDK-åtkomst: Bra NLP-verktyg tillhandahåller REST-API:er och SDK:er för språk som Python och Java. Jag letar efter tydlig dokumentation, versionshanterade slutpunkter och kompatibilitet med ramverk.
- Driftsättning och skalbarhet: Jag bedömer hur varje plattform hanterar produktionsarbetsbelastningar—om den stöder automatisk skalning av inferens, batchbearbetning och flexibla beräkningsalternativ som tilldelning av GPU- eller TPU-resurser.
När jag har en lista över verktyg som uppfyller kriterierna tittar jag på vad som skiljer varje plattform från de andra.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
RAG-ramverk och stöd för vektorsökning är just nu viktiga särskiljande faktorer. Team som bygger LLM-drivna applikationer behöver inbyggd generering av inbäddningar och hämtningskedjor, inte eftermonterade nödlösningar. Jag letar också efter verktyg för förklarbarhet och detektering av snedvridning—när man driftsätter sentimentmodeller i produktion vill intressenter förstå varför en förutsägelse gjordes. Modellbibliotek för specifika områden sparar också mycket tid, särskilt för team inom vård eller juridik som annars skulle behöva ägna veckor åt att finjustera modeller för allmänna ändamål.
Bortom funktionerna
Flexibilitet vid driftsättning är viktig när säkerhetsteamet kräver lokal drift eller nätverksisolerade miljöer. Jag utvärderar om en plattform stöder moln-, hybrid- och egenhostade alternativ tillsammans med Kubernetes-orkestrering. Kontroller för datasekretess är lika viktiga—jag kontrollerar efterlevnad av SOC 2, alternativ för datalagringsregion och policyer utan datalagring, särskilt när bearbetningskedjor bearbetar känslig text som patientjournaler. Ekosystempassningen kompletterar bilden: ett verktyg som kan integreras med din MLOps-teknikstack och datainfrastruktur sparar månader av anpassat integrationsarbete.
Så väljer du NLP-program
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för val av programvara följer här en checklista över faktorer att ha i åtanke:
| Faktor | Vad du bör tänka på |
|---|---|
| FaktorSkalbarhet | Vad du bör tänka påKan programvaran växa tillsammans med ditt team? Leta efter verktyg som kan hantera större datamängder utan extra kostnader. Ta hänsyn till framtida behov och möjliga expansioner. |
| FaktorIntegrationer | Vad du bör tänka påFungerar den med dina befintliga system? Kontrollera kompatibiliteten med dina nuvarande verktyg för att undvika störningar i arbetsflödet. |
| FaktorAnpassningsbarhet | Vad du bör tänka påKan du anpassa den efter dina behov? Se till att du kan justera inställningar eller funktioner så att de passar dina specifika processer. |
| FaktorAnvändarvänlighet | Vad du bör tänka påÄr gränssnittet användarvänligt? Komplexa verktyg kan bromsa införandet. Leta efter intuitiv design som kräver minimal utbildning. |
| FaktorImplementering och introduktion | Vad du bör tänka påHur lång tid tar det att komma igång? Bedöm den tid som behövs för installation och utbildning. En snabb introduktion kan spara tid och resurser. |
| FaktorKostnad | Vad du bör tänka påRyms den inom din budget? Jämför prisplaner och var uppmärksam på dolda avgifter. Ta hänsyn till den totala ägandekostnaden, inte bara det ursprungliga priset. |
| FaktorSäkerhetsåtgärder | Vad du bör tänka påÄr dina data skyddade? Säkerställ att dataskyddsstandarder följs och leta efter kryptering och andra säkerhetsfunktioner. |
| FaktorTillgång till support | Vad du bör tänka påÄr supporttjänsterna tillgängliga när de behövs? Utvärdera tillgängligheten och kvaliteten på kundsupportkanaler som chatt, e-post eller telefon. |
Vad är NLP-program?
NLP-programvara är ett verktyg som bearbetar och analyserar data om mänskligt språk. Yrkesverksamma som dataforskare, marknadsförare och kundserviceteam använder dessa verktyg för att utvinna insikter och förbättra kommunikationen. Funktioner för textanalys, sentimentanalys och språköversättning hjälper till att förstå och svara på användarnas behov.
Sammantaget förbättrar dessa verktyg, inklusive programvara för konversationsintelligens, beslutsfattandet och effektiviteten i språkrelaterade uppgifter.
Funktioner
När du väljer NLP-programvara bör du hålla utkik efter följande viktiga funktioner:
- Textanalys: Bearbetar stora mängder textdata för att utvinna meningsfulla insikter och hjälper team att förstå trender och mönster.
- Sentimentanalys: Identifierar och kategoriserar åsikter som uttrycks i text för att bedöma kundernas attityder och förbättra strategierna för engagemang.
- Språköversättning: Konverterar text från ett språk till ett annat och underlättar global kommunikation och tillgänglighet.
- Röstigenkänningsprogramvara: Transkriberar talat språk till text, möjliggör röstinmatning och förbättrar tillgängligheten.
- Entitetsigenkänning: Identifierar och klassificerar viktiga element i text, såsom namn och datum, för bättre dataorganisering.
- Flerspråkigt stöd: Erbjuder funktioner på flera språk, vilket möjliggör bredare användning i olika regioner.
- Anpassningsbara modeller: Gör det möjligt för användare att anpassa algoritmer efter specifika behov, vilket ökar resultatens relevans och noggrannhet.
- Bearbetning i realtid: Ger omedelbar analys och återkoppling, vilket är avgörande för tidskänsliga tillämpningar och beslutsfattande.
- Inställningar för datasekretess: Säkerställer efterlevnad av dataskyddsbestämmelser och skyddar känslig information.
- Molnintegration: Möjliggör smidigt samarbete och åtkomst till data på olika plattformar och enheter.
Fördelar
Att implementera NLP-programvara ger flera fördelar för ditt team och ditt företag. Här är några som du kan se fram emot:
- Förbättrad kommunikation: Programvara för naturlig språkgenerering och taligenkänning gör global och tillgänglig kommunikation enklare.
- Förbättrat beslutsfattande: Textanalys och sentimentanalys ger insikter som ligger till grund för strategier och åtgärder.
- Tidsbesparingar: Bearbetning i realtid ger snabb återkoppling, vilket möjliggör snabbare svar och åtgärder.
- Kostnadseffektivitet: Automatisering av uppgifter som entitetsigenkänning minskar behovet av manuell datahantering och sparar resurser.
- Ökad noggrannhet: Anpassningsbara modeller säkerställer att resultaten skräddarsys efter specifika behov, vilket förbättrar resultatens precision.
- Datasäkerhet: Inställningar för datasekretess hjälper till att hålla känslig information säker och i enlighet med bestämmelserna.
- Skalbarhet: Flerspråkigt stöd och molnintegration möjliggör tillväxt och anpassningsförmåga på olika marknader.
Kostnader & prissättning
Att välja NLP-programvara kräver en förståelse för de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i NLP-programvarulösningar:
Jämförelsetabell för abonnemang för NLP-programvara
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| AbonnemangstypGratisabonnemang | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande textanalys, begränsat språkstöd och support från användargemenskapen. |
| AbonnemangstypPersonligt abonnemang | Genomsnittligt pris$10-$30/user/month | Vanliga funktionerSentimentanalys, språköversättning och e-postsupport. |
| AbonnemangstypFöretagsabonnemang | Genomsnittligt pris$40-$100/user/month | Vanliga funktionerTaligenkänning, entitetsigenkänning och telefonsupport. |
| AbonnemangstypAbonnemang för stora företag | Genomsnittligt pris$150+/user/month | Vanliga funktionerAnpassningsbara modeller, bearbetning i realtid och dedikerad kontohantering. |
Vanliga frågor om NLP-programvara
Här är svar på vanliga frågor om NLP-programvara:
Kan NLP-programvara integreras med mina befintliga verktyg?
De flesta NLP-programvaror erbjuder integrationsmöjligheter med populära plattformar som CRM-system och dataanalysverktyg. Kontrollera kompatibiliteten med din nuvarande teknikstack för att säkerställa ett smidigt arbetsflöde och smidig datadelning. Vissa lösningar kan kräva anpassad API-utveckling för integrationen.
Hur säker är NLP-programvara?
Säkerhetsfunktionerna varierar mellan olika leverantörer, men leta efter datakryptering, efterlevnad av dataskyddsbestämmelser och regelbundna säkerhetsuppdateringar. Se till att programvaran uppfyller branschens standarder för datasekretess och dataskydd, särskilt om den hanterar känslig information.
Går det att anpassa NLP-programvara?
Många NLP-verktyg erbjuder anpassningsalternativ för att skräddarsy funktioner och modeller efter dina behov. Det kan innebära att algoritmer justeras eller att specifika arbetsflöden för databehandling skapas. Anpassningsnivån kan dock variera, så kontrollera funktionerna innan du väljer en lösning.
Vilken typ av support finns tillgänglig för användare av NLP-programvara?
Supporttjänsterna sträcker sig från onlineresurser som vanliga frågor och handledningar till livekundsupport via chatt, e-post eller telefon. Utvärdera dessa tjänsters tillgänglighet och svarstid och överväg hur viktigt det är att ha dedikerad support, särskilt under implementeringen.
Är NLP samma sak som AI?
NLP är ett delområde inom artificiell intelligens. Medan AI-programvara omfattar ett brett spektrum av funktioner fokuserar NLP specifikt på bearbetning av mänskligt språk.
Kan NLP-programvara förstå slang eller informellt språk?
Vissa NLP-verktyg tränas för att känna igen informellt språk, slang eller regionala uttryck, men träffsäkerheten kan variera beroende på vilka data som användes för att träna modellen.
Vad händer härnäst:
Om du håller på att undersöka NLP-programvara kan du kontakta en SoftwareSelect-rådgivare för kostnadsfria rekommendationer.
Du fyller i ett formulär och har ett kort samtal där de går igenom detaljerna kring dina behov. Därefter får du en kortlista med programvara att granska. De hjälper dig även genom hela inköpsprocessen, inklusive prisförhandlingar.