

ETL-arbetsflöden: designguide & bästa praxis

I genomsnitt hanterar organisationer regelbundet 400 datakällor. När man bokstavligen måste hantera hundratals datamängder kan dataintegration och korrekt dataanalys vara omöjliga utan rätt arbetsflöden.
I den här guiden introducerar jag ETL-arbetsflöden och ger tips om hur du bygger ETL-datapipelines som ger förbättrad funktionalitet och datakvalitet.
Vad är ETL-arbetsflöden?
Vår ultimata guide till ETL förklarar detaljerna i ETL-processen, inklusive processerna extrahering, transformering och inläsning. För optimal funktionalitet måste dessa processer fungera tillsammans så att information flödar effektivt från datakällan till datalagret.

ETL-arbetsflöden ansvarar för denna övergripande process. De omfattar vanligtvis olika API-verktyg, anslutningar och databehandlingssteg för att säkerställa att processen för extrahering, transformering och inläsning fungerar väl och tillgodoser organisationens behov.
Fördelar med ETL-arbetsflöden
Några fördelar med välfungerande ETL-arbetsflöden är:
- Förbättrad dataåtkomst. Med rätt ETL-processer kan du ge medarbetare åtkomst till data i realtid. Processen för extrahering, transformering och inläsning säkerställer att data är redo att användas när den når datalagringen, vilket gör det enklare att köra SQL-rapporter, datamodeller och andra frågor.
- Möjlighet att hantera stordata. Avancerade ETL-processer kan hantera stora datamängder och integrera ostrukturerade data utan tidskrävande manuella processer. Det gör det enklare för organisationer att hantera och dra nytta av stordata.
- Bättre datatransformationsprocesser. Det korrekta ETL-arbetsflödet integrerar element som datarensning och transformering för att förbättra omvandlingen av rådata till strukturerade datamängder som du kan använda.
- Effektivitetsstöd genom automatisering. Import av källdata, valideringsprocesser och andra uppgifter kan hanteras av ETL-verktyg som stöder automatisering, vilket minskar tiden det tar att hantera data.
- Möjlighet att tillämpa affärsregler i datahanteringsprocesser. Du kan anpassa ETL-lösningar efter olika organisatoriska behov, inklusive integrering av affärs- och efterlevnadsregler i arbetsflödet för extrahering, transformering och inläsning.
Översikt över ETL-processen
Innan vi går igenom de viktigaste komponenterna i ETL-arbetsflöden och hur man modellerar dem ska vi först undersöka hur dessa processer fungerar, inklusive målen och utmaningarna för varje steg.
Extrahering
Under extraheringsdelen av ETL samlas information in från en eller flera datakällor. Dataextrahering kan omfatta både rådata och tidigare bearbetade data, och du kan behöva hantera olika filtyper, inklusive CSV och XML.
- Mål: Att samla in så heltäckande och omfattande data som möjligt.
- Utmaningar: Att identifiera datasjöar och datakällor, få lämplig åtkomst till data och tidsplanera datainsamlingen för att säkerställa aktuella processer.
Transformering
Datatransformationsprocessen innebär att data konverteras till format som fungerar med de relationsdatabaser och andra metoder för datalagring och dataanalys som du vill använda. Under detta ETL-steg kan du överväga verktyg för att utföra datamappning och rensning, ta bort dubbletter, formatera, lägga till metadata och utföra andra uppgifter – både genom automatisering och manuella arbetsflöden.
- Mål: Ren och användbar data som är formaterad för att fungera i ditt målsystem eller datalager.
- Utmaningar: Datakvalitet är en vanlig utmaning som organisationer möter när de transformerar data; ju lägre kvaliteten är, desto mer datatransformering krävs. Andra utmaningar är potentiell dataförlust, integrering av flera datatyper och att säkerställa säkerheten under hela processen.
Inläsning
I det sista steget i ETL-processerna läser du in data i det slutliga datalagret, så att den blir tillgänglig för organisationen att använda efter behov.
- Mål: Att säkerställa att säker och ren data är redo att användas i analysverktyg eller av CRM-system eller annan affärsprogramvara.
- Utmaningar: Att säkerställa datakvalitet och datasäkerhet är också utmaningar i detta steg, och organisationer måste skapa processer för datastyrning som definierar vem som får åtkomst till data och hur åtkomsten sker. Det kan också vara viktigt att stödja åtkomst till data i realtid – eller så nära realtid som möjligt – men batchbearbetning kan orsaka tidsfördröjningar i processen.
Viktiga komponenter i ETL-arbetsflöden
Det första steget när du bygger ETL-arbetsflöden är att överväga vilka viktiga komponenter som bör ingå. Användningsfallen för dessa arbetsflöden varierar, och du kan behöva ta hänsyn till unika data- och processberoenden för din organisation.
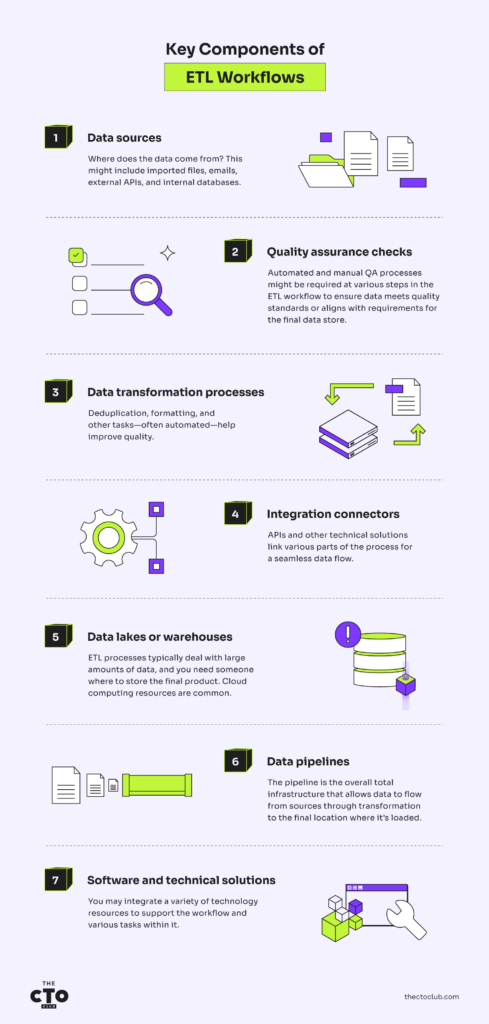
Några komponenter som dataingenjörer vanligtvis överväger för ETL-arbetsflöden är:
- Datakällor. Var kommer data ifrån? Det kan handla om importerade filer, e-postmeddelanden, externa API:er och interna databaser.
- Kvalitetssäkringskontroller. Automatiserade och manuella QA-processer kan krävas i olika steg av ETL-arbetsflödet för att säkerställa att data uppfyller kvalitetsstandarder eller överensstämmer med kraven för det slutliga datalagret.
- Datatransformationsprocesser. Avduplicering, formatering och andra uppgifter – ofta automatiserade – bidrar till att förbättra kvaliteten.
- Integrationsanslutningar. API:er och andra tekniska lösningar kopplar samman olika delar av processen för ett sömlöst dataflöde.
- Datasjöar eller datalager. ETL-processer hanterar vanligtvis stora mängder data, och du behöver någonstans att lagra slutprodukten. Molnbaserade datorresurser är vanliga.
- Datapipelines. Pipelinen är den övergripande infrastrukturen som gör att data kan flöda från källorna genom transformationen till den slutliga plats där den läses in.
- Programvara och tekniska lösningar. Du kan integrera en mängd olika tekniska resurser för att stödja arbetsflödet och de olika uppgifterna i det.
Modellering av ETL-arbetsflöden
När du modellerar dina ETL-pipelines måste du överväga om du vill bearbeta data i batcher eller som dataströmmar.
Bygga en ETL-pipeline med batchbearbetning
Vid batchbearbetning hanterar arbetsflödet data i batcher eller delar. Varje batch bestäms vanligtvis av tid – du kan till exempel köra batchar dagligen, med jämna mellanrum under dagen eller i början av varje timme.
Batchbearbetning är en bra lösning när:
- Du vill dra nytta av stordriftsfördelar
- Du har automatisering på plats som snabbt kan hantera stora datamängder
- Åtkomst till och bearbetning av data inte är särskilt tidskänslig
Bygga en ETL-pipeline med strömbearbetning
Strömbearbetning gör att data kan flöda genom ETL i realtid utan att batchar med data byggs upp i något steg av processen. Det är mer flexibelt än batchbearbetning, men det kan vara svårare att säkerställa datakvalitet och konsekvens med den här typen av pipeline.
Strömbearbetning är en bra lösning när:
- Data kommer in i processen i små delar och med oregelbundna intervall
- Åtkomsten till data är tidskänslig, vilket gör det avgörande att omedelbart få in data i processen
- Du vill få tillgång till trendbaserade insikter utan att vänta på att batchbearbetning av data ska slutföras
Exempel på ETL-arbetsflöden
Att förstå din branschspecifika datahantering och dina behov av dataflöden är avgörande för att framgångsrikt planera ETL-arbetsflöden. Ta del av dessa exempel från olika branscher för att förstå hur krav och beroenden kan variera.
ETL för vårdens dataflöden
Vårdorganisationer behöver korrekt och snabb åtkomst till patient- och behandlingsdata, vilket gör ETL-processer avgörande för framgång. Data kan komma från en mängd olika källor, bland annat patientportaler, elektroniska patientjournaler, bilddiagnostikutrustning och tredjepartsleverantörer som läkemedelsföretag.
En av de största utmaningarna med ETL inom vården är att skapa säkra processer som följer regler som HIPAA. Dessa processer är också beroende av datakällor som matas in av patienter, vårdgivare och automatisering, vilket skapar ytterligare utmaningar i datatransformationsprocessen.
När du modellerar datapipelines för vården kan du behöva använda både ström- och batchbearbetning. Vårdgivare kan till exempel behöva åtkomst till diagnostiska data i realtid, medan kodnings- och faktureringsdata kan batchbearbetas i slutet av dagen för skade- och ersättningsanspråk.
ETL för dataflöden inom e-handel
E-handelsdata kommer från många källor, inklusive e-post, kundportaler, API:er och appar, sociala medier, webbplatser, CRM-system samt redovisnings- eller betalningsprocesser. Detta skapar en enorm utmaning när data ska omvandlas utan att försämras.
Batchbearbetning fungerar vanligtvis bra för många e-handelsprocesser. Du kan till exempel hämta orderdata varje timme och mata in den i ETL-processer som stöder lager- och leveransuppgifter. Du kan också samla in betalningsdata dagligen så att de ekonomiska registren uppdateras.
Om du däremot vill erbjuda kunderna självbetjäning dygnet runt kan strömbaserade arbetsflöden vara mer lämpliga. Anta till exempel att du har en chattbot som ger kunder information om beställningar, betalningar, returer och krediter. Om dina ETL-processer körs i dagliga batcher är informationen som chattboten tillhandahåller alltid minst 24 timmar gammal.
ETL för finansiella dataflöden
Banker, kreditkortsföretag, appar för ekonomihantering och andra organisationer och tjänster inom finanssektorn är starkt beroende av korrekta data. Dessa organisationer måste också hantera omfattande regleringar och efterlevnadsstandarder för att hålla data säker.
Datakällor kan omfatta importerade data från andra finansiella organisationer, ACH- och clearingdata, information från kundinriktade appar samt mindre strukturerade format som e-post. Finansiella organisationer kan också vilja använda en kombination av batch- och strömningsbaserade pipelines för att uppfylla kundernas behov.
Tekniska framsteg inom ETL-processer
För flera decennier sedan revolutionerade molntekniken databearbetningen, och den är fortfarande en viktig del av utvecklingen inom programvara och lösningar för datalager. För närvarande fokuserar dock trender inom utvecklingen av ETL-teknik ofta på att integrera AI, maskininlärning och automatisering i arbetsflöden. Några specifika framsteg omfattar:
- AI:s förmåga att hantera stora datamängder. Verktyg för artificiell intelligens kan bearbeta enorma mängder data på några sekunder, vilket skapar stöd för en skalbarhet i ETL-processer som tidigare inte har varit möjlig.
- Behandling av naturligt språk. Maskininlärning och behandling av naturligt språk gör det möjligt för automatiserade lösningar att hantera dataomvandling med en mer omfattande uppsättning färdigheter inom "kritiskt tänkande" än vad som tidigare varit möjligt. Detta skapar möjligheter att automatisera uppgifter som historiskt har krävt mänsklig medverkan.
- Stöd för dataförvaltning. Nästan alla branscher hanterar i dag skärpta regulatoriska krav, och tekniska lösningar bidrar i allt högre grad till att stödja efterlevnad och datasäkerhet.
Bästa metoder för att optimera ETL-arbetsflöden
Det som fungerar bäst för en annan organisation behöver inte vara den bästa metoden för ditt företag när det gäller ETL. Jag har dock sammanställt några allmänna bästa metoder som du kan införa för att optimera ETL-arbetsflöden i nästan alla miljöer.
- Välj rätt verktyg för dina behov. Undersök verktyg för ETL-arbetsflöden och ETL-processer för att hitta partner och lösningar som uppfyller dina unika databehov. Överväg att sätta samman ett team som kartlägger önskade ETL-arbetsflöden, listar de utmaningar du står inför och utvärderar möjliga lösningar utifrån dessa faktorer.
- Se till att dina val av arbetsflöden är korrekta. Ta dig tid att förstå ETL jämfört med ELT och om du behöver batch- eller strömningsbaserade arbetsflöden.
- Övervaka dina processer regelbundet. Använd verktyg som SQL Servers prestandaövervakare – eller andra relevanta prestandaövervakare – för att förstå hur dina ETL-arbetsflöden fungerar. Håll ett öga på effektivitets- och kvalitetsmått och gör justeringar efter behov för kontinuerliga förbättringar.
- Integrera teknik som stöder kvalitet och skalbarhet. Överväg alternativ som parallell databehandling och datakomprimering för att optimera dina arbetsflöden.
Viktiga slutsatser
Utformningen av dina ETL-arbetsflöden kan avgöra om dina dataprocesser lyckas eller misslyckas. Ta dig tid att överväga konsekvenserna av beslut kring arbetsflöden, kartlägg ideala arbetsflöden och välj rätt verktyg för att stödja extrahering, omvandling och inläsning av data.
Håll dig uppdaterad om teknik och bästa praxis inom data genom att prenumerera på CTO Clubs nyhetsbrev.

