

10 bästa ETL-verktyg med öppen källkod recenserade 2026

Bästa ETL-verktygen med öppen källkod – urval


De bästa ETL-verktygen med öppen källkod hjälper team att automatisera extrahering, transformering och inläsning av data, så att de kan upprätthålla korrekta och konsekventa datamängder i olika system. De gör det enklare att hantera komplexa datakällor, tillämpa transformeringar i stor skala och minska det manuella arbetet med att hantera datapipelines.
När pipelines bygger på anpassade skript, när schemaändringar orsakar tysta fel eller när team saknar insyn i hur data rör sig mellan systemen, kan datakvaliteten och tillförlitligheten försämras. Dessa problem bromsar analysarbetet, ökar underhållstiden och skapar friktion mellan teknik- och datateam.
Med över 20 år i branschen som teknikchef har jag testat och granskat dussintals ETL-verktyg med öppen källkod för att bedöma prestanda, integrationskvalitet och användarvänlighet. Den här guiden lyfter fram de främsta alternativen som stöder skalbara arbetsflöden och mer förutsägbara dataoperationer. Varje recension behandlar funktioner, för- och nackdelar samt användningsområden där verktyget passar bäst, så att du kan välja rätt verktyg.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av de bästa ETL-verktygen med öppen källkod
Den här jämförelsetabellen sammanfattar prisuppgifterna för mitt urval av de bästa ETL-verktygen med öppen källkod, så att du kan hitta det bästa alternativet för din budget och verksamhetens behov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för komplexa datauppgifter | Gratis provperiod tillgänglig | Från $5,500/enhet/år | Website | |
| 2 | Bäst för bearbetning av loggdata | 7 dagars kostnadsfri provperiod tillgänglig | Prisuppgifter på begäran | Website | |
| 3 | Bäst för Python-skriptning av ETL | Not available | Gratis att använda | Website | |
| 4 | Bäst för datatransformation | 30 dagars kostnadsfri provperiod | Från $4/användare/månad | Website | |
| 5 | Bäst för integration av stora datamängder | 14 dagars provperiod tillgänglig | Prisuppgift på begäran | Website | |
| 6 | Bäst för automatiserad dataintegration | 14 dagars gratis provperiod + gratisplan + gratis demo tillgänglig | Från $239/månad (faktureras årsvis) | Website | |
| 7 | Bäst för integrationsmönster | Not available | Gratis att använda | Website | |
| 8 | Bäst för dataströmning i realtid | Gratisplan tillgänglig | Gratis | Website | |
| 9 | Bäst för automatisering av dataflöden | Not available | Gratis att använda | Website | |
| 10 | Bäst för skalbara ETL-lösningar | Gratisabonnemang tillgängligt | Gratis | Website |
Recensioner av de bästa ETL-verktygen med öppen källkod
Nedan hittar du mina detaljerade sammanfattningar av de bästa ETL-verktygen med öppen källkod som kom med i mitt urval. Mina recensioner ger en detaljerad överblick över de viktigaste funktionerna, för- & nackdelarna, integrationerna och de ideala användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
CloverDX
Bäst för komplexa datauppgifter
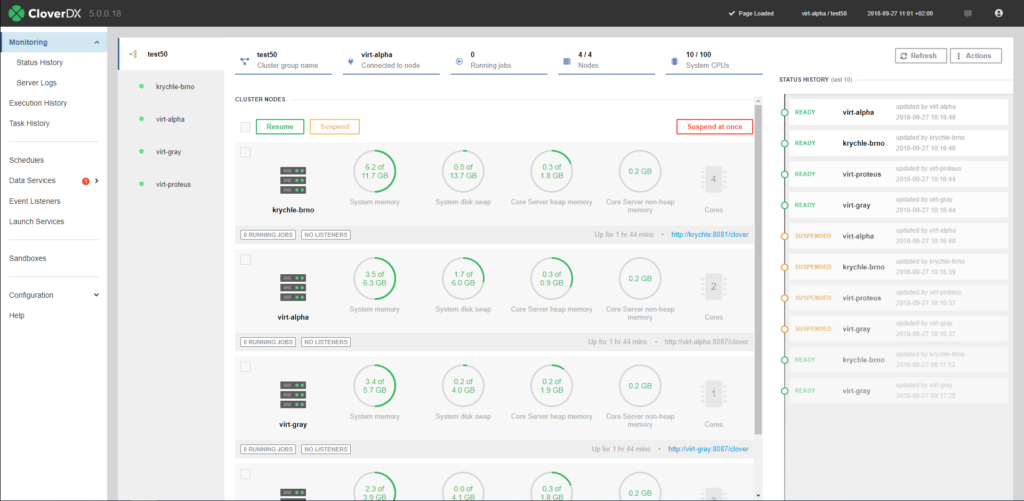
CloverDX är en dataintegrationsplattform som betjänar affärsanvändare och IT-team genom att automatisera, orkestrera och transformera data. Den stöder olika distributionsalternativ, vilket gör den flexibel för olika affärsbehov.
Varför jag valde CloverDX: CloverDX är utformad för komplexa datauppgifter med sitt intuitiva gränssnitt och sina flexibla distributionsalternativ, inklusive lokala installationer och molntjänster som AWS, Azure och Google Cloud. Den erbjuder datatjänster för API-åtkomst och samarbetsverktyg, vilket säkerställer att teamet kan arbeta effektivt i olika miljöer. Inkluderingen av en datakatalog ger tillförlitlig dataåtkomst, vilket är avgörande för att upprätthålla dataintegriteten. Dessa funktioner gör CloverDX till ett utmärkt val för team som hanterar komplexa dataprocesser.
Utmärkande funktioner och integrationer:
Funktioner inkluderar ett intuitivt gränssnitt för affärsanvändare, datatjänster för API-åtkomst och en datakatalog för tillförlitlig dataåtkomst. Dessa delar säkerställer att du kan hantera och få åtkomst till data effektivt. Plattformen erbjuder även samarbetsverktyg för att förbättra lagarbetet.
Integrationer inkluderar AWS, Azure, Google Cloud, Snowflake, Salesforce, Microsoft SQL Server, Oracle, PostgreSQL, MongoDB och Kafka.
Pros and Cons
Pros:
- Stöder komplexa dataprocesser
- Flexibla distributionsalternativ
- Starka funktioner för API-åtkomst
Cons:
- Potentiellt brant inlärningskurva
- Kräver teknisk expertis

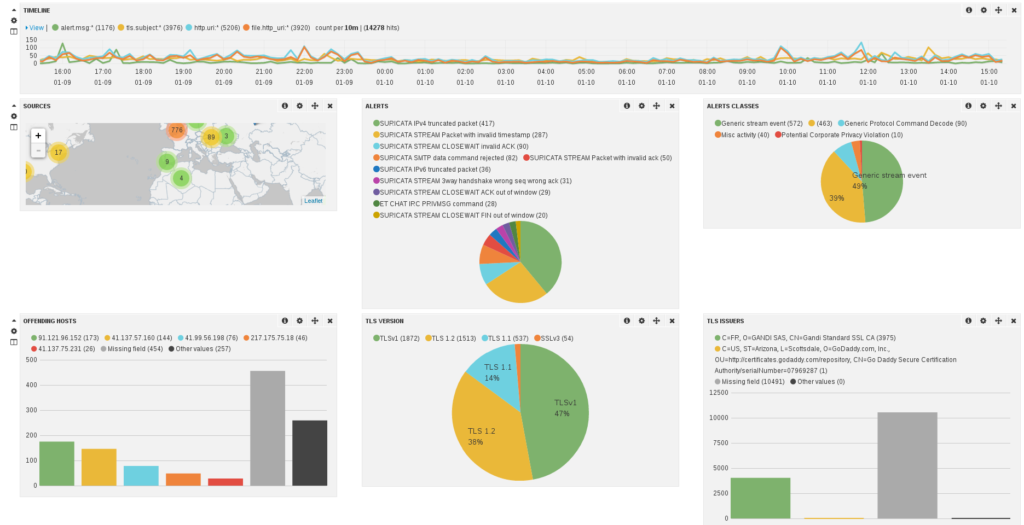
Logstash är en databehandlingspipeline med öppen källkod som gör det möjligt för utvecklare och IT-team att samla in, omvandla och lagra loggar från olika källor. Den är utformad för att hantera stora mängder loggdata, vilket gör den idealisk för organisationer som behöver centralisera och analysera sin logginformation.
Varför jag valde Logstash: Logstash är utmärkt för bearbetning av loggdata och erbjuder en flexibel pipelinearkitektur som låter dig samla loggar från flera källor. Verktyget har kraftfulla funktioner för filtrering och omvandling, så att ditt team kan anpassa data efter specifika behov. Logstashs realtidsbearbetning säkerställer att dina loggdata är aktuella och användbara. Kompatibiliteten med Elasticsearch och Kibana gör det till ett utmärkt val för dem som redan använder Elastic Stack.
Utmärkande funktioner & integrationer:
Funktioner inkluderar en flexibel pipelinearkitektur som stöder komplexa dataomvandlingar, vilket gör att du kan anpassa loggbearbetningen. Logstashs realtidsbearbetning säkerställer att dina loggdata alltid är uppdaterade. Verktyget erbjuder även robusta filtreringsalternativ för att anpassa data efter dina specifika krav.
Integrationer inkluderar Elasticsearch, Kibana, Beats, AWS, Azure, Google Cloud, Kafka, RabbitMQ, JDBC och Redis.
Pros and Cons
Pros:
- Hanterar stora mängder loggdata
- Databearbetning i realtid
- Flexibel pipelinearkitektur
Cons:
- Kan vara resurskrävande
- Begränsad inbyggd analys

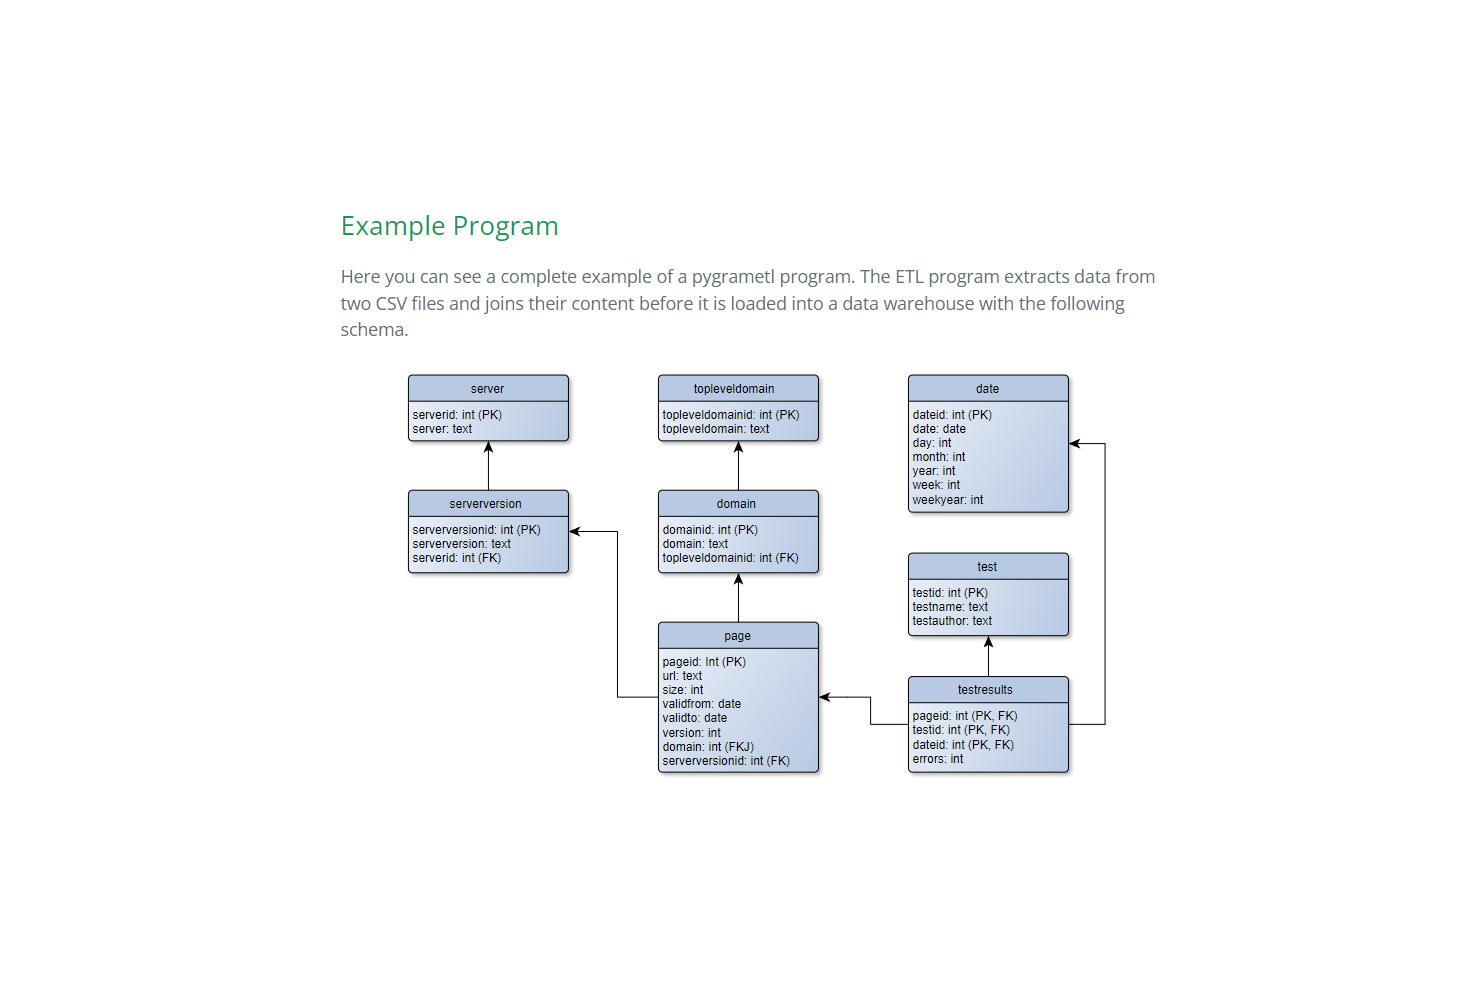
pygrametl är ett ramverk med öppen källkod för utveckling av ETL-processer i Python. Det utformades som ett alternativ till grafiska BI-program, samtidigt som det har samma användarvänlighet. Det stöder CPython och Jython, vilket gör det möjligt för ETL-utvecklare att använda befintlig Java-kod och JDBC-drivrutiner.
Utvecklare kan extrahera data från många källor som är tillgängliga i pygrametl, till exempel SQL, CSV och Pandas. Användare kan även definiera sina egna datakällor. Plattformen tillhandahåller filter och aggregeringsfunktioner för transformering av data. Standardaggregat inkluderar AVG, Count, CountDistinct, Max, Min och Sum.
pygrametl kan läsa in transformerade data i alla datalager som stöder dimensionsmodellering. Systemet tillhandahåller strukturer för definition av faktatabeller och dimensioner, inklusive långsamt föränderliga och snöflingedimensioner.
Utvecklare kan ladda ner pygrametl kostnadsfritt.

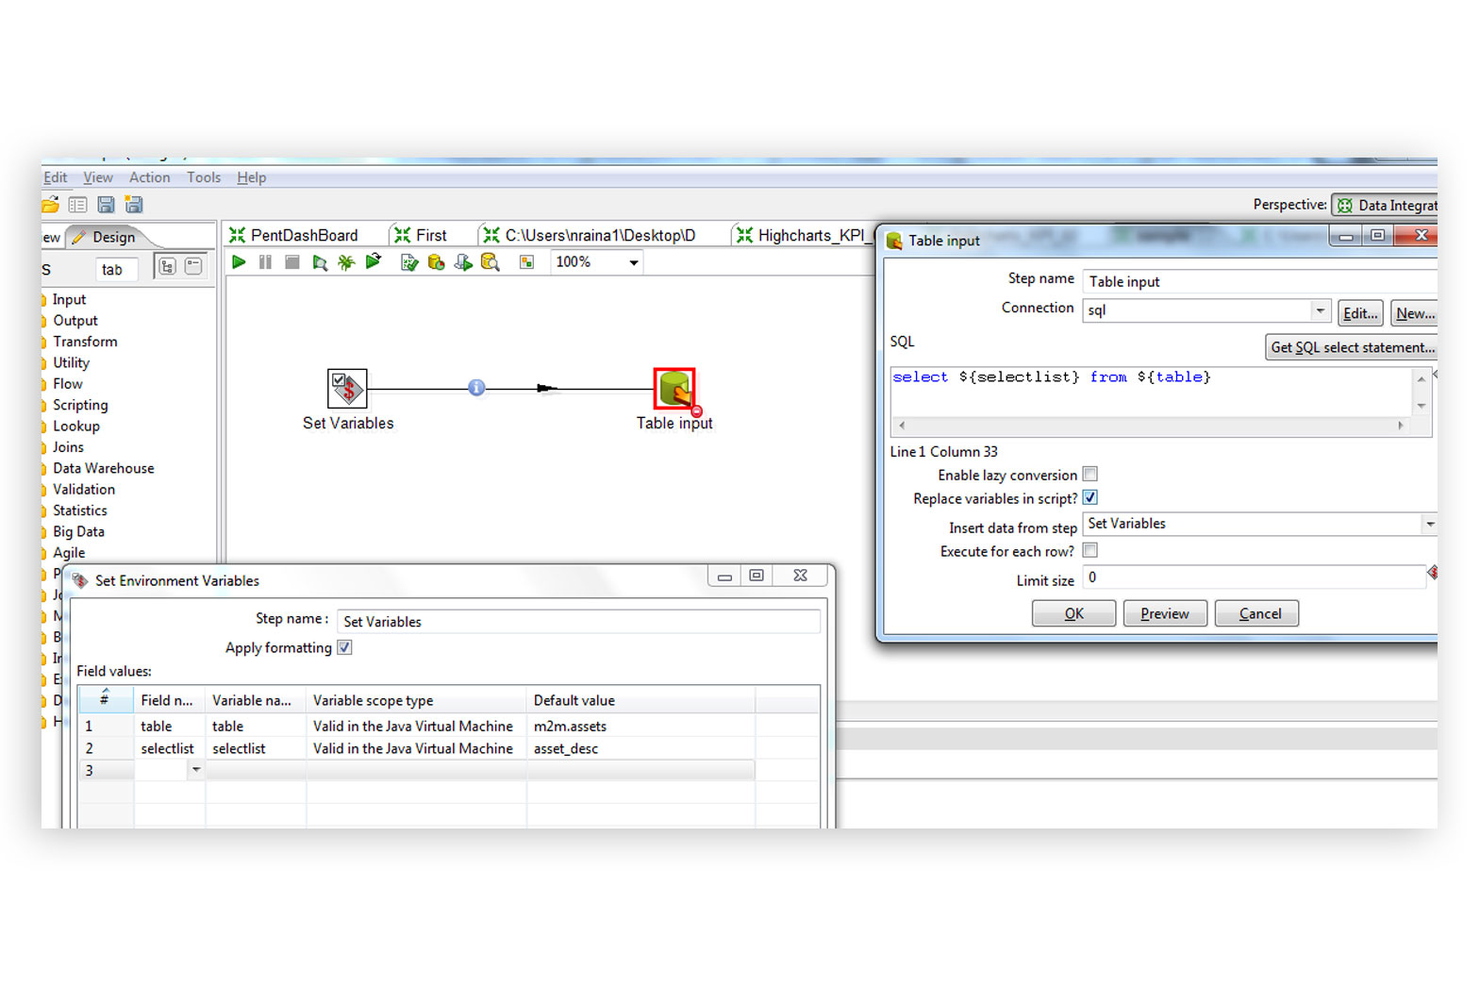
Pentaho Kettle är ett ETL-verktyg med öppen källkod som riktar sig till dataingenjörer och affärsanalytiker som behöver utföra komplexa datatransformationer. Det tillhandahåller ett visuellt gränssnitt för att utforma datapipelines, vilket gör det enklare att hantera dataflöden och genomföra transformationer effektivt.
Varför jag valde Pentaho Kettle: Det är känt för sina funktioner för datatransformation och tillhandahåller ett visuellt dra-och-släpp-gränssnitt som förenklar skapandet av komplexa arbetsflöden. Kettle erbjuder omfattande stöd för olika datakällor, vilket säkerställer att ditt team kan integrera data från flera källor. Det grafiska gränssnittet minskar behovet av omfattande kodning, vilket är fördelaktigt för team med begränsad programmeringserfarenhet. Verktygets flexibilitet när det gäller att hantera olika datatyper och format gör det till ett mångsidigt val för varierande databehov.
Utmärkande funktioner och integrationer:
Funktioner inkluderar ett visuellt dra-och-släpp-gränssnitt som förenklar utformningen av arbetsflöden och gör det möjligt att bygga komplexa datatransformationer utan kodning. Verktyget stöder ett brett utbud av datakällor, vilket gör integrationen enkel. Kettles flexibilitet när det gäller att hantera flera datatyper och format säkerställer kompatibilitet med olika datamiljöer.
Integrationer inkluderar Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP och Hadoop.
Pros and Cons
Pros:
- Visuellt gränssnitt för transformationer
- Hanterar olika datatyper
- Omfattande stöd för datakällor
Cons:
- Kan vara resurskrävande
- Komplex initial konfiguration

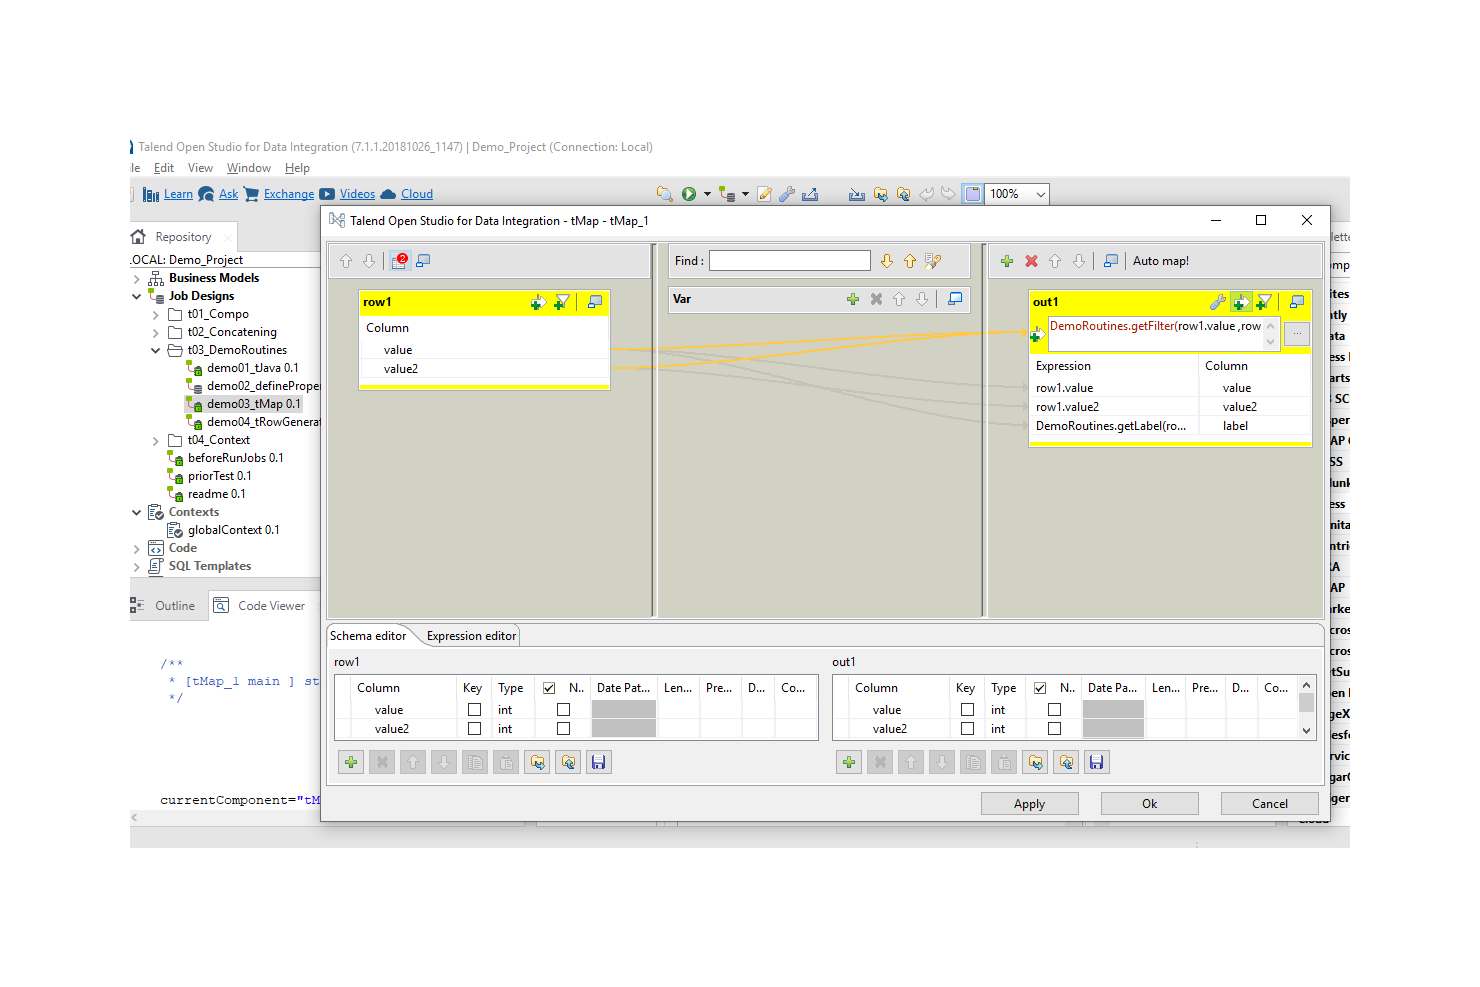
Talend Open Studio är en svit med verktyg med öppen källkod som gör det möjligt för ETL-utvecklare att bygga grundläggande datapipelines på kortare tid. Den har en Eclipse-baserad utvecklingsmiljö och fler än 900 förbyggda anslutningar, inklusive Oracle, Teradata, Marketo och Microsoft SQL Server. Plattformen omfattar fem komponenter: Talend Open Studio för dataintegration, stora datamängder, datakvalitet, företagsbuss (ESB) och hantering av masterdata (MDM).
Talend Open Studio är ett utmärkt komplement till många verktyg för beslutsstöd (BI). Det erbjuder flera metoder för att konvertera flera datauppsättningar till format som är kompatibla med populära BI-plattformar, inklusive Jasper, OLAP och SPSS. Användare kan också få fram insikter direkt från Talend Open Studio, som kan generera grundläggande visualiseringar, inklusive stapeldiagram.
Talend Open Studio stöder integrationer med flera databaser, inklusive Microsoft SQL Server, Postgres, MySQL, Teradata och Greenplum.
Talend Open Studio är gratis att ladda ner för alla användare.

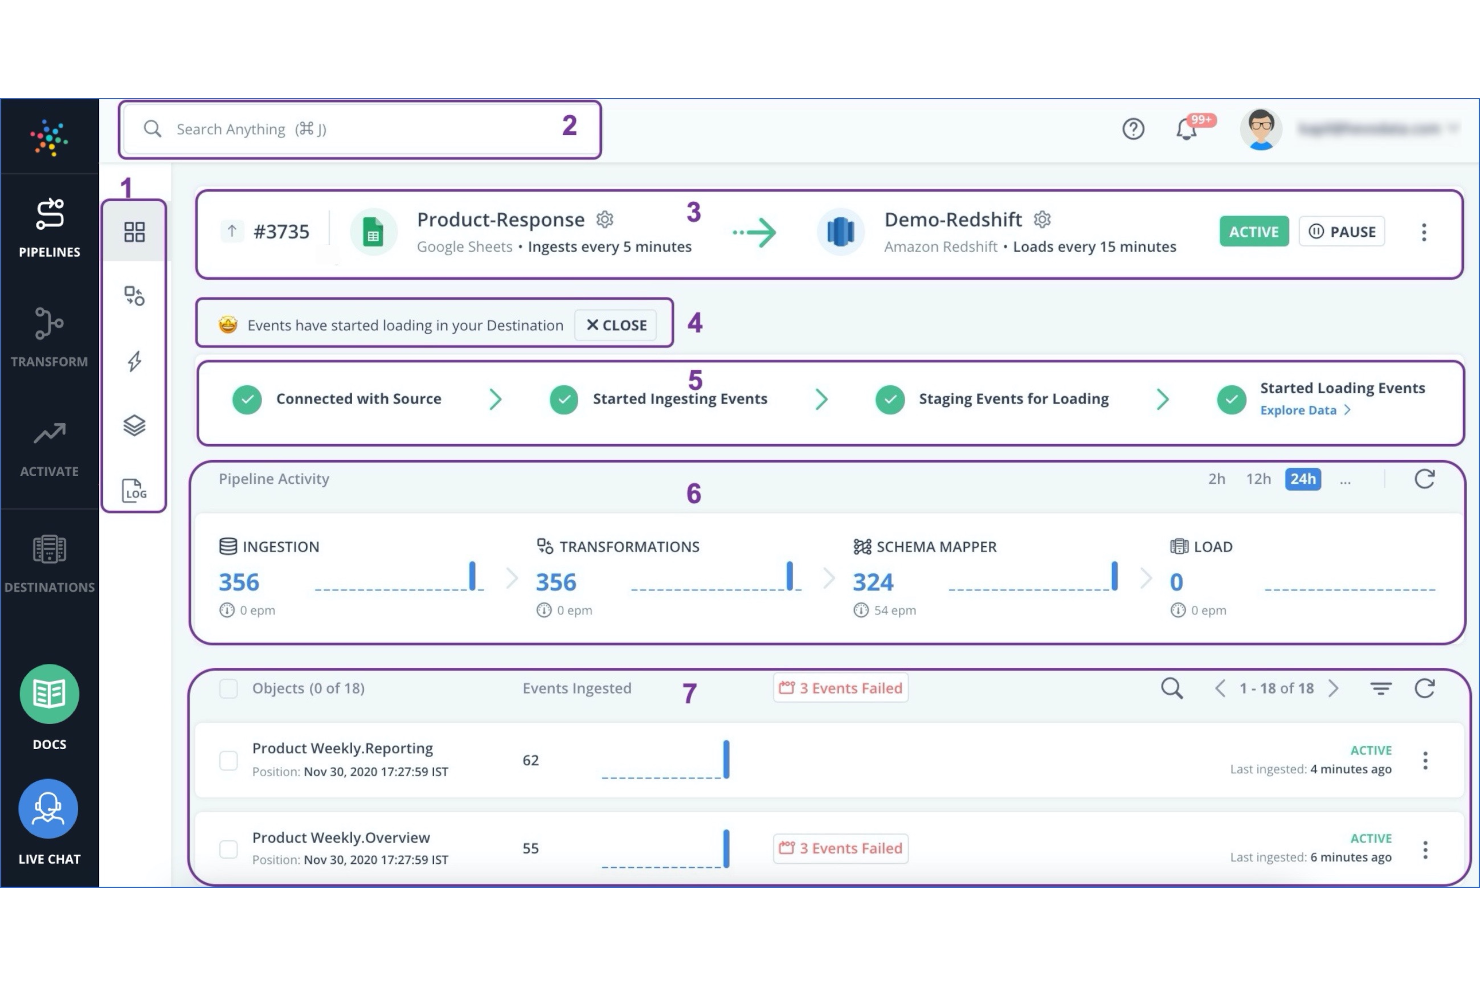
Hevo Data är en ETL- och dataintegrationsplattform för datateam som söker tillförlitliga och automatiserade datapipelines. Den underlättar datainhämtning från olika källor med minimal konfiguration och utan programmering, vilket förbättrar datakvaliteten och beslutsfattandet.
Varför jag valde Hevo Data: Plattformen utmärker sig genom automatiserad dataintegration, med funktioner som övervakning av pipelines i realtid och höghastighetsreplikering av data, vilket säkerställer att ditt team hålls uppdaterat med minimal ansträngning. Hevos funktioner för efterlevnad och säkerhet ger sinnesro, särskilt för företagsanvändare. Plattformens transparenta prissättning innebär inga dolda avgifter, vilket är ett stort plus vid budgetering. Det användarvänliga gränssnittet gör att du kan hantera data utan omfattande programmeringskunskaper.
Utmärkande funktioner & integrationer:
Funktioner omfattar övervakning av pipelines i realtid som håller dina data aktuella, avancerade hanteringsalternativ för bättre kontroll samt funktioner för efterlevnad och säkerhet som skyddar känslig information. Dessa funktioner hjälper ditt team att arbeta effektivt och säkert. Hevo erbjuder även höghastighetsreplikering av data för att säkerställa datakonsistens.
Integrationer omfattar Salesforce, Google Analytics, Amazon Redshift, Snowflake, BigQuery, MySQL, PostgreSQL, Oracle, MS SQL Server och HubSpot.
Pros and Cons
Pros:
- Automatiserad dataintegration
- Övervakning i realtid
- Höghastighetsreplikering
Cons:
- Begränsade anpassningsalternativ
- Inte lämpligt för alla datatyper

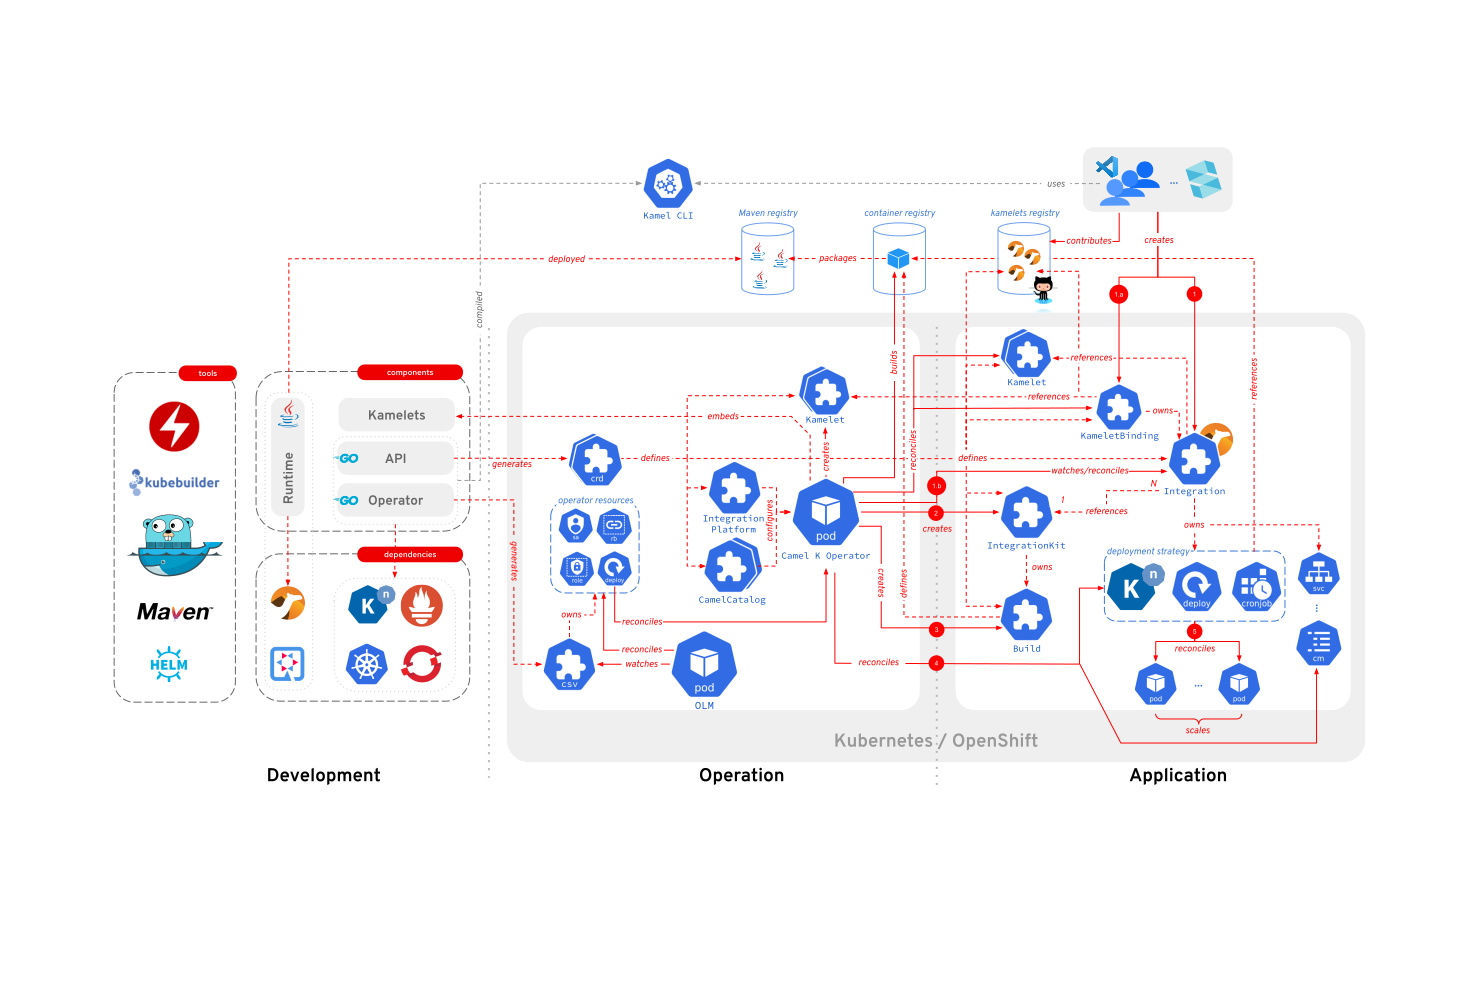
Apache Camel är ett integrationsramverk med öppen källkod som är utformat för utvecklare och arkitekter som behöver implementera mönster för företagsintegration. Det underlättar dirigering och medling av meddelanden mellan system, vilket gör det idealiskt för komplexa integrationsscenarier.
Varför jag valde Apache Camel: Det utmärker sig genom att använda integrationsmönster för att effektivisera anslutningen mellan olika system. Camel stöder ett brett utbud av protokoll och dataformat, vilket säkerställer att ditt team enkelt kan ansluta olika system. Dess domänspecifika språk (DSL) ger ett flexibelt sätt att definiera regler för dirigering och medling, vilket är avgörande för att hantera komplexa integrationer. Verktygets förmåga att integrera med olika slutpunkter erbjuder oöverträffad mångsidighet vid utformning av integrationslösningar.
Utmärkande funktioner & integrationer:
Funktioner omfattar en omfattande uppsättning mönster för företagsintegration som förenklar integrationsprocessen. Verktygets domänspecifika språk gör det enkelt att definiera komplexa dirigeringsregler. Apache Camel stöder även ett brett utbud av dataformat och protokoll, vilket säkerställer kompatibilitet med flera system.
Integrationer omfattar AWS, Apache Kafka, ActiveMQ, RabbitMQ, Salesforce, Google Cloud, Azure, JMS, fil och FTP.
Pros and Cons
Pros:
- Omfattande integrationsmönster
- Stöd för många dataformat
- Mångsidig integrering av slutpunkter
Cons:
- Dokumentationen kan vara knapphändig
- Resurskrävande för stora installationer

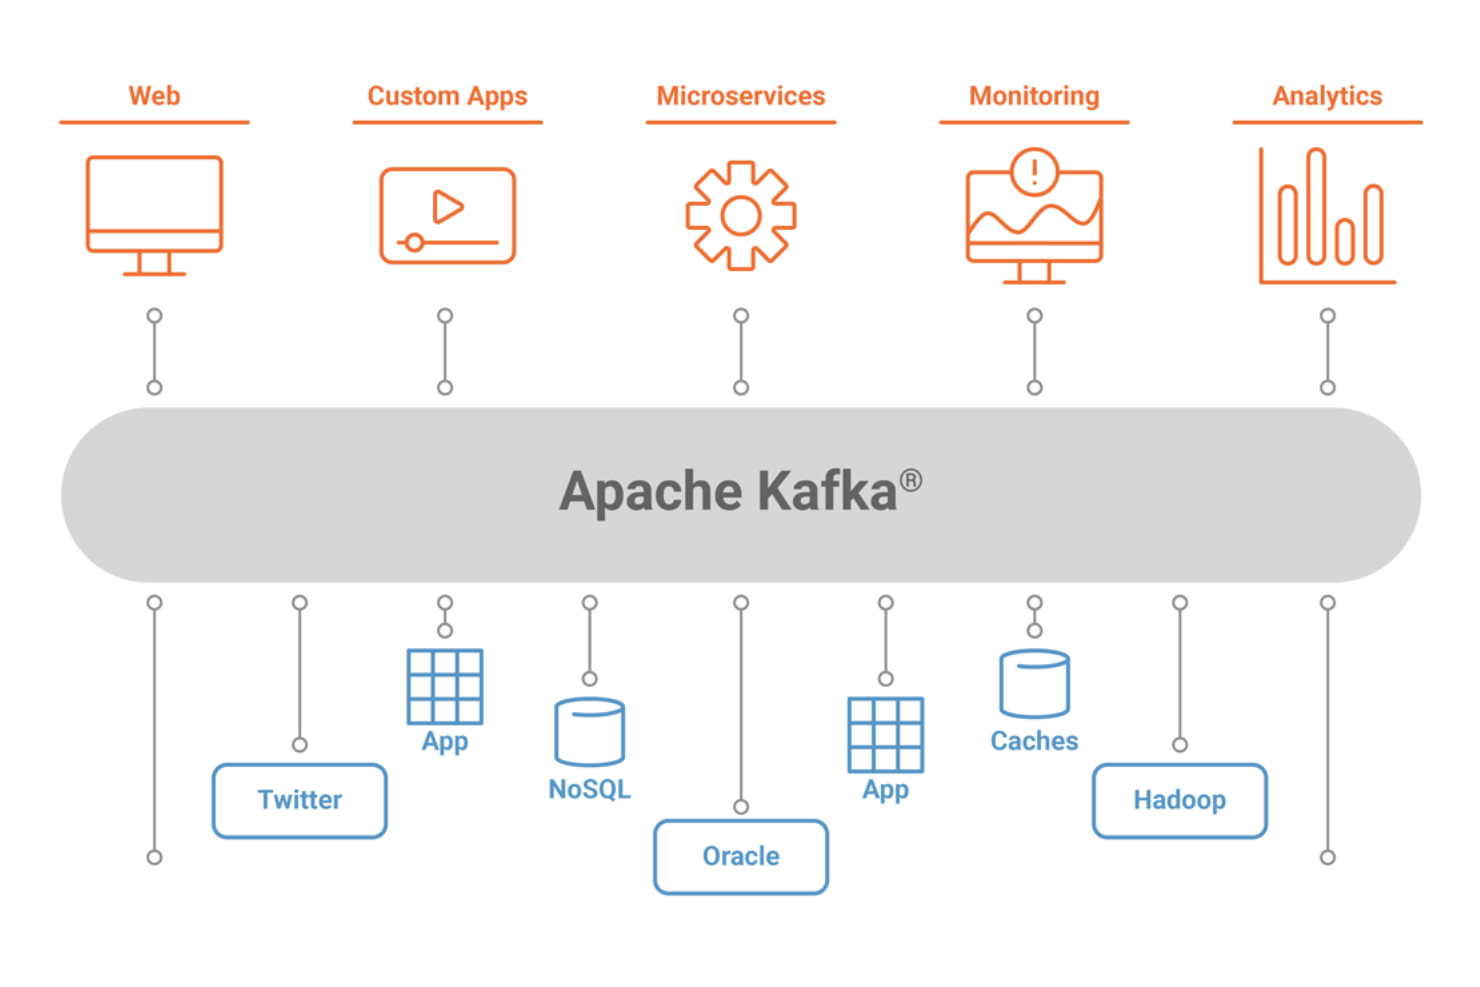
Apache Kafka är en distribuerad plattform för händelseströmning som används av utvecklare och företag för att bygga datapipelines och strömningsapplikationer i realtid. Den är utformad för att hantera stora datamängder snabbt och effektivt, vilket gör den idealisk för företag som behöver databehandling i realtid.
Varför jag valde Apache Kafka: Den är utformad för dataströmning i realtid och stöder databehandling med hög genomströmning och låg latens, vilket är viktigt för moderna datadrivna applikationer. Kafkas distribuerade arkitektur säkerställer hög tillgänglighet och feltolerans, så att dina data alltid är åtkomliga. Plattformens skalbarhet gör att du kan hantera växande databehov utan att kompromissa med prestandan. Kafka erbjuder också starka garantier för datalagring, vilket säkerställer dataintegriteten över tid.
Utmärkande funktioner & integrationer:
Funktioner omfattar en distribuerad arkitektur som säkerställer hög tillgänglighet, inbyggd datareplikering för feltolerans och ett robust meddelandesystem för skalbar databehandling. Dessa funktioner gör plattformen väl lämpad för att effektivt hantera stora datamängder. Kafkas loggbaserade lagringssystem säkerställer datalagring och tillförlitlighet.
Integrationer omfattar Confluent, AWS, Azure, Google Cloud, MongoDB, Cassandra, Elasticsearch, Splunk, Hadoop och MySQL.
Pros and Cons
Pros:
- Hanterar data med hög genomströmning
- Bearbetning med låg latens
- Stark datalagring
Cons:
- Begränsad inbyggd övervakning
- Konfigurationen kan vara utmanande

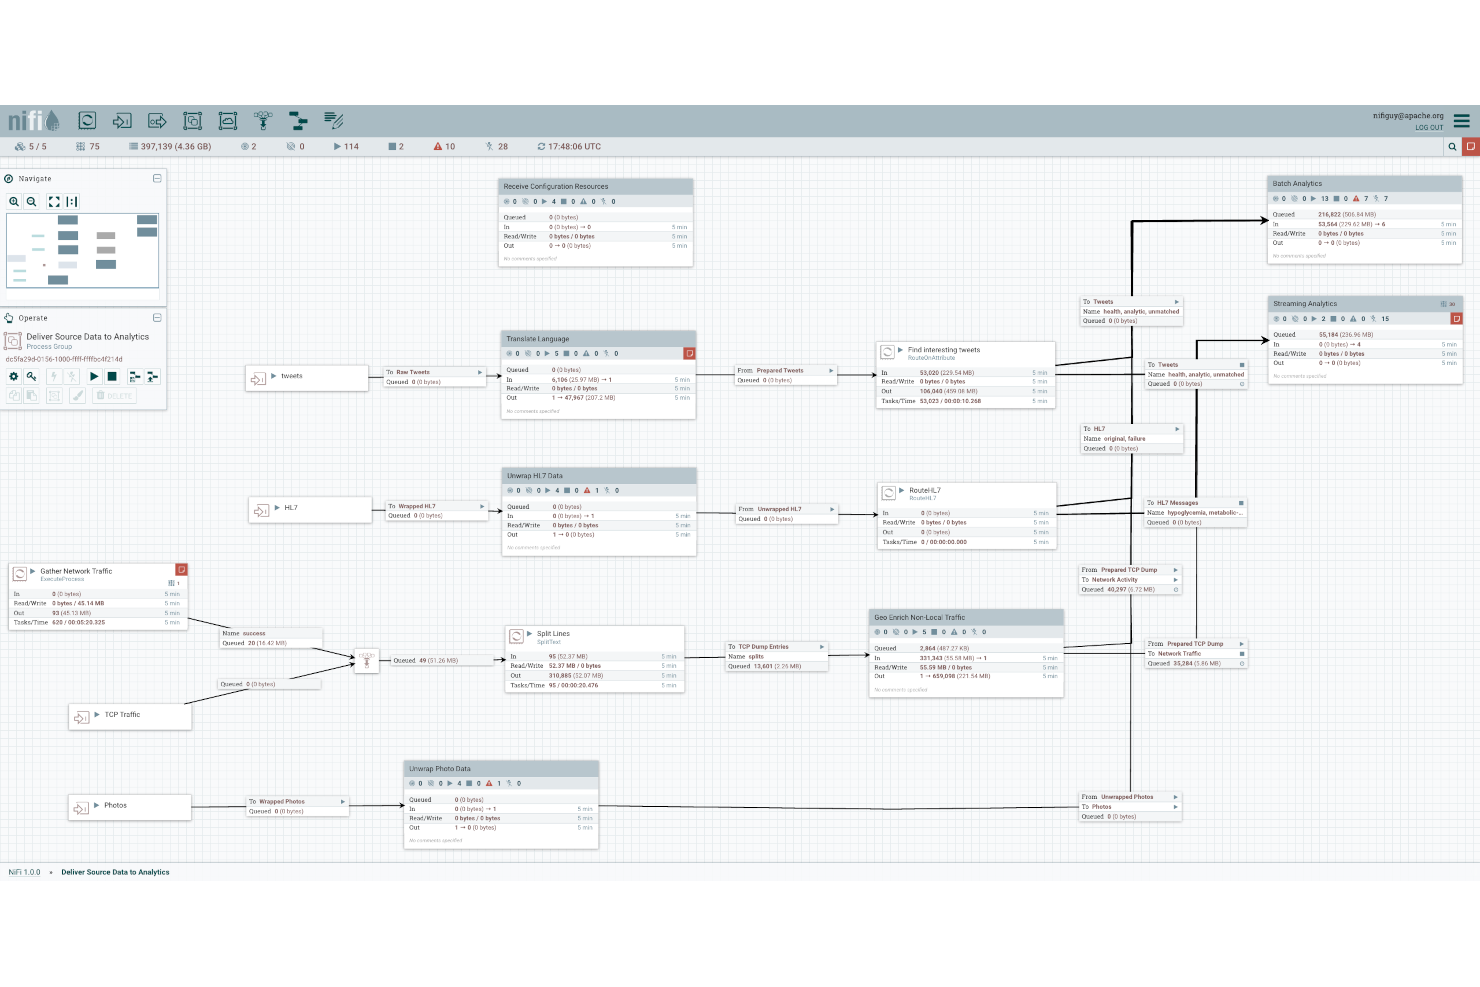
Apache NiFi är ett dataintegreringsverktyg med öppen källkod som är utformat för utvecklare och dataingenjörer som behöver automatisera dataflöden. Det möjliggör insamling, bearbetning och distribution av data mellan olika system, vilket gör det idealiskt för hantering av data i realtid.
Därför valde jag Apache NiFi: Det är utformat för automatisering av dataflöden och har ett användarvänligt gränssnitt för att utforma komplexa arbetsflöden. NiFi:s dra-och-släpp-gränssnitt förenklar skapandet av datapipelines, vilket är avgörande för team utan omfattande erfarenhet av programmering. Verktyget stöder hantering av dataflöden i realtid, vilket säkerställer att dina data förblir aktuella och relevanta. De inbyggda säkerhetsfunktionerna ger ett extra skyddslager för känsliga data.
Utmärkande funktioner & integreringar:
Funktionerna omfattar ett dra-och-släpp-gränssnitt som förenklar utformningen av arbetsflöden och gör det enkelt att skapa datapipelines. NiFi:s hantering av dataflöden i realtid säkerställer att dina data alltid är uppdaterade. Verktyget erbjuder även inbyggda säkerhetsfunktioner för att skydda dina känsliga uppgifter.
Integreringarna omfattar AWS, Azure, Google Cloud, Kafka, HDFS, MongoDB, Elasticsearch, MySQL, PostgreSQL och JMS.
Pros and Cons
Pros:
- Automatiserar dataflöden effektivt
- Användarvänligt dra-och-släpp-gränssnitt
- Datahantering i realtid
Cons:
- Kan vara resurskrävande
- Komplex initial konfiguration

KETL är en ETL-plattform med öppen källkod som är utformad för dataingenjörer och IT-proffs som behöver skalbara lösningar för dataintegration och schemaläggning. Den tillhandahåller en trådad, XML-baserad arkitektur som stöder komplex datamanipulation, vilket gör den lämplig för omfattande databearbetningsuppgifter.
Varför jag valde KETL: Den erbjuder skalbara ETL-lösningar genom sin förmåga att hantera stora datavolymer över flera servrar och processorer. Plattformens hanterare för jobbexekvering och schemaläggning säkerställer effektiv arbetsflödeshantering, vilket är avgörande för storskalig drift. Dess centraliserade databas för jobbdefinitioner bidrar till att upprätthålla ordning och kontroll över dataprocesserna. Dessutom gör KETL:s funktioner för prestandaövervakning att ditt team effektivt kan följa upp och optimera dataarbetsflöden.
Utmärkande funktioner & integrationer:
Funktioner inkluderar en trådad arkitektur som förbättrar skalbarhet och prestanda. KETL stöder ett stort antal jobbtyper, inklusive SQL, OS och XML, vilket ger flexibilitet vid bearbetning av olika dataformat. Plattformens centraliserade databas för jobbdefinitioner bidrar till att effektivisera arbetsflödeshanteringen och säkerställa konsekvens.
Integrationer inkluderar Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP och Hadoop.
Pros and Cons
Pros:
- Skalbar över flera servrar
- Stöder komplex datamanipulation
- Centraliserad jobbdatabas
Cons:
- Begränsat stöd från communityn
- Dokumentationen kan vara knapphändig
Andra ETL-verktyg med öppen källkod
Här är några ytterligare ETL-verktyg med öppen källkod som inte kom med i mitt urval, men som ändå är värda att undersöka:
- Singer
Bäst för skript för dataextraktion
- Scriptella
Bäst för enkel ETL-skriptning
- Bubbles
Python ETL-ramverk för bearbetning, granskning och inspektion av data


Hur jag utvärderar ETL-verktyg med öppen källkod
Jag delar upp min utvärdering i två lager—grundläggande funktioner för ETL/ELT-pipelines för att kvalificera ett verktyg, följt av särskiljande egenskaper som CDC, stöd för Kubernetes och täckning av anslutningar, vilka är viktiga i produktionsskala.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer verktyg till min lista poängsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion som listas nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- Licensiering med öppen källkod: Jag kontrollerar att projektet använder en erkänd OSI-godkänd licens (Apache 2.0, MIT, GPL med flera) och att källkoden är offentligt tillgänglig för egen drift, förgrening och bidrag från communityn.
- Fullständigt stöd för ETL/ELT-pipelines: Varje verktyg måste kunna hantera extrahering, transformering och inläsning som ett sammanhängande arbetsflöde—inte bara synkronisera data från A till B utan någon logik däremellan.
- Bibliotek med förbyggda anslutningar: Jag utvärderar bredden av anslutningar för databaser, molndatalager, SaaS-appar och filformat, eftersom ett verktyg med endast ett fåtal anslutningar innebär att teamet måste skriva anpassad kod för varje ny källa.
- Datatransformeringsmotor: Oavsett om den är SQL-baserad, som modeller i dbt-stil, bygger på Python-skript eller visuell mappning, letar jag efter ett transformeringslager som hanterar verkliga behov som typkonvertering, deduplicering och join-operationer.
- Orkestrering och schemaläggning av pipelines: Verktyg bör stödja schemalagda körningar, beroendehantering, nya försök och jobbövervakning så att pipelines inte tyst misslyckas klockan två på natten utan att någon märker det.
- Utbyggbarhet och anpassade anslutningar: Jag letar efter ett dokumenterat SDK eller pluginramverk som låter teamet bygga anslutningar till interna API:er eller nischade system som inte täcks av standardkatalogen.
När jag har en lista över verktyg som uppfyller dessa kriterier överväger jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer med varandra:
Utmärkande funktioner
Insamling av dataändringar är viktigt när dina pipelines behöver återspegla uppdateringar i källdatabasen nära realtid—till exempel genom att synkronisera ändringar av orderstatus till ett datalager utan att läsa in hela tabeller på nytt varje timme. Jag utvärderar också datahärledning och observerbarhet, eftersom spårning av beroenden på kolumnnivå och upptäckt av schemadrift innan en instrumentpanel slutar fungera sparar timmar av felsökning. En visuell pipelinebyggare är också värd att notera, särskilt för team där analytiker eller medarbetare med mindre fokus på kod behöver bygga eller ändra pipelines tillsammans med ingenjörer.
Bortom funktionerna
Communityns aktivitet är en stark signal om långsiktig livskraft—jag kontrollerar frekvensen av incheckningar, utgivningstakten och hur underhållare svarar på problemrapporter och pull-förfrågningar. Flexibilitet vid driftsättning är också viktig: ett verktyg som stöder Docker, Kubernetes och Helm-diagram ger teamet alternativ oavsett om ni kör lokalt eller hos flera molnleverantörer. Jag granskar även licensens tydlighet noggrant, eftersom vissa projekt med öppen kärna låser viktiga funktioner som RBAC eller SSO bakom betalnivåer, vilket kan överraska team när de skalar upp.
Så väljer du ETL-verktyg med öppen källkod
Det är lätt att fastna i långa funktionslistor och komplexa prismodeller. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
| Skalbarhet | Se till att verktyget kan hantera ökningen av din datavolym. Tänk på framtida behov och om verktyget effektivt stöder både batchbearbetning och realtidsbearbetning. |
| Integrationer | Kontrollera om verktyget kan integreras med dina befintliga system och datakällor, såsom databaser, molntjänster och tredjepartsapplikationer, för att effektivisera arbetsflöden. |
| Anpassningsbarhet | Leta efter möjligheten att anpassa dataarbetsflöden så att de passar dina specifika processer. Ju mer anpassningsbart verktyget är, desto bättre kan det anpassas efter dina föränderliga behov. |
| Användarvänlighet | Utvärdera användargränssnittet. Ett verktyg som är enkelt att navigera i minskar inlärningskurvan för ditt team och påskyndar implementeringen. |
| Budget | Jämför priset med din budget. Ta hänsyn till den totala ägandekostnaden, inklusive dolda kostnader, för att säkerställa att den överensstämmer med dina ekonomiska begränsningar. |
| Säkerhetsskydd | Se till att verktyget erbjuder robusta säkerhetsfunktioner för att skydda dina känsliga data. Leta efter kryptering, användaråtkomstkontroller och efterlevnad av regelverk. |
| Support | Kontrollera tillgången till kundsupport. Snabb och hjälpsam support kan vara avgörande under implementering och felsökning. |
| Prestanda | Bedöm verktygets bearbetningshastighet och tillförlitlighet. Det bör konsekvent leverera data i tid utan fel för att stödja verksamhetens drift. |
Trender inom ETL-verktyg med öppen källkod
I min research samlade jag in otaliga produktuppdateringar, pressmeddelanden och versionsloggar från olika leverantörer av ETL-verktyg med öppen källkod. Här är några framväxande trender som jag håller ögonen på:
- Realtidsbearbetning: Fler verktyg fokuserar på bearbetning av data i realtid, vilket gör det möjligt för företag att snabbt reagera på förändringar och fatta välgrundade beslut. Apache Kafka har till exempel förbättrat sina strömningsfunktioner för att stödja analys i realtid.
- Dataobserverbarhet: Leverantörer lägger till funktioner för att förbättra datasynlighet och övervakning, vilket hjälper team att snabbare identifiera och lösa problem. Verktyg som Apache NiFi erbjuder nu förbättrade funktioner för dataspårning och datahärkomst för att säkerställa dataintegritet.
- Molnbaserad arkitektur: I takt med övergången till molnbaserad databehandling utformas ETL-verktyg för att effektivt utnyttja molnresurser. Talend Open Studio erbjuder till exempel molnbaserade funktioner för att optimera prestanda och skalbarhet.
- Gränssnitt med låg kodnivå: Efterfrågan på plattformar med låg kodnivå eller utan kod ökar, vilket gör ETL-verktyg tillgängliga för användare utan teknisk bakgrund. Verktyg som Pentaho Kettle använder fler visuella gränssnitt för att förenkla skapandet av datapipelines.
- Datastyrning: I takt med att dataskyddsbestämmelserna skärps integrerar ETL-verktyg fler funktioner för datastyrning. Detta omfattar alternativ för datamaskering och kryptering, som håller på att bli standard i lösningar som Hevo Data för att säkerställa efterlevnad och säker datahantering.
Vad är ETL-verktyg med öppen källkod?
ETL-verktyg med öppen källkod underlättar extrahering, transformering och inläsning av data från olika källor till en centraliserad plats. Dataingenjörer, analytiker och IT-specialister använder vanligtvis dessa verktyg för att effektivt hantera och bearbeta stora datamängder.
Realtidsbearbetning, dataobserverbarhet och molnbaserade funktioner bidrar till snabba beslut, problemlösning och effektiv resursanvändning. Sammantaget ger dessa verktyg den flexibilitet och skalbarhet som krävs för att hantera komplexa dataarbetsflöden och stödja datadrivna strategier. För att säkerställa tillförlitlighet i stor skala bör team komplettera sina ETL-verktyg med robusta verktyg för automatisering av ETL-tester.
Funktioner i ETL-verktyg med öppen källkod
När du väljer ETL-verktyg med öppen källkod bör du hålla utkik efter följande viktiga funktioner:
- Realtidsbearbetning: Bearbetar data när den kommer in, vilket hjälper dig att fatta beslut i rätt tid och snabbt reagera på förändringar.
- Dataobserverbarhet: Ger insyn i dataflöden, så att du snabbt kan övervaka och lösa problem.
- Molnbaserad arkitektur: Utnyttjar molnresurser effektivt för att förbättra skalbarhet och prestanda.
- Lågkodgränssnitt: Förenklar skapandet av datapipelines och gör verktygen tillgängliga för användare utan teknisk bakgrund.
- Datastyrning: Säkerställer efterlevnad och säkerhet genom funktioner som datamaskering och kryptering.
- Integration av flera datakällor: Ansluter till olika datakällor för att centralisera och effektivisera databehandlingen.
- Skalbarhet: Hanterar växande datamängder och stöder både batchbearbetning och realtidsbearbetning.
- Anpassningsbarhet: Gör det möjligt att anpassa dataarbetsflöden efter specifika affärsbehov och processer.
- Prestandaövervakning: Spårar och optimerar dataarbetsflöden för att upprätthålla effektivitet och noggrannhet.
- Schemaläggningshanterare: Automatiserar körningen av uppgifter och hanterar arbetsflöden för att förbättra produktiviteten.
Fördelar med ETL-verktyg med öppen källkod
Implementering av ETL-verktyg med öppen källkod ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Kostnadseffektivitet: Eftersom dessa verktyg har öppen källkod medför de ofta inga licensavgifter, vilket minskar de totala kostnaderna för din verksamhet.
- Flexibilitet: Anpassningsbara arbetsflöden gör det möjligt att utforma dataprocesser efter dina specifika behov och anpassa dem när behoven förändras.
- Skalbarhet: Stöder både batchbearbetning och realtidsbearbetning, så att din verksamhet kan hantera växande datamängder utan att prestandan försämras.
- Förbättrat beslutsfattande: Realtidsbearbetning av data säkerställer att ditt team har tillgång till aktuell information, vilket möjliggör välgrundade beslut i rätt tid.
- Förbättrad datakvalitet: Funktioner som dataobserverbarhet och datastyrning bidrar till att upprätthålla datans noggrannhet och efterlevnad, vilket ökar förtroendet för dina data.
- Stöd från communityn: Dessa verktyg stöds ofta av en stark utvecklarcommunity som tillhandahåller resurser och delad kunskap för felsökning och förbättringar.
- Integrationsmöjligheter: Ansluter enkelt till olika datakällor och system, vilket effektiviserar datahanteringen i hela organisationen.
Kostnader och priser för ETL-verktyg med öppen källkod
För att välja ETL-verktyg med öppen källkod behöver du förstå de olika prismodellerna och abonnemangen som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamets storlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar med ETL-verktyg med öppen källkod:
Jämförelsetabell för abonnemang för ETL-verktyg med öppen källkod
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
| Gratisabonnemang | $0 | Grundläggande dataextrahering, begränsade integrationer och stöd från communityn. |
| Personligt abonnemang | $5-$25/användare/månad | Förbättrade datatransformationer, personlig support och begränsade anpassningsmöjligheter. |
| Företagsabonnemang | $50-$100/användare/månad | Avancerad databehandling, flera integrationer och verktyg för teamsamarbete. |
| Enterprise-abonnemang | $100-$500/användare/månad | Fullständig anpassning, support på företagsnivå och omfattande säkerhetsfunktioner. |
ETL-verktyg med öppen källkod (vanliga frågor)
Här är några svar på vanliga frågor om ETL-verktyg med öppen källkod:
Vilka begränsningar har ETL-verktyg?
ETL-verktyg lagrar ofta inte data permanent, vilket innebär att du behöver ytterligare lagringslösningar. De kan också orsaka datafördröjning, vilket leder till fördröjningar i datatillgängligheten. Inlärningskurvan kan vara brant, och skalning av verktygen för att hantera stora datamängder kan kräva extra resurser. Dessutom kan de ha svårt att hantera ostrukturerade data.
Vilket ETL-verktyg med öppen källkod är bäst?
Det bästa ETL-verktyget med öppen källkod beror på dina specifika behov. Verktyg som Apache NiFi passar utmärkt för dataflöden i realtid, medan Talend Open Studio är utmärkt för breda dataintegreringsuppgifter. Ta hänsyn till faktorer som teamets expertis, datans komplexitet och integreringsbehoven när du väljer verktyg.
Vad kan avancerade ETL-verktyg läsa in och konvertera strukturerade och ostrukturerade data till?
Avancerade ETL-verktyg kan läsa in och konvertera både strukturerade och ostrukturerade data till format som är kompatibla med system som Hadoop. De hanterar flera filer parallellt, vilket förenklar processen att slå samman olika data i ett enhetligt transformationsarbetsflöde.
Vad är skillnaden mellan API- och ETL-verktyg?
API:er är idealiska för datautbyte i realtid och kommunikation mellan applikationer. ETL-verktyg lämpar sig däremot bättre för batchbearbetning, där data från flera källor behöver konsolideras, transformeras och läsas in i ett målsystem för analys.
Hur hanterar ETL-verktyg datasäkerhet?
ETL-verktyg hanterar datasäkerhet genom att implementera kryptering, åtkomstkontroller och efterlevnadsåtgärder. De säkerställer att känsliga data skyddas under processerna för extrahering, transformering och inläsning. Vissa verktyg erbjuder även inbyggda granskningsfunktioner för att spåra dataåtkomst och ändringar.
Kan ETL-verktyg integreras med molntjänster?
Ja, många ETL-verktyg kan integreras sömlöst med molntjänster. De stöder dataförflyttning till och från molnplattformar som AWS, Google Cloud och Azure, vilket gör att du kan dra nytta av molnlagring och molnbaserad databehandling i dina dataarbetsflöden.
Vad händer härnäst?
Förbättra din SaaS-tillväxt och ditt ledarskap. Prenumerera på vårt nyhetsbrev för de senaste insikterna från CTO:er och blivande teknikledare.
Vi hjälper dig att skala smartare och leda starkare med guider, resurser och strategier från ledande experter!