

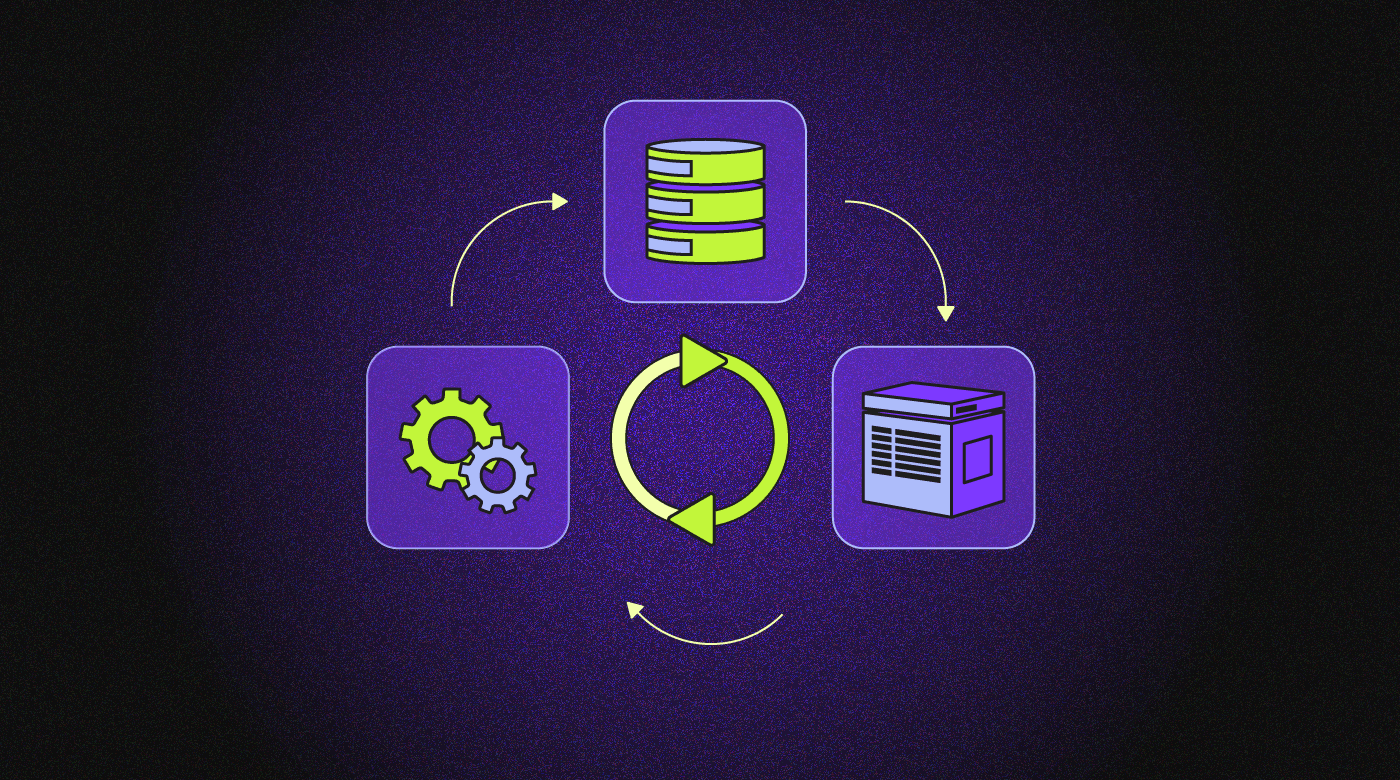
Os pipelines de ETL são um conjunto de processos utilizados para mover dados de uma ou mais fontes para uma base de dados ou armazém de dados. ETL significa “extrair, transformar e carregar”, descrevendo os processos necessários para o fazer. Saber como criar pipelines de ETL eficientes pode melhorar significativamente os seus esforços de inteligência empresarial e simplificar a gestão de dados.
Os pipelines de ETL são frequentemente utilizados na ciência de dados devido à sua utilidade na limpeza de dados e na otimização de conjuntos de dados. No entanto, também são úteis em contextos empresariais, especialmente no mundo moderno dos grandes volumes de dados.
Atualmente, muitas ferramentas podem simplificar os fluxos de trabalho de gestão de dados e, como iremos discutir neste guia, estas ferramentas constituem uma parte crucial dos pipelines de ETL modernos.
O que são pipelines de ETL?
ETL significa Extrair, Transformar e Carregar. Vejamos cada etapa do processo por ordem:
- Extrair: Este processo obtém dados de uma API, extraindo-os de uma base de dados ou lendo-os de um despejo (como um ficheiro XML ou JSON). Dependendo do número de fontes de dados das quais pretende extrair dados, configurar conectores e analisar os dados pode ser um processo complexo. As ferramentas de gestão de dados podem frequentemente ajudar a converter dados de várias fontes para um único formato consistente.
- Transformar: Depois de os dados terem sido obtidos, o passo seguinte consiste em higienizá-los, remover duplicados, uniformizar os dados (por exemplo, garantindo que todas as datas seguem o mesmo formato), reestruturá-los para corresponderem ao esquema da base de dados de destino e assegurar que todos os campos estão corretamente mapeados. Este pode ser um processo demorado e algo que poderá ter de ser revisto regularmente se alguma das fontes de dados alterar a forma como fornece os dados.
- Carregar: Por fim, os dados transformados podem ser importados para a base de dados, o armazém de dados ou a plataforma de destino. O processo exato para concluir este carregamento pode variar consoante a plataforma de destino. O carregamento inicial pode demorar algum tempo, uma vez que envolve o carregamento de uma grande quantidade de dados para preencher a base de dados. No futuro, as atualizações podem ser geridas através de alterações incrementais aos dados, mas podem ser realizadas atualizações completas ocasionais para garantir a integridade dos dados. Muitos engenheiros de dados automatizam o processo de atualização e agendam-no para períodos fora das horas de maior utilização, quando os sistemas de origem registam um tráfego mínimo.
Planeamento e conceção de pipelines de ETL eficazes
O enorme volume de dados processado pelos pipelines de ETL faz com que a sua implementação seja um empreendimento significativo. Para garantir o sucesso do processo, os engenheiros de dados devem ter uma boa compreensão dos dados que irão processar e dos objetivos das pessoas que trabalham com esses dados.
Have an account? Log In
Principais considerações antes de criar um pipeline de ETL
Existem alguns desafios fundamentais ao lidar com grandes volumes de dados:
- Volume de dados: Um elemento fundamental é a quantidade de dados recolhidos e os custos associados ao armazenamento (e à transmissão) desses dados. Em alguns casos, as organizações não têm controlo sobre o volume de dados fornecido por terceiros quando solicitam uma exportação. No entanto, pode decidir que dados manter e quais são redundantes.
- Variedade dos dados: Também deve considerar os tipos e formatos dos dados com que está a trabalhar e se esses dados são estruturados ou não estruturados. Os engenheiros de dados podem enfrentar este desafio utilizando ferramentas de transformação e uniformização para converter todos os dados para um formato comum.
- Velocidade dos dados: Descreve a velocidade e a frequência com que os dados são recolhidos. Uma elevada velocidade dos dados pode causar problemas ao tentar automatizar os pipelines, especialmente se procura os dados mais precisos de todas as fontes para tomar decisões baseadas em dados.
Depois de resolver essas questões, pode considerar o objetivo da consolidação dos dados e as metas finais da análise de dados. Essas metas podem influenciar as decisões relativas à conceção da base de dados.
Escolher as ferramentas e tecnologias de ETL certas
É possível desenvolver as suas próprias ferramentas de ETL de raiz — e algumas organizações mais pequenas optam por seguir este caminho, partindo do princípio de que será mais barato e fácil do que trabalhar com soluções prontas a utilizar.
Embora isto possa ser verdade quando se importam dados de apenas uma ou duas fontes que raramente alteram os seus formatos de exportação, raramente é a melhor opção. As ferramentas de ETL oferecem soluções mais avançadas de processamento, limpeza e criação de perfis de dados, funcionalidades avançadas de automatização e processamento em lote, bem como benefícios significativos em termos de fiabilidade e facilidade de utilização.
Ao escolher uma solução de ETL, considere o seguinte:
- Formatos de dados suportados (ficheiros SQL, XML, JSON, CSV, etc.)
- Integrações de API
- Disponibilidade de transmissão em tempo real para ingestão de dados (o Apache Kafka é uma solução popular para este efeito)
- Se a solução é nativa da nuvem (As ferramentas que permitem o carregamento fácil de dados para lagos de dados do Amazon AWS ou do Google Cloud podem ser inestimáveis para organizações que necessitam de flexibilidade e agilidade no armazenamento de dados)
- Tempos de resposta do suporte
- Preço
Estão disponíveis muitas soluções ETL de código aberto, algumas das quais oferecem edições comunitárias gratuitas e financiam o seu desenvolvimento através da cobrança de suporte técnico. Se a sua organização tiver um orçamento limitado para a implementação de ETL, escolher uma solução de código aberto amplamente utilizada poderá permitir-lhe poupar muito dinheiro.
Princípios de conceção para pipelines ETL escaláveis e fáceis de manter
Ao conceber um pipeline ETL, é crucial considerar não só as fontes de dados com que está atualmente a trabalhar, mas também a forma como as suas necessidades poderão evoluir no futuro. Alguns aspetos a considerar incluem:
- Conceção modular: Divida o sistema em extração de dados, limpeza de dados e processo de carregamento. Considere os vários formatos de dados com que poderá ter de trabalhar e crie um sistema modular, para que seja fácil alterar diferentes partes do sistema sem interromper todo o pipeline.
- Gestão de erros: Conceba o sistema para que falhe de forma controlada e apresente uma mensagem de erro clara se encontrar dados que não compreenda ou que estejam num formato incorreto. É preferível que o sistema ignore os registos que não consegue processar e forneça uma mensagem de aviso do que falhar completamente, provocando atrasos no processo de carregamento ou, pior ainda, carregando dados incorretos e corrompendo o repositório de dados principal.
- Documentação clara e completa: Uma documentação clara é essencial. Tenha em mente que nem todos os membros da sua equipa são cientistas de dados. Muitas das pessoas que interagem com os dados podem ser líderes de equipa ou responsáveis de departamento que simplesmente pretendem uma forma fácil de aceder simultaneamente a dados em tempo real provenientes de várias fontes diferentes. Disponha de um conjunto de documentação para essas pessoas e de outro para os programadores, que explique o pipeline em maior detalhe. Descreva princípios de conceção essenciais, como a modularidade, a gestão de erros e as práticas de documentação.
Pipeline ETL vs pipeline de dados
Os pipelines ETL e os pipelines de dados são processos semelhantes, mas com casos de utilização ligeiramente diferentes. Um pipeline ETL abrange a extração de dados de uma ou mais fontes, a transformação desses dados e, em seguida, o seu carregamento.
Em contrapartida, um pipeline de dados pode incluir algumas ou todas as etapas acima, mas não termina com o processo de carregamento. Depois de os dados serem carregados, podem ser utilizados noutros processos e fluxos de trabalho, por exemplo, num sistema de visualização ou para acionar condicionalmente uma ação num sistema de automatização.

Author's Tip
Pense num pipeline ETL como um tipo de pipeline de dados com uma função estritamente definida: recolher dados estruturados e não estruturados, transformá-los num formato comum e armazená-los num armazém de dados ou numa base de dados.
Principais vantagens dos pipelines ETL
Os pipelines ETL podem ser extremamente úteis para alimentar sistemas de análise e de inteligência empresarial. Como unificam dados provenientes de várias fontes, por exemplo, reunindo dados das redes sociais, de sistemas CRM, de ferramentas ERP e de outras bases de dados, facilitam a obtenção de informações empresariais precisas.
O processo ETL envolve a otimização, validação e limpeza dos dados, ajudando a garantir que as informações que chegam à base de dados sejam tão precisas e atuais quanto possível.
A fiabilidade dos seus pipelines ETL depende das ferramentas que utiliza. Um pipeline pode ser tão simples como alguns scripts Python ou algo mais robusto que utilize Snowflake, Kafka e outras ferramentas modernas. Atualmente, as ferramentas disponíveis para processar dados e criar um pipeline ETL estão bastante maduras. As interfaces gráficas de utilizador fáceis de utilizar e as comunidades de utilizadores ativas permitem que até cientistas de dados principiantes comecem a trabalhar com pipelines ETL.
Desvantagens dos pipelines ETL
Embora as cadeias de ferramentas para criar pipelines ETL estejam maduras e os armazéns de dados na nuvem sejam atualmente muito mais acessíveis do que eram há alguns anos, ainda existem alguns desafios no que diz respeito à criação de pipelines de dados:
- Lidar com dados estruturados, não estruturados e semiestruturados pode ser difícil.
- Os custos do armazenamento de dados podem ser proibitivos para algumas organizações.
- A transmissão de dados em tempo real pode ser complexa e consumir muitos recursos.
- Mapear bases de dados e configurar integrações não é uma tarefa única. Os fornecedores de dados podem alterar os respetivos formatos de exportação ou esquemas de bases de dados, exigindo que altere o seu pipeline.
Implementação de um pipeline ETL
Considere o seguinte fluxo de trabalho para implementar um pipeline ETL:
- Crie dados de referência, para ter algo com que trabalhar ao efetuar transformações de dados.
- Crie conectores para as fontes de dados com que gostaria de trabalhar, tais como:
- Interfaces de API para plataformas de redes sociais
- Ferramentas de extração para páginas Web (se os TOS o permitirem)
- Analisadores para ficheiros XML/CSV/JSON
- Conectores de bases de dados para os seus próprios sistemas no local
- Defina regras para validar os dados.
- Aplique transformações para limpar e uniformizar os dados e remover duplicados.
- Carregue os dados para um sistema de preparação.
- Carregue os dados do sistema de preparação para o armazém de dados.
Alguns dos passos acima são opcionais. Por exemplo, os dados de referência não são necessários, mas são úteis porque facilitam a definição de regras para testar os dados e efetuar transformações. Além disso, não é necessário preparar os dados antes de os carregar. No entanto, é uma boa prática fazê-lo, porque é mais fácil reverter a camada de preparação se algo correr mal e essa camada pode ser utilizada para relatórios de auditoria e outros requisitos de conformidade.
More Articles
Ferramentas de pipeline ETL a experimentar
Muitas ferramentas ETL disponíveis podem simplificar o processamento, a agregação, a limpeza e o carregamento de dados no sistema de destino. O mercado de software ETL está avaliado em cerca de $3.1 mil milhões e prevê-se que atinja $10.3 mil milhões até 2030, pelo que não faltam opções.
Algumas ferramentas populares incluem:
- Informatica Power Center: Uma solução versátil com suporte para a nuvem, incluindo ferramentas de baixo código e sem código para pipelines ETL
- Apache Airflow: Uma plataforma de código aberto poderosa, com opções de interface de linha de comandos e de interface gráfica
- IBM Infosphere Datastage: Uma solução rápida e poderosa com funcionalidades de balanceamento de carga e paralelização
Existem muitas outras opções, incluindo soluções da Oracle e da Microsoft. Ao selecionar uma solução ETL, considere o seu orçamento e o ecossistema existente, uma vez que continuar a trabalhar com fornecedores que já conhece bem pode ser uma opção fiável e económica.
Principais conclusões
Os pipelines ETL são uma parte crucial da gestão de dados para as empresas modernas que processam volumes significativos de dados. A implementação de um pipeline ETL pode ajudar a melhorar a tomada de decisões da sua organização e proporcionar à sua empresa uma vantagem competitiva.
No entanto, lidar com dados brutos provenientes de várias fontes pode ser um desafio, e os líderes tecnológicos devem salientar a importância de um planeamento e de uma documentação cuidadosos ao longo de todo o processo, bem como cumprir os regulamentos de proteção de dados e privacidade.
Para saber mais sobre pipelines ETL, processamento de dados e outros desafios e inovações relacionados com megadados, subscreva a newsletter do CTO Club.