

Het vinden van de juiste monitoringstool kan een hele uitdaging zijn. Je wilt iets dat aansluit bij de behoeften van je team zonder onnodige complexiteit. Daarom zijn veel organisaties op zoek naar alternatieven voor LogicMonitor.
In mijn ervaring zoeken bedrijven vaak naar andere oplossingen die betere schaalbaarheid, specifieke functies of een betere prijs-kwaliteitverhouding bieden. Ze kunnen tot de conclusie komen dat LogicMonitor niet aansluit bij hun huidige doelen of budget.
Ik heb verschillende opties onafhankelijk getest en beoordeeld om je een onbevooroordeeld beeld te geven van wat er beschikbaar is. Ik begeleid je bij het vinden van de beste tools om je specifieke uitdagingen aan te pakken.
Of je nu op zoek bent naar betere cloudintegratie of de flexibiliteit van opensourcesoftware, deze lijst helpt je de juiste oplossing te vinden. Laten we de beste opties bekijken die je monitoringtaken beter beheersbaar kunnen maken.
Wat is LogicMonitor?
LogicMonitor is productiviteitssoftware voor IT-professionals en bedrijven die efficiënte monitoringoplossingen nodig hebben. IT-teams gebruiken het om infrastructuur, applicaties en netwerkprestaties te monitoren, waardoor waardevolle inzichten in de werking van systemen ontstaan.
Geautomatiseerde monitoring, aanpasbare dashboards en realtimewaarschuwingen helpen bij het opsporen van problemen en het optimaliseren van prestaties. Over het algemeen biedt LogicMonitor een gecentraliseerd platform om je systemen soepel te laten werken.
Vergelijkingstabel van LogicMonitor-alternatieven
In deze vergelijkingstabel worden de prijsgegevens van mijn belangrijkste alternatieven voor LogicMonitor samengevat:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Beste voor AI-gestuurde observeerbaarheid | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $7/maand Gratis proefperiode van 15 dagen + gratis demo beschikbaar | Website |
Beste keuze voor kosteneffectieve monitoring | 4.0 out of 5 | 4 | 3 | 4 | 4 | 4 | 5 | $325/maand Gratis abonnement + gratis proefperiode van 5 dagen + gratis demo beschikbaar | Website |
Het beste voor cloudmonitoringdiensten | 4.3 out of 5 | 4 | 4 | 4 | 4 | 5 | 5 | $15/host/maand Gratis abonnement + gratis proefperiode van 14 dagen + gratis demo beschikbaar | Website |
Het beste voor AI-aangedreven gegevensanalyse | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $15/host/maand Gratis abonnement beschikbaar | Website |
Het beste voor geautomatiseerde realtime gegevenstoegang | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $0.04/maand 14 dagen gratis proberen + gratis demo beschikbaar | Website |
Beste keuze voor uniforme, flexibele observability | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $19/maand Gratis abonnement beschikbaar | Website |
Beste voor geïntegreerde IT-oplossingen | 3.7 out of 5 | 3 | 3 | 4 | 3 | 5 | 4 | Prijs op aanvraag Gratis proefperiode van 30 dagen beschikbaar | Website |
Meest geschikt voor aanpasbaar overzichtspaneel | 3.3 out of 5 | 4 | 2 | 4 | 3 | 4 | 3 | $200/maand Gratis abonnement + proefperiode van 30 dagen + demo beschikbaar | Website |
Het beste voor open-source-observability | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $49/maand Gratis proefperiode van 30 dagen + gratis demo beschikbaar | Website |
Beste voor inzichten op basis van AI | 3.2 out of 5 | 3 | 4 | 3 | 2 | 3 | 4 | Prijzen op aanvraag Gratis abonnement + gratis demo beschikbaar | Website |


Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Beoordelingen van de beste LogicMonitor-alternatieven
Hieronder vind je mijn uitgebreide samenvattingen van de beste alternatieven voor LogicMonitor die op mijn shortlist zijn terechtgekomen. In mijn beoordelingen bespreek ik de belangrijkste functies, voor- en nadelen, integraties en ideale gebruikssituaties van elke tool in detail, zodat je de beste oplossing voor jouw behoeften kunt vinden.
 Beste voor AI-gestuurde observeerbaarheid
- Gratis proefperiode van 15 dagen + gratis demo beschikbaar
- Vanaf $7/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5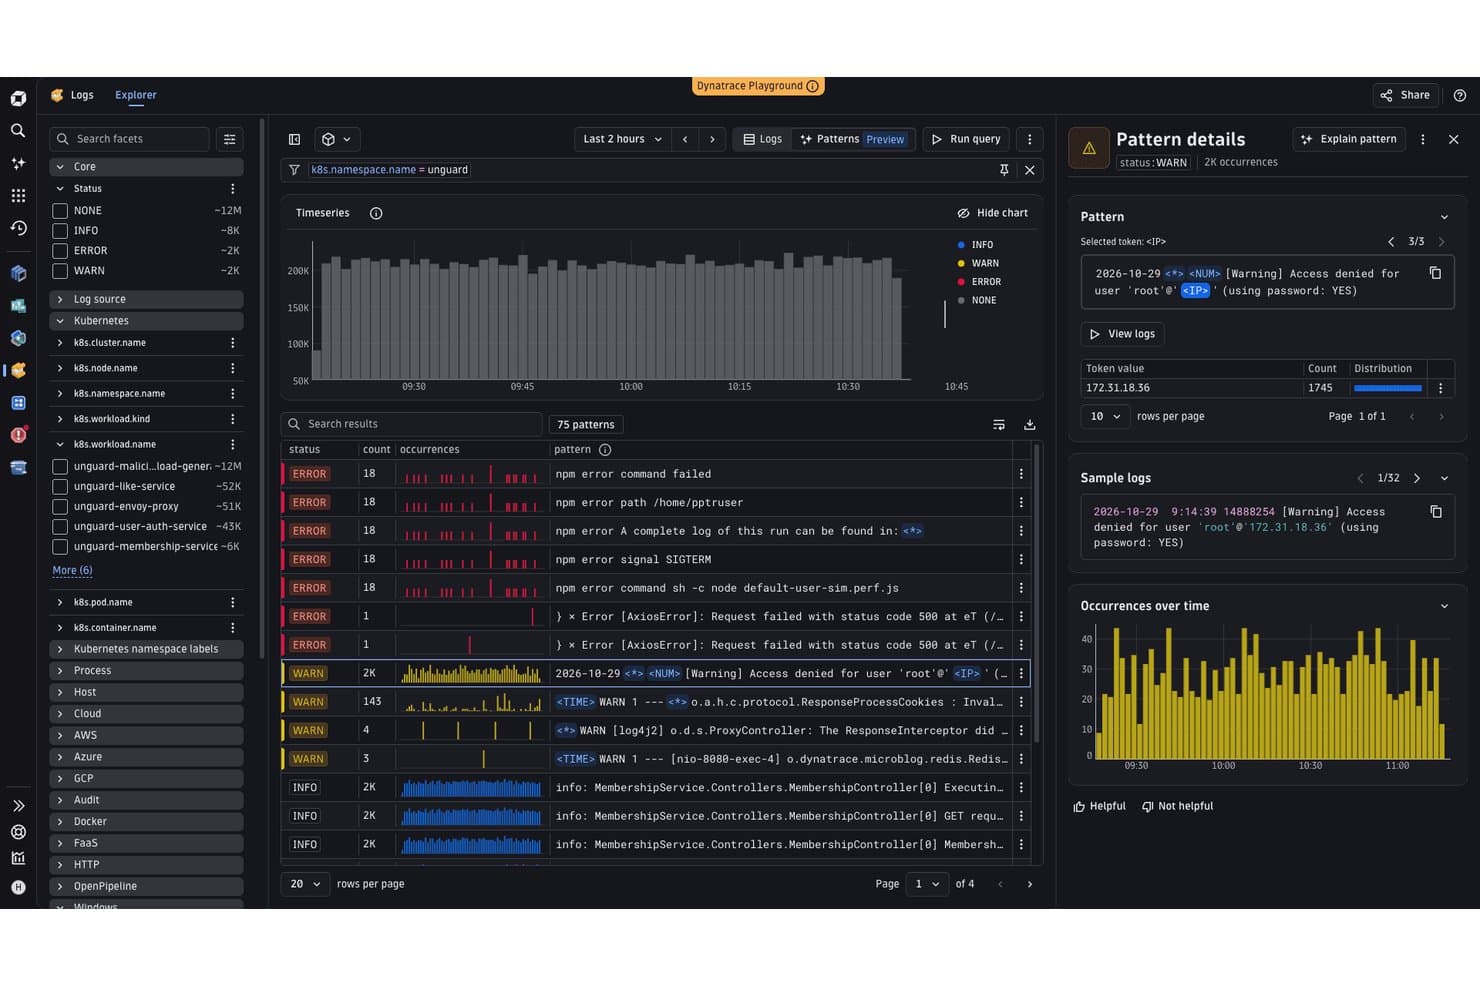
De Dynatrace Logs-app groepeert logregels in patronen op basis van status, met grafieken van het aantal voorkomens en details. Dynatrace is een platform voor observeerbaarheid van de volledige stack dat AI gebruikt om je applicaties, infrastructuur en cloudomgevingen automatisch te ontdekken, in kaart te brengen en te monitoren—waardoor het zeer geschikt is voor IT-operations- en DevOps-teams die te maken hebben met complexe, snel veranderende systemen waarin handmatige oorzaakanalyse niet realistisch is.
Voor wie is Dynatrace het meest geschikt?
Dynatrace is zeer geschikt voor DevOps- en IT-operationsteams die complexe, gedistribueerde omgevingen beheren waarin volledig inzicht in de stack en AI-gestuurde oorzaakanalyse belangrijker zijn dan speciale netwerkmonitoring.
Waarom ik Dynatrace heb gekozen
Ik heb Dynatrace gekozen als een van de beste alternatieven voor LogicMonitor omdat de AI-gestuurde observeerbaarheid veel verder gaat dan waarschuwingen op basis van drempelwaarden. Davis AI gebruikt Smartscape-topologie om gebeurtenissen op hosts, in containers en bij services automatisch met elkaar in verband te brengen. Daardoor hoef ik niet tientallen waarschuwingen te onderzoeken, maar krijg ik één hoofdoorzaak. PurePath volgt elke transactie van begin tot eind op codeniveau, waardoor ik precies kan vaststellen waar een vertraging ontstaat zonder handmatig logs te hoeven doorzoeken.
Belangrijkste functies van Dynatrace
- Automatische detectie met OneAgent: Wordt per host geïnstalleerd en ontdekt automatisch processen, services en afhankelijkheden zonder handmatige configuratie.
- Loganalyse met DQL: Neemt loggegevens op, verrijkt ze en doorzoekt ze met Dynatrace Query Language, met een configureerbare bewaartermijn van 10 dagen tot 10 jaar.
- Synthetische monitoring: Simuleert gebruikersreizen via Browser Monitor en controleert de beschikbaarheid van API's en services via HTTP Monitor vanaf openbare en private locaties.
- Workflowautomatisering: Start geautomatiseerde workflows vanuit gebeurtenissen, planningen of API-aanroepen, met ondersteuning voor voorwaarden, lussen en nieuwe pogingen.
Integraties van Dynatrace
Dynatrace heeft integraties via de integratiecatalogus met Jira, Slack, Cursor, GitHub Copilot Coding Agent, JetBrains en Windsurf. Het biedt ook API's voor omgevingsbeheer, configuratiebeheer en accountbeheer voor aangepaste integraties en workflowconnectiviteit.
Pros and Cons
Pros:
- Brengt waarschuwingen met elkaar in verband via Smartscape-topologie
- OneAgent ontdekt afhankelijkheden tussen applicaties en infrastructuur
- PurePath volgt transacties tot op het niveau van de code
Cons:
- Netwerkmonitoring blijft achter bij gespecialiseerde platforms
- Voor het configureren van aangepaste dashboards is inspanning nodig
 Beste keuze voor kosteneffectieve monitoring
- Gratis abonnement + gratis proefperiode van 5 dagen + gratis demo beschikbaar
- Vanaf $325/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5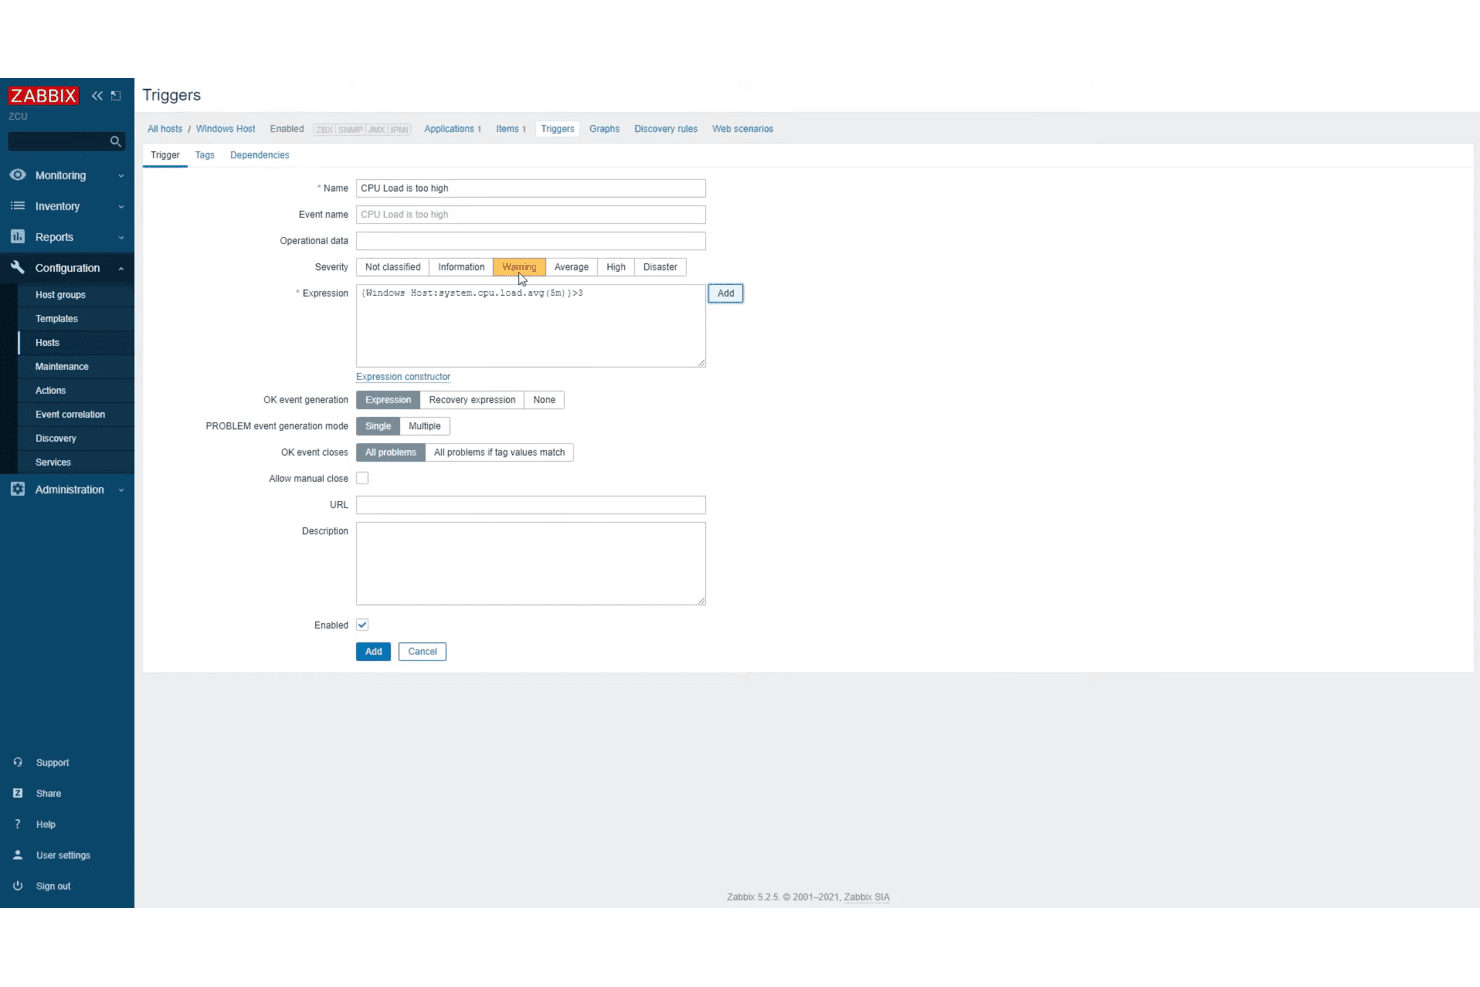
Een Zabbix-trigger configureren die een waarschuwing geeft wanneer de CPU-belasting van een Windows-host een drempelwaarde overschrijdt. Zabbix is een open-source monitoringplatform voor IT-teams die brede infrastructuurinzichten nodig hebben—over servers, netwerken, cloud, containers en applicaties heen—zonder kosten per apparaat of metriek te betalen.
Voor wie is Zabbix het meest geschikt?
Zabbix is zeer geschikt voor IT-teams die monitoring van infrastructuur op ondernemingsniveau nodig hebben, maar kosten voor licenties per apparaat niet kunnen rechtvaardigen.
Waarom ik voor Zabbix heb gekozen
Ik heb Zabbix gekozen als een van de beste opties, omdat geen enkele andere tool op deze lijst je volledig af laat zien van licenties per apparaat en toch monitoring op ondernemingsniveau biedt voor servers, netwerken, cloud en containers. De open-sourcekern heeft geen limieten voor het aantal hosts, geen limieten voor het aantal metrieken en geen afgeschermde functies, waardoor een team dat duizenden eindpunten beheert evenveel aan licenties betaalt als een team dat er tien beheert: nul. Ik waardeer ook de voorspellende triggerfuncties, die historische gegevens gebruiken om in te schatten wanneer een drempelwaarde wordt overschreden voordat dit daadwerkelijk gebeurt.
Belangrijkste functies van Zabbix
- Regels voor gebeurteniscorrelatie: Configureer regels om gerelateerde gebeurtenissen te groeperen, steeds terugkerende waarschuwingen te ontdubbelen en verouderde problemen automatisch te sluiten bij verschillende triggers en peilingsmethoden.
- Dashboards voor kosten in meerdere clouds: Bekijk en vergelijk infrastructuuruitgaven voor AWS, Azure, Google Cloud en Oracle Cloud vanuit één dashboard.
- Ondersteuning voor OpenTelemetry APM: Ontvang gedistribueerde traces, metrieken en logboeken van applicaties of OpenTelemetry Collectors via een Zabbix-proxy, met ClickHouse als bron voor telemetriegegevens.
- Geautomatiseerde herstelacties: Voer geconfigureerde scripts of opdrachten uit als reactie op gedetecteerde problemen, waaronder het opnieuw starten van services of het opnieuw schalen van cloudresources.
Zabbix-integraties
Zabbix vermeldt 204 officiële sjablonen en 570 merken voor 2.010 oplossingen, waaronder AWS, Azure, Google Cloud Platform, ServiceNow, Slack, PagerDuty, Kafka en RabbitMQ. De JSON-RPC API, REST-streaming-API, webhooks en Python-bibliotheek ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Brede zichtbaarheid over servers en netwerken
- Flexibele waarschuwingen en gebeurteniscorrelatie
- Voorspellingen signaleren naderende metriekdrempels
Cons:
- Waarschuwingsdrempels moeten handmatig worden afgestemd
- Zelf gehoste implementaties vereisen extra databaseonderhoud
 Het beste voor cloudmonitoringdiensten
- Gratis abonnement + gratis proefperiode van 14 dagen + gratis demo beschikbaar
- Vanaf $15/host/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5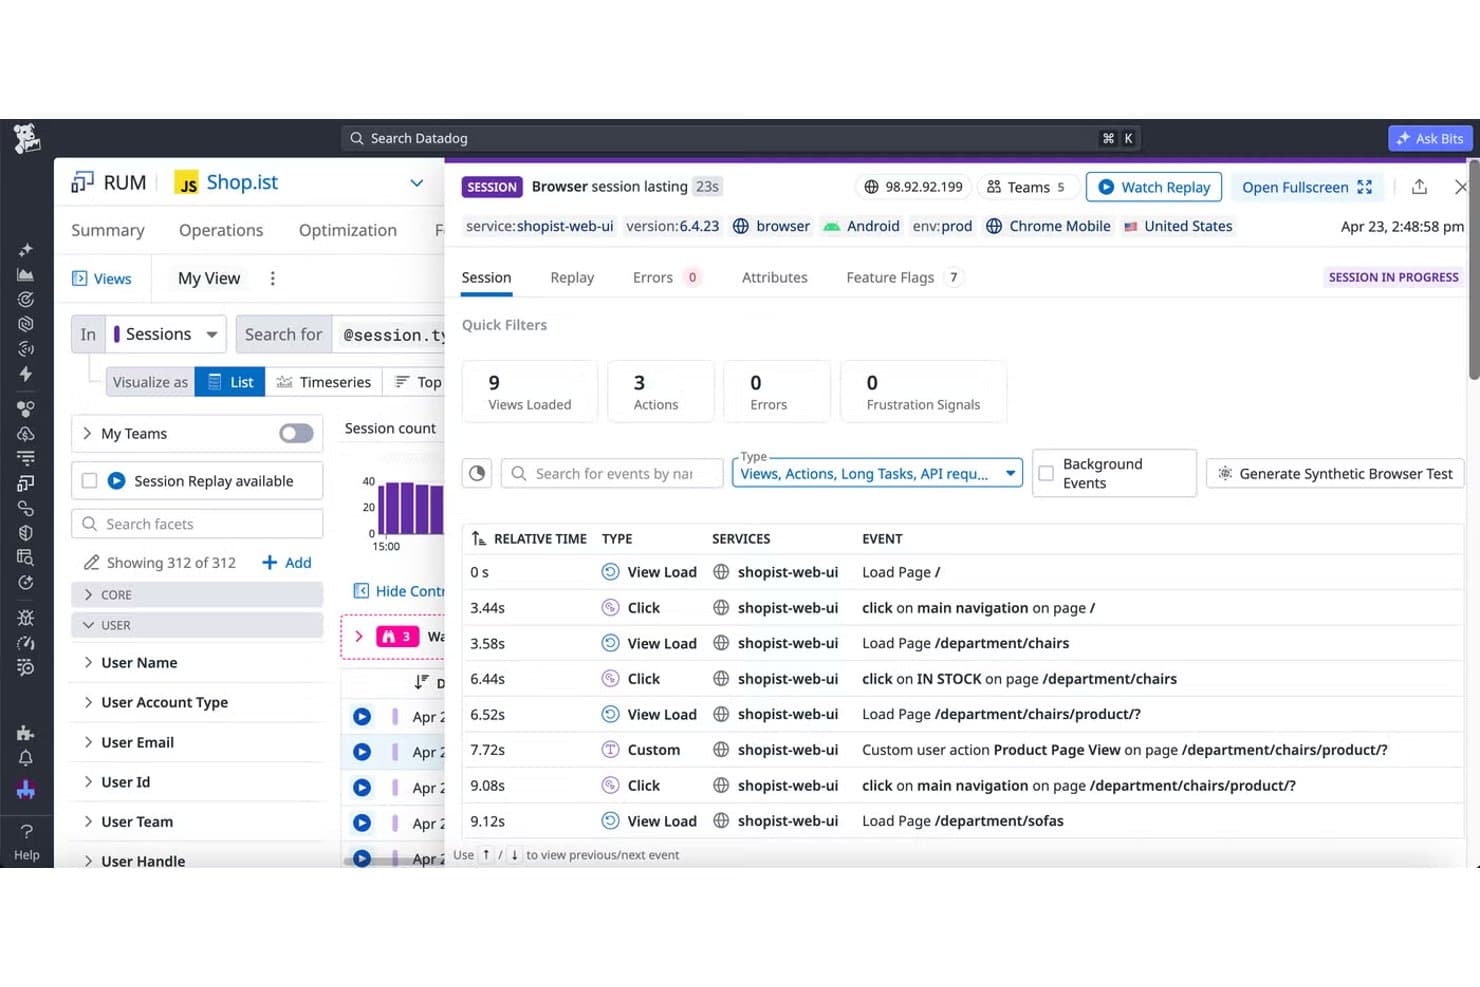
Datadog RUM-sessieoverzicht met de paginaladingen, klikken en aangepaste acties van een gebruiker in volgorde. Datadog is een op SaaS gebaseerd platform voor observeerbaarheid dat IT- en DevOps-teams uniform inzicht geeft in cloud-, hybride en on-premises infrastructuur—waarbij metrische gegevens, logboeken, traces en beveiligingssignalen op één plek worden gecombineerd om contextwisselingen tijdens incidentrespons te beperken.
Voor wie is Datadog het meest geschikt?
Datadog is zeer geschikt voor DevOps-engineers en IT-operationsteams die cloud-native of hybride omgevingen beheren en behoefte hebben aan uniform inzicht in infrastructuur, logboeken, traces en beveiligingssignalen binnen één platform.
Waarom ik voor Datadog heb gekozen
Ik heb Datadog gekozen als een van de beste alternatieven voor LogicMonitor omdat het speciaal is ontwikkeld voor cloudmonitoring en tienduizenden metrische gegevens in AWS, Azure en GCP bijhoudt, terwijl deze in één weergave worden gecorreleerd met logboeken, traces en beveiligingssignalen. Ik ben vooral te spreken over Watchdog, de AI-engine die automatisch afwijkingen naar voren brengt, zodat mijn team tijdens een incident niet handmatig door ruis hoeft te zoeken. Ook de voorspellingsmonitors zijn echt nuttig: ik kan CPU- of geheugentrends modelleren met seizoensgebonden of lineaire algoritmen en tot drie maanden vooruit waarschuwingsdrempels instellen.
Belangrijkste functies van Datadog
- Infrastructuur zoeken op basis van tags: Filter en analyseer metrische gegevens in je volledige infrastructuur met behulp van aangepaste tags om hosts, containers en cloudresources op basis van elke gewenste dimensie te groeperen.
- Correlatie tussen signalen: Koppel infrastructuurmetrische gegevens aan logboeken, traces en beveiligingssignalen in één weergave om incidenten te onderzoeken zonder van tool te wisselen.
- Netwerktopologie in kaart brengen: Visualiseer netwerkapparaten, interfaces en fysieke verbindingen, met de mogelijkheid om verkeer, SNMP-traps, Syslog-berichten en naburige apparaten te inspecteren.
- Monitoring van live processen: Bekijk realtime activiteit op procesniveau in je hosts en containers, inclusief resourcegebruik en uitgevoerde opdrachten, vanuit een gecentraliseerde interface.
Datadog-integraties
Datadog biedt meer dan 1.000 integraties, waaronder Amazon Web Services, Microsoft Azure, Google Cloud Platform, Kubernetes, Docker, Jira, PagerDuty, OpenTelemetry, PostgreSQL en Redis. De REST API en clientbibliotheken ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Correlatie van infrastructuur, logboeken en traces
- Aangepaste dashboards maken de actuele systeemstatus inzichtelijk
- Voorspellingsmonitors helpen capaciteitstrends te voorzien
Cons:
- Facturen op basis van gebruik kunnen moeilijk te voorspellen zijn
- Het afstellen van waarschuwingen kan leiden tot meldingsmoeheid
 Het beste voor AI-aangedreven gegevensanalyse
- Gratis abonnement beschikbaar
- Vanaf $15/host/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.3/5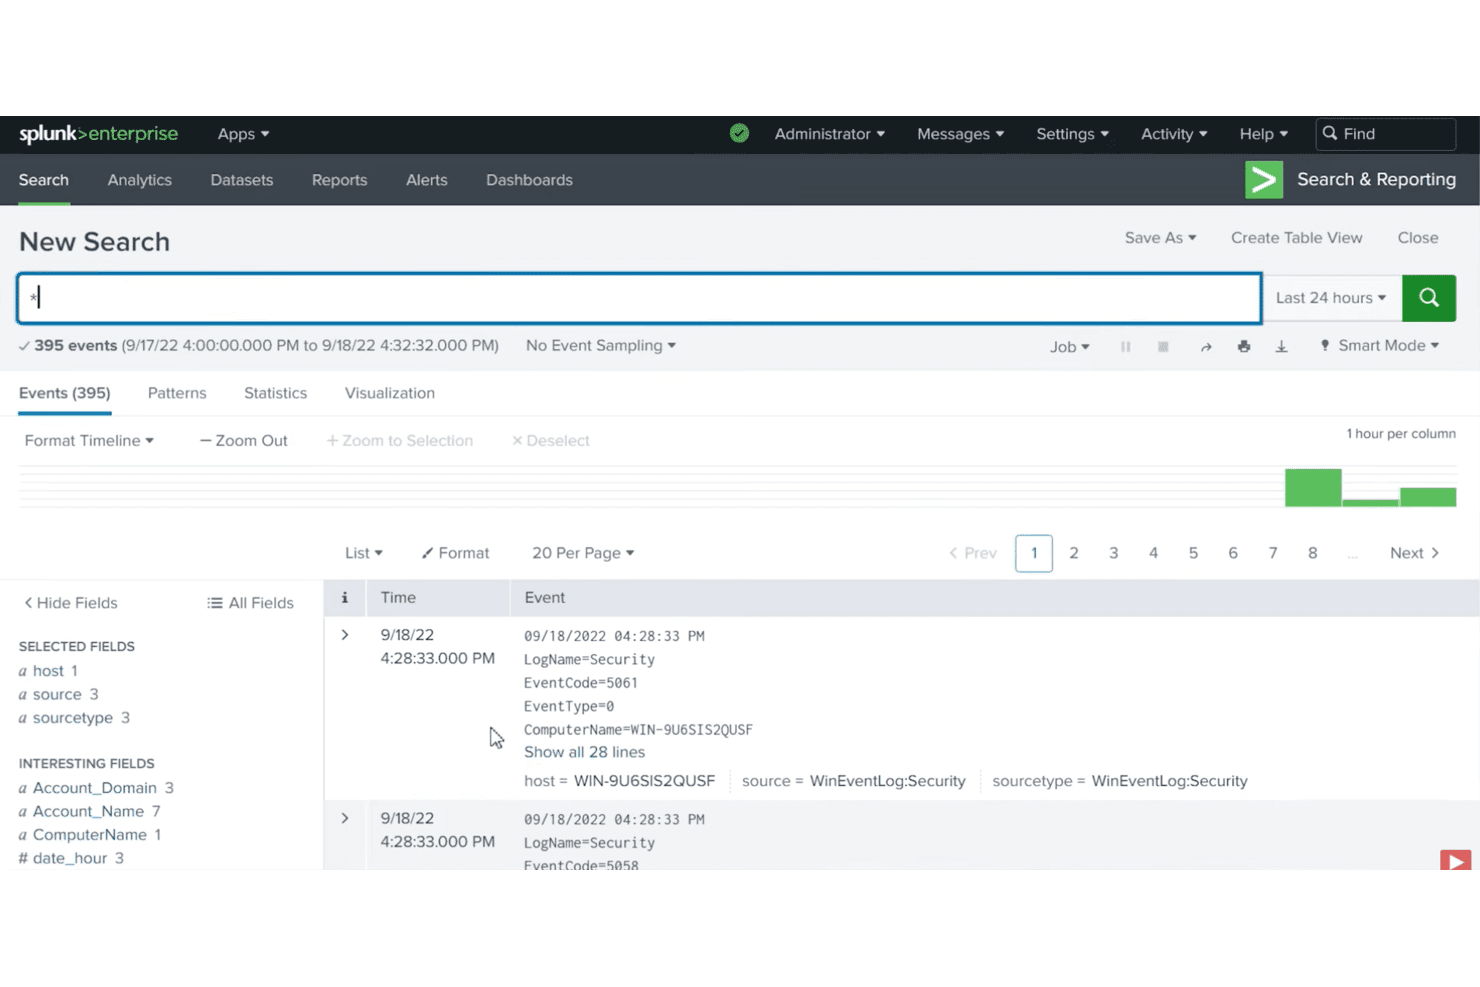
Splunk Enterprise-zoekweergave met Windows Security-gebeurtenissen, selecteerbare velden en een tijdlijn. Splunk Observability Cloud is een SaaS-monitoringplatform dat infrastructuur-, applicatieprestatie- en digitale ervaringsgegevens verenigt. Daardoor is het zeer geschikt voor IT- en DevOps-teams die AI-ondersteunde analyse van hoofdoorzaken nodig hebben in hybride en cloudomgevingen.
Voor wie is Splunk het meest geschikt?
Splunk Observability Cloud is zeer geschikt voor DevOps- en IT-operations-teams in middelgrote tot grote organisaties die AI-ondersteunde analyse van hoofdoorzaken nodig hebben in hybride en cloudomgevingen.
Waarom ik voor Splunk koos
Ik heb Splunk gekozen als een van de beste alternatieven voor LogicMonitor vanwege de manier waarop de AI SRE-laag het onderzoekswerk afhandelt dat doorgaans bij je team terechtkomt. De AI-agent voor probleemoplossing combineert metrieken, traces en logs om waarschijnlijke hoofdoorzaken in duidelijke taal zichtbaar te maken, terwijl de AI-assistent je in staat stelt query's uit te voeren op APM-, infrastructuur- en Kubernetes-gegevens zonder ook maar één query te schrijven. Ik vind het vooral goed dat NoSample-tracering 100% van de tracedata vastlegt, zodat er vóór de analyse niets verloren gaat.
Belangrijkste functies van Splunk
- Infrastructuurdashboards: Vooraf gebouwde dashboards en visualisaties voor clouddiensten, systemen en Kubernetes-omgevingen geven je team realtime inzicht in de status van hybride infrastructuur.
- Dynamische waarschuwingen met detectors: Detectors bewaken meetsignalen en activeren waarschuwingen op basis van regels met meerdere voorwaarden. Meldingen worden verzonden naar tools zoals PagerDuty, Slack, ServiceNow en Microsoft Teams.
- Op OpenTelemetry gebaseerde gegevensinname: Verzamelt metrieken, traces en logs met behulp van instrumentatie volgens open standaarden, met ondersteuning voor Prometheus, Telegraf en collectd naast meer dan 200 integraties.
- Log Observer Connect: Verbindt logs die al zijn opgeslagen in Splunk Cloud Platform of Splunk Enterprise rechtstreeks met workflows voor probleemoplossing in Observability Cloud, zonder extra kosten.
Splunk-integraties
Splunk Observability Cloud documenteert meer dan 200 ondersteunde integraties op basis van open standaarden, waaronder AWS, Microsoft Azure, Google Cloud Platform, Jira, Microsoft Teams, PagerDuty, ServiceNow, Slack en Amazon EventBridge. Het ondersteunt ook OpenTelemetry, Prometheus, Telegraf, collectd en REST API-verbindingen.
Pros and Cons
Pros:
- Verenigt telemetrie voor snellere probleemoplossing
- Vat waarschijnlijke oorzaken samen in duidelijke taal
- Legt elke trace vast voor onderzoeken
Cons:
- De kosten stijgen naarmate het aantal telemetriebronnen toeneemt
- SignalFlow vereist handmatige afstemming van detectors
Learn more about Splunk: Het beste voor geautomatiseerde realtime gegevenstoegang
- 14 dagen gratis proberen + gratis demo beschikbaar
- Vanaf $0.04/maand
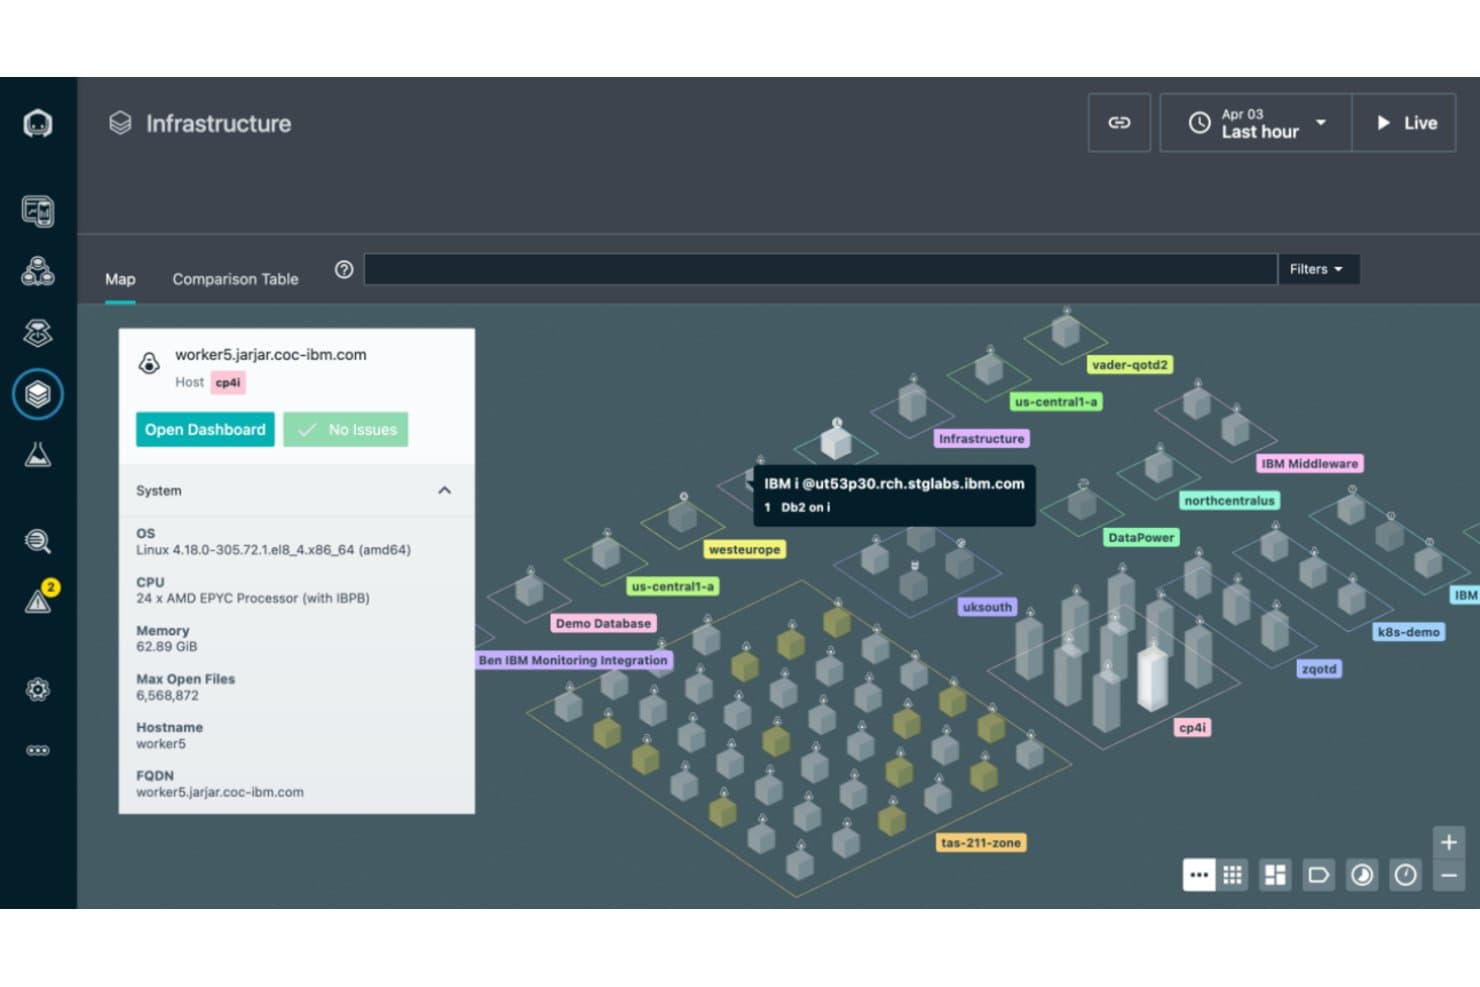
De infrastructuurkaart van IBM Instana toont hosts gegroepeerd per zone, met hostdetails en actuele status. IBM Instana is een door AI aangedreven observabilityplatform voor DevOps-teams die behoefte hebben aan automatische detectie, realtime afhankelijkheidskoppeling en diepgaand inzicht in applicatieprestaties binnen cloud-, hybride en gecontaineriseerde omgevingen.
Voor wie is IBM Instana het meest geschikt?
IBM Instana is zeer geschikt voor DevOps-engineers die complexe cloudgebaseerde omgevingen beheren en behoefte hebben aan realtime, automatische detectie en afhankelijkheidskoppeling zonder handmatig instrumentatiewerk.
Waarom ik voor IBM Instana heb gekozen
Ik heb IBM Instana opgenomen in mijn topkeuzes omdat de geautomatiseerde realtime toegang tot gegevens echt onderscheidend is: de dynamische grafiek detecteert en koppelt elke host, service en afhankelijkheid continu in kaart, waarbij elke seconde wordt bijgewerkt zonder handmatige instrumentatie. Ik waardeer hoe dit wordt gecombineerd met een agentische AI-analyse van hoofdoorzaken, die trace-statistieken, topologie en anomaliesignalen met elkaar in verband brengt om snel waarschijnlijke oorzaken aan het licht te brengen. Tijdens een actueel incident betekent dit dat mijn team niet handmatig door dashboards hoeft te zoeken.
Belangrijkste functies van IBM Instana
- Slimme waarschuwingen met adaptieve drempelwaarden: De waarschuwingsengine van Instana gebruikt statistische baselines en vooraf gebouwde blauwdrukken om incidenten te detecteren, met gegroepeerde waarschuwingen en routering naar Slack, PagerDuty, e-mail en webhooks.
- Gedistribueerde transactietracing: Instana volgt aanvragen door applicatiecomponenten zonder sampling en legt details op codeniveau vast voor database-, browser- en mobiele lagen.
- Integratie met OpenTelemetry Collector: Instana neemt telemetrie van de OpenTelemetry Collector op om microservices en cloudgebaseerde applicaties te monitoren naast native geïnstrumenteerde componenten.
- Kosteninzichten voor Kubernetes: Instana biedt direct beschikbare dashboards en historische uitgavenanalyses voor het monitoren van resourcekosten binnen Kubernetes-clusters.
Integraties van IBM Instana
IBM Instana ondersteunt meer dan 300 technologieën, waaronder Slack, PagerDuty, OpenTelemetry Collector, Splunk, Amazon EC2, AWS RDS, Google Cloud, Kubernetes en VMware Tanzu. REST- en GraphQL-API's plus SDK's ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Realtime afhankelijkheidskaarten helpen bij het prioriteren van incidenten
- Automatische detectie vermindert handmatige instrumentatie
- Snelle telemetrie helpt serviceproblemen te lokaliseren
Cons:
- Hiaten in netwerkapparaten kunnen afzonderlijke monitoring vereisen
- Waarschuwingsvolumes vereisen vaak handmatige filtering
Learn more about IBM Instana: Beste keuze voor uniforme, flexibele observability
- Gratis abonnement beschikbaar
- Vanaf $19/maand
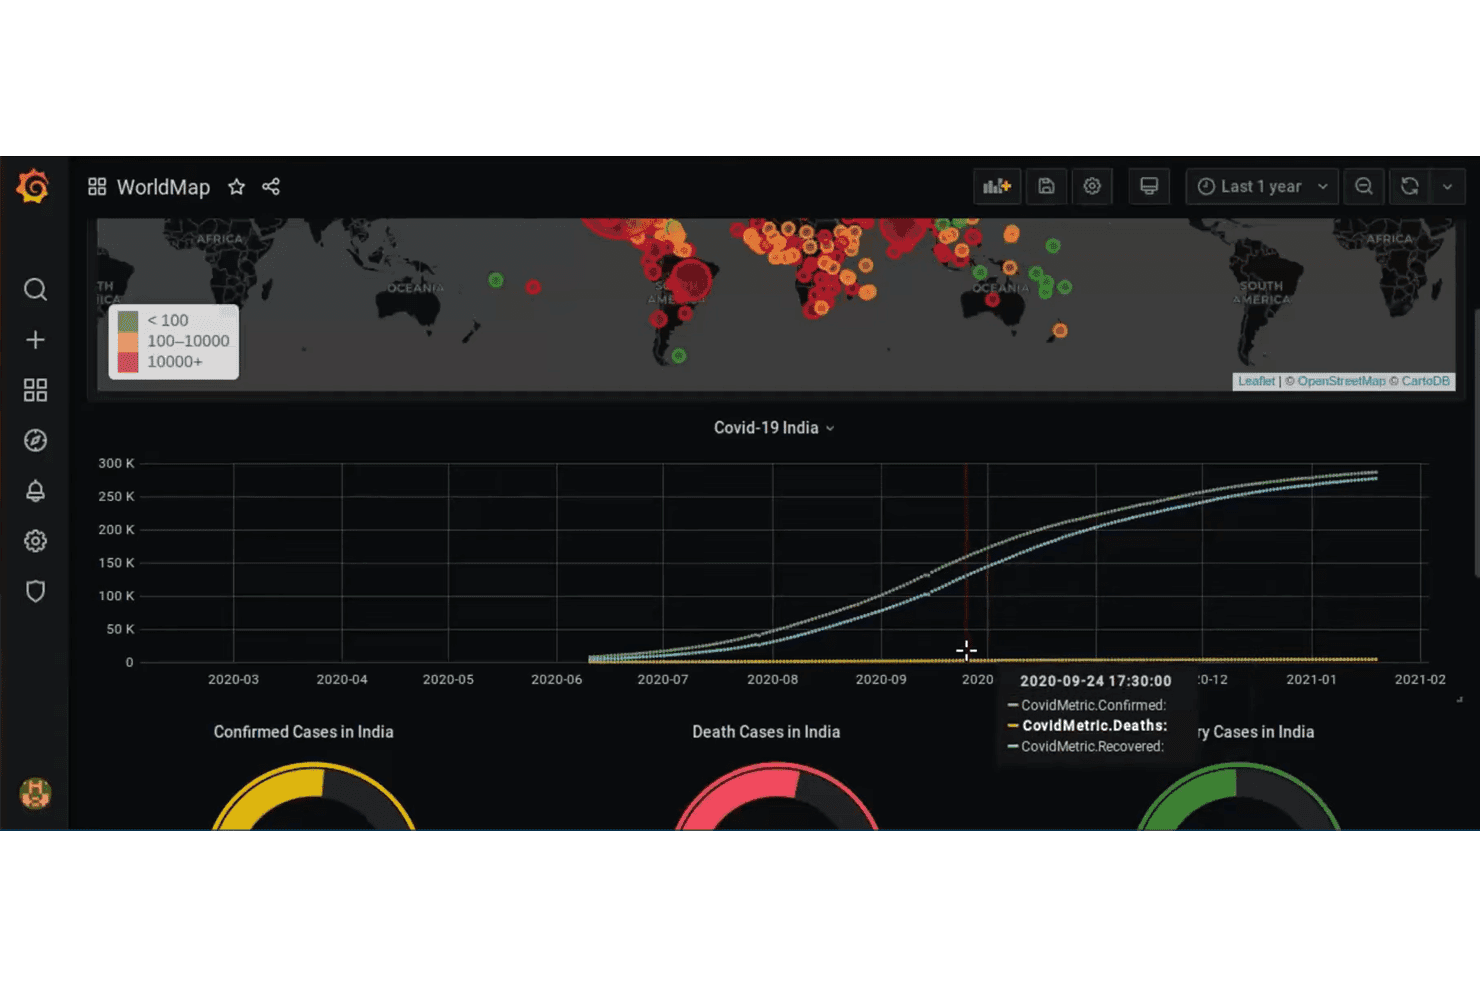
Grafana-dashboard dat wereldwijde en Indiase COVID-19-cijfers in de loop der tijd visualiseert als kaarten en tijdreeksgrafieken. Grafana Cloud is een beheerd observabilityplatform dat metrieken, logs, traces en profielen op één plek samenbrengt. Daarmee is het bijzonder geschikt voor DevOps-engineers en IT-operationsteams die flexibele monitoring op basis van open standaarden nodig hebben voor cloud-, hybride en gecontaineriseerde omgevingen.
Voor wie is Grafana Cloud het meest geschikt?
Grafana Cloud is bijzonder geschikt voor DevOps-engineers en IT-operationsteams die metrieken, logs, traces en profielen willen verenigen in cloud-native en hybride omgevingen met behulp van open standaarden zoals OpenTelemetry en Prometheus.
Waarom ik voor Grafana Cloud heb gekozen
Ik heb Grafana Cloud aan mijn topkeuzes toegevoegd omdat het metrieken, logs, traces en profielen samenbrengt in één beheerd platform. Dat is precies wat je nodig hebt wanneer de geïsoleerde aanpak van LogicMonitor beperkend begint aan te voelen. Ik ben vooral te spreken over de Kennisgrafiek, die relaties tussen services, Kubernetes-workloads, databases en infrastructuur in kaart brengt. Zo kun je een piek in de latentie via gedistribueerde traces terugvolgen tot een knelpunt in een database zonder tussen verschillende tools te hoeven schakelen. De door AI aangedreven functie Onderzoeken kan die telemetrie automatisch analyseren, hypotheses opstellen en een gestructureerd rapport opleveren wanneer een waarschuwing wordt geactiveerd.
Belangrijkste functies van Grafana Cloud
- Adaptieve telemetrie: Voegt telemetrie met een lagere waarde automatisch samen, neemt er steekproeven van of verwijdert deze voor metrieken, logs, traces en profielen om datavolumes en kosten te beheersen.
- Synthetische monitoring: Controleert API-eindpunten en webapplicaties vanaf wereldwijd verspreide probes en ondersteunt HTTP/HTTPS-, DNS-, TCP- en ICMP Ping-controles voor beschikbaarheid en prestaties.
- Grafana Alloy-verzamelaar: Een open-source OpenTelemetry-collector met ondersteuning voor Prometheus-pipelines die metrieken, logs, traces en profielen uit je bestaande infrastructuur verwerkt.
- RBAC met aangepaste rollen: Hiermee kun je gedetailleerde rechten toewijzen aan gebruikers, teams en serviceaccounts, met aangepaste rollen die zijn beperkt tot specifieke acties binnen dashboards en gegevensbronnen.
Integraties van Grafana Cloud
Grafana Cloud biedt meer dan 150 integraties met gegevensbronnen, waaronder AWS, Microsoft Azure, Google Cloud, SNMP, VMware vSphere en LogicMonitor Devices. REST-, HTTP-, Grafana Cloud-, trace- en synthetische-monitoring-API's, evenals webhooks, ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Flexibele dashboards brengen telemetrie samen
- Weergaven met meerdere signalen ondersteunen onderzoek naar incidenten
- Kennisgrafiek koppelt afwijkingen aan oorzaken
Cons:
- Voor SNMP-configuratie moeten apparaten handmatig worden ingesteld
- Geavanceerde waarschuwingsregels vergen configuratie-inspanningen
Learn more about Grafana Cloud: Beste voor geïntegreerde IT-oplossingen
- Gratis proefperiode van 30 dagen beschikbaar
- Prijs op aanvraag
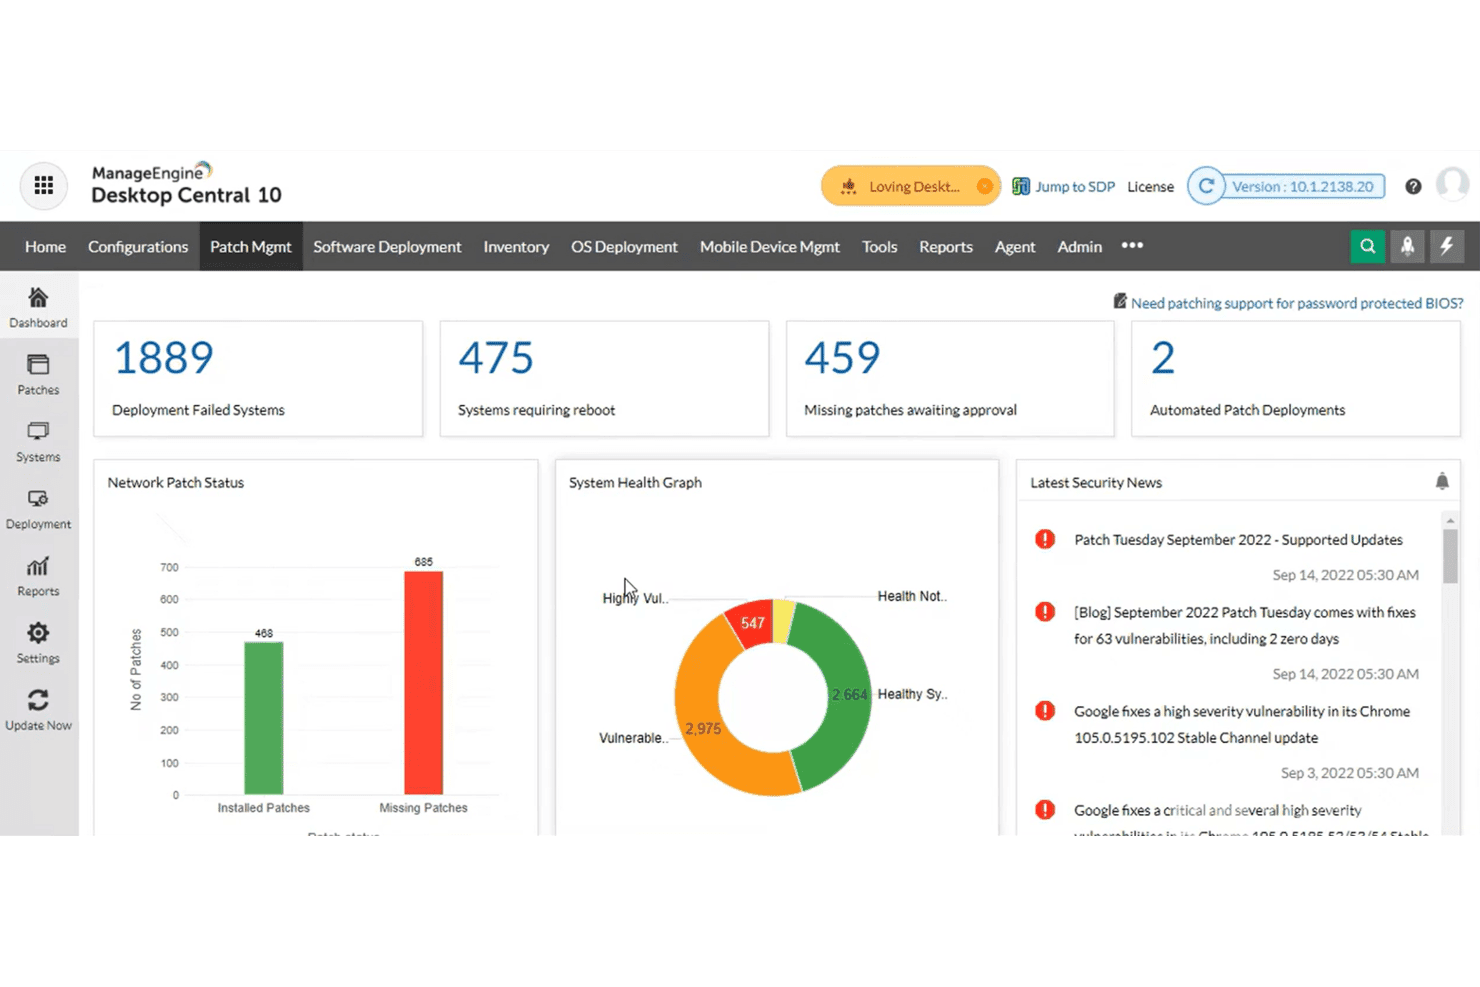
Dashboard voor patchbeheer van ManageEngine Desktop Central 10, met de patchstatus van het netwerk en de systeemstatus. ManageEngine OpManager is een platform voor netwerk- en infrastructuurmonitoring dat aantrekkelijk is voor IT-operationsteams die complexe on-premisesomgevingen beheren. Het biedt diepgaand inzicht in apparaten, servers, opslag en virtuele infrastructuur, met AI-gestuurde prognoses en codevrije workflowautomatisering.
Voor wie is ManageEngine het meest geschikt?
ManageEngine OpManager is zeer geschikt voor IT-operationsteams die grote on-premisesomgevingen beheren en behoefte hebben aan diepgaand inzicht in hun infrastructuur zonder de prijzen van SolarWinds te betalen.
Waarom ik voor ManageEngine heb gekozen
Ik heb voor ManageEngine OpManager gekozen omdat het de volledige infrastructuurstack op één plek dekt, precies wat je nodig hebt wanneer je LogicMonitor vervangt. Ik waardeer vooral de topologietoewijzing, die automatisch laag 2-netwerkkaarten opbouwt, zodat je een storing rechtstreeks van een alarm naar het getroffen segment kunt traceren zonder door afzonderlijke tools te hoeven zoeken. De AI-gestuurde capaciteitsplanning voorspelt wanneer apparaten geheugendrempels bereiken, zodat je kunt ingrijpen voordat er een storing optreedt.
Belangrijkste functies van ManageEngine OpManager
- Codevrije workflowautomatisering: Met een slepen-en-neerzetten-bouwer kun je workflows maken die worden geactiveerd door netwerkstoringen of volgens een schema, om services, processen, bestanden en mappen automatisch te beheren.
- 3D-vloerweergave van het datacenter: Geeft een realtime 3D-replica van je datacenter en de racks weer, met de actuele apparaatstatus rechtstreeks in de fysieke indeling.
- Probleem- en gebeurteniscorrelatie: Groepeert gerelateerde alarmen in één probleemrecord met ernst, correlatiemethode en een percentage voor ruisreductie om alarmmoeheid te verminderen.
- MCP-serverintegratie: Hiermee kunnen AI-clients zoals Claude Desktop of Cursor via prompts in natuurlijke taal OpManager-monitoringsgegevens opvragen, waaronder apparaatstatus, alarmen en prestatietrends.
Integraties van ManageEngine
ManageEngine OpManager biedt native integraties met ServiceNow, Jira Service Management, Microsoft Teams, Slack, Grafana, Microsoft Sentinel en ManageEngine ServiceDesk Plus. De REST API maakt gebruik van OpenAPI-documentatie en webhooks ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Uniform inzicht in netwerken, servers en opslag
- Topologiekaarten helpen storingen naar getroffen segmenten te traceren
- Capaciteitsprognoses signaleren resourceproblemen vroegtijdig
Cons:
- Standaard alarmprofielen kunnen buitensporig veel meldingen genereren
- Het kan tijd kosten om aangepaste rapporten te configureren
Learn more about ManageEngine: Meest geschikt voor aanpasbaar overzichtspaneel
- Gratis abonnement + proefperiode van 30 dagen + demo beschikbaar
- Vanaf $200/maand (jaarlijks gefactureerd)
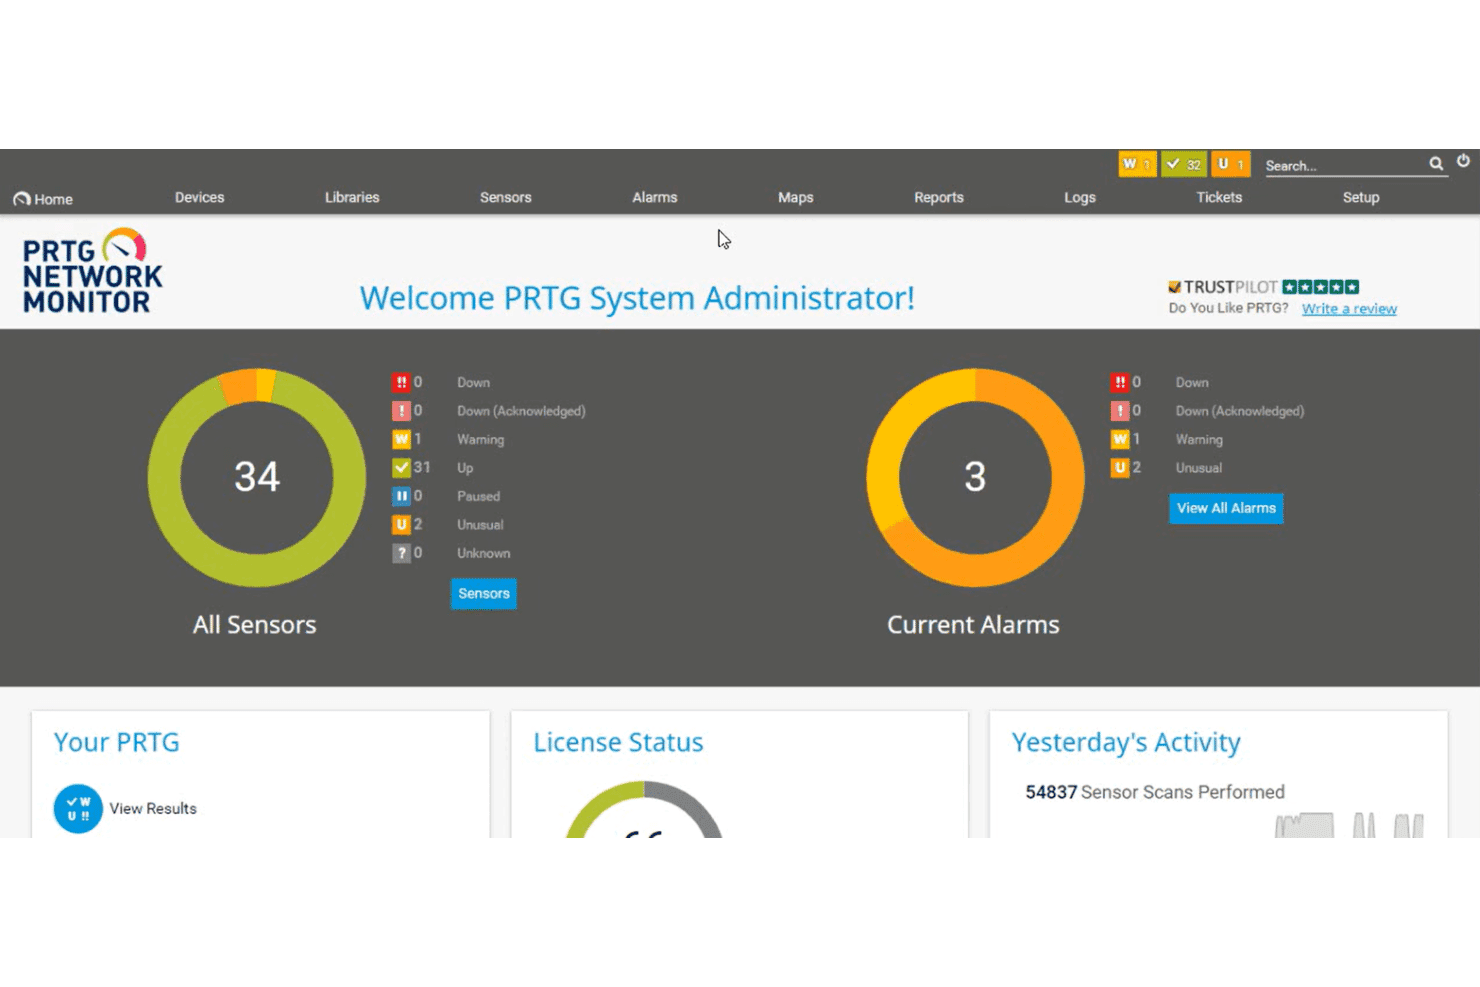
Het dashboard van PRTG Network Monitor met een overzicht van de sensorstatus en huidige alarmen in één oogopslag. Paessler PRTG is een lokaal geïnstalleerde netwerkbewakingstool die aantrekkelijk is voor netwerkbeheerders en IT-teams die brede zichtbaarheid nodig hebben over IT-, OT- en IoT-infrastructuur—waarbij apparaten, verkeer, servers en applicaties vanuit één platform worden gedekt.
Voor wie is Paessler PRTG het meest geschikt?
PRTG is zeer geschikt voor netwerkbeheerders en IT-teams die lokaal geïnstalleerde of hybride omgevingen beheren en behoefte hebben aan een zeer visuele, op sensoren gebaseerde bewakingsconfiguratie die ze kunnen afstemmen op hun infrastructuur.
Waarom ik voor Paessler PRTG heb gekozen
Ik heb Paessler PRTG gekozen als een van de beste alternatieven voor LogicMonitor omdat de aanpassingsmogelijkheden voor overzichtspanelen en kaarten verder gaan dan bij de meeste tools die ik heb getest. Ik kan infrastructuuroverzichten maken met een editor voor slepen en neerzetten, apparaatstatuspictogrammen, geografische kaarten en aangepaste HTML-achtergronden toevoegen en deze vervolgens openbaar delen of insluiten via een iFrame. Met meer dan 300 beschikbare weergavecomponenten kan ik NOC-achtige weergaven maken die problemen op de hele locatie in één oogopslag zichtbaar maken zonder door menu's te hoeven zoeken.
Belangrijkste functies van Paessler PRTG
- Automatische detectie op basis van sensoren: Scant netwerksegmenten met behulp van ping, SNMP en WMI en past vervolgens automatisch apparaat- en sensorsjablonen toe om de bewaking te starten.
- Alarmering via meerdere kanalen met escalatie: Stuurt meldingen via e-mail, sms, pushberichten, Teams of Slack, met configureerbare escalatieniveaus en geplande meldingsvensters.
- Door AI aangestuurde anomaliedetectie: Analyseert historische sensorgegevens om basiswaarden vast te stellen en waarschuwt wanneer gemonitorde waarden afwijken van verwachte patronen.
- Geplande rapportage en rapportage op aanvraag: Genereert rapporten in HTML-, PDF-, CSV- of XML-formaat voor afzonderlijke sensoren of groepen, volgens een vast schema of handmatig geactiveerd.
Integraties van Paessler PRTG
Paessler PRTG biedt native integraties met Microsoft Teams, Slack en PagerDuty. Het biedt ook REST API's voor aangepaste integraties en het monitoren van XML- of JSON-gegevens.
Pros and Cons
Pros:
- Aangepaste kaarten maken problemen op locaties zichtbaar
- Automatische detectie dekt uiteenlopende infrastructuursensoren
- Escalatiemeldingen helpen serviceproblemen vroegtijdig te detecteren
Cons:
- Topologie voor analyse van de hoofdoorzaak vereist een afzonderlijke betaalde uitbreiding
- Bewaking in de cloud blijft achter bij providergerichte platforms
Learn more about Paessler PRTG: Het beste voor open-source-observability
- Gratis proefperiode van 30 dagen + gratis demo beschikbaar
- Vanaf $49/maand
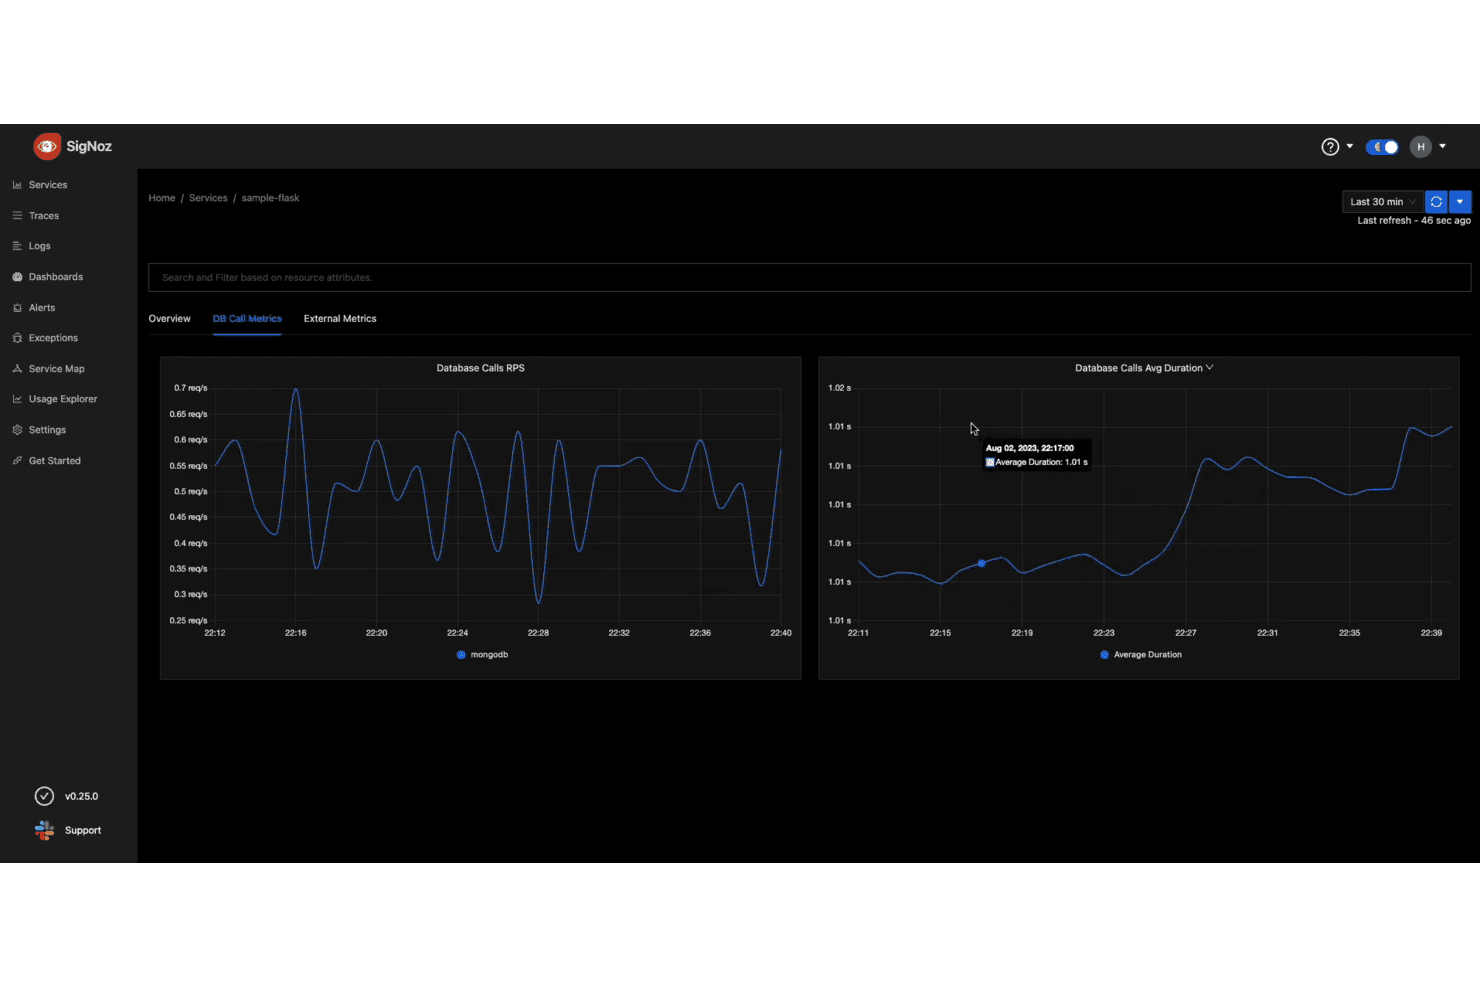
SigNoz-serviceweergave met het aantal MongoDB-databaseaanroepen en de gemiddelde duur in de loop van de tijd. SigNoz is een op OpenTelemetry gebaseerd observabilityplatform dat aantrekkelijk is voor DevOps-engineers en infrastructuurteams die uniforme logs, metrieken en traces willen zonder de ondoorzichtige facturering per host die hoort bij tools zoals Datadog of New Relic.
Voor wie is SigNoz het meest geschikt?
SigNoz is zeer geschikt voor DevOps-engineers en platformteams die volledige controle over hun observabilitystack willen zonder kosten per host te betalen.
Waarom ik voor SigNoz heb gekozen
Ik heb SigNoz gekozen als een van de beste opties, omdat het het enige op OpenTelemetry gebaseerde platform in deze lijst is waarmee je je volledige observabilitystack zelf kunt hosten zonder kosten per host of afhankelijkheid van een leverancier. Ik vind het geweldig dat logs, metrieken en traces op één plek worden samengebracht, zodat ik bij het afgaan van een waarschuwing rechtstreeks van een servicemaprand met verhoogde P99-latentie naar de bijbehorende trace en log kan gaan zonder van tool te wisselen. De AI-ondersteunde correlatie van waarschuwingen via de MCP-server is daar een echt nuttige laag bovenop. Hiermee kan ik bepalen welke upstreamservice verantwoordelijk is voor een piek voordat ik zelfs maar een terminal open.
Belangrijkste functies van SigNoz
- Waarschuwingen voor meerdere signalen: Maak waarschuwingen voor metrieken, logs, traces, uitzonderingen en anomalieën, met routeringsbeleidsregels die meldingen doorsturen naar Slack, PagerDuty, Opsgenie, Microsoft Teams, e-mail of webhooks.
- Op OpenTelemetry gebaseerde instrumentatie: Verzamel en stuur telemetrie door vanuit applicaties, hosts, Kubernetes en clouddiensten met behulp van de OpenTelemetry Collector, zonder bedrijfseigen agents.
- Querybouwer: Filter, aggregeer en pas wiskundige functies toe op logs, metrieken en traces vanuit één interface. PromQL en ClickHouse SQL worden ook ondersteund.
- SOC 2 Type II- en HIPAA-compliance: SigNoz Cloud voldoet aan de SOC 2 Type II- en HIPAA-normen, met datacenters in de VS, de EU en India.
Integraties van SigNoz
SigNoz documenteert 112 integraties, waaronder AWS, Azure, Google Cloud Platform, PostgreSQL, MySQL, Redis, MongoDB, NGINX en RabbitMQ. Het biedt ook een API voor aangepaste integraties en ondersteunt verbindingen met de OpenTelemetry Collector voor SNMP-compatibele firewalls, routers en switches.
Pros and Cons
Pros:
- Zelf hosten houdt telemetrie onder jouw controle
- Logs, metrieken en traces worden gecombineerd bij onderzoeken
- AI-ondersteunde correlatie van waarschuwingen versnelt het opsporen van fouten
Cons:
- SNMP-polling vereist handmatige toewijzing van OID's
- Zelf gehost ClickHouse vereist voortdurend bijsturen
Learn more about SigNoz: 10Beste voor inzichten op basis van AI
Last9
- Gratis abonnement + gratis demo beschikbaar
- Prijzen op aanvraag
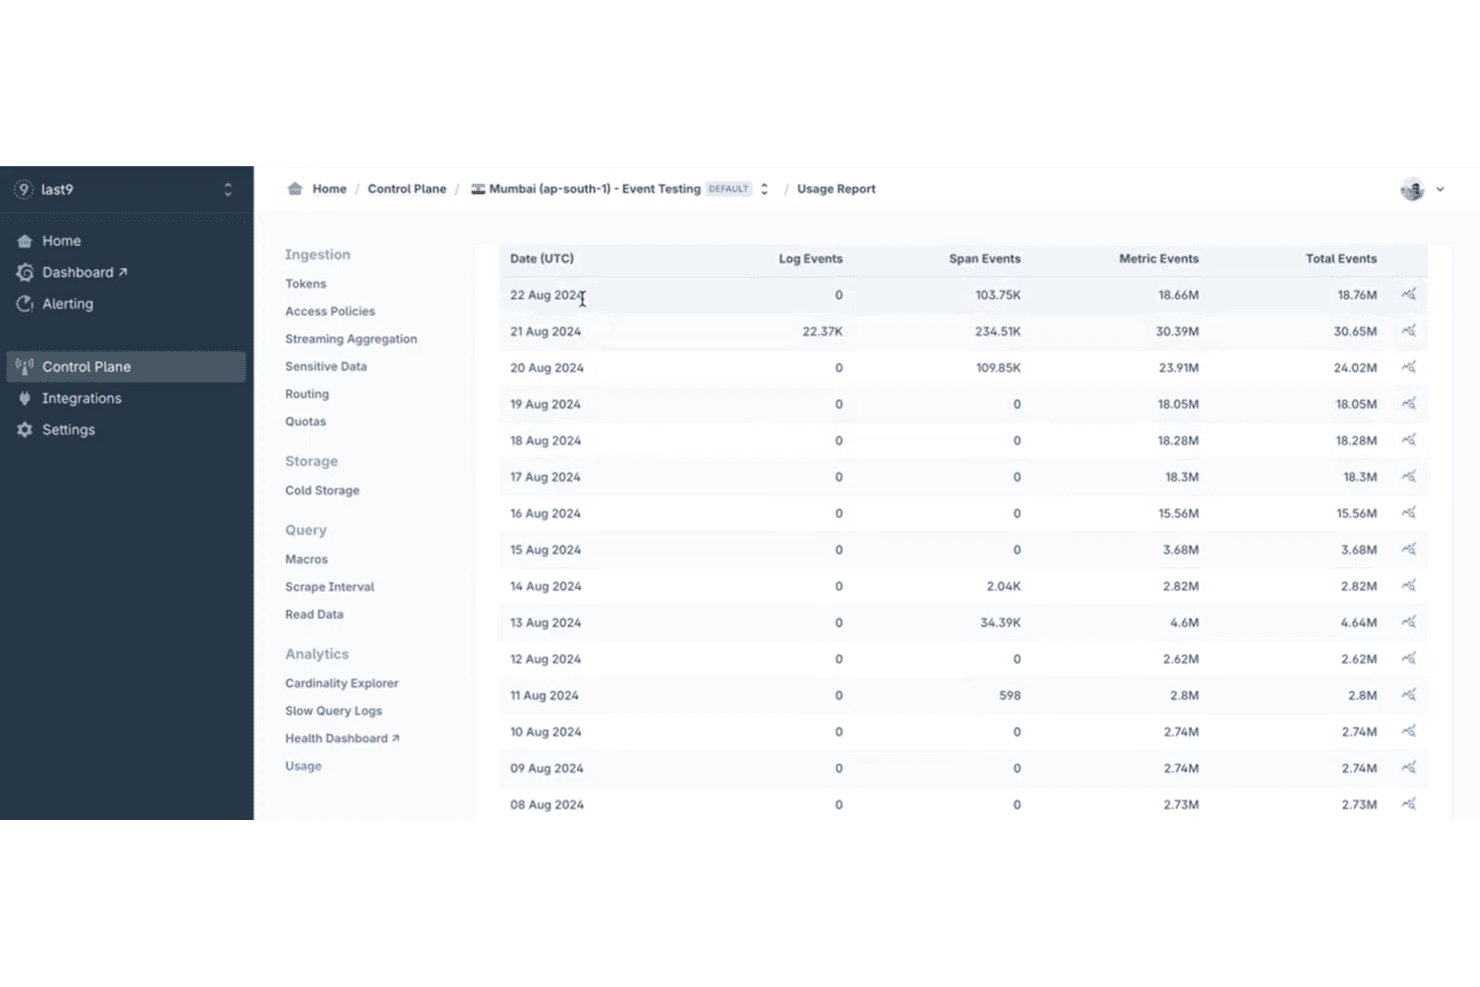
Gebruiksrapport van de besturingslaag van Last9 met dagelijkse volumes van logboek-, span- en metriekgebeurtenissen per datum. Last9 is een voor OpenTelemetry native observeerbaarheidsplatform voor DevOps- en engineeringteams die metriekgegevens, logboeken en traceringen moeten verenigen — met onderzoek op basis van AI en ondersteuning voor hoge kardinaliteit, waardoor het een sterke keuze is voor teams die monitoringtools met hoge kosten ontgroeien.
Voor wie is Last9 het meest geschikt?
Last9 is een sterke keuze voor DevOps- en teams voor sitebetrouwbaarheidstechniek die native observeerbaarheid voor OpenTelemetry nodig hebben, met ingebouwd onderzoek op basis van AI.
Waarom ik voor Last9 heb gekozen
Ik heb Last9 gekozen als een van de beste opties omdat het onderzoek op basis van AI verder gaat dan een typisch dashboard voor waarschuwingen. Last9 AI kan je live metriekgegevens, logboeken en traceringen gezamenlijk opvragen en vervolgens gecorreleerd bewijsmateriaal tonen en regels voor waarschuwingen of dashboards voorstellen ter goedkeuring. De Ontdekkingskaart visualiseert realtimeafhankelijkheden tussen services met foutpercentages en P95-latentie, zodat ik bij een incident de impact over microservices heen kan volgen zonder signalen handmatig aan elkaar te koppelen.
Belangrijkste functies van Last9
- Native gegevensinvoer voor OpenTelemetry: Last9 verzamelt metriekgegevens, logboeken en traceringen native via OpenTelemetry, zonder dat leverancierspecifieke agents nodig zijn.
- PromQL- en LogQL-waarschuwingsregels: Waarschuwingsregels kunnen rechtstreeks in PromQL of LogQL worden geschreven of worden aangemaakt met een begeleide interface voor het opstellen van regels.
- Gelaagde bewaring van metriekgegevens: Gegevens worden opgeslagen in de lagen Blaze, Hot en Cold, waarbij standaard maximaal één jaar aan gegevens wordt bewaard zonder neerwaartse bemonstering of aggregaties.
- Monitoring van netwerkapparaten op basis van SNMP: Last9 verzamelt telemetrie van switches, routers, firewalls en UPS-eenheden met behulp van de SNMP-ontvanger van de OpenTelemetry Collector of de Prometheus SNMP Exporter.
Integraties van Last9
Last9 vermeldt meer dan 100 integraties, waaronder AWS, Azure, Google Cloud, Kubernetes, Prometheus, Grafana, Slack, Datadog en New Relic. Het biedt ook een REST API en MCP-server voor aangepaste integraties en workflows met AI-agents.
Pros and Cons
Pros:
- Correlatie van logboeken, metriekgegevens en traceringen met AI
- Beoordelaars melden snellere foutopsporing tussen services
- Gebruikers prijzen de gerichte, bruikbare waarschuwingen
Cons:
- Hosting van het platform op locatie wordt niet gedocumenteerd
- Sommige beoordelaars melden vertragingen bij het vernieuwen van dashboards
Learn more about Last9:
Andere alternatieven voor LogicMonitor
Hier zijn enkele aanvullende alternatieven voor LogicMonitor die mijn shortlist niet hebben gehaald, maar die toch het bekijken waard zijn:
- 11NinjaOneIdeaal voor endpointbeheer
- 12ObkioHet beste voor optimalisatie van netwerkprestaties
- 13Azure MonitorIdeaal voor inzichten in Azure-services
Hoe ik LogicMonitor-alternatieven beoordeel
Ik beoordeel elke optie aan de hand van twee lagen: de basis waaraan een tool moet voldoen—hybride monitoring, flexibele gegevensverzameling en intelligente waarschuwingen—en wat de beste tools onderscheidt.
Kernfunctionaliteit (basisvereisten voor deze lijst)
Bij het selecteren van tools voor mijn lijst beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder genoemde kernfunctionaliteit. Vervolgens bereken ik de totaalscore van de tool als percentage. Elke tool moet een minimale totaalscore van 75% behalen om in aanmerking te komen voor opname.
- Monitoring van hybride infrastructuur: Ik controleer of elke tool statistieken kan ophalen uit lokale servers, cloudwerklasten, containers en netwerkapparatuur in één overzicht.
- Flexibele methoden voor gegevensverzameling: Elke tool moet gegevensverzameling op basis van agents en zonder agents ondersteunen via protocollen zoals SNMP, WMI en REST API's, zodat uiteenlopende omgevingen kunnen worden gedekt.
- Intelligente waarschuwingen en AIOps: Ik zoek naar dynamische drempelwaarden en correlatie van waarschuwingen die ruis wegnemen, in plaats van alleen statische regels die je inbox overspoelen tijdens een normale piek.
- Dashboards en rapportage: Met goede dashboards kun je SLA-gerichte weergaven voor leidinggevenden en gedetailleerde panelen voor engineers bouwen zonder een afzonderlijke BI-tool nodig te hebben.
- Integratie-ecosysteem: Ik beoordeel hoe goed elke tool verbinding maakt met ITSM-platforms, chattools en automatiseringssystemen waarop je team dagelijks al vertrouwt.
- Schaalbare architectuur voor meerdere tenants: Voor MSP's en gedistribueerde teams let ik op de granulariteit van RBAC, tenantisolatie en de mogelijkheid om weergaven per klant of bedrijfseenheid af te bakenen.
Zodra ik een lijst heb met tools die aan deze criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (wat leveranciers onderscheidt)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
Automatische ontdekking met topologietoewijzing is een belangrijke onderscheidende factor. Wanneer een tool zelfstandig serviceafhankelijkheden in kaart brengt, besteedt je team minder tijd aan het documenteren van infrastructuur en meer tijd aan het aanpakken van echte problemen. Ik let ook op ingebouwde loganalyse en APM naast infrastructuurstatistieken—tools zoals Datadog en Dynatrace combineren deze functies, waardoor er minder contextwisselingen nodig zijn. Automatisering die door gebeurtenissen wordt geactiveerd is eveneens belangrijk, vooral wanneer je team herstelprocedures moet starten of configuratieverschillen rechtstreeks vanuit het monitoringplatform moet bijhouden.
Meer dan functies alleen
Transparantie over prijzen is belangrijk wanneer je overstapt van LogicMonitor. Ik beoordeel of een leverancier kosten per apparaat, per host of op basis van gegevensinvoer in rekening brengt—en hoe voorspelbaar de kosten blijven naarmate je omgeving groeit. Flexibiliteit bij de implementatie is een andere belangrijke factor. Sommige teams hebben SaaS nodig, terwijl andere teams in gereguleerde sectoren zelf gehoste of luchtspleetopties vereisen; tools zoals Zabbix en PRTG bieden lokale modellen, terwijl Datadog uitsluitend SaaS aanbiedt. Ik kijk ook naar de tijd tot waarde: hoe snel kun je van de eerste installatie naar betekenisvolle dashboards en bruikbare waarschuwingen gaan?
Waarom zoeken naar een alternatief voor LogicMonitor?
Hoewel LogicMonitor een goede keuze is voor productiviteitssoftware, zijn er verschillende redenen waarom sommige gebruikers op zoek gaan naar alternatieve oplossingen. Misschien zoek je een andere optie omdat:
- Je meer aanpassingsmogelijkheden nodig hebt
- Je team betere schaalbaarheid nodig heeft
- Je kosten wilt besparen
- Je bedrijf specifieke integraties nodig heeft
- Je op zoek bent naar eenvoudigere gebruikersinterfaces
- Je betere regionale ondersteuning nodig hebt
Als een van deze punten herkenbaar is, ben je hier aan het juiste adres. Mijn lijst bevat verschillende opties voor productiviteitssoftware die beter geschikt zijn voor teams die met deze uitdagingen van LogicMonitor te maken hebben en op zoek zijn naar alternatieve oplossingen.
Functies
Hier zijn enkele van de belangrijkste functies van LogicMonitor om u te helpen vergelijken wat alternatieve oplossingen te bieden hebben:
- Uniforme monitoring: Biedt uitgebreide monitoring van infrastructuur, cloudomgevingen en logboeken en ondersteunt de belangrijkste cloudproviders.
- AIOps-integratie: Maakt gebruik van AI-gestuurde tools voor gebeurtenisinformatie en automatisering om de operationele efficiëntie te verbeteren.
- Voorspellende analyses: Biedt analyse van hoofdoorzaken en inzichten in services om het oplossen van incidenten te verbeteren.
- Uitgebreide integraties: Biedt meer dan 3.000 technologie-integraties voor dynamische schaalbaarheid en veerkracht.
- Aanpasbare dashboards: Hiermee kunt u realtime dashboards maken en delen die zijn afgestemd op uw specifieke behoeften.
- Detectie van afwijkingen: Identificeert proactief ongebruikelijk gedrag om te voorkomen dat gebruikers hiervan hinder ondervinden.
- Dynamische drempelwaarden: Stelt automatisch intelligente drempelwaarden in op basis van historische gegevens.
- API's en integraties: Breid de functionaliteit uit met API's en integraties voor verschillende technologieën.
- Ondersteuning voor cloud en multicloud: Bewaakt containers en belangrijke cloudproviders zoals AWS, Google Cloud, Microsoft Azure en Oracle Cloud.
- Logbeheer: Biedt mogelijkheden voor logbeheer en analyse.