

10 alternative a Elasticsearch selezionate per il 2026

Selezione delle alternative a Elasticsearch


Una valida alternativa a Elasticsearch offre una ricerca rapida e scalabile, un'indicizzazione flessibile dei dati e analisi affidabili senza vincolarti a un unico ecosistema. Se stai cercando opzioni diverse da Elasticsearch, probabilmente stai valutando fattori come la flessibilità dell'open source, i costi, la facilità di distribuzione o le funzionalità avanzate di intelligenza artificiale.
Con così tante piattaforme di ricerca e analisi disponibili, è difficile capire quale sia adatta ai tuoi requisiti tecnici e ai tuoi obiettivi aziendali. Questo elenco ti aiuterà a confrontare le migliori alternative a Elasticsearch per il 2026, così potrai scegliere con sicurezza la soluzione giusta per le esigenze del tuo team.
Che cos'è Elasticsearch?
Elasticsearch è un motore open source ad alte prestazioni per la ricerca e l'analisi, basato su Apache Lucene e progettato per eseguire ricerche scalabili in tempo reale su dati strutturati e non strutturati. Archivia i dati come documenti JSON e supporta casi d'uso relativi alla ricerca full-text, alla registrazione dei log e all'analisi. Spesso utilizzato all'interno dello stack ELK, rappresenta una potente alternativa per i team che necessitano di ricerca distribuita ed elaborazione rapida dei dati.
Tabella comparativa delle alternative a Elasticsearch
Questa tabella comparativa riassume i dettagli sui prezzi delle mie principali alternative a Elasticsearch:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideale per l'ottimizzazione avanzata della pertinenza | Piano gratuito + demo gratuita disponibile | Prezzi su richiesta | Website | |
| 2 | Ideale per l'ottimizzazione della ricerca nei siti di vendita al dettaglio | Dimostrazione gratuita disponibile | Prezzi su richiesta | Website | |
| 3 | Ideale per informazioni sui documenti basate sull'intelligenza artificiale | Prova gratuita di 30 giorni disponibile | A partire da $500/mese | Website | |
| 4 | Ideale per l'estensibilità del codice aperto | Piano gratuito disponibile | Gratuito e a codice aperto, con prezzi opzionali per i servizi gestiti offerti dai fornitori di servizi cloud | Website | |
| 5 | Ideale per l'analisi unificata di log e metriche | Versione open source disponibile (self-hosted) | Modello di prezzi con pagamento in base al consumo | Website | |
| 6 | Ideale per implementazioni di ricerca ultrarapide | Versione a codice sorgente aperto disponibile | A partire da $30/mese | Website | |
| 7 | Ideale per API intuitive per gli sviluppatori | Versione a codice sorgente aperto + dimostrazione gratuita disponibile | Modello di prezzo con pagamento a consumo (basato sulle risorse) | Website | |
| 8 | Ideale per la scalabilità di livello aziendale | Not available | Gratuito e a codice aperto | Website | |
| 9 | Ideale per l'elaborazione di grandi volumi di dati in tempo reale | Not available | Gratuito e a codice aperto, con opzioni di servizi gestiti a pagamento | Website | |
| 10 | Ideale per informazioni sui documenti basate sull'intelligenza artificiale | Prova gratuita di 30 giorni disponibile | A partire da $500/mese | Website |
Perché Fidarti delle Nostre Recensioni Software
Testiamo e recensiamo software dal 2023. Come leader tecnologici, sappiamo quanto sia cruciale e difficile prendere la decisione giusta nella scelta di un software.
Investiamo in una ricerca approfondita per aiutare il nostro pubblico a effettuare scelte migliori di acquisto software. Abbiamo testato oltre 2.000 strumenti per diversi casi d’uso tecnologici e scritto più di 1.000 recensioni complete. Scopri come restiamo trasparenti e la nostra metodologia di recensione del software.
Recensioni delle migliori alternative a Elasticsearch
Di seguito trovi le mie descrizioni dettagliate delle migliori alternative a Elasticsearch incluse nella mia selezione. Le mie recensioni offrono uno sguardo approfondito sulle funzionalità, sui casi d’uso principali e sulle integrazioni di ciascuna piattaforma, per aiutarti a trovare quella più adatta a te.
Algolia
Ideale per l'ottimizzazione avanzata della pertinenza
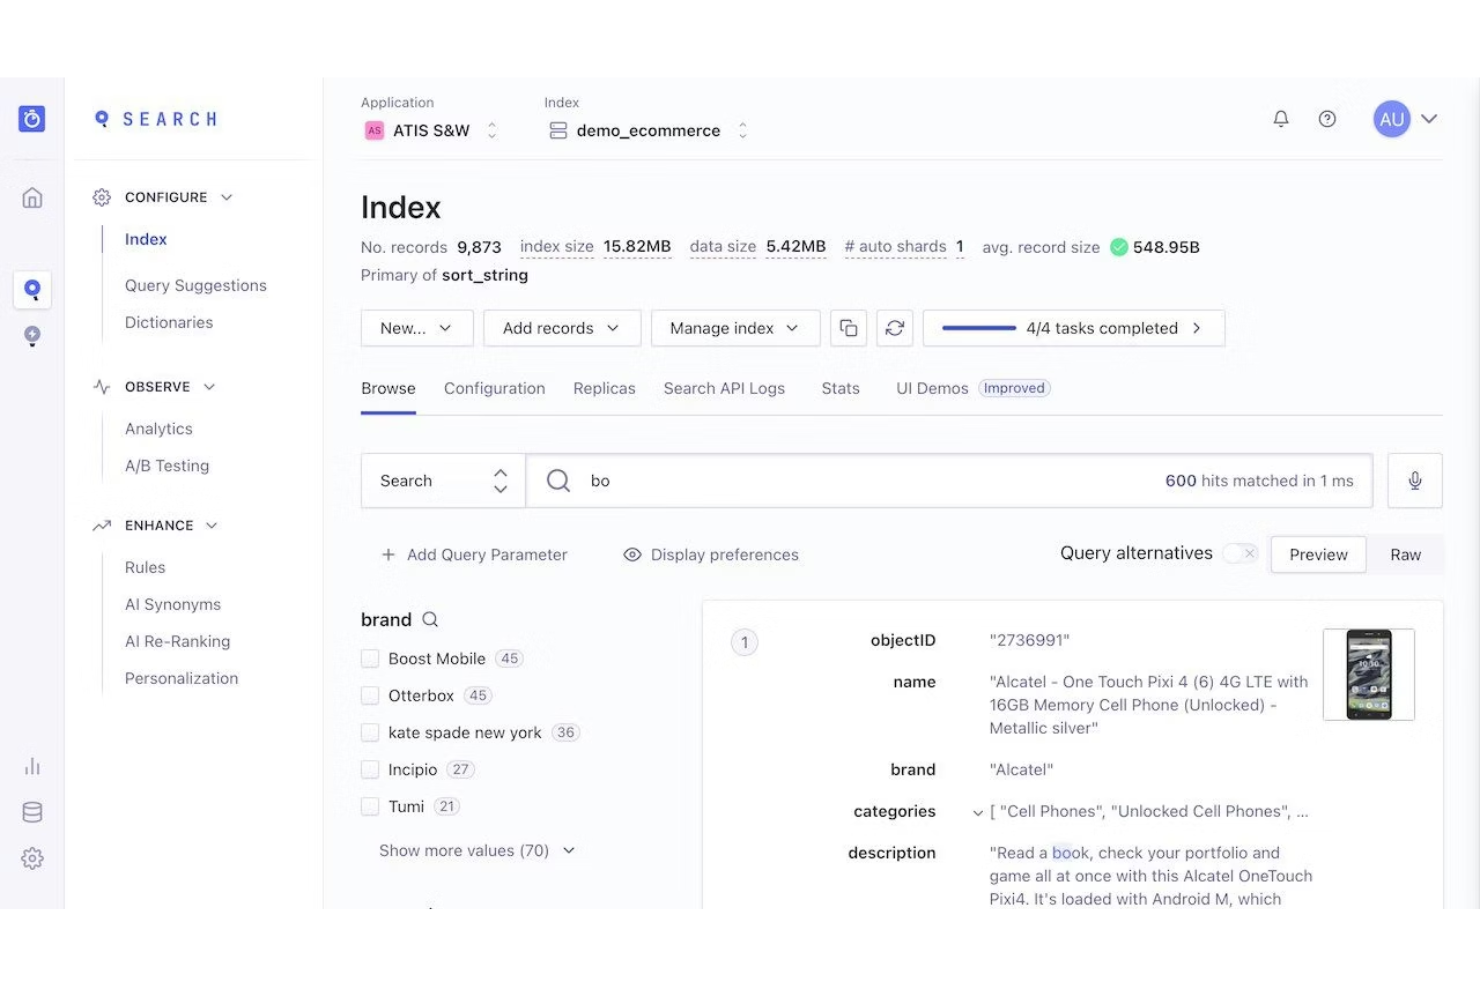
Se hai bisogno di un controllo granulare sulla pertinenza delle ricerche, Algolia è la soluzione che fa per te. Questa piattaforma di ricerca basata sul cloud si rivolge ai team di prodotto, alle aziende di e-commerce e ai fornitori SaaS che desiderano ottimizzare il ranking e fornire risultati altamente personalizzati. A differenza di Elasticsearch, Algolia si distingue per le sue avanzate funzionalità di ottimizzazione della pertinenza e di indicizzazione in tempo reale.
Perché Algolia è una buona alternativa a Elasticsearch
Per i team che necessitano di un'ottimizzazione avanzata della pertinenza, Algolia offre un livello di controllo superiore a quello fornito da Elasticsearch immediatamente disponibile. Ho scelto Algolia perché consente di ottimizzare il ranking con regole personalizzate, logica aziendale e segnali relativi al comportamento degli utenti.
La sua formula di ranking dinamico e le funzionalità di pertinenza basate sull'intelligenza artificiale aiutano a fornire risultati di ricerca che corrispondono più precisamente all'intento dell'utente. Queste funzionalità rendono Algolia una scelta eccellente per le aziende in cui la precisione e la personalizzazione delle ricerche sono priorità assolute.
Funzionalità principali di Algolia
Alcune altre funzionalità di Algolia la rendono un'opzione flessibile per un'ampia gamma di applicazioni basate sulla ricerca:
- Ricerca geografica: Algolia supporta la ricerca basata sulla posizione, consentendo di filtrare e classificare i risultati in base alla prossimità geografica.
- Ricerca su più indici: È possibile interrogare più indici con una singola richiesta di ricerca per gestire esigenze di dati più complesse.
- Faccettatura e filtraggio: La piattaforma offre funzionalità integrate di faccettatura e filtraggio per aiutare gli utenti a restringere i risultati di ricerca in base agli attributi.
- Dashboard di analisi: Algolia include una dashboard di analisi in tempo reale per monitorare le prestazioni della ricerca e il comportamento degli utenti.
Integrazioni di Algolia
Le integrazioni native includono Android, accesso API, Supabase, Meteor, Adobe Commerce, Bubble, WordPress, Adobe, Gatsby, Zendesk, BigCommerce, Netlify, Salesforce Commerce Cloud e altro ancora.
Pros and Cons
Pros:
- L'ottimizzazione avanzata della pertinenza consente un controllo granulare del ranking delle ricerche
- L'indicizzazione in tempo reale supporta aggiornamenti immediati dei risultati di ricerca
- Tolleranza integrata agli errori di battitura e supporto linguistico per il pubblico internazionale
Cons:
- I prezzi possono aumentare rapidamente con volumi di utilizzo più elevati
- Supporto limitato per le aggregazioni complesse rispetto a Elasticsearch
Ideale per l'ottimizzazione della ricerca nei siti di vendita al dettaglio
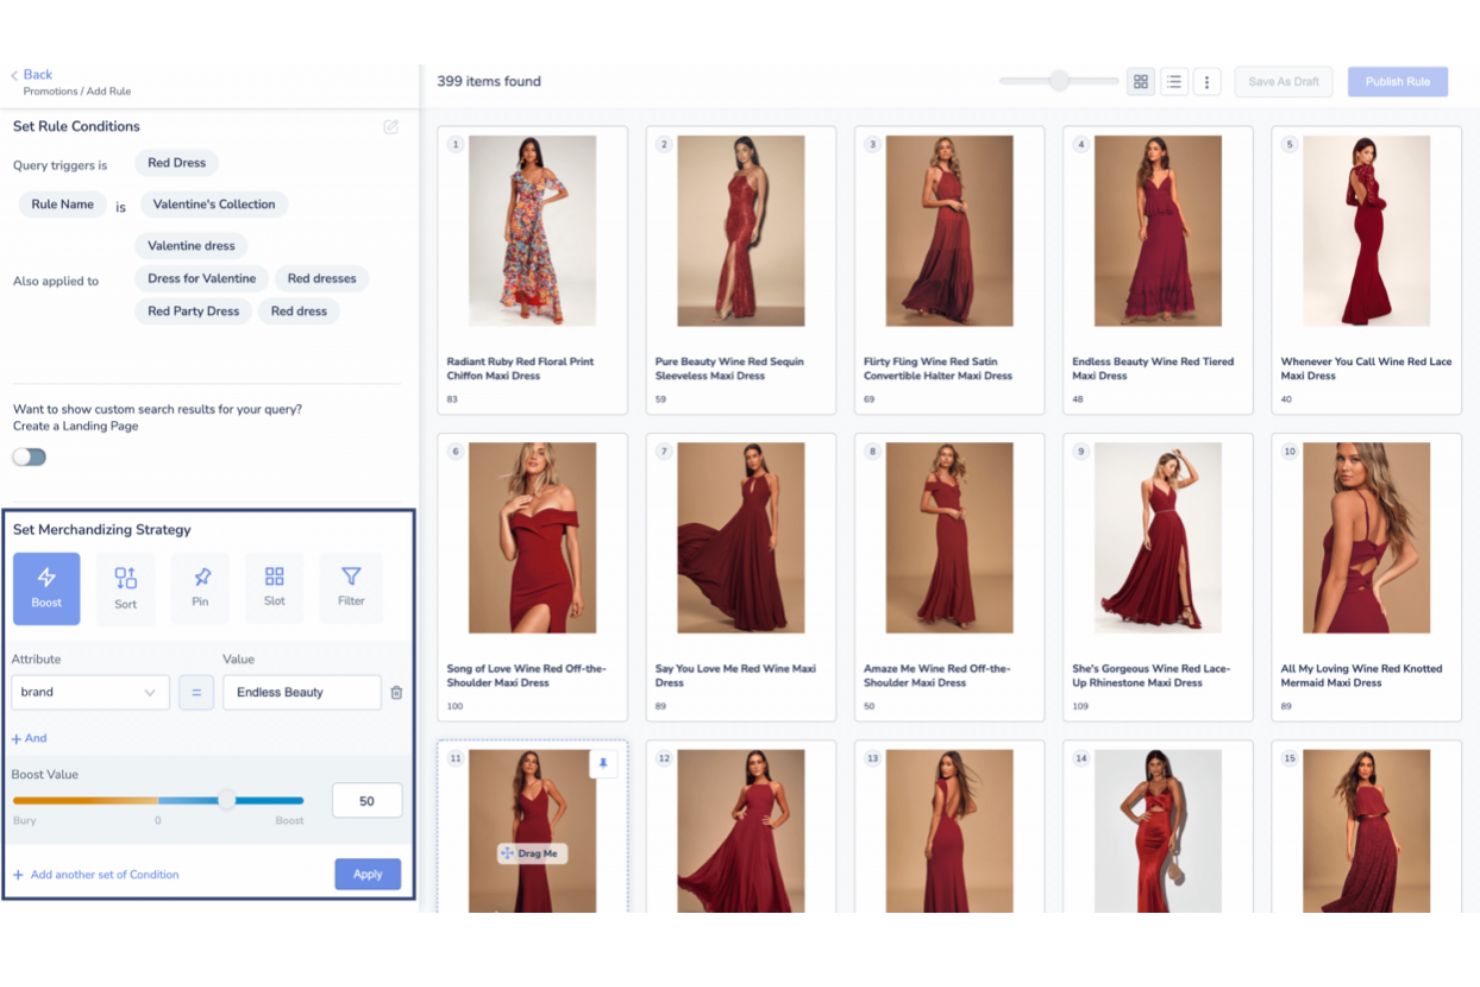
I rivenditori che desiderano aumentare la scoperta dei prodotti e i tassi di conversione possono prendere in considerazione Netcore Unbxd per le esigenze di ricerca del proprio sito. Questa piattaforma è progettata specificamente per il commercio elettronico e offre strumenti di merchandising basati sull'IA ed esperienze di ricerca personalizzate che vanno oltre ciò che Elasticsearch offre generalmente di base. Netcore Unbxd aiuta i team del settore della vendita al dettaglio ad affrontare sfide come la regolazione della rilevanza, le raccomandazioni dinamiche e gli aggiornamenti dell'inventario in tempo reale.
Perché Netcore Unbxd è una valida alternativa a Elasticsearch
Per le aziende del settore della vendita al dettaglio concentrate sull'ottimizzazione della ricerca del sito per il commercio elettronico, Netcore Unbxd offre funzionalità specializzate che lo distinguono da Elasticsearch. Ho scelto Netcore Unbxd perché fornisce raccomandazioni sui prodotti basate sull'IA e strumenti di merchandising personalizzati per i negozi online.
Funzionalità come la navigazione dinamica a faccette e la ricerca in tempo reale consapevole dell'inventario aiutano i rivenditori a fornire risultati più pertinenti e ad aumentare le conversioni. Se hai bisogno di una soluzione di ricerca progettata specificamente per il settore della vendita al dettaglio, questa piattaforma affronta sfide che i motori di ricerca generici spesso trascurano.
Funzionalità principali di Netcore Unbxd
Alcune altre funzionalità che rendono Netcore Unbxd interessante per i team del commercio elettronico includono:
- Ricerca visiva: consente agli acquirenti di cercare prodotti utilizzando immagini anziché parole chiave.
- Test A/B per la ricerca: esegue esperimenti sugli algoritmi e sulle configurazioni di ricerca per misurare l'impatto sul comportamento degli utenti.
- Completamento automatico e correzione ortografica: fornisce suggerimenti in tempo reale e corregge gli errori di battitura mentre gli utenti digitano nella barra di ricerca.
- Pannello di controllo analitico: consente di accedere a report dettagliati sulle prestazioni della ricerca, sulle ricerche degli utenti e sulle metriche di conversione.
Integrazioni di Netcore Unbxd
Netcore Unbxd non elenca attualmente integrazioni native.
Pros and Cons
Pros:
- Le raccomandazioni sui prodotti basate sull'IA si adattano al comportamento degli acquirenti in tempo reale
- La ricerca visiva supporta la scoperta dei prodotti basata sulle immagini per i siti di commercio elettronico
- Il pannello di controllo analitico integrato monitora le prestazioni della ricerca e i tassi di conversione
Cons:
- Alcune funzionalità avanzate richiedono una configurazione manuale o il supporto del fornitore
- La documentazione e le risorse di supporto possono essere difficili da consultare
Ideale per informazioni sui documenti basate sull'intelligenza artificiale
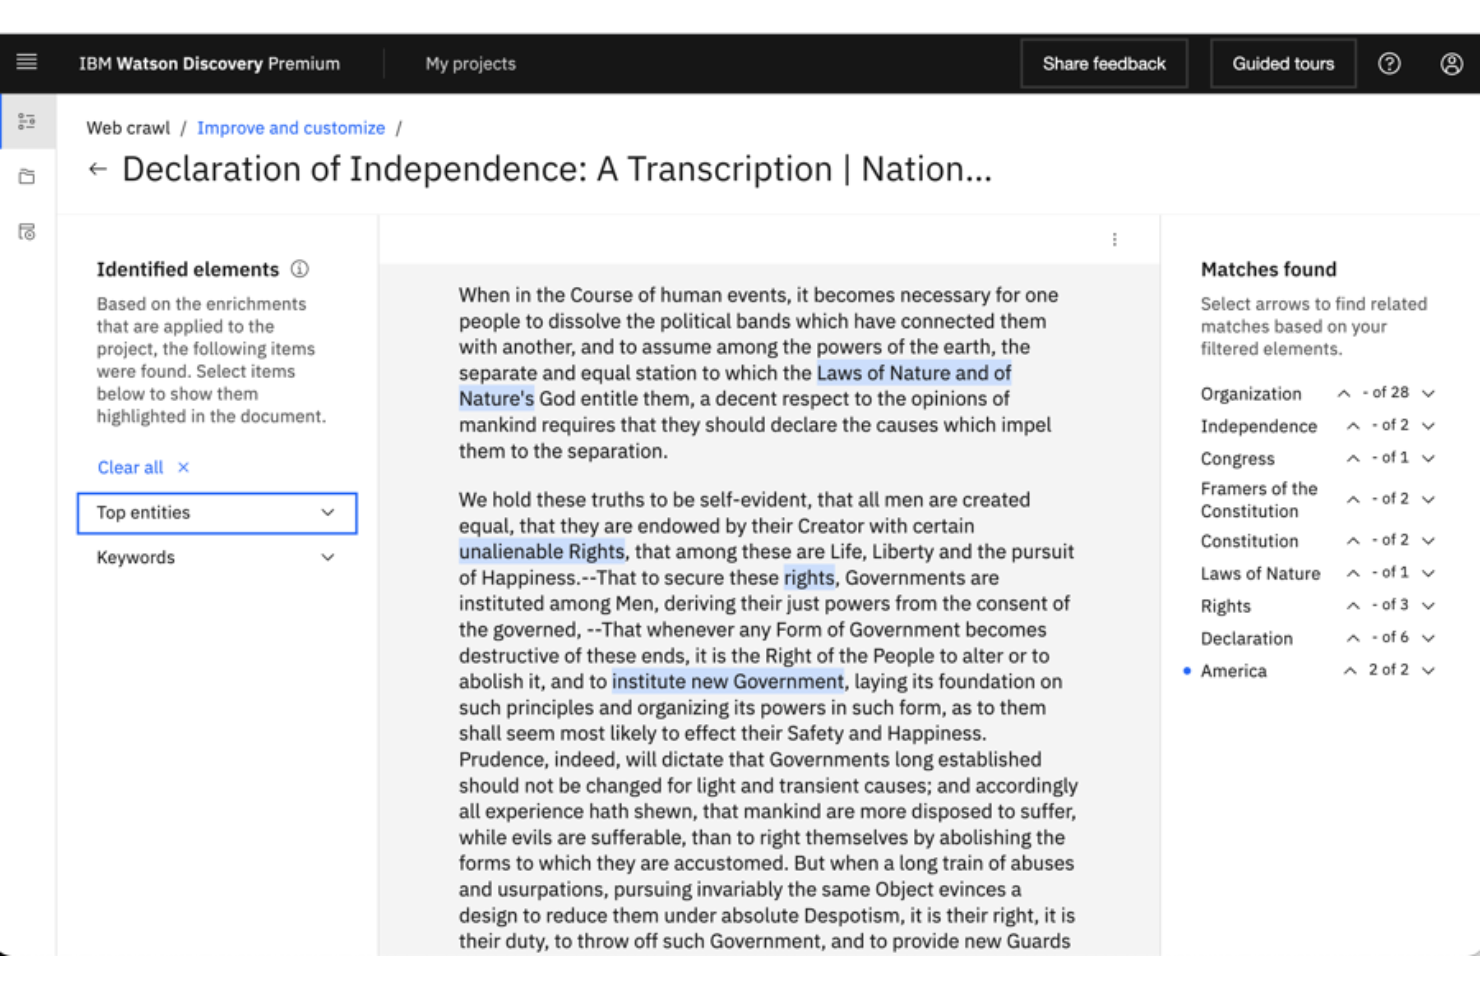
Per i team che devono estrarre informazioni da grandi volumi di documenti non strutturati, IBM Watson Discovery offre ricerca e analisi avanzate basate sull'intelligenza artificiale. È una soluzione particolarmente adatta alle aziende, agli enti di ricerca e ai settori regolamentati che devono individuare informazioni pertinenti da fonti di dati complesse.
A differenza di Elasticsearch, Watson Discovery utilizza l'elaborazione del linguaggio naturale e l'apprendimento automatico per comprendere il contesto e fornire risposte più precise dai documenti.
Perché IBM Watson Discovery è una valida alternativa a Elasticsearch
Ciò che distingue IBM Watson Discovery è la sua attenzione alle informazioni sui documenti basate sull'intelligenza artificiale, che va oltre la tradizionale ricerca per parole chiave. Ho scelto questo strumento perché utilizza l'elaborazione del linguaggio naturale per estrarre significato e contesto dai dati non strutturati, facilitando l'individuazione di risposte pertinenti nei documenti complessi.
Funzionalità come il recupero di passaggi e l'estrazione avanzata di entità aiutano gli utenti a individuare informazioni precise che potrebbero sfuggire ai motori di ricerca standard. Se il tuo team deve analizzare e comprendere grandi raccolte di documenti, Watson Discovery offre funzionalità difficili da eguagliare con il solo Elasticsearch.
Funzionalità principali di IBM Watson Discovery
Alcune altre funzionalità di IBM Watson Discovery lo rendono una scelta versatile per la ricerca e l'analisi dei documenti:
- Connettori dati personalizzati: connetti una vasta gamma di fonti di dati, inclusi archivi cloud e repository di contenuti aziendali.
- Arricchimento intelligente dei documenti: aggiungi automaticamente tag e arricchisci i documenti con metadati per migliorarne la ricercabilità.
- Addestramento della rilevanza: perfeziona i risultati di ricerca addestrando il sistema su ciò che è più importante per la tua organizzazione.
- Dashboard di analisi integrata: visualizza tendenze e schemi nei tuoi dati con strumenti di analisi integrati.
Integrazioni di IBM Watson Discovery
IBM Watson Discovery non elenca attualmente integrazioni native.
Pros and Cons
Pros:
- L'elaborazione avanzata del linguaggio naturale fornisce risultati di ricerca sensibili al contesto
- I modelli di intelligenza artificiale preaddestrati estraggono entità e relazioni dai documenti
- Supporta l'acquisizione da più fonti di dati, inclusi repository cloud
Cons:
- La configurazione iniziale e la preparazione dei dati possono richiedere molto tempo per grandi insiemi di dati
- La personalizzazione dei modelli di intelligenza artificiale può richiedere competenze specialistiche

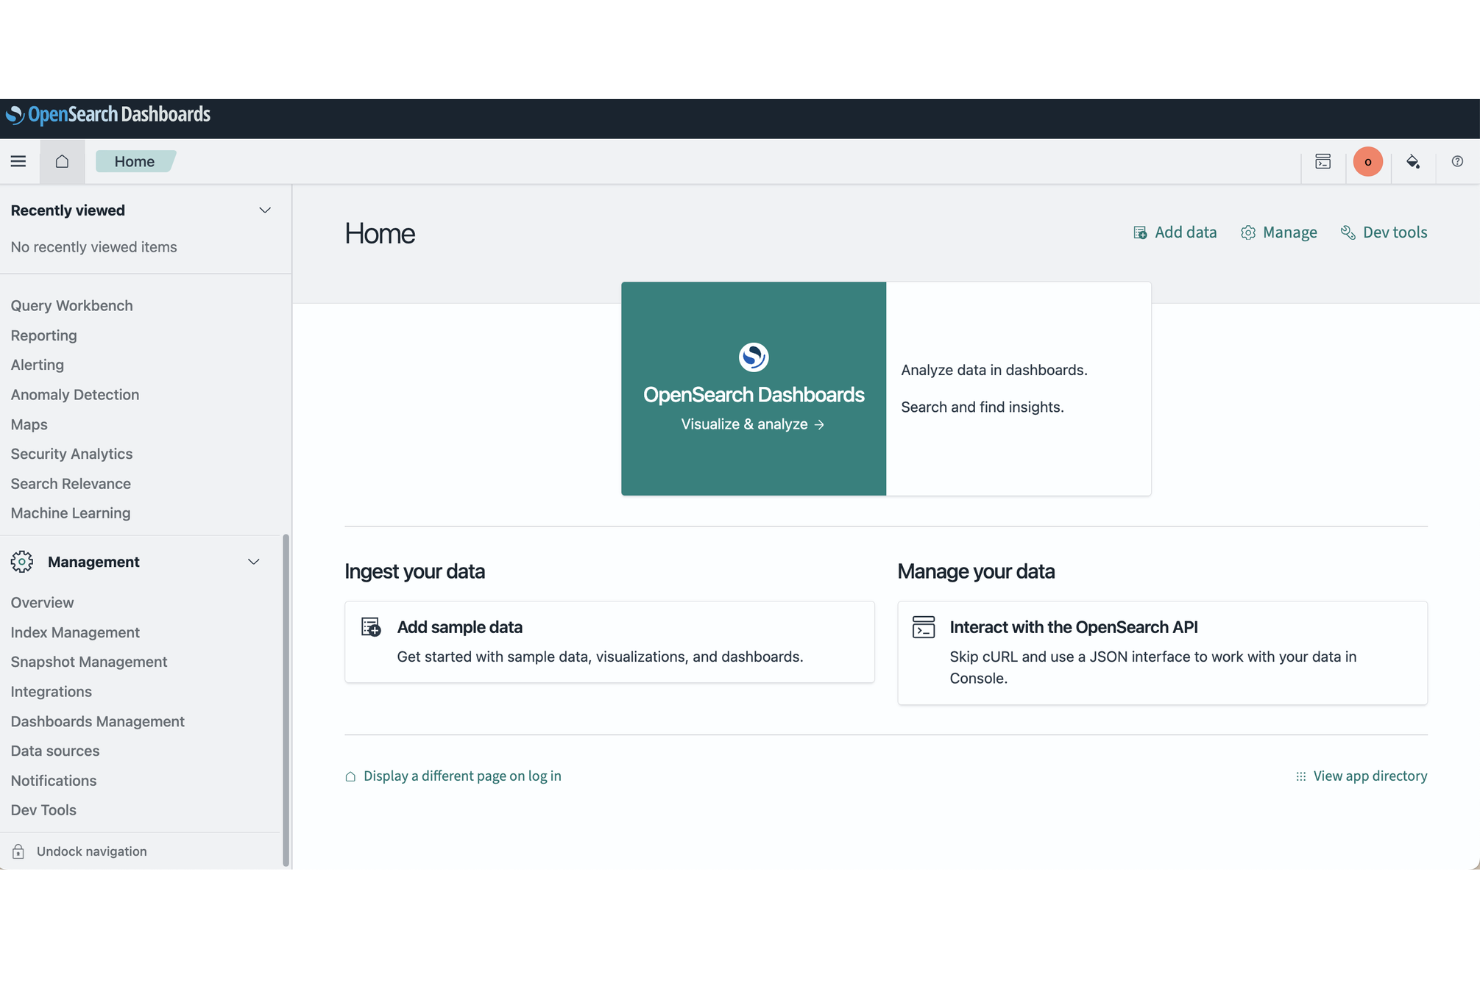
Se cerchi una suite a codice aperto per la ricerca e l'analisi con ampie possibilità di estensione, OpenSearch si distingue tra le alternative a Elasticsearch. È progettato per i team IT e gli sviluppatori che desiderano il pieno controllo sulla propria infrastruttura di ricerca, con la flessibilità necessaria per creare estensioni personalizzate e adattare la piattaforma a requisiti specifici.
OpenSearch è apprezzato dalle organizzazioni che danno priorità alla trasparenza, allo sviluppo guidato dalla comunità e alla possibilità di personalizzare le funzionalità senza vincoli verso un singolo fornitore.
Perché OpenSearch è una buona alternativa a Elasticsearch
OpenSearch è una scelta valida se vuoi che l'estensibilità del codice aperto sia al centro della tua piattaforma di ricerca. Ho scelto OpenSearch perché è completamente a codice aperto, con un processo di sviluppo trasparente e un'architettura adatta alle estensioni che consente di creare o modificare funzionalità in base alle proprie esigenze.
La piattaforma supporta estensioni personalizzate, miglioramenti guidati dalla comunità e l'accesso diretto al codice sorgente per una personalizzazione approfondita. Queste caratteristiche rendono OpenSearch particolarmente interessante per i team che vogliono evitare vincoli verso un singolo fornitore e mantenere il pieno controllo sulla propria infrastruttura di ricerca.
Funzionalità principali di OpenSearch
Altre funzionalità di OpenSearch lo rendono un'opzione flessibile per i progetti di ricerca e analisi:
- Pannelli di controllo integrati: OpenSearch Dashboards offre strumenti di visualizzazione per monitorare e analizzare i dati di ricerca.
- Struttura per gli avvisi: La piattaforma include avvisi integrati per notificare ai team anomalie o superamenti delle soglie.
- Rilevamento delle anomalie: Il rilevamento delle anomalie basato sull'apprendimento automatico aiuta a identificare schemi insoliti nei flussi di dati.
- Controllo granulare degli accessi: È possibile impostare autorizzazioni e ruoli dettagliati per gestire l'accesso degli utenti e la sicurezza dei dati.
Integrazioni di OpenSearch
Compatibile a livello di API con le API di Elasticsearch, supporta estensioni, pannelli di controllo e integrazioni tramite strumenti di un ecosistema aperto.
Pros and Cons
Pros:
- La licenza completamente a codice aperto consente l'uso e la modifica senza restrizioni
- Lo sviluppo attivo della comunità favorisce aggiornamenti frequenti e nuove funzionalità
- I pannelli di controllo integrati offrono visualizzazione e monitoraggio senza strumenti aggiuntivi
Cons:
- Meno integrazioni native rispetto alle piattaforme di ricerca commerciali
- La documentazione può essere aggiornata in ritardo rispetto alle nuove versioni e alle estensioni della comunità

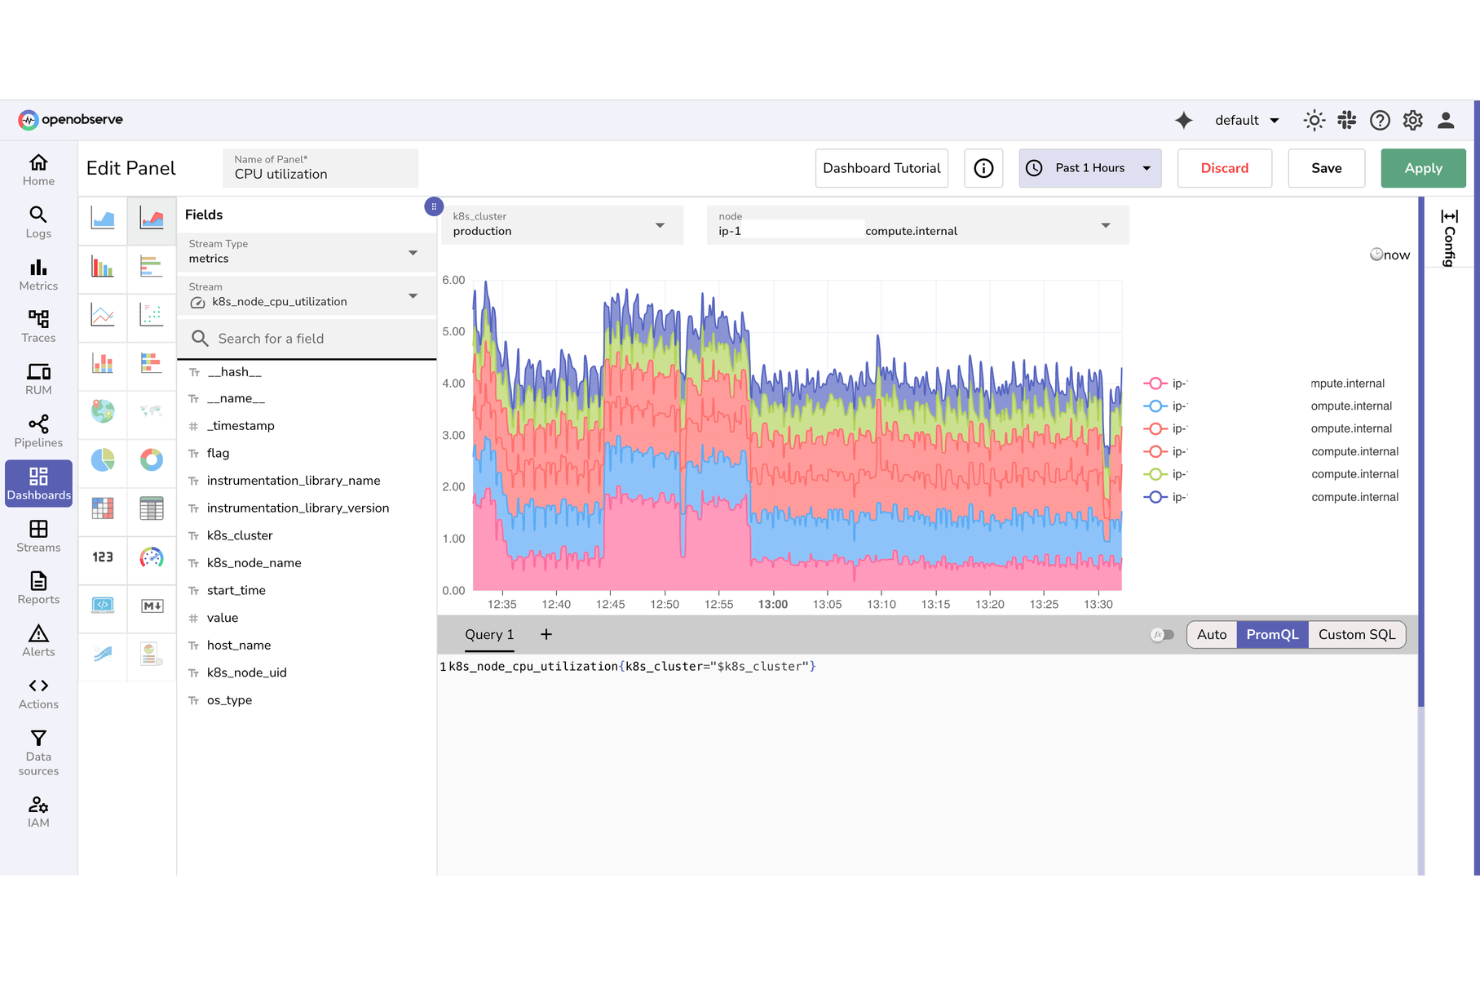
Se stai cercando un'unica piattaforma per gestire sia i log che le metriche, OpenObserve offre analisi unificate. È progettato per i team IT, gli ingegneri DevOps e gli SRE che desiderano consolidare i dati di osservabilità senza gestire strumenti separati. OpenObserve si distingue dalle alternative a Elasticsearch offrendo supporto nativo per l'acquisizione, l'archiviazione e l'interrogazione sia dei log che delle metriche in un unico sistema.
Perché OpenObserve è una buona alternativa a Elasticsearch
OpenObserve adotta un approccio diverso combinando l'analisi dei log e delle metriche in un'unica piattaforma, una caratteristica che trovo particolarmente preziosa per un'osservabilità unificata. A differenza di Elasticsearch, che spesso richiede strumenti o plugin separati per le metriche, OpenObserve acquisisce, archivia e interroga nativamente entrambi i tipi di dati insieme.
Questo modello unificato aiuta i team IT e gli SRE a correlare gli eventi e i dati sulle prestazioni senza passare da un sistema all'altro. Se desideri semplificare il tuo stack di osservabilità e ridurre il carico operativo, OpenObserve offre un'alternativa mirata.
Funzionalità principali di OpenObserve
Altre funzionalità di OpenObserve ne fanno una scelta flessibile per l'osservabilità e l'analisi:
- Linguaggio di interrogazione simile a SQL: Interroga i tuoi dati utilizzando una sintassi SQL familiare sia per i log che per le metriche.
- Controllo degli accessi basato sui ruoli: Gestisci le autorizzazioni degli utenti e l'accesso ai dati con RBAC integrato.
- Criteri di conservazione dei dati: Imposta periodi di conservazione personalizzati per diversi flussi di dati per ottimizzare lo spazio di archiviazione.
- Supporto per l'archiviazione di oggetti compatibile con S3: Archivia i dati su S3 o su sistemi di archiviazione di oggetti compatibili per garantire scalabilità e durata.
Integrazioni di OpenObserve
OpenObserve offre interrogazioni basate su API e SQL, con integrazioni incentrate sulle pipeline di osservabilità e sui sistemi di archiviazione di oggetti.
Pros and Cons
Pros:
- La piattaforma unificata gestisce nativamente sia l'analisi dei log che quella delle metriche
- Il linguaggio di interrogazione simile a SQL semplifica la ricerca nei dati di osservabilità
- Il supporto per l'archiviazione compatibile con S3 consente una conservazione dei dati conveniente
Cons:
- Meno integrazioni native rispetto alle piattaforme di osservabilità consolidate
- Le opzioni di visualizzazione sono meno estese rispetto a Grafana o Kibana
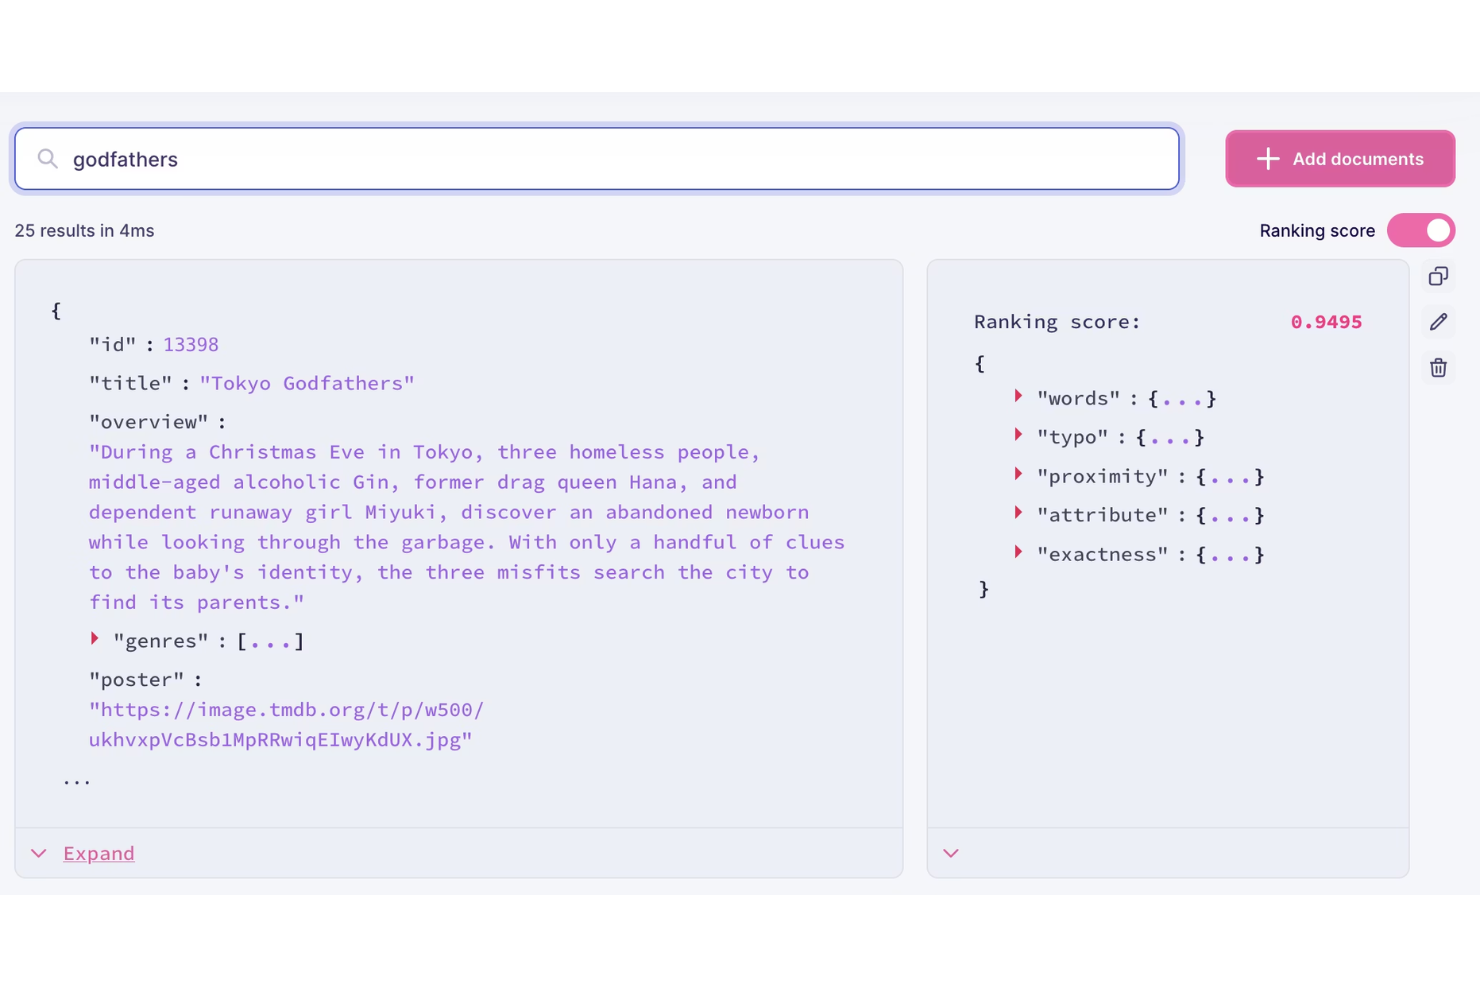
Meilisearch offre un motore di ricerca leggero e a codice sorgente aperto, progettato per i team che necessitano di funzionalità di ricerca rapide e facili da implementare. La sua configurazione semplice e i risultati di ricerca istantanei lo rendono particolarmente adatto agli sviluppatori che realizzano applicazioni rivolte agli utenti o strumenti interni. Se desideri una soluzione che privilegi la velocità e la facilità d'uso rispetto a configurazioni complesse, Meilisearch si distingue da Elasticsearch e da altre alternative.
Perché Meilisearch è una buona alternativa a Elasticsearch
Ciò che distingue Meilisearch come alternativa a Elasticsearch è la sua attenzione alla realizzazione di implementazioni di ricerca estremamente rapide. È una scelta adatta ai team che necessitano di risultati di ricerca istantanei, grazie al suo indice in memoria e agli aggiornamenti in tempo reale. Meilisearch supporta immediatamente la tolleranza agli errori di battitura e regole di classificazione personalizzabili, aiutando gli utenti a ottenere rapidamente risultati pertinenti. Queste funzionalità lo rendono particolarmente interessante per i progetti in cui velocità e reattività sono priorità assolute.
Funzionalità principali di Meilisearch
Altre funzionalità di Meilisearch ne fanno una scelta flessibile per diverse esigenze di ricerca:
- API RESTful: Meilisearch fornisce un'API RESTful semplice per una facile integrazione con applicazioni web e mobili.
- Ricerca a faccette: La piattaforma supporta il filtraggio a faccette, consentendo agli utenti di perfezionare i risultati di ricerca in base a categorie o attributi.
- Supporto multilingue: Meilisearch gestisce più lingue, risultando adatto alle applicazioni globali.
- Gestione dei sinonimi: È possibile definire sinonimi personalizzati per migliorare la pertinenza della ricerca e l'esperienza utente.
Integrazioni di Meilisearch
Le integrazioni native includono SDK per .NET, Dart, Go, Java, JavaScript, PHP, Python, Ruby, Rust e Swift.
Pros and Cons
Pros:
- Fornisce risultati di ricerca estremamente rapidi per set di dati piccoli e medi
- Offre immediatamente tolleranza agli errori di battitura e supporto per i sinonimi
- Processo di implementazione semplice con una configurazione minima richiesta
Cons:
- Non dispone delle funzionalità avanzate di analisi e aggregazione presenti in Elasticsearch
- Non supporta il clustering distribuito per implementazioni su larga scala

Gli sviluppatori alla ricerca di un motore di ricerca intuitivo e basato innanzitutto sulle API si rivolgono spesso a Typesense. Questa soluzione a codice sorgente aperto è progettata per i team che desiderano una configurazione rapida, una scalabilità semplice e un sovraccarico operativo minimo rispetto a Elasticsearch. Typesense si distingue per le sue API intuitive e l'indicizzazione in tempo reale, risultando particolarmente adatto ai progetti in cui l'esperienza degli sviluppatori e la rapidità di distribuzione sono le priorità principali.
Perché Typesense è una buona alternativa a Elasticsearch
Se desideri un motore di ricerca con API intuitive per gli sviluppatori, vale la pena prendere in seria considerazione Typesense. Ho scelto Typesense perché le sue API REST e basate su JSON rendono semplice integrare e gestire le funzionalità di ricerca senza configurazioni complesse.
La piattaforma offre inoltre l'indicizzazione istantanea della ricerca e la tolleranza automatica agli errori di battitura, aiutando i team a fornire risultati rapidi e pertinenti con una configurazione minima. Queste funzionalità rendono Typesense una scelta valida per i progetti in cui la produttività degli sviluppatori e un'implementazione semplice sono priorità.
Funzionalità principali di Typesense
Altre funzionalità di Typesense ne fanno un'opzione flessibile per i team che sviluppano applicazioni basate sulla ricerca:
- Ricerca sfaccettata: Typesense supporta la ricerca sfaccettata, consentendo agli utenti di filtrare i risultati in base a più attributi.
- Gestione dei sinonimi: È possibile definire sinonimi personalizzati per migliorare la precisione della ricerca e l'esperienza dell'utente.
- Alta disponibilità integrata: La piattaforma offre replica e commutazione automatica integrate per garantire l'affidabilità.
- Licenza a codice sorgente aperto: Typesense è disponibile con una licenza a codice sorgente aperto, che consente l'hosting autonomo e la personalizzazione.
Integrazioni di Typesense
Le integrazioni includono Laravel, Symfony, Gatsby, Firebase, Twilio, Adobe Commerce, WooCommerce, Prepr e altro.
Pros and Cons
Pros:
- La progettazione delle API è semplice e coerente per un'integrazione rapida
- L'indicizzazione in tempo reale supporta aggiornamenti istantanei dei dati di ricerca
- La tolleranza agli errori di battitura integrata migliora la precisione della ricerca per gli utenti
Cons:
- Mancano funzionalità native avanzate di analisi e creazione di pannelli di controllo
- Nessun supporto integrato per aggregazioni complesse o interrogazioni nidificate
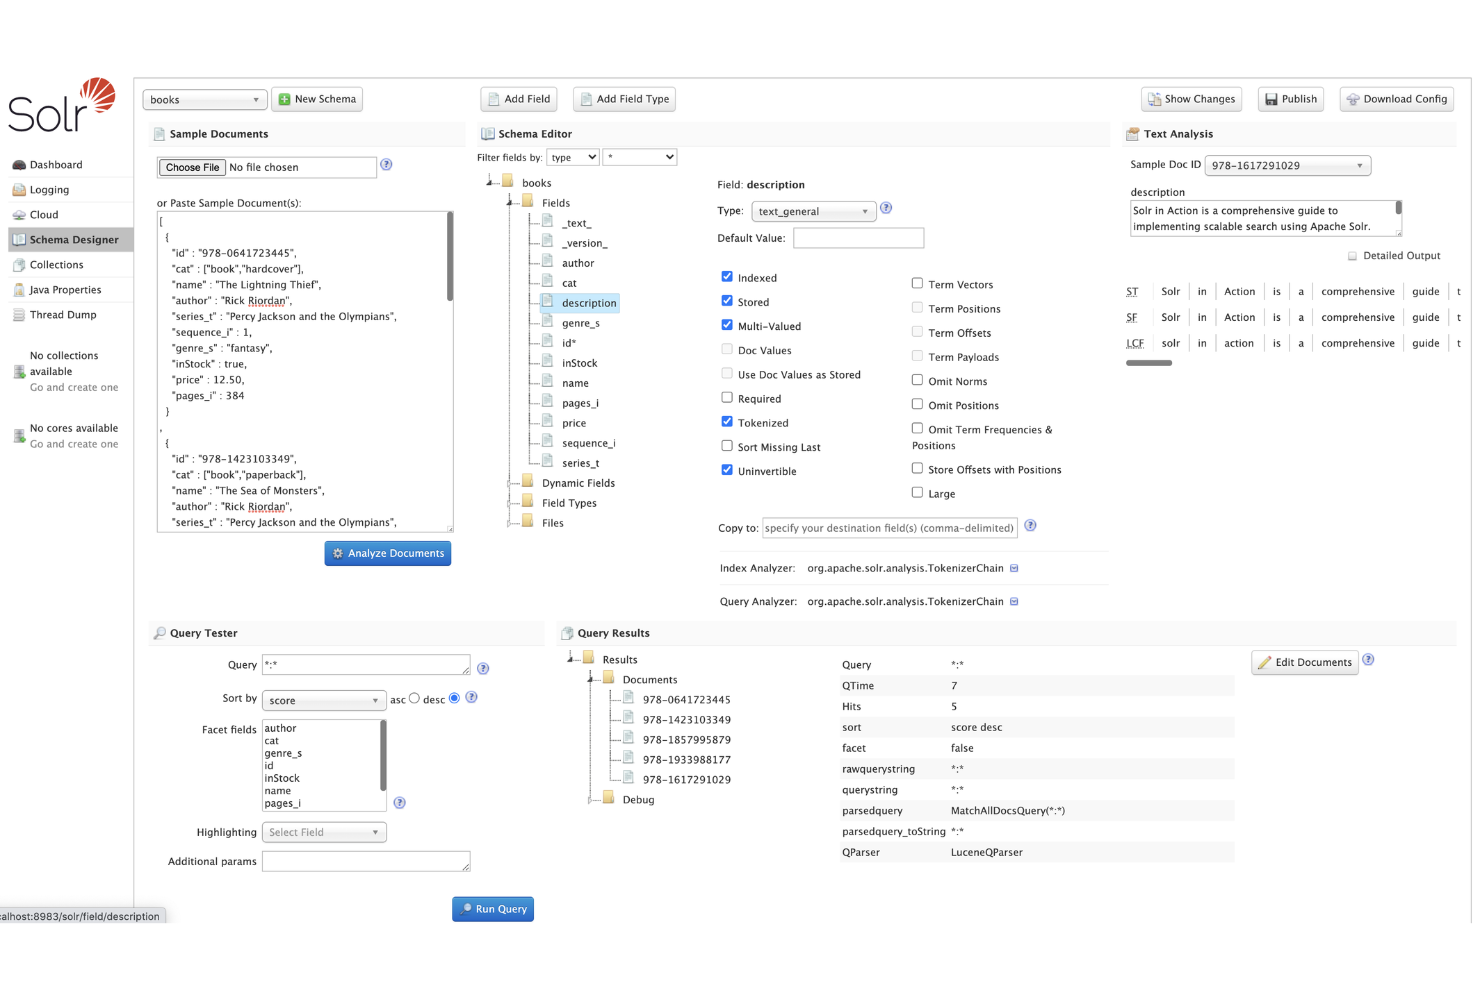
Le organizzazioni con esigenze elevate di scalabilità e affidabilità prendono spesso in considerazione Apache Solr per la propria infrastruttura di ricerca aziendale. Solr è progettato per implementazioni su larga scala e offre indicizzazione distribuita, suddivisione in partizioni e replica, supportando un'elevata disponibilità e volumi di dati enormi.
La sua architettura flessibile e il suo ecosistema maturo lo rendono una scelta valida per i team IT che gestiscono ambienti di ricerca complessi e mission-critical, oltre le funzionalità normalmente offerte da Elasticsearch già pronte all'uso.
Perché Apache Solr è una valida alternativa a Elasticsearch
Per i team che danno priorità alla scalabilità di livello aziendale, Apache Solr offre un'architettura collaudata per gestire carichi di lavoro di ricerca enormi. Ho scelto Solr perché le sue funzionalità di indicizzazione distribuita, suddivisione in partizioni e replica sono progettate per supportare un'elevata disponibilità e la scalabilità orizzontale tra cluster di grandi dimensioni.
La gestione flessibile dello schema e le opzioni avanzate di memorizzazione nella cache di Solr aiutano inoltre i team IT a ottimizzare le prestazioni per ambienti complessi e caratterizzati da grandi quantità di dati. Queste funzionalità rendono Solr particolarmente adatto alle organizzazioni che necessitano di una ricerca affidabile e su larga scala, oltre ciò che Elasticsearch può offrire normalmente già pronto all'uso.
Caratteristiche principali di Apache Solr
Alcune altre funzionalità di Solr lo rendono un'opzione versatile per i progetti di ricerca aziendale:
- Funzionalità di ricerca nel testo integrale: Solr supporta l'analisi avanzata del testo, la tokenizzazione e la normalizzazione morfologica per ottenere risultati di ricerca precisi.
- Architettura estensibile basata su estensioni: È possibile aggiungere estensioni personalizzate per ampliare le funzionalità fondamentali di Solr in base a casi d'uso specifici.
- Ricerca geospaziale: Solr include il supporto integrato per le query basate sulla posizione e l'indicizzazione dei dati spaziali.
- Gestione avanzata dei documenti: La piattaforma può indicizzare e cercare un'ampia gamma di formati di documenti, inclusi file XML, JSON e file di testo avanzato.
Integrazioni Apache
Integrazione basata su API tramite API simili a REST, con estensioni e connettori sviluppati attraverso il suo ecosistema e lo sviluppo personalizzato.
Pros and Cons
Pros:
- L'architettura distribuita supporta un'elevata disponibilità e implementazioni su larga scala
- La progettazione flessibile dello schema consente di gestire modelli di dati complessi e in evoluzione
- L'analisi avanzata del testo e la tokenizzazione migliorano la precisione della ricerca
Cons:
- La documentazione può essere frammentata tra versioni e fonti della community
- L'aggiornamento tra versioni principali può richiedere un notevole impegno di migrazione
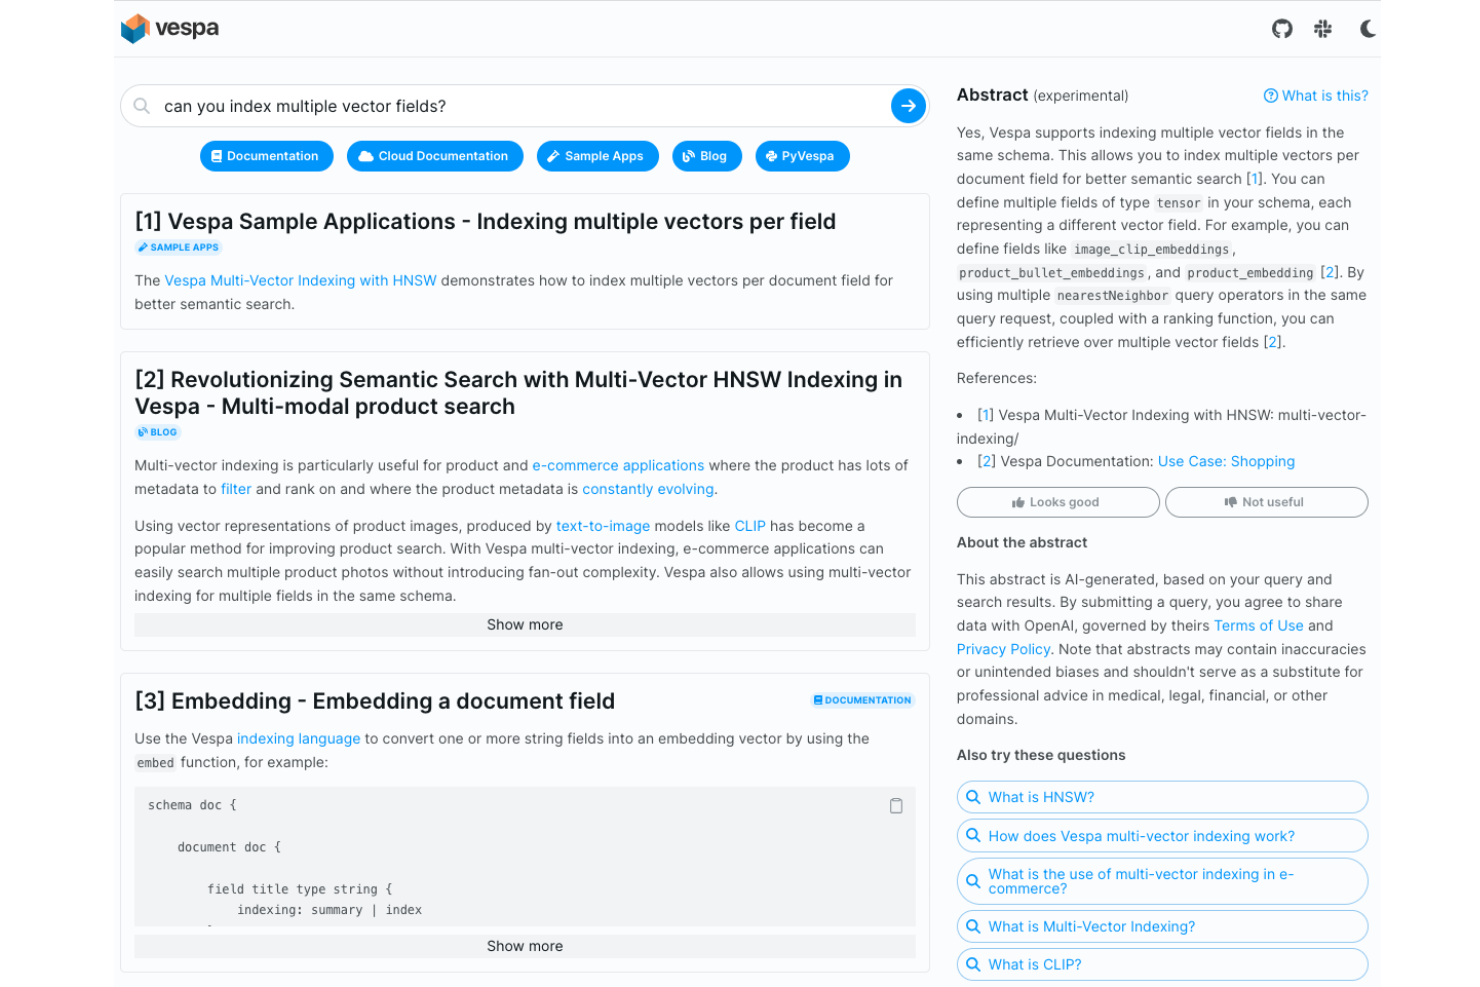
Per i team che gestiscono set di dati enormi e in rapido movimento, Vespa offre un motore di elaborazione di grandi volumi di dati in tempo reale che va oltre la ricerca tradizionale. È progettato per specialisti IT e ingegneri dei dati che devono combinare ricerca, raccomandazioni e analisi su dati attivi su larga scala. Vespa si distingue dalle alternative a Elasticsearch grazie al supporto per l'elaborazione a bassa latenza e ad alto throughput di query complesse e modelli di apprendimento automatico direttamente sui dati mentre vengono trasmessi.
Perché Vespa è una buona alternativa a Elasticsearch
Vespa si distingue per l'elaborazione di grandi volumi di dati in tempo reale, un'esigenza fondamentale per le organizzazioni che lavorano con set di dati ad alta velocità e su larga scala. Ho scelto Vespa perché può eseguire query complesse, raccomandazioni e inferenze di apprendimento automatico direttamente sui dati attivi durante il loro flusso continuo.
L'architettura della piattaforma è progettata per operazioni a bassa latenza e ad alto throughput, risultando adatta a casi d'uso come personalizzazione, rilevamento delle frodi e ricerca su larga scala. Queste funzionalità rendono Vespa una valida alternativa a Elasticsearch quando serve qualcosa di più della semplice ricerca: servono analisi e processi decisionali in tempo reale su dati aggiornati.
Funzionalità principali di Vespa
Altre funzionalità di Vespa la rendono una scelta versatile per ambienti di dati esigenti:
- Supporto nativo per i tensori: Vespa elabora e archivia strutture di dati tensoriali per casi d'uso avanzati di classificazione e apprendimento automatico.
- Pipeline di elaborazione dei documenti: La piattaforma include pipeline integrate per l'acquisizione, la trasformazione e l'indicizzazione dei documenti.
- Gestione flessibile degli schemi: È possibile definire e aggiornare dinamicamente gli schemi dei dati senza tempi di inattività.
- Controllo degli accessi integrato: Vespa offre un controllo degli accessi basato sui ruoli per gestire le autorizzazioni degli utenti e la sicurezza dei dati.
Integrazioni di Vespa
Le integrazioni seguono un approccio basato sulle API, con supporto per applicazioni personalizzate, pipeline di dati e integrazioni di apprendimento automatico.
Pros and Cons
Pros:
- L'elaborazione in tempo reale supporta analisi a bassa latenza sui dati trasmessi in flusso continuo
- Il supporto nativo per i tensori consente inferenze avanzate di apprendimento automatico
- La licenza a codice aperto offre pieno accesso al codice sorgente
Cons:
- Richiede un'infrastruttura significativa per ottenere prestazioni ottimali su larga scala
- La configurazione iniziale può essere complessa per i nuovi utenti
Lucidworks
Ideale per informazioni sui documenti basate sull'intelligenza artificiale
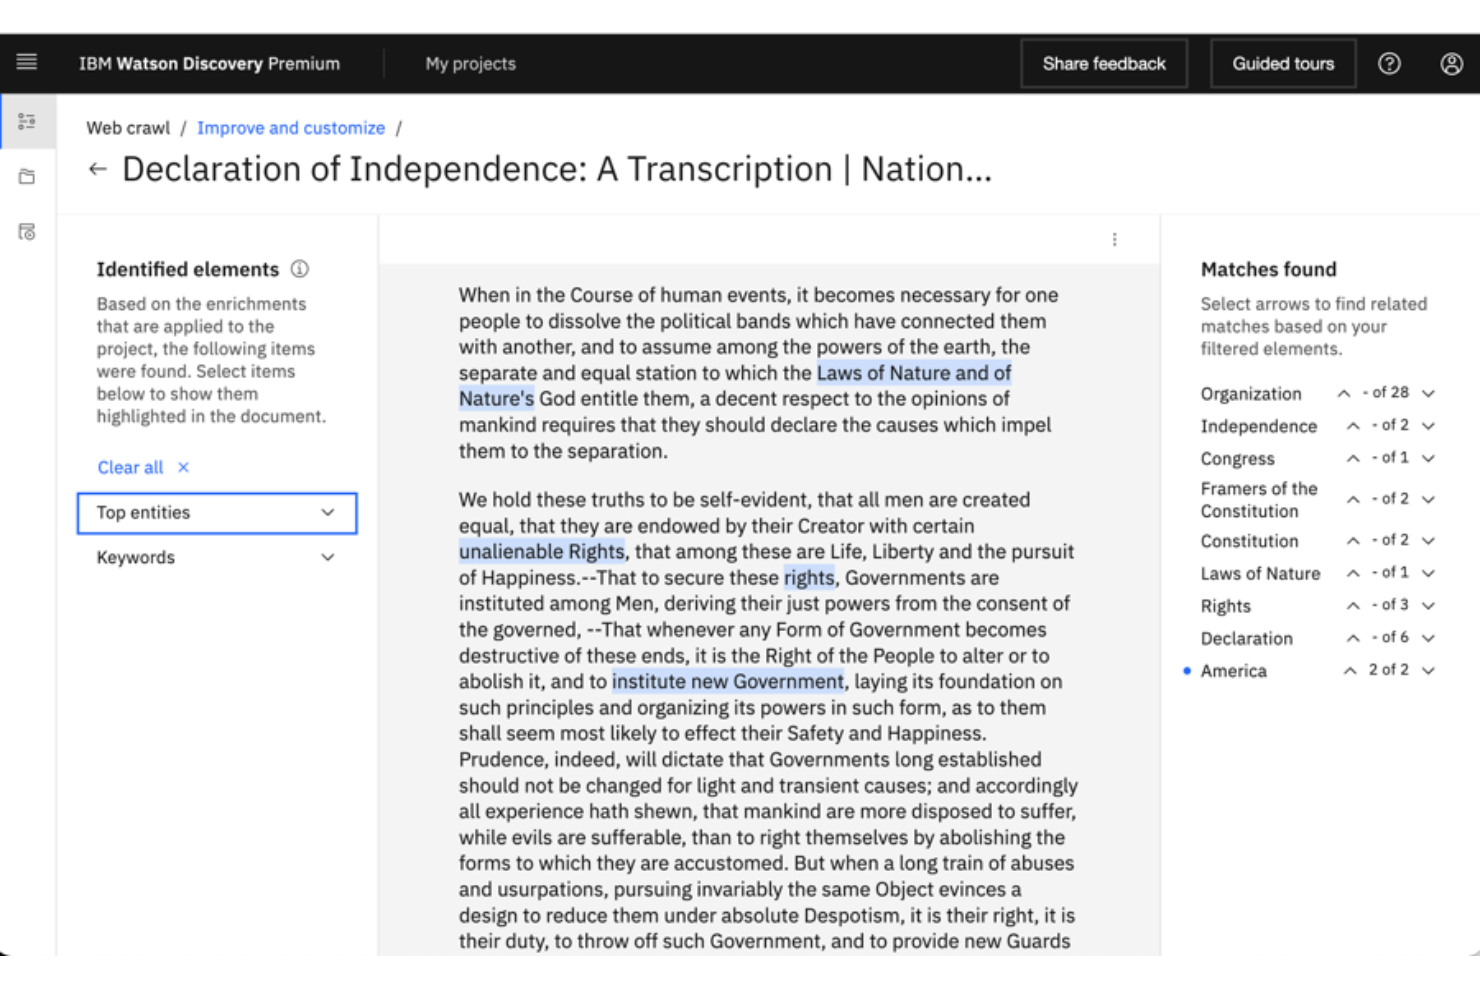
Per i team che devono estrarre informazioni da grandi volumi di documenti non strutturati, IBM Watson Discovery offre funzionalità avanzate di ricerca e analisi basate sull'intelligenza artificiale. È una soluzione particolarmente adatta ad aziende, organizzazioni di ricerca e settori regolamentati che devono individuare informazioni rilevanti da fonti di dati complesse.
A differenza di Elasticsearch, Watson Discovery utilizza l'elaborazione del linguaggio naturale e l'apprendimento automatico per comprendere il contesto e fornire risposte più precise dai documenti.
Perché IBM Watson Discovery è una buona alternativa a Elasticsearch
Ciò che distingue IBM Watson Discovery è la sua attenzione alle informazioni sui documenti basate sull'intelligenza artificiale, che va oltre la tradizionale ricerca per parole chiave. Ho scelto questo strumento perché utilizza l'elaborazione del linguaggio naturale per estrarre significato e contesto dai dati non strutturati, rendendo più semplice trovare risposte rilevanti in documenti complessi.
Funzionalità come il recupero di passaggi e l'estrazione avanzata di entità aiutano gli utenti a individuare informazioni precise che potrebbero sfuggire ai motori di ricerca standard. Se il tuo team deve analizzare e comprendere grandi quantità di documenti, Watson Discovery offre funzionalità difficili da eguagliare con il solo Elasticsearch.
Funzionalità principali di IBM Watson Discovery
Altre funzionalità di IBM Watson Discovery ne fanno una scelta versatile per la ricerca e l'analisi dei documenti:
- Connettori dati personalizzati: Collegati a una vasta gamma di fonti di dati, tra cui archivi cloud e repository di contenuti aziendali.
- Arricchimento intelligente dei documenti: Contrassegna e arricchisci automaticamente i documenti con metadati per migliorare la ricercabilità.
- Addestramento sulla rilevanza: Ottimizza i risultati di ricerca addestrando il sistema su ciò che è più importante per la tua organizzazione.
- Dashboard analitica integrata: Visualizza tendenze e modelli nei tuoi dati con strumenti di analisi integrati.
Integrazioni di IBM Watson Discovery
IBM Watson Discovery non elenca attualmente integrazioni native.
Pros and Cons
Pros:
- L'elaborazione avanzata del linguaggio naturale fornisce risultati di ricerca sensibili al contesto
- I modelli di intelligenza artificiale preaddestrati estraggono entità e relazioni dai documenti
- Supporta l'acquisizione da più fonti di dati, inclusi repository cloud
Cons:
- La configurazione iniziale e la preparazione dei dati possono richiedere molto tempo per grandi insiemi di dati
- La personalizzazione dei modelli di intelligenza artificiale può richiedere competenze specialistiche
Altre alternative a Elasticsearch
Ecco alcune ulteriori alternative a Elasticsearch che non sono state incluse nella mia selezione, ma che vale comunque la pena prendere in considerazione:
- FactFinder
Ideale per la scoperta dei prodotti nell'e-commerce
- Microsoft Azure AI Search
Ideale per un'integrazione fluida con il cloud
- SigNoz
Ideale con strumenti di osservabilità integrati


Come Valuto le Alternative a Elasticsearch
Che si tratti di sostituire cluster Elastic con licenza SSPL o potenziare la ricerca vettoriale nelle app di intelligenza artificiale, valuto gli strumenti partendo dalle funzionalità di ricerca essenziali, per poi considerare fattori differenzianti come il TCO e le opzioni di distribuzione.
Funzionalità di Base (Requisiti Minimi per Questa Lista)
Quando seleziono gli strumenti da inserire nella mia lista, valuto ciascuno su una scala da 0 (non offre la funzionalità) a 5 (eccelle in quest'area) per ognuna delle funzionalità di base elencate di seguito. Successivamente, calcolo il punteggio totale dello strumento in una percentuale. Ogni strumento deve raggiungere un punteggio totale minimo del 65% per essere considerato per l'inclusione.
- Motore di Ricerca Full-Text: Valuto come ogni strumento gestisce tokenizzazione, stemming, analyzer e punteggi di rilevanza—come ad esempio il fuzzy matching su cataloghi di prodotti o la ricerca di documenti multilingue.
- Architettura Distribuita e Scalabile: Lo scaling orizzontale, lo sharding e la replica sono fondamentali quando l'indice cresce da milioni a miliardi di documenti, quindi verifico come ciascun strumento gestisce il clustering.
- API RESTful e Query DSL: Una API REST ben documentata e un linguaggio di query espressivo sono ciò con cui i tuoi ingegneri interagiscono ogni giorno, quindi cerco flessibilità nella costruzione delle query e la disponibilità di SDK client.
- Indicizzazione in Tempo Reale: Controllo la rapidità con cui i nuovi documenti diventano ricercabili dopo l'ingestione—soprattutto per casi d'uso come il tracking live degli ordini o il monitoraggio degli eventi di sicurezza, dove dati non aggiornati sono un problema.
- Supporto a Log e Analisi: Strumenti come OpenSearch e Zinc gestiscono entrambi l'aggregazione dei log, quindi valuto quanto ogni piattaforma supporta l'ingestione strutturata dei log, le aggregazioni e i flussi di osservabilità.
- Indicizzazione di Tipi di Dato Multipli: Oltre al testo, esamino il supporto per dati numerici, geospaziali e vettoriali—in particolare per team che realizzano ricerche ibride o applicazioni basate sulla localizzazione.
Una volta che ho una lista di strumenti che soddisfano questi criteri, considero ciò che distingue ogni piattaforma.
Fattori Differenzianti (Cosa Distingue i Fornitori)
Ecco come confronto i diversi fornitori:
Caratteristiche Distintive
Le funzionalità di ricerca vettoriale e semantica stanno diventando sempre più importanti man mano che i team sviluppano pipeline RAG e sistemi di retrieval potenziati dall'intelligenza artificiale, quindi valuto come ogni strumento gestisce le query kNN e il retrieval ibrido lessicale/vettoriale. Anche l'offerta cloud gestita conta—i team che vogliono evitare la gestione dei cluster traggono vantaggio da piattaforme come Meilisearch Cloud o Amazon OpenSearch Serverless. Guardo anche al supporto per le query SQL, che permette agli analisti di interrogare i dati indicizzati senza dover imparare un DSL proprietario.
Oltre le Caratteristiche
La licenza è una delle prime cose che verifico. Il passaggio da Apache 2.0 a SSPL è stato ciò che ha spinto molti team a esplorare alternative come OpenSearch, quindi esamino attentamente i termini di licenza e il modello di governance di ciascun strumento. Anche la compatibilità dell'ecosistema conta—valuto se pipeline Logstash esistenti, agenti Beats o collector OpenTelemetry funzionano senza grandi modifiche. La flessibilità di distribuzione conclude la mia valutazione, soprattutto per i team di settori regolamentati che necessitano di opzioni on-premise, air-gapped o ibride.
Perché cercare un'alternativa a Elasticsearch?
Sebbene Elasticsearch sia una buona scelta tra le alternative a Elasticsearch, ci sono diversi motivi per cui alcuni utenti cercano soluzioni alternative. Potresti cercare un'alternativa a Elasticsearch perché…
- La gestione e la scalabilità dei cluster richiedono competenze interne significative
- La regolazione della rilevanza integrata è limitata per i casi d'uso nel commercio elettronico o nella vendita al dettaglio
- Le funzionalità avanzate di analisi e reportistica non sono incluse per impostazione predefinita
- Manca il supporto nativo per la ricerca vettoriale o per immagini
- I costi delle licenze e dell'assistenza possono essere imprevedibili su larga scala
- Le integrazioni con specifiche piattaforme di commercio elettronico o analisi sono limitate
Se ti riconosci in una di queste situazioni, sei nel posto giusto. Il mio elenco contiene diverse alternative a Elasticsearch più adatte ai team che affrontano queste difficoltà con Elasticsearch e cercano soluzioni alternative.
Caratteristiche principali di Elasticsearch
Ecco alcune delle caratteristiche principali di Elasticsearch, per aiutarti a confrontare le funzionalità offerte dalle soluzioni alternative:
- Ricerca a testo completo con supporto per query complesse
- Indicizzazione e recupero dei dati in tempo reale
- Architettura distribuita per la scalabilità orizzontale
- API RESTful per l'integrazione con altri sistemi
- Supporto per dati strutturati e non strutturati
- Funzionalità integrate di aggregazione e analisi
- Controllo degli accessi basato sui ruoli e funzionalità di sicurezza
- Integrazione con Kibana per la visualizzazione dei dati
- Supporto multilingue per implementazioni globali
- Istantanee e ripristino per il salvataggio dei dati e il ripristino d'emergenza