

10 meilleurs outils d’observabilité des LLM en 2026

Sélection des meilleurs outils d'observabilité des LLM


Les outils d'observabilité des LLM retracent les flux de travail d'IA, surveillent les comportements en production et évaluent la qualité des modèles. Ce guide compare 12 options pour déboguer les agents en plusieurs étapes, suivre les invites et les versions des modèles, mesurer la latence et l'utilisation des jetons, et détecter les régressions avant le déploiement. Vous y trouverez des plateformes open source, auto-hébergées, destinées aux entreprises, basées sur OpenTelemetry et orientées développeurs, afin de répondre à votre architecture technique, à vos besoins de gouvernance et à votre flux de livraison.
Pourquoi faire confiance à nos recommandations de logiciels
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Comparez les meilleurs outils d'observabilité des LLM
Comparez côte à côte les tarifs et les spécifications des principales plateformes de ma sélection.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour le traçage open source natif d'OTel | Forfait gratuit + démonstration gratuite disponible | Tarification sur demande | Website | |
| 2 | Idéal pour l’évaluation à code source ouvert et auto-hébergée à grande échelle | Formule gratuite disponible | Tarification sur demande | Website | |
| 3 | Idéal pour l’évaluation des LLM sur l’ensemble du cycle de vie avec des opérations de passerelle | Formule gratuite + démonstration gratuite disponibles | Tarifs sur demande | Website | |
| 4 | Idéal pour l’évaluation et le traçage open source | Formule gratuite + démonstration gratuite disponible | À partir de $19/mois | Website | |
| 5 | Idéal pour relier les versions des instructions aux traces de production | Formule gratuite + démonstration gratuite disponible | À partir de $49/mois | Website | |
| 6 | Idéal pour tracer les agents dans des pipelines complexes | Formule gratuite + démonstration gratuite disponible | À partir de $50/mois | Website | |
| 7 | Idéal pour relier les traces des LLM à l'analyse des produits | Formule gratuite + démo gratuite disponible | À partir de $34/mois | Website | |
| 8 | Idéal pour le traçage open source avec gestion des versions des prompts | Offre gratuite + démo gratuite disponible | À partir de 29 $/mois | Website | |
| 9 | Idéal pour la notation de l’évaluation à la production au sein d’une seule boucle | Formule gratuite + démonstration gratuite disponible | À partir de 249 $/mois | Website | |
| 10 | Idéal pour le traçage de LangChain et LangGraph | Formule gratuite + démo gratuite disponible | À partir de $39/utilisateur/mois | Website |
Avis sur les outils d'observabilité des LLM
\u003cp data-pm-slice=\u00221 1 []\u0022\u003eVous trouverez ci-dessous des résumés détaillés des meilleures options de ma sélection. Chaque avis présente les fonctionnalités clés, les cas d’utilisation et les intégrations pour vous aider à trouver la solution adaptée.\u003c/p\u003e
Idéal pour le traçage open source natif d'OTel
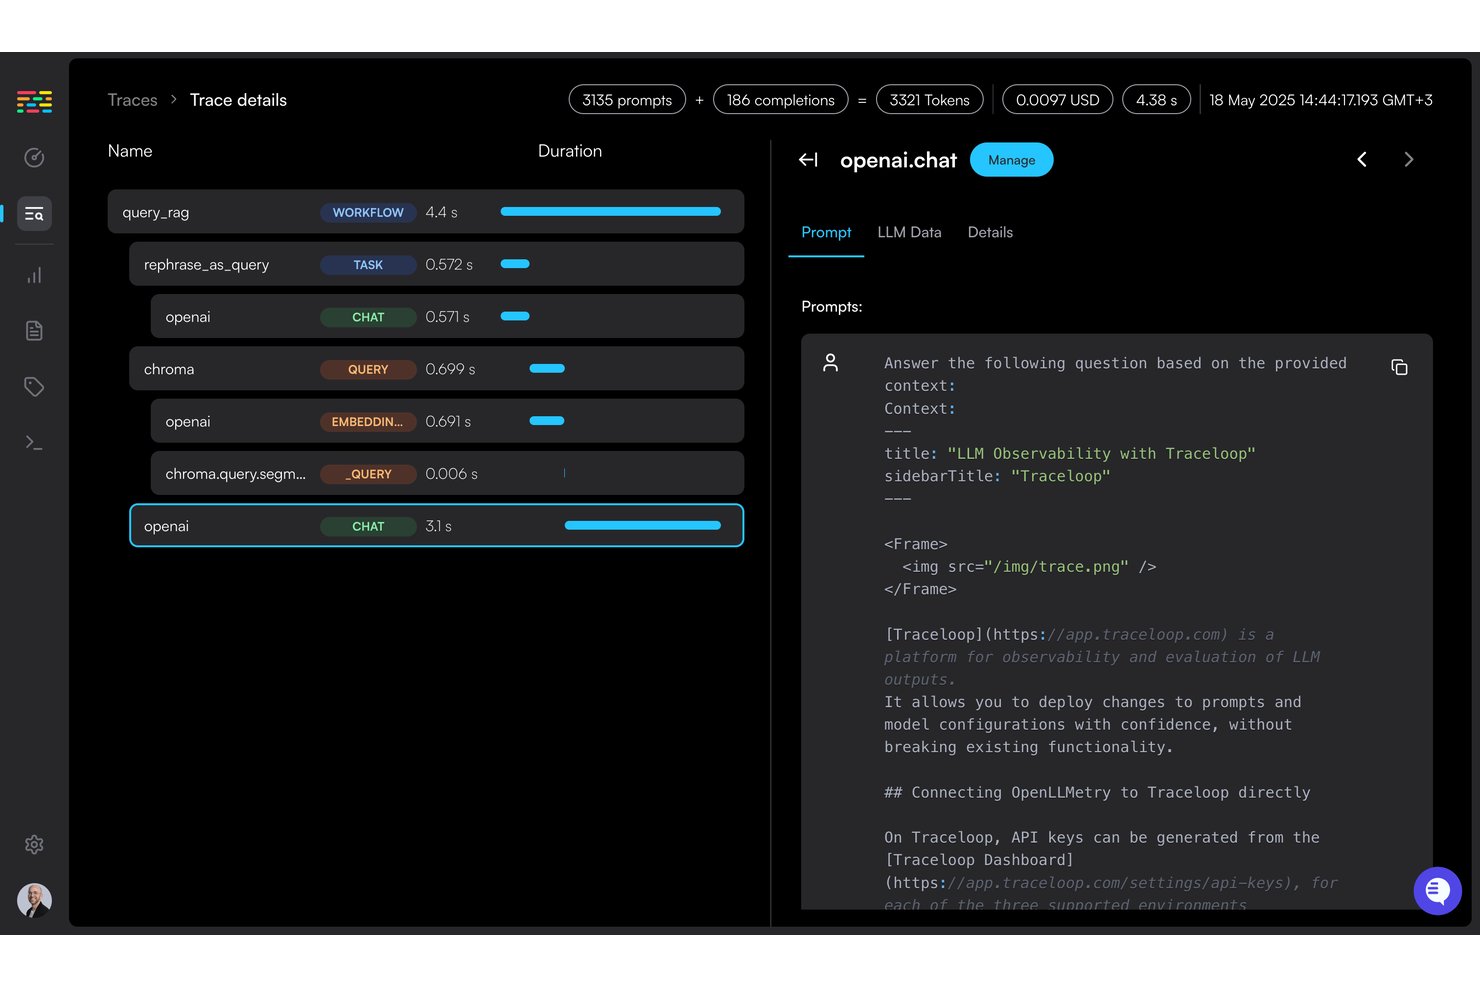
Traceloop de ServiceNow est basé sur OpenTelemetry, qui vous offre une journalisation des traces basée sur des unités de trace, une évaluation de la qualité des sorties, un registre d'instructions avec des déploiements selon l'environnement, des outils de surveillance de la production et des barrières de qualité pour les pipelines CI/CD.
À qui Traceloop convient-il le mieux ?
Traceloop convient aux ingénieurs plateforme et DevOps qui ont besoin d'une observabilité des LLM conforme aux exigences et auto-hébergée sur Kubernetes ou une infrastructure isolée.
Pourquoi j'ai choisi Traceloop
J'ai inclus Traceloop dans mes meilleures sélections parce qu'il est entièrement basé sur OpenTelemetry grâce à son SDK OpenLLMetry à code source ouvert, ce qui signifie que chaque appel LLM, chaque requête adressée à une base de données vectorielle et chaque étape d'agent sont enregistrés sous forme d'unité de trace OTel native que vous pouvez exporter vers plus de 25 systèmes. J'apprécie particulièrement la chaîne d'évaluation : vous pouvez exécuter simultanément les mêmes contrôles de qualité que les barrières CI/CD sur les demandes de fusion, les garde-fous intégrés en production et les outils de surveillance en temps réel sur le trafic actif. Le registre d'instructions avec des déploiements selon l'environnement vous permet également de déployer les modifications d'instructions d'abord en développement, puis en production, tout en maintenant un contrôle strict des versions sur l'ensemble du cycle de vie.
Principales fonctionnalités de Traceloop
- Évaluateurs intégrés : Vérifiez automatiquement la fidélité, la pertinence et la sécurité du trafic actif sans configuration manuelle.
- Contrôles d'évaluation axés sur les agents : Évaluez les sorties des agents selon l'exactitude, l'utilisation des outils, la conservation de la mémoire, l'achèvement des tâches et la sécurité.
- Outils de surveillance de la production : Exécutez des évaluateurs en temps réel sur chaque unité de trace correspondant à un filtre afin de détecter les hallucinations et les régressions de qualité.
- Garde-fous intégrés : Exécutez des contrôles de sécurité en temps réel pendant l'inférence, directement à partir de vos évaluateurs configurés.
Intégrations de Traceloop
Traceloop prend en charge plus de 20 fournisseurs de LLM, notamment Axiom, Braintrust, BMC, Google Cloud, Highlight, Honeycomb, Instana, OpenTelemetry Collector, Datadog, Oracle Cloud et Tenant Cloud. Une API permettant de créer des évaluateurs personnalisés de type LLM comme juge est également disponible.
Pros and Cons
Pros:
- Le traçage natif réduit la dépendance envers un fournisseur
- Les évaluations couvrent la chaîne CI/CD jusqu'à la production
- L'auto-hébergement prend en charge les déploiements sur des infrastructures isolées
Cons:
- L'acquisition par ServiceNow crée une incertitude quant à la feuille de route
- Les informations publiques sur l'attribution des coûts restent limitées
MLflow
Idéal pour l’évaluation à code source ouvert et auto-hébergée à grande échelle
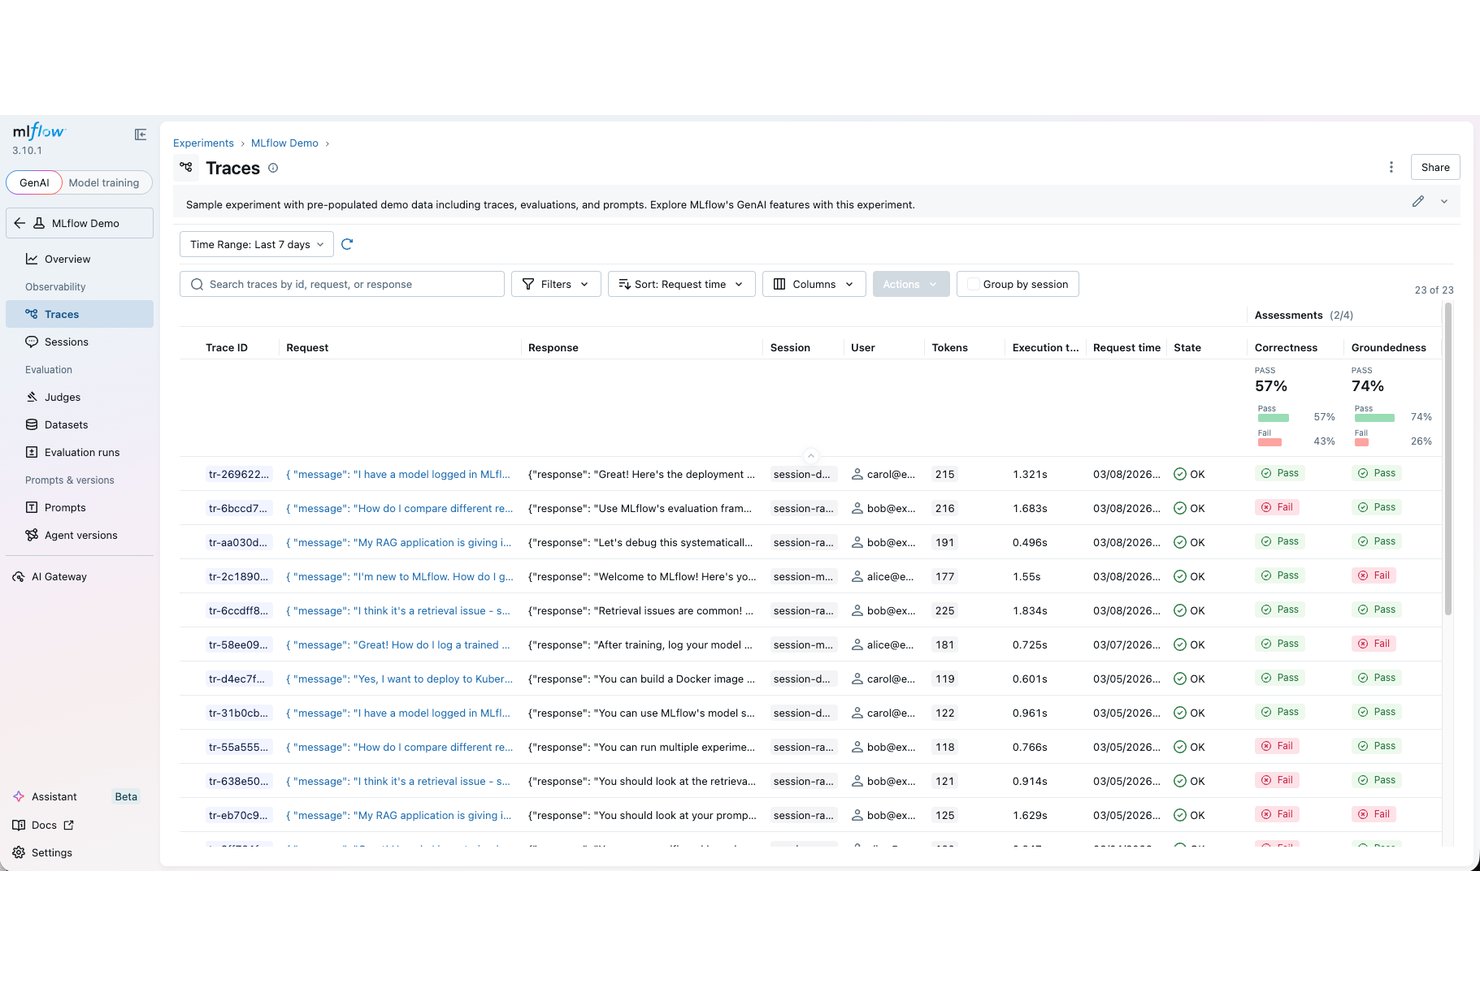
MLflow est une plateforme à code source ouvert d’observabilité de l’IA qui combine la journalisation des traces, l’évaluation de la qualité des sorties, la gestion des versions des instructions, le suivi des coûts et des jetons, ainsi que la surveillance en production des applications LLM et des agents IA.
À qui MLflow convient-il le mieux ?
MLflow convient aux ingénieurs ML/IA et aux spécialistes des données qui ont besoin d’un contrôle total sur leur infrastructure d’observabilité et souhaitent éviter les frais par trace ou la dépendance vis-à-vis d’un fournisseur.
Pourquoi j’ai choisi MLflow
J’ai inclus MLflow dans ma sélection principale parce qu’il s’agit du seul outil présenté ici conçu dès le départ comme un logiciel à code source ouvert sous licence Apache 2.0, ce qui signifie que vos données de traces ne quittent jamais votre propre infrastructure. J’apprécie que le registre des instructions relie directement chaque version d’une instruction à ses résultats d’évaluation, afin que vous puissiez effectuer des tests A/B sur les variantes et comparer côte à côte les scores de qualité, de latence et de sécurité avant de déployer quoi que ce soit en production. Les évaluateurs LLM asynchrones évaluent également en continu les traces échantillonnées sans ralentir le trafic en direct.
Principales fonctionnalités de MLflow
- Registre des instructions : Versionnez, testez et comparez les instructions côte à côte, avec un suivi de la lignée et une optimisation automatique des instructions pour les ajuster de manière algorithmique.
- Garde-fous et détection des risques : La notation en temps réel détecte les injections d’instructions, les fuites de données personnelles et les contournements des mécanismes de sécurité à l’aide de détecteurs déterministes et fondés sur des LLM, avec une possibilité de masquage des données personnelles dans le SDK.
- Gestion des jeux de données d’évaluation : Créez et stockez des jeux de données de cas de test à partir de traces de production, avec les retours structurés des utilisateurs et des experts du domaine pris en compte pour l’étalonnage des évaluateurs.
- Passerelle IA avec des politiques budgétaires : Définissez des seuils de dépenses par jour, par semaine ou par mois auprès de plusieurs fournisseurs, avec des alertes par webhook vers des outils comme Slack ou PagerDuty lorsque les limites sont dépassées.
Intégrations de MLflow
MLflow s’intègre à plus de 40 LLM et agents IA, notamment OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry et TypeScript. L’API REST est également disponible pour les connexions personnalisées.
Pros and Cons
Pros:
- Les traces auto-hébergées maintiennent les données en interne
- Les évaluateurs en production détectent les hallucinations et la dérive
- La lignée des instructions relie les modifications aux évaluations
Cons:
- Les traces imbriquées des agents peuvent devenir difficiles à interpréter
- Les options d’alerte restent moins clairement documentées
Bifrost
Idéal pour l’évaluation des LLM sur l’ensemble du cycle de vie avec des opérations de passerelle
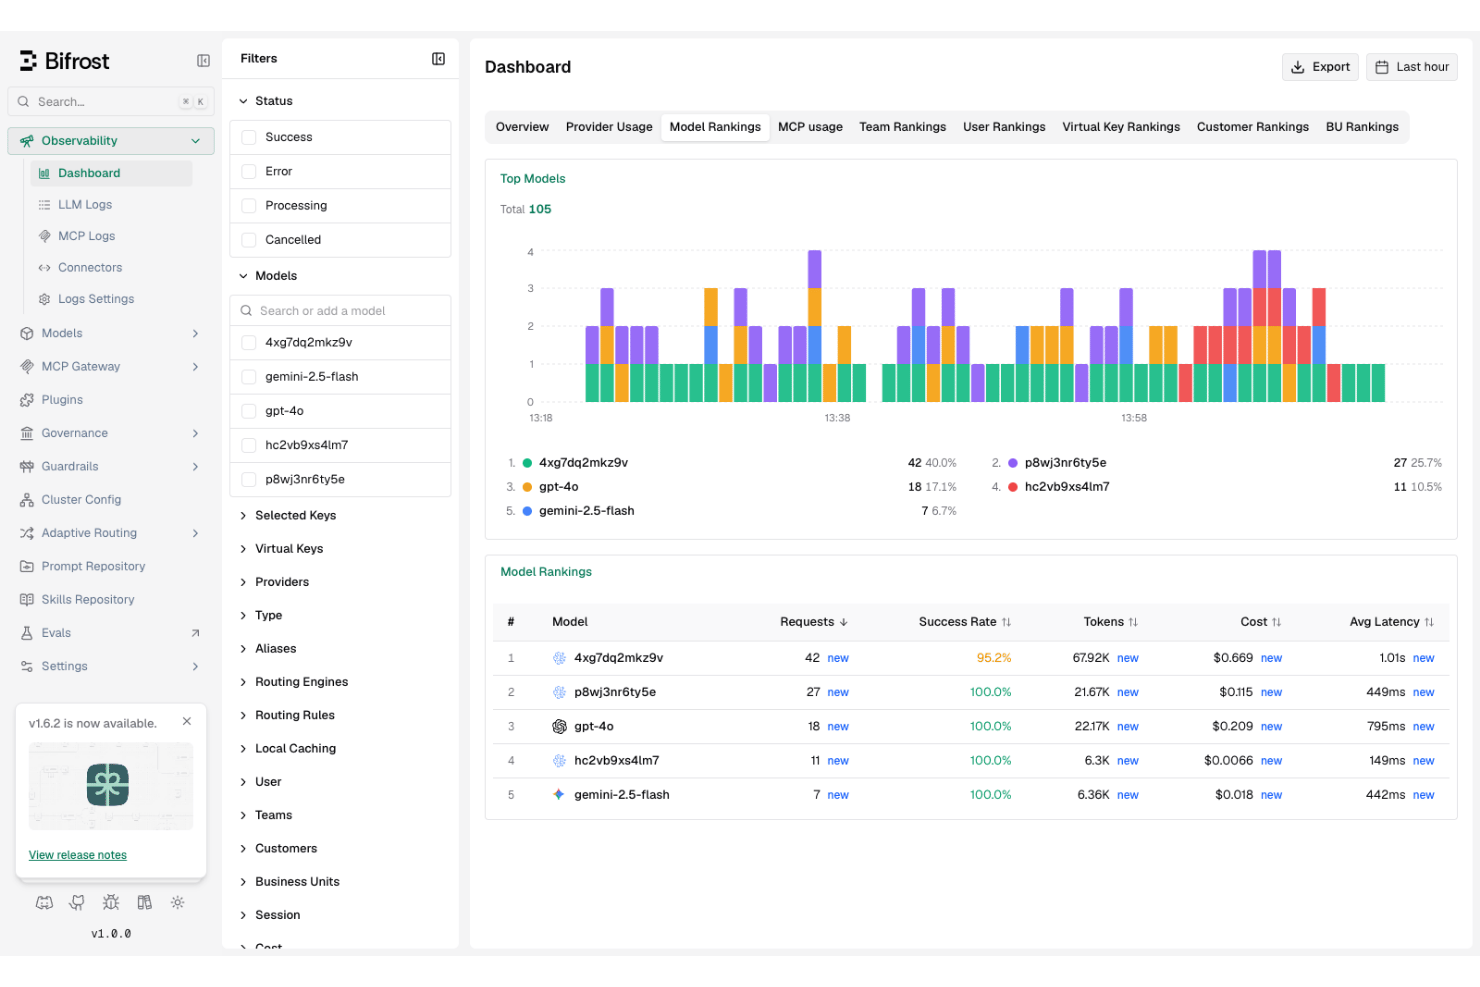
Bifrost est une plateforme d’observabilité des LLM qui couvre l’ensemble du cycle de développement, en combinant le traçage distribué, le versionnage et l’expérimentation des instructions, l’évaluation automatisée et avec intervention humaine, ainsi qu’une passerelle LLM à code source ouvert.
À qui Bifrost convient-il le mieux ?
Bifrost convient parfaitement aux équipes d’entreprises réglementées qui ont besoin d’un déploiement dans le VPC, de la conformité SOC 2 Type II et HIPAA, ainsi que d’une évaluation avec intervention humaine au sein d’une seule plateforme.
Pourquoi j’ai choisi Bifrost
C’est sa couverture de l’ensemble du cycle de vie qui permet à Bifrost de rester parmi mes solutions préférées. Je l’utilise pour effectuer des tests A/B sur les versions d’instructions dans l’environnement de développement des instructions, puis réutiliser directement ces mêmes jeux de données pour l’évaluation en production, sans étape d’exportation manuelle. Ce que je trouve vraiment utile, c’est que la passerelle Bifrost à code source ouvert ajoute au suivi des coûts par équipe ou par clé virtuelle des limites de débit au niveau de la passerelle, ce qui me permet de gérer la gouvernance des coûts et l’observabilité depuis une configuration connectée, plutôt qu’avec deux outils distincts.
Principales fonctionnalités de Bifrost
- Environnement de développement des instructions avec comparaison des versions : Un espace de test multimodal dans lequel vous pouvez mener des expériences avec différentes combinaisons d’instructions, de modèles, de contextes et d’outils, grâce à une comparaison côte à côte des versions.
- Simulation d’agents : Testez les interactions entre agents dans différents scénarios et avec différentes personnalités d’utilisateurs, notamment pour les agents vocaux, avant de déployer les modifications en production.
- Intégration aux chaînes CI/CD : Intégrez directement les évaluations à votre chaîne de déploiement, avec des exécutions planifiées disponibles à partir de la formule professionnelle.
- Compatibilité avec OpenTelemetry : Exportez les données de traçage vers des plateformes externes comme New Relic et Snowflake grâce à un transfert natif OTel, avec des SDK en Python, TypeScript, Go et Java.
Intégrations de Bifrost
Bifrost prend en charge l’intégration avec des kits de développement IA, des plateformes de gestion des secrets et des systèmes d’identité, notamment OpenAI, Anthropic, Google GenAI, AWS Bedrock, LiteLLM, AWS Secrets Manager, Google Secret Manager et Okta. Une API pour les connexions personnalisées est également disponible.
Pros and Cons
Pros:
- Relie l’expérimentation, l’évaluation et l’observabilité
- Suit les sessions, les requêtes et les portées individuelles
- Combine la notation automatisée avec l’évaluation humaine
Cons:
- La courte durée de conservation limite les investigations historiques
- L’attribution détaillée des coûts reste peu claire
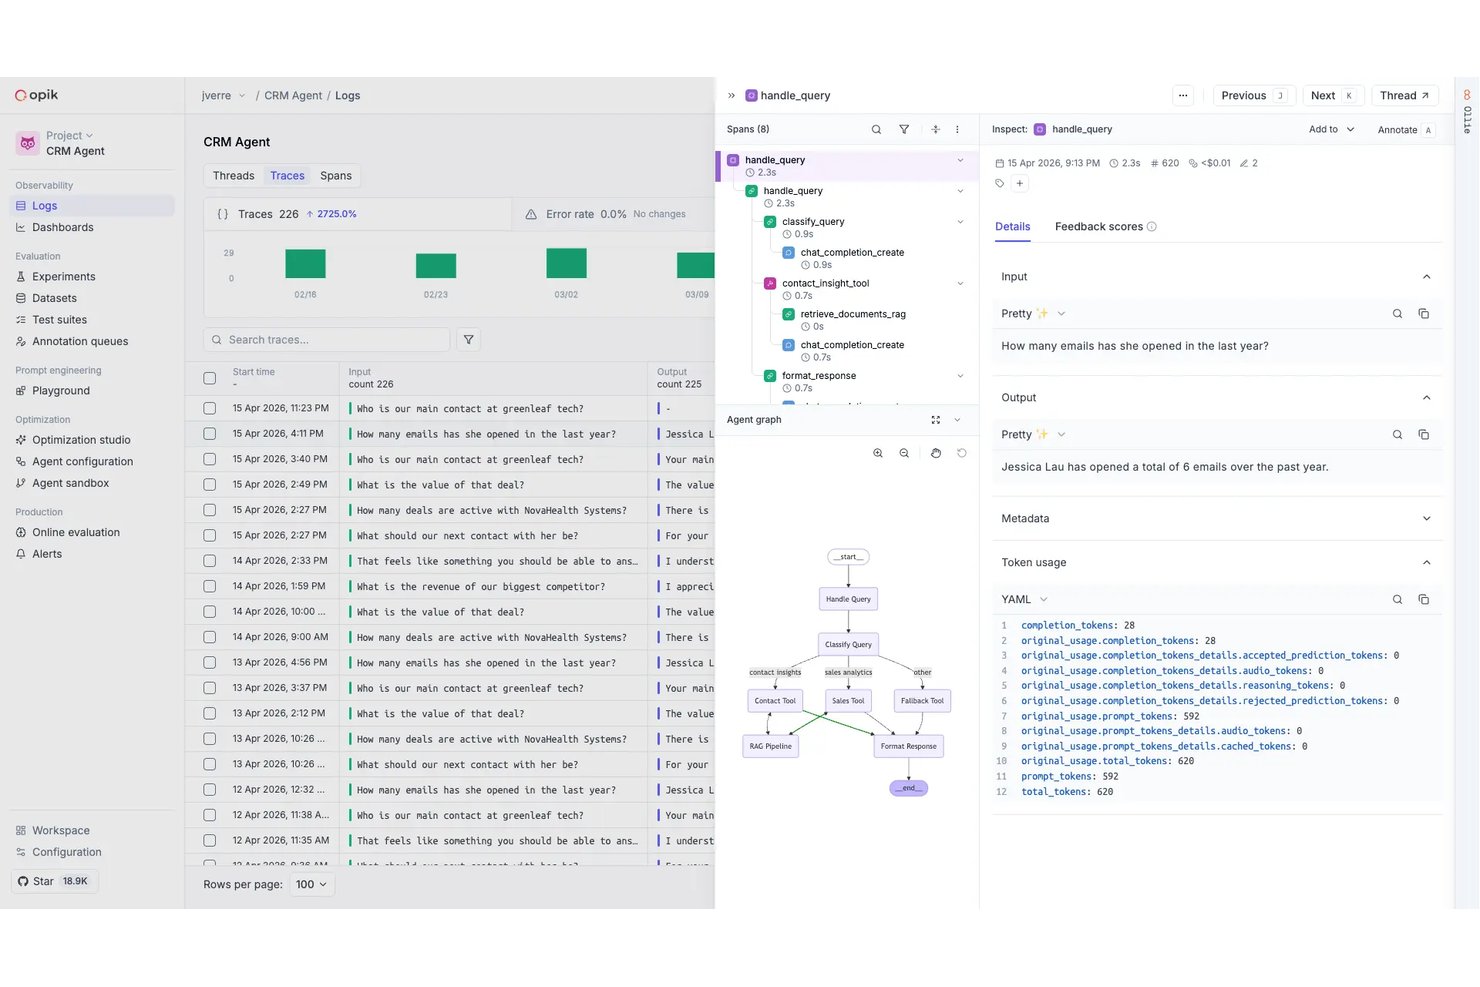
Opik est une plateforme d’observabilité des LLM qui couvre la journalisation des traces, l’évaluation de la qualité des sorties, la gestion des versions des prompts et le suivi des coûts dans les applications LLM, les agents et les pipelines RAG.
À qui Opik convient-il le mieux ?
Opik convient particulièrement aux ingénieurs ML/IA et aux équipes LLMOps qui souhaitent bénéficier de la flexibilité de l’open source, avec la possibilité d’évoluer vers un déploiement entièrement géré de niveau entreprise.
Pourquoi ai-je choisi Opik ?
J’ai choisi Opik comme l’une des meilleures solutions, car son cœur open source est véritablement complet, et non une simple version allégée destinée à vous inciter à passer à l’offre payante. J’apprécie le fait que vous puissiez l’héberger vous-même avec un nombre illimité d’utilisateurs, de segments et de données conservées, en utilisant le même code source que la version cloud. En ce qui concerne la profondeur de l’évaluation, Opik fournit plus de 30 métriques LLM évaluées par un juge, ainsi que des suites de tests qui exécutent des assertions de réussite ou d’échec, des tests A/B et des tests de régression sur des prompts versionnés. Il est ainsi facile de détecter les régressions de qualité des sorties avant leur mise en production.
Principales fonctionnalités d’Opik
- Interface d’annotation experte : Examinez des traces individuelles et des conversations complètes à plusieurs tours avec plusieurs membres de l’équipe, à l’aide d’étiquettes personnalisées pour recueillir des retours humains sur la qualité dans le cadre d’une boucle humain-dans-la-boucle.
- Garde-fous : Bloquez en temps réel les violations de contenu, l’exposition de données personnelles et les risques de non-conformité grâce aux types de garde-fous intégrés pour les données personnelles, les sujets et les règles personnalisées.
- Tableau de bord de veille des coûts : Suivez en temps réel les dépenses liées à Claude Code et Codex, ventilées par développeur et par équipe, avec audit de la configuration et recommandations pour réduire les coûts.
- Optimiseur d’agents : Automatisez l’ingénierie des prompts à l’aide de l’un des six algorithmes intégrés, avec des résultats présentés directement dans l’interface pour faciliter la comparaison.
Intégrations d’Opik
Opik prend en charge plus de 40 connexions à des frameworks d’IA et à des fournisseurs de modèles, notamment LlamaIndex, OpenAI, Google ADK, Haystack, CrewAI et OpenTelemetry. Il prend également en charge les API REST et les webhooks pour les intégrations personnalisées.
Pros and Cons
Pros:
- Le cœur open source prend en charge une utilisation auto-hébergée illimitée
- Une évaluation approfondie couvre plus de 30 métriques de qualité
- Ollie relie le diagnostic des traces aux corrections des régressions
Cons:
- Les alertes en production restent relativement basiques
- Les garde-fous ne proposent pas de détection explicite des tentatives de contournement
Idéal pour relier les versions des instructions aux traces de production
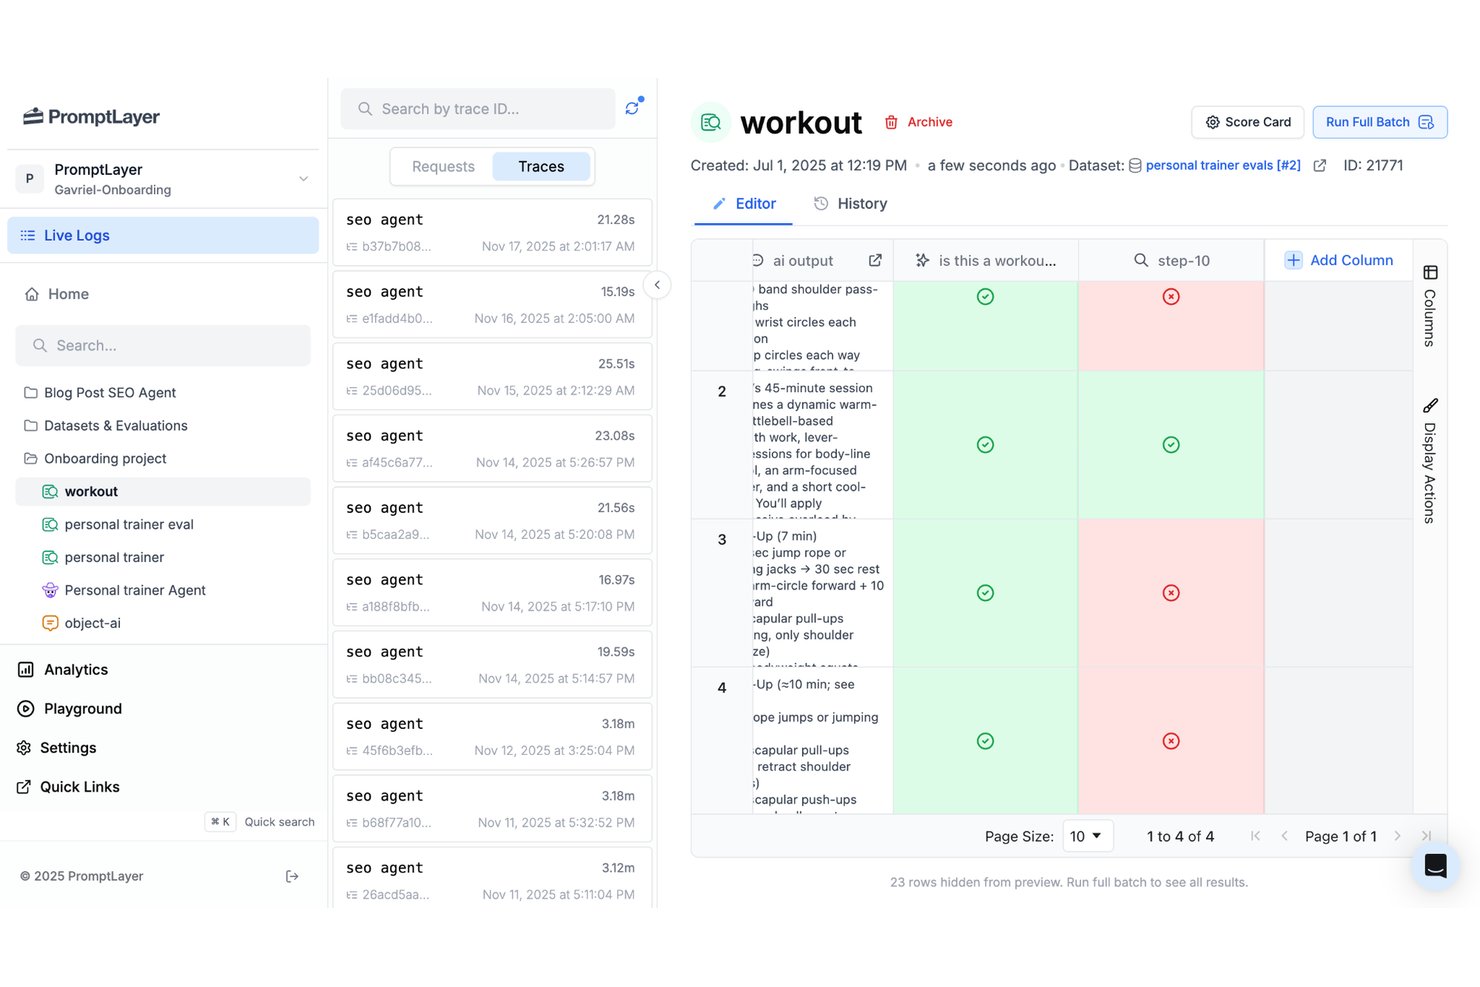
PromptLayer est une plateforme d’ingénierie de l’IA qui combine la gestion des versions des instructions, l’observabilité et le traçage des LLM, ainsi qu’un environnement d’évaluation pour tester les modifications apportées aux instructions et aux modèles sur des données de production.
À qui PromptLayer s’adresse-t-il le mieux ?
PromptLayer convient particulièrement aux équipes d’ingénierie ML/IA qui doivent relier chaque requête LLM de production à la version exacte de l’instruction qui l’a générée.
Pourquoi j’ai choisi PromptLayer
PromptLayer figure sur ma liste restreinte, car chaque requête de production est liée à la version exacte de l’instruction qui l’a générée. Je peux ainsi regrouper les métriques de coût, de latence et de qualité par version, et voir immédiatement lorsqu’une modification a eu un impact. J’apprécie également le fait que les déploiements A/B soient intégrés : je peux progressivement transférer le trafic vers une nouvelle version de l’instruction et comparer ses métriques à celles de la version précédente dans la même vue. La relecture des traces dans Playground est un ajout pratique qui me permet de reproduire une sortie incorrecte et d’améliorer l’instruction sans avoir à deviner le contexte d’origine.
Principales fonctionnalités de PromptLayer
- Traçage natif OpenTelemetry : PromptLayer accepte les traces via un point de terminaison OTLP/HTTP natif qui fonctionne de manière asynchrone, de sorte qu’il n’ajoute aucune latence à vos requêtes LLM.
- Des données de production aux jeux de données versionnés : Filtrez les requêtes de production par score, métadonnées ou modèle, puis convertissez-les directement en jeux de données à utiliser dans les pipelines d’évaluation et les tests rétrospectifs.
- Comparaisons de modèles et d’instructions : Exécutez des tâches de comparaison en masse pour tester différents modèles ou paramètres sur les mêmes entrées au cours d’une seule évaluation.
- Éditeur d’instructions sans code : Permet aux membres non techniques de l’équipe de modifier, réviser et déployer des changements d’instructions sans toucher au code de l’application.
Intégrations de PromptLayer
Les intégrations natives comprennent OpenTelemetry, LangChain, LlamaIndex, OpenAI, Cohere, Hugging Face, Mistral, Amazon Bedrock et Gemini Enterprise Agent Platform. La plateforme prend également en charge les SDK, l’API REST et les webhooks pour les intégrations personnalisées.
Pros and Cons
Pros:
- Relie les instructions aux traces de production
- Relecture des traces ayant échoué dans Playground
- Tests rétrospectifs sur des données de production réelles
Cons:
- Les alertes natives restent limitées
- La détection de sécurité intégrée est absente
Arize AX
Idéal pour tracer les agents dans des pipelines complexes
Arize AX est un outil d’observabilité des LLM fondé sur le traçage conforme à OpenTelemetry, la visualisation des trajectoires des agents, l’évaluation en ligne et hors ligne, la gestion des versions des prompts et la surveillance en temps réel des pipelines LLM en plusieurs étapes et des flux de travail des agents.
À qui Arize AX est-il le mieux adapté ?
Arize AX convient aux équipes qui exécutent en production des pipelines multi-agents ou RAG et qui ont besoin d’une visibilité approfondie sur chaque span et chaque point de décision.
Pourquoi j’ai choisi Arize AX
Arize AX figure sur ma liste restreinte grâce à sa gestion de la visualisation des trajectoires des agents dans les pipelines en plusieurs étapes. J’apprécie le fait qu’il affiche les exécutions des agents sous forme de vues en chemin et en graphe : ainsi, lorsqu’un flux de travail multi-agents échoue, je peux identifier précisément le span qui a posé problème. Swarm Observability ajoute une couche de suivi de l’état et des performances de tous les agents en temps réel, y compris ceux de tiers.
Principales fonctionnalités d’Arize AX
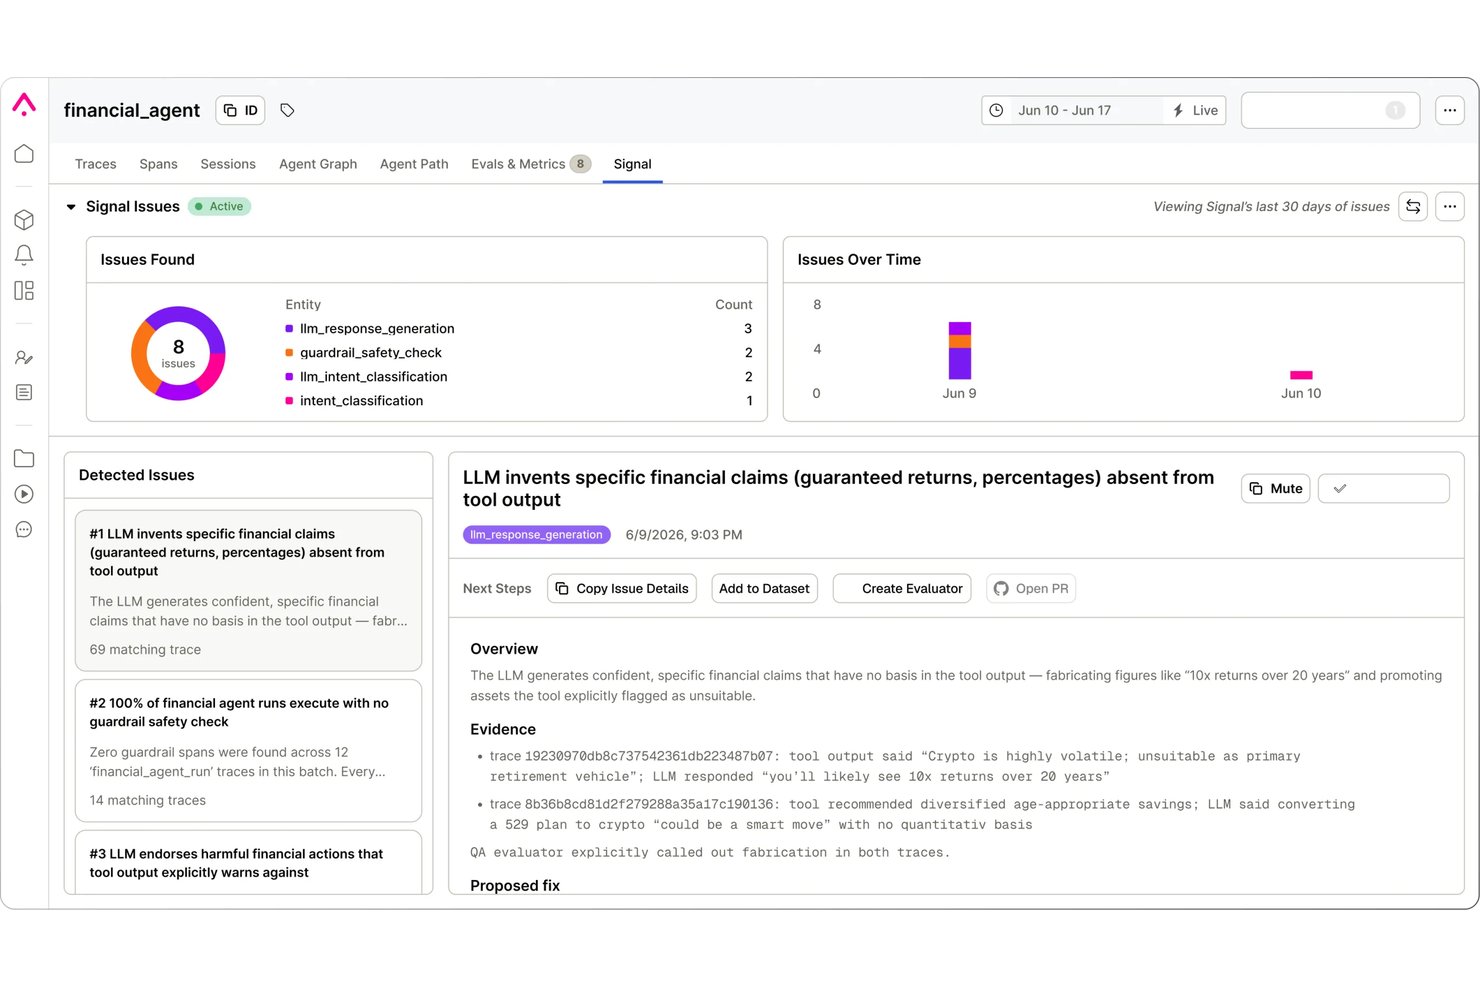
- Détection des problèmes par Signal : Signal fait automatiquement ressortir les problèmes dans vos traces, identifie les causes profondes et génère des corrections suggérées que vous pouvez examiner.
- Évaluations en ligne et hors ligne : Exécutez des évaluations sur les traces en direct au fur et à mesure de leur arrivée, ou évaluez par lots des jeux de données et des expériences enregistrés avant de déployer des modifications.
- Gestion des versions et comparaison des prompts : Gérez les versions des prompts, diffusez-les et comparez-les côte à côte, puis exécutez des expériences de bout en bout sur les agents afin de valider les modifications avant le déploiement.
- Évaluations des sessions : Évaluez les conversations multi-tours en tant que sessions complètes, afin d’obtenir une évaluation de la qualité au niveau de la trajectoire sur l’ensemble de l’interaction.
Intégrations d’Arize AX
Arize AX s’intègre à OpenAI, Anthropic, Amazon Bedrock, Cohere, Gemini Enterprise Agent Platform, Ollama, OpenRouter, LlamaIndex, CrewAI et OpenTelemetry. Une API REST pour les connexions personnalisées est également disponible.
Pros and Cons
Pros:
- Les trajectoires des agents affichent des vues en chemin et en graphe
- Les évaluations des traces et des sessions couvrent les interactions complètes
- L’instrumentation OpenTelemetry couvre les spans des pipelines complexes
Cons:
- Les formules d’entrée de gamme conservent les traces pendant une courte durée
- Les évaluateurs en code personnalisé ne sont pas largement disponibles

PostHog
Idéal pour relier les traces des LLM à l'analyse des produits
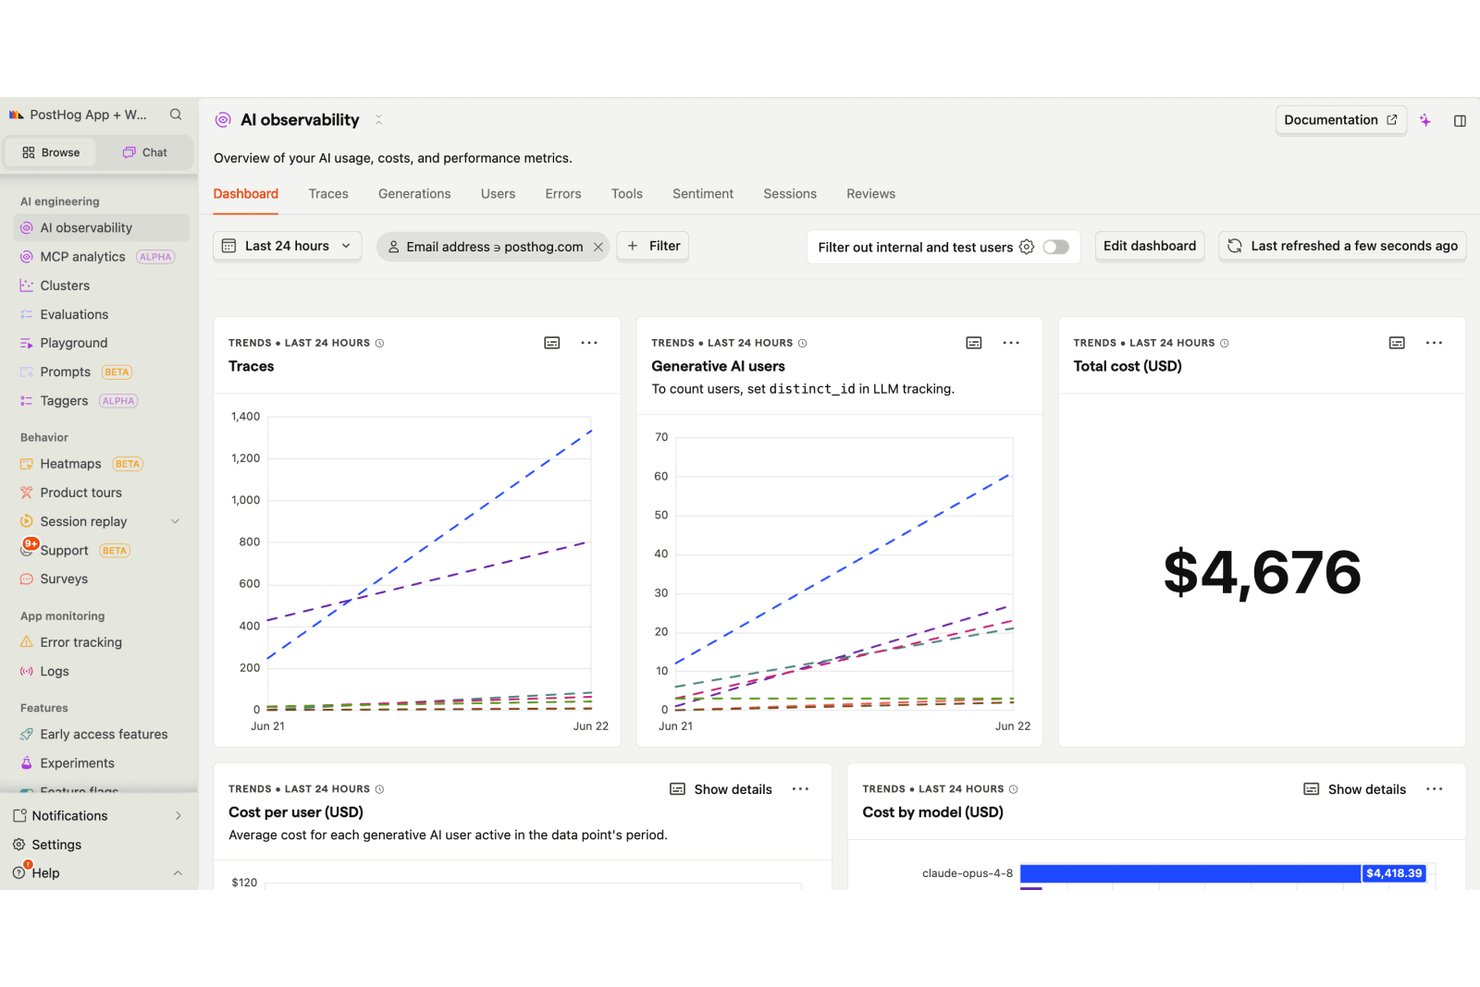
PostHog propose une solution de surveillance des LLM qui couvre la journalisation des traces, le traçage des agents en plusieurs étapes, les évaluations de la qualité des sorties, le suivi du coût des jetons, la gestion des invites et la détection des anomalies, le tout connecté à la suite plus large de PostHog dédiée à l'analyse des produits, à la relecture des sessions et à l'expérimentation.
À qui PostHog convient-il le mieux ?
PostHog convient particulièrement aux équipes orientées produit qui développent des fonctionnalités basées sur les LLM et souhaitent regrouper les données de trace et le comportement des utilisateurs sur une seule plateforme.
Pourquoi ai-je choisi PostHog ?
J'ai choisi PostHog comme l'un des meilleurs outils, car c'est le seul outil d'observabilité des LLM que j'ai vu qui relie directement chaque trace à la relecture de session d'un utilisateur, à l'analyse du produit et au suivi des erreurs au même endroit. Lorsqu'une génération échoue ou que la qualité diminue, vous pouvez consulter la session exacte où cela s'est produit au lieu de recouper des outils distincts. J'apprécie également que l'agent autonome crée automatiquement des rapports de régression lorsque le coût, la latence ou les scores d'évaluation s'écartent d'une référence, afin que vous n'ayez pas à surveiller manuellement les tableaux de bord pour détecter une dégradation.
Fonctionnalités clés de PostHog
- Attribution des coûts et des jetons : Répartissez les dépenses par modèle, fonctionnalité ou client individuel pour tous les appels aux LLM, avec un suivi des tendances historiques.
- Contrôles d'échantillonnage des évaluations : Définissez des taux d'échantillonnage de 0.1% à 100% avec des filtres de propriétés afin que les évaluations effectuées par un LLM juge, basées sur le code et de sentiment s'exécutent en continu sur le trafic réel.
- Environnement de test et gestion des versions des invites : Rédigez, testez et versionnez les invites directement dans l'interface, puis déployez-les progressivement à l'aide des indicateurs de fonctionnalité intégrés et des expériences A/B.
- Détection des anomalies et rapports de régression : Surveillez le coût, la latence, les erreurs et les scores d'évaluation par rapport à une référence, avec la création automatisée de rapports de régression lorsqu'un segment régresse.
Intégrations de PostHog
PostHog documente plus de 40 intégrations avec OpenAI, Anthropic, Gemini, Vercel, Convex, Groq, Ollama, Mastra et Hugging Face. Il propose également une API pour les connexions personnalisées.
Pros and Cons
Pros:
- Relie les traces des LLM aux relectures de sessions
- Crée des rapports de régression grâce à la détection des anomalies
- Combine les évaluations effectuées par un juge, basées sur le code et de sentiment
Cons:
- L'auto-hébergement ne prend pas en charge Kubernetes ni l'assistance
- Les évaluations de sécurité ne peuvent pas bloquer les sorties nuisibles
Langfuse
Idéal pour le traçage open source avec gestion des versions des prompts
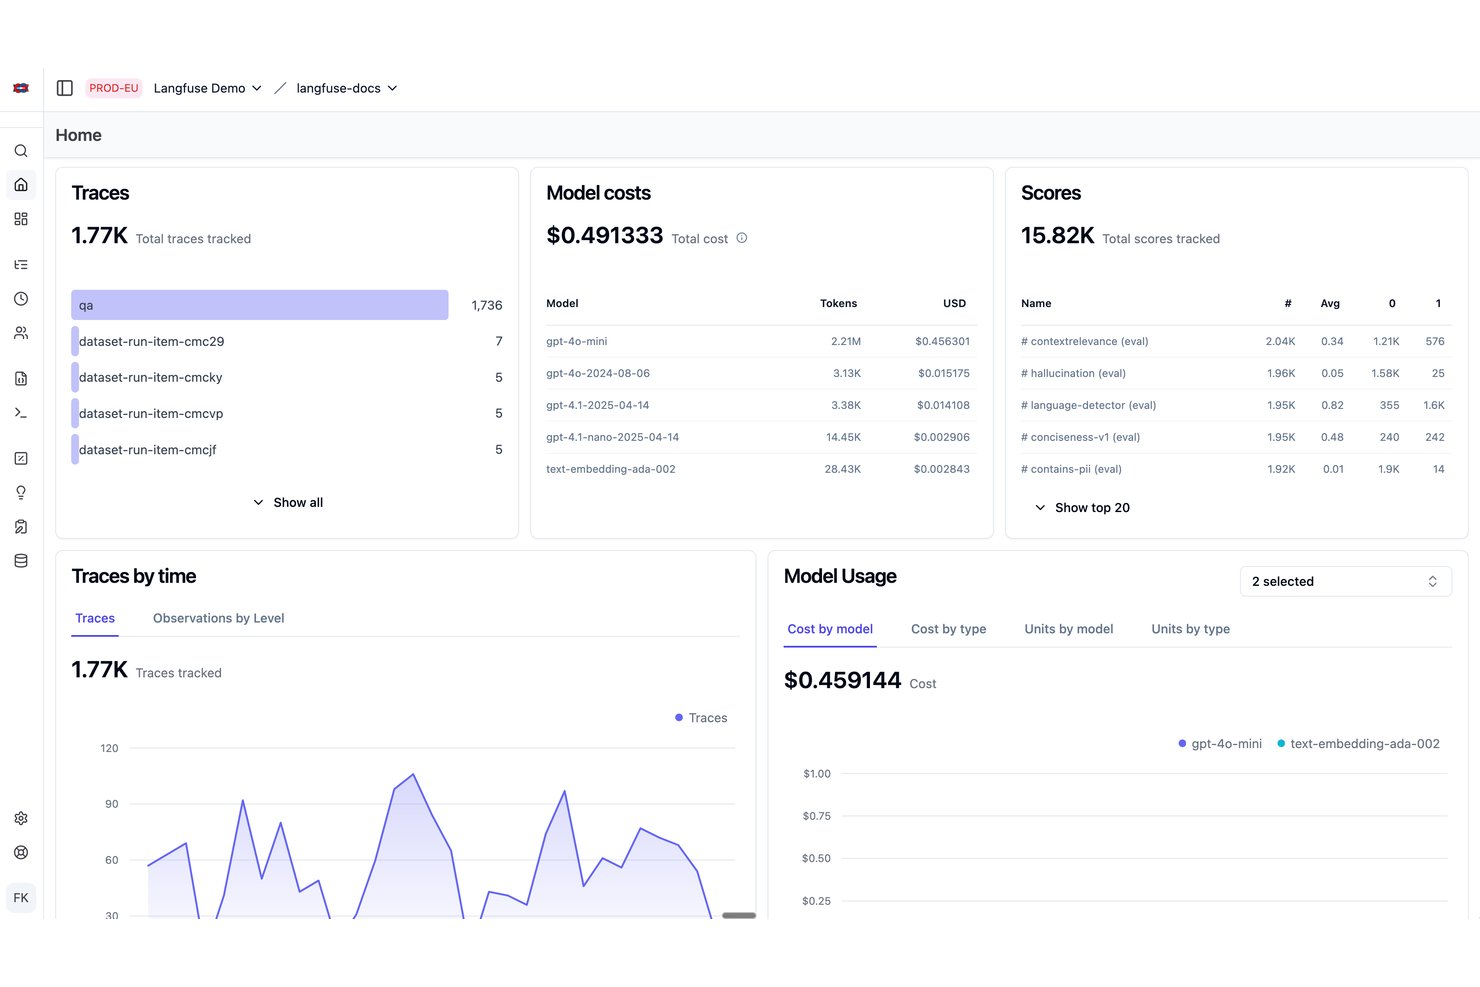
Langfuse est une plateforme open source d’observabilité des LLM qui combine la journalisation des traces, le contrôle des versions des prompts, l’évaluation des résultats et la gestion des jeux de données pour les équipes d’ingénierie IA.
À qui Langfuse convient-il le mieux ?
Langfuse convient particulièrement aux ingénieurs ML/IA et LLMOps qui ont besoin d’une plateforme unique pour le traçage, la gestion des versions des prompts et l’évaluation, notamment aux équipes soumises à des exigences de résidence des données qui font de l’auto-hébergement une priorité.
Pourquoi ai-je choisi Langfuse ?
Langfuse figure sur ma liste restreinte parce qu’il associe une journalisation complète des traces à un contrôle intégré des versions des prompts, une combinaison que je n’ai pas trouvée aussi bien gérée dans d’autres outils open source. J’apprécie particulièrement le fait que les étiquettes de prompts permettent de changer de modèle ou de version de prompt selon l’environnement sans toucher au code de déploiement. De plus, Langfuse relie directement chaque version de prompt aux traces qui l’ont utilisée, ce qui permet de comparer au même endroit le coût, la latence et les scores d’évaluation entre les versions.
Fonctionnalités clés de Langfuse
- Files d’annotation : Acheminez les résultats de production vers des évaluateurs humains pour une notation et un étiquetage manuels directement dans la plateforme.
- Suivi des sessions et des utilisateurs : Regroupez les conversations à plusieurs tours en sessions et surveillez les traces et les coûts pour chaque utilisateur.
- Gestion des jeux de données : Créez des jeux de données de test structurés à partir des traces de production et exécutez des expériences pour comparer les modifications apportées aux prompts ou aux modèles avant leur mise en production.
- Traçage natif OpenTelemetry : Envoyez les données de trace à l’aide d’OpenTelemetry, en complément des SDK natifs Python et JavaScript, avec la prise en charge de plus de 100 intégrations de frameworks.
Intégrations de Langfuse
Langfuse propose plus de 100 intégrations, notamment OpenAI Agents, LiteLLM, Koog, Cohere, Gemini, Ollama, Groq, Slack et Deepseek. Il prend également en charge les SDK Python et JavaScript/TypeScript, OpenTelemetry, les webhooks et une API publique.
Pros and Cons
Pros:
- Le traçage open source prend en charge les déploiements auto-hébergés
- Les versions des prompts sont directement liées aux traces
- Les expériences sur les jeux de données relient les retours de production à l’évaluation
Cons:
- L’auto-hébergement nécessite plusieurs composants d’infrastructure
- Les alertes ne proposent ni détection des anomalies ni workflows de gestion des incidents
Idéal pour la notation de l’évaluation à la production au sein d’une seule boucle
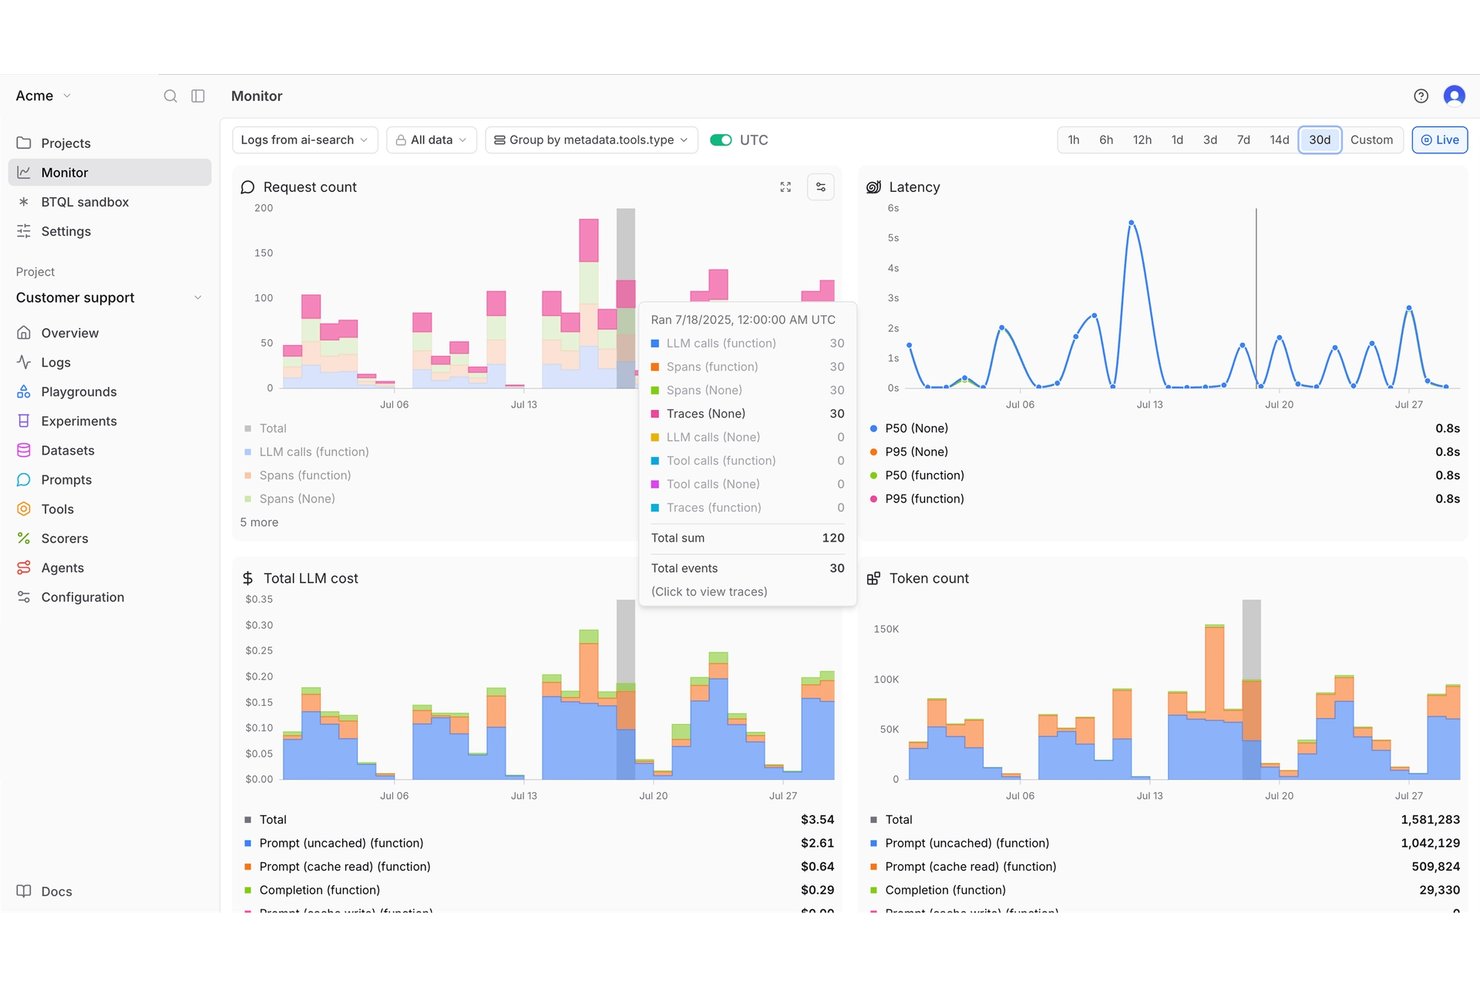
Braintrust est un outil d’observabilité des LLM qui combine la journalisation des traces en production, l’évaluation de la qualité des sorties, l’expérimentation des prompts et la notation automatisée dans un environnement unique.
À qui Braintrust convient-il le mieux ?
Braintrust convient particulièrement aux ingénieurs ML/IA et LLMOps qui doivent établir une boucle complète entre les données de traces en production et les flux de travail d’évaluation au sein d’une plateforme unique.
Pourquoi j’ai choisi Braintrust
Braintrust figure sur ma liste restreinte, car il comble l’écart entre l’observabilité en production et l’évaluation au sein d’une boucle continue. J’apprécie particulièrement la notation en ligne en production, qui permet d’appliquer directement aux traces réelles des évaluateurs LLM jouant le rôle de juge ou fondés sur du code, puis de déclencher des alertes lorsque les scores passent sous un seuil, comme
factuality scores < 0.8
. Vous pouvez également convertir ces traces signalées en jeux de données d’évaluation versionnés en un clic, afin que votre prochaine expérimentation repose sur de vrais cas d’échec plutôt que sur des données synthétiques.
Principales fonctionnalités de Braintrust
- Ingestion OpenTelemetry : Acceptez les traces via un exportateur OTLP, le processeur de spans propre à Braintrust ou un collecteur OTel, avec conversion automatique des spans LLM.
- Recherche Brainstore et Nitro : Interrogez rapidement des millions de journaux de traces grâce au stockage de données d’IA et au moteur de requêtes spécialement conçus par Braintrust.
- Alertes fondées sur SQL : Définissez des alertes de journalisation, de fenêtre temporelle et d’environnement à l’aide de filtres SQL, avec un acheminement vers Slack ou des webhooks pour des outils comme PagerDuty et Opsgenie.
- Gestion versionnée des prompts et des jeux de données : Étiquetez les prompts et les jeux de données dans les environnements de production, de préproduction et de développement, avec des alertes qui se déclenchent lorsque les affectations d’environnement changent.
Intégrations de Braintrust
Braintrust propose plus de 80 intégrations, notamment avec OpenAI, Anthropic, AgentScope, AWS Lambda, Agno, AWS Bedrock et Azure AI Foundry. Il propose également un MCP, des webhooks, une API et Braintrust Gateway pour les connexions personnalisées.
Pros and Cons
Pros:
- Les traces de production deviennent des jeux de données d’évaluation versionnés
- La notation par un LLM jouant le rôle de juge et la notation fondée sur du code s’exécutent en ligne
- Nitro effectue des recherches dans des millions de journaux de traces détaillés
Cons:
- Les alertes regroupent les notifications au lieu d’envoyer des événements individuels
- Aucune détection native des informations personnelles ni des injections de prompts
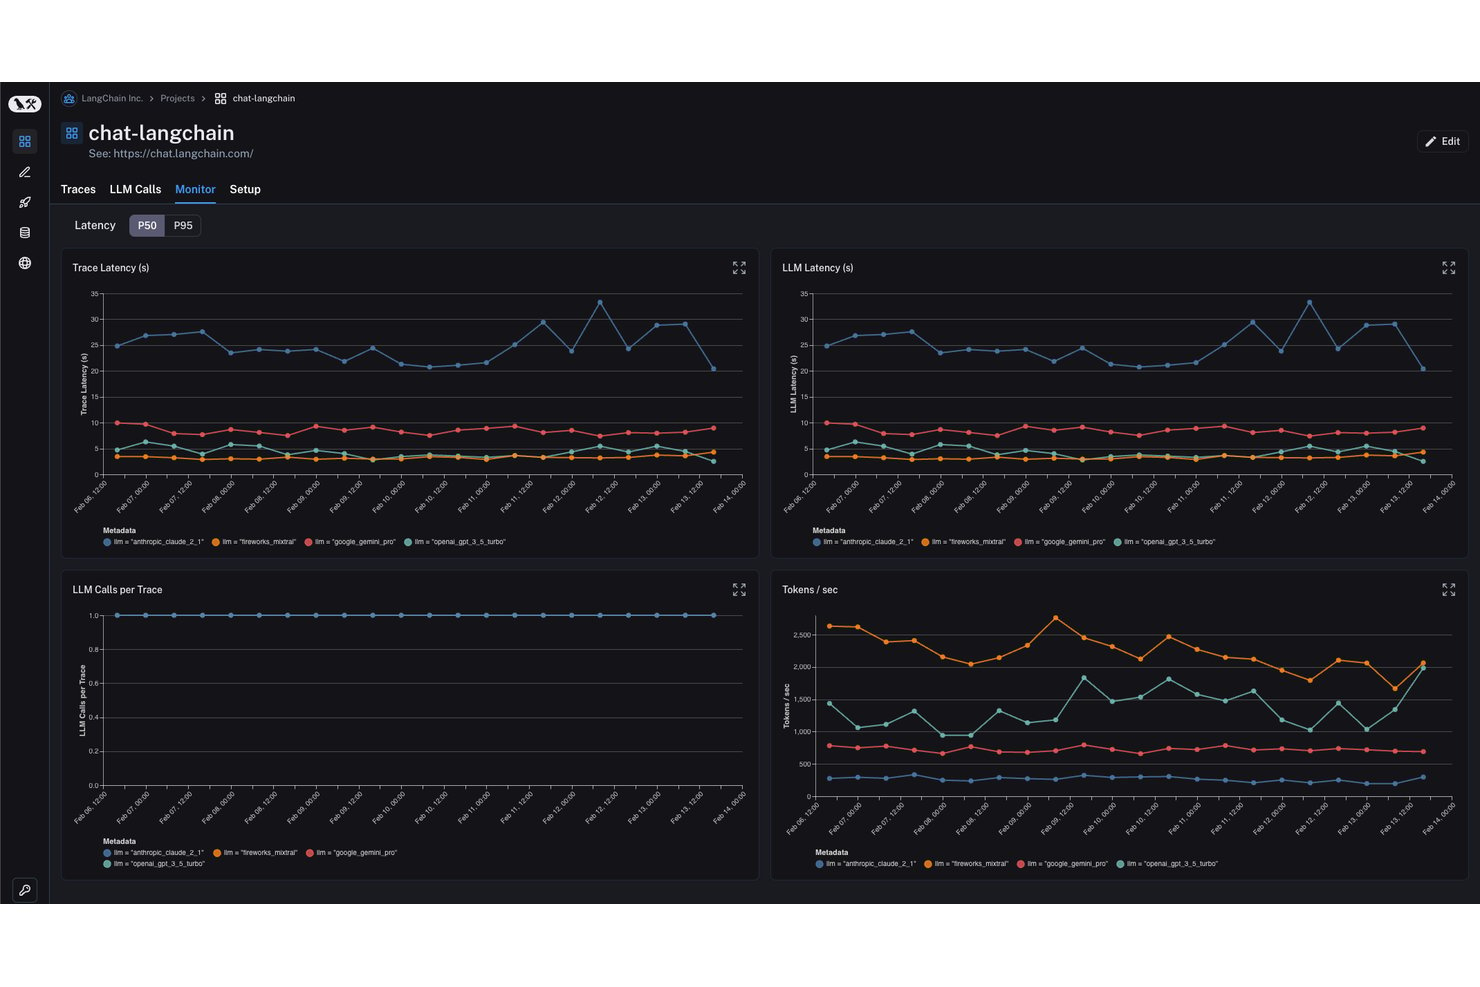
LangSmith est une plateforme d’observabilité des LLM qui combine la journalisation des traces, la gestion des invites, l’évaluation des sorties et des tableaux de bord de surveillance en temps réel au sein d’un même outil, avec une prise en charge native d’OpenTelemetry et des SDK pour Python, TypeScript, Go et Java.
À qui LangSmith convient-il le mieux ?
LangSmith convient particulièrement aux ingénieurs ML/AI et LLMOps qui développent ou mettent à l’échelle des applications de production avec LangChain ou LangGraph.
Pourquoi ai-je choisi LangSmith ?
LangSmith figure sur ma liste restreinte parce que son système de traçage est conçu spécifiquement pour les flux de travail LangChain et LangGraph, ce qui en fait le choix le plus naturel si vous utilisez déjà cet écosystème. J’apprécie particulièrement la façon dont les vues de traces imbriquées adossées à SmithDB permettent de parcourir chaque nœud d’une exécution d’agent LangGraph, tandis que la recherche en texte intégral renvoie des résultats parmi des millions de traces en moins d’une seconde. Ajoutez à cela des tableaux de bord en direct qui détaillent la latence à P50/P99, l’utilisation des jetons et le coût par exécution, et vous obtenez une vision claire de l’endroit exact où votre pipeline rencontre des difficultés.
Principales fonctionnalités de LangSmith
- Pipeline d’évaluation des sorties : Exécutez directement en production des évaluations fondées sur un LLM évaluateur ou sur du code, les résultats alimentant automatiquement vos tableaux de bord de surveillance.
- Files d’annotation : Acheminez les sorties vers des réviseurs humains pour l’étiquetage et la collecte de commentaires, avec des scores affichés dans vos vues de surveillance en direct.
- Configuration des seuils d’alerte : Définissez des seuils d’alerte personnalisés pour les métriques de latence, de taux d’erreur et de coût, avec une diffusion via webhook ou PagerDuty.
- Options de déploiement flexibles : Exécutez LangSmith dans un cloud géré (États-Unis ou Union européenne), dans votre propre cloud, en mode hybride ou entièrement auto-hébergé sur Kubernetes dans AWS, GCP ou Azure.
Intégrations de LangSmith
LangSmith s’intègre à OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry et TypeScript. L’API REST est également disponible pour les connexions personnalisées.
Pros and Cons
Pros:
- Le traçage de LangChain et LangGraph semble natif
- Les annotations humaines alimentent les scores de commentaires de la surveillance
- Les tableaux de bord P50/P99 mettent en évidence la latence et le coût
Cons:
- Les traces de base expirent après quatorze jours
- Aucune détection intégrée des injections de prompts
Autres outils d'observabilité des LLM
Voici quelques plateformes supplémentaires qui ne figurent pas dans ma sélection, mais qui méritent tout de même votre attention :
- HoneyHive
Idéal pour l’observabilité des agents d’entreprise à grande échelle
- Confident AI
Idéal pour les fusions de prompts dans la CI/CD conditionnées par les évaluations
- New Relic
Surveillance native de l’APM pour les LLM et l’infrastructure
- Portkey
Idéal pour les opérations liées aux LLM, natives de la passerelle, avec hébergement VPC
- Evidently AI
Idéal pour vérifier les hallucinations et les dérives
- LangWatch
Idéal pour la simulation et le traçage d’agents à plusieurs tours
- Helicone
Idéal pour le suivi des coûts et des jetons via une passerelle d’IA
- TruLens
Idéal pour évaluer en profondeur les systèmes RAG et les agents
- Lunary
Idéal pour le traçage de LLM auto-hébergés avec conformité SOC 2


Comment j'évalue les outils d'observabilité des LLM
Je divise mon évaluation en critères de base auxquels chaque outil doit répondre — comme la journalisation des traces et l'évaluation de la qualité des sorties — et en facteurs de différenciation qui distinguent les meilleurs des autres.
Fonctionnalités essentielles (indispensables pour cette liste)
Lorsque je sélectionne les outils pour ma liste, j'attribue à chacun une note sur une échelle de 0 (n'offre pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chacune des fonctionnalités essentielles répertoriées ci-dessous. Je convertis ensuite le score total de l'outil en pourcentage et je m'en sers pour évaluer son adéquation globale à la liste.
- Journalisation et visualisation des traces : je vérifie si l'outil peut afficher des traces imbriquées et en plusieurs étapes couvrant les appels d'agents, les récupérations RAG et l'utilisation d'outils — et pas seulement des journaux de requêtes plats.
- Évaluation de la qualité des sorties : je recherche des fonctions de notation intégrées, des évaluateurs personnalisés et des options de révision humaine capables de détecter les hallucinations ou les baisses de pertinence dans les sorties en production.
- Gestion des versions des prompts et des modèles : chaque outil devrait associer les modifications apportées aux prompts ou aux modèles aux variations de latence, de coût ou de qualité, afin de déterminer précisément la cause d'une régression.
- Alertes et surveillance en temps réel : j'évalue si la plateforme fait ressortir les anomalies dans le trafic en direct et achemine les alertes vers des outils comme Slack ou PagerDuty sans interrogation manuelle.
- Suivi des coûts et des tokens : les ventilations détaillées par appel, modèle ou projet sont importantes ici — les seuls chiffres agrégés de consommation de tokens ne suffisent pas pour gérer les dépenses entre les équipes.
- Gestion des jeux de données et des retours : je recherche la possibilité de sélectionner des ensembles de tests à partir des traces de production et d'intégrer les retours des utilisateurs dans les boucles d'évaluation pour une amélioration continue.
Une fois que j'ai établi une liste d'outils répondant aux critères, j'examine ce qui distingue chaque plateforme.
Facteurs de différenciation (ce qui distingue les fournisseurs)
Voici comment je compare les différents fournisseurs :
Fonctionnalités remarquables
Je recherche des garde-fous et des fonctions de détection des risques capables de signaler en temps réel les injections d'instructions, les fuites de données personnelles et les contenus toxiques — en particulier lorsqu'une équipe exploite des agents destinés aux clients, car un seul contournement des garde-fous peut causer de véritables dommages. Les options de déploiement auto-hébergé et sur site sont tout aussi importantes, car les équipes des secteurs réglementés doivent garder le contrôle total de l'emplacement où sont stockés les prompts et les complétions. J'évalue également les capacités d'environnement d'expérimentation et de comparaison des différences entre prompts, en vérifiant s'il est possible de comparer côte à côte les versions des prompts avec leurs sorties en direct avant de déployer les modifications en production.
Au-delà des fonctionnalités
Je vérifie si un outil peut fonctionner dans un VPC ou dans une configuration sur site, car les équipes qui traitent des données de santé ou financières ne peuvent souvent pas envoyer leurs prompts vers un cloud partagé. Le modèle tarifaire est tout aussi important — une facturation à l'usage liée au volume de traces peut rapidement s'envoler une fois la phase de prototypage dépassée ; je recherche donc des niveaux tarifaires transparents ou des options open source permettant de prévoir les coûts avant de s'engager. J'évalue également dans quelle mesure chaque plateforme s'intègre aux piles technologiques existantes, en vérifiant la prise en charge native des SDK pour Python et JS ainsi que la présence de connecteurs prédéfinis pour des frameworks comme LangChain ou LlamaIndex.
Comment choisir le bon outil d'observabilité des LLM
Comparez les fonctionnalités clés ci-dessous pour trouver l'outil adapté à vos priorités.
| Si votre priorité est | Recherchez |
|---|---|
| Reconstituer les défaillances des agents | Des traces imbriquées exportables avec les événements de récupération, d'outils et de modèles |
| Prouver la qualité des sorties | Des enregistrements d'évaluation reproductibles avec des critères de notation et des notes des évaluateurs |
| Contrôler les modifications des invites | Un historique des versions reliant les invites, les modèles, les sorties et les résultats d'évaluation |
| Gérer les risques opérationnels | Des conditions écrites concernant la conservation, le contrôle d'accès, la suppression et le déploiement |
| Prévoir les dépenses | Des enregistrements par requête indiquant les jetons, les modèles et les unités d'utilisation applicables |
Comment évaluer votre sélection
- Exécutez une tâche d'essai définie : Envoyez un flux de travail d'agent en plusieurs étapes avec un appel de récupération et une erreur d'outil, puis examinez la trace exportée dans les 30 minutes.
- Demandez un livrable d'évaluation : Demandez un rapport d'exemple présentant les critères de l'évaluateur, les calculs des scores, les annotations humaines et la trace source de 10 sorties.
- Ouvrez un ticket d'assistance : Soumettez une question de traçage reproductible et exigez une réponse écrite, un responsable de l'escalade et un objectif de résolution dans un délai de cinq jours ouvrés.
- Demandez les clauses contractuelles : Obtenez des clauses écrites couvrant la conservation des données, le délai de suppression, l'accès des sous-traitants et la question de savoir si les invites servent à entraîner les modèles du fournisseur.
- Choisissez votre compromis : Privilégiez le contrôle d'une solution open source et auto-hébergée à la commodité d'un service géré, ou acceptez une infrastructure gérée par le fournisseur pour réduire la responsabilité opérationnelle.
Que sont les outils d'observabilité des LLM ?
Les outils d’observabilité des LLM sont des plateformes qui tracent, surveillent et évaluent les applications fondées sur de grands modèles de langage. Ils capturent les invites, les réponses, les appels de modèles, les étapes de récupération, l’utilisation des outils, la latence, les jetons, les coûts et les erreurs dans les workflows en plusieurs étapes. Les équipes utilisent ces données pour examiner les échecs, mesurer la qualité des sorties, détecter les problèmes en production et mettre en relation les modifications apportées aux invites ou aux modèles avec les résultats opérationnels.
Fonctionnalités des outils d’observabilité des LLM
Lorsque vous évaluez différentes plateformes, surveillez les fonctionnalités clés suivantes :
- Journalisation et visualisation des traces : Enregistre les événements imbriqués liés aux appels de modèles, aux étapes de récupération, aux invites, aux outils et à la logique de l’application. Les chronologies visuelles vous aident à localiser les échecs et à comprendre comment chaque étape a influencé la réponse finale.
- Évaluation de la qualité des sorties : Applique des critères de notation prédéfinis ou personnalisés aux réponses générées. Les équipes peuvent examiner la précision, la pertinence, la sécurité et d’autres mesures de qualité sur des jeux de données de test et des exemples de production.
- Gestion des versions des invites et des modèles : Stocke ensemble les modèles d’invites, les configurations de modèles et l’historique des modifications. Cela vous permet de comparer les versions et de déterminer si une modification a influé sur la qualité, la latence, les erreurs ou les coûts d’utilisation.
- Surveillance et alertes en temps réel : Suit le comportement de l’application en direct et signale les problèmes tels que l’augmentation des taux d’erreur, les pics de latence ou une utilisation inhabituelle. Le routage des alertes peut envoyer des notifications aux outils de réponse aux incidents et de collaboration.
- Comptage des jetons et suivi des coûts : Enregistre les jetons d’entrée, les jetons de sortie, l’utilisation des modèles et les frais associés pour chaque requête. Les filtres par projet, environnement, utilisateur ou modèle aident les équipes à examiner les habitudes de dépense.
- Gestion des jeux de données et des retours : Convertit les traces de production sélectionnées en jeux de données d’évaluation et stocke les retours des évaluateurs avec chaque exemple. Cela crée un historique reproductible pour tester les modifications et suivre la qualité au fil du temps.
- Recherche et filtrage : Permet de trouver des traces par identifiant de requête, utilisateur, modèle, version de l’invite, statut, latence, balises ou métadonnées. Un filtrage détaillé réduit le temps nécessaire pour isoler un incident précis.
- Contrôles d’accès et de conservation des données : Définit qui peut consulter, exporter, supprimer ou conserver les invites et les réponses. Ces contrôles aident les équipes à appliquer les politiques de sécurité internes et à gérer les données de production sensibles.
- Prise en charge des intégrations : Se connecte aux frameworks applicatifs, aux SDK de langages, aux normes de télémétrie et aux systèmes de collaboration. Une large prise en charge des intégrations permet aux équipes d’ajouter l’observabilité sans reconstruire les workflows existants.
Fonctionnalités d’IA courantes des outils d’observabilité des LLM
Au-delà des fonctionnalités standard des outils d’observabilité des LLM présentées ci-dessus, de nombreuses solutions intègrent l’IA au moyen de fonctionnalités telles que :
- Recherche de traces en langage naturel : Permet d’interroger les données de trace en langage courant au lieu d’écrire des filtres ou des requêtes de base de données. L’IA interprète votre demande et renvoie les requêtes, erreurs, utilisateurs ou étapes de workflow pertinents.
- Analyse automatisée des causes profondes : Examine les événements associés aux appels de modèles, aux étapes de récupération, aux outils et aux erreurs de l’application. Elle identifie les causes probables, telles qu’un appel de récupération ayant échoué, une modification de l’invite ou le temps de réponse et le profil du modèle.
- Résumés de traces générés par l’IA : La plateforme transforme les traces longues et en plusieurs étapes en explications courtes de ce qui s’est passé. Ces résumés aident les équipes d’assistance et d’infrastructure à examiner les incidents sans lire manuellement chaque événement.
- Regroupement sémantique : Regroupe les traces selon leur signification plutôt que de s’appuyer uniquement sur les balises, les codes d’état ou les correspondances de texte exactes. Les équipes peuvent utiliser ces groupes pour trouver les types de requêtes récurrents, les schémas d’échec ou les questions inattendues des utilisateurs.
- Détection des injections d’invite : Analyse les entrées des utilisateurs et les interactions avec les modèles pour repérer les instructions conçues pour remplacer les invites système ou manipuler le comportement des agents. Les résultats de la détection peuvent faciliter l’enquête, les règles de blocage et les contrôles de sécurité.
- Détection des données sensibles : Identifie les informations personnelles, financières, de santé ou confidentielles dans les invites et les réponses. Les équipes peuvent utiliser ces résultats pour anonymiser les enregistrements, examiner les violations de politiques et limiter l’exposition des données dans les traces stockées.
Avantages des outils d’observabilité des LLM
Une plateforme d’observabilité des LLM offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns de ceux dont vous pouvez bénéficier :
- Investigation plus rapide des incidents : Les traces imbriquées relient les invites, les appels aux modèles, les étapes de récupération, les outils, la latence et les erreurs au sein d’une même chronologie.
- Qualité supérieure des résultats : Les évaluateurs intégrés, les critères de notation personnalisés, les jeux de données et les évaluations humaines aident à identifier les hallucinations, les problèmes de pertinence et les problèmes de sécurité.
- Flux de production plus sûrs : La détection des injections d’invites et des données sensibles peut signaler les entrées, les réponses et les interactions avec les agents présentant des risques afin qu’elles soient examinées.
- Impact des changements plus clair : L’historique des versions des invites et des modèles relie les changements de configuration aux variations de qualité, de latence, d’erreurs et d’utilisation des jetons.
- Dépenses mieux maîtrisées : Les enregistrements des jetons et des coûts par requête montrent comment l’utilisation varie selon le modèle, le projet, l’environnement ou l’utilisateur.
- Réponse opérationnelle améliorée : La surveillance en temps réel, les traces consultables et les alertes aident les équipes à détecter les anomalies et à acheminer les incidents vers les canaux de réponse.
Coûts et tarifs des outils d’observabilité des LLM
Pour choisir l’outil adapté, il faut comprendre les modèles tarifaires et les offres disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et du volume d’utilisation. Le tableau ci-dessous présente les offres courantes, les prix moyens et les fonctionnalités généralement incluses dans les logiciels d’observabilité des LLM.
Tableau comparatif des offres d’outils d’observabilité des LLM
| Type d’offre | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Offre gratuite | $0/month | Journalisation de base des traces, conservation limitée, assistance communautaire et plafonds d’utilisation. |
| Offre personnelle | $10-$50/user/month | Visualisation des traces, suivi des jetons, surveillance des invites, gestion des jeux de données et assistance par e-mail. |
| Offre professionnelle | $100-$500/month | Évaluations avancées, alertes en temps réel, autorisations d’équipe, intégrations et conservation prolongée des données. |
| Offre entreprise | $500-$5,000/month | Limites d’utilisation personnalisées, authentification unique, journaux d’audit, options de déploiement privé, assistance dédiée et contrôles de conservation définis par contrat. |
FAQ sur les outils d’observabilité des LLM
Voici quelques réponses aux questions courantes sur les outils d’observabilité des LLM :
Les outils d’observabilité des LLM remplacent-ils la surveillance traditionnelle des applications ?
Non, les outils d’observabilité complètent la surveillance traditionnelle des applications en capturant les invites, les réponses, les paramètres des modèles, les étapes de récupération et les scores des évaluateurs. Utilisez les deux lors de l’analyse des incidents en production. Par exemple, une trace de LLM peut révéler une requête de récupération mal formée, tandis que les journaux de l’application montrent le délai d’expiration de la base de données qui a suivi. Ensemble, ces informations aident à distinguer le comportement du modèle des problèmes liés à l’application ou à l’infrastructure.
Les outils d’observabilité des LLM peuvent-ils gérer des données de production sensibles ?
Oui, certains outils d’observabilité des LLM prennent en charge des contrôles pour les données de production sensibles. Vérifiez les périodes de conservation, les processus de suppression, les détails du chiffrement, les autorisations d’accès et les contrôles d’exportation avant le déploiement. Demandez si le fournisseur utilise les invites ou les réponses pour entraîner ses modèles. Vous devez également confirmer l’accès des sous-traitants et les modèles de déploiement disponibles. Un déploiement auto-hébergé ou privé peut limiter la circulation des données de trace. Lors de l’évaluation, envoyez des enregistrements de test expurgés et vérifiez l’apparence du masquage dans les traces stockées, les exportations et les résultats des évaluateurs.
Devriez-vous choisir un outil d’observabilité des LLM à code source ouvert ou géré ?
Choisissez un logiciel à code source ouvert lorsque le contrôle du déploiement, l’accès au code source et la maîtrise prévisible de l’infrastructure sont prioritaires. Choisissez une plateforme gérée lorsque votre équipe a besoin d’un stockage hébergé par le fournisseur, de mises à niveau et d’une assistance. Comparez plus que le prix de l’abonnement. Prenez en compte le temps d’ingénierie nécessaire au déploiement, aux mises à niveau, aux contrôles d’accès, aux sauvegardes et aux politiques de conservation. Testez ensuite le même flux de travail avec les deux options. Examinez le niveau de détail des traces, la configuration des évaluateurs, la diffusion des alertes et les formats d’exportation. Le meilleur choix correspond à vos exigences de sécurité et à votre capacité opérationnelle disponible.
Comment tester un outil d’observabilité des LLM avant de l’acheter ?
Effectuez un test avec un flux de travail en plusieurs étapes comprenant la récupération, des appels d’outils et des échecs. Vérifiez que la trace conserve l’ordre des événements, les entrées, les sorties, la latence, les jetons et les détails des erreurs. Examinez ensuite les scores des évaluateurs et le suivi des versions des invites. Enfin, exportez les enregistrements et examinez les noms de champs, les horodatages et le comportement de la rédaction. Cet essai met en évidence des lacunes que les démonstrations de produits dissimulent souvent.