

Databricks contre Cloudera : comparaison et avis pour 2026
Le choix entre Databricks et Cloudera dépend de la manière dont votre équipe gère les données dans des environnements cloud et hybrides. Je compare leurs points forts, leurs compromis et les cas d’utilisation auxquels ils conviennent le mieux.

Nous évaluons les outils indépendamment ; les commissions aident à financer nos tests. Consultez notre politique de transparence et notre méthodologie.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Tarification et coûts cachés de Databricks par rapport à Cloudera
Databricks applique une tarification basée sur la consommation pour l’ingénierie des données, l’entreposage, l’IA et d’autres charges de travail, les coûts étant déterminés par l’utilisation des ressources de calcul ainsi que par l’infrastructure cloud, le stockage, la mise en réseau et l’assistance. Cloudera adopte une approche hybride : ses services cloud sont facturés à la consommation via les Cloudera Compute Units (CCU), tandis que les déploiements sur site reposent sur des abonnements annuels. Dans les deux cas, l’infrastructure et la mise en réseau peuvent augmenter le coût total au-delà des frais de la plateforme principale.
Pour comparer les deux solutions, il est utile de ne pas s’arrêter aux tarifs affichés et de déterminer où vos charges de travail seront exécutées, ainsi que la fréquence d’exécution des pipelines, des tâches de traitement en continu et des transformations. Avec Databricks, des ressources de calcul inefficaces ou exécutées pendant une longue durée, ainsi que le transfert de données, peuvent accroître les dépenses. Cloudera peut quant à elle entraîner des coûts supplémentaires liés à l’infrastructure, à la mise en réseau, à Private Link, à l’observabilité et à des services tels que Data Flow ou Lakehouse Optimizer. La prise en compte du modèle de déploiement, du volume des charges de travail, de l’assistance et des besoins de mise à l’échelle donnera une vision plus réaliste du coût à long terme.
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Intégration | Databricks | Cloudera |
|---|---|---|
| IntégrationMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntégrationAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntégrationGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntégrationTableau | Databricks✅ | Cloudera✅ |
| IntégrationInformatica | Databricks✅ | Cloudera✅ |
| IntégrationSalesforce | Databricks✅ | Cloudera✅ |
| IntégrationQlik | Databricks✅ | Cloudera✅ |
| IntégrationOracle Database | Databricks✅ | Cloudera✅ |
| IntégrationMongoDB | Databricks✅ | Cloudera✅ |
| IntégrationAPI | Databricks✅ | Cloudera✅ |
| IntégrationZapier | Databricks✅ | Cloudera❌ |
Databricks et Cloudera prennent tous deux en charge de vastes écosystèmes couvrant les plateformes cloud, les bases de données, les outils de BI, les API et les services de données. Databricks intègre ces connexions à Lakeflow, Partner Connect et ses flux de travail gérés d’ingénierie des données, tandis que Cloudera met l’accent sur la connectivité entre les environnements cloud, sur site et hybrides.
| Facteur | Databricks | Cloudera |
|---|---|---|
| FacteurChiffrement | DatabricksChiffre les données au repos et en transit, avec prise en charge des clés gérées par le client, de la gestion native des clés dans le cloud et d'une protection granulaire des données et actifs d'IA gouvernés. | ClouderaPrend en charge le chiffrement au repos et en transit, la gestion des clés et les contrôles de sécurité dans les environnements cloud et sur site. |
| FacteurContrôles d'accès | DatabricksUnity Catalog centralise les politiques d'accès granulaires aux données, modèles, applications et actifs d'IA, avec SSO, intégrations d'identité, contrôles au niveau des lignes et des colonnes, ainsi que des liaisons aux espaces de travail. | ClouderaUtilise Apache Ranger, Knox et des intégrations d'identité pour gérer l'authentification, l'autorisation, le SSO et l'accès granulaire dans les environnements hybrides. |
| FacteurConformité réglementaire | DatabricksDétient les certifications SOC 1 Type II, SOC 2 Type II, ISO 27001, ISO 27017 et ISO 27018, avec une prise en charge de la conformité HIPAA, PCI DSS, HITRUST et FedRAMP Moderate et High selon le cloud, la région et la configuration. | ClouderaMaintient des certifications et programmes comprenant SOC 2 Type II, ISO 27001, PCI DSS et FedRAMP Moderate pour les environnements Cloudera admissibles. |
| FacteurFiabilité | DatabricksPrend en charge la mise à l'échelle automatique, les capacités de calcul sans serveur et gérées, l'isolation des charges de travail et la disponibilité native du cloud sur AWS, Azure et Google Cloud, avec des stratégies de reprise configurées selon les exigences des charges de travail. | ClouderaPrend en charge les déploiements multizones, l'infrastructure redondante, le basculement et la reprise après sinistre dans les déploiements cloud et hybrides. |
| FacteurGouvernance des données | DatabricksUnity Catalog fournit l'audit, la découverte, la classification et la traçabilité centralisés et automatisés, des données sources aux notebooks, tâches, modèles, services et tableaux de bord. | ClouderaSDX combine Apache Ranger et Atlas pour appliquer des politiques, effectuer l'audit et gérer les métadonnées, la classification et la traçabilité des données cloud et sur site. |
Les deux plateformes offrent une sécurité et une gouvernance de niveau entreprise, mais l'accent diffère. Databricks réunit le contrôle des accès, l'audit, la classification et la traçabilité via Unity Catalog pour les charges de travail liées aux données et à l'IA, tandis que Cloudera étend la gouvernance centralisée aux environnements hybrides et sur site grâce à SDX, Ranger et Atlas.
| Facteur | Databricks | Cloudera |
|---|---|---|
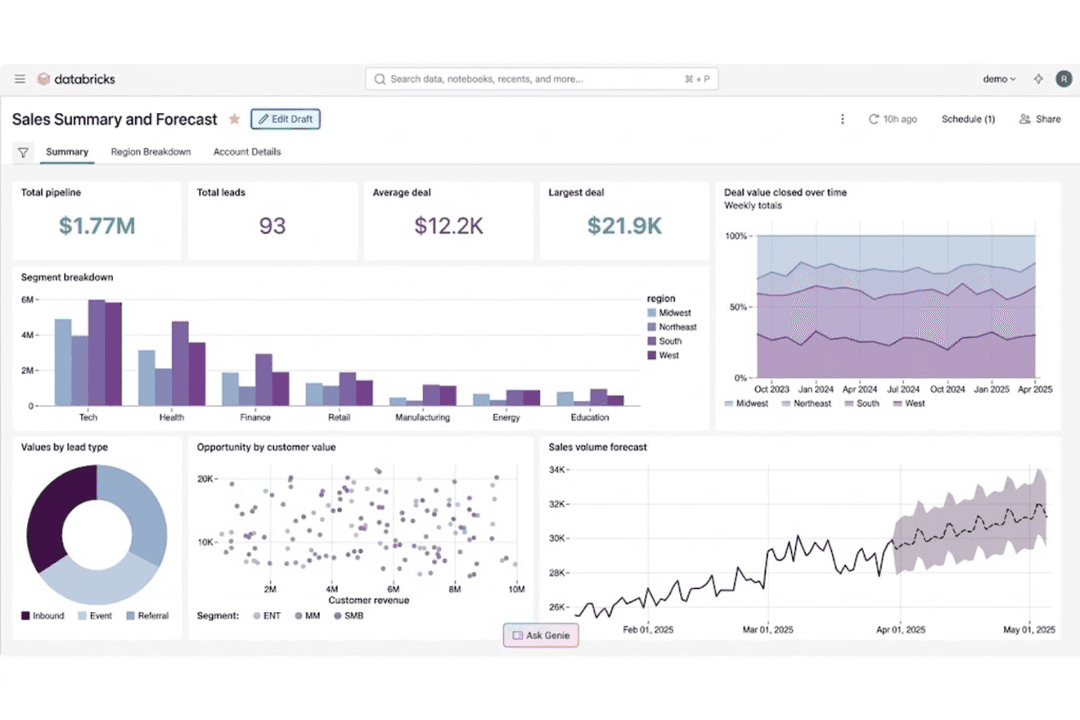
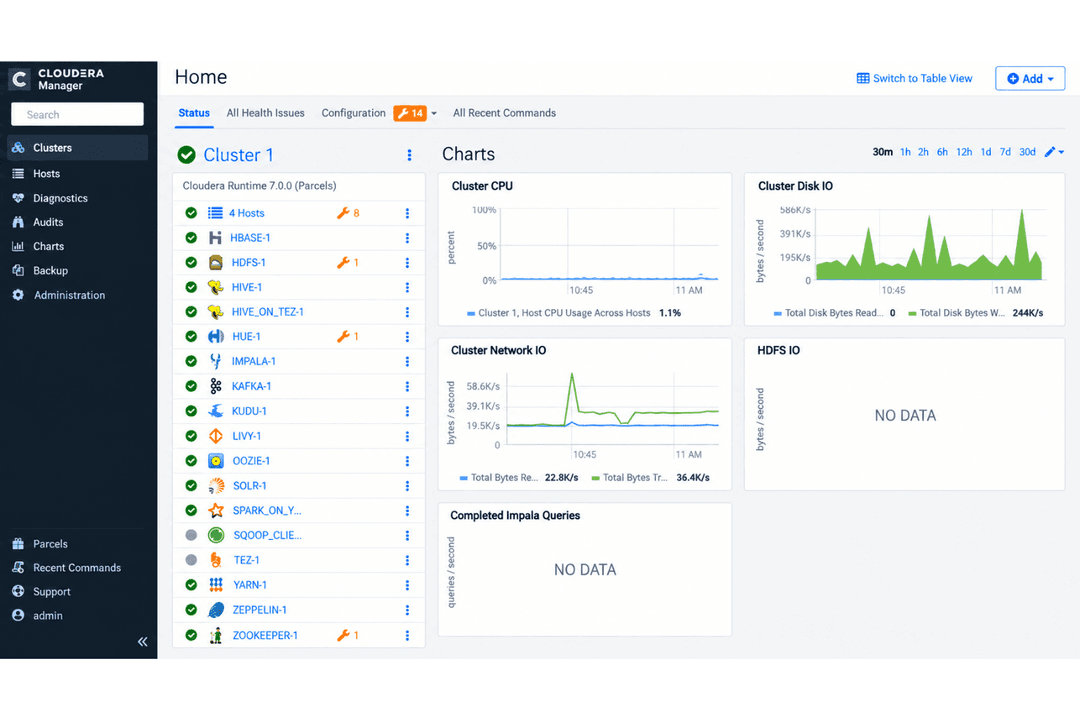
| FacteurInterface utilisateur | DatabricksCombine des notebooks collaboratifs, des outils SQL, des tableaux de bord et des flux de travail visuels dans un seul espace de travail pour les équipes d'ingénierie, d'analyse et d'IA. | ClouderaUtilise des consoles d'administration et des interfaces propres à chaque service pour gérer les données et l'infrastructure hybride. |
| FacteurProcessus de configuration | DatabricksLes espaces de travail cloud peuvent être provisionnés rapidement, tandis que les capacités de calcul sans serveur et gérées réduisent la configuration de l'infrastructure pour les charges de travail courantes. | ClouderaLa configuration dépend du modèle de déploiement, avec une configuration supplémentaire pour les environnements hybrides et sur site. |
| FacteurIntégration | DatabricksFournit une configuration guidée, des notebooks d'exemple, des formations et des services gérés qui aident les équipes à passer de l'expérimentation initiale à des flux de travail de production gouvernés. | ClouderaRequiert une bonne connaissance de son écosystème étendu, en particulier lorsque les équipes travaillent avec des technologies telles que NiFi, Spark, Ranger et une infrastructure hybride. |
| FacteurDocumentation | DatabricksPropose une documentation complète, des tutoriels, des conseils de mise en œuvre et des formations couvrant l'ingénierie des données, la gouvernance, l'analyse et l'IA. | ClouderaFournit une documentation technique sur le cloud, les environnements sur site, la sécurité et l'administration de la plateforme. |
| FacteurAccès à l'assistance | DatabricksPropose des ressources publiques et une assistance payante à plusieurs niveaux, avec des contacts techniques, des procédures d'escalade et une couverture des incidents critiques pour les déploiements d'entreprise. | ClouderaInclut une assistance aux entreprises et des ressources techniques pour les offres cloud et sur site. |
Du point de vue de la facilité d'utilisation, Databricks combine un environnement de développement technique avec des services gérés qui réduisent le travail lié à l'infrastructure pour les pipelines, l'analyse et l'IA. Cloudera prend en charge les environnements cloud, sur site et hybrides, ce qui implique davantage de considérations liées au déploiement. Pour les équipes de données axées sur le cloud, Databricks fournit un flux de travail cohérent du développement à la production, tandis que Cloudera convient aux organisations qui doivent fonctionner sur une infrastructure mixte.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
Qui devrait utiliser Databricks et qui devrait utiliser Cloudera ?
Si vous recherchez une plateforme DataOps qui réunit l'ingénierie des données, l'analyse, la gouvernance et l'IA dans un même environnement axé sur le cloud, Databricks est probablement le meilleur choix. Elle est particulièrement utile pour les équipes qui souhaitent bénéficier de pipelines gérés, de notebooks collaboratifs, de la prise en charge des flux de données et d'une gouvernance centralisée sans avoir à gérer autant d'infrastructure manuellement.
Si, au contraire, vous devez exécuter des flux de travail de données dans des environnements cloud, sur site et hybrides, Cloudera peut mieux répondre aux besoins de votre infrastructure. Il s’agit d’un choix solide pour les entreprises soumises à des exigences strictes en matière de conformité ou de localisation des données, disposant d’écosystèmes de logiciels libres bien établis et d’équipes gérant des plateformes de données distribuées dans plusieurs environnements.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |