

Databricks est puissant, mais ce n’est pas toujours la solution la mieux adaptée. Votre équipe a peut-être rencontré des difficultés liées aux tarifs, peiné à maîtriser la courbe d’apprentissage de la plateforme ou besoin d’une solution plus flexible pour les configurations multicloud ou sur site. Quoi qu’il en soit, si vous êtes ici, vous cherchez probablement une alternative offrant des fonctionnalités similaires de lac de données et d’entrepôt de données, sans les compromis.
J’ai travaillé avec des équipes chargées des données dans des start-ups et de grandes entreprises afin d’évaluer et de mettre en œuvre des plateformes comme Databricks, Snowflake et d’autres. J’ai pu constater directement ce qu’il faut pour prendre en charge des analyses à grande échelle, unifier des sources de données hétérogènes et créer des pipelines fiables réellement utilisés.
Dans ce guide, je vous présenterai les alternatives à Databricks qui méritent d’être envisagées : des outils qui vous aident à stocker, transformer et explorer les données de manière plus intuitive, tout en vous permettant de monter en charge et de vous adapter à mesure que votre équipe grandit.
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

Tableau comparatif : concurrent de Databricks
Ce tableau comparatif résume les informations tarifaires de ma sélection des meilleurs concurrents de Databricks.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour l’entreposage de données dans le cloud | Non | Tarification sur demande | Website | |
| 2 | Idéal pour le déploiement de données multicloud | Formule gratuite disponible | Tarification sur demande | Website | |
| 3 | Idéal pour les tâches d’intégration des données | Essai gratuit disponible | $1,170/utilisateur/an (facturé annuellement) | Website | |
| 4 | Idéal pour le traitement en mémoire | Forfait gratuit disponible | Tarification sur demande | Website | |
| 5 | Idéal pour les requêtes SQL rapides | Oui | À partir de 6,25 $ par Tio traité | Website | |
| 6 | Idéal pour les besoins des bases de données d’entreprise | Essai gratuit disponible | $68/user/month (facturé annuellement) | Website | |
| 7 | Idéal pour l’analytique SQL | Essai gratuit de 30 jours | $30/utilisateur/mois (facturé annuellement) | Website | |
| 8 | Idéal pour le traitement Hadoop | Non disponible | À partir de $0.007084/vCPU-hour | Website | |
| 9 | Idéal pour Spark et Hadoop gérés | Non disponible | À partir de $0.06/heure-DCU | Website | |
| 10 | Meilleur pour les solutions d’IA et de ML | Démo gratuite disponible | Tarification sur demande | Website |


Avis sur les meilleurs concurrents de Databricks
Vous trouverez ci-dessous mes résumés détaillés des meilleurs concurrents de Databricks retenus dans ma sélection. Mes avis présentent en détail les principales fonctionnalités, les avantages et les inconvénients, les intégrations et les cas d’utilisation idéaux de chaque outil afin de vous aider à trouver celui qui vous convient le mieux.
 Idéal pour l’entreposage de données dans le cloud
- Non
- Tarification sur demande
Visit WebsiteCustomer Rating:4.6/5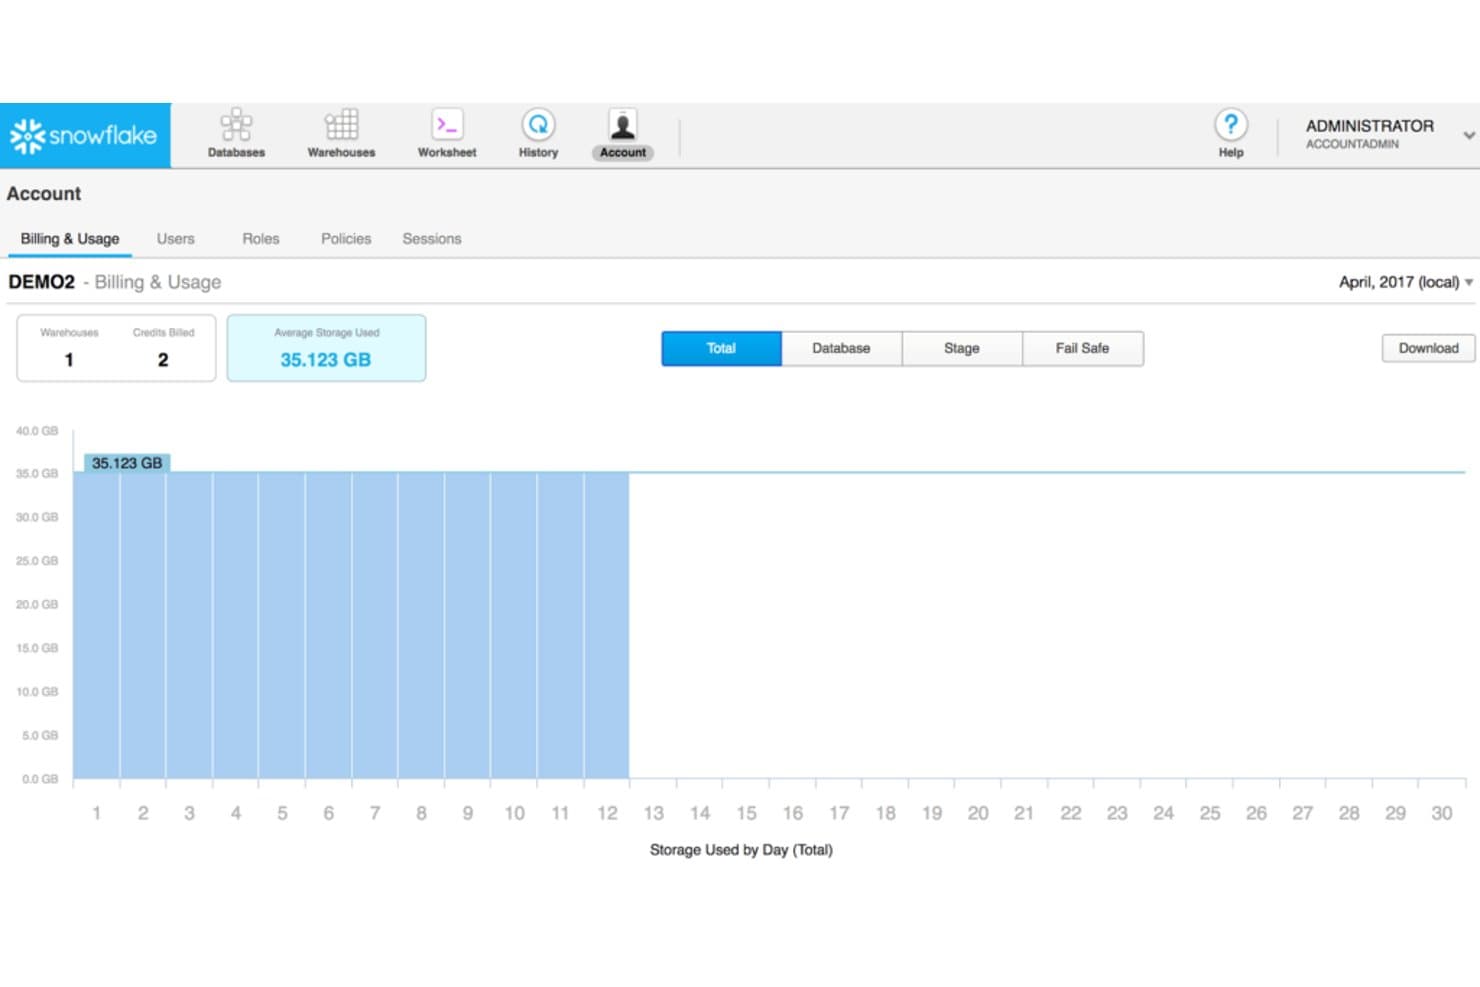
Snowflake suit le stockage et l’utilisation des crédits par jour dans un seul tableau de bord. Snowflake fournit aux équipes informatiques et d’analyse une plateforme de données cloud permettant de rassembler des ensembles de données disparates, d’exécuter des requêtes SQL à grande échelle et de fournir un accès gouverné sans gérer l’infrastructure d’entrepôt.
À qui Snowflake convient-il le mieux ?
Les équipes d’ingénierie des données et d’analyse qui ont besoin d’un entrepôt cloud pour interroger et partager des données entre différents systèmes d’entreprise.
Pourquoi j’ai choisi Snowflake
J’ai choisi Snowflake comme solution « idéale pour l’entreposage de données dans le cloud » parce que la séparation du stockage et du calcul me permet de faire évoluer les analyses SQL sans redimensionner la couche de données. J’apprécie également son partage de données gouverné lorsque les équipes doivent interroger des ensembles de données entre différents systèmes d’entreprise sans les copier dans des entrepôts distincts.
Principales fonctionnalités de Snowflake
- Tables dynamiques : définissez des pipelines de données avec SQL et définissez le délai d’actualisation cible.
- Snowpipe : chargez les données depuis des fichiers intermédiaires au fur et à mesure de leur arrivée.
- Voyage dans le temps : interrogez, clonez ou restaurez des données historiques pendant la période de conservation.
- Marketplace Snowflake : découvrez et utilisez des ensembles de données et des applications tiers.
Intégrations de Snowflake
Snowflake propose des connecteurs Openflow pour Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL et Microsoft SQL Server. Il fournit également des connecteurs natifs pour ServiceNow, MySQL et Kafka, ainsi que des API REST pour les intégrations personnalisées.
Pros and Cons
Pros:
- La mise à l’échelle indépendante du calcul gère les variations de charge de travail
- Les entrepôts SQL gérés réduisent la maintenance de l’infrastructure
- Le partage sécurisé évite de copier les ensembles de données entre les équipes
Cons:
- Les pics d’utilisation peuvent rendre les dépenses imprévisibles
- Les fonctionnalités propriétaires peuvent compliquer la migration de plateforme
Learn more about Snowflake: Idéal pour le déploiement de données multicloud
- Formule gratuite disponible
- Tarification sur demande
Visit WebsiteCustomer Rating:4.5/5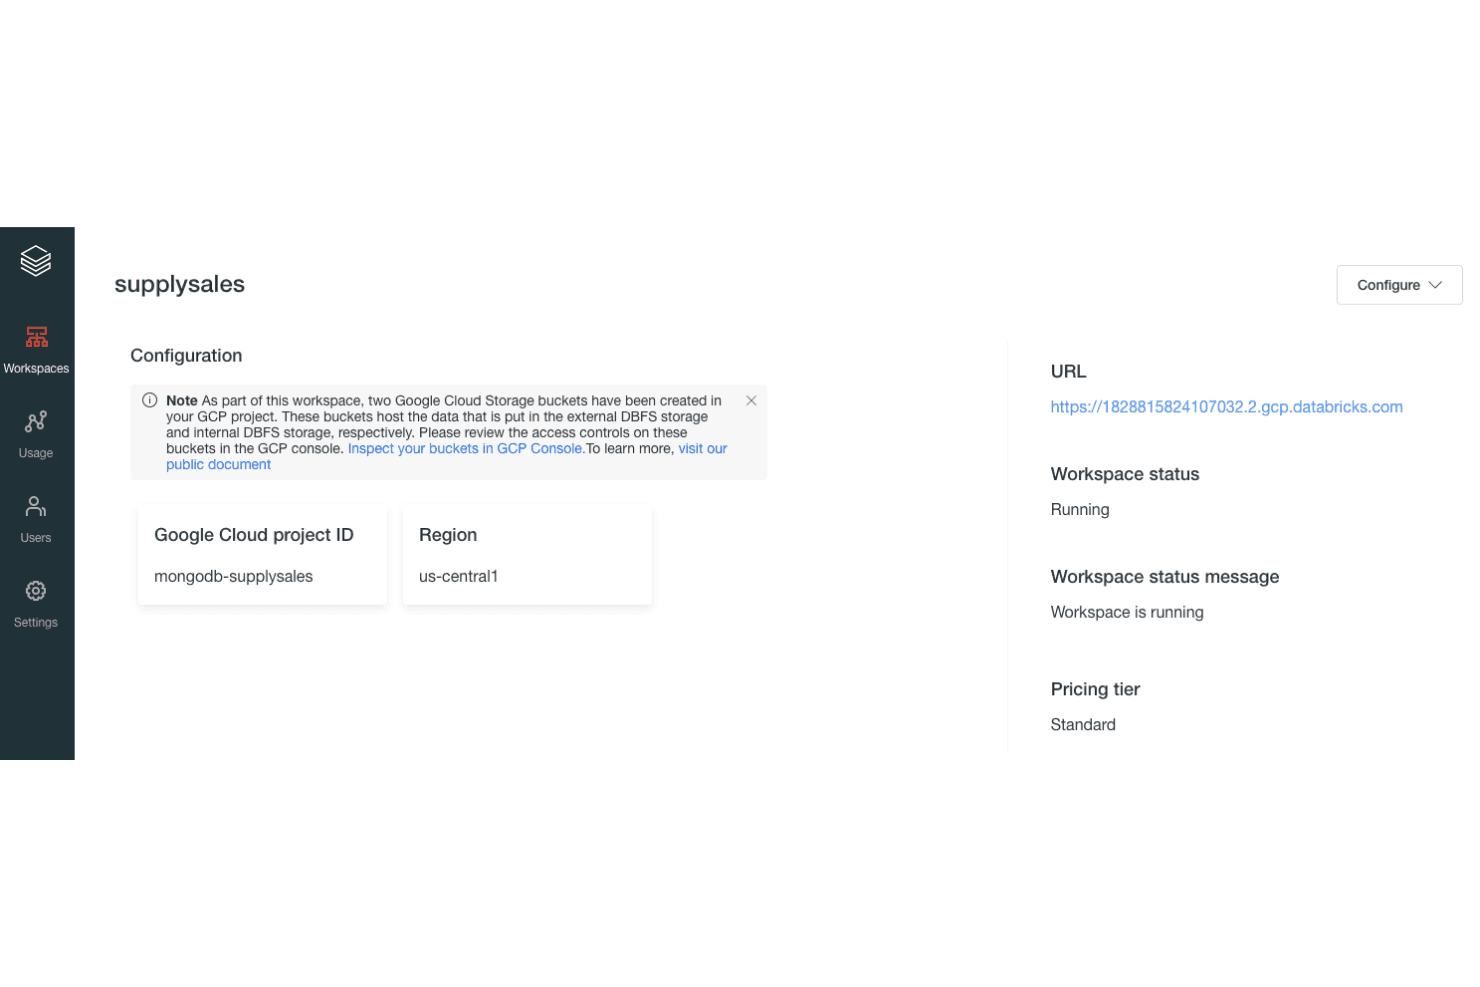
MongoDB Atlas s’intègre aux espaces de travail Databricks sur GCP pour le traitement des données. MongoDB Atlas fournit aux équipes informatiques et aux équipes de données une base de données documentaire gérée pour les applications qui nécessitent des modèles de données flexibles, des requêtes fiables et moins de maintenance de base de données.
À qui MongoDB Atlas convient-il le mieux ?
Les équipes informatiques et les équipes responsables des plateformes qui déploient des applications auprès de plusieurs fournisseurs cloud apprécieront la base de données gérée et la flexibilité multicloud de MongoDB Atlas.
Pourquoi j’ai choisi MongoDB Atlas
J’ai choisi MongoDB Atlas comme alternative à Databricks pour son déploiement de données multicloud. Atlas prend en charge les clusters multicloud sur AWS, Azure et Google Cloud, tandis que son pipeline d’agrégation vous permet d’analyser les données d’application stockées dans MongoDB. Je l’utiliserais pour interroger les données opérationnelles à proximité des services exécutés auprès de différents fournisseurs cloud.
Fonctionnalités clés de MongoDB Atlas
- Recherche Atlas : créez des index de texte intégral et exécutez des recherches classées par pertinence.
- Graphiques Atlas : créez des tableaux de bord et des visualisations à partir de données MongoDB.
- Fédération des données : interrogez les données réparties entre les bases de données Atlas et le stockage d’objets dans le cloud.
- Sauvegardes automatisées : planifiez des instantanés de base de données et restaurez-les à partir de points enregistrés.
Intégrations de MongoDB Atlas
MongoDB Atlas documente les intégrations avec Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta et Microsoft Entra ID. Il fournit également une API d’administration pour les intégrations personnalisées.
Pros and Cons
Pros:
- Clusters multicloud sur AWS, Azure et Google Cloud
- Les documents flexibles s’adaptent à l’évolution des modèles de données des applications
- Les pipelines d’agrégation analysent les données opérationnelles sur place
Cons:
- Moins adapté aux charges de travail analytiques étendues sur une architecture de lac de données et d’entrepôt
- Les performances des agrégations peuvent nécessiter un réglage minutieux des requêtes
Learn more about MongoDB Atlas: Idéal pour les tâches d’intégration des données
- Essai gratuit disponible
- $1,170/utilisateur/an (facturé annuellement)
Visit WebsiteCustomer Rating:4.2/5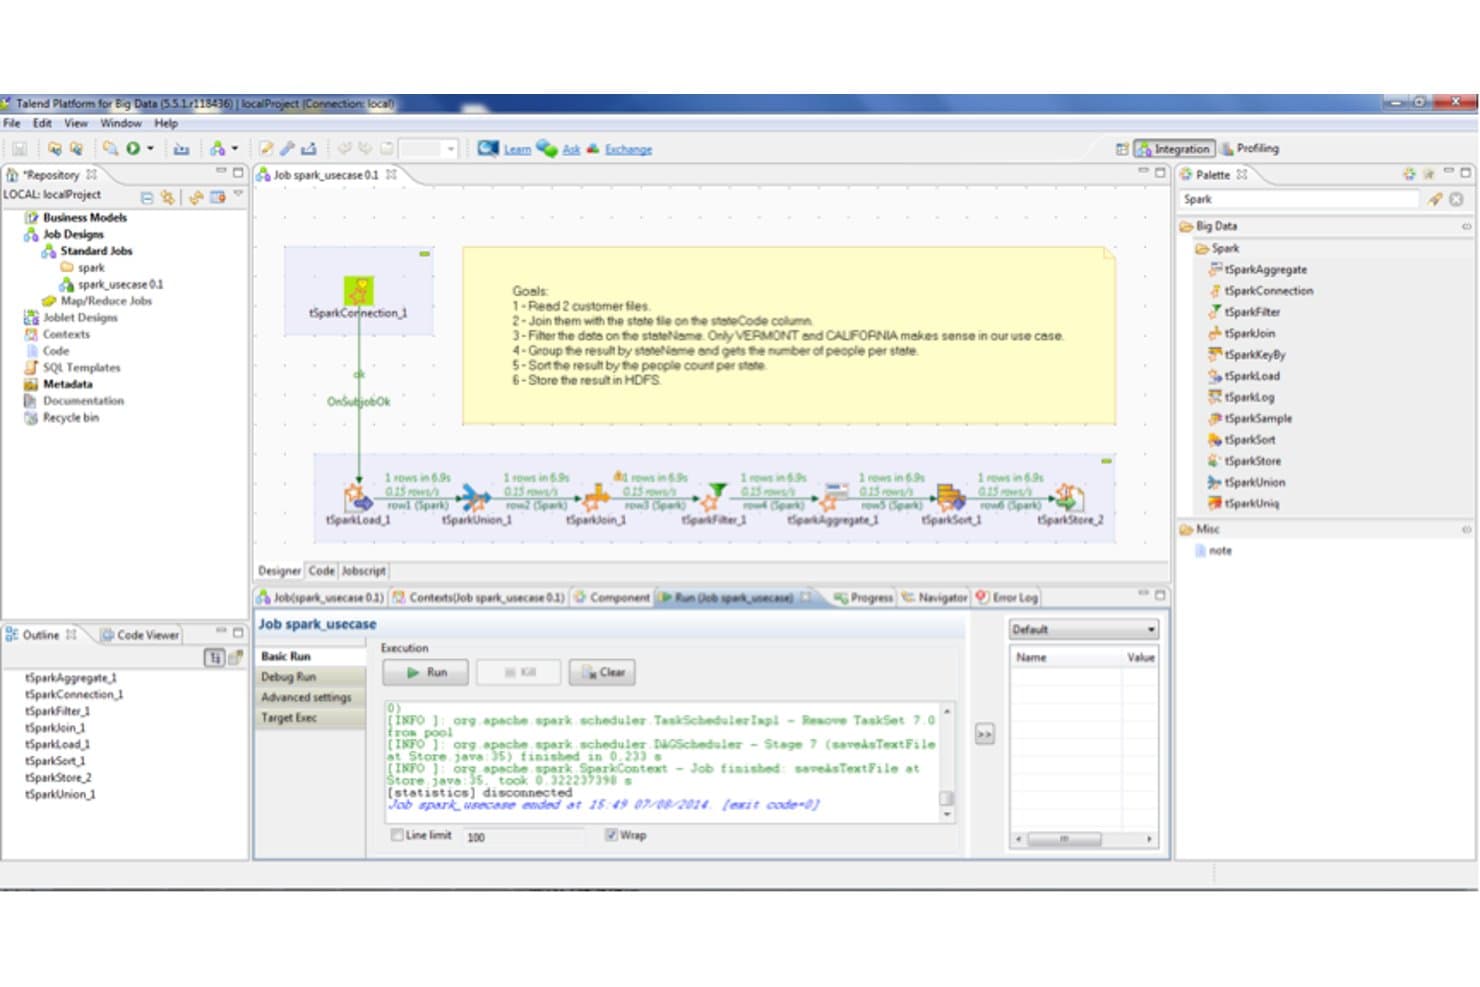
Talend permet aux utilisateurs de créer et d’exécuter visuellement des pipelines de données Spark. Talend est une plateforme d’intégration des données destinée aux équipes informatiques et aux équipes chargées des données, qui connecte les informations entre les systèmes, contribuant ainsi à réduire les silos et à maintenir des pipelines de données faciles à gérer à mesure que les environnements évoluent.
À qui Talend convient-il le mieux ?
Talend convient aux équipes informatiques et d’ingénierie des données qui doivent connecter des systèmes infonuagiques, sur site et existants.
Pourquoi j’ai choisi Talend
J’ai choisi Talend comme concurrent de Databricks, car « Idéal pour les tâches d’intégration des données » correspond exactement à son domaine d’utilisation. Son concepteur visuel de tâches et ses transformations tMap me permettent de joindre et de remodeler des enregistrements entre une base de données existante et un entrepôt de données infonuagique. J’apprécie également les composants de qualité des données de Talend, qui permettent de détecter les enregistrements mal formés avant qu’ils n’atteignent les systèmes en aval.
Fonctionnalités clés de Talend
- Connecteurs : Connectez des bases de données, des applications infonuagiques, des fichiers et d’autres systèmes au moyen de connecteurs prédéfinis.
- Capture des modifications des données : Capturez les insertions, mises à jour et suppressions dans les bases de données au moment où elles se produisent.
- Traçabilité des données : Suivez les flux de données depuis les systèmes sources, à travers les tâches, jusqu’à leurs destinations.
- Découverte des métadonnées : Analysez les sources de données afin d’identifier les jeux de données, les formats et les modèles.
Intégrations de Talend
Talend comprend des connecteurs ou des composants pour des systèmes tels que Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle et MongoDB. Il prend également en charge les services REST et SOAP, et Qlik Talend Data Integration fournit des API pour gérer les connexions de données.
Pros and Cons
Pros:
- Les tâches visuelles gèrent les jointures et le remodelage
- Les pipelines par lots et en temps réel prennent en charge diverses charges de travail
- Les outils de qualité des données signalent les enregistrements mal formés
Cons:
- Les tâches volumineuses peuvent nécessiter un réglage de la JVM
- Le code Java généré complique le débogage et les audits
Learn more about Talend: Idéal pour le traitement en mémoire
- Forfait gratuit disponible
- Tarification sur demande
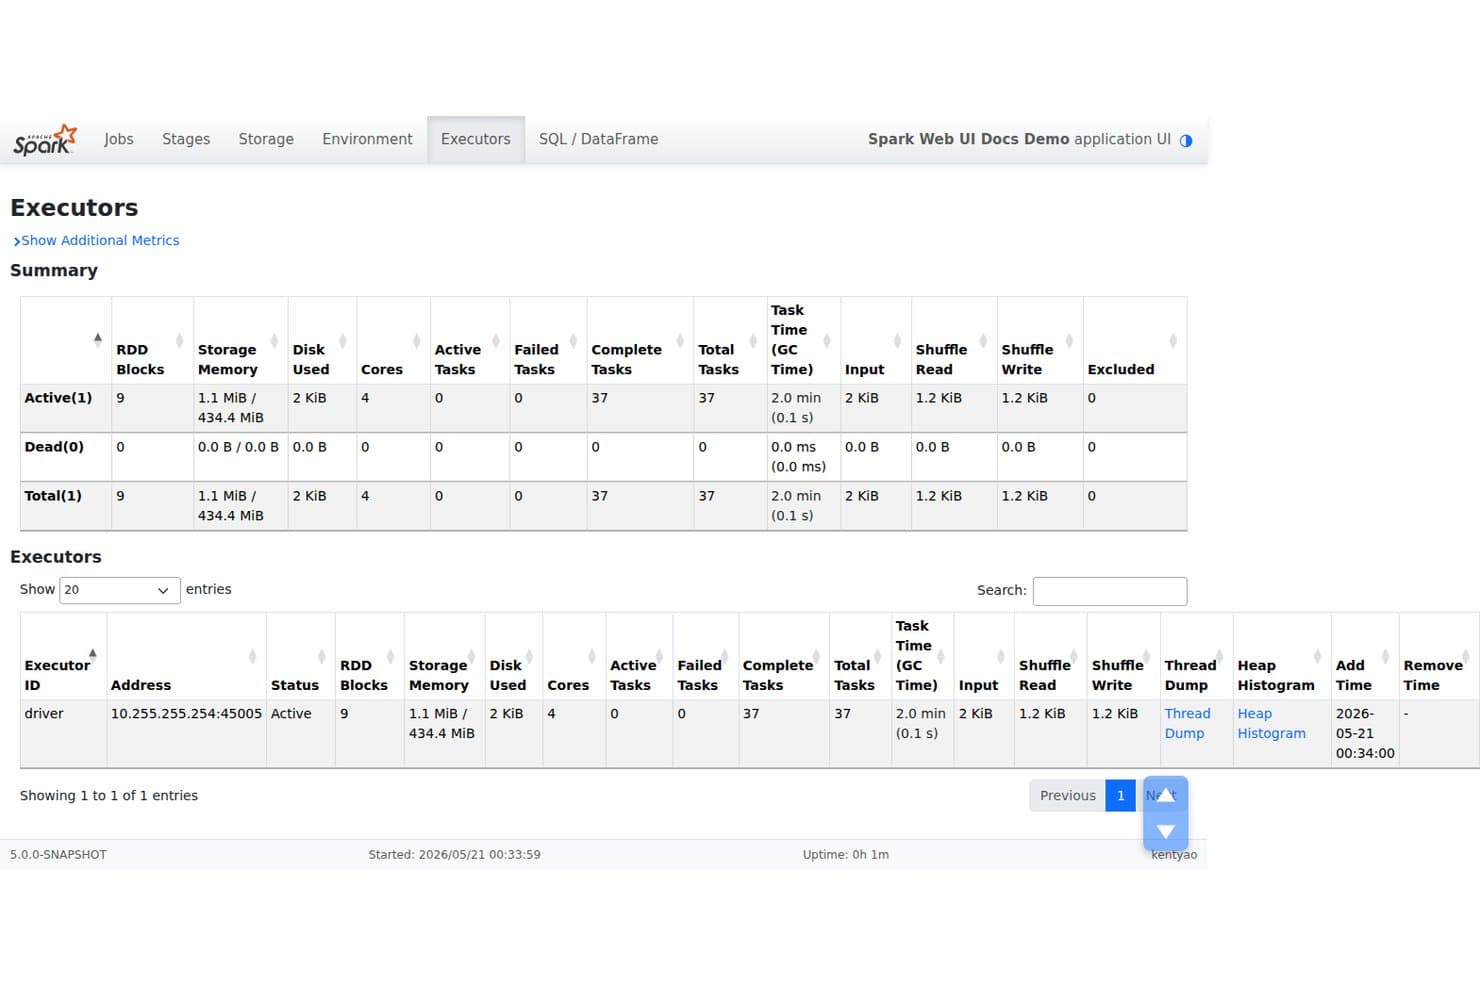
Apache Spark suit en temps réel les ressources des exécuteurs, les tâches et la mémoire. Apache Spark est un moteur d’analyse open source destiné aux équipes chargées des données et de l’infrastructure qui doivent traiter de grands ensembles de données, exécuter des charges de travail distribuées et créer des pipelines de données dans divers environnements.
À qui Apache Spark convient-il le mieux ?
Les équipes d’ingénierie des données et d’analytique qui ont besoin d’un traitement rapide et itératif de grands ensembles de données sur des clusters trouveront Apache Spark particulièrement adapté.
Pourquoi j’ai choisi Apache Spark
J’ai choisi Apache Spark comme alternative à Databricks, car il est idéal pour le traitement en mémoire. Spark peut mettre en cache ou conserver les RDD et les DataFrames en mémoire, de sorte que les requêtes répétées et les calculs itératifs évitent de relire les données sources. Cela est utile lors de l’affinement d’agrégats volumineux de données d’événements au cours de plusieurs passes d’analyse.
Principales fonctionnalités d’Apache Spark
- Spark SQL : Interrogez les données structurées avec SQL et les API DataFrame.
- Flux structurés : Traitez les données en direct avec les API de flux de Spark.
- MLlib : Créez des flux de travail d’apprentissage automatique avec des algorithmes et des pipelines évolutifs.
- Gestionnaires de cluster : Déployez des applications sur des clusters autonomes, YARN ou Kubernetes.
Intégrations d’Apache Spark
Apache Spark prend en charge les connecteurs pour Apache Kafka et Apache Hive, ainsi que les connexions JDBC à des bases de données telles que PostgreSQL, MySQL, Oracle et Microsoft SQL Server. Son API de source de données prend en charge les connecteurs personnalisés ; les dépendances du connecteur Kafka et les pilotes JDBC spécifiques aux bases de données peuvent devoir être ajoutés séparément.
Pros and Cons
Pros:
- Les jeux de données mis en cache accélèrent les charges de travail itératives
- Le traitement par lots, le streaming, SQL et l’apprentissage automatique partagent un même moteur
- S’exécute localement ou sur des clusters Kubernetes et YARN
Cons:
- La pression exercée sur la mémoire peut provoquer des erreurs d’insuffisance de mémoire
- Le réglage et le débogage des tâches distribuées nécessitent une expertise
Learn more about Apache Spark: Idéal pour les requêtes SQL rapides
- Oui
- À partir de 6,25 $ par Tio traité
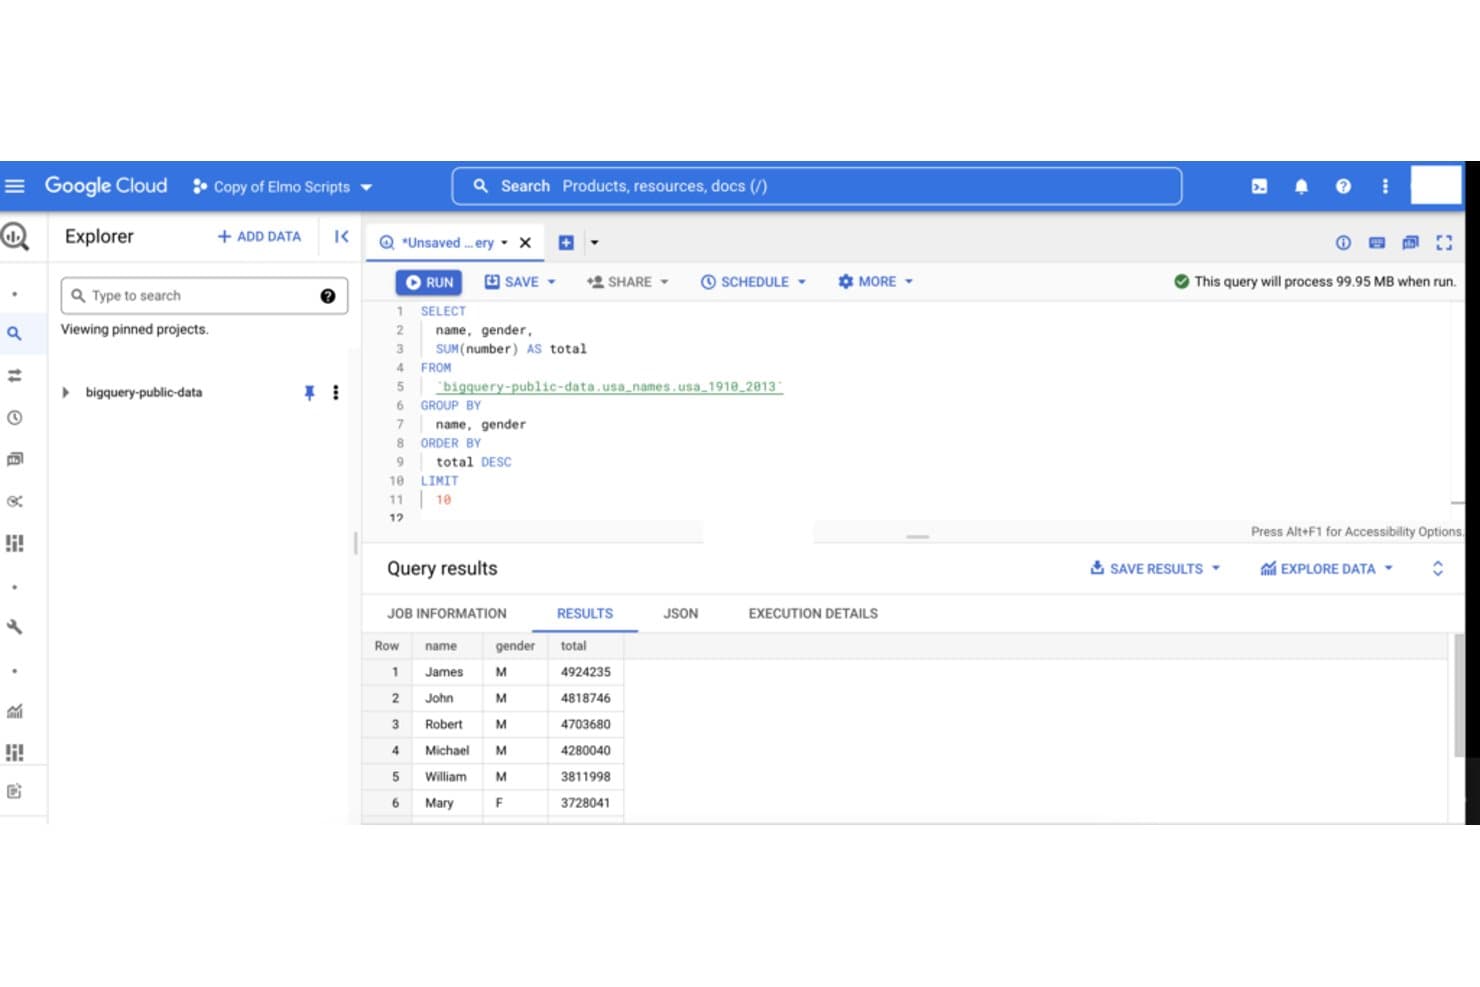
Google BigQuery permet aux utilisateurs d’exécuter des requêtes SQL sur de grands ensembles de données publics. Pour les équipes informatiques et les équipes chargées des données qui ont besoin d’analyses évolutives sans gérer l’infrastructure d’un entrepôt, Google BigQuery est un entrepôt de données cloud permettant d’interroger et d’analyser de grands ensembles de données avec SQL.
À qui Google BigQuery convient-il le mieux ?
Les analystes et ingénieurs des données qui doivent exécuter rapidement des requêtes SQL sur de grands ensembles de données cloud trouveront que Google BigQuery est une solution pratique.
Pourquoi j’ai choisi Google BigQuery
J’ai choisi Google BigQuery comme solution « idéale pour les requêtes SQL rapides », en alternative à Databricks. Son moteur de requêtes sans serveur exécute GoogleSQL sur de grands ensembles de données, tandis que le partitionnement et le regroupement des tables peuvent réduire la quantité de données analysées pour les rapports récurrents. Je l’apprécie pour interroger les journaux d’application ou les données d’événements sans avoir à gérer des clusters d’entrepôt.
Principales fonctionnalités de Google BigQuery
- BigQuery ML : Créez et exécutez des modèles d’apprentissage automatique avec SQL.
- Requêtes planifiées : Configurez l’exécution des tâches SQL à des intervalles définis.
- BigQuery Data Transfer Service : Planifiez l’importation de données depuis des sources prises en charge.
- Vues autorisées : Partagez les résultats des requêtes sans accorder l’accès aux tables sous-jacentes.
Intégrations de Google BigQuery
Google documente les intégrations directes de BigQuery avec Looker, Looker Studio, Vertex AI Workbench, Managed Service for Apache Spark et Tableau. Les connexions de données et les flux de chargement prennent également en charge Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 et Azure Blob Storage ; les API REST et Storage de BigQuery permettent de créer des intégrations personnalisées.
Pros and Cons
Pros:
- Analyses SQL rapides sur de grands ensembles de données
- Le fonctionnement sans serveur évite la gestion des clusters
- Le partitionnement et le regroupement peuvent réduire la quantité de données analysées
Cons:
- Les coûts des requêtes peuvent augmenter fortement sans garde-fous
- L’exploration par les utilisateurs métier nécessite souvent une expertise en SQL
Learn more about Google BigQuery: Idéal pour les besoins des bases de données d’entreprise
- Essai gratuit disponible
- $68/user/month (facturé annuellement)
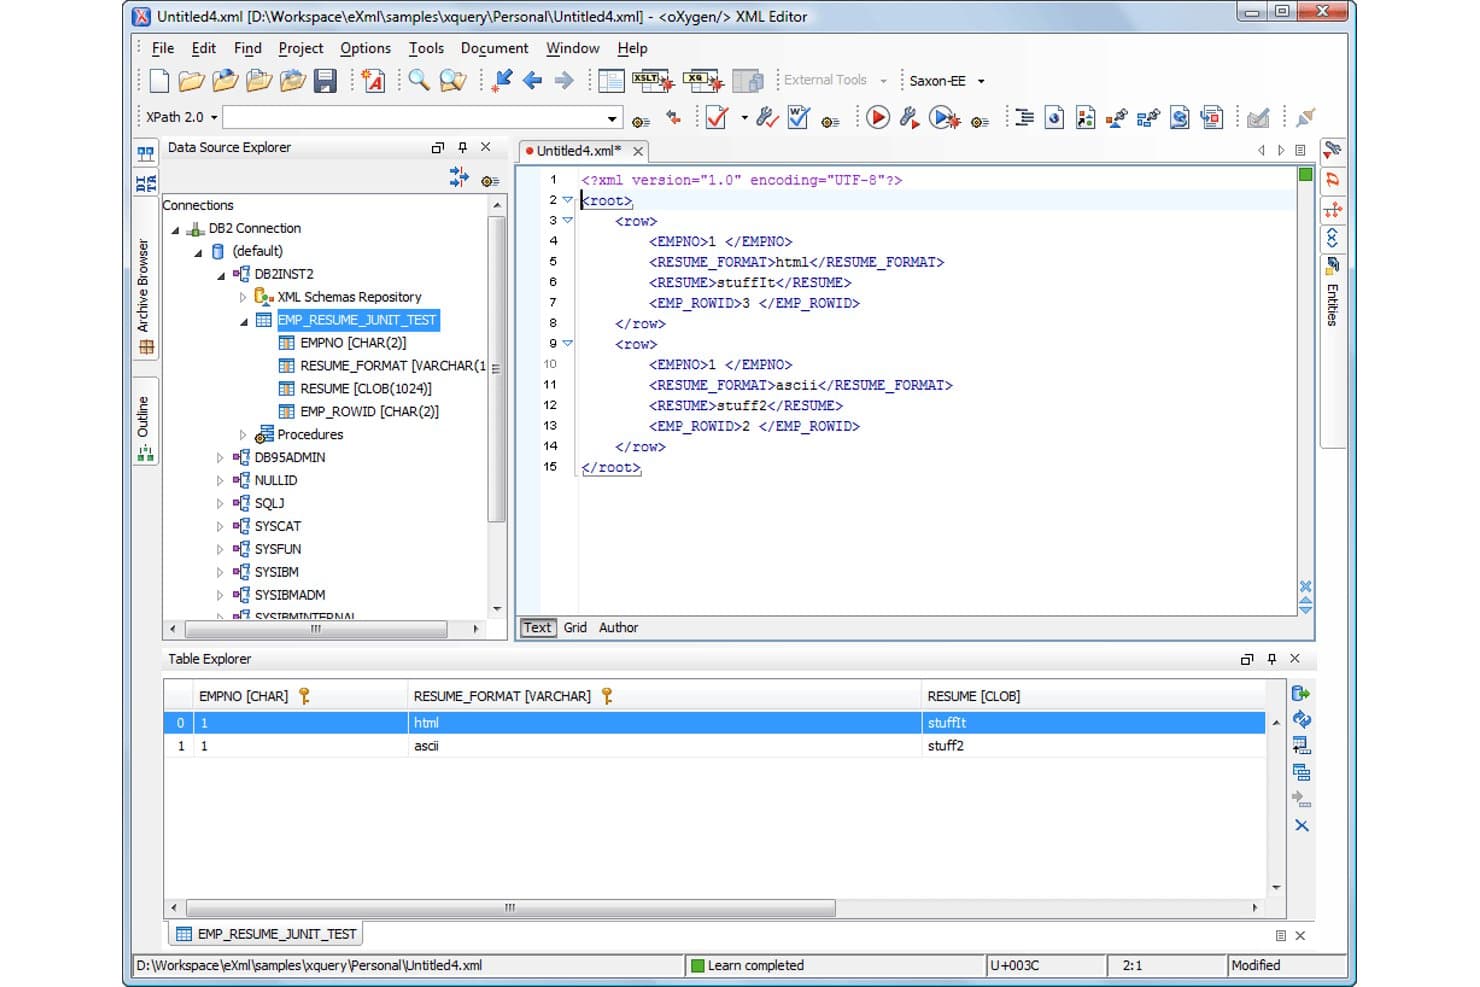
IBM Db2 permet aux utilisateurs de parcourir les schémas de bases de données et d’interroger visuellement les données XML. IBM Db2 est un système de gestion de bases de données relationnelles destiné aux organisations qui doivent exécuter des charges de travail de données structurées dans des environnements complexes, en prenant en charge les équipes qui gèrent des applications d’entreprise, des transactions et des analyses.
À qui IBM Db2 convient-il le mieux ?
Aux administrateurs de bases de données et aux équipes informatiques des grandes organisations qui prennent en charge des applications métier à fort volume.
Pourquoi ai-je choisi IBM Db2 ?
J’ai choisi IBM Db2, idéal pour les besoins des bases de données d’entreprise, comme alternative à Databricks pour les systèmes métier essentiels. Il prend en charge les données transactionnelles, analytiques et vectorielles sur une même plateforme, avec une optimisation des charges de travail alimentée par l’IA pour les systèmes ERP, la facturation et le traitement des commandes. J’apprécie cette compatibilité lorsque les charges de travail relationnelles et les analyses doivent partager une infrastructure.
Fonctionnalités clés d’IBM Db2
- Déploiement hybride : Exécutez Db2 sur site, dans le cloud ou dans des environnements hybrides.
- Chiffrement natif : Chiffrez les données de la base de données et gérez les clés de chiffrement au moyen d’un magasin de clés.
- Partitionnement des tables : Divisez les données des tables en partitions selon les valeurs de colonnes spécifiées.
- Outils de sauvegarde et de récupération : Db2 Advanced Recovery prend en charge la sauvegarde, la récupération et l’extraction des données de la base de données.
Intégrations d’IBM Db2
Les intégrations natives ne sont pas clairement documentées. Db2 prend en charge l’accès fédéré à des sources de données telles qu’Oracle et Microsoft SQL Server, ainsi que la connectivité JDBC, ODBC et CLI pour les applications.
Pros and Cons
Pros:
- Traitement rapide pour les charges de travail transactionnelles d’entreprise
- Haute disponibilité avec HADR et récupération
- Le partitionnement prend en charge les charges de travail importantes et mixtes
Cons:
- L’administration et le réglage nécessitent une expertise spécialisée
- Les opérations natives dans le cloud sont en retrait par rapport aux plateformes plus récentes
Learn more about IBM Db2: Idéal pour l’analytique SQL
- Essai gratuit de 30 jours
- $30/utilisateur/mois (facturé annuellement)
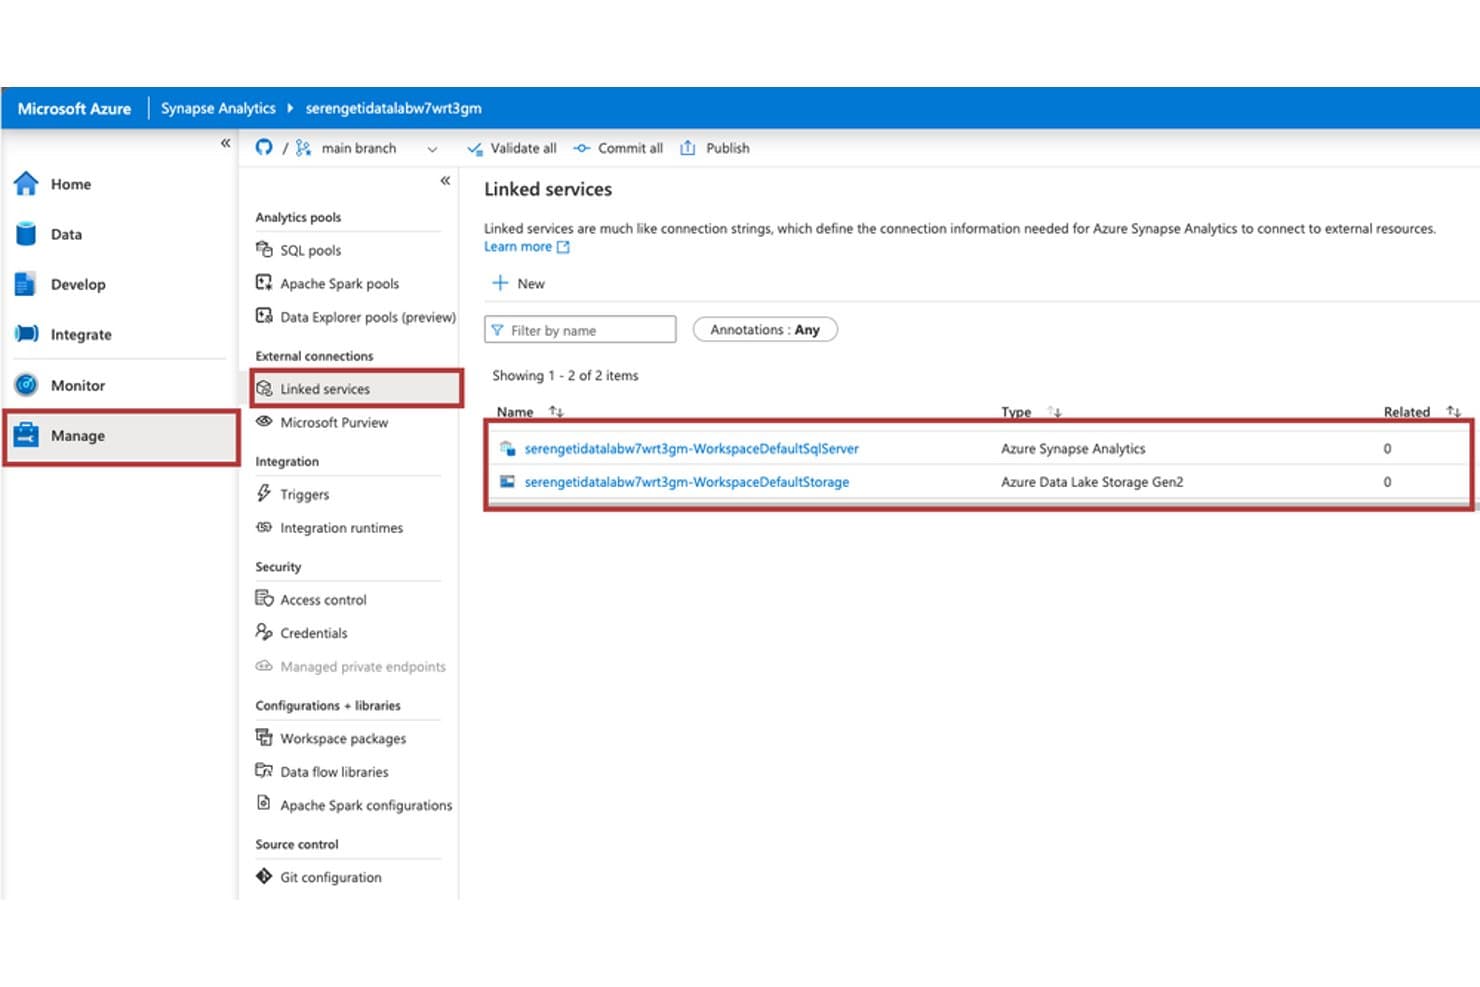
Azure Synapse Analytics gère les connexions externes via les services liés. Azure Synapse Analytics est une plateforme d’analytique cloud destinée aux équipes chargées des données et de l’informatique qui doivent connecter les données d’entreprise, exécuter des requêtes et prendre en charge les rapports dans le cadre de charges de travail d’entrepôt de données et de mégadonnées.
À qui Azure Synapse Analytics convient-il le mieux ?
Il convient aux ingénieurs et analystes de données qui ont besoin d’un accès SQL à des jeux de données intégrés pour les rapports et l’analytique d’entreprise.
Pourquoi j’ai choisi Azure Synapse Analytics
J’ai choisi Azure Synapse Analytics pour le cas d’utilisation « Idéal pour l’analytique SQL » : son pool SQL sans serveur interroge les fichiers du lac de données avec T-SQL, tandis que les pools SQL dédiés prennent en charge les charges de travail d’entrepôt approvisionnées. J’apprécie cette séparation lorsque je dois examiner des jeux de données bruts et fournir des rapports récurrents de BI via SQL.
Principales fonctionnalités d’Azure Synapse Analytics
- Pools Apache Spark : exécutez des tâches et des blocs-notes Spark pour le traitement distribué des données.
- Pipelines : orchestrez le déplacement et la transformation des données entre les sources connectées.
- Synapse Studio : gérez les données, le code et les ressources d’analytique dans un espace de travail partagé.
- Intégration Power BI : connectez les données Synapse à Power BI pour créer des rapports.
Intégrations d’Azure Synapse Analytics
Azure Synapse Analytics dispose de connecteurs de pipeline intégrés pour Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 et SAP HANA, ainsi que d’une connexion directe à Power BI via Synapse Studio. Il fournit également des API REST pour les intégrations personnalisées.
Pros and Cons
Pros:
- Les requêtes T-SQL sans serveur lisent les fichiers du lac de données
- Les pools MPP dédiés prennent en charge les charges de travail d’entrepôt
- Combine les requêtes SQL avec le traitement Spark
Cons:
- Le réglage des pools SQL nécessite une expertise pratique
- Le débogage et la surveillance des pipelines peuvent être limités
Learn more about Azure Synapse Analytics: Idéal pour le traitement Hadoop
- Non disponible
- À partir de $0.007084/vCPU-hour
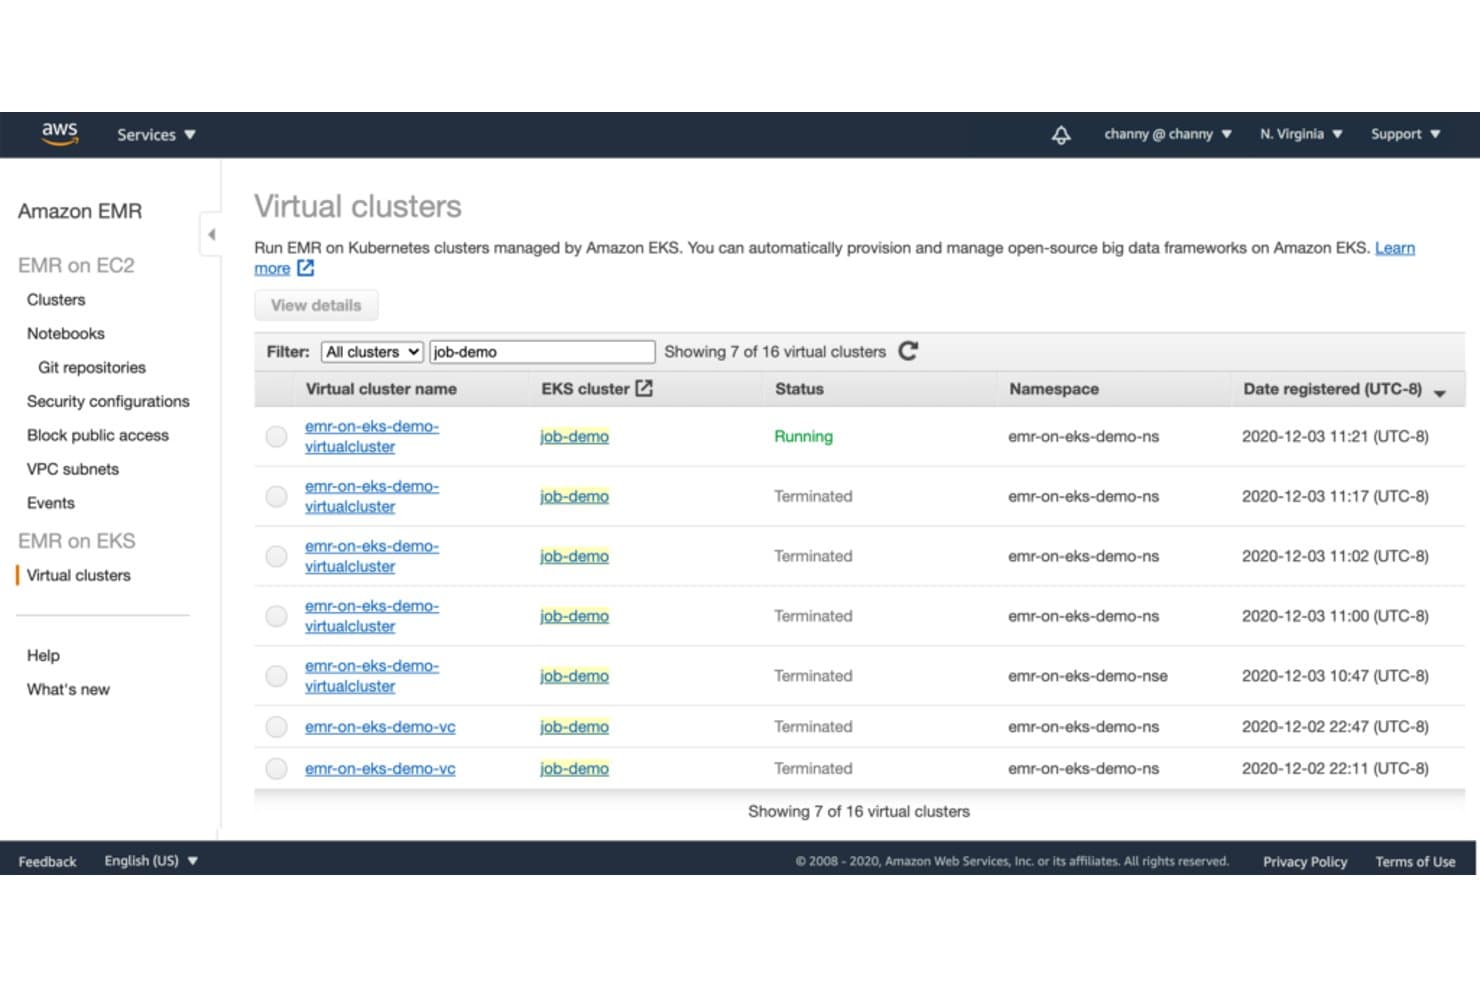
Amazon EMR permet aux utilisateurs de gérer des clusters virtuels exécutés sur Amazon EKS. Amazon EMR est la plateforme gérée de mégadonnées d’AWS destinée aux équipes d’ingénierie des données et d’analytique qui doivent traiter de grands ensembles de données, faire évoluer des charges de travail distribuées et réduire les tâches liées à l’exploitation des clusters de calcul.
À qui Amazon EMR convient-il le mieux ?
Amazon EMR convient aux équipes d’ingénierie des données qui exécutent des tâches Hadoop ou Spark pour traiter de grands ensembles de données sur des clusters distribués.
Pourquoi ai-je choisi Amazon EMR ?
J’ai choisi Amazon EMR comme alternative à Databricks pour une raison : idéal pour le traitement Hadoop. Ses clusters gérés exécutent Apache Hadoop et Spark, ce qui me permet d’utiliser MapReduce pour traiter les journaux d’application archivés et Spark pour analyser les résultats.
Principales fonctionnalités d’Amazon EMR
- EMR Serverless : Exécutez des applications de données sans provisionner ni gérer de clusters.
- Mise à l’échelle automatique : Ajustez la capacité du cluster en fonction de la demande de la charge de travail.
- EMR sur EKS : Exécutez des charges de travail EMR sur des clusters Amazon EKS.
- AWS Glue Data Catalog : Utilisez un catalogue partagé pour les métadonnées des tables.
Intégrations d’Amazon EMR
Amazon EMR propose des intégrations documentées avec AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 et Amazon CloudWatch. Il fournit également une API pour l’accès programmatique et les intégrations personnalisées.
Pros and Cons
Pros:
- Exécute des charges de travail Hadoop et Spark éprouvées
- Prend en charge les déploiements en cluster, sans serveur et sur EKS
- Traite de grands ensembles de données sur des charges de travail variées
Cons:
- Une mise à l’échelle automatique lente peut laisser les tâches avec des ressources insuffisantes
- La mise à l’échelle des clusters nécessite parfois un réglage manuel
Learn more about Amazon EMR: Idéal pour Spark et Hadoop gérés
- Non disponible
- À partir de $0.06/heure-DCU
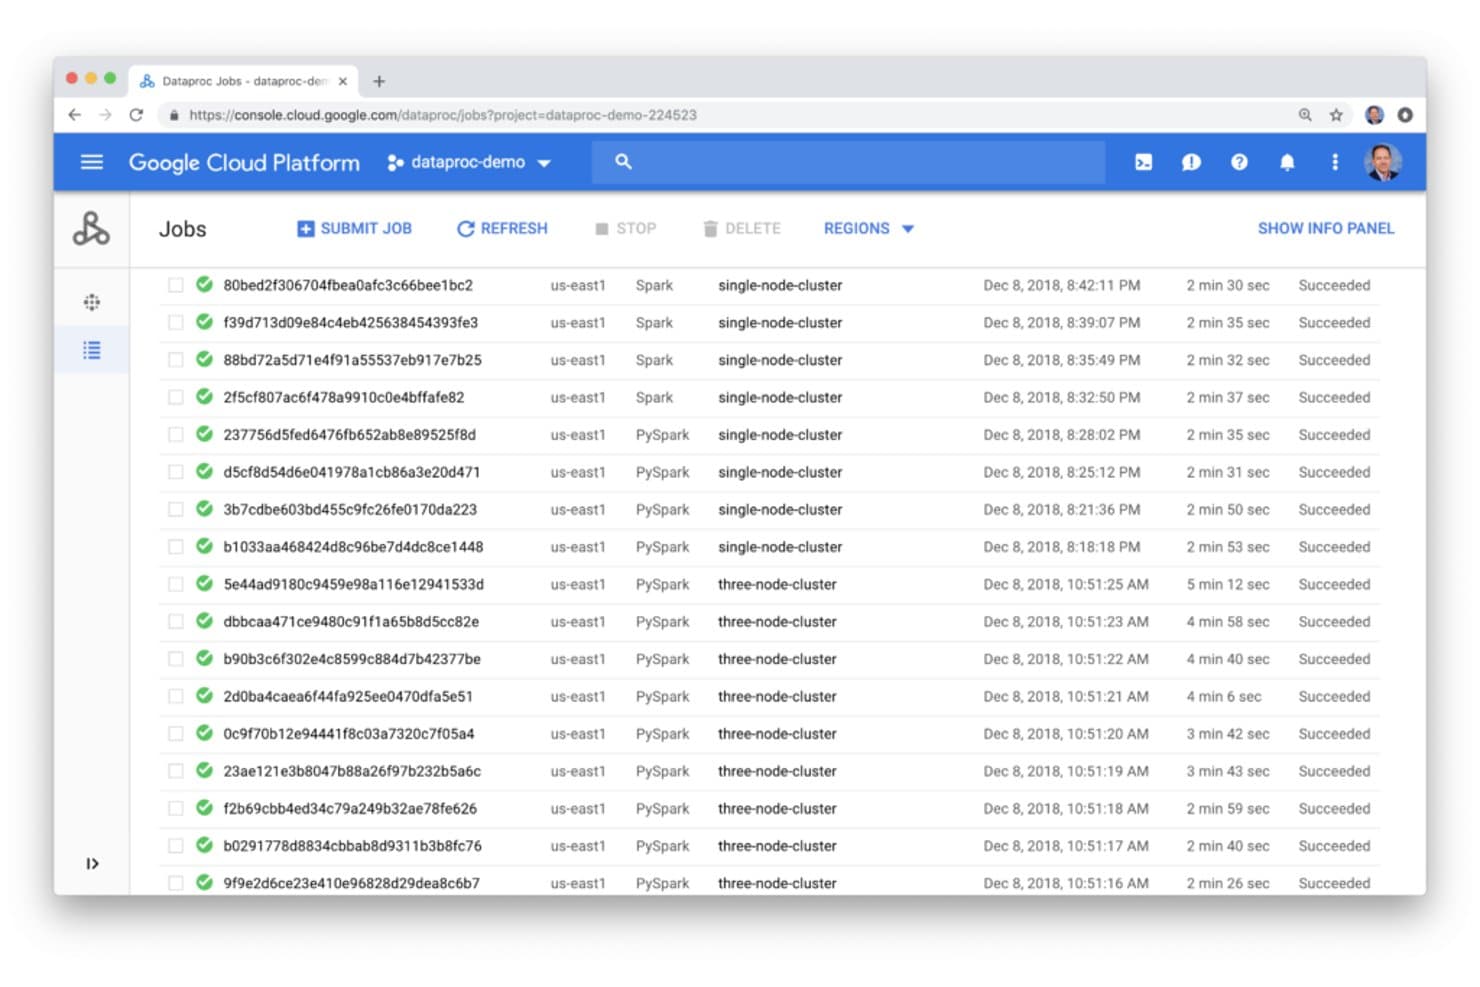
Google Cloud Dataproc permet aux utilisateurs de surveiller et de gérer les tâches Spark en un coup d’œil. Google Cloud Dataproc fournit aux équipes d’ingénierie des données et aux équipes informatiques une plateforme cloud gérée pour les charges de travail d’analyse à grande échelle, contribuant à réduire l’administration des clusters et à prendre en charge les pipelines de données sur Google Cloud.
À qui Google Cloud Dataproc convient-il le mieux ?
Les équipes d’ingénierie des données qui exécutent des tâches Spark ou Hadoop sur Google Cloud peuvent utiliser Dataproc pour gérer les opérations des clusters.
Pourquoi j’ai choisi Google Cloud Dataproc
J’ai choisi Google Cloud Dataproc pour les charges de travail où « Idéal pour Spark et Hadoop gérés » est la priorité. Les clusters gérés et les politiques de mise à l’échelle automatique permettent de gérer les tâches par lots dont les besoins en ressources varient, tandis que Dataproc Serverless exécute des lots Spark sans provisionnement de cluster. Par exemple, vous pouvez traiter les journaux d’événements nocturnes avec Spark et éviter de laisser un cluster inactif entre les exécutions.
Principales fonctionnalités de Google Cloud Dataproc
- Moteur Lightning : accélère l’exécution de Spark grâce au traitement vectorisé, à la mise en cache et à un brassage optimisé.
- Prise en charge d’Apache Iceberg : fonctionne avec des formats de tables ouverts sur Google Cloud Storage.
- Accélération par GPU : prend en charge NVIDIA RAPIDS pour le traitement des données compatible avec les GPU.
- Contrôles de sécurité : s’intègre à IAM, VPC Service Controls et Kerberos.
Intégrations de Google Cloud Dataproc
Google Cloud Dataproc propose des intégrations intégrées avec BigQuery, Cloud Storage, Bigtable, Cloud Logging et Cloud Monitoring. Il fournit également une API REST et Cloud SDK pour gérer les clusters et les tâches.
Pros and Cons
Pros:
- Exécute les tâches Spark existantes avec un minimum de réécriture
- Création et suppression rapides des clusters
- Les lots sans serveur évitent l’administration des clusters
Cons:
- L’optimisation des clusters nécessite toujours une expertise en infrastructure
- Les coûts peuvent sembler élevés pour les charges de travail soutenues
Learn more about Google Cloud Dataproc:
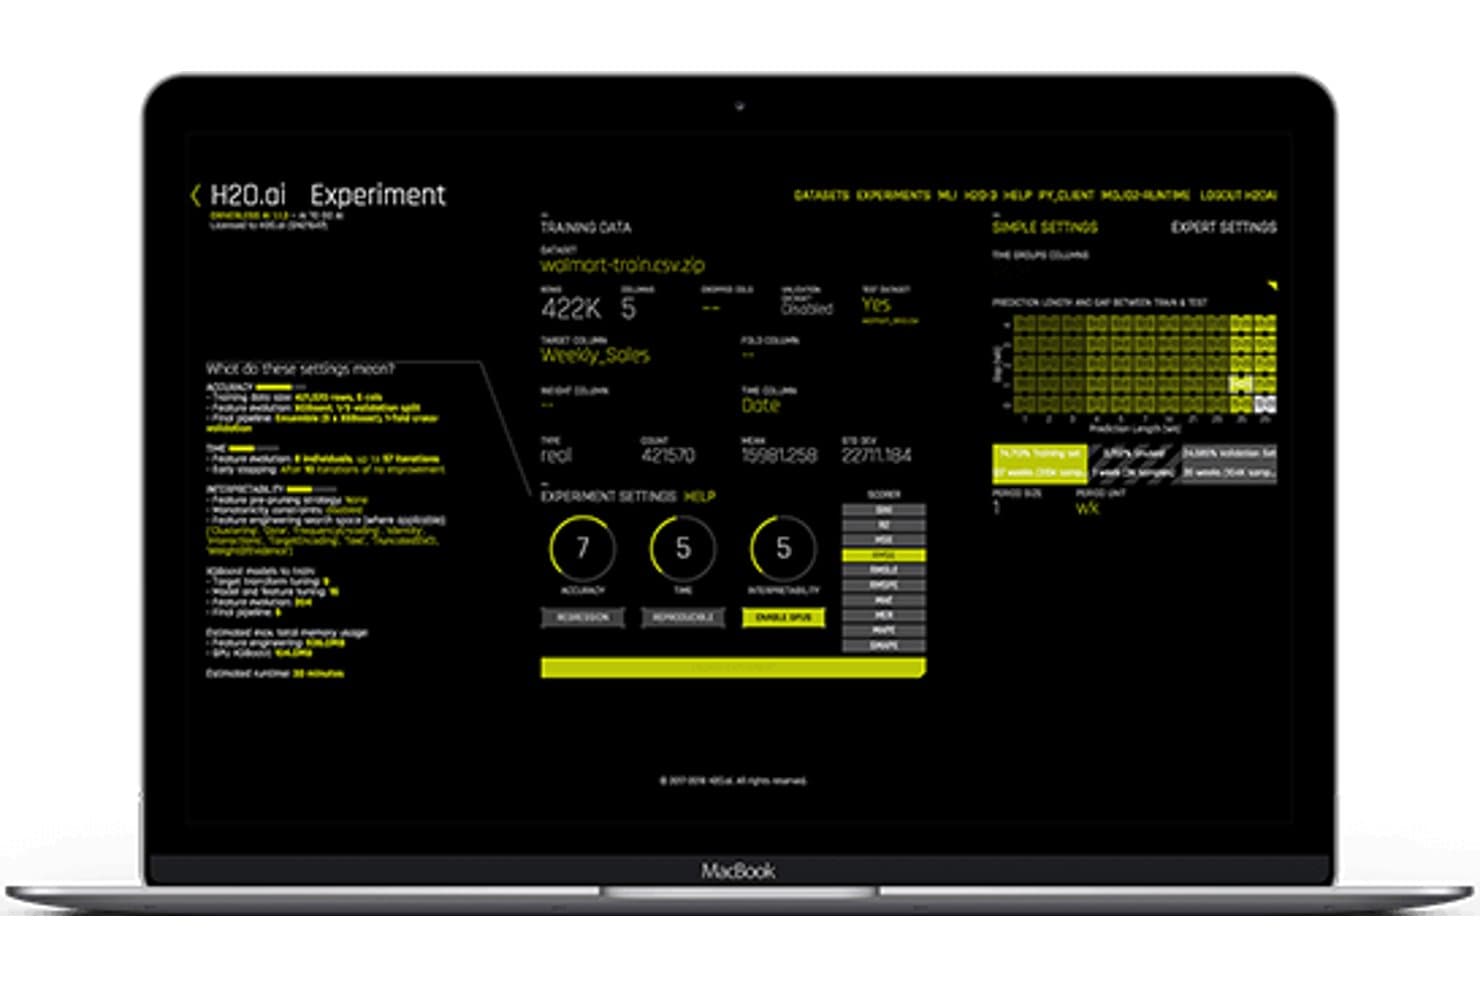
H2O.ai permet aux utilisateurs de configurer et d’exécuter visuellement des expériences AutoML. Pour les équipes qui évaluent des alternatives à Databricks, H2O.ai fournit une plateforme d’IA et d’apprentissage automatique qui aide les équipes chargées des données et de l’informatique à créer des modèles prédictifs à partir de grands ensembles de données et à mettre les analyses au service de leurs activités.
À qui H2O.ai convient-il le mieux ?
H2O.ai convient aux scientifiques des données et aux ingénieurs en apprentissage automatique responsables du développement de modèles d’IA et de leur mise en production.
Pourquoi j’ai choisi H2O.ai
J’ai choisi H2O.ai comme alternative à Databricks « la meilleure pour les solutions d’IA et de ML » parce que la plateforme se concentre sur la création de modèles prédictifs à partir de grands ensembles de données. H2O-3 distribue l’apprentissage automatique en mémoire sur des clusters, tandis qu’AutoML teste les algorithmes et classe les modèles dans un tableau de classement. J’apprécie cette approche lorsque je dois comparer des modèles avant d’en mettre un en production.
Principales fonctionnalités de H2O.ai
- Déploiement flexible : Exécutez la plateforme sur site, dans un cloud privé, dans le cloud ou dans des environnements isolés.
- Prise en charge indépendante des modèles : Choisissez, remplacez ou affinez les modèles et les grands modèles de langage.
- Explicabilité : Examinez les explications relatives aux décisions prises par l’IA.
- Pistes d’audit : Suivez l’activité de la plateforme grâce à des pistes prêtes pour l’audit.
Intégrations de H2O.ai
H2O Driverless AI fournit des connecteurs de données pour Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, les sources JDBC et les tables Delta. Ces connecteurs permettent aux équipes d’interroger ou d’importer des données depuis des plateformes existantes pour les flux de travail d’apprentissage automatique.
Pros and Cons
Pros:
- AutoML accélère la comparaison et le prototypage des modèles
- L’entraînement distribué en mémoire s’adapte aux clusters
- Le déploiement isolé prend en charge les environnements contrôlés
Cons:
- Les options de manipulation des données sont limitées
- L’interface utilisateur peu pratique peut ralentir les flux de travail
Learn more about H2O.ai:
Autre concurrent de Databricks
Voici quelques autres alternatives concurrentes de Databricks qui ne figurent pas dans ma sélection, mais qui méritent tout de même d’être découvertes :
- 11DremioIdéal pour l’analytique en libre-service
- 12QuboleIdéal pour les charges de travail big data
- 13Azure DatabricksIdéal pour l’analytics collaborative
- 14TigerGraphIdéal pour l'analyse graphique
Comment j’évalue les concurrents de Databricks
Que votre équipe exécute des pipelines Spark à grande échelle ou gère un cycle de vie ML, j’évalue chaque alternative en deux étapes : d’abord les exigences fondamentales liées au lakehouse et au calcul, puis les éléments différenciateurs.
Fonctionnalités essentielles (prérequis pour cette liste)
Lorsque je sélectionne les outils de ma liste, j’évalue chacun d’eux sur une échelle allant de 0 (n’offre pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chaque fonctionnalité essentielle répertoriée ci-dessous. Je convertis ensuite le score total de l’outil en pourcentage. Chaque outil doit atteindre un score total minimal de 65 % pour être pris en compte.
- Architecture lakehouse unifiée : je vérifie si une plateforme peut gérer à la fois les requêtes sur un entrepôt de données structuré et le stockage de données non structurées dans un lac de données, avec la prise en charge de formats de tables ouverts tels que Delta, Iceberg ou Hudi.
- Traitement distribué des données : les charges de travail par lots et en flux à grande échelle nécessitent un moteur distribué capable d’ajuster automatiquement ses ressources. J’évalue donc les options de calcul et la façon dont la plateforme gère des tâches telles que les exécutions ETL de plusieurs téraoctets.
- Flux de travail ML/IA intégrés : je recherche une prise en charge de bout en bout du cycle de vie ML, du suivi des expériences et du registre des modèles jusqu’au déploiement et à la mise à disposition, plutôt qu’un simple notebook capable d’exécuter des scripts d’entraînement.
- Environnement de notebooks collaboratifs : les équipes d’ingénieurs des données, d’analystes et d’ingénieurs ML ont besoin de notebooks partagés et multilingues. J’évalue donc la collaboration en temps réel, le contrôle des versions et la prise en charge de SQL, Python, Scala et R.
- Gouvernance et sécurité des données : un catalogue de données unifié, des contrôles d’accès granulaires et le suivi de la traçabilité sont essentiels ici. J’examine comment chaque plateforme gère les autorisations sur les tables, les colonnes et les ressources d’IA depuis un emplacement unique.
- Intégration multicloud et ouverte : la dépendance à un fournisseur est une préoccupation réelle. J’évalue donc si chaque outil fonctionne sur AWS, Azure et GCP, ainsi que la qualité de sa connexion avec des orchestrateurs comme Airflow, des outils de BI comme Tableau et des couches d’ingestion comme dbt.
Une fois que j’ai établi une liste d’outils répondant à ces critères, j’examine ce qui distingue chaque plateforme.
Facteurs différenciateurs (ce qui distingue les fournisseurs)
Voici comment je compare les différents fournisseurs :
Fonctionnalités remarquables
Le calcul sans serveur est un facteur différenciateur majeur. J’évalue si une plateforme permet aux équipes d’exécuter des requêtes et des tâches sans gérer de clusters, ce qui réduit la charge opérationnelle des groupes dont les charges de travail sont imprévisibles. Les outils natifs de GenAI gagnent en importance chaque année, en particulier pour les équipes qui créent des pipelines RAG ou effectuent directement l’affinage de LLM au sein de leur plateforme de données. J’examine également les contrôles d’optimisation des coûts, tels que le suivi des dépenses par charge de travail et les politiques automatisées des clusters, car les coûts de calcul cloud peuvent rapidement s’envoler dans les grandes équipes d’ingénierie.
Au-delà des fonctionnalités
Le coût total de possession est l’un des premiers éléments que j’évalue. La tarification basée sur la consommation peut sembler intéressante jusqu’à ce que les frais de sortie des données et les niveaux d’assistance premium gonflent la facture. La richesse de l’écosystème compte également : je vérifie la qualité des connexions de chaque plateforme avec des outils comme Airflow, dbt et Tableau, car la plupart des équipes ne remplacent pas l’intégralité de leur pile technologique. La mise en œuvre et le délai avant création de valeur complètent mon évaluation. Les outils de migration depuis des systèmes existants comme Hadoop ou Redshift peuvent réduire de plusieurs semaines la durée d’une transition, tandis qu’une documentation solide rend l’intégration des nouveaux ingénieurs bien moins pénible.
Comment choisir un concurrent de Databricks
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré tout au long de votre processus personnalisé de sélection de logiciels, voici une liste des facteurs à garder à l’esprit :
| Facteur | Éléments à prendre en compte |
| Évolutivité | Assurez-vous que la solution peut gérer la croissance de vos données sans perte de performance. Vérifiez qu’elle prend en charge la mise à l’échelle horizontale et verticale pour plus de flexibilité. |
| Intégrations | Recherchez une compatibilité avec vos outils existants, tels que les lacs de données ou les outils de BI, afin de garantir un flux de données fluide et d’éviter les processus cloisonnés. |
| Personnalisation | Évaluez la capacité de la plateforme à s’adapter aux flux de travail et aux processus spécifiques de votre équipe. Des tableaux de bord personnalisables peuvent répondre aux différents besoins des équipes. |
| Facilité d’utilisation | Prenez en compte la courbe d’apprentissage et le caractère intuitif de l’interface pour votre équipe. Une plateforme conviviale peut réduire le temps de formation et favoriser l’adoption. |
| Budget | Comparez les modèles tarifaires et assurez-vous qu’ils correspondent à votre budget. Prenez en compte les coûts cachés, tels que le stockage ou les frais liés aux utilisateurs supplémentaires, qui pourraient influencer votre décision. |
| Mesures de sécurité | Évaluez les fonctionnalités de sécurité de la plateforme, telles que le chiffrement des données et la conformité aux normes du secteur, afin de protéger les données sensibles. |
| Assistance | Vérifiez la disponibilité des options d’assistance client, notamment le chat en direct et les forums communautaires, afin de vous assurer que votre équipe peut obtenir de l’aide lorsqu’elle en a besoin. |
| Performance | Examinez la manière dont la plateforme gère les grands ensembles de données et le traitement en temps réel afin de vous assurer qu’elle répond aux attentes de votre équipe en matière de performance. |
Tendances chez les concurrents de Databricks
Dans le cadre de mes recherches, j’ai recueilli d’innombrables mises à jour de produits, communiqués de presse et journaux de publication provenant de différents fournisseurs concurrents de Databricks. Voici quelques-unes des tendances émergentes que je surveille :
- Analyses en temps réel : Les entreprises exigent de plus en plus des informations exploitables en temps réel. Les fournisseurs améliorent leurs plateformes afin de traiter et d’analyser les données en temps réel, permettant ainsi aux utilisateurs de prendre des décisions immédiates. Des solutions comme Google BigQuery intègrent des fonctionnalités prenant en charge la diffusion de données en temps réel.
- Analyses augmentées : Cette tendance consiste à utiliser l’IA et l’apprentissage automatique pour améliorer les processus d’analyse des données. Elle gagne en popularité, car elle aide les utilisateurs à découvrir des informations exploitables sans effort manuel. IBM Watson Studio en est un exemple, en proposant des fonctionnalités d’analyse augmentée pour automatiser l’analyse des données.
- Démocratisation des données : De plus en plus de plateformes s’attachent à rendre les données accessibles aux utilisateurs non techniques. Cette tendance est essentielle pour favoriser une culture axée sur les données au sein des organisations. Des outils sont développés avec des interfaces intuitives et des fonctionnalités en libre-service, comme celles proposées par Alteryx.
- Gouvernance des données : Alors que les réglementations relatives à la confidentialité des données se durcissent, les fonctionnalités de gouvernance des données deviennent de plus en plus importantes. Les fournisseurs intègrent des outils de gouvernance pour aider les utilisateurs à se conformer aux réglementations et à gérer les données de manière responsable. Azure Synapse Analytics, par exemple, propose des fonctionnalités de gouvernance intégrées.
- Prise en charge du cloud hybride : De nombreuses entreprises souhaitent bénéficier de flexibilité dans leurs stratégies cloud. La prise en charge du cloud hybride se développe, permettant aux utilisateurs de gérer les données dans des environnements sur site et cloud. Cloudera est à la pointe de cette tendance, en proposant des solutions prenant en charge les déploiements de cloud hybride.
Qu’est-ce qu’un concurrent de Databricks ?
Les concurrents de Databricks sont des solutions logicielles conçues pour offrir des fonctionnalités de traitement des données, d’analyse et d’apprentissage automatique. Ces outils sont généralement utilisés par les scientifiques des données, les ingénieurs et les analystes pour obtenir des informations exploitables et orienter les décisions commerciales.
Les fonctionnalités d’analyse en temps réel, d’analyse augmentée et de gouvernance des données facilitent le traitement efficace des données, la découverte d’informations exploitables et la gestion responsable des données. Globalement, ces outils permettent aux entreprises d’exploiter leurs données pour améliorer la prise de décision et la planification stratégique.
Fonctionnalités d’un concurrent de Databricks
Lors du choix d’un concurrent de Databricks, prêtez attention aux principales fonctionnalités suivantes :
- Analyses en temps réel : permettent de traiter immédiatement les données et d'obtenir des informations afin de prendre rapidement des décisions commerciales.
- Analyses augmentées : utilisent l'IA pour automatiser l'analyse des données et contribuer à révéler des informations sans intervention manuelle.
- Gouvernance des données : garantit la conformité aux réglementations relatives à la confidentialité des données et une gestion responsable des données.
- Prise en charge du cloud hybride : permet de gérer les données dans des environnements sur site et dans le cloud afin de bénéficier d'une plus grande flexibilité.
- Collaboration interactive : facilite le travail d'équipe en fournissant des espaces de travail partagés et des outils pour l'analyse conjointe des données.
- Mise à l'échelle automatique : ajuste les ressources en fonction de la charge de travail et optimise les performances sans intervention manuelle.
- Intégration de l'apprentissage automatique : offre des fonctionnalités intégrées d'apprentissage automatique pour produire des prévisions et des informations avancées à partir des données.
- Personnalisation : permet de créer des flux de travail et des tableaux de bord personnalisés adaptés aux besoins et aux processus spécifiques de l'équipe.
- Mesures de sécurité : fournit des fonctionnalités de chiffrement et de conformité pour protéger les données sensibles.
- Interface conviviale : garantit une utilisation simple, réduit la courbe d'apprentissage et favorise l'adoption au sein de l'équipe.
Avantages d'un concurrent de Databricks
La mise en œuvre d'un concurrent de Databricks présente plusieurs avantages pour votre équipe et votre entreprise. Voici quelques-uns de ceux dont vous pouvez bénéficier :
- Prise de décision améliorée : les analyses en temps réel et les analyses augmentées fournissent des informations immédiates et améliorent les capacités de prise de décision de votre équipe.
- Collaboration accrue : les fonctionnalités de collaboration interactive permettent à votre équipe de travailler efficacement ensemble, ce qui favorise la réalisation de projets de données plus cohérents.
- Évolutivité : la mise à l'échelle automatique permet à votre système de gérer efficacement la croissance des volumes de données sans ajustements manuels.
- Rentabilité : les modèles de tarification à l'usage garantissent que vous ne payez que les ressources utilisées, ce qui optimise la gestion du budget.
- Sécurité améliorée : les mesures de sécurité intégrées protègent vos données et garantissent la conformité aux normes du secteur.
- Flexibilité : la prise en charge du cloud hybride offre la flexibilité nécessaire pour gérer les données dans différents environnements et s'adapter aux besoins de votre entreprise.
- Personnalisation : les fonctionnalités personnalisables vous permettent d'adapter les flux de travail et les tableaux de bord à vos besoins spécifiques, ce qui améliore la productivité.
Coûts et tarifs d'un concurrent de Databricks
Le choix d'un concurrent de Databricks nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l'équipe, des modules complémentaires et d'autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions concurrentes de Databricks :
Tableau comparatif des forfaits d'un concurrent de Databricks
| Type de forfait | Prix moyen | Fonctionnalités courantes |
| Forfait gratuit | $0 | Traitement de base des données, stockage limité et assistance communautaire. |
| Forfait personnel | $10-$30 /utilisateur /mois | Analyses de données améliorées, tableaux de bord personnels et assistance par e-mail. |
| Forfait professionnel | $50-$100 /utilisateur /mois | Outils d'analyse avancés, fonctionnalités de collaboration en équipe et assistance prioritaire. |
| Forfait entreprise | $150-$300/utilisateur /mois | Intégrations personnalisées, gestion de compte dédiée et sécurité de niveau entreprise. |
FAQ sur les concurrents de Databricks
Voici quelques réponses aux questions courantes sur les concurrents de Databricks :
Quel est le principal concurrent de Databricks ?
Snowflake est souvent considéré comme le principal concurrent de Databricks en raison des capacités similaires de leurs plateformes de données basées sur le cloud. Les deux solutions offrent de nombreuses fonctionnalités de traitement et d’analyse des données, mais Snowflake est réputé pour ses atouts en matière d’entreposage de données. Selon vos besoins spécifiques, l’une ou l’autre peut constituer un choix pertinent.
Qu'est-ce qui remplacera Databricks ?
Bien qu’aucun outil unique ne soit destiné à remplacer Databricks, des solutions comme SQL Server offrent des fonctionnalités convaincantes. SQL Server s’intègre bien aux outils d’analyse de données tels que Power BI et propose un solide système de gestion de bases de données relationnelles. Votre choix dépendra de vos besoins spécifiques en matière de traitement des données.
Quelles sont les limites de Databricks ?
Databricks présente certaines limites, notamment des restrictions concernant le nombre de widgets dans un bloc-notes ainsi que le nombre de caractères autorisés pour les noms et les entrées des widgets. Ces contraintes peuvent influencer la manière dont vous concevez et utilisez les données dans les blocs-notes. Il est donc important d’en tenir compte si elles ont une incidence sur vos flux de travail.
Quels sont les concurrents d'Amazon Databricks ?
Amazon Databricks est confronté à la concurrence de plateformes comme Snowflake, qui offrent des capacités similaires de traitement des données. Snowflake propose une solution d’entreposage de données basée sur le cloud, largement reconnue pour son évolutivité et sa facilité d’utilisation, ce qui en fait un concurrent sérieux sur le marché.
Comment les tarifs de Databricks se comparent-ils à ceux de ses concurrents ?
Les tarifs de Databricks peuvent varier considérablement en fonction de l’utilisation et des fonctionnalités. Il est important de les comparer à ceux de concurrents comme Snowflake et Google BigQuery, en tenant compte de facteurs tels que le stockage des données, les coûts de traitement et les fonctionnalités supplémentaires. Évaluez la structure tarifaire de chaque plateforme afin de trouver celle qui correspond le mieux à votre budget.
Quelles fonctionnalités dois-je rechercher chez un concurrent de Databricks ?
Lorsque vous évaluez les concurrents de Databricks, recherchez des fonctionnalités telles que l’analyse en temps réel, l’intégration de l’apprentissage automatique et la gouvernance des données. Ces capacités améliorent le traitement et l’analyse de vos données, tout en apportant de la valeur à votre équipe. Tenez compte de vos besoins métier spécifiques pour déterminer les fonctionnalités les plus essentielles.