

Web-Scraping-Tools sind Anwendungen, die die Extraktion von Daten aus Websites automatisieren und das Sammeln von Informationen ohne manuelles Kopieren und Einfügen vereinfachen. Wenn Sie nach den besten Web-Scraping-Tools suchen, müssen Sie wahrscheinlich große Mengen an Webdaten zuverlässig erfassen – ohne auf Hindernisse wie Maßnahmen gegen Bots oder sich ändernde Seitenstrukturen zu stoßen.
Bei der großen Auswahl auf dem Markt ist es schwierig zu wissen, welches Tool tatsächlich zu Ihrem Technologie-Stack passt, Ihre Zielseiten verarbeiten kann und mit Ihren Anforderungen skaliert. Dieser Leitfaden stellt die besten Tools vor, damit Sie Funktionen und Ansätze vergleichen und genau die Lösung finden können, die für Ihre IT-Projekte geeignet ist.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle: Web-Scraping-Tools
Diese Vergleichstabelle fasst die Preisdetails meiner Auswahl der besten Web-Scraping-Tools zusammen.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten geeignet für integrierte Headless-Browser-Steuerung | Kostenloser Plan verfügbar | Ab $30/Monat | Website | |
| 2 | Am besten geeignet für unauffälliges Scraping und Umgehung von Erkennungssystemen | 14-tägige kostenlose Testphase | Ab $69/Monat | Website | |
| 3 | Am besten geeignet für dynamische JavaScript-Websites | Kostenloser Plan verfügbar | Ab $189/Monat | Website | |
| 4 | Am besten für direkte Pipeline-Integration | 30-tägige kostenlose Testphase | Ab $199/Monat (jährliche Abrechnung) | Website | |
| 5 | Am besten geeignet für vorgefertigte Roboterautomatisierungs-Vorlagen | Kostenloser Plan verfügbar | Ab $19/Monat (jährliche Abrechnung) | Website | |
| 6 | Am besten für Nutzer der Point-and-Click-Oberfläche | Kostenloser Plan verfügbar | Ab $69/Monat (jährlich abgerechnet) | Website | |
| 7 | Am besten geeignet für die verwaltete Datenerfassung mit Anti-Bot-Schutz | Kostenlose Testversion verfügbar | Ab 0,5 $/1.000 Datensätze | Website | |
| 8 | Am besten geeignet für Proxy-Infrastrukturen im Unternehmensmaßstab | Kostenloser Plan verfügbar | Ab $1,5/1.000 Datensätze/Monat | Website | |
| 9 | Am besten für automatische Datenschema-Erkennung | 30-tägige kostenlose Testphase | Ab $0.13/1.000 Anfragen | Website | |
| 10 | Am besten geeignet für einfache, API-gesteuerte Scraping-Workflows | Kostenloser Tarif verfügbar | Ab $49/Monat | Website |


Tests der besten Web-Scraping-Tools
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Web-Scraping-Tools, die es in meine engere Auswahl geschafft haben. Meine Tests bieten einen detaillierten Überblick über die Funktionen, Integrationen und besten Anwendungsfälle jedes Tools, damit Sie die beste Lösung für Ihre Anforderungen finden.
 Am besten geeignet für integrierte Headless-Browser-Steuerung
- Kostenloser Plan verfügbar
- Ab $30/Monat
Visit WebsiteCustomer Rating:4.9/5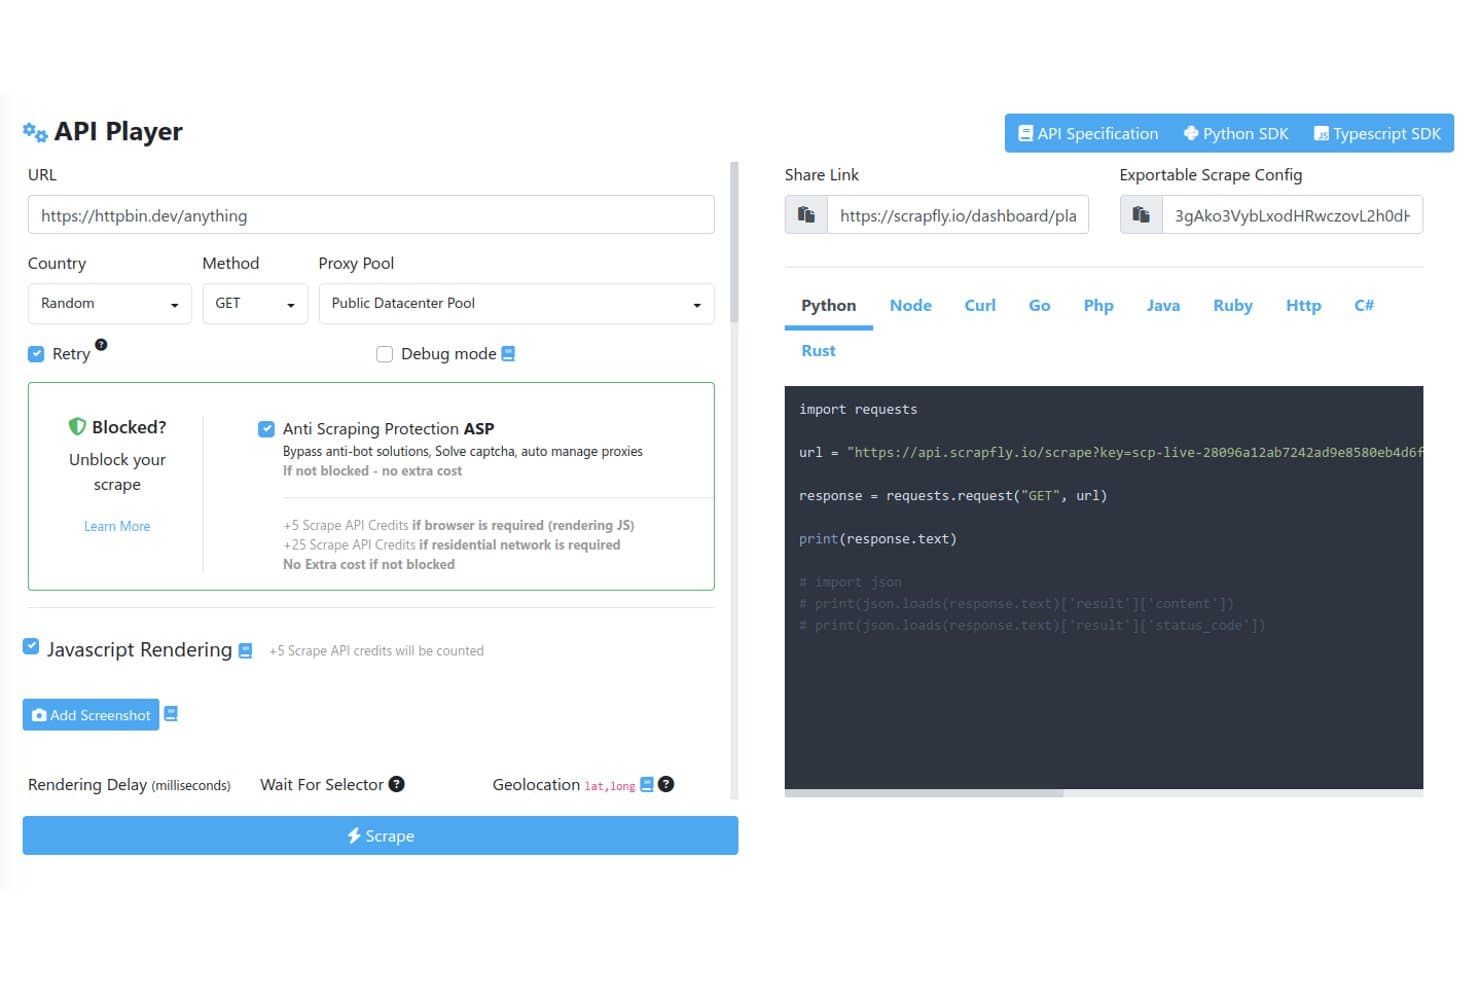
Scrapfly bietet einen interaktiven API-Player mit konfigurierbaren Scraping-Optionen wie Proxy-Pools, Anti-Scraping-Schutzumgehung, JavaScript-Rendering und automatisch generierten Codebeispielen in mehreren Sprachen. Scrapfly ist eine Web-Scraping-API, die Proxy-Rotation, Anti-Bot-Umgehung, Headless-Browser-Rendering, Webseiten-Crawling, Screenshot-Erfassung und LLM-basierte Datenextraktion unter einem einzigen API-Schlüssel vereint.
Für wen ist Scrapfly am besten geeignet?
Scrapfly eignet sich besonders für Entwickler und Data Engineers, die eine code-zentrierte Scraping-API mit SDKs für Python, TypeScript, Go und Rust suchen.
Warum ich Scrapfly ausgewählt habe
Ich habe Scrapfly ausgewählt, weil seine Dual-Engine-Browserarchitektur einzigartig ist. Curlium sorgt mit Chrome JA4-Fingerprinting für maximale Geschwindigkeit, während Scrapium einen unauffälligen Chromium über CDP mit passenden Fingerprints ausführt, sodass Sessions während des Crawlings gewechselt werden können, ohne die Erkennung auszulösen. Zudem ist Scrapium vollständig kompatibel mit Playwright und Puppeteer, weshalb ich benutzerdefinierte JS-Szenarien und Wait-for-Regeln schreiben kann, ohne meinen bestehenden Browser-Automatisierungscode anpassen zu müssen.
Schlüsselmerkmale von Scrapfly
- Multi-Methoden-Extraktions-API: Extrahiert strukturierte Daten über CSS, XPath, Regex, JSON-Schema und LLM-basierte Vorlagen.
- Integrierte Proxy-Pools: Bietet verwaltete Datacenter- und Residential-Proxys mit Geotargeting und BYO-Proxy-Unterstützung.
- Crawler-API: Durchkämmt komplette Websites mit Kontrolle über Crawl-Tiefe, Ratenbegrenzungen und Projektausteilung.
- Native Scheduler-Integrationen: Unterstützt Zapier, Make und n8n für automatisierte Workflows, wiederkehrende Aufgaben und Webhook-Auslöser.
Scrapfly-Integrationen
Scrapfly bietet native Integrationen mit Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI und OpenClaw. Es stehen außerdem SDKs für Python, TypeScript, Go und Rust zur Verfügung. Für eigene Integrationen gibt es eine API.
Pros and Cons
Pros:
- Duales Stealth-Browser-Engine-Setup
- Umgeht Cloudflare, DataDome und Imperva
- Extraktionsvorlagen für gängige Seitentypen
Cons:
- Kein integrierter Job-Scheduler im Produkt
- Nicht geeignet für nicht-technische Nutzer
Learn more about Scrapfly: Am besten geeignet für unauffälliges Scraping und Umgehung von Erkennungssystemen
- 14-tägige kostenlose Testphase
- Ab $69/Monat
Visit WebsiteCustomer Rating:4.7/5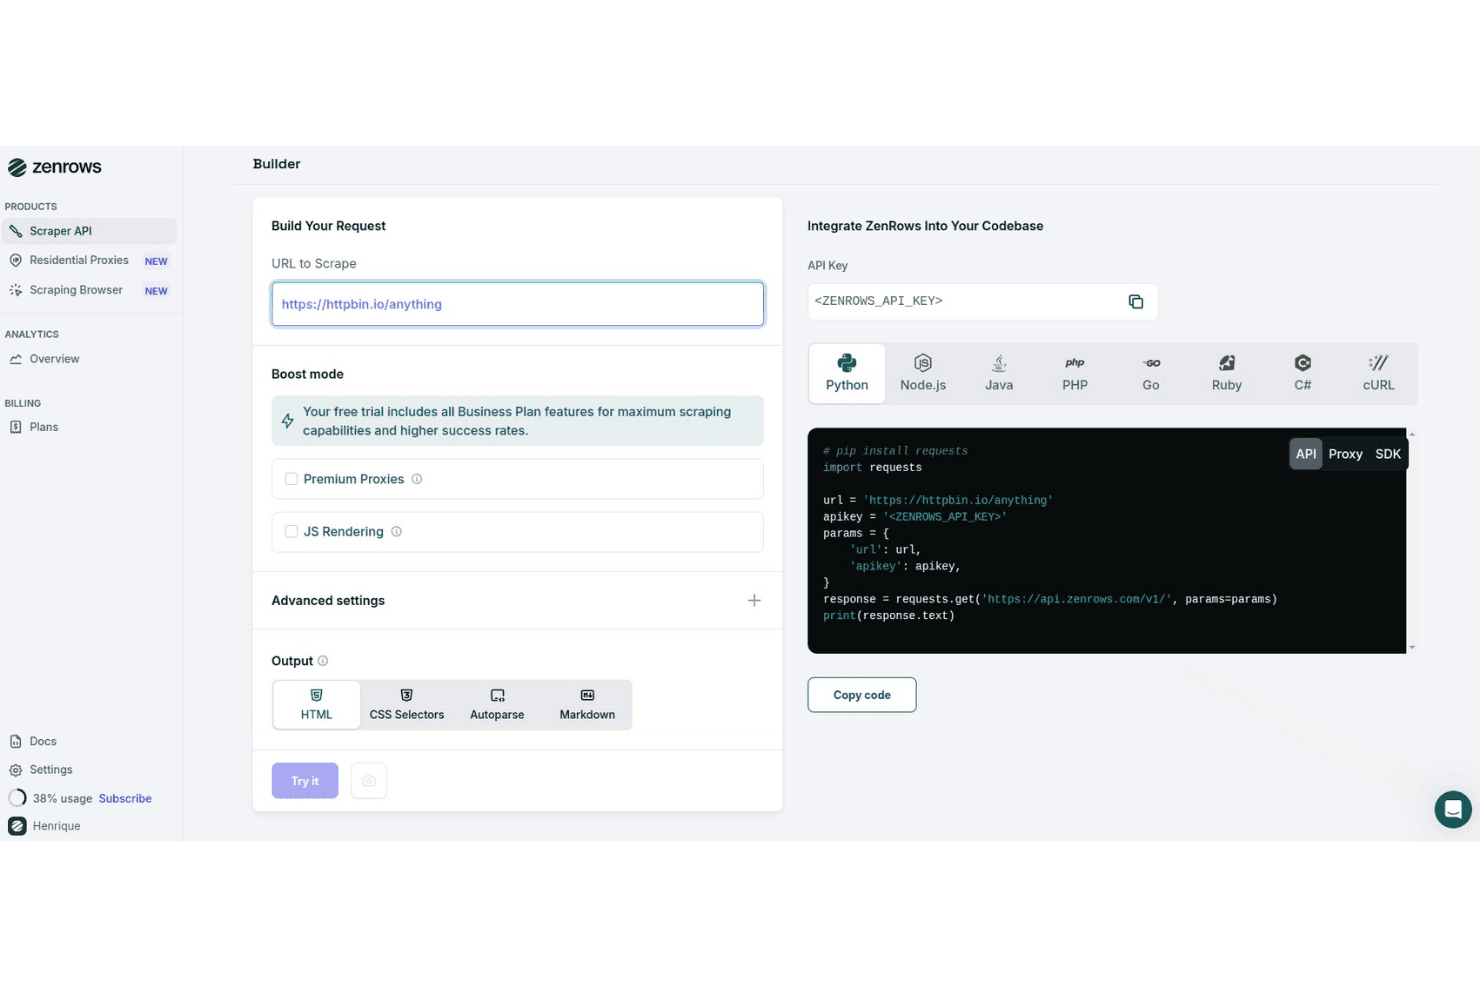
ZenRows bietet einen visuellen Request-Builder mit Code-Generierung in mehreren Programmiersprachen, Boost-Mode-Optionen und Auswahl des Ausgabeformats für Web-Scraping. ZenRows ist eine Web-Scraping-API und Cloud-Browser-Plattform, die Anti-Bot-Umgehung, Rotation von Residential-Proxys, JavaScript-Rendering und strukturierte Datenausgabe in einem einzigen Toolkit für Entwickler vereint.
Für wen ist ZenRows am besten geeignet?
ZenRows ist besonders geeignet für Entwickler und Dateningenieure, die großflächig Websites mit aggressivem Anti-Bot-Schutz scrapen müssen.
Warum ich ZenRows ausgewählt habe
ZenRows verdient seinen Platz auf meiner Auswahlliste durch seinen Ansatz zur Anti-Bot-Umgehung. Ich habe Cloudflare-geschützte Seiten gescrapet, bei denen Standard-Tools regelmäßig scheitern, und ZenRows schafft es, sie mit Fingerprinting-Umgehung und automatischer CAPTCHA-Lösung ohne manuelle Konfiguration zu überwinden. Der Scraping-Browser geht noch weiter und nutzt komplette Chromium-Sitzungen mit Stealth-Headern, die das Verhalten echter Nutzer nachahmen, um eine Erkennung auf Websites mit DataDome oder PerimeterX zu vermeiden.
ZenRows Hauptfunktionen
- Universelle Scraper-API: Stellen Sie Anfragen über einen einzigen Endpunkt, der sich an verschiedene Website-Strukturen und Scraping-Anforderungen anpasst.
- Residential-Proxy-Infrastruktur: Wählen Sie aus einem Pool von über 55 Millionen Residential-IPs in mehr als 185 Ländern für geo-targetetes Crawling.
- Automatische Auswertung für strukturierte Ausgaben: Extrahieren und erhalten Sie Daten automatisch als JSON, HTML oder Markdown mit integriertem Parsing für bekannte Webseiten.
- Mehrsprachige SDKs: Greifen Sie auf offizielle SDKs für Python, Node.js, Go, PHP, Ruby, Java und C# zu, um sie in Ihre Entwicklungsabläufe zu integrieren.
ZenRows Integrationen
ZenRows bietet native Integrationen mit Playwright, Puppeteer, n8n, Make, Clay und Zapier. Eine API für eigene Integrationen steht zur Verfügung.
Pros and Cons
Pros:
- Umgeht Cloudflare und DataDome zuverlässig
- Hohe Erfolgsquote auf geschützten Seiten
- Vollständige Headless-Browser-Sitzungen mit Stealth-Modus
Cons:
- Keine native Planung oder Job-Orchestrierung
- Kosten steigen bei hohem Anfragevolumen schnell an
Learn more about ZenRows: Am besten geeignet für dynamische JavaScript-Websites
- Kostenloser Plan verfügbar
- Ab $189/Monat
Visit WebsiteCustomer Rating:4.4/5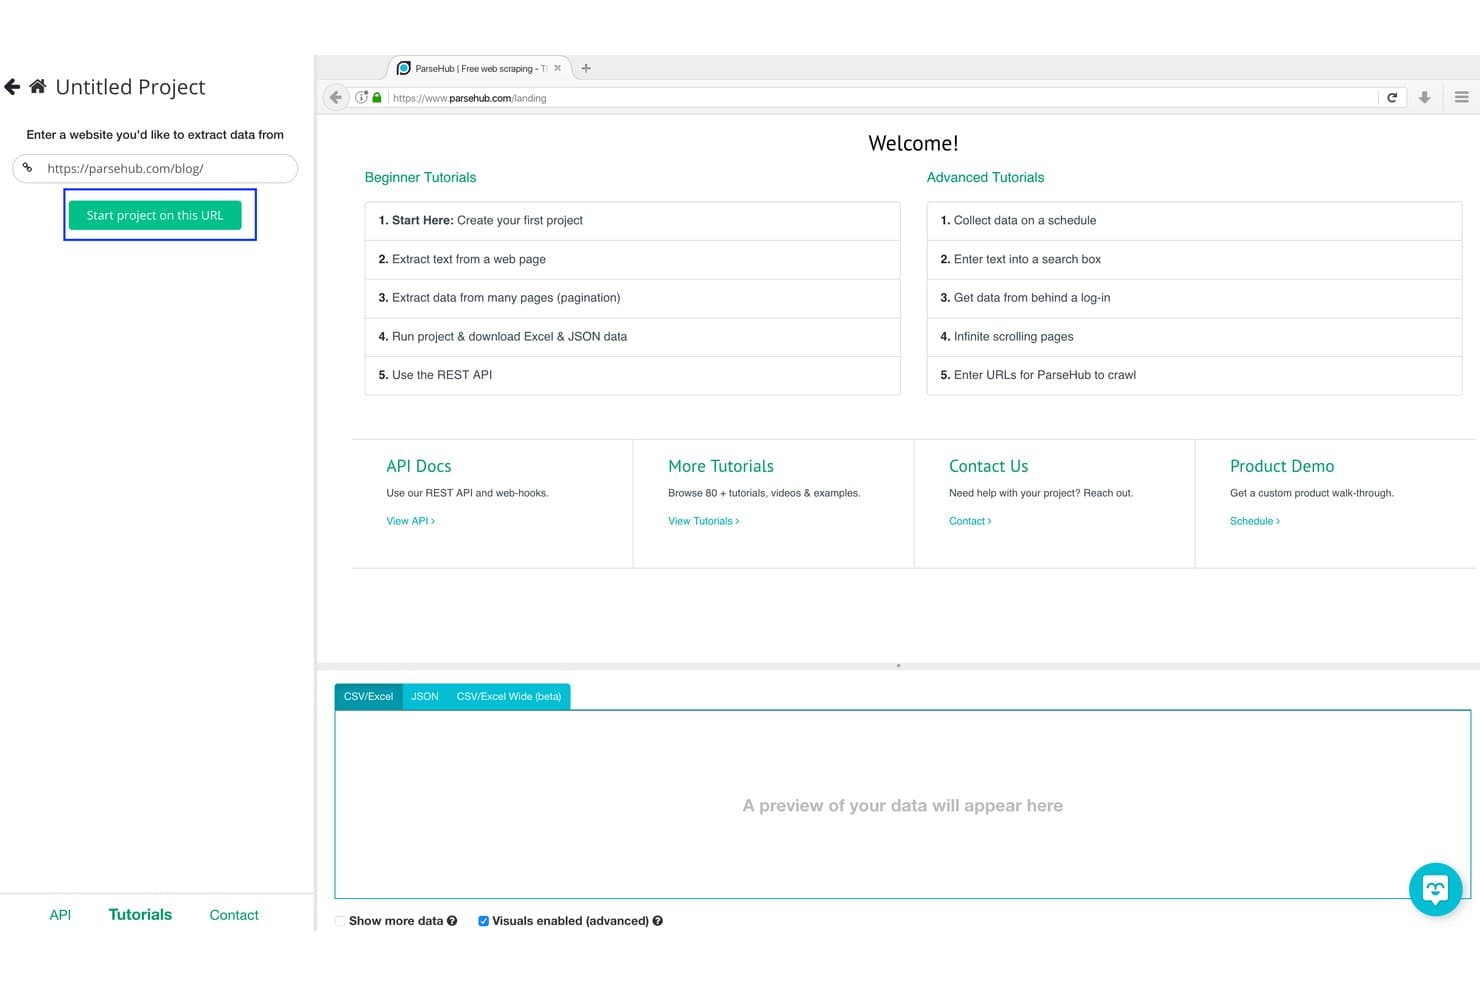
ParseHub bietet eine visuelle Projekt-Setup-Oberfläche, in der Nutzer eine URL eingeben und dann auf 'Start project on this URL' klicken, um mit dem Scraping von Daten von Webseiten zu beginnen. ParseHub ist ein visuelles Web-Scraping-Tool, das Daten von dynamischen Webseiten mit einer klickbasierten Oberfläche extrahiert und dabei JavaScript, AJAX, unendliches Scrollen, Formulareingaben sowie geplante cloudbasierte Ausführungen unterstützt.
Für wen ist ParseHub am besten geeignet?
ParseHub ist ideal für Analysten im Bereich Wettbewerbsbeobachtung und nicht-technische Forscher, die Daten von JavaScript-lastigen Seiten sammeln möchten, ohne Code schreiben zu müssen.
Warum ich ParseHub gewählt habe
ParseHub verdient seinen Platz auf meiner Bestenliste, weil es die JavaScript-Rendering-Herausforderungen bewältigt, an denen die meisten No-Code-Scraper scheitern. Ich habe es genutzt, um Daten von Seiten mit unendlichem Scrollen und Inhalten aus Dropdown-Menüs zu extrahieren, wo statische HTML-Scraper nur leere Ergebnisse liefern würden. Die Machine-Learning-Engine erkennt die Seitenstruktur automatisch, sodass ich einen funktionierenden Scraper für kataloglastige AJAX-Seiten erstellen kann, ohne eine einzige XPath-Zeile zu schreiben.
ParseHub Hauptfunktionen
- Point-and-click visueller Builder: Auswählen und Extrahieren von Seitenelementen, ganz ohne manuelle Selector-Programmierung.
- Cloudbasierte Terminplanung: Wiederkehrende Scraping-Aufgaben auf der Cloud-Infrastruktur von ParseHub einplanen.
- REST-API-Zugriff: Verwaltung, Auslösen und Herunterladen der Scrapergebnisse programmatisch über die API.
- Automatische IP-Rotation: Weniger Blockierungen durch rotierende ausgehende IPs bei cloudbasierten Ausführungen.
ParseHub Integrationen
ParseHub bietet native Integrationen mit Google Sheets, Tableau, Dropbox und AWS S3. Eine API steht für eigene Integrationen und Workflow-Automatisierung zur Verfügung.
Pros and Cons
Pros:
- Unterstützt JavaScript, AJAX und unendliches Scrollen nativ
- Visueller Builder erfordert keine Selector-Programmierung
- Scraping läuft automatisch auf Cloud-Infrastruktur
Cons:
- Begrenzung bei großen gleichzeitigen Scraping-Aufträgen
- Keine eingebaute CAPTCHA-Lösung
Learn more about ParseHub: Am besten für direkte Pipeline-Integration
- 30-tägige kostenlose Testphase
- Ab $199/Monat (jährliche Abrechnung)
Visit WebsiteCustomer Rating:4.2/5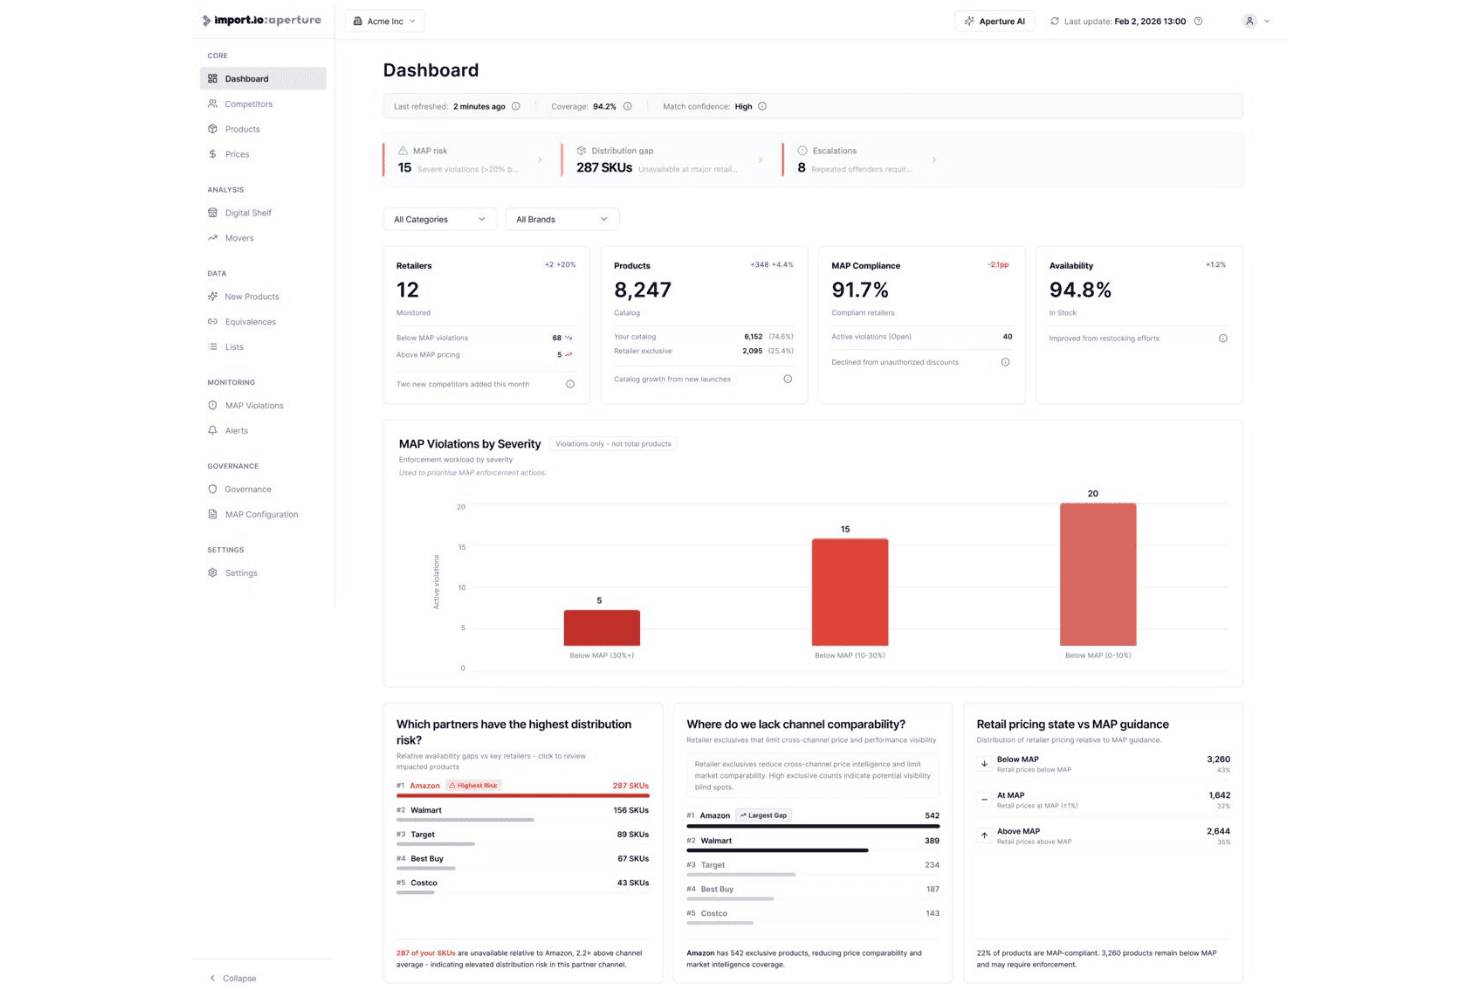
Die Aperture-Plattform von Import.io bietet ein Dashboard zur Anzeige von MAP-Compliance, Produktverfügbarkeit, Lücken in der Händlerverteilung und Preisverstößen. Import.io ist eine KI-native, verwaltete Web-Scraping-Plattform, die strukturierte Daten im Unternehmensmaßstab aus Websites extrahiert. Sie verarbeitet JavaScript-gerenderte Seiten, geschützte Quellen und liefert Daten direkt in Datenpipelines und Analysesysteme.
Für wen eignet sich Import.io am besten?
Import.io ist ideal für Dateningenieur- und Wettbewerbsanalyse-Teams in mittelgroßen bis großen Unternehmen, die gepflegte Datenpipelines benötigen, ohne eigene Scraper entwickeln oder betreiben zu müssen.
Warum ich Import.io gewählt habe
Import.io steht auf meiner Auswahlliste, weil strukturierte Daten direkt aus dem Web in Ihr Warehouse, Dashboard oder zu einem API-Endpunkt gelangen, ohne dass ein manueller Export zwischengeschaltet ist. Mir gefällt, dass Webhooks und API-Übertragungen natives Feature der Plattform sind und kein nachträglicher Zusatz. Besonders wertvoll finde ich die sich selbst reparierenden Pipelines: Sie passen sich automatisch an, wenn Zielseiten umgebaut werden, sodass ich nicht jedes Mal Extraktoren neu erstellen muss, wenn ein Händler seine Seitenstruktur ändert.
Import.io Hauptfunktionen
- KI-gestützte Extraktionsmodelle: Erkennen automatisch Seitenstrukturen und passen das Schema an, wenn Websites sich ändern.
- Enterprise-Proxy-Management: Unterstützt Premium- und Residential-Proxies für das Scraping geschützter oder geografisch eingeschränkter Websites.
- Visueller Point-and-Click-Builder: Ermöglicht das Auswählen und Extrahieren von Daten aus komplexen Webseiten ohne Programmierkenntnisse.
- Automatische PII-Entfernung: Erkennt und entfernt personenbezogene Informationen innerhalb der extrahierten Datensätze für die Einhaltung von Datenschutzbestimmungen.
Import.io Integrationen
Import.io bietet native Integrationen mit Google Sheets, Power BI, Tableau und Excel und stellt eine API für individuelle Integrationen sowie Webhooks zu anderen Systemen bereit.
Pros and Cons
Pros:
- Selbstheilende Pipelines passen sich automatisch an Webseitenänderungen an
- Verarbeitet stark geschützte und login-gesicherte Seiten
- Verwaltete Datenextraktion reduziert den Engineering-Aufwand im eigenen Haus
Cons:
- Begrenzte Transparenz über die zugrunde liegende Scraping-Infrastruktur
- Nur bedingt für kleinere Scraping-Projekte geeignet
Learn more about Import.io: Am besten geeignet für vorgefertigte Roboterautomatisierungs-Vorlagen
- Kostenloser Plan verfügbar
- Ab $19/Monat (jährliche Abrechnung)
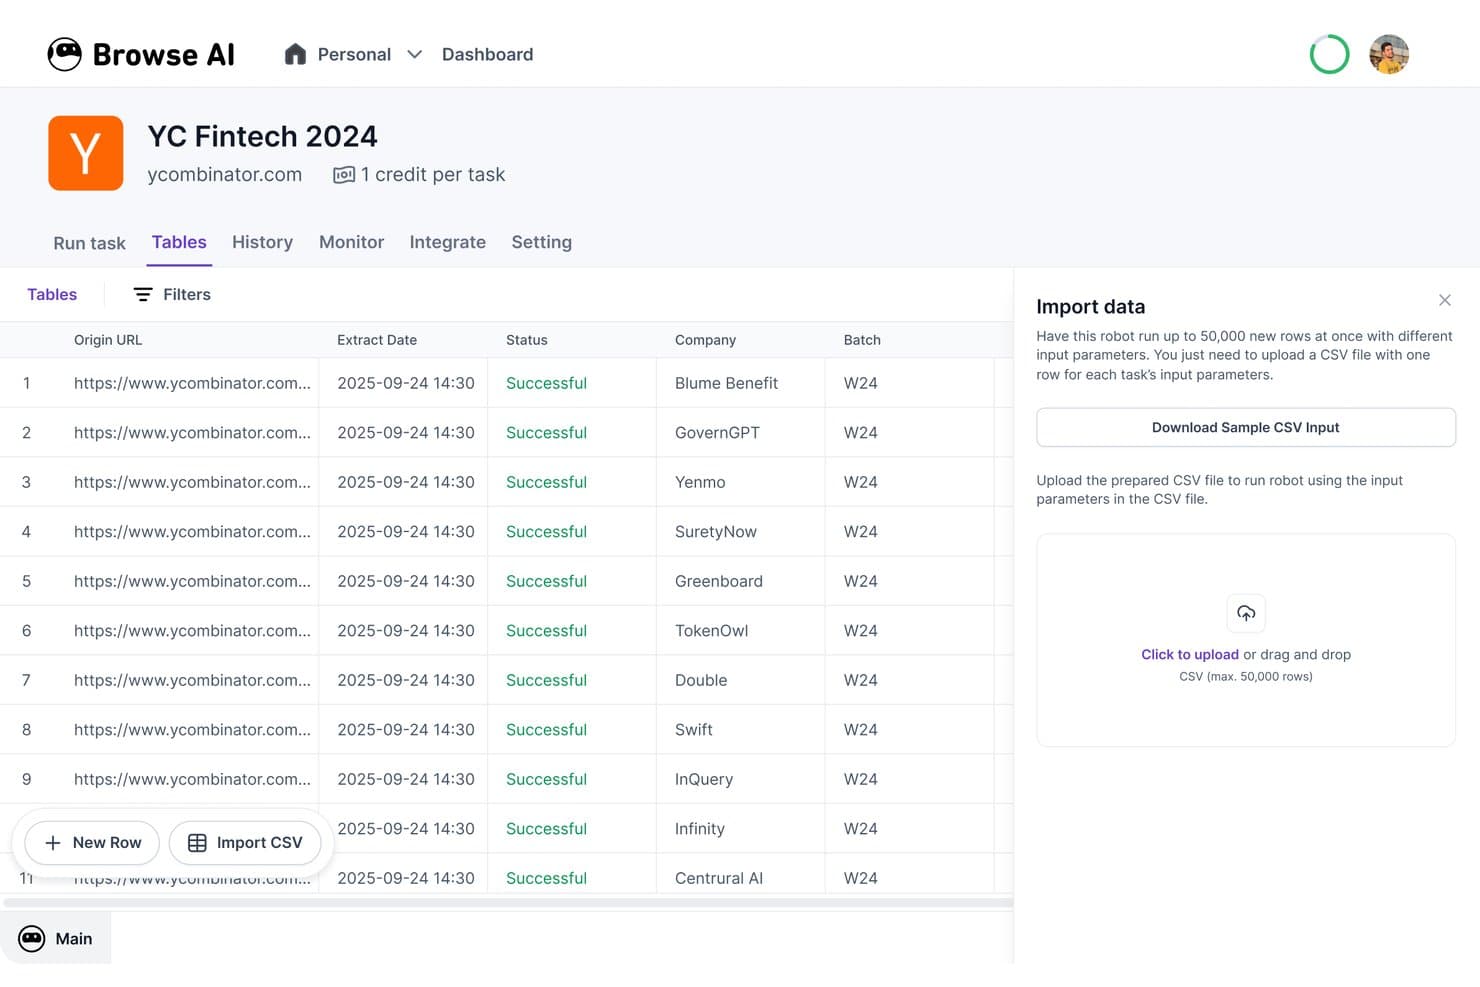
Browse AI bietet ein No-Code-Web-Scraping-Dashboard, mit dem Nutzer strukturierte Daten von Websites wie Y Combinator extrahieren und die Ergebnisse als CSV-Dateien exportieren können. Browse AI ist eine No-Code-Web-Scraping- und Website-Überwachungsplattform, die einen visuellen Point-and-Click-Daten-Extractor mit über 250 vorgefertigten Robotervorlagen zur automatisierten, geplanten Datenerfassung von Websites kombiniert.
Für wen ist Browse AI am besten geeignet?
Browse AI eignet sich besonders für Wettbewerbsanalysten und nicht-technische Teams, die strukturierte Webdaten sammeln müssen, ohne Code zu schreiben.
Warum ich Browse AI gewählt habe
Browse AI erhält seinen Platz auf meiner Auswahlliste, weil die Bibliothek der vorgefertigten Roboter seiner Zeit weit voraus ist. Ich kann strukturierte Listen von Amazon, Google Maps oder Indeed abrufen, ohne einen eigenen Scraper erstellen zu müssen, und jeder Roboter behandelt bereits Paginierung und dynamische Inhalte für die jeweilige Seite. Was ich ebenfalls schätze, ist die KI-gesteuerte Layoutanpassung, die einen Roboter automatisch aktualisiert, wenn sich die Seitenstruktur einer Zielseite ändert, sodass Scrapes nicht unbemerkt mitten im Prozess ausfallen.
Wichtige Funktionen von Browse AI
- JavaScript-Rendering: Automatisiert die Extraktion von modernen, JavaScript-lastigen Websites und Single-Page-Anwendungen.
- Unterstützung für Residential Proxies: Wechselt automatisch zwischen Residential IPs, um Anti-Bot-Systeme ohne manuelle Proxy-Konfiguration zu umgehen.
- Webhooks und API-Zugang: Ermöglicht die programmgesteuerte Einreichung von Scraping-Aufgaben und den Abruf von Daten für die Integration mit internen Systemen.
- Automatische Änderungserkennung: Überwacht Websites auf visuelle oder inhaltliche Änderungen und sendet Benachrichtigungen, sobald Updates erkannt werden.
Browse AI Integrationen
Browse AI bietet native Integrationen mit Google Sheets, Airtable, AWS S3, Zapier und Make.com. API- und Webhook-Zugang stehen für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Über 250 vorgefertigte Roboter sofort einsatzbereit
- Passt sich automatisch an, wenn sich das Layout der Zielseite ändert
- Bewältigt CAPTCHA und dynamische Seiten nativ
Cons:
- Begrenzte Kontrolle auf Selektor-Ebene für Entwickler
- Kreditkosten steigen bei größerem Volumen schnell an
Learn more about Browse AI: Am besten für Nutzer der Point-and-Click-Oberfläche
- Kostenloser Plan verfügbar
- Ab $69/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.7/5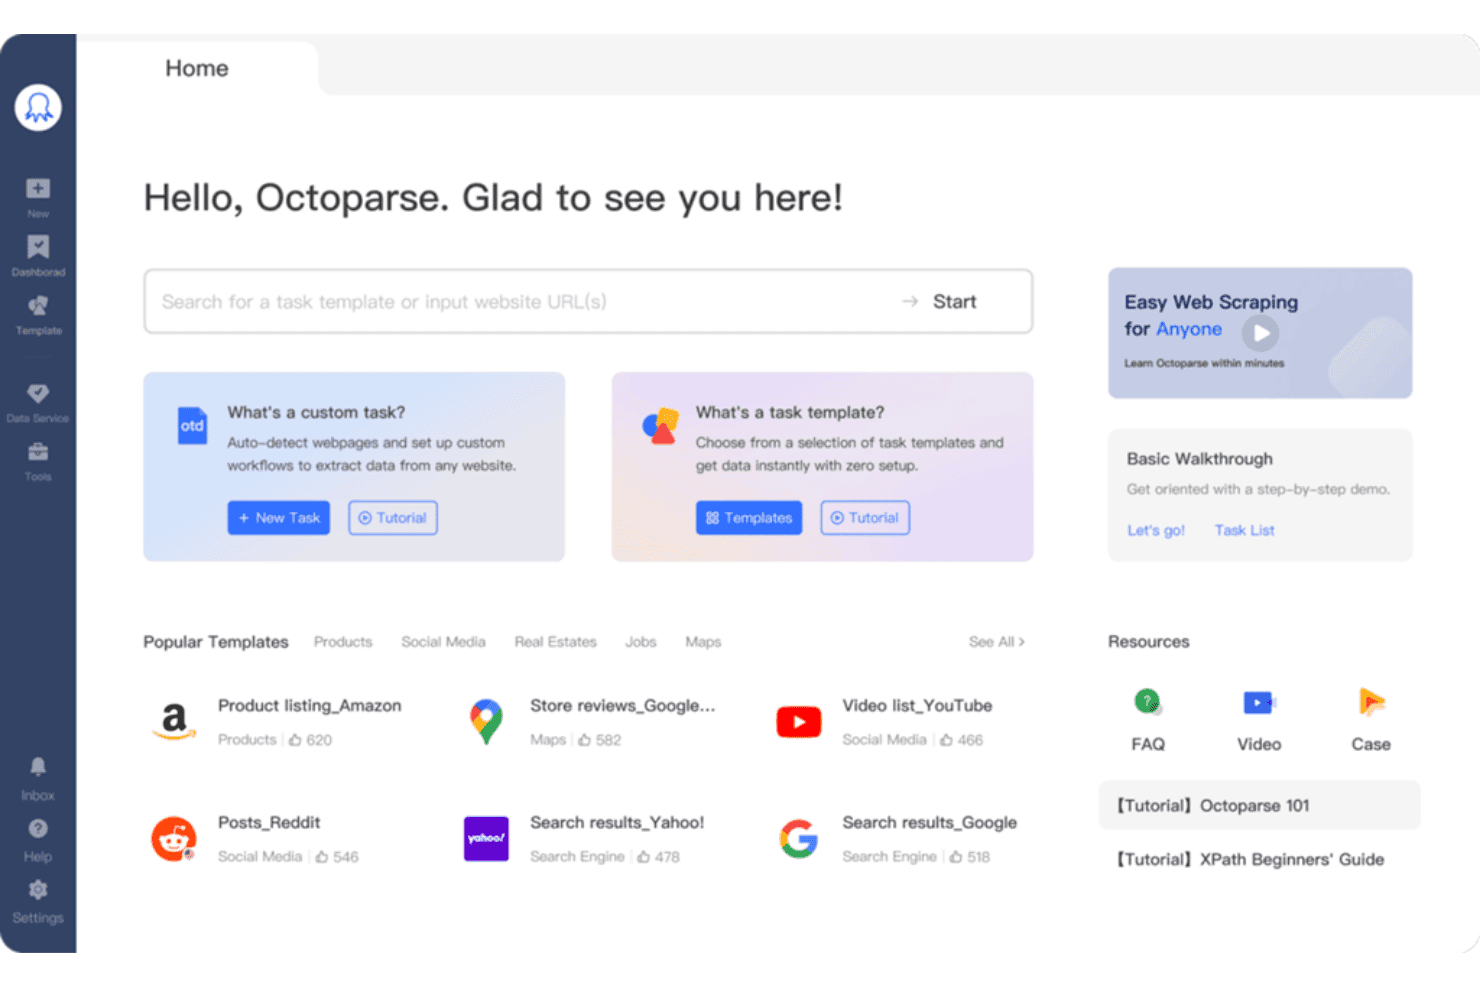
Octoparse bietet ein zentrales Dashboard mit beliebten Scraping-Vorlagen, der Möglichkeit zur Erstellung eigener Aufgaben und schnellen Einstiegshilfen für die Webdatenerfassung. Octoparse ist ein No-Code-Web-Scraping-Tool, das einen visuellen Workflow-Builder, KI-gestützte automatische Erkennung, cloudbasierte Extraktion und Unterstützung für JavaScript-gerenderte Seiten kombiniert, um strukturierte Daten von Websites zu sammeln.
Für wen ist Octoparse am besten geeignet?
Octoparse eignet sich besonders für Analysten im Bereich Wettbewerbsbeobachtung und Geschäftsleute, die regelmäßig Webdaten sammeln müssen, aber keinen Programmierhintergrund haben.
Warum ich Octoparse ausgewählt habe
Octoparse verdient seinen Platz auf meiner Auswahlliste, weil der Point-and-Click-Workflow-Builder tatsächlich die technische Hürde für Web Scraping entfernt. Mir gefällt, dass die KI-Auto-Detect-Funktion automatisch einen vollständigen Extraktionsworkflow entwirft, indem sie die Zielseite analysiert, sodass ich Selektoren nicht mehr manuell von Grund auf anlegen muss. Dank der über 500 vorgefertigten Vorlagen für Seiten wie Amazon oder Google Maps kann ich in wenigen Minuten einen funktionierenden Scraper für die gängigsten Ziele einrichten.
Octoparse Hauptfunktionen
- Cloudbasierte parallele Läufe: Führen Sie bis zu 20 Scraping-Aufgaben parallel mit der Cloud-Engine von Octoparse für eine schnellere Datensammlung aus.
- IP-Rotation und Residential-Proxies: Automatische IP-Adressen-Wechsel und Zugriff auf Residential-Proxies, um Sperrungen zu reduzieren und Anti-Bot-Maßnahmen zu umgehen.
- Datenbank- und Cloud-Exporte: Exportieren Sie extrahierte Daten direkt nach MySQL, SQL Server, PostgreSQL, Oracle, Google Sheets, Dropbox, Amazon S3 oder über eine API.
- Automatisches CAPTCHA-Lösen: Lösen Sie gängige CAPTCHAs während der Scraping-Aufgaben, um den Ablauf kontinuierlich zu halten und manuellen Eingriff zu minimieren.
Octoparse Integrationen
Octoparse bietet native Integrationen mit Google Sheets, Google Drive, Dropbox, Amazon S3, MySQL, SQL Server, PostgreSQL und Oracle. Es lässt sich auch mit Zapier verbinden und bietet für benutzerdefinierte Integrationen eine API an.
Pros and Cons
Pros:
- Über 500 vorgefertigte Vorlagen für gängige Websites
- KI erkennt und erstellt Extraktionsentwürfe automatisch
- Verarbeitet Infinite Scroll, Ajax und dynamische Seiten
Cons:
- Desktop-Client läuft nur unter Windows
- Maximal 20 gleichzeitige Cloud-Prozesse
Learn more about Octoparse: Am besten geeignet für die verwaltete Datenerfassung mit Anti-Bot-Schutz
- Kostenlose Testversion verfügbar
- Ab 0,5 $/1.000 Datensätze
Visit WebsiteCustomer Rating:4.5/5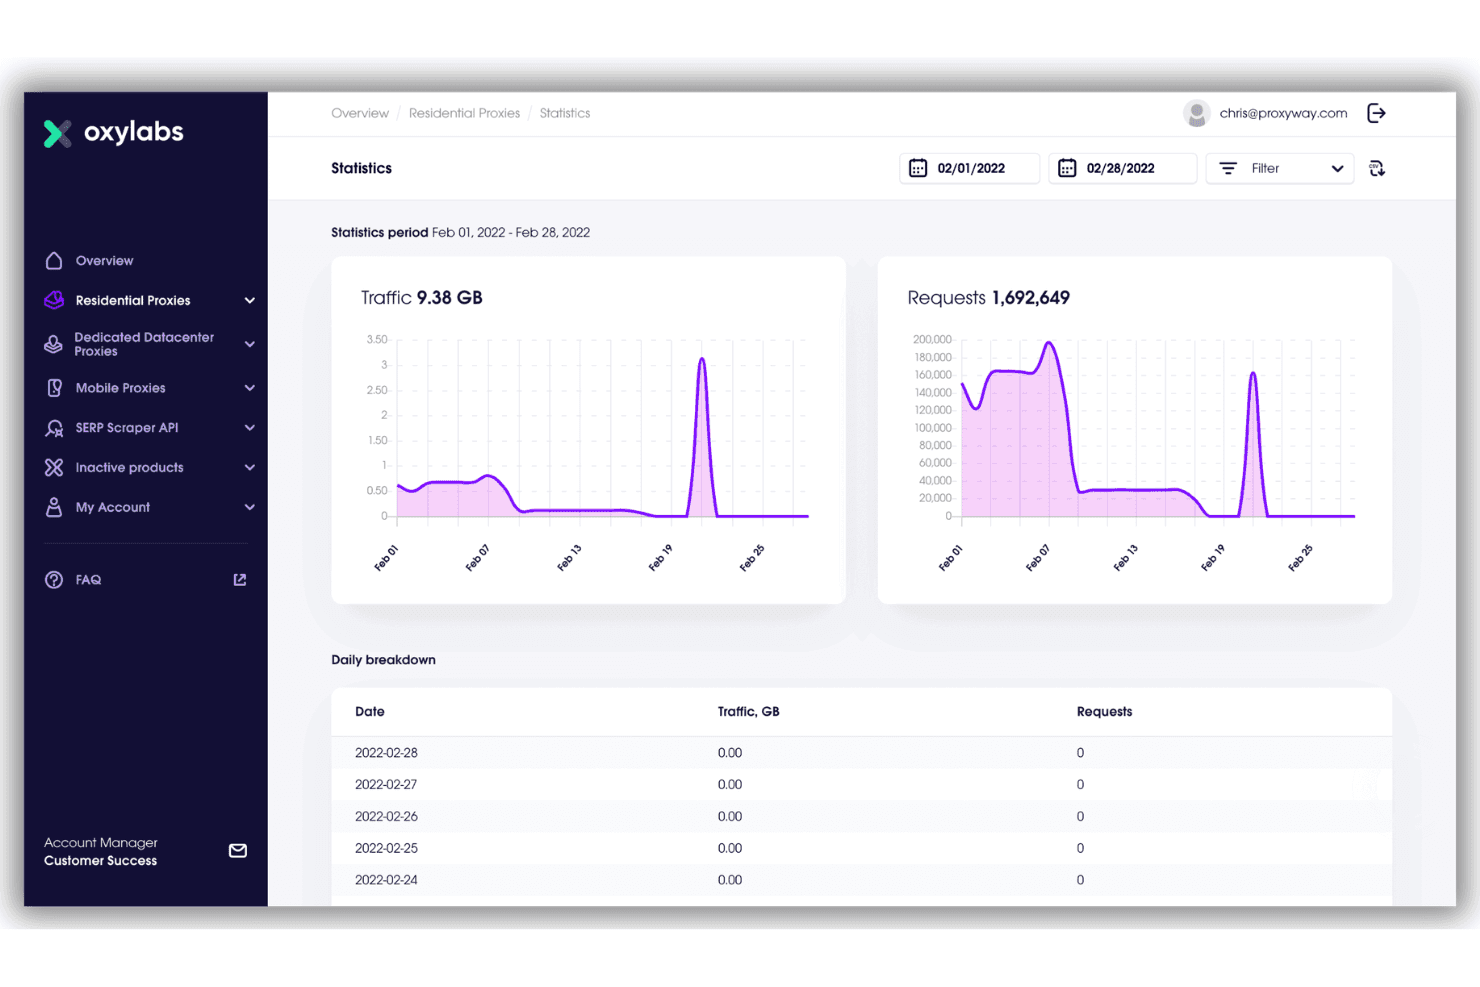
Oxylabs bietet ein detailliertes Statistik-Dashboard für private Proxys, das den Datenverkehr und die Anforderungsmetriken für einen ausgewählten Zeitraum im Februar 2022 anzeigt. Oxylabs ist eine Web-Scraper-API, die Proxy-Verwaltung, CAPTCHA-Lösung, JavaScript-Rendering und die strukturierte Datenextraktion für mehr als 50 vorkonfigurierte Website-Ziele übernimmt.
Für wen ist Oxylabs am besten geeignet?
Dateningenieure und Backend-Entwickler, die groß angelegte, geschäftskritische Scraping-Pipelines betreiben und eine Infrastruktur auf Unternehmensniveau sowie zuverlässigen Schutz vor Anti-Bot-Systemen benötigen.
Warum ich Oxylabs ausgewählt habe
Oxylabs hat sich einen Platz auf meiner Shortlist verdient, weil der Dienst den schwierigsten Teil des Web-Scrapings bewältigt: die Umgehung der Bot-Erkennung, ohne dass ich mich selbst darum kümmern muss. Die API übernimmt die CAPTCHA-Lösung, die Proxy-Rotation über mehr als 177 Millionen private IP-Adressen und automatische Wiederholungsversuche, ohne dass ich eine eigene Fehlerbehandlungslogik implementieren muss. Außerdem gefällt mir das erfolgsbasierte Preismodell, bei dem nur 2xx- und 4xx-Antworten auf das Kontingent angerechnet werden, sodass systemseitige Fehler meine Ergebnisse nicht aufbrauchen.
Die wichtigsten Funktionen von Oxylabs
- Benutzerdefinierter Parser: Definieren Sie CSS- oder XPath-Selektoren, um präzise strukturierte Daten aus Seiteninhalten zu extrahieren.
- KI-Assistent OxyCopilot: Erstellen Sie Scraping-Anweisungen und Parserlogik mithilfe von Eingabeaufforderungen in natürlicher Sprache.
- Vorgefertigte Ziel-Connectoren: Verwenden Sie spezielle Endpunkte für Amazon, Google, eBay, Walmart, Zillow und andere große Websites.
- Integrationen für Cloud-Speicher: Exportieren Sie Ergebnisse direkt in AWS S3 und Google Cloud Storage zur Verwendung in Datenpipelines.
Integrationen von Oxylabs
Oxylabs bietet native Integrationen mit AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com und Zapier. Für benutzerdefinierte Integrationen stehen eine API sowie SDKs für Python und Go zur Verfügung.
Pros and Cons
Pros:
- Mehr als 177 Millionen private IP-Adressen in 195 Ländern
- Erfolgsbasierte Preisgestaltung verhindert die Verschwendung des Anfragekontingents
- Vorgefertigte Endpunkte für mehr als 50 große Websites
Cons:
- Höhere Kosten als bei selbst verwalteten Scraping-Tools
- Keine visuelle Scraping-Oberfläche ohne Code verfügbar
Learn more about Oxylabs: Am besten geeignet für Proxy-Infrastrukturen im Unternehmensmaßstab
- Kostenloser Plan verfügbar
- Ab $1,5/1.000 Datensätze/Monat
Visit WebsiteCustomer Rating:4.7/5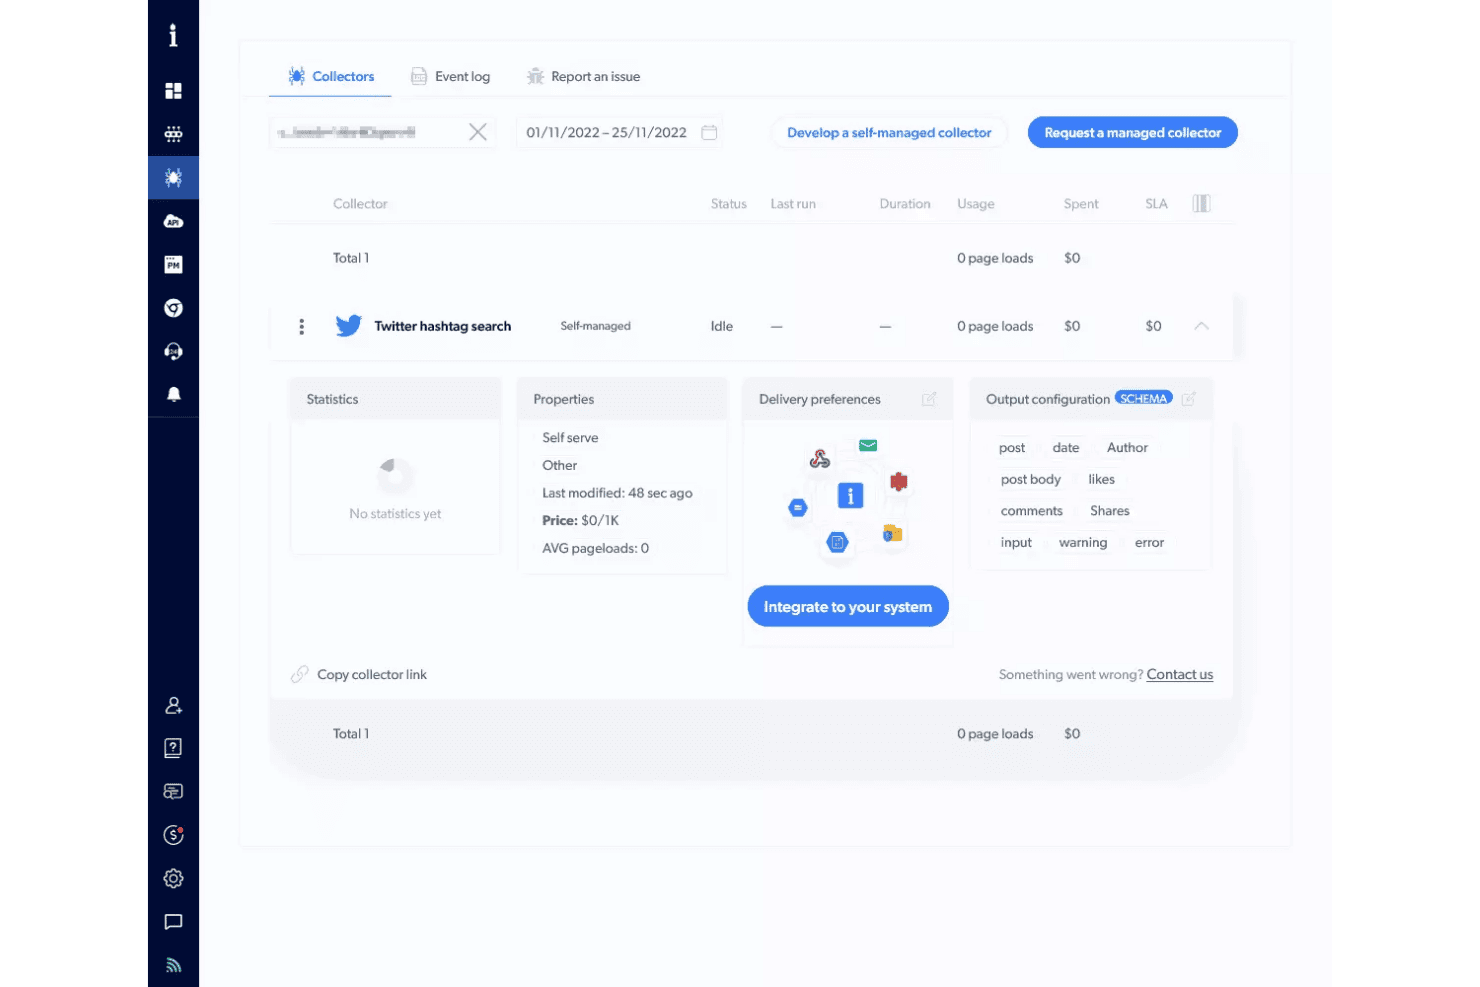
Das Collectors-Dashboard von Bright Data bietet einen Twitter-Hashtag-Such-Collector mit selbstverwaltetem Status, Ausgabekonfiguration und Systemintegrationsoptionen. Bright Data ist eine Web-Scraping-API und No-Code-Scraper-Plattform, die Proxy-Management, JavaScript-Rendering, CAPTCHA-Lösung und strukturierte Datenlieferung über 1.278+ vorgefertigte Scraper für beliebte Websites kombiniert.
Für wen ist Bright Data am besten geeignet?
Dateningenieure und Backend-Entwickler in mittelgroßen bis großen Unternehmen, die strukturierte Webdaten in großem Maßstab erfassen müssen, ohne selbst Proxy-Infrastrukturen zu verwalten.
Warum ich Bright Data ausgewählt habe
Bright Data verdient seinen Platz auf meiner Shortlist aufgrund des schieren Umfangs seines Proxy-Netzwerks: 400M+ Residential IPs in 195 Ländern mit automatischer Rotation, CAPTCHA-Lösung und Web Unlocker, um Cloudflare, Akamai und DataDome ohne jegliche Konfiguration zu umgehen. Ich habe LinkedIn Sales Navigator und Amazon in großen Mengen mit Bright Data gescraped und dabei bei Tausenden von Anfragen keine Blockierungen erlebt. Das AI Scraper Studio ermöglicht es außerdem, für jede neue Domain innerhalb von Minuten eine funktionierende Scraper-API zu generieren.
Wichtige Funktionen von Bright Data
- Vorgefertigte Scraper-Vorlagen: Über 1.200 einsatzbereite Scraper stehen für den schnellen Einsatz auf großen Plattformen wie LinkedIn, Amazon und YouTube zur Verfügung.
- KI-gestützte Schema-Erkennung: Das AI Scraper Studio erstellt individuelle Ausgabe-Schemata und automatisiert die Datenzuordnung von neuen Domains.
- Job-Management-APIs: Bietet Batch-Planung, wiederkehrende Ausführungen und Webhook-Trigger für die Integration in Workflow-Automatisierungstools.
- Direkte Datenlieferung: Unterstützt den Export von Daten nach JSON, NDJSON, CSV, XLSX oder das direkte Pushen zu S3, Snowflake, GCS, PubSub oder SFTP.
Integrationen von Bright Data
Bright Data bietet native Integrationen mit Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake und Pub/Sub und stellt eine API für kundenspezifische Integrationen bereit.
Pros and Cons
Pros:
- 400M+ Residential IPs in 195 Ländern
- Vorgefertigte Scraper für 1.200+ beliebte Websites
- Web Unlocker umgeht Cloudflare und DataDome
Cons:
- Nutzer berichten über Abrechnungsstreitigkeiten bei fehlgeschlagenem Scraping
- Zu komplex für Käufer ohne Entwicklerhintergrund
Learn more about Bright Data: Am besten für automatische Datenschema-Erkennung
- 30-tägige kostenlose Testphase
- Ab $0.13/1.000 Anfragen
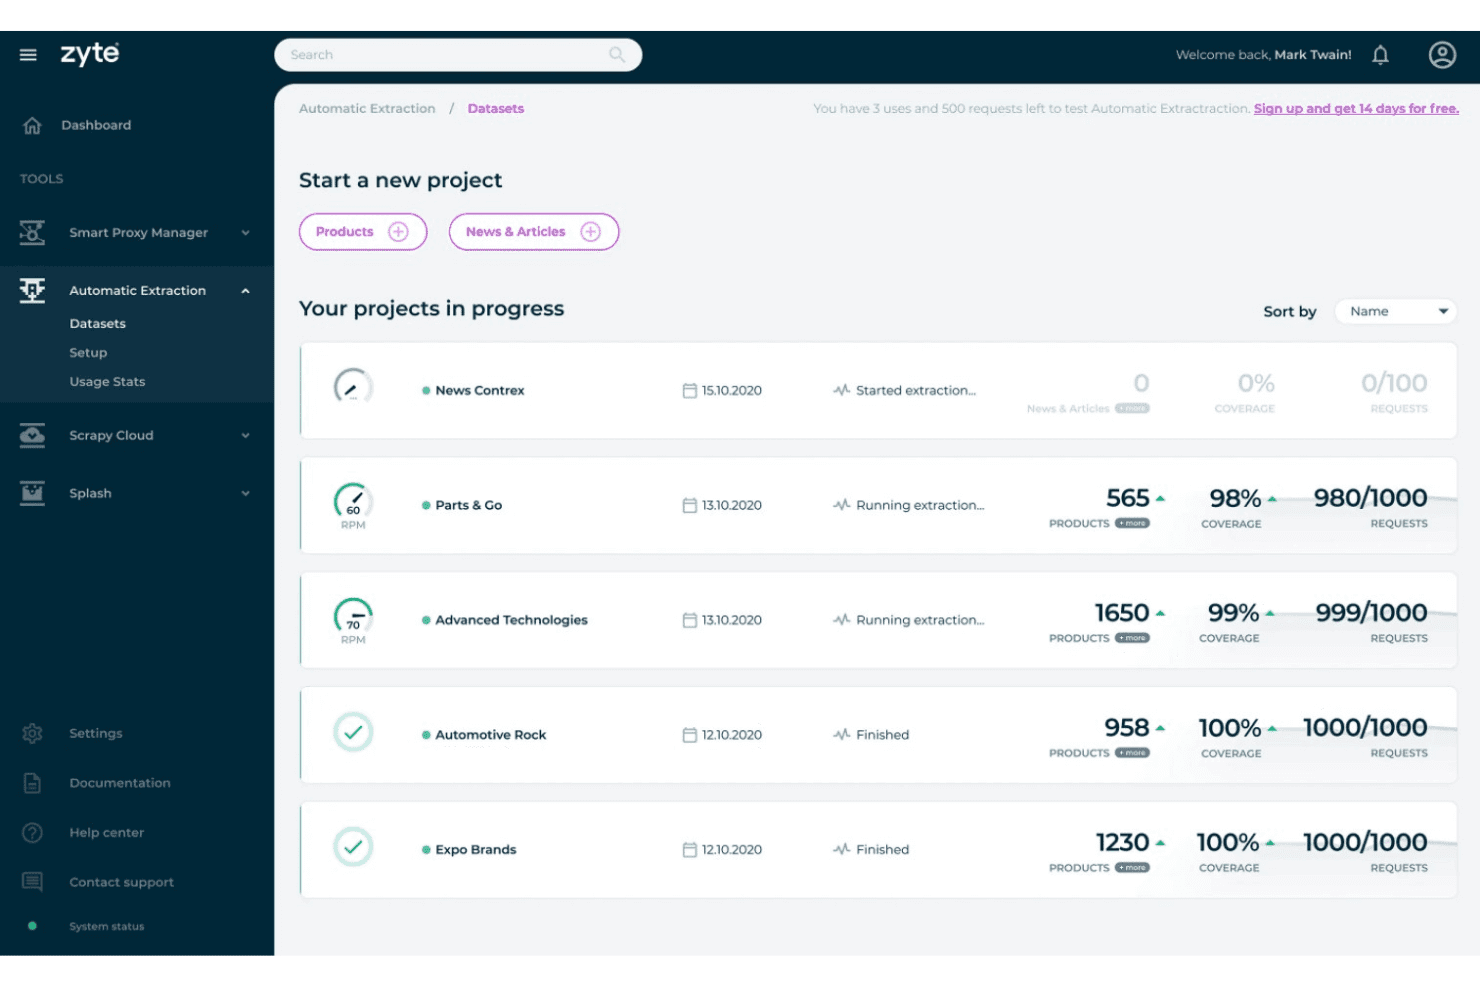
Das Feature zur automatischen Extraktion von Zyte bietet laufende und abgeschlossene Datenextraktionsprojekte mit Übersichten zur Abdeckung, Produktanzahl und Nutzungsstatistiken der Anfragen. Die Zyte API ist eine Web-Scraping-API, die Headless-Browser-Rendering, automatische Proxy-Rotation, CAPTCHA-Lösung und KI-gestützte Datenextraktion in einem einzigen Endpunkt vereint.
Für wen ist die Zyte API am besten geeignet?
Die Zyte API ist ideal für Data Engineers und Python-Entwickler, die produktionsreife Scraping-Pipelines entwickeln, um ML-Modelle oder Analysesysteme zu versorgen.
Warum ich die Zyte API ausgewählt habe
Die Zyte API schafft es auf meine Shortlist, weil sie die automatische Schemenerkennung hervorragend umsetzt. Zeigen Sie auf eine Produktseite oder einen Artikel und die durch ein LLM unterstützte Extraktionsschicht liefert typisiertes, strukturiertes JSON zurück – ganz ohne CSS-Selector oder XPath-Ausdruck. Wenn sich das Seitenlayout ändert, passt sich die KI an. Das heißt, ich muss nicht ständig Parser nach jedem Katalog-Redesign eines Wettbewerbers nachbessern.
Wichtigste Funktionen der Zyte API
- Sofortiges Browser-Rendering: Die Zyte API startet vorgewärmte Headless-Browser, um dynamische Seiten bei Bedarf zu laden.
- Vollständige Proxy-Infrastruktur: Wechselt automatisch zwischen Residential-, Rechenzentrums- und Mobile-IP-Adressen bei jeder Anfrage.
- Sitzungsmanagement: Hält persistente Cookies und Nutzersitzungen für Workflows, die Authentifizierung oder mehrstufige Aktionen erfordern.
- Cloud-Delivery-Integrationen: Überträgt extrahierte Daten direkt an Zielorte wie AWS S3, Google Cloud oder Azure zur weiteren Verarbeitung.
Zyte API Integrationen
Zyte API bietet native Integrationen mit Scrapy, Scrapy Cloud und Python SDKs und stellt eine API für individuelle Anbindungen bereit. Außerdem wird die Cloud-Übertragung zu AWS S3, Google Cloud und Azure unterstützt.
Pros and Cons
Pros:
- KI erkennt Schemata automatisch ohne manuelle Selektoren
- Umgeht Anti-Bot-Schutz ohne zusätzliche Konfiguration
- Vorgewärmte Browser vermeiden Kaltstart-Verzögerungen
Cons:
- Wiederkehrende Aufgabenplanung benötigt externe Tools
- Erfordert Programmierkenntnisse zur Implementierung
Learn more about Zyte API: Am besten geeignet für einfache, API-gesteuerte Scraping-Workflows
- Kostenloser Tarif verfügbar
- Ab $49/Monat
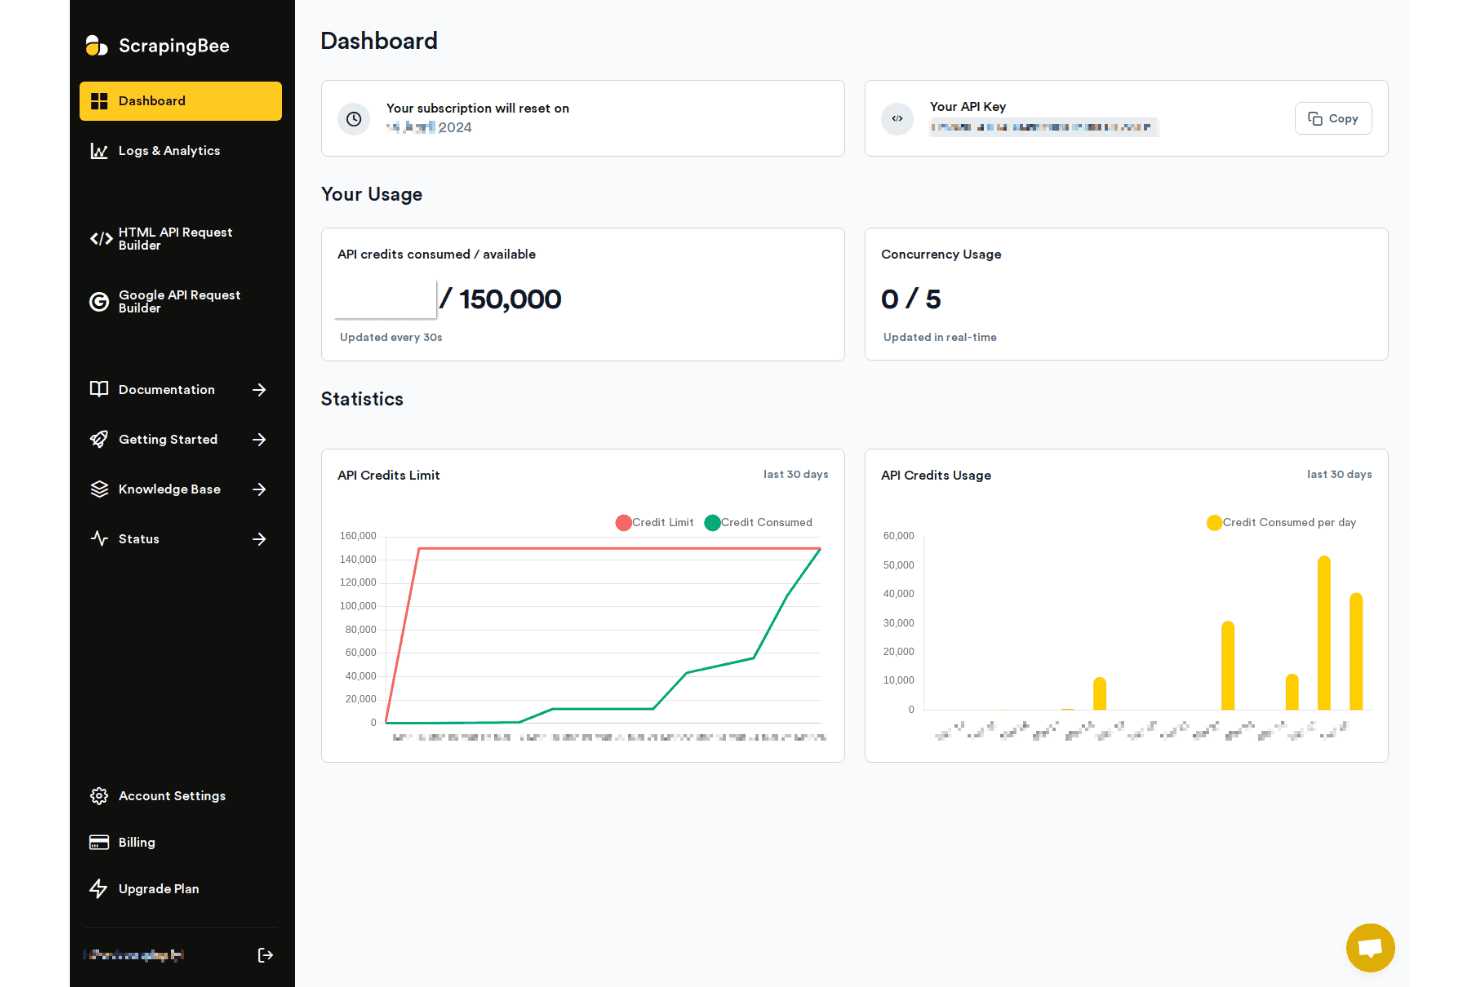
Das ScrapingBee-Dashboard bietet Einblick in die Nutzung der API-Credits, Informationen zur Parallelität sowie 30-Tage-Nutzungsdiagramme zur Überwachung der Scraping-Aktivität. ScrapingBee ist eine Web-Scraping-API, die Headless-Chrome-Rendering, Proxy-Rotation und Anti-Bot-Umgehung übernimmt, mit speziellen Extraktions-APIs für Plattformen wie Google, Amazon und Walmart.
Für wen ist ScrapingBee am besten geeignet?
ScrapingBee ist ideal für Entwickler und Data Engineers, die eine zuverlässige, code-basierte API zur Extraktion von Webdaten benötigen, ohne selbst Proxy- oder Browser-Infrastruktur aufbauen zu müssen.
Warum habe ich ScrapingBee ausgewählt?
ScrapingBee landet auf meiner Auswahlliste, weil die API die Komplexität des modernen Web-Scrapings hervorragend abstrahiert. Eine einzige Anfrage übernimmt das Headless-Chrome-Rendering, die intelligente Proxy-Rotation und die JavaScript-Ausführung, sodass ich keinen Code für Browser-Management schreiben oder Proxy-Pools separat konfigurieren muss. Außerdem gefällt mir das AI Query-Feature, mit dem ich beschreiben kann, was extrahiert werden soll – in natürlicher Sprache, anstatt für jede neue Zielseite CSS- oder XPath-Selektoren zu schreiben.
ScrapingBee Hauptfunktionen
- Vorgefertigte Scraping-APIs: Wählen Sie vorgefertigte Endpunkte für Plattformen wie Amazon, Walmart und Google Search, um gängige Datenerfassungsaufgaben zu vereinfachen.
- AI Query-Extraktion: Beschreiben Sie, welche Daten extrahiert werden sollen, in natürlicher Sprache und generieren Sie automatisch strukturierte Ergebnisse.
- Markdown-Scraper: Wandeln Sie jede Webseite in Markdown oder reinen Text um, um die schnelle Weiterverarbeitung durch nachgelagerte KI-Modelle oder Datenbanken zu ermöglichen.
- No-Code-Integrationen: Verbinden Sie sich mit Make, n8n und Zapier, um Arbeitsabläufe zu automatisieren, ohne eigene Planungsskripte schreiben zu müssen.
ScrapingBee Integrationen
ScrapingBee bietet native Integrationen für Make, n8n und Zapier und stellt eine API für individuelle Integrationen bereit.
Pros and Cons
Pros:
- Es wird nur für erfolgreiche Anfragen abgerechnet
- Übernimmt Headless-Chrome-Verwaltung ohne Zusatzaufwand
- Vorgefertigte APIs für Amazon und Google
Cons:
- Kein integrierter, nativer Job-Scheduler
- Guthabenkosten steigen bei Skalierung schnell an
Learn more about ScrapingBee:
Weitere Web-Scraping-Tools
Hier finden Sie einige weitere Optionen für Web-Scraping-Tools, die es nicht in meine engere Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- 11ScraperAPIAm besten für problemloses IP-Routing im großen Maßstab
- 12CrawlbaseAm besten für API-Zugriff auf globale Datenquellen
- 13ScrapyAm besten geeignet für anpassbare Python-Scraping-Frameworks
- 14ScrapingdogAm besten geeignet für schnelle Bereitstellung mit minimalem Aufwand
So bewerte ich Web-Scraping-Tools
Ich teile meine Bewertung in zwei Ebenen auf: die grundlegenden Funktionen, die ein Tool für reales Web-Scraping beherrschen muss – JS-Rendering, Proxy-Rotation und geplante Aufgaben – sowie die Unterscheidungsmerkmale, die die besten Optionen hervorheben.
Grundlegende Funktionen (Voraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jedes einzelne für jede der unten aufgeführten Kernfunktionen auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (zeichnet sich in diesem Bereich aus). Anschließend rechne ich die Gesamtpunktzahl des Tools in einen Prozentsatz um. Jedes Tool muss eine Mindestgesamtpunktzahl von 65% erreichen, um für die Aufnahme berücksichtigt zu werden.
- Datenerfassungs-Engine: Ich prüfe, ob ein Tool mehrere Selektormethoden wie CSS, XPath und reguläre Ausdrücke unterstützt oder einen visuellen Builder für Teams bietet, die eine Einrichtung per Klicken und Auswählen bevorzugen.
- JavaScript-Rendering: Websites, die mit React, Vue oder Angular erstellt wurden, benötigen Unterstützung für Browser ohne grafische Oberfläche. Ich prüfe, ob zuverlässiges Rendering mit konfigurierbaren Wartebedingungen verfügbar ist.
- Proxy- & Anti-Bot-Handhabung: Ich achte auf integrierte Proxy-Rotation, CAPTCHA-Lösung und Umgehungsmechanismen, die Schutzmaßnahmen wie Cloudflare oder DataDome ohne zusätzliche Einrichtung bewältigen.
- Planung & Automatisierung: Wiederkehrende Scraping-Aufgaben sollten unbeaufsichtigt ausgeführt werden. Ich bewerte, ob das Tool eine Cron-ähnliche Planung, Webhook-Trigger und eine Logik für Wiederholungen bei Fehlern unterstützt.
- Export strukturierter Daten: Ich prüfe, welche Ausgabeformate verfügbar sind und ob das Tool Daten direkt an Ziele wie S3, Google Sheets, Datenbanken oder APIs übertragen kann.
- Skalierbarkeit & Parallelität: Große Aufgaben über Tausende von Seiten hinweg benötigen parallele Anfragen. Ich untersuche die Parallelitätslimits und ob das Tool verteiltes Crawling unterstützt.
Sobald ich eine Liste von Tools habe, die die Kriterien erfüllen, prüfe ich, wodurch sich die einzelnen Plattformen voneinander abheben.
Unterscheidungsmerkmale (Was Anbieter voneinander abhebt)
So vergleiche ich verschiedene Anbieter miteinander:
Herausragende Funktionen
Bei der Umgehung von Anti-Bot-Maßnahmen sehe ich die größten Unterschiede zwischen den Tools. Ich achte auf integrierte CAPTCHA-Lösung und Browser-Fingerprinting, die Schutzmaßnahmen wie Cloudflare oder DataDome bewältigen, ohne dass Drittanbieter-Proxy-Dienste beschafft werden müssen. Auch Vorlagen zur automatischen Erkennung sind sehr wichtig – Tools wie Bright Data und Zyte bieten vorgefertigte Scraper für häufige Ziele wie Amazon oder Google-SERPs, wodurch stundenlange manuelle Konfiguration von Selektoren eingespart werden. Außerdem bewerte ich die Planungs- und Überwachungsfunktionen, insbesondere Fehlermeldungen und automatische Wiederholungen, die Datenpipelines am Laufen halten, wenn Zielseiten ihre Layouts über Nacht ändern.
Über die Funktionen hinaus
Die Preismodelle unterscheiden sich in diesem Bereich stark – einige Anbieter rechnen pro API-Anfrage ab, andere nach Bandbreite oder Anzahl erfolgreich zurückgegebener Seiten. Ich prüfe, ob die Kosten planbar bleiben, wenn die Skalierung auf Millionen von Seiten pro Monat anwächst. Die Proxy-Infrastruktur ist ein weiteres wichtiges Unterscheidungsmerkmal. Ich prüfe, ob ein Tool Pools mit Privatkunden- und Rechenzentrums-Proxys inklusive integrierter Geolokalisierung auf Stadtebene umfasst, da die Beschaffung separater Proxy-Verträge Kosten und Komplexität erhöht. Auch der Umgang mit Compliance ist wichtig, insbesondere für Teams, die in regulierten Branchen Daten sammeln und bei denen der Umgang mit GDPR und robots.txt klar dokumentiert sein muss.
So wählen Sie Web-Scraping-Tools aus
Es ist leicht, sich in langen Funktionslisten und komplexen Preisstrukturen zu verlieren. Damit Sie sich bei der Auswahl der passenden Software für Ihre individuellen Anforderungen auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit wichtigen Faktoren:
| Faktor | Was Sie berücksichtigen sollten |
|---|---|
| FaktorSkalierbarkeit | Was Sie berücksichtigen solltenKann das Tool erwartete Volumensteigerungen und parallele Crawling-Vorgänge ohne erhebliche Kostensteigerungen oder Ratenbegrenzungen bewältigen? |
| FaktorIntegrationen | Was Sie berücksichtigen solltenÜbermittelt das Tool Daten direkt an Ihre Zielsysteme (Cloud-Speicher, Datenbanken, Workflows), oder sind manuelle Schritte erforderlich? |
| FaktorAnpassbarkeit | Was Sie berücksichtigen solltenKönnen Sie die Extraktionslogik an individuelle Seitenstrukturen anpassen, oder sind Sie auf vorgegebene Vorlagen und Regeln beschränkt? |
| FaktorBenutzerfreundlichkeit | Was Sie berücksichtigen solltenKönnen sowohl technische als auch nicht technische Benutzer Scraping-Vorgänge verwalten, oder benötigen Sie fortlaufend die Unterstützung von Entwicklern, um Änderungen vorzunehmen? |
| FaktorImplementierung und Einführung | Was Sie berücksichtigen solltenWie schnell kann Ihr Team eine erste Datenpipeline einrichten, und welche Unterstützung oder Dokumentation ist verfügbar, wenn Probleme auftreten? |
| FaktorKosten | Was Sie berücksichtigen solltenIst die Preisgestaltung bei zunehmender Nutzung vorhersehbar? Berücksichtigen Sie realistisch Auslastungsspitzen, Wiederholungslogik und falsch positive Ergebnisse in Ihrem Arbeitsaufkommen. |
| FaktorSicherheitsvorkehrungen | Was Sie berücksichtigen solltenSetzt das Tool Ihr Unternehmen oder Ihren Workflow Compliance-Risiken, Datenlecks oder unbefugten Zugriffsmöglichkeiten aus? |
| FaktorCompliance-Anforderungen | Was Sie berücksichtigen solltenEntspricht der Ansatz des Anbieters Ihren internen und regionalen Vorschriften (z. B. DSGVO, Einhaltung der robots.txt und Umgang mit personenbezogenen Daten)? |
Was sind Web-Scraping-Tools?
Web-Scraping-Tools sind Softwareplattformen, die das Abrufen und Extrahieren strukturierter Daten aus Websites automatisieren. Mit diesen Tools können Sie Informationen von Seiten erfassen – einschließlich dynamischer und von JavaScript erzeugter Inhalte – und sie für Analysen, Berichte oder die Integration in interne Datenbanken verwenden. Die meisten bieten Optionen zur Konfiguration von Extraktionsregeln und zum Export von Daten in entwicklerfreundlichen Formaten.
Funktionen von Web-Scraping-Tools
Bei der Auswahl von Web-Scraping-Tools sollten Sie auf die folgenden wichtigen Funktionen achten:
- Datenextraktions-Engine: Ermöglicht es Ihnen, mithilfe von CSS-Selektoren, XPath oder Point-and-Click-Oberflächen festzulegen, wie Inhalte von Websites gesammelt werden, um strukturierte Ergebnisse zu erhalten.
- JavaScript-Rendering: Lädt dynamische Anwendungen oder Single-Page-Apps durch die Ausführung von JavaScript und stellt so sicher, dass Daten erfasst werden, die im statischen HTML nicht erscheinen.
- Proxy-Verwaltung: Wechselt IP-Adressen, häufig mithilfe von privaten Proxy-Diensten, um geografische Sperren, Ratenbegrenzungen oder Bot-Schutz zu umgehen, damit Sie Websites zuverlässig und in großem Umfang scrapen können.
- CAPTCHA-Verarbeitung: Erkennt CAPTCHA-Herausforderungen automatisch und löst sie oder umgeht sie, damit Datenpipelines weiterlaufen, wenn Maßnahmen gegen Bots ausgelöst werden.
- Planung und Automatisierung: Plant wiederkehrende Scraping-Vorgänge oder löst Jobs in bestimmten Intervallen aus, was einen unbeaufsichtigten Betrieb und die Integration in Datenpipelines ermöglicht.
- Export strukturierter Daten: Unterstützt die Ausgabe in JSON, CSV oder XML sowie die direkte Übertragung an Cloud-Speicher, APIs oder Datenbanken, wodurch manuelle Konvertierungs- und Upload-Schritte entfallen.
- Änderungserkennung und Benachrichtigungen: Überwacht Zielwebsites auf Inhaltsaktualisierungen, Preisänderungen oder neue Einträge und benachrichtigt Sie, wenn sich die Ergebnisse von vorherigen Durchläufen unterscheiden.
- Steuerung der Parallelität: Verarbeitet mehrere Anfragen parallel, um Scraping-Sitzungen zu beschleunigen, und unterstützt umfangreiche Crawl-Jobs über Tausende von Seiten.
- Fehlerbehandlung und Protokollierung: Erfasst fehlgeschlagene Extraktionen, Verbindungsabbrüche oder Änderungen an Websites und stellt detaillierte Fehlerprotokolle bereit, um Scraping-Probleme schnell zu diagnostizieren und zu beheben.
- Benutzerzugriffskontrollen: Beschränkt, wer Projekte bearbeiten, Jobs verwalten oder Exporte einsehen darf, um die Sicherheit zu gewährleisten und versehentliche oder unbefugte Änderungen zu verhindern.
Gängige KI-Funktionen von Web-Scraping-Tools
Über die oben aufgeführten Standardfunktionen von Web-Scraping-Tools hinaus integrieren viele dieser Lösungen KI mit Funktionen wie:
- Automatische Erkennung von Datenfeldern: Verwendet KI, um relevante Datenfelder auf komplexen oder unbekannten Webseiten automatisch zu identifizieren und zuzuordnen, wodurch die manuelle Einrichtung von Selektoren reduziert wird.
- Adaptive Erkennung der Website-Struktur: Lernt Änderungen an Website-Layouts und passt sich daran an, wodurch Ausfallzeiten und Wartungsaufwand bei der Aktualisierung des Designs von Zielwebsites minimiert werden.
- Intelligente Umgehung von Bot-Schutz: Setzt KI ein, um menschliche Browsing-Muster nachzuahmen und Scraping-Strategien in Echtzeit anzupassen, wodurch fortschrittliche Systeme zur Bot-Erkennung umgangen werden können.
- Inhaltsanalyse in natürlicher Sprache: Nutzt KI, um unstrukturierten Text zu extrahieren, zusammenzufassen oder zu kategorisieren, sodass sich Bewertungen, Artikel oder Forenbeiträge leichter analysieren lassen.
- Automatisierte Vorlagenerstellung: Erstellt wiederverwendbare Scraping-Vorlagen für ähnliche Websites, indem Seitenstrukturen und Inhaltsmuster mithilfe von maschinellem Lernen analysiert werden.
- Intelligente Fehlerkorrektur: Erkennt häufige Extraktionsfehler oder Anomalien mithilfe KI-gestützter Diagnosen und behebt sie, wodurch der Bedarf an manueller Fehlerbehebung reduziert wird.
Vorteile von Web-Scraping-Tools
Die Implementierung von Web-Scraping-Tools bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige davon:
- Datenerfassung im großen Maßstab: Automatisiert die Extraktion von Informationen aus zahlreichen Websites und Seiten und macht große Datensätze für Analysen oder maschinelles Lernen verfügbar.
- Markteinblicke in Echtzeit: Überwacht Preise von Wettbewerbern, Produktkataloge und Website-Änderungen sofort mithilfe von Planung, Änderungserkennung und Benachrichtigungsfunktionen.
- Ressourceneffizienz: Plant und automatisiert Jobs, reduziert den manuellen Aufwand und ermöglicht es Entwicklern, sich auf Projekte mit höherem Mehrwert zu konzentrieren.
- Konstante Datenqualität: Exportiert strukturierte Daten in zuverlässigen Formaten wie JSON oder CSV und minimiert so aufwendige Datenbereinigung und Integrationsarbeit.
- Umgehung von Hindernissen durch Bot-Schutz: Verwendet integrierten Proxy-Wechsel oder externe rotierende Proxy-Dienste sowie CAPTCHA-Verarbeitung und die Umgehung von Bot-Schutz, um auf Inhalte zuzugreifen, die andere Lösungen nicht erreichen können.
- Anpassungsfähigkeit an Website-Änderungen: Vertraut auf intelligente Fehlerbehandlung und bei KI-gestützten Tools auf eine automatisch angepasste Extraktion, wenn sich Website-Layouts oder -Strukturen ändern.
- Sicherer Zugriff und Compliance: Schützt Datenpipelines durch Benutzerberechtigungen, Prüfprotokollierung und die Ausrichtung an Compliance-Rahmenwerken oder Datenschutzbestimmungen.
Kosten und Preise von Web-Scraping-Tools
Die Auswahl von Web-Scraping-Tools erfordert ein Verständnis der verschiedenen verfügbaren Preismodelle und Tarife. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre durchschnittlichen Preise und typische in Web-Scraping-Tool-Lösungen enthaltene Funktionen zusammen:
Tarifvergleichstabelle für Web-Scraping-Tools
| Tariftyp | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| TariftypKostenloser Tarif | Durchschnittlicher Preis$0-$10/Monat | Übliche FunktionenBegrenzte Extraktionsläufe, grundlegende Zeitplanung, Unterstützung durch die Community und grundlegende Datenexportformate. |
| TariftypPersönlicher Tarif | Durchschnittlicher Preis$15-$40/Monat | Übliche FunktionenMehr Extraktionskontingente, JavaScript-Rendering, API-Zugriff und grundlegende Fehlerbehandlung. |
| TariftypGeschäftstarif | Durchschnittlicher Preis$55-$150/Monat | Übliche FunktionenHöhere Parallelität, Proxy-Rotation, erweiterte Zeitplanung, Tools für die Teamzusammenarbeit und bevorzugter Support. |
| TariftypUnternehmenstarif | Durchschnittlicher Preis$250+/Monat | Übliche FunktionenIndividuelle Integrationen, SLA-Garantien, geografisch ausgerichtete Proxys, betreute Einführung und dedizierte Kontoverwaltung. |
FAQs zu Web-Scraping-Tools
Hier finden Sie Antworten auf häufige Fragen zu Web-Scraping-Tools:
Benötige ich Programmierkenntnisse, um Web-Scraping-Tools zu verwenden?
Nein, Programmierkenntnisse sind nicht unbedingt erforderlich. Viele visuelle Tools bieten eine Lösung ohne Code, beispielsweise eine Chrome-Erweiterung mit Punkt-und-Klick-Bedienung, mit der technisch nicht versierte Benutzer Extraktionsroutinen visuell erstellen und die Seitenübersicht einer Website durchsuchen können, um Datensätze für Aufgaben wie die Lead-Generierung zu sammeln.
Komplexe Logik, umfangreiche Datenpipelines oder Scraping in großem Umfang basieren jedoch in der Regel auf Programmiertools:
- Python: Eine herkömmliche Python-Bibliothek wie BeautifulSoup eignet sich ideal dazu, statische HTML-Dokumente sauber zu analysieren.
- JavaScript: Eine spezialisierte Node.js-Bibliothek (wie Puppeteer oder Playwright) ermöglicht es Entwicklern, programmgesteuert mit dynamischen Webelementen zu interagieren.
Können Web-Scraping-Tools dynamische und JavaScript-lastige Websites verarbeiten?
Ja, die meisten modernen Tools bieten JavaScript-Rendering-Engines, um dynamische Inhalte aus Single-Page-Anwendungen (SPAs) und interaktiven Websites zu erfassen.
Wie begegnen Web-Scraping-Tools Maßnahmen gegen Bots auf Websites?
Um Schutzmaßnahmen gegen Bots zu überwinden, setzen hochentwickelte Tools mehrere Umgehungsstrategien ein:
- Rotierende Proxys: Verteilung von Anfragen über umfangreiche IP-Pools (Rechenzentrums- und Privat-Proxys), um Ratenbegrenzungen oder IP-Sperren zu vermeiden.
- Automatisierte CAPTCHA-Löser: Lösen oder Umgehen visueller und verhaltensbasierter Herausforderungen.
- Maskierung des Browser-Fingerabdrucks: Ändern von Browser-Headern, Canvas-Fingerabdrücken und Benutzeragenten in Engines (wie WebKit oder Chromium), um menschliche Interaktionen in gängigen Browsern wie Firefox oder Chrome nachzuahmen.
Ist Web-Scraping legal?
Die Rechtmäßigkeit von Web-Scraping hängt davon ab, welche Daten Sie sammeln, wie Sie sie verwenden und welche Nutzungsbedingungen auf der Website gelten. Prüfen Sie vor dem Vorgehen stets die rechtlichen Richtlinien und Compliance-Anforderungen.
Wie erhalte und speichere ich die gescrapten Daten?
Sie können Daten in der Regel in Formate wie CSV, JSON oder Excel exportieren oder sie je nach Integrationsoptionen des Tools direkt an Cloud-Speicher, Webhooks oder Datenbanken übertragen.