

10 beste Tools zur Beobachtung von LLMs im Jahr 2026

Auswahl der besten Tools für LLM-Beobachtbarkeit


Tools für LLM-Beobachtbarkeit verfolgen KI-Workflows, überwachen das Verhalten in der Produktion und bewerten die Modellqualität. Dieser Leitfaden vergleicht 12 Optionen zum Debuggen mehrstufiger Agenten, zur Nachverfolgung von Prompts und Modellversionen, zur Messung von Latenz und Token-Nutzung sowie zum Erkennen von Regressionen vor der Bereitstellung. Sie finden Open-Source-, selbst gehostete, für Unternehmen geeignete, auf OpenTelemetry basierende und entwicklerorientierte Plattformen, die zu Ihrer technischen Architektur, Ihren Governance-Anforderungen und Ihrem Bereitstellungsworkflow passen.
Warum Sie unseren Software-Empfehlungen vertrauen können
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Vergleichen Sie die besten Tools für LLM-Beobachtbarkeit
Vergleichen Sie Preise und Spezifikationen der wichtigsten Plattformen meiner Auswahl direkt miteinander.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für quelloffene OTel-native Ablaufverfolgung geeignet | Kostenloser Tarif + kostenlose Demo verfügbar | Preise auf Anfrage | Website | |
| 2 | Am besten geeignet für Open-Source-Evaluierung im Self-Hosting in großem Maßstab | Kostenloser Tarif verfügbar | Preise auf Anfrage | Website | |
| 3 | Am besten für die LLM-Bewertung über den gesamten Lebenszyklus mit Gateway-Betrieb | Kostenloser Tarif + kostenlose Demo verfügbar | Preise auf Anfrage | Website | |
| 4 | Am besten geeignet für Open-Source-Bewertung und Tracing | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $19/Monat | Website | |
| 5 | Am besten geeignet für die Verknüpfung von Prompt-Versionen mit Produktions-Ablaufverfolgungen | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $49/Monat | Website | |
| 6 | Am besten für das Tracing von Agenten über komplexe Pipelines hinweg geeignet | Kostenloser Tarif + kostenlose Demo verfügbar | Ab 50 $/Monat | Website | |
| 7 | Am besten geeignet, um LLM-Traces mit Produktanalysen zu verknüpfen | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $34/Monat | Website | |
| 8 | Am besten geeignet für Open-Source-Tracing mit Prompt-Versionierung | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $29/Monat | Website | |
| 9 | Am besten geeignet für die Bewertung von der Entwicklung bis zur Produktion in einem Kreislauf | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $249/Monat | Website | |
| 10 | Am besten für LangChain- und LangGraph-Tracing geeignet | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $39/Nutzer/Monat | Website |
Bewertungen von Tools für LLM-Beobachtbarkeit
Nachfolgend finden Sie detaillierte Zusammenfassungen der wichtigsten Empfehlungen aus meiner Auswahl. Jede Bewertung behandelt zentrale Funktionen, Anwendungsfälle und Integrationen, damit Sie die passende Lösung finden.
Am besten für quelloffene OTel-native Ablaufverfolgung geeignet
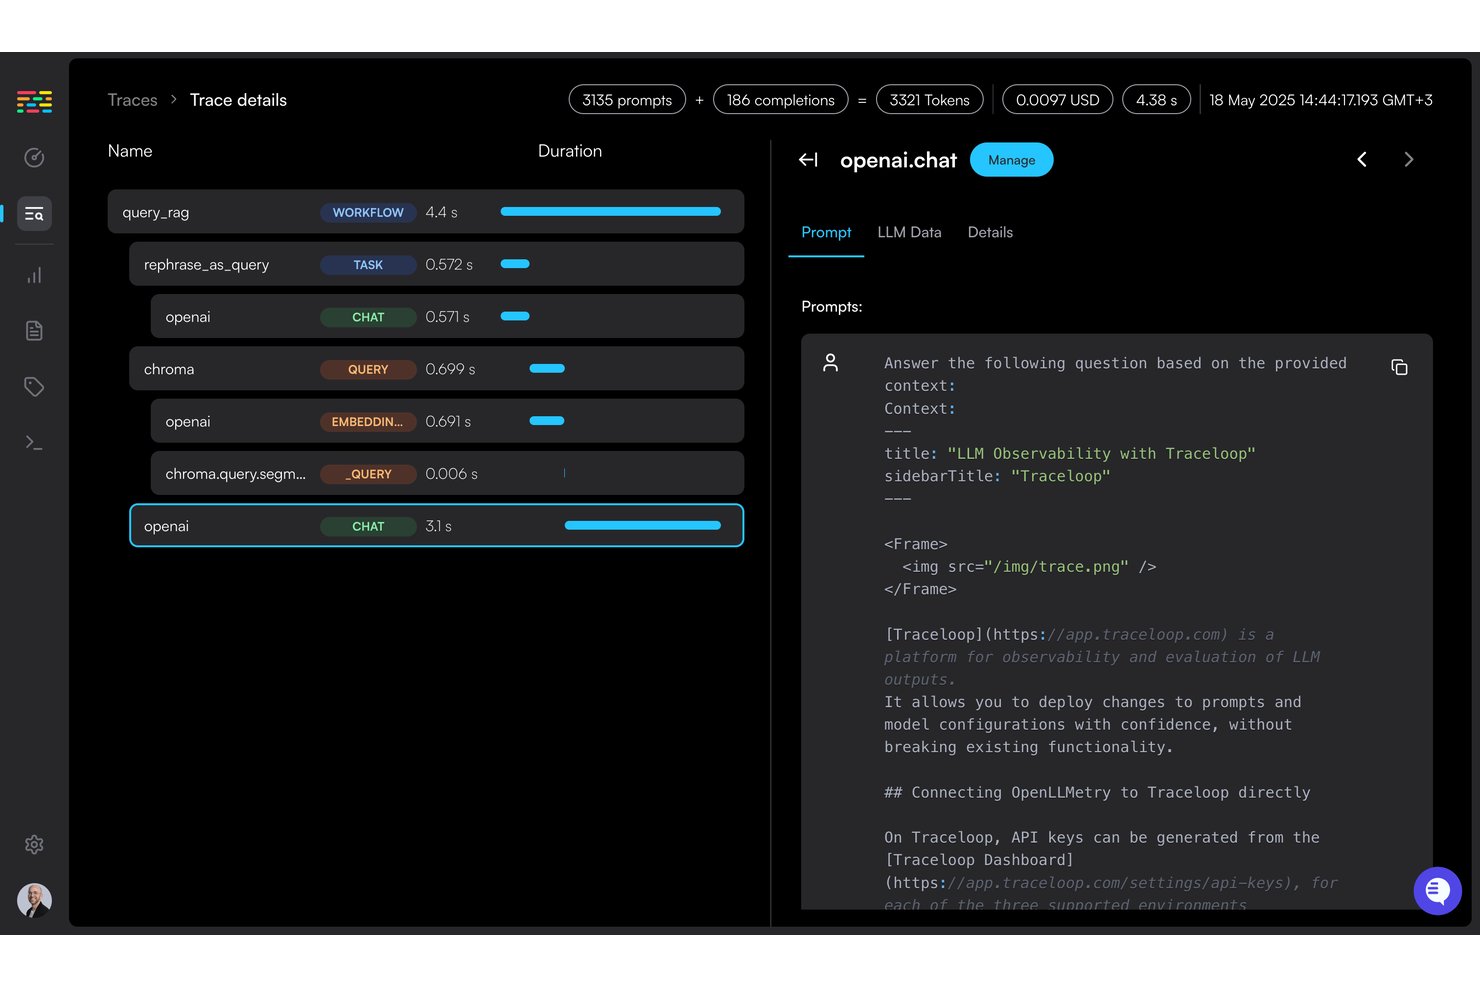
Traceloop von ServiceNow basiert auf OpenTelemetry und bietet dadurch spanbasierte Ablaufverfolgungsprotokollierung, eine Bewertung der Ausgabequalität, eine Prompt-Registrierung mit umgebungsbasierten Bereitstellungen, Überwachungen in der Produktion sowie Qualitätsschranken für CI/CD.
Für wen ist Traceloop am besten geeignet?
Traceloop eignet sich für Plattform- und DevOps-Ingenieure, die eine regelkonforme, selbst gehostete LLM-Überwachung auf Kubernetes oder in einer vom Internet isolierten Infrastruktur benötigen.
Warum ich Traceloop ausgewählt habe
Ich habe Traceloop in meine Empfehlungen aufgenommen, weil es vollständig auf OpenTelemetry basiert und dafür das quelloffene OpenLLMetry-SDK verwendet. Dadurch wird jeder LLM-Aufruf, jede Abfrage an eine Vektordatenbank und jeder Agentenschritt als nativer OTel-Span aufgezeichnet, den Sie an mehr als 25 Backend-Systeme exportieren können. Besonders gut gefällt mir die Bewertungspipeline: Sie können dieselben Qualitätsprüfungen gleichzeitig als CI/CD-Schranken für Pull Requests, als integrierte Sicherheitsvorkehrungen in der Produktion und als Echtzeitüberwachungen für den laufenden Datenverkehr einsetzen. Die Prompt-Registrierung mit umgebungsbasierten Bereitstellungen ermöglicht es außerdem, Prompt-Änderungen zunächst in der Entwicklungsumgebung und erst danach in der Produktion bereitzustellen, sodass die Versionskontrolle über den gesamten Lebenszyklus hinweg zuverlässig bleibt.
Wichtige Funktionen von Traceloop
- Integrierte Bewertungsfunktionen: Prüfen Sie Faktentreue, Relevanz und Sicherheit im laufenden Datenverkehr automatisch, ohne dass eine manuelle Einrichtung erforderlich ist.
- Auf Agenten ausgerichtete Bewertungsprüfungen: Bewerten Sie Agentenausgaben hinsichtlich Korrektheit, Werkzeugnutzung, Beibehaltung von Informationen, Aufgabenerfüllung und Sicherheit.
- Überwachungen in der Produktion: Führen Sie Bewertungen in Echtzeit für jeden Span aus, der einem Filter entspricht, um Halluzinationen und Qualitätsverschlechterungen zu erkennen.
- Integrierte Sicherheitsvorkehrungen: Führen Sie während der Inferenz in Echtzeit Sicherheitsprüfungen aus, die direkt aus Ihren konfigurierten Bewertungsfunktionen erstellt werden.
Integrationen von Traceloop
Traceloop unterstützt mehr als 20 LLM-Anbieter, darunter Axiom, Braintrust, BMC, Google Cloud, Highlight, Honeycomb, Instana, OpenTelemetry Collector, Datadog, Oracle Cloud und Tenant Cloud. Außerdem steht eine API zum Erstellen benutzerdefinierter Bewertungsfunktionen nach dem Prinzip „LLM als Prüfer“ zur Verfügung.
Pros and Cons
Pros:
- Native Ablaufverfolgung verringert die Abhängigkeit von einzelnen Anbietern
- Bewertungen erstrecken sich von CI/CD bis in die Produktion
- Selbsthosting unterstützt vom Internet isolierte Bereitstellungen
Cons:
- Die Übernahme durch ServiceNow führt zu Unsicherheit hinsichtlich der Produktentwicklung
- Öffentlich verfügbare Details zur Kostenverteilung bleiben begrenzt
MLflow
Am besten geeignet für Open-Source-Evaluierung im Self-Hosting in großem Maßstab
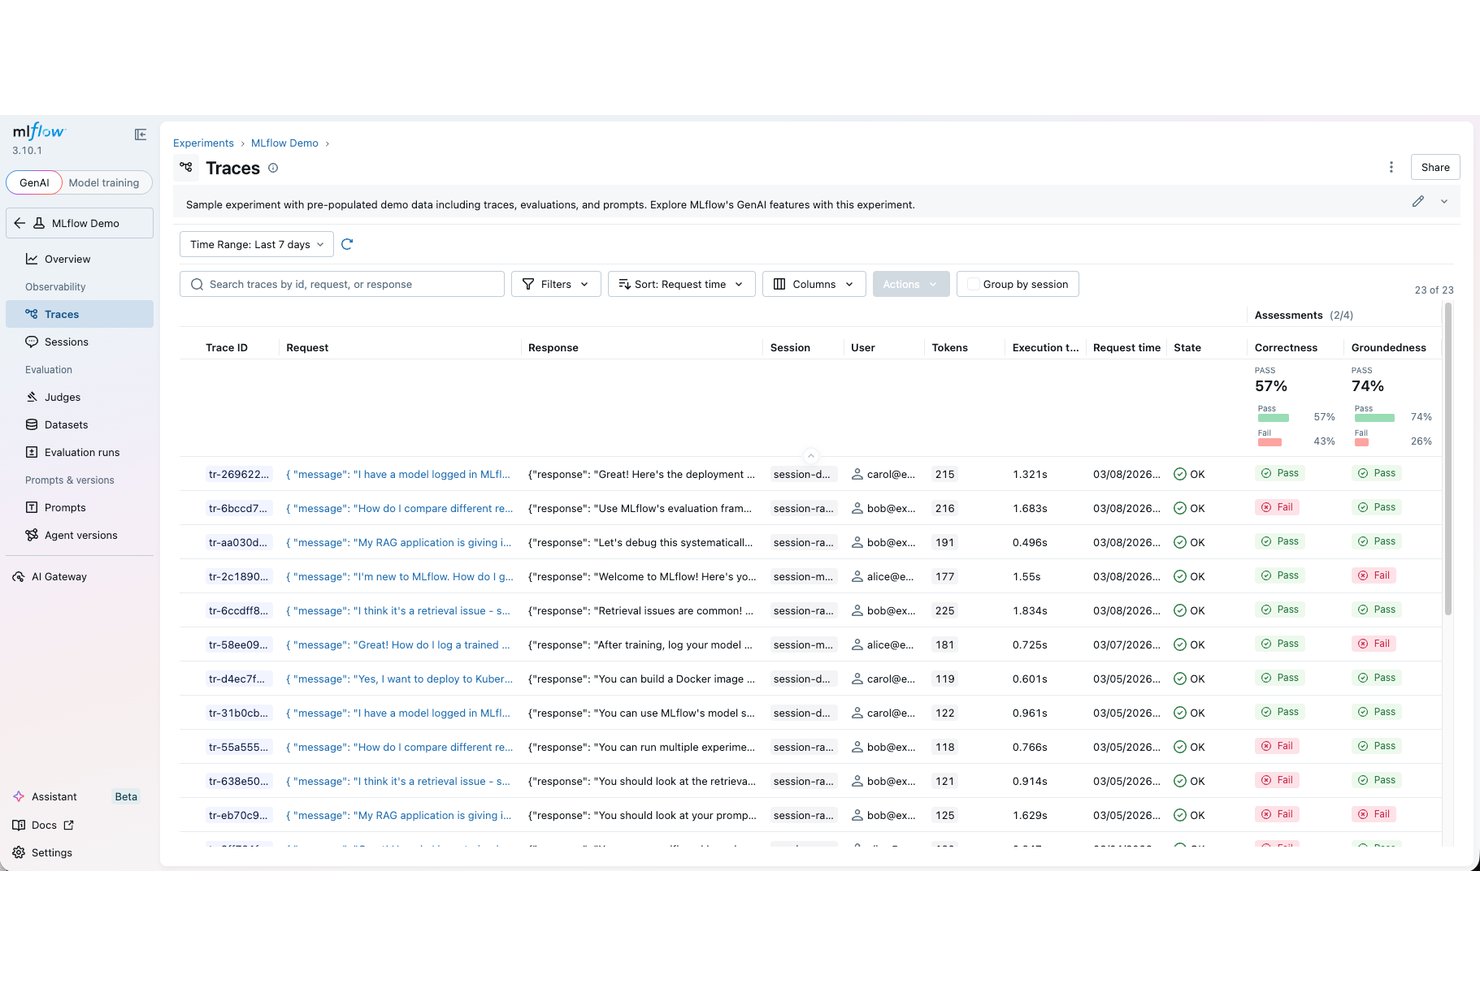
MLflow ist eine Open-Source-Plattform zur Beobachtung von KI-Anwendungen, die Trace-Protokollierung, Bewertung der Ausgabequalität, Prompt-Versionierung, Kosten- und Token-Verfolgung sowie Produktionsüberwachung für LLM-Anwendungen und KI-Agenten kombiniert.
Für wen ist MLflow am besten geeignet?
MLflow eignet sich für ML-/KI-Ingenieure und Datenwissenschaftler, die vollständige Kontrolle über ihre Infrastruktur zur Beobachtung benötigen und Gebühren pro Trace oder die Abhängigkeit von einem Anbieter vermeiden möchten.
Warum ich MLflow ausgewählt habe
Ich habe MLflow in meine Top-Auswahl aufgenommen, weil es das einzige Tool hier ist, das von Grund auf als Open-Source-Software unter der Apache-2.0-Lizenz entwickelt wurde. Das bedeutet, dass Ihre Trace-Daten niemals Ihre eigene Infrastruktur verlassen. Mir gefällt, dass die Prompt-Registrierung jede Prompt-Version direkt mit ihren Bewertungsergebnissen verknüpft, sodass Sie A/B-Tests mit Varianten durchführen und Qualität, Latenz sowie Sicherheitsbewertungen nebeneinander sehen können, bevor Sie etwas in die Produktion übernehmen. Die asynchronen LLM-Bewertungsmodelle bewerten außerdem kontinuierlich Stichproben von Traces, ohne den Live-Datenverkehr zu verlangsamen.
Wichtige Funktionen von MLflow
- Prompt-Registrierung: Versionieren, testen und vergleichen Sie Prompts nebeneinander, mit Herkunftsverfolgung und automatischer Prompt-Optimierung zur algorithmischen Feinabstimmung von Prompts.
- Schutzmechanismen und Sicherheitserkennung: Die Echtzeitbewertung erkennt Prompt-Injection, das Durchsickern personenbezogener Daten und Umgehungsversuche mithilfe deterministischer und LLM-basierter Erkennungsverfahren; außerdem ist eine Schwärzung personenbezogener Daten im SDK verfügbar.
- Verwaltung von Bewertungsdatensätzen: Erstellen und speichern Sie Testfalldatensätze aus Produktions-Traces, wobei strukturiertes Feedback von Nutzern und Fachexperten in die Kalibrierung der Bewertungsmodelle einfließt.
- KI-Gateway mit Budgetrichtlinien: Legen Sie Ausgabengrenzen pro Tag, Woche oder Monat über mehrere Anbieter hinweg fest, mit Webhook-Warnungen an Tools wie Slack oder PagerDuty, wenn Grenzen überschritten werden.
MLflow-Integrationen
MLflow lässt sich in mehr als 40 LLMs und KI-Agenten integrieren, darunter OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry und TypeScript. Die REST-API ist ebenfalls für benutzerdefinierte Verbindungen verfügbar.
Pros and Cons
Pros:
- Selbst gehostete Traces halten Daten im eigenen Unternehmen
- Bewertungsmodelle in der Produktion bewerten Halluzinationen und Drift
- Die Prompt-Herkunft verknüpft Änderungen mit Bewertungen
Cons:
- Verschachtelte Agenten-Traces können unübersichtlich werden
- Die Benachrichtigungsoptionen sind weiterhin weniger eindeutig dokumentiert
Bifrost
Am besten für die LLM-Bewertung über den gesamten Lebenszyklus mit Gateway-Betrieb
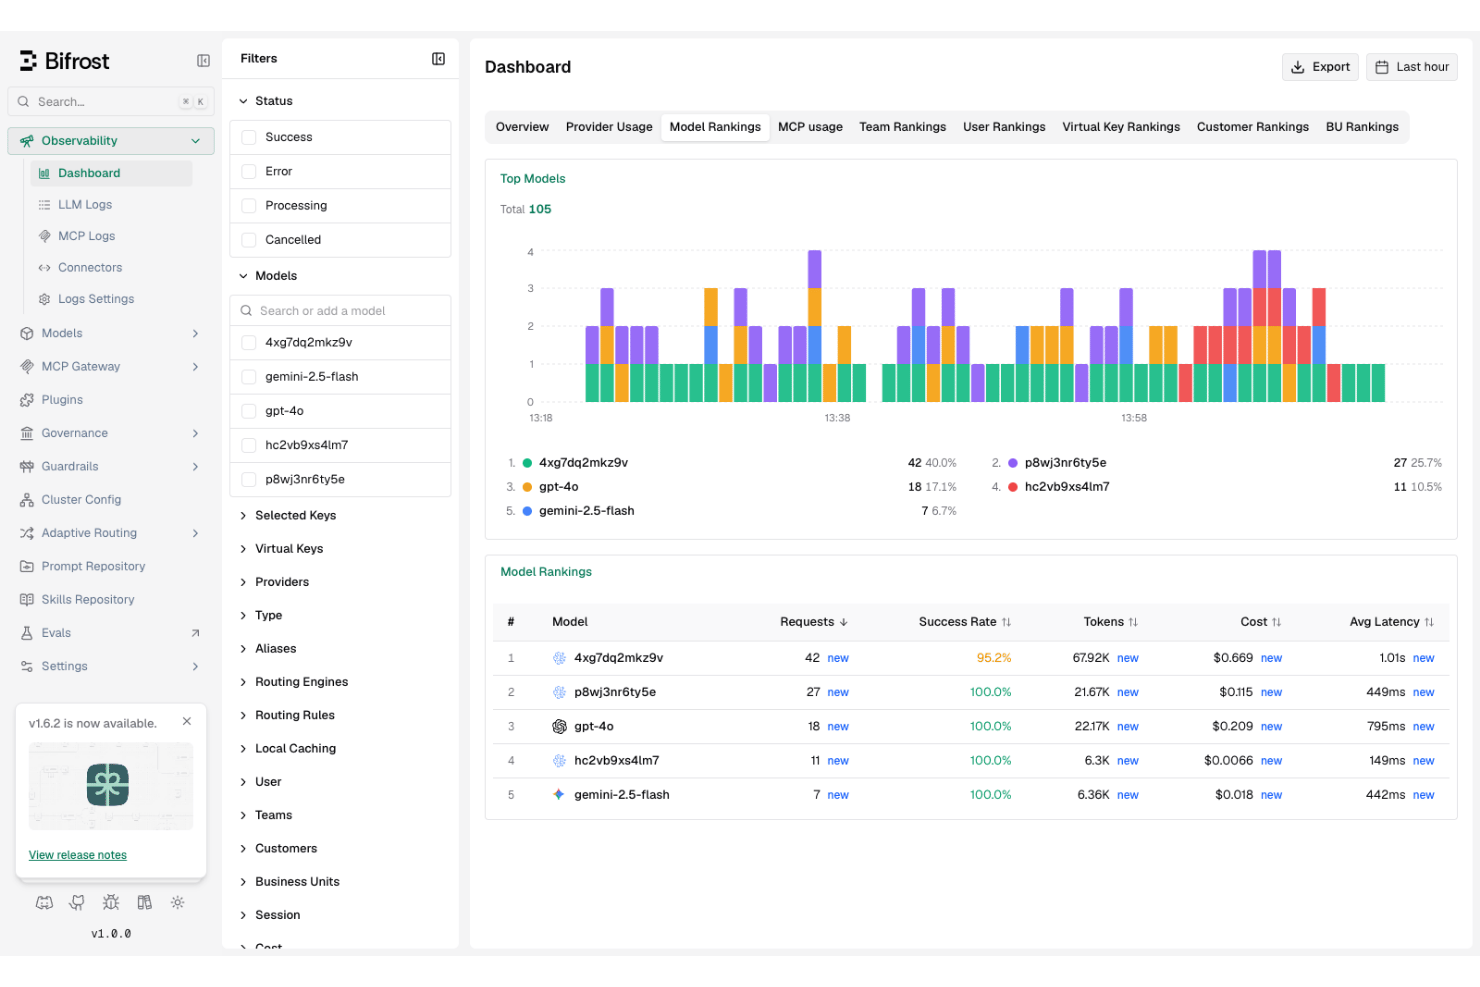
Bifrost ist eine Plattform zur Beobachtung von LLMs, die den gesamten Entwicklungslebenszyklus abdeckt und verteiltes Tracing, Prompt-Versionierung und Experimente, automatisierte sowie menschliche Bewertungen und ein Open-Source-LLM-Gateway kombiniert.
Für wen ist Bifrost am besten geeignet?
Bifrost eignet sich hervorragend für regulierte Unternehmensteams, die eine Bereitstellung innerhalb der VPC, SOC 2 Typ II, HIPAA-Konformität und eine Bewertung durch Menschen in einem einzigen System benötigen.
Warum ich Bifrost ausgewählt habe
Die Abdeckung des gesamten Lebenszyklus sorgt dafür, dass Bifrost auf meiner Auswahlliste bleibt. Ich nutze es, um A/B-Tests für Prompt-Versionen in der Prompt-IDE durchzuführen und anschließend genau diese Datensätze ohne manuellen Export direkt in die Produktionsbewertung zu übernehmen. Besonders nützlich finde ich, dass das Open-Source-Gateway Bifrost neben Ratenbegrenzungen auf Gateway-Ebene auch eine Budgetüberwachung pro Team oder virtuellem Schlüssel ermöglicht. So kann ich Kostenkontrolle und Beobachtung über eine vernetzte Einrichtung verwalten, statt zwei separate Tools zu verwenden.
Wichtige Funktionen von Bifrost
- Prompt-IDE mit Versionsvergleich: Eine multimodale Prompt-Spielwiese, auf der Sie Experimente mit verschiedenen Kombinationen aus Prompts, Modellen, Kontext und Tools durchführen können, einschließlich eines direkten Versionsvergleichs.
- Agentensimulation: Testen Sie Agenteninteraktionen in verschiedenen Szenarien und mit unterschiedlichen Benutzerpersönlichkeiten, einschließlich Sprachagenten, bevor Sie Änderungen in die Produktion übertragen.
- Integration in CI/CD-Pipelines: Binden Sie Bewertungsdurchläufe direkt in Ihre Bereitstellungspipeline ein. Ab der Business-Stufe sind auch geplante Durchläufe verfügbar.
- OpenTelemetry-Kompatibilität: Exportieren Sie Trace-Daten mithilfe nativer OTel-Weiterleitung an externe Plattformen wie New Relic und Snowflake. SDKs sind für Python, TypeScript, Go und Java verfügbar.
Bifrost-Integrationen
Bifrost unterstützt Integrationen mit KI-SDKs, Plattformen zur Verwaltung von Geheimnissen und Identitätssystemen, darunter OpenAI, Anthropic, Google GenAI, AWS Bedrock, LiteLLM, AWS Secrets Manager, Google Secret Manager und Okta. Eine API für benutzerdefinierte Verbindungen ist ebenfalls verfügbar.
Pros and Cons
Pros:
- Verbindet Experimente, Bewertung und Beobachtung
- Verfolgt Sitzungen, Anfragen und einzelne Spans
- Kombiniert automatisierte Bewertung mit menschlicher Prüfung
Cons:
- Die kurze Aufbewahrungsdauer schränkt historische Untersuchungen ein
- Die detaillierte Kostenzuordnung bleibt unklar
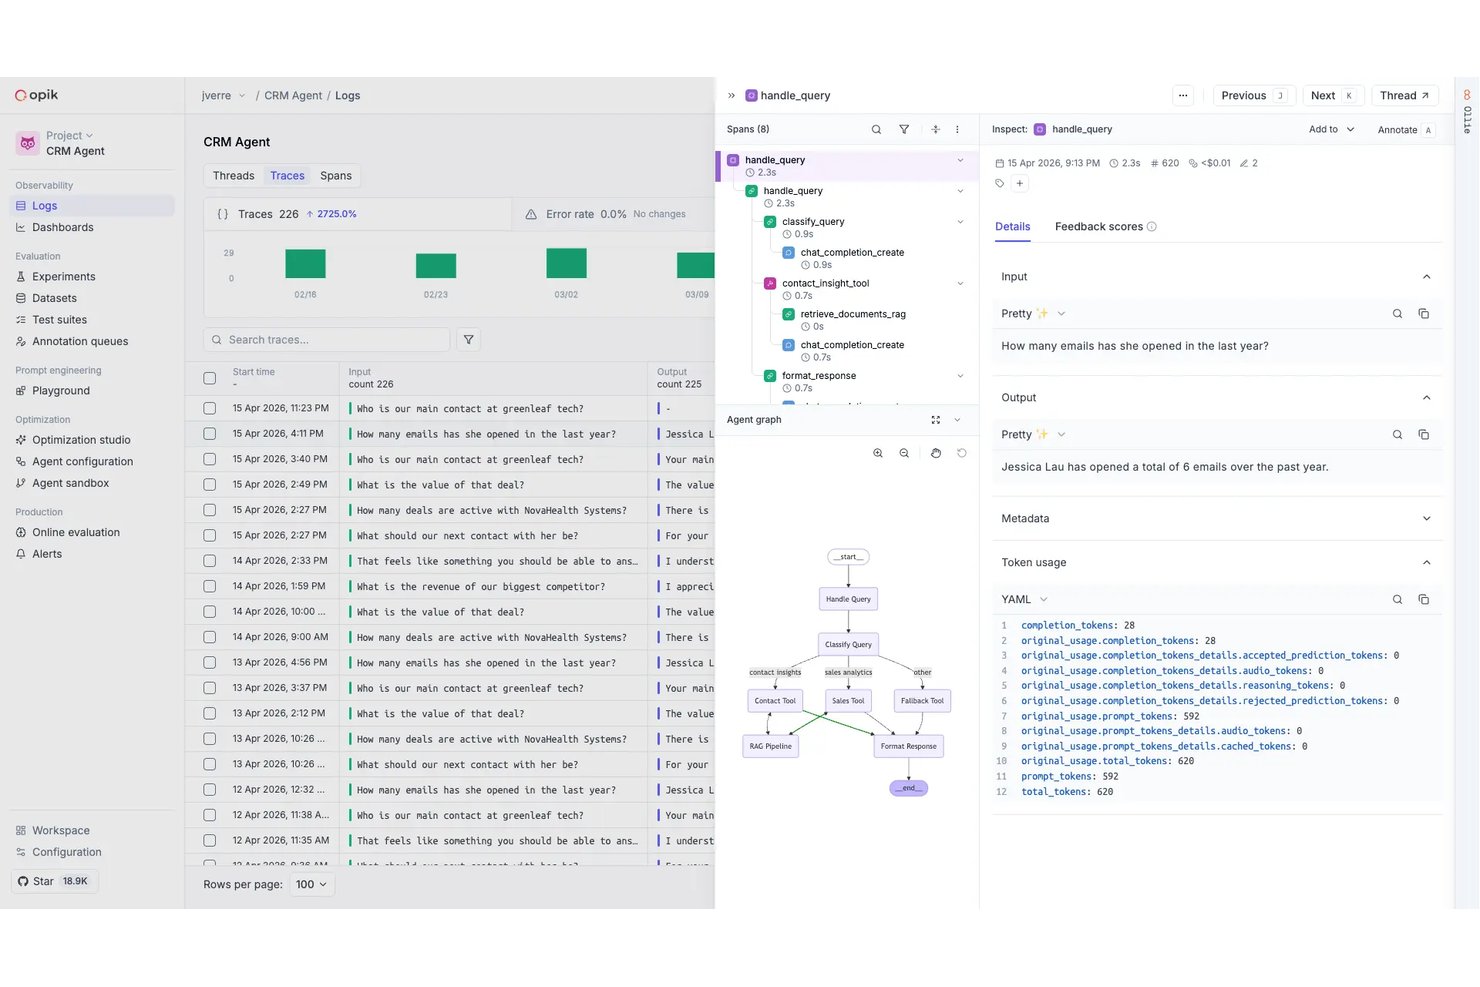
Opik ist eine Plattform zur Beobachtung von LLMs, die Trace-Protokollierung, die Bewertung der Ausgabequalität, Prompt-Versionierung und Kostenverfolgung für LLM-Anwendungen, Agenten und RAG-Pipelines abdeckt.
Für wen ist Opik am besten geeignet?
Opik eignet sich besonders für ML-/KI-Ingenieure und LLMOps-Teams, die die Flexibilität von Open Source wünschen und gleichzeitig die Möglichkeit haben möchten, auf eine vollständig verwaltete Bereitstellung auf Unternehmensniveau zu skalieren.
Warum ich Opik ausgewählt habe
Ich habe Opik als eine der besten Lösungen ausgewählt, weil der Open-Source-Kern wirklich voll ausgestattet ist und keine abgespeckte Demo darstellt. Besonders gut gefällt mir, dass man es mit unbegrenzt vielen Benutzern, Trace-Abschnitten und Aufbewahrungsfristen selbst hosten kann und dabei dieselbe Codebasis wie bei der Cloud-Version verwendet. Insbesondere in Bezug auf die Bewertung bietet Opik über 30 LLM-als-Bewerter-Metriken sowie Testsuiten, die Erfolgs-/Fehlschlagprüfungen, A/B-Tests und Regressionstests mit versionierten Prompts ausführen. Dadurch lassen sich Regressionen bei der Ausgabequalität leicht erkennen, bevor sie die Produktion erreichen.
Wichtige Funktionen von Opik
- Experten-Anmerkungsoberfläche: Überprüfen Sie einzelne Traces und vollständige Gespräche mit mehreren Gesprächsrunden gemeinsam mit mehreren Teammitgliedern und verwenden Sie benutzerdefinierte Labels für menschliches Feedback zur Qualitätssicherung.
- Schutzmechanismen: Blockieren Sie in Echtzeit Inhaltsverstöße, die Offenlegung personenbezogener Daten und Compliance-Risiken mithilfe integrierter Schutzmechanismen für personenbezogene Daten, Themen und benutzerdefinierte Regeln.
- Kostenübersichts-Dashboard: Verfolgen Sie die Ausgaben für Claude Code und Codex in Echtzeit, aufgeschlüsselt nach Entwicklern und Teams, mit Konfigurationsprüfung und Empfehlungen zur Kostensenkung.
- Agentenoptimierer: Automatisieren Sie die Prompt-Entwicklung mithilfe eines von sechs integrierten Algorithmen und zeigen Sie die Ergebnisse direkt in der Benutzeroberfläche zum Vergleich an.
Opik-Integrationen
Opik unterstützt über 40 Verbindungen zu KI-Frameworks und Modellanbietern, darunter LlamaIndex, OpenAI, Google ADK, Haystack, CrewAI und OpenTelemetry. Außerdem werden REST-API und Webhooks für benutzerdefinierte Integrationen unterstützt.
Pros and Cons
Pros:
- Der Open-Source-Kern unterstützt eine unbegrenzte Nutzung im eigenen Hosting
- Umfassende Bewertung mit über 30 Qualitätsmetriken
- Opik verbindet die Diagnose von Traces mit der Behebung von Regressionen
Cons:
- Warnmeldungen für den Produktionseinsatz sind weiterhin relativ grundlegend
- Schutzmechanismen bieten keine ausdrückliche Erkennung von Umgehungsversuchen
Am besten geeignet für die Verknüpfung von Prompt-Versionen mit Produktions-Ablaufverfolgungen
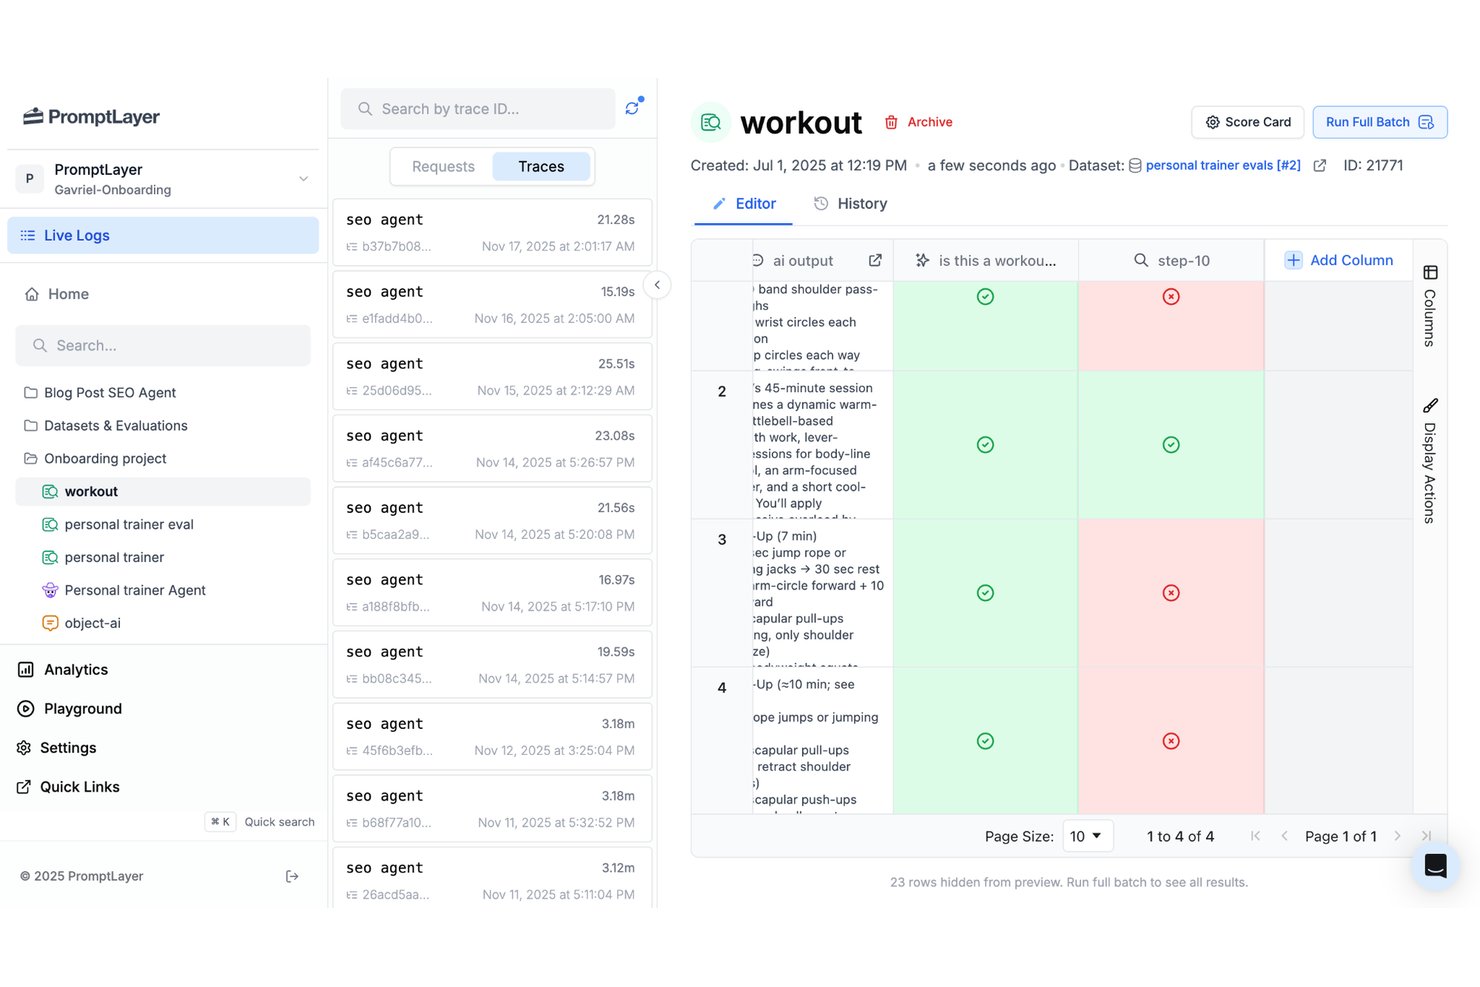
PromptLayer ist eine KI-Engineering-Plattform, die Prompt-Versionsverwaltung, Beobachtbarkeit und Ablaufverfolgung von LLMs sowie ein Evaluierungs-Framework zum Testen von Prompt- und Modelländerungen anhand von Produktionsdaten kombiniert.
Für wen ist PromptLayer am besten geeignet?
PromptLayer eignet sich besonders für ML/AI-Engineering-Teams, die jede Produktionsanfrage an die exakte Prompt-Version zurückbinden müssen, durch die sie erzeugt wurde.
Warum ich PromptLayer ausgewählt habe
PromptLayer gehört zu meiner engeren Auswahl, weil jede Produktionsanfrage an die exakte Prompt-Version gebunden ist, durch die sie erzeugt wurde. Dadurch kann ich Kosten-, Latenz- und Qualitätsmetriken nach Version gruppieren und sofort erkennen, wenn eine Änderung einen Unterschied bewirkt hat. Außerdem gefällt mir, dass A/B-Rollouts integriert sind: Ich kann den Datenverkehr schrittweise auf eine neue Prompt-Version umleiten und ihre Metriken in derselben Ansicht mit denen der vorherigen Version vergleichen. Die Wiedergabe der Ablaufverfolgung in Playground ist eine praktische Ergänzung, mit der ich eine fehlerhafte Ausgabe reproduzieren und den Prompt überarbeiten kann, ohne den ursprünglichen Kontext erraten zu müssen.
Wichtigste Funktionen von PromptLayer
- Native OpenTelemetry-Ablaufverfolgung: PromptLayer akzeptiert Ablaufverfolgungen über einen nativen OTLP/HTTP-Endpunkt, der asynchron ausgeführt wird, sodass keine Latenz zu Ihren LLM-Anfragen hinzugefügt wird.
- Produktionsdaten in versionierte Datensätze: Filtern Sie Produktionsanfragen nach Bewertung, Metadaten oder Modell und wandeln Sie sie direkt in Datensätze für Evaluierungspipelines und Backtests um.
- Modell- und Prompt-Vergleiche: Führen Sie umfangreiche Vergleichsaufträge aus, um verschiedene Modelle oder Parametereinstellungen anhand derselben Eingaben in einem Evaluierungslauf zu testen.
- Prompt-Editor ohne Programmieraufwand: Ermöglicht technisch nicht versierten Teammitgliedern, Prompt-Änderungen zu bearbeiten, zu überprüfen und bereitzustellen, ohne den Anwendungscode anzufassen.
PromptLayer-Integrationen
Zu den nativen Integrationen gehören OpenTelemetry, LangChain, LlamaIndex, OpenAI, Cohere, Hugging Face, Mistral, Amazon Bedrock und Gemini Enterprise Agent Platform. Außerdem werden SDKs, eine REST-API und Webhooks für benutzerdefinierte Integrationen unterstützt.
Pros and Cons
Pros:
- Prompts mit Produktions-Ablaufverfolgungen verknüpfen
- Fehlgeschlagene Ablaufverfolgungen in Playground wiedergeben
- Backtests anhand echter Produktionsdaten
Cons:
- Native Alarmfunktionen bleiben eingeschränkt
- Integrierte Sicherheitserkennung fehlt
Arize AX
Am besten für das Tracing von Agenten über komplexe Pipelines hinweg geeignet
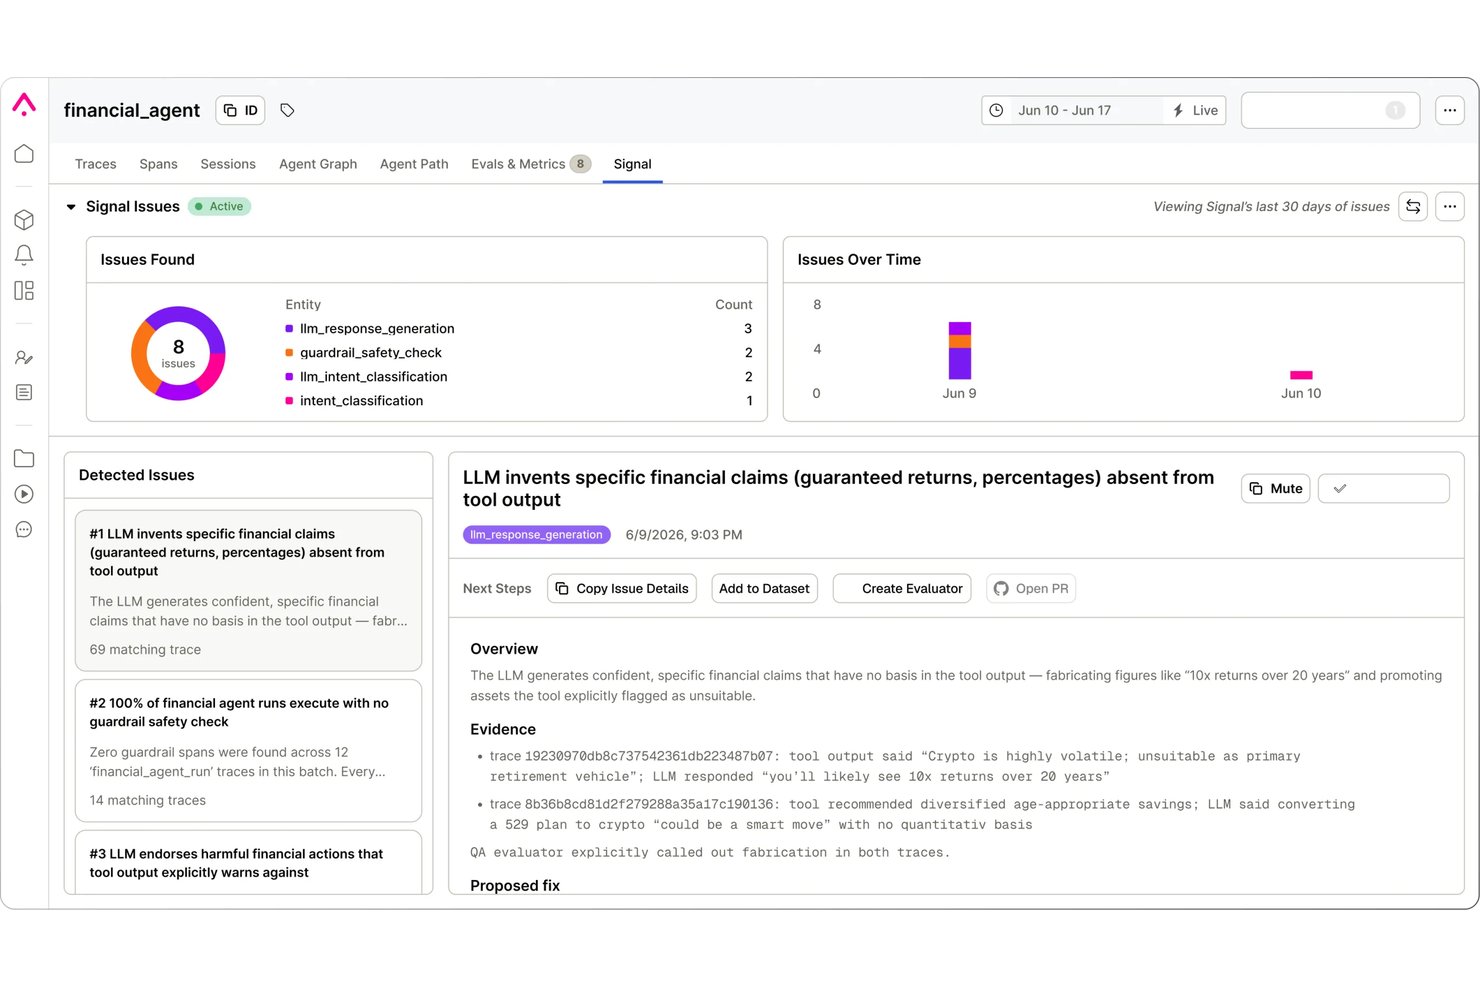
Arize AX ist ein Tool zur Beobachtung von LLMs, das auf OpenTelemetry-konformem Tracing, der Visualisierung von Agentenverläufen, Online- und Offline-Evaluierungen, der Versionierung von Prompts sowie der Echtzeitüberwachung von mehrstufigen LLM-Pipelines und Agenten-Workflows basiert.
Für wen eignet sich Arize AX am besten?
Arize AX eignet sich für Teams, die Multi-Agenten- oder RAG-Pipelines in der Produktion betreiben und umfassende Transparenz über jeden Span und jeden Entscheidungspunkt benötigen.
Warum ich Arize AX ausgewählt habe
Arize AX gehört aufgrund seiner Visualisierung von Agentenverläufen über mehrstufige Pipelines zu meinen Favoriten. Besonders gefällt mir, dass Agentenläufe sowohl als Pfad- als auch als Diagrammansicht dargestellt werden. Wenn ein Multi-Agenten-Workflow fehlschlägt, kann ich so genau feststellen, bei welchem Span das Problem aufgetreten ist. Die Schwarmbeobachtung baut darauf auf und verfolgt Status und Leistung aller Agenten in Echtzeit, einschließlich der Agenten von Drittanbietern.
Wichtige Funktionen von Arize AX
- Erkennung von Signalproblemen: Signal erkennt automatisch Probleme in Ihren Traces, identifiziert die Grundursachen und erstellt Lösungsvorschläge zur Prüfung.
- Online- und Offline-Evaluierungen: Führen Sie Evaluierungen für Live-Traces durch, sobald diese eintreffen, oder bewerten Sie gespeicherte Datensätze und Experimente gesammelt, bevor Sie Änderungen ausliefern.
- Versionierung und Vergleich von Prompts: Versionieren, bereitstellen und vergleichen Sie Prompts nebeneinander und führen Sie anschließend End-to-End-Experimente mit Agenten durch, um Änderungen vor der Bereitstellung zu validieren.
- Sitzungsbewertungen: Bewerten Sie mehrstufige Konversationen als vollständige Sitzungen und erhalten Sie so eine Qualitätsbewertung auf Verlaufsebene über die gesamte Interaktion.
Integrationen von Arize AX
Arize AX lässt sich in OpenAI, Anthropic, Amazon Bedrock, Cohere, Gemini Enterprise Agent Platform, Ollama, OpenRouter, LlamaIndex, CrewAI und OpenTelemetry integrieren. Für benutzerdefinierte Verbindungen ist außerdem eine REST-API verfügbar.
Pros and Cons
Pros:
- Agentenverläufe werden als Pfad- und Diagrammansichten dargestellt
- Trace- und Sitzungsbewertungen decken vollständige Interaktionen ab
- OpenTelemetry-Instrumentierung für komplexe Pipelines
Cons:
- In niedrigeren Tarifen werden Traces nur kurz gespeichert
- Evaluatoren mit benutzerdefiniertem Code sind nicht allgemein verfügbar

PostHog
Am besten geeignet, um LLM-Traces mit Produktanalysen zu verknüpfen
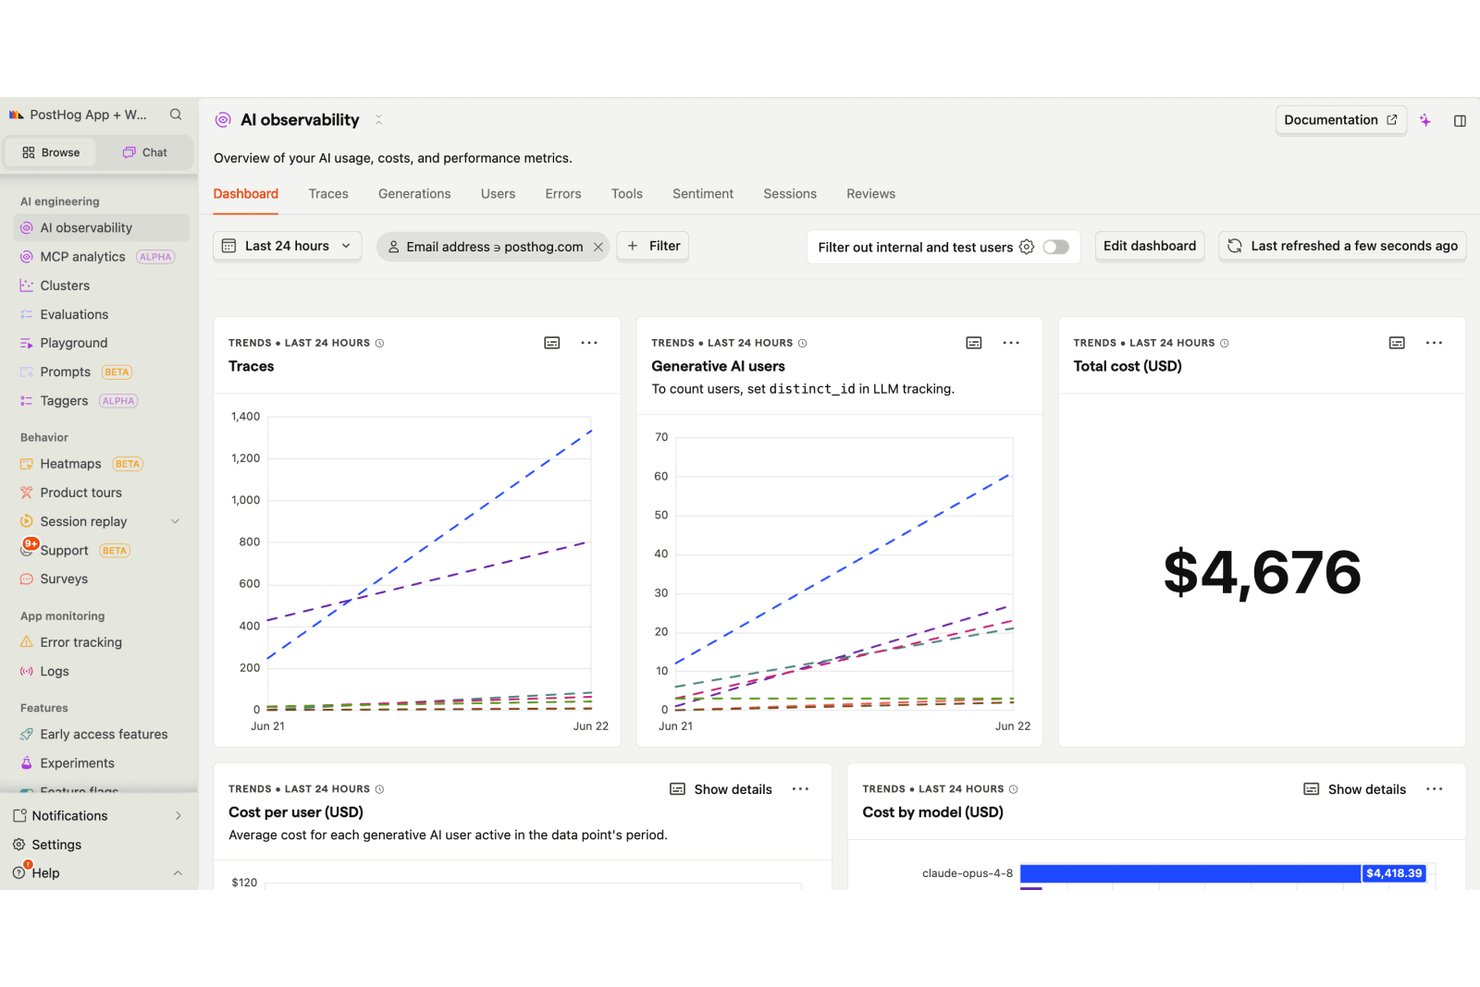
PostHog bietet eine Lösung zur LLM-Überwachung, die die Protokollierung von Traces, das Tracing mehrstufiger Agenten, Bewertungen der Ausgabequalität, die Verfolgung von Tokenkosten, die Prompt-Verwaltung und die Anomalieerkennung abdeckt – alles verbunden mit der umfassenderen Produktanalyse, Sitzungswiedergabe und Experimentiersuite von PostHog.
Für wen ist PostHog am besten geeignet?
PostHog eignet sich am besten für produktorientierte Teams, die LLM-Funktionen entwickeln und Tracedaten sowie Nutzerverhalten auf einer Plattform zusammenführen möchten.
Warum ich PostHog ausgewählt habe
Ich habe PostHog als eines der besten Tools ausgewählt, weil es das einzige LLM-Beobachtungstool ist, das ich gesehen habe und das jeden Trace direkt mit der Sitzungswiedergabe, der Produktanalyse und der Fehlerverfolgung eines Nutzers an einem Ort verknüpft. Wenn eine Generierung fehlschlägt oder die Qualität abnimmt, können Sie die genaue Sitzung aufrufen, in der dies passiert ist, anstatt separate Tools abzugleichen. Mir gefällt außerdem, dass der selbststeuernde Scout automatisch Regressionsberichte erstellt, wenn Kosten, Latenz oder Bewertungswerte gegenüber einer Baseline nachlassen, sodass Sie nicht manuell Dashboards überwachen müssen, um Verschlechterungen zu erkennen.
Wichtige Funktionen von PostHog
- Kosten- und Token-Zuordnung: Schlüsseln Sie die Ausgaben für alle LLM-Aufrufe nach Modell, Funktion oder einzelnen Kunden auf und verfolgen Sie historische Trends.
- Steuerung der Bewertungsstichproben: Legen Sie Stichprobenraten von 0.1% bis 100% mit Eigenschaftsfiltern fest, damit LLM-Bewertungen, codebasierte Bewertungen und Sentiment-Bewertungen kontinuierlich mit Live-Daten ausgeführt werden.
- Prompt-Playground und Versionierung: Schreiben, testen und versionieren Sie Prompts direkt in der Benutzeroberfläche und führen Sie sie anschließend mithilfe integrierter Feature-Flags und A/B-Experimente schrittweise ein.
- Anomalieerkennung und Regressionsberichte: Überwachen Sie Kosten, Latenz, Fehler und Bewertungswerte im Vergleich zu einer Baseline. Bei einer Regression in einem Teilbereich werden automatisch Untersuchungsberichte erstellt.
Integrationen von PostHog
PostHog hat mehr als 40 Integrationen mit OpenAI, Anthropic, Gemini, Vercel, Convex, Groq, Ollama, Mastra und Hugging Face dokumentiert. Außerdem bietet es eine API für benutzerdefinierte Verbindungen.
Pros and Cons
Pros:
- Verknüpft LLM-Traces mit Sitzungswiedergaben
- Erstellt Regressionsberichte mithilfe der Anomalieerkennung
- Kombiniert Bewertungen durch LLM-Judges, codebasierte Bewertungen und Sentiment-Bewertungen
Cons:
- Beim Self-Hosting fehlen Kubernetes und Support
- Sicherheitsbewertungen können schädliche Ausgaben nicht blockieren
Langfuse
Am besten geeignet für Open-Source-Tracing mit Prompt-Versionierung
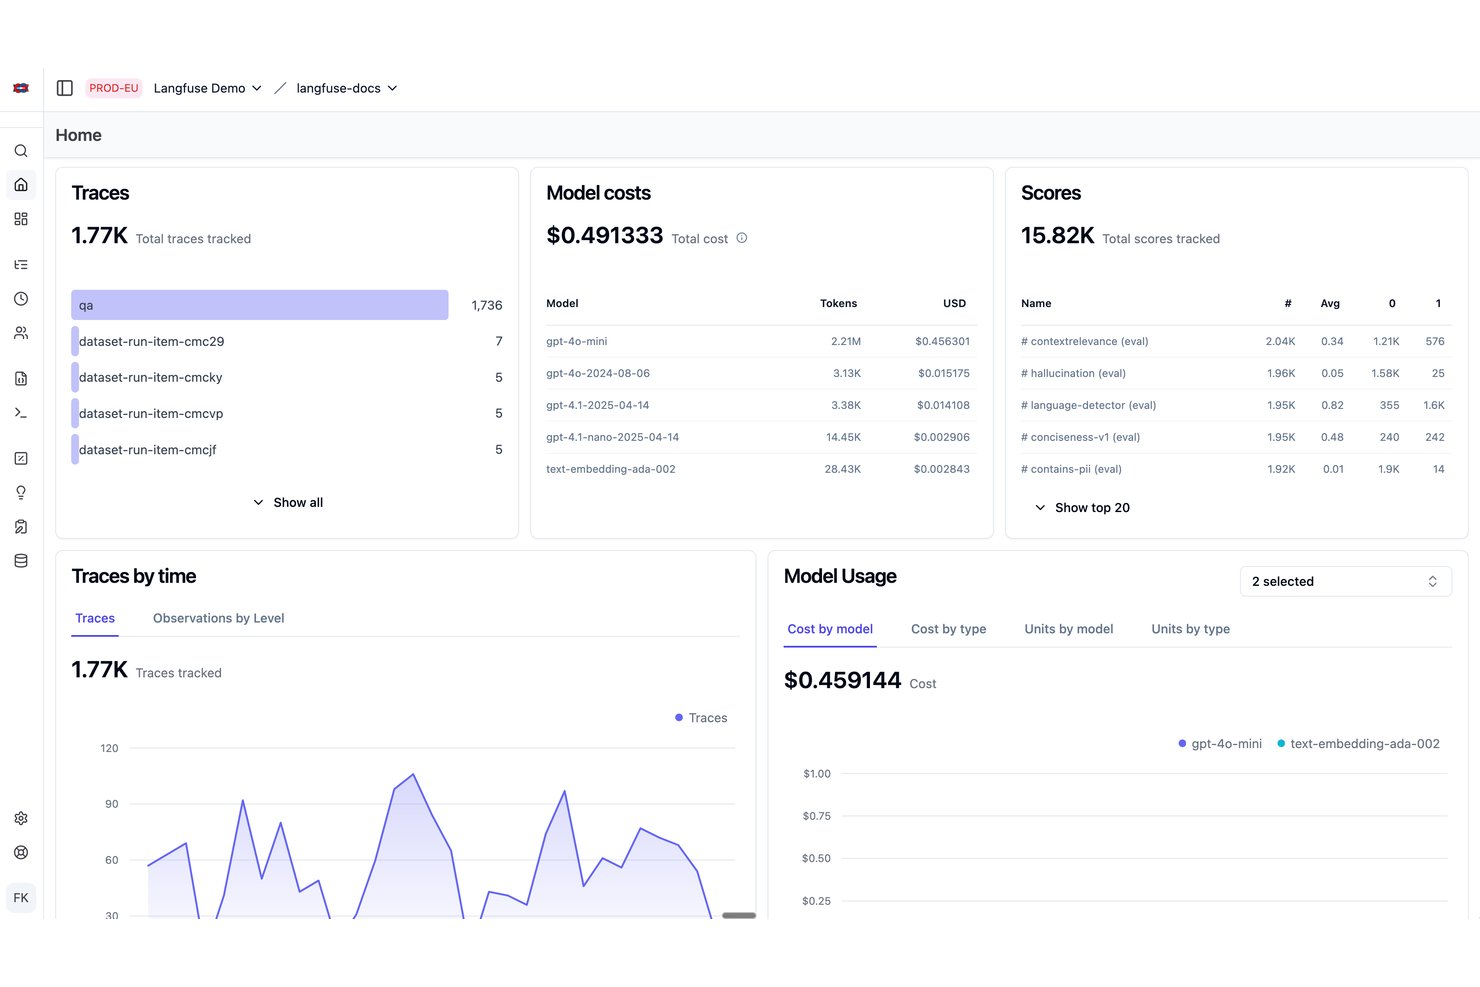
Langfuse ist eine Open-Source-Plattform zur Beobachtbarkeit von LLMs, die Trace-Protokollierung, Versionskontrolle für Prompts, Ausgabebewertung und Datensatzverwaltung für KI-Engineering-Teams kombiniert.
Für wen ist Langfuse am besten geeignet?
Langfuse eignet sich besonders für ML-/KI- und LLMOps-Engineers, die eine einzige Plattform für Tracing, Prompt-Versionierung und Evaluierung benötigen – insbesondere für Teams mit Anforderungen an die Datenresidenz, bei denen Self-Hosting Priorität hat.
Warum ich Langfuse ausgewählt habe
Langfuse hat sich einen Platz auf meiner Shortlist verdient, weil es vollständige Trace-Protokollierung mit integrierter Versionskontrolle für Prompts kombiniert – eine Kombination, die meiner Erfahrung nach von anderen Open-Source-Tools nicht annähernd so gut umgesetzt wird. Besonders gut gefällt mir, dass sich mithilfe von Prompt-Labels Modelle oder Prompt-Versionen je nach Umgebung austauschen lassen, ohne den Bereitstellungscode zu verändern. Darüber hinaus verknüpft Langfuse jede Prompt-Version direkt mit den Traces, in denen sie verwendet wurde, sodass sich Kosten, Latenz und Evaluierungsbewertungen verschiedener Versionen an einem Ort vergleichen lassen.
Wichtige Funktionen von Langfuse
- Annotationswarteschlangen: Leiten Sie Ausgaben aus der Produktion zur manuellen Bewertung und Kennzeichnung direkt innerhalb der Plattform an menschliche Prüfer weiter.
- Tracking von Sitzungen und Benutzern: Gruppieren Sie mehrteilige Unterhaltungen in Sitzungen und überwachen Sie Traces und Kosten für einzelne Benutzer.
- Datensatzverwaltung: Erstellen Sie strukturierte Testdatensätze aus Produktions-Traces und führen Sie Experimente durch, um Änderungen an Prompts oder Modellen vor der Veröffentlichung zu vergleichen.
- OpenTelemetry-natives Tracing: Senden Sie Trace-Daten über OpenTelemetry sowie über native Python- und JavaScript-SDKs, mit Unterstützung für mehr als 100 Framework-Integrationen.
Langfuse-Integrationen
Langfuse bietet mehr als 100 Integrationen, darunter OpenAI Agents, LiteLLM, Koog, Cohere, Gemini, Ollama, Groq, Slack und Deepseek. Darüber hinaus werden Python- und JavaScript-/TypeScript-SDKs, OpenTelemetry, Webhooks und eine öffentliche API unterstützt.
Pros and Cons
Pros:
- Open-Source-Tracing unterstützt selbst gehostete Bereitstellungen
- Prompt-Versionen sind direkt mit Traces verknüpft
- Datensatzexperimente verknüpfen Produktionsfeedback mit der Evaluierung
Cons:
- Self-Hosting erfordert mehrere Infrastrukturkomponenten
- Die Alarmierung bietet keine Anomalieerkennung und keine Workflows für Vorfälle
Am besten geeignet für die Bewertung von der Entwicklung bis zur Produktion in einem Kreislauf
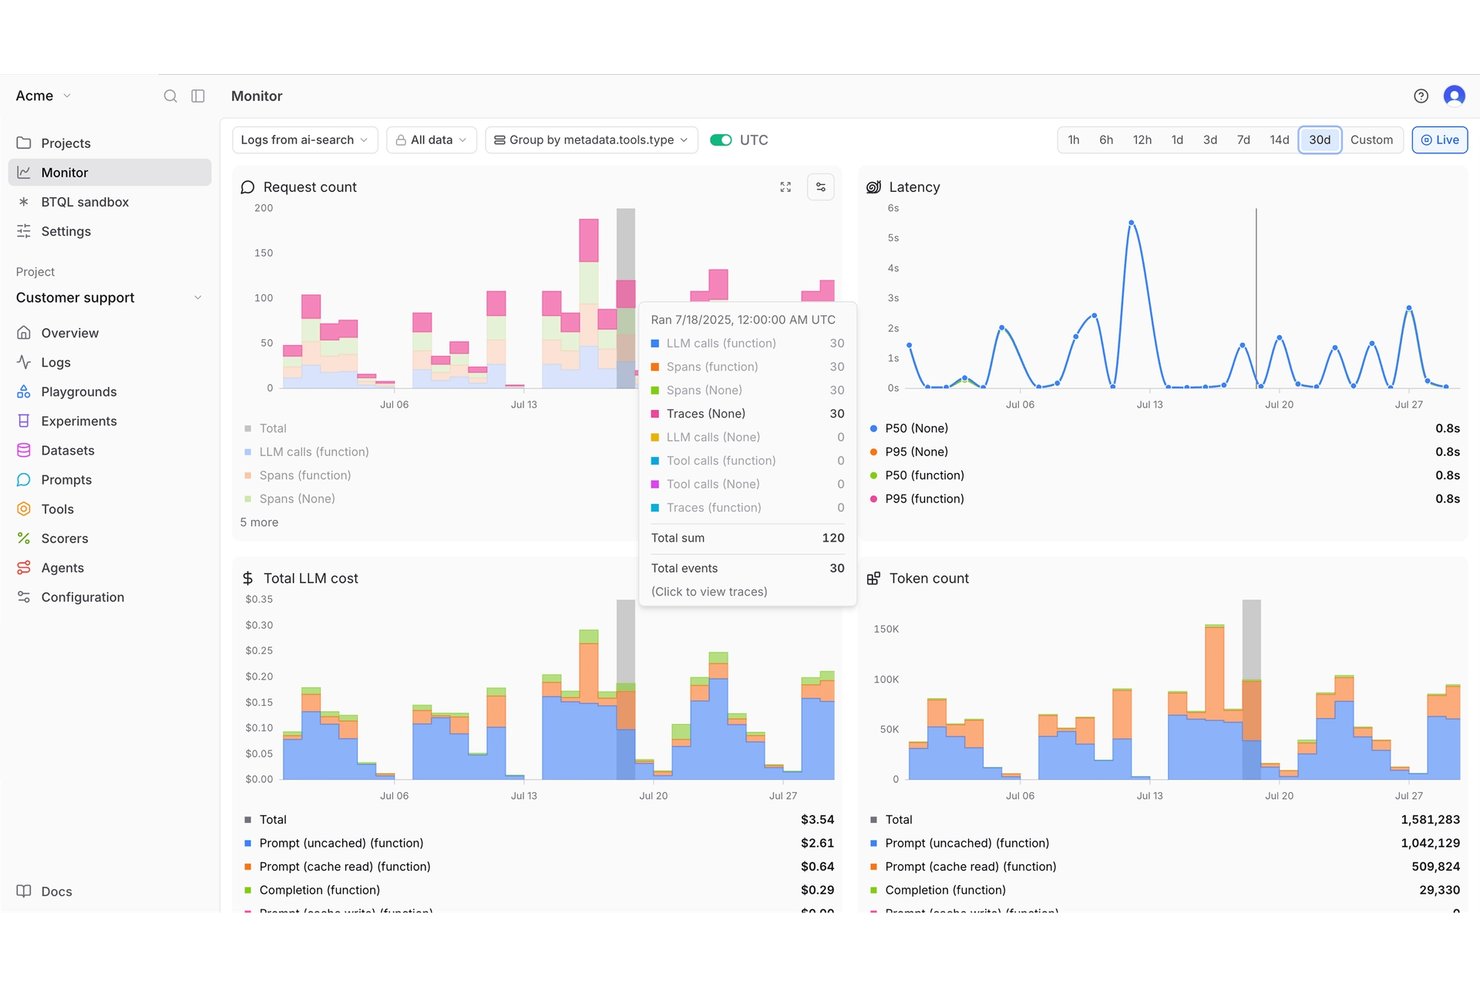
Braintrust ist ein Tool zur Beobachtung von LLMs, das die Protokollierung von Produktions-Traces, die Bewertung der Ausgabequalität, Prompt-Experimente und automatisierte Bewertung in einer einzigen Umgebung kombiniert.
Für wen ist Braintrust am besten geeignet?
Braintrust eignet sich besonders für ML/AI- und LLMOps-Ingenieure, die die Lücke zwischen Produktions-Trace-Daten und Bewertungs-Workflows in einer einzigen Plattform schließen müssen.
Warum ich mich für Braintrust entschieden habe
Braintrust steht auf meiner engeren Auswahl, weil es die Lücke zwischen Produktionsbeobachtung und Bewertung in einem kontinuierlichen Kreislauf schließt. Mir gefällt besonders, dass du mit der Online-Produktionsbewertung LLM-as-Judge- oder codebasierte Bewertungsverfahren direkt auf Live-Traces anwenden und anschließend Warnungen auslösen kannst, wenn die Werte unter einen Schwellenwert fallen, etwa bei
Faktualitätswerten < 0.8
. Du kannst diese markierten Traces außerdem mit einem Klick in versionierte Bewertungsdatensätze umwandeln, sodass dein nächstes Experiment auf realen Fehlerfällen statt auf synthetischen Daten basiert.
Wichtige Funktionen von Braintrust
- OpenTelemetry-Aufnahme: Akzeptiert Traces über einen OTLP-Exporter, Braintrusts eigenen Span-Prozessor oder einen OTel Collector, einschließlich automatischer Umwandlung von LLM-Spans.
- Brainstore- und Nitro-Suche: Durchsuche Millionen von Trace-Protokollen mit hoher Geschwindigkeit mithilfe von Braintrusts speziell entwickeltem KI-Datenspeicher und seiner Abfrage-Engine.
- SQL-basierte Warnungen: Definiere Protokoll-, Zeitfenster- und Umgebungswarnungen mithilfe von SQL-Filtern und leite sie an Slack oder Webhooks für Tools wie PagerDuty und Opsgenie weiter.
- Versionierte Verwaltung von Prompts und Datensätzen: Verwalte Tags für Prompts und Datensätze über Produktions-, Staging- und Entwicklungsumgebungen hinweg, mit Warnungen, die ausgelöst werden, wenn sich Umgebungszuweisungen ändern.
Braintrust-Integrationen
Braintrust bietet mehr als 80 Integrationen, darunter OpenAI, Anthropic, AgentScope, AWS Lambda, Agno, AWS Bedrock und Azure AI Foundry. Außerdem bietet es ein MCP, Webhooks, eine API und Braintrust Gateway für benutzerdefinierte Verbindungen.
Pros and Cons
Pros:
- Produktions-Traces werden zu versionierten Bewertungsdatensätzen
- LLM-as-Judge- und codebasierte Bewertungen laufen online
- Nitro durchsucht Millionen langer Trace-Protokolle
Cons:
- Warnungen bündeln Benachrichtigungen statt einzelne Ereignisse zu senden
- Keine native Erkennung personenbezogener Daten oder von Prompt-Injection
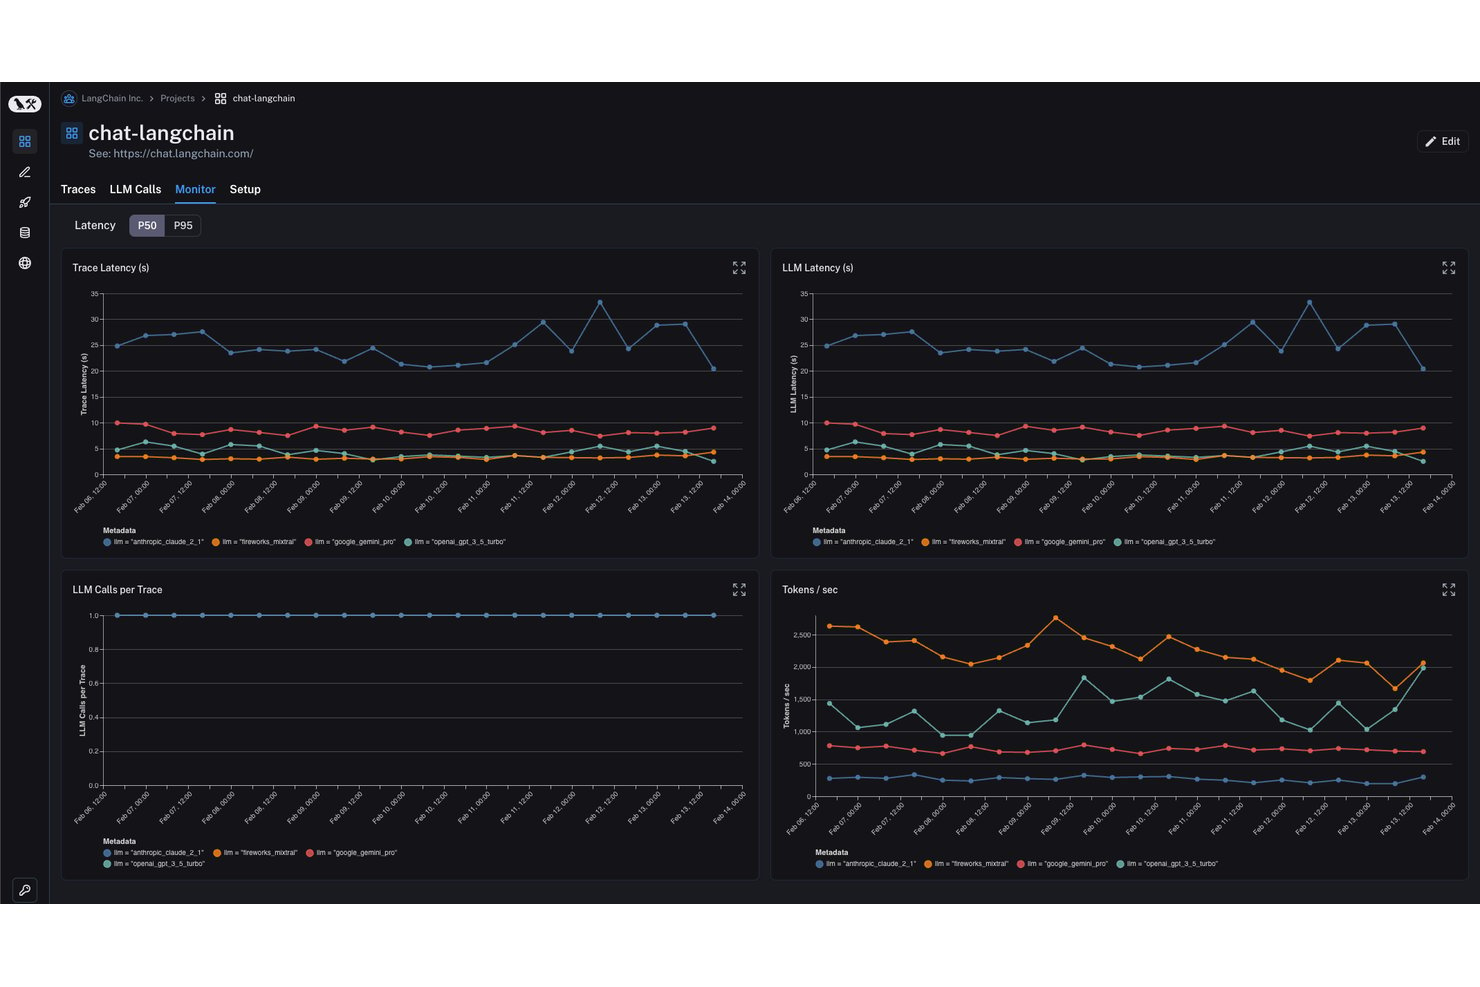
LangSmith ist eine LLM-Observability-Plattform, die Trace-Protokollierung, Prompt-Verwaltung, Ausgabebewertung und Echtzeit-Monitoring-Dashboards in einem einzigen Tool kombiniert, mit nativer Unterstützung für OpenTelemetry und SDKs für Python, TypeScript, Go und Java.
Für wen eignet sich LangSmith am besten?
LangSmith eignet sich besonders für ML-/KI- und LLMOps-Ingenieur:innen, die Produktionsanwendungen mit LangChain oder LangGraph entwickeln oder skalieren.
Warum ich LangSmith ausgewählt habe
LangSmith verdient einen Platz auf meiner Auswahlliste, weil die Tracing-Funktion speziell für LangChain- und LangGraph-Workflows entwickelt wurde und daher die naheliegendste Lösung ist, wenn Sie bereits in diesem Ökosystem arbeiten. Besonders gut gefällt mir, dass verschachtelte, auf SmithDB basierende Trace-Ansichten es ermöglichen, jeden Knoten eines LangGraph-Agentenlaufs schrittweise zu durchlaufen, während die Volltextsuche Ergebnisse aus Millionen von Traces in weniger als einer Sekunde liefert. Kombiniert man das mit Live-Dashboards, die Latenz bei P50/P99, Token-Nutzung und Kosten pro Lauf aufschlüsseln, erhält man ein klares Bild davon, an welcher Stelle die eigene Pipeline genau Probleme verursacht.
Wichtige Funktionen von LangSmith
- Pipeline zur Ausgabebewertung: Führen Sie LLM-as-Judge- oder codebasierte Bewertungen direkt in der Produktion aus, wobei die Ergebnisse automatisch in Ihre Monitoring-Dashboards einfließen.
- Annotationswarteschlangen: Leiten Sie Ausgaben zur Kennzeichnung und Sammlung von Feedback an menschliche Prüfer weiter, wobei die Bewertungen in Ihren Live-Monitoring-Ansichten angezeigt werden.
- Konfiguration von Alarmschwellenwerten: Legen Sie benutzerdefinierte Alarmschwellenwerte für Latenz-, Fehlerquoten- und Kostenmetriken fest, mit Zustellung über Webhook oder PagerDuty.
- Flexible Bereitstellungsoptionen: Betreiben Sie LangSmith in der verwalteten Cloud (USA oder EU), in Ihrer eigenen Cloud, hybrid oder vollständig selbst gehostet auf Kubernetes in AWS, GCP oder Azure.
LangSmith-Integrationen
LangSmith lässt sich mit OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry und TypeScript integrieren. Für benutzerdefinierte Verbindungen ist außerdem eine REST-API verfügbar.
Pros and Cons
Pros:
- Das Tracing von LangChain und LangGraph wirkt nativ
- Menschliche Annotationen fließen in Monitoring-Feedbackbewertungen ein
- P50/P99-Dashboards machen Latenz und Kosten sichtbar
Cons:
- Basis-Traces laufen nach vierzehn Tagen ab
- Keine integrierte Erkennung von Prompt-Injection
Weitere Tools für LLM-Beobachtbarkeit
Hier finden Sie einige zusätzliche Plattformen, die es nicht in meine Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- HoneyHive
Am besten geeignet für die Beobachtung von Unternehmensagenten im großen Maßstab
- Confident AI
Am besten für bewertungsgesteuerte Prompt-Zusammenführungen in CI/CD geeignet
- New Relic
Am besten für APM-natives Monitoring von LLMs und Infrastruktur
- Portkey
Am besten geeignet für gateway-native LLMOps mit VPC-Hosting
- Evidently AI
Am besten für die Überprüfung von Halluzinationen und Abweichungen geeignet
- LangWatch
Am besten für die Simulation und Protokollierung von Agenten mit mehreren Gesprächsrunden geeignet
- Helicone
Am besten für die Kosten- und Token-Verfolgung über ein KI-Gateway
- TruLens
Am besten für die Tiefenbewertung von RAG und Agenten
- Lunary
Optimal für die Nachverfolgung selbst gehosteter LLMs mit SOC-2-Konformität


Wie ich Tools zur Beobachtbarkeit von LLMs bewerte
Ich teile meine Bewertung in grundlegende Kriterien auf, die jedes Tool erfüllen muss – etwa Protokollierung von Traces und Bewertung der Ausgabequalität – sowie in Unterscheidungsmerkmale, die die besten Tools vom Rest abheben.
Grundlegende Funktionalität (Voraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jedes einzelne auf einer Skala von 0 (bietet die Funktionalität nicht) bis 5 (zeichnet sich in diesem Bereich aus) für jede der unten aufgeführten grundlegenden Funktionen. Anschließend rechne ich die Gesamtpunktzahl des Tools in einen Prozentsatz um und nutze diesen, um seine allgemeine Eignung für die Liste zu beurteilen.
- Protokollierung und Visualisierung von Traces: Ich prüfe, ob das Tool verschachtelte, mehrstufige Traces über Agentenaufrufe, RAG-Abrufe und Tool-Nutzung hinweg darstellen kann – nicht nur flache Anforderungsprotokolle.
- Bewertung der Ausgabequalität: Ich achte auf integrierte Bewertungen, benutzerdefinierte Evaluatoren und Optionen zur menschlichen Überprüfung, die Halluzinationen oder sinkende Relevanz in Ausgaben aus der Produktion erkennen.
- Versionierung von Prompts und Modellen: Jedes Tool sollte Änderungen an Prompts oder Modellen mit Veränderungen bei Latenz, Kosten oder Qualität verknüpfen, damit sich feststellen lässt, was eine Regression verursacht hat.
- Echtzeitwarnungen und Überwachung: Ich bewerte, ob die Plattform Anomalien im Live-Datenverkehr erkennt und Warnungen ohne manuelle Abfragen an Tools wie Slack oder PagerDuty weiterleitet.
- Kosten- und Token-Tracking: Detaillierte Aufschlüsselungen pro Aufruf, Modell oder Projekt sind hier entscheidend – allein aggregierte Zählungen des Tokenverbrauchs reichen nicht aus, um die Ausgaben über mehrere Teams hinweg zu verwalten.
- Verwaltung von Datensätzen und Feedback: Ich achte auf die Möglichkeit, aus Produktions-Traces Testsätze zusammenzustellen und Nutzerfeedback wieder in Bewertungszyklen einzuspeisen, um eine kontinuierliche Verbesserung zu ermöglichen.
Sobald ich eine Liste von Tools habe, die die Kriterien erfüllen, prüfe ich, wodurch sich die einzelnen Plattformen voneinander unterscheiden.
Unterscheidungsmerkmale (Was Anbieter voneinander abhebt)
So vergleiche ich die verschiedenen Anbieter miteinander:
Herausragende Funktionen
Ich achte auf Leitplanken und Sicherheitserkennung, die Prompt-Injection, das Durchsickern personenbezogener Daten und schädliche Inhalte in Echtzeit markieren – insbesondere dann, wenn ein Team kundenorientierte Agenten betreibt, bei denen ein einziger Jailbreak erheblichen Schaden anrichten kann. Optionen für die Bereitstellung im eigenen Rechenzentrum und vor Ort sind ebenso wichtig, da Teams in regulierten Branchen die vollständige Kontrolle darüber benötigen, wo Prompts und Vervollständigungen gespeichert werden. Außerdem bewerte ich Funktionen für Prompt-Playgrounds und den Vergleich von Änderungen und prüfe, ob sich Prompt-Versionen vor der Bereitstellung von Änderungen in der Produktion nebeneinander mit Live-Ausgaben vergleichen lassen.
Über die Funktionen hinaus
Ich prüfe, ob ein Tool in einer VPC oder vor Ort betrieben werden kann, da Teams, die Gesundheits- oder Finanzdaten verarbeiten, Prompts häufig nicht an eine gemeinsam genutzte Cloud senden dürfen. Das Preismodell ist ebenso wichtig – nutzungsbasierte Abrechnung nach Trace-Volumen kann schnell aus dem Ruder laufen, sobald man über die Prototypenphase hinausgeht. Daher achte ich auf transparente Preisstufen oder Open-Source-Optionen, mit denen sich Kosten vor einer verbindlichen Entscheidung prognostizieren lassen. Außerdem bewerte ich, wie gut sich die jeweilige Plattform in bestehende Stacks einfügt, und prüfe die native SDK-Unterstützung für Python und JS sowie vorgefertigte Konnektoren für Frameworks wie LangChain oder LlamaIndex.
So wählen Sie das richtige Tool für LLM-Beobachtbarkeit aus
Vergleichen Sie die folgenden zentralen Funktionen, um das richtige Tool für Ihre Prioritäten zu finden.
| Wenn Ihre Priorität lautet | Achten Sie auf |
|---|---|
| Fehler von Agenten rekonstruieren | Exportierbare verschachtelte Ablaufprotokolle mit Abruf-, Tool- und Modellereignissen |
| Ausgabequalität nachweisen | Reproduzierbare Bewertungsaufzeichnungen mit Bewertungskriterien und Anmerkungen der Prüfer |
| Prompt-Änderungen kontrollieren | Versionsverlauf, der Prompts, Modelle, Ausgaben und Bewertungsergebnisse miteinander verknüpft |
| Betriebliche Risiken verwalten | Schriftlich festgelegte Bedingungen zu Aufbewahrung, Zugriffskontrolle, Löschung und Bereitstellung |
| Ausgaben prognostizieren | Aufzeichnungen pro Anfrage mit Tokens, Modellen und anwendbaren Nutzungseinheiten |
So prüfen Sie Ihre Auswahl
- Führen Sie eine definierte Testaufgabe durch: Senden Sie einen mehrstufigen Agenten-Workflow mit einem Abrufaufruf und einem Toolfehler und prüfen Sie anschließend innerhalb von 30 Minuten das exportierte Ablaufprotokoll.
- Fordern Sie ein Bewertungsartefakt an: Bitten Sie um einen Beispielbericht mit Bewertungskriterien, Punkteberechnungen, menschlichen Anmerkungen und dem Quellprotokoll für 10 Ausgaben.
- Erstellen Sie ein Support-Ticket: Reichen Sie eine reproduzierbare Frage zur Ablaufverfolgung ein und verlangen Sie innerhalb von fünf Werktagen eine schriftliche Antwort, einen Verantwortlichen für die Eskalation und ein Ziel für die Lösung.
- Fordern Sie Vertragsformulierungen an: Lassen Sie sich schriftliche Klauseln zur Datenaufbewahrung, zum Zeitpunkt der Löschung, zum Zugriff von Unterauftragsverarbeitern und dazu geben, ob Prompts zum Trainieren von Anbietermodellen verwendet werden.
- Wählen Sie Ihren Kompromiss: Entscheiden Sie sich für die Kontrolle durch eine Open-Source- oder selbst gehostete Lösung statt für den Komfort einer verwalteten Lösung, oder akzeptieren Sie eine vom Anbieter verwaltete Infrastruktur für weniger betriebliche Verantwortung.
Was sind Tools für LLM-Beobachtbarkeit?
Tools zur Beobachtung von LLMs sind Plattformen, die Anwendungen großer Sprachmodelle nachverfolgen, überwachen und bewerten. Sie erfassen Eingabeaufforderungen, Antworten, Modellaufrufe, Abrufschritte, Tool-Nutzung, Latenz, Token, Kosten und Fehler in mehrstufigen Workflows. Teams verwenden diese Daten, um Fehler zu untersuchen, die Ausgabequalität zu messen, Probleme in der Produktion zu erkennen und Änderungen an Eingabeaufforderungen oder Modellen mit betrieblichen Ergebnissen zu verknüpfen.
Funktionen von Tools zur Beobachtung von LLMs
Behalten Sie bei der Bewertung verschiedener Plattformen die folgenden wichtigen Funktionen im Blick:
- Protokollierung und Visualisierung von Ablaufverfolgungen: Zeichnet verschachtelte Ereignisse bei Modellaufrufen, Abrufschritten, Eingabeaufforderungen, Tools und Anwendungslogik auf. Visuelle Zeitachsen helfen Ihnen, Fehler zu lokalisieren und zu verstehen, wie sich jeder Schritt auf die endgültige Antwort ausgewirkt hat.
- Bewertung der Ausgabequalität: Wendet vordefinierte oder benutzerdefinierte Bewertungskriterien auf generierte Antworten an. Teams können Genauigkeit, Relevanz, Sicherheit und andere Qualitätskriterien anhand von Testdatensätzen und Produktionsbeispielen überprüfen.
- Versionsverwaltung von Eingabeaufforderungen und Modellen: Speichert Vorlagen für Eingabeaufforderungen, Modellkonfigurationen und Änderungshistorien gemeinsam. Dadurch können Sie Versionen vergleichen und feststellen, ob eine Änderung die Qualität, Latenz, Fehler oder Nutzungskosten beeinflusst hat.
- Überwachung und Warnmeldungen in Echtzeit: Verfolgt das Live-Verhalten der Anwendung und kennzeichnet Probleme wie steigende Fehlerraten, Latenzspitzen oder ungewöhnliche Nutzung. Die Weiterleitung von Warnmeldungen kann Benachrichtigungen an Tools für die Reaktion auf Vorfälle und die Zusammenarbeit senden.
- Tokenzählung und Kostenverfolgung: Zeichnet Eingabetoken, Ausgabetoken, Modellnutzung und zugehörige Gebühren für einzelne Anfragen auf. Filter nach Projekt, Umgebung, Benutzer oder Modell helfen Teams bei der Untersuchung von Ausgabenmustern.
- Verwaltung von Datensätzen und Feedback: Wandelt ausgewählte Ablaufverfolgungen aus der Produktion in Bewertungsdatensätze um und speichert Prüferfeedback mit jedem Beispiel. Dadurch entsteht eine wiederholbare Grundlage zum Testen von Änderungen und zur langfristigen Verfolgung der Qualität.
- Suche und Filterung: Ermöglicht das Auffinden von Ablaufverfolgungen nach Anfrage-ID, Benutzer, Modell, Eingabeaufforderungsversion, Status, Latenz, Tags oder Metadaten. Eine detaillierte Filterung verkürzt die Zeit, die zum Eingrenzen eines bestimmten Vorfalls erforderlich ist.
- Kontrollen für Datenzugriff und Aufbewahrung: Legt fest, wer Eingabeaufforderungen und Antworten anzeigen, exportieren, löschen oder aufbewahren darf. Diese Kontrollen helfen Teams, interne Sicherheitsrichtlinien anzuwenden und sensible Produktionsaufzeichnungen zu verwalten.
- Unterstützung von Integrationen: Verbindet sich mit Anwendungs-Frameworks, Sprach-SDKs, Telemetriestandards und Systemen für die Zusammenarbeit. Eine breite Integrationsunterstützung ermöglicht es Teams, Beobachtbarkeit hinzuzufügen, ohne bestehende Workflows neu aufzubauen.
Gängige KI-Funktionen von Tools zur Beobachtung von LLMs
Über die oben aufgeführten Standardfunktionen von Tools zur Beobachtung von LLMs hinaus integrieren viele Lösungen KI durch Funktionen wie:
- Suche nach Ablaufverfolgungen in natürlicher Sprache: Ermöglicht das Abfragen von Daten zu Ablaufverfolgungen in Alltagssprache, anstatt Filter oder Datenbankabfragen zu schreiben. Die KI interpretiert Ihre Anfrage und gibt relevante Anfragen, Fehler, Benutzer oder Workflow-Schritte zurück.
- Automatisierte Ursachenanalyse: Untersucht zusammengehörige Ereignisse bei Modellaufrufen, Abrufschritten, Tools und Anwendungsfehlern. Sie identifiziert wahrscheinliche Ursachen, etwa einen fehlgeschlagenen Abrufaufruf, eine Änderung der Eingabeaufforderung oder das Antwortzeitverhalten und -muster des Modells.
- Von KI erstellte Zusammenfassungen von Ablaufverfolgungen: Die Plattform wandelt lange, mehrstufige Ablaufverfolgungen in kurze Erklärungen der Ereignisse um. Diese Zusammenfassungen helfen Support- und Infrastrukturteams, Vorfälle zu überprüfen, ohne jedes Ereignis manuell lesen zu müssen.
- Semantische Gruppierung: Gruppiert Ablaufverfolgungen nach ihrer Bedeutung, anstatt sich ausschließlich auf Tags, Statuscodes oder exakte Textübereinstimmungen zu stützen. Teams können diese Gruppen nutzen, um wiederkehrende Anfragetypen, Fehlermuster oder unerwartete Benutzerfragen zu finden.
- Erkennung von Prompt-Injection: Analysiert Benutzereingaben und Modellinteraktionen auf Anweisungen, die System-Prompts außer Kraft setzen oder das Verhalten von Agenten manipulieren sollen. Die Erkennungsergebnisse können Untersuchungen, Blockierungsregeln und Sicherheitsprüfungen unterstützen.
- Erkennung sensibler Daten: Identifiziert personenbezogene, finanzielle, gesundheitliche oder vertrauliche Informationen in Eingabeaufforderungen und Antworten. Teams können die Ergebnisse nutzen, um Datensätze zu schwärzen, Verstöße gegen Richtlinien zu überprüfen und die Offenlegung in gespeicherten Ablaufverfolgungen zu begrenzen.
Vorteile von Tools zur Beobachtung von LLMs
Eine Plattform zur Beobachtung von LLMs bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Schnellere Untersuchung von Vorfällen: Verschachtelte Traces verbinden Prompts, Modellaufrufe, Abrufschritte, Tools, Latenz und Fehler in einer Zeitleiste.
- Höhere Ausgabequalität: Integrierte Evaluatoren, benutzerdefinierte Bewertungskriterien, Datensätze und menschliche Prüfungen helfen dabei, Halluzinationen, Relevanzprobleme und Sicherheitsprobleme zu erkennen.
- Sicherere Workflows in der Produktion: Die Erkennung von Prompt-Injection und sensiblen Daten kann riskante Eingaben, Antworten und Agenteninteraktionen zur Überprüfung markieren.
- Klarere Auswirkungen von Änderungen: Versionsverläufe von Prompts und Modellen verknüpfen Konfigurationsänderungen mit Veränderungen bei Qualität, Latenz, Fehlern und Token-Nutzung.
- Besser kontrollierbare Ausgaben: Token- und Kostenaufzeichnungen pro Anfrage zeigen, wie die Nutzung je nach Modell, Projekt, Umgebung oder Benutzer variiert.
- Bessere Reaktion im Betrieb: Echtzeitüberwachung, durchsuchbare Traces und Warnmeldungen helfen Teams dabei, Anomalien zu erkennen und Vorfälle an die zuständigen Reaktionskanäle weiterzuleiten.
Kosten und Preise von Tools zur Beobachtung von LLMs
Für die Auswahl des richtigen Tools müssen die verfügbaren Preismodelle und Tarife verstanden werden. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und Nutzungsvolumen. Die folgende Tabelle fasst gängige Tarife, Durchschnittspreise und typische in Software zur Beobachtung von LLMs enthaltene Funktionen zusammen.
Vergleichstabelle der Tarife für Tools zur Beobachtung von LLMs
| Tariftyp | Durchschnittlicher Preis | Gängige Funktionen |
|---|---|---|
| Kostenloser Tarif | $0/month | Grundlegende Protokollierung von Traces, begrenzte Aufbewahrung, Community-Support und Nutzungsobergrenzen. |
| Persönlicher Tarif | $10-$50/user/month | Visualisierung von Traces, Token-Tracking, Prompt-Überwachung, Datensatzverwaltung und E-Mail-Support. |
| Geschäftstarif | $100-$500/month | Erweiterte Evaluierungen, Echtzeitwarnungen, Teamberechtigungen, Integrationen und verlängerte Datenaufbewahrung. |
| Unternehmenstarif | $500-$5,000/month | Benutzerdefinierte Nutzungsgrenzen, Single Sign-on, Prüfprotokolle, Optionen für private Bereitstellungen, dedizierter Support und vertragsbasierte Kontrollen der Aufbewahrung. |
Häufig gestellte Fragen zu Tools zur Beobachtung von LLMs
Hier finden Sie Antworten auf häufige Fragen zu Tools zur Beobachtung von LLMs:
Ersetzen Tools zur Beobachtung von LLMs die herkömmliche Anwendungsüberwachung?
Nein, Tools zur Beobachtung ergänzen die herkömmliche Anwendungsüberwachung, indem sie Prompts, Antworten, Modelleinstellungen, Abrufschritte und Evaluatorbewertungen erfassen. Verbinden Sie beide Systeme, wenn Sie Vorfälle in der Produktion untersuchen. Ein LLM-Trace kann beispielsweise eine fehlerhaft formatierte Abrufabfrage aufdecken, während Anwendungsprotokolle die darauf folgende Zeitüberschreitung der Datenbank zeigen. Zusammen helfen diese Erkenntnisse dabei, Modellverhalten von Problemen der Anwendung oder Infrastruktur zu unterscheiden.
Können Tools zur Beobachtung von LLMs mit sensiblen Produktionsdaten umgehen?
Ja, einige Tools zur Beobachtung von LLMs unterstützen Kontrollen für sensible Produktionsdaten. Prüfen Sie vor der Bereitstellung Aufbewahrungsfristen, Löschabläufe, Verschlüsselungsdetails, Zugriffsberechtigungen und Exportkontrollen. Fragen Sie, ob der Anbieter Prompts oder Antworten zum Trainieren seiner Modelle verwendet. Sie sollten außerdem den Zugriff von Unterauftragsverarbeitern und die verfügbaren Bereitstellungsmodelle bestätigen. Eine selbst gehostete oder private Bereitstellung kann einschränken, wohin Trace-Daten übertragen werden. Senden Sie während der Evaluierung redigierte Testdatensätze und überprüfen Sie, wie die Maskierung in gespeicherten Traces, Exporten und Evaluatorergebnissen erscheint.
Sollten Sie ein quelloffenes oder verwaltetes Tool zur Beobachtung von LLMs wählen?
Wählen Sie quelloffene Software, wenn Bereitstellungskontrolle, Zugriff auf den Quellcode und eine planbare Verantwortung für die Infrastruktur am wichtigsten sind. Wählen Sie eine verwaltete Plattform, wenn Ihr Team vom Anbieter gehosteten Speicher, Aktualisierungen und Support benötigt. Vergleichen Sie mehr als nur den Abonnementpreis. Berücksichtigen Sie den Zeitaufwand für Entwicklung, Bereitstellung, Aktualisierungen, Zugriffskontrollen, Backups und Aufbewahrungsrichtlinien. Testen Sie anschließend denselben Workflow in beiden Optionen. Prüfen Sie die Trace-Details, die Einrichtung der Evaluatoren, die Zustellung von Warnmeldungen und die Exportformate. Die bessere Wahl entspricht Ihren Sicherheitsanforderungen und den verfügbaren betrieblichen Kapazitäten.
Wie testet man ein Tool zur Beobachtung von LLMs vor dem Kauf?
Testen Sie einen mehrstufigen Workflow mit Abruf, Tool-Aufrufen und Fehlern. Stellen Sie sicher, dass der Trace die Reihenfolge der Ereignisse, Eingaben, Ausgaben, Latenz, Tokens und Fehlerdetails bewahrt. Überprüfen Sie anschließend die Evaluatorbewertungen und die Versionsverfolgung von Prompts. Exportieren Sie schließlich Datensätze und prüfen Sie Feldnamen, Zeitstempel und das Verhalten bei der Redigierung. Dieser Test macht Lücken sichtbar, die Produktdemonstrationen häufig verbergen.