

Die 10 besten Tools zur Bereitstellung von ML-Modellen im Jahr 2026
Auswahl der besten Tools zur Bereitstellung von ML-Modellen


Mit Tools zur Bereitstellung von ML-Modellen können Sie trainierte Modelle des maschinellen Lernens in produktionsbereite Dienste umwandeln, die Sie tatsächlich nutzen können. Wenn Sie nach Möglichkeiten suchen, Ihre KI-gestützten Anwendungen zuverlässig zu starten, zu überwachen und zu verwalten, ist die Wahl der richtigen Bereitstellungsplattform entscheidend. Sicherheit, Skalierung, Automatisierung und Transparenz können Ihren Arbeitsablauf maßgeblich beeinflussen.
In dieser Liste stelle ich die Tools zur Bereitstellung von ML-Modellen vor, denen ich am meisten vertraue, und zeige Ihnen genau, wo jedes davon in Ihren Technologiestapel passt, damit Sie die Plattform auswählen können, die den Anforderungen Ihres Projekts und den Erwartungen Ihres Teams entspricht.
Warum Sie unseren Software-Bewertungen vertrauen können
Wir testen und bewerten seit 2023 Software. Als Technologie-Führungskräfte wissen wir, wie kritisch und herausfordernd es ist, die richtige Entscheidung bei der Softwareauswahl zu treffen.
Wir investieren viel in gründliche Recherche, um unserer Zielgruppe zu helfen, bessere Kaufentscheidungen zu treffen. Wir haben über 2.000 Tools für verschiedene Technikanwendungsfälle getestet und mehr als 1.000 umfassende Softwarebewertungen geschrieben. Erfahren Sie wie wir transparent bleiben und unsere Methodik der Softwarebewertung.
Zusammenfassung der besten Tools zur Bereitstellung von ML-Modellen
Diese Vergleichstabelle fasst die Preisinformationen für meine Auswahl der besten Tools zur Bereitstellung von ML-Modellen zusammen, damit Sie das beste Tool für Ihr Budget und Ihre geschäftlichen Anforderungen finden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für die native Orchestrierung von Modellen mit Kubernetes | Kostenloser Plan verfügbar | Kostenlos nutzbar | Website | |
| 2 | Am besten für standardisierte Inferenz-APIs auf Kubernetes geeignet | Kostenloser Tarif verfügbar | Kostenlos nutzbar | Website | |
| 3 | Am besten geeignet zum Verpacken von Modellen als Produktions-APIs | Kostenloser Plan + kostenlose Demo verfügbar | Preise auf Anfrage | Website | |
| 4 | Am besten geeignet für das Hosting von Transformer-Modellen im großen Maßstab | Kostenloser Tarif + kostenlose Demo verfügbar | Ab $9/Monat | Website | |
| 5 | Am besten für die Bereitstellung serverloser Python-Funktionen geeignet | Kostenloser Tarif verfügbar | Ab $250 + Compute/Monat | Website | |
| 6 | Am besten für automatisiertes End-to-End-Modellmanagement | Kostenloser Tarif verfügbar | Ab $0.204/Stunde | Website | |
| 7 | Am besten für die Vereinheitlichung von Daten- und KI-Workflows geeignet | Kostenloser Tarif verfügbar | Ab 0.085 $/Stunde | Website | |
| 8 | Am besten geeignet für den Bau individueller Web-UIs für Modelle | Kostenlose Version verfügbar | Preise auf Anfrage | Website | |
| 9 | Am besten geeignet für verteiltes Serving mit Python und Ray | Kostenloses Guthaben von $100 verfügbar | Preis auf Anfrage | Website | |
| 10 | Bestens geeignet für das Management von Modellen in regulierten Branchen | Not available | Preise auf Anfrage | Website |
Bewertungen der besten Tools zur Bereitstellung von ML-Modellen
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Tools zur Bereitstellung von ML-Modellen, die es in meine engere Auswahl geschafft haben. Meine Bewertungen bieten einen detaillierten Einblick in die Funktionen, Integrationen und besten Einsatzmöglichkeiten jeder Plattform, damit Sie die beste Lösung für sich finden.
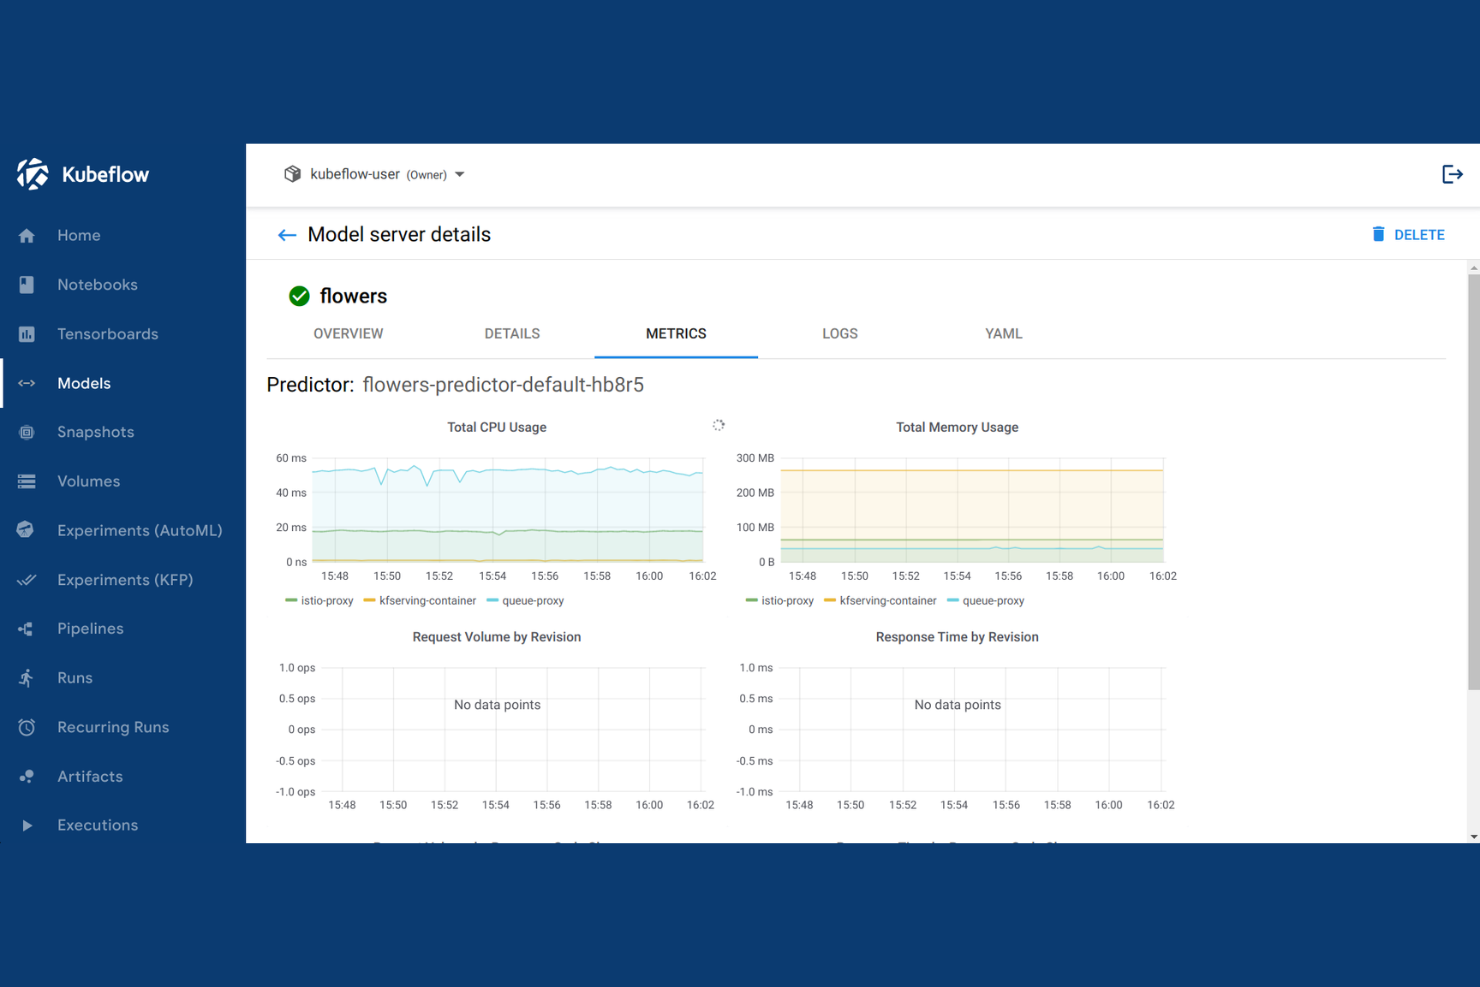
Kubeflow ist eine quelloffene ML-Plattform auf Basis von Kubernetes, die die Orchestrierung von Pipelines, das Modelltraining, die Optimierung von Hyperparametern und die Bereitstellung von Modellen mit mehreren Frameworks in Cloud- und On-Premises-Infrastrukturen abdeckt.
Für wen ist Kubeflow am besten geeignet?
Kubeflow eignet sich besonders für ML-Engineering-Teams, die bereits Kubernetes einsetzen und umfangreiche Trainingsaufgaben sowie die Bereitstellung von Produktionsmodellen auf ihrer eigenen Infrastruktur verwalten müssen.
Warum ich Kubeflow ausgewählt habe
Ich habe Kubeflow als eine der besten Lösungen ausgewählt, weil es speziell für Kubernetes entwickelt wurde. Das bedeutet, dass jede Komponente als native Kubernetes-Workload ausgeführt wird. Mir gefällt, dass ich mit Kubeflow Pipelines durchgängig automatisierte ML-Workflows als containerisierte DAGs definieren kann, sodass jeder Schritt unabhängig skaliert werden kann. Kubeflow Trainer übernimmt das verteilte Training mit PyTorch, JAX und DeepSpeed, ohne dass eine individuelle Clusterkonfiguration erforderlich ist. Außerdem kann ich Katib verwenden, um automatisierte Hyperparametersuchen direkt für laufende Trainingsaufgaben auf demselben Cluster durchzuführen.
Wichtigste Funktionen von Kubeflow
- KServe: Stellen Sie trainierte Modelle als skalierbare Inferenzdienste auf Kubernetes bereit, und nutzen Sie dafür vorkonfigurierte Bereitstellungsumgebungen für TensorFlow, PyTorch und scikit-learn.
- Modellregister: Speichern, versionieren und verfolgen Sie registrierte Modelle über verschiedene Trainingsläufe hinweg, bevor Sie sie in Bereitstellungsumgebungen überführen.
- Notebook-Server: Starten Sie Jupyter-Notebook-Instanzen direkt auf dem Cluster mit konfigurierbaren CPU-, GPU- und Speicherkapazitäten.
- Isolation mehrerer Benutzer: Verwalten Sie separate Namespaces und Zugriffskontrollen für verschiedene Teams oder Projekte innerhalb eines gemeinsam genutzten Clusters.
Kubeflow-Integrationen
Kubeflow bietet keine herkömmlichen nativen Integrationen. Stattdessen arbeitet es innerhalb des Kubernetes-Ökosystems und unterstützt ML-Frameworks wie TensorFlow, PyTorch, JAX, XGBoost, HuggingFace und Apache Spark über die Operatoren seiner Teilprojekte. Sie können Kubeflow außerdem auf verwalteten Kubernetes-Diensten von AWS, Google Cloud, Microsoft Azure und Red Hat OpenShift bereitstellen.
Pros and Cons
Pros:
- Bereitstellung bei allen großen Cloud-Kubernetes-Anbietern
- Jeder Pipelineschritt wird in einem isolierten Container ausgeführt
- Erzielt hervorragende Ergebnisse beim verteilten Training und bei der Orchestrierung
Cons:
- Die komplexe Ersteinrichtung erfordert Kubernetes-Kenntnisse
- Erfordert ein dediziertes Plattformteam für die Wartung

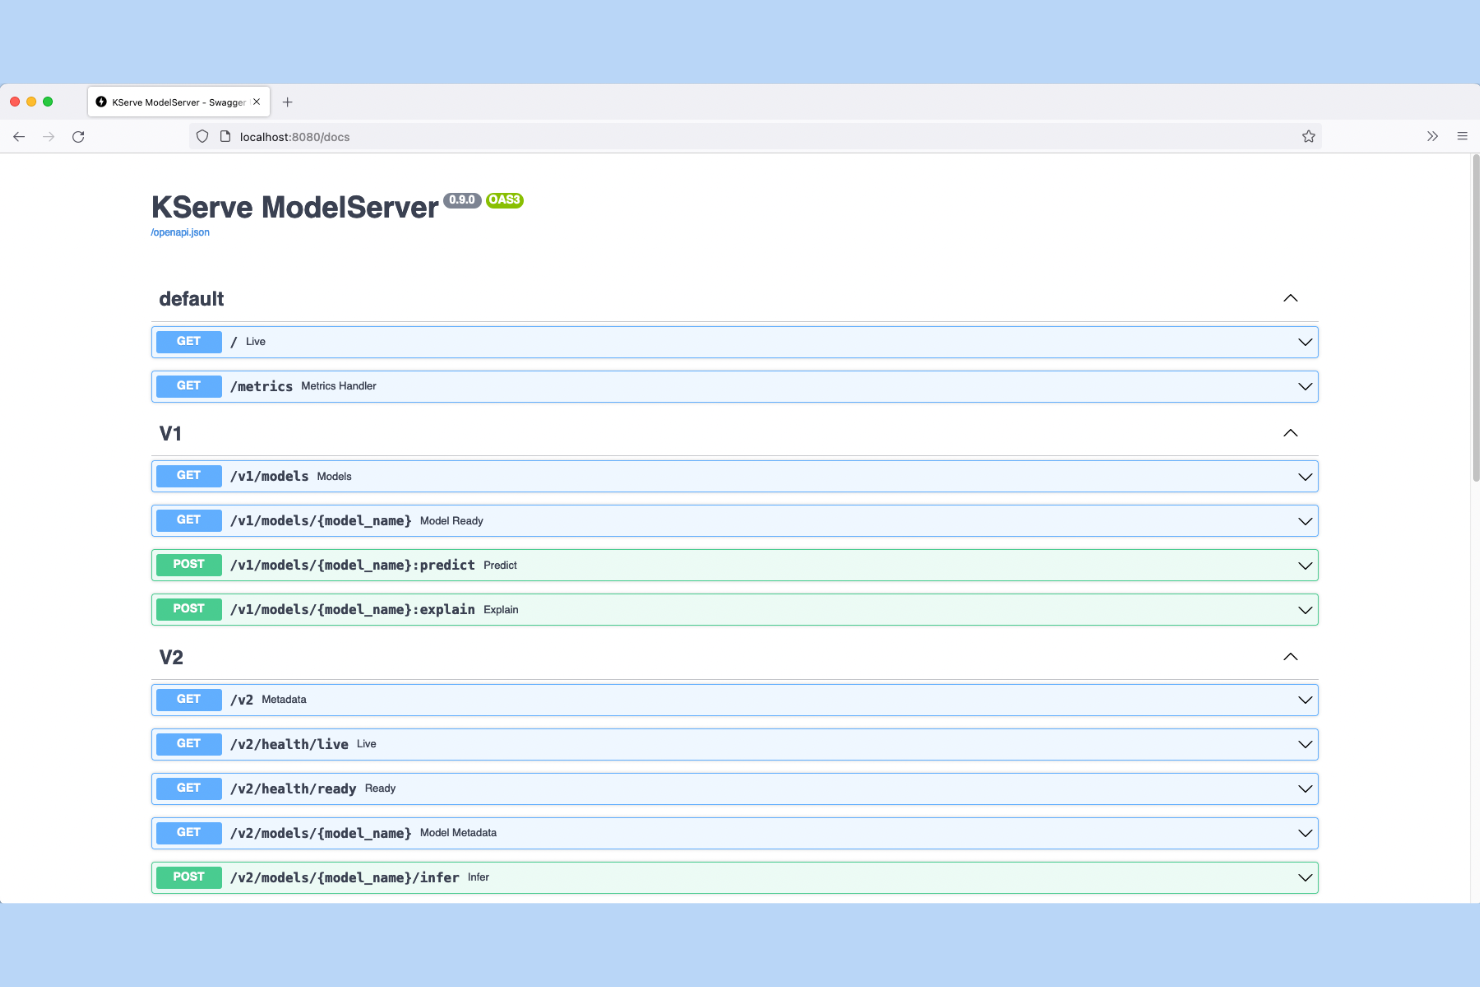
KServe ist eine quelloffene, Kubernetes-native Plattform für die Modellinferenz, die das Bereitstellen von Modellen verschiedener Frameworks, Canary-Rollouts, automatische Skalierung und die Erklärbarkeit von Modellen über eine standardisierte Inferenz-API-Schicht ermöglicht.
Für wen ist KServe am besten geeignet?
KServe eignet sich besonders für Teams für ML-Engineering in mittelgroßen bis großen Unternehmen, die das Bereitstellen von Modellen in großem Maßstab auf Kubernetes betreiben und eine frameworkunabhängige Inferenzschicht benötigen.
Warum ich KServe ausgewählt habe
Ich habe KServe als eine der besten Lösungen ausgewählt, weil es auf dem Open-Inference-Protokoll (V2) basiert, einer standardisierten API-Spezifikation, mit der mein Team Bereitstellungs-Backends wie Triton oder vLLM austauschen kann, ohne den Client-Code neu schreiben zu müssen. Außerdem nutze ich die InferenceService-CRD, um Canary-Rollouts deklarativ zu definieren und dabei einen Prozentsatz des Live-Datenverkehrs an eine neue Modellversion weiterzuleiten, bevor diese vollständig ausgerollt wird. Sowohl REST- als auch gRPC-Inferenzendpunkte werden unterstützt, sodass ich nicht an eine einzige Transportschicht gebunden bin.
Die wichtigsten Funktionen von KServe
- Automatische Skalierung bis auf null: Die von Knative unterstützte automatische Skalierung fährt Inferenz-Pods bei Inaktivität auf null herunter und startet sie bei Bedarf wieder.
- Anforderungs-/Antwort-Transformatoren: Die Vor- und Nachverarbeitungslogik läuft als separater Transformer-Container neben dem Modellserver.
- Canary-Rollouts: Der Datenverkehr wird schrittweise auf eine neue Modellversion umgeleitet, sodass Änderungen in der Produktion getestet werden können, ohne sie vollständig bereitzustellen.
- Nutzdatenprotokollierung: Inferenzanforderungen und -antworten werden zur Erstellung von Prüfpfaden und zur Modellüberwachung an konfigurierbare Ziele protokolliert.
KServe-Integrationen
KServe bietet native Integrationen mit Knative, Istio und der Kubernetes Gateway API für serverlose Skalierung und die Weiterleitung des eingehenden Datenverkehrs. Im Lieferumfang enthalten sind integrierte Bereitstellungs-Laufzeiten für vLLM, llm-d, NVIDIA Triton Inference Server, Seldon MLServer, TorchServe und Hugging Face. Außerdem werden Modellspeicher von Amazon S3, Google Cloud Storage und Azure Blob Storage unterstützt. Für benutzerdefinierte Integrationen stehen ein Python-SDK für das Serving sowie REST-/gRPC-Inferenz-APIs zur Verfügung.
Pros and Cons
Pros:
- Automatische Skalierung bis auf null reduziert die Kosten für ungenutzte GPUs
- Frameworkunabhängiges Bereitstellen über ein standardisiertes Inferenzprotokoll
- Integrierte Canary-Rollouts für sichere Aktualisierungen
Cons:
- Für den Betrieb sind Kubernetes-Kenntnisse erforderlich
- Der serverlose Modus begrenzt die Anpassungsmöglichkeiten für Volume-Einhängungen

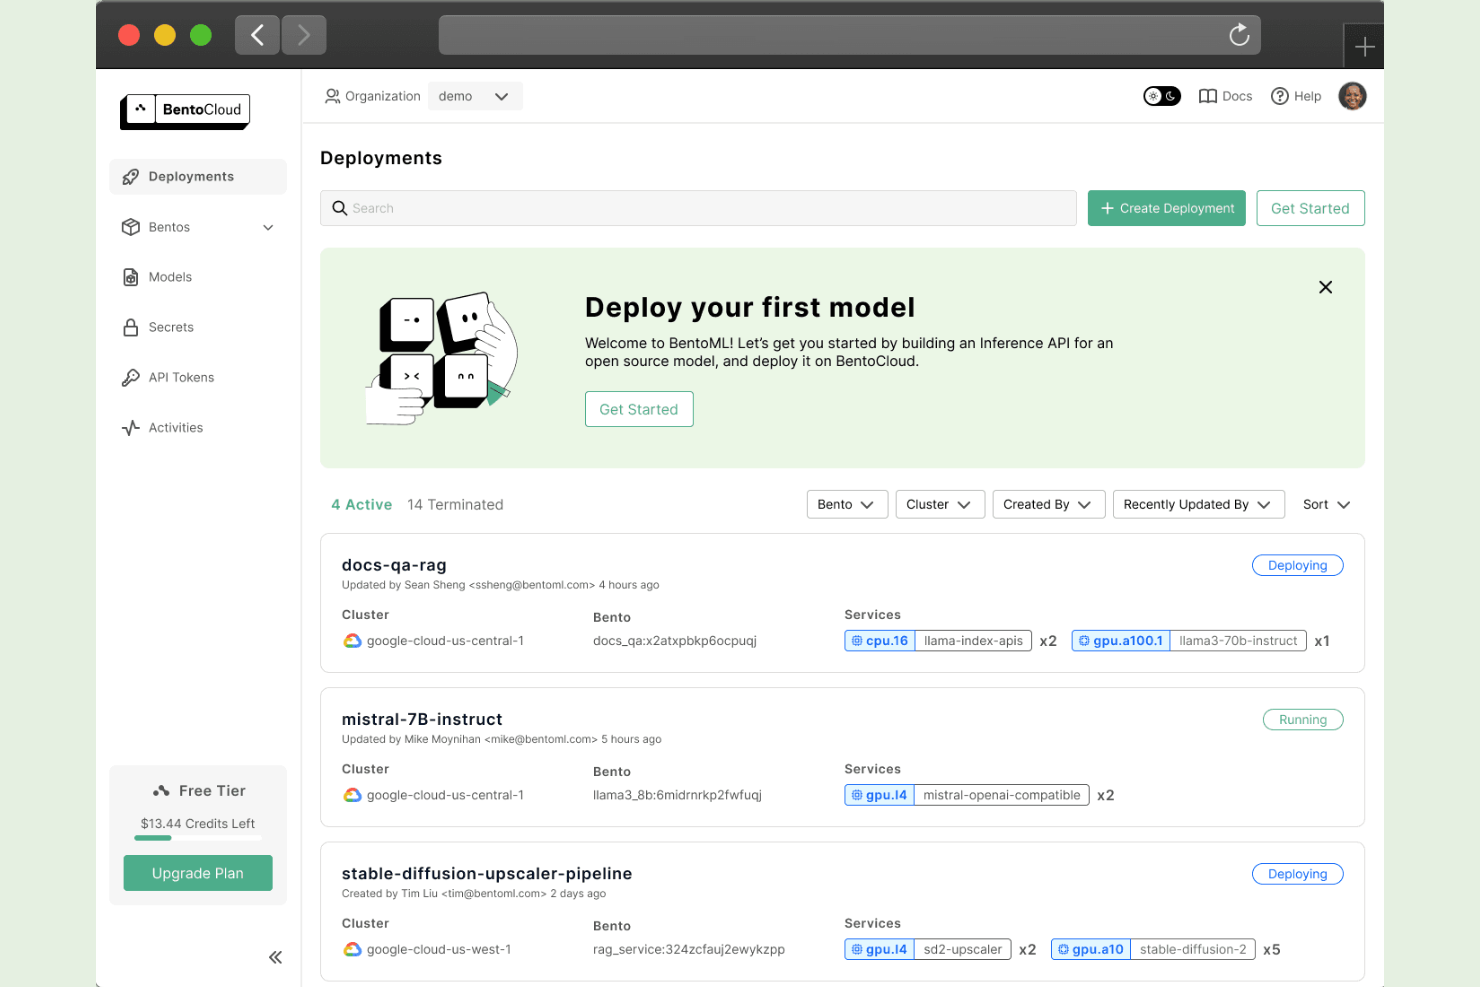
BentoML basiert auf dem Konzept eines 'Bento'-Artefakts und ist ein nativer Python-Framework für das Bereitstellen von Modellen, das die Service-Definition, Containerisierung und das Verpacken von Modellen verschiedener Frameworks für die produktive Bereitstellung übernimmt.
Für wen ist BentoML am besten geeignet?
BentoML eignet sich besonders für ML-Teams in wachstumsstarken Unternehmen, die schnell von einem trainierten Modell zu einer produktionsreifen API gelangen möchten, ohne auf eine dedizierte MLOps-Plattform angewiesen zu sein.
Warum ich mich für BentoML entschieden habe
Ich habe BentoML in meine Top-Auswahl aufgenommen, weil es eines der wenigen Frameworks ist, das das Modell-Artefakt und die Serving-Schicht als eine einzelne, versionierte Einheit behandelt. Mir gefällt, dass BentoML sowohl REST- als auch gRPC-Endpunkte aus derselben Service-Definition automatisch generiert, sodass mein Team keine separaten API-Spezifikationen pflegen muss. Die Runner-Abstraktion erlaubt es zudem, jedes Modell in einem eigenen Prozess zu isolieren, was bedeutet, dass ein CPU-basierter Preprocessing-Schritt nicht mit einem GPU-Model-Runner um Ressourcen konkurriert.
BentoML Hauptfunktionen
- Adaptives Batching: Gruppiert gleichzeitige Inferenzanfragen automatisch zu einem einzigen Batch und reduziert so den GPU-Overhead pro Anfrage ohne Code-Änderungen.
- Eingebaute Prometheus-Metriken: Stellt einen /metrics-Endpunkt standardmäßig bereit, sodass Sie Latenz und Durchsatz der Anfragen überwachen können, ohne eigene Instrumentierung zu benötigen.
- LLM-Gateway: Bietet eine einheitliche API-Schnittstelle über mehrere LLM-Anbieter hinweg und ermöglicht eine zentrale Steuerung von Routing und Kosten.
- Containerisierter Image-Build: Erstellt per einfachem CLI-Befehl ein produktionsreifes Docker-Image direkt aus einem Bento-Artefakt.
BentoML Integrationen
BentoML bietet dokumentierte Integrationen mit Tools aus dem MLOps-Ökosystem wie Airflow, MLflow, Ray, Spark, Arize AI, Flink und Triton Inference Server. Außerdem ist eine Integration mit Datadog zur Erfassung von BentoML-Service-Metriken vorhanden. Für eigene Integrationen steht eine API zur Verfügung, und die containerisierte Ausgabe von BentoML kann nativ mit Kubernetes und Docker für flexible Bereitstellung verwendet werden.
Pros and Cons
Pros:
- Integriertes Modellversionierung und Rollback-Verfolgung
- Erzeugt Docker-Container aus YAML-Konfiguration
- Bearbeitet gleichzeitige Anfragen über Worker-Skalierung
Cons:
- Konfigurationsdateien können unnötig komplex wirken
- Eigene Modell-Loader erfordern zusätzlichen Aufwand

Am besten geeignet für das Hosting von Transformer-Modellen im großen Maßstab
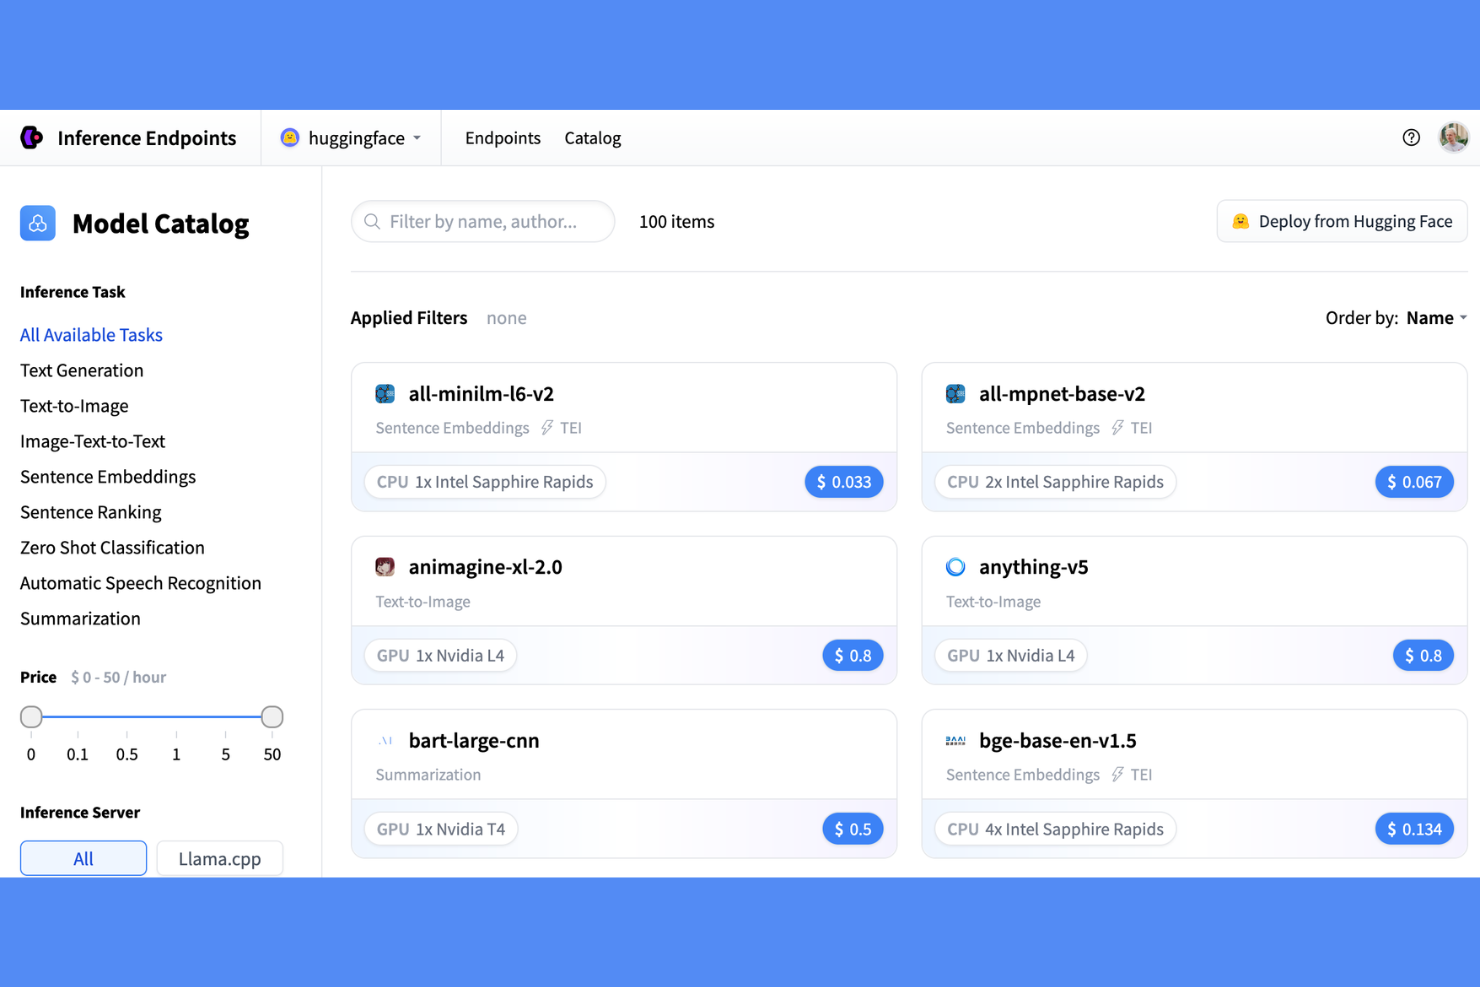
Eine verwaltete Inferenz-Plattform, die auf dem Hugging Face Hub aufbaut: Hugging Face Inference Endpoints übernimmt die dedizierte Cloud-Bereitstellung, Endpunkt-Konfiguration und Hardware-Auswahl für ML-Modelle über AWS, Azure und Google Cloud hinweg.
Für wen sind Hugging Face Inference Endpoints am besten geeignet?
Sie sind besonders geeignet für KI-orientierte Start-ups und mittelgroße Technologieunternehmen, die produktionsreifes Modellhosting benötigen, ohne eine eigene Serving-Infrastruktur aufbauen und betreiben zu müssen.
Warum ich Hugging Face Inference Endpoints ausgewählt habe
Hugging Face Inference Endpoints verdienen ihren Platz auf meiner Auswahlliste, weil sie speziell auf das Transformer-Modell-Ökosystem zugeschnitten sind – wie es keine andere Bereitstellungsplattform ist. Mein Team kann jedes Modell aus dem Hub, einschließlich großformatiger LLMs und multimodaler Transformer, im Produktionsmaßstab bereitstellen – mit konfigurierbaren Autoscaling-Regeln, die auf echten Traffic reagieren. Ich schätze auch die Geschwindigkeit bis zum fertigen Endpunkt: Ein Modell, dessen Containerisierung und Bereitstellung normalerweise Tage dauern würde, ist in wenigen Minuten live.
Wichtige Funktionen von Hugging Face Inference Endpoints
- Multi-Cloud-Bereitstellung: Wählen Sie, ob Sie Ihren Endpunkt auf AWS, Azure oder Google Cloud bereitstellen – ohne separate Cloud-Konten verwalten zu müssen.
- Privates Netzwerk: Sperren Sie Endpunkte in einer dedizierten VPC ab, sodass nur Ihre internen Systeme auf die Modell-API zugreifen können.
- Token-basierte Authentifizierung: Sichern Sie jeden Endpunkt mit einem API-Token ab, um zu steuern, welche Dienste oder Nutzer Inferenz-Anfragen senden dürfen.
- Nutzungsmonitoring: Überwachen Sie Anfragevolumen, Latenz und Fehlerquoten direkt im Endpoint-Dashboard in Echtzeit.
Integrationen von Hugging Face Inference Endpoints
Hugging Face Inference Providers arbeitet mit einem wachsenden Ökosystem aus Entwickler-Tools, Frameworks und Plattformen; und viele Tools ohne explizite Unterstützung sind über die OpenAI-kompatible API dennoch oft nutzbar. Dokumentierte Integrationen umfassen AWS Bedrock und SageMaker, Google Gemini Enterprise Agent Platform und Azure AI Foundry sowie LLM-Frameworks wie LangChain, LlamaIndex, Haystack, CrewAI und PydanticAI. Inference Endpoints sind vollständig per API verwaltbar, die Endpunkte sind via Swagger dokumentiert – so können Sie eigene Integrationen bauen. Zapier-Support ist nicht klar dokumentiert.
Pros and Cons
Pros:
- Bereitstellung mit nur einem Klick direkt aus dem Hugging Face Hub
- Unterstützt mehrere Inferenz-Engine-Backends
- Autoscaling mit Abrechnung auf Null-Nutzung
Cons:
- Cold Starts beim Skalieren ab Null
- GPU-Rechenkosten steigen bei großem Maßstab schnell an

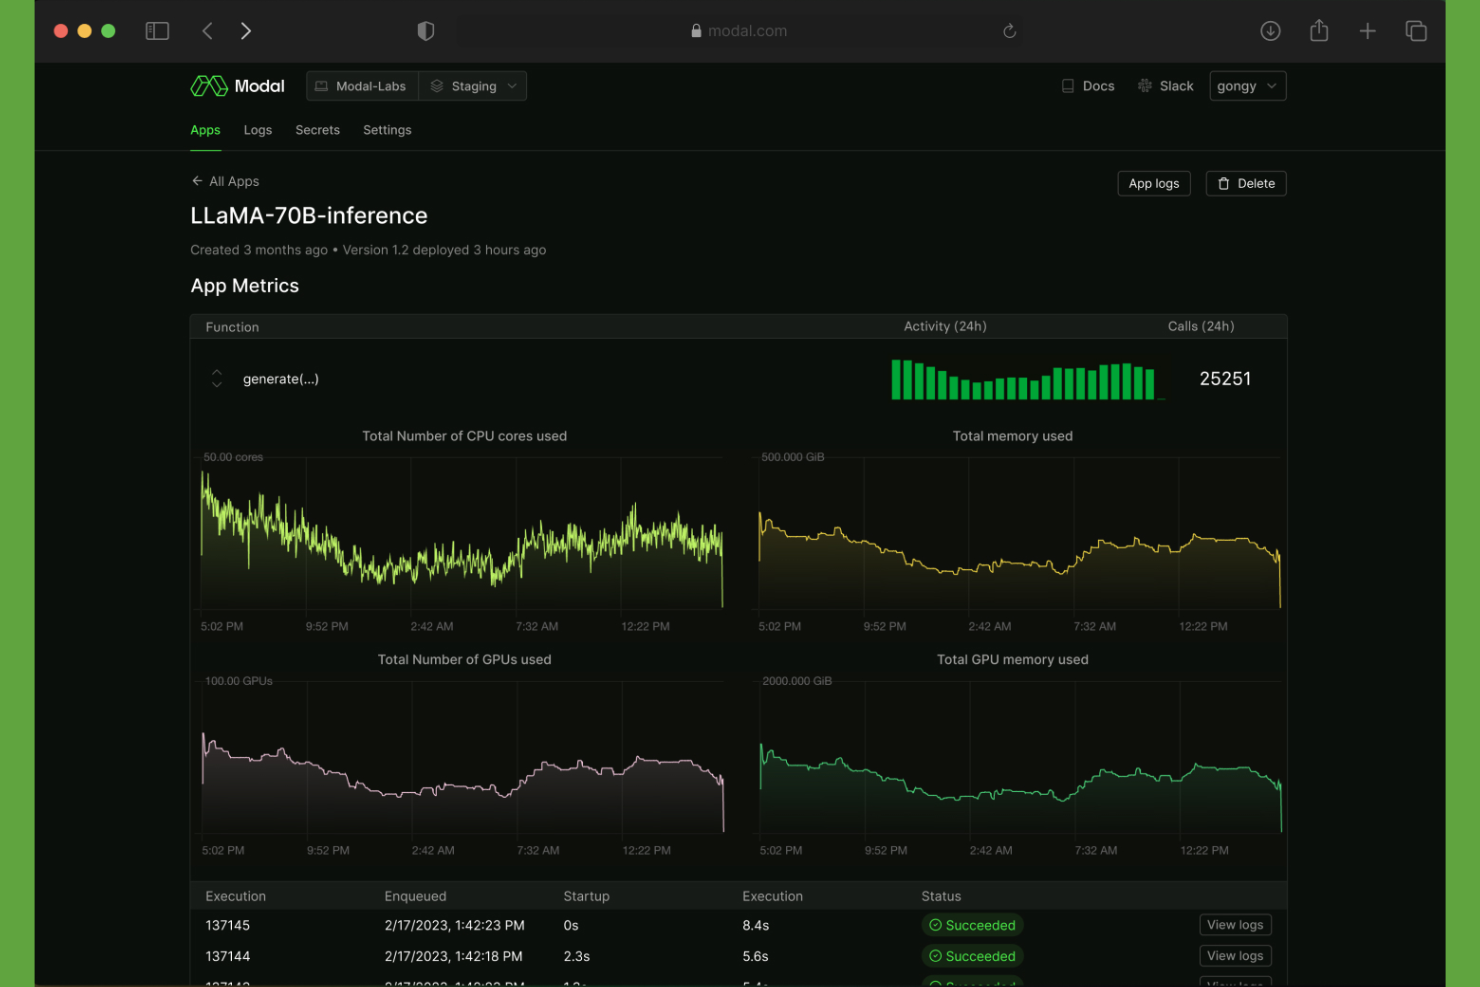
Modal ist eine serverlose Cloud-Plattform zum Ausführen von Python-basierten ML-Workloads und deckt GPU-beschleunigte Inferenz, Batch-Jobs, Trainingsläufe und geplante Aufgaben ab – ganz ohne Container- oder Infrastrukturverwaltung.
Für wen ist Modal am besten geeignet?
Modal eignet sich besonders für Startups und wachsende Teams, die ML-Modelle schnell bereitstellen müssen, ohne dedizierte Infrastruktur-Engineers einzustellen.
Warum ich Modal gewählt habe
Ich habe Modal in meine Topauswahl aufgenommen, weil es die Lücke zwischen dem Schreiben von Python-Code und dem skalierbaren Ausführen auf GPUs schließt. Ich kann spezielle Hardware wie A100 oder H100 direkt in meiner Funktionsdefinition anfordern und Modal stellt diese auf Abruf bereit. Es gibt keinen Cluster zu verwalten und keine YAML-Dateien zu schreiben. Außerdem gefällt mir, dass dieselbe Funktion sowohl lokal als auch in der Produktion identisch ausgeführt wird, was die Debugging-Zeit erheblich reduziert.
Wichtige Funktionen von Modal
- Benutzerdefinierte Container-Images: Definiert Abhängigkeiten, Umgebungsvariablen und Systempakete direkt im Code, was für konsistente Laufzeitumgebungen bei allen Deployments sorgt.
- Persistente Volumes: Cloud-Volumes lassen sich einbinden, um Modellgewichte zwischen Läufen zu cachen; das reduziert Kaltstartzeiten bei wiederholten Deployments.
- Geheimes Management: API-Keys und Zugangsdaten werden sicher zur Laufzeit gespeichert und eingebunden, ohne sie in den Code hardcoden zu müssen.
- Parallele Batch-Ausführung: Verwenden Sie .map(), um Inferenzvorgänge gleichzeitig über große Datensätze und mehrere Container hinweg auszuführen.
Modal-Integrationen
Modal bietet eine kleine Auswahl dokumentierter Integrationen mit Fokus auf Beobachtbarkeit und Benachrichtigungen, etwa für Datadog, alle OpenTelemetry-kompatiblen Anbieter, Slack und Okta SSO. Zudem werden Cloud-Bucket-Mounts für AWS S3, Google Cloud Storage und Cloudflare R2 unterstützt, ebenso wie CI/CD-Workflows über GitHub Actions. Eine Zapier-Unterstützung ist nicht dokumentiert, aber Modal stellt ein Python-SDK und Web-Endpunkte für eigene Integrationen bereit.
Pros and Cons
Pros:
- Keine Dockerfiles oder Kubernetes-Konfiguration nötig
- Unterstützt Training, Batch-Prozesse und Inferenz
- Verteilt Workloads über mehrere Clouds und Regionen
Cons:
- Code mit Decorators führt zu Herstellerbindung
- Enterprise-Funktionen erfordern Premium-Preisniveau

Amazon SageMaker (auch bekannt als AWS SageMaker) ist eine AWS-ML-Plattform, die den gesamten Lebenszyklus eines Modells abdeckt – von Training und Feinabstimmung über Bereitstellung, Überwachung und Governance – innerhalb einer einheitlichen Entwicklungsumgebung auf Lakehouse-Architektur.
Für wen ist Amazon SageMaker am besten geeignet?
Amazon SageMaker eignet sich ideal für Data-Science- und ML-Engineering-Teams, die bereits im AWS-Ökosystem arbeiten.
Warum ich Amazon SageMaker ausgewählt habe
Amazon SageMaker verdient seinen Platz auf meiner Bestenliste, weil es automatisiertes End-to-End-Management für Modelle bietet, ohne dass man verschiedene Tools zusammenstellen muss. Besonders gefallen mir SageMaker MLOps, das Pipeline-Orchestrierung, Modellregister und Bereitstellungs-Tracking an einem Ort bündelt. Zudem verlasse ich mich auf die integrierten Inferenz-, AI-Ops- und Überwachungsfunktionen von SageMaker AI, um Modelle nach ihrer Bereitstellung zu beobachten und Drift zu erkennen, bevor daraus Produktionsprobleme werden.
Wichtige Funktionen von Amazon SageMaker
- SageMaker JumpStart: Zugriff auf über 1.000 vorgefertigte KI-Modelle von führenden Anbietern, um sie direkt in SageMaker bereitzustellen oder feinzuabstimmen.
- SageMaker HyperPod: Skalieren Sie Trainings- und Feinabstimmungsaufträge auf Hundertschaften oder Tausende von KI-Beschleunigern mit automatisiertem Cluster-Management.
- Multi-Mode-Inferenz: Modelle können mit Echtzeit-, serverloser, asynchroner oder Batch-Inferenz auf über 70 Instanztypen bereitgestellt werden.
- Managed MLflow: Iterative Experimente lassen sich verfolgen, organisieren und vergleichen – ohne Infrastruktur oder Server verwalten zu müssen.
Amazon SageMaker Integrationen
Amazon SageMaker ist nativ mit dem AWS-Ökosystem integriert, einschließlich Amazon S3, Amazon Redshift, Amazon Athena, Amazon EMR und AWS Glue sowie Amazon Bedrock und Amazon Q Developer. Zudem arbeitet es mit Drittanbieter-Tools wie Datadog, Hugging Face, MLflow und Pinecone zusammen. Eine API für benutzerdefinierte Integrationen ist verfügbar.
Pros and Cons
Pros:
- Mehrere Inferenzmodi für unterschiedliche Workloads
- Integriertes AutoML und Hyperparameter-Tuning
- Shadow-Testing für sichere Modelleinführungen
Cons:
- Enge Verknüpfung mit dem AWS-Ökosystem
- Fehlgeschlagene Trainingsaufträge sind schwer zu debuggen

Am besten für die Vereinheitlichung von Daten- und KI-Workflows geeignet
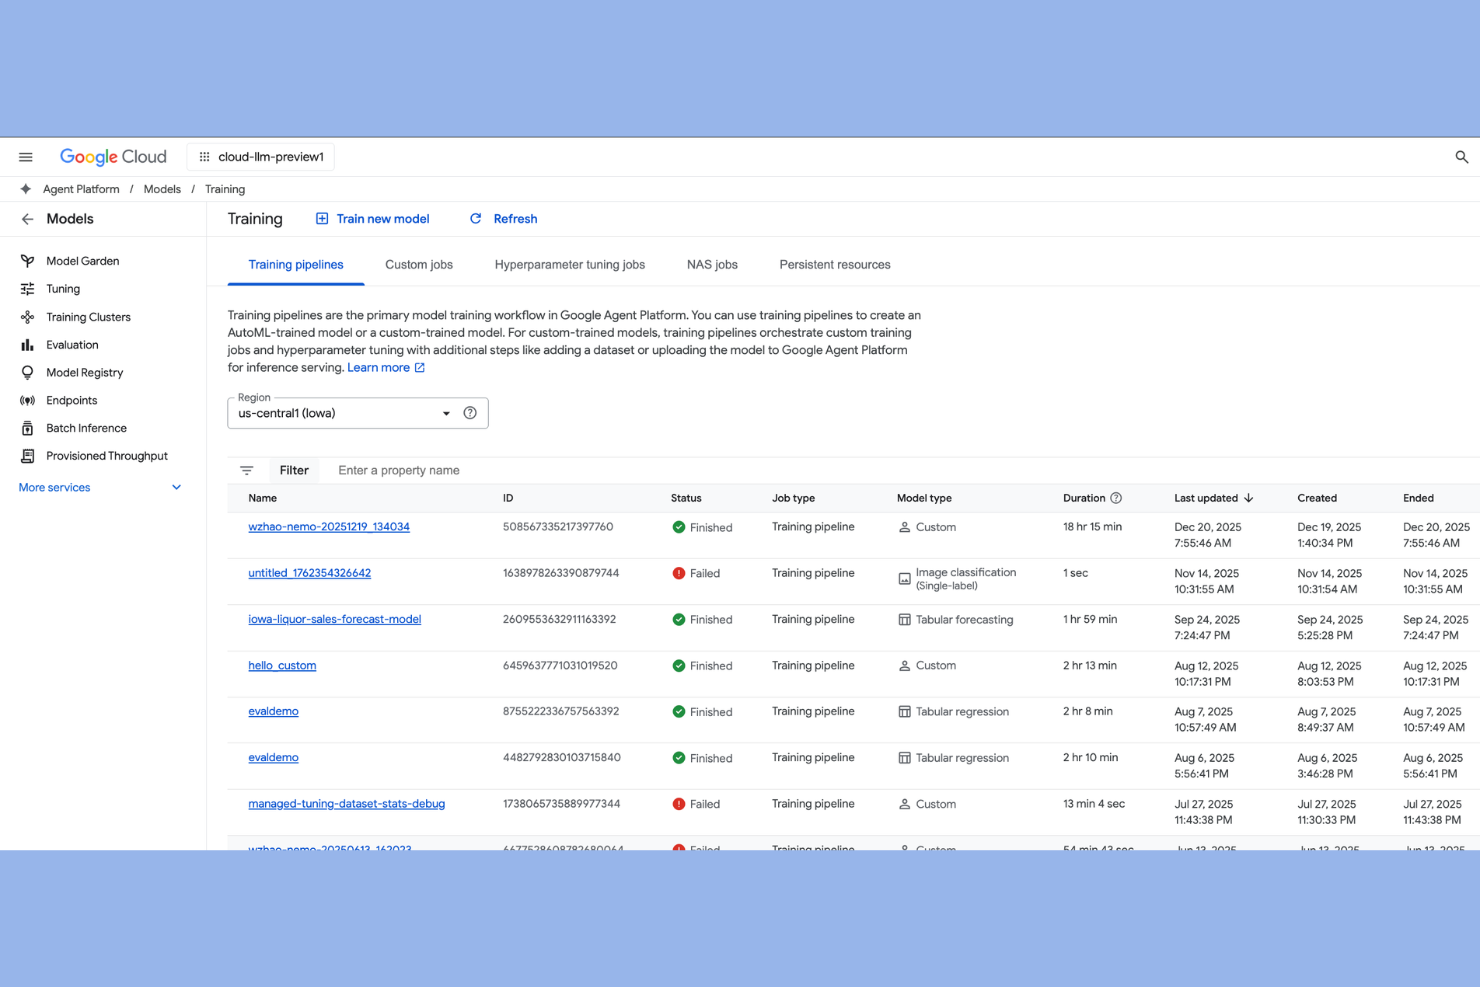
Gemini Enterprise Agent Platform (zuvor Vertex AI) ist die durchgängige ML-Plattform von Google Cloud, die Modelltraining, Feinabstimmung, Evaluierung, Bereitstellung und die Entwicklung von KI-Agenten in einer einzigen verwalteten Umgebung abdeckt.
Für wen eignet sich die Gemini Enterprise Agent Platform am besten?
Die Gemini Enterprise Agent Platform eignet sich besonders für ML-Engineering- und Data-Science-Teams, die ihre Dateninfrastruktur bereits auf der Google Cloud Platform betreiben.
Warum ich mich für die Gemini Enterprise Agent Platform entschieden habe
Ich habe die Gemini Enterprise Agent Platform in meine beste Auswahl aufgenommen, weil sie die Lücke zwischen Daten- und Modellverwaltung tatsächlich schließt. Besonders gefällt mir, wie die Pipelines der Gemini Enterprise Agent Platform direkt mit BigQuery verbunden werden und mein Team dadurch Trainingspipelines auf Basis von Live-Daten aus dem Datenlager erstellen kann, ohne etwas exportieren zu müssen. Der Featurespeicher der Gemini Enterprise Agent Platform ermöglicht es uns außerdem, Features sowohl für das Training als auch für die Inferenz konsistent zu definieren, bereitzustellen und zu überwachen, wodurch eine wesentliche Ursache für Abweichungen zwischen Training und Bereitstellung entfällt.
Wichtige Funktionen der Gemini Enterprise Agent Platform
- Modellregistrierung der Gemini Enterprise Agent Platform: Ein zentrales Repository zum Versionieren, Organisieren und Verwalten von Modellen während ihres gesamten Lebenszyklus vor und nach der Bereitstellung.
- Endpunkte für Onlinevorhersagen: Stellen Modelle über dedizierte Endpunkte bereit, die Echtzeitvorhersagen mit konfigurierbarer Rechenleistung und einer Aufteilung des Datenverkehrs zwischen Modellversionen liefern.
- Modellüberwachung der Gemini Enterprise Agent Platform: Erkennt Feature-Abweichungen und Vorhersagedrift in bereitgestellten Modellen, indem der Live-Datenverkehr mit einer Trainingsdaten-Baseline verglichen wird.
- Experimente der Gemini Enterprise Agent Platform: Verfolgt, vergleicht und visualisiert iterative Trainingsläufe, damit Teams die leistungsfähigsten Modellkonfigurationen ermitteln können.
Integrationen der Gemini Enterprise Agent Platform
Die Gemini Enterprise Agent Platform lässt sich nativ in das gesamte Google-Cloud-Ökosystem integrieren, einschließlich BigQuery, Cloud Storage, Dataflow und Pub/Sub, und unterstützt außerdem Kubeflow Pipelines sowie vorgefertigte Container für TensorFlow, scikit-learn, XGBoost und PyTorch. Ihre Datenspeicher unterstützen zudem Datenverbindungen von Drittanbietern für Tools wie Jira und Shopify. Die Plattform ist auf Zapier verfügbar, und für benutzerdefinierte Integrationen steht eine API zur Verfügung.
Pros and Cons
Pros:
- Die Modellbibliothek bietet mehr als 200 bereitstellbare Modelle
- Die endpunktbasierte Bereitstellung aus der Modellbibliothek ist unkompliziert
- Native BigQuery-Integration für Daten-Workflows
Cons:
- Für ungenutzte dedizierte Endpunkte fallen weiterhin Gebühren an
- Nicht übereinstimmende Regionszuordnungen erzeugen undurchsichtige Fehlermeldungen


Baseten ist eine Plattform für Modellausführung (Inference), mit der ML-Teams eigene, Open-Source- und feinabgestimmte Modelle mit GPU-beschleunigter Bereitstellung, automatischer Skalierung und Performance-Optimierungstools direkt in der Plattform betreiben können.
Für wen ist Baseten am besten geeignet?
Baseten eignet sich für AI-Produktteams in wachsenden Unternehmen, die volle Kontrolle über die Modellausführung für latenzkritische oder hochskalierende Deployments benötigen.
Warum ich Baseten ausgewählt habe
Baseten steht auf meiner Auswahlliste, weil du damit individuelle Web-UIs direkt auf deinen Modellen aufbauen und bereitstellen kannst, ohne einen separaten Frontend-Stack zu benötigen. Ich nutze den Applikations-Builder von Baseten, um interaktive Schnittstellen zu erstellen, die direkt Modell-Endpunkte ansprechen – praktisch für interne Tools oder Demos für Stakeholder. Modell und UI bleiben gemeinsam versioniert und deployed.
Baseten Schlüsselfunktionen
- Truss-Modellverpackung: Verpacke jedes eigene oder feinabgestimmte Modell als reproduzierbares Python-Artefakt mit eingebautem Abhängigkeitsmanagement und Live-Reload für lokale Tests.
- Baseten Chains: Baue mehrstufige, zusammengesetzte KI-Workflows, wobei jeder Schritt auf unabhängig konfigurierbarer Hardware mit eigener Autoskalierung läuft.
- Secret-Management: Speichere und injiziere API-Schlüssel und Umgebungs-Zugangsdaten direkt in Modellbereitstellungen, ohne diese im Ausführungscode zu hinterlegen.
- A/B-Traffic-Splitting: Leite Live-Inferenz-Traffic über mehrere Modellversionen gleichzeitig, um Performance zu vergleichen, bevor ein neues Deployment vollumfänglich übernommen wird.
Baseten-Integrationen
Baseten unterstützt den Export von Metriken zu Prometheus, Datadog, Grafana Cloud und New Relic über seinen OpenTelemetry-basierten Metrik-Endpunkt. Es ist vollständig OpenAI-kompatibel, sodass du jede Client- oder Gateway-Lösung verwenden kannst, welche das OpenAI SDK nutzt, einschließlich LiteLLM, LlamaIndex und Cloudflare AI Gateway. Für eigene Integrationen steht eine API zur Verfügung.
Pros and Cons
Pros:
- Truss Open-Source-Paketierung vereinfacht die Modellbereitstellung
- Bereitstellung mit einem Klick aus Trainings-Checkpoints
- Kaltstarts unter einer Sekunde auf GPU-Instanzen
Cons:
- Nutzungsabhängige Preise können unvorhersehbar ansteigen
- Erfordert ML-Engineering-Expertise für den Betrieb

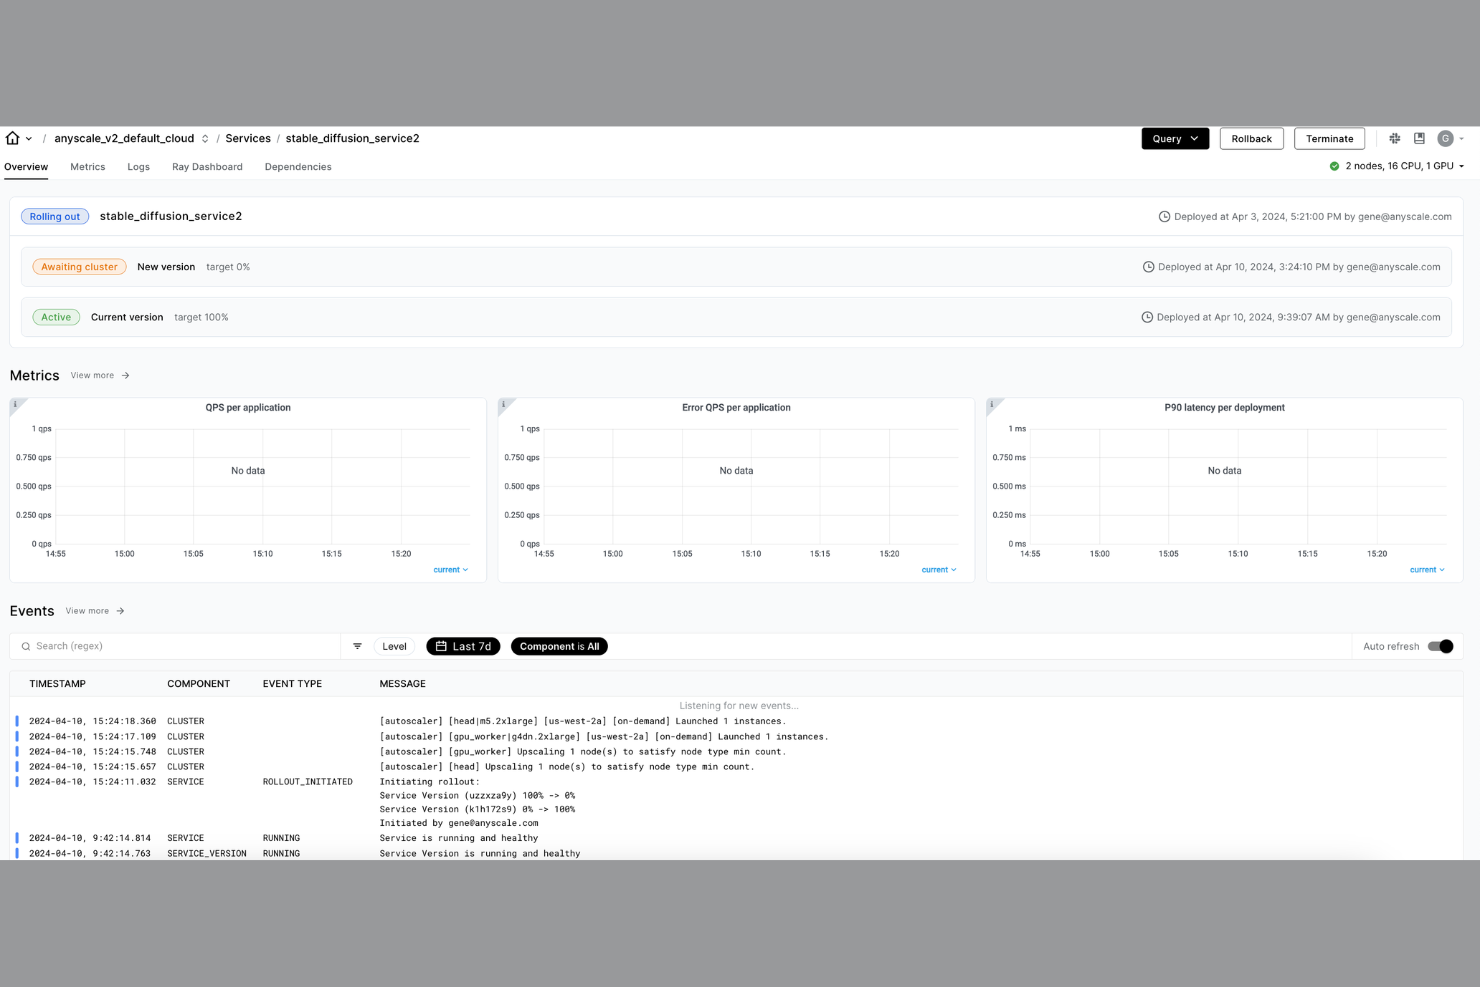
Anyscale basiert auf dem Open-Source-Framework Ray und ist eine verwaltete ML-Modellbereitstellungsplattform, die verteiltes Inferenz, automatisches Skalieren und Multi-Model-Deployments über GPU- und CPU-Cluster hinweg übernimmt.
Für wen ist Anyscale am besten geeignet?
Anyscale eignet sich besonders für ML-Ingenieure und Data-Science-Teams in mittleren bis großen Unternehmen, die Python-basierte Workloads in großem Umfang ausführen und GPU-Cluster-Management ohne manuellen Infrastrukturaufwand benötigen.
Warum ich Anyscale ausgewählt habe
Ich habe Anyscale als eine der besten Optionen gewählt, weil es die einzige verwaltete Plattform ist, die direkt auf Ray aufbaut. Das bedeutet, mein Team kann Standard-Python verwenden, um verteilte Serving-Logik zu definieren, ohne eine eigene Orchestrierungs-DSL lernen zu müssen. Besonders gefällt mir die Deployment-Graph-API von Ray Serve, mit der ich mehrere Modelle zu einer einzelnen Inferenz-Pipeline mit expliziter Request-Routing-Logik zusammenstellen kann. Auch die Möglichkeit zur Fraktionierung von GPUs nutze ich häufig, um leichte Modelle auf gemeinsam genutzter Hardware zu bündeln, ohne dedizierte Instanzen starten zu müssen.
Anyscale Hauptfunktionen
- Automatisches Skalieren: Skaliert die Anzahl der Replikate automatisch nach oben oder unten entsprechend der aktuellen Anfragerate und Warteschlangentiefe.
- Traffic Splitting: Leitet einen konfigurierbaren Prozentsatz des Live-Traffics an neue Modellversionen weiter, um stufenweise Rollouts ohne Ausfallzeit zu ermöglichen.
- Batching von Anfragen: Fasst eingehende Inferenzanfragen zu Batches zusammen, um die GPU-Auslastung bei parallelen Aufrufen zu maximieren.
- Multi-Node-Modellbereitstellung: Verteilt ein großes Modell auf mehrere Knoten, wenn die Speicherkapazität einer einzigen GPU überschritten wird.
Anyscale Integrationen
Anyscale integriert sich mit populären KI/ML-Bibliotheken und Frameworks mit über 50 Integrationen in Datenplattformen, Orchestrierung, ML-Frameworks, Observability und LLM-App-Frameworks. Dazu zählen MLflow, Weights & Biases, MongoDB, Snowflake, Databricks, Hugging Face, PyTorch und TensorFlow sowie Airflow, Prefect, Dagster, Datadog, LangChain und LlamaIndex. Eine API steht für eigene Integrationen zur Verfügung, und die Plattform kann außerdem als First-Party-Service auf Amazon EKS, Google GKE, Azure AKS und OCI Kubernetes Engine bereitgestellt werden.
Pros and Cons
Pros:
- Skaliert Python-Code über verteilte GPU-Cluster hinweg
- Framework-unabhängige Modellbereitstellung via Ray Serve
- Spot-Instanz-Unterstützung mit automatischer Ausfallsicherheit
Cons:
- Stark an das Ray-Ökosystem gekoppelt
- Erfordert vertiefte Kenntnisse in verteilten Systemen

Bestens geeignet für das Management von Modellen in regulierten Branchen
Weitere Tools zur Bereitstellung von ML-Modellen
Hier finden Sie einige weitere Tools zur Bereitstellung von ML-Modellen, die es nicht in meine engere Auswahl geschafft haben, die sich aber dennoch lohnen:


Wie ich ML-Modell-Bereitstellungstools bewerte
Ich bewerte jedes Tool auf zwei Ebenen: Zum einen das Basis-Setup, um ein PyTorch-Modell an einem REST-Endpunkt mit automatischer Skalierung und Driftüberwachung bereitzustellen, zum anderen die Unterscheidungsmerkmale, die für MLOps-Teams relevant sind.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jedes einzelne auf einer Skala von 0 (bietet diese Funktion nicht) bis 5 (hervorragend in diesem Bereich) für jede unten aufgeführte Kernfunktion. Anschließend berechne ich die Gesamtpunktzahl des Tools als Prozentsatz. Jedes Tool muss eine Mindestpunktzahl von 65 % erreichen, um in die engere Auswahl zu kommen.
- Modellbereitstellung & Inferenz: Ich prüfe, ob ein Tool Modelle hinter REST- oder gRPC-Endpunkten für Echtzeitvorhersagen bereitstellen kann und ob auch Batch-Inferenz für Offline-Scoring-Jobs unterstützt wird.
- Unterstützung mehrerer Frameworks: Ich schaue, welche ML-Frameworks nativ enthalten sind – wie TensorFlow, PyTorch, XGBoost und ONNX – und ob für ungewöhnlichere Laufzeiten eigene Container möglich sind.
- Modellversionierung & Registry: Ein solides Registry-System ermöglicht das Nachverfolgen von Modell-Artefakten, Metadaten und Herkunft, sodass man einen fehlerhaften Rollout in wenigen Minuten zurücksetzen kann, statt mühsam das richtige Artefakt zu suchen.
- Skalierung & Ressourcenverwaltung: Ich untersuche, wie automatische Skalierung unter Last funktioniert, ob GPU- und CPU-Zuweisung konfigurierbar ist und ob das Tool Scale-to-Zero unterstützt, um Kosten in Leerlaufphasen zu sparen.
- Monitoring & Beobachtbarkeit: Produktivmodelle verschlechtern sich oft unbemerkt – deshalb achte ich auf Erkennung von Data Drift, Messung der Vorhersagelatenz und Warnfunktionen, die Performance-Probleme melden, bevor Endnutzer betroffen sind.
- CI/CD & Bereitstellungsautomatisierung: Ich prüfe, ob das Tool automatisierte Pipelines mit progressiven Rollout-Strategien (wie Canary- oder A/B-Tests) unterstützt, sowie Git-basierte Trigger für erneute Modellbereitstellungen.
Sobald ich eine Liste von Tools habe, die diese Kriterien erfüllen, prüfe ich, was jede Plattform besonders macht.
Unterscheidungsmerkmale (Was die Anbieter unterscheidet)
So vergleiche und differenziere ich verschiedene Anbieter:
Herausragende Funktionen
Canary- und Shadow-Bereitstellungen heben Tools ab. Ich achte auf die Möglichkeit, einen Teil des Live-Traffics auf eine neue Modellversion zu lenken, während das aktuelle Modell weiterhin ausgeliefert wird – so werden Genauigkeitsverluste erkannt, bevor sie alle Nutzer betreffen. GPU-Optimierung ist ein weiteres Unterscheidungskriterium: Dynamisches Batching und Quantisierung über Beschleuniger wie NVIDIA Triton oder TensorRT können die Kosten pro Vorhersage bei hohem Volumen drastisch senken. Scale-to-Zero ist ebenso relevant, denn Leerlaufendpunkte, die weiterhin GPU-Stunden verbrauchen, summieren sich bei inferenzlastigen Workloads schnell.
Mehr als nur Features
Integration in das MLOps-Ökosystem ist entscheidend – ich prüfe, ob ein Tool an Experimenten-Tracker wie MLflow oder Weights & Biases, Orchestrierer wie Airflow und CI/CD-Systeme wie GitHub Actions angebunden werden kann. Auch Infrastrukturflexibilität ist wichtig: Teams in regulierten Branchen benötigen oft Self-Hosted-Kubernetes oder BYOC-Optionen, statt reiner SaaS-Lösungen. Ich bewerte außerdem die Governance- und Compliance-Fähigkeiten, insbesondere RBAC, Audit-Logging und Zertifikate wie SOC 2 oder HIPAA, die in der Regel von Enterprise-Security-Teams bei der Beschaffung verlangt werden.
So wählen Sie Tools zur Bereitstellung von ML-Modellen aus
Bei langen Funktionslisten und komplexen Preisstrukturen verliert man leicht den Überblick. Damit Sie sich bei der Auswahl der passenden Software für Ihre individuellen Anforderungen auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was ist zu beachten? |
|---|---|
| Skalierbarkeit | Kann das Tool plötzliche Zunahmen des Inferenzverkehrs ohne manuellen Eingriff bewältigen? Achten Sie auf die Unterstützung sowohl von Spitzenlast- als auch von Szenarien mit geringem Volumen. |
| Integrationen | Verbindet sich die Plattform nativ mit Ihren Werkzeugen zur Experimentverfolgung, CI/CD-Werkzeugen oder Datenlagern, oder müssen Sie eigenen Code entwickeln und warten? |
| Anpassbarkeit | Können Sie Bereitstellungsabläufe, Zugriffssteuerungen für Modelle und Ressourcenverwaltung an Ihre spezifischen Richtlinien und Teamstrukturen anpassen? |
| Benutzerfreundlichkeit | Wie steil ist die Lernkurve für Ihr Team? Berücksichtigen Sie die Komplexität der Benutzeroberfläche, die Qualität der Dokumentation und die Frage, ob die Einarbeitung andere Projekte verlangsamen wird. |
| Implementierung und Einarbeitung | Wie viel Zeit wird das Entwicklungsteam benötigen, um von der Testphase bis zur Produktion zu gelangen? Achten Sie auf versteckte Einrichtungsschritte, Netzwerkanforderungen oder verpflichtende Schulungen. |
| Kosten | Sind die Preismodelle transparent und bei steigender Nutzung planbar? Vergleichen Sie die Abrechnungsmethoden – pro Vorhersage, Rechenstunde oder Endpunkt – für Ihre Arbeitslasten. |
| Sicherheitsvorkehrungen | Welche Verschlüsselungs-, Zugriffssteuerungs- und Prüfmechanismen sind vorhanden? Prüfen Sie, ob das Angebot Ihre internen Sicherheitsstandards und die Anforderungen Ihrer Kunden erfüllt. |
| Compliance-Anforderungen | Benötigen Sie HIPAA, DSGVO oder SOC 2 Typ II? Vergewissern Sie sich, dass der Anbieter die erforderlichen Bescheinigungen bereitstellt und die für Ihre Branche notwendigen Prüfprotokolle unterstützt. |
Was sind Tools zur Bereitstellung von ML-Modellen?
Tools zur Bereitstellung von ML-Modellen sind Plattformen, die Ihnen helfen, trainierte Modelle für maschinelles Lernen zu operationalisieren und sie über APIs oder Batch-Endpunkte für den praktischen Einsatz verfügbar zu machen. Diese Tools verwalten Aufgaben wie das Bereitstellen von Modellen, die Skalierung, Überwachung und Versionierung, sodass Sie präzise Vorhersagen liefern und die Zuverlässigkeit aufrechterhalten können, während sich die Arbeitslasten weiterentwickeln.
Funktionen
Achten Sie bei der Auswahl von Tools zur Bereitstellung von ML-Modellen auf die folgenden wichtigen Funktionen:
- Unterstützung mehrerer Frameworks: Stellen Sie Modelle bereit, die mit TensorFlow, PyTorch, scikit-learn, XGBoost und ONNX erstellt wurden, ohne den Modellcode oder Konvertierungsschritte überarbeiten zu müssen.
- Automatische Skalierung der Inferenz: Weist Rechenressourcen automatisch auf Grundlage von Verkehrsmustern zu und bewältigt plötzliche Spitzen oder ruhige Zeiträume, um sowohl Leistung als auch Kosteneffizienz aufrechtzuerhalten.
- Modellversionierung: Verfolgt verschiedene Modellversionen, sodass Sie Modelle in Produktionspipelines mit minimalen Unterbrechungen problemlos zurücksetzen, vergleichen oder zur produktiven Nutzung freigeben können.
- Canary- und Shadow-Bereitstellungen: Ermöglicht schrittweise Einführungen oder die Spiegelung des Live-Datenverkehrs, sodass Sie neue Modelle vor der vollständigen Bereitstellung sicher anhand realer Daten validieren können.
- Batch- und Echtzeitbereitstellung: Unterstützt sowohl Anwendungsfälle mit Echtzeit-APIs als auch die asynchrone Batch-Verarbeitung und bietet dadurch Flexibilität für geschäftliche Anwendungen oder Arbeitsabläufe in der Datenwissenschaft.
- Ressourcenverwaltung: Ermöglicht Ihnen, die CPU-, GPU- und Speichernutzung pro Modell zuzuweisen und zu überwachen, wodurch Sie Kosten optimieren und den Zustand des Dienstes in der Produktion aufrechterhalten können.
- Sicherheitsvorkehrungen: Umfasst Zugriffskontrollen, Verschlüsselung und Netzwerkisolierung zum Schutz von Modellartefakten und sensiblen Inferenzdaten.
- Integrationsunterstützung: Verbindet sich nativ oder über APIs mit MLOps-Tools, CI/CD-Pipelines und Dateninfrastrukturen, um kontinuierliche Bereitstellung und Überwachung zu optimieren.
- Protokollierung und Überwachung: Bietet Einblick in Anfrageprotokolle, Latenzmetriken und Fehlerraten für eine proaktive Fehlerbehebung und zuverlässige Betriebsabläufe.
- Compliance und Überprüfbarkeit: Bietet Funktionen wie Prüfprotokolle und Unterstützung bei der Einhaltung gesetzlicher Vorschriften und hilft Ihnen so, Branchenanforderungen im Gesundheitswesen, im Finanzwesen oder in anderen regulierten Bereichen zu erfüllen.
Häufige KI-Funktionen
Über die oben aufgeführten Standardfunktionen von Tools zur Bereitstellung von ML-Modellen hinaus integrieren viele dieser Lösungen KI mit Funktionen wie:
- Automatisierte Erkennung von Drift: Nutzt KI, um eingehende Daten und Vorhersagen auf Verschiebungen in der Verteilung zu überwachen, und benachrichtigt Teams, wenn zur Aufrechterhaltung der Modellgenauigkeit ein erneutes Training oder eine Untersuchung erforderlich ist.
- Intelligente Ressourcenzuweisung: Wendet KI-Algorithmen an, um Arbeitslastmuster vorherzusagen und Rechenressourcen dynamisch zuzuweisen, wodurch Kosten gesenkt und Latenzen ohne manuelle Feinabstimmung minimiert werden.
- Selbstheilende Bereitstellungen: Nutzt KI, um ausgefallene oder beeinträchtigte Modellendpunkte zu erkennen und den Datenverkehr automatisch umzuleiten oder eine erneute Bereitstellung auszulösen, wodurch Ausfallzeiten und manuelle Eingriffe minimiert werden.
- Prädiktive Skalierung: Nutzt KI, um auf Grundlage der historischen Nutzung Verkehrsspitzen oder -rückgänge vorherzusagen und die Infrastruktur proaktiv zu skalieren, damit eine konsistente Leistung und Kostenkontrolle gewährleistet sind.
- Anomalieerkennung bei der Inferenz: Setzt KI ein, um ungewöhnliche oder verdächtige Vorhersageanfragen in Echtzeit zu kennzeichnen, und hilft Teams dabei, potenzielle Probleme mit der Datenqualität oder Sicherheitsbedrohungen zu erkennen.
- Automatisierte Ursachenanalyse: Nutzt KI zur Analyse von Protokollen und Metriken und ermittelt die Ursache von Leistungseinbußen oder Fehlern, sodass Teams Probleme schneller und mit weniger Rätselraten beheben können.
Vorteile
Die Implementierung von Tools zur Bereitstellung von ML-Modellen bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Beschleunigte Bereitstellungszyklen: Automatisierte Paketierung, Versionierung und Integration in CI/CD-Pipelines ermöglichen es Teams, Modelle schnell von der Entwicklung in die Produktion zu überführen.
- Gleichbleibende Skalierbarkeit: Automatische Skalierung und dynamisches Ressourcenmanagement stellen sicher, dass Ihre Bereitstellungen stabil und reaktionsfähig bleiben, wenn sich die Nachfrage ändert.
- Verbesserte Sicherheitslage: Integrierte Zugriffskontrollen, Verschlüsselung und Prüfprotokollierung tragen dazu bei, Modelle und sensible Daten gemäß den organisatorischen und regulatorischen Anforderungen zu schützen.
- Geringerer Betriebsaufwand: Zentralisierte Überwachung, Alarmierung und Protokollierung minimieren die manuelle Fehlerbehebung und setzen technische Ressourcen für Aufgaben mit höherem Mehrwert frei.
- Zuverlässige Modell-Governance: Versionsverwaltung und Protokollierung von Bereitstellungen erleichtern die Nachverfolgung von Modellen, das Zurücksetzen von Änderungen und den Compliance-Nachweis bei Prüfungen.
- Flexible Workflow-Integration: Die Unterstützung mehrerer Frameworks, Bereitstellungsstrategien und Umgebungsaufsetzungen ermöglicht es Teams, die Funktionen der Werkzeuge an ihre geschäftlichen Anforderungen anzupassen.
- Bessere Vorbereitung auf Compliance-Anforderungen: Umfassende Prüfpfade und Compliance-Funktionen erleichtern die Erfüllung von HIPAA-, DSGVO- oder branchenspezifischen Anforderungen und senken das Risiko für regulierte Unternehmen.
Kosten und Preise
Bei der Auswahl von Werkzeugen für die Bereitstellung von ML-Modellen ist es wichtig, die verschiedenen verfügbaren Preismodelle und Tarife zu verstehen. Die Kosten variieren abhängig von Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre durchschnittlichen Preise und typische enthaltene Funktionen von Lösungen für die Bereitstellung von ML-Modellen zusammen:
Vergleichstabelle der Tarife
| Tarifart | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| Kostenloser Tarif | $0 | Eingeschränkte Bereitstellungen, grundlegende Überwachung, Zugriff für einen einzelnen Benutzer und Community-Support. |
| Persönlicher Tarif | $10-$30/user/month | Individuelle Nutzung, standardmäßige Modellversionierung, moderate Ressourcenzuweisung und E-Mail-Support. |
| Geschäftstarif | $40-$100/user/month | Teamzusammenarbeit, automatische Skalierung, Integrationsunterstützung, verbesserte Sicherheit und rollenbasierte Zugriffskontrollen. |
| Unternehmenstarif | $150-$500+/user/month | Erweiterte Compliance, Premium-Support, dedizierte Infrastruktur, individuelle SLAs sowie erweiterte Prüfungs- und Sicherheitswerkzeuge. |
FAQs zu Werkzeugen für die Bereitstellung von ML-Modellen
Hier finden Sie Antworten auf häufige Fragen zu Werkzeugen für die Bereitstellung von ML-Modellen:
Wie unterscheiden sich Werkzeuge für die Bereitstellung von ML-Modellen von herkömmlichen Werkzeugen für die Anwendungsbereitstellung?
Werkzeuge für die Bereitstellung von ML-Modellen sind darauf ausgelegt, die besonderen Herausforderungen bei der Bereitstellung, Überwachung und Aktualisierung von Machine-Learning-Modellen zu bewältigen. Dazu gehören beispielsweise die Verwaltung von Modellversionen, die Nachverfolgung von Inferenzprotokollen, die Unterstützung der automatischen Skalierung für Modellverkehr und die Integration in Datenpipelines. Herkömmliche Werkzeuge für die Anwendungsbereitstellung unterstützen diese Anforderungen normalerweise nicht.
Kann ich Modelle, die mit unterschiedlichen Frameworks erstellt wurden, mit demselben Bereitstellungswerkzeug bereitstellen?
Ja, die meisten Werkzeuge für die Bereitstellung von ML-Modellen sind mit mehreren Frameworks kompatibel. Dadurch können Sie Modelle aus TensorFlow, PyTorch, XGBoost und weiteren Frameworks ohne manuelle Konvertierungen oder Neuentwicklungen bereitstellen. Dies erleichtert Teams die Arbeit mit unterschiedlichen Technologien und die Standardisierung von Produktionsprozessen.
Auf welche Sicherheitsfunktionen sollte ich bei diesen Werkzeugen achten?
Achten Sie auf Funktionen wie Zugriffskontrollen, verschlüsselte Endpunkte, Prüfpfade und Netzwerkisolierung. Diese tragen dazu bei, sicherzustellen, dass nur autorisierte Benutzer Modelle bereitstellen oder aktualisieren können und Ihre Modellressourcen sowie Datenvorhersagen geschützt bleiben.
Unterstützen diese Werkzeuge sowohl Echtzeit- als auch Batch-Inferenz?
Ja, führende Werkzeuge für die Bereitstellung von ML-Modellen unterstützen sowohl die echtzeitbasierte Bereitstellung von Vorhersagen über APIs als auch die Batch-Verarbeitung. Dadurch kann Ihr Team flexibel verschiedene Anwendungsfälle bedienen – von anwenderorientierten Anwendungen bis hin zu umfangreichen Offline-Bewertungsaufträgen.
Wie unterstützen diese Werkzeuge die Überwachung und Wartung von Modellen?
Sie stellen integrierte Überwachungs-Dashboards, Alarmierungen, Protokollierung und automatische Erkennung von Modell-Drift bereit. Mit diesen Funktionen können Sie Leistungseinbußen, Datenprobleme oder Betriebsfehler frühzeitig erkennen – oft bevor sie sich auf Endbenutzer oder Geschäftsergebnisse auswirken.