

10 beste Tools zur Verfolgung von ML-Experimenten im Jahr 2026
Beste Werkzeuge zur Verfolgung von ML-Experimenten – Auswahlliste


Werkzeuge zur Verfolgung von ML-Experimenten helfen Ihnen dabei, Experimente im Bereich des maschinellen Lernens zu protokollieren, zu organisieren und zu vergleichen, sodass Sie Ergebnisse verwalten und Erkenntnisse zuverlässig reproduzieren können. Wenn Sie nach praktischen Möglichkeiten suchen, Experimente zu verfolgen, Fortschritte mit Ihrem Team zu teilen oder Ihre Modelle und Datensätze zu organisieren, kann das richtige Werkzeug einen großen Unterschied machen.
In dieser Liste finden Sie Lösungen, die auf verschiedene technische Technologie-Stacks und Arbeitsabläufe zugeschnitten sind. Sie helfen Ihnen dabei, Reibungsverluste zu reduzieren, die Berichterstattung zu vereinfachen und sich auf eine zuverlässige Verwaltung von ML-Experimenten zu konzentrieren.
Warum Sie unseren Software-Bewertungen vertrauen können
Wir testen und bewerten seit 2023 Software. Als Technologie-Führungskräfte wissen wir, wie kritisch und herausfordernd es ist, die richtige Entscheidung bei der Softwareauswahl zu treffen.
Wir investieren viel in gründliche Recherche, um unserer Zielgruppe zu helfen, bessere Kaufentscheidungen zu treffen. Wir haben über 2.000 Tools für verschiedene Technikanwendungsfälle getestet und mehr als 1.000 umfassende Softwarebewertungen geschrieben. Erfahren Sie wie wir transparent bleiben und unsere Methodik der Softwarebewertung.
Zusammenfassung der besten Werkzeuge zur Verfolgung von ML-Experimenten
Diese Vergleichstabelle fasst die Preisinformationen meiner besten Auswahl an Werkzeugen zur Verfolgung von ML-Experimenten zusammen, damit Sie das beste Werkzeug für Ihr Budget und Ihre geschäftlichen Anforderungen finden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für den Echtzeit-Vergleich von Experimenten | Kostenloser Plan verfügbar | Ab $19/Nutzer/Monat | Website | |
| 2 | Am besten für anpassbare Visualisierungs-Dashboards | Kostenloser Plan verfügbar | Ab $60/Monat | Website | |
| 3 | Am besten geeignet für die automatische Versionierung von Pipelines | Kostenlose 14-Tage-Testversion verfügbar | Preis auf Anfrage | Website | |
| 4 | Am besten für automatische Pipeline-Orchestrierung | Kostenloser Plan verfügbar | Ab $15/Nutzer/Monat | Website | |
| 5 | Am besten für Open-Source-Modell-Lifecycle-Support geeignet | Kostenlose Demo + kostenloser Plan dauerhaft verfügbar | Für immer kostenlos (Open Source) | Website | |
| 6 | Am besten für die Integration mit Deep-Learning-Frameworks geeignet | Kostenloser dauerhaft verfügbarer Tarif | Für immer kostenlos (Open Source) | Website | |
| 7 | Am besten geeignet für Kubernetes-native Workflowverwaltung | Kostenloser Tarif verfügbar | Kostenlos und Open Source | Website | |
| 8 | Am besten geeignet für die Integration mit dem AWS-Cloud-Ökosystem | Kostenlose Version verfügbar | Ab $0.204/Stunde | Website | |
| 9 | Am besten geeignet für Plugin-Architektur zur Erweiterbarkeit | Kostenloser Plan verfügbar | Ab $399/Monat | Website | |
| 10 | Am besten für hybride und lokale Bereitstellungsoptionen | Kostenloser Plan + kostenlose Demo verfügbar | Ab $450/Monat (jährlich abgerechnet) | Website |
Bewertungen der besten Werkzeuge zur Verfolgung von ML-Experimenten
Nachfolgend finden Sie meine detaillierten Zusammenfassungen der besten Werkzeuge zur Verfolgung von ML-Experimenten, die es in meine Auswahlliste geschafft haben. Meine Bewertungen bieten einen detaillierten Überblick über die Funktionen, Integrationen und besten Anwendungsfälle jeder Plattform, damit Sie die beste Lösung für sich finden.

Comet
Am besten für den Echtzeit-Vergleich von Experimenten

Comet ist eine Plattform zur Nachverfolgung von ML-Experimenten und Modellevaluierung, die Metriken, Hyperparameter und Artefakte aus Trainingsdurchläufen protokolliert und sich mit dem Opik-Produkt auch auf die Beobachtbarkeit von LLMs und die Bewertung agentischer KI erweitert.
Für wen ist Comet am besten geeignet?
Comet eignet sich besonders für ML- und KI-Teams in Wachstumsunternehmen oder Großunternehmen, die viele Experimente durchführen und eine Live-Übersicht über Trainingsdurchläufe benötigen.
Warum habe ich Comet ausgewählt?
Ich habe Comet als eine der besten Lösungen ausgewählt, weil das Live-Dashboard zur Experimentverfolgung die Metriken in Echtzeit während des Trainings aktualisiert, sodass mein Team eine auseinanderlaufende Verlustkurve frühzeitig erkennt und einen schlechten Durchlauf stoppen kann, bevor unnötig Rechenleistung verschwendet wird. Ich nutze auch die Vergleichsansicht, um dutzende Durchläufe nach Hyperparameterwerten zu filtern und sofort zu erkennen, welche Konfiguration die beste Validierungsgenauigkeit erzielt hat. Neben klassischem MLOps erweitert Comet jetzt dank Opik seine Funktionen auf die LLM-Evaluierung, sodass ich beim Wechsel vom Modelltraining zur Überwachung von Produktionsagenten nicht das Tool wechseln muss.
Comet Hauptfunktionen
- Modell-Registry: Speichern, versionieren und verwalten Sie trainierte Modelle zentral mit Statuslabels wie Staging und Produktion.
- Artefakt-Protokollierung: Protokollieren und versionieren Sie Datensätze, Bilder, Konfusionsmatrizen und Audiodateien direkt neben den Experimentdurchläufen.
- Eigene Panels: Erstellen Sie eigene Visualisierungen innerhalb der Comet-Oberfläche mit JavaScript, um über die Standard-Metrikdiagramme hinauszugehen.
- Systemmetriken-Verfolgung: Erfasst automatisch GPU-Auslastung, CPU-Last und Speicherverbrauch bei jedem Durchlauf, ohne dass zusätzliche Instrumentierung erforderlich ist.
Comet Integrationen
Comet bietet über 30 native Integrationen, darunter PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, Ray, Kubeflow, Snowflake und Vertex AI. Es ist auf Zapier verfügbar und stellt eine REST-API sowie Python-, Java-, JavaScript- und R-SDKs für individuelle Integrationen bereit.
Pros and Cons
Pros:
- Automatische Metrikprotokollierung mit minimalem Codeaufwand
- Echtzeit-Visualisierung von Trainingsdurchläufen
- Verfolgt sowohl ML-Experimente als auch LLMs
Cons:
- Pro-Plan beschränkt Teams auf 10 Nutzer
- Die Möglichkeiten zur UI-Anpassung sind begrenzt


Weights & Biases ist eine Plattform zur Nachverfolgung von ML-Experimenten, die Metriken, Hyperparameter und Modell-Checkpoints protokolliert und mit der Sie Läufe über interaktive Dashboards visualisieren und vergleichen können.
Für wen ist Weights & Biases am besten geeignet?
Weights & Biases eignet sich besonders gut für Data Scientists und ML-Ingenieure, die häufig Experimente durchführen und detaillierte Vergleichsmöglichkeiten für Läufe in großen Teams benötigen.
Warum habe ich Weights & Biases ausgewählt?
Weights & Biases gehört zu meinen Favoriten, weil die anpassbaren Visualisierungs-Dashboards besonders leistungsfähig sind. Ich kann während eines Trainingslaufs die aktuelle GPU-Auslastung, Verlustkurven und Beispielvorhersagen in ein einziges interaktives Dashboard integrieren, was Engpässe schnell sichtbar macht. Die Sweeps-Funktion ermöglicht mir die Visualisierung von Hyperparameter-Suchergebnissen direkt neben meinen Experimentmetriken, sodass ich alles in einer Ansicht vergleichen kann. Mit Reports kann mein Team diese Dashboards kommentieren und teilen, ohne die Plattform zu verlassen.
Wichtige Funktionen von Weights & Biases
- Artefakte: Versionieren und Nachverfolgen von Datensätzen, Modellen und Auswertungsergebnissen über verschiedene Experimentiervorgänge hinweg.
- Modell-Registry: Zentralisierte Ablage trainierter Modelle mit direktem Bezug zu den entsprechenden Experimenten.
- Laufgruppierung: Organisieren verwandter Läufe in Gruppen, um Ergebnisse über verschiedene Trainingskonfigurationen hinweg zu vergleichen.
- Benachrichtigungen: Automatisierte Benachrichtigungen bei Erreichen von Metrik-Schwellenwerten, Fehlern oder Abschluss eines Jobs einrichten.
Weights & Biases Integrationen
Weights & Biases bietet native Integrationen mit PyTorch, Keras, TensorFlow, Scikit-learn, XGBoost, Hugging Face Transformers und PyTorch Lightning, sowie LLM-Tools wie LangChain und LlamaIndex. Ebenfalls werden Kubeflow, Jenkins, Airflow, GitHub Actions, AWS SageMaker und Google Vertex AI unterstützt. Für eigene Integrationen stehen eine API und ein Python SDK zur Verfügung.
Pros and Cons
Pros:
- Echtzeit-Metrik-Streaming in Live-Dashboards
- Automatische Protokollierung von Git-Commits und Konfiguration
- Umfassende kollaborative Berichte mit eingebetteten Diagrammen
Cons:
- Web-Oberfläche wird langsam bei vielen parallelen Läufen
- Lücken in der Dokumentation bei grundlegenden Funktionen

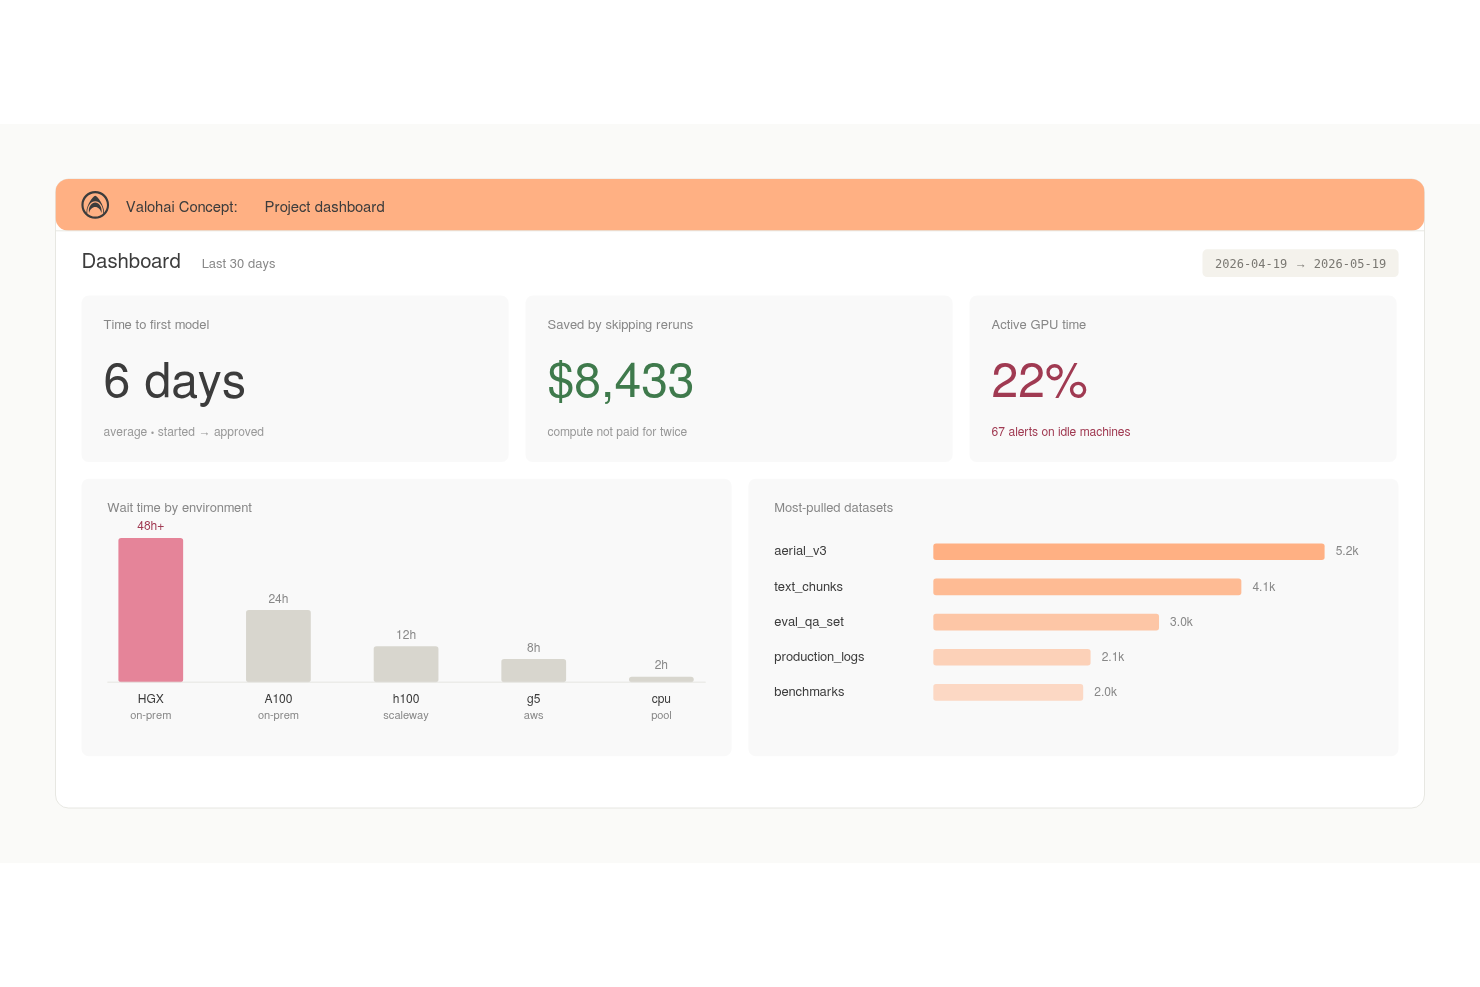
Valohai ist eine ML-Plattform, die automatische Experimentverfolgung, Datensatzversionierung, Modellherkunft und die Orchestrierung von Cloud-Computing für Teams kombiniert, die Modelle in großem Maßstab entwickeln und trainieren.
Für wen ist Valohai am besten geeignet?
Valohai eignet sich besonders für ML-Engineering-Teams in mittelständischen bis großen Unternehmen, die häufige Trainingsaufträge in mehreren Cloud-Umgebungen ausführen.
Warum ich Valohai ausgewählt habe
Ich habe Valohai als eine der besten Lösungen ausgewählt, weil die automatische Versionierung tatsächlich in jedem Lauf integriert ist. Metriken, Metadaten, Protokolle und Hyperparameter werden ohne manuelle Kennzeichnung versioniert, sodass ich nie rekonstruieren muss, was wann ausgeführt wurde. Außerdem gefällt mir, dass Valohai die vollständige Herkunft von Datensätzen und Modellen erfasst. Dadurch kann ich genau nachvollziehen, welche Datensatzversion ein bestimmtes Modell hervorgebracht hat. Jeder Lauf ist von Anfang an reproduzierbar, wodurch das Rätselraten entfällt, das die Prüfung von Experimenten erschwert.
Die wichtigsten Funktionen von Valohai
- Vergleichsansicht für Experimente: Zeigt mehrere Läufe nebeneinander an und ermöglicht es, Hyperparameter, Metriken und Ausgaben verschiedener Experimente in einer einzigen Tabelle zu vergleichen.
- Pipeline-Builder: Ein visueller Editor zum Erstellen mehrstufiger ML-Pipelines, bei dem jeder Knoten einem versionierten Ausführungsschritt entspricht.
- Orchestrierung von Cloud-Computing: Stellt für jeden Trainingslauf automatisch Cloud-Instanzen in AWS, GCP oder Azure bereit und beendet sie anschließend.
- Bereitstellungsauslöser: Überführt trainierte Modelle direkt aus derselben Plattform, die für das Training verwendet wird, an einen Bereitstellungsendpunkt.
Valohai-Integrationen
Valohai bietet über seine Ökosystem-Bibliothek eine kleine Auswahl vorgefertigter Integrationen, darunter Konnektoren für Snowflake, BigQuery und Redshift, eine Hugging-Face-Vorlage sowie Integrationen mit Slurm und OVHcloud. Die Plattform läuft auf AWS, GCP, Azure und Oracle Cloud Infrastructure und stellt eine REST-API zum Erstellen eigener Integrationen bereit.
Pros and Cons
Pros:
- Erfasst Metriken aus automatisch ausgegebenem JSON
- Läuft in jeder Cloud oder auf lokaler Hardware
- Vollständige Herkunftsverfolgung vom Modell bis zum Datensatz
Cons:
- Das Einbinden von Skripten in das Valohai-Format erfordert Aufwand
- Die Hauptansicht für Experimente wirkt optisch wenig überzeugend


ClearML ist eine Open-Source-MLOps-Plattform, die das Tracking von Experimenten, die Versionierung von Datensätzen, das Modellmanagement und die Orchestrierung von Pipelines über den gesamten Lebenszyklus des maschinellen Lernens hinweg abdeckt.
Für wen ist ClearML am besten geeignet?
ClearML eignet sich besonders für ML-Ingenieure und Data Scientists in Unternehmen, die ihre MLOps-Infrastruktur selbst hosten und vollständige Kontrolle über ihre Pipelines benötigen.
Warum habe ich ClearML ausgewählt?
ClearML hat sich einen Platz auf meiner Shortlist verdient, weil die automatische Orchestrierung der Pipelines wirklich ohne manuelle Eingriffe funktioniert. Wenn ich einen Job in eine Warteschlange einstelle, containerisiert ClearML ihn samt seiner vollständigen Umgebung und übernimmt die gesamte Planung und Ressourcenverwaltung automatisch. Ich muss den Code nicht umschreiben, um zwischen On-Premises, Cloud oder HPC-Cluster zu wechseln. Außerdem gefällt mir, dass gecachte Pipeline-Komponenten bei Wiederholungen redundante Schritte überspringen lassen, was die Durchlaufzeit bei iterativem Training deutlich verkürzt.
ClearML Hauptfunktionen
- Automatische Experimentprotokollierung: Erfasst automatisch Metriken, Hyperparameter, Konsolenausgaben und Quellcode jedes Trainingslaufs, ohne zusätzliche Instrumentierung.
- ClearML Datenversionierung: Versioniert und verwaltet Datensätze mit vollständiger Herkunftsnachverfolgung und verknüpft jede Datensatzversion direkt mit den verwendenden Experimenten.
- Modell-Registry: Speichert, kennzeichnet und ruft trainierte Modelle mit Versionskontrolle und Staging-Tags über den gesamten Entwicklungszyklus ab.
- Hyperparameter-Optimierung: Führt automatische HPO-Suchen über Experimente mit integrierten Suchstrategien wie Bayesscher Optimierung und Zufallssuche durch.
ClearML Integrationen
ClearML bietet native Integrationen mit PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, FastAI, Optuna und Hydra sowie Visualisierungstools wie Matplotlib und TensorBoard. Eine API und ein Python SDK stehen für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Selbstgehosteter Open-Source-Server spart Abonnementkosten
- Protokolliert Code, Datensätze und Hyperparameter automatisch ohne Instrumentierung
- Modulares Design ermöglicht den Einsatz einzelner Komponenten
Cons:
- Lücken in der Dokumentation verlangsamen das Onboarding neuer Nutzer
- Navigation zwischen Modulen wirkt bei großem Umfang uneinheitlich

MLflow ist eine Open-Source-Plattform zur Nachverfolgung von ML-Experimenten, die den gesamten Modelllebenszyklus abdeckt – von der Protokollierung von Experimenten und dem Vergleich von Läufen bis hin zu Verpackung, Versionierung und Bereitstellung von Modellen.
Für wen ist MLflow am besten geeignet?
MLflow ist besonders geeignet für ML-Ingenieure und Data Scientists in Unternehmen, die ihre Werkzeuge selbst hosten und die volle Kontrolle über ihre Infrastruktur zur Experimentverfolgung haben möchten, ohne von einem Anbieter abhängig zu sein.
Warum ich MLflow ausgewählt habe
MLflow verdient einen Platz auf meiner Auswahlliste, weil es den kompletten Modelllebenszyklus in einem Open-Source-Framework abdeckt. Ich verwende die MLflow Tracking API, um Parameter, Metriken und Artefakte über verschiedene Läufe hinweg zu protokollieren, und anschließend das Model Registry, um Modelle von der Entwicklung bis zur Produktion zu versionieren und zu übertragen. Besonders schätze ich, dass ich Modelle mit MLflows standardisiertem Format paketieren und auf jedes Ziel ausrollen kann, ohne den Serving-Code umschreiben zu müssen.
MLflow Hauptfunktionen
- Automatische Protokollierung: Erfasst automatisch Parameter, Metriken und Artefakte aus unterstützten Bibliotheken wie Scikit-learn, XGBoost und PyTorch, ohne dass manuelle Log-Aufrufe nötig sind.
- UI zum Vergleich von Läufen: Visualisiert und vergleicht Metriken über mehrere Trainingsläufe hinweg nebeneinander in der integrierten Weboberfläche von MLflow.
- MLflow-Projekte: Verpackt ML-Code mit seinen Abhängigkeiten und Einstiegspunkten, sodass jeder Lauf genau auf jeder Maschine reproduziert werden kann.
- Plugin-System: Erweitert MLflows Protokollierung, Speicherung und Bereitstellung durch Community-Plugins, ohne den Kerncode zu verändern.
MLflow-Integrationen
MLflow bietet über 60 eingebaute Integrationen, darunter PyTorch, TensorFlow, Scikit-learn, XGBoost, LightGBM, Hugging Face Transformers, LangChain, LlamaIndex und OpenAI. Außerdem werden AWS SageMaker, Azure ML, Databricks und OpenTelemetry unterstützt. Für individuelle Integrationen sind eine REST-API und ein Python SDK verfügbar.
Pros and Cons
Pros:
- Framework-unabhängige Protokollierung über ML-Bibliotheken hinweg
- Komplette Modellversionierung mit Phasenübergängen
- Selbst auf jeder Infrastruktur hostbar
Cons:
- Erfordert DevOps-Aufwand für Set-up in Produktion
- Begrenzte eingebaute Visualisierung für Hardware-Profiling

TensorFlow ist ein Open-Source-Framework für maschinelles Lernen von Google, das Modelldesign, Training, Evaluierung und Bereitstellung in Workflows für Deep Learning und neuronale Netze abdeckt.
Für wen ist TensorFlow am besten geeignet?
TensorFlow eignet sich besonders für Forschungsteams und ML-Ingenieure, die Deep-Learning-Modelle in großem Maßstab erstellen und trainieren, insbesondere in Produktionsumgebungen.
Warum ich TensorFlow ausgewählt habe
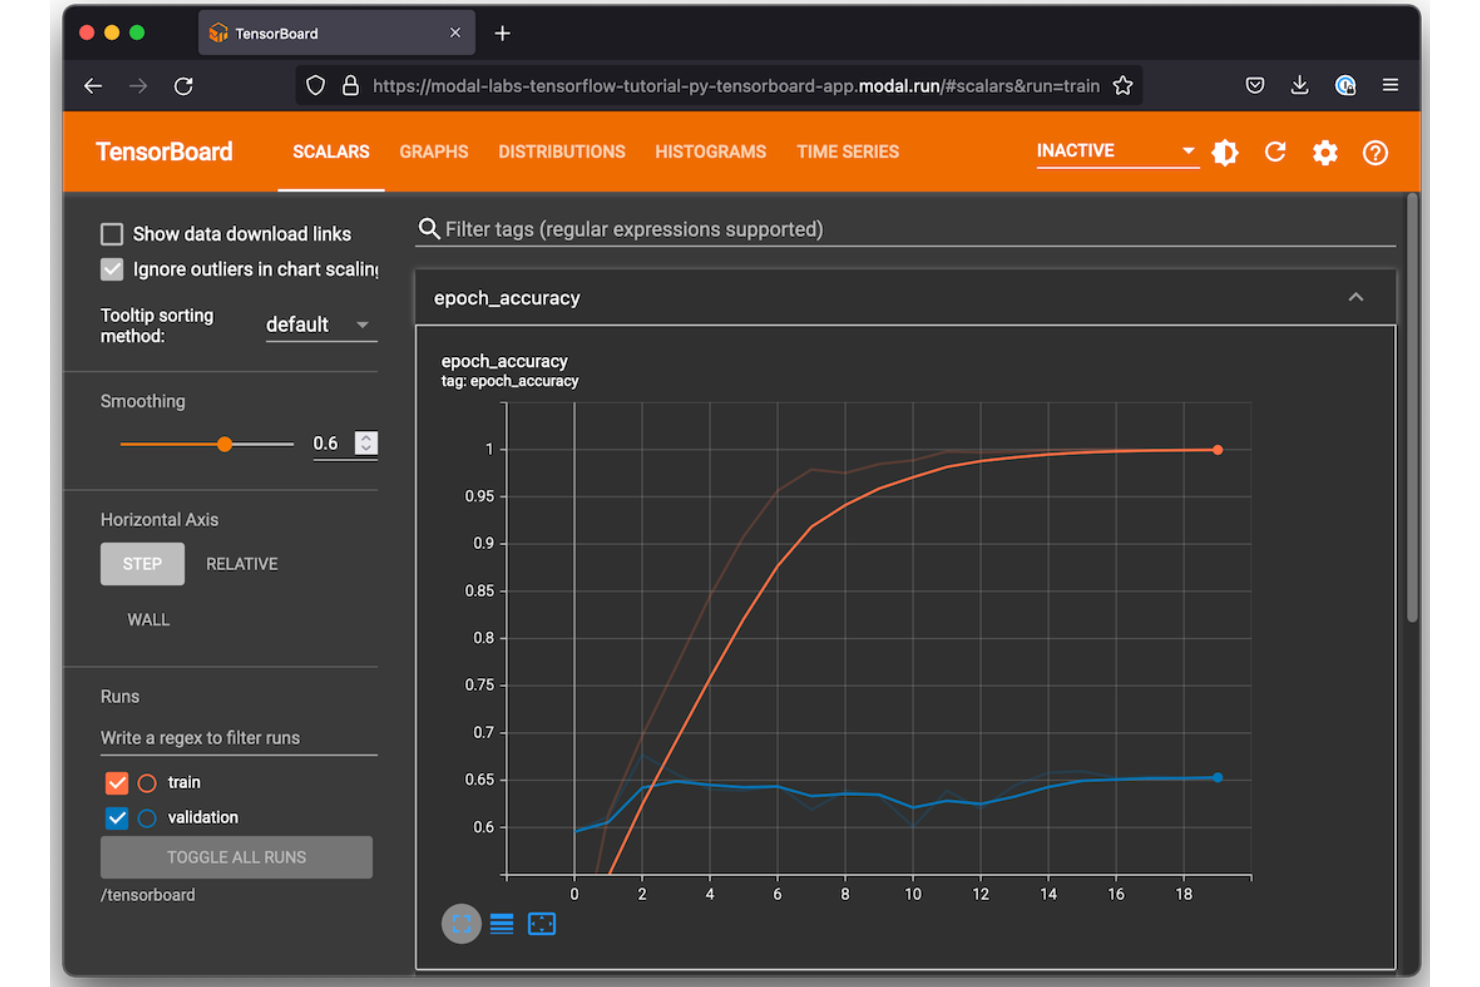
Ich habe TensorFlow in meine Top-Auswahl aufgenommen, weil ich mit der nativen Keras-API Deep-Learning-Architekturen erstellen und weiterentwickeln kann, ohne den Kontext oder das Framework wechseln zu müssen. Außerdem nutze ich TensorBoard direkt in TensorFlow, um Trainingsmetriken zu verfolgen, Berechnungsgraphen zu visualisieren und Durchläufe direkt miteinander zu vergleichen. TensorFlow Hub bietet mir Zugriff auf vortrainierte Modelle, die ich feinabstimmen kann, wodurch sich die Trainingszeit für Experimente zum Transferlernen erheblich verkürzt.
Wichtige Funktionen von TensorFlow
- TensorFlow Extended (TFX): Ein Framework für Produktions-ML-Pipelines zur Orchestrierung von Datenvalidierung, Datentransformation, Training und Modellbewertung.
- tf.data API: Erstellt skalierbare Eingabepipelines zum Laden, Vorverarbeiten und Stapeln von Datensätzen während des Modelltrainings.
- TensorFlow Serving: Stellt trainierte Modelle über REST- oder gRPC-Endpunkte in der Produktion bereit, ohne den Modellcode zu ändern.
- SavedModel-Format: Serialisiert trainierte Modelle mit vollständigen Berechnungsgraphen und Gewichtungen zum reproduzierbaren erneuten Laden und Teilen.
TensorFlow-Integrationen
TensorFlow ist ein Open-Source-Framework und keine SaaS-Plattform, daher bietet es keine herkömmlichen nativen Integrationen mit Drittanbieter-Tools. Stattdessen umfasst sein Ökosystem integrierte Bibliotheken wie TensorBoard, TFX, TensorFlow.js, TensorFlow Serving, Keras und ML Metadata, die Experimentverfolgung, Pipeline-Orchestrierung und Modellbereitstellung innerhalb des Frameworks übernehmen. Drittanbieter-Tools zur Experimentverfolgung wie MLflow und Weights & Biases bieten eigene Integrationen mit TensorFlow, und für benutzerdefinierte Erweiterungen steht eine Python-API zur Verfügung.
Pros and Cons
Pros:
- Echtzeitvisualisierung von Trainingsmetriken und Graphen
- Integrierte Tools zur Abstimmung und Optimierung von Hyperparametern
- Bereitstellung auf CPUs, GPUs und TPUs
Cons:
- TensorBoard wird bei vielen Experimenten langsamer
- Speichert Daten lokal ohne integrierte Funktionen für die Zusammenarbeit
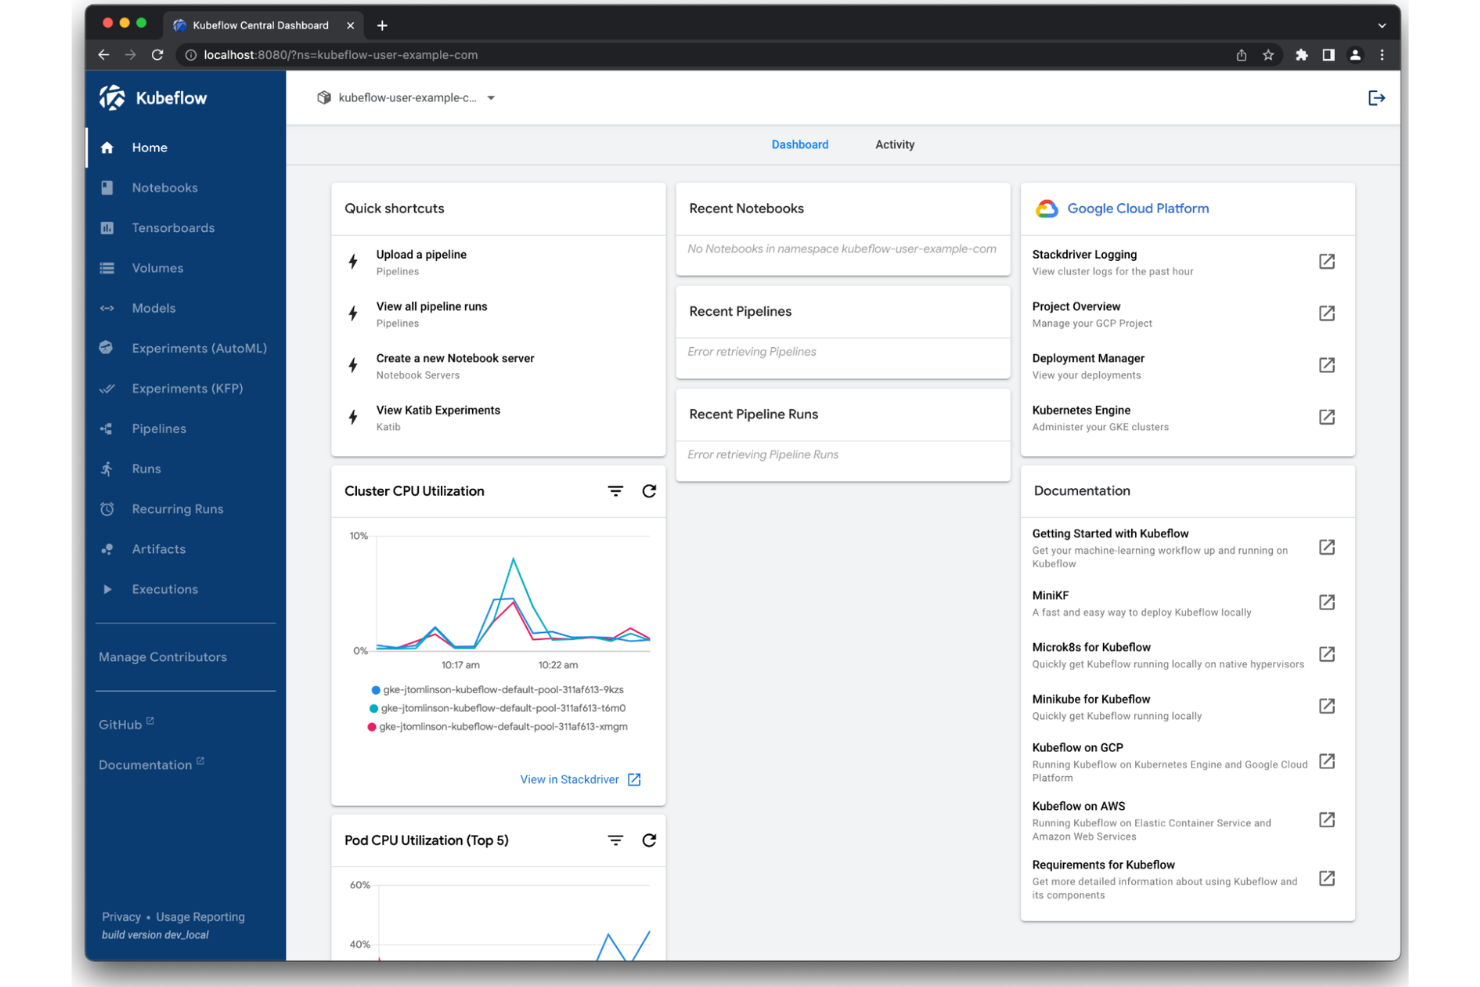
Kubeflow ist eine Open-Source-ML-Plattform auf Basis von Kubernetes, die Pipeline-Orchestrierung, Experimentverfolgung, Modelltraining und Hyperparameteroptimierung nativ innerhalb einer containerisierten Infrastruktur abdeckt.
Für wen ist Kubeflow am besten geeignet?
Kubeflow eignet sich besonders für ML-Engineering-Teams, die ihre Workloads bereits auf Kubernetes ausführen und ihre Infrastruktur zur Experimentverfolgung auf derselben Plattform betreiben möchten.
Warum ich Kubeflow ausgewählt habe
Kubeflow hat sich einen Platz auf meiner Auswahlliste verdient, weil jeder Pipeline-Schritt direkt einem Kubernetes-Pod zugeordnet wird und Experimentläufe dadurch dieselben Ressourcensteuerungen wie alle anderen Cluster-Workloads erhalten. Ich verwende Kubeflow Pipelines, um Trainingsläufe zu versionieren und erneut auszuführen, ohne die Kubernetes-Umgebung verlassen zu müssen. Seine Katib-Komponente führt parallele Hyperparameteroptimierungsversuche als native Kubernetes-Jobs aus, ohne dass eine separate Infrastruktur erforderlich ist.
Die wichtigsten Funktionen von Kubeflow
- Isolation durch Namespaces für mehrere Benutzer: Trennt Experimente und Pipelines nach Team oder Projekt mithilfe von Kubernetes-Zugriffssteuerungen auf Namespace-Ebene.
- Kubeflow Notebooks: Startet Jupyter-Notebook-Server direkt im Cluster und hält die Datenexploration in derselben Umgebung wie die Trainingsläufe.
- Verfolgung der Artefaktabstammung: Erfasst Eingaben, Ausgaben und Metadaten für jeden Pipeline-Schritt und verknüpft Datensätze und Modelle mit bestimmten Läufen.
- Trainingsoperator: Verwaltet verteilte Trainingsjobs für Frameworks wie PyTorch, TensorFlow und XGBoost als native benutzerdefinierte Kubernetes-Ressourcen.
Kubeflow-Integrationen
Kubeflow bietet keine herkömmlichen nativen Integrationen. Stattdessen funktioniert es innerhalb des Kubernetes-Ökosystems und unterstützt ML-Frameworks wie TensorFlow, PyTorch, JAX, XGBoost, HuggingFace und Apache Spark über die Operatoren seiner Unterprojekte. Außerdem kann Kubeflow auf verwalteten Kubernetes-Diensten von AWS, Google Cloud, Microsoft Azure und Red Hat OpenShift bereitgestellt werden.
Pros and Cons
Pros:
- Führt Experimente direkt auf Kubernetes-Pods aus
- Pipeline-Versionierung verfolgt jeden Trainingslauf
- Parallele Hyperparameteroptimierung über die Katib-Komponente
Cons:
- Die Einrichtung des Clusters erfordert umfassende Kubernetes-Kenntnisse
- Die Benutzeroberfläche wirkt im Vergleich zu kommerziellen Alternativen veraltet

Amazon SageMaker ist eine vollständig verwaltete ML-Plattform auf AWS, die alle Phasen des maschinellen Lernens abdeckt: von der Experimentnachverfolgung über Modelltraining und Hyperparameter-Tuning bis hin zur Modellregistrierung und Bereitstellung.
Für wen eignet sich Amazon SageMaker am besten?
Amazon SageMaker ist besonders geeignet für Data-Science- und ML-Engineering-Teams, die bereits Workloads auf AWS-Infrastruktur betreiben.
Warum habe ich Amazon SageMaker ausgewählt?
Ich habe Amazon SageMaker in meine Top-Auswahl aufgenommen, weil die Experimentnachverfolgung direkt und tief in das AWS-Ökosystem integriert ist – auf eine Weise, die andere Tools nicht leisten können. SageMaker Experiments protokolliert Abläufe, Parameter und Metriken nativ zusammen mit S3-Artefaktspeicherung und IAM-gesteuertem Zugriff, sodass keine separate Infrastruktur verwaltet werden muss. Mein Team nutzt zudem SageMaker Pipelines, um Trainingsjobs, Auswertungen und Modellregistrierungen in einen einzigen, auditierbaren Workflow zu integrieren, ohne AWS verlassen zu müssen.
Amazon SageMaker Hauptfunktionen
- SageMaker-Modellregister: Versionieren, Genehmigen und Bereitstellen von trainierten Modellen mitsamt Metadaten-Tracking über den gesamten Modelllebenszyklus.
- Automatisches Modelltuning: Führen Sie Hyperparameter-Optimierungsjobs nach Bayesschen, zufälligen oder Grid-Search-Strategien im großen Maßstab durch.
- SageMaker Debugger: Überprüfen Sie Trainingsjobs in Echtzeit, um Probleme wie verschwindende Gradienten oder Überanpassung frühzeitig zu erkennen.
- SageMaker Feature Store: Speichern, Teilen und Abrufen von ML-Features für Trainings- und Inferenz-Workloads aus einem zentralisierten Repository.
Amazon SageMaker Integrationen
Amazon SageMaker ist nativ in das gesamte AWS-Ökosystem integriert, darunter Amazon S3, Amazon Redshift, AWS Glue, Amazon EMR, Amazon Athena, Amazon ECR, AWS Lambda, Amazon CloudWatch und MLflow. Es steht eine API für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Verfolgt Parameter, Daten und Codeversionen pro Durchlauf
- Automatisches Checkpointing während langer Trainingsjobs
- Integriertes Modellmonitoring zusammen mit Experimentprotokollen
Cons:
- Ungenutzte Ressourcen können stillschweigend zu Abrechnungskosten führen
- Modellartefakte verwenden AWS-spezifische Formate, was die Portierbarkeit einschränkt


ZenML ist eine Open-Source-Plattform zur Orchestrierung von ML-Pipelines, die Workflow-Orchestrierung, Artefakt-Versionierung, Modell-Herkunftsnachverfolgung und Experiment-Tracking über jede Cloud-Infrastruktur oder jeden ML-Stack hinweg ermöglicht.
Für wen ist ZenML am besten geeignet?
ZenML ist ideal für ML-Ingenieur:innen und Data-Science-Teams, die ML-Pipelines standardisieren und in verschiedenen Cloud-Umgebungen oder Infrastruktur-Stacks skalieren müssen.
Warum ich ZenML gewählt habe
ZenML verdient seinen Platz auf meiner Auswahlliste, weil seine Stack-Komponentenarchitektur es mir ermöglicht, jeden Teil meiner ML-Infrastruktur auszutauschen, ohne den Pipeline-Code neu schreiben zu müssen. Ich kann MLflow oder Weights & Biases als Experiment-Tracker einsetzen, den Artefakt-Speicher von lokal auf S3 wechseln und den Orchestrator zu Kubeflow ändern – alles durch das Ändern des aktiven Stacks. Außerdem verwende ich die individuellen Komponenten-Flavors von ZenML, um proprietäre Tracking-Integrationen zu bauen, die sich direkt in die gleiche Pipeline-Abstraktion einfügen.
ZenML Hauptfunktionen
- Pipeline-Step-Caching: Gibt automatisch Ausgaben von bereits ausgeführten Schritten in den Cache, sodass unveränderte Schritte bei iterativen Experimenten nicht erneut ausgeführt werden müssen.
- Artefakt-Versionierung: Verfolgt jedes Artefakt, das durch einen Pipeline-Run erstellt wurde – einschließlich Datensätze, Modelle und Metriken – mit vollständiger Herkunft zum ursprünglichen Schritt.
- Modell-Registry: Speichert und versioniert trainierte Modelle zusammen mit den zugehörigen Metadaten, Pipeline-Läufen und dem Bereitstellungsverlauf in einem zentralen Register.
- ZenML Dashboard: Stellt eine Web-Oberfläche bereit, um Pipeline-Läufe zu durchsuchen, Experimentausgaben zu vergleichen und Artefakt-Metadaten stackübergreifend zu inspizieren.
ZenML-Integrationen
ZenML bietet 66 native Integrationen im gesamten ML-Ökosystem, darunter MLflow, Weights & Biases, Neptune, Comet und TensorBoard, sowie Orchestratoren wie Kubeflow, Apache Airflow, Kubernetes und Databricks sowie Cloud-Infrastrukturen für AWS, Google Cloud und Microsoft Azure. Eine API steht für individuelle Integrationen zur Verfügung.
Pros and Cons
Pros:
- Infrastrukturwechsel ohne Neuschreiben des Pipeline-Codes
- Cloud-unabhängiger Stack verhindert Anbieterbindung
- Automatische Artefakt-Versionierung über Pipeline-Läufe hinweg
Cons:
- Verlässt sich auf Drittanbietertools für die Experiment-Visualisierung
- Die anfängliche Stack-Konfiguration erfordert erheblichen Einrichtungsaufwand


Polyaxon ist eine Plattform für das Nachverfolgen von ML-Experimenten und die Orchestrierung von Pipelines, die Experiment-Tracking, Hyperparameter-Optimierung, Versionsverwaltung von Artefakten, Modell-Registry und verteiltes Job-Scheduling über Cloud- und On-Premises-Infrastruktur hinweg abdeckt.
Für wen ist Polyaxon am besten geeignet?
Polyaxon eignet sich besonders gut für ML-Ingenieure in Großunternehmen, die unter strikten Richtlinien zur Datenverwaltung arbeiten oder Workloads auf privater Infrastruktur ausführen müssen.
Warum ich Polyaxon ausgewählt habe
Ich habe Polyaxon in meine Top-Auswahl aufgenommen, weil es eine der wenigen ML-Experiment-Tracking-Plattformen ist, die von Grund auf dafür entwickelt wurde, vollständig in der eigenen Infrastruktur betrieben zu werden. Ich betreibe es in einem privaten Kubernetes-Cluster, und jedes Experiment-Log, jedes Artefakt und jedes Modell bleibt innerhalb unseres Netzwerks. Die agentenbasierte Architektur ermöglicht es mir, isolierte lokale Umgebungen mit einem zentralen Kontrollzentrum zu verbinden, ohne Rohdaten extern preiszugeben, was in regulierten Branchen eine echte Anforderung ist.
Polyaxon Hauptfunktionen
- Hyperparameter-Suche und -Optimierung: Führen Sie Gruppen von Experimenten parallel mit verteilten Suchstrategien aus, um optimale Modellkonfigurationen zu finden.
- Komponenten-Hub: Definieren Sie wiederverwendbare Module mit typisierten Ein- und Ausgaben, die im Team-Pipeline-Prozess gemeinsam genutzt und versioniert werden können.
- Leistungsstarke Suche: Filtern Sie Durchläufe nach Name, Beschreibung, regulärem Ausdruck, bestimmten Feldern, Metriken oder Konfigurationen, um Experimente schnell zu finden.
- SLA-Durchsetzung: Wenden Sie TTL-, Timeout- und Retry-Richtlinien auf einzelne Operationen an, um sicherzustellen, dass Pipelines innerhalb der definierten Grenzen laufen.
Polyaxon Integrationen
Polyaxon bietet eine breite Palette nativer Integrationen für ML-Tracking, Orchestrierung und Infrastruktur, darunter TensorBoard, PyTorch, TensorFlow, Keras, XGBoost, Hugging Face, Kubeflow, Slack, GitHub und Jenkins. Es gibt außerdem eine Verbindung zu Zapier und eine API für individuelle Integrationen sowie CI/CD-Automatisierung.
Pros and Cons
Pros:
- Kubernetes-native verteilte Trainingsjob-Planung
- Integrierte Mandantenfähigkeit mit feingranularen Zugriffsrechten
- Unterstützt lokale, Cloud- und hybride Bereitstellungen
Cons:
- Erfordert tiefgehende Kubernetes-Expertise für den Betrieb
- Kleinere Community als MLflow oder W&B
Weitere Werkzeuge zur Verfolgung von ML-Experimenten
Hier finden Sie einige weitere Werkzeuge zur Verfolgung von ML-Experimenten, die es nicht in meine Auswahlliste geschafft haben, aber dennoch einen Blick wert sind:
- Databricks
Am besten geeignet für einen konsolidierten Analysearbeitsplatz für Teams
- Domino Data Lab
Am besten geeignet für zentrale Steuerung in gemeinschaftlicher Forschung
- iguazio
Am besten geeignet für die Echtzeitüberwachung von Modellen im großen Maßstab
- Dagster
Am besten geeignet für die programmatische Erstellung von Datenpipelines


So bewerte ich Tools für das ML-Experiment-Tracking
Meine Bewertung unterteile ich in zwei Ebenen: Was jedes Tool leisten muss (wie z. B. automatisches Logging von PyTorch-Läufen) und was die besten Tools unterscheidet.
Kernfunktionalität (Grundvoraussetzungen für diese Liste)
Wenn ich Tools für meine Liste auswähle, bewerte ich jedes Einzelne auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (hervorragend in diesem Bereich) für jede unten aufgelistete Kernfunktionalität. Anschließend berechne ich die Gesamtpunktzahl des Tools als Prozentsatz. Jedes Tool muss mindestens insgesamt 65 % erreichen, um überhaupt in Betracht gezogen zu werden.
- Experiment-Logging: Ich prüfe, ob das Tool Metriken, Hyperparameter und System-Telemetriedaten aus Trainingsläufen automatisch erfasst oder ob für jeden Datenpunkt eine manuelle SDK-Integration notwendig ist.
- Laufvergleich und Visualisierung: Tabellen zum Nebeneinanderstellen der Läufe sind ein Anfang, aber ich suche nach interaktiven Grafiken wie z. B. Parallelkoordinatendiagrammen, die Muster über Dutzende Läufe in Ihren ML-Projekten sichtbar machen.
- Artefakt- und Modellversionierung: Ich bewerte, wie jedes Tool Datensätze, Modellprüfpunkte und Ausgaben versioniert – inklusive der Frage, ob Artefakte auf den exakten Lauf zurückverlinkt werden, der sie erzeugt hat.
- Unterstützung von ML-Frameworks: Das Tool sollte Frameworks abdecken, die Ihr Team tatsächlich nutzt — von PyTorch und TensorFlow bis hin zu Hugging Face Transformers und XGBoost — und das bei minimalem Wrapper-Code.
- Reproduzierbarkeit und Abstammung: Mir sind Tools wichtig, die Code-Commits, Abhängigkeits-Snapshots und den Status des Datensatzes gemeinsam erfassen, sodass Sie ein Experiment von vor sechs Monaten erneut ausführen und das gleiche Ergebnis erhalten können.
- Zusammenarbeit und Teilen: Teams, die über Zeitzonen hinweg arbeiten, brauchen gemeinsame Arbeitsbereiche, rollenbasierte Zugriffsrechte und die Möglichkeit, Kommentare zu einzelnen Läufen zu hinterlassen oder bestimmte Läufe zu teilen, ohne ständig CSVs zu exportieren.
Habe ich eine Liste von Tools, die diese Kriterien erfüllen, schaue ich darauf, was jede Plattform besonders macht.
Unterscheidungsmerkmale (Wodurch sich Anbieter abheben)
So vergleiche und kontrastiere ich verschiedene Anbieter:
Herausragende Funktionen
Hyperparameter-Optimierung ist ein wichtiges Unterscheidungsmerkmal. Ich achte auf eingebaute Sweep-Funktionalitäten, die die Suche über verteilte Läufe automatisieren und die Performance verschiedener Konfigurationen in einer Ansicht visualisieren. Echtzeit-Monitoring der Ressourcen bringt echten Mehrwert – wenn Sie GPU- und Speicher-Auslastung während des Trainings verfolgen können, erkennen Sie Engpässe, bevor ein Lauf Stunden an Rechenkapazität vergeudet. Kollaboratives Reporting rundet das Paket für größere Teams ab: Teilbare Dashboards ersetzen manuelle Tabellen und ermöglichen es Datenwissenschaftlern, Ergebnisse direkt mit Stakeholdern zu diskutieren – ganz ohne Toolwechsel.
Mehr als nur Features
Flexibilität beim Deployment ist für viele Teams wichtiger als erwartet. Ich prüfe, ob ein Tool Self-Hosting oder abgeschottete („air-gapped") Installationen für Teams mit sensibler IP oder regulierten Daten unterstützt. Auch die Skalierbarkeit bewerte ich — das Protokollieren von Tausenden paralleler Läufe darf die Abfrage-Performance nicht bremsen oder zu unvorhersehbaren Kostenexplosionen führen. Das Onboarding hebt Tools ebenfalls hervor: Gute Schnellstart-Dokumentation und eine aktive Community sorgen dafür, dass Ihr Team Trainingsskripte in Stunden, nicht in Wochen, einbindet.
So wählen Sie Werkzeuge zur Verfolgung von ML-Experimenten aus
Es ist leicht, sich in langen Funktionslisten und komplexen Preisstrukturen zu verlieren. Damit Sie sich während Ihres individuellen Auswahlprozesses auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was Sie berücksichtigen sollten |
|---|---|
| Skalierbarkeit | Kann das Werkzeug das erwartete Volumen und die erwartete Häufigkeit von Experimenten bewältigen, wenn Ihr Team und Ihre Daten wachsen? |
| Integrationen | Kann es direkt mit Ihren bevorzugten ML-Entwicklungsframeworks, Orchestrierungswerkzeugen und Bereitstellungssystemen verbunden werden? |
| Anpassbarkeit | Können Sie Metadatenfelder, Arbeitsablaufschritte und Berichte an die individuellen Anforderungen Ihres Teams anpassen? |
| Benutzerfreundlichkeit | Werden Ihre Forschenden und Ingenieurinnen und Ingenieure die Benutzeroberfläche intuitiv finden, oder gibt es eine steile Lernkurve? |
| Implementierung und Einführung | Wie schnell können Sie vom Kauf bis zur Verfolgung Ihres ersten Experiments gelangen? Welche Ressourcen werden für die Einrichtung benötigt? |
| Kosten | Sind nutzungsbasierte Preise, Speicherkosten oder erforderliche Zusatzoptionen für Ihren voraussichtlichen Bedarf klar und vorhersehbar? |
| Sicherheitsvorkehrungen | Unterstützt das Werkzeug Verschlüsselung, granular anpassbare Berechtigungen und Authentifizierung zum Schutz sensibler Daten? |
| Compliance-Anforderungen | Hilft Ihnen das Werkzeug dabei, Branchen-, Kunden- oder geografische Vorschriften einzuhalten (SOC 2, ISO 27001, DSGVO)? |
Was sind Werkzeuge zur Verfolgung von ML-Experimenten?
Werkzeuge zur Verfolgung von ML-Experimenten sind Softwareplattformen, die Experimente mit maschinellen Lernmodellen einschließlich ihrer Parameter, ihres Codes, ihrer Datensätze und ihrer Metriken protokollieren, organisieren und versionieren. Diese Werkzeuge helfen Ihrem Team dabei, die Experimenthistorie zu speichern, Ergebnisse zu vergleichen und frühere Durchläufe vollständig zu reproduzieren. Dadurch werden Zusammenarbeit und Prüfung einfacher, wenn Projektabläufe komplexer werden.
Funktionen
Achten Sie bei der Auswahl von Tools zur ML-Experimentverfolgung auf die folgenden wichtigen Funktionen:
- Experimentprotokollierung: Zeichnet die Parameter, Konfigurationen, Quellcodeverweise und Metriken jedes Trainingslaufs auf, um eine klare Prüfspur zu bewahren.
- Laufvergleich: Ermöglicht es Ihnen, mehrere Experimente nebeneinander anzuzeigen und zu analysieren, um zu verstehen, wie sich unterschiedliche Einstellungen oder Änderungen auf Ihre Ergebnisse auswirken.
- Versionierung von Artefakten: Erstellt automatisch Versionen von Datensätzen, versionierten ML-Modellen und anderen Ausgaben, sodass Sie frühere Arbeiten jederzeit reproduzieren oder darauf aufbauen können.
- Framework-Integrationen: Verbindet sich direkt mit beliebten ML-Frameworks und ermöglicht den schnellen Einstieg in die Nachverfolgung mit nur minimalen Änderungen an Ihrem Arbeitsablauf.
- Nachverfolgung der Daten- und Modellherkunft: Bildet die vollständige Kette von den Rohdaten bis zum endgültigen Modell ab und unterstützt so Anforderungen an Reproduzierbarkeit und die Einhaltung gesetzlicher Vorschriften.
- Werkzeuge für die Zusammenarbeit: Ermöglicht es mehreren Benutzern, Kommentare zu verfassen, Erkenntnisse zu dokumentieren und Ergebnisse im gesamten Team zu teilen.
- Benutzerdefinierte Metadaten: Ermöglicht das Hinzufügen projektspezifischer Felder oder Tags, sodass Sie Experimente entsprechend den Anforderungen Ihres Arbeitsablaufs kategorisieren können.
- Rollenbasierte Zugriffskontrolle: Beschränkt den Zugriff auf sensible Daten und Aktionen und unterstützt so die Governance- und Sicherheitsstandards auf Organisationsebene.
- Dashboards und Visualisierungen: Erstellt anpassbare Berichte und Datenvisualisierungen, um Trends und Anomalien in Ihren Experimentdaten schnell hervorzuheben.
- Suche und Filterung: Ermöglicht es Ihrem Team, relevante Experimente, Läufe und Artefakte einfach anhand von Parametern, Datum oder anderen Kriterien zu finden, wodurch mit zunehmender Projektgröße Zeit gespart wird.
Gängige KI-Funktionen von Tools zur ML-Experimentverfolgung
Über die oben aufgeführten Standardfunktionen von Tools zur ML-Experimentverfolgung hinaus integrieren viele dieser Lösungen KI mit Funktionen wie:
- Automatisierte Anomalieerkennung: Verwendet KI, um Experimentmetriken zu überwachen und ungewöhnliche Muster oder Ausreißer zu kennzeichnen, sodass Teams Datenabweichungen oder unerwartetes Modellverhalten frühzeitig erkennen können.
- Intelligente Hyperparameter-Empfehlungen: Wendet maschinelles Lernen an, um auf Grundlage historischer Experimentdaten optimale Hyperparameterwerte zu empfehlen, wodurch manuelles Ausprobieren reduziert und die Modellabstimmung beschleunigt wird.
- Experimentsuche in natürlicher Sprache: Ermöglicht es Benutzern, Experimente mithilfe von Umgangssprache zu suchen und zu filtern, sodass nichttechnische Beteiligte leichter auf Experimentergebnisse zugreifen und diese verstehen können.
- Vorausschauende Ressourcenverteilung: Verwendet KI, um den Rechen- und Speicherbedarf für bevorstehende Läufe zu prognostizieren, sodass Teams Ressourcen planen und Engpässe vermeiden können.
- Automatisierte Zusammenfassung von Experimenten: Nutzt KI, um prägnante Zusammenfassungen der Experimentergebnisse zu erstellen und wichtige Erkenntnisse sowie Trends für eine schnellere Berichterstattung und Entscheidungsfindung hervorzuheben.
Vorteile
Die Implementierung von Tools zur ML-Experimentverfolgung bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Reproduzierbarkeit von Experimenten: Verfolgen Sie Parameter, Datensätze und Umgebungsdetails, um frühere Experimente einfach neu zu erstellen und zu validieren.
- Optimierte Zusammenarbeit: Gemeinsam genutzte Dashboards, Kommentarfunktionen und Projektdokumentation helfen Teams, zusammenzuarbeiten und Ergebnisse effektiv zu kommunizieren.
- Schnellere Modellentwicklung: Nebeneinander angezeigte Laufvergleiche und automatisierte Versionierung von Artefakten beschleunigen Experimentzyklen und Entscheidungsfindung.
- Zentralisiertes Wissensmanagement: Die gesamte Projekthistorie und alle Experimentmetadaten werden an einem Ort gespeichert, sodass institutionelles Wissen auch bei wachsenden Teams erhalten bleibt.
- Verbesserte Compliance und Prüfbarkeit: Die integrierte Nachverfolgung der Daten- und Modellherkunft sowie Prüfprotokolle unterstützen regulatorische Anforderungen und Governance-Standards von Unternehmen.
- Kontrolle der Ressourcenkosten: Funktionen zur Überwachung von Ressourcen in Echtzeit und zur vorausschauenden Verteilung ermöglichen es Teams, die Hardwarenutzung zu optimieren und unnötige Ausgaben zu vermeiden.
- Unterstützung anpassbarer Arbeitsabläufe: Flexible Metadatenfelder und Arbeitsablaufoptionen passen sich den bestehenden Prozessen und Präferenzen Ihres Teams an.
Kosten und Preise
Bei der Auswahl von Tools zur ML-Experimentverfolgung ist es wichtig, die verschiedenen verfügbaren Preismodelle und Tarife zu verstehen. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, deren Durchschnittspreise und typische in Lösungen für Tools zur ML-Experimentverfolgung enthaltene Funktionen zusammen:
Vergleichstabelle der Pläne für Tools zur ML-Experimentverfolgung
| Plantyp | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| Kostenloser Tarif | $0 | Grundlegende Nachverfolgung von Experimenten, begrenzte Nutzerzahl, Community-Support und öffentliche Projekte. |
| Persönlicher Tarif | $5-$25/Nutzer/Monat | Unbegrenzte Experimente, mehr Speicherplatz, private Projekte und grundlegende Integrationen. |
| Geschäftstarif | $30-$70/Nutzer/Monat | Tools für die Zusammenarbeit im Team, rollenbasierte Zugriffskontrolle, erweiterte Integrationen, erhöhte Sicherheit und Prüfprotokolle. |
| Unternehmenstarif | $80-$150/Nutzer/Monat | Benutzerdefinierte Bereitstellungsoptionen, SSO/SAML, Tools für die Compliance, Premium-Support und erweiterte Anpassungsmöglichkeiten. |
FAQs zu Tools für die Nachverfolgung von ML-Experimenten
Hier sind einige Antworten auf häufige Fragen zu Tools für die Nachverfolgung von ML-Experimenten:
Erfordern diese Tools umfangreiche Einrichtung oder viele Codeänderungen?
Nein, die meisten Tools bieten leichtgewichtige SDKs oder Plugins, mit denen Sie die Protokollierung von Experimenten mit minimalen Codeänderungen beginnen können. Häufig lässt sich die Nachverfolgung mit nur wenigen Zeilen in Ihre Skripte integrieren.
Wie unterstützen diese Tools die Compliance und Prüfungen im Team?
Sie protokollieren die Parameter, den Code und die Ergebnisse jedes Durchlaufs, erstellen nachvollziehbare Experimentverläufe und führen Prüfpfade – dadurch wird es einfacher, die Compliance zu dokumentieren und bei Überprüfungen oder Prüfungen Nachweise zu teilen.
Funktionieren diese Lösungen mit Jupyter-Notebooks?
Ja, die meisten Tools zur Nachverfolgung von ML-Experimenten sind für die direkte Verwendung in Jupyter-Notebooks sowie mit Skripten und Pipelines konzipiert, sodass Sie Ihren Arbeitsablauf nicht ändern müssen.
Was passiert, wenn unser Team aus dem kostenlosen Tarif herauswächst?
Sie können auf eine kostenpflichtige Stufe mit mehr Nutzern, höheren Speicherlimits, erweiterten Integrationen und Unternehmensfunktionen upgraden. Prüfen Sie die Preise genau, damit Sie beim Wechsel nicht überrascht werden.
Kann ich mit diesen Tools sensible oder proprietäre Daten speichern?
Ja, aber Sie sollten die Sicherheitsvorkehrungen des Anbieters wie Verschlüsselung, Zugriffskontrollen und Compliance-Zertifizierungen prüfen, um sicherzustellen, dass Ihre Daten geschützt bleiben. Optionen für die lokale Bereitstellung oder eine private Cloud können noch mehr Kontrolle bieten.