

Software til IT-driftsstyring hjælper dig med at administrere – og skabe overblik over – hele din IT-infrastruktur, herunder overvågning, automatisering, sikkerhed og tjenestetilstand på tværs af lokale og cloudbaserede miljøer.
Denne liste er udarbejdet til CTO'er og IT-ledere, der har brug for samlet indsigt, hurtigere analyse af grundlæggende årsager og løsninger, der er klar til hybrid drift og drift i flere cloudmiljøer. Du finder muligheder for AI-drevet automatisering, dybdegående observerbarhed, indbyggede sikkerhedsintegrationer og den tilpasningsmulighed, du har brug for til at skalere det, der betyder noget.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel for software til IT-driftsstyring
Sammenlign priser og vigtige specifikationer for mine bedste valg af software til IT-driftsstyring i tabellen nedenfor.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til SecOps-integreret log- og metrikdrift | Gratis prøveperiode tilgængelig | Fra $0.15/credit | Website | |
| 2 | Bedst til OTel-baseret fuldstackdriftsindsigt | 14 dages gratis prøveperiode | Fra $99/måned | Website | |
| 3 | Bedst til hybrid ITOps med flere lejere i MSP-klassen | Gratis demo tilgængelig | Priser oplyses efter forespørgsel | Website | |
| 4 | Bedst til dybdegående indsigt i lager- og GPU-drift | Gratis demo tilgængelig | Pris oplyses efter anmodning | Website | |
| 5 | Bedst til AI-drevet fuldstack-validering af udgivelser | 15 dages gratis prøveperiode | Fra $7/vært/måned | Website | |
| 6 | Bedst til samlet telemetri med indbygget FinOps | 14 dages gratis prøveperiode | Fra $15/vært/måned (faktureres årligt) | Website | |
| 7 | Bedst til automatisering af fejl-til-løsning-arbejdsgange uden kode | 30-dages gratis prøveperiode | Fra $1,233/år (faktureres årligt) | Website | |
| 8 | Bedst til AI-drevet vurdering af ændringsrisici | Gratis demo tilgængelig | Fra $9/bruger/måned (faktureres årligt) | Website | |
| 9 | Bedst til overvågning af open source-drift i alle skalaer | Gratis download tilgængelig | Fra $325/måned (faktureres årligt) | Website | |
| 10 | Bedst til ML-drevet reduktion af alarmstøj | Gratis demo tilgængelig | Priser oplyses efter anmodning | Website |


Anmeldelser af den bedste software til IT-driftsstyring
Nedenfor finder du mine detaljerede opsummeringer af den bedste software til IT-driftsstyring, som kom med på min kortliste. Mine anmeldelser giver et detaljeret indblik i funktionerne, de bedste anvendelsesområder og integrationerne for hver platform, så du kan finde den bedste løsning til dig.
 Bedst til SecOps-integreret log- og metrikdrift
- Gratis prøveperiode tilgængelig
- Fra $0.15/credit
Visit WebsiteCustomer Rating:4.3/5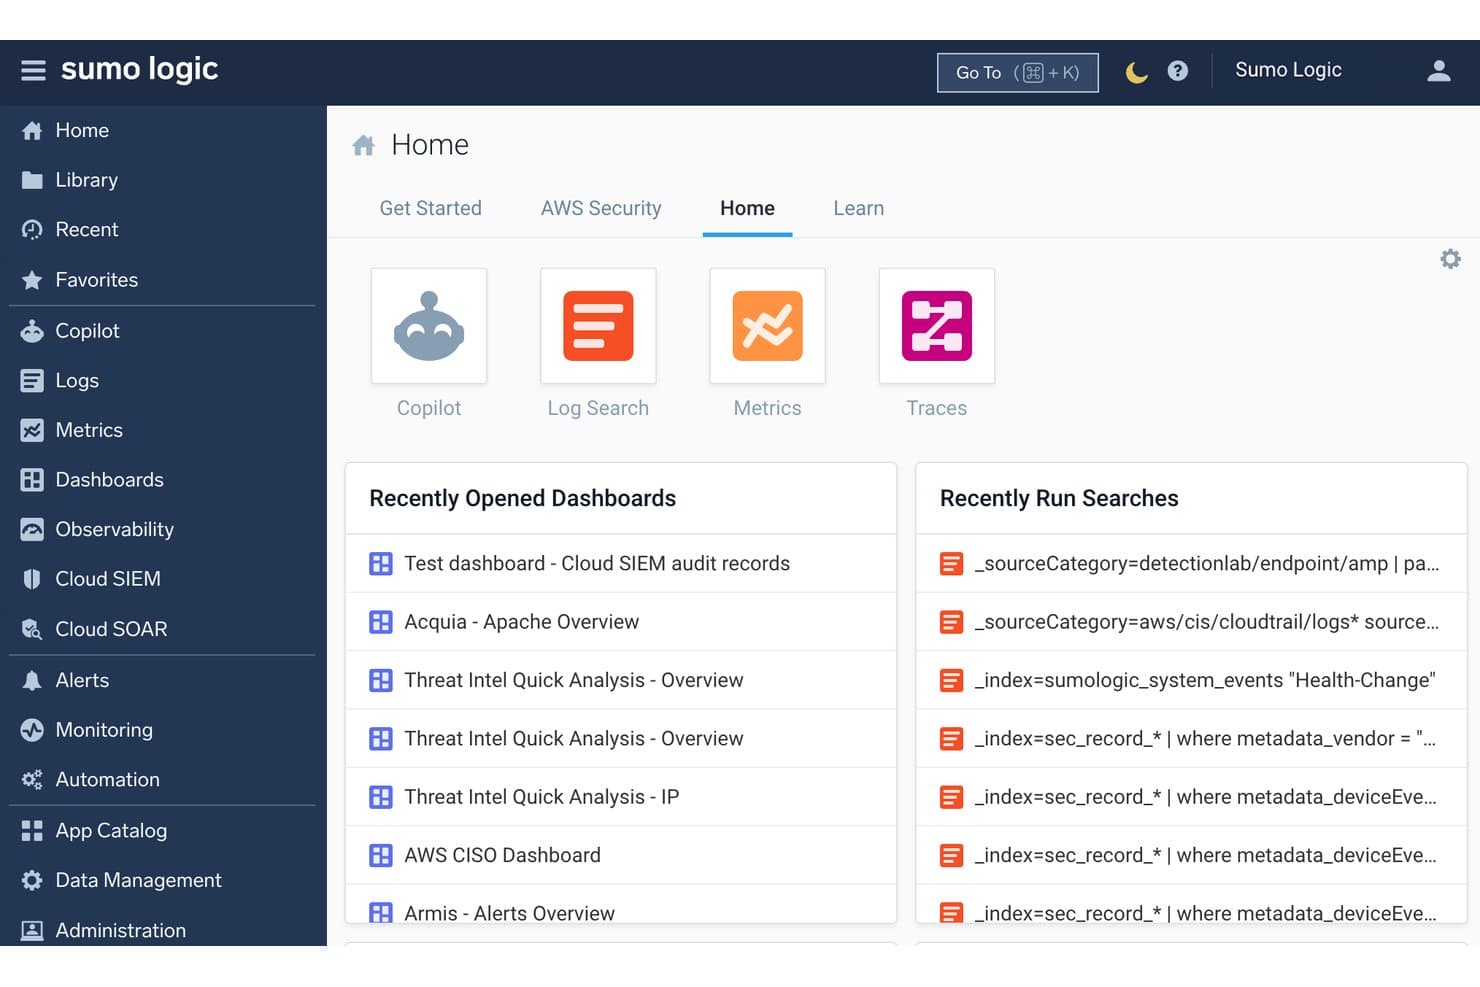
Sumo Logic giver teams hurtig adgang til logsøgning, metrikker og seneste aktivitet. Sumo Logic er en cloudbaseret platform til administration af IT-drift, der samler loganalyse, infrastrukturovervågning, metrikker, distribueret sporing og sikkerhedsdrift i én samlet SaaS-baseret observabilitets- og SIEM-løsning.
Hvem er Sumo Logic bedst til?
Sumo Logic er velegnet til sikkerhedsbevidste IT- og driftsteams, der har brug for loganalyse, metrikker og SIEM-funktioner i én SaaS-platform.
Hvorfor valgte jeg Sumo Logic?
Sumo Logic kommer med på min liste, fordi det er en af de få platforme, der samler loganalyse og sikkerhedsdrift i ét reelt samlet SaaS-værktøj. Jeg kan godt lide, hvordan de patenterede LogReduce- og LogExplain-operatorer identificerer de grundlæggende årsager direkte i rå logdata og reducerer den manuelle mønstergenkendelse, der forsinker løsning af hændelser. Dojo AI-platformen med flere agenter skiller sig også ud: SOC Analyst Agent automatiserer sorteringen af niveau 1-advarsler og leverer evidensbaserede vurderinger, hvilket mit team finder uvurderligt, når SecOps- og ITOps-arbejdsgange overlapper.
Vigtige funktioner i Sumo Logic
- AI-drevne metrikovervågninger: ML-baseret anomalidetektion finjusterer automatisk sæsonbaserede grundlinjer for dine metrikdata og reducerer mængden af falsk positive advarsler.
- Administration af flere organisationer: En overordnet organisation styrer overvågninger, dashboards, roller og adgang på tværs af underordnede organisationer fra én centraliseret grænseflade.
- Dashboards til compliance-rapportering: Forudbyggede dashboards sammenholder dine data med PCI-, HIPAA-, GDPR-, SOX- og ISO-rammeværk, så du løbende kan få indblik i din compliance-status.
- OpenTelemetry-distributionsagent: Én samlet agent indsamler logfiler, metrikker og spor på tværs af Linux, Windows, macOS og mere end 25 kildekonfigurationer.
Integrationer til Sumo Logic
Sumo Logic tilbyder mere end 450 integrationer, herunder ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes og Docker. Platformen tilbyder også REST API'er, webhooks, Terraform, SumoQL og en åben integrationsramme til tilpasset forbindelse.
Pros and Cons
Pros:
- Dojo AI automatiserer sortering og løsning af hændelser
- Compliance-dashboards kan direkte sammenholdes med større rammeværk
- Centraliserer logfiler, metrikker og spor i én platform
Cons:
- Avanceret automatisering prioriterer sikkerhed frem for IT-drift
- Forespørgsler på store historiske datasæt kan være langsomme
 Bedst til OTel-baseret fuldstackdriftsindsigt
- 14 dages gratis prøveperiode
- Fra $99/måned
Visit WebsiteCustomer Rating:4.3/5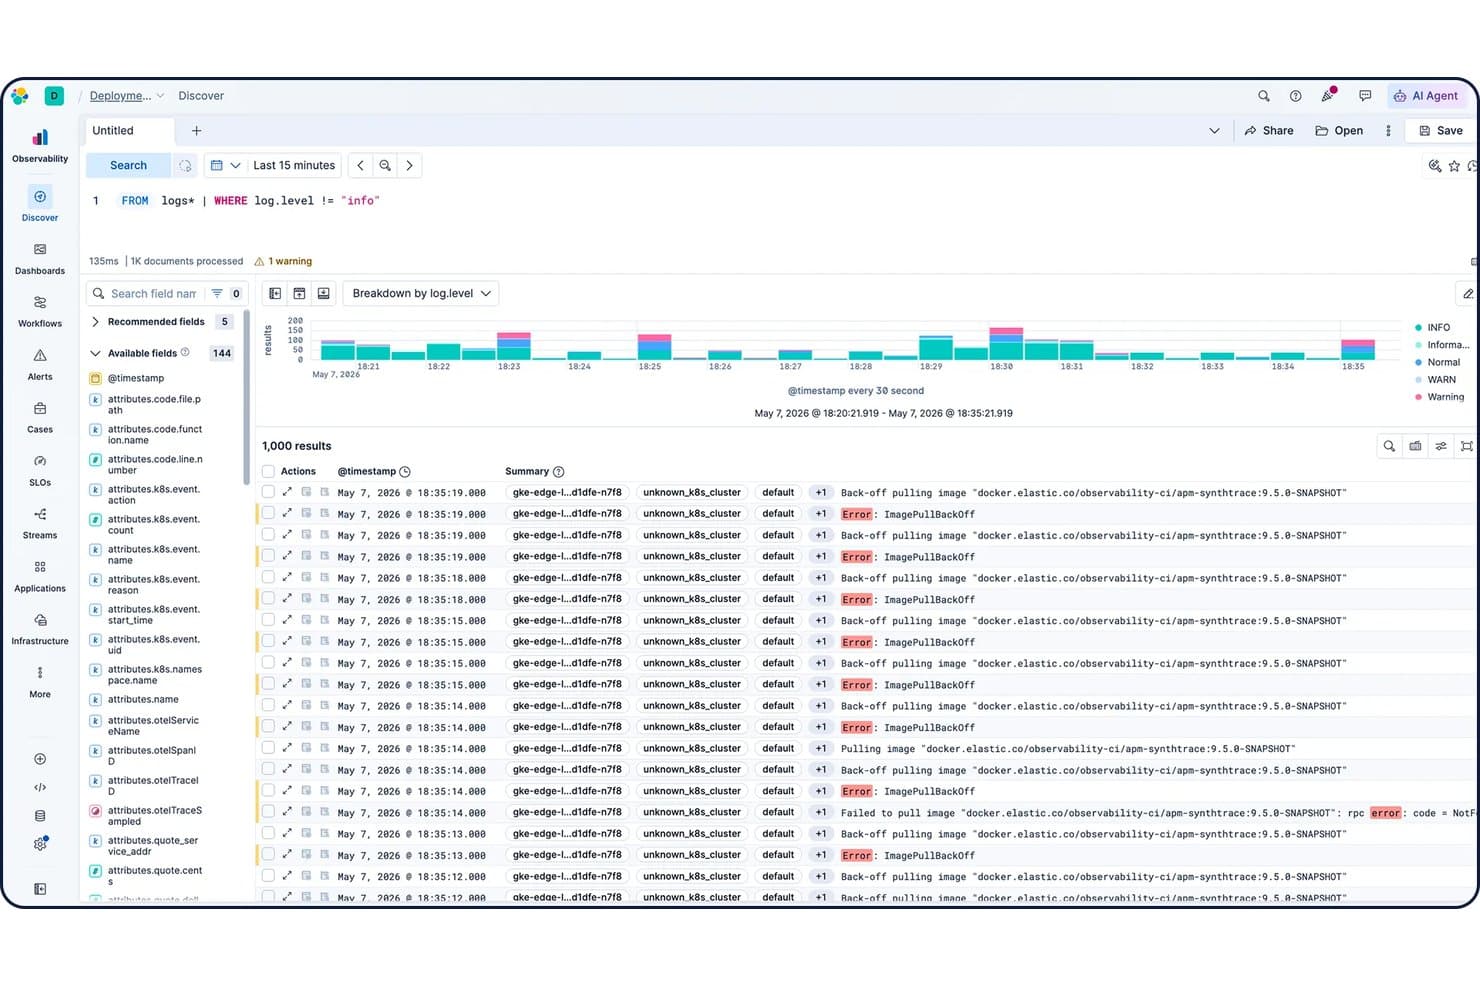
Elastic Observability filtrerer logge efter niveau i Discover-visningen. Elastic Observability er en fuldstack-observabilitetsplatform, der samler logovervågning, infrastrukturmålinger, APM, distribueret sporing, syntetisk overvågning og AIOps på tværs af lokale, cloudbaserede og hybride miljøer.
Hvem er Elastic Observability bedst egnet til?
Elastic Observability er velegnet til SRE'er og infrastrukturingeniører i mellemstore og store virksomheder, som har brug for samlet indsigt i logge, målinger, spor og APM på tværs af hybride miljøer og miljøer med flere cloudplatforme – især teams, der allerede har investeret i OpenTelemetry.
Hvorfor jeg valgte Elastic Observability
Elastic Observability er med på min liste over favoritter, fordi det er en af de få platforme, der er bygget med OpenTelemetry som førsteprioritet. Det betyder, at dine logge, målinger, spor og APM-data ender i ét enkelt skema, uden at du tvinges til at kæmpe med proprietære agenter. Jeg er især glad for ML-laget uden konfiguration: Over 100 forudkonfigurerede job til anomalidetektion kører automatisk på tværs af alle datastrømme, så dit team ikke manuelt skal finjustere modeller, når der sker dataindlæsning i Comcast-skala. Den Streams-baserede logparsning og ES|QL-forespørgselsmotoren gør det virkelig hurtigt at finde de grundlæggende årsager på tværs af hybride miljøer.
Vigtige funktioner i Elastic Observability
- Syntetisk overvågning: Kør lette test og fulde browserbaserede test af brugerrejser ved hjælp af en global, administreret testinfrastruktur eller private lokale placeringer.
- Sporing af servicelivsmål (SLO): Definer, overvåg og rapportér om pålidelighedsmål direkte i Kibana sammen med dine eksisterende dashboards og alarmer.
- Alarmer i Kibana: Konfigurer regelbaserede alarmer på tværs af APM-, målings-, oppetids- og sikkerhedsdata ved hjælp af formularbaseret opsætning med understøttelse af notifikationer via flere kanaler.
- Over 550 forudbyggede integrationer: Opret forbindelse til cloududbydere, ITSM-værktøjer, sikkerhedsplatforme og datakilder ved hjælp af forudbyggede agenter og agentløse indsamlere.
Integrationer til Elastic Observability
Elastic Observability tilbyder over 550 forudbyggede integrationer, herunder AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes og OpenTelemetry. Platformen understøtter også REST-API'er, webhooks, Elastic Agent, Logstash, Beats og OpenTelemetry-indsamlere til brugerdefinerede forbindelser.
Pros and Cons
Pros:
- Samlet indsigt på tværs af hybride miljøer og miljøer med flere cloudplatforme
- ML uden konfiguration registrerer automatisk anomalier
- OTel-baseret dataindlæsning undgår leverandørlåsning
Cons:
- Indbygget vagtplanlægning er ikke inkluderet
- Dokumentationen er utilstrækkelig til komplekse OTel-opsætninger
Learn more about Elastic Observability: Bedst til hybrid ITOps med flere lejere i MSP-klassen
- Gratis demo tilgængelig
- Priser oplyses efter forespørgsel
Visit WebsiteCustomer Rating:4.1/5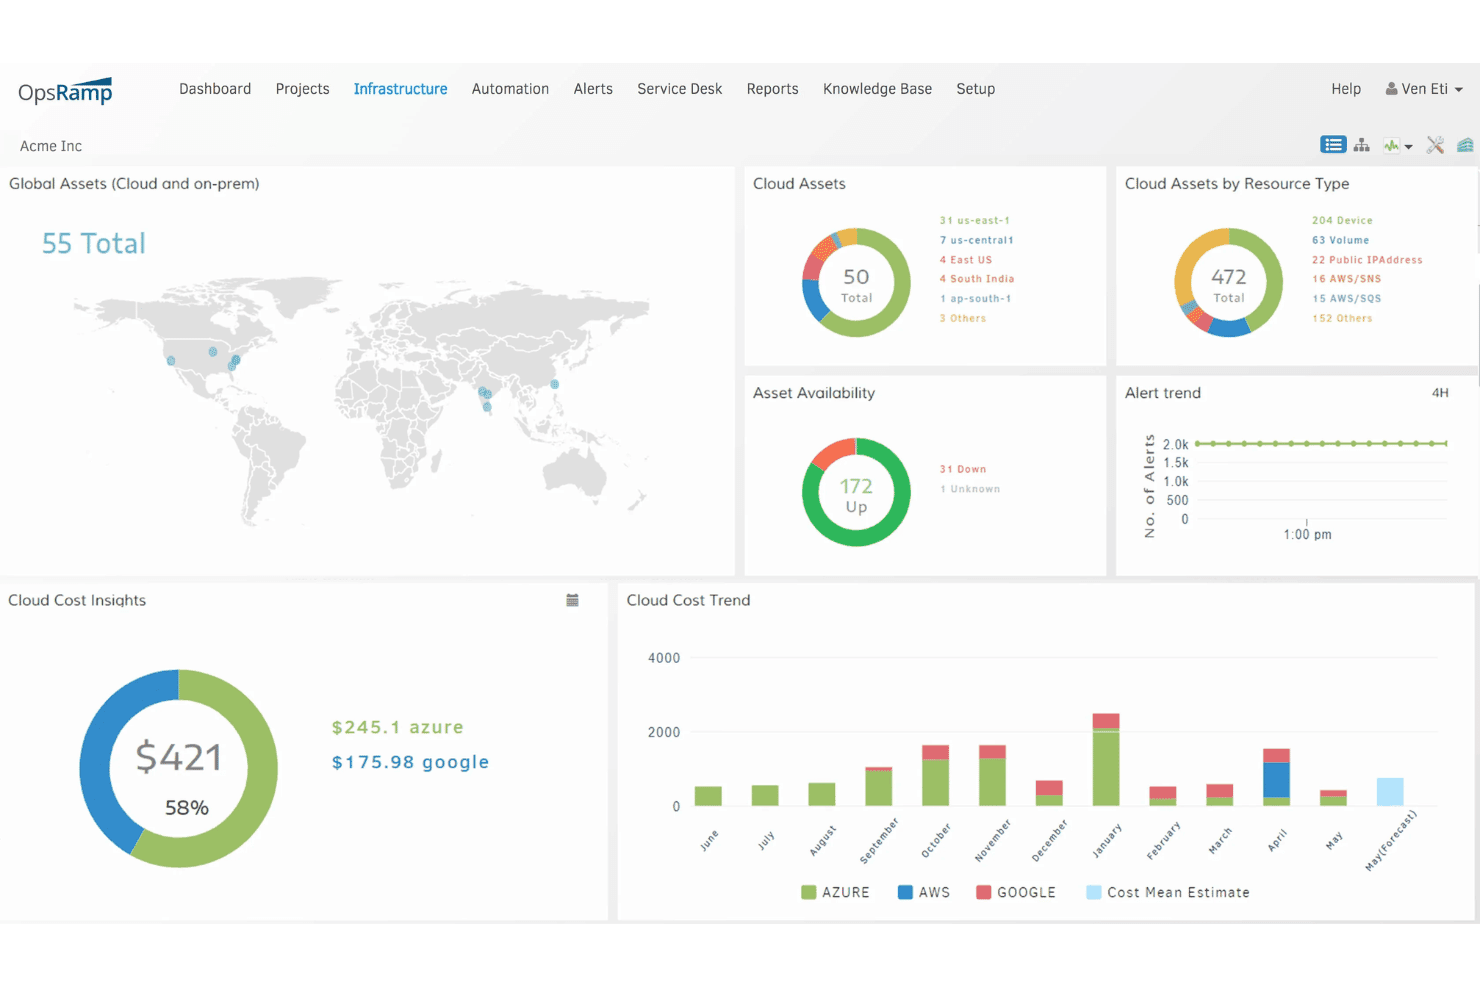
OpsRamp giver brugerne et samlet overblik over cloudomkostninger, aktiver og alarmer. HPE OpsRamp er en AIOps-drevet platform til styring af IT-drift, som samler infrastrukturovervågning, hændelseskorrelation, incidenthåndtering, automatisering af driftsprocedurer og synlighed på tværs af hybrid- og multicloudmiljøer i lokale, private cloud- og offentlige cloudmiljøer.
Hvem er OpsRamp bedst til?
OpsRamp er velegnet til administrerede tjenesteudbydere (MSP'er) og store virksomheder, der driver komplekse hybride IT-miljøer på tværs af lokale miljøer og multicloudmiljøer.
Hvorfor jeg valgte OpsRamp
OpsRamp kommer på min shortlist, fordi den multilejerbaserede arkitektur er specifikt udviklet til MSP'er, der administrerer snesevis af kundemiljøer fra én samlet visning. Jeg kan især godt lide dens AIOps-motor til hændelseskorrelation, som grupperer relaterede alarmer på tværs af lejere og reducerer støj med op til 90 %, så dit team ikke drukner i supportsager på tværs af kundekonti. Dens topologi- og tjenestekort giver dig et realtidsoverblik over afhængigheder på tværs af hybride miljøer, der spænder over AWS, Azure, GCP og lokale miljøer, hvilket reelt er svært at genskabe i den skala.
Vigtige funktioner i OpsRamp
- Automatiseringsmotor til driftsprocedurer: Udfør foruddefinerede afhjælpningsscripts automatisk som reaktion på registrerede problemer med RBAC-styret adgang til opgaver og procesarbejdsgange.
- Multilejerbaseret kundestyring: Administrer flere kundemiljøer fra én enkelt platforminstans med integrationskonfiguration pr. lejer og isoleret datahåndtering.
- Rapportering af cloudomkostninger: Opdel cloudforbruget efter konto, region, tjeneste og instanstype på tværs af AWS, Azure og GCP med tilpasselige datointervaller.
- Modtagelse via OpenTelemetry: Indlæs målinger, logge og sporinger fra enhver OpenTelemetry-kompatibel kilde sammen med eBPF-assisteret automatisk instrumentering for dyb indsigt i arbejdsbelastninger.
Integrationer til OpsRamp
OpsRamp tilbyder over 3.000 integrationer, herunder ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry og Prometheus. Dens OAuth 2.0 REST API, webhooks og JSON-import/-eksport understøtter brugerdefinerede forbindelser.
Pros and Cons
Pros:
- Multilejerbaseret administration af MSP-kundemiljøer
- Op til 90 procents reduktion af alarmstøj
- Visualiseringer af hybrid- og multicloudtopologier
Cons:
- Funktionerne til applikationsovervågning er stadig under udvikling
- Dashboardets ydeevne kan blive langsommere i stor skala
Learn more about OpsRamp: Bedst til dybdegående indsigt i lager- og GPU-drift
- Gratis demo tilgængelig
- Pris oplyses efter anmodning
Visit WebsiteCustomer Rating:4.3/5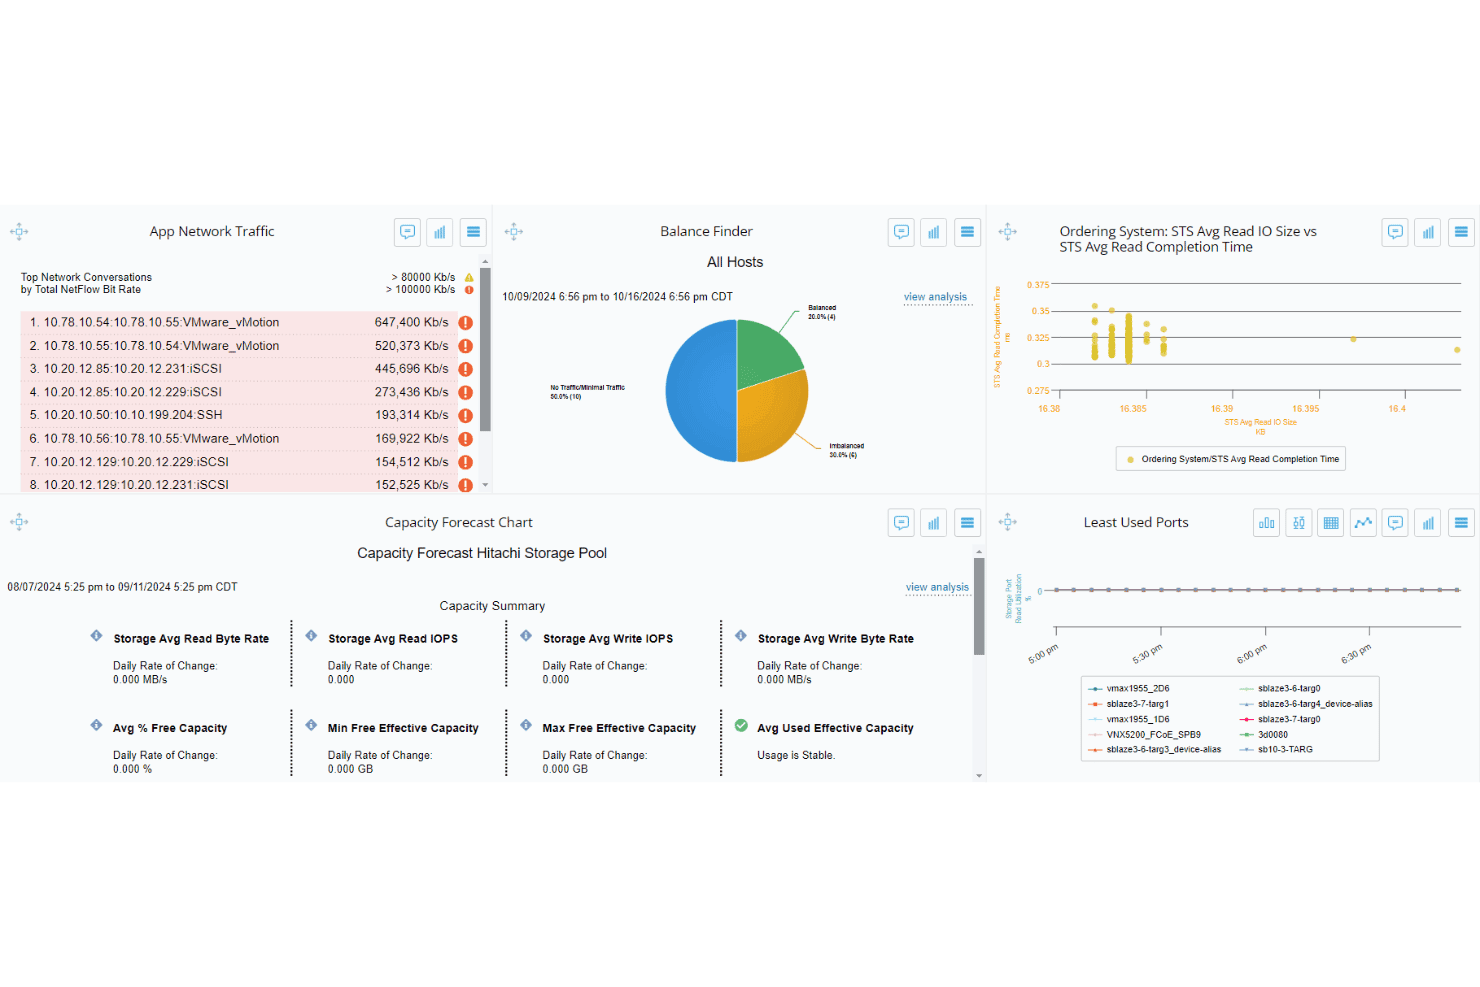
Virtana overvåger netværkstrafik, lagerkapacitet og værtsbalance i ét instrumentbræt. Virtana er en AIOps- og infrastrukturobservabilitetsplatform, der overvåger hybride miljøer på tværs af computer-, lager-, netværks-, Kubernetes- og GPU-infrastruktur med AI-drevet hændelseskorrelation, anomalidetektion og automatiseret hændelseshåndtering indbygget i kernen.
Hvem er Virtana bedst egnet til?
Virtana er et stærkt valg for infrastruktur- og NetOps-ingeniører, der administrerer komplekse hybride miljøer, hvor dybdegående lagerindsigt, synlighed i GPU-arbejdsbelastninger og AI-drevet hændelseskorrelation er ufravigelige krav.
Hvorfor jeg valgte Virtana
Jeg valgte Virtana som en af de bedste, fordi ingen anden platform på min shortlist indsamler lagermetrikker med samme dybde: over 16.000 metrikker på tværs af blok-, NAS-, SAN-, SDS- og HCI-miljøer, alt sammen korreleret med computer- og netværkskontekst i realtid. Jeg er især imponeret over det dedikerede modul til AI Factory-observabilitet, som sporer GPU-udnyttelse, inaktiv kapacitet, drosling samt NVLink-/PCIe-gennemstrømning for teams, der kører LLM-trænings- eller inferensarbejdsbelastninger i stor skala. Den ML-baserede anomalidetektion opnår op til 95 % nøjagtighed og identificerer problemer, før tærskler overskrides, i stedet for efter skaden er sket.
Vigtige funktioner i Virtana
- Agentisk AI-afhjælpning: AI-agenter gennemgår din systemafhængighedsgraf for selvstændigt at undersøge problemer og udføre styrede afhjælpningsarbejdsgange uden manuelle overdragelser.
- Forudsigelse af kapacitetsbehov: Bruger op til 12 måneders historiske data til at forudsige behovet for computer-, lager-, netværks- og GPU-kapacitet op til et år frem.
- Tovejs-synkronisering med ServiceNow: Opretter, opdaterer og lukker automatisk ServiceNow-hændelser baseret på registrerede hændelser med kortlægning af forretningskritikalitet og CMDB-integration.
- Topologi- og afhængighedskortlægning: Opdager og kortlægger løbende relationer på tværs af applikationer, tjenester og infrastruktur for at vedligeholde en levende, søgbar systemmodel.
Virtana-integrationer
Virtana har en indbygget ServiceNow-integration samt integrationer med Slack, Microsoft Teams, PagerDuty, AWS, Azure, GCP, Kubernetes, VMware og OpenTelemetry. REST API'er og en MCP-server understøtter tilpassede integrationer og adgang for AI-agenter.
Pros and Cons
Pros:
- Indsamler over 16.000 lagermetrikker på tværs af miljøer
- Sporer GPU- og AI-arbejdsbelastningers ydeevne indbygget
- AI-drevet anomalidetektion opnår høj nøjagtighed
Cons:
- Visualiseringerne i brugergrænsefladen kan føles begrænsede
- Anmeldelsesgrundlaget er mindre end hos de største konkurrenter
Learn more about Virtana: Bedst til AI-drevet fuldstack-validering af udgivelser
- 15 dages gratis prøveperiode
- Fra $7/vært/måned
Visit WebsiteCustomer Rating:4.5/5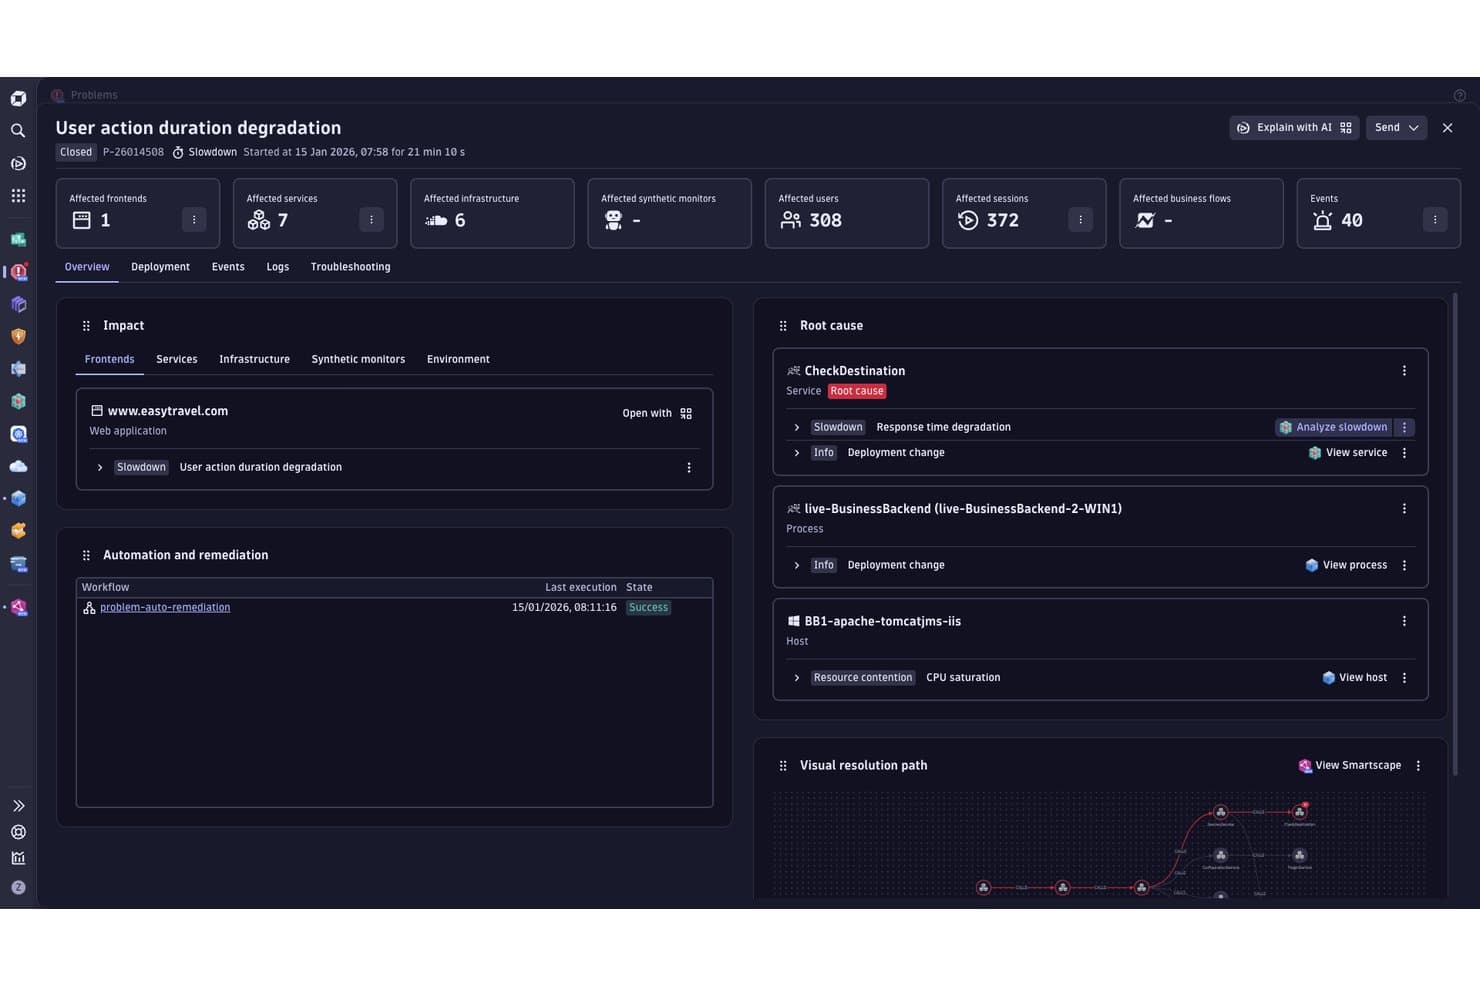
Dynatrace identificerer automatisk de grundlæggende årsager til ydeevneproblemer. Dynatrace er en fuldstack-platform til administration af IT-drift, der omfatter infrastrukturmonitorering, AIOps-drevet hændelsesregistrering, loganalyse og workflowautomatisering på tværs af hybride miljøer og multicloud-miljøer.
Hvem er Dynatrace bedst egnet til?
Dynatrace er velegnet til IT- og SRE-teams i virksomheder, der administrerer komplekse hybride miljøer eller multicloud-miljøer og har brug for AI-drevet observerbarhed, automatiseret hændelsesrespons og validering af udgivelser i stor skala.
Hvorfor jeg valgte Dynatrace
Jeg valgte Dynatrace som en af de bedste, fordi dens Site Reliability Guardian er den mest grundige opsætning til validering af udgivelser, jeg har set i denne kategori: Den evaluerer automatisk hver implementering i forhold til foruddefinerede SLO'er og KPI'er, før koden når produktion, og blokerer fejlbehæftede udgivelser uden manuel gennemgang. Kombiner det med Davis AI's evne til at spore en anomali i produktionen tilbage til én enkelt grundlæggende årsag på tværs af milliarder af aktive afhængigheder, så får du en platform, der opdager det, der slipper forbi kvalitetskontrollerne, og forklarer præcis hvorfor.
Vigtige funktioner i Dynatrace
- Smartscape-topologikortlægning: Opdager og visualiserer automatisk afhængigheder i realtid på tværs af værter, containere, tjenester og processer i hybride miljøer og multicloud-miljøer.
- Grail-datasø: Samler målinger, logfiler, spor, hændelser og sikkerhedssignaler i ét enkelt indeksfrit lager, der kan forespørges via DQL uden skemakonfiguration.
- Workflowbyggeren AutomationEngine: En visuel editor uden eller med minimal kode til opbygning af hændelsesdrevne eller planlagte automatiseringsworkflows baseret på aktuelle observerbarhedsdata.
- Forudsigende alarmering: Forudsiger kapacitets- og ydeevneoverskridelser, før de opstår, ved hjælp af kontinuerligt indlærte adfærdsbaselines på tværs af alle overvågede komponenter.
Integrationer med Dynatrace
Dynatrace tilbyder over 900 integrationer via Dynatrace Hub, herunder ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud og OpenTelemetry. Dens REST API, webhooks og AppEngine SDK understøtter brugerdefinerede integrationer.
Pros and Cons
Pros:
- En enkelt agent opdager automatisk aktiver i hele stacken
- Davis AI identificerer den egentlige grundlæggende årsag
- Automatiseret afhjælpning med kontroller med menneskelig involvering
Cons:
- Forbrugsbaseret prissætning gør budgetlægning vanskelig
- Kun SaaS begrænser mulighederne for isolerede miljøer
 Bedst til samlet telemetri med indbygget FinOps
- 14 dages gratis prøveperiode
- Fra $15/vært/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.5/5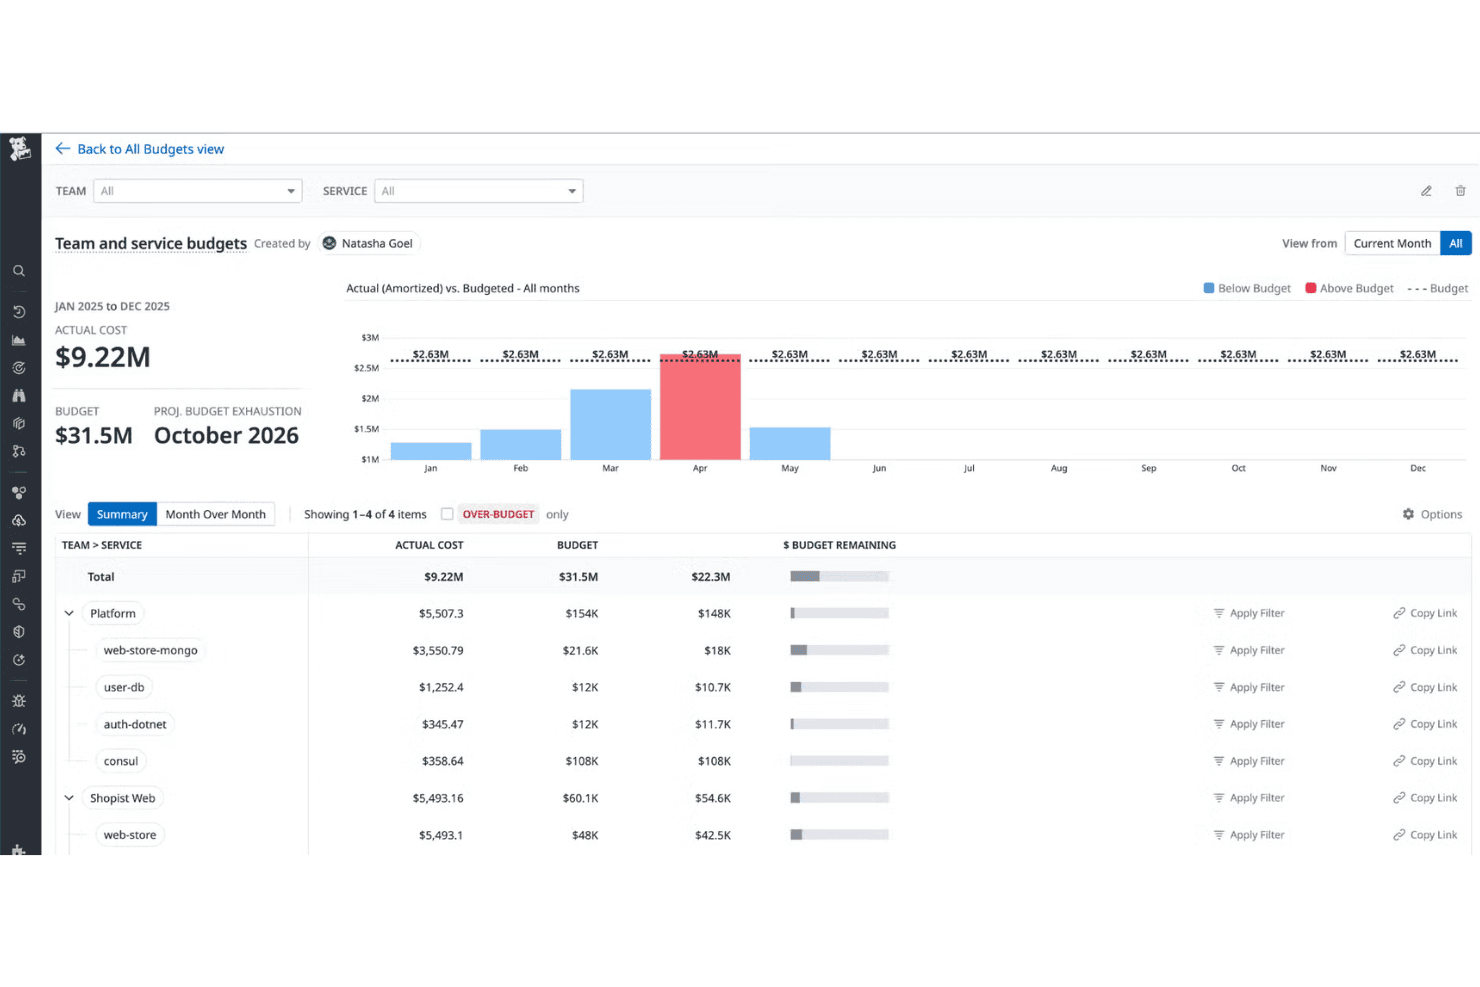
Datadog holder styr på teams' og tjenesters budgetter sammenholdt med de faktiske cloududgifter. Datadog er en cloudbaseret platform til IT-driftstyring og observerbarhed, der samler infrastrukturovervågning, APM, logstyring, netværksovervågning, hændelsesstyring, AIOps og workflowautomatisering på tværs af hybride miljøer og miljøer med flere cloududbydere.
Hvem er Datadog bedst egnet til?
Datadog er velegnet til udviklings- og IT-driftsteams, der administrerer komplekse miljøer med flere cloududbydere eller hybride miljøer, og som har brug for infrastrukturovervågning, APM og indsigt i cloudomkostninger samlet ét sted.
Hvorfor jeg valgte Datadog
Datadog kommer med på min kandidatliste, fordi det er den eneste platform, jeg har brugt, hvor fuldstack-telemetri og indsigt i cloudomkostninger reelt findes samme sted. Jeg kan godt lide, at styring af cloudomkostninger knytter infrastrukturtal direkte sammen med udgifter på tværs af AWS, Azure, GCP og OCI, så når Watchdog markerer en CPU-anomali på en Kubernetes-klynge, kan jeg se omkostningspåvirkningen uden at skifte værktøj. Det indbyggede FinOps-lag kombineret med AI-drevet anomalidetektion på tværs af målepunkter, logfiler og spor gør platformen særligt velegnet til teams, der har brug for operationelt og økonomisk ansvar samlet i én visning.
Vigtige funktioner i Datadog
- Watchdog-anomalidetektion: En AI-motor, der automatisk identificerer præstationsanomalier på tværs af infrastrukturtal, APM-spor og logfiler uden behov for manuel konfiguration af tærskelværdier.
- Vagtplanlægning og eskaleringspolitikker: Konfigurerbare vagtrotationer med routingsregler og notifikationer via flere kanaler, herunder SMS, taleopkald, pushbeskeder og e-mail.
- Bygger til workflowautomatisering: En visuel grænseflade med begrænset kodning, der indeholder over 1.750 forudbyggede handlinger og over 150 skabeloner til automatisering af hændelsesrespons samt DevOps- og sikkerhedsarbejdsgange.
- Styring af cloud-sikkerhedsposition (CSPM): Kontinuerlige konfigurationskontroller på tværs af cloudkonti og containere, knyttet til over 15 compliance-rammer, herunder PCI DSS, HIPAA og SOC 2.
Datadog-integrationer
Datadog tilbyder over 1.000 leverandørunderstøttede integrationer, herunder AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes og Prometheus. Dets REST API og SDK'er understøtter brugerdefinerede integrationer.
Pros and Cons
Pros:
- Samlet visning af infrastruktur, apps og omkostninger
- AI-anomalidetektion hjælper med at reducere støj fra alarmer
- Hændelsesstyring fra start til slut er indbygget
Cons:
- Modulær prissætning medfører uforudsigelige omkostninger
- Ingen selvhostet implementering for brugere, der ikke er offentlige myndigheder
 Bedst til automatisering af fejl-til-løsning-arbejdsgange uden kode
- 30-dages gratis prøveperiode
- Fra $1,233/år (faktureres årligt)
Visit WebsiteCustomer Rating:4.3/5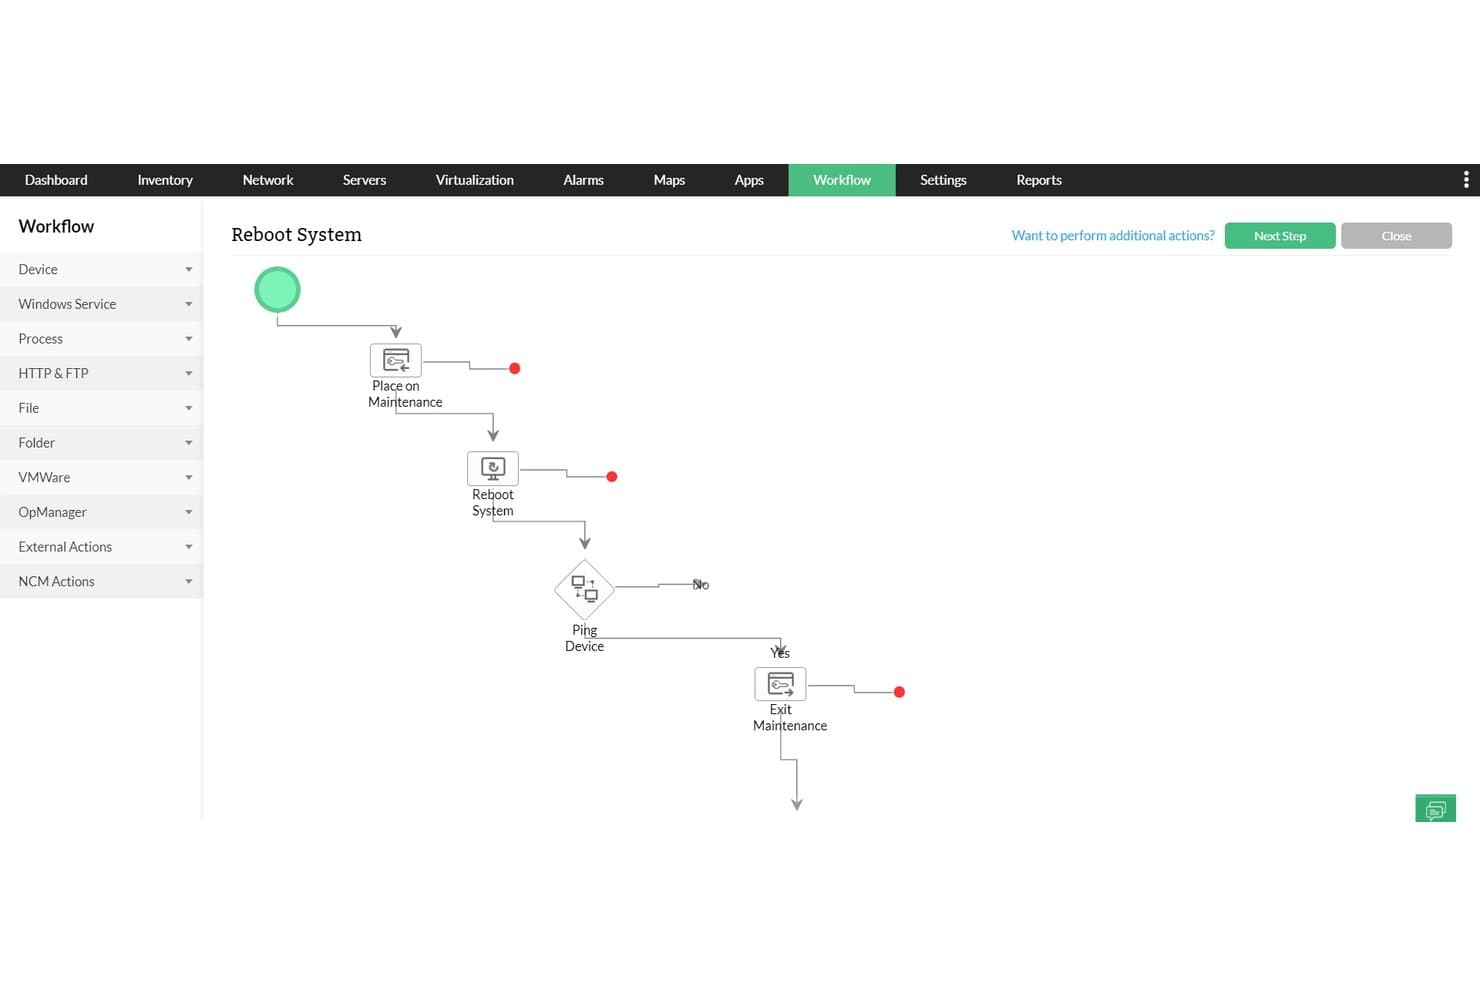
ManageEngine OpManager automatiserer genstarter af systemer med en visuel arbejdsgangseditor. ManageEngine OpManager er en lokal platform til styring af IT-drift, som overvåger netværksenheder, fysiske og virtuelle servere, lagring og cloudinfrastruktur sammen med indbygget automatisering af arbejdsgange, AIOps-drevet alarmering og ITSM-integrationer.
Hvem egner ManageEngine OpManager sig bedst til?
OpManager egner sig godt til infrastruktur- og NetOps-teams, der administrerer store lokale eller hybride miljøer og har brug for én konsol, der dækker overvågning af netværk, servere, lagring og virtualisering uden betaling pr. interface.
Hvorfor valgte jeg ManageEngine OpManager?
Jeg valgte ManageEngine OpManager som en af de bedste, fordi automatiseringen af arbejdsgange uden kode reelt er en af de mest effektive, jeg har set i denne kategori. Den visuelle arbejdsgangseditor med træk-og-slip-funktion giver dig mere end 70 forudbyggede handlinger på tværs af ni kategorier, og du kan udløse dem automatisk ved registrering af fejl eller køre dem efter en tidsplan. Det, jeg især finder nyttigt, er, at arbejdsgange eksporteres som XML, så du kan kopiere en velfungerende fejlreaktionssekvens til andre miljøer uden at skulle bygge den fra bunden igen.
Vigtige funktioner i ManageEngine OpManager
- Adaptive ML-tærskler: Træner automatisk på 14 dages historiske data og opdaterer grundlinjer hver time på tværs af mere end 3.000 ydeevnemålinger for at reducere behovet for manuel justering af tærskler.
- Distribueret Probe-Central-arkitektur: Implementerer eksterne prober, der indsamler og gemmer data lokalt og derefter samler dem på en central server—skalerer til mere end 50.000 enheder på tværs af distribuerede lokationer.
- Kortlægning af netværkstopologi på lag 2: Genererer automatisk visuelle kort over fysiske netværksforbindelser, herunder detaljer på switchportniveau, 3D-visninger af rackskabe og plantegninger over datacenterets etager.
- AIOps-drevne prognosealarmer: Bruger den indbyggede Zia ML-motor til at forudsige udtømning af ressourcer for CPU, hukommelse, disk og båndbredde, før tærsklerne faktisk overskrides.
Integrationer til ManageEngine OpManager
ManageEngine OpManager har indbyggede integrationer med ServiceNow, Jira Service Management, ServiceDesk Plus, Freshdesk, Slack, Microsoft Teams, Grafana og ManageEngine Log360. Den understøtter også REST API-adgang og webhooks til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Arbejdsgangseditor uden kode til automatiseret reaktion
- Adaptive ML-tærskler med opdateringer af grundlinjer hver time
- Synlighed på tværs af flere cloudmiljøer med opgradering til Nexus-platformen
Cons:
- Kompleks opsætningsproces i blandede miljøer
- Smart hændelseskorrelation er stadig i betafasen
Learn more about ManageEngine OpManager: Bedst til AI-drevet vurdering af ændringsrisici
- Gratis demo tilgængelig
- Fra $9/bruger/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.4/5 Learn more about BigPanda:
 Bedst til overvågning af open source-drift i alle skalaer
- Gratis download tilgængelig
- Fra $325/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.4/5 10Bedst til ML-drevet reduktion af alarmstøj
Moogsoft
- Gratis demo tilgængelig
- Priser oplyses efter anmodning
Visit WebsiteCustomer Rating:4.5/5Learn more about Moogsoft:
Anden software til IT-driftsstyring
Her er nogle yderligere muligheder for software til IT-driftsstyring, som ikke kom med på min kortliste, men som stadig er værd at undersøge:
- 11CheckmkBedst til servicebaseret prissætning på tværs af hybrid infrastruktur
- 12Grafana CloudBedst til ML-styret observabilitet af drift i hele stakken
- 13SolarWinds Observability SaaSBedst til fuldstack-observabilitet med rødder i NetOps
How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
Sådan vælger du software til IT-driftsstyring
Når du skal beslutte, hvilken software til IT-driftsstyring der passer bedst til dit miljø, bør du begynde med at fokusere på dine mest presserende driftsmæssige udfordringer:
| Hvis din prioritet er... | Se efter... |
|---|---|
| Hvis din prioritet er...Hurtig og præcis analyse af grundlæggende årsager | Se efter...AI-baseret hændelseskorrelation og automatiserede kørselsbøger |
| Hvis din prioritet er...Hybride miljøer og miljøer med flere cloudmiljøer | Se efter...Indbyggede forbindelser til lokale miljøer, AWS, Azure og GCP |
| Hvis din prioritet er...Reduktion af manuelle afhjælpningsopgaver | Se efter...Visuelle arbejdsgangsbyggere med forudbyggede automatiseringer |
| Hvis din prioritet er...Kontrol over udgifter til overvågning | Se efter...Gennemsigtige, brugsbaserede priser og omkostningsoversigter |
| Hvis din prioritet er...Dybe integrationer med ITSM-værktøjer | Se efter...Forudbyggede forbindelser og åben API-dokumentation |
Sådan vurderer du din kortliste
- Test arbejdsgange for hændelseshåndtering: Gennemfør en prøveperiode på 48 timer, og simulér mindst tre typer af driftsforstyrrelser for at kontrollere hændelsesgruppering og automatiserede svar.
- Bed om en demonstration af et topologikort: Bed leverandøren om at generere et komplet afhængighedskort – inklusive hybride klynger – ved hjælp af liveeksempeldata eller anonymiserede eksempeldata.
- Opret en sag på tværs af platforme: Opret en supportsag med henvisning til en integration med flere cloudmiljøer, og dokumentér svarenes nøjagtighed og SLA'er over en periode på 3 dage.
- Vurder rapporteringens fuldstændighed: Gennemgå eller eksportér et eksempel på et analysedashboard, og bekræft synligheden af omkostninger, SLA'er og tilpassede målinger for din faktiske stak.
- SaaS-smidighed kontra kontrol ved selvhosting: Beslut, om hurtig funktionslevering i SaaS opvejer de krav til overholdelse af regler og adgang, som lokale installationer eller installationer uden netværksforbindelse opfylder.
Hvad er software til IT-driftsstyring?
Software til styring af it-drift er en kategori af værktøjer, der er udviklet til at overvåge, automatisere og administrere it-infrastruktur, applikationer, netværk og tjenester på tværs af lokale og cloudbaserede miljøer. Disse platforme hjælper dit team med at centralisere alarmer, opretholde systemernes tilstand, administrere hændelser og optimere ressourceforbruget. Ved at samle driftsdata og automatisering understøtter software til styring af it-drift hurtigere fejlfinding, øger effektiviteten og gør det muligt for din organisation at skalere teknologien på en pålidelig måde.
Funktioner i software til styring af it-drift
Når du vælger software til styring af it-drift, bør du holde øje med følgende vigtige funktioner:
- Overvågning af infrastruktur og applikationer: Sporer servere, netværk, containere og applikationer i realtid. Hjælper dig med at opdage unormal systemadfærd, forringet ydeevne eller driftsafbrydelser, før brugerne bliver påvirket.
- Alarmering og hændelsesstyring: Centraliserer alarmer og effektiviserer eskaleringsarbejdsgange. Gør det muligt for dit team at reagere hurtigt, sætte hændelser i kontekst og følge løsningen fra start til slut.
- Automatisering og orkestrering: Giver værktøjer til at automatisere rutineopgaver og koordinere arbejdsgange på tværs af forskellige miljøer. Reducerer den manuelle indsats og mindsker risikoen for menneskelige fejl under implementeringer eller vedligeholdelse.
- Understøttelse af hybrid- og multicloudmiljøer: Tilbyder samlet synlighed på tværs af lokal, privat cloud- og offentlig cloud-infrastruktur. Hjælper dig med at administrere komplekse miljøer som én samlet driftsenhed.
- Tilpasselige dashboards og rapportering: Lader dig oprette dashboards og rapporter, der er tilpasset dine behov. Understøtter trendanalyse, SLA-overvågning og deling af indsigt med tekniske og forretningsmæssige interessenter.
- Integration og API-adgang: Opretter forbindelse til ITSM-, DevOps- og samarbejdsplatforme. Gør det muligt for dit team at integrere it-driftsdata direkte i systemer til sagsstyring, chat og andre systemer.
- Topologi- og afhængighedskortlægning: Visualiserer relationerne mellem systemer, tjenester og infrastrukturelementer. Gør det nemmere at spore den grundlæggende årsag til hændelser og forstå driftsrisici.
- Bruger- og rollebaseret adgangskontrol: Giver dig mulighed for at definere, hvem der kan se eller redigere dele af dit miljø. Beskytter følsomme data og begrænser eksponeringen baseret på brugernes ansvarsområder.
- Kapacitetsplanlægning og prognoser: Analyserer tendenser i ressourceforbruget for at forudsige fremtidige behov. Hjælper dig med at forudse opgraderinger af infrastrukturen og budgettere med vækst.
- Sporing af ændringer og revisionslogge: Registrerer konfigurationsændringer og brugerhandlinger. Understøtter krav til overholdelse af regler og hjælper med at fejlfinde tidligere hændelser ved at give en tydelig ændringshistorik.
Almindelige AI-funktioner i software til styring af it-drift
Ud over de almindelige funktioner i software til styring af it-drift, der er nævnt ovenfor, integrerer mange af disse løsninger AI med funktioner som:
- AI-drevet afvigelsesregistrering: Bruger maskinlæring til automatisk at identificere usædvanlige mønstre eller adfærd i systemmålinger, logge eller netværkstrafik. Det hjælper dit team med at opdage nye problemer, før de eskalerer, selv når tærsklerne ikke er blevet indstillet manuelt.
- Automatiseret analyse af grundlæggende årsager: Anvender AI-algoritmer til at sammenholde hændelser, logge og ydelsesdata på tværs af din teknologistak. Denne funktion udpeger den sandsynlige årsag til hændelser, reducerer den tid, dit team bruger på undersøgelser, og fremskynder genoprettelsen.
- Forudsigelse af hændelser: Udnytter historiske data og AI-modeller til at forudse potentielle driftsafbrydelser eller forringelser af ydeevnen. Det giver dig mulighed for at tage proaktive skridt for at forhindre hændelser og planlægge vedligeholdelse mere effektivt.
- Intelligent reduktion af alarmstøj: Bruger AI til at gruppere relaterede alarmer, undertrykke dubletter og prioritere meddelelser baseret på påvirkning og kontekst. Det reducerer alarmtræthed og sikrer, at dit team fokuserer på de vigtigste problemer.
- AI-drevne forslag til afhjælpning: Analyserer hændelsesdata og tidligere løsninger for at anbefale næste skridt eller automatiserede rettelser. Det hjælper dit team med at reagere hurtigere og standardiserer bedste praksis på tværs af driften.
Fordele ved software til styring af it-drift
Implementering af software til styring af it-drift giver flere fordele for dit team og din virksomhed. Her er nogle af de fordele, du kan se frem til:
- Centraliseret synlighed: Saml overvågningen af servere, netværk, applikationer og cloudressourcer i ét dashboard, så dit team kan være på forkant med problemer på tværs af miljøer.
- Hurtigere løsning af hændelser: Brug funktioner til samling af alarmer, AI-drevet korrelation og automatiseret analyse af den grundlæggende årsag til hurtigt at identificere, prioritere og reagere på driftsproblemer.
- Mindre manuelt arbejde: Automatisér tilbagevendende vedligeholdelse, afhjælpning og arbejdsgaver ved hjælp af forudbyggede værktøjer til automatisering og orkestrering, så der frigøres tid til initiativer med større værdi.
- Proaktiv risikostyring: Forudsig nedbrud og flaskehalse i ressourcerne med AI-drevne værktøjer til registrering af afvigelser og prognoser, som synliggør potentielle problemer, før de eskalerer.
- Optimering af omkostninger og ressourcer: Følg infrastrukturforbrug, applikationsydelse og ressourceudgifter gennem rapporterings- og analysefunktioner, der hjælper dig med at styre budgetter og kapacitetsplanlægning.
- Stærkere sikkerhed og compliance: Benyt kontroller af brugeradgang, revisionslogge og funktioner til sporing af ændringer for at beskytte følsomme data og understøtte lovgivningsmæssige krav.
- Problemfri integration med økosystemet: Forbind ITSM-, DevOps- og chatplatforme ved hjælp af forudbyggede integrationer og åbne API'er, så det bliver lettere at integrere driftsdata i den måde, dit team allerede arbejder på.
Omkostninger og priser for software til IT-driftstyring
Valg af software til IT-driftstyring kræver en forståelse af de forskellige prismodeller og abonnementer, der er tilgængelige. Omkostningerne varierer afhængigt af funktioner, teamstørrelse, tilføjelser med mere. Tabellen nedenfor opsummerer almindelige abonnementer, deres gennemsnitlige priser og typiske funktioner, der er inkluderet i softwareløsninger til IT-driftstyring:
Sammenligningstabel over abonnementer til software til IT-driftstyring
| Abonnementstype | Gennemsnitspris | Almindelige funktioner |
|---|---|---|
| AbonnementstypeGratis abonnement | Gennemsnitspris$0 | Almindelige funktionerGrundlæggende infrastrukturovervågning, begrænset alarmhåndtering, adgang for små teams og support fra fællesskabet. |
| AbonnementstypePersonligt abonnement | Gennemsnitspris$10–$30/bruger/måned | Almindelige funktionerOvervågning i realtid, automatisering på begynderniveau, grundlæggende dashboards, integration med populære værktøjer og e-mailsupport. |
| AbonnementstypeVirksomhedsabonnement | Gennemsnitspris$40–$80/bruger/måned | Almindelige funktionerOvervågning af hele teknologistakken, alarmhåndtering og hændelsesstyring, automatisering af arbejdsgange, avancerede dashboards, API-adgang og rollebaseret adgangskontrol. |
| AbonnementstypeAbonnement til store virksomheder | Gennemsnitspris$90–$200/bruger/måned | Almindelige funktionerSynlighed på tværs af hybride miljøer og flere cloudmiljøer, AI-drevne funktioner, tilpassede SLA'er, compliance-support, dedikerede integrationer og førsteklasses support. |
Ofte stillede spørgsmål om software til it-driftstyring
Her er svar på almindelige spørgsmål om software til it-driftstyring:
Hvordan sammenligner man forskellige platforme til software til it-driftstyring?
Start med at opstille en liste over de funktioner, du absolut har brug for – såsom understøttelse af flere cloudmiljøer, automatisering og integrationsdybde. Afprøv derefter platformene ved hjælp af almindelige hændelsesscenarier, og sammenlign, hvordan hvert værktøj håndterer alarmer, årsagsanalyse og rapportering. De samlede ejeromkostninger, integrationer med økosystemet og fleksibiliteten ved implementering er også vigtige at undersøge, før du træffer en endelig beslutning.
Kan software til it-driftstyring automatisere hændelseshåndtering?
Ja, det meste moderne software til it-driftstyring giver dig mulighed for at automatisere hændelseshåndtering gennem køreplaner, værktøjer til opbygning af arbejdsgange og endda AI-drevet automatisk afhjælpning. Det hjælper dig med at reducere manuelle trin og sikrer en ensartet reaktion på tilbagevendende problemer.
Hvilke integrationer bør jeg se efter i software til it-driftstyring?
Se efter API-adgang, færdigbyggede forbindelser til ITSM-værktøjer (såsom ServiceNow), chatplatforme (såsom Slack eller Microsoft Teams) og DevOps-pipelines. Dybe integrationer giver dit team mulighed for at sende alarmer, udløse arbejdsgange og synkronisere sager på tværs af dine eksisterende systemer uden brugerdefineret middleware.
Hjælper software til it-driftstyring med overholdelse af krav og revision?
Ja, effektiv software til it-driftstyring registrerer systemændringer og brugerhandlinger og leverer de revisionslogge, der er nødvendige for at overholde krav. Det er især nyttigt i regulerede sektorer, hvor du har brug for tydelig dokumentation af kontroller og en komplet ændringshistorik til rapportering.
Hvordan kan jeg forhindre uventede omkostninger med software til it-driftstyring?
Gennemgå altid, hvordan platformen opkræver betaling for dataindlæsning, brugerdefinerede målinger og brugerlicenser. Vælg værktøjer med gennemsigtige, brugsbaserede priser og omkostningsoversigter i appen, så du kan overvåge forbruget og undgå uventede ekstraomkostninger, efterhånden som dit miljø vokser.
Hvad er den bedste måde at få interessenternes opbakning til en ny platform til it-driftstyring?
Vis, hvordan platformen hjælper med at nå forretningsmålene: hurtigere løsning af hændelser, proaktiv risikostyring og forbedret rapportering. Del resultater fra en demonstration eller et pilotprojekt, fremhæv de forventede effektiviseringer, og knyt funktionerne til de udfordringer, som interessenterne genkender.