

Att hitta rätt verktyg för testdatahantering kan vara en utmanande uppgift. Med så många tillgängliga alternativ är det svårt att avgöra vilket som verkligen uppfyller dina behov utan att slösa värdefull tid eller resurser. Om du har stött på problem med verktyg som är alltför komplexa, inte kan skalas i takt med dina projekt eller inte följer regler för dataskydd är du inte ensam. Ett bra verktyg för testdatahantering bör effektivisera skapandet, hanteringen och säkerheten för dina datauppsättningar samtidigt som det integreras sömlöst i dina testarbetsflöden.
Som yrkesverksam inom programvarutestning med praktisk erfarenhet av dussintals verktyg har jag stött på och överkommit samma utmaningar som du står inför. Därför har jag skapat den här guiden: för att förenkla din sökning och ge dig en utvald lista över de bästa verktygen för testdatahantering som finns tillgängliga idag. Oavsett om automation, efterlevnad eller skalbarhet är din prioritet hjälper det här inlägget dig att fatta ett välgrundat beslut.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell för verktyg för testdatahantering
Tabellen nedan jämför prisuppgifter för mina främsta verktyg för testdatahantering.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för efterlevnadsanpassad maskering med automatisk skapning av delmängder | 14 dagars kostnadsfri provperiod | Pris på begäran | Website | |
| 2 | Bäst för CI/CD-inbyggda syntetiska testdata | Kostnadsfri demonstration tillgänglig | Pris på begäran | Website | |
| 3 | Bäst för att hantera olika testdatamiljöer från en central plats | 14 dagars kostnadsfri provperiod | Från €15,000/användare/år (faktureras årligen) | Website | |
| 4 | Bäst för TDM under hela livscykeln med databaskloning | Gratis demo tillgänglig | Pris på begäran | Website | |
| 5 | Bäst för maskering av testdata inklusive stordatorer | Inte tillgängligt | Prisuppgift på begäran | Website | |
| 6 | Bäst för företag med komplexa miljöer | 30 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 7 | Bäst delmängdsurval mellan databaser i reglerade branscher | Gratis demonstration tillgänglig | Pris på begäran | Website | |
| 8 | Bäst för maskering i pipelines med flera databaser | Gratis demo tillgänglig | Prisuppgift på begäran | Website | |
| 9 | Bäst för visuell, täckningsdriven datadesign | 14 dagars kostnadsfri provperiod | Pris på begäran | Website | |
| 10 | Bäst för Git-liknande databaskloning för fem databasmotorer | Gratis demonstration tillgänglig | Pris på begäran | Website |




Recensioner av de bästa verktygen för testdatahantering
Nedan finns mina detaljerade sammanfattningar av de bästa verktygen för testdatahantering som tog sig till min kortlista. Mina recensioner ger en detaljerad överblick över de viktigaste funktionerna, fördelarna & nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa för dig.
 Bäst för efterlevnadsanpassad maskering med automatisk skapning av delmängder
- 14 dagars kostnadsfri provperiod
- Pris på begäran
Visit WebsiteCustomer Rating:4.3/5
Tonic maskerar och avidentifierar känsliga databaskolumner för säkra testdata. Tonic Structural är en plattform för hantering av testdata som maskerar, skapar delmängder av och tillhandahåller produktionsdata för icke-produktionsmiljöer, med stöd för relationsdatabaser, NoSQL, datalager och filkällor.
Vem passar Tonic bäst för?
Tonic Structural passar särskilt bra för regelefterlevnadsinriktade team inom vård och finans som behöver maskera och skapa delmängder av produktionsdata samtidigt som de upprätthåller sekretessdokumentation redo för granskning.
Varför jag valde Tonic
Tonic tar plats på min kortlista eftersom maskerings- och delmängdskapaciteten är så tätt sammankopplade på ett sätt som jag sällan ser. Jag uppskattar hur Privacy Hub markerar varje kolumn som Utsatt, Skyddad eller Inte känslig och sedan låter dig tillämpa generatorer i bulk samt exportera en fullständig sekretessrapport för granskningsändamål. Den patenterade delmängdsskaparen hanterar virtuella främmande nycklar och cirkulära beroenden automatiskt, så att din maskerade delmängd förblir referentiellt intakt även i komplexa scheman med flera tabeller.
Viktiga funktioner i Tonic
- Structural Agent: En AI-chattassistent som är inbyggd i appen och sammanfattar resultaten från känslighetsskanningar, rekommenderar generatorer och tillämpar dem automatiskt på dina kolumner.
- Kontroller för differentialsekretess: Kategoriska och kontinuerliga generatorer stöder differentialsekretess, med en konfigurerbar sekretessbudget för att begränsa statistiska slutsatser från transformerade data.
- Utdata till containerarkiv: Structural skriver maskerade data och data i delmängder direkt som containervolymar för PostgreSQL, MySQL och SQL Server, vilket låter dig starta isolerade databaser på begäran.
- Versionshistorik: Registrerar varje ändring av arbetsytans konfiguration – generatorer, regler för delmängder, tabellägen och skript efter körning – med uppgift om vem som gjort ändringen och möjlighet att återställa tidigare versioner.
Integrationer med Tonic
Tonic erbjuder inbyggda integrationer med PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, Snowflake, BigQuery, Redshift, Databricks och Amazon S3. Plattformen stöder även REST API, GitHub Actions, Kubernetes, Helm och containerregister, inklusive Amazon ECR, Google Artifact Registry och Azure Container Registry.
Pros and Cons
Pros:
- Bevarar kopplingar i komplexa scheman
- Privacy Hub kartlägger känsliga kolumner för granskningar
- Produktionsliknande data behåller statistiska samband
Cons:
- Syntes från grunden kräver den separata produkten Fabricate
- Containeriserade databaser kräver Kubernetes-distribution
Learn more about Tonic: Bäst för CI/CD-inbyggda syntetiska testdata
- Kostnadsfri demonstration tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.6/5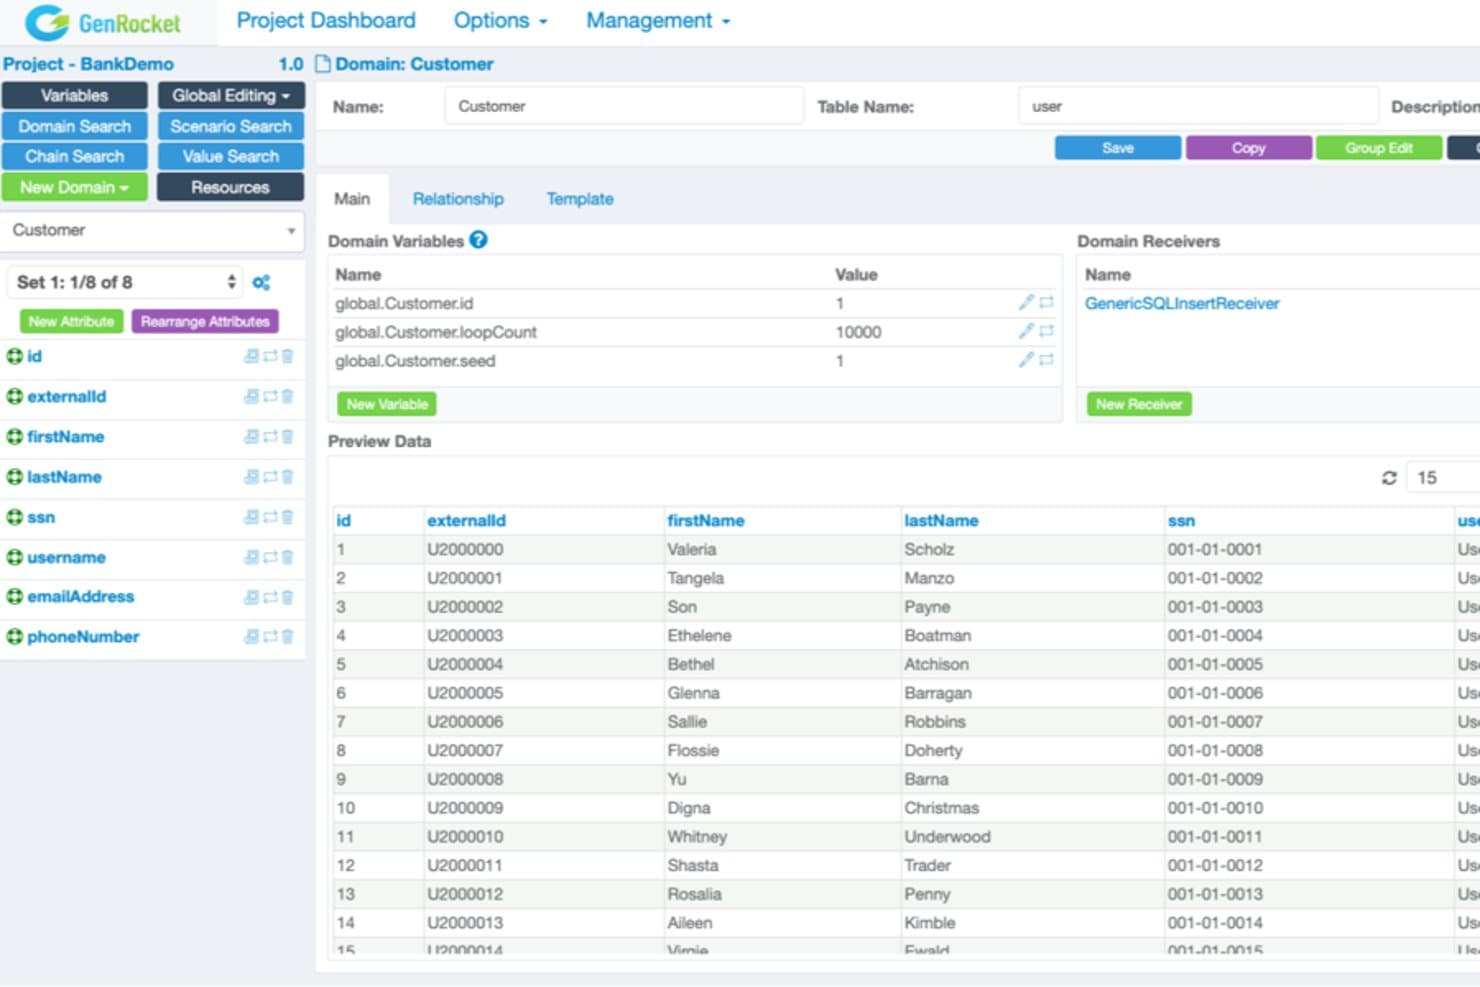
GenRocket låter användare förhandsgranska och konfigurera testdatadomäner visuellt. GenRocket är en plattform för hantering av syntetiska testdata som genererar data i realtid från metadata och scheman och omfattar datamaskering, intelligent delmängdsurval, utdata i flera format samt självbetjäningsprovisionering i CI/CD-pipelines.
Vem passar GenRocket bäst för?
GenRocket passar bra för QA- och DevOps-team som behöver syntetiska testdata på begäran, genererade direkt i CI/CD-pipelines, utan att produktionsdata någonsin berörs.
Varför jag valde GenRocket
GenRocket hamnar på min kortlista eftersom det är den enda plattform för testdata som jag har sett som är specifikt byggd för att generera syntetiska data i realtid, direkt i en CI/CD-pipeline, utan att någonsin beröra produktionen. Den patenterade motorn för referensintegritet håller data konsekventa över flera scheman och databaser samtidigt, vilket är genuint ovanligt. Jag uppskattar också att varje testfallsdatauppsättning genereras på så lite som 100 millisekunder, så att pipelinekörningen inte stannar upp i väntan på dataprovitionering.
Viktiga funktioner i GenRocket
- G-Delta-detektering av schemaändringar: Identifierar automatiskt ändringar i databasscheman i MySQL, MS SQL, Oracle och PostgreSQL och utlöser sedan G-Refactor för att uppdatera alla berörda testdatafall.
- Maskering på plats: Ersätter känsliga fält i Oracle-, MS SQL Server-, IBM DB2-, PostgreSQL- och MySQL-databaser med syntetiskt genererade motsvarigheter, utan att någonsin läsa verkliga produktionsvärden.
- G-Portal-självbetjäningsportal: Ger utvecklare och testare ett rollbaserat gränssnitt för att söka efter, begära, spåra och hämta testdatafall utan att behöva involvera ett centralt datateam för varje begäran.
- Över 750 intelligenta datageneratorer: Täcker i princip alla datatyper, domäner och affärsregler, inklusive villkorslogik, beroenden mellan fält och reguljära uttrycksbegränsningar.
GenRocket-integreringar
GenRocket integreras med Jenkins, Azure DevOps, TeamCity, CircleCI, GitHub, Cucumber, Selenium, JUnit, JMeter och LoadRunner. Plattformen stöder även REST API, JDBC, SOAP, TCP/IP-sockets och Docker-distribution för anpassade CI/CD-arbetsflöden.
Pros and Cons
Pros:
- Generering av syntetiska data bevarar referensintegriteten
- Dataprovisionering i realtid för CI/CD-pipelines
- Obegränsad datamängd utan uppdateringscykler
Cons:
- Ingen formatbevarande eller reversibel maskering
- PII-detektering är inte fullt tillgänglig förrän {{year}}
Learn more about GenRocket: Bäst för att hantera olika testdatamiljöer från en central plats
- 14 dagars kostnadsfri provperiod
- Från €15,000/användare/år (faktureras årligen)
Visit WebsiteCustomer Rating:4.5/5
Datamaskering hjälper dig att hålla känslig kundinformation privat. DATPROF är en plattform för testdatahantering som kombinerar datamaskering, delmängder, syntetisk datagenerering, PII-identifiering, databasvirtualisering och centraliserad provisionering över relationsdatabaser, NoSQL- och molndatakällor.
Vem passar DATPROF bäst för?
DATPROF passar väl för dataingenjörer och databasadministratörer på medelstora till stora företag som hanterar komplexa miljöer med flera databaser, där referensintegritet och efterlevnad av regelverk inte är förhandlingsbara.
Varför jag valde DATPROF
Jag valde DATPROF som en av de bästa lösningarna eftersom licensmodellen, som är oberoende av datavolym, verkligen skiljer den från mängden: licenskostnaden förblir oförändrad oavsett om du maskerar 500 GB eller 100 TB, vilket är viktigt när du skapar en delmängd av en produktionsdatabas, som den på 23 TB som Heineken minskade till 130 GB. Den patenterade identifieringen av främmande nyckel-cykler i DATPROF Subset hanterar komplexa scheman med flera tusen tabeller och bevarar samtidigt referensintegriteten mellan olika system. Kombinera detta med den centraliserade orkestreringen i Runtime-portalen, så kan varje teammedlem tillhandahålla sin egen uppdaterade miljö utan att behöva vänta på en databasadministratör.
Viktiga funktioner i DATPROF
- Deterministisk maskering mellan system: Tillämpar konsekvent maskerade värden för samma indata i flera databaser samtidigt, vilket bevarar referensintegriteten för spårbarhet i hela testflödet.
- Identifiering och profilering av PII: Skannar databaser för att automatiskt identifiera var känsliga data finns, med stöd för anpassade identifieringsregler med reguljära uttryck eller listbaserade uttryck.
- Självbetjäningsportal för provisionering: Gör det möjligt för testare och utvecklare att logga in i DATPROF Runtime och själva uppdatera sina testmiljöer utan att behöva vänta på en databasadministratör.
- Databaskloning med kopiering vid skrivning: DATPROF Virtualize startar virtuella databasmiljöer i full storlek utan att förbruka extra lagringsutrymme, och återställning av ögonblicksbilder slutförs på mindre än 20 sekunder.
DATPROF-integrationer
DATPROF stöder CI/CD-integrationer med Jenkins, Azure DevOps, GitLab och Bamboo, samt integrationer för testautomatisering med Parasoft och Tosca. Dess REST API stöder anpassade integrationer, och listningar på marknadsplatser finns via Azure Marketplace och AWS Marketplace.
Pros and Cons
Pros:
- Maskering bevarar referensintegriteten mellan databaser
- Delmängder minskar effektivt omfattande produktionsdataset
- Rollbaserad webbportal för självbetjäningsuppdatering
Cons:
- Begränsat inbyggt stöd för SaaS-datakällor
- Ingen stordator- eller bredare NoSQL-databastäckning
Learn more about DATPROF: Bäst för TDM under hela livscykeln med databaskloning
- Gratis demo tillgänglig
- Pris på begäran

Enov8 ger en överblick över personligt identifierbar information i olika datakällor för ledningen. Enov8 är en plattform för testdatahantering som täcker hela TDM-livscykeln, inklusive AI-driven dataprofilering, maskning, delmängder, syntetisk datagenerering och databasvirtualisering via dess vME-kloningsmotor.
Vem passar Enov8 bäst för?
Enov8 passar bra för DevOps- och QA-team i reglerade branscher som behöver en enda plattform för att hantera maskning, delmängder, syntetiska data och databasvirtualisering tillsammans.
Varför jag valde Enov8
Jag valde Enov8 som ett av de bästa alternativen eftersom det är det enda verktyget på min lista som kombinerar TDM under hela livscykeln med sin vME-databaskloningsmotor, som skapar produktionsrealistiska databaskopior på cirka 40 MB per klon oavsett källans storlek. Jag uppskattar att maskning, delmängder och syntetisk datagenerering alla matas direkt in i virtualiseringslagret, så att klonerna redan är integritetssäkra innan de når en testmiljö.
Viktiga funktioner i Enov8
- AI-driven upptäckt av personligt identifierbar information: En ML-driven profileringsmotor skannar automatiskt anslutna datakällor för att klassificera känsliga fält och flagga kolumner med regulatorisk risk innan maskningen påbörjas.
- Reservationer av testdata: Ett inbyggt bokningssystem låter team reservera och hantera dataset centralt, vilket förhindrar konflikter mellan samtidiga användare och miljöer.
- Valideringsskanning efter maskning: En ML-driven valideringskörning bekräftar maskningens effektivitet efter varje säkerhetsomgång och genererar granskningsklara efterlevnadsunderlag.
- Integrationsnav för DevOps Manager: Ett språkoberoende orkestreringslager som innehåller automatiseringsskript i Python, Bash, Ansible, Java med mera och ansluter Enov8 till CI/CD-pipelines i Jenkins, GitLab CI/CD och Azure DevOps.
Enov8-integrationer
Enov8 stöder över 100 integrationer, däribland Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy och Ansible. Dess REST API, webhooks, schemaläggare och DevOps Manager-stöd möjliggör anpassade CI/CD-arbetsflöden.
Pros and Cons
Pros:
- Databasvirtualisering med små kloner på 40 MB
- AI-driven upptäckt av personligt identifierbar information och validering av maskning
- Central bokning av testdata förhindrar konflikter vid tilldelning
Cons:
- Volymen av offentliga recensioner är relativt begränsad
- Inga intyg om efterlevnad från tredje part anges
Learn more about Enov8: Bäst för maskering av testdata inklusive stordatorer
- Inte tillgängligt
- Prisuppgift på begäran

Broadcom Test Data Manager håller reda på status för importjobb i en och samma vy. Broadcom Test Data Manager är en testdatahanteringsplattform för företag som kombinerar datamaskering, generering av syntetiska data, delmängder, upptäckt av PII, databasvirtualisering och självbetjäningsprovisionering – med särskilt stöd för stordatormiljöer utöver moderna distribuerade databaser och molndatabaser.
Vem passar Broadcom Test Data Manager bäst för?
Stora företag som kör stordatormiljöer parallellt med moderna distribuerade system får störst nytta av den här plattformen.
Varför jag valde Broadcom Test Data Manager
Jag har inkluderat Broadcom Test Data Manager bland mina toppval eftersom det är den enda plattform jag har sett som hanterar stordatormiljöer som en förstklassig del parallellt med moderna distribuerade system. Den dedikerade CA TDM for Mainframe-modulen låter dig maskera och skapa delmängder av data i z/OS, VSAM och IMS via samma användargränssnitt som du använder för SQL Server eller Oracle. Den automatiserade PII-värmekartan genomsöker hela stordatorscheman och markerar känsliga fält innan du tillämpar en enda maskeringsregel, vilket minskar det manuella kartläggningsarbete som vanligtvis belastar efterlevnadsteamen.
Viktiga funktioner i Broadcom Test Data Manager
- Självbetjäningsportal för data: En centraliserad katalog där testare kan begära, reservera och frigöra testdata efter behov med hjälp av dynamiska formulär, utan att behöva vänta på databasadministratörer.
- DAVE-databasvirtualisering: En kloningsmotor med kopiering vid skrivning som på några minuter skapar självständiga databaskloner från en delad basavbild med minimalt lagringsutrymme.
- Automatisering av Javelin-arbetsflöden: En inbyggd visuell automatiseringsmotor som samordnar maskerings-, delmängds- och provisioneringsuppgifter och kan utlösas via REST API eller CI/CD-pipelines.
- Bevarande av referensintegritet: Maskerings- och delmängdsåtgärder bevarar relationer mellan tabeller så att testdatamängder förblir funktionellt sammanhängande för testning från början till slut.
Integrationer med Broadcom Test Data Manager
Dokumenterade integrationer omfattar Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM och CA Agile Central. REST API:er stöder anpassade CI/CD-arbetsflöden, medan Docker och Kubernetes stöder containeriserade distributioner.
Pros and Cons
Pros:
- Maskering av testdata inklusive stordatorer
- Automatiserad upptäckt av PII och värmekartor
- Databasvirtualisering med kopiering vid skrivning (DAVE)
Cons:
- Det finns inget tillgängligt SaaS-distributionsalternativ
- Användargränssnittet känns föråldrat och komplext
Learn more about Broadcom Test Data Manager: Bäst för företag med komplexa miljöer
- 30 dagars kostnadsfri provperiod tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.5/5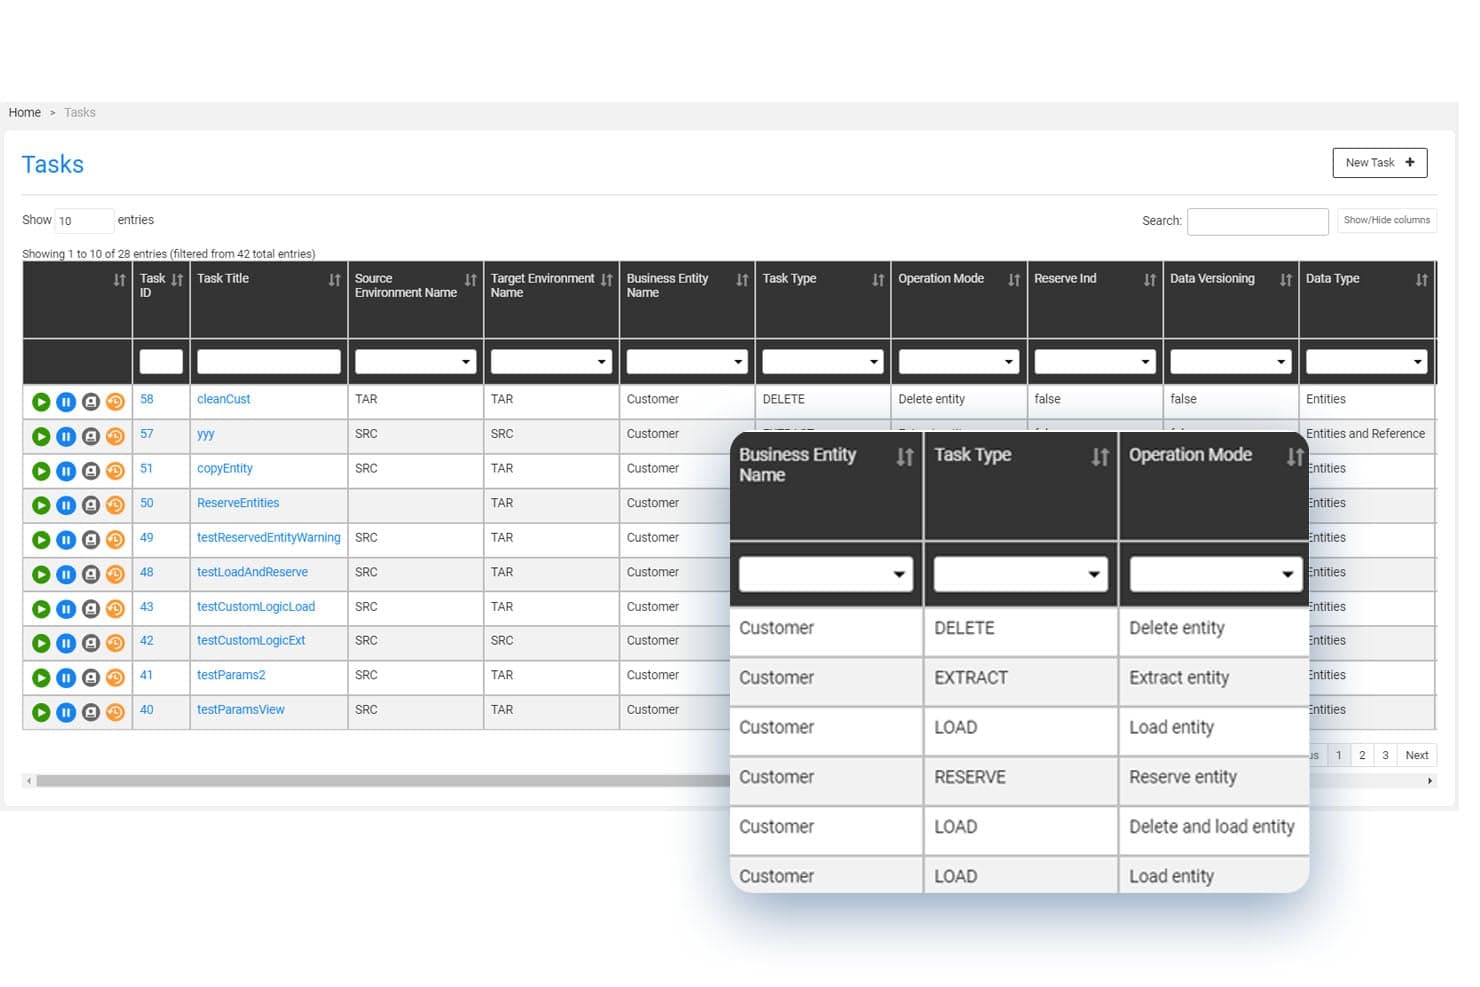
K2View för testdatahantering låter användare hantera och filtrera datauppgifter efter typ och åtgärdsläge. K2View för testdatahantering är en företagsplattform för TDM som förenar datamaskering, syntetisk datagenerering, delmängdsurval och självbetjäningsprovisionering över relationella datakällor, NoSQL-, stordator- och molndatakällor genom en patenterad mikrodatabas™-arkitektur.
Vem passar K2View för testdatahantering bäst för?
K2View är byggt för stora företag som hanterar testdata över blandade miljöer – stordatorer, moln, NoSQL och relationella datakällor – samtidigt.
Varför jag valde K2View för testdatahantering
K2View tar plats på min kortlista eftersom den patenterade mikrodatabas™-arkitekturen löser ett problem som de flesta TDM-verktyg undviker: att upprätthålla referentiell integritet över stordator-, NoSQL- och molnkällor samtidigt. Jag är särskilt imponerad av maskering under överföring, vilket innebär att PII maskeras vid extraktionspunkten och aldrig hamnar omaskerad i en testmiljö. Det entitetscentrerade delmängdsurvalet gör att team kan hämta en fullständig kundpost som sträcker sig över Oracle, Kafka och MongoDB i en enda åtgärd, utan manuella kopplingsregler.
Viktiga funktioner i K2View för testdatahantering
- Självbetjäningsportal för TDM: Ett webbaserat gränssnitt som låter testare begära, reservera och återställa testdata utan att involvera data- eller DBA-team.
- Ögonblicksbild och återställning med tidsmaskin: Sparar specifika testdatatillstånd när som helst, så att testare direkt kan återställa miljöer till en känd konfiguration.
- Automatiserad upptäckt av PII: Inbyggda klassificerare skannar alla anslutna källor, märker känsliga fält och rekommenderar eller tillämpar automatiskt maskeringsprinciper.
- Agentbaserad TDM: En AI-driven funktion som läser testfall och självständigt sammanställer kompatibla datamängder som är klara för provisionering, utan manuell konfiguration.
Integrationer med K2View för testdatahantering
K2View erbjuder inbyggda anslutningar för Oracle, SQL Server, PostgreSQL, DB2, MongoDB, Snowflake, Salesforce, Amazon S3, Kafka och stordatorsystem. REST-, JDBC- och ODBC-anslutning stöder anpassade integrationer och CI/CD-arbetsflöden med Jenkins, GitHub Actions och Azure DevOps.
Pros and Cons
Pros:
- Maskering under överföring förhindrar exponering av omaskerad PII
- Entitetscentrerat delmängdsurval sträcker sig över stordatorer och moln
- Automatiserad upptäckt av PII är inbyggd i plattformen
Cons:
- Inte utformad för små team
- API-baserad CI/CD-integration kräver konfiguration
Learn more about K2View Test Data Management: Bäst delmängdsurval mellan databaser i reglerade branscher
- Gratis demonstration tillgänglig
- Pris på begäran

IBM InfoSphere Optim hjälper dig att snabbt skapa testdata. IBM Test Data Management är en lösning för hantering av testdata i företag som omfattar datamaskering, delmängdsurval mellan databaser och tillhandahållande av data vid behov från ett stort antal relations- och stordatakällor.
Vem passar IBM Test Data Management bäst för?
IBM Test Data Management passar särskilt bra för stora företag i reglerade branscher – finansiella tjänster, hälso- och sjukvård samt försäkring – som använder komplexa miljöer med flera databaser eller stordatorer och där datamaskering och delmängdsurval mellan databaser krävs för efterlevnad.
Varför jag valde IBM Test Data Management
IBM Test Data Management finns med på min kortlista tack vare hur lösningen hanterar delmängdsurval mellan databaser på affärsobjektsnivå och samtidigt hämtar referensintegritetsbevarade delmängder från flera anslutna databaser. Jag är särskilt imponerad av funktionen för federerad extrahering, som gör det möjligt för team att arbeta över heterogena datalandskap, inklusive stordatakällor som VSAM och IMS, där nästan inget konkurrerande verktyg fungerar. De över 40 fördefinierade maskeringsreglerna med formatbevarande utdata gör lösningen verkligt användbar i miljöer som regleras av GDPR och HIPAA.
Viktiga funktioner i IBM Test Data Management
- Integration med Governance Catalog: Dra och släpp regler för dataklassificering direkt på kolumnmappningar för att automatiskt tilldela maskeringsrutiner från en central policykatalog.
- Apache Spark-körmiljö: En inbäddad Spark-motor hanterar storskalig databearbetning i automatiserade arbetsflöden för delmängdsurval och maskering.
- Rollbaserad åtkomstkontroll: Rollbaserad åtkomstkontroll med Keycloak, LDAP-, SAML-, OIDC- och Kerberos-stöd styr vem som får åtkomst till, begära och uppdatera testdatauppsättningar.
- Efterlevnadsrapportering: Inbyggd rapportering validerar att dataskyddspolicyer efterlevs i miljöer som regleras av GDPR och HIPAA.
Integrationer med IBM Test Data Management
Dokumenterade integrationer omfattar IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark samt databaser som Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza och begränsat stöd för MongoDB. Dess REST API enligt OpenAPI 2.0 stöder anpassad orkestrering och CI/CD-arbetsflöden, medan z/OS-utgåvan ansluter till VSAM och IMS.
Pros and Cons
Pros:
- Bevarar referensintegriteten mellan databaser
- Formatbevarande maskering stöder reglerade data
- Hanterar delmängder från VSAM och IMS
Cons:
- Ingen inbyggd generering av syntetiska data
- Fysiska kopior ersätter virtuell kloning
Learn more about IBM Test Data Management: Bäst för maskering i pipelines med flera databaser
- Gratis demo tillgänglig
- Prisuppgift på begäran

Tonic.ai låter användare hantera maskeringsregler för data i databastabeller. Tonic.ai är en plattform för hantering av testdata som omfattar maskering och delmängdsurval av strukturerade data, redigering av ostrukturerade data och helt syntetisk datagenerering i relationsdatabaser, NoSQL-lager och molnbaserade datalager.
Vem passar Tonic.ai bäst för?
Tonic.ai passar mycket bra för dataingenjörer och databasadministratörer som hanterar testdata i komplexa miljöer med flera databaser, inklusive relationsdatabaser, NoSQL-lager och molnbaserade datalager.
Varför jag valde Tonic.ai
Jag valde Tonic.ai som en av de bästa lösningarna eftersom dess deterministiska maskeringsmotor tillämpar konsekventa maskerade värden för samma indata i PostgreSQL, MongoDB, Snowflake och alla andra källor i din pipeline samtidigt. Det innebär att ett kund-ID som maskeras i din relationsdatabas motsvarar samma maskerade värde i ditt datalager och dokumentlager, vilket bevarar kopplingarna mellan systemen. Dess patenterade motor för delmängdsurval förstärker detta genom att extrahera referentiellt sammanhängande delmängder, vilket gjorde det möjligt för eBay att minska en datamängd på 8PB till en ren testmiljö på 1GB utan att bryta några relationer mellan tabeller.
Viktiga funktioner i Tonic.ai
- Automatiserad identifiering av PII/PHI: Genomsöker anslutna datakällor, upptäcker känsliga fält och rekommenderar maskeringstransformeringar utan manuell mappning kolumn för kolumn.
- Tonic Ephemeral: Startar isolerade databaser på begäran i CI/CD-pipelines med direkta DNS-anslutningar och stänger sedan automatiskt ner dem efter testkörningen.
- Identifiering av schemaändringar: Identifierar nya eller ändrade kolumner och kan automatiskt blockera datagenerering för att förhindra oavsiktligt läckage av PII till testmiljöer.
- Förinställningar för generatorer: Gör det möjligt att spara och återanvända namngivna maskerings- och transformeringsregler globalt mellan arbetsytor, så att maskeringspolicyer förblir konsekventa i stor skala.
Tonic.ai-integreringar
Tonic.ai erbjuder en inbyggd integrering med GitHub Actions samt REST API-anslutning för Jenkins och GitLab CI. Plattformen ansluter till PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, DynamoDB, Snowflake, BigQuery, Redshift och Databricks.
Pros and Cons
Pros:
- Patenterad motor för delmängdsurval bevarar referentiell integritet
- Deterministisk maskering över flera databasplattformar
- Automatiserad identifiering av PII med AI-rekommendationer
Cons:
- Inget inbyggt stöd för stordatorer som datakälla
- Den första installationen kan vara komplex för större företag
Learn more about Tonic.ai: Bäst för visuell, täckningsdriven datadesign
- 14 dagars kostnadsfri provperiod
- Pris på begäran

Curiosity Software visualiserar datarelationer med hjälp av ett radiellt partitionsdiagram. Curiosity Software är en plattform för testdatahantering som kombinerar datamaskering, generering av syntetiska data, delmängder, virtualisering och självbetjäningstillhandahållande över fler än 250 källintegrationer – inklusive stordatorsystem som VSAM, IMS och CICS.
Vem passar Curiosity Software bäst för?
Curiosity Software passar företagsinriktade QA-team och dataingenjörer som arbetar i komplexa miljöer med flera datakällor – särskilt de som stöder stordatorsystem eller hanterar efterlevnadsdriven testdata i stor skala.
Varför jag valde Curiosity Software
Jag valde Curiosity Software som en av de bästa lösningarna eftersom dess täckningsdrivna metod för datadesign verkligen skiljer den från mängden. I stället för att manuellt skripta regler för testdata bygger du visuella dataflödesmodeller som kodifierar affärslogik och begränsningar, och plattformen identifierar automatiskt täckningsluckor och genererar syntetiska data för att fylla dem. Jag tycker att verktyget 'Hitta och skapa' är särskilt användbart: det lokaliserar befintliga data som dina tester behöver och genererar riktade syntetiska poster endast där luckor kvarstår, så att du aldrig behöver tillhandahålla för mycket data eller arbeta utan insyn.
Viktiga funktioner i Curiosity Software
- Automatiserad upptäckt av PII: Genomsöker anslutna datakällor för att automatiskt hitta och flagga känsliga fält innan data tillhandahålls i miljöer som inte är i produktion.
- Portal för självbetjäningstillhandahållande: En webbaserad portal låter team begära och tillhandahålla testdata vid behov med hjälp av parameteriserade, återanvändbara jobb utan att involvera testdatateamet.
- Integration med CI/CD-pipelines: Testdatajobb kan utlösas dynamiskt via API i Jenkins, GitLab, GitHub, Azure DevOps och Bitbucket för leverans av data precis när den behövs.
- Grafbaserad datahärkomst: Lagrar spårbarhet och relationsdata mellan källor med Neo4j och skapar visuella representationer av pipelines som synliggör främmande nycklar, kopplingar och övergivna referenser.
Curiosity Software-integrationer
Curiosity Software erbjuder fler än 250 integrationer, inklusive Oracle, SQL Server, Snowflake, Salesforce, VSAM, IMS, Jenkins, GitHub, GitLab och Azure DevOps. Dess API:er stöder anpassade integrationer och CI/CD-utlöst leverans av testdata precis när den behövs i moln-, lokala och hybrida miljöer.
Pros and Cons
Pros:
- Visuell modellbaserad design av testdata
- Maskering och delmängder av stordata ingår
- Automatiserad upptäckt av PII med efterlevnadsdrivna funktioner
Cons:
- Alternativen för delmängder är mindre detaljerat beskrivna i dokumentationen
- Inga publicerade SOC 2- eller ISO 27001-certifieringar
Learn more about Curiosity Software: Bäst för Git-liknande databaskloning för fem databasmotorer
- Gratis demonstration tillgänglig
- Pris på begäran

Redgate SQL Provision låter användare hantera databaskloner över flera SQL-instanser. Redgate SQL Provision är ett verktyg för testdatahantering som omfattar datamaskering, delmängder och Git-liknande databaskloning för SQL Server, PostgreSQL, MySQL, MariaDB och Oracle.
Vem passar Redgate SQL Provision bäst för?
Redgate SQL Provision passar bra för databasadministratörer och QA-ingenjörer som behöver snabb, versionskontrollerad databaskloning och maskering för flera relationsdatabasmotorer.
Varför jag valde Redgate SQL Provision
Jag valde Redgate SQL Provision som ett av de bästa alternativen eftersom dess Git-liknande databaskloning verkligen skiljer sig från allt annat jag har sett för fem databasmotorer. Redgate Clone startar en aktiv databehållare på några sekunder, oavsett databasens storlek, så en SQL Server-databas på 5 TB skapas lika snabbt som en på 128 MB. Du kan skapa grenar, återställa och spara revisioner som i ett Git-arbetsflöde, vilket gör det enkelt att ge varje testare en egen isolerad miljö utan att duplicera lagring.
Viktiga funktioner i Redgate SQL Provision
- Anonymiserings-CLI (
rganonymize): Ett kommandoradsverktyg i tre steg som klassificerar PII-kolumner, mappar maskeringsregler och ersätter verkliga värden i SQL Server, PostgreSQL, MySQL, MariaDB och Oracle. - Deterministisk maskering: Maskerar samma indatavärde till samma utdata varje gång med hjälp av ett fast startvärde, vilket håller maskerade data konsekventa i relaterade tabeller.
- Dataurval: CLI-verktyget
rgsubsethämtar en konfigurerbar del av källdatabasen – som standard 10 % – samtidigt som det följer främmande nycklar för att bevara referentiell integritet. - AI-anpassade datauppsättningar: Låter dig beskriva de värden du behöver på vanligt språk och genererar en granskningsbar lista med upp till 1 000 värden för användning som ersättningsvärden vid maskering.
Integrationer med Redgate SQL Provision
Redgate SQL Provision integreras med SQL Server, PostgreSQL, MySQL, MariaDB, Oracle, Docker, AWS CloudFormation, Azure Kubernetes Service, SQL Data Catalog, PowerShell och dbatools. Dess CLI-verktyg stöder skriptbaserade CI/CD-arbetsflöden, men inbyggda insticksprogram för Jenkins, Azure DevOps och GitHub Actions är inte dokumenterade.
Pros and Cons
Pros:
- Git-liknande förgrening uppdaterar testdatabaser snabbt
- Deterministisk maskering bevarar konsekvens mellan tabeller
- Urval med hänsyn till främmande nycklar skyddar den referentiella integriteten
Cons:
- Generering av syntetiska data begränsas till värdelistor
- Produktens positionering skapar osäkerhet hos köpare
Learn more about Redgate SQL Provision:
Andra verktyg för testdatahantering
Här är några ytterligare alternativ för verktyg för testdatahantering som inte tog sig till min kortlista, men som ändå är värda att ta en titt på:
- 11Perforce DelphixBäst för att virtualisera fullständiga databaskloner från produktionsmiljön
- 12SynthesizedBäst för SAP-inbyggd maskering av testdata
- 13Tricentis ToscaBäst för AI-driven testning
- 14InformaticaBäst för företagstestning
- 15BMC CompuwareBäst för omedelbar testning
- 16Rocket Data ExpressBäst för att spara testresurser
- 17Accelario Continuous DataOps PlatformBäst för CI/CD-utlöst databasvirtualisering
- 18Avo Test Data ManagementBäst för snabb och tillförlitlig generering av testdata
- 19SynthoBäst för integritetsfokuserad generering av syntetiska data
- 20IRI VoracityBäst för gemensam maskering av strukturerade och mörka data
Så utvärderar jag verktyg för testdatahantering
Jag granskar dessa verktyg i två lager: de grundläggande funktionerna – maskning, delmängder och etablering via CI/CD – som ett verktyg måste ha för att kvalificera sig, samt de särskiljande egenskaper som gör ett verktyg mer lämpligt än ett annat.
Grundläggande funktionalitet (minimikrav för denna lista)
När jag väljer ut verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje grundläggande funktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- Datamaskning och anonymisering: Jag kontrollerar om ett verktyg kan maskera PII konsekvent i länkade tabeller – till exempel ersätta riktiga namn i en ordertabell och samtidigt behålla samma maskerade värde i kundtabellen.
- Generering av syntetiska data: Att generera falska men realistiska data som bevarar referensintegriteten är viktigt här, särskilt för team som inte kan använda produktionsdata på grund av integritetsbestämmelser.
- Skapande av delmängder av data: Jag undersöker hur väl ett verktyg kan extrahera ett mindre utsnitt av en produktionsdatabas samtidigt som främmande nyckelrelationer förblir intakta över dussintals eller hundratals relaterade tabeller.
- Stöd för databaser från flera källor: Ett verktyg bör kunna ansluta till de databaser som teamet faktiskt använder – Oracle, PostgreSQL, SQL Server, MongoDB, stordatorskällor och platta filer – utan att anpassade skript krävs för varje källa.
- Etablering av testdata och självbetjäning: Jag utvärderar om QA-ingenjörer och utvecklare själva kan begära, uppdatera eller återställa datauppsättningar via en portal eller ett API, i stället för att skapa ärenden hos en DBA.
- Integration med CI/CD och automatisering: Verktyget bör kunna anslutas till din befintliga pipeline – Jenkins, GitLab CI och Azure DevOps – så att etableringen av data körs automatiskt tillsammans med byggen och testsviter.
När jag har en lista över verktyg som uppfyller kriterierna granskar jag vad som särskiljer varje plattform.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer med varandra:
Utmärkande funktioner
Datavirtualisering är en viktig faktor – jag letar efter verktyg som kan skapa lättviktiga kloner från en enda auktoritativ kopia, så att teamen inte behöver vänta i timmar på nya miljöer. AI-driven dataidentifiering är också viktig, eftersom det är tidskrävande och felkänsligt att manuellt märka PII i hundratals kolumner. Verktyg som automatiskt klassificerar känsliga fält sparar mycket tid när maskningspolicyer konfigureras. Jag kontrollerar också om det finns inbyggd efterlevnadsrapportering med granskningsspår, särskilt för team som omfattas av GDPR- eller HIPAA-granskningar, där det är avgörande att kunna bevisa att data maskades korrekt innan den nådde en testmiljö.
Utöver funktionerna
Distributionsflexibilitet är något jag alltid utvärderar – om ett verktyg stöder lokal drift, molndrift eller hybrid drift är viktigt när regler för datalagring anger var kopior av produktionsdata får finnas. Säkerhetscertifieringar som SOC 2 Type II och ISO 27001 väger också tungt, eftersom dessa verktyg hanterar känsliga produktionsdata dagligen. Jag kontrollerar även skalbarheten, särskilt hur masknings- och delmängdsjobb presterar mot databaser på terabyteskala med komplexa scheman. Ett verktyg som fungerar bra med ett utvecklingsurval men får problem i stagingmiljön håller inte måttet för företagskunder.
Så väljer du ett verktyg för testdatahantering
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du går igenom din unika process för programvaruval följer här en checklista över faktorer att tänka på:
| Faktor | Att tänka på |
|---|---|
| FaktorSkalbarhet | Att tänka påKommer verktyget att växa med ditt team? Ta hänsyn till framtida datamängder och användartillväxt. Leta efter flexibla abonnemang som kan hantera skalning utan betydande kostnadsökningar. |
| FaktorIntegrationer | Att tänka påFungerar det med dina befintliga system? Kontrollera kompatibiliteten med dina nuvarande testverktyg, databaser och arbetsflöden för att undvika störningar. |
| FaktorAnpassningsbarhet | Att tänka påKan du anpassa verktyget efter dina behov? Utvärdera om verktyget tillåter anpassade datamallar och arbetsflöden som passar dina processer. |
| FaktorAnvändarvänlighet | Att tänka påÄr det användarvänligt för ditt team? Ta hänsyn till inlärningskurvan och om icke-teknisk personal enkelt kan navigera i verktyget utan omfattande utbildning. |
| FaktorImplementering och introduktion | Att tänka påHur snabbt kan du komma igång? Leta efter verktyg som erbjuder snabb konfigurering, utbildningsresurser och support för att säkerställa en smidig övergång. |
| FaktorKostnad | Att tänka påRyms det inom din budget? Jämför prismodeller och se till att det inte finns några dolda avgifter. Kontrollera om det finns en kostnadsfri provperiod eller demonstration som du kan testa innan du bestämmer dig. |
| FaktorSäkerhetsskydd | Att tänka påHur skyddar det dina data? Se till att verktyget följer standarder för datasäkerhet och erbjuder kryptering samt åtkomstkontroller för att skydda känslig information. |
| FaktorEfterlevnadskrav | Att tänka påUppfyller det regulatoriska krav? Kontrollera om verktyget stöder efterlevnad av relevanta dataskyddsbestämmelser som GDPR eller HIPAA, beroende på kraven inom din bransch. |
Vad är verktyg för testdatahantering?
Verktyg för testdatahantering är programvara som används för att generera, hantera och underhålla data för programvarutestning. De hanterar skapandet och bearbetningen av testdata och säkerställer att den är korrekt, säker och lämplig för en mängd olika testscenarier.
Dessa verktyg spelar en viktig roll när det gäller att organisera och tillhandahålla data för funktionstester, prestandatester och regressionstester inom programvaruutveckling. De används ofta tillsammans med verktyg för databastestning för att säkerställa omfattande datavalidering.
Funktioner
Håll utkik efter följande viktiga funktioner när du väljer verktyg för testdatahantering:
- Datamaskering: Skyddar känslig information genom att ersätta den med fiktiva data, vilket säkerställer efterlevnad av integritetskrav.
- Dataurval: Extraherar en delmängd av data från stora datamängder, vilket gör testningen mer hanterbar och effektiv.
- Integrationsmöjligheter: Ansluter till befintliga testverktyg och databaser, vilket underlättar smidiga arbetsflöden.
- Anpassade datamallar: Gör det möjligt för användare att skapa mallar som är anpassade efter deras specifika testbehov, vilket ökar flexibiliteten.
- AI-baserad datagenerering: Använder artificiell intelligens för att generera realistiska testdata, vilket förbättrar testernas noggrannhet.
- Datatillhandahållande i realtid: Ger omedelbar åtkomst till nödvändiga testdata, vilket minskar förseningar i testprocessen.
- Stöd för flera moln: Gör det möjligt för verktyget att fungera i olika molnmiljöer och ger flexibilitet vid driftsättning.
- Kryptering och åtkomstkontroller: Säkerställer datasäkerheten genom att kryptera data och ange användarbehörigheter.
- Utbildningsresurser: Erbjuder handledningar, webbseminarier och annat utbildningsmaterial som stöd för introduktion av användare och införande av verktyget.
- Stöd för regelefterlevnad: Bidrar till att säkerställa att datahanteringen uppfyller branschstandarder och bestämmelser som GDPR eller HIPAA.
Fördelar
Att implementera verktyg för testdatahantering ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Förbättrad dataintegritet: Funktioner för datamaskering hjälper till att skydda känslig information och säkerställer efterlevnad av integritetsbestämmelser.
- Effektivare testning: Datatillhandahållande i realtid minskar förseningar och möjliggör snabbare testcykler.
- Högre datanoggrannhet: AI-baserad datagenerering skapar realistiska testdata, vilket ökar testresultatens tillförlitlighet.
- Kostnadsbesparingar: Dataurval extraherar endast nödvändiga data, vilket minskar kostnaderna för lagring och bearbetning.
- Flexibilitet vid driftsättning: Stöd för flera moln gör det möjligt för verktyget att fungera i olika miljöer och anpassa sig efter dina infrastrukturbehov.
- Användarvänlig introduktion: Tillgång till utbildningsresurser och handledningar underlättar ett snabbt införande och effektiv användning av verktyget.
- Regelefterlevnad: Funktioner för stöd vid regelefterlevnad hjälper till att uppfylla branschstandarder och minskar risken för juridiska problem.
Kostnader och priser
För att välja verktyg för testdatahantering krävs en förståelse för de olika prismodellerna och abonnemangen som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för testdatahantering:
Jämförelsetabell för abonnemang för verktyg för testdatahantering
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| AbonnemangstypGratisabonnemang | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande datamaskering, begränsat dataurval och begränsade integrationsmöjligheter. |
| AbonnemangstypPersonligt abonnemang | Genomsnittligt pris$5-$25/användare/månad | Vanliga funktionerFörbättrad dataintegritet, AI-baserad datagenerering och grundläggande support. |
| AbonnemangstypFöretagsabonnemang | Genomsnittligt pris$30-$75/användare/månad | Vanliga funktionerAvancerat dataurval, stöd för flera moln och tillgång till utbildningsresurser. |
| AbonnemangstypFöretagsabonnemang | Genomsnittligt pris$100+/användare/månad | Vanliga funktionerAnpassade datamallar, omfattande stöd för regelefterlevnad, premiumkundsupport och fullständiga integrationsmöjligheter. |
Vanliga frågor om verktyg för testdatahantering
Här är några svar på vanliga frågor om verktyg för testdatahantering:
Bör du välja funktioner för maskning eller syntetiska data?
Maskning skyddar verkliga data genom att dölja personuppgifter. Programvara som genererar syntetiska data skapar falska men realistiska datamängder. Välj maskning om du använder produktionsdata, och syntetiska data om du vill ha säkrare, helt genererade testuppsättningar.
Om du fortfarande befinner dig i fasen “behöver samla in mer testdata” kan du prova: 10 bästa verktygen för användbarhetstestning för verklig användarfeedback.
Varför är datasäkerhet viktigt i TDM-verktyg?
TDM-programvara hanterar ofta känsliga produktionsdata. Utan korrekt maskning eller kryptering riskerar du dataläckor eller efterlevnadsproblem. Välj alltid ett verktyg som stöder kryptering, anonymisering och åtkomstkontroller.
Vilka integrationer bör ett TDM-verktyg stödja?
Det bör fungera med dina CI/CD-verktyg, till exempel Jenkins, GitLab eller Azure DevOps. Integration med större databaser (Oracle, SQL Server, PostgreSQL) och molnplattformar är också avgörande för smidig automatisering.
Hur testar man ett TDM-verktyg innan man köper det?
Genomför ett mindre koncepttest. Prova att klona, maskera och uppdatera data i din verkliga miljö. Se hur snabbt det körs och om det passar in i ditt befintliga arbetsflöde.
Hur kan TDM-verktyg hjälpa till med efterlevnad?
Bra verktyg spårar varje dataändring, sparar revisionsloggar och säkerställer att maskerade data förblir konsekventa. Detta hjälper ditt team att följa regler som GDPR, HIPAA eller CCPA.