

Verktyg för webbskrapning är applikationer som automatiserar insamlingen av data från webbplatser, vilket gör det enkelt att samla in information utan manuell kopiering och inklistring. Om du letar efter de bästa verktygen för webbskrapning behöver du förmodligen samla in stora mängder webbdata på ett tillförlitligt sätt – utan att stöta på hinder som antibot-skydd eller föränderliga webbplatsstrukturer.
Med så många alternativ på marknaden är det svårt att veta vilket verktyg som faktiskt passar din teknikstack, kan hantera dina målwebbplatser och skalas efter dina behov. Den här guiden går igenom de främsta verktygen så att du kan jämföra funktioner och tillvägagångssätt och hitta exakt det som fungerar för dina IT-projekt.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell: verktyg för webbskrapning
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av verktyg för webbskrapning.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för inbyggd kontroll av webbläsare utan grafiskt gränssnitt | Gratisabonnemang tillgängligt | Från 30 USD/månad | Website | |
| 2 | Bäst för diskret skrapning och kringgående av upptäckt | 14 dagars kostnadsfri provperiod | Från $69/månad | Website | |
| 3 | Bäst för hantering av dynamiska JavaScript-webbplatser | Gratisplan tillgänglig | Från $189/månad | Website | |
| 4 | Bäst för direkt integrering i datapipelines | 30 dagars kostnadsfri provperiod | Från $199/månad (faktureras årsvis) | Website | |
| 5 | Bäst för mallar för automatisering med färdigbyggda robotar | Gratisabonnemang tillgängligt | Från 19 USD/månad (faktureras årligen) | Website | |
| 6 | Bäst för hanterad datainsamling som kringgår bottar | Gratis provperiod tillgänglig | Från $0.5/1 000 poster | Website | |
| 7 | Bäst för proxyinfrastruktur i företagsskala | Gratisabonnemang tillgängligt | Från $1.5/1,000 poster/månad | Website | |
| 8 | Bäst för automatisk identifiering av datascheman | 30 dagars kostnadsfri provperiod | Från $0.13/1 000 förfrågningar | Website | |
| 9 | Bäst för enkla API-drivna skrapningsarbetsflöden | Gratisabonnemang tillgängligt | Från $49/månad | Website | |
| 10 | Bäst för problemfri IP-rotation i stor skala | 7 dagars kostnadsfri provperiod | Från $49/månad | Website |


Recensioner av de bästa verktygen för webbskrapning
Nedan följer mina detaljerade sammanfattningar av de bästa verktygen för webbskrapning som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över funktionerna, integrationerna och de bästa användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
 Bäst för inbyggd kontroll av webbläsare utan grafiskt gränssnitt
- Gratisabonnemang tillgängligt
- Från 30 USD/månad
Visit WebsiteCustomer Rating:4.9/5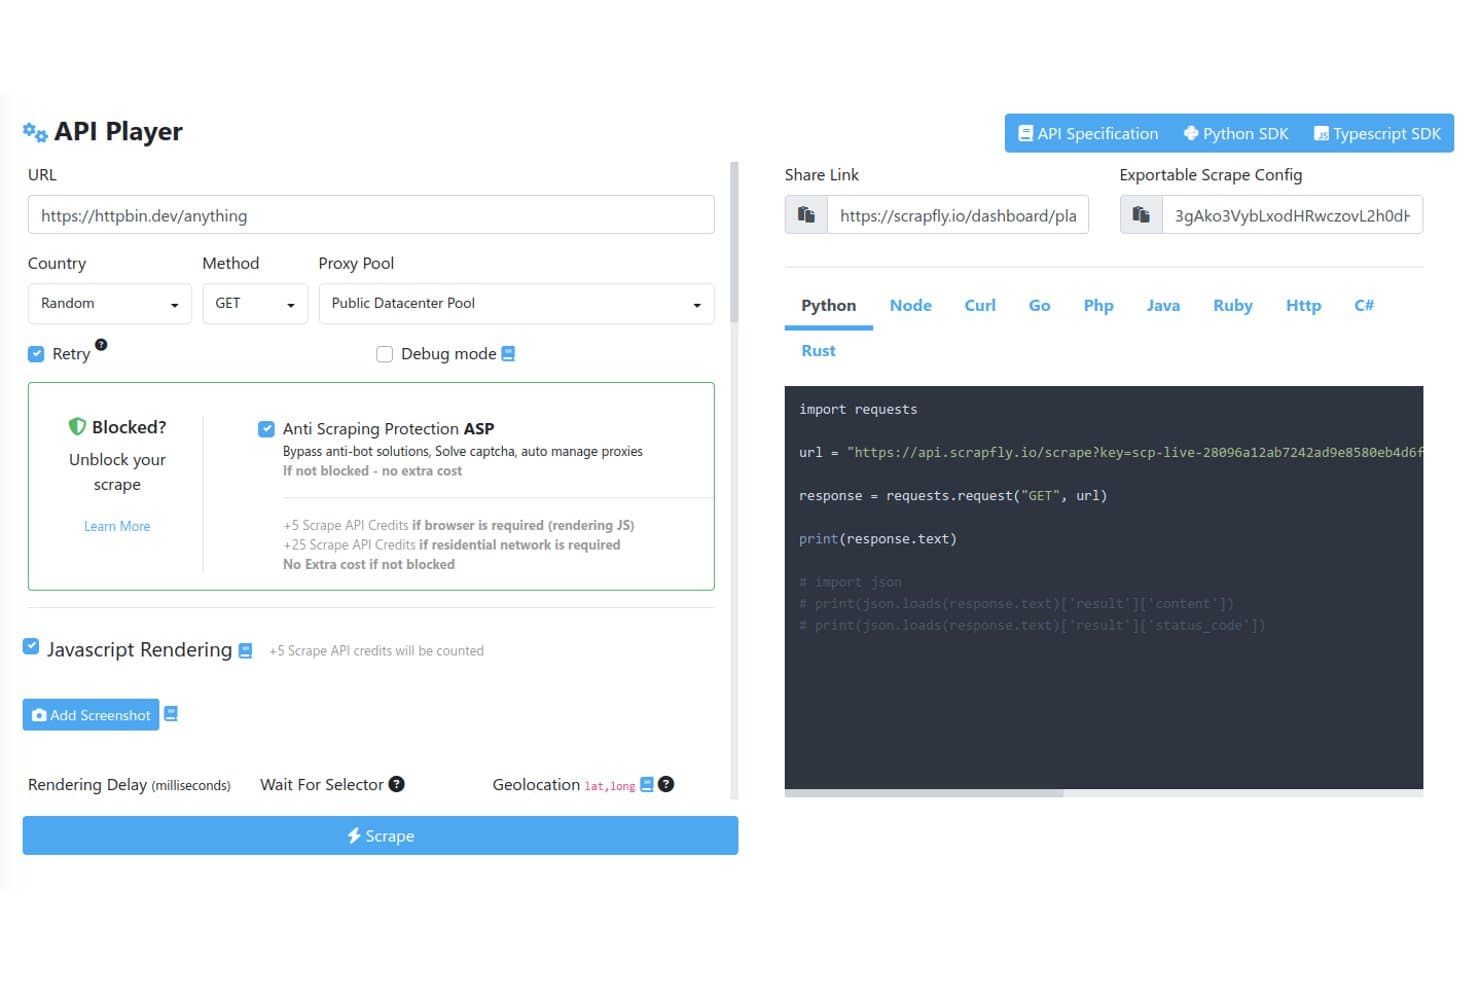
Scrapfly erbjuder en interaktiv API-spelare med konfigurerbara skrapningsalternativ, inklusive proxypooler, kringgående av skydd mot webbskrapning, JavaScript-rendering och automatiskt genererade kodexempel på flera språk. Scrapfly är ett API för webbskrapning som kombinerar proxyrotation, kringgående av antibotsskydd, rendering i en webbläsare utan grafiskt gränssnitt, webbplatsgenomsökning, skärmdumpstagning och LLM-baserad dataextrahering under samma API-nyckel.
Vem passar Scrapfly bäst för?
Scrapfly passar bra för utvecklare och dataingenjörer som vill ha ett kodbaserat API för webbskrapning med SDK:er i Python, TypeScript, Go och Rust.
Varför jag valde Scrapfly
Jag valde Scrapfly eftersom dess webbläsararkitektur med två motorer skiljer sig från allt annat jag har testat. Curlium hanterar pixelperfekt Chrome JA4-fingeravtryck för hög hastighet, medan Scrapium kör Chromium i smygläge över CDP med matchande fingeravtryck, så att sessioner kan byta motor mitt under en genomsökning utan att utlösa upptäckt. Jag uppskattar också att Scrapium är fullt kompatibelt med Playwright och Puppeteer, vilket innebär att jag kan skriva anpassade JS-scenarier och regler för när väntan ska avslutas utan att behöva ändra min befintliga kod för webbläsarautomatisering.
Viktiga funktioner i Scrapfly
- API för extrahering med flera metoder: Extraherar strukturerade data med CSS, XPath, reguljära uttryck, JSON-scheman och LLM-baserade mallar.
- Integrerade proxypooler: Tillhandahåller hanterade proxyservrar i datacenter och bostadsnätverk med geografisk inriktning samt stöd för egna proxyservrar.
- API för genomsökning: Genomsöker hela webbplatser med kontroll över genomsökningsdjup, hastighetsbegränsningar och projektpartitionering.
- Integreringar för inbyggd schemaläggning: Har stöd för Zapier, Make och n8n för automatiserade arbetsflöden, återkommande jobb och webhook-utlösare.
Integreringar med Scrapfly
Scrapfly erbjuder inbyggda integreringar med Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI och OpenClaw. Det tillhandahåller även SDK:er för Python, TypeScript, Go och Rust. Ett API finns tillgängligt för anpassade integreringar.
Pros and Cons
Pros:
- Två webbläsarmotorer i smygläge
- Kringgår Cloudflare, DataDome och Imperva
- Extraheringsmallar för vanliga webbplatstyper
Cons:
- Ingen inbyggd schemaläggare för jobb i produkten
- Inte lämpligt för icke-tekniska användare
Learn more about Scrapfly: Bäst för diskret skrapning och kringgående av upptäckt
- 14 dagars kostnadsfri provperiod
- Från $69/månad
Visit WebsiteCustomer Rating:4.7/5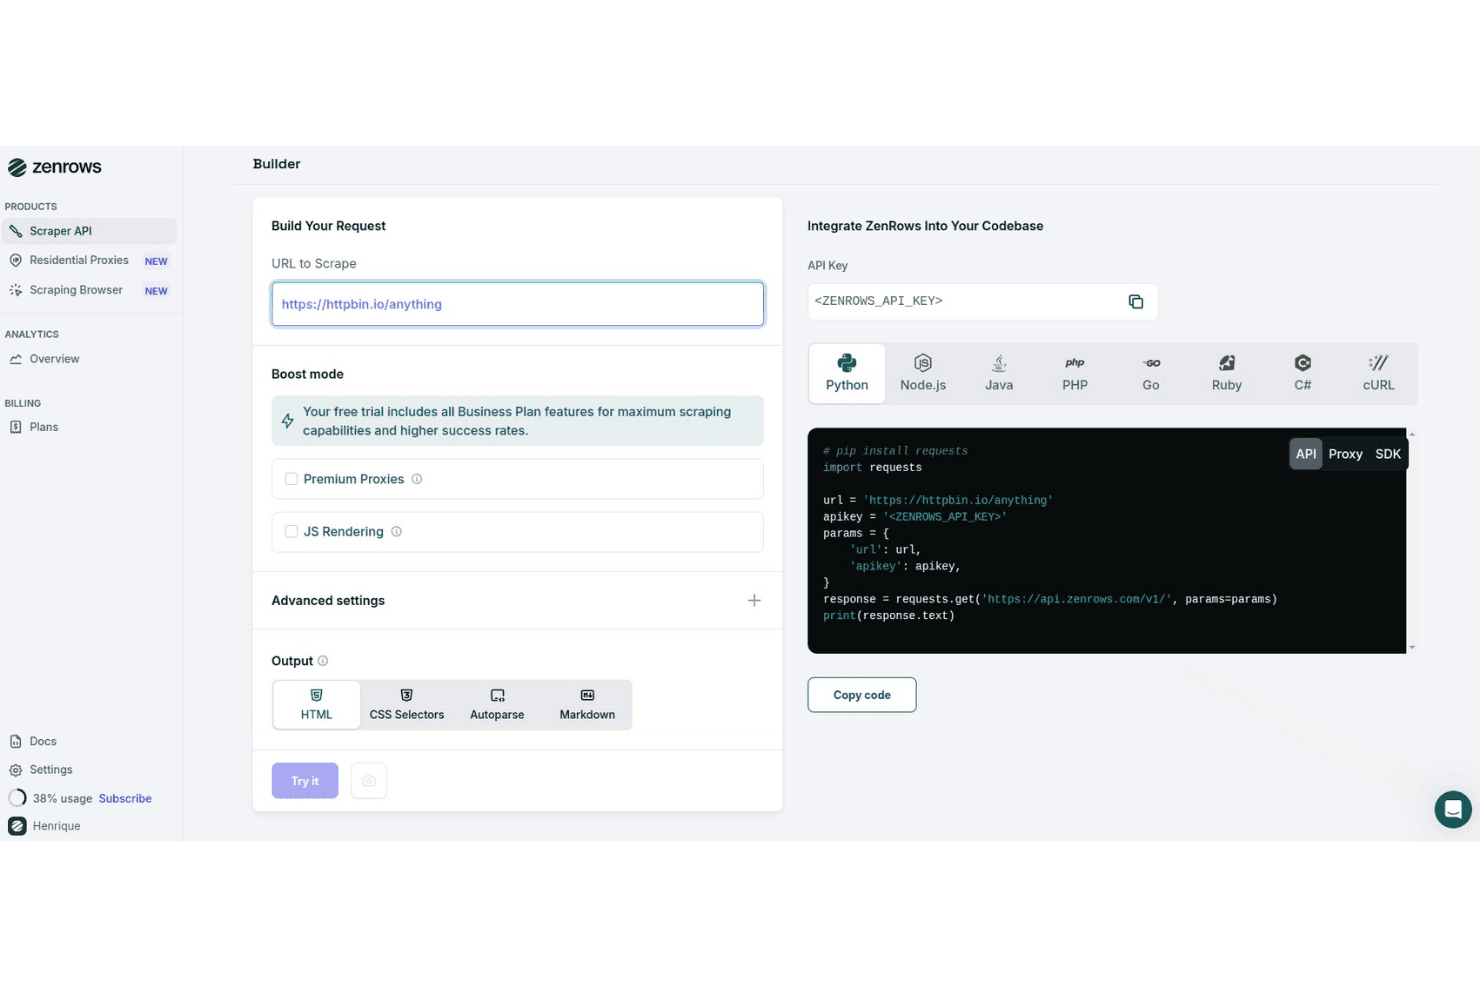
ZenRows erbjuder en visuell verktygsbyggare för förfrågningar med kodgenerering på flera språk, alternativ för förstärkningsläge och val av resultatformat för webbskrapning. ZenRows är ett API för webbskrapning och en molnwebbläsarplattform som kombinerar kringgående av antibotsskydd, rotation av proxyservrar för privatanslutningar, JavaScript-rendering och extrahering av strukturerade data i ett enda verktyg för utvecklare.
Vem passar ZenRows bäst för?
ZenRows passar utmärkt för utvecklare och dataingenjörer som behöver skrapa webbplatser med aggressivt antibotsskydd i stor skala.
Varför jag valde ZenRows
ZenRows finns med på min kortlista tack vare hur väl tjänsten hanterar antibotsskydd. Jag har skrapat Cloudflare-skyddade webbplatser där standardverktyg konsekvent misslyckas, och ZenRows tar sig igenom med hjälp av kringgående av webbläsaravtryck och automatisk CAPTCHA-lösning utan någon manuell konfiguration. Webbläsaren för skrapning går ännu längre genom att köra fullständiga Chromium-sessioner med diskreta HTTP-huvuden som nära efterliknar verkligt användarbeteende för att undvika upptäckt på webbplatser som använder DataDome eller PerimeterX.
ZenRows viktigaste funktioner
- Universellt skrapnings-API: Skicka förfrågningar via en enda slutpunkt som anpassar sig till olika webbplatsstrukturer och skrapningskrav.
- Proxyinfrastruktur med IP-adresser från privatanslutningar: Välj bland över 55 miljoner IP-adresser från privatanslutningar i fler än 185 länder för geografiskt riktad insamling.
- Automatisk tolkning för strukturerade resultat: Extrahera och ta emot data automatiskt i JSON-, HTML- eller Markdown-format med inbyggd tolkning för populära webbplatser.
- SDK:er för flera språk: Använd officiella SDK:er för Python, Node.js, Go, PHP, Ruby, Java och C# för integrering i utvecklingsarbetsflöden.
ZenRows integrationer
ZenRows erbjuder inbyggda integrationer med Playwright, Puppeteer, n8n, Make, Clay och Zapier. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Kringgår Cloudflare och DataDome på ett tillförlitligt sätt
- Hög lyckandefrekvens på skyddade sidor
- Fullständiga webbläsarsessioner utan gränssnitt i diskret läge
Cons:
- Ingen inbyggd schemaläggning eller jobborkestrering
- Kostnaderna ökar snabbt vid stora volymer av förfrågningar
Learn more about ZenRows: Bäst för hantering av dynamiska JavaScript-webbplatser
- Gratisplan tillgänglig
- Från $189/månad
Visit WebsiteCustomer Rating:4.4/5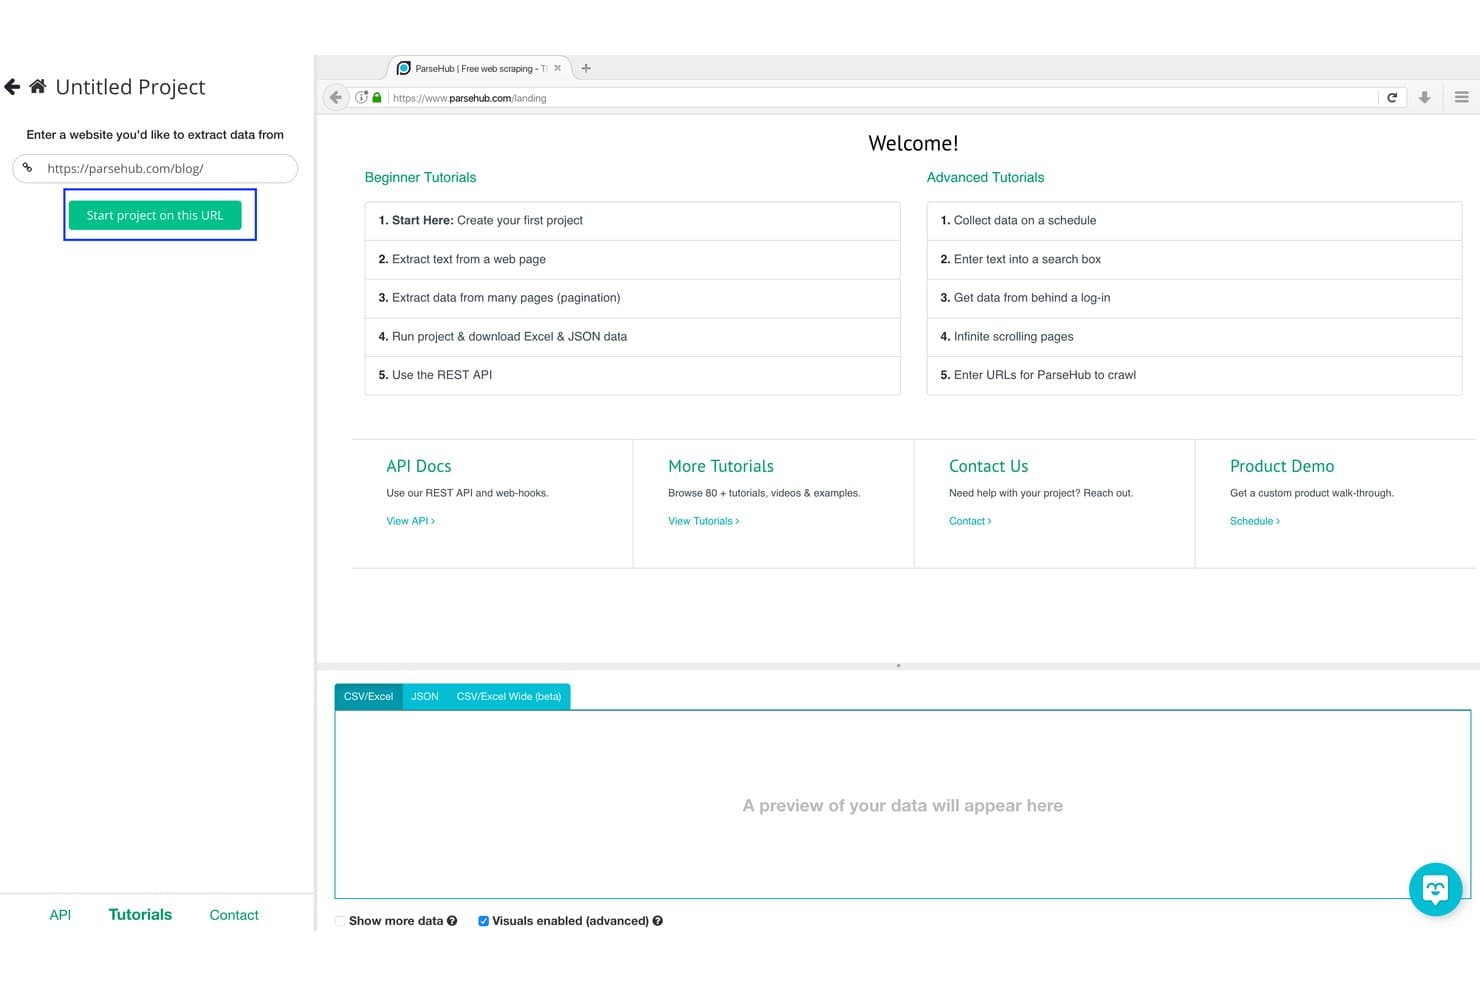
ParseHub erbjuder ett visuellt gränssnitt för projektkonfiguration där användare anger en URL och klickar på 'Starta projekt på den här URL:en' för att börja skrapa data från webbplatser. ParseHub är ett visuellt verktyg för webbskrapning som extraherar data från dynamiska webbplatser med hjälp av ett klickbaserat gränssnitt, med stöd för JavaScript, AJAX, oändlig rullning, formulärfält och schemalagda molnbaserade körningar.
Vem passar ParseHub bäst för?
ParseHub passar bra för analytiker inom konkurrensanalys och icke-tekniska forskare som behöver samla in data från JavaScript-tunga webbplatser utan att skriva kod.
Varför jag valde ParseHub
ParseHub förtjänar sin plats som ett av de bästa verktygen på min kortlista eftersom det hanterar de utmaningar med JavaScript-rendering som gör att de flesta kodfria skrapverktyg misslyckas. Jag har använt det för att extrahera data från sidor med oändlig rullning och innehåll som utlöses av rullgardinsmenyer, där skrapverktyg för statisk HTML returnerar tomma resultat. Dess maskininlärningsmotor identifierar sidstrukturen automatiskt, vilket innebär att jag kan bygga ett fungerande skrapverktyg för en AJAX-tung produktkatalog utan att skriva en enda rad XPath.
Viktiga funktioner i ParseHub
- Visuell byggare med peka-och-klicka: Välj och extrahera sidelement utan att manuellt koda väljare.
- Molnbaserad schemaläggning: Schemalägg återkommande skrapningsuppgifter på ParseHubs molninfrastruktur.
- REST API-åtkomst: Hantera, utlösa och ladda ner skrapresultat programmatiskt med hjälp av API:et.
- Automatisk IP-rotation: Minska blockering genom att rotera utgående IP-adresser vid molnbaserade körningar.
ParseHub-integreringar
ParseHub erbjuder inbyggda integreringar med Google Sheets, Tableau, Dropbox och AWS S3. Ett API finns tillgängligt för anpassade integreringar och automatisering av arbetsflöden.
Pros and Cons
Pros:
- Hanterar JavaScript, AJAX och oändlig rullning inbyggt
- Den visuella byggaren kräver ingen kodning av väljare
- Skrapningar körs automatiskt på molninfrastruktur
Cons:
- Har begränsningar för stora samtidiga skrapningsjobb
- Ingen inbyggd CAPTCHA-lösning
Learn more about ParseHub: Bäst för direkt integrering i datapipelines
- 30 dagars kostnadsfri provperiod
- Från $199/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.2/5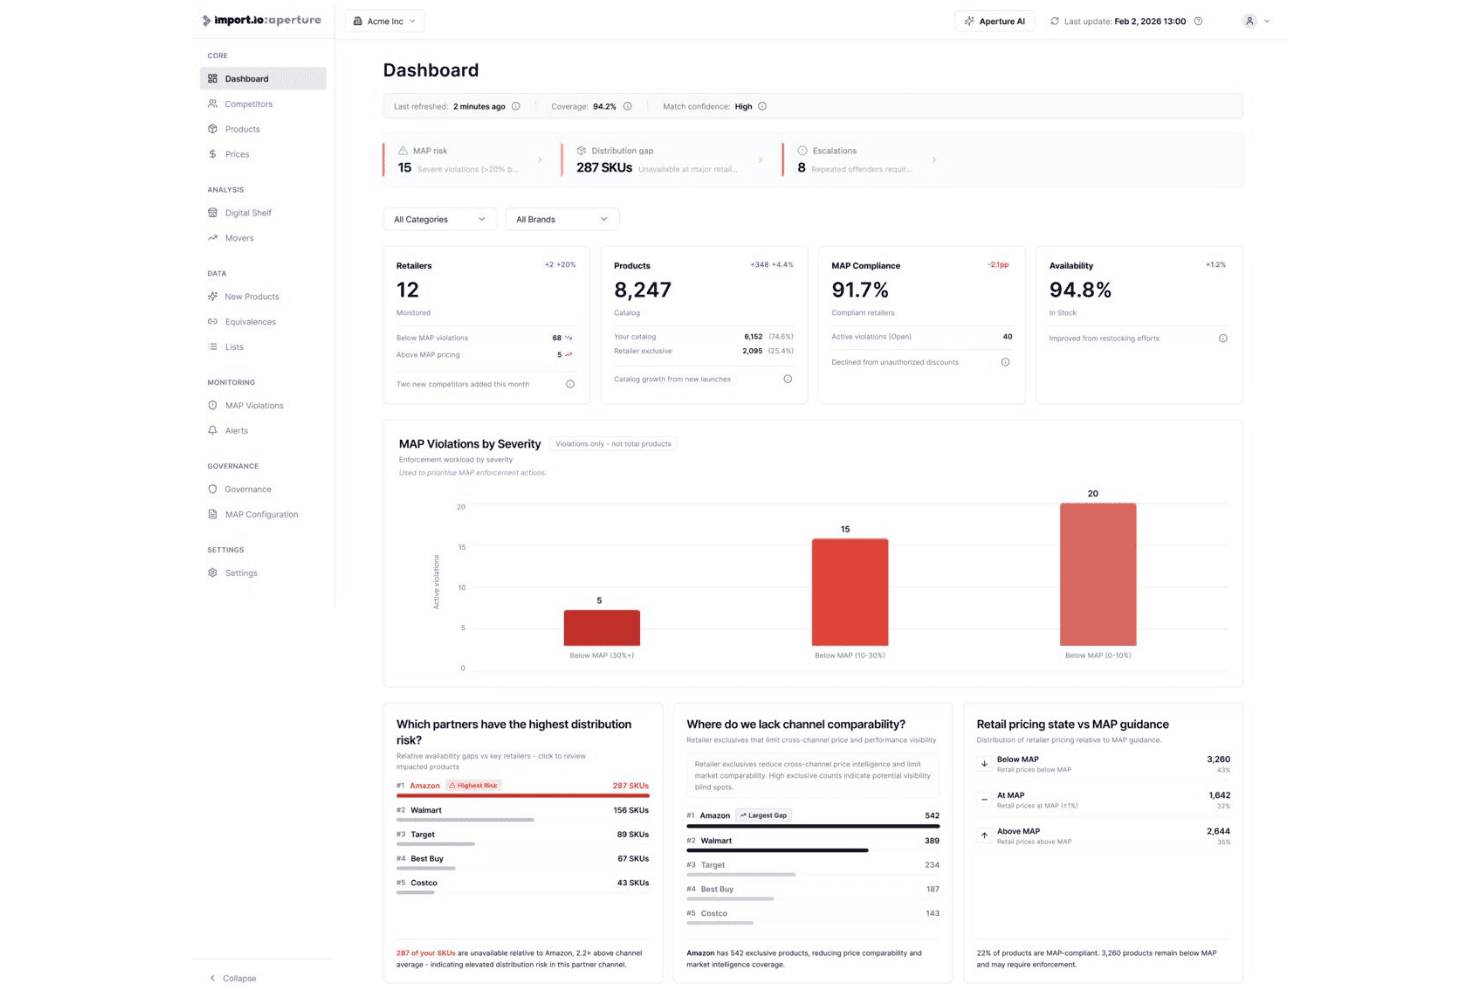
Import.io:s Aperture-plattform erbjuder en instrumentpanel som visar MAP-efterlevnad, produkttillgänglighet, luckor i återförsäljardistributionen och prisöverträdelser. Import.io är en AI-integrerad, hanterad plattform för webbskrapning som extraherar strukturerade data från webbplatser i företagsskala och hanterar JavaScript-renderade sidor, skyddade källor samt direktleverans till datapipelines och analyssystem.
Vem passar Import.io bäst för?
Import.io passar team inom datateknik och konkurrensanalys på medelstora till stora företag som behöver underhållna datapipelines utan att bygga eller hantera skrapverktyg internt.
Varför jag valde Import.io
Import.io finns med på min kortlista eftersom strukturerade data flyttas direkt från webben till ert datalager, er instrumentpanel eller er API-slutpunkt utan något manuellt exportsteg däremellan. Jag uppskattar att webhookar och API-leverans är inbyggda i plattformen och inte en efterhandslösning. Det jag tycker är mest värdefullt är de självläkande datapipelines: de anpassar sig automatiskt när målwebbplatser ändrar struktur, så att jag inte behöver bygga om extraktorer varje gång en återförsäljare uppdaterar sidlayouten.
Viktiga funktioner i Import.io
- AI-assisterade extraktionsmodeller: Identifierar automatiskt sidstrukturer och anpassar schemat när webbplatser förändras.
- Hantering av företagsproxyer: Stöder premiumproxyer och privatproxyer för skrapning av skyddade eller geografiskt begränsade webbplatser.
- Visuell byggare med peka-och-klicka: Välj och extrahera data från komplexa webbsidor utan att skriva kod.
- Automatisk maskering av personuppgifter: Identifierar och tar bort personligt identifierbar information i skrapade datamängder för regelefterlevnad.
Integrationer med Import.io
Import.io erbjuder inbyggda integrationer med Google Sheets, Power BI, Tableau och Excel samt ett API för anpassade integrationer och webhookar till andra system.
Pros and Cons
Pros:
- Självläkande datapipelines anpassar sig automatiskt till förändringar på webbplatser
- Hanterar starkt skyddade webbplatser och webbplatser med inloggningskrav
- Hanterad extraktion minskar arbetsbelastningen för intern utveckling
Cons:
- Begränsad insyn i den underliggande skrapinfrastrukturen
- Begränsad lämplighet för småskalig skrapning
Learn more about Import.io: Bäst för mallar för automatisering med färdigbyggda robotar
- Gratisabonnemang tillgängligt
- Från 19 USD/månad (faktureras årligen)
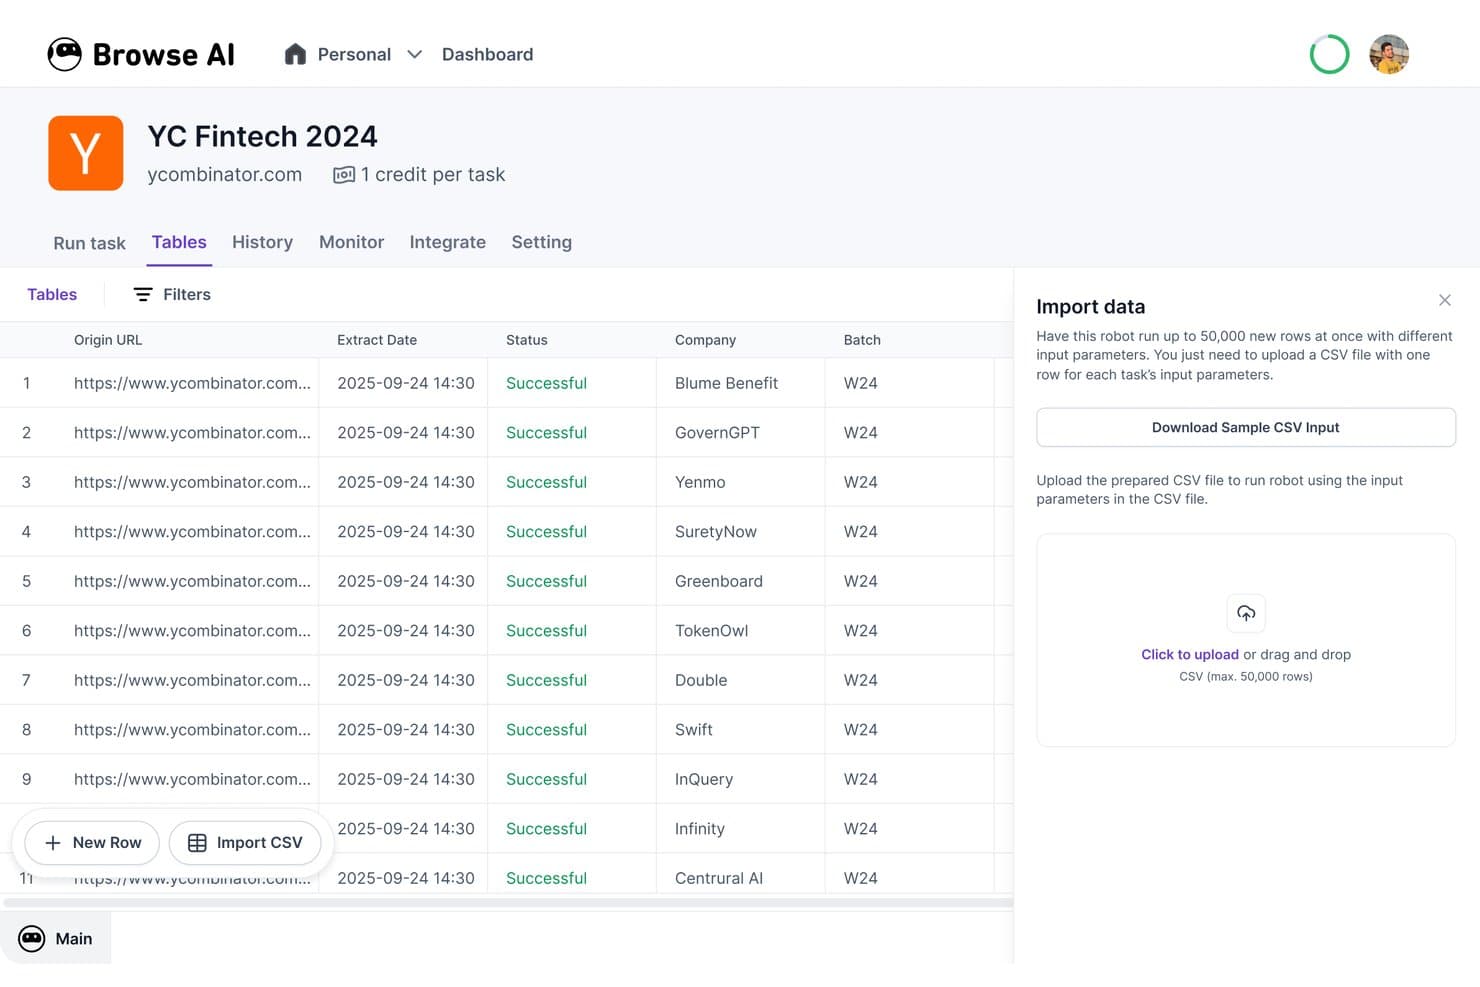
Browse AI erbjuder en instrumentpanel för webbsökning utan kod där användare kan extrahera strukturerade data från webbplatser som Y Combinator och exportera resultaten som CSV-filer. Browse AI är en plattform för webbsökning utan kod och webbplatsövervakning som kombinerar en visuell dataextraktor med peka-och-klicka-funktion med över 250 färdigbyggda robotmallar för automatiserad, schemalagd datainsamling från webbplatser.
Vem passar Browse AI bäst för?
Browse AI passar bra för analytiker inom konkurrensanalys och icke-tekniska team som behöver samla in strukturerad webbdata utan att skriva kod.
Varför jag valde Browse AI
Browse AI tar plats på min kortlista tack vare hur långt före konkurrenterna biblioteket med färdigbyggda robotar ligger. Jag kan hämta strukturerade listningar från Amazon, Google Maps eller Indeed utan att bygga en skrapare från grunden, och varje robot hanterar redan sidnumrering och dynamiskt innehåll för den specifika webbplatsen. Jag uppskattar också den AI-drivna layoutanpassningen, som automatiskt uppdaterar en robot när en målwebbplats ändrar sin sidstruktur, så att insamlingar inte går sönder obemärkt mitt i datapipelineflödet.
Viktiga funktioner i Browse AI
- JavaScript-rendering: Automatiserar extrahering från moderna, JavaScript-tunga webbplatser och ensidesapplikationer.
- Stöd för bostadsproxyservrar: Roterar automatiskt bostads-IP-adresser för att kringgå antibot-system utan manuell proxykonfiguration.
- Webhooks och API-åtkomst: Möjliggör programmatisk inskickning av skrapningsuppgifter och hämtning av data för integration med interna system.
- Automatiserad ändringsdetektering: Övervakar webbplatser efter visuella förändringar eller innehållsförändringar och skickar aviseringar när uppdateringar upptäcks.
Integrationer med Browse AI
Browse AI erbjuder inbyggda integrationer med Google Sheets, Airtable, AWS S3, Zapier och Make.com. API- och webhook-åtkomst är tillgänglig för anpassade integrationer.
Pros and Cons
Pros:
- Över 250 färdigbyggda robotar redo att distribueras
- Anpassar sig automatiskt när målwebbplatsers layouter ändras
- Hanterar CAPTCHA och dynamiska sidor inbyggt
Cons:
- Begränsad kontroll på väljarnivå för utvecklare
- Kreditkostnaderna ökar snabbt vid stora volymer
Learn more about Browse AI: Bäst för hanterad datainsamling som kringgår bottar
- Gratis provperiod tillgänglig
- Från $0.5/1 000 poster
Visit WebsiteCustomer Rating:4.5/5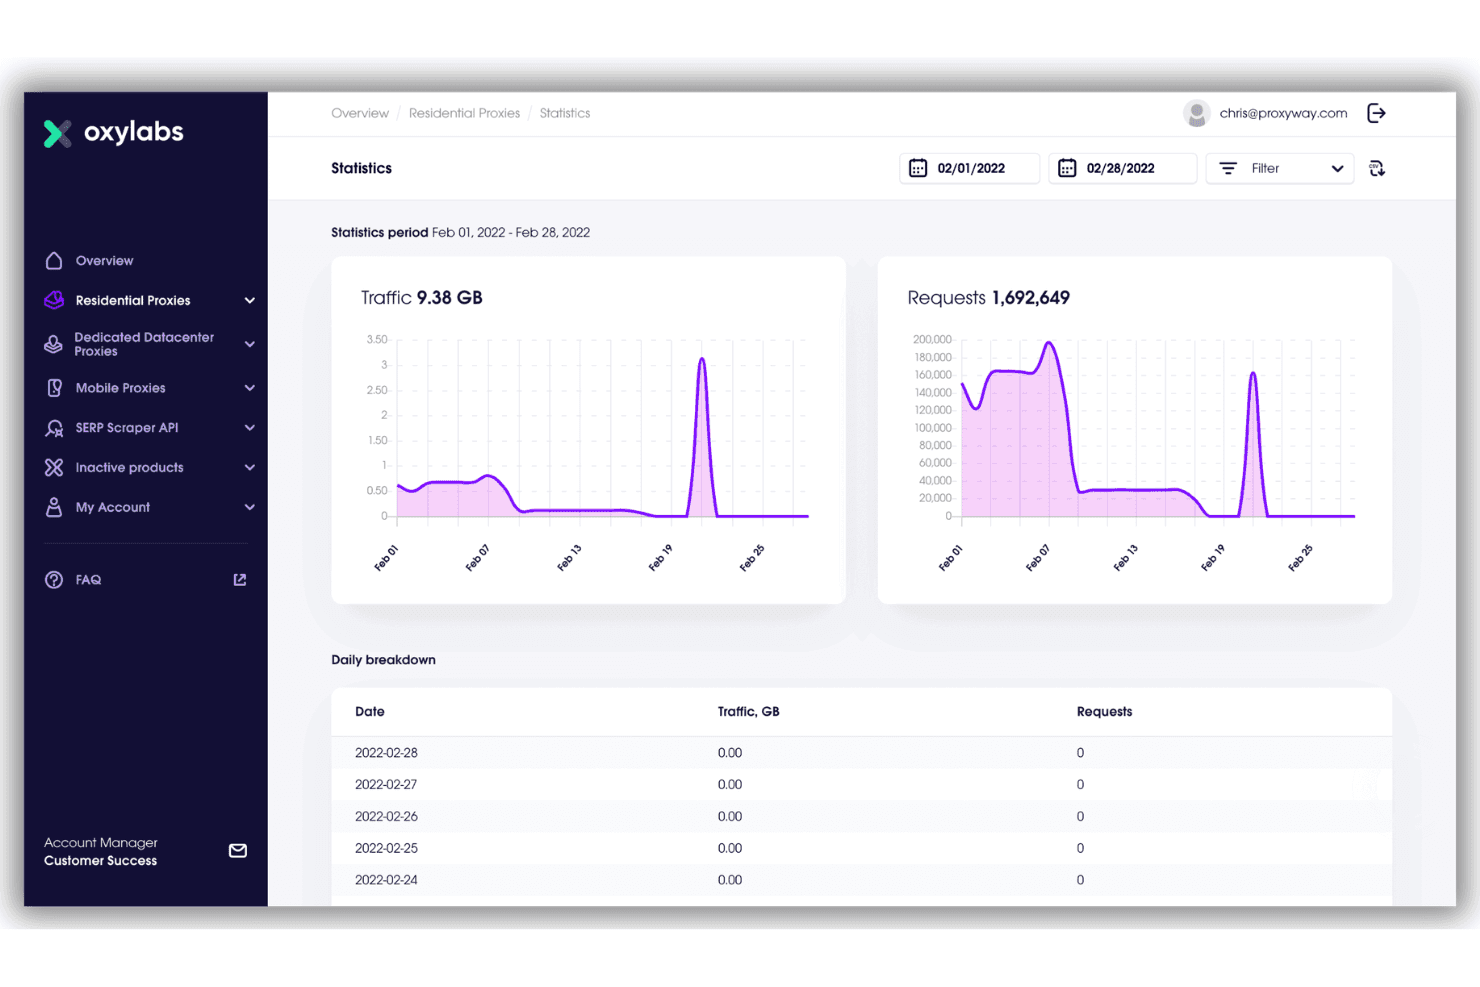
Oxylabs erbjuder en detaljerad statistikpanel för proxyservrar för privatpersoner som visar trafik- och förfrågningsmått över ett valt datumintervall i februari 2022. Oxylabs är ett API för webbskrapning som hanterar proxyhantering, CAPTCHA-lösning, JavaScript-rendering och extrahering av strukturerade data från över 50 förkonfigurerade webbplatsmål.
Vilka passar Oxylabs bäst för?
Dataingenjörer och serverdelsutvecklare som kör storskaliga, verksamhetskritiska datainsamlingsflöden och behöver infrastruktur på företagsnivå samt tillförlitlighet mot system som motverkar bottar.
Varför jag valde Oxylabs
Oxylabs tar plats på min kortlista tack vare hur tjänsten hanterar den svåraste delen av webbskrapning: att ta sig förbi botdetektering utan att du behöver hantera det själv. API:et hanterar CAPTCHA-lösning, proxyrotation över mer än 177 miljoner IP-adresser för privatpersoner och automatiska återförsök utan någon anpassad felhanteringslogik från min sida. Jag uppskattar också den resultatbaserade prismodellen, där endast svar med statuskoderna 2xx och 4xx räknas av från din kvot, så fel på systemsidan förbrukar inte dina resultat.
Viktiga funktioner i Oxylabs
- Anpassad parser: Definiera CSS- eller XPath-selektorer för att extrahera exakt strukturerade data från sidinnehåll.
- AI-assistenten OxyCopilot: Skapa skrapningsinstruktioner och tolkningslogik med hjälp av instruktioner på naturligt språk.
- Förkonfigurerade målanslutningar: Använd dedikerade slutpunkter för Amazon, Google, eBay, Walmart, Zillow och andra stora webbplatser.
- Integrationer för molnlagring: Exportera resultat direkt till AWS S3 och Google Cloud Storage för användning i dataflöden.
Integrationer med Oxylabs
Oxylabs erbjuder inbyggda integrationer med AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com och Zapier. Ett API samt SDK:er för Python och Go finns tillgängliga för anpassade integrationer.
Pros and Cons
Pros:
- Mer än 177 miljoner IP-adresser för privatpersoner i 195 länder
- Resultatbaserad prissättning undviker att förfrågningskvoten slösas bort
- Förkonfigurerade slutpunkter för över 50 stora webbplatser
Cons:
- Högre kostnad än egenhanterade skrapningsverktyg
- Inget visuellt gränssnitt för skrapning utan kod är tillgängligt
Learn more about Oxylabs: Bäst för proxyinfrastruktur i företagsskala
- Gratisabonnemang tillgängligt
- Från $1.5/1,000 poster/månad
Visit WebsiteCustomer Rating:4.7/5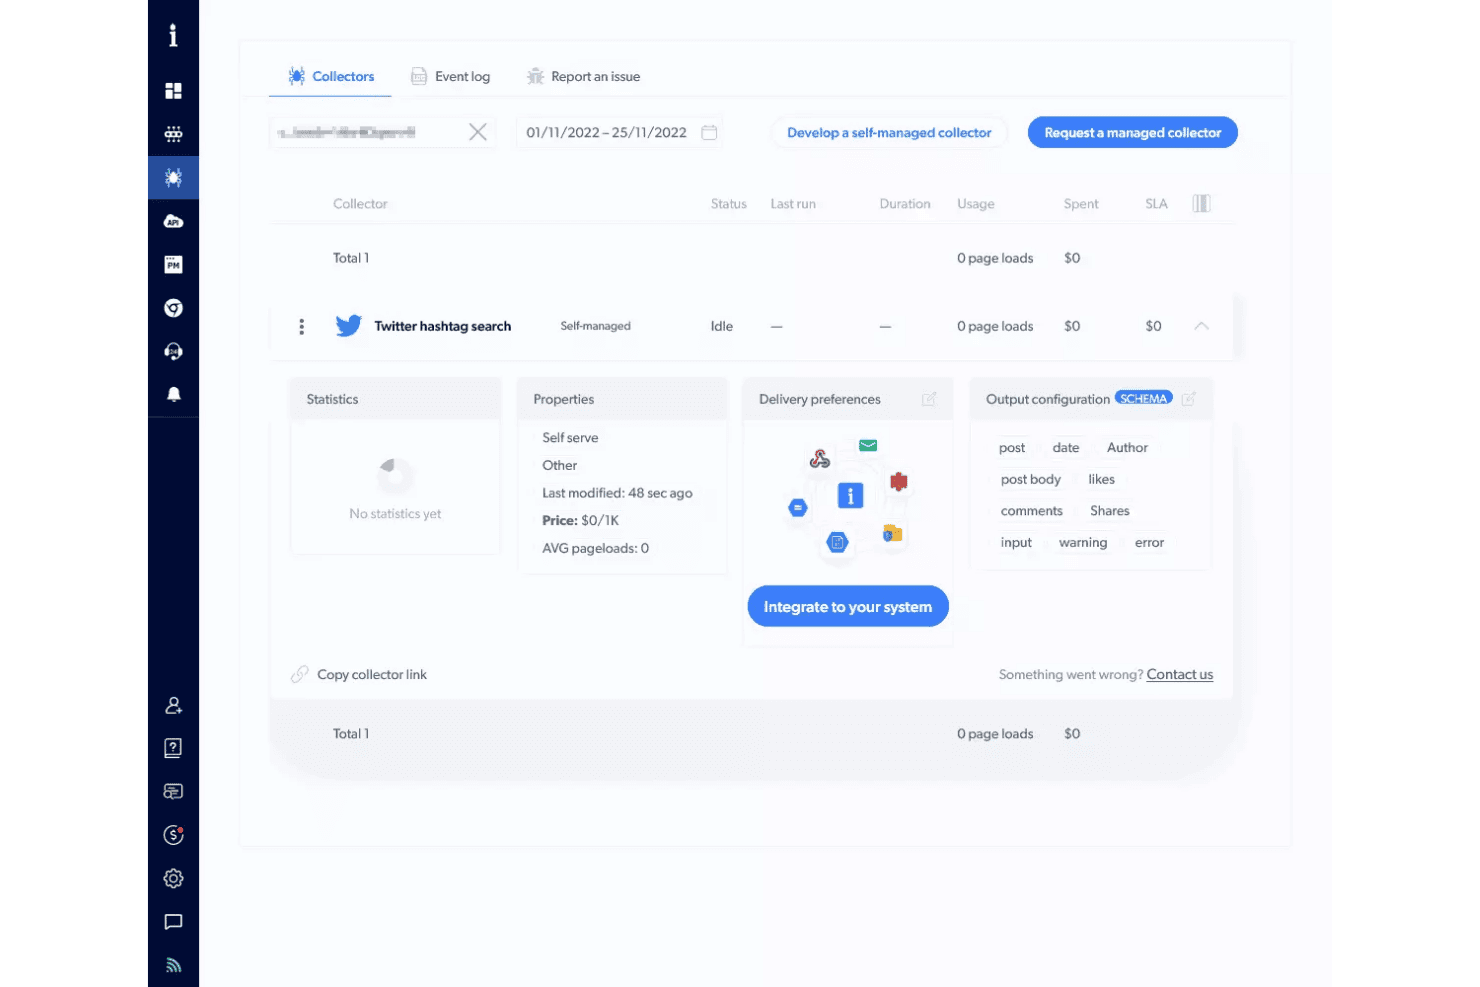
Bright Datas instrumentpanel för Collectors erbjuder en insamlare för sökning efter Twitter-hashtaggar med självhanterad status, utdatakonfiguration och alternativ för systemintegrering. Bright Data är ett API för webbskrapning och en plattform för skrapning utan kod som kombinerar proxihantering, JavaScript-rendering, CAPTCHA-lösning och strukturerad dataleverans genom 1,278+ färdigbyggda skrapare för populära webbplatser.
Vem passar Bright Data bäst för?
Dataingenjörer och backendutvecklare på medelstora till stora organisationer som behöver samla in strukturerad webbdata i stor skala utan att själva hantera proxyinfrastruktur.
Varför jag valde Bright Data
Bright Data hamnar på min kortlista tack vare den enorma omfattningen av proxynätverket: över 400 miljoner bostads-IP-adresser i 195 länder, med automatisk rotation, CAPTCHA-lösning och Web Unlocker som är utformad för att kringgå Cloudflare, Akamai och DataDome utan någon konfiguration. Jag har skrapat LinkedIn Sales Navigator och Amazon i stor skala med Bright Data och stött på noll blockeringar under tusentals förfrågningar. AI Scraper Studio låter mig dessutom generera ett fungerande skrapnings-API för vilken ny domän som helst på några minuter.
Viktiga funktioner i Bright Data
- Förbyggda mallar för skrapare: Över 1,200 färdiga skrapare finns tillgängliga för snabb implementering på stora plattformar som LinkedIn, Amazon och YouTube.
- AI-driven schemadetektering: AI Scraper Studio genererar anpassade utdatascheman och automatiserar datamappning från nya domäner.
- API:er för jobbadministration: Erbjuder batchschemaläggning, återkommande körningar och webhook-utlösare för integrering med verktyg för arbetsflödesautomatisering.
- Direkt dataleverans: Stöder export till JSON, NDJSON, CSV och XLSX eller direkt överföring till S3, Snowflake, GCS, PubSub eller SFTP.
Bright Data-integreringar
Bright Data erbjuder inbyggda integreringar med Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake och Pub/Sub samt ett API för anpassade integreringar.
Pros and Cons
Pros:
- Över 400 miljoner bostads-IP-adresser i 195 länder
- Förbyggda skrapare för över 1,200 populära webbplatser
- Web Unlocker kringgår Cloudflare och DataDome
Cons:
- Användare rapporterar faktureringstvister vid misslyckade skrapningar
- Alltför komplext för köpare utan utvecklarbakgrund
Learn more about Bright Data: Bäst för automatisk identifiering av datascheman
- 30 dagars kostnadsfri provperiod
- Från $0.13/1 000 förfrågningar
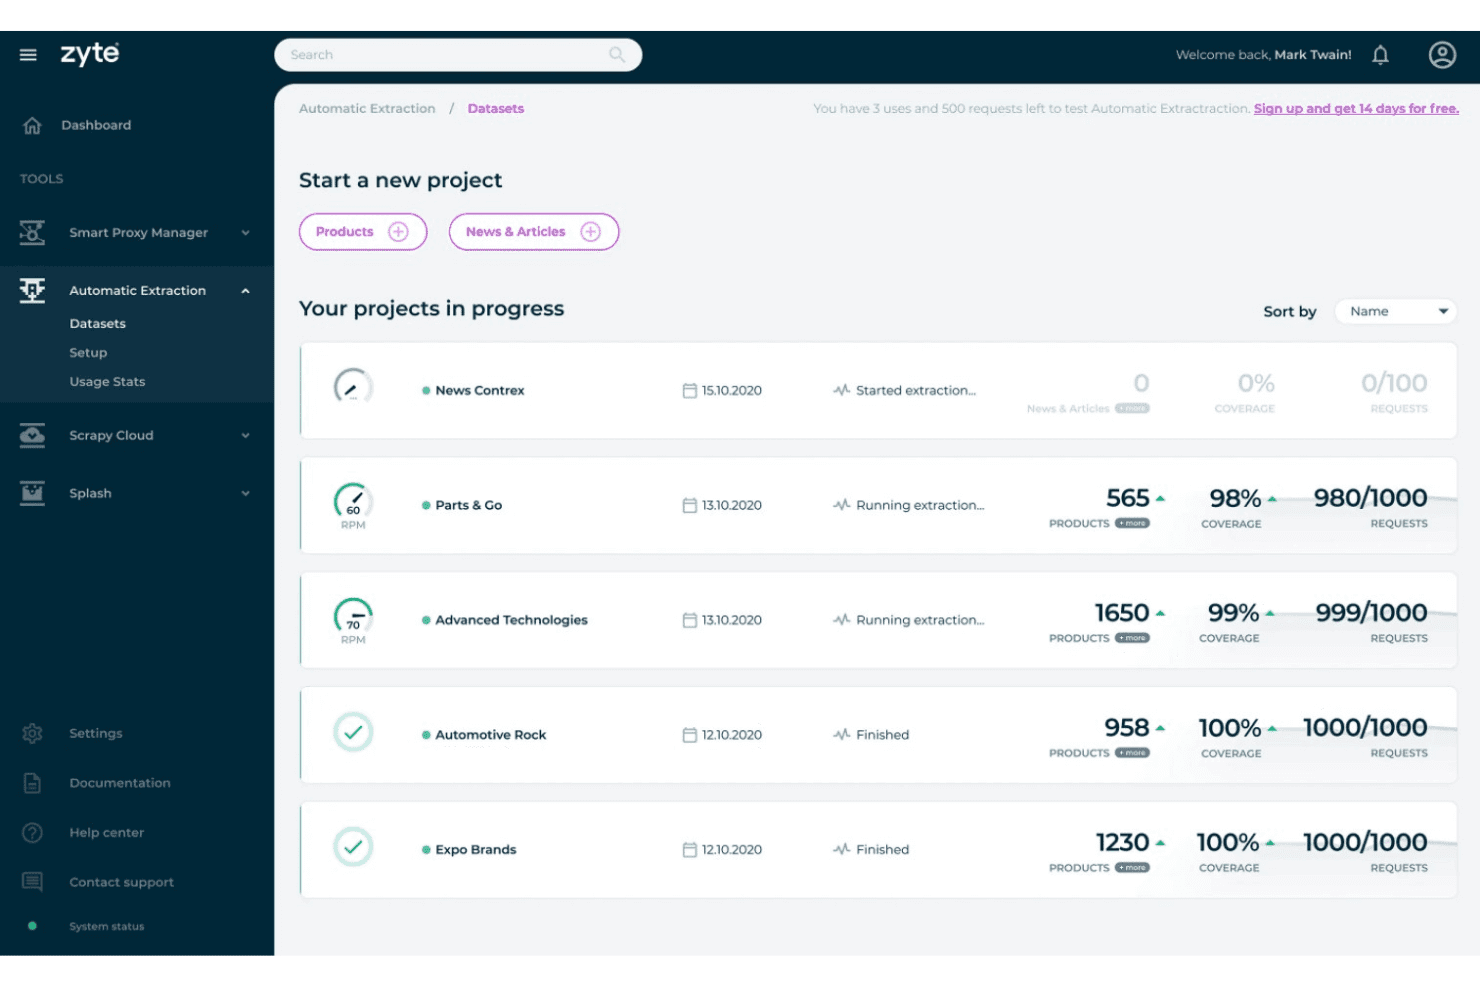
Zytes funktion för automatisk extrahering erbjuder pågående och slutförda dataextraheringsprojekt med täckning, antal produkter och mätvärden för användning av förfrågningar. Zyte API är ett webbskrapnings-API som kombinerar rendering med webbläsare utan grafiskt gränssnitt, automatisk proxyrotation, CAPTCHA-lösning och AI-driven dataextrahering i en enda slutpunkt.
Vem passar Zyte API bäst för?
Zyte API passar särskilt bra för dataingenjörer och Python-utvecklare som bygger webbskrapningspipelines i produktionsskala och matar ML-modeller eller analyssystem.
Varför jag valde Zyte API
Zyte API tar plats på min kortlista tack vare hur tjänsten hanterar automatisk identifiering av datascheman. Rikta den mot en produktsida eller artikel, så returnerar dess LLM-drivna extraheringslager typad, strukturerad JSON utan att jag behöver använda en enda CSS-selektor eller XPath-uttryck. När en webbplats uppdaterar sin layout anpassar sig AI:n, vilket innebär att jag inte ständigt behöver korrigera parsers varje gång en konkurrent gör om sin katalogsida.
Viktiga funktioner i Zyte API
- Omedelbar webbläsarrendering: Zyte API startar förvärmda webbläsare utan grafiskt gränssnitt för att läsa in dynamiska webbplatser på begäran.
- Fullständig proxyinfrastruktur: Roterar automatiskt mellan bostads-IP-adresser, datacenter-IP-adresser och mobila IP-adresser vid varje förfrågan.
- Sessionshantering: Bevarar beständiga cookies och användarsessioner för arbetsflöden som kräver autentisering eller åtgärder i flera steg.
- Integrationer för molnleverans: Skickar skrapad data direkt till destinationer som AWS S3, Google Cloud eller Azure för vidare bearbetning.
Integrationer med Zyte API
Zyte API erbjuder inbyggda integrationer med Scrapy, Scrapy Cloud och Python-SDK:er samt ett API för anpassade integrationer. Tjänsten stöder även molnleverans till AWS S3, Google Cloud och Azure.
Pros and Cons
Pros:
- AI identifierar automatiskt scheman utan manuella selektorer
- Kringgår antibot-skydd utan ytterligare konfiguration
- Förvärmda webbläsare eliminerar fördröjningar vid kallstart
Cons:
- Schemaläggning av återkommande jobb kräver externa verktyg
- Kräver programmeringskunskaper för implementering
Learn more about Zyte API: Bäst för enkla API-drivna skrapningsarbetsflöden
- Gratisabonnemang tillgängligt
- Från $49/månad
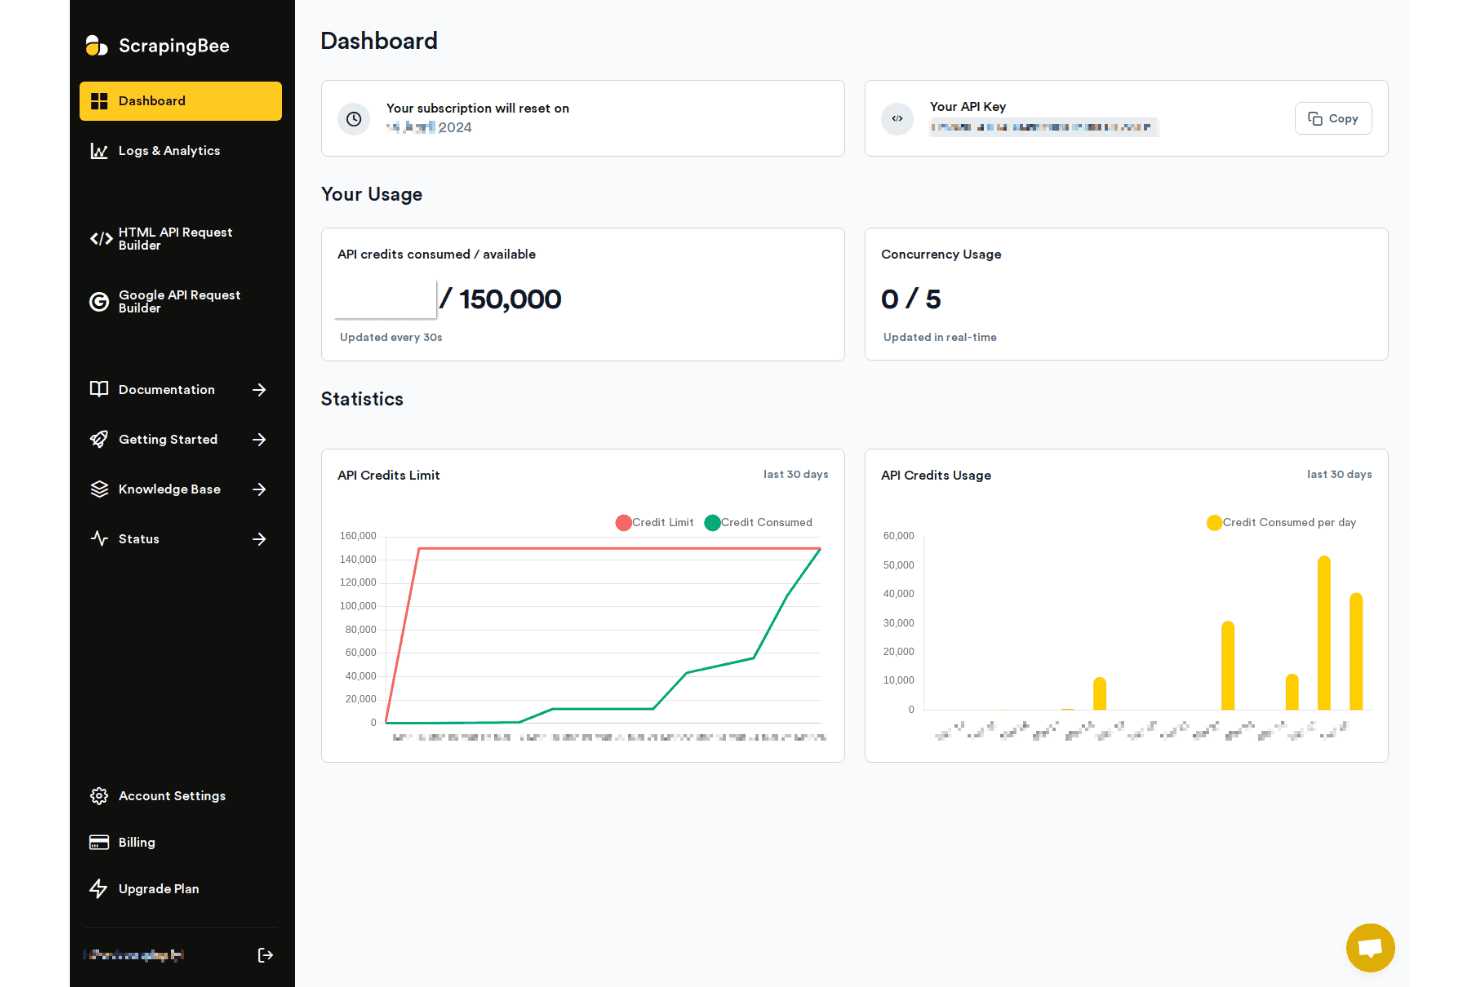
ScrapingBee erbjuder en instrumentpanel med användning av API-krediter, statistik över samtidighet och 30-dagarsdiagram över användningen för övervakning av skrapningsaktivitet. ScrapingBee är ett API för webbskrapning som hanterar rendering med Chrome utan grafiskt gränssnitt, rotation av proxyservrar och kringgående av antibotsskydd, med särskilda API:er för extrahering från plattformar som Google, Amazon och Walmart.
Vem passar ScrapingBee bäst för?
ScrapingBee passar bra för utvecklare och dataingenjörer som behöver ett tillförlitligt, kodcentrerat API för att extrahera webbdata utan att bygga proxy- eller webbläsarinfrastruktur från grunden.
Varför jag valde ScrapingBee
ScrapingBee tar plats på min kortlista tack vare hur smidigt API:et abstraherar bort komplexiteten i modern webbskrapning. En enda begäran hanterar rendering med Chrome utan grafiskt gränssnitt, diskret proxyrotation och körning av JavaScript, så jag behöver inte skriva kod för webbläsarhantering eller konfigurera proxypooler separat. Jag gillar också AI-frågefunktionen, som låter mig beskriva vad som ska extraheras med vanligt språk i stället för att skriva CSS- eller XPath-selektorer för varje ny webbplats jag vill rikta in mig på.
Viktiga funktioner i ScrapingBee
- Särskilda skrapnings-API:er: Välj färdigbyggda slutpunkter för plattformar som Amazon, Walmart och Google Sök för att förenkla vanliga datainsamlingsuppgifter.
- Extrahering med AI-frågor: Beskriv vilka data som ska extraheras med vanligt språk och generera strukturerade resultat automatiskt.
- Markdown-skrapare: Konvertera valfri webbsida till Markdown eller oformaterad text för snabb inläsning i efterföljande AI-modeller eller databaser.
- Integrationer utan kod: Anslut till Make, n8n och Zapier för att automatisera arbetsflöden utan att skriva anpassade skript för schemaläggning.
ScrapingBee-integrationer
ScrapingBee erbjuder inbyggda integrationer med Make, n8n och Zapier samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Tar endast betalt för lyckade begäranden
- Hanterar Chrome utan grafiskt gränssnitt utan extra konfiguration
- Särskilda API:er för Amazon och Google
Cons:
- Ingen inbyggd schemaläggare för jobb
- Kreditkostnaderna ökar snabbt vid stor skala
Learn more about ScrapingBee: Bäst för problemfri IP-rotation i stor skala
- 7 dagars kostnadsfri provperiod
- Från $49/månad
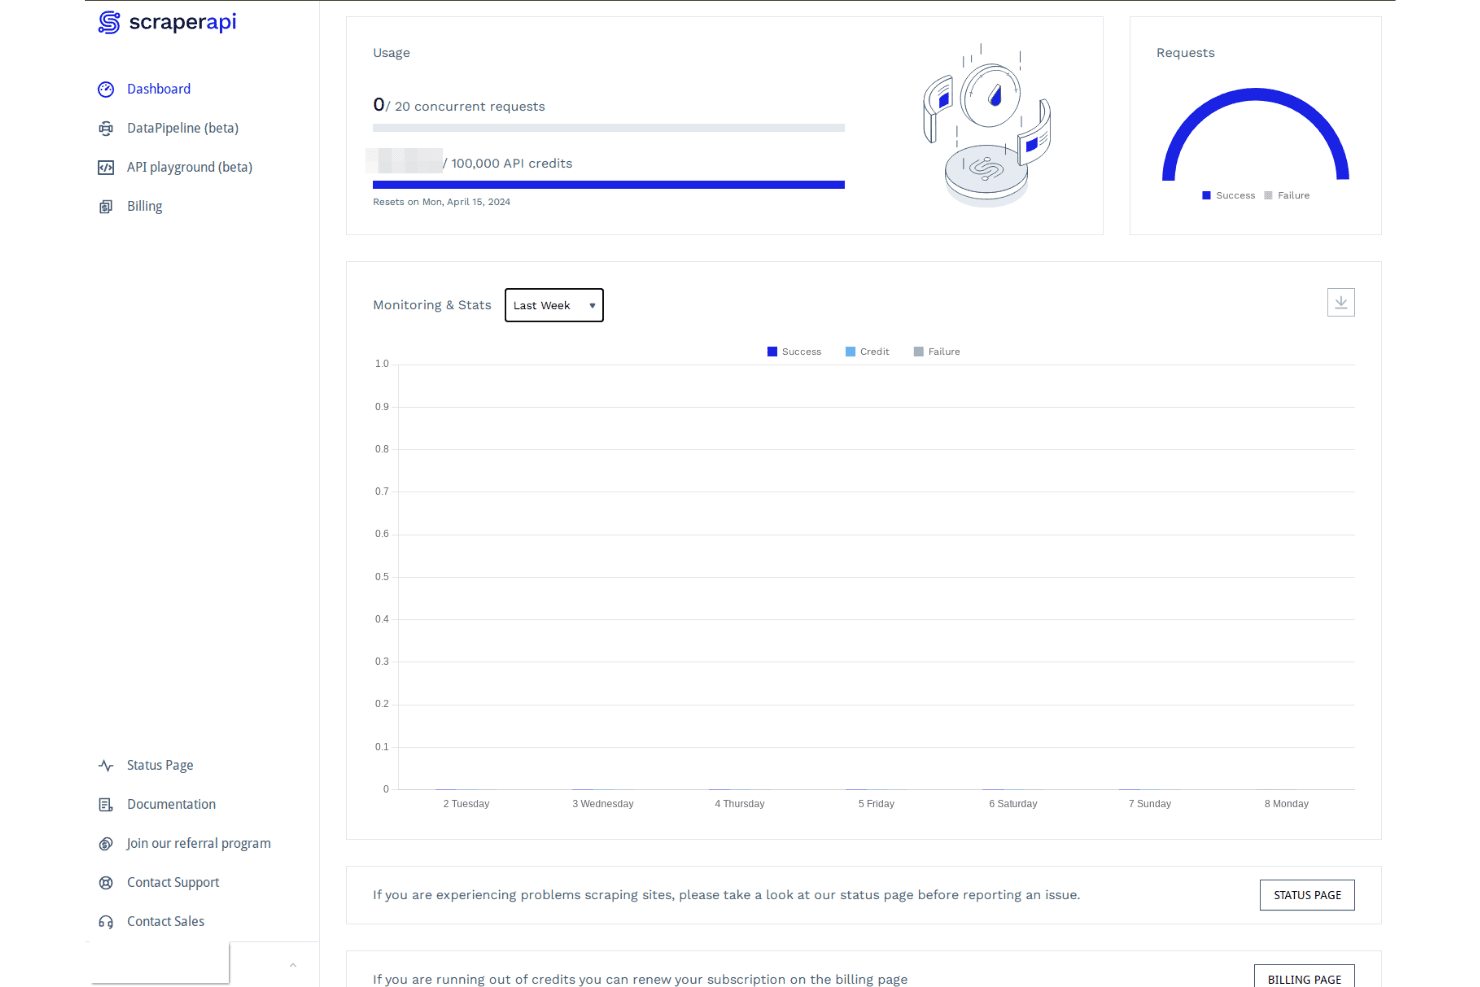
ScraperAPIs instrumentpanel visar användningsstatistik, API-krediter, samtidiga begäranden och ett veckodiagram för övervakning av skrapningsprestanda. ScraperAPI är ett API för webbskrapning som hanterar proxyrotation, JavaScript-rendering, CAPTCHA-förbikoppling och extrahering av strukturerade data, med förbyggda slutpunkter för större e-handels- och sökplattformar.
Vem passar ScraperAPI bäst för?
ScraperAPI passar bra för backendutvecklare och dataingenjörer som behöver samla in data från webbplatser med botskydd eller omfattande JavaScript i stor skala.
Varför jag valde ScraperAPI
ScraperAPI finns med på min kortlista tack vare hur tjänsten hanterar proxyhanteringen i bakgrunden. När jag hämtar produktprisdata från Amazon eller Google Shopping i stor skala behöver jag inte själv konfigurera eller underhålla en proxypool. ScraperAPI dirigerar varje begäran genom sitt proxynätverk med över 40 miljoner proxyservrar och försöker automatiskt igen vid fel. Jag uppskattar också premiumproxynivån, som aktiveras för webbplatser som skyddas av Cloudflare eller Datadome utan att jag behöver göra någon extra konfiguration.
Viktiga funktioner i ScraperAPI
- Slutpunkter för strukturerade data: Förbyggda API:er returnerar analyserad JSON från Amazon, Google Search, Walmart och liknande webbplatser för vanliga skrapningsmål.
- Beständiga sessioner: Stöder klibbiga sessioner för att behålla samma IP-adress över flera begäranden när det behövs.
- Stöd för asynkron skrapning: Möjliggör asynkron datainsamling för effektiv hantering av miljontals samtidiga begäranden.
- Globalt proxynätverk: Ger tillgång till över 40 miljoner IP-adresser i fler än 50 länder för att stödja geografiskt riktad skrapning i stor skala.
Integrationer med ScraperAPI
ScraperAPI tillhandahåller SDK:er för Python, Node.js, PHP, Ruby, Java och cURL samt erbjuder en LangChain-integration för AI-arbetsflöden. Ett API finns tillgängligt för anpassade integrationer. Inbyggda integrationer är inte tydligt dokumenterade.
Pros and Cons
Pros:
- Debiteras endast för lyckade begäranden
- Förbyggda JSON-slutpunkter för Amazon, Google och Walmart
- Geografisk inriktning i fler än 50 länder
Cons:
- Krediter förs inte över mellan faktureringsperioder
- JavaScript-rendering och premiumproxyservrar kan snabbt bli kostsamma
Learn more about ScraperAPI:
Andra verktyg för webbskrapning
Här är några ytterligare alternativ för verktyg för webbskrapning som inte kom med på min kortlista, men som ändå kan vara värda att undersöka:
- 11CrawlbaseBäst för API-åtkomst till globala datakällor
- 12ScrapyBäst för anpassningsbara Python-ramverk för webbskrapning
- 13ScrapingdogBäst för snabb driftsättning med minimal konfiguration
Så utvärderar jag verktyg för webbskrapning
Jag delar upp min utvärdering i två lager: den grundnivå som ett verktyg behöver för att hantera webbskrapning i verkliga miljöer – JS-rendering, proxyrotation och schemalagda jobb – samt de särskiljande egenskaper som skiljer de bästa alternativen från mängden.
Grundläggande funktioner (krav för den här listan)
När jag väljer ut verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärkt inom området) för varje grundläggande funktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- Motor för datautvinning: Jag utvärderar om ett verktyg stöder flera väljarmetoder som CSS, XPath och regex, eller erbjuder en visuell byggare för team som föredrar en konfiguration med peka-och-klicka.
- JavaScript-rendering: Webbplatser som bygger på React, Vue eller Angular behöver stöd för huvudlösa webbläsare. Jag kontrollerar att renderingen är tillförlitlig och har konfigurerbara väntvillkor.
- Proxy- och antibot-hantering: Jag letar efter inbyggd proxyrotation, CAPTCHA-lösning och mekanismer för att kringgå skydd som Cloudflare eller DataDome utan extra konfiguration.
- Schemaläggning och automatisering: Återkommande skrapningar bör köras utan övervakning. Jag utvärderar om verktyget stöder schemaläggning i cron-stil, webhook-utlösare och logik för återförsök vid fel.
- Export av strukturerade data: Jag kontrollerar vilka utdataformat som är tillgängliga och om verktyget kan skicka data direkt till destinationer som S3, Google Sheets, databaser eller API:er.
- Skalbarhet och samtidighet: Stora jobb över tusentals sidor kräver parallella förfrågningar. Jag granskar samtidighetsgränserna och om verktyget stöder distribuerad genomsökning.
När jag har en lista över verktyg som uppfyller kriterierna undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Det är inom kringgående av antibot-skydd som jag ser den största skillnaden mellan verktygen. Jag letar efter inbyggd CAPTCHA-lösning och webbläsarfingeravtryck som hanterar skydd som Cloudflare eller DataDome utan att du behöver skaffa proxytjänster från tredje part. Mallar för automatisk identifiering spelar också stor roll – verktyg som Bright Data och Zyte erbjuder färdiga skrapare för vanliga mål som Amazon eller Googles SERP-resultat, vilket sparar timmar av manuell konfigurering av väljare. Jag utvärderar även funktioner för schemaläggning och övervakning, särskilt felaviseringar och automatiska återförsök som håller datapipelines igång när målwebbplatser ändrar sin layout över natten.
Mer än funktioner
Prismodellerna varierar kraftigt inom detta område – vissa leverantörer tar betalt per API-förfrågan, medan andra debiterar efter bandbredd eller antalet returnerade sidor. Jag utvärderar om kostnaderna förblir förutsägbara när du skalar upp till miljontals sidor per månad. Proxyinfrastrukturen är en annan viktig särskiljande faktor. Jag kontrollerar om ett verktyg inkluderar pooler med bostads- och datacenterproxyservrar samt inbyggd geoinriktning på stadsnivå, eftersom separata proxyavtal innebär extra kostnader och komplexitet. Efterlevnad är också viktigt, särskilt för team som skrapar data i reglerade branscher där hanteringen av GDPR och robots.txt måste vara tydligt dokumenterad.
Så väljer du verktyg för webbskrapning
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| FaktorSkalbarhet | Vad du bör tänka påKan verktyget hantera de förväntade volymökningarna och parallella genomsökningarna utan kraftiga kostnadsökningar eller hastighetsbegränsningar? |
| FaktorIntegrationer | Vad du bör tänka påKommer verktyget att leverera data direkt till dina målsystem (molnlagring, databaser, arbetsflöden), eller krävs manuella steg? |
| FaktorAnpassningsbarhet | Vad du bör tänka påKan du anpassa extraktionslogiken för unika webbplatsstrukturer, eller är du begränsad till förinställda mallar och regler? |
| FaktorAnvändarvänlighet | Vad du bör tänka påKan både tekniska och icke-tekniska användare hantera skrapningar, eller behöver du löpande involvera utvecklare för att göra ändringar? |
| FaktorImplementering och introduktion | Vad du bör tänka påHur snabbt kan ditt team konfigurera en första datapipeline, och vilket stöd eller vilken dokumentation finns tillgänglig om ni kör fast? |
| FaktorKostnad | Vad du bör tänka påÄr prissättningen förutsägbar när användningen ökar? Var realistisk när det gäller toppar, logik för nya försök och falska positiva resultat i din arbetsbelastning. |
| FaktorSäkerhetsskydd | Vad du bör tänka påUtsätter verktyget din verksamhet eller dina arbetsflöden för efterlevnadsrisker, dataläckor eller obehöriga åtkomstpunkter? |
| FaktorEfterlevnadskrav | Vad du bör tänka påÄr leverantörens tillvägagångssätt förenligt med dina interna och regionala regler (t.ex. GDPR, efterlevnad av robots.txt och hantering av PII)? |
Vad är verktyg för webbskrapning?
Verktyg för webbskrapning är programvaruplattformar som automatiserar hämtning och extrahering av strukturerade data från webbplatser. Med dessa verktyg kan du samla in information från sidor – inklusive dynamiskt och JavaScript-genererat innehåll – för användning i analyser, rapporter eller integration med interna databaser. De flesta erbjuder alternativ för att konfigurera extraktionsregler och exportera data i utvecklarvänliga format.
Funktioner i verktyg för webbskrapning
Håll utkik efter följande viktiga funktioner när du väljer verktyg för webbskrapning:
- Motor för dataextrahering: Låter dig definiera hur innehåll samlas in från webbplatser med hjälp av CSS-selektorer, XPath eller peka-och-klicka-gränssnitt för strukturerade resultat.
- JavaScript-rendering: Läser in dynamiska appar eller ensidiga applikationer genom att köra JavaScript, vilket säkerställer att data som inte visas i den statiska HTML-koden fångas upp.
- Proxyhantering: Roterar IP-adresser, ofta med hjälp av proxyservrar för privatpersoners anslutningar, för att kringgå geografiska blockeringar, hastighetsbegränsningar eller botskydd så att du kan skrapa webbplatser tillförlitligt i stor skala.
- CAPTCHA-hantering: Identifierar och löser eller kringgår CAPTCHA-utmaningar automatiskt för att hålla datapipelines igång när åtgärder mot bottar aktiveras.
- Schemaläggning och automatisering: Ställer in återkommande skrapningar eller utlöser jobb baserat på specifika intervall, vilket möjliggör obevakad drift och integrering i datapipelines.
- Export av strukturerade data: Stöder utdata till JSON, CSV, XML eller direktleverans till molnlagring, API:er eller databaser, vilket eliminerar manuella konverterings- och uppladdningssteg.
- Ändringsdetektering och aviseringar: Övervakar målwebbplatser efter innehållsuppdateringar, prisändringar eller nya listningar och meddelar dig om resultaten skiljer sig från tidigare körningar.
- Kontroll av samtidighet: Hanterar flera förfrågningar parallellt för snabbare skrapningssessioner och stöder storskaliga genomsökningsjobb över tusentals sidor.
- Felhantering och loggning: Spårar misslyckade extraheringar, anslutningsavbrott eller ändringar på webbplatser och tillhandahåller detaljerade felloggar för att snabbt diagnostisera och åtgärda skrapningsproblem.
- Användarbehörigheter: Begränsar vem som får redigera projekt, hantera jobb eller visa exporter för att upprätthålla säkerheten och förhindra oavsiktliga eller obehöriga ändringar.
Vanliga AI-funktioner i verktyg för webbskrapning
Utöver de standardfunktioner i verktyg för webbskrapning som anges ovan integrerar många av dessa lösningar AI med funktioner som:
- Automatisk identifiering av datafält: Använder AI för att automatiskt identifiera och kartlägga relevanta datafält på komplexa eller obekanta webbsidor, vilket minskar behovet av manuell konfigurering av selektorer.
- Adaptiv identifiering av webbplatsstruktur: Lär sig och anpassar sig till förändringar i webbplatsers layouter, vilket minimerar driftstopp och underhåll när målwebbplatser uppdaterar sin design.
- Intelligent kringgående av botskydd: Använder AI för att efterlikna mänskliga webbläsningsmönster och anpassa skrapningsstrategier i realtid, vilket bidrar till att kringgå avancerade system för bottidentifiering.
- Innehållstolkning med naturligt språk: Utnyttjar AI för att extrahera, sammanfatta eller kategorisera ostrukturerad text, vilket gör det enklare att analysera recensioner, artiklar eller foruminlägg.
- Automatisk generering av mallar: Skapar återanvändbara skrapningsmallar för liknande webbplatser genom att analysera sidstruktur och innehållsmönster med maskininlärning.
- Smart felkorrigering: Identifierar och löser vanliga extraheringsfel eller avvikelser med hjälp av AI-drivna diagnostikfunktioner, vilket minskar behovet av manuell felsökning.
Fördelar med verktyg för webbskrapning
Att implementera verktyg för webbskrapning ger flera fördelar för ditt team och ditt företag. Här är några av de fördelar du kan se fram emot:
- Datainsamling i stor skala: Automatisera extraheringen av information från många webbplatser och sidor, så att stora datamängder blir tillgängliga för analys eller maskininlärning.
- Marknadsinsikter i realtid: Övervaka konkurrenters priser, produktkataloger och webbplatsändringar omedelbart med funktioner för schemaläggning, ändringsdetektering och aviseringar.
- Effektiv användning av resurser: Schemalägg och automatisera jobb, vilket minskar det manuella arbetet och låter utvecklare fokusera på projekt med högre värde.
- Jämn datakvalitet: Exportera strukturerade data i tillförlitliga format som JSON eller CSV, vilket minimerar tidskrävande datarensning och integrationsarbete.
- Kringgå hinder från botskydd: Använd inbyggd proxyrotation eller externa roterande proxyservrar, tillsammans med CAPTCHA-hantering och kringgående av botskydd, för att få åtkomst till innehåll som andra lösningar inte kan nå.
- Anpassningsförmåga vid webbplatsändringar: Förlita dig på smart felhantering och (för AI-aktiverade verktyg) automatiskt anpassad extrahering när webbplatsers layouter eller strukturer ändras.
- Säker åtkomst och efterlevnad: Skydda datapipelines med användarbehörigheter, revisionsloggning och anpassning till ramverk för efterlevnad eller sekretessbestämmelser.
Kostnader och priser för verktyg för webbskrapning
Att välja verktyg för webbskrapning kräver en förståelse för de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och mycket mer. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för verktyg för webbskrapning:
Jämförelsetabell för abonnemang för verktyg för webbskrapning
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| AbonnemangstypGratisabonnemang | Genomsnittligt pris$0-$10/månad | Vanliga funktionerBegränsat antal extraktioner, grundläggande schemaläggning, support från communityn och grundläggande format för dataexport. |
| AbonnemangstypPersonligt abonnemang | Genomsnittligt pris$15-$40/månad | Vanliga funktionerFler extraktionskrediter, JavaScript-rendering, API-åtkomst och grundläggande felhantering. |
| AbonnemangstypFöretagsabonnemang | Genomsnittligt pris$55-$150/månad | Vanliga funktionerHögre samtidighet, proxyrotation, avancerad schemaläggning, verktyg för teamsamarbete och prioriterad support. |
| AbonnemangstypEnterprise-abonnemang | Genomsnittligt pris$250+/månad | Vanliga funktionerAnpassade integrationer, SLA-garantier, geografiskt riktade proxyservrar, assisterad introduktion och dedikerad kontoansvarig. |
Vanliga frågor om verktyg för webbskrapning
Här är några svar på vanliga frågor om verktyg för webbskrapning:
Behöver jag kunskaper i kodning för att använda verktyg för webbskrapning?
Nej, du behöver inte nödvändigtvis programmeringskunskaper. Många visuella verktyg erbjuder en lösning utan kod, till exempel ett klickbaserat Chrome-tillägg som gör det möjligt för användare utan teknisk bakgrund att visuellt skapa extraktionsrutiner och navigera på en webbplatskarta för att samla in poster för uppgifter som generering av potentiella kunder.
Komplex anpassad logik, dataströmmar eller webbskrapning i stor skala bygger däremot vanligtvis på programmeringsverktyg:
- Python: Ett traditionellt Python-bibliotek som BeautifulSoup är idealiskt för att på ett rent sätt tolka statiska HTML-dokument.
- JavaScript: Ett specialiserat Node.js-bibliotek (som Puppeteer eller Playwright) gör det möjligt för utvecklare att programmässigt interagera med dynamiska webbelement.
Kan verktyg för webbskrapning hantera dynamiska och JavaScript-tunga webbplatser?
Ja, de flesta moderna verktyg erbjuder JavaScript-renderingsmotorer för att skrapa dynamiskt innehåll från ensidiga applikationer (SPAs) och interaktiva webbplatser.
Hur hanterar verktyg för webbskrapning webbplatsernas åtgärder mot bottar?
För att kringgå skydd mot bottar använder avancerade verktyg flera strategier för att undvika upptäckt:
- Roterande proxyservrar: Fördelar förfrågningar över stora IP-pooler (datacenter- och privatproxyservrar) för att undvika hastighetsbegränsningar eller IP-blockeringar.
- Automatiserade CAPTCHA-lösare: Löser eller kringgår visuella och beteendebaserade utmaningar.
- Maskering av webbläsarens fingeravtryck: Ändrar webbläsarhuvuden, canvas-avtryck och användaragenter i motorer (som WebKit eller Chromium) för att efterlikna mänskliga interaktioner i större webbläsare som Firefox eller Chrome.
Är webbskrapning laglig?
Lagligheten kring webbskrapning beror på vilka data du samlar in, hur du använder dem och webbplatsens användarvillkor. Gå alltid igenom juridiska riktlinjer och efterlevnadskrav innan du börjar.
Hur tar jag emot och lagrar de skrapade uppgifterna?
Du kan vanligtvis exportera data till format som CSV, JSON och Excel eller skicka dem direkt till molnlagring, webhooks eller databaser, beroende på verktygets integrationsalternativ.