

De 10 bästa programvarorna för naturlig språk-generering 2026

10 Bästa programvaran för generering av naturligt språk – kortlista
- 1. Vertex AI


Efter en djupgående utvärdering har jag valt ut de 12 bästa verktygen för generering av naturligt språk för att hantera just den utmaning du står inför.
I chatbotarnas och virtuella assistenternas tidevarv utmärker sig programvara för generering av naturligt språk (NLG) som en verklig spelväxlare. Genom att utnyttja datavetenskap och stordata simulerar dessa verktyg mänskligt språk och omvandlar textdata till sammanhängande berättelser. Jag har själv sett hur NLG-teknik hjälper till med sammanfattningar för sociala medier, frågebesvarande i självbetjäningsportaler och textklassificering inom sjukvården.
Leverantörer har integrerat NLG- och NLU-ramverk i sina plattformar, vilket låser upp kraftfulla fördelar. I grund och botten översätter NLG-programvara data till människoliknande berättelser och ger företag ett verktyg som förbättrar varje kundinteraktion och får tekniken att kännas mer intuitiv och människocentrerad.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av den bästa programvaran för generering av naturligt språk
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av programvara för generering av naturligt språk, så att du kan hitta den bästa lösningen för din budget och verksamhetens behov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Gratisabonnemang tillgängligt | Prisuppgift på begäran | Website | ||
| 2 | Bäst för NLG med kontext på 1 miljon tokens i API-skala | Gratisabonnemang tillgängligt | Från $20/månad | Website | |
| 3 | Bäst för styrd NLG i reglerade företag | Nej | Pris på begäran | Website | |
| 4 | Bäst för NLG från dokument till text i stor skala | Gratisplan tillgänglig | Från $14.99/månad | Website | |
| 5 | 6 månaders kostnadsfri provperiod + kostnadsfri demo tillgänglig | Pris på begäran | Website | ||
| 6 | Bäst för forskningsbaserade modeller för generering av naturligt språk | Nej | Pris på begäran | Website | |
| 7 | Bäst för mallstyrd omvandling från data till text i stor skala | Gratis demo tillgänglig | Pris på begäran | Website | |
| 8 | Bäst för deterministisk narrativ presentation av BI-instrumentpaneler | Gratis provperiod + gratis demonstration tillgänglig | Pris på begäran | Website | |
| 9 | Bäst för produktbeskrivningar inom e-handel | Inte tillgängligt | Pris på begäran | Website | |
| 10 | Bäst för regulatoriskt skrivande inom läkemedel och finans | Gratis demo tillgänglig | Pris på begäran | Website |
Recensioner av den bästa programvaran för generering av naturligt språk
Nedan finns mina detaljerade sammanfattningar av den bästa programvaran för generering av naturligt språk som kom med på min kortlista. I mina recensioner får du en detaljerad genomgång av de viktigaste funktionerna, fördelarna & nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.

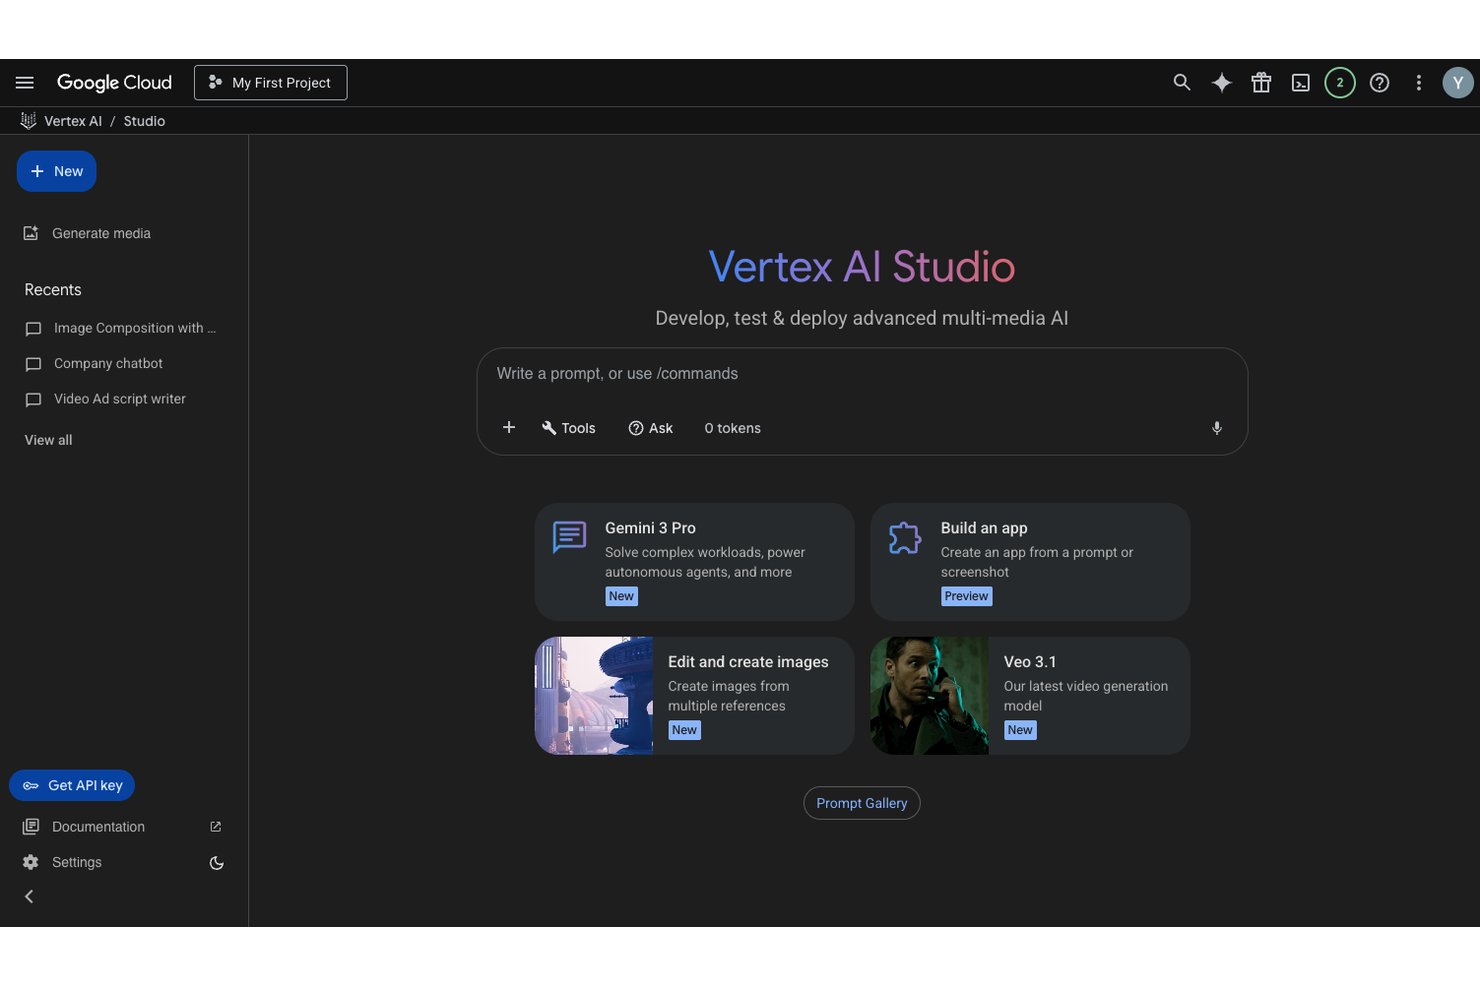
Vertex AI är Googles AI-utvecklingsplattform i Google Cloud som ger dig tillgång till över 200 språkmodeller – inklusive Gemini-familjen – för textgenerering, sammanfattning, strukturerad data-till-text-utdata samt automatiskt skapande av rapporter och dokumentation.
Vem passar Vertex AI bäst för?
Vertex AI passar särskilt bra för IT- och teknikteam som redan arbetar inom Google Clouds ekosystem och behöver integrera NLG i befintliga datapipelines, observerbarhetsarbetsflöden eller interna verktyg i stor skala.
Varför jag valde Vertex AI
Vertex AI tar plats på min kortlista eftersom det är det bästa alternativet jag har hittat för team som redan använder Google Cloud och vill väva in NLG direkt i sina befintliga datapipelines. Jag uppskattar att du kan hämta strukturerade data direkt från BigQuery eller Cloud Storage, skicka dem genom en Gemini-modell med tvingad JSON-schemautdata och få tillförlitlig textgenerering utan att behöva sätta upp separat infrastruktur. Den inbyggda RAG-motorn innebär också att jag kan förankra genererade incidentsammanfattningar eller tekniska rapporter i verkliga företagskunskapsbaser, vilket minskar hallucinationer avsevärt i IT-utdata med höga krav på tillförlitlighet.
Viktiga funktioner i Vertex AI
- Övervakad finjustering: Finjustera Gemini-modeller på dina egna märkta datamängder genom en helt hanterad tjänst – ingen GPU-provisionering krävs.
- Modellregister: Spåra, versionshantera och hantera specialtränade modeller med fullständig granskningsloggning och kontroller för driftsättning.
- Batchinferens: Bearbeta upp till 200 000 förfrågningar per jobb asynkront, med automatisk parallellisering och hantering av nya försök.
- Konfigurerbara säkerhetsfilter: Ange tröskelvärden för innehåll per kategori och skadetyp för att styra tonen och säkerheten i genererade utdata.
Vertex AI-integreringar
Vertex AI har inbyggda integreringar med BigQuery, Cloud Storage, Cloud SQL, Looker, Pub/Sub, Google Kubernetes Engine, Cloud Run, Cloud Logging, Cloud Monitoring och Apigee. Dess REST API och SDK:er stöder anpassade integreringar och CI/CD-arbetsflöden.
Pros and Cons
Pros:
- NLG förankrad i företagsdatakällor
- Skalbar realtidsgenerering och batchgenerering
- Utdata på flera språk stöder globala team
Cons:
- Kvotfel är vanliga för nya konton
- Batchjobb saknar garantier för drifttid eller genomströmning

Claude
Bäst för NLG med kontext på 1 miljon tokens i API-skala
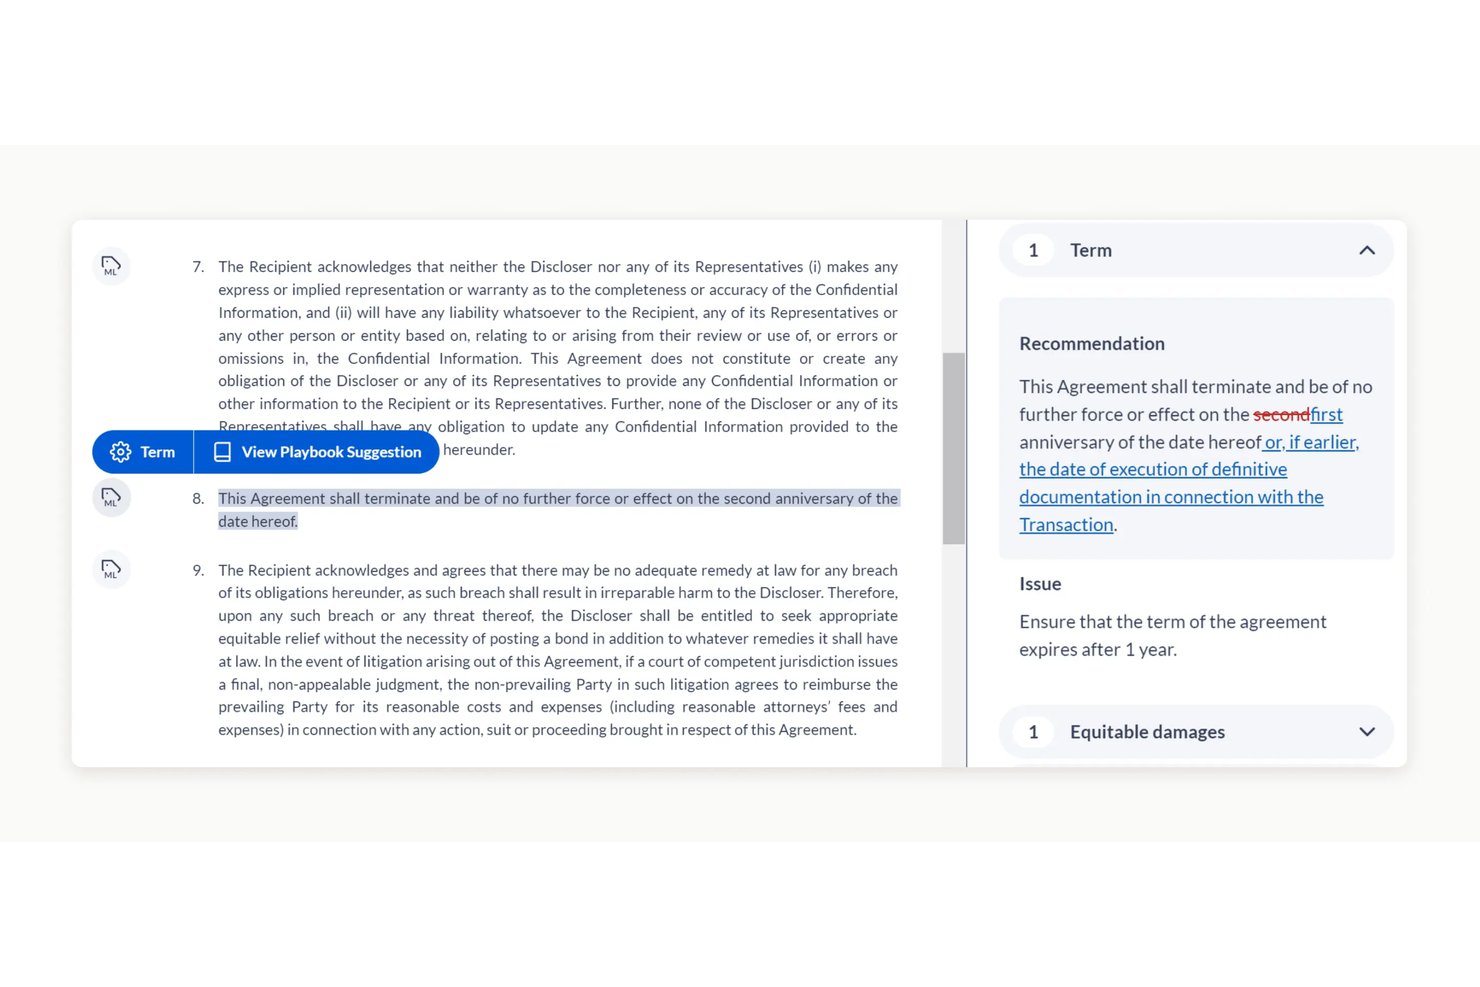
Claude är en NLG API-plattform från Anthropic som kombinerar ett kontextfönster på 1 miljon tokens, textgenerering i flera format och ett SDK-ekosystem med stöd för sju språk för att hantera strukturerad data-till-text, batchbearbetning och RAG-arbetsflöden i stor skala.
Vem passar Claude bäst för?
Claude passar bra för teknik- och DevOps-team som behöver köra NLG-arbetsbelastningar i stor skala via ett API, särskilt när de tar in fullständiga loggfiler, dokumentationsuppsättningar eller dataexporter i ett enda anrop.
Varför jag valde Claude
Jag har tagit med Claude bland mina toppval eftersom dess kontextfönster på 1 miljon tokens verkligen saknar motstycke för NLG-arbetsbelastningar i API-skala. Jag kan mata in en hel loggfil, en fullständig databasexport eller en omfattande dokumentationsuppsättning i ett enda anrop och få tillbaka en sammanhängande, strukturerad berättelse. API:t för meddelandebatcher hanterar upp till 100 000 förfrågningar per batch till halva den vanliga tokenkostnaden, vilket gör textgenereringspipelines med hög volym praktiska utan att budgeten skenar.
Viktiga funktioner i Claude
- Strukturerade utdata: Begränsar API-svar till JSON-scheman som definierats av kunden, vilket säkerställer att efterföljande pipelines tar emot ren, tolkningsbar text utan manuell efterbearbetning.
- Citeringsfunktion: Förankrar genererad text direkt i källdokument som tillhandahålls vid inferenstillfället, vilket ger dig ett granskningsbart spår för varje påstående i resultatet.
- Direktuppspelning i realtid via SSE: Levererar utdata token för token via server-sända händelser, så att du kan bygga direkta incidentsammanfattningar och dynamiska instrumentpaneler utan att vänta på att hela svaret ska bli klart.
- Stöd för flerspråkiga utdata: Tolkar och genererar text på språket i konversationens sammanhang, med uttrycklig språkkontroll tillgänglig via systemprompten för översättningsarbetsflöden.
Claude-integrationer
Claude stöder över 818 MCP-anslutningsintegrationer, däribland GitHub, Atlassian, Microsoft 365, Slack, Notion, Google Drive och Asana. Dess REST-API och sju officiella SDK:er stöder anpassade integrationer och CI/CD-arbetsflöden.
Pros and Cons
Pros:
- Hanterar fullständiga loggfiler i ett enda anrop
- Upprätthåller JSON-schema för strukturerade utdata
- Direktuppspelning i realtid token för token tillgänglig
Cons:
- Ingen direkt finjustering utanför AWS
- Strikta hastighetsbegränsningar frustrerar användare med hög volym

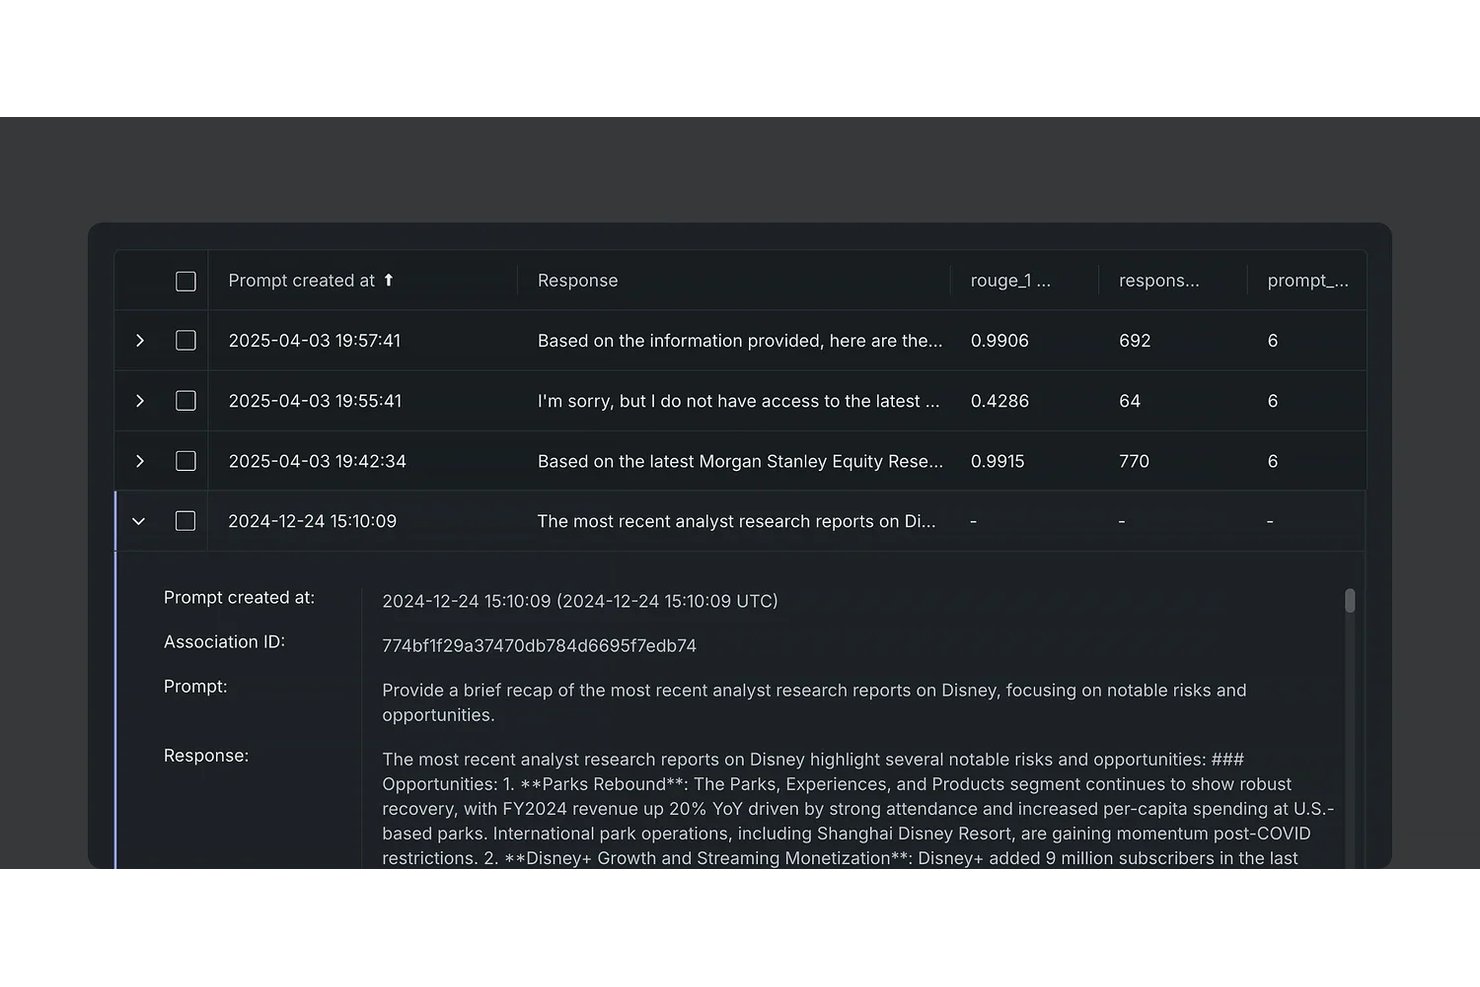
DataRobot är en AI- och maskininlärningsplattform för företag som levererar NLG via sin arbetsyta för generativ AI och stöder omvandling av strukturerad data till text, RAG-pipelines, finjustering av LLM:er och agentbaserade arbetsflöden i reglerade driftsmiljöer.
Vem passar DataRobot bäst för?
DataRobot passar bra för AI- och ML-team inom företag i reglerade branscher som behöver styrd och granskningsbar NLG med flexibla driftsättningsalternativ, inklusive luftgapade och lokala miljöer.
Varför jag valde DataRobot
Jag valde DataRobot som en av de bästa lösningarna eftersom det är den enda NLG-lösning jag skulle lita på i en reglerad miljö där varje genererat resultat behöver ett fullständigt granskningsspår. Dess spårning av LLM-härkomst loggar varje prompt och vektorinmatning, och styrningslagret kopplas direkt till ramverk som EU:s AI-förordning och NIST AI RMF. Jag värdesätter också dess kontroller mot hallucinationer högt: utvärdering med en LLM som bedömare och NVIDIA NeMo Guardrails arbetar tillsammans för att flagga hallucinerade resultat innan de når produktion.
Viktiga funktioner i DataRobot
- Byggare av RAG-pipelines: Skapa, registrera och driftsätt vektordatabaser med stöd för Pinecone, Elasticsearch och FAISS, inklusive strategier för uppdelning i delar, indexering av metadata och omskrivning av frågor.
- LLM-gateway med över 70 modeller: Få åtkomst till över 70 stora språkmodeller och inbäddningsmodeller via ett enda gränssnitt utan att behöva hantera separata API-nycklar eller konton.
- API för batchprognoser: Kör storskaliga offlineprognoser från JDBC-källor, molndatalager och S3 med hanterad orkestrering via Apache Airflow.
- OpenTelemetry-kompatibel spårning: Spåra fullständig härkomst för prompter, vektorinmatningar och modellversioner med granskningsspår som matas direkt in i SIEM-verktyg och observabilitetspipelines.
Integrationer med DataRobot
DataRobot erbjuder integrationer med AWS, Microsoft Azure, Google Cloud Platform, Snowflake, Databricks, SAP, OpenAI, Google Gemini, Pinecone och Elasticsearch. Dess REST API, Python SDK, R-klient, CLI och OpenAI-kompatibla slutpunkter stöder anpassade integrationer.
Pros and Cons
Pros:
- Fullständiga granskningsspår och funktioner för regelefterlevnad
- Kontroller mot hallucinationer med realtidsövervakning
- Åtkomst till över 70 språkmodeller
Cons:
- NLG-funktionerna är sekundära i förhållande till ML-plattformen
- Ogenomskinlig, anpassad licensmodell för företag

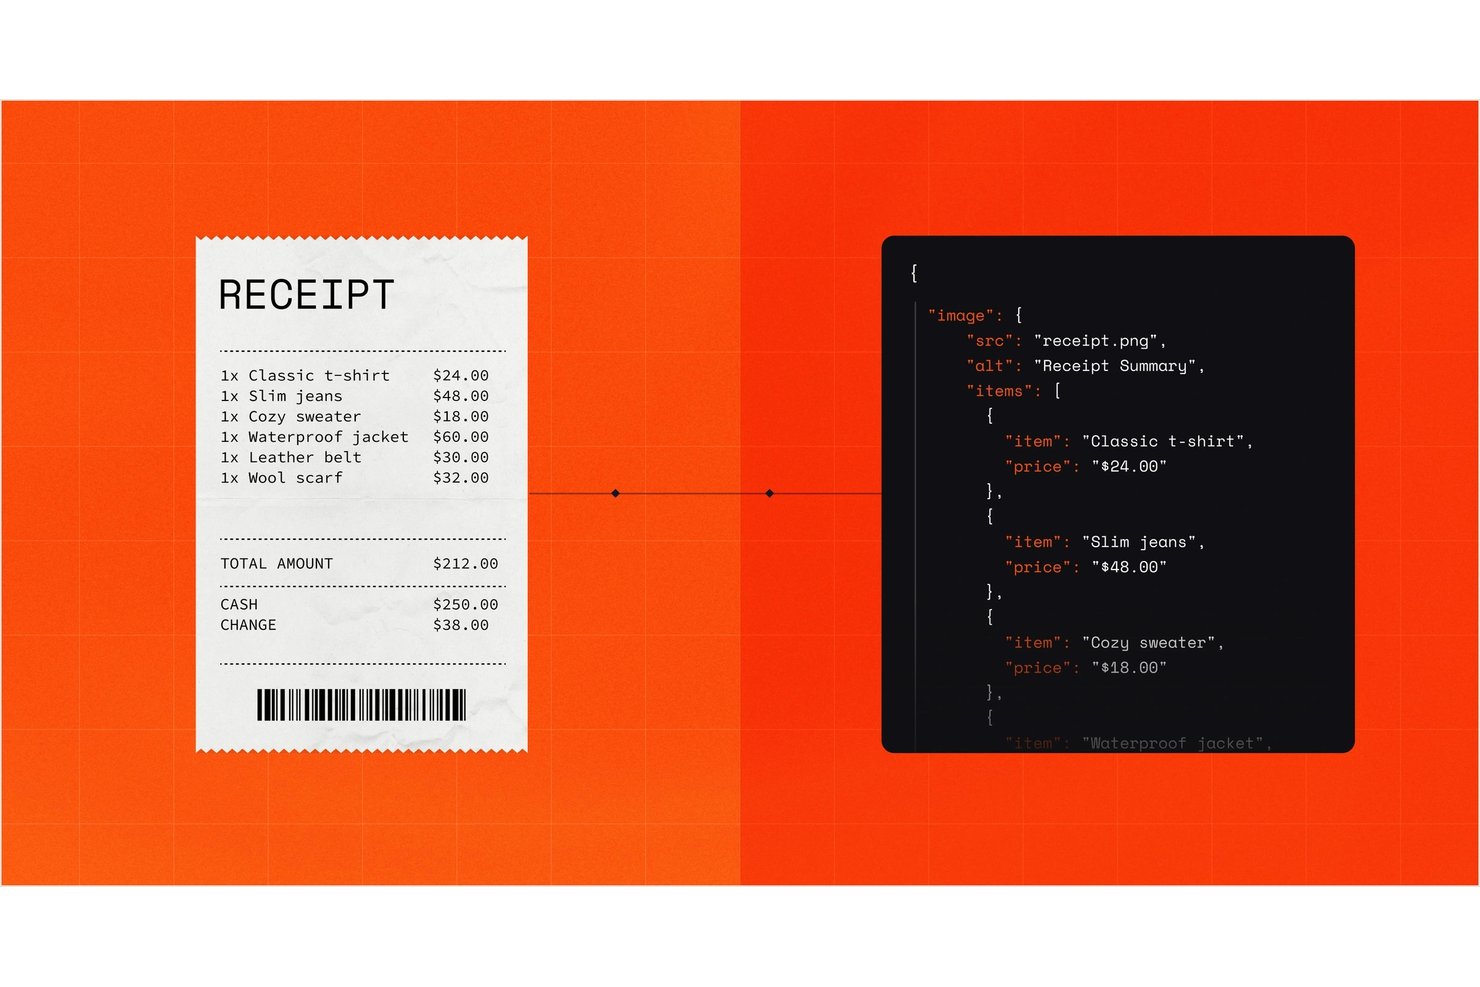
Mistral Document AI är en NLG-plattform byggd kring OCR och dokumentförståelse för företag, som omvandlar PDF-filer, skanningar, DOCX-filer och handskrivna dokument till strukturerad text, JSON och utdata på naturligt språk på över 170 språk.
Vem passar Mistral Document AI bäst för?
Mistral Document AI passar väl för AI/ML-ingenjörer och tekniska team som behöver bearbeta stora mängder dokument—PDF-filer, skanningar och DOCX-filer—till strukturerad text eller JSON i företagsskala.
Varför jag valde Mistral Document AI
Jag valde Mistral Document AI eftersom plattformen hanterar konvertering från dokument till text i en skala som de flesta NLG-plattformar helt enkelt inte kan matcha, med bearbetning av upp till 1 000 sidor per minut på en enda GPU och stöd för batchjobb med upp till en miljon förfrågningar. OCR 4.1-modellen går långt utöver grundläggande textextrahering och returnerar begränsningsrutor på styckenivå samt konfidenspoäng på blocknivå för över 170 språk, inklusive handskrivna indata. Jag uppskattar också att du kan definiera anpassade JSON-scheman för att styra exakt vilken strukturerad utdata som extraheras, vilket gör plattformen praktisk för att bygga automatiserade dokumentpipelines i stället för bara enstaka extraheringar.
Viktiga funktioner i Mistral Document AI
- Inbyggt RAG-stöd: Kombinerar inbäddningsmodellen
mistral-embedmed dokumentsökning för att möjliggöra frågor på naturligt språk över extraherat innehåll. - Modererings-API: En kostnadsfri klassificerare som flaggar utdata inom 11 innehållskategorier, med konfigurerbara tröskelvärden som kan infogas direkt i API-förfrågningar.
- Finjustering i tre nivåer: Erbjuder egenhostad LoRA, hanterad serverlös drift och anpassad förträning på företagsnivå för att motsvara dina krav på infrastruktur och data.
- Strömmad SSE-utdata: Levererar svar token för token via Server-Sent Events och stöder livepaneler, chattbotar och gränssnitt för sammanfattning av incidenter i realtid.
Integrationer med Mistral Document AI
Mistral Document AI stöder över 20 MCP-anslutningar, inklusive GitHub, Notion, Jira, Confluence, Pinecone och Sentry. Plattformen erbjuder även SDK:er för Python och JavaScript/TypeScript samt ett REST-API för anpassade integrationer.
Pros and Cons
Pros:
- Utmärkt för konvertering från dokument till text i stora volymer
- Bredast stöd för flerspråkig OCR i kategorin
- Flexibel driftsättning, inklusive lokalt och i luftgappade miljöer
Cons:
- Inga inbyggda anslutningar till ITSM- eller observerbarhetsverktyg
- Strikta hastighetsbegränsningar i instegsplanerna
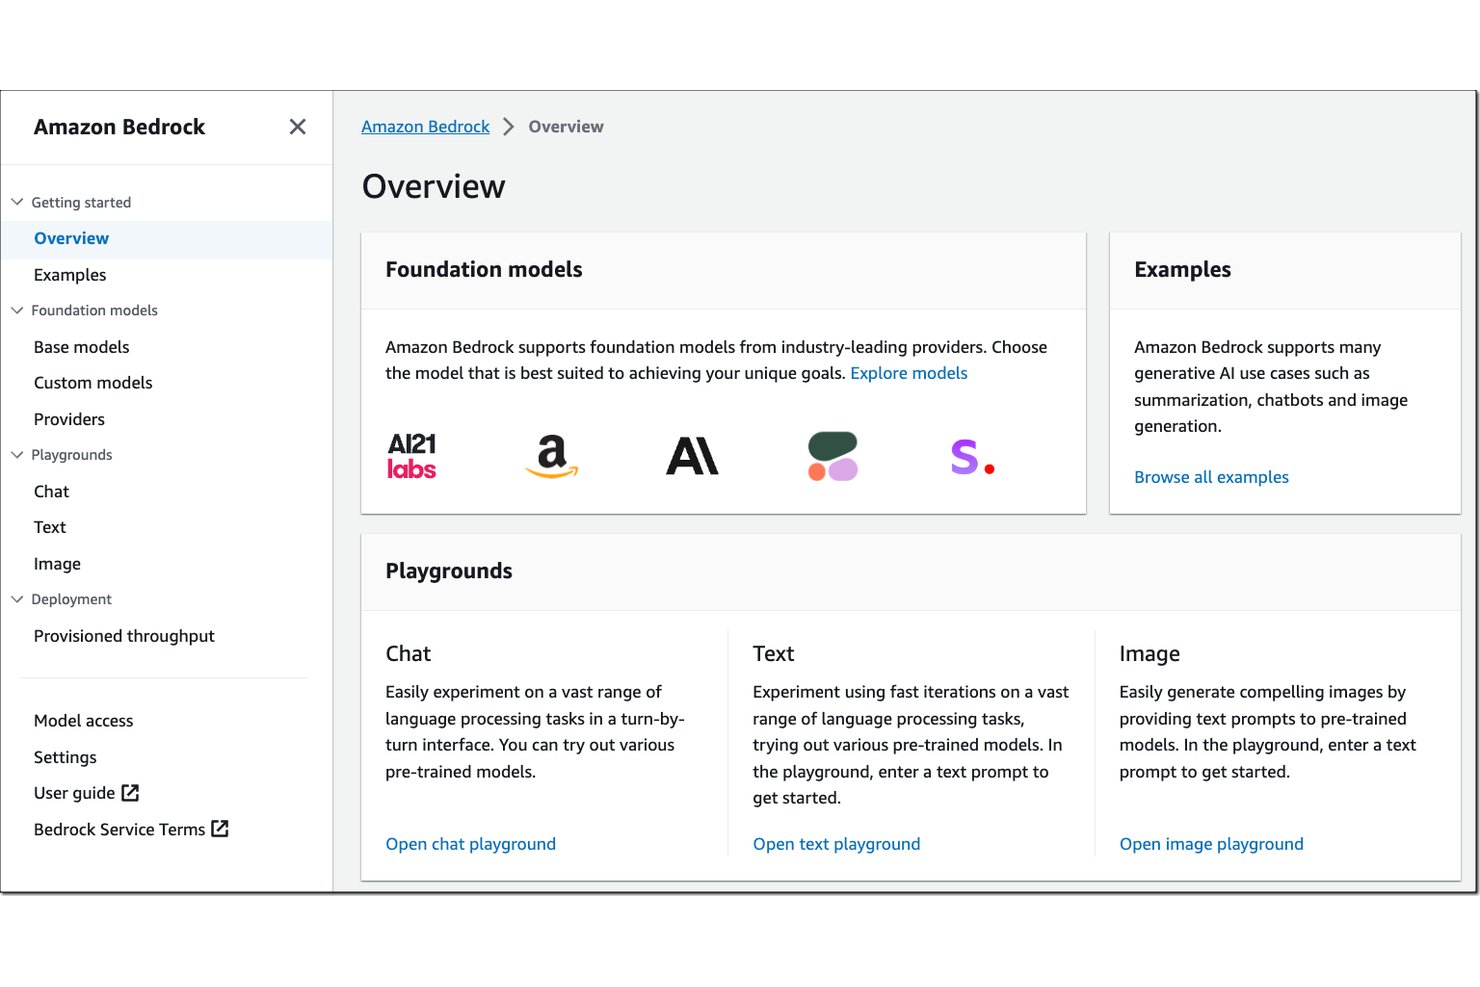
Amazon Bedrock är AWS:s helt hanterade plattform för NLG och grundmodeller, som ger dig API-åtkomst till över 100 modeller från leverantörer som Anthropic, Meta och Mistral samt inbyggda verktyg för RAG, finjustering, batchinferens och skyddsmekanismer.
Vem passar Amazon Bedrock bäst för?
Amazon Bedrock passar mycket bra för teknik- och IT-team som redan kör arbetsbelastningar på AWS och behöver integrera NLG i sin befintliga molninfrastruktur utan att själva hantera modellhosting.
Varför jag valde Amazon Bedrock
Amazon Bedrock finns med på min kortlista eftersom tjänsten är helt byggd inom AWS-ekosystemet, vilket gör den till det naturligaste valet om din infrastruktur redan finns där. Jag uppskattar att den ger API-åtkomst till över 100 grundmodeller via ett enda enhetligt gränssnitt, så att du kan växla mellan Anthropic Claude, Meta Llama och Amazon Nova utan att behöva bygga om din pipeline. Det inbyggda lagret med skyddsmekanismer, med kontroller för automatiserade resonemang som når 99 % noggrannhet, är det som skiljer tjänsten från mängden för team som behöver verifierbara NLG-resultat snarare än text som bara låter trovärdig.
Viktiga funktioner i Amazon Bedrock
- Hämtningsförstärkt generering (RAG): En helt hanterad tjänst för kunskapsbaser som importerar data från S3, SharePoint, Confluence och Google Drive och hämtar förankrad kontext för textgenerering.
- API för batchinferens: Bearbetar promptjobb i stora volymer asynkront till ungefär 50 % lägre kostnad än begärandebaserad prissättning, med resultat som levereras till S3.
- Skyddsmekanismer i Amazon Bedrock: Ett konfigurerbart säkerhetspolicysystem i sex lager som omfattar maskering av personligt identifierbar information, nekade ämnen, innehållsfilter och matematiskt verifierade kontroller av resultatens noggrannhet.
- Import av anpassade modeller: Gör det möjligt att ta in externt tränade modeller i Bedrock och använda dem via samma hanterade API som inbyggda grundmodeller.
Integrationer med Amazon Bedrock
Amazon Bedrock har inbyggda integrationer i hela AWS, bland annat med Amazon S3, Amazon CloudWatch, AWS CloudTrail, AWS IAM, AWS KMS, Amazon VPC och AWS PrivateLink. Tjänsten ansluter till SharePoint, Confluence, Google Drive, Splunk MLTK, LangChain, LlamaIndex och CrewAI, med API:er och SDK:er för anpassade integrationer.
Pros and Cons
Pros:
- Enhetlig åtkomst till över 100 språkmodeller
- Kraftfulla skyddsmekanismer med kontroller för automatiserade resonemang
- Hanterar textgenerering i realtid och i batch
Cons:
- Komplex konfiguration av flera tjänster krävs
- Begränsade möjligheter till finjustering av populära modeller

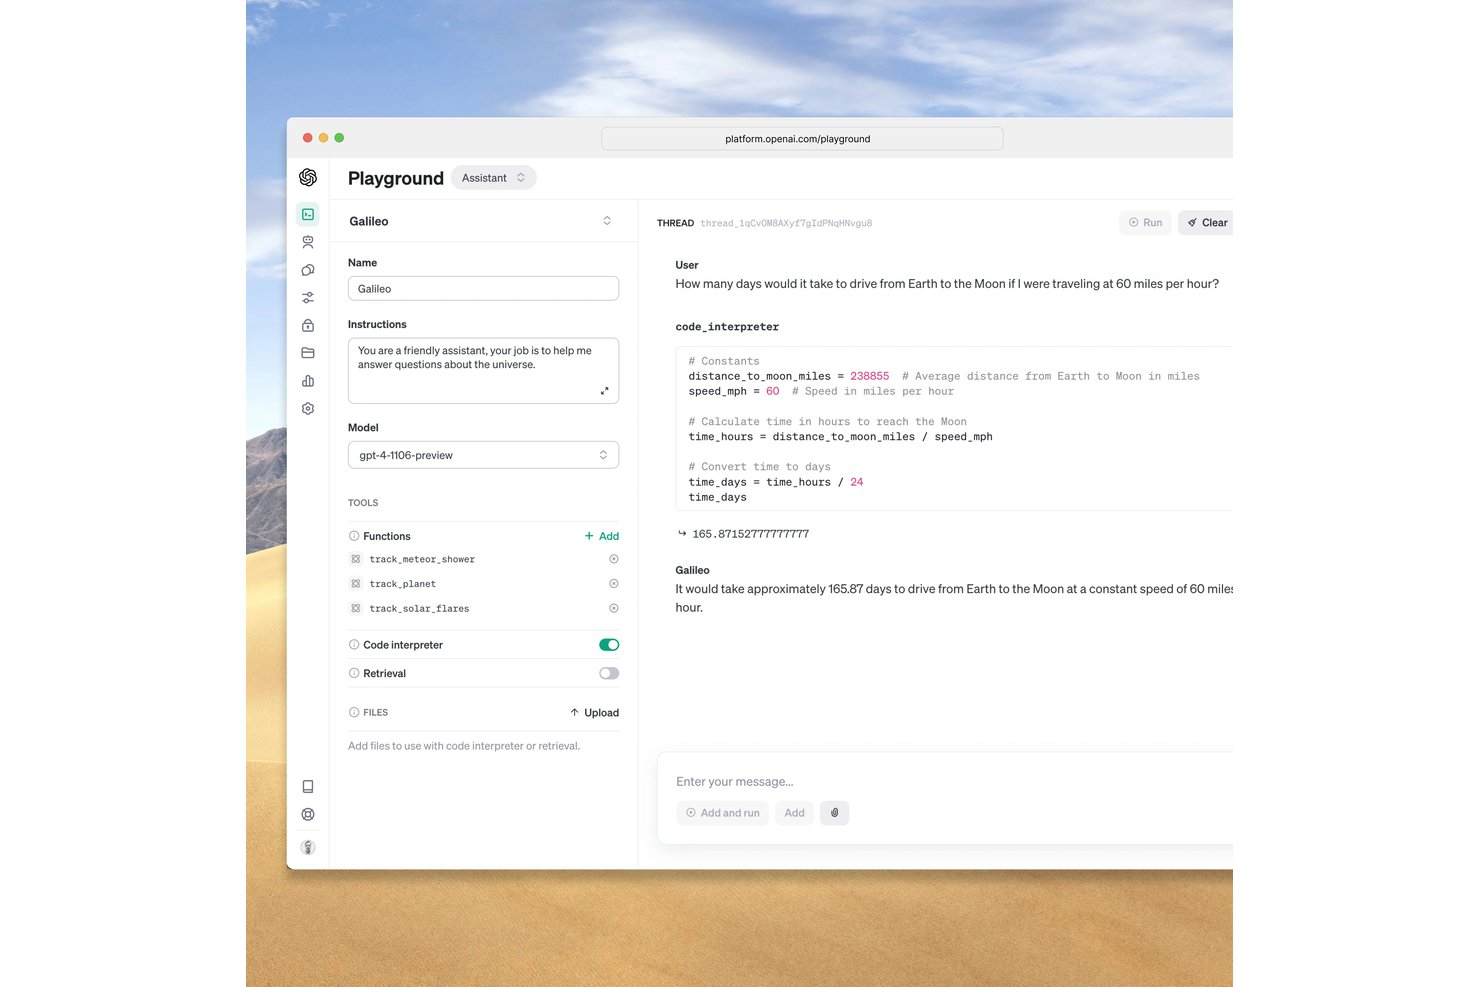
OpenAI är en AI-plattform som tillhandahåller generering av naturligt språk via ett utvecklar-API och erbjuder strukturerade textutdata, generering i flera format, hämtelseförstärkt generering, strömning i realtid och batchbearbetning genom ett brett utbud av språkmodeller.
För vilka passar OpenAI bäst?
OpenAI passar bra för teknik- och IT-team som behöver funktioner för generering av naturligt språk på produktionsnivå, direkt integrerade i applikationer via ett moget och väldokumenterat API.
Varför jag valde OpenAI
OpenAI finns med på min kortlista eftersom modellutbudet, som bygger på forskning och sträcker sig från GPT-5.x till den resonemangsfokuserade o-serien, konsekvent sätter riktmärket för kvalitet inom generering av naturligt språk. Jag uppskattar särskilt funktionen för strukturerade utdata, som säkerställer strikt efterlevnad av JSON Schema så att den genererade texten passar exakt i efterföljande pipelines, oavsett om det gäller en incidentrapport eller ett API-referensdokument. De inbyggda vektorarkiven och verktyget för filsökning gör det också möjligt att förankra genereringen i egna kunskapsbaser utan att behöva konfigurera extern infrastruktur.
OpenAI – viktiga funktioner
- Batch-API: Bearbetar upp till 50 000 API-begäranden per batch till 50 % lägre kostnad, med ett 24-timmarsfönster för slutförande och separata hastighetsgränser.
- Strömning i realtid: Levererar utdata token för token via SSE- och WebSocket-transport, vilket möjliggör incidentöversikter i realtid och interaktiva applikationsgränssnitt.
- Stöd för flera språk: Genererar text på 50–95+ mänskliga språk, inklusive flerspråkig semantisk sökning via inbäddningsmodellen
text-embedding-3-large. - Versionslåsta modellversioner: Gör det möjligt för utvecklare att låsa begäranden till specifika daterade modellversioner (t.ex.
gpt-4.1-2025-04-14) för reproducerbara och konsekventa utdata i olika distributioner.
OpenAI-integreringar
OpenAI har integreringar med Microsoft 365 och Google Workspace samt Datadog, GitHub, Slack, Notion och AWS Bedrock. Dess API, SDK:er och MCP-stöd möjliggör anpassade anslutningar till tekniska verktyg och datakällor.
Pros and Cons
Pros:
- Strukturerade utdata som garanterar text som följer schemat
- Batch-API för dokumentproduktion i stora volymer
- Token-för-token-strömning för incidentsammanfattningar
Cons:
- Plattformen för finjustering tar inte emot nya användare
- Inga lokala distributioner eller distributioner i isolerade nätverk är tillgängliga

Bäst för mallstyrd omvandling från data till text i stor skala
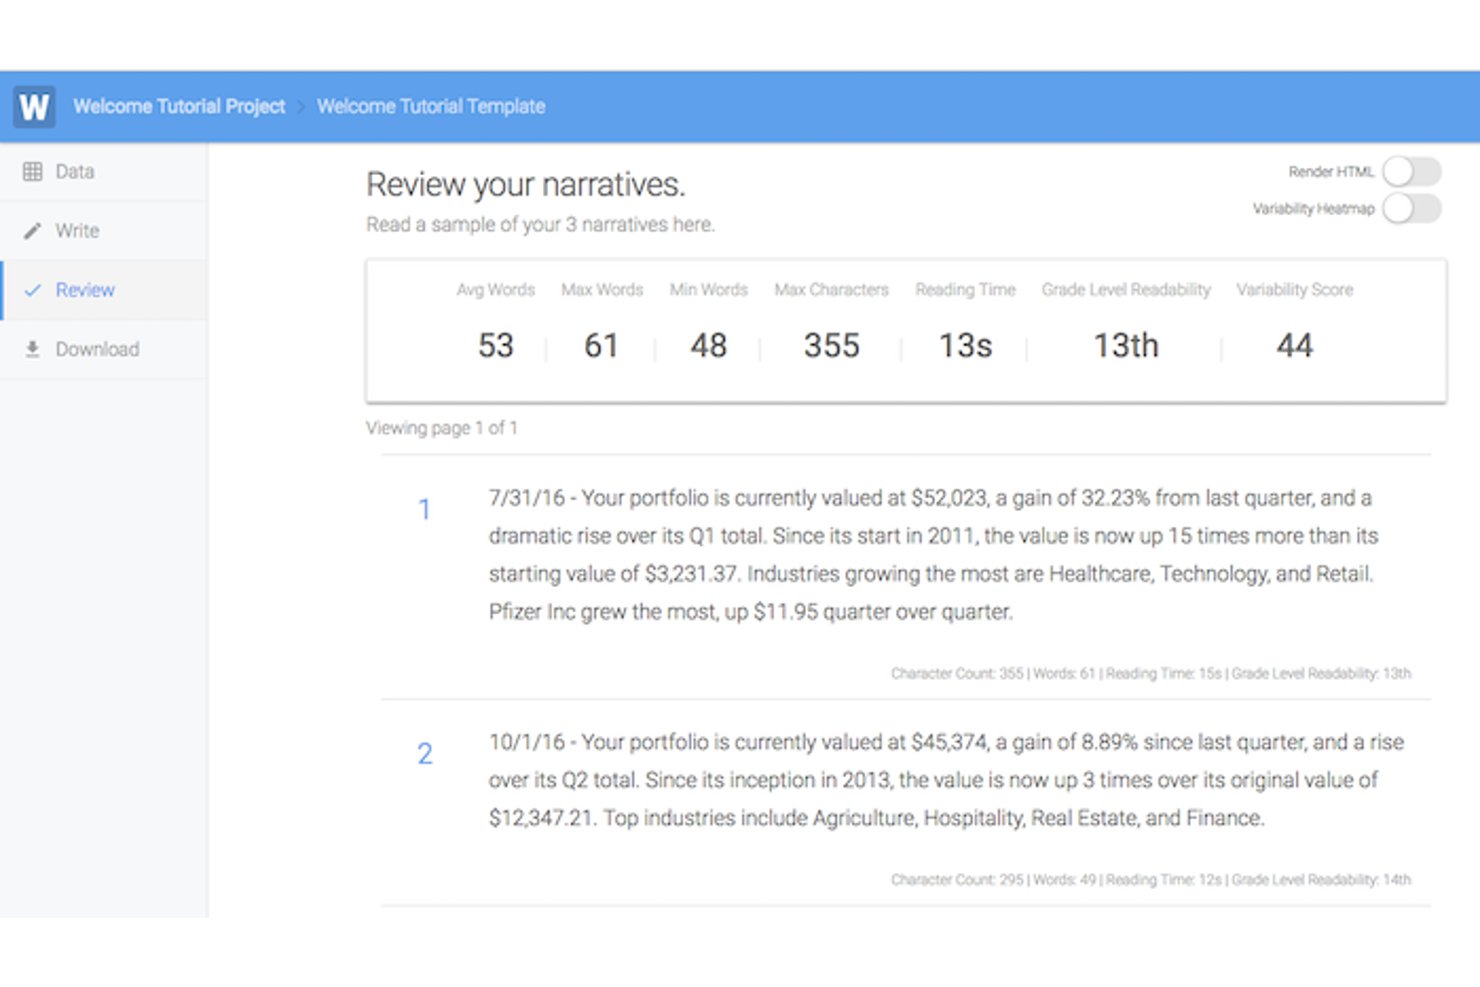
Wordsmith från Automated Insights är en mallstyrd NLG-plattform som omvandlar strukturerade dataindata—CSV-filer, JSON-nyttolaster och databasposter—till skrivna berättelser i stor skala med hjälp av villkorsstyrd förgrening, synonymvariation och ett REST API med Python-, Node.js- och Ruby-SDK:er.
Vem passar Automated Insights Wordsmith bäst för?
Wordsmith passar bra för datatunga team inom finans, försäkring och media som behöver generera tusentals konsekventa, revisionsklara berättelser från strukturerade data i stor skala.
Varför jag valde Wordsmith
Jag valde Wordsmith som ett av de bästa alternativen eftersom inget annat verktyg på den här listan har bevisat mallstyrd NLG i den skala som plattformen hanterar: över 1,5 miljarder berättelser årligen, inklusive AP:s automatiserade resultatrapporter och miljontals fantasy-sammanfattningar från Yahoo Sports som genereras under en enda NFL-söndag. Med mallredigeraren kan du använda villkorsstyrd förgrening och synonymvariation för att styra varje utdata exakt, utan hallucinationer. Denna determinism är det som gör verktyget oumbärligt inom finans, försäkring och alla områden där revisionsklar och förutsägbar textutdata inte är valfritt.
Viktiga funktioner i Automated Insights Wordsmith
- Värmekarta för variation: Markerar avsnitt med låg variation i dina mallar och visar förslag för att öka mångfalden i berättelserna mellan genererade utdata.
- Zapier-anslutning: Kopplar Wordsmith till tusentals appar—inklusive Google Sheets, Salesforce och Airtable—utan att du behöver skriva anpassad integrationskod.
- Tillägg för BI-verktyg: Inbyggda tillägg för Tableau, MicroStrategy, Qlik och TIBCO Spotfire bäddar in genererade berättelser direkt i dina befintliga instrumentpaneler.
- Datatestare: Gör det möjligt att testa förgreningslogik mot aktiva datarader i mallredigeraren innan du publicerar ändringar i produktion.
Integrationer med Automated Insights Wordsmith
Automated Insights Wordsmith erbjuder integrationer med Tableau, MicroStrategy, Qlik, TIBCO Spotfire och Amazon Alexa, samt åtkomst via REST API och Python-, Node.js- och Ruby-SDK:er. Plattformen har även stöd för Zapier.
Pros and Cons
Pros:
- Skalar till miljarder berättelser årligen
- Garanterar revisionsklara utdata utan hallucinationer
- Omfattande alternativ för mall- och regelkonfiguration
Cons:
- Ingen finjustering av språkmodeller är tillgänglig
- Installationen kräver betydande mallutveckling i förväg

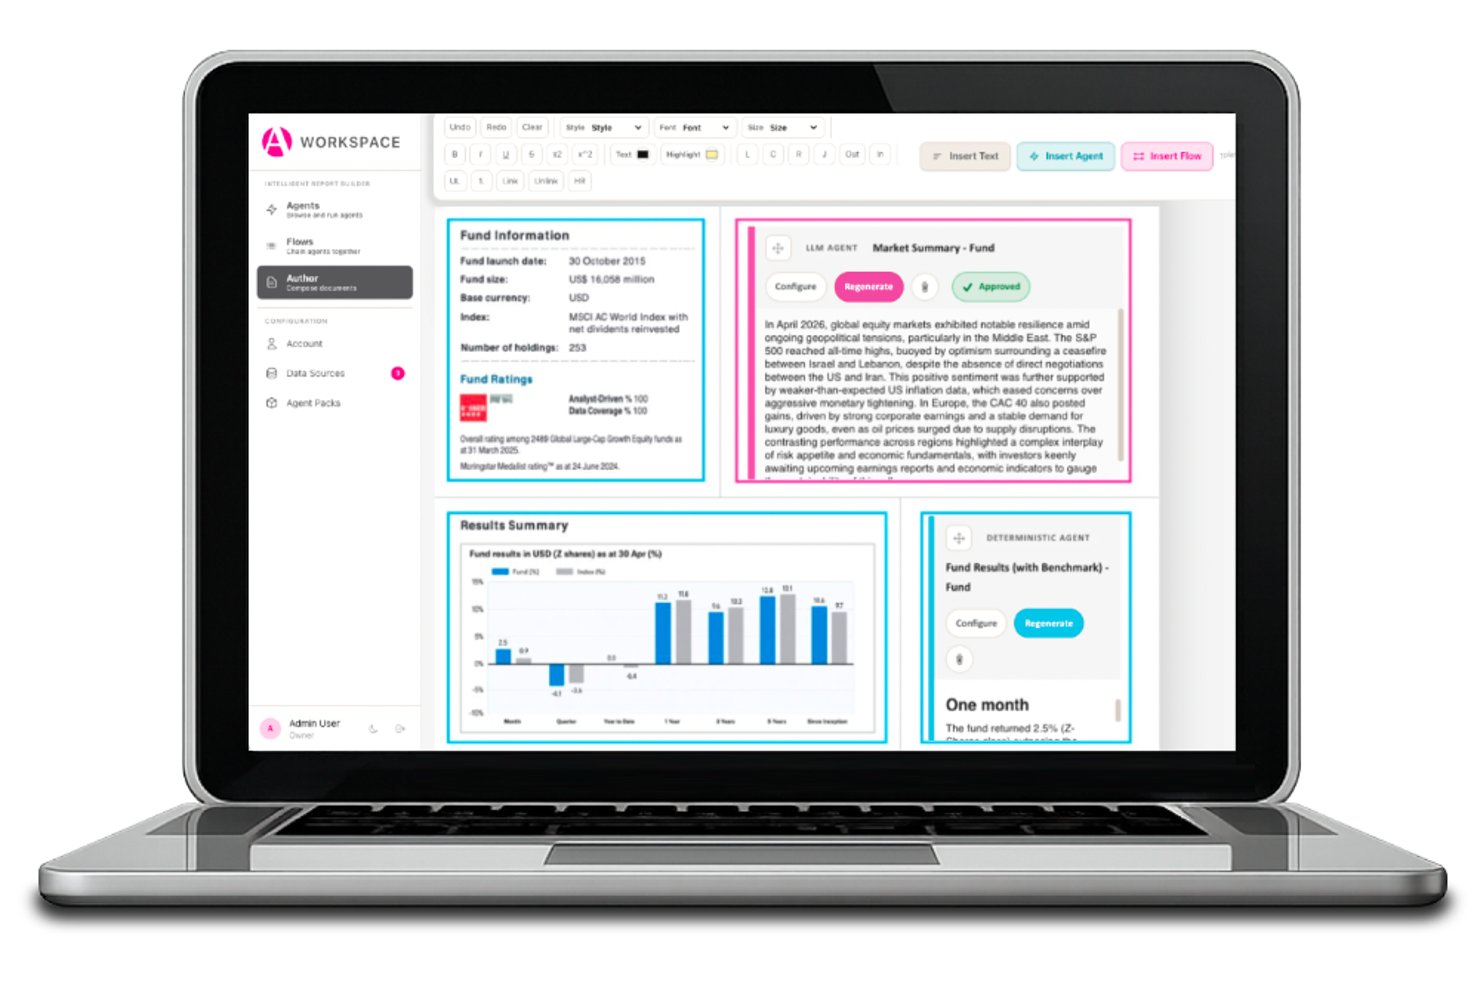
Arria NLG är en plattform för generering av naturligt språk som omvandlar strukturerade data till skrivna och talade narrativ med hjälp av en hybridarkitektur med deterministiska metoder och LLM, med inbyggda integrationer för BI-verktyg som Power BI, Tableau och Qlik.
Vem passar Arria NLG bäst för?
Arria NLG passar särskilt bra för företagsanalys- och BI-team som behöver deterministiska och granskningsbara narrativ som genereras direkt från strukturerade data i stor skala.
Varför jag valde Arria NLG
Arria NLG finns med på min kortlista eftersom den deterministiska arkitekturen löser ett problem som de flesta verktyg för generering av naturligt språk bortser från: noggrannhet vid rapportering med höga krav. I stället för att generera text som låter trovärdig beräknar Arria först den korrekta insikten och beskriver den sedan i text, vilket är viktigt när du skapar narrativ för BI-instrumentpaneler som ligger till grund för verkliga beslut. Jag uppskattar särskilt Arria Authors modell för utdata i tre lager, som kombinerar deterministiska regler, kommentarer skrivna av människor och valfria LLM-sammanfattningar i en enda granskningsbar rapport.
Viktiga funktioner i Arria NLG
- Arria Connect SDK: Bädda in funktioner för generering av naturligt språk i valfri API-baserad plattform med direkta REST-anrop, ett komplett bibliotek för användargränssnitt och API eller ett huvudlöst API för processautomation.
- Arria Answers: En modul för konversationsbaserad AI som låter användare ställa frågor till godkända datakällor och få spårbara, faktabaserade svar med full insyn i hur varje svar genererades.
- Lokal distribution: Kör Arria helt bakom din egen brandvägg och håll alla data inom din kontrollerade miljö för att uppfylla strikta krav på säkerhet och datalagring inom ett visst geografiskt område.
- Generering av batchrapporter: Generera automatiskt tusentals anpassade narrativa rapporter genom att skicka JSON- eller CSV-data via HTTPS, med Kubernetes-baserad automatisk skalning på AWS.
Integrationer med Arria NLG
Arria NLG erbjuder sex dokumenterade inbyggda integrationer med Microsoft Power BI, Microsoft Excel, Tableau, Qlik, TIBCO Spotfire och MicroStrategy. Arria Connect erbjuder även åtkomst via REST API, komplett SDK och huvudlöst API för anpassade integrationer.
Pros and Cons
Pros:
- Deterministiska narrativ eliminerar risken för datahallucinationer
- Mycket anpassningsbar mall- och regelmotor
- Kan skalas för att automatiskt generera tusentals rapporter
Cons:
- Saknar inbyggt stöd för koddokumentation
- Kräver manuell redigering för ett tillgängligt textspråk

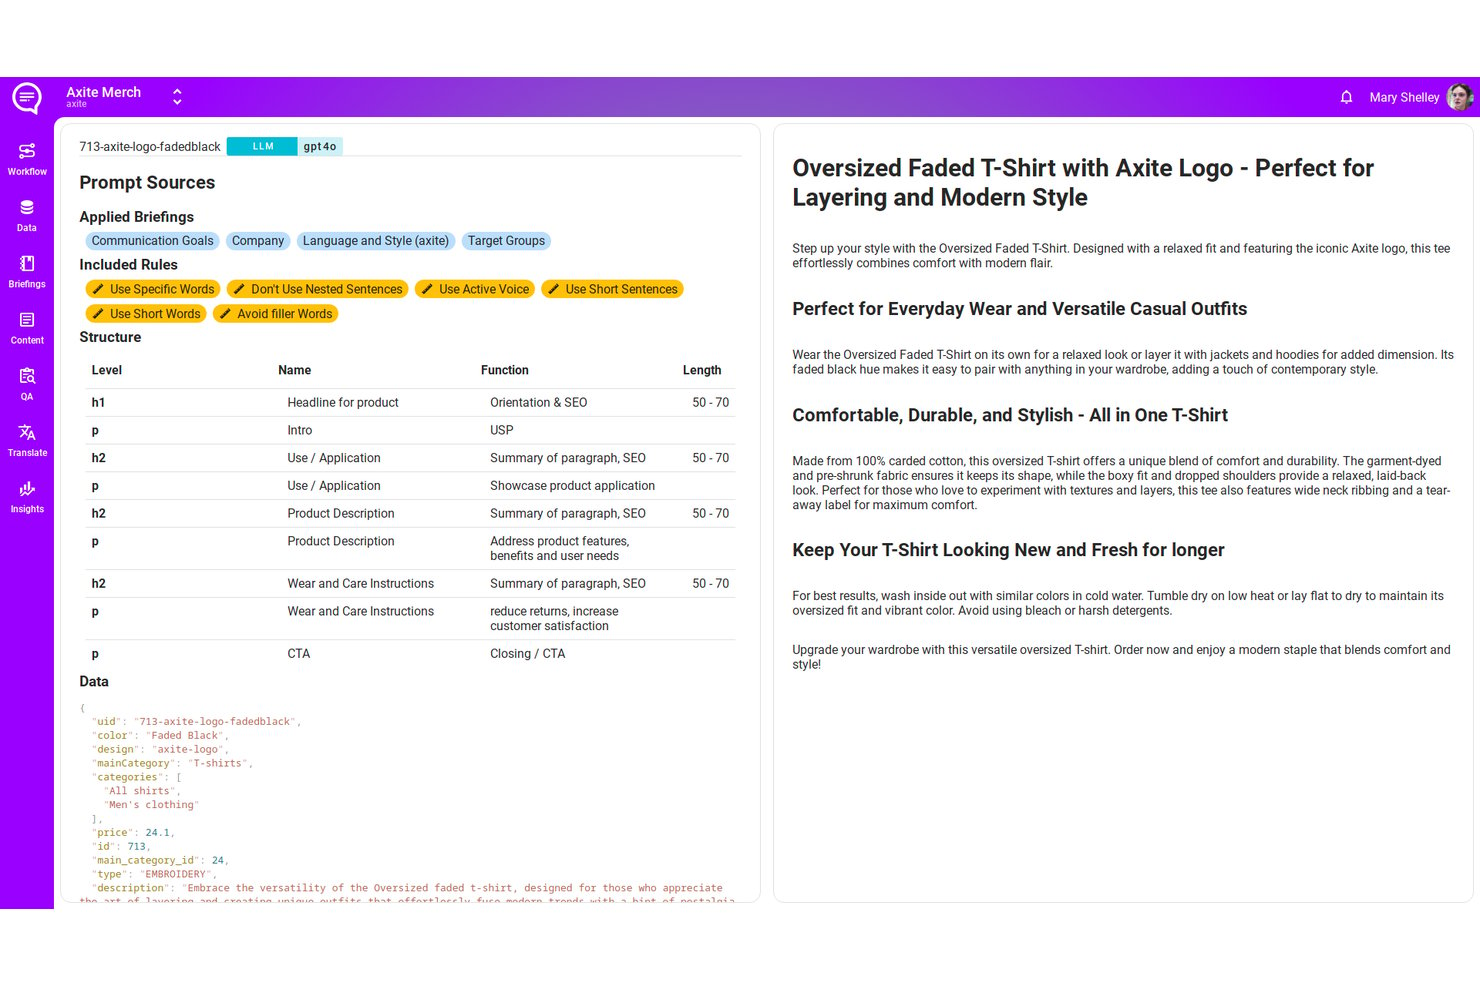
AX Semantics är en regelbaserad NLG-plattform som omvandlar strukturerad produktdata till naturlig text på över 110 språk med hjälp av en deklarativ innehållsmotor med inbyggd QA, batchbearbetning och webhook-baserad leverans.
Vem passar AX Semantics bäst för?
AX Semantics passar utmärkt för e-handelsteam som hanterar stora produktkataloger och behöver korrekta, flerspråkiga produktbeskrivningar i stor skala.
Varför jag valde AX Semantics
AX Semantics tar plats på min kortlista eftersom den regelbaserade NLG-motorn är särskilt utvecklad för exakt det som stora e-handelskataloger kräver: att omvandla strukturerad produktdata till korrekta, varumärkeskonsekventa beskrivningar i stor skala. Jag uppskattar att den hanterar inbyggd morfologi på över 110 språk, vilket innebär att en produktbeskrivning på tyska eller japanska inte är en efterhandsöversättning, utan grammatiskt korrekt text som genereras utifrån källregler. Den deklarativa innehållsmotorn tillämpar dessutom automatiska QA-kontroller innan någon text publiceras, så att den faktamässiga korrektheten förblir förankrad i källdatan.
Viktiga funktioner i AX Semantics
- Återkopplingsloop för resultat: Kopplar publicerat innehåll till SEO-rankningar, konverteringsfrekvenser och returdata för att styra och förbättra framtida regler för innehållsgenerering.
- Automatiserade QA-kontroller: Kontrollerar genererad text mot källdatan före publicering för att upptäcka faktamässiga avvikelser innan texten går live.
- Tilldelning av A/B-varianter för innehåll: Tilldelar innehållsvarianter till olika målgruppssegment för testning via axite Tag, utan att manuell duplicering behövs.
- Batchimport på 5 GB: Accepterar JSONL-uppladdningar på upp till 5 GB, vilket möjliggör storskalig bearbetning av produktkataloger i en enda pipelinekörning.
Integrationer med AX Semantics
AX Semantics erbjuder en anslutning till marknadsplatsen Contentserv, REST Data API, webhook-leverans och en Make-modul för anpassade innehållsflöden. Tjänsten finns även listad på Zapier.
Pros and Cons
Pros:
- Hallucinationsfria resultat som är förankrade i källdata
- Inbyggda grammatikregler för över 110 språk
- Återkopplingsloop för resultat kopplar samman innehåll och resultat
Cons:
- Ingen kostnadsfri provperiod eller demonstration
- Inte lämpligt för teknisk dokumentation eller IT-rapporter

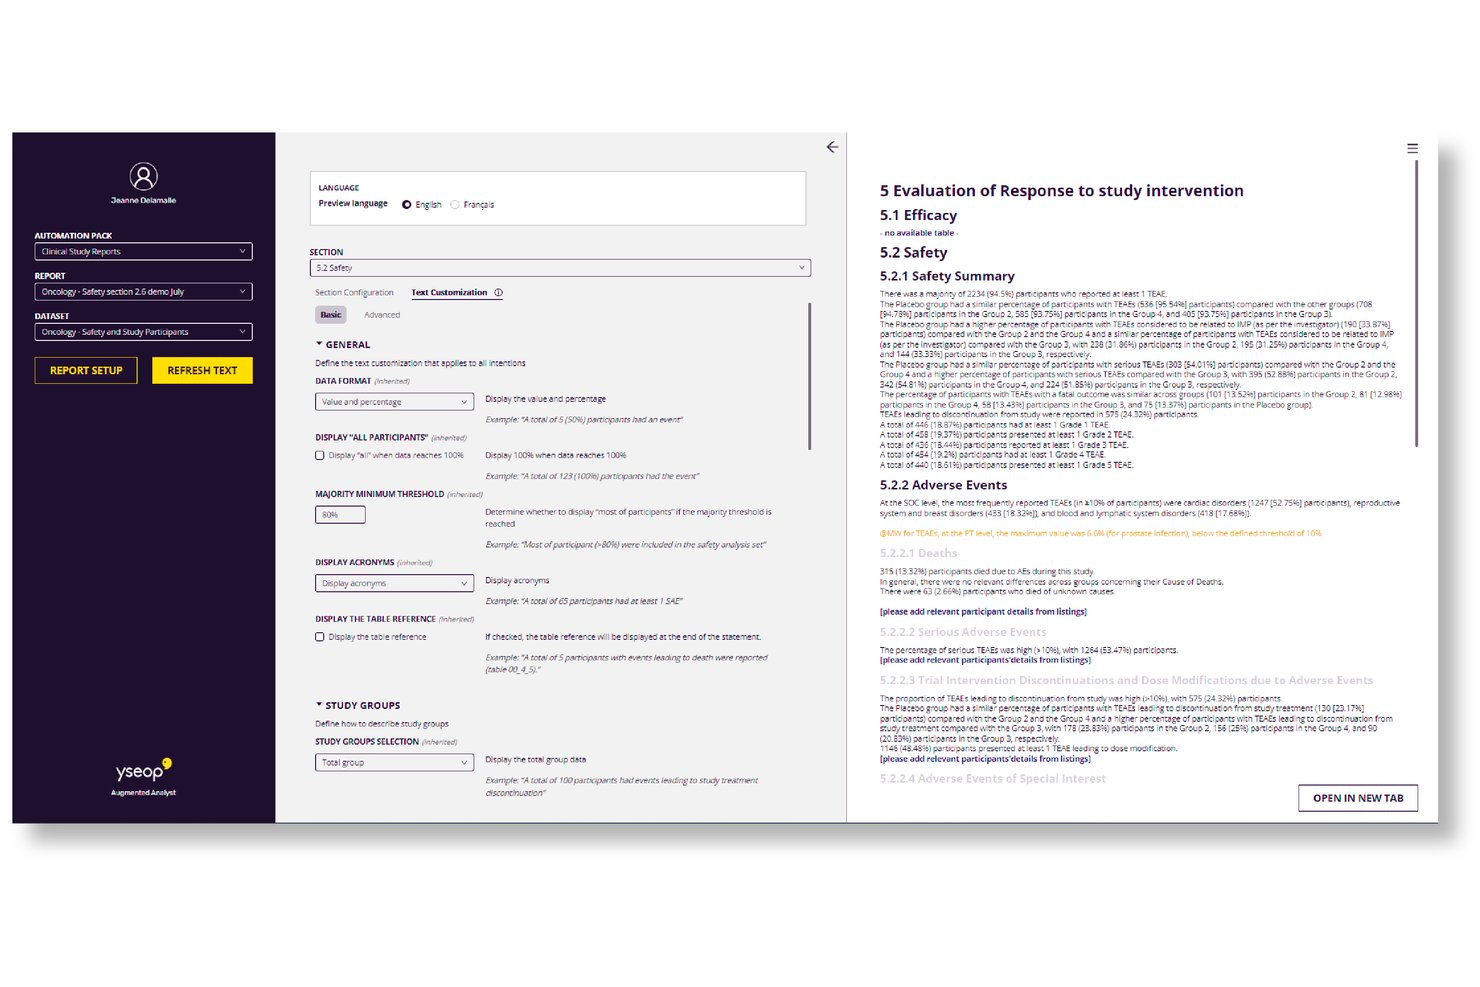
Yseop är en NLG-plattform som använder en kombination av symbolisk AI och stora språkmodeller för att omvandla strukturerade data till regelverksefterlevande, lättlästa regulatoriska dokument och finansdokument.
Vem passar Yseop bäst för?
Yseop är utvecklat för medicinska skribenter och finansanalytiker på större läkemedels- och bankföretag som behöver generera regelverksefterlevande, revisionsklara regulatoriska dokument i stor skala.
Varför jag valde Yseop
Yseop tar plats på min kortlista eftersom plattformen är särskilt utvecklad för de två reglerade skrivmiljöer där fel i NLG får de allvarligaste konsekvenserna: regulatoriska läkemedelsinlämningar och finansiell rapportering. Jag är särskilt imponerad av dess arkitektur för sammansatt AI, som kombinerar symbolisk AI med domänspecifika LLM:er för att skapa helt spårbara resultat, ända ner till källdatan bakom varje genererad mening. Vid en validering hos GSK krävde mindre än 7 % av innehållet omskrivning. Det är den typen av precision som gör plattformen användbar både för eCTD-inlämningar och kreditriskrapporter.
Yseops viktigaste funktioner
- Automatiseringspaket: Förkonfigurerade komponentpaket som gör det möjligt för medicinska skribenter och ekonomiteam att konfigurera dokumentgenerering för specifika dokumenttyper utan att skriva kod.
- Flerspråkig dokumentgenerering: Skapar regulatoriska dokument och finansdokument på flera språk för att stödja globala inlämningskrav.
- Kontrollpunkter för mänskligt godkännande: Inbyggda granskningskontroller som förhindrar att automatiserade resultat går vidare i arbetsflödet utan godkännande från en kvalificerad granskare.
- GxP-kompatibelt revisionsspår: Spårar all dataåtkomst, alla datainteraktioner och alla innehållsändringar för att upprätthålla inlämningsklar dokumentation under hela skrivprocessen.
Yseop-integreringar
Yseop har dokumenterade integreringar med Microsoft Word, Veeva Vault, Tableau, Qlik och Power BI. Det finns inget offentligt dokumenterat REST API eller SDK för anpassade integreringar.
Pros and Cons
Pros:
- Särskilt utvecklat för läkemedels- och finansdokument
- Deterministiska resultat med full spårbarhet till data
- Inbyggd GxP-efterlevnad och revisionsspår
Cons:
- Ingen offentlig API- eller SDK-åtkomst för utvecklare
- Inte lämpligt för NLG-användningsfall av allmän karaktär
Annan programvara för generering av naturligt språk
Nedan finns en lista över ytterligare programvara för generering av naturligt språk som jag tog med i min kortlista, men som inte kom med bland de 10 bästa. De är definitivt värda att undersöka.
- Writer
Bäst för graf-RAG-baserad förankrad NLG via API
- Narrativa
Bäst för automatisering av nyhets- och rapportgenerering
- Retresco
Bäst för automatisering av företagsinnehåll
- Hugging Face Transformers
Bäst för finjustering av NLG på proprietära data


Hur jag utvärderar programvara för generering av naturligt språk
Jag delar upp min utvärdering i två lager: grundläggande krav – som att omvandla loggdata till incidentsammanfattningar via API – och de särskiljande faktorer som skiljer ett bra verktyg från det rätta verktyget.
Grundläggande funktioner (minimikrav för denna lista)
När jag väljer ut verktyg till min lista poängsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje grundläggande funktion som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att komma i fråga för inkludering.
- Generering av text från strukturerade data: Jag kontrollerar om verktyget kan ta emot strukturerade indata, till exempel JSON-nyttolaster, databasfrågor eller systemloggar, och omvandla dem till lättlästa berättande texter.
- Åtkomst till API/SDK för utvecklare: Alla verktyg jag utvärderar behöver programmatiska slutpunkter så att team kan bädda in NLG i pipelines, interna appar eller övervakningsstackar.
- Anpassningsbara språkmodeller: Jag undersöker möjligheten att finjustera eller konfigurera modeller med domänspecifika data, till exempel genom träning på organisationens språk i driftmanualer eller ärendehistorik.
- Stöd för utdata i flera format: Verktyget bör kunna generera olika texttyper från samma datakälla, oavsett om det handlar om en sammanfattning för ledningen, en detaljerad incidentrapport eller infogad koddokumentation.
- Konfiguration av mallar & regler: Jag utvärderar hur mycket kontroll du får över utdataformat, ton och logik – till exempel möjligheten att ställa in regler så att en efteranalys följer teamets standardformat.
- Skalbar batchbearbetning: Användningsfall med stora volymer är viktiga, så jag tittar på hur väl en plattform hanterar samtidiga förfrågningar, till exempel att generera hundratals sammanfattningar av serverhälsa under natten.
När jag har en lista över verktyg som uppfyller dessa kriterier undersöker jag vad som särskiljer varje plattform.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Generering med förstärkt informationshämtning är en viktig särskiljande faktor som jag letar efter, eftersom den gör det möjligt för verktyget att förankra utdata i den faktiska kunskapsbasen – exempelvis driftmanualer, interna wikis eller kodarkiv. Det är viktigt när genererade incidentsammanfattningar behöver återspegla den verkliga infrastrukturen. Jag utvärderar också kontroller mot hallucinationer, till exempel konfidenspoäng och lager för faktagranskning, eftersom felaktiga uppgifter i en efteranalys eller en uppdatering av en statussida snabbt kan urholka förtroendet. Direktströmning är också värt att väga in, särskilt för team som bygger livechattbotar eller dynamiska berättelser för instrumentpaneler.
Mer än funktioner
Flexibilitet vid driftsättning är mycket viktigt här. Jag kontrollerar om en leverantör stöder lokal drift, VPC-isolerad drift eller hybrid drift, eftersom många IT-team hanterar känsliga infrastrukturdata som inte får lämna deras miljö. Integrationsstödet är en annan viktig faktor – jag utvärderar inbyggda anslutningar till verktyg som Datadog, ServiceNow och GitHub, eftersom NLG-utdata bara är användbara om de passar in i befintliga arbetsflöden för observerbarhet och ITSM. Säkerhetscertifieringar som SOC 2 Type II och kontroller för datahemvist väger också tungt, särskilt när den genererade texten berör data från produktionssystem.
Så väljer du programvara för generering av naturligt språk
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du går igenom din unika process för programvaruval kommer här en checklista med faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan programvaran växa med ditt företag? Ta hänsyn till användarbegränsningar, databehandlingskapacitet och hur väl den anpassar sig till ökade arbetsbelastningar utan att prestandan försämras. |
| Integrationer | Fungerar den med dina nuvarande verktyg? Kontrollera kompatibiliteten med CRM-system, analysplattformar och andra viktiga applikationer för att säkerställa en sömlös integrering i arbetsflödet. |
| Anpassningsbarhet | Hur flexibel är programvaran? Leta efter alternativ för att anpassa gränssnitt, rapporter och utdata efter dina specifika behov och branschkrav. |
| Användarvänlighet | Är programvaran användarvänlig? Utvärdera inlärningskurvan, gränssnittsdesignen och tillgången till supportmaterial för nya användare. |
| Implementering och introduktion | Hur smidig är installationsprocessen? Bedöm den tid och de resurser som krävs för den första implementeringen och utbildningen, inklusive tillgång till handledningar och support. |
| Kostnad | Ryms den inom din budget? Jämför prisplaner, dolda avgifter och valuta för pengarna. Ta hänsyn till långsiktiga kostnader och potentiell avkastning på investeringen. |
| Säkerhetsåtgärder | Hur säkra är dina data? Säkerställ att programvaran följer dataskyddslagar och erbjuder kryptering, åtkomstkontroller och regelbundna säkerhetsuppdateringar. |
Vad är programvara för naturlig språkgenerering?
Programvara för naturlig språkgenerering (NLG) är en delmängd av artificiell intelligens som automatiserar skapandet av text baserat på strukturerade data. Den används främst av innehållsskapare, dataanalytiker och företag och syftar till att producera sammanhängande berättelser, rapporter eller beskrivningar, effektivisera processer för innehållsgenerering, säkerställa konsekvens och omvandla data till lättförståeliga berättelser anpassade för olika målgrupper.
Funktioner
När du väljer programvara för naturlig språkgenerering bör du hålla utkik efter följande viktiga funktioner:
- Automatiskt textskapande: Skapar text automatiskt från datainmatningar, vilket sparar tid och arbete för användarna.
- Flerspråkiga funktioner: Stöder flera språk, så att du kan nå en global målgrupp med ditt innehåll.
- Datadrivna insikter: Analyserar data för att producera korrekt och relevant innehåll, vilket underlättar välgrundade beslut.
- Anpassningsbara mallar: Erbjuder mallar som du kan anpassa efter specifika bransch- eller företagsbehov.
- Prediktiv prestationsbedömning: Utvärderar den potentiella framgången för ditt innehåll före publicering och optimerar resultaten.
- Dataintegrering i realtid: Integreras med datakällor i realtid för att säkerställa att innehållet är aktuellt och relevant. Den här funktionen är särskilt viktig när du väljer programvara för konversationsintelligens.
- Adaptivt lärande: Anpassar innehållsgenereringen utifrån användarfeedback och förbättrar noggrannheten över tid.
- Personalisering av innehåll: Anpassar innehållet efter varumärkets röst och målgruppens preferenser, vilket ökar engagemanget.
- Säkerhetsåtgärder: Skyddar dina data med kryptering och åtkomstkontroller och säkerställer efterlevnad av regelverk.
Fördelar
Implementering av naturlig språkgenerering eller NLP-programvara ger flera fördelar för ditt team och ditt företag. Här är några av dem:
- Tidsbesparingar: Automatiserar textskapandet och frigör ditt team så att det kan fokusera på mer strategiska uppgifter.
- Global räckvidd: Flerspråkiga funktioner gör att du kan kommunicera effektivt med internationella målgrupper.
- Förbättrad noggrannhet: Datadrivna insikter säkerställer att det producerade innehållet är relevant och precist.
- Ökat engagemang: Personalisering anpassar innehållet efter din målgrupp och ökar interaktion och intresse.
- Skalbarhet: Anpassar sig enkelt till ökade innehållsbehov när ditt företag växer.
- Konsekvens: Anpassningsbara mallar skapar enhetlighet i innehållet och upprätthåller varumärkets röst i allt material.
Kostnader och priser
För att välja programvara för naturlig språkgenerering krävs en förståelse av de olika prismodeller och planer som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga planer, deras genomsnittliga priser och typiska funktioner som ingår i programvarulösningar för naturlig språkgenerering:
Jämförelsetabell för planer för programvara för naturlig språkgenerering
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisplan | $0 | Grundläggande textskapande, begränsad anpassning och tillgång till supportresurser. |
| Personlig plan | $10-$30/användare/månad | Textskapande, grundläggande analys, flerspråkigt stöd och begränsade personaliseringsalternativ. |
| Företagsplan | $50-$100/användare/månad | Avancerad analys, utökad anpassning, dataintegration i realtid och verktyg för teamsamarbete. |
| Företagslösning | $200+/användare/månad | Fullständig anpassning, dedikerad support, avancerade säkerhetsfunktioner och omfattande dataintegration. |
Vanliga frågor om programvara för naturlig språk-generering
Här är några svar på vanliga frågor om programvara för naturlig språk-generering:
Hur hanterar programvara för naturlig språk-generering datasekretess?
Programvara för naturlig språk-generering innehåller vanligtvis datakryptering och åtkomstkontroller för att skydda sekretessen. Du bör säkerställa att programvaran följer relevanta dataskyddsbestämmelser, såsom GDPR. Det är också viktigt att kontrollera hur programvaruleverantören hanterar lagring och delning av data.
Vilka integrationsmöjligheter har programvara för naturlig språk-generering?
De flesta verktyg för naturlig språk-generering integreras med populära plattformar som CRM-system, analysprogramvara och innehållshanteringssystem. Kontrollera om programvaran stöder API-åtkomst för anpassade integrationer. Säkerställ att den kan ansluta till de verktyg som ditt team redan använder.
Hur kan jag mäta effektiviteten hos programvara för naturlig språk-generering?
Effektiviteten kan mätas genom att utvärdera kvaliteten och relevansen hos det genererade innehållet. Leta efter funktioner som poängsättning av förutsagd prestanda. Bedöm också hur väl verktyget uppfyller dina specifika affärsbehov och förbättrar ditt arbetsflöde.
Vilken grad av anpassning finns tillgänglig i programvara för naturlig språk-generering?
Anpassningsmöjligheterna varierar mellan olika verktyg, men omfattar ofta möjligheten att anpassa mallar, justera språktonen och ändra resultat så att de överensstämmer med varumärkesriktlinjer. Säkerställ att programvaran erbjuder tillräcklig flexibilitet för att uppfylla dina affärskrav utan omfattande tekniska justeringar.
Hur viktigt är användarstöd när man väljer programvara för naturlig språk-generering?
Ett starkt användarstöd är avgörande för en smidig upplevelse. Leta efter leverantörer som erbjuder support dygnet runt, omfattande dokumentation och utbildningsresurser. Snabba svarstider och flera supportkanaler kan ha stor inverkan på teamets produktivitet.
Finns det branschspecifika lösningar för naturlig språk-generering?
Ja, vissa lösningar är anpassade för specifika branscher som finans, sjukvård eller e-handel. Dessa verktyg kan erbjuda specialiserade mallar och funktioner som är utformade för branschspecifika innehållsbehov. Överväg om ett branschspecifikt verktyg bättre kan tillgodose dina unika krav.
Vad händer härnäst:
Om du håller på att undersöka programvara för naturlig språk-generering kan du kontakta en SoftwareSelect-rådgivare för kostnadsfria rekommendationer.
Du fyller i ett formulär och har ett kort samtal där de går igenom dina specifika behov. Därefter får du en kortlista med programvara att granska. De hjälper dig även genom hela köpprocessen, inklusive prisförhandlingar.