

Programvara för hantering av IT-drift hjälper dig att hantera – och skapa överblick över – hela din IT-infrastruktur, inklusive övervakning, automatisering, säkerhet och tjänsternas hälsa i lokala och molnbaserade miljöer.
Den här listan är framtagen för CTO:er och IT-chefer som behöver en samlad överblick, snabbare rotorsaksanalys och lösningar som är redo för hybrid- och multimolndrift. Här hittar du alternativ för AI-driven automatisering, djupgående observerbarhet, inbyggda säkerhetsintegrationer och den anpassningsbarhet du behöver för att skala det som är viktigt.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell för programvara för hantering av IT-drift
Jämför priser och viktiga specifikationer för mina främsta val av programvara för hantering av IT-drift i tabellen nedan.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för SecOps-integrerad logg- och mätvärdeshantering | Gratis provperiod tillgänglig | Från $0.15/credit | Website | |
| 2 | Bäst för fullständig driftinsyn med OTel som grund | 14 dagars kostnadsfri provperiod | Från $99/månad | Website | |
| 3 | Bäst för MSP-anpassad hantering av hybrid-IT-drift med flera klientorganisationer | Gratis demo tillgänglig | Pris på begäran | Website | |
| 4 | Bäst för djupgående insyn i lagrings- och GPU-drift | Gratis demo tillgänglig | Pris på begäran | Website | |
| 5 | Bäst för AI-driven releasevalidering i hela teknikstacken | 15 dagars kostnadsfri provperiod | Från $7/värd/månad | Website | |
| 6 | Bäst för AI-drivna insatser för grundorsaksanalys från larm till topologi | 14 dagars kostnadsfri provperiod | Pris på begäran | Website | |
| 7 | Bäst för fullstackobservabilitet på transaktionsnivå | Gratisabonnemang tillgängligt | Från $99/användare/månad | Website | |
| 8 | Bäst för hybrid-IT-drift i stor skala med CMDB som nav | Gratis demo tillgänglig | Pris på begäran | Website | |
| 9 | Bäst för drift av Cisco-inbyggd tjänstehälsa över flera domäner | Gratis demo tillgänglig | Pris på begäran | Website | |
| 10 | Bäst för agentisk AI inom drift från stordator till moln | Gratis demo tillgänglig | Pris på begäran | Website |


Recensioner av den bästa programvaran för hantering av IT-drift
Nedan finns mina detaljerade sammanfattningar av den bästa programvaran för hantering av IT-drift som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över funktionerna, de bästa användningsområdena och integrationerna för varje plattform för att hjälpa dig hitta den bästa lösningen för dig.
 Bäst för SecOps-integrerad logg- och mätvärdeshantering
- Gratis provperiod tillgänglig
- Från $0.15/credit
Visit WebsiteCustomer Rating:4.3/5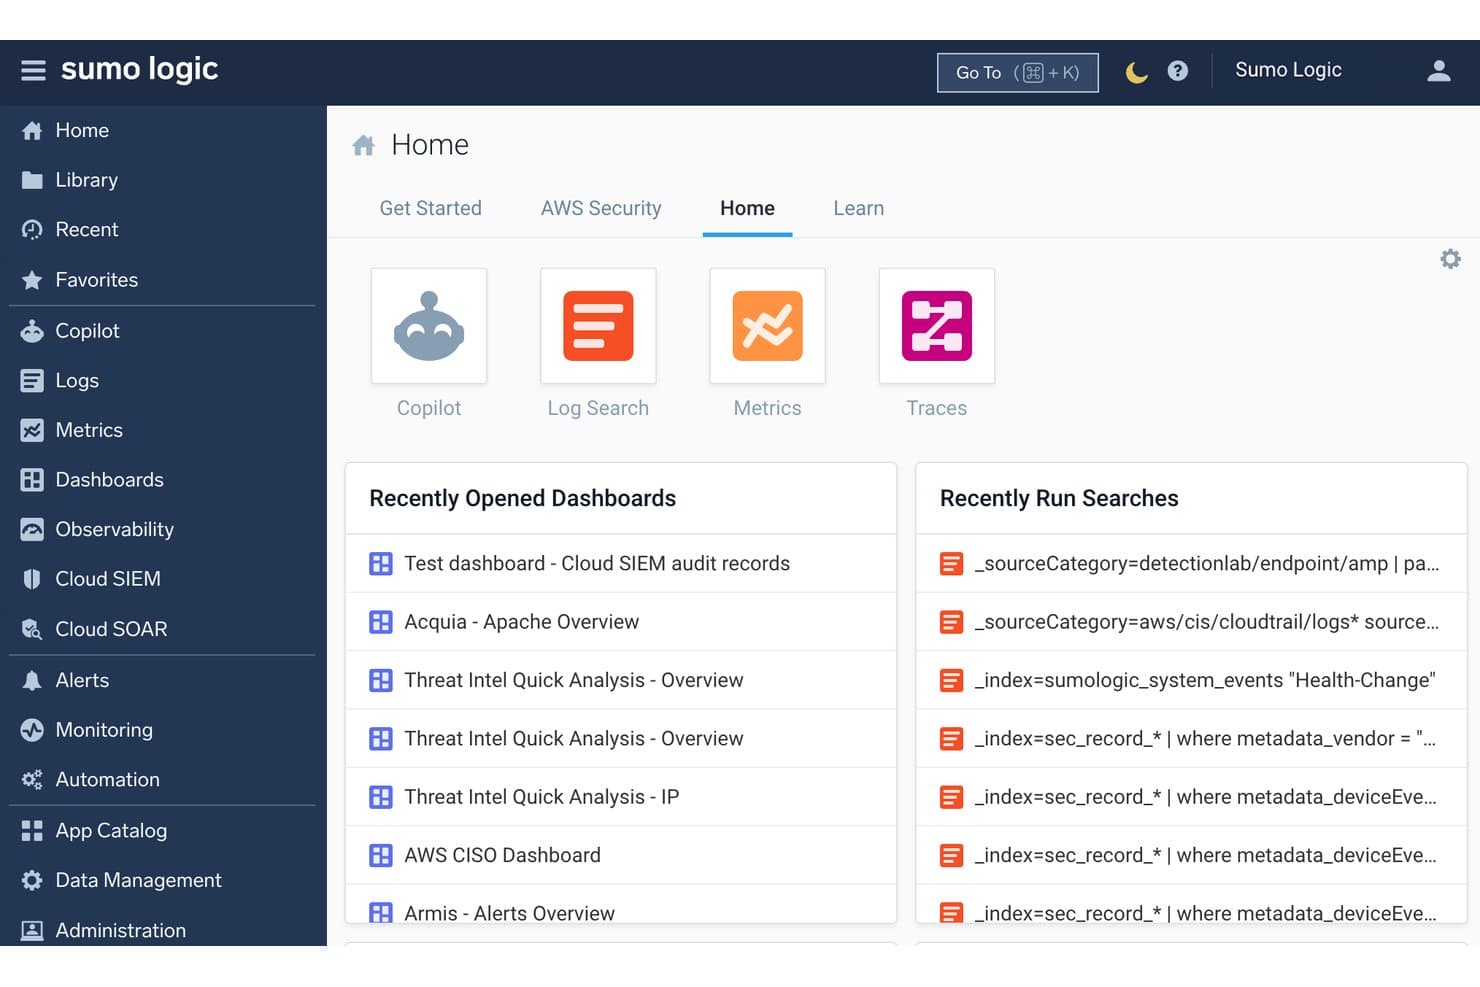
Sumo Logic ger team snabb åtkomst till loggsökning, mätvärden och senaste aktivitet. Sumo Logic är en molnbaserad plattform för hantering av IT-drift som förenar logganalys, infrastrukturövervakning, mätvärden, distribuerad spårning och säkerhetsdrift i en enda SaaS-baserad lösning för observerbarhet och SIEM.
Vem passar Sumo Logic bäst för?
Sumo Logic passar bra för säkerhetsmedvetna IT- och driftteam som behöver logganalys, mätvärden och SIEM-funktioner i en enda SaaS-plattform.
Varför jag valde Sumo Logic
Sumo Logic finns med på min kortlista eftersom det är en av få plattformar som samlar logganalys och säkerhetsdrift i ett enda, genuint enhetligt SaaS-verktyg. Jag uppskattar hur de patenterade operatorerna LogReduce och LogExplain identifierar grundorsaker direkt från rå loggdata, vilket minskar det manuella mönstersökande som fördröjer incidentlösningen. Dojo AI-plattformen med flera agenter utmärker sig också: SOC Analyst Agent automatiserar den första nivån av larmtriage och levererar evidensbaserade bedömningar, vilket mitt team tycker är ovärderligt när SecOps- och ITOps-arbetsflöden överlappar.
Viktiga funktioner i Sumo Logic
- AI-drivna mätvärdesövervakare: ML-baserad avvikelsedetektering justerar automatiskt säsongsbaserade normalvärden för dina mätvärdesdata och minskar mängden falska larm.
- Hantering av flera organisationer: En överordnad organisation styr övervakare, instrumentpaneler, roller och åtkomst i underordnade organisationer från ett enda centraliserat gränssnitt.
- Instrumentpaneler för efterlevnadsrapportering: Förbyggda instrumentpaneler jämför dina data med PCI-, HIPAA-, GDPR-, SOX- och ISO-ramverk för kontinuerlig insyn i efterlevnadsstatusen.
- OpenTelemetry Distribution Agent: En enda enhetlig agent samlar in loggar, mätvärden och spårningar i Linux, Windows, macOS och över 25 källkonfigurationer.
Integrationer med Sumo Logic
Sumo Logic erbjuder över 450 integrationer, inklusive ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes och Docker. Plattformen tillhandahåller även REST API:er, webhooks, Terraform, SumoQL och ett öppet integrationsramverk för anpassad anslutning.
Pros and Cons
Pros:
- Dojo AI automatiserar incidenttriage och -lösning
- Instrumentpaneler för efterlevnad kopplas direkt till viktiga ramverk
- Samlar loggar, mätvärden och spårningar i en enda plattform
Cons:
- Avancerad automatisering prioriterar säkerhet framför IT-drift
- Det kan gå långsamt att söka i stora historiska datamängder
 Bäst för fullständig driftinsyn med OTel som grund
- 14 dagars kostnadsfri provperiod
- Från $99/månad
Visit WebsiteCustomer Rating:4.3/5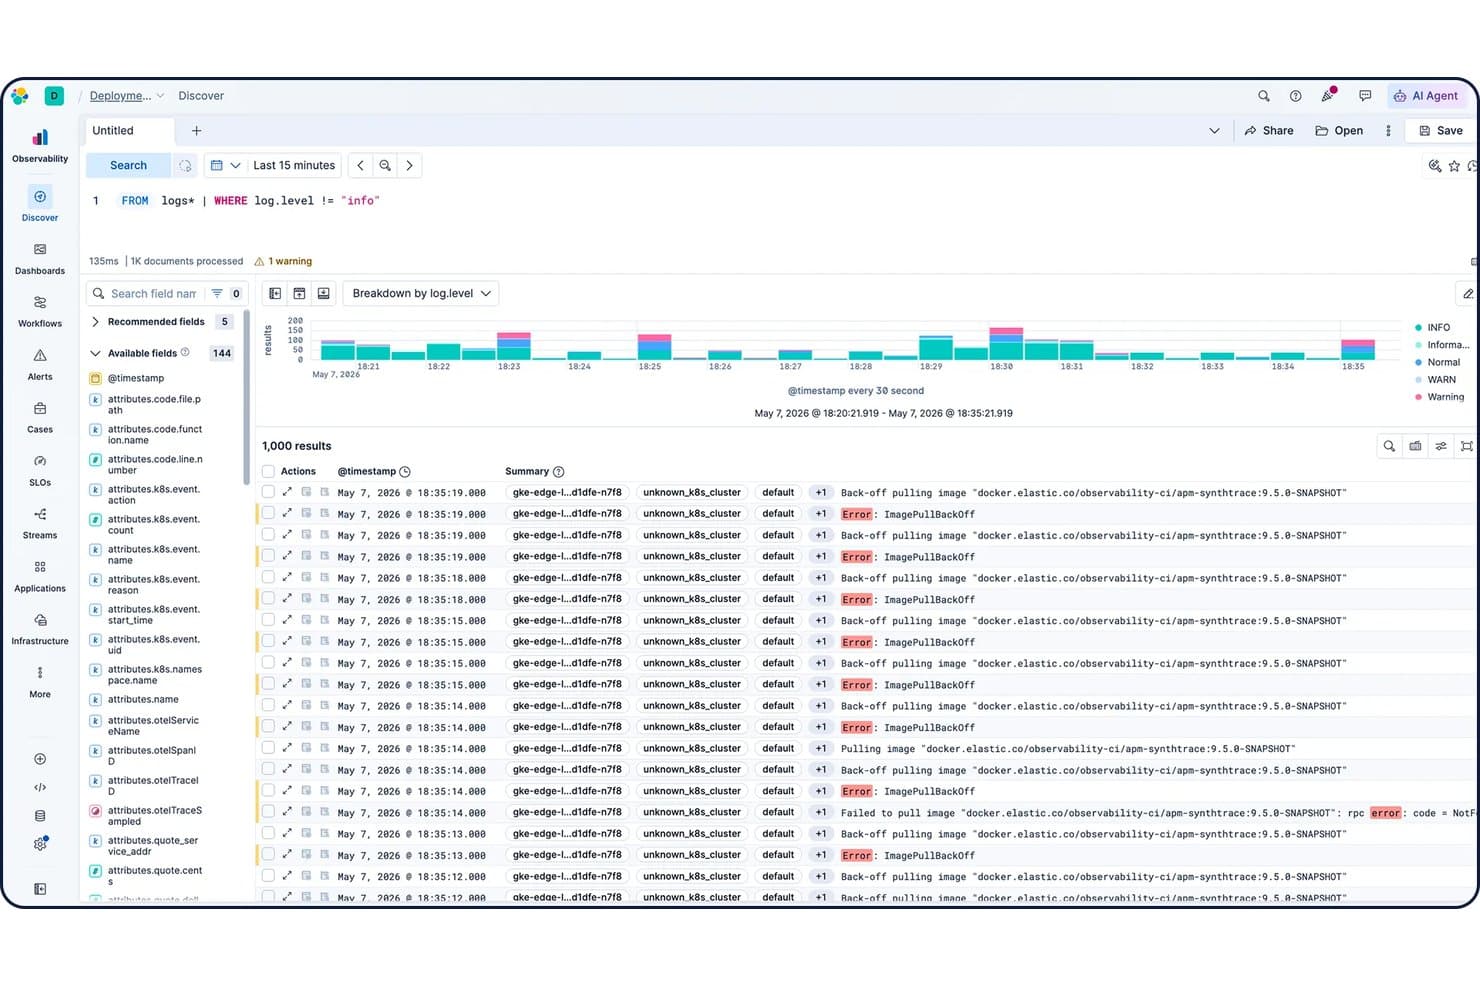
Elastic Observability filtrerar loggar efter nivå i vyn Discover. Elastic Observability är en fullstackplattform för observabilitet som förenar loggövervakning, infrastrukturmätvärden, APM, distribuerad spårning, syntetisk övervakning och AIOps i lokala, molnbaserade och hybrida miljöer.
Vem passar Elastic Observability bäst för?
Elastic Observability passar bra för SRE:er och infrastrukturingenjörer på medelstora till stora företag som behöver enhetlig insyn i loggar, mätvärden, spårningar och APM i hybrida miljöer och multicloudmiljöer – särskilt team som redan använder OpenTelemetry.
Varför jag valde Elastic Observability
Elastic Observability finns med på min kortlista eftersom det är en av få plattformar som är byggda med OpenTelemetry som utgångspunkt, vilket innebär att dina loggar, mätvärden, spårningar och APM-data hamnar i ett enda schema utan att du behöver brottas med proprietära agenter. Jag uppskattar särskilt ML-lagret utan konfiguration: över 100 förkonfigurerade jobb för avvikelsedetektering körs automatiskt över varje dataström, så när datainhämtning i Comcast-skala sker behöver ditt team inte finjustera modeller manuellt. Den Streams-baserade loggparsningen och frågemotorn ES|QL gör det genuint snabbt att hitta grundorsaker i hybrida miljöer.
Viktiga funktioner i Elastic Observability
- Syntetisk övervakning: Kör lättviktstester och fullständiga webbläsartester mot användarflöden med hjälp av en global hanterad testinfrastruktur eller privata lokala platser.
- Spårning av servicenivåmål (SLO): Definiera, övervaka och rapportera tillförlitlighetsmål direkt i Kibana tillsammans med dina befintliga instrumentpaneler och aviseringar.
- Aviseringar i Kibana: Konfigurera regelbaserade aviseringar för APM-, mätvärdes-, drifttids- och säkerhetsdata med formulärbaserad konfiguration och stöd för aviseringar via flera kanaler.
- Över 550 förbyggda integrationer: Anslut till molnleverantörer, ITSM-verktyg, säkerhetsplattformar och datakällor med hjälp av förbyggda agenter och agentlösa insamlare.
Integrationer med Elastic Observability
Elastic Observability erbjuder över 550 förbyggda integrationer, däribland AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes och OpenTelemetry. Plattformen stöder även REST API:er, webhooks, Elastic Agent, Logstash, Beats och OpenTelemetry-insamlare för anpassad anslutning.
Pros and Cons
Pros:
- Enhetlig insyn i hybrida miljöer och multicloudmiljöer
- ML utan konfiguration upptäcker avvikelser automatiskt
- OTel-baserad inläsning undviker leverantörsinlåsning
Cons:
- Inbyggd schemaläggning av jourberedskap ingår inte
- Dokumentationen är bristfällig för komplexa OTel-konfigurationer
Learn more about Elastic Observability: Bäst för MSP-anpassad hantering av hybrid-IT-drift med flera klientorganisationer
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.1/5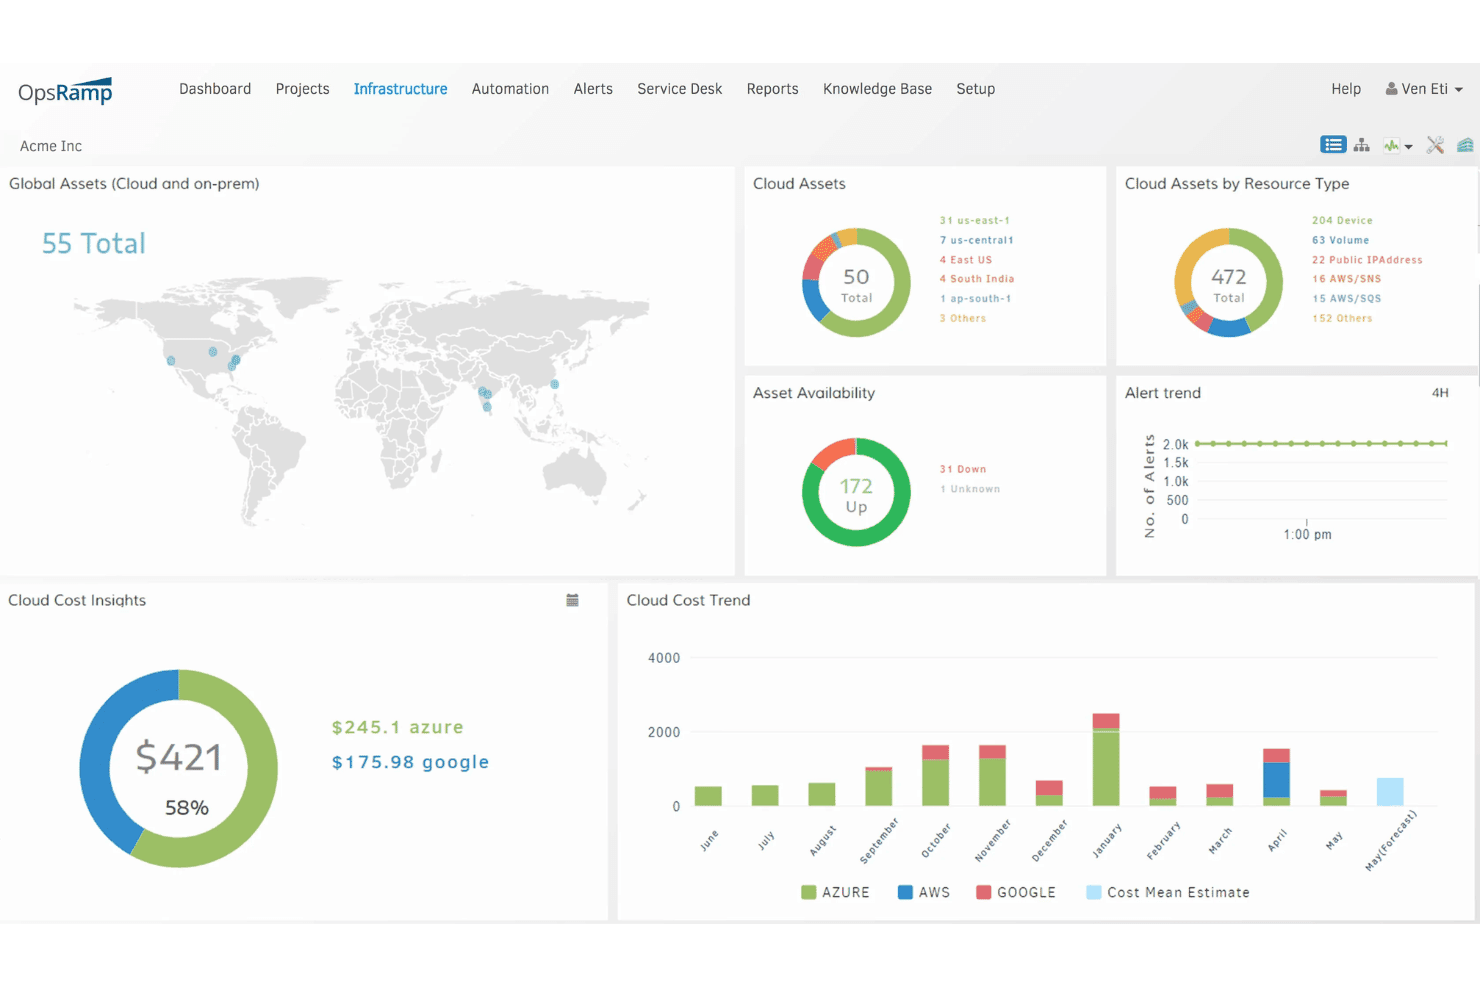
OpsRamp ger användarna en enhetlig vy över molnkostnader, tillgångar och aviseringar. HPE OpsRamp är en plattform för hantering av IT-drift som drivs av AIOps och förenar infrastrukturövervakning, händelsekorrelation, incidenthantering, körboksautomatisering och insyn i hybrid- och multicloudmiljöer över lokala miljöer, privata moln och publika moln.
Vem passar OpsRamp bäst för?
OpsRamp passar mycket bra för hanterade tjänsteleverantörer och stora företag som driver komplexa hybrid-IT-miljöer över lokala miljöer och multicloudmiljöer.
Varför jag valde OpsRamp
OpsRamp tar plats på min kortlista eftersom dess arkitektur med flera klientorganisationer är särskilt utformad för MSP:er som hanterar dussintals kundmiljöer från en enda översiktsvy. Jag uppskattar särskilt dess AIOps-motor för händelsekorrelation, som grupperar relaterade aviseringar mellan klientorganisationer och minskar bruset med upp till 90 %, så att ditt team inte drunknar i ärenden från olika kundkonton. Dess topologi- och tjänstekartor ger dig en aktuell vy över beroenden i hybridmiljöer som omfattar AWS, Azure, GCP och lokala miljöer, något som verkligen är svårt att återskapa i den skalan.
Viktiga funktioner i OpsRamp
- Motor för körboksautomatisering: Kör fördefinierade åtgärdsskript automatiskt som svar på upptäckta problem, med RBAC-styrd åtkomst till jobb och processarbetsflöden.
- Hantering av klientorganisationer med flera klienter: Hantera flera kundmiljöer från en enda plattformsinstans, med konfiguration av integrationer per klientorganisation och isolerad datahantering.
- Rapportering av molnkostnader: Dela upp molnutgifter efter konto, region, tjänst och instanstyp i AWS, Azure och GCP med anpassningsbara datumintervall.
- Inläsning via OpenTelemetry: Läs in mätvärden, loggar och spårningar från valfri OpenTelemetry-kompatibel källa tillsammans med eBPF-assisterad automatisk instrumentering för djupgående insyn i arbetsbelastningar.
Integrationer i OpsRamp
OpsRamp erbjuder över 3 000 integrationer, inklusive ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry och Prometheus. Dess OAuth 2.0 REST API, webhooks och JSON-import/export stöder anpassade anslutningar.
Pros and Cons
Pros:
- Hantering av flera klientorganisationer för MSP-kundmiljöer
- Upp till 90 procents minskning av brus från aviseringar
- Visualiseringar av topologier för hybrid- och multicloudmiljöer
Cons:
- Funktionerna för applikationsövervakning är fortfarande under utveckling
- Instrumentpanelens prestanda kan försämras i stor skala
Learn more about OpsRamp: Bäst för djupgående insyn i lagrings- och GPU-drift
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.3/5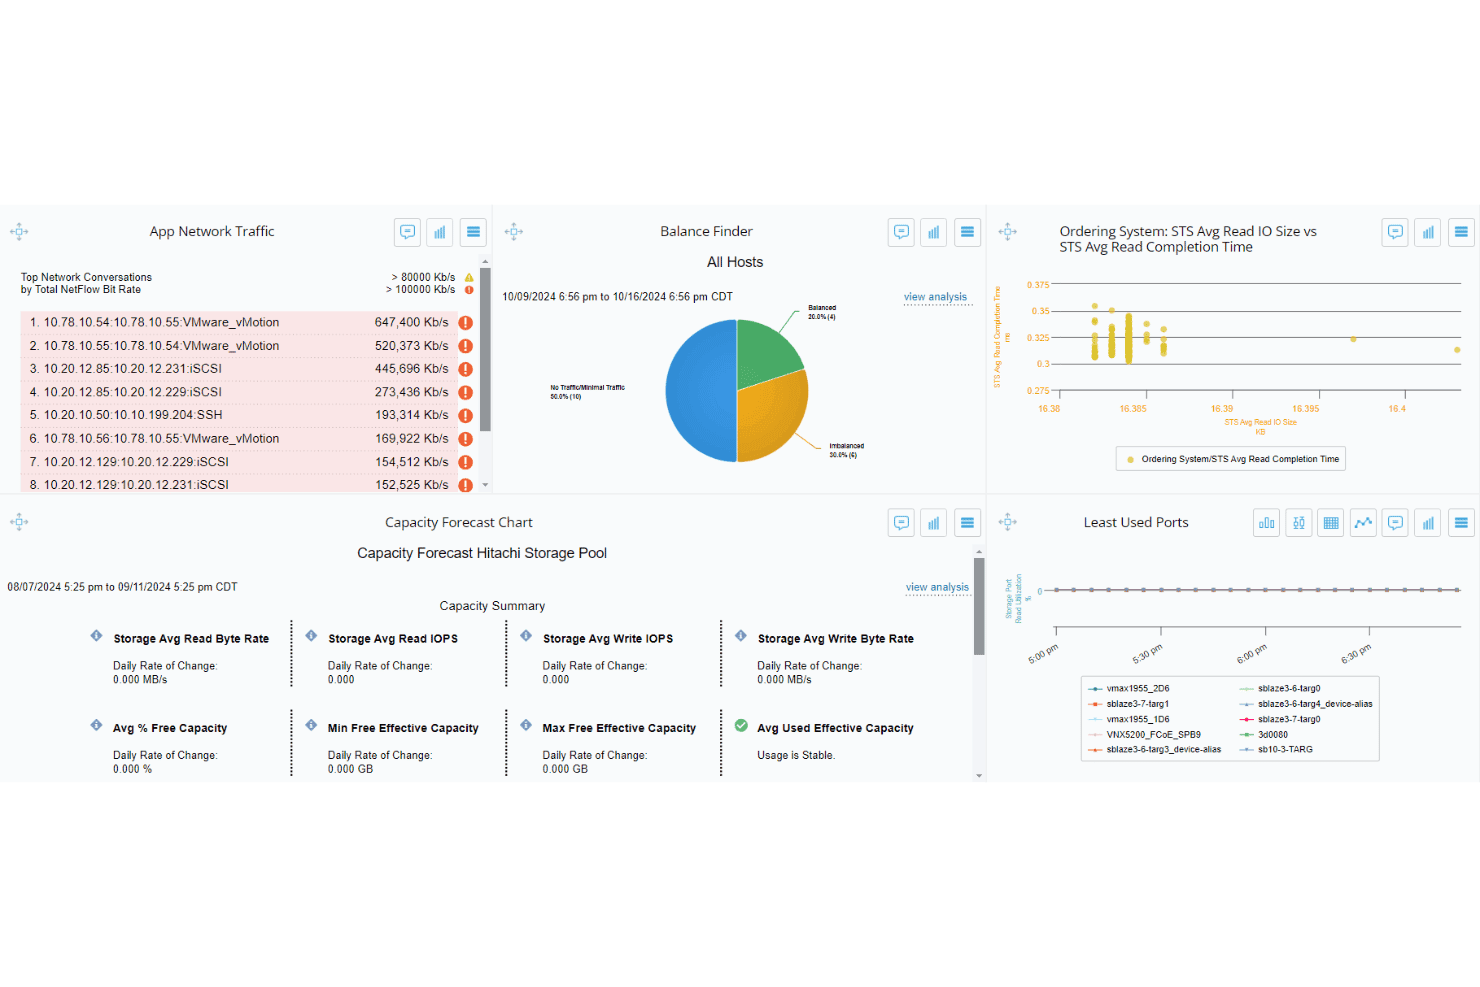
Virtana övervakar nätverkstrafik, lagringskapacitet och värdbalans i en och samma instrumentpanel. Virtana är en AIOps- och infrastrukturobservabilitetsplattform som övervakar hybrida miljöer inom datorkraft, lagring, nätverk, Kubernetes och GPU-infrastruktur, med AI-driven händelsekorrelation, avvikelsedetektering och automatiserad incidenthantering inbyggt i kärnan.
Vem passar Virtana bäst för?
Virtana passar bra för infrastruktur- och NetOps-ingenjörer som hanterar komplexa hybrida miljöer där djupgående lagringsinsikter, insyn i GPU-arbetsbelastningar och AI-driven incidentkorrelation är oumbärliga.
Varför jag valde Virtana
Jag valde Virtana som en av de bästa eftersom ingen annan plattform på min kortlista samlar in lagringsmätvärden på den här detaljnivån: över 16,000 mätvärden som omfattar blocklagring, NAS, SAN, SDS och HCI-miljöer, allt korrelerat mot kontext från datorkraft och nätverk i realtid. Jag är särskilt imponerad av den dedikerade modulen för observabilitet i AI-fabriker, som spårar GPU-utnyttjande, ledig kapacitet, strypning samt NVLink-/PCIe-genomströmning för team som kör LLM-tränings- eller inferensarbetsbelastningar i stor skala. Den ML-baserade avvikelsedetekteringen når upp till 95 % träffsäkerhet och identifierar problem innan tröskelvärden överskrids, i stället för efter att skadan redan skett.
Viktiga funktioner i Virtana
- Agentisk AI-åtgärd: AI-agenter går igenom systemets beroendegraf för att självständigt undersöka problem och utföra styrda åtgärdsarbetsflöden utan manuella överlämningar.
- Prediktiv kapacitetsprognostisering: Använder upp till 12 månaders historiska data för att prognostisera behov av datorkraft, lagring, nätverk och GPU-kapacitet upp till ett år framåt.
- Dubbelriktad synkronisering med ServiceNow: Skapar, uppdaterar och stänger automatiskt ServiceNow-incidenter baserat på upptäckta händelser, med mappning av verksamhetskritikalitet och CMDB-integration.
- Topologi- och beroendemappning: Upptäcker och kartlägger kontinuerligt relationer mellan applikationer, tjänster och infrastruktur för att upprätthålla en aktuell och sökbar systemmodell.
Integrationer med Virtana
Virtana har en inbyggd ServiceNow-integration samt integrationer med Slack, Microsoft Teams, PagerDuty, AWS, Azure, GCP, Kubernetes, VMware och OpenTelemetry. REST API:er och en MCP-server stöder anpassade integrationer och åtkomst för AI-agenter.
Pros and Cons
Pros:
- Samlar in 16,000+ lagringsmätvärden i olika miljöer
- Spårar GPU- och AI-arbetsbelastningars prestanda inbyggt
- AI-driven avvikelsedetektering uppnår hög träffsäkerhet
Cons:
- Visualiseringarna i användargränssnittet kan upplevas som begränsade
- Recensionsunderlaget är mindre än hos de största konkurrenterna
Learn more about Virtana: Bäst för AI-driven releasevalidering i hela teknikstacken
- 15 dagars kostnadsfri provperiod
- Från $7/värd/månad
Visit WebsiteCustomer Rating:4.5/5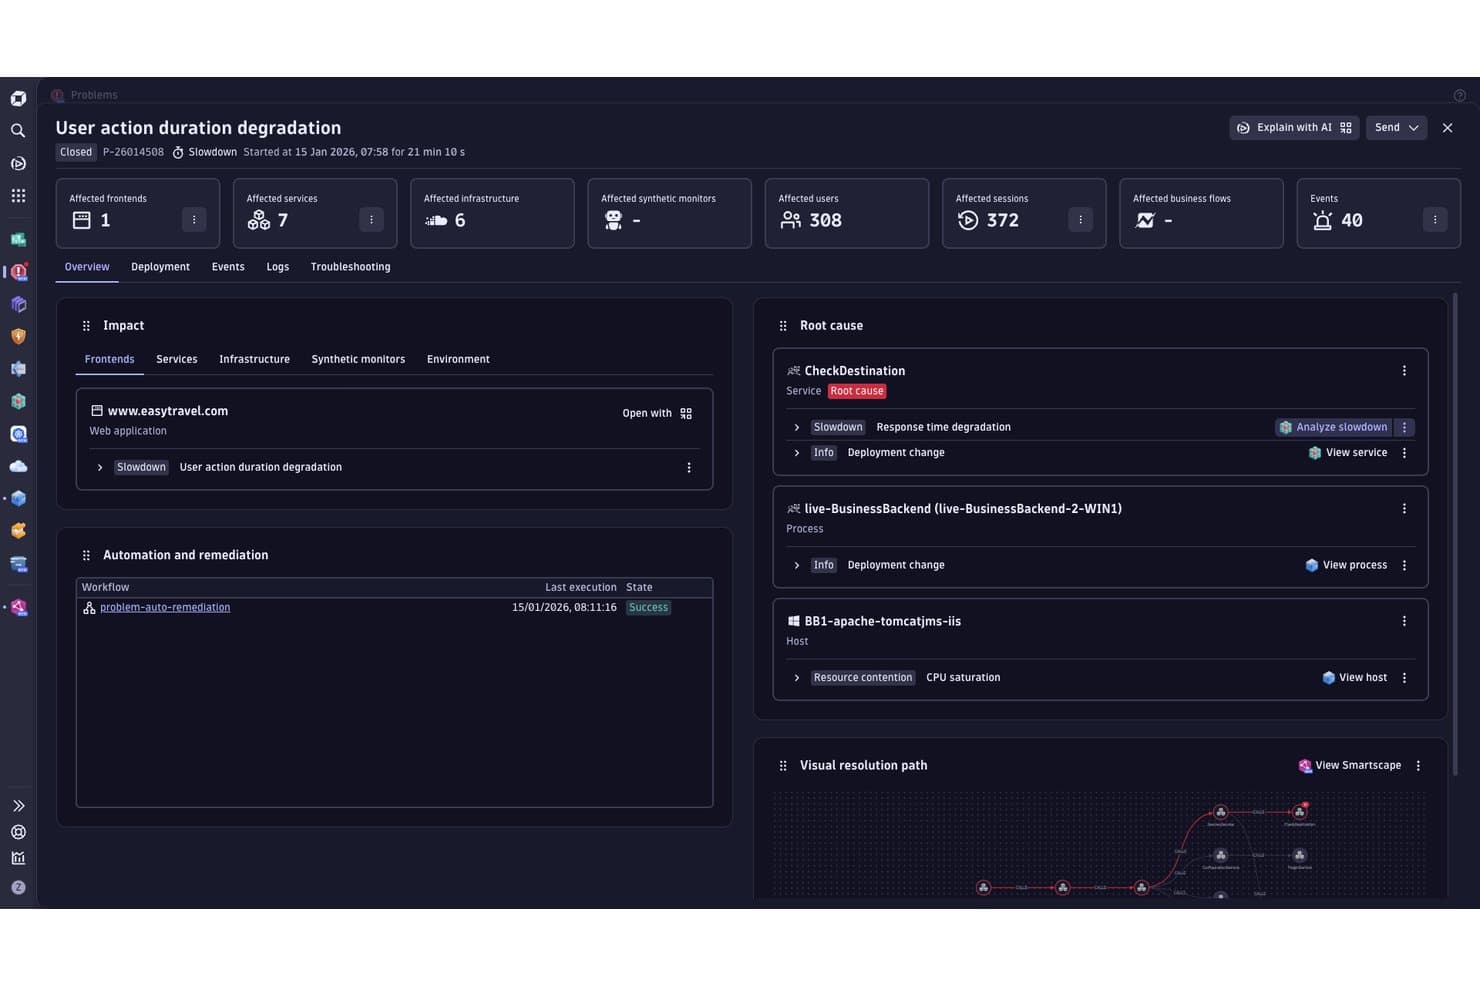
Dynatrace identifierar automatiskt grundorsakerna till prestandaproblem. Dynatrace är en plattform för hantering av IT-drift i hela teknikstacken, med övervakning av infrastruktur, AIOps-driven incidentdetektering, logganalys och automatisering av arbetsflöden i hybrid- och multicloudmiljöer.
Vem passar Dynatrace bäst för?
Dynatrace passar bra för företagsinriktade IT- och SRE-team som hanterar komplexa hybrid- eller multicloudmiljöer och behöver AI-driven observerbarhet, automatiserad incidenthantering och validering av releaser i stor skala.
Varför jag valde Dynatrace
Jag valde Dynatrace som en av de bästa eftersom deras Site Reliability Guardian är den mest grundliga lösningen för releasevalidering som jag har sett i den här kategorin: den utvärderar automatiskt varje driftsättning mot fördefinierade SLO:er och KPI:er innan koden når produktion och blockerar bristfälliga releaser utan manuell granskning. Kombinera det med Davis AI:s förmåga att spåra en avvikelse i produktion tillbaka till en enda grundorsak över miljarder aktiva beroenden, så får du en plattform som upptäcker det som passerar kvalitetsgrindarna och förklarar exakt varför.
Viktiga funktioner i Dynatrace
- Smartscape-topologikartläggning: Upptäcker och visualiserar automatiskt beroenden i realtid mellan värdar, containrar, tjänster och processer i hybrid- och multicloudmiljöer.
- Grail-datasjö: Samlar mätvärden, loggar, spårningar, händelser och säkerhetssignaler i ett enda indexfritt lager som kan genomsökas via DQL utan schemakonfiguration.
- AutomationEngine för att bygga arbetsflöden: En visuell redigerare utan kod eller med lite kod för att skapa händelsestyrda eller schemalagda automatiseringsarbetsflöden baserade på aktuella observerbarhetsdata.
- Förutsägande aviseringar: Prognostiserar kapacitets- och prestandaöverträdelser innan de inträffar genom kontinuerligt inlärda beteendebaslinjer för varje övervakad komponent.
Dynatrace-integrationer
Dynatrace erbjuder över 900 integrationer via Dynatrace Hub, bland annat ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud och OpenTelemetry. Deras REST API, webhooks och AppEngine SDK stöder anpassade integrationer.
Pros and Cons
Pros:
- En enda agent upptäcker automatiskt tillgångar i hela teknikstacken
- Davis AI identifierar den verkliga grundorsaken
- Automatiserad åtgärdshantering med kontroller där människor deltar
Cons:
- Förbrukningsbaserad prissättning är svår att budgetera
- Enbart SaaS begränsar alternativen för behov av isolerade miljöer
 Bäst för AI-drivna insatser för grundorsaksanalys från larm till topologi
- 14 dagars kostnadsfri provperiod
- Pris på begäran
Visit WebsiteCustomer Rating:4.5/5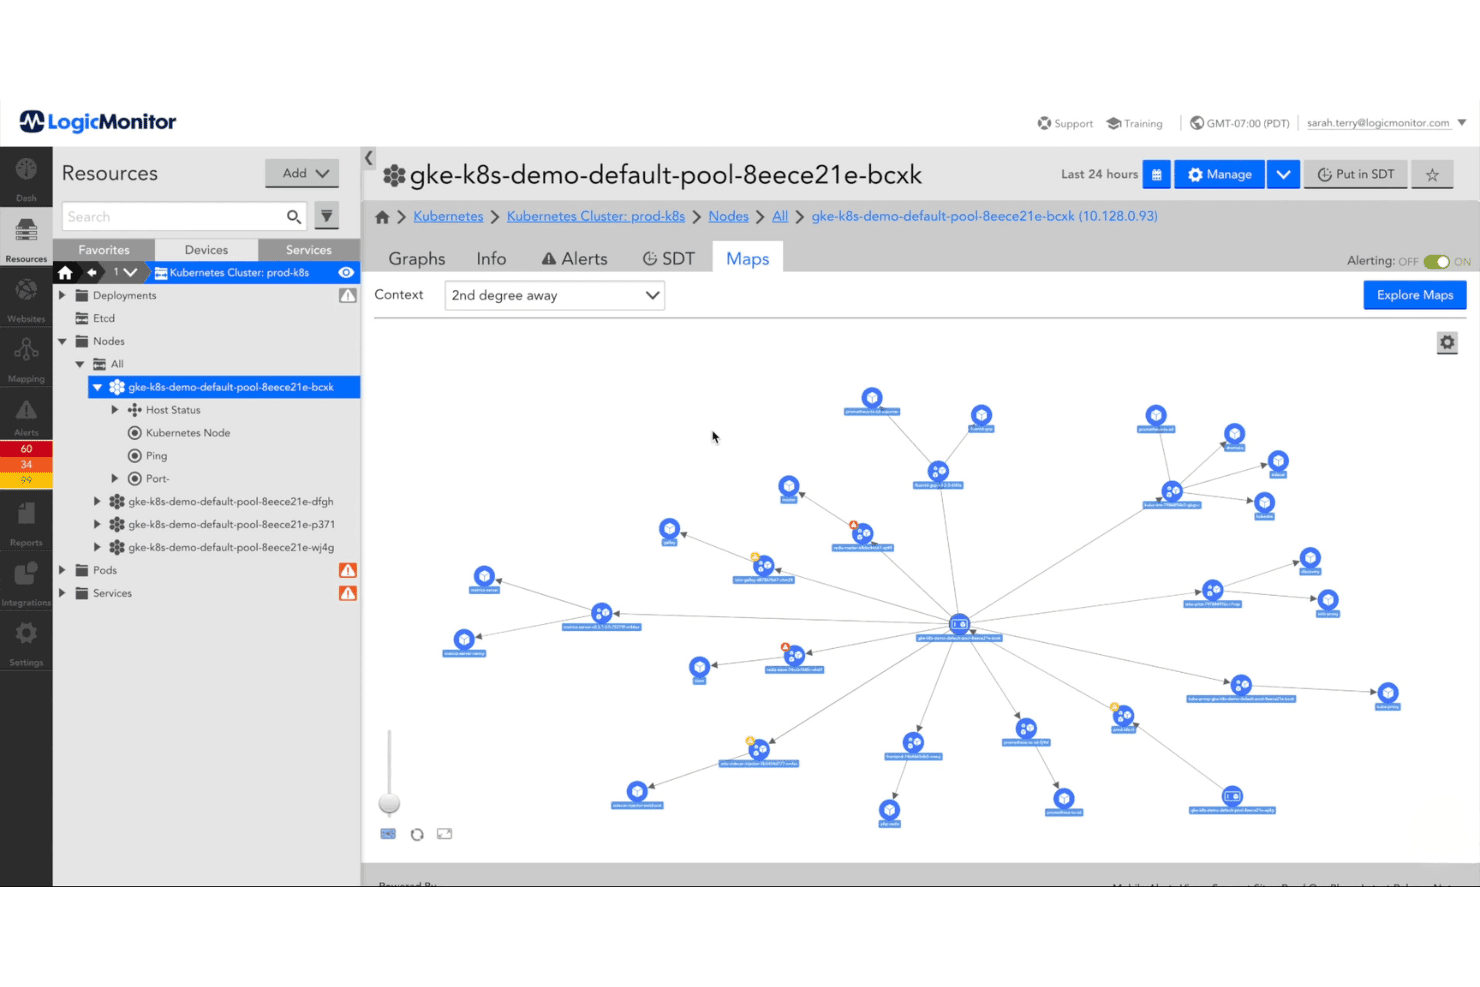
LogicMonitor kartlägger relationer mellan Kubernetes-noder med interaktiva vyer över nätverkstopologin. LogicMonitor är en plattform för hantering av hela teknikstacken inom IT-drift som täcker övervakning av infrastruktur, nätverk, moln, containrar och applikationer samt AIOps-drivna larmkorrelationer, topologikartläggning och logganalys i en enda enhetlig plattform.
Vem passar LogicMonitor bäst för?
LogicMonitor passar bra för team inom infrastruktur- och nätverksdrift som hanterar stora hybrida miljöer över lokala datacenter och flera moln.
Varför jag valde LogicMonitor
LogicMonitor finns med på min kortlista eftersom plattformen kopplar larmkorrelation till topologimedveten analys av grundorsaker på ett mycket effektivt sätt. Edwin AI komprimerar larmstormar till prioriterade och förklarliga incidenter, och ITOps Context Graph kombinerar topologi-, telemetri- och förändringsdata så att du kan fastställa en sannolik grundorsak på några minuter i stället för timmar. Jag har sett team minska larmbruset med 78 % efter att ha infört Edwin AI, vilket innebär att jourtekniker lägger mindre tid på att sortera brus och mer tid på att lösa det faktiska problemet.
Viktiga funktioner i LogicMonitor
- Övervakning av infrastruktur från hela teknikstacken: Spårar servrar, nätverksenheter, virtuella maskiner, databaser, lagring och containrar i hybrida miljöer från en enda plattform.
- LM Exchange: Ger dig tillgång till över 2 000 färdigbyggda LogicModules som täcker molnleverantörer, nätverksutrustning, databaser och applikationer.
- Logganalys & intelligens: Korrelerar loggdata med mätvärden i realtid så att du kan utreda incidenter utan att byta verktyg.
- Dubbelriktade ITSM-integrationer: Synkroniserar livscykler för larm och ärenden med ServiceNow, Jira Service Management, PagerDuty, ConnectWise och Autotask.
LogicMonitor-integrationer
LogicMonitor erbjuder över 2 000 integrationer på marknadsplatsen via LM Exchange samt inbyggda integrationer med ServiceNow, Jira Service Management, PagerDuty, ConnectWise och Datto Autotask. Ett dokumenterat REST API stöder anpassade integrationer.
Pros and Cons
Pros:
- Minskar larmbrus med Edwin AI
- Kartlägger topologin för snabb grundorsaksanalys
- Anpassningsbara instrumentpaneler för olika IT-roller
Cons:
- Prisstrukturen är svår att förstå
- Förändringar i gränssnittet gör navigeringen utmanande
Learn more about LogicMonitor: Bäst för fullstackobservabilitet på transaktionsnivå
- Gratisabonnemang tillgängligt
- Från $99/användare/månad
Visit WebsiteCustomer Rating:4.3/5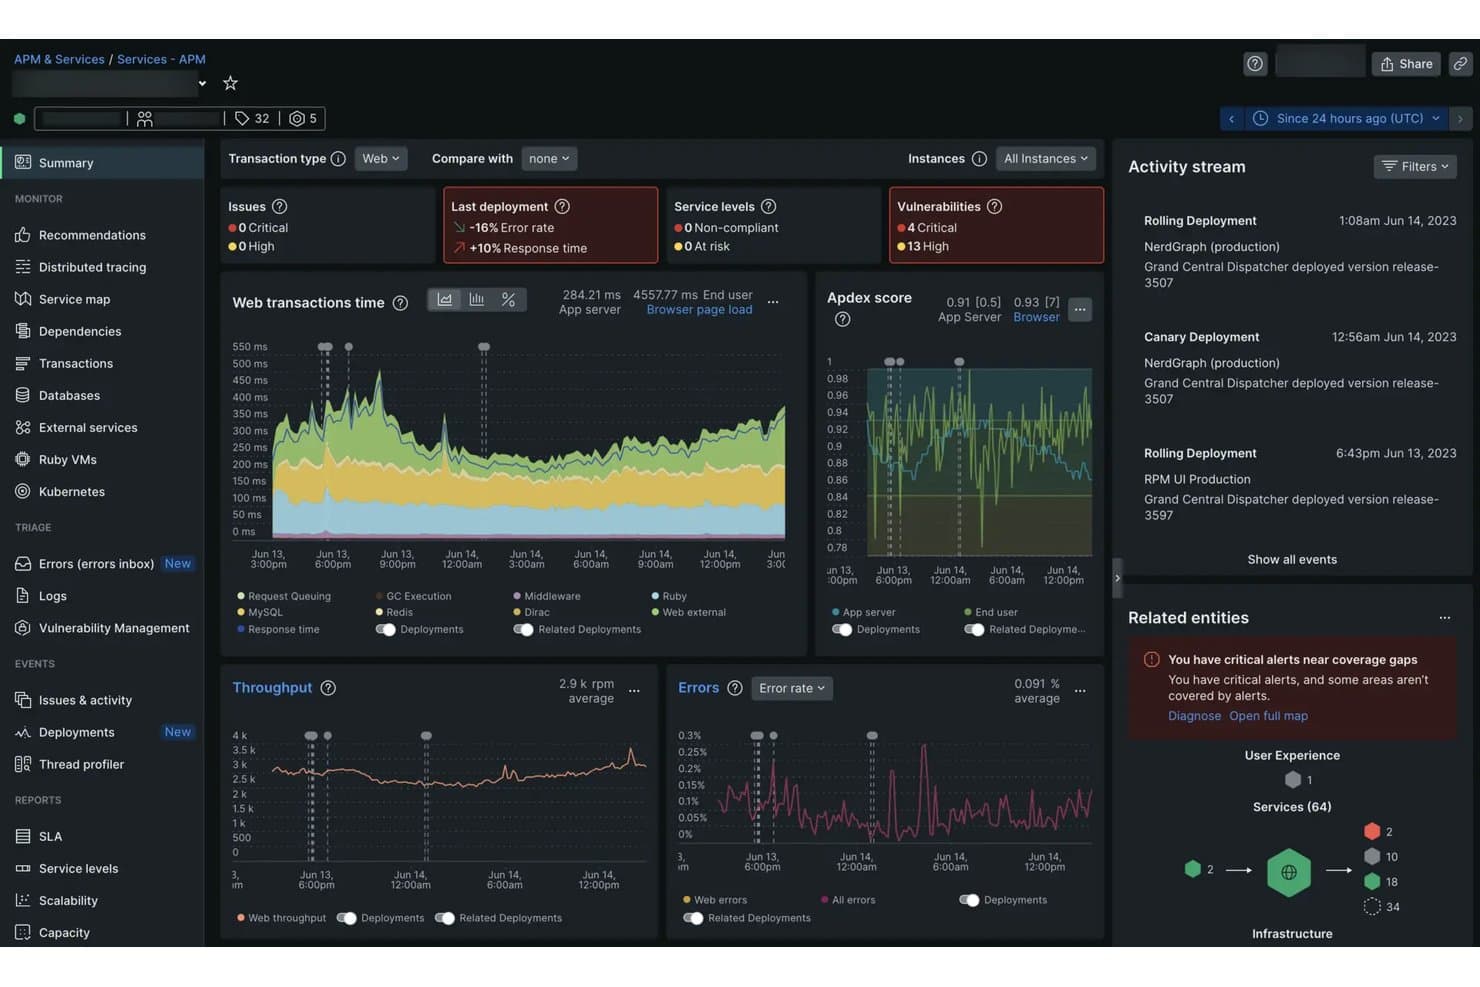
New Relic tillhandahåller en fullständig APM-sammanfattning med prestandamätvärden. New Relic är en fullständig observabilitetsplattform som förenar mätvärden, loggar, spårningar och data om digitala upplevelser från infrastruktur, applikationer, molnmiljöer och nätverk i ett enda gränssnitt.
Vem passar New Relic bäst för?
New Relic passar mycket bra för SRE:er och infrastrukturingenjörer som hanterar komplexa produktionsmiljöer med hög trafik, där insyn på transaktionsnivå över hela stacken är oumbärlig.
Varför jag valde New Relic
New Relic finns med på min kortlista tack vare Transaction 360, som korrelerar telemetri, aviseringar och distributionsändringar på individuell transaktionsnivå och minskar MTTR med upp till 5 gånger. Jag uppskattar också hur Autopilot-agenter självständigt undersöker incidenter med hjälp av aktuell telemetri och körböcker och sedan visar transparenta, granskningsbara resonemang i stället för att bara utföra en åtgärd för att lösa problemet. Kombinationen av spårning på transaktionsnivå och agentbaserad incidenthantering är det som gör New Relic till mitt förstahandsval för fullstackobservabilitet.
Viktiga funktioner i New Relic
- Smarta aviseringar: Dynamisk tröskeljustering använder historisk volatilitet för att minimera falska positiva resultat och dirigerar automatiskt aviseringar till rätt team med hjälp av entitetstaggar.
- Molnkostnadsinformation: Kostnadsuppföljning i realtid för AWS, Azure, GCP och Kubernetes, med rekommendationer om rätt dimensionering kopplade till faktiska användningsmönster samt aviseringar vid budgettrösklar.
- Automatisering av arbetsflöden: En kodfri dra-och-släpp-arbetsyta låter dig bygga arbetsflöden för åtgärder i flera steg med villkorslogik, loopar och aktiva NRQL-frågor.
- Federerade loggar: Fråga loggar direkt från S3-bucketar utan återinläsning eller dataförflyttning, vilket stöder krav på datahemvist och efterlevnad.
New Relic-integrationer
New Relic erbjuder över 800 färdigbyggda integrationer, bland annat ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud Platform, Kubernetes och VMware. NerdGraph, REST API, webhooks, OpenTelemetry och Prometheus stöder anpassad anslutning.
Pros and Cons
Pros:
- Korrelerar mätvärden, loggar och spårningar direkt
- Automatiserar dirigering av aviseringar med hjälp av entitetstaggar
- Transparent AI-driven incidentundersökning
Cons:
- Förbrukningsbaserad prissättning kan snabbt öka
- Förlängd datalagring kräver en betald uppgradering
Learn more about New Relic: Bäst för hybrid-IT-drift i stor skala med CMDB som nav
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.4/5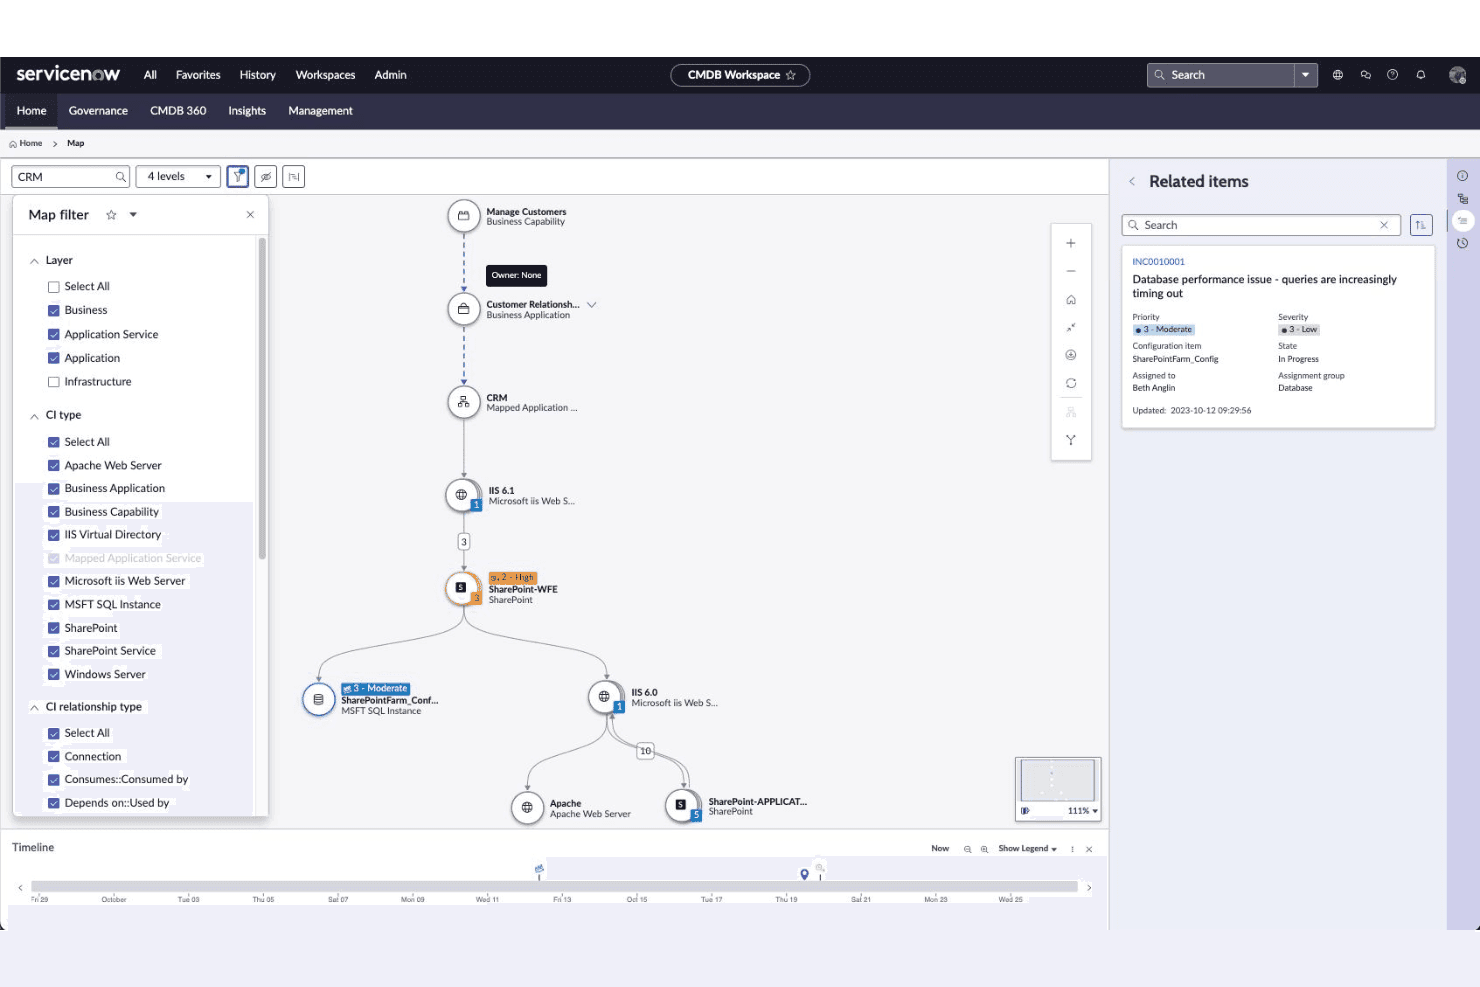
ServiceNow ITOM kartlägger CRM-applikationens beroenden över infrastrukturlager. ServiceNow ITOM är en plattform för hantering av IT-drift i företag, uppbyggd kring en kontinuerligt uppdaterad CMDB, med agentlös upptäckt, AIOps-drivet händelsehantering, tjänstekartläggning, molnsynlighet och automatiserad orkestrering över hybrida miljöer och miljöer med flera moln.
Vem passar ServiceNow ITOM bäst för?
ServiceNow ITOM är byggt för stora företag med komplexa hybrida IT-miljöer där en kontinuerligt uppdaterad CMDB utgör den operativa ryggraden.
Varför jag valde ServiceNow ITOM
ServiceNow ITOM tar plats på min kortlista eftersom CMDB:n här inte bara är en databas – den är den levande operativa ryggraden som upptäcktsfunktionen och Service Graph-anslutningar kontinuerligt fyller med verkliga data från hela din hybrida miljö. Jag uppskattar särskilt hur tjänstekartläggningen automatiskt bygger visualiseringar av beroenden mellan infrastruktur och verksamhetstjänster, så att du kan se exakt vilka tjänster som påverkas innan användarna märker något när en AWS-instans försämras. AIOps LEAP tar det hela ett steg längre genom att analysera stängda incidenter för att generera och distribuera automatiserade åtgärdshandböcker, komplett med en ROI-instrumentpanel som följer upp vad som faktiskt har sparats.
Viktiga funktioner i ServiceNow ITOM
- Analys av hälsologgar: Använder AI för att analysera loggdata i realtid, flagga avvikelser och visa rekommendationer för åtgärder innan problemen eskalerar.
- Syntetisk övervakning: Simulerar slutanvändartransaktioner för att upptäcka problem med tillgänglighet och prestanda innan riktiga användare påverkas.
- Molnaccelerering: Automatiserar etablering och avveckling av molnresurser samtidigt som policyer för taggning, kostnader och säkerhet tillämpas i AWS, Azure och GCP.
- Certifikathantering: Upptäcker och spårar automatiskt TLS/PKI-certifikat i hela din miljö och utlöser förnyelsearbetsflöden innan giltighetstiden löper ut.
ServiceNow ITOM-integrationer
ServiceNow ITOM integreras med AWS, Microsoft Azure, Google Cloud Platform, Alibaba Cloud, Datadog, Dynatrace, Splunk, PagerDuty, Jenkins och GitHub. REST- och SOAP-API:er, webhooks och ServiceNow Store-integrationer stöder anpassad anslutning.
Pros and Cons
Pros:
- CMDB driver insyn i verksamheten i realtid
- GenAI automatiserar incidenttriage och åtgärder
- Upptäckt i flera moln omfattar AWS, Azure och GCP
Cons:
- Endast SaaS utan möjlighet till självhostning
- Avancerade funktioner kräver separata modullicenser
Learn more about ServiceNow ITOM: Bäst för drift av Cisco-inbyggd tjänstehälsa över flera domäner
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.9/5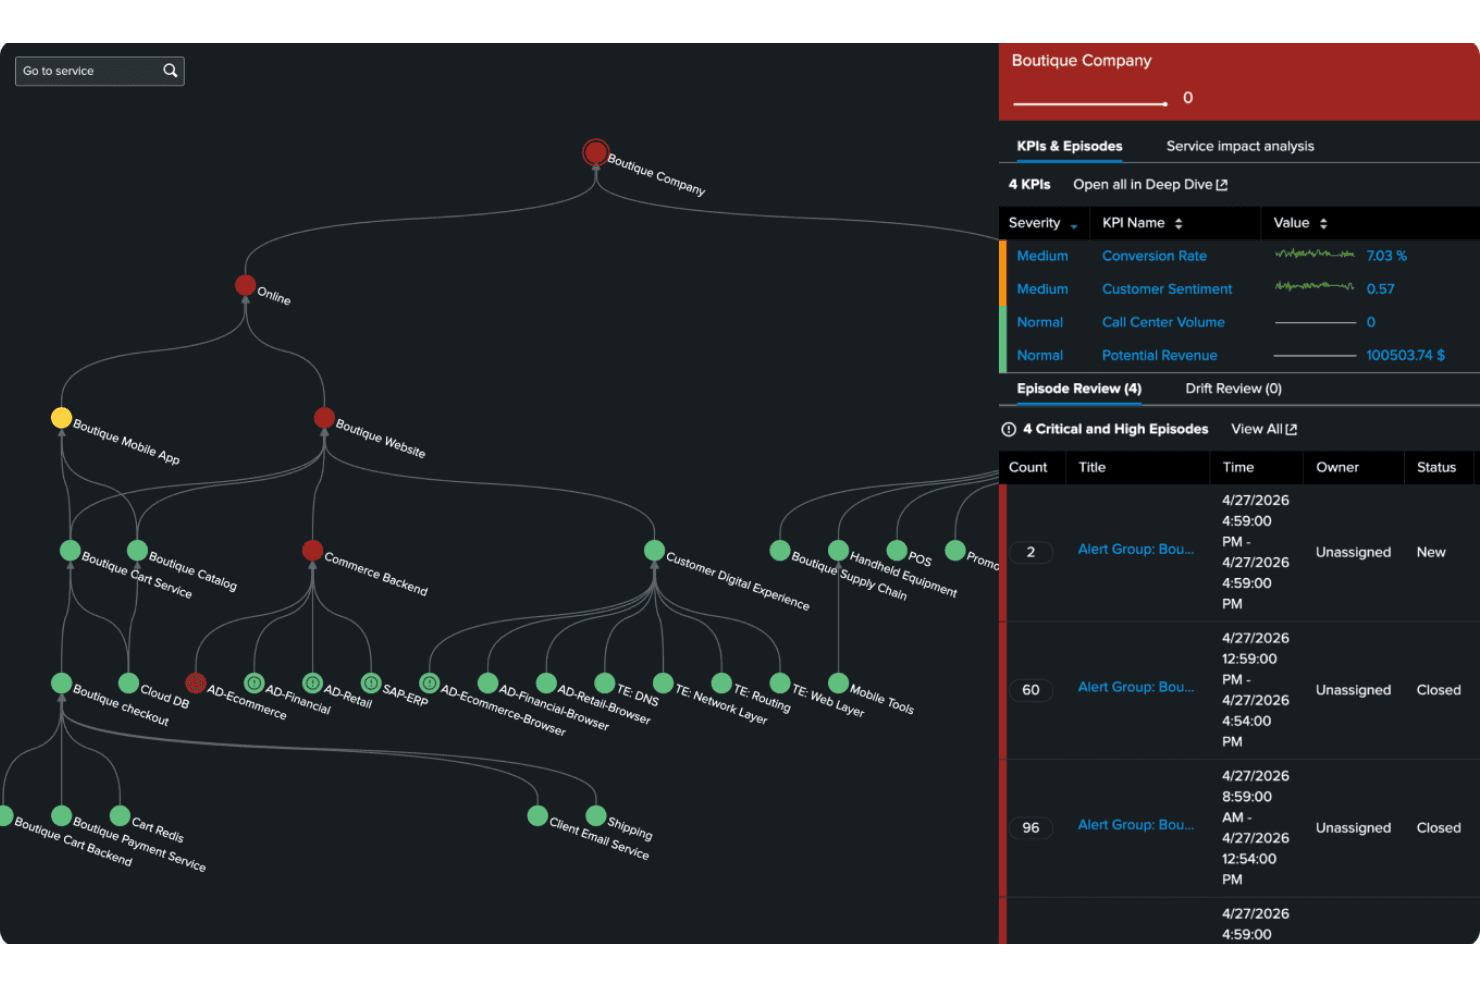
Splunk ITSI visualiserar tjänstehälsa och episoder i en beroendekarta. Splunk IT Service Intelligence (ITSI) är en AIOps-driven plattform för hantering av IT-drift som levererar KPI-baserad poängsättning av tjänstehälsa, AI-driven larmkorrelation, topologikartläggning och insyn över flera domäner i infrastruktur, applikationer och nätverk.
Vem passar Splunk IT Service Intelligence bäst för?
Splunk ITSI passar väl för IT-driftteam i större företag – särskilt team som redan använder Splunk eller arbetar i Cisco-miljöer – och som behöver korrelera tjänstehälsa över infrastruktur, applikationer och nätverk i stor skala.
Varför jag valde Splunk IT Service Intelligence
Splunk ITSI finns med på min kortlista tack vare hur plattformen hanterar tjänstehälsa över flera domäner i Cisco-inbyggda miljöer. Jag uppskattar att den hämtar signaler från Cisco ThousandEyes, Meraki och Catalyst Center direkt till sin KPI-baserade modell för hälsopoäng, så att synligheten från nätverk till applikationer inte behöver sammanfogas manuellt. Dess Event iQ-motor korrelerar sedan dessa signaler till konsoliderade episoder, vilket filtrerar bort larmbrus innan teamet slösar tid på dubbletter.
Viktiga funktioner i Splunk IT Service Intelligence
- Glasstabeller: Skapa pixelperfekta dra-och-släpp-instrumentpaneler som kopplar aktuella poäng för tjänstehälsa till affärs-KPI:er som uppfyllelse av SLA eller intäktspåverkan.
- Adaptiv tröskelsättning: ML-modeller fastställer baslinjen för varje KPI:s normala beteende över tid och utlöser larm vid statistiska avvikelser i stället för vid fasta tröskelvärden.
- Arbetsyta för granskning av episoder: Ett centraliserat gränssnitt för prioritering där AI-korrelerade larmgrupper visas med allvarlighetsgrad, kontext för berörda tjänster och rekommenderade nästa steg.
- Modellering av tjänsteberoenden: Definiera och visualisera hierarkiska relationer mellan företagstjänster, underordnade tjänster, värdar och nätverksenheter för att snabbare isolera grundorsaker.
Integrationer med Splunk IT Service Intelligence
Splunk IT Service Intelligence integreras med ServiceNow, PagerDuty, Jira Cloud, Cisco ThousandEyes, Cisco Catalyst Center, Cisco Meraki, Splunk Observability Cloud, AppDynamics och Red Hat Ansible Automation Platform. Plattformen erbjuder även integrationer via Splunkbase-marknadsplatsen, åtkomst till REST API, Python SDK:er, webhooks och Kafka.
Pros and Cons
Pros:
- Avancerad AI-driven larmkorrelation och prioritering
- Samlad övervakning över flera domäner i Cisco-miljöer
- Mycket anpassningsbara instrumentpaneler för affärsmått
Cons:
- Höga resurskrav vid stora driftsättningar
- Komplex implementering för modellering av tjänster och entiteter
Learn more about Splunk IT Service Intelligence: Bäst för agentisk AI inom drift från stordator till moln
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4/5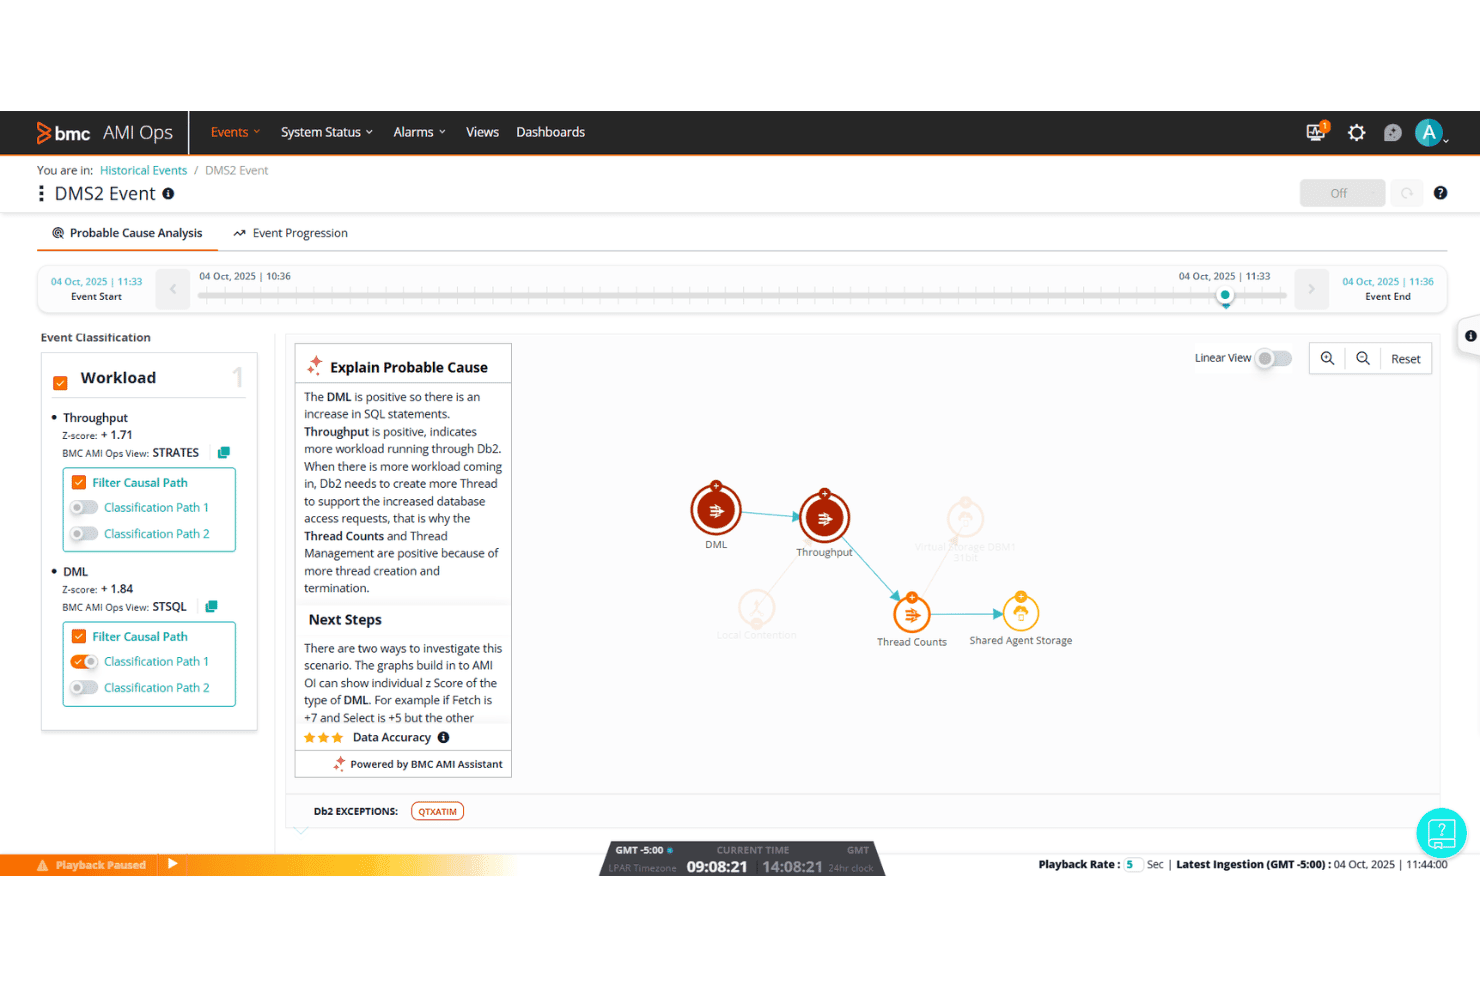
BMC Helix AIOps förklarar sannolika orsaker med AI-driven händelseanalys. BMC Helix AIOps är en molnbaserad plattform för hantering av IT-drift som förenar händelseövervakning, AI-driven incidentkorrelation, automatiserad åtgärdshantering och topologikartläggning i lokala miljöer, molnmiljöer och stordatormiljöer.
Vem passar BMC Helix AIOps bäst för?
BMC Helix AIOps är utvecklad för stora företag som kör komplexa hybrida miljöer som omfattar stordatorsystem, lokal infrastruktur och flera publika moln.
Varför jag valde BMC Helix AIOps
BMC Helix AIOps tar plats på min kortlista eftersom det är en av de få plattformar jag har sett som verkligen sträcker sig från stordator till moln utan att behandla någon av ändarna som en eftertanke. Jag förlitar mig på HelixGPT:s agentiska AI-funktioner, särskilt Agent Builder och Ops Swarmer, för att hantera autonom incidenttriagering i z/OS-miljöer och Kubernetes-kluster inom samma arbetsflöde. Den AI-drivna situationskorrelationen minskar mängden larmbrus med upp till 90 %, vilket i praktiken innebär att mitt team inte drunknar i dubblettlarm från 600 instrumentpaneler.
Viktiga funktioner i BMC Helix AIOps
- Analys av sannolik orsak: AI korrelerar topologi- och händelsedata för att identifiera den mest sannolika grundorsaken till en situation innan den manuella utredningen påbörjas.
- HelixGPT-analysverktyg för eftergranskning: Skapar automatiskt detaljerade sammanfattningar av granskningar efter incidenter för att stödja SRE- och driftteam efter att problemet har lösts.
- Dynamisk tjänstemodellering: Integreras med BMC Helix Discovery för att automatiskt generera och kontinuerligt uppdatera tjänstemodeller som kartlägger beroenden i din hybrida miljö.
- Rollbaserade vyer för instrumentpaneler: Segmenterar driftdata och rapportering efter roll och ger varje teammedlem en filtrerad vy av de mätvärden och händelser som är relevanta för deras funktion.
Integrationer med BMC Helix AIOps
BMC Helix AIOps integreras med BMC Helix ITSM, ServiceNow, AWS, Azure, Google Cloud Platform, Microsoft Teams, Slack, BMC Helix Discovery och Jitterbit. Plattformen stöder även REST API:er, CMDB-anslutning, övervakningsverktyg från tredje part och distribution via AWS Marketplace.
Pros and Cons
Pros:
- Inbyggd övervakning av stordatorer och hybrida moln
- AI-driven minskning av larmbrus med upp till 90 %
- Automatisk topologi- och beroendekartläggning ingår
Cons:
- Konfigurationen kräver betydande teknisk expertis
- Anpassning av instrumentpaneler är mindre intuitiv än hos konkurrenterna
Learn more about BMC Helix AIOps:
Annan programvara för hantering av IT-drift
Här är några ytterligare alternativ för programvara för hantering av IT-drift som inte kom med på min kortlista, men som fortfarande är värda att ta en titt på:
- 11DatadogBäst för enhetlig telemetri med inbyggd FinOps
- 12ManageEngine OpManagerBäst för arbetsflödesautomation utan kod från fel till lösning
- 13BigPandaBäst för AI-driven poängsättning av förändringsrisk
- 14PagerDutyBäst för incidenthantering i stor skala under jour
- 15ZabbixBäst för övervakning av drift med öppen källkod i alla skalor
- 16MoogsoftBäst för ML-driven minskning av larmbrus
- 17CheckmkBäst för tjänstebaserad prissättning i hybridinfrastruktur
- 18Ivanti NeuronsLämpar sig bäst för IT- och SecOps-automatisering förankrad i ITSM
- 19Grafana CloudBäst för ML-styrd observabilitet i hela teknikstacken
- 20SolarWinds Observability SaaSBäst för observabilitet i hela stacken med rötter i nätverksdrift
How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
Så väljer du programvara för hantering av IT-drift
När du avgör vilken programvara för hantering av IT-drift som passar bäst i din miljö bör du börja med att fokusera på dina mest akuta driftutmaningar:
| Om din prioritet är... | Leta efter... |
|---|---|
| Om din prioritet är...Snabb och korrekt rotorsaksanalys | Leta efter...AI-baserad incidentkorrelation och automatiserade körböcker |
| Om din prioritet är...Hybrid- och multimolnmiljöer | Leta efter...Inbyggda anslutningar för lokal drift, AWS, Azure och GCP |
| Om din prioritet är...Att minska manuella åtgärdsuppgifter | Leta efter...Visuella arbetsflödesbyggare med förbyggd automatisering |
| Om din prioritet är...Att kontrollera utgifter kopplade till övervakning | Leta efter...Transparent, användningsbaserad prissättning och kostnadsöversikter |
| Om din prioritet är...Djupa integrationer med ITSM-verktyg | Leta efter...Förbyggda anslutningar och öppen API-dokumentation |
Så granskar du din kortlista
- Testa arbetsflöden för incidenttriage: Genomför en 48-timmars provperiod och simulera minst tre typer av driftstörningar för att verifiera incidentgruppering och automatiserade svar.
- Be om en demonstration av en topologikarta: Be leverantören skapa en heltäckande beroendekarta – inklusive hybridkluster – med hjälp av aktuella eller avidentifierade exempeldata.
- Skapa ett plattformsöverskridande ärende: Öppna ett supportärende som hänvisar till en multimolnintegration och dokumentera svarens korrekthet och SLA:er under en period på 3 dagar.
- Utvärdera rapporteringens fullständighet: Granska eller exportera ett exempel på en analyspanel och bekräfta insyn i kostnader, SLA:er och anpassade mätvärden för din faktiska miljö.
- SaaS-smidighet kontra kontroll över egen drift: Avgör om snabb funktionsleverans i SaaS väger tyngre än de efterlevnads- och åtkomstbehov som tillgodoses av lokala eller nätverksisolerade driftsättningar.
Vad är programvara för hantering av IT-drift?
Programvara för hantering av IT-drift är en kategori verktyg som är utformade för att övervaka, automatisera och hantera IT-infrastruktur, applikationer, nätverk och tjänster i lokala och molnbaserade miljöer. Dessa plattformar hjälper ditt team att centralisera aviseringar, upprätthålla systemens hälsa, hantera incidenter och optimera resursanvändningen. Genom att konsolidera driftdata och automatisering stöder programvara för hantering av IT-drift snabbare felsökning, ökad effektivitet och möjliggör för din organisation att skala tekniken på ett tillförlitligt sätt.
Funktioner i programvara för hantering av IT-drift
När du väljer programvara för hantering av IT-drift bör du hålla utkik efter följande viktiga funktioner:
- Övervakning av infrastruktur och applikationer: Spårar servrar, nätverk, containrar och applikationer i realtid. Hjälper dig att upptäcka onormalt systembeteende, försämrad prestanda eller avbrott innan användarna påverkas.
- Aviseringar och incidenthantering: Centraliserar aviseringar och effektiviserar arbetsflöden för eskalering. Gör det möjligt för ditt team att reagera snabbt, sätta incidenter i rätt sammanhang och spåra lösningen från början till slut.
- Automatisering och orkestrering: Tillhandahåller verktyg för att automatisera rutinuppgifter och samordna arbetsflöden i olika miljöer. Minskar manuellt arbete och begränsar mänskliga fel under driftsättningar eller underhåll.
- Stöd för hybridmiljöer och flera moln: Erbjuder en samlad överblick över lokal infrastruktur, privat molninfrastruktur och offentlig molninfrastruktur. Hjälper dig att hantera komplexa miljöer som en enda operativ enhet.
- Anpassningsbara instrumentpaneler och rapporter: Låter dig skapa instrumentpaneler och rapporter som är anpassade efter dina behov. Stöder trendanalys, SLA-övervakning och delning av insikter med tekniska och affärsmässiga intressenter.
- Integration och API-åtkomst: Ansluter till plattformar för ITSM, DevOps och samarbete. Gör det möjligt för ditt team att bädda in IT-driftdata direkt i ärendehanteringssystem, chattar och andra system.
- Topologi- och beroendekartläggning: Visualiserar relationerna mellan system, tjänster och infrastrukturelement. Gör det enklare att spåra grundorsaken till incidenter och förstå operativa risker.
- Användar- och rollbaserad åtkomstkontroll: Gör det möjligt för dig att definiera vem som kan visa eller redigera delar av din miljö. Skyddar känsliga data och begränsar exponeringen utifrån användarnas ansvarsområden.
- Kapacitetsplanering och prognoser: Analyserar trender i resursförbrukningen för att förutsäga framtida behov. Hjälper dig att förutse uppgraderingar av infrastrukturen och budgetera för tillväxt.
- Ändringsspårning och granskningsloggar: Registrerar konfigurationsändringar och användaråtgärder. Stöder efterlevnadskrav och hjälper till att felsöka tidigare incidenter genom att tillhandahålla en tydlig ändringshistorik.
Vanliga AI-funktioner i programvara för hantering av IT-drift
Utöver de standardfunktioner för programvara för hantering av IT-drift som anges ovan integrerar många av dessa lösningar AI med funktioner som:
- AI-baserad avvikelsedetektering: Använder maskininlärning för att automatiskt identifiera ovanliga mönster eller beteenden i systemmätvärden, loggar eller nätverkstrafik. Detta hjälper ditt team att upptäcka framväxande problem innan de eskalerar, även när tröskelvärden inte har angetts manuellt.
- Automatiserad grundorsaksanalys: Använder AI-algoritmer för att korrelera händelser, loggar och prestandadata i hela din teknikstack. Funktionen identifierar den sannolika källan till incidenter, minskar tiden ditt team lägger på undersökningar och påskyndar återställningen.
- Prediktiva incidentprognoser: Använder historiska data och AI-modeller för att förutse potentiella avbrott eller försämrad prestanda. Detta gör det möjligt för dig att vidta proaktiva åtgärder för att förhindra incidenter och planera underhåll mer effektivt.
- Intelligent minskning av aviseringsbrus: Använder AI för att gruppera relaterade aviseringar, undertrycka dubbletter och prioritera meddelanden utifrån påverkan och sammanhang. Detta minskar aviseringsutmattningen och säkerställer att ditt team fokuserar på de viktigaste problemen.
- AI-drivna åtgärdsförslag: Analyserar incidentdata och tidigare lösningar för att rekommendera nästa steg eller automatiserade korrigeringar. Detta hjälper ditt team att reagera snabbare och standardiserar bästa praxis i hela driften.
Fördelar med programvara för hantering av IT-drift
Att implementera programvara för hantering av IT-drift ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Centraliserad överblick: Samla övervakningen av servrar, nätverk, applikationer och molnresurser i en enda instrumentpanel, så att ditt team kan ligga steget före problem i alla miljöer.
- Snabbare incidentlösning: Använd funktioner för samlad avisering, AI-driven korrelation och automatiserad grundorsaksanalys för att snabbt identifiera, prioritera och hantera driftsproblem.
- Minskat manuellt arbete: Automatisera återkommande underhålls-, åtgärds- och arbetsflödesuppgifter med hjälp av förbyggda verktyg för automatisering och orkestrering, vilket frigör tid för initiativ med högre värde.
- Proaktiv riskhantering: Förutsäg driftstopp och flaskhalsar i resurser med AI-drivna verktyg för avvikelsedetektering och prognostisering som identifierar potentiella problem innan de eskalerar.
- Optimering av kostnader och resurser: Följ upp infrastrukturens användning, applikationers prestanda och resurskostnader med hjälp av rapporterings- och analysfunktioner, så att du kan hantera budgetar och kapacitetsplanering.
- Starkare säkerhet och efterlevnad: Förlita dig på åtkomstkontroller för användare, granskningsloggar och funktioner för ändringsspårning för att skydda känsliga data och stödja lagstadgade krav.
- Sömlös integrering med ekosystemet: Anslut ITSM-, DevOps- och chattplattformar med hjälp av förbyggda integrationer och öppna API:er, vilket gör det enklare att integrera driftdata i det sätt som ditt team redan arbetar på.
Kostnader och priser för programvara för IT-driftshantering
För att välja programvara för IT-driftshantering krävs en förståelse av de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamets storlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för programvara för IT-driftshantering:
Jämförelsetabell för abonnemang för programvara för IT-driftshantering
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| AbonnemangstypGratisabonnemang | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande infrastrukturövervakning, begränsad avisering, åtkomst för små team och support från användarcommunityn. |
| AbonnemangstypPersonligt abonnemang | Genomsnittligt pris$10–$30/användare/månad | Vanliga funktionerÖvervakning i realtid, automatisering på nybörjarnivå, grundläggande instrumentpaneler, integrering med populära verktyg och e-postsupport. |
| AbonnemangstypFöretagsabonnemang | Genomsnittligt pris$40–$80/användare/månad | Vanliga funktionerFullständig stackövervakning, avisering och incidenthantering, arbetsflödesautomatisering, avancerade instrumentpaneler, API-åtkomst och rollbaserad åtkomstkontroll. |
| AbonnemangstypAbonnemang för stora företag | Genomsnittligt pris$90–$200/användare/månad | Vanliga funktionerÖverblick över hybridmiljöer och flera moln, AI-drivna funktioner, anpassade SLA:er, stöd för efterlevnad, dedikerade integrationer och premiumsupport. |
Vanliga frågor om programvara för IT-driftshantering
Här är svar på vanliga frågor om programvara för IT-driftshantering:
Hur jämför man olika plattformar för programvara för IT-driftshantering?
Börja med att lista de funktioner ni måste ha – som stöd för flera moln, automatisering och integrationsmöjligheter. Testa sedan plattformarna med hjälp av vanliga incidentscenarier och jämför hur varje verktyg hanterar aviseringar, grundorsaksanalys och rapportering. Total ägandekostnad, integrationer med ekosystemet och flexibilitet vid driftsättning är också viktiga faktorer att undersöka innan ni fattar ett slutgiltigt beslut.
Kan programvara för IT-driftshantering automatisera incidenthantering?
Ja, med de flesta moderna programvaror för IT-driftshantering kan ni automatisera incidenthantering genom körböcker, arbetsflödesbyggare och till och med AI-driven automatisk åtgärd. Det hjälper er att minska antalet manuella steg och säkerställer en konsekvent hantering av återkommande problem.
Vilka integrationer bör jag leta efter i programvara för IT-driftshantering?
Leta efter API-åtkomst, färdiga anslutningar till ITSM-verktyg (som ServiceNow), chattplattformar (som Slack eller Microsoft Teams) och DevOps-pipelines. Djupa integrationer gör det möjligt för teamet att skicka aviseringar, utlösa arbetsflöden och synkronisera ärenden mellan era befintliga system utan anpassad mellanprogramvara.
Hjälper programvara för IT-driftshantering till med efterlevnad och revision?
Ja, robust programvara för IT-driftshantering spårar systemändringar och användaråtgärder samt tillhandahåller de revisionsloggar som krävs för efterlevnad. Detta är särskilt användbart i reglerade branscher där ni behöver tydliga bevis på kontroller och en fullständig ändringshistorik för rapportering.
Hur kan jag förhindra oväntade kostnader med programvara för IT-driftshantering?
Granska alltid hur plattformen tar betalt för datainmatning, anpassade mätvärden och användarplatser. Välj verktyg med transparent, användningsbaserad prissättning och kostnadsöversikter i appen, så att ni kan övervaka utgifterna och undvika oväntade kostnadsökningar när er miljö växer.
Vilket är det bästa sättet att få intressenternas stöd för en ny plattform för IT-driftshantering?
Visa hur plattformen bidrar till att uppnå verksamhetsmålen: snabbare incidentlösning, proaktiv riskhantering och förbättrad rapportering. Dela en demonstration eller resultat från ett pilotprojekt, lyft fram förväntade effektivitetsvinster och koppla funktionerna till problemområden som intressenterna känner igen.