

De bästa Nagios-alternativen hjälper team att övervaka system utan att behöva hantera komplexa installationskrav eller stöta på skalningsbegränsningar. De erbjuder tydligare instrumentpaneler, enklare konfigurationer och flexibla integrationer som gör det lättare att följa prestandan för servrar, nätverk och applikationer.
Många organisationer börjar leta efter alternativ efter att ha kämpat med problem som att konfigurera Nagios-tillägg som inte integreras smidigt, slösa tid på att felsöka kryptiska felmeddelanden eller stöta på prestandabegränsningar när övervakningsbehoven växer. Dessa utmaningar saktar ner verksamheten och gör det svårare för IT-team att upprätthålla insyn i stor skala.
Jag har testat övervakningsplattformar i aktiva produktionsmiljöer, arbetat med team som migrerar från äldre Nagios-installationer och utvärderat hur dessa verktyg fungerar i hybrida infrastrukturer och molninfrastrukturer. Dessa erfarenheter visade mig vilka lösningar som faktiskt minskar övervakningsarbetet och vilka som skapar nya komplexiteter.
I den här guiden ser du vilka Nagios-alternativ som erbjuder enklare installation, bättre skalbarhet och mer användbara insikter, så att ditt team kan fokusera på att åtgärda problem i stället för att kämpa med övervakningssystemet.
Vad är Nagios?
Nagios är en plattform med öppen källkod för övervakning och nätverkshantering, utformad för nätverks- och systemövervakning. IT-proffs och systemadministratörer använder vanligtvis Nagios för att hålla koll på kritisk infrastruktur och säkerställa smidig drift.
Funktionerna för aviseringar, rapportering och övervakning hjälper dig att upptäcka problem, analysera prestanda och hantera nätverksresurser effektivt. Sammantaget skapar Nagios värde genom att hjälpa ditt team att upprätthålla systemets tillförlitlighet och minimera driftstopp.
Jämförelsetabell över Nagios-alternativ
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av Nagios-alternativ:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bäst för enhetlig övervakning av enheter och sensorer | 3.7 out of 5 | 4 | 4 | 4 | 3 | 4 | 3 | $200 per månad Gratisabonnemang + 30 dagars kostnadsfri provperiod tillgänglig | Website |
Bäst för komplex IT-infrastruktur | 3.3 out of 5 | 3 | 3 | 3 | 4 | 4 | 3 | $1,400/år Gratisplan + 60 dagars provperiod + demo tillgänglig | Website |
Bäst för övervakning av flera moln | 3.7 out of 5 | 4 | 4 | 3 | 4 | 4 | 3 | $10/månad Gratisplan + 30 dagars provperiod + demo tillgänglig | Website |
Bäst för övervakning av webbapplikationer | 3.5 out of 5 | 4 | 1 | 4 | 4 | 4 | 4 | $13.33/månad Gratis abonnemang + 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för enkel konfiguration utan extra handpåläggning | 3.0 out of 5 | 3 | 2 | 2 | 4 | 3 | 4 | Pris på begäran Gratisplan + demoversion tillgänglig | Website |
Bäst för fullständig observerbarhet | 3.8 out of 5 | 4 | 4 | 4 | 4 | 4 | 3 | $2.80/månad Kostnadsfritt abonnemang + 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för grafer | 3.0 out of 5 | 3 | 2 | 3 | 3 | 4 | 3 | Pris på begäran Inte tillgängligt | Website |
Bäst för AIOps och observerbarhet | 3.5 out of 5 | 3 | 4 | 3 | 4 | 4 | 3 | Pris på begäran Gratis demonstration tillgänglig | Website |
Bäst för övervakning från början till slut | 4.3 out of 5 | 4 | 4 | 4 | 5 | 5 | 4 | €283/månad Kostnadsfritt abonnemang + 30 dagars provperiod + demo tillgänglig | Website |
Bäst för distribuerade nätverk | 3.3 out of 5 | 3 | 3 | 3 | 4 | 4 | 3 | $6,000/år Gratisplan tillgänglig | Website |


Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Recensioner av de bästa Nagios-alternativen
Nedan finns mina detaljerade sammanfattningar av de bästa Nagios-alternativen som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över de viktigaste funktionerna, fördelarna och nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
 Bäst för enhetlig övervakning av enheter och sensorer
- Gratisabonnemang + 30 dagars kostnadsfri provperiod tillgänglig
- Från $200 per månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.6/5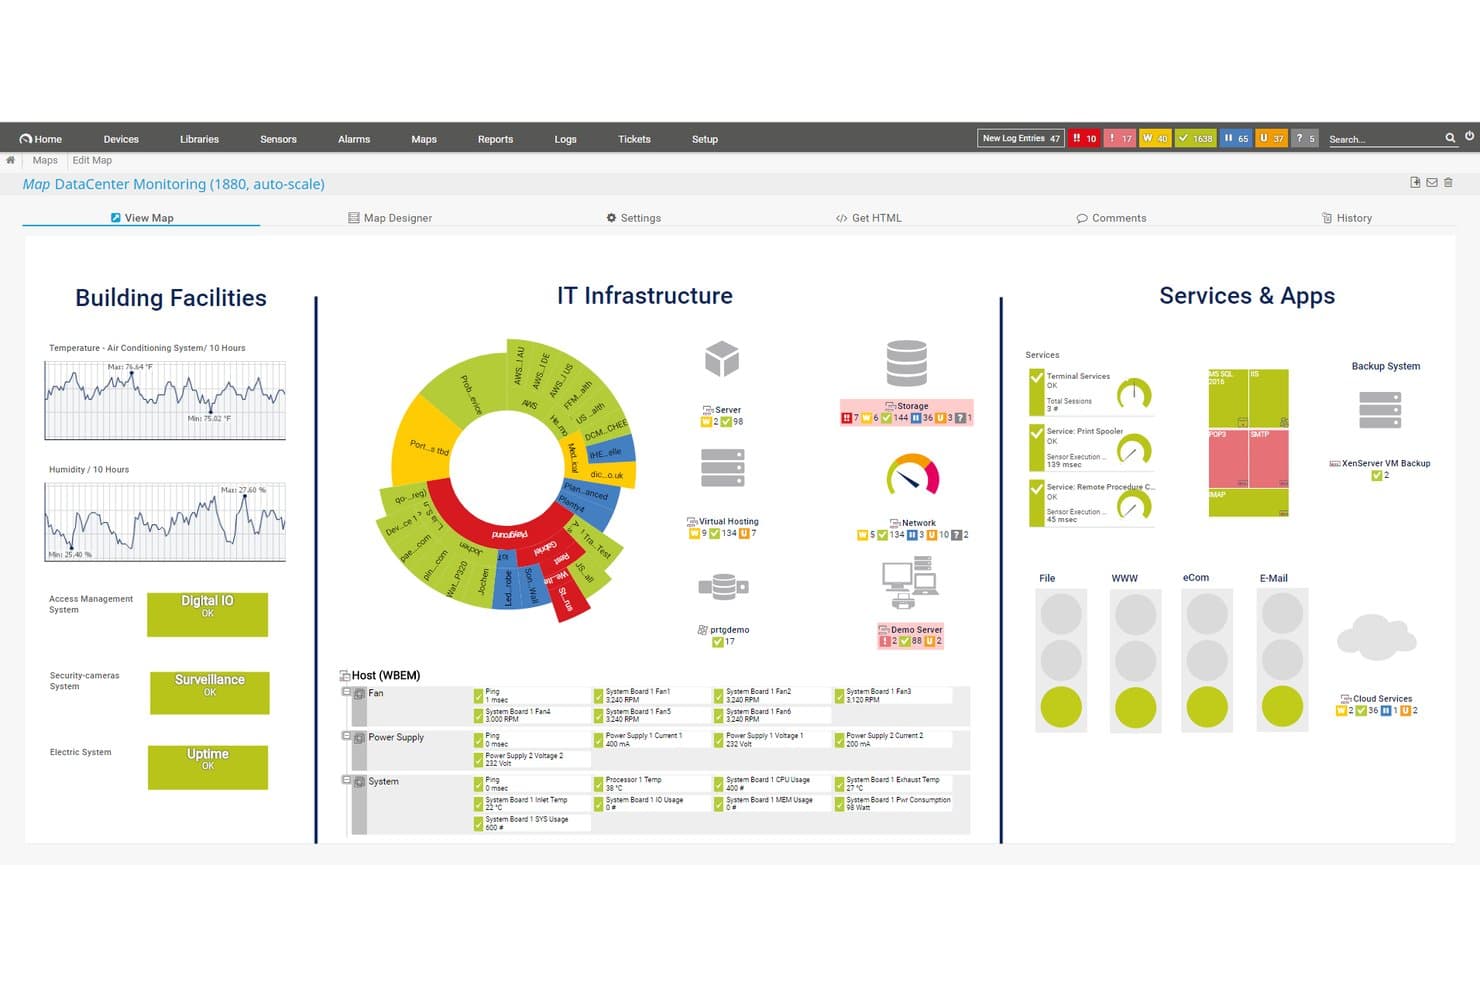
Paessler PRTG erbjuder en anpassningsbar karta för övervakning av datacenter som visar byggnadsfaciliteter, IT-infrastruktur samt tjänster och appar i en enhetlig instrumentpanelsvy. Paessler PRTG är en lokalt installerad plattform för nätverksövervakning som ger IT-team och systemadministratörer en enda plats för att övervaka servrar, nätverksenheter, applikationer och OT/IoT-infrastruktur med hjälp av över 250 förkonfigurerade sensorer och agentlös automatisk identifiering.
Vem passar Paessler PRTG bäst för?
PRTG passar bra för IT-team som hanterar blandade lokala miljöer och behöver bred täckning av enheter och sensorer utan att bygga övervakningen från grunden.
Varför jag valde Paessler PRTG
Jag valde PRTG som ett av de bästa alternativen eftersom det samlar allt i ett enda övervakningslager utan att kräva att du bygger sensortäckning från grunden. Det jag verkligen gillar är hur dess över 250 förkonfigurerade sensorer omfattar servrar, nätverksenheter, virtuella miljöer och OT/IoT-utrustning, så att du inte behöver sammanfoga separata verktyg för att få en fullständig bild. Den adaptiva baslinjebaserade avvikelsedetekteringen tillför också ett stort värde: PRTG flaggar automatiskt ovanligt beteende utan att du manuellt behöver definiera varje tröskelvärde.
Viktiga funktioner i Paessler PRTG
- Aviseringar via flera kanaler: Skickar aviseringar via e-post, SMS, push, Microsoft Teams, Slack, syslog och SNMP-fällor, med konfigurerbara eskaleringsnivåer och scheman.
- Distribuerad övervakning med prober: Använder klassiska fjärrprober och plattformsoberoende prober för att övervaka undernät bakom brandväggar och fördela belastningen mellan system.
- Skapa anpassade sensorer: Skapar anpassade sensorer med PowerShell, Python, SSH-skript, anpassad REST och HTTP Push Data för att övervaka sådant som de förkonfigurerade sensorerna inte täcker.
- Schemalagd rapportering och rapportering på begäran: Genererar sensorbaserade rapporter och sammanfattningsrapporter enligt ett schema eller på begäran, med export av historiska data i formaten XML, CSV, HTML och PDF.
Integrationer med Paessler PRTG
Paessler PRTG har inbyggda integrationer med Microsoft Teams och Slack samt integrationer med NetBrain, Martello iQ och Siemon. REST API v2, HTTP API v1 och anpassade sensorer stöder ytterligare integrationer.
Pros and Cons
Pros:
- Förbyggda sensorer minskar manuella Nagios-kontroller
- Bred enhetstäckning samlar övervakningen
- Instrumentpaneler synliggör nätverkets hälsa
Cons:
- Föråldrade kartor begränsar operativa vyer
- Genomsnittsberäkning av historiska data begränsar trenddetaljer
Learn more about Paessler PRTG: Bäst för komplex IT-infrastruktur
- Gratisplan + 60 dagars provperiod + demo tillgänglig
- Från $1,400/år (faktureras årligen)
Visit WebsiteCustomer Rating:4.7/5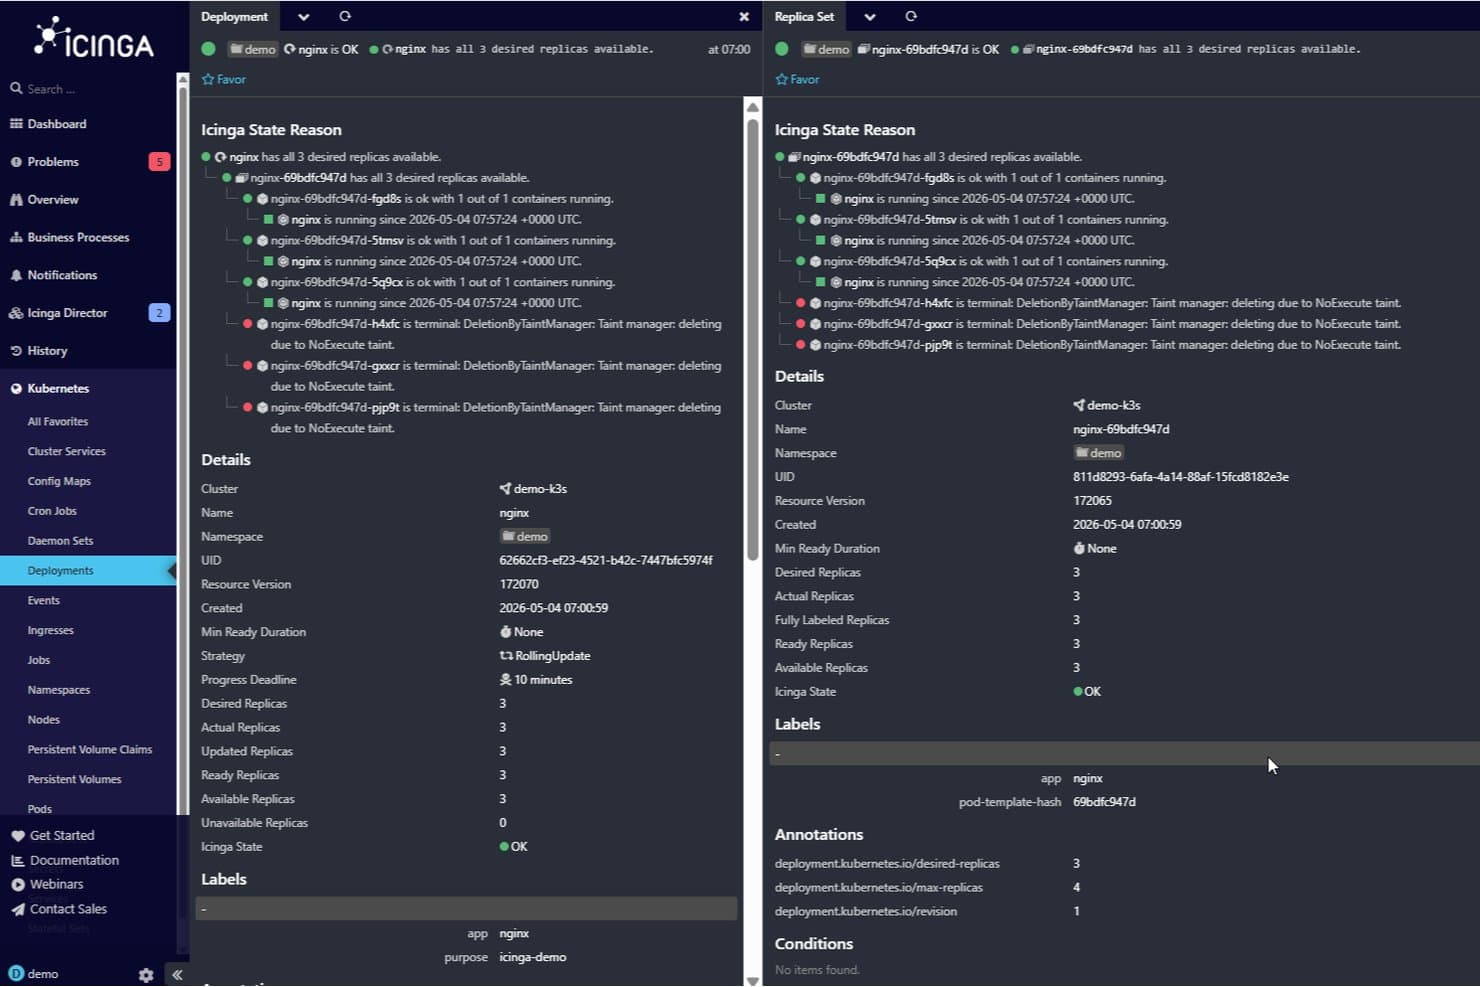
Icinga håller koll på alla distributioner i en och samma instrumentpanel med etiketter, detaljer och anteckningar. Icinga är en övervakningsplattform med öppen källkod som är utvecklad för team som hanterar stora, distribuerade IT-miljöer och erbjuder fullständig insyn i hela teknikstacken för servrar, nätverk, applikationer och molninfrastruktur från ett enda gränssnitt.
Vem passar Icinga bäst för?
Icinga passar väl för infrastruktur- och driftteam som hanterar stora, distribuerade miljöer i lokala, hybrida och multicloud-baserade system.
Varför jag valde Icinga
Icinga hamnar på min kortlista eftersom plattformen är byggd för att hantera den skala och komplexitet som får enklare övervakningsverktyg att gå bet. Jag uppskattar hur arkitekturen med master, satellit och agent låter mitt team distribuera kontroller över fjärrplatser, nätverkssegment och molnmiljöer utan att förlora den centraliserade överblicken. Jag förlitar mig också på dess beroendekartläggning för att dämpa kaskaderande larmbrus när en överordnad nod slutar fungera, vilket håller incidentköerna hanterbara på över 80 platser. Kompatibilitet med Nagios-pluginer innebär att befintliga kontrollskript kan användas vidare i stället för att skrivas om från grunden.
Viktiga funktioner i Icinga
- Kompatibilitet med Nagios-pluginer: Använd befintliga Nagios-kompatibla övervakningspluginer direkt i Icinga utan att skriva om kontrollskripten.
- Insamling och lagring av mätvärden: Skriv insamlade systemmätvärden till tidsseriedatabaser, inklusive Graphite, InfluxDB, Elasticsearch och OpenTSDB.
- Rollbaserad åtkomstkontroll: Tilldela användare och team detaljerade åtkomstbehörigheter baserat på deras roller i övervakningsmiljön.
- Automatiserade konfigurationsregler: Definiera tillämpningsregler som automatiskt skapar värd- och tjänstekontroller när den övervakade miljön förändras.
Icinga-integrationer
Icinga erbjuder en dokumenterad Grafana-integration samt integrationer med Puppet, Ansible, Chef, AWS, Azure, Google Cloud Platform, Graphite, InfluxDB, Elastic och Graylog. Dess REST API stöder anpassade integrationer och automatisering av konfigurationen.
Pros and Cons
Pros:
- Hanterar stora, distribuerade övervakningsinstallationer
- Mallar minskar repetitiv värdkonfiguration
- Återanvänder Nagios-kompatibla kontroller
Cons:
- Nagios-migreringar kräver att konfigurationen byggs om
- Aviseringsleverans kräver externa skript
Learn more about Icinga: Bäst för övervakning av flera moln
- Gratisplan + 30 dagars provperiod + demo tillgänglig
- Från $10/månad
Visit WebsiteCustomer Rating:4.7/5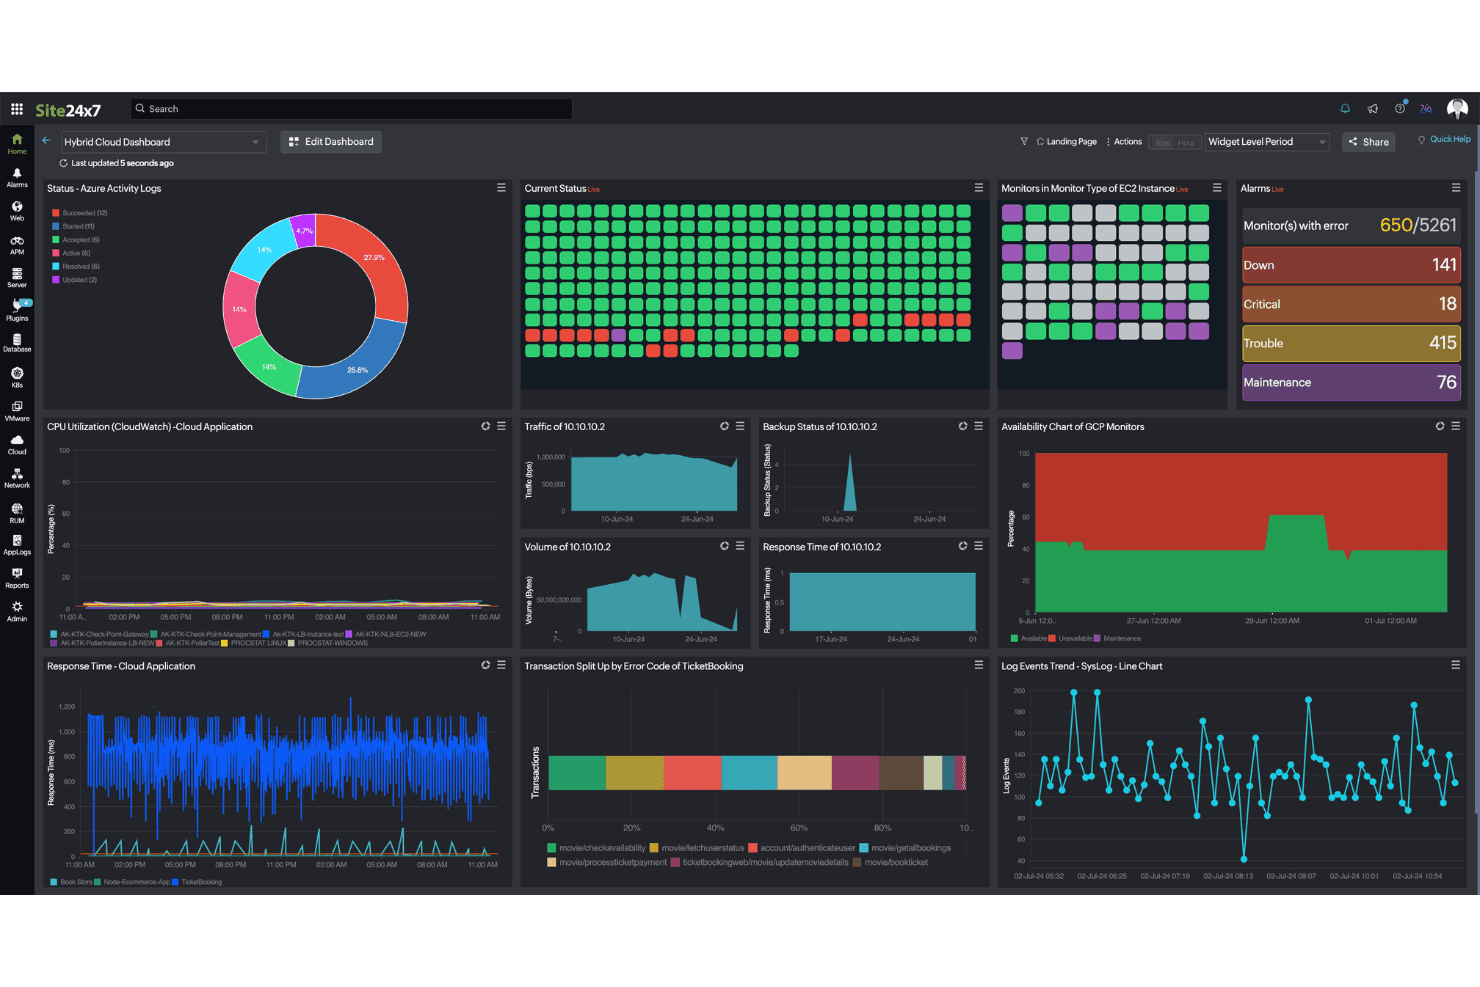
Site24x7 samlar övervakningen av hybridmoln i Azure, AWS och GCP på en enda instrumentpanel. Site24x7 är en AI-baserad observerbarhetsplattform från Zoho som hjälper IT-team, DevOps-ingenjörer och systemadministratörer att övervaka servrar, nätverk, molninfrastruktur och applikationer från en enda konsol.
Vem passar Site24x7 bäst för?
Site24x7 passar mycket bra för IT- och DevOps-team som kör arbetsbelastningar i AWS, Azure och GCP och vill ha en samlad överblick utan att behöva hantera flera övervakningsverktyg.
Varför jag valde Site24x7
Jag valde Site24x7 som ett av de bästa alternativen till Nagios eftersom plattformen samlar övervakning av AWS, Azure och GCP under en enda konsol, något Nagios helt enkelt inte byggdes för att göra. Jag uppskattar särskilt den lokala avsökaren, som utökar insynen i interna resurser bakom brandväggar och VPN-anslutningar på olika filialkontor utan att kräva en egen värdbaserad server. Den Zia-drivna avvikelsedetekteringen går dessutom längre än statiska tröskelvärden genom att dynamiskt spåra mätvärdestoppar i din miljö med flera moln, så att du inte hela tiden behöver finjustera aviseringar manuellt.
Viktiga funktioner i Site24x7
- Körning av Nagios-insticksprogram: Kör dina befintliga Nagios-insticksprogram via Site24x7:s Linux-agent och skicka resultaten till Site24x7 utan att underhålla en dedikerad Nagios-server.
- Programupptäckt och beroendekartläggning (ADDM): Visualisera programrelationer och topologi med hjälp av data om "Körs på", "Ansluter till" och infrastrukturberoenden från agenter samt nätverks-, moln- och virtualiseringskällor.
- Hantering av nätverkskonfiguration: Automatisera konfigurationssäkerhetskopior, upptäck obehöriga ändringar, identifiera sårbarheter i fast programvara och övervaka efterlevnaden för nätverksenheter.
- Aviseringsprofiler med flera kanaler: Konfigurera aviseringar via e-post, SMS, röstsamtal och pushaviseringar med inställningar för eskalering, ihållande aviseringar och fördröjningar vid upprepade fel.
Integrationer med Site24x7
Site24x7 erbjuder inbyggda integrationer med ServiceNow, PagerDuty, Opsgenie, Jira, Slack och Microsoft Teams samt webbanslutningar för incidentarbetsflöden. Plattformen tillhandahåller ett REST API för anpassade integrationer och stöder Zapier.
Pros and Cons
Pros:
- Samlad övervakning av moln och infrastruktur
- Behåller Nagios-insticksprogram i drift via en agent
- Den lokala avsökaren övervakar brandväggsskyddade system och filialsystem
Cons:
- Nagios-insticksprogram kräver manuell JSON-konfiguration
- Aviseringsbrus kan kräva justering av tröskelvärden
Learn more about Site24x7: Bäst för övervakning av webbapplikationer
- Gratis abonnemang + 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $13.33/månad
Visit WebsiteCustomer Rating:4.5/5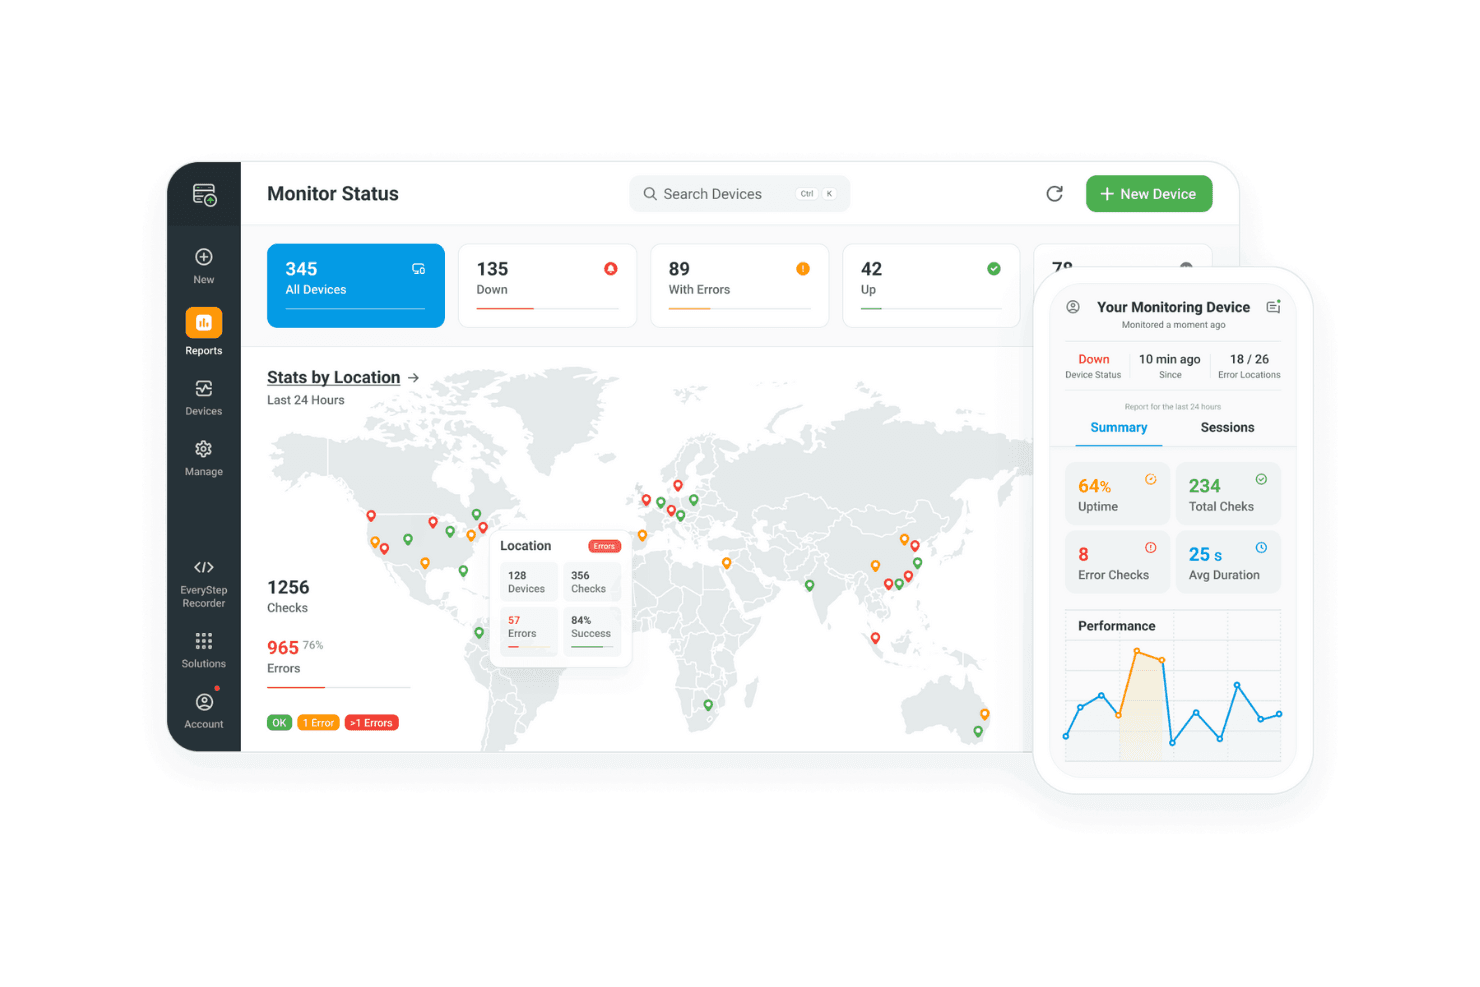
Dotcom-Monitor spårar enheters drifttid, fel och platsstatistik i realtid. Dotcom-Monitor är en plattform för syntetisk övervakning och infrastrukturövervakning som tilltalar DevOps- och SRE-team som behöver övervaka webbapplikationer, API:er, servrar och nätverkstjänster från en enda instrumentpanel – med inbyggda kontroller i riktiga webbläsare, protokollövervakning och täckning av privata nätverk.
Vem passar Dotcom-Monitor bäst för?
Dotcom-Monitor passar bra för DevOps- och SRE-team som behöver syntetisk övervakning av webbappar, API:er och infrastruktur från en enda instrumentpanel.
Varför jag valde Dotcom-Monitor
Jag valde Dotcom-Monitor som ett av de bästa alternativen eftersom det erbjuder syntetisk övervakning i riktiga webbläsare för kontroller av webbapplikationer på ett sätt som Nagios helt enkelt inte kan matcha. Jag uppskattar hur EveryStep Web Recorder fångar användarresor i flera steg, som inloggningar eller kassaflöden, och spelar upp dem kontinuerligt från platser över hela världen. När en kontroll misslyckas får jag en skärmbild, en videoinspelning och ett vattenfallsdiagram tillsammans med aviseringen, så att jag kan fastställa exakt var en transaktion bröts utan att behöva leta igenom loggar.
Viktiga funktioner i Dotcom-Monitor
- Privata agenter: Distribuerar lättviktiga agenter i ditt privata nätverk för att övervaka interna system, intranät och brandväggsskyddade tjänster utan att inkommande brandväggsregler krävs.
- Protokoll- och drifttidskontroller: Övervakar HTTP/HTTPS, DNS, SSL/TLS, SMTP, FTP, VoIP/SIP, TCP/UDP, ICMP och traceroute från en enda plattform.
- Prestandaräknare (MetricsView): Samlar in Windows-prestandaräknare, Linux Collectd-mätvärden och SNMP v1/v2/v3-data, med konfigurerbara tröskelvärden och baslinjebaserade aviseringar.
- REST API- och CI/CD-integrering: Tillhandahåller ett fullständigt REST API för programmatisk skapande av enheter, konfiguration av aviseringar och etablering av övervakning direkt från distributionspipelines.
Integreringar med Dotcom-Monitor
Dotcom-Monitor erbjuder inbyggda integreringar med PagerDuty, Slack, Microsoft Teams, Splunk On-Call, ServiceNow, Okta och Salesforce. Det stöder anpassade integreringar via sitt REST API och CI/CD-arbetsflöden samt Zapier.
Pros and Cons
Pros:
- Kontroller i riktiga webbläsare avslöjar trasiga användarresor
- Privata agenter når brandväggsskyddade interna system
- Felaviseringar innehåller svarsinformation och traceroutes
Cons:
- Ingen automatisk identifiering av värdar eller tjänster
- Navigering med många övervakningsobjekt kan försvåra rapporteringen
Learn more about Dotcom-Monitor: Bäst för enkel konfiguration utan extra handpåläggning
- Gratisplan + demoversion tillgänglig
- Pris på begäran
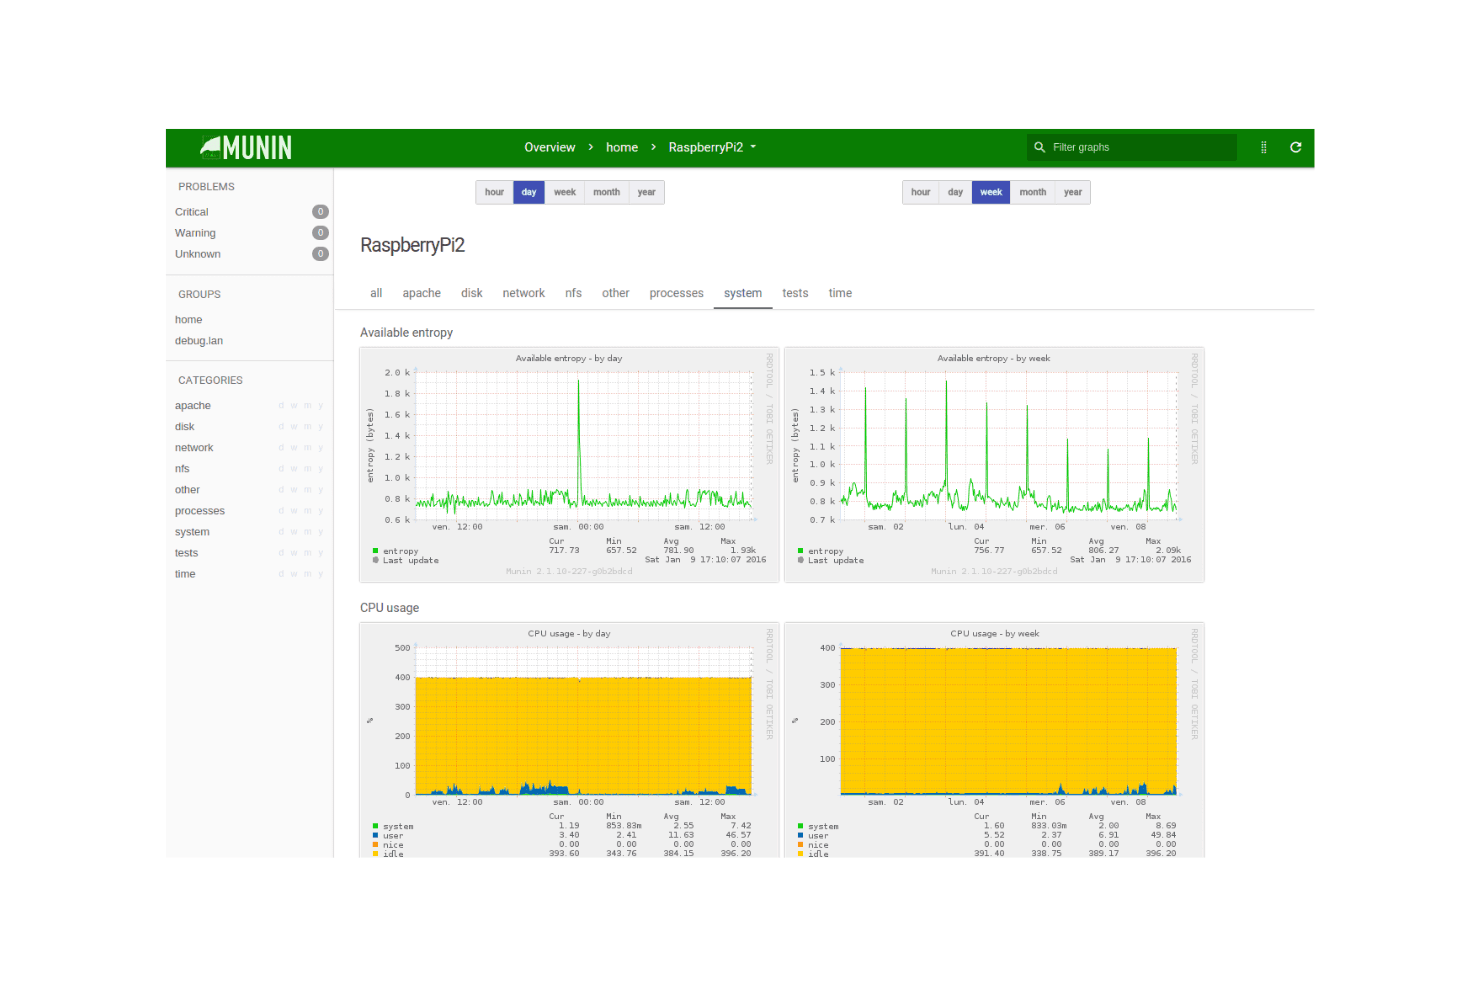
Munin visualiserar CPU-användning och systementropi på en Raspberry Pi. Munin är ett nätverksövervakningsverktyg med öppen källkod som följer resurstrender över tid och presenterar dem som historiska diagram – vilket gör det väl lämpat för systemadministratörer och DevOps-team som behöver diagnostisera prestandaproblem och planera kapacitet i serverinfrastrukturen.
Vem passar Munin bäst för?
Munin passar bra för systemadministratörer och DevOps-team som vill ha ett kostnadseffektivt verktyg med öppen källkod för att följa infrastrukturtrender och diagnostisera prestandaproblem över tid.
Varför jag valde Munin
Jag valde Munin som ett av de bästa alternativen eftersom den enkla konfigurationen utan extra handpåläggning verkligen lever upp till löftet:
munin-node-configure --suggestskannar din nod och visar vilka insticksprogram som sannolikt kommer att fungera, och skriver sedan ut skalkommandona för att installera dem. När du lägger insticksprogram i insticksprogramkatalogen börjar Munin skapa diagram över RRD-baserade trender i vyer för timme, dag, vecka, månad och år, utan att någon manuell diagramkonfiguration krävs. Jag uppskattar också att biblioteket med 500 insticksprogram täcker allt från PostgreSQL-lås till disk-I/O direkt från början, vilket minskar mycket av grundarbetet jämfört med Nagios.Munins viktigaste funktioner
- Tröskelbaserad avisering: Konfigurera varnings- och kritiska tröskelvärden per insticksprogram, med stöd för aviseringar via e-post, anpassade skript, Slack och PagerDuty.
- Huvudserver-/nodarkitektur: En central Munin-huvudserver frågar noder var femte minut, lagrar data i RRD-filer och tillhandahåller diagramrapporter som kan nås via webbläsaren.
- Stöd för SNMPv3: Avfråga nätverksenheter med SNMP-versionerna 1, 2c eller 3, där läget
authPrivger både autentisering och kryptering. - TLS-kryptering mellan huvudserver och nod: Skydda kommunikationen mellan huvudserver och nod med konfigurerbar TLS, inklusive en strikt konfiguration där certifikatutfärdaren verifieras.
Munins integrationer
Munin integreras med Nagios via
send_nscaoch NSCA för passiva kontroller, men matchande värdar och tjänster måste registreras i Nagios. Inget offentligt API eller några andra namngivna integrationer är dokumenterade.Pros and Cons
Pros:
- Förslag på insticksprogram förenklar den första övervakningskonfigurationen
- Historiska diagram tydliggör resurstrender
- Anpassade insticksprogram visar detaljerade tjänstemätvärden
Cons:
- Avfrågning var femte minut kan fördröja upptäckten av driftstörningar
- Det föråldrade diagramgränssnittet begränsar instrumentpanelens användbarhet
Learn more about Munin: Bäst för fullständig observerbarhet
- Kostnadsfritt abonnemang + 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $2.80/månad
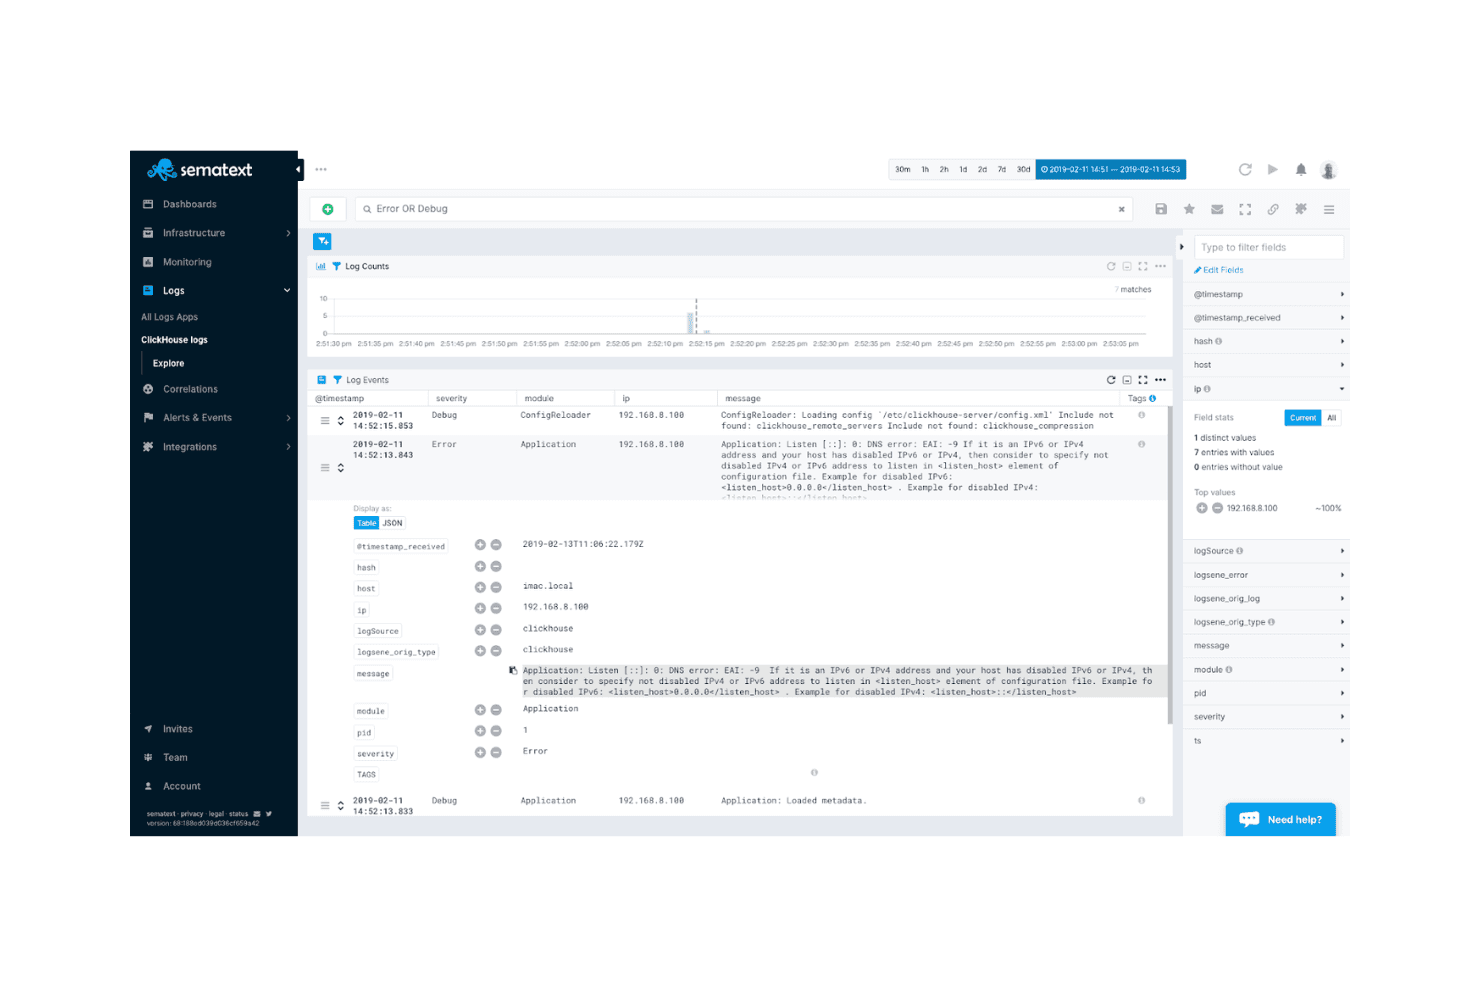
Sematext låter användare söka i och filtrera loggar efter allvarlighetsgrad i realtid. Sematext är en molnbaserad plattform för infrastrukturövervakning som tilltalar DevOps- och SRE-team som behöver övervaka servrar, containrar, Kubernetes och molninstanser – med anomalibaserade aviseringar och inbyggd kartläggning av nätverkstopologi.
Vem passar Sematext bäst för?
Sematext passar utmärkt för DevOps- och SRE-team som hanterar containeriserade eller Kubernetes-tunga miljöer och behöver infrastrukturmått, aviseringar och insyn i nätverkstopologin på samma plats.
Varför jag valde Sematext
Jag valde Sematext som ett av de bästa alternativen eftersom det ger fullständig observerbarhet över servrar, containrar och Kubernetes på ett sätt som Nagios helt enkelt inte kan matcha utan omfattande plugin-arbete. Jag uppskattar särskilt Nätverkskarta, som använder eBPF för att visualisera aktiva anslutningar mellan tjänster, poddar och processer i hela infrastrukturen. Kombinera detta med anomalibaserade aviseringar som upptäcker ovanliga toppar jämfört med en beräknad baslinje, så får du en övervakningslösning som upptäcker problem innan tröskelvärden ens har överskridits.
Viktiga funktioner i Sematext
- Aviseringar om utebliven kontakt: Få automatiska meddelanden när en övervakad server, container eller applikation slutar skicka data till Sematext Cloud.
- Schemalagda rapporter: Skicka instrumentpanelbilder med e-post till mottagare dagligen, veckovis, månadsvis eller kvartalsvis utan att ge dem full åtkomst till plattformen.
- Automatisk tjänsteidentifiering: Sematext Agent söker igenom aktiva tjänster och loggar, så att du kan aktivera övervakning av nya instanser, till exempel Elasticsearch-noder, direkt från identifieringsgränssnittet.
- Instrumentpaneler med flera källor: Kombinera mått, loggar, infrastrukturinventering, klusterdata och händelser från flera appar i en enda anpassningsbar instrumentpanel med Diagrambyggaren.
Integrationer med Sematext
Sematext erbjuder över 100 inbyggda integrationer, inklusive Nagios, Slack, PagerDuty, Opsgenie, Microsoft Teams och Pushover. Plattformen har även stöd för anpassade webhooks, Zapier och ett REST API för anpassade integrationer.
Pros and Cons
Pros:
- Anomalivarningar upptäcker ovanliga toppar i infrastrukturen
- Nätverkskartor synliggör beroenden mellan tjänster och processer
- Användare uppskattar detaljerade instrumentpaneler för felsökning
Cons:
- Vissa recensenter rapporterar långsamma och trånga instrumentpaneler
- Användare rapporterar problem med konfigurationen under driftsättningar
Learn more about Sematext:
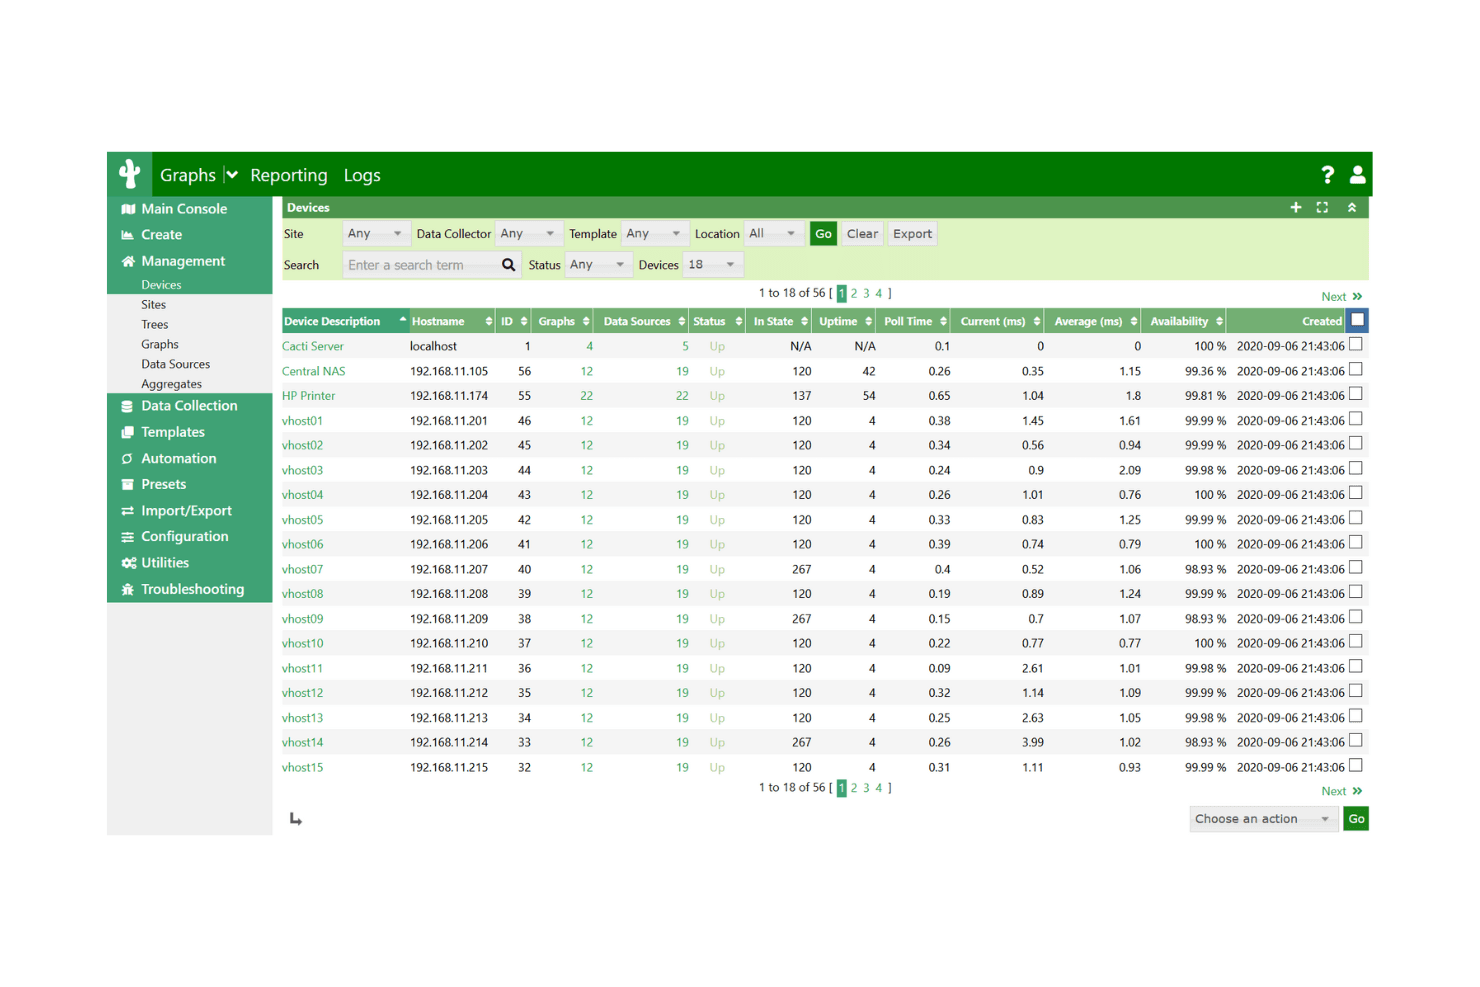
Cacti visar alla övervakade enheter med mått för drifttid och tillgänglighet. Cacti är en nätverksövervakningsplattform med öppen källkod, baserad på RRDtool, som är byggd för nätverksingenjörer och systemadministratörer som behöver detaljerad grafvisning och prestandaspårning i stora miljöer med SNMP-kompatibla enheter som routrar, switchar och brandväggar.
Vem passar Cacti bäst för?
Cacti passar bra för nätverksdrifttekniker och systemadministratörer som behöver detaljerad, långsiktig grafvisning av SNMP-kompatibla enheter som routrar, switchar och brandväggar i stora lokala miljöer.
Varför jag valde Cacti
Jag valde Cacti som ett av de bästa alternativen till Nagios eftersom dess RRDtool-baserade grafikmotor verkligen saknar motstycke när det gäller långsiktig visualisering av nätverksprestanda. Där Nagios fokuserar på aviseringar låter Cacti mig skapa detaljerade, anpassningsbara grafer för routrar, switchar och brandväggar med hjälp av SNMP-data, och följa gränssnittstrafik, processorbelastning och BGP-rutter över tid. Jag uppskattar också att enhetsmallar låter mig gruppera grafmallar och dataförfrågningar efter enhetstyp, så att övervakning av en ny uppsättning Cisco-switchar kan införas på några minuter i stället för flera timmar.
Cactis viktigaste funktioner
- Thold-tillägg: Konfigurerar tröskelvärden för höga och låga nivåer, tidsbaserade tröskelvärden samt avvikelser från baslinjen utifrån grafdata, med eskaleringar via e-post, Syslog och SNMP Trap.
- Fjärravfrågare: Fördelar avfrågningsbelastningen över flera servrar och placerar insamlingskällor närmare de övervakade enheterna i stora nätverk.
- Profiler för datakällor: Styr storlek och lagringsinställningar för RRD-filer för att hantera hur länge historiska prestandadata sparas.
- ReportIt-tillägg: Skapar schemalagda rapporter med rullande tidsintervall och exporterar data till formaten CSV, SML och XML.
Cactis integrationer
Cacti har inga inbyggda integrationer som är tydligt dokumenterade.
Pros and Cons
Pros:
- Detaljerade SNMP-grafer bevarar prestandahistoriken
- Anpassade enhetsmallar skräddarsyr nätverksövervakningen
- Fjärravfrågare fördelar insamlingen över stora nätverk
Cons:
- Aviseringar om tjänsteavbrott kan komma sent
- Tilläggsuppdateringar och konfiguration kräver underhåll
Learn more about Cacti: Bäst för AIOps och observerbarhet
- Gratis demonstration tillgänglig
- Pris på begäran
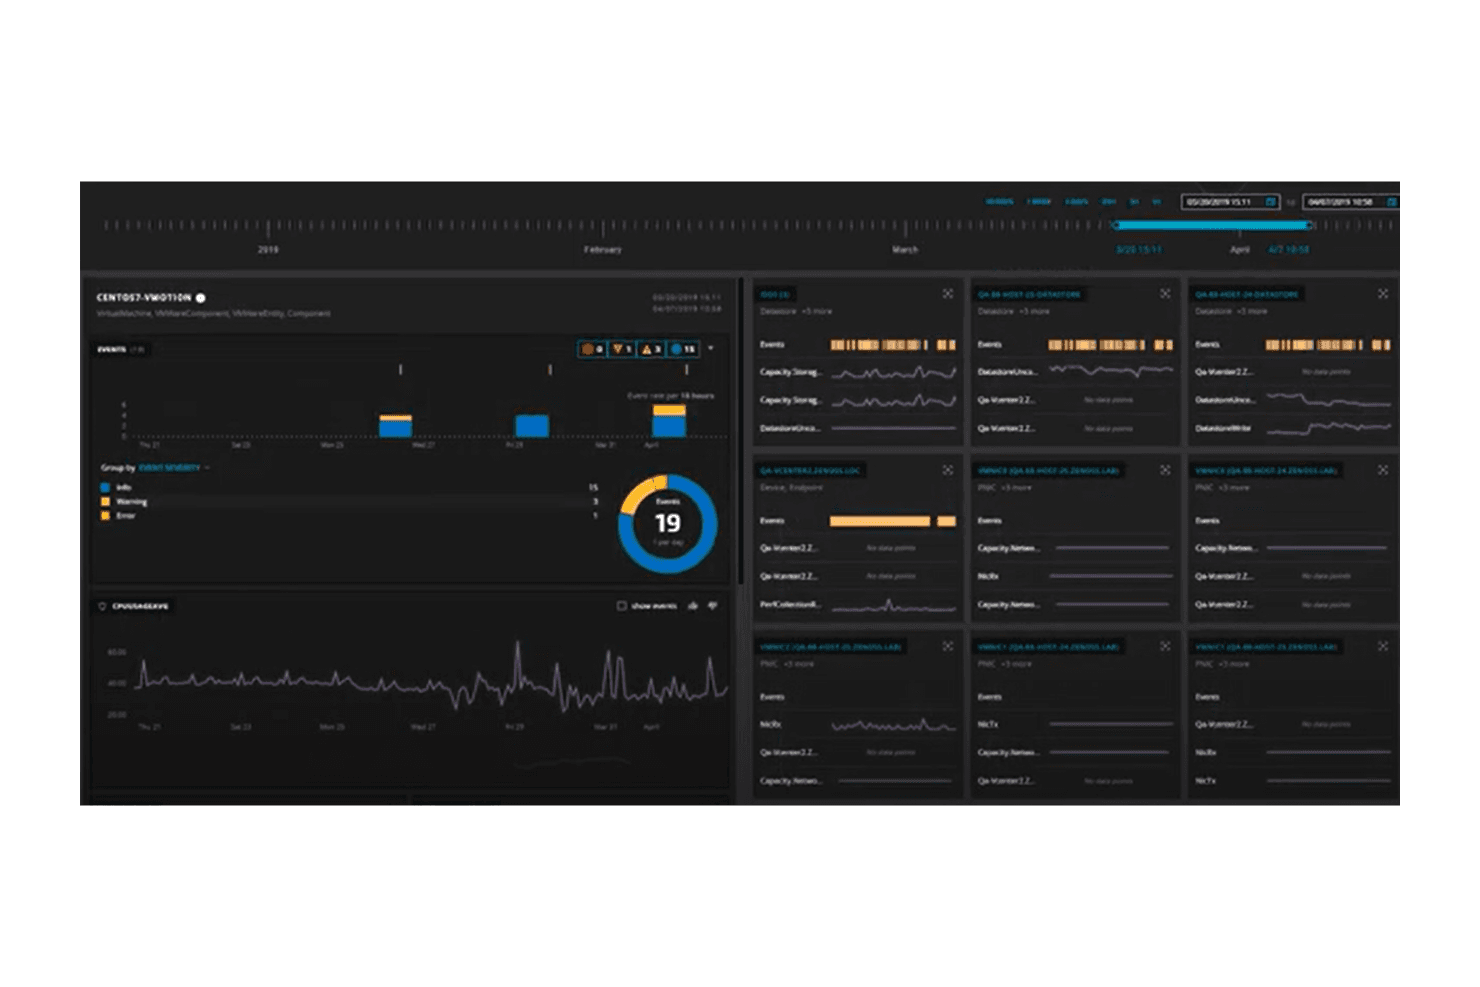
Zenoss Core övervakar infrastrukturella händelser och prestandamätvärden i realtid. Virtana Service Observability (tidigare Zenoss) är en AIOps-driven övervakningsplattform som kopplar samman infrastruktur, applikationer och molnmiljöer i en enhetlig tjänstevy – vilket gör den väl lämpad för driftteam som hanterar komplexa hybridmiljöer och behöver AI-assisterad grundorsaksanalys och beroendekartläggning.
Vem passar Zenoss Core bäst för?
Zenoss Core passar väl för driftteam som hanterar komplexa hybridmiljöer och behöver AI-driven grundorsaksanalys och kartläggning av beroenden på tjänstenivå i en enda enhetlig vy.
Varför jag valde Zenoss Core
Jag valde Zenoss Core som ett av de bästa alternativen till Nagios eftersom det ersätter Nagios statiska kontrollbaserade modell med en aktiv, AI-driven tjänstekarta som kontinuerligt upptäcker och korrelerar beroenden i hybridinfrastrukturen. Jag uppskattar särskilt hur dess avvikelsedetektering och grundorsaksanalys, rangordnad efter sannolikhet, begränsar sökningen till var en incident faktiskt har sitt ursprung i stället för att överösa dig med frånkopplade aviseringar. Den automatiska upptäckten håller tjänstemodellerna synkroniserade när molnresurser och lokala resurser förändras, så du behöver inte uppdatera konfigurationer manuellt varje gång något ändras.
Viktiga funktioner i Zenoss Core
- Händelsekorrelation och filtrering: Samlar, deduplicerar och maskerar händelser från fysiska, virtuella och molnbaserade resurser för att lyfta fram dem som sannolikt påverkar tjänsteleveransen mest.
- ZenPack-utbyggbarhet: Utökar övervakningen med återanvändbara enhetsklasser, övervakningsmallar, datakällor, diagram och händelseklasser som kan installeras eller byggas anpassat.
- Regler för aviseringar i flera kanaler: Kombinerar händelser, tröskelvärden för mätvärden och utlösare baserade på avvikelsepoäng med destinationer som PagerDuty, Microsoft Teams, Slack och ServiceNow i en enda konfigurerbar regel.
- Rollbaserade åtkomstkontroller: Begränsar vem som kan skapa och hantera utlösare, destinationer och aviseringsregler baserat på tilldelade roller inom plattformen.
Integrationer med Zenoss Core
Zenoss Core har dokumenterade integrationer med ServiceNow, BMC Remedy, CA Service Desk, HP Service Manager, Cisco UCS Director, Chef och Puppet. REST API:er och en gRPC-datamottagare stöder anpassade integrationer.
Pros and Cons
Pros:
- Korrelerar lagrings-, SAN- och servertopologi
- Kartlägger tjänsteberoenden till tjänstepåverkan
- Recensenter uppskattar det lättlästa gränssnittet
Cons:
- Recensenter efterfrågar tydligare visualiseringar av övervakningen
- Recensenter nämner begränsad övervakning av applikationsprestanda
Learn more about Zenoss Core: Bäst för övervakning från början till slut
- Kostnadsfritt abonnemang + 30 dagars provperiod + demo tillgänglig
- Från €283/månad (faktureras årsvis)
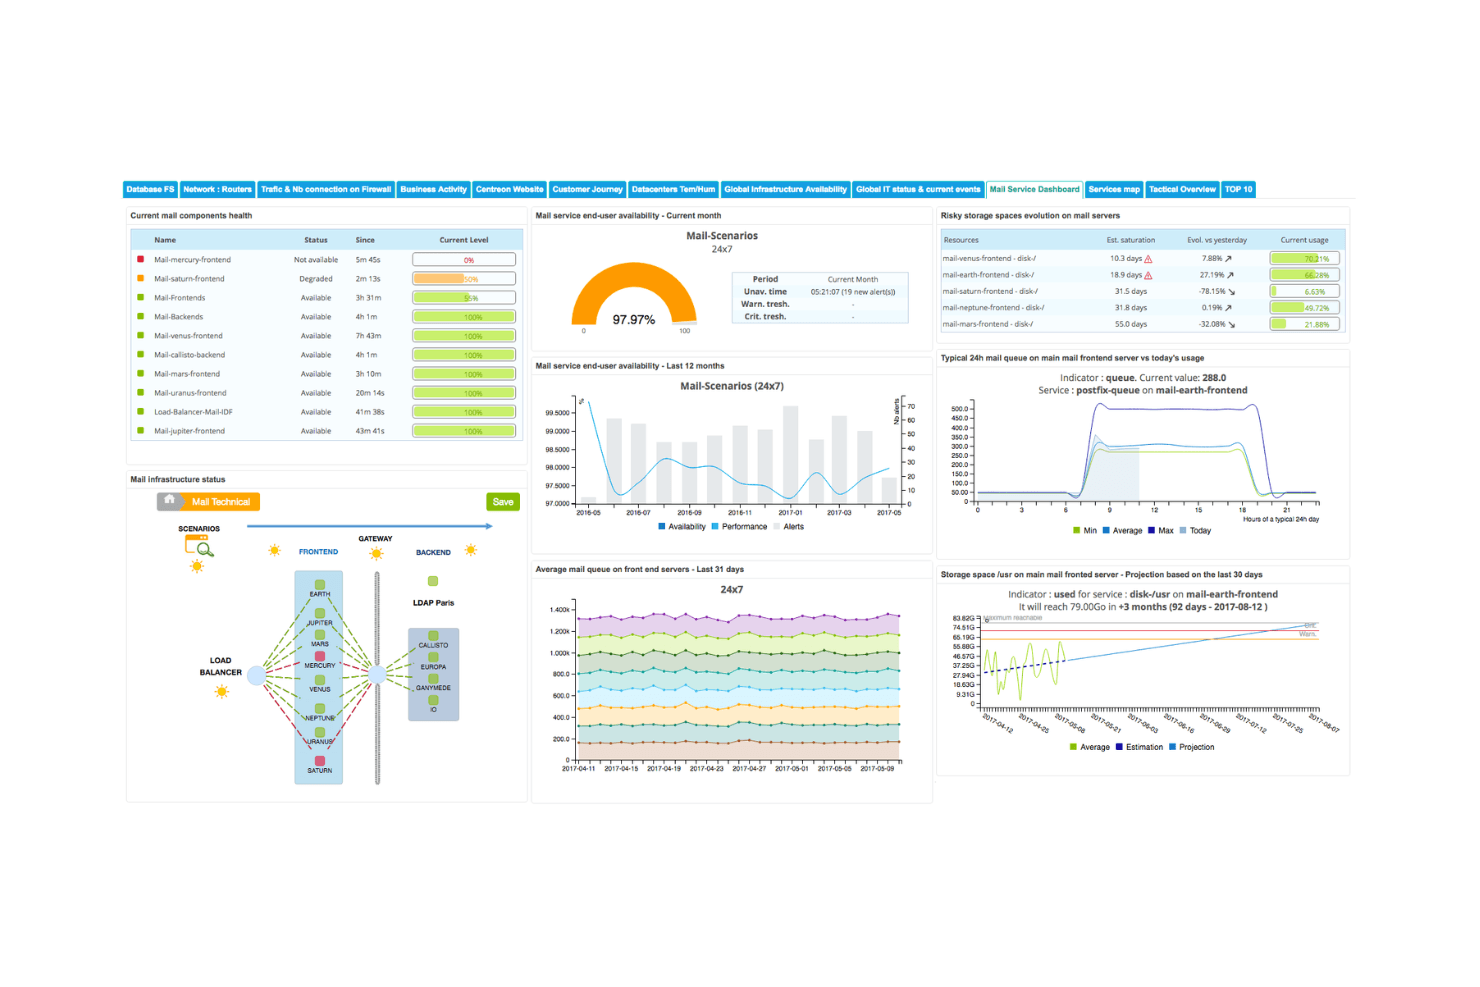
Centreon tillhandahåller en enhetlig instrumentpanel för e-posttjänster med realtidsövervakning av infrastrukturen. Centreon är en hybrid IT-övervakningsplattform utvecklad för systemadministratörer och DevOps-team som behöver samlad insyn i servrar, nätverk, molntjänster, containrar och OT-system – utan att behöva hantera separata verktyg för varje lager i sin infrastruktur.
Vem passar Centreon bäst för?
Centreon passar bra för systemadministratörer och DevOps-team som hanterar heterogena miljöer med lokal infrastruktur, molntjänster och äldre system sida vid sida.
Varför jag valde Centreon
Centreon tar plats på min kortlista eftersom det är en av få plattformar som verkligen täcker övervakning från början till slut av servrar, nätverk, molntjänster, containrar och OT-system utan att kräva separata verktyg för varje lager. Jag uppskattar särskilt funktionen för övervakning av affärsaktiviteter, som kopplar teknisk tjänstestatus direkt till affärsaktiviteter så att mitt team inte bara kan se att något ligger nere, utan också vilka verksamhetsprocesser som påverkas. De fler än 700 färdigbyggda övervakningsanslutningarna, med expertanpassade standardinställningar, innebär att jag kan ta in Kubernetes-kluster och äldre AS/400-system i samma övervakningsvy.
Viktiga funktioner i Centreon
- Verktyg för migrering av Nagios CFG: Ett kostnadsfritt verktyg med öppen källkod läser dina befintliga Nagios CFG-filer och konverterar dem till Centreon CLAPI-kommandon för direktimport.
- Eskalering av aviseringar via flera kanaler: Skickar aviseringar via e-post, SMS, Slack, Microsoft Teams och Telegram, med konfigurerbara intervall för återsändning och eskaleringsregler.
- Distribuerad pollararkitektur: Distribuerar pollare och valfria fjärrservrar mellan platser eller nätverkszoner för att samla in och buffra övervakningsdata oberoende av den centrala servern.
- Rollbaserad åtkomstkontroll: Tilldelar användargrupper och detaljerade rättigheter för pollare, resurser, gränssnittsmenyer och åtgärder, med stöd för LDAP, SAMLv2 och OpenID Connect.
Centreon-integreringar
Centreon erbjuder 736 övervakningsanslutningar på marknadsplatsen, inklusive Amazon EC2, Azure Virtual Machine, Kubernetes API, VMware vCenter, Cisco Standard SNMP, Microsoft SQL Server och PostgreSQL. Plattformen integreras med ServiceNow, Jira, PagerDuty, Grafana och Kafka, med stöd för REST API v1 och v2, CLAPI och MAP API.
Pros and Cons
Pros:
- Verktyget för migrering av Nagios CFG förenklar övergången
- Grafiska arbetsflöden ersätter manuellt redigerad konfiguration
- Enhetlig övervakning av äldre och moderna system
Cons:
- Anslutningspluginer kräver separat underhåll
- Den inledande konfigurationen och tröskelvärdena tar tid
Learn more about Centreon:
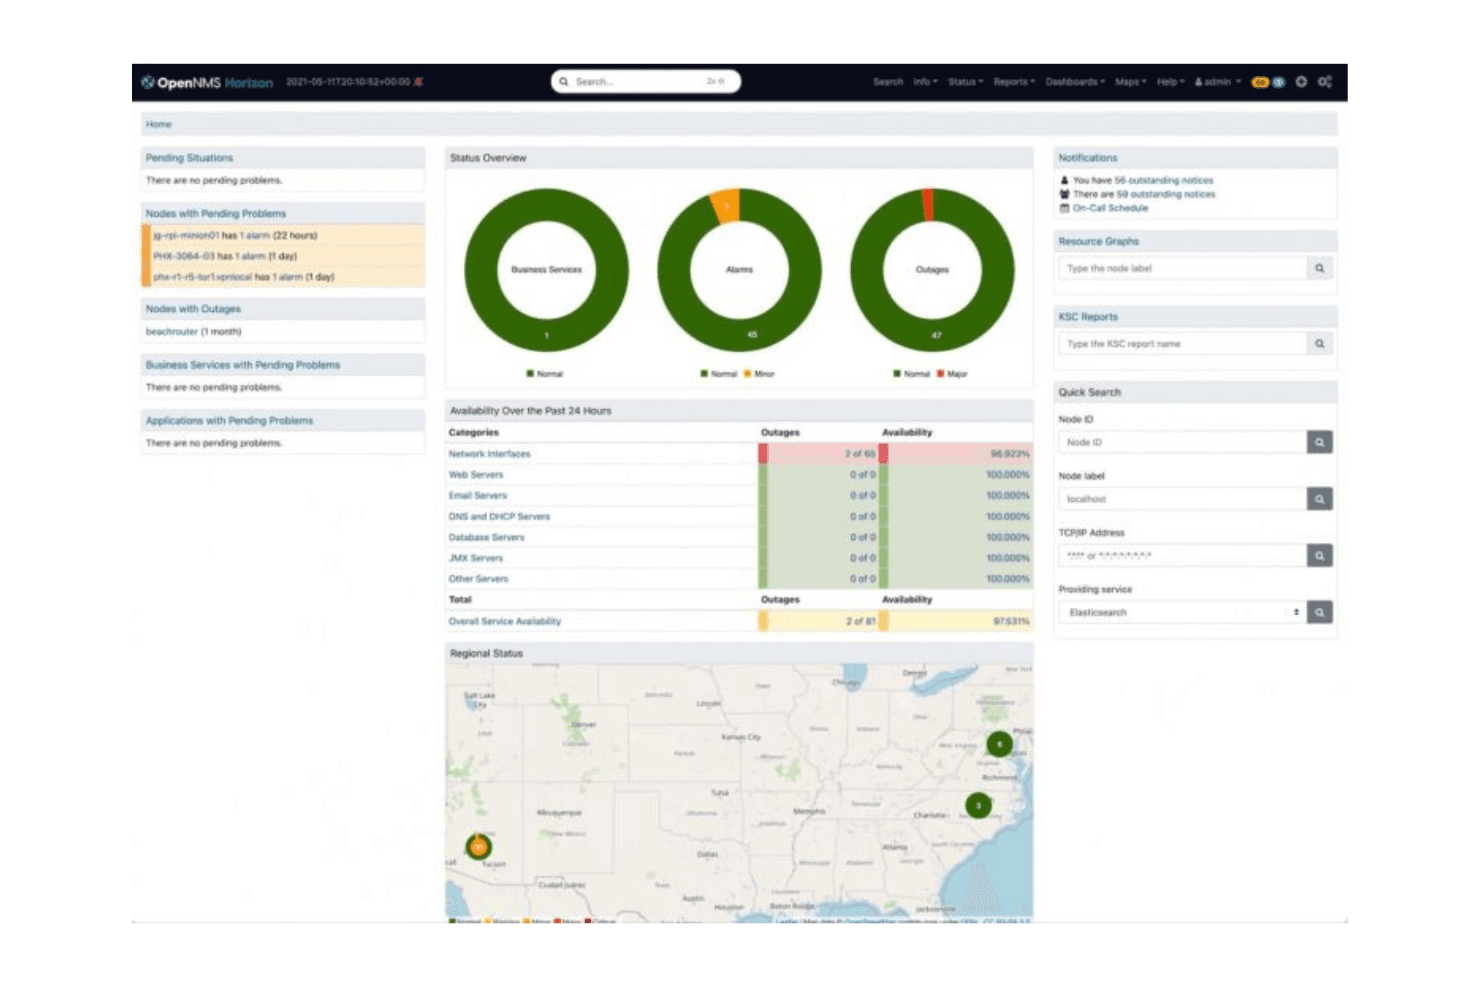
OpenNMS tillhandahåller en central instrumentpanel för övervakning av nätverksstatus och avbrott. OpenNMS är en nätverksövervakningsplattform med öppen källkod, byggd för tekniskt kunniga team som behöver djupt protokollstöd, distribuerad övervakning över fjärranslutna eller brandväggsskyddade platser samt skalbar insyn i fel och prestanda i stora, komplexa infrastrukturer.
Vem passar OpenNMS bäst för?
OpenNMS passar bra för nätverksdriftsteam som hanterar stora, distribuerade infrastrukturer och behöver djupt protokollstöd samt flexibel fjärrövervakning över brandväggsskyddade eller segmenterade platser.
Varför jag valde OpenNMS
Jag valde OpenNMS eftersom dess Minion-arkitektur verkligen löser problemet med distribuerad övervakning, som Nagios hanterar dåligt. Minions placeras i brandväggsskyddade eller NAT-separerade nätverkssegment och vidarebefordrar data till kärnan, så att mitt team kan övervaka fjärranslutna platser utan att öppna hål i brandväggen eller köra en separat övervakningsinstans på varje plats. Jag uppskattar också att OpenNMS automatiskt upptäcker topologi på lager 2 och lager 3, vilket ger mitt team en aktuell karta över hur enheterna förhåller sig till varandra över dessa distribuerade segment.
Viktiga funktioner i OpenNMS
- ALEC-larmkorrelation: Grupperar relaterade larm i situationer på högre nivå med hjälp av tidsmässig klustring, maskininlärning och aktuella topologidata.
- Insamling av NetFlow och strömmande telemetri: Samlar in och bearbetar NetFlow v5/v9, IPFIX, sFlow och leverantörsspecifika telemetrisystem, inklusive Cisco NX-OS och OpenConfig.
- Säkerhetskopiering av enhetskonfigurationer: Schemalägger eller utlöser säkerhetskopiering av enhetskonfigurationer på begäran, behåller versionshistorik och stöder jämförelse sida vid sida över tid.
- REST API och API för utveckling av insticksmoduler: Exponerar inventering, mätvärden, händelser, larm och flöden via ett REST API, med ett stabilt API för insticksmoduler som gör det möjligt att utöka eller använda plattformens funktioner.
OpenNMS-integreringar
OpenNMS har dokumenterade inbyggda integreringar med PagerDuty, Grafana, Jira, Remedy, TSRM, Slack och Mattermost, samt anslutning till Kafka och Prometheus RemoteWrite. Dess REST- och insticksmoduls-API:er stöder anpassade integreringar.
Pros and Cons
Pros:
- Minions når brandväggsskyddade fjärrnätverk
- Bred SNMP-täckning omfattar blandad infrastruktur
- Recensenter uppskattar grafer och nätverksrapporter
Cons:
- XML-redigering försvårar ersättning av Nagios
- Föråldrade instrumentpaneler kräver extra navigering
Learn more about OpenNMS:
Andra Nagios-alternativ
Här är några ytterligare Nagios-alternativ som inte kom med på min kortlista, men som ändå är värda att ta en titt på:
- 11MonitorixBäst för lättviktig övervakning
- 12op5 MonitorBäst för skalbarhet på företagsnivå
- 13NaemonBäst för modulär arkitektur – pris på begäran
- 14ArgusBäst för system- och nätverksövervakning
Så utvärderar jag alternativ till Nagios
Jag delar upp min utvärdering i två lager: den grundnivå som varje verktyg måste klara – aviseringar i realtid, täckning av flera miljöer och automatisk upptäckt – samt de särskiljande egenskaper som skiljer de bästa från resten.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer verktyg till min lista poängsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en minsta totalpoäng på 75 % för att övervägas för inkludering.
- Infrastrukturövervakning: Jag kontrollerar om ett verktyg övervakar servrar, nätverksenheter och tjänster med hälsokontroller i realtid och prestandamätvärden – till exempel CPU-, minnes-, disk- och gränssnittsutnyttjande över en blandad uppsättning Linux- och Windows-värdar.
- Aviseringar och meddelanden: Varje verktyg bör stödja aviseringar via flera kanaler (e-post, Slack, PagerDuty, SMS) med konfigurerbara tröskelvärden och eskaleringspolicyer, så att rätt jourhavande tekniker får en avisering när en disk blir full klockan två på natten.
- Instrumentpaneler och visualisering: Jag utvärderar om instrumentpanelerna är tillräckligt anpassningsbara för att skapa rollspecifika vyer – till exempel en väggskärm i ett NOC som visar nätverksstatus jämfört med en panel för containerprestanda för ett DevOps-team.
- Automatisk upptäckt och agentstöd: Verktyg som automatiskt upptäcker värdar och tjänster via SNMP, WMI eller molnleverantörers API:er sparar timmar av manuell konfiguration, och jag letar efter flexibla agentbaserade och agentlösa alternativ som kan täcka både brandväggsskyddade segment och moln-VPC:er.
- Integrationer och utbyggbarhet: Jag granskar färdiga integrationer med ITSM-plattformar som ServiceNow eller Jira Service Management, samt API-åtkomst och stöd för plugin-program för att skriva anpassade kontroller eller mata in data i verktyg som Grafana.
- Täckning av flera miljöer: Oavsett om du kör servrar på fysisk hårdvara, arbetsbelastningar i flera moln över AWS och Azure eller Kubernetes-kluster, utvärderar jag hur väl varje verktyg övervakar lokala miljöer, molnmiljöer och containeriserade miljöer.
När jag har en lista över verktyg som uppfyller dessa kriterier tar jag hänsyn till vad som särskiljer varje plattform.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
AIOps-funktioner spelar en stor roll här. Verktyg som använder maskininlärning för att fastställa normalbeteende och flagga verkliga avvikelser minskar mängden brus från aviseringar på sätt som statiska tröskelvärden aldrig kan. Jag utvärderar också kartläggning av beroenden och topologi – när en central switch går ner påskyndar det felsökningen avsevärt att se konsekvenserna för alla beroende tjänster. Automatisering och självläkning kompletterar bilden. Jag letar efter verktyg som automatiskt kan utlösa åtgärder i körböcker, till exempel starta om en tjänst som har slutat fungera eller rensa en tillfällig katalog innan en avisering ens når jourteamet.
Mer än funktioner
Stöd för migrering är mycket viktigt när du lämnar Nagios. Jag kontrollerar om ett verktyg kan importera befintliga kontrollkonfigurationer eller återanvända anpassade plugin-program för att undvika att bygga om allt från grunden. Pristransparens är minst lika viktig – Nagios-användare är vana vid ekonomi kring öppen källkod, så jag utvärderar om leverantörer erbjuder en kostnadsfri nivå eller förutsägbar prissättning per värd som inte skjuter i höjden när miljön växer. Även communityns och ekosystemets hälsa väger tungt. En aktiv marknadsplats för plugin-program och en frekvent utgivningstakt signalerar långsiktig livskraft.
Varför leta efter ett Nagios-alternativ?
Även om Nagios är ett bra val för programvaruutveckling finns det flera anledningar till att vissa användare söker alternativa lösningar. Du kanske letar efter ett Nagios-alternativ eftersom …
- Du behöver mer intuitiva användargränssnitt
- Ditt team behöver bättre skalbarhet
- Du letar efter enklare konfiguration
- Du vill ha avancerade analysfunktioner
- Ditt företag behöver snabbare aviseringssystem
Om något av detta låter bekant har du kommit rätt. Min lista innehåller flera alternativ för programvaruutveckling som är bättre lämpade för team som möter dessa utmaningar med Nagios och letar efter alternativa lösningar. För team som överväger bredare övervakningslösningar kan en utforskning av alternativ till New Relic ge ytterligare alternativ för omfattande övervakning av applikationsprestanda.
Viktiga funktioner i Nagios
Här är några av de viktigaste funktionerna i Nagios, som hjälper dig att ställa alternativa lösningars erbjudanden mot varandra och jämföra dem:
- Övervakningsfunktioner: Spårar prestandan och tillgängligheten för servrar, applikationer och nätverksenheter.
- Aviseringssystem: Skickar aviseringar via e-post eller SMS när problem uppstår, vilket möjliggör snabba åtgärder.
- Webbgränssnitt: Tillhandahåller en användarvänlig instrumentpanel för övervakning och rapportering i realtid.
- Anpassningsbara insticksprogram: Stöder en mängd olika insticksprogram för utökad funktionalitet anpassad efter specifika behov.
- Skalbarhet: Kan skalas för att övervaka stora miljöer med många enheter.
- Stöd från användargemenskapen: Har stöd av en stark användargemenskap för felsökning och förbättringar.
- Problemlösning: Funktioner som bekräftelser av aviseringar och händelsehanterare för automatisk problemlösning.
- Proaktiv planering: Verktyg för trendanalys, kapacitetsplanering och hantering av schemalagda driftstopp.
- Rapportering: Genererar tillgänglighets- och historiska rapporter för att följa upp prestanda och efterlevnad av SLA:er.
- Stöd för flera klientorganisationer: Gör det möjligt för flera användare att få tillgång till anpassade vyer av infrastrukturen.