A garantia da qualidade exige uma combinação de medidas proativas e protocolos reativos eficientes. Com o equilíbrio adequado, pode prestar aos utilizadores um serviço e uma funcionalidade excelentes num servidor disponível durante todo o ano. A única forma de alcançar esse equilíbrio é identificar as métricas de monitorização de servidores mais relevantes.
Mas quais poderão ser? Isso depende dos atributos pretendidos, incluindo os descritos no Modelo de Maturidade da Qualidade, e dos objetivos de monitorização. Ainda assim, existem algumas métricas de estado e desempenho que os engenheiros de garantia da qualidade devem acompanhar sempre, independentemente das circunstâncias.
Ao selecionar desde o início as métricas ideais de monitorização de servidores, pode estabelecer uma referência de desempenho para utilizar como comparação quando surgirem inevitavelmente problemas de estado e desempenho.
Neste breve guia, analisaremos por que motivo deve acompanhar estas métricas essenciais. Além disso, obterá informações adicionais sobre a sua relevância e sobre como monitorizá-las.
1. Utilização da CPU
Uma das principais motivações para a monitorização de servidores é acompanhar o estado da infraestrutura e o desempenho básico do servidor. Uma parte essencial desse processo consiste no diagnóstico proativo e na mitigação de potenciais problemas de desempenho. A medição da utilização da CPU e do disco é fundamental para estes esforços. Por conseguinte, a utilização da CPU é uma das métricas de desempenho mais fundamentais e monitorizadas com maior frequência.
Esta métrica é considerada “baseada no anfitrião,” uma vez que regista a capacidade de uma máquina individual para funcionar e manter-se estável. Dito isto, a monitorização da utilização da CPU implica uma combinação de monitorização passiva e ativa. A última é especialmente útil para testes de carga controlados, enquanto a primeira recolhe medições no destino durante tráfego real.
Como medir a utilização da CPU
Antes de começar, terá de:
- Selecionar as unidades específicas que pretende monitorizar.
- Determinar onde essas unidades estão localizadas.
- Certificar-se de que o seu coletor de dados tem acesso aos processos do computador.
Depois de configurar tudo, terá de determinar a taxa de amostragem a que pretende acompanhar estas métricas. Por exemplo, pode medir a utilização da CPU a cada 30 segundos ou um minuto.
Existem várias formas de acompanhar a utilização da CPU, como utilizar o gestor de tarefas ou um comando como wmic CPU get load percentage em sistemas Windows. No entanto, quando tenta obter uma visão geral do servidor, é preferível apresentar estes dados num painel.
Lembre-se: o desempenho da CPU é influenciado por condições do hardware, como a temperatura da CPU e a velocidade da ventoinha. Poderá querer monitorizar estes fatores juntamente com a utilização (representada como uma percentagem) nestes dois estados, ignorando o estado de inatividade.
Dois elementos essenciais que deverá acompanhar atentamente são o Tempo privilegiado e o Tempo do utilizador, uma vez que a soma dos dois dará o Tempo do processador, definidos da seguinte forma:
- Tempo privilegiado: percentagem de tempo que os processadores utilizam para executar processos não pertencentes ao utilizador (ou seja, processos do kernel)
- Tempo do utilizador: percentagem de tempo que os processadores utilizam para executar processos do utilizador (por exemplo, shell de comandos, servidor de correio eletrónico, compilador)
- Tempo do processador: quantidade total de tempo durante o qual a CPU esteve ocupada
Tenha em atenção que ultrapassar 100% nem sempre significa que um sistema está sobrecarregado. Por exemplo, se tiver um sistema multiprocessador, isso significa apenas que a soma das duas ou mais CPUs é superior a 100% (por exemplo, 50% e 60%). Acompanhe o desempenho individual para manter o estado do sistema.
Juntamente com a utilização da CPU e do disco, as esperas também são consideradas essenciais na monitorização do estado e do desempenho da infraestrutura.
Have an account? Log In
Esperas
As esperas ajudam a perceber com que eficiência as tarefas são executadas e alertam-no para possíveis estrangulamentos. No entanto, saber apenas quais são as esperas não será suficiente. Terá de realizar uma investigação adicional para identificar o problema exato de desempenho.
As esperas elevadas são aceitáveis em picos, pois poderá ter algumas tarefas intensivas em execução, mas qualquer valor superior a isso é normalmente motivo de preocupação.
2. Tempo de atividade do servidor
O seu servidor é inútil se não estiver disponível para os utilizadores. Assim, monitorizar o tempo de atividade do servidor é indispensável. Sempre que a disponibilidade do servidor descer abaixo de 99.999% (o padrão conhecido como os “cinco noves”), terá um problema grave em mãos.
Utilize as fórmulas abaixo para obter informações claras e práticas a partir dos seus esforços de monitorização.
Como medir o tempo de atividade do servidor
Eis alguns conceitos fundamentais que deve conhecer ao monitorizar o tempo de atividade do servidor:
- Disponibilidade: O período de tempo durante o qual o seu serviço ou aplicação está ativo e disponível para os utilizadores. Fórmula: (Tempo total - Tempo de inatividade)/Tempo total
- Tempo médio entre falhas (MTBF): O tempo médio que separa os incidentes de inatividade. Fórmula: (Tempo total - Tempo de inatividade)/Número de incidentes de inatividade
- Tempo médio até à resolução (MTTR): O tempo médio necessário para resolver uma interrupção. Fórmula: Tempo total de inatividade/Número de incidentes de inatividade
- Tempo médio até ao reconhecimento (MTTA): O tempo médio necessário para reconhecer uma interrupção atual. Fórmula: Tempo total até ao reconhecimento/Número de incidentes de inatividade
Todas estas métricas ajudam a criar uma visão geral que ilustra a fiabilidade da sua infraestrutura e a capacidade de resposta da sua equipa.
Por exemplo, ter um MTTR e um MTTA saudáveis é positivo. Mas, se também tiver um MTBF elevado, terá de investigar mais aprofundadamente as causas principais do tempo de inatividade do seu servidor. Caso contrário, a empresa continua em risco de sofrer perdas financeiras significativas e de prejudicar a confiança dos utilizadores.
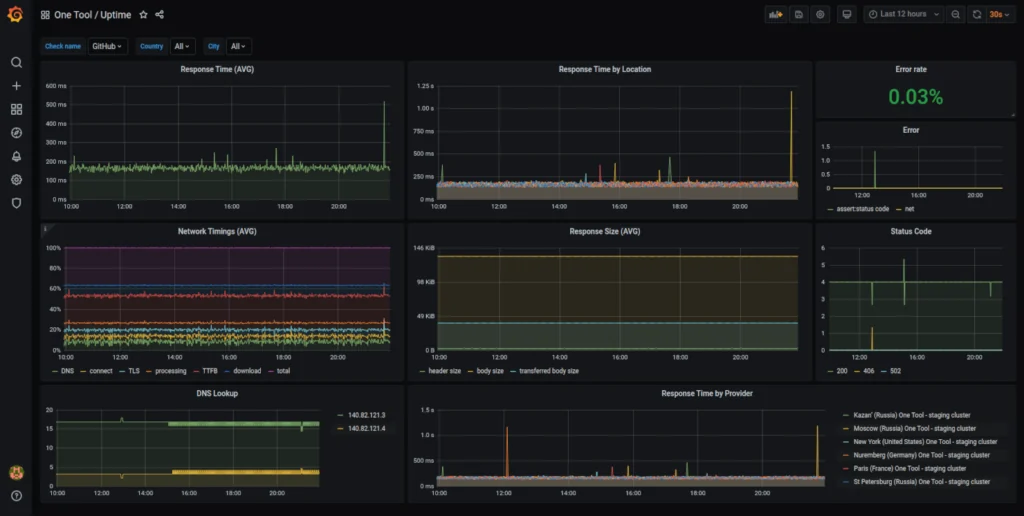
Em última análise, deve esforçar-se por alcançar os “cinco noves”, mantendo o tempo de inatividade num máximo aproximado de cinco minutos por ano. O Grafana e o Prometheus são softwares de monitorização de servidores frequentemente recomendados como ferramentas fáceis de utilizar e de acesso simples para este aspeto da monitorização do desempenho.
3. Transações (e taxas de erro)
É necessário ter uma visão clara da quantidade de tráfego que a sua infraestrutura suporta num determinado momento. Por isso, é essencial acompanhar as suas transações — ou o número de pedidos por segundo — e o tempo médio de resposta correspondente. Estas informações podem ajudá-lo a determinar a quantidade de recursos e a capacidade necessárias para manter o servidor a funcionar sem problemas.
Ao mesmo tempo, acompanhar a taxa de erro, ou seja, a percentagem de pedidos falhados relativamente ao total recebido, pode fornecer informações adicionais sobre a capacidade de carga do seu serviço. Para maximizar o valor desta métrica, é melhor estabelecer uma linha de base ao longo do tempo através de uma monitorização passiva.
Isto é crucial para a sua capacidade de monitorizar tendências. Se puder analisar o histórico e determinar a capacidade máxima e os recursos necessários para um funcionamento sem problemas, poderá agir proativamente para atribuir esses recursos e identificar problemas na infraestrutura, reduzindo as taxas de erro observadas e otimizando o tempo médio de resposta.
Como monitorizar transações e taxas de erro
As ferramentas seguintes são fiáveis para técnicas de monitorização passiva do desempenho:
- Analisadores de tráfego: Foram concebidos para recolher medições a um “nível microscópico”, “escutando” o fluxo de tráfego em redes com e sem fios. O Wireshark é um dos padrões mais amplamente aceites e recolhe dados sobre atributos como o carimbo temporal, o endereço MAC e o endereço IP, o tempo de vida, entre outros. Podem ser utilizados online ou offline.
- Recursos de registo: Normalmente, estão integrados nos sistemas operativos e nas aplicações. Recolhem principalmente informações sobre as atividades e os eventos gerados pelas aplicações para utilização offline.
Uma das dez melhores ferramentas de monitorização de servidores Web particularmente adequada para monitorizar transações é o Monitis. É um sistema de monitorização tudo-em-um para servidores, sites e aplicações. É adequado tanto para sistemas Windows como Linux e ideal para abranger os aspetos básicos, incluindo a disponibilidade.
O objetivo e a finalidade dos esforços de monitorização influenciarão as medições exatas e a utilização destas técnicas.
More Articles
Outras métricas a monitorizar com as transações
O tempo de resposta e o número total de threads estão diretamente relacionados com as transações. Estes dados indicarão quanto tempo o seu servidor demora a responder a um pedido e o número de threads (que permitem a realização das transações) utilizados para tratar todos estes pedidos.
Cada thread consome tempo de CPU e RAM. Um número excessivo pode conduzir a um desempenho abaixo do ideal. Há bastante informação a monitorizar nestes elementos, incluindo:
- O número total de threads num servidor Web ou num conjunto de contentores, incluindo estes tipos:
- Ativas
- Inativas
- Bloqueadas
- Em espera
- Pedidos de utilizadores pendentes e comprimento da fila
Pode normalmente medir o tempo de resposta do servidor como o Tempo até ao Primeiro Byte (TTFB). Este é o número de milissegundos que um navegador demora a receber o primeiro byte de uma resposta do servidor. Regra geral, qualquer valor superior a cinco segundos é crítico.
Escolher as métricas certas para monitorizar o desempenho do servidor
Existe uma longa lista de métricas que pode monitorizar ao acompanhar o estado e o desempenho do seu servidor, mas os objetivos específicos dependem sobretudo da finalidade dos seus esforços de monitorização.
Embora algumas sejam mais adequadas para obter informações sobre a capacidade de carga do seu hardware e sistema operativo, outras são ideais para observar a atividade dos utilizadores. Em qualquer caso, a CPU, o tempo de atividade e as transações são elementos fundamentais que não podem ser ignorados.
À medida que avança como líder de QA e os seus objetivos mudam inevitavelmente, irá sem dúvida adicionar mais métricas de monitorização do servidor ao seu painel. Para obter mais informações especializadas sobre quais devem ser e como geri-las, subscreva o boletim informativo.