


Organizacje regularnie korzystają średnio z 400 źródeł danych. Przy dosłownie setkach zbiorów danych do obsłużenia integracja danych i dokładna analiza danych mogą być niemożliwe bez odpowiednich przepływów pracy.
W tym przewodniku przedstawię przepływy pracy ETL i podam wskazówki dotyczące tworzenia potoków danych ETL, które zapewniają większą funkcjonalność i wyższą jakość danych.
Czym są przepływy pracy ETL?
Nasz kompleksowy przewodnik po ETL wyjaśnia szczegóły procesu ETL, w tym procesy wyodrębniania, przekształcania i ładowania. Aby zapewnić optymalną funkcjonalność, procesy te muszą współpracować, tak aby informacje sprawnie przepływały ze źródła danych do hurtowni danych.
Przepływy pracy ETL odpowiadają za cały ten proces. Zazwyczaj obejmują różne narzędzia API, konektory i etapy przetwarzania danych, aby zapewnić prawidłowe działanie procesu wyodrębniania, przekształcania i ładowania oraz jego zgodność z potrzebami organizacji.
Korzyści płynące z przepływów pracy ETL
Niektóre korzyści wynikające z dobrze zaprojektowanych przepływów pracy ETL obejmują:
- Lepszy dostęp do danych. Odpowiednie procesy ETL umożliwiają pracownikom dostęp do danych w czasie rzeczywistym. Proces wyodrębniania, przekształcania i ładowania zapewnia gotowość danych do użycia po zapisaniu ich w magazynie danych, ułatwiając tworzenie raportów SQL, modeli danych i wykonywanie innych zapytań.
- Możliwość obsługi dużych zbiorów danych. Zaawansowane procesy ETL mogą obsługiwać duże zbiory danych i integrować nieustrukturyzowane dane bez czasochłonnych procesów ręcznych. Ułatwia to organizacjom zarządzanie dużymi zbiorami danych i czerpanie z nich korzyści.
- Lepsze procesy przekształcania danych. Odpowiedni przepływ pracy ETL obejmuje takie elementy jak oczyszczanie i przekształcanie danych, aby usprawnić konwersję nieprzetworzonych danych do postaci ustrukturyzowanych zbiorów danych, które można wykorzystać.
- Wsparcie wydajności dzięki automatyzacji. Importowanie danych źródłowych, uruchamianie procesów walidacji i inne zadania mogą być obsługiwane przez narzędzia ETL wspierające automatyzację, co skraca czas potrzebny na zarządzanie danymi.
- Możliwość stosowania reguł biznesowych w procesach zarządzania danymi. Rozwiązania ETL można dostosować do różnych potrzeb organizacji, w tym zintegrować reguły biznesowe i zasady zgodności z przepływem pracy obejmującym wyodrębnianie, przekształcanie i ładowanie.
Przegląd procesu ETL
Zanim omówimy kluczowe elementy przepływów pracy ETL i sposoby ich modelowania, przyjrzyjmy się najpierw działaniu tych procesów, w tym celom i wyzwaniom związanym z każdym etapem.
Wyodrębnianie
Podczas etapu wyodrębniania w procesie ETL informacje są gromadzone z jednego lub większej liczby źródeł danych. Wyodrębnianie danych może obejmować zarówno dane nieprzetworzone, jak i wcześniej przetworzone, a także różne typy plików, w tym CSV i XML.
- Cel: Przechwycenie możliwie najbardziej całościowych i kompletnych danych.
- Wyzwania: Identyfikowanie jezior danych i źródeł, uzyskiwanie odpowiedniego dostępu do danych oraz synchronizacja gromadzenia danych w celu zapewnienia aktualności procesów.
Have an account? Log In
Przekształcanie
Proces przekształcania danych obejmuje konwertowanie danych do formatów współpracujących z relacyjnymi bazami danych oraz innymi wykorzystywanymi metodami przechowywania i analizy danych. Na tym etapie ETL można rozważyć użycie narzędzi do mapowania danych i czyszczenia, usuwania duplikatów, formatowania, dodawania metadanych oraz wykonywania innych zadań — zarówno w ramach automatyzacji, jak i ręcznych przepływów pracy.
- Cel: Czyste, użyteczne dane sformatowane tak, aby działały w systemie docelowym lub magazynie danych.
- Wyzwania: Jakość danych jest częstym wyzwaniem, z którym organizacje mierzą się podczas przekształcania danych; im niższa jakość, tym więcej pracy wymaga przekształcanie danych. Inne wyzwania obejmują ryzyko utraty danych, integrowanie wielu typów danych oraz zapewnienie bezpieczeństwa w całym procesie.
Ładowanie
W ostatnim etapie procesów ETL dane są ładowane do docelowej hurtowni danych, dzięki czemu stają się dostępne do wykorzystania zgodnie z potrzebami organizacji.
- Cel: Zapewnienie, że bezpieczne i czyste dane są gotowe do wykorzystania w analizach, systemach CRM lub innym oprogramowaniu biznesowym.
- Wyzwania: Zapewnienie jakości i bezpieczeństwa danych również na tym etapie stanowi wyzwanie, a organizacje muszą tworzyć procesy zarządzania danymi, aby określić, kto może uzyskiwać dostęp do danych i w jaki sposób. Ważne może być także zapewnienie dostępu do danych w czasie rzeczywistym — lub możliwie najbardziej zbliżonym do rzeczywistego — jednak przetwarzanie wsadowe może powodować opóźnienia w procesie.
Kluczowe elementy przepływów pracy ETL
Pierwszym krokiem podczas tworzenia przepływów pracy ETL jest rozważenie kluczowych elementów, które powinny zostać uwzględnione. Zastosowania tych przepływów pracy są różne, dlatego może być konieczne uwzględnienie unikalnych zależności dotyczących danych i procesów w Twojej organizacji.
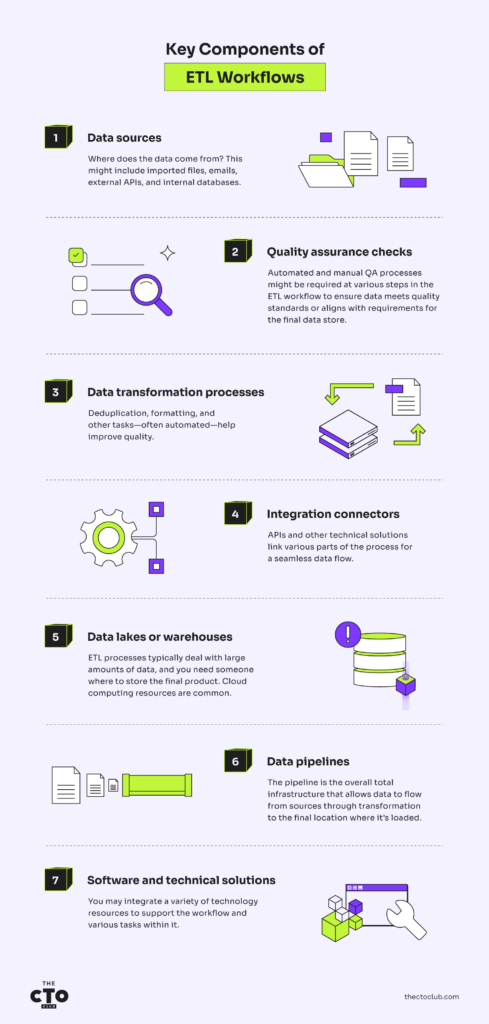
Jednak niektóre elementy, które inżynierowie danych zwykle uwzględniają w przepływach pracy ETL, to:
- Źródła danych. Skąd pochodzą dane? Mogą to być importowane pliki, wiadomości e-mail, zewnętrzne interfejsy API i wewnętrzne bazy danych.
- Kontrole jakości. Na różnych etapach przepływu pracy ETL mogą być wymagane zautomatyzowane i ręczne procesy kontroli jakości, aby upewnić się, że dane spełniają standardy jakości lub są zgodne z wymaganiami dotyczącymi końcowego magazynu danych.
- Procesy transformacji danych. Usuwanie duplikatów, formatowanie i inne zadania — często zautomatyzowane — pomagają poprawić jakość.
- Łączniki integracyjne. Interfejsy API i inne rozwiązania techniczne łączą różne części procesu, zapewniając płynny przepływ danych.
- Jeziora danych lub hurtownie danych. Procesy ETL zazwyczaj operują na dużych ilościach danych, dlatego potrzebne jest miejsce do przechowywania produktu końcowego. Często wykorzystywane są zasoby chmurowe.
- Potoki danych. Potok to cała infrastruktura, która umożliwia przepływ danych ze źródeł przez transformację do końcowej lokalizacji, w której są ładowane.
- Oprogramowanie i rozwiązania techniczne. Możesz integrować różne zasoby technologiczne, aby obsługiwać przepływ pracy i poszczególne zadania w jego ramach.
Modelowanie przepływów pracy ETL
Podczas modelowania potoków ETL musisz rozważyć, czy chcesz przetwarzać dane wsadowo, czy strumieniowo.
Tworzenie potoku ETL z przetwarzaniem wsadowym
W przypadku przetwarzania wsadowego przepływ pracy zarządza danymi w partiach lub porcjach. Każda partia jest zazwyczaj określana na podstawie czasu — możesz przetwarzać dane codziennie, okresowo w ciągu dnia lub na początku każdej godziny.
Przetwarzanie wsadowe jest dobrym rozwiązaniem, gdy:
- Chcesz wykorzystać korzyści skali
- Masz wdrożoną automatyzację, która może szybko obsługiwać duże partie danych
- Dostęp do danych i ich przetwarzanie nie są szczególnie zależne od czasu
Tworzenie potoku ETL z przetwarzaniem strumieniowym
Przetwarzanie strumieniowe umożliwia przepływ danych przez ETL w czasie rzeczywistym, bez tworzenia partii danych na którymkolwiek etapie procesu. Jest bardziej elastyczne niż przetwarzanie wsadowe, ale w przypadku tego typu potoku zapewnienie jakości i spójności danych może być trudniejsze.
Przetwarzanie strumieniowe jest dobrym rozwiązaniem, gdy:
- Dane wchodzą do procesu w małych porcjach i w nieregularnych odstępach czasu
- Dostęp do danych jest zależny od czasu, dlatego kluczowe jest ich natychmiastowe wprowadzenie do procesu
- Chcesz mieć dostęp do aktualnych analiz bez oczekiwania na przetworzenie danych wsadowych
Przykłady przepływów pracy ETL
Zrozumienie specyficznych dla danej branży potrzeb związanych z przepływem danych i zarządzaniem nimi ma kluczowe znaczenie dla skutecznego planowania przepływów pracy ETL. Rozważ poniższe przykłady z różnych branż, aby zrozumieć, jak wymagania i zależności mogą się różnić.
ETL dla przepływów danych w ochronie zdrowia
Organizacje ochrony zdrowia wymagają dokładnego i terminowego dostępu do danych pacjentów oraz danych dotyczących leczenia, co sprawia, że procesy ETL są niezbędne do osiągnięcia sukcesu. Dane mogą pochodzić z różnych źródeł, w tym z portali pacjentów, elektronicznej dokumentacji medycznej, urządzeń do obrazowania oraz dostawców zewnętrznych, takich jak firmy farmaceutyczne.
Jednym z największych wyzwań związanych z ETL w ochronie zdrowia jest tworzenie bezpiecznych procesów zgodnych z przepisami, takimi jak HIPAA. Procesy te zależą również od danych dostarczanych przez pacjentów, świadczeniodawców i systemy automatyzacji, co stwarza dodatkowe wyzwania w procesie transformacji danych.
Podczas modelowania potoków danych w ochronie zdrowia może być konieczne zastosowanie przetwarzania strumieniowego i wsadowego. Na przykład świadczeniodawcy mogą potrzebować dostępu do danych diagnostycznych w czasie rzeczywistym, podczas gdy dane dotyczące kodowania i rozliczeń można przetwarzać wsadowo pod koniec dnia na potrzeby rozliczania roszczeń.
ETL dla przepływów danych w handlu elektronicznym
Dane z handlu elektronicznego pochodzą z wielu źródeł, w tym z wiadomości e-mail, portali klientów, interfejsów API i aplikacji, mediów społecznościowych, stron internetowych, systemów CRM oraz procesów księgowych lub płatniczych. Stanowi to ogromne wyzwanie w zakresie przekształcania danych bez pogorszenia ich jakości.
Przetwarzanie wsadowe zazwyczaj dobrze sprawdza się w wielu procesach handlu elektronicznego. Możesz na przykład pobierać dane zamówień co godzinę i przekazywać je do procesów ETL obsługujących zadania magazynowe i wysyłkowe. Możesz również codziennie pobierać dane dotyczące płatności, aby aktualizować dokumentację finansową.
Jeśli jednak chcesz zapewnić klientom samoobsługę przez całą dobę, przez 7 dni w tygodniu, bardziej odpowiednie mogą być przepływy oparte na strumieniach. Załóżmy na przykład, że masz chatbota, który dostarcza klientom informacji o zamówieniach, płatnościach, zwrotach i uznaniach. Jeśli procesy ETL działają w ramach codziennych partii, informacje przekazywane przez chatbota są zawsze opóźnione o co najmniej 24 godziny.
ETL dla przepływów danych finansowych
Banki, firmy obsługujące karty kredytowe, aplikacje do zarządzania pieniędzmi oraz inne organizacje i usługi z sektora finansowego w dużym stopniu polegają na dokładnych danych. Organizacje te muszą również przestrzegać rygorystycznych regulacji i standardów zgodności, aby zapewnić bezpieczeństwo danych.
Źródła danych mogą obejmować importowane dane z innych organizacji finansowych, dane ACH i izb rozliczeniowych, informacje z aplikacji przeznaczonych dla klientów oraz mniej ustrukturyzowane formaty, takie jak wiadomości e-mail. Organizacje finansowe mogą również chcieć korzystać z połączenia potoków wsadowych i strumieniowych, aby spełniać potrzeby klientów.
More Articles
Postęp technologiczny w procesach ETL
Kilka dekad temu technologia chmurowa zrewolucjonizowała przetwarzanie danych i nadal stanowi ogromny element postępu w dziedzinie oprogramowania i rozwiązań do obsługi hurtowni danych. Obecnie jednak trendy w rozwoju technologii ETL koncentrują się zazwyczaj na integrowaniu sztucznej inteligencji, uczenia maszynowego i automatyzacji z przepływami pracy. Do konkretnych osiągnięć należą:
- Możliwość obsługi dużych zbiorów danych przez sztuczną inteligencję. Narzędzia sztucznej inteligencji mogą przetwarzać ogromne ilości danych w ciągu kilku sekund, zapewniając skalowalność procesów ETL, która wcześniej nie była możliwa.
- Przetwarzanie języka naturalnego. Uczenie maszynowe i przetwarzanie języka naturalnego pozwalają zautomatyzowanym rozwiązaniom podchodzić do transformacji danych z bardziej kompleksowym zestawem umiejętności „krytycznego myślenia”, niż było to wcześniej możliwe. Stwarza to możliwości automatyzacji zadań, które historycznie wymagały interwencji człowieka.
- Wsparcie zarządzania danymi. Prawie każda branża musi dziś mierzyć się z bardziej rygorystycznymi wymogami regulacyjnymi, a rozwiązania technologiczne coraz częściej pomagają zapewnić zgodność z przepisami i bezpieczeństwo danych.
Najlepsze praktyki optymalizacji przepływów pracy ETL
To, co najlepiej sprawdza się w innej organizacji, niekoniecznie musi być najlepszą praktyką dla Twojej firmy w zakresie ETL. Zebrałem jednak kilka ogólnych najlepszych praktyk, które możesz wdrożyć, aby optymalizować przepływy pracy ETL w niemal każdym środowisku.
- Wybierz narzędzia odpowiednie do swoich potrzeb. Przeprowadź rozeznanie dotyczące narzędzi do obsługi przepływów pracy i procesów ETL, aby znaleźć partnerów i rozwiązania odpowiadające Twoim unikalnym potrzebom w zakresie danych. Rozważ utworzenie zespołu, który opracuje mapę pożądanych przepływów pracy ETL, wymieni napotykane wyzwania i oceni potencjalne rozwiązania z uwzględnieniem tych czynników.
- Upewnij się, że wybrane przepływy pracy są właściwe. Poświęć czas, aby zrozumieć różnice między ETL i ELT oraz ustalić, czy potrzebujesz przepływów wsadowych, czy strumieniowych.
- Regularnie monitoruj swoje procesy. Korzystaj z narzędzi takich jak SQL Server Monitor wydajności lub innych odpowiednich monitorów wydajności, aby zrozumieć, jak działają Twoje przepływy pracy ETL. Obserwuj wskaźniki wydajności i jakości, a w razie potrzeby wprowadzaj zmiany w celu ciągłego doskonalenia.
- Integruj technologie wspierające jakość i skalę. Rozważ takie rozwiązania jak obliczenia równoległe i kompresja danych, aby zoptymalizować przepływy pracy.
Najważniejsze wnioski
Projekt przepływów pracy ETL może zdecydować o powodzeniu lub porażce procesów związanych z danymi. Poświęć czas na rozważenie konsekwencji decyzji dotyczących przepływów pracy, opracowanie mapy idealnych przepływów oraz wybór odpowiednich narzędzi do obsługi wyodrębniania, przekształcania i ładowania danych.
Bądź na bieżąco z technologią i najlepszymi praktykami dotyczącymi danych, zapisując się do newslettera CTO Club.