

Databricks is krachtig, maar niet altijd de juiste keuze. Misschien liep je team tegen een muur aan met de prijsstelling, had het moeite met de leercurve van het platform of heb je iets flexibelers nodig voor multi-cloud- of on-premisesomgevingen. Wat de reden ook is: als je hier bent, ben je waarschijnlijk op zoek naar een alternatief dat vergelijkbare functionaliteit voor een data lakehouse biedt, zonder de nadelen.
Ik heb samengewerkt met datateams binnen start-ups en grote ondernemingen om platforms zoals Databricks, Snowflake en andere te evalueren en implementeren. Ik heb uit eerste hand gezien wat ervoor nodig is om grootschalige analyses te ondersteunen, rommelige gegevensbronnen samen te voegen en betrouwbare gegevenspijplijnen te bouwen die daadwerkelijk worden gebruikt.
In deze gids bespreek ik de Databricks-alternatieven die het overwegen waard zijn: tools waarmee je gegevens intuïtiever kunt opslaan, transformeren en verkennen, terwijl je de ruimte krijgt om op te schalen en je aan te passen naarmate je team groeit.
Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Vergelijkingstabel: Databricks-concurrent
Deze vergelijkingstabel bevat een samenvatting van de prijsdetails van mijn beste keuzes onder de Databricks-concurrenten.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Beste voor clouddatawarehousing | Nee | Prijs op aanvraag | Website | |
| 2 | Ideaal voor de implementatie van gegevens in meerdere clouds | Gratis abonnement beschikbaar | Prijzen op aanvraag | Website | |
| 3 | Het beste voor gegevensintegratietaken | Gratis proefversie beschikbaar | $1,170/gebruiker/jaar (jaarlijks gefactureerd) | Website | |
| 4 | Het beste voor verwerking in het geheugen | Gratis abonnement beschikbaar | Prijzen op aanvraag | Website | |
| 5 | Meest geschikt voor snelle SQL-query's | Ja | Vanaf $6.25/TiB verwerkt | Website | |
| 6 | Het beste voor zakelijke databasebehoeften | Gratis proefversie beschikbaar | $68/gebruiker/maand (jaarlijks gefactureerd) | Website | |
| 7 | Beste voor SQL-analyses | 30 dagen gratis uitproberen | $30/gebruiker/maand (jaarlijks gefactureerd) | Website | |
| 8 | Beste voor Hadoop-verwerking | Niet beschikbaar | Vanaf $0.007084/vCPU-hour | Website | |
| 9 | Meest geschikt voor beheerde Spark en Hadoop | Niet beschikbaar | Vanaf $0.06/DCU-hour | Website | |
| 10 | Beste voor AI- en ML-oplossingen | Gratis demo beschikbaar | Prijs op aanvraag | Website |


Beoordeling van de beste Databricks-concurrenten
Hieronder vind je mijn gedetailleerde samenvattingen van de beste Databricks-concurrenten die op mijn shortlist zijn gekomen. In mijn beoordelingen bespreek ik de belangrijkste functies, voor- en nadelen, integraties en ideale gebruiksscenario’s van elke tool, zodat je de beste optie voor jouw situatie kunt vinden.

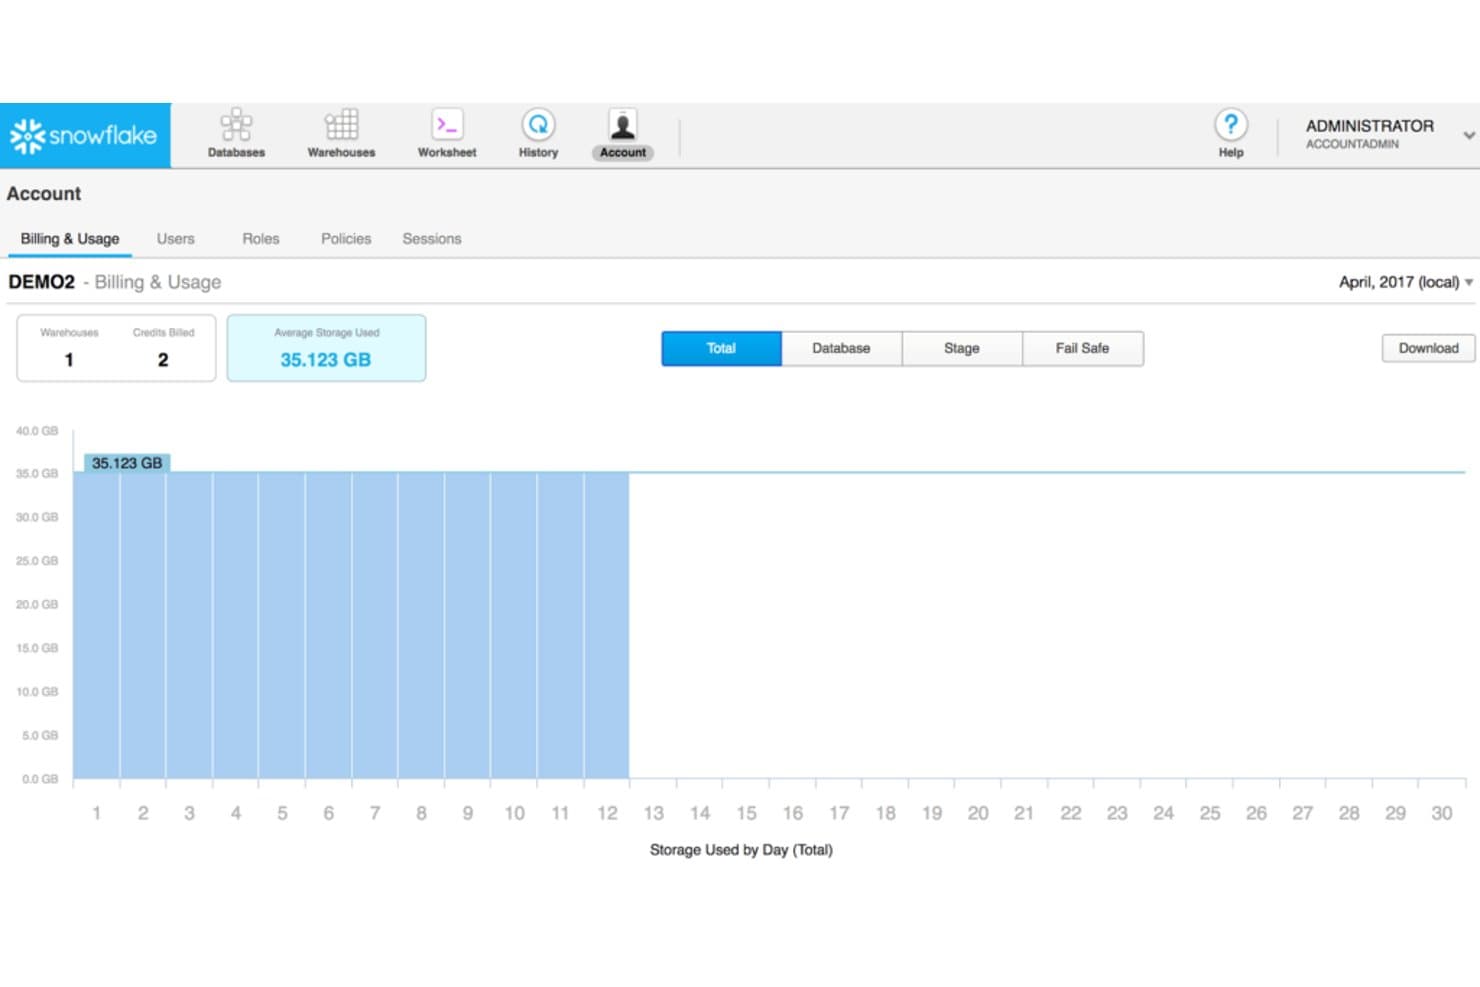
Snowflake houdt het opslag- en kredietgebruik per dag bij in één dashboard. Snowflake biedt IT- en analyticsteams een cloudgegevensplatform om uiteenlopende gegevenssets samen te brengen, SQL-query's op schaal uit te voeren en beheerde toegang te bieden zonder datawarehouse-infrastructuur te beheren.
Voor wie is Snowflake het meest geschikt?
Data-engineering- en analyticsteams die een clouddatawarehouse nodig hebben om gegevens uit verschillende bedrijfssystemen te bevragen en te delen.
Waarom ik voor Snowflake heb gekozen
Ik heb Snowflake gekozen als “Beste voor clouddatawarehousing” omdat de gescheiden opslag en rekenkracht het mogelijk maken om SQL-analyses op te schalen zonder de gegevenslaag opnieuw te dimensioneren. Ik waardeer ook het beheerde delen van gegevens wanneer teams gegevenssets uit verschillende bedrijfssystemen moeten bevragen zonder ze naar afzonderlijke datawarehouses te kopiëren.
Belangrijkste functies van Snowflake
- Dynamische tabellen: Definieer gegevenspijplijnen met SQL en stel de gewenste vernieuwingsvertraging in.
- Snowpipe: Laad gegevens uit gefaseerde bestanden zodra deze binnenkomen.
- Tijdreizen: Vraag historische gegevens op, maak er een kloon van of herstel ze binnen de bewaartermijn.
- Snowflake-marktplaats: Ontdek gegevenssets en applicaties van derden en krijg er toegang toe.
Integraties van Snowflake
Snowflake biedt Openflow-connectoren voor Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL en Microsoft SQL Server. Het biedt ook native connectoren voor ServiceNow, MySQL en Kafka, plus REST API's voor aangepaste integraties.
Pros and Cons
Pros:
- Onafhankelijk schalen van rekenkracht kan wisselende werklasten opvangen
- Beheerde SQL-datawarehouses verminderen het benodigde infrastructuuronderhoud
- Veilig delen voorkomt dat gegevenssets tussen teams worden gekopieerd
Cons:
- Pieken in het gebruik kunnen de kosten onvoorspelbaar maken
- Eigen functies kunnen de migratie van het platform bemoeilijken
Learn more about Snowflake: Ideaal voor de implementatie van gegevens in meerdere clouds
- Gratis abonnement beschikbaar
- Prijzen op aanvraag
Visit WebsiteCustomer Rating:4.5/5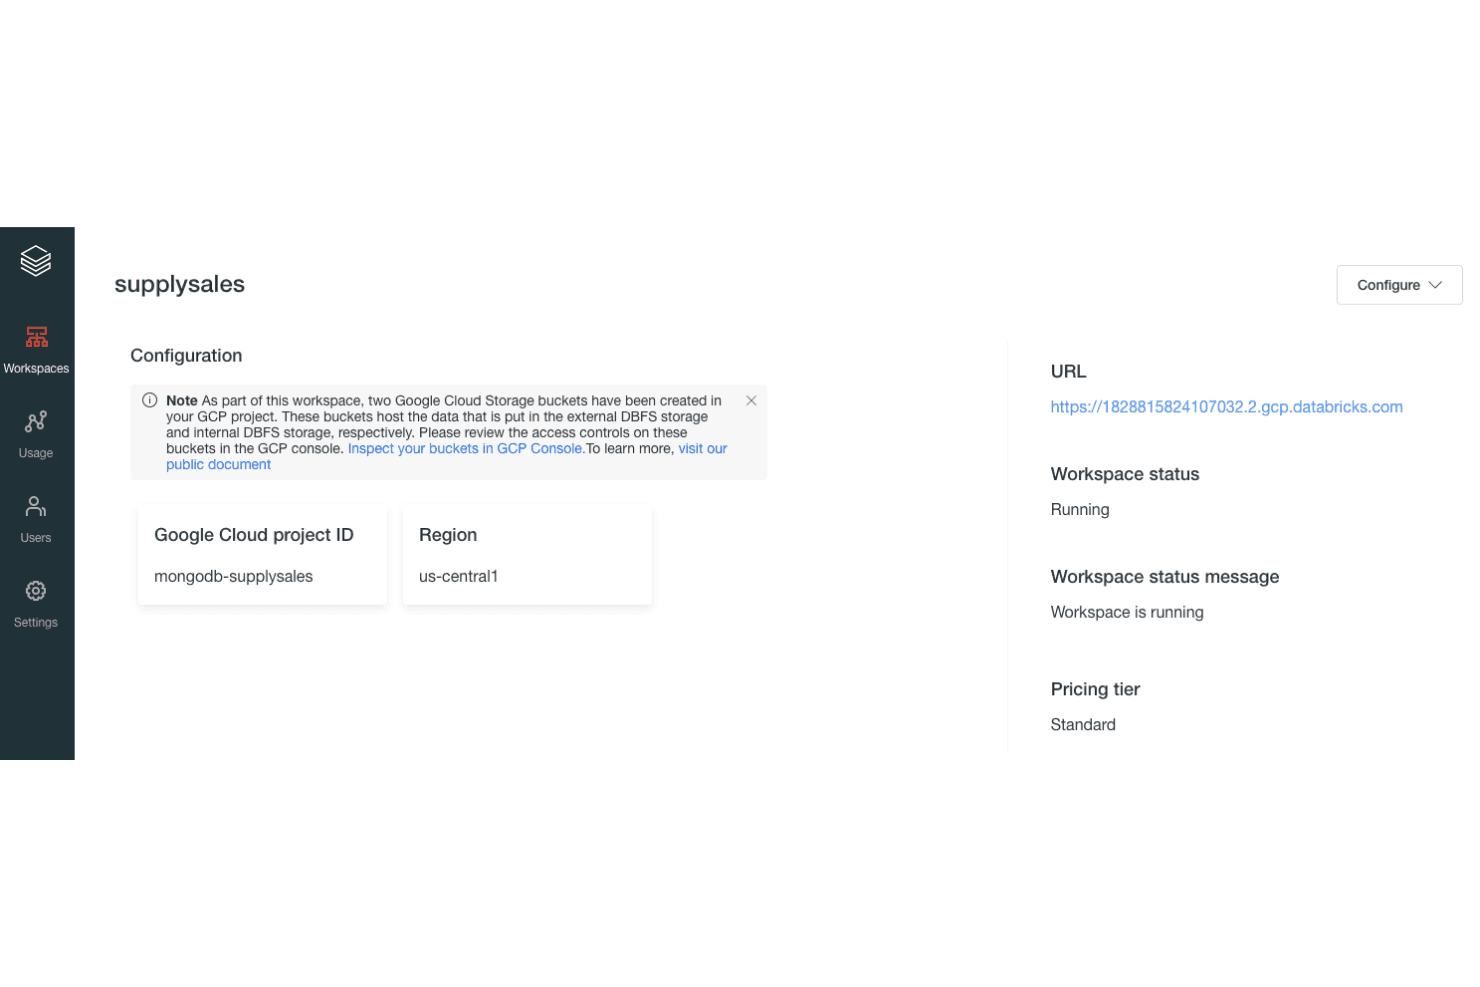
MongoDB Atlas integreert met Databricks-werkruimten op GCP voor gegevensverwerking. MongoDB Atlas biedt IT- en datateams een beheerde documentdatabase voor applicaties die flexibele datamodellen, betrouwbare query's en minder databaseonderhoud nodig hebben.
Voor wie is MongoDB Atlas het meest geschikt?
IT- en platformteams die applicaties implementeren bij meerdere cloudproviders zullen de beheerde database en multicloudflexibiliteit van MongoDB Atlas waarderen.
Waarom ik MongoDB Atlas heb gekozen
Ik heb MongoDB Atlas gekozen als alternatief voor Databricks, omdat het ideaal is voor de implementatie van gegevens in meerdere clouds. Atlas ondersteunt multicloudclusters op AWS, Azure en Google Cloud, terwijl je met de aggregatiepijplijn applicatiegegevens in MongoDB kunt analyseren. Ik zou het gebruiken om operationele gegevens op te vragen die zich dicht bij services bevinden die bij verschillende cloudproviders draaien.
Belangrijkste functies van MongoDB Atlas
- Zoeken in Atlas: Maak full-textindexen en voer zoekopdrachten uit die op relevantie zijn gerangschikt.
- Atlas-grafieken: Bouw dashboards en visualisaties op basis van MongoDB-gegevens.
- Gegevensfederatie: Vraag gegevens op uit Atlas-databases en cloudobjectopslag.
- Geautomatiseerde back-ups: Plan databasesnapshots en herstel gegevens vanaf opgeslagen herstelpunten.
Integraties van MongoDB Atlas
MongoDB Atlas beschrijft integraties met Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta en Microsoft Entra ID. Het biedt ook een beheer-API voor aangepaste integraties.
Pros and Cons
Pros:
- Multicloudclusters op AWS, Azure en Google Cloud
- Flexibele documenten zijn geschikt voor veranderende datamodellen van applicaties
- Met aggregatiepijplijnen kunnen operationele gegevens op hun huidige locatie worden geanalyseerd
Cons:
- Minder geschikt voor brede lakehouse-analyses
- Voor goede prestaties van aggregaties kan zorgvuldige optimalisatie van query's nodig zijn
Learn more about MongoDB Atlas: Het beste voor gegevensintegratietaken
- Gratis proefversie beschikbaar
- $1,170/gebruiker/jaar (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.2/5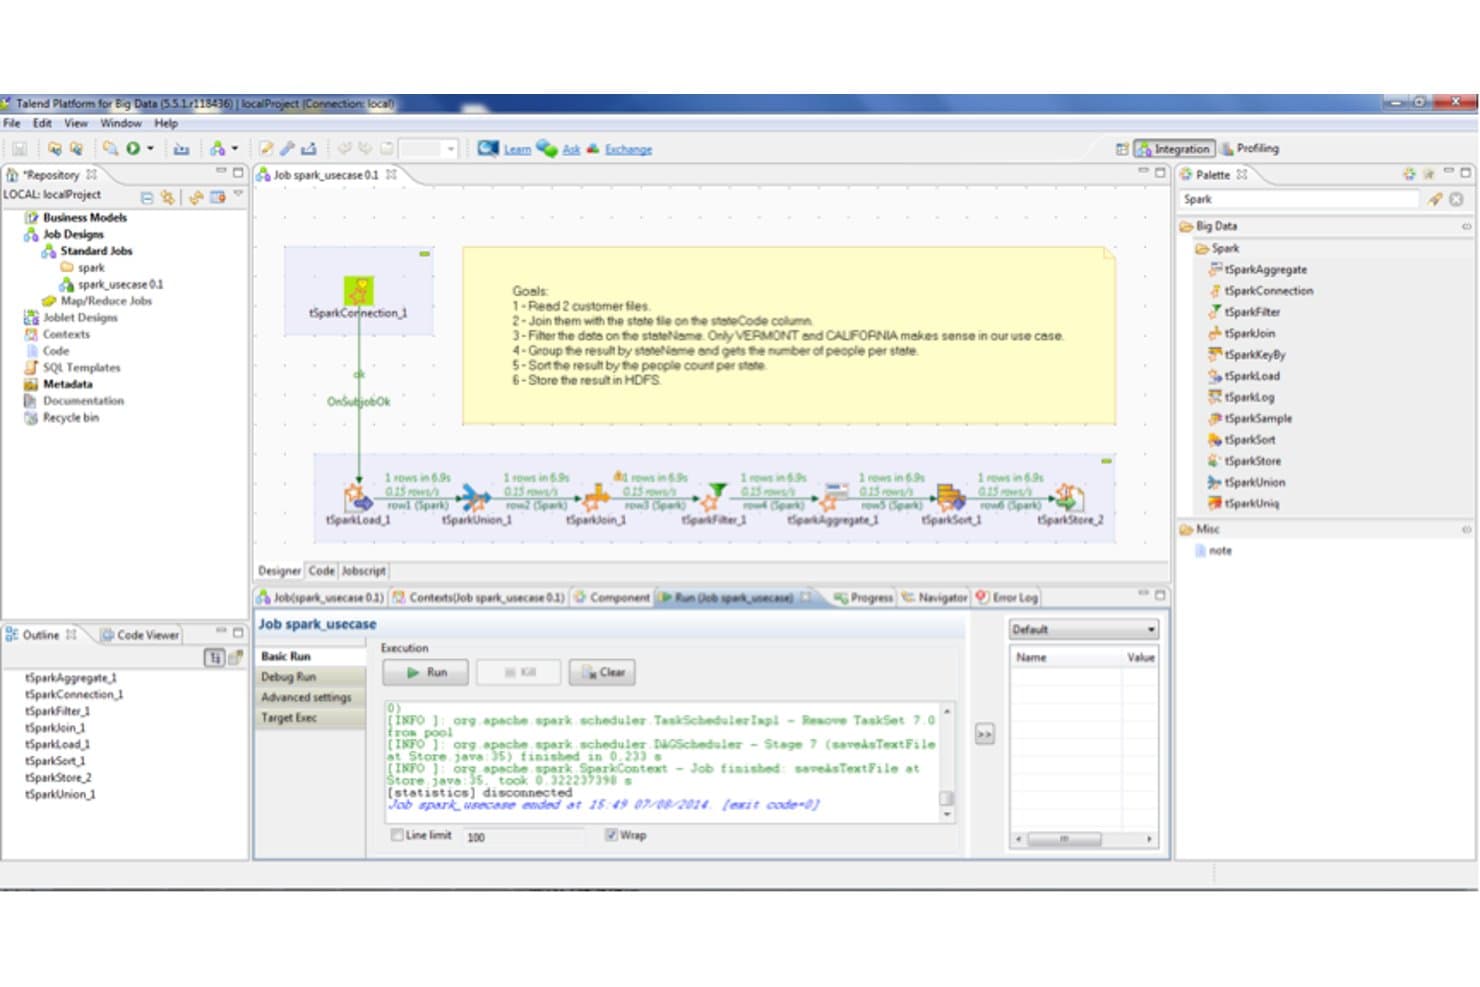
Met Talend kunnen gebruikers visueel Spark-datapijplijnen bouwen en uitvoeren. Talend is een platform voor gegevensintegratie voor IT- en datateams dat informatie tussen systemen verbindt, waardoor silo's worden verminderd en datapijplijnen beheersbaar blijven naarmate omgevingen groeien.
Voor wie is Talend het meest geschikt?
Talend is geschikt voor IT- en data-engineeringteams die cloud-, on-premises- en verouderde systemen met elkaar moeten verbinden.
Waarom ik Talend heb gekozen
Ik heb Talend gekozen als concurrent van Databricks omdat “Het beste voor gegevensintegratietaken” precies aangeeft waar het geschikt voor is. Met de visuele taakontwerper en tMap-transformaties kan ik records tussen een verouderde database en een clouddatawarehouse samenvoegen en hervormen. Ik waardeer ook de componenten voor gegevenskwaliteit van Talend, waarmee verkeerd gevormde records kunnen worden onderschept voordat ze volgende systemen bereiken.
Belangrijkste functies van Talend
- Connectoren: Verbind databases, cloudapplicaties, bestanden en andere systemen via vooraf gebouwde connectoren.
- Wijzigingsgegevens vastleggen: Leg database-invoegingen, updates en verwijderingen vast zodra ze plaatsvinden.
- Gegevensherkomst: Volg gegevensstromen van bronsystemen via taken naar hun bestemmingen.
- Metagegevens ontdekken: Scan gegevensbronnen om datasets, indelingen en patronen te identificeren.
Integraties van Talend
Talend bevat connectoren of componenten voor systemen zoals Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle en MongoDB. Het ondersteunt ook REST- en SOAP-services, en Qlik Talend Data Integration biedt API's voor het beheren van gegevensverbindingen.
Pros and Cons
Pros:
- Visuele taken verwerken samenvoegingen en hervormingen
- Batch- en realtime-pijplijnen ondersteunen uiteenlopende workloads
- Hulpmiddelen voor gegevenskwaliteit markeren verkeerd gevormde records
Cons:
- Grote taken kunnen JVM-afstemming vereisen
- Gegenereerde Java maakt foutopsporing en audits complexer
Learn more about Talend: Het beste voor verwerking in het geheugen
- Gratis abonnement beschikbaar
- Prijzen op aanvraag
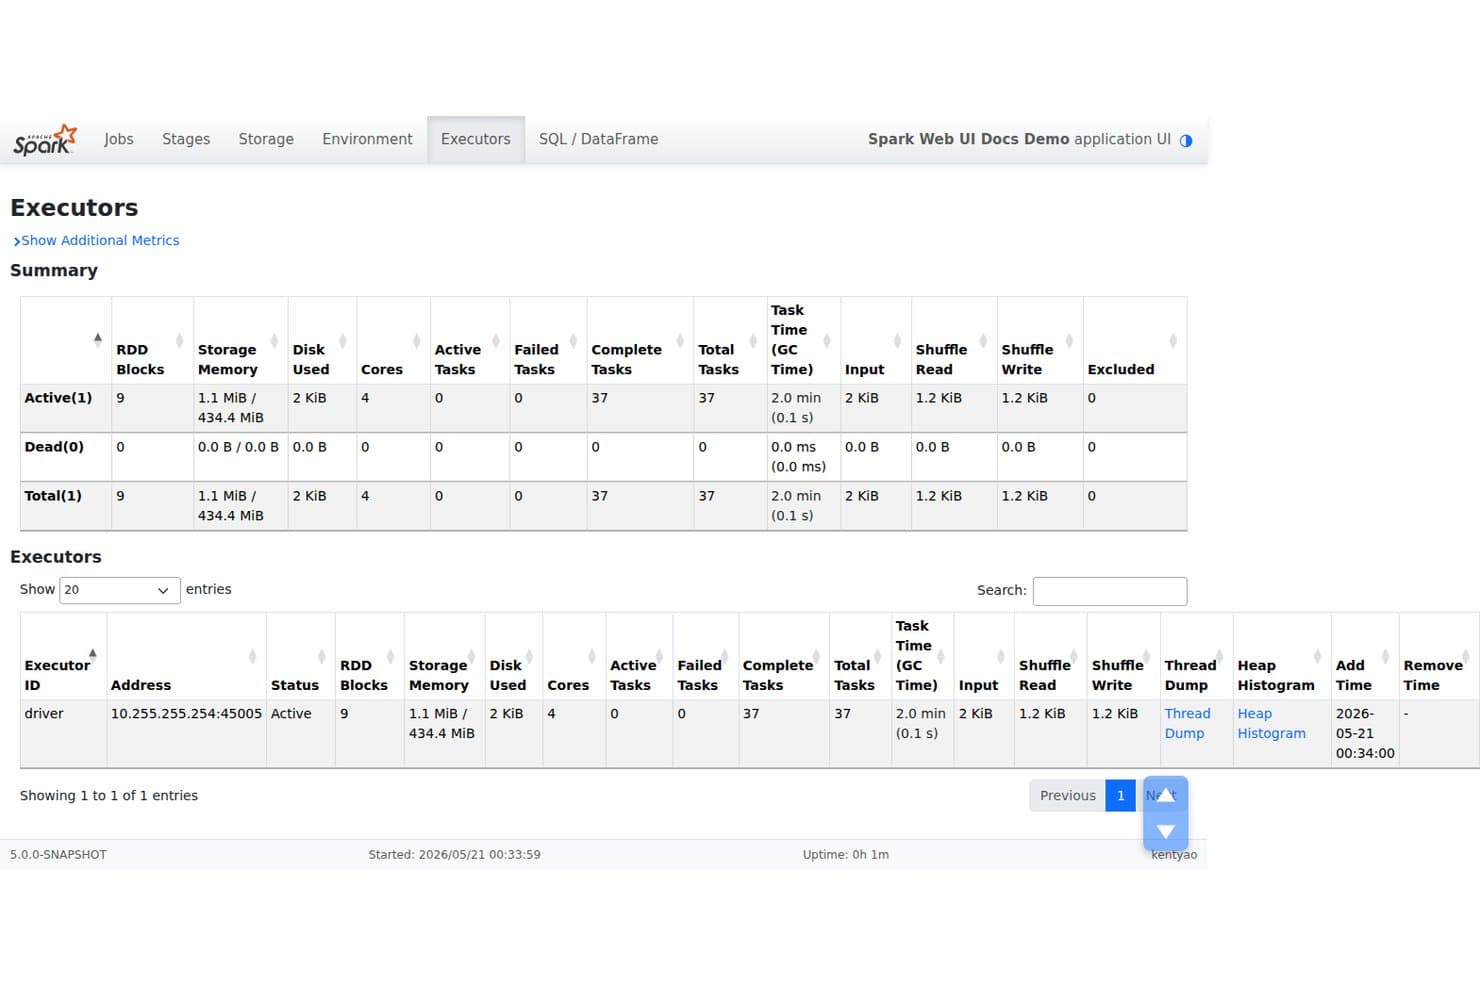
Apache Spark houdt executorresources, taken en geheugen in realtime bij. Apache Spark is een open-sourceanalyse-engine voor data- en infrastructuurteams die grote datasets moeten verwerken, gedistribueerde werklasten moeten uitvoeren en datapijplijnen moeten bouwen in diverse omgevingen.
Voor wie is Apache Spark het meest geschikt?
Data-engineering- en analyticsteams die snelle, iteratieve verwerking van grote datasets in clusters nodig hebben, zijn geschikt voor Apache Spark.
Waarom ik voor Apache Spark heb gekozen
Ik heb Apache Spark gekozen als alternatief voor Databricks omdat het het beste geschikt is voor verwerking in het geheugen. Spark kan RDD's en DataFrames in het geheugen cachen of persistent maken, zodat herhaalde query's en iteratieve berekeningen voorkomen dat brongegevens opnieuw moeten worden gelezen. Dat is handig bij het verfijnen van aggregaties van grote hoeveelheden gebeurtenisgegevens over meerdere analysenrondes.
Belangrijkste functies van Apache Spark
- Spark SQL: Query gestructureerde gegevens met SQL- en DataFrame-API's.
- Structured Streaming: Verwerk livegegevens met de streaming-API's van Spark.
- MLlib: Bouw machinelearningworkflows met schaalbare algoritmen en pijplijnen.
- Clusterbeheerders: Implementeer applicaties op zelfstandige clusters, YARN of Kubernetes.
Integraties van Apache Spark
Apache Spark ondersteunt connectors voor Apache Kafka en Apache Hive, plus JDBC-verbindingen met databases zoals PostgreSQL, MySQL, Oracle en Microsoft SQL Server. De Data Source API ondersteunt aangepaste connectors; afhankelijkheden voor de Kafka-connector en databasespecifieke JDBC-stuurprogramma's moeten mogelijk afzonderlijk worden toegevoegd.
Pros and Cons
Pros:
- Gecachte datasets versnellen iteratieve werklasten
- Batchverwerking, streaming, SQL en ML delen één engine
- Draait lokaal of in Kubernetes- en YARN-clusters
Cons:
- Geheugendruk kan leiden tot fouten door onvoldoende geheugen
- Voor het afstemmen en debuggen van gedistribueerde taken is expertise nodig
Learn more about Apache Spark:
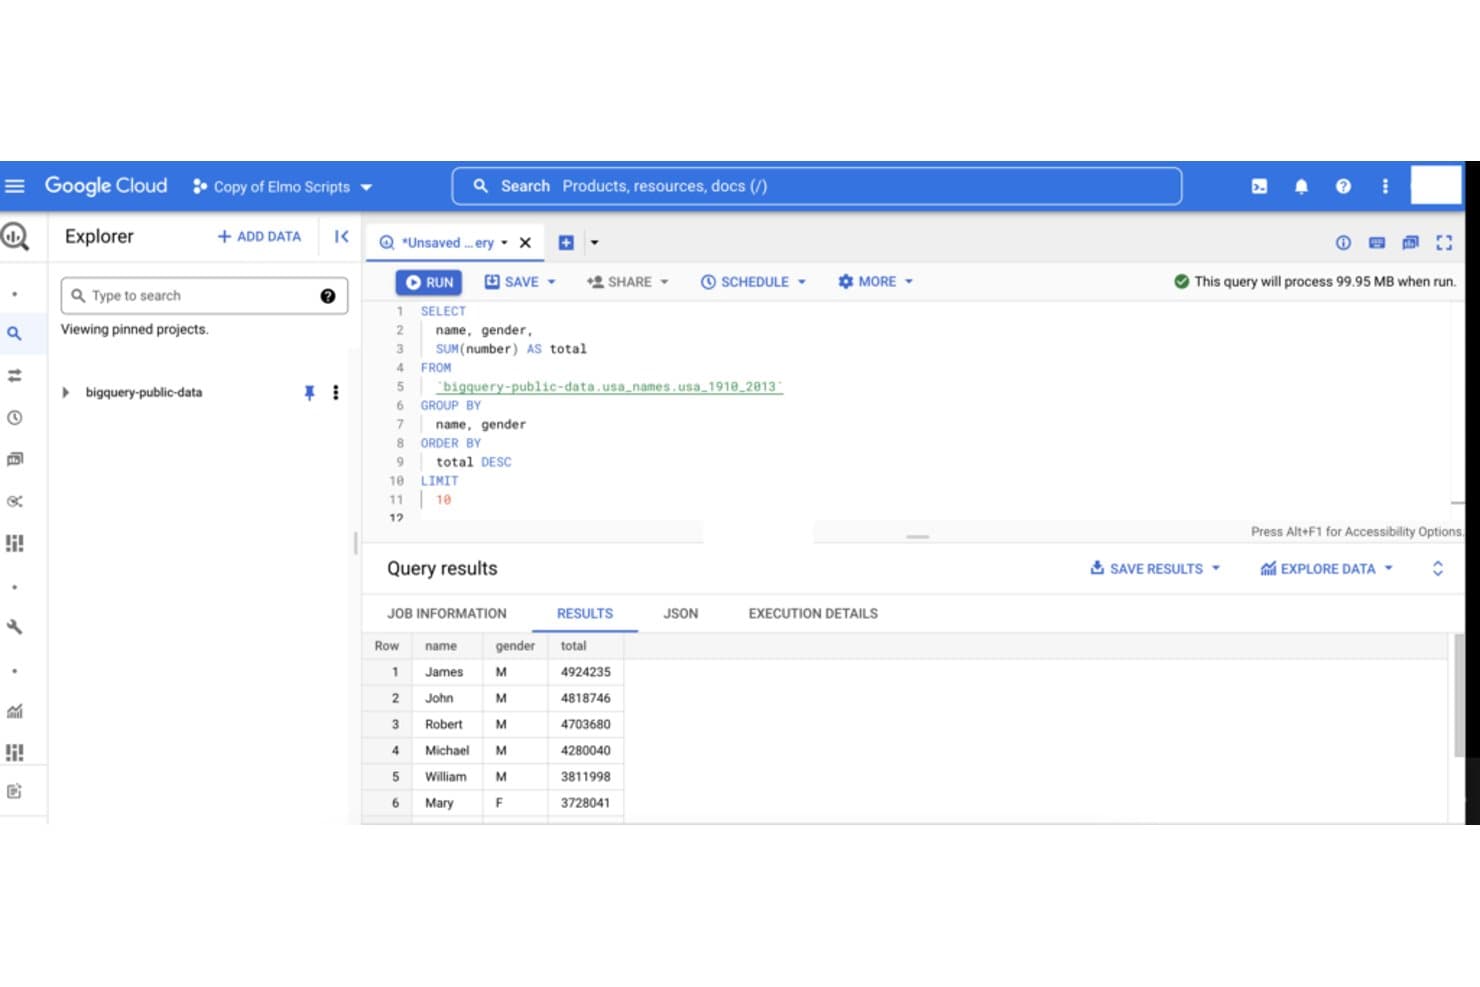
Met Google BigQuery kunnen gebruikers SQL-query's uitvoeren op grote openbare datasets. Voor IT- en datateams die schaalbare analyses nodig hebben zonder de infrastructuur van een datawarehouse te beheren, is Google BigQuery een cloud datawarehouse voor het opvragen en analyseren van grote datasets met SQL.
Voor wie is Google BigQuery het meest geschikt?
Data-analisten en data-engineers die snelle SQL-query's moeten uitvoeren op grote datasets in de cloud, zullen Google BigQuery een praktische oplossing vinden.
Waarom ik Google BigQuery heb gekozen
Ik heb Google BigQuery gekozen als mijn alternatief voor Databricks dat het meest geschikt is voor snelle SQL-query's. De serverloze query-engine voert GoogleSQL uit op grote datasets, terwijl tabelpartitionering en clustering de hoeveelheid gescande data voor terugkerende rapporten kunnen verminderen. Ik vind het geschikt voor het opvragen van applicatielogboeken of gebeurtenisgegevens zonder warehouseclusters te hoeven beheren.
Belangrijkste functies van Google BigQuery
- BigQuery ML: Maak machine-learningmodellen met SQL en voer ze uit.
- Geplande query's: Stel SQL-taken in om met gekozen tussenpozen te worden uitgevoerd.
- BigQuery Data Transfer Service: Plan gegevensimporten vanuit ondersteunde bronnen.
- Geautoriseerde weergaven: Deel queryresultaten zonder toegang te verlenen tot de onderliggende tabellen.
Integraties van Google BigQuery
Google documenteert directe BigQuery-integraties met Looker, Looker Studio, Vertex AI Workbench, Managed Service for Apache Spark en Tableau. Gegevensverbindingen en laadworkflows ondersteunen ook Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 en Azure Blob Storage; de REST- en Storage-API's van BigQuery ondersteunen aangepaste integraties.
Pros and Cons
Pros:
- Snelle SQL-scans op grote datasets
- Serverloze werking maakt clusterbeheer overbodig
- Partitionering en clustering kunnen de hoeveelheid gescande data verminderen
Cons:
- Querykosten kunnen zonder beperkingen snel oplopen
- Verkenning door zakelijke gebruikers vereist vaak kennis van SQL
Learn more about Google BigQuery: Het beste voor zakelijke databasebehoeften
- Gratis proefversie beschikbaar
- $68/gebruiker/maand (jaarlijks gefactureerd)
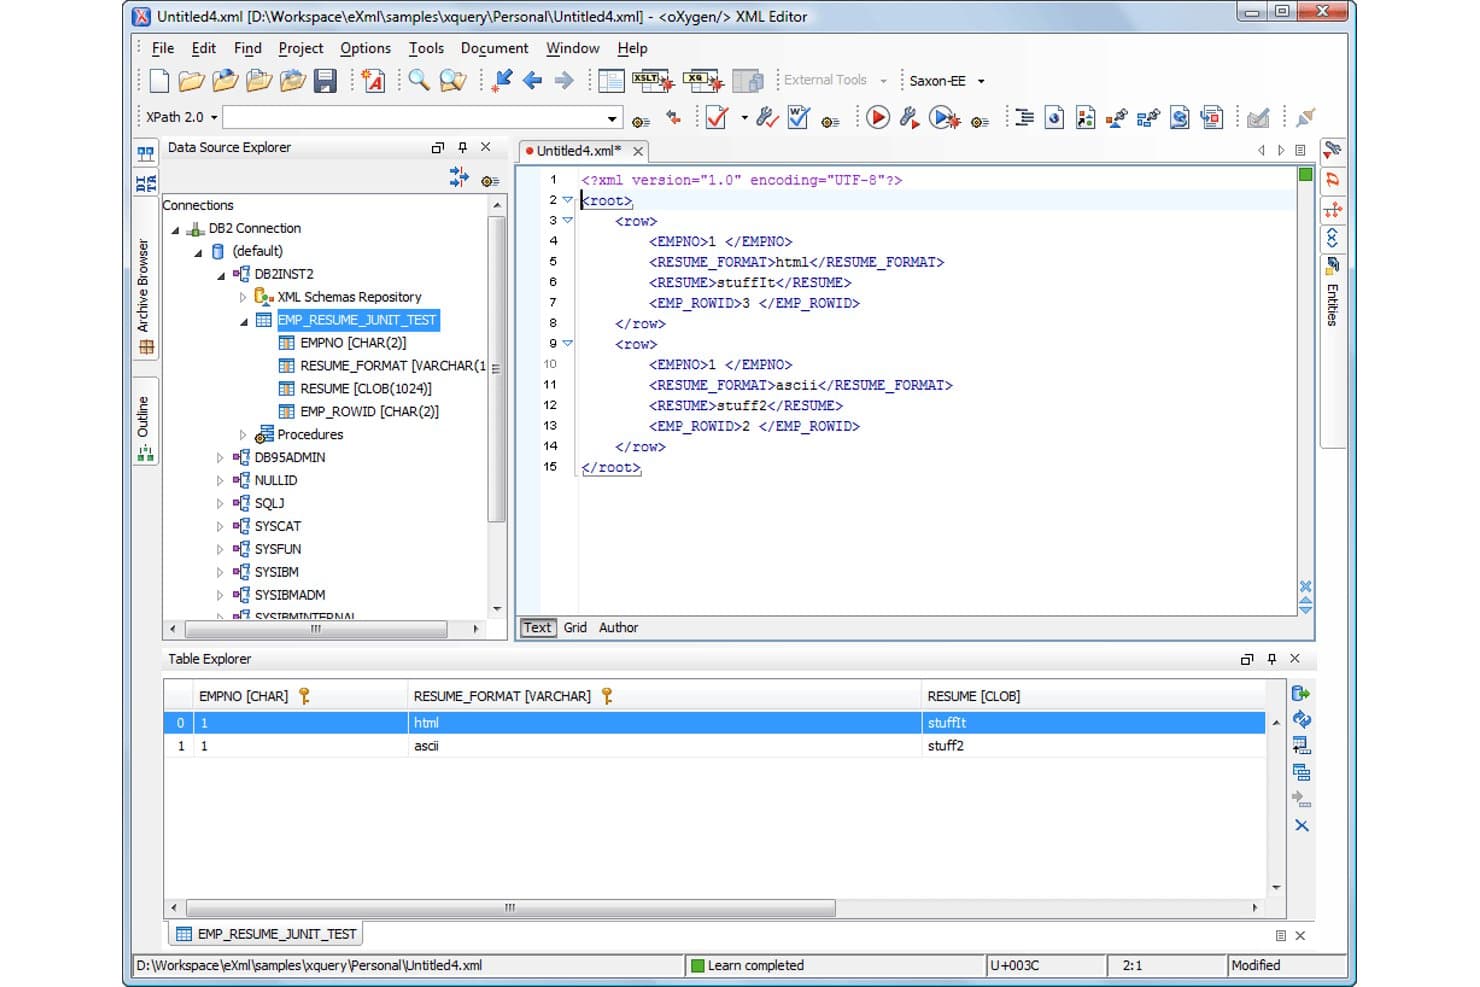
Met IBM Db2 kunnen gebruikers databaseschema's bekijken en XML-gegevens visueel opvragen. IBM Db2 is een relationeel databasemanagementsysteem voor organisaties die gestructureerde gegevensverwerkingen in complexe omgevingen moeten uitvoeren en teams ondersteunt die bedrijfsapplicaties, transacties en analyses beheren.
Voor wie is IBM Db2 het meest geschikt?
Databasebeheerders en IT-teams bij grote organisaties die bedrijfskritische applicaties met grote gegevensvolumes ondersteunen.
Waarom ik voor IBM Db2 heb gekozen
Ik heb IBM Db2, het beste voor zakelijke databasebehoeften, gekozen als alternatief voor Databricks voor kernbedrijfssystemen. Het ondersteunt transactionele, analytische en vectorgegevens op één platform, met AI-aangedreven optimalisatie van werklasten voor ERP, facturering en orderverwerking. Ik waardeer die geschiktheid wanneer relationele werklasten en analyses infrastructuur moeten delen.
Belangrijkste functies van IBM Db2
- Hybride implementatie: Voer Db2 uit op locatie, in de cloud of in hybride omgevingen.
- Ingebouwde versleuteling: Versleutel databasegegevens en beheer versleutelingssleutels via een sleutelarchief.
- Tabelpartitionering: Deel tabelgegevens op in partities op basis van opgegeven kolomwaarden.
- Back-up- en herstelhulpmiddelen: Db2 Advanced Recovery ondersteunt het maken van back-ups, herstel en gegevensextractie van databases.
Integraties van IBM Db2
Eigen integraties zijn niet duidelijk gedocumenteerd. Db2 ondersteunt gefedereerde toegang tot gegevensbronnen zoals Oracle en Microsoft SQL Server, plus JDBC-, ODBC- en CLI-connectiviteit voor applicaties.
Pros and Cons
Pros:
- Snelle verwerking voor transactionele bedrijfswerklasten
- Hoge beschikbaarheid met HADR en herstel
- Partitionering ondersteunt grote, gemengde werklasten
Cons:
- Voor beheer en afstemming is gespecialiseerde expertise vereist
- Cloudgebaseerde activiteiten lopen achter op nieuwere platforms
Learn more about IBM Db2: Beste voor SQL-analyses
- 30 dagen gratis uitproberen
- $30/gebruiker/maand (jaarlijks gefactureerd)
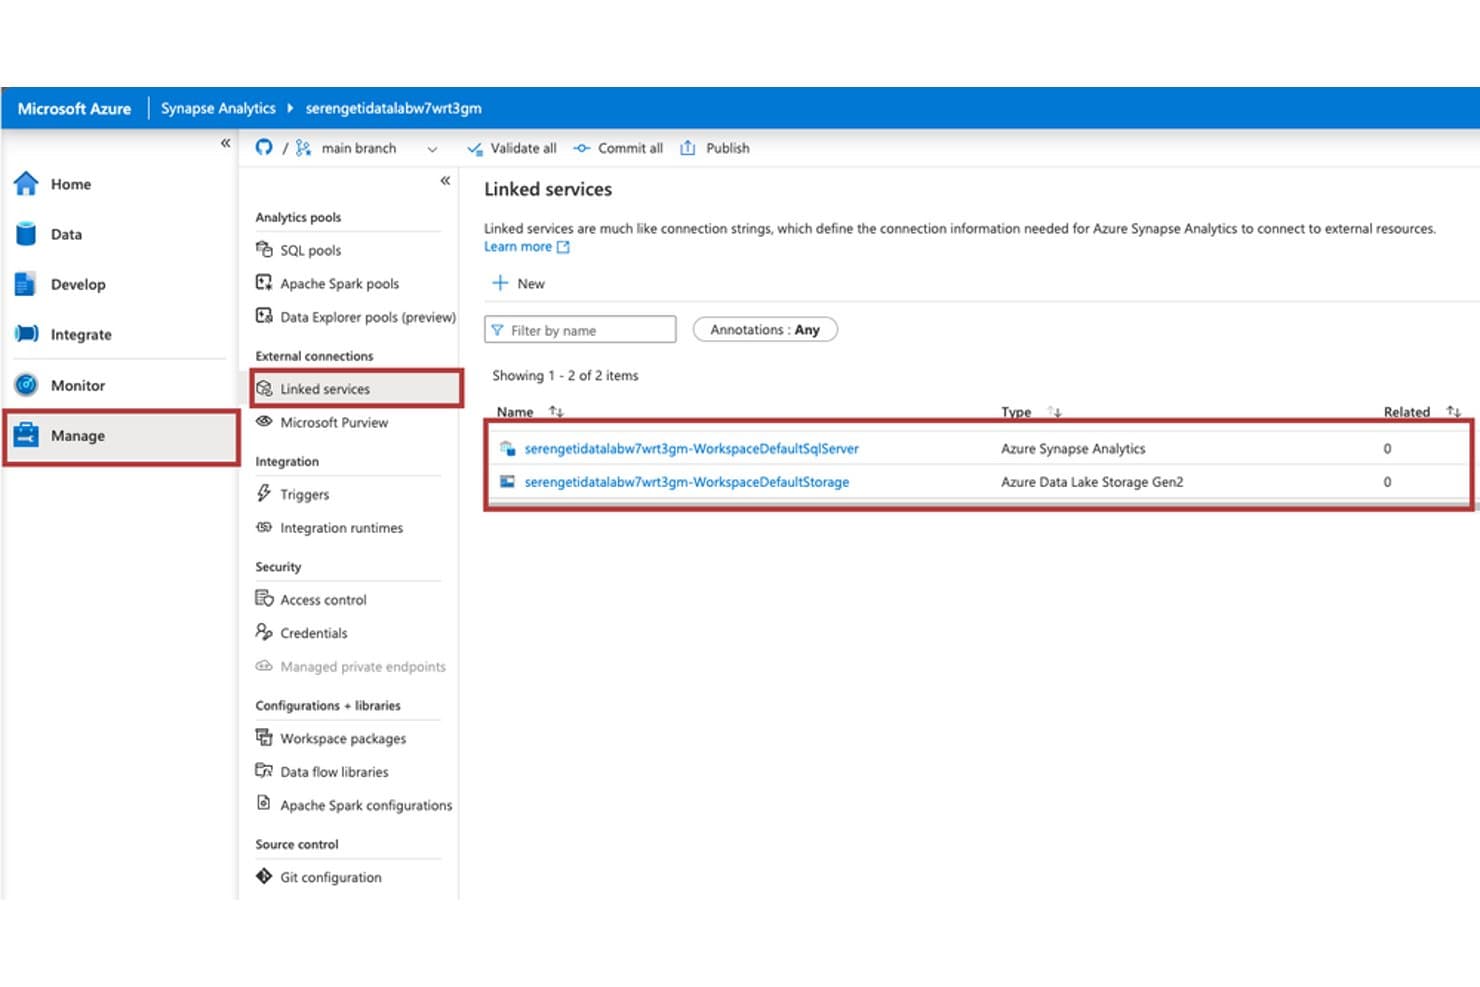
Azure Synapse Analytics beheert externe verbindingen via gekoppelde services. Azure Synapse Analytics is een cloudanalyseplatform voor data- en IT-teams die bedrijfsgegevens moeten verbinden, query's moeten uitvoeren en rapportage moeten ondersteunen voor datawarehouse- en bigdatalasten.
Voor wie is Azure Synapse Analytics het meest geschikt?
Het is geschikt voor data-engineers en analisten die SQL-toegang nodig hebben tot geïntegreerde datasets voor bedrijfsrapportage en -analyse.
Waarom ik Azure Synapse Analytics heb gekozen
Ik heb Azure Synapse Analytics gekozen voor de toepassing Beste voor SQL-analyses: de serverloze SQL-pool bevraagt bestanden in het datameer met T-SQL, terwijl toegewezen SQL-pools ingerichte datawarehousewerklasten ondersteunen. Ik vind deze scheiding prettig wanneer ik onbewerkte datasets moet inspecteren en terugkerende BI-rapporten via SQL moet aanbieden.
Belangrijkste functies van Azure Synapse Analytics
- Apache Spark-pools: Voer Spark-taken en notebooks uit voor gedistribueerde gegevensverwerking.
- Pipelines: Orkestreer gegevensverplaatsing en transformatie tussen verbonden bronnen.
- Synapse Studio: Beheer gegevens, code en analysebronnen in een gedeelde werkruimte.
- Power BI-integratie: Verbind Synapse-gegevens met Power BI om rapporten te maken.
Integraties van Azure Synapse Analytics
Azure Synapse Analytics beschikt over ingebouwde pipelineconnectoren voor Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 en SAP HANA, plus een directe Power BI-verbinding via Synapse Studio. Het biedt ook REST API's voor aangepaste integraties.
Pros and Cons
Pros:
- Serverloze T-SQL-query's lezen bestanden uit het datameer
- Toegewezen MPP-pools verwerken datawarehousewerklasten
- Combineert SQL-query's met Spark-verwerking
Cons:
- Voor het afstemmen van SQL-pools is praktische expertise vereist
- Foutopsporing en monitoring van pipelines kunnen beperkt zijn
Learn more about Azure Synapse Analytics:
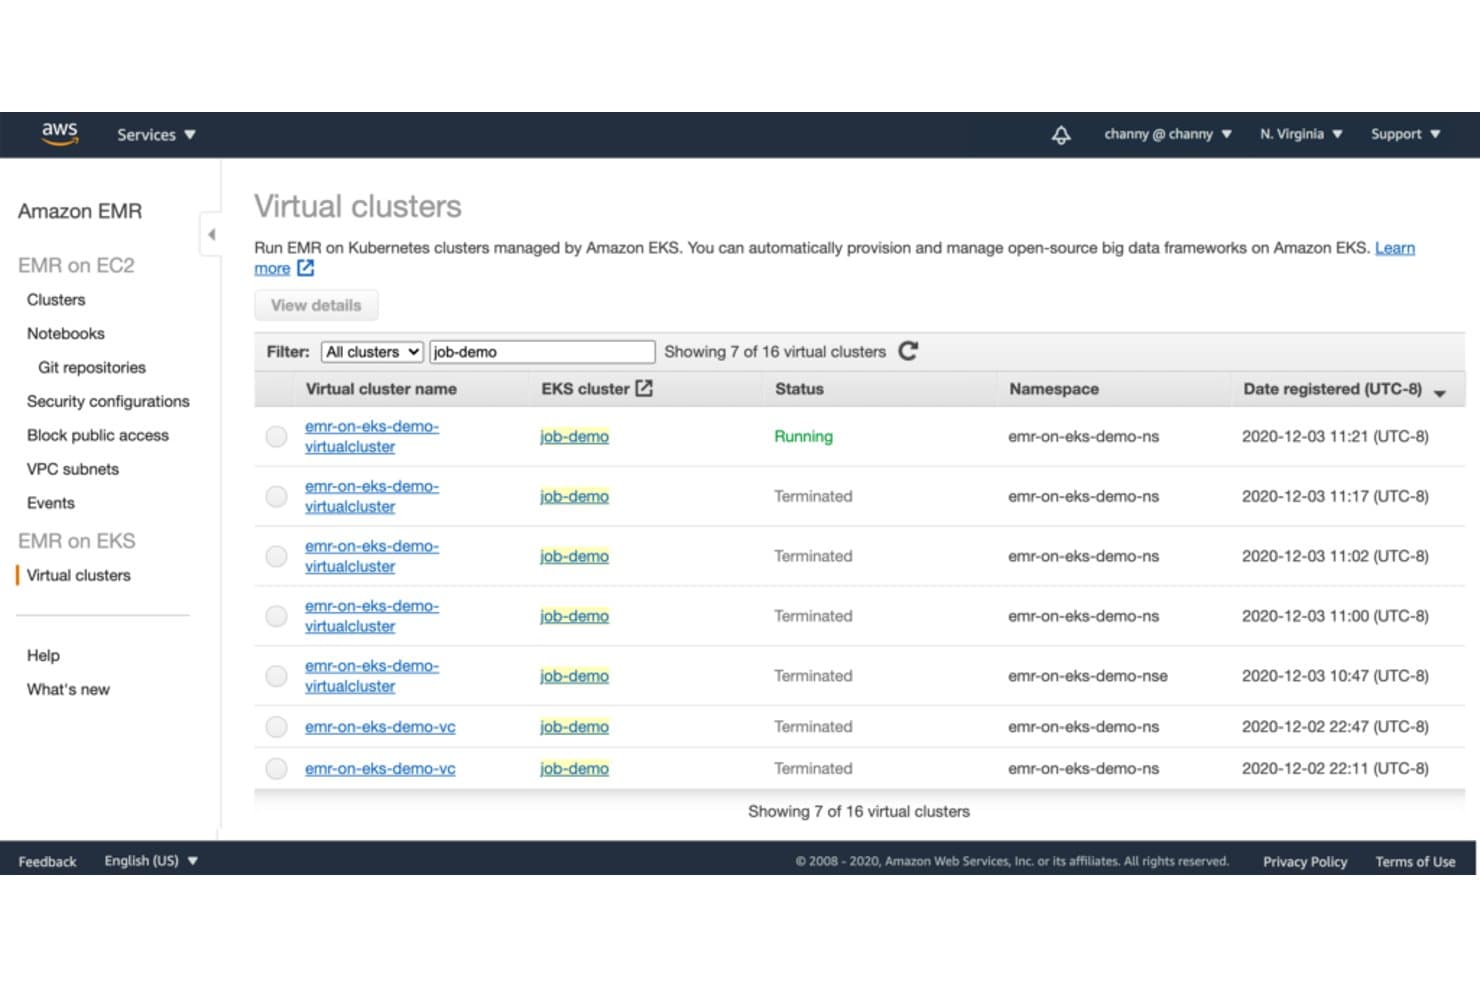
Met Amazon EMR kunnen gebruikers virtuele clusters beheren die op Amazon EKS draaien. Amazon EMR is het beheerde bigdataplatform van AWS voor gegevensengineering- en analyseteams die grote datasets moeten verwerken, gedistribueerde werklasten moeten schalen en minder werk willen hebben aan het beheren van rekenclusters.
Voor wie is Amazon EMR het meest geschikt?
Amazon EMR is geschikt voor gegevensengineeringteams die Hadoop- of Spark-taken uitvoeren om grote datasets over gedistribueerde clusters te verwerken.
Waarom ik voor Amazon EMR heb gekozen
Ik heb Amazon EMR om één reden als alternatief voor Databricks gekozen: het is het beste voor Hadoop-verwerking. De beheerde clusters voeren Apache Hadoop en Spark uit, zodat ik MapReduce kan gebruiken om gearchiveerde applicatielogboeken te verwerken en Spark om de resultaten te analyseren.
Belangrijkste functies van Amazon EMR
- EMR Serverless: Voer datatoepassingen uit zonder clusters in te richten of te beheren.
- Automatisch schalen: Pas de capaciteit van clusters aan op basis van de vraag vanuit de werklast.
- EMR op EKS: Voer EMR-werklasten uit op Amazon EKS-clusters.
- AWS Glue Data Catalog: Gebruik een gedeelde catalogus voor metagegevens van tabellen.
Integraties van Amazon EMR
Amazon EMR heeft gedocumenteerde integraties met AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 en Amazon CloudWatch. Het biedt ook een API voor programmatische toegang en aangepaste integraties.
Pros and Cons
Pros:
- Voert bestaande Hadoop- en Spark-werklasten uit
- Ondersteunt implementaties met clusters, zonder server en EKS
- Verwerkt grote datasets voor uiteenlopende werklasten
Cons:
- Langzaam automatisch schalen kan ertoe leiden dat taken onvoldoende middelen krijgen
- Voor het schalen van clusters is soms handmatige afstemming nodig
Learn more about Amazon EMR: Meest geschikt voor beheerde Spark en Hadoop
- Niet beschikbaar
- Vanaf $0.06/DCU-hour
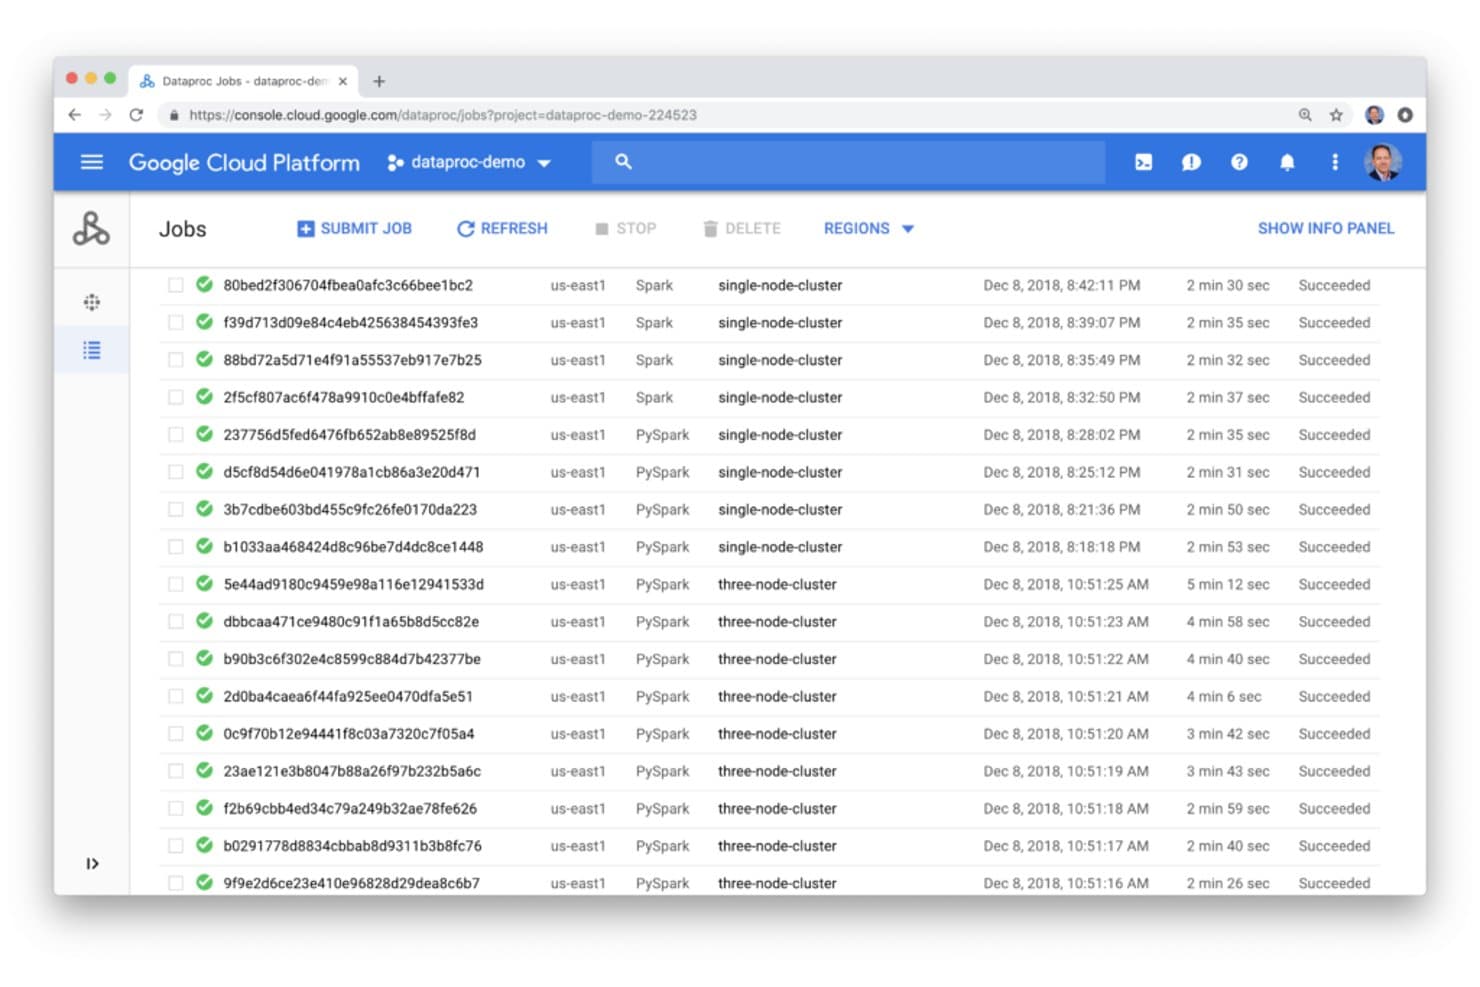
Met Google Cloud Dataproc kunnen gebruikers Spark-taken in één oogopslag bewaken en beheren. Google Cloud Dataproc biedt data-engineering- en IT-teams een beheerd cloudplatform voor grootschalige analysetaken, waarmee clusterbeheer wordt verminderd en datapijplijnen in Google Cloud worden ondersteund.
Voor wie is Google Cloud Dataproc het meest geschikt?
Data-engineeringteams die Spark- of Hadoop-taken uitvoeren in Google Cloud kunnen Dataproc gebruiken om clusterbewerkingen te beheren.
Waarom ik voor Google Cloud Dataproc heb gekozen
Ik heb voor Google Cloud Dataproc gekozen voor werklasten waarbij “Meest geschikt voor beheerde Spark en Hadoop” de prioriteit is. Beheerde clusters en beleid voor automatisch schalen helpen bij het verwerken van batchtaken met veranderende resourcebehoeften, terwijl Dataproc Serverless Spark-batches uitvoert zonder dat clusters hoeven te worden ingericht. Je kunt bijvoorbeeld nachtelijke gebeurtenislogboeken met Spark verwerken en voorkomen dat een cluster tussen uitvoeringen inactief blijft.
Belangrijkste functies van Google Cloud Dataproc
- Lightning Engine: Versnelt de uitvoering van Spark met gevectoriseerde verwerking, caching en geoptimaliseerde shuffle-bewerkingen.
- Ondersteuning voor Apache Iceberg: Werkt met open tabelindelingen in Google Cloud Storage.
- GPU-versnelling: Ondersteunt NVIDIA RAPIDS voor gegevensverwerking met GPU's.
- Beveiligingscontroles: Integreert met IAM, VPC Service Controls en Kerberos.
Integraties van Google Cloud Dataproc
Google Cloud Dataproc beschikt over ingebouwde integraties met BigQuery, Cloud Storage, Bigtable, Cloud Logging en Cloud Monitoring. Het biedt ook een REST API en Cloud SDK voor het beheren van clusters en taken.
Pros and Cons
Pros:
- Bestaande Spark-taken worden uitgevoerd met minimale herschrijvingen
- Clusters worden snel aangemaakt en verwijderd
- Serverloze batches voorkomen clusterbeheer
Cons:
- Voor het afstemmen van clusters is nog steeds expertise op het gebied van infrastructuur nodig
- De kosten kunnen hoog aanvoelen voor langdurige werklasten
Learn more about Google Cloud Dataproc:
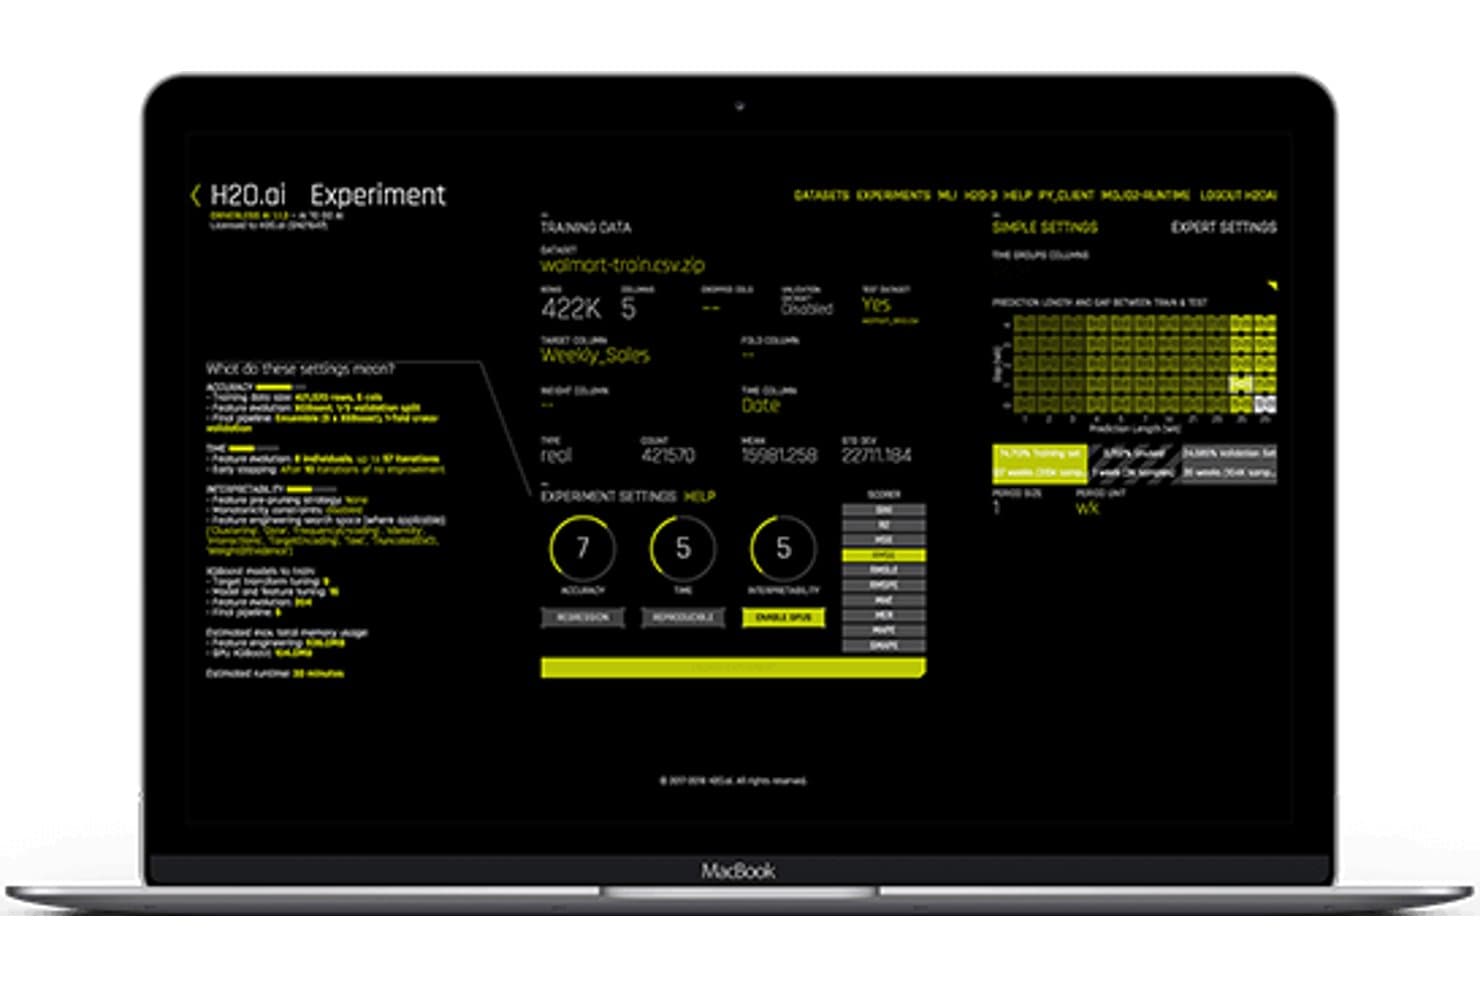
Met H2O.ai kunnen gebruikers AutoML-experimenten visueel configureren en uitvoeren. Voor teams die alternatieven voor Databricks evalueren, biedt H2O.ai een AI- en machinelearningplatform waarmee data- en IT-teams voorspellende modellen kunnen bouwen op basis van grote datasets en analyses in de praktijk kunnen toepassen.
Voor wie is H2O.ai het meest geschikt?
H2O.ai is geschikt voor datawetenschappers en machinelearningengineers die verantwoordelijk zijn voor het ontwikkelen van AI-modellen en het in productie brengen daarvan.
Waarom ik voor H2O.ai heb gekozen
Ik heb H2O.ai gekozen als mijn alternatief voor Databricks dat het beste is voor AI- en ML-oplossingen, omdat het zich richt op het bouwen van voorspellende modellen op basis van grote datasets. H2O-3 verdeelt in-memory machinelearning over clusters, terwijl AutoML algoritmen test en modellen rangschikt op een scorebord. Ik vind deze combinatie geschikt wanneer ik modellen moet vergelijken voordat ik er een in productie neem.
Belangrijkste functies van H2O.ai
- Flexibele implementatie: Gebruik het platform lokaal, in een private cloud, in de cloud of in omgevingen zonder netwerkverbinding.
- Modelonafhankelijke ondersteuning: Kies, vervang of verfijn modellen en grote taalmodellen.
- Uitlegbaarheid: Bekijk toelichtingen bij AI-gestuurde beslissingen.
- Audittrail: Houd platformactiviteiten bij met auditklare audittrails.
Integraties van H2O.ai
H2O Driverless AI biedt dataconnectoren voor Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, JDBC-bronnen en Delta Tables. Met deze connectoren kunnen teams gegevens uit bestaande platforms opvragen of importeren voor machinelearningworkflows.
Pros and Cons
Pros:
- AutoML versnelt het vergelijken van modellen en het maken van prototypes
- Gedistribueerde in-memorytraining schaalt over clusters
- Implementatie zonder netwerkverbinding ondersteunt gecontroleerde omgevingen
Cons:
- De mogelijkheden voor gegevensmanipulatie zijn beperkt
- Een omslachtige gebruikersinterface kan workflows vertragen
Learn more about H2O.ai:
Andere Databricks-concurrenten
Hier zijn enkele aanvullende alternatieven voor Databricks die niet op mijn shortlist zijn gekomen, maar die toch het bekijken waard zijn:
- 11DremioBest voor selfserviceanalyses
- 12QuboleBeste voor bigdataworkloads
- 13Azure DatabricksBeste voor gezamenlijke gegevensanalyse
Hoe ik Databricks-concurrenten evalueer
Of je team nu Spark-pijplijnen op grote schaal uitvoert of een ML-levenscyclus beheert, ik evalueer elk alternatief in twee lagen: eerst de vereisten voor de kerndata lakehouse-architectuur en rekenkracht, en daarna de onderscheidende factoren.
Basisfunctionaliteit (vereisten voor deze lijst)
Bij het selecteren van tools voor mijn lijst beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde basisfunctionaliteit. Vervolgens zet ik de totaalscore van de tool om in een percentage. Elke tool moet een minimale totaalscore van 65% behalen om in aanmerking te komen voor opname.
- Verenigde data lakehouse-architectuur: Ik controleer of een platform zowel gestructureerde datawarehousequery's als ongestructureerde data lake-opslag aankan, met ondersteuning voor open tabelindelingen zoals Delta, Iceberg of Hudi.
- Gedistribueerde gegevensverwerking: Grootschalige batch- en streamingwerklasten hebben een gedistribueerde engine nodig die automatisch schaalt. Daarom evalueer ik de rekenopties en hoe het platform omgaat met taken zoals ETL-uitvoeringen van meerdere terabytes.
- Geïntegreerde ML/AI-werkstromen: Ik zoek naar ondersteuning gedurende de volledige ML-levenscyclus, van het volgen van experimenten en modelregistratie tot implementatie en beschikbaarstelling, in plaats van alleen een notitieboek dat trainingsscripts kan uitvoeren.
- Collaboratieve notitieboekomgeving: Teams van data-engineers, analisten en ML-engineers hebben gedeelde notitieboeken voor meerdere talen nodig. Daarom evalueer ik realtime samenwerking, versiebeheer en taalondersteuning voor SQL, Python, Scala en R.
- Datagovernance & beveiliging: Een verenigde datacatalogus, fijnmazige toegangscontroles en het bijhouden van de herkomst van gegevens zijn hierbij belangrijk. Ik kijk hoe elk platform machtigingen voor tabellen, kolommen en AI-middelen op één plek beheert.
- Multi-cloud & open integratie: Vendor lock-in is een reëel probleem. Daarom evalueer ik of elke tool op AWS, Azure en GCP werkt en hoe goed deze verbinding maakt met orkestrators zoals Airflow, BI-tools zoals Tableau en opname- en transformatielagen zoals dbt.
Zodra ik een lijst heb met tools die aan deze criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (waarmee leveranciers zich onderscheiden)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
Serverloze rekenkracht is een belangrijke onderscheidende factor. Ik evalueer of een platform teams query's en taken laat uitvoeren zonder clusters te beheren, wat de overhead verlaagt voor groepen met onvoorspelbare werklasten. Ingebouwde GenAI-hulpmiddelen worden elk jaar belangrijker, vooral voor teams die RAG-pijplijnen bouwen of LLM's rechtstreeks binnen hun dataplatform afstemmen. Ik kijk ook naar regelmogelijkheden voor kostenoptimalisatie, zoals uitgavenregistratie per werklast en geautomatiseerd clusterbeleid, omdat cloudrekenkosten bij grote engineeringteams snel kunnen oplopen.
Meer dan functies
De totale eigendomskosten zijn een van de eerste dingen die ik evalueer. Verbruikgebaseerde prijzen kunnen aantrekkelijk lijken totdat kosten voor gegevensuitvoer en premium ondersteuningsniveaus de rekening opdrijven. Ook de diepgang van het ecosysteem is belangrijk—Iik controleer hoe goed elk platform verbinding maakt met tools zoals Airflow, dbt en Tableau, aangezien de meeste teams niet hun volledige stack vervangen. Implementatie en de tijd tot waarde maken mijn evaluatie compleet. Migratietools voor verouderde systemen zoals Hadoop of Redshift kunnen weken van een overgang afhalen, en goede documentatie maakt het inwerken van nieuwe engineers aanzienlijk minder lastig.
Een Databricks-concurrent kiezen
Het is gemakkelijk om verstrikt te raken in lange lijsten met functies en complexe prijsstructuren. Om je te helpen gefocust te blijven terwijl je je unieke softwareselectieproces doorloopt, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waar u rekening mee moet houden |
| Schaalbaarheid | Zorg ervoor dat de oplossing uw datagroei kan verwerken zonder prestatieverlies. Controleer of zowel horizontaal als verticaal schalen wordt ondersteund voor meer flexibiliteit. |
| Integraties | Let op compatibiliteit met uw bestaande tools, zoals datalakes of BI-tools, om een soepele gegevensstroom te garanderen en geïsoleerde processen te voorkomen. |
| Aanpasbaarheid | Beoordeel in hoeverre het platform zich kan aanpassen aan de specifieke workflows en processen van uw team. Aanpasbare dashboards kunnen inspelen op de verschillende behoeften van teams. |
| gebruiksgemak | Houd rekening met de leercurve en hoe intuïtief de interface voor uw team is. Een gebruiksvriendelijk platform kan de trainingstijd verkorten en de acceptatie verhogen. |
| Budget | Vergelijk prijsmodellen en zorg ervoor dat deze binnen uw budget passen. Houd rekening met verborgen kosten, zoals opslag- of extra gebruikerskosten, die uw beslissing kunnen beïnvloeden. |
| Beveiligingsmaatregelen | Beoordeel de beveiligingsfuncties van het platform, zoals gegevensversleuteling en naleving van industrienormen, om gevoelige gegevens te beschermen. |
| Ondersteuning | Controleer de beschikbaarheid van opties voor klantenondersteuning, waaronder livechat en communityforums, zodat uw team hulp kan krijgen wanneer dat nodig is. |
| Prestaties | Bekijk hoe het platform grote datasets en realtimeverwerking verwerkt, zodat het voldoet aan de prestatieverwachtingen van uw team. |
Trends onder Databricks-concurrenten
Voor mijn onderzoek heb ik talloze productupdates, persberichten en releaselogboeken van verschillende leveranciers die concurreren met Databricks verzameld. Dit zijn enkele opkomende trends die ik in de gaten houd:
- Realtimeanalyse: Bedrijven vragen steeds vaker om realtime-inzichten uit gegevens. Leveranciers verbeteren hun platforms om gegevens in realtime te verwerken en te analyseren, zodat gebruikers direct beslissingen kunnen nemen. Oplossingen zoals Google BigQuery integreren functies die realtimegegevensstromen ondersteunen.
- Uitgebreide analyse: Bij deze trend worden AI en machine learning gebruikt om gegevensanalyseprocessen te verbeteren. De trend wordt steeds populairder omdat gebruikers hiermee inzichten kunnen ontdekken zonder handmatige inspanning. IBM Watson Studio is hiervan een voorbeeld en biedt mogelijkheden voor uitgebreide analyse om gegevensanalyse te automatiseren.
- Democratisering van gegevens: Meer platforms richten zich erop gegevens toegankelijk te maken voor niet-technische gebruikers. Deze trend is cruciaal voor het bevorderen van een datagedreven cultuur binnen organisaties. Er worden tools ontwikkeld met intuïtieve interfaces en selfservicefuncties, zoals die van Alteryx.
- Gegevensbeheer: Naarmate de regelgeving rond gegevensprivacy strenger wordt, worden functies voor gegevensbeheer steeds belangrijker. Leveranciers integreren tools voor gegevensbeheer om gebruikers te helpen aan regelgeving te voldoen en gegevens verantwoord te beheren. Azure Synapse Analytics biedt bijvoorbeeld ingebouwde functies voor gegevensbeheer.
- Ondersteuning voor hybride clouds: Veel bedrijven willen flexibiliteit in hun cloudstrategieën. Ondersteuning voor hybride clouds groeit, waardoor gebruikers gegevens kunnen beheren in zowel lokale als cloudomgevingen. Cloudera loopt voorop in deze trend met oplossingen die implementaties in hybride clouds ondersteunen.
Wat is een concurrent van Databricks?
Concurrenten van Databricks zijn softwareoplossingen die mogelijkheden bieden voor gegevensverwerking, analyse en machine learning. Deze tools worden doorgaans gebruikt door datawetenschappers, engineers en analisten om inzichten te verkrijgen en zakelijke beslissingen te ondersteunen.
Functies voor realtimeanalyse, uitgebreide analyse en gegevensbeheer helpen bij het efficiënt verwerken van gegevens, het ontdekken van inzichten en het verantwoord beheren van gegevens. Over het algemeen stellen deze tools bedrijven in staat hun gegevens te benutten voor betere besluitvorming en strategische planning.
Functies van een concurrent van Databricks
Let bij het selecteren van een concurrent van Databricks op de volgende belangrijke functies:
- Realtimeanalyses: Maakt onmiddellijke gegevensverwerking en inzichten mogelijk, zodat u snel zakelijke beslissingen kunt nemen.
- Uitgebreide analyses: Gebruikt AI om gegevensanalyses te automatiseren en helpt inzichten te ontdekken zonder handmatige inspanning.
- Gegevensbeheer: Zorgt voor naleving van regelgeving inzake gegevensprivacy en verantwoord gegevensbeheer.
- Ondersteuning voor hybride clouds: Maakt het mogelijk gegevens te beheren in zowel lokale als cloudomgevingen voor meer flexibiliteit.
- Interactieve samenwerking: Bevordert teamwerk door gedeelde werkruimten en hulpmiddelen voor gezamenlijke gegevensanalyse te bieden.
- Automatische schaalvergroting: Past middelen aan op basis van de werklast en optimaliseert de prestaties zonder handmatige tussenkomst.
- Integratie van machinaal leren: Biedt ingebouwde mogelijkheden voor machinaal leren voor geavanceerde voorspellingen en inzichten op basis van gegevens.
- Aanpasbaarheid: Maakt gepersonaliseerde werkstromen en dashboards mogelijk die aansluiten op specifieke teambehoeften en processen.
- Beveiligingsmaatregelen: Biedt versleuteling en functies voor naleving van regelgeving om gevoelige gegevens te beschermen.
- Gebruiksvriendelijke interface: Zorgt voor gebruiksgemak, verkort de leercurve en vergroot de acceptatie binnen uw team.
Voordelen van een concurrent van Databricks
Het implementeren van een concurrent van Databricks biedt verschillende voordelen voor uw team en uw bedrijf. Hier zijn enkele voordelen waar u naar kunt uitkijken:
- Betere besluitvorming: Realtimeanalyses en uitgebreide analyses bieden onmiddellijke inzichten, waardoor de besluitvormingsmogelijkheden van uw team verbeteren.
- Meer samenwerking: Functies voor interactieve samenwerking stellen uw team in staat effectief samen te werken, wat leidt tot meer samenhangende gegevensprojecten.
- Schaalbaarheid: Dankzij automatische schaalvergroting kan uw systeem gegevensgroei efficiënt verwerken zonder handmatige aanpassingen.
- Kostenefficiëntie: Prijsmodellen waarbij u betaalt naar gebruik zorgen ervoor dat u alleen betaalt voor de middelen die u gebruikt, waardoor budgetbeheer wordt geoptimaliseerd.
- Verbeterde beveiliging: Ingebouwde beveiligingsmaatregelen beschermen uw gegevens en zorgen voor naleving van industrienormen.
- Flexibiliteit: Ondersteuning voor hybride clouds biedt de flexibiliteit om gegevens in verschillende omgevingen te beheren en zich aan te passen aan uw bedrijfsbehoeften.
- Aanpassing: Met aanpasbare functies kunt u werkstromen en dashboards afstemmen op uw specifieke vereisten, waardoor de productiviteit toeneemt.
Kosten en prijzen van een concurrent van Databricks
Bij het selecteren van een concurrent van Databricks is inzicht in de verschillende beschikbare prijsmodellen en abonnementen vereist. De kosten variëren op basis van functies, teamgrootte, uitbreidingen en meer. In de onderstaande tabel worden veelvoorkomende abonnementen, hun gemiddelde prijzen en de typische inbegrepen functies van oplossingen van concurrenten van Databricks samengevat:
Vergelijkingstabel van abonnementen voor een concurrent van Databricks
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
| Gratis abonnement | $0 | Basisgegevensverwerking, beperkte opslag en ondersteuning door de community. |
| Persoonlijk abonnement | $10-$30 /gebruiker /maand | Uitgebreidere gegevensanalyses, persoonlijke dashboards en ondersteuning via e-mail. |
| Zakelijk abonnement | $50-$100 /gebruiker /maand | Geavanceerde analysetools, functies voor teamsamenwerking en ondersteuning met prioriteit. |
| Ondernemingsabonnement | $150-$300/gebruiker /maand | Aangepaste integraties, speciaal accountbeheer en beveiliging op ondernemingsniveau. |
Veelgestelde vragen over Databricks-concurrenten
Hier vindt u antwoorden op veelgestelde vragen over concurrenten van Databricks:
Wie is de grootste concurrent van Databricks?
Snowflake wordt vaak beschouwd als de grootste concurrent van Databricks vanwege de vergelijkbare cloudgebaseerde mogelijkheden van het dataplatform. Beide bieden uitgebreide functies voor gegevensverwerking en analyse, maar Snowflake staat bekend om zijn sterke punten op het gebied van datawarehousing. Afhankelijk van uw specifieke behoeften kan elk van beide een goede keuze zijn.
Wat zal Databricks vervangen?
Hoewel geen enkele tool Databricks volledig zal vervangen, bieden alternatieven zoals SQL Server aantrekkelijke functies. SQL Server kan goed worden geïntegreerd met analysetools zoals Power BI en biedt een robuust relationeel databasebeheersysteem. Uw keuze hangt af van uw specifieke vereisten voor gegevensverwerking.
Wat zijn de beperkingen van Databricks?
Databricks kent enkele beperkingen, zoals restricties op het aantal widgets in een notebook en limieten voor het aantal tekens in widgetnamen en invoerwaarden. Deze beperkingen kunnen van invloed zijn op de manier waarop u gegevens in notebooks ontwerpt en ermee werkt. Houd hier dus rekening mee als ze gevolgen hebben voor uw werkprocessen.
Wie zijn de concurrenten van Amazon Databricks?
Amazon Databricks ondervindt concurrentie van platforms zoals Snowflake, die vergelijkbare mogelijkheden voor gegevensverwerking bieden. Snowflake biedt een cloudgebaseerde datawarehouseoplossing die algemeen wordt erkend vanwege de schaalbaarheid en het gebruiksgemak, waardoor het een sterke concurrent op de markt is.
Hoe verhouden de prijzen van Databricks zich tot die van concurrenten?
De prijzen van Databricks kunnen aanzienlijk variëren afhankelijk van het gebruik en de functies. Het is belangrijk om Databricks te vergelijken met concurrenten zoals Snowflake en Google BigQuery, waarbij u factoren zoals gegevensopslag, verwerkingskosten en aanvullende functies in overweging neemt. Bekijk de prijsstructuur van elk platform om de beste keuze voor uw budget te vinden.
Op welke functies moet ik letten bij een concurrent van Databricks?
Let bij het beoordelen van concurrenten van Databricks op functies zoals realtimeanalyse, integratie van machine learning en gegevensbeheer. Deze mogelijkheden verbeteren uw gegevensverwerking en -analyse en bieden uw team meerwaarde. Houd rekening met uw specifieke bedrijfsbehoeften om te bepalen welke functies het belangrijkst zijn.