


Som teknologileder eller bedriftseier forstår du at det å ligge foran konkurrentene krever mer enn bare ambisjoner – det krever datadrevet beslutningstaking. Det er her DevOps-verktøy kommer inn i bildet.
Med bare litt data kan du forbedre teamets ytelse, prosesseffektiviteten og kundetilfredsheten.
Det betyr ikke at det er enkelt. Implementering av DevOps-måleparametere har sine utfordringer. Det krever en strategisk tankegang, en samarbeidskultur og en forpliktelse til kontinuerlig forbedring. Resultatet er imidlertid optimaliserte arbeidsflyter og prosesser som du kan bygge et solid grunnlag for å skalere virksomheten på.
Denne artikkelen utforsker viktige DevOps-måleparametere og hvordan du måler dem for å fastsette relevante ytelsesindikatorer (KPI-er). Deretter ser vi på hvordan du kan bruke disse måleparameterne til å skalere virksomheten effektivt.
De 5 søylene for prosessmodenhet
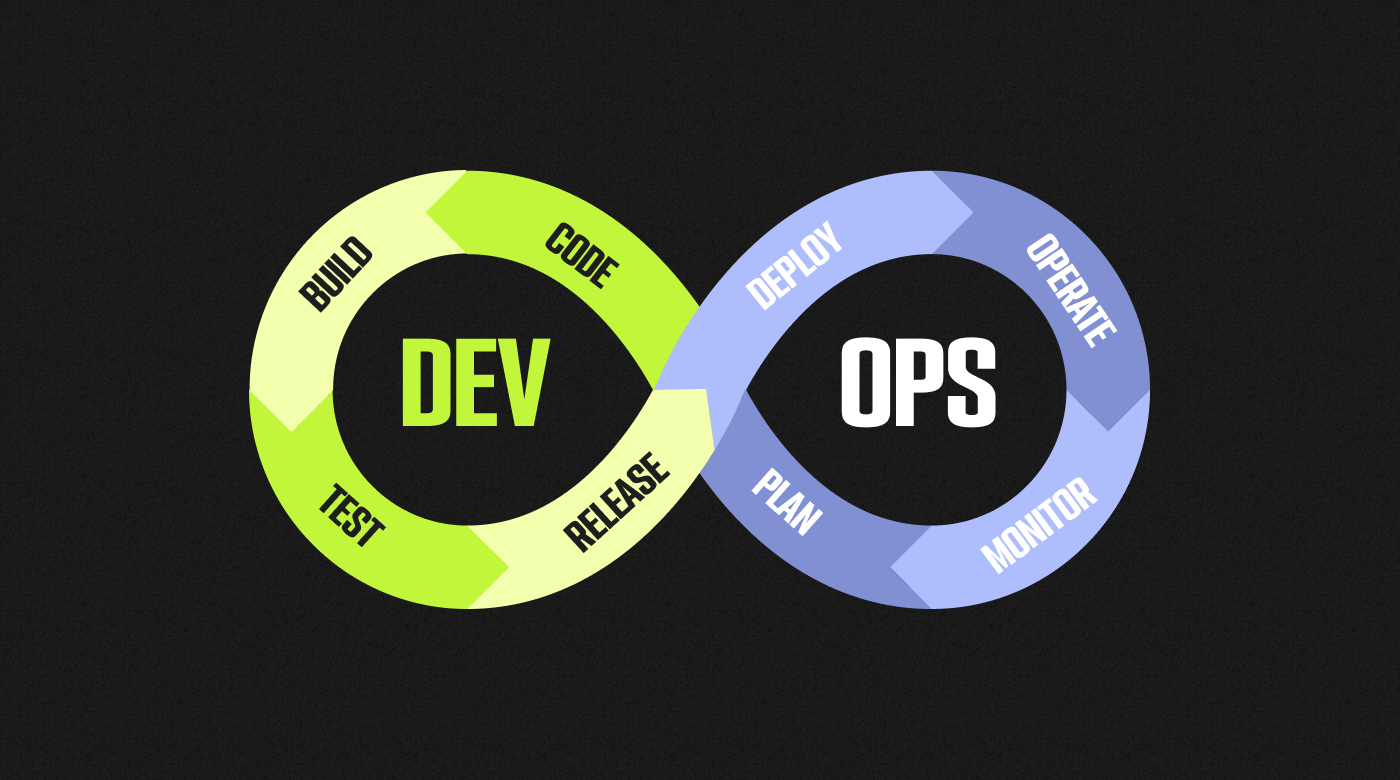
DevOps kombinerer og automatiserer prosesser, praksiser og verktøy som brukes i programvareutvikling og drift, for å øke kvaliteten og hastigheten i utviklingslivssykluser.
Implementering av forretningsprosesser har fem viktige søyler, kjent som modenhetsmodellen for kapabilitet (CMM). Denne modellen fokuserer på fem modenhetsnivåer for implementering og kontinuerlig forbedring av tjeneste- eller produktutvikling i forretningsmodellen din.
De fem søylene finnes i mange varianter, men initial, repeterbar, definert, kapabel og effektiv er de opprinnelige stadiene. Et alternativ er kultur, automatisering, måling, deling og tilbakemelding. Hvert stadium har det samme konseptet; det er bare betegnelsene som har utviklet seg.
Her er et eksempel på de fem søylene for prosessmodenhet, med korte beskrivelser av hver:

Det finnes flere måleparametere og rammeverk som kan brukes til å implementere og måle suksessen med DevOps i teamet ditt. La oss utforske disse i denne delen.
Prinsippbaserte DevOps-rammeverk
Det finnes tre hovedrammeverk i DevOps som er basert på prinsipper. Prinsippbasert viser til en praktisk tilnærming med brede retningslinjer, i motsetning til en regelbasert tilnærming med foreskrevne trinn.
Accelerate-rammeverket
Forfatterne Dr. Nicole Forsgren, Jez Humble og Gene Kim undersøker hva som skiller høytytende teknologiselskaper fra andre i boken «Accelerate: Vitenskapen bak smidig programvare og DevOps: Bygging og skalering av høytytende teknologiorganisasjoner».
Det er i denne boken Accelerate-rammeverket for DevOps oppsto. Det fokuserer på tekniske praksiser og ledelsespraksiser i DevOps-team i høytytende teknologiorganisasjoner. Du kan se på det som en studie av beste praksis for et DevOps-team.
De tre viktigste fokusområdene innen tekniske praksiser er:
- Kontinuerlig levering: Kontinuerlig levering omfatter områder som versjonskontroll, kontinuerlig integrasjon, utrulling og testautomatisering samt håndtering av testdata. Selv om kontinuerlig levering er et eget prinsipp, brukes det som en samlebetegnelse i Accelerate-rammeverket. Bakgrunnen for denne tilnærmingen er at DevOps-team på høyeste nivå utfører disse elementene samtidig, i stedet for isolert fra hverandre.
- Arkitektur: Det viste seg at høytytende DevOps-team utførte det meste av testingen uten behov for et integrert miljø, distribuerte nye applikasjoner uavhengig av applikasjonene de var avhengige av, og prioriterte testing og mulighet for utrulling fremfor den nyeste teknologien.
- Produkt og prosess: Kundetilbakemeldinger innhentes regelmessig gjennom hele utviklingen, samtidig som man arbeider i små partier, eksperimenterer og kontinuerlig optimaliserer prosesser. Dette viste seg å levere verdi, utbedre feil raskt og muliggjøre en tilbakemeldingssløyfe fra kundene.
Det finnes to viktige fokusområder innen ledelsespraksis. Disse er:
- Lean-ledelse og overvåking: Accelerate-rammeverket viste at minimale godkjenningsprosesser forbedrer ytelsen ved programvareleveranser sammenlignet med team som trenger godkjenning fra tredjeparter. Overvåking av kapasitet ved hjelp av grenser for pågående arbeid og visuelle verktøy for prosjektstyring forbedrer også ytelsen.
- Kultur: Rammeverket legger stor vekt på betydningen av å skape det riktige arbeidsmiljøet for bedre DevOps-ytelse. Samarbeid og læring er to viktige ingredienser i dette, sammen med en støttende og oppmuntrende tilnærming til teamarbeid. Disse teamene bør støttes av transformasjonsledelse. Personer i slike lederposisjoner har en tendens til å være motiverende og intellektuelt stimulerende, og de anerkjenner teamets prestasjoner.
«Ledetid for endringer» er en DevOps-måling vi skal utforske nærmere nedenfor. Den måler hvor lang tid en kodeendring bruker fra en utviklers innsjekking til den er vellykket distribuert til produksjon. Ved å bruke denne målingen innenfor Accelerate-rammeverket kan du måle og forbedre hastigheten og effektiviteten i programvareleveringsprosessen, noe som fører til raskere og mer pålitelige distribusjoner.
Rammeverket for de tre måtene
Rammeverket for de tre måtene ble introdusert i Føniksprosjektet, skrevet av Gene Kim, Kevin Behr og George Spafford, og omtales i DevOps-håndboken. Det forbedrer DevOps-ytelsen ved å fokusere på prinsippene flyt, tilbakemeldinger og kontinuerlig læring.

Her er en oversikt over rammeverket for de tre måtene:
- Den første måten: Flyttenkning:
Den første måten handler om å oppnå en uavbrutt arbeidsflyt fra utvikling til drift og levere verdi til kundene raskt og pålitelig.
«Ledetid til produksjon» er en måling du kan bruke her ved å måle tiden det tar for en kodeendring å gå fra den første innsjekkingen til den er distribuert til produksjonsmiljøet, og ha som mål å redusere ledetiden ved å optimalisere leveringsprosessen, automatisere prosesser og minimere manuelle inngrep.
- Den andre måten: Forsterk tilbakemeldingssløyfene
Den andre måten etablerer raske og effektive tilbakemeldingssløyfer gjennom hele programvareleveringsprosessen for å muliggjøre kontinuerlig læring, forbedring og kvalitetssikring.
Ved å bruke målingen «gjennomsnittlig tid til oppdagelse (MTTD)» beregner du den gjennomsnittlige tiden det tar å oppdage et problem eller avvik etter at en kodeendring er distribuert til produksjon. Fokuser på å redusere MTTD ved å forbedre overvåking, varslingssystemer og tilbakemeldingssløyfer for raskt å identifisere og løse problemer.
- Den tredje måten: En kultur for kontinuerlig eksperimentering og læring
Den tredje og siste måten oppmuntrer til en kultur for kontinuerlig læring, eksperimentering og risikotaking for å fremme innovasjon, tilpasningsevne og organisatorisk vekst.
Målingen «feilrate for endringer» egner seg godt her. Du følger med på prosentandelen kodeendringer som fører til feil eller problemer etter distribusjon. Skap en kultur for eksperimentering ved å etablere et trygt miljø for testing, lære av feil og kontinuerlig forbedre prosesser for å redusere feilraten for endringer.
CALMS-rammeverket
CALMS-rammeverket bygger på prinsippene kultur, automatisering, lean, måling og deling. Det er et ideelt alternativ for team som ønsker å gå over til en DevOps-tilnærming til programvareutvikling og eliminere at utviklings- og driftsteam arbeider i siloer.
Du har allerede hørt om skaperen av CALMS-rammeverket, fordi han var medforfatter av Accelerate og DevOps-håndboken, som beskriver henholdsvis Accelerate- og rammeverket for de tre måtene. Jez Humble utviklet CALMS-rammeverket som en egnethetsvurdering for å avgjøre om selskaper er organisert og klare til å implementere DevOps-prosesser.
I likhet med CMM, men spesifikt for administrasjon av DevOps, kan du bruke CALMS-rammeverket til å teste om virksomheten din er klar.
Dette er de fem pilarene du bør følge:
- Kultur: Utviklings- og driftsteamene dine har arbeidet innenfor sine egne grupper, hver med sine egne prosesser og kommunikasjonsstiler. Du må fremme en følelse av felles ansvar for å sikre en DevOps-klar kultur.
- Automatisering: DevOps handler om å effektivisere prosesser, hastighet og effektivitet. Nøkkelen? Automatisering. Teamene dine må forberede seg på å automatisere manuelle oppgaver og prosedyrer der det er mulig. Dette trinnet støtter kontinuerlig bygging, testing, distribusjon og overvåking av programvareutgivelser som utgjør DevOps-livssyklusen.
- Lean: Prinsippene i lean-metodikken, en tilnærming til virksomhets- og prosjektstyring, brukes til å minimere sløsing og optimalisere verdistrømmer. Du må sørge for realistisk arbeidskapasitet og visualisere prosjektstatus for å fremskynde prosessene.
- Måling: Selskapet ditt kan være klart til å rulle ut DevOps hvis du har kommet så langt, og teamene dine er forpliktet til å samle inn og analysere data for å forbedre prosessene.
- Deling: I tillegg til en kultur med felles ansvar må teamene dine være åpne og villige til å dele data og informasjon, slik at alle har de samme felles målene og ikke konkurrerer med hverandre. Dette siste vurderingspunktet sikrer smidige overleveringer og rask vekst.
Have an account? Log In
Utfordringer ved implementering av DevOps
En av de største utfordringene med å implementere DevOps er motstanden mot endringer i kulturen. Du har to team, hvert med sine egne prosesser, verktøy og kommunikasjonsstiler. Å omdanne dem til én samordnet enhet med felles mål, ansvarsområder og måleverdier er en betydelig transformasjon. Det er avgjørende å opprettholde høy moral og en transparent tilnærming til hvert trinn i implementeringsprosessen for å sikre en problemfri gjennomføring. Kostnadene ved nye verktøy og metoder må også tas i betraktning.
Hvis teamet ditt foretrekker å følge regelbaserte rammeverk, kan det være en stor omstilling å begynne å arbeide med prinsippbaserte rammeverk. Det går raskt fremover og utvikler seg ofte sammen med teamet, så det kan være komplisert å navigere for medarbeidere som har brukt tradisjonelle tilnærminger i mange år, eller for nye teammedlemmer som skal finne sin plass i det dynamiske miljøet.
Til slutt kan den kontinuerlige arbeidsflyten føre til ulike sårbarheter, med programvareutgivelser som distribueres uten datakryptering eller autentisering, samt bufferoverskridelser. Dette kan utsette DevOps-team for sikkerhetsrisiko og brudd, så det er viktig å stramme inn prosessene på dette området mens DevOps-teamet modnes. Dette er også grunnen til at implementeringen ikke bør begynne før CALMS-rammeverket er brukt til å vurdere om dere er klare.
Hvorfor er DevOps-måleverdier viktige?
Som nevnt ovenfor kan felles mål og måleverdier være utfordrende for team som innfører DevOps i en virksomhet. Uten DevOps-måleverdier ville det ikke vært noen testing eller måling, og heller ingen forbedringer av utviklingen. Det ville bare vært iterasjoner av den samme programvaren basert på antakelser og ideer, som ble sendt ut i det ukjente, før man prøvde noe nytt. Uten tilbakemeldinger eller måleverdier for produktsuksess for å forstå hvordan noe fungerer, finnes det ingen retning.
Økonomiavdelinger ønsker for eksempel å holde kostnadene så lave som mulig, mens utviklere ønsker å holde ytelsen så høy som mulig. Disse to målene er kanskje ikke forenlige med mindre risikoene er vurdert og teamene forstår hverandres mål.
Der utviklerne dine kanskje velger å lansere et uferdig produkt og håndtere det senere, fører kostnaden av denne påvirkningen til teknisk gjeld. Implementering av DevOps kan samordne målene og strategiene til begge teamene, og du kan hjelpe utviklerne med å forstå kostnadskonsekvensene av de tekniske beslutningene deres.
Dette er bare én liten del av DevOps og betydningen av felles måleverdier.
Forstå DevOps-måleverdier
Å implementere DevOps og forstå prinsippbaserte rammeverk er én ting, men det er med DevOps-måleverdier du virkelig begynner å se fordelene ved denne samarbeidsbaserte tilnærmingen til programvareutviklingens livssyklus. Som med de fleste forretningsstrategier finnes det uendelig mange måleverdier du kan velge å måle for å oppnå vekst, avhengig av bransjen, målgruppen og målene dine.
Google Clouds team for DevOps-forskning og -vurdering (DORA) er det lengst eksisterende forskningsteamet av sitt slag. De fant opprinnelig fire nøkkelmåleverdier for å måle ytelsen til «eliten» innen DevOps. Siden har det blitt lagt til en femte nøkkelmåleverdi, og klyngeanalysen deres identifiserer nå bare tre nivåer av DevOps-team: høyt, middels og lavt, der «eliten» er en saga blott.
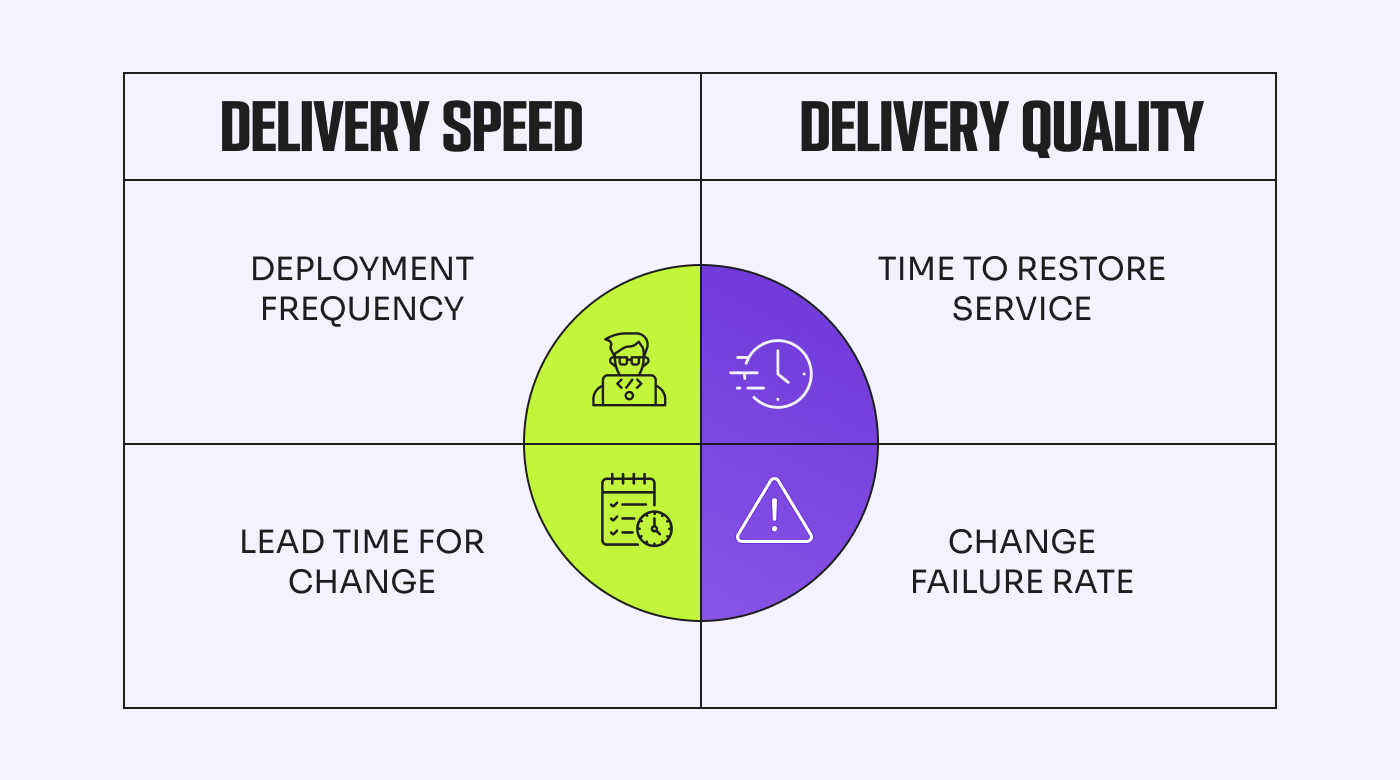
De fire viktigste DORA-måleverdiene
Her er en nærmere titt på de fire DORA-måleverdiene:
1. Distribusjonsfrekvens (DF)
DF måler hvor ofte du lykkes med å lansere til produksjon. Denne måleverdien handler om konsistens og er en utmerket indikasjon på måloppnåelse.
Teamene i «elite»-kategorien ville konsekvent distribuere til produksjon flere ganger daglig, mens team med lav ytelse ville ligge nærmere én gang hvert halvår.
Å forbedre DF er så enkelt som å lansere flere mindre oppdateringer. Den viktigste fordelen med dette er at det synliggjør eventuelle prosesshindringer, flaskehalser eller komplekse prosjekter som krever oppmerksomhet. Større team foretrekker kanskje å distribuere med jevne mellomrom ved å bygge smidige utgivelsestog; dette bidrar til å redusere overveldelsen som følger av et ekstremt høyt tempo og mange mennesker.
2. Ledetid for endringer (LTC)
LTC viser til tiden det tar før en commit kommer i produksjon. Denne måleverdien er en god indikator på teamets responsivitet og smidighet, ettersom den måler hvor raskt de kan reagere på brukernes behov og krav.
Den gamle «elite»-standarden ville sikte mot mindre enn én dag for LTC, mens team med lavere ytelse kunne bruke mer enn seks måneder. Ytelse i den nedre delen av skalaen for LTC skyldes sannsynligvis ineffektive prosesser.
Du kan forbedre denne måleverdien ved å forbedre automatiseringsprosessene, spesielt testingen. Ved å forbedre kontinuerlig integrasjon og pipelinen for kontinuerlig levering (CI/CD) kan du få oppdateringer raskere ut i produksjon. En risiko du imidlertid bør være oppmerksom på her, er bærekraft. Hvis teamet ditt ikke kan opprettholde dette forbedrede tempoet, kan du få en dårlig brukeropplevelse og potensielle sikkerhetssårbarheter.
3. Endringsfeilrate (CFR)
CFR er prosentandelen av utrullinger som forårsaker en feil i produksjon. Feilen kan være nedetid, tilbakerullinger eller redusert tjenestekvalitet. Denne måleverdien viser hvor effektivt teamet ditt er når det distribuerer endringer.
Referanseverdiene for eliteytelse er 0-15 %, mens høy, middels og lav ytelse alle ligger på 16-30 %.
Å forbedre CFR handler om kvalitet fremfor kvantitet. Selskaper lanserer varierende antall endringer og har derfor også varierende antall feil. Modifikasjoner av høyeste kvalitet vil imidlertid føre til færre feil, enten de distribuerer endringer to ganger i året eller to ganger om dagen.
4. Gjennomsnittlig gjenopprettingstid (MTTR)
MTTR er hvor lang tid teamet ditt bruker på å gjenopprette tjenesten etter en feil eller forstyrrelse. Denne måleverdien måler ikke bare teamets smidighet, men er også en god indikator på stabiliteten til programvaren din.
Hvis du sikter mot et «elite»-nivå, må du ha en MTTR på under én time. Team med lav ytelse kan bruke mer enn seks måneder.
Du kan forbedre MTTR ved å fokusere på små, raske utgivelser, slik at feil blir enklere å finne og løse. Du kan også utforske funksjonsflagg for å gi teamet ditt mer kontroll – spesielt hvis de er eksperimentelle.
Det er én måleverdi til som må omtales.
5. Pålitelighet
Bonusmåleverdi nummer fem er pålitelighet. Denne måleverdien ble oppdaget senere av DORA-teamet (2021), fordi tilgjengelighet tidligere ble målt som en referanseverdi for pålitelig programvare. Det ble imidlertid besluttet at pålitelighet i større grad omfatter tilgjengelighet, ventetid, ytelse og skalerbarhet. Det innebærer i praksis å måle driftsytelse i tillegg til utvikling.
Andre viktige DevOps-måleverdier
- Syklustid: Syklustid er den totale tiden fra en oppgave startes til den leveres ferdig. Ved første øyekast måler den arbeidshastigheten til teamet ditt. Du kan imidlertid gå dypere inn i denne måleverdien for å finne flaskehalser som lange køtider og pull-forespørsler som tar lang tid.
- Gjennomsnittlig tid mellom feil (MTBF): MTBF måler den gjennomsnittlige tiden mellom systemfeil, nedetid eller hendelser. Denne måleverdien vurderer påliteligheten og stabiliteten til programvaresystemene dine og synliggjør hvor effektive strategiene dine for forebyggende vedlikehold og feilbegrensning er.
- Gjennomsnittlig tid til oppdagelse (MTTD): Dette er den gjennomsnittlige tiden teamet ditt bruker på å bekrefte en feil. En lav MTTD indikerer effektive systemer for overvåking og varsling, noe som muliggjør rask respons på og løsning av hendelser.
- Tid til begrensning (TTM): TTM er tiden det tar å løse et problem etter at det er oppdaget. Denne måleverdien bidrar til å vurdere prosessene for respons på og løsning av hendelser, og viser hvor effektive teamene dine er når det gjelder å håndtere og gjenopprette etter problemer.
- Ledetid for endringer (CLT): CLT gir en referanseverdi for prosessen med å implementere endringer fra start til slutt, inkludert utvikling, testing, gjennomgang og utrulling. En kortere CLT betyr raskere leveransesykluser og økt smidighet.
- Feilfluktrate: Feilfluktraten viser hvor mange feil som ikke oppdages under testing og lanseres i produksjon – hvor mange som «slipper gjennom». Denne måleverdien er ideell hvis du vil følge med på forbedringer i test- og automatiseringsprosessene.
Slik setter du KPI-er med DevOps-måleverdier
Nå som du har god forståelse av måleverdiene du kan bruke til å implementere og optimalisere DevOps i virksomheten din, vil du utforske nøkkelindikatorer (KPI-er) for å sette mål og referanseverdier for teamet ditt.
Måleverdier kontra KPI-er
Du lurer kanskje på hva forskjellen mellom måleparametere og KPI-er er. En måleparameter er det du måler. Det er en kvantifiserbar måling som gir data om et bestemt aspekt ved ytelsen. Ikke alle måleparametere er nødvendigvis knyttet til spesifikke mål eller måltall.
På den annen side er KPI-er en type måleparameter som er strategisk valgt og definert for å gjenspeile de mest kritiske aspektene ved ytelse og fremdrift mot strategiske mål. KPI-er er vanligvis knyttet til målsettinger og har ofte tilhørende måltall, terskler eller referanseverdier som må nås.
Fastsette KPI-er for DevOps-teamet ditt
Det første steget for å fastsette KPI-er for DevOps-teamet ditt er å knytte DevOps-måleparametere til virksomhetens strategi og mål. Ved å prioritere de viktigste måleparameterne å følge med på kan du begynne å etablere måltall og referanseverdier for kontinuerlig forbedring. Når du velger riktige måleparametere, må du ta hensyn til selskapets størrelse, produkt og marked. Fokuser på det som vil gi den mest handlingsrettede innsikten, og unngå den vanlige fallgruven med for mange måleparametere.
Det er like viktig å overvåke KPI-ene som å fastsette dem. Utforsk verktøy for datavisualisering for å gi teamet ditt sanntidsdata i intuitive dashbord. Dette sikrer full oversikt, gir ansvarlighet og gjør det mulig for alle å samarbeide om felles mål, samkjøre utviklings- og driftsteam og støtte innføringen og modningen av DevOps.

Hvis vi tar utgangspunkt i DORAs kjernemåleparametere, kan vi se referanseverdiene for hver måleparameter basert på team med svært høy, høy, middels og lav ytelse. Denne tabellen kan hjelpe deg med å fastsette KPI-er for din egen virksomhet, avhengig av hva du anser som en prioritet.
Når du fastsetter KPI-ene, er det best å vurdere teamet og virksomheten din nøye uten å sammenligne dem med andre selskaper. Hvis vi ser på CFR som et eksempel, er referanseverdien den samme for høy, middels og lav ytelse. Dette vil i stor grad avhenge av distribusjonsfrekvensen din, men kan også påvirke den motsatt vei. Hvis teamet ditt bruker all tiden sin på å rette feil, får de mindre tid til å utvikle og lansere oppdateringer. KPI-er kan også endre seg etter hvert som DevOps-teamet ditt modnes. Tette prosesser for automatisering og testing bør automatisk bety at du kan heve kravene til måltallene dine.
More Articles
Slik bruker du DevOps-måleparametere til å skalere
Ettersom det globale DevOps-markedet forventes å nå $24.71 milliarder innen 2027 (en sammensatt årlig vekstrate på 22.9 %, basert på markedsstørrelsen på $10.84 billion i 2023), bør du se dette som et tegn hvis du ser etter det beste tidspunktet for å begynne å innføre dette i virksomheten din.
DevOps akselererer ikke bare utviklingen og reduserer tiden til markedet, men forbedrer også samarbeidet ved å fjerne siloer, øker kvaliteten gjennom kontinuerlig testing og tilbakemeldingssløyfer og utnytter ressursene effektivt, noe som sparer penger. Til slutt er det enkelt å skalere, støtter virksomhetens vekst til nye høyder, og 83 % av IT-beslutningstakere oppnådde høyere forretningsverdi ved å innføre DevOps i 2021.
Ytelsesmåling og kontinuerlig forbedring
Overvåking av ytelse er nøkkelen til å skalere en virksomhet som bruker DevOps. Det er en arbeidsform med høyt tempo og en kontinuerlig produksjonsflyt, så måling og rapportering bør være like hyppig. DevOps-måleparametere lar deg følge med på ytelsen til utviklings- og leveranseprosessene dine. Ved å kvantifisere viktige aspekter som distribusjonsfrekvens, ledetid og feilrate ved endringer kan du identifisere flaskehalser, ineffektivitet og områder som kan forbedres. Dette gjør det mulig å optimalisere arbeidsflyter og prosesser ofte.
Ved å følge med på måleparametere som feilrate ved endringer og gjennomsnittlig tid til gjenoppretting kan du identifisere trender som gjør det mulig å oppdage problemer tidlig. Denne proaktive tilnærmingen betyr at du kan iverksette korrigerende tiltak og minimere påvirkningen på kundene, noe som gir pålitelighet – en annen viktig forutsetning for å skalere med høy kvalitet.
Til slutt vil bruk av DevOps-måleparametere bidra til å modne DevOps-teamet ditt ved å fremme en kultur for kontinuerlig forbedring. Tilbakemeldingssløyfer fremmer læring og vekst; det må alltid være rom for å eksperimentere med ulike tilnærminger.
Hvilke DevOps-måleparametere støtter virksomhetens vekst?
Når du fastsetter KPI-er, bør de fleste måleparametere vurderes innenfor teamet ditt og posisjoneres med tanke på vekst, i stedet for å sammenlignes med andre virksomheter og grupper på ulike modenhetsnivåer.
Et lavt LTC kan for eksempel vise at teamet ditt er effektivt, men hvis de ikke klarer å opprettholde tempoet, er det ikke bærekraftig og kan etter hvert påvirke brukeropplevelsen. Denne målingen bør gjøres over tid i stedet for å sette en KPI som samsvarer med et høytytende eller til og med eksepsjonelt modent DevOps-team. Å sette KPI-er for å redusere LTC fra måned til måned, kvartalsvis eller årlig viser vekst i teamet og virksomheten.
CFR er en verdifull måling fordi ikke alle har samme antall feil eller problemer, men ved å angi dette som en prosentandel kan du måle hvor vellykkede utrullingene dine er. Teamet ditt kan ha svært få feil hvis de lanserer endringer sjelden, men hvis hver lansering forårsaker et problem, vil CFR være svært høy. Hvis du følger CI/CD-praksis, kan du se et høyere antall feil, men hvis CFR-en din er lav, har du en fordel fordi du har både hastighet og kvalitet som støtter vekst. MTTR bør også måles over tid for å sikre jevn vekst.
DORA fant at team på alle nivåer av utviklingsytelse oppnådde bedre resultater når de fokuserte på operasjonell ytelse. Dette kan innebære å sette KPI-er for hendelsesrapporter eller åpne saker, oppetid for applikasjoner og tilgjengelighet.
Et høyt antall åpne saker kan tyde på et problem med kundetilfredsheten, men å sikte mot en reduksjon over tid gjenspeiler vekst på dette området. Du kan gå mer i dybden og måle respons- og køtider for å fremskynde forbedringen av denne målingen.
Den ene målingen som fullt ut kombinerer både utvikling og drift i et DevOps-team, er syklustiden. Dette åpner for å bygge en kultur for tilbakemeldinger og vekst. Etter hvert som andre målinger forbedres og automatiseringen modnes, bør du forvente at syklustiden reduseres. Hvis kundeservicen din er god og antallet utviklingsfeil er lavt, har du funnet en vinnende kombinasjon for å skalere virksomheten.
Ta i bruk en målingsdrevet kultur for langsiktig suksess
Vi har sett hvordan datadrevet beslutningstaking kan gjennomføres ved å spore og måle relevante DevOps-målinger. Den riktige tilnærmingen kan være til nytte for teamets ytelse, prosesseffektivitet og kundetilfredshet.
Selv om alle DevOps-rammeverk dreier seg om kultur, samarbeid og kontinuerlig forbedring, vil det å identifisere hvilket rammeverk og hvilke målinger som gjelder for vekststrategien din, hjelpe virksomheten med å skalere mest mulig effektivt.
Husk å abonnere på nyhetsbrevet vårt for å holde deg oppdatert på det siste fra bransjeekspertene våre.


