

Gli strumenti di estrazione di dati dal web sono applicazioni che automatizzano l’estrazione di dati dai siti web, rendendo semplice raccogliere informazioni senza doverle copiare e incollare manualmente. Se stai cercando i migliori strumenti di estrazione di dati dal web, probabilmente hai bisogno di raccogliere grandi volumi di dati web in modo affidabile, senza imbatterti in ostacoli come le difese anti-bot o le modifiche alla struttura dei siti.
Con così tante opzioni disponibili sul mercato, è difficile sapere quale strumento si adatterà realmente al tuo stack tecnologico, gestirà i siti di tuo interesse e crescerà insieme alle tue esigenze. Questa guida analizza i migliori strumenti, così puoi confrontarne funzionalità e approcci e trovare esattamente quello più adatto ai tuoi progetti IT.
Perché fidarsi dei nostri consigli sui software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Il nostro team testa e recensisce software dal 2012. In quanto leader tecnologici noi stessi, sappiamo quanto sia difficile — e importante — scegliere il software giusto.
Per questa guida, abbiamo valutato gli strumenti attraverso test praticie ricerche indipendenti, assegnando un punteggio agli strumenti in base ai nostri criteri di selezione.
Le nostre recensioni riflettono il nostro giudizio editoriale umano, non un discorso di vendita.
Revisori esperti:
- Paulo Gardini MiguelDirettore tecnico
 Tim FisherVP dell'IA
 Gabriel RosasTech Lead e architetto software
 Christhian GruhnTech Lead e architetto della piattaforma

Tabella comparativa: strumenti di estrazione di dati dal web
Questa tabella comparativa riassume i dettagli dei prezzi degli strumenti di estrazione di dati dal web che ho selezionato tra i migliori.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideale per il controllo integrato del browser headless | Piano gratuito disponibile | A partire da $30/mese | Website | |
| 2 | Ideale per scraping furtivo e superare i sistemi di rilevamento | Prova gratuita di 14 giorni | Da $69/mese | Website | |
| 3 | Ideale per la gestione di siti web dinamici basati su JavaScript | Piano gratuito disponibile | Da $189/mese | Website | |
| 4 | Ideale per l'integrazione diretta nei pipeline dati | Prova gratuita di 30 giorni | A partire da $199/mese (fatturazione annuale) | Website | |
| 5 | Ideale per modelli di automazione robot predefiniti | Piano gratuito disponibile | A partire da $19/mese (fatturazione annuale) | Website | |
| 6 | Ideale per utenti che preferiscono interfacce point-and-click | Piano gratuito disponibile | Da $69/mese (fatturati annualmente) | Website | |
| 7 | Ideale per la raccolta gestita di dati con protezione contro i bot | Prova gratuita disponibile | A partire da $0.5/1,000 record | Website | |
| 8 | Ideale per infrastruttura proxy a livello enterprise | Disponibile piano gratuito | Da $1,5/1.000 record/mese | Website | |
| 9 | Ideale per il rilevamento automatico degli schemi dati | Prova gratuita di 30 giorni | Da $0.13/1.000 richieste | Website | |
| 10 | Ideale per workflow di scraping semplici e guidati da API | Piano gratuito disponibile | Da $49/mese | Website |


Recensioni dei migliori strumenti di estrazione di dati dal web
Di seguito trovi i miei riepiloghi dettagliati dei migliori strumenti di estrazione di dati dal web inclusi nella mia selezione. Le mie recensioni offrono un’analisi approfondita delle funzionalità, delle integrazioni e dei migliori casi d’uso di ogni strumento, per aiutarti a trovare quello più adatto a te.
 Ideale per il controllo integrato del browser headless
- Piano gratuito disponibile
- A partire da $30/mese
Visit WebsiteCustomer Rating:4.9/5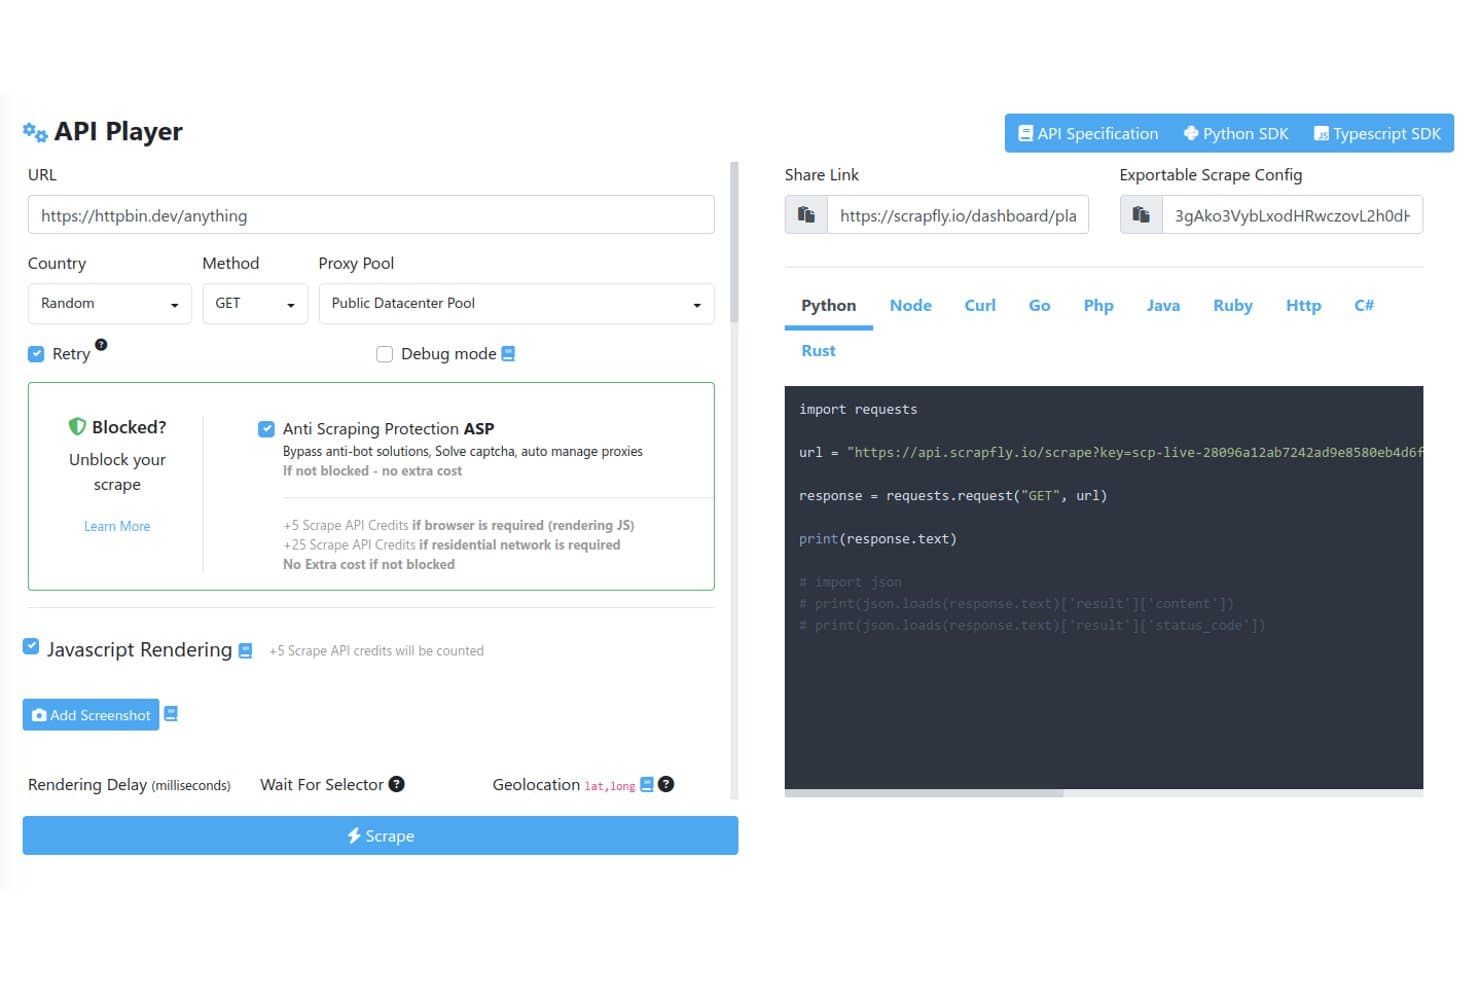
Scrapfly offre un API Player interattivo con opzioni di scraping configurabili, inclusi pool di proxy, aggiramento delle protezioni anti-scraping, rendering JavaScript e snippet di codice auto-generati in più linguaggi. Scrapfly è un'API di web scraping che combina rotazione dei proxy, aggiramento dei sistemi anti-bot, rendering con browser headless, crawling di siti, acquisizione di screenshot ed estrazione dati potenziata da LLM, tutto sotto un'unica API key.
Per chi è ideale Scrapfly?
Scrapfly è particolarmente adatto a sviluppatori e data engineer che desiderano un'API di scraping orientata al codice, con SDK in Python, TypeScript, Go e Rust.
Perché ho scelto Scrapfly
Ho scelto Scrapfly perché la sua architettura a doppio motore browser è unica rispetto a tutto ciò che ho testato. Curlium gestisce la fingerprinting Chrome JA4 byte-perfect per la velocità, mentre Scrapium esegue Chromium stealth tramite CDP con fingerprint corrispondenti, così le sessioni possono alternarsi durante il crawl senza attivare i sistemi di rilevamento. Apprezzo anche che Scrapium sia pienamente compatibile con Playwright e Puppeteer, il che significa che posso scrivere scenari JS personalizzati e regole di attesa senza modificare il mio codice esistente di automazione browser.
Caratteristiche principali di Scrapfly
- API di estrazione multi-metodo: Estrae dati strutturati tramite CSS, XPath, regex, schema JSON e template potenziati da LLM.
- Pool proxy integrati: Fornisce proxy gestiti sia da datacenter che residenziali con geo-targeting e supporto BYO proxy.
- Crawler API: Esplora interi siti con controllo su profondità di crawl, limiti di frequenza e suddivisione di progetto.
- Integrazioni di scheduling native: Supporta Zapier, Make e n8n per workflow automatizzati, lavori ricorrenti e trigger webhook.
Integrazioni Scrapfly
Scrapfly offre integrazioni native con Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI e OpenClaw. Fornisce inoltre SDK per Python, TypeScript, Go e Rust. Un'API è disponibile per integrazioni personalizzate.
Pros and Cons
Pros:
- Doppi motori browser stealth
- Bypassa Cloudflare, DataDome e Imperva
- Template di estrazione per i tipi di siti più comuni
Cons:
- Nessun scheduler lavori nativo all'interno del prodotto
- Non adatto a utenti non tecnici
Learn more about Scrapfly: Ideale per scraping furtivo e superare i sistemi di rilevamento
- Prova gratuita di 14 giorni
- Da $69/mese
Visit WebsiteCustomer Rating:4.7/5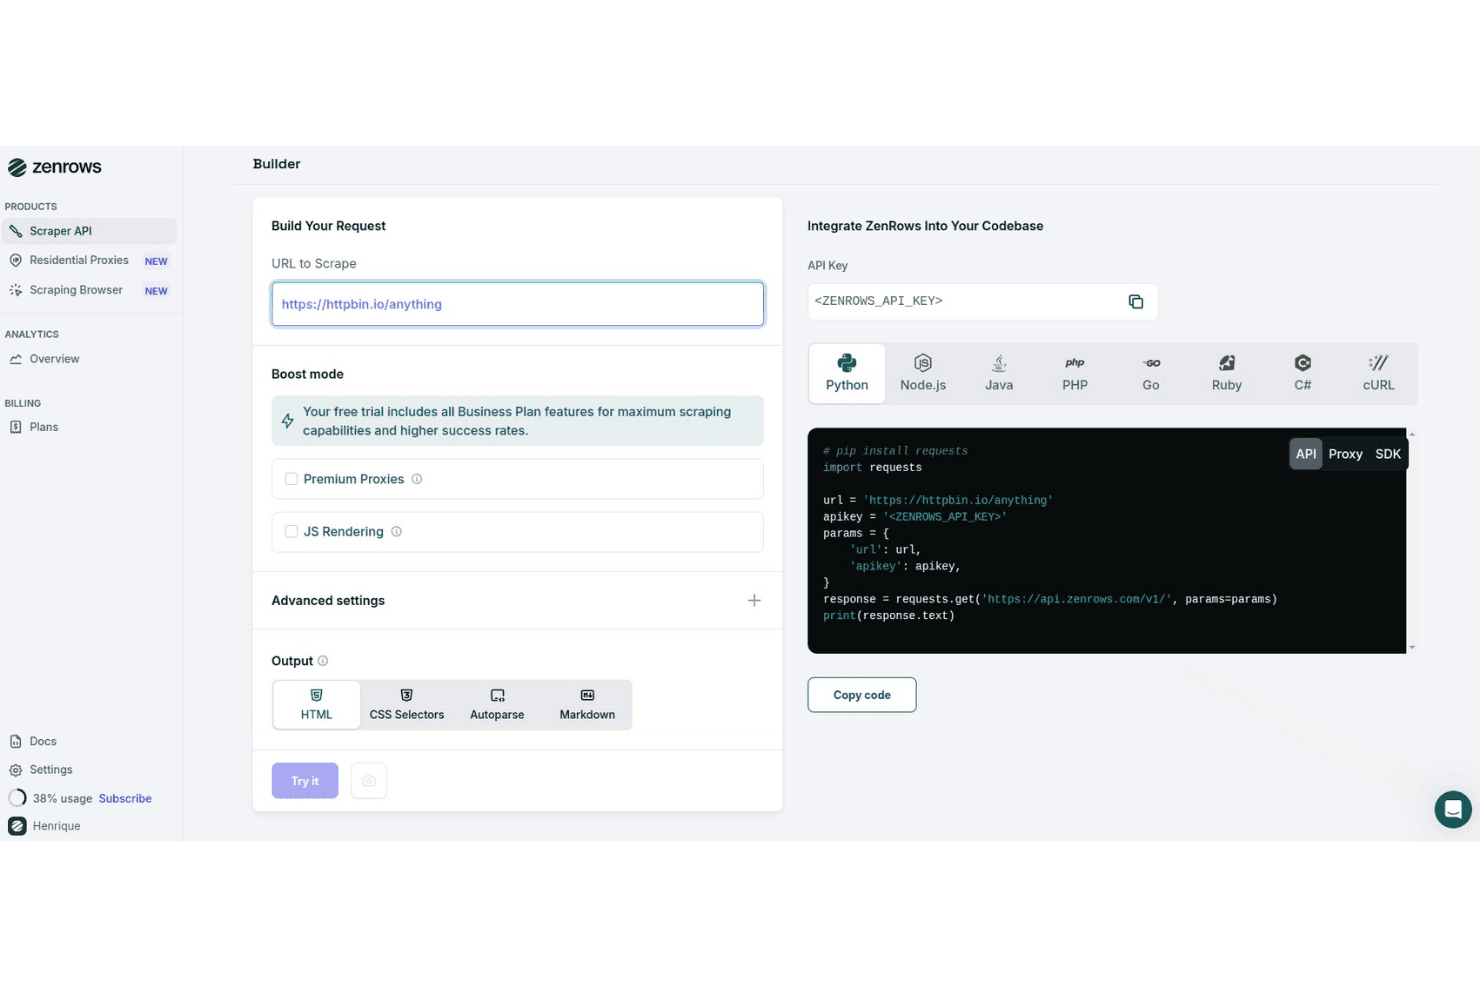
ZenRows offre un builder visivo di richieste con generazione di codice in più linguaggi, opzioni boost mode e selezione del formato di output per lo scraping web. ZenRows è un'API per lo scraping web e una piattaforma di cloud browser che unisce superamento dei sistemi anti-bot, rotazione di proxy residenziali, rendering JavaScript ed estrazione di dati strutturati in un unico toolkit pensato per gli sviluppatori.
Per chi è ZenRows?
ZenRows è ideale per sviluppatori e data engineer che devono effettuare scraping su siti dotati di protezioni anti-bot aggressive su ampia scala.
Perché ho scelto ZenRows
ZenRows si guadagna il suo posto nella mia shortlist per il modo in cui gestisce la protezione anti-bot. Ho effettuato scraping su siti protetti da Cloudflare dove gli strumenti standard falliscono costantemente, mentre ZenRows riesce a superare i blocchi utilizzando bypass tramite fingerprinting e risoluzione automatica dei CAPTCHA senza alcuna configurazione manuale. Il Browser di Scraping va oltre, eseguendo sessioni complete di Chromium con intestazioni stealth che imitano da vicino il comportamento di utenti reali per evitare la rilevazione su siti che usano DataDome o PerimeterX.
Caratteristiche principali di ZenRows
- Universal Scraper API: Invia richieste tramite un unico endpoint che si adatta alle diverse strutture dei siti e alle esigenze di scraping.
- Infrastruttura di proxy residenziali: Scegli da un pool di oltre 55 milioni di IP residenziali in più di 185 paesi per crawling geo-mirato.
- Parsing automatico per output strutturato: Estrai e ricevi dati in JSON, HTML o Markdown automaticamente con parsing integrato per i siti più popolari.
- SDK multi-lingua: Accedi agli SDK ufficiali per Python, Node.js, Go, PHP, Ruby, Java e C# per integrare ZenRows nei flussi di lavoro di sviluppo.
Integrazioni di ZenRows
ZenRows offre integrazioni native con Playwright, Puppeteer, n8n, Make, Clay e Zapier. È disponibile un'API per integrazioni personalizzate.
Pros and Cons
Pros:
- Supera Cloudflare e DataDome in modo affidabile
- Alta percentuale di successo su pagine protette
- Sessioni complete di browser headless con modalità furtiva
Cons:
- Nessuna pianificazione o orchestrazione dei job nativa
- I costi aumentano rapidamente con l'alto volume di richieste
Learn more about ZenRows: Ideale per la gestione di siti web dinamici basati su JavaScript
- Piano gratuito disponibile
- Da $189/mese
Visit WebsiteCustomer Rating:4.4/5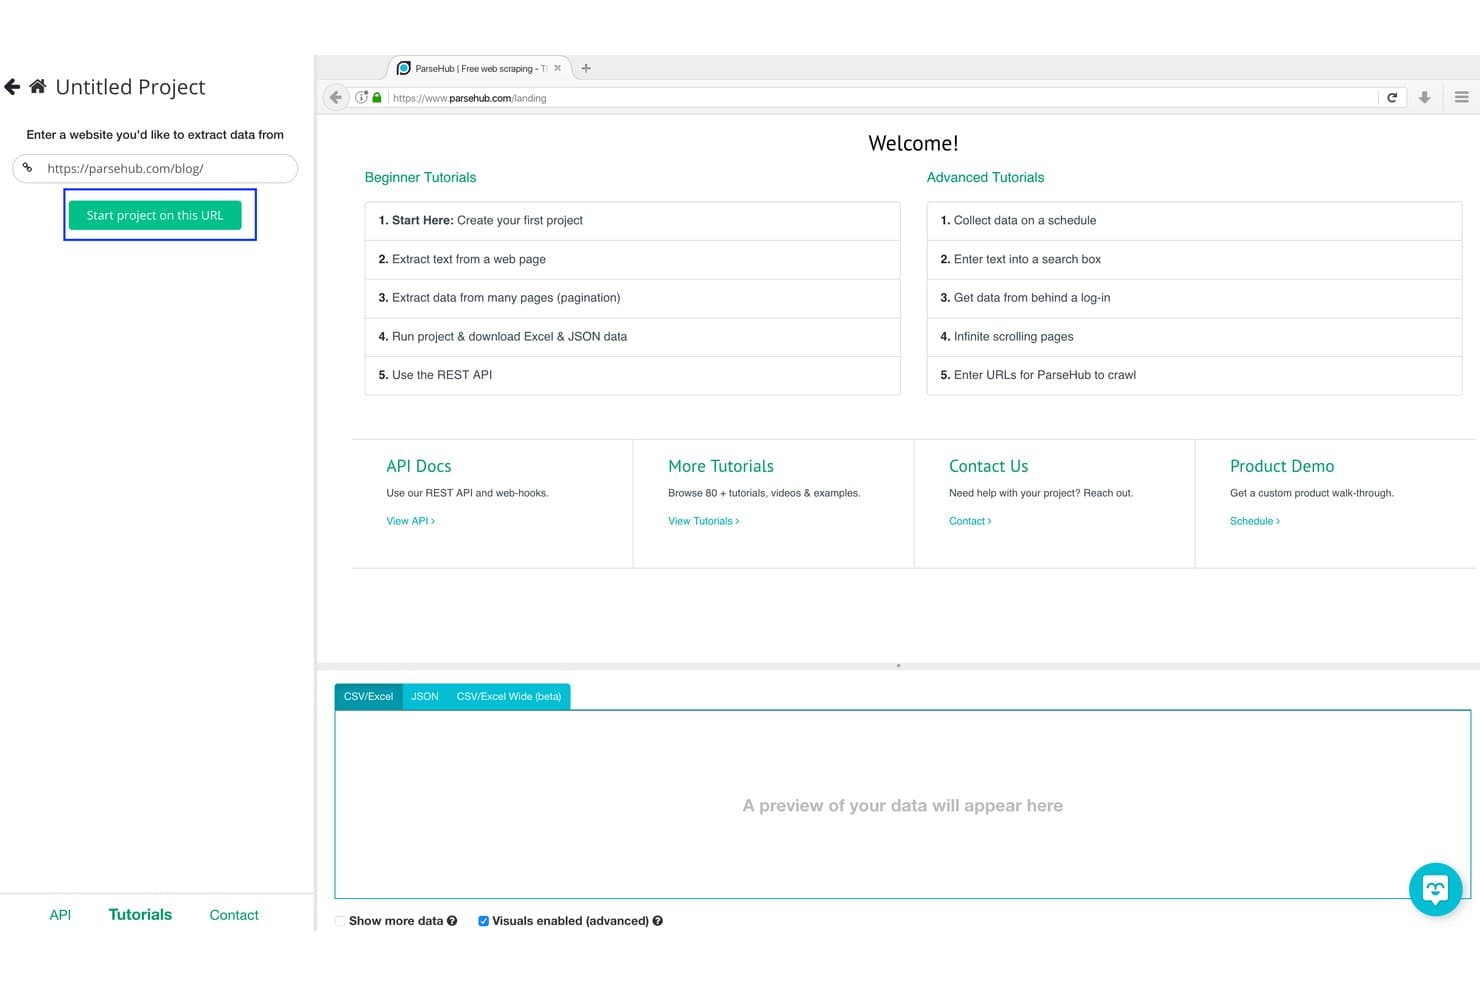
ParseHub offre un'interfaccia visuale per la configurazione dei progetti, dove gli utenti inseriscono un URL e cliccano su 'Avvia progetto su questo URL' per iniziare a estrarre dati dai siti web. ParseHub è uno strumento di web scraping visuale che estrae dati da siti web dinamici utilizzando un'interfaccia basata sui clic, con supporto per JavaScript, AJAX, scroll infinito, input nei form e esecuzioni pianificate in cloud.
Per chi è più indicato ParseHub?
ParseHub è ideale per analisti di intelligence competitiva e ricercatori non tecnici che hanno bisogno di raccogliere dati da siti ricchi di JavaScript senza scrivere codice.
Perché ho scelto ParseHub
ParseHub si è guadagnato il suo posto tra i migliori della mia lista perché gestisce le difficoltà del rendering JavaScript che bloccano la maggior parte degli scraper no-code. L'ho usato per estrarre dati da pagine con scroll infinito e contenuti attivati da menu a discesa, dove gli scraper HTML statici restituiscono risultati vuoti. Il suo motore di apprendimento automatico rileva automaticamente la struttura della pagina, il che significa che posso costruire uno scraper funzionante per un catalogo prodotti caricato tramite AJAX senza scrivere una sola riga di XPath.
Caratteristiche chiave di ParseHub
- Visual builder punta e clicca: Seleziona ed estrai elementi della pagina senza scrivere manualmente selettori.
- Pianificazione cloud: Pianifica compiti di scraping ricorrenti sull'infrastruttura cloud di ParseHub.
- Accesso REST API: Gestisci, avvia e scarica i risultati di scraping in modo programmato usando l'API.
- Rotazione automatica IP: Riduci i blocchi ruotando gli IP in uscita nelle esecuzioni in cloud.
Integrazioni di ParseHub
ParseHub offre integrazioni native con Google Sheets, Tableau, Dropbox e AWS S3. È disponibile un'API per integrazioni personalizzate e automazione dei flussi di lavoro.
Pros and Cons
Pros:
- Gestisce nativamente JavaScript, AJAX e scroll infinito
- Il builder visuale non richiede la scrittura di selettori
- Gli scraping vengono eseguiti automaticamente sull'infrastruttura cloud
Cons:
- Limite sui lavori di scraping concorrenti di grandi dimensioni
- Nessuna soluzione CAPTCHA integrata
Learn more about ParseHub: Ideale per l'integrazione diretta nei pipeline dati
- Prova gratuita di 30 giorni
- A partire da $199/mese (fatturazione annuale)
Visit WebsiteCustomer Rating:4.2/5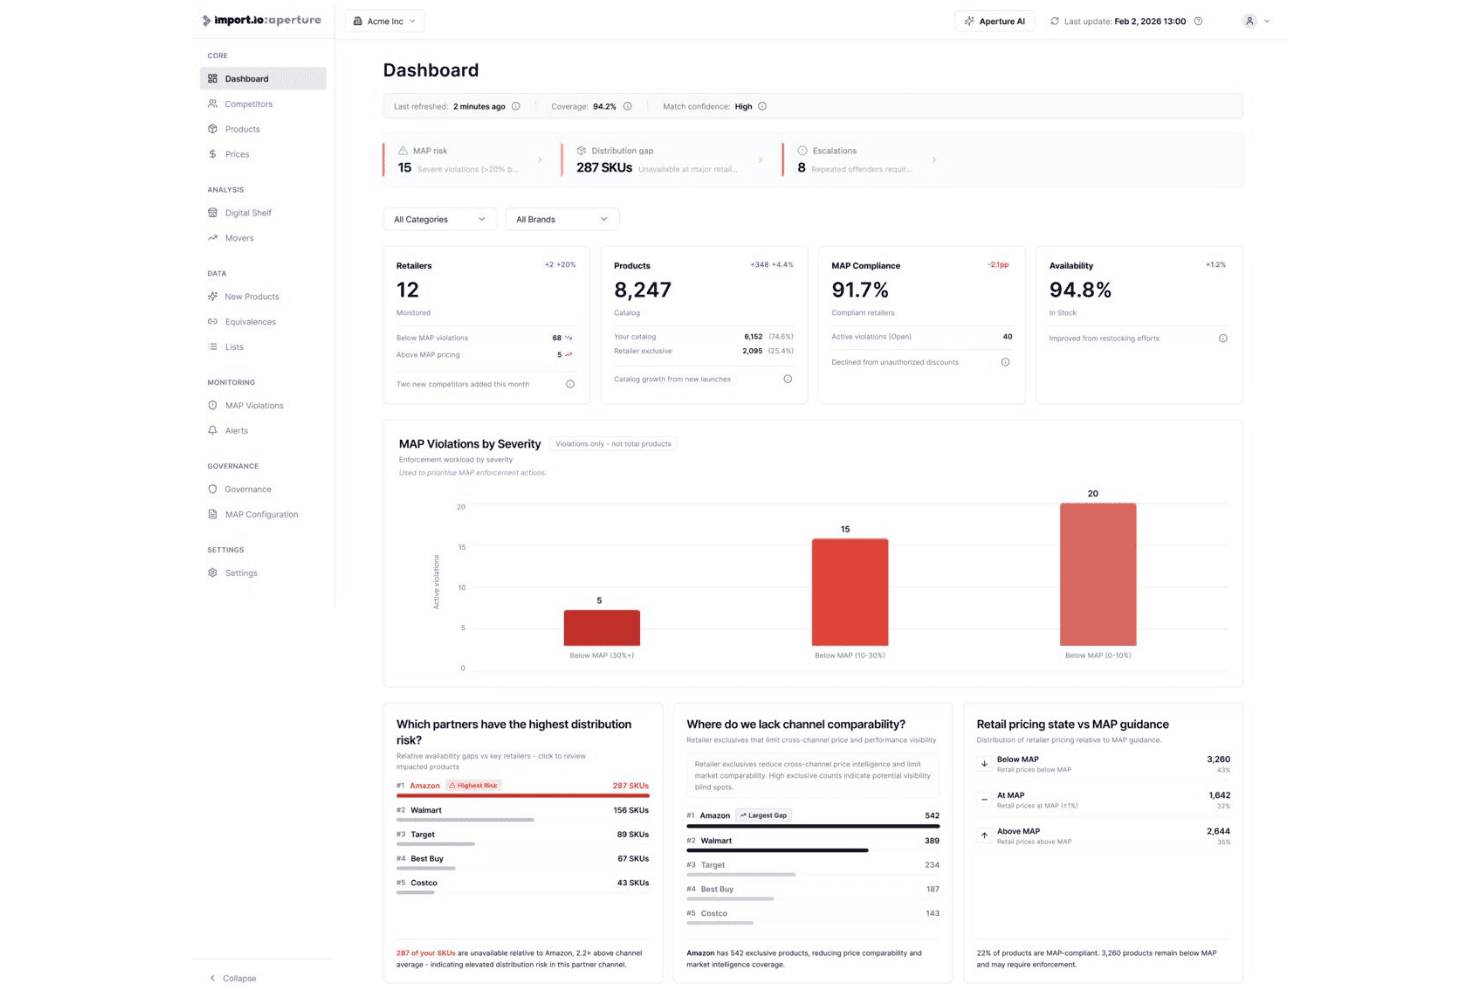
La piattaforma Aperture di Import.io offre un dashboard che mostra la conformità MAP, la disponibilità dei prodotti, le lacune nella distribuzione dei rivenditori e le violazioni dei prezzi. Import.io è una piattaforma di web scraping gestita, supportata nativamente dall'IA, che estrae dati strutturati dai siti web su scala aziendale, gestendo pagine rese tramite JavaScript, fonti protette e la consegna diretta nei pipeline dati e sistemi di analisi.
Per chi è Import.io?
Import.io è ideale per i team di ingegneria dei dati e di intelligence competitiva nelle medie e grandi aziende che necessitano di pipeline dati mantenute senza dover creare o gestire scraper internamente.
Perché ho scelto Import.io
Import.io si guadagna un posto nella mia lista perché i dati strutturati passano direttamente dal web al tuo data warehouse, dashboard o endpoint API senza un passaggio manuale di esportazione intermedio. Apprezzo il fatto che i webhook e la consegna tramite API siano funzionalità native della piattaforma e non una soluzione posticcia. Quello che trovo più prezioso sono le pipeline auto-rigeneranti: si adattano automaticamente quando i siti target vengono ristrutturati, così non devo ricostruire gli estrattori ogni volta che un rivenditore aggiorna il layout della pagina.
Funzionalità principali di Import.io
- Modelli di estrazione assistiti dall'IA: Rilevano automaticamente le strutture delle pagine e adattano gli schemi man mano che i siti web cambiano.
- Gestione proxy a livello enterprise: Supporta proxy premium e residenziali per l'estrazione da siti protetti o geo-limitati.
- Builder visuale punta-e-clicca: Permette di selezionare ed estrarre dati da pagine web complesse senza scrivere codice.
- Mascheramento automatico delle PII: Identifica e rimuove le informazioni personali identificabili all'interno dei dataset estratti per garantire la conformità.
Integrazioni Import.io
Import.io offre integrazioni native con Google Sheets, Power BI, Tableau ed Excel, e mette a disposizione un'API per integrazioni personalizzate e webhook verso altri sistemi.
Pros and Cons
Pros:
- Le pipeline auto-rigeneranti si adattano automaticamente ai cambiamenti dei siti
- Gestione di siti altamente protetti e con accesso tramite login
- L'estrazione gestita riduce il carico di lavoro tecnico interno
Cons:
- Trasparenza limitata sull'infrastruttura di scraping sottostante
- Adatto solo in parte a compiti di scraping su piccola scala
Learn more about Import.io: Ideale per modelli di automazione robot predefiniti
- Piano gratuito disponibile
- A partire da $19/mese (fatturazione annuale)
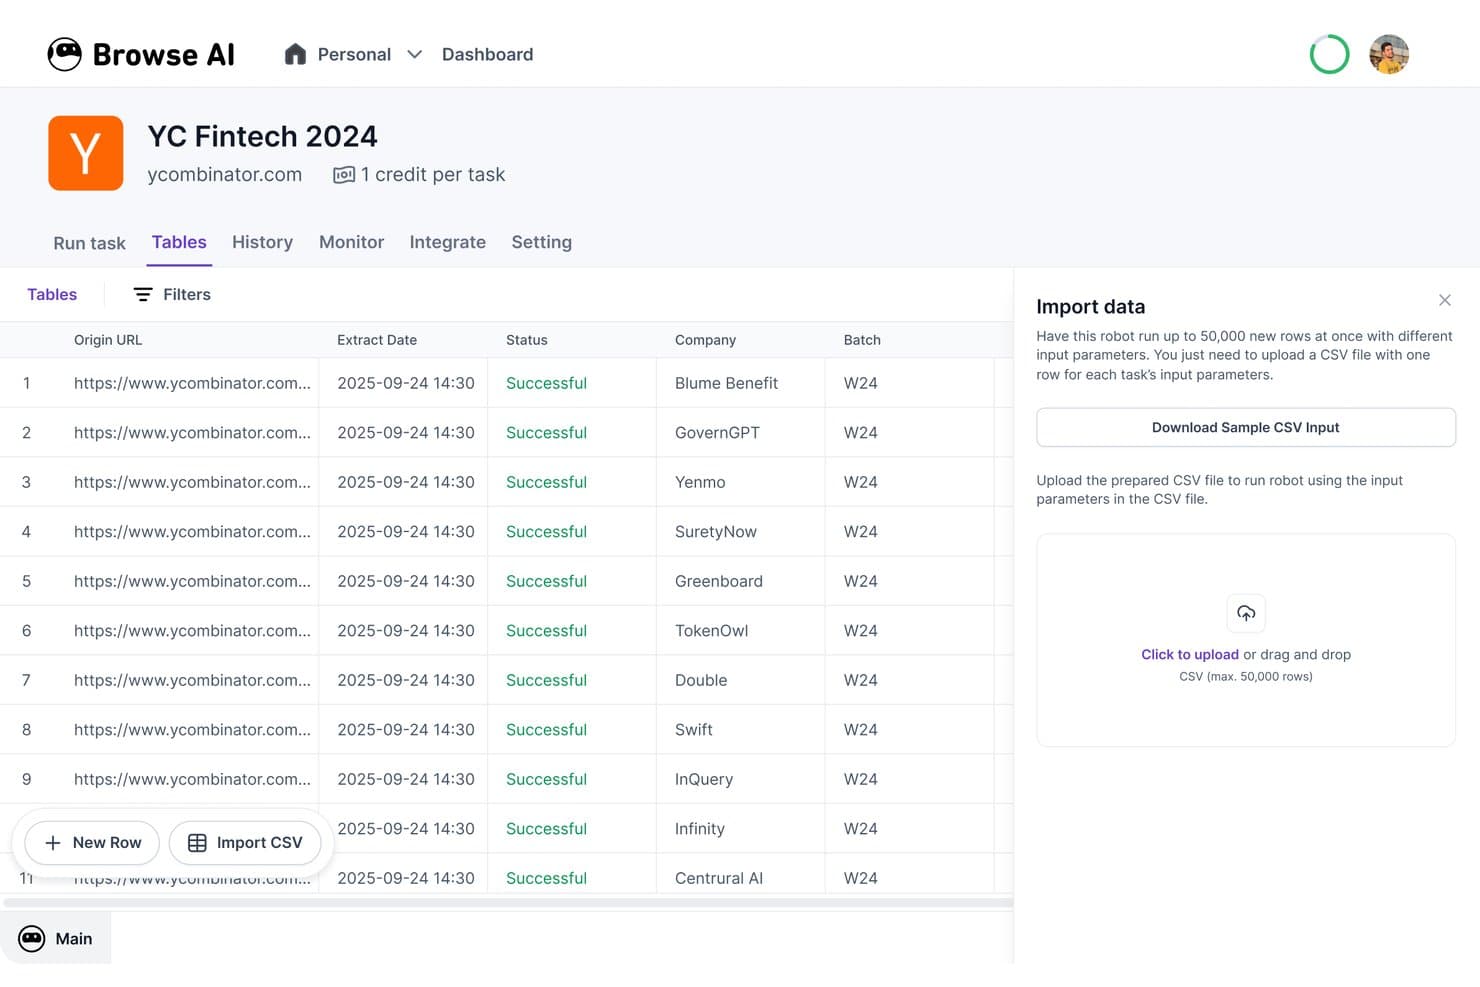
Browse AI offre una dashboard di web scraping senza codice dove gli utenti possono estrarre dati strutturati da siti come Y Combinator ed esportare i risultati come file CSV. Browse AI è una piattaforma di web scraping e monitoraggio dei siti web senza codice che combina un estrattore di dati visuale point-and-click con oltre 250 modelli di robot predefiniti per la raccolta automatica e programmata di dati dai siti web.
Per Chi È Più Adatto Browse AI?
Browse AI è particolarmente indicato per analisti di intelligence competitiva e team non tecnici che devono raccogliere dati web strutturati senza scrivere codice.
Perché Ho Scelto Browse AI
Browse AI si guadagna un posto nella mia lista dei preferiti grazie alla sua avanzata libreria di robot preimpostati. Posso estrarre elenchi strutturati da Amazon, Google Maps o Indeed senza dover creare uno scraper da zero, e ogni robot gestisce già la paginazione e i contenuti dinamici specifici di quel sito. Apprezzo anche l'adattamento del layout tramite intelligenza artificiale, che aggiorna automaticamente un robot quando la struttura della pagina di destinazione cambia, così le estrazioni non vengono interrotte inaspettatamente durante il processo.
Caratteristiche Principali di Browse AI
- Rendering JavaScript: Automatizza l'estrazione da siti web moderni ricchi di JavaScript e applicazioni a pagina singola.
- Supporto proxy residenziali: Ruota automaticamente gli IP residenziali per aggirare i sistemi anti-bot senza dover configurare manualmente i proxy.
- Webhook e accesso API: Consente l'invio programmato di task di scraping e il recupero dei dati per l'integrazione con sistemi interni.
- Rilevamento automatico dei cambiamenti: Monitora i siti web per rilevare cambiamenti visivi o di contenuto e invia avvisi quando vengono identificati.
Integrazioni di Browse AI
Browse AI offre integrazioni native con Google Sheets, Airtable, AWS S3, Zapier e Make.com. L'accesso API e ai webhook è disponibile per integrazioni personalizzate.
Pros and Cons
Pros:
- Oltre 250 robot predefiniti pronti all'uso
- Si adatta automaticamente ai cambiamenti dei layout dei siti
- Gestisce CAPTCHAs e pagine dinamiche nativamente
Cons:
- Controllo limitato a livello di selettori per sviluppatori
- Il costo in crediti cresce rapidamente con alti volumi
Learn more about Browse AI: Ideale per utenti che preferiscono interfacce point-and-click
- Piano gratuito disponibile
- Da $69/mese (fatturati annualmente)
Visit WebsiteCustomer Rating:4.7/5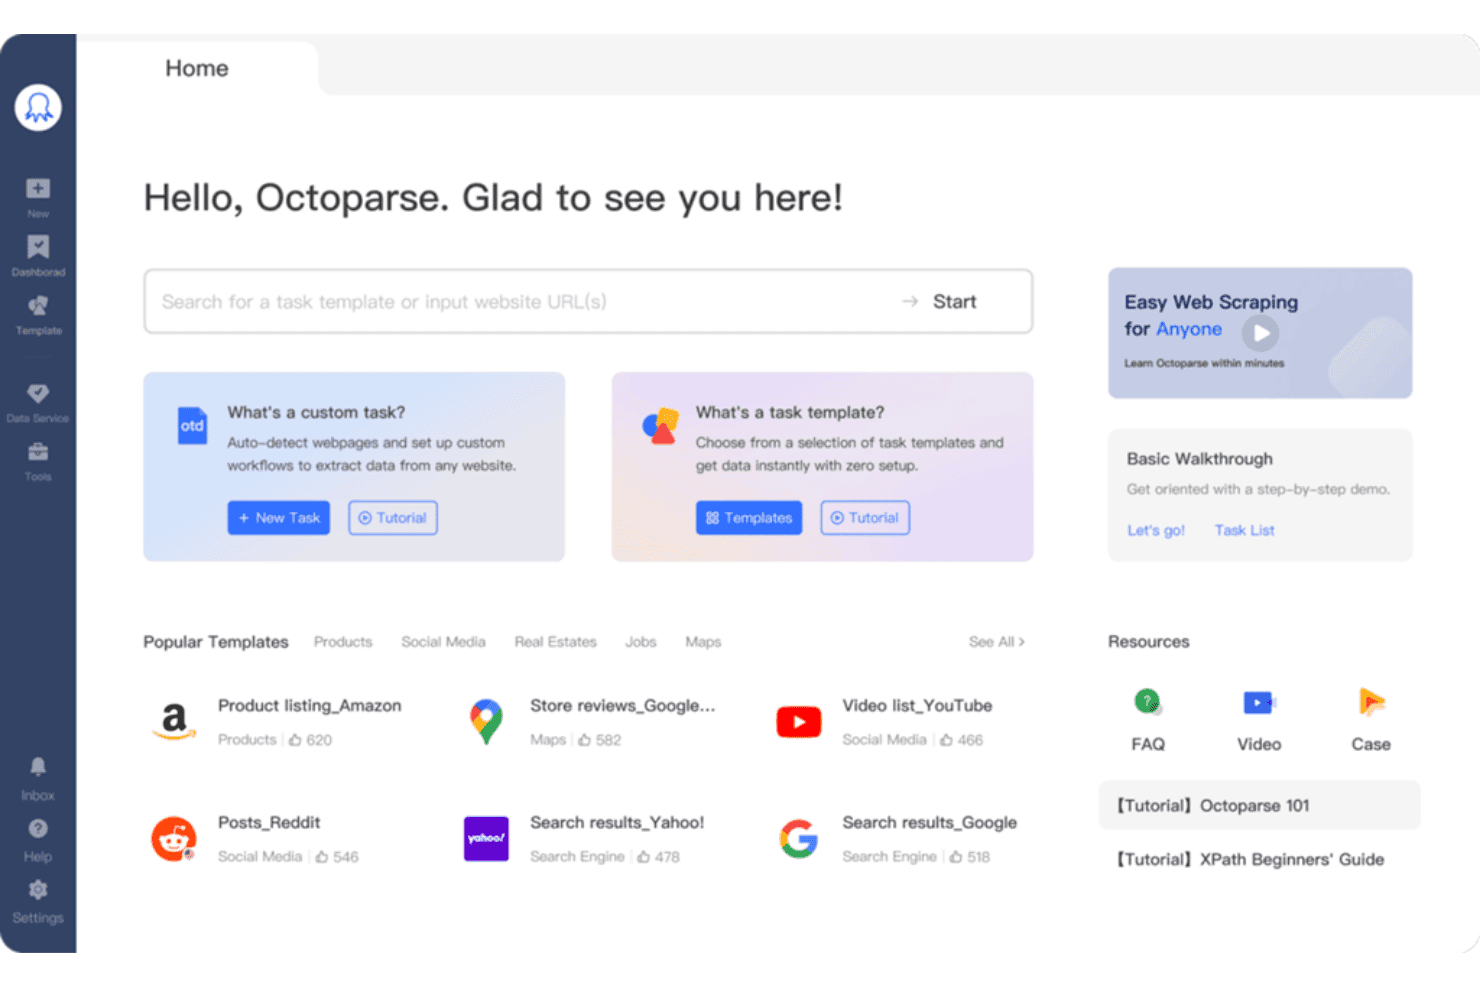
Octoparse offre una dashboard principale con template di scraping popolari, creazione di attività personalizzate e risorse per un avvio rapido nell'estrazione di dati dal web. Octoparse è uno strumento di web scraping no-code che combina un costruttore di flussi di lavoro visivo, rilevamento automatico alimentato da IA, estrazione basata su cloud e supporto per pagine renderizzate in JavaScript per raccogliere dati strutturati dai siti web.
Per chi è Octoparse?
Octoparse è ideale per gli analisti di intelligence competitiva e per gli utenti business che devono raccogliere regolarmente dati dal web ma non hanno competenze di programmazione.
Perché ho scelto Octoparse
Octoparse si guadagna un posto nella mia lista perché il costruttore di flussi di lavoro point-and-click elimina davvero la barriera tecnica al web scraping. Mi piace la funzione AI Auto-detect perché crea automaticamente un flusso di estrazione completo analizzando la pagina di destinazione, così non devo mappare manualmente i selettori da zero. I più di 500 modelli preimpostati per siti come Amazon o Google Maps mi permettono di avviare uno scraper funzionante in pochi minuti sugli obiettivi più comuni.
Funzionalità principali di Octoparse
- Esecuzioni concorrenti basate su cloud: Esegui fino a 20 attività di scraping in parallelo utilizzando il motore cloud di Octoparse per una raccolta dati più veloce.
- Rotazione IP e proxy residenziali: Ruota automaticamente gli indirizzi IP e accedi a proxy residenziali per ridurre i blocchi e aggirare le misure anti-bot.
- Esportazione su database e cloud: Esporta i dati estratti direttamente su MySQL, SQL Server, PostgreSQL, Oracle, Google Sheets, Dropbox, Amazon S3 o tramite API.
- Risoluzione automatica dei CAPTCHA: Risolvi automaticamente i CAPTCHA più comuni durante le attività di scraping per mantenere la continuità e minimizzare l'intervento manuale.
Integrazioni di Octoparse
Octoparse offre integrazioni native con Google Sheets, Google Drive, Dropbox, Amazon S3, MySQL, SQL Server, PostgreSQL e Oracle. Si collega anche con Zapier e fornisce un'API per integrazioni personalizzate.
Pros and Cons
Pros:
- Oltre 500 modelli predefiniti per i siti più comuni
- L’IA rileva automaticamente e crea bozze di estrazione
- Gestisce scroll infinito, Ajax e pagine dinamiche
Cons:
- Il client desktop funziona solo su Windows
- Limitato a 20 processi cloud concorrenti
Learn more about Octoparse: Ideale per la raccolta gestita di dati con protezione contro i bot
- Prova gratuita disponibile
- A partire da $0.5/1,000 record
Visit WebsiteCustomer Rating:4.5/5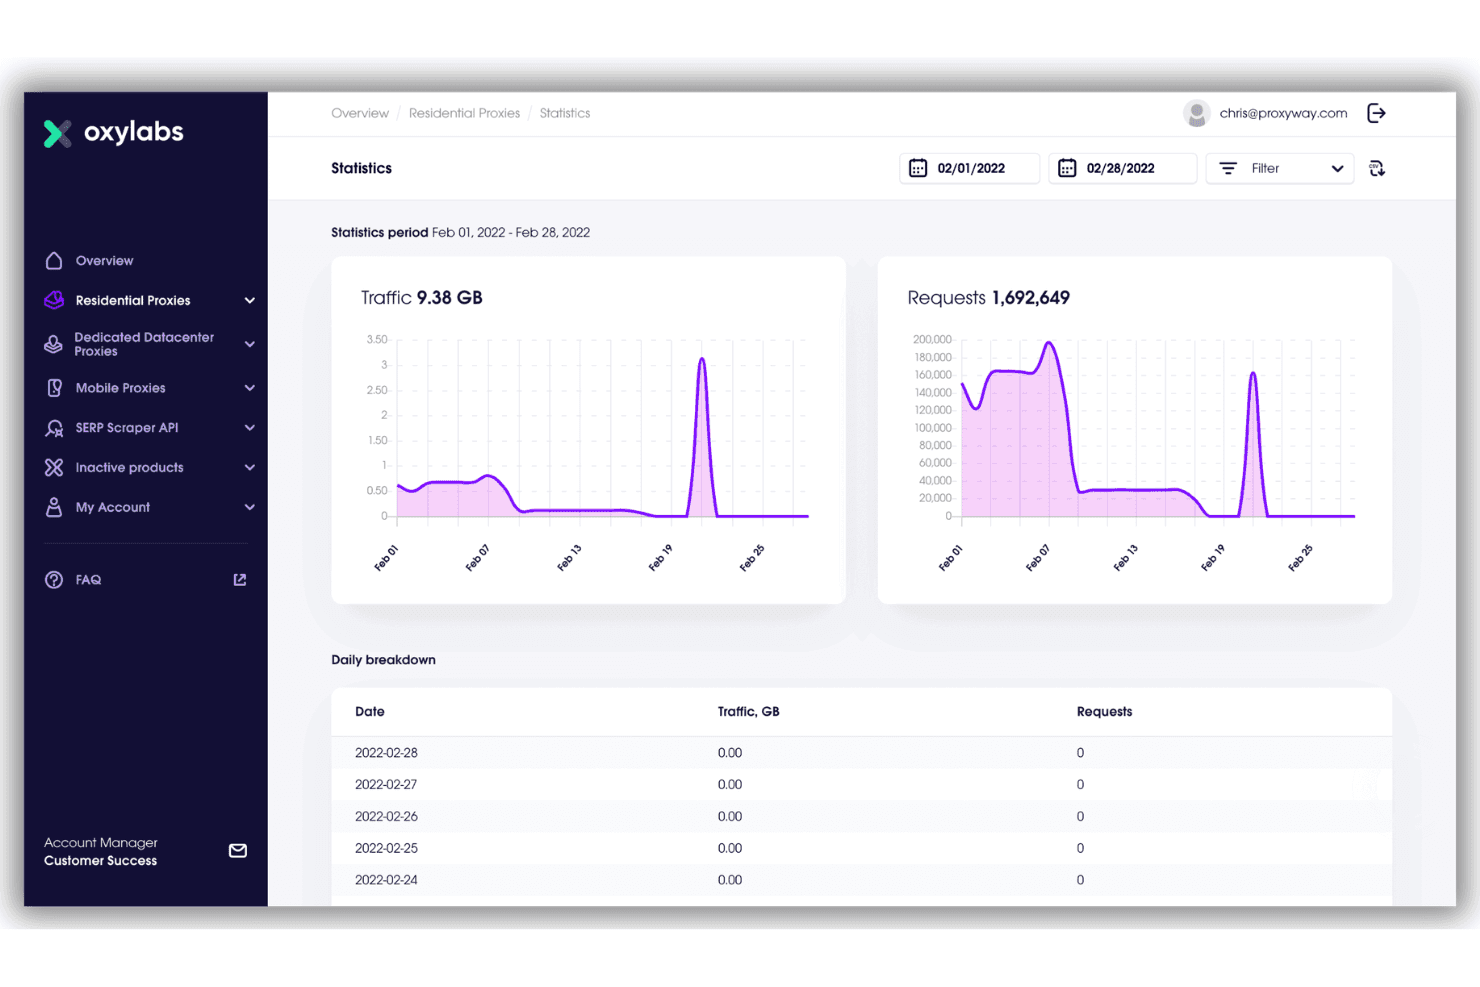
Oxylabs offre un pannello di controllo dettagliato delle statistiche per i proxy residenziali, che mostra il traffico e le metriche delle richieste nell'intervallo di date selezionato nel febbraio 2022. Oxylabs è un'API per la raccolta di dati dal web che gestisce i proxy, la risoluzione dei CAPTCHA, il rendering JavaScript e l'estrazione di dati strutturati da oltre 50 siti web preconfigurati.
Per chi è più adatto Oxylabs?
Ingegneri dei dati e sviluppatori del back-end che gestiscono flussi di raccolta dati su larga scala e critici per l'attività aziendale e necessitano di un'infrastruttura di livello aziendale e di affidabilità contro i bot.
Perché ho scelto Oxylabs
Oxylabs è entrato nella mia lista ristretta per il modo in cui gestisce la parte più difficile della raccolta di dati dal web: superare il rilevamento dei bot senza dovermi occupare personalmente di questo aspetto. L'API gestisce la risoluzione dei CAPTCHA, la rotazione dei proxy tra oltre 177 milioni di IP residenziali e i nuovi tentativi automatici, senza alcuna logica personalizzata di gestione degli errori da parte mia. Apprezzo anche il modello di prezzo basato sul successo, in cui solo le risposte 2xx e 4xx vengono conteggiate ai fini della quota, così gli errori lato sistema non consumano i risultati.
Funzionalità principali di Oxylabs
- Parser personalizzato: Definisci selettori CSS o XPath per estrarre dati strutturati con precisione dal contenuto delle pagine.
- Assistente IA OxyCopilot: Genera istruzioni per la raccolta dei dati e logica di analisi utilizzando istruzioni in linguaggio naturale.
- Connettori per siti preconfigurati: Utilizza punti di accesso dedicati per Amazon, Google, eBay, Walmart, Zillow e altri siti importanti.
- Integrazioni con l'archiviazione cloud: Esporta i risultati direttamente su AWS S3 e Google Cloud Storage per utilizzarli nei flussi di dati.
Integrazioni di Oxylabs
Oxylabs offre integrazioni native con AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com e Zapier. Sono disponibili un'API e SDK per Python e Go per le integrazioni personalizzate.
Pros and Cons
Pros:
- Oltre 177 milioni di IP residenziali in 195 Paesi
- Il prezzo basato sul successo evita di sprecare la quota di richieste
- Punti di accesso preconfigurati per oltre 50 siti importanti
Cons:
- Costo più elevato rispetto agli strumenti di raccolta dati autogestiti
- Non è disponibile alcuna interfaccia visiva per la raccolta di dati senza codice
Learn more about Oxylabs: Ideale per infrastruttura proxy a livello enterprise
- Disponibile piano gratuito
- Da $1,5/1.000 record/mese
Visit WebsiteCustomer Rating:4.7/5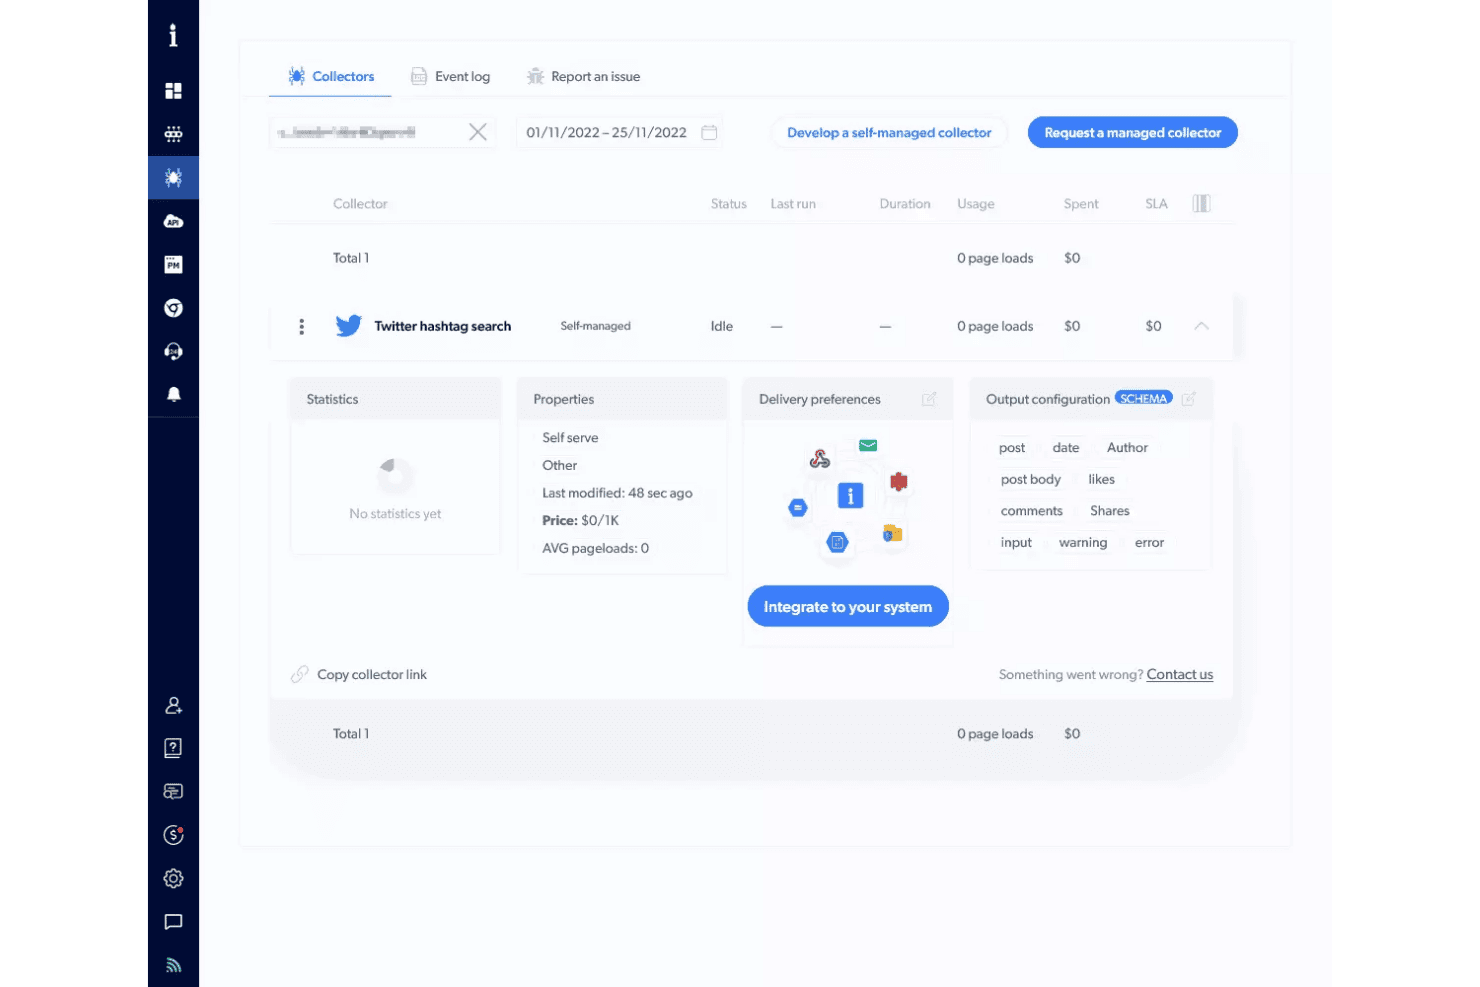
La dashboard Collectors di Bright Data propone un collector di ricerca hashtag di Twitter con stato autogestito, configurazione output e opzioni di integrazione di sistema. Bright Data è una piattaforma API di web scraping e scraping senza codice che combina gestione di proxy, rendering JavaScript, risoluzione CAPTCHA e consegna di dati strutturati attraverso più di 1.278 scraper preconfigurati per siti web popolari.
Per chi è ideale Bright Data?
Ingegneri dei dati e sviluppatori backend in aziende di medie e grandi dimensioni che devono raccogliere dati web strutturati su larga scala senza dover gestire in proprio l'infrastruttura proxy.
Perché ho scelto Bright Data
Bright Data merita un posto nella mia lista per la vasta scala della sua rete di proxy: oltre 400 milioni di IP residenziali in 195 paesi, con rotazione automatica, risoluzione CAPTCHA e Web Unlocker progettato per aggirare Cloudflare, Akamai e DataDome senza alcuna configurazione. Ho effettuato scraping voluminosi di LinkedIn Sales Navigator e Amazon utilizzando Bright Data e non ho mai incontrato blocchi su migliaia di richieste. L'AI Scraper Studio consente inoltre di generare in pochi minuti una API funzionante di scraper per qualsiasi nuovo dominio.
Funzionalità chiave di Bright Data
- Template di scraper preconfigurati: Oltre 1.200 scraper pronti all'uso disponibili per un dispiegamento rapido su grandi piattaforme come LinkedIn, Amazon e YouTube.
- Rilevamento schema basato su AI: AI Scraper Studio genera schemi di output personalizzati e automatizza il mapping dei dati da nuovi domini.
- API di gestione dei job: Offre pianificazione batch, esecuzioni ricorrenti e webhook per l'integrazione con strumenti di automazione dei processi.
- Consegna diretta dei dati: Supporta esportazione dei dati in JSON, NDJSON, CSV, XLSX o invio diretto su S3, Snowflake, GCS, PubSub o SFTP.
Integrazioni di Bright Data
Bright Data offre integrazioni native con Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake e Pub/Sub, nonché un'API per integrazioni personalizzate.
Pros and Cons
Pros:
- Oltre 400 milioni di IP residenziali in 195 paesi
- Scraper preconfigurati per oltre 1.200 siti web popolari
- Web Unlocker evita i blocchi di Cloudflare e DataDome
Cons:
- Alcuni utenti segnalano contestazioni di fatturazione su scraping falliti
- Troppo complesso per acquirenti non sviluppatori
Learn more about Bright Data: Ideale per il rilevamento automatico degli schemi dati
- Prova gratuita di 30 giorni
- Da $0.13/1.000 richieste
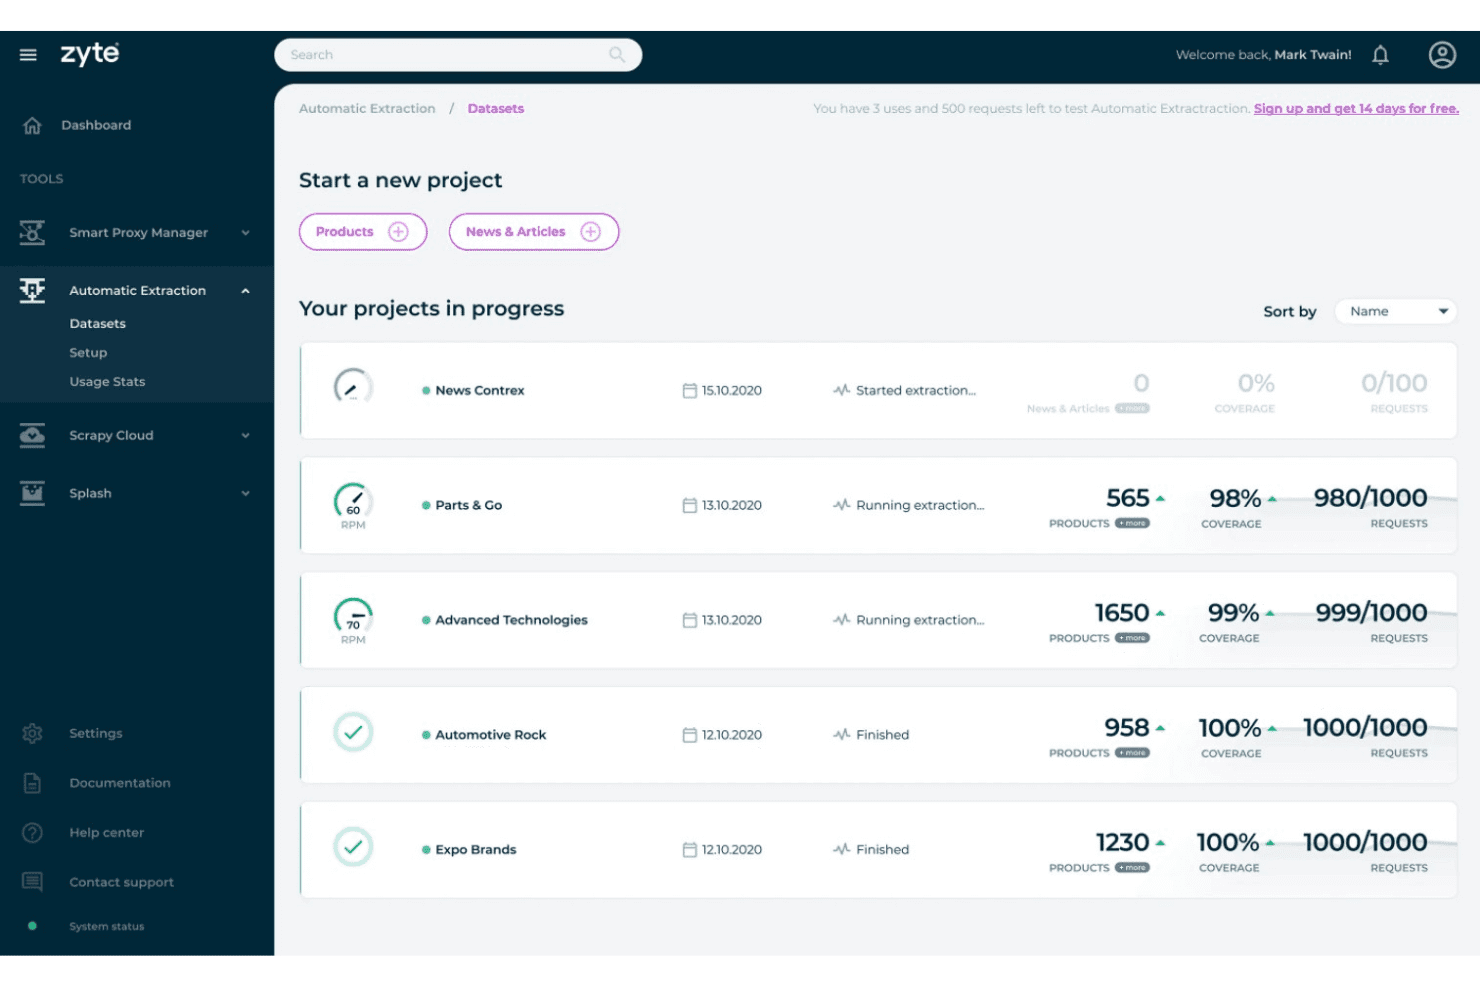
La funzione di Estrazione Automatica di Zyte offre progetti di estrazione dati in corso e completati con metriche di copertura, numero di prodotti e utilizzo delle richieste. Zyte API è un'API di web scraping che combina rendering di browser headless, rotazione automatica dei proxy, risoluzione dei CAPTCHA e estrazione dati alimentata dall'IA in un unico endpoint.
Per chi è ideale Zyte API?
Zyte API è particolarmente indicato per data engineer e sviluppatori Python che costruiscono pipeline di scraping su scala produttiva a supporto di modelli ML o sistemi di analisi dati.
Perché ho scelto Zyte API
Zyte API si guadagna il suo posto nella mia shortlist grazie al modo in cui gestisce il rilevamento automatico degli schemi. Basta indicare una pagina prodotto o un articolo, e il suo livello di estrazione alimentato da LLM restituisce JSON tipizzati e strutturati senza che io debba usare selettori CSS o espressioni XPath. Quando un sito aggiorna il suo layout, l'IA si adatta, il che significa che non devo costantemente modificare i parser ogni volta che un concorrente ridefinisce la propria pagina catalogo.
Funzionalità chiave di Zyte API
- Rendering istantaneo tramite browser: Zyte API attiva browser headless già pre-riscaldati per caricare siti dinamici su richiesta.
- Infrastruttura proxy completa: Ruota automaticamente indirizzi IP residenziali, datacenter e mobile ad ogni richiesta.
- Gestione delle sessioni: Mantiene cookie persistenti e sessioni utente per flussi di lavoro che richiedono autenticazione o azioni multi-step.
- Integrazioni cloud: Invia i dati estratti direttamente a destinazioni come AWS S3, Google Cloud o Azure per ulteriori elaborazioni.
Integrazioni Zyte API
Zyte API offre integrazioni native con Scrapy, Scrapy Cloud e SDK Python, e fornisce un'API per integrazioni personalizzate. Supporta inoltre la consegna cloud verso AWS S3, Google Cloud e Azure.
Pros and Cons
Pros:
- L'IA rileva automaticamente gli schemi senza selettori manuali
- Supera le protezioni anti-bot senza configurazioni aggiuntive
- I browser pre-riscaldati eliminano i ritardi di avvio a freddo
Cons:
- La pianificazione ricorrente dei job richiede strumenti esterni
- Richiede conoscenze di programmazione per l'implementazione
Learn more about Zyte API: Ideale per workflow di scraping semplici e guidati da API
- Piano gratuito disponibile
- Da $49/mese
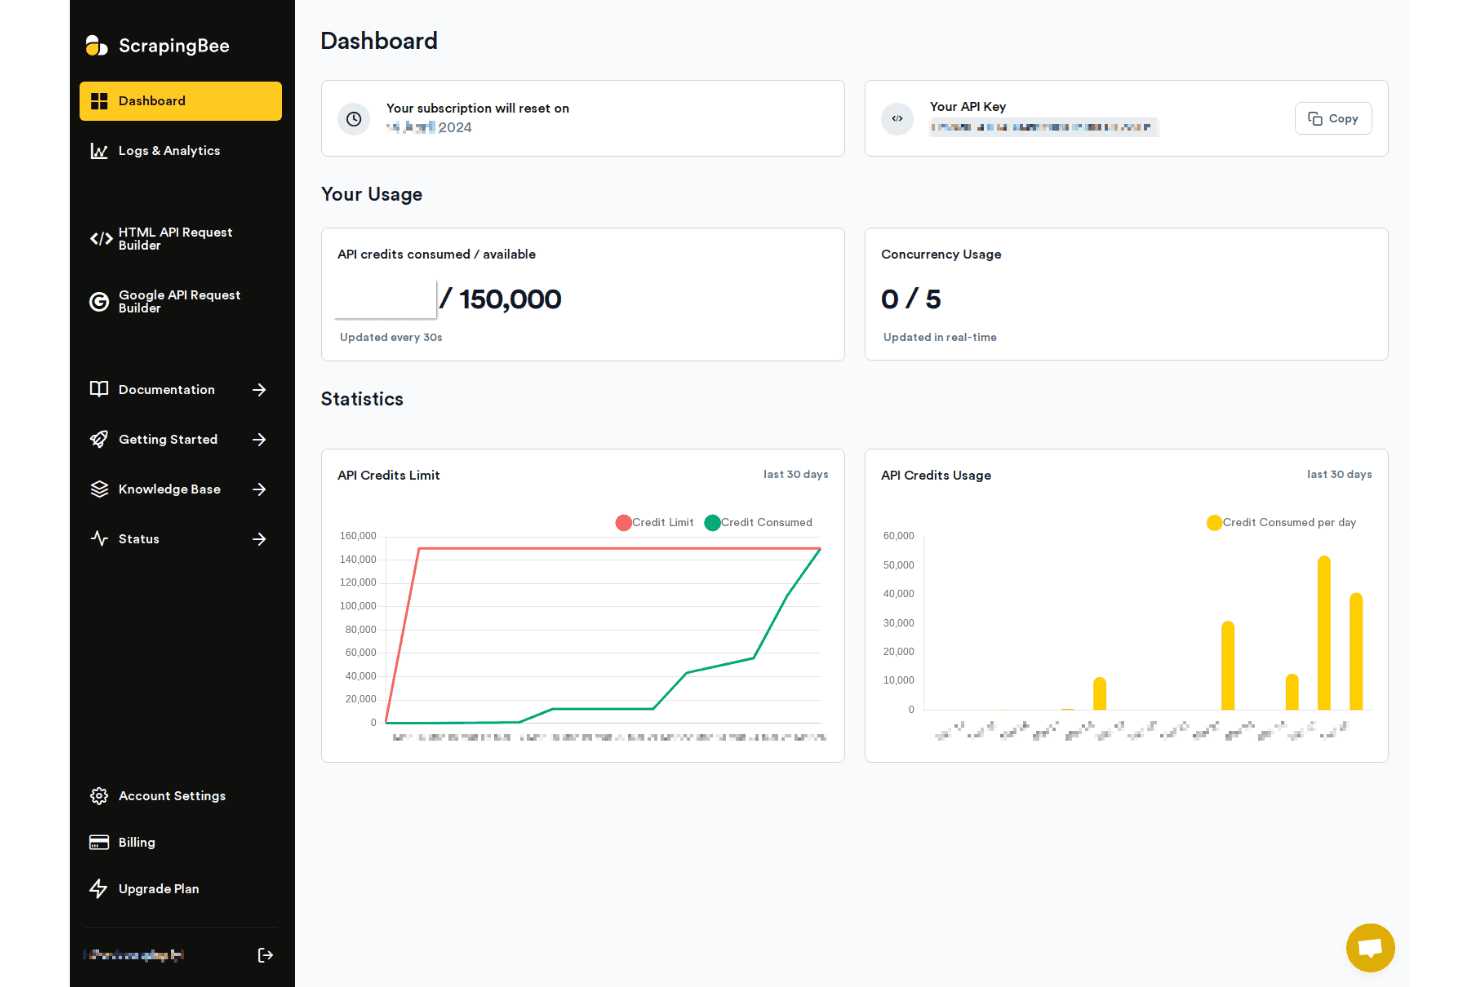
ScrapingBee offre una dashboard con utilizzo dei crediti API, statistiche di concorrenza e grafici dei consumi degli ultimi 30 giorni per monitorare l'attività di scraping. ScrapingBee è un'API di web scraping che gestisce il rendering di Chrome headless, la rotazione dei proxy e l'aggiramento dei sistemi anti-bot, con API di estrazione dedicate per piattaforme come Google, Amazon e Walmart.
Per chi è più indicato ScrapingBee?
ScrapingBee è particolarmente adatto a sviluppatori e data engineer che necessitano di un'API affidabile, orientata al codice, per estrarre dati dal web senza dover costruire da zero infrastrutture di proxy o browser.
Perché ho scelto ScrapingBee
ScrapingBee si è meritato un posto nella mia shortlist per come la sua API astragga perfettamente la complessità del web scraping moderno. Una singola richiesta gestisce il rendering di Chrome headless, la rotazione stealth dei proxy e l'esecuzione di JavaScript, così non devo scrivere codice per la gestione del browser o configurare pool di proxy separatamente. Apprezzo anche la funzione AI Query, che mi permette di descrivere cosa estrarre in linguaggio naturale anziché scrivere selettori CSS o XPath per ogni nuovo sito che voglio analizzare.
Funzionalità principali di ScrapingBee
- API di scraping dedicate: Scegli endpoint preconfigurati per piattaforme come Amazon, Walmart e Google Search per semplificare le operazioni di raccolta dati più comuni.
- Estrazione con AI Query: Descrivi in linguaggio naturale quali dati vuoi estrarre e genera automaticamente risultati strutturati.
- Scraper Markdown: Converte qualsiasi pagina web in Markdown o testo semplice per un rapido inserimento in modelli AI a valle o database.
- Integrazioni no-code: Collegati con Make, n8n e Zapier per automatizzare i flussi di lavoro senza scrivere script personalizzati di schedulazione.
Integrazioni ScrapingBee
ScrapingBee offre integrazioni native con Make, n8n e Zapier, e fornisce un'API per integrazioni personalizzate.
Pros and Cons
Pros:
- Addebito solo per richieste andate a buon fine
- Gestisce Chrome headless senza configurazioni aggiuntive
- API dedicate per Amazon e Google
Cons:
- Nessun scheduler di job integrato nativo
- I costi dei crediti crescono velocemente su larga scala
Learn more about ScrapingBee:
Altri strumenti di estrazione di dati dal web
Ecco alcune opzioni aggiuntive di strumenti di estrazione di dati dal web che non sono state incluse nella mia selezione, ma che vale comunque la pena prendere in considerazione:
- 11ScraperAPIIdeale per la rotazione IP senza problemi su larga scala
- 12CrawlbaseIdeale per l'accesso API a fonti di dati globali
- 13ScrapyIdeale per framework di scraping Python personalizzabili
- 14ScrapingdogIdeale per la distribuzione rapida con configurazione minima
Come Valuto gli Strumenti di Web Scraping
Divido la mia valutazione in due livelli: la base che uno strumento deve avere per gestire scraping nel mondo reale—rendering JS, rotazione dei proxy, job programmati—e i fattori che differenziano le migliori opzioni.
Funzionalità di Base (Requisiti Minimi per Questa Lista)
Quando seleziono gli strumenti per la mia lista, valuto ciascuno su una scala da 0 (la funzionalità non è presente) a 5 (eccelle in quest'area) per ogni funzione di base elencata qui sotto. Poi calcolo il punteggio totale dello strumento in percentuale. Ogni strumento deve raggiungere un punteggio totale minimo del 65% per essere considerato per l'inclusione.
- Motore di Estrazione Dati: Valuto se uno strumento supporta vari metodi di selezione come CSS, XPath e regex, o se offre un costruttore visivo per i team che preferiscono una configurazione point-and-click.
- Rendering JavaScript: I siti costruiti con React, Vue o Angular necessitano del supporto di browser headless. Verifico la capacità di rendering affidabile e le condizioni di attesa configurabili.
- Gestione Proxy & Anti-Bot: Cerco rotazione proxy integrata, risoluzione CAPTCHA e meccanismi di bypass in grado di gestire protezioni come Cloudflare o DataDome senza configurazioni aggiuntive.
- Pianificazione & Automazione: Gli scraping ricorrenti devono essere eseguiti automaticamente. Valuto se lo strumento supporta pianificazioni in stile cron, attivatori via webhook e logica di ripetizione in caso di fallimento.
- Esportazione di Dati Strutturati: Controllo quali formati di output sono disponibili e se lo strumento può inviare i dati direttamente a destinazioni come S3, Google Sheets, database o API.
- Scalabilità & Concorrenza: I grandi lavori su migliaia di pagine richiedono richieste parallele. Guardo i limiti di concorrenza e se lo strumento supporta il crawling distribuito.
Una volta ottenuta una lista degli strumenti che soddisfano i criteri, considero ciò che distingue ciascuna piattaforma.
Fattori di Differenziazione (Cosa Distingue i Fornitori)
Ecco come confronto i diversi fornitori:
Caratteristiche Distintive
Il bypass anti-bot è dove riscontro la maggiore differenza tra gli strumenti. Cerco la presenza di risoluzione CAPTCHA integrata e fingerprinting del browser in grado di gestire protezioni come Cloudflare o DataDome senza richiedere proxy di terze parti. Anche i template di auto-detection sono molto importanti: strumenti come Bright Data e Zyte offrono scraper preconfigurati per target comuni come Amazon o Google SERP, risparmiando ore di configurazione manuale dei selettori. Valuto anche le capacità di pianificazione e monitoraggio, in particolare gli avvisi di fallimento e i tentativi automatici che garantiscono la continuità delle pipeline di dati quando i siti target cambiano layout durante la notte.
Oltre le Funzionalità
I modelli di pricing variano molto in questo settore—alcuni fornitori fatturano per richiesta API, altri per banda o per pagine restituite con successo. Valuto se i costi rimangono prevedibili quando si scala a milioni di pagine al mese. L'infrastruttura proxy è un altro fattore chiave. Verifico se uno strumento include pool di proxy residenziali e datacenter con geo-targeting a livello di città integrato, poiché stipulare contratti proxy separati aumenta il costo e la complessità. Anche la conformità è importante, soprattutto per i team che operano in settori regolamentati dove la gestione GDPR e robots.txt deve essere chiaramente documentata.
Come scegliere gli strumenti di estrazione di dati dal web
È facile perdersi tra lunghi elenchi di funzionalità e strutture tariffarie complesse. Per aiutarti a rimanere concentrato mentre affronti il tuo specifico processo di selezione del software, ecco una lista di fattori da tenere presenti:
| Fattore | Cosa considerare |
|---|---|
| FattoreScalabilità | Cosa considerareLo strumento è in grado di gestire gli aumenti di volume previsti e le scansioni parallele senza significativi aumenti dei costi o limiti di frequenza? |
| FattoreIntegrazioni | Cosa considerareLo strumento trasferirà i dati direttamente ai sistemi di destinazione (archiviazione su cloud, database, flussi di lavoro) o saranno necessari passaggi manuali? |
| FattorePersonalizzazione | Cosa considerarePuoi adattare la logica di estrazione a strutture di siti uniche o sei limitato a modelli e regole preimpostati? |
| FattoreSemplicità d’uso | Cosa considerareSia gli utenti tecnici sia quelli non tecnici possono gestire le scansioni o sarà necessario il coinvolgimento continuo degli sviluppatori per apportare modifiche? |
| FattoreImplementazione e avvio | Cosa considerareCon quale rapidità il tuo team può configurare una prima pipeline di dati e quale assistenza o documentazione è disponibile in caso di difficoltà? |
| FattoreCosto | Cosa considerareIl prezzo rimane prevedibile con l’aumentare dell’utilizzo? Valuta realisticamente i picchi, la logica dei nuovi tentativi e i falsi positivi del tuo carico di lavoro. |
| FattoreMisure di sicurezza | Cosa considerareLo strumento espone la tua azienda o il tuo flusso di lavoro a rischi di conformità, fughe di dati o punti di accesso non autorizzati? |
| FattoreRequisiti di conformità | Cosa considerareL’approccio del fornitore è in linea con le tue regole interne e regionali (ad esempio GDPR, rispetto del file robots.txt, gestione dei dati personali)? |
Cosa sono gli strumenti di estrazione di dati dal web?
Gli strumenti di estrazione di dati dal web sono piattaforme software che automatizzano il recupero e l’estrazione di dati strutturati dai siti web. Questi strumenti consentono di acquisire informazioni dalle pagine, inclusi i contenuti dinamici e generati da JavaScript, per utilizzarle nelle analisi, nei rapporti o nell’integrazione con i database interni. La maggior parte offre opzioni per configurare le regole di estrazione ed esportare i dati in formati adatti agli sviluppatori.
Funzionalità degli strumenti di estrazione di dati dal web
Quando selezioni strumenti di web scraping, presta attenzione alle seguenti funzionalità chiave:
- Motore di estrazione dei dati: Consente di definire come vengono raccolti i contenuti dai siti web utilizzando selettori CSS, XPath o interfacce punta e clicca per ottenere risultati strutturati.
- Rendering JavaScript: Carica applicazioni dinamiche o a pagina singola eseguendo JavaScript, assicurando che vengano acquisiti i dati che non compaiono nell'HTML statico.
- Gestione dei proxy: Ruota gli indirizzi IP, spesso utilizzando servizi proxy residenziali, per aggirare blocchi geografici, limiti di frequenza o protezioni anti-bot, così da poter eseguire scraping dei siti in modo affidabile su larga scala.
- Gestione dei CAPTCHA: Rileva e risolve o aggira automaticamente le sfide CAPTCHA per mantenere attive le pipeline di dati quando vengono attivate misure anti-bot.
- Pianificazione e automazione: Imposta scraping ricorrenti o attiva processi a intervalli specifici, consentendo il funzionamento senza supervisione e l'integrazione nelle pipeline di dati.
- Esportazione di dati strutturati: Supporta l'output in JSON, CSV, XML o la consegna diretta a servizi di archiviazione cloud, API o database, eliminando i passaggi manuali di conversione e caricamento.
- Rilevamento delle modifiche e avvisi: Monitora i siti target alla ricerca di aggiornamenti dei contenuti, variazioni dei prezzi o nuovi annunci e ti avvisa se i risultati differiscono da quelli delle esecuzioni precedenti.
- Controlli della concorrenza: Gestisce più richieste in parallelo per sessioni di scraping più rapide e supporta processi di scansione su larga scala attraverso migliaia di pagine.
- Gestione degli errori e registrazione: Tiene traccia delle estrazioni non riuscite, delle interruzioni della connessione o delle modifiche ai siti, fornendo registri dettagliati degli errori per diagnosticare e risolvere rapidamente i problemi di scraping.
- Controlli degli accessi degli utenti: Limita chi può modificare i progetti, gestire i processi o visualizzare le esportazioni, al fine di mantenere la sicurezza e prevenire modifiche accidentali o non autorizzate.
Funzionalità comuni dell'intelligenza artificiale negli strumenti di web scraping
Oltre alle funzionalità standard degli strumenti di web scraping elencate sopra, molte di queste soluzioni stanno integrando l'intelligenza artificiale con funzionalità come:
- Rilevamento automatico dei campi dati: Utilizza l'intelligenza artificiale per identificare e mappare automaticamente i campi dati rilevanti su pagine web complesse o sconosciute, riducendo la configurazione manuale dei selettori.
- Riconoscimento adattivo della struttura dei siti: Apprende e si adatta alle modifiche nei layout dei siti web, riducendo al minimo i tempi di inattività e la manutenzione quando i siti target aggiornano il proprio design.
- Elusione intelligente dei sistemi anti-bot: Applica l'intelligenza artificiale per imitare i modelli di navigazione umana e adattare le strategie di scraping in tempo reale, contribuendo ad aggirare i sistemi avanzati di rilevamento dei bot.
- Analisi dei contenuti in linguaggio naturale: Sfrutta l'intelligenza artificiale per estrarre, riassumere o categorizzare testo non strutturato, semplificando l'analisi di recensioni, articoli o post nei forum.
- Generazione automatica di modelli: Crea modelli di scraping riutilizzabili per siti simili analizzando la struttura delle pagine e i modelli dei contenuti con l'apprendimento automatico.
- Correzione intelligente degli errori: Rileva e risolve gli errori o le anomalie comuni di estrazione utilizzando diagnosi basate sull'intelligenza artificiale, riducendo la necessità di risoluzione manuale dei problemi.
Vantaggi degli strumenti di web scraping
L'implementazione di strumenti di web scraping offre numerosi vantaggi al tuo team e alla tua azienda. Eccone alcuni:
- Raccolta di dati su larga scala: Automatizza l'estrazione di informazioni da numerosi siti e pagine, rendendo disponibili grandi set di dati per l'analisi o l'apprendimento automatico.
- Informazioni di mercato in tempo reale: Monitora istantaneamente i prezzi dei concorrenti, i cataloghi dei prodotti e le modifiche ai siti web grazie alle funzionalità di pianificazione, rilevamento delle modifiche e avvisi.
- Efficienza delle risorse: Pianifica e automatizza i processi, riducendo il lavoro manuale e consentendo agli sviluppatori di concentrarsi su progetti di maggior valore.
- Qualità dei dati costante: Esporta dati strutturati in formati affidabili come JSON o CSV, riducendo al minimo il noioso lavoro di pulizia e integrazione dei dati.
- Superamento degli ostacoli anti-bot: Utilizza la rotazione dei proxy integrata o servizi proxy rotanti esterni, insieme alla gestione dei CAPTCHA e all'elusione dei sistemi anti-bot, per accedere a contenuti che altre soluzioni non riescono a raggiungere.
- Adattabilità alle modifiche dei siti: Affidati alla gestione intelligente degli errori e, per gli strumenti dotati di intelligenza artificiale, all'estrazione con adattamento automatico quando cambiano i layout o le strutture dei siti web.
- Accesso sicuro e conformità: Proteggi le pipeline di dati con autorizzazioni degli utenti, registri di controllo e allineamento ai framework di conformità o alle normative sulla privacy.
Costi e prezzi degli strumenti di web scraping
La scelta degli strumenti per l'estrazione di dati dal web richiede una comprensione dei vari modelli e piani tariffari disponibili. I costi variano in base alle funzionalità, alle dimensioni del team, ai componenti aggiuntivi e ad altro ancora. La tabella seguente riassume i piani più comuni, i relativi prezzi medi e le funzionalità tipicamente incluse nelle soluzioni per l'estrazione di dati dal web:
Tabella comparativa dei piani per gli strumenti di estrazione di dati dal web
| Tipo di piano | Prezzo medio | Funzionalità comuni |
|---|---|---|
| Tipo di pianoPiano gratuito | Prezzo medio$0-$10/mese | Funzionalità comuniNumero limitato di estrazioni, pianificazione di base, supporto della comunità e formati iniziali per l'esportazione dei dati. |
| Tipo di pianoPiano personale | Prezzo medio$15-$40/mese | Funzionalità comuniPiù crediti per le estrazioni, rendering JavaScript, accesso API e gestione di base degli errori. |
| Tipo di pianoPiano aziendale | Prezzo medio$55-$150/mese | Funzionalità comuniMaggiore concorrenza, rotazione dei proxy, pianificazione avanzata, strumenti per la collaborazione del team e supporto prioritario. |
| Tipo di pianoPiano per grandi aziende | Prezzo medio$250+/mese | Funzionalità comuniIntegrazioni personalizzate, garanzie SLA, proxy con targeting geografico, configurazione iniziale gestita e gestione dedicata dell'account. |
Domande frequenti sugli strumenti di estrazione di dati dal web
Ecco alcune risposte alle domande comuni sugli strumenti di estrazione di dati dal web:
Sono necessarie competenze di programmazione per utilizzare gli strumenti di estrazione di dati dal web?
No, non è necessariamente richiesta una conoscenza della programmazione. Molti strumenti visivi offrono una soluzione senza codice, come un’estensione di Chrome basata sul clic e la selezione, che consente agli utenti non tecnici di creare visivamente routine di estrazione e di navigare nella mappa del sito per raccogliere record per attività come la generazione di contatti potenziali.\r\nTuttavia, la logica personalizzata, le pipeline di dati complesse o l’estrazione di grandi volumi si basano generalmente su strumenti di programmazione:\r\n\u003cul\u003e\r\n \t\u003cli\u003ePython: una libreria Python tradizionale come BeautifulSoup è ideale per analizzare in modo ordinato i documenti HTML statici.\u003c/li\u003e\r\n \t\u003cli\u003eJavaScript: una libreria Node.js specializzata, come Puppeteer o Playwright, consente agli sviluppatori di interagire programmaticamente con gli elementi web dinamici.\u003c/li\u003e\r\n\u003c/ul\u003e
Gli strumenti di estrazione di dati dal web sono in grado di gestire siti web dinamici e con un uso intensivo di JavaScript?
Sì, la maggior parte degli strumenti moderni offre motori di rendering JavaScript per estrarre contenuti dinamici da applicazioni a pagina singola (SPA) e siti interattivi.
In che modo gli strumenti di estrazione di dati dal web gestiscono le misure anti-bot dei siti web?
Per superare le protezioni anti-bot, gli strumenti più sofisticati adottano diverse strategie di elusione:\r\n\u003cul\u003e\r\n \t\u003cli\u003eProxy rotanti: distribuiscono le richieste su ampi insiemi di indirizzi IP, sia di data center sia residenziali, per evitare i limiti di frequenza o i divieti IP.\u003c/li\u003e\r\n \t\u003cli\u003eRisolutori CAPTCHA automatizzati: risolvono o aggirano le verifiche visive e comportamentali.\u003c/li\u003e\r\n \t\u003cli\u003eMascheramento dell’impronta digitale del browser: modificano le intestazioni del browser, le impronte del canvas e gli agenti utente nei motori, come WebKit o Chromium, per imitare le interazioni umane nei principali browser come Firefox o Chrome.\u003c/li\u003e\r\n\u003c/ul\u003e
L'estrazione di dati dal web è legale?
La legalità dell’estrazione di dati dal web dipende dai dati raccolti, dal modo in cui vengono utilizzati e dai termini di servizio del sito web. Consultare sempre le linee guida legali e i requisiti di conformità prima di procedere.
Come posso ricevere e archiviare i dati estratti?
In genere è possibile esportare i dati in formati come CSV, JSON ed Excel oppure inviarli direttamente a sistemi di archiviazione cloud, webhook o database, a seconda delle opzioni di integrazione dello strumento.