

10 meilleurs outils de lac de données en 2026

10 Sélection des meilleurs outils de lac de données


Les outils de lac de données vous permettent de stocker, d’organiser et d’analyser de vastes quantités de données structurées et non structurées dans l’ensemble de votre entreprise. Si vous comparez les meilleurs outils de lac de données, vous ne pouvez pas vous permettre de choisir au hasard : quelle plateforme permettra à votre équipe de garder le contrôle des coûts, de la conformité et des performances à mesure que vos données se développent ?
Dans ce guide, je vous présenterai des options éprouvées qui aident les responsables informatiques à assurer la gouvernance, la scalabilité, l’intégration et la pérennité, afin que vous puissiez choisir en toute confiance la base adaptée aux charges de travail d’analytique et d’IA en 2026.
Pourquoi faire confiance à nos avis logiciels
Nous testons et analysons des logiciels depuis 2023. En tant que dirigeants technologiques, nous savons à quel point il est crucial et difficile de faire le bon choix lors de la sélection d’un logiciel.
Nous investissons dans des recherches approfondies pour aider notre audience à prendre de meilleures décisions d’achat de logiciels. Nous avons testé plus de 2 000 outils pour différents usages technologiques et rédigé plus de 1 000 avis complets. Découvrez comment nous restons transparents & notre méthodologie d’évaluation des logiciels.
Comparez les meilleurs outils de lac de données
Comparez les tarifs et les caractéristiques, côte à côte, des outils de lac de données qui figurent dans ma sélection.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour les lacs de données Apache Iceberg optimisés automatiquement | Essai gratuit disponible | À partir de $300/mois (facturé annuellement) | Website | |
| 2 | Idéal pour la gouvernance des lakehouses hybrides d’entreprises réglementées | Essai gratuit de 60 jours disponible | À partir de $0.04/CCU/heure | Website | |
| 3 | Idéal pour un lakehouse Iceberg ouvert sans dépendance propriétaire | Essai gratuit de 30 jours | À partir de $0.20/DCU | Website | |
| 4 | Idéal pour la gouvernance des lacs de données des secteurs réglementés | Démonstration gratuite disponible | Tarification sur demande | Website | |
| 5 | Idéal pour la gouvernance inter-moteurs sur les tables lake ouvertes | Essai gratuit de 90 jours | À partir de $0.12 par heure-DCU | Website | |
| 6 | Idéal pour le partage de données sans copie entre les clouds | Essai gratuit de 30 jours | À partir de $2.00/credit | Website | |
| 7 | Idéal pour un lac de données natif GCP avec stockage hiérarchisé | Formule gratuite disponible | À partir de 0,020 $/Go/mois | Website | |
| 8 | Idéal pour une plateforme lakehouse fondée sur des formats de tables ouverts | Essai gratuit de 14 jours | À partir de $0.22/DBU | Website | |
| 9 | Idéal pour le stockage d'objets au cœur des lacs de données AWS | Non disponible | À partir de 0,023 $/Go/mois | Website | |
| 10 | Idéal pour les lacs de données d’entreprise natifs de Microsoft | Crédit de $200 pendant 30 jours (aucun niveau gratuit dédié) | À partir de $0.023/Go/mois | Website |
Avis sur les outils de lac de données
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils de lac de données qui figurent dans ma sélection. Mes avis proposent un examen approfondi des fonctionnalités, des capacités et des cas d’utilisation les plus adaptés à chaque plateforme, afin de vous aider à trouver celle qui vous convient le mieux.

Qlik
Idéal pour les lacs de données Apache Iceberg optimisés automatiquement
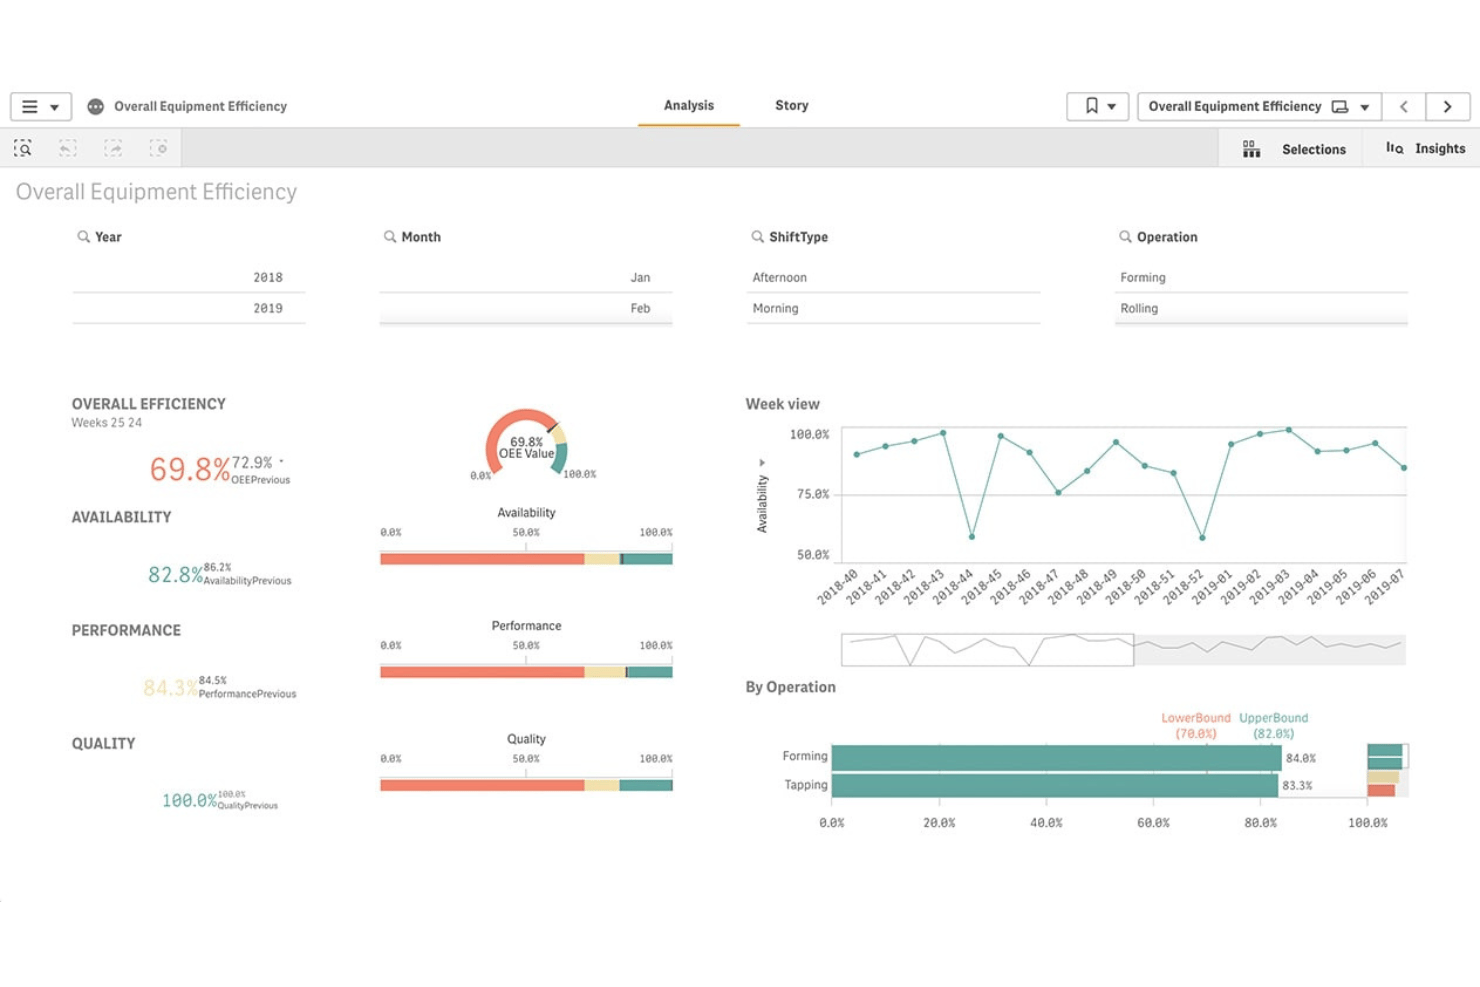
Qlik est une plateforme d’intégration de données et de lac de données conçue nativement sur Apache Iceberg, qui combine l’ingestion fondée sur la capture des données modifiées (CDC), l’évolution automatisée des schémas, les pipelines de données multiformats et la gouvernance intégrée dans les environnements de stockage objet cloud.
À qui Qlik convient-il le mieux ?
Qlik convient particulièrement aux grandes entreprises des secteurs réglementés qui ont besoin d’une intégration des données, d’une gouvernance et d’une gestion du lac de données de bout en bout sur une seule plateforme.
Pourquoi j’ai choisi Qlik
J’ai choisi Qlik parce que son optimiseur Iceberg adaptatif le distingue : il exécute en continu la compaction, l’indexation et le nettoyage des instantanés sur vos tables Iceberg sans aucun réglage manuel, offrant des vitesses de requête 2,5 à 5 fois supérieures et jusqu’à 50 % d’économies sur les coûts de stockage. Je m’appuie également sur sa mise en miroir sans copie pour transférer directement des tables Iceberg actives vers Snowflake sans dupliquer les données ni ajouter de complexité aux pipelines.
Fonctionnalités clés de Qlik
- Réplication CDC fondée sur les journaux : Qlik Replicate capture les modifications directement dans les journaux de transactions des bases de données, sans agents, afin de maintenir les données du lac à jour sans affecter les performances du système source.
- Pipeline d’ingestion multiformat : Ingérez des données aux formats Parquet, Avro, ORC, JSON et CSV depuis plus de 200 sources, notamment des bases de données, des applications SaaS, SAP, des mainframes et des plateformes de diffusion en continu comme Kafka et Kinesis.
- Traçabilité au niveau des colonnes et analyse d’impact : Suivez les données de la source à la consommation au niveau des colonnes, afin de disposer d’une piste d’audit claire pour la gouvernance et les rapports de conformité.
- Gestion automatisée des zones bronze/argent/or : Qlik Compose for Data Lakes automatise la génération des schémas, la création du catalogue Hive et les mises à jour continues des zones via CDC, éliminant ainsi le codage manuel des pipelines pour les architectures de lac de données à plusieurs niveaux.
Intégrations de Qlik
Qlik prend en charge plus de 200 sources d’ingestion, notamment Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP et Salesforce. Ses tables Iceberg s’intègrent à Spark, Amazon Athena, Trino, Presto, Databricks, Dremio et Tableau.
Pros and Cons
Pros:
- Gestion automatiquement optimisée des tables Apache Iceberg
- Réplication CDC avancée en temps réel fondée sur les journaux
- Contrôles approfondis de conformité et de gouvernance pour les entreprises
Cons:
- Plateforme complexe nécessitant de solides compétences techniques
- Processus opaque d’octroi de licences et d’estimation des coûts
Cloudera
Idéal pour la gouvernance des lakehouses hybrides d’entreprises réglementées
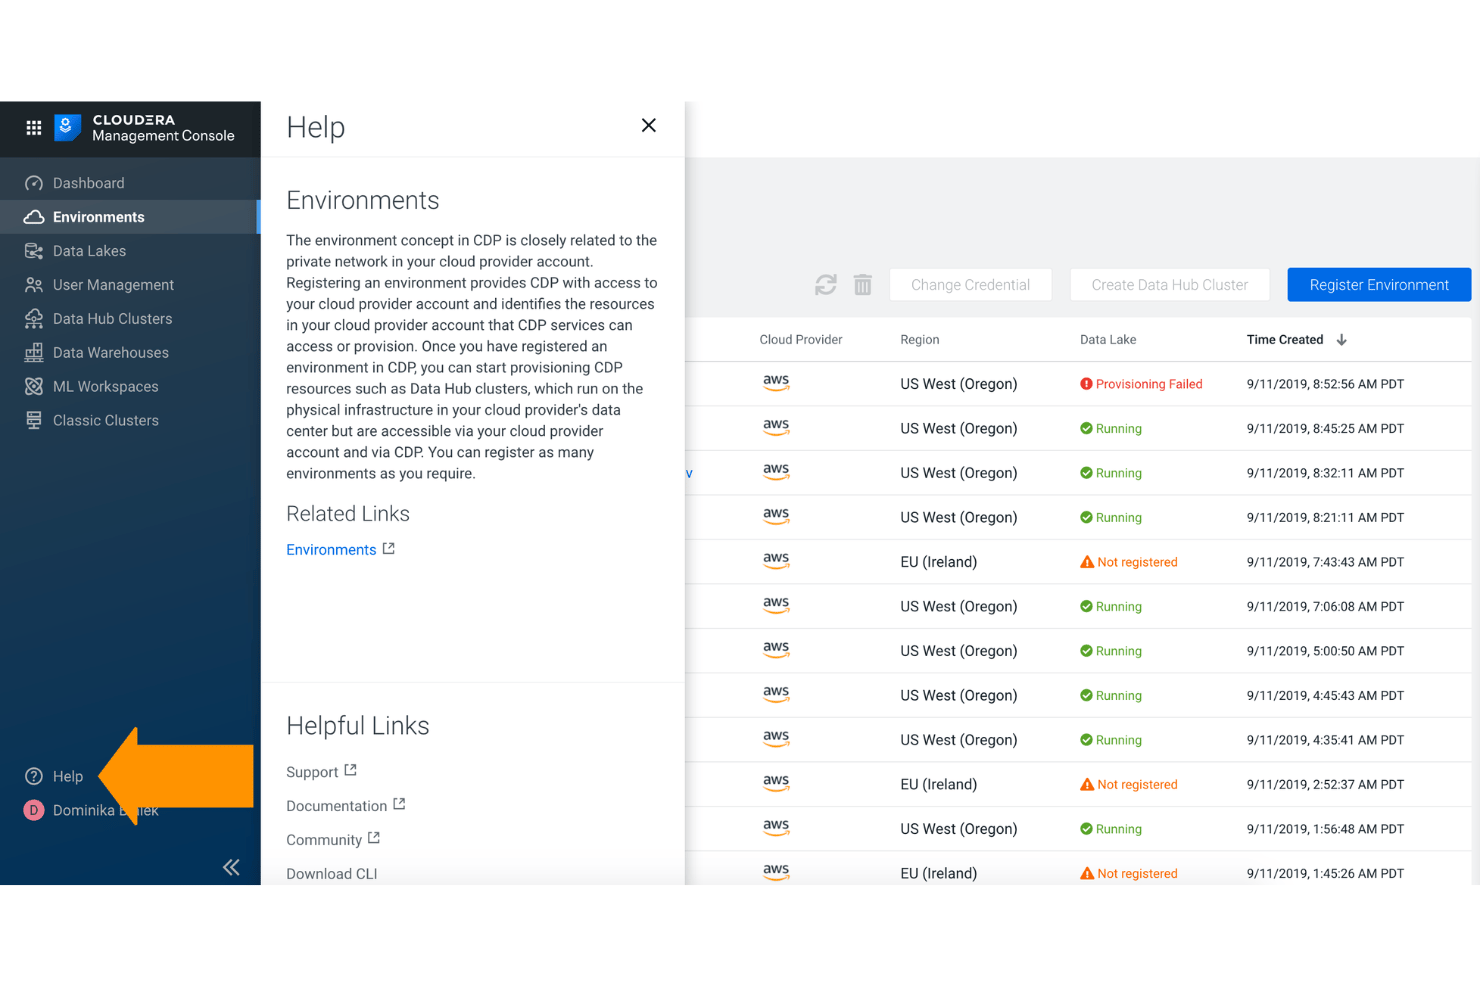
Cloudera est une plateforme de lakehouse de données ouvertes qui couvre le stockage évolutif multicloud et sur site, l’ingestion de données multiformat via plus de 450 connecteurs, la gestion de schémas à la lecture basée sur Apache Iceberg et la gouvernance centralisée dans les environnements hybrides.
À qui Cloudera convient-elle le mieux ?
Cloudera convient particulièrement aux grandes entreprises des secteurs réglementés — banques, administrations, télécommunications — qui ont besoin d’une gouvernance unifiée dans des environnements sur site et multicloud.
Pourquoi ai-je choisi Cloudera ?
Cloudera figure sur ma liste restreinte, car aucune autre plateforme n’égale la profondeur de sa gouvernance dans les environnements hybrides. Je suis particulièrement impressionné par Cloudera SDX, qui applique les politiques Apache Ranger et Apache Atlas une seule fois et les fait respecter partout, que vos données se trouvent dans un cluster HDFS sur site, Azure ADLS ou AWS S3. Les banques et les administrations qui exploitent une infrastructure mixte peuvent définir de manière centralisée des règles de masquage au niveau des colonnes et des politiques ABAC, avec les certifications FedRAMP Moderate et PCI DSS 4.0 à l’appui de leurs exigences de conformité.
Principales fonctionnalités de Cloudera
- Exploration temporelle Apache Iceberg : Interrogez des instantanés historiques de vos données à tout moment grâce aux fonctionnalités intégrées de gestion des versions et d’exploration temporelle d’Iceberg.
- Lakehouse Optimizer : Automatise la compaction des tables Iceberg, le classement en Z et l’élagage des partitions afin d’améliorer les performances des requêtes et de réduire les coûts de calcul.
- Concepteur visuel de pipelines Cloudera Data Flow (NiFi) : Concevez et déployez des pipelines d’ingestion de données au moyen d’une interface glisser-déposer comprenant plus de 450 processeurs et connecteurs préconfigurés.
- Partage de données sans copie via le catalogue REST Iceberg : Les moteurs externes tels que Databricks, Snowflake et Athena peuvent interroger directement les tables Iceberg gérées par Cloudera, sans déplacement ni duplication des données.
Intégrations de Cloudera
Cloudera Data Flow fournit plus de 450 connecteurs préconfigurés, notamment pour Apache Kafka, MongoDB, Salesforce, Snowflake et Google BigQuery. La plateforme s’intègre également à AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau et Power BI grâce à son catalogue REST Iceberg.
Pros and Cons
Pros:
- Prise en charge des environnements hybrides et sur site inégalée
- Gouvernance d’entreprise pour les exigences strictes de conformité
- Partage sans copie entre les moteurs de requêtes externes
Cons:
- La configuration initiale nécessite souvent des compétences spécialisées
- Satisfaction à l’égard de la gestion des métadonnées inférieure à la moyenne des concurrents

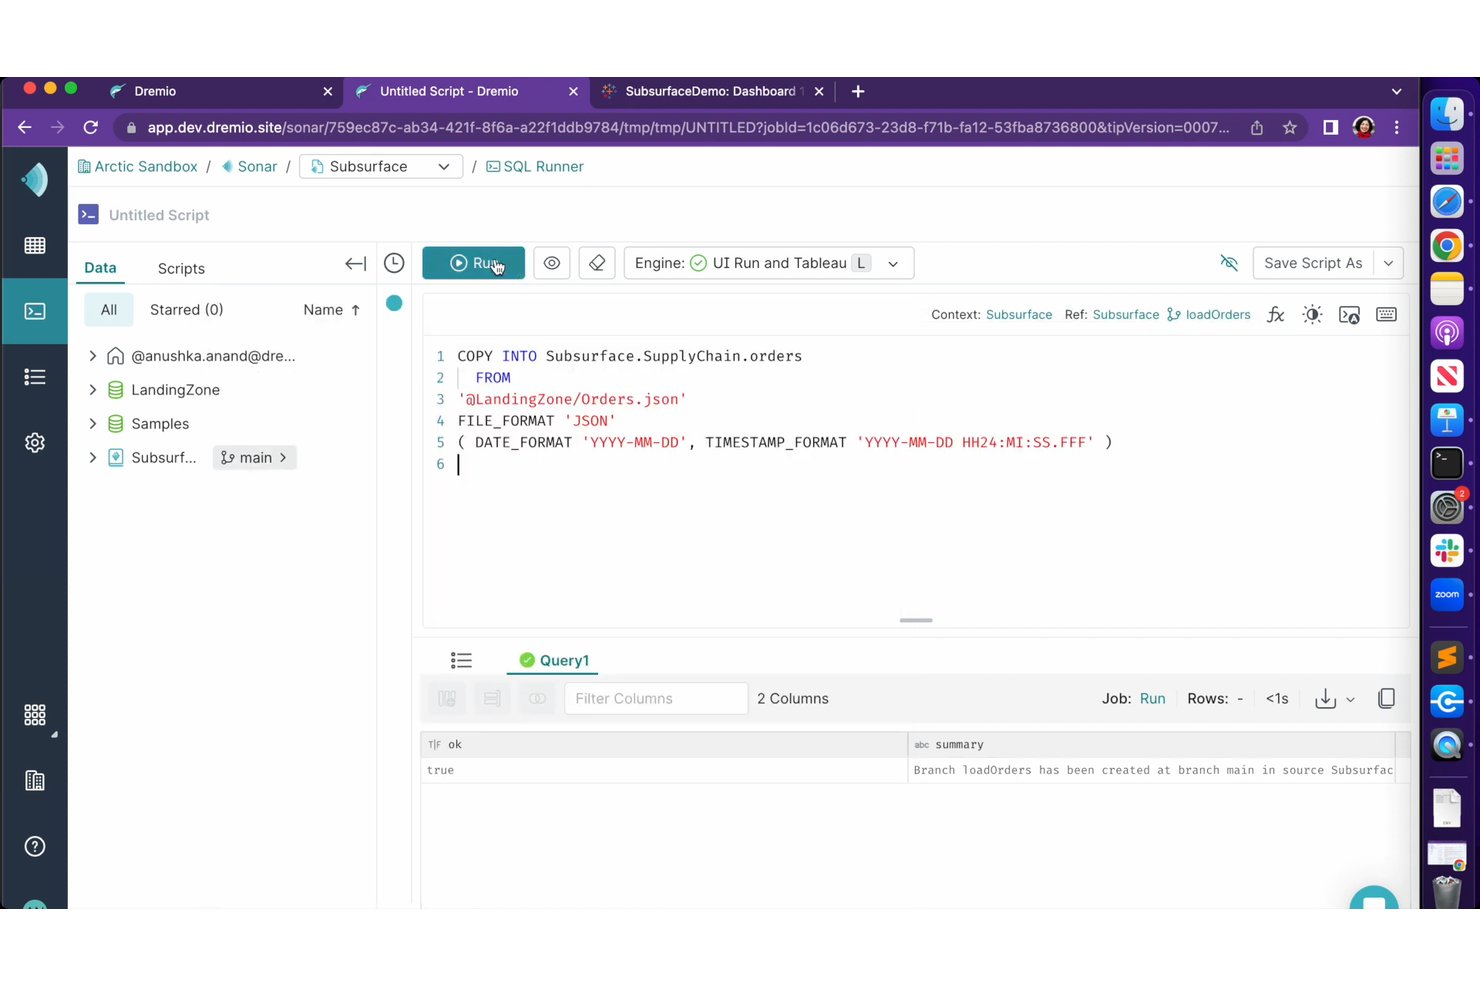
Dremio est une plateforme lakehouse ouverte construite nativement sur Apache Iceberg et Apache Arrow, qui combine un moteur de requêtes SQL, un accès fédéré aux données, une accélération automatisée des requêtes, une gestion des versions des données de type Git et un catalogue ouvert multi-moteur.
À qui Dremio convient-il le mieux ?
Dremio convient particulièrement aux équipes d'ingénierie et d'architecture des données qui construisent des lakehouses ouverts sur Apache Iceberg et qui ont besoin d'un accès aux requêtes depuis plusieurs moteurs sans être liées à un catalogue ou à un format de stockage propriétaire.
Pourquoi j'ai choisi Dremio
Dremio figure dans ma sélection parce qu'il est construit nativement sur Apache Iceberg, ce qui signifie que vos données restent dans vos propres compartiments S3 ou ADLS et que n'importe quel moteur (Spark, Flink, Trino, DuckDB) peut les lire et les écrire via le catalogue ouvert Polaris, sans conversion de format. J'apprécie particulièrement les réflexions autonomes, qui observent discrètement les modèles de requêtes et matérialisent les accélérations en arrière-plan, afin que vos tableaux de bord de BI obtiennent rapidement des résultats sans réglage manuel ni extractions propriétaires.
Fonctionnalités clés de Dremio
- Catalogue ouvert (Apache Polaris) : Un catalogue multi-moteur construit sur Apache Polaris qui permet à Spark, Flink, Trino et DuckDB de lire et d'écrire des tables Iceberg via une API REST standard.
- Branchement « données comme code » : Le contrôle des versions des données de type Git via Project Nessie crée des branches de données isolées sans copie pour le développement, les tests et l'expérimentation en ML, avec des fusions et des restaurations atomiques.
- Ingestion COPY INTO : Une commande SQL native qui charge en masse les fichiers CSV, JSON et Parquet depuis le stockage objet directement dans des tables Iceberg, avec évolution du schéma et gestion des partitions.
- Contrôle d'accès granulaire : La sécurité au niveau des lignes et le masquage des colonnes sont appliqués au moment de l'exécution des requêtes, de manière cohérente sur tous les moteurs interrogeant le catalogue.
Intégrations de Dremio
Dremio s'intègre à Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage et Google Cloud Storage. Son catalogue REST Polaris ainsi que ses interfaces ODBC, JDBC et Arrow Flight prennent en charge les connexions personnalisées aux moteurs et aux applications.
Pros and Cons
Pros:
- Traite Apache Iceberg nativement sans conversion
- Branchement des données de type Git pour les voyages dans le temps
- Le catalogue REST ouvert se connecte à n'importe quel moteur de requêtes
Cons:
- Complexité de l'administration supérieure à celle des outils concurrents
- Pas de magasin de fonctionnalités ML intégré dédié
Idéal pour la gouvernance des lacs de données des secteurs réglementés
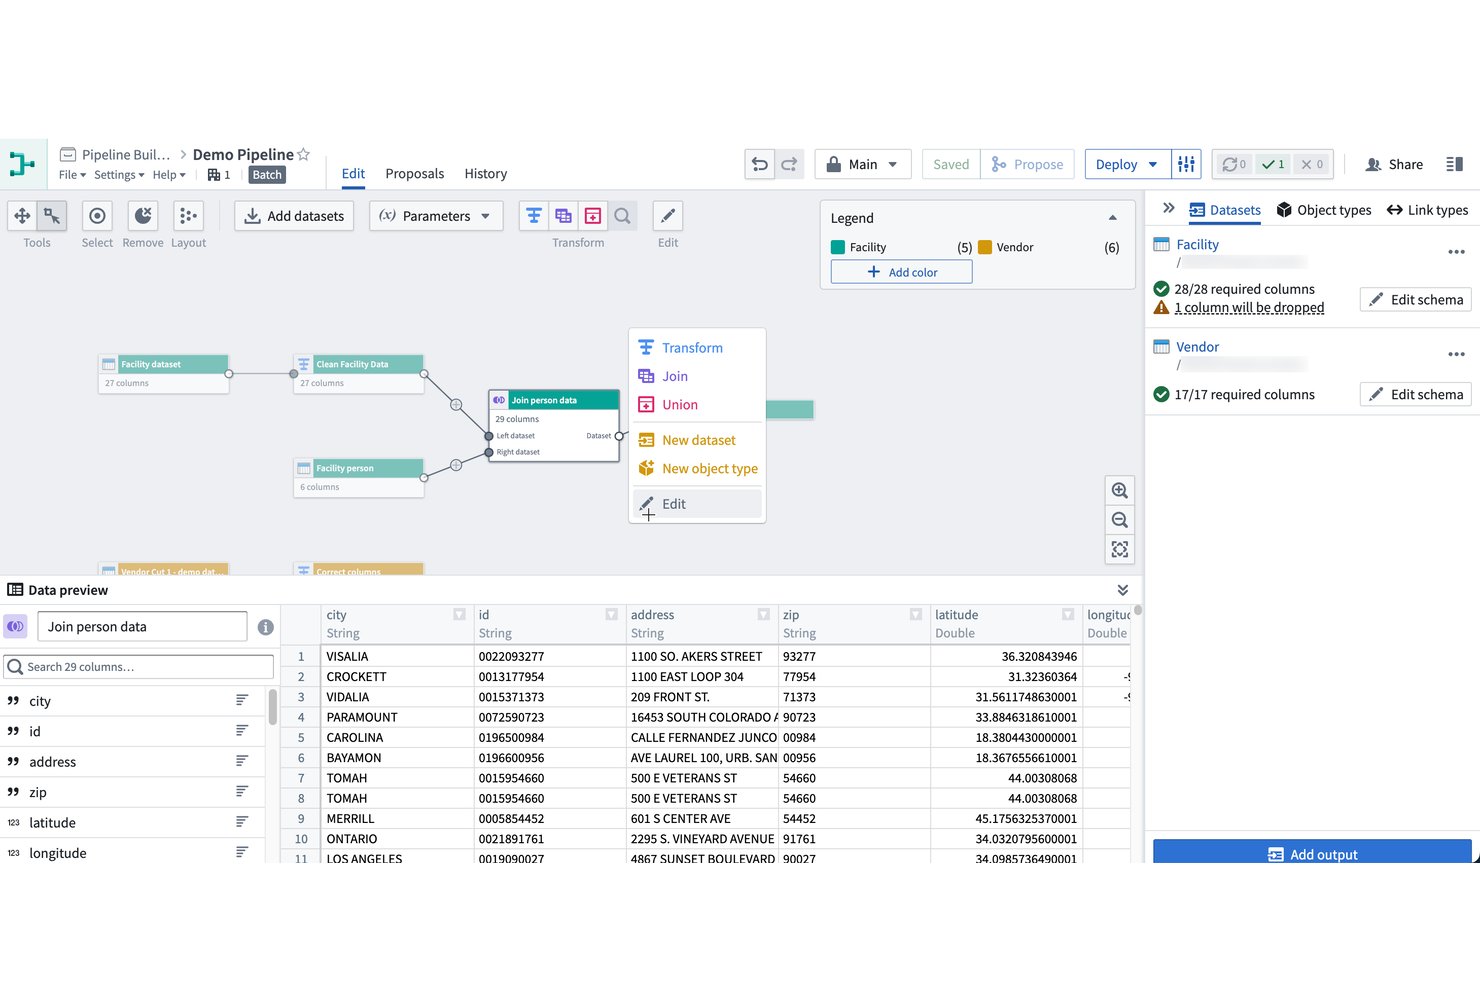
Palantir Foundry est une plateforme de lac de données qui combine l’ingestion multiformat, l’orchestration des pipelines, la modélisation sémantique des données via sa couche d’ontologie et des contrôles de gouvernance intégrés dans les environnements cloud, sur site et isolés.
À qui Palantir Foundry convient-il le mieux ?
Palantir Foundry est spécialement conçu pour les grandes entreprises des secteurs réglementés — finance, santé, défense et administration publique — qui ont besoin d’une gouvernance granulaire des données dans des environnements complexes et multisources.
Pourquoi ai-je choisi Palantir Foundry ?
J’ai choisi Palantir Foundry parce que son architecture de gouvernance n’a véritablement aucun équivalent dans les secteurs réglementés. La plateforme superpose des contrôles d’accès fondés sur l’objectif, la classification et les rôles, avec des marquages de données qui se propagent automatiquement via la traçabilité : ainsi, une balise PII appliquée à un jeu de données source suit les données à travers chaque transformation en aval. Ajoutez à cela les certifications FedRAMP High, HIPAA, ITAR et SOC 2 Type 2, ainsi que la couche d’ontologie qui associe les données brutes du lac à des objets métier auditables, et vous obtenez une plateforme conçue dès le départ pour les environnements où la gouvernance est indispensable.
Principales fonctionnalités de Palantir Foundry
- Plus de 200 connecteurs de données préconfigurés : Connectez-vous aux bases de données, aux entrepôts de données, aux plateformes de flux de données, aux systèmes ERP, au stockage cloud, aux sources IoT et aux outils géospatiaux via une interface d’ingestion unique.
- Catalogue REST Apache Iceberg : Exposez les jeux de données Foundry aux moteurs de calcul externes compatibles avec Iceberg — notamment Trino, Spark, Flink, Databricks et Snowflake — sans dupliquer les données.
- Tables virtuelles pour une fédération sans copie : Interrogez directement depuis Foundry les tables externes de Databricks, Snowflake et les espaces de stockage compatibles avec S3, sans ingérer ni déplacer les données sous-jacentes.
- Studio de modèles AIP : Créez, entraînez, évaluez et déployez des modèles de ML dans Foundry, avec un accès natif aux LLM et la prise en charge d’environnements de développement Python et R.
Intégrations de Palantir Foundry
Palantir Foundry propose plus de 200 connecteurs de données natifs, notamment Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau et Power BI. La plateforme prend également en charge la connectivité personnalisée via son API compatible avec S3, son catalogue REST Iceberg et ses tables virtuelles.
Pros and Cons
Pros:
- Gouvernance des données de premier ordre pour la conformité
- La couche d’ontologie permet l’accès aux données par les utilisateurs métier
- Partage de données sans copie avec des tables virtuelles
Cons:
- Tarification contractuelle élevée avec un montant total peu clair
- Risque de dépendance à la plateforme en raison des modèles propriétaires
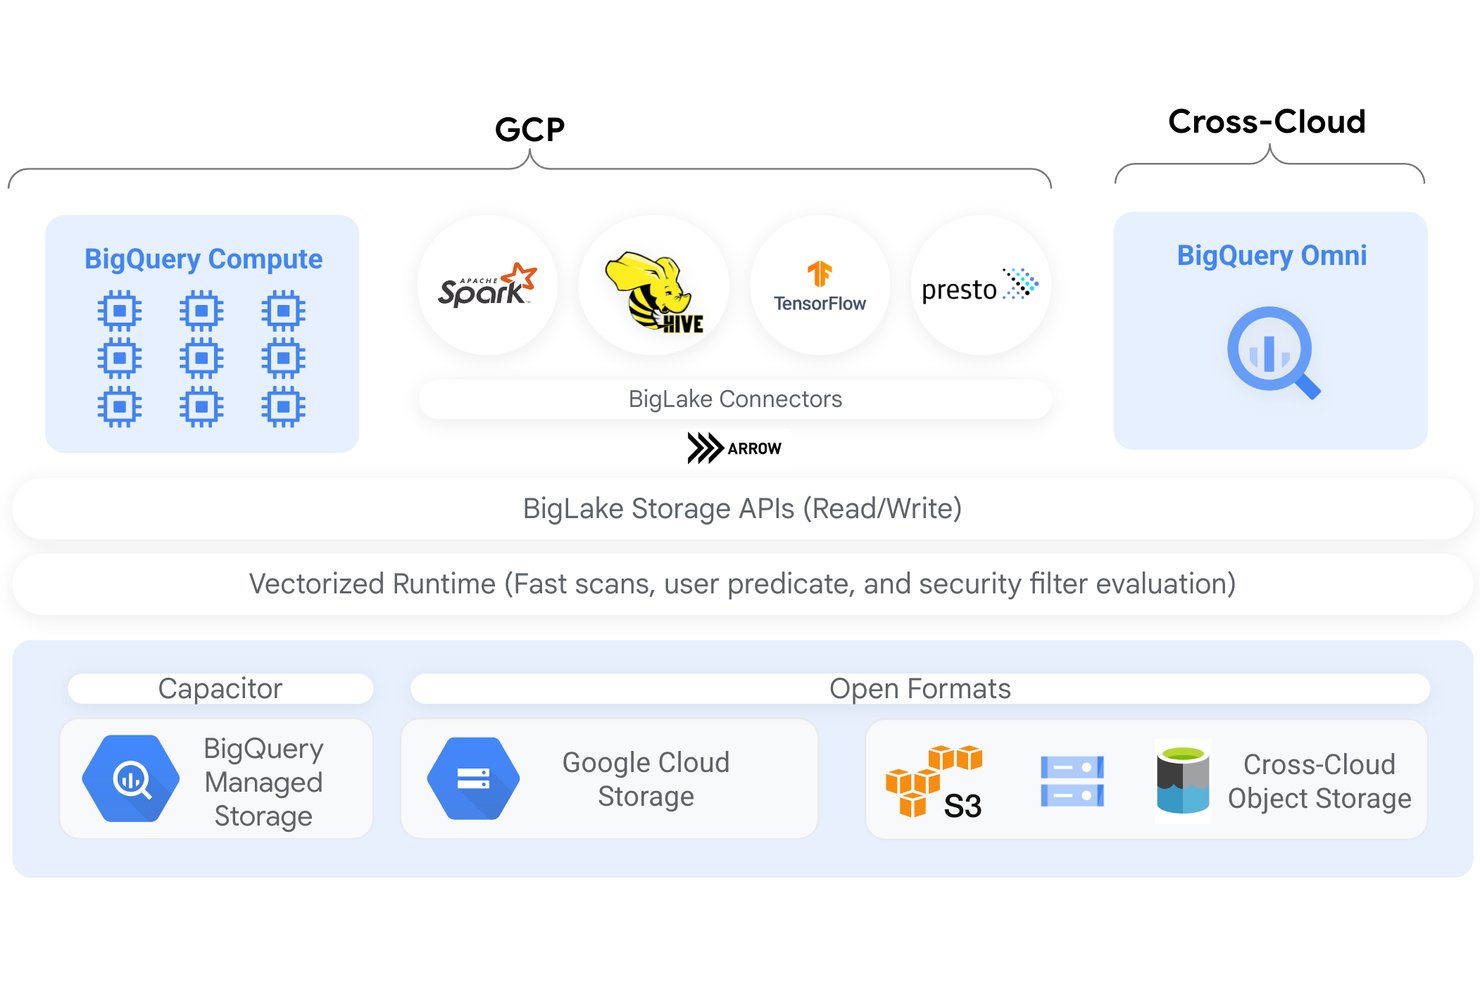
BigLake est la plateforme lakehouse de Google Cloud qui étend BigQuery grâce à la prise en charge des tables aux formats ouverts, à l'accès aux requêtes inter-moteurs, à la gestion unifiée des métadonnées et à une gouvernance granulaire sur GCS, S3 et Azure Blob Storage.
À qui BigLake convient-il le mieux ?
BigLake convient particulièrement aux équipes d'ingénierie et d'architecture des données déjà investies dans Google Cloud et qui ont besoin d'une gouvernance cohérente sur plusieurs moteurs de requêtes et formats de tables ouverts.
Pourquoi ai-je choisi BigLake ?
J'ai choisi BigLake comme l'une des meilleures solutions, car c'est la seule plateforme lakehouse que j'ai vue appliquer de manière cohérente des politiques d'accès au niveau des lignes et des colonnes dans BigQuery, Spark, Trino et Presto, et pas seulement au sein d'un moteur unique. Cela signifie qu'une balise de politique appliquée à une colonne sensible suit les données, quel que soit le moteur utilisé par votre équipe pour les interroger. Le catalogue REST Lakehouse Iceberg rend cela possible en servant de point de terminaison unique, compatible avec la gouvernance, pour tous les moteurs open source qui lisent et écrivent dans les mêmes tables Iceberg.
Principales fonctionnalités de BigLake
- Maintenance automatisée des tables : BigLake gère automatiquement la compaction des fichiers, le clustering, la collecte des éléments obsolètes et la génération des métadonnées pour les tables Iceberg stockées dans GCS.
- Ingestion multiformat : Ingérez des données aux formats Parquet, ORC, Avro, CSV, JSON ainsi que dans des formats de tables ouverts comme Apache Iceberg, Delta Lake et Apache Hudi via des fichiers manifestes.
- Interrogation intercloud avec BigQuery Omni : Exécutez directement des requêtes SQL BigQuery sur des données stockées dans Amazon S3 ou Azure Data Lake Storage Gen 2 sans les déplacer vers GCS.
- Réplication par capture des données modifiées : Diffusez les données opérationnelles de Cloud Spanner, AlloyDB et Cloud SQL directement vers les tables BigLake pour permettre des analyses quasi en temps réel.
Intégrations de BigLake
BigLake s'intègre nativement à BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker et Vertex AI. Son catalogue REST Iceberg connecte les moteurs open source aux tables lake partagées.
Pros and Cons
Pros:
- Sécurité au niveau des lignes et des colonnes appliquée à tous les moteurs
- Formats de tables ouverts avec prise en charge complète d'Iceberg
- Fédération de catalogues pour la gestion multicloud des métadonnées
Cons:
- Le DML n'est pas pris en charge pour les tables externes non-Iceberg
- CMEK indisponible pour les tables mises en cache depuis S3 ou Azure
Idéal pour le partage de données sans copie entre les clouds
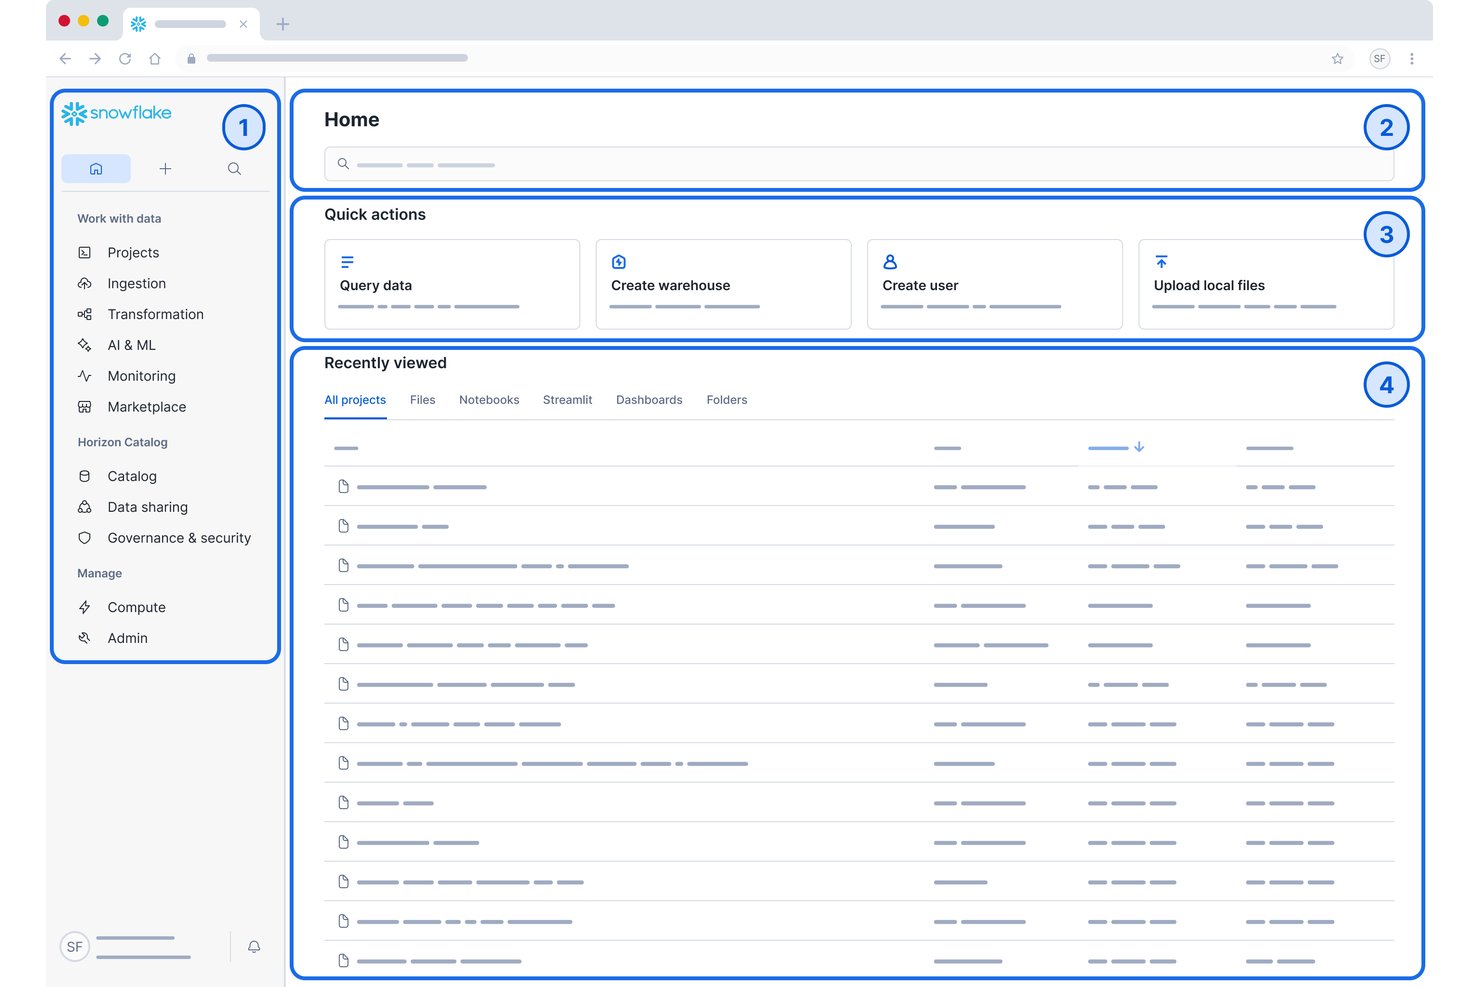
Snowflake est une plateforme de lac de données et d’analytique native du cloud qui combine un stockage élastique, un moteur de requêtes SQL intégré, Snowpark pour les charges de travail Python/Java/Scala, la prise en charge d’Apache Iceberg et le partage de données sans copie entre AWS, Azure et GCP.
À qui Snowflake s’adresse-t-il le mieux ?
Snowflake convient particulièrement aux équipes de données d’entreprise qui gèrent des environnements multicloud à grande échelle, où la gouvernance, la conformité et le partage de données entre organisations sont des exigences incontournables.
Pourquoi j’ai choisi Snowflake
Snowflake figure sur ma liste restreinte, car son partage de données sans copie vous permet de partager des jeux de données actifs entre des comptes AWS, Azure et GCP sans dupliquer ni déplacer un seul octet. J’ai travaillé avec Snowflake Marketplace, qui met en relation plus de 820 fournisseurs de données, et le provisionnement automatique multicloud rend le partage entre régions véritablement fluide. Ajoutez à cela la prise en charge native d’Apache Iceberg et Snowpipe Streaming, capable de gérer plus d’un million de transactions par seconde, et vous obtenez une plateforme de lac de données conçue pour répondre aux exigences des grandes entreprises.
Principales fonctionnalités de Snowflake
- Environnement d’exécution multilingue Snowpark : Écrivez des charges de travail d’ingénierie des données et d’apprentissage automatique en Python, Java ou Scala, puis exécutez-les directement dans le moteur de requêtes de Snowflake sans déplacer les données.
- Prise en charge des tables Apache Iceberg : Stockez et gérez les données au format de table ouvert Iceberg sur un stockage géré par Snowflake, avec évolution des schémas, voyage dans le temps et interopérabilité avec Spark, Trino et Flink.
- Catalogue Horizon : Une couche de gouvernance intégrée avec suivi de la traçabilité au niveau des colonnes, classification automatisée des données personnelles, enrichissement des métadonnées assisté par l’IA et fonctions de métriques de données pour une surveillance continue de la qualité des données.
- Snowpipe Streaming : Ingérez des données au niveau des lignes en temps réel à plus d’un million de transactions par seconde directement dans Snowflake ou dans des tables Apache Iceberg, sans délais liés au traitement par lots.
Intégrations de Snowflake
Snowflake propose des intégrations natives avec Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker et Apache Airflow. Il se connecte à Apache Spark, Trino, Amazon S3, Azure Blob Storage et Google Cloud Storage, avec des API pour les intégrations personnalisées.
Pros and Cons
Pros:
- Partage de données sans copie entre les clouds
- Gouvernance intégrée et traçabilité au niveau des colonnes
- Séparation élastique du stockage et du calcul
Cons:
- Aucune prise en charge du déploiement sur site
- Le suivi des coûts peut être difficile

Idéal pour un lac de données natif GCP avec stockage hiérarchisé
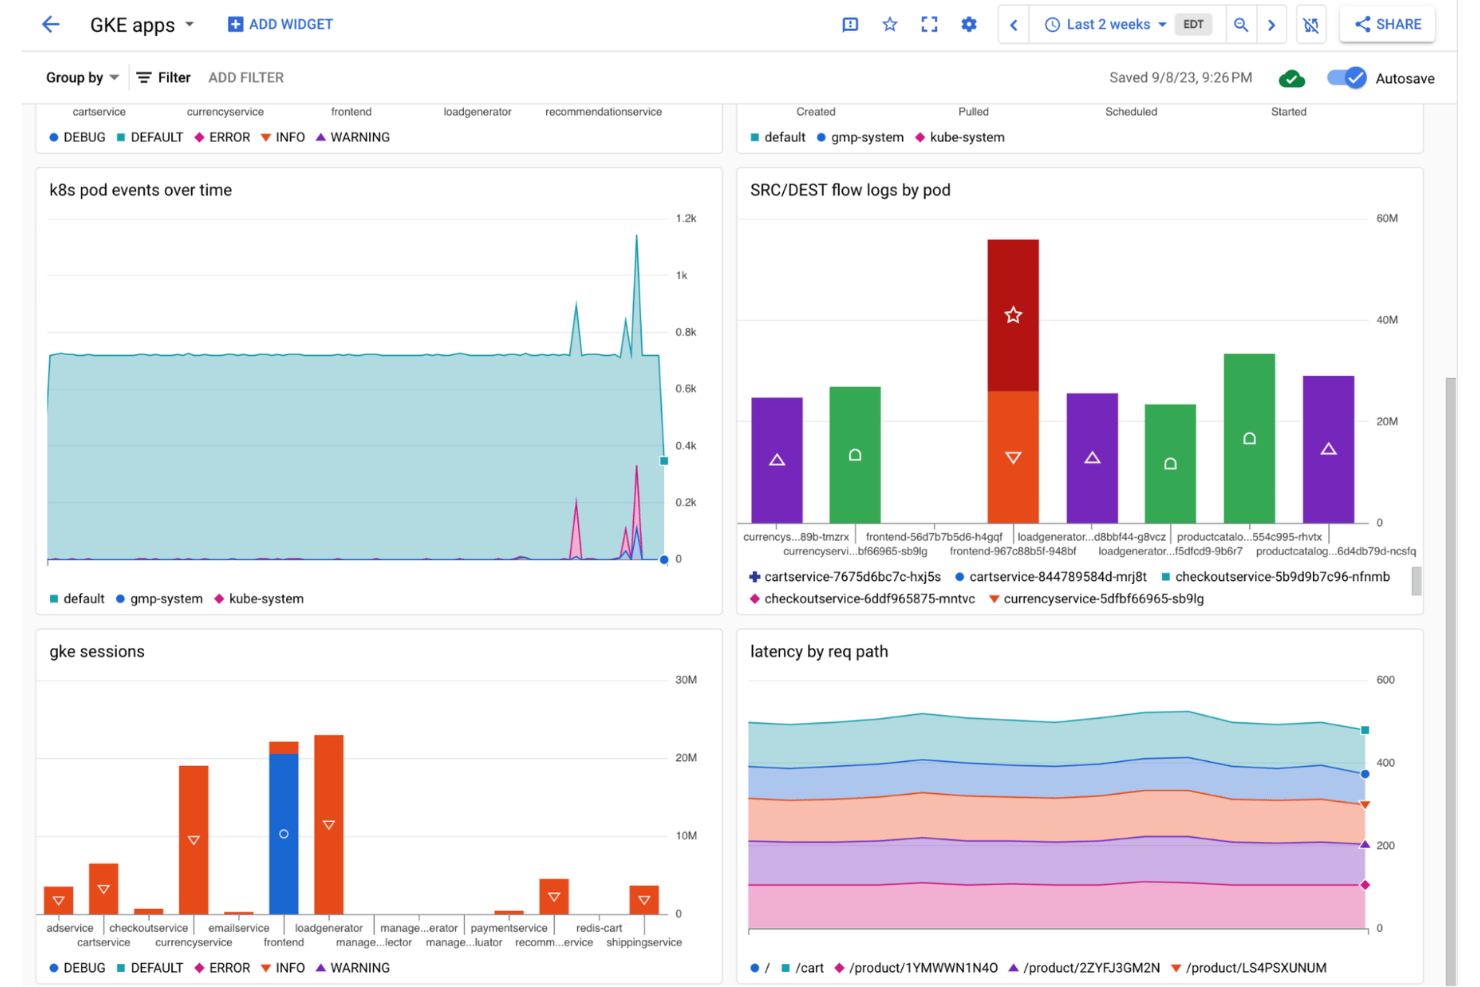
Google Cloud Storage est un service de stockage d’objets géré conçu pour les architectures de lacs de données, offrant des classes de stockage hiérarchisées, la prise en charge des formats de tables ouverts via Apache Iceberg et BigLake, ainsi qu’une intégration approfondie avec BigQuery, Dataflow, Dataproc et Vertex AI.
À qui Google Cloud Storage convient-il le mieux ?
Google Cloud Storage convient particulièrement aux équipes d’ingénierie des données et d’infrastructure qui opèrent déjà au sein de l’écosystème GCP et qui ont besoin d’un stockage d’objets évolutif comme fondation d’une architecture de lac de données.
Pourquoi ai-je choisi Google Cloud Storage ?
J’ai choisi Google Cloud Storage parce qu’il constitue la fondation native d’un lac de données basé sur GCP, avec des classes de stockage hiérarchisées (de Standard à Archive à 0,0012 $US/Go/mois) et Autoclass qui déplace automatiquement les objets entre les niveaux en fonction des habitudes d’accès. Ce que je trouve particulièrement intéressant, c’est BigLake : il ajoute les transactions ACID, le voyage dans le temps et l’évolution des schémas directement aux tables Apache Iceberg reposant sur GCS, transformant ainsi le stockage d’objets brut en lac de données interrogeable sans déplacer les données. BigQuery peut ensuite interroger ces mêmes tables Iceberg sur place, sans export.
Fonctionnalités clés de Google Cloud Storage
- Ingestion multiformat : Storage Transfer Service, Dataflow, Pub/Sub et Datastream prennent en charge l’ingestion par lots, en continu et CDC depuis des bases de données telles que MySQL, PostgreSQL et Oracle vers GCS.
- Gouvernance et contrôles d’accès : les autorisations basées sur IAM, le chiffrement CMEK/CSEK, VPC Service Controls, Cloud DLP et la journalisation des audits appliquent la sécurité à toutes les données stockées.
- Découverte des métadonnées via Knowledge Catalog : Dataplex analyse automatiquement les compartiments GCS afin d’extraire les schémas, de créer des glossaires métier et de générer la traçabilité des données de bout en bout dans GCS et BigQuery.
- Prise en charge de plusieurs moteurs de requêtes : les tables Iceberg reposant sur GCS peuvent être interrogées par BigQuery, Serverless Spark, Trino, Flink et Presto via le catalogue REST Iceberg.
Intégrations de Google Cloud Storage
Google Cloud Storage propose des intégrations natives avec BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker et Knowledge Catalog. Les API REST, XML, gRPC et les bibliothèques clientes prennent en charge les intégrations personnalisées avec les plateformes de données et les moteurs de traitement.
Pros and Cons
Pros:
- Prise en charge des lacs de données avec les tables Apache Iceberg
- Analyses multicomposants avec BigQuery et Spark
- Options d’archivage et de hiérarchisation automatiques du stockage
Cons:
- La plupart des fonctionnalités nécessitent plusieurs services GCP
- Facturation complexe avec des frais distincts pour les opérations et la sortie de données

Idéal pour une plateforme lakehouse fondée sur des formats de tables ouverts
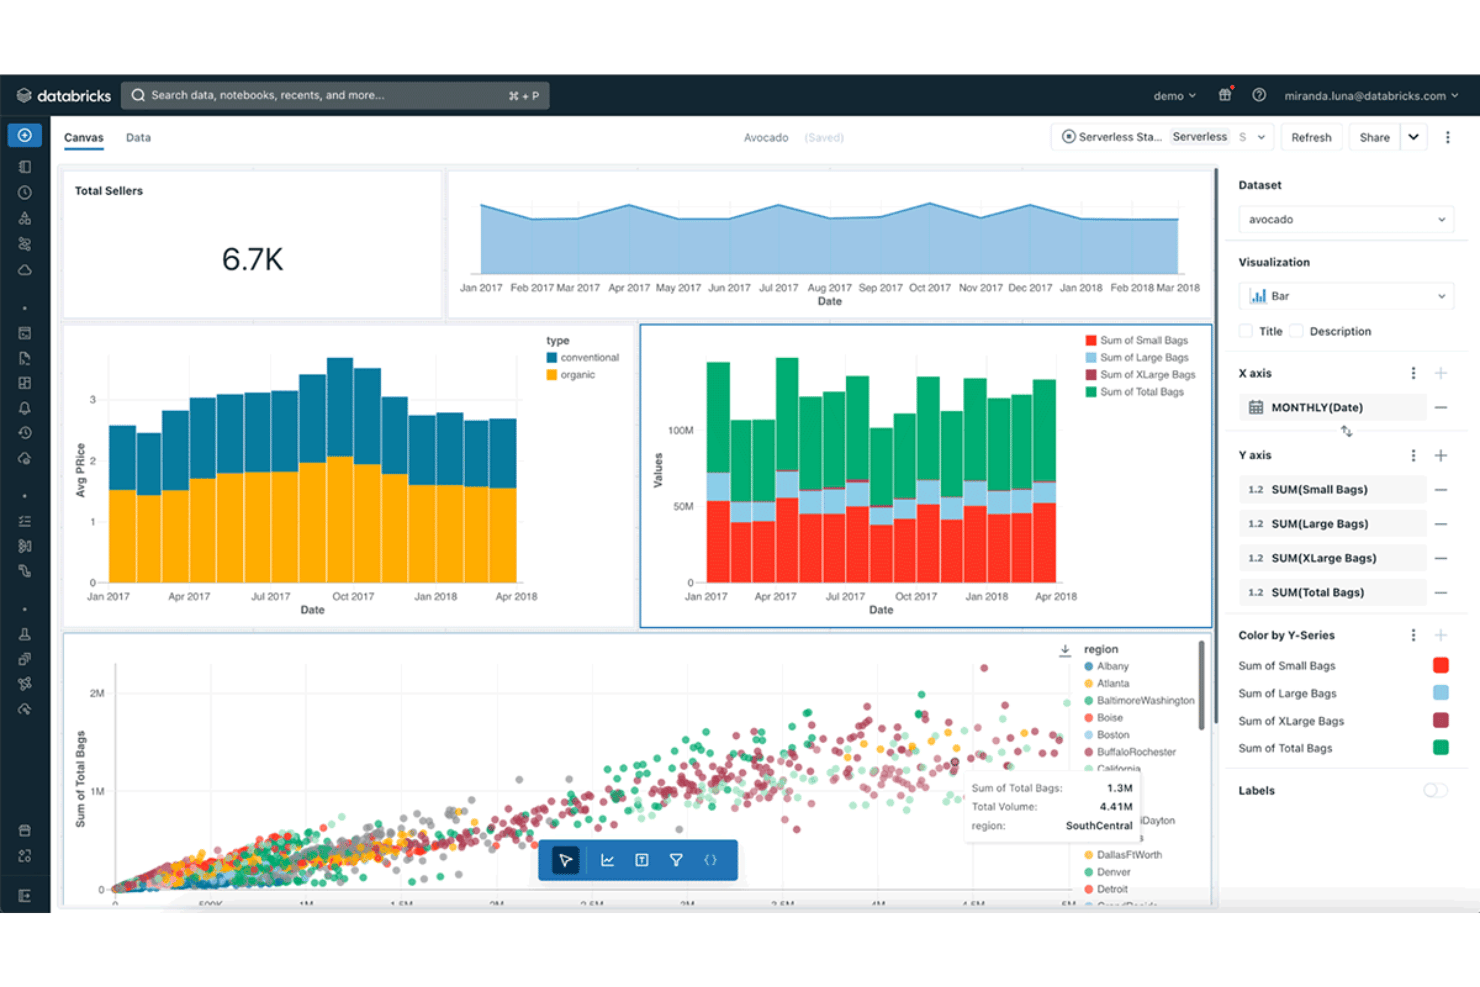
Databricks Lakehouse Platform est une plateforme lakehouse de données native du cloud qui unifie l’ingénierie des données, l’analytique SQL, l’apprentissage automatique et le développement de l’IA sur des formats de tables ouverts tels que Delta Lake, Apache Iceberg et Apache Hudi.
À qui Databricks Lakehouse Platform convient-elle le mieux ?
Databricks convient particulièrement aux équipes d’entreprise chargées des données et de l’apprentissage automatique qui doivent exécuter des pipelines d’ingénierie, des analyses SQL et des charges de travail d’IA sur une seule plateforme, sans déplacer les données entre les systèmes.
Pourquoi j’ai choisi Databricks Lakehouse Platform
Databricks figure dans ma sélection parce que c’est l’équipe qui a littéralement inventé Delta Lake, et cette origine est importante lorsque vous évaluez la prise en charge des formats de tables ouverts. J’ai travaillé avec la prise en charge native par la plateforme de Delta Lake, d’Iceberg et de Hudi, et ce qui la distingue, c’est que les transactions ACID, le voyage dans le temps et l’évolution des schémas ne sont pas des ajouts rapportés. Unity Catalog ajoute directement par-dessus une traçabilité automatisée au niveau des colonnes et un contrôle d’accès fondé sur les attributs, de sorte que la gouvernance accompagne les données dans les différents clouds.
Fonctionnalités clés de Databricks Lakehouse Platform
- Lakeflow Connect : Une couche d’ingestion gérée et sans serveur comprenant plus de 100 connecteurs natifs pour les applications SaaS, les bases de données, le stockage cloud et les sources de flux, notamment Kafka, Kinesis et Event Hubs.
- Pipelines déclaratifs Apache Spark : Un cadre pour créer des pipelines ETL par lots et de flux en temps réel, avec application intégrée de la qualité des données basée sur des contraintes et capture automatisée des modifications (CDC).
- Entrepôts SQL Databricks : Un moteur SQL accéléré par Photon qui prend en charge le langage SQL ANSI pour les charges de travail analytiques, avec une connectivité JDBC/ODBC pour les outils de veille stratégique tels que Tableau, Power BI et Looker.
- Intégration de MLflow : Un environnement MLflow géré pour le suivi des expériences, le registre des modèles et leur déploiement, installé au même endroit que vos données du lakehouse et connecté au magasin de fonctionnalités et au service de modèles.
Intégrations de Databricks Lakehouse Platform
Databricks propose plus de 100 connecteurs Lakeflow Connect natifs, notamment pour Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive et Google Analytics. La plateforme se connecte également à Kafka, Kinesis, Event Hubs, S3, ADLS et GCS, avec JDBC/ODBC et des API pour une connectivité personnalisée.
Pros and Cons
Pros:
- Prise en charge native de Delta Lake, d’Iceberg et de Hudi
- Traçabilité automatisée au niveau des colonnes avec Unity Catalog
- MLflow intégré et plateforme d’IA unifiée
Cons:
- Les coûts liés aux DBU et au cloud peuvent augmenter rapidement
- Aucune option de déploiement sur site disponible

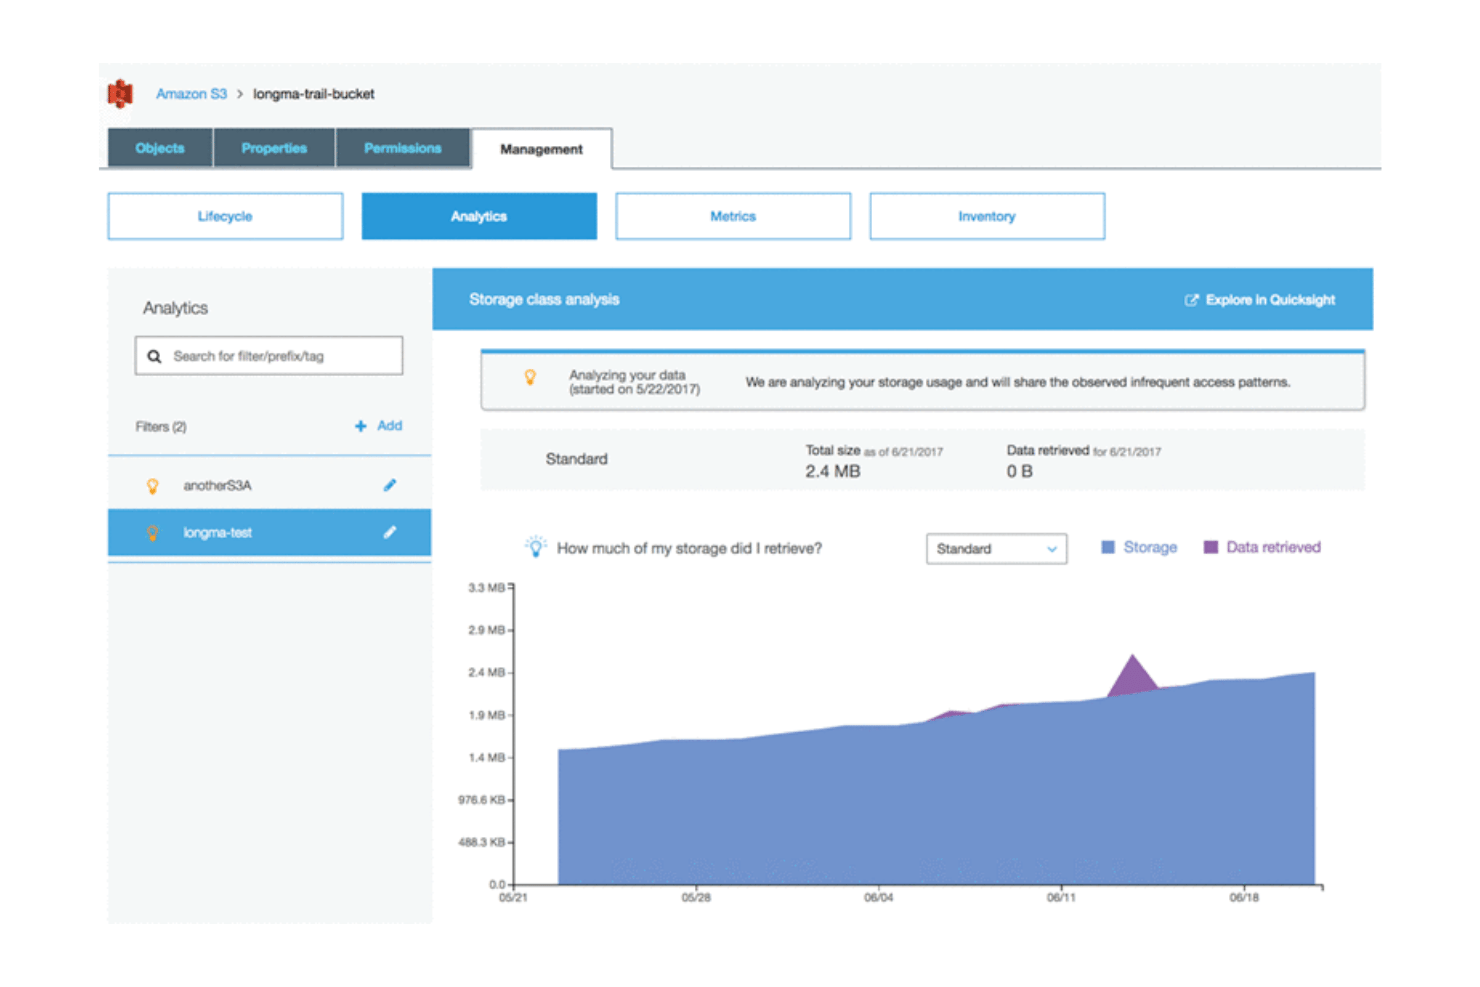
Amazon S3 est le service de stockage d'objets d'AWS qui constitue la couche de stockage fondamentale des lacs de données. Il prend en charge tous les formats de données à l'échelle de l'exaoctet, avec des classes de stockage hiérarchisées, une gestion native des tables Apache Iceberg via S3 Tables et une intégration étroite dans tout l'écosystème analytique AWS.
À qui Amazon S3 convient-il le mieux ?
Amazon S3 convient parfaitement aux équipes d'ingénierie des données et d'infrastructure qui créent des pipelines analytiques sur AWS et qui ont besoin d'une base de stockage éprouvée à l'échelle de l'exaoctet, se connectant directement au reste de l'écosystème AWS.
Pourquoi ai-je choisi Amazon S3 ?
Amazon S3 figure dans ma sélection parce qu'il constitue la couche de stockage d'objets sur laquelle sont déjà construits la plupart des lacs de données en production. J'apprécie particulièrement le fait que S3 Tables offre une prise en charge native d'Apache Iceberg avec des transactions ACID, le voyage dans le temps et la compaction automatique intégrés, résolvant ainsi le problème des petits fichiers qui affecte la plupart des architectures de lacs de données. Ajoutez à cela S3 Intelligent-Tiering, qui déplace automatiquement les données froides vers une classe facturée 0,00099 $/Go/mois, et vous bénéficiez d'un contrôle sérieux des coûts de stockage sans intervention manuelle.
Principales fonctionnalités d'Amazon S3
- Ingestion multiformat : S3 accepte tous les types de fichiers — Parquet, ORC, Avro, JSON, CSV et formats non structurés — via des chargements par lots, des flux transmis par Kinesis et MSK, ou des déclencheurs pilotés par les événements utilisant les notifications d'événements S3.
- Contrôle d'accès précis avec Lake Formation : Appliquez des politiques d'accès aux données au niveau de la table, de la colonne, de la ligne et de la cellule dans l'ensemble de votre lac de données reposant sur S3, sans dupliquer les données.
- S3 Vectors : Service natif de stockage et d'interrogation d'index vectoriels intégré directement à S3, conçu pour la recherche sémantique et les charges de travail de génération augmentée par récupération, avec un coût jusqu'à 90 % inférieur à celui des approches traditionnelles.
- S3 Inventory : Générez des rapports planifiés sur les attributs des objets, la classe de stockage, l'état du chiffrement et l'état de la réplication dans vos compartiments, pour les flux de travail d'audit et de gouvernance.
Intégrations d'Amazon S3
Amazon S3 propose des intégrations natives dans AWS, notamment avec AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum et Amazon SageMaker. Il se connecte également à Apache Spark, Trino, Snowflake, Databricks, Tableau et Power BI grâce à des connecteurs et des API documentés.
Pros and Cons
Pros:
- Le stockage d'objets à l'échelle de l'exaoctet prend en charge tous les formats de données
- Tables Iceberg ACID intégrées avec compaction automatique
- 143 certifications de conformité et contrôle d'accès au niveau des objets
Cons:
- La tarification est complexe et nécessite une gestion rigoureuse
- La création d'un lac de données nécessite l'assemblage de plusieurs services AWS
Idéal pour les lacs de données d’entreprise natifs de Microsoft
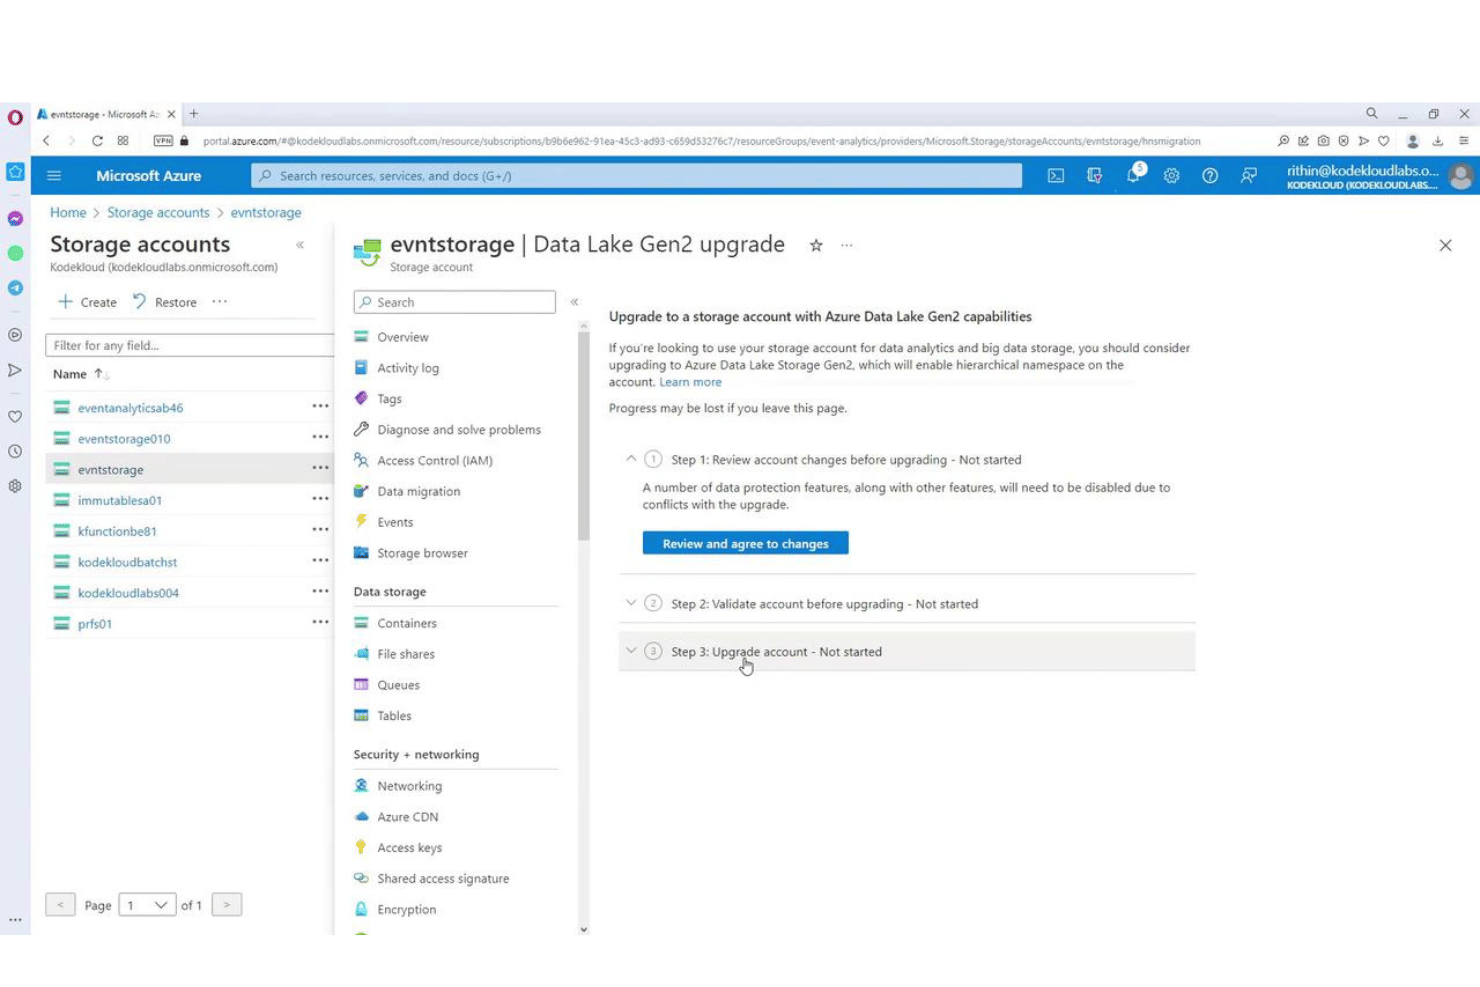
Azure Data Lake Storage Gen2 est le service de stockage de lacs de données infonuagiques de Microsoft, basé sur Azure Blob Storage avec un espace de noms hiérarchique, qui prend en charge le stockage à l’échelle de l’exaoctet, l’ingestion de données multiformat, les contrôles d’accès conformes à POSIX et l’intégration native avec l’écosystème d’analyse et de ML d’Azure.
À qui Azure Data Lake Storage convient-il le mieux ?
Azure Data Lake Storage Gen2 convient naturellement aux équipes informatiques et aux équipes de données des entreprises qui utilisent déjà Microsoft Azure et qui ont besoin d’un stockage à l’échelle de l’exaoctet étroitement intégré à Synapse, Databricks et Microsoft Fabric.
Pourquoi j’ai choisi Azure Data Lake Storage
J’ai choisi Azure Data Lake Storage Gen2 comme l’une des meilleures solutions, car il constitue la base de stockage native de toute la pile d’analyse Microsoft, et cette intégration étroite est importante à l’échelle de l’entreprise. Lorsque votre organisation utilise Synapse, Databricks et Microsoft Fabric, ADLS Gen2 est déjà la couche sous-jacente à tous ces services, ce qui signifie qu’une seule copie des données peut être interrogée par chaque moteur via le pilote ABFS. J’apprécie particulièrement les listes de contrôle d’accès conformes à POSIX, qui permettent de définir des autorisations de lecture/écriture/exécution au niveau de chaque fichier et répertoire, et pas seulement au niveau du conteneur.
Fonctionnalités clés d’Azure Data Lake Storage
- Hiérarchisation automatisée du cycle de vie : Définissez des stratégies qui déplacent automatiquement les données entre les niveaux Chaud, Froid, Très froid et Archive en fonction de leur ancienneté ou de leur dernière date d’accès afin de gérer les coûts de stockage à grande échelle.
- Compatibilité avec le pilote ABFS : Le pilote Azure Blob File System fournit aux charges de travail basées sur Hadoop, Spark, Hive et HDFS un accès natif en lecture/écriture à ADLS Gen2 sans modification du code.
- Raccourcis OneLake : Créez des références dynamiques vers des données situées dans d’autres espaces de travail OneLake, dans Amazon S3 ou dans des conteneurs Azure Blob Storage, sans copier ni déplacer les données sous-jacentes.
- Intégration aux magasins de données Azure Machine Learning : Enregistrez directement les conteneurs ADLS Gen2 comme magasins de données dans les espaces de travail Azure ML, afin de donner aux scientifiques des données un accès direct aux données du lac pour l’entraînement des modèles et l’expérimentation.
Intégrations d’Azure Data Lake Storage
Azure Data Lake Storage propose des intégrations natives dans l’écosystème Microsoft, notamment avec Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning et Azure Event Hubs. Il prend également en charge Apache Spark et Kafka grâce à des connecteurs documentés, ainsi que ABFS et des API pour l’accès personnalisé aux données.
Pros and Cons
Pros:
- Intégration native avec les outils d’analyse Microsoft
- L’espace de noms hiérarchique prend en charge un contrôle d’accès granulaire
- Formats de tables ouverts via la couche de calcul
Cons:
- Purview est requis pour le catalogage avancé des données
- Disponible uniquement sur Microsoft Azure
Autres outils de lac de données
Voici quelques autres options d’outils de lac de données qui ne figurent pas dans ma sélection, mais qui méritent tout de même votre attention :
- IBM watsonx.data
Idéal pour un lac de données analytique ouvert avec accès aux données d’ordinateurs centraux
- Microsoft Fabric
Ideale per l'integrazione del data lake nell'ecosistema Microsoft
- Starburst
Idéal pour le SQL fédéré sur des lacs multicloud
- Alibaba Cloud Hybrid Cloud
Idéal pour les déploiements de lacs de données cloud hybrides dans la région APAC
- Teradata Vantage
Idéal pour les charges de travail d’IA/ML sur des données de lac à l’échelle du pétaoctet
- MinIO
Idéal pour le stockage lakehouse sur site et l’IA


How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Comment choisir des outils de lac de données
Quels facteurs influencent réellement la capacité d’un outil de lac de données à fournir la scalabilité, la gouvernance et l’intégration dont votre équipe a besoin pour les charges de travail d’analytique en conditions réelles ?
| Si votre priorité est... | Recherchez... |
|---|---|
| La conformité réglementaire | La journalisation des audits et les politiques d’accès intégrées |
| Un déploiement multicloud ou hybride | La prise en charge native de plusieurs fournisseurs cloud |
| L’indépendance vis-à-vis des fournisseurs | La compatibilité avec les formats de tables ouverts |
| Les performances analytiques à grande échelle | Le stockage hiérarchisé et l’intégration native aux moteurs de requêtes |
| La préparation à l’IA et au ML | Des connecteurs directs vers les outils et moteurs d’IA/ML |
Comment évaluer votre sélection
- Confirmez les fonctionnalités de gouvernance : demandez des captures d’écran de la console d’administration montrant le contrôle d’accès basé sur les rôles et la configuration du journal d’audit.
- Testez la prise en charge des formats ouverts : effectuez une ingestion en direct de fichiers Parquet ou Iceberg et vérifiez l’évolution du schéma dans un environnement d’essai.
- Validez les affirmations concernant le multicloud : demandez une documentation publique présentant les étapes de déploiement sur au moins deux fournisseurs cloud.
- Vérifiez l’intégration analytique : demandez un exemple de flux de travail ou une configuration pour Spark, Trino ou Presto, avec des résultats de requêtes documentés.
- Compromis — suite d’entreprise ou lakehouse ouvert : déterminez si vous avez besoin de la conformité et de l’assistance d’une suite clé en main, ou si la flexibilité et la compatibilité avec une pile ouverte sont plus importantes pour votre architecture.
Que sont les outils de lac de données ?
Les outils de lac de données sont des plateformes et des logiciels qui vous aident à stocker, gérer et analyser de grands volumes de données structurées et non structurées dans un référentiel centralisé. Ces outils permettent à votre équipe d’ingérer des données brutes, d’appliquer un schéma lorsque cela est nécessaire et d’organiser les ressources pour les projets d’analytique ou d’IA. Vous pouvez vous attendre à des fonctionnalités prenant en charge la gouvernance, la scalabilité et l’intégration avec les moteurs de requêtes et les plateformes d’analytique populaires.
Fonctionnalités des outils de lac de données
Lors de la sélection d’outils de lac de données, soyez attentif aux fonctionnalités clés suivantes :
- Stockage d’objets évolutif : Permet de stocker et de gérer des pétaoctets de données structurées et non structurées, avec des options de stockage par niveaux ou à froid pour maîtriser les coûts à mesure que vos besoins de stockage augmentent.
- Prise en charge des schémas à la lecture : Permet de déposer d’abord les données brutes et d’appliquer un schéma ultérieurement au moment de l’interrogation, ce qui facilite la gestion d’ensembles de données diversifiés et évolutifs sans rechargement.
- Ingestion de données multiformat : Prend en charge l’importation de données dans divers formats tels que Parquet, Avro, JSON, ORC et CSV, et accepte à la fois les sources de données par lots et en continu pour offrir davantage de flexibilité dans la manière dont les données arrivent.
- Intégration aux moteurs de requêtes : Offre une compatibilité avec des moteurs tels que Spark, Trino, Presto ou Athena, afin que vous puissiez exécuter directement des charges de travail d’analyse et de création de rapports sur votre lac de données, sans intergiciel supplémentaire.
- Gestion des métadonnées et des catalogues : Comprend des outils de catalogage des données, de recherche d’actifs, de suivi de la traçabilité et d’étiquetage, qui vous aident à garder les données organisées et faciles à trouver à mesure que de nouveaux ensembles de données sont ajoutés.
- Gouvernance et contrôles d’accès : Offre des autorisations granulaires, le chiffrement et la journalisation des audits afin que vous puissiez contrôler qui accède à quelles données, surveiller l’utilisation et respecter les exigences réglementaires.
- Gestion des versions et exploration temporelle des données : Permet de suivre les modifications, de revenir à des versions antérieures des ensembles de données et de conserver des vues historiques, ce qui est précieux pour l’audit, la récupération et la reproductibilité.
- Intégration aux outils d’orchestration : Se connecte nativement à des orchestrateurs de flux de travail tels qu’Apache Airflow, ce qui vous permet d’automatiser les pipelines de données et de coordonner les tâches entre les systèmes.
- Outils de surveillance et de gestion des coûts : Fournit des tableaux de bord et des alertes concernant l’utilisation du stockage, les modes d’accès et les coûts, afin que vous puissiez maintenir un environnement efficace et économique.
- Prise en charge des formats de tables ouverts : Accepte des formats tels que Delta Lake ou Apache Iceberg, permettant des fonctionnalités avancées comme les transactions ACID et l’interopérabilité avec plusieurs outils d’analyse.
Fonctionnalités d’IA courantes des outils de lac de données
Au-delà des fonctionnalités standard des outils de lac de données énumérées ci-dessus, bon nombre de ces solutions intègrent l’IA grâce à des fonctionnalités telles que :
- Classification automatisée des données : Utilise des modèles d’IA pour analyser et catégoriser les données entrantes en fonction de leur contenu, de leur sensibilité ou des exigences de conformité. Cela aide votre équipe à organiser plus rapidement les actifs et à appliquer les contrôles d’accès appropriés sans étiquetage manuel.
- Détection des anomalies pour la qualité des données : Applique des algorithmes d’apprentissage automatique pour surveiller les flux de données et signaler les schémas inhabituels, les valeurs manquantes ou les valeurs aberrantes. Cela vous permet de détecter rapidement les problèmes d’intégrité des données et de réduire le risque d’analyses erronées ou d’erreurs en aval.
- Optimisation prédictive des charges de travail : Exploite l’IA pour analyser les schémas historiques de requêtes et l’utilisation du stockage, puis recommande ou applique automatiquement des optimisations telles que le partitionnement, la mise en cache ou la mise à l’échelle des ressources. Cela vous aide à maintenir les performances et à maîtriser les coûts à mesure que l’utilisation augmente.
- Interfaces de requêtes en langage naturel : Intègre des outils de discussion ou de recherche alimentés par l’IA qui permettent aux utilisateurs de poser des questions sur les données en langage courant. Cela réduit les obstacles pour les utilisateurs non techniques qui souhaitent explorer des ensembles de données et produire des informations sans écrire de requêtes SQL ni de code.
- Enrichissement automatisé des métadonnées : Utilise l’IA pour extraire le contexte, les relations et les termes métier des données brutes, puis renseigne le catalogue de données avec des descriptions plus riches et des informations de traçabilité. Cela permet aux équipes de découvrir, d’exploiter en toute confiance et de réutiliser plus facilement les actifs de données.
Avantages des outils de lac de données
La mise en œuvre d’outils de lac de données offre plusieurs avantages à votre équipe et à votre entreprise. En voici quelques-uns dont vous pouvez bénéficier :
- Gestion centralisée des données : Les outils de lac de données vous permettent de stocker des données structurées et non structurées au même endroit, ce qui facilite l’organisation des ressources et la prise en charge des projets d’analyse ou d’IA.
- Évolutivité pour les charges de travail à l’échelle du pétaoctet : Ces plateformes peuvent gérer d’immenses volumes de données et prendre en charge des niveaux de stockage cloud et sur site, afin de vous permettre de vous adapter à l’augmentation des besoins sans revoir l’architecture.
- Ingestion flexible des données : Vous pouvez ingérer des données provenant d’une grande variété de formats et de sources, et gérer à la fois les flux par lots et en temps réel grâce aux connecteurs intégrés et à la prise en charge des formats.
- Gouvernance et contrôle des accès granulaires : Les autorisations détaillées, le chiffrement et la journalisation des audits vous aident à maintenir la sécurité et la conformité avec des normes telles que HIPAA, SOC 2 et GDPR.
- Intégration avec les outils d’analyse et d’IA : La compatibilité native avec des moteurs de requêtes comme Spark, Trino et Presto, ainsi que les connecteurs directs vers les outils d’IA/ML, vous permet d’analyser les données sans délai ni travail d’intégration supplémentaire.
- Gestion automatisée des métadonnées et de la qualité des données : De nombreuses plateformes incluent des catalogues, le suivi de la traçabilité et des outils pilotés par l’IA qui vous aident à enrichir les métadonnées, à classer les données et à détecter les anomalies afin de préserver l’intégrité des données.
- Prise en charge des formats de tables ouverts et des cas d’utilisation avancés : Des fonctionnalités telles que la compatibilité avec Delta Lake ou Apache Iceberg permettent les transactions ACID, le versionnage des données et le partage de données sans copie afin de prendre en charge des analyses plus avancées et des architectures multicloud.
Coûts et tarifs des outils de lac de données
La sélection d’outils de lac de données nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et d’autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions d’outils de lac de données :
Tableau comparatif des forfaits des outils de lac de données
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Forfait gratuit | $0 | Stockage d’objets de base, ingestion limitée des données, prise en charge du schéma à la lecture et intégration avec un moteur de requêtes. |
| Forfait personnel | $50–$300/mois | Limites de stockage plus élevées, prise en charge de plusieurs formats de données, catalogage de base et intégration avec des outils d’analyse. |
| Forfait professionnel | $1,000–$5,000/mois | Stockage à l’échelle du pétaoctet, contrôles de gouvernance avancés, options multicloud et fonctionnalités de catalogage des données. |
| Forfait entreprise | $10,000+/mois | Stockage illimité, fonctionnalités complètes de conformité, automatisation optimisée par l’IA, intégration avec des outils d’orchestration et assistance premium. |
FAQ sur les outils de lac de données
Voici quelques réponses aux questions courantes sur les outils de lac de données :
Comment les outils de lac de données gèrent-ils les exigences de sécurité et de conformité ?
Les outils de lac de données assurent la sécurité grâce aux contrôles d’accès, au chiffrement et à la journalisation des audits. La plupart des plateformes de premier plan prennent en charge des autorisations granulaires jusqu’au niveau de la ligne ou de la colonne, ainsi que des intégrations avec les fournisseurs de SSO et de gestion des identités. Pour la conformité, recherchez des certifications de fournisseurs telles que SOC 2, HIPAA ou GDPR, ainsi que des options de clés de chiffrement gérées par le client. Ces fonctionnalités vous aident à répondre aux exigences réglementaires sans créer de couches supplémentaires.
Les outils de lac de données peuvent-ils s’intégrer aux plateformes d’analyse ou de BI existantes ?
Oui, la plupart des outils de lac de données proposent des connecteurs directs pour les plateformes d’analyse et de BI. Vous pouvez vous attendre à une prise en charge native de Spark, Trino, Presto et Athena, ainsi qu’à des intégrations avec Tableau et Power BI. Si vos équipes utilisent des outils spécialisés, vérifiez la disponibilité d’API ouvertes ou de pilotes ODBC/JDBC permettant de connecter des flux de travail personnalisés.
Quelle est la différence entre les outils de lac de données et les entrepôts de données ?
Les outils de lac de données se concentrent sur le stockage de données brutes, semi-structurées et non structurées à l’aide d’un schéma appliqué à la lecture, tandis que les entrepôts de données stockent des données structurées avec des schémas prédéfinis (schéma appliqué à l’écriture). Les lacs de données sont mieux adaptés à l’ingestion flexible et aux charges de travail d’IA/ML, tandis que les entrepôts conviennent aux analyses préparées avec des performances de requête optimisées. Certains fournisseurs proposent désormais des architectures lakehouse qui combinent les deux approches.
Les outils de lac de données prennent-ils en charge plusieurs formats et types d’ingestion de données ?
Oui, la plupart des outils de lac de données acceptent un large éventail de formats tels que Parquet, Avro, JSON, ORC et CSV. Ils prennent également en charge les sources de données par lots et en continu, ce qui permet de gérer aussi bien les tâches d’ingestion quotidiennes que les flux d’événements en temps réel à l’aide de connecteurs prédéfinis ou personnalisés.
Comment évaluez-vous l’évolutivité des outils de lac de données ?
J’examine les options de stockage objet de chaque plateforme, ses performances avec des charges à l’échelle du pétaoctet et sa prise en charge multicloud. La possibilité de répartir le stockage par niveaux, de traiter les données entre plusieurs régions et d’éviter les goulots d’étranglement grâce à des formats comme Delta Lake ou Iceberg est essentielle. Veillez à consulter les tests de performance documentés et à recueillir des références auprès de clients dont les volumes de données sont similaires aux vôtres.
Les formats de tables ouverts comme Delta Lake ou Apache Iceberg sont-ils importants ?
Oui, les formats de tables ouverts sont importants si vous souhaitez bénéficier de transactions ACID, du versionnage et d’une gestion des données indépendante des fournisseurs. Ils permettent d’activer des fonctionnalités comme le voyage dans le temps et le partage de données sans copie. Si vous visez un modèle lakehouse ou souhaitez pérenniser votre architecture, exigez la compatibilité avec les formats ouverts au sein de votre outil de lac de données.