

Les outils de récupération de données web sont des applications qui automatisent l’extraction de données à partir de sites web, ce qui simplifie la collecte d’informations sans avoir à effectuer de copier-coller manuellement. Si vous recherchez les meilleurs outils de récupération de données web, vous devez probablement recueillir de gros volumes de données web de manière fiable, sans vous heurter à des obstacles tels que les protections anti-robots ou les changements de structure des sites.
Avec autant d’options disponibles sur le marché, il est difficile de savoir quel outil s’intégrera réellement à votre environnement technique, prendra en charge les sites ciblés et évoluera avec vos besoins. Ce guide présente les meilleurs outils afin que vous puissiez comparer leurs fonctionnalités et leurs approches, et trouver exactement ce qui convient à vos projets informatiques.
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

Résumé des meilleurs outils de récupération de données web
Ce tableau comparatif résume les tarifs de mes meilleurs outils de récupération de données web afin de vous aider à trouver celui qui convient le mieux à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour le contrôle navigateur sans tête intégré | Offre gratuite disponible | À partir de $30/mois | Website | |
| 2 | Idéal pour le scraping furtif et le contournement de la détection | Essai gratuit de 14 jours | À partir de 69 $/mois | Website | |
| 3 | Idéal pour gérer les sites web dynamiques en JavaScript | Offre gratuite disponible | À partir de $189/mois | Website | |
| 4 | Idéal pour l’intégration directe aux pipelines | Essai gratuit de 30 jours | À partir de $199/mois (facturé annuellement) | Website | |
| 5 | Idéal pour les modèles de robots préconçus | Offre gratuite disponible | À partir de 19 $/mois (facturé annuellement) | Website | |
| 6 | Idéal pour une infrastructure proxy à l’échelle entreprise | Offre gratuite disponible | À partir de 1,5 $/1 000 enregistrements/mois | Website | |
| 7 | Meilleure pour la détection automatique de schémas de données | Essai gratuit de 30 jours | À partir de $0,13/1 000 requêtes | Website | |
| 8 | Idéal pour des workflows de scraping simples et pilotés par API | Formule gratuite disponible | À partir de $49/mois | Website | |
| 9 | Idéal pour la rotation d'IP sans effort à grande échelle | Essai gratuit de 7 jours | À partir de 49 $/mois | Website | |
| 10 | Idéal pour les utilisateurs d’une interface en point-and-click | Offre gratuite disponible | À partir de 69 $/mois (facturé annuellement) | Website |


Avis sur les meilleurs outils de récupération de données web
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils de récupération de données web qui ont été retenus dans ma sélection. Mes avis offrent un examen approfondi des fonctionnalités, des intégrations et des meilleurs cas d’utilisation de chaque outil pour vous aider à trouver celui qui vous convient le mieux.
 Idéal pour le contrôle navigateur sans tête intégré
- Offre gratuite disponible
- À partir de $30/mois
Visit WebsiteCustomer Rating:4.9/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.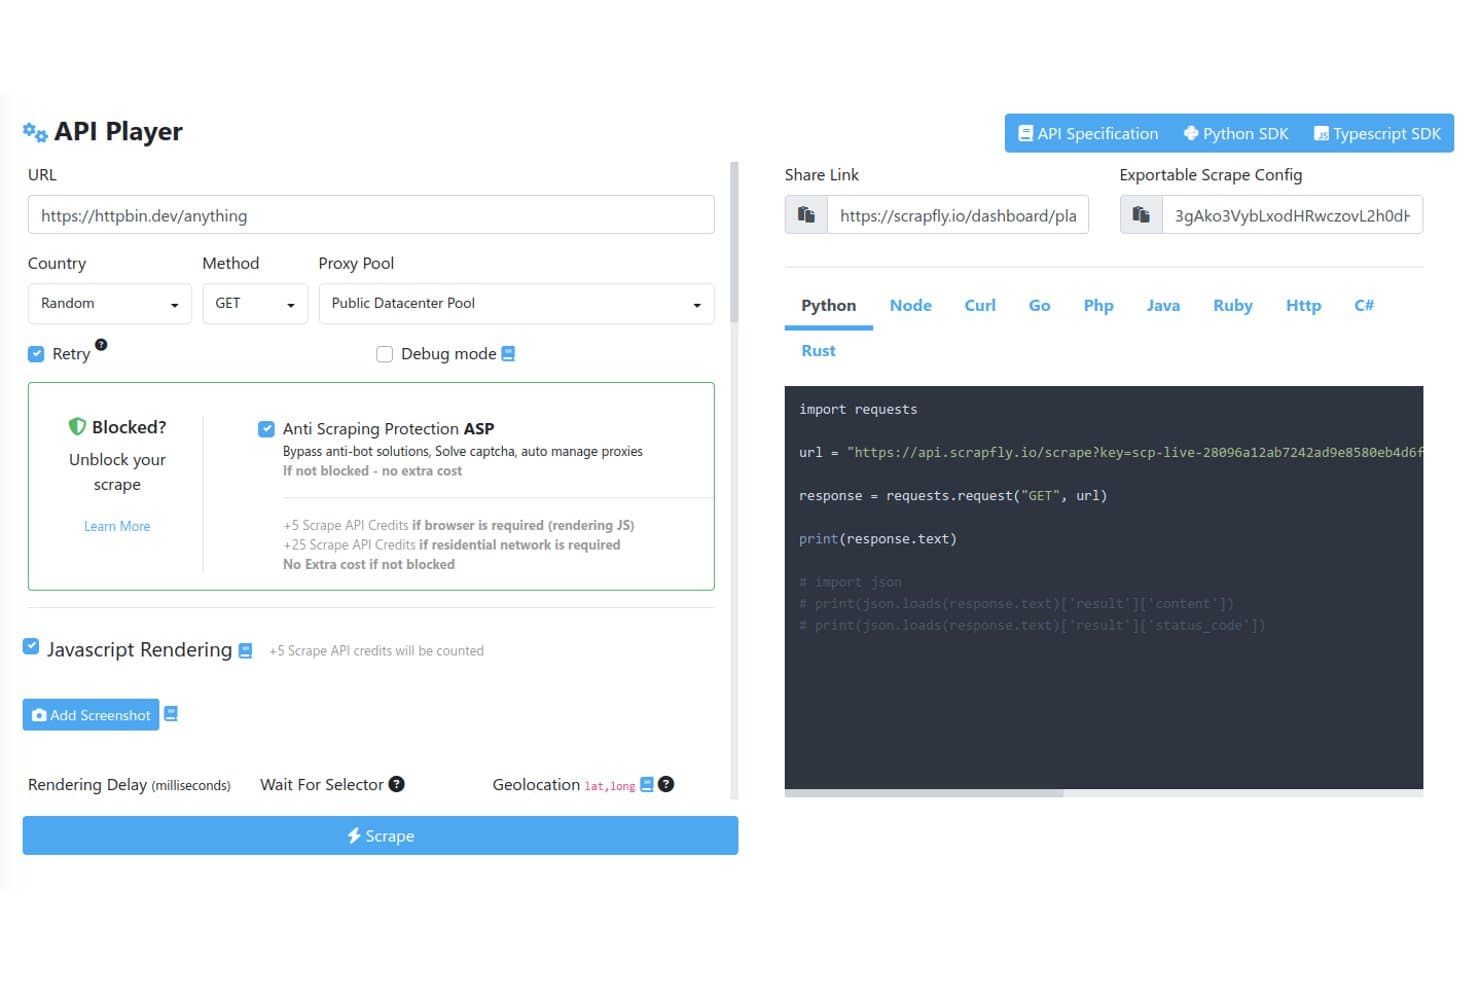
Scrapfly propose un API Player interactif avec des options de scraping configurables, dont les pools de proxys, le contournement des protections anti-scraping, le rendu JavaScript et la génération automatique de snippets de code en plusieurs langages. Scrapfly est une API de web scraping qui combine rotation de proxy, contournement des protections anti-bot, rendu via navigateur sans tête, exploration de sites, capture d’écran et extraction de données alimentée par LLM, le tout sous une seule clé d’API.
À qui s'adresse Scrapfly ?
Scrapfly est particulièrement adapté aux développeurs et ingénieurs data qui souhaitent une API de scraping orientée code, avec des SDKs pour Python, TypeScript, Go et Rust.
Pourquoi j'ai choisi Scrapfly
J'ai choisi Scrapfly pour son architecture à double moteur, unique parmi tous mes tests. Curlium gère l’empreinte digitale Chrome JA4 parfaite pour la vitesse, tandis que Scrapium exécute Chromium furtif via CDP avec des empreintes correspondantes, ce qui permet de changer de session au milieu d’un crawl sans déclencher de détection. J’apprécie aussi que Scrapium soit entièrement compatible avec Playwright et Puppeteer, ce qui me permet d’écrire des scénarios JS personnalisés et des règles de type wait-for sans toucher à mon code d’automatisation navigateur existant.
Fonctionnalités clés de Scrapfly
- API d’extraction multi-méthodes : Extrait des données structurées en utilisant CSS, XPath, regex, schéma JSON et modèles pilotés par LLM.
- Pools de proxy intégrés : Propose des proxys datacenter et résidentiels gérés, avec géociblage et prise en charge BYO proxy.
- API de crawler : Parcourt des sites entiers avec contrôle de la profondeur, des limites de débit et du partitionnement de projet.
- Intégrations de planification natives : Prise en charge de Zapier, Make et n8n pour les workflows automatisés, tâches récurrentes et déclencheurs webhook.
Intégrations Scrapfly
Scrapfly propose des intégrations natives avec Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI et OpenClaw. Des SDKs sont également disponibles pour Python, TypeScript, Go et Rust. Une API est proposée pour les intégrations personnalisées.
Pros and Cons
Pros:
- Double moteur navigateur furtif
- Contourne Cloudflare, DataDome et Imperva
- Modèles d’extraction pour types de sites courants
Cons:
- Pas de planificateur de tâches natif intégré
- Pas adapté aux utilisateurs non techniques
Learn more about Scrapfly: Idéal pour le scraping furtif et le contournement de la détection
- Essai gratuit de 14 jours
- À partir de 69 $/mois
Visit WebsiteCustomer Rating:4.7/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.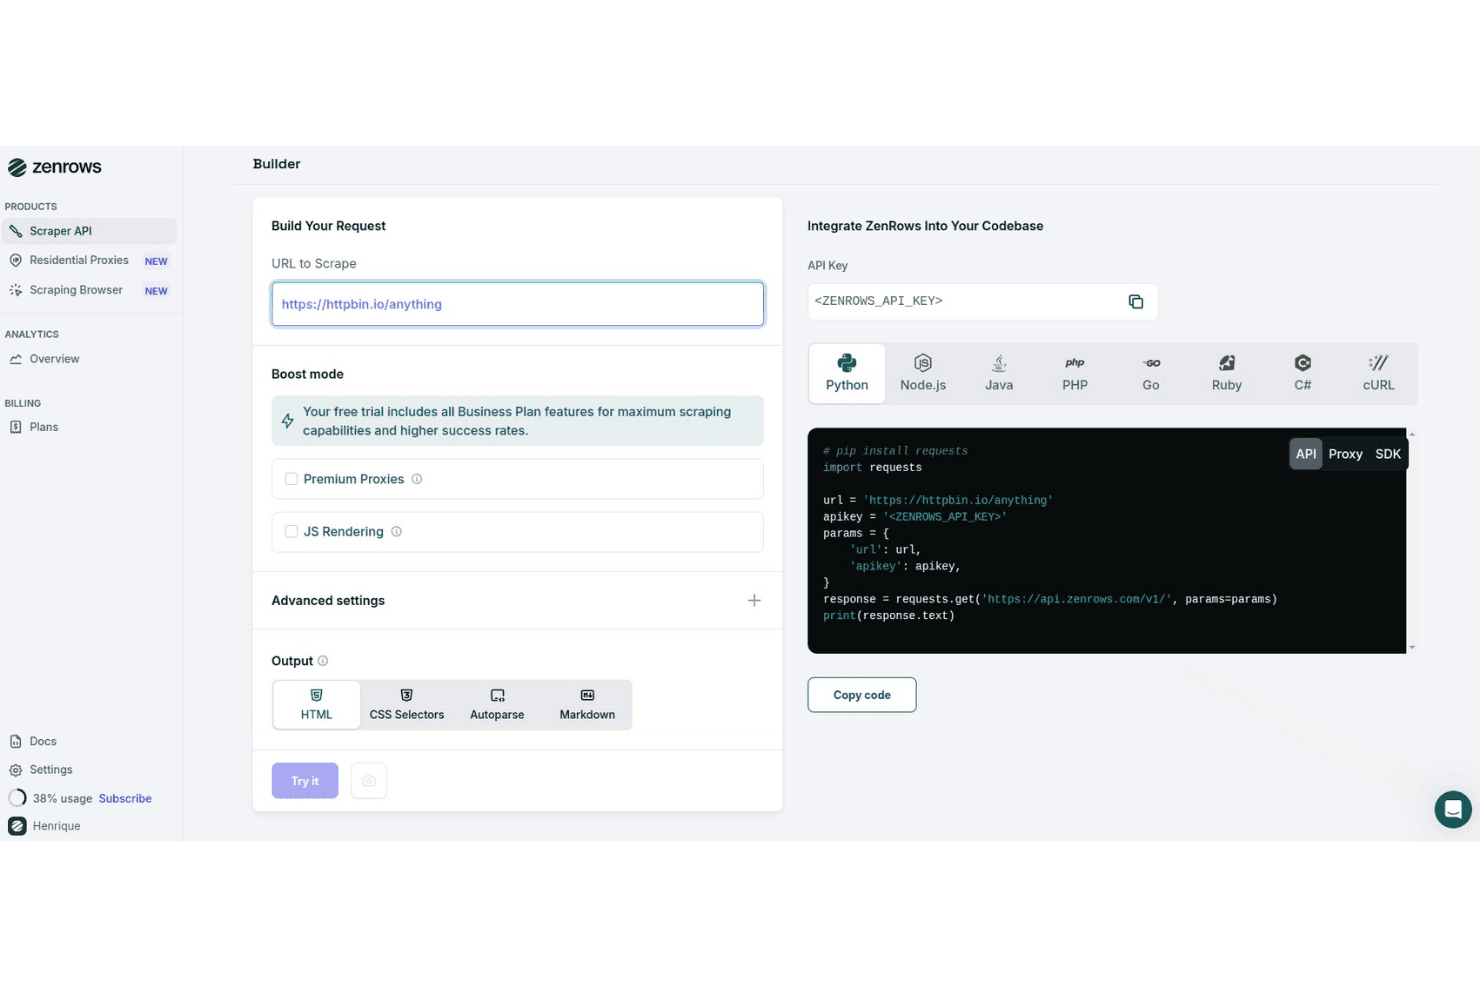
ZenRows propose un générateur de requêtes visuel avec génération de code multilingue, options de boost mode et sélection du format de sortie pour le scraping web. ZenRows est une API de scraping web et une plateforme de navigateur cloud qui combine le contournement des protections anti-bots, la rotation de proxy résidentiel, le rendu JavaScript et l'extraction de données structurées dans un seul outil destiné aux développeurs.
Pour qui ZenRows est-il le mieux adapté ?
ZenRows convient particulièrement aux développeurs et ingénieurs de données qui doivent extraire des données de sites avec une protection anti-bot particulièrement agressive et à grande échelle.
Pourquoi j'ai choisi ZenRows
ZenRows mérite sa place dans ma sélection grâce à sa gestion des systèmes anti-bot. J'ai extrait des données de sites protégés par Cloudflare où les outils classiques échouent constamment, et ZenRows s'en sort grâce au contournement d'empreinte digitale et à la résolution automatique de CAPTCHA sans configuration manuelle. Le Navigateur de Scraping va plus loin en lançant des sessions Chromium complètes avec des en-têtes furtifs qui imitent étroitement le comportement réel des utilisateurs afin d'éviter la détection sur les sites utilisant DataDome ou PerimeterX.
Fonctionnalités clés de ZenRows
- API Universal Scraper : Envoyez des requêtes via un point d'accès unique qui s'adapte à différentes structures de sites et exigences de scraping.
- Infrastructure de proxys résidentiels : Choisissez parmi plus de 55 millions d'adresses IP résidentielles dans plus de 185 pays pour un crawling ciblé en fonction de la géolocalisation.
- Analyse automatique pour une sortie structurée : Extrayez et recevez des données automatiquement au format JSON, HTML ou Markdown avec un parsing intégré pour les sites populaires.
- SDKs multilingues : Accédez à des SDKs officiels pour Python, Node.js, Go, PHP, Ruby, Java et C# afin de vous intégrer dans les flux de développement.
Intégrations ZenRows
ZenRows propose des intégrations natives avec Playwright, Puppeteer, n8n, Make, Clay et Zapier. Une API est disponible pour les intégrations personnalisées.
Pros and Cons
Pros:
- Contourne Cloudflare et DataDome de manière fiable
- Taux de réussite élevé sur les pages protégées
- Sessions complètes de navigateur sans interface avec mode furtif
Cons:
- Pas de planification native ni d'orchestration des tâches
- Les coûts augmentent rapidement avec un volume élevé de requêtes
Learn more about ZenRows: Idéal pour gérer les sites web dynamiques en JavaScript
- Offre gratuite disponible
- À partir de $189/mois
Visit WebsiteCustomer Rating:4.4/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.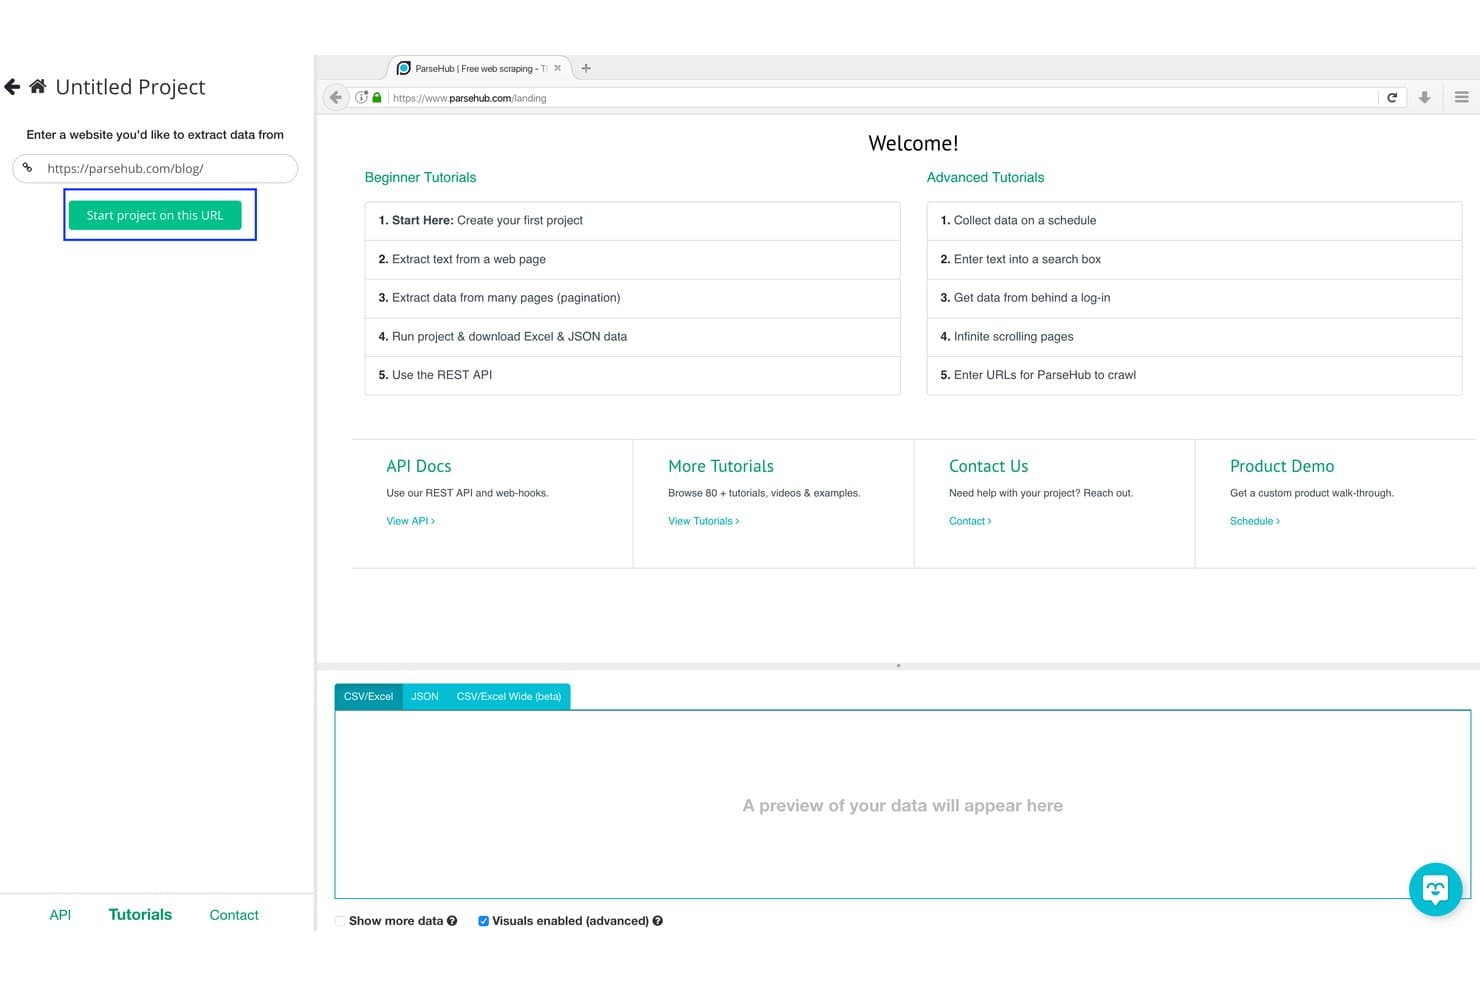
ParseHub propose une interface de configuration de projet visuelle où les utilisateurs saisissent une URL et cliquent sur 'Démarrer le projet sur cette URL' pour commencer à extraire des données des sites web. ParseHub est un outil d'extraction de données web visuel qui permet d'extraire des données depuis des sites dynamiques grâce à une interface basée sur le clic, prenant en charge JavaScript, AJAX, le défilement infini, les champs de saisie de formulaire et l'exécution planifiée dans le cloud.
Pour qui ParseHub est-il le mieux adapté ?
ParseHub convient particulièrement aux analystes en veille concurrentielle et aux chercheurs non techniques qui doivent collecter des données sur des sites riches en JavaScript sans écrire de code.
Pourquoi j'ai choisi ParseHub
ParseHub mérite sa place parmi les meilleurs de ma liste car il gère les défis de rendu JavaScript qui stoppent la majorité des extracteurs sans code. Je l'ai utilisé pour extraire des données depuis des pages à défilement infini et des contenus déclenchés par menu déroulant, là où les extracteurs HTML statiques renvoient des résultats vides. Son moteur d'apprentissage automatique détecte automatiquement la structure de page, ce qui me permet de créer un extracteur fonctionnel pour un catalogue produit rempli d'AJAX sans écrire une seule ligne de XPath.
Fonctionnalités clés de ParseHub
- Éditeur visuel par point et clic : Sélectionnez et extrayez les éléments de la page sans coder manuellement de sélecteurs.
- Planification dans le cloud : Programmez des tâches d'extraction récurrentes sur l'infrastructure cloud de ParseHub.
- Accès à l'API REST : Gérez, déclenchez et téléchargez les résultats d'extraction de manière automatisée via l'API.
- Rotation automatique des adresses IP : Réduisez le blocage en faisant tourner les adresses IP sortantes lors des exécutions cloud.
Intégrations ParseHub
ParseHub propose des intégrations natives avec Google Sheets, Tableau, Dropbox et AWS S3. Une API est disponible pour des intégrations personnalisées et l'automatisation des workflows.
Pros and Cons
Pros:
- Gère nativement JavaScript, AJAX et le défilement infini
- L'éditeur visuel ne nécessite aucune saisie de sélecteur
- Les extractions se font automatiquement sur l'infrastructure cloud
Cons:
- Limite sur les gros volumes d'extractions simultanées
- Pas de résolution CAPTCHA intégrée
Learn more about ParseHub: Idéal pour l’intégration directe aux pipelines
- Essai gratuit de 30 jours
- À partir de $199/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.2/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.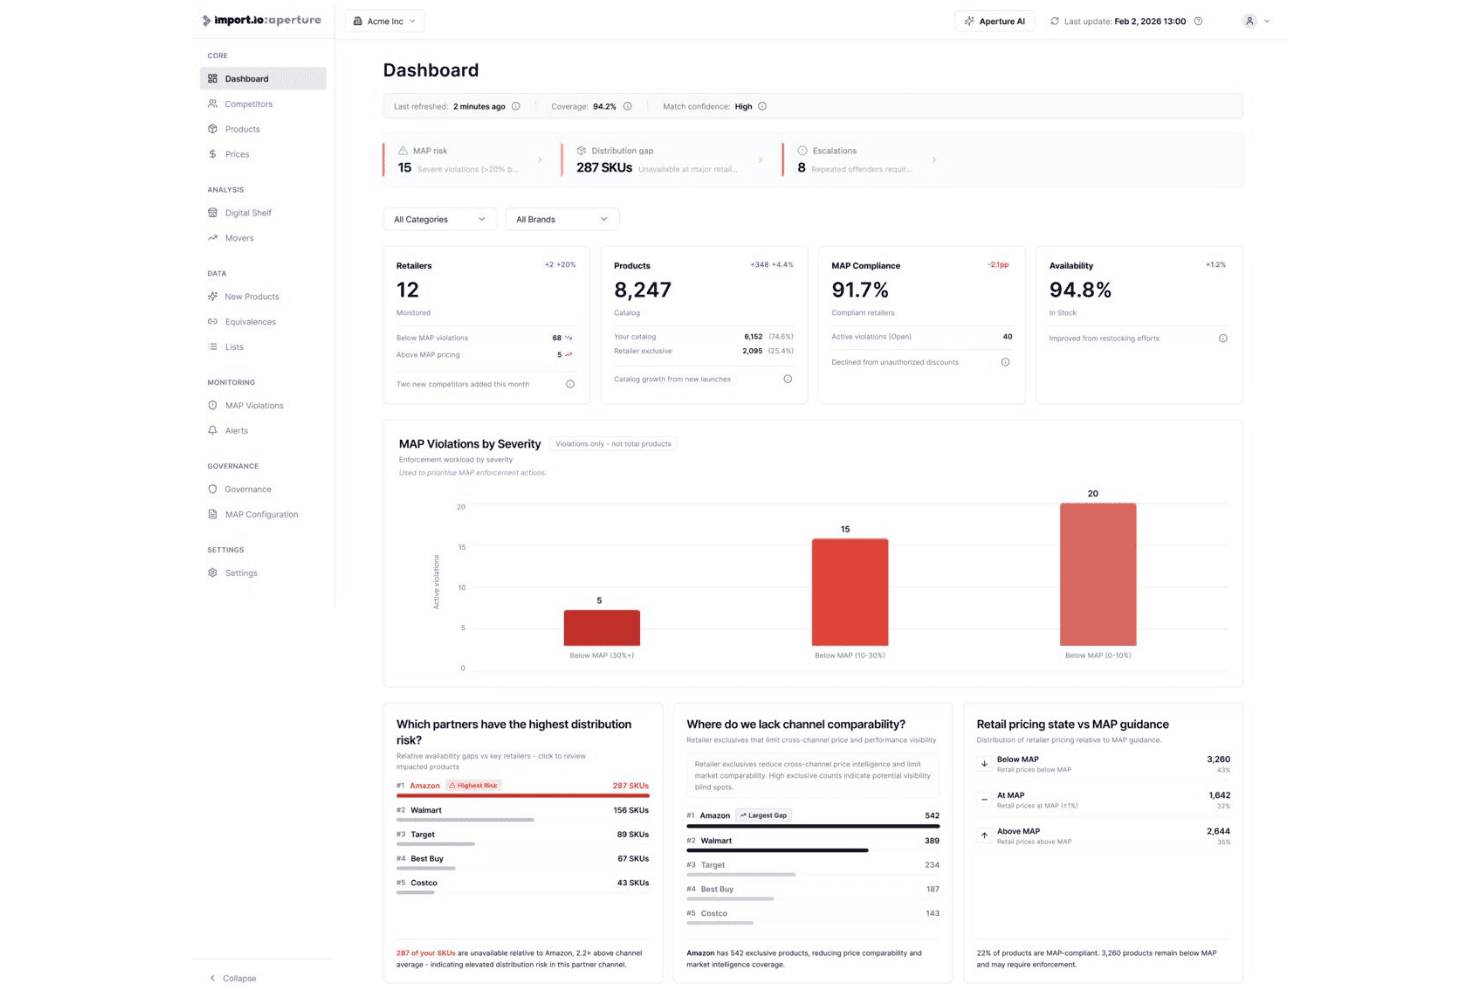
La plateforme Aperture d’Import.io propose un tableau de bord affichant la conformité MAP, la disponibilité des produits, les écarts dans la distribution des détaillants et les violations tarifaires. Import.io est une plateforme de collecte de données web (web scraping) gérée et native à l’IA, qui extrait des données structurées depuis des sites web à l’échelle de l’entreprise, gérant les pages générées en JavaScript, les sources protégées et la livraison directe vers les pipelines de données et les systèmes d’analyse.
À qui s’adresse Import.io ?
Import.io convient aux équipes d’ingénierie de données et d’intelligence concurrentielle au sein d’entreprises moyennes à grandes qui ont besoin de pipelines de données maintenus sans avoir à créer ou gérer des extracteurs en interne.
Pourquoi j’ai choisi Import.io
Import.io mérite sa place sur ma liste parce que les données structurées sont transférées directement du web vers votre entrepôt, tableau de bord ou point de terminaison API sans étape d’exportation manuelle. J’apprécie que les webhooks et la livraison par API soient natifs à la plateforme et non une réflexion après coup. Ce que je trouve le plus précieux, ce sont les pipelines auto-réparateurs : ils s’adaptent automatiquement lorsque les sites cibles sont restructurés, je n’ai donc pas à reconstruire les extracteurs à chaque fois qu’un détaillant modifie la mise en page de sa page.
Principales fonctionnalités d’Import.io
- Modèles d’extraction assistés par IA : Détectent automatiquement la structure des pages et adaptent le schéma au fur et à mesure des changements sur les sites web.
- Gestion des proxys pour entreprises : Prise en charge des proxys premium et résidentiels pour le scraping de sites protégés ou géo-restreints.
- Constructeur visuel pointer-cliquer : Permet de sélectionner et d’extraire des données de pages web complexes sans écrire de code.
- Masquage automatique des données personnelles : Identifie et supprime les informations personnellement identifiables dans les jeux de données collectés afin de respecter la conformité.
Intégrations Import.io
Import.io propose des intégrations natives avec Google Sheets, Power BI, Tableau et Excel, et fournit une API pour des intégrations personnalisées et des webhooks vers d’autres systèmes.
Pros and Cons
Pros:
- Les pipelines auto-réparateurs s’adaptent automatiquement aux changements de sites
- Gère des sites fortement protégés et nécessitant une connexion
- L’extraction gérée réduit la charge de travail des équipes d’ingénierie interne
Cons:
- Transparence limitée sur l’infrastructure de scraping sous-jacente
- Pertinence limitée pour les tâches de scraping à petite échelle
Learn more about Import.io: Idéal pour les modèles de robots préconçus
- Offre gratuite disponible
- À partir de 19 $/mois (facturé annuellement)
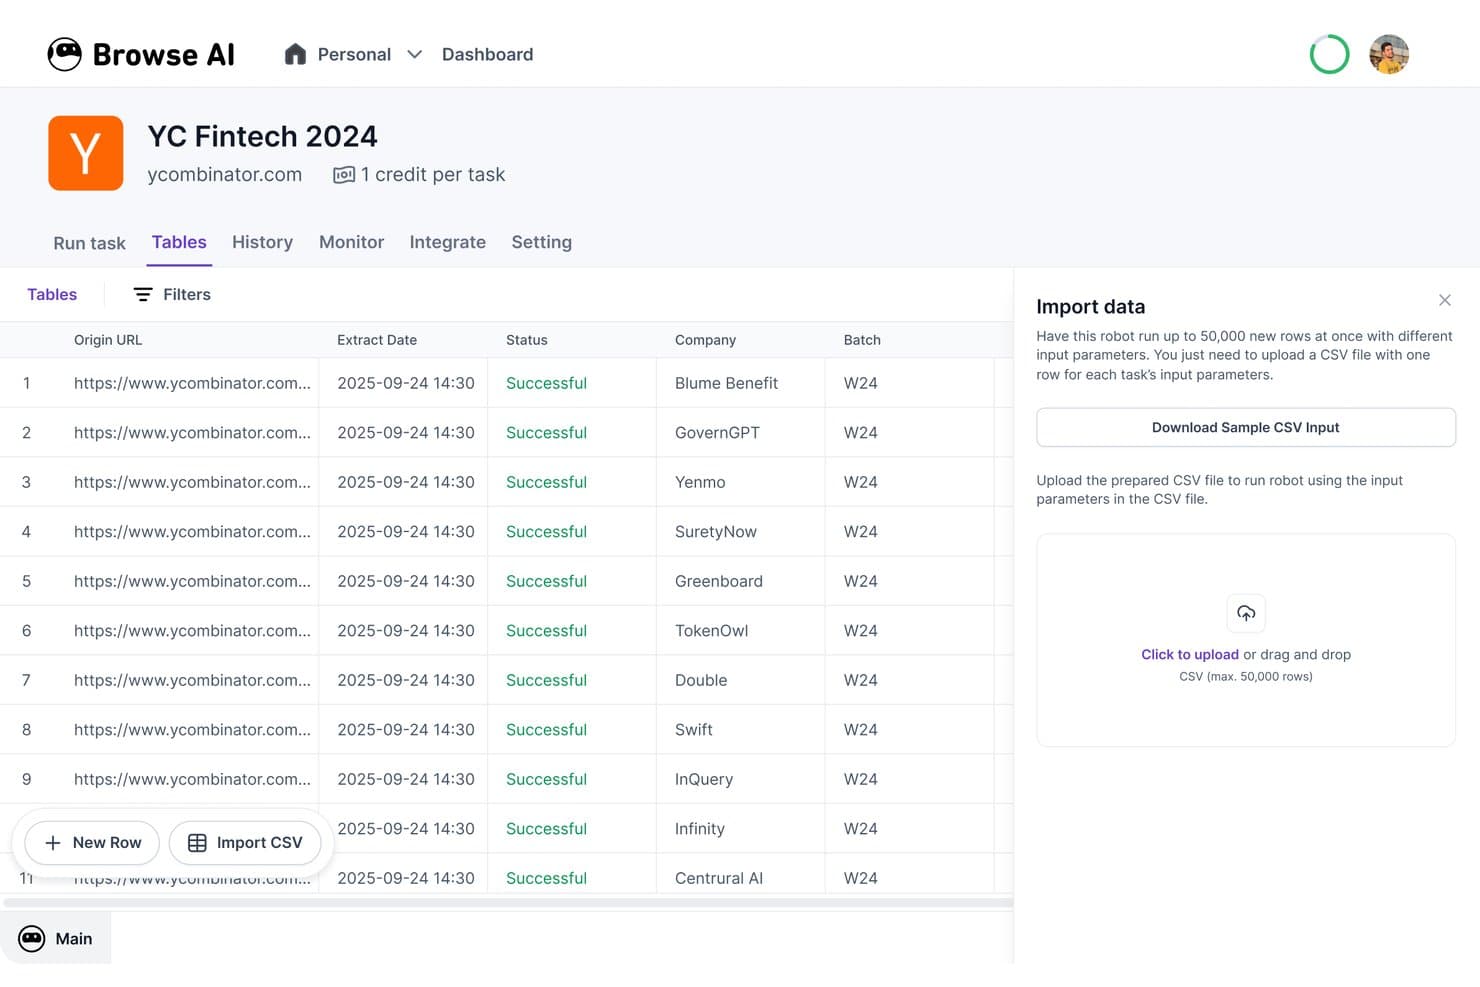
Browse AI propose un tableau de bord de collecte de données web sans code, permettant aux utilisateurs d'extraire des données structurées de sites comme Y Combinator et d'exporter les résultats sous forme de fichiers CSV. Browse AI est une plateforme de collecte de données web et de surveillance de sites sans code, qui combine un extracteur de données visuel point-&-click avec plus de 250 modèles de robots préconçus pour la collecte automatique et planifiée de données depuis des sites web.
Pour qui Browse AI est-il le mieux adapté ?
Browse AI convient parfaitement aux analystes en veille concurrentielle et aux équipes non techniques ayant besoin de collecter des données structurées sans écrire de code.
Pourquoi j'ai choisi Browse AI
J'ai sélectionné Browse AI grâce à l'avance de sa bibliothèque de robots préconçus. Je peux extraire des listes structurées d'Amazon, Google Maps ou Indeed sans avoir à construire un scraper de zéro, et chaque robot gère déjà la pagination et le contenu dynamique propre à ce site. Ce que j'apprécie aussi, c'est l'adaptation automatique de la mise en page par IA, qui met à jour le robot lorsque la structure d'une page cible change, évitant que la collecte ne tombe en panne sans avertissement en plein pipeline.
Fonctionnalités principales de Browse AI
- Rendu JavaScript : Automatisation de l'extraction sur des sites web modernes, riches en JavaScript, et applications monopage.
- Support des proxys résidentiels : Rotation automatique des IP résidentielles pour contourner les systèmes anti-bots sans configuration manuelle.
- Webhooks et accès API : Soumission programmée de tâches d'extraction et récupération des données pour intégration avec des systèmes internes.
- Détection automatique des changements : Surveillance des sites pour tout changement visuel ou de contenu avec alertes lors de la mise à jour.
Intégrations Browse AI
Browse AI propose des intégrations natives avec Google Sheets, Airtable, AWS S3, Zapier et Make.com. L'accès API et webhook est disponible pour les intégrations personnalisées.
Pros and Cons
Pros:
- Plus de 250 robots préconçus prêts à l'emploi
- S'adapte automatiquement aux changements de mise en page des sites cibles
- Gère nativement les CAPTCHAs et pages dynamiques
Cons:
- Contrôle limité des sélecteurs pour les développeurs
- Le coût en crédits augmente rapidement avec le volume
Learn more about Browse AI: Idéal pour une infrastructure proxy à l’échelle entreprise
- Offre gratuite disponible
- À partir de 1,5 $/1 000 enregistrements/mois
Visit WebsiteCustomer Rating:4.7/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.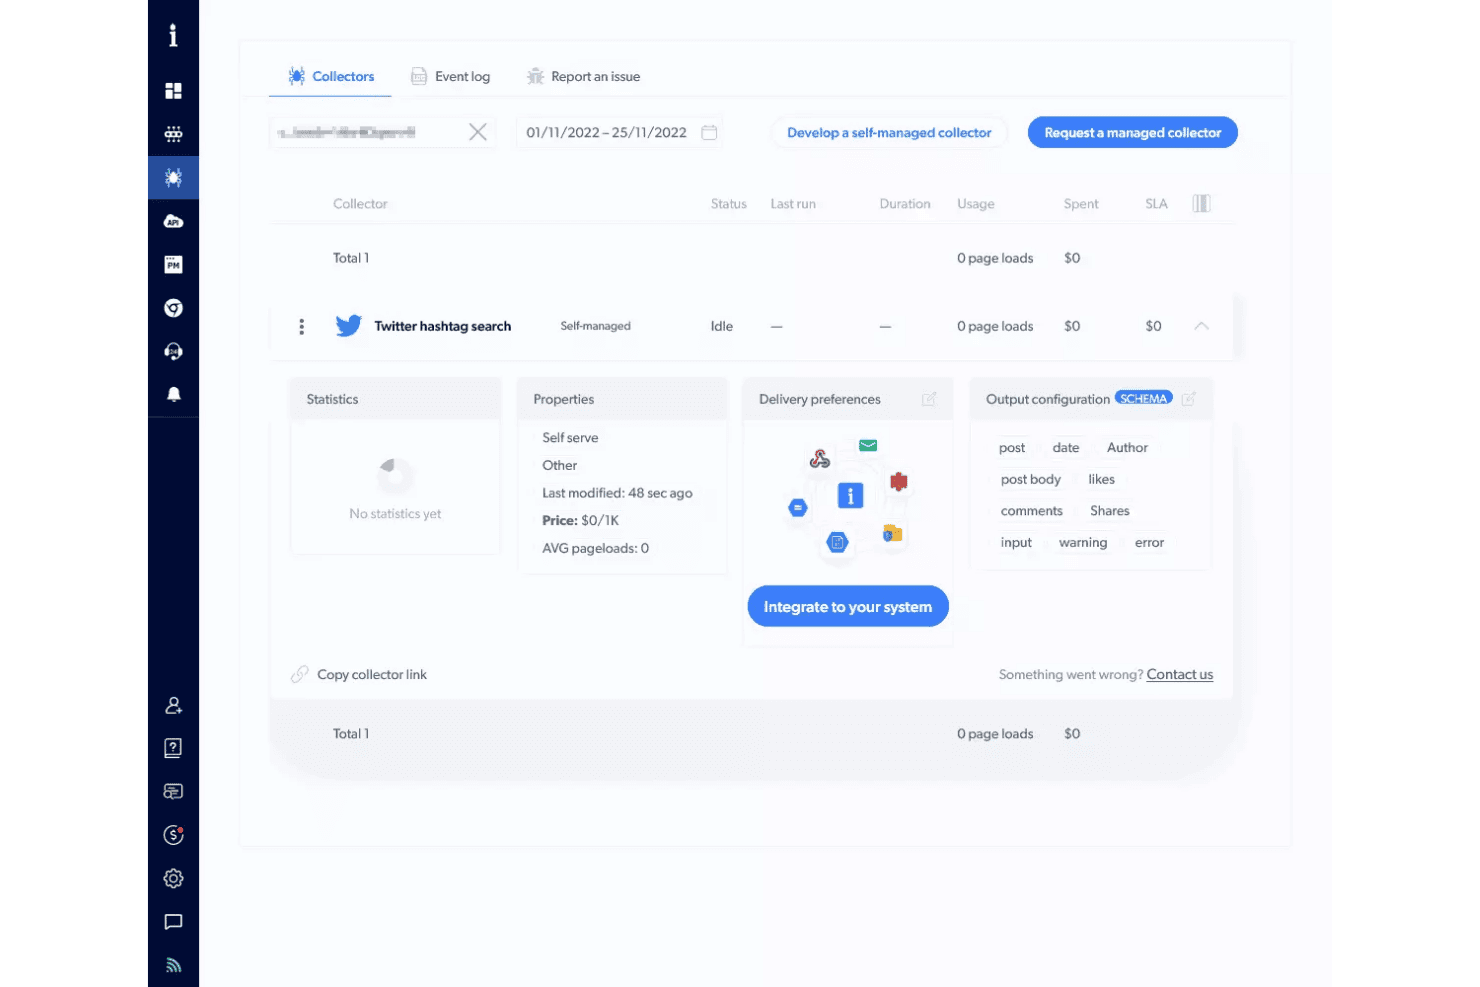
Le tableau de bord Collectors de Bright Data propose un collecteur de recherche de hashtags Twitter avec statut autogéré, configuration de la sortie et options d'intégration système. Bright Data est une API de collecte de données web et une plateforme de scraping sans code qui combine gestion des proxies, rendu JavaScript, résolution de CAPTCHA et livraison de données structurées à travers plus de 1 278 extracteurs préconfigurés pour les sites populaires.
Pour qui Bright Data est-il le mieux adapté ?
Les ingénieurs data et développeurs backend dans des entreprises de taille moyenne à grande qui doivent collecter des données web structurées à grande échelle sans gérer eux-mêmes l'infrastructure proxy.
Pourquoi j'ai choisi Bright Data
Bright Data figure sur ma liste grâce à l'ampleur de son réseau de proxies : plus de 400 millions d'IP résidentielles dans 195 pays, avec rotation automatique, résolution de CAPTCHA et Web Unlocker conçu pour contourner Cloudflare, Akamai et DataDome sans aucune configuration. J'ai récupéré des données en masse sur LinkedIn Sales Navigator et Amazon avec Bright Data sans aucun blocage malgré des milliers de requêtes. L'AI Scraper Studio me permet également de générer en quelques minutes une API de scraping opérationnelle pour tout nouveau domaine.
Fonctionnalités clés de Bright Data
- Modèles d'extracteurs préconfigurés : Plus de 1 200 scrapers prêts à l'emploi sont disponibles pour un déploiement rapide sur les principales plateformes comme LinkedIn, Amazon et YouTube.
- Détection de schéma propulsée par l'IA : L'AI Scraper Studio génère des schémas de sortie personnalisés et automatise la correspondance des données sur de nouveaux domaines.
- APIs de gestion des tâches : Offre la planification par lots, des exécutions récurrentes et des déclencheurs webhook pour l'intégration aux outils d'automatisation des workflows.
- Livraison directe des données : Prise en charge de l'exportation des données vers JSON, NDJSON, CSV, XLSX, ou envoi direct vers S3, Snowflake, GCS, PubSub ou SFTP.
Intégrations Bright Data
Bright Data propose des intégrations natives avec Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake et Pub/Sub, ainsi qu'une API pour des intégrations personnalisées.
Pros and Cons
Pros:
- Plus de 400 millions d'IP résidentielles dans 195 pays
- Extracteurs pré-développés pour plus de 1 200 sites populaires
- Web Unlocker contourne Cloudflare et DataDome
Cons:
- Des utilisateurs signalent des litiges de facturation suite à des échecs de scraping
- Complexité excessive pour les acheteurs non-développeurs
Learn more about Bright Data: Meilleure pour la détection automatique de schémas de données
- Essai gratuit de 30 jours
- À partir de $0,13/1 000 requêtes
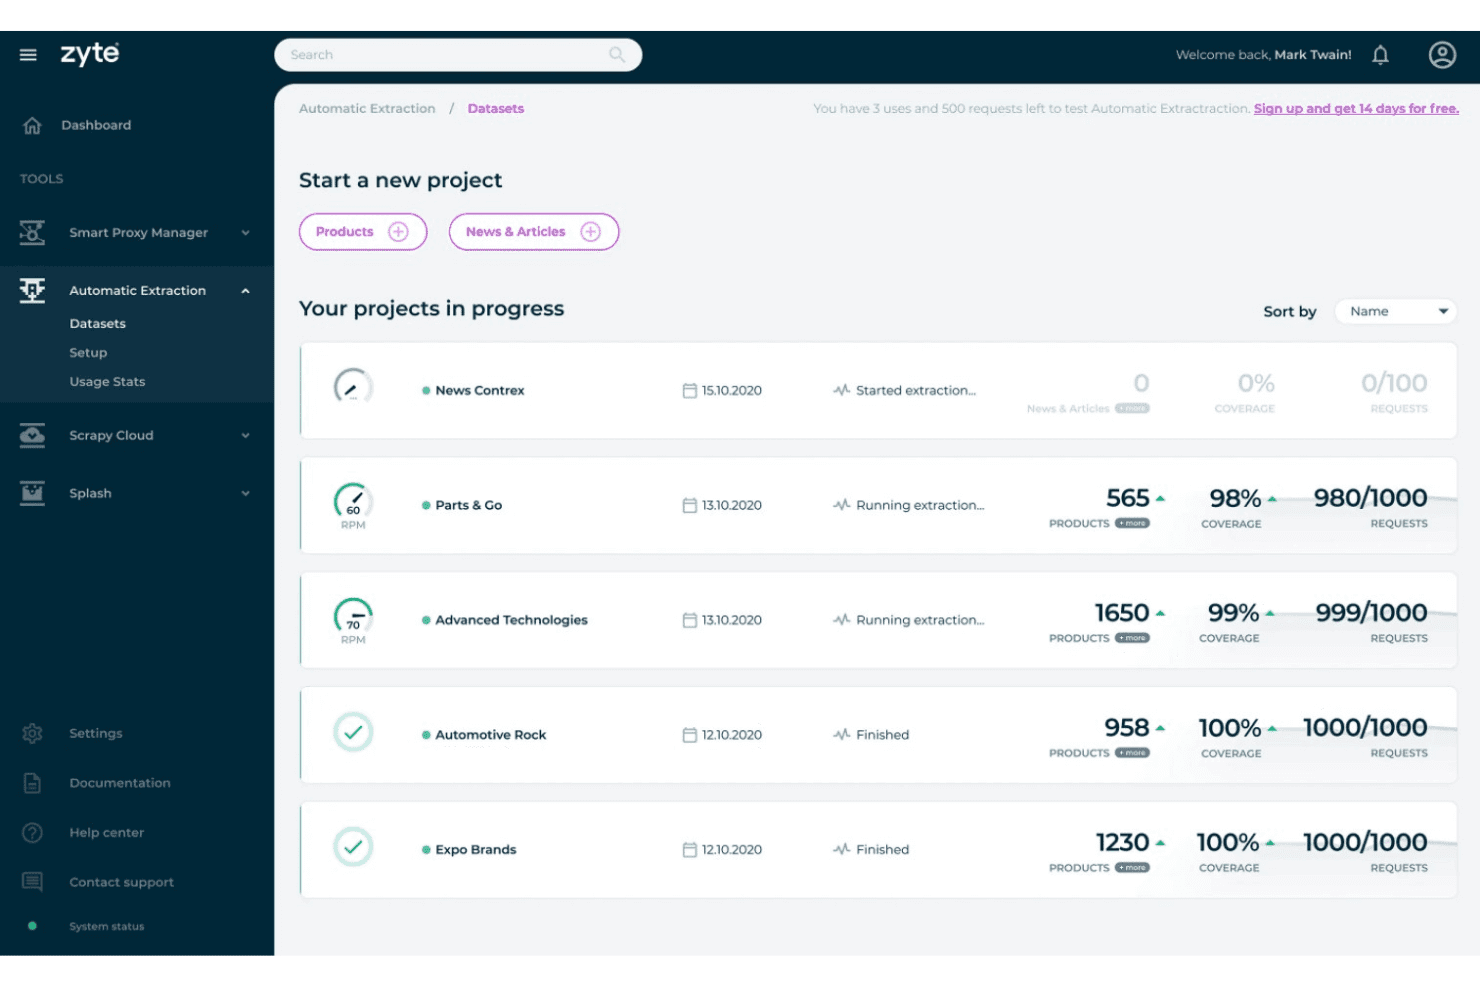
La fonctionnalité d'extraction automatique de Zyte propose des projets d'extraction de données en cours et terminés, avec couverture, nombre de produits et métriques d'utilisation des requêtes. L'API Zyte est une API de scraping web qui combine rendu de navigateur sans interface graphique, rotation automatique de proxy, résolution de CAPTCHA et extraction de données alimentée par l'IA dans un seul point de terminaison.
À qui s'adresse l'API Zyte ?
L'API Zyte convient particulièrement aux ingénieurs de données et aux développeurs Python qui construisent des pipelines de scraping à l'échelle de la production pour alimenter des modèles de ML ou des systèmes d'analyse.
Pourquoi j'ai choisi l'API Zyte
L'API Zyte a gagné sa place dans ma sélection pour sa gestion de la détection automatique de schémas. Pointez-la vers une page produit ou un article, et sa couche d'extraction basée sur un LLM renvoie un JSON typé et structuré sans nécessiter le moindre sélecteur CSS ou expression XPath de ma part. Lorsqu'un site modifie sa mise en page, l'IA s'adapte, ce qui veut dire que je ne passe pas mon temps à corriger les analyseurs à chaque refonte de la page catalogue d'un concurrent.
Fonctionnalités clés de l'API Zyte
- Rendu instantané du navigateur : L'API Zyte lance des navigateurs sans interface préchauffés pour charger à la demande des sites dynamiques.
- Infrastructure proxy complète : Fait tourner automatiquement IP résidentielles, datacenters et mobiles à chaque requête.
- Gestion de session : Maintient cookies persistants et sessions utilisateur pour les workflows nécessitant une authentification ou des actions en plusieurs étapes.
- Intégrations cloud : Envoie les données extraites directement vers des destinations comme AWS S3, Google Cloud ou Azure pour un traitement ultérieur.
Intégrations de l'API Zyte
L'API Zyte propose des intégrations natives avec Scrapy, Scrapy Cloud et des SDK Python, et fournit une API pour des intégrations personnalisées. Elle prend aussi en charge la livraison cloud vers AWS S3, Google Cloud et Azure.
Pros and Cons
Pros:
- L'IA détecte automatiquement les schémas sans sélecteurs manuels
- Contourne les protections anti-bot sans configuration supplémentaire
- Les navigateurs préchauffés éliminent les délais de démarrage à froid
Cons:
- La planification récurrente des tâches requiert un outil externe
- Nécessite des connaissances en programmation pour être mis en œuvre
Learn more about Zyte API: Idéal pour des workflows de scraping simples et pilotés par API
- Formule gratuite disponible
- À partir de $49/mois
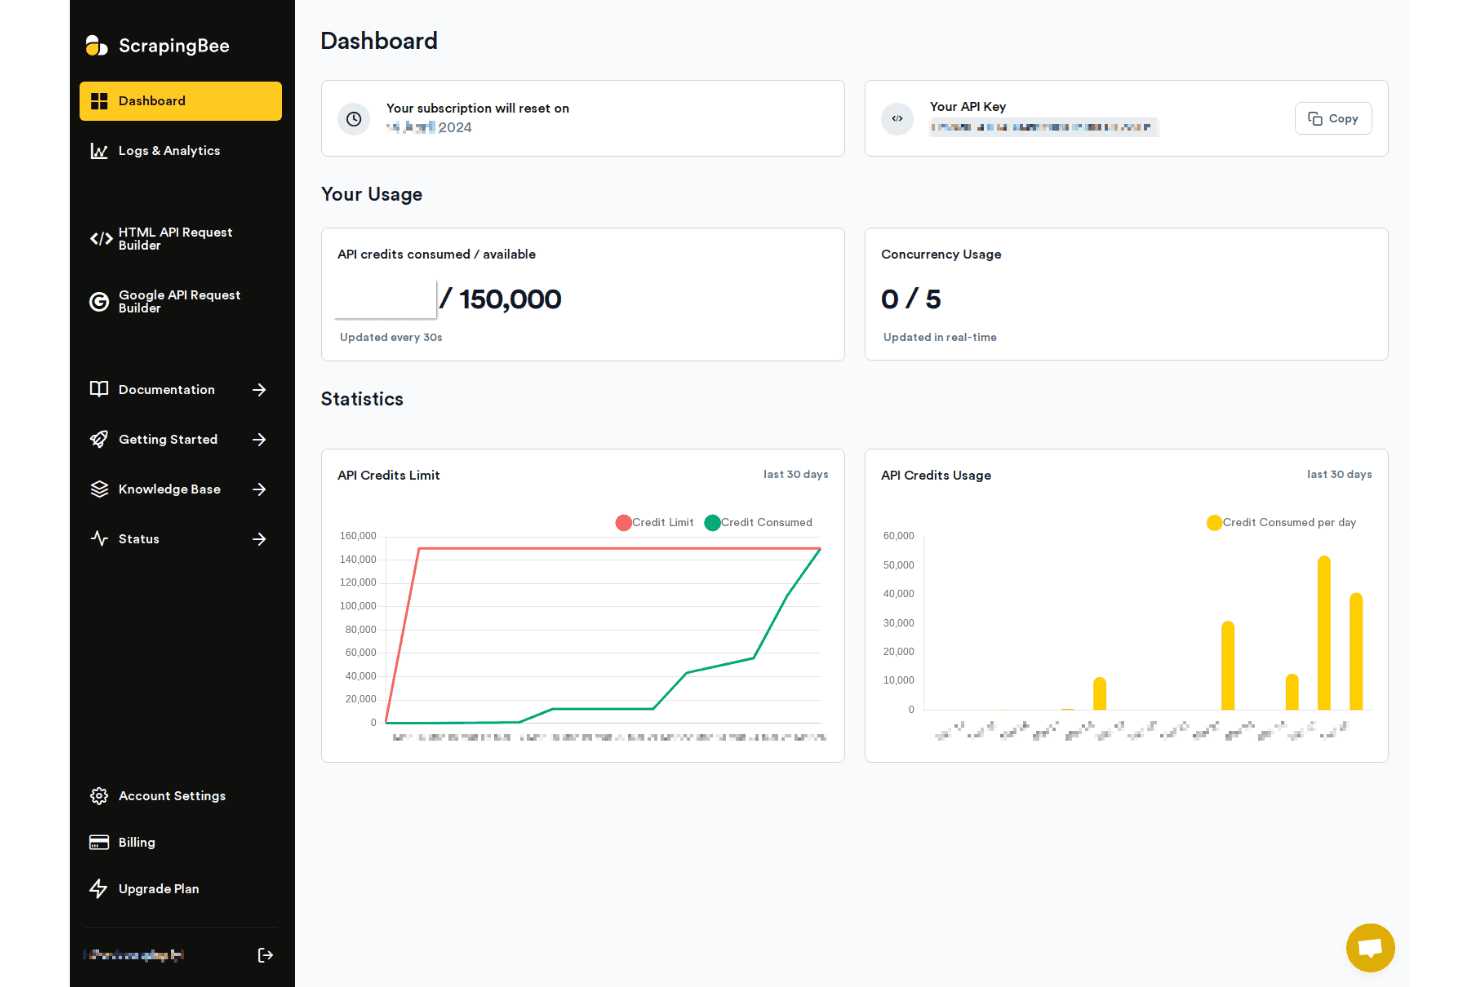
ScrapingBee propose un tableau de bord affichant l'utilisation des crédits API, les statistiques de concurrence et des graphiques d'activité sur 30 jours pour surveiller le scraping. ScrapingBee est une API de collecte de données web qui prend en charge le rendu avec Chrome sans interface graphique, la rotation des proxies et le contournement des anti-bots, avec des API d'extraction dédiées pour des plateformes comme Google, Amazon et Walmart.
Pour qui ScrapingBee est-elle la mieux adaptée ?
ScrapingBee convient particulièrement aux développeurs et ingénieurs data qui ont besoin d'une API fiable, orientée code, pour extraire des données web sans devoir mettre en place eux-mêmes une infrastructure de proxy ou de navigateur.
Pourquoi j'ai choisi ScrapingBee
ScrapingBee mérite sa place dans ma sélection grâce à l'élégance avec laquelle son API masque la complexité du scraping sur le web moderne. Une seule requête gère le rendu avec Chrome sans interface graphique, la rotation furtive des proxies et l'exécution JavaScript, ce qui m'évite d'avoir à écrire du code de gestion de navigateur ou à configurer séparément des pools de proxies. J'apprécie aussi la fonction de requête IA, qui me permet de décrire ce que je veux extraire en langage naturel plutôt que de devoir écrire des sélecteurs CSS ou XPath pour chaque nouveau site visé.
Fonctionnalités clés de ScrapingBee
- APIs dédiées au scraping : Choisissez des points de terminaison préconfigurés pour des plateformes comme Amazon, Walmart et Google Search pour simplifier les tâches courantes de collecte de données.
- Extraction via requête IA : Décrivez les données à extraire en langage naturel pour générer automatiquement des résultats structurés.
- Scraper Markdown : Convertissez n'importe quelle page web en Markdown ou en texte brut pour une ingestion rapide dans des modèles d'IA ou des bases de données en aval.
- Intégrations sans code : Connectez-vous avec Make, n8n et Zapier pour automatiser des workflows sans écrire de scripts de planification personnalisés.
Intégrations ScrapingBee
ScrapingBee propose des intégrations natives avec Make, n8n et Zapier, et offre une API pour des intégrations personnalisées.
Pros and Cons
Pros:
- Facture uniquement les requêtes réussies
- Gère Chrome sans interface graphique sans configurations supplémentaires
- APIs dédiées pour Amazon et Google
Cons:
- Pas de planificateur de tâches intégré nativement
- Le coût des crédits augmente rapidement à grande échelle
Learn more about ScrapingBee: Idéal pour la rotation d'IP sans effort à grande échelle
- Essai gratuit de 7 jours
- À partir de 49 $/mois
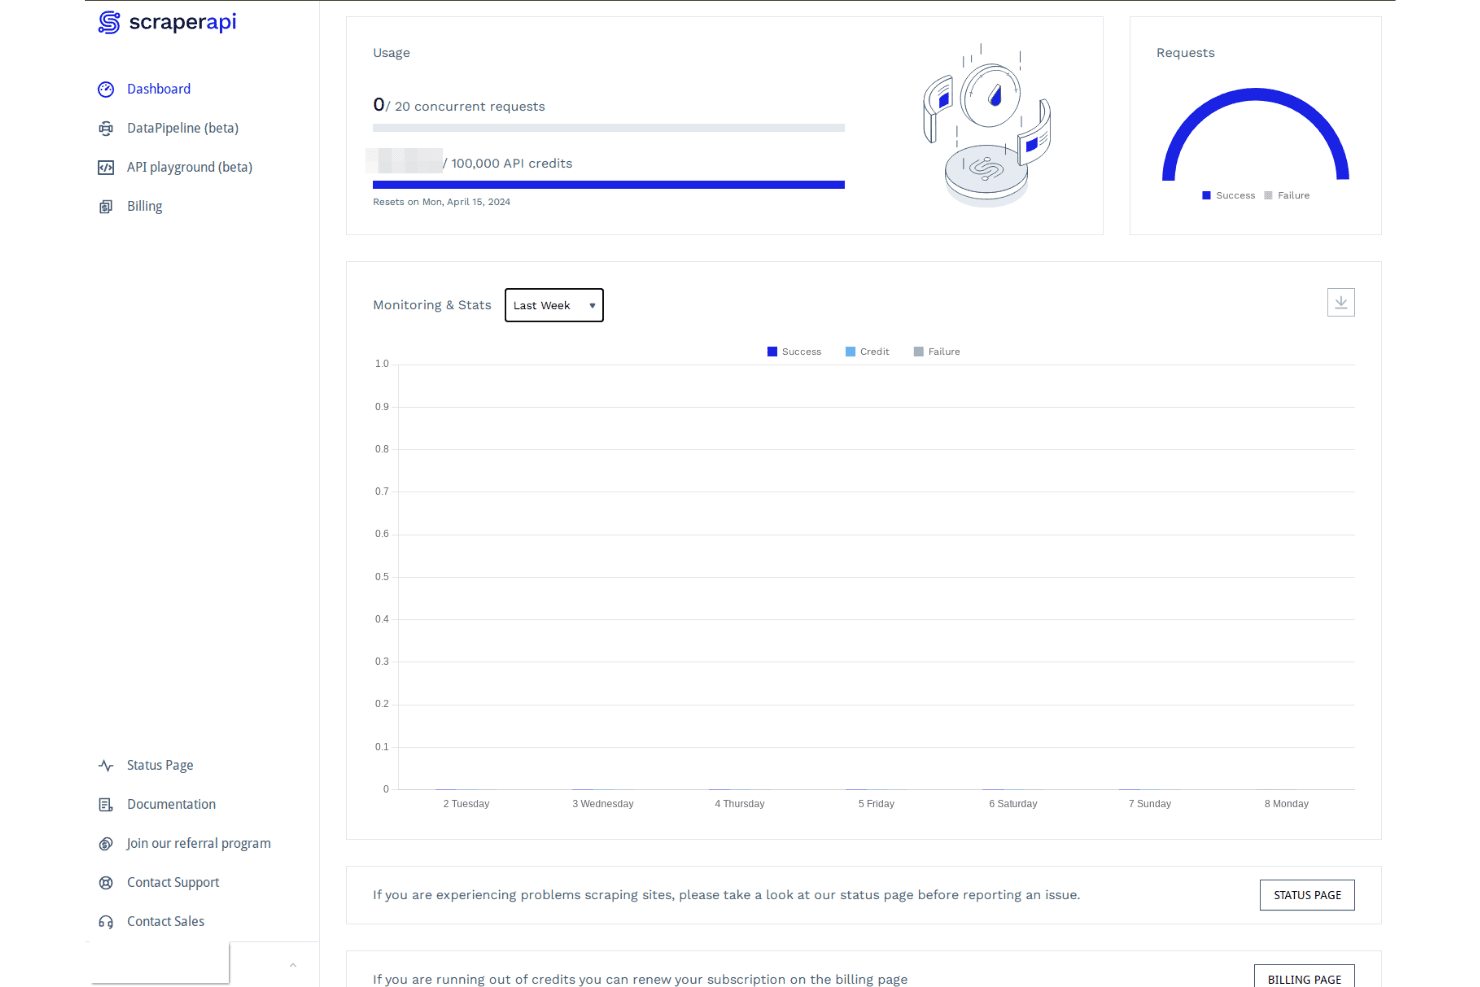
Le tableau de bord de ScraperAPI propose des statistiques d'utilisation, des crédits API, des requêtes simultanées et un graphique de suivi hebdomadaire de la performance du scraping. ScraperAPI est une API de scraping web qui gère la rotation des proxies, le rendu JavaScript, le contournement des CAPTCHA et l'extraction de données structurées, avec des points de terminaison préconfigurés pour les principales plateformes de e-commerce et de recherche.
À qui s'adresse ScraperAPI ?
ScraperAPI convient particulièrement aux développeurs backend et aux ingénieurs de données qui doivent collecter des données sur des sites protégés contre les robots ou fortement basés sur JavaScript, à grande échelle.
Pourquoi j'ai choisi ScraperAPI
J'ai retenu ScraperAPI dans ma sélection pour sa gestion automatisée des proxies en arrière-plan. Lorsque je récupère en masse des données de prix produits depuis Amazon ou Google Shopping, je n'ai pas à configurer ou entretenir moi-même un pool de proxies. ScraperAPI achemine chaque requête via son réseau de plus de 40 millions de proxies et réessaie automatiquement en cas d'échec. J'apprécie également le niveau premium des proxies, qui s'active sur les sites protégés par Cloudflare ou Datadome sans configuration supplémentaire de ma part.
Fonctionnalités clés de ScraperAPI
- Points de terminaison pour données structurées : APIs préconfigurées renvoyant du JSON analysé depuis Amazon, Google Search, Walmart et des sites similaires pour les besoins courants de scraping.
- Persistance de session : Prise en charge des sessions persistantes pour conserver la même IP sur plusieurs requêtes si nécessaire.
- Support du scraping asynchrone : Permet la collecte de données en mode asynchrone pour gérer efficacement des millions de requêtes simultanées.
- Réseau global de proxies : Accès à plus de 40 millions d’adresses IP dans plus de 50 pays pour un scraping géociblé à grande échelle.
Intégrations ScraperAPI
ScraperAPI propose des SDK pour Python, Node.js, PHP, Ruby, Java, et cURL, et offre une intégration LangChain pour les flux de travail IA. Une API est disponible pour des intégrations personnalisées. Les intégrations natives ne sont pas clairement documentées.
Pros and Cons
Pros:
- Facturation uniquement pour les requêtes réussies
- Points de terminaison JSON préconfigurés pour Amazon, Google et Walmart
- Géociblage dans plus de 50 pays
Cons:
- Les crédits ne sont pas reportés d'une période de facturation à l'autre
- Le rendu JS et les proxies premium augmentent la facture
Learn more about ScraperAPI: Idéal pour les utilisateurs d’une interface en point-and-click
- Offre gratuite disponible
- À partir de 69 $/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.7/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.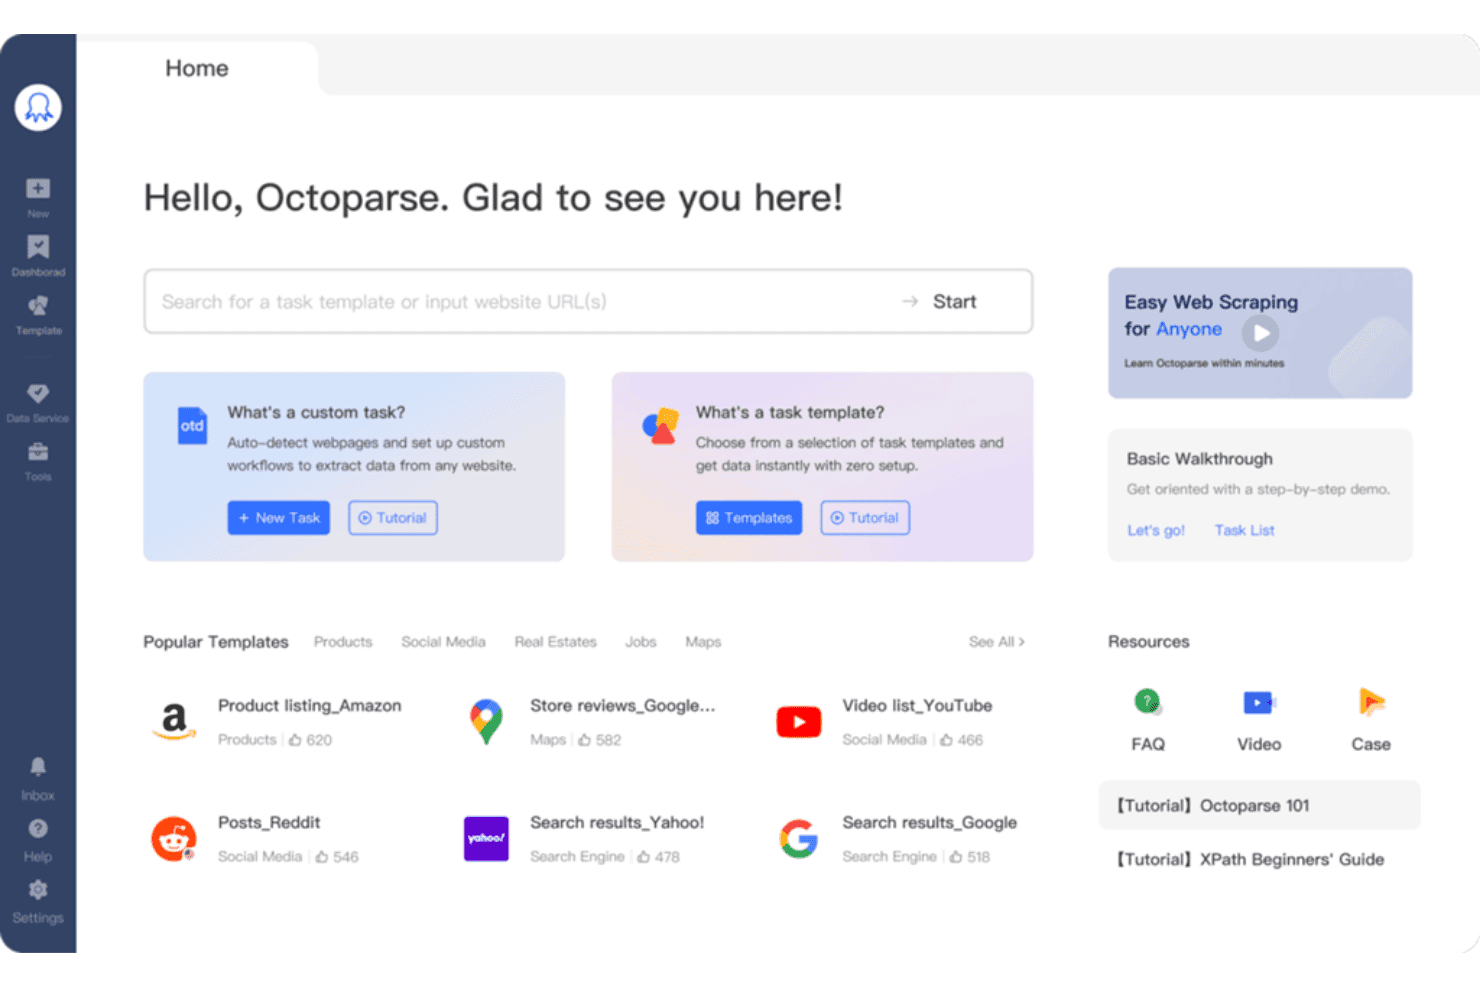
Octoparse propose un tableau de bord d’accueil regroupant des modèles de scraping populaires, la création de tâches personnalisées et des ressources pour débuter rapidement l’extraction de données web. Octoparse est un outil de collecte de données web sans code qui combine un constructeur de flux de travail visuel, une détection automatique alimentée par l'IA, une extraction basée sur le cloud et la prise en charge des pages rendues en JavaScript pour collecter des données structurées à partir de sites web.
Pour qui Octoparse est-il le mieux adapté ?
Octoparse convient particulièrement aux analystes en veille concurrentielle et aux utilisateurs professionnels qui ont besoin de collecter régulièrement des données web sans pour autant disposer de compétences en programmation.
Pourquoi j'ai choisi Octoparse
Octoparse mérite sa place dans ma sélection car le constructeur de flux de travail en point-and-click supprime véritablement la barrière technique du scraping web. J'apprécie la fonction de Détection automatique par IA, qui crée un flux d'extraction complet en analysant automatiquement la page cible, m'évitant ainsi de devoir mapper manuellement les sélecteurs dès le départ. Les plus de 500 modèles prédéfinis pour des sites comme Amazon ou Google Maps permettent de lancer un scraper fonctionnel en quelques minutes sur les cibles les plus fréquentes.
Fonctionnalités clés d'Octoparse
- Exécutions simultanées basées sur le cloud : Exécutez jusqu'à 20 tâches de scraping en parallèle à l'aide du moteur cloud d'Octoparse pour collecter des données plus rapidement.
- Rotation d'IP et proxy résidentiel : Changez automatiquement d'adresse IP et accédez à des proxys résidentiels pour réduire les blocages et contourner les mesures anti-bot.
- Exportation vers bases de données et le cloud : Exportez les données extraites directement vers MySQL, SQL Server, PostgreSQL, Oracle, Google Sheets, Dropbox, Amazon S3, ou via API.
- Résolution automatique des CAPTCHAs : Solvez les CAPTCHAs courants lors des tâches de scraping pour maintenir la continuité et limiter les interventions manuelles.
Intégrations Octoparse
Octoparse propose des intégrations natives avec Google Sheets, Google Drive, Dropbox, Amazon S3, MySQL, SQL Server, PostgreSQL et Oracle. L'outil se connecte également à Zapier et propose une API pour des intégrations personnalisées.
Pros and Cons
Pros:
- Plus de 500 modèles prédéfinis pour les sites courants
- L’IA détecte et extrait automatiquement les brouillons
- Gère le scroll infini, Ajax et les pages dynamiques
Cons:
- Client de bureau disponible uniquement sous Windows
- Limité à 20 processus cloud simultanés
Learn more about Octoparse:
Autres outils de récupération de données web
Voici quelques autres options d’outils de récupération de données web qui n’ont pas été retenues dans ma sélection, mais qui méritent tout de même d’être examinées :
- 11OxylabsIdéal pour la collecte de données anti-bot gérée
- 12CrawlbaseIdéal pour l'accès API à des sources de données mondiales
- 13ScrapyIdéal pour des frameworks de scraping Python personnalisables
- 14ScrapingdogIdéal pour un déploiement rapide avec une configuration minimale
Comment j'évalue les outils de scraping web
Je divise mon évaluation en deux niveaux : le socle de base qu'un outil doit couvrir pour gérer des tâches de scraping en conditions réelles (rendu JavaScript, rotation de proxy, tâches planifiées) et les éléments différenciateurs qui font la différence entre les meilleures options.
Fonctionnalités de base (Critères éliminatoires pour cette liste)
Lorsque je sélectionne les outils pour ma liste, j'attribue à chacun une note de 0 (fonctionnalité absente) à 5 (excellent dans ce domaine) pour chacune des fonctionnalités essentielles listées ci-dessous. Ensuite, je calcule le score total de l'outil en pourcentage. Chaque outil doit atteindre un score total minimum de 65 % pour être retenu.
- Moteur d'extraction de données : J'évalue si l'outil prend en charge plusieurs méthodes de sélection comme CSS, XPath et regex, ou s'il propose un générateur visuel pour les équipes qui préfèrent une configuration par pointage et clic.
- Rendu JavaScript : Les sites bâtis sur React, Vue ou Angular nécessitent la prise en charge de navigateurs sans interface (headless browser). Je vérifie la fiabilité du rendu avec des conditions d'attente configurables.
- Gestion des proxies et de l'anti-bot : Je recherche une rotation de proxy intégrée, la résolution de CAPTCHA et des mécanismes de contournement capables de gérer des protections comme Cloudflare ou DataDome sans configuration supplémentaire.
- Planification et automatisation : Les collectes récurrentes doivent s'exécuter sans intervention. J'évalue si l'outil prend en charge la planification type cron, les déclenchements via webhook, ainsi qu'une logique de relance en cas d'échec.
- Export de données structurées : Je vérifie les formats de sortie disponibles et si l'outil peut envoyer directement les données vers des destinations comme S3, Google Sheets, des bases de données ou des APIs.
- Scalabilité et concurrence : Les gros volumes sur des milliers de pages requièrent des requêtes parallèles. J'examine les limites de concurrence et si l'outil permet un crawling distribué.
Une fois que j'ai une liste d'outils répondant aux critères, j'analyse ce qui distingue chaque plateforme.
Facteurs différenciants (Ce qui distingue les éditeurs)
Voici comment je compare et différencie les différents éditeurs :
Fonctionnalités remarquables
Le contournement des protections anti-bot est le domaine où j'observe les écarts les plus marqués entre les outils. Je recherche des solutions intégrées de résolution de CAPTCHA et d'empreinte navigateur capables de passer outre des protections telles que Cloudflare ou DataDome, sans devoir recourir à des services tiers de proxy. Les modèles d’auto-détection sont également essentiels : des outils comme Bright Data et Zyte proposent des extracteurs préconfigurés pour des cibles courantes comme Amazon ou les SERP de Google, économisant des heures de configuration manuelle de sélecteurs. J’évalue aussi les capacités de planification et de monitoring, notamment la gestion des alertes d’échec et les relances automatiques qui assurent le bon fonctionnement des flux de données quand la structure des sites cibles change du jour au lendemain.
Au-delà des fonctionnalités
Les modèles tarifaires varient fortement dans ce secteur : certains facturent à la requête API, d'autres à la bande passante ou au nombre de pages avec résultat. J‘évalue si les coûts restent prévisibles lorsqu’on passe à plusieurs millions de pages par mois. L’infrastructure proxy constitue un autre critère distinctif clé. Je vérifie ainsi si l’outil intègre des pools de proxies résidentiels et datacenter avec ciblage géographique fin, car obtenir séparément des contrats proxy augmente coûts et complexité. La conformité est aussi cruciale, surtout pour les équipes opérant dans des secteurs réglementés où la gestion du RGPD et du robots.txt doit être clairement documentée.
Comment choisir des outils de récupération de données web
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré pendant votre processus unique de sélection de logiciels, voici une liste de contrôle des facteurs à prendre en compte :
| Facteur | Points à prendre en compte |
|---|---|
| FacteurÉvolutivité | Points à prendre en compteL’outil peut-il gérer les augmentations de volume prévues et les explorations parallèles sans hausses importantes des coûts ni limites de débit ? |
| FacteurIntégrations | Points à prendre en compteL’outil fournira-t-il les données directement à vos systèmes cibles (stockage cloud, bases de données, flux de travail) ou nécessitera-t-il des étapes manuelles ? |
| FacteurPersonnalisation | Points à prendre en comptePouvez-vous adapter la logique d’extraction aux structures de sites particulières, ou êtes-vous limité à des modèles et des règles prédéfinis ? |
| FacteurFacilité d’utilisation | Points à prendre en compteLes utilisateurs techniques comme non techniques peuvent-ils gérer les extractions, ou devrez-vous faire appel régulièrement à des développeurs pour effectuer des modifications ? |
| FacteurMise en œuvre et intégration | Points à prendre en compteÀ quelle vitesse votre équipe peut-elle configurer un premier pipeline de données, et quelle assistance ou documentation est disponible en cas de difficulté ? |
| FacteurCoût | Points à prendre en compteLa tarification reste-t-elle prévisible lorsque l’utilisation augmente ? Soyez réaliste concernant les pics d’activité, la logique de nouvelle tentative et les faux positifs dans votre charge de travail. |
| FacteurMesures de sécurité | Points à prendre en compteL’outil expose-t-il votre entreprise ou votre flux de travail à des risques de conformité, à des fuites de données ou à des points d’accès non autorisés ? |
| FacteurExigences de conformité | Points à prendre en compteL’approche du fournisseur est-elle conforme à vos règles internes et régionales (par exemple, le RGPD, le respect de robots.txt et le traitement des données personnelles) ? |
Que sont les outils de récupération de données web ?
Les outils de récupération de données web sont des plateformes logicielles qui automatisent la récupération et l’extraction de données structurées à partir de sites web. Ces outils vous permettent de capturer des informations à partir de pages, y compris du contenu dynamique généré par JavaScript, afin de les utiliser pour l’analyse, la création de rapports ou l’intégration à des bases de données internes. La plupart proposent des options permettant de configurer des règles d’extraction et d’exporter les données dans des formats adaptés aux développeurs.
Fonctionnalités des outils d’extraction de données web
Lorsque vous choisissez des outils d’extraction de données web, soyez attentif aux fonctionnalités clés suivantes :
- Moteur d’extraction des données : Permet de définir la manière dont le contenu est collecté sur les sites web à l’aide de sélecteurs CSS, de XPath ou d’interfaces à pointer-cliquer afin d’obtenir des résultats structurés.
- Rendu JavaScript : Charge les applications dynamiques ou monopages en exécutant JavaScript, afin de garantir la capture des données qui n’apparaissent pas dans le HTML statique.
- Gestion des proxys : Fait tourner les adresses IP, souvent en utilisant des services de proxy résidentiels, pour contourner les blocages géographiques, les limites de débit ou la protection contre les robots, afin de permettre une extraction fiable des sites à grande échelle.
- Gestion des CAPTCHA : Détecte et résout ou contourne automatiquement les défis CAPTCHA afin de maintenir les pipelines de données en fonctionnement lorsque des mesures anti-robots sont déclenchées.
- Planification et automatisation : Définit des extractions récurrentes ou déclenche des tâches selon des intervalles précis, permettant un fonctionnement sans surveillance et une intégration aux pipelines de données.
- Exportation de données structurées : Prend en charge la sortie au format JSON, CSV ou XML, ainsi que la transmission directe vers un stockage cloud, des API ou des bases de données, éliminant les étapes manuelles de conversion et de téléversement.
- Détection des changements et alertes : Surveille les sites ciblés pour repérer les mises à jour de contenu, les changements de prix ou les nouvelles annonces, et vous avertit si les résultats diffèrent de ceux des exécutions précédentes.
- Contrôles de simultanéité : Gère plusieurs requêtes en parallèle pour accélérer les sessions d’extraction et prendre en charge les tâches d’exploration à grande échelle sur des milliers de pages.
- Gestion des erreurs et journalisation : Suit les extractions échouées, les interruptions de connexion ou les changements de site, en fournissant des journaux d’erreurs détaillés pour diagnostiquer et corriger rapidement les problèmes d’extraction.
- Contrôles d’accès des utilisateurs : Restreint les personnes pouvant modifier les projets, gérer les tâches ou consulter les exportations afin de préserver la sécurité et d’éviter les modifications accidentelles ou non autorisées.
Fonctionnalités d’IA courantes des outils d’extraction de données web
Au-delà des fonctionnalités standard des outils d’extraction de données web présentées ci-dessus, bon nombre de ces solutions intègrent l’IA avec des fonctionnalités telles que :
- Détection automatique des champs de données : Utilise l’IA pour identifier et mapper automatiquement les champs de données pertinents sur des pages web complexes ou inconnues, réduisant ainsi la configuration manuelle des sélecteurs.
- Reconnaissance adaptative de la structure des sites : Apprend et s’adapte aux changements de mise en page des sites web, réduisant les temps d’arrêt et les opérations de maintenance lorsque les sites ciblés mettent à jour leur conception.
- Contournement intelligent des systèmes anti-robots : Utilise l’IA pour imiter les habitudes de navigation humaines et adapter les stratégies d’extraction en temps réel, contribuant ainsi à contourner les systèmes avancés de détection des robots.
- Analyse du contenu en langage naturel : Exploite l’IA pour extraire, résumer ou catégoriser du texte non structuré, ce qui facilite l’analyse des avis, des articles ou des publications de forums.
- Génération automatisée de modèles : Crée des modèles d’extraction réutilisables pour des sites similaires en analysant la structure des pages et les modèles de contenu grâce à l’apprentissage automatique.
- Correction intelligente des erreurs : Détecte et résout les erreurs ou anomalies courantes d’extraction à l’aide de diagnostics pilotés par l’IA, réduisant ainsi le besoin de dépannage manuel.
Avantages des outils d’extraction de données web
La mise en œuvre d’outils d’extraction de données web offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns des bénéfices dont vous pouvez profiter :
- Collecte de données à grande échelle : Automatisez l’extraction d’informations à partir de nombreux sites et pages, rendant de grands ensembles de données disponibles pour l’analyse ou l’apprentissage automatique.
- Informations en temps réel sur le marché : Surveillez instantanément les prix des concurrents, les catalogues de produits et les changements de sites web grâce à la planification, à la détection des changements et aux fonctionnalités d’alerte.
- Efficacité des ressources : Planifiez et automatisez les tâches, réduisant ainsi les efforts manuels tout en permettant aux développeurs de se concentrer sur des projets à plus forte valeur ajoutée.
- Qualité constante des données : Exportez des données structurées dans des formats fiables comme JSON ou CSV, en réduisant les tâches fastidieuses de nettoyage et d’intégration des données.
- Contournement des obstacles anti-robots : Utilisez la rotation intégrée des proxys, la gestion des CAPTCHA et le contournement des systèmes anti-robots pour accéder à du contenu que d’autres solutions ne peuvent pas atteindre.
- Adaptabilité aux changements des sites : Appuyez-vous sur une gestion intelligente des erreurs et, pour les outils dotés de l’IA, sur une extraction à adaptation automatique lorsque la mise en page ou la structure des sites web évolue.
- Accès sécurisé et conformité : Protégez les pipelines de données grâce aux autorisations des utilisateurs, à la journalisation des audits et à l’alignement sur les référentiels de conformité ou les réglementations relatives à la confidentialité.
Coûts et tarification des outils d’extraction de données web
La sélection d’outils d’extraction de données web nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et d’autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions d’outils d’extraction de données web :
Tableau comparatif des forfaits des outils d’extraction de données web
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Type de forfaitForfait gratuit | Prix moyen$0-$10/mois | Fonctionnalités courantesExécutions d’extraction limitées, planification de base, assistance communautaire et formats d’exportation de données pour débutants. |
| Type de forfaitForfait personnel | Prix moyen$15-$40/mois | Fonctionnalités courantesDavantage de crédits d’extraction, rendu JavaScript, accès à l’API et gestion basique des erreurs. |
| Type de forfaitForfait professionnel | Prix moyen$55-$150/mois | Fonctionnalités courantesConcurrence accrue, rotation des serveurs proxy, planification avancée, outils de collaboration d’équipe et assistance prioritaire. |
| Type de forfaitForfait entreprise | Prix moyen$250+/mois | Fonctionnalités courantesIntégrations personnalisées, garanties de niveau de service, serveurs proxy ciblés par zone géographique, intégration accompagnée et gestionnaire de compte dédié. |
FAQ sur les outils d’extraction de données web
Voici quelques réponses aux questions courantes sur les outils d’extraction de données web :
Ai-je besoin de compétences en programmation pour utiliser des outils d’extraction de données web ?
Non, vous n’avez pas nécessairement besoin d’une expertise en programmation. De nombreux outils visuels proposent une solution sans code, comme une extension Chrome utilisant le principe du pointer-cliquer, qui permet aux utilisateurs non techniques de créer visuellement des routines d’extraction et de parcourir le plan du site pour recueillir des données dans le cadre de tâches telles que la génération de prospects.
Cependant, la logique personnalisée, les pipelines de données complexes ou l’extraction à grande échelle reposent généralement sur des outils de programmation :
- Python : une bibliothèque Python traditionnelle comme BeautifulSoup est idéale pour analyser proprement des documents HTML statiques.
- JavaScript : une bibliothèque Node.js spécialisée, telle que Puppeteer ou Playwright, permet aux développeurs d’interagir programmatiquement avec des éléments web dynamiques.
Les outils d’extraction de données web peuvent-ils gérer les sites web dynamiques et fortement dépendants de JavaScript ?
Oui, la plupart des outils modernes proposent des moteurs de rendu JavaScript pour extraire le contenu dynamique des applications monopages (SPA) et des sites interactifs.
Comment les outils d’extraction de données web gèrent-ils les mesures anti-robots des sites web ?
Pour contourner les protections anti-robots, les outils sophistiqués mettent en œuvre plusieurs stratégies d’évasion :
- Rotation des serveurs proxy : répartition des requêtes sur de vastes pools d’adresses IP, de centres de données et résidentielles, afin d’éviter les limitations de débit ou les blocages d’adresses IP.
- Solveurs CAPTCHA automatisés : résolution ou contournement des défis visuels et comportementaux.
- Masquage de l’empreinte du navigateur : modification des en-têtes du navigateur, des empreintes canvas et des agents utilisateurs dans des moteurs tels que WebKit ou Chromium, afin d’imiter les interactions humaines sur les principaux navigateurs comme Firefox ou Chrome.
L’extraction de données web est-elle légale ?
La légalité de l’extraction de données web dépend des données que vous collectez, de la manière dont vous les utilisez et des conditions d’utilisation du site web. Consultez toujours les directives juridiques et les exigences de conformité avant de commencer.
Comment recevoir et stocker les données extraites ?
Vous pouvez généralement exporter les données dans des formats tels que CSV, JSON ou Excel, ou les envoyer directement vers un stockage cloud, des webhooks ou des bases de données, selon les options d’intégration de l’outil.