

Datajärvityökalujen avulla voit tallentaa, järjestää ja analysoida valtavia määriä jäsenneltyä ja jäsentämätöntä dataa koko liiketoimintasi alueella. Jos vertailet parhaita datajärvityökaluja, et voi tehdä valintaa arvaamalla – minkä alustan avulla tiimisi pystyy hallitsemaan kustannuksia, vaatimustenmukaisuutta ja suorituskykyä datamääriesi kasvaessa?
Tässä oppaassa esittelen hyväksi todettuja vaihtoehtoja, joiden avulla IT-johtajat voivat varmistaa hallinnan, skaalautuvuuden, integraatiot ja tulevaisuuden tarpeisiin varautumisen, jotta voit valita luottavaisin mielin oikean perustan analytiikka- ja tekoälykuormille vuonna 2026.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Vertaa parhaita datajärvityökaluja
Vertaile rinnakkain niiden datajärvityökalujen hintoja ja teknisiä tietoja, jotka pääsivät esivalintaani.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Paras automaattisesti optimoituihin Apache Iceberg -datajärviin | Ilmainen kokeiluversio saatavilla | Alkaen $300/kuukausi (laskutetaan vuosittain) | Website | |
| 2 | Paras säänneltyjen yritysten hybridi-datajärvihallintaan | 60 päivän maksuton kokeilu saatavilla | Alkaen 0,04 $/CCU/tunti | Website | |
| 3 | Paras avoimeen Iceberg-lakehouseen ilman toimittajalukkoa | 30 päivän ilmainen kokeilu | Alkaen $0.20/DCU | Website | |
| 4 | Paras säänneltyjen toimialojen datajärvien hallintaan | Ilmainen esittely saatavilla | Hinta pyydettäessä | Website | |
| 5 | Paras eri moottoreiden väliseen hallintaan avoimissa datajärvitalotauluissa | 90 päivän maksuton kokeilujakso | Alkaen $0.12 DCU-tunnilta | Website | |
| 6 | Paras nollakopioiseen tietojen jakamiseen pilvien välillä | 30 päivän maksuton kokeilu | Alkaen $2.00/krediitti | Website | |
| 7 | Parhaiten GCP-natiiviin lakehouseen, jossa käytetään porrastettua tallennusta | Ilmainen paketti saatavilla | Alkaen 0.020 $/Gt/kuukausi | Website | |
| 8 | Parhaiten avoimiin taulukkomuotoihin perustuvaan lakehouseen | 14 päivän maksuton kokeilu | Alkaen $0.22/DBU | Website | |
| 9 | Paras AWS:n datajärvien ytimessä olevaan objektien tallennukseen | Ei saatavilla | Alkaen $0.023/GB/month | Website | |
| 10 | Parhaiten Microsoft-natiiveihin yritysten datajärviin | $200 hyvitys 30 päiväksi (ei erillistä ilmaistasoa) | Alkaen $0.023/GB/month | Website |




Datajärvityökalujen arviot
Alla ovat yksityiskohtaiset yhteenvedot parhaista datajärvityökaluista, jotka pääsivät esivalintaani. Arvioni tarjoavat yksityiskohtaisen katsauksen kunkin alustan ominaisuuksiin, toimintoihin ja parhaisiin käyttötapauksiin, jotta löydät itsellesi parhaan vaihtoehdon.
 1Paras automaattisesti optimoituihin Apache Iceberg -datajärviin
Qlik
- Ilmainen kokeiluversio saatavilla
- Alkaen $300/kuukausi (laskutetaan vuosittain)
Visit WebsiteCustomer Rating:4.4/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.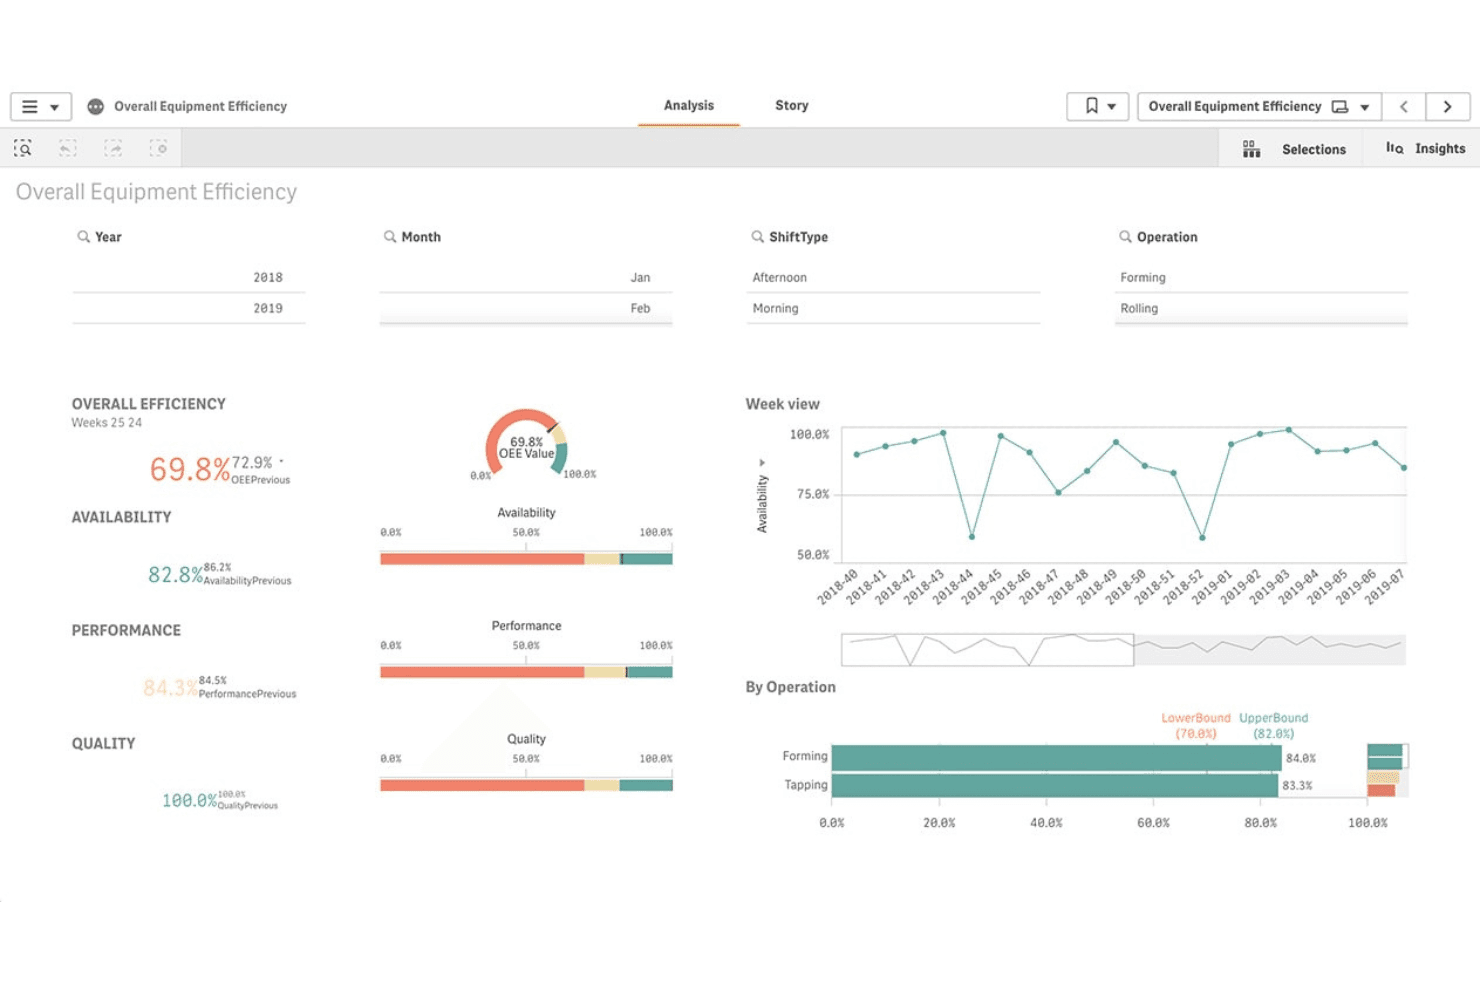
Qlik seuraa laitteiston kokonaistehokkuutta reaaliaikaisilla KPI-koontinäytöillä. Qlik on natiivisti Apache Icebergiin rakennettu dataintegraatio- ja datajärvialusta, joka yhdistää CDC-pohjaisen tietojen syötön, automaattisen skeeman evoluution, usean formaatin dataputket ja sisäänrakennetun hallinnan pilvipohjaisissa objektitallennusympäristöissä.
Kenelle Qlik sopii parhaiten?
Qlik sopii erinomaisesti suurille säännellyillä toimialoilla toimiville yrityksille, jotka tarvitsevat päästä päähän ulottuvaa dataintegraatiota, hallintaa ja datajärven hallintaa yhdellä alustalla.
Miksi valitsin Qlikin
Valitsin Qlikin, koska sen Adaptive Iceberg -optimointityökalu erottaa sen muista: se suorittaa jatkuvasti tiivistämistä, indeksointia ja tilannevedosten puhdistusta Iceberg-taulukoissa ilman manuaalista hienosäätöä. Tämä nopeuttaa kyselyitä 2,5–5-kertaisesti ja säästää tallennuskustannuksissa jopa 50 %. Hyödynnän myös sen nollakopiopeilausta reaaliaikaisten Iceberg-taulukoiden siirtämiseen suoraan Snowflakeen ilman tietojen monistamista tai dataputkien monimutkaisuuden lisäämistä.
Qlikin tärkeimmät ominaisuudet
- Lokeihin perustuva CDC-replikointi: Qlik Replicate tallentaa muutokset suoraan tietokantojen tapahtumalokeista ilman tarvittavia agentteja, pitäen datajärven tiedot ajan tasalla vaikuttamatta lähdejärjestelmän suorituskykyyn.
- Usean formaatin tietojen syöttöputki: Syötä tietoja Parquet-, Avro-, ORC-, JSON- ja CSV-muodoissa yli 200 lähteestä, mukaan lukien tietokannat, SaaS-sovellukset, SAP, keskustietokoneet sekä suoratoistoalustat, kuten Kafka ja Kinesis.
- Saraketason alkuperä- ja vaikutusanalyysi: Seuraa tietoja lähteestä kulutukseen saraketasolla, mikä tarjoaa selkeän tarkastusketjun hallintaa ja vaatimustenmukaisuusraportointia varten.
- Automaattinen pronssi-, hopea- ja kulta-alueiden hallinta: Qlik Compose for Data Lakes automatisoi skeemojen luomisen, Hive-luettelon luomisen ja jatkuvat aluepäivitykset CDC:n avulla, mikä poistaa monitasoisten datajärviarkkitehtuurien manuaalisen dataputkien koodauksen tarpeen.
Qlikin integraatiot
Qlik tukee yli 200 tietojen syöttölähdettä, mukaan lukien Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP ja Salesforce. Sen Iceberg-taulukot integroituvat Sparkiin, Amazon Athenaan, Trinoon, Prestoan, Databricksiin, Dremioon ja Tableauhun.
Pros and Cons
Pros:
- Automaattisesti optimoitu Apache Iceberg -taulukoiden hallinta
- Edistynyt reaaliaikainen lokeihin perustuva CDC-replikointi
- Laajat yritystason vaatimustenmukaisuus- ja hallintatoiminnot
Cons:
- Monimutkainen alusta, joka edellyttää laajaa teknistä osaamista
- Epäselvä lisensointi- ja kustannusarvioprosessi
Learn more about Qlik: Paras säänneltyjen yritysten hybridi-datajärvihallintaan
- 60 päivän maksuton kokeilu saatavilla
- Alkaen 0,04 $/CCU/tunti
Visit WebsiteCustomer Rating:4.1/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.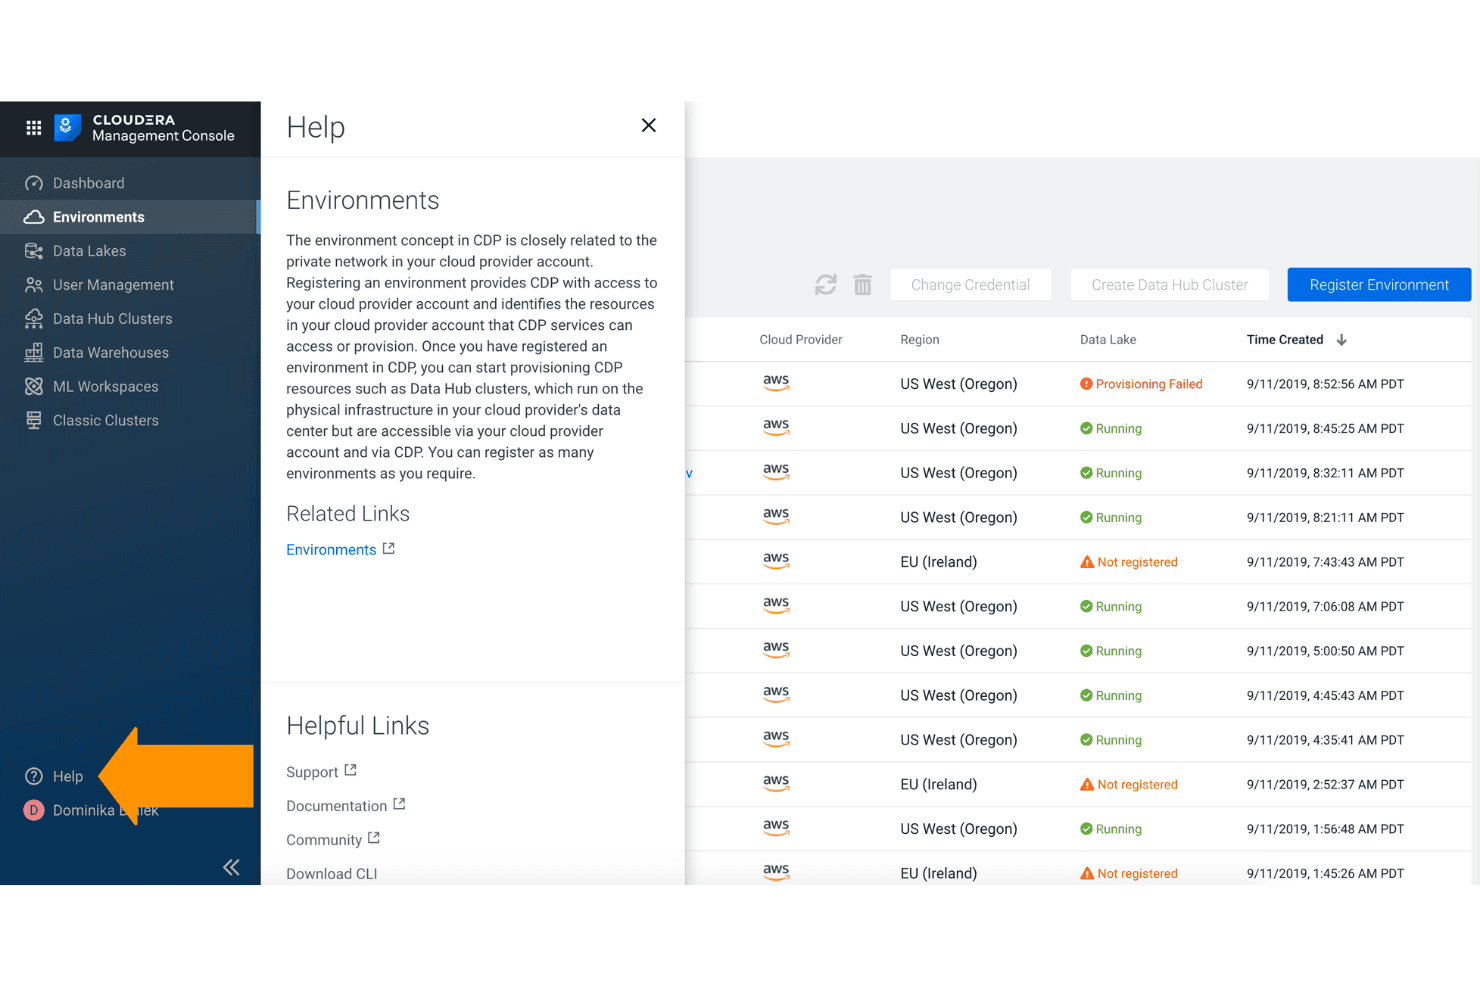
Clouderan avulla käyttäjät voivat hallita ja valvoa pilviympäristöjä eri alueilla. Cloudera on avoimen datan lakehouse-alusta, joka kattaa skaalautuvan monipilvi- ja paikallisen tallennuksen, monimuotoisen datan siirron yli 450 liittimen kautta, Apache Icebergiin perustuvan lukuhetken skeeman sekä keskitetyn hallinnan hybridiympäristöissä.
Kenelle Cloudera sopii parhaiten?
Cloudera sopii erinomaisesti suurille säänneltyjen toimialojen yrityksille, kuten pankeille, viranomaisille ja teleoperaattoreille, jotka tarvitsevat yhtenäisen hallinnan paikallisten ja monipilviympäristöjen välillä.
Miksi valitsin Clouderan
Cloudera päätyi suosikkilistalleni, koska mikään muu alusta ei yllä sen hallinnan syvyyteen hybridiympäristöissä. Olen erityisen vaikuttunut Cloudera SDX:stä, joka soveltaa Apache Ranger- ja Apache Atlas -käytännöt kerran ja valvoo niitä kaikkialla riippumatta siitä, sijaitsevatko tietosi paikallisessa HDFS-klusterissa, Azure ADLS:ssä tai AWS S3:ssa. Sekä yhdistelmää infrastruktuuria käyttävät pankit että viranomaiset voivat määrittää saraketason peittosäännöt ja ABAC-käytännöt keskitetysti, ja FedRAMP Moderate- sekä PCI DSS 4.0 -sertifioinnit tukevat vaatimustenmukaisuutta.
Clouderan keskeiset ominaisuudet
- Apache Icebergin aikamatkustus: Tee kyselyitä tietojesi historiallisista tilannevedoksista milloin tahansa Icebergin sisäisen versioinnin ja aikamatkustusominaisuuksien avulla.
- Lakehouse-optimointityökalu: Automatisoi Iceberg-taulujen tiivistämisen, Z-järjestämisen ja osioiden karsinnan kyselysuorituskyvyn parantamiseksi ja laskentakustannusten pienentämiseksi.
- Cloudera Data Flow (NiFi) -visuaalinen putkirakentaja: Suunnittele ja ota käyttöön datan siirtoputkia vetämällä ja pudottamalla yli 450 valmiiksi rakennettua prosessoria ja liitintä sisältävässä käyttöliittymässä.
- Nollakopioihin perustuva datan jakaminen Iceberg REST -luettelon kautta: Ulkoiset moottorit, kuten Databricks, Snowflake ja Athena, voivat tehdä kyselyitä Clouderan hallinnoimiin Iceberg-tauluihin suoraan ilman datan siirtämistä tai monistamista.
Clouderan integraatiot
Cloudera Data Flow tarjoaa yli 450 valmiiksi rakennettua liitintä, mukaan lukien Apache Kafka, MongoDB, Salesforce, Snowflake ja Google BigQuery. Se integroituu myös AWS:n, Microsoft Azuren, Google Cloud Platformin, Databricksin, Tableaun ja Power BI:n kanssa Iceberg REST -luettelonsa kautta.
Pros and Cons
Pros:
- Hybridi- ja paikallisen ympäristön tuki on vertaansa vailla
- Yritystason hallinta tiukkoja vaatimustenmukaisuustarpeita varten
- Nollakopioihin perustuva jakaminen ulkoisten kyselymoottorien välillä
Cons:
- Alkuperäinen määritys edellyttää usein asiantuntijatason osaamista
- Metadatan hallintaan liittyvä tyytyväisyys on kilpailijoiden keskiarvoa heikompaa
Learn more about Cloudera: Paras avoimeen Iceberg-lakehouseen ilman toimittajalukkoa
- 30 päivän ilmainen kokeilu
- Alkaen $0.20/DCU
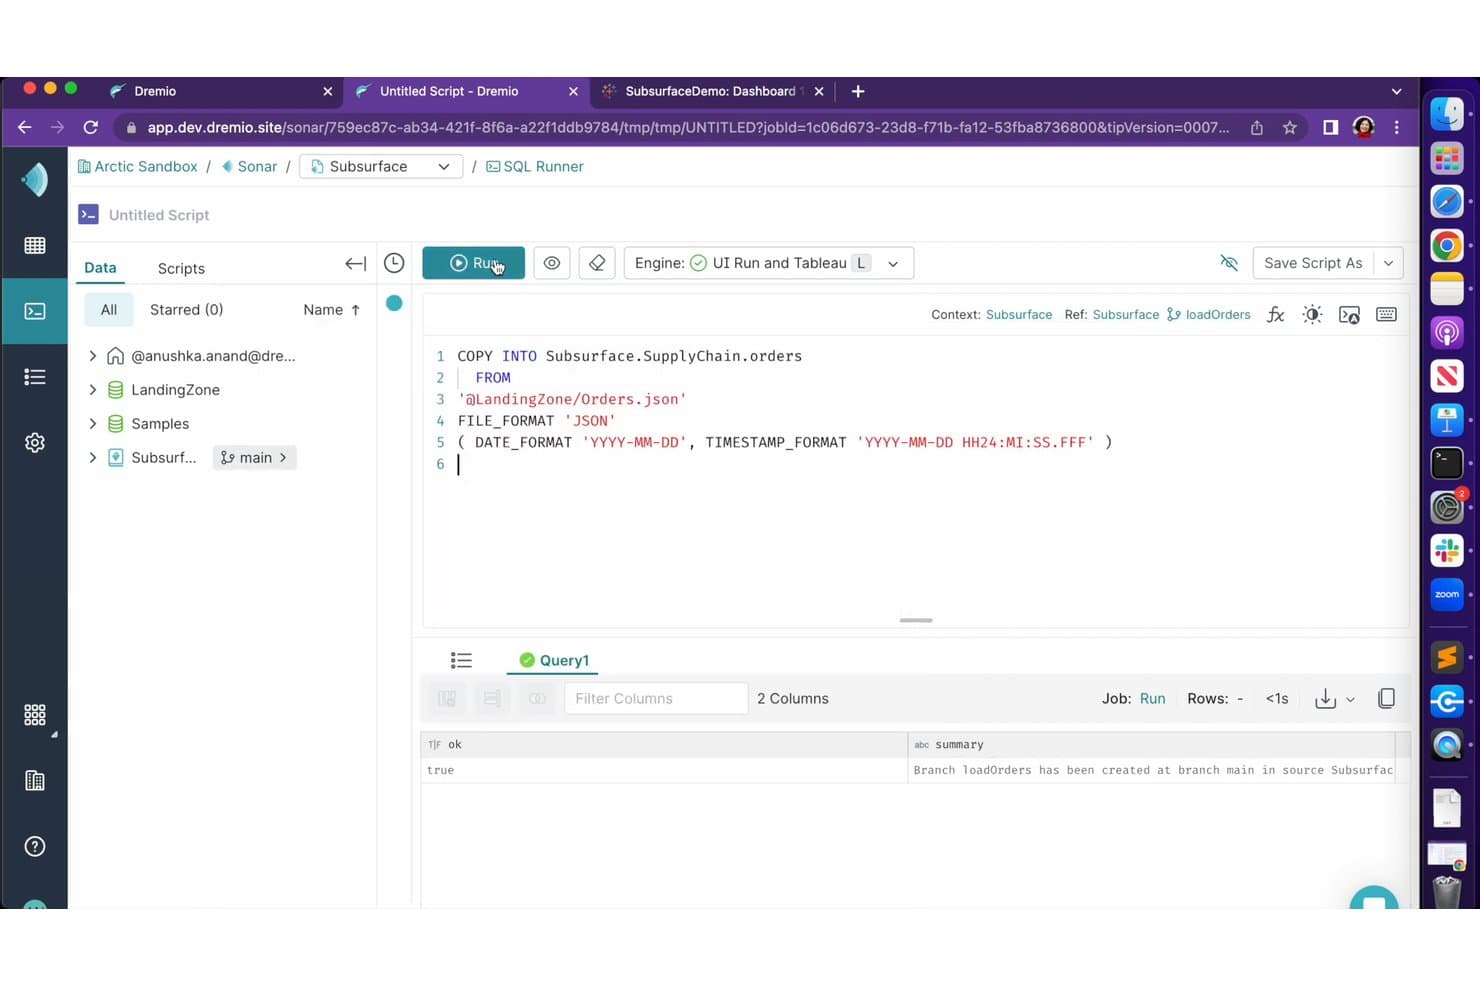
Dremion avulla käyttäjät voivat ladata JSON-dataa tauluihin SQL COPY INTO -komennoilla. Dremio on avoin lakehouse-alusta, joka on rakennettu natiivisti Apache Icebergin ja Apache Arrow'n päälle. Se yhdistää SQL-kyselymoottorin, yhdistetyn datan käytön, automaattisen kyselyjen kiihdytyksen, Git-tyylisen datan versioinnin ja monimoottorisen avoimen katalogin.
Kenelle Dremio sopii parhaiten?
Dremio sopii erinomaisesti data- ja arkkitehtuuritiimeille, jotka rakentavat avoimia lakehouse-ympäristöjä Apache Icebergin päälle ja tarvitsevat monimoottorisen kyselykäytön ilman sitoutumista omisteiseen katalogiin tai tallennusmuotoon.
Miksi valitsin Dremion
Dremio päätyi suosikkilistalleni, koska se on rakennettu natiivisti Apache Icebergin päälle. Tämä tarkoittaa, että data pysyy omissa S3- tai ADLS-säilöissäsi ja mikä tahansa moottori (Spark, Flink, Trino, DuckDB) voi lukea ja kirjoittaa sitä avoimen Polaris-katalogin kautta ilman muunnoksia. Erityisesti pidän autonomisista heijastuksista, jotka seuraavat kyselymalleja huomaamattomasti ja luovat kiihdytyksiä taustalla. Näin BI-koontinäyttösi saavat tulokset nopeasti ilman manuaalista hienosäätöä tai omisteisia poimintoja.
Dremion tärkeimmät ominaisuudet
- Avoin katalogi (Apache Polaris): Apache Polarisiin perustuva monimoottorinen katalogi, jonka avulla Spark, Flink, Trino ja DuckDB voivat lukea ja kirjoittaa Iceberg-tauluja standardoidun REST-ohjelmointirajapinnan kautta.
- Data koodina -haaroitus: Project Nessien Git-tyylinen versionhallinta luo kehitystä, testausta ja koneoppimiskokeiluja varten eristettyjä, dataa kopioimattomia datahaaroja, joissa on atomiset yhdistämiset ja palautukset.
- COPY INTO -tiedonkeruu: Natiivi SQL-komento, joka lataa CSV-, JSON- ja Parquet-tiedostot joukkoina objektitallennuksesta suoraan Iceberg-tauluihin ja tukee skeeman evoluutiota sekä osioiden käsittelyä.
- Hienojakoinen käyttöoikeuksien hallinta: Kyselyn aikana valvottava rivitason tietoturva ja sarakkeiden peittäminen, jotka otetaan johdonmukaisesti käyttöön kaikissa moottoreissa, jotka käyttävät katalogia kyselyihin.
Dremion integraatiot
Dremio integroituu Apache Sparkiin, Apache Flinkiin, Trinoon, DuckDB:hen, Tableaun, Power BI:hin, dbt Coreen, Amazon S3:een, Azure Data Lake Storageen ja Google Cloud Storageen. Sen Polaris REST -katalogi-, ODBC-, JDBC- ja Arrow Flight -rajapinnat tukevat mukautettuja moottori- ja sovellusyhteyksiä.
Pros and Cons
Pros:
- Käsittelee Apache Iceberg -dataa natiivisti ilman muunnoksia
- Git-tyylinen datahaaroitus aikamatkustusta varten
- Avoin REST-katalogi yhdistää minkä tahansa kyselymoottorin
Cons:
- Hallinnointi on monimutkaisempaa kuin verrokkityökaluissa
- Ei erillistä sisäänrakennettua koneoppimisen ominaisuusvarastoa
Learn more about Dremio: Paras säänneltyjen toimialojen datajärvien hallintaan
- Ilmainen esittely saatavilla
- Hinta pyydettäessä
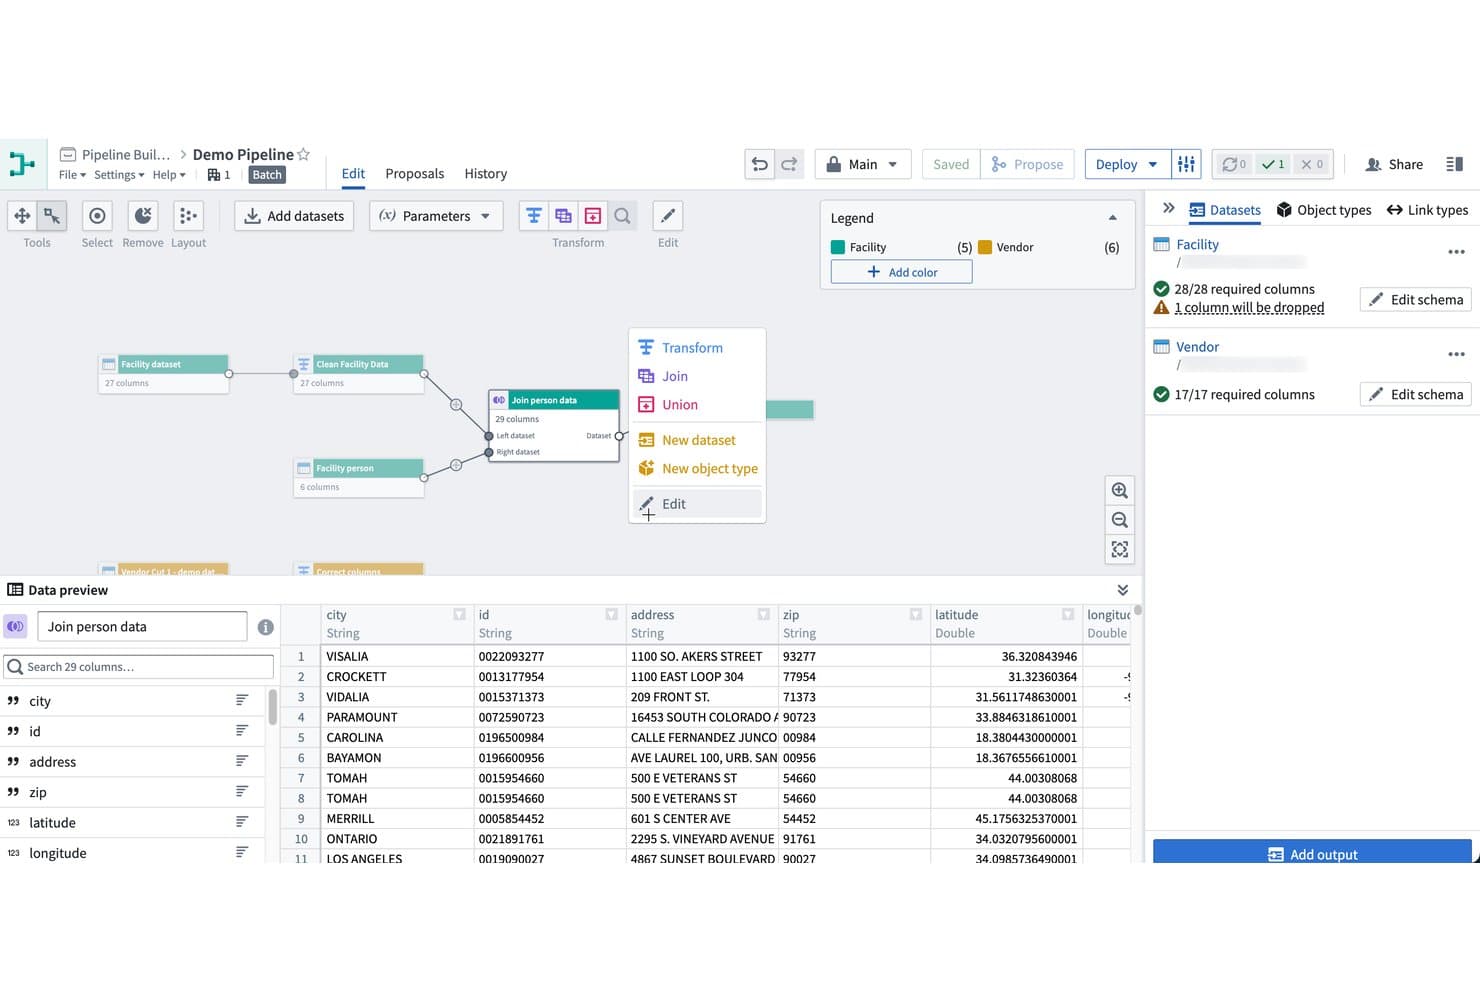
Palantir Foundryn avulla käyttäjät voivat rakentaa tietoaineistoja visuaalisesti ja yhdistää niitä putkissa. Palantir Foundry on datajärvialusta, joka yhdistää monimuotoisen tiedon sisäänoton, putkien orkestroinnin, semanttisen tietomallinnuksen Ontology-kerroksen avulla sekä sisäänrakennetut hallintakeinot pilvi-, paikallis- ja erillisverkkoympäristöissä.
Kenelle Palantir Foundry sopii parhaiten?
Palantir Foundry on suunniteltu suurille säänneltyjen toimialojen yrityksille—rahoitus-, terveydenhuolto-, puolustus- ja viranomaisorganisaatioille—jotka tarvitsevat yksityiskohtaista tiedonhallintaa monimutkaisissa ja useista lähteistä koostuvissa ympäristöissä.
Miksi valitsin Palantir Foundryn
Valitsin Palantir Foundryn, koska sen hallinta-arkkitehtuurilla ei aidosti ole vertaa säännellyillä toimialoilla. Alusta yhdistää tarkoitukseen perustuvat, luokitukseen perustuvat ja roolipohjaiset käyttöoikeusvalvonnat sekä datamerkinnät, jotka siirtyvät automaattisesti tietoaineiston jäljitettävyyden kautta niin, että lähdeaineistoon lisätty PII-tunniste seuraa tietoa jokaisen myöhemmän muunnoksen läpi. Kun tähän yhdistetään FedRAMP High-, HIPAA-, ITAR- ja SOC 2 Type 2 -sertifioinnit sekä Ontology-kerros, joka yhdistää järven raakatiedot auditoitaviin liiketoimintaobjekteihin, kyseessä on alusta, joka on rakennettu alusta alkaen ympäristöihin, joissa hallinta ei ole valinnaista.
Palantir Foundryn tärkeimmät ominaisuudet
- Yli 200 valmista dataliitintä: Yhdistä tietokantoihin, tietovarastoihin, suoratoistoalustoihin, ERP-järjestelmiin, pilvitallennustiloihin, IoT-lähteisiin ja paikkatietotyökaluihin yhden tiedon sisäänotto-liittymän kautta.
- Apache Iceberg REST Catalog: Aseta Foundry-tietoaineistot ulkoisten Iceberg-yhteensopivien laskentamoottorien—kuten Trinon, Sparkin, Flinkin, Databricksin ja Snowflaken—saataville ilman tietojen monistamista.
- Virtuaalitaulukot nollakopiointiin perustuvaa federointia varten: Tee kyselyitä Databricksin, Snowflaken ja S3-yhteensopivien tallennustilojen ulkoisiin taulukoihin suoraan Foundrysta ilman taustalla olevien tietojen sisäänottoa tai siirtämistä.
- AIP-mallinnusstudio: Rakenna, kouluta, arvioi ja tarjoa ML-malleja Foundryn sisällä sekä hyödynnä LLM-malleja natiivisti ja Python- ja R-kehitysympäristöjen tuella.
Palantir Foundryn integraatiot
Palantir Foundry tarjoaa yli 200 natiivia dataliitintä, kuten Amazon S3:n, Snowflaken, Databricksin, PostgreSQL:n, SAP:n, Apache Kafkan, Amazon Kinesisin, Tableaun ja Power BI:n. Se tukee myös mukautettuja yhteyksiä S3-yhteensopivan API:n, Iceberg REST Catalogin ja virtuaalitaulukoiden kautta.
Pros and Cons
Pros:
- Luokkansa paras vaatimustenmukaisuutta tukeva tiedonhallinta
- Ontology-kerros mahdollistaa liiketoimintakäyttäjien pääsyn tietoihin
- Nollakopiointiin perustuva tietojen jakaminen virtuaalitaulukoilla
Cons:
- Korkea sopimushinnoittelu ja epäselvät kokonaissummat
- Omisteisten mallien aiheuttama alustariippuvuuden riski
Learn more about Palantir Foundry: Paras eri moottoreiden väliseen hallintaan avoimissa datajärvitalotauluissa
- 90 päivän maksuton kokeilujakso
- Alkaen $0.12 DCU-tunnilta
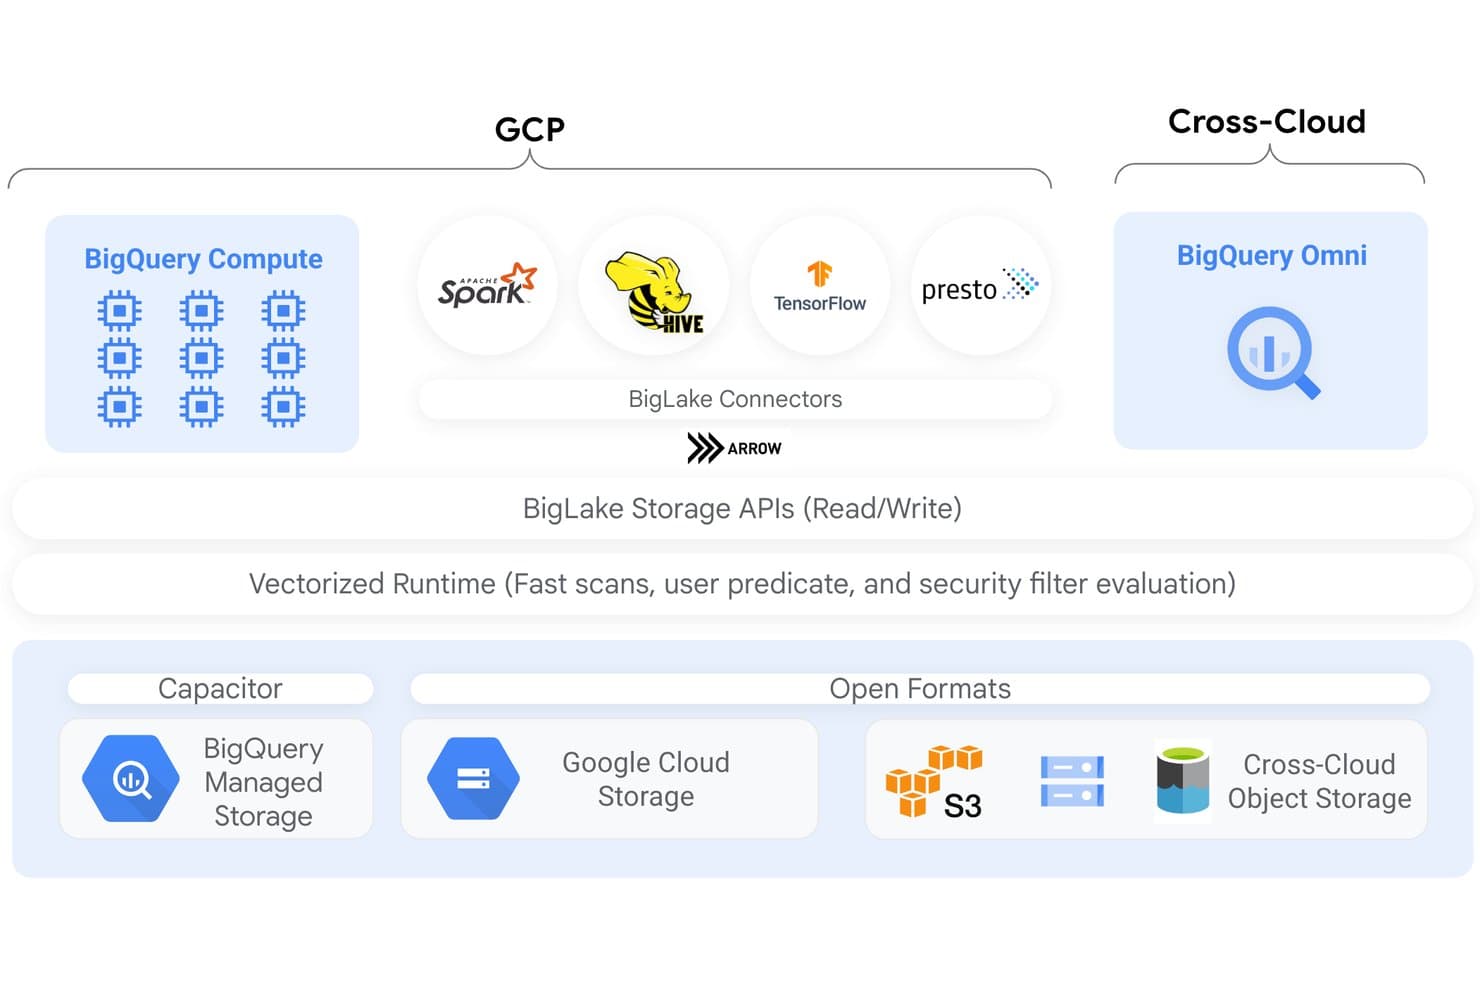
BigLake yhdistää laskennan ja tallennustilan GCP- ja pilvienvälisissä ympäristöissä. BigLake on Google Cloudissa toimiva datajärvitaloalusta, joka laajentaa BigQueryä avoimen formaatin taulujen tuella, eri moottoreiden välisellä kyselykäytöllä, yhtenäisellä metatietojen hallinnalla ja tarkkarajaisella hallinnalla GCS:ssä, S3:ssa ja Azure Blob Storagessa.
Kenelle BigLake sopii parhaiten?
BigLake sopii erinomaisesti data- ja arkkitehtuuritiimeille, jotka ovat jo investoineet Google Cloudiin ja tarvitsevat yhdenmukaista hallintaa useiden kyselymoottoreiden ja avointen taulumuotojen välillä.
Miksi valitsin BigLaken
Valitsin BigLaken yhdeksi parhaista, koska se on ainoa näkemäni datajärvitaloalusta, joka valvoo rivi- ja saraketason käyttöoikeuskäytäntöjä yhdenmukaisesti BigQueryn, Sparkin, Trinon ja Preston välillä – ei vain yhden moottorin sisällä. Tämä tarkoittaa, että arkaluonteiseen sarakkeeseen liitetty käytäntötunniste seuraa dataa riippumatta siitä, millä moottorilla tiimisi sitä kyselyttää. Datajärvitalon Iceberg REST Catalog tekee tämän mahdolliseksi toimimalla yhtenä hallinnan huomioivana päätepisteenä kaikille avoimen lähdekoodin moottoreille, jotka lukevat samoja Iceberg-tauluja ja kirjoittavat niihin.
BigLaken tärkeimmät ominaisuudet
- Automaattinen taulujen ylläpito: BigLake käsittelee automaattisesti tiedostojen tiivistyksen, klusteroinnin, roskien keruun ja metatietojen luonnin GCS:ään tallennetuille Iceberg-tauluille.
- Monimuotoinen tiedonsiirto: Siirrä dataa Parquet-, ORC-, Avro-, CSV- ja JSON-muodoissa sekä avoimissa taulumuodoissa, kuten Apache Icebergissä, Delta Lakessa ja Apache Hudissa, luettelotiedostojen avulla.
- BigQuery Omnin pilvienvälinen kysely: Suorita BigQuery SQL -kyselyitä suoraan Amazon S3:een tai Azure Data Lake Storage Gen 2:een tallennettua dataa vastaan siirtämättä sitä GCS:ään.
- Muutosdatan kaappauksen replikointi: Suoratoista operatiivista dataa Cloud Spannerista, AlloyDB:stä ja Cloud SQL:stä suoraan BigLake-tauluihin lähes reaaliaikaista analytiikkaa varten.
BigLaken integraatiot
BigLakella on natiiviset integraatiot BigQueryn, Apache Sparkin, Apache Flinkin, Trinon, Preston, Google Cloud Storagen, Amazon S3:n, Azure Data Lake Storage Gen2:n, Lookerin ja Vertex AI:n kanssa. Sen Iceberg REST Catalog yhdistää avoimen lähdekoodin moottorit jaettuihin datajärvitalotauluihin.
Pros and Cons
Pros:
- Rivi- ja saraketason suojaus valvottuna eri moottoreissa
- Avoimet taulumuodot ja täysi Iceberg-tuki
- Luettelofederaatio monipilviympäristöjen metatietojen hallintaan
Cons:
- DML:ää ei tueta muissa kuin Iceberg-muotoisissa ulkoisissa tauluissa
- CMEK ei ole käytettävissä S3- tai Azure-välimuistitauluille
Learn more about BigLake: Paras nollakopioiseen tietojen jakamiseen pilvien välillä
- 30 päivän maksuton kokeilu
- Alkaen $2.00/krediitti
Visit WebsiteCustomer Rating:4.6/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.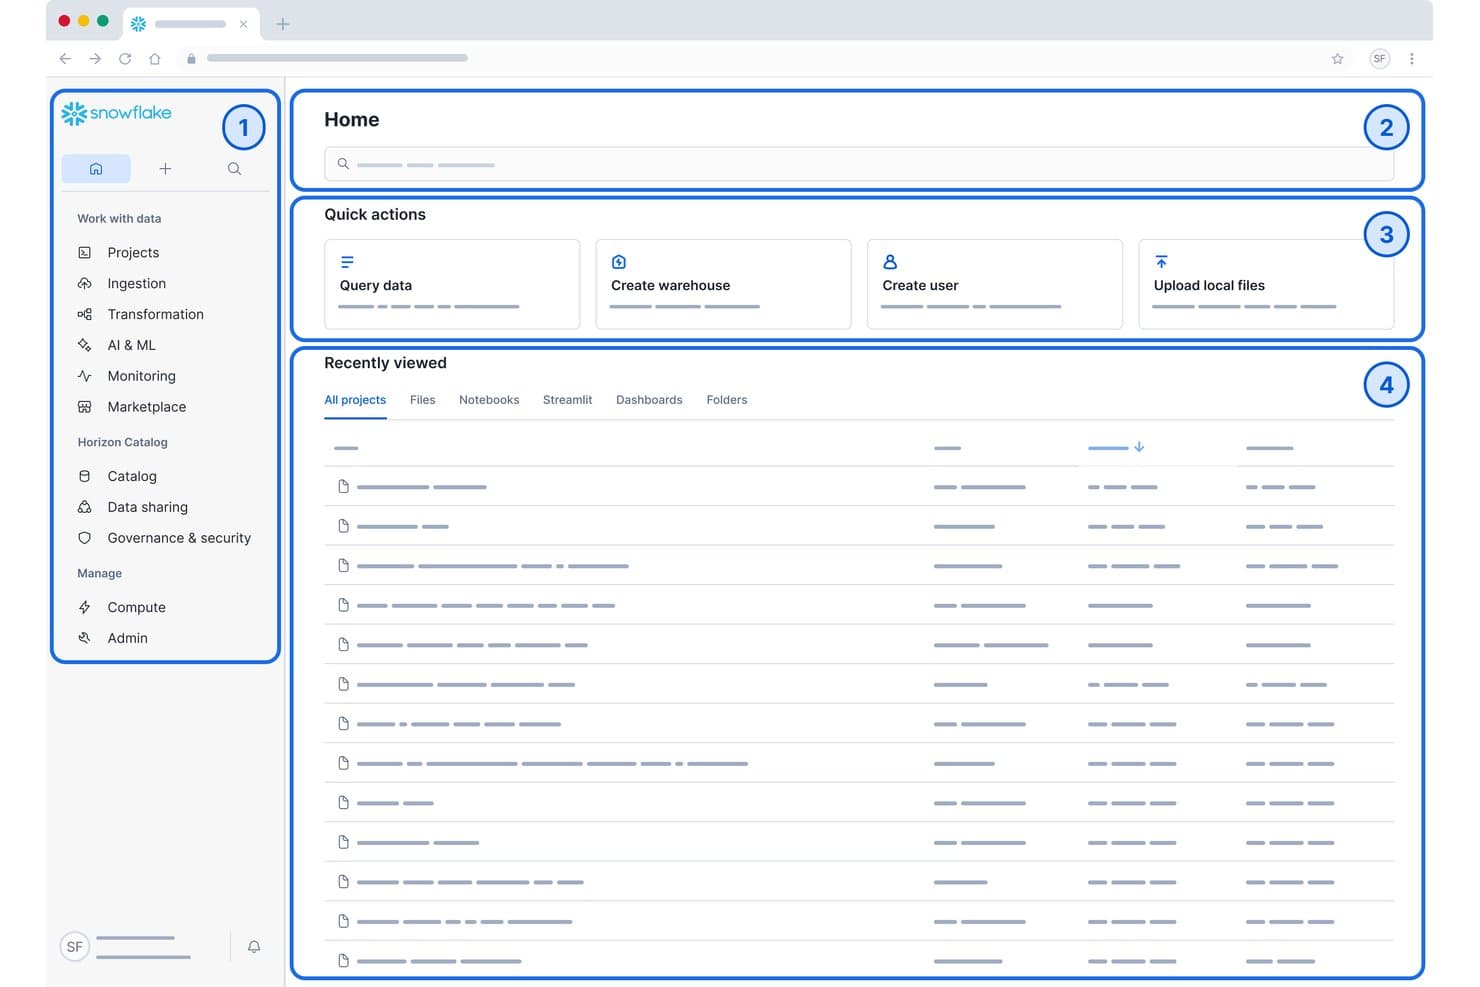
Snowflaken aloitusnäkymä kokoaa tietokyselyt, tietovarastojen luomisen ja viimeisimmät projektit yhteen. Snowflake on pilvipohjainen datajärvi- ja analytiikka-alusta, joka yhdistää joustavan tallennustilan, sisäänrakennetun SQL-kyselymoottorin, Python-, Java- ja Scala-työkuormien Snowparkin, Apache Iceberg -tuen sekä nollakopioisen tietojen jakamisen AWS:n, Azuren ja GCP:n välillä.
Kenelle Snowflake sopii parhaiten?
Snowflake sopii erinomaisesti yritysten datatiimeille, jotka hallitsevat laajoja, monipilviympäristöjä ja joille hallinta, vaatimustenmukaisuus sekä tietojen jakaminen organisaatioiden välillä ovat ehdottomia vaatimuksia.
Miksi valitsin Snowflaken
Snowflake päätyi suosikkilistalleni, koska sen nollakopioisen tietojen jakamisen avulla voit jakaa reaaliaikaisia tietoaineistoja AWS:n, Azuren ja GCP:n tilien välillä monistamatta tai siirtämättä tavuakaan. Olen käyttänyt sen Snowflake Marketplacea, joka yhdistää yli 820 tietojen tarjoajaan, ja pilvien välinen automaattinen toimitus tekee jakamisesta alueiden välillä aidosti vaivatonta. Kun tähän yhdistetään natiivi Apache Iceberg -tuki ja Snowpipe Streaming, joka käsittelee yli miljoona tapahtumaa sekunnissa, tuloksena on todelliseen yritystason mittakaavaan rakennettu datajärvialusta.
Snowflaken tärkeimmät ominaisuudet
- Snowparkin monikielinen suoritusympäristö: Kirjoita tietotekniikan ja koneoppimisen työkuormat Pythonilla, Javalla tai Scalalla ja suorita ne suoraan Snowflaken kyselymoottorissa siirtämättä tietoja sen ulkopuolelle.
- Apache Iceberg -taulujen tuki: Tallenna ja hallitse tietoja avoimessa Iceberg-taulumuodossa Snowflaken hallinnoimassa tallennustilassa hyödyntäen skeeman evoluutiota, aikamatkustusta sekä yhteentoimivuutta Sparkin, Trinon ja Flinkin kanssa.
- Horizon Catalog: Sisäänrakennettu hallintakerros, joka sisältää saraketason tietolinjojen seurannan, automaattisen PII-luokittelun, tekoälyavusteisen metatietojen rikastamisen sekä tietomittarifunktiot jatkuvaan tietojen laadun valvontaan.
- Snowpipe Streaming: Siirrä rivitason tietoja reaaliajassa yli miljoonan tapahtuman sekuntinopeudella suoraan Snowflake- tai Apache Iceberg -tauluihin ilman eräajojen aiheuttamia viiveitä.
Snowflake-integraatiot
Snowflake tarjoaa natiivit integraatiot Apache Kafkan, dbt:n, Tableaun, Microsoft Power BI:n, Lookerin ja Apache Airflow'n kanssa. Se yhdistyy Apache Sparkiin, Trinoon, Amazon S3:een, Azure Blob Storageen ja Google Cloud Storageen, ja mukautettuja integraatioita varten on saatavilla rajapintoja.
Pros and Cons
Pros:
- Nollakopioinen tietojen jakaminen pilvien välillä
- Sisäänrakennettu hallinta ja saraketason tietolinjat
- Tallennustilan ja laskennan joustava erottaminen
Cons:
- Ei tukea paikalliselle käyttöönotolle
- Kustannusten seuranta voi olla haastavaa
Learn more about Snowflake: Parhaiten GCP-natiiviin lakehouseen, jossa käytetään porrastettua tallennusta
- Ilmainen paketti saatavilla
- Alkaen 0.020 $/Gt/kuukausi
Visit WebsiteCustomer Rating:4.3/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.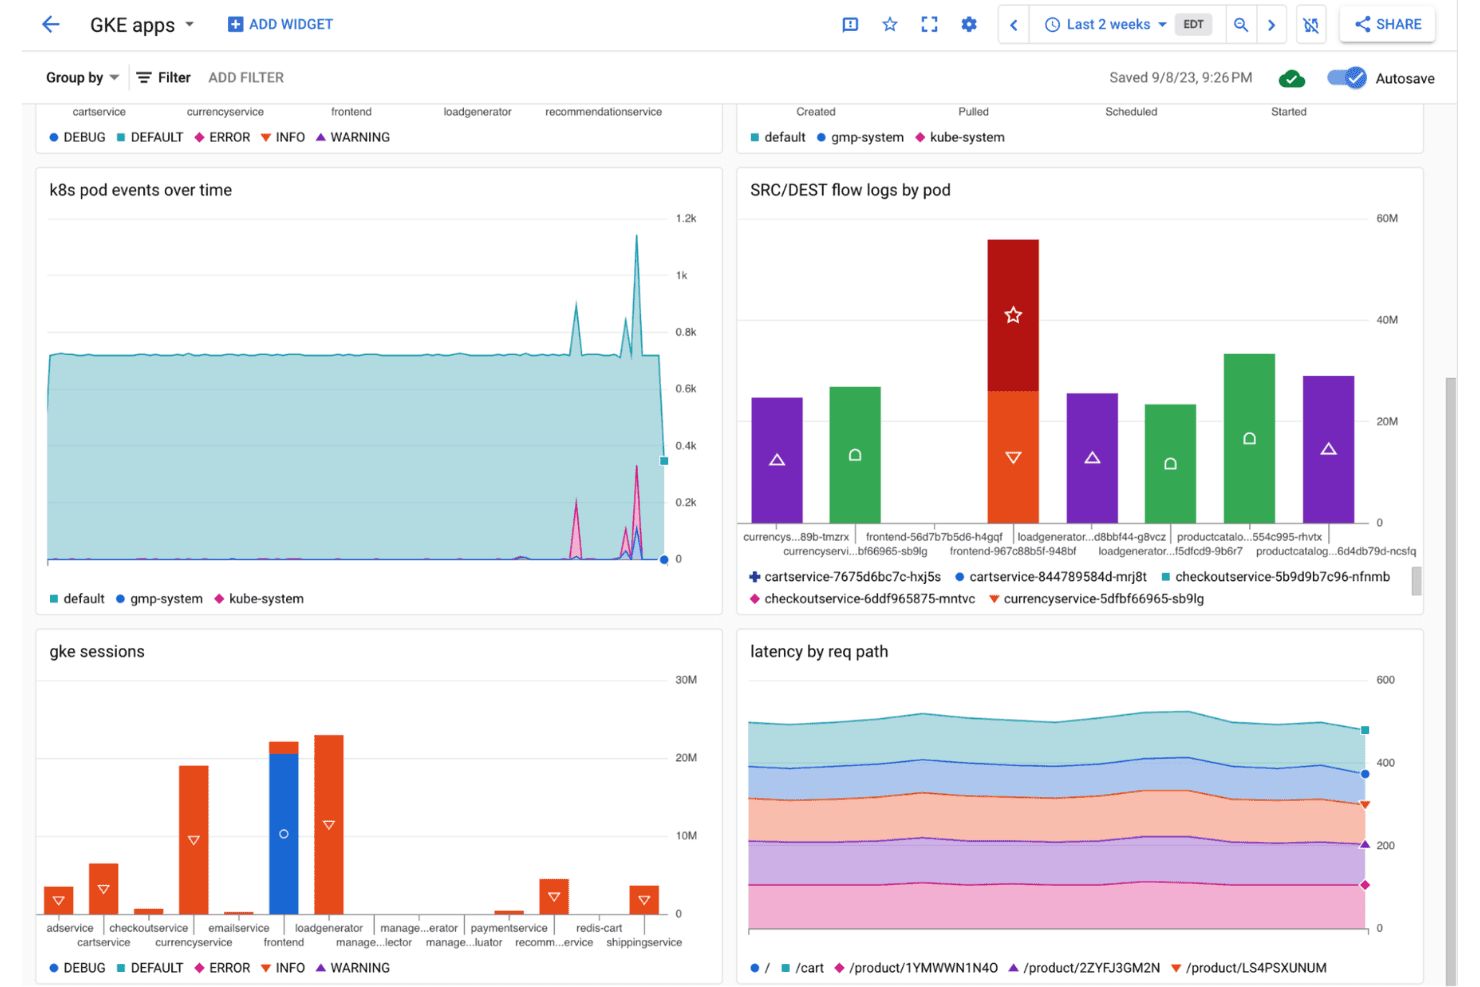
Google Cloud Storage näyttää GKE-sovellusten valvontakoontinäyttöjä, joissa näkyvät pod-tapahtumat ja viivemittarit. Google Cloud Storage on hallinnoitu objektitallennuspalvelu, joka on suunniteltu datajärviarkkitehtuureihin ja tarjoaa porrastetut tallennusluokat, Apache Icebergin ja BigLaken kautta tuetun avoimen taulukkomuodon sekä tiiviin integraation BigQueryn, Dataflow'n, Dataproc:n ja Vertex AI:n kanssa.
Kenelle Google Cloud Storage sopii parhaiten?
Google Cloud Storage sopii erinomaisesti data- ja infrastruktuuritiimeille, jotka toimivat jo GCP-ekosysteemissä ja tarvitsevat skaalautuvaa objektitallennusta lakehouse-arkkitehtuurin perustaksi.
Miksi valitsin Google Cloud Storagen
Valitsin Google Cloud Storagen, koska se on GCP-pohjaisen lakehousen natiiviperusta, joka tarjoaa porrastetut tallennusluokat (Standardista Archiveen hintaan 0.0012 $/Gt/kuukausi) ja Autoclass-ominaisuuden, joka siirtää objekteja automaattisesti tasojen välillä käyttömallien perusteella. Erityisen kiinnostavana pidän BigLakea: se lisää ACID-transaktiot, aikamatkustuksen ja skeeman evoluution suoraan GCS-pohjaisiin Apache Iceberg -tauluihin, jolloin raaka objektitallennus muuttuu kyseltäväksi lakehouseksi ilman datan siirtämistä. BigQuery voi sen jälkeen kysellä samoja Iceberg-tauluja suoraan niiden nykyisestä sijainnista ilman vientiä.
Google Cloud Storagen tärkeimmät ominaisuudet
- Monimuotoinen tiedonsiirto: Storage Transfer Service, Dataflow, Pub/Sub ja Datastream tukevat erä-, suoratoisto- ja CDC-tiedonsiirtoa MySQL:n, PostgreSQL:n ja Oraclen kaltaisista tietokannoista GCS:ään.
- Hallinta ja käyttöoikeusvalvonta: IAM-pohjaiset käyttöoikeudet, CMEK/CSEK-salaus, VPC Service Controls, Cloud DLP ja auditointilokit varmistavat kaiken tallennetun datan tietoturvan.
- Metadatan haku Knowledge Catalogin avulla: Dataplex skannaa GCS-säilöt automaattisesti skeemojen poimimista ja liiketoimintasanastojen muodostamista varten sekä luo päästä päähän ulottuvan datalinjaston GCS:n ja BigQueryn välille.
- Usean kyselymoottorin tuki: GCS-pohjaisia Iceberg-tauluja voi kysellä BigQuerylla, Serverless Sparkilla, Trinolla, Flinkillä ja Prestolla Iceberg REST Catalogin kautta.
Google Cloud Storagen integraatiot
Google Cloud Storagella on natiivit integraatiot BigQueryn, Dataprocin, Dataflown, Pub/Subin, Datastreamin, Vertex AI:n, Lookerin ja Knowledge Catalogin kanssa. REST-, XML- ja gRPC-rajapinnat sekä asiakaskirjastojen rajapinnat tukevat mukautettuja integraatioita data-alustojen ja käsittelymoottoreiden kanssa.
Pros and Cons
Pros:
- Lakehouse-tuki Apache Iceberg -tauluille
- Usean moottorin analytiikka BigQuerylla ja Sparkilla
- Automaattiset arkistointi- ja tallennustason vaihtovaihtoehdot
Cons:
- Useimmat ominaisuudet edellyttävät useita GCP-palveluita
- Monimutkainen laskutus, jossa käyttötoiminnoista ja tiedonsiirrosta peritään erilliset maksut
Learn more about Google Cloud Storage: Parhaiten avoimiin taulukkomuotoihin perustuvaan lakehouseen
- 14 päivän maksuton kokeilu
- Alkaen $0.22/DBU
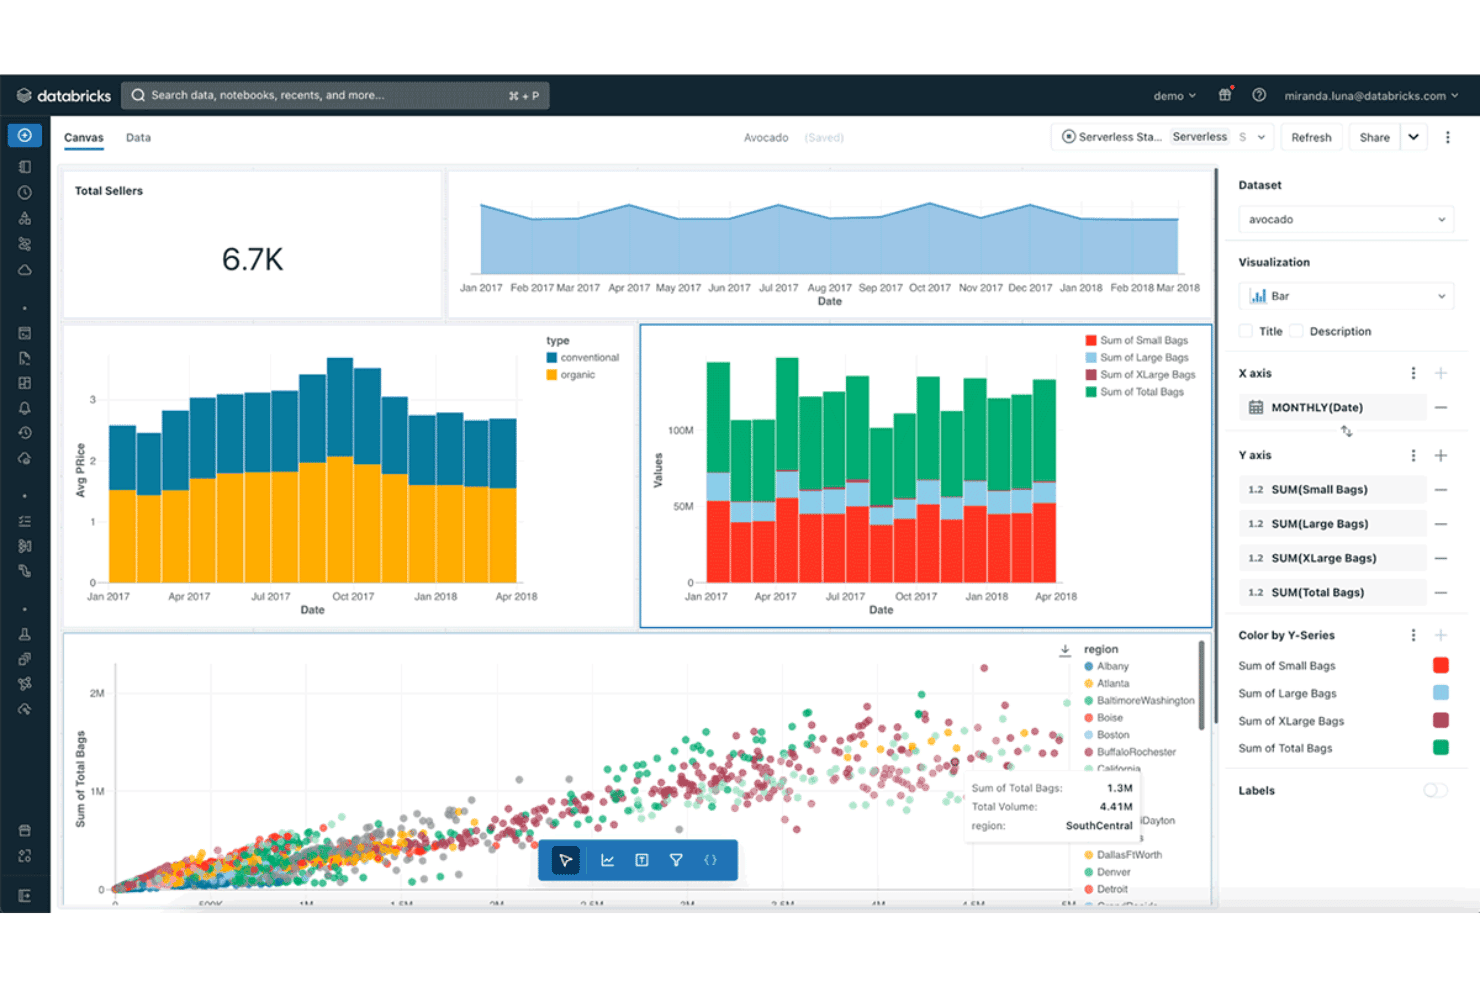
Databricks visualisoi avokadomyynnin tietoja interaktiivisten koontinäyttökaavioiden avulla. Databricks Lakehouse Platform on pilvinatiivi data lakehouse -alusta, joka yhdistää data-analytiikan, SQL-analytiikan, koneoppimisen ja tekoälyn kehityksen avoimiin taulukkomuotoihin, kuten Delta Lakeen, Apache Icebergiin ja Apache Hudiin.
Kenelle Databricks Lakehouse Platform sopii parhaiten?
Databricks sopii erinomaisesti yritysten data- ja ML-tiimeille, joiden on suoritettava suunnitteluputkia, SQL-analytiikkaa ja tekoälykuormia yhdellä alustalla ilman datan siirtämistä järjestelmien välillä.
Miksi valitsin Databricks Lakehouse Platformin
Databricks ansaitsee paikkansa suosikkilistallani, koska kyseessä on tiimi, joka kirjaimellisesti keksi Delta Laken, ja tällä alkuperällä on merkitystä, kun arvioit avoimien taulukkomuotojen tukea. Olen työskennellyt alustan natiivin Delta Lake-, Iceberg- ja Hudi-tuen kanssa, ja sen erottaa muista se, etteivät ACID-tapahtumat, aikamatkustus ja skeeman evoluutio ole irrallisia lisäosia. Unity Catalog lisää suoraan tämän päälle automaattisen saraketason tietojen alkuperän seurannan ja attribuuttipohjaisen käyttöoikeuksien hallinnan, joten hallinta seuraa dataa pilvien välillä.
Databricks Lakehouse Platformin tärkeimmät ominaisuudet
- Lakeflow Connect: Hallittu, palvelimeton tietojen sisäänoton kerros, jossa on yli 100 natiiviliitintä SaaS-sovelluksille, tietokannoille, pilvitallennukselle ja suoratoistolähteille, kuten Kafkalle, Kinesisille ja Event Hubsille.
- Apache Spark -deklaratiiviset putket: Kehys eräajoina ja reaaliaikaisina suoratoistona toimivien ETL-putkien rakentamiseen. Siinä on sisäänrakennettu rajoitteisiin perustuva datan laadun valvonta ja automaattinen CDC.
- Databricks SQL -varastot: Photon-kiihdytetty SQL-moottori, joka tukee ANSI SQL:ää analytiikkakuormissa ja tarjoaa JDBC/ODBC-yhteydet BI-työkaluihin, kuten Tableaulle, Power BI:lle ja Lookerille.
- MLflow-integraatio: Hallittu MLflow-ympäristö kokeiden seurantaan, mallirekisteriin ja käyttöönottoon. Se sijaitsee yhdessä lake-datasi kanssa ja on yhdistetty Feature Storeen ja Model Servingiin.
Databricks Lakehouse Platformin integraatiot
Databricks tarjoaa yli 100 natiivista Lakeflow Connect -liitintä, mukaan lukien Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive ja Google Analytics. Se yhdistyy myös Kafkaan, Kinesisiin, Event Hubsiin, S3:een, ADLS:ään ja GCS:ään sekä tarjoaa JDBC/ODBC-yhteydet ja rajapinnat mukautettuja yhteyksiä varten.
Pros and Cons
Pros:
- Natiivi Delta Lake-, Iceberg- ja Hudi-tuki
- Automaattinen saraketason tietojen alkuperän seuranta Unity Catalogin avulla
- Sisäänrakennettu MLflow ja yhtenäinen tekoälyalusta
Cons:
- DBU- ja pilvikustannukset voivat kasvaa nopeasti
- Paikallisen käyttöönoton vaihtoehtoa ei ole saatavilla
Learn more about Databricks Lakehouse Platform: Paras AWS:n datajärvien ytimessä olevaan objektien tallennukseen
- Ei saatavilla
- Alkaen $0.023/GB/month
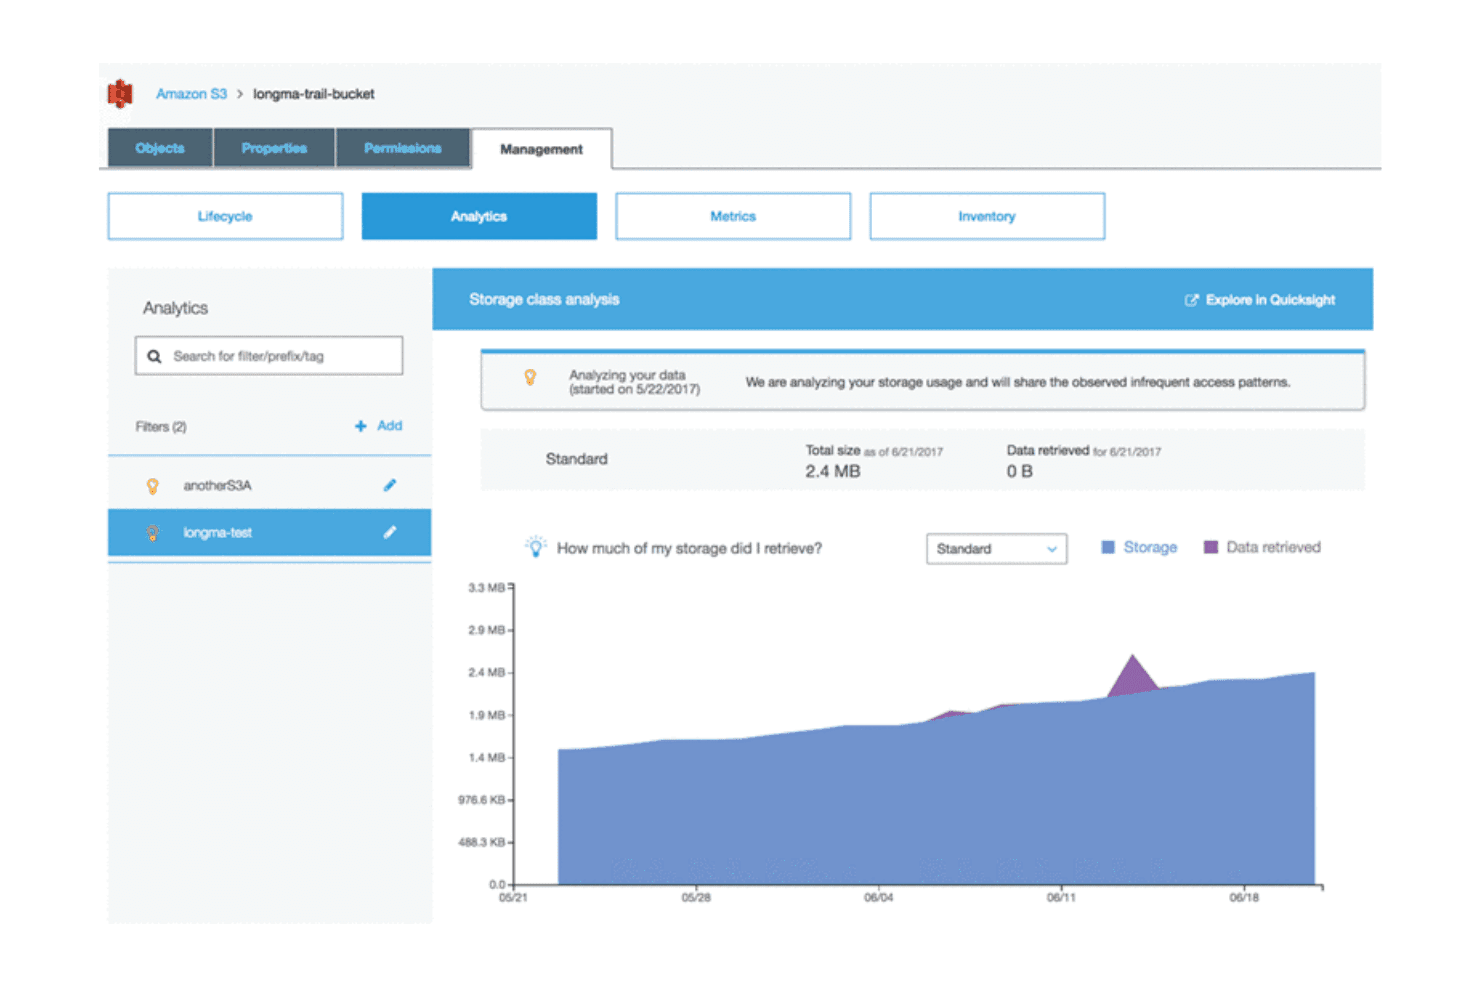
Amazon S3 analysoi tallennuksen käyttötapoja tietojen noutokustannusten optimoimiseksi. Amazon S3 on AWS:n objektien tallennuspalvelu, joka toimii datajärvien perustana olevana tallennuskerroksena ja tukee mitä tahansa datamuotoa eksatavun mittakaavassa. Se tarjoaa kerroksittaiset tallennusluokat, natiivin Apache Iceberg -taulujen hallinnan S3 Tablesin kautta sekä syvän integraation koko AWS:n analytiikkaekosysteemiin.
Kenelle Amazon S3 sopii parhaiten?
Amazon S3 sopii data- ja infrastruktuuritiimeille, jotka rakentavat analytiikkaputkia AWS:ssä ja tarvitsevat todistetusti toimivan, eksatavun mittakaavaan soveltuvan tallennusperustan, joka yhdistyy suoraan muuhun AWS-ekosysteemiin.
Miksi valitsin Amazon S3:n
Amazon S3 päätyi kärkivalintojeni joukkoon, koska se on objektien tallennuskerros, jonka päälle useimmat tuotantokäytössä olevat datajärvet on jo rakennettu. Pidän siitä, että S3 Tables tarjoaa natiivin Apache Iceberg -tuen, ACID-transaktiot, aikamatkustuksen ja automaattisen tiivistyksen valmiina. Tämä ratkaisee pienten tiedostojen ongelman, joka vaivaa useimpia datajärviarkkitehtuureja. Kun tähän yhdistetään S3 Intelligent-Tieringin automaattinen kylmän datan siirtäminen hintaan $0.00099/GB/month, saadaan tehokas tallennuskustannusten hallinta ilman manuaalisia toimia.
Amazon S3:n tärkeimmät ominaisuudet
- Monimuotoinen tiedon vastaanotto: S3 hyväksyy minkä tahansa tiedostotyypin—Parquet-, ORC-, Avro-, JSON- ja CSV-tiedostot sekä strukturoimattomat tiedostomuodot—erälatauksina, Kinesisin ja MSK:n kautta suoratoistona tai tapahtumapohjaisten käynnistimien avulla S3 Event Notifications -palvelua käyttäen.
- Lake Formationin hienojakoinen käyttöoikeuksien hallinta: Valvo tietojen käyttöä koskevia käytäntöjä taulukko-, sarake-, rivi- ja solutasolla koko S3-pohjaisessa datajärvessäsi ilman tietojen monistamista.
- S3 Vectors: Suoraan S3:een sisäänrakennettu natiivi vektori-indeksien tallennus- ja kyselypalvelu, joka on suunniteltu semanttiseen hakuun ja hakua hyödyntävän generoinnin työkuormiin jopa 90 % perinteisiä lähestymistapoja edullisemmin.
- S3 Inventory: Luo ajoitettuja raportteja objektien määritteistä, tallennusluokasta, salauksen tilasta ja replikoinnin tilasta kaikissa säilöissäsi auditointi- ja hallintaprosesseja varten.
Amazon S3 -integraatiot
Amazon S3 tarjoaa natiivit integraatiot AWS:n palveluihin, kuten AWS Glueen, Amazon Athenaan, Amazon EMR:ään, AWS Lake Formationiin, Amazon Kinesisiin, Amazon Redshift Spectrumiin ja Amazon SageMakeriin. Se yhdistyy myös Apache Sparkiin, Trinoon, Snowflakeen, Databricksiin, Tableaun ja Power BI:hin dokumentoitujen liittimien ja ohjelmointirajapintojen kautta.
Pros and Cons
Pros:
- Eksatavun mittakaavaan soveltuva objektien tallennus tukee mitä tahansa datamuotoa
- Sisäänrakennetut ACID-yhteensopivat Iceberg-taulut automaattisella tiivistyksellä
- 143 vaatimustenmukaisuussertifiointia ja objektitason käyttöoikeuksien hallinta
Cons:
- Hinnoittelu on monimutkaista ja vaatii tarkkaa hallintaa
- Datajärvien rakentaminen edellyttää useiden AWS-palvelujen kokoamista yhteen
Learn more about Amazon S3: Parhaiten Microsoft-natiiveihin yritysten datajärviin
- $200 hyvitys 30 päiväksi (ei erillistä ilmaistasoa)
- Alkaen $0.023/GB/month
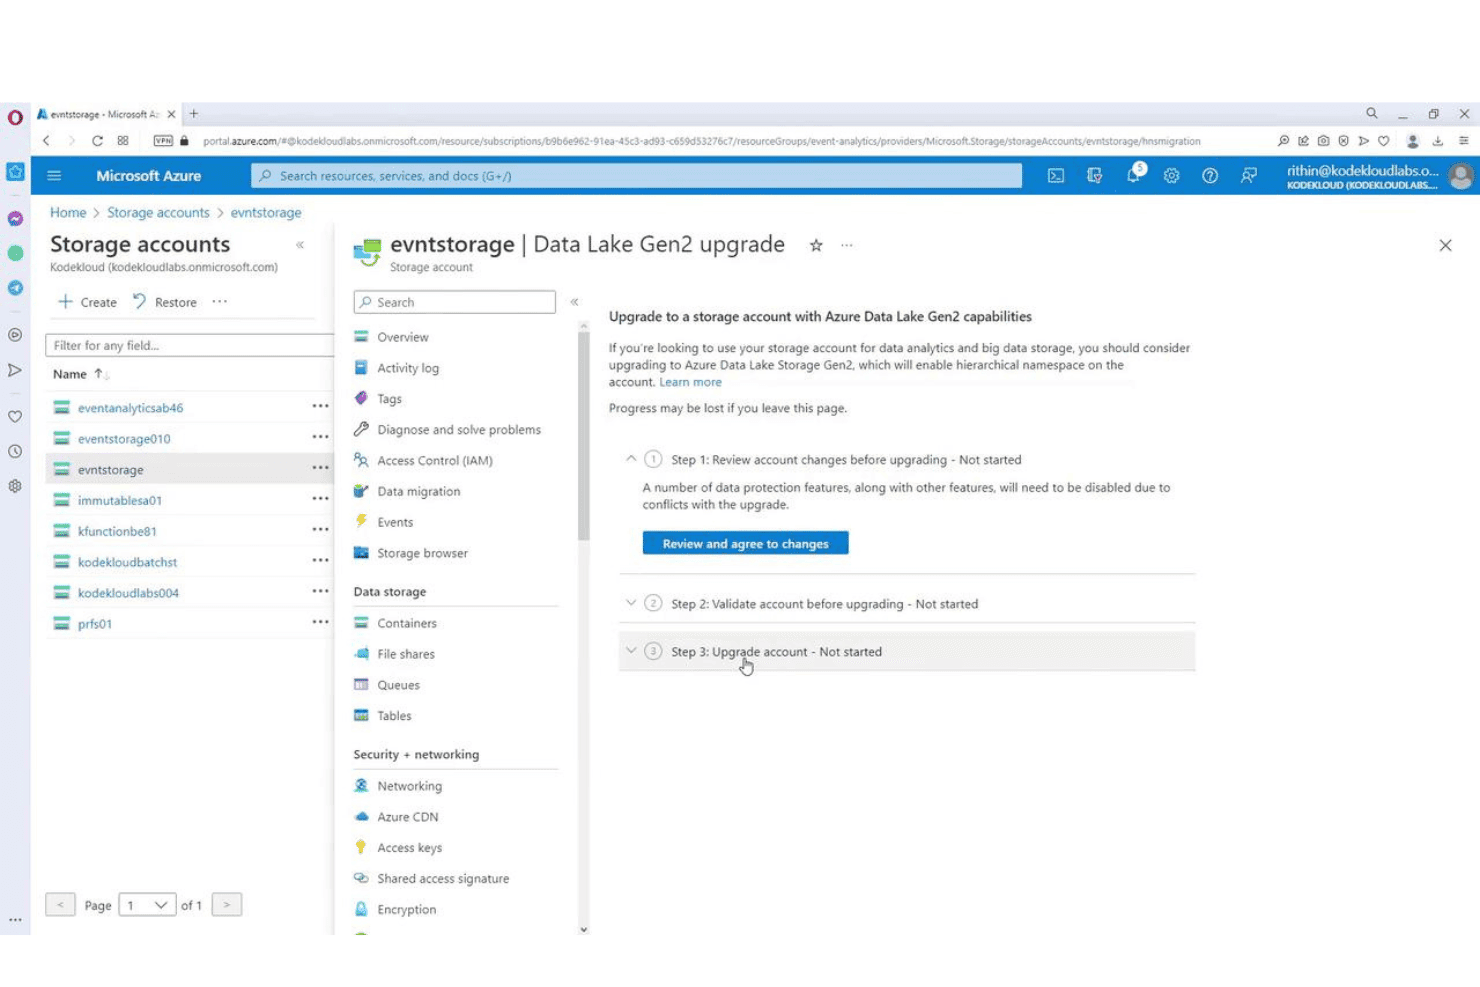
Azure Storage antaa käyttäjien päivittää tilit Data Lake Gen2 -ominaisuuksiin. Azure Data Lake Storage Gen2 on Microsoftin pilvipohjainen datajärvipalvelu, joka on rakennettu Azure Blob Storagen päälle hierarkkisella nimiavaruudella ja joka tukee eksatavun mittakaavan tallennusta, monimuotoisen datan tuontia, POSIX-yhteensopivia käyttöoikeusmäärittelyjä sekä natiivia integrointia Azuren analytiikka- ja koneoppimisekosysteemiin.
Kenelle Azure Data Lake Storage sopii parhaiten?
Azure Data Lake Storage Gen2 sopii luontevasti yritysten IT- ja datatiimeille, jotka käyttävät jo Microsoft Azurea ja tarvitsevat eksatavun mittakaavan tallennusta, joka on tiiviisti integroitu Synapseen, Databricksiin ja Microsoft Fabriciin.
Miksi valitsin Azure Data Lake Storagen
Valitsin Azure Data Lake Storage Gen2:n yhdeksi parhaista vaihtoehdoista, koska se on koko Microsoftin analytiikkapinon natiivi tallennusperusta, ja tämä tiivis integraatio on merkittävä etu yritysten mittakaavassa. Kun organisaatiosi käyttää Synapsea, Databricksia ja Microsoft Fabrica, ADLS Gen2 on jo kaiken alla oleva perusta, mikä tarkoittaa, että jokainen käsittelymoottori voi tehdä kyselyitä samaan datakopioon ABFS-ohjaimen kautta. Pidän erityisesti POSIX-yhteensopivista ACL-käyttöoikeusluetteloista, joiden avulla luku-, kirjoitus- ja suoritusoikeudet voidaan määrittää yksittäisen tiedoston ja hakemiston tasolla eikä ainoastaan säilön tasolla.
Azure Data Lake Storagen tärkeimmät ominaisuudet
- Automaattinen elinkaaren mukainen porrastus: Määritä käytännöt, jotka siirtävät dataa automaattisesti kuuma-, viileä-, kylmä- ja arkistotasoille datan iän tai viimeisimmän käyttöajan perusteella, jotta tallennuskustannuksia voidaan hallita laajassa mittakaavassa.
- ABFS-ohjaimen yhteensopivuus: Azure Blob File System -ohjain tarjoaa Hadoop-, Spark-, Hive- ja HDFS-pohjaisille työkuormille natiivin luku- ja kirjoitusoikeuden ADLS Gen2:een ilman koodimuutoksia.
- OneLake-pikakuvakkeet: Luo reaaliaikaisia viittauksia muiden OneLake-työtilojen, Amazon S3:n tai Azure Blob Storage -säilöjen dataan ilman taustalla olevan datan kopiointia tai siirtämistä.
- Azure Machine Learning -tietovaraston integrointi: Rekisteröi ADLS Gen2 -säilöt suoraan tietovarastoiksi Azure ML -työtiloihin, jolloin datatieteilijät saavat suoran pääsyn datajärven dataan mallien koulutusta ja kokeiluja varten.
Azure Data Lake Storagen integraatiot
Azure Data Lake Storagella on natiivit integraatiot Microsoft-ekosysteemin eri osiin, kuten Azure Data Factoryyn, Azure Databricksiin, Azure Synapse Analyticsiin, Microsoft Fabriciin, Microsoft Purviewiin, Azure Machine Learningiin ja Azure Event Hubsiin. Se tukee myös Apache Sparkia ja Kafkaa dokumentoitujen liittimien kautta sekä ABFS:ää ja ohjelmointirajapintoja mukautettua datan käyttöä varten.
Pros and Cons
Pros:
- Natiivi integraatio Microsoftin analytiikkatyökaluihin
- Hierarkkinen nimiavaruus tukee tarkkarajaista käyttöoikeuksien hallintaa
- Avoimet taulukkomuodot laskentakerroksen kautta
Cons:
- Edistynyt datan luettelointi edellyttää Purviewia
- Saatavilla vain Microsoft Azuressa
Learn more about Azure Data Lake Storage:
Muut datajärvityökalut
Tässä on joitakin muita datajärvityökaluja, jotka eivät päässeet esivalintaani, mutta joihin kannattaa silti tutustua:
- 11IBM watsonx.dataSopii parhaiten avoimeen datajärvitaloon, jossa on pääsy keskuslaskentatietoihin
- 12Microsoft FabricParas Microsoft-teknologiapinon datajärvi-integraatioihin
- 13StarburstParas yhdistettyyn SQL-kyselyyn useiden pilvipalveluiden datajärvissä
- 14Alibaba Cloud Hybrid CloudSopii parhaiten APAC-alueen hybridipilven datajärviratkaisujen käyttöönottoihin
- 15Teradata VantageSoveltuu parhaiten tekoälyn ja koneoppimisen työkuormiin petatavun mittakaavan datajärvissä
- 16MinIOParas tekoälylle ja paikalliseen lakehouse-tallennukseen
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Kuinka valita datajärvityökaluja
Mitkä tekijät vaikuttavat käytännössä siihen, pystyykö datajärvityökalu tarjoamaan tiimisi tarvitsemat skaalautuvuuden, hallinnan ja integraatiot tosielämän analytiikkakuormille?
| Jos ensisijainen tavoitteesi on... | Etsi... |
|---|---|
| Jos ensisijainen tavoitteesi on...Sääntelyn vaatimustenmukaisuus | Etsi...Sisäänrakennettu tarkastusloki ja käyttöoikeuskäytännöt |
| Jos ensisijainen tavoitteesi on...Monipilvi- tai hybridikäyttöönotto | Etsi...Alkuperäinen tuki useille pilvipalveluntarjoajille |
| Jos ensisijainen tavoitteesi on...Riippumattomuus toimittajasta | Etsi...Yhteensopivuus avoimen taulukkomuodon kanssa |
| Jos ensisijainen tavoitteesi on...Analytiikan suorituskyky mittakaavassa | Etsi...Tasotettu tallennustila ja natiivi kyselyintegraatio |
| Jos ensisijainen tavoitteesi on...Tekoäly- ja ML-valmius | Etsi...Suorat liittimet tekoäly- ja ML-työkaluihin ja -moottoreihin |
Kuinka arvioida esivalintasi
- Varmista hallintaominaisuudet: Pyydä kuvakaappauksia hallintakonsolista, joissa näkyvät roolipohjainen käyttöoikeuksien hallinta ja tarkastuslokin määritykset.
- Testaa avoimien tiedostomuotojen tuki: Suorita Parquet- tai Iceberg-tiedostojen reaaliaikainen tuonti ja varmista skeeman kehittyminen kokeiluympäristössä.
- Vahvista monipilveä koskevat väitteet: Pyydä julkista dokumentaatiota, jossa kuvataan käyttöönoton vaiheet vähintään kahdella pilvipalveluntarjoajalla.
- Tarkista analytiikkaintegraatio: Pyydä työnkulkuesimerkki tai määritys Sparkille, Trinolle tai Prestolle sekä dokumentoidut kyselytulokset.
- Kompromissi – yritysohjelmistopaketti vai avoin lakehouse: Päätä, tarvitsetko valmiin ohjelmistopaketin vaatimustenmukaisuuden ja tuen vai ovatko joustavuus ja avoimen teknologiapinon yhteensopivuus arkkitehtuurillesi tärkeämpiä.
Mitä datajärvityökalut ovat?
Datajärvityökalut ovat alustoja ja ohjelmistoja, joiden avulla voit tallentaa, hallita ja analysoida suuria määriä jäsenneltyä ja jäsentämätöntä dataa keskitettyyn tietovarastoon. Näiden työkalujen avulla tiimisi voi tuoda raakadataa, soveltaa skeemaa tarvittaessa ja järjestää aineistoja analytiikka- tai tekoälyprojekteja varten. Voit odottaa ominaisuuksia, jotka tukevat hallintaa, skaalautuvuutta ja integraatiota suosittujen kyselymoottorien ja analytiikka-alustojen kanssa.
Datajärvityökalujen ominaisuudet
Kun valitset datajärvityökaluja, kiinnitä huomiota seuraaviin keskeisiin ominaisuuksiin:
- Skaalautuva objektitallennus: Mahdollistaa petatavujen suuruisten jäsenneltyjen ja jäsentämättömien tietojen tallentamisen ja hallinnan sekä porrastetun tai kylmätallennuksen käytön kustannusten hallitsemiseksi tallennustarpeiden kasvaessa.
- Lukuaikaisen skeeman tuki: Mahdollistaa raakadatasta aloittamisen ja skeeman käyttämisen myöhemmin kyselyn aikana, mikä helpottaa monimuotoisten ja muuttuvien tietojoukkojen käsittelyä ilman uudelleenlatausta.
- Monimuotoinen tietojen vastaanotto: Tukee tietojen tuontia eri muodoissa, kuten Parquet-, Avro-, JSON-, ORC- ja CSV-muodoissa, sekä erä- ja suoratoistolähteitä, mikä lisää joustavuutta tietojen saapumistapaan.
- Kyselymoottorien integrointi: Tarjoaa yhteensopivuuden Spark-, Trino-, Presto- ja Athena-moottoreiden kaltaisten ratkaisujen kanssa, joten voit suorittaa analytiikka- ja raportointikuormia suoraan datajärvessäsi ilman ylimääräistä väliohjelmistoa.
- Metatietojen ja luetteloiden hallinta: Sisältää työkaluja tietojen luettelointiin, aineistojen hakuun, tietojen alkuperän seurantaan ja merkitsemiseen, mikä auttaa pitämään tiedot järjestyksessä ja löydettävissä uusien tietojoukkojen lisääntyessä.
- Hallinta ja käyttöoikeudet: Tarjoaa tarkkarajaiset käyttöoikeudet, salauksen ja auditointilokit, jotta voit hallita, kuka käyttää mitäkin tietoja, seurata käyttöä ja täyttää sääntelyvaatimukset.
- Tietojen versiointi ja aikamatkustus: Mahdollistaa muutosten seurannan, tietojoukkojen aiempiin versioihin palauttamisen ja historiallisten näkymien ylläpitämisen, mikä on hyödyllistä auditoinnissa, palautuksessa ja toistettavuudessa.
- Integrointi orkestrointityökaluihin: Yhdistyy natiivisti Apache Airflow -tyyppisiin työnkulkujen orkestroijiin, jolloin voit automatisoida tietoputkia ja koordinoida tehtäviä eri järjestelmien välillä.
- Valvonta- ja kustannustenhallintatyökalut: Tarjoaa koontinäyttöjä ja hälytyksiä tallustilan käytöstä, käyttökuvioista ja kustannuksista, jotta voit pitää ympäristösi tehokkaana ja budjetin mukaisena.
- Avoimien taulukkomuotojen tuki: Tukee Delta Lake- ja Apache Iceberg -muotojen kaltaisia ratkaisuja mahdollistaen edistyneet ominaisuudet, kuten ACID-transaktiot ja yhteentoimivuuden useiden analytiikkatyökalujen kanssa.
Datajärvityökalujen yleiset tekoälyominaisuudet
Edellä lueteltujen datajärvityökalujen vakiotoimintojen lisäksi monet näistä ratkaisuista ottavat käyttöön tekoälyä esimerkiksi seuraavilla ominaisuuksilla:
- Automaattinen tietojen luokittelu: Käyttää tekoälymalleja saapuvien tietojen tarkistamiseen ja luokitteluun sisällön, arkaluonteisuuden tai vaatimustenmukaisuusvaatimusten perusteella. Tämä auttaa tiimiäsi järjestämään aineistot nopeammin ja soveltamaan oikeita käyttöoikeuksia ilman manuaalista merkitsemistä.
- Tietojen laadun poikkeamien tunnistus: Soveltaa koneoppimisalgoritmeja tietovirtojen valvontaan ja epätavallisten mallien, puuttuvien arvojen tai poikkeavien havaintojen merkitsemiseen. Näin voit havaita tietojen eheysongelmat ajoissa ja vähentää virheellisen analytiikan tai myöhempien virheiden riskiä.
- Ennakoiva kuormituksen optimointi: Hyödyntää tekoälyä aiempien kyselymallien ja tallennustilan käytön analysointiin ja suosittelee tai ottaa automaattisesti käyttöön optimointeja, kuten osiointia, välimuistia tai resurssien skaalausta. Tämä auttaa ylläpitämään suorituskykyä ja hallitsemaan kustannuksia käytön kasvaessa.
- Luonnollisen kielen kyselyliittymät: Integroi tekoälyä hyödyntäviä keskustelu- tai hakutyökaluja, joiden avulla käyttäjät voivat esittää tietoja koskevia kysymyksiä arkikielellä. Tämä madaltaa teknisten taitojen puutetta omaavien käyttäjien kynnystä tutkia tietojoukkoja ja tuottaa oivalluksia kirjoittamatta SQL-koodia tai muuta koodia.
- Automaattinen metatietojen rikastaminen: Käyttää tekoälyä kontekstin, suhteiden ja liiketoimintatermien poimimiseen raakadatasta ja täyttää sitten tietoluettelon kattavammilla kuvauksilla ja alkuperätiedoilla. Tämä helpottaa tietoaineistojen löytämistä, niihin luottamista ja niiden uudelleenkäyttöä tiimeissä.
Datajärvityökalujen hyödyt
Datajärvityökalujen käyttöönotto tarjoaa useita hyötyjä tiimillesi ja liiketoiminnallesi. Tässä muutamia hyötyjä, joita voit odottaa:
- Keskitetty datanhallinta: Datalake-työkalujen avulla voit tallentaa rakenteista ja rakenteistamatonta dataa yhteen paikkaan, mikä helpottaa resurssien järjestämistä ja analytiikka- tai AI-projektien tukemista.
- Petatavun mittakaavan työkuormien skaalautuvuus: Nämä alustat pystyvät käsittelemään valtavia datamääriä ja tukevat sekä pilvi- että paikallisia tallennustasoja, joten voit mukautua kasvaviin tarpeisiin ilman arkkitehtuurin uudelleensuunnittelua.
- Joustava datan tuonti: Voit tuoda dataa monenlaisista muodoista ja lähteistä sekä käsitellä sekä eräajoina että reaaliaikaisina virtoina saapuvaa dataa sisäänrakennettujen liitäntöjen ja muototuen ansiosta.
- Yksityiskohtainen hallinta ja käyttöoikeuksien valvonta: Tarkkarajaiset käyttöoikeudet, salaus ja auditointilokit auttavat ylläpitämään tietoturvaa ja vaatimustenmukaisuutta HIPAA-, SOC 2- ja GDPR-standardien kaltaisten standardien kanssa.
- Integrointi analytiikka- ja AI-työkaluihin: Natiivi yhteensopivuus Spark-, Trino- ja Presto-kyselymoottoreiden kaltaisten työkalujen kanssa sekä suorat liitännät AI/ML-työkaluihin tarkoittavat, että voit analysoida dataa ilman viiveitä tai ylimääräistä integrointityötä.
- Metatietojen ja datan laadun automaattinen hallinta: Moniin alustoihin sisältyy luetteloita, alkuperän seurantaa ja AI-pohjaisia työkaluja, jotka auttavat rikastamaan metatietoja, luokittelemaan dataa ja havaitsemaan poikkeamia datan eheyden ylläpitämiseksi.
- Avoimien taulukkomuotojen ja edistyneiden käyttötapausten tuki: Delta Laken tai Apache Icebergin yhteensopivuuden kaltaiset ominaisuudet mahdollistavat ACID-transaktiot, datan versioinnin ja datan jakamisen ilman kopiointia edistyneemmän analytiikan ja monipilviarkkitehtuurien tukemiseksi.
Datalake-työkalujen kustannukset ja hinnoittelu
Datalake-työkalujen valinta edellyttää saatavilla olevien erilaisten hinnoittelumallien ja pakettien ymmärtämistä. Kustannukset vaihtelevat ominaisuuksien, tiimin koon, lisäosien ja muiden tekijöiden perusteella. Alla oleva taulukko sisältää yhteenvedon datalake-työkaluratkaisujen yleisistä paketeista, niiden keskimääräisistä hinnoista ja tyypillisistä ominaisuuksista:
Datalake-työkalujen pakettien vertailutaulukko
| Pakettityyppi | Keskimääräinen hinta | Yleiset ominaisuudet |
|---|---|---|
| PakettityyppiIlmainen paketti | Keskimääräinen hinta$0 | Yleiset ominaisuudetPerustason objektitallennus, rajoitettu datan tuonti, lukuhetken skeeman tuki ja integrointi yhteen kyselymoottoriin. |
| PakettityyppiHenkilökohtainen paketti | Keskimääräinen hinta$50–$300/kuukaudessa | Yleiset ominaisuudetSuuremmat tallennusrajat, useiden dataformaattien tuki, perustason luettelointi ja integrointi analytiikkatyökaluihin. |
| PakettityyppiYrityspaketti | Keskimääräinen hinta$1,000–$5,000/kuukaudessa | Yleiset ominaisuudetPetatavun mittakaavan tallennus, edistyneet hallintakontrollit, monipilvivaihtoehdot ja datan luettelointiominaisuudet. |
| PakettityyppiSuuryrityspaketti | Keskimääräinen hinta$10,000+/kuukaudessa | Yleiset ominaisuudetRajaton tallennus, kattavat vaatimustenmukaisuusominaisuudet, AI-pohjainen automaatio, integrointi orkestrointityökaluihin ja ensiluokkainen tuki. |
Datajärvityökalujen usein kysytyt kysymykset
Tässä on vastauksia datajärvityökaluja koskeviin yleisiin kysymyksiin:
Miten datajärvityökalut käsittelevät turvallisuus- ja vaatimustenmukaisuusvaatimuksia?
Datajärvityökalut toteuttavat tietoturvan käyttöoikeuksien hallinnan, salauksen ja auditointilokien avulla. Useimmat johtavat alustat tukevat tarkkoja käyttöoikeuksia aina rivi- tai saraketasolle asti sekä SSO- ja identiteetinhallintapalveluntarjoajien integrointeja. Vaatimustenmukaisuuden osalta kannattaa etsiä toimittajan sertifiointeja, kuten SOC 2, HIPAA tai GDPR, sekä mahdollisuuksia asiakkaan hallinnoimien salausavainten käyttöön. Näiden ominaisuuksien avulla voit täyttää sääntelyvaatimukset rakentamatta ylimääräisiä kerroksia.
Voivatko datajärvityökalut integroitua olemassa oleviin analytiikka- tai BI-alustoihin?
Kyllä, useimmat datajärvityökalut tarjoavat suoria liitäntöjä analytiikka- ja BI-alustoihin. Niiltä pitäisi löytyä valmiiksi tuki Sparkille, Trinolle, Prestolle ja Athenalle sekä integraatiot Tableaun ja Power BI:n kanssa. Jos tiimisi käyttävät erikoistuneita työkaluja, tarkista, onko saatavilla avoimia ohjelmointirajapintoja tai ODBC/JDBC-ajureita, joiden avulla voit yhdistää mukautettuja työnkulkuja.
Mikä ero on datajärvityökaluilla ja tietovarastoilla?
Datajärvityökalut keskittyvät raakadatan, puolistrukturoidun datan ja strukturoimattoman datan tallentamiseen siten, että skeema määritetään dataa luettaessa, kun taas tietovarastot tallentavat strukturoitua dataa ennalta määritettyjen skeemojen mukaisesti. Datajärvet soveltuvat paremmin joustavaan datan vastaanottoon ja tekoäly- ja koneoppimistyökuormiin, kun taas tietovarastot sopivat kuratoituun analytiikkaan ja optimoituun kyselysuorituskykyyn. Jotkin toimittajat tarjoavat nykyään arkkitehtuureja, joissa datajärvien ja tietovarastojen lähestymistavat yhdistyvät.
Tukevatko datajärvityökalut useita dataformaatteja ja datan vastaanottotapoja?
Kyllä, useimmat datajärvityökalut hyväksyvät useita formaatteja, kuten Parquet, Avro, JSON, ORC ja CSV. Ne tukevat myös sekä eräajoina että suoratoistona toimitettavia datalähteitä, joten voit käsitellä kaikkea päivittäisistä datan vastaanottotöistä reaaliaikaisiin tapahtumavirtoihin valmiiden tai mukautettujen liitäntöjen avulla.
Miten datajärvityökalujen skaalautuvuutta arvioidaan?
Tarkastelen kunkin alustan objektitallennusvaihtoehtoja, suorituskykyä petatavun kokoisilla datamäärillä sekä monipilvitukea. Keskeistä on mahdollisuus sijoittaa dataa eri tallennusluokkiin, käsitellä dataa eri alueilla ja välttää pullonkaulat Delta Laken tai Icebergin kaltaisten formaattien avulla. Muista tarkistaa dokumentoidut vertailutulokset ja hankkia suosituksia asiakkailta, joiden datamäärät ovat samankaltaisia kuin omasi.
Ovatko avoimet taulukkoformaatit, kuten Delta Lake tai Apache Iceberg, tärkeitä?
Kyllä, avoimet taulukkoformaatit ovat tärkeitä, jos haluat ACID-transaktiot, versioinnin ja toimittajariippumattoman datanhallinnan. Niiden avulla voit ottaa käyttöön esimerkiksi ajallisen versiohistorian ja datan jakamisen ilman kopiointia. Jos tavoittelet datajärven ja tietovaraston yhdistävää arkkitehtuuria tai haluat varautua tulevaisuuden tarpeisiin, varmista, että datajärvityökalusi on yhteensopiva avoimien formaattien kanssa.