

Databricks on tehokas, mutta se ei aina ole oikea ratkaisu. Tiimisi on ehkä törmännyt hinnoitteluun liittyviin ongelmiin, kamppaillut alustan oppimiskäyrän kanssa tai tarvinnut joustavamman ratkaisun monipilvi- tai paikallisiin ympäristöihin. Olipa syy mikä tahansa, jos olet täällä, etsit todennäköisesti vaihtoehtoa, joka tarjoaa vastaavat datajärvitalon toiminnot ilman kompromisseja.
Olen työskennellyt datatiimien kanssa startup-yrityksissä ja suuryrityksissä arvioiden ja ottaen käyttöön Databricksin, Snowflaken ja muiden kaltaisia alustoja. Olen nähnyt käytännössä, mitä tarvitaan laajamittaisen analytiikan tukemiseen, sekavien tietolähteiden yhdistämiseen ja luotettavien, todella käytettyjen tietoputkien rakentamiseen.
Tässä oppaassa esittelen harkitsemisen arvoiset Databricks-vaihtoehdot – työkalut, joiden avulla voit tallentaa, muuntaa ja tutkia dataa intuitiivisemmin sekä kasvattaa ja mukauttaa ratkaisua tiimisi kasvaessa.
Miksi luottaa ohjelmistosuosituksiimme
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Tiimimme on testannut ja arvioinut ohjelmistoja vuodesta 2012 lähtien. Teknologiajohtajina tiedämme itse, kuinka vaikeaa — ja tärkeää — oikean ohjelmiston valitseminen on.
Tätä opasta varten arvioimme työkaluja käytännön testauksen ja itsenäisen tutkimuksen avulla, pisteyttäen työkalut valintakriteeriemme perusteella.
Arvostelumme perustuvat inhimilliseen toimitukselliseen harkintaamme, eivät myyntipuheeseen.
Asiantuntija-arvioijat:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Vertailutaulukko: Databricks-kilpailijat
Tämä vertailutaulukko kokoaa yhteen tärkeimpien Databricks-kilpailijavalintojeni hinnoittelutiedot.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Paras pilvipohjaiseen tietovarastointiin | Ei | Hinta pyydettäessä | Website | |
| 2 | Paras monipilvidatan käyttöönottoon | Ilmainen paketti saatavilla | Hinta pyydettäessä | Website | |
| 3 | Parhaiten dataintegraatiotehtäviin | Ilmainen kokeilu saatavilla | $1,170/user/year (laskutetaan vuosittain) | Website | |
| 4 | Paras muistissa tapahtuvaan käsittelyyn | Ilmainen sopimus saatavilla | Hinnoittelu pyynnöstä | Website | |
| 5 | Beste Lösung für Boutique-Hotels | 30-tägige kostenlose Testversion | Ab $50/Nutzer/Monat (jährlich abgerechnet) | Website | |
| 6 | Paras yritystason tietokantatarpeisiin | Ilmainen kokeilu saatavilla | $68/käyttäjä/kuukausi (laskutetaan vuosittain) | Website | |
| 7 | Paras SQL-analytiikkaan | 30 päivän ilmainen kokeilu | $30/käyttäjä/kuukausi (laskutetaan vuosittain) | Website | |
| 8 | Paras Hadoop-käsittelyyn | Ei saatavilla | Alkaen $0.007084/vCPU-hour | Website | |
| 9 | Paras hallittuihin Spark- ja Hadoop-ympäristöihin | Ei saatavilla | Alkaen $0.06/DCU-tunti | Website | |
| 10 | Paras tekoäly- ja koneoppimisratkaisuihin | Ilmainen esittely saatavilla | Hinnoittelu pyynnöstä | Website |


Parhaiden Databricks-kilpailijoiden arviot
Alla ovat yksityiskohtaiset yhteenvetoni parhaista Databricks-kilpailijoista, jotka pääsivät listalleni. Arvioni tarjoavat yksityiskohtaisen katsauksen kunkin työkalun tärkeimpiin ominaisuuksiin, etuihin ja haittoihin, integraatioihin ja ihanteellisiin käyttötapauksiin, jotta löydät itsellesi parhaan vaihtoehdon.

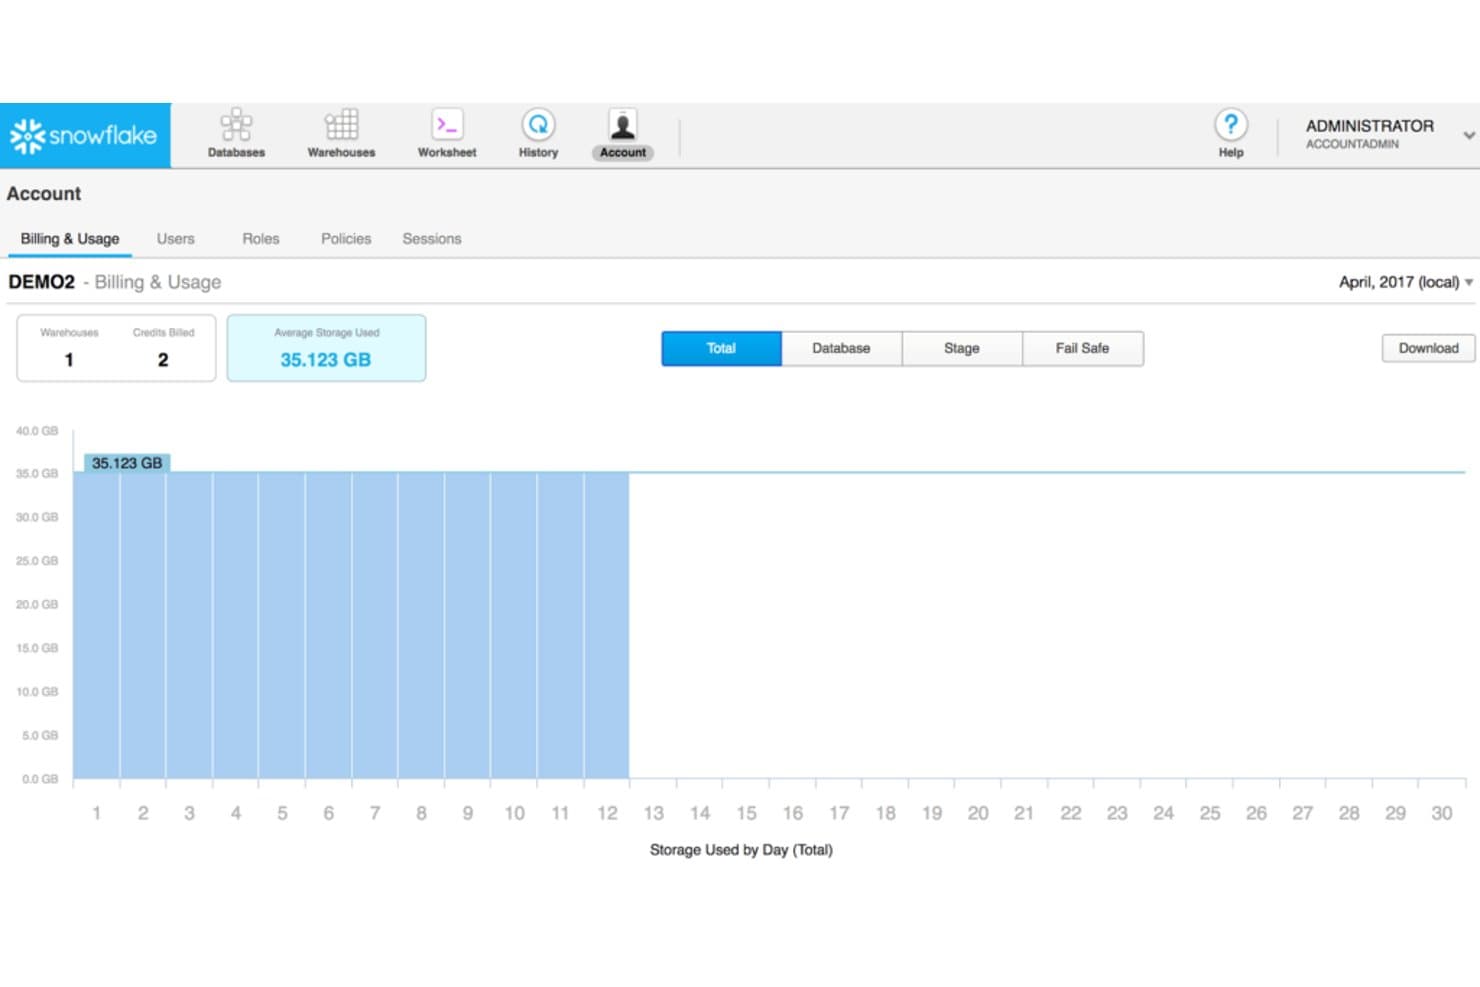
Snowflake seuraa tallennustilan ja krediittien käyttöä päiväkohtaisesti yhdessä hallintapaneelissa. Snowflake tarjoaa IT- ja analytiikkatiimeille pilvipohjaisen data-alustan, jolla voidaan yhdistää erilaisia tietoaineistoja, suorittaa SQL-kyselyitä laajassa mittakaavassa ja tarjota hallittu käyttöoikeus ilman tietovaraston infrastruktuurin hallintaa.
Kenelle Snowflake sopii parhaiten?
Datatekniikan ja analytiikan tiimeille, jotka tarvitsevat pilvipohjaisen tietovaraston tietojen kyselyyn ja jakamiseen eri liiketoimintajärjestelmien välillä.
Miksi valitsin Snowflaken
Valitsin Snowflaken parhaaksi pilvipohjaiseen tietovarastointiin, koska sen erillinen tallennustila ja laskenta mahdollistavat SQL-analytiikan skaalaamisen ilman datakerroksen koon muuttamista. Arvostan myös sen hallittua tietojen jakamista, kun tiimien on tehtävä kyselyitä eri liiketoimintajärjestelmien tietoaineistoihin kopioimatta niitä erillisiin tietovarastoihin.
Snowflaken tärkeimmät ominaisuudet
- Dynaamiset taulut: Määritä tietoputket SQL:n avulla ja aseta päivityksen tavoiteviive.
- Snowpipe: Lataa tiedot valmistelluista tiedostoista niiden saapuessa.
- Aikamatka: Tee kyselyitä, kloonaa tai palauta historiatietoja säilytysjakson aikana.
- Snowflake-markkinapaikka: Etsi ja käytä kolmansien osapuolten tietoaineistoja ja sovelluksia.
Snowflaken integraatiot
Snowflake tarjoaa Openflow-liittimiä Salesforceen, HubSpotiin, Google Sheetsiin, Jira Cloudiin, Slackiin, Shopifyhin, Google BigQueryyn, MongoDB:hen, PostgreSQL:ään ja Microsoft SQL Serveriin. Se tarjoaa myös natiiviliittimet ServiceNow'lle, MySQL:lle ja Kafkalle sekä REST-ohjelmointirajapinnat mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Laskennan itsenäinen skaalaus käsittelee työkuormien vaihteluita
- Hallinnoidut SQL-tietovarastot vähentävät infrastruktuurin ylläpitotarvetta
- Suojattu jakaminen poistaa tietoaineistojen kopiointitarpeen tiimien välillä
Cons:
- Käytön piikit voivat tehdä kustannuksista ennakoimattomia
- Omistusoikeudelliset ominaisuudet voivat vaikeuttaa alustan vaihtamista
Learn more about Snowflake: Paras monipilvidatan käyttöönottoon
- Ilmainen paketti saatavilla
- Hinta pyydettäessä
Visit WebsiteCustomer Rating:4.5/5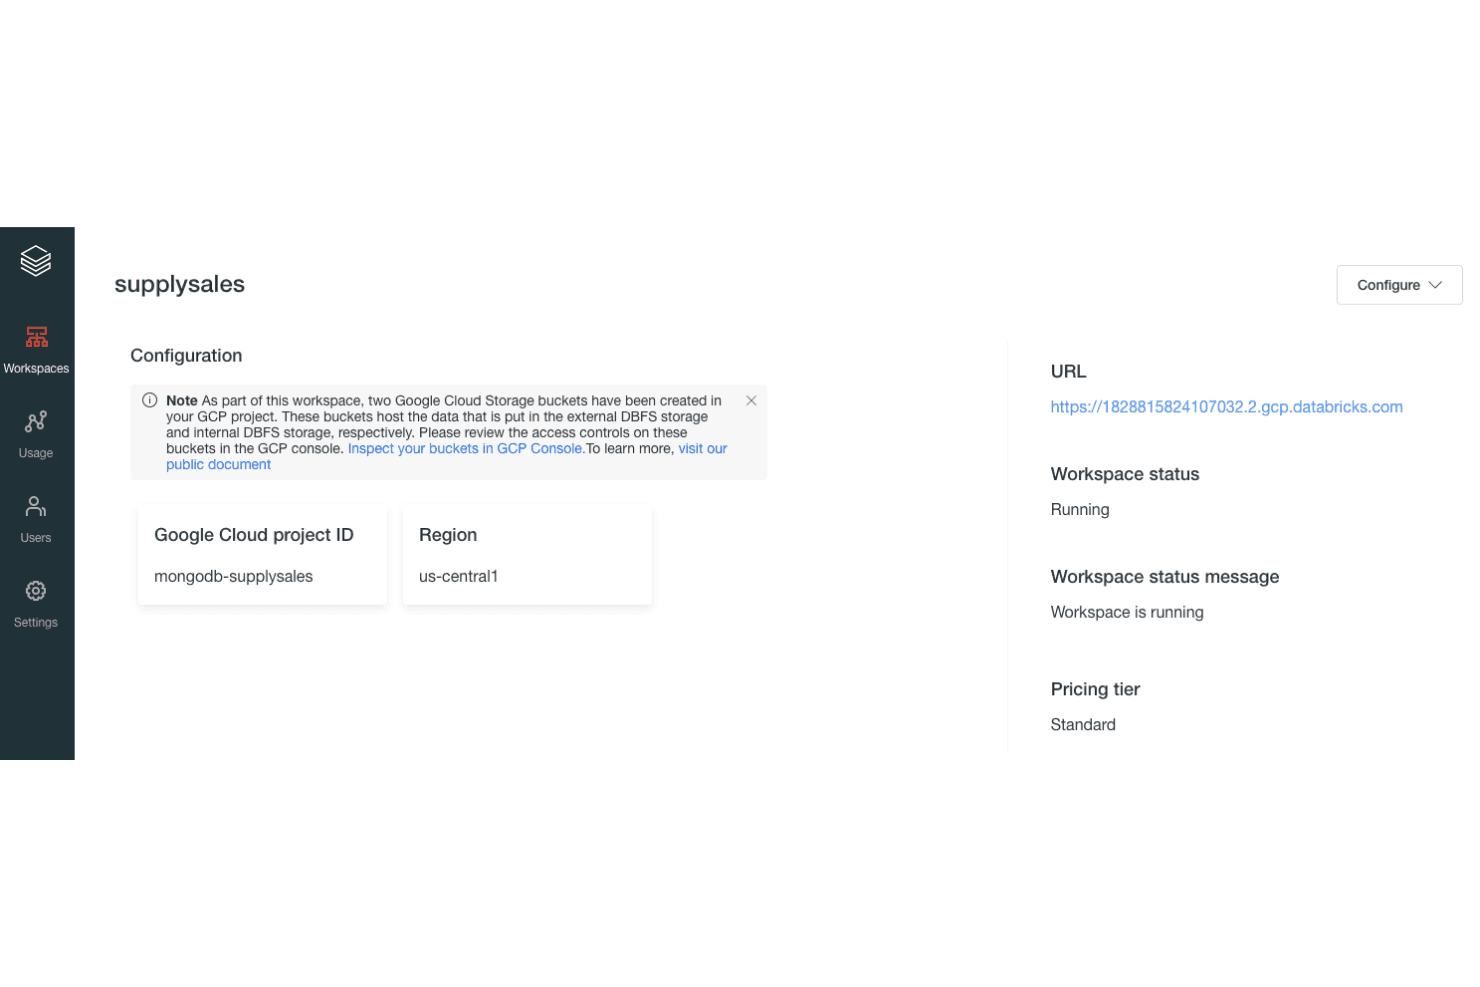
MongoDB Atlas integroituu GCP:n Databricks-työtiloihin tietojenkäsittelyä varten. MongoDB Atlas tarjoaa IT- ja datatiimeille hallinnoidun dokumenttitietokannan sovelluksille, jotka tarvitsevat joustavia tietomalleja, luotettavia kyselyitä ja vähemmän tietokannan ylläpitoa.
Kenelle MongoDB Atlas sopii parhaiten?
Useilla pilvipalveluntarjoajilla sovelluksia käyttöön ottavat IT- ja alustatiimit arvostavat MongoDB Atlasin hallinnoitua tietokantaa ja monipilvijoustavuutta.
Miksi valitsin MongoDB Atlasin
Valitsin MongoDB Atlasin Databricks-vaihtoehdoksi kohteeseen Paras monipilvidatan käyttöönottoon. Atlas tukee AWS:n, Azuren ja Google Cloudin välisiä monipilviklustereita, ja sen aggregointiputken avulla voit analysoida MongoDB:hen tallennettuja sovellustietoja. Käyttäisin sitä eri pilvipalveluntarjoajilla toimivien palveluiden lähellä sijaitsevien operatiivisten tietojen kyselyyn.
MongoDB Atlasin tärkeimmät ominaisuudet
- Atlas Search: Luo kokoteksti-indeksejä ja suorita osuvuuden mukaan järjestettyjä hakuja.
- Atlas Charts: Luo koontinäyttöjä ja visualisointeja MongoDB-tiedoista.
- Datan federointi: Tee kyselyitä Atlas-tietokantojen ja pilvipohjaisen objektitallennuksen tiedoista.
- Automaattiset varmuuskopiot: Ajasta tietokannan tilannevedoksia ja palauta tietokanta tallennetuista palautuspisteistä.
MongoDB Atlas -integraatiot
MongoDB Atlas dokumentoi integraatiot Datadogin, PagerDutyn, Prometheuksen, Splunkin, Slackin, Microsoft Teamsin, HashiCorp Terraformin, HashiCorp Vaultin, Oktan ja Microsoft Entra ID:n kanssa. Se tarjoaa myös hallintarajapinnan mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Monipilviklusterit AWS:ssä, Azuressa ja Google Cloudissa
- Joustavat dokumentit mukautuvat muuttuviin sovellusten tietomalleihin
- Aggregointiputket analysoivat operatiivisia tietoja niiden sijaintipaikassa
Cons:
- Sopii heikommin laajoihin lakehouse-analytiikan kuormituksiin
- Aggregoinnin suorituskyky voi edellyttää huolellista kyselyiden hienosäätöä
Learn more about MongoDB Atlas: Parhaiten dataintegraatiotehtäviin
- Ilmainen kokeilu saatavilla
- $1,170/user/year (laskutetaan vuosittain)
Visit WebsiteCustomer Rating:4.2/5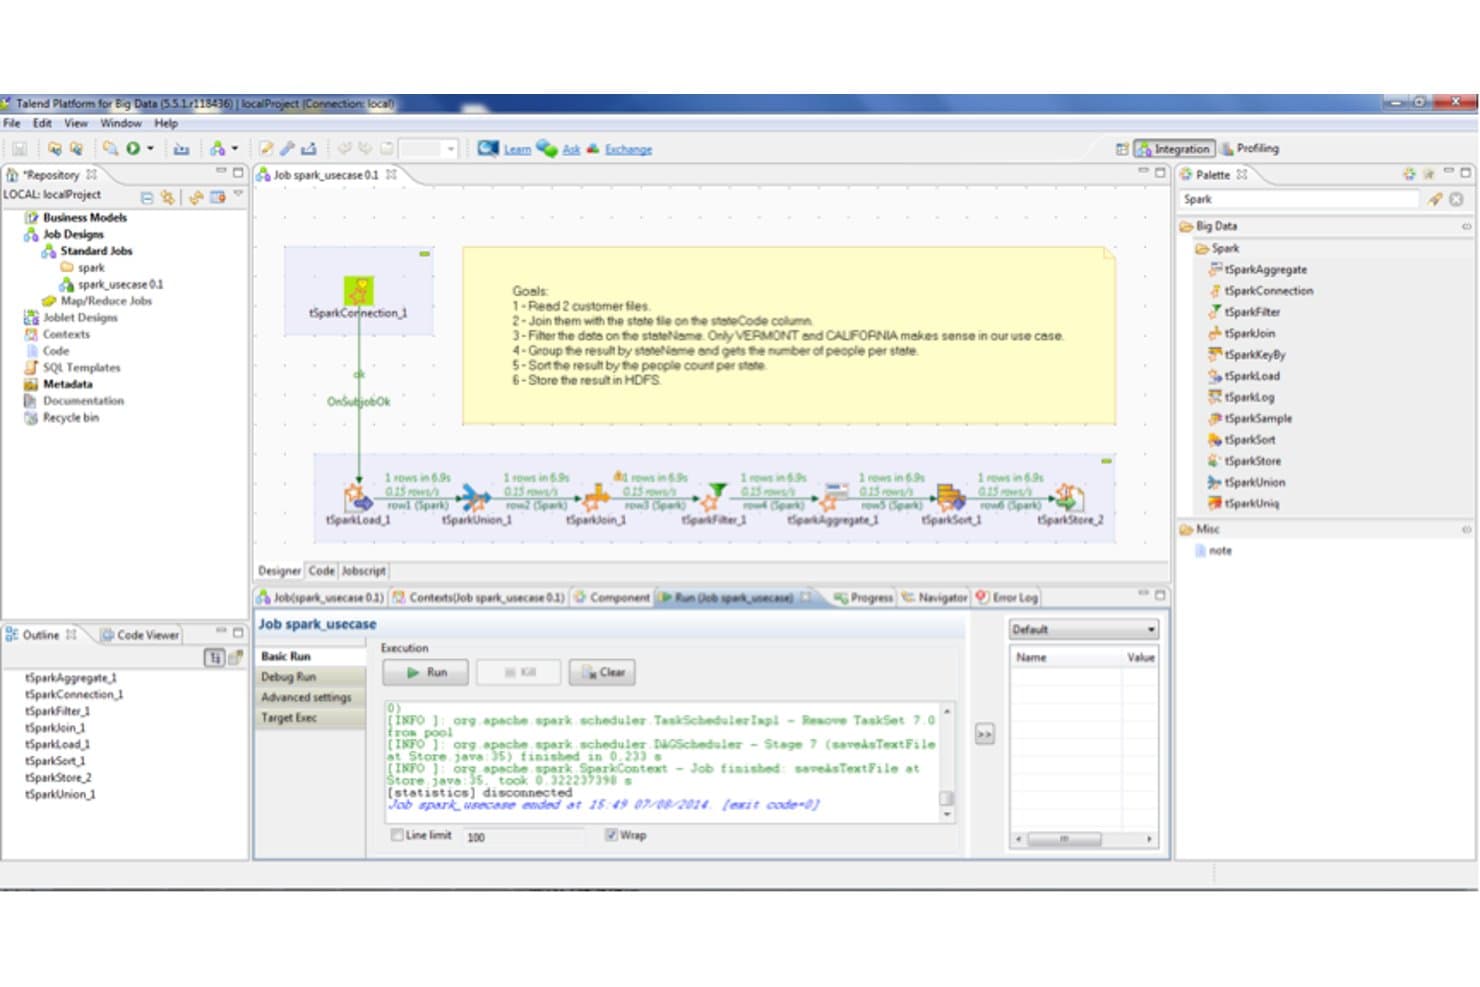
Talendin avulla käyttäjät voivat rakentaa ja suorittaa Spark-dataputkia visuaalisesti. Talend on IT- ja datatiimeille tarkoitettu dataintegraatioalusta, joka yhdistää eri järjestelmien tiedot, auttaa vähentämään siiloja ja pitää dataputket hallittavina ympäristöjen kasvaessa.
Kenelle Talend sopii parhaiten?
Talend sopii IT- ja datatekniikkatiimeille, joiden on yhdistettävä pilvi-, paikallis- ja vanhoja järjestelmiä.
Miksi valitsin Talendin
Valitsin Talendin Databricksin kilpailijaksi, koska ”Parhaiten dataintegraatiotehtäviin” kuvaa täsmälleen sen vahvuuksia. Sen visuaalisen työn suunnittelijan ja tMap-muunnosten avulla voin yhdistää ja muokata tietueita vanhan tietokannan ja pilvidatavaraston välillä. Arvostan myös Talendin tietojen laadun komponentteja, jotka auttavat havaitsemaan virheellisesti muodostetut tietueet ennen kuin ne päätyvät jatkokäsittelyjärjestelmiin.
Talendin tärkeimmät ominaisuudet
- Liittimet: Yhdistä tietokantoja, pilvisovelluksia, tiedostoja ja muita järjestelmiä valmiiden liittimien avulla.
- Muuttuneiden tietojen sieppaus: Sieppaa tietokantojen lisäykset, päivitykset ja poistot niiden tapahtuessa.
- Tietojen alkuperä: Seuraa tietovirtoja lähdejärjestelmistä työtehtävien kautta niiden kohteisiin.
- Metatietojen etsintä: Skannaa tietolähteitä tunnistaaksesi tietoaineistot, muodot ja rakenteet.
Talend-integraatiot
Talend sisältää liittimiä tai komponentteja esimerkiksi Salesforce-, Snowflake-, SAP-, Kafka-, Amazon S3-, Azure Synapse Analytics-, PostgreSQL-, Microsoft SQL Server-, Oracle- ja MongoDB-järjestelmille. Se tukee myös REST- ja SOAP-palveluita, ja Qlik Talend Data Integration tarjoaa ohjelmointirajapintoja datayhteyksien hallintaan.
Pros and Cons
Pros:
- Visuaaliset työtehtävät käsittelevät yhdistämisiä ja muokkauksia
- Erä- ja reaaliaikaiset dataputket tukevat monenlaisia työkuormia
- Tietojen laadun työkalut merkitsevät virheellisesti muodostetut tietueet
Cons:
- Suuret työtehtävät voivat edellyttää JVM:n säätämistä
- Luotu Java-koodi vaikeuttaa virheenkorjausta ja auditointeja
Learn more about Talend: Paras muistissa tapahtuvaan käsittelyyn
- Ilmainen sopimus saatavilla
- Hinnoittelu pyynnöstä
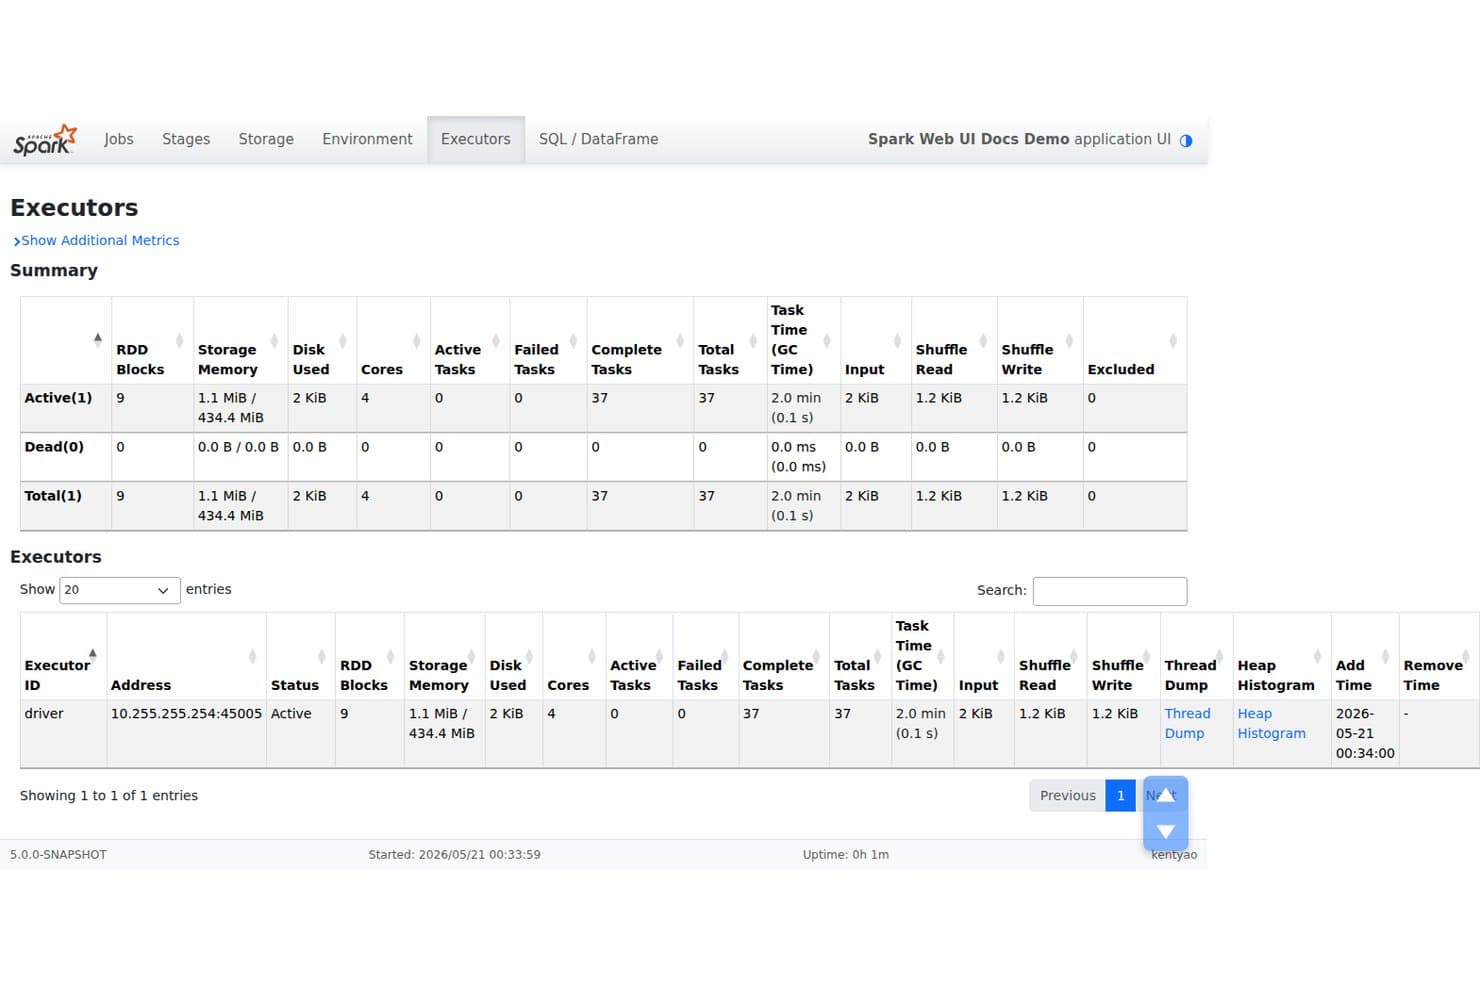
Apache Spark seuraa suorittimien resursseja, tehtäviä ja muistia reaaliajassa. Apache Spark on avoimen lähdekoodin analytiikkamoottori data- ja infrastruktuuritiimeille, joiden on käsiteltävä suuria tietoaineistoja, suoritettava hajautettuja työkuormia ja rakennettava datan käsittelyputkia erilaisissa ympäristöissä.
Kenelle Apache Spark sopii parhaiten?
Apache Spark sopii hyvin data- ja analytiikkatiimeille, jotka tarvitsevat suurten tietoaineistojen nopeaa ja iteratiivista käsittelyä klustereissa.
Miksi valitsin Apache Sparkin
Valitsin Apache Sparkin Databricks-vaihtoehdoksi, koska se sopii parhaiten muistissa tapahtuvaan käsittelyyn. Spark voi tallentaa RDD:t ja DataFramet muistiin tai säilyttää ne siellä, joten toistuvissa kyselyissä ja iteratiivisissa laskelmissa lähdedataa ei tarvitse lukea uudelleen. Tämä on hyödyllistä, kun suurista tapahtumatietojen koosteista tehdään tarkennuksia useiden analyysikierrosten aikana.
Apache Sparkin tärkeimmät ominaisuudet
- Spark SQL: Käsittele rakenteisia tietoja SQL- ja DataFrame-rajapintojen avulla.
- Strukturoitu suoratoisto: Käsittele reaaliaikaista dataa Sparkin suoratoistorajapintojen avulla.
- MLlib: Rakenna koneoppimisen työnkulkuja skaalautuvien algoritmien ja putkien avulla.
- Klusterinhallinta: Ota sovelluksia käyttöön itsenäisissä klustereissa, YARN-ympäristössä tai Kubernetesissa.
Apache Sparkin integraatiot
Apache Spark tukee Apache Kafkan ja Apache Hiven liittimiä sekä JDBC-yhteyksiä tietokantoihin, kuten PostgreSQL:ään, MySQL:ään, Oracleen ja Microsoft SQL Serveriin. Sen tietolähderajapinta tukee mukautettuja liittimiä; Kafkan liittimien riippuvuudet ja tietokantakohtaiset JDBC-ajurit on ehkä lisättävä erikseen.
Pros and Cons
Pros:
- Välimuistiin tallennetut tietoaineistot nopeuttavat iteratiivisia työkuormia
- Eräajo, suoratoisto, SQL ja koneoppiminen käyttävät samaa moottoria
- Toimii paikallisesti tai Kubernetes- ja YARN-klustereissa
Cons:
- Muistipaine voi aiheuttaa muistin loppumiseen liittyviä virheitä
- Hajautettujen töiden virittäminen ja vianmääritys vaativat asiantuntemusta
Learn more about Apache Spark: Beste Lösung für Boutique-Hotels
- 30-tägige kostenlose Testversion
- Ab $50/Nutzer/Monat (jährlich abgerechnet)
Hier sehen Sie die Registerkarte „Reservierung“ von Little Hotelier. Sie zeigt alle Rechnungen der Reservierungen in den Suchergebnissen an und ermöglicht die Suche nach Reservierungen anhand der Rechnungsnummer. Little Hotelier ist eine Softwarelösung für die Immobilienverwaltung, die speziell für Boutique-Hotels entwickelt wurde. Sie bietet eine Reihe maßgeschneiderter Funktionen, die kleinen Betrieben helfen, ihren Umsatz zu steigern und gleichzeitig ein unvergessliches Gästeerlebnis zu bieten.
Warum ich Little Hotelier ausgewählt habe: Auf meiner Suche nach den geeignetsten Verwaltungstools für verschiedene Hoteltypen erwies sich Little Hotelier als eine der besten Lösungen für Boutique-Hotels. Beim Vergleich und der Bewertung verschiedener Softwarelösungen wurde deutlich, dass Little Hotelier ein einzigartiges Angebot bereithält, das auf die Besonderheiten und spezifischen Anforderungen von Boutique-Hotels zugeschnitten ist.
Ich habe es für diese Liste ausgewählt, weil es die besonderen Bedürfnisse dieser kleineren, persönlicheren Unterkünfte wirklich versteht und erfüllt.
Besondere Funktionen & Integrationen:
Zu den Funktionen gehören eine umfassende Buchungsmaschine, die die Reservierungsverwaltung für Boutique-Hotels optimiert. Das cloudbasierte Immobilienverwaltungssystem gewährleistet einen reibungslosen Betrieb an der Rezeption mit integrierten Modulen, die von Gästeprofilen bis zur Zahlungsabwicklung reichen.
Zu den Integrationen gehören Airbnb, booking.com und GDS, die Buchungen über mehrere Plattformen ermöglichen.
Pros and Cons
Pros:
- Speziell auf Boutique-Hotels zugeschnittene Funktionen machen die Lösung zur optimalen Wahl für solche Betriebe.
- Leistungsstarke Integrationen mit wichtigen Buchungsplattformen verbessern die Möglichkeiten für Online-Buchungen.
- Umfassendes cloudbasiertes Immobilienverwaltungssystem für optimierte Abläufe.
Cons:
- Für sehr kleine Pensionen könnte die Lösung zu viele Funktionen bieten.
- Begrenzte Anpassungsmöglichkeiten für größere Hotelketten.
- Regelmäßige Aktualisierungen können für Benutzer eine kurze Einarbeitungszeit erfordern.
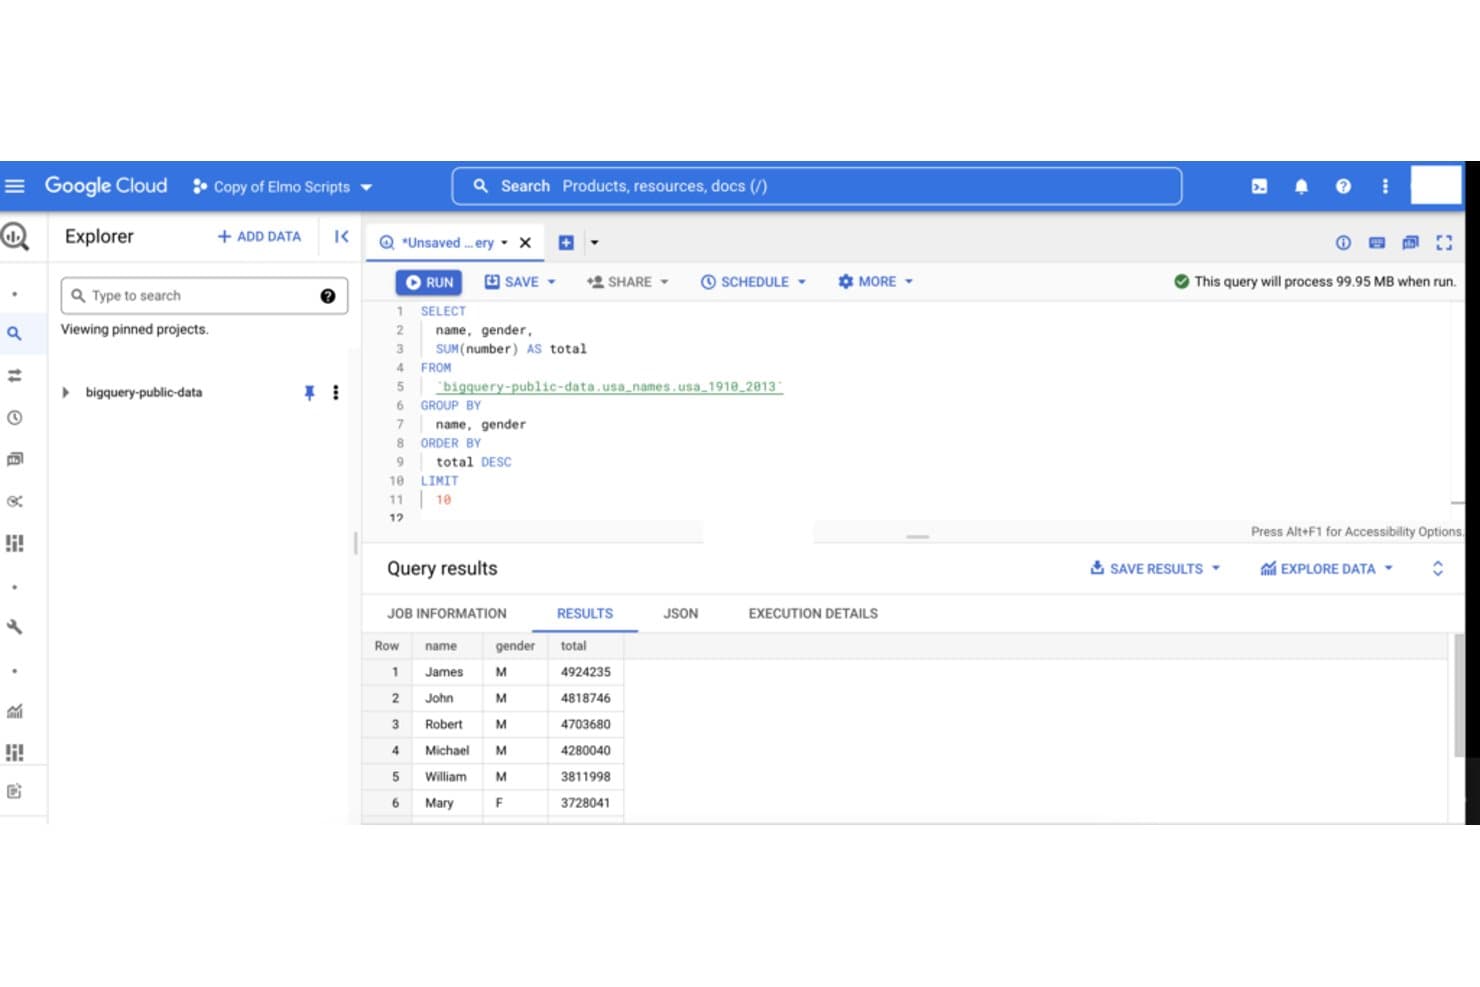
Learn more about Google BigQuery: Paras yritystason tietokantatarpeisiin
- Ilmainen kokeilu saatavilla
- $68/käyttäjä/kuukausi (laskutetaan vuosittain)
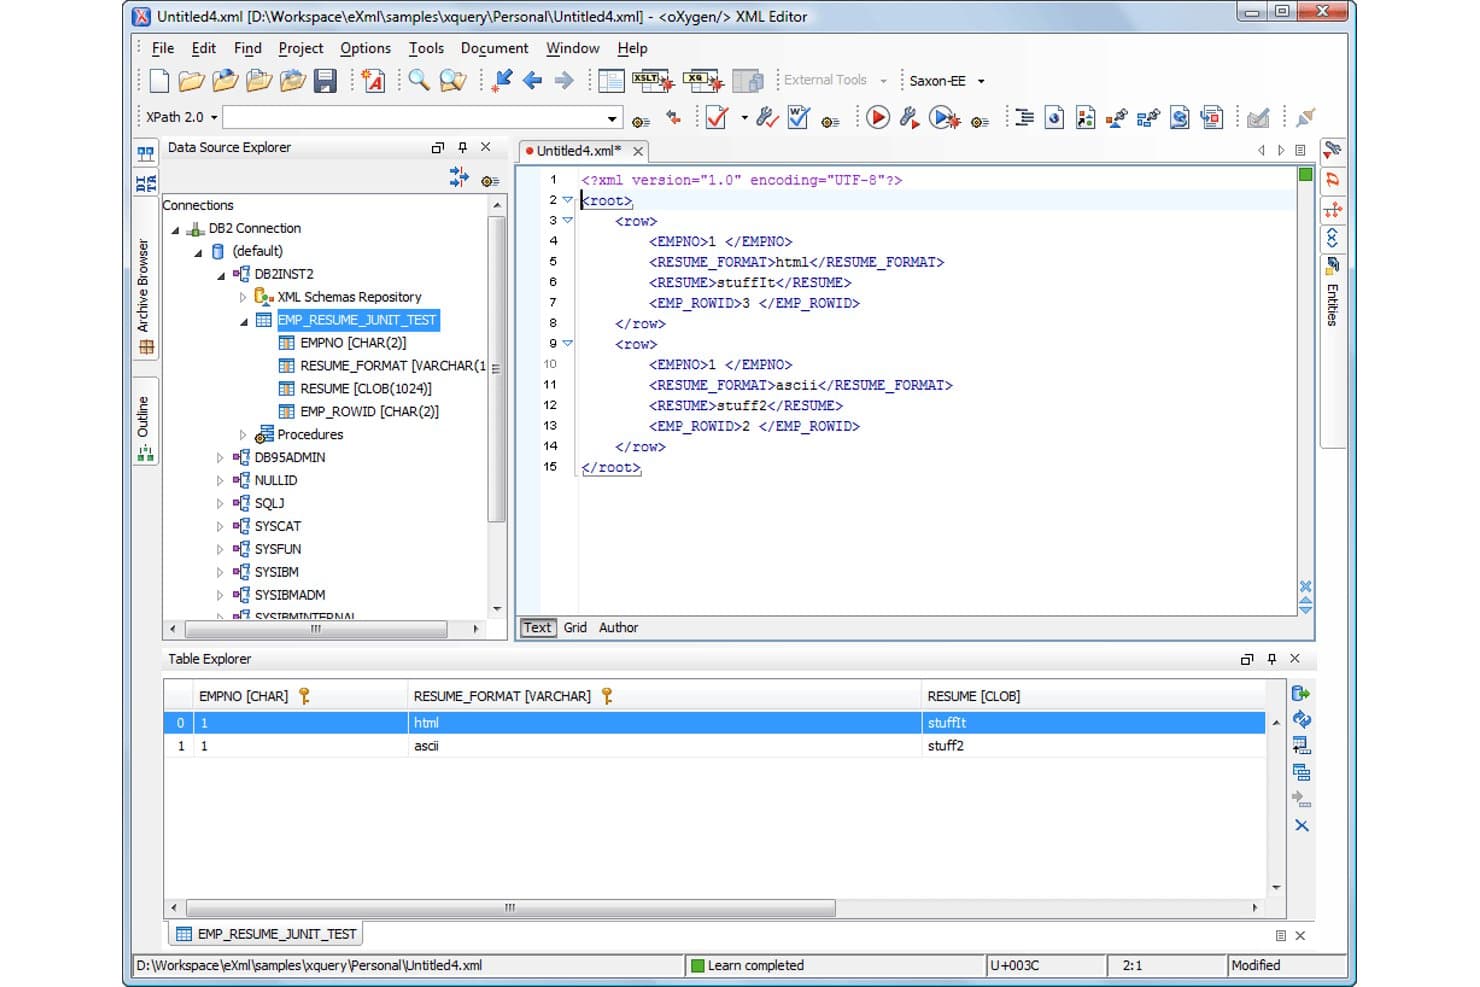
IBM Db2:n avulla käyttäjät voivat selata tietokantaskeemoja ja tehdä XML-kyselyjä visuaalisesti. IBM Db2 on relaatiotietokantojen hallintajärjestelmä organisaatioille, joiden on suoritettava jäsenneltyjen tietojen työkuormia monimutkaisissa ympäristöissä ja jotka tukevat yrityssovelluksia, tapahtumia ja analytiikkaa hallinnoivia tiimejä.
Kenelle IBM Db2 sopii parhaiten?
Suurten organisaatioiden tietokantojen ylläpitäjille ja IT-tiimeille, jotka tukevat suuren volyymin liiketoimintasovelluksia.
Miksi valitsin IBM Db2:n
Valitsin IBM Db2:n yritystason tietokantatarpeisiin sopivaksi Databricks-vaihtoehdoksi liiketoiminnan ydinjärjestelmiin. Se tukee tapahtuma-, analytiikka- ja vektoritietoja yhdellä alustalla sekä tekoälypohjaista työkuormien optimointia ERP-järjestelmiä, laskutusta ja tilausten käsittelyä varten. Arvostan tätä soveltuvuutta silloin, kun relaatiotyökuormien ja analytiikan on jaettava infrastruktuuri.
IBM Db2:n tärkeimmät ominaisuudet
- Hybridikäyttöönotto: Suorita Db2 paikallisessa ympäristössä, pilvessä tai hybridiympäristöissä.
- Natiivi salaus: Salaa tietokannan tiedot ja hallitse salausavaimia avainsäilön kautta.
- Taulujen osiointi: Jaa taulujen tiedot osioihin määritettyjen sarakearvojen perusteella.
- Varmuuskopiointi- ja palautustyökalut: Db2 Advanced Recovery tukee tietokantojen varmuuskopiointia, palautusta ja tietojen poimintaa.
IBM Db2 -integraatiot
Natiiveja integraatioita ei ole dokumentoitu selkeästi. Db2 tukee yhdistettyä pääsyä tietolähteisiin, kuten Oracleen ja Microsoft SQL Serveriin, sekä JDBC-, ODBC- ja CLI-yhteyksiä sovelluksia varten.
Pros and Cons
Pros:
- Nopea käsittely yritysten tapahtumatyökuormille
- Korkea käytettävyys HADR:n ja palautuksen avulla
- Osiointi tukee suuria ja sekalaisia työkuormia
Cons:
- Hallinta ja optimointi edellyttävät erityisasiantuntemusta
- Pilvinatiivinen toiminta jää jälkeen uudemmista alustoista
Learn more about IBM Db2: Paras SQL-analytiikkaan
- 30 päivän ilmainen kokeilu
- $30/käyttäjä/kuukausi (laskutetaan vuosittain)
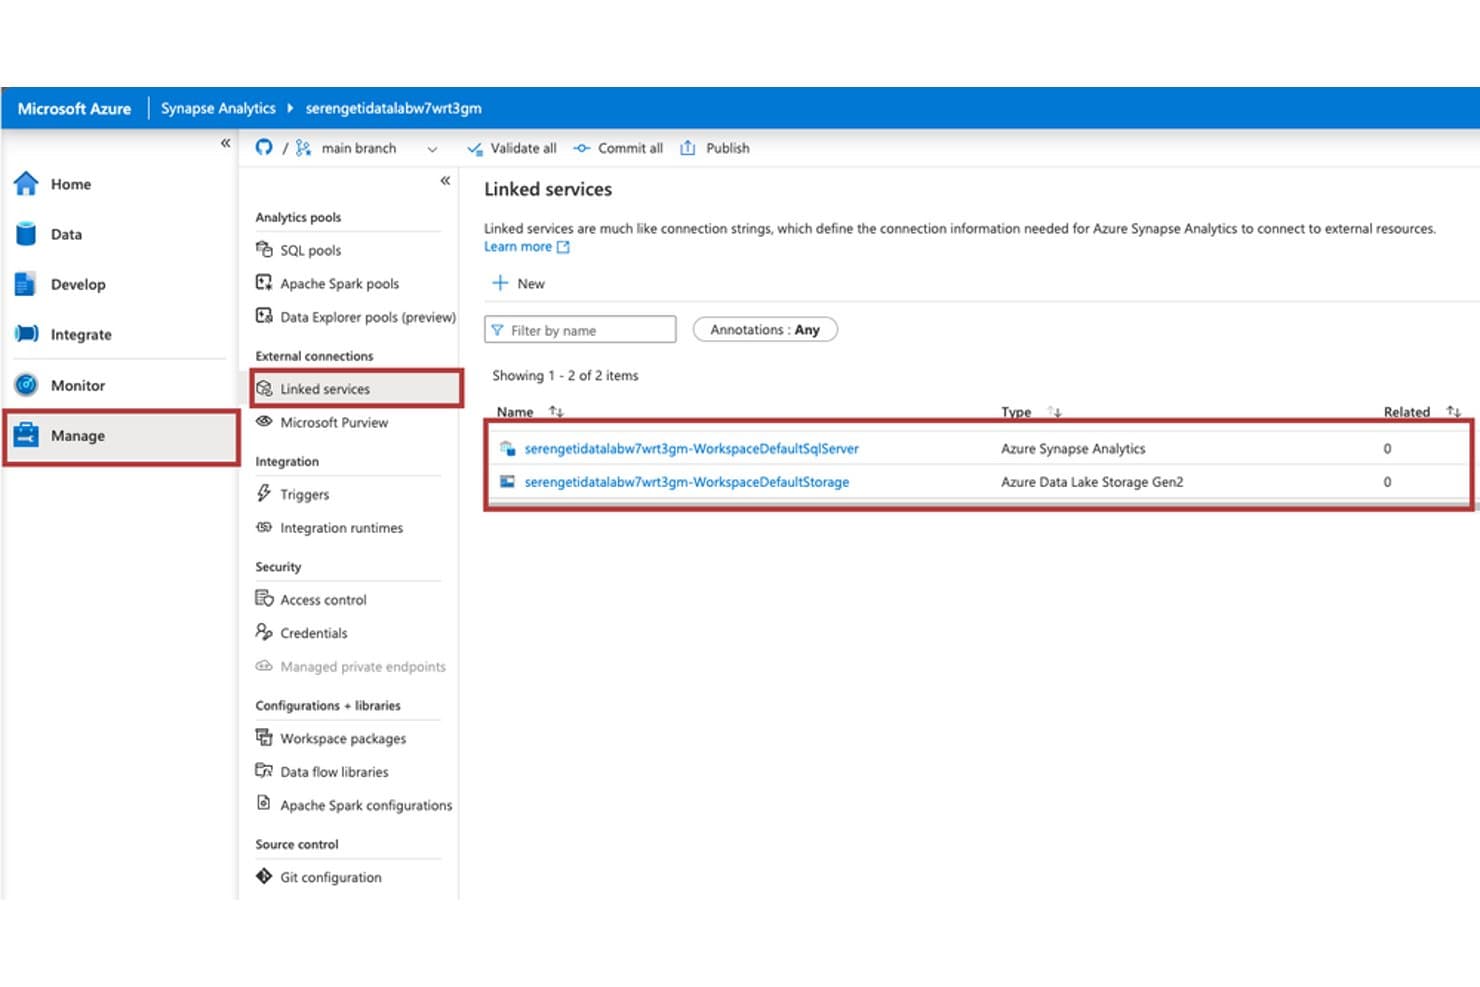
Azure Synapse Analytics hallitsee ulkoisia yhteyksiä linkitettyjen palveluiden kautta. Azure Synapse Analytics on pilvianalytiikka-alusta data- ja IT-tiimeille, jotka tarvitsevat yritysdatan yhdistämistä, kyselyiden suorittamista ja raportoinnin tukemista sekä tietovarastointi- että suurdatakuormituksissa.
Kenelle Azure Synapse Analytics sopii parhaiten?
Se sopii data-insinööreille ja analyytikoille, jotka tarvitsevat SQL-käyttöoikeuden integroituihin tietojoukkoihin yritysraportointia ja analytiikkaa varten.
Miksi valitsin Azure Synapse Analyticsin
Valitsin Azure Synapse Analyticsin SQL-analytiikan parhaaksi vaihtoehdoksi: sen palvelimeton SQL-pooli tekee kyselyitä datajärven tiedostoista T-SQL:llä, kun taas dedikoidut SQL-poolit tukevat käyttöön varattuja tietovarastokuormituksia. Pidän tästä jaosta, kun minun täytyy tarkastella raakatietojoukkoja ja tuottaa toistuvia BI-raportteja SQL:n avulla.
Azure Synapse Analyticsin tärkeimmät ominaisuudet
- Apache Spark -poolit: Suorita Spark-tehtäviä ja muistikirjoja hajautettua tietojenkäsittelyä varten.
- Putket: Orkestroi tietojen siirtoa ja muuntamista yhdistettyjen lähteiden välillä.
- Synapse Studio: Hallitse tietoja, koodia ja analytiikkaresursseja jaetussa työtilassa.
- Power BI -integraatio: Yhdistä Synapse-tiedot Power BI:hin raporttien luomista varten.
Azure Synapse Analytics -integraatiot
Azure Synapse Analytics sisältää sisäänrakennetut putkiliittimet seuraaville: Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 ja SAP HANA. Lisäksi se tarjoaa suoran Power BI -yhteyden Synapse Studion kautta. Se tarjoaa myös REST-rajapinnat mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Palvelimettomat T-SQL-kyselyt lukevat datajärven tiedostoja
- Dedikoidut MPP-poolit käsittelevät tietovarastokuormituksia
- Yhdistää SQL-kyselyt Spark-käsittelyyn
Cons:
- SQL-poolien säätäminen edellyttää käytännön asiantuntemusta
- Putkien virheenkorjaus ja valvonta voivat olla rajallisia
Learn more about Azure Synapse Analytics:
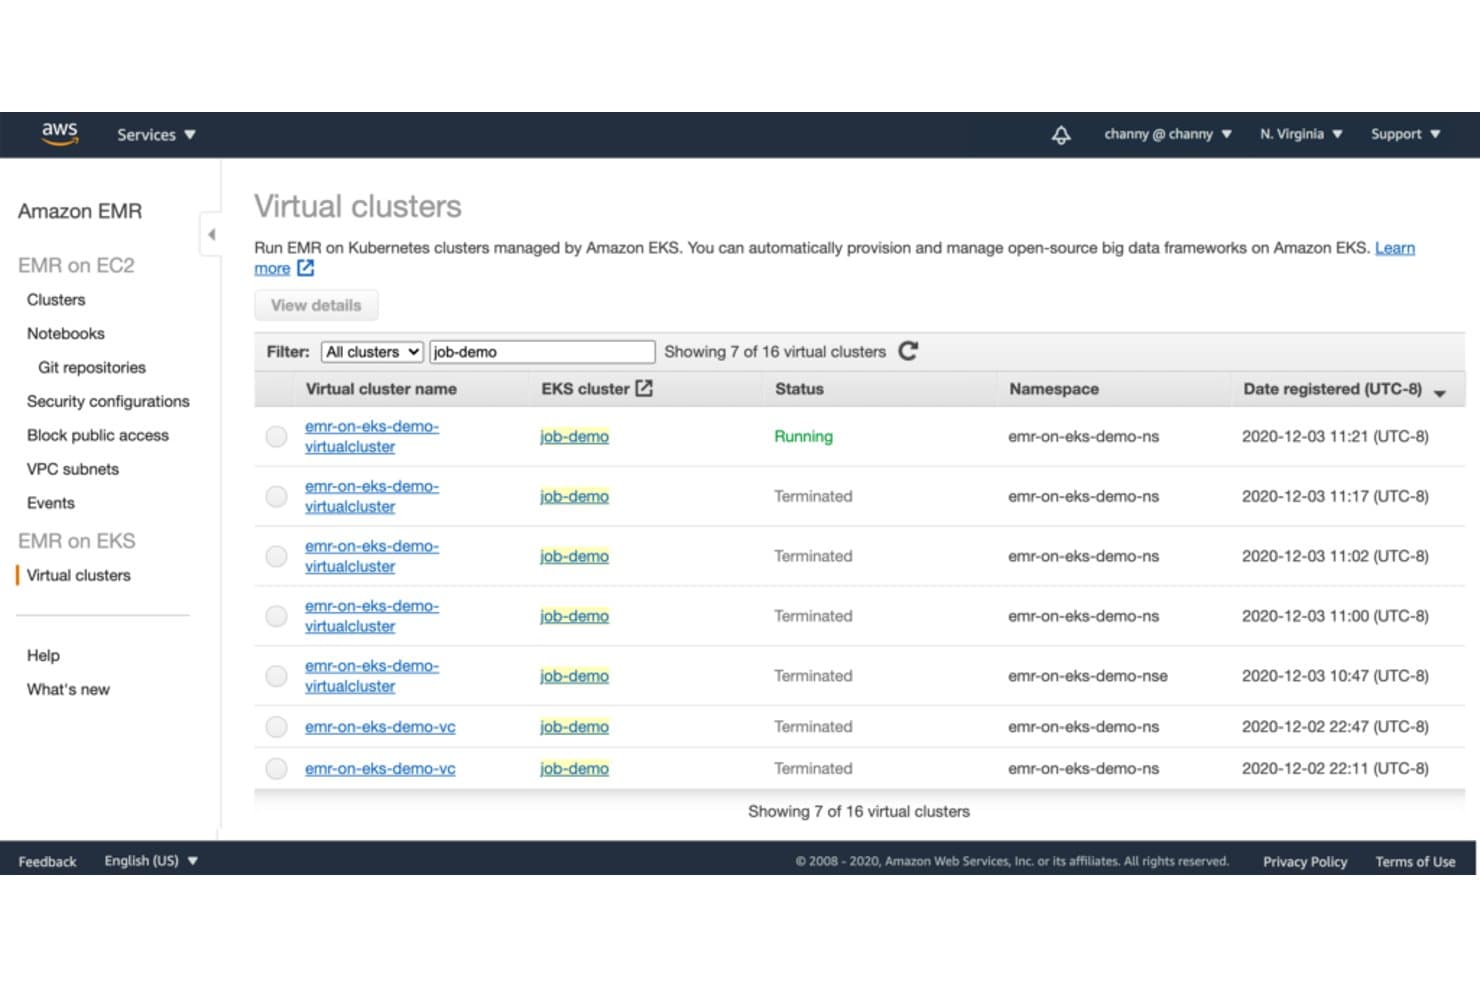
Amazon EMR:n avulla käyttäjät voivat hallita Amazon EKS:ssä toimivia virtuaaliklustereita. Amazon EMR on AWS:n hallinnoitu massadata-alusta data- ja analytiikkatiimeille, joiden on käsiteltävä suuria tietojoukkoja, skaalattava hajautettuja työkuormia ja vähennettävä laskentaklustereiden käytön hallintaan liittyvää työtä.
Kenelle Amazon EMR sopii parhaiten?
Amazon EMR sopii data- ja insinööritiimeille, jotka suorittavat Hadoop- tai Spark-töitä suurten tietojoukkojen käsittelemiseksi hajautetuissa klustereissa.
Miksi valitsin Amazon EMR:n
Valitsin Amazon EMR:n Databricks-vaihtoehdoksi yhdestä syystä: paras Hadoop-käsittelyyn. Sen hallinnoiduissa klustereissa käytetään Apache Hadoopia ja Sparkia, joten voin käyttää MapReducea arkistoitujen sovelluslokien käsittelyyn ja Sparkia tulosten analysointiin.
Amazon EMR:n tärkeimmät ominaisuudet
- EMR Serverless: Suorita datasovelluksia ilman klustereiden käyttöönottoa tai hallintaa.
- Automaattinen skaalaus: Säädä klusterin kapasiteettia työkuorman tarpeen mukaan.
- EMR on EKS: Suorita EMR-työkuormia Amazon EKS -klustereissa.
- AWS Glue Data Catalog: Käytä jaettua luetteloa taulukoiden metatiedoille.
Amazon EMR:n integraatiot
Amazon EMR:llä on dokumentoidut integraatiot AWS Glue Data Catalogin, AWS Lake Formationin, Amazon S3:n ja Amazon CloudWatchin kanssa. Se tarjoaa myös ohjelmalliseen käyttöön tarkoitetun API:n sekä mukautettuja integraatioita.
Pros and Cons
Pros:
- Suorittaa vakiintuneita Hadoop- ja Spark-työkuormia
- Tukee klusteri-, palvelimetonta ja EKS-käyttöönottoa
- Käsittelee suuria tietojoukkoja monenlaisissa työkuormissa
Cons:
- Hidas automaattinen skaalaus voi jättää työt ilman riittäviä resursseja
- Klusterin skaalaus vaatii toisinaan manuaalista säätöä
Learn more about Amazon EMR: Paras hallittuihin Spark- ja Hadoop-ympäristöihin
- Ei saatavilla
- Alkaen $0.06/DCU-tunti
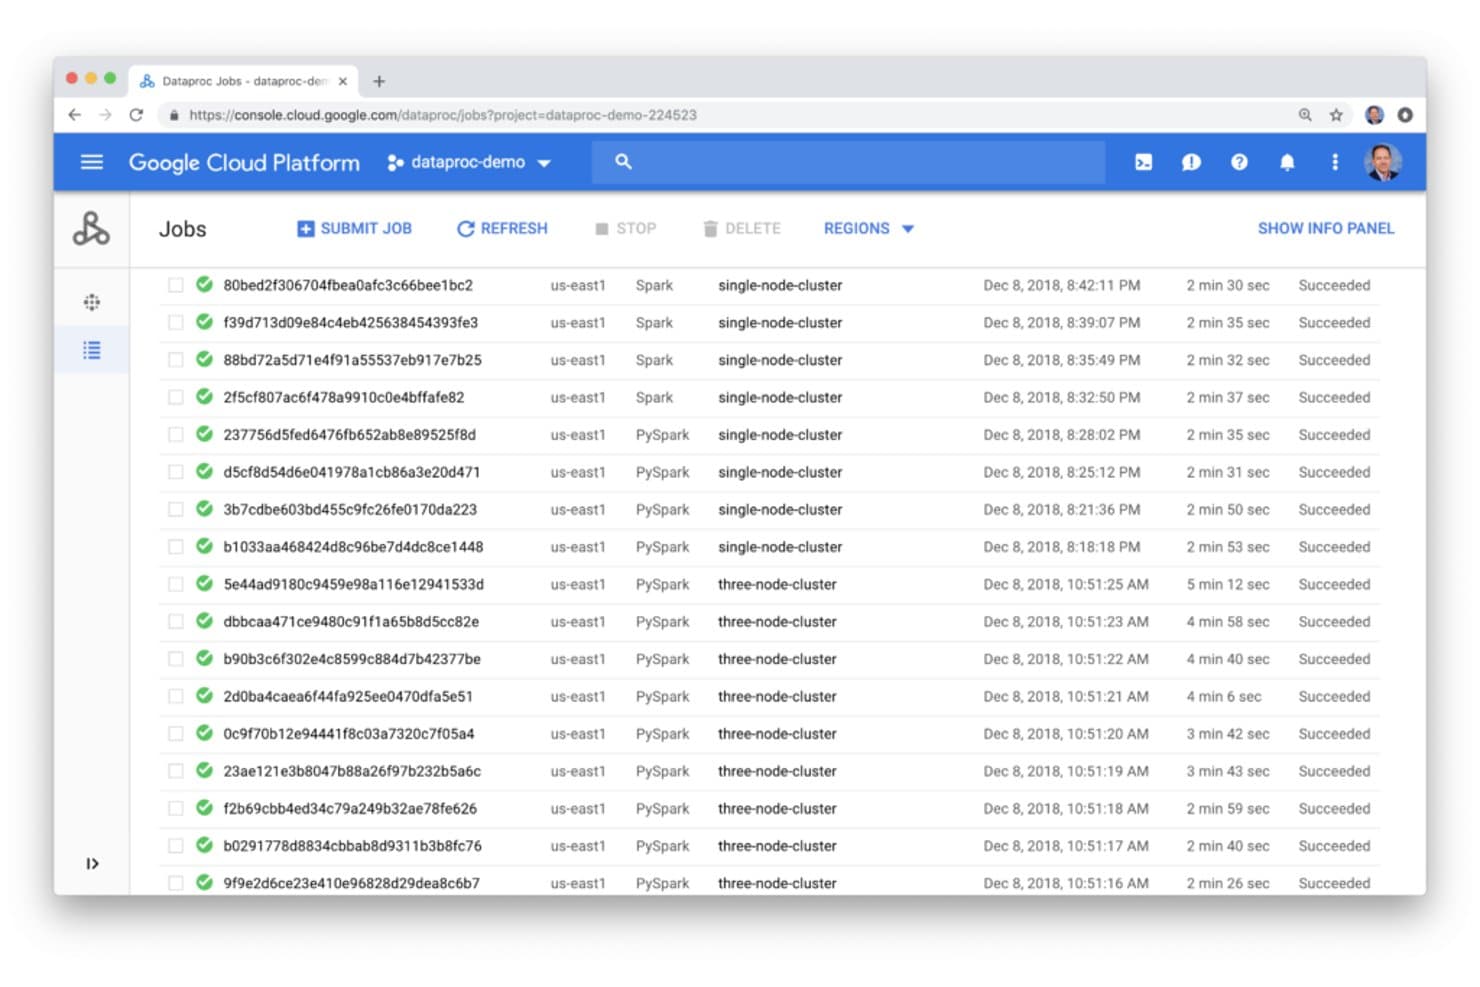
Google Cloud Dataproc mahdollistaa Spark-töiden seurannan ja hallinnan yhdellä silmäyksellä. Google Cloud Dataproc tarjoaa data- ja IT-tiimeille hallitun pilvialustan laajamittaisiin analytiikkakuormiin, mikä auttaa vähentämään klusterien hallintaa ja tukee datan käsittelyputkia Google Cloudissa.
Kenelle Google Cloud Dataproc sopii parhaiten?
Google Cloudissa Spark- tai Hadoop-töitä suorittavat datatekniikan tiimit voivat käyttää Dataprocia klusteritoimintojen hallintaan.
Miksi valitsin Google Cloud Dataprocin
Valitsin Google Cloud Dataprocin kuormituksiin, joissa etusijalla on “Paras hallittuihin Spark- ja Hadoop-ympäristöihin”. Hallitut klusterit ja automaattisen skaalauksen käytännöt auttavat käsittelemään eräajoja, joiden resurssitarpeet vaihtelevat, kun taas Dataproc Serverless suorittaa Spark-eräajoja ilman klusterin valmistelua. Voit esimerkiksi käsitellä öisiä tapahtumalokeja Sparkilla ja välttää klusterin jättämisen käyttämättömäksi ajokertojen välillä.
Google Cloud Dataprocin tärkeimmät ominaisuudet
- Lightning Engine: Nopeuttaa Sparkin suoritusta vektorikäsittelyn, välimuistin ja optimoidun sekoituksen avulla.
- Apache Iceberg -tuki: Toimii Google Cloud Storagen avoimien taulukkomuotojen kanssa.
- GPU-kiihdytys: Tukee NVIDIA RAPIDSia GPU-pohjaiseen tietojenkäsittelyyn.
- Tietoturvan hallinta: Integroituu IAM:n, VPC Service Controlsin ja Kerberoksen kanssa.
Google Cloud Dataprocin integraatiot
Google Cloud Dataproc sisältää valmiit integraatiot BigQueryyn, Cloud Storageen, Bigtableen, Cloud Loggingiin ja Cloud Monitoringiin. Se tarjoaa myös REST-ohjelmointirajapinnan ja Cloud SDK:n klustereiden ja töiden hallintaan.
Pros and Cons
Pros:
- Olemassa olevat Spark-työt toimivat vähäisillä uudelleenkirjoituksilla
- Klusterien nopea luonti ja purkaminen
- Palvelimettomat eräajot välttävät klusterien hallinnan
Cons:
- Klusterin säätäminen vaatii edelleen infrastruktuuriosaamista
- Kustannukset voivat tuntua korkeilta jatkuvissa kuormituksissa
Learn more about Google Cloud Dataproc:
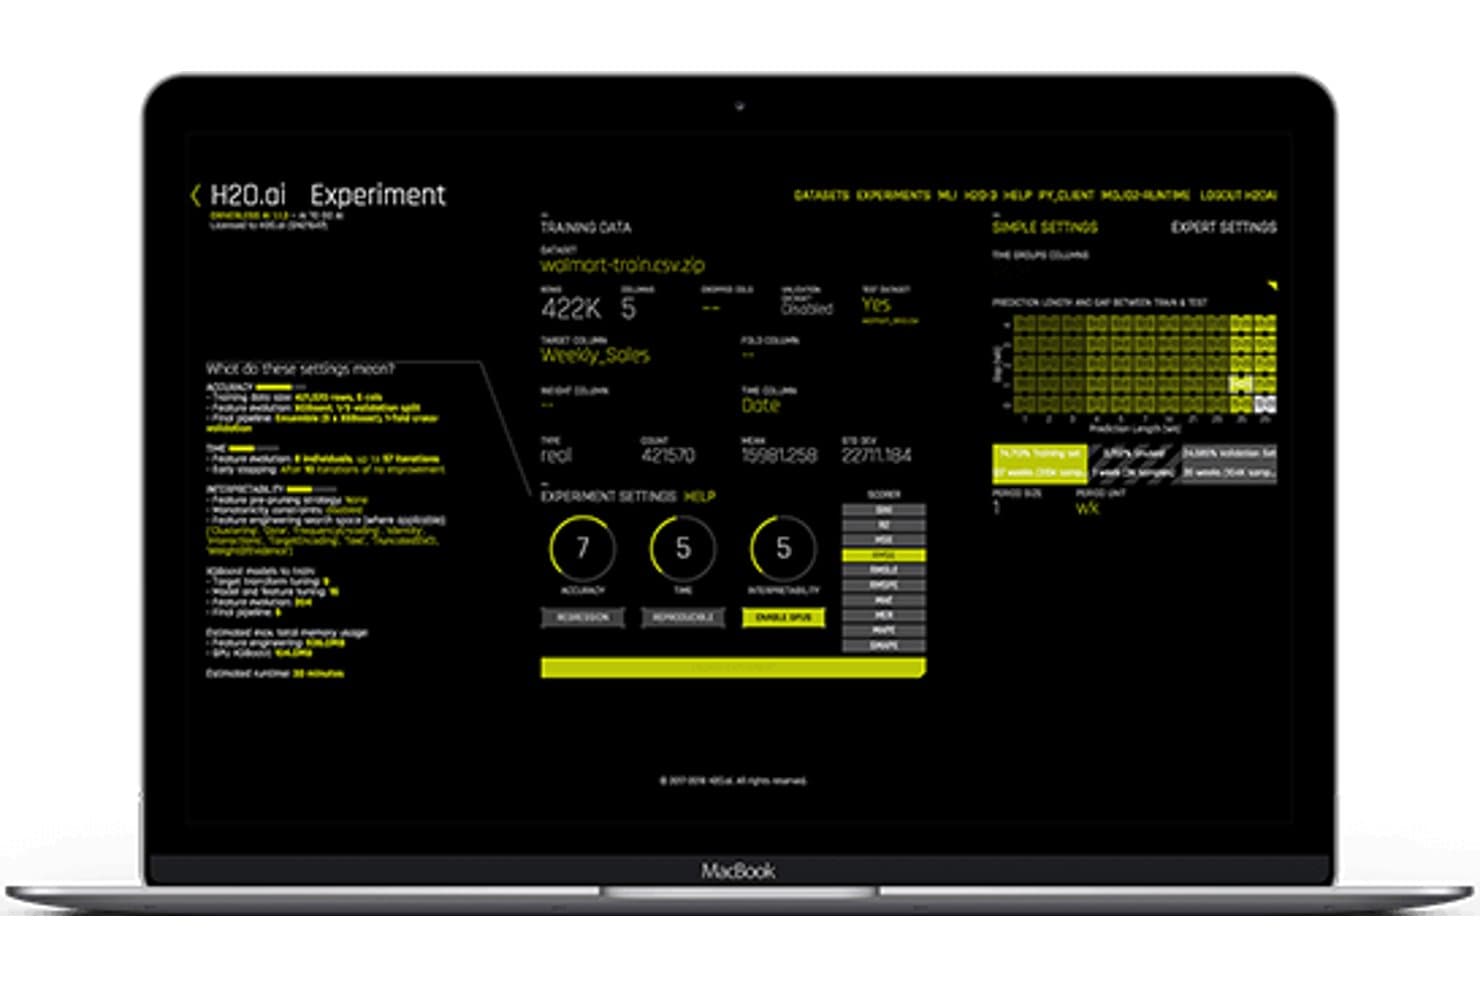
H2O.ai:n avulla käyttäjät voivat määrittää ja suorittaa AutoML-kokeita visuaalisesti. Databricksin vaihtoehtoja arvioiville tiimeille H2O.ai tarjoaa tekoäly- ja koneoppimisalustan, joka auttaa data- ja IT-tiimejä rakentamaan ennustemalleja suurista tietojoukoista ja hyödyntämään analytiikkaa käytännössä.
Kenelle H2O.ai sopii parhaiten?
H2O.ai sopii datatieteilijöille ja koneoppimisinsinööreille, jotka vastaavat tekoälymallien kehittämisestä ja viemisestä tuotantoon.
Miksi valitsin H2O.ai:n
Valitsin H2O.ai:n ”Paras tekoäly- ja koneoppimisratkaisuihin” -vaihtoehdoksi Databricksille, koska se keskittyy ennustemallien rakentamiseen suurista tietojoukoista. H2O-3 hajauttaa muistissa tapahtuvan koneoppimisen klustereille, kun taas AutoML testaa algoritmeja ja asettaa mallit paremmuusjärjestykseen tulostaulukossa. Pidän tästä ratkaisusta, kun minun on vertailtava malleja ennen yhden viemistä tuotantoon.
H2O.ai:n tärkeimmät ominaisuudet
- Joustava käyttöönotto: Käytä alustaa paikallisessa ympäristössä, yksityisessä pilvessä, pilvessä tai eristetyissä ympäristöissä.
- Mallista riippumaton tuki: Valitse, vaihda tai hienosäädä malleja ja suuria kielimalleja.
- Selitettävyys: Tarkastele tekoälypohjaisten päätösten selityksiä.
- Auditointipolut: Seuraa alustan toimintaa auditointiin soveltuvien lokien avulla.
H2O.ai-integraatiot
H2O Driverless AI tarjoaa dataliittimet Amazon S3:lle, HDFS:lle, Snowflakelle, Google BigQuerylle, Databricksille, Google Cloud Storagelle, Azure Blob Storagelle, Hivelle, JDBC-lähteille ja Delta-tauluille. Näiden liittimien avulla tiimit voivat hakea tai tuoda dataa olemassa olevista alustoista koneoppimisen työnkulkuja varten.
Pros and Cons
Pros:
- AutoML nopeuttaa mallien vertailua ja prototyyppien luomista
- Hajautettu muistissa tapahtuva koulutus skaalautuu klustereille
- Eristetty käyttöönotto tukee hallittuja ympäristöjä
Cons:
- Datan käsittelymahdollisuudet ovat rajalliset
- Hankalakäyttöinen käyttöliittymä voi hidastaa työnkulkuja
Learn more about H2O.ai:
Muut Databricks-kilpailijat
Tässä on joitakin muita Databricks-kilpailijoita, jotka eivät päässeet listalleni mutta joihin kannattaa silti tutustua:
- 11DremioParas itsepalveluanalytiikkaan
- 12QuboleSopii parhaiten massadatan työkuormiin
- 13Azure DatabricksParas yhteistyöhön perustuvaan analytiikkaan
Miten arvioin Databricks-kilpailijoita
Arvioin jokaisen vaihtoehdon kahdella tasolla riippumatta siitä, suorittaako tiimisi Spark-putkia suuressa mittakaavassa vai hallinnoiko se koneoppimisen elinkaarta: ensin ydinalueina järvitalo- ja laskentavaatimukset, minkä jälkeen tarkastelen erottavia tekijöitä.
Ydintoiminnot (tämän luettelon perusvaatimukset)
Kun valitsen työkaluja luettelooni, annan kullekin työkalulle arvosanan asteikolla 0:sta (ei tarjoa toimintoa) 5:een (erinomainen tällä alueella) jokaisesta alla luetellusta ydintoiminnosta. Sen jälkeen muunnan työkalun kokonaispistemäärän prosenttiosuudeksi. Työkalun on saavutettava vähintään 65 prosentin kokonaispistemäärä, jotta se voidaan ottaa mukaan.
- Yhtenäinen järvitaloarkkitehtuuri: Tarkistan, pystyykö alusta käsittelemään sekä jäsenneltyjä tietovarastokyselyjä että jäsentämättömän datan datajärvitallennusta ja tukeeko se avoimia taulukkomuotoja, kuten Delta, Iceberg tai Hudi.
- Hajautettu datankäsittely: Laajamittaiset erä- ja suoratoistotyökuormat tarvitsevat hajautetun laskentamoottorin, joka skaalautuu automaattisesti, joten arvioin laskentavaihtoehtoja ja sitä, miten alusta käsittelee esimerkiksi useiden teratavujen ETL-ajoja.
- Integroidut ML/AI-työnkulut: Etsin koneoppimisen elinkaaren päästä päähän kattavaa tukea kokeiden seurannasta ja mallirekisteristä käyttöönottoon ja tarjoiluun sen sijaan, että kyseessä olisi vain muistikirja, jolla voi suorittaa koulutusskriptejä.
- Yhteistyöhön perustuva muistikirjaympäristö: Data-tekniikan asiantuntijoiden, analyytikoiden ja ML-asiantuntijoiden tiimit tarvitsevat jaettuja, useita kieliä tukevia muistikirjoja, joten arvioin reaaliaikaista yhteistyötä, versionhallintaa ja SQL:n, Pythonin, Scalan sekä R:n kielitukea.
- Datan hallinta & turvallisuus: Yhtenäinen dataluettelo, tarkkarajaiset käyttöoikeudet ja datan alkuperän seuranta ovat tässä keskeisiä. Tarkastelen, miten kukin alusta hallinnoi taulukoiden, sarakkeiden ja tekoälyresurssien käyttöoikeuksia yhdessä paikassa.
- Monipilvi & avoin integraatio: Toimittajalukkiutuminen on todellinen huolenaihe, joten arvioin, toimiiko kukin työkalu AWS:ssä, Azuressa ja GCP:ssä sekä miten hyvin se yhdistyy Airflow'n kaltaisiin orkestroijiin, Tableaun kaltaisiin BI-työkaluihin ja dbt:n kaltaisiin tiedonsiirtokerroksiin.
Kun minulla on luettelo työkaluista, jotka täyttävät nämä kriteerit, tarkastelen, mikä erottaa kunkin alustan muista.
Erottavat tekijät (mikä erottaa toimittajat toisistaan)
Näin vertailen eri toimittajia:
Huomionarvoiset ominaisuudet
Palvelimeton laskenta on merkittävä erottava tekijä. Arvioin, mahdollistaako alusta tiimien suorittaa kyselyjä ja töitä ilman klustereiden hallintaa, mikä vähentää ennakoimattomien työkuormien kanssa työskentelevien ryhmien yleiskustannuksia. Alkuperäiset GenAI-työkalut ovat vuosi vuodelta tärkeämpiä erityisesti tiimeille, jotka rakentavat RAG-putkia tai hienosäätävät LLM-malleja suoraan data-alustansa sisällä. Tarkastelen myös kustannusten optimoinnin hallintakeinoja, kuten työkuormakohtaista kulutusseurantaa ja automaattisia klusterikäytäntöjä, sillä pilvilaskennan kustannukset voivat kasvaa nopeasti suurissa suunnittelutiimeissä.
Ominaisuuksia laajempi tarkastelu
Kokonaiskustannukset ovat yksi ensimmäisistä arvioimistani asioista. Kulutukseen perustuva hinnoittelu voi vaikuttaa houkuttelevalta, kunnes datan siirtomaksut ja ensiluokkaiset tukitasot paisuttavat laskua. Myös ekosysteemin laajuudella on merkitystä – tarkistan, miten hyvin kukin alusta yhdistyy Airflown, dbt:n ja Tableaun kaltaisiin työkaluihin, koska useimmat tiimit eivät korvaa koko teknologista pinoaan. Käyttöönotto ja hyödyn saavuttamiseen kuluva aika täydentävät arviointini. Siirtymistyökalut Hadoopin tai Redshiftin kaltaisista vanhoista järjestelmistä voivat lyhentää siirtymää viikoilla, ja kattava dokumentaatio tekee uusien insinöörien perehdyttämisestä huomattavasti helpompaa.
Näin valitset Databricks-kilpailijan
On helppoa juuttua pitkiin ominaisuusluetteloihin ja monimutkaisiin hinnoittelurakenteisiin. Jotta voit keskittyä olennaiseen edetessäsi yksilöllisessä ohjelmistonvalintaprosessissasi, tässä on tarkistuslista huomioitavista tekijöistä:
| Tekijä | Huomioitavaa |
| Skaalautuvuus | Varmista, että ratkaisu pystyy käsittelemään datan kasvua ilman suorituskyvyn heikkenemistä. Tarkista, tukeeko se sekä vaaka- että pystysuuntaista skaalausta joustavuuden varmistamiseksi. |
| Integraatiot | Etsi yhteensopivuutta nykyisten työkalujesi, kuten datajärvien tai BI-työkalujen, kanssa varmistaaksesi sujuvan tiedonkulun ja välttääksesi siiloutuneet prosessit. |
| Muokattavuus | Arvioi alustan kykyä mukautua tiimisi erityisiin työnkulkuihin ja prosesseihin. Muokattavat koontinäytöt voivat vastata eri tiimien tarpeisiin. |
| Helppokäyttöisyys | Arvioi oppimiskynnystä ja sitä, kuinka intuitiivinen käyttöliittymä on tiimillesi. Helppokäyttöinen alusta voi lyhentää koulutukseen kuluvaa aikaa ja lisätä käyttöönottoa. |
| Budjetti | Vertaile hinnoittelumalleja ja varmista, että ne sopivat budjettiisi. Ota huomioon piilokustannukset, kuten tallennustila- tai lisäkäyttäjämaksut, jotka voivat vaikuttaa päätökseesi. |
| Tietoturvan suojatoimet | Arvioi alustan tietoturvaominaisuudet, kuten tietojen salaus ja alan standardien noudattaminen, arkaluonteisten tietojen suojaamiseksi. |
| Tuki | Tarkista asiakastukivaihtoehtojen saatavuus, mukaan lukien reaaliaikainen chat ja yhteisöfoorumit, jotta tiimisi saa apua tarvittaessa. |
| Suorituskyky | Selvitä, miten alusta käsittelee suuria tietoaineistoja ja reaaliaikaista käsittelyä, jotta se vastaa tiimisi suorituskykyodotuksia. |
Databricksin kilpailijoiden trendit
Tutkimukseni aikana keräsin lukemattomia tuoteuutisia, lehdistötiedotteita ja julkaisutietoja eri Databricks-kilpailijoilta. Tässä ovat esiin nousevat trendit, joita seuraan:
- Reaaliaikainen analytiikka: Yritykset vaativat yhä enemmän reaaliaikaisia näkemyksiä datasta. Toimittajat kehittävät alustojaan käsittelemään ja analysoimaan dataa reaaliajassa, mikä mahdollistaa välittömien päätösten tekemisen. Google BigQueryn kaltaisiin ratkaisuihin sisällytetään ominaisuuksia, jotka tukevat reaaliaikaista tietojen suoratoistoa.
- Laajennettu analytiikka: Tässä trendissä tekoälyä ja koneoppimista käytetään data-analytiikkaprosessien tehostamiseen. Se yleistyy, koska sen avulla käyttäjät voivat löytää oivalluksia ilman manuaalista työtä. IBM Watson Studio on tästä esimerkki, sillä se tarjoaa laajennetun analytiikan ominaisuuksia data-analyysin automatisointiin.
- Datan demokratisointi: Yhä useammat alustat keskittyvät tekemään datasta muidenkin kuin teknisten käyttäjien saatavilla olevaa. Tämä trendi on ratkaisevan tärkeä dataohjautuvan kulttuurin edistämisessä organisaatioissa. Työkaluja kehitetään intuitiivisilla käyttöliittymillä ja itsepalveluominaisuuksilla, kuten Alteryxissa.
- Datan hallinta: Tietosuojasäännösten tiukentuessa datan hallintaominaisuuksien merkitys kasvaa. Toimittajat integroivat hallintatyökaluja auttaakseen käyttäjiä noudattamaan säädöksiä ja hallitsemaan dataa vastuullisesti. Esimerkiksi Azure Synapse Analytics tarjoaa sisäänrakennettuja hallintaominaisuuksia.
- Hybridipilven tuki: Monet yritykset haluavat joustavuutta pilvistrategioihinsa. Hybridipilven tuki yleistyy, minkä ansiosta käyttäjät voivat hallita dataa sekä paikallisissa että pilviympäristöissä. Cloudera johtaa tätä trendiä tarjoamalla ratkaisuja, jotka tukevat hybridipilven käyttöönottoja.
Mikä on Databricksin kilpailija?
Databricksin kilpailijat ovat ohjelmistoratkaisuja, jotka on suunniteltu tarjoamaan tietojenkäsittely-, analytiikka- ja koneoppimisominaisuuksia. Näitä työkaluja käyttävät yleensä datatieteilijät, insinöörit ja analyytikot oivallusten hankkimiseen ja liiketoimintapäätösten tukemiseen.
Reaaliaikainen analytiikka, laajennettu analytiikka ja datan hallintaominaisuudet auttavat käsittelemään dataa tehokkaasti, löytämään oivalluksia ja hallitsemaan dataa vastuullisesti. Kaiken kaikkiaan nämä työkalut antavat yrityksille mahdollisuuden hyödyntää dataansa päätöksenteon ja strategisen suunnittelun parantamiseksi.
Databricksin kilpailijan ominaisuudet
Kun valitset Databricksin kilpailijaa, kiinnitä huomiota seuraaviin keskeisiin ominaisuuksiin:
- Reaaliaikainen analytiikka: Mahdollistaa tietojen välittömän käsittelyn ja oivallusten saamisen, joten voit tehdä nopeita liiketoimintapäätöksiä.
- Laajennettu analytiikka: Hyödyntää tekoälyä tietojen analysoinnin automatisointiin ja auttaa löytämään oivalluksia ilman manuaalista työtä.
- Tietohallinto: Varmistaa tietosuojasäännösten noudattamisen ja vastuullisen tiedonhallinnan.
- Hybridipilven tuki: Mahdollistaa tietojen hallinnan sekä paikallisissa että pilviympäristöissä ja tarjoaa näin joustavuutta.
- Vuorovaikutteinen yhteistyö: Helpottaa tiimityötä tarjoamalla jaettuja työtiloja ja työkaluja yhteiseen tietojen analysointiin.
- Automaattinen skaalautuminen: Säätää resursseja työkuorman perusteella ja optimoi suorituskyvyn ilman manuaalisia toimia.
- Koneoppimisen integrointi: Tarjoaa sisäänrakennetut koneoppimisominaisuudet edistyneitä ennusteita ja tietoon perustuvia oivalluksia varten.
- Mukautettavuus: Mahdollistaa yksilölliset työnkulut ja koontinäytöt, jotka vastaavat tiimisi erityistarpeita ja prosesseja.
- Turvallisuussuojaukset: Tarjoaa salauksen ja vaatimustenmukaisuusominaisuudet arkaluonteisten tietojen suojaamiseksi.
- Helppokäyttöinen käyttöliittymä: Helpottaa käyttöä, lyhentää oppimiskäyrää ja lisää käyttöönottoa tiimissäsi.
Databricksin kilpailijan hyödyt
Databricksin kilpailijan käyttöönotto tarjoaa tiimillesi ja yrityksellesi useita hyötyjä. Tässä muutamia etuja, joita voit odottaa:
- Parempi päätöksenteko: Reaaliaikainen ja laajennettu analytiikka tarjoavat välittömiä oivalluksia ja parantavat tiimisi päätöksentekokykyä.
- Yhteistyön lisääntyminen: Vuorovaikutteiset yhteistyöominaisuudet mahdollistavat tehokkaan työskentelyn yhdessä, mikä johtaa yhtenäisempiin tietoprojekteihin.
- Skaalautuvuus: Automaattinen skaalautuminen mahdollistaa järjestelmän tehokkaan mukautumisen tietomäärän kasvuun ilman manuaalisia säätöjä.
- Kustannustehokkuus: Käytön mukaan laskutettavat hinnoittelumallit varmistavat, että maksat vain käyttämistäsi resursseista, mikä optimoi budjetinhallintaa.
- Parantunut tietoturva: Sisäänrakennetut turvallisuussuojaukset suojaavat tietojasi ja varmistavat alan standardien noudattamisen.
- Joustavuus: Hybridipilven tuki tarjoaa joustavuutta tietojen hallintaan erilaisissa ympäristöissä ja mukautuu yrityksesi tarpeisiin.
- Mukauttaminen: Mukautettavien ominaisuuksien avulla voit räätälöidä työnkulut ja koontinäytöt vastaamaan erityisvaatimuksiasi, mikä parantaa tuottavuutta.
Databricksin kilpailijan kustannukset ja hinnoittelu
Databricksin kilpailijan valinta edellyttää saatavilla olevien erilaisten hinnoittelumallien ja suunnitelmien ymmärtämistä. Kustannukset vaihtelevat ominaisuuksien, tiimin koon, lisäosien ja muiden tekijöiden perusteella. Alla oleva taulukko sisältää yhteenvedon Databricksin kilpailijaratkaisuissa yleisesti käytetyistä suunnitelmista, niiden keskimääräisistä hinnoista ja tyypillisistä ominaisuuksista:
Databricksin kilpailijan suunnitelmien vertailutaulukko
| Suunnitelman tyyppi | Keskimääräinen hinta | Yleiset ominaisuudet |
| Ilmainen suunnitelma | $0 | Perustason tietojenkäsittely, rajoitettu tallennustila ja yhteisön tuki. |
| Henkilökohtainen suunnitelma | $10-$30 /käyttäjä /kuukausi | Laajennettu tietojen analytiikka, henkilökohtaiset koontinäytöt ja sähköpostituki. |
| Yrityssuunnitelma | $50-$100 /käyttäjä /kuukausi | Edistyneet analytiikkatyökalut, tiimin yhteistyöominaisuudet ja ensisijainen tuki. |
| Yritystason suunnitelma | $150-$300/käyttäjä /kuukausi | Mukautetut integraatiot, nimetty asiakkuudenhallinta ja yritystason tietoturva. |
Databricksin kilpailijoita koskevat usein kysytyt kysymykset
Tässä vastauksia yleisiin Databricksin kilpailijaa koskeviin kysymyksiin:
Kuka on Databricksin suurin kilpailija?
Snowflakea pidetään usein Databricksin suurimpana kilpailijana sen samankaltaisten pilvipohjaisten data-alustaominaisuuksien vuoksi. Molemmat tarjoavat laajat datankäsittely- ja analytiikkaominaisuudet, mutta Snowflake tunnetaan vahvuudestaan tietovarastoinnissa. Erityistarpeistasi riippuen kumpi tahansa voi olla hyvä valinta.
Mikä korvaa Databricksin?
Vaikka mikään yksittäinen työkalu ei ole korvaamassa Databricksia, SQL Serverin kaltaiset vaihtoehdot tarjoavat vakuuttavia ominaisuuksia. SQL Server integroituu hyvin data-analytiikkatyökaluihin, kuten Power BI:hin, ja tarjoaa vankan relaatiotietokantojen hallintajärjestelmän. Valintasi riippuu erityisistä datankäsittelyvaatimuksistasi.
Mitkä ovat Databricksin rajoitukset?
Databricksilla on joitakin rajoituksia, kuten muistikirjassa olevien pienoisohjelmien määrää sekä pienoisohjelmien nimien ja syötteiden merkkimäärää koskevat rajoitukset. Nämä rajoitteet voivat vaikuttaa siihen, miten suunnittelet ja käsittelet dataa muistikirjoissa, joten suunnittele toteutus niiden mukaisesti, jos ne vaikuttavat työnkulkuihisi.
Ketkä ovat Amazon Databricksin kilpailijoita?
Amazon Databricks kilpailee Snowflaken kaltaisten alustojen kanssa, jotka tarjoavat samankaltaisia datankäsittelyominaisuuksia. Snowflake tarjoaa pilvipohjaisen tietovarastoratkaisun, joka tunnetaan laajalti skaalautuvuudestaan ja helppokäyttöisyydestään, mikä tekee siitä vahvan kilpailijan markkinoilla.
Miten Databricksin hinnoittelu vertautuu kilpailijoihin?
Databricksin hinnoittelu voi vaihdella merkittävästi käytön ja ominaisuuksien perusteella. On tärkeää verrata sitä kilpailijoihin, kuten Snowflakeen ja Google BigQueryyn, ja ottaa huomioon esimerkiksi datan tallennus, käsittelykustannukset ja lisäominaisuudet. Arvioi kunkin alustan hinnoittelurakenne löytääksesi budjettiisi parhaiten sopivan vaihtoehdon.
Mitä ominaisuuksia minun tulisi etsiä Databricksin kilpailijasta?
Kun arvioit Databricksin kilpailijoita, etsi ominaisuuksia, kuten reaaliaikainen analytiikka, koneoppimisen integrointi ja datanhallinta. Nämä ominaisuudet tehostavat datankäsittelyä ja -analyysiä sekä tuottavat lisäarvoa tiimillesi. Pohdi liiketoimintasi erityistarpeita määrittääksesi, mitkä ominaisuudet ovat tärkeimpiä.