

Las 10 mejores herramientas de lago de datos en 2026

10 Lista de las mejores herramientas de lagos de datos


Las herramientas de lagos de datos te permiten almacenar, organizar y analizar grandes cantidades de datos estructurados y no estructurados en toda tu empresa. Si estás comparando las mejores herramientas de lagos de datos, no puedes permitirte elegir a ciegas: ¿qué plataforma mantendrá a tu equipo al mando de los costes, el cumplimiento normativo y el rendimiento a medida que crezcan tus datos?
En esta guía, te mostraré opciones probadas que ayudan a los líderes de TI a ofrecer gobernanza, escalabilidad, integración y preparación para el futuro, para que puedas elegir con confianza la base adecuada para las cargas de trabajo de análisis e IA en 2026.
Por qué confiar en nuestras reseñas de software
Llevamos probando y revisando software desde 2023. Como líderes tecnológicos, sabemos lo crítico y difícil que es tomar la decisión correcta al seleccionar software.
Invertimos en una investigación profunda para ayudar a nuestra audiencia a tomar mejores decisiones de compra de software. Hemos probado más de 2,000 herramientas para diferentes casos de uso tecnológicos y escrito más de 1,000 reseñas de software exhaustivas. Descubre cómo mantenemos la transparencia y nuestra metodología de revisión de software.
Compara las mejores herramientas de lagos de datos
Compara precios y especificaciones, uno al lado del otro, de las herramientas de lagos de datos que llegaron a mi lista de selección.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | La mejor opción para lagos de datos Apache Iceberg optimizados automáticamente | Prueba gratuita disponible | Desde $300/mes (facturado anualmente) | Website | |
| 2 | La mejor opción para la gobernanza de lakehouses híbridos empresariales regulados | Prueba gratuita de 60 días disponible | Desde $0.04/CCU/hora | Website | |
| 3 | Ideal para un lago de datos abierto basado en Iceberg sin dependencia de un proveedor | Prueba gratuita de 30 días | Desde $0.20/DCU | Website | |
| 4 | La mejor opción para la gobernanza de lagos de datos en sectores regulados | Demostración gratuita disponible | Precios bajo solicitud | Website | |
| 5 | La mejor opción para la gobernanza entre motores en tablas de lago de datos abiertas | Prueba gratuita de 90 días | Desde $0.12 por hora de DCU | Website | |
| 6 | Ideal para compartir datos sin copias entre nubes | Prueba gratuita de 30 días | Desde $2.00/crédito | Website | |
| 7 | Ideal para lagos de datos y almacenes nativos de GCP con almacenamiento por niveles | Plan gratuito disponible | Desde $0.020/GB/mes | Website | |
| 8 | Ideal para un lago de datos basado en formatos de tablas abiertos | Prueba gratuita de 14 días | Desde $0.22/DBU | Website | |
| 9 | Ideal para el almacenamiento de objetos en el núcleo de los lagos de datos de AWS | No disponible | Desde $0.023/GB/mes | Website | |
| 10 | Ideal para lagos de datos empresariales nativos de Microsoft | Crédito de $200 durante 30 días (sin nivel gratuito específico) | Desde $0.023/GB/mes | Website |
Reseñas de herramientas de lagos de datos
A continuación encontrarás mis resúmenes detallados de las mejores herramientas de lagos de datos que llegaron a mi lista de selección. Mis reseñas ofrecen un análisis detallado de las características, capacidades y mejores casos de uso de cada plataforma para ayudarte a encontrar la mejor opción para ti.

Qlik
La mejor opción para lagos de datos Apache Iceberg optimizados automáticamente
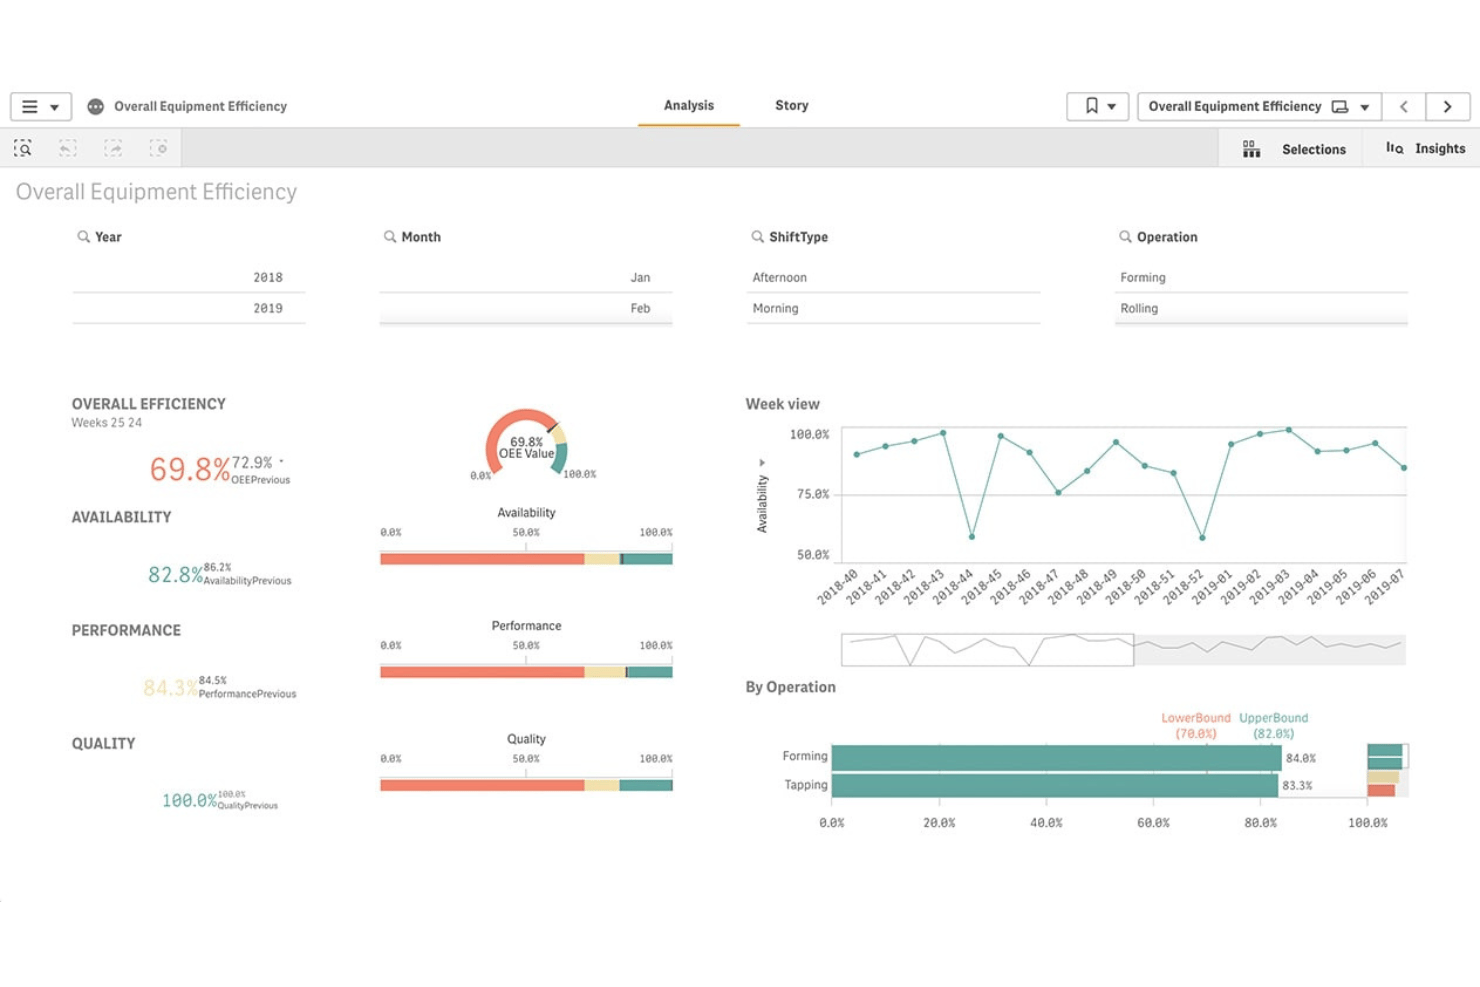
Qlik es una plataforma de integración de datos y lago de datos creada de forma nativa sobre Apache Iceberg que combina la ingestión basada en CDC, la evolución automatizada de esquemas, las canalizaciones de datos multiformato y la gobernanza integrada en entornos de almacenamiento de objetos en la nube.
¿Para quién es más adecuado Qlik?
Qlik es una opción excelente para grandes empresas de sectores regulados que necesitan integración de datos integral, gobernanza y gestión de lagos de datos en una sola plataforma.
Por qué elegí Qlik
Elegí Qlik porque su Optimizador Adaptativo de Iceberg lo diferencia: ejecuta continuamente la compactación, la indexación y la limpieza de instantáneas en sus tablas de Iceberg sin necesidad de ajustes manuales, lo que ofrece velocidades de consulta entre 2.5x y 5x superiores y ahorros de hasta un 50% en los costes de almacenamiento. También confío en su replicación en espejo sin copia para enviar tablas de Iceberg activas directamente a Snowflake sin duplicar datos ni añadir complejidad a las canalizaciones.
Características principales de Qlik
- Replicación CDC basada en registros: Qlik Replicate captura los cambios directamente de los registros de transacciones de las bases de datos sin necesidad de agentes, manteniendo actualizados los datos del lago sin afectar al rendimiento del sistema de origen.
- Canalización de ingestión multiformato: Ingiera datos en Parquet, Avro, ORC, JSON y CSV desde más de 200 fuentes, incluidas bases de datos, aplicaciones SaaS, SAP, sistemas centrales y plataformas de transmisión como Kafka y Kinesis.
- Linaje de datos y análisis de impacto a nivel de columna: Realice un seguimiento de los datos desde el origen hasta el consumo a nivel de columna, obteniendo un registro de auditoría claro para los informes de gobernanza y cumplimiento.
- Gestión automatizada de zonas bronce/plata/oro: Qlik Compose for Data Lakes automatiza la generación de esquemas, la creación del catálogo de Hive y las actualizaciones continuas de las zonas mediante CDC, eliminando la codificación manual de canalizaciones para arquitecturas de lagos de datos de varios niveles.
Integraciones de Qlik
Qlik admite más de 200 fuentes de ingestión, incluidas Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP y Salesforce. Sus tablas de Iceberg se integran con Spark, Amazon Athena, Trino, Presto, Databricks, Dremio y Tableau.
Pros and Cons
Pros:
- Gestión optimizada automáticamente de tablas Apache Iceberg
- Replicación CDC avanzada en tiempo real basada en registros
- Controles profundos de cumplimiento y gobernanza empresarial
Cons:
- Plataforma compleja con requisitos técnicos exigentes
- Proceso opaco de licenciamiento y estimación de costes
Cloudera
La mejor opción para la gobernanza de lakehouses híbridos empresariales regulados
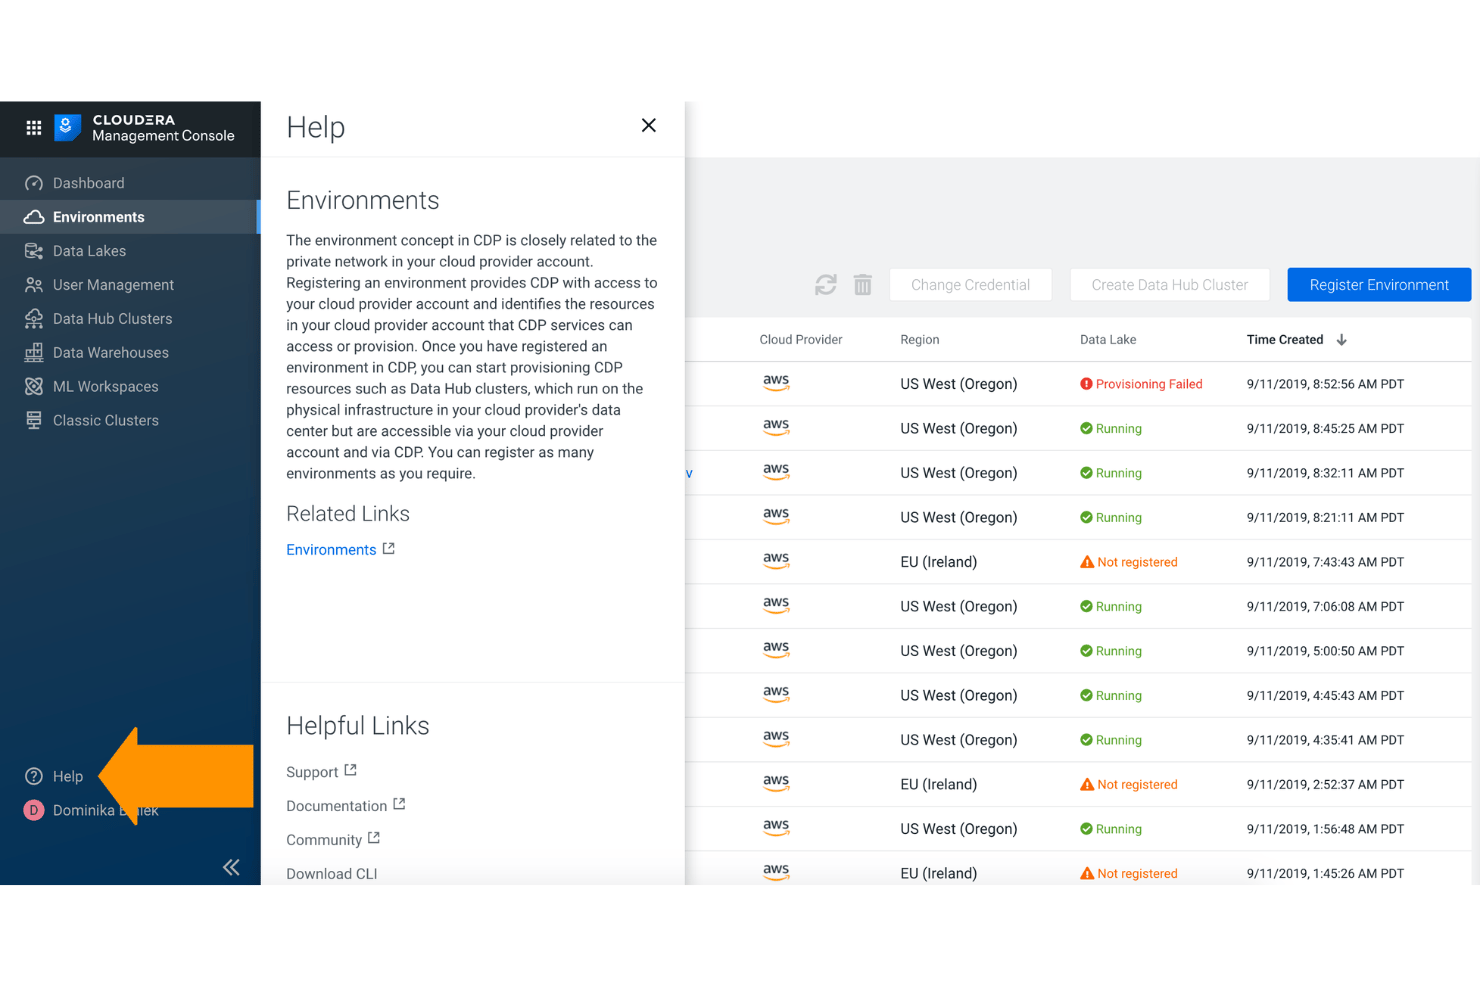
Cloudera es una plataforma abierta de lakehouse de datos que abarca almacenamiento escalable multinube y local, ingesta de datos en múltiples formatos mediante más de 450 conectores, esquemas basados en Apache Iceberg definidos al leer y gobernanza centralizada en entornos híbridos.
¿Para quién es más adecuada Cloudera?
Cloudera es una opción excelente para grandes empresas de sectores regulados —banca, gobierno y telecomunicaciones— que necesitan una gobernanza unificada en entornos locales y multinube.
Por qué elegí Cloudera
Cloudera ocupa un lugar en mi lista de opciones porque ninguna otra plataforma iguala la profundidad de su gobernanza en entornos híbridos. Me impresiona especialmente Cloudera SDX, que aplica las políticas de Apache Ranger y Apache Atlas una sola vez y las hace cumplir en todas partes, tanto si los datos están en un clúster HDFS local, Azure ADLS o AWS S3. Los bancos y organismos gubernamentales que ejecutan infraestructuras mixtas pueden definir de forma centralizada reglas de enmascaramiento a nivel de columna y políticas ABAC, con las certificaciones FedRAMP Moderate y PCI DSS 4.0 respaldando sus requisitos de cumplimiento.
Características principales de Cloudera
- Viaje en el tiempo de Apache Iceberg: Consulta instantáneas históricas de tus datos en cualquier momento mediante las capacidades integradas de versionado y viaje en el tiempo de Iceberg.
- Optimizador del lakehouse: Automatiza la compactación de tablas Iceberg, el ordenamiento Z y la poda de particiones para mejorar el rendimiento de las consultas y reducir los costes informáticos.
- Generador visual de canalizaciones de Cloudera Data Flow (NiFi): Diseña e implementa canalizaciones de ingesta de datos mediante una interfaz de arrastrar y soltar con más de 450 procesadores y conectores prediseñados.
- Intercambio de datos sin copias mediante el catálogo REST de Iceberg: Los motores externos como Databricks, Snowflake y Athena pueden consultar directamente las tablas Iceberg administradas por Cloudera sin mover ni duplicar los datos.
Integraciones de Cloudera
Cloudera Data Flow ofrece más de 450 conectores prediseñados, incluidos Apache Kafka, MongoDB, Salesforce, Snowflake y Google BigQuery. También se integra con AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau y Power BI mediante su catálogo REST de Iceberg.
Pros and Cons
Pros:
- La compatibilidad con entornos híbridos y locales es insuperable
- Gobernanza empresarial para necesidades estrictas de cumplimiento
- Intercambio sin copias entre motores de consulta externos
Cons:
- La configuración inicial suele requerir conocimientos especializados
- La satisfacción con la gestión de metadatos está por debajo de la media de la competencia

Dremio
Ideal para un lago de datos abierto basado en Iceberg sin dependencia de un proveedor
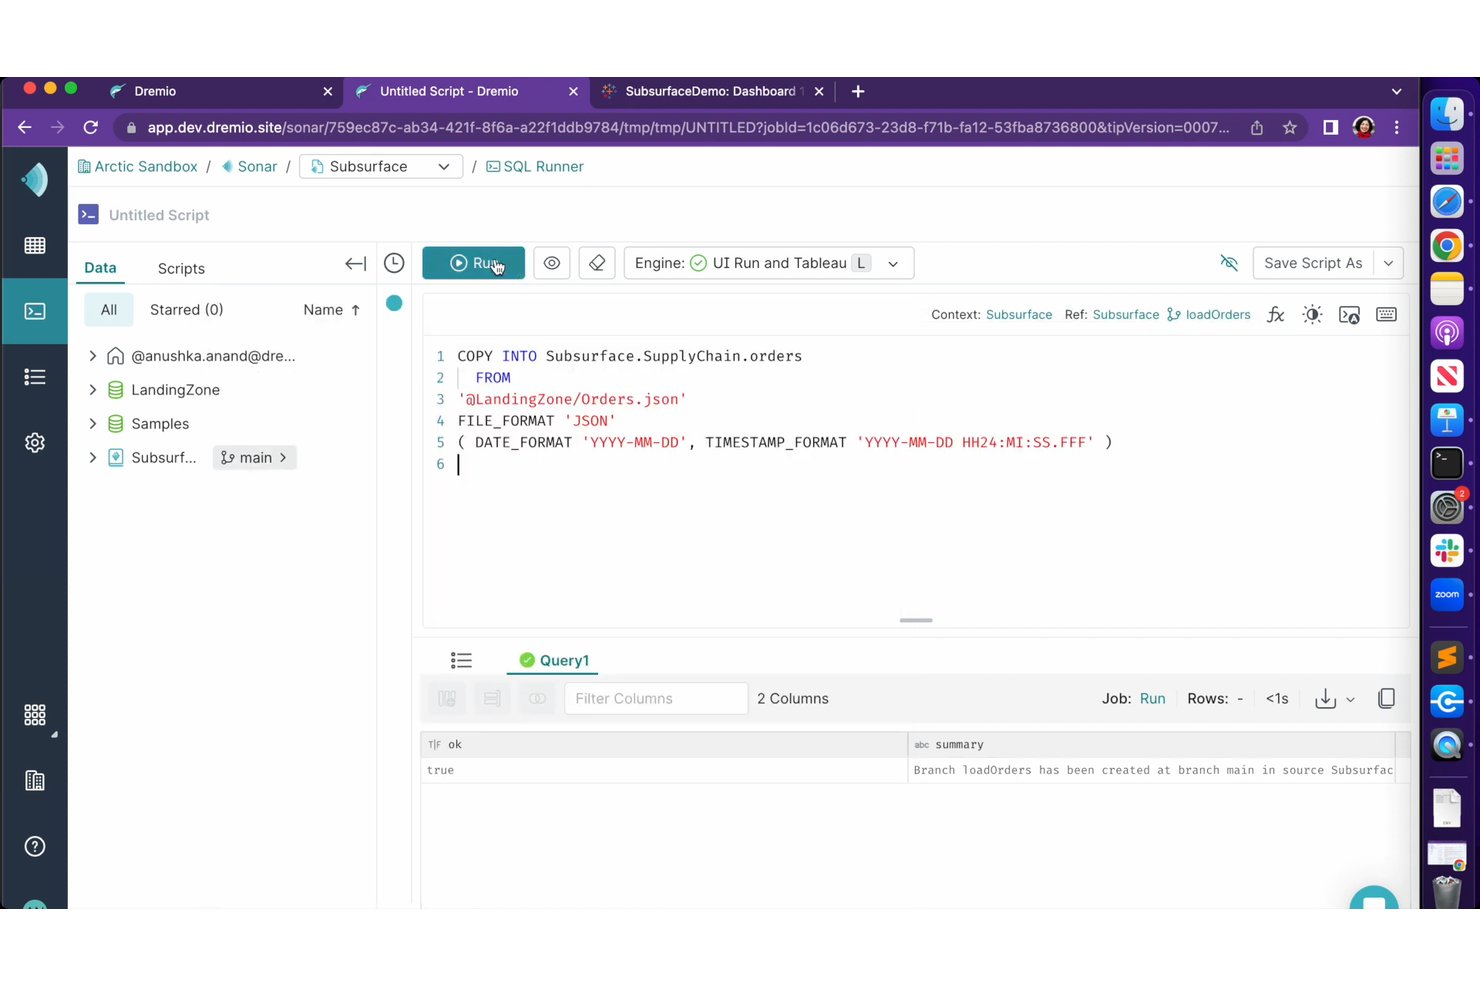
Dremio es una plataforma de lago de datos abierta construida de forma nativa sobre Apache Iceberg y Apache Arrow, que combina un motor de consultas SQL, acceso federado a datos, aceleración automatizada de consultas, control de versiones de datos al estilo de Git y un catálogo abierto para múltiples motores.
¿Para quién es más adecuado Dremio?
Dremio es una opción excelente para equipos de ingeniería y arquitectura de datos que crean lagos de datos abiertos sobre Apache Iceberg y necesitan acceso a consultas desde varios motores sin quedar vinculados a un catálogo o formato de almacenamiento propietario.
Por qué elegí Dremio
Dremio ocupa un lugar en mi lista de opciones principales porque está construido de forma nativa sobre Apache Iceberg, lo que significa que tus datos permanecen en tus propios depósitos de S3 o ADLS y cualquier motor (Spark, Flink, Trino, DuckDB) puede leerlos y escribirlos mediante el catálogo abierto Polaris sin conversión de formato. Me gustan especialmente las Reflexiones autónomas, que observan silenciosamente los patrones de consulta y materializan aceleraciones en segundo plano, de modo que tus paneles de BI obtienen resultados rápidos sin ajustes manuales ni extracciones propietarias.
Características principales de Dremio
- Catálogo abierto (Apache Polaris): Un catálogo para múltiples motores basado en Apache Polaris que permite a Spark, Flink, Trino y DuckDB leer y escribir tablas de Iceberg mediante una API REST estándar.
- Ramificación de datos como código: El control de versiones al estilo de Git mediante Project Nessie crea ramas de datos aisladas sin copias para desarrollo, pruebas y experimentación con ML, con fusiones y reversiones atómicas.
- Ingesta con COPY INTO: Un comando SQL nativo que carga archivos CSV, JSON y Parquet desde el almacenamiento de objetos directamente en tablas de Iceberg, con evolución del esquema y gestión de particiones.
- Control de acceso detallado: Seguridad a nivel de fila y enmascaramiento de columnas aplicados en el momento de la consulta de forma coherente en todos los motores que consultan el catálogo.
Integraciones de Dremio
Dremio se integra con Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage y Google Cloud Storage. Sus interfaces de catálogo REST de Polaris, ODBC, JDBC y Arrow Flight admiten conexiones de motores y aplicaciones personalizadas.
Pros and Cons
Pros:
- Procesa Apache Iceberg de forma nativa sin conversión
- Ramificación de datos al estilo de Git para viajar en el tiempo
- El catálogo REST abierto conecta cualquier motor de consultas
Cons:
- La administración es más compleja que la de herramientas similares
- No incluye un almacén de características de ML integrado y específico
La mejor opción para la gobernanza de lagos de datos en sectores regulados
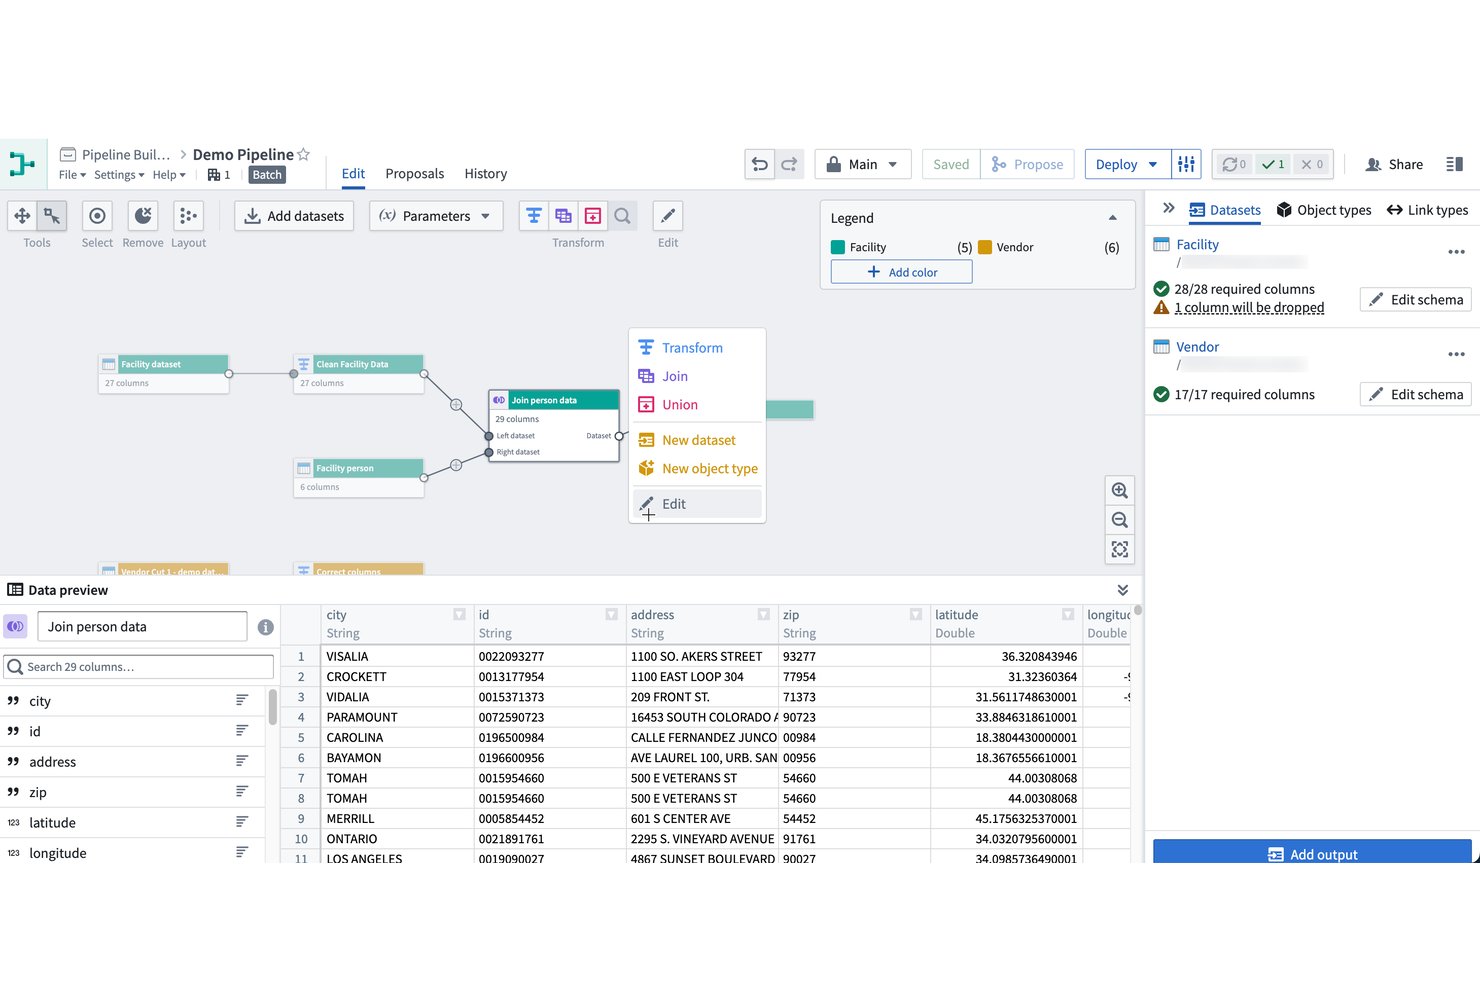
Palantir Foundry es una plataforma de lago de datos que combina la ingesta multiformato, la orquestación de canalizaciones, el modelado semántico de datos mediante su capa Ontology y controles de gobernanza integrados en entornos de nube, locales y aislados.
¿Para quién es más adecuado Palantir Foundry?
Palantir Foundry está diseñado específicamente para grandes empresas de sectores regulados—finanzas, atención sanitaria, defensa y gobierno—que necesitan una gobernanza de datos granular en entornos complejos y con múltiples fuentes.
Por qué elegí Palantir Foundry
Elegí Palantir Foundry porque su arquitectura de gobernanza realmente no tiene rival en los sectores regulados. La plataforma combina controles de acceso basados en propósito, clasificación y roles, junto con marcas de datos que se propagan automáticamente a través del linaje, de modo que una etiqueta de información personal identificable (PII) en un conjunto de datos de origen sigue los datos a través de cada transformación posterior. Si a esto se suman las certificaciones FedRAMP High, HIPAA, ITAR y SOC 2 Type 2, además de la capa Ontology, que asigna los datos sin procesar del lago a objetos empresariales auditables, se obtiene una plataforma construida desde cero para entornos donde la gobernanza no es opcional.
Características principales de Palantir Foundry
- Más de 200 conectores de datos prediseñados: Conéctese a bases de datos, almacenes de datos, plataformas de transmisión, sistemas ERP, almacenamiento en la nube, fuentes de IoT y herramientas geoespaciales mediante una única interfaz de ingesta.
- Catálogo REST de Apache Iceberg: Exponga los conjuntos de datos de Foundry a motores de computación externos compatibles con Iceberg—incluidos Trino, Spark, Flink, Databricks y Snowflake—sin duplicar los datos.
- Tablas virtuales para federación sin copias: Consulte directamente desde Foundry tablas externas en Databricks, Snowflake y almacenes compatibles con S3 sin ingerir ni mover los datos subyacentes.
- Estudio de modelos AIP: Cree, entrene, evalúe y sirva modelos de ML dentro de Foundry, con acceso nativo a LLM y compatibilidad con entornos de desarrollo de Python y R.
Integraciones de Palantir Foundry
Palantir Foundry ofrece más de 200 conectores de datos nativos, incluidos Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau y Power BI. También admite conectividad personalizada mediante su API compatible con S3, el catálogo REST de Iceberg y las tablas virtuales.
Pros and Cons
Pros:
- Gobernanza de datos líder del sector para el cumplimiento normativo
- La capa Ontology permite el acceso a los datos por parte de usuarios empresariales
- Intercambio de datos sin copias con tablas virtuales
Cons:
- Precios contractuales elevados con totales poco claros
- Riesgo de dependencia de la plataforma debido a modelos propietarios
BigLake
La mejor opción para la gobernanza entre motores en tablas de lago de datos abiertas
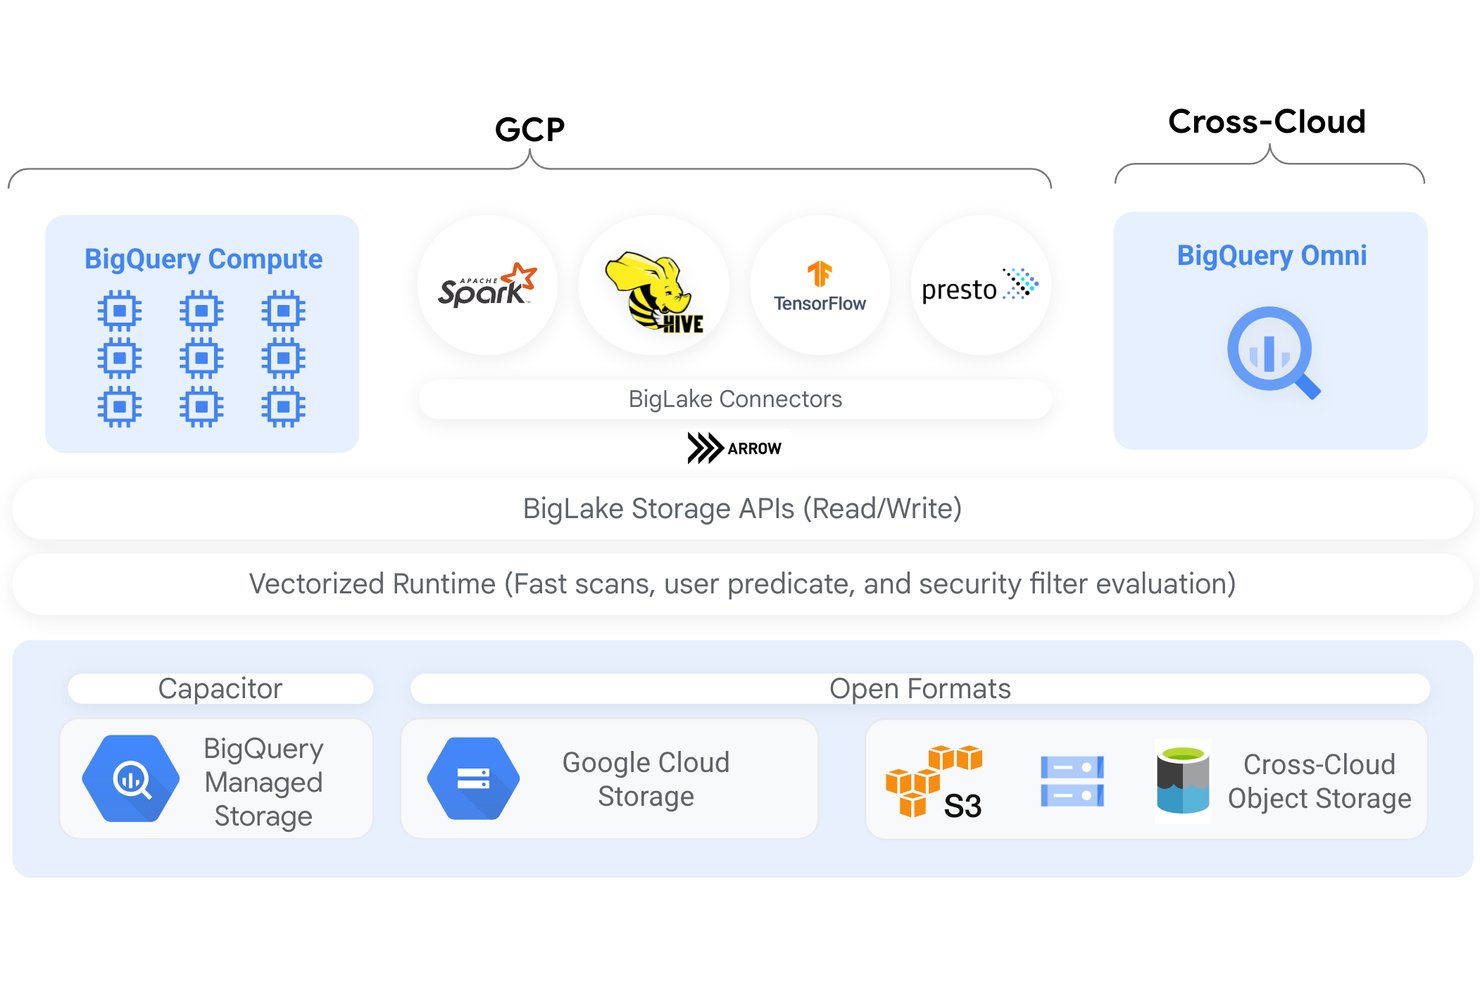
BigLake es la plataforma de lago de datos de Google Cloud que amplía BigQuery con compatibilidad con tablas en formatos abiertos, acceso a consultas entre motores, gestión unificada de metadatos y gobernanza detallada en GCS, S3 y Azure Blob Storage.
¿Para quién es más adecuado BigLake?
BigLake es una opción muy adecuada para los equipos de ingeniería y arquitectura de datos que ya invierten en Google Cloud y necesitan una gobernanza coherente en varios motores de consulta y formatos de tablas abiertos.
Por qué elegí BigLake
Elegí BigLake como una de las mejores opciones porque es la única plataforma de lago de datos que he visto que aplica de forma coherente políticas de acceso a nivel de fila y columna en BigQuery, Spark, Trino y Presto, no solo dentro de un único motor. Esto significa que una etiqueta de política aplicada a una columna sensible sigue los datos independientemente del motor mediante el cual el equipo los consulte. El Catálogo REST de Iceberg para la plataforma de lago de datos lo hace posible al funcionar como un único punto de conexión con reconocimiento de la gobernanza para todos los motores de código abierto que leen y escriben en las mismas tablas de Iceberg.
Características principales de BigLake
- Mantenimiento automatizado de tablas: BigLake gestiona automáticamente la compactación de archivos, la agrupación en clústeres, la recolección de basura y la generación de metadatos para las tablas de Iceberg almacenadas en GCS.
- Ingesta en varios formatos: Ingiera datos en Parquet, ORC, Avro, CSV, JSON y formatos de tablas abiertos como Apache Iceberg, Delta Lake y Apache Hudi mediante archivos de manifiesto.
- Consultas entre nubes con BigQuery Omni: Ejecute consultas SQL de BigQuery directamente sobre datos almacenados en Amazon S3 o Azure Data Lake Storage Gen 2 sin moverlos a GCS.
- Replicación de captura de datos de cambios: Transmita datos operativos desde Cloud Spanner, AlloyDB y Cloud SQL directamente a tablas de BigLake para realizar análisis casi en tiempo real.
Integraciones de BigLake
BigLake ofrece integraciones nativas con BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker y Vertex AI. Su Catálogo REST de Iceberg conecta los motores de código abierto con tablas de lago de datos compartidas.
Pros and Cons
Pros:
- Seguridad a nivel de fila y columna aplicada en todos los motores
- Formatos de tablas abiertos con compatibilidad completa con Iceberg
- Federación de catálogos para la gestión de metadatos multicloud
Cons:
- DML no es compatible con tablas externas que no sean de Iceberg
- CMEK no está disponible para tablas almacenadas en caché de S3 o Azure
Ideal para compartir datos sin copias entre nubes
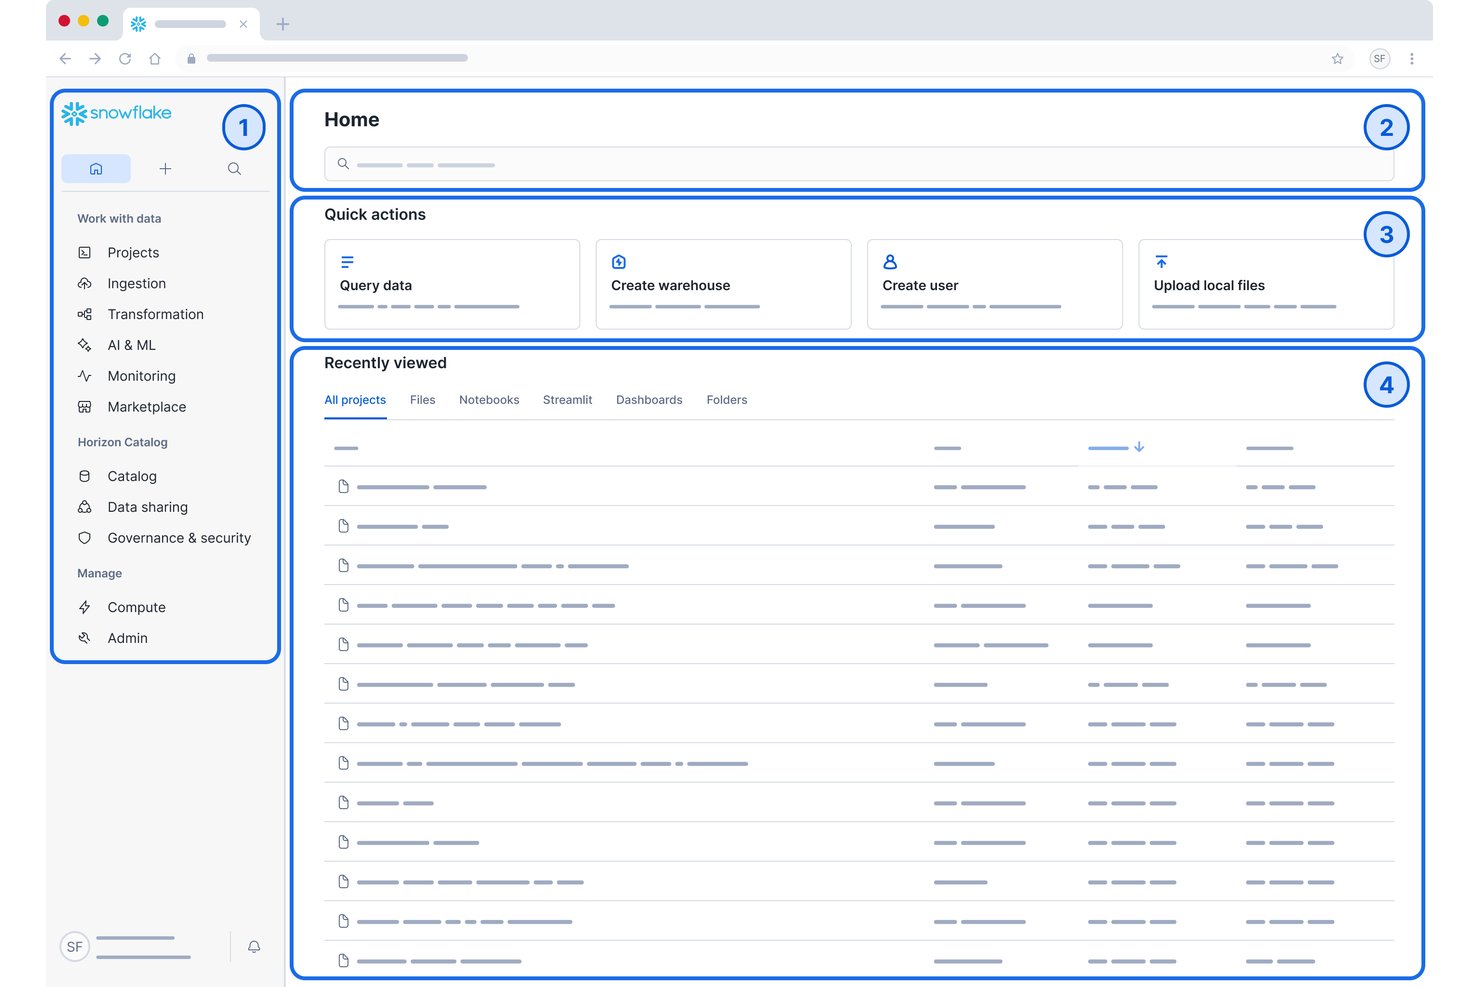
Snowflake es una plataforma nativa de la nube para lagos de datos y análisis que combina almacenamiento elástico, un motor de consultas SQL integrado, Snowpark para cargas de trabajo en Python/Java/Scala, compatibilidad con Apache Iceberg y uso compartido de datos sin copias entre AWS, Azure y GCP.
¿Para quién es más adecuado Snowflake?
Snowflake es una excelente opción para equipos de datos empresariales que gestionan entornos multinube a gran escala, donde la gobernanza, el cumplimiento normativo y el uso compartido de datos entre organizaciones son requisitos innegociables.
Por qué elegí Snowflake
Snowflake ocupa un lugar en mi lista de opciones porque su uso compartido de datos sin copias permite compartir conjuntos de datos activos entre cuentas de AWS, Azure y GCP sin duplicar ni mover un solo byte. He trabajado con Snowflake Marketplace, que conecta con más de 820 proveedores de datos, y el aprovisionamiento automático entre nubes hace que compartir datos entre regiones sea realmente sencillo. Si a esto se suma la compatibilidad nativa con Apache Iceberg y Snowpipe Streaming, que gestiona más de 1 millón de transacciones por segundo, se obtiene una plataforma de lago de datos creada para la verdadera escala empresarial.
Características principales de Snowflake
- Entorno de ejecución multilingüe de Snowpark: Escribe cargas de trabajo de ingeniería de datos y aprendizaje automático en Python, Java o Scala y ejecútalas directamente dentro del motor de consultas de Snowflake sin mover los datos fuera.
- Compatibilidad con tablas Apache Iceberg: Almacena y gestiona datos en el formato de tabla abierto Iceberg en almacenamiento administrado por Snowflake, con evolución de esquemas, Viaje en el tiempo e interoperabilidad con Spark, Trino y Flink.
- Catálogo Horizon: Una capa de gobernanza integrada con seguimiento del linaje a nivel de columna, clasificación automatizada de información de identificación personal (PII), enriquecimiento de metadatos asistido por IA y funciones de métricas de datos para la supervisión continua de la calidad de los datos.
- Snowpipe Streaming: Ingiere datos a nivel de fila en tiempo real a más de 1 millón de transacciones por segundo directamente en tablas de Snowflake o Apache Iceberg, sin demoras por procesamiento en lotes.
Integraciones de Snowflake
Snowflake ofrece integraciones nativas con Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker y Apache Airflow. Se conecta con Apache Spark, Trino, Amazon S3, Azure Blob Storage y Google Cloud Storage, y proporciona API para integraciones personalizadas.
Pros and Cons
Pros:
- Uso compartido de datos sin copias entre nubes
- Gobernanza integrada y linaje a nivel de columna
- Separación elástica del almacenamiento y la computación
Cons:
- No admite implementaciones locales
- El seguimiento de costes puede ser complicado

Ideal para lagos de datos y almacenes nativos de GCP con almacenamiento por niveles
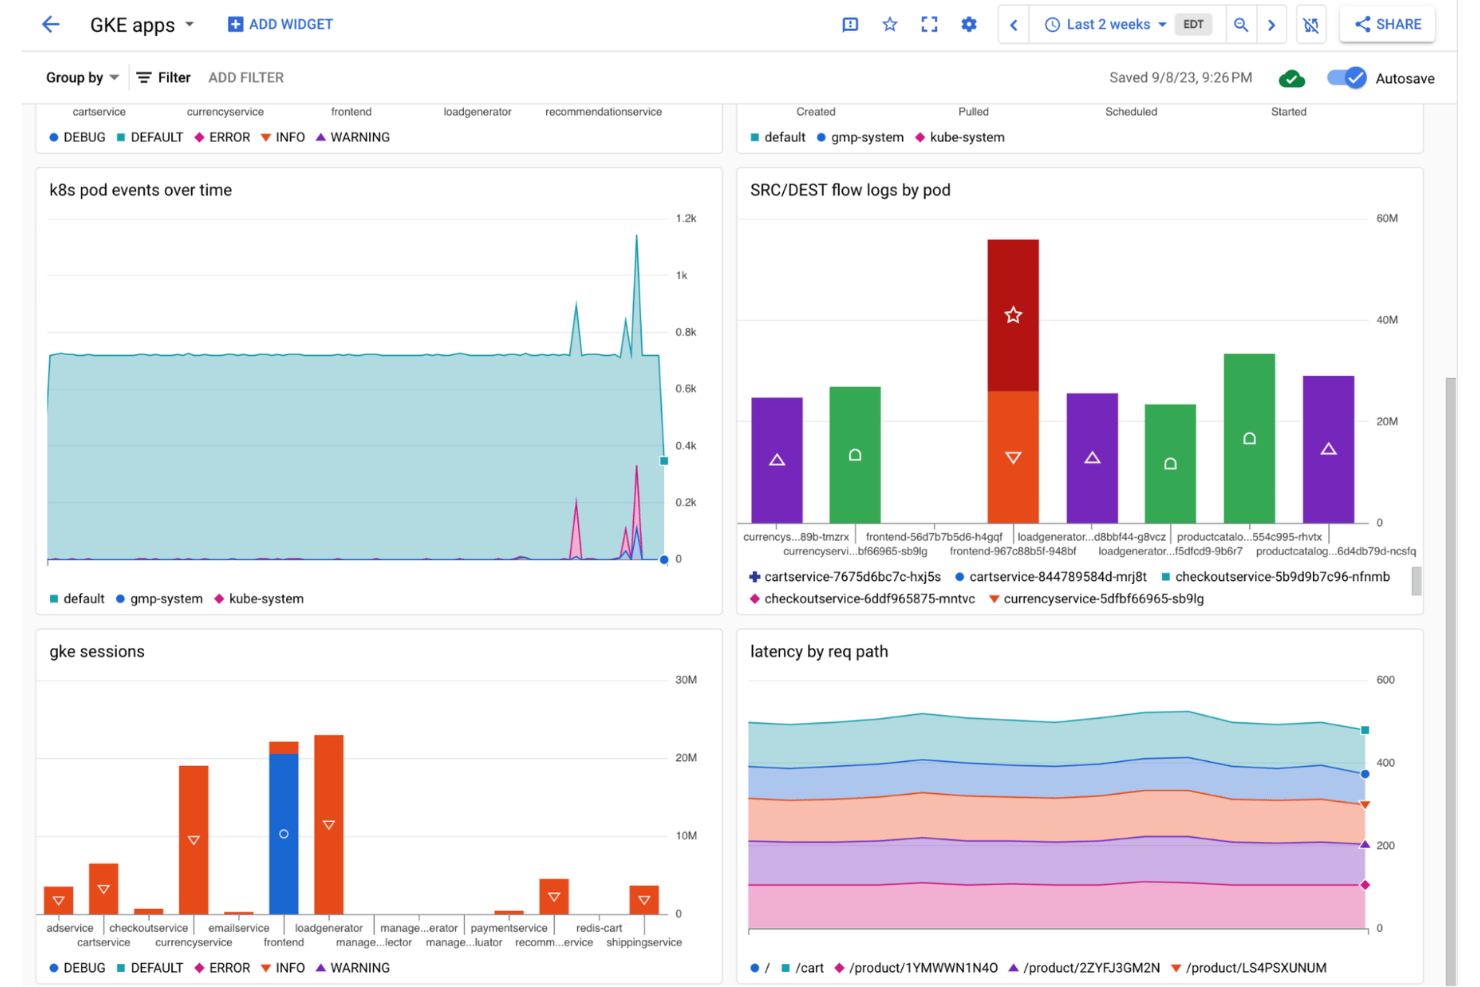
Google Cloud Storage es un servicio administrado de almacenamiento de objetos creado para arquitecturas de lagos de datos, que ofrece clases de almacenamiento por niveles, compatibilidad con formatos de tablas abiertos mediante Apache Iceberg y BigLake, e integración profunda con BigQuery, Dataflow, Dataproc y Vertex AI.
¿Para quién es más adecuado Google Cloud Storage?
Google Cloud Storage es una opción excelente para equipos de ingeniería de datos e infraestructura que ya operan dentro del ecosistema de GCP y necesitan un almacén de objetos escalable como base de una arquitectura de lago de datos y almacén.
Por qué elegí Google Cloud Storage
Elegí Google Cloud Storage porque es la base nativa para un lago de datos y almacén basado en GCP, con clases de almacenamiento por niveles (desde Estándar hasta Archivo a $0.0012/GB/mes) y Autoclass, que cambia automáticamente los objetos entre niveles según los patrones de acceso. Lo que me parece especialmente atractivo es BigLake: añade transacciones ACID, viaje en el tiempo y evolución de esquemas directamente a las tablas Apache Iceberg respaldadas por GCS, convirtiendo el almacenamiento de objetos sin procesar en un lago de datos y almacén consultable sin mover los datos. Después, BigQuery consulta esas mismas tablas Iceberg en su ubicación original, sin necesidad de exportarlas.
Características principales de Google Cloud Storage
- Ingesta multiformato: Storage Transfer Service, Dataflow, Pub/Sub y Datastream admiten la ingesta por lotes, en streaming y mediante CDC desde bases de datos como MySQL, PostgreSQL y Oracle a GCS.
- Gobernanza y controles de acceso: los permisos basados en IAM, el cifrado CMEK/CSEK, VPC Service Controls, Cloud DLP y el registro de auditoría aplican la seguridad en todos los datos almacenados.
- Descubrimiento de metadatos mediante Knowledge Catalog: Dataplex analiza automáticamente los depósitos de GCS para extraer esquemas, crear glosarios empresariales y generar el linaje de datos integral en GCS y BigQuery.
- Compatibilidad con consultas de varios motores: las tablas Iceberg respaldadas por GCS pueden consultarse mediante BigQuery, Spark sin servidor, Trino, Flink y Presto a través del catálogo REST de Iceberg.
Integraciones de Google Cloud Storage
Google Cloud Storage ofrece integraciones nativas con BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker y Knowledge Catalog. Las API REST, XML, gRPC y de bibliotecas cliente permiten integraciones personalizadas con plataformas de datos y motores de procesamiento.
Pros and Cons
Pros:
- Compatibilidad con lagos de datos y almacenes mediante tablas Apache Iceberg
- Análisis con varios motores mediante BigQuery y Spark
- Opciones automatizadas de archivado y organización del almacenamiento por niveles
Cons:
- La mayoría de las funciones requieren varios servicios de GCP
- Facturación compleja con cargos independientes por operaciones y salida de datos

Ideal para un lago de datos basado en formatos de tablas abiertos
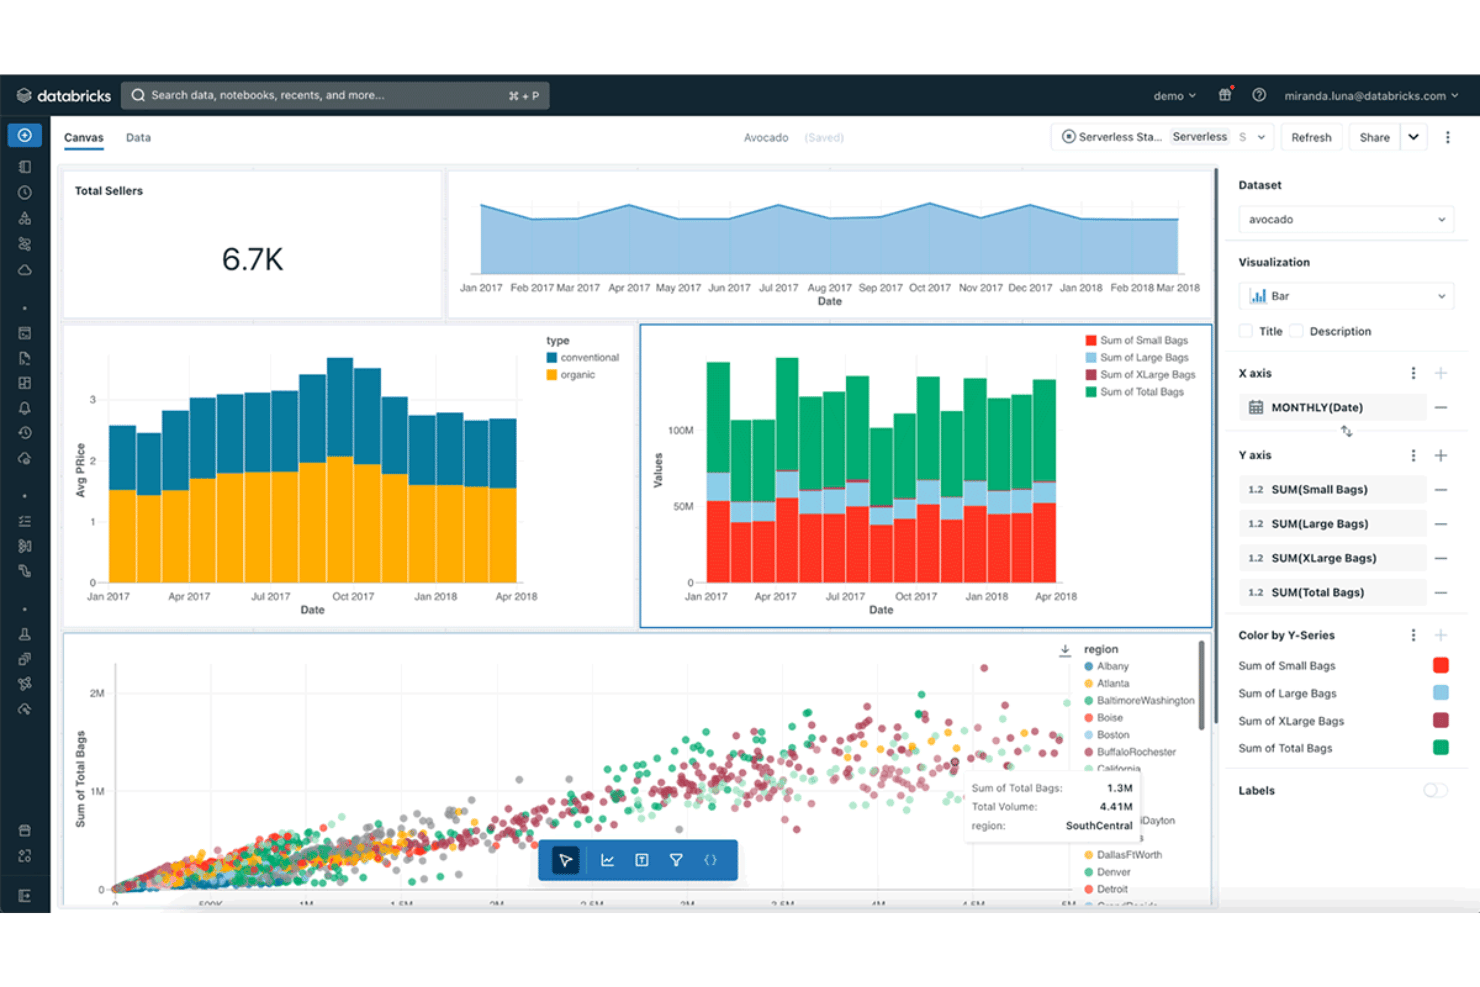
Databricks Lakehouse Platform es una plataforma de lago de datos nativa de la nube que unifica la ingeniería de datos, el análisis SQL, el aprendizaje automático y el desarrollo de IA en formatos de tablas abiertos como Delta Lake, Apache Iceberg y Apache Hudi.
¿Para quién es más adecuada Databricks Lakehouse Platform?
Databricks es una opción excelente para equipos empresariales de datos y aprendizaje automático que necesitan ejecutar canalizaciones de ingeniería, análisis SQL y cargas de trabajo de IA en una sola plataforma sin mover los datos entre sistemas.
Por qué elegí Databricks Lakehouse Platform
Databricks ocupa un lugar en mi lista de opciones finalistas porque es el equipo que literalmente inventó Delta Lake, y ese origen es importante al evaluar la compatibilidad con formatos de tablas abiertos. He trabajado con la compatibilidad nativa de la plataforma con Delta Lake, Iceberg y Hudi, y lo que la diferencia es que las transacciones ACID, el viaje en el tiempo y la evolución del esquema no son complementos añadidos. Unity Catalog incorpora directamente un linaje automatizado a nivel de columna y un control de acceso basado en atributos, de modo que la gobernanza acompaña a los datos entre nubes.
Características principales de Databricks Lakehouse Platform
- Lakeflow Connect: Una capa de ingesta administrada y sin servidor con más de 100 conectores nativos para aplicaciones SaaS, bases de datos, almacenamiento en la nube y fuentes de transmisión, incluidas Kafka, Kinesis y Event Hubs.
- Canalizaciones declarativas de Apache Spark: Un marco para crear canalizaciones ETL por lotes y de transmisión en tiempo real, con aplicación integrada de la calidad de los datos basada en restricciones y captura automatizada de cambios de datos (CDC).
- Almacenes SQL de Databricks: Un motor SQL acelerado por Photon que admite SQL ANSI para cargas de trabajo analíticas, con conectividad JDBC/ODBC para herramientas de inteligencia empresarial como Tableau, Power BI y Looker.
- Integración con MLflow: Un entorno MLflow administrado para el seguimiento de experimentos, el registro de modelos y la implementación, ubicado junto con los datos del lago y conectado al almacén de características y al servicio de modelos.
Integraciones de Databricks Lakehouse Platform
Databricks ofrece más de 100 conectores nativos de Lakeflow Connect, incluidos Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive y Google Analytics. También se conecta a Kafka, Kinesis, Event Hubs, S3, ADLS y GCS, con JDBC/ODBC y API para conectividad personalizada.
Pros and Cons
Pros:
- Compatibilidad nativa con Delta Lake, Iceberg y Hudi
- Linaje automatizado a nivel de columna con Unity Catalog
- MLflow integrado y plataforma de IA unificada
Cons:
- Los costes de DBU más los de la nube pueden aumentar rápidamente
- No hay opción de implementación local disponible

Ideal para el almacenamiento de objetos en el núcleo de los lagos de datos de AWS
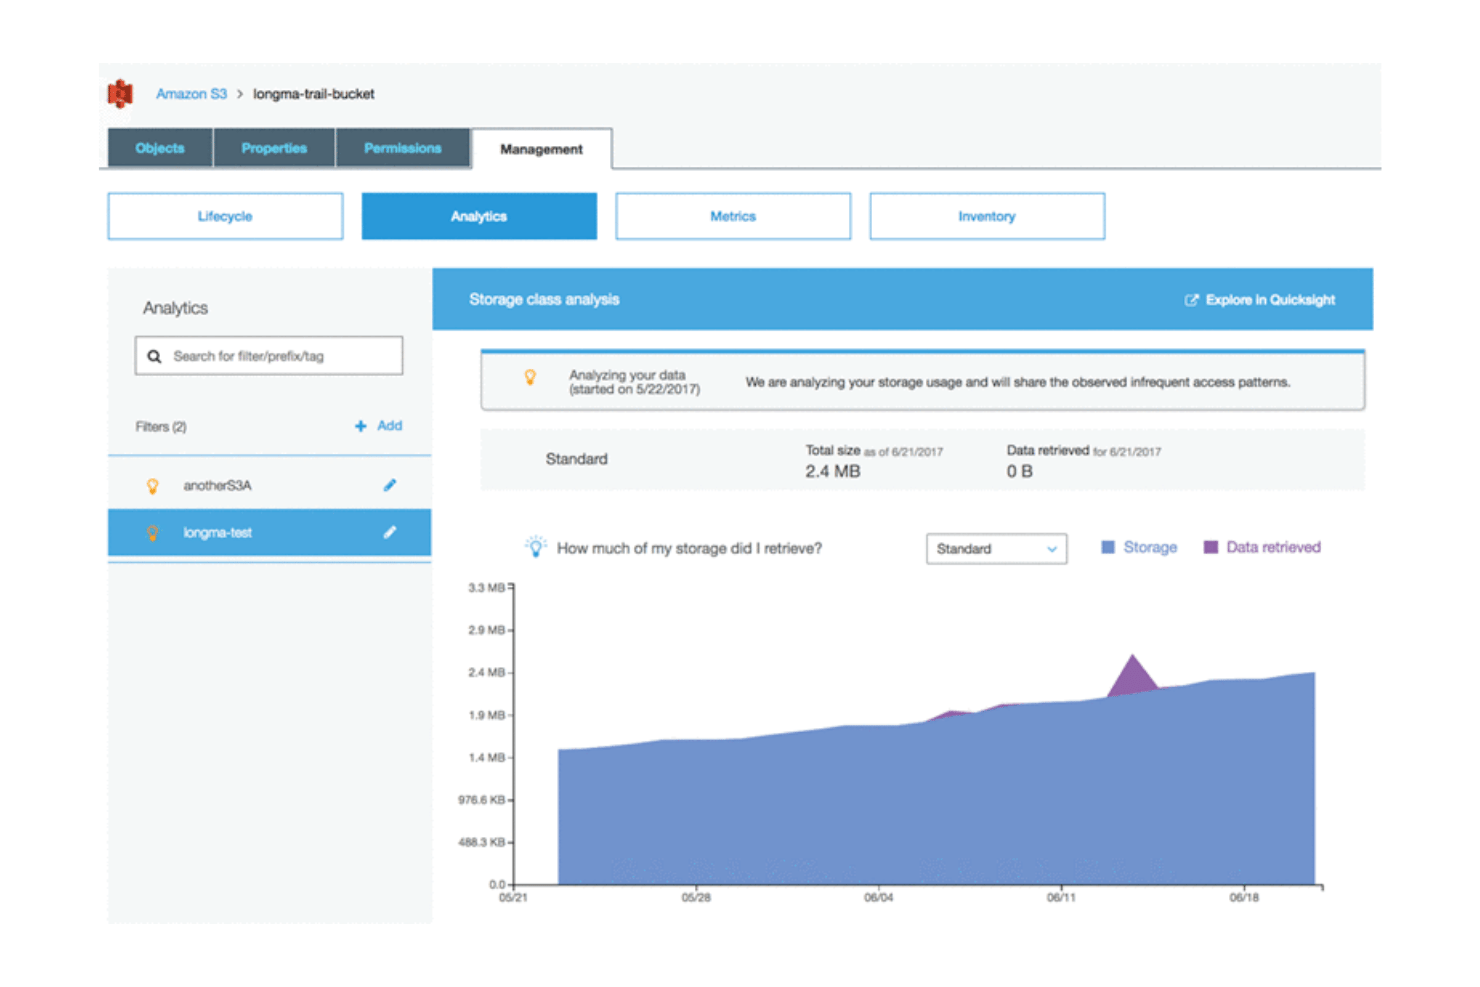
Amazon S3 es el servicio de almacenamiento de objetos de AWS que funciona como la capa de almacenamiento fundamental para los lagos de datos, compatible con cualquier formato de datos a escala de exabytes, con clases de almacenamiento por niveles, gestión nativa de tablas Apache Iceberg mediante S3 Tables y una integración profunda en todo el ecosistema de análisis de AWS.
¿Para quién es más adecuado Amazon S3?
Amazon S3 es la opción adecuada para los equipos de ingeniería de datos e infraestructura que desarrollan canalizaciones de análisis en AWS y necesitan una base de almacenamiento probada a escala de exabytes que se conecte directamente con el resto del ecosistema de AWS.
Por qué elegí Amazon S3
Amazon S3 ocupa un lugar en mi lista de favoritos porque es la capa de almacenamiento de objetos sobre la que ya se construyen la mayoría de los lagos de datos de producción. Me encanta que S3 Tables ofrezca compatibilidad nativa con Apache Iceberg, con transacciones ACID, viajes en el tiempo y compactación automática integrados, lo que resuelve el problema de los archivos pequeños que afecta a la mayoría de las arquitecturas de lagos de datos. Si a esto se suma que S3 Intelligent-Tiering reduce automáticamente los datos inactivos a $0.00099/GB/mes, se obtiene un control considerable de los costes de almacenamiento sin intervención manual.
Características principales de Amazon S3
- Ingesta en múltiples formatos: S3 acepta cualquier tipo de archivo—Parquet, ORC, Avro, JSON, CSV y formatos no estructurados—mediante cargas por lotes, transmisión a través de Kinesis y MSK, o activadores basados en eventos mediante las notificaciones de eventos de S3.
- Control de acceso detallado de Lake Formation: Aplica políticas de acceso a los datos a nivel de tabla, columna, fila y celda en todo tu lago de datos respaldado por S3 sin duplicar los datos.
- S3 Vectors: Un servicio nativo de almacenamiento y consulta de índices vectoriales integrado directamente en S3, diseñado para cargas de trabajo de búsqueda semántica y generación aumentada mediante recuperación, con un coste de hasta un 90 % inferior al de los enfoques tradicionales.
- S3 Inventory: Genera informes programados sobre los atributos de los objetos, la clase de almacenamiento, el estado del cifrado y el estado de replicación en tus buckets para flujos de trabajo de auditoría y gobernanza.
Integraciones de Amazon S3
Amazon S3 ofrece integraciones nativas en AWS, incluidas AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum y Amazon SageMaker. También se conecta con Apache Spark, Trino, Snowflake, Databricks, Tableau y Power BI mediante conectores y API documentados.
Pros and Cons
Pros:
- El almacenamiento de objetos a escala de exabytes admite cualquier formato de datos
- Tablas Iceberg ACID integradas con compactación automática
- 143 certificaciones de cumplimiento y control de acceso a nivel de objeto
Cons:
- Los precios son complejos y requieren una gestión minuciosa
- La creación de lagos de datos requiere reunir varios servicios de AWS
Ideal para lagos de datos empresariales nativos de Microsoft
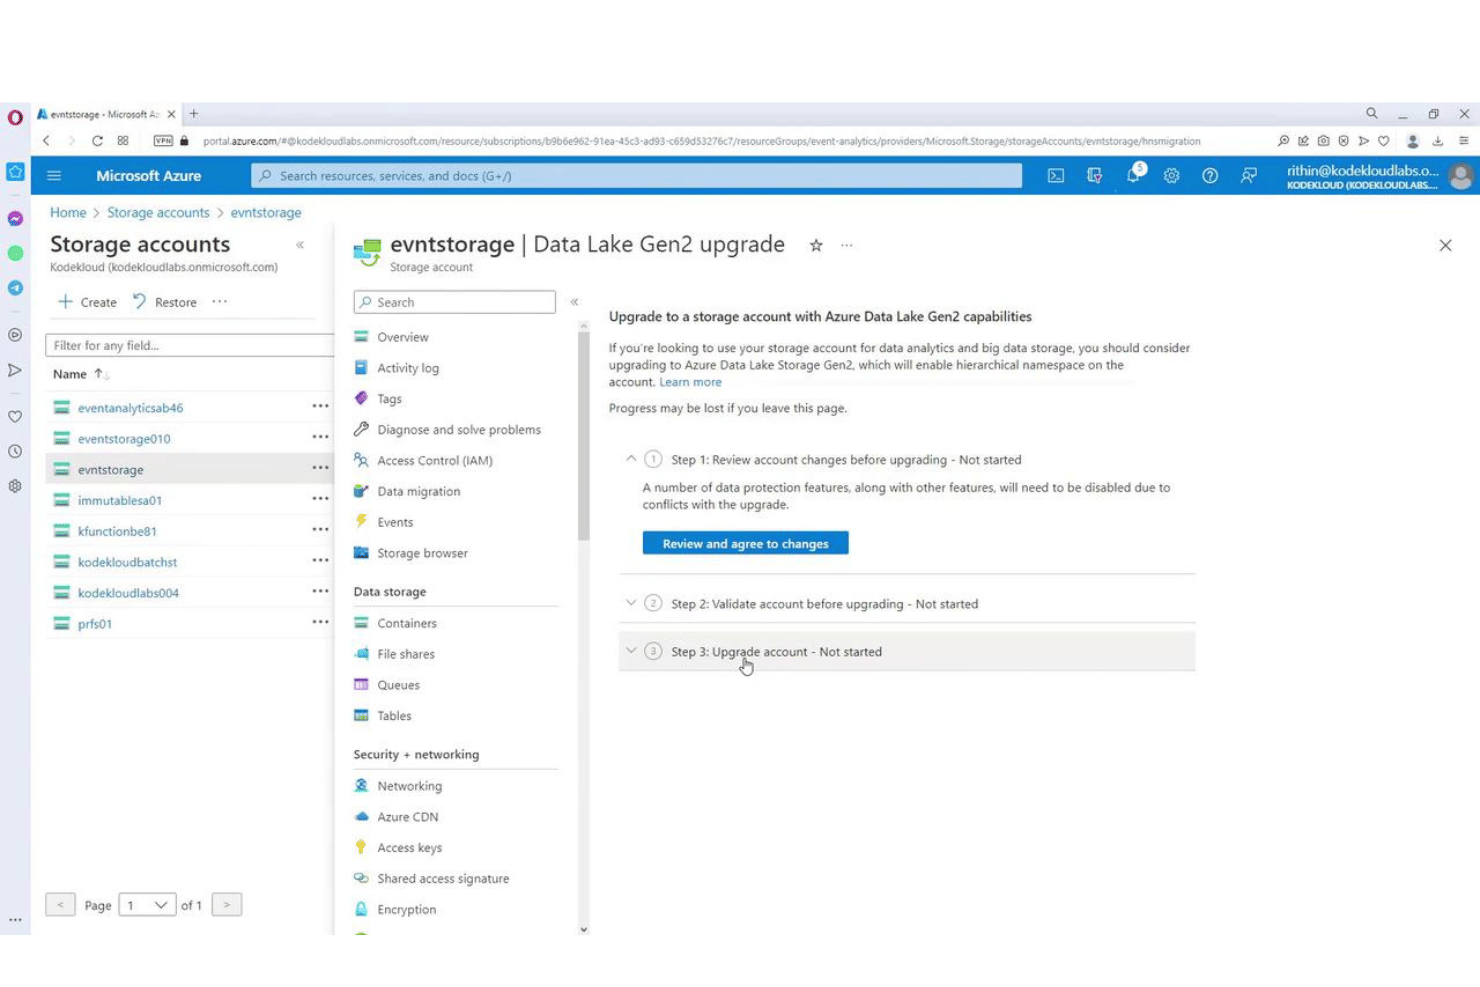
Azure Data Lake Storage Gen2 es el servicio de almacenamiento de lagos de datos basado en la nube de Microsoft, construido sobre Azure Blob Storage con un espacio de nombres jerárquico, que admite almacenamiento a escala de exabytes, ingesta de datos en múltiples formatos, controles de acceso compatibles con POSIX e integración nativa con el ecosistema de análisis y aprendizaje automático de Azure.
¿Para quién es más adecuado Azure Data Lake Storage?
Azure Data Lake Storage Gen2 es la opción natural para los equipos empresariales de TI y datos que ya trabajan con Microsoft Azure y necesitan almacenamiento a escala de exabytes estrechamente integrado con Synapse, Databricks y Microsoft Fabric.
Por qué elegí Azure Data Lake Storage
Elegí Azure Data Lake Storage Gen2 como uno de los mejores porque es la base de almacenamiento nativa de toda la pila de análisis de Microsoft, y esa estrecha integración es importante a escala empresarial. Cuando tu organización utiliza Synapse, Databricks y Microsoft Fabric, ADLS Gen2 ya es la infraestructura subyacente de todo ello, lo que significa que todos los motores pueden consultar una única copia de los datos mediante el controlador ABFS. Me gustan especialmente las ACL compatibles con POSIX, que permiten establecer permisos de lectura/escritura/ejecución a nivel de archivo y directorio individual, no solo a nivel de contenedor.
Características principales de Azure Data Lake Storage
- Clasificación automatizada por niveles del ciclo de vida: Establece políticas que trasladan automáticamente los datos entre los niveles Caliente, Fresco, Frío y Archivo según su antigüedad o la última vez que se accedió a ellos para gestionar los costes de almacenamiento a escala.
- Compatibilidad con el controlador ABFS: El controlador Azure Blob File System proporciona a las cargas de trabajo basadas en Hadoop, Spark, Hive y HDFS acceso nativo de lectura/escritura a ADLS Gen2 sin cambios en el código.
- Accesos directos de OneLake: Crea referencias dinámicas a datos de otros espacios de trabajo de OneLake, Amazon S3 o contenedores de Azure Blob Storage sin copiar ni mover los datos subyacentes.
- Integración con el almacén de datos de Azure Machine Learning: Registra directamente los contenedores de ADLS Gen2 como almacenes de datos en los espacios de trabajo de Azure ML, proporcionando a los científicos de datos acceso directo a los datos del lago para entrenar modelos y realizar experimentos.
Integraciones de Azure Data Lake Storage
Azure Data Lake Storage cuenta con integraciones nativas en todo el ecosistema de Microsoft, incluidas Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning y Azure Event Hubs. También admite Apache Spark y Kafka mediante conectores documentados, además de ABFS y API para el acceso personalizado a los datos.
Pros and Cons
Pros:
- Integración nativa con las herramientas de análisis de Microsoft
- El espacio de nombres jerárquico admite un control de acceso granular
- Formatos de tabla abiertos mediante la capa de cómputo
Cons:
- Requiere Purview para la catalogación avanzada de datos
- Solo está disponible en Microsoft Azure
Otras herramientas de lagos de datos
Estas son algunas opciones adicionales de herramientas de lagos de datos que no llegaron a mi lista de selección, pero que aún vale la pena conocer:
- IBM watsonx.data
Ideal para una arquitectura abierta de lago de datos y almacén con acceso a datos de equipos centrales
- Microsoft Fabric
Ideal para la integración de lagos de datos del ecosistema Microsoft
- Starburst
Ideal para SQL federado entre lagos de datos multinube
- Alibaba Cloud Hybrid Cloud
Ideal para implementaciones de lagos de datos en la nube híbrida en APAC
- Teradata Vantage
Ideal para cargas de trabajo de IA/ML en datos de lagos de datos a escala de petabytes
- MinIO
Ideal para IA y almacenamiento local de tipo lago de datos


How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Cómo elegir herramientas de lagos de datos
¿Qué factores influyen realmente en que una herramienta de lagos de datos pueda ofrecer la escala, la gobernanza y la integración que tu equipo necesita para las cargas de trabajo de análisis del mundo real?
| Si tu prioridad es... | Busca... |
|---|---|
| Cumplimiento normativo | Registros de auditoría y políticas de acceso integrados |
| Implementación multinube o híbrida | Compatibilidad nativa con varios proveedores de nube |
| Independencia del proveedor | Compatibilidad con formatos de tablas abiertos |
| Rendimiento de análisis a escala | Almacenamiento por niveles e integración nativa con consultas |
| Preparación para IA y ML | Conectores directos a herramientas y motores de IA/ML |
Cómo evaluar tu lista de selección
- Confirma las funciones de gobernanza: Solicita capturas de pantalla de la consola de administración que muestren el control de acceso basado en roles y la configuración del registro de auditoría.
- Prueba la compatibilidad con formatos abiertos: Realiza una ingesta en directo de archivos Parquet o Iceberg y verifica la evolución del esquema en un entorno de prueba.
- Valida las afirmaciones sobre multinube: Solicita documentación pública que muestre los pasos de implementación en al menos dos proveedores de nube.
- Comprueba la integración con análisis: Solicita un ejemplo de flujo de trabajo o una configuración para Spark, Trino o Presto, con resultados de consultas documentados.
- Compromiso entre una suite empresarial y una arquitectura abierta de lago de datos: Decide si necesitas el cumplimiento normativo y la asistencia de una suite lista para usar, o si la flexibilidad y la compatibilidad con una pila abierta son más valiosas para tu arquitectura.
¿Qué son las herramientas de lagos de datos?
Las herramientas de lagos de datos son plataformas y programas que te ayudan a almacenar, gestionar y analizar grandes volúmenes de datos estructurados y no estructurados en un repositorio centralizado. Estas herramientas permiten a tu equipo ingerir datos sin procesar, aplicar esquemas cuando sea necesario y organizar activos para proyectos de análisis o IA. Puedes esperar funciones compatibles con la gobernanza, la escalabilidad y la integración con motores de consulta y plataformas de análisis populares.
Características de las herramientas de lagos de datos
Al seleccionar herramientas de lagos de datos, presta atención a las siguientes características clave:
- Almacenamiento de objetos escalable: Permite almacenar y gestionar petabytes de datos estructurados y no estructurados, con opciones de almacenamiento por niveles o en frío para controlar los costes a medida que crecen tus necesidades de almacenamiento.
- Compatibilidad con esquemas al leer: Permite cargar primero los datos sin procesar y aplicar un esquema posteriormente en el momento de la consulta, lo que facilita trabajar con conjuntos de datos diversos y cambiantes sin volver a cargarlos.
- Ingesta de datos en varios formatos: Admite la importación de datos en diversos formatos, como Parquet, Avro, JSON, ORC y CSV, y admite tanto fuentes de datos por lotes como de transmisión para ofrecer mayor flexibilidad en la forma en que llegan los datos.
- Integración con motores de consulta: Ofrece compatibilidad con motores como Spark, Trino, Presto o Athena, de modo que puedes ejecutar cargas de trabajo de análisis y generación de informes directamente sobre tu lago de datos sin middleware adicional.
- Gestión de metadatos y catálogos: Incluye herramientas para catalogar datos, buscar activos, realizar un seguimiento del linaje y añadir etiquetas, lo que te ayuda a mantener los datos organizados y localizables a medida que se incorporan nuevos conjuntos de datos.
- Gobernanza y controles de acceso: Ofrece permisos detallados, cifrado y registros de auditoría para que puedas controlar quién accede a cada dato, supervisar el uso y cumplir los requisitos normativos.
- Versionado de datos y viajes en el tiempo: Permite realizar un seguimiento de los cambios, volver a versiones anteriores de los conjuntos de datos y mantener vistas históricas, lo que resulta valioso para la auditoría, la recuperación y la reproducibilidad.
- Integración con herramientas de orquestación: Se conecta de forma nativa con orquestadores de flujos de trabajo como Apache Airflow, lo que permite automatizar canalizaciones de datos y coordinar tareas entre sistemas.
- Herramientas de supervisión y gestión de costes: Proporciona paneles y alertas sobre el uso del almacenamiento, los patrones de acceso y los costes, para que puedas mantener tu entorno eficiente y ajustado al presupuesto.
- Compatibilidad con formatos de tablas abiertos: Admite formatos como Delta Lake o Apache Iceberg, lo que permite utilizar funciones avanzadas como transacciones ACID e interoperabilidad con múltiples herramientas de análisis.
Funciones de IA habituales en las herramientas de lagos de datos
Además de las funciones estándar de las herramientas de lagos de datos mencionadas anteriormente, muchas de estas soluciones están incorporando IA con funciones como:
- Clasificación automatizada de datos: Utiliza modelos de IA para analizar y categorizar los datos entrantes según su contenido, sensibilidad o requisitos de cumplimiento. Esto ayuda a tu equipo a organizar los activos más rápidamente y aplicar los controles de acceso adecuados sin etiquetado manual.
- Detección de anomalías para la calidad de los datos: Aplica algoritmos de aprendizaje automático para supervisar los flujos de datos y señalar patrones inusuales, valores ausentes o valores atípicos. Esto permite detectar pronto los problemas de integridad de los datos y reducir el riesgo de análisis incorrectos o errores posteriores.
- Optimización predictiva de cargas de trabajo: Utiliza IA para analizar los patrones históricos de consulta y el uso del almacenamiento, y después recomienda o aplica automáticamente optimizaciones como la partición, el almacenamiento en caché o el escalado de recursos. Esto te ayuda a mantener el rendimiento y controlar los costes a medida que crece el uso.
- Interfaces de consulta en lenguaje natural: Integra herramientas de chat o búsqueda basadas en IA que permiten a los usuarios hacer preguntas sobre los datos en lenguaje sencillo. Esto reduce la barrera para que los usuarios no técnicos exploren conjuntos de datos y generen información útil sin escribir SQL ni código.
- Enriquecimiento automatizado de metadatos: Utiliza IA para extraer contexto, relaciones y términos empresariales de los datos sin procesar, y después completa el catálogo de datos con descripciones más detalladas e información del linaje. Esto facilita que los equipos descubran, confíen en los activos de datos y los reutilicen.
Beneficios de las herramientas de lagos de datos
La implementación de herramientas de lagos de datos ofrece varios beneficios para tu equipo y tu empresa. Estos son algunos de los que puedes esperar:
- Gestión centralizada de datos: Las herramientas de lagos de datos permiten almacenar datos estructurados y no estructurados en un solo lugar, lo que facilita la organización de los activos y el respaldo de proyectos de análisis o IA.
- Escalabilidad para cargas de trabajo a escala de petabytes: Estas plataformas pueden manejar volúmenes masivos de datos y admitir niveles de almacenamiento tanto en la nube como locales, por lo que puedes adaptarte a las demandas crecientes sin rediseñar la arquitectura.
- Ingesta flexible de datos: Puedes ingerir datos de una amplia variedad de formatos y fuentes, y gestionar flujos tanto por lotes como en tiempo real, gracias a los conectores integrados y la compatibilidad con distintos formatos.
- Gobernanza y control de acceso granulares: Los permisos detallados, el cifrado y los registros de auditoría te ayudan a mantener la seguridad y el cumplimiento de estándares como HIPAA, SOC 2 y GDPR.
- Integración con herramientas de análisis e IA: La compatibilidad nativa con motores de consulta como Spark, Trino y Presto, así como los conectores directos con herramientas de IA/ML, permite analizar datos sin demoras ni trabajo adicional de integración.
- Gestión automatizada de metadatos y calidad de datos: Muchas plataformas incluyen catálogos, seguimiento del linaje y herramientas basadas en IA que ayudan a enriquecer los metadatos, clasificar los datos y detectar anomalías para mantener su integridad.
- Compatibilidad con formatos de tablas abiertos y casos de uso avanzados: Funciones como la compatibilidad con Delta Lake o Apache Iceberg permiten realizar transacciones ACID, versionar datos y compartir datos sin copias para respaldar análisis más avanzados y arquitecturas multinube.
Costos y precios de las herramientas de lagos de datos
Seleccionar herramientas de lagos de datos requiere comprender los distintos modelos de precios y planes disponibles. Los costos varían según las funciones, el tamaño del equipo, los complementos y otros factores. La tabla siguiente resume los planes habituales, sus precios promedio y las funciones que suelen incluir las soluciones de herramientas de lagos de datos:
Tabla comparativa de planes para herramientas de lagos de datos
| Tipo de plan | Precio promedio | Funciones comunes |
|---|---|---|
| Plan gratuito | $0 | Almacenamiento de objetos básico, ingesta de datos limitada, compatibilidad con esquemas al leer e integración con un motor de consulta. |
| Plan personal | $50–$300/mes | Límites de almacenamiento más amplios, compatibilidad con múltiples formatos de datos, catalogación básica e integración con herramientas de análisis. |
| Plan empresarial | $1,000–$5,000/mes | Almacenamiento a escala de petabytes, controles avanzados de gobernanza, opciones multinube y capacidades de catalogación de datos. |
| Plan corporativo | $10,000+/mes | Almacenamiento ilimitado, funciones completas de cumplimiento, automatización basada en IA, integración con herramientas de orquestación y soporte prémium. |
Preguntas frecuentes sobre herramientas de lagos de datos
Estas son algunas respuestas a preguntas frecuentes sobre las herramientas de lagos de datos:
¿Cómo gestionan las herramientas de lagos de datos los requisitos de seguridad y cumplimiento normativo?
Las herramientas de lagos de datos aplican medidas de seguridad mediante controles de acceso, cifrado y registros de auditoría. La mayoría de las plataformas líderes admiten permisos detallados hasta el nivel de fila o columna, además de integraciones con SSO y proveedores de identidad. Para el cumplimiento normativo, busca certificaciones del proveedor como SOC 2, HIPAA o GDPR, así como opciones de claves de cifrado administradas por el cliente. Estas funciones te ayudan a cumplir las necesidades regulatorias sin crear capas adicionales.
¿Pueden las herramientas de lagos de datos integrarse con plataformas de análisis o BI existentes?
Sí, la mayoría de las herramientas de lagos de datos ofrecen conectores directos para plataformas de análisis y BI. Deberías esperar compatibilidad inmediata con Spark, Trino, Presto y Athena, además de integraciones con Tableau y Power BI. Si tus equipos utilizan herramientas especializadas, comprueba que existan API abiertas o controladores ODBC/JDBC que permitan conectar flujos de trabajo personalizados.
¿Cuál es la diferencia entre las herramientas de lagos de datos y los almacenes de datos?
Las herramientas de lagos de datos se centran en almacenar datos sin procesar, semiestructurados y no estructurados mediante esquemas aplicados al leer, mientras que los almacenes de datos almacenan datos estructurados con esquemas predefinidos (esquemas aplicados al escribir). Los lagos de datos son mejores para la ingesta flexible y las cargas de trabajo de IA/ML, mientras que los almacenes son adecuados para análisis seleccionados con un rendimiento de consulta optimizado. Algunos proveedores ofrecen ahora arquitecturas lakehouse que combinan ambos enfoques.
¿Admiten las herramientas de lagos de datos varios formatos y tipos de ingesta de datos?
Sí, la mayoría de las herramientas de lagos de datos aceptan una amplia variedad de formatos, como Parquet, Avro, JSON, ORC y CSV. También encontrarás compatibilidad con fuentes de datos por lotes y en streaming, lo que permite gestionar desde trabajos de ingesta diarios hasta flujos de eventos en tiempo real mediante conectores prediseñados o personalizados.
¿Cómo se evalúan las herramientas de lagos de datos en cuanto a escalabilidad?
Analizo las opciones de almacenamiento de objetos de cada plataforma, el rendimiento con cargas a escala de petabytes y la compatibilidad con múltiples nubes. La capacidad de organizar el almacenamiento por niveles, procesar datos entre regiones y evitar cuellos de botella con formatos como Delta Lake o Iceberg es fundamental. Asegúrate de consultar las referencias documentadas y recopilar opiniones de clientes con volúmenes de datos similares a los tuyos.
¿Son importantes los formatos de tablas abiertos como Delta Lake o Apache Iceberg?
Sí, los formatos de tablas abiertos son importantes si quieres transacciones ACID, control de versiones y una gestión de datos independiente del proveedor. Permiten habilitar funciones como el desplazamiento temporal y el uso compartido de datos sin copias. Si tu objetivo es adoptar un modelo lakehouse o preparar tu arquitectura para el futuro, exige compatibilidad con formatos abiertos en tu herramienta de lago de datos.